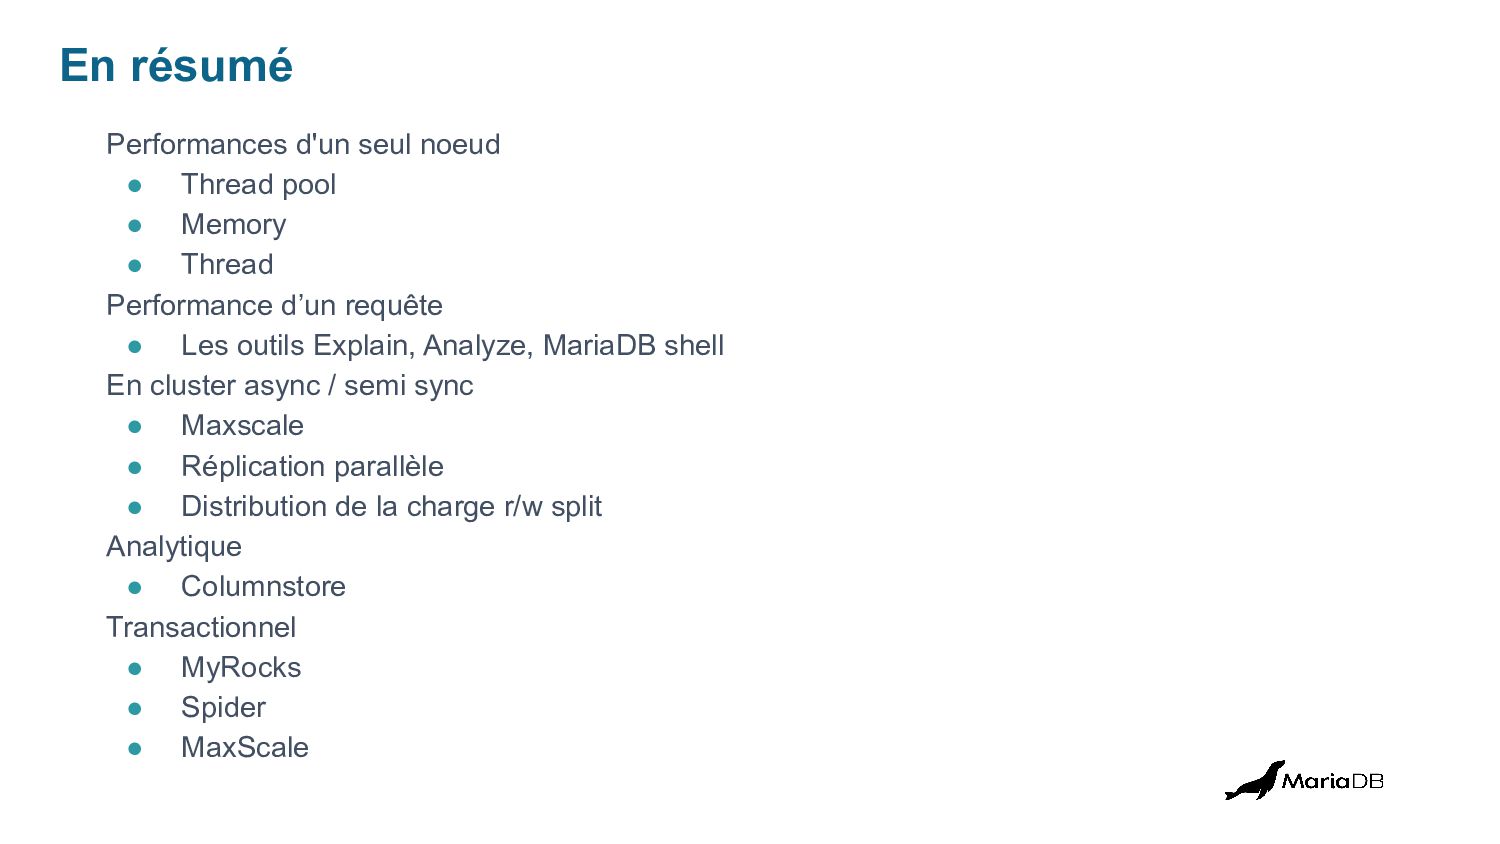
de stockage ◦ Plugins • Architecture Linux like ◦ Hautement ajustable ◦ 800 variables de configuration • Solution green (codé en C) ◦ Package de 100 Mo • Réplication entre différents moteurs • Ecosystem de plus en plus complet ◦ MaxScale ◦ MariaBackup ◦ MariaDB Shell ◦ Connecteurs ◦ Cloud DBaaS SkySQL
Linux like • Ne pas utiliser la configuration par défaut en production • Bien comprendre les besoins de l’application ◦ R/W ratio ◦ Nombre de connections max ◦ Cache hit ratio
chaque client • Allocation pour les join et sort • Libération à la fermeture de la session ou de la connection • Toujours penser au OOM • SWAP (encore et toujours …)
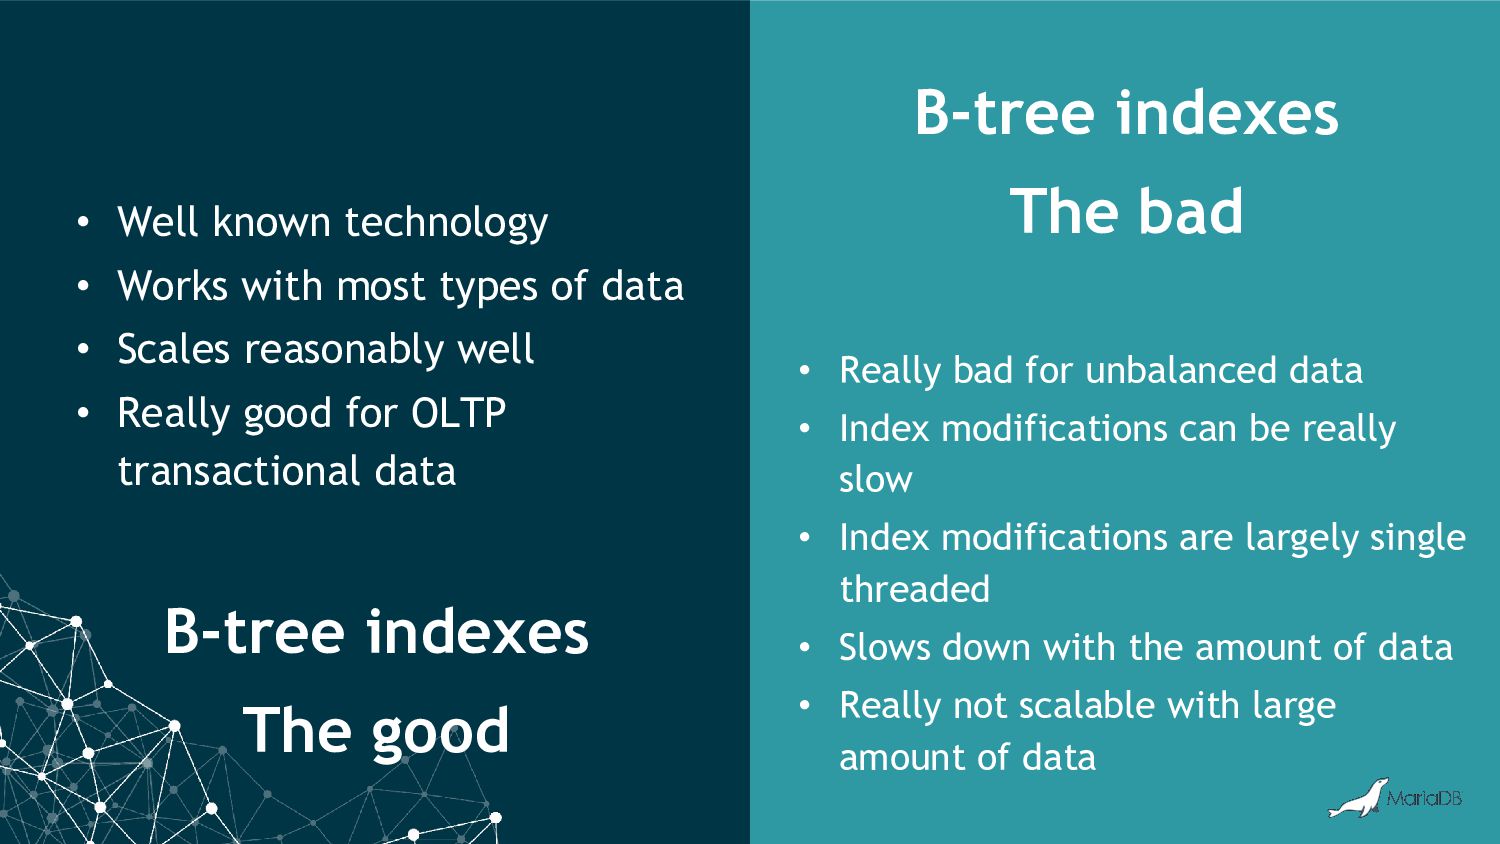
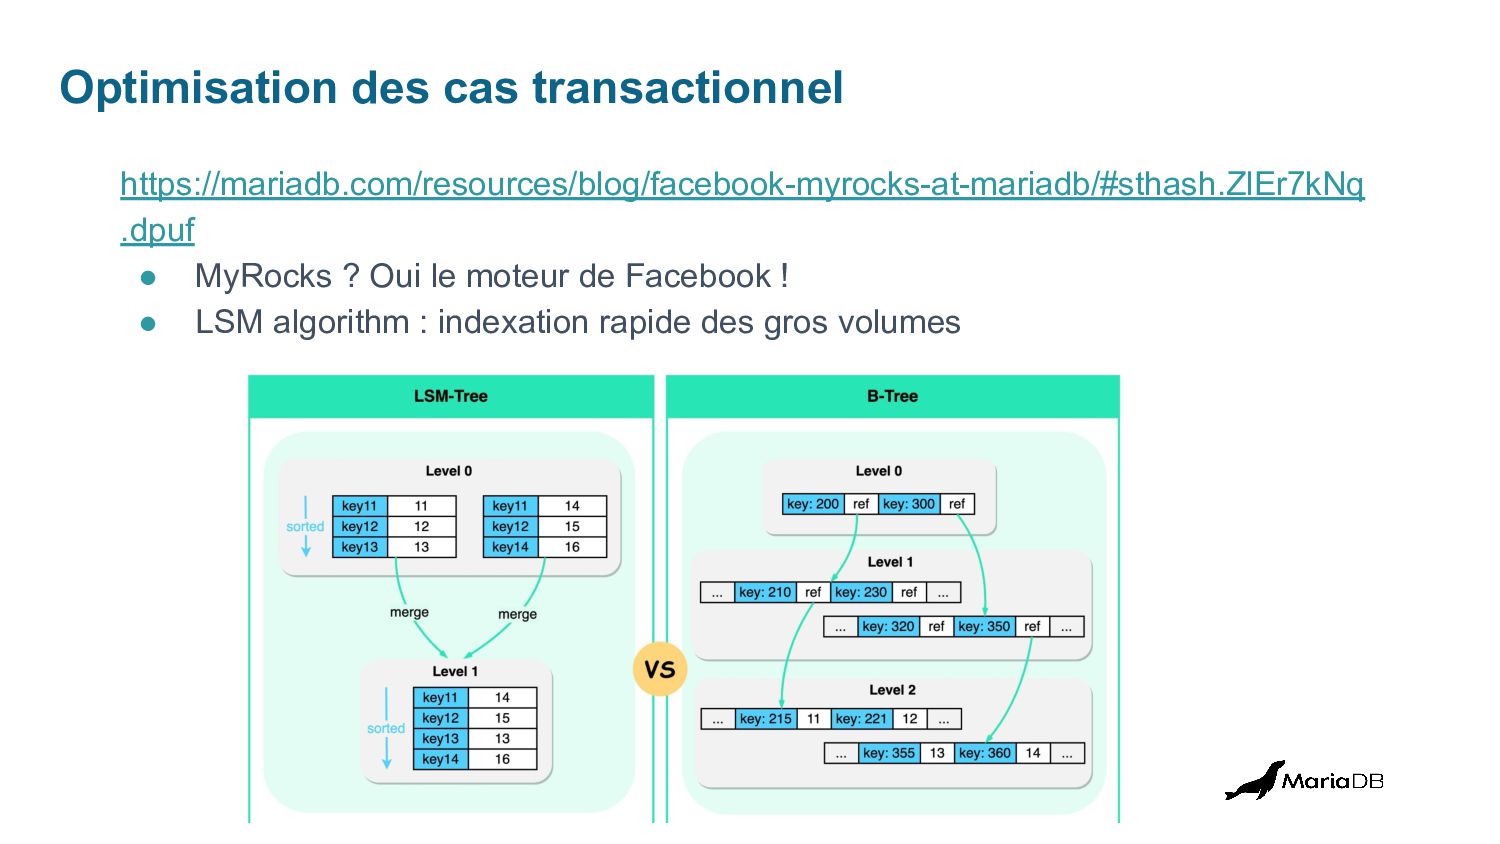
principalement ◦ Overhead en écriture ◦ Très bonne solution dans les cas de requête en lecture portant sur un dataset conséquent • Les limites du modèle B-tree ?
known technology • Works with most types of data • Scales reasonably well • Really good for OLTP transactional data • Really bad for unbalanced data • Index modifications can be really slow • Index modifications are largely single threaded • Slows down with the amount of data • Really not scalable with large amount of data
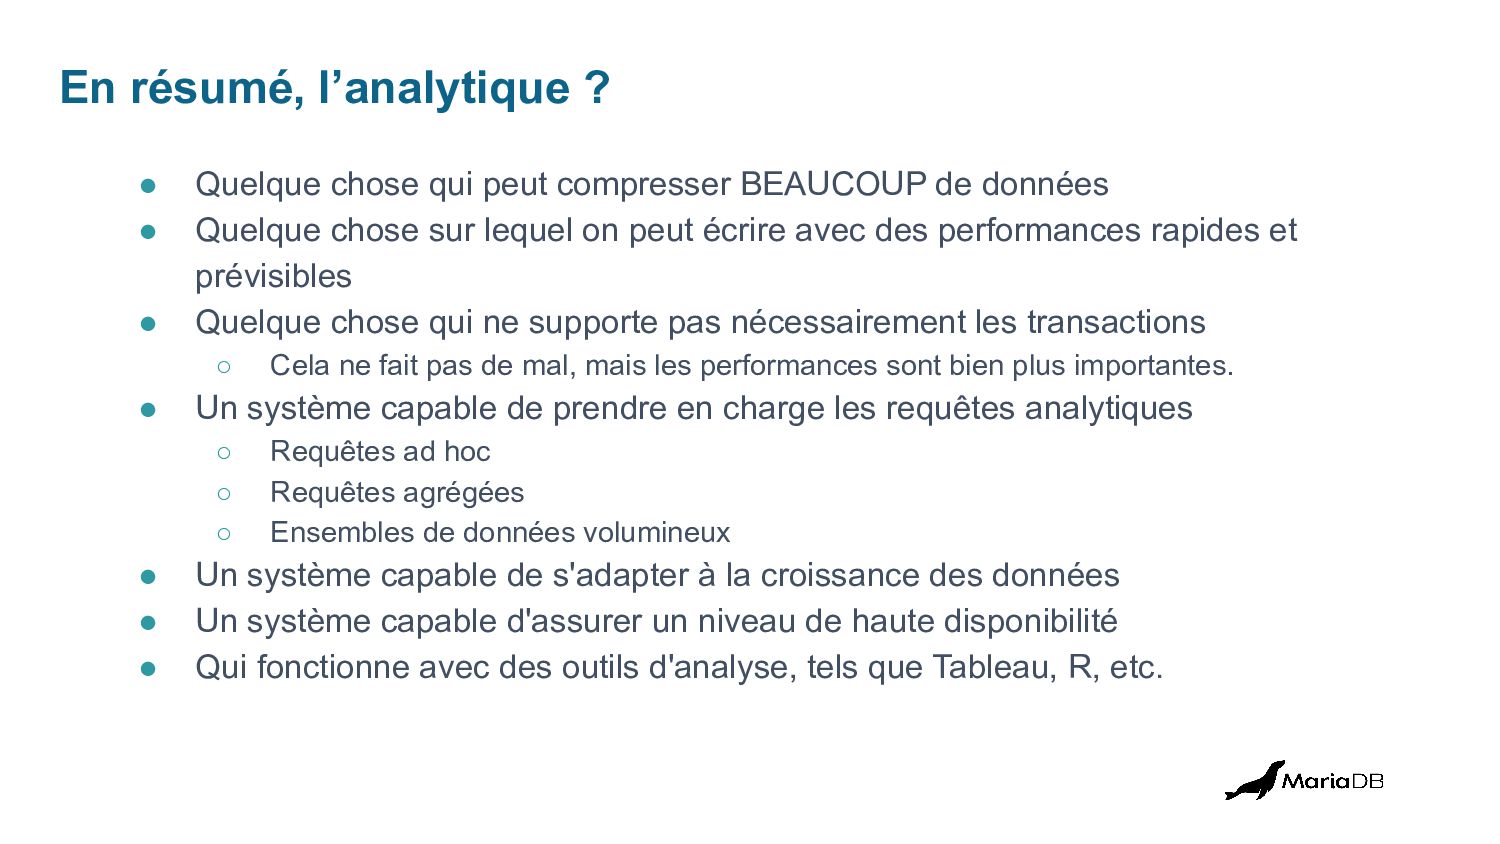
BEAUCOUP de données • Quelque chose sur lequel on peut écrire avec des performances rapides et prévisibles • Quelque chose qui ne supporte pas nécessairement les transactions ◦ Cela ne fait pas de mal, mais les performances sont bien plus importantes. • Un système capable de prendre en charge les requêtes analytiques ◦ Requêtes ad hoc ◦ Requêtes agrégées ◦ Ensembles de données volumineux • Un système capable de s'adapter à la croissance des données • Un système capable d'assurer un niveau de haute disponibilité • Qui fonctionne avec des outils d'analyse, tels que Tableau, R, etc.
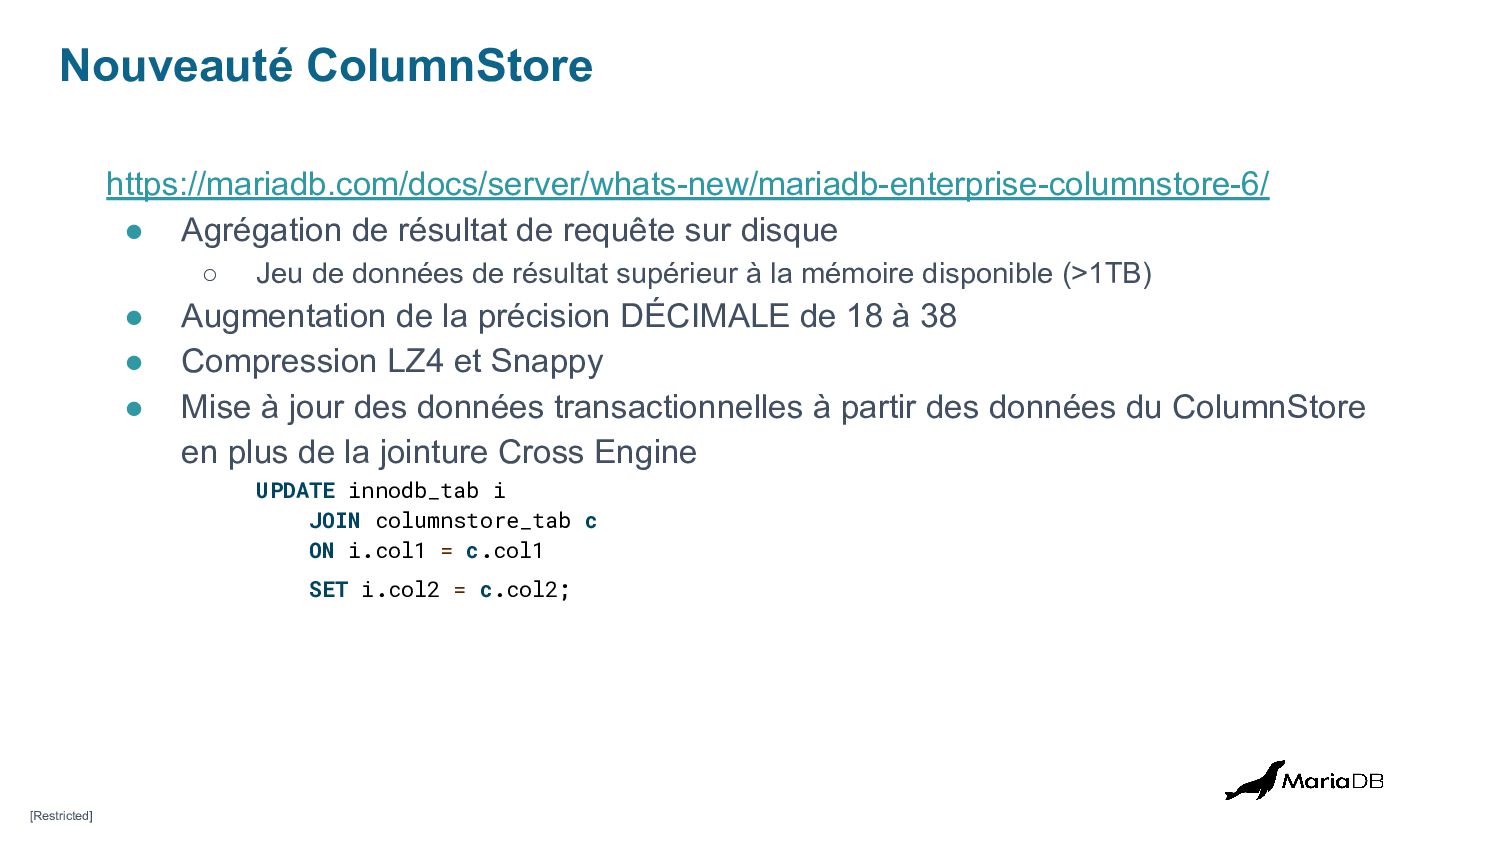
disque ◦ Jeu de données de résultat supérieur à la mémoire disponible (>1TB) • Augmentation de la précision DÉCIMALE de 18 à 38 • Compression LZ4 et Snappy • Mise à jour des données transactionnelles à partir des données du ColumnStore en plus de la jointure Cross Engine UPDATE innodb_tab i JOIN columnstore_tab c ON i.col1 = c.col1 SET i.col2 = c.col2; [Restricted]
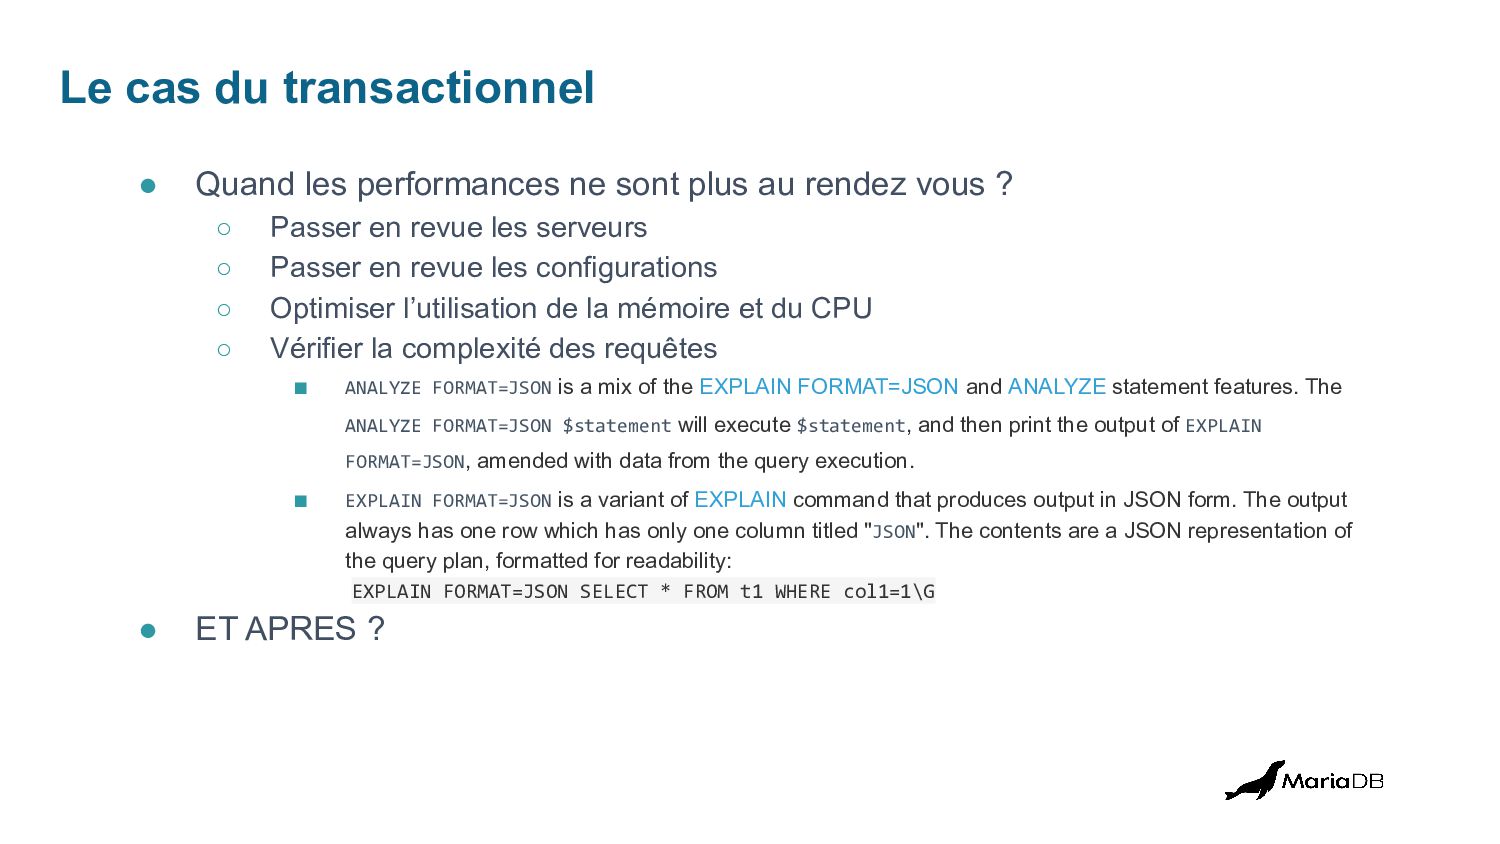
plus au rendez vous ? ◦ Passer en revue les serveurs ◦ Passer en revue les configurations ◦ Optimiser l’utilisation de la mémoire et du CPU ◦ Vérifier la complexité des requêtes ▪ ANALYZE FORMAT=JSON is a mix of the EXPLAIN FORMAT=JSON and ANALYZE statement features. The ANALYZE FORMAT=JSON $statement will execute $statement, and then print the output of EXPLAIN FORMAT=JSON, amended with data from the query execution. ▪ EXPLAIN FORMAT=JSON is a variant of EXPLAIN command that produces output in JSON form. The output always has one row which has only one column titled "JSON". The contents are a JSON representation of the query plan, formatted for readability: EXPLAIN FORMAT=JSON SELECT * FROM t1 WHERE col1=1\G • ET APRES ?
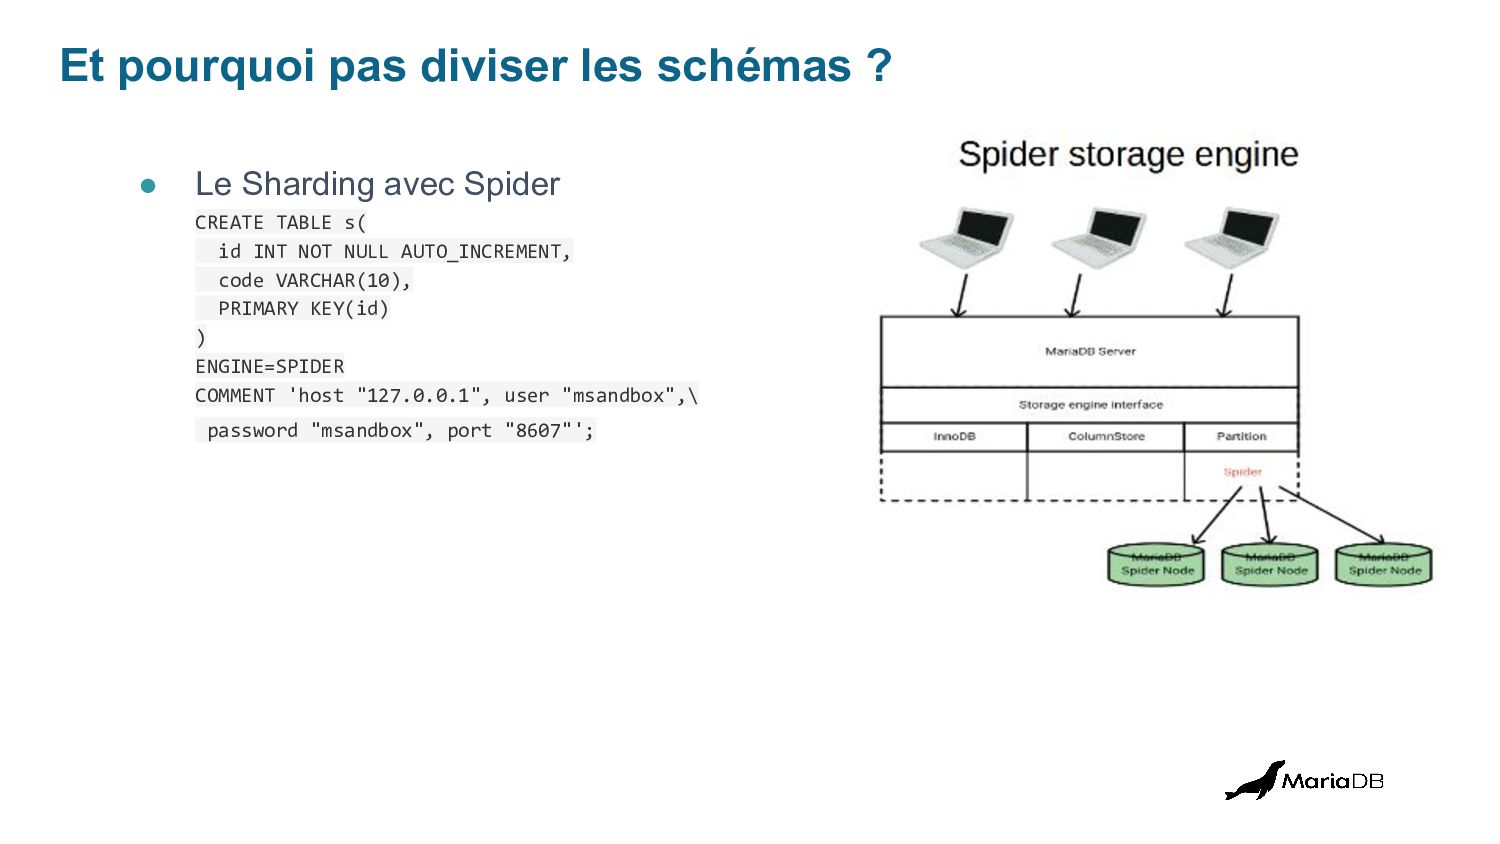
avec Spider CREATE TABLE s( id INT NOT NULL AUTO_INCREMENT, code VARCHAR(10), PRIMARY KEY(id) ) ENGINE=SPIDER COMMENT 'host "127.0.0.1", user "msandbox",\ password "msandbox", port "8607"';
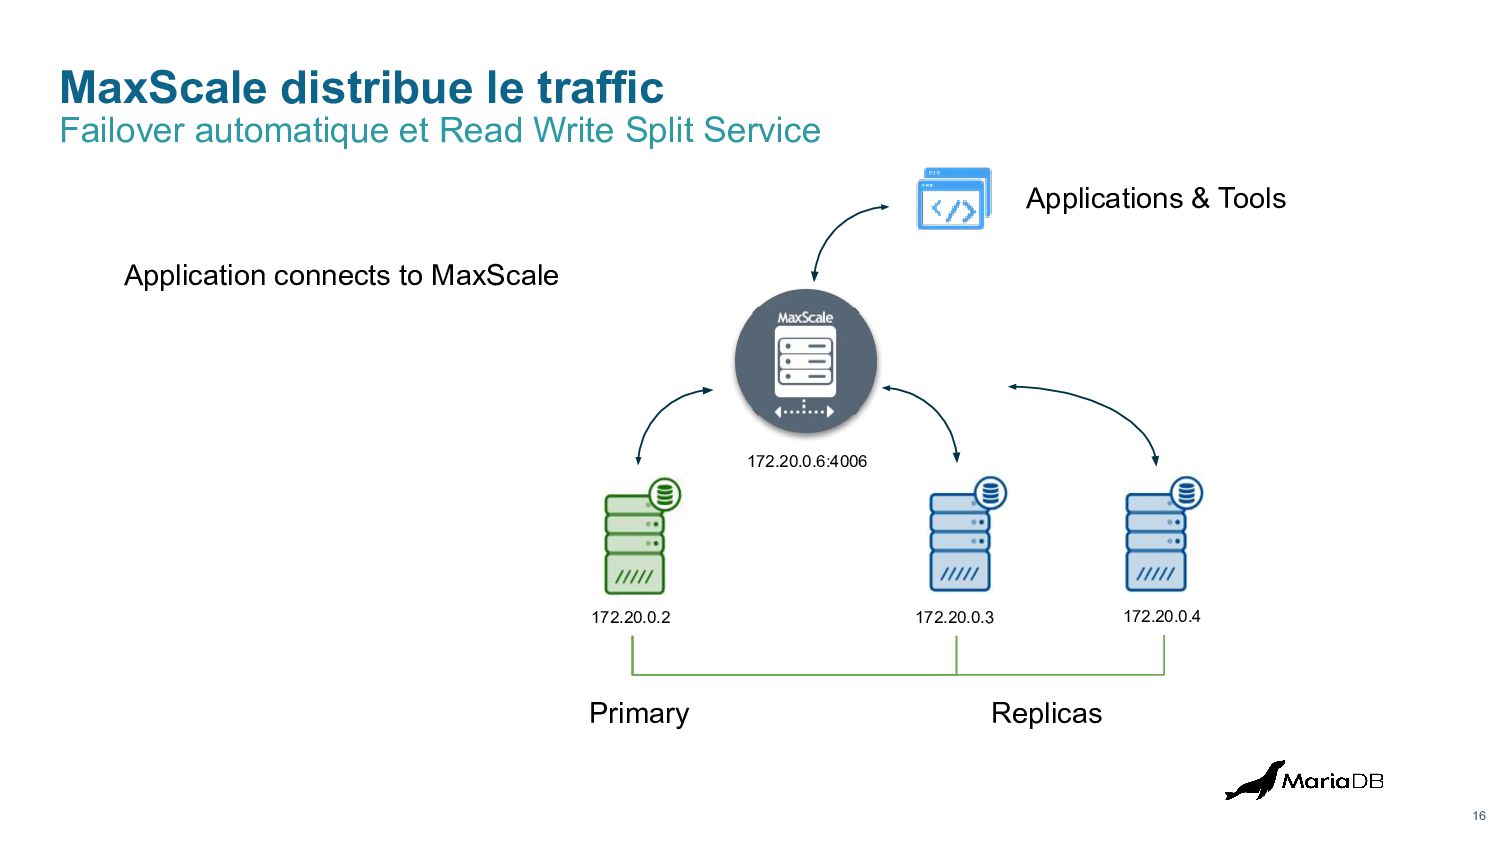
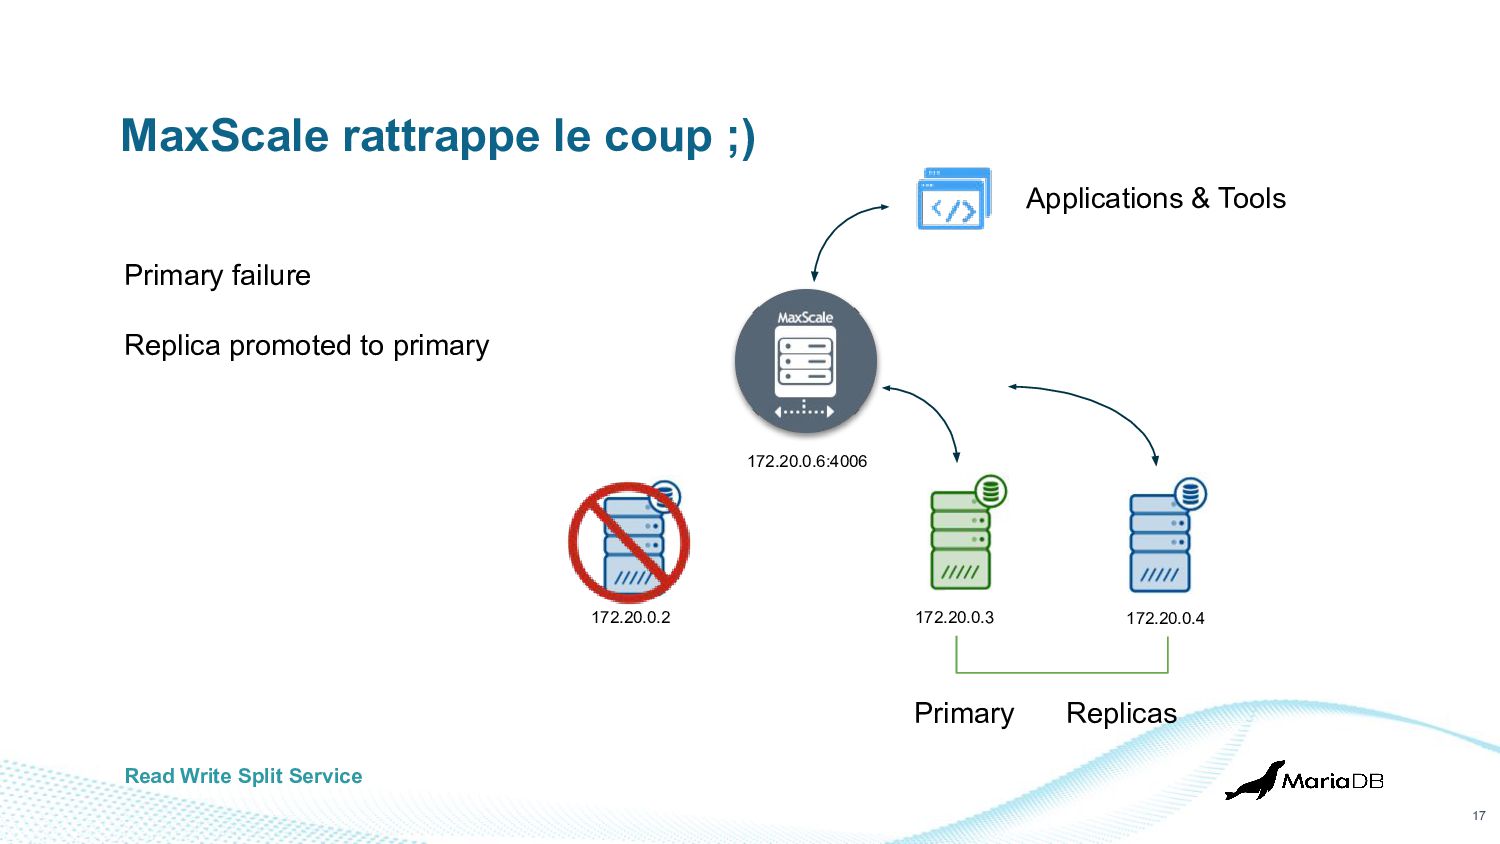
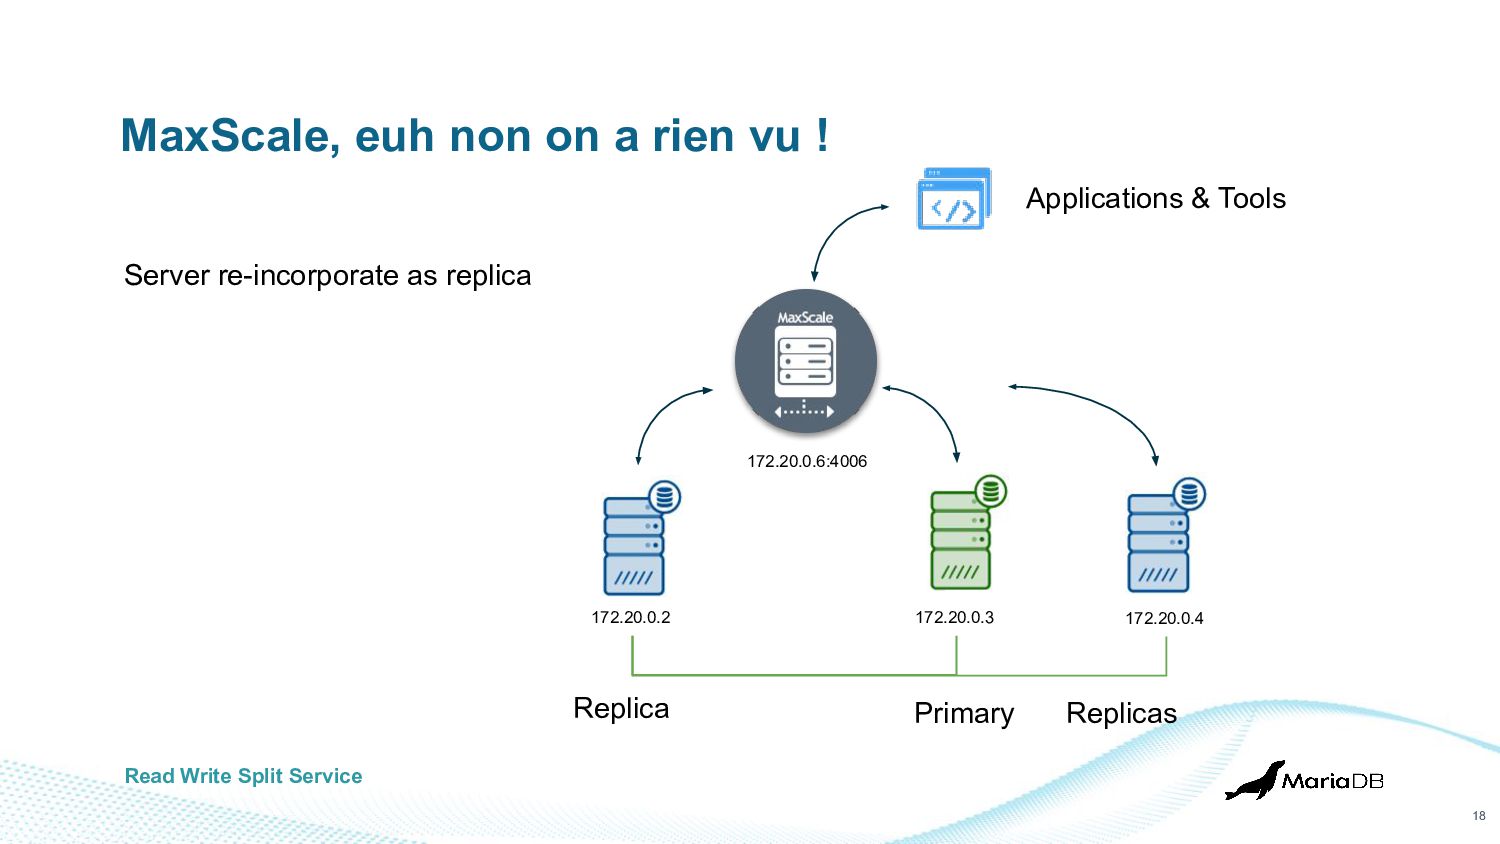
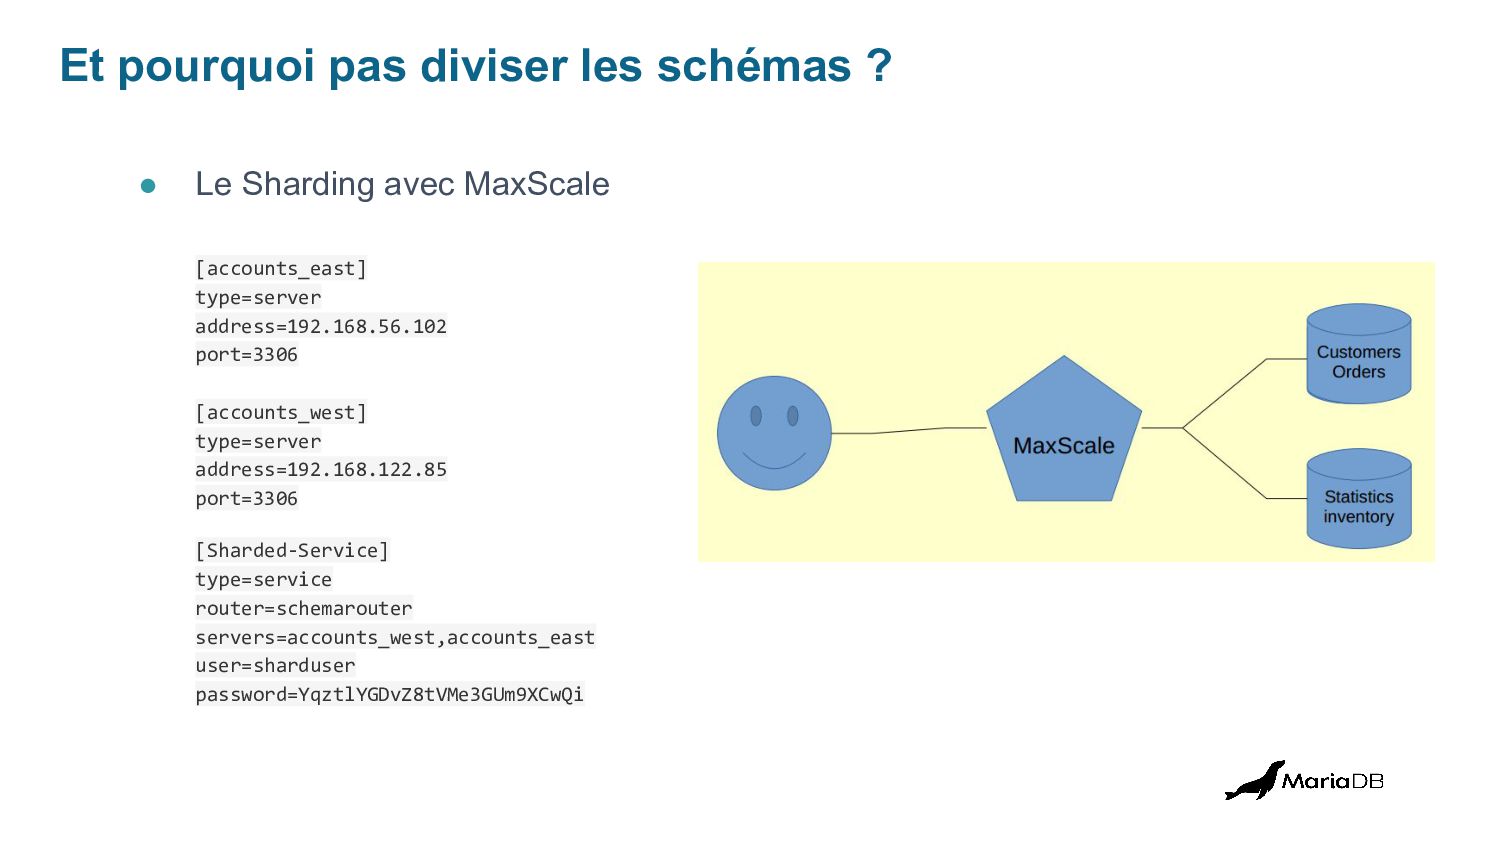
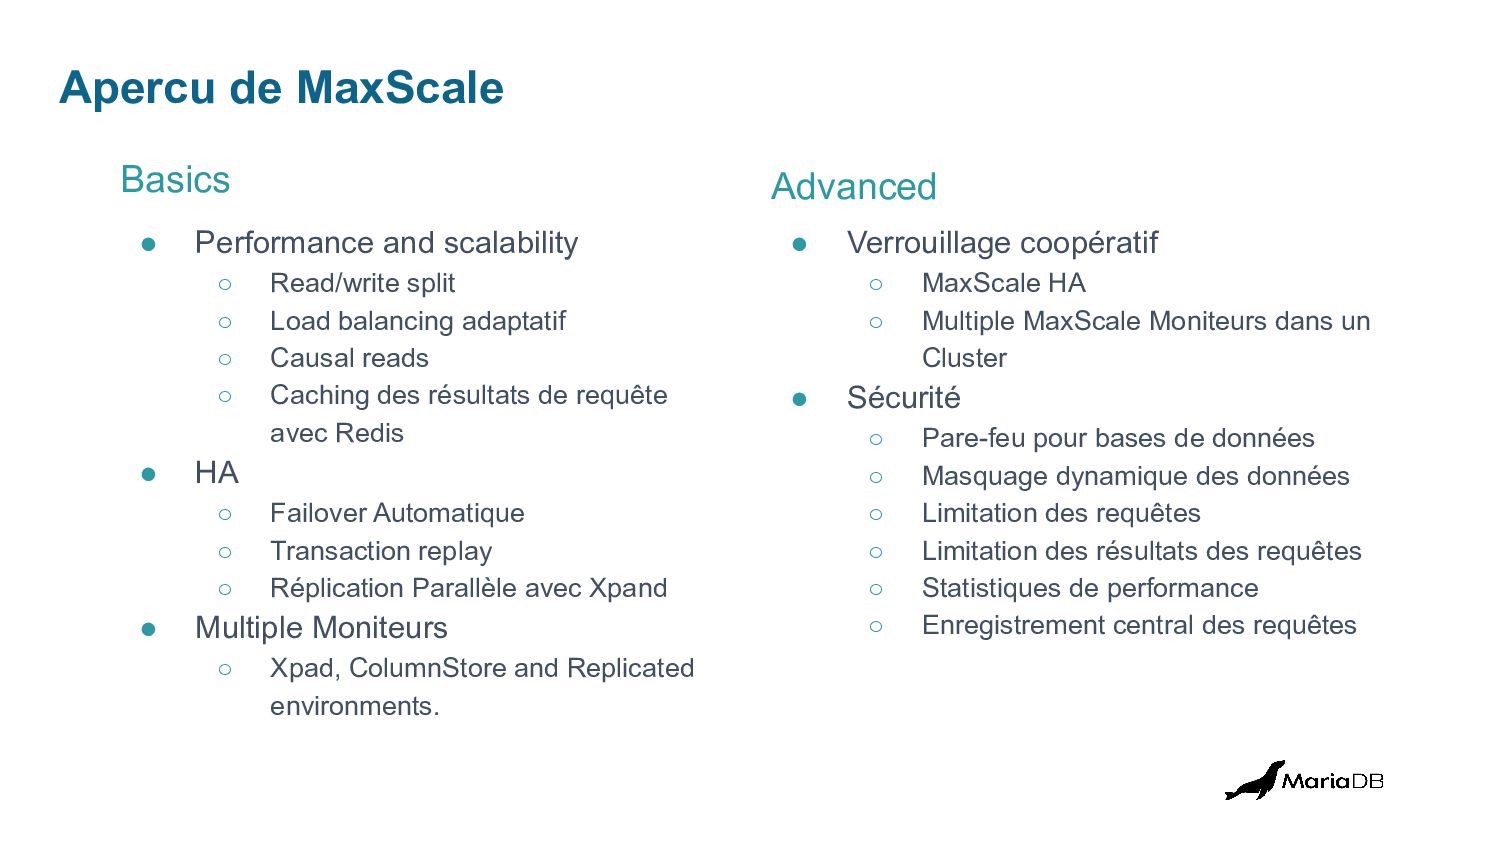
split ◦ Load balancing adaptatif ◦ Causal reads ◦ Caching des résultats de requête avec Redis • HA ◦ Failover Automatique ◦ Transaction replay ◦ Réplication Parallèle avec Xpand • Multiple Moniteurs ◦ Xpad, ColumnStore and Replicated environments. • Verrouillage coopératif ◦ MaxScale HA ◦ Multiple MaxScale Moniteurs dans un Cluster • Sécurité ◦ Pare-feu pour bases de données ◦ Masquage dynamique des données ◦ Limitation des requêtes ◦ Limitation des résultats des requêtes ◦ Statistiques de performance ◦ Enregistrement central des requêtes Basics


 raspython3
 teamlab
 shogo4131
 occhi
 yahonda
 yuuuuuuu168
 codmoninc
 codatum
 takonda
 kenichiodo
 pfn
 takahashim
 danielanewman
 addyosmani
 gr2m
 destraynor
 varn
 soysaucechin
 axbom
 tamaranovitovic
 lindahogenes
 bkeepers
 eileencodes