Share
Embed
Introdução à modelagem de dados NoSQL com ArangoDB
Workshop apresentado no 8º Fórum de Profissionais PHP
Lucas de Souza Vieira
November 17, 2017
Transcript
59 slides
-
Sobre o palestrante Desenvolvedor Web e comunicador científico apaixonado. Graduando
em Engenharia da Computação pela UEMA. Desenvolvedor Web no Núcleo de Tecnologias para a Educação da UEMA. Redes Sociais: ◦ Github: https://github.com/lucassouzavieira ◦ Twitter: https://twitter.com/lucassouzavs ◦ Linkedin: https://www.linkedin.com/in/lucassouzavieira/ ◦ Speaker Deck: https://speakerdeck.com/lucassouzavieira -
Roadmap • Revisando Bancos Relacionais • Bancos de dados NoSQL
• Persistência Poliglota -
Modelo Relacional • O modelo relacional é a base para
a maior parte dos bancos que utilizam SQL • Implementação ◦ Tabelas com colunas fixas. ◦ Todas as linhas tem as mesmas colunas • O banco só armazena atributos previamente definidos/permitidos pelo schema -
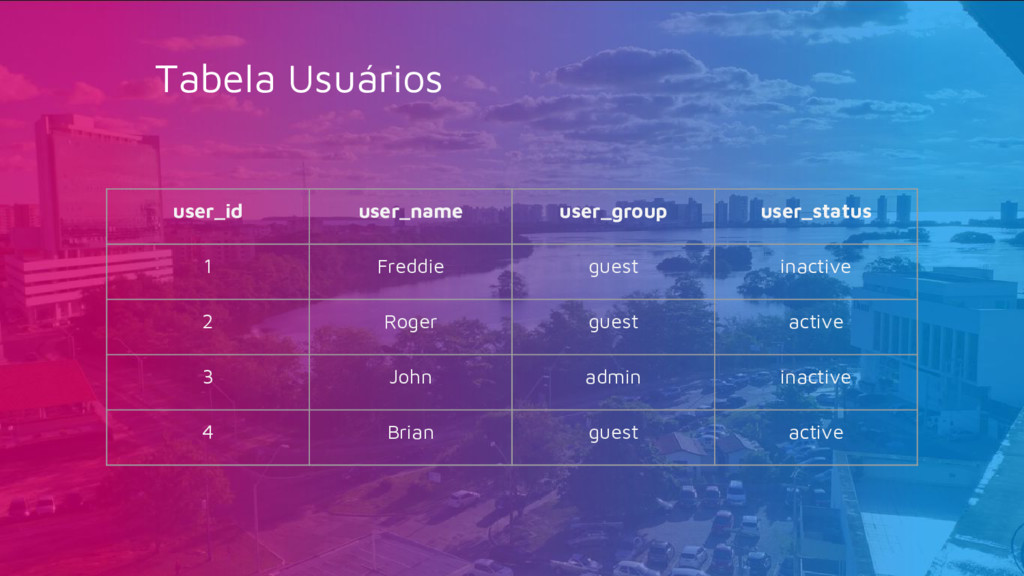
Tabela Usuários user_id user_name user_group user_status 1 Freddie guest inactive
2 Roger guest active 3 John admin inactive 4 Brian guest active -
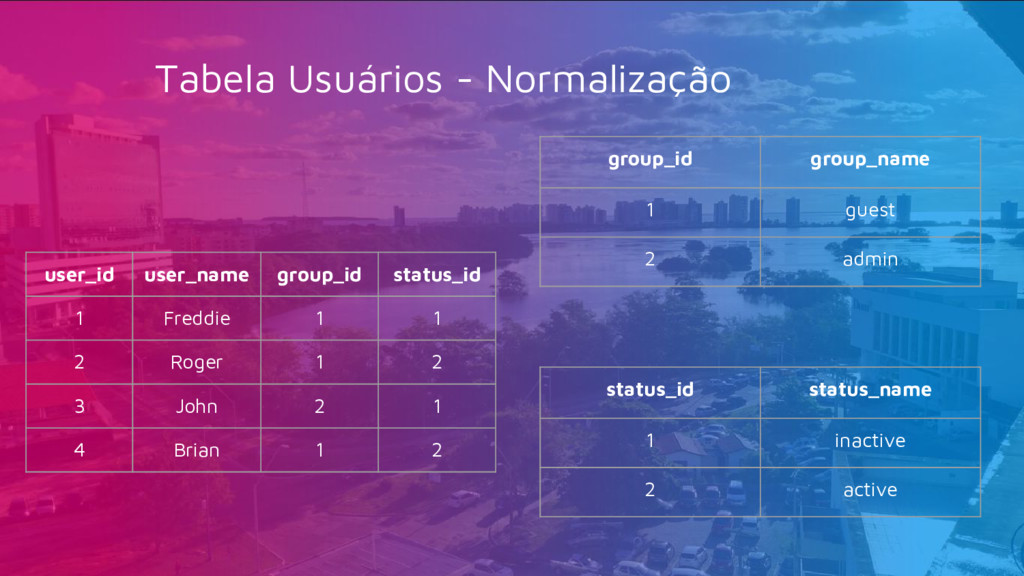
Tabela Usuários - Normalização user_id user_name group_id status_id 1 Freddie
1 1 2 Roger 1 2 3 John 2 1 4 Brian 1 2 group_id group_name 1 guest 2 admin status_id status_name 1 inactive 2 active -
Por quê normalizamos ? • Menor duplicação dos dados •
Menor uso de espaço em disco • Dados altamente consistentes e íntegros -
Transações • Bancos de dados relacionais normalmente permitem a execução
de transações • Transações podem conter múltiplas operações Lembra do exemplo clássico da transação bancária ? -
Consistência e Integridade • Bancos relacionais oferecem muitas maneiras de
checar os nossos dados ◦ A nível de Schema ( Colunas e Tipos de dados ) ◦ Referências ( Chaves-estrangeiras, integridade referencial ) ◦ E outras podem ser definidas pelo usuário ( Constraints ) -
Normalização • É importante normalizar os dados para fazer um
uso adequado do banco de dados relacional • A falta de normalização pode causar problemas com a integridade dos dados e pode também dificultar sua recuperação através de consultas SQL. • Desnormalização só é tolerada em favor de desempenho -
Bancos Relacionais e dados dinâmicos • Esquemas rígidos vs Linguagens
de Programação. • Alternativa: campos BLOB • ALTER TABLE ◦ Queda de performance / Database lock. ◦ Reajuste de registros ◦ O código da aplicação precisa se manter “ciente” sobre o schema do banco -
Bancos Relacionais e Escalabilidade • Escalar bancos relacionais é uma
tarefa difícil: ◦ Transações e Joins são custosas para o banco. ◦ Falta de suporte nativo para escalabilidade ou particionamento. ◦ Muitas vezes o particionamento é implementado na própria aplicação. -
O que são ? Uma nova geração de banco de
dados, focados principalmente em: • Serem não relacionais • Distribuídos • Open Source • Escaláveis horizontalmente O que não são ? ( Ou não pretendem ser) • Substitutos absolutos para os bancos de dados relacionais -
Por quê ? Os bancos de dados NoSQL surgiram em
resposta à esses problemas dos bancos relacionais. Os bancos relacionais tem sido a principal tecnologia de banco de dados há mais de 30 anos. No entanto, enfrentam alguns problemas: • Dificuldade para escalar • Dificuldade para lidar com grandes volumes de dados • Incompatibilidade de Impedância -
Como ? Os bancos de dados NoSQL abrem mão de
alguns recursos comumente encontrados em bancos relacionais em favor da disponibilidade e da distributividade. -
NoSQL - Ecossistema • O mundo NoSQL não é padronizado
( ainda… ) • O bancos NoSQL não são tão maduros quanto os bancos relacionais. -
NoSQL - Queries • Variam muito de um banco para
outro • Recursos comuns dos bancos relacionais não estão presentes ou funcionam de uma forma muito diferente nos bancos NoSQL. -
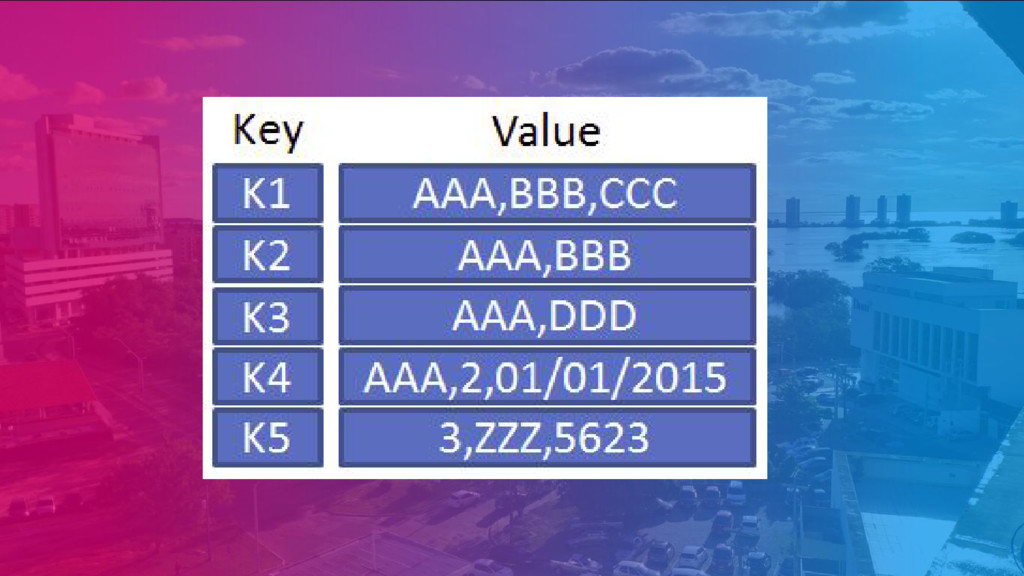
Chave-valor • Armazena um mapeamento de uma chave para um
valor • Para o banco, o “value” não tem estrutura: Você pode armazenar qualquer coisa. • O valor só pode ser recuperado pela chave. Nem todos os bancos oferecem uma listagem das chaves para que você possa recuperá-las. ( Embora alguns bancos permitam índices secundários para recuperação dos dados ). • Alguns bancos dessa categoria trabalham com o conceito de banco em memória. • Exemplos: Riak, Redis, Memcached -
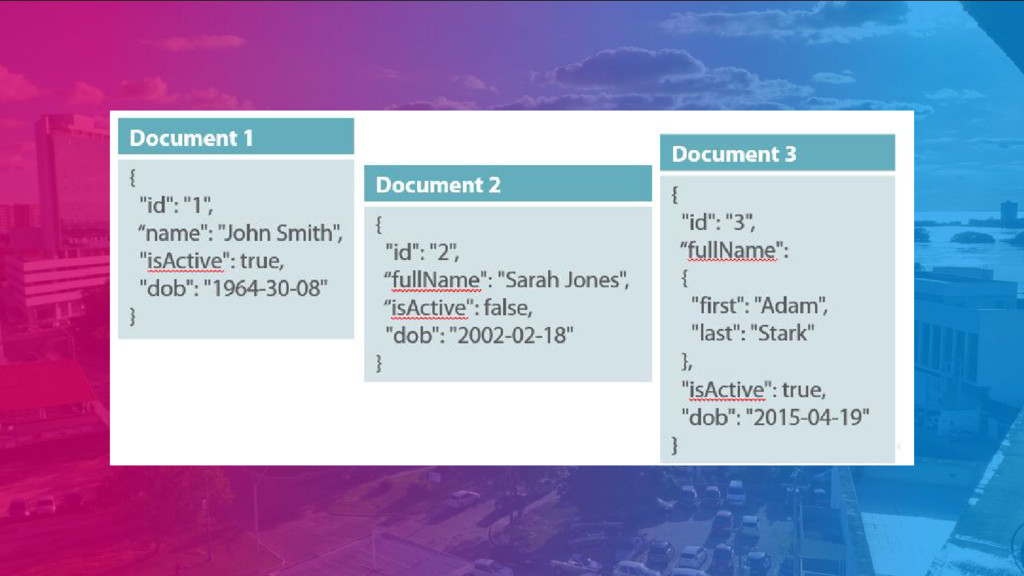
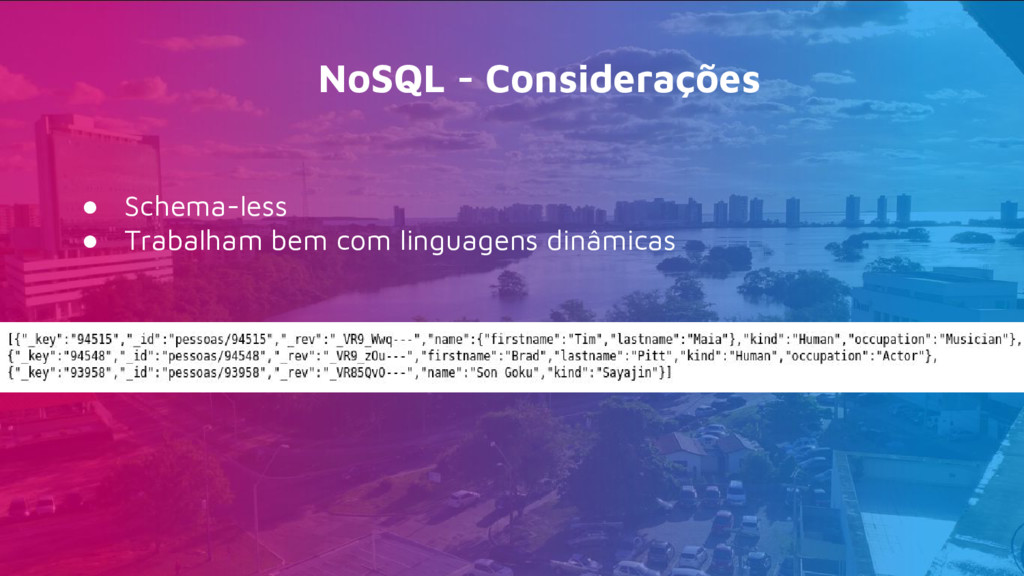
Documentos • Documentos semi-estruturados: JSON, BSON, XML • Permitem consultas
com base nos valores internos do documento. • Exemplos: MongoDB, CouchDB, Azure DocumentDB -
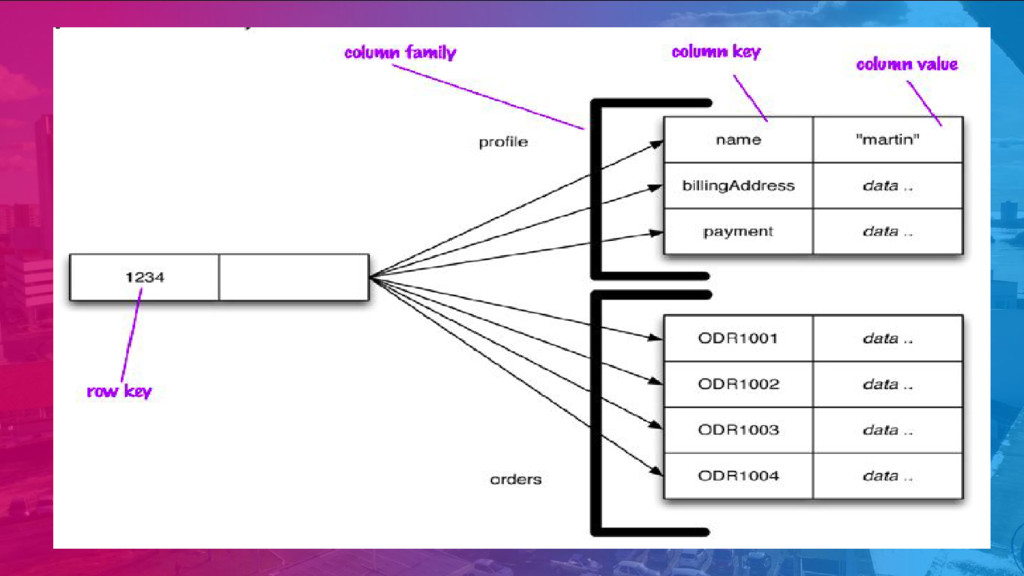
Família de Colunas • Cada coluna é uma tripla: linha,
coluna e timestamp • Colunas são agrupadas em Super Colunas. • Família de colunas: ◦ Colunas de uma mesma família são armazenadas no mesmo sistema de arquivos. • Exemplos: Apache Cassandra, HBase -
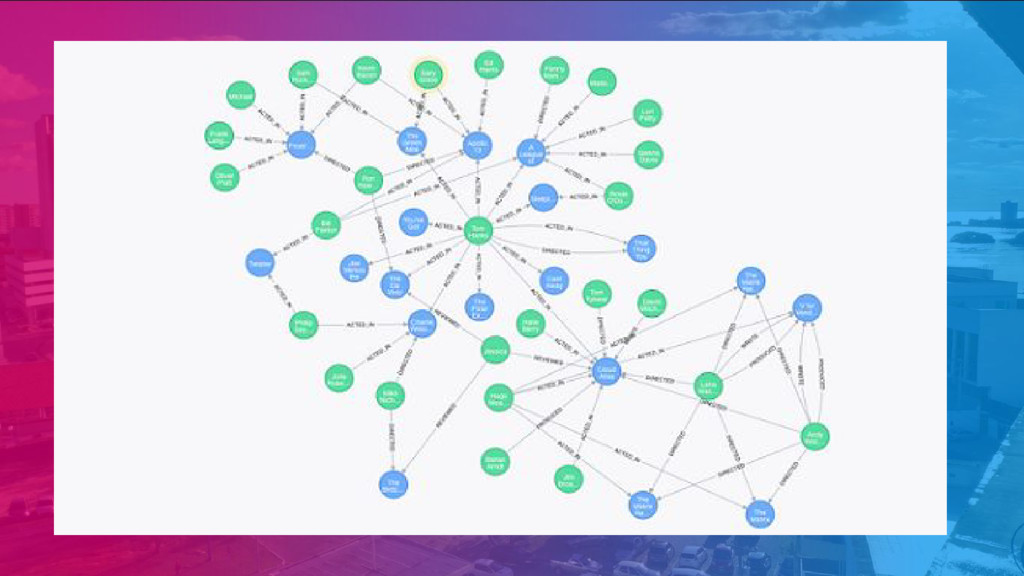
Grafos • Os dados são modelados como nós e arestas.
Aspectos importantes dos relacionamentos são armazenados também. • Exemplos: Neo4J, InfiniteGraph -
NoSQL - Mudanças no schema ? A aplicação pode: •
Atualizar todos os dados anteriores • Atualizar os dados eventualmente • Nunca atualizar -
NoSQL & ACID Na grande maioria dos bancos NoSQL, uma
operação que afeta um único registro é atômica. Em operações que afetam mais de um registro o banco pode não garantir a atomicidade, consistência e isolação. -
NoSQL & ACID Exemplo com dois clientes acessando o mesmo
dado em paralelo: READ userA.friends [ userB, userC] READ userB.profile => Ok ! DELETE userB.* => Ok ! -
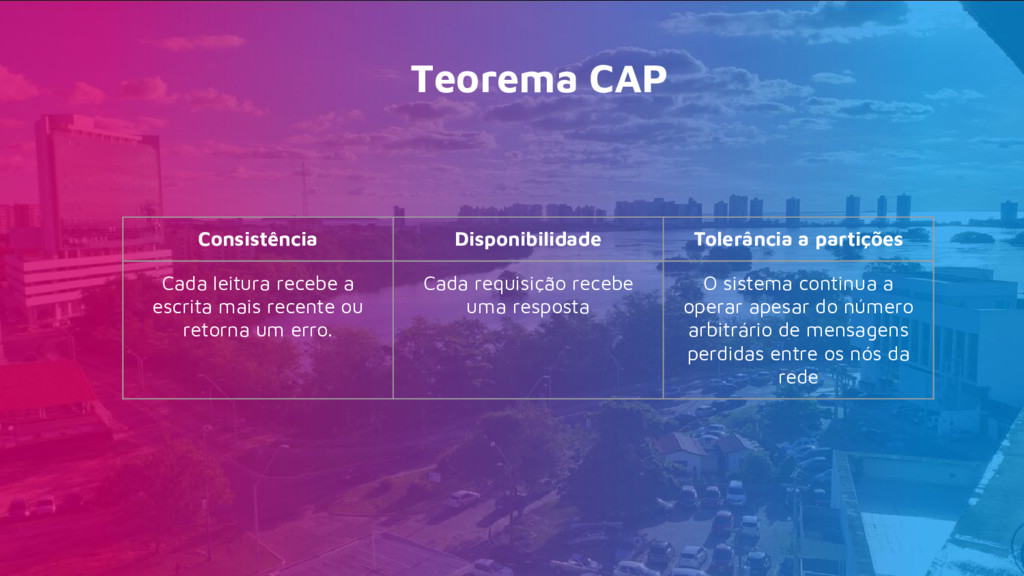
Teorema CAP Consistência Disponibilidade Tolerância a partições Cada leitura recebe
a escrita mais recente ou retorna um erro. Cada requisição recebe uma resposta O sistema continua a operar apesar do número arbitrário de mensagens perdidas entre os nós da rede -
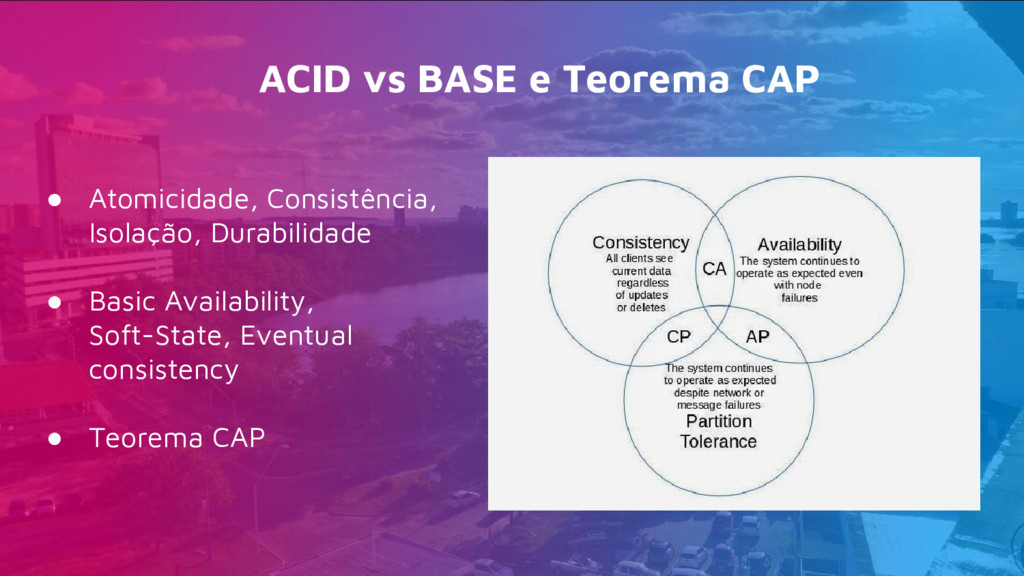
ACID vs BASE e Teorema CAP • Atomicidade, Consistência, Isolação,
Durabilidade • Basic Availability, Soft-State, Eventual consistency • Teorema CAP -
NoSQL - Consistência Eventual • Bancos NoSQL distribuídos prezam principalmente
pela disponibilidade e tolerância a particionamento. • Dados entram em conflito normalmente. • Sua aplicação pode ter que tratar em algum momento dados conflitantes. -
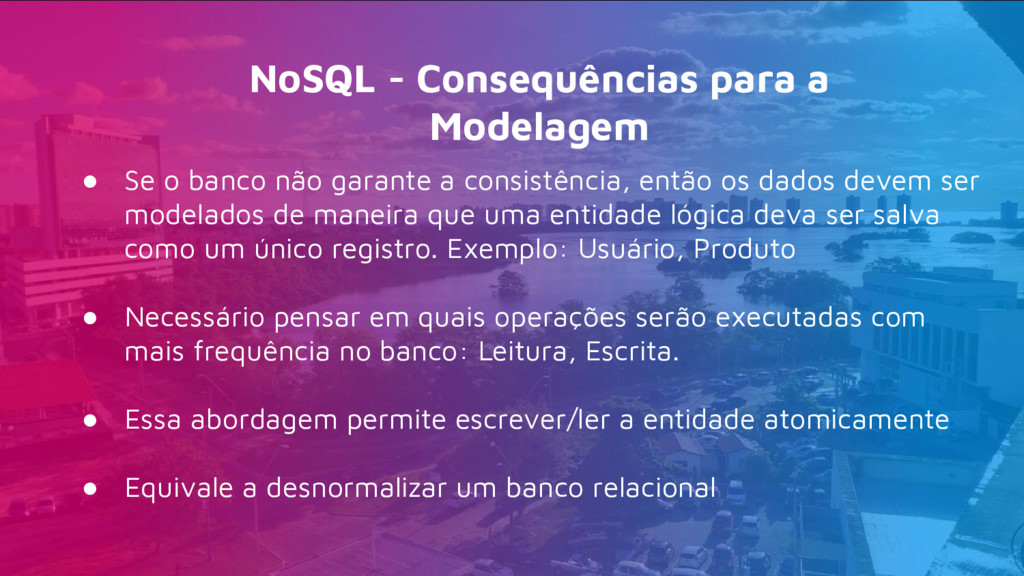
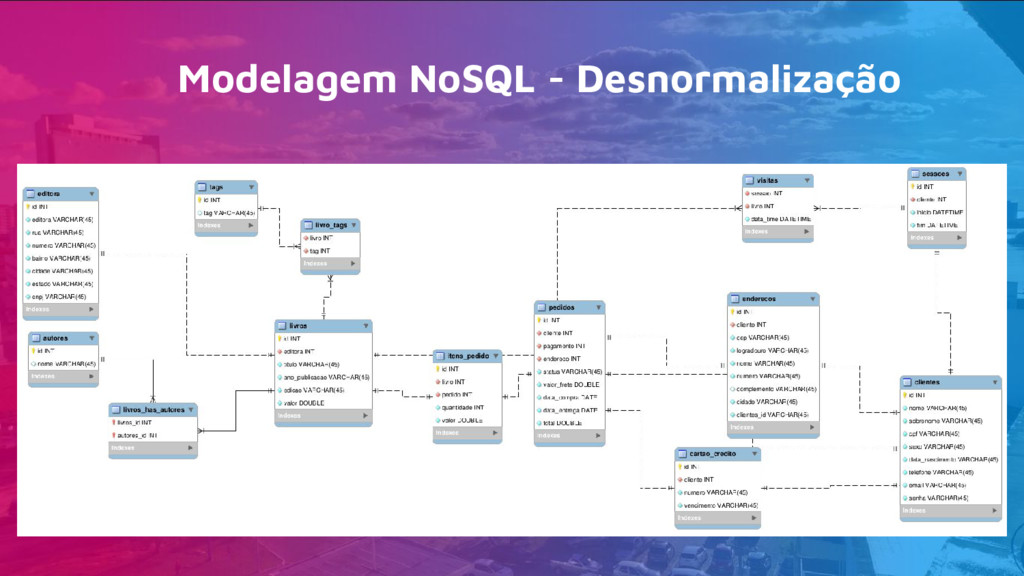
NoSQL - Consequências para a Modelagem • Se o banco
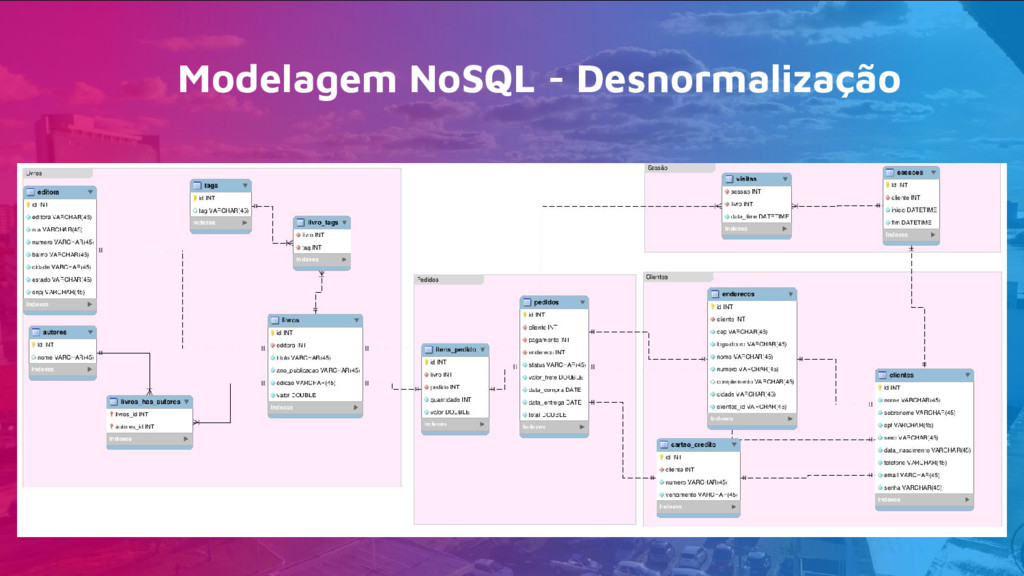
não garante a consistência, então os dados devem ser modelados de maneira que uma entidade lógica deva ser salva como um único registro. Exemplo: Usuário, Produto • Necessário pensar em quais operações serão executadas com mais frequência no banco: Leitura, Escrita. • Essa abordagem permite escrever/ler a entidade atomicamente • Equivale a desnormalizar um banco relacional -
NoSQL - Agregação • Dados podem ser agregados e então
duplicados no banco de dados. • Exemplo: agregar os dados de um ou mais autores no próprio registro de determinado livro. • Isto também facilita a consulta, já que ao recuperar o livro os dados do autor estão embutidos. -
NoSQL - Agregação • Pode causar muita duplicação • Atualizações
podem ser problemáticas, pois há cópias distribuídas pelo banco e todas elas precisam ser atualizadas. • As próprias cópias podem se tornar inconsistentes -
NoSQL - Linkagem • Linkagem consiste em armazenar referências no
documento para outros documentos. • O banco não garante a consistência da referência • Em geral usado para relações muitos-para-muitos entre os dados • Exemplo de Uso: Comentários em um artigo feitos por usuários de uma aplicação. -
NoSQL - Agregação vs Linkagem • Agregação deve ser usada:
◦ Quando os dados incorporados muito raramente (ou nunca) sofrem atualizações. ◦ Cache ◦ Quando o tempo de vida da incorporação é curto • Em outros caso, deve-se considerar usar a linkagem -
O fim da era de modelagem única • A persistência
poliglota é a possibilidade de se aplicar diversos modelos de dados para a construção de uma aplicação. Pode-se buscar vantagens em cada modelo para a resolução de uma parte do problema e aplicá-la. • Exemplo: ◦ Aplicação de E-commerce: ▪ Sistema de Recomendação: Grafos (Neo4J) ▪ Sessões de usuário: Chave-valor (Riak) ▪ Produtos, Clientes, Vendas: Documentos (MongoDB) ▪ Data-warehouse: Relacional (PostgreSQL) -
Persistência Poliglota • Nem tudo são flores… • Desvantagens: ◦
Muitas tecnologias envolvidas ◦ Aumento da complexidade -
Bancos de Dados Multi-Modelos • Trabalham com dois ou mais
modelos de dados • Focam em ser no mínimo tão eficientes em desempenho quanto os bancos NoSQL especializados nos modelos que aborda. • Reduzem os custos de aprendizagem e manutenção. • Exemplos: ArangoDB, CosmosDB, CouchBase, CrateDB -
ArangoDB • Multi-modelos nativo - combina chave-valor, documentos e grafos
em uma única instância e uma só linguagem de consulta (AQL) • Escrito em C++ • Extensível através de JavaScript ( Foxx framework, Services ) • Lançamento: 2011 • Atualmente com cerca de 1.4 milhões de downloads • Mais de 180 casos de uso do banco em produção Companhia: • ArangoDB GmbH - 2014 • Equipe: ~30 pessoas • Sede: Colonia, Alemanha -
ArangoDB para startups • O ArangoDB também é uma startup
• Oferecem: ◦ Suporte profissional com preço reduzido ◦ Ajudam a desenvolver seu produto rapidamente ◦ Resposta rápida a problemas críticos • ArangoDB GmbH recebeu entre 2016 e 2017 mais de € 6 milhões em investimentos. • Informações: ◦ https://www.arangodb.com/startup-accelerator-program/ -
ArangoDB: Principais recursos • Documentos ◦ JOINS ◦ Transações •
Grafos ◦ Distribuídos ◦ Pattern Matching ◦ Transações • Cluster ◦ Recuperação automática de falha ◦ Multi-master -
• Driver PHP para ArangoDB: ◦ https://github.com/lucassouzavieira/arangodb-php-driver • MongoDB: ◦
https://github.com/mongodb/mongo • ArangoDB: ◦ https://github.com/arangodb/arangodb • Redis: ◦ https://github.com/antirez/redis • Memcached: ◦ https://github.com/memcached/memcached Alguns projetos interessantes no Github: -
Links • https://www.arangodb.com/2015/10/benchmark-postgresql-mongodb-arangodb/ • https://www.arangodb.com/documentation/ • https://docs.arangodb.com/3.1/AQL/index.html • http://nosql-database.org/ •
https://highlyscalable.wordpress.com/2012/03/01/nosql-data-modeling-techniques/ • https://martinfowler.com/nosql.html Referências Livro • NoSQL Essencial - Pramod J. Sadalage, Martin Fowler.