Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
「あの人しかできない」を減らす ハーネス構築(LLM Wiki)の話
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
mae
November 03, 2026
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
「あの人しかできない」を減らす ハーネス構築(LLM Wiki)の話
mae
November 03, 2026
More Decks by mae
See All by mae
PM初めて1年の振り返り
mae_hidari
0
100
若手向けITコミュニティを運営する理由
mae_hidari
1
5.6k
コミュニティ運営のコツ
mae_hidari
1
95
Featured
See All Featured
The World Runs on Bad Software
bkeepers
PRO
72
12k
New Earth Scene 8
popppiees
4
2.8k
How GitHub (no longer) Works
holman
316
150k
Navigating Weather and Climate Data
rabernat
0
590
svc-hook: hooking system calls on ARM64 by binary rewriting
retrage
2
670
Skip the Path - Find Your Career Trail
mkilby
1
290
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
820
Documentation Writing (for coders)
carmenintech
77
5.6k
[Rails World 2026] Durable orchestration on Rails: from continuation to workflow
palkan
3
1.2k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.9k
Distributed Sagas: A Protocol for Coordinating Microservices
caitiem20
333
23k
A Soul's Torment
seathinner
8
3.9k
Transcript
「あの人しかできない」を減らす ハーネス構築(LLM Wiki)の話 決定論的解決を目指そう byまえ
自己紹介とプロジェクト - 所属:鈴木商店 経歴:フロントエンジニア4.5年、プロマネ2.5年 - PJ - 準委任の受託PJ 医薬系の業務システム。10年開発が継続している。 自分のPJ歴は4.5年くらい
チームでAI(Claude・Codex)を開発・運用・PM業務に活用
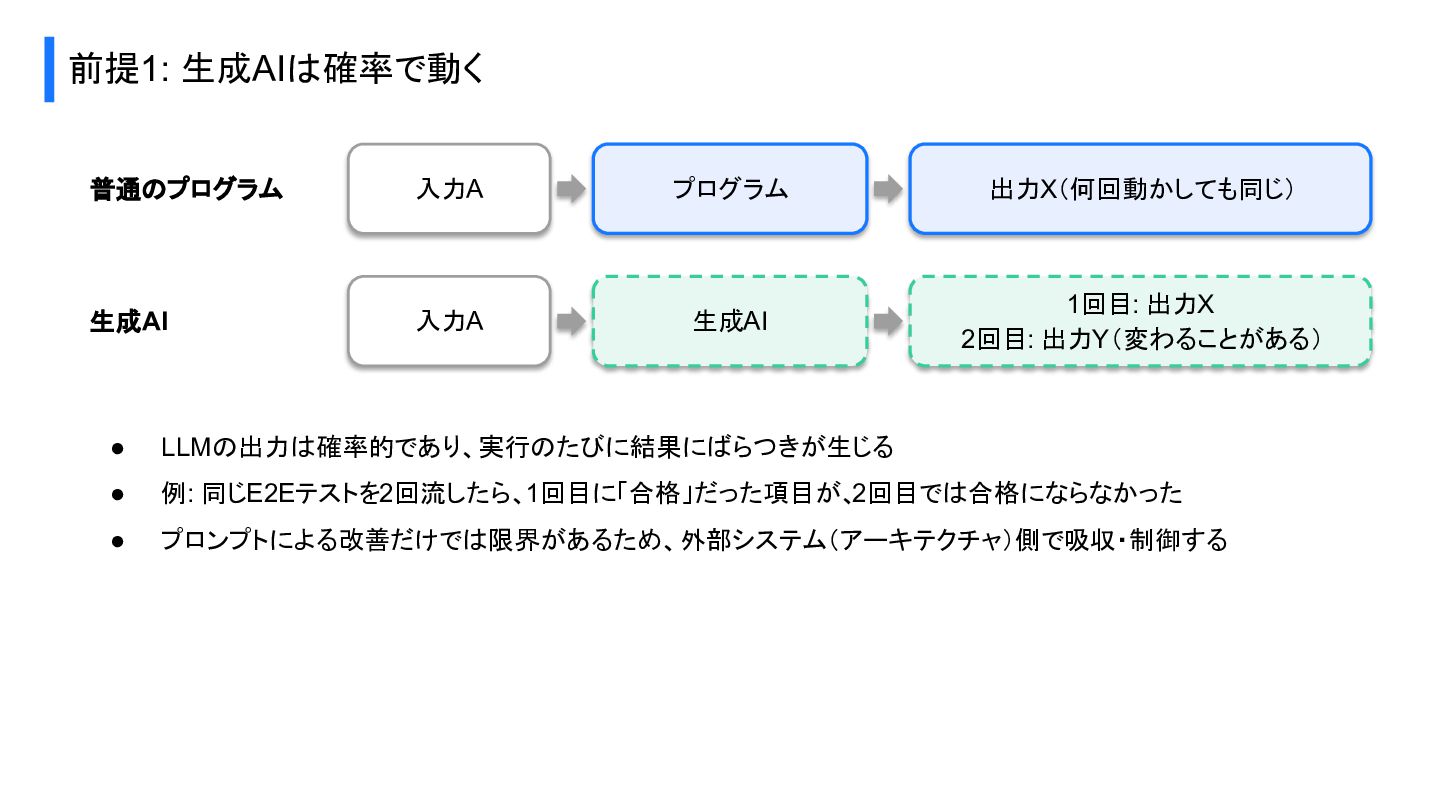
前提1: 生成AIは確率で動く 普通のプログラム 入力A プログラム 出力X(何回動かしても同じ) 生成AI 入力A 生成AI 1回目:
出力X 2回目: 出力Y(変わることがある) • LLMの出力は確率的であり、実行のたびに結果にばらつきが生じる • 例: 同じE2Eテストを2回流したら、1回目に「合格」だった項目が、2回目では合格にならなかった • プロンプトによる改善だけでは限界があるため、外部システム(アーキテクチャ)側で吸収・制御する
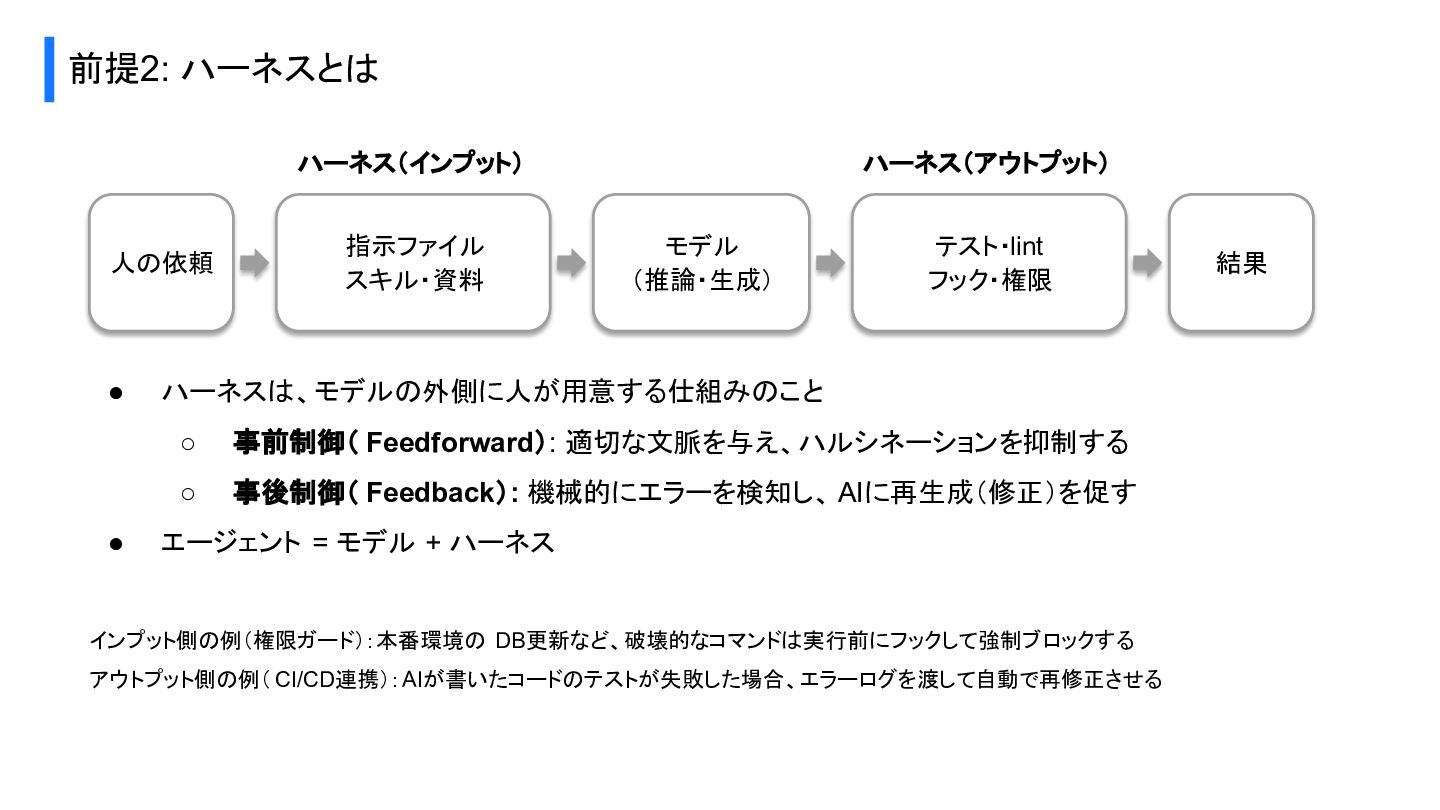
前提2: ハーネスとは ハーネス(インプット) 人の依頼 • • 指示ファイル スキル・資料 ハーネス(アウトプット) モデル
(推論・生成) テスト・lint フック・権限 ハーネスは、モデルの外側に人が用意する仕組みのこと ◦ 事前制御( Feedforward): 適切な文脈を与え、ハルシネーションを抑制する ◦ 事後制御( Feedback): 機械的にエラーを検知し、 AIに再生成(修正)を促す エージェント = モデル + ハーネス インプット側の例(権限ガード):本番環境の DB更新など、破壊的なコマンドは実行前にフックして強制ブロックする アウトプット側の例( CI/CD連携):AIが書いたコードのテストが失敗した場合、エラーログを渡して自動で再修正させる 結果
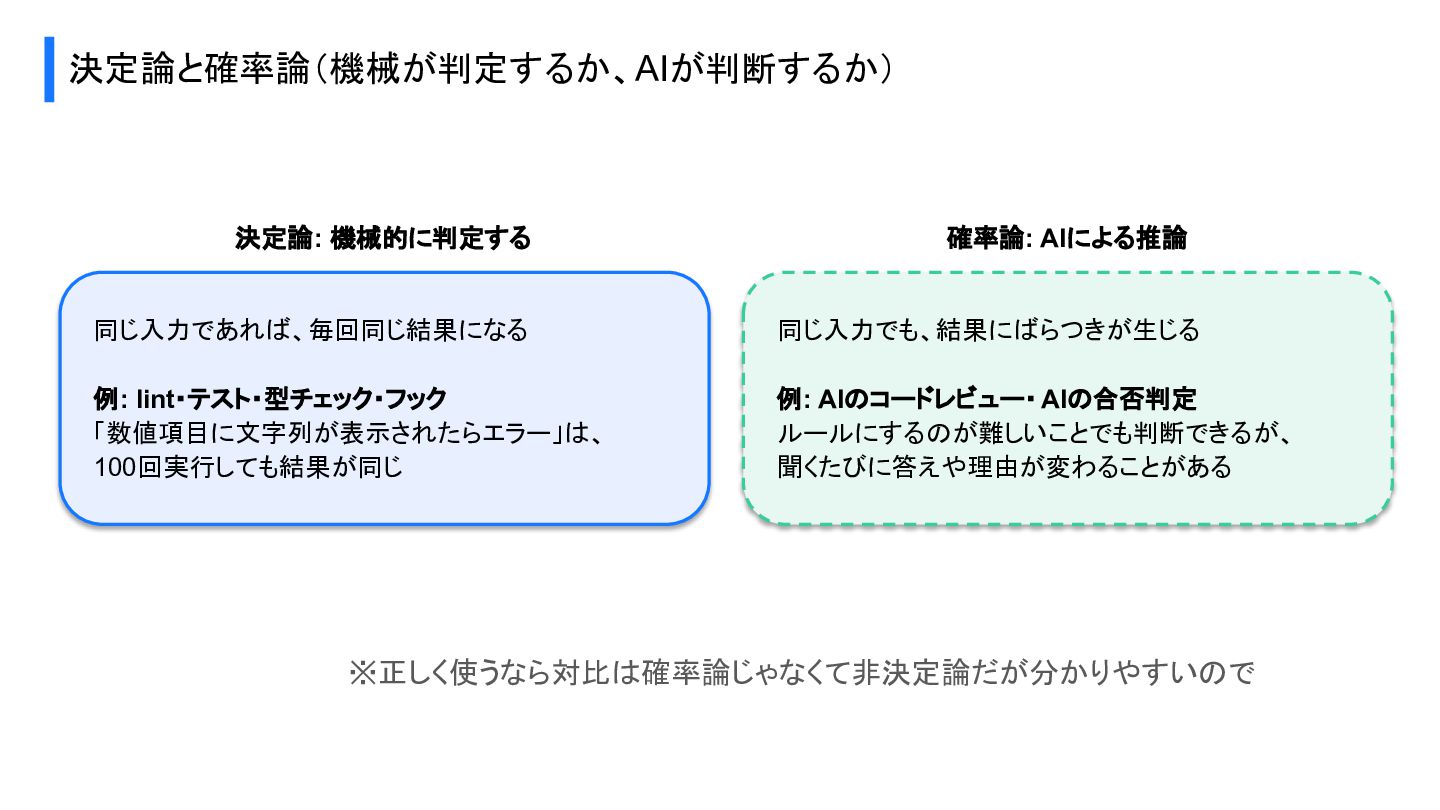
決定論と確率論(機械が判定するか、AIが判断するか) 決定論: 機械的に判定する 確率論: AIによる推論 同じ入力であれば、毎回同じ結果になる 同じ入力でも、結果にばらつきが生じる 例: lint・テスト・型チェック・フック 「数値項目に文字列が表示されたらエラー」は、
100回実行しても結果が同じ 例: AIのコードレビュー・ AIの合否判定 ルールにするのが難しいことでも判断できるが、 聞くたびに答えや理由が変わることがある ※正しく使うなら対比は確率論じゃなくて非決定論だが分かりやすいので
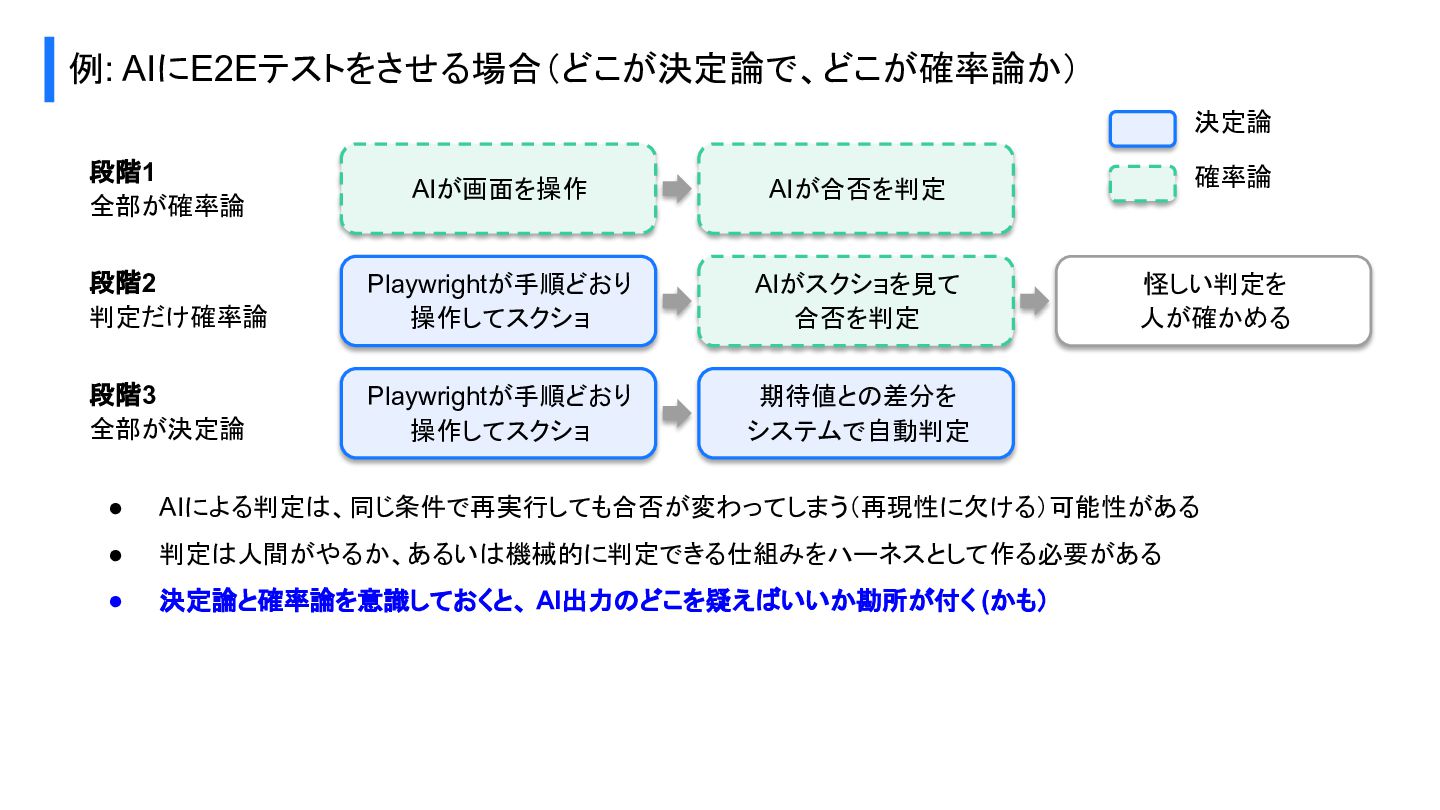
例: AIにE2Eテストをさせる場合(どこが決定論で、どこが確率論か) 決定論 段階1 全部が確率論 AIが画面を操作 AIが合否を判定 段階2 判定だけ確率論 Playwrightが手順どおり
操作してスクショ AIがスクショを見て 合否を判定 段階3 全部が決定論 Playwrightが手順どおり 操作してスクショ 期待値との差分を システムで自動判定 確率論 怪しい判定を 人が確かめる • AIによる判定は、同じ条件で再実行しても合否が変わってしまう(再現性に欠ける)可能性がある • 判定は人間がやるか、あるいは機械的に判定できる仕組みをハーネスとして作る必要がある • 決定論と確率論を意識しておくと、 AI出力のどこを疑えばいいか勘所が付く (かも)
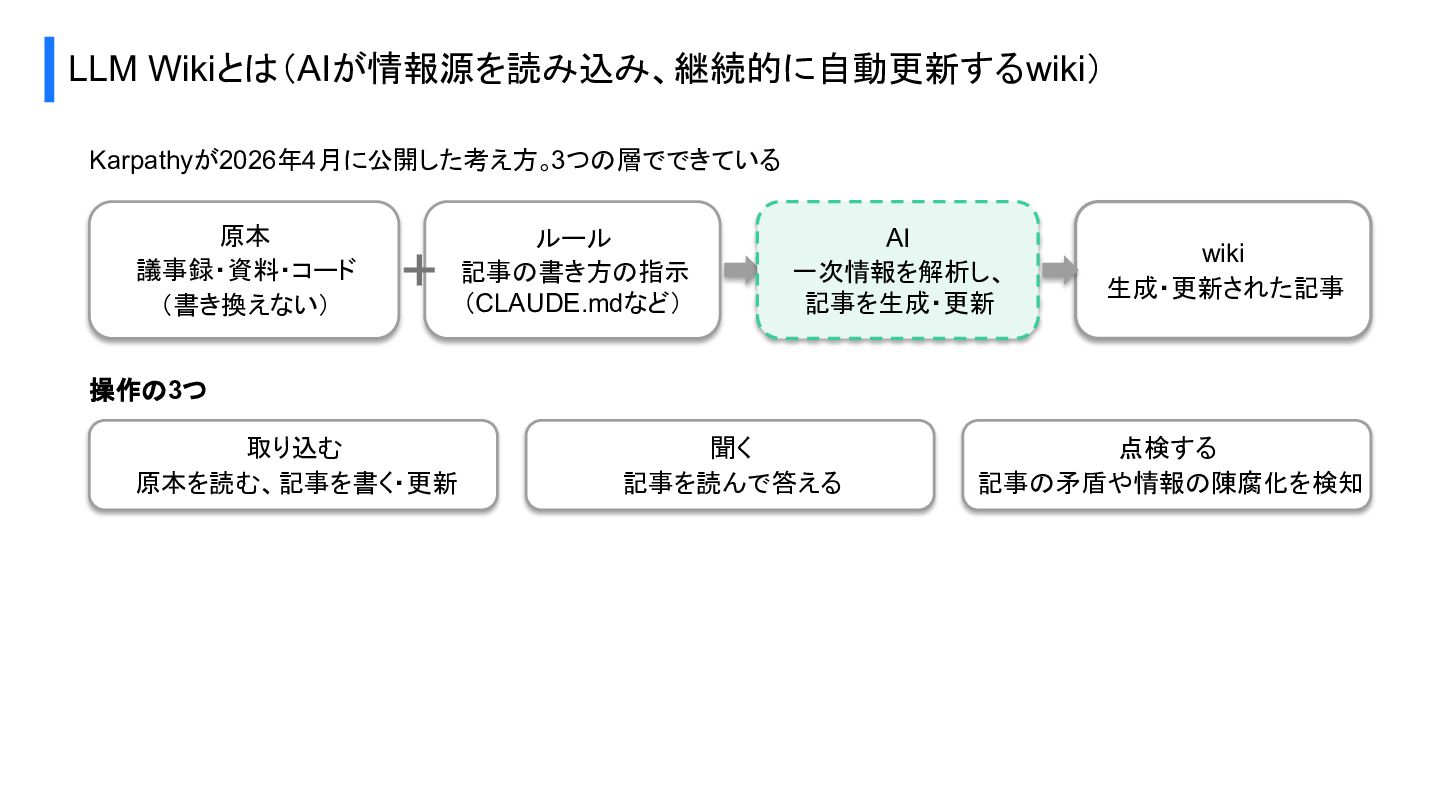
LLM Wikiとは(AIが情報源を読み込み、継続的に自動更新するwiki) Karpathyが2026年4月に公開した考え方。3つの層でできている 原本 議事録・資料・コード (書き換えない) + ルール 記事の書き方の指示 (CLAUDE.mdなど)
AI 一次情報を解析し、 記事を生成・更新 wiki 生成・更新された記事 操作の3つ 取り込む 原本を読む、記事を書く・更新 聞く 記事を読んで答える 点検する 記事の矛盾や情報の陳腐化を検知
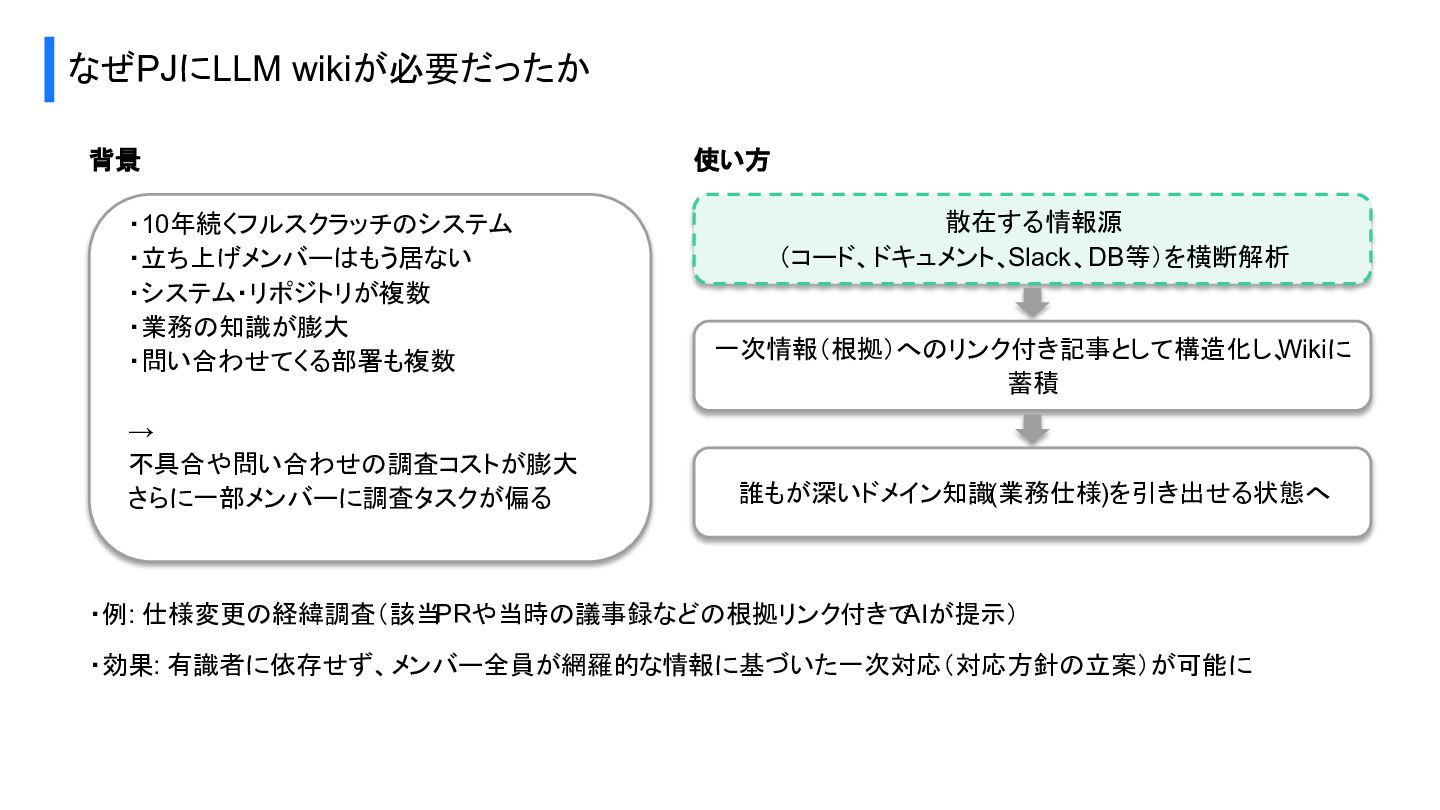
なぜPJにLLM wikiが必要だったか 背景 ・10年続くフルスクラッチのシステム ・立ち上げメンバーはもう居ない ・システム・リポジトリが複数 ・業務の知識が膨大 ・問い合わせてくる部署も複数 → 不具合や問い合わせの調査コストが膨大
さらに一部メンバーに調査タスクが偏る 使い方 散在する情報源 (コード、ドキュメント、Slack、DB等)を横断解析 一次情報(根拠)へのリンク付き記事として構造化し、Wikiに 蓄積 誰もが深いドメイン知識(業務仕様)を引き出せる状態へ ・例: 仕様変更の経緯調査(該当PRや当時の議事録などの根拠リンク付きでAIが提示) ・効果: 有識者に依存せず、メンバー全員が網羅的な情報に基づいた一次対応(対応方針の立案)が可能に
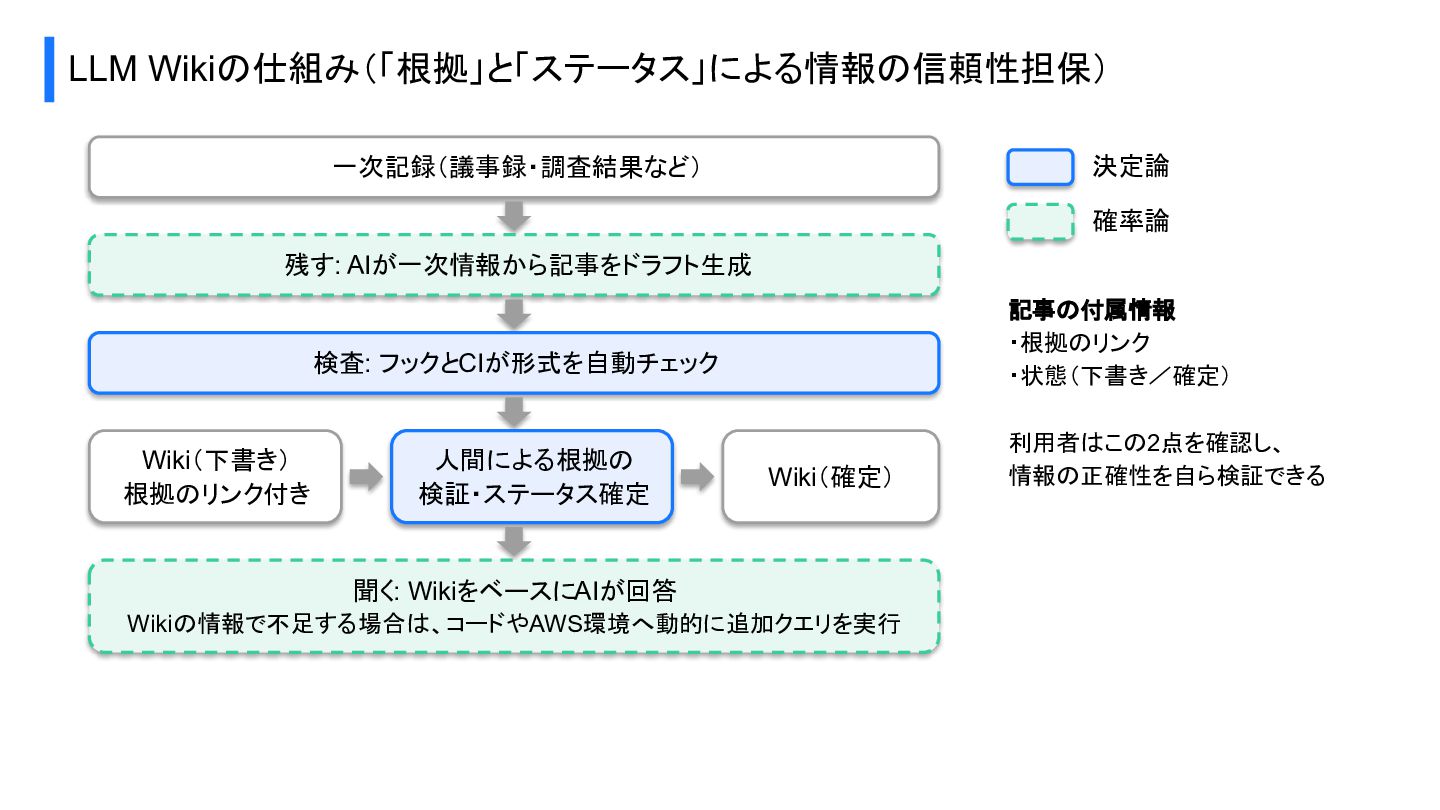
LLM Wikiの仕組み(「根拠」と「ステータス」による情報の信頼性担保) 決定論 一次記録(議事録・調査結果など) 確率論 残す: AIが一次情報から記事をドラフト生成 記事の付属情報 ・根拠のリンク ・状態(下書き/確定)
検査: フックとCIが形式を自動チェック Wiki(下書き) 根拠のリンク付き 人間による根拠の 検証・ステータス確定 Wiki(確定) 聞く: WikiをベースにAIが回答 Wikiの情報で不足する場合は、コードやAWS環境へ動的に追加クエリを実行 利用者はこの2点を確認し、 情報の正確性を自ら検証できる
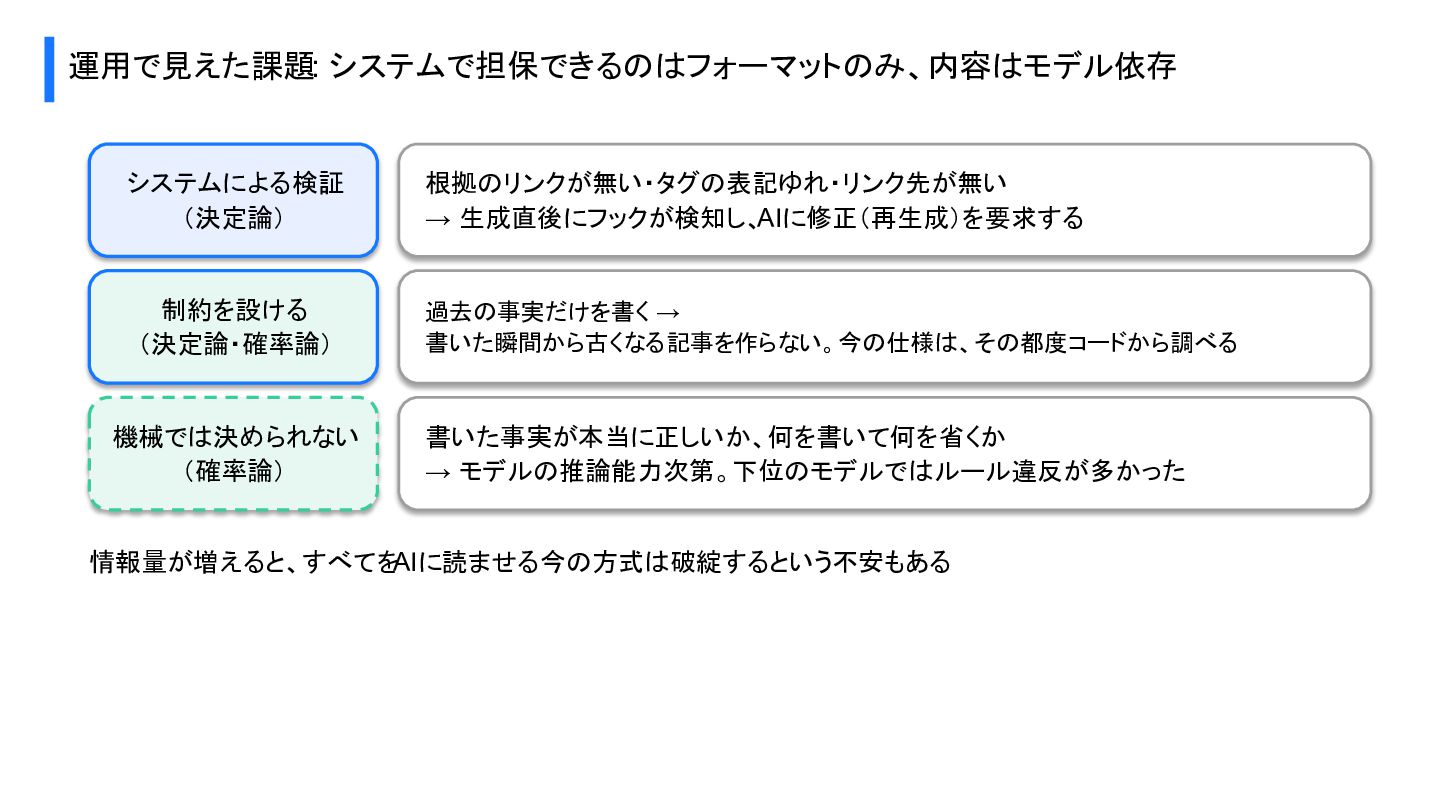
運用で見えた課題: システムで担保できるのはフォーマットのみ、内容はモデル依存 システムによる検証 (決定論) 根拠のリンクが無い・タグの表記ゆれ・リンク先が無い → 生成直後にフックが検知し、AIに修正(再生成)を要求する 制約を設ける (決定論・確率論) 過去の事実だけを書く
→ 書いた瞬間から古くなる記事を作らない。今の仕様は、その都度コードから調べる 機械では決められない (確率論) 書いた事実が本当に正しいか、何を書いて何を省くか → モデルの推論能力次第。下位のモデルではルール違反が多かった 情報量が増えると、すべてをAIに読ませる今の方式は破綻するという不安もある
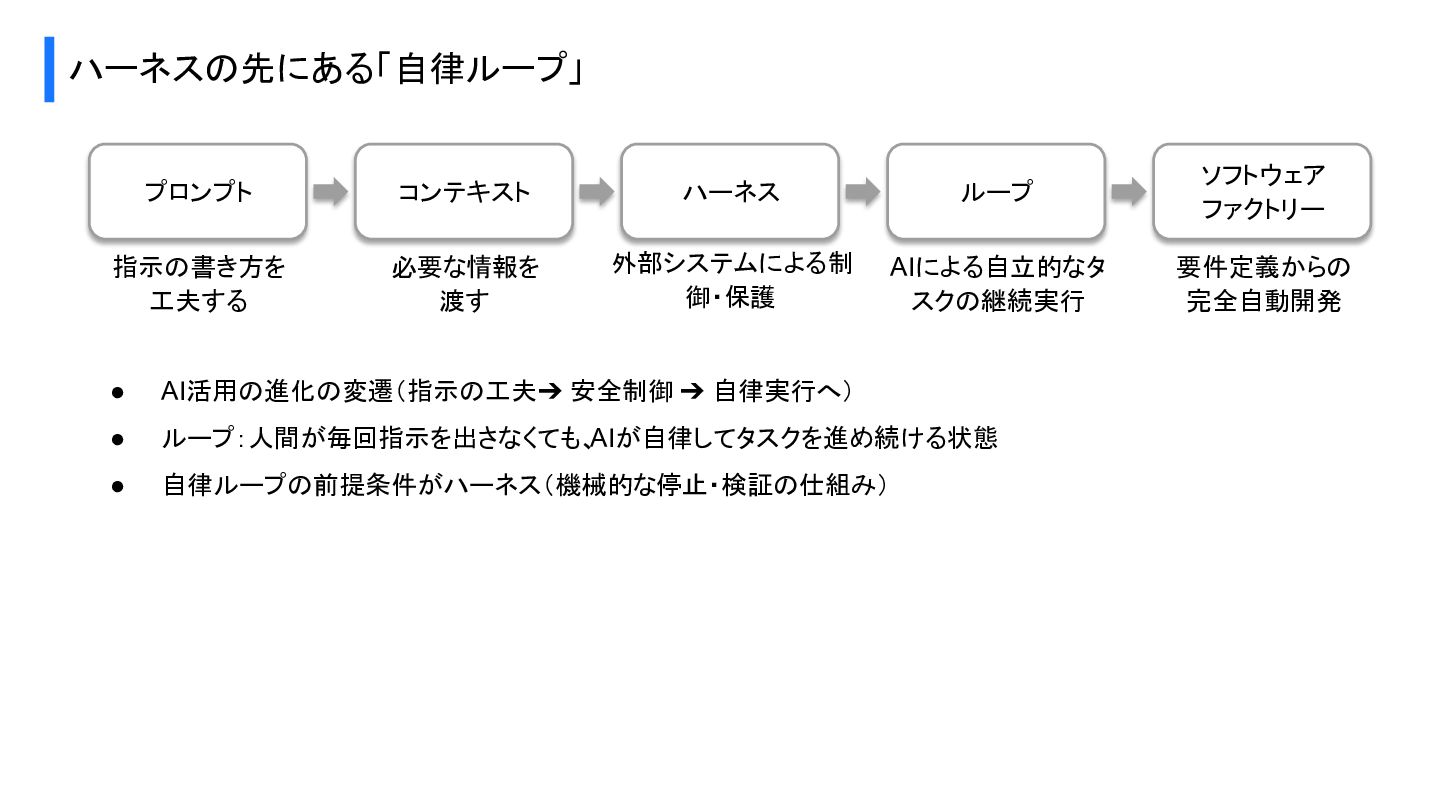
ハーネスの先にある「自律ループ」 プロンプト コンテキスト ハーネス ループ ソフトウェア ファクトリー 指示の書き方を 工夫する 必要な情報を
渡す 外部システムによる制 御・保護 AIによる自立的なタ スクの継続実行 要件定義からの 完全自動開発 • AI活用の進化の変遷(指示の工夫➔ 安全制御 ➔ 自律実行へ) • ループ:人間が毎回指示を出さなくても、AIが自律してタスクを進め続ける状態 • 自律ループの前提条件がハーネス(機械的な停止・検証の仕組み)
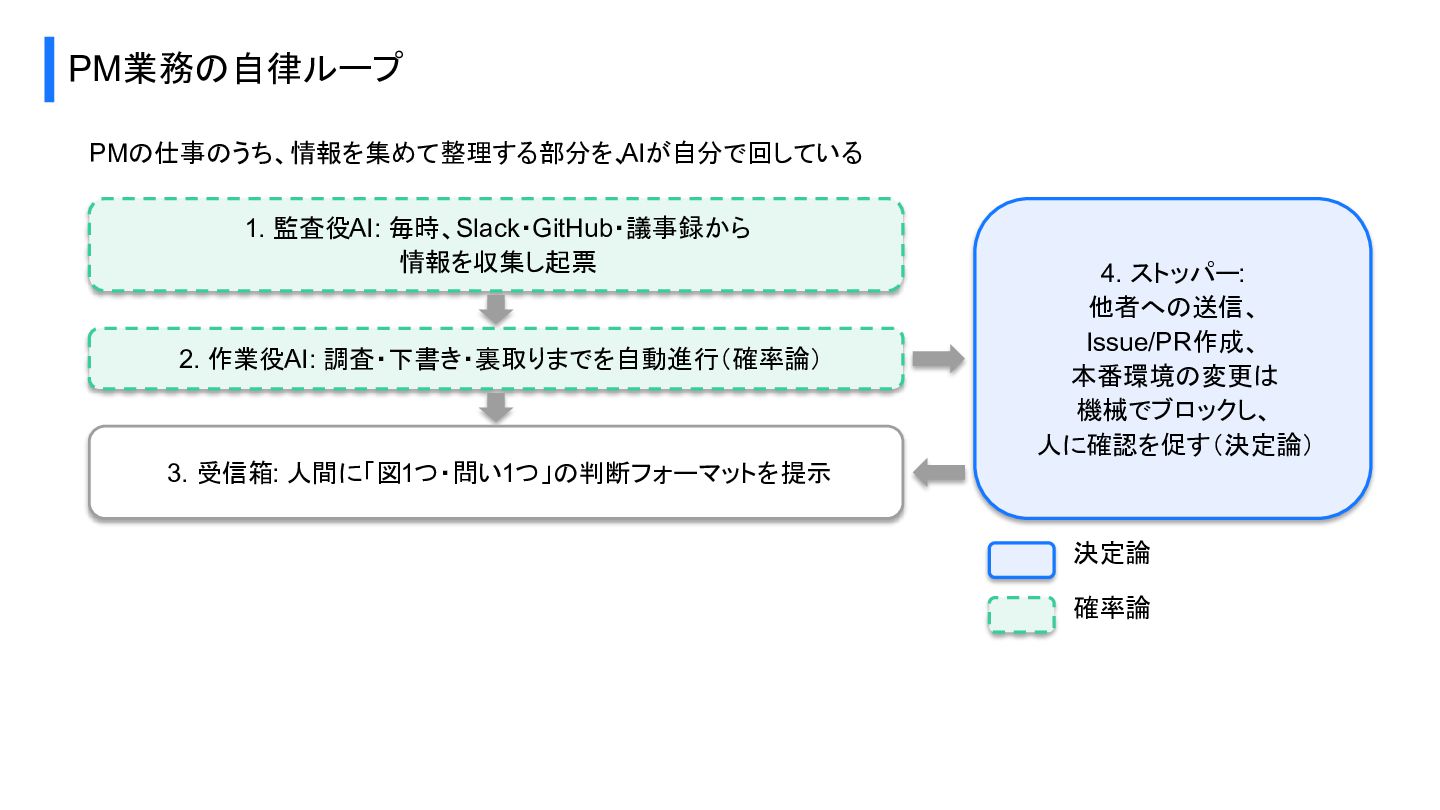
PM業務の自律ループ PMの仕事のうち、情報を集めて整理する部分を、AIが自分で回している 1. 監査役AI: 毎時、Slack・GitHub・議事録から 情報を収集し起票 2. 作業役AI: 調査・下書き・裏取りまでを自動進行(確率論) 4.
ストッパー: 他者への送信、 Issue/PR作成、 本番環境の変更は 機械でブロックし、 人に確認を促す(決定論) 3. 受信箱: 人間に「図1つ・問い1つ」の判断フォーマットを提示 決定論 確率論
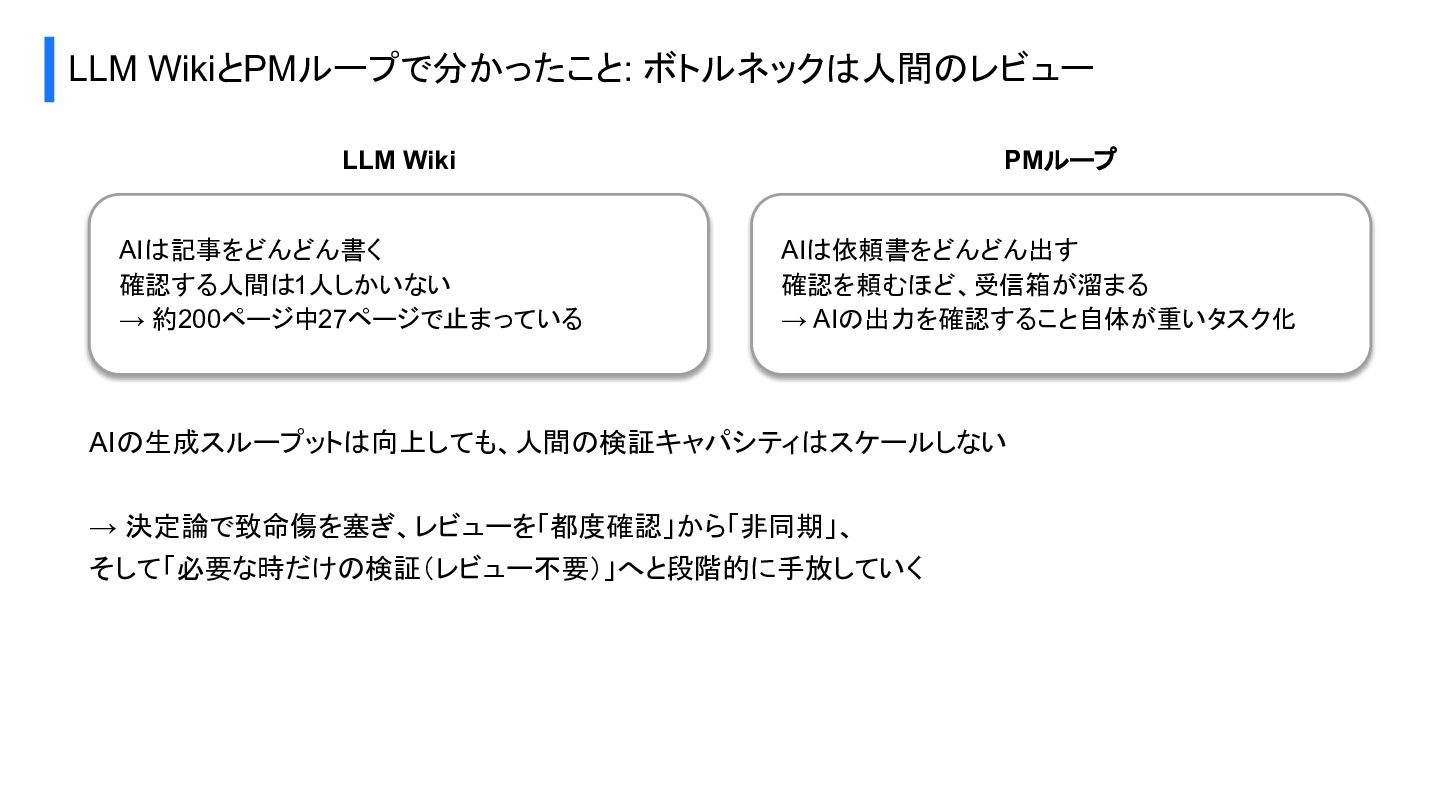
LLM WikiとPMループで分かったこと: ボトルネックは人間のレビュー LLM Wiki AIは記事をどんどん書く 確認する人間は1人しかいない → 約200ページ中27ページで止まっている PMループ
AIは依頼書をどんどん出す 確認を頼むほど、受信箱が溜まる → AIの出力を確認すること自体が重いタスク化 AIの生成スループットは向上しても、人間の検証キャパシティはスケールしない → 決定論で致命傷を塞ぎ、レビューを「都度確認」から「非同期」、 そして「必要な時だけの検証(レビュー不要)」へと段階的に手放していく
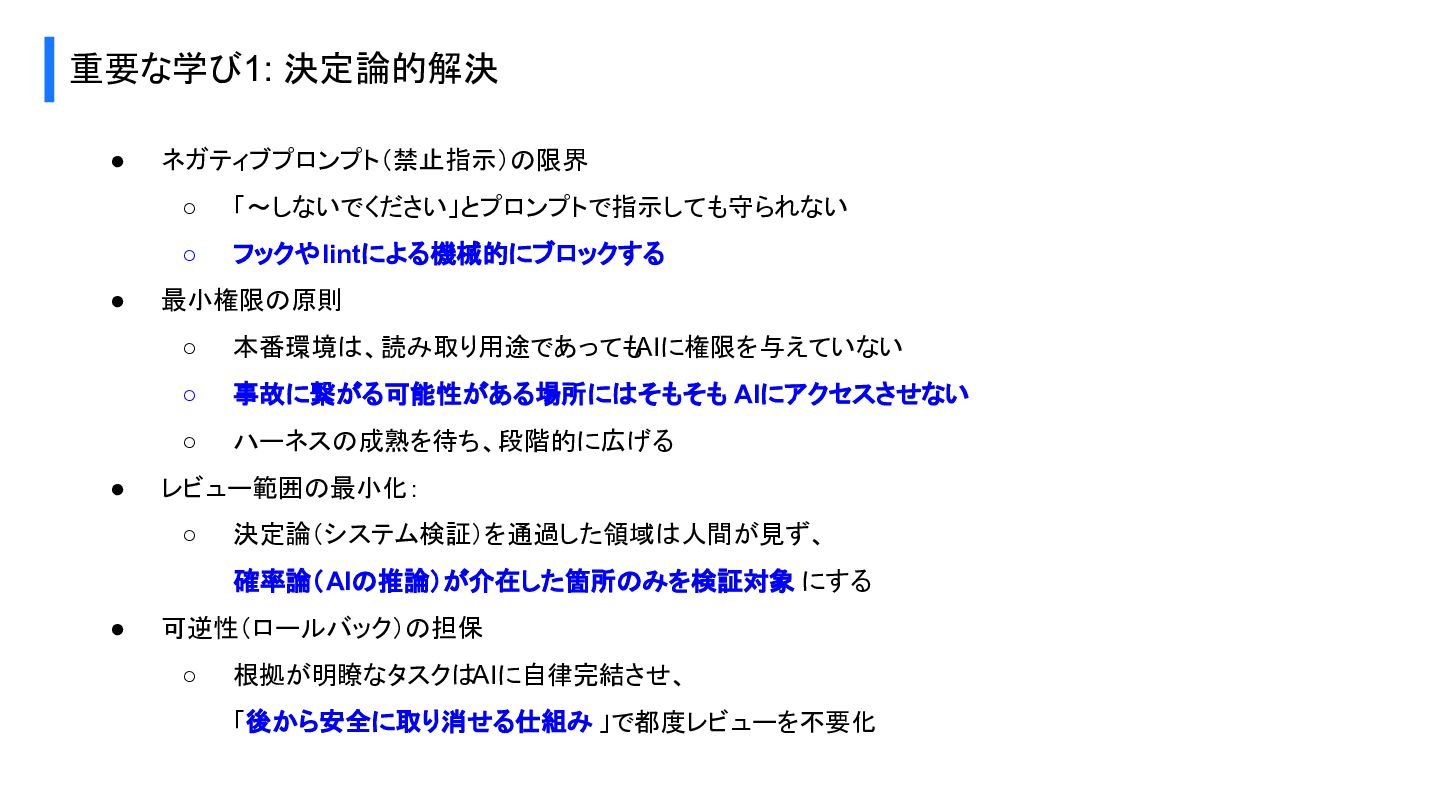
重要な学び1: 決定論的解決 • • • ネガティブプロンプト(禁止指示)の限界 ◦ 「〜しないでください」とプロンプトで指示しても守られない ◦ フックやlintによる機械的にブロックする
最小権限の原則 ◦ 本番環境は、読み取り用途であってもAIに権限を与えていない ◦ 事故に繋がる可能性がある場所にはそもそも AIにアクセスさせない ◦ ハーネスの成熟を待ち、段階的に広げる レビュー範囲の最小化: ◦ 決定論(システム検証)を通過した領域は人間が見ず、 確率論(AIの推論)が介在した箇所のみを検証対象 にする • 可逆性(ロールバック)の担保 ◦ 根拠が明瞭なタスクはAIに自律完結させ、 「後から安全に取り消せる仕組み 」で都度レビューを不要化
重要な学び2: 人間が検証した結果をフィードバックする 「人が確認した正解」を機械の判定ルールに変えていく • 人が検証・承認した結果を、次回のテストシナリオの「期待値(正解データ)」として機械検査に組み込む • ルール化が難しい定性的な業務判断であっても、 人間とAIのやりとりを蓄積・分析することで機械的な判定ロジックへ落とし込める
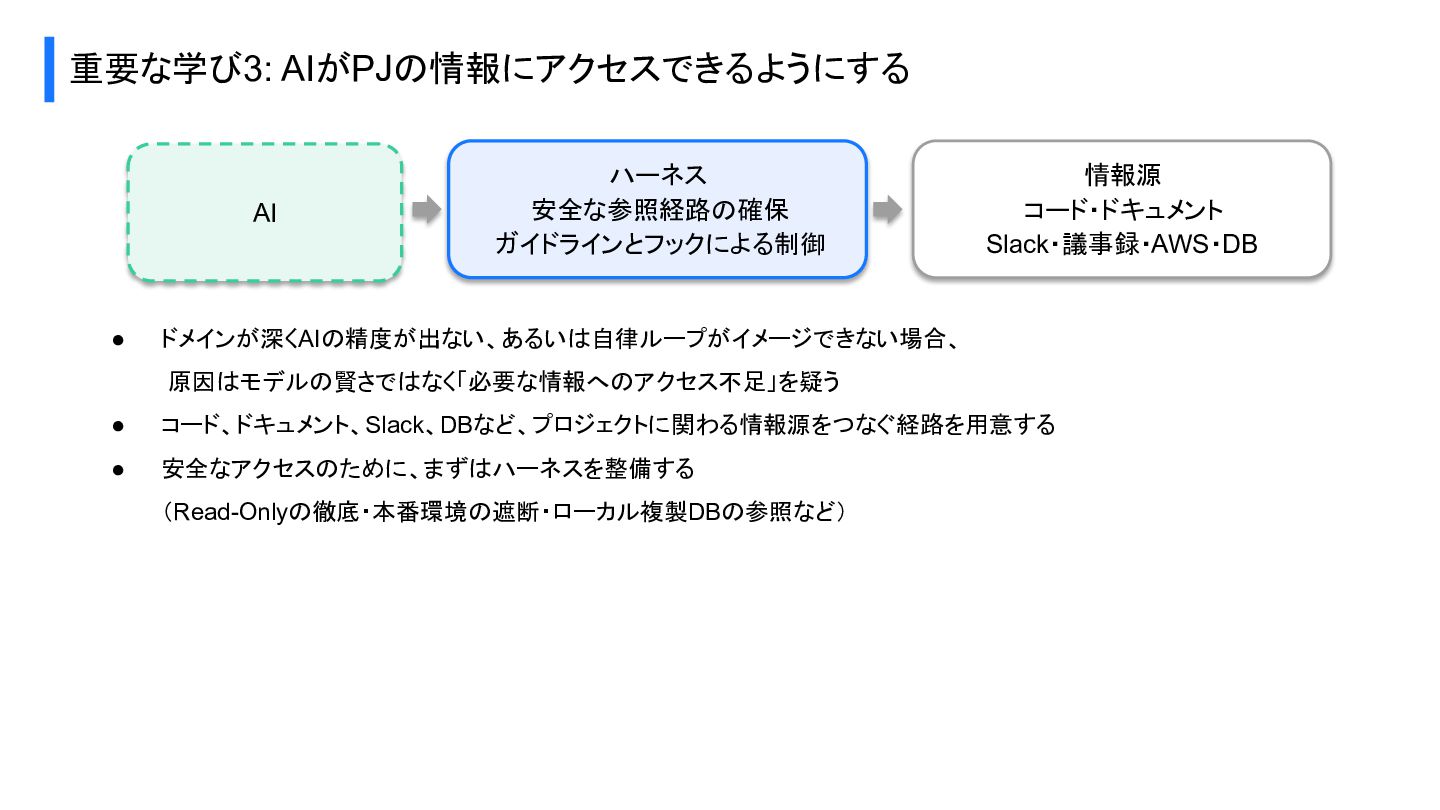
重要な学び3: AIがPJの情報にアクセスできるようにする AI • ハーネス 安全な参照経路の確保 ガイドラインとフックによる制御 情報源 コード・ドキュメント Slack・議事録・AWS・DB
ドメインが深くAIの精度が出ない、あるいは自律ループがイメージできない場合、 原因はモデルの賢さではなく「必要な情報へのアクセス不足」を疑う • コード、ドキュメント、Slack、DBなど、プロジェクトに関わる情報源をつなぐ経路を用意する • 安全なアクセスのために、まずはハーネスを整備する (Read-Onlyの徹底・本番環境の遮断・ローカル複製DBの参照など)
その他Tips: スキルは業務のutil関数(チーム運用の勘所) - コード以外の業務を関数化するイメージ - チームで同じスキルを使えば、ドキュメントの品質が勝手に揃う - 修正もそのスキルを1箇所直すだけで済むのでメンテが楽 - 単一責任の原則:1つのスキルに何でもかんでも詰め込まない
- 疎結合にしておくと、他のループやタスクでも使い回せるし壊れない
その他: AI slop対策(AIっぽい文章を減らす) - 個人的認識負荷への貢献No1 - 全人類の敵 - AIに対する暴言が最も加速する時間 -
スキル「yomiyasu」でレビューさせる - 「スロップ表現100連発」(Zenn、todesking氏)を投げつける - Gemini Flashで日本語を改善(Geminiはがとても日本語上手、最高。それ以外では使わないけど)
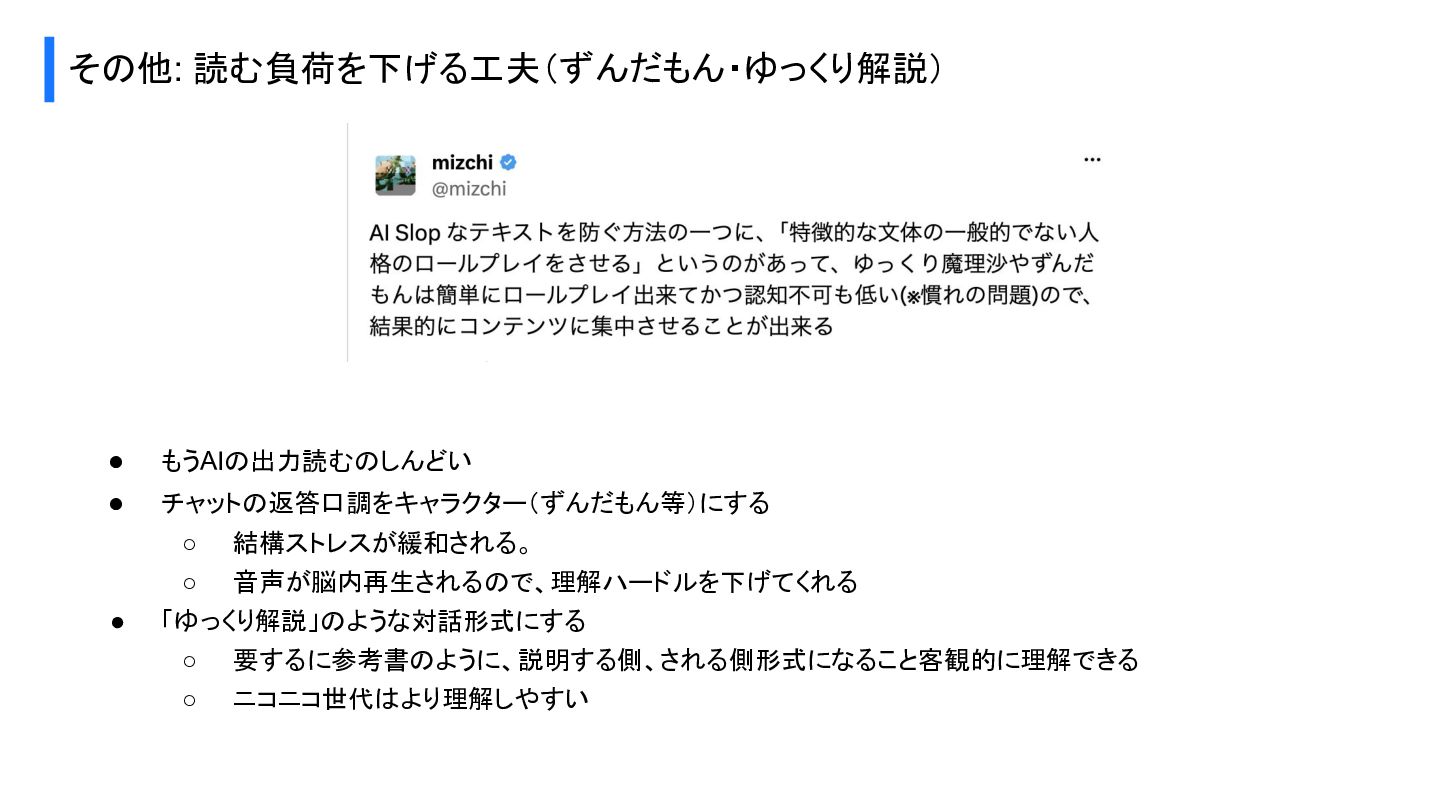
その他: 読む負荷を下げる工夫(ずんだもん・ゆっくり解説) • • • もうAIの出力読むのしんどい チャットの返答口調をキャラクター(ずんだもん等)にする ◦ 結構ストレスが緩和される。 ◦
音声が脳内再生されるので、理解ハードルを下げてくれる 「ゆっくり解説」のような対話形式にする ◦ ◦ 要するに参考書のように、説明する側、される側形式になること客観的に理解できる ニコニコ世代はより理解しやすい
参考にした資料 ・木下 雄一朗「ハーネス設計入門 〜 基礎知識の整理から実務へのステップアップ〜」(2026-09) https://speakerdeck.com/kinopeee/hanesu-sekkei-nyuumon-kiso-chishiki-no-seiri-kara-jitsumu-heno-suteppu-appu ・watany「僕のハーネスを紹介します」(2026-10) https://speakerdeck.com/watany/let-me-introduce-my-harness-2 ・Andrej Karpathy「LLM
Wiki」(2026-04) https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f ・todesking「スロップ表現100連発」(Zenn) ・nanaism「yomiyasu」 https://github.com/nanaism/yomiyasu ・mizchi氏のポスト https://x.com/mizchi/status/2105599333479657610?s=12&t=uQ7iXxYDJ0_dnmx1pylLlQ

 Your Podcast. Everywhere. Effortlessly.


 mae_hidari
 bkeepers
 popppiees
 holman
 rabernat
 retrage
 mkilby
 portentint
 carmenintech
 palkan
 rmw
 caitiem20
 seathinner