Share
Embed
自動化したのに回らない テスト運用の壁―AI時代の品質責任と生産性
mabl は過去数ヶ月で、テスト作成やメンテナンスの手間を減らす新機能を多数リリースしてまいりました。本ウェビナーでは、専門知識がない方にも分かりやすく、実際の画面を見ながら「何が変わったか」「どう役立つか」を中心にご紹介します。
https://mabl-japan.connpass.com/event/407967/
Masahiko Funaki(舟木 将彦)
October 28, 2026
Transcript
18 slides
-
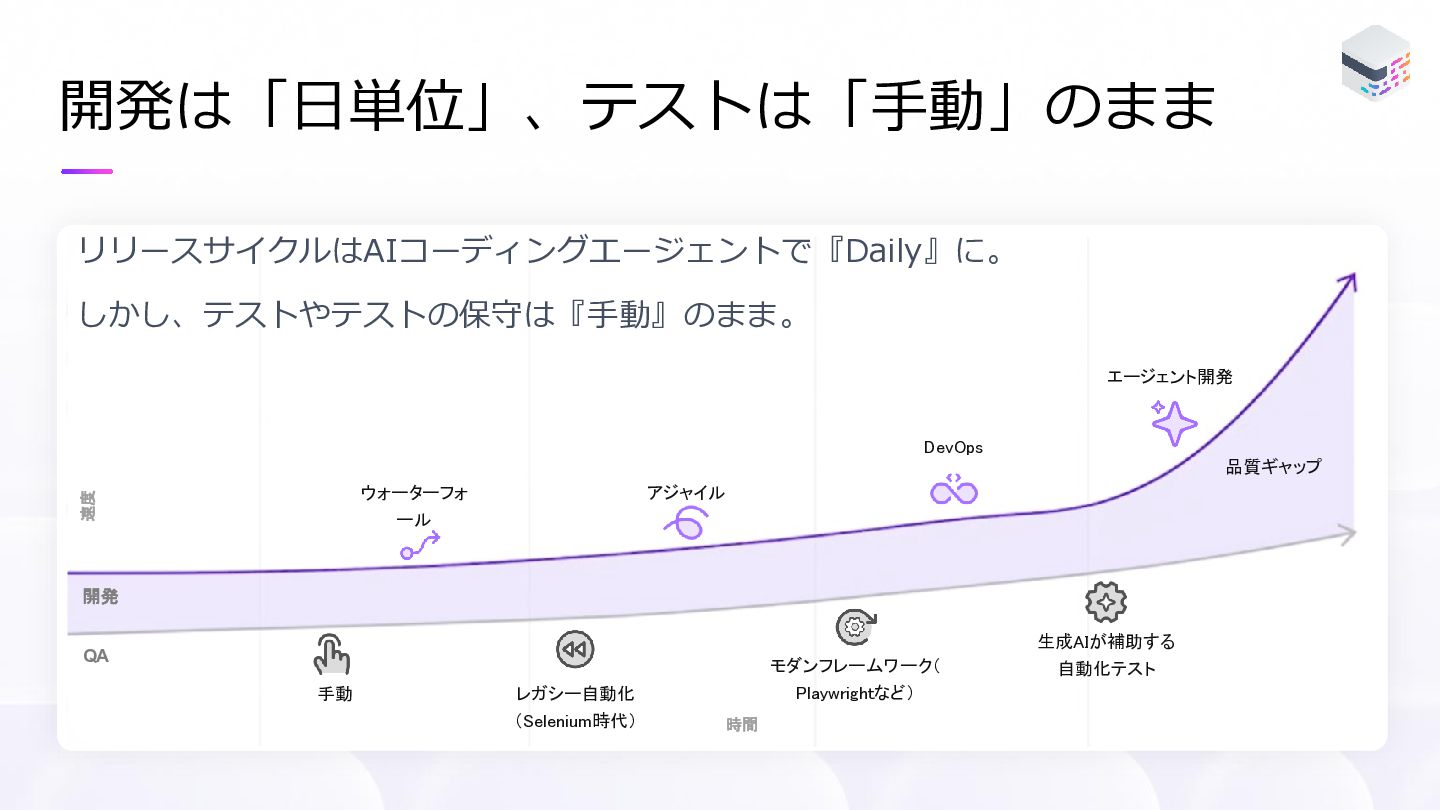
開発は「日単位」、テストは「手動」のまま リリースサイクルはAIコーディングエージェントで『Daily』に。 しかし、テストやテストの保守は『手動』のまま。 エージェント開発 DevOps 品質ギャップ 速度 ウォーターフォ アジャイル ール
開発 生成AIが補助する QA モダンフレームワーク( 手動 Playwrightなど) レガシー自動化 (Selenium時代) 時間 自動化テスト -
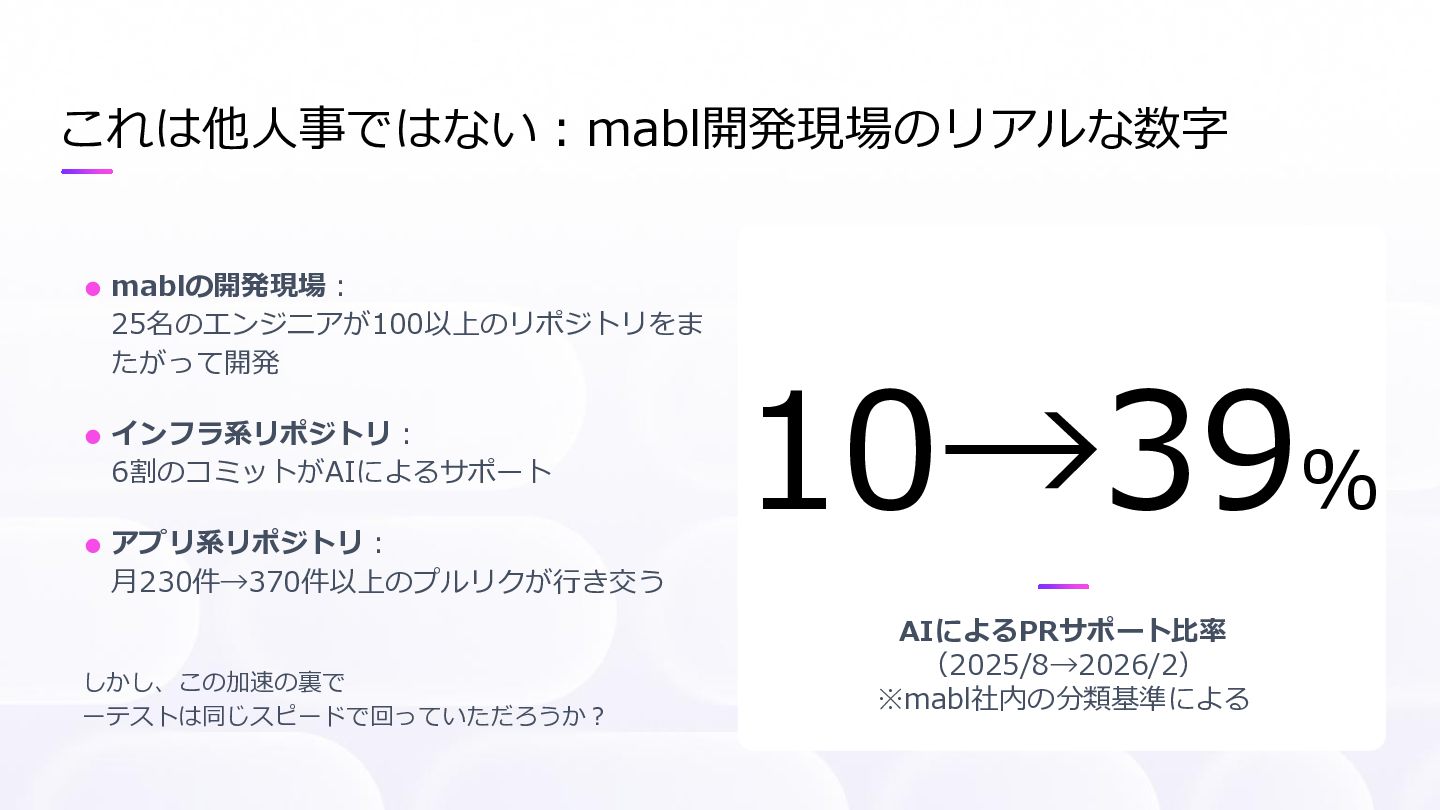
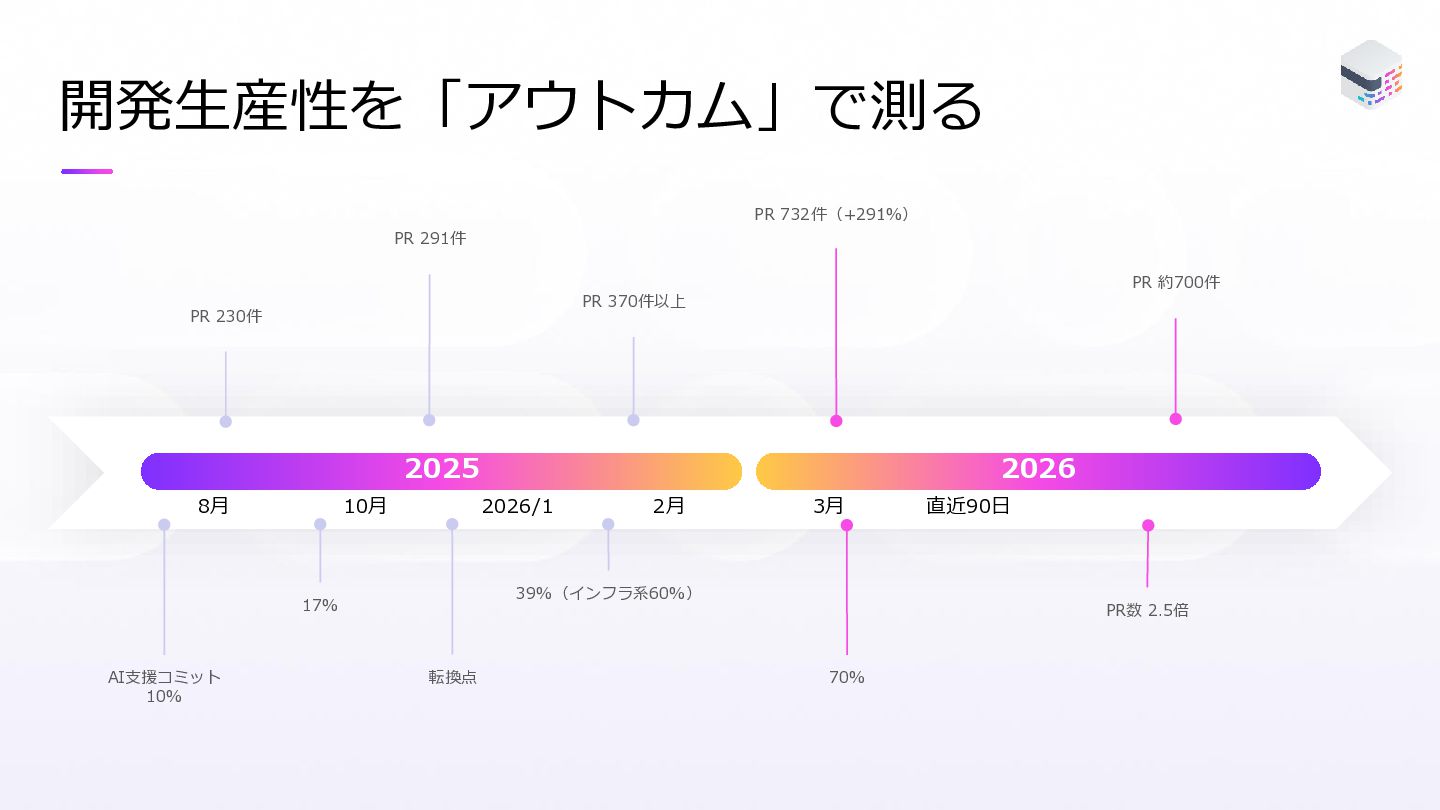
これは他人事ではない:mabl開発現場のリアルな数字 • mablの開発現場: 25名のエンジニアが100以上のリポジトリをま たがって開発 • インフラ系リポジトリ: 6割のコミットがAIによるサポート • アプリ系リポジトリ:
10→39% 月230件→370件以上のプルリクが行き交う しかし、この加速の裏で ーテストは同じスピードで回っていただろうか? AIによるPRサポート比率 (2025/8→2026/2) ※mabl社内の分類基準による -
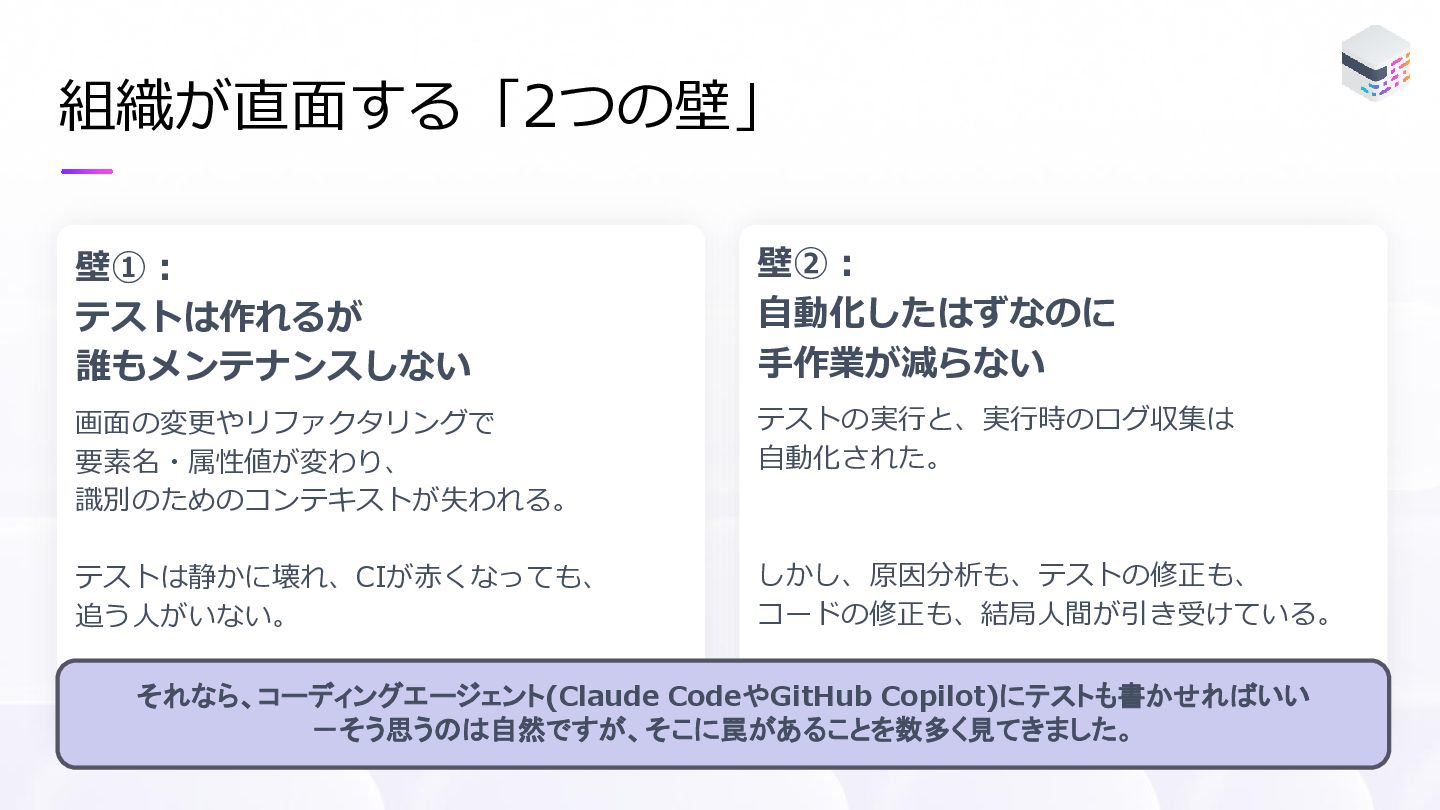
組織が直面する「2つの壁」 壁①: テストは作れるが 誰もメンテナンスしない 壁②: 自動化したはずなのに 手作業が減らない 画面の変更やリファクタリングで 要素名・属性値が変わり、 識別のためのコンテキストが失われる。
テストの実行と、実行時のログ収集は 自動化された。 テストは静かに壊れ、CIが赤くなっても、 追う人がいない。 しかし、原因分析も、テストの修正も、 コードの修正も、結局人間が引き受けている。 それなら、コーディングエージェント(Claude CodeやGitHub Copilot)にテストも書かせればいい -そう思うのは自然ですが、そこに罠があることを数多く見てきました。 -
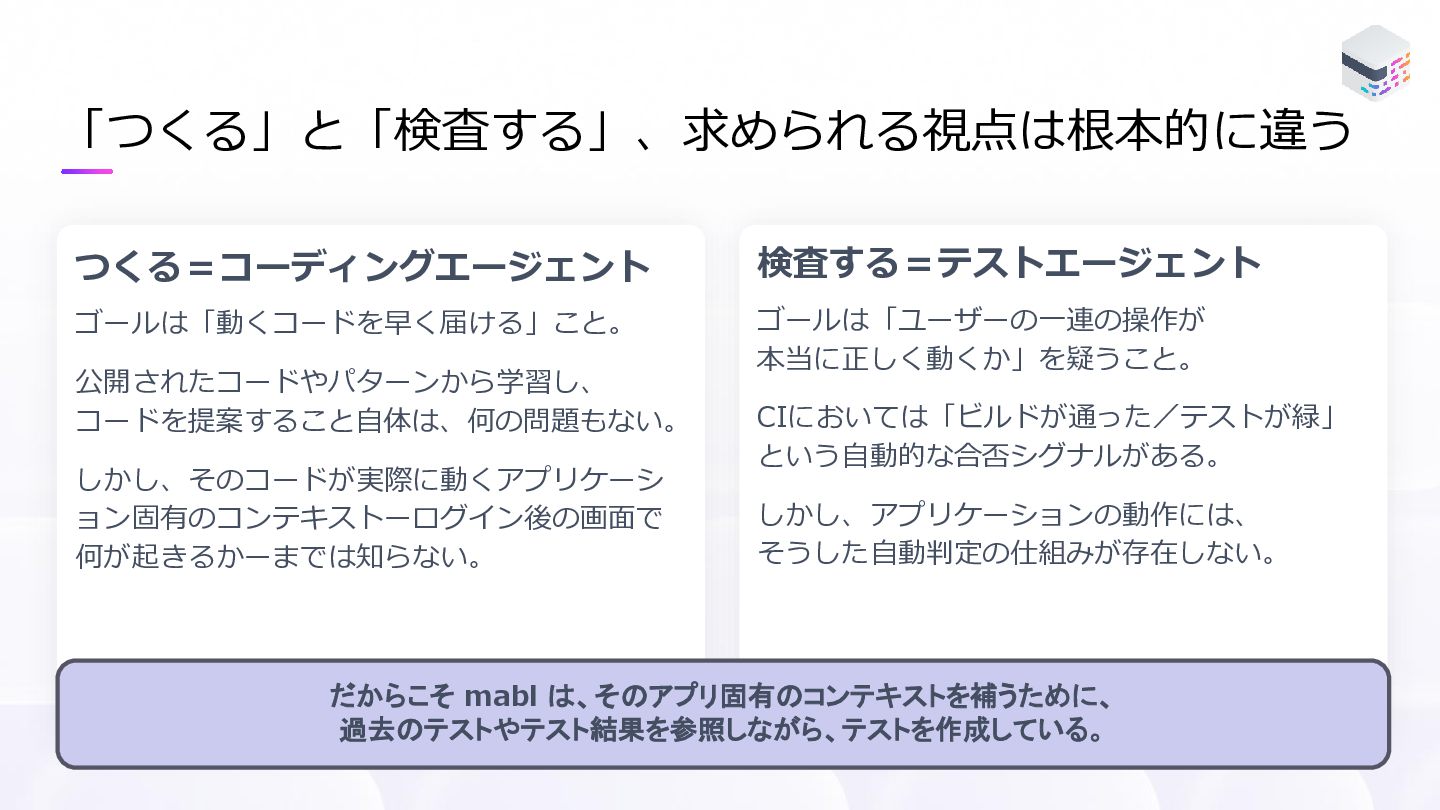
「つくる」と「検査する」、求められる視点は根本的に違う つくる=コーディングエージェント 検査する=テストエージェント ゴールは「動くコードを早く届ける」こと。 ゴールは「ユーザーの一連の操作が 本当に正しく動くか」を疑うこと。 公開されたコードやパターンから学習し、 コードを提案すること自体は、何の問題もない。 しかし、そのコードが実際に動くアプリケーシ ョン固有のコンテキストーログイン後の画面で
何が起きるかーまでは知らない。 CIにおいては「ビルドが通った/テストが緑」 という自動的な合否シグナルがある。 しかし、アプリケーションの動作には、 そうした自動判定の仕組みが存在しない。 だからこそ mabl は、そのアプリ固有のコンテキストを補うために、 過去のテストやテスト結果を参照しながら、テストを作成している。 -
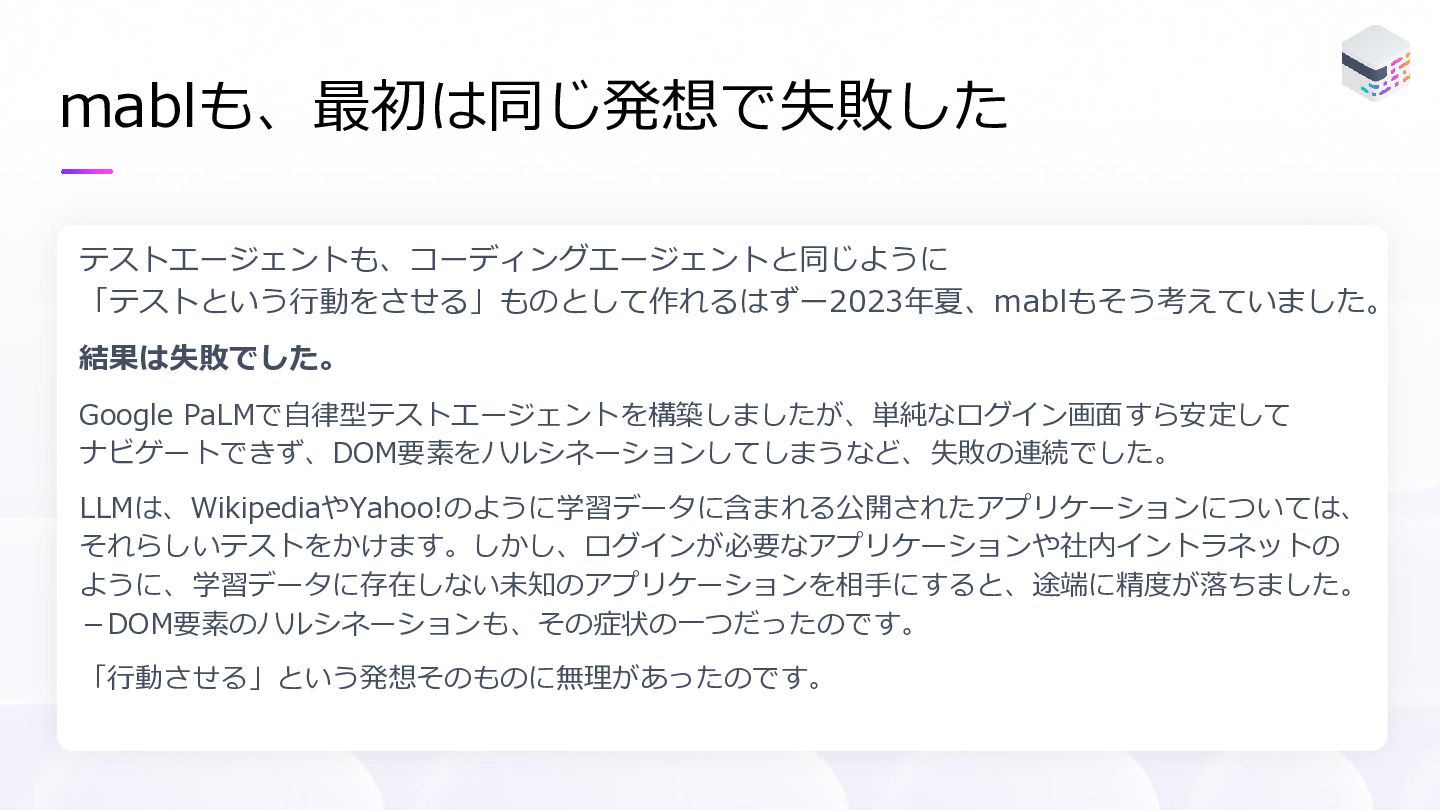
mablも、最初は同じ発想で失敗した テストエージェントも、コーディングエージェントと同じように 「テストという行動をさせる」ものとして作れるはずー2023年夏、mablもそう考えていました。 結果は失敗でした。 Google PaLMで自律型テストエージェントを構築しましたが、単純なログイン画面すら安定して ナビゲートできず、DOM要素をハルシネーションしてしまうなど、失敗の連続でした。 LLMは、WikipediaやYahoo!のように学習データに含まれる公開されたアプリケーションについては、 それらしいテストをかけます。しかし、ログインが必要なアプリケーションや社内イントラネットの ように、学習データに存在しない未知のアプリケーションを相手にすると、途端に精度が落ちました。
-DOM要素のハルシネーションも、その症状の一つだったのです。 「行動させる」という発想そのものに無理があったのです。 -
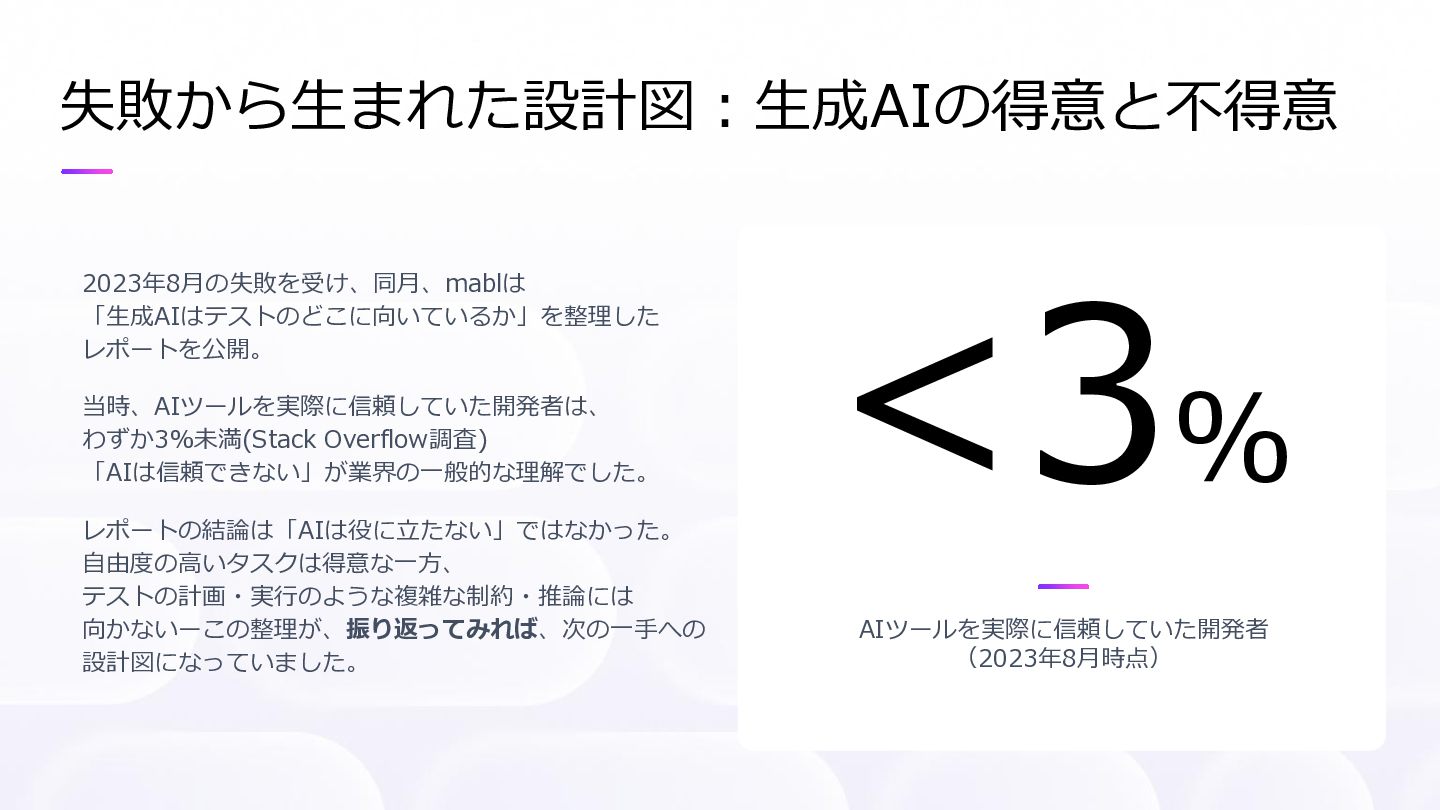
失敗から生まれた設計図:生成AIの得意と不得意 2023年8月の失敗を受け、同月、mablは 「生成AIはテストのどこに向いているか」を整理した レポートを公開。 当時、AIツールを実際に信頼していた開発者は、 わずか3%未満(Stack Overflow調査) 「AIは信頼できない」が業界の一般的な理解でした。 レポートの結論は「AIは役に立たない」ではなかった。 自由度の高いタスクは得意な一方、
テストの計画・実行のような複雑な制約・推論には 向かないーこの整理が、振り返ってみれば、次の一手への 設計図になっていました。 <3% AIツールを実際に信頼していた開発者 (2023年8月時点) -
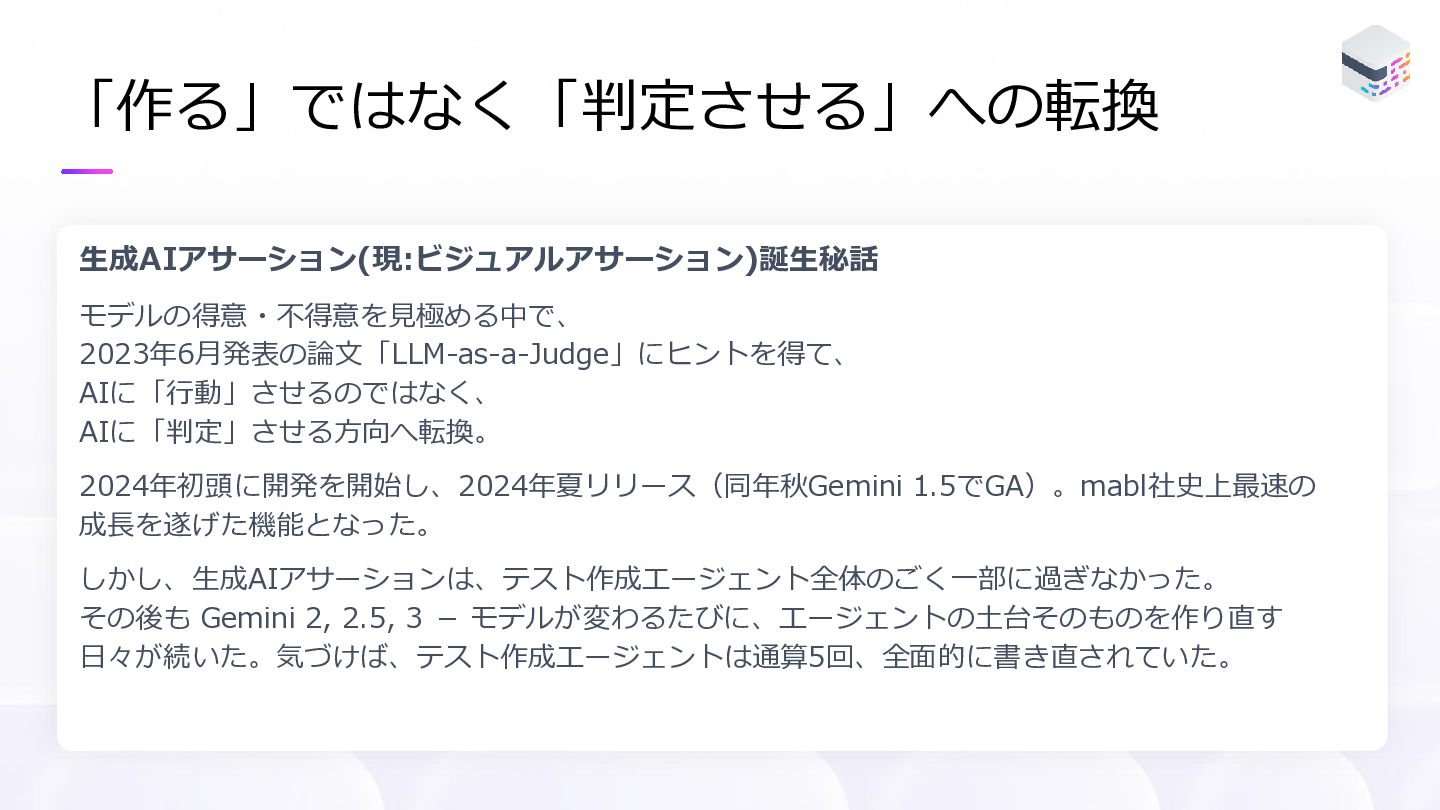
「作る」ではなく「判定させる」への転換 生成AIアサーション(現:ビジュアルアサーション)誕生秘話 モデルの得意・不得意を見極める中で、 2023年6月発表の論文「LLM-as-a-Judge」にヒントを得て、 AIに「行動」させるのではなく、 AIに「判定」させる方向へ転換。 2024年初頭に開発を開始し、2024年夏リリース(同年秋Gemini 1.5でGA)。mabl社史上最速の 成長を遂げた機能となった。 しかし、生成AIアサーションは、テスト作成エージェント全体のごく一部に過ぎなかった。
その後も Gemini 2, 2.5, 3 - モデルが変わるたびに、エージェントの土台そのものを作り直す 日々が続いた。気づけば、テスト作成エージェントは通算5回、全面的に書き直されていた。 -
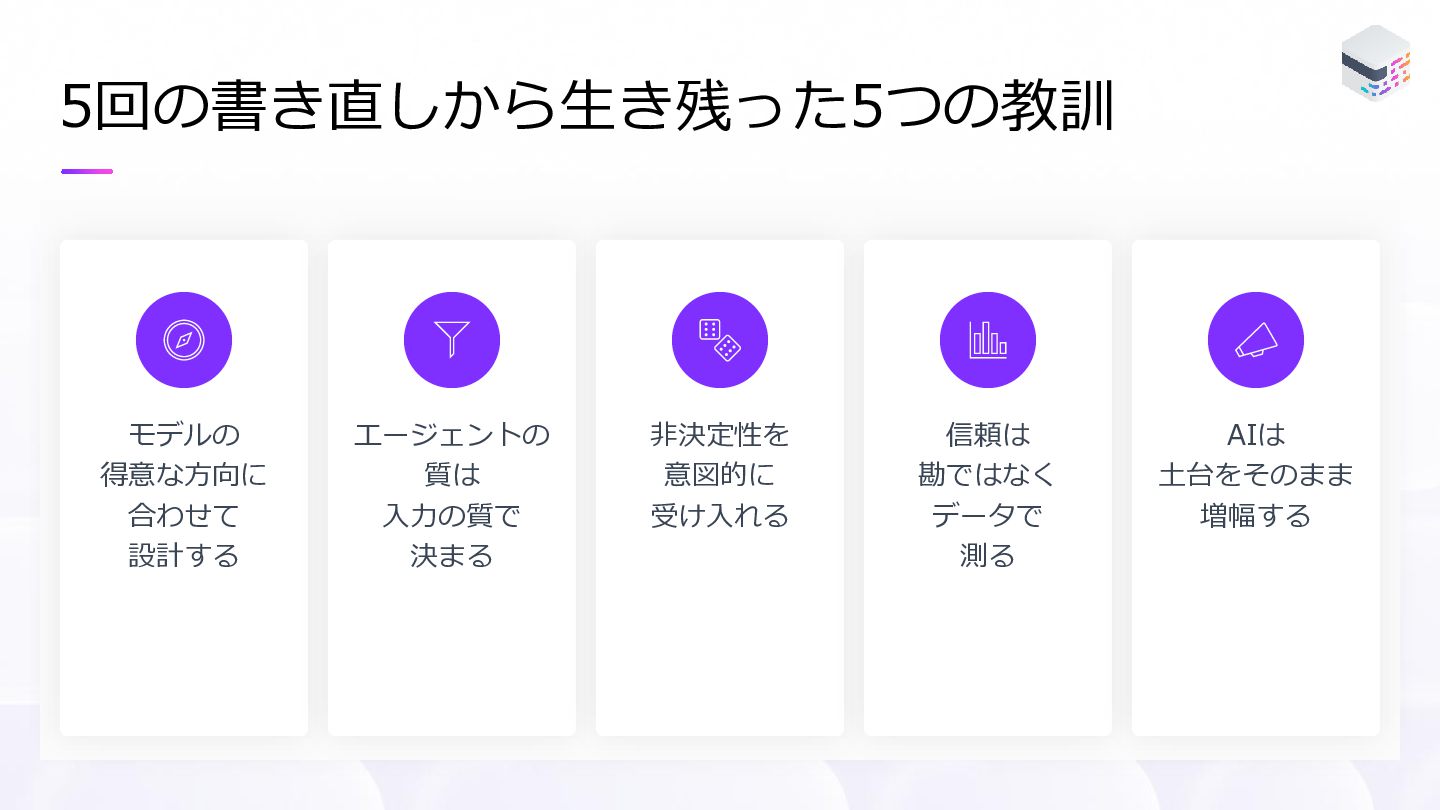
5回の書き直しから生き残った5つの教訓 モデルの 得意な方向に 合わせて 設計する エージェントの 質は 入力の質で 決まる 非決定性を
意図的に 受け入れる 信頼は 勘ではなく データで 測る AIは 土台をそのまま 増幅する -
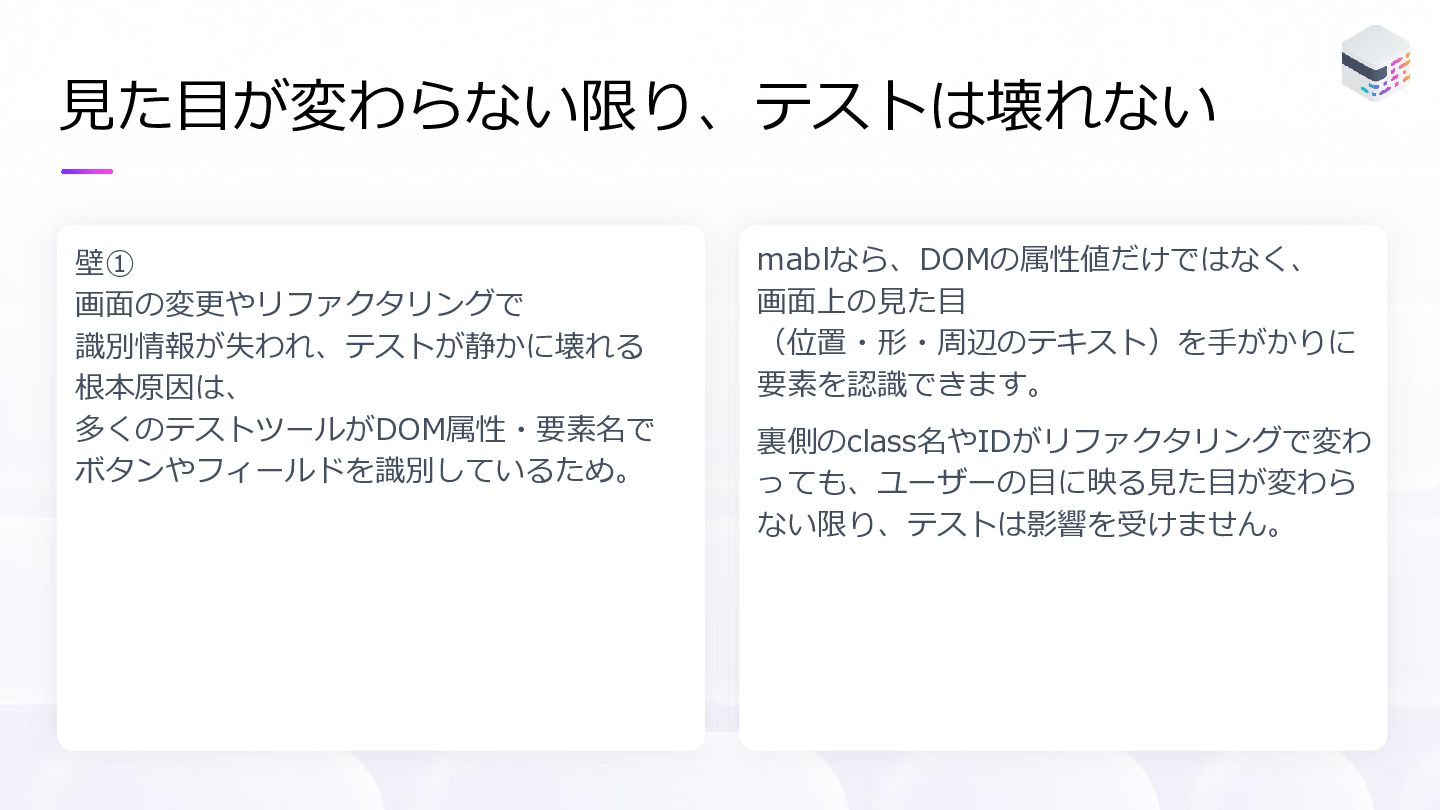
見た目が変わらない限り、テストは壊れない 壁① 画面の変更やリファクタリングで 識別情報が失われ、テストが静かに壊れる 根本原因は、 多くのテストツールがDOM属性・要素名で ボタンやフィールドを識別しているため。 mablなら、DOMの属性値だけではなく、 画面上の見た目 (位置・形・周辺のテキスト)を手がかりに
要素を認識できます。 裏側のclass名やIDがリファクタリングで変わ っても、ユーザーの目に映る見た目が変わら ない限り、テストは影響を受けません。 -
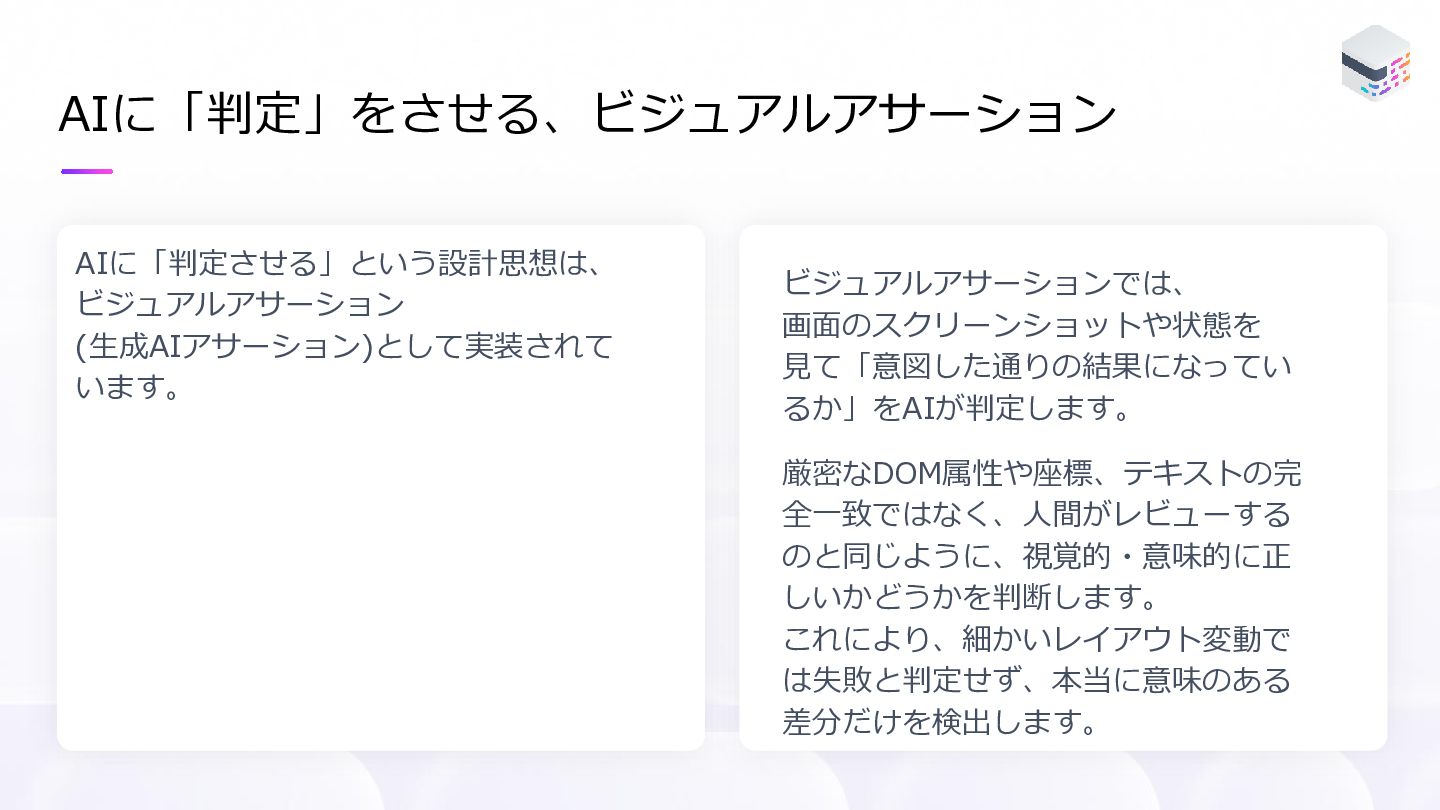
AIに「判定」をさせる、ビジュアルアサーション AIに「判定させる」という設計思想は、 ビジュアルアサーション (生成AIアサーション)として実装されて います。 ビジュアルアサーションでは、 画面のスクリーンショットや状態を 見て「意図した通りの結果になってい るか」をAIが判定します。 厳密なDOM属性や座標、テキストの完
全一致ではなく、人間がレビューする のと同じように、視覚的・意味的に正 しいかどうかを判断します。 これにより、細かいレイアウト変動で は失敗と判定せず、本当に意味のある 差分だけを検出します。 -
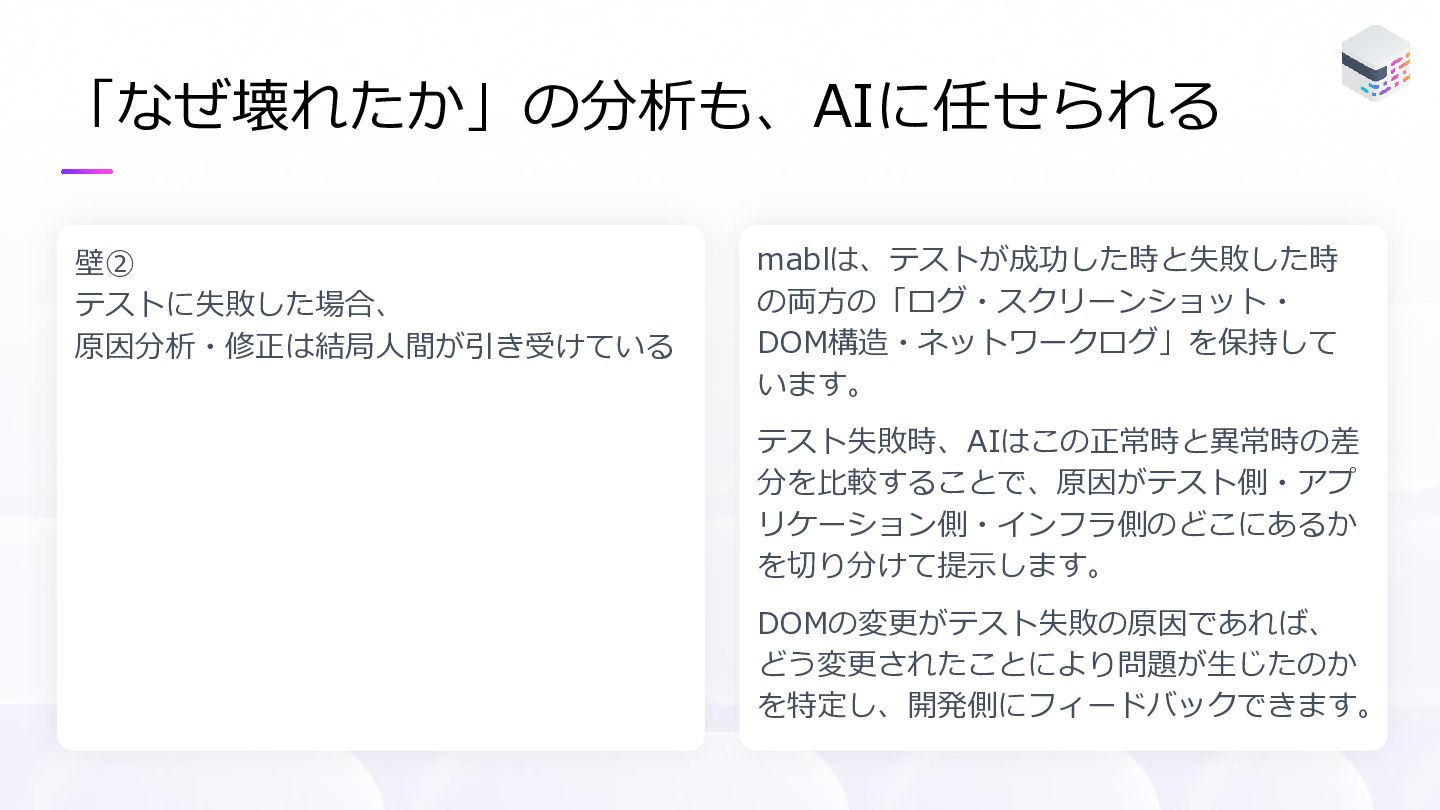
「なぜ壊れたか」の分析も、AIに任せられる 壁② テストに失敗した場合、 原因分析・修正は結局人間が引き受けている mablは、テストが成功した時と失敗した時 の両方の「ログ・スクリーンショット・ DOM構造・ネットワークログ」を保持して います。 テスト失敗時、AIはこの正常時と異常時の差 分を比較することで、原因がテスト側・アプ
リケーション側・インフラ側のどこにあるか を切り分けて提示します。 DOMの変更がテスト失敗の原因であれば、 どう変更されたことにより問題が生じたのか を特定し、開発側にフィードバックできます。 -
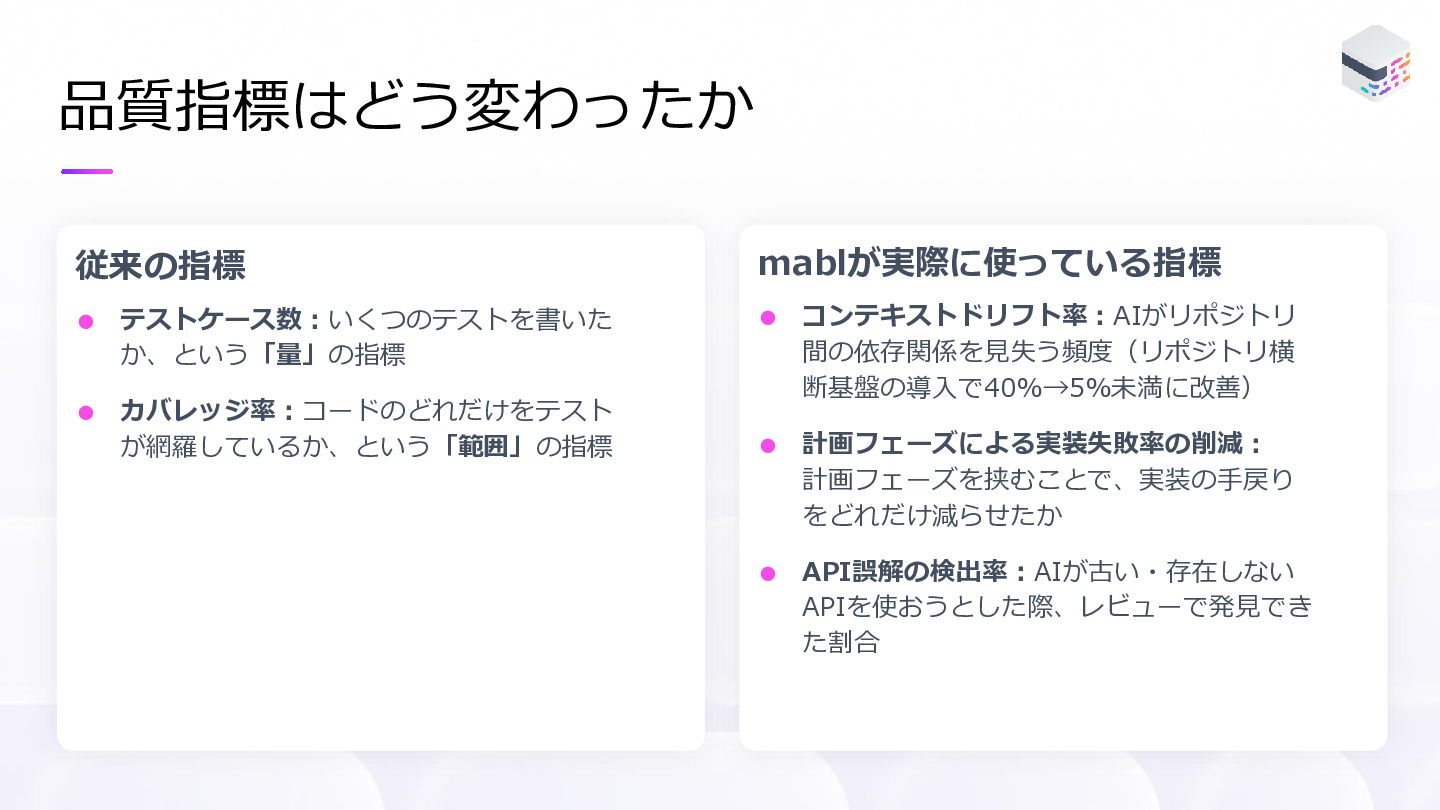
品質指標はどう変わったか 従来の指標 • テストケース数:いくつのテストを書いた か、という「量」の指標 • カバレッジ率:コードのどれだけをテスト が網羅しているか、という「範囲」の指標 mablが実際に使っている指標 •
コンテキストドリフト率:AIがリポジトリ 間の依存関係を見失う頻度(リポジトリ横 断基盤の導入で40%→5%未満に改善) • 計画フェーズによる実装失敗率の削減: 計画フェーズを挟むことで、実装の手戻り をどれだけ減らせたか • API誤解の検出率:AIが古い・存在しない APIを使おうとした際、レビューで発見でき た割合 -
開発生産性を「アウトカム」で測る PR 732件(+291%) PR 291件 PR 約700件 PR 370件以上 PR
230件 2025 8月 10月 2026/1 2月 3月 39%(インフラ系60%) 17% AI支援コミット 10% 2026 転換点 直近90日 PR数 2.5倍 70%