AutoGluon: State-of-the-Art Automated Machine L...
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed
AutoGluon: State-of-the-Art Automated Machine Learning
AutoGluon: State-of-the-Art Automated Machine Learning
## 3行のコードからプロダクショングレードのモデルまで
データサイエンティスト・機械学習エンジニアによる徹底解説

MIKIO KUBO
July 07, 2025
Transcript
72 slides
-
本日のアジェンダ 1. はじめに: AutoGluonの概要、強み、基本理念 2. AutoGluon のアーキテクチャ: 動作原理(スタッキングとバギング) 3. テーブルデータ予測のマスター:
TabularPredictor の詳細な使い方 4. テーブルを超えて: マルチモーダルと時系列への応用 5. 高度なトピックとデプロイ: 特徴量エンジニアリング、クラウド展開 6. まとめとベストプラクティス 2 -
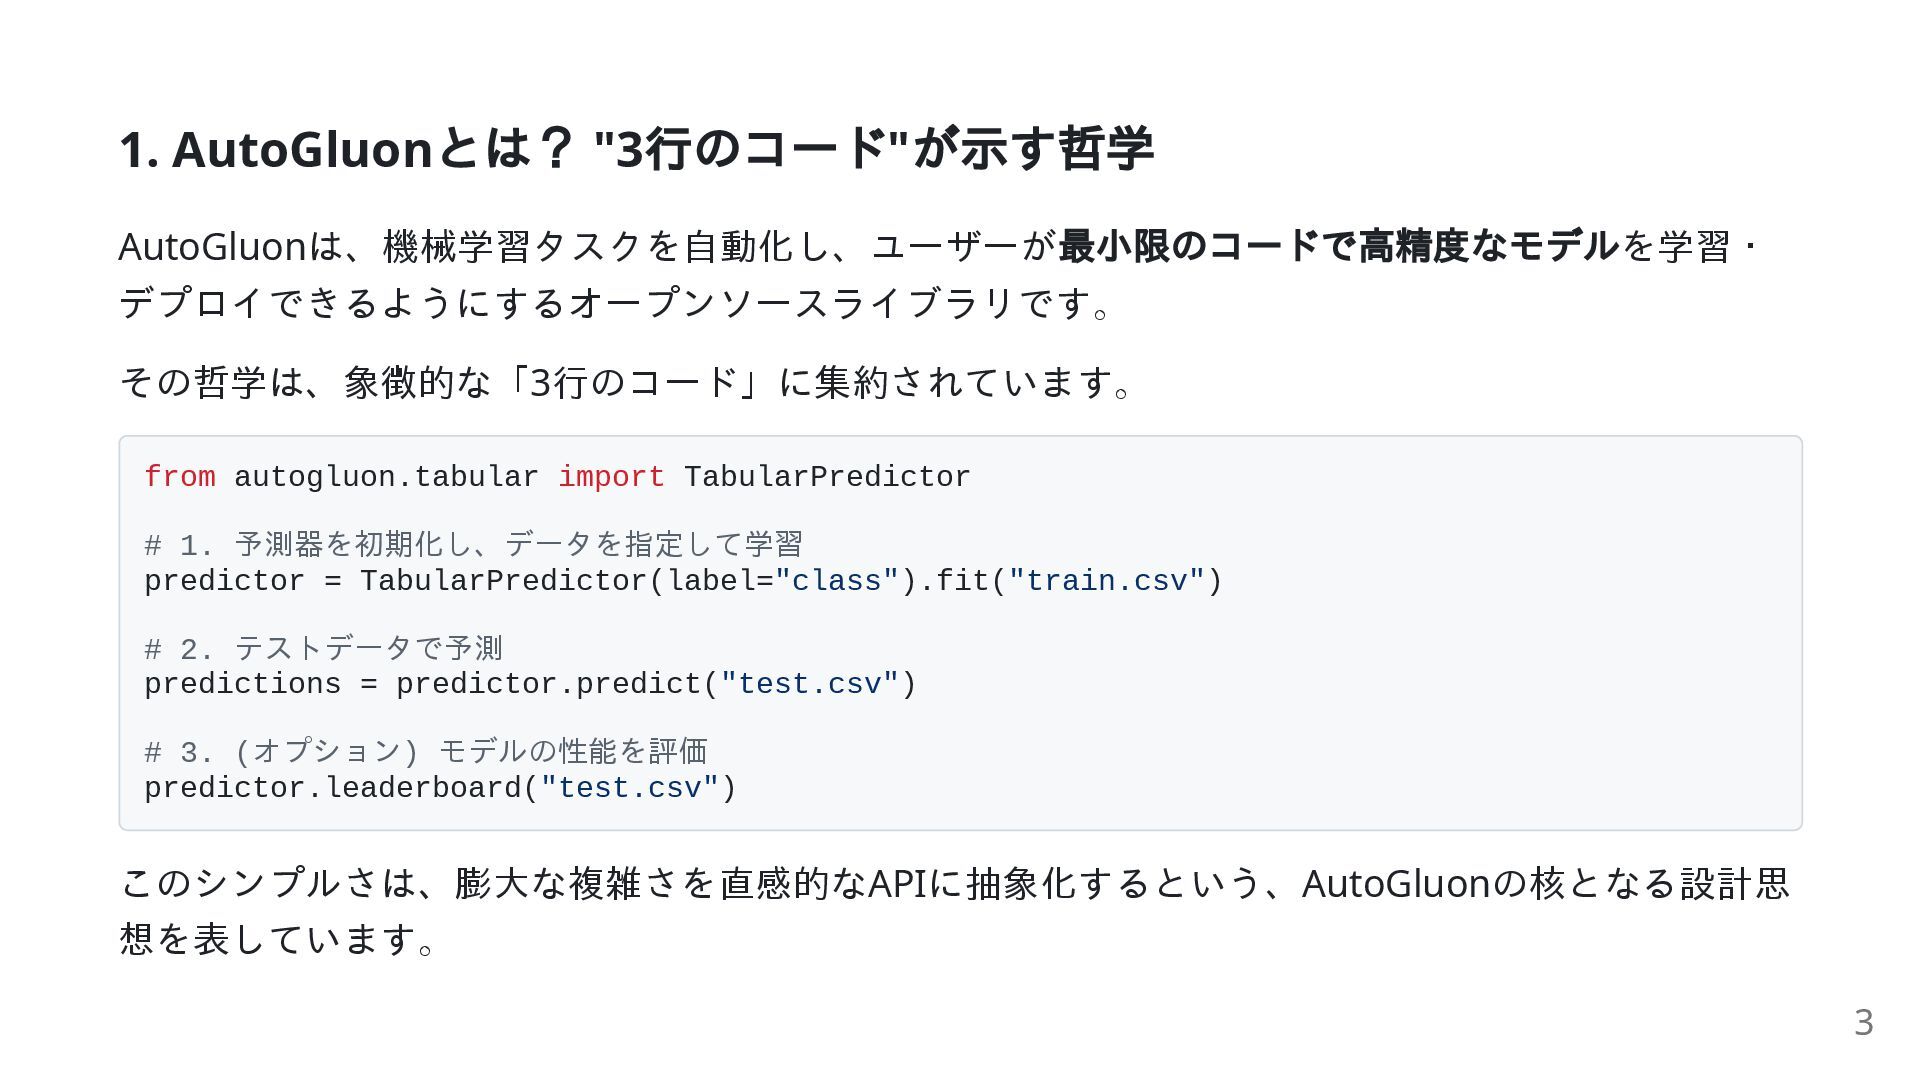
1. AutoGluon とは? "3 行のコード" が示す哲学 AutoGluonは、機械学習タスクを自動化し、ユーザーが 最小限のコードで高精度なモデルを学習・ デプロイできるようにするオープンソースライブラリです。 その哲学は、象徴的な「3行のコード」に集約されています。
from autogluon.tabular import TabularPredictor # 1. 予測器を初期化し、データを指定して学習 predictor = TabularPredictor(label="class").fit("train.csv") # 2. テストデータで予測 predictions = predictor.predict("test.csv") # 3. (オプション) モデルの性能を評価 predictor.leaderboard("test.csv") このシンプルさは、膨大な複雑さを直感的なAPIに抽象化するという、AutoGluonの核となる設計思 想を表しています。 3 -
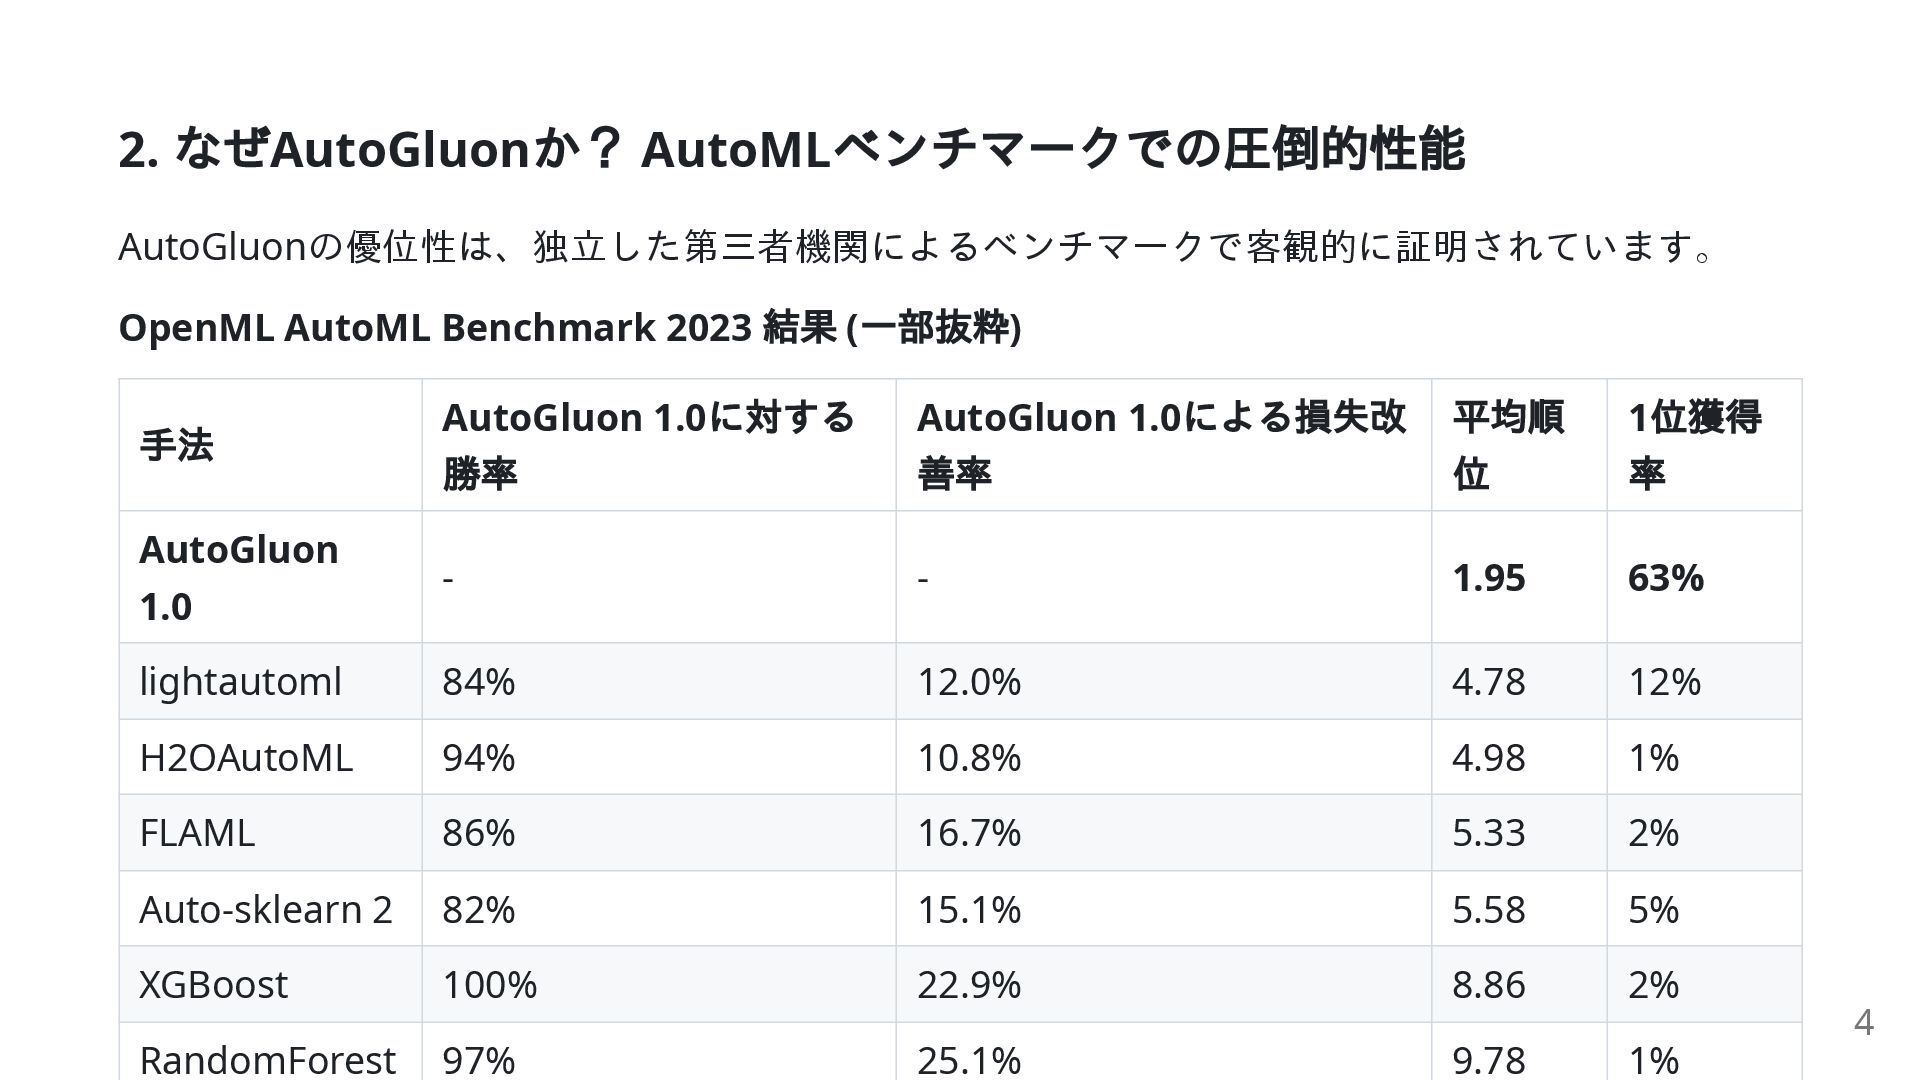
2. なぜAutoGluon か? AutoML ベンチマークでの圧倒的性能 AutoGluonの優位性は、独立した第三者機関によるベンチマークで客観的に証明されています。 OpenML AutoML Benchmark 2023
結果 ( 一部抜粋) 手法 AutoGluon 1.0 に対する 勝率 AutoGluon 1.0 による損失改 善率 平均順 位 1 位獲得 率 AutoGluon 1.0 - - 1.95 63% lightautoml 84% 12.0% 4.78 12% H2OAutoML 94% 10.8% 4.98 1% FLAML 86% 16.7% 5.33 2% Auto-sklearn 2 82% 15.1% 5.58 5% XGBoost 100% 22.9% 8.86 2% RandomForest 97% 25.1% 9.78 1% 4 -
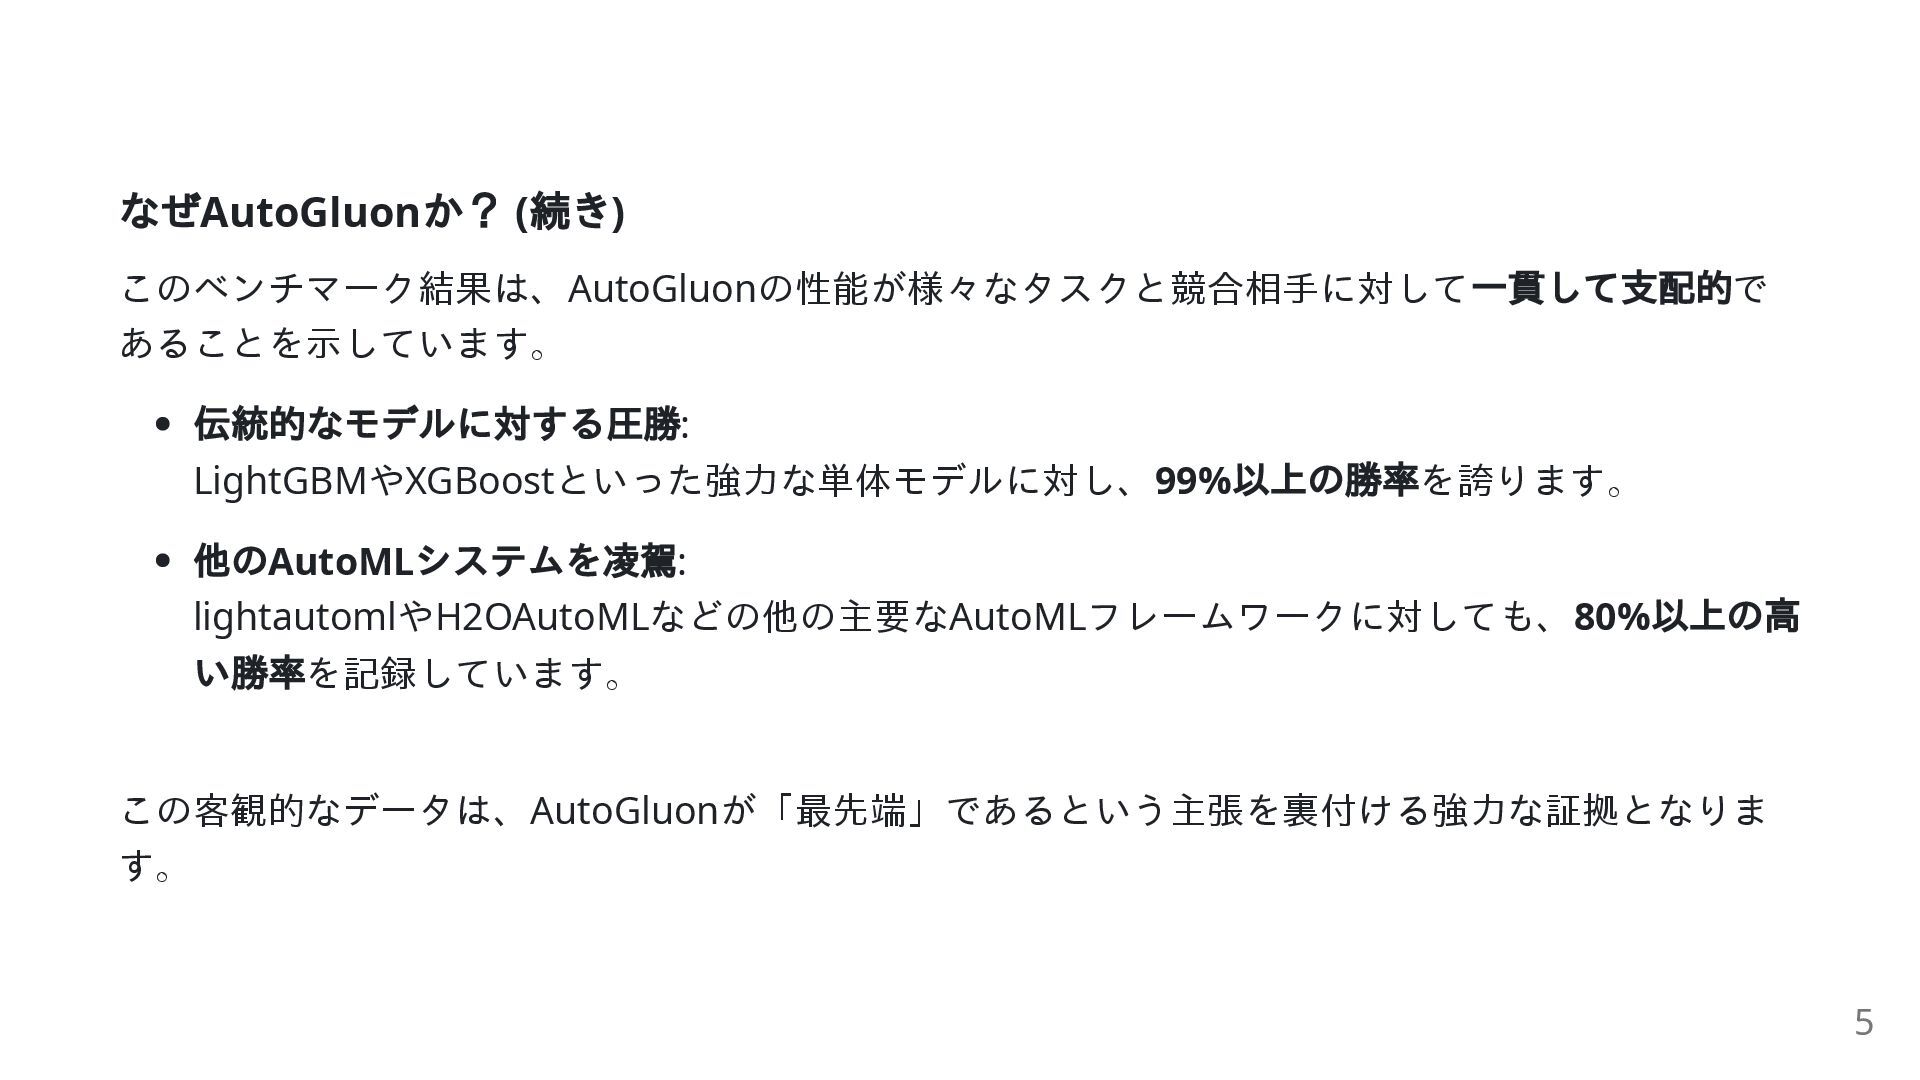
なぜAutoGluon か? ( 続き) このベンチマーク結果は、AutoGluonの性能が様々なタスクと競合相手に対して 一貫して支配的で あることを示しています。 伝統的なモデルに対する圧勝: LightGBMやXGBoostといった強力な単体モデルに対し、99% 以上の勝率を誇ります。
他のAutoML システムを凌駕: lightautomlやH2OAutoMLなどの他の主要なAutoMLフレームワークに対しても、80% 以上の高 い勝率を記録しています。 この客観的なデータは、AutoGluonが「最先端」であるという主張を裏付ける強力な証拠となりま す。 5 -
3. AutoGluon の基本理念:HPO よりもアンサンブル AutoGluonが他の多くのAutoMLツールと一線を画す、最も重要な設計思想はその基本理念にありま す。 従来のAutoML (CASH): 最適な「単一のモデル」と「そのハイパーパラメータ」を見つけるために、広大な探索空間を 探索することに焦点を当てます。
AutoGluon のアプローチ: **複数のモデルをアンサンブルし、それらを多層に積み重ねる(スタッキングする)**ことで 成功を収めています。 「完璧な単一モデル」を探し求めるよりも、「多数の優れたモデル」を賢く組み合わせる 方が、与えられた時間内でより良い結果を生む。 この設計思想こそが、AutoGluonの 速度、堅牢性、そして精度の高さの根源となっています。 6 -
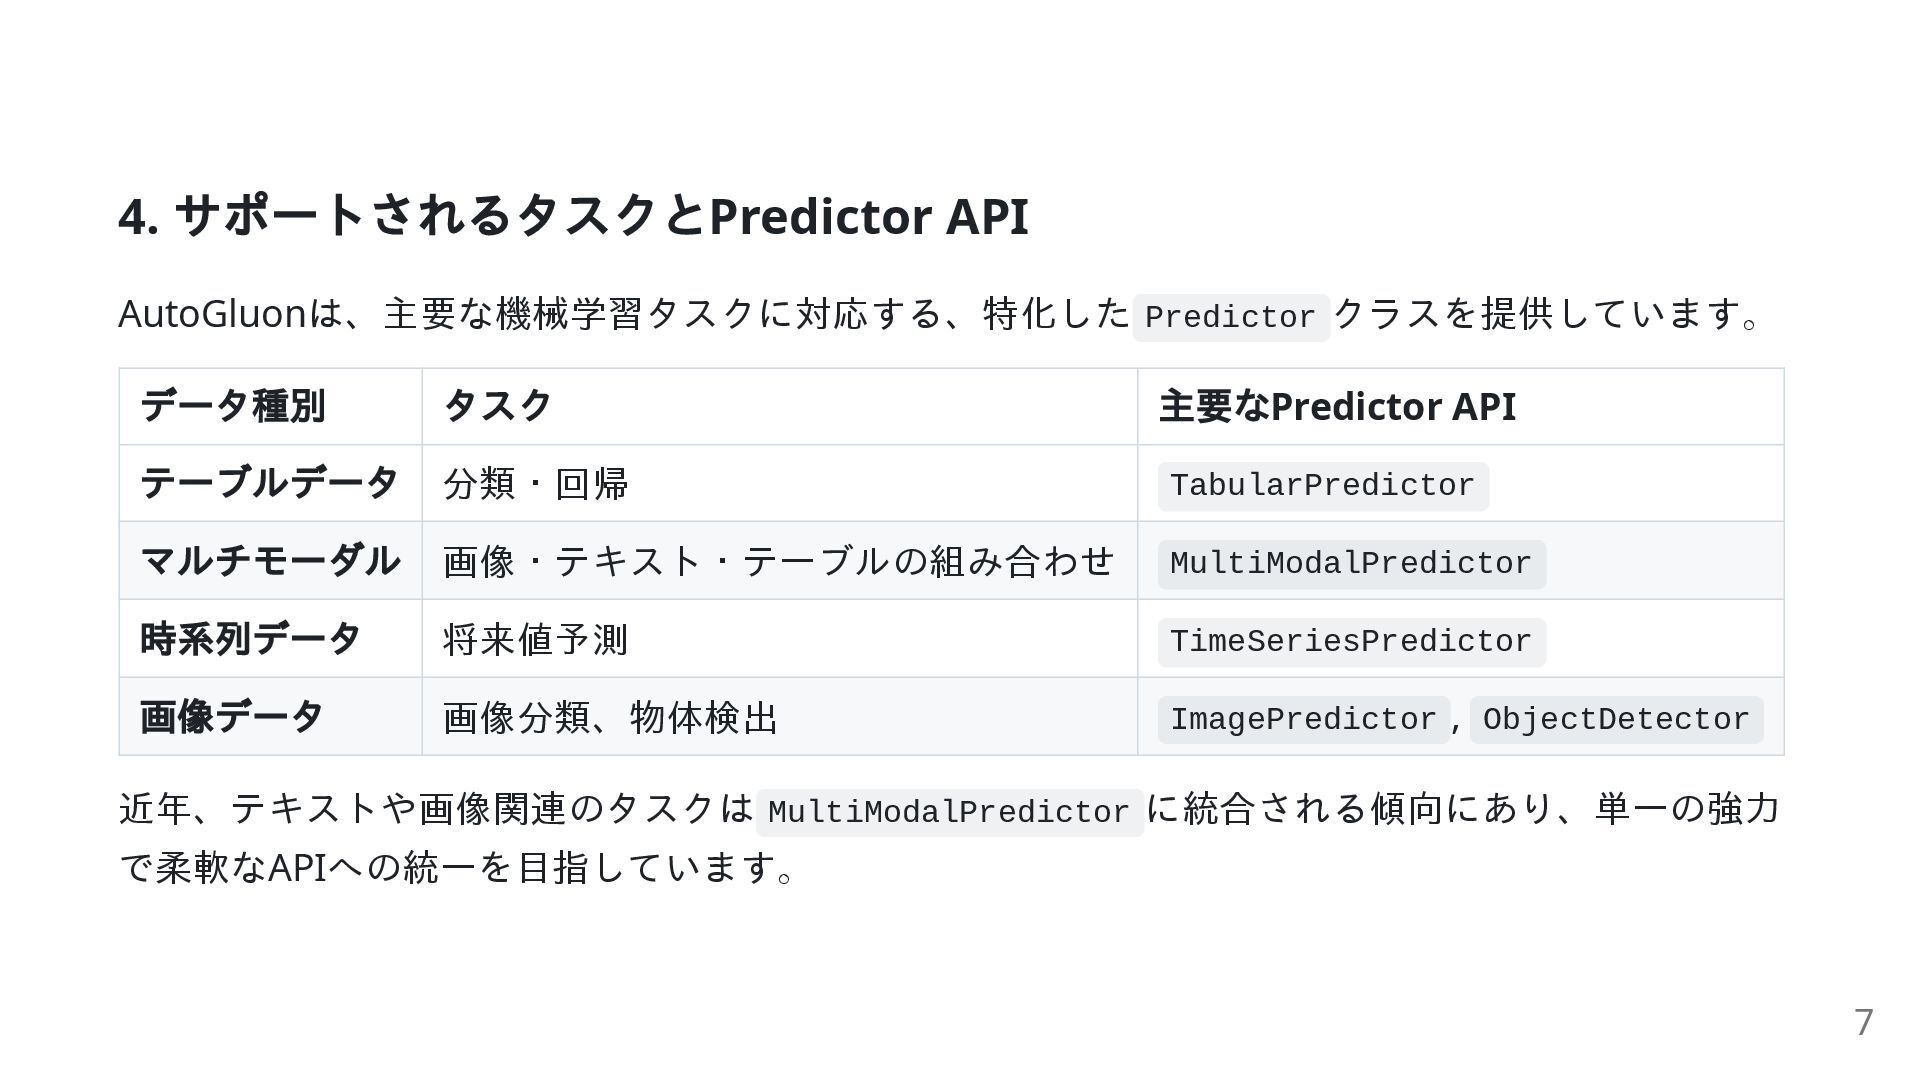
4. サポートされるタスクとPredictor API AutoGluonは、主要な機械学習タスクに対応する、特化した Predictor クラスを提供しています。 データ種別 タスク 主要なPredictor API
テーブルデータ 分類・回帰 TabularPredictor マルチモーダル 画像・テキスト・テーブルの組み合わせ MultiModalPredictor 時系列データ 将来値予測 TimeSeriesPredictor 画像データ 画像分類、物体検出 ImagePredictor , ObjectDetector 近年、テキストや画像関連のタスクは MultiModalPredictor に統合される傾向にあり、単一の強力 で柔軟なAPIへの統一を目指しています。 7 -
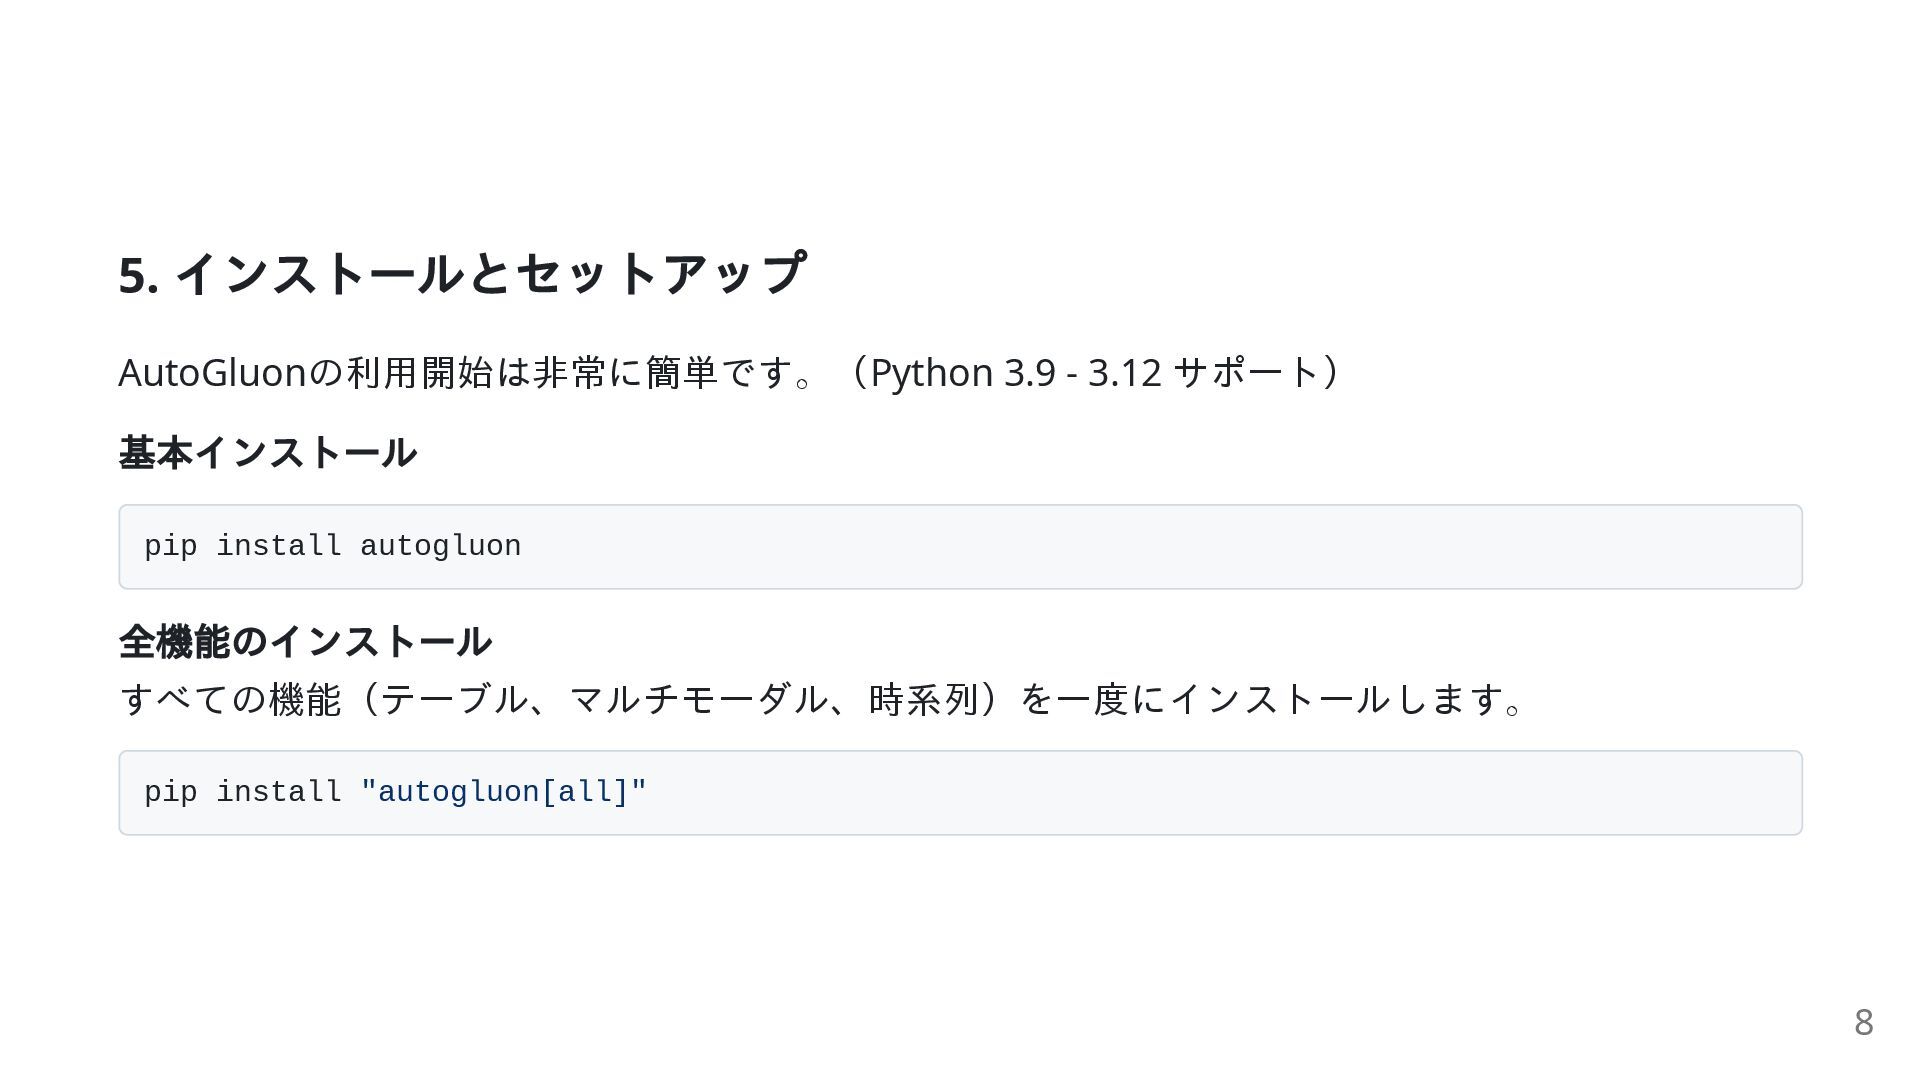
5. インストールとセットアップ AutoGluonの利用開始は非常に簡単です。(Python 3.9 - 3.12 サポート) 基本インストール pip install
autogluon 全機能のインストール すべての機能(テーブル、マルチモーダル、時系列)を一度にインストールします。 pip install "autogluon[all]" 8 -
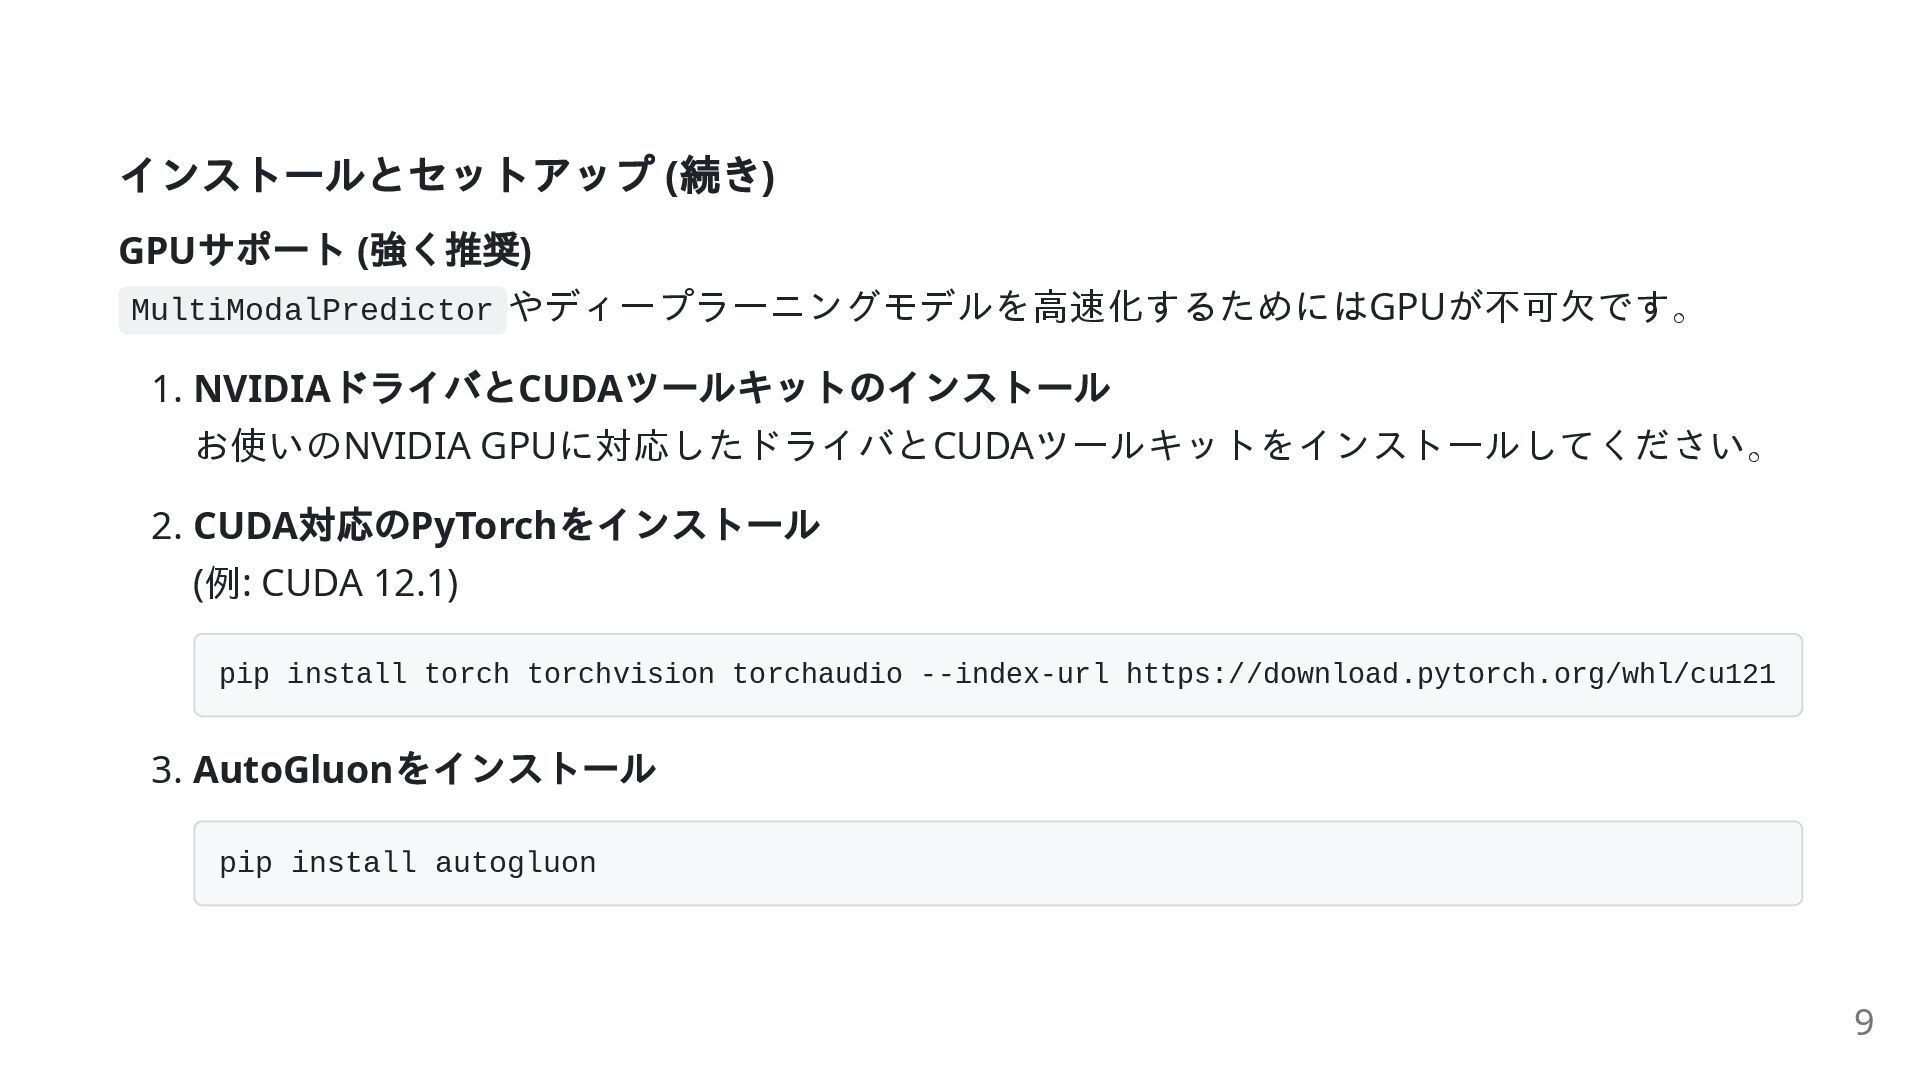
インストールとセットアップ ( 続き) GPU サポート ( 強く推奨) MultiModalPredictor やディープラーニングモデルを高速化するためにはGPUが不可欠です。 1.
NVIDIA ドライバとCUDA ツールキットのインストール お使いのNVIDIA GPUに対応したドライバとCUDAツールキットをインストールしてください。 2. CUDA 対応のPyTorch をインストール (例: CUDA 12.1) pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121 3. AutoGluon をインストール pip install autogluon 9 -
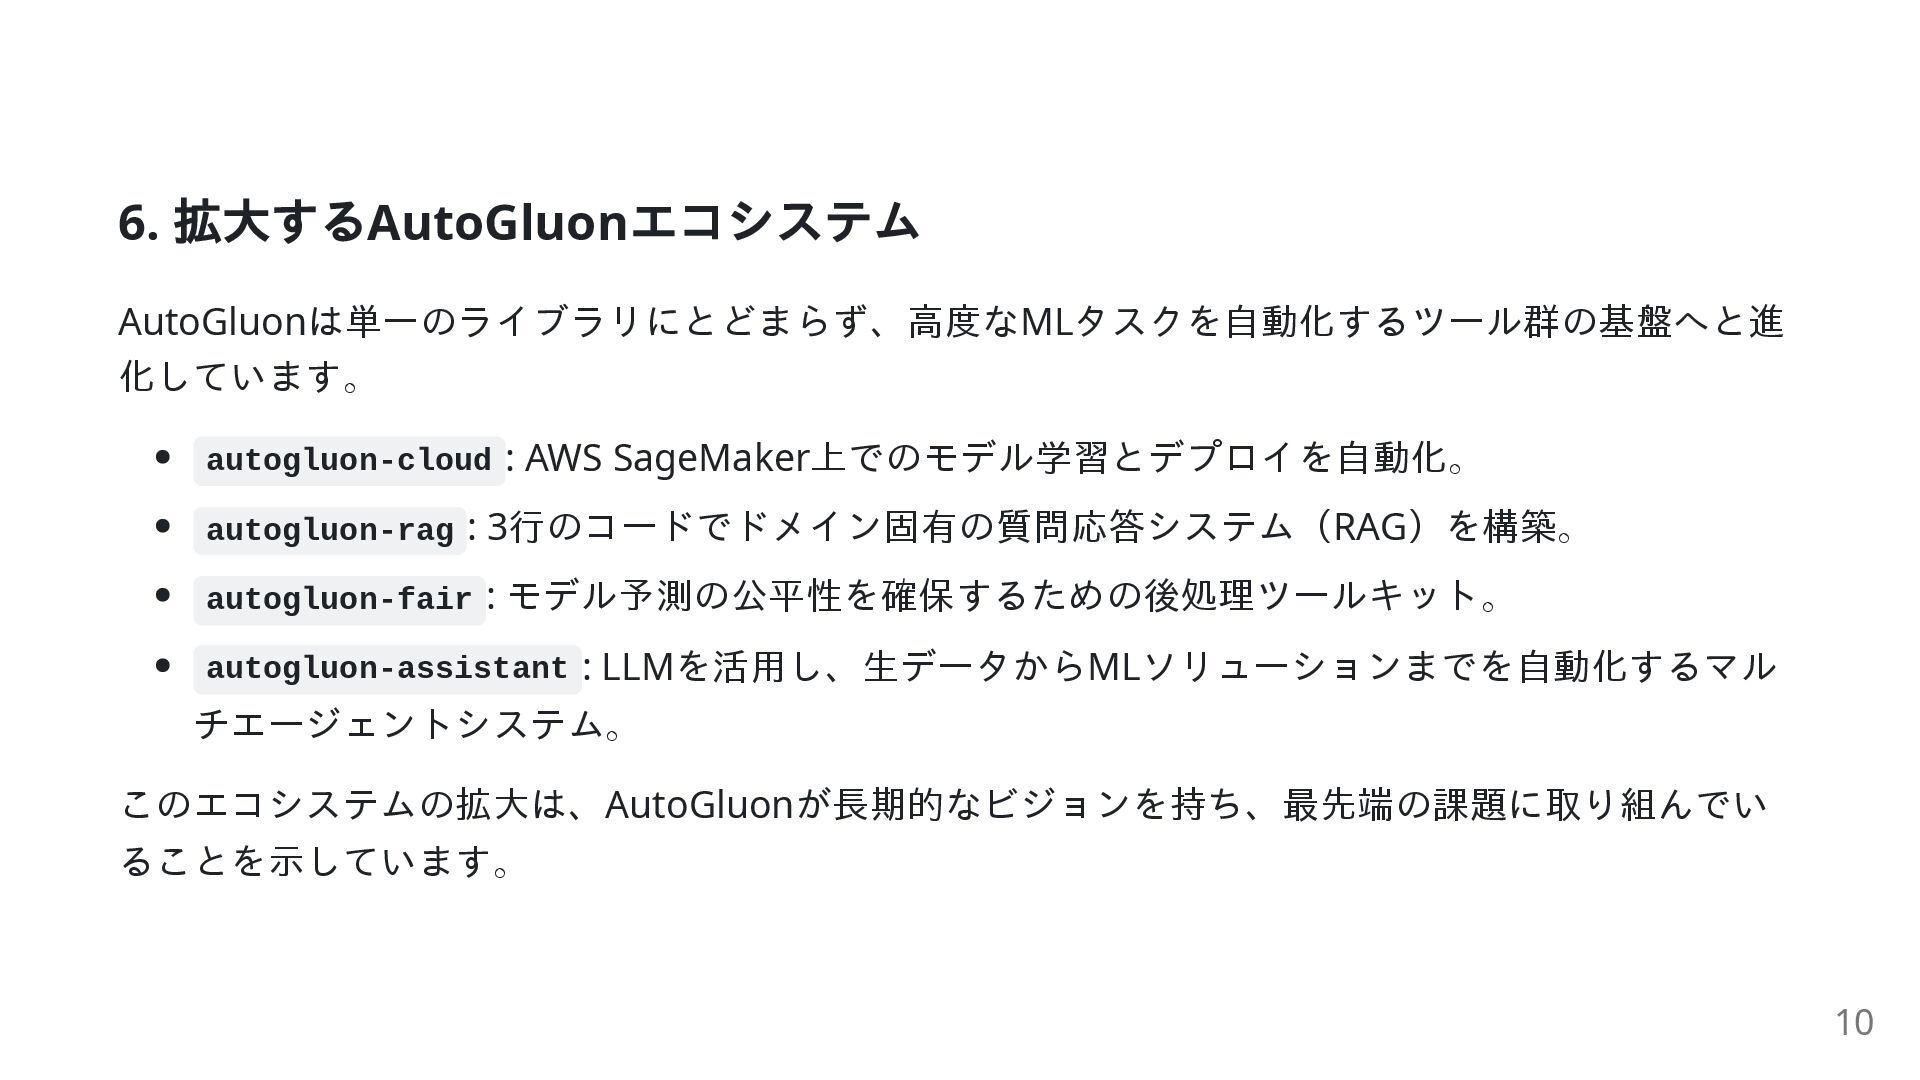
6. 拡大するAutoGluon エコシステム AutoGluonは単一のライブラリにとどまらず、高度なMLタスクを自動化するツール群の基盤へと進 化しています。 autogluon-cloud : AWS SageMaker上でのモデル学習とデプロイを自動化。 autogluon-rag
: 3行のコードでドメイン固有の質問応答システム(RAG)を構築。 autogluon-fair : モデル予測の公平性を確保するための後処理ツールキット。 autogluon-assistant : LLMを活用し、生データからMLソリューションまでを自動化するマル チエージェントシステム。 このエコシステムの拡大は、AutoGluonが長期的なビジョンを持ち、最先端の課題に取り組んでい ることを示しています。 10 -
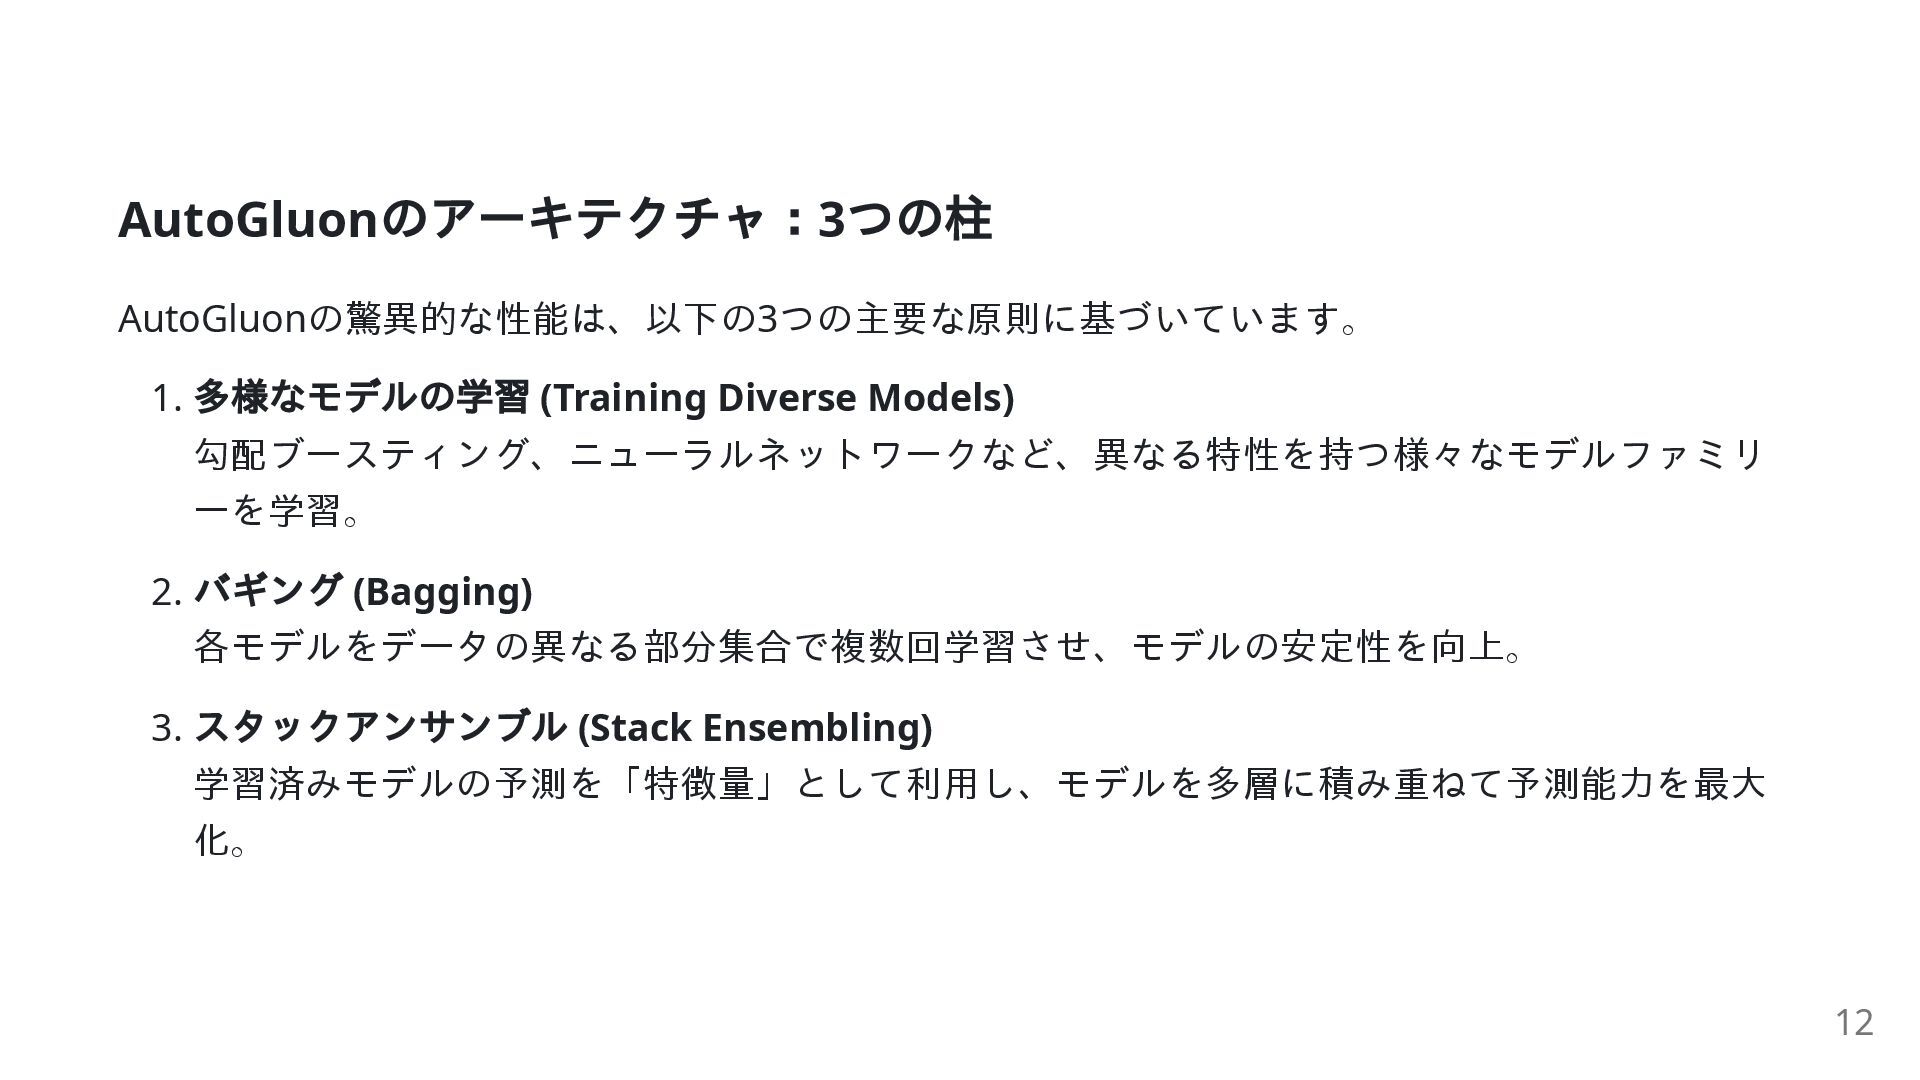
AutoGluon のアーキテクチャ:3 つの柱 AutoGluonの驚異的な性能は、以下の3つの主要な原則に基づいています。 1. 多様なモデルの学習 (Training Diverse Models) 勾配ブースティング、ニューラルネットワークなど、異なる特性を持つ様々なモデルファミリ
ーを学習。 2. バギング (Bagging) 各モデルをデータの異なる部分集合で複数回学習させ、モデルの安定性を向上。 3. スタックアンサンブル (Stack Ensembling) 学習済みモデルの予測を「特徴量」として利用し、モデルを多層に積み重ねて予測能力を最大 化。 12 -
詳細解説:クロスバリデーションを利用したバギング AutoGluonのバギングは、クロスバリデーションを巧みに組み合わせ、2つの目的を同時に達成しま す。 プロセス ( 例: 8 分割CV) 1. 分割
(Partitioning): 学習データを8個の互いに素な部分集合(フォールド)に分割します。 2. 学習 (Model Training): 各フォールドkについて、kを除く他の7個のフォールドを使ってモデルを学習させます。 3. 結果: このプロセスにより、同じモデルアーキテクチャのインスタンスが8個生成されます。この8個 のモデルの集合が「バギングされたモデル」となります。 13 -
クロスバリデーションを利用したバギング ( 続き) この手法の巧みさは、その副産物にあります。 分散の低減 ( バギング本来の目的): 複数のモデル予測を平均化することで、単一モデルよりも安定し、過学習を抑制します。 Out-of-Fold (OOF)
予測の生成: 各データポイントに対して、 そのデータを含まないデータで学習されたモデルによる「クリー ンな」予測値が得られます。 このOOF 予測こそが、次のステップであるスタックアンサンブルを堅牢に機能させるための鍵とな ります。 14 -
最も重要な概念:Out-of-Fold (OOF) 予測 Out-of-Fold (OOF) 予測とは? 学習データ内の各データポイントに対して、そのデータポイントが学習に使われなかったモデルに よって行われた予測のこと。 なぜ重要なのか? これは**データリーク(情報の漏洩)**を防ぐために不可欠です。
もし、スタッカーモデルが、ベースモデルの学習データ内での予測(=答えを知っている状態での予 測)を特徴量として学習してしまうと、その予測を過度に信用し、未知のデータに対して全く機能 しない 深刻な過学習を引き起こします。 OOF予測は、モデルが未知データにどう振る舞うかをシミュレートし、次の層のモデルにとって信 頼できる有効な特徴量セットを作り出します。 15 -
詳細解説:多層スタックアンサンブル スタックアンサンブルは、モデルの予測を新たな特徴量として利用し、モデルを階層的に積み重ね る技術です。 レイヤー1 ( ベースレイヤー): 複数のバギング済みモデル(LightGBM, CatBoost, NNなど)が、 元の特徴量のみを使って学
習。 これらのモデルがOOF予測を生成します。 レイヤー2 ( スタッカーレイヤー): 新しいモデル群が学習されます。 入力は「 元の特徴量 + レイヤー1 のOOF 予測」。 このプロセスはさらに繰り返されます。 16 -
多層スタックアンサンブル ( 続き) AutoGluon の秘訣:スキップ接続 各層のモデルは「 元の特徴量+下位層全てのOOF 予測」を入力として受け取ります。 なぜこれが強力なのか? 上位層のモデルは、下位層のモデルの予測を
組み合わせる方法を学習します。 同時に、下位層の全モデルが見逃した可能性のある 元データ内のパターンを直接捉えることが できます。 これにより、情報の損失を防ぎ、予測能力を最大化します。 17 -
最終層:重み付きアンサンブル スタックの最終層には、 WeightedEnsemble_L<X> という特別なモデルが一つだけ存在します。 役割: このモデルは特徴量を使わず、直下のスタッカーモデル群の予測値を受け取り、それらの 最適 な重み付き平均を学習します。 アルゴリズム: 検証スコアを最大化するために、貪欲法(Greedy
Algorithm)を用いて効率的に最適な重みを 見つけ出します。 この最終ステップは「ブレンディング」の一種であり、最も強力なモデル群の組み合わせを微調整 し、 性能を最後の一滴まで絞り出す役割を担います。 18 -
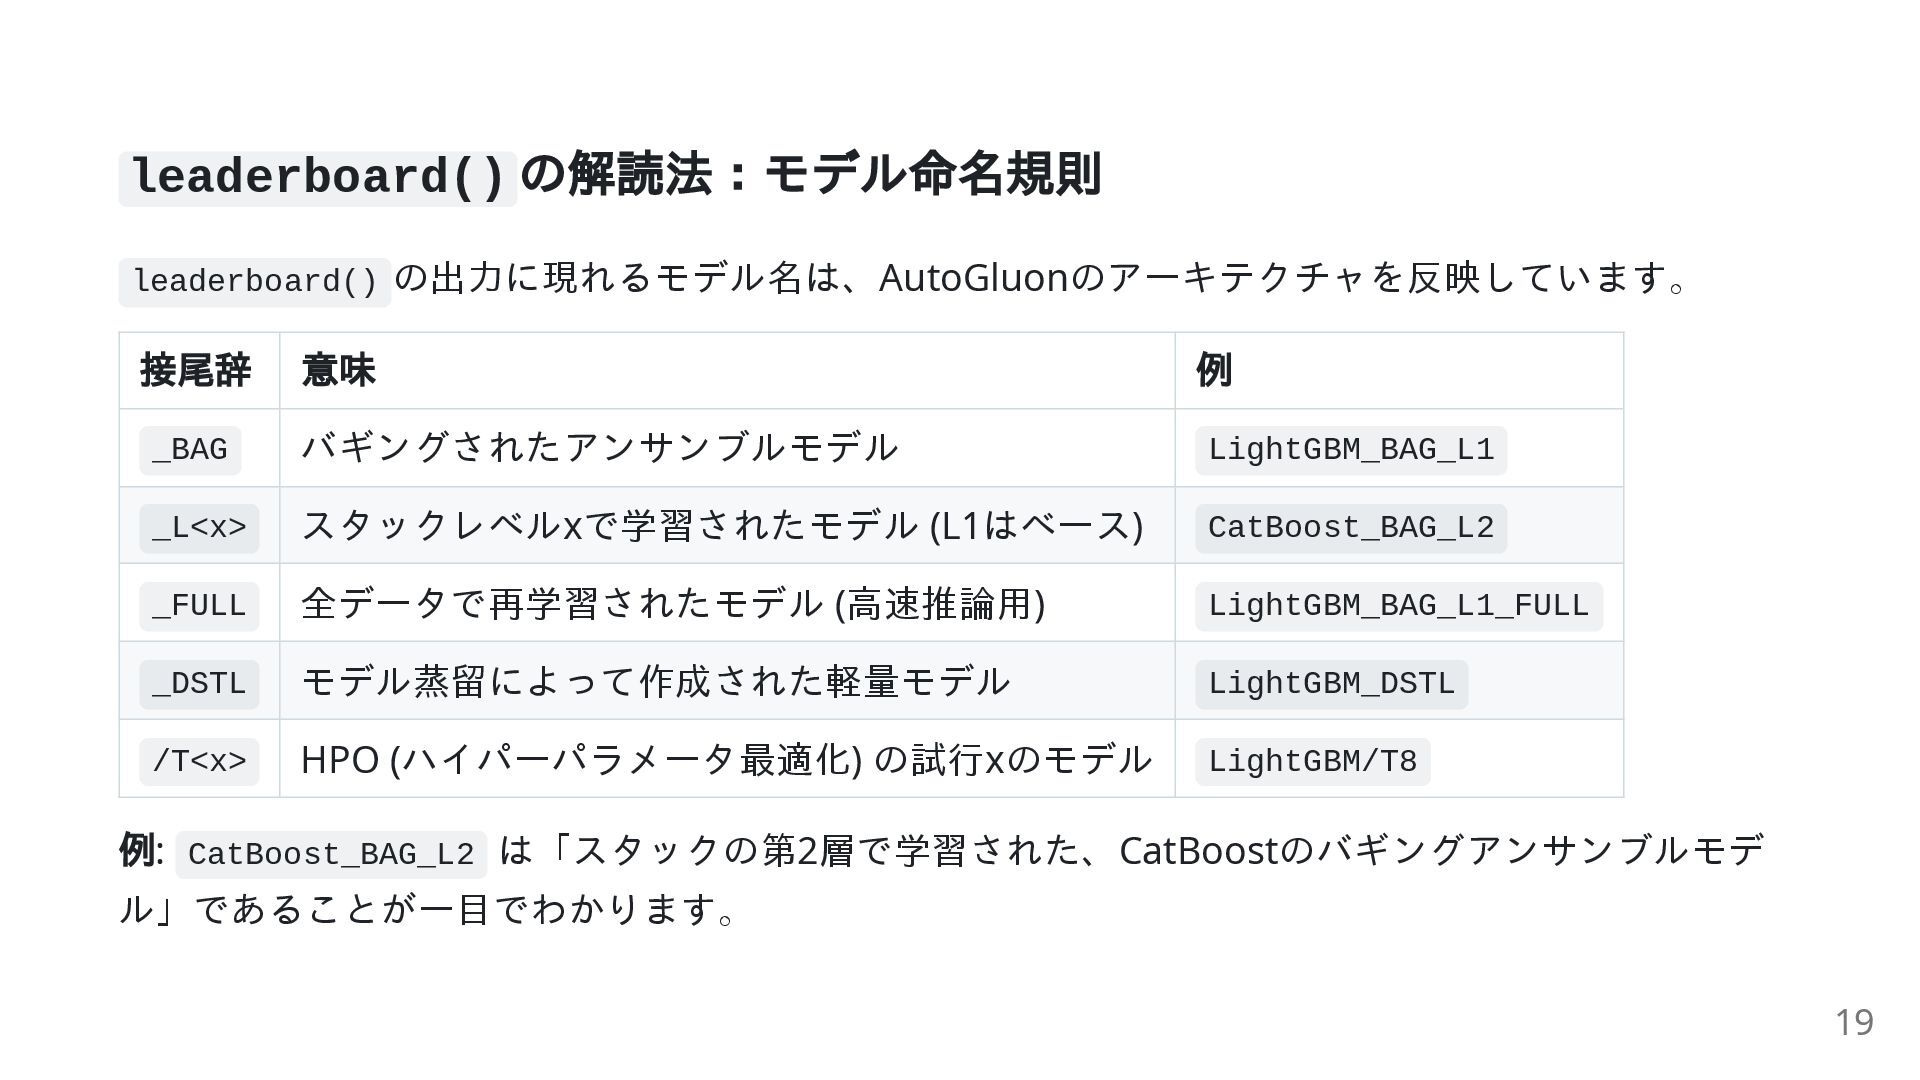
leaderboard() の解読法:モデル命名規則 leaderboard() の出力に現れるモデル名は、AutoGluonのアーキテクチャを反映しています。 接尾辞 意味 例 _BAG バギングされたアンサンブルモデル LightGBM_BAG_L1
_L<x> スタックレベルxで学習されたモデル (L1はベース) CatBoost_BAG_L2 _FULL 全データで再学習されたモデル (高速推論用) LightGBM_BAG_L1_FULL _DSTL モデル蒸留によって作成された軽量モデル LightGBM_DSTL /T<x> HPO (ハイパーパラメータ最適化) の試行xのモデル LightGBM/T8 例: CatBoost_BAG_L2 は「スタックの第2層で学習された、CatBoostのバギングアンサンブルモデ ル」であることが一目でわかります。 19 -
アーキテクチャのまとめ AutoGluonの学習プロセスは、以下の流れで進行します。 データ → ベースモデル群 (L1) → OOF 予測 →
スタッカーモデル群 (L2) → ... → 重み付きアンサンブ ル 学習されるモデルの総数は、およそ M x N x K + 1 となります。 M: スタックの層の数 N: 各層のモデルタイプの数 K: バギングのフォールド数 +1: 最終的な重み付きアンサンブル この堅牢で多層的なアプローチこそが、AutoGluonが他のAutoMLツールを凌駕する性能を発揮する 理由です。 20 -
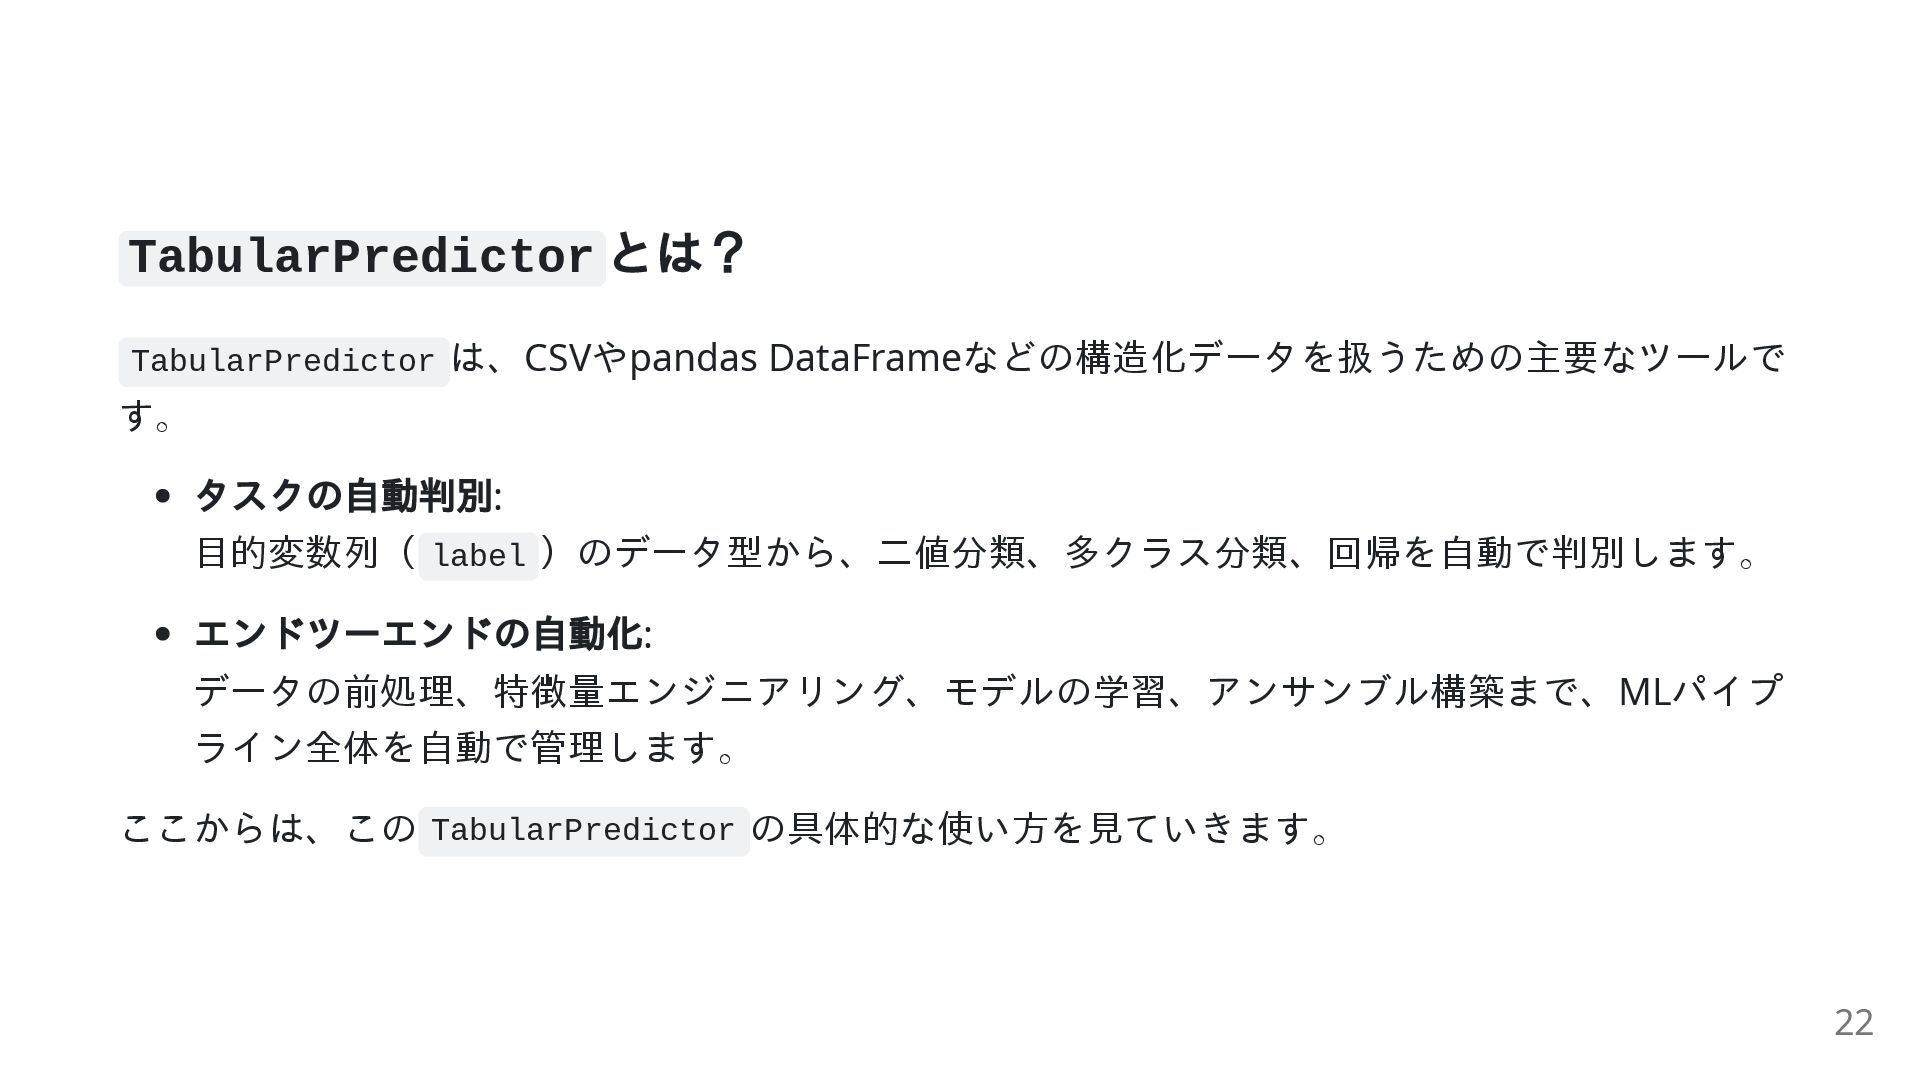
TabularPredictor とは? TabularPredictor は、CSVやpandas DataFrameなどの構造化データを扱うための主要なツールで す。 タスクの自動判別: 目的変数列( label )のデータ型から、二値分類、多クラス分類、回帰を自動で判別します。
エンドツーエンドの自動化: データの前処理、特徴量エンジニアリング、モデルの学習、アンサンブル構築まで、MLパイプ ライン全体を自動で管理します。 ここからは、この TabularPredictor の具体的な使い方を見ていきます。 22 -
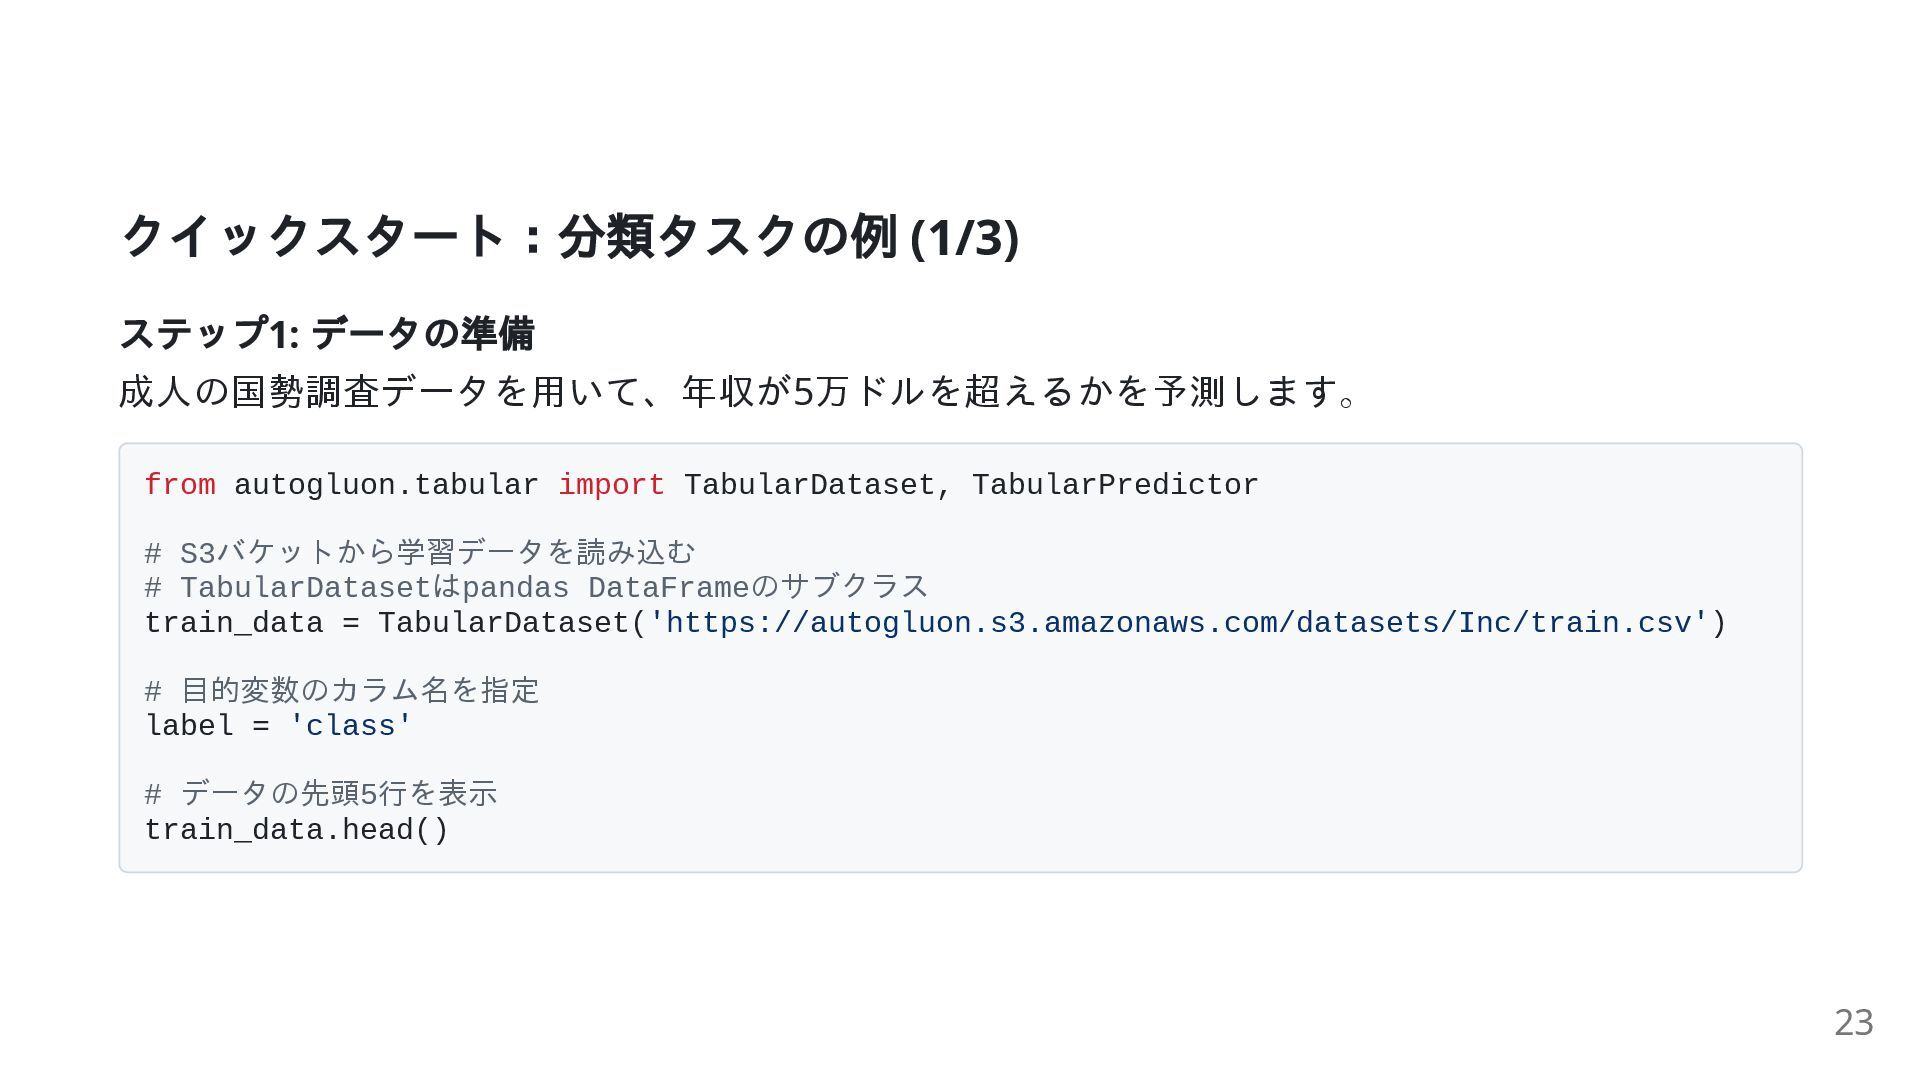
クイックスタート:分類タスクの例 (1/3) ステップ1: データの準備 成人の国勢調査データを用いて、年収が5万ドルを超えるかを予測します。 from autogluon.tabular import TabularDataset, TabularPredictor
# S3バケットから学習データを読み込む # TabularDatasetはpandas DataFrameのサブクラス train_data = TabularDataset('https://autogluon.s3.amazonaws.com/datasets/Inc/train.csv') # 目的変数のカラム名を指定 label = 'class' # データの先頭5行を表示 train_data.head() 23 -
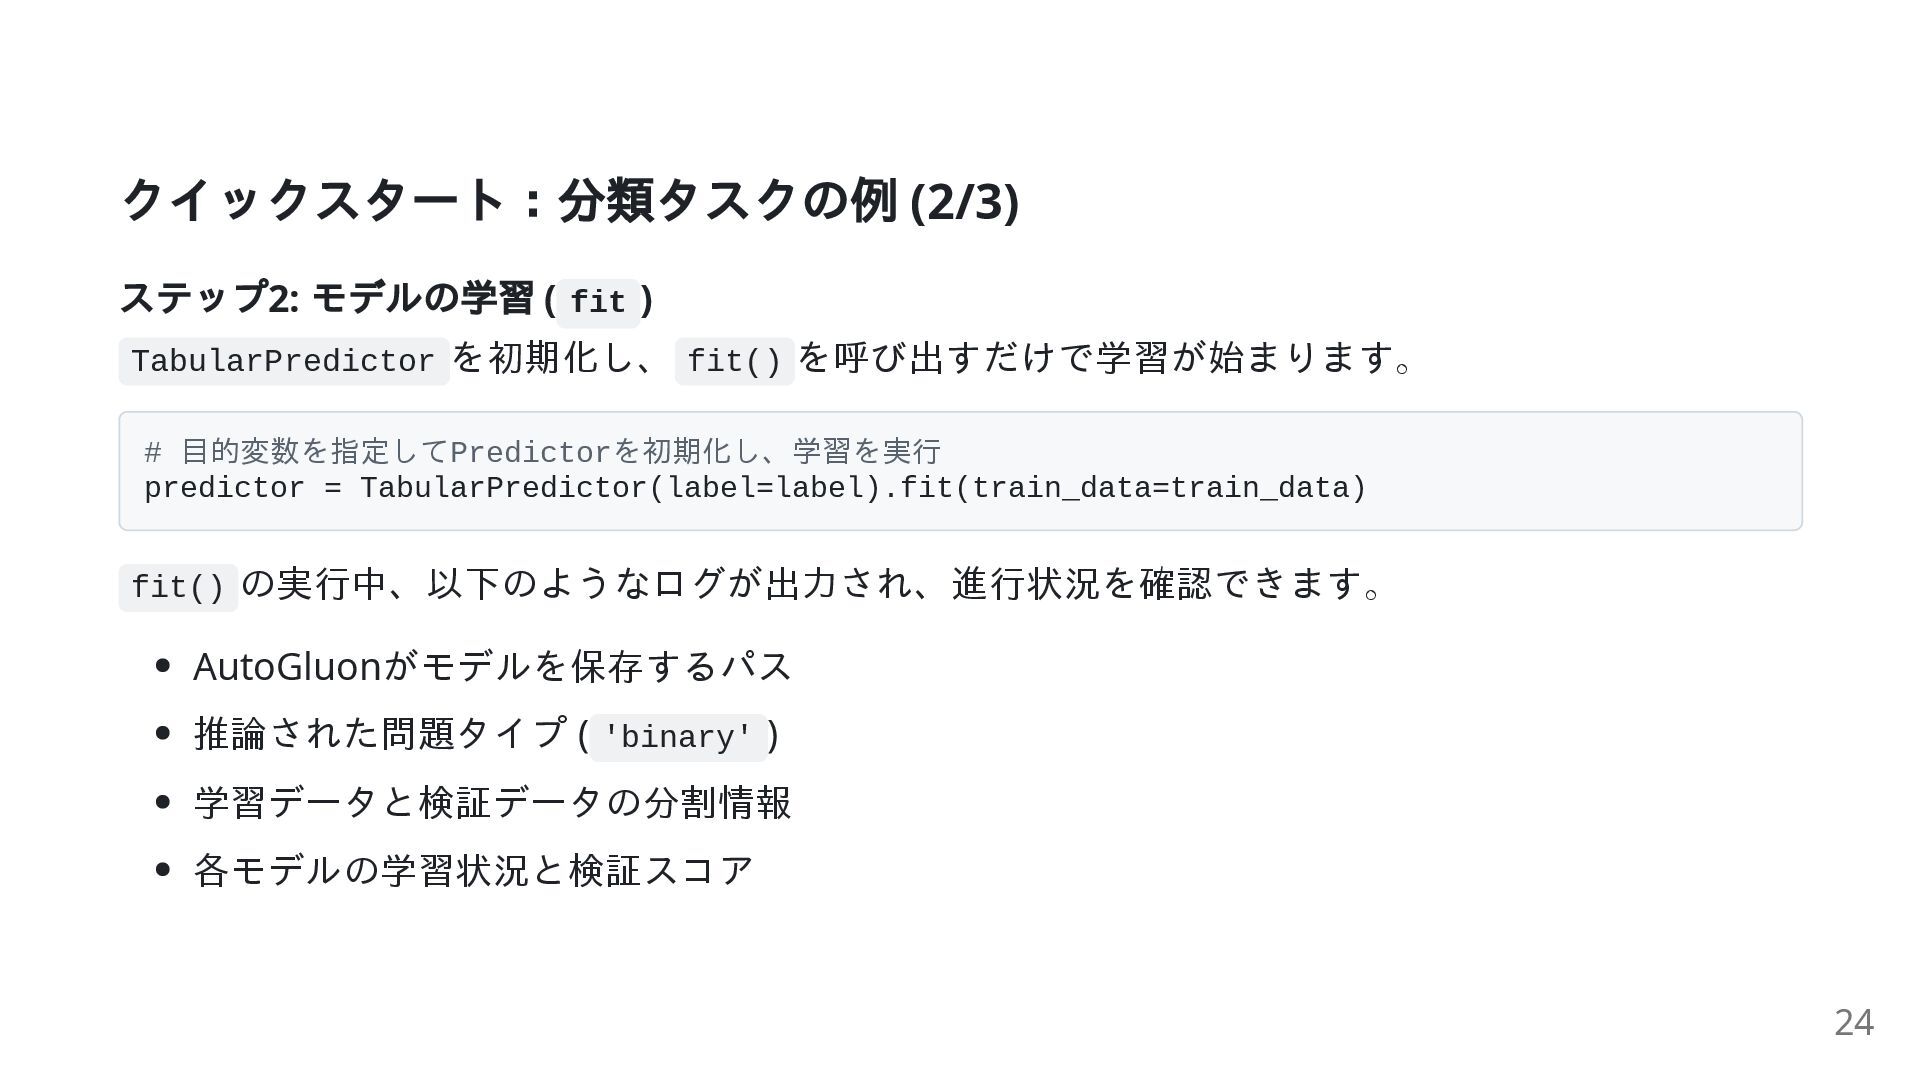
クイックスタート:分類タスクの例 (2/3) ステップ2: モデルの学習 ( fit ) TabularPredictor を初期化し、 fit()
を呼び出すだけで学習が始まります。 # 目的変数を指定してPredictorを初期化し、学習を実行 predictor = TabularPredictor(label=label).fit(train_data=train_data) fit() の実行中、以下のようなログが出力され、進行状況を確認できます。 AutoGluonがモデルを保存するパス 推論された問題タイプ ( 'binary' ) 学習データと検証データの分割情報 各モデルの学習状況と検証スコア 24 -
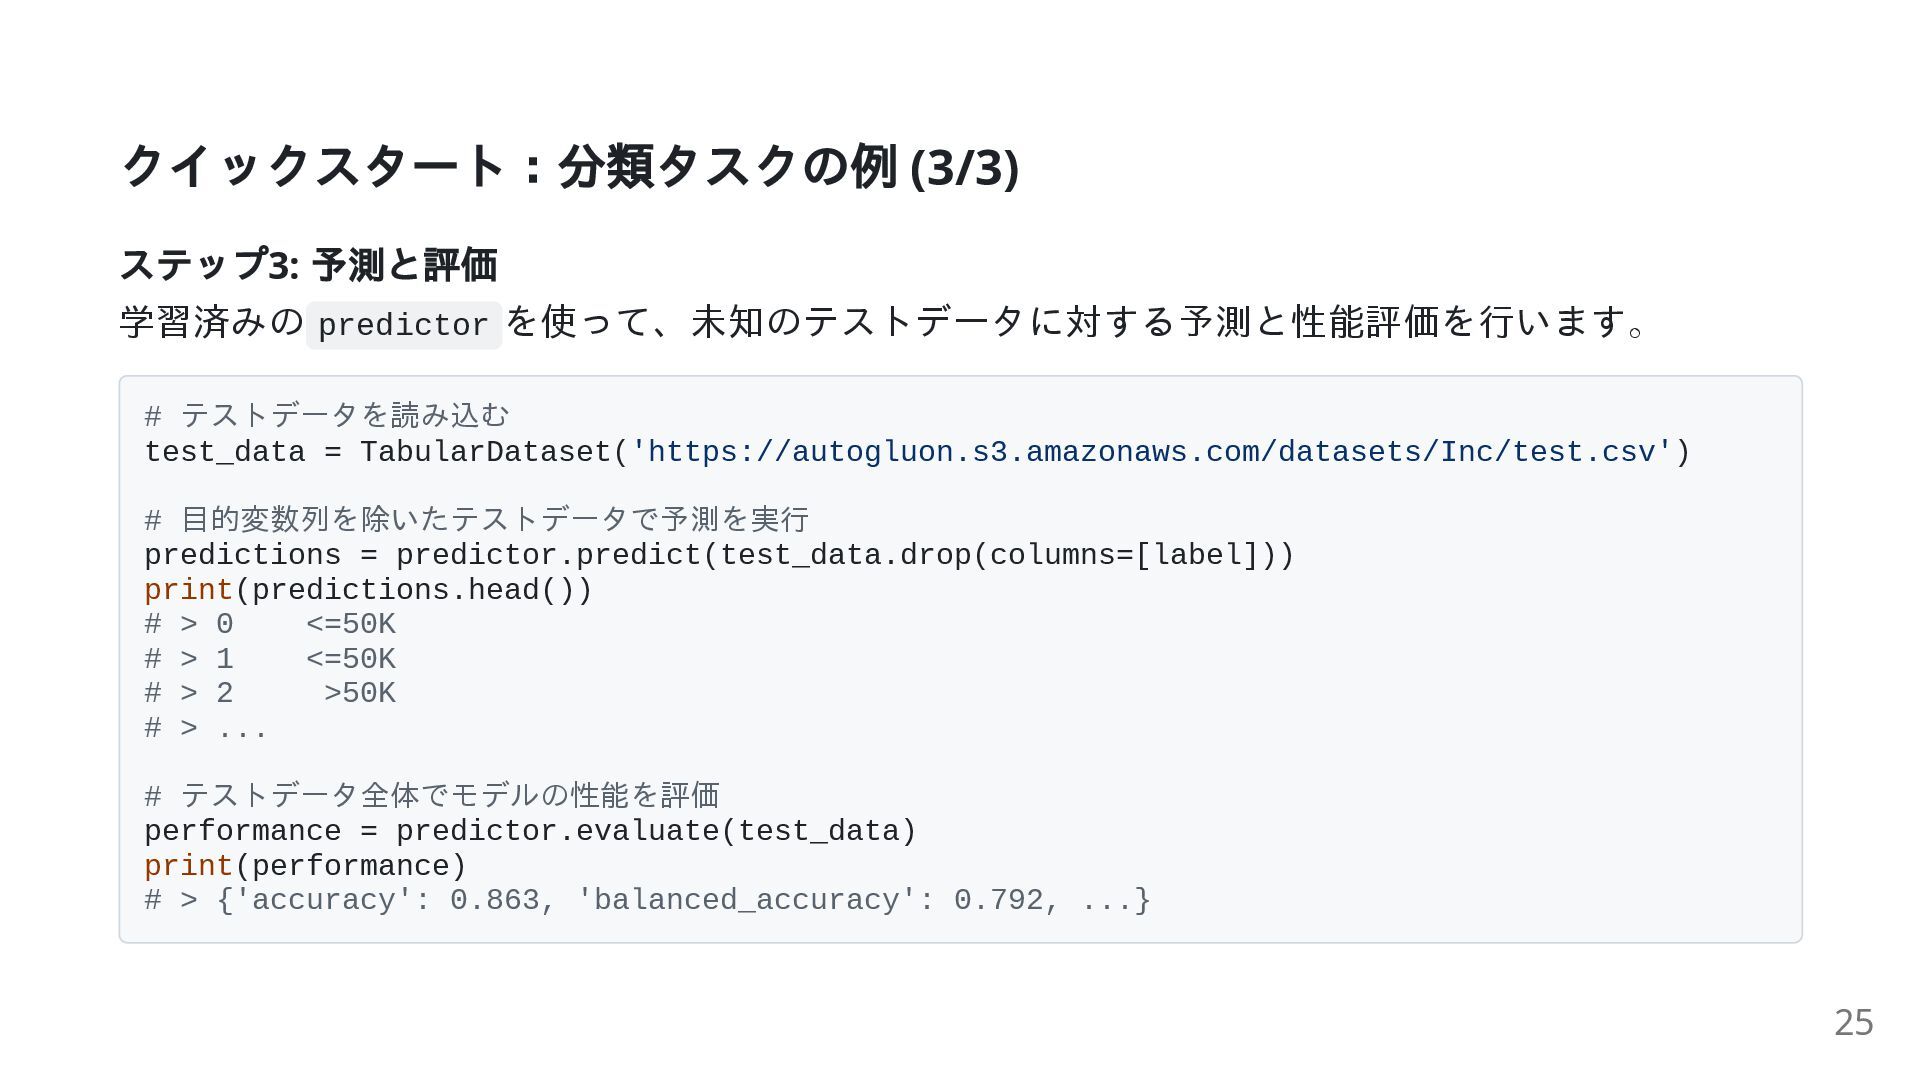
クイックスタート:分類タスクの例 (3/3) ステップ3: 予測と評価 学習済みの predictor を使って、未知のテストデータに対する予測と性能評価を行います。 # テストデータを読み込む test_data
= TabularDataset('https://autogluon.s3.amazonaws.com/datasets/Inc/test.csv') # 目的変数列を除いたテストデータで予測を実行 predictions = predictor.predict(test_data.drop(columns=[label])) print(predictions.head()) # > 0 <=50K # > 1 <=50K # > 2 >50K # > ... # テストデータ全体でモデルの性能を評価 performance = predictor.evaluate(test_data) print(performance) # > {'accuracy': 0.863, 'balanced_accuracy': 0.792, ...} 25 -
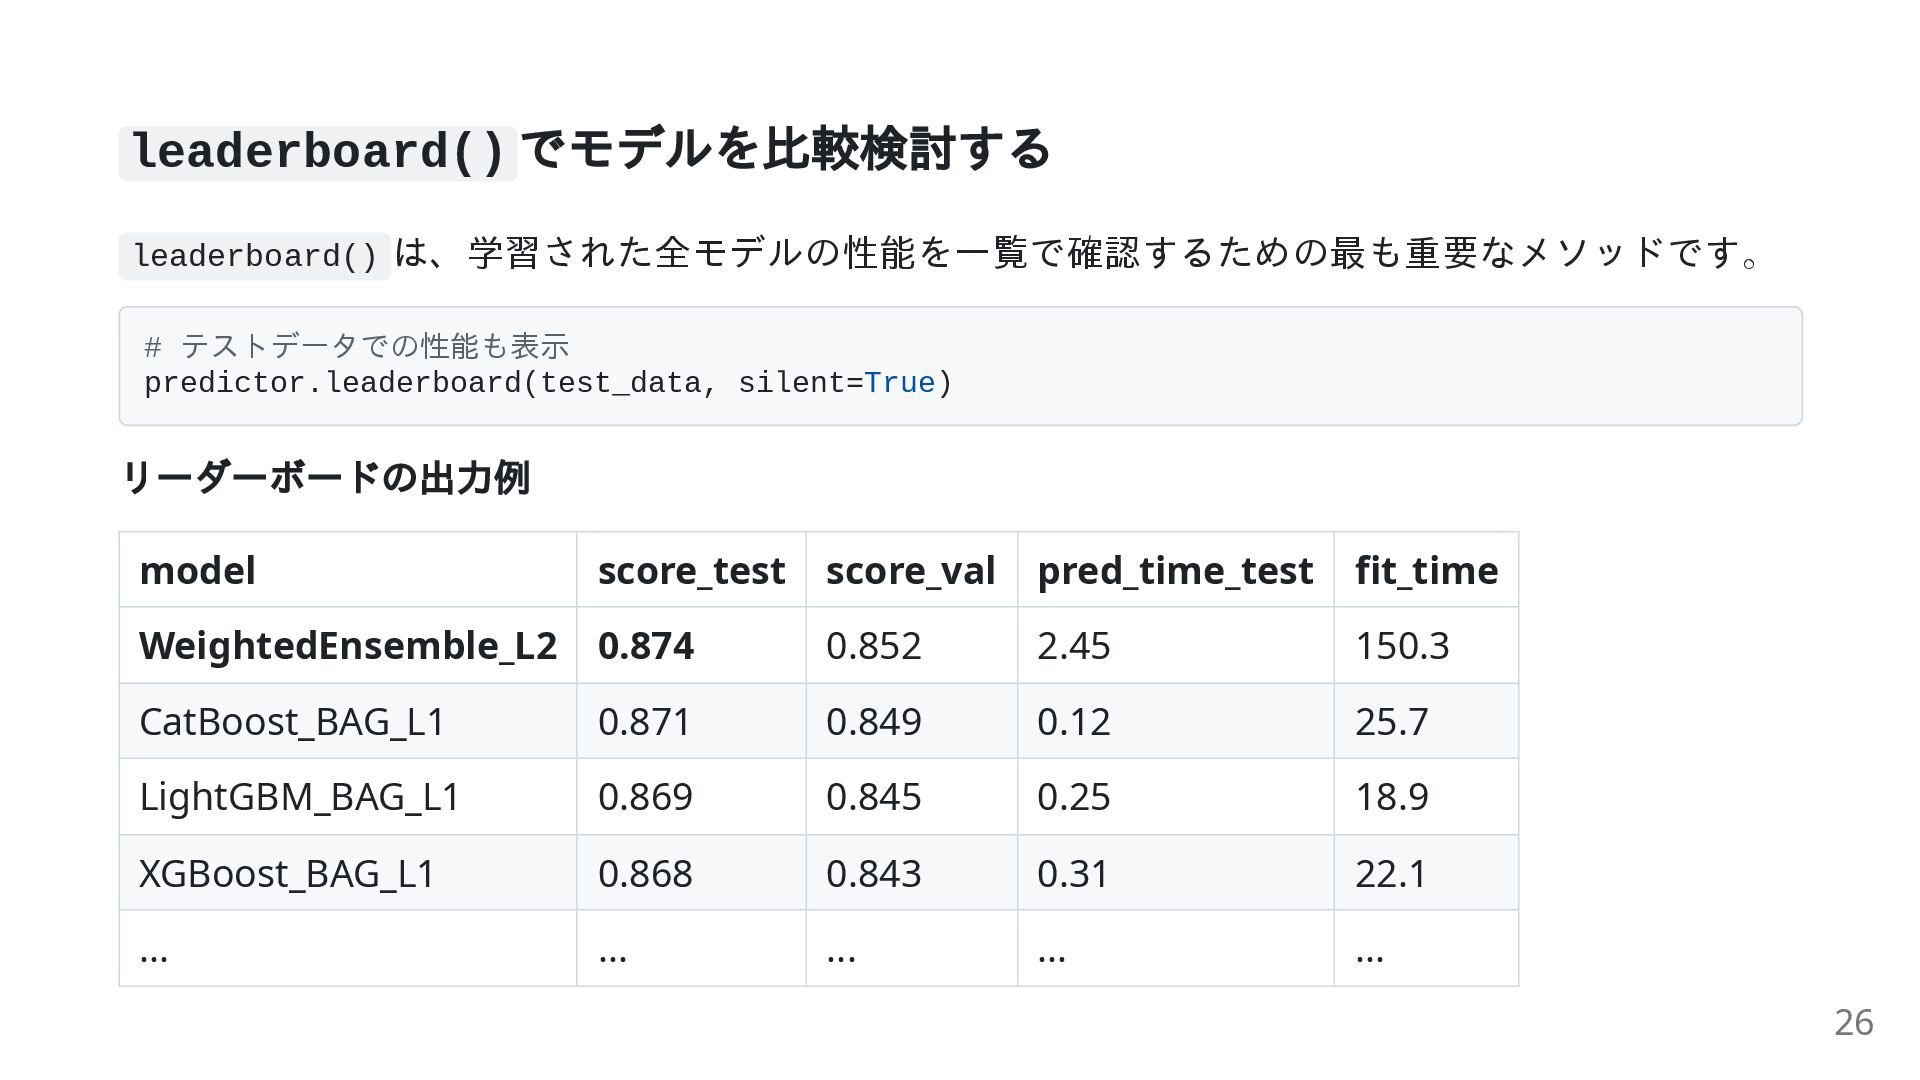
leaderboard() でモデルを比較検討する leaderboard() は、学習された全モデルの性能を一覧で確認するための最も重要なメソッドです。 # テストデータでの性能も表示 predictor.leaderboard(test_data, silent=True) リーダーボードの出力例 model
score_test score_val pred_time_test fit_time WeightedEnsemble_L2 0.874 0.852 2.45 150.3 CatBoost_BAG_L1 0.871 0.849 0.12 25.7 LightGBM_BAG_L1 0.869 0.845 0.25 18.9 XGBoost_BAG_L1 0.868 0.843 0.31 22.1 ... ... ... ... ... 26 -
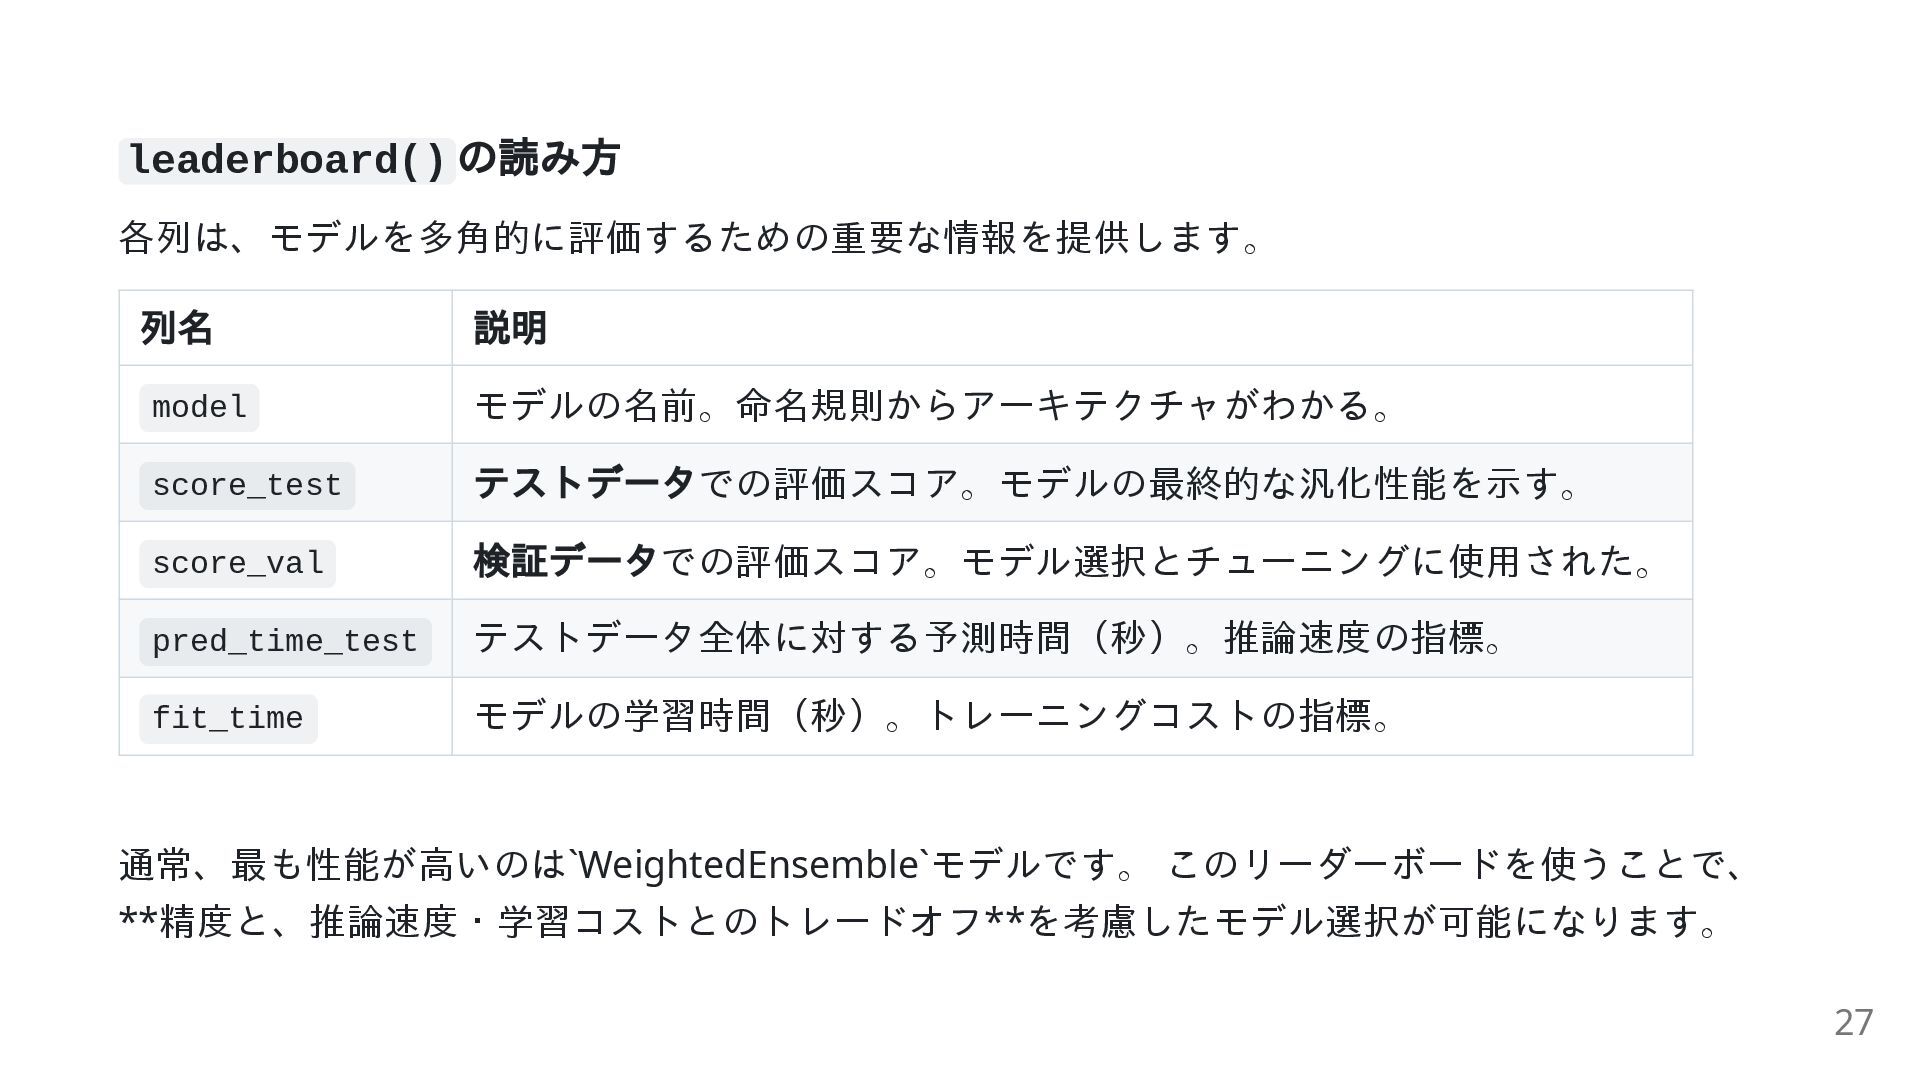
leaderboard() の読み方 各列は、モデルを多角的に評価するための重要な情報を提供します。 列名 説明 model モデルの名前。命名規則からアーキテクチャがわかる。 score_test テストデータでの評価スコア。モデルの最終的な汎化性能を示す。 score_val
検証データでの評価スコア。モデル選択とチューニングに使用された。 pred_time_test テストデータ全体に対する予測時間(秒)。推論速度の指標。 fit_time モデルの学習時間(秒)。トレーニングコストの指標。 通常、最も性能が高いのは`WeightedEnsemble`モデルです。 このリーダーボードを使うことで、 **精度と、推論速度・学習コストとのトレードオフ**を考慮したモデル選択が可能になります。 27 -
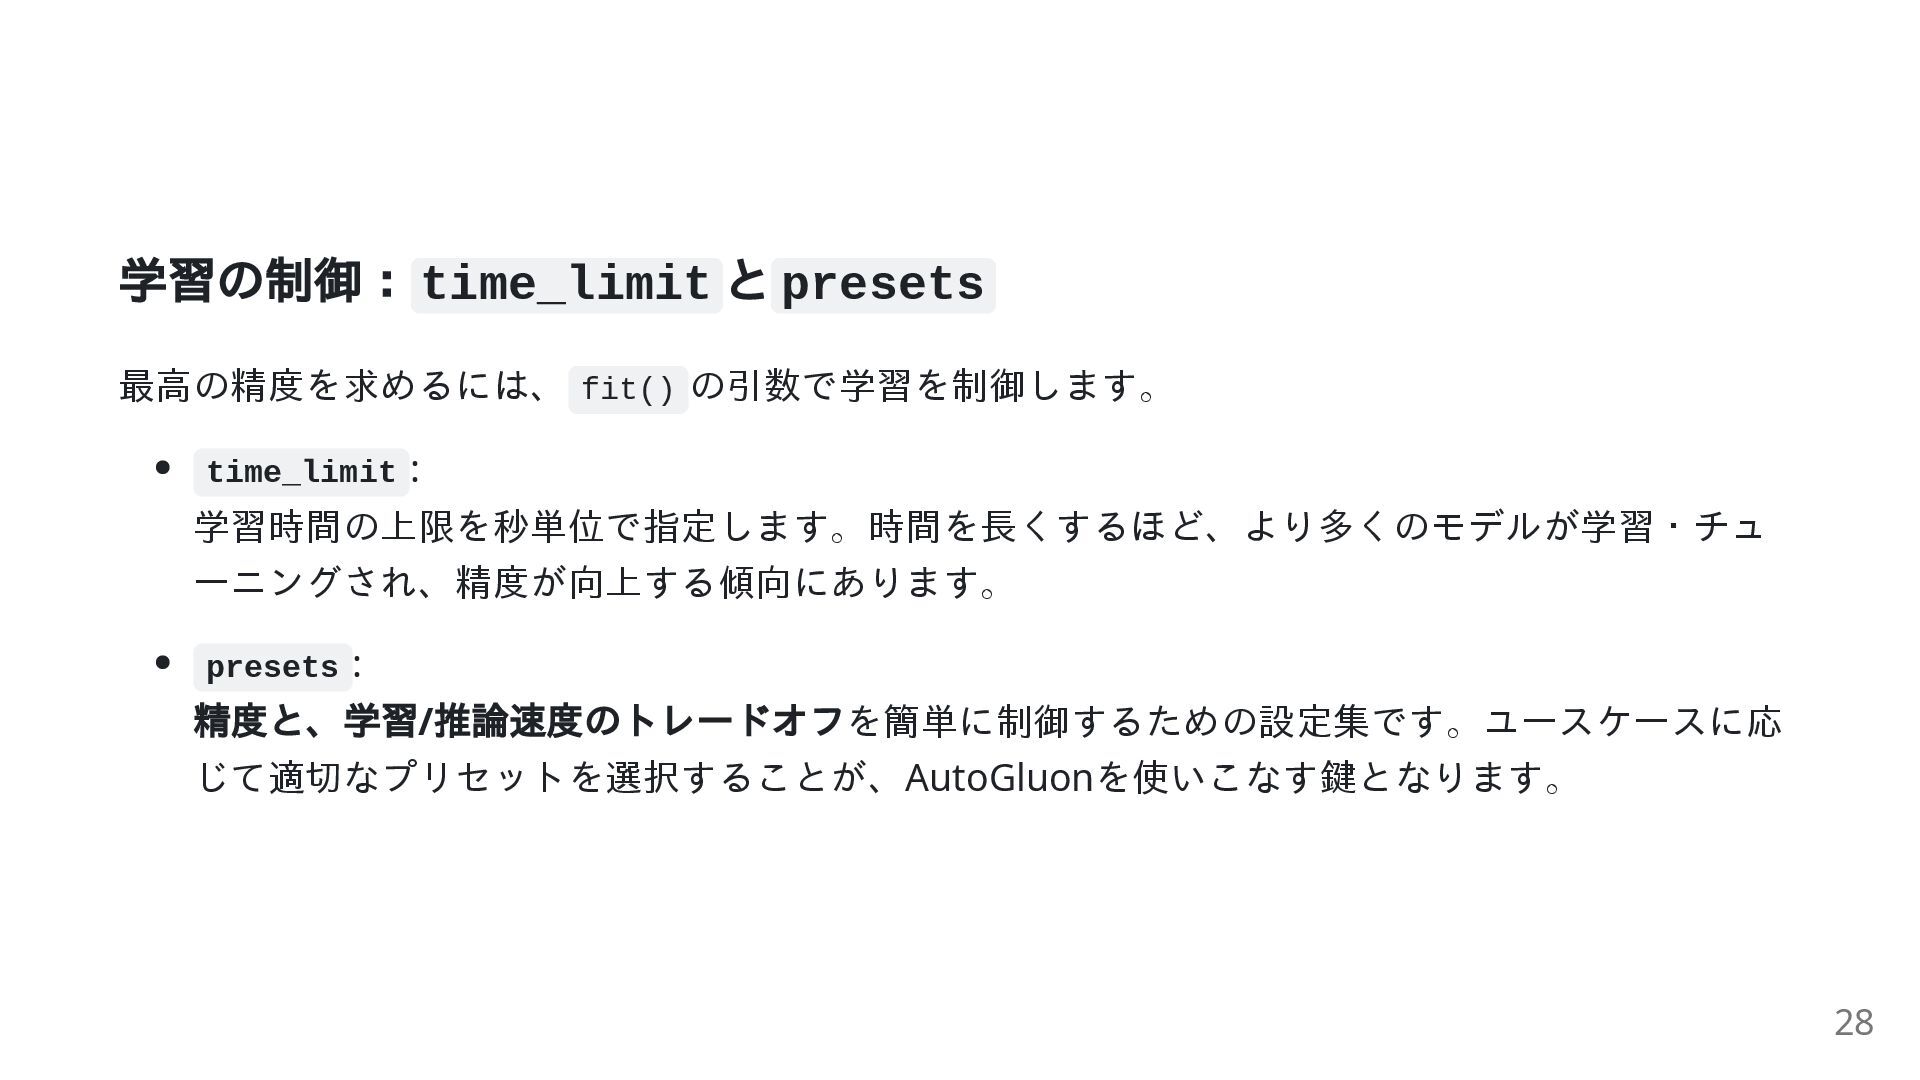
学習の制御:time_limit とpresets 最高の精度を求めるには、 fit() の引数で学習を制御します。 time_limit : 学習時間の上限を秒単位で指定します。時間を長くするほど、より多くのモデルが学習・チュ ーニングされ、精度が向上する傾向にあります。 presets
: 精度と、学習/ 推論速度のトレードオフを簡単に制御するための設定集です。ユースケースに応 じて適切なプリセットを選択することが、AutoGluonを使いこなす鍵となります。 28 -
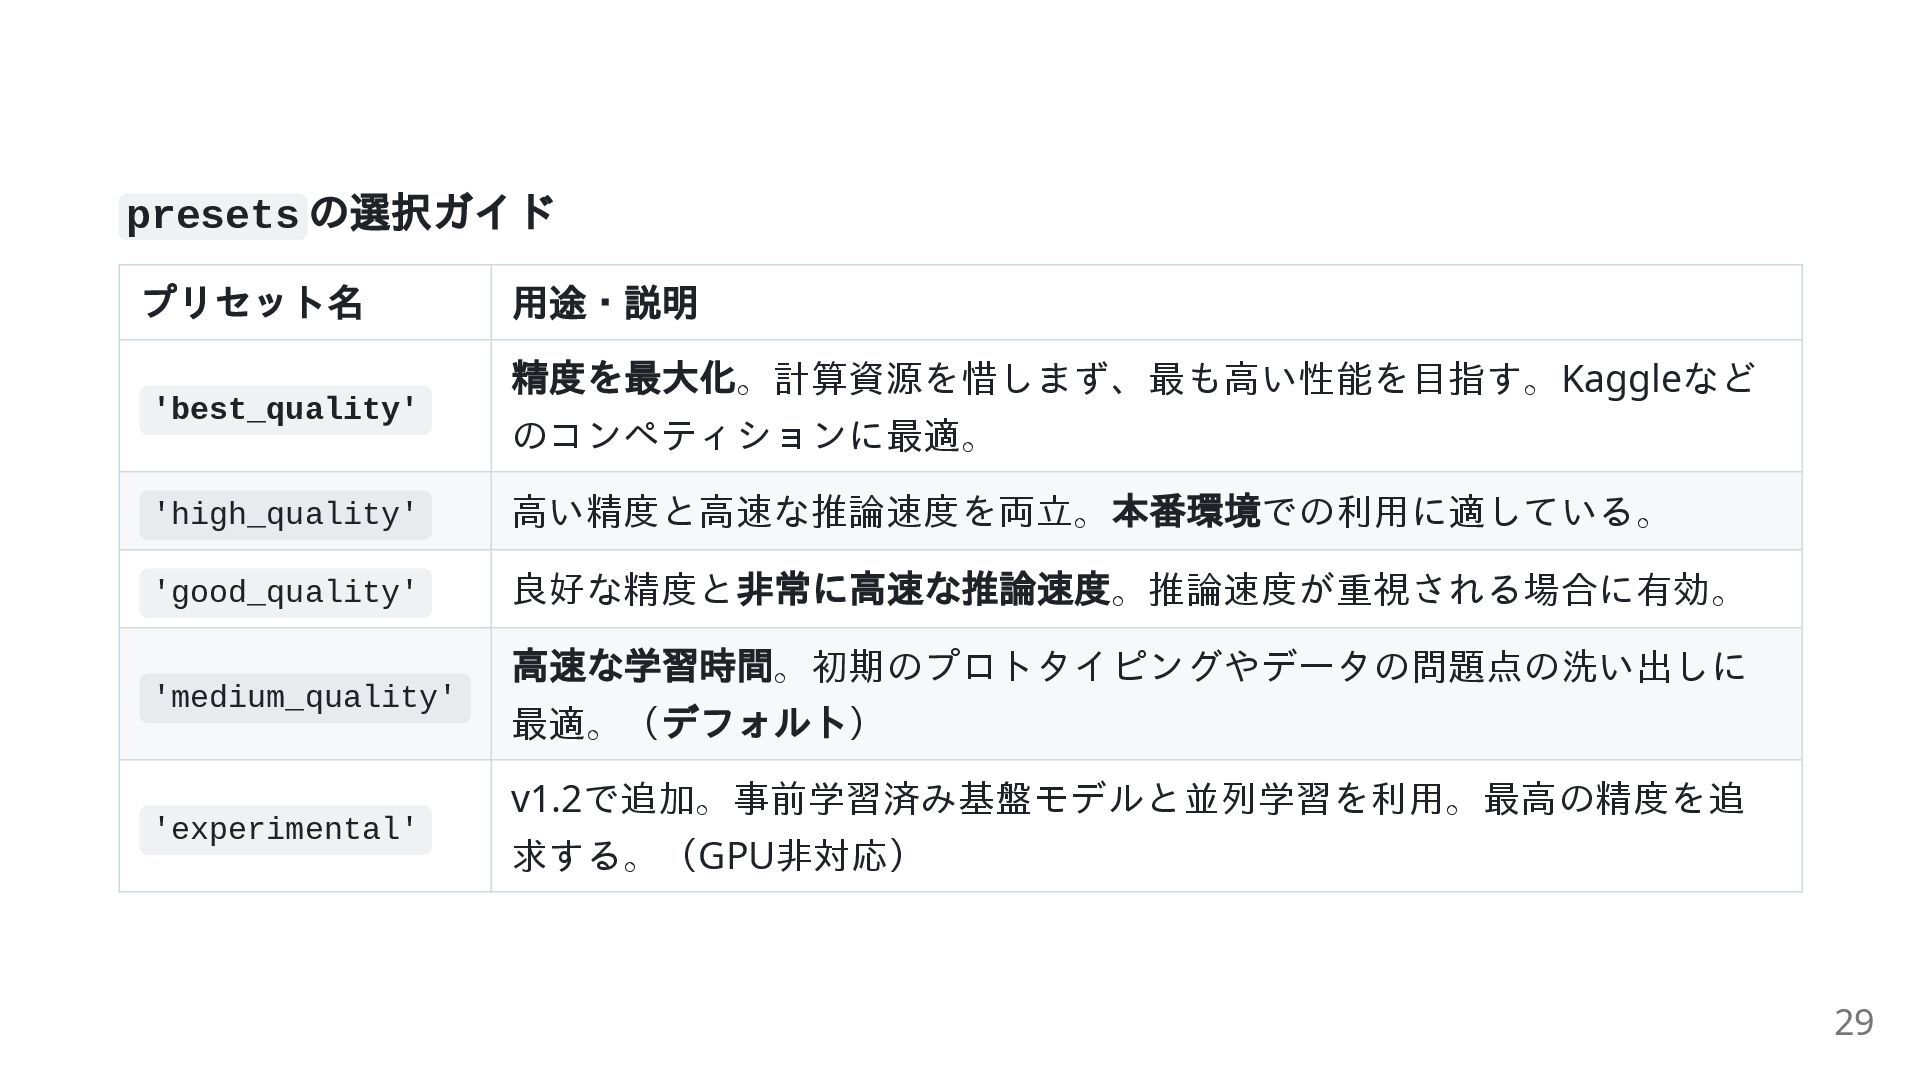
presets の選択ガイド プリセット名 用途・説明 'best_quality' 精度を最大化。計算資源を惜しまず、最も高い性能を目指す。Kaggleなど のコンペティションに最適。 'high_quality' 高い精度と高速な推論速度を両立。 本番環境での利用に適している。
'good_quality' 良好な精度と 非常に高速な推論速度。推論速度が重視される場合に有効。 'medium_quality' 高速な学習時間。初期のプロトタイピングやデータの問題点の洗い出しに 最適。( デフォルト) 'experimental' v1.2で追加。事前学習済み基盤モデルと並列学習を利用。最高の精度を追 求する。(GPU非対応) 29 -
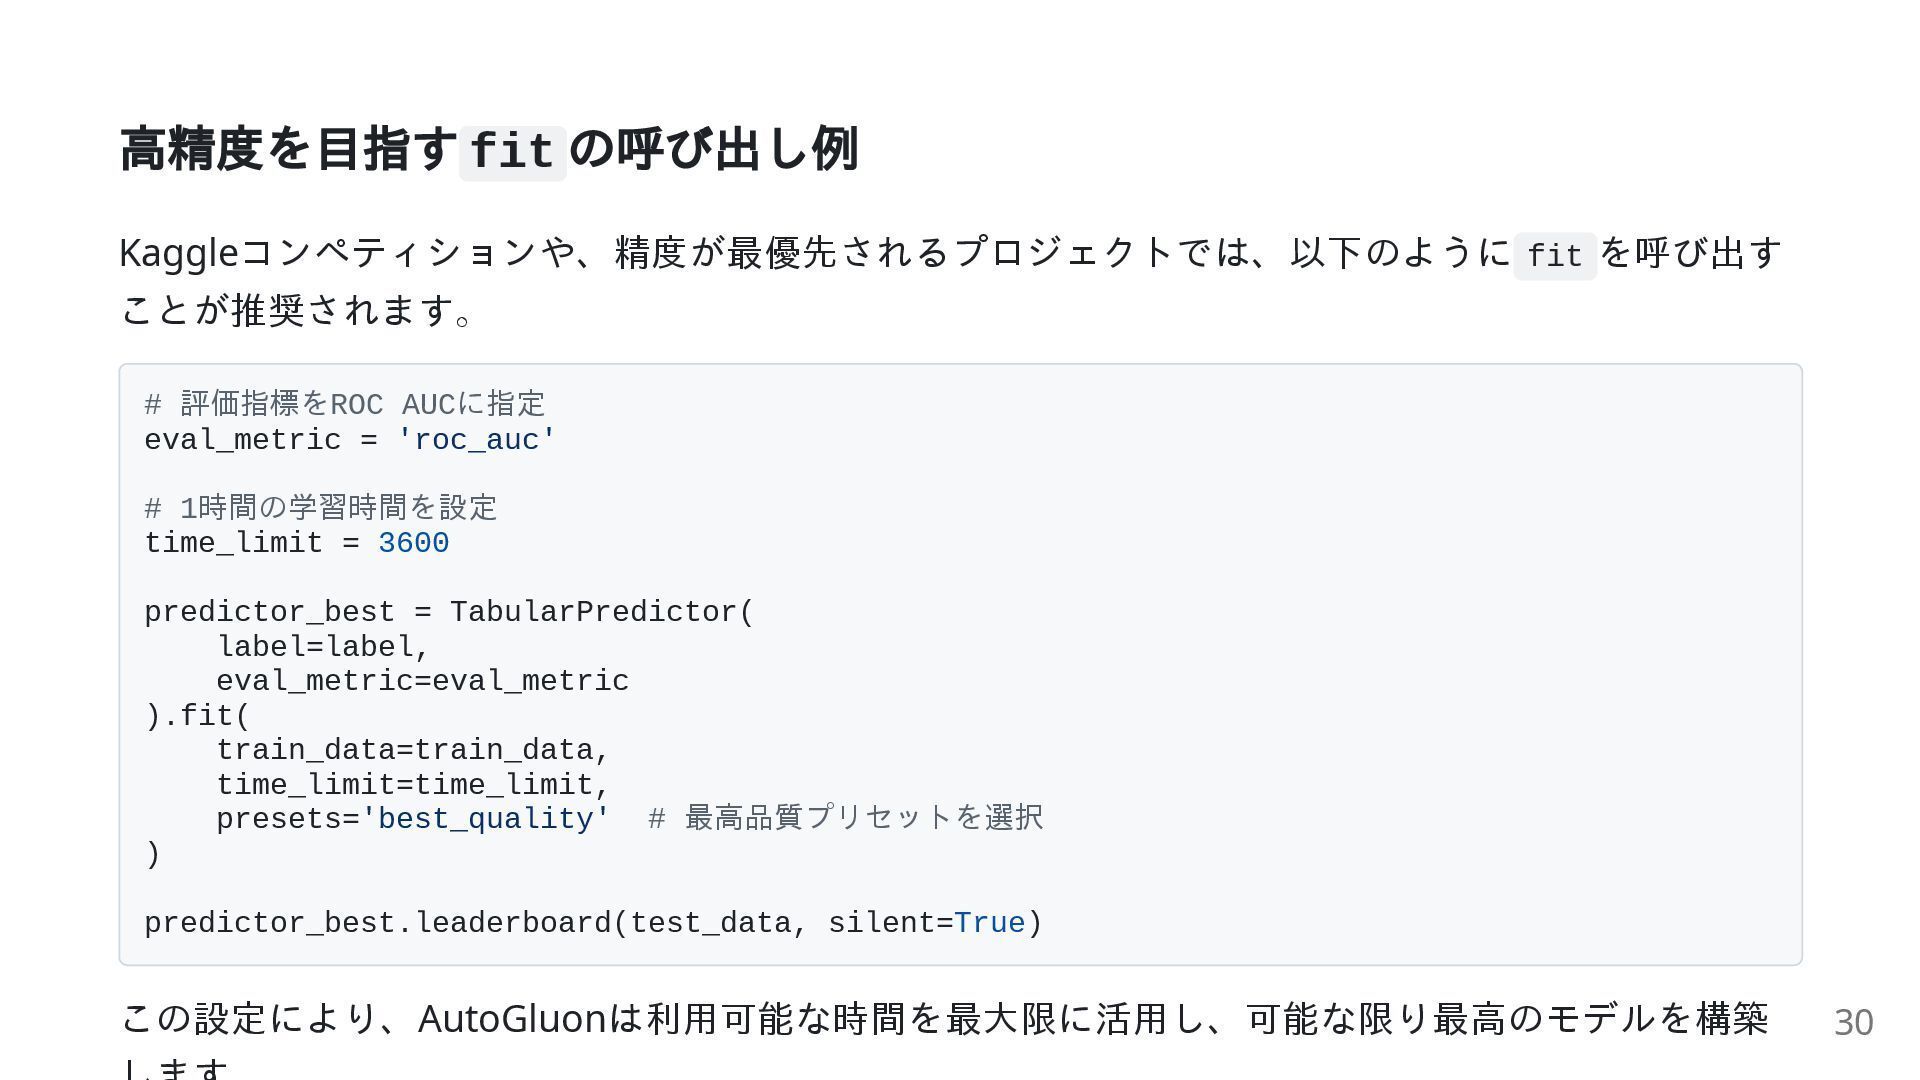
高精度を目指すfit の呼び出し例 Kaggleコンペティションや、精度が最優先されるプロジェクトでは、以下のように fit を呼び出す ことが推奨されます。 # 評価指標をROC AUCに指定 eval_metric
= 'roc_auc' # 1時間の学習時間を設定 time_limit = 3600 predictor_best = TabularPredictor( label=label, eval_metric=eval_metric ).fit( train_data=train_data, time_limit=time_limit, presets='best_quality' # 最高品質プリセットを選択 ) predictor_best.leaderboard(test_data, silent=True) この設定により、AutoGluonは利用可能な時間を最大限に活用し、可能な限り最高のモデルを構築 30 -
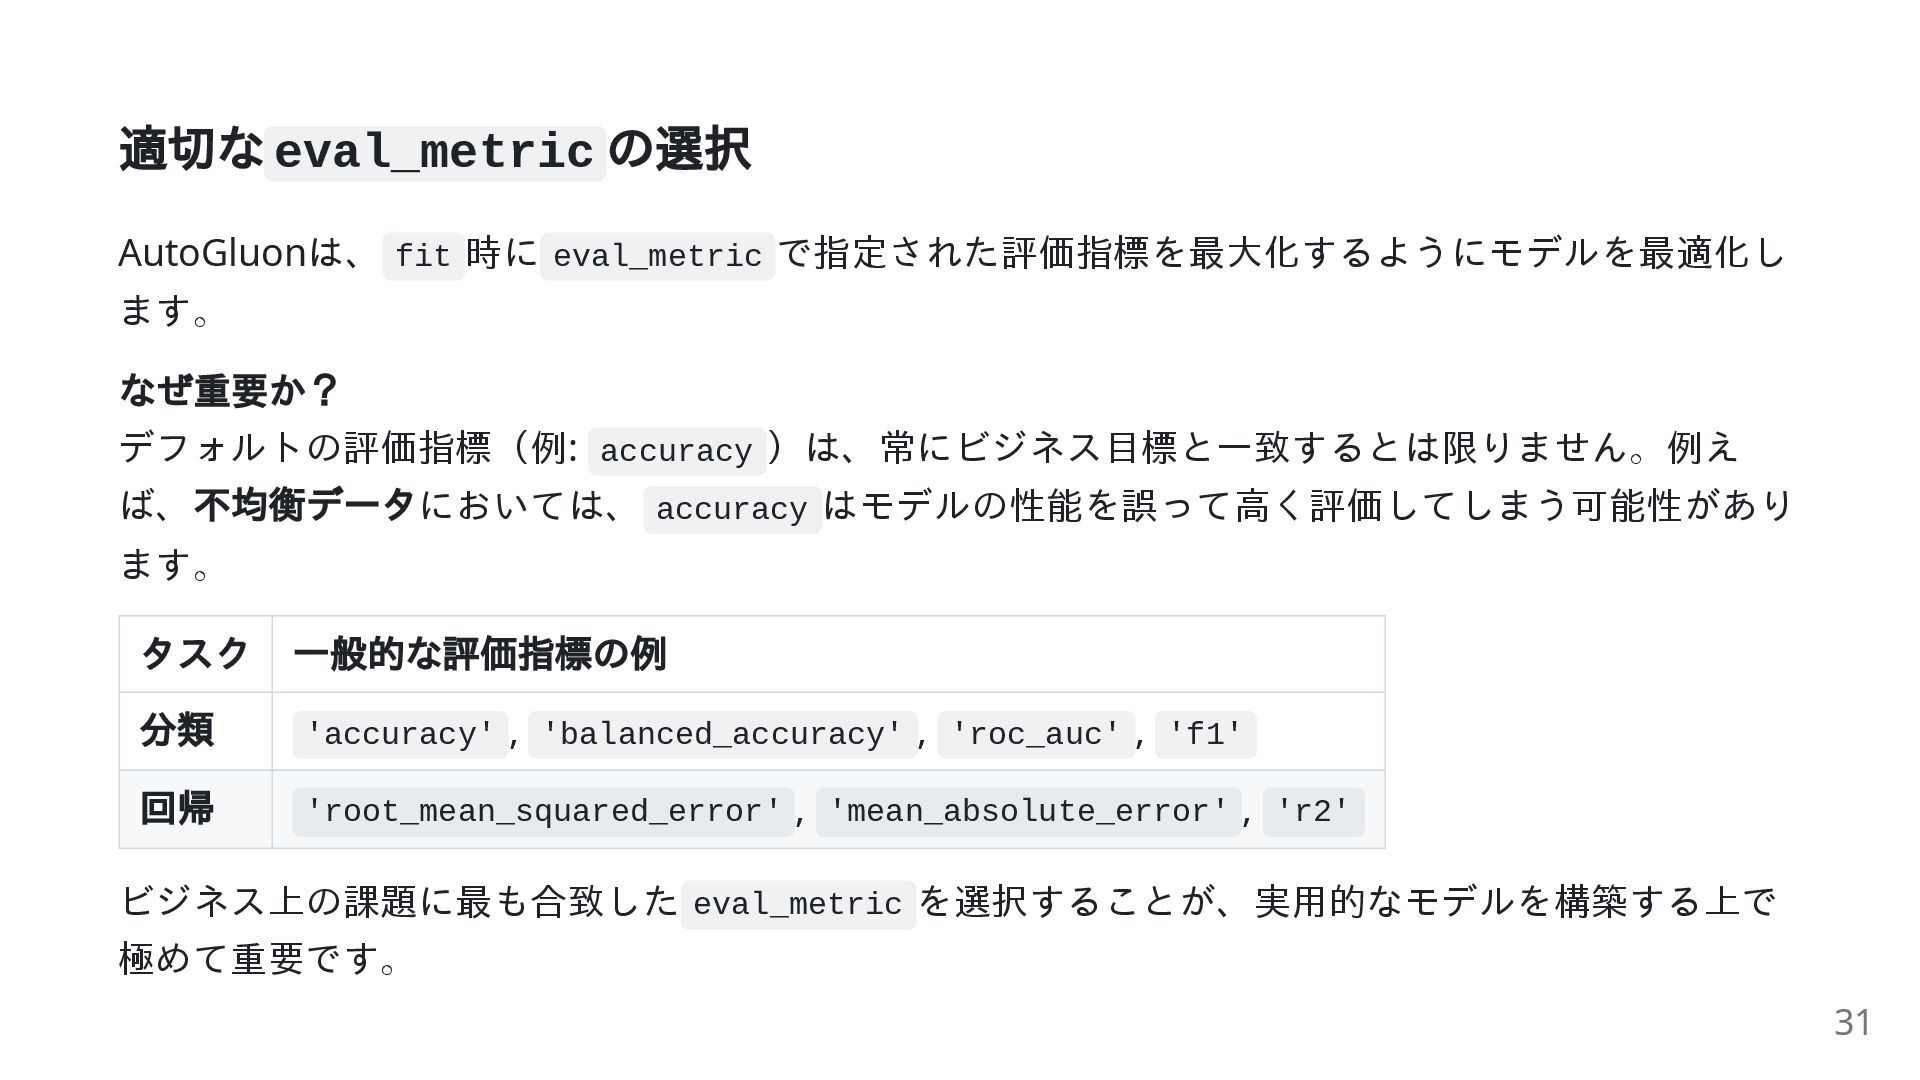
適切なeval_metric の選択 AutoGluonは、 fit 時に eval_metric で指定された評価指標を最大化するようにモデルを最適化し ます。 なぜ重要か? デフォルトの評価指標(例:
accuracy )は、常にビジネス目標と一致するとは限りません。例え ば、 不均衡データにおいては、 accuracy はモデルの性能を誤って高く評価してしまう可能性があり ます。 タスク 一般的な評価指標の例 分類 'accuracy' , 'balanced_accuracy' , 'roc_auc' , 'f1' 回帰 'root_mean_squared_error' , 'mean_absolute_error' , 'r2' ビジネス上の課題に最も合致した eval_metric を選択することが、実用的なモデルを構築する上で 極めて重要です。 31 -
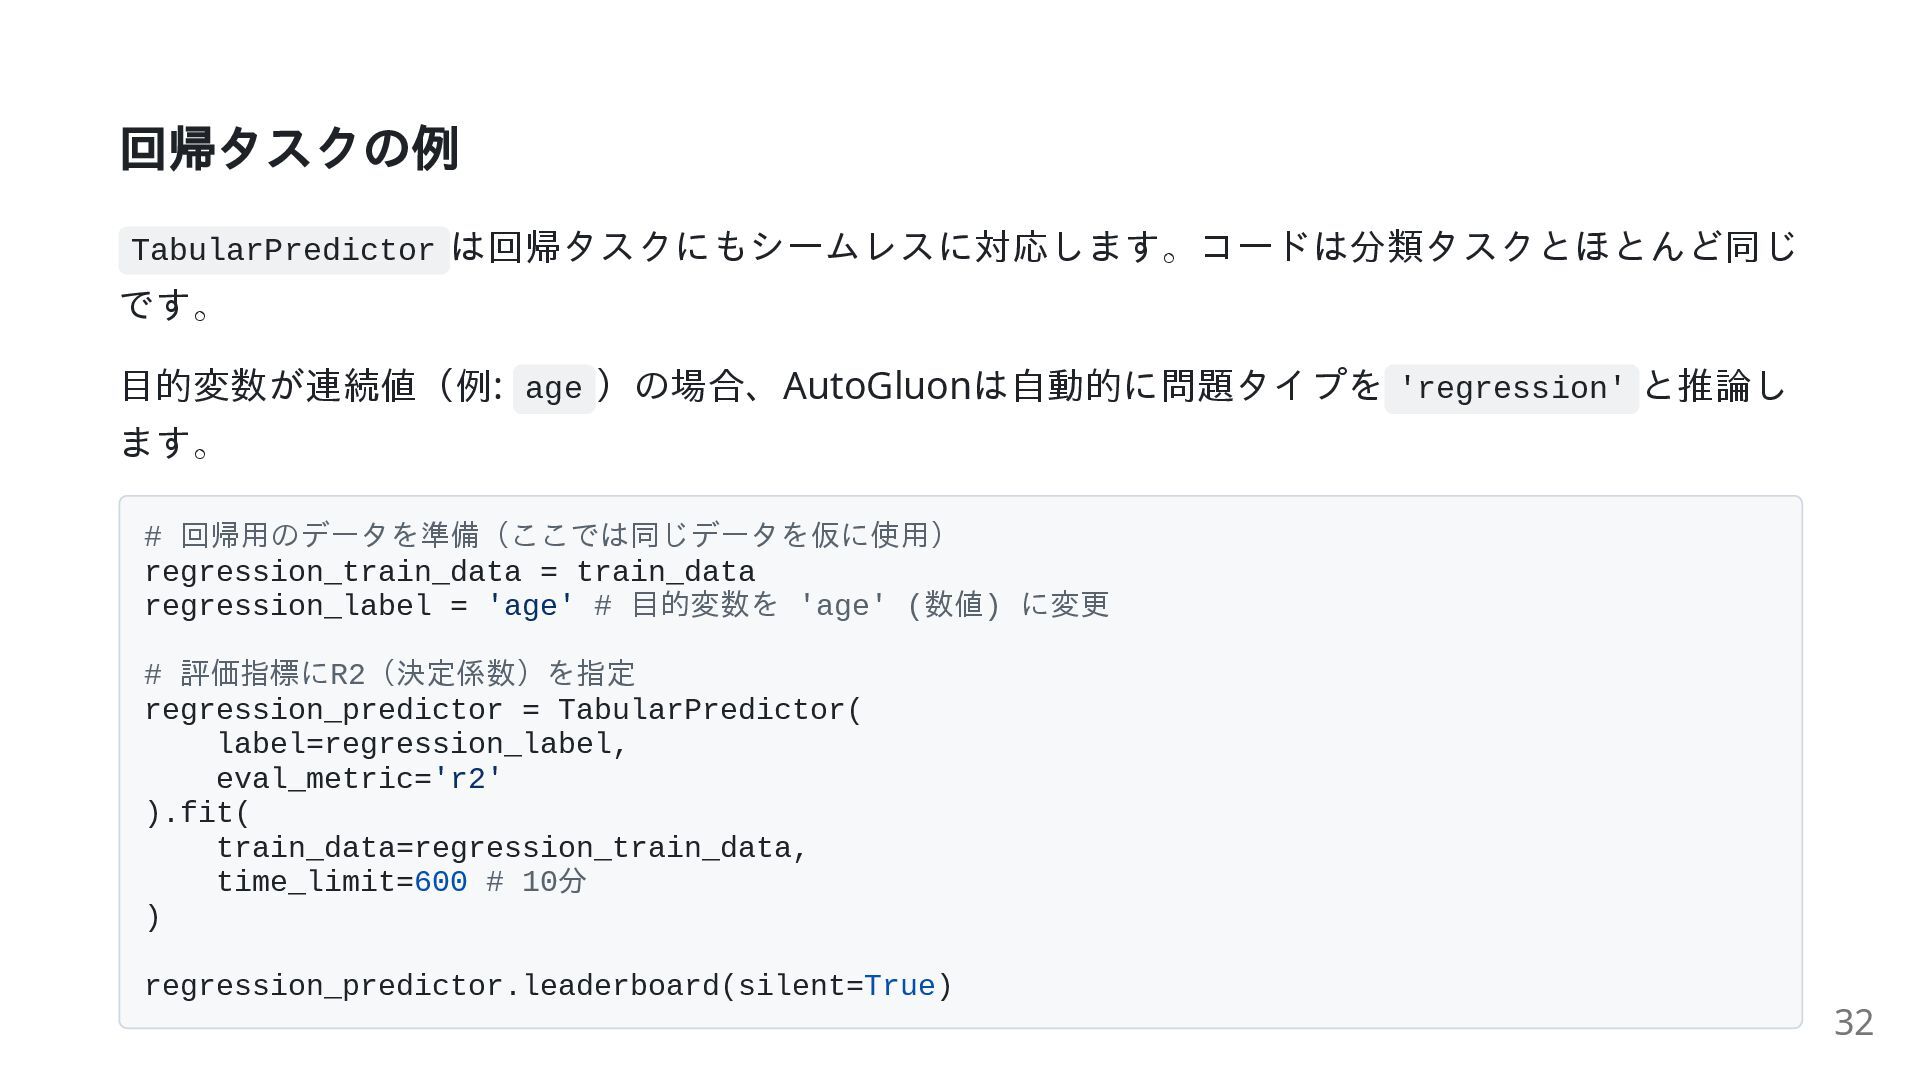
回帰タスクの例 TabularPredictor は回帰タスクにもシームレスに対応します。コードは分類タスクとほとんど同じ です。 目的変数が連続値(例: age )の場合、AutoGluonは自動的に問題タイプを 'regression' と推論し ます。
# 回帰用のデータを準備(ここでは同じデータを仮に使用) regression_train_data = train_data regression_label = 'age' # 目的変数を 'age' (数値) に変更 # 評価指標にR2(決定係数)を指定 regression_predictor = TabularPredictor( label=regression_label, eval_metric='r2' ).fit( train_data=regression_train_data, time_limit=600 # 10分 ) regression_predictor.leaderboard(silent=True) 32 -
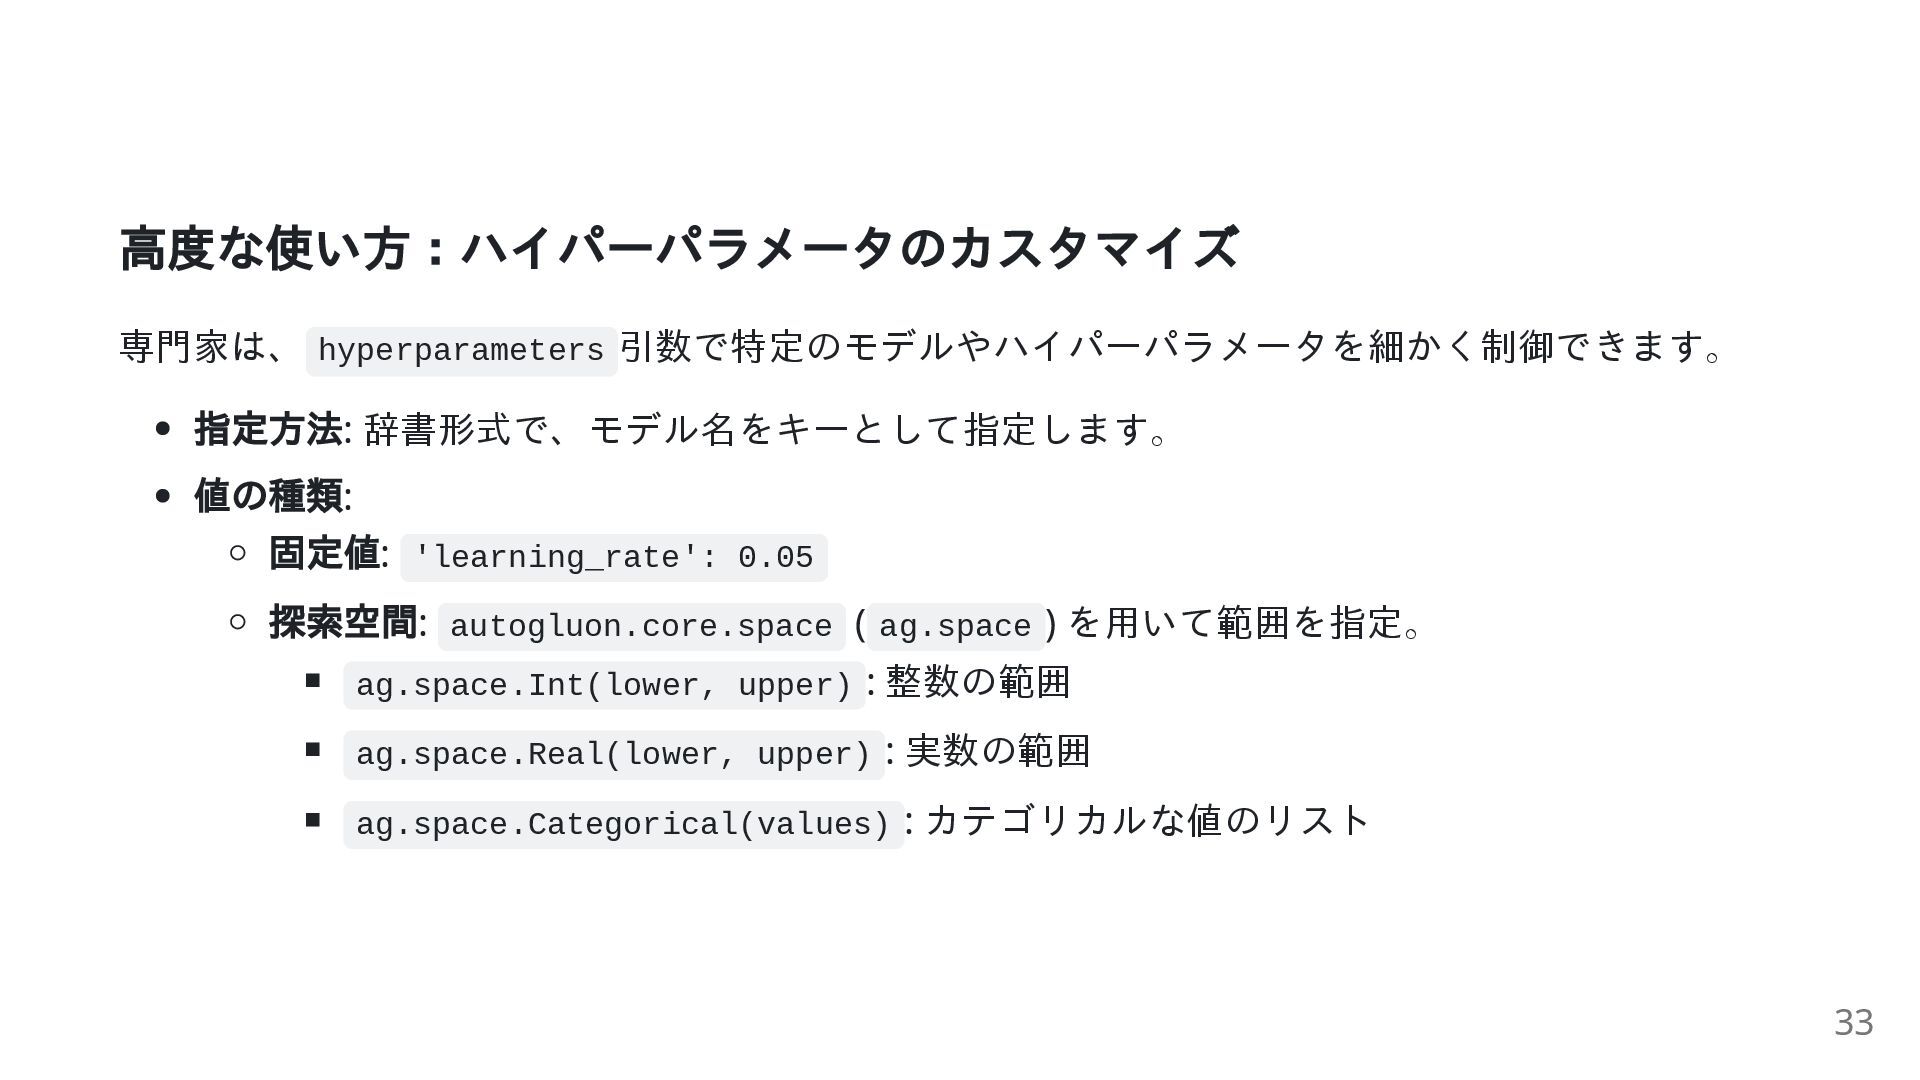
高度な使い方:ハイパーパラメータのカスタマイズ 専門家は、 hyperparameters 引数で特定のモデルやハイパーパラメータを細かく制御できます。 指定方法: 辞書形式で、モデル名をキーとして指定します。 値の種類: 固定値: 'learning_rate': 0.05
探索空間: autogluon.core.space ( ag.space ) を用いて範囲を指定。 ag.space.Int(lower, upper) : 整数の範囲 ag.space.Real(lower, upper) : 実数の範囲 ag.space.Categorical(values) : カテゴリカルな値のリスト 33 -
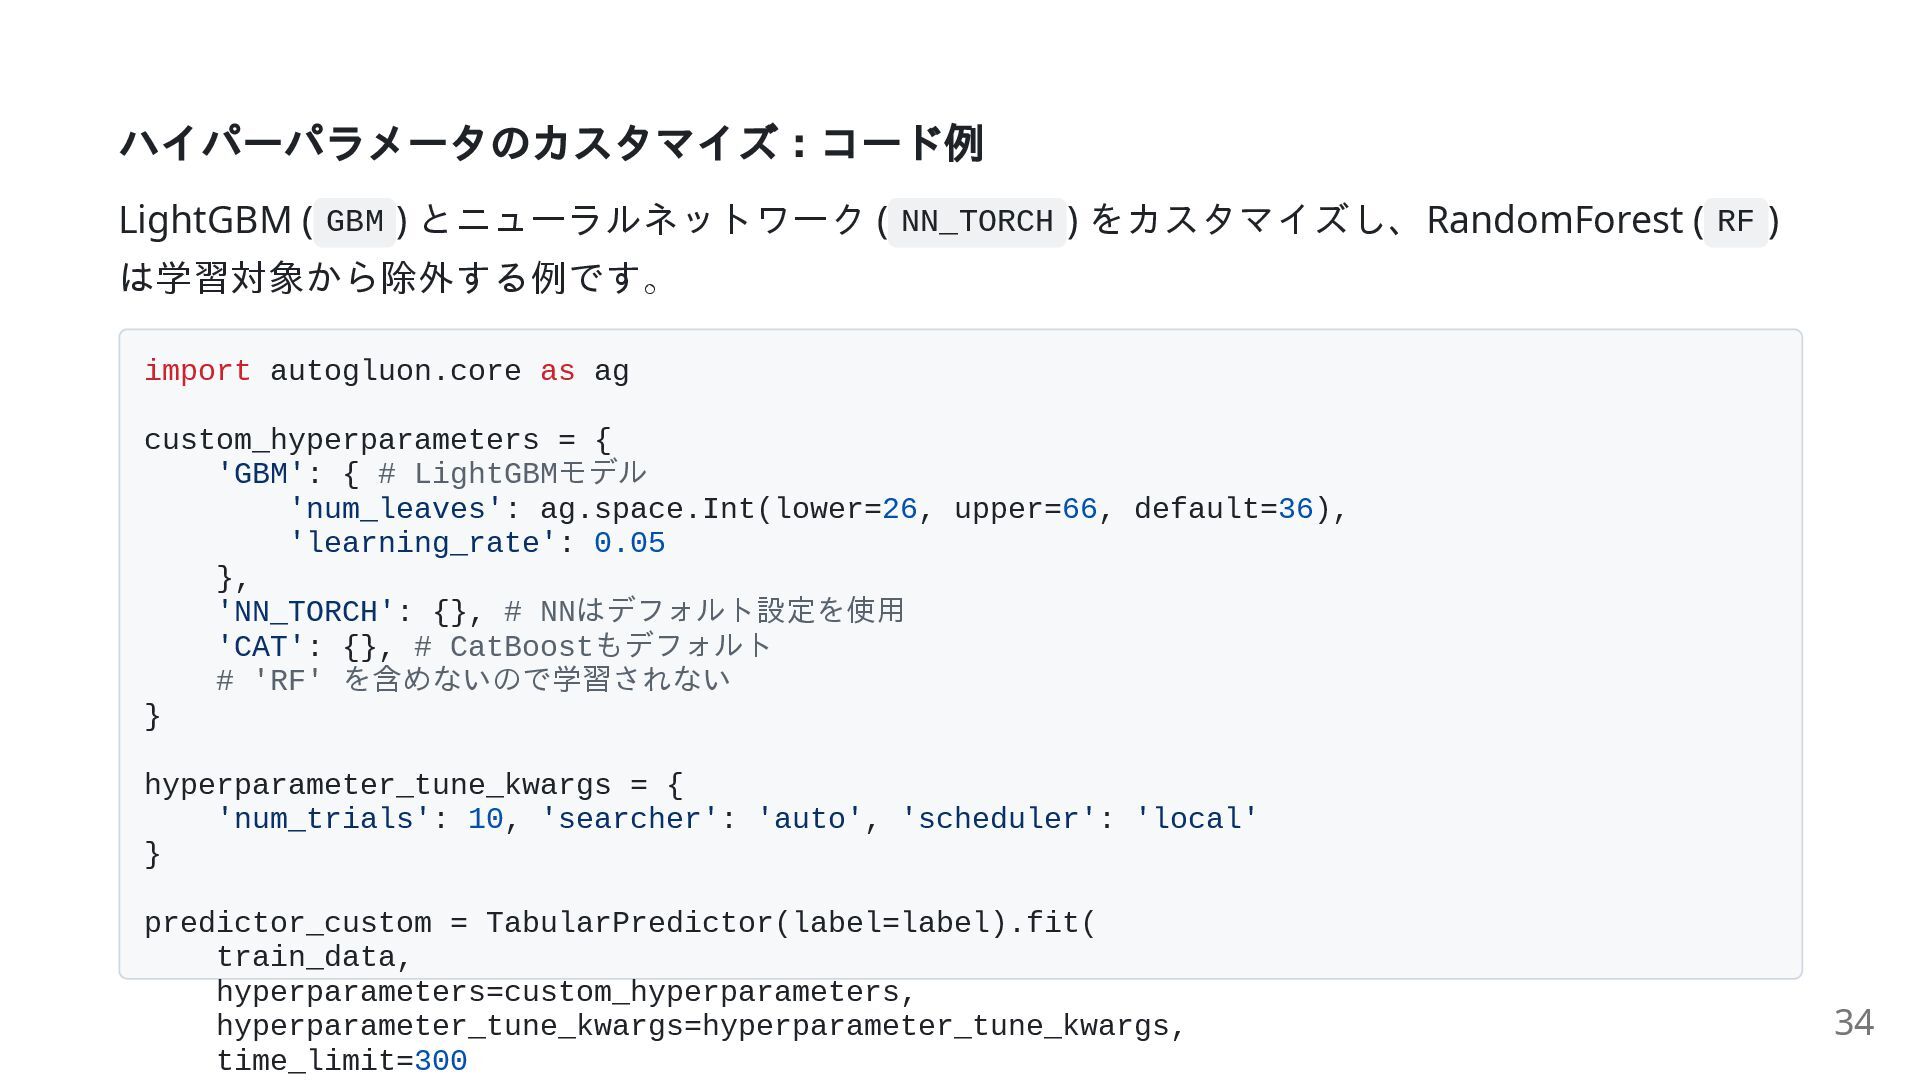
ハイパーパラメータのカスタマイズ:コード例 LightGBM ( GBM ) とニューラルネットワーク ( NN_TORCH ) をカスタマイズし、RandomForest
( RF ) は学習対象から除外する例です。 import autogluon.core as ag custom_hyperparameters = { 'GBM': { # LightGBMモデル 'num_leaves': ag.space.Int(lower=26, upper=66, default=36), 'learning_rate': 0.05 }, 'NN_TORCH': {}, # NNはデフォルト設定を使用 'CAT': {}, # CatBoostもデフォルト # 'RF' を含めないので学習されない } hyperparameter_tune_kwargs = { 'num_trials': 10, 'searcher': 'auto', 'scheduler': 'local' } predictor_custom = TabularPredictor(label=label).fit( train_data, hyperparameters=custom_hyperparameters, hyperparameter_tune_kwargs=hyperparameter_tune_kwargs, time_limit=300 34 -
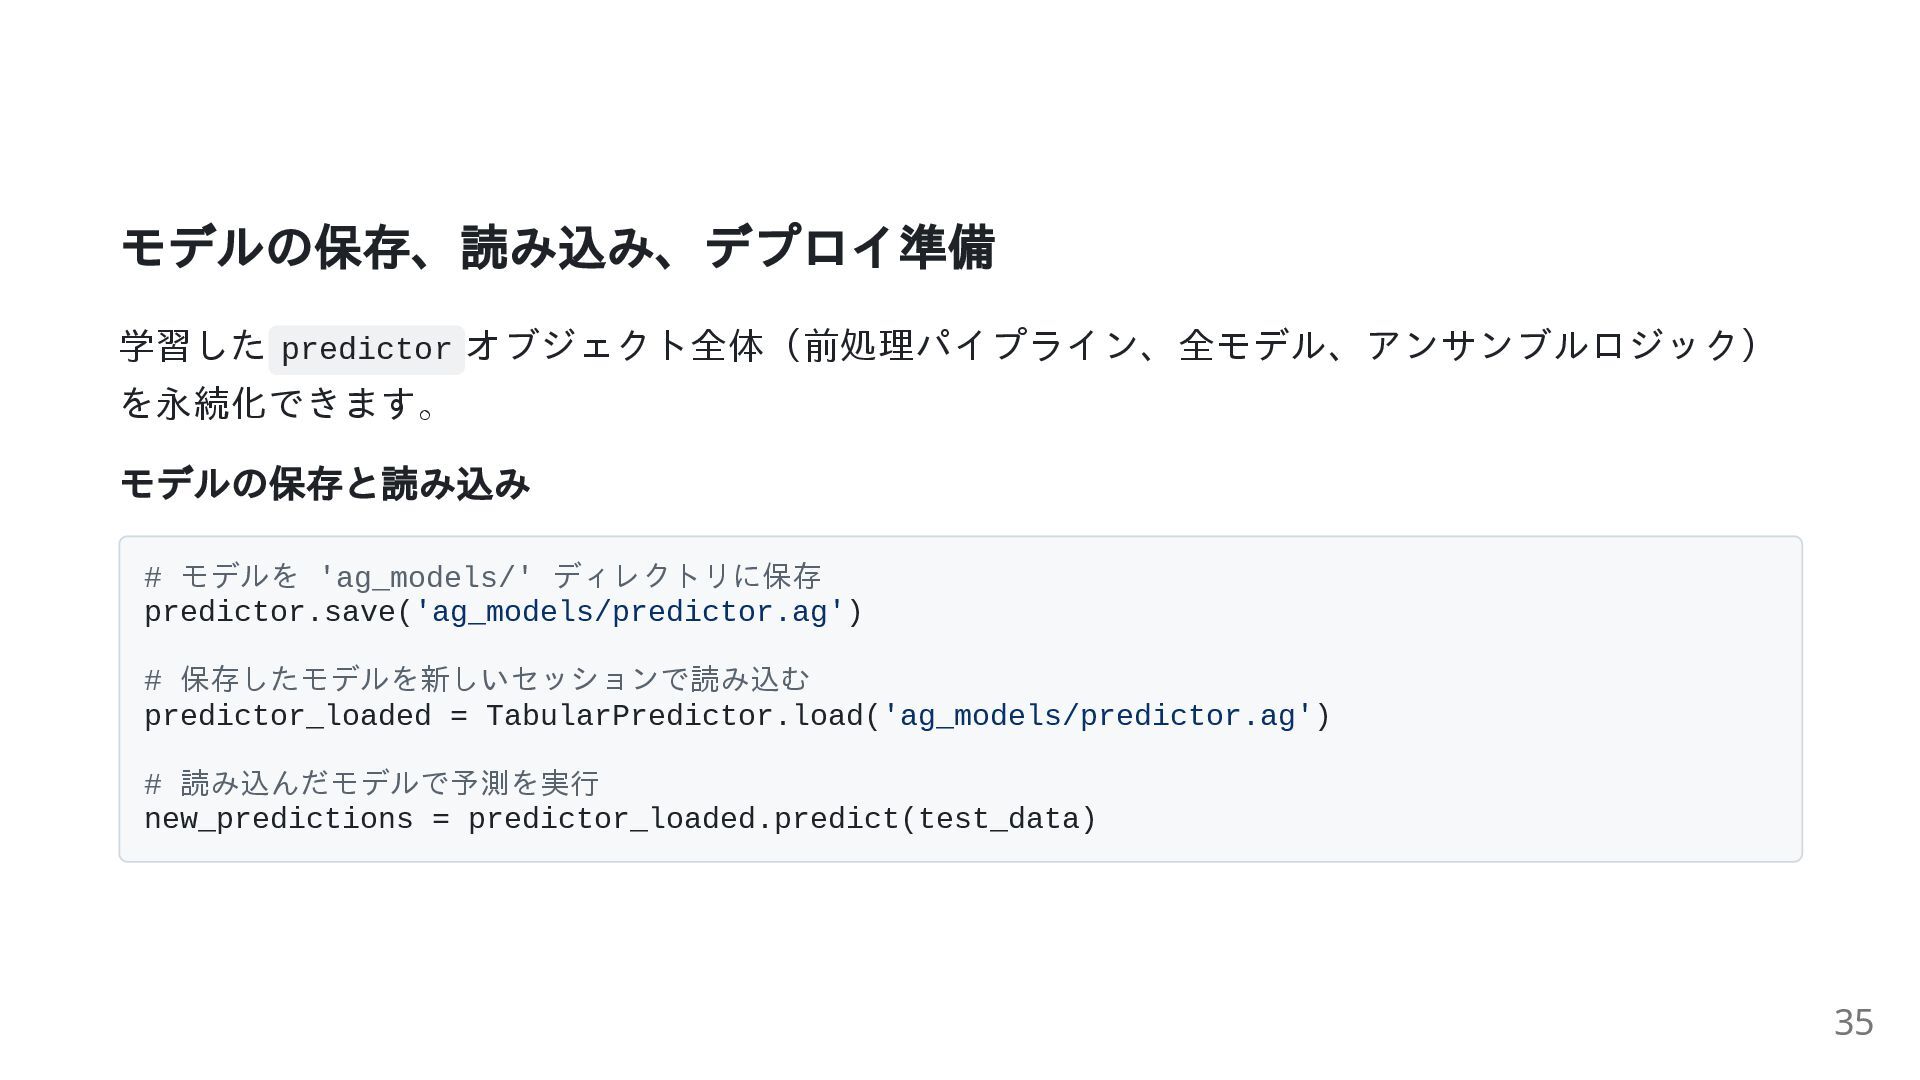
モデルの保存、読み込み、デプロイ準備 学習した predictor オブジェクト全体(前処理パイプライン、全モデル、アンサンブルロジック) を永続化できます。 モデルの保存と読み込み # モデルを 'ag_models/' ディレクトリに保存
predictor.save('ag_models/predictor.ag') # 保存したモデルを新しいセッションで読み込む predictor_loaded = TabularPredictor.load('ag_models/predictor.ag') # 読み込んだモデルで予測を実行 new_predictions = predictor_loaded.predict(test_data) 35 -
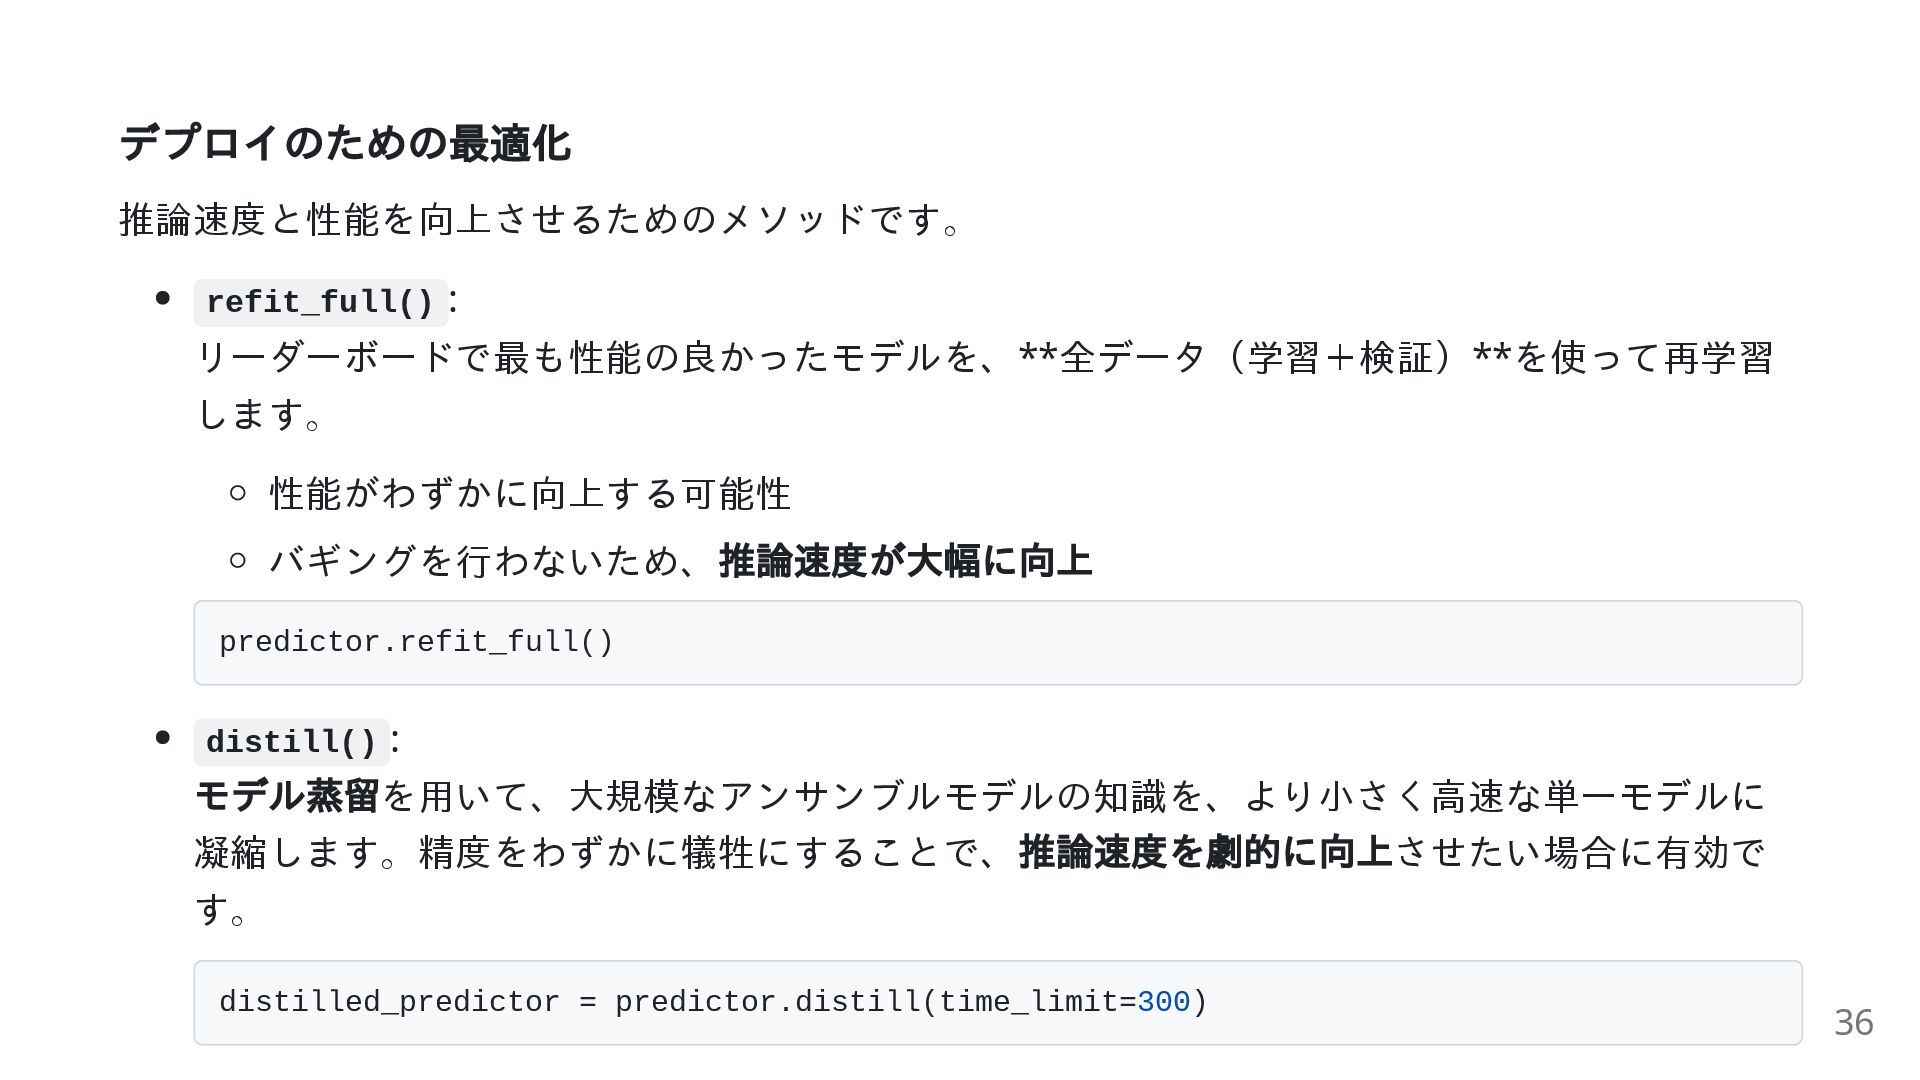
デプロイのための最適化 推論速度と性能を向上させるためのメソッドです。 refit_full() : リーダーボードで最も性能の良かったモデルを、**全データ(学習+検証)**を使って再学習 します。 性能がわずかに向上する可能性 バギングを行わないため、 推論速度が大幅に向上 predictor.refit_full()
distill() : モデル蒸留を用いて、大規模なアンサンブルモデルの知識を、より小さく高速な単一モデルに 凝縮します。精度をわずかに犠牲にすることで、 推論速度を劇的に向上させたい場合に有効で す。 distilled_predictor = predictor.distill(time_limit=300) 36 -
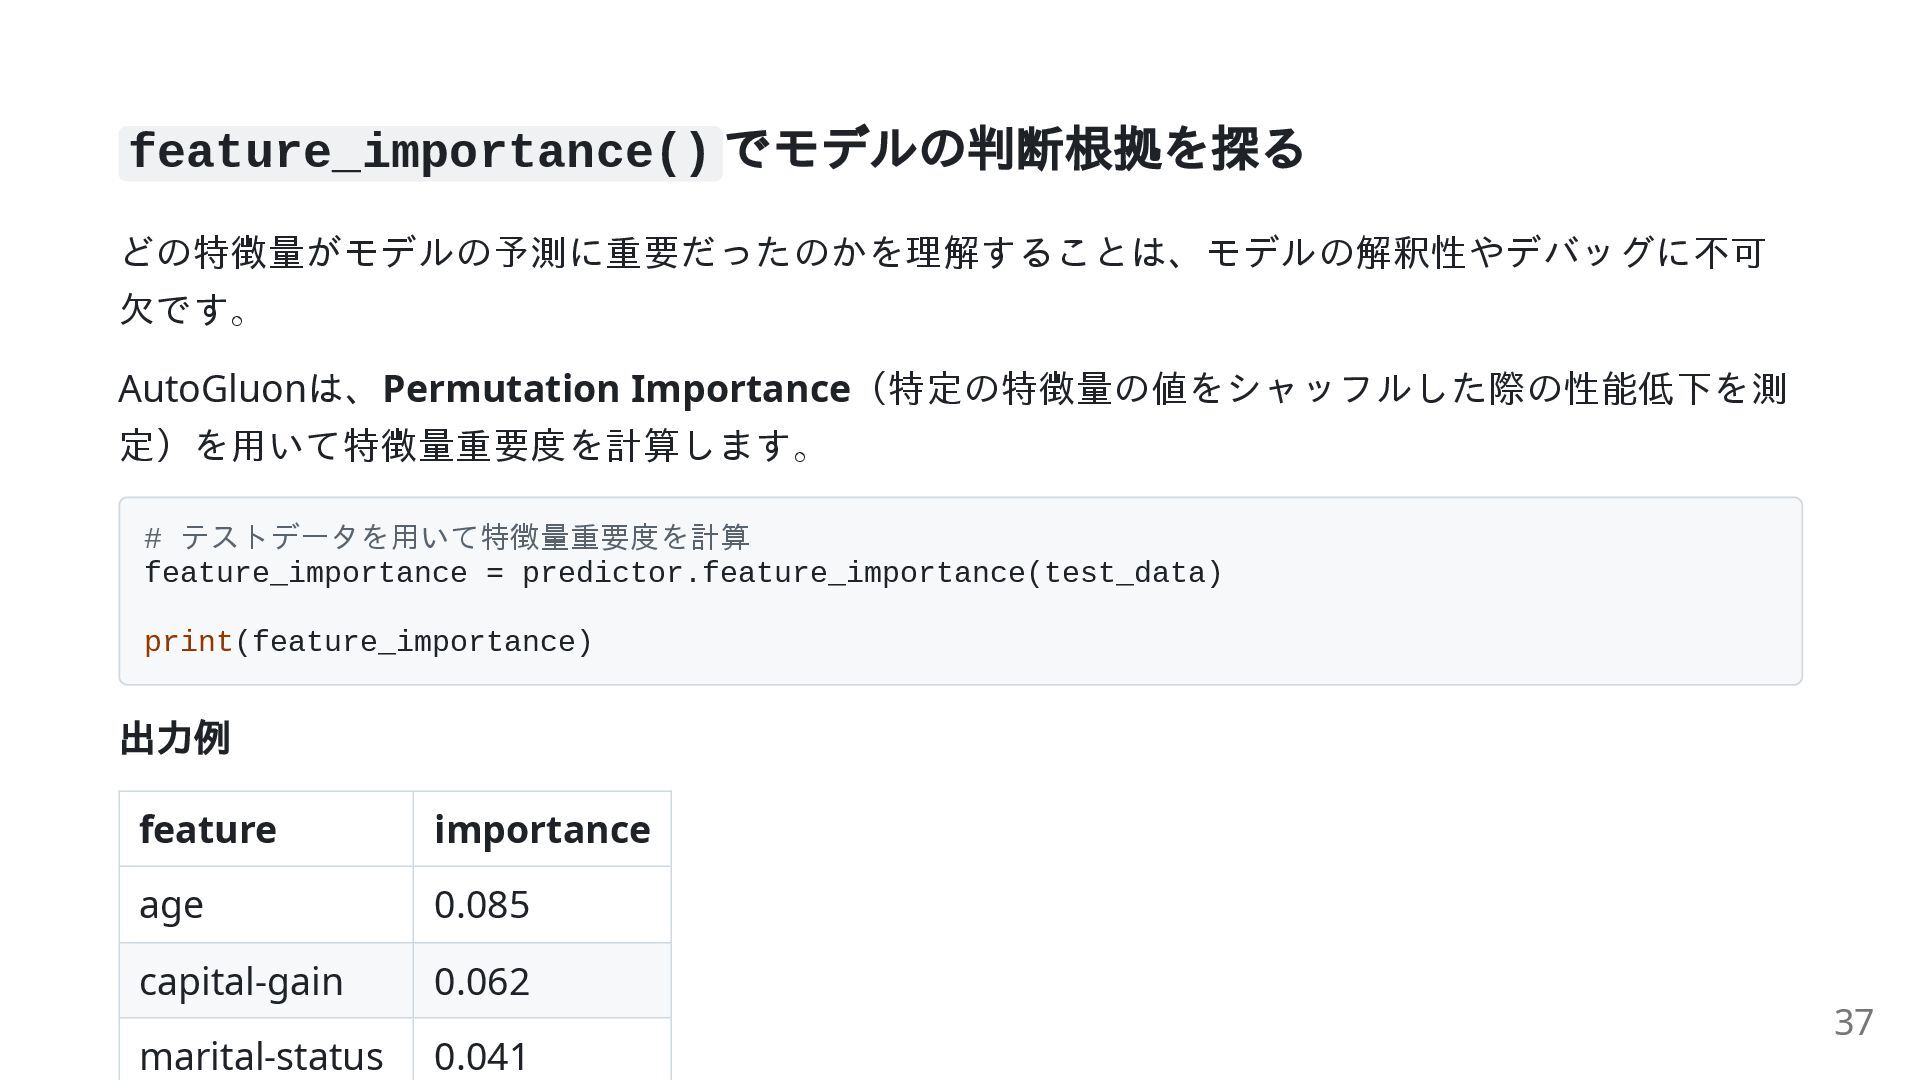
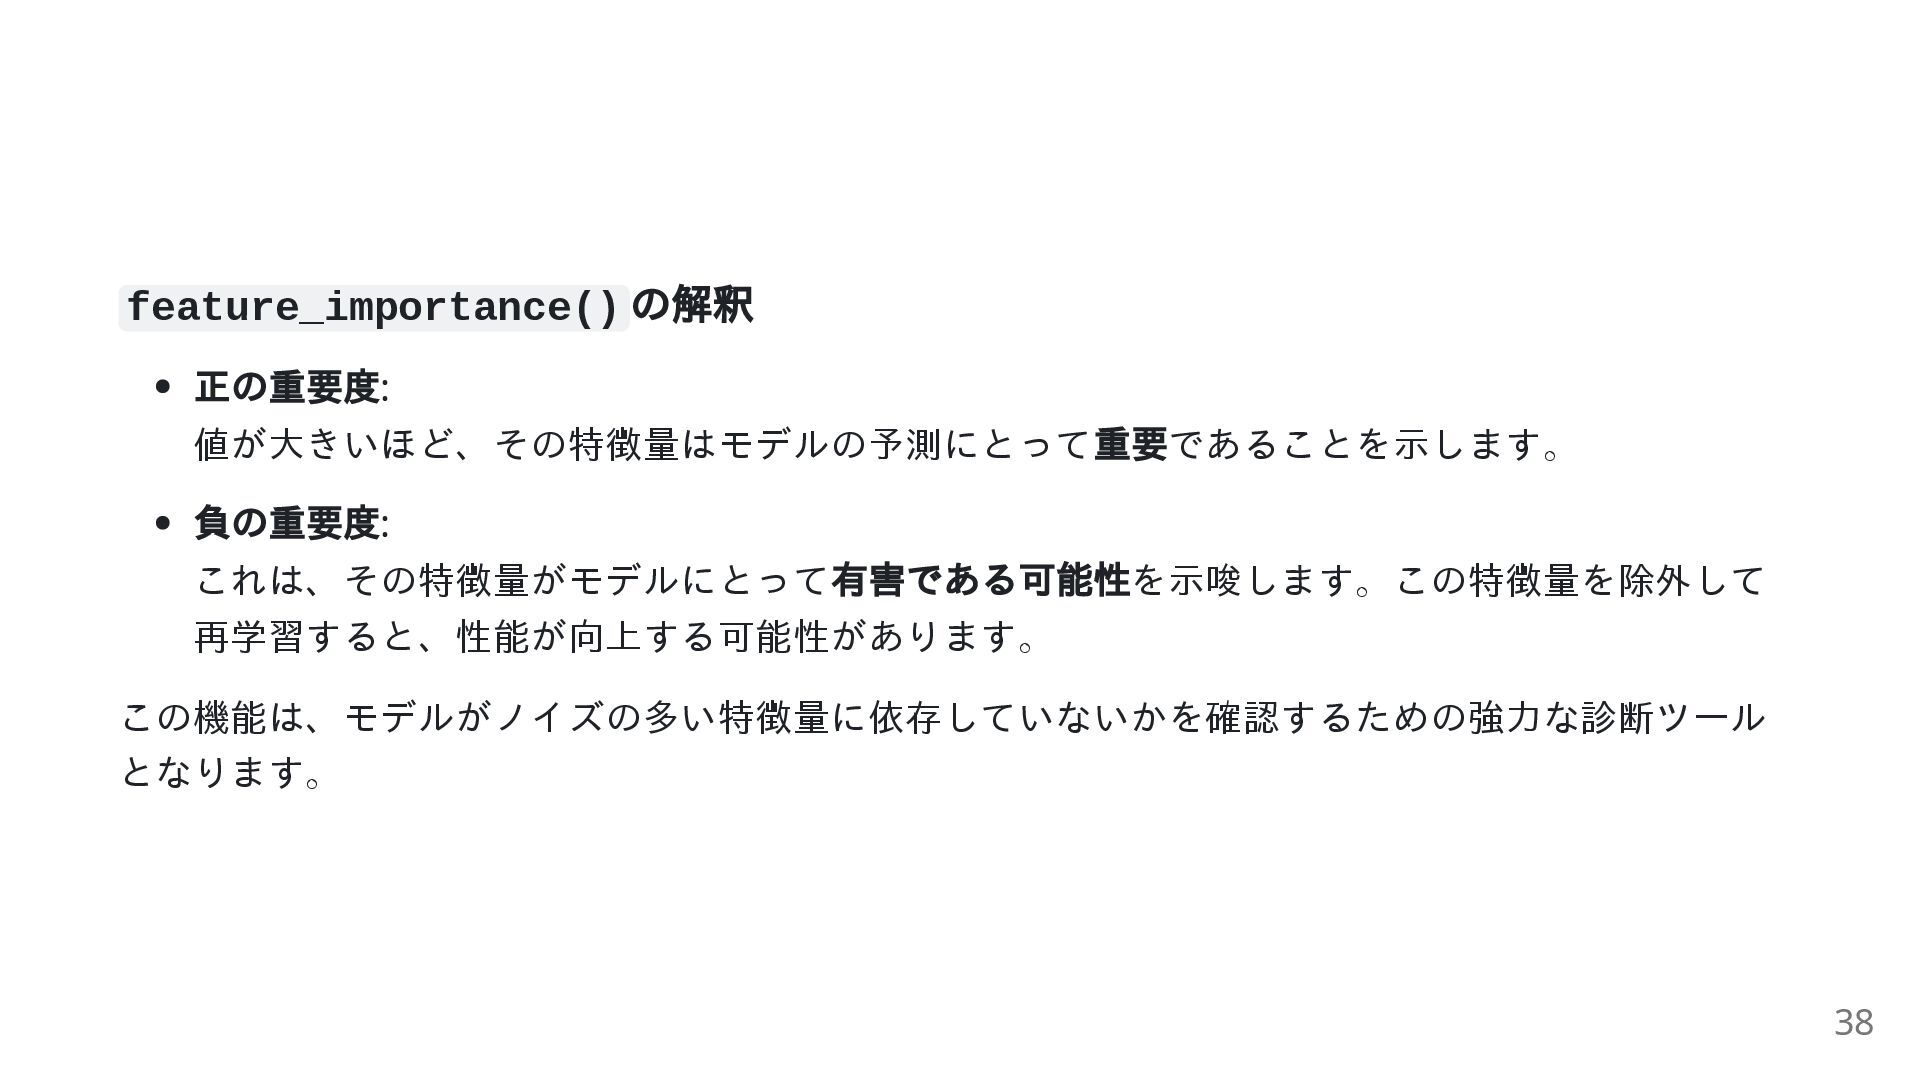
feature_importance() でモデルの判断根拠を探る どの特徴量がモデルの予測に重要だったのかを理解することは、モデルの解釈性やデバッグに不可 欠です。 AutoGluonは、Permutation Importance(特定の特徴量の値をシャッフルした際の性能低下を測 定)を用いて特徴量重要度を計算します。 # テストデータを用いて特徴量重要度を計算 feature_importance
= predictor.feature_importance(test_data) print(feature_importance) 出力例 feature importance age 0.085 capital-gain 0.062 marital-status 0.041 37 -
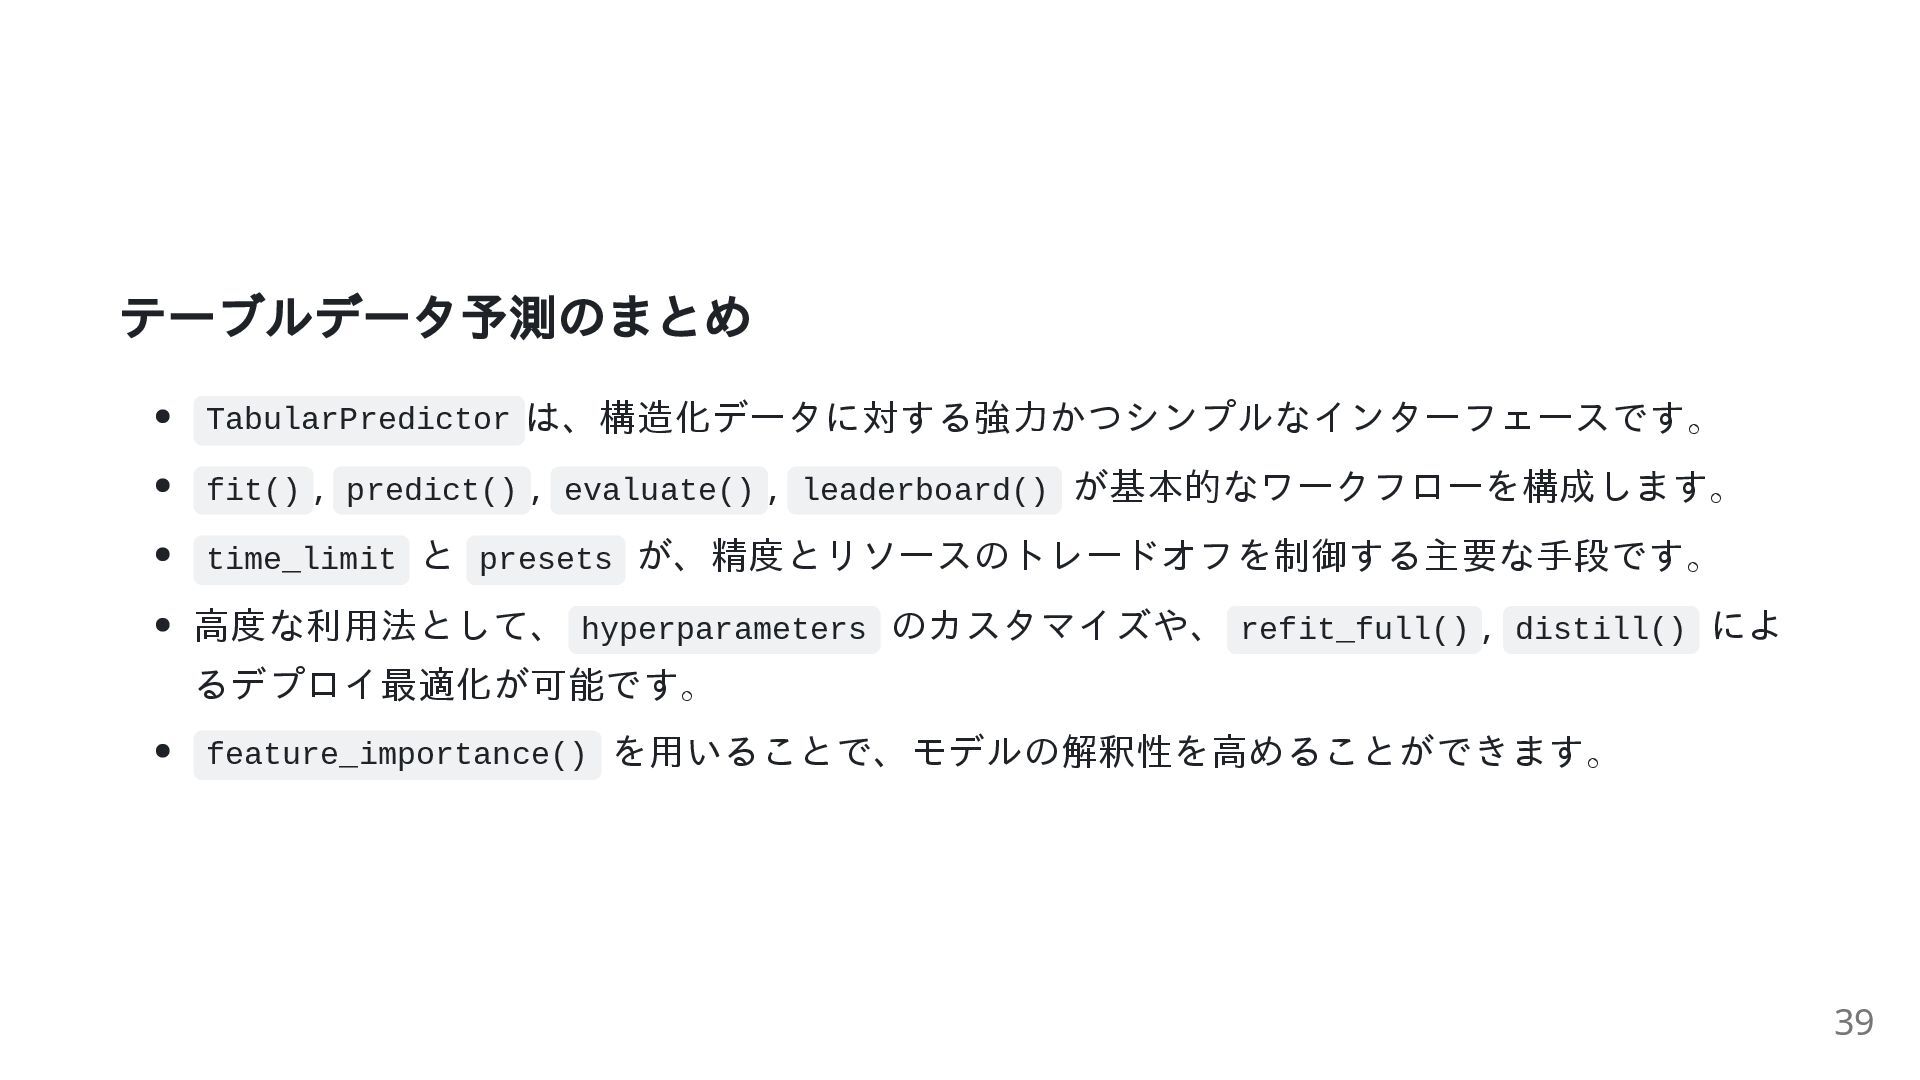
テーブルデータ予測のまとめ TabularPredictor は、構造化データに対する強力かつシンプルなインターフェースです。 fit() , predict() , evaluate() , leaderboard()
が基本的なワークフローを構成します。 time_limit と presets が、精度とリソースのトレードオフを制御する主要な手段です。 高度な利用法として、 hyperparameters のカスタマイズや、 refit_full() , distill() によ るデプロイ最適化が可能です。 feature_importance() を用いることで、モデルの解釈性を高めることができます。 39 -
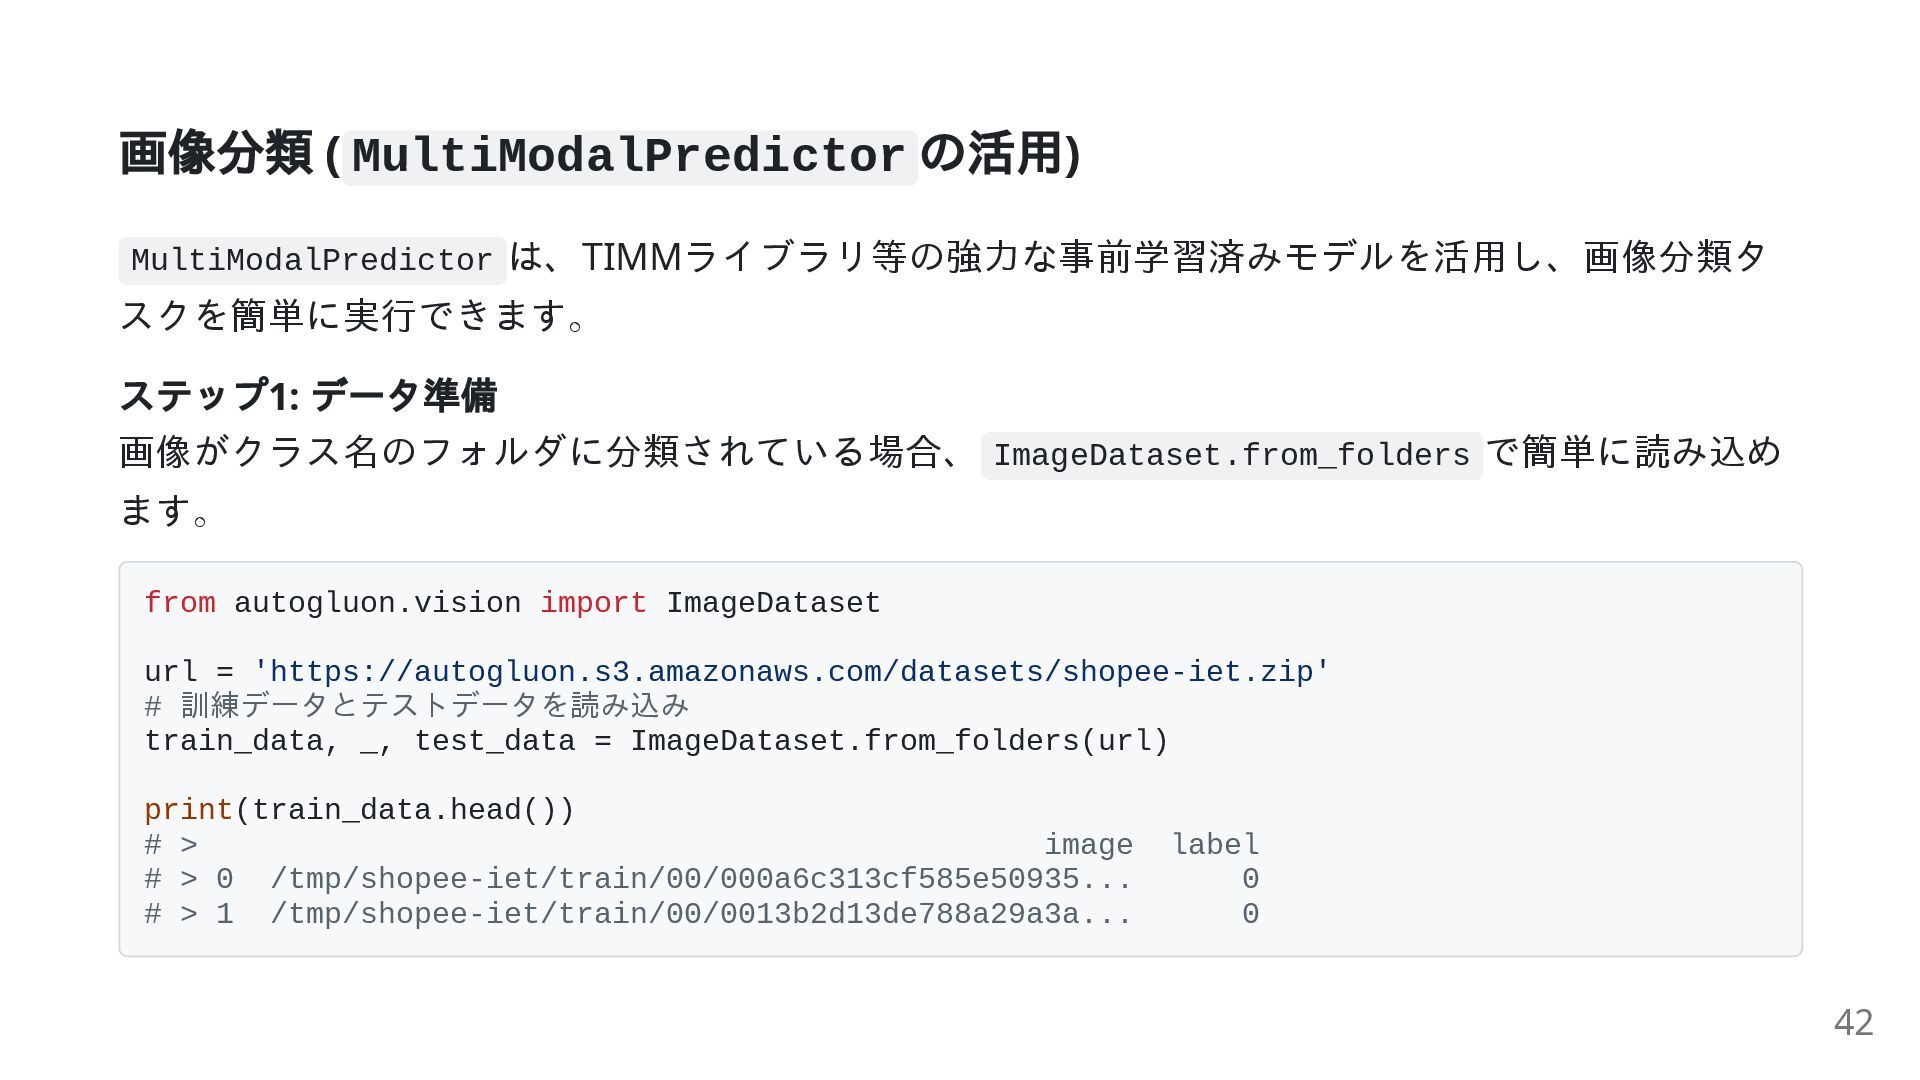
画像分類 ( MultiModalPredictor の活用) MultiModalPredictor は、TIMMライブラリ等の強力な事前学習済みモデルを活用し、画像分類タ スクを簡単に実行できます。 ステップ1: データ準備 画像がクラス名のフォルダに分類されている場合、
ImageDataset.from_folders で簡単に読み込め ます。 from autogluon.vision import ImageDataset url = 'https://autogluon.s3.amazonaws.com/datasets/shopee-iet.zip' # 訓練データとテストデータを読み込み train_data, _, test_data = ImageDataset.from_folders(url) print(train_data.head()) # > image label # > 0 /tmp/shopee-iet/train/00/000a6c313cf585e50935... 0 # > 1 /tmp/shopee-iet/train/00/0013b2d13de788a29a3a... 0 42 -
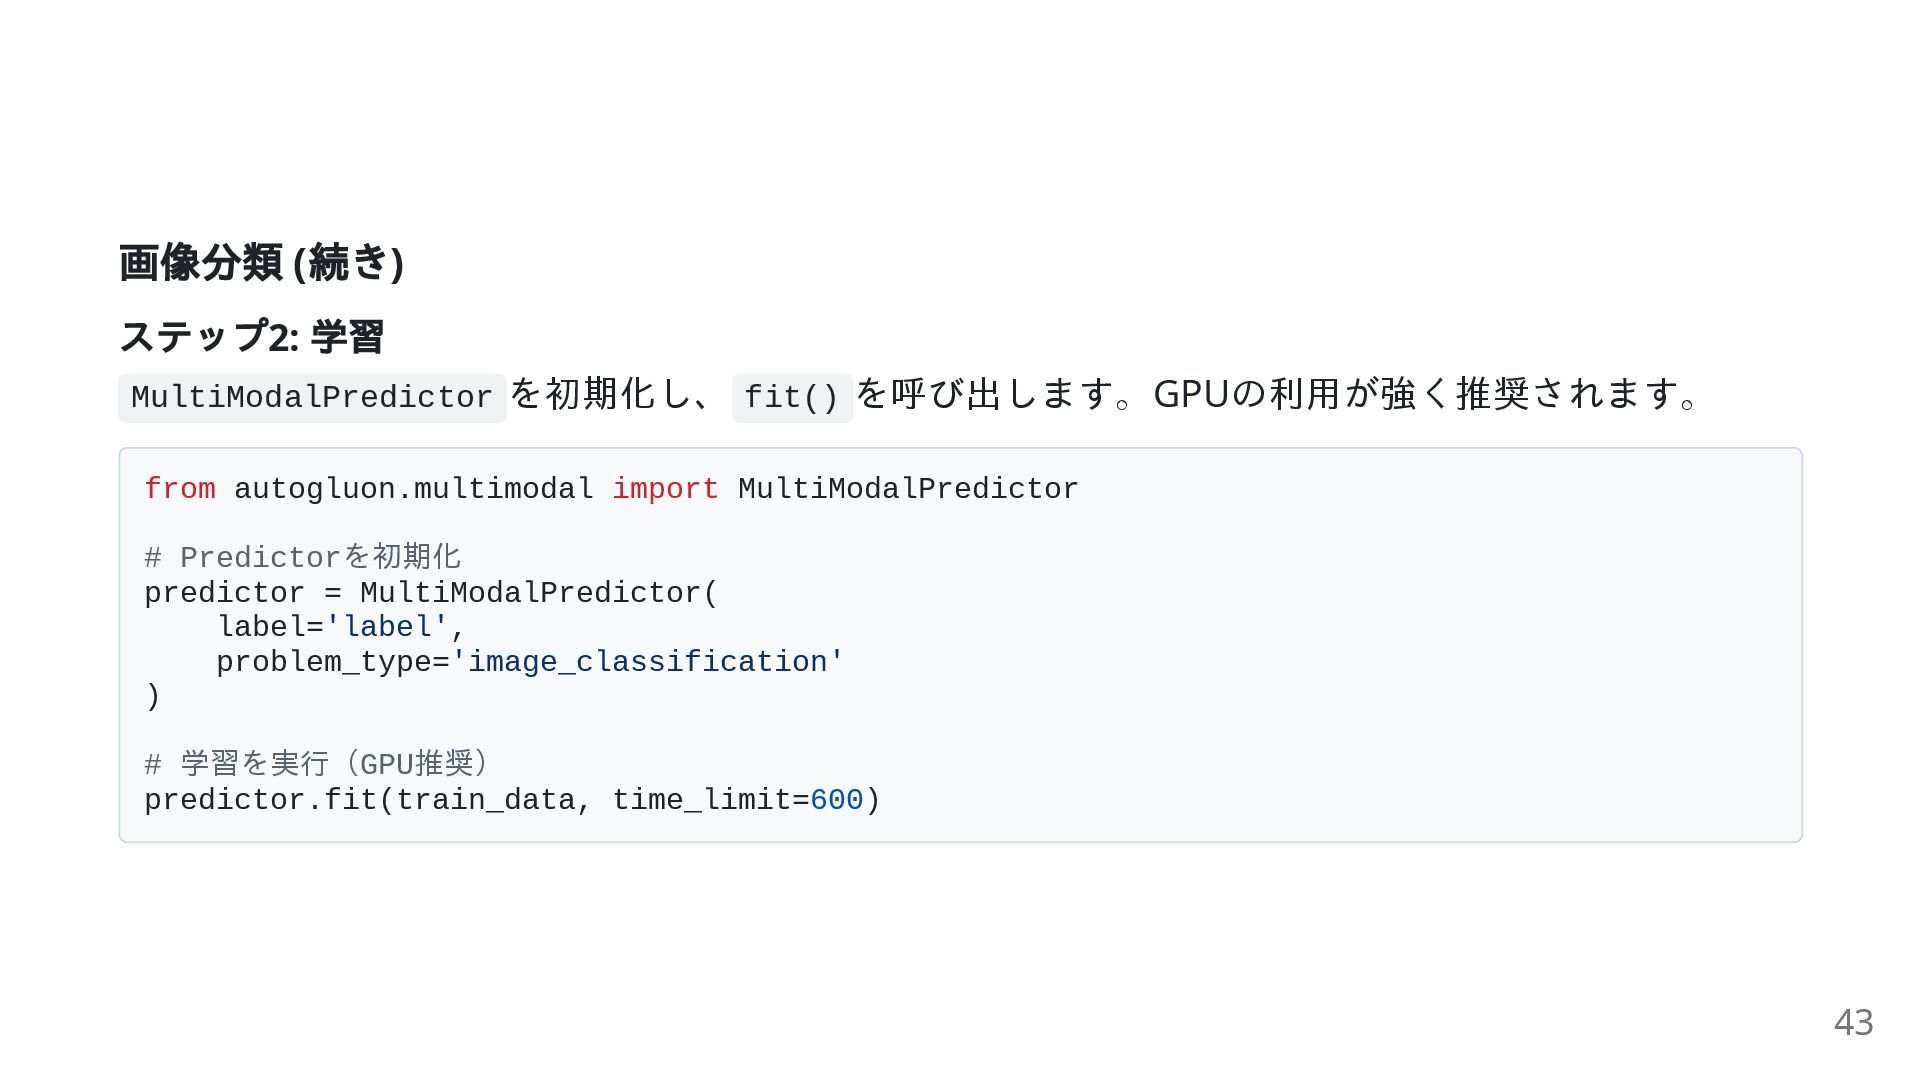
画像分類 ( 続き) ステップ2: 学習 MultiModalPredictor を初期化し、 fit() を呼び出します。GPUの利用が強く推奨されます。 from
autogluon.multimodal import MultiModalPredictor # Predictorを初期化 predictor = MultiModalPredictor( label='label', problem_type='image_classification' ) # 学習を実行(GPU推奨) predictor.fit(train_data, time_limit=600) 43 -
画像分類 ( 続き) ステップ3: 予測と特徴量抽出 予測: 学習済みモデルで新しい画像のクラスを予測します。 image_path = test_data.iloc[0]['image']
prediction = predictor.predict(image_path) probabilities = predictor.predict_proba(image_path) 特徴量抽出: 画像から高次元の特徴量ベクトルを抽出できます。これは類似画像検索などに非常に有 用です。 image_features = predictor.extract_embedding(test_data) print(image_features.shape) # > (12186, 768) 44 -
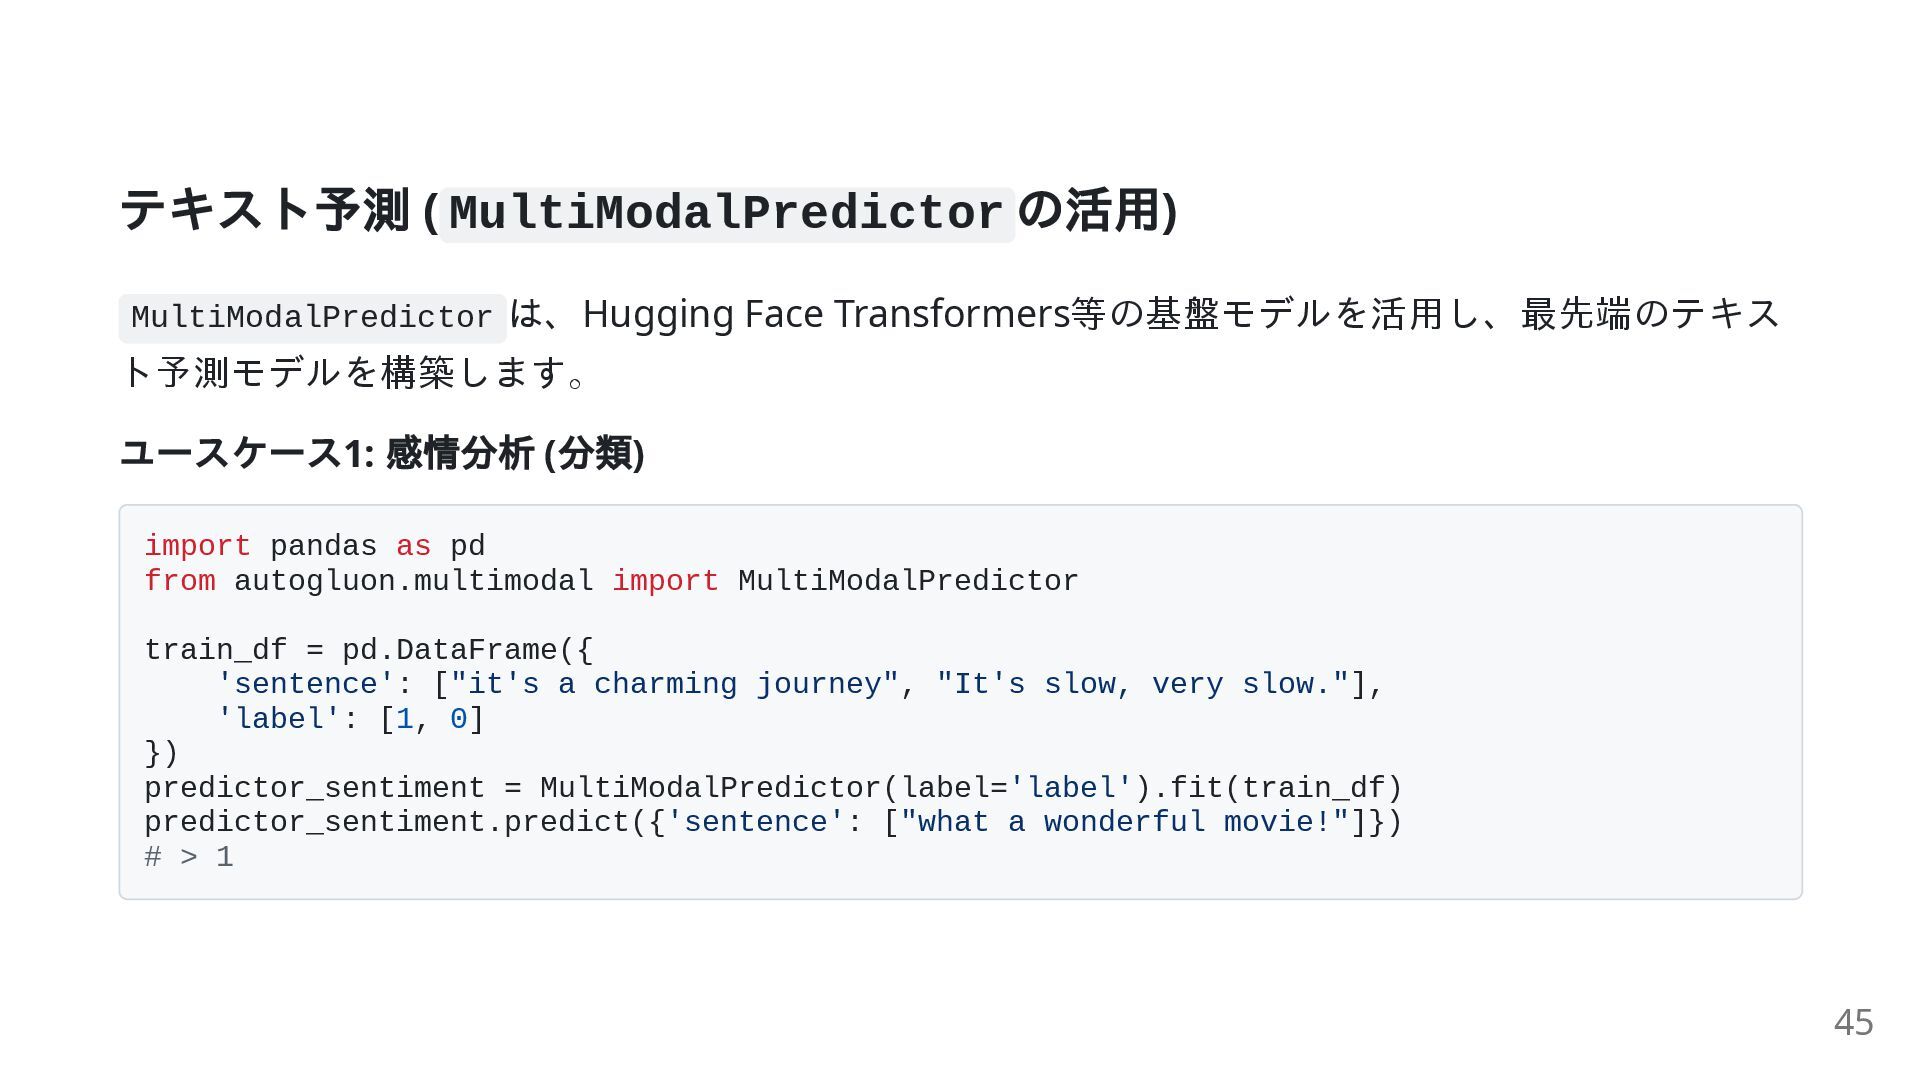
テキスト予測 ( MultiModalPredictor の活用) MultiModalPredictor は、Hugging Face Transformers等の基盤モデルを活用し、最先端のテキス ト予測モデルを構築します。 ユースケース1:
感情分析 ( 分類) import pandas as pd from autogluon.multimodal import MultiModalPredictor train_df = pd.DataFrame({ 'sentence': ["it's a charming journey", "It's slow, very slow."], 'label': [1, 0] }) predictor_sentiment = MultiModalPredictor(label='label').fit(train_df) predictor_sentiment.predict({'sentence': ["what a wonderful movie!"]}) # > 1 45 -
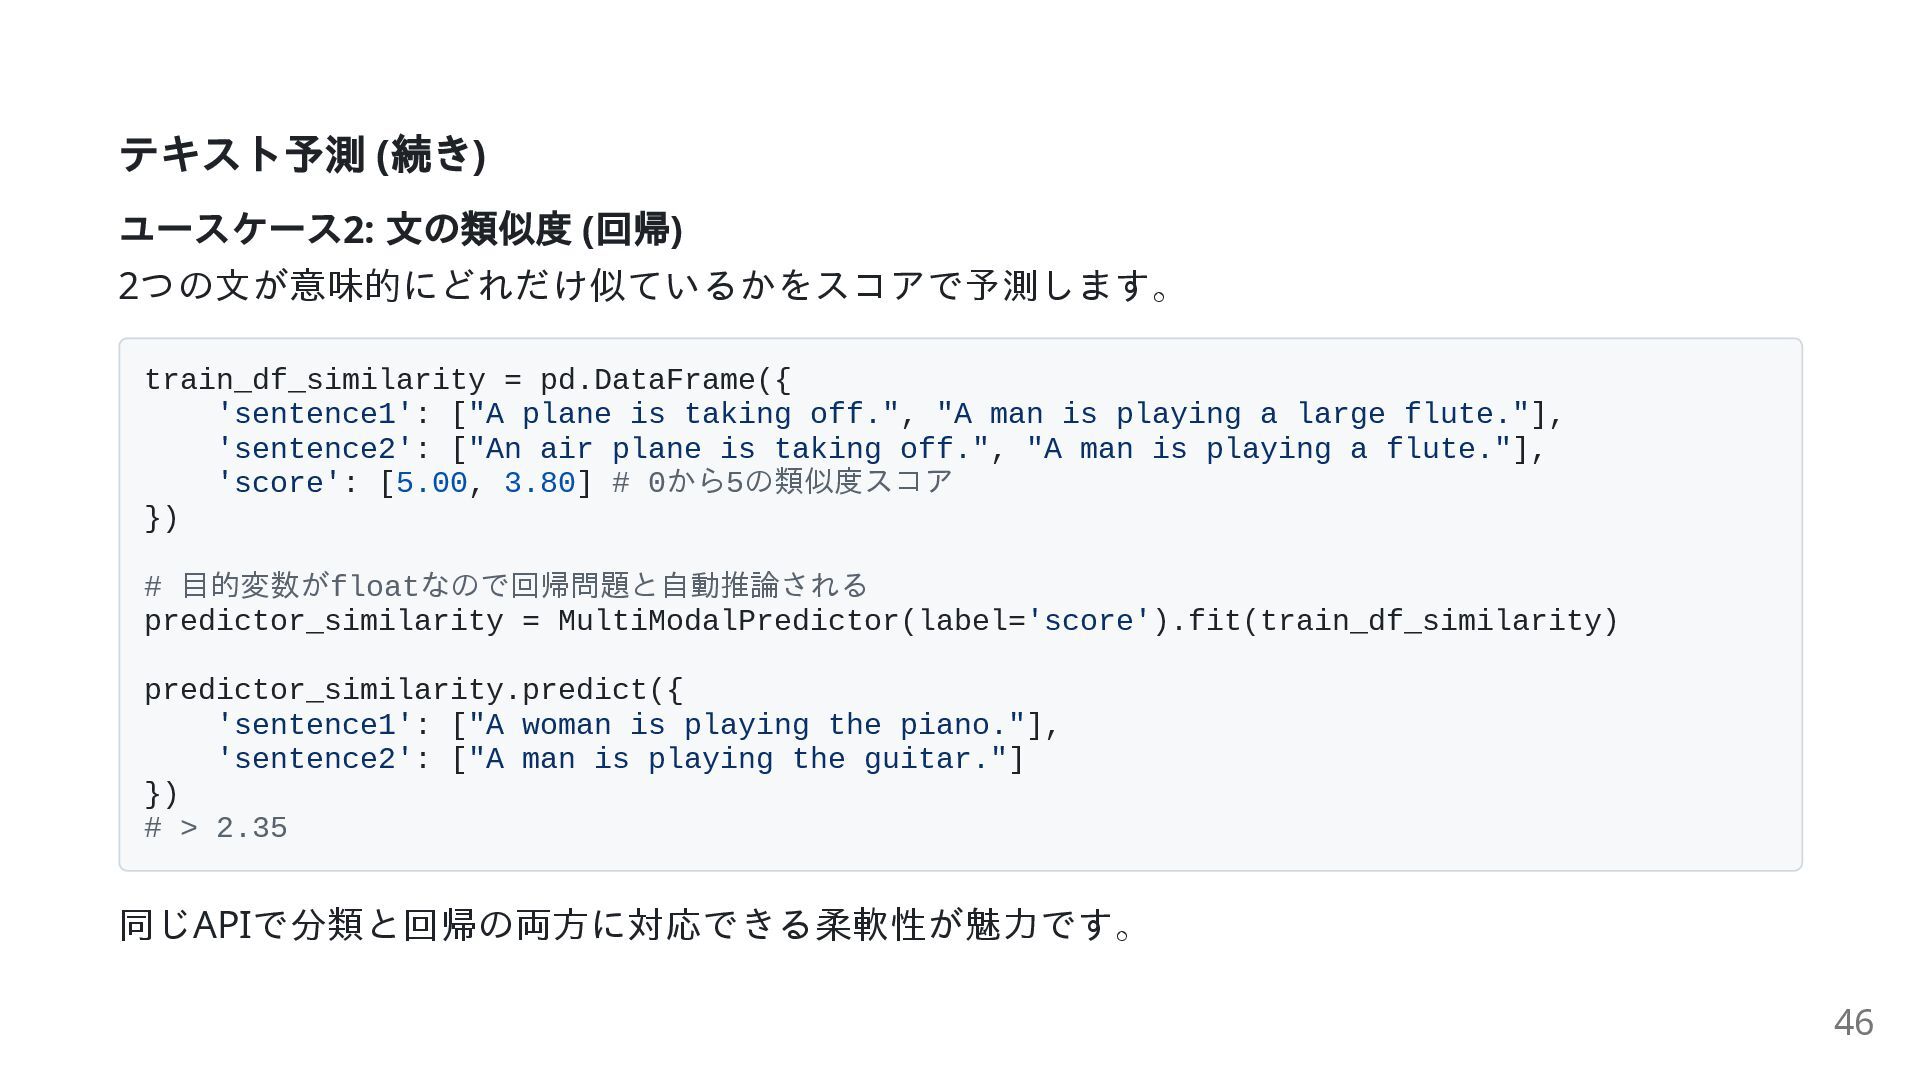
テキスト予測 ( 続き) ユースケース2: 文の類似度 ( 回帰) 2つの文が意味的にどれだけ似ているかをスコアで予測します。 train_df_similarity =
pd.DataFrame({ 'sentence1': ["A plane is taking off.", "A man is playing a large flute."], 'sentence2': ["An air plane is taking off.", "A man is playing a flute."], 'score': [5.00, 3.80] # 0から5の類似度スコア }) # 目的変数がfloatなので回帰問題と自動推論される predictor_similarity = MultiModalPredictor(label='score').fit(train_df_similarity) predictor_similarity.predict({ 'sentence1': ["A woman is playing the piano."], 'sentence2': ["A man is playing the guitar."] }) # > 2.35 同じAPIで分類と回帰の両方に対応できる柔軟性が魅力です。 46 -
AutoGluon による高度な時系列予測 ** AutoGluon-TimeSeries の核心** 目的: 複数の時系列データの将来値を予測します。 主な機能: 確率的予測: 将来の値の期待値(平均予測)だけでなく、予測される値の範囲(分位点予
測)も提供します。これにより、結果の不確実性を評価できます。 多様なモデルの自動アンサンブル: 統計モデル: ARIMA, ETS, Thetaなど、個々の時系列に適合させる伝統的で高速なモデ ル。 機械学習/ 深層学習モデル: DeepAR, Temporal Fusion Transformer, PatchTSTなど、全 時系列データから横断的に学習する「グローバルモデル」。 これらを賢く組み合わせた 加重アンサンブルを自動で構築し、最高の精度を追求しま す。 47 -
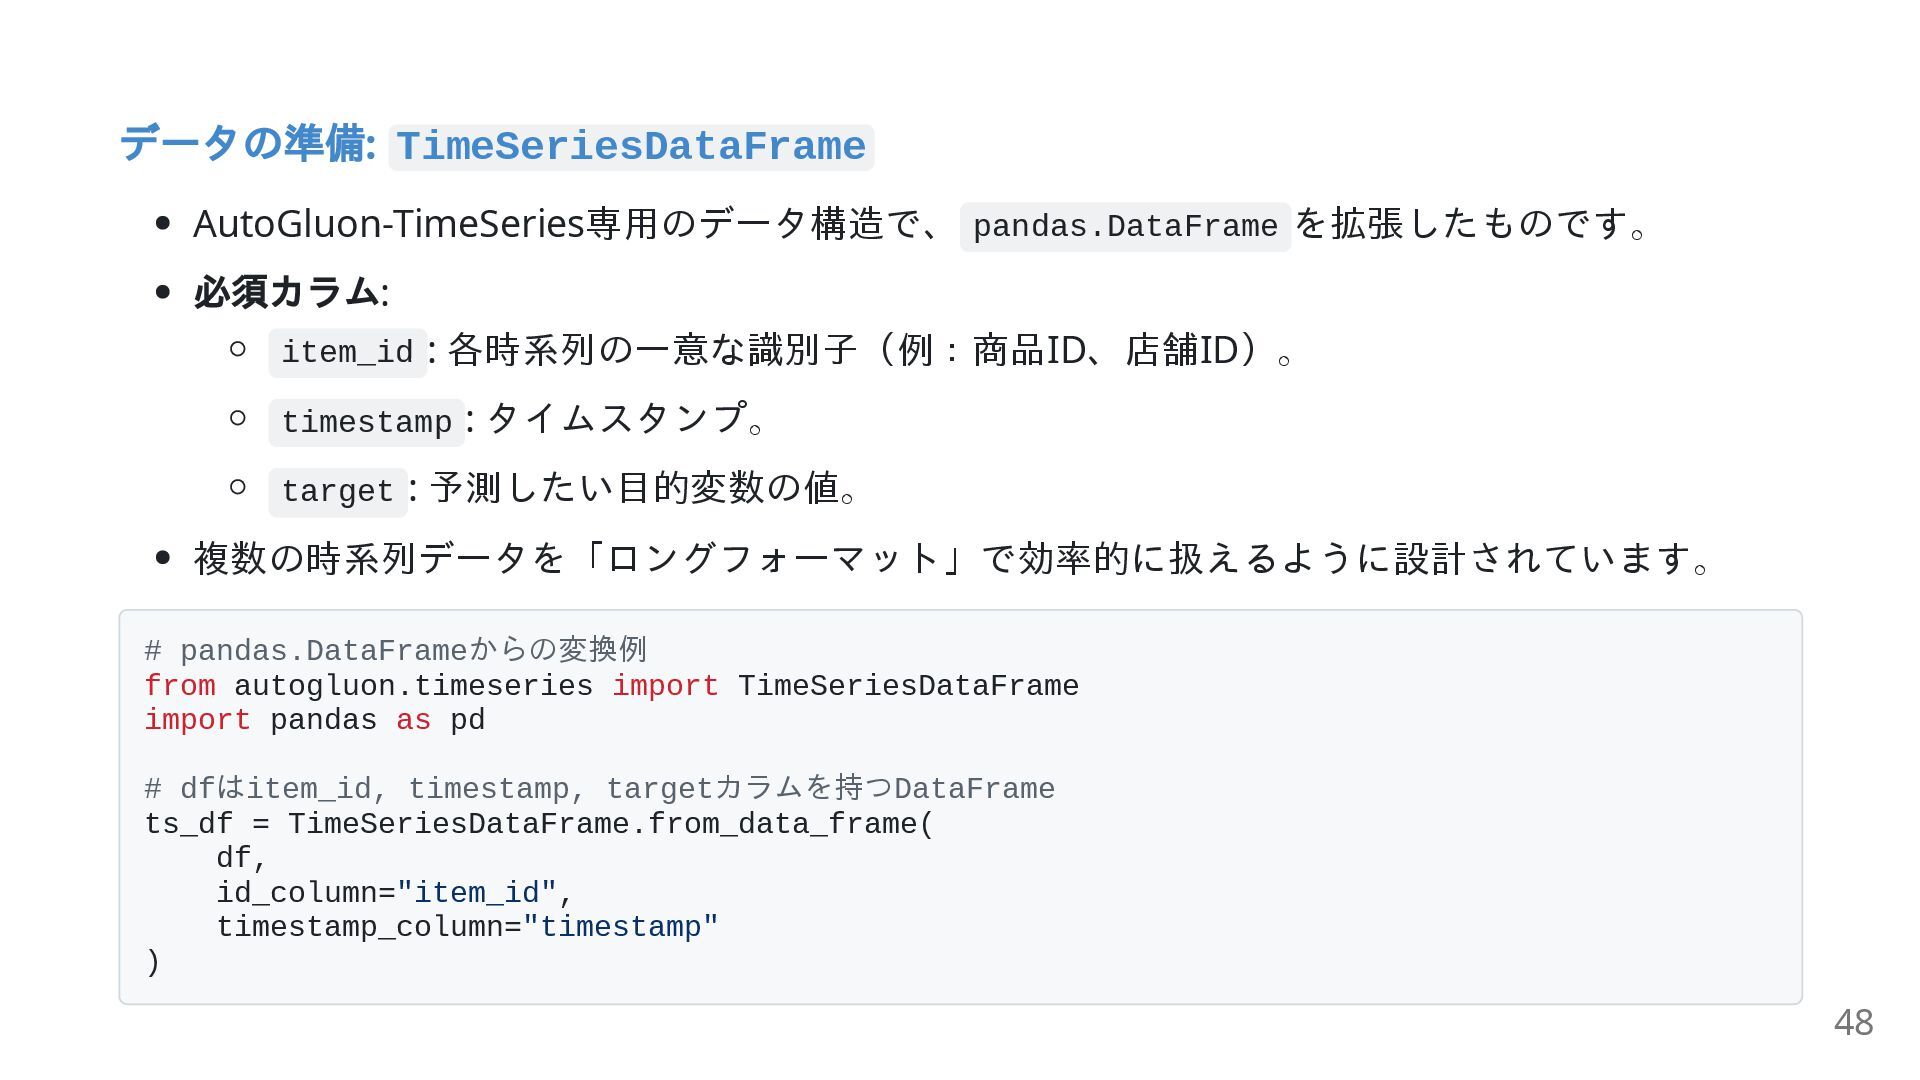
データの準備: TimeSeriesDataFrame AutoGluon-TimeSeries専用のデータ構造で、 pandas.DataFrame を拡張したものです。 必須カラム: item_id : 各時系列の一意な識別子(例:商品ID、店舗ID)。 timestamp
: タイムスタンプ。 target : 予測したい目的変数の値。 複数の時系列データを「ロングフォーマット」で効率的に扱えるように設計されています。 # pandas.DataFrameからの変換例 from autogluon.timeseries import TimeSeriesDataFrame import pandas as pd # dfはitem_id, timestamp, targetカラムを持つDataFrame ts_df = TimeSeriesDataFrame.from_data_frame( df, id_column="item_id", timestamp_column="timestamp" ) 48 -
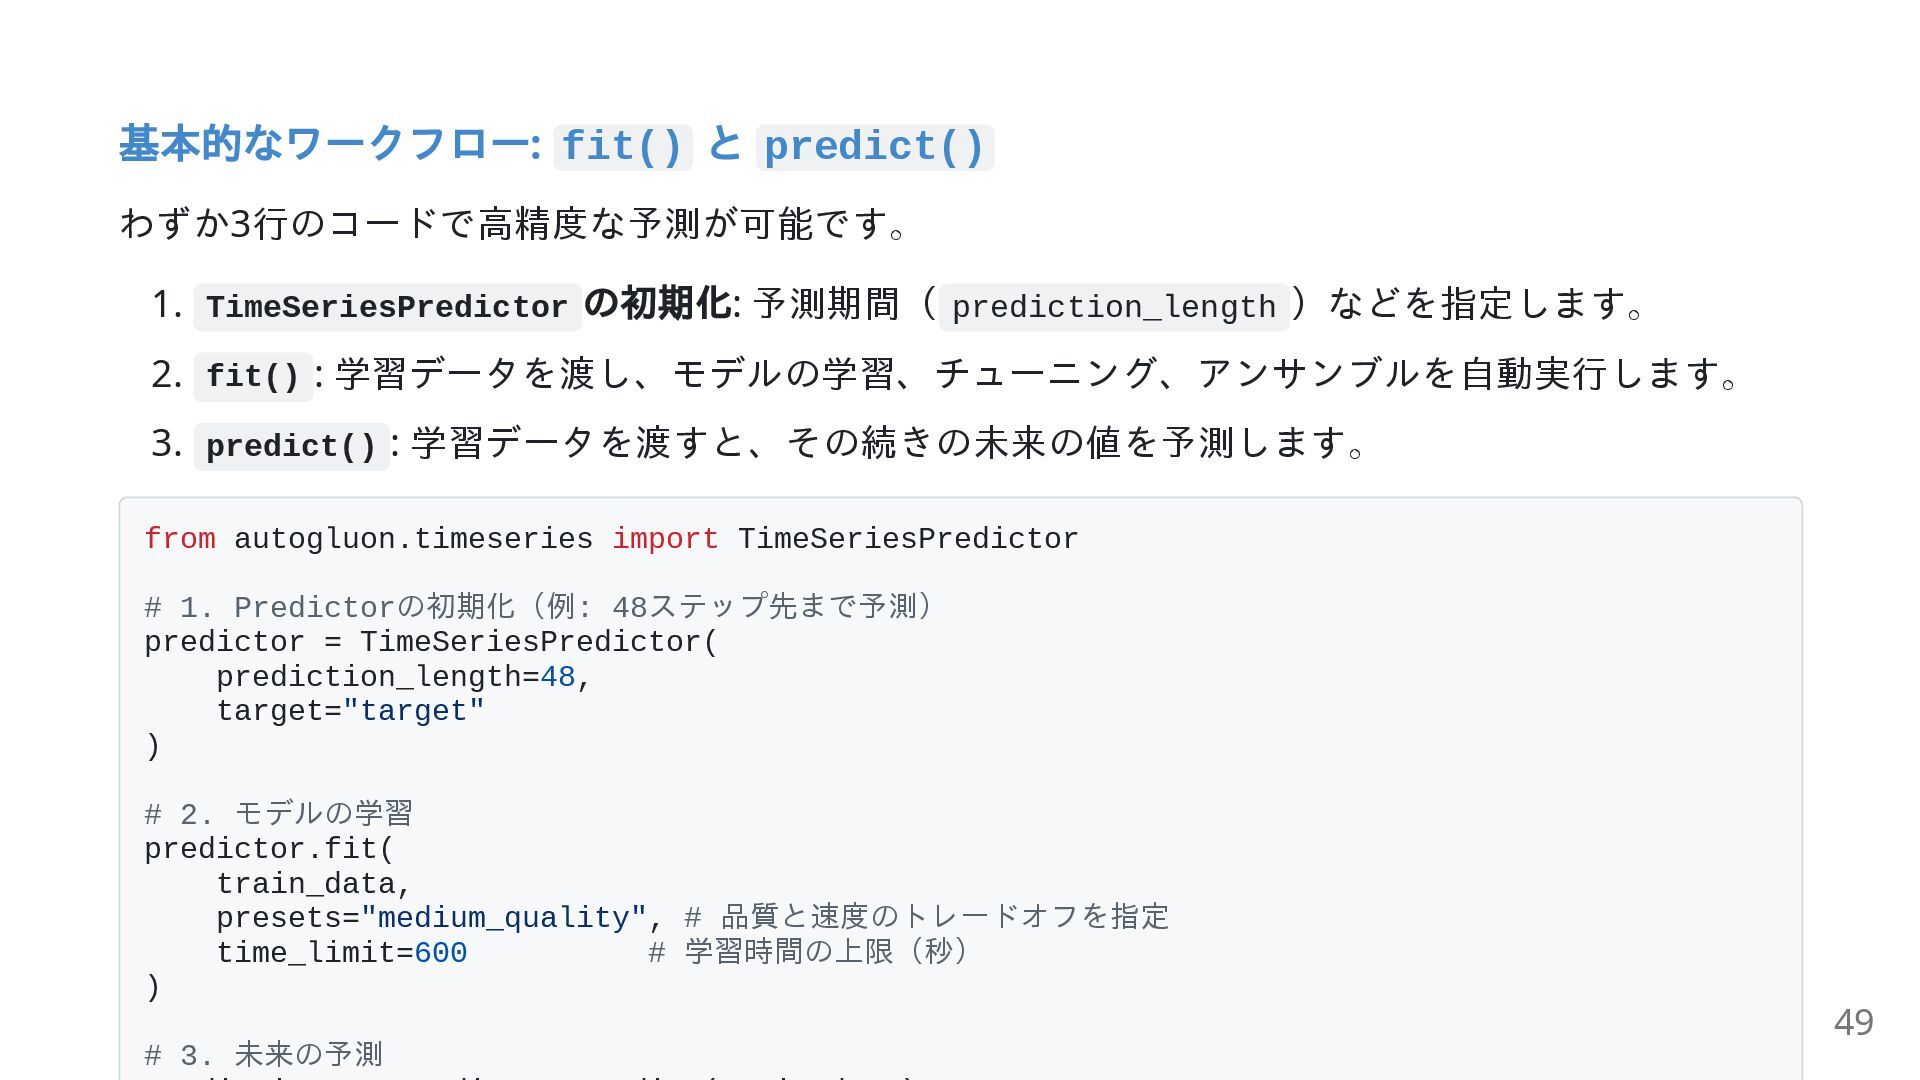
基本的なワークフロー: fit() と predict() わずか3行のコードで高精度な予測が可能です。 1. TimeSeriesPredictor の初期化: 予測期間( prediction_length
)などを指定します。 2. fit() : 学習データを渡し、モデルの学習、チューニング、アンサンブルを自動実行します。 3. predict() : 学習データを渡すと、その続きの未来の値を予測します。 from autogluon.timeseries import TimeSeriesPredictor # 1. Predictorの初期化(例: 48ステップ先まで予測) predictor = TimeSeriesPredictor( prediction_length=48, target="target" ) # 2. モデルの学習 predictor.fit( train_data, presets="medium_quality", # 品質と速度のトレードオフを指定 time_limit=600 # 学習時間の上限(秒) ) # 3. 未来の予測 49 -
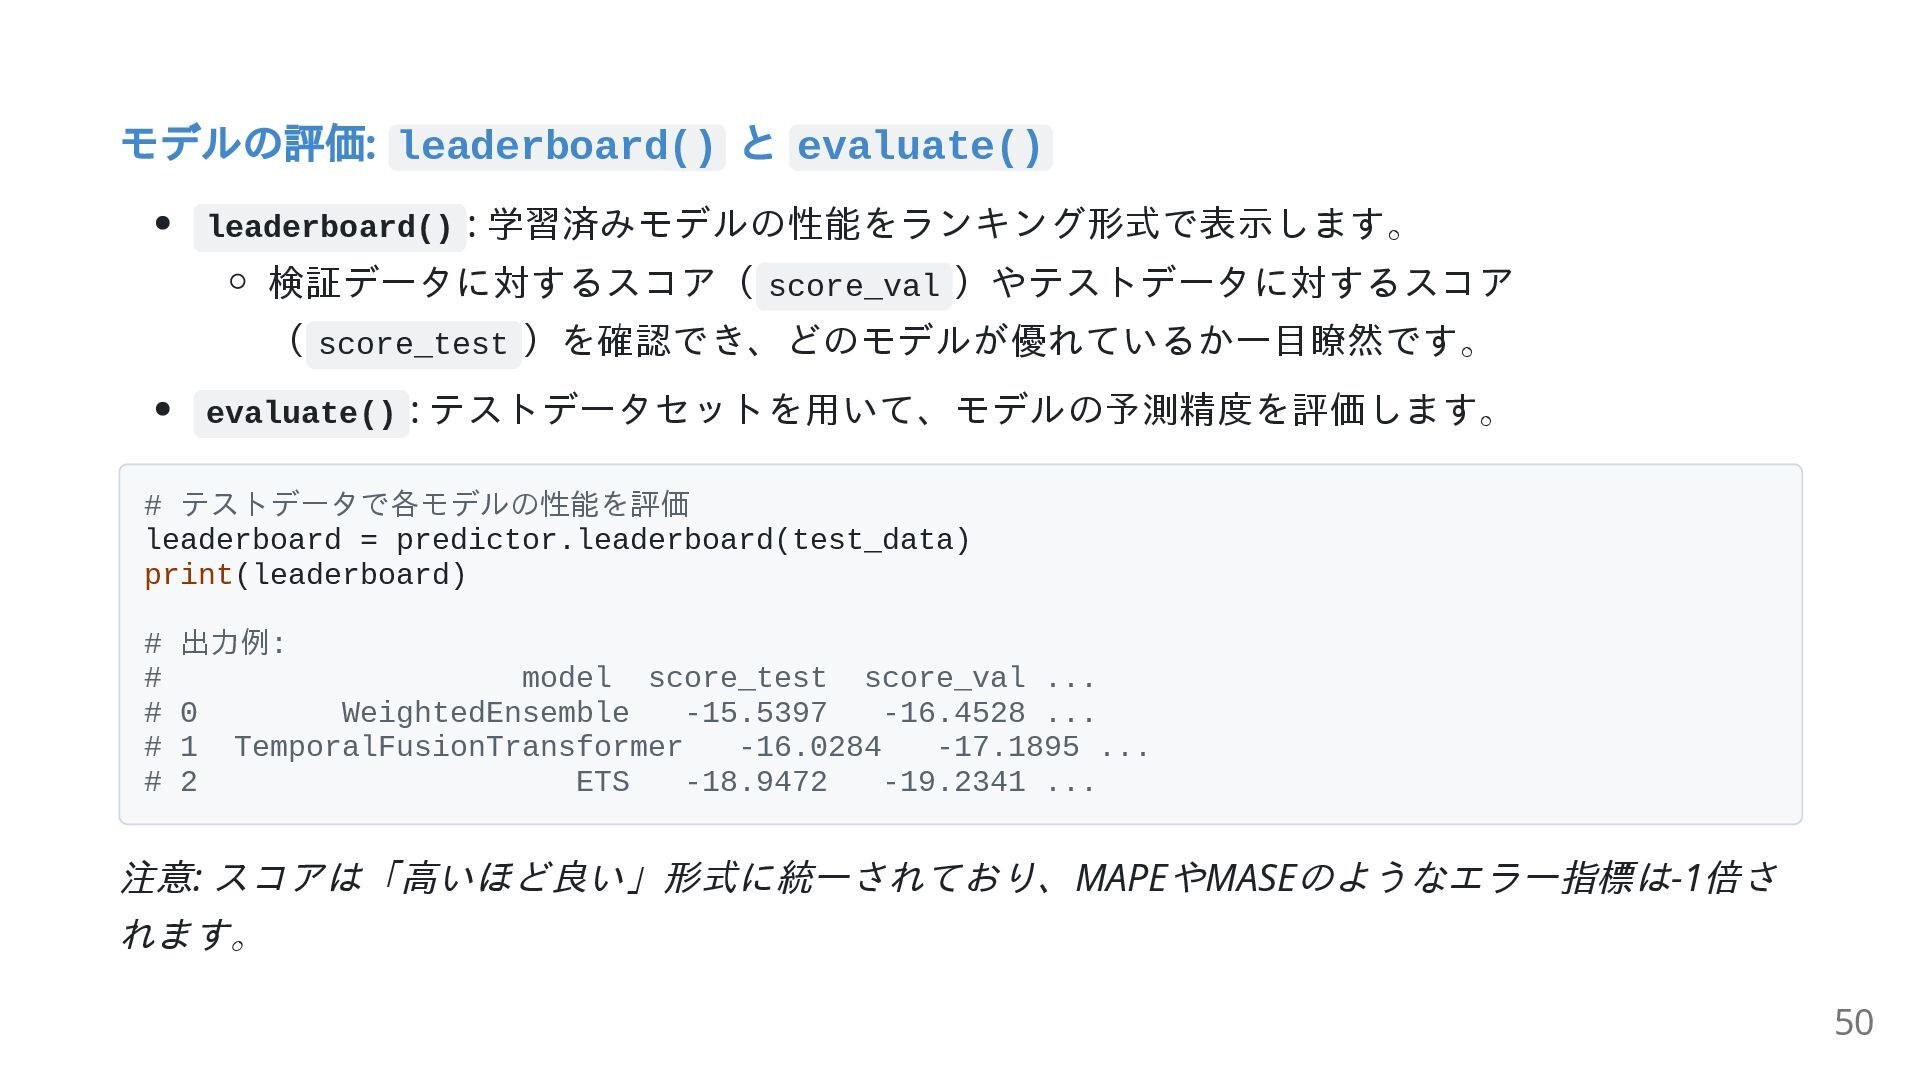
モデルの評価: leaderboard() と evaluate() leaderboard() : 学習済みモデルの性能をランキング形式で表示します。 検証データに対するスコア( score_val )やテストデータに対するスコア
( score_test )を確認でき、どのモデルが優れているか一目瞭然です。 evaluate() : テストデータセットを用いて、モデルの予測精度を評価します。 # テストデータで各モデルの性能を評価 leaderboard = predictor.leaderboard(test_data) print(leaderboard) # 出力例: # model score_test score_val ... # 0 WeightedEnsemble -15.5397 -16.4528 ... # 1 TemporalFusionTransformer -16.0284 -17.1895 ... # 2 ETS -18.9472 -19.2341 ... 注意: スコアは「高いほど良い」形式に統一されており、MAPEやMASEのようなエラー指標は-1倍さ れます。 50 -
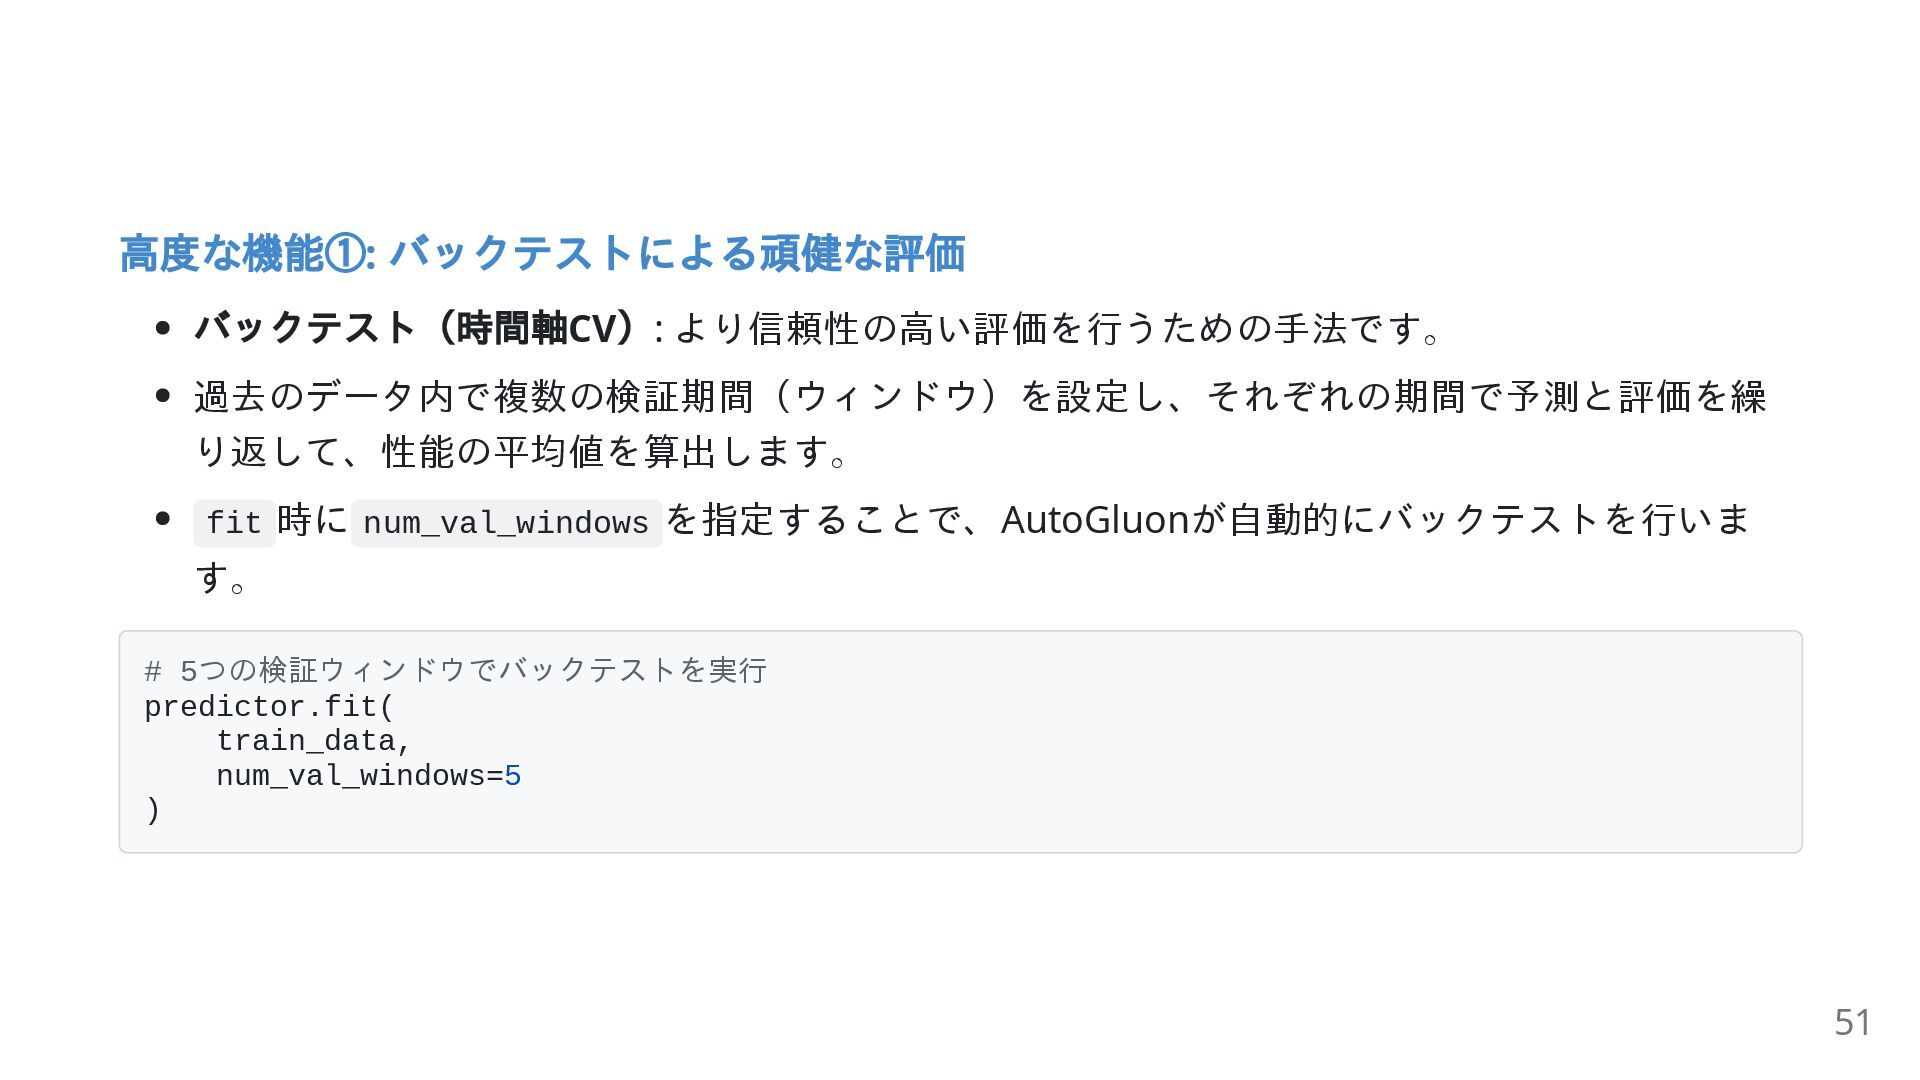
高度な機能①: バックテストによる頑健な評価 バックテスト(時間軸CV ): より信頼性の高い評価を行うための手法です。 過去のデータ内で複数の検証期間(ウィンドウ)を設定し、それぞれの期間で予測と評価を繰 り返して、性能の平均値を算出します。 fit 時に num_val_windows
を指定することで、AutoGluonが自動的にバックテストを行いま す。 # 5つの検証ウィンドウでバックテストを実行 predictor.fit( train_data, num_val_windows=5 ) 51 -
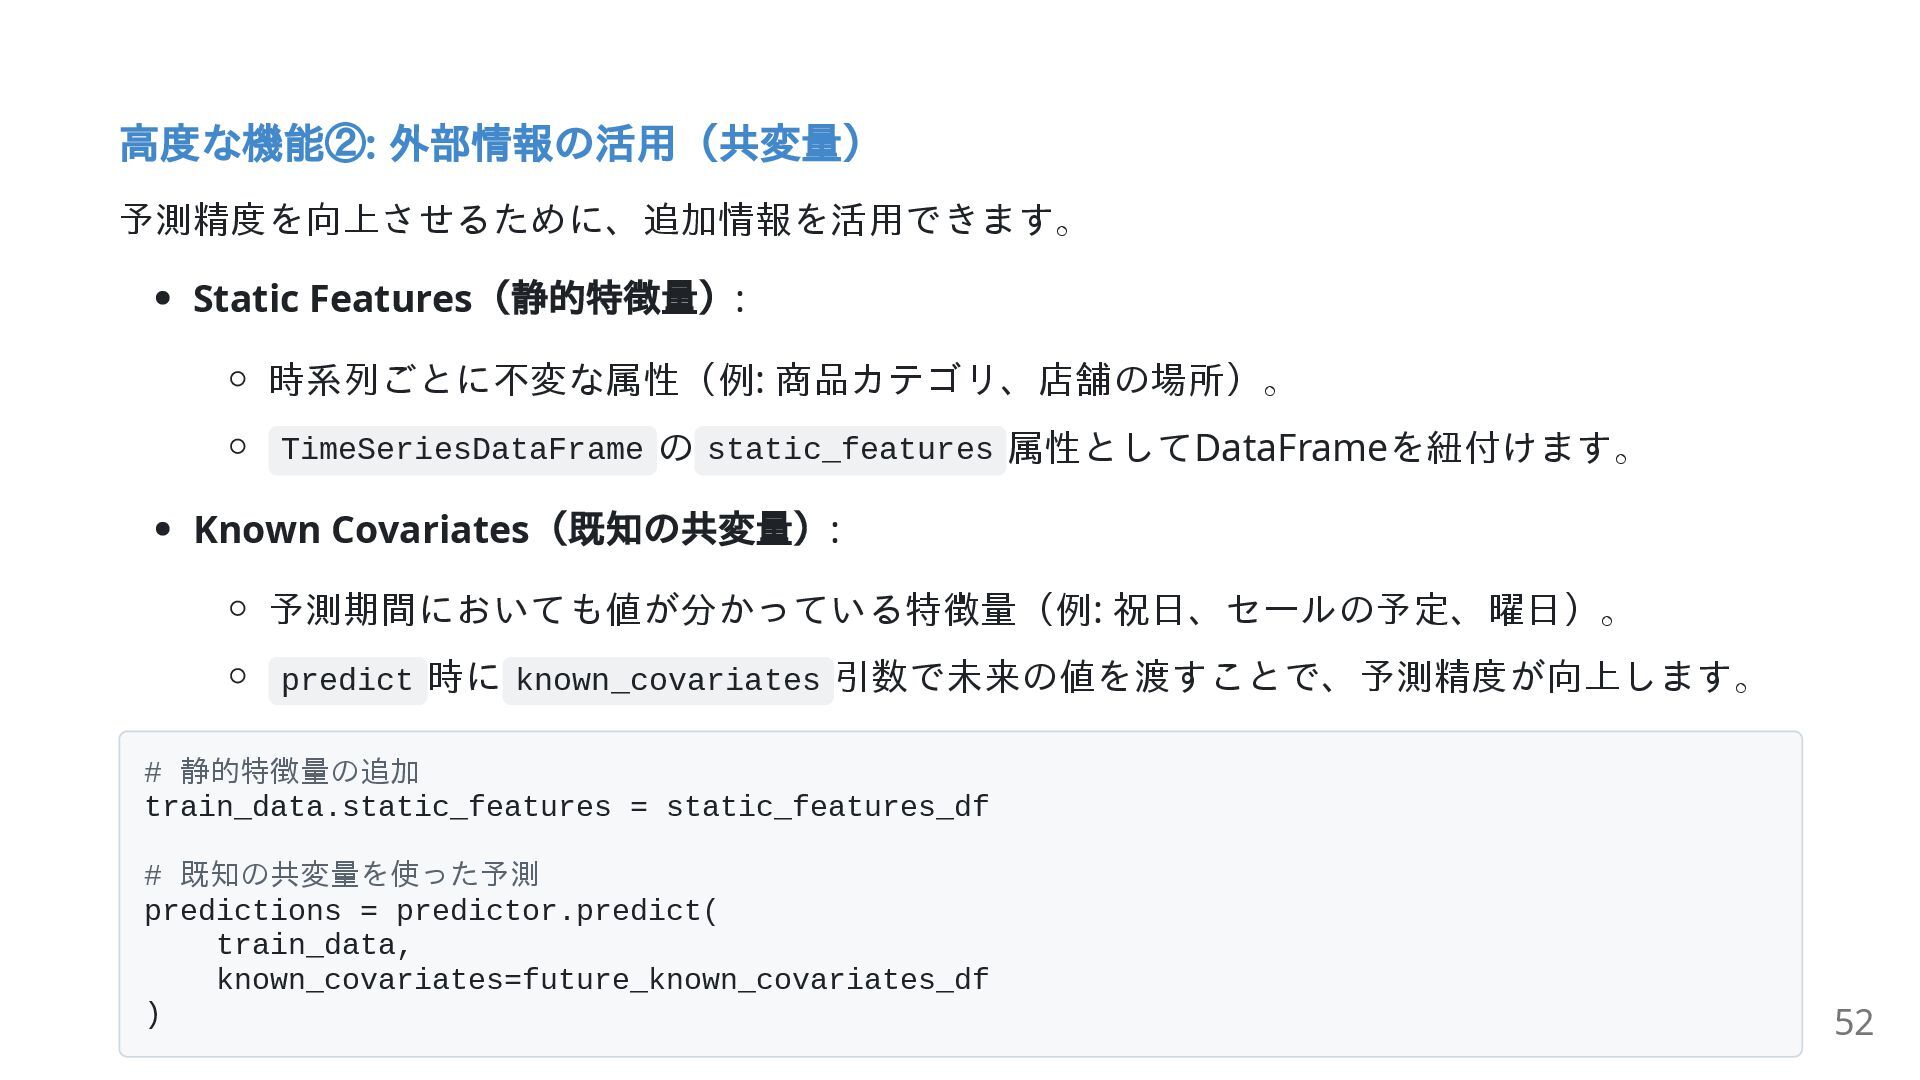
高度な機能②: 外部情報の活用(共変量) 予測精度を向上させるために、追加情報を活用できます。 Static Features (静的特徴量): 時系列ごとに不変な属性(例: 商品カテゴリ、店舗の場所)。 TimeSeriesDataFrame の
static_features 属性としてDataFrameを紐付けます。 Known Covariates (既知の共変量): 予測期間においても値が分かっている特徴量(例: 祝日、セールの予定、曜日)。 predict 時に known_covariates 引数で未来の値を渡すことで、予測精度が向上します。 # 静的特徴量の追加 train_data.static_features = static_features_df # 既知の共変量を使った予測 predictions = predictor.predict( train_data, known_covariates=future_known_covariates_df ) 52 -
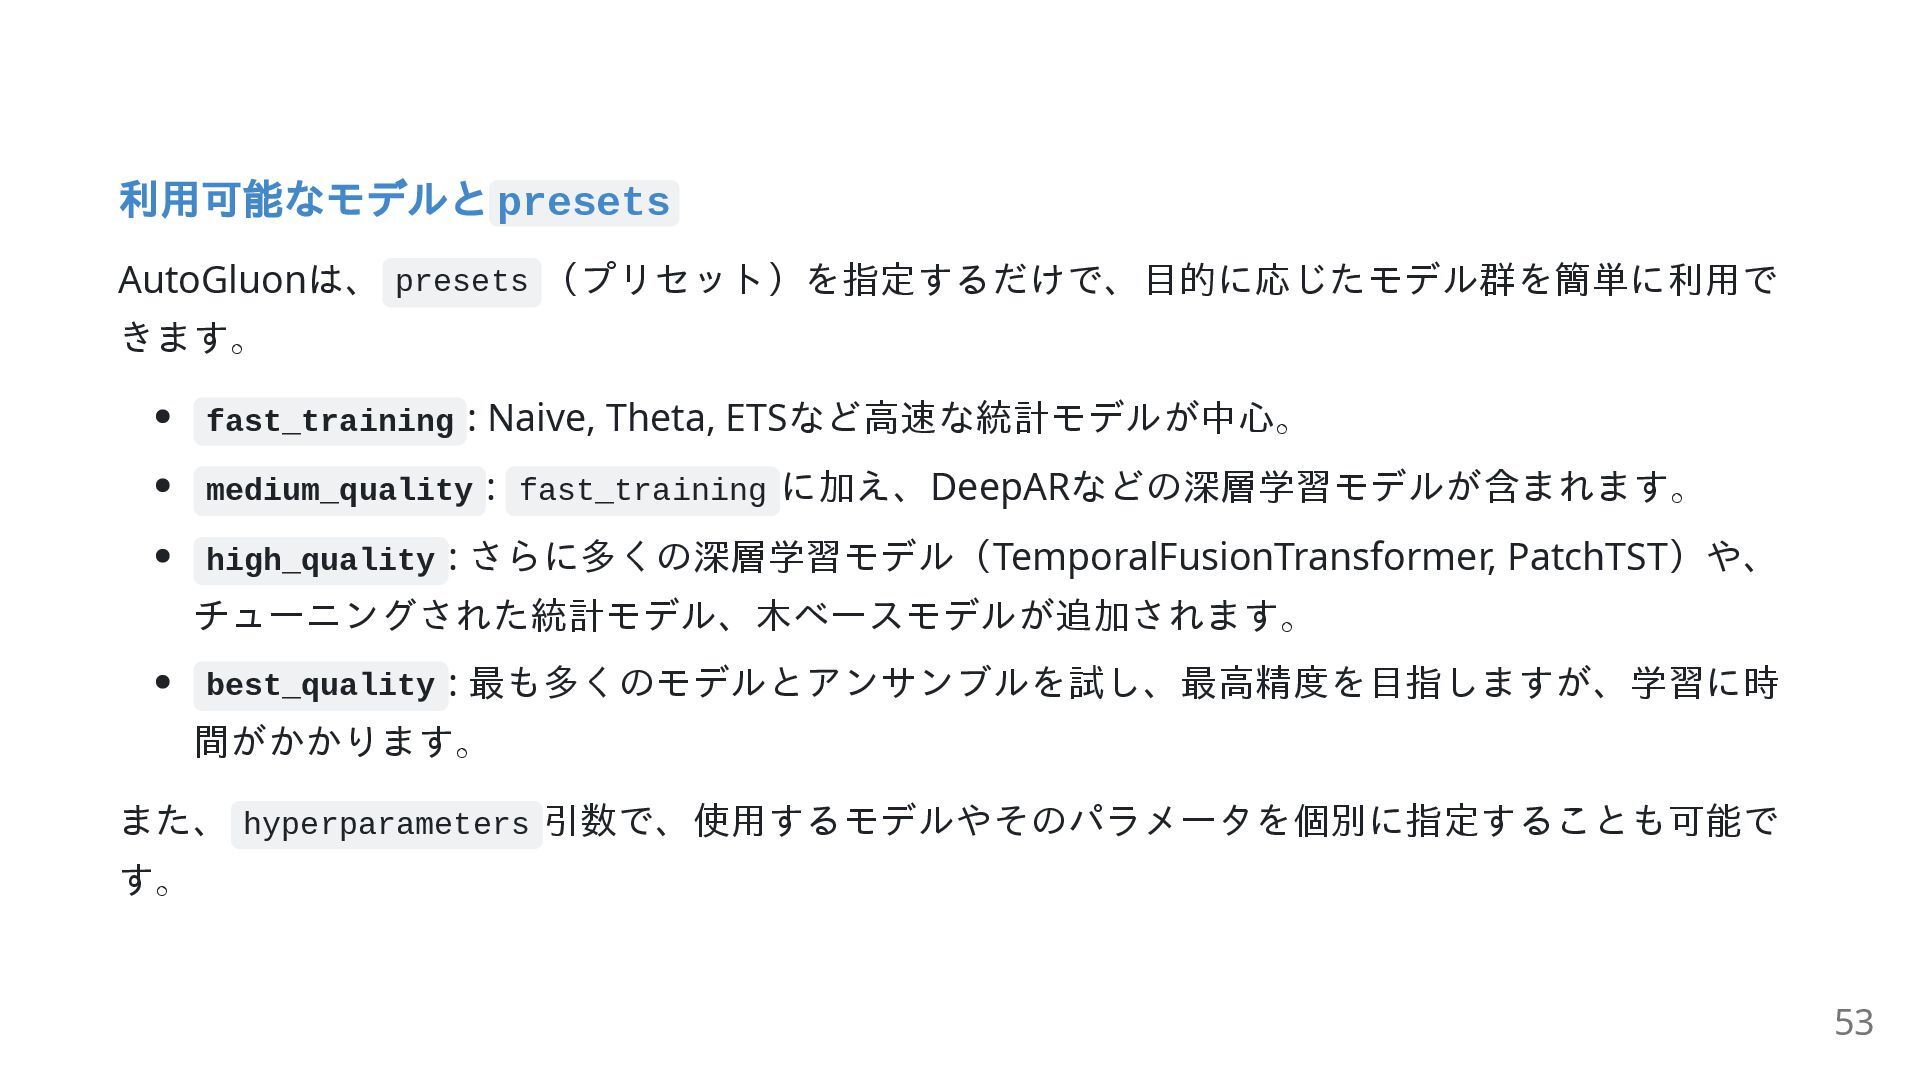
利用可能なモデルとpresets AutoGluonは、 presets (プリセット)を指定するだけで、目的に応じたモデル群を簡単に利用で きます。 fast_training : Naive, Theta, ETSなど高速な統計モデルが中心。
medium_quality : fast_training に加え、DeepARなどの深層学習モデルが含まれます。 high_quality : さらに多くの深層学習モデル(TemporalFusionTransformer, PatchTST)や、 チューニングされた統計モデル、木ベースモデルが追加されます。 best_quality : 最も多くのモデルとアンサンブルを試し、最高精度を目指しますが、学習に時 間がかかります。 また、 hyperparameters 引数で、使用するモデルやそのパラメータを個別に指定することも可能で す。 53 -
まとめ 強力かつシンプル: AutoGluon-TimeSeriesは、わずか数行のコードで、最先端の統計モデルか ら深層学習モデルまでを駆使した高精度な時系列予測を実現します。 専用データ構造: TimeSeriesDataFrame により、複数の時系列と関連情報(静的特徴量、共変 量)を体系的に扱えます。 実践的な機能: fit
, predict というシンプルなAPIに加え、 leaderboard によるモデル比較 や、バックテストによる頑健な評価が容易に行えます。 柔軟な拡張性: presets による手軽な設定から、個別のモデル指定や共変量の活用まで、初心者 から上級者まで幅広いニーズに対応します。 54 -
究極の挑戦:真のマルチモーダル予測 AutoGluonの真価は、 テーブル、テキスト、画像の全てを 組み合わせた予測モデルを構築できる点にあります。 PetFinderデータセット(ペットの里親決定速度予測)を例 に解説します。 この例で学ぶこと: ユーザーの主な仕事は、モデル構築ではなく、 データの 準備とメタデータの定義になる。
データを正しく記述することで、非常に複雑で強力な自 動化パイプラインの能力を最大限に引き出せる。 55 -
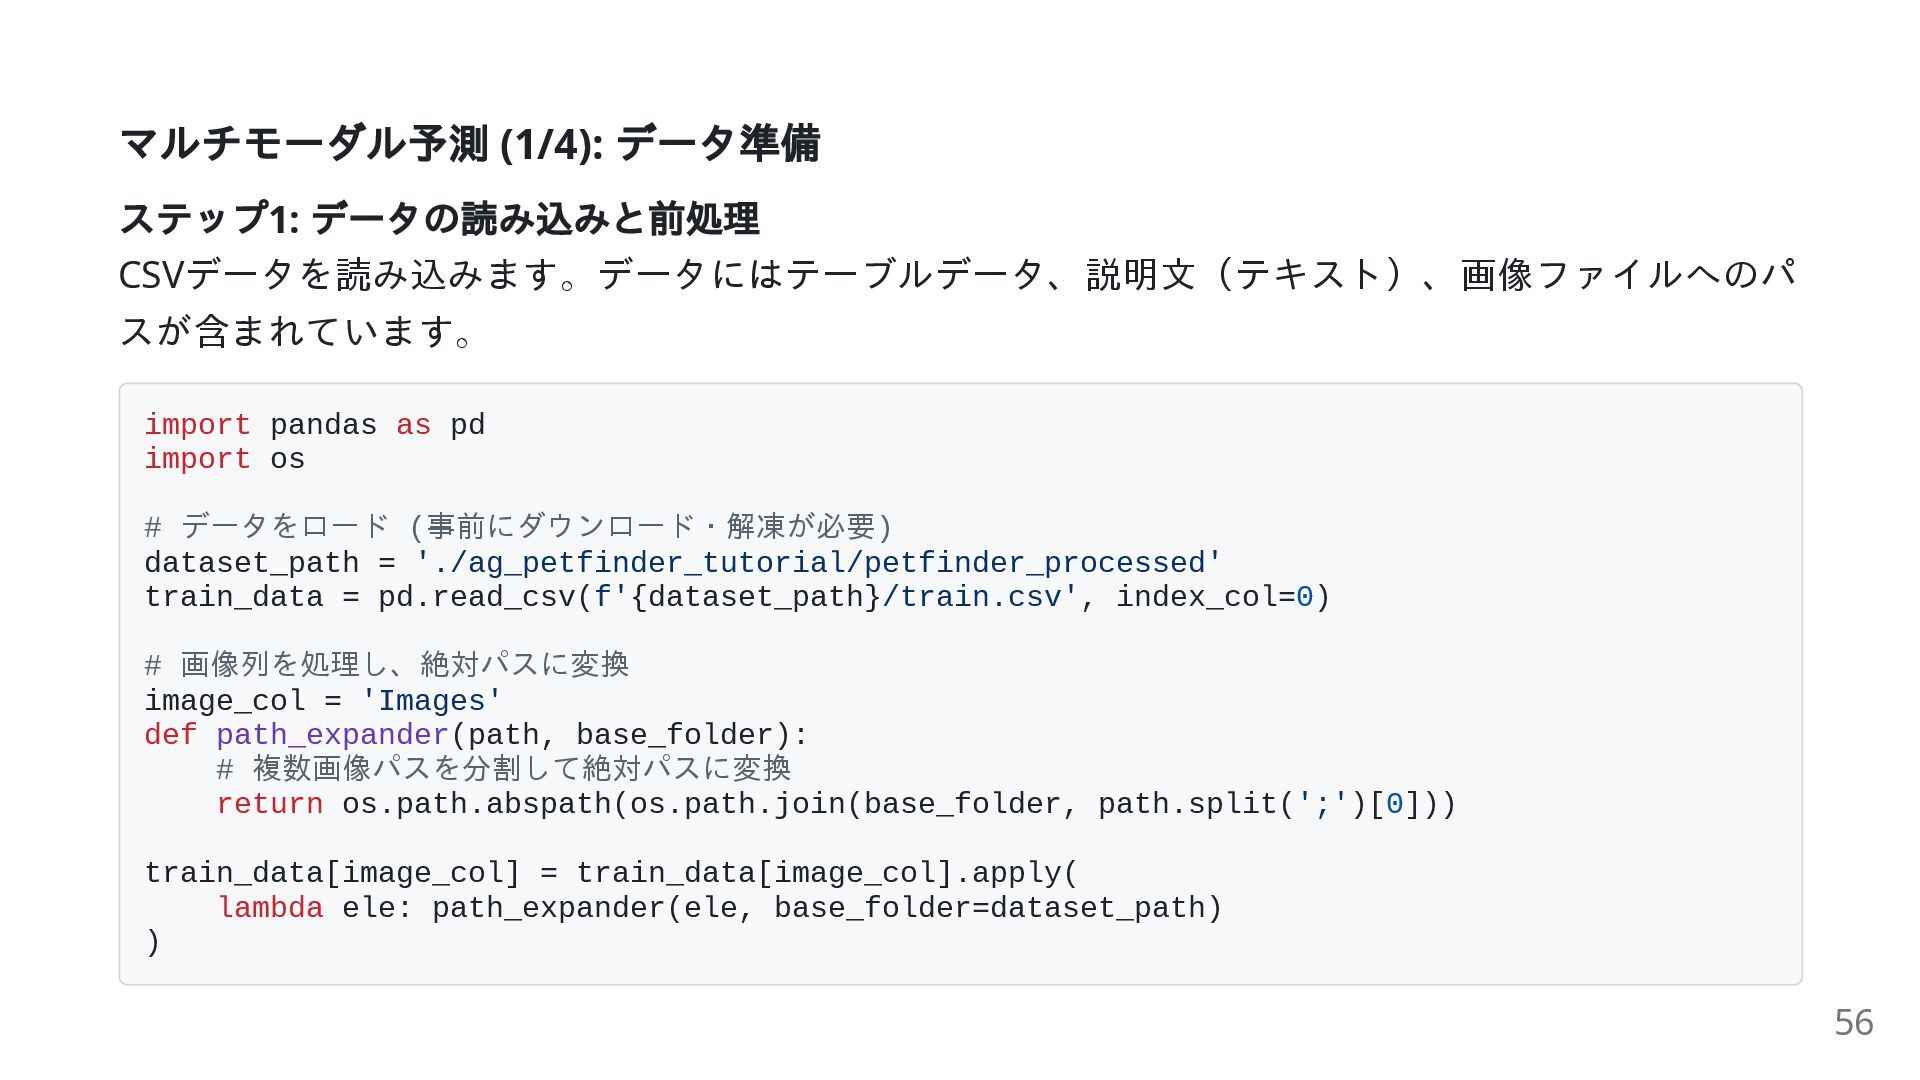
マルチモーダル予測 (1/4): データ準備 ステップ1: データの読み込みと前処理 CSVデータを読み込みます。データにはテーブルデータ、説明文(テキスト)、画像ファイルへのパ スが含まれています。 import pandas as
pd import os # データをロード (事前にダウンロード・解凍が必要) dataset_path = './ag_petfinder_tutorial/petfinder_processed' train_data = pd.read_csv(f'{dataset_path}/train.csv', index_col=0) # 画像列を処理し、絶対パスに変換 image_col = 'Images' def path_expander(path, base_folder): # 複数画像パスを分割して絶対パスに変換 return os.path.abspath(os.path.join(base_folder, path.split(';')[0])) train_data[image_col] = train_data[image_col].apply( lambda ele: path_expander(ele, base_folder=dataset_path) ) 56 -
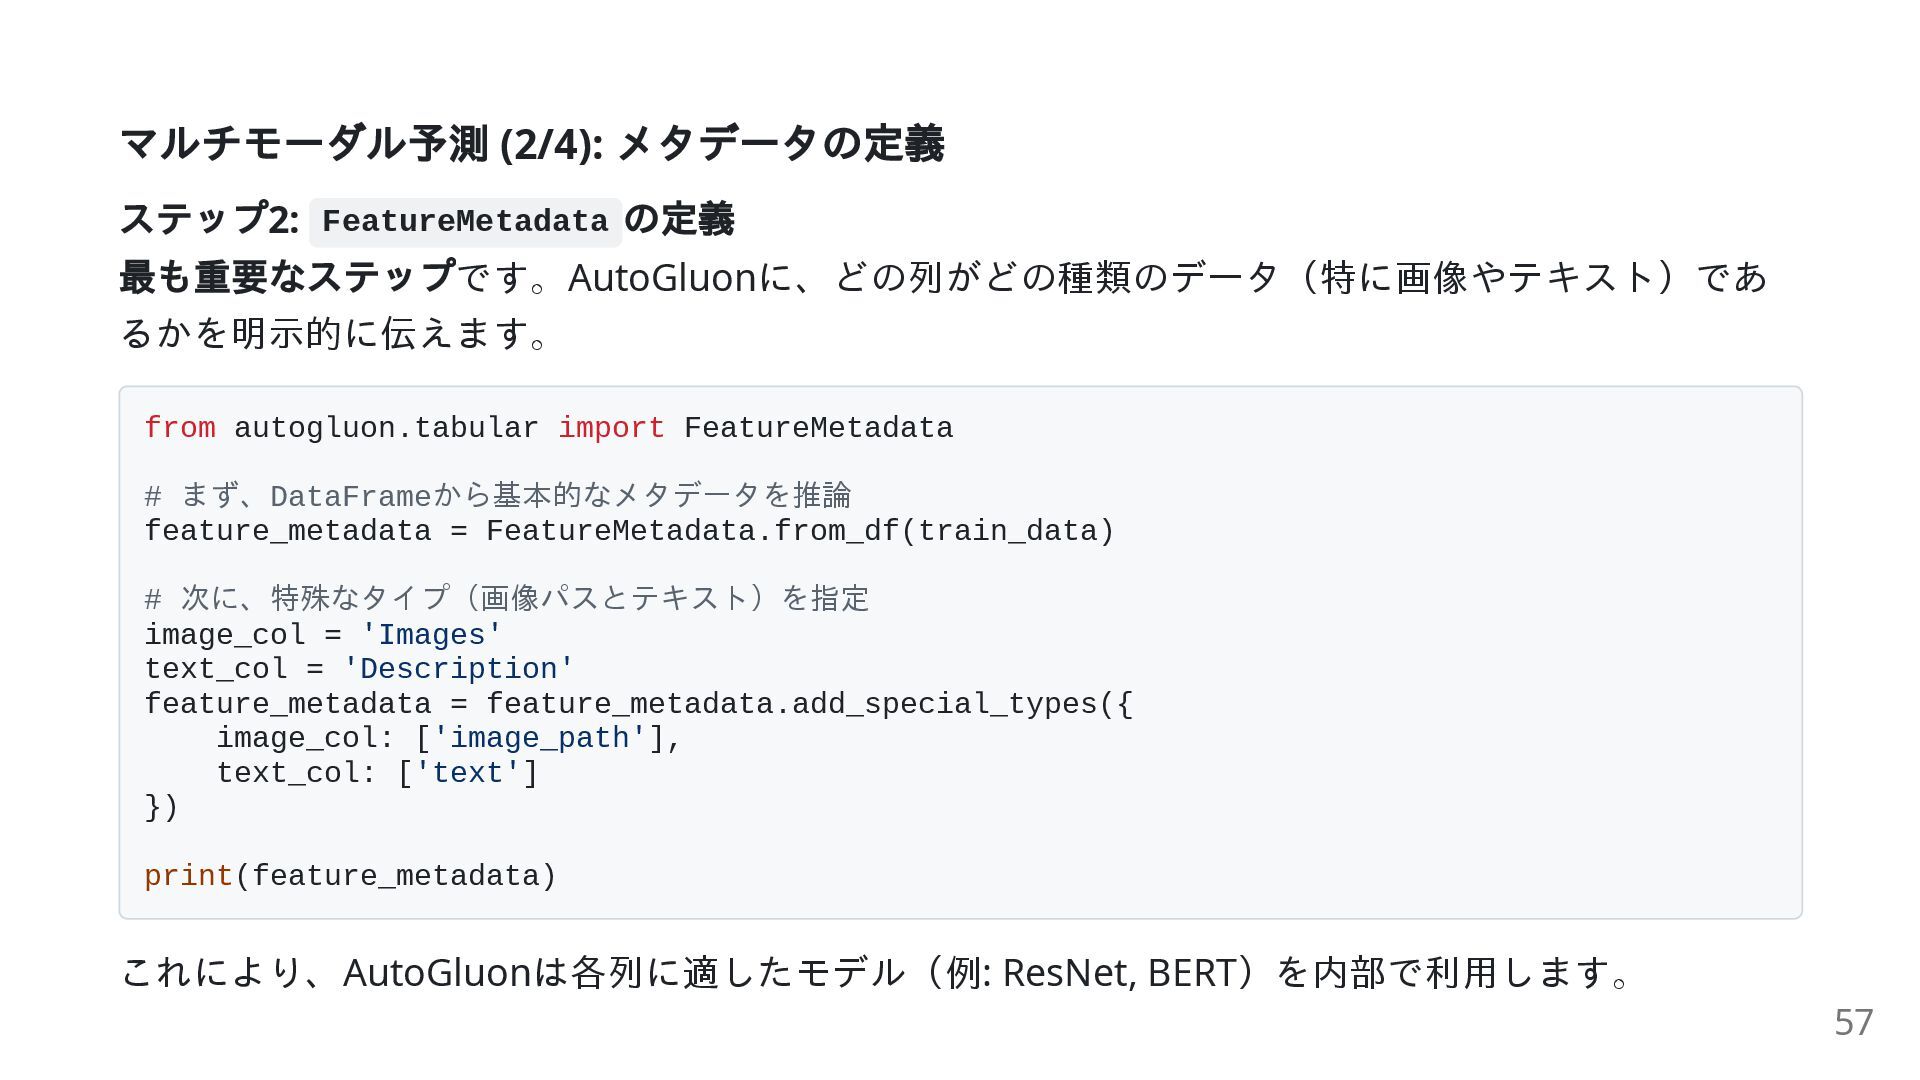
マルチモーダル予測 (2/4): メタデータの定義 ステップ2: FeatureMetadata の定義 最も重要なステップです。AutoGluonに、どの列がどの種類のデータ(特に画像やテキスト)であ るかを明示的に伝えます。 from autogluon.tabular
import FeatureMetadata # まず、DataFrameから基本的なメタデータを推論 feature_metadata = FeatureMetadata.from_df(train_data) # 次に、特殊なタイプ(画像パスとテキスト)を指定 image_col = 'Images' text_col = 'Description' feature_metadata = feature_metadata.add_special_types({ image_col: ['image_path'], text_col: ['text'] }) print(feature_metadata) これにより、AutoGluonは各列に適したモデル(例: ResNet, BERT)を内部で利用します。 57 -
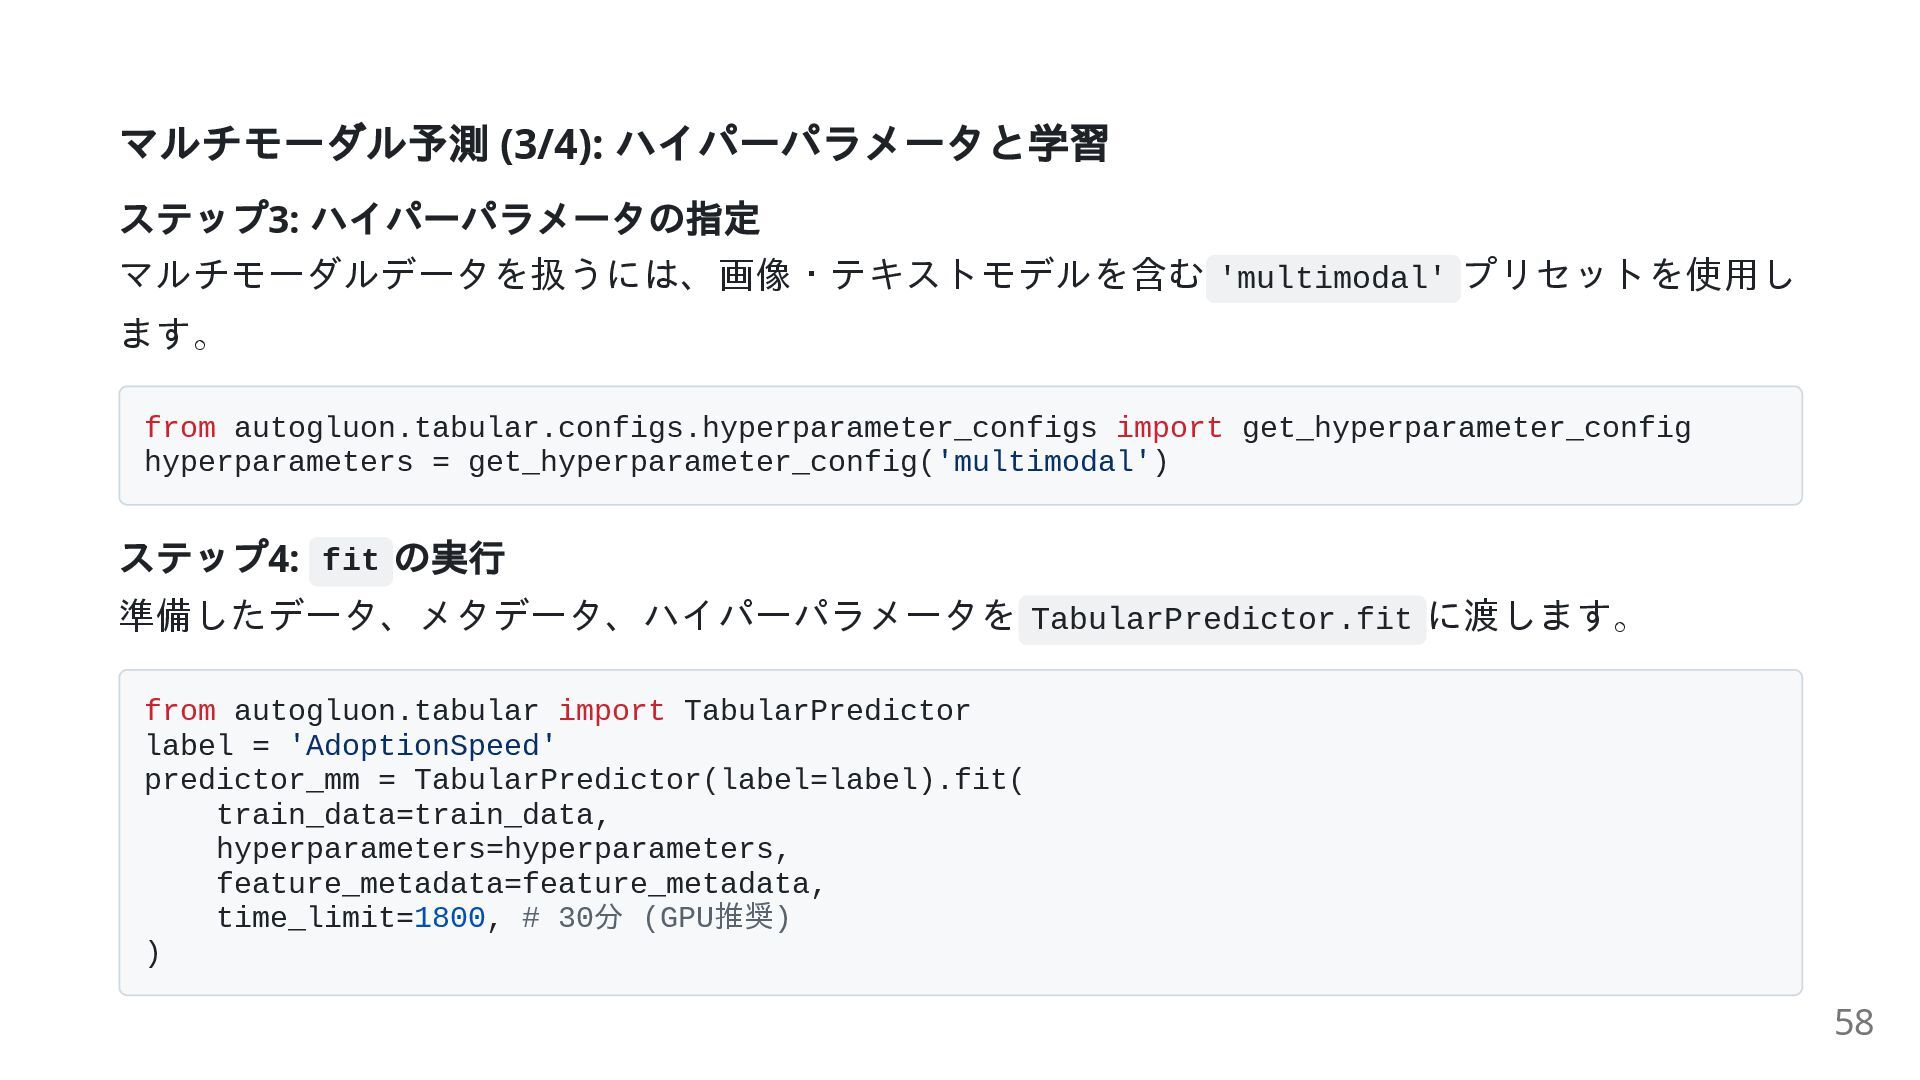
マルチモーダル予測 (3/4): ハイパーパラメータと学習 ステップ3: ハイパーパラメータの指定 マルチモーダルデータを扱うには、画像・テキストモデルを含む 'multimodal' プリセットを使用し ます。 from
autogluon.tabular.configs.hyperparameter_configs import get_hyperparameter_config hyperparameters = get_hyperparameter_config('multimodal') ステップ4: fit の実行 準備したデータ、メタデータ、ハイパーパラメータを TabularPredictor.fit に渡します。 from autogluon.tabular import TabularPredictor label = 'AdoptionSpeed' predictor_mm = TabularPredictor(label=label).fit( train_data=train_data, hyperparameters=hyperparameters, feature_metadata=feature_metadata, time_limit=1800, # 30分 (GPU推奨) ) 58 -
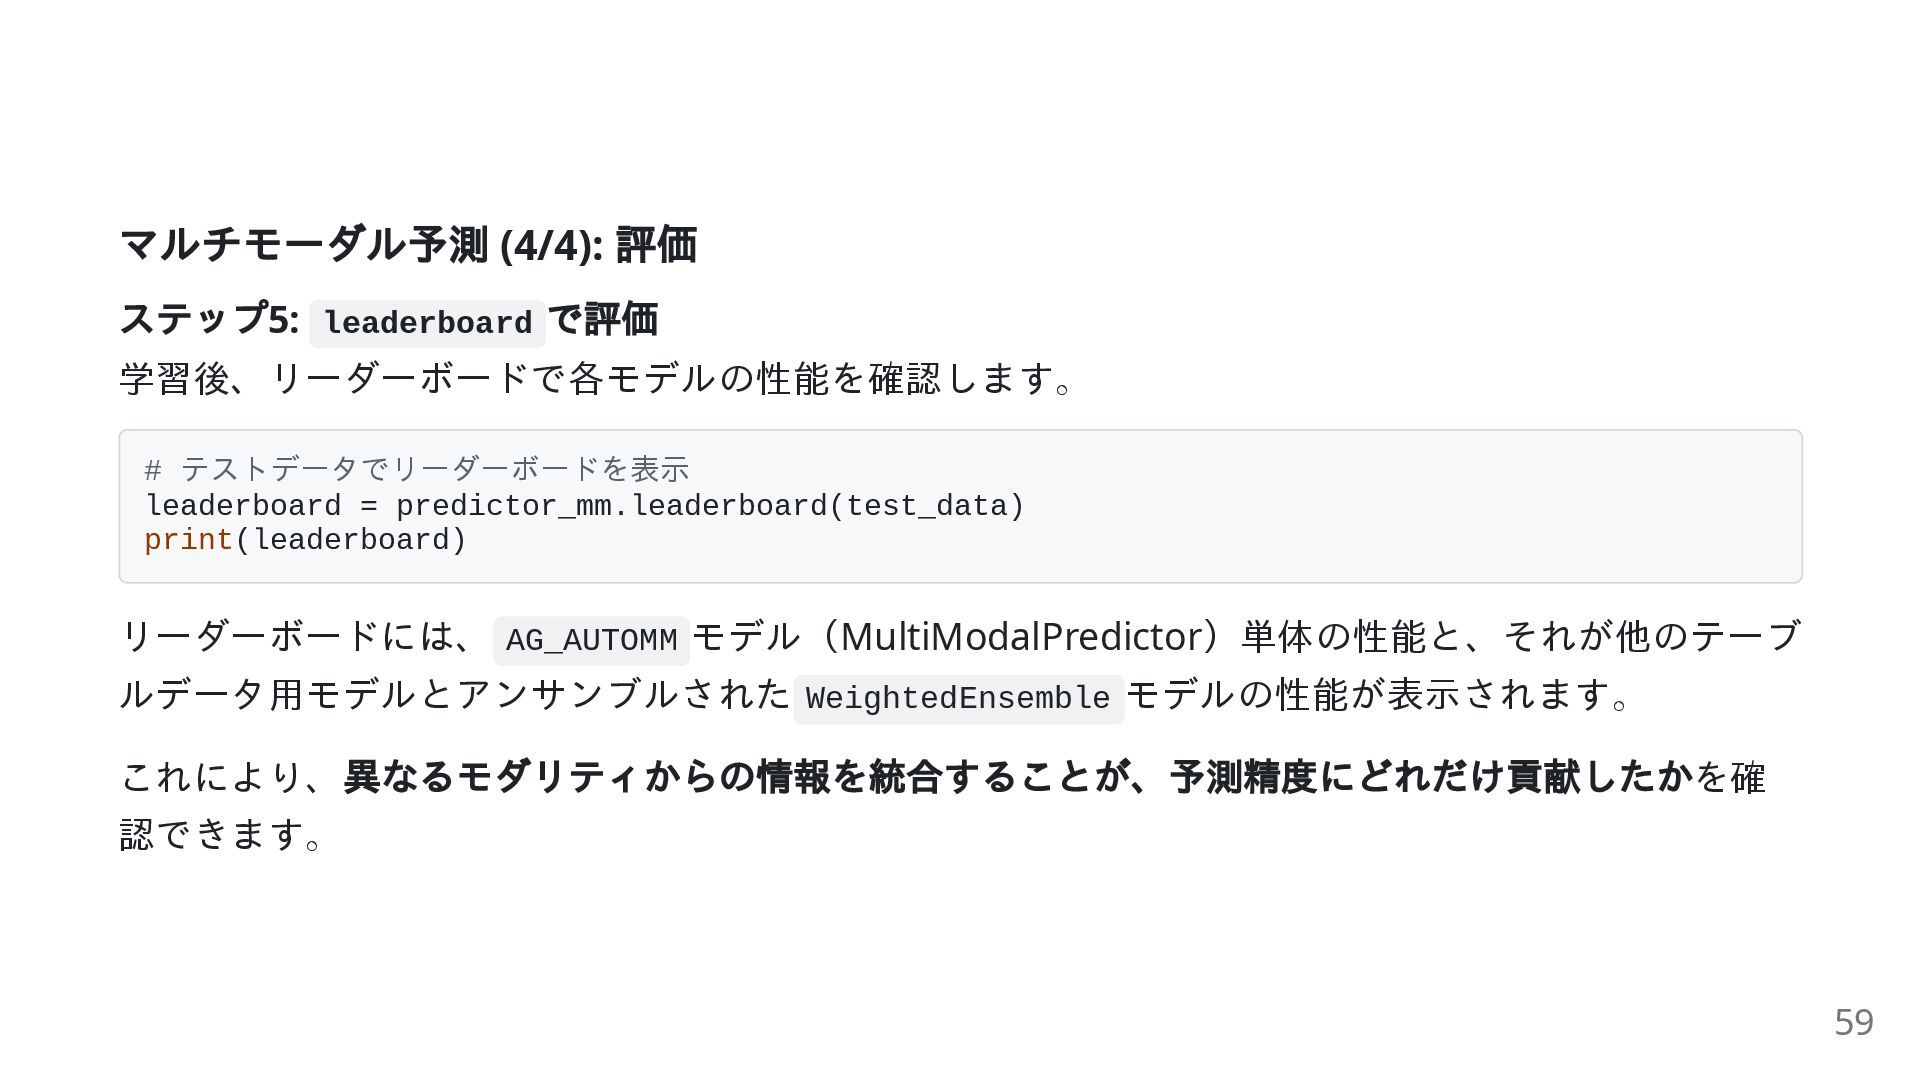
マルチモーダル予測 (4/4): 評価 ステップ5: leaderboard で評価 学習後、リーダーボードで各モデルの性能を確認します。 # テストデータでリーダーボードを表示 leaderboard
= predictor_mm.leaderboard(test_data) print(leaderboard) リーダーボードには、 AG_AUTOMM モデル(MultiModalPredictor)単体の性能と、それが他のテーブ ルデータ用モデルとアンサンブルされた WeightedEnsemble モデルの性能が表示されます。 これにより、 異なるモダリティからの情報を統合することが、予測精度にどれだけ貢献したかを確 認できます。 59 -
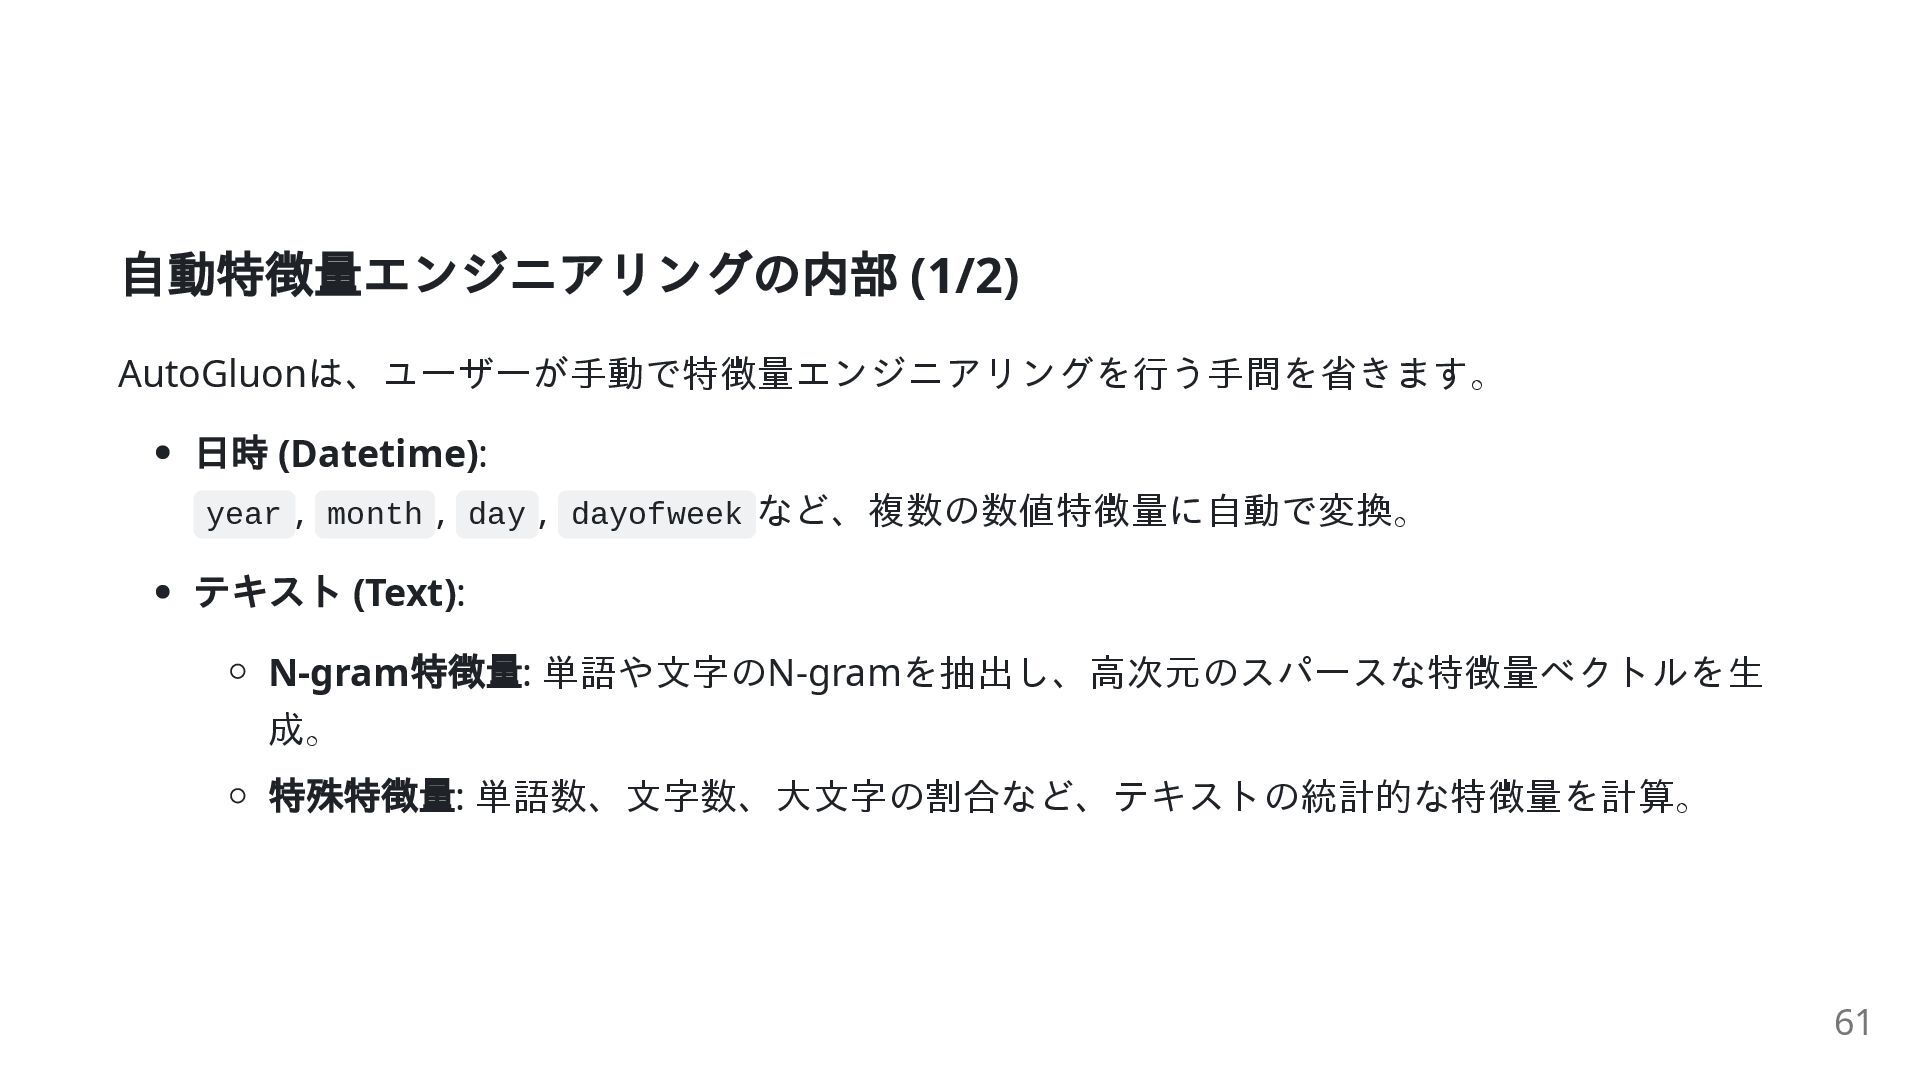
自動特徴量エンジニアリングの内部 (1/2) AutoGluonは、ユーザーが手動で特徴量エンジニアリングを行う手間を省きます。 日時 (Datetime): year , month , day
, dayofweek など、複数の数値特徴量に自動で変換。 テキスト (Text): N-gram 特徴量: 単語や文字のN-gramを抽出し、高次元のスパースな特徴量ベクトルを生 成。 特殊特徴量: 単語数、文字数、大文字の割合など、テキストの統計的な特徴量を計算。 61 -
自動特徴量エンジニアリングの内部 (2/2) カテゴリカル変数 (Categorical): 値の種類が多い(ハイカーディナリティな)変数でも効率的に扱えるよう、内部でエンベディ ング処理などを実行。 欠損値 (Missing Values): 数値データは中央値などで、カテゴリカルデータは特別なカテゴリで、賢く補完。
なぜ手動でやらない方が良いのか? AutoGluonはこれらの処理を、後続の モデル(木モデルとNN )の特性を考慮して最適化していま す。手動でワンホットエンコーディングなどを行うと、内部ロジックと衝突し、かえって性能を低 下させる可能性があります。 62 -
デプロイ:AutoGluon on AWS SageMaker 学習したモデルは、特にAWS環境内で簡単に本番デプロイできます。 Option 1: リアルタイム推論エンドポイント APIリクエストに対して即座に予測を返すサービスを構築。 Option
2: バッチ変換ジョブ 大規模なデータセットに対して、オフラインで一括して予測を生成。 Option 3: autogluon.cloud SageMakerの詳細を抽象化し、数行のコードでクラウド上での学習・推論を可能にするライブ ラリ。 63 -
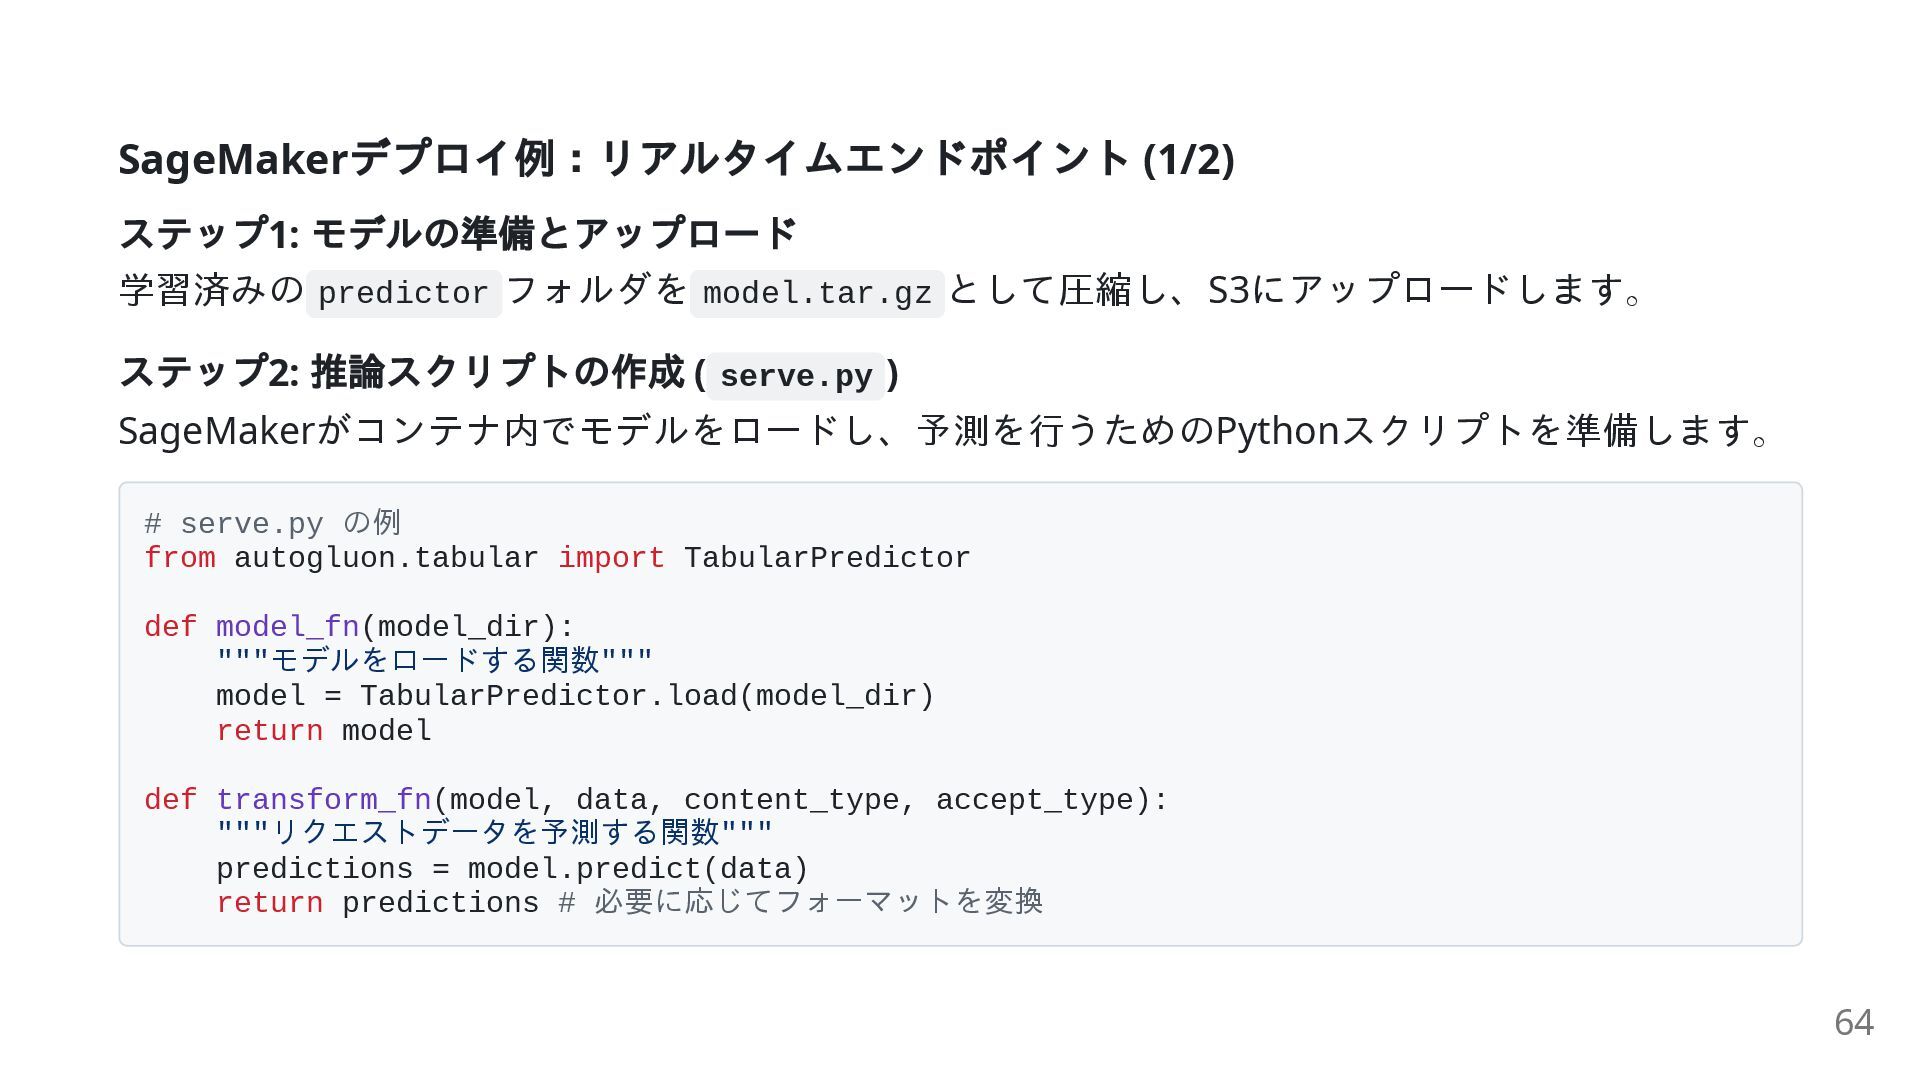
SageMaker デプロイ例:リアルタイムエンドポイント (1/2) ステップ1: モデルの準備とアップロード 学習済みの predictor フォルダを model.tar.gz として圧縮し、S3にアップロードします。
ステップ2: 推論スクリプトの作成 ( serve.py ) SageMakerがコンテナ内でモデルをロードし、予測を行うためのPythonスクリプトを準備します。 # serve.py の例 from autogluon.tabular import TabularPredictor def model_fn(model_dir): """モデルをロードする関数""" model = TabularPredictor.load(model_dir) return model def transform_fn(model, data, content_type, accept_type): """リクエストデータを予測する関数""" predictions = model.predict(data) return predictions # 必要に応じてフォーマットを変換 64 -
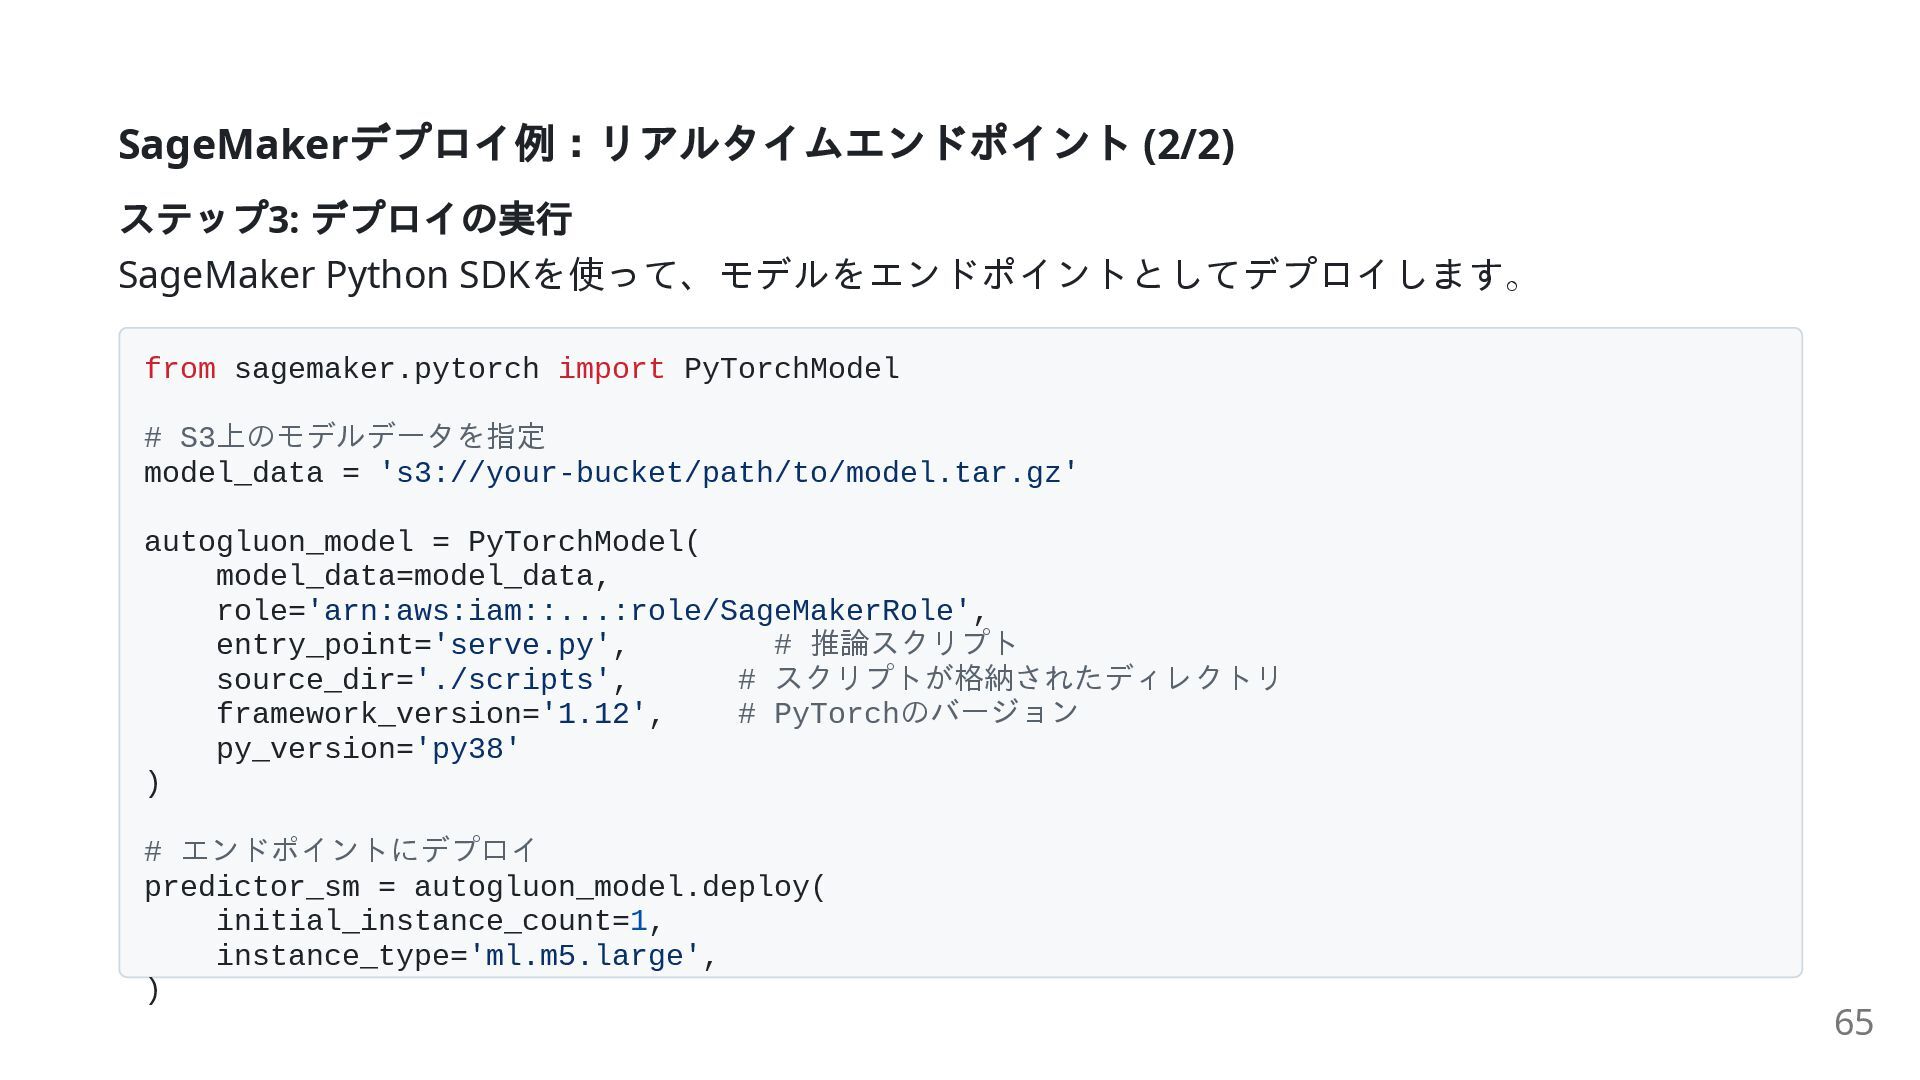
SageMaker デプロイ例:リアルタイムエンドポイント (2/2) ステップ3: デプロイの実行 SageMaker Python SDKを使って、モデルをエンドポイントとしてデプロイします。 from sagemaker.pytorch
import PyTorchModel # S3上のモデルデータを指定 model_data = 's3://your-bucket/path/to/model.tar.gz' autogluon_model = PyTorchModel( model_data=model_data, role='arn:aws:iam::...:role/SageMakerRole', entry_point='serve.py', # 推論スクリプト source_dir='./scripts', # スクリプトが格納されたディレクトリ framework_version='1.12', # PyTorchのバージョン py_version='py38' ) # エンドポイントにデプロイ predictor_sm = autogluon_model.deploy( initial_instance_count=1, instance_type='ml.m5.large', ) 65 -
性能と精度のベストプラクティス (1/2) 精度を最大化するには: presets='best_quality' を使用する。 time_limit を十分に長く設定する(数時間〜1日)。 num_bag_folds (バギング分割数) や
num_stack_levels (スタック層) を増やすことを検討す る。 学習・推論速度を最大化するには: プロトタイピングには presets='medium_quality' を使用する。 高速な推論が必要な場合は、 presets='good_quality' や presets='high_quality' を選択す る。 predictor.refit_full() や predictor.distill() を使って、高速な単一モデルを作成す る。 66 -
まとめ:AutoGluon の主な強み 最先端の性能 (State-of-the-Art Performance) 独立したベンチマークで証明された、業界トップクラスの予測精度。 圧倒的な使いやすさ (Ease of Use)
わずか数行のコードで、非常に複雑なMLパイプラインを抽象化。 堅牢性 (Robustness) 多層アンサンブルに基づくアプローチにより、過学習や単一モデルの失敗に強い。 多様性 (Versatility) テーブル、画像、テキスト、時系列、そしてそれらの組み合わせ(マルチモーダル)に対応。 拡張性 (Extensibility) 専門家のニーズに応えるためのカスタマイズ・拡張ポイントを提供。 68 -
AutoGluon のユースケース 迅速なプロトタイピング あらゆる教師あり学習問題に対して、強力なベースラインモデルを迅速に構築。 データサイエンスコンペティション (Kaggle など) 最小限の労力で高い順位を狙うための強力な武器。 本番ML システム
特にクラウドサービスと組み合わせることで、堅牢で高性能なモデルを構築・デプロイ。 ベンチマーキング 自作のカスタムモデルの性能を評価するための「ゴールドスタンダード」として利用。 69 -
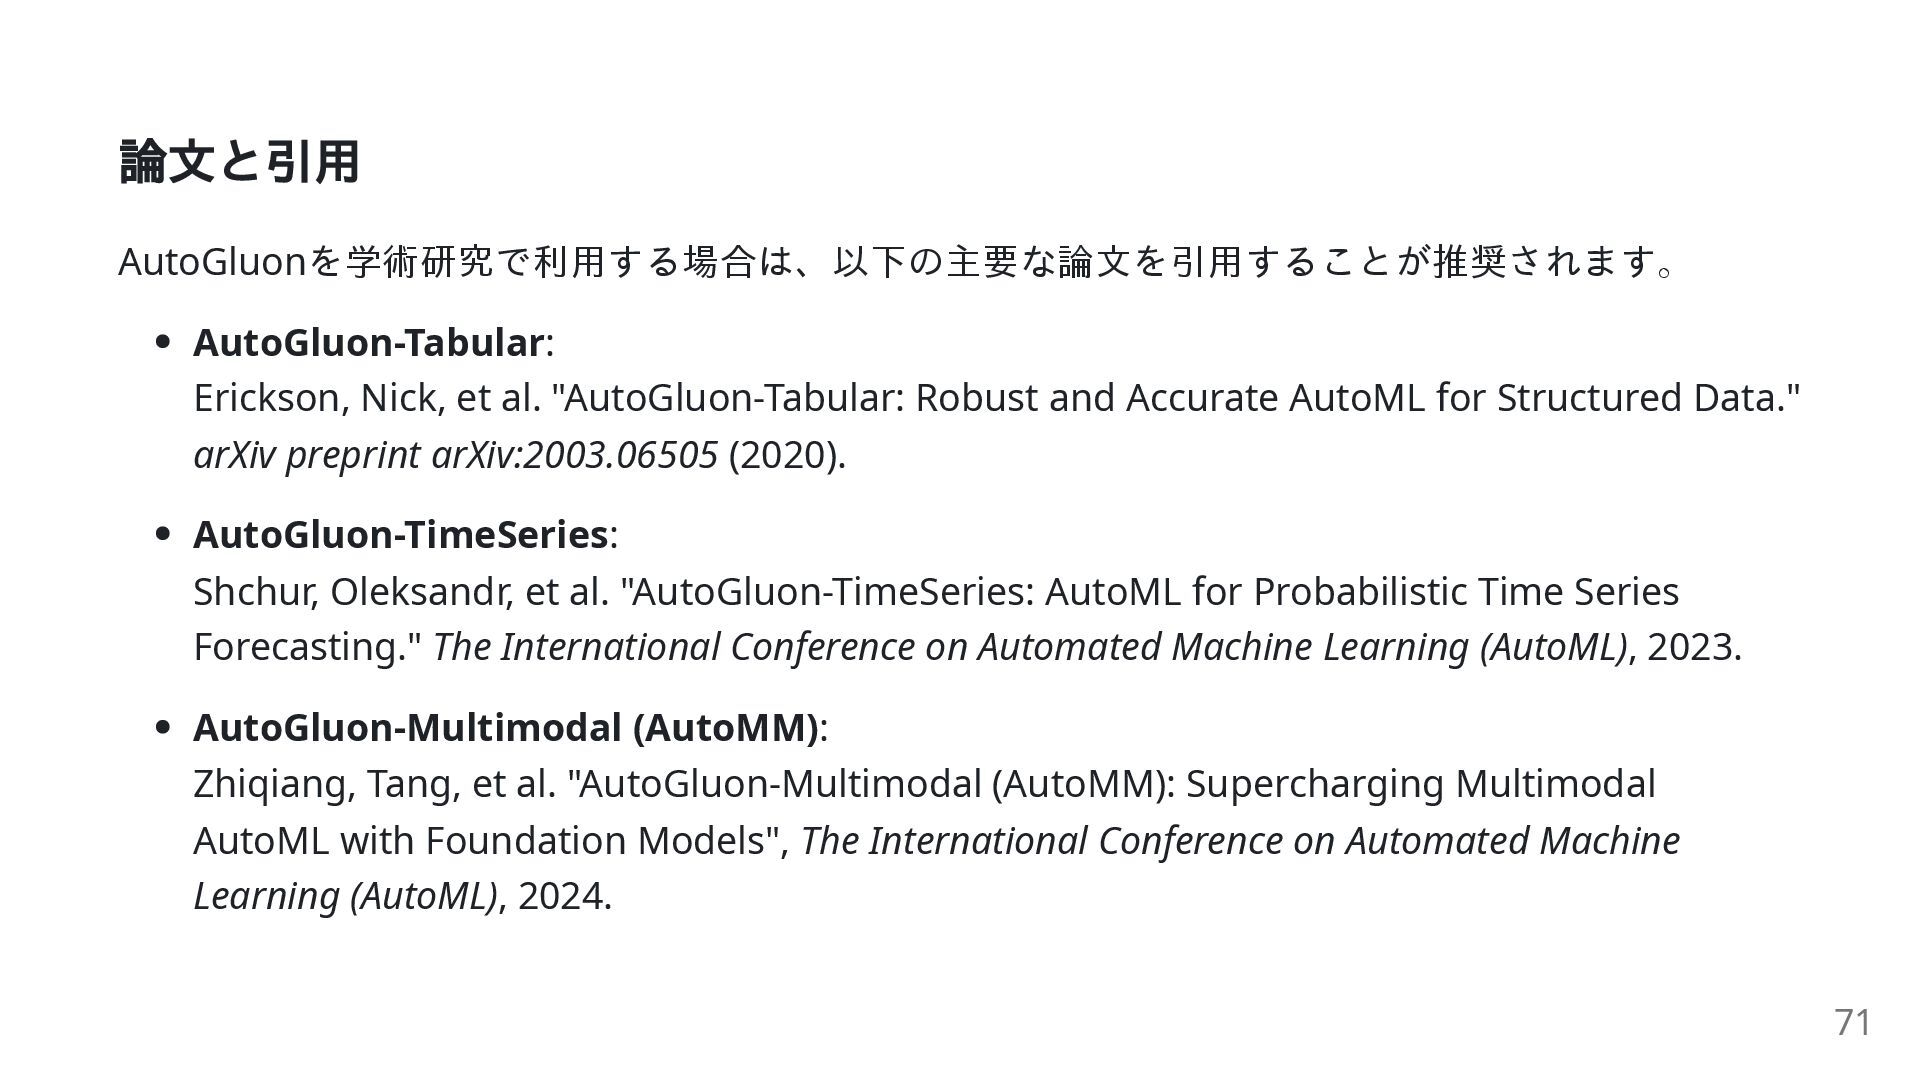
論文と引用 AutoGluonを学術研究で利用する場合は、以下の主要な論文を引用することが推奨されます。 AutoGluon-Tabular: Erickson, Nick, et al. "AutoGluon-Tabular: Robust and
Accurate AutoML for Structured Data." arXiv preprint arXiv:2003.06505 (2020). AutoGluon-TimeSeries: Shchur, Oleksandr, et al. "AutoGluon-TimeSeries: AutoML for Probabilistic Time Series Forecasting." The International Conference on Automated Machine Learning (AutoML), 2023. AutoGluon-Multimodal (AutoMM): Zhiqiang, Tang, et al. "AutoGluon-Multimodal (AutoMM): Supercharging Multimodal AutoML with Foundation Models", The International Conference on Automated Machine Learning (AutoML), 2024. 71
 mickey_kubo
 onozaty
 omatty198
 naruogram
 fornewid
 nasum
 barnbarn
 sms_tech
 kosukesaigusa
 akihisaikeda
 kinakomoti321
 ooga04
 sodainc
 stephenakadiri
 katarinadahlin
 smashingmag
 marktimemedia
 aleyda
 frankvandijk
 jonoalderson
 baasie
 techseoconnect
 davetheseo
 malarkey