Share
Embed
Pytorch強化学習プラットフォーム? Horizonのドキュメントを読む
mogamin
March 08, 2019
Transcript
19 slides
-
Pytorch 強化学習プラットフォーム? Horizonのドキュメントを読む 08.Mar.2019 Machine Learning Casual Talks #9 LT
Takashi,MOGAMI @mogamin -
WHO AM I? Takashi, MOGAMI / @mogamin ウルシステムズ株式会社 シニアコンサルタント 画像処理(OpenCV)、DeepLearningや強化学習がメインの業務。時間があ
ればkaggleやSIGNATEで技術を磨いたり、社内でarxiv論文を読む活動し たり。最近ではブロックチェーン(Ethereum)を使った研究開発を推進中。 - Scrum Master - AWS Certified Solutions Architect Professional -
AGENDA - 強化学習とは - PyTorch用強化学習フレームワークが出た - Horizonのドキュメントをできる限り読み解く - Readme編 -
Document編 - Installation編 - Usage編 ※本内容は個人の見解です。所属組織とは一切関係ありません。 -
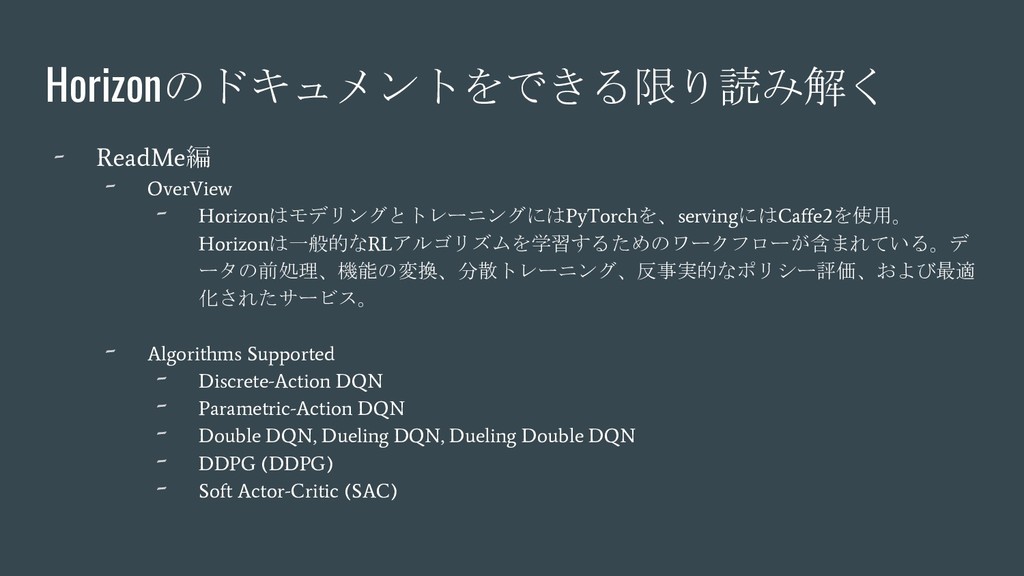
Horizonのドキュメントをできる限り読み解く - ReadMe編 - OverView - HorizonはモデリングとトレーニングにはPyTorchを、servingにはCaffe2を使用。 Horizonは一般的なRLアルゴリズムを学習するためのワークフローが含まれている。デ ータの前処理、機能の変換、分散トレーニング、反事実的なポリシー評価、および最適 化されたサービス。
- Algorithms Supported - Discrete-Action DQN - Parametric-Action DQN - Double DQN, Dueling DQN, Dueling Double DQN - DDPG (DDPG) - Soft Actor-Critic (SAC) -
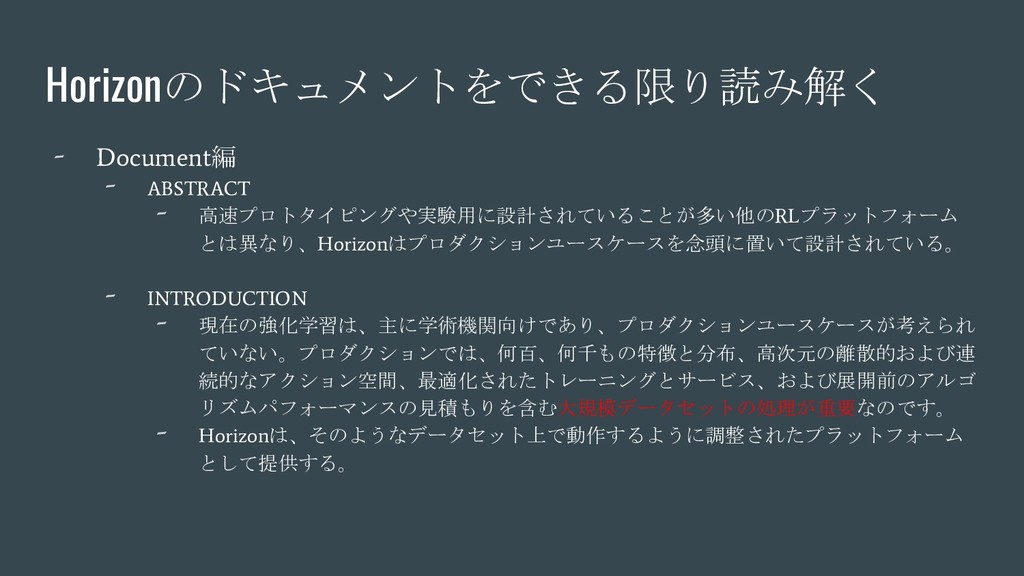
Horizonのドキュメントをできる限り読み解く - Document編 - ABSTRACT - 高速プロトタイピングや実験用に設計されていることが多い他のRLプラットフォーム とは異なり、Horizonはプロダクションユースケースを念頭に置いて設計されている。 - INTRODUCTION
- 現在の強化学習は、主に学術機関向けであり、プロダクションユースケースが考えられ ていない。プロダクションでは、何百、何千もの特徴と分布、高次元の離散的および連 続的なアクション空間、最適化されたトレーニングとサービス、および展開前のアルゴ リズムパフォーマンスの見積もりを含む大規模データセットの処理が重要なのです。 - Horizonは、そのようなデータセット上で動作するように調整されたプラットフォーム として提供する。 -
Horizonのドキュメントをできる限り読み解く - Document編 - DATA PREPROCESSING - 多くのRLモデルのデータは、状態/アクションの連続したペアで学習している。本番の 環境では一般的にログに記録されることが多く、RLに適した形式ではない。Horizonで は、収集されたログデータを変換するSparkパイプライン(タイムラインパイプライン
と呼ばれます)が含まれている。 - MDP ID - Sequence Number - State Features - Action - Action Probability - Reward - Possible Actions - 内部的には、Hiveテーブルに対して書き込む。変換後もHiveテーブルに書き込む。 -
Horizonのドキュメントをできる限り読み解く - Document編 - FEATURE NORMALIZATION - 文献によれば、ニューラルネットワークは、データが正規分布していると、より速くよ り良く学習することが示されている(Ioffe&Szegedy、2015)。 -
RLは、大きな特徴量にさらされると不安定になる可能性があるため、特徴量の正規化 が非常に重要である。 - Horizonは学習データセットを自動的に分析し、各フィーチャに最適な変換関数と対応 する正規化パラメータを決定するワークフローが含まれている。 - そのワークフローでは、特徴がどのように正規化されるべきかを「正規化仕様」として 作成される。A “normalization specification” is then created which describes how the feature should be normalized during training. -
Horizonのドキュメントをできる限り読み解く - Document編 - TRAINING - トレーニングは、CPU、GPU、または複数のGPUを使用して実行できる。 - オープンソース版における多数のマシンにまたがるマルチGPUトレーニングは、近い将 来リリースされる予定。
- GPUおよびマルチGPUトレーニングを使用して、数時間で数千万の例にわたる数百か ら数千の機能を含む大規模なRLモデルをトレーニングできる。(すべてのバッチで機 能の正規化およびポリシー評価を行う) -
Horizonのドキュメントをできる限り読み解く - Document編 - REPORTING AND EVALUATION - 時間差損失(TD-loss)は関数近似誤差を測定する。 -
たとえばDQNでは、ベルマン方程式によって与えられるQの期待値とモデルによ って出力されるQの実際の値との差を測定する。ラベルが定常分布からのもので ある教師あり学習とは異なりRLではラベル自体がモデルの関数である。主に最適 化ループが安定していることを確認するために使用される。 - モンテカルロ損失(MC損失)は、モデルのQ値を記録された値(記録された報酬の割 引合計)と比較する。 - プロセスの可視化として、TensorboardXプラグインを使用してメトリックを表示できる。 -
Horizonのドキュメントをできる限り読み解く - Document編 - CASE STUDY: NOTIFICATIONS AT FACEBOOK -
これまでは、クリックスルー率(CTR)とその通知が意味のあるアクティビティにつな がることを予測するために、教師付き学習モデルを使用してきた。が、長期的または増 分的な価値を捉えるものではなかった。 - 通知の設定は人によって異なる。しきい値に基づくフィルタリングでは、通知に対する 感度が異なる人への通知にどう調整するべきかが、見逃されてきていた。 - この問題に対処するためにHorizonで送信するべき通知をDiscrete-Action DQNモデルで 学習したところ、以前のモデルと比較して、特定の種類の通知とFacebook上のアクティ ビティ促進に大幅な改善が見られた。 - Facebook上でのアクティビティに報酬を加え、通知送信量の増大に対してペナルティを 付加させた。 -
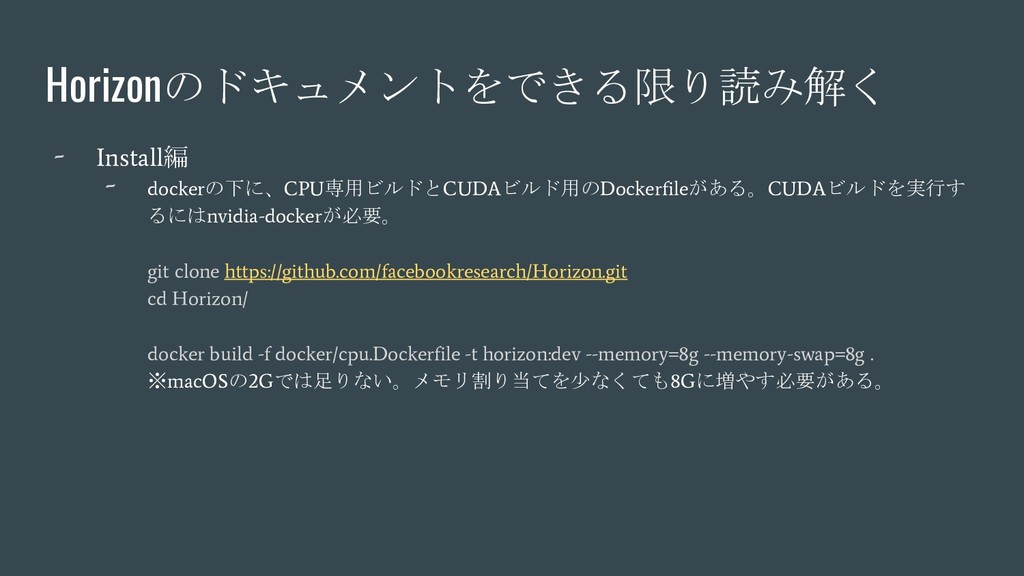
Horizonのドキュメントをできる限り読み解く - Install編 - dockerの下に、CPU専用ビルドとCUDAビルド用のDockerfileがある。CUDAビルドを実行す るにはnvidia-dockerが必要。 git clone https://github.com/facebookresearch/Horizon.git cd
Horizon/ docker build -f docker/cpu.Dockerfile -t horizon:dev --memory=8g --memory-swap=8g . ※macOSの2Gでは足りない。メモリ割り当てを少なくても8Gに増やす必要がある。