Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ニコニコ大百科と日本語情報抽出方法の検当
Search
Mokke Meguru
March 30, 2020
Research
2.6k
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ニコニコ大百科と日本語情報抽出方法の検当
サイボウズ・ラボユース第9期成果発表会
Mokke Meguru
March 30, 2020
Other Decks in Research
See All in Research
GLIM とMegaParticles:正規分布近似の限界とタイトカップリング&パーティクルフィルタの進展 / GLIM and MegaParticles : Progress of the distribution representation in SLAM
koide3
0
890
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
370
Développer des solutions de réduction des émissions de méthane entérique : 1ers résultats Méthane 2030
institudelelevage
PRO
0
160
研究室単位での自律的 IPv6接続性確立に向けたAS共同運用モデルの提案と実証
reokashiwa
PRO
0
220
論文紹介: Understanding Epistemic Language with a Language-augmented Bayesian Theory of Mind
hisaokatsumi
0
170
CDCL を用いた MILP の厳密解法
imai448
0
280
Kaggle|AI Agent Security — しくじり先生、俺みたいになるな
pomcho555
1
110
SoftMatcha 2: 1兆語規模コーパスの超高速かつ柔らかい検索
e869120_sub
7
3.9k
進化?迷走?CasualConc ファミリーアプリの現在地 @ 英語コーパス学会 2026
casualconc
0
110
2026年 オープンキャンパス 研究室紹介
junkurihara
0
210
J-STAGEの現況と全文XML登載必須化について
xspa2012
0
290
[ACL 2026 Demo] Fast-MIA: Efficient and Scalable Membership Inference for LLMs
upura
0
130
Featured
See All Featured
Documentation Writing (for coders)
carmenintech
77
5.5k
Facilitating Awesome Meetings
lara
57
7.2k
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
410
4 Signs Your Business is Dying
shpigford
187
23k
My Coaching Mixtape
mlcsv
0
330
Paper Plane (Part 1)
katiecoart
PRO
2
11k
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
490
Discover your Explorer Soul
emna__ayadi
2
1.3k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Building AI with AI
inesmontani
PRO
1
1.3k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
Transcript
ニコニコ大百科と 日本語情報抽出方法の 検討 サイボウズ・ラボユース 第9期 成果報告会 江畑 拓哉 メンター: 中谷
秀洋 2020.03.30 あ
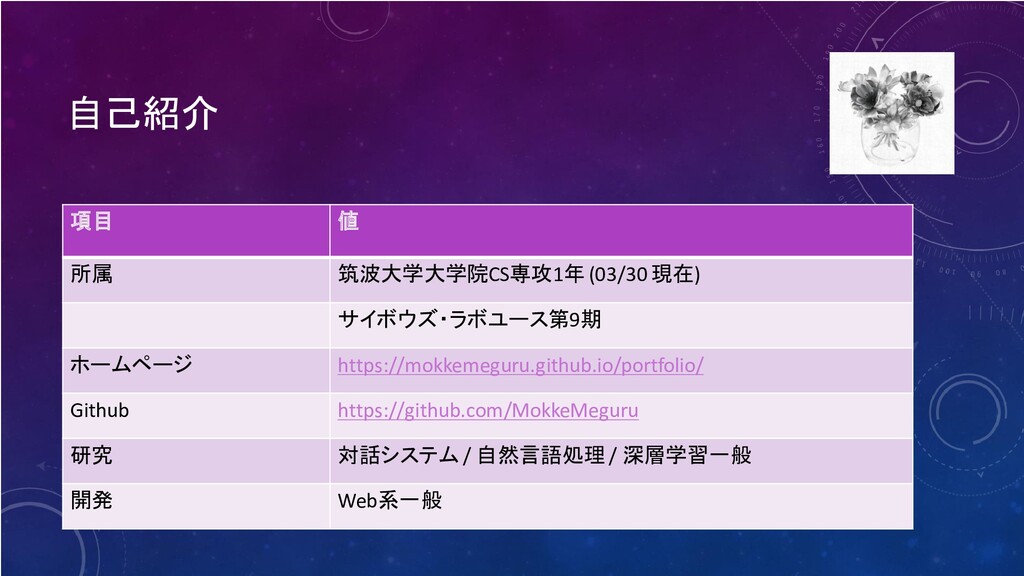
自己紹介 項目 値 所属 筑波大学大学院CS専攻1年(03/30 現在) サイボウズ・ラボユース第9期 ホームページ https://mokkemeguru.github.io/portfolio/ Github
https://github.com/MokkeMeguru 研究 対話システム / 自然言語処理 / 深層学習一般 開発 Web系一般
動機 ニコニコ大百科の知識を コンピュータに理解させたい コンピュータが知識を獲得すると何が良いのか? - その知識を用いて対話システムを組むことができる ⇒ 知識がないと話ができない、対話システムのコアの一つ - Question-Answering
ができる - 情報検索ができる Copyrights © 2005-2020 AHS Co. Ltd. All rights reserved. 知識 発話 応答
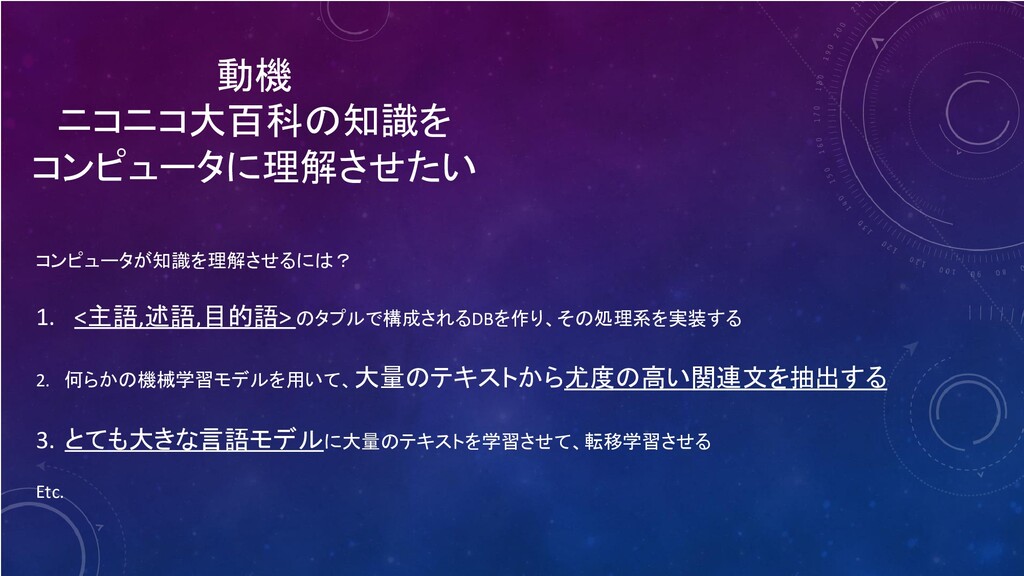
動機 ニコニコ大百科の知識を コンピュータに理解させたい コンピュータが知識を理解させるには? 1. <主語,述語,目的語> のタプルで構成されるDBを作り、その処理系を実装する 2. 何らかの機械学習モデルを用いて、大量のテキストから尤度の高い関連文を抽出する 3.
とても大きな言語モデルに大量のテキストを学習させて、転移学習させる Etc.
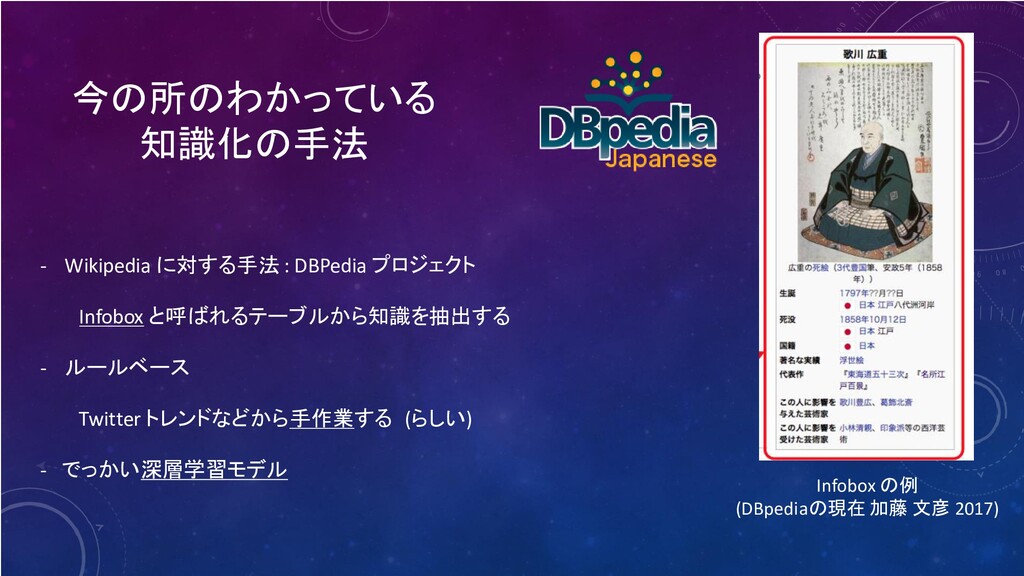
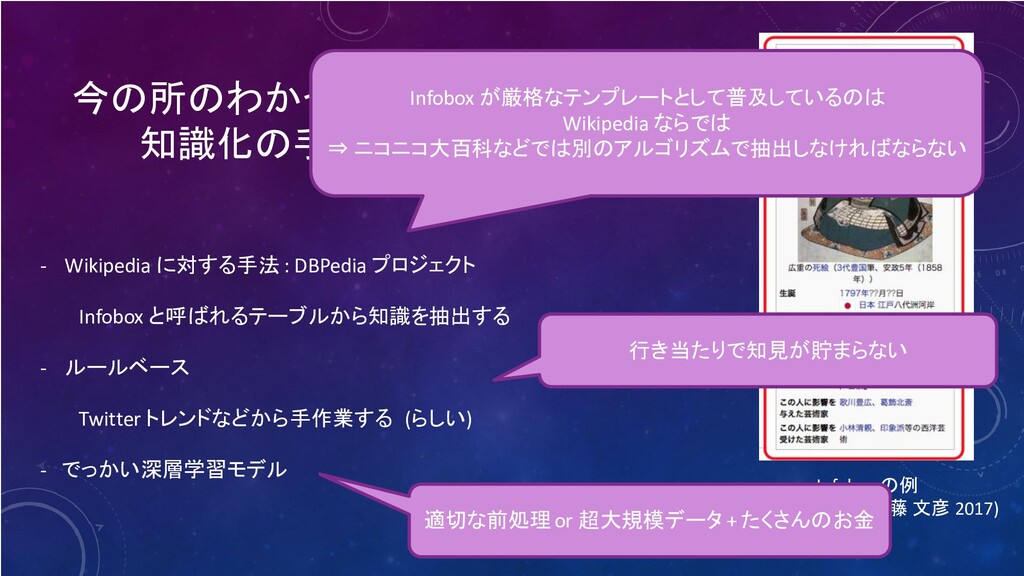
今の所のわかっている 知識化の手法 - Wikipedia に対する手法 : DBPedia プロジェクト Infobox と呼ばれるテーブルから知識を抽出する
- ルールベース Twitter トレンドなどから手作業する (らしい) - でっかい深層学習モデル Infobox の例 (DBpediaの現在 加藤 文彦 2017)
今の所のわかっている 知識化の手法 Infobox の例 (DBpediaの現在 加藤 文彦 2017) Infobox が厳格なテンプレートとして普及しているのは
Wikipedia ならでは ⇒ ニコニコ大百科などでは別のアルゴリズムで抽出しなければならない 行き当たりで知見が貯まらない - Wikipedia に対する手法 : DBPedia プロジェクト Infobox と呼ばれるテーブルから知識を抽出する - ルールベース Twitter トレンドなどから手作業する (らしい) - でっかい深層学習モデル 適切な前処理or 超大規模データ + たくさんのお金
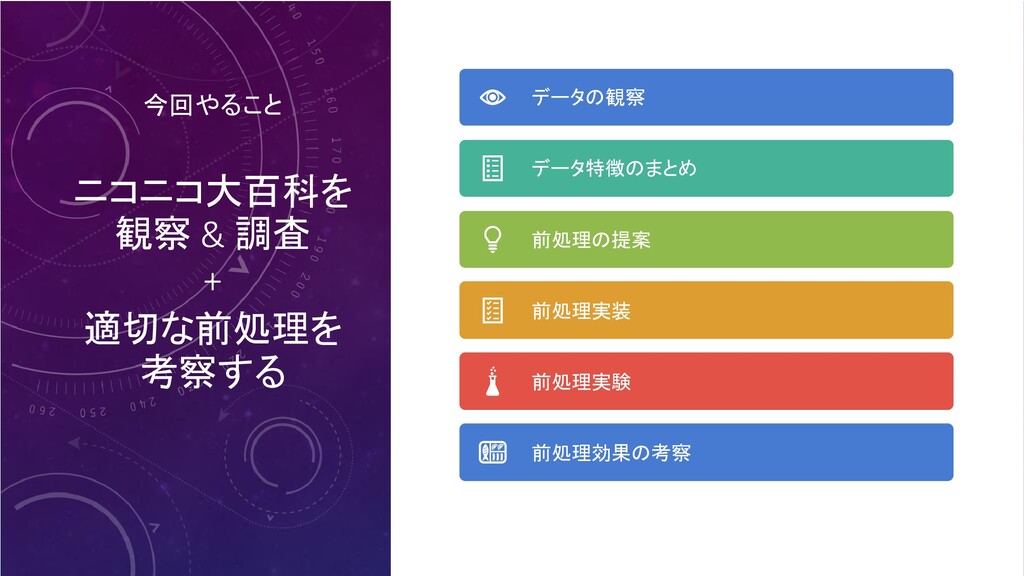
今回やること ニコニコ大百科を 観察 & 調査 + 適切な前処理を 考察する データの観察 データ特徴のまとめ
前処理の提案 前処理実装 前処理実験 前処理効果の考察
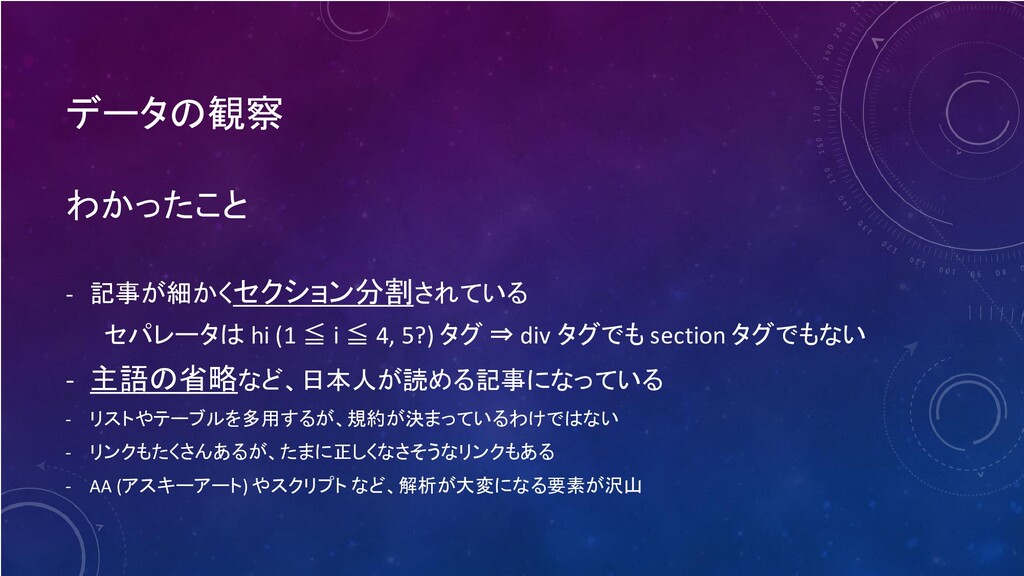
データの観察 わかったこと - 記事が細かくセクション分割されている セパレータは hi (1 ≦ i ≦
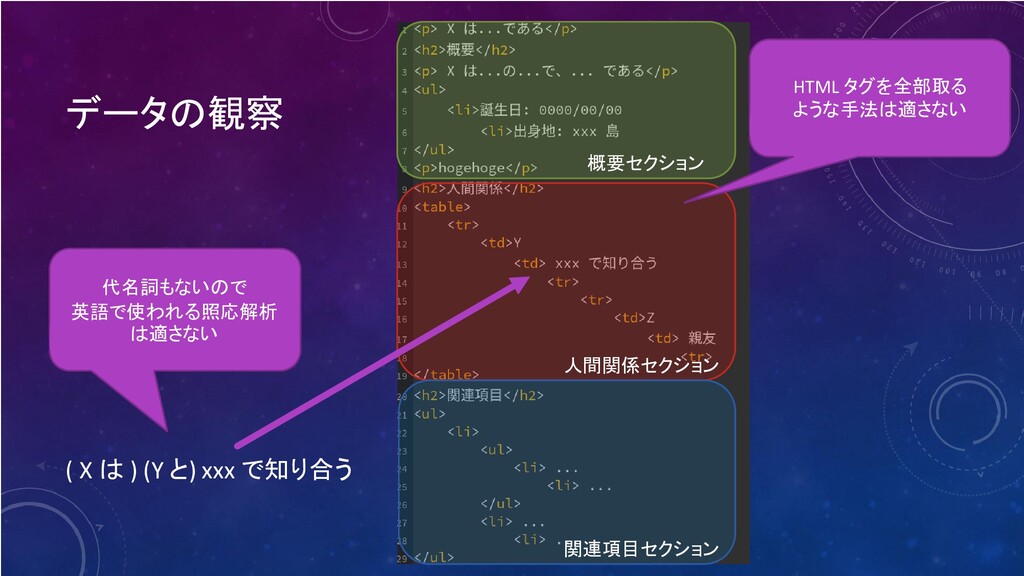
4, 5?) タグ ⇒ div タグでも section タグでもない - 主語の省略など、日本人が読める記事になっている - リストやテーブルを多用するが、規約が決まっているわけではない - リンクもたくさんあるが、たまに正しくなさそうなリンクもある - AA (アスキーアート) やスクリプト など、解析が大変になる要素が沢山
データの観察 ( X は ) (Y と) xxx で知り合う 概要セクション
人間関係セクション 関連項目セクション HTML タグを全部取る ような手法は適さない 代名詞もないので 英語で使われる照応解析 は適さない
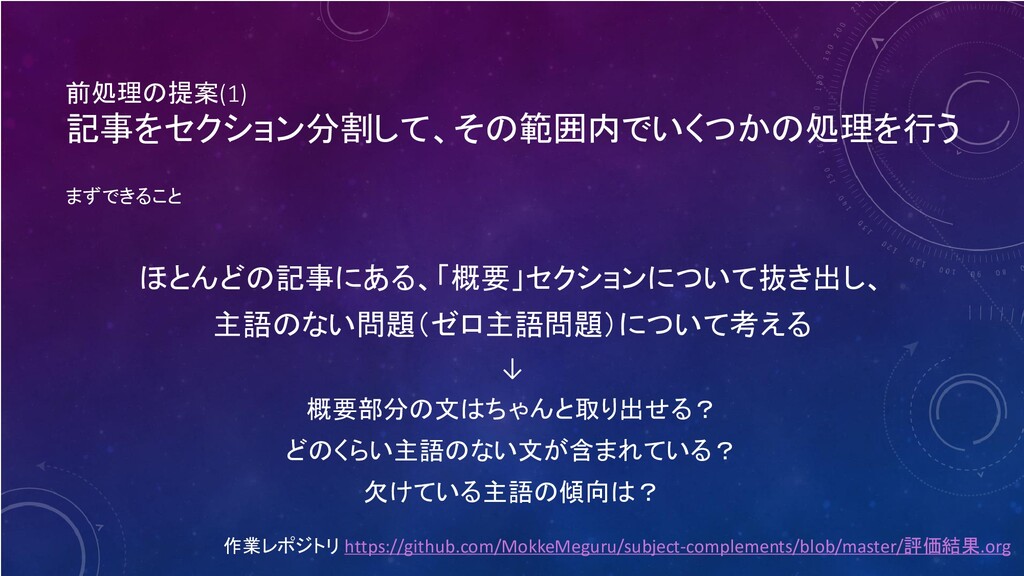
前処理の提案(1) 記事をセクション分割して、その範囲内でいくつかの処理を行う まずできること ほとんどの記事にある、「概要」セクションについて抜き出し、 主語のない問題(ゼロ主語問題)について考える ↓ 概要部分の文はちゃんと取り出せる? どのくらい主語のない文が含まれている? 欠けている主語の傾向は? 作業レポジトリ
https://github.com/MokkeMeguru/subject-complements/blob/master/評価結果.org
前処理実装 (1) / 前処理実験 調査結果 発表資料 https://www.nii.ac.jp/dsc/idr/userforum/poster/IDR-UF2019_P11.pdf できている 83% できていない
9% 判断できない 8% 概要部分の文抽出精度 タイトル 67% タイトルでない 33% 欠けている主語が 記事タイトルである割合 半分近くが主語が欠けている 欠けている 45% 欠けていない 55% 主語の欠けている文の割合 少なくとも概要部の多くは 主語で記事タイトルを 補完できる
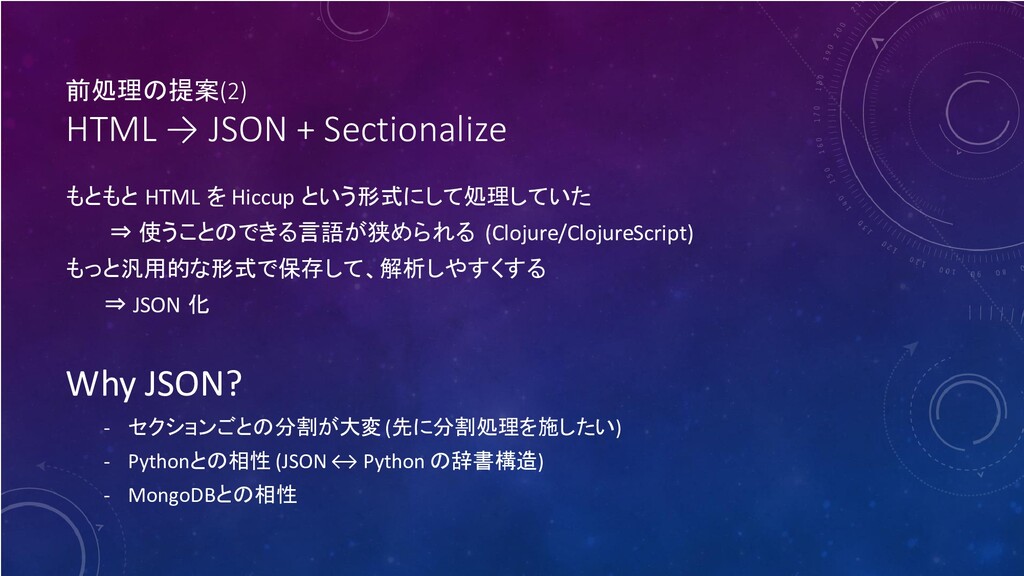
前処理の提案(2) HTML → JSON + Sectionalize もともと HTML を Hiccup
という形式にして処理していた ⇒ 使うことのできる言語が狭められる (Clojure/ClojureScript) もっと汎用的な形式で保存して、解析しやすくする ⇒ JSON 化 Why JSON? - セクションごとの分割が大変(先に分割処理を施したい) - Pythonとの相性 (JSON ↔ Python の辞書構造) - MongoDBとの相性
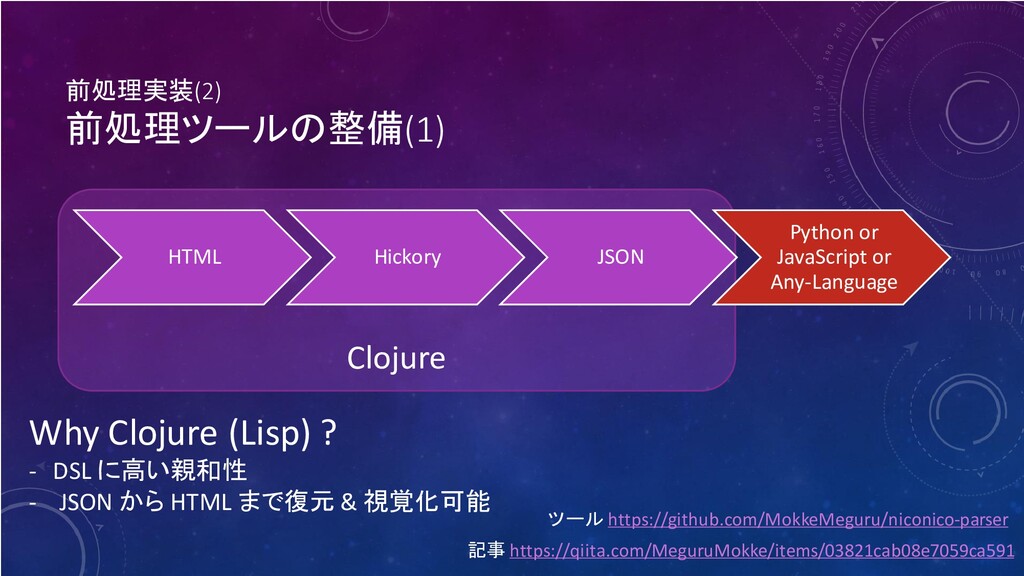
Clojure 前処理実装(2) 前処理ツールの整備(1) ツール https://github.com/MokkeMeguru/niconico-parser HTML Hickory JSON Python or
JavaScript or Any-Language Why Clojure (Lisp) ? - DSL に高い親和性 - JSON から HTML まで復元 & 視覚化可能 記事 https://qiita.com/MeguruMokke/items/03821cab08e7059ca591
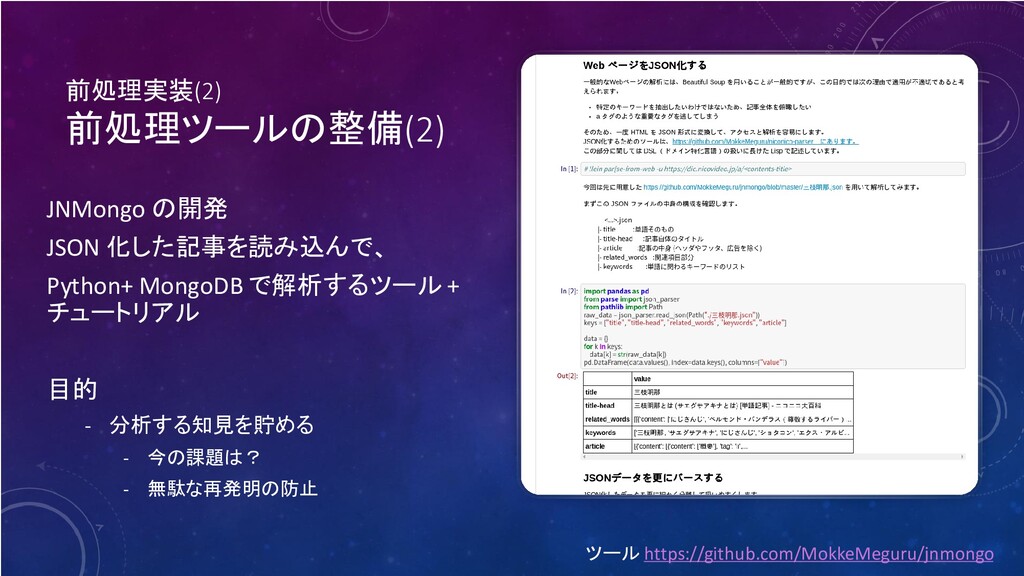
前処理実装(2) 前処理ツールの整備(2) JNMongo の開発 JSON 化した記事を読み込んで、 Python+ MongoDB で解析するツール +
チュートリアル 目的 - 分析する知見を貯める - 今の課題は? - 無駄な再発明の防止 ツール https://github.com/MokkeMeguru/jnmongo
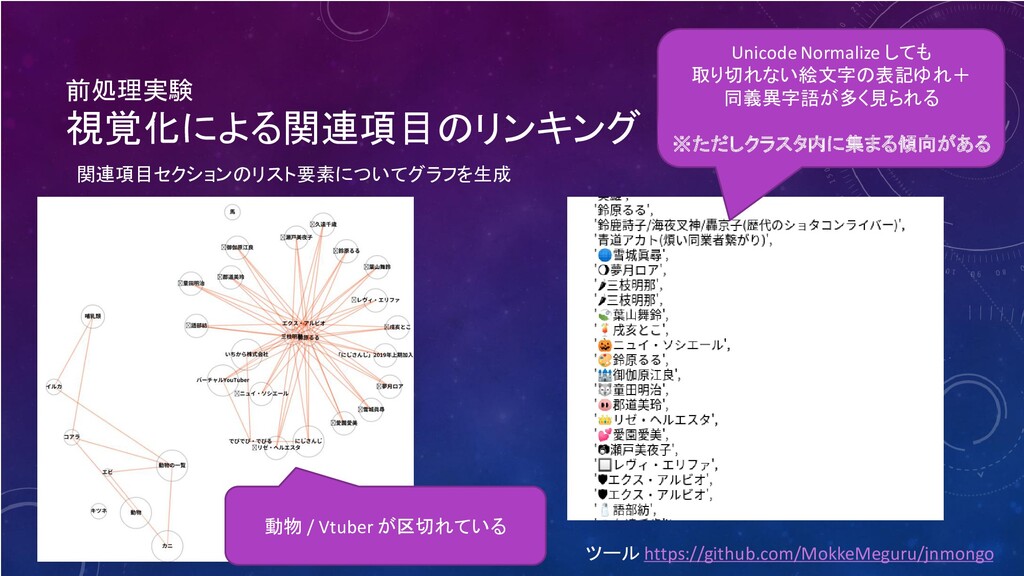
前処理実験 視覚化による関連項目のリンキング 動物 / Vtuber が区切れている Unicode Normalize しても 取り切れない絵文字の表記ゆれ+
同義異字語が多く見られる ※ただしクラスタ内に集まる傾向がある 関連項目セクションのリスト要素についてグラフを生成 ツール https://github.com/MokkeMeguru/jnmongo
前処理効果の考察・今後の課題 • ニコニコ大百科 / 日本語ならではの課題を洗い出すことができた • 特にニコニコ大百科についての特徴である、「セクション分割」という特徴を生か した前処理をいくつか提案し、実装、試験し、特にゼロ主語の問題については有 意な解決策を提案できた •
Pixiv大百科や Wikipedia についても同様のことが言えるのかを調査をしたい • 他研究者のために、より定量的な評価を導入したい
まとめ • ニコニコ大百科について、知識化をするための前処理について実験、 考察、ツールの開発を行った • 特に「ゼロ主語」、「セクション分割」について注目し、前処理を行った • 今後の研究のためにツールの整備・チュートリアルの作成をした Thank you
for watching


 koide3
 rfujii
 institudelelevage
 reokashiwa
 hisaokatsumi
 imai448
 pomcho555
 e869120_sub
 casualconc
 junkurihara
 xspa2012
 upura
 carmenintech
 lara
 minecr
 shpigford
 mlcsv
 katiecoart
 ks91
 emna__ayadi
 honnibal
 inesmontani
 samlambert
 sstephenson