Share
Embed
Moscow Python Meetup №96. Кирилл Гладких (Ecom.tech, Python Разработчик). Ускорение обработки данных путем миграций с Pandas на Polars
Расскажу про успешный опыт ускорения многопоточного приложения написанного на pandas. Покажу сравнение синтаксиса и производительности polars с другими решениями. Дам полезные советы по миграции.
Видео: https://moscowpython.ru/meetup/96/pandas-to-polaris/
Расскажу про успешный опыт ускорения многопоточного приложения написанного на pandas. Покажу сравнение синтаксиса и производительности polars с другими решениями. Дам полезные советы по миграции.
Moscow Python Meetup PRO
November 28, 2024
Transcript
57 slides
-
КАК МЫ УСКОРИЛИ ПРОГНОЗ СПРОСА ПУТЕМ МИГРАЦИИ С PANDAS
НА POLARS Moscow Python Meetup #96 Python-разработчик в ecom.tech (ex Samokat.tech) Кирилл Гладких КАК МЫ УСКОРИЛИ ПРОГНОЗ СПРОСА ПУТЕМ МИГРАЦИИ С PANDAS НА POLARS -
Гладких Кирилл • 5 лет разработки на Python • Работаю
в ecom.tech в команде продуктовизации ML-моделей для серисов Самоката • Люблю котиков и путешествия -
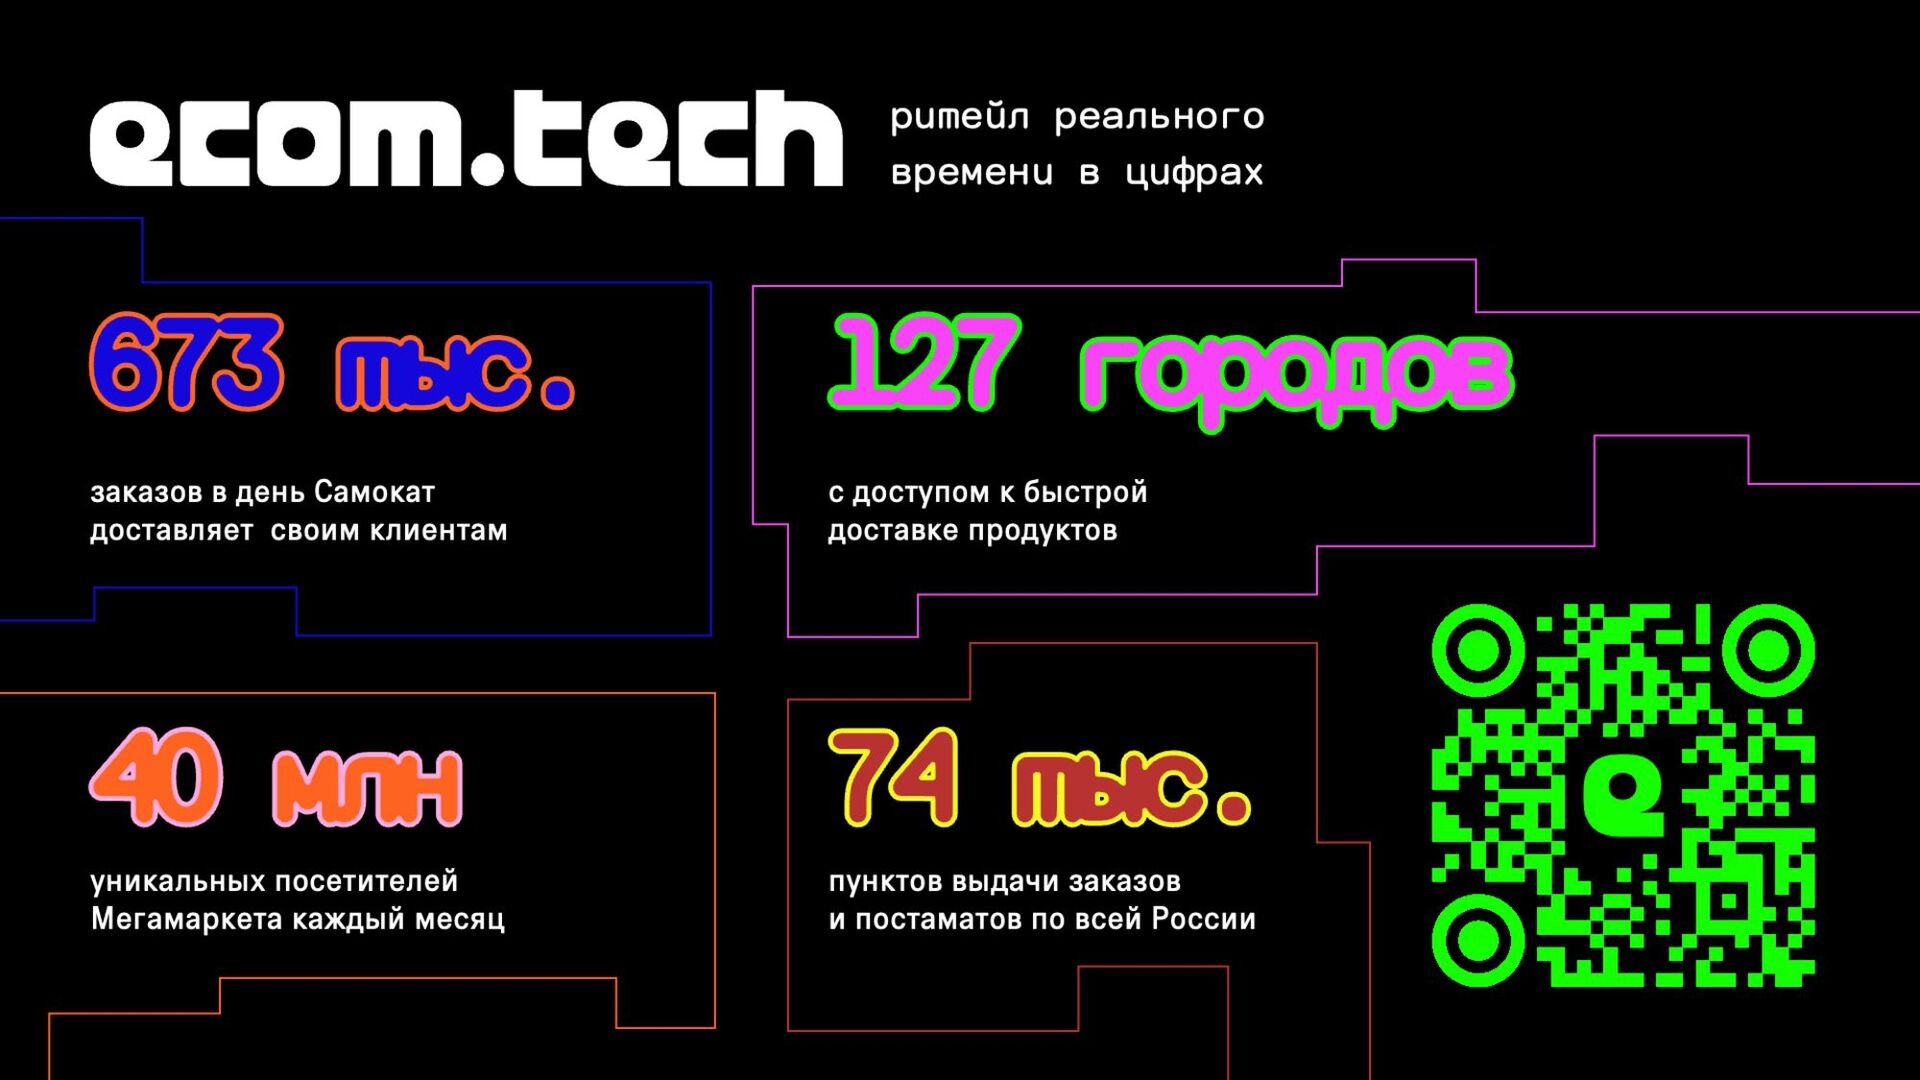
ритейл реального времени в цифрах заказов в день Самокат
доставляет своим клиентам с доступом к быстрой доставке продуктов уникальных посетителей Мегамаркета каждый месяц пунктов выдачи заказов и постаматов по всей России 673 тыс. 127 городов 74 тыс. 40 млн -
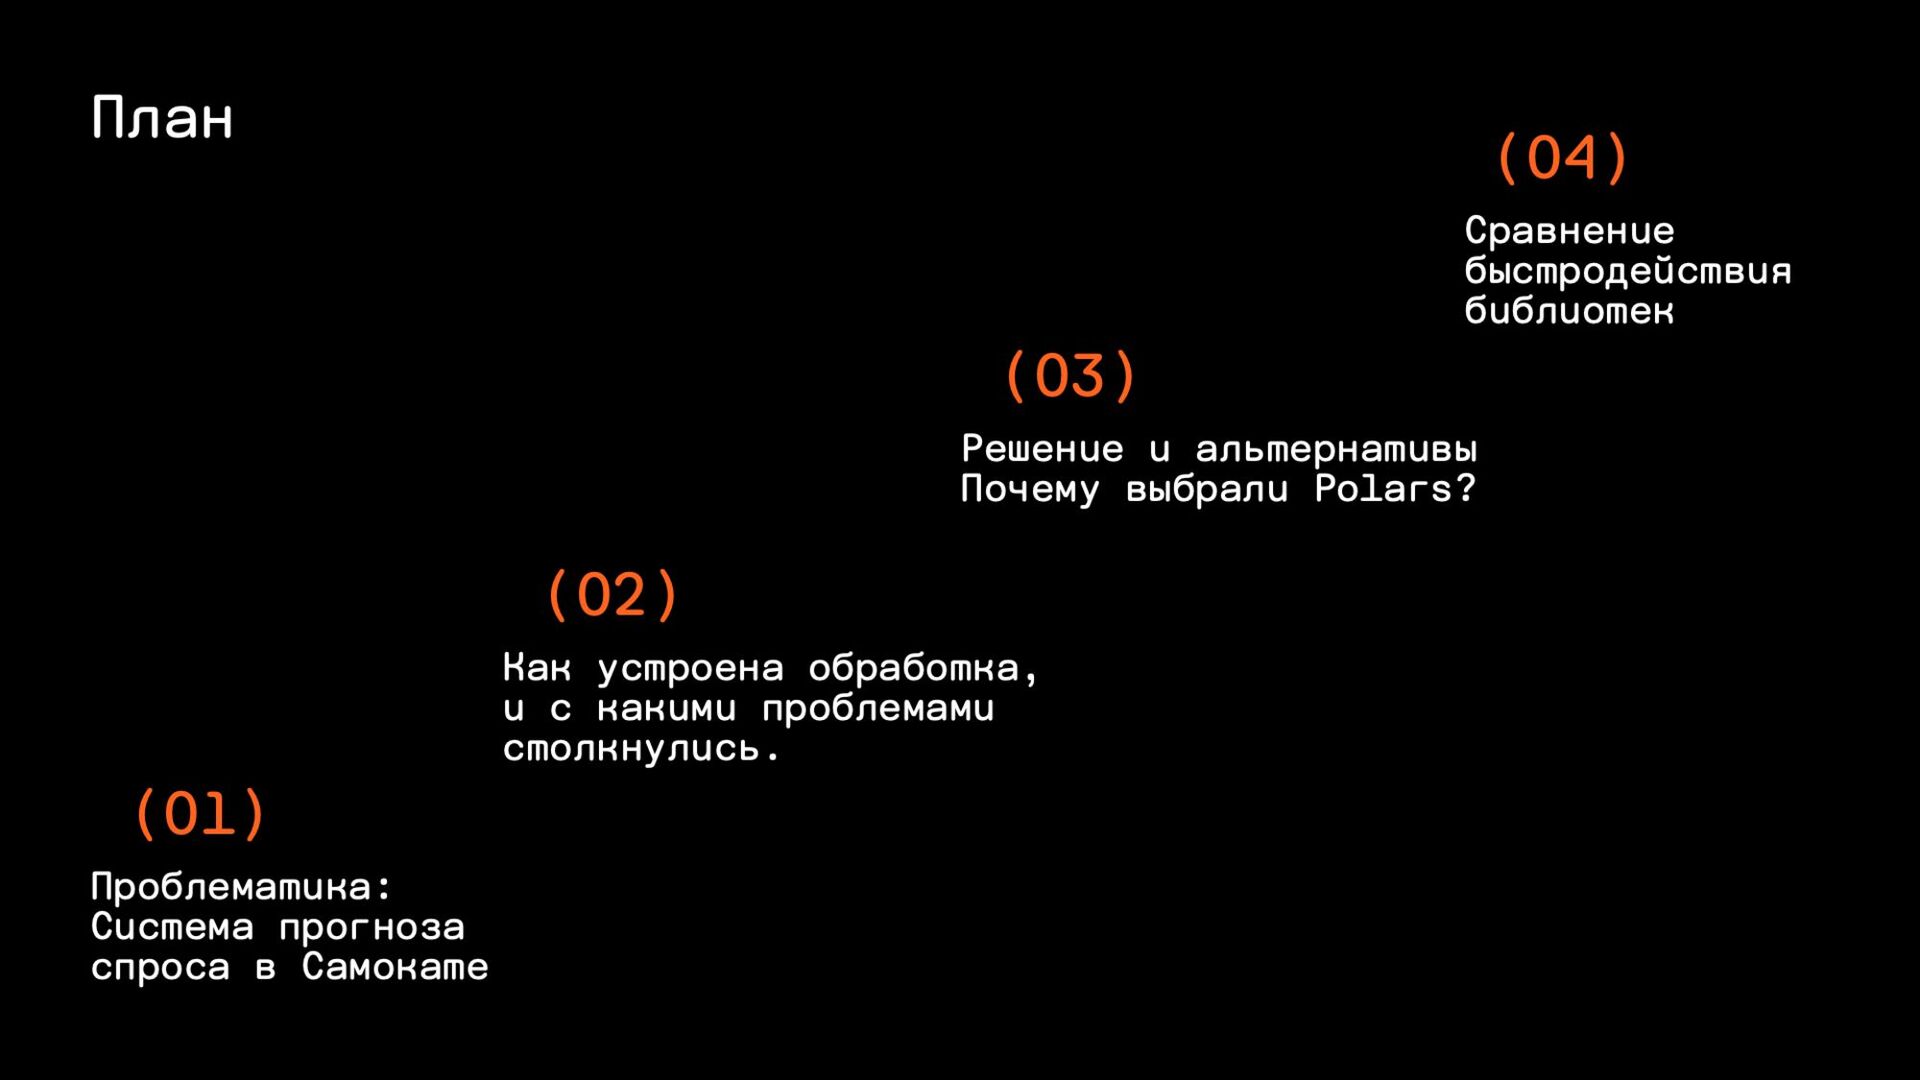
План (01) Проблематика: Система прогноза спроса в Самокате (02) Как
устроена обработка, и с какими проблемами столкнулись. (03) Решение и альтернативы Почему выбрали Polars? (04) Сравнение быстродействия библиотек -
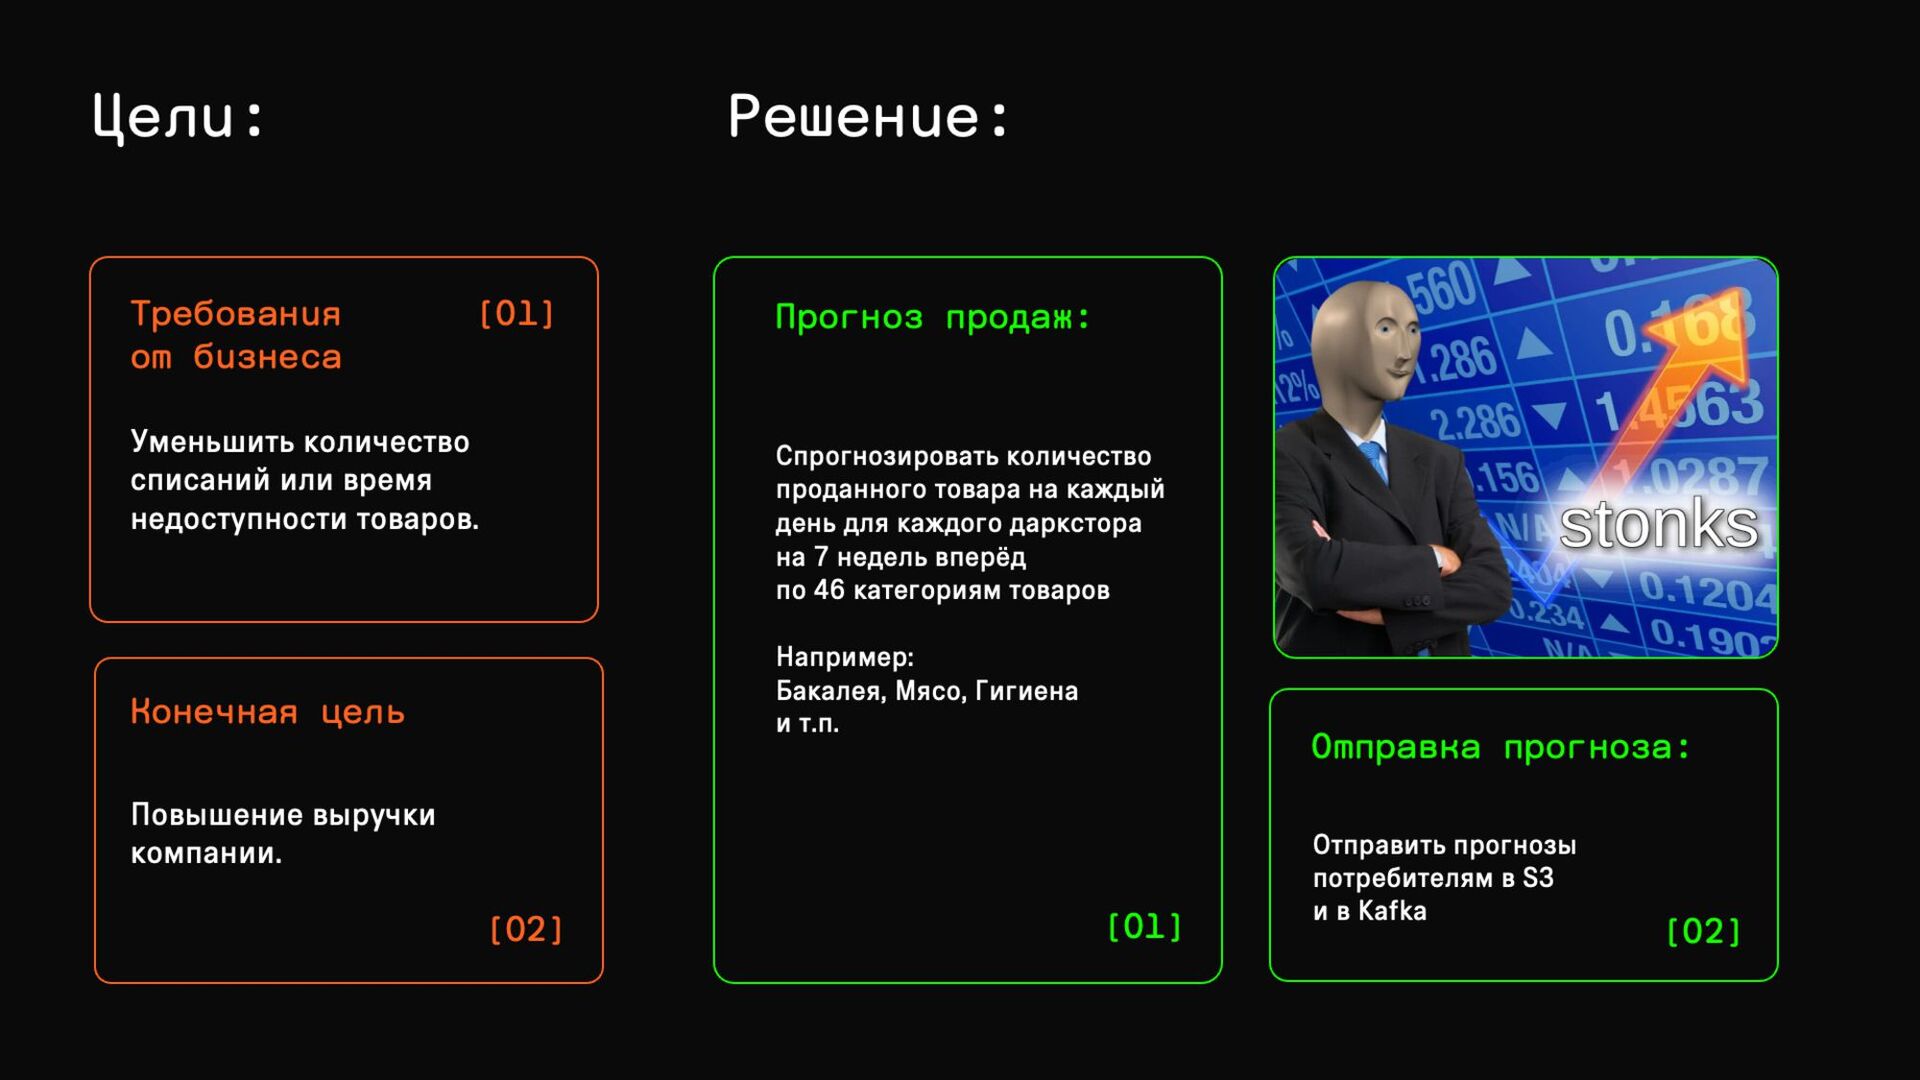
Цели: Уменьшить количество списаний или время недоступности товаров. Повышение выручки
компании. Требования от бизнеса Конечная цель [01] [02] -
Цели: Уменьшить количество списаний или время недоступности товаров. Прогноз продаж:
Спрогнозировать количество проданного товара на каждый день для каждого даркстора на 7 недель вперёд по 46 категориям товаров Например: Бакалея, Мясо, Гигиена и т.п. Повышение выручки компании. Требования от бизнеса Конечная цель [01] [02] Решение: [01] -
Цели: Уменьшить количество списаний или время недоступности товаров. Прогноз продаж:
Спрогнозировать количество проданного товара на каждый день для каждого даркстора на 7 недель вперёд по 46 категориям товаров Например: Бакалея, Мясо, Гигиена и т.п. Повышение выручки компании. Отправка прогноза: Отправить прогнозы потребителям в S3 и в Kafka [02] Требования от бизнеса Конечная цель [01] [02] Решение: [01] -
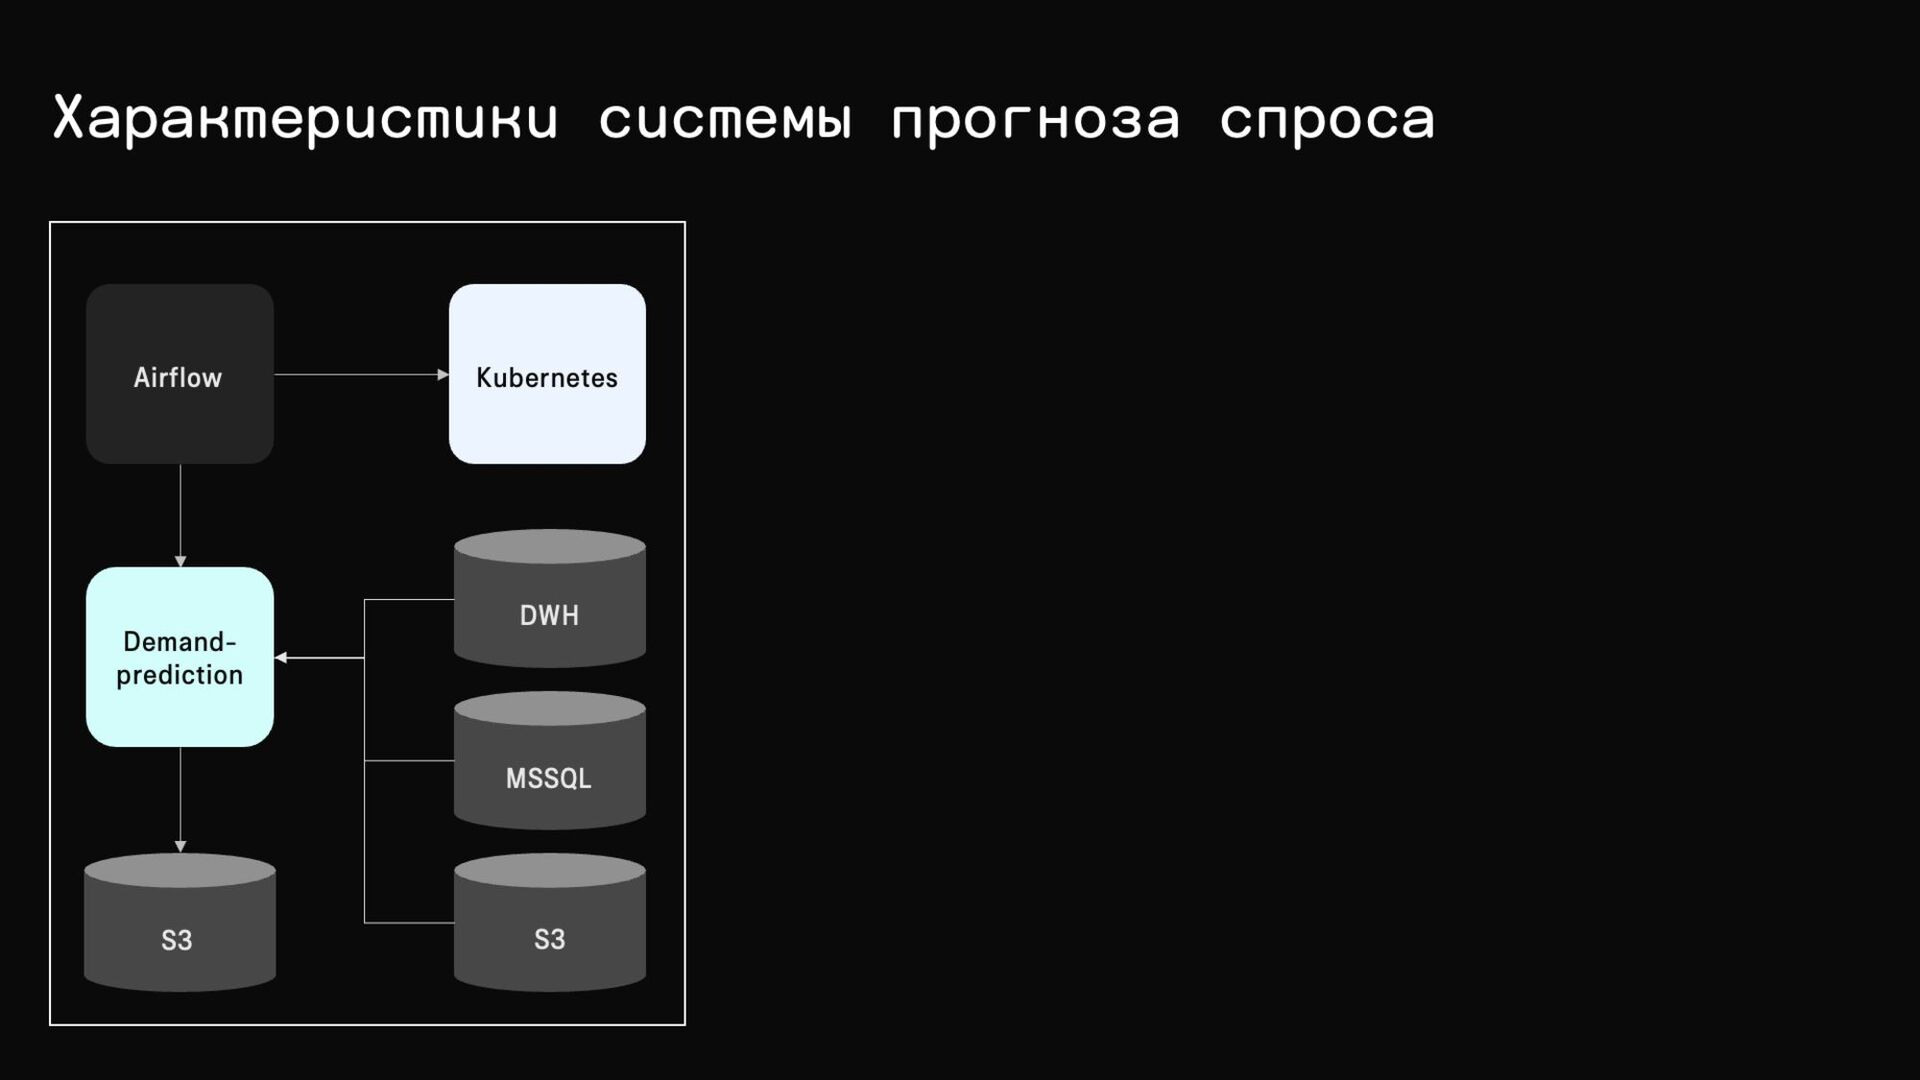
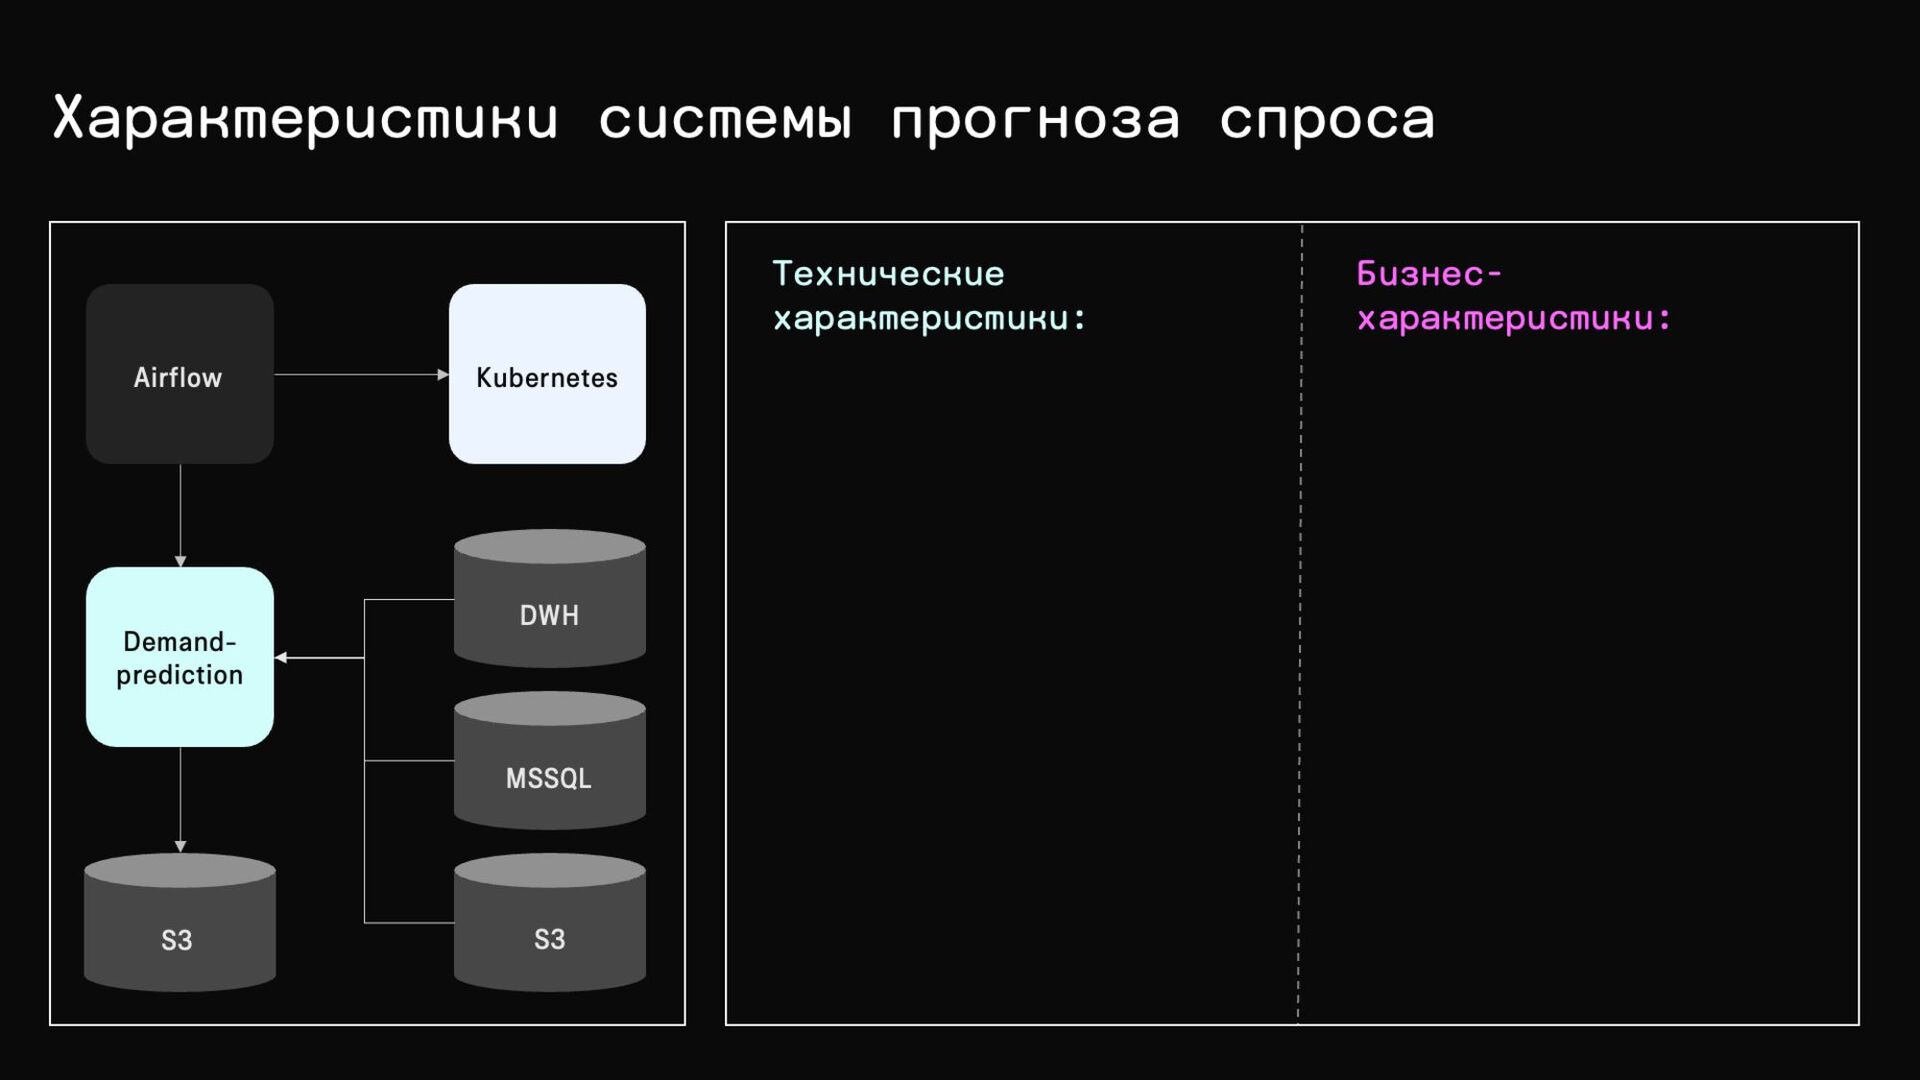
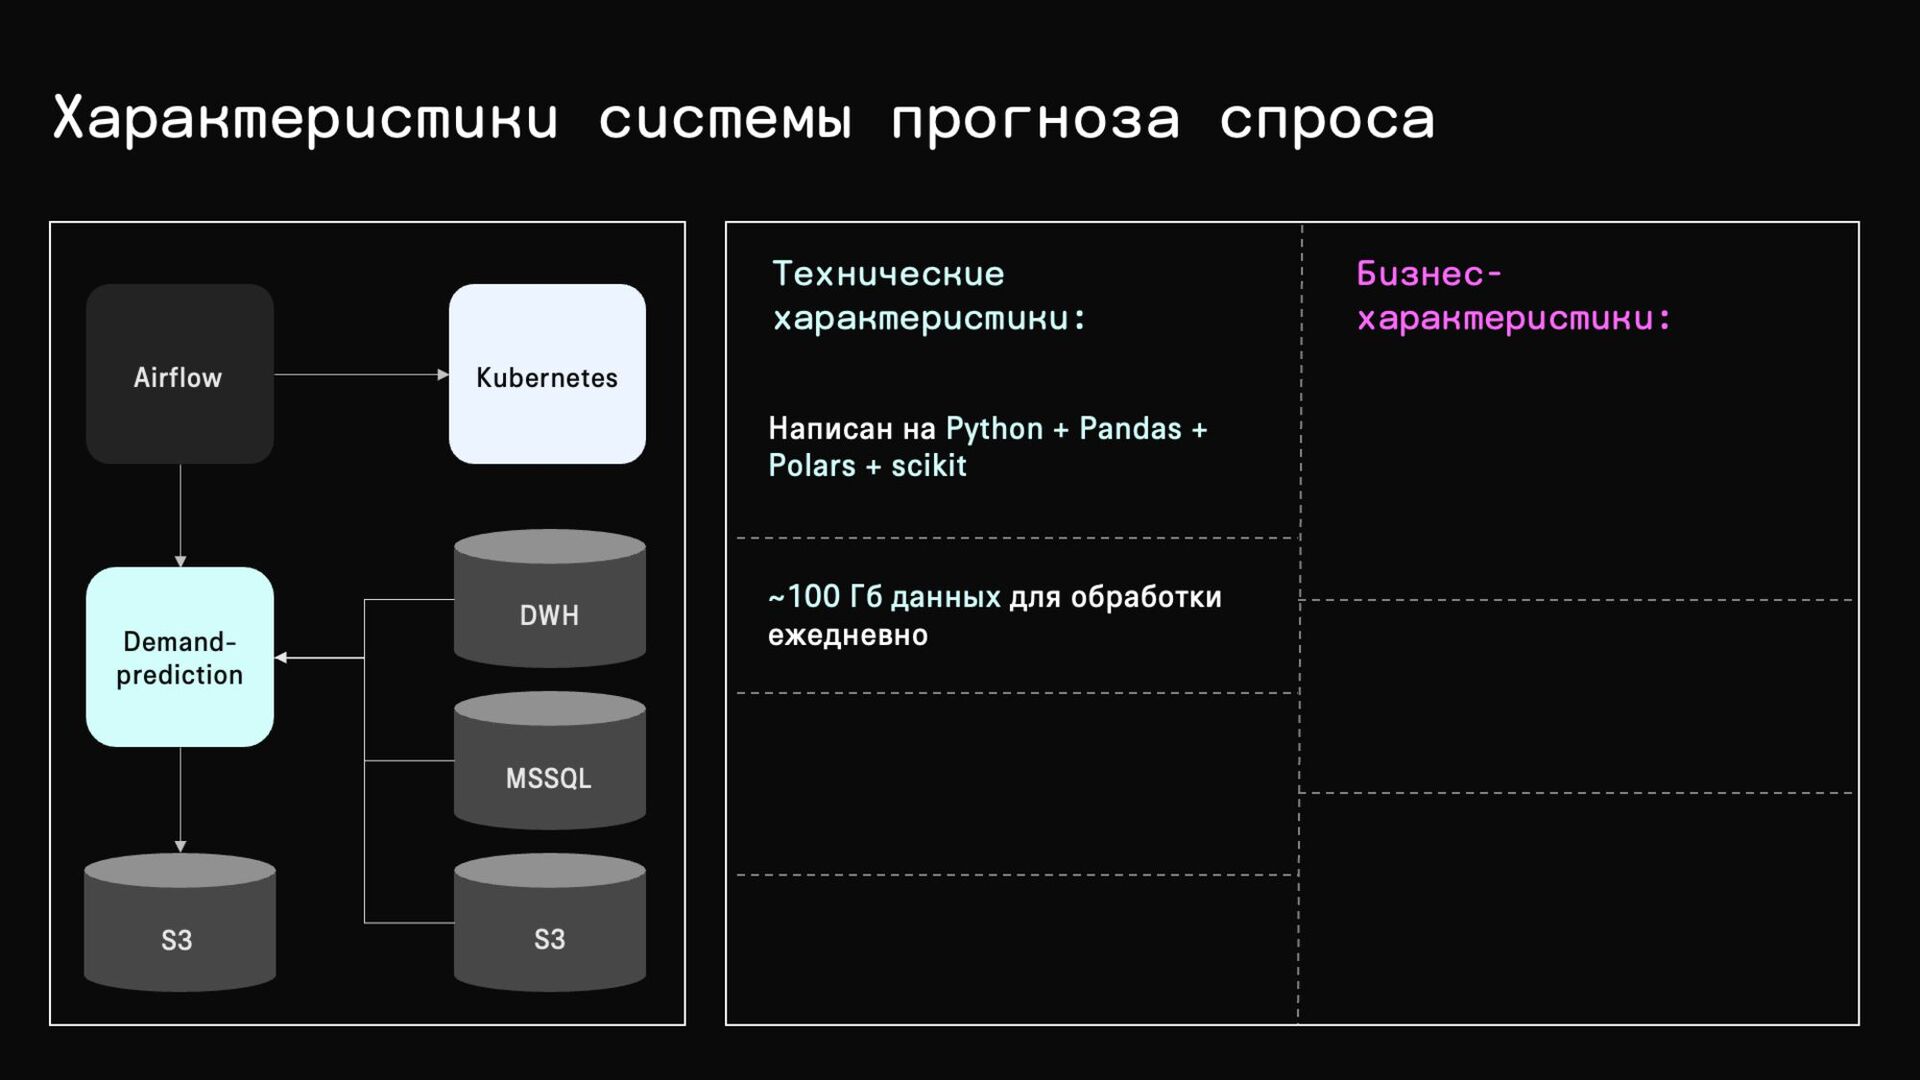
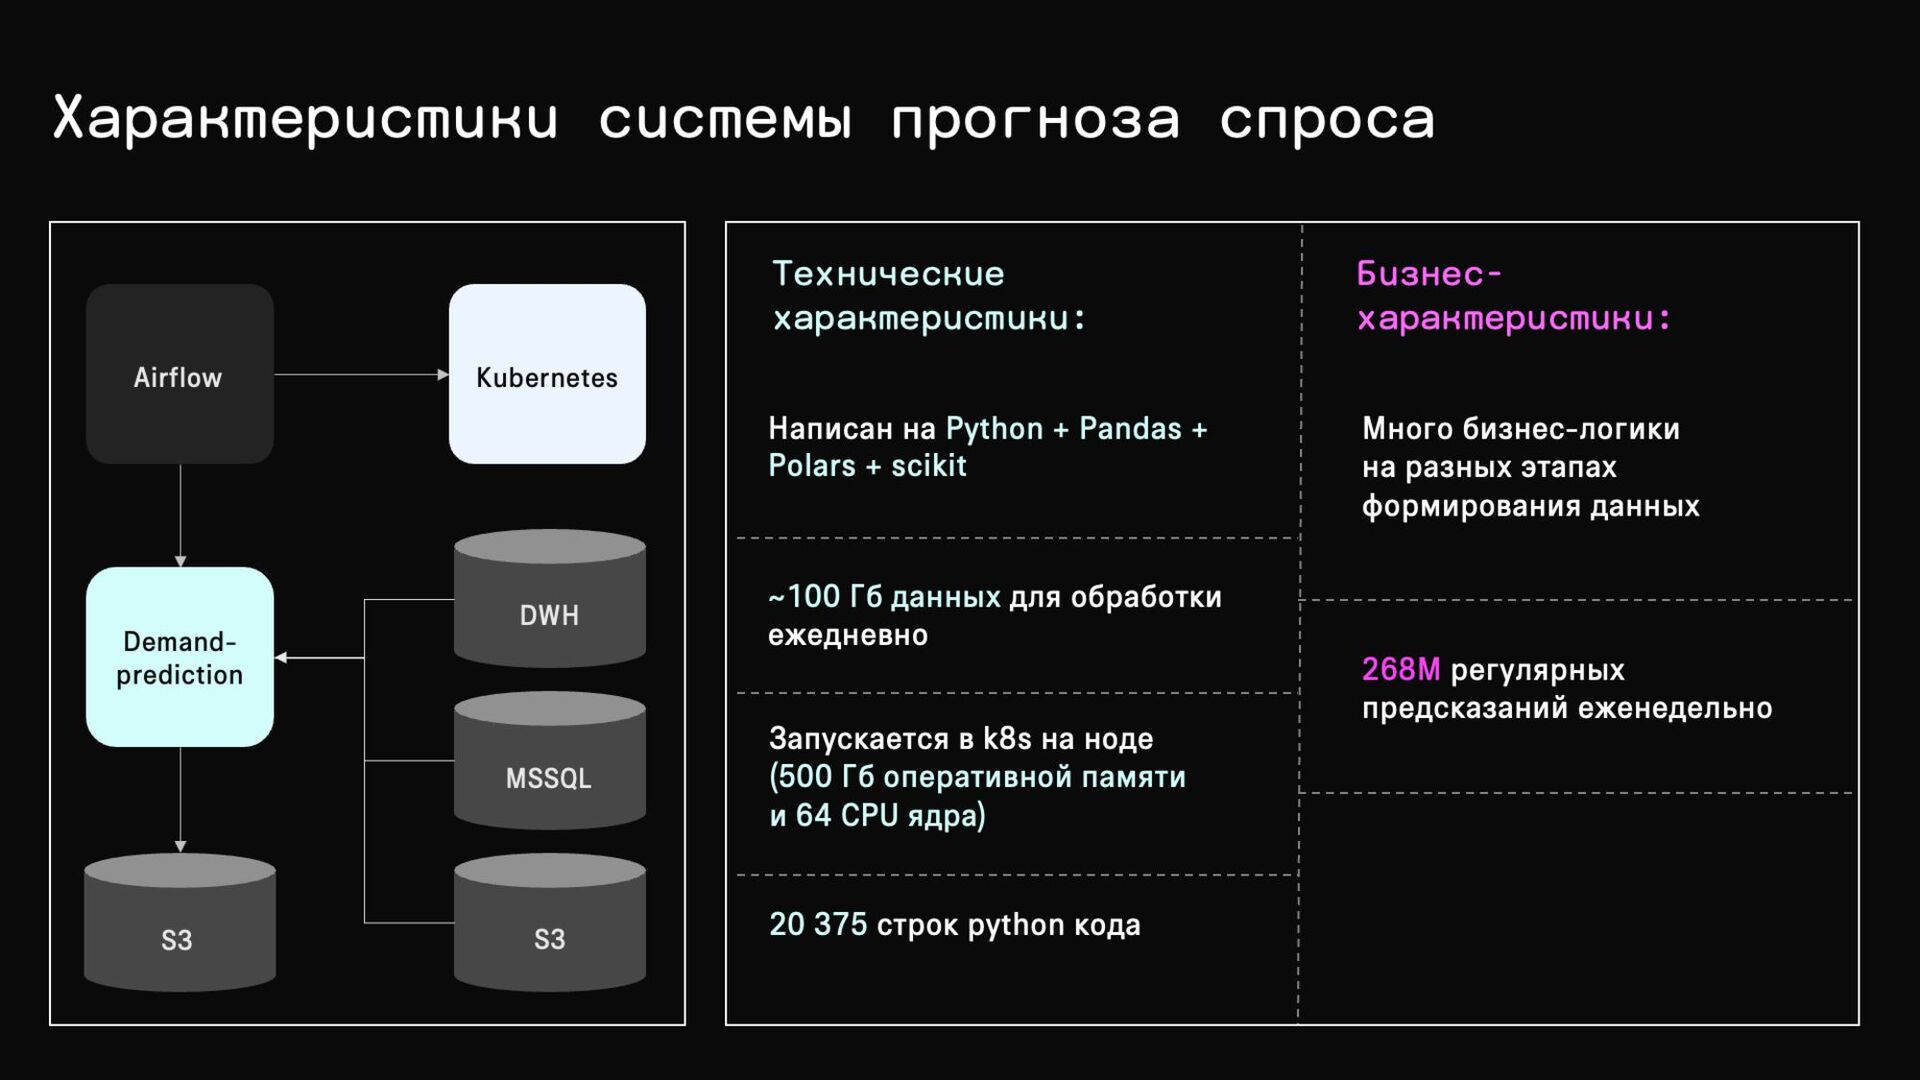
Характеристики системы прогноза спроса Airflow Kubernetes DWH MSSQL S3 S3
Demand- prediction -
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: Airflow Kubernetes
DWH MSSQL S3 S3 Demand- prediction -
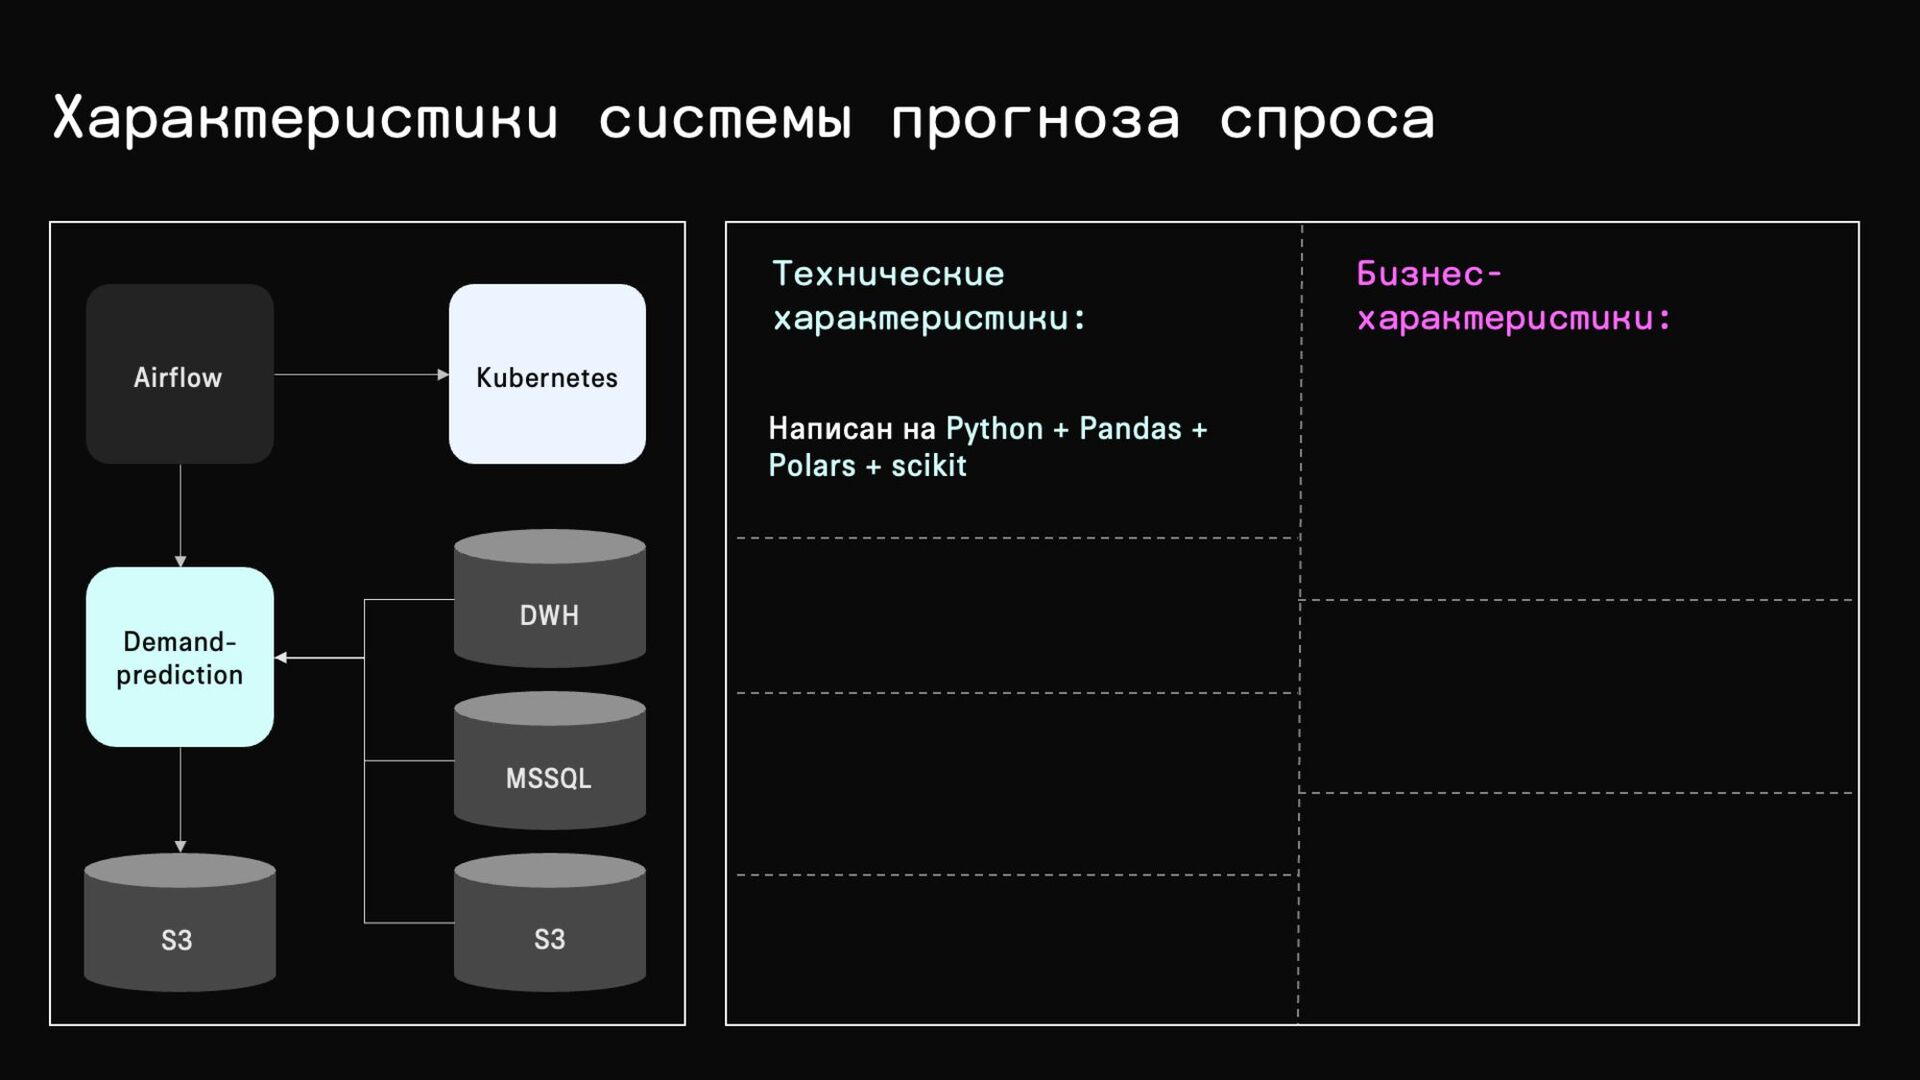
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: Написан на
Python + Pandas + Polars + scikit Airflow Kubernetes DWH MSSQL S3 S3 Demand- prediction -
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: ~100 Гб
данных для обработки ежедневно Написан на Python + Pandas + Polars + scikit Airflow Kubernetes DWH MSSQL S3 S3 Demand- prediction -
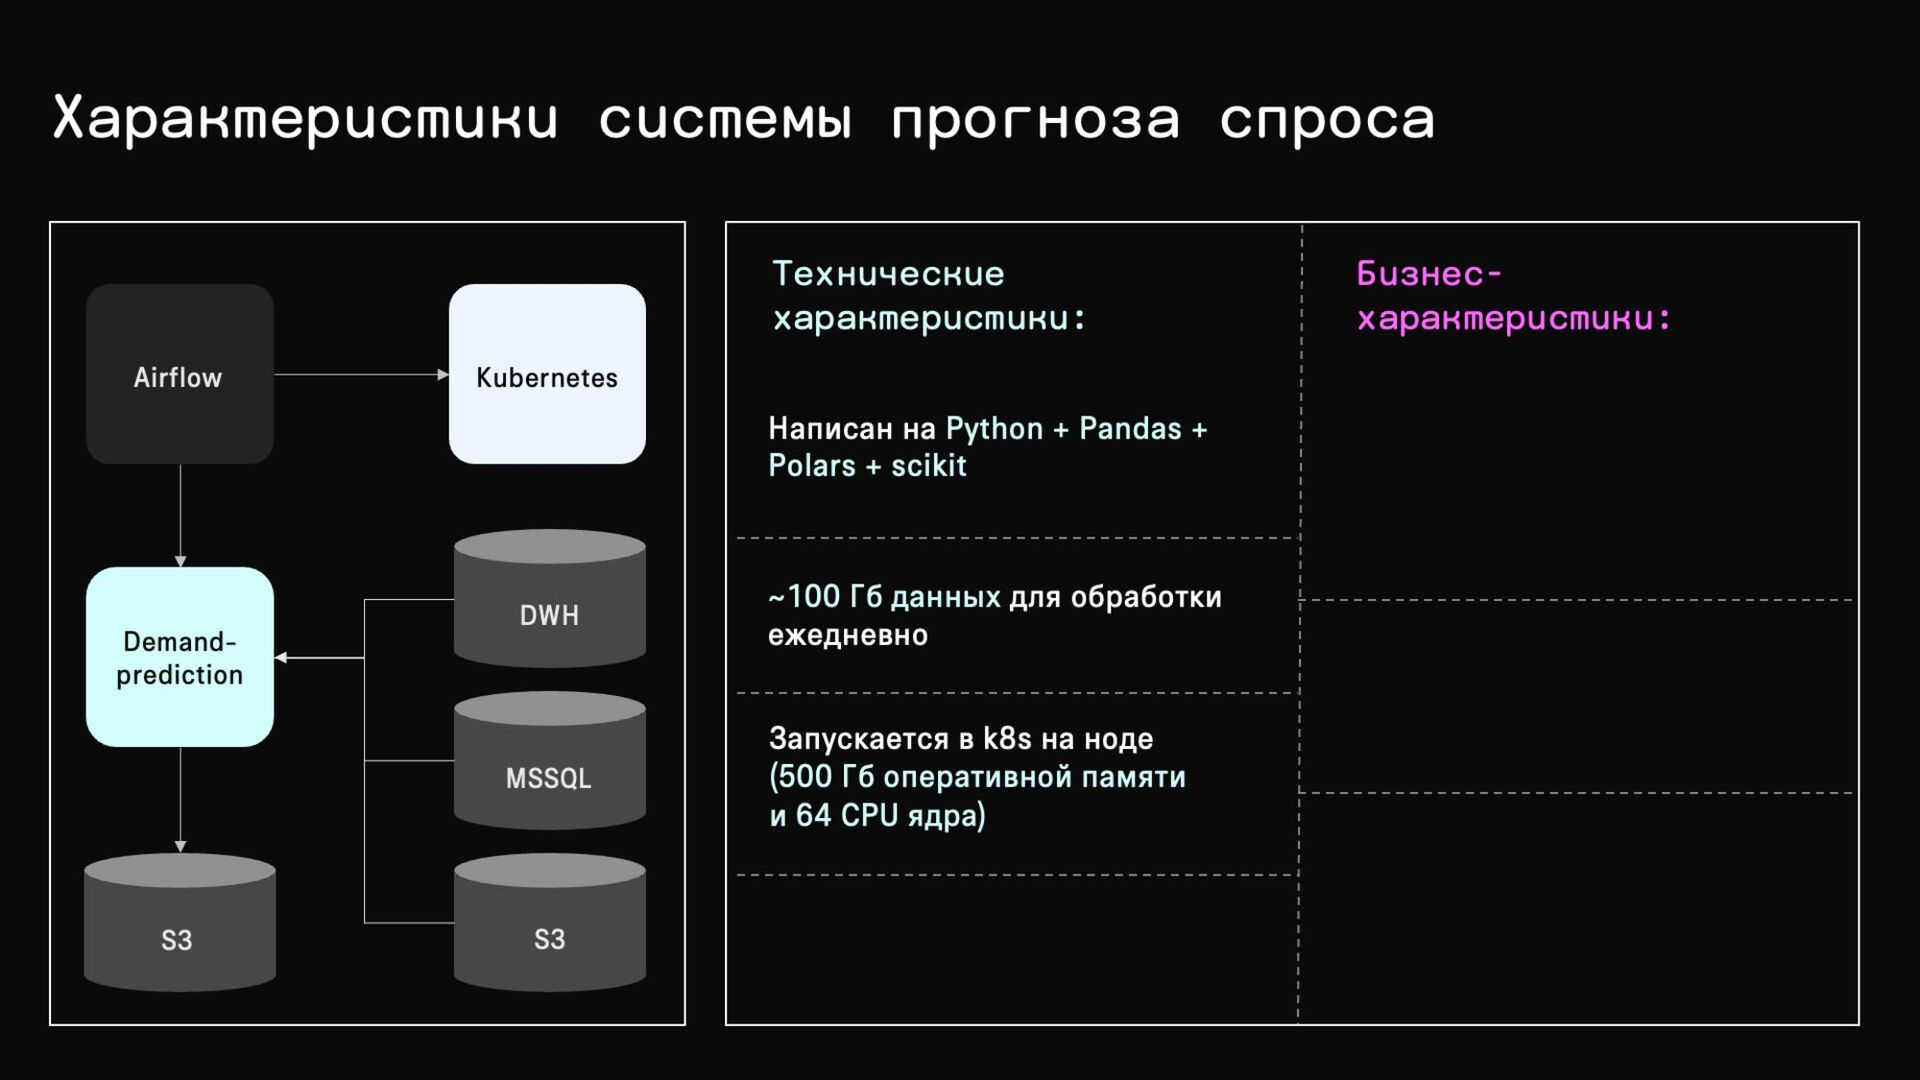
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: ~100 Гб
данных для обработки ежедневно Написан на Python + Pandas + Polars + scikit Запускается в k8s на ноде (500 Гб оперативной памяти и 64 CPU ядра) Airflow Kubernetes DWH MSSQL S3 S3 Demand- prediction -
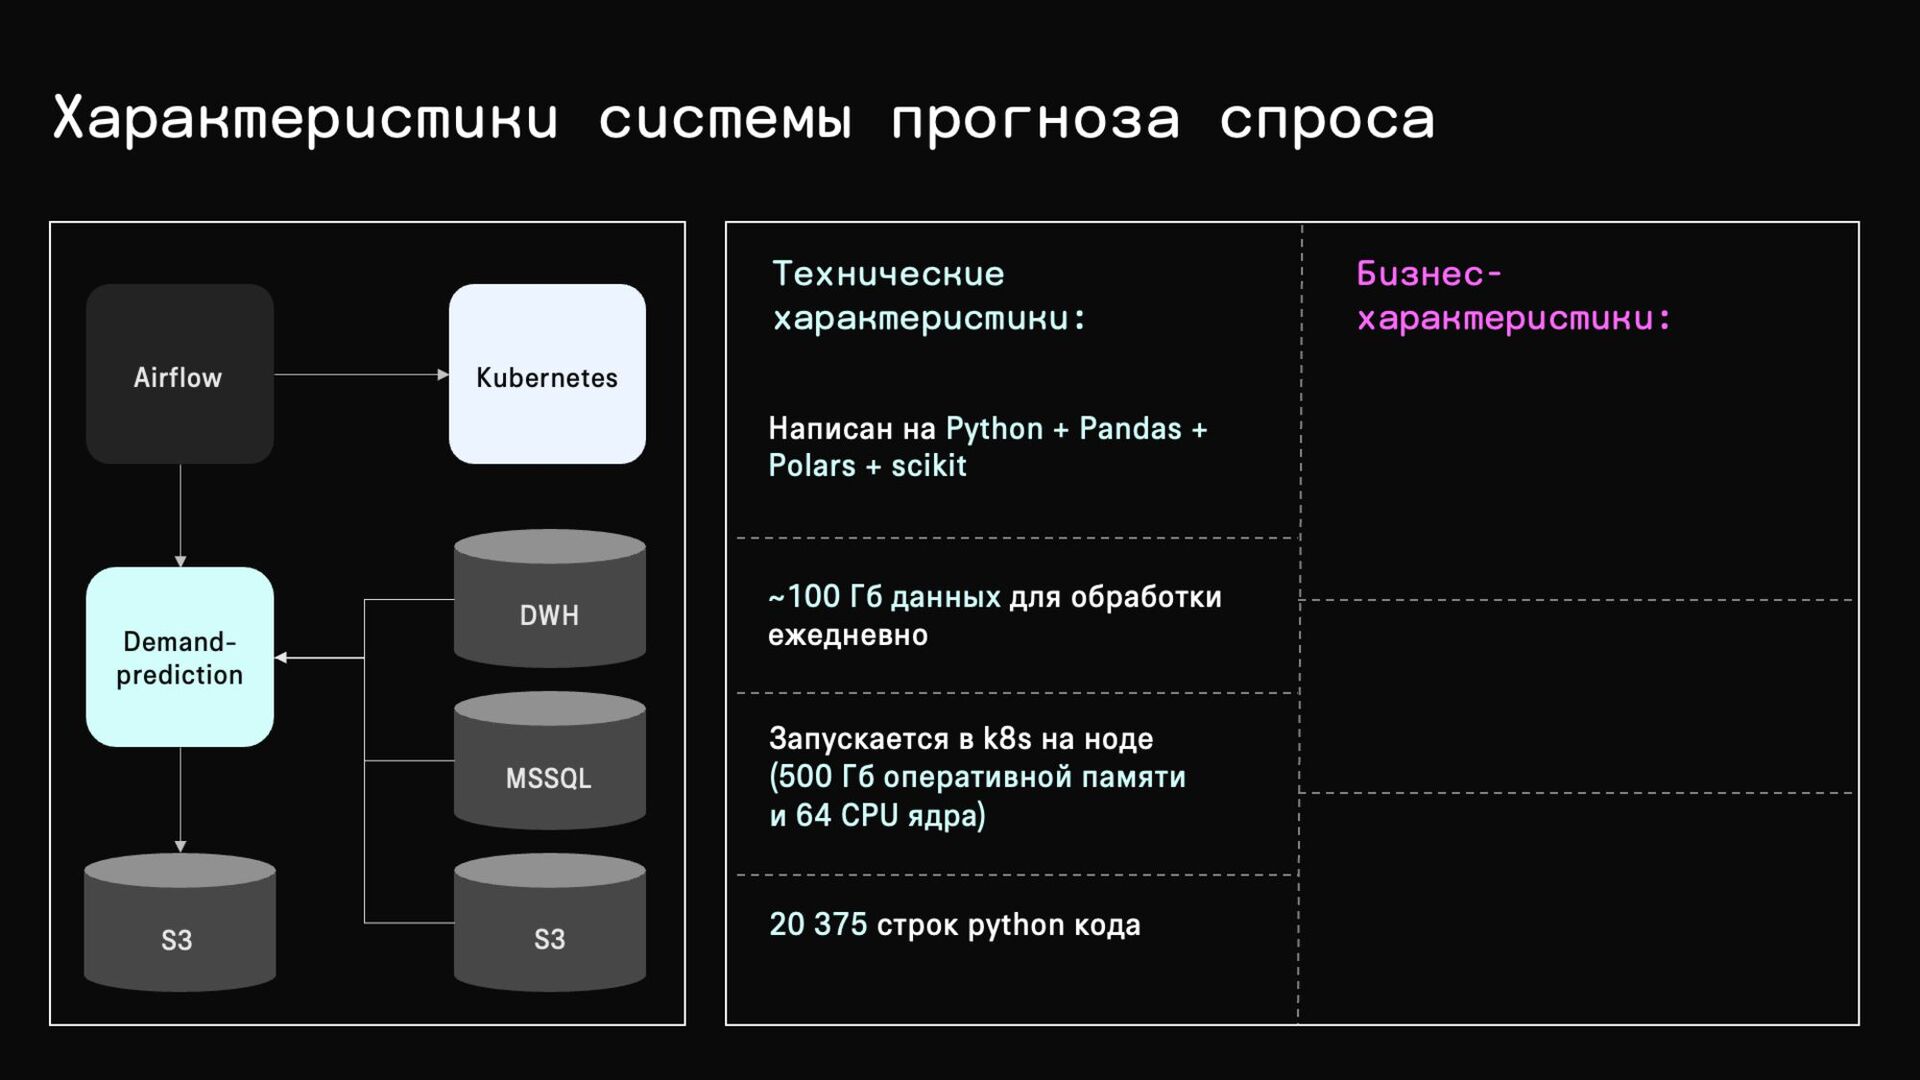
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: ~100 Гб
данных для обработки ежедневно Написан на Python + Pandas + Polars + scikit Запускается в k8s на ноде (500 Гб оперативной памяти и 64 CPU ядра) 20 375 строк python кода Airflow Kubernetes DWH MSSQL S3 S3 Demand- prediction -
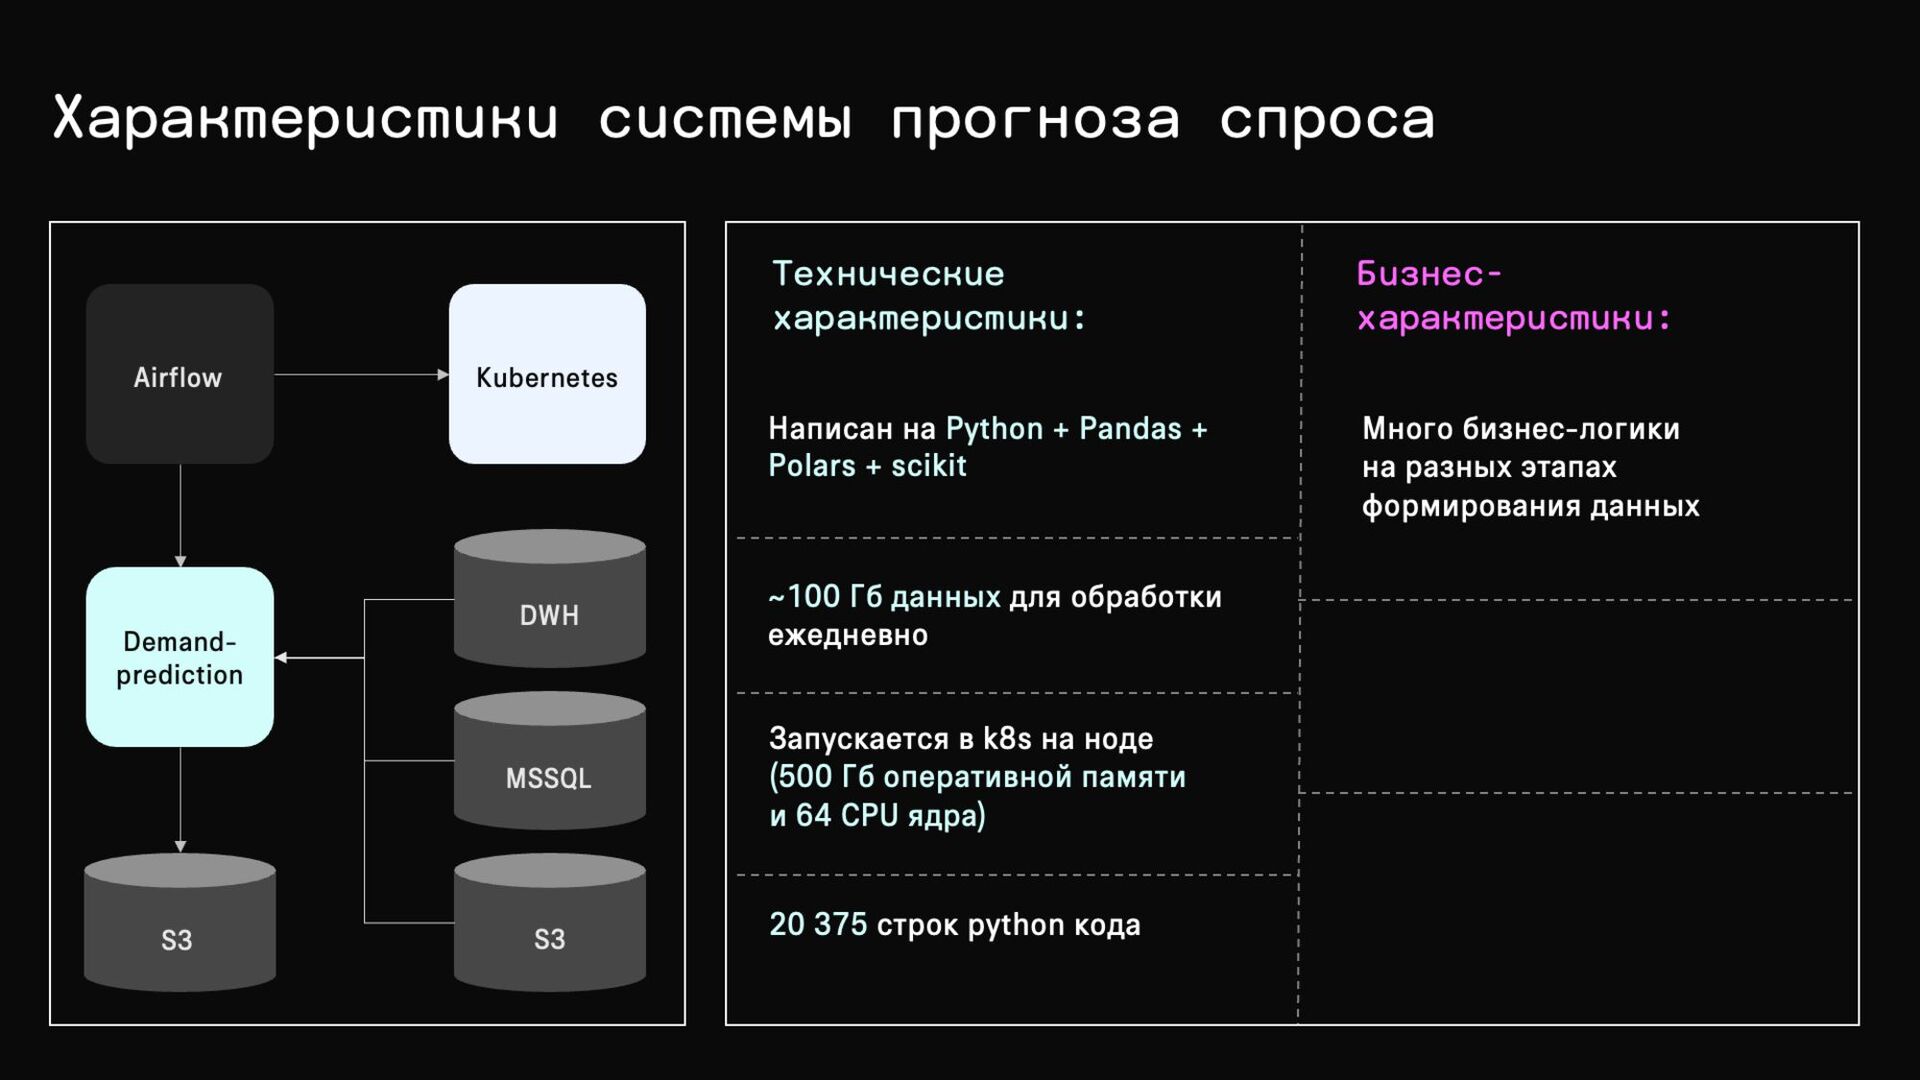
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: ~100 Гб
данных для обработки ежедневно Написан на Python + Pandas + Polars + scikit Запускается в k8s на ноде (500 Гб оперативной памяти и 64 CPU ядра) 20 375 строк python кода Много бизнес-логики на разных этапах формирования данных Airflow Kubernetes DWH MSSQL S3 S3 Demand- prediction -
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: ~100 Гб
данных для обработки ежедневно Написан на Python + Pandas + Polars + scikit Запускается в k8s на ноде (500 Гб оперативной памяти и 64 CPU ядра) 20 375 строк python кода Много бизнес-логики на разных этапах формирования данных 268М регулярных предсказаний еженедельно Airflow Kubernetes DWH MSSQL S3 S3 Demand- prediction -
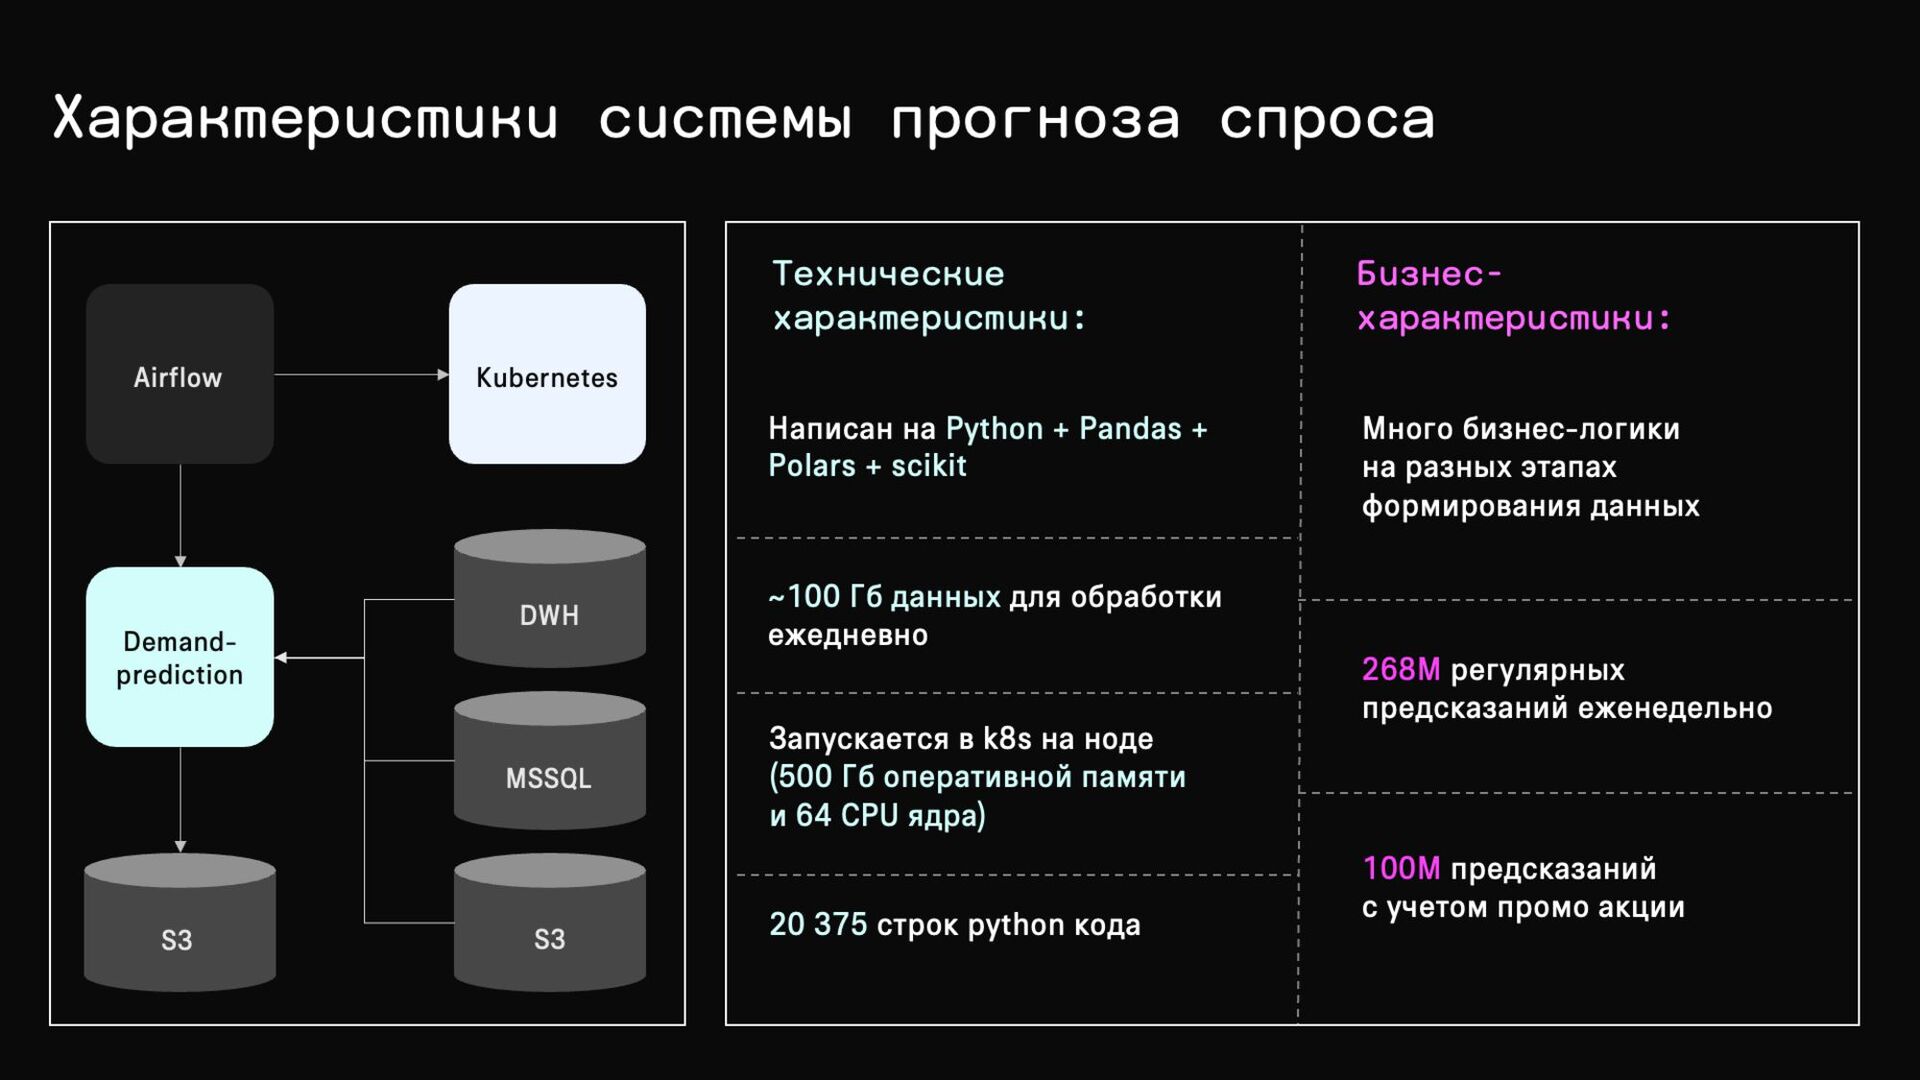
Характеристики системы прогноза спроса Технические характеристики: Бизнес- характеристики: ~100 Гб
данных для обработки ежедневно Написан на Python + Pandas + Polars + scikit Запускается в k8s на ноде (500 Гб оперативной памяти и 64 CPU ядра) 20 375 строк python кода Много бизнес-логики на разных этапах формирования данных 268М регулярных предсказаний еженедельно 100М предсказаний с учетом промо акции Airflow Kubernetes DWH MSSQL S3 S3 Demand- prediction -
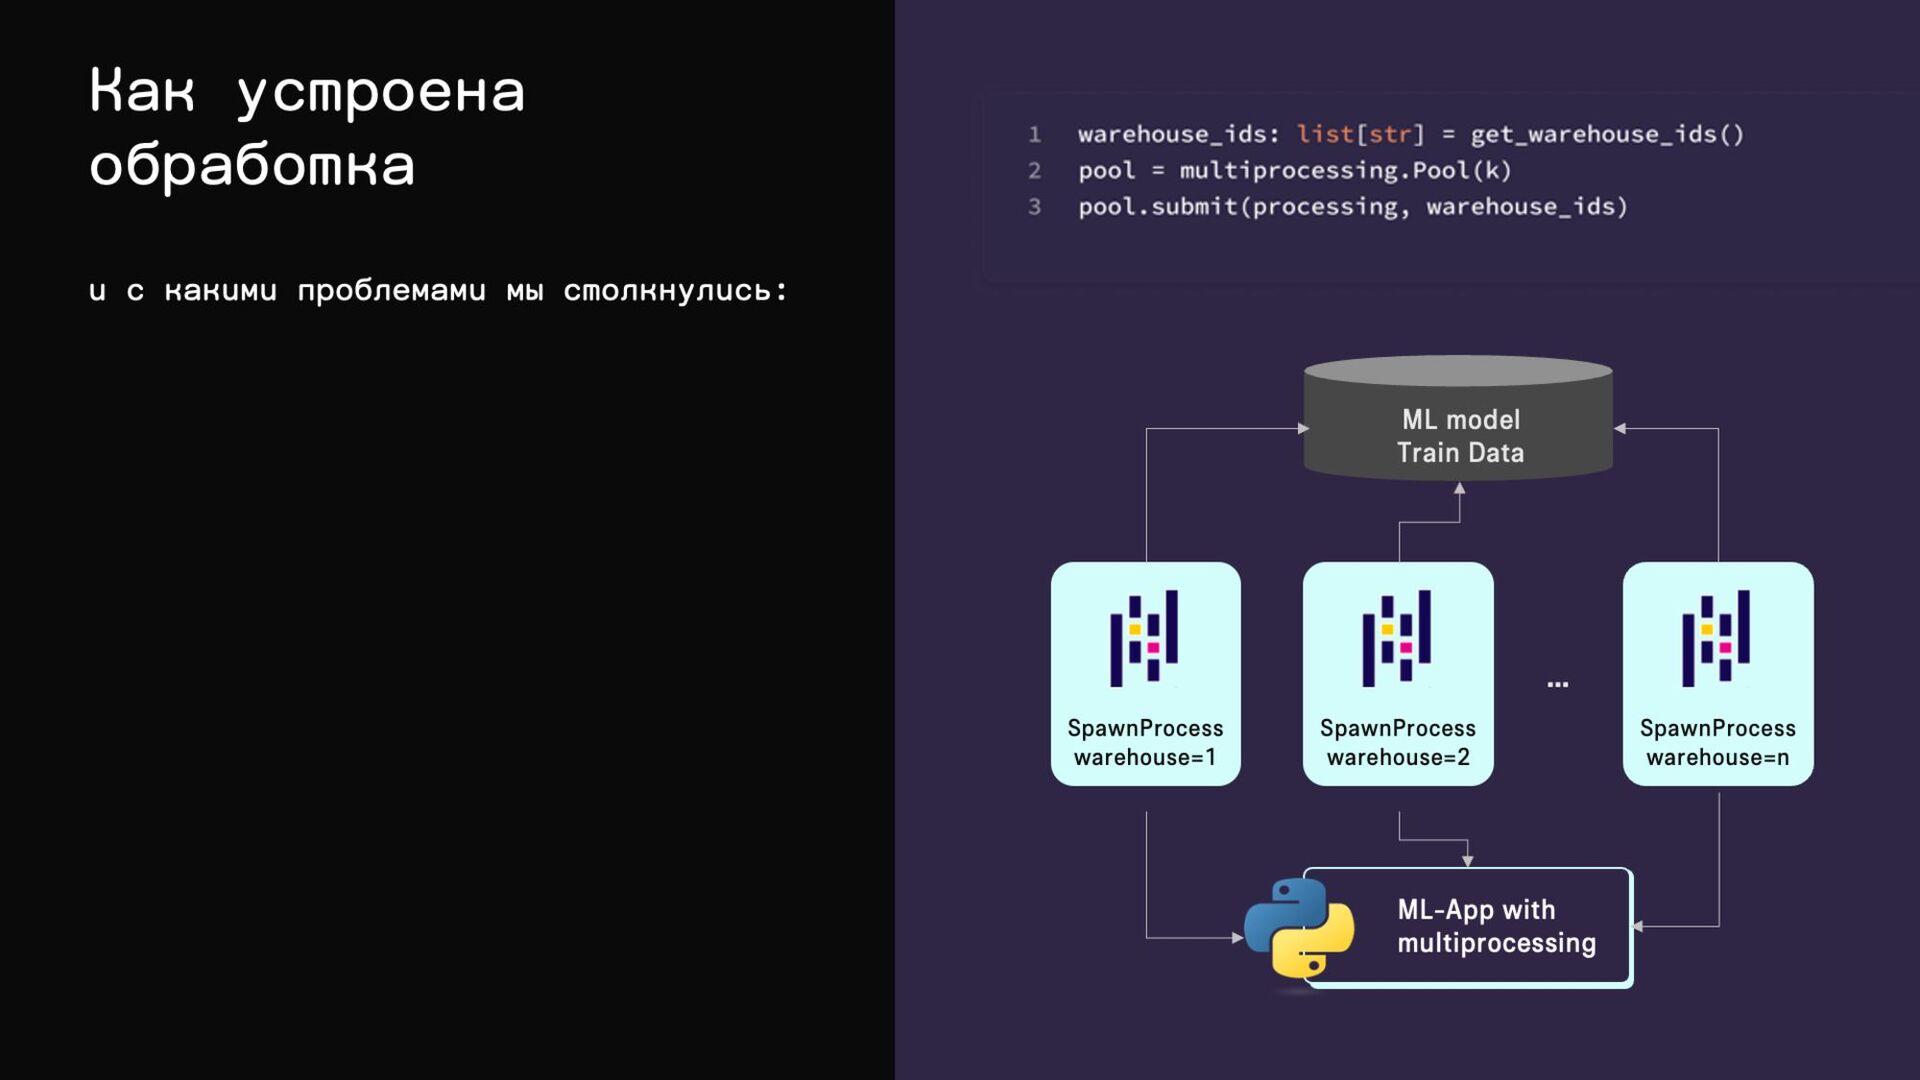
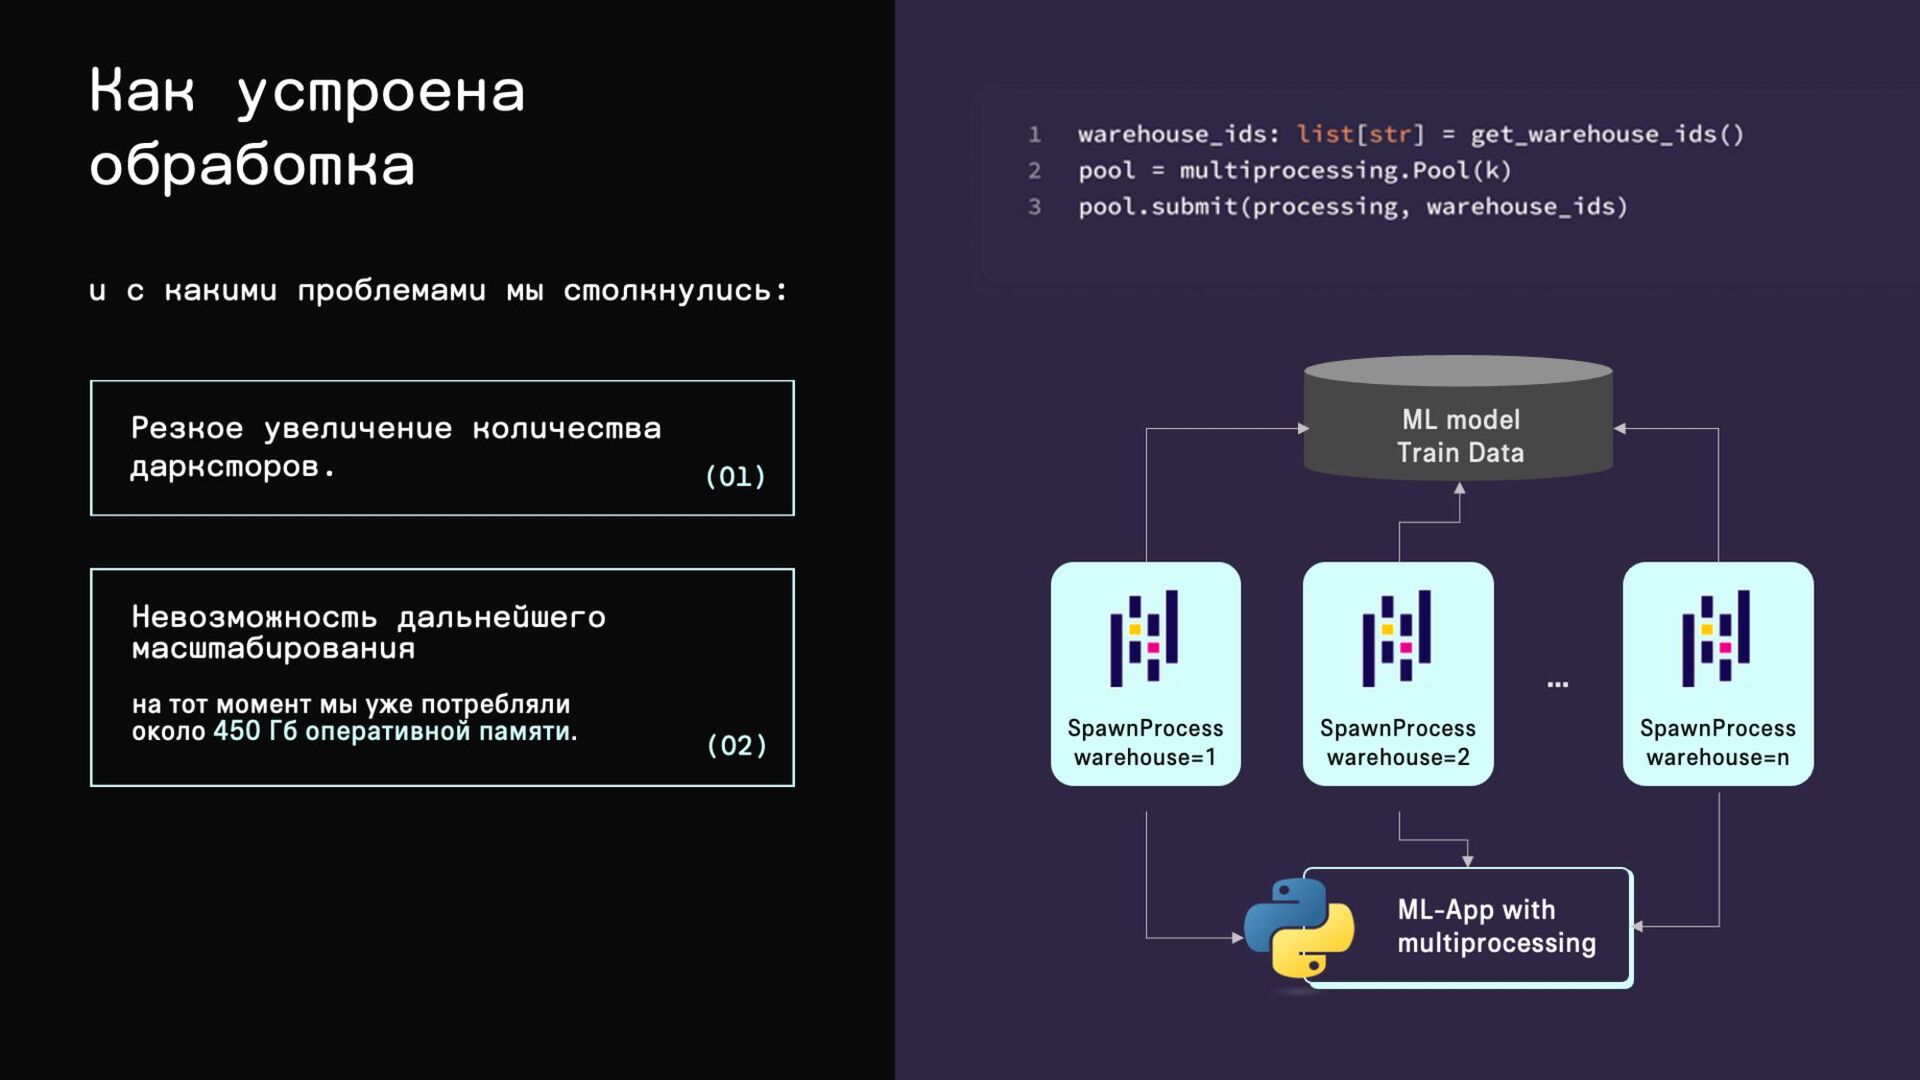
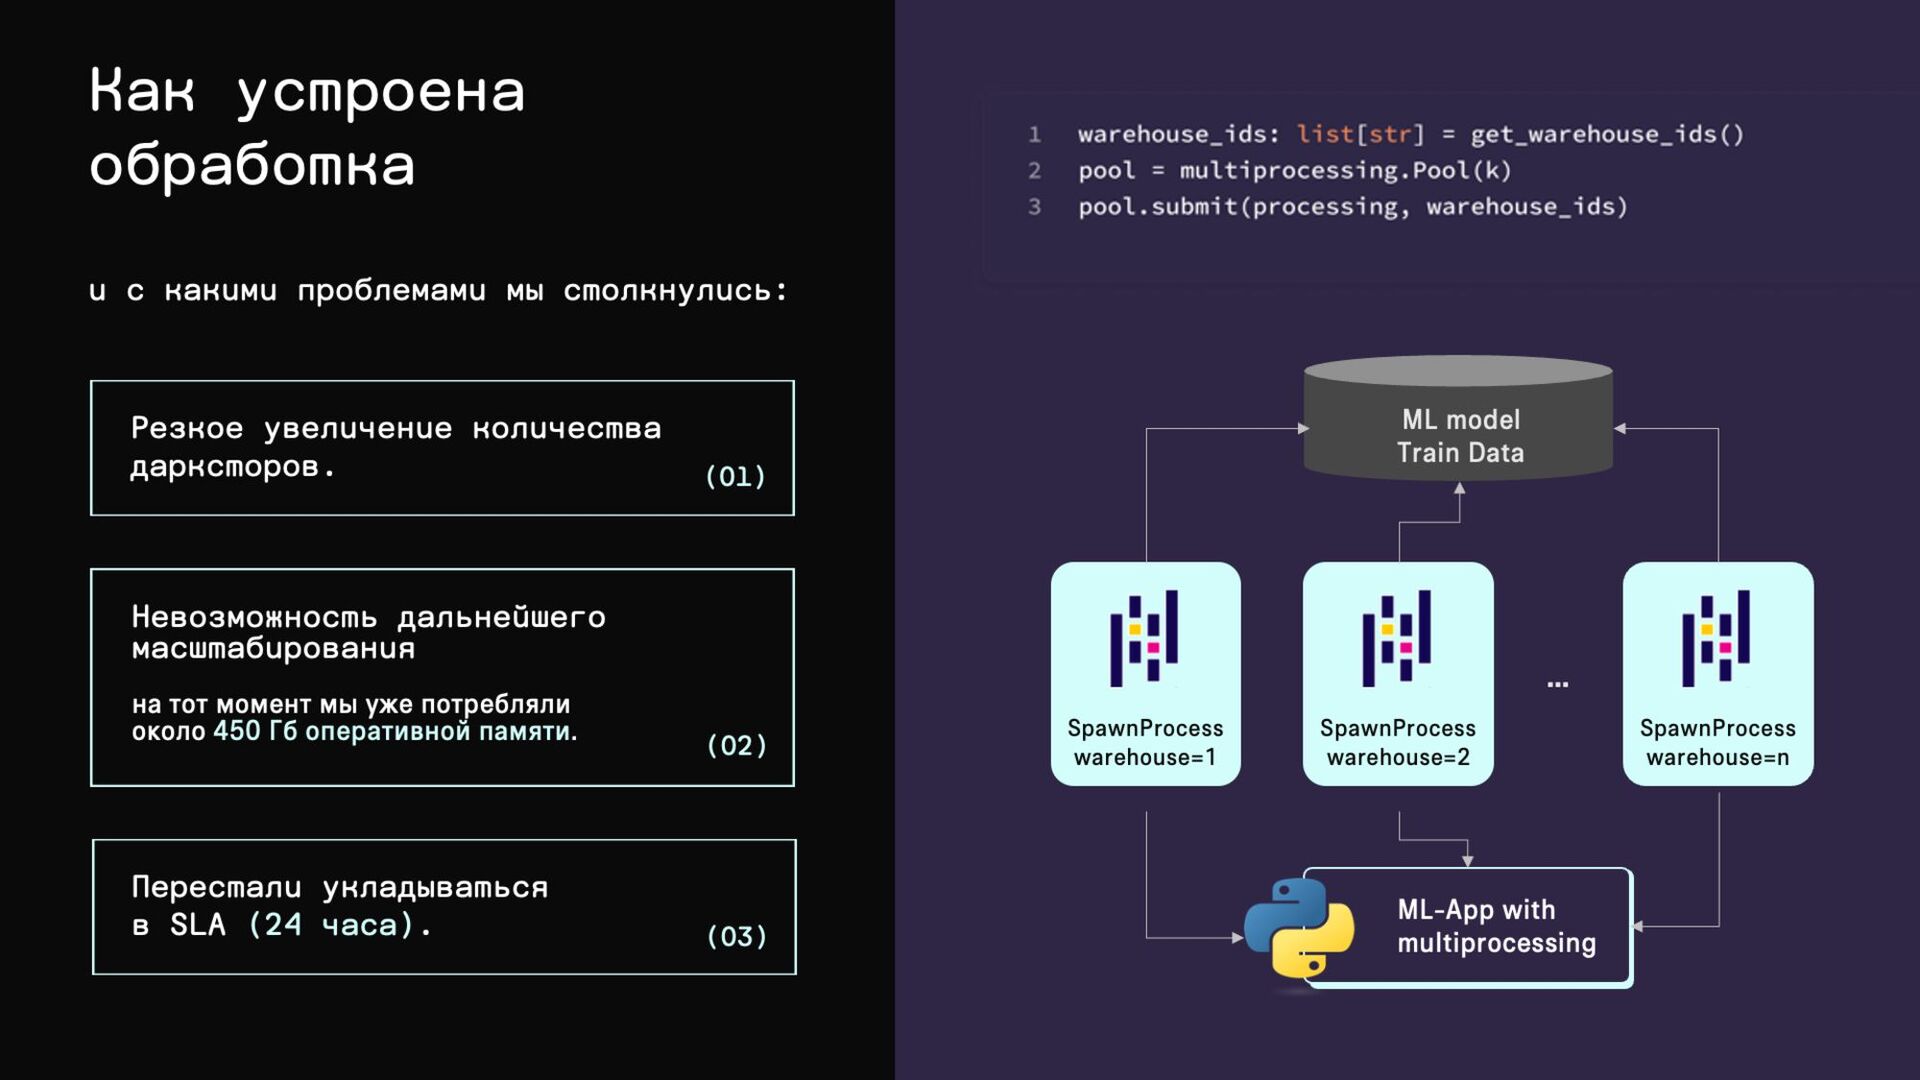
и с какими проблемами мы столкнулись: Как устроена обработка
ML model Train Data SpawnProcess warehouse=1 ML-App with multiprocessing SpawnProcess warehouse=2 SpawnProcess warehouse=n … -
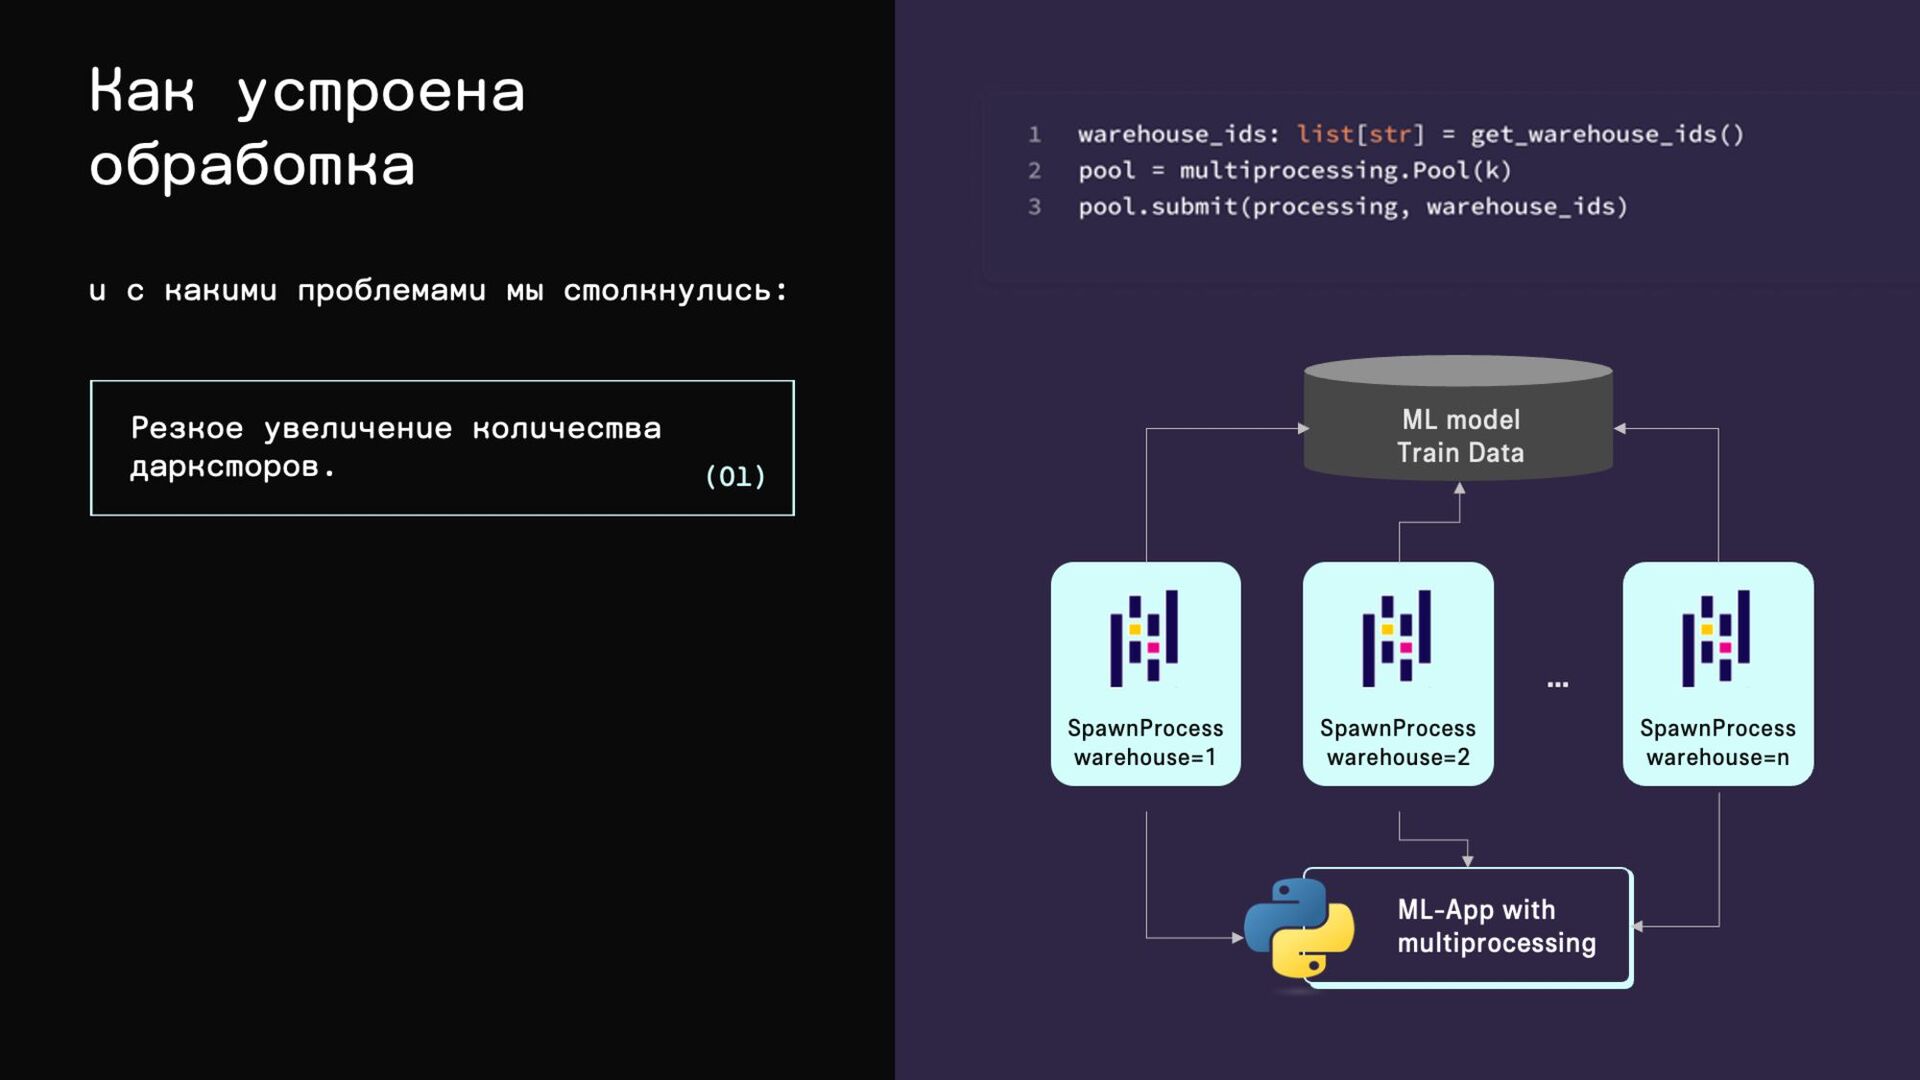
и с какими проблемами мы столкнулись: Как устроена обработка
ML model Train Data SpawnProcess warehouse=1 ML-App with multiprocessing SpawnProcess warehouse=2 SpawnProcess warehouse=n Резкое увеличение количества дарксторов. (01) … -
и с какими проблемами мы столкнулись: Невозможность дальнейшего масштабирования
на тот момент мы уже потребляли около 450 Гб оперативной памяти. (02) Как устроена обработка ML model Train Data SpawnProcess warehouse=1 ML-App with multiprocessing SpawnProcess warehouse=2 SpawnProcess warehouse=n Резкое увеличение количества дарксторов. (01) … -
и с какими проблемами мы столкнулись: Перестали укладываться в
SLA (24 часа). Невозможность дальнейшего масштабирования на тот момент мы уже потребляли около 450 Гб оперативной памяти. (02) (03) Как устроена обработка ML model Train Data SpawnProcess warehouse=1 ML-App with multiprocessing SpawnProcess warehouse=2 SpawnProcess warehouse=n Резкое увеличение количества дарксторов. (01) … -
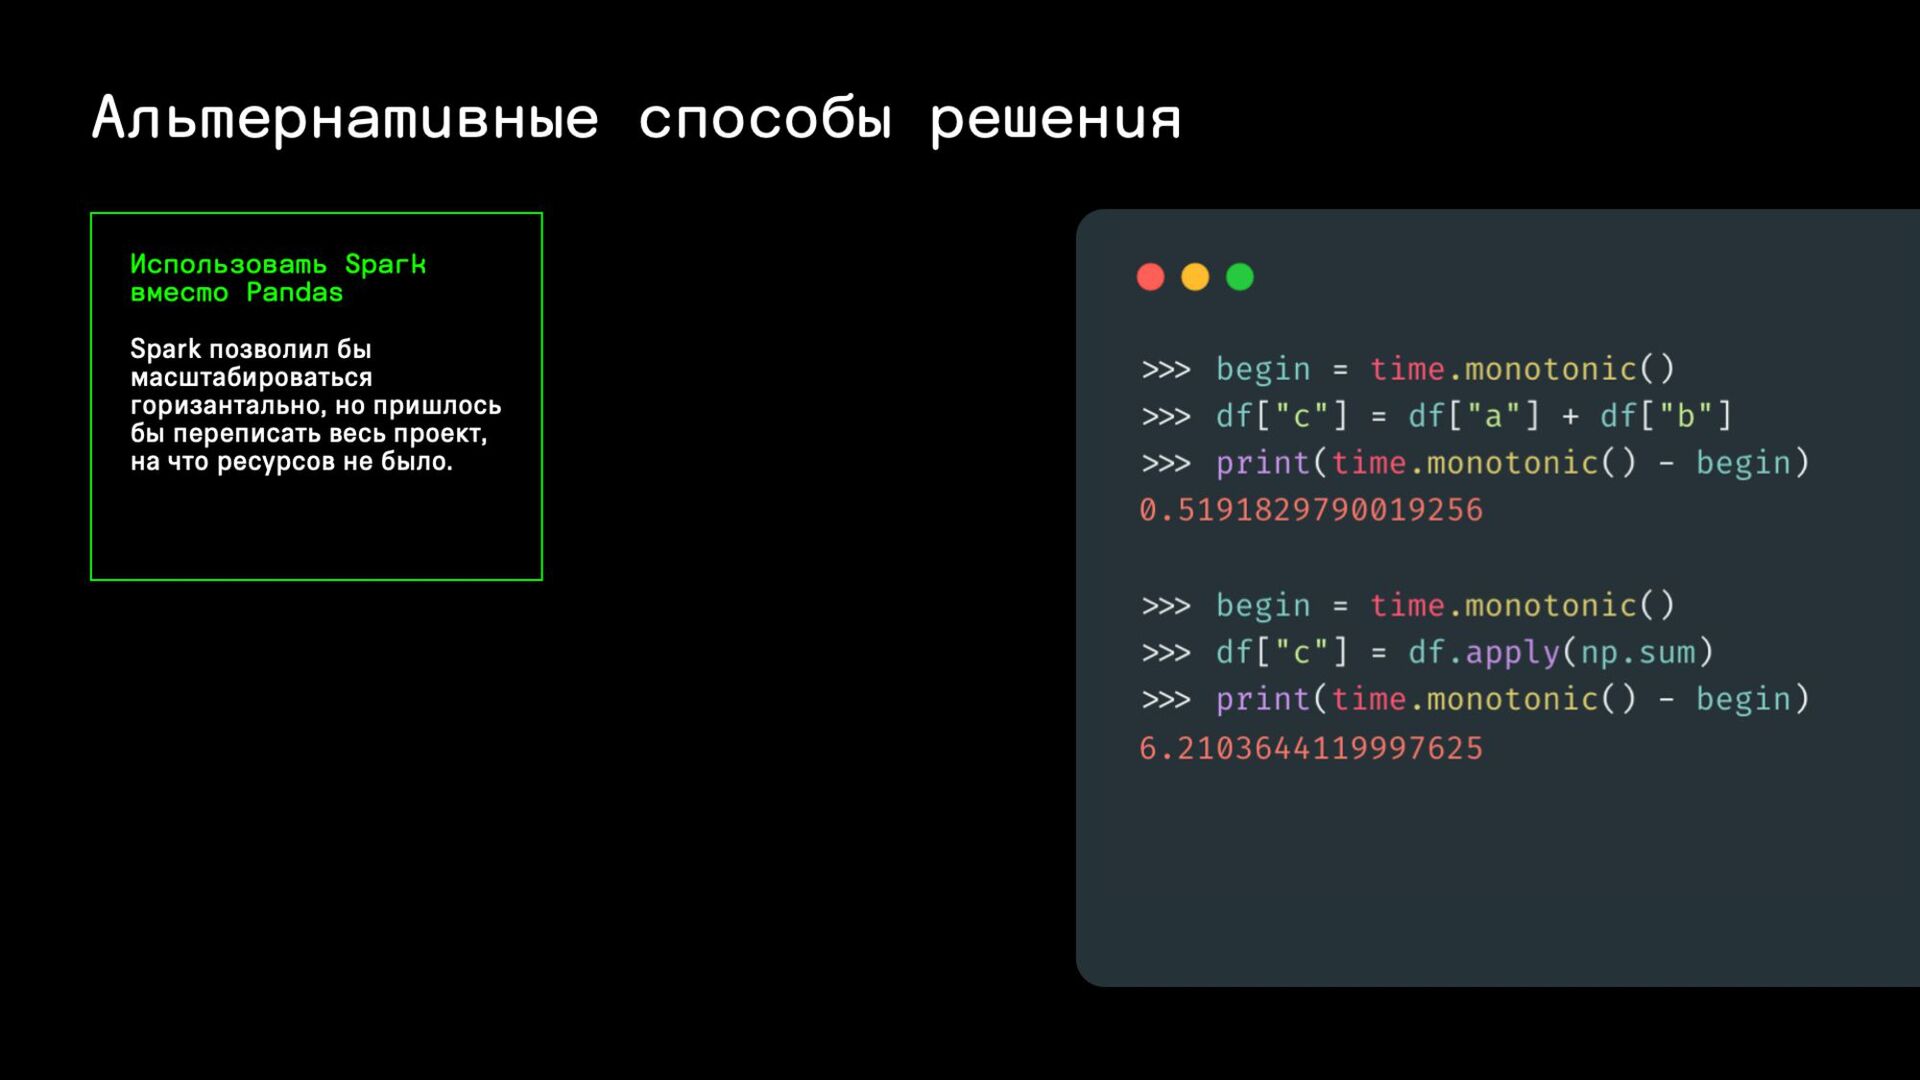
Альтернативные способы решения Использовать Spark вместо Pandas Spark позволил
бы масштабироваться горизантально, но пришлось бы переписать весь проект, на что ресурсов не было. -
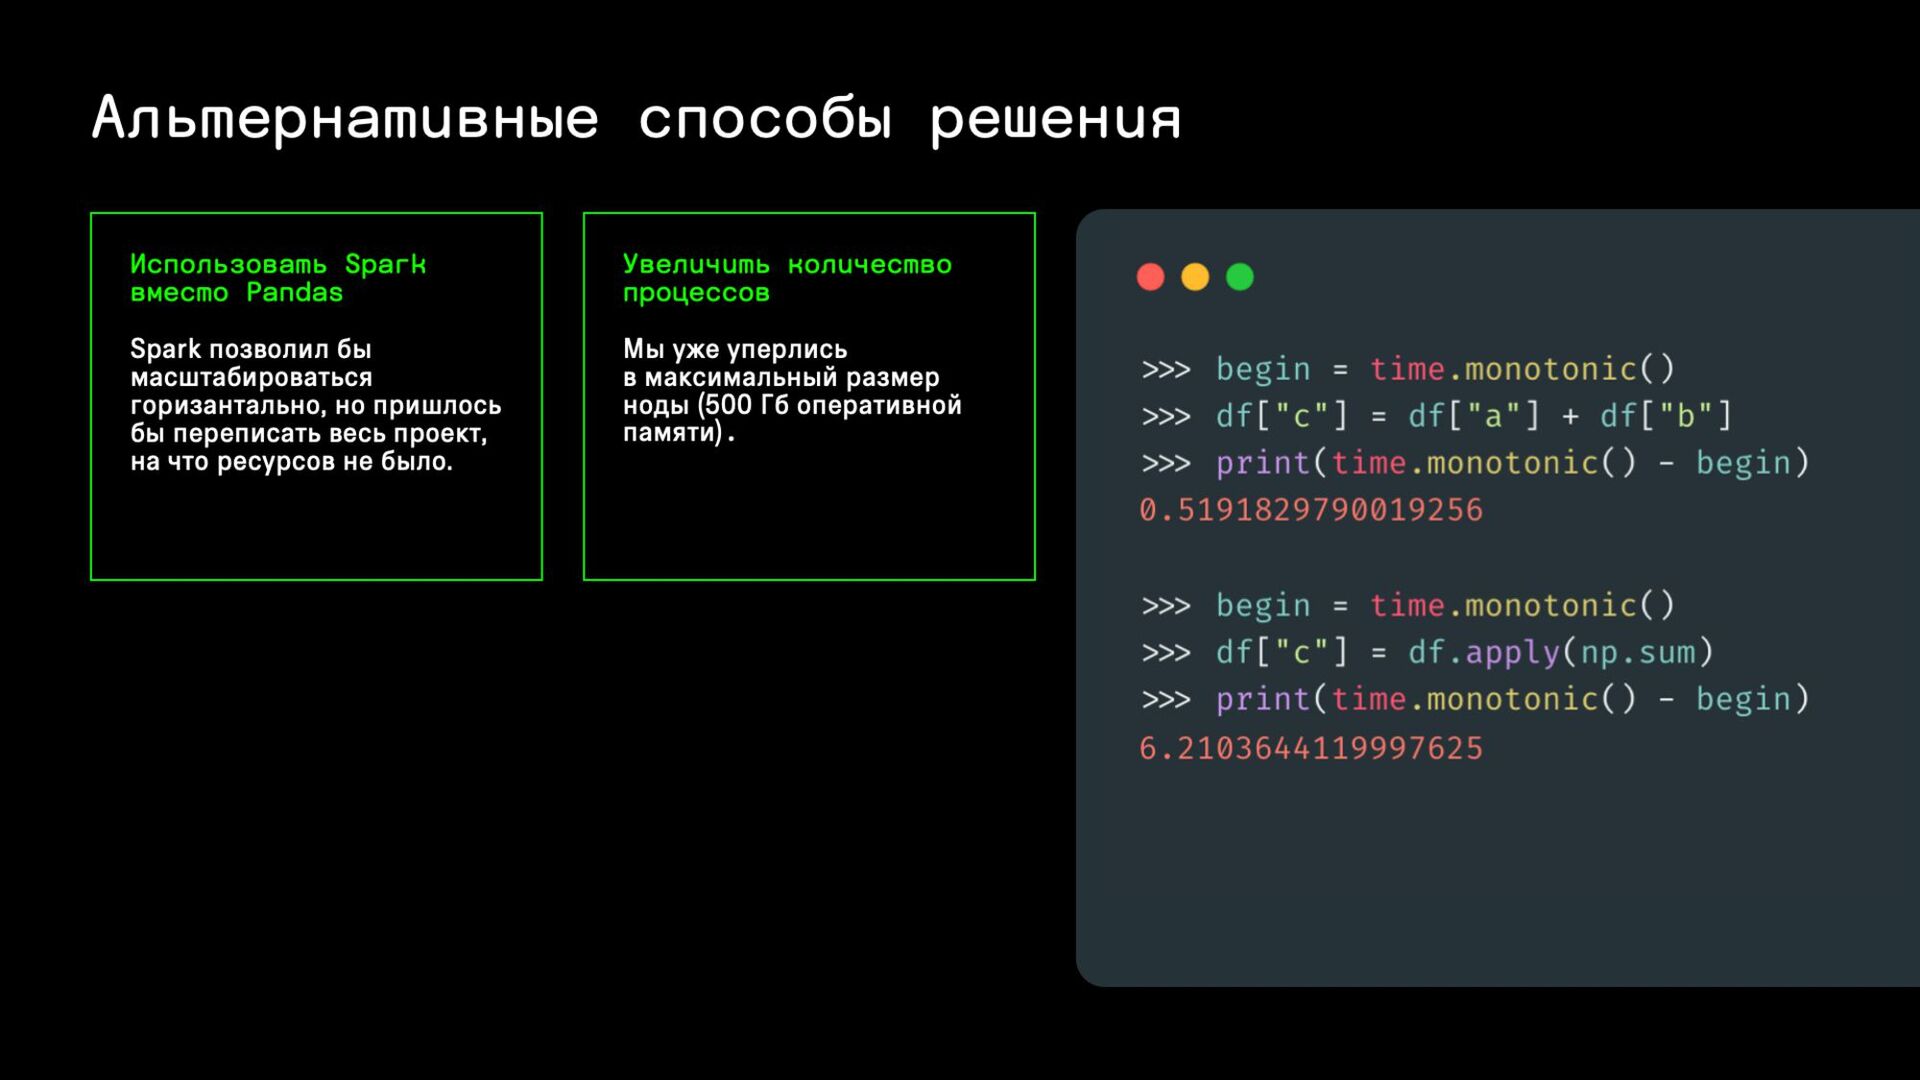
Альтернативные способы решения Использовать Spark вместо Pandas Spark позволил
бы масштабироваться горизантально, но пришлось бы переписать весь проект, на что ресурсов не было. Увеличить количество процессов Мы уже уперлись в максимальный размер ноды (500 Гб оперативной памяти). -
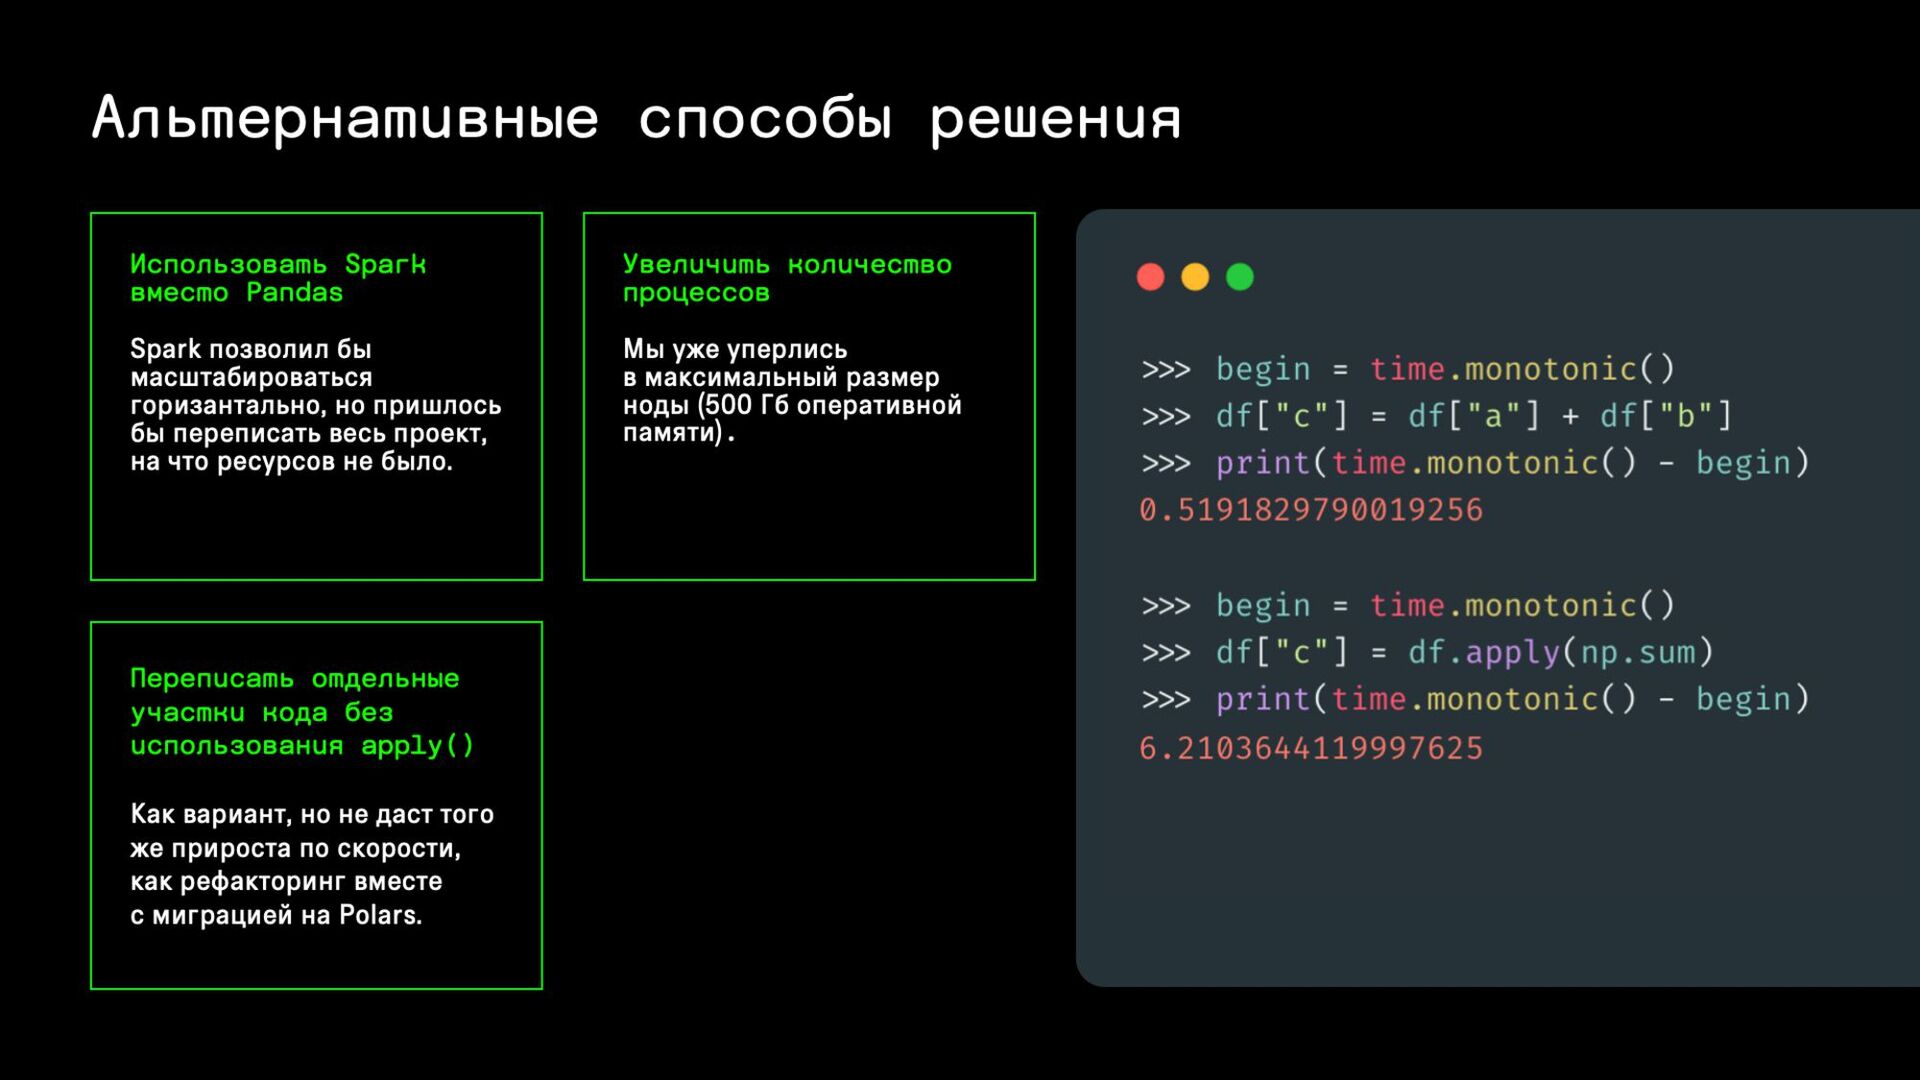
Альтернативные способы решения Использовать Spark вместо Pandas Spark позволил
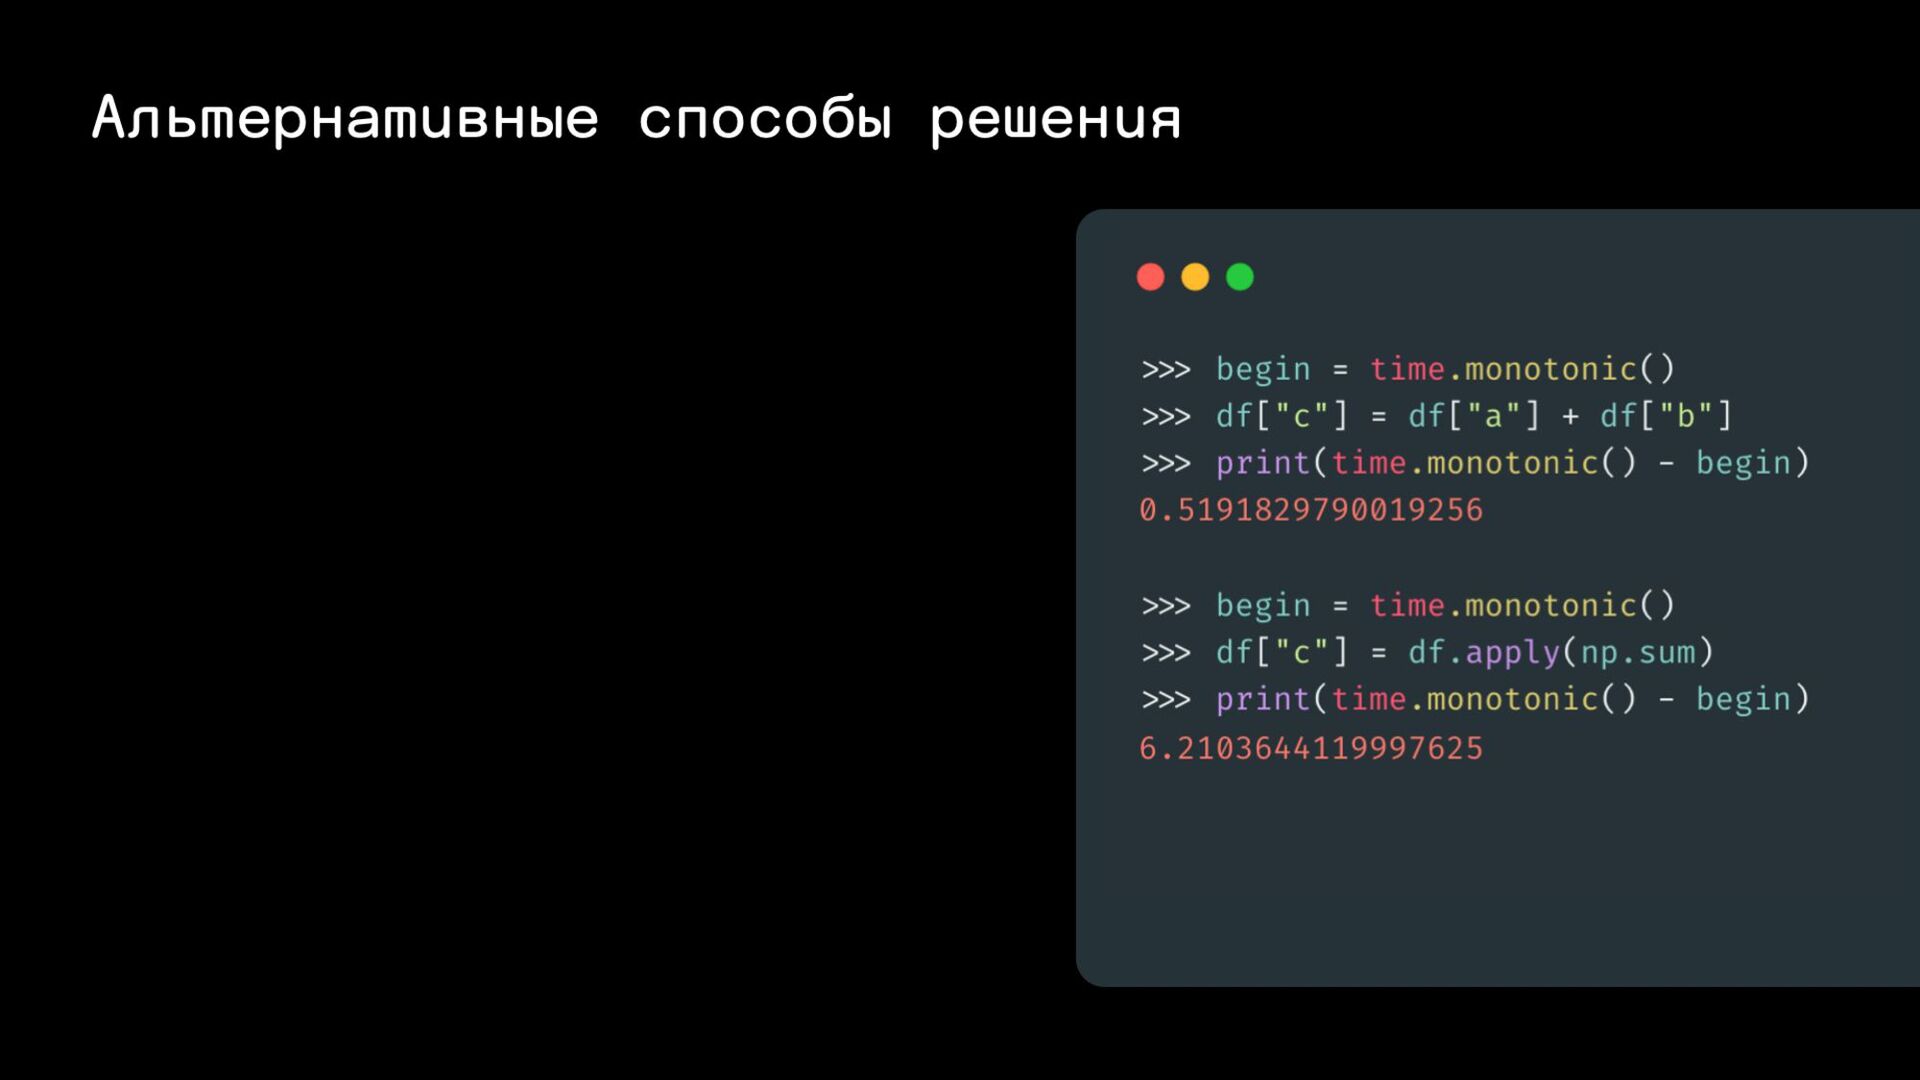
бы масштабироваться горизантально, но пришлось бы переписать весь проект, на что ресурсов не было. Увеличить количество процессов Мы уже уперлись в максимальный размер ноды (500 Гб оперативной памяти). Переписать отдельные участки кода без использования apply() Как вариант, но не даст того же прироста по скорости, как рефакторинг вместе с миграцией на Polars. -
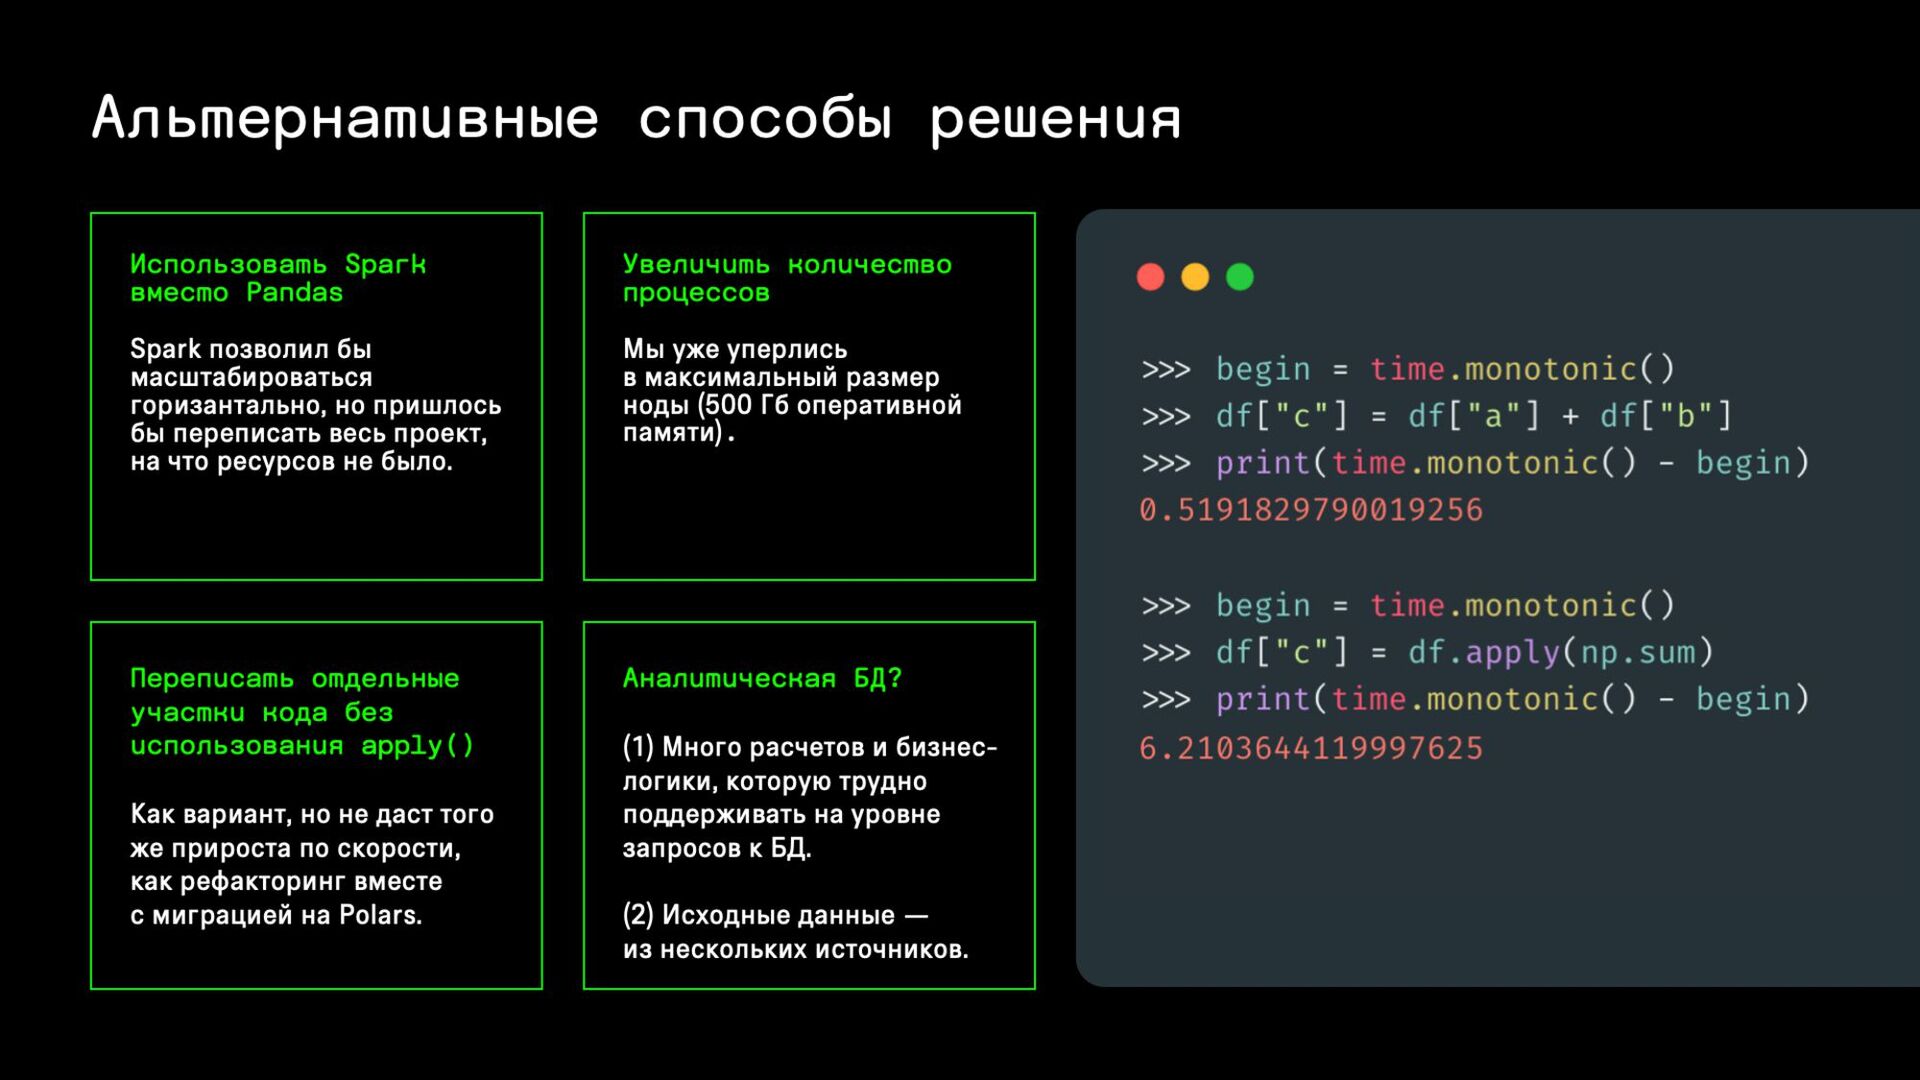
Альтернативные способы решения Использовать Spark вместо Pandas Spark позволил
бы масштабироваться горизантально, но пришлось бы переписать весь проект, на что ресурсов не было. Увеличить количество процессов Мы уже уперлись в максимальный размер ноды (500 Гб оперативной памяти). Переписать отдельные участки кода без использования apply() Как вариант, но не даст того же прироста по скорости, как рефакторинг вместе с миграцией на Polars. Аналитическая БД? (1) Много расчетов и бизнес- логики, которую трудно поддерживать на уровне запросов к БД. (2) Исходные данные — из нескольких источников. -
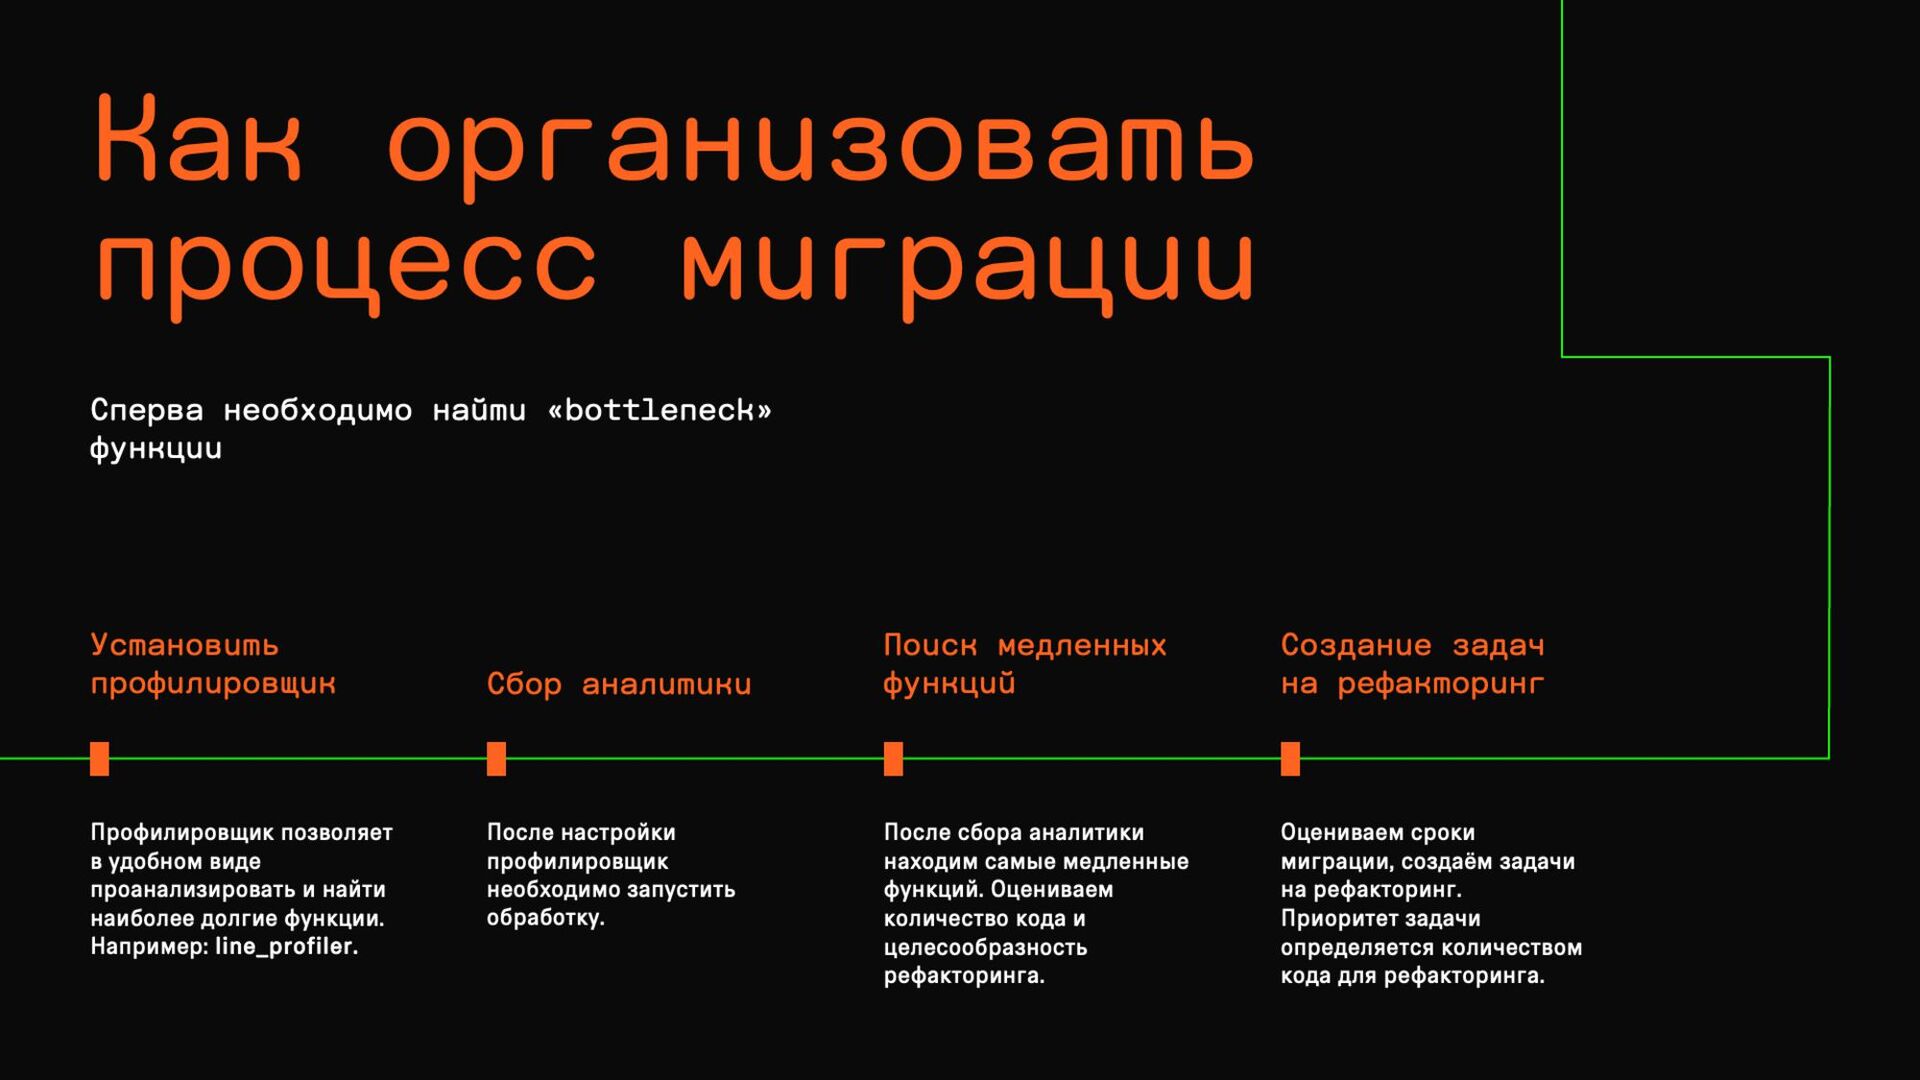
Установить профилировщик Профилировщик позволяет в удобном виде проанализировать и найти
наиболее долгие функции. Например: line_profiler. Сбор аналитики После настройки профилировщик необходимо запустить обработку. Поиск медленных функций После сбора аналитики находим самые медленные функций. Оцениваем количество кода и целесообразность рефакторинга. Создание задач на рефакторинг Оцениваем сроки миграции, создаём задачи на рефакторинг. Приоритет задачи определяется количеством кода для рефакторинга. Как организовать процесс миграции Сперва необходимо найти «bottleneck» функции -
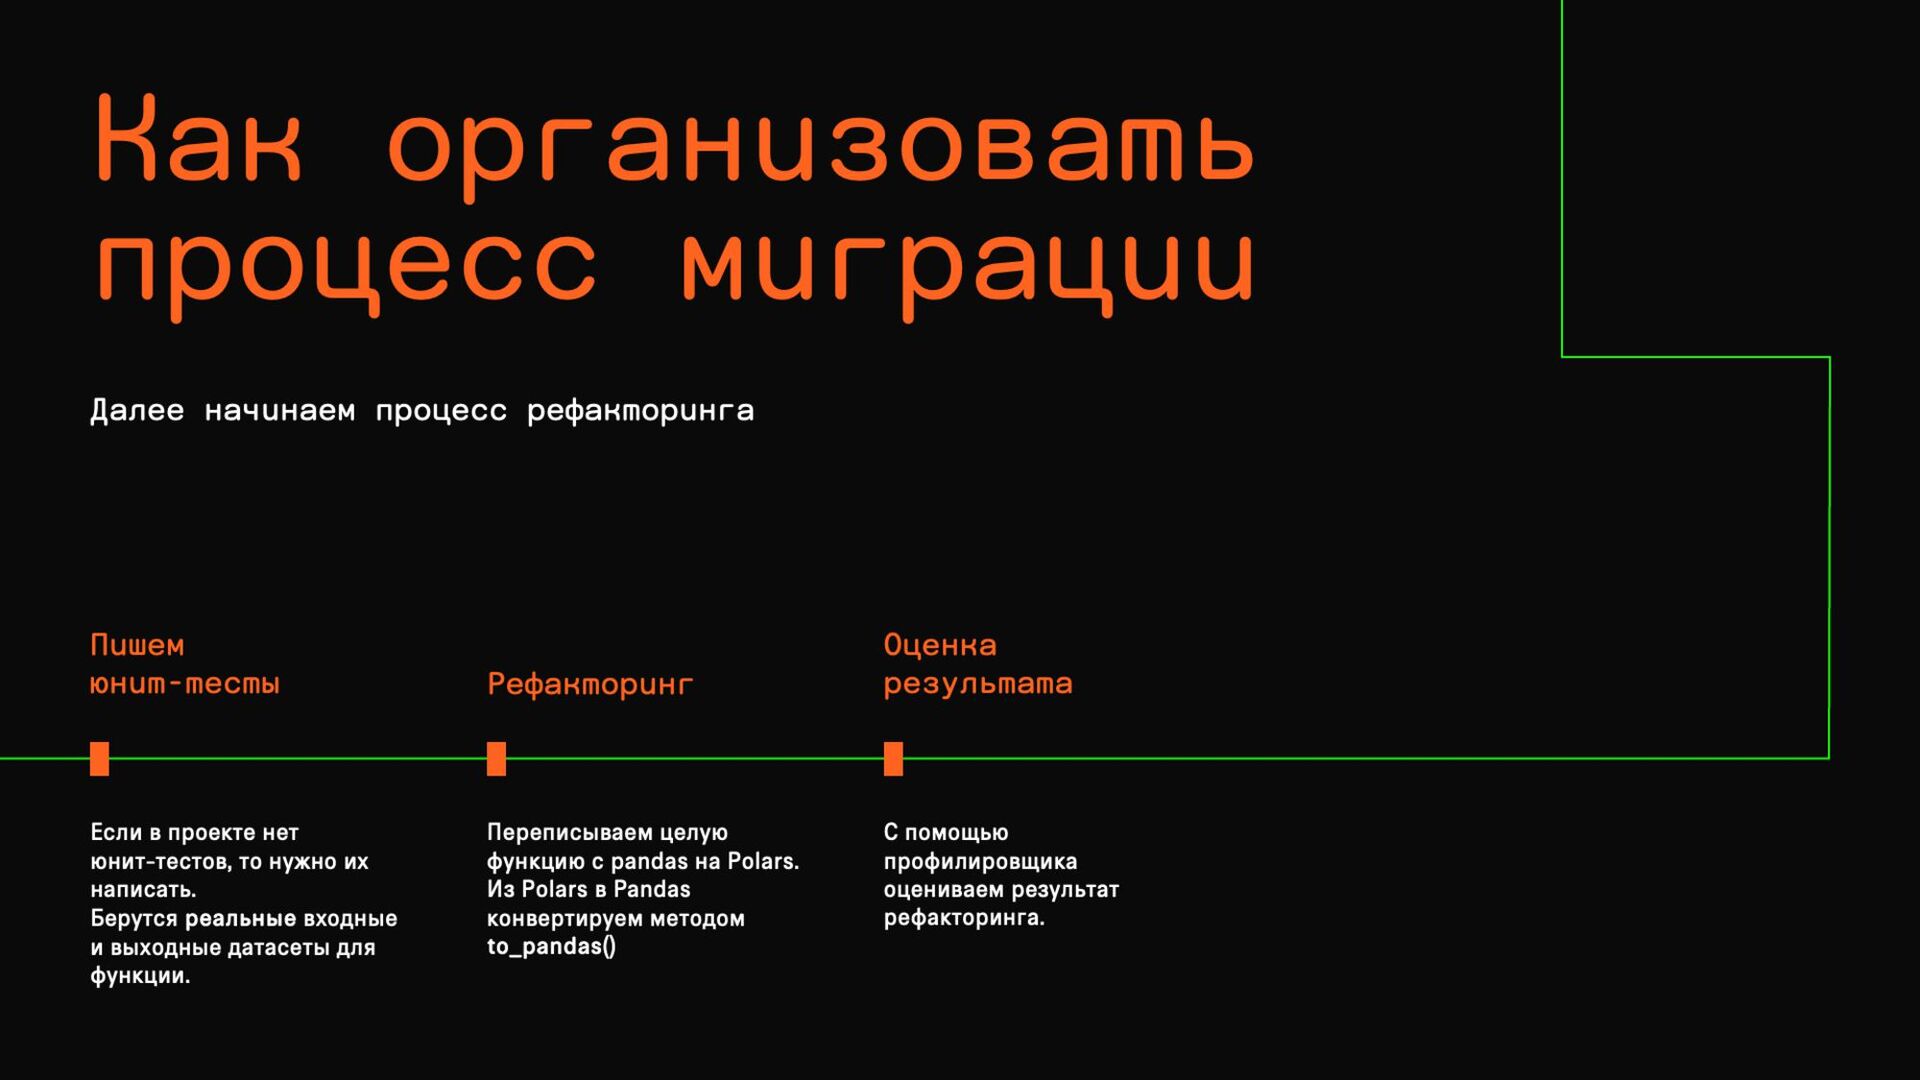
Пишем юнит-тесты Если в проекте нет юнит-тестов, то
нужно их написать. Берутся реальные входные и выходные датасеты для функции. Рефакторинг Переписываем целую функцию с pandas на Polars. Из Polars в Pandas конвертируем методом to_pandas() Оценка результата С помощью профилировщика оцениваем результат рефакторинга. Далее начинаем процесс рефакторинга Как организовать процесс миграции -
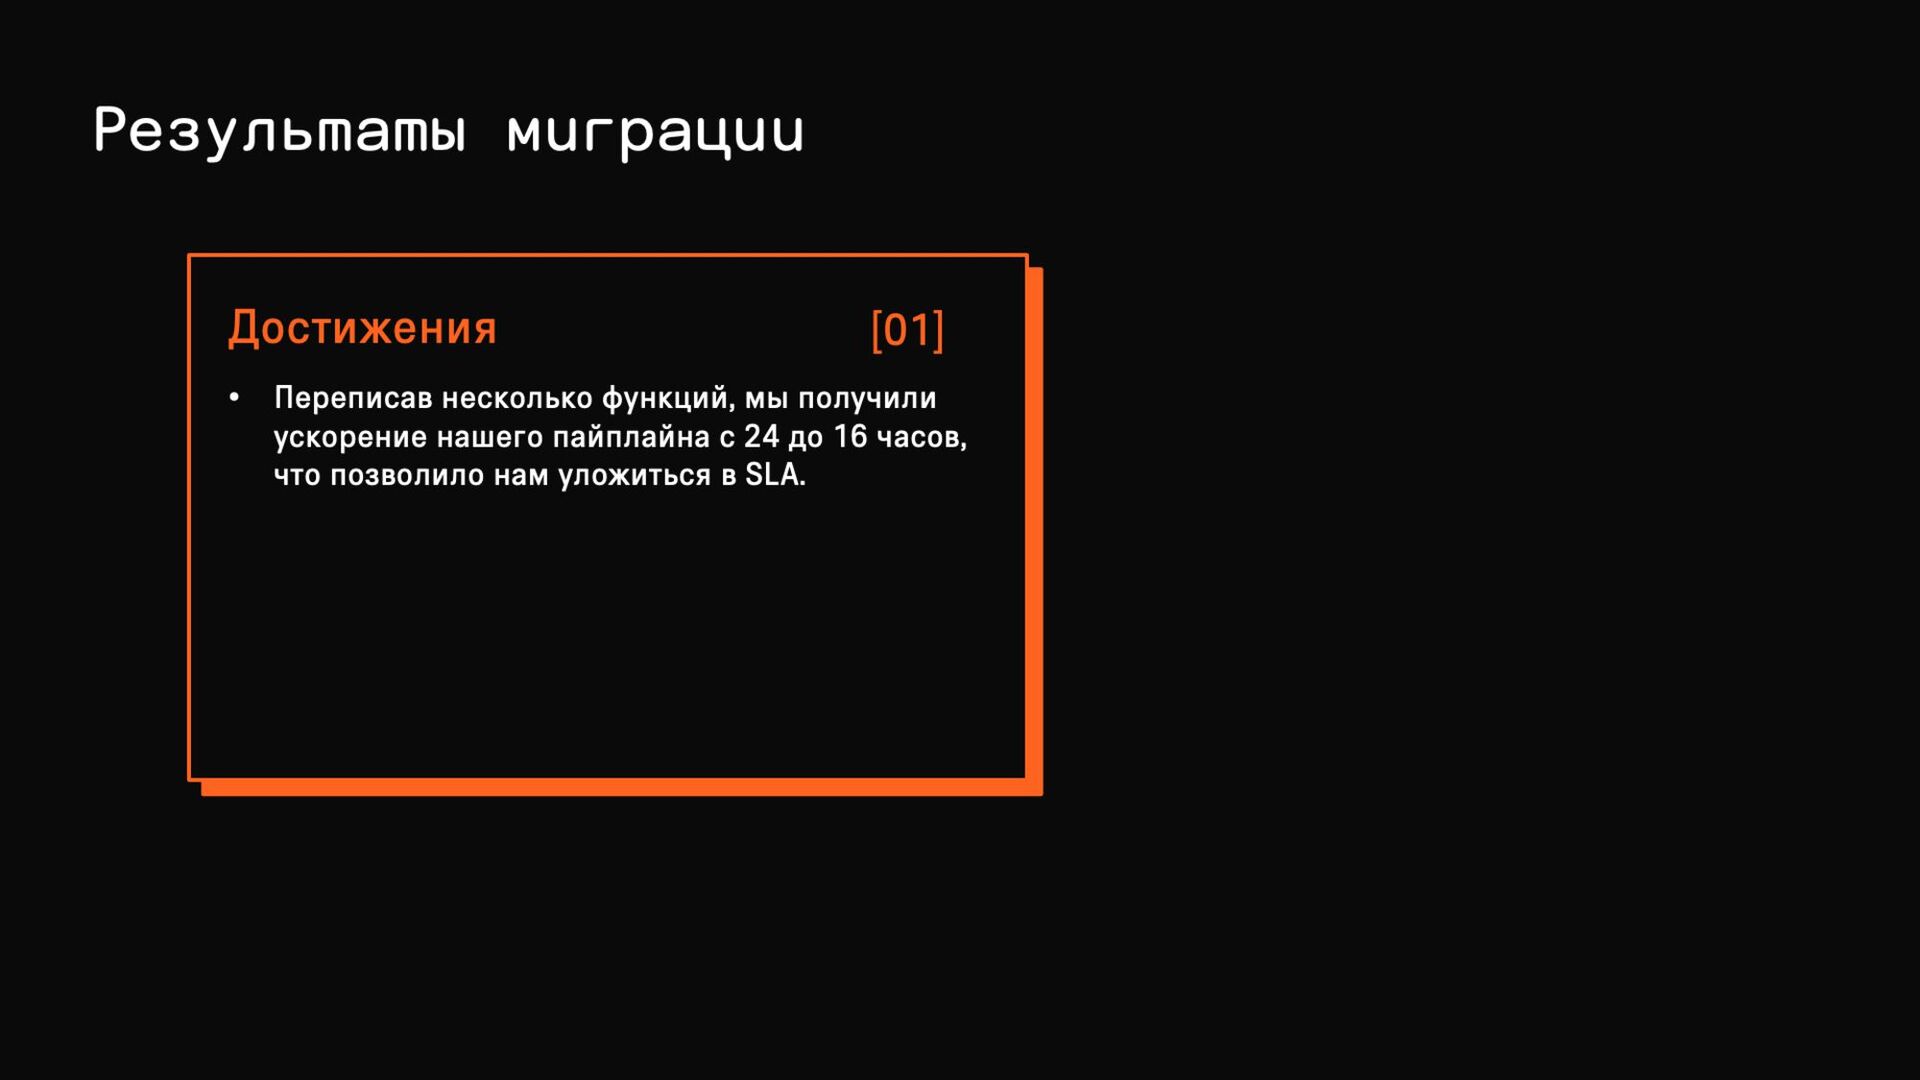
Результаты миграции Достижения • Переписав несколько функций, мы получили ускорение
нашего пайплайна с 24 до 16 часов, что позволило нам уложиться в SLA. [01] -
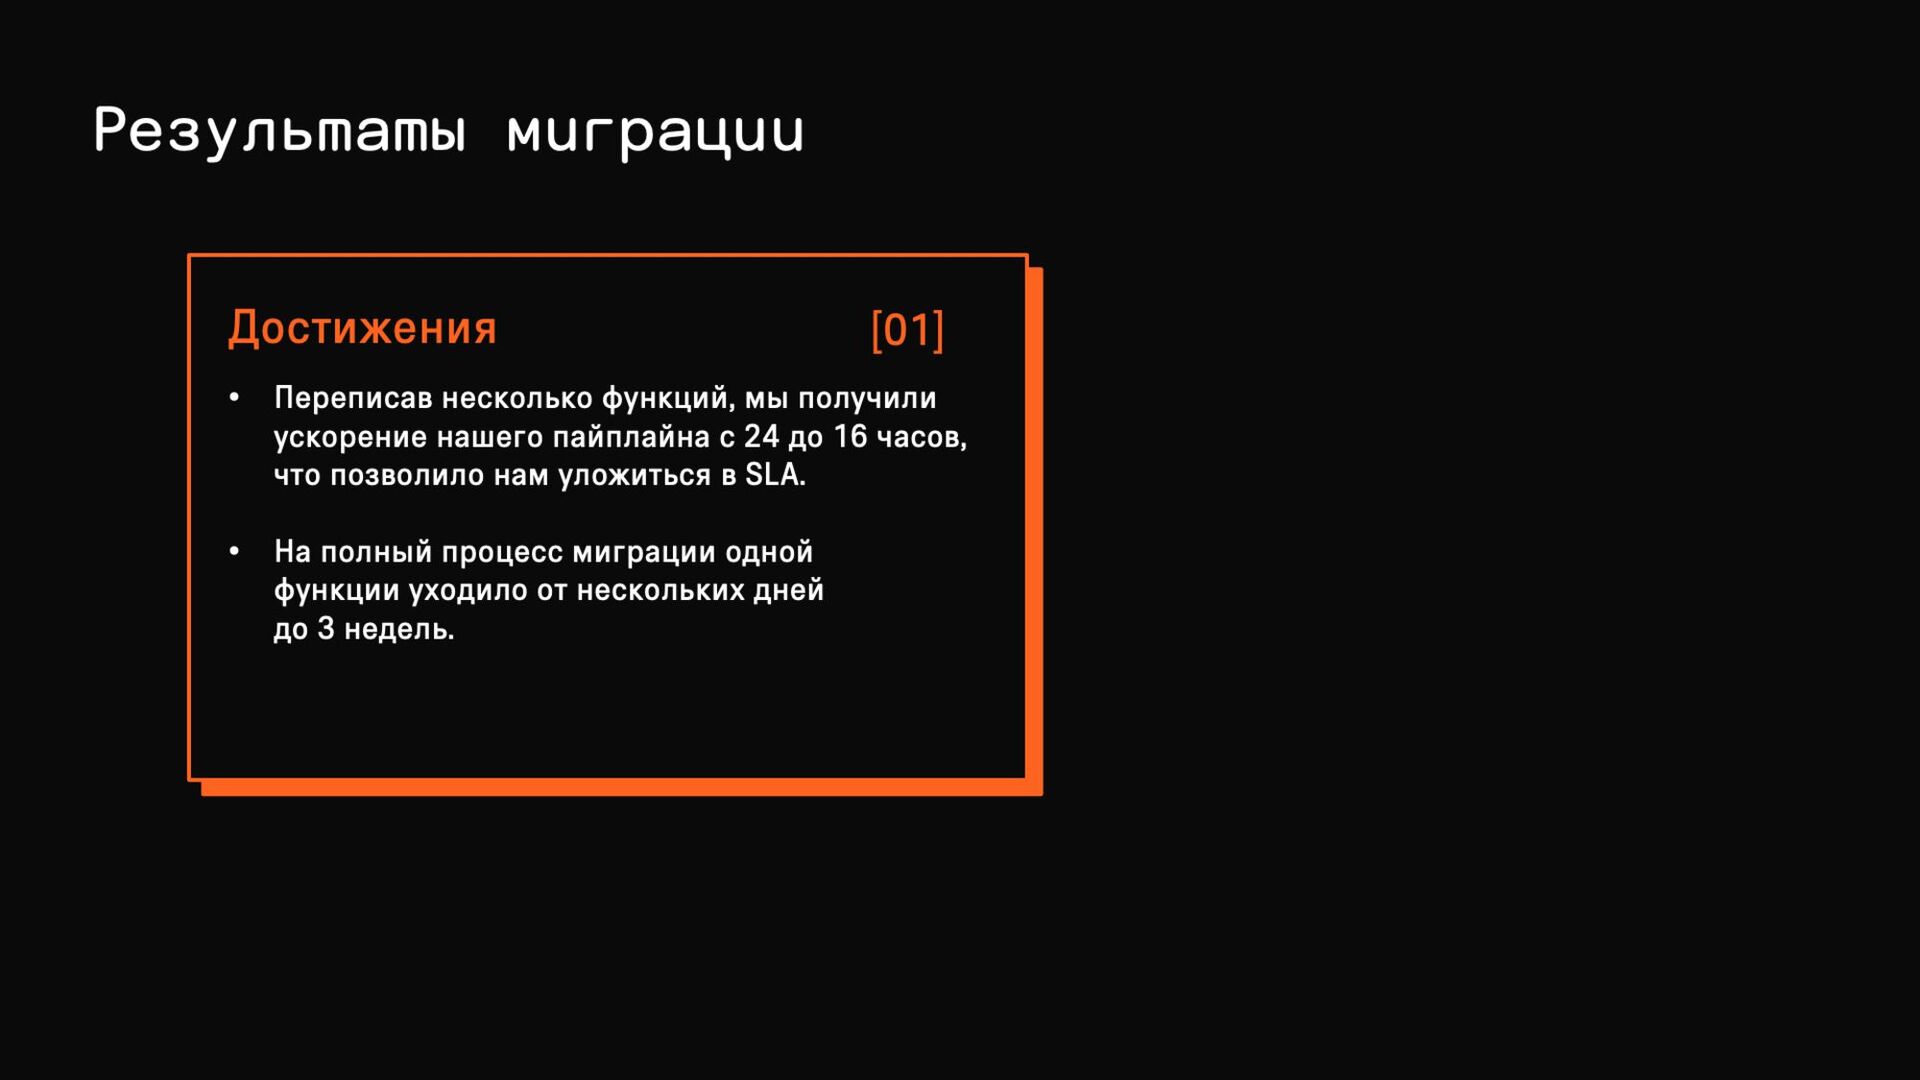
Результаты миграции Достижения • Переписав несколько функций, мы получили ускорение
нашего пайплайна с 24 до 16 часов, что позволило нам уложиться в SLA. • На полный процесс миграции одной функции уходило от нескольких дней до 3 недель. [01] -
Результаты миграции Достижения • Переписав несколько функций, мы получили ускорение
нашего пайплайна с 24 до 16 часов, что позволило нам уложиться в SLA. • На полный процесс миграции одной функции уходило от нескольких дней до 3 недель. • Уменьшили расходы на инфраструктуру. [01] -
Результаты миграции Достижения • Переписав несколько функций, мы получили ускорение
нашего пайплайна с 24 до 16 часов, что позволило нам уложиться в SLA. • На полный процесс миграции одной функции уходило от нескольких дней до 3 недель. • Уменьшили расходы на инфраструктуру. Минусы [02] [01] -
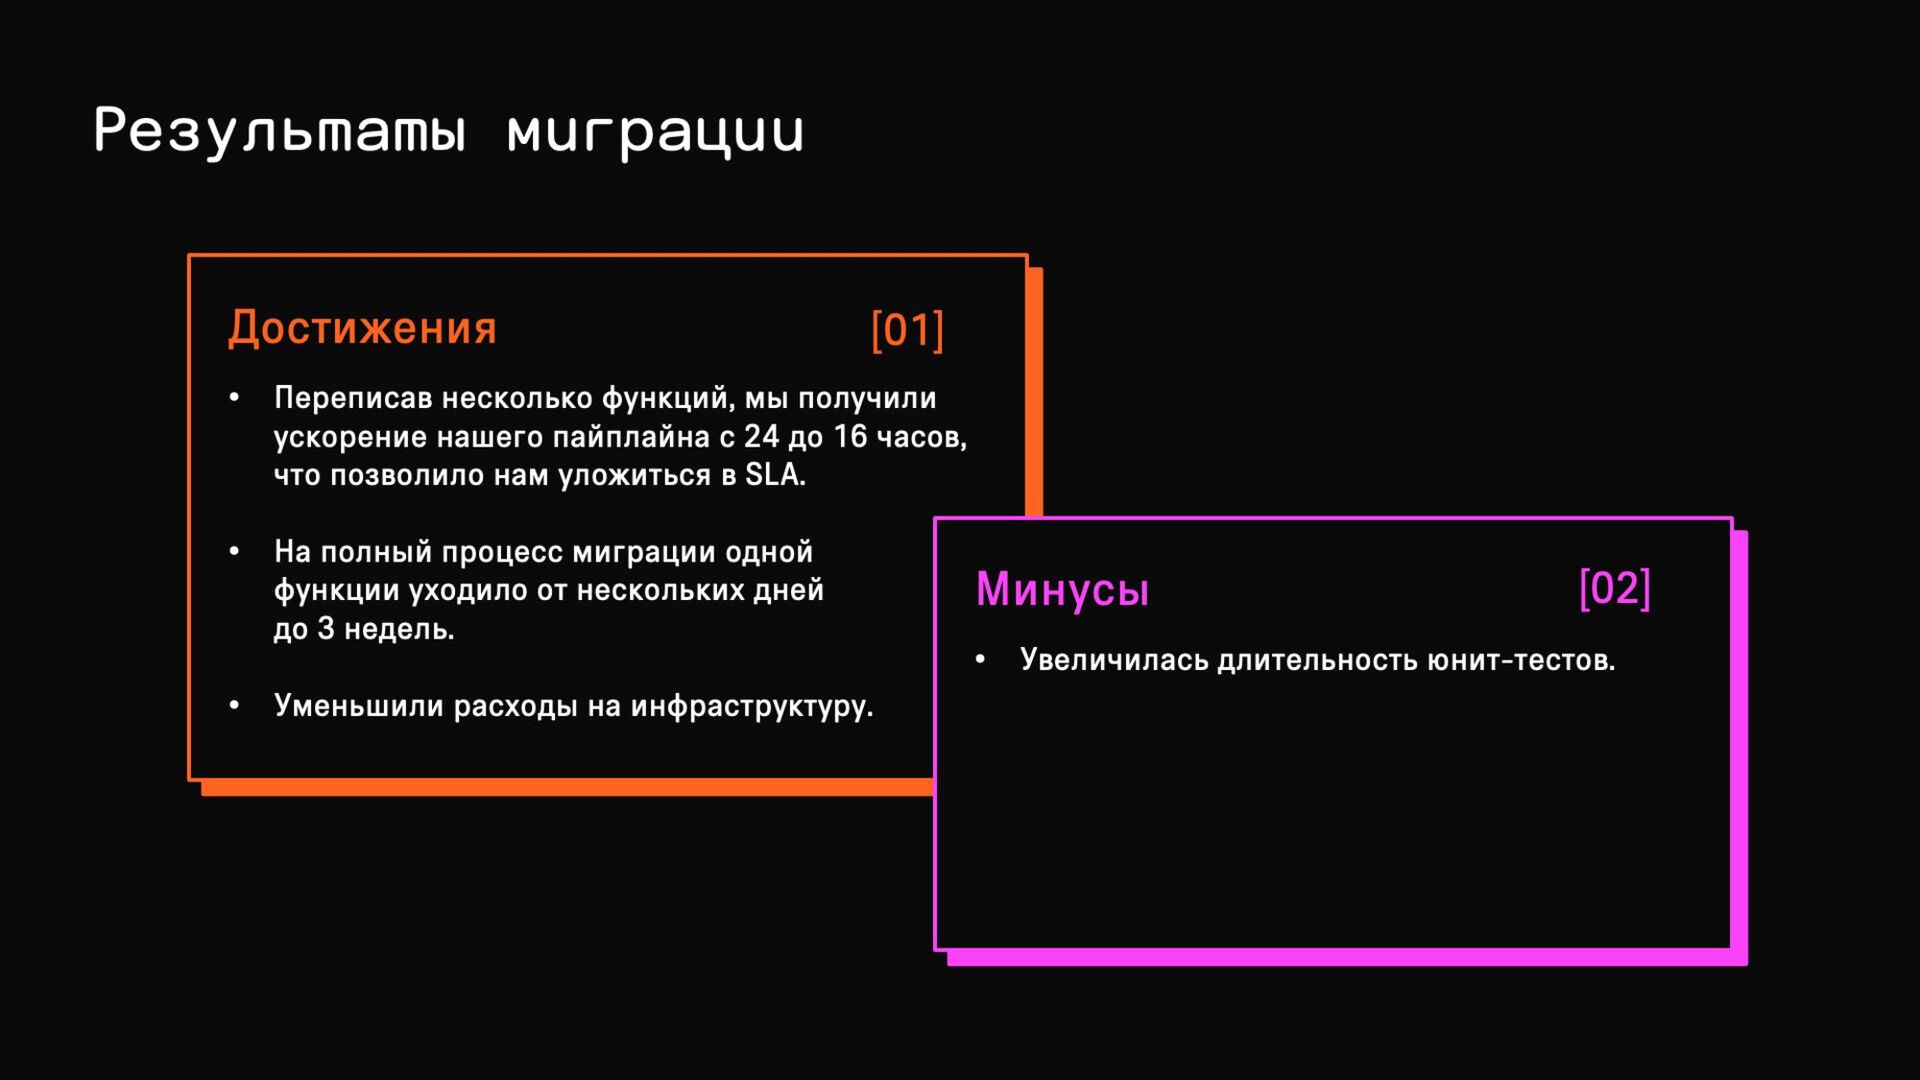
Результаты миграции Достижения • Переписав несколько функций, мы получили ускорение
нашего пайплайна с 24 до 16 часов, что позволило нам уложиться в SLA. • На полный процесс миграции одной функции уходило от нескольких дней до 3 недель. • Уменьшили расходы на инфраструктуру. Минусы • Увеличилась длительность юнит-тестов. [02] [01] -
Результаты миграции Достижения • Переписав несколько функций, мы получили ускорение
нашего пайплайна с 24 до 16 часов, что позволило нам уложиться в SLA. • На полный процесс миграции одной функции уходило от нескольких дней до 3 недель. • Уменьшили расходы на инфраструктуру. Минусы • Увеличилась длительность юнит-тестов. • В случае нового увеличения количества складов необходима дальнейшая оптимизация или миграция на кластерные вычисления. [02] [01] -
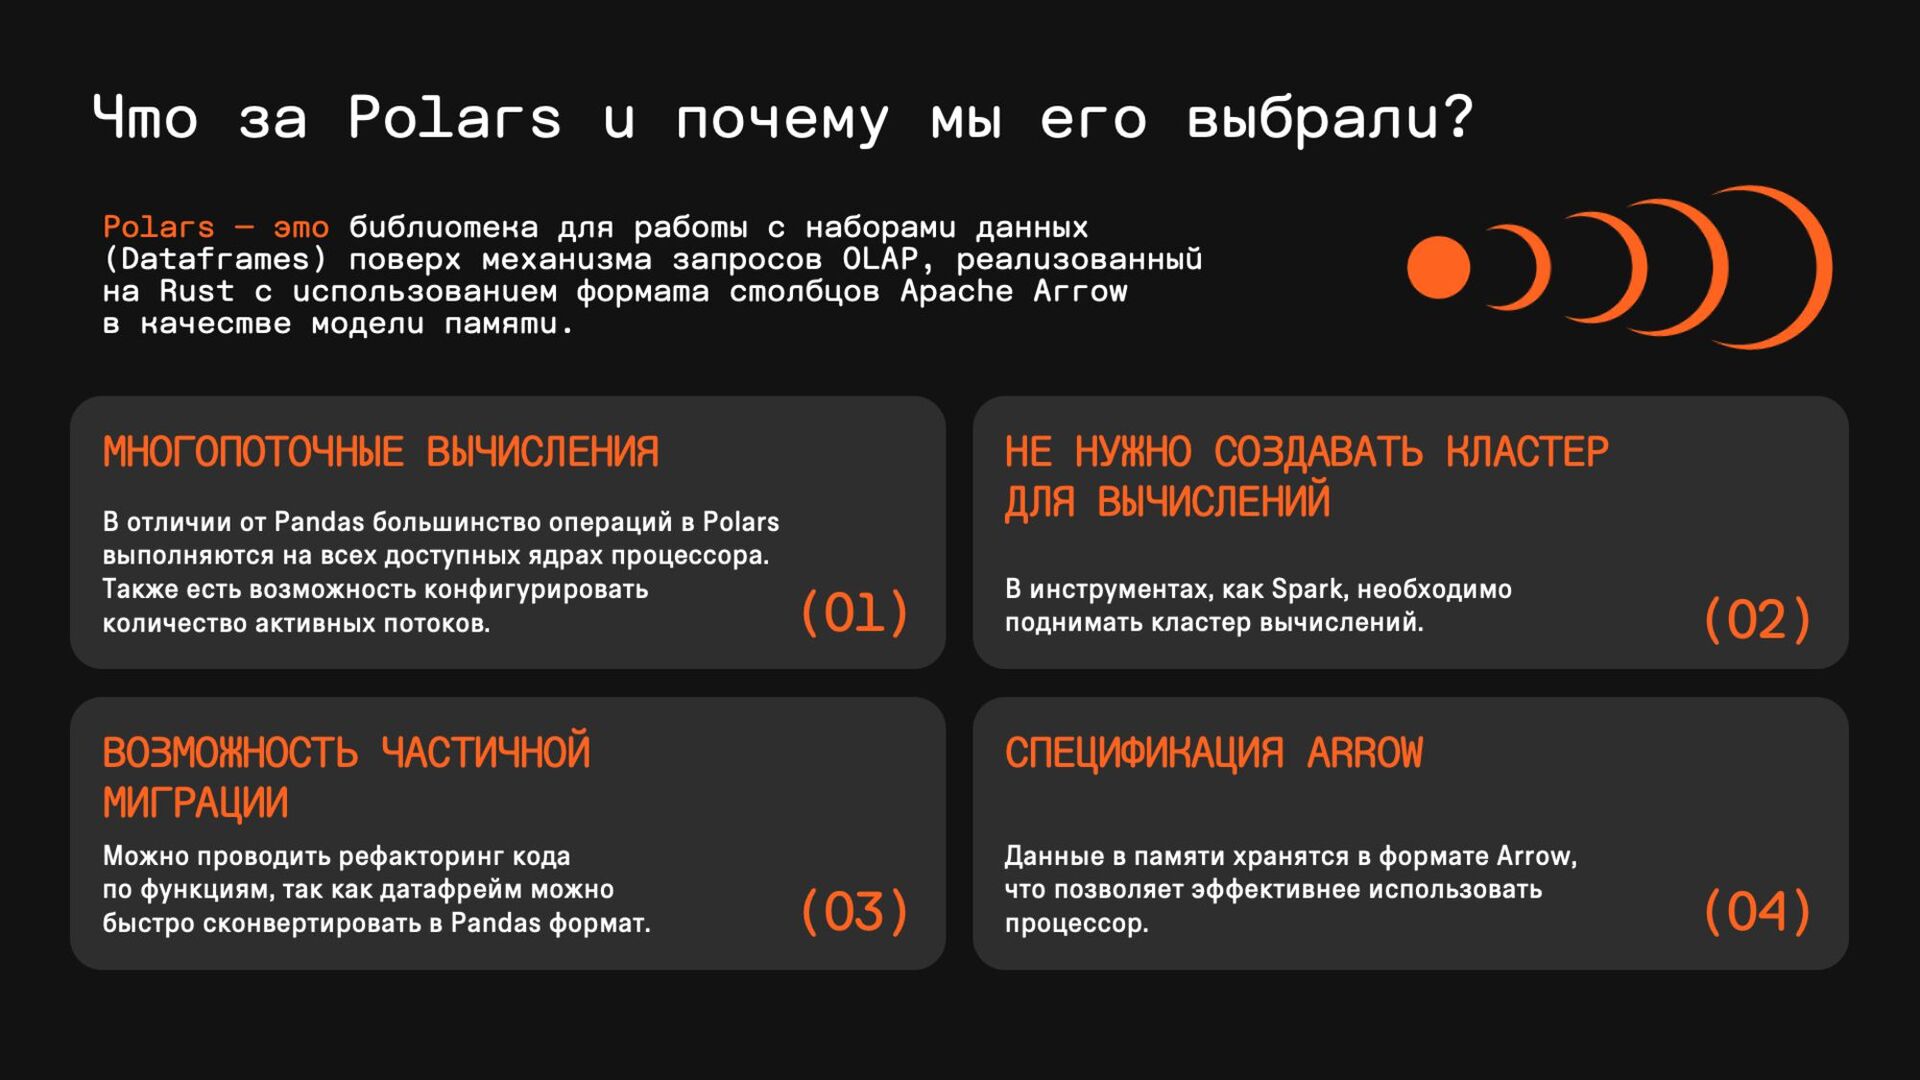
Что за Polars и почему мы его выбрали? Polars —
это библиотека для работы с наборами данных (Dataframes) поверх механизма запросов OLAP, реализованный на Rust с использованием формата столбцов Apache Arrow в качестве модели памяти. -
МНОГОПОТОЧНЫЕ ВЫЧИСЛЕНИЯ (01) В отличии от Pandas большинство операций в
Polars выполняются на всех доступных ядрах процессора. Также есть возможность конфигурировать количество активных потоков. Что за Polars и почему мы его выбрали? Polars — это библиотека для работы с наборами данных (Dataframes) поверх механизма запросов OLAP, реализованный на Rust с использованием формата столбцов Apache Arrow в качестве модели памяти. -
МНОГОПОТОЧНЫЕ ВЫЧИСЛЕНИЯ (01) В отличии от Pandas большинство операций в
Polars выполняются на всех доступных ядрах процессора. Также есть возможность конфигурировать количество активных потоков. НЕ НУЖНО СОЗДАВАТЬ КЛАСТЕР ДЛЯ ВЫЧИСЛЕНИЙ (02) В инструментах, как Spark, необходимо поднимать кластер вычислений. Что за Polars и почему мы его выбрали? Polars — это библиотека для работы с наборами данных (Dataframes) поверх механизма запросов OLAP, реализованный на Rust с использованием формата столбцов Apache Arrow в качестве модели памяти. -
МНОГОПОТОЧНЫЕ ВЫЧИСЛЕНИЯ (01) В отличии от Pandas большинство операций в
Polars выполняются на всех доступных ядрах процессора. Также есть возможность конфигурировать количество активных потоков. ВОЗМОЖНОСТЬ ЧАСТИЧНОЙ МИГРАЦИИ (03) Можно проводить рефакторинг кода по функциям, так как датафрейм можно быстро сконвертировать в Pandas формат. НЕ НУЖНО СОЗДАВАТЬ КЛАСТЕР ДЛЯ ВЫЧИСЛЕНИЙ (02) В инструментах, как Spark, необходимо поднимать кластер вычислений. Что за Polars и почему мы его выбрали? Polars — это библиотека для работы с наборами данных (Dataframes) поверх механизма запросов OLAP, реализованный на Rust с использованием формата столбцов Apache Arrow в качестве модели памяти. -
МНОГОПОТОЧНЫЕ ВЫЧИСЛЕНИЯ (01) В отличии от Pandas большинство операций в
Polars выполняются на всех доступных ядрах процессора. Также есть возможность конфигурировать количество активных потоков. ВОЗМОЖНОСТЬ ЧАСТИЧНОЙ МИГРАЦИИ (03) Можно проводить рефакторинг кода по функциям, так как датафрейм можно быстро сконвертировать в Pandas формат. НЕ НУЖНО СОЗДАВАТЬ КЛАСТЕР ДЛЯ ВЫЧИСЛЕНИЙ (02) В инструментах, как Spark, необходимо поднимать кластер вычислений. СПЕЦИФИКАЦИЯ ARROW (04) Данные в памяти хранятся в формате Arrow, что позволяет эффективнее использовать процессор. Что за Polars и почему мы его выбрали? Polars — это библиотека для работы с наборами данных (Dataframes) поверх механизма запросов OLAP, реализованный на Rust с использованием формата столбцов Apache Arrow в качестве модели памяти. -
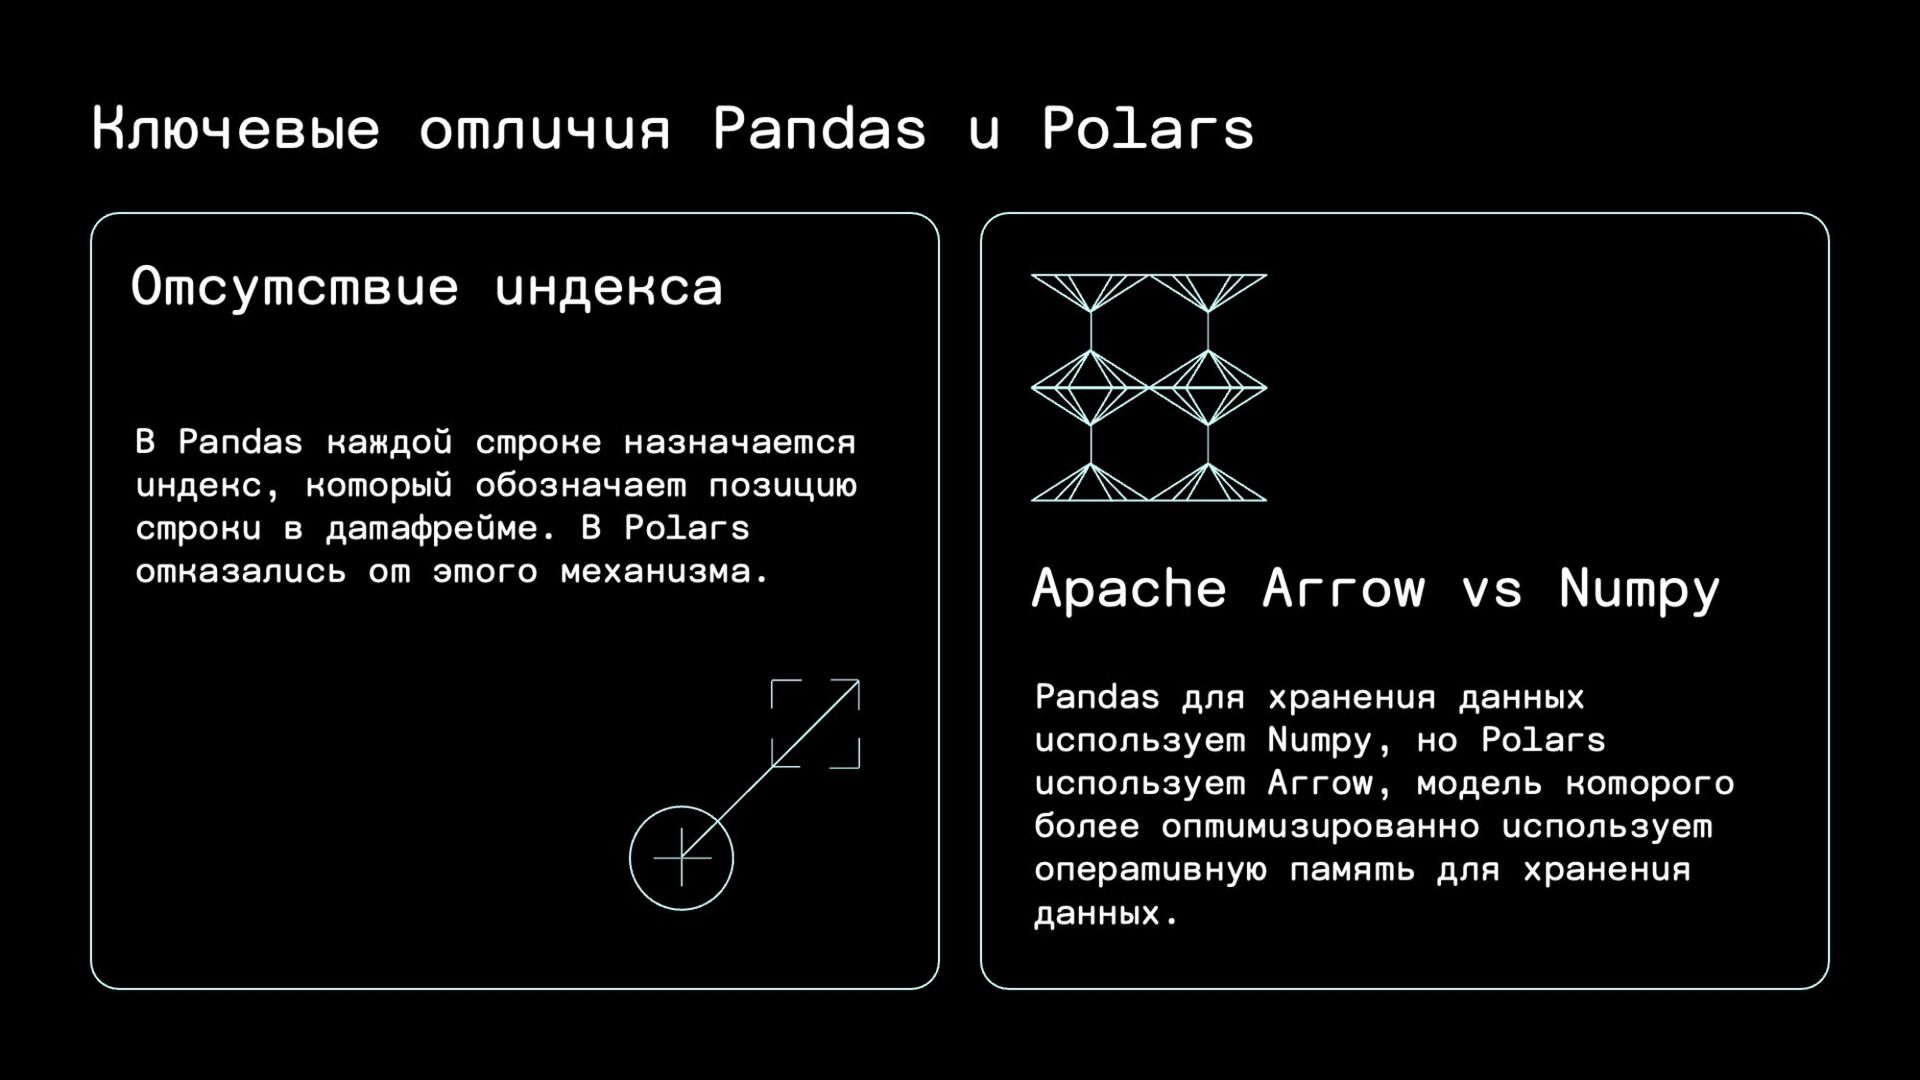
Отсутствие индекса Apache Arrow vs Numpy В Pandas каждой строке
назначается индекс, который обозначает позицию строки в датафрейме. В Polars отказались от этого механизма. Pandas для хранения данных использует Numpy, но Polars использует Arrow, модель которого более оптимизированно использует оперативную память для хранения данных. Ключевые отличия Pandas и Polars -
Параллельные вычисления Для параллелизации вычислений в Pandas необходимо
использовать инструменты Dask или Modin. Ленивые вычисления В Polars есть механизм оптимизации плана запроса, что позволяет ускорить вычисления. Ключевые отличия Pandas и Polars -
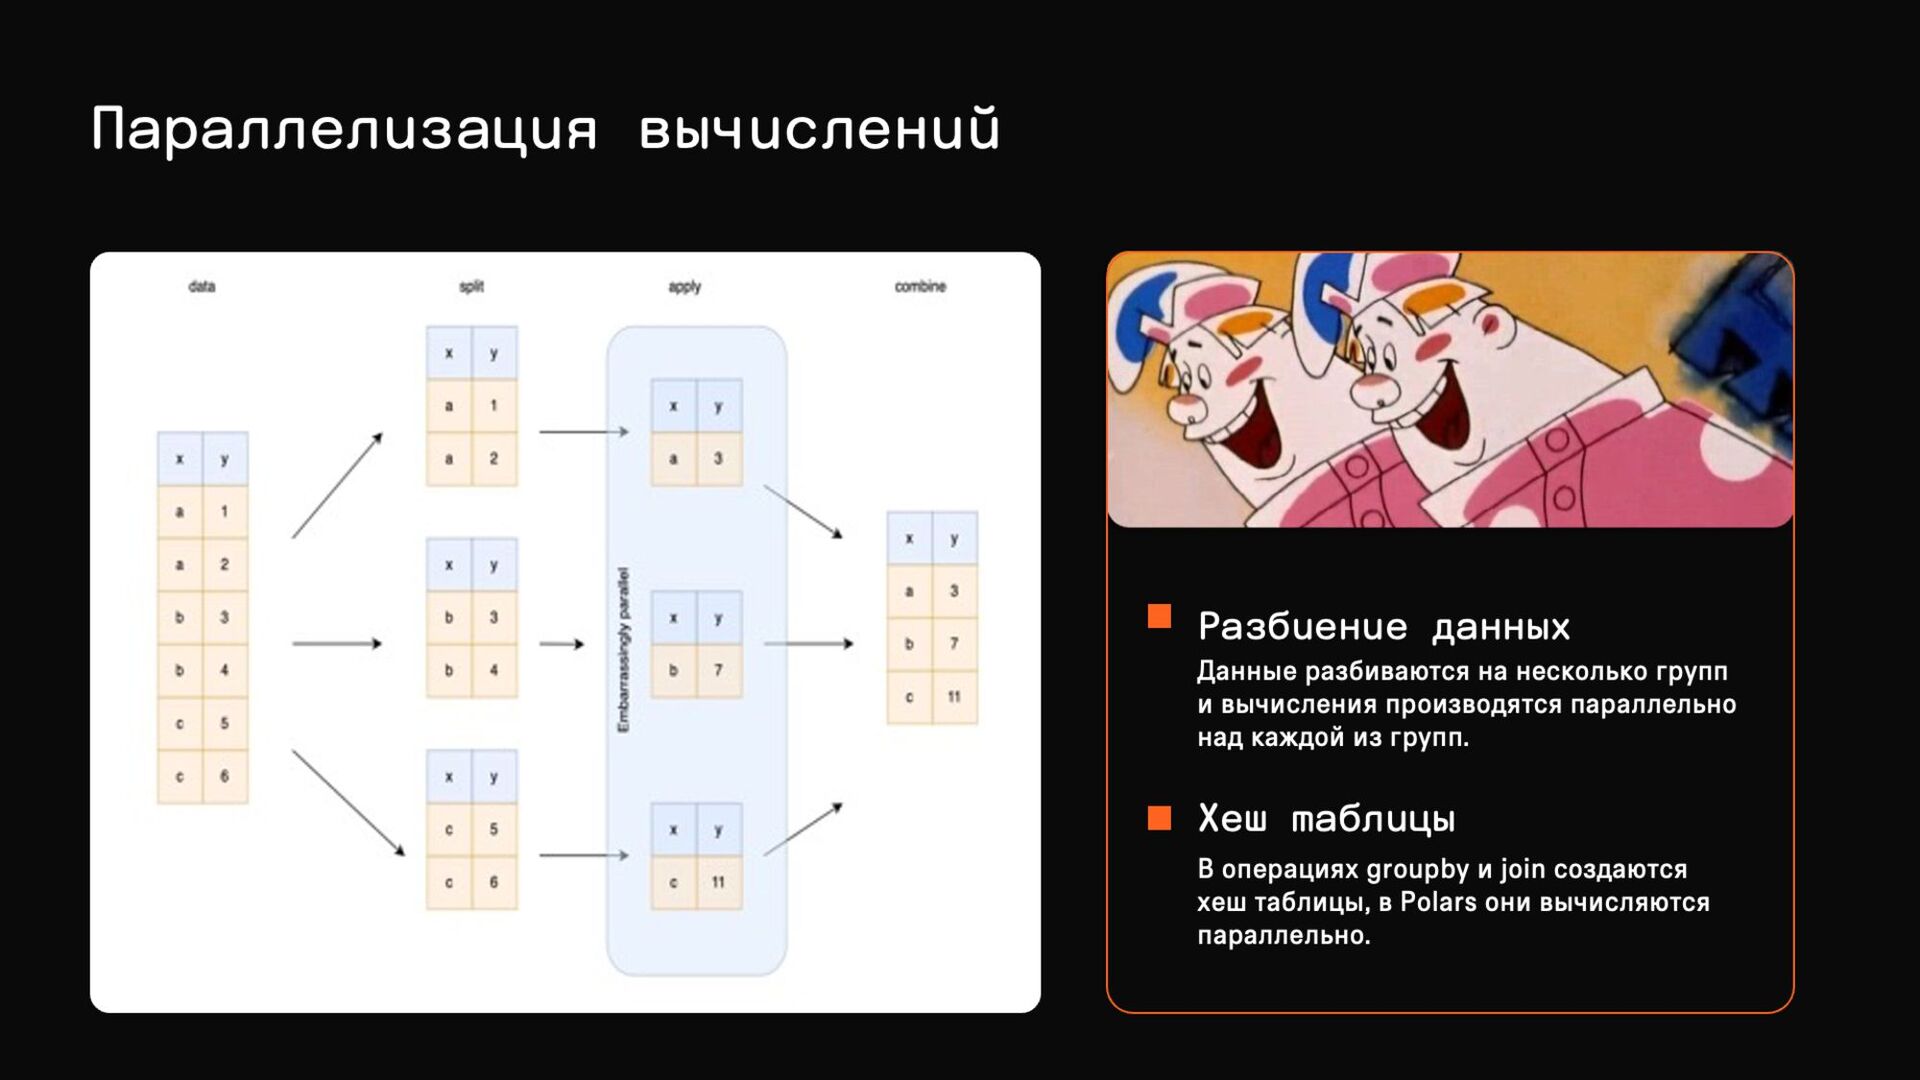
Параллелизация вычислений Разбиение данных Данные разбиваются на несколько групп и
вычисления производятся параллельно над каждой из групп. Хеш таблицы В операциях groupby и join создаются хеш таблицы, в Polars они вычисляются параллельно. -
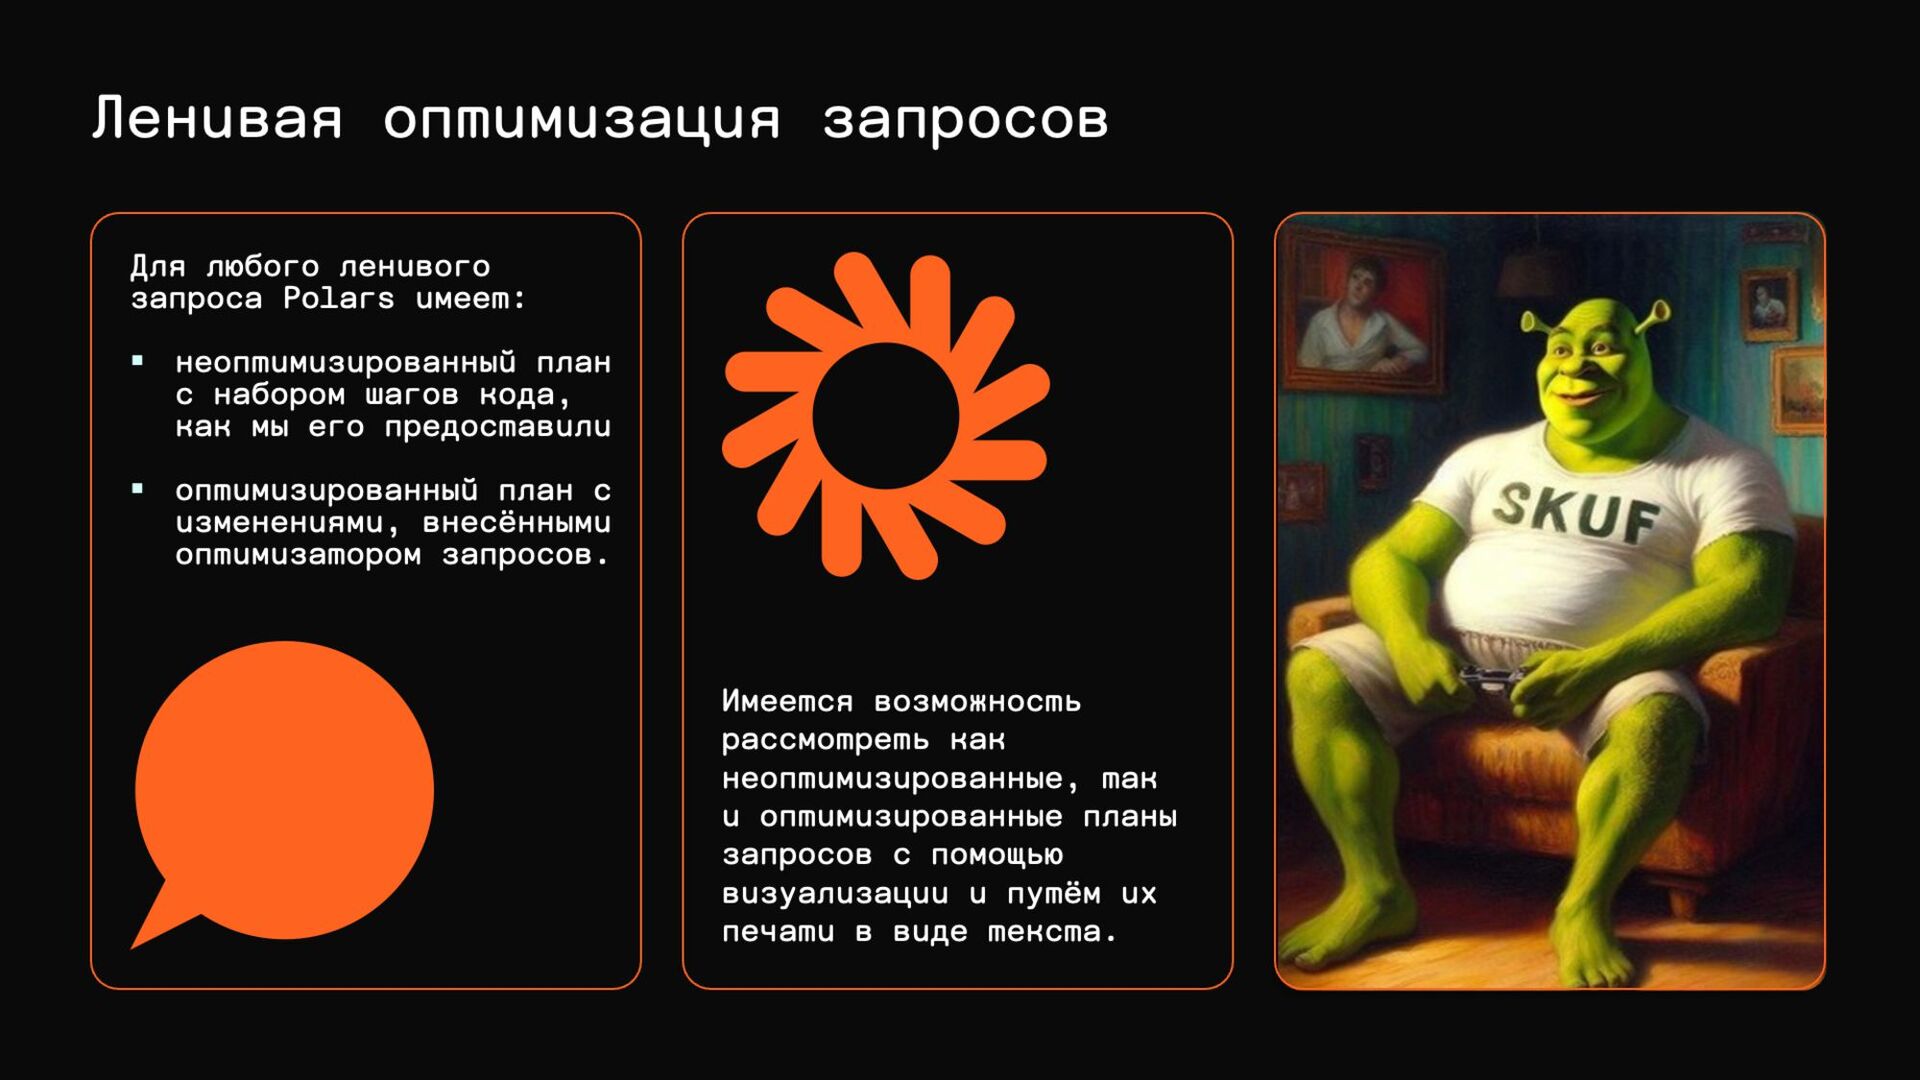
Ленивая оптимизация запросов Для любого ленивого запроса Polars имеет: ▪
неоптимизированный план с набором шагов кода, как мы его предоставили ▪ оптимизированный план с изменениями, внесёнными оптимизатором запросов. Имеется возможность рассмотреть как неоптимизированные, так и оптимизированные планы запросов с помощью визуализации и путём их печати в виде текста. -
Ленивая оптимизация запросов WITH COLUMNS [col(“Fare”).round()] WITH COLUMNS
[col(“Fare”).round()] Parquet SCAN titanic.parquet π 3/12; σ[(col(“Survived”))=(1)] Parquet SCAN titanic.parquet π */12; σ None FILTER BY [(col(“Survived”))==(1)] π 3/3 Без оптимизаций запросов С оптимизацией запросов -
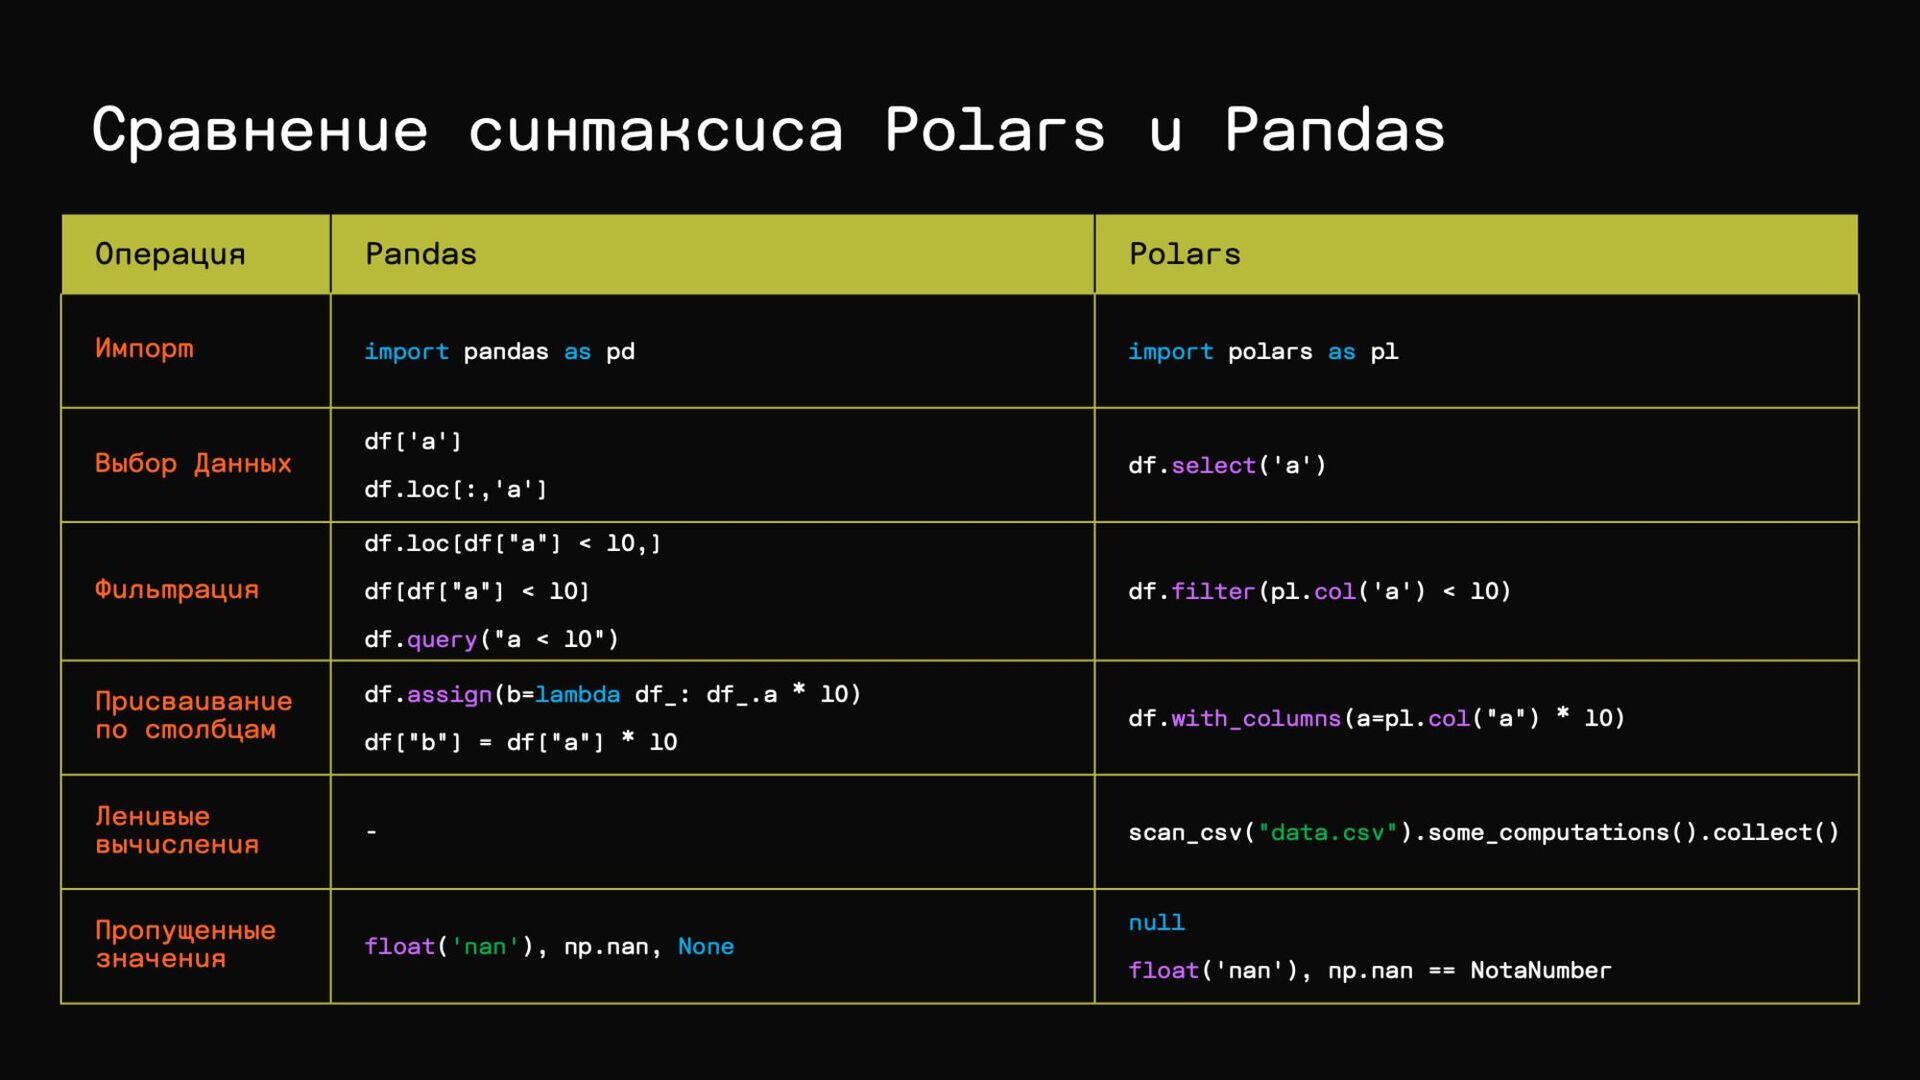
Операция Pandas Polars Импорт import pandas as pd import polars
as pl Выбор Данных df['a'] df.loc[:,'a'] df.select('a') Фильтрация df.loc[df["a"] < 10,] df[df["a"] < 10] df.query("a < 10") df.filter(pl.col('a') < 10) Присваивание по столбцам df.assign(b=lambda df_: df_.a * 10) df["b"] = df["a"] * 10 df.with_columns(a=pl.col("a") * 10) Ленивые вычисления - scan_csv("data.csv").some_computations().collect() Пропущенные значения float('nan'), np.nan, None null float('nan'), np.nan == NotaNumber Сравнение синтаксиса Polars и Pandas -
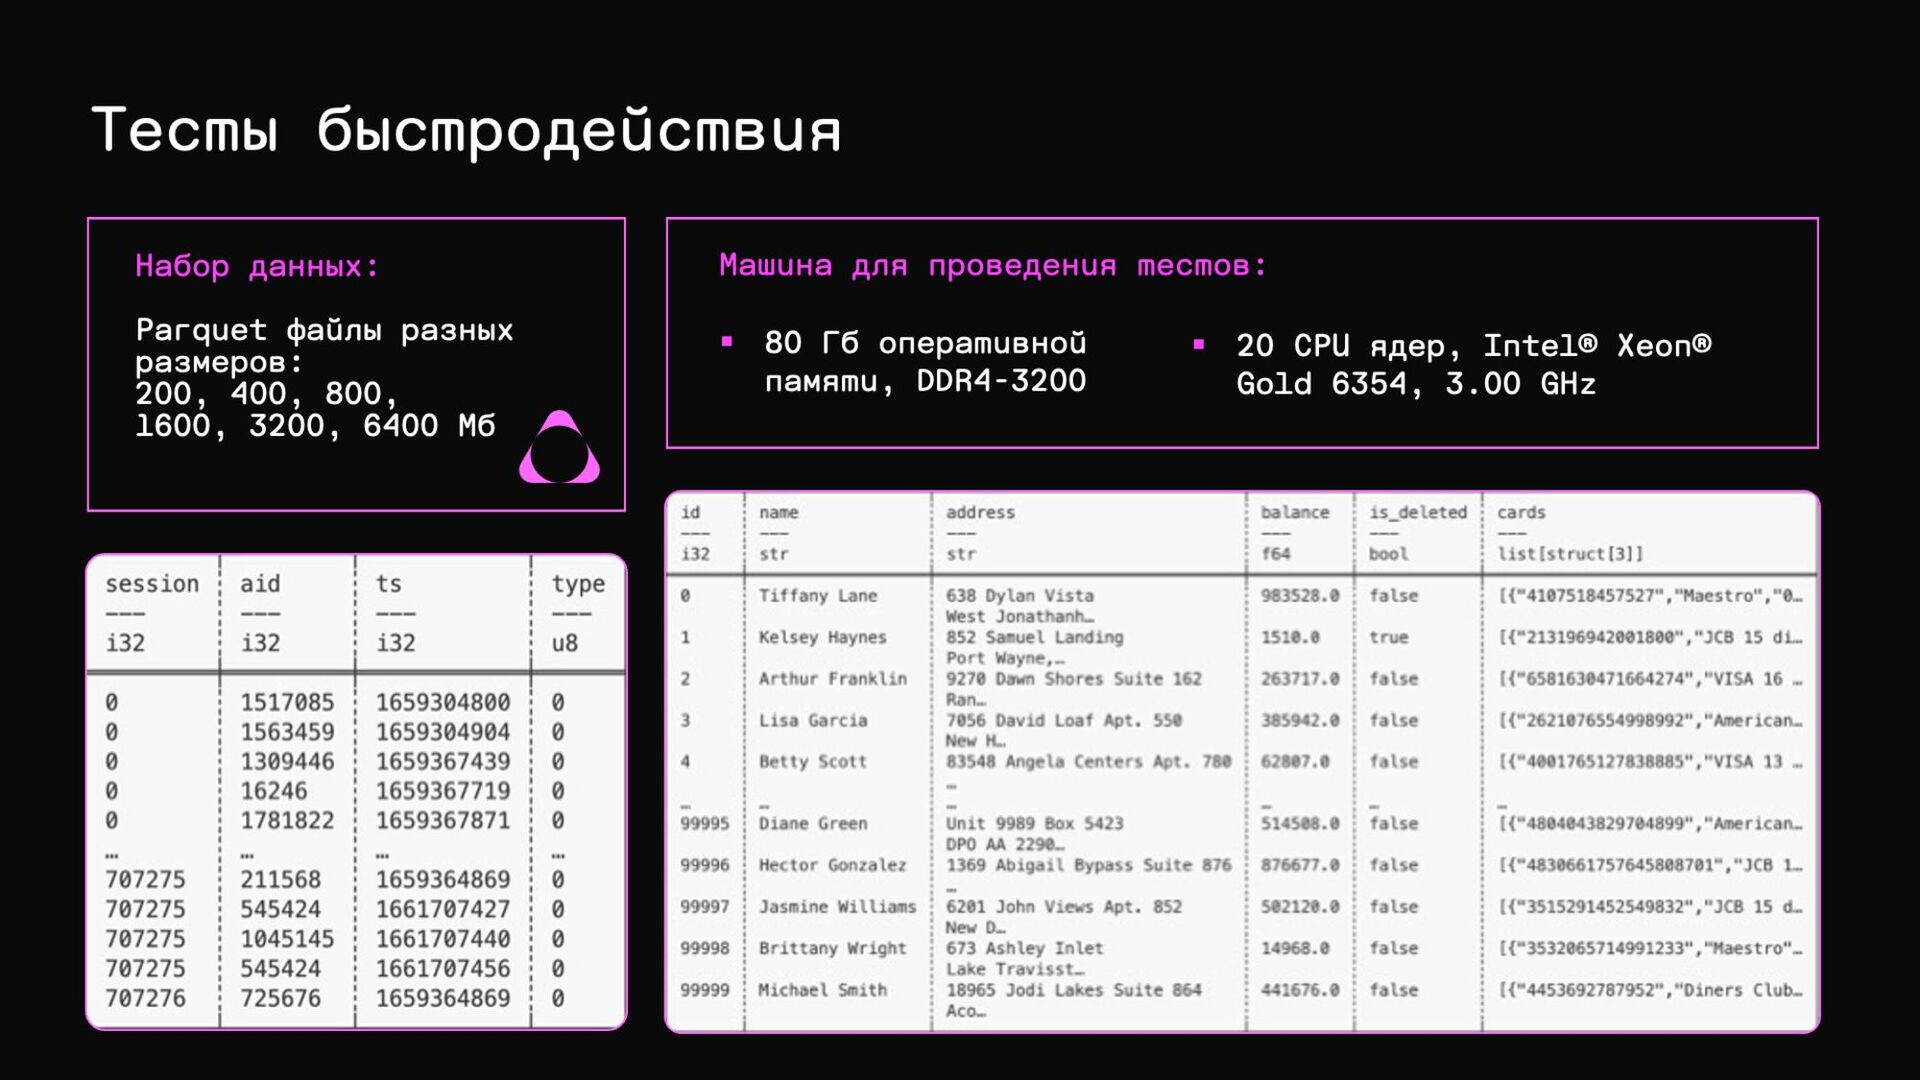
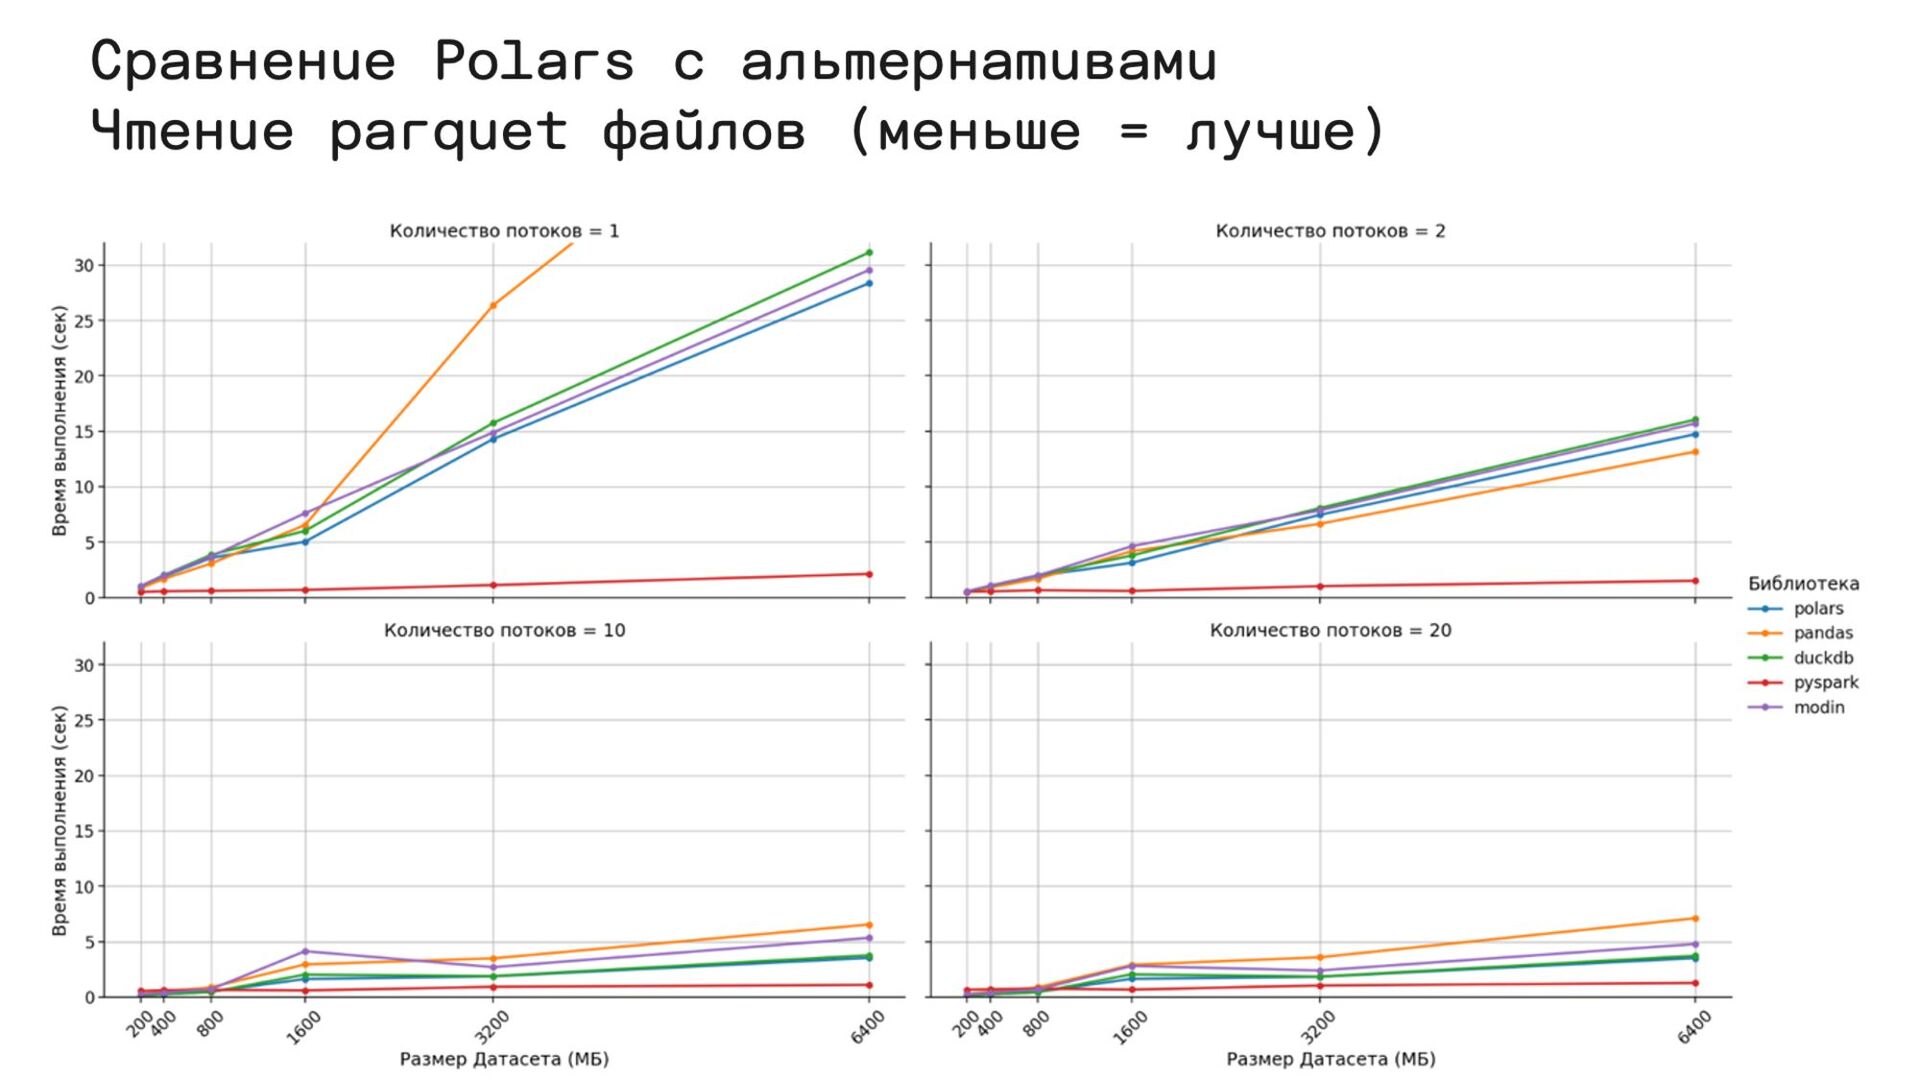
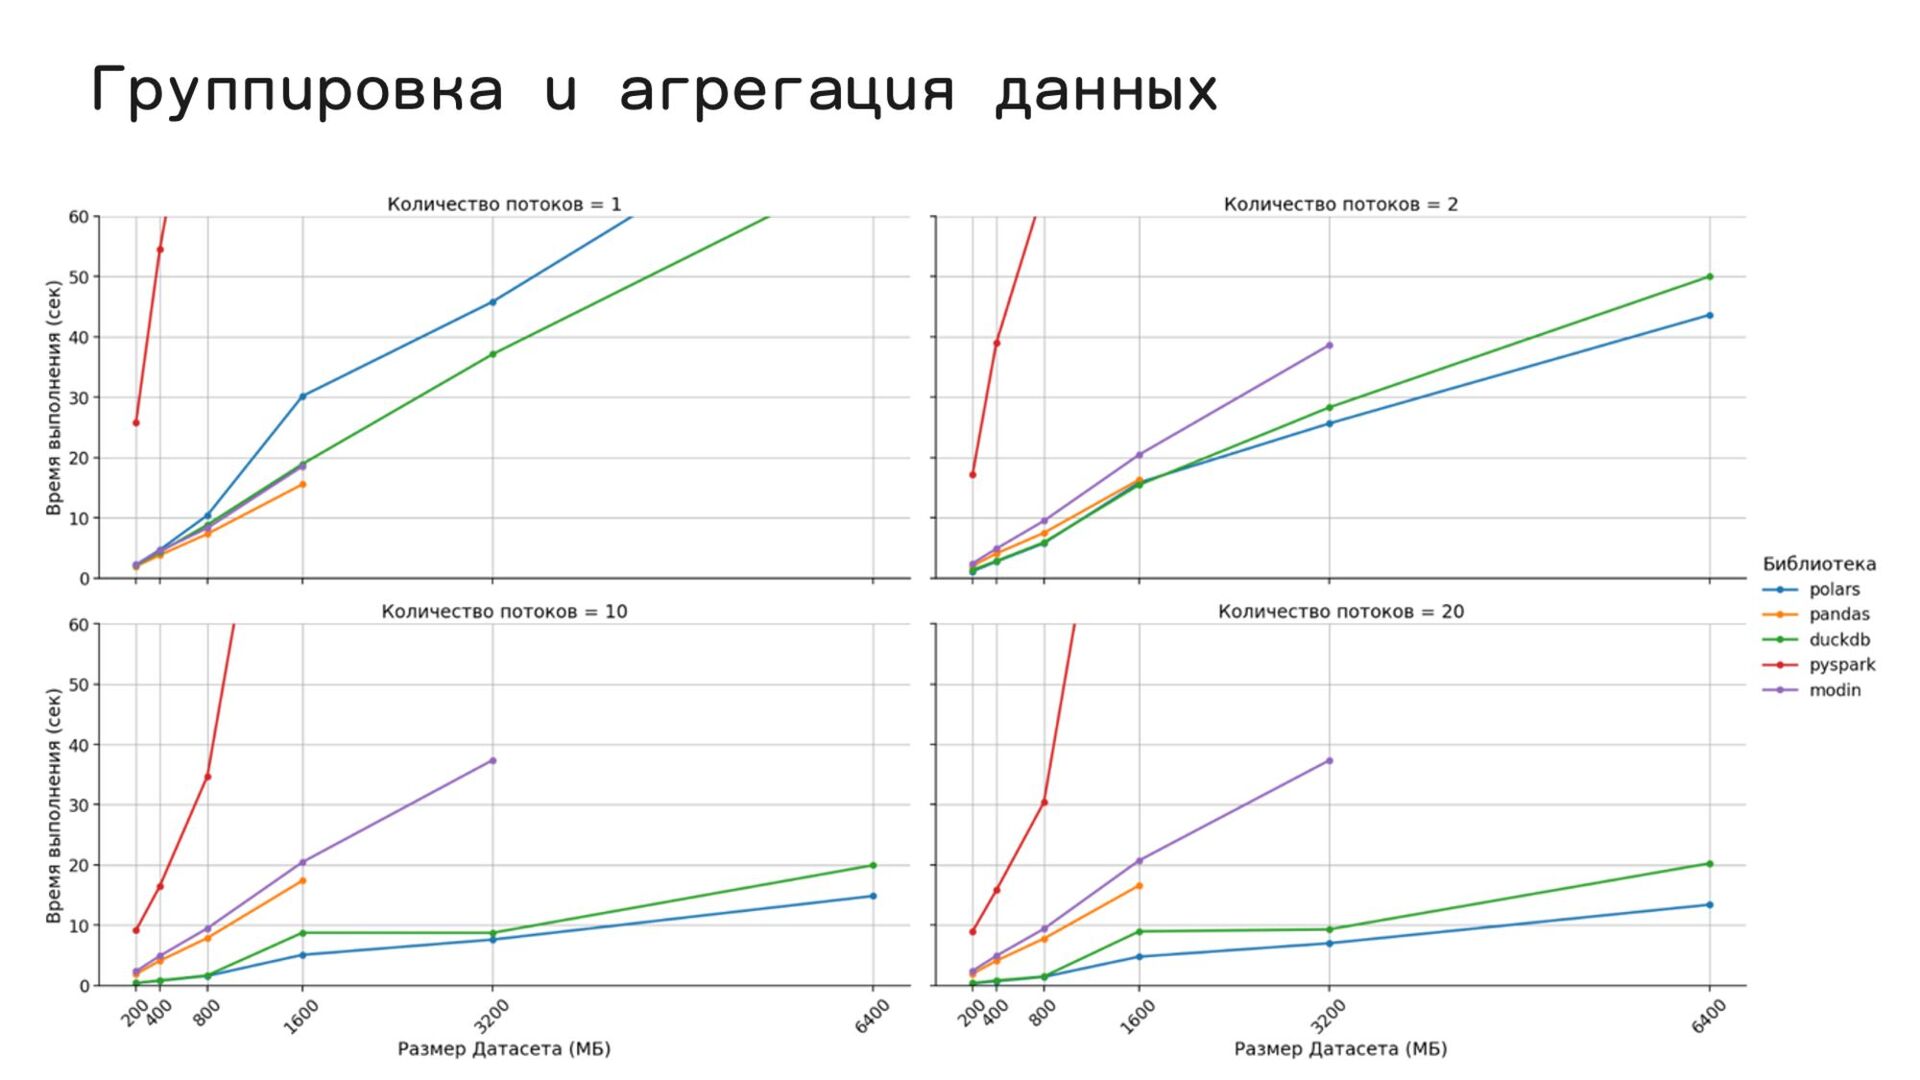
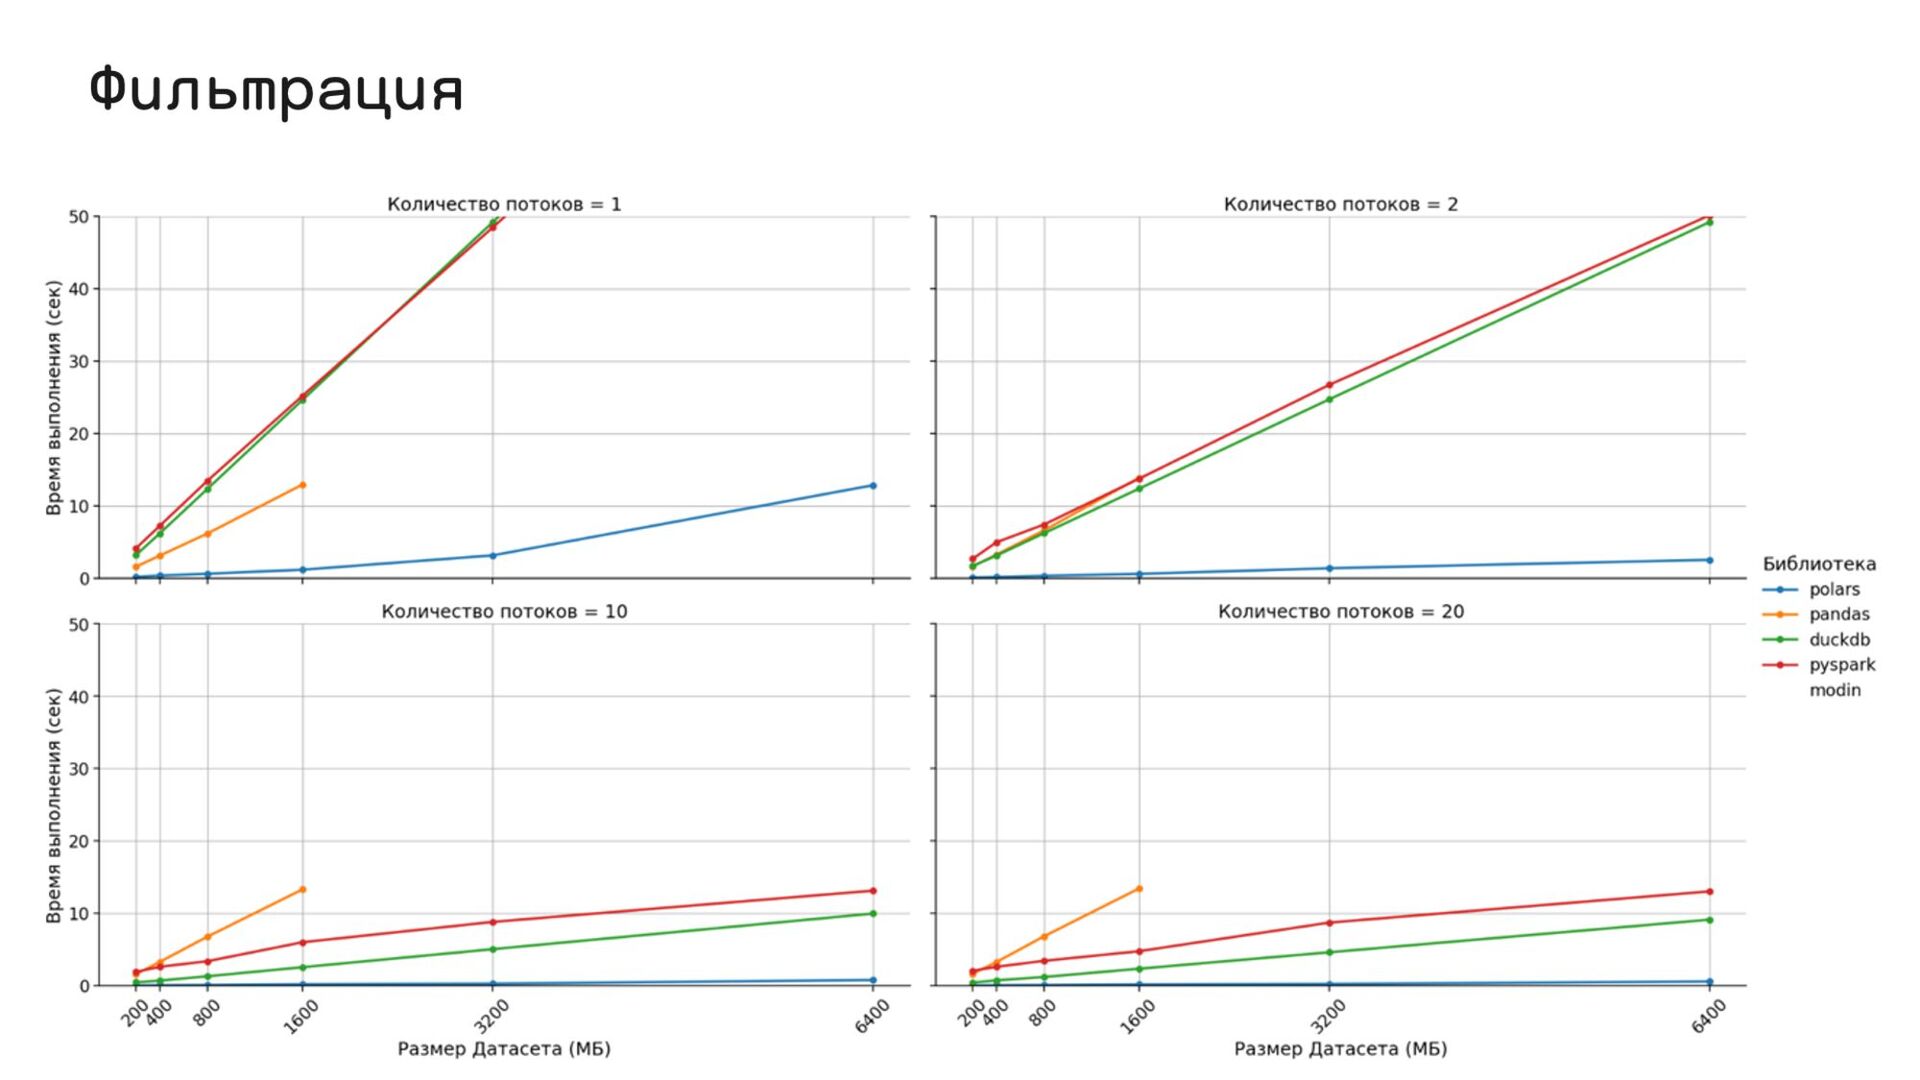
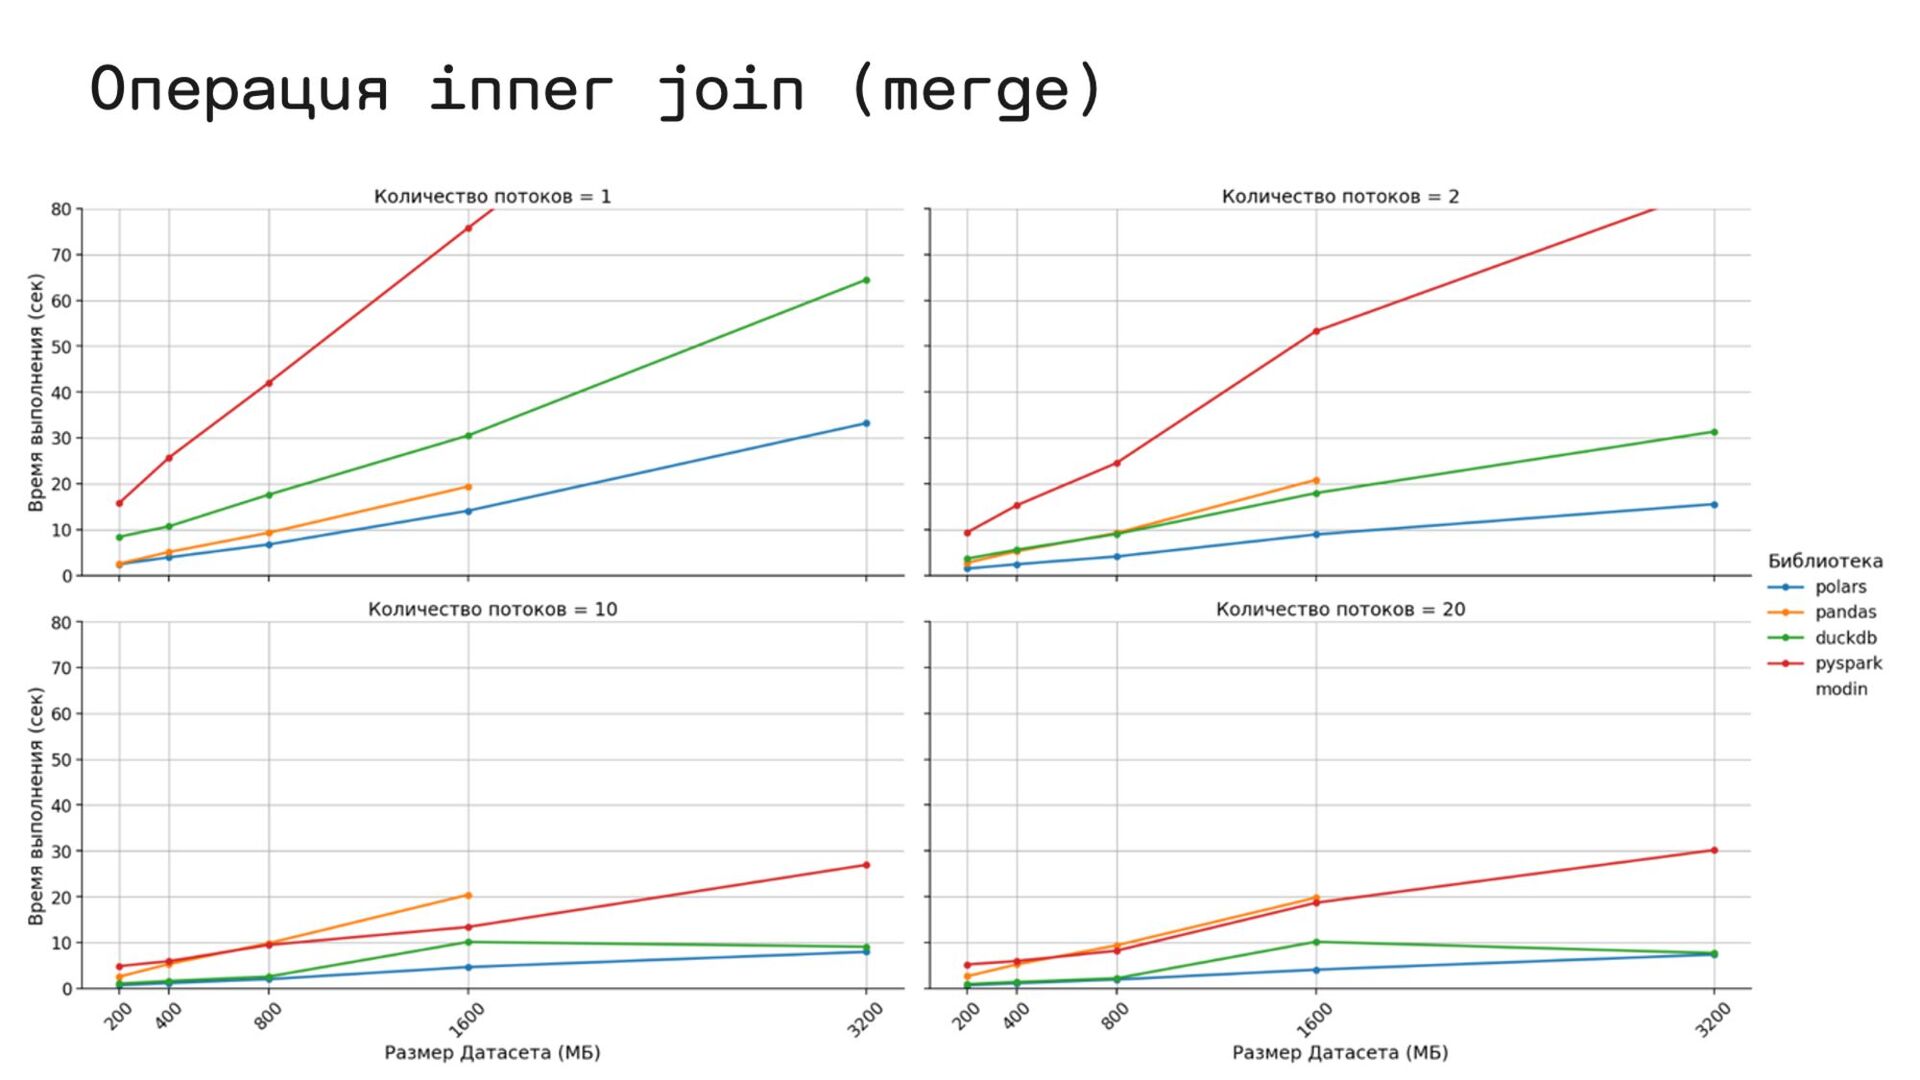
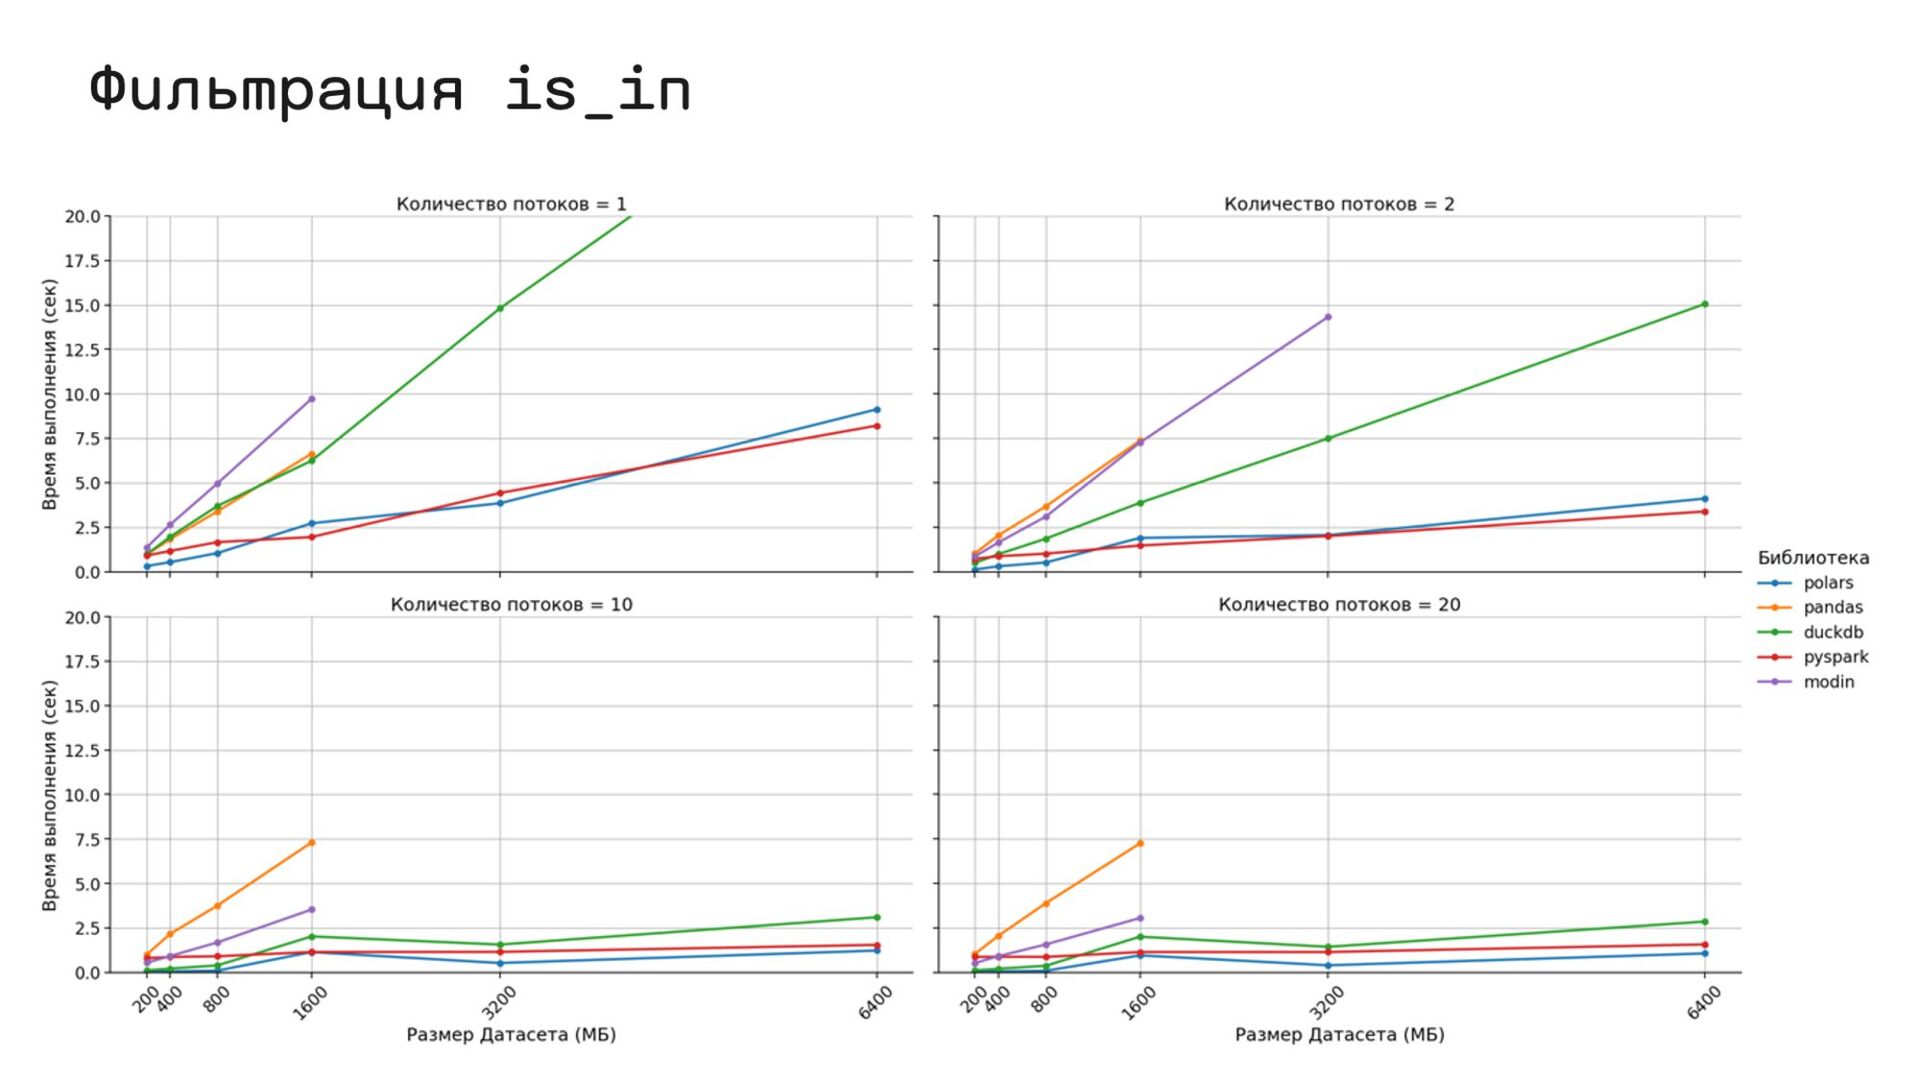
Тесты быстродействия ▪ 80 Гб оперативной памяти, DDR4-3200 Набор
данных: Parquet файлы разных размеров: 200, 400, 800, 1600, 3200, 6400 Мб ▪ 20 CPU ядер, Intel® Xeon® Gold 6354, 3.00 GHz Машина для проведения тестов: