Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
GPT-4による足し算実験から示唆されるLLMの課題
Search
moroqq82
August 08, 2023
Research
230
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
GPT-4による足し算実験から示唆されるLLMの課題
2023年8月8日の汎用人工知能研究会で発表した資料です。
https://www.sig-agi.org/sig-agi/event/sig-agi-24
moroqq82
August 08, 2023
More Decks by moroqq82
See All by moroqq82
LA-Bench2025取り組みと解法(専門家評価部門 最優秀賞)
motohiro_okaya
0
33
ロボが人間並みに器用になる日は近い~ロボット触覚と深層強化学習の融合
motohiro_okaya
0
31
Business Platform based on Artificial General Intelligence
motohiro_okaya
0
150
Other Decks in Research
See All in Research
The story of RefactoringMiner. Slow research, long-term impact
tsantalis
0
170
【中間報告】国会議員の立法・政策実務を支える環境を巡る現状と課題
polipoli
0
650
Research Engineerという仕事 / Research Engineering: Bridging Research and Business
chck
1
350
視覚若手の会LENSって何??
mickey_0226
0
310
ふとした出会いで生まれたSkillが、 社内利用1位になるまで
mikimhk
22
24k
人間中心の意思決定支援AI
yukinobaba
PRO
7
4.1k
Google Cloud Next 2026 DM Recap Agentic Data Cloudを添えて / Google Cloud Next 2026 DM Recap
nnaka2992
0
140
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
370
敵対生成プロンプト同時探索による内省型プロンプト最適化
kinoue_smarthr
0
420
高性能計算機クラスタを用いた大規模点群処理による森林の単木抽出と構造解析
kentaitakura
1
130
LA-Bench 2025:実験指示から 実行可能手順を生成するためのデータセット/LA-Bench 2025: A Dataset for Generating Executable Experimental Procedures from Experimental Instructions
stktu
0
190
SoftMatcha 2: 1兆語規模コーパスの超高速かつ柔らかい検索
e869120_sub
7
3.9k
Featured
See All Featured
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
450
Become a Pro
speakerdeck
PRO
31
6.3k
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
620
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
Rails Girls Zürich Keynote
gr2m
96
14k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
560
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
570
Done Done
chrislema
187
17k
Intergalactic Javascript Robots from Outer Space
tanoku
273
27k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.3k
Let's Do A Bunch of Simple Stuff to Make Websites Faster
chriscoyier
508
140k
Large-scale JavaScript Application Architecture
addyosmani
515
110k
Transcript
GPT-4による足し算実験から示唆され るLLMの課題 SIG-AGI-024-02 2023年8月8日 岡谷 基弘 1
これからお話しすること 人間は自然に行っているが Large Language Models(LLM)では できない可能性の高い事象について 2 実験結果はありますが、さほど新しくありません。 どちらかというと思想の表明に近いです
GPT-4による足し算実験 3
LLMによる算術タスクについて GPT-4であっても単純な計算間違いをすることは知られている。[Bubeck+ 2023](*1) また、LLMでは推論過程が合っていても算術演算を間違えることが知られている[Liu+ 2023](*2) *1 Bubeck, et al., “Sparks
of Artificial General Intelligence: Early experiments with GPT-4”, arXiv:2303.12712 *2 Liu, et al., “Goat: Fine-tuned LLaMA Outperforms GPT-4 on Arithmetic Tasks”, arXiv2305.14201 4 GPT-4ではどれくらいの桁で足し算を間違えるのか簡単な実験で検証
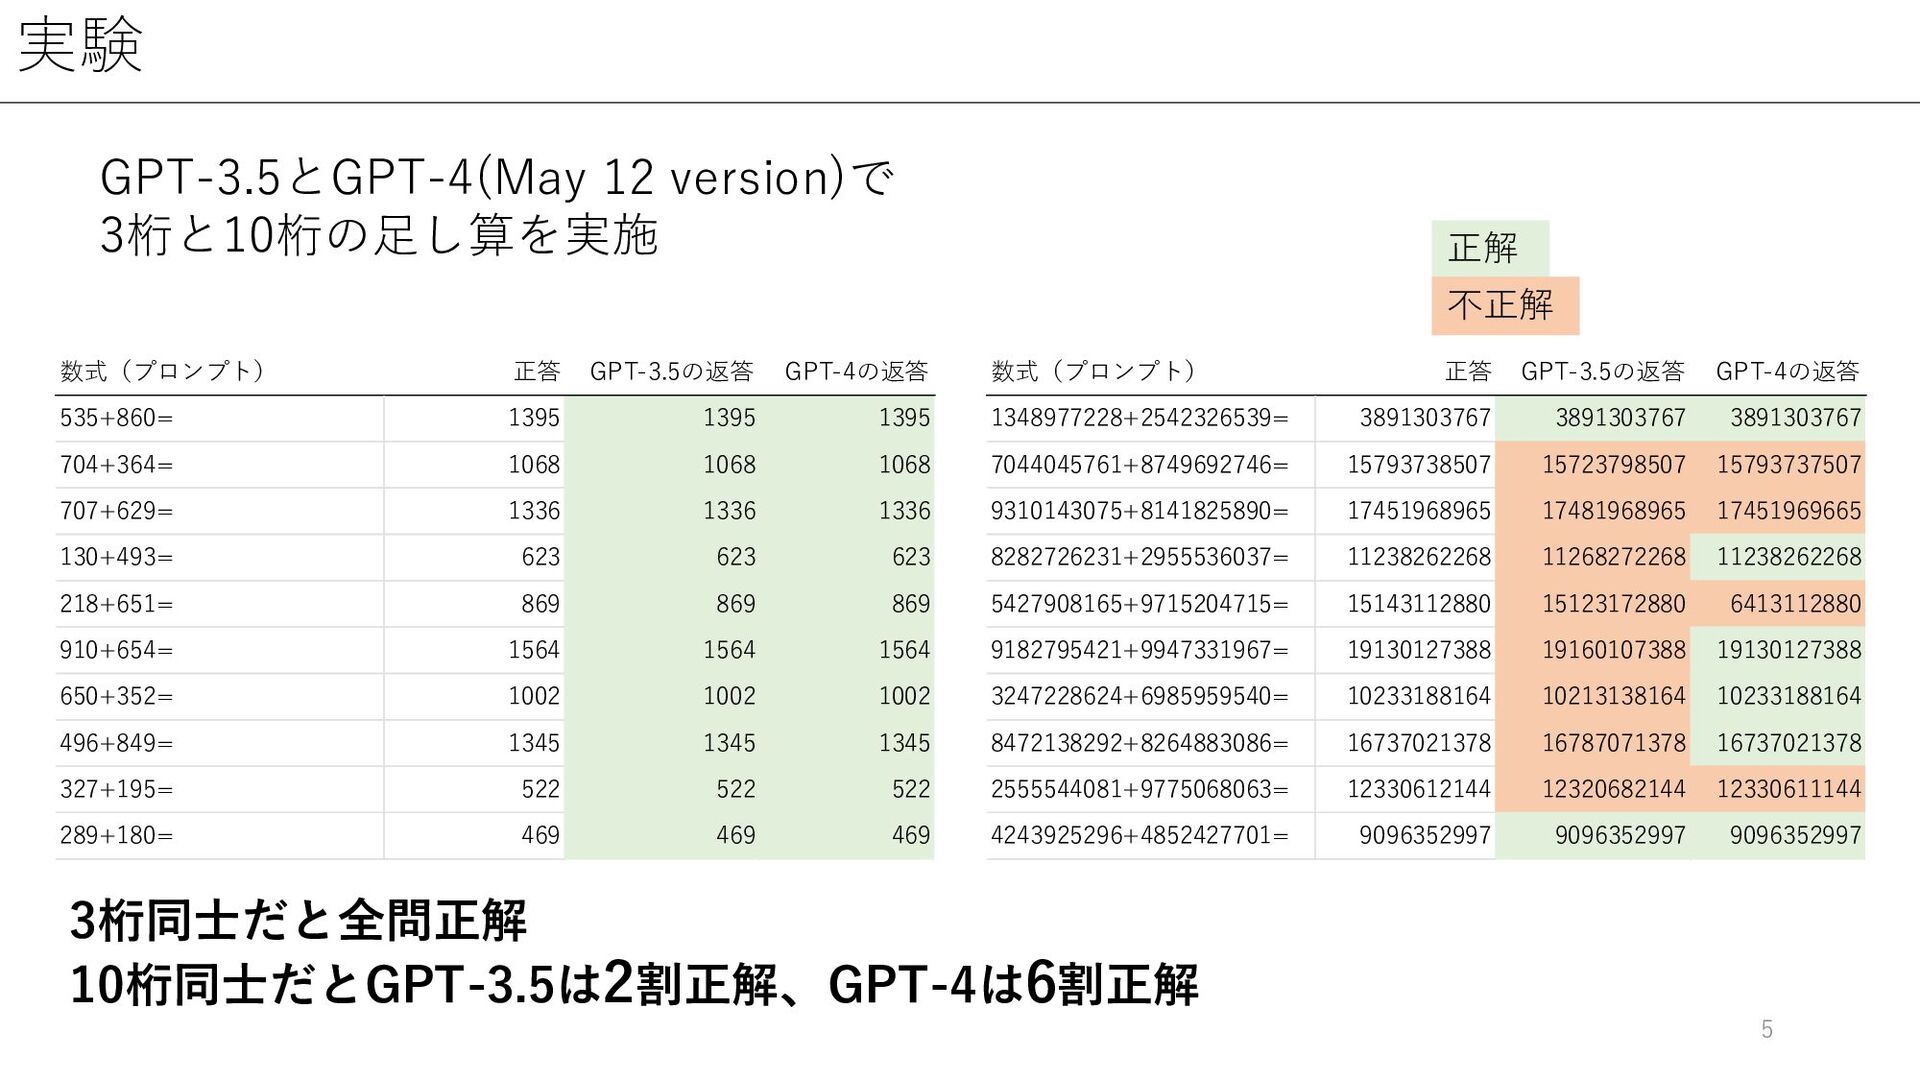
実験 5 GPT-3.5とGPT-4(May 12 version)で 3桁と10桁の足し算を実施 3桁同士だと全問正解 10桁同士だとGPT-3.5は2割正解、GPT-4は6割正解 正解 不正解
数式(プロンプト) 正答 GPT-3.5の返答 GPT-4の返答 535+860= 1395 1395 1395 704+364= 1068 1068 1068 707+629= 1336 1336 1336 130+493= 623 623 623 218+651= 869 869 869 910+654= 1564 1564 1564 650+352= 1002 1002 1002 496+849= 1345 1345 1345 327+195= 522 522 522 289+180= 469 469 469 数式(プロンプト) 正答 GPT-3.5の返答 GPT-4の返答 1348977228+2542326539= 3891303767 3891303767 3891303767 7044045761+8749692746= 15793738507 15723798507 15793737507 9310143075+8141825890= 17451968965 17481968965 17451969665 8282726231+2955536037= 11238262268 11268272268 11238262268 5427908165+9715204715= 15143112880 15123172880 6413112880 9182795421+9947331967= 19130127388 19160107388 19130127388 3247228624+6985959540= 10233188164 10213138164 10233188164 8472138292+8264883086= 16737021378 16787071378 16737021378 2555544081+9775068063= 12330612144 12320682144 12330611144 4243925296+4852427701= 9096352997 9096352997 9096352997
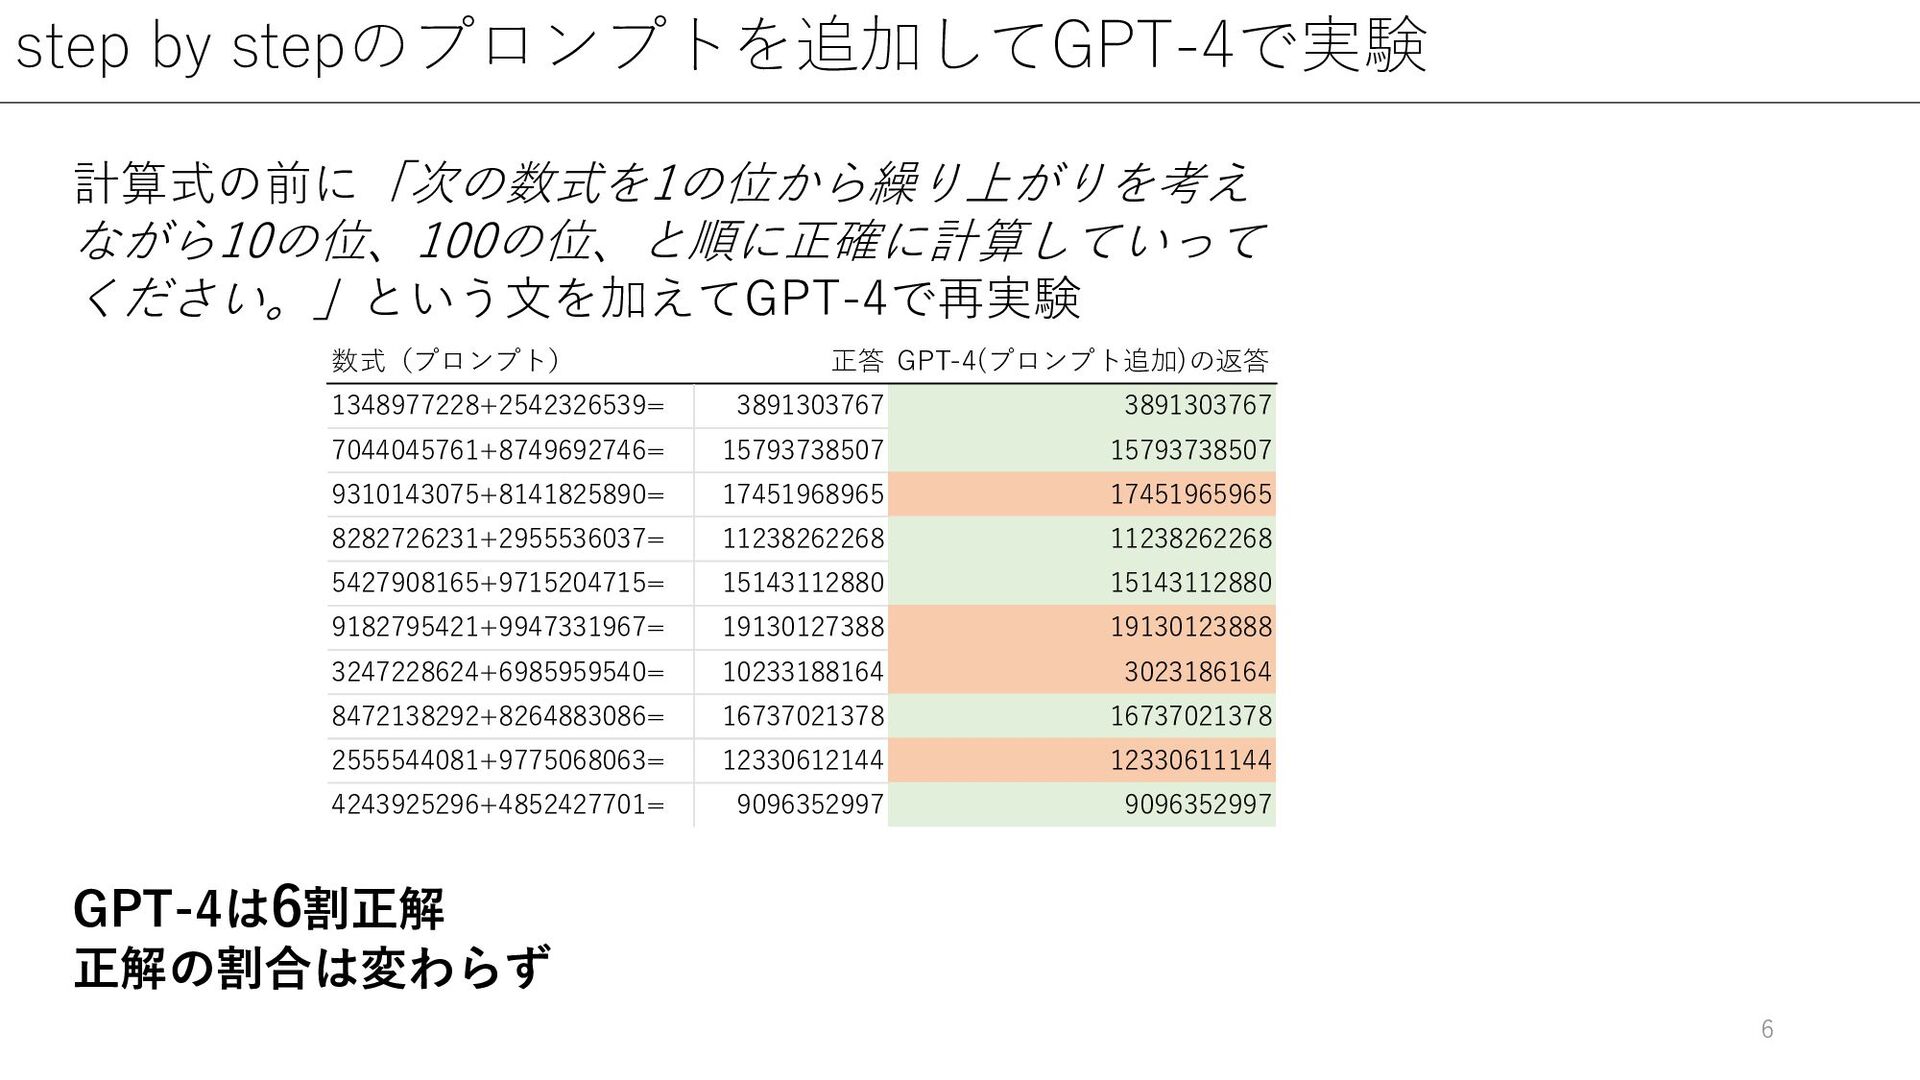
step by stepのプロンプトを追加してGPT-4で実験 6 計算式の前に「次の数式を1の位から繰り上がりを考え ながら10の位、100の位、と順に正確に計算していって ください。」という文を加えてGPT-4で再実験 GPT-4は6割正解 正解の割合は変わらず 数式(プロンプト)
正答 GPT-4(プロンプト追加)の返答 1348977228+2542326539= 3891303767 3891303767 7044045761+8749692746= 15793738507 15793738507 9310143075+8141825890= 17451968965 17451965965 8282726231+2955536037= 11238262268 11238262268 5427908165+9715204715= 15143112880 15143112880 9182795421+9947331967= 19130127388 19130123888 3247228624+6985959540= 10233188164 3023186164 8472138292+8264883086= 16737021378 16737021378 2555544081+9775068063= 12330612144 12330611144 4243925296+4852427701= 9096352997 9096352997
step by stepプロンプト追加時の出力例 7 "次の数式を1の位から繰り上がりを考えながら10の位、100の位、と順に正確に計算していってください。 9182795421+9947331967=" GPT-4の回答 まず、一の位から順に計算していきましょう。繰り上がりを含めると以下のようになります。 一の位: 1
+ 7 = 8 十の位: 2 + 6 = 8 百の位: 4 + 9 = 13 (ここで1が繰り上がる) 千の位: 5(繰り上げを含む) + 1 = 6 万の位: 9 + 3 = 12 (ここで1が繰り上がる) 十万の位: 7(繰り上げを含む) + 1 = 8 百万の位: 8 + 4 = 12 (ここで1が繰り上がる) 千万の位: 2(繰り上げを含む) + 7 = 9 億の位: 1 + 9 = 10 (ここで1が繰り上がる) 十億の位: 9(繰り上げを含む) + 9 = 18 したがって、計算結果は19130123888となります。 ① 合っている ① 間違い ②ところどころ数字の読み間違い 推論過程が合っていて も計算が間違っている 例がある。 数字の読み間違いはtoken化 の一貫性の問題[Liu+ 2023] かもしれない。 途中計算が合っているのに最 後の計算が間違っているのは 別の問題もありそう。 本当は3
考察 人間とLLMの違いは何か 8
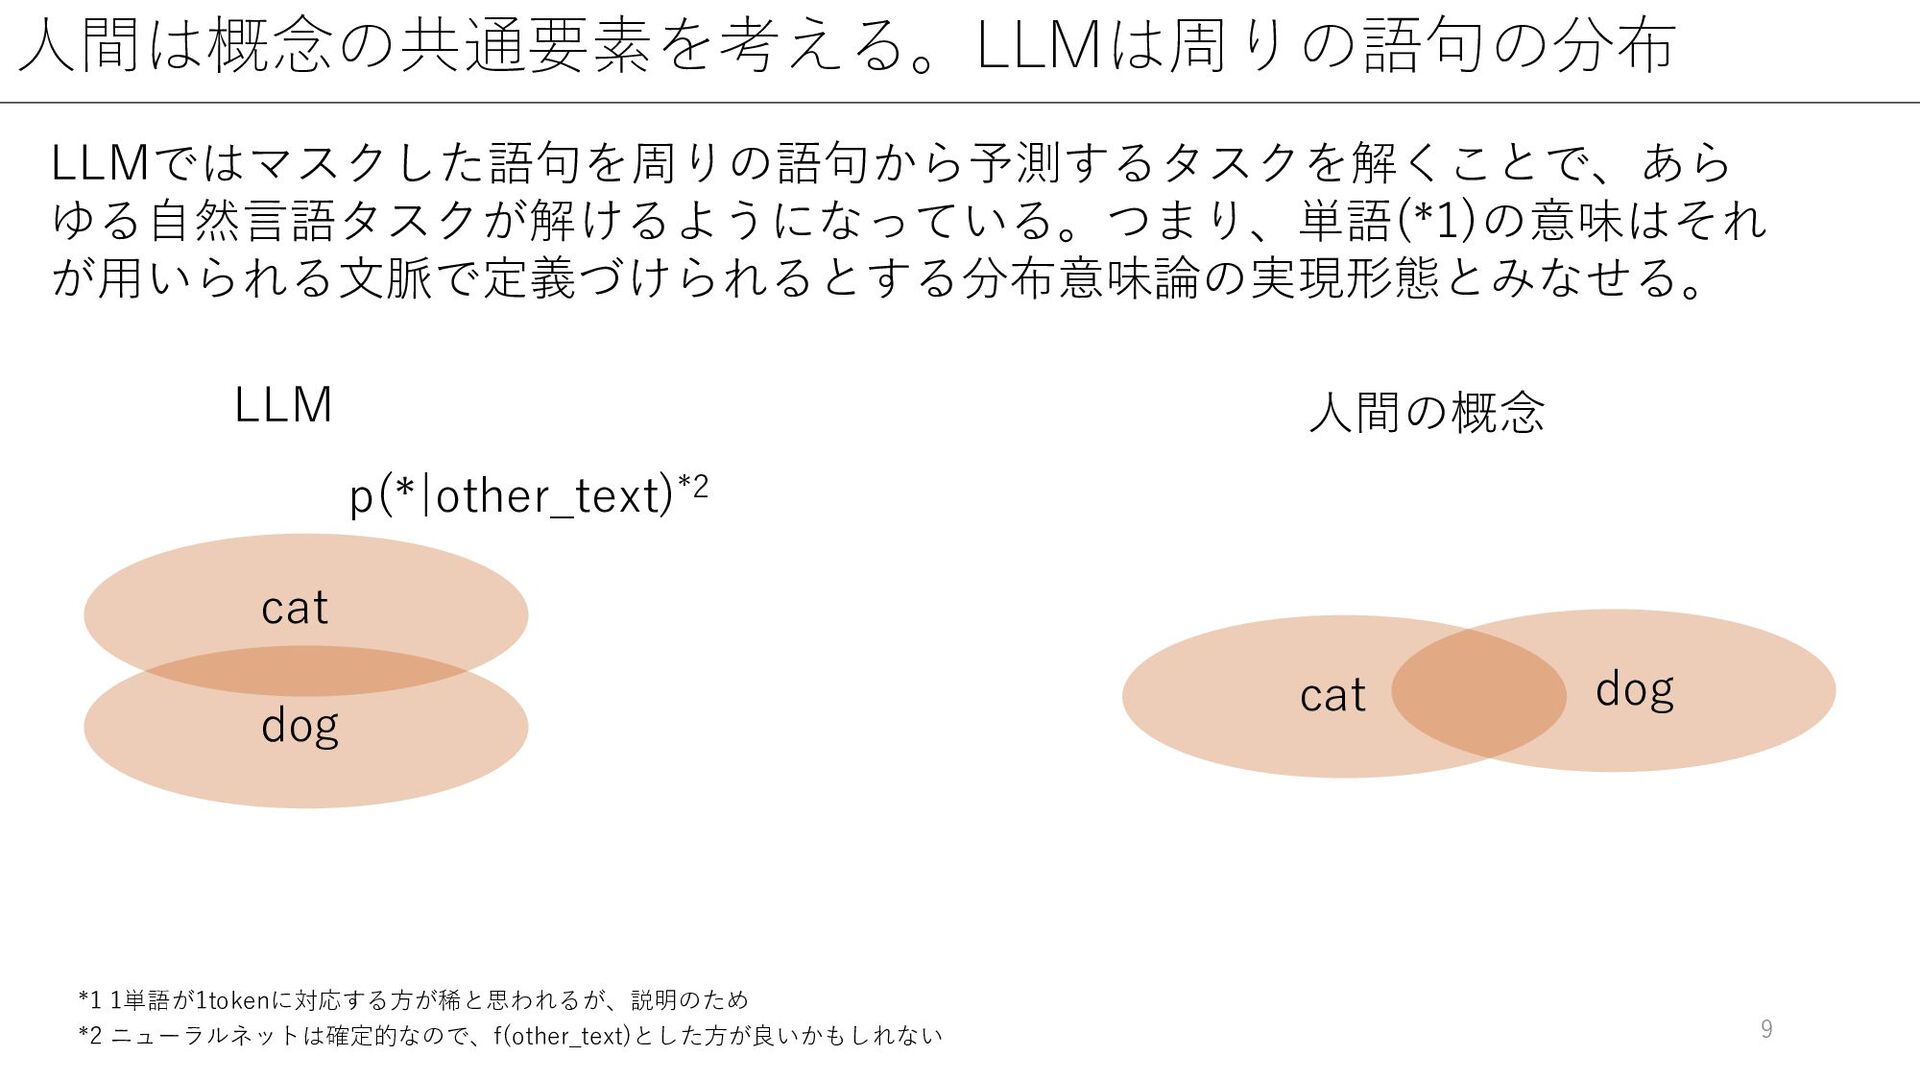
人間は概念の共通要素を考える。LLMは周りの語句の分布 9 cat dog p(*|other_text)*2 cat dog 人間の概念 LLM LLMではマスクした語句を周りの語句から予測するタスクを解くことで、あら
ゆる自然言語タスクが解けるようになっている。つまり、単語(*1)の意味はそれ が用いられる文脈で定義づけられるとする分布意味論の実現形態とみなせる。 *1 1単語が1tokenに対応する方が稀と思われるが、説明のため *2 ニューラルネットは確定的なので、f(other_text)とした方が良いかもしれない
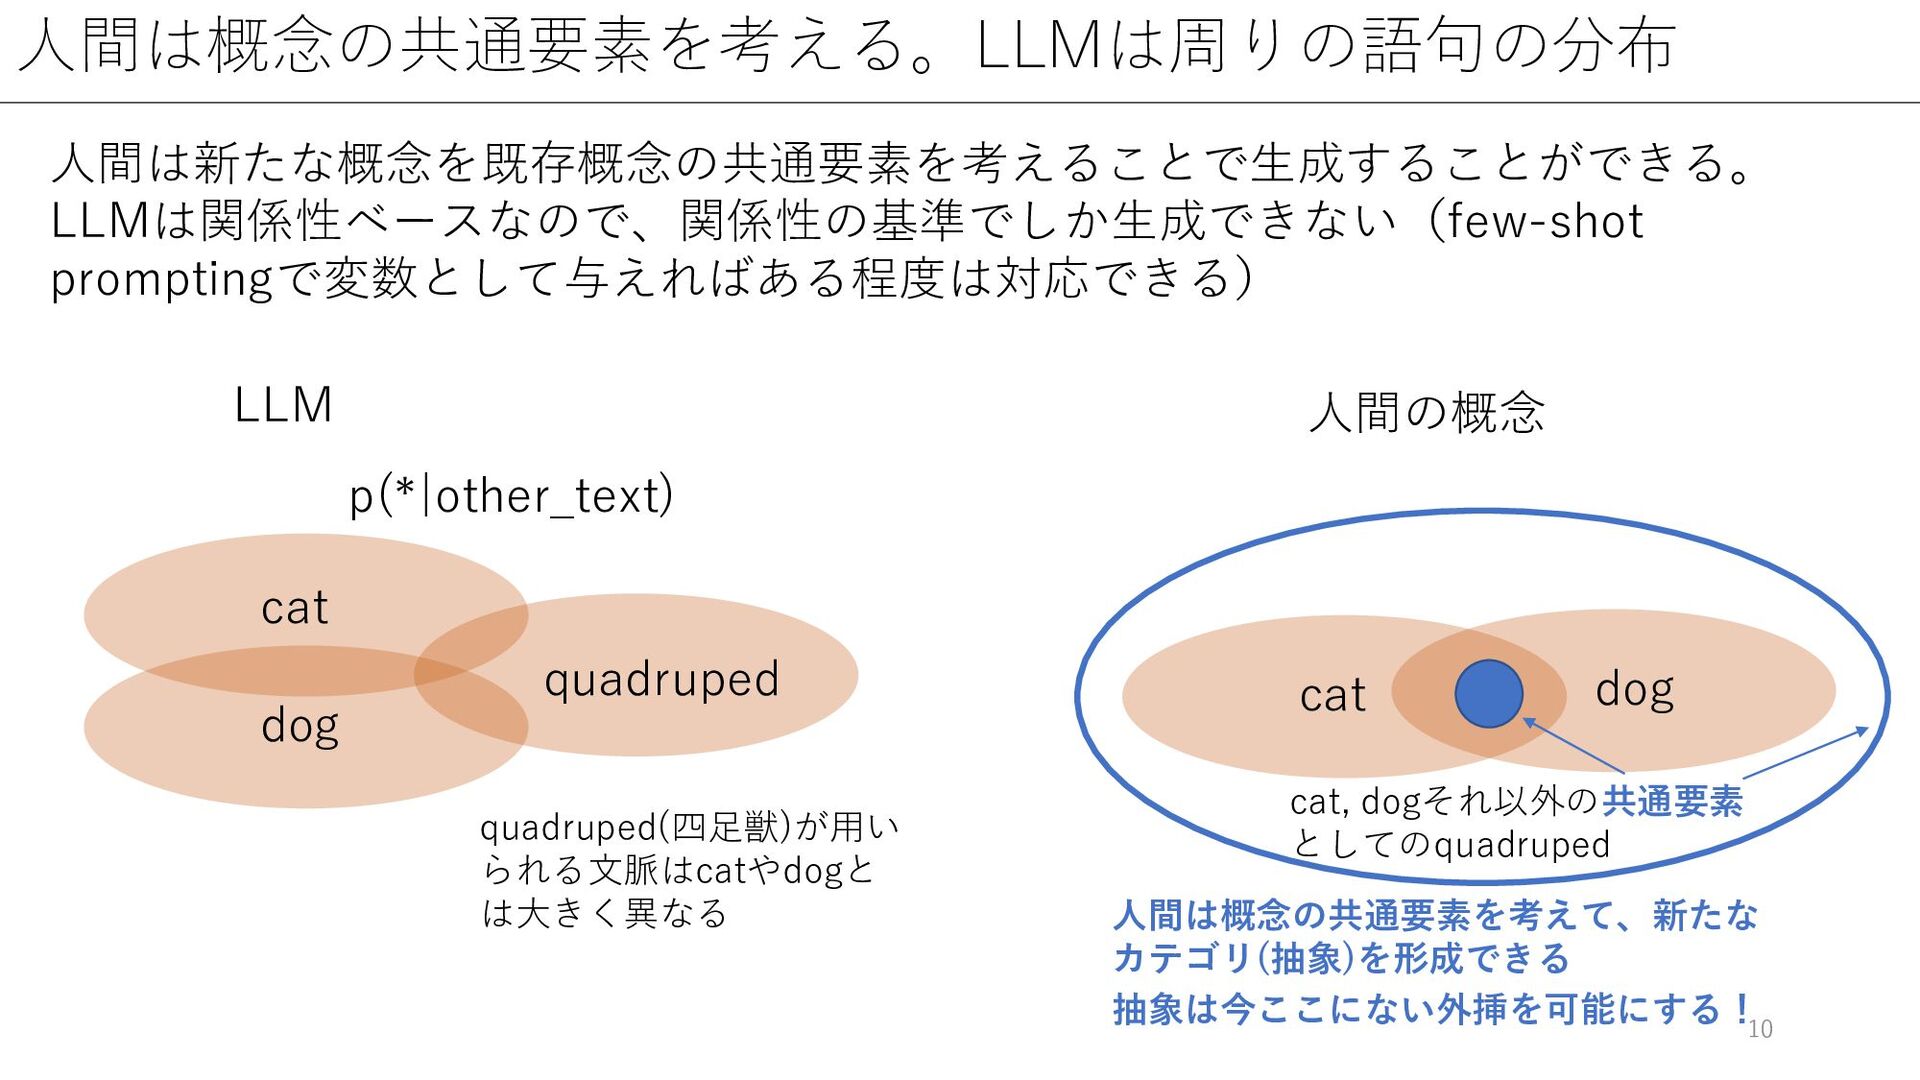
人間は概念の共通要素を考える。LLMは周りの語句の分布 10 cat dog p(*|other_text) cat dog 人間の概念 LLM 人間は新たな概念を既存概念の共通要素を考えることで生成することができる。
LLMは関係性ベースなので、関係性の基準でしか生成できない(few-shot promptingで変数として与えればある程度は対応できる) quadruped quadruped(四足獣)が用い られる文脈はcatやdogと は大きく異なる cat, dogそれ以外の共通要素 としてのquadruped 人間は概念の共通要素を考えて、新たな カテゴリ(抽象)を形成できる 抽象は今ここにない外挿を可能にする!
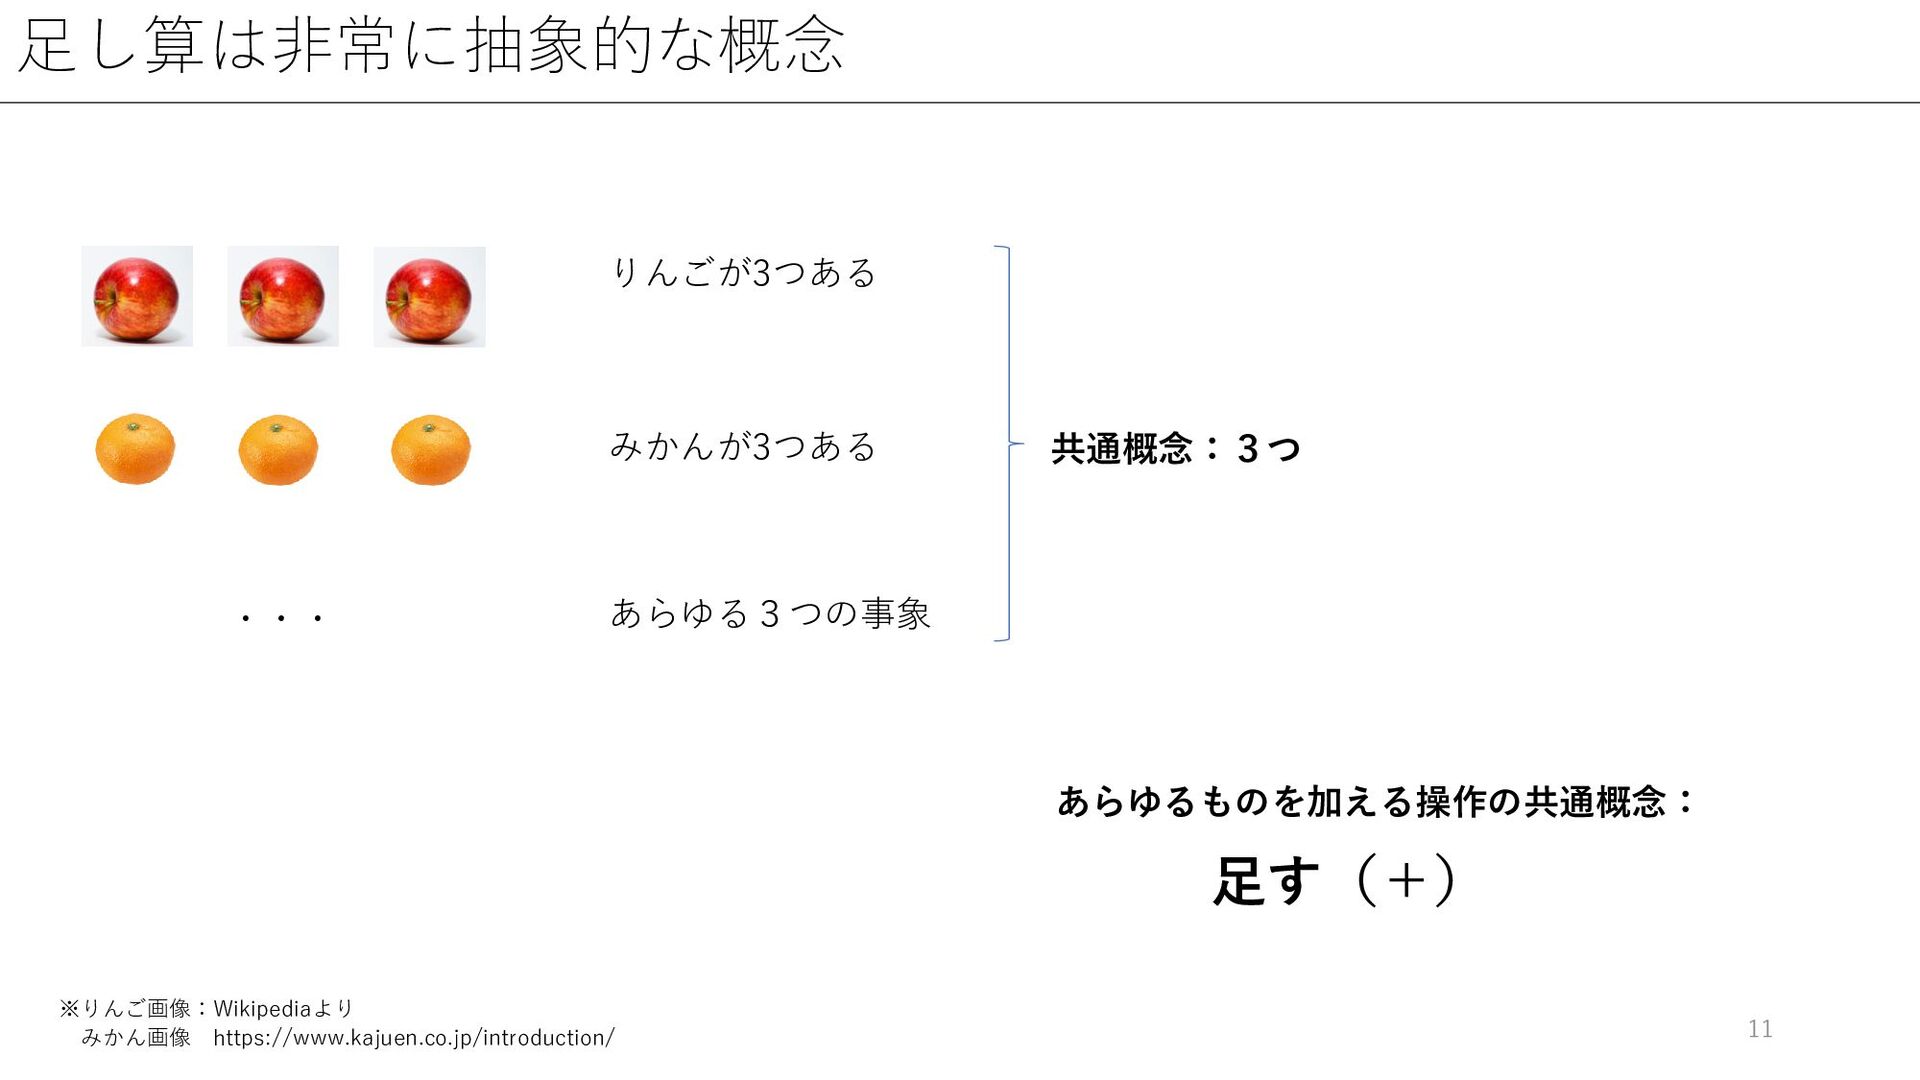
足し算は非常に抽象的な概念 11 ※りんご画像:Wikipediaより みかん画像 https://www.kajuen.co.jp/introduction/ りんごが3つある みかんが3つある 共通概念:3つ ・・・ あらゆる3つの事象
あらゆるものを加える操作の共通概念: 足す(+)
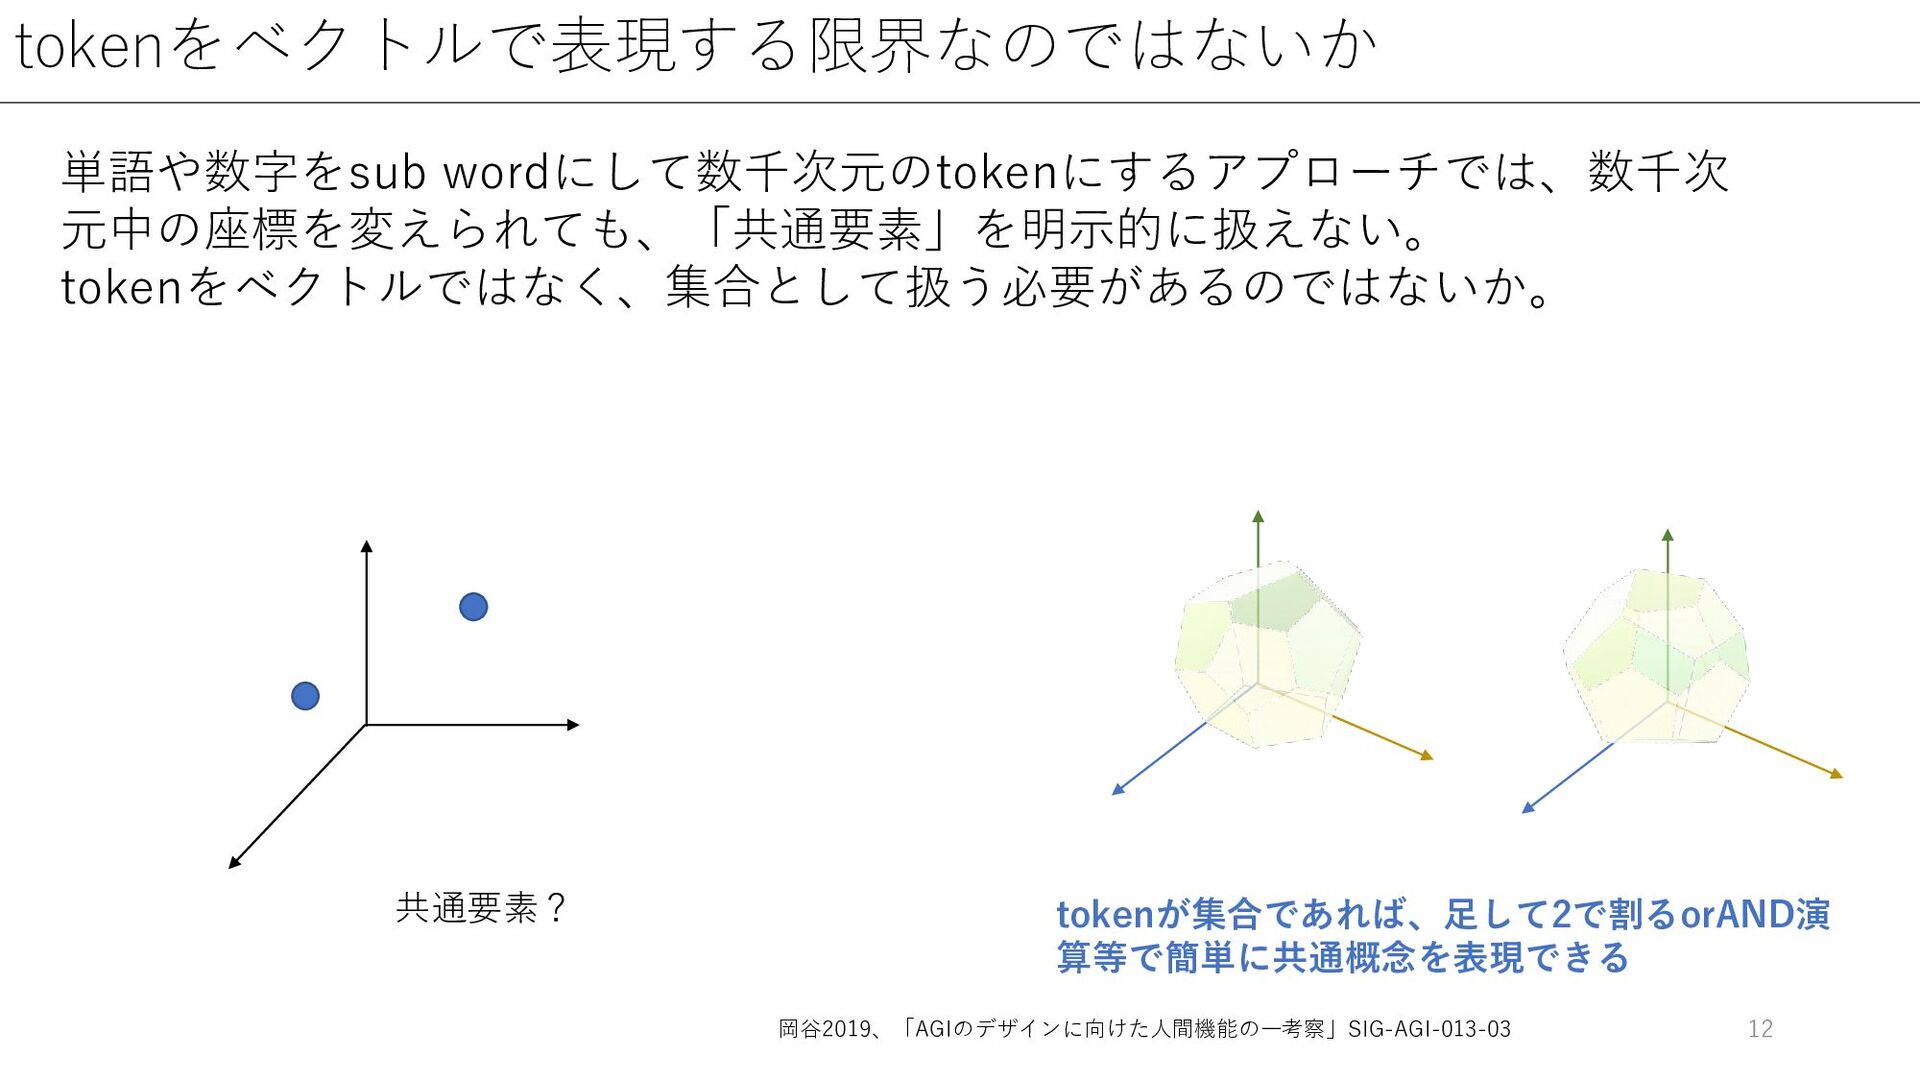
tokenをベクトルで表現する限界なのではないか 12 単語や数字をsub wordにして数千次元のtokenにするアプローチでは、数千次 元中の座標を変えられても、「共通要素」を明示的に扱えない。 tokenをベクトルではなく、集合として扱う必要があるのではないか。 共通要素? tokenが集合であれば、足して2で割るorAND演 算等で簡単に共通概念を表現できる 岡谷2019、「AGIのデザインに向けた人間機能の一考察」SIG-AGI-013-03
まとめ 13
まとめ 14 • GPT-4で簡単な足し算実験を行った。3桁同士の足し算はすべて正答だったが、10桁では6割の 正解率にとどまった • step by stepを促すプロンプトを追加しても正解率は変化しなかった •
LLMが簡単な足し算を間違えることは以前から知られており、数字のtokenの一貫性の欠如な どが原因の一つとして知られている • LLMの学習方法から考えれば、tokenをベクトル表現している点が人間の認知と乖離している ように思われる。tokenのベクトル表現では概念同士の共通要素を新たな概念として取り出せ ないことが、足し算のルールを抽出できない本質的な理由なのではないか • tokenをベクトル表現ではなく集合表現するなどの根本的な対応を行わない限り、算術演算を 今の学習方法では完璧には習得できないと考えられる(もっとも、実用的には算術演算を検出し て電卓を呼び出せば良いだけではある(*1)) • LLMの計算量はナイーブにはtoken次元の二乗に比例するため、通常の計算機でtokenの集合表 現は困難なのではないか。何らかの自然計算が必要と推測される。 *1 2023年7月15日現在 Code Interpreterで実現可能
END 15


 motohiro_okaya
 tsantalis
 polipoli
 chck
 mickey_0226
 mikimhk
 yukinobaba
 nnaka2992
 rfujii
 kinoue_smarthr
 kentaitakura
 stktu
 e869120_sub
 apolaine
 speakerdeck
 reverentgeek
 gr2m
 samtorres
 chrislema
 tanoku
 szymonslowik
 chriscoyier
 addyosmani


 また、LLMでは推論過程が合っていても算術演算を間違えることが知られている[Liu+ 2023](*2) *1 Bubeck, et al., “Sparks](https://files.speakerdeck.com/presentations/052449c59c49414ea373529311d8fb24/slide_3.jpg)