時系列予測の100年と、これから A Century of Time Series Forec...
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed
時系列予測の100年と、これから A Century of Time Series Forecasting, and What Comes Next

Neurogica
November 07, 2026
Transcript
35 slides
-
アジェンダ 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 • 時系列予測とは • 古典⼿法の100年と、単純な⼿法の強さ
• 深層学習の登場と、線形1層との⽐較 • 学習なしで予測する時系列基盤モデル、2026年まで • これからを考える前提、基盤モデルの6つの課題 • 6つの課題に応える研究の⽅向 • 現場の時系列のための基盤モデルyoft • 100年の系譜と、これから © Neurogica Inc. 研究の⽅向 yoft まとめ -
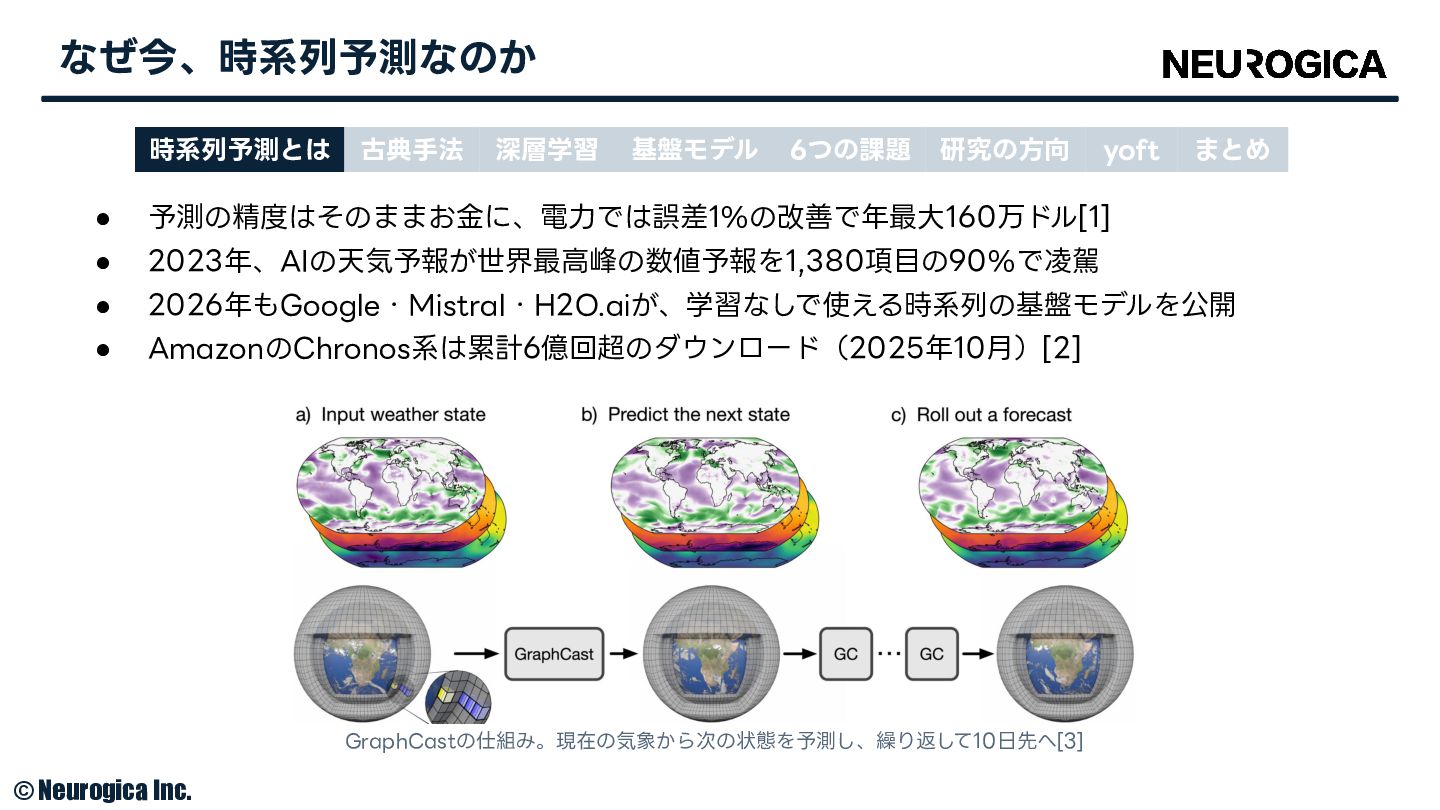
なぜ今、時系列予測なのか 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ •
予測の精度はそのままお⾦に、電⼒では誤差1%の改善で年最⼤160万ドル[1] • 2023年、AIの天気予報が世界最⾼峰の数値予報を1,380項⽬の90%で凌駕 • 2026年もGoogle・Mistral・H2O.aiが、学習なしで使える時系列の基盤モデルを公開 • AmazonのChronos系は累計6億回超のダウンロード(2025年10⽉)[2] GraphCastの仕組み。現在の気象から次の状態を予測し、繰り返して10⽇先へ[3] © Neurogica Inc. -
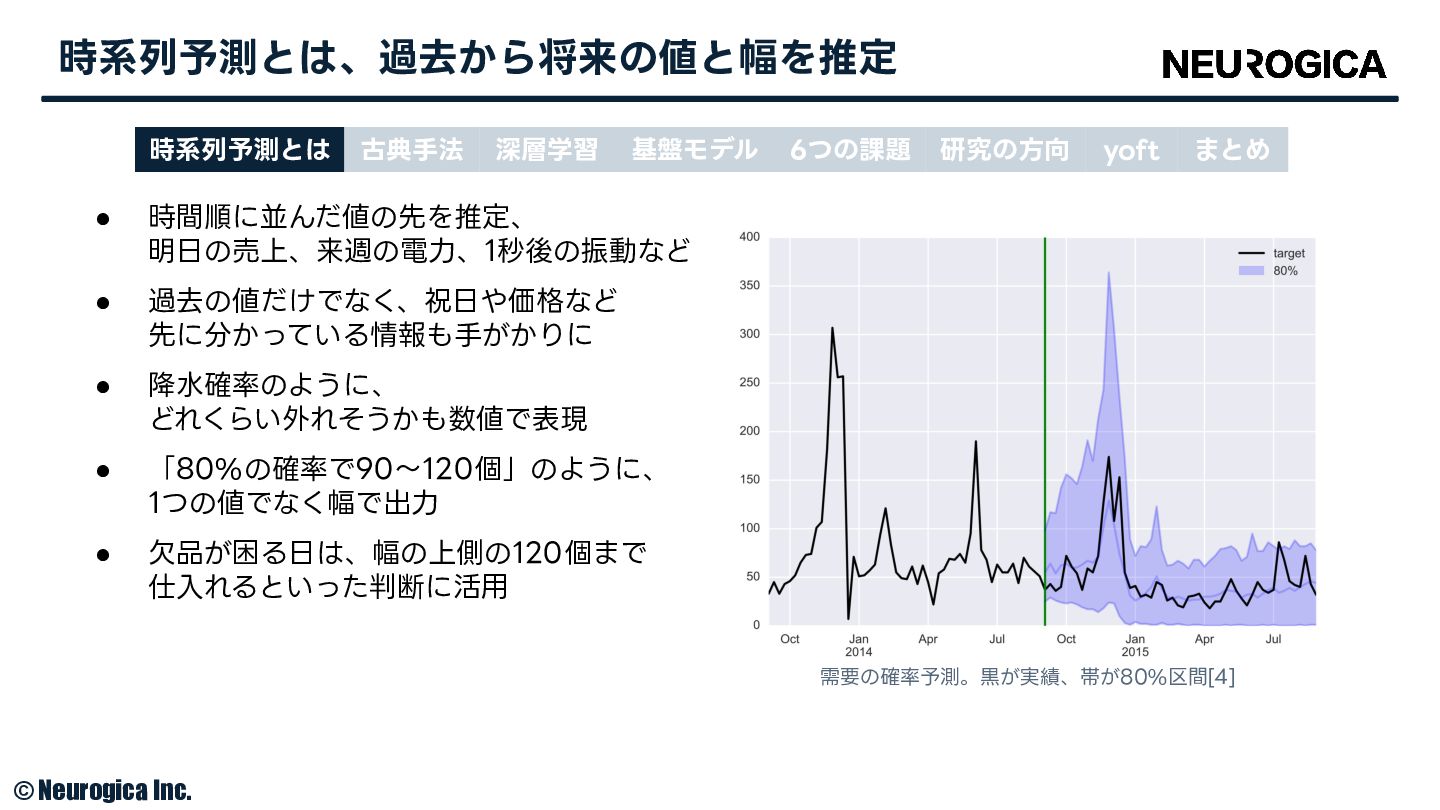
時系列予測とは、過去から将来の値と幅を推定 時系列予測とは 古典⼿法 深層学習 基盤モデル • 時間順に並んだ値の先を推定、 明⽇の売上、来週の電⼒、1秒後の振動など • 過去の値だけでなく、祝⽇や価格など
先に分かっている情報も⼿がかりに • 降⽔確率のように、 どれくらい外れそうかも数値で表現 • 「80%の確率で90〜120個」のように、 1つの値でなく幅で出⼒ • ⽋品が困る⽇は、幅の上側の120個まで 仕⼊れるといった判断に活⽤ 6つの課題 研究の⽅向 yoft まとめ 需要の確率予測。⿊が実績、帯が80%区間[4] © Neurogica Inc. -
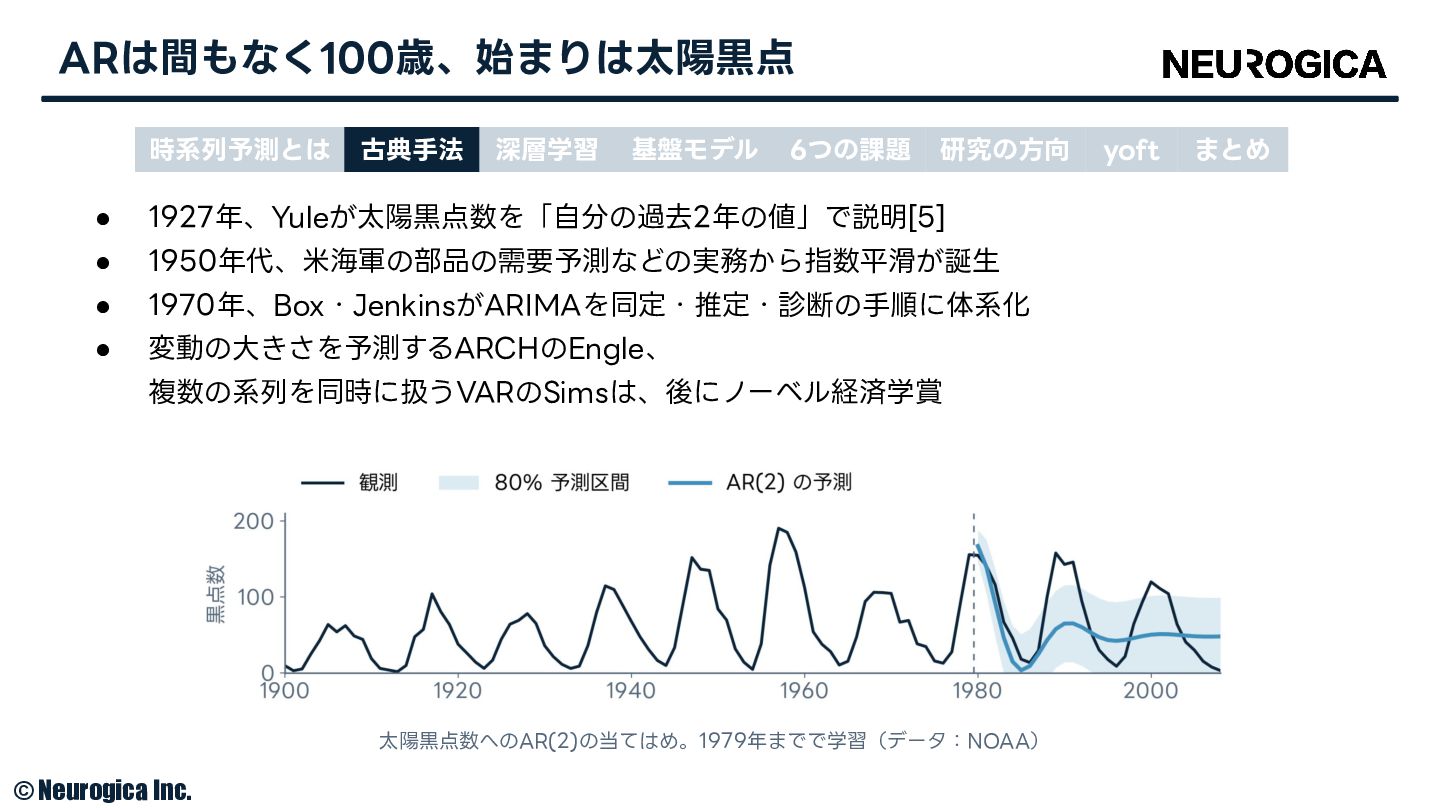
ARは間もなく100歳、始まりは太陽⿊点 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • 1927年、Yuleが太陽⿊点数を「⾃分の過去2年の値」で説明[5] •
1950年代、⽶海軍の部品の需要予測などの実務から指数平滑が誕⽣ • 1970年、Box・JenkinsがARIMAを同定・推定・診断の⼿順に体系化 • 変動の⼤きさを予測するARCHのEngle、 複数の系列を同時に扱うVARのSimsは、後にノーベル経済学賞 太陽⿊点数へのAR(2)の当てはめ。1979年までで学習(データ:NOAA) © Neurogica Inc. yoft まとめ -
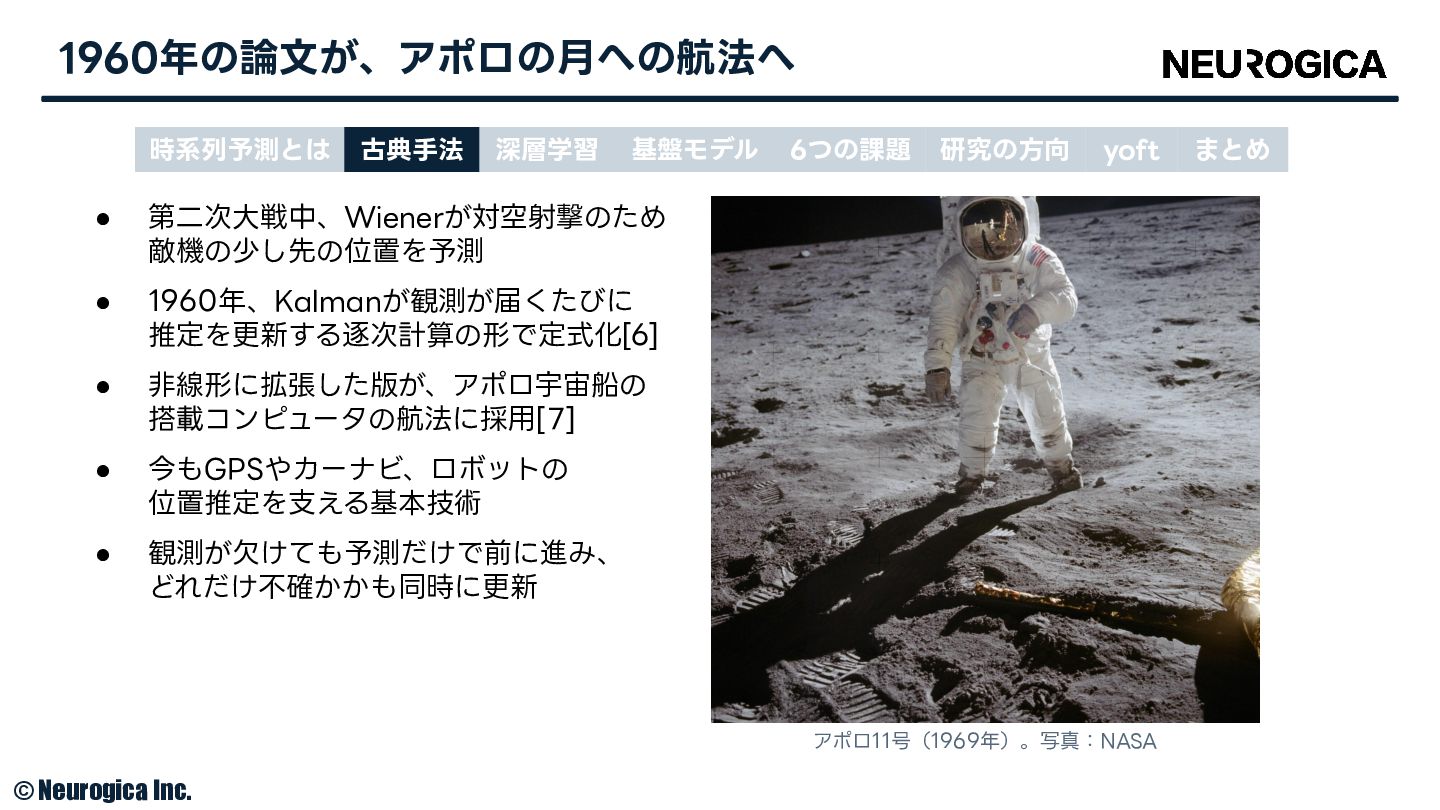
1960年の論⽂が、アポロの⽉への航法へ 時系列予測とは 古典⼿法 深層学習 基盤モデル • 第⼆次⼤戦中、Wienerが対空射撃のため 敵機の少し先の位置を予測 • 1960年、Kalmanが観測が届くたびに
推定を更新する逐次計算の形で定式化[6] • ⾮線形に拡張した版が、アポロ宇宙船の 搭載コンピュータの航法に採⽤[7] • 今もGPSやカーナビ、ロボットの 位置推定を⽀える基本技術 • 観測が⽋けても予測だけで前に進み、 どれだけ不確かかも同時に更新 6つの課題 研究の⽅向 yoft アポロ11号(1969年)。写真:NASA © Neurogica Inc. まとめ -
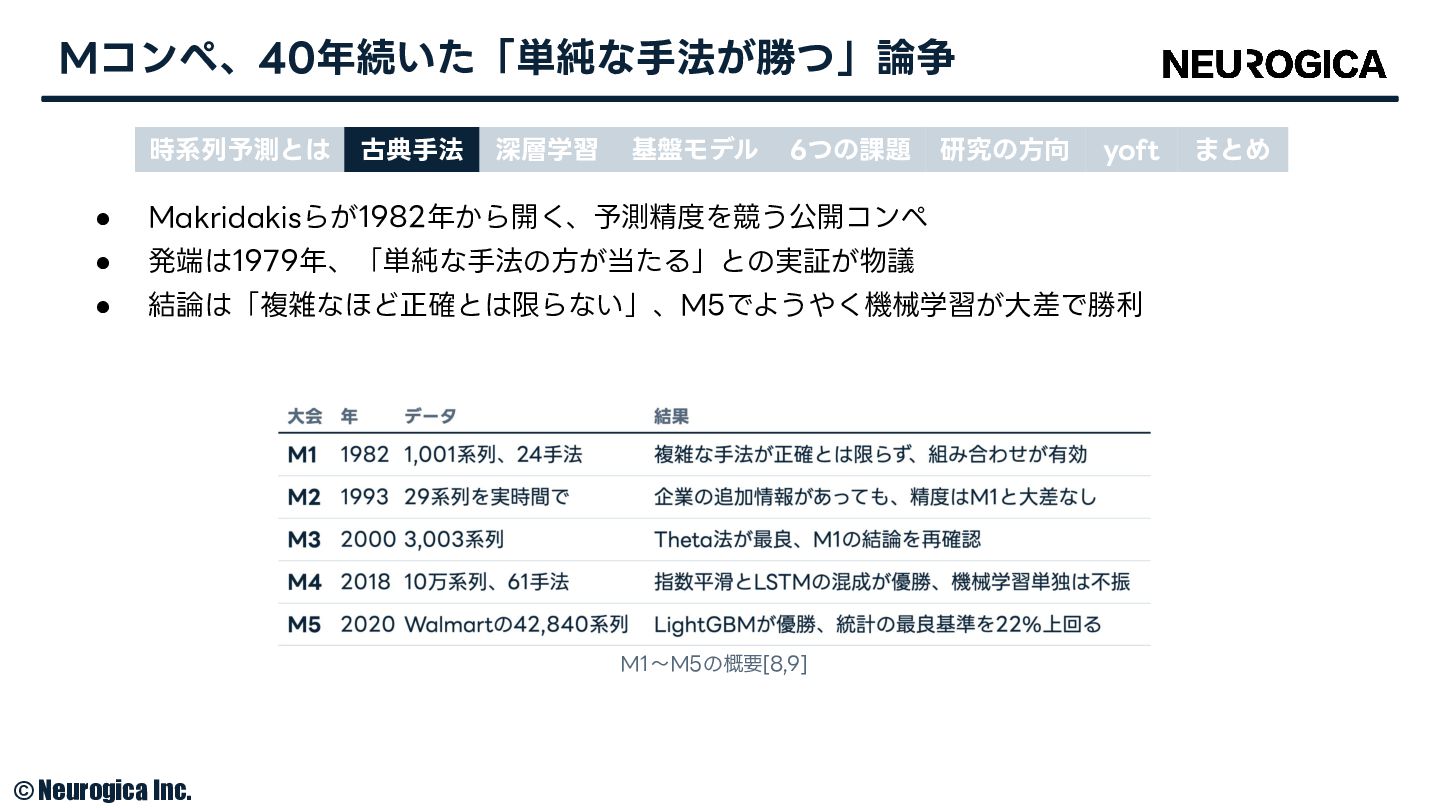
Mコンペ、40年続いた「単純な⼿法が勝つ」論争 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft • Makridakisらが1982年から開く、予測精度を競う公開コンペ
• 発端は1979年、「単純な⼿法の⽅が当たる」との実証が物議 • 結論は「複雑なほど正確とは限らない」、M5でようやく機械学習が⼤差で勝利 M1〜M5の概要[8,9] © Neurogica Inc. まとめ -
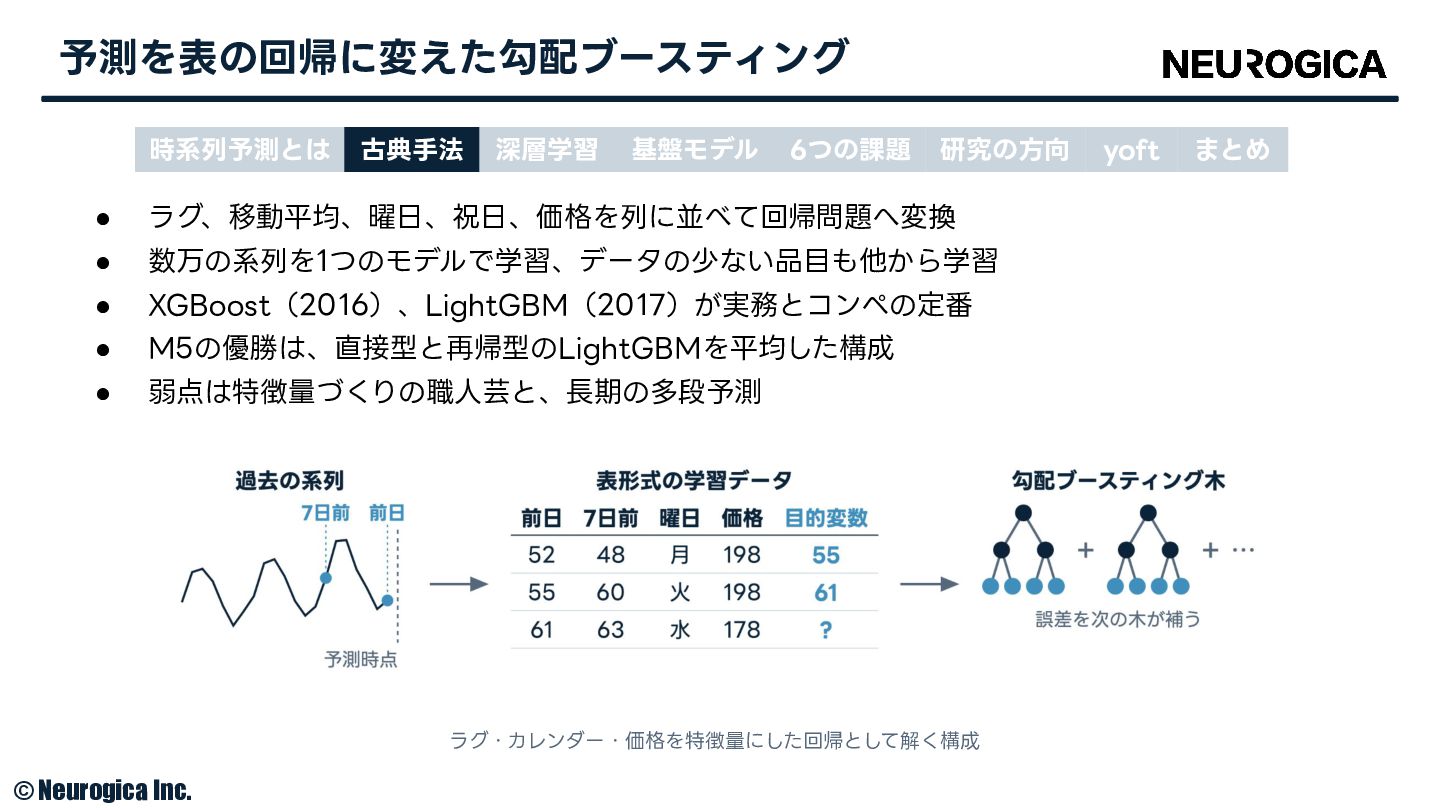
予測を表の回帰に変えた勾配ブースティング 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • ラグ、移動平均、曜⽇、祝⽇、価格を列に並べて回帰問題へ変換 •
数万の系列を1つのモデルで学習、データの少ない品⽬も他から学習 • XGBoost(2016)、LightGBM(2017)が実務とコンペの定番 • M5の優勝は、直接型と再帰型のLightGBMを平均した構成 • 弱点は特徴量づくりの職⼈芸と、⻑期の多段予測 ラグ・カレンダー・価格を特徴量にした回帰として解く構成 © Neurogica Inc. yoft まとめ -
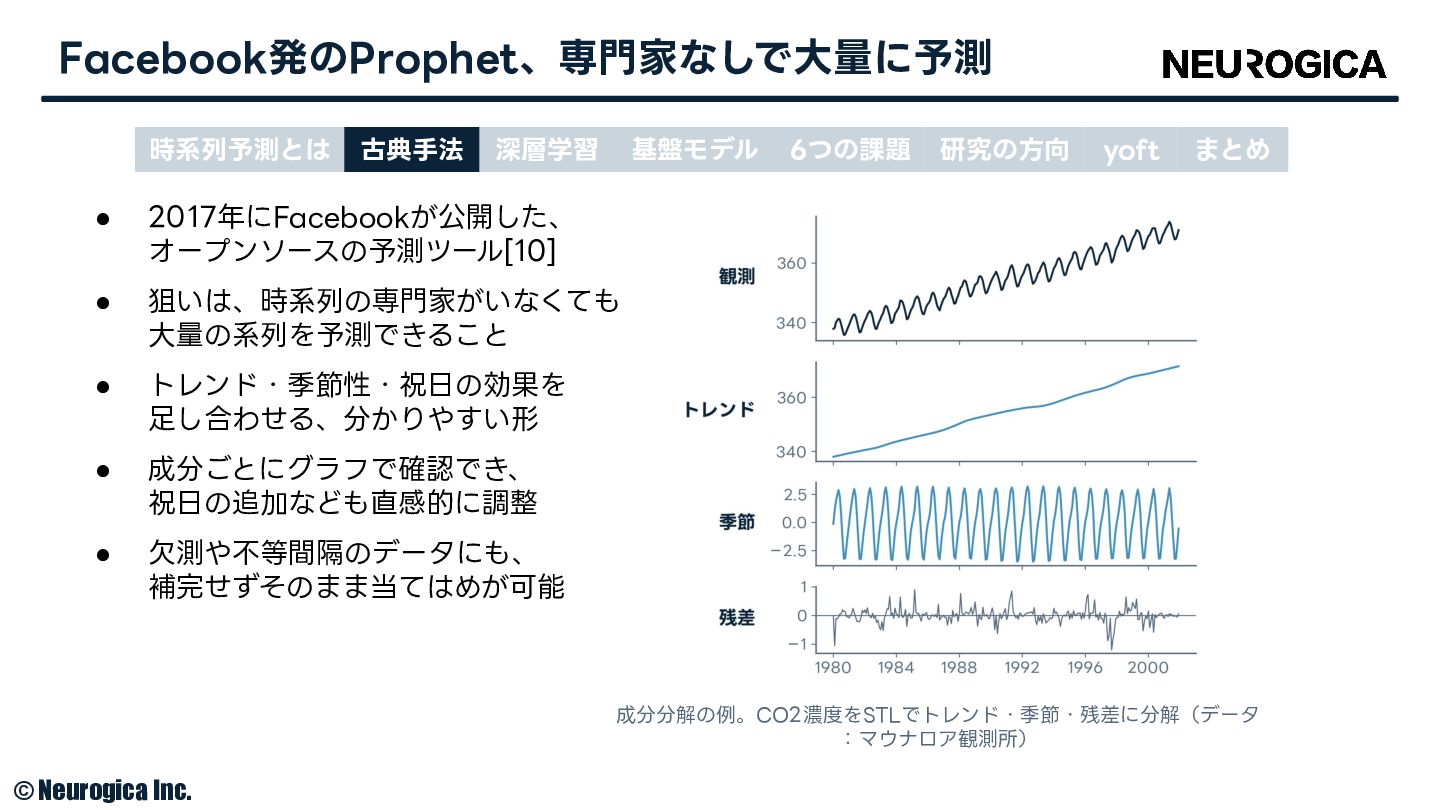
Facebook発のProphet、専⾨家なしで⼤量に予測 時系列予測とは 古典⼿法 深層学習 基盤モデル • 2017年にFacebookが公開した、 オープンソースの予測ツール[10] • 狙いは、時系列の専⾨家がいなくても
⼤量の系列を予測できること • トレンド・季節性・祝⽇の効果を ⾜し合わせる、分かりやすい形 • 成分ごとにグラフで確認でき、 祝⽇の追加なども直感的に調整 • ⽋測や不等間隔のデータにも、 補完せずそのまま当てはめが可能 6つの課題 研究の⽅向 yoft まとめ 成分分解の例。CO2濃度をSTLでトレンド・季節・残差に分解(データ :マウナロア観測所) © Neurogica Inc. -
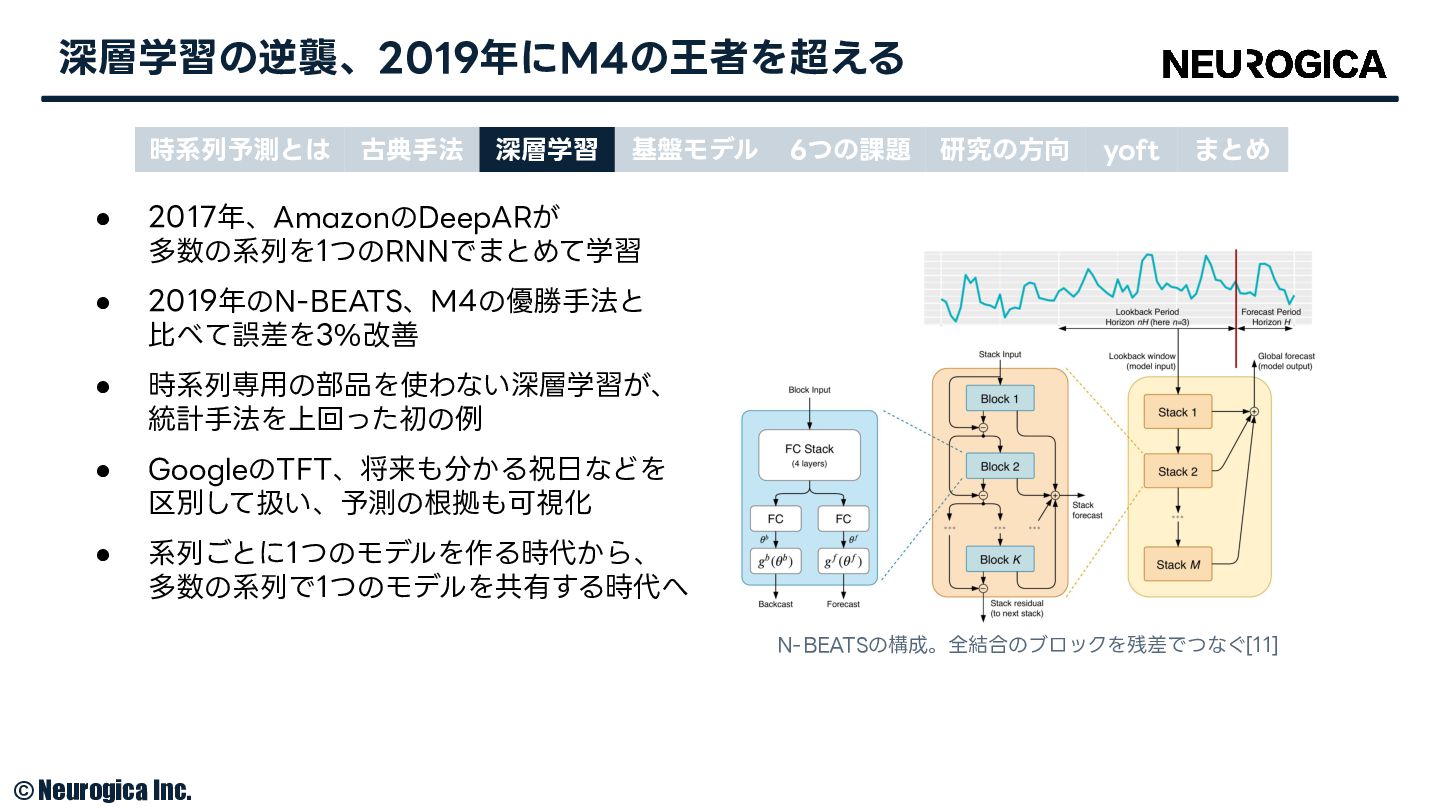
深層学習の逆襲、2019年にM4の王者を超える 時系列予測とは 古典⼿法 深層学習 基盤モデル • 2017年、AmazonのDeepARが 多数の系列を1つのRNNでまとめて学習 • 2019年のN-BEATS、M4の優勝⼿法と
⽐べて誤差を3%改善 • 時系列専⽤の部品を使わない深層学習が、 統計⼿法を上回った初の例 • GoogleのTFT、将来も分かる祝⽇などを 区別して扱い、予測の根拠も可視化 • 系列ごとに1つのモデルを作る時代から、 多数の系列で1つのモデルを共有する時代へ 6つの課題 研究の⽅向 yoft まとめ N-BEATSの構成。全結合のブロックを残差でつなぐ[11] © Neurogica Inc. -
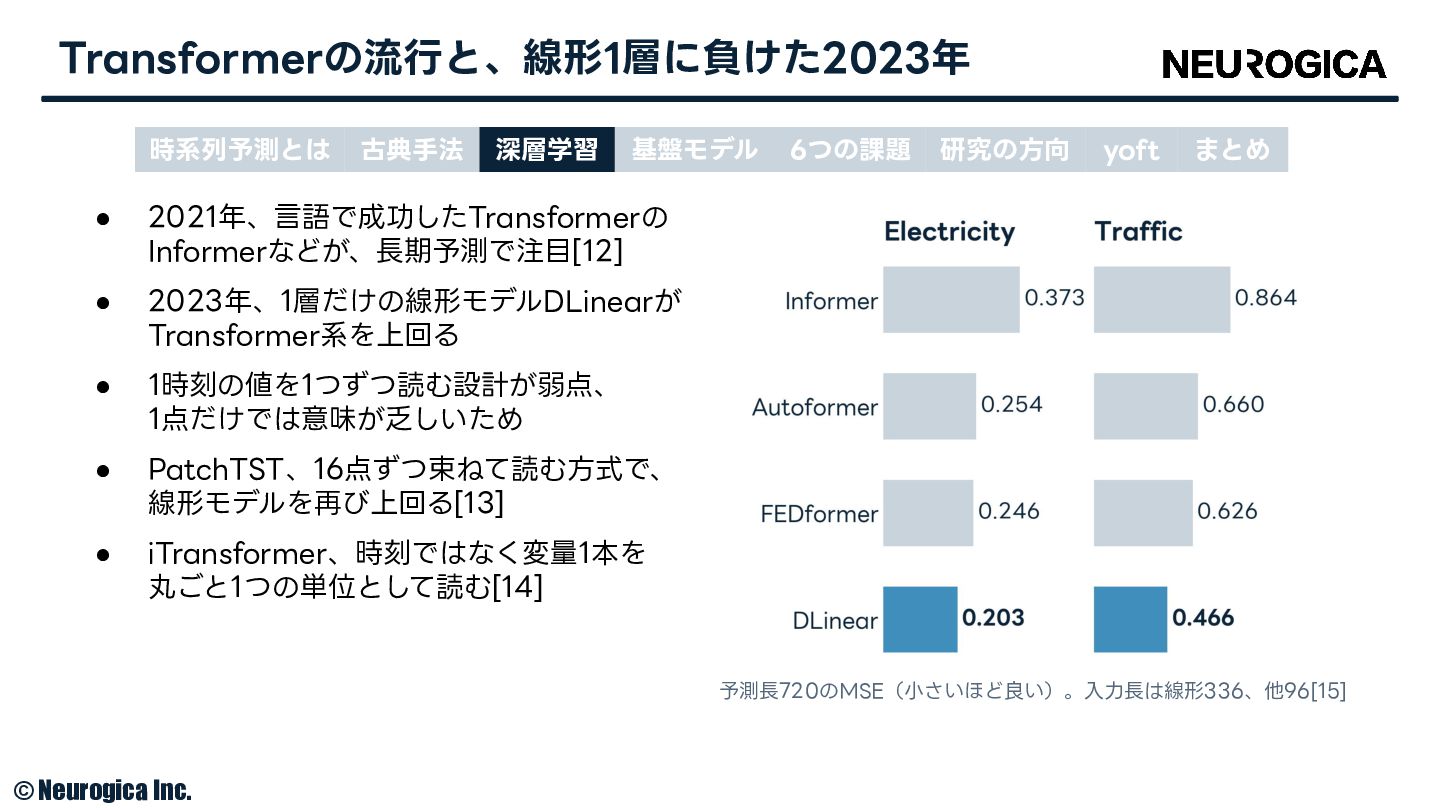
Transformerの流⾏と、線形1層に負けた2023年 時系列予測とは 古典⼿法 深層学習 基盤モデル • 2021年、⾔語で成功したTransformerの Informerなどが、⻑期予測で注⽬[12] • 2023年、1層だけの線形モデルDLinearが
Transformer系を上回る • 1時刻の値を1つずつ読む設計が弱点、 1点だけでは意味が乏しいため • PatchTST、16点ずつ束ねて読む⽅式で、 線形モデルを再び上回る[13] • iTransformer、時刻ではなく変量1本を 丸ごと1つの単位として読む[14] 6つの課題 研究の⽅向 yoft まとめ 予測⻑720のMSE(⼩さいほど良い)。⼊⼒⻑は線形336、他96[15] © Neurogica Inc. -
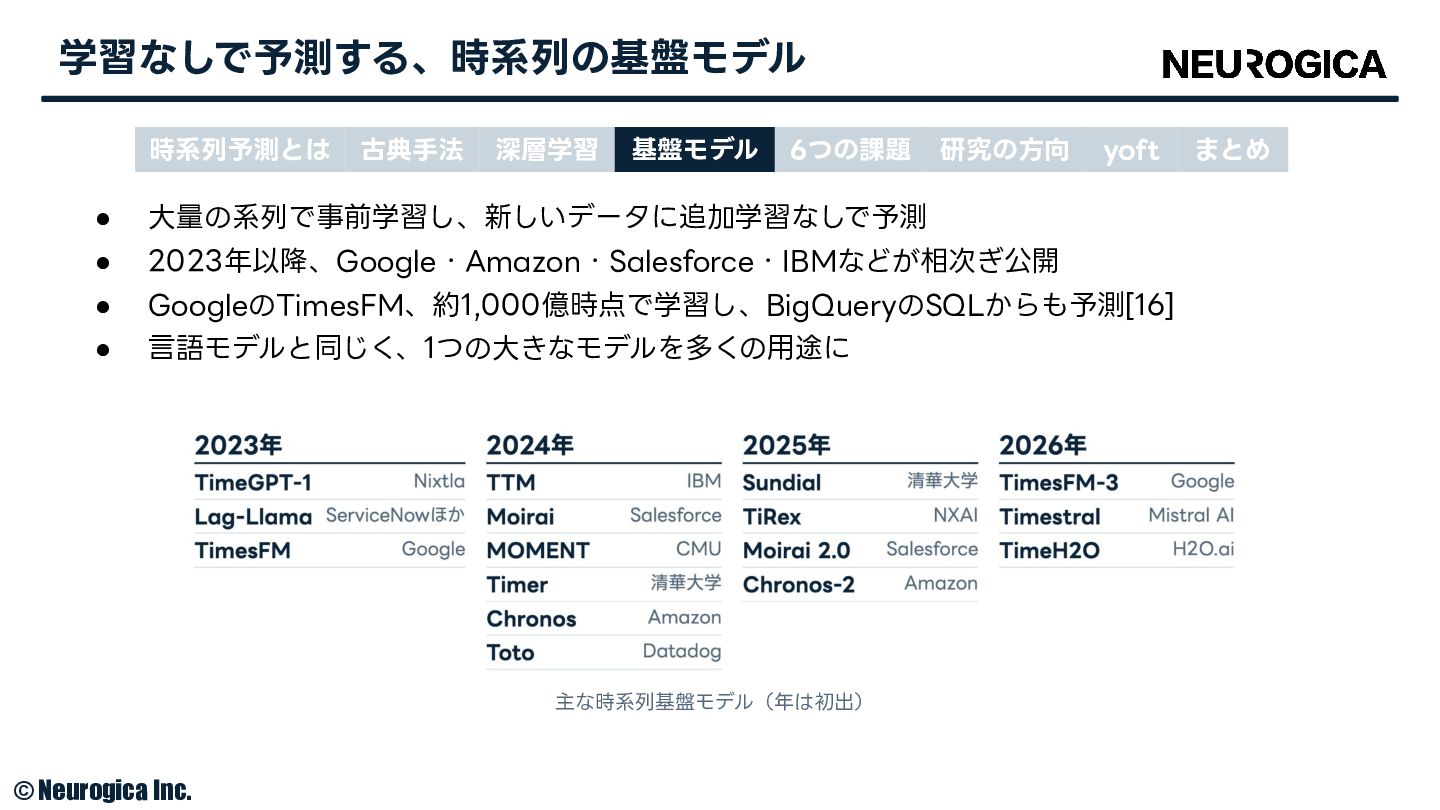
学習なしで予測する、時系列の基盤モデル 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft • ⼤量の系列で事前学習し、新しいデータに追加学習なしで予測
• 2023年以降、Google・Amazon・Salesforce・IBMなどが相次ぎ公開 • GoogleのTimesFM、約1,000億時点で学習し、BigQueryのSQLからも予測[16] • ⾔語モデルと同じく、1つの⼤きなモデルを多くの⽤途に 主な時系列基盤モデル(年は初出) © Neurogica Inc. まとめ -
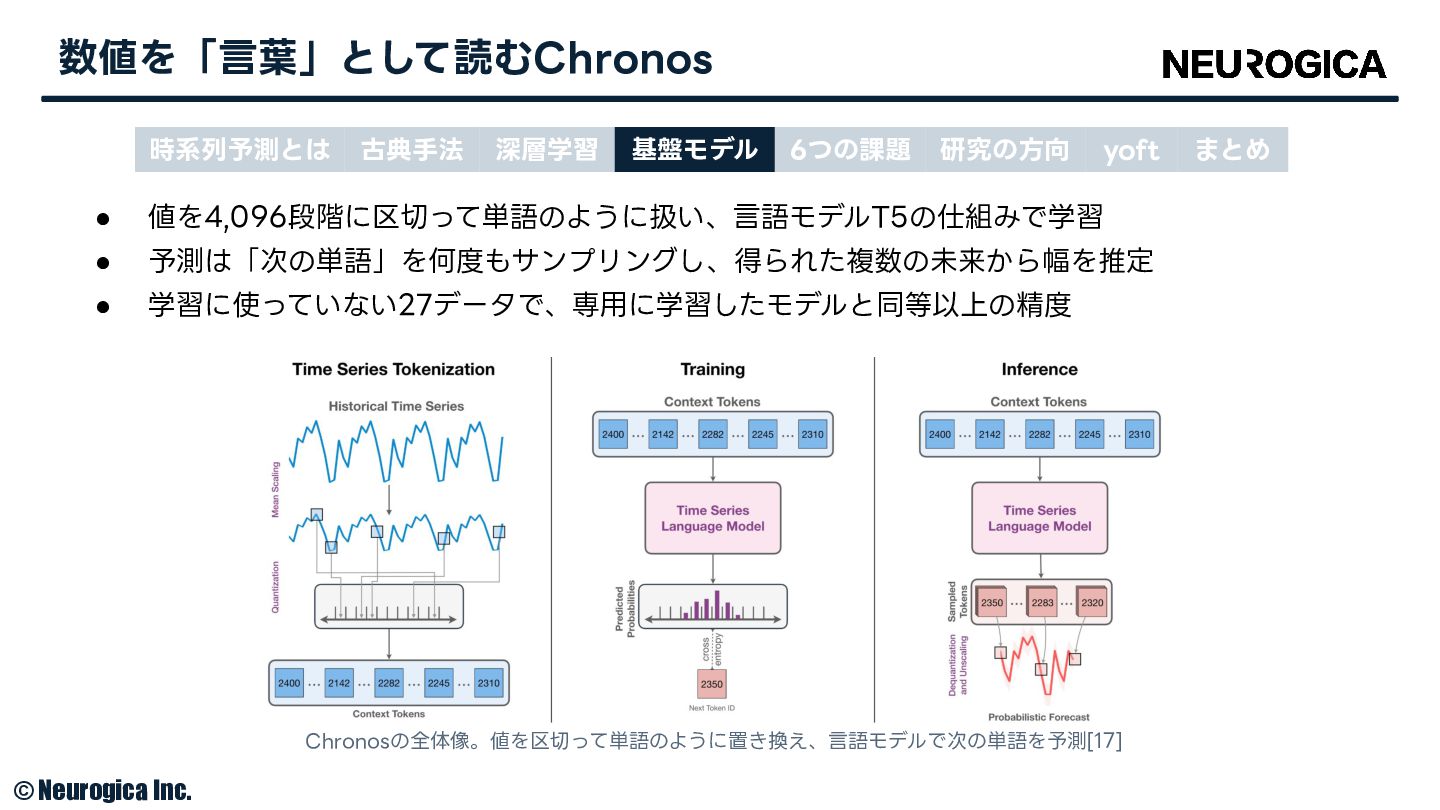
数値を「⾔葉」として読むChronos 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft • 値を4,096段階に区切って単語のように扱い、⾔語モデルT5の仕組みで学習
• 予測は「次の単語」を何度もサンプリングし、得られた複数の未来から幅を推定 • 学習に使っていない27データで、専⽤に学習したモデルと同等以上の精度 Chronosの全体像。値を区切って単語のように置き換え、⾔語モデルで次の単語を予測[17] © Neurogica Inc. まとめ -
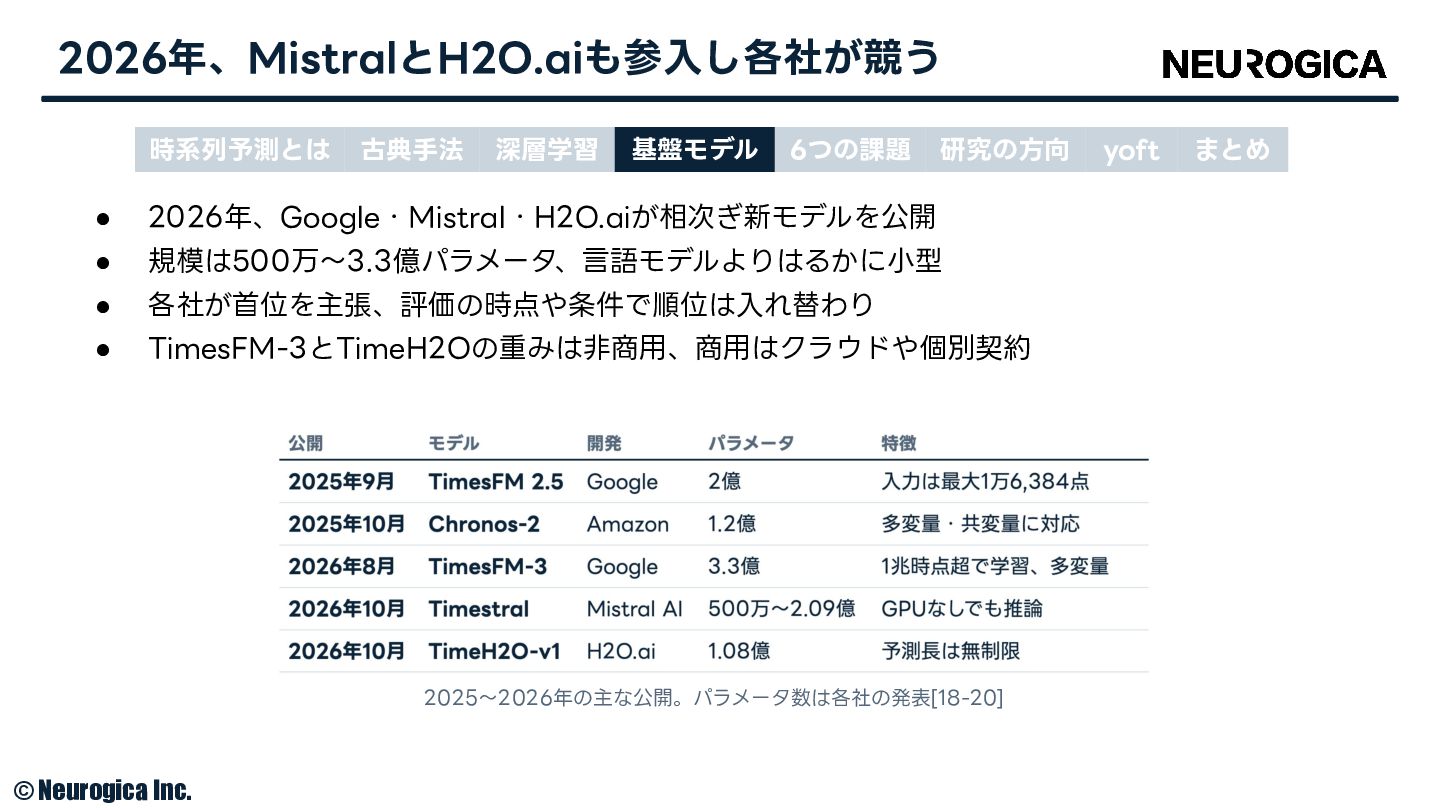
2026年、MistralとH2O.aiも参⼊し各社が競う 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • 2026年、Google・Mistral・H2O.aiが相次ぎ新モデルを公開 •
規模は500万〜3.3億パラメータ、⾔語モデルよりはるかに⼩型 • 各社が⾸位を主張、評価の時点や条件で順位は⼊れ替わり • TimesFM-3とTimeH2Oの重みは⾮商⽤、商⽤はクラウドや個別契約 2025〜2026年の主な公開。パラメータ数は各社の発表[18-20] © Neurogica Inc. yoft まとめ -
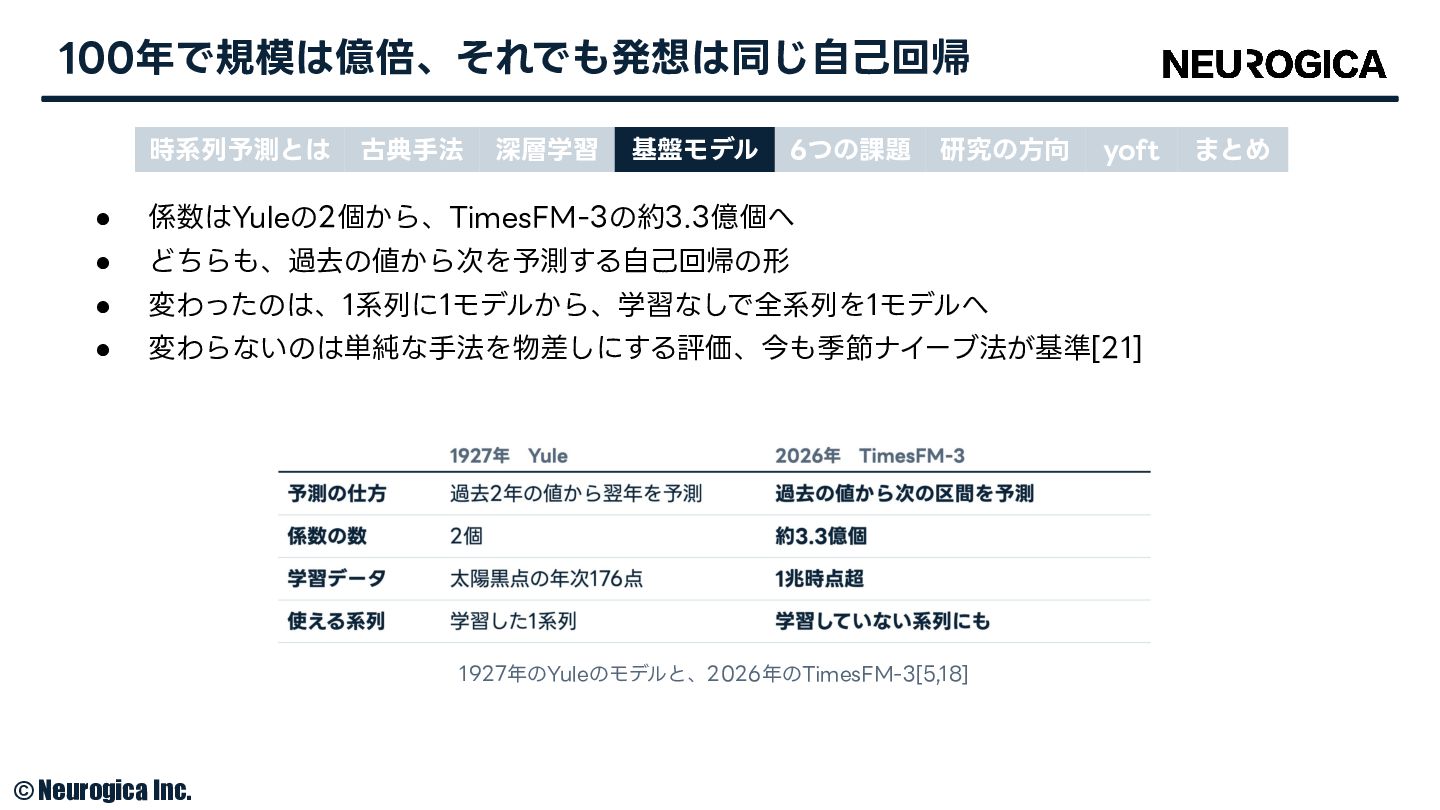
100年で規模は億倍、それでも発想は同じ⾃⼰回帰 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft • 係数はYuleの2個から、TimesFM-3の約3.3億個へ
• どちらも、過去の値から次を予測する⾃⼰回帰の形 • 変わったのは、1系列に1モデルから、学習なしで全系列を1モデルへ • 変わらないのは単純な⼿法を物差しにする評価、今も季節ナイーブ法が基準[21] 1927年のYuleのモデルと、2026年のTimesFM-3[5,18] © Neurogica Inc. まとめ -
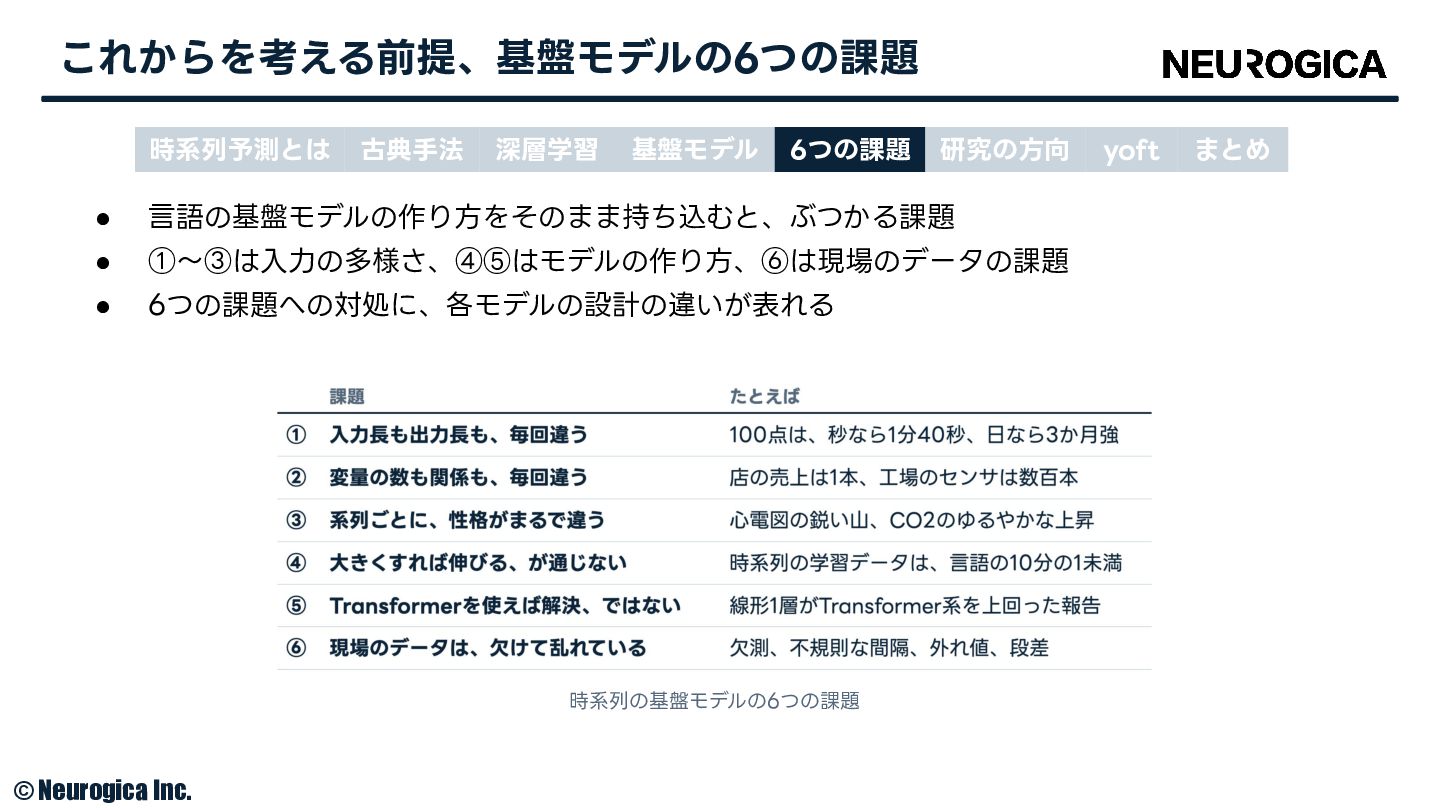
これからを考える前提、基盤モデルの6つの課題 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • ⾔語の基盤モデルの作り⽅をそのまま持ち込むと、ぶつかる課題 •
①〜③は⼊⼒の多様さ、④⑤はモデルの作り⽅、⑥は現場のデータの課題 • 6つの課題への対処に、各モデルの設計の違いが表れる 時系列の基盤モデルの6つの課題 © Neurogica Inc. yoft まとめ -
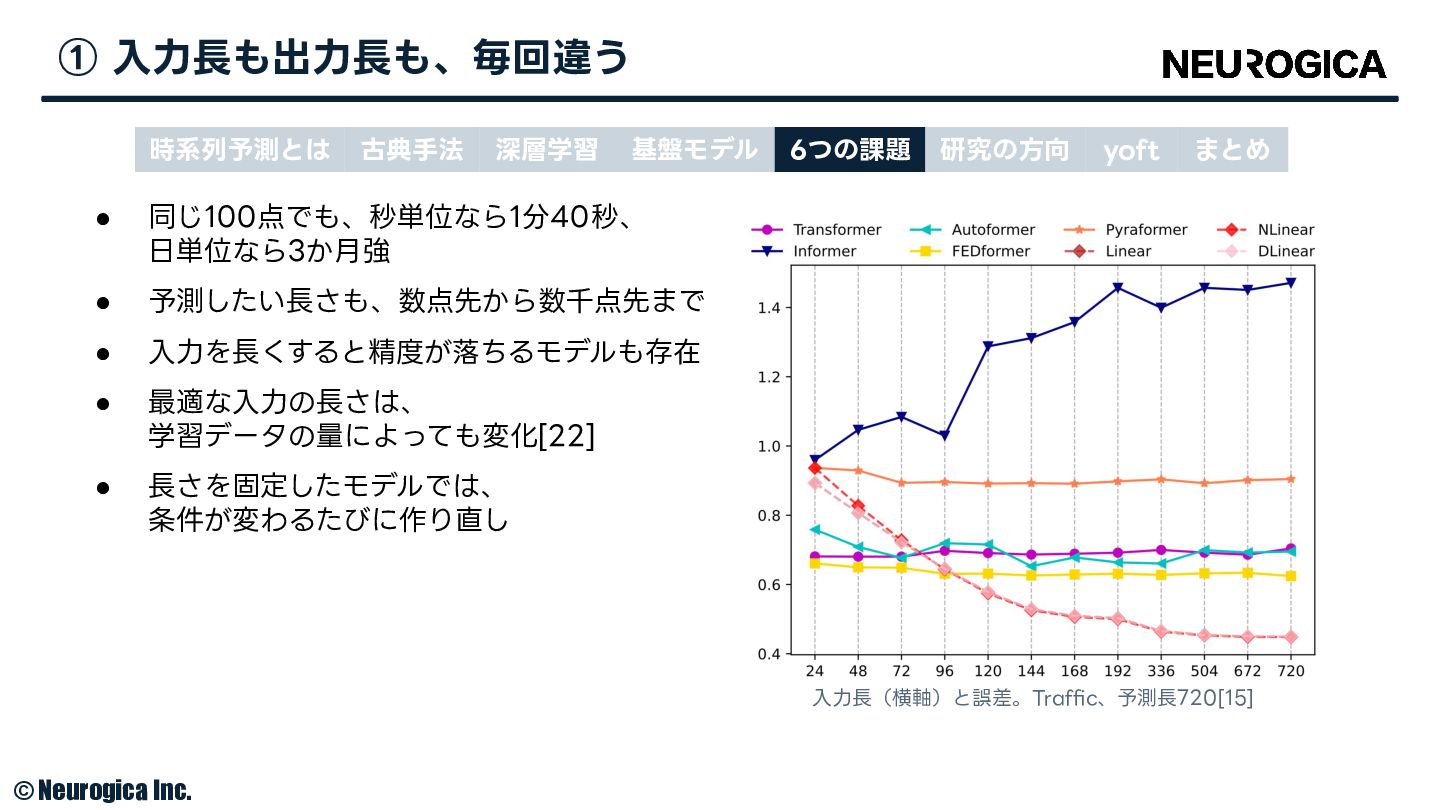
① ⼊⼒⻑も出⼒⻑も、毎回違う 時系列予測とは 古典⼿法 深層学習 基盤モデル • 同じ100点でも、秒単位なら1分40秒、 ⽇単位なら3か⽉強 •
予測したい⻑さも、数点先から数千点先まで • ⼊⼒を⻑くすると精度が落ちるモデルも存在 • 最適な⼊⼒の⻑さは、 学習データの量によっても変化[22] • ⻑さを固定したモデルでは、 条件が変わるたびに作り直し 6つの課題 研究の⽅向 yoft まとめ ⼊⼒⻑(横軸)と誤差。Traffic、予測⻑720[15] © Neurogica Inc. -
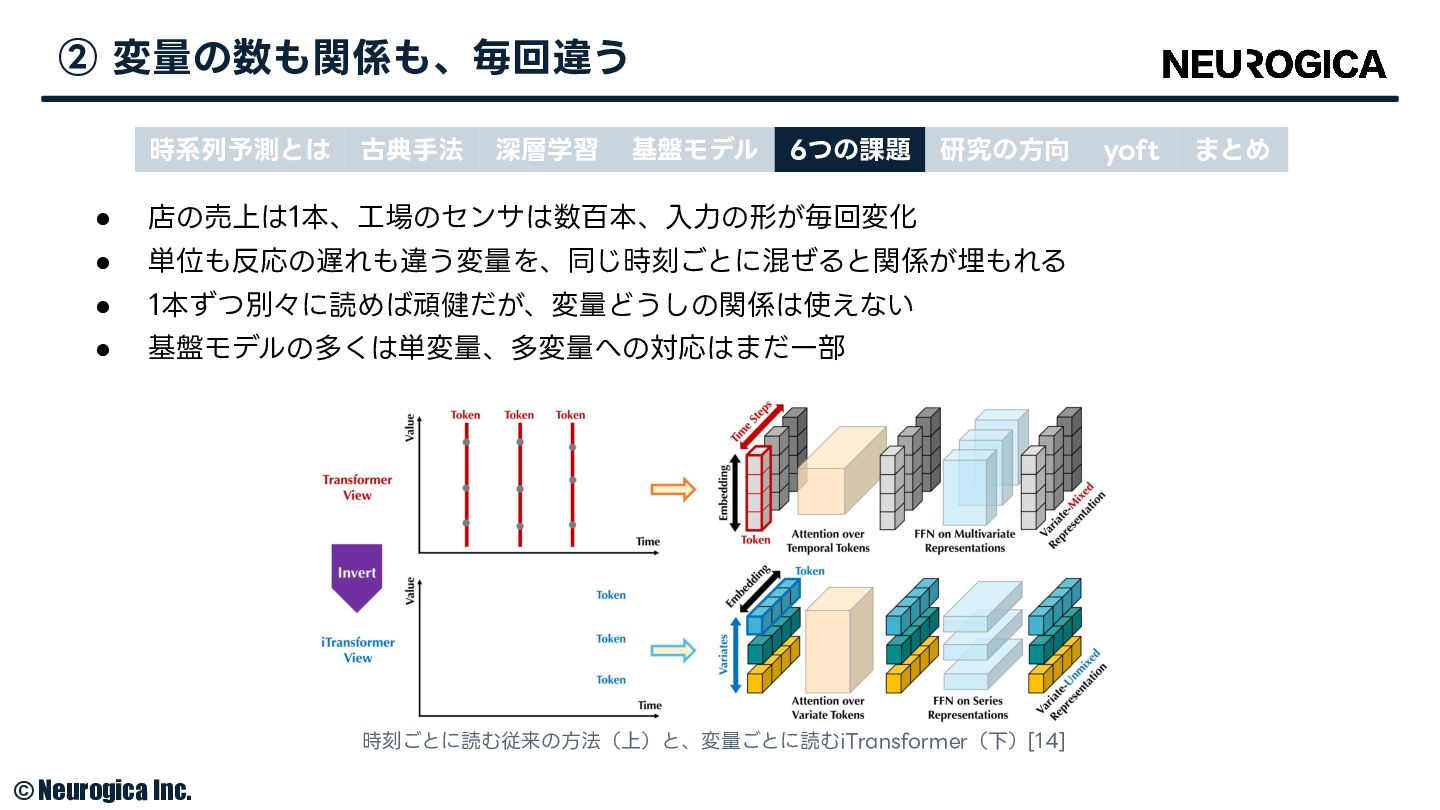
② 変量の数も関係も、毎回違う 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • 店の売上は1本、⼯場のセンサは数百本、⼊⼒の形が毎回変化
• 単位も反応の遅れも違う変量を、同じ時刻ごとに混ぜると関係が埋もれる • 1本ずつ別々に読めば頑健だが、変量どうしの関係は使えない • 基盤モデルの多くは単変量、多変量への対応はまだ⼀部 時刻ごとに読む従来の⽅法(上)と、変量ごとに読むiTransformer(下)[14] © Neurogica Inc. yoft まとめ -
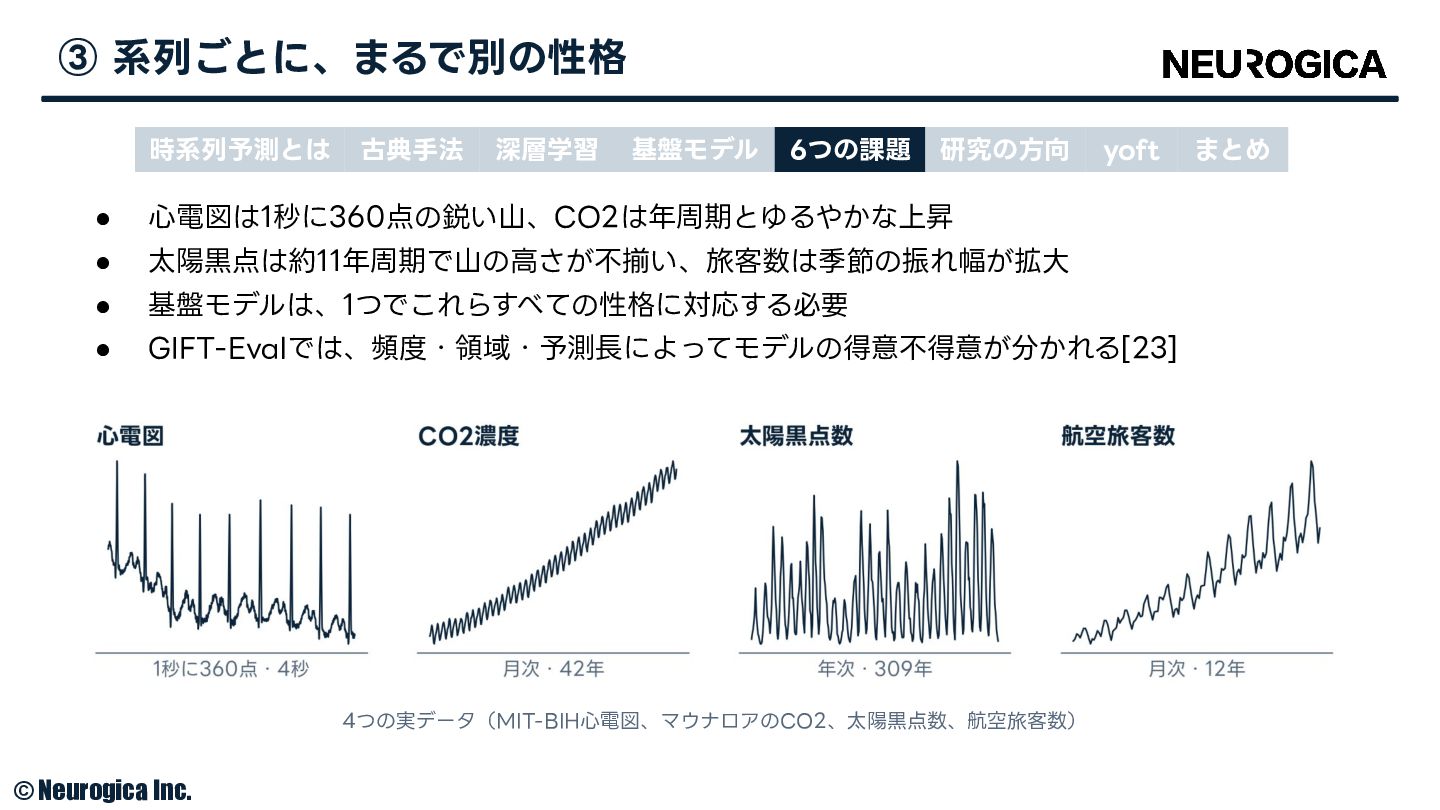
③ 系列ごとに、まるで別の性格 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft •
⼼電図は1秒に360点の鋭い⼭、CO2は年周期とゆるやかな上昇 • 太陽⿊点は約11年周期で⼭の⾼さが不揃い、旅客数は季節の振れ幅が拡⼤ • 基盤モデルは、1つでこれらすべての性格に対応する必要 • GIFT-Evalでは、頻度・領域・予測⻑によってモデルの得意不得意が分かれる[23] 4つの実データ(MIT-BIH⼼電図、マウナロアのCO2、太陽⿊点数、航空旅客数) © Neurogica Inc. まとめ -
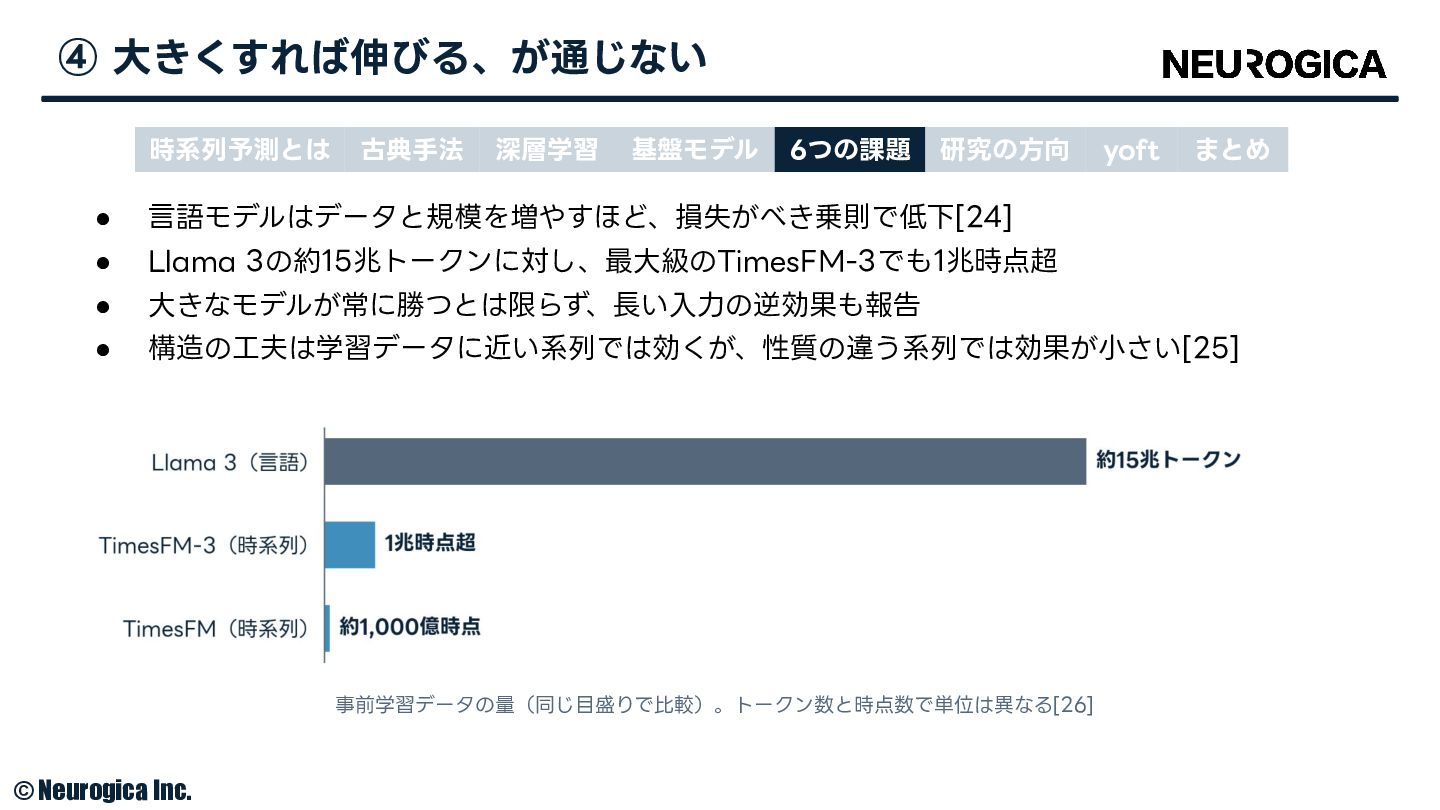
④ ⼤きくすれば伸びる、が通じない 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ
• ⾔語モデルはデータと規模を増やすほど、損失がべき乗則で低下[24] • Llama 3の約15兆トークンに対し、最⼤級のTimesFM-3でも1兆時点超 • ⼤きなモデルが常に勝つとは限らず、⻑い⼊⼒の逆効果も報告 • 構造の⼯夫は学習データに近い系列では効くが、性質の違う系列では効果が⼩さい[25] 事前学習データの量(同じ⽬盛りで⽐較)。トークン数と時点数で単位は異なる[26] © Neurogica Inc. -
⑤ Transformerを使えば解決、ではない 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ
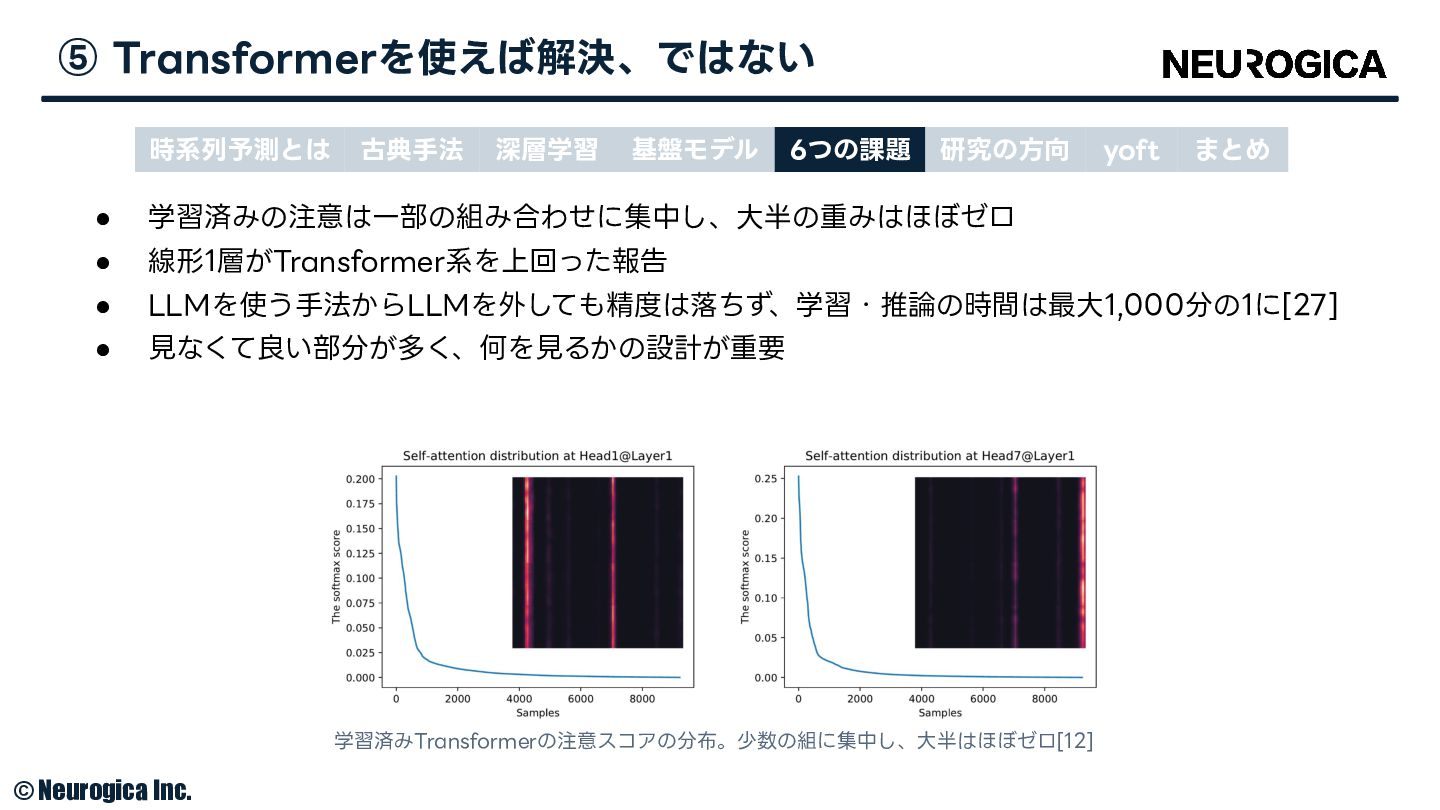
• 学習済みの注意は⼀部の組み合わせに集中し、⼤半の重みはほぼゼロ • 線形1層がTransformer系を上回った報告 • LLMを使う⼿法からLLMを外しても精度は落ちず、学習・推論の時間は最⼤1,000分の1に[27] • ⾒なくて良い部分が多く、何を⾒るかの設計が重要 学習済みTransformerの注意スコアの分布。少数の組に集中し、⼤半はほぼゼロ[12] © Neurogica Inc. -
⑥ 現場のデータは、⽋けて乱れている 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft •
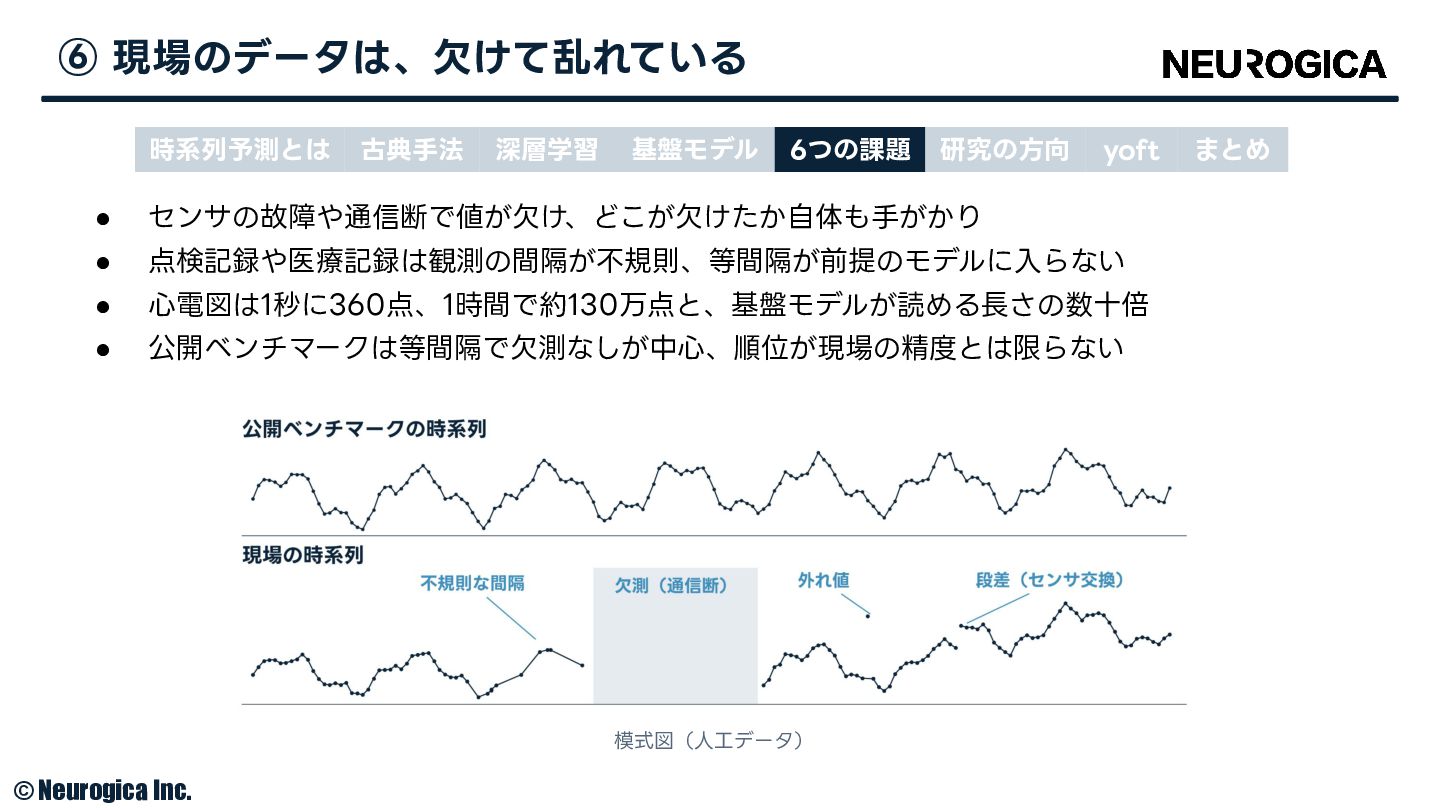
センサの故障や通信断で値が⽋け、どこが⽋けたか⾃体も⼿がかり • 点検記録や医療記録は観測の間隔が不規則、等間隔が前提のモデルに⼊らない • ⼼電図は1秒に360点、1時間で約130万点と、基盤モデルが読める⻑さの数⼗倍 • 公開ベンチマークは等間隔で⽋測なしが中⼼、順位が現場の精度とは限らない 模式図(⼈⼯データ) © Neurogica Inc. まとめ -
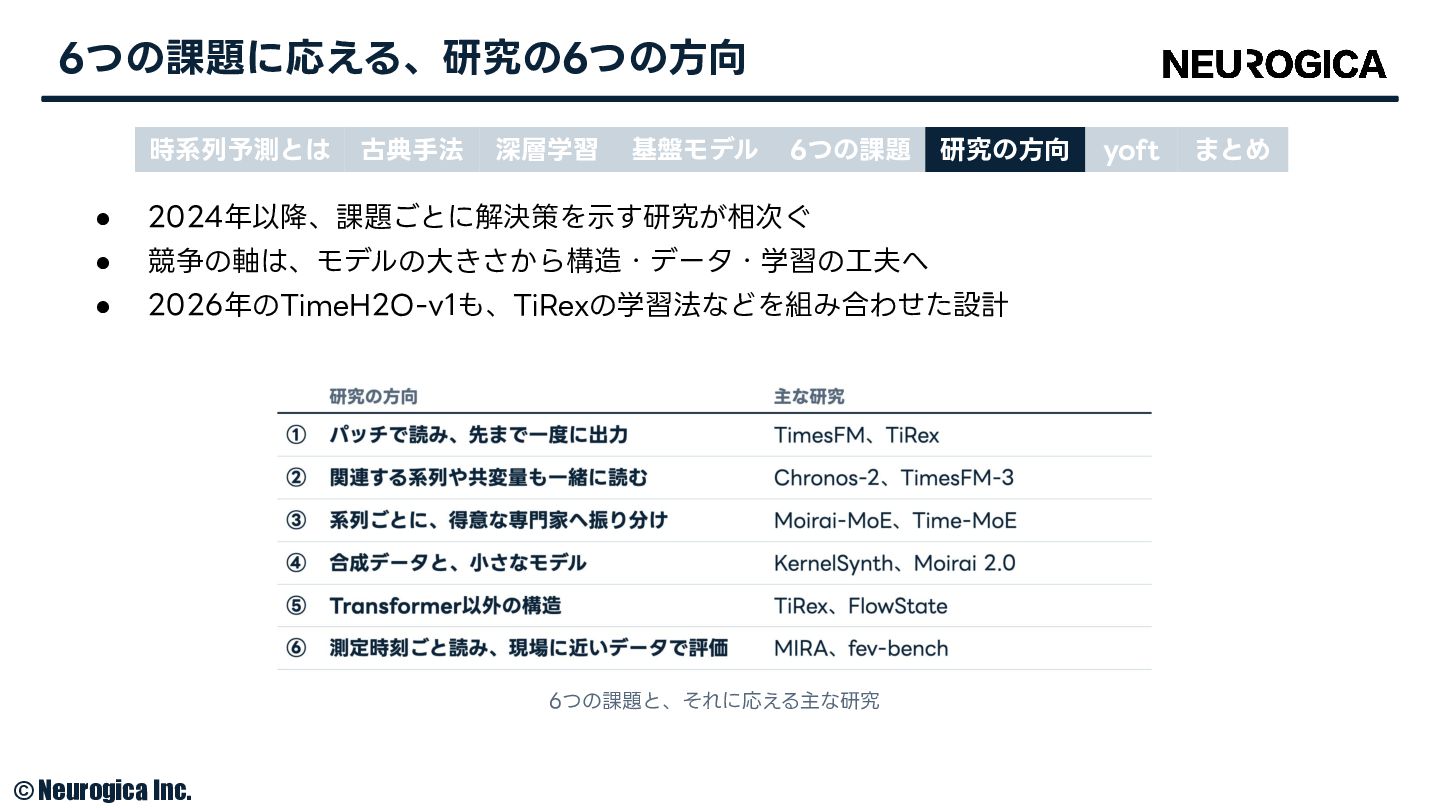
6つの課題に応える、研究の6つの⽅向 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • 2024年以降、課題ごとに解決策を⽰す研究が相次ぐ •
競争の軸は、モデルの⼤きさから構造・データ・学習の⼯夫へ • 2026年のTimeH2O-v1も、TiRexの学習法などを組み合わせた設計 6つの課題と、それに応える主な研究 © Neurogica Inc. yoft まとめ -
① ⻑さの違いには、パッチで読み先まで⼀度に出⼒ 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ
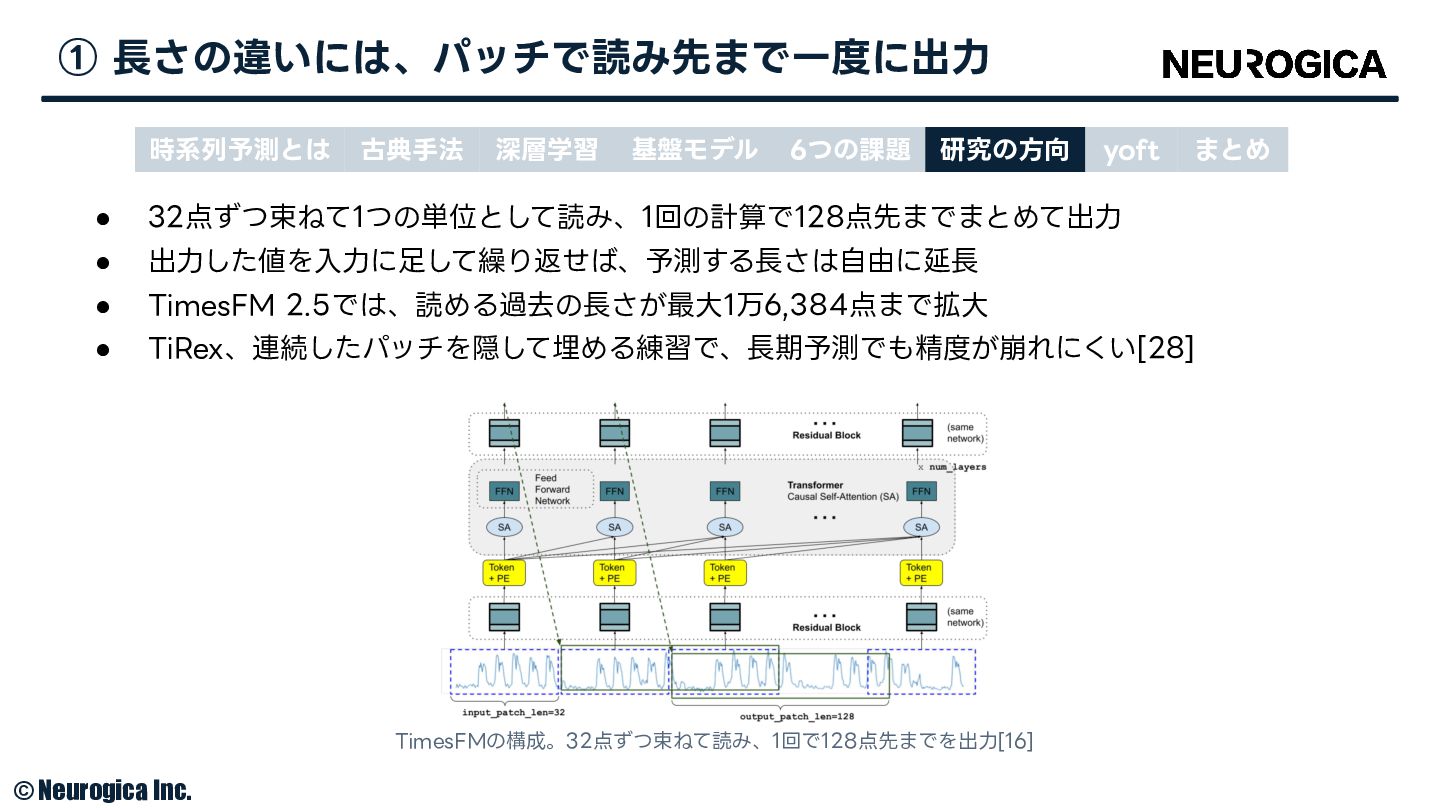
• 32点ずつ束ねて1つの単位として読み、1回の計算で128点先までまとめて出⼒ • 出⼒した値を⼊⼒に⾜して繰り返せば、予測する⻑さは⾃由に延⻑ • TimesFM 2.5では、読める過去の⻑さが最⼤1万6,384点まで拡⼤ • TiRex、連続したパッチを隠して埋める練習で、⻑期予測でも精度が崩れにくい[28] TimesFMの構成。32点ずつ束ねて読み、1回で128点先までを出⼒[16] © Neurogica Inc. -
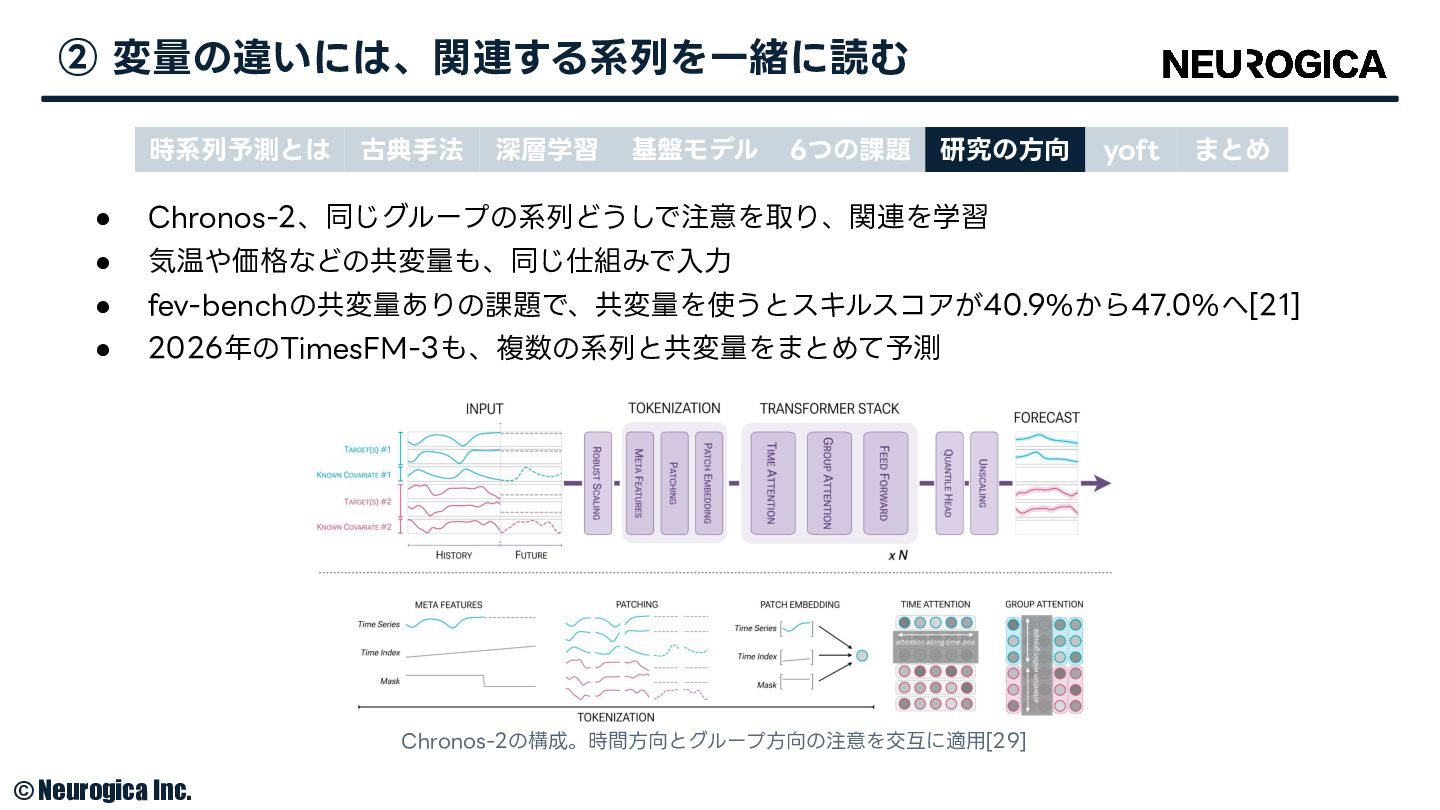
② 変量の違いには、関連する系列を⼀緒に読む 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ
• Chronos-2、同じグループの系列どうしで注意を取り、関連を学習 • 気温や価格などの共変量も、同じ仕組みで⼊⼒ • fev-benchの共変量ありの課題で、共変量を使うとスキルスコアが40.9%から47.0%へ[21] • 2026年のTimesFM-3も、複数の系列と共変量をまとめて予測 Chronos-2の構成。時間⽅向とグループ⽅向の注意を交互に適⽤[29] © Neurogica Inc. -
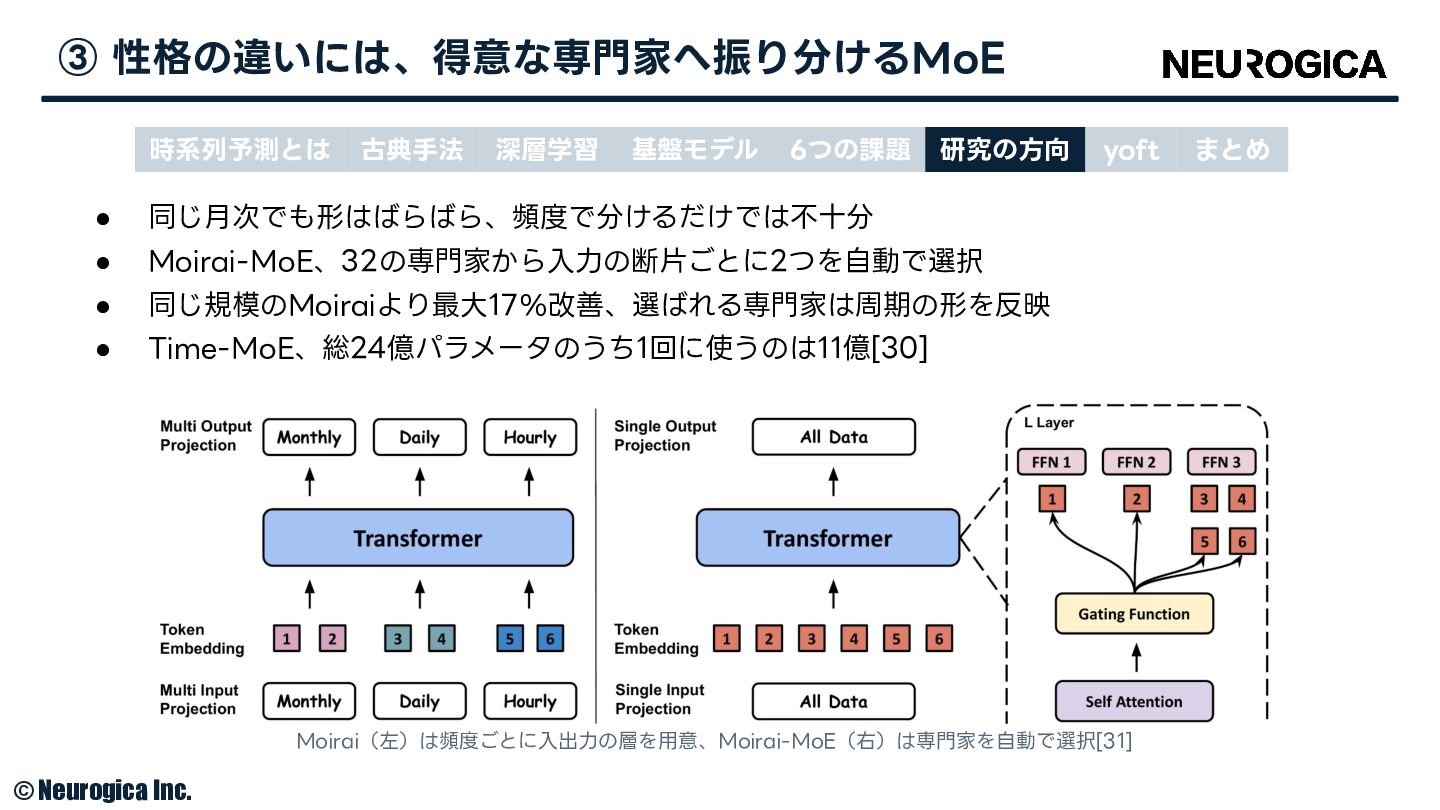
③ 性格の違いには、得意な専⾨家へ振り分けるMoE 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • 同じ⽉次でも形はばらばら、頻度で分けるだけでは不⼗分
• Moirai-MoE、32の専⾨家から⼊⼒の断⽚ごとに2つを⾃動で選択 • 同じ規模のMoiraiより最⼤17%改善、選ばれる専⾨家は周期の形を反映 • Time-MoE、総24億パラメータのうち1回に使うのは11億[30] yoft Moirai(左)は頻度ごとに⼊出⼒の層を⽤意、Moirai-MoE(右)は専⾨家を⾃動で選択[31] © Neurogica Inc. まとめ -
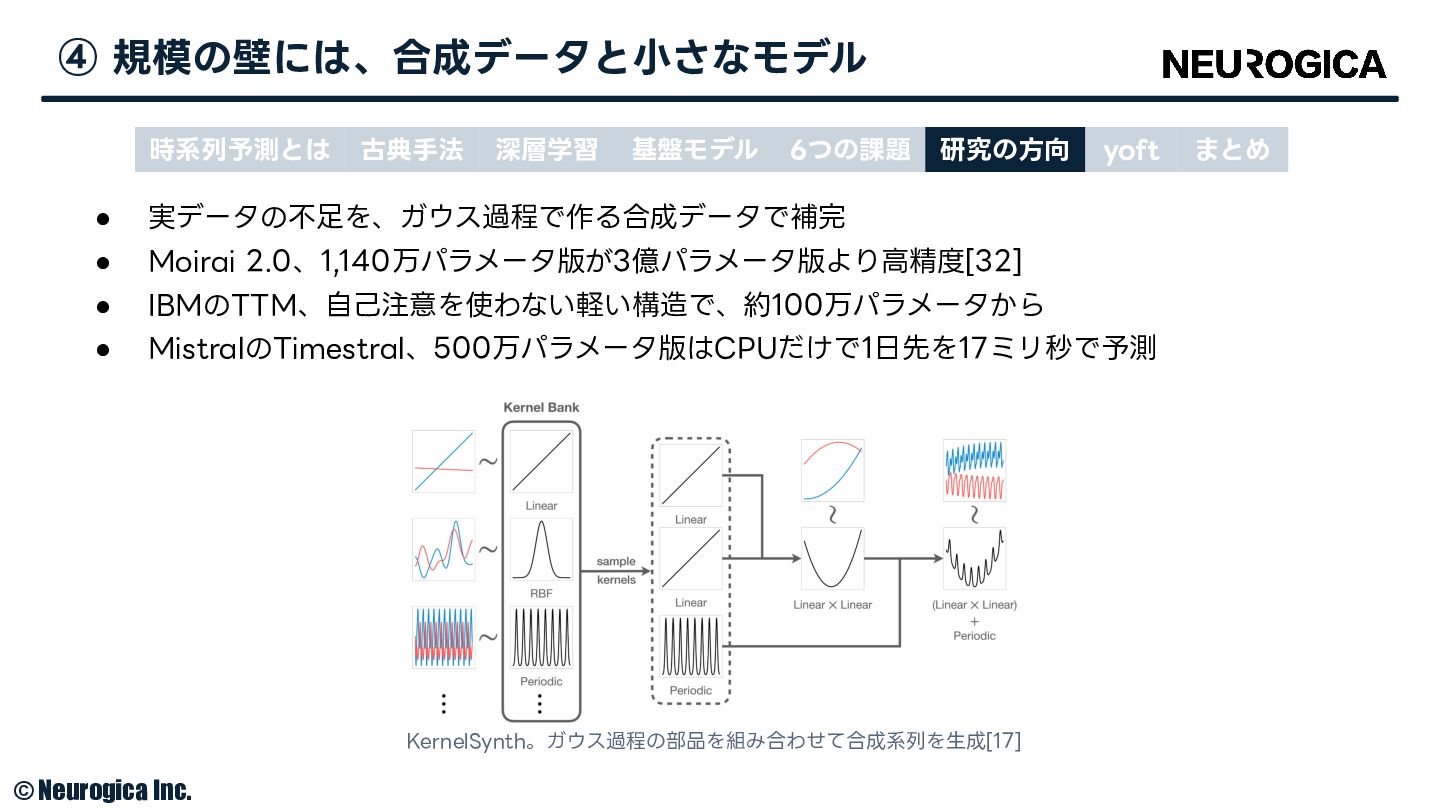
④ 規模の壁には、合成データと⼩さなモデル 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft •
実データの不⾜を、ガウス過程で作る合成データで補完 • Moirai 2.0、1,140万パラメータ版が3億パラメータ版より⾼精度[32] • IBMのTTM、⾃⼰注意を使わない軽い構造で、約100万パラメータから • MistralのTimestral、500万パラメータ版はCPUだけで1⽇先を17ミリ秒で予測 KernelSynth。ガウス過程の部品を組み合わせて合成系列を⽣成[17] © Neurogica Inc. まとめ -
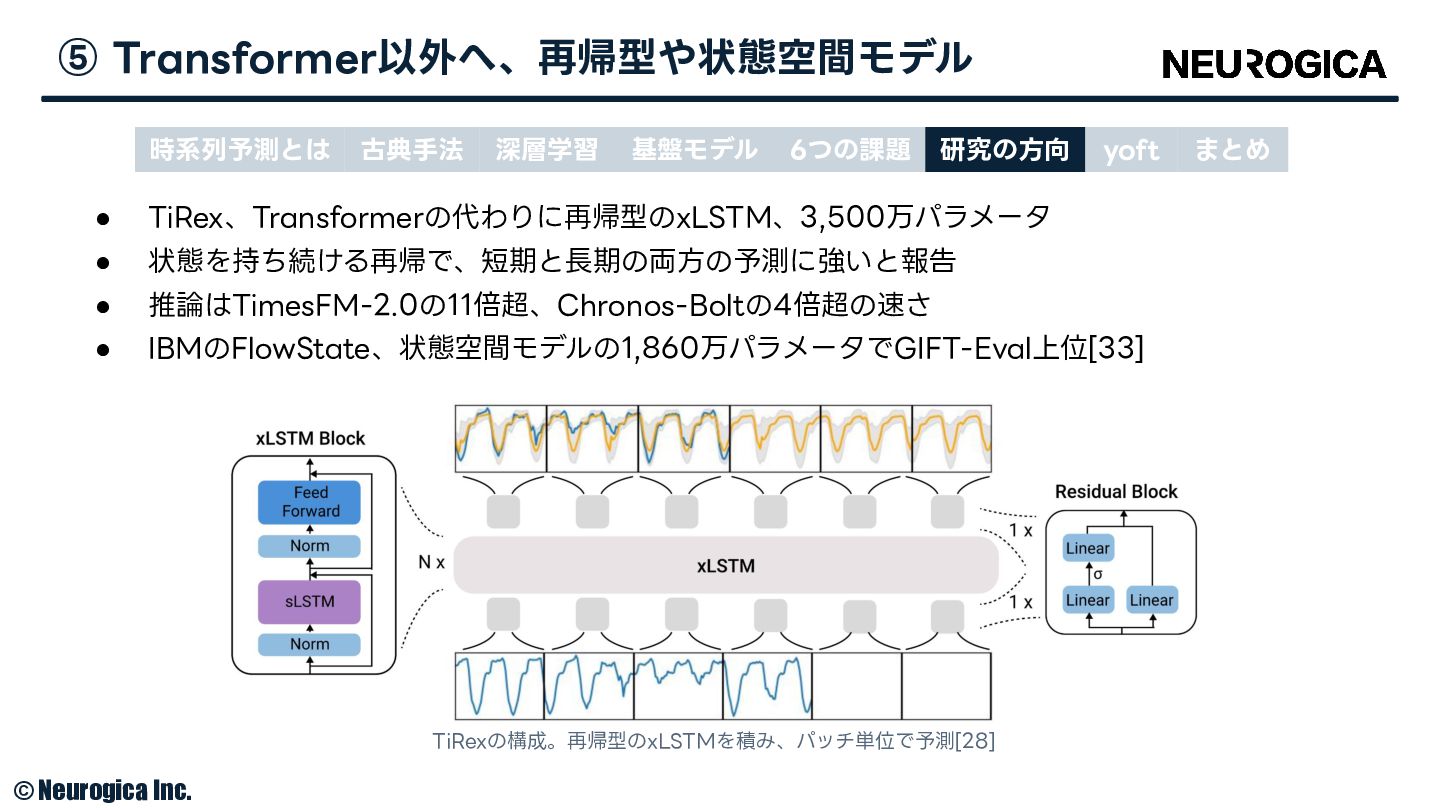
⑤ Transformer以外へ、再帰型や状態空間モデル 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft •
TiRex、Transformerの代わりに再帰型のxLSTM、3,500万パラメータ • 状態を持ち続ける再帰で、短期と⻑期の両⽅の予測に強いと報告 • 推論はTimesFM-2.0の11倍超、Chronos-Boltの4倍超の速さ • IBMのFlowState、状態空間モデルの1,860万パラメータでGIFT-Eval上位[33] TiRexの構成。再帰型のxLSTMを積み、パッチ単位で予測[28] © Neurogica Inc. まとめ -
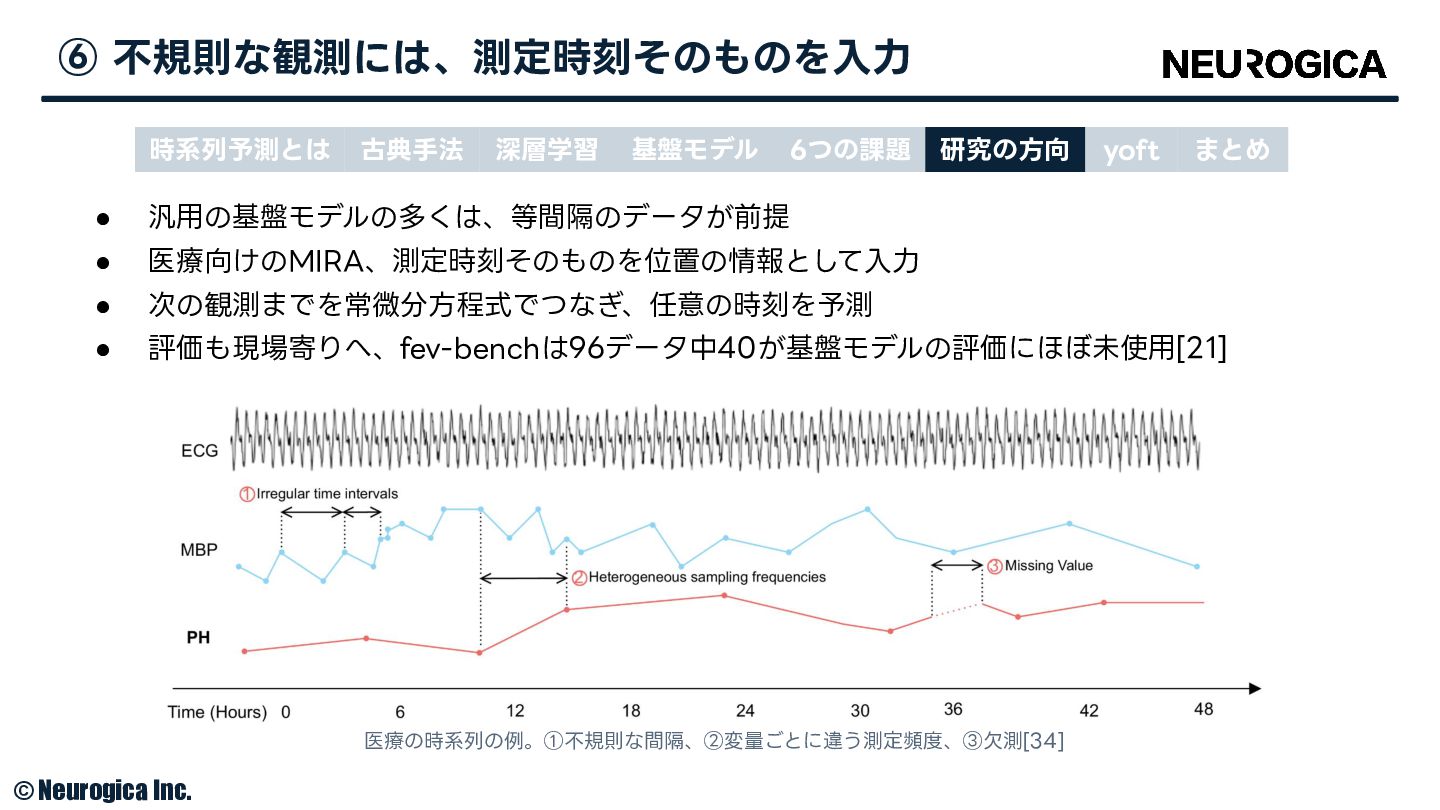
⑥ 不規則な観測には、測定時刻そのものを⼊⼒ 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ
• 汎⽤の基盤モデルの多くは、等間隔のデータが前提 • 医療向けのMIRA、測定時刻そのものを位置の情報として⼊⼒ • 次の観測までを常微分⽅程式でつなぎ、任意の時刻を予測 • 評価も現場寄りへ、fev-benchは96データ中40が基盤モデルの評価にほぼ未使⽤[21] 医療の時系列の例。①不規則な間隔、②変量ごとに違う測定頻度、③⽋測[34] © Neurogica Inc. -
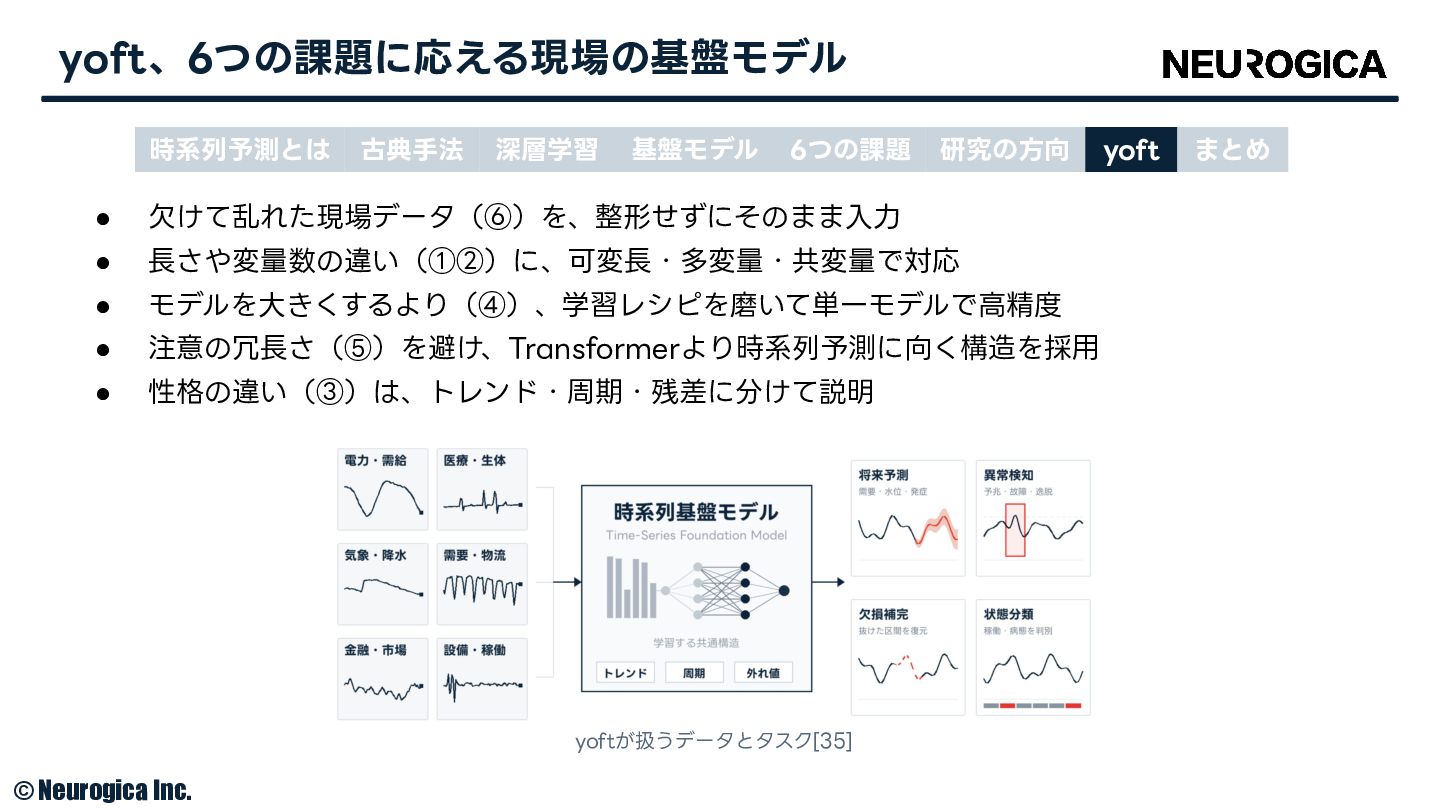
yoft、6つの課題に応える現場の基盤モデル 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • ⽋けて乱れた現場データ(⑥)を、整形せずにそのまま⼊⼒ •
⻑さや変量数の違い(①②)に、可変⻑・多変量・共変量で対応 • モデルを⼤きくするより(④)、学習レシピを磨いて単⼀モデルで⾼精度 • 注意の冗⻑さ(⑤)を避け、Transformerより時系列予測に向く構造を採⽤ • 性格の違い(③)は、トレンド・周期・残差に分けて説明 yoftが扱うデータとタスク[35] © Neurogica Inc. yoft まとめ -
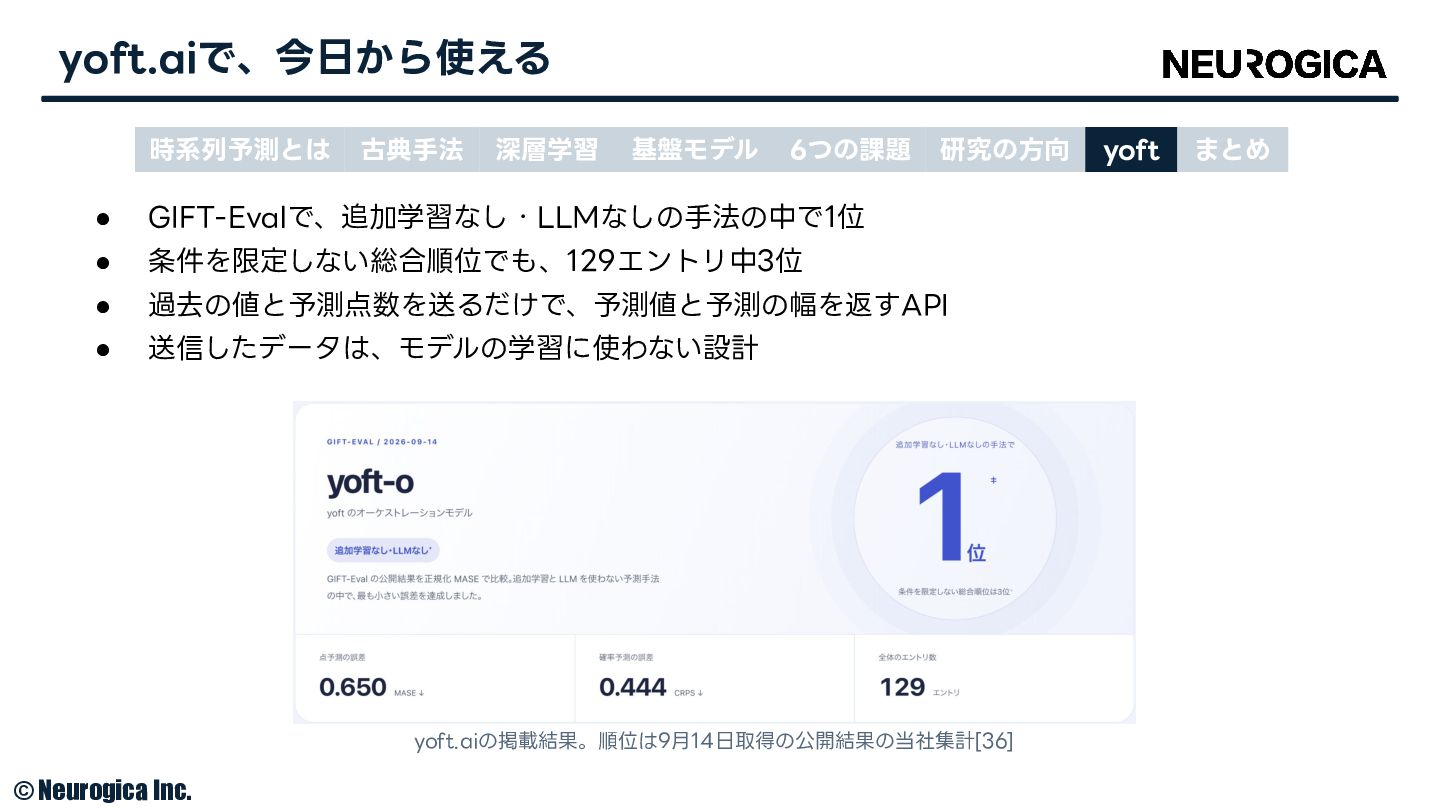
yoft.aiで、今⽇から使える 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • GIFT-Evalで、追加学習なし・LLMなしの⼿法の中で1位 •
条件を限定しない総合順位でも、129エントリ中3位 • 過去の値と予測点数を送るだけで、予測値と予測の幅を返すAPI • 送信したデータは、モデルの学習に使わない設計 yoft.aiの掲載結果。順位は9⽉14⽇取得の公開結果の当社集計[36] © Neurogica Inc. yoft まとめ -
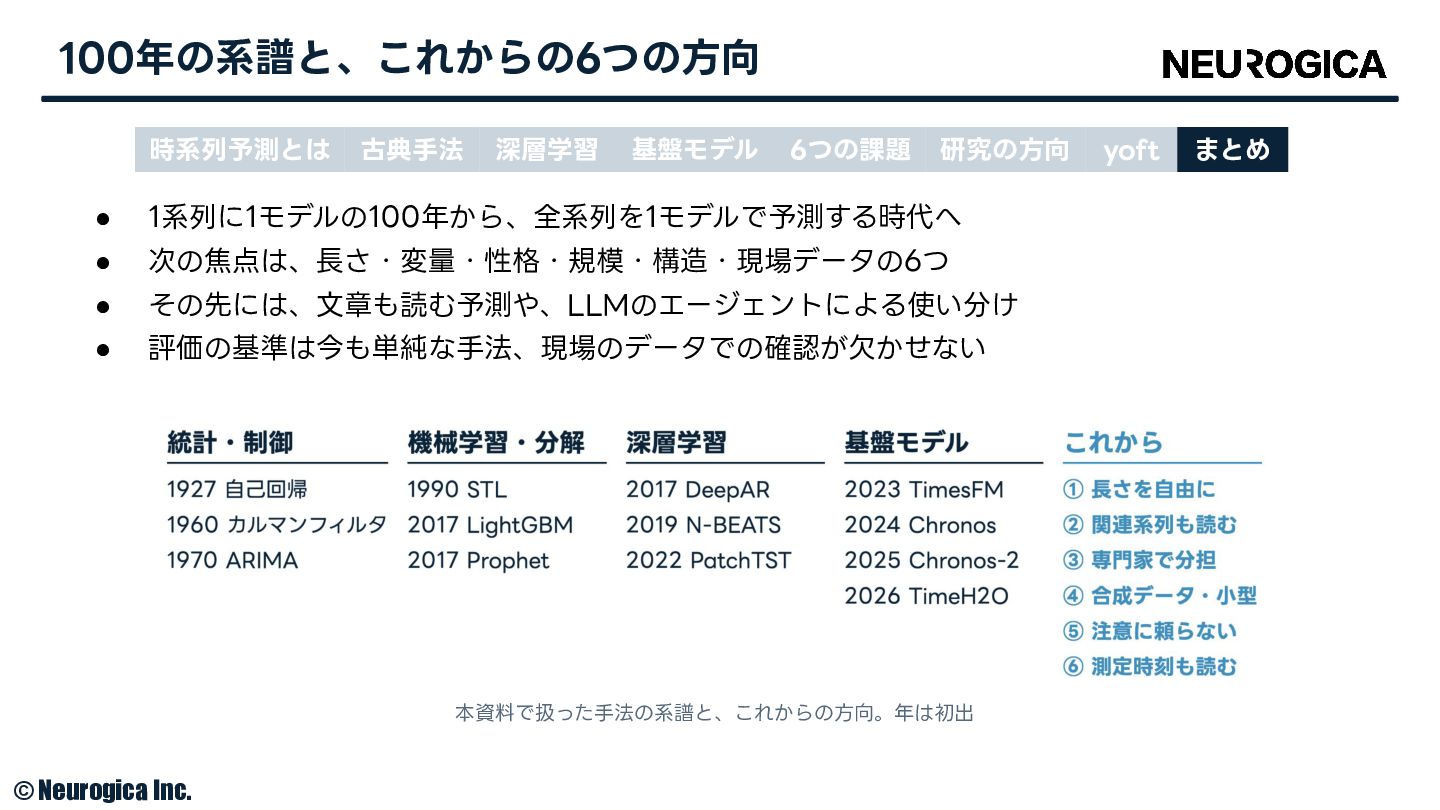
100年の系譜と、これからの6つの⽅向 時系列予測とは 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 • 1系列に1モデルの100年から、全系列を1モデルで予測する時代へ •
次の焦点は、⻑さ・変量・性格・規模・構造・現場データの6つ • その先には、⽂章も読む予測や、LLMのエージェントによる使い分け • 評価の基準は今も単純な⼿法、現場のデータでの確認が⽋かせない 本資料で扱った⼿法の系譜と、これからの⽅向。年は初出 © Neurogica Inc. yoft まとめ -
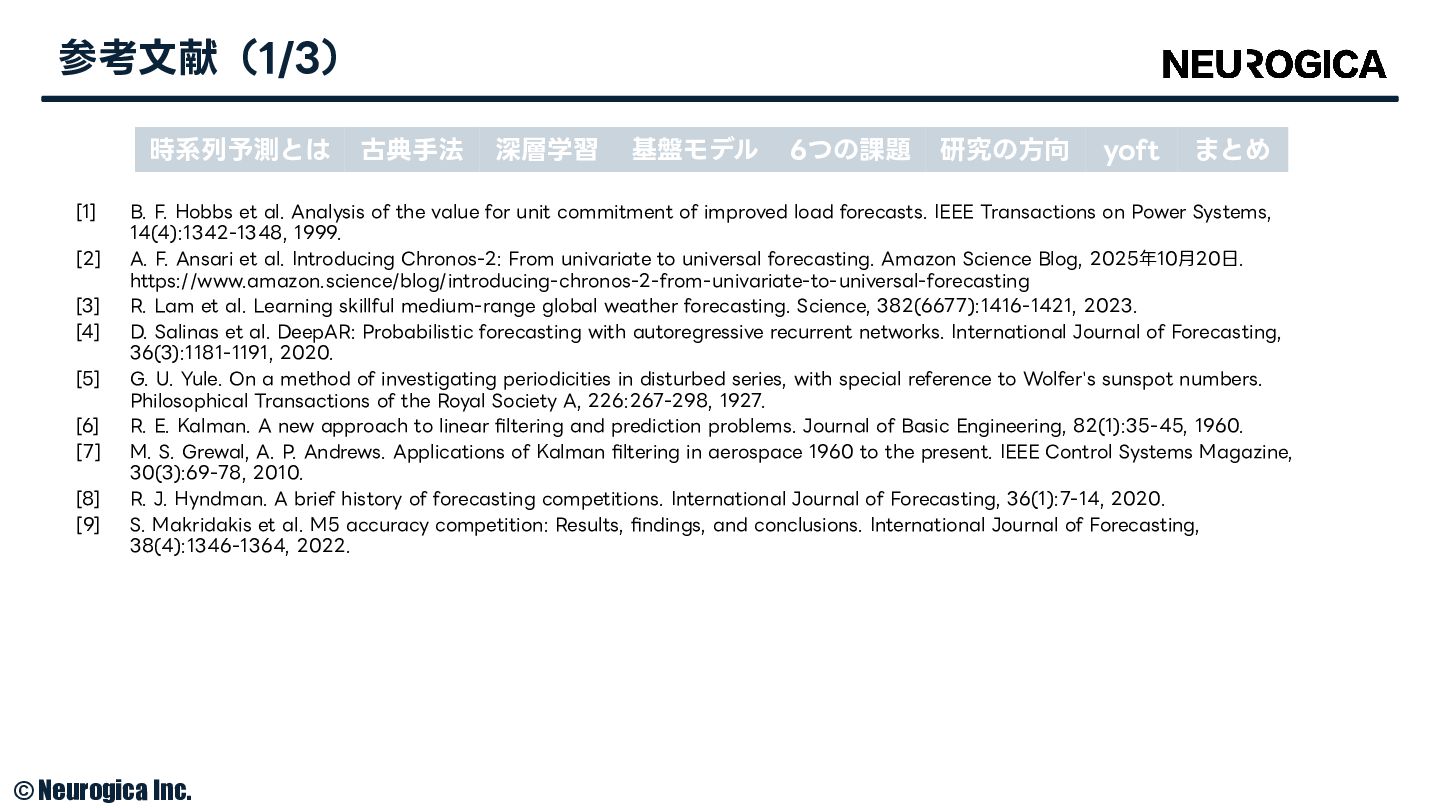
参考⽂献(1/3) 時系列予測とは [1] [2] [3] [4] [5] [6] [7] [8]
[9] 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ B. F. Hobbs et al. Analysis of the value for unit commitment of improved load forecasts. IEEE Transactions on Power Systems, 14(4):1342-1348, 1999. A. F. Ansari et al. Introducing Chronos-2: From univariate to universal forecasting. Amazon Science Blog, 2025年10⽉20⽇. https://www.amazon.science/blog/introducing-chronos-2-from-univariate-to-universal-forecasting R. Lam et al. Learning skillful medium-range global weather forecasting. Science, 382(6677):1416-1421, 2023. D. Salinas et al. DeepAR: Probabilistic forecasting with autoregressive recurrent networks. International Journal of Forecasting, 36(3):1181-1191, 2020. G. U. Yule. On a method of investigating periodicities in disturbed series, with special reference to Wolfer's sunspot numbers. Philosophical Transactions of the Royal Society A, 226:267-298, 1927. R. E. Kalman. A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82(1):35-45, 1960. M. S. Grewal, A. P. Andrews. Applications of Kalman filtering in aerospace 1960 to the present. IEEE Control Systems Magazine, 30(3):69-78, 2010. R. J. Hyndman. A brief history of forecasting competitions. International Journal of Forecasting, 36(1):7-14, 2020. S. Makridakis et al. M5 accuracy competition: Results, findings, and conclusions. International Journal of Forecasting, 38(4):1346-1364, 2022. © Neurogica Inc. -
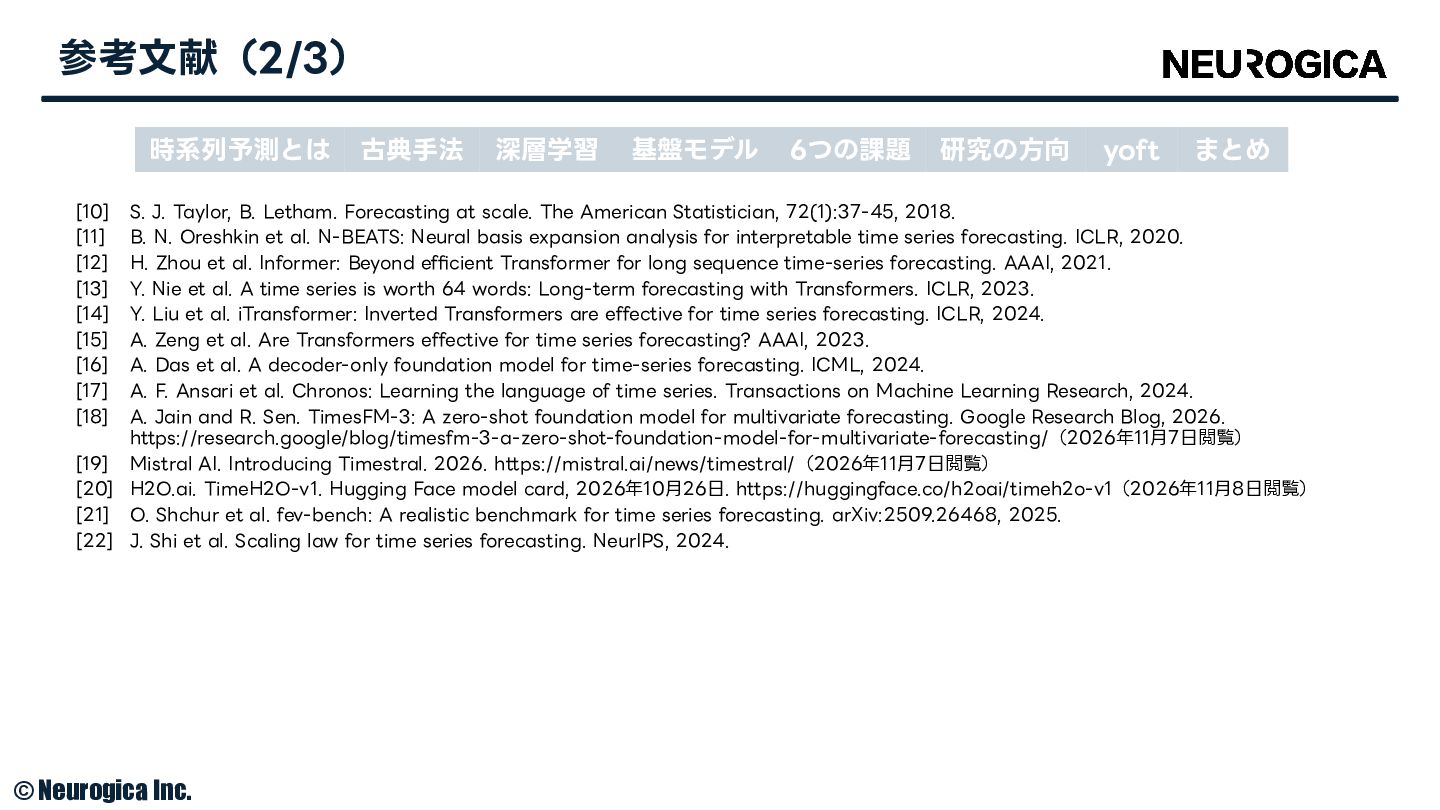
参考⽂献(2/3) 時系列予測とは [10] [11] [12] [13] [14] [15] [16] [17]
[18] 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ S. J. Taylor, B. Letham. Forecasting at scale. The American Statistician, 72(1):37-45, 2018. B. N. Oreshkin et al. N-BEATS: Neural basis expansion analysis for interpretable time series forecasting. ICLR, 2020. H. Zhou et al. Informer: Beyond efficient Transformer for long sequence time-series forecasting. AAAI, 2021. Y. Nie et al. A time series is worth 64 words: Long-term forecasting with Transformers. ICLR, 2023. Y. Liu et al. iTransformer: Inverted Transformers are effective for time series forecasting. ICLR, 2024. A. Zeng et al. Are Transformers effective for time series forecasting? AAAI, 2023. A. Das et al. A decoder-only foundation model for time-series forecasting. ICML, 2024. A. F. Ansari et al. Chronos: Learning the language of time series. Transactions on Machine Learning Research, 2024. A. Jain and R. Sen. TimesFM-3: A zero-shot foundation model for multivariate forecasting. Google Research Blog, 2026. https://research.google/blog/timesfm-3-a-zero-shot-foundation-model-for-multivariate-forecasting/(2026年11⽉7⽇閲覧) [19] Mistral AI. Introducing Timestral. 2026. https://mistral.ai/news/timestral/(2026年11⽉7⽇閲覧) [20] H2O.ai. TimeH2O-v1. Hugging Face model card, 2026年10⽉26⽇. https://huggingface.co/h2oai/timeh2o-v1(2026年11⽉8⽇閲覧) [21] O. Shchur et al. fev-bench: A realistic benchmark for time series forecasting. arXiv:2509.26468, 2025. [22] J. Shi et al. Scaling law for time series forecasting. NeurIPS, 2024. © Neurogica Inc. -
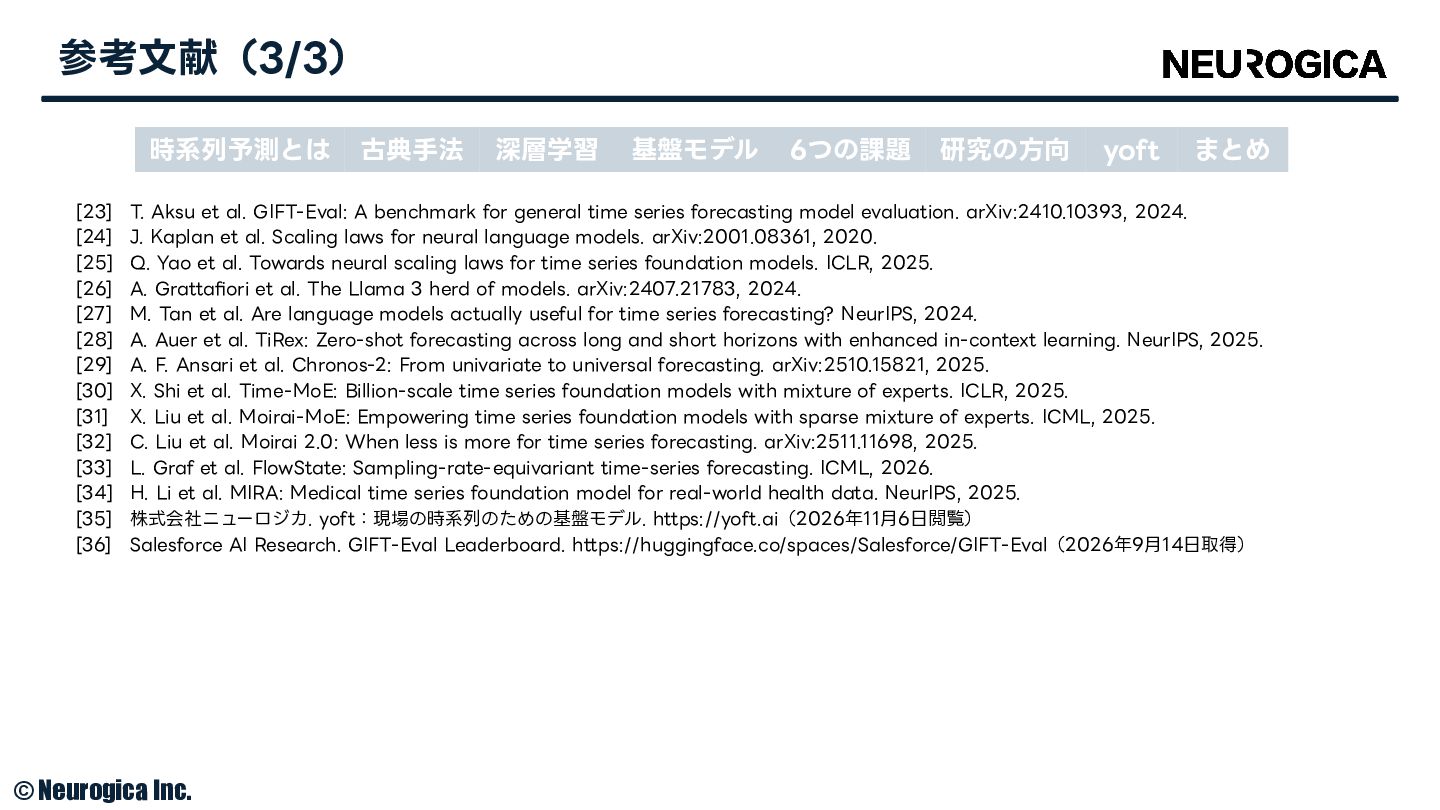
参考⽂献(3/3) 時系列予測とは [23] [24] [25] [26] [27] [28] [29] [30]
[31] [32] [33] [34] [35] [36] 古典⼿法 深層学習 基盤モデル 6つの課題 研究の⽅向 yoft まとめ T. Aksu et al. GIFT-Eval: A benchmark for general time series forecasting model evaluation. arXiv:2410.10393, 2024. J. Kaplan et al. Scaling laws for neural language models. arXiv:2001.08361, 2020. Q. Yao et al. Towards neural scaling laws for time series foundation models. ICLR, 2025. A. Grattafiori et al. The Llama 3 herd of models. arXiv:2407.21783, 2024. M. Tan et al. Are language models actually useful for time series forecasting? NeurIPS, 2024. A. Auer et al. TiRex: Zero-shot forecasting across long and short horizons with enhanced in-context learning. NeurIPS, 2025. A. F. Ansari et al. Chronos-2: From univariate to universal forecasting. arXiv:2510.15821, 2025. X. Shi et al. Time-MoE: Billion-scale time series foundation models with mixture of experts. ICLR, 2025. X. Liu et al. Moirai-MoE: Empowering time series foundation models with sparse mixture of experts. ICML, 2025. C. Liu et al. Moirai 2.0: When less is more for time series forecasting. arXiv:2511.11698, 2025. L. Graf et al. FlowState: Sampling-rate-equivariant time-series forecasting. ICML, 2026. H. Li et al. MIRA: Medical time series foundation model for real-world health data. NeurIPS, 2025. 株式会社ニューロジカ. yoft:現場の時系列のための基盤モデル. https://yoft.ai(2026年11⽉6⽇閲覧) Salesforce AI Research. GIFT-Eval Leaderboard. https://huggingface.co/spaces/Salesforce/GIFT-Eval(2026年9⽉14⽇取得) © Neurogica Inc.
 neurogica
 biwashi
 comi190327
 wind111
 knwoop
 oidfj
 hagino3000
 daitak
 sat
 110y
 minorun365
 mikanichinose
 ykimi
 axbom
 lara
 aarron
 jonoalderson
 reverentgeek
 colly
 aleyda
 427marketing
 codingconduct
 samanthasiow
 techseoconnect
 inesmontani