Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
汎用の音声認識を「現場の言葉」に寄せる — 業界特化モデル開発の実践
Search
Nishika-Inc
November 11, 2026
27
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
汎用の音声認識を「現場の言葉」に寄せる — 業界特化モデル開発の実践
Nishika-Inc
November 11, 2026
Transcript
20 slides
「現場の⾔葉」を測ってから寄せる 業界特化⾳声認識の評価とデータづくり Nishika AI Product Lab #3|2026.11.10|笠原遼之佑 Nishika AI Product
Lab #3
⾃⼰紹介 笠原 遼之佑 筑波⼤学⼤学院 修⼠2年 Nishika AIエンジニア(インターン) • 業界‧ユースケース特化の⾳声認識モデル開発 などに従事
• 趣味はPCゲーム Nishika AI Product Lab #3
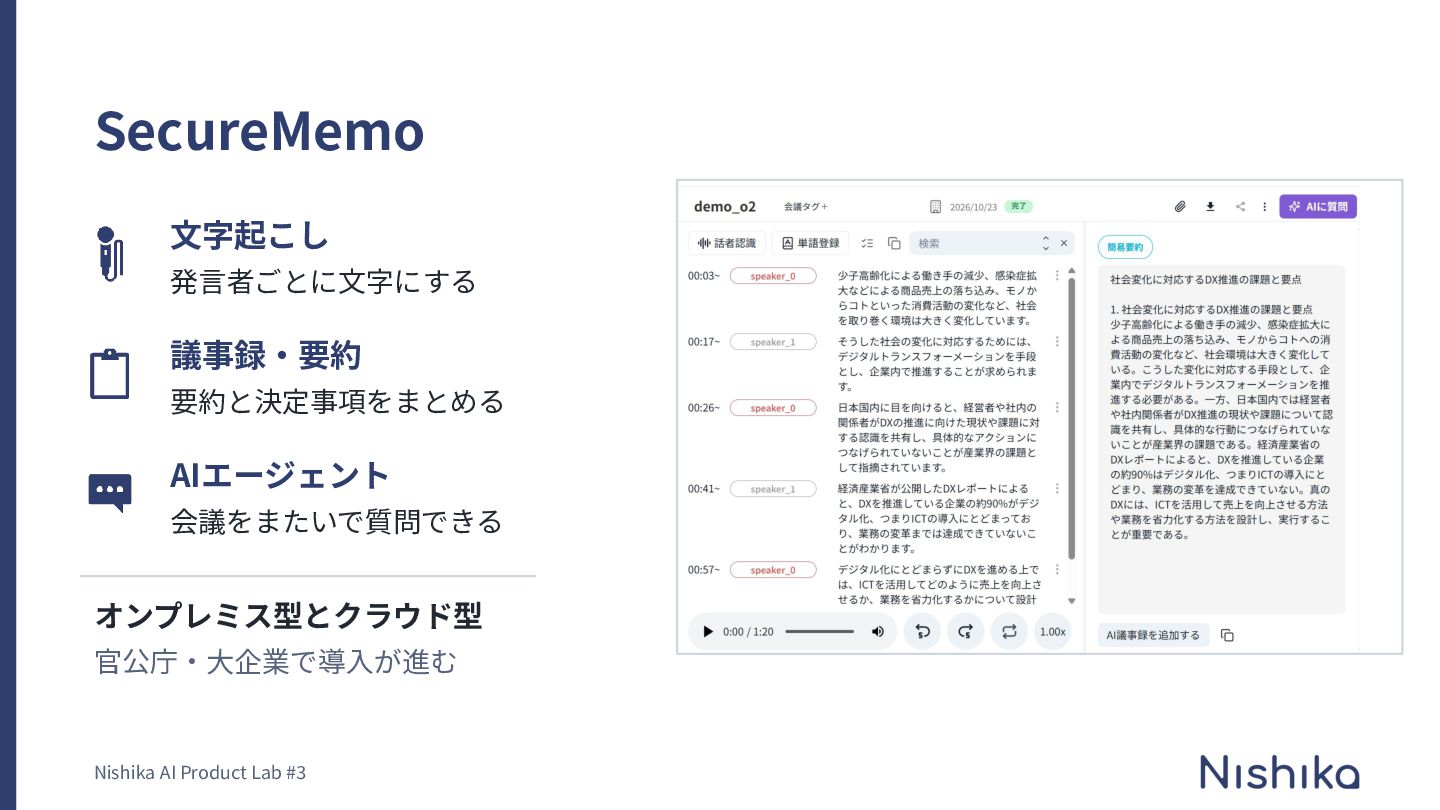
SecureMemo ⽂字起こし 発⾔者ごとに⽂字にする 議事録‧要約 要約と決定事項をまとめる AIエージェント 会議をまたいで質問できる オンプレミス型とクラウド型 官公庁‧⼤企業で導⼊が進む Nishika
AI Product Lab #3
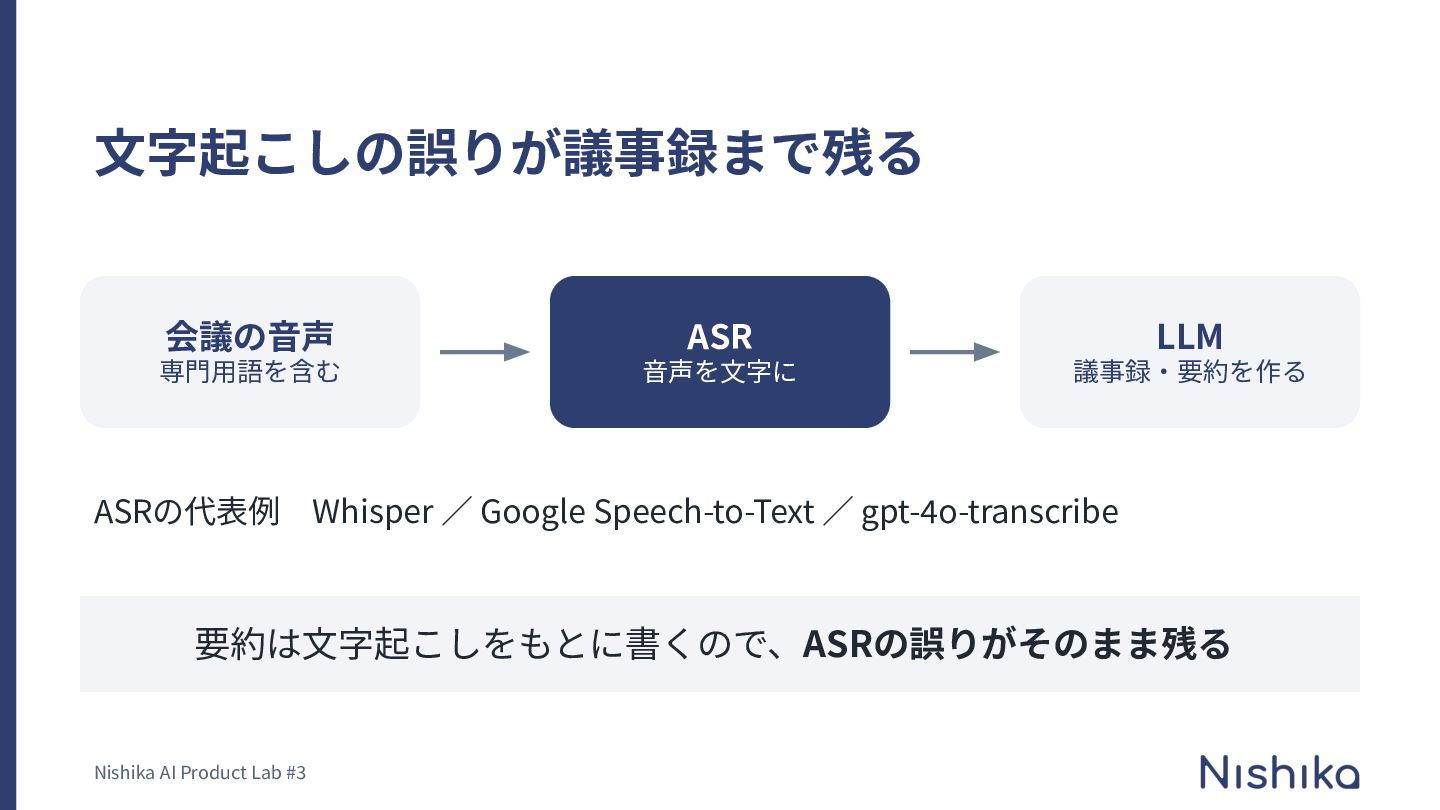
⽂字起こしの誤りが議事録まで残る 会議の⾳声 ASR LLM 専⾨⽤語を含む ⾳声を⽂字に 議事録‧要約を作る ASRの代表例 Whisper ∕
Google Speech-to-Text ∕ gpt-4o-transcribe 要約は⽂字起こしをもとに書くので、ASRの誤りがそのまま残る Nishika AI Product Lab #3
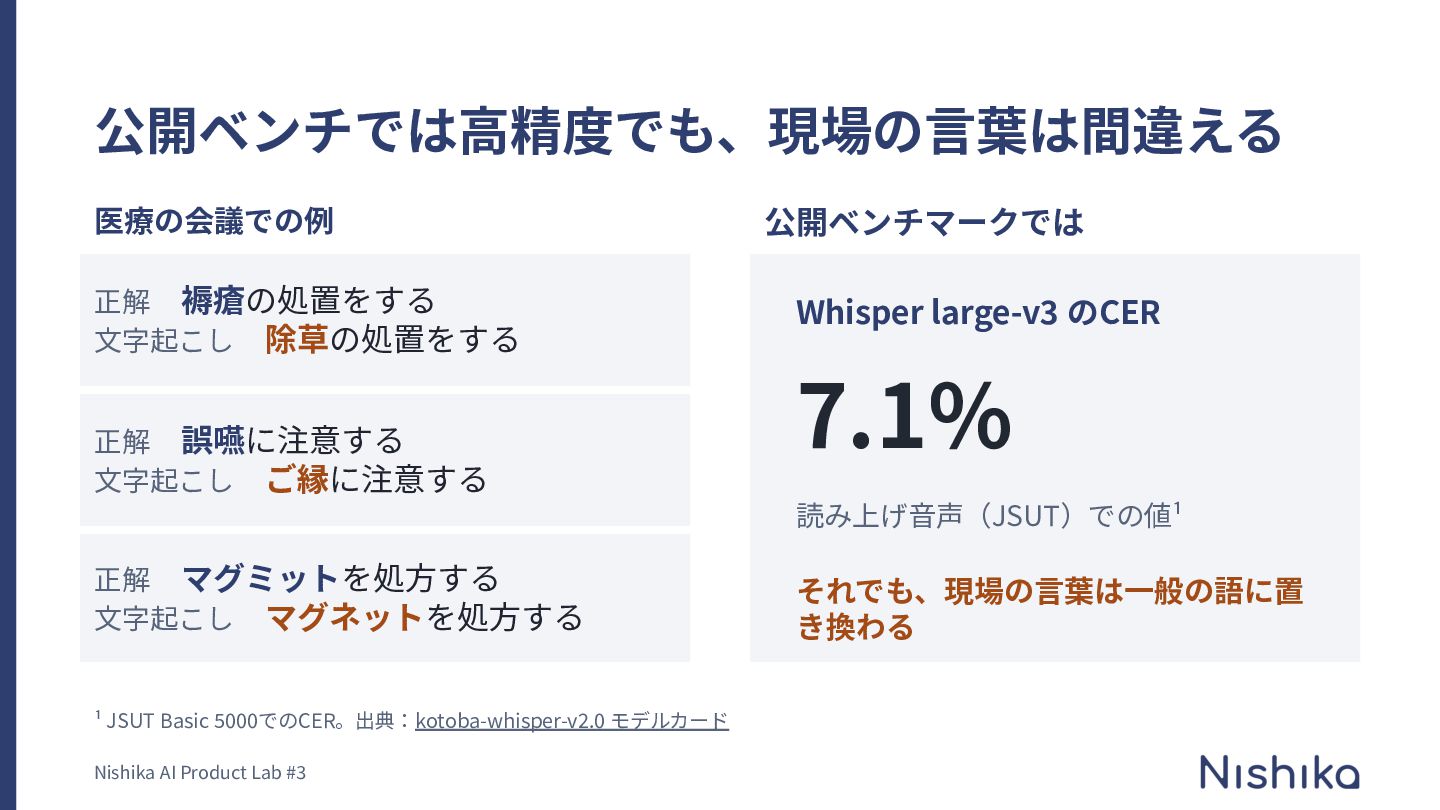
公開ベンチでは⾼精度でも、現場の⾔葉は間違える 医療の会議での例 正解 褥瘡の処置をする ⽂字起こし 除草の処置をする 正解 誤嚥に注意する ⽂字起こし ご縁に注意する
公開ベンチマークでは Whisper large-v3 のCER 7.1% 読み上げ⾳声(JSUT)での値¹ 正解 マグミットを処⽅する ⽂字起こし マグネットを処⽅する ¹ JSUT Basic 5000でのCER。出典:kotoba-whisper-v2.0 モデルカード Nishika AI Product Lab #3 それでも、現場の⾔葉は⼀般の語に置 き換わる
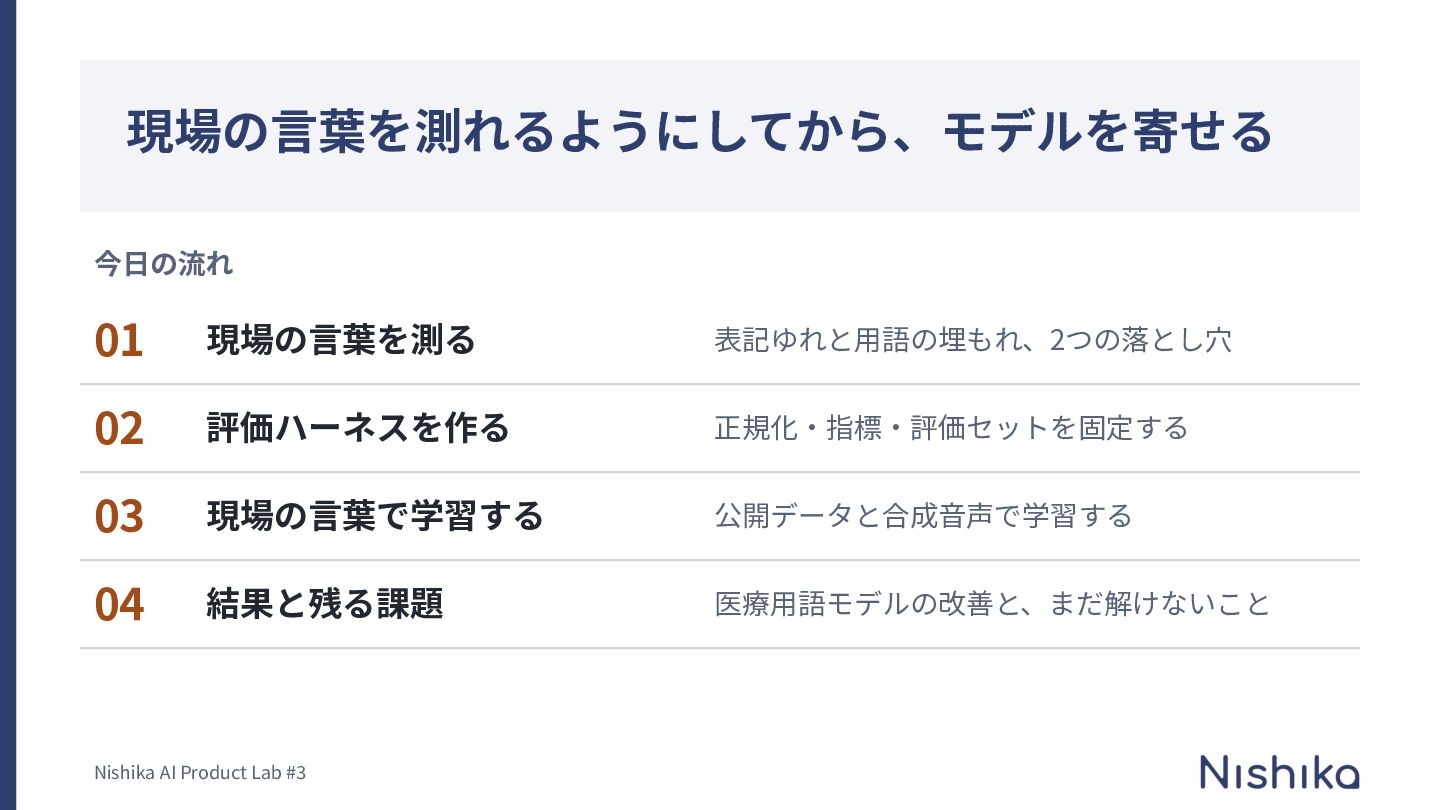
現場の⾔葉を測れるようにしてから、モデルを寄せる 今⽇の流れ 01 現場の⾔葉を測る 表記ゆれと⽤語の埋もれ、2つの落とし⽳ 02 評価ハーネスを作る 正規化‧指標‧評価セットを固定する 03 現場の⾔葉で学習する
公開データと合成⾳声で学習する 04 結果と残る課題 医療⽤語モデルの改善と、まだ解けないこと Nishika AI Product Lab #3
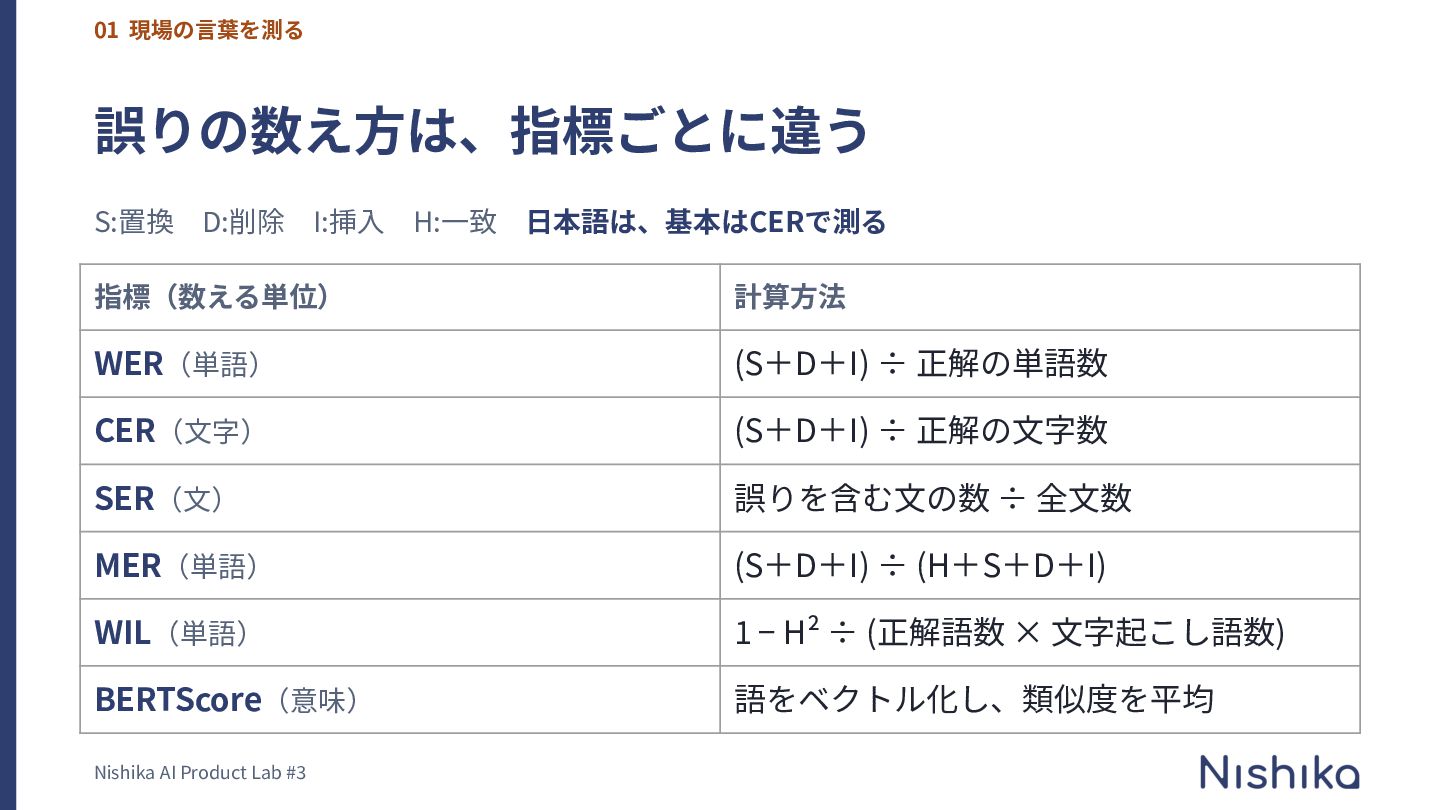
01 現場の⾔葉を測る 誤りの数え⽅は、指標ごとに違う S:置換 D:削除 I:挿⼊ H:⼀致 ⽇本語は、基本はCERで測る 指標(数える単位) 計算⽅法
WER(単語) (S+D+I) ÷ 正解の単語数 CER(⽂字) (S+D+I) ÷ 正解の⽂字数 SER(⽂) 誤りを含む⽂の数 ÷ 全⽂数 MER(単語) (S+D+I) ÷ (H+S+D+I) WIL(単語) 1 − H² ÷ (正解語数 × ⽂字起こし語数) BERTScore(意味) 語をベクトル化し、類似度を平均 Nishika AI Product Lab #3
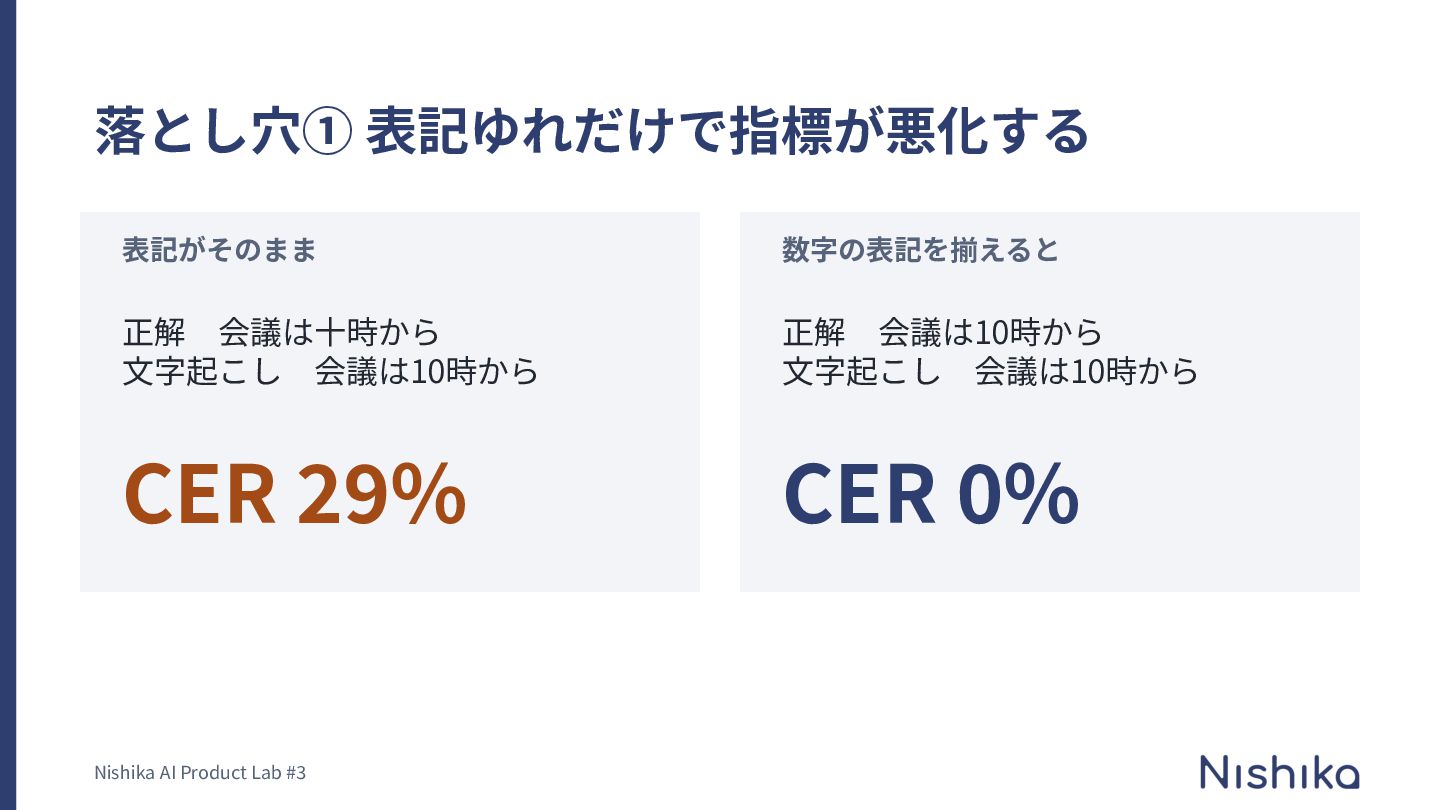
落とし⽳① 表記ゆれだけで指標が悪化する 表記がそのまま 数字の表記を揃えると 正解 会議は⼗時から ⽂字起こし 会議は10時から 正解 会議は10時から
⽂字起こし 会議は10時から CER 29% CER 0% Nishika AI Product Lab #3
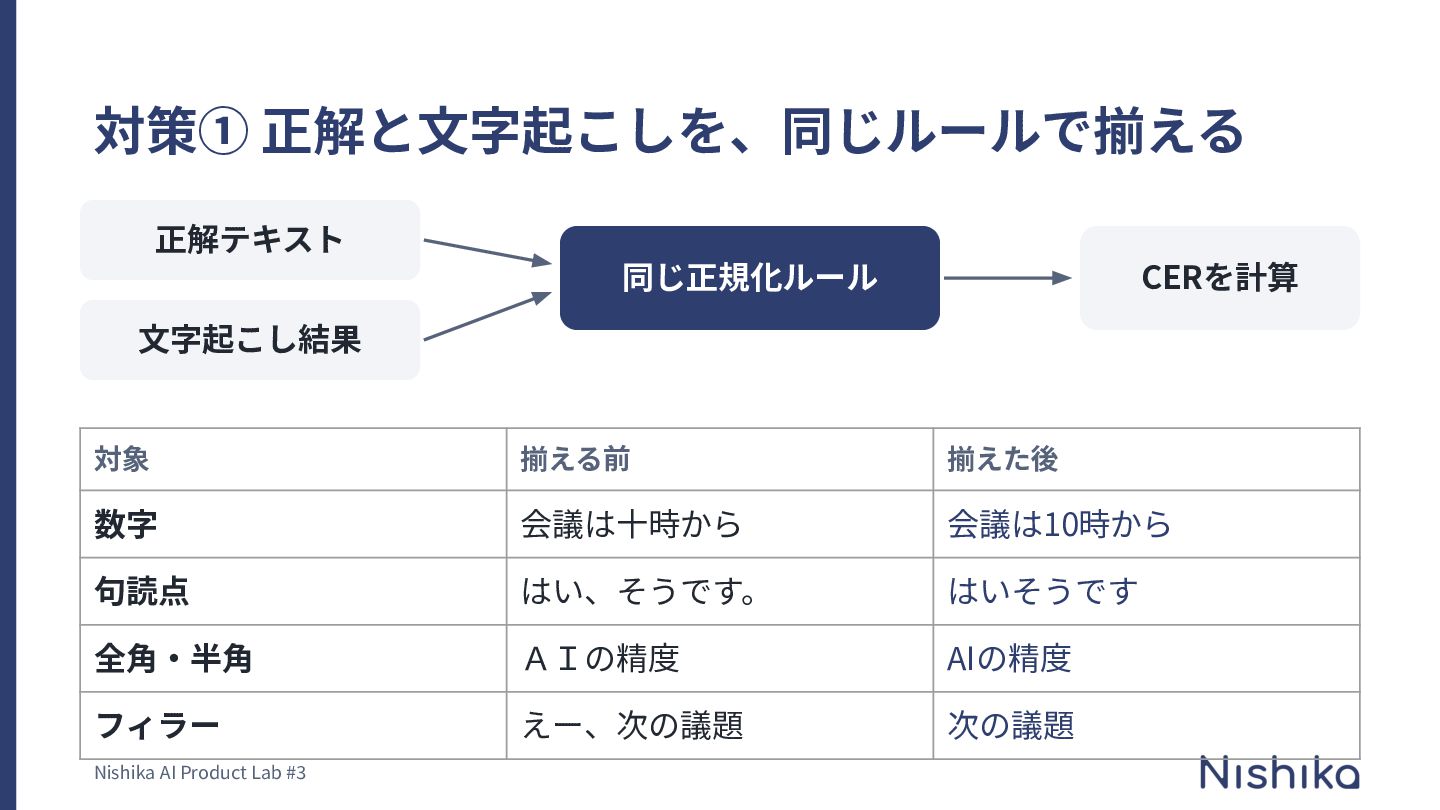
対策① 正解と⽂字起こしを、同じルールで揃える 正解テキスト 同じ正規化ルール CERを計算 ⽂字起こし結果 対象 揃える前 揃えた後 数字
会議は⼗時から 会議は10時から 句読点 はい、そうです。 はいそうです 全⾓‧半⾓ AIの精度 AIの精度 フィラー えー、次の議題 次の議題 Nishika AI Product Lab #3
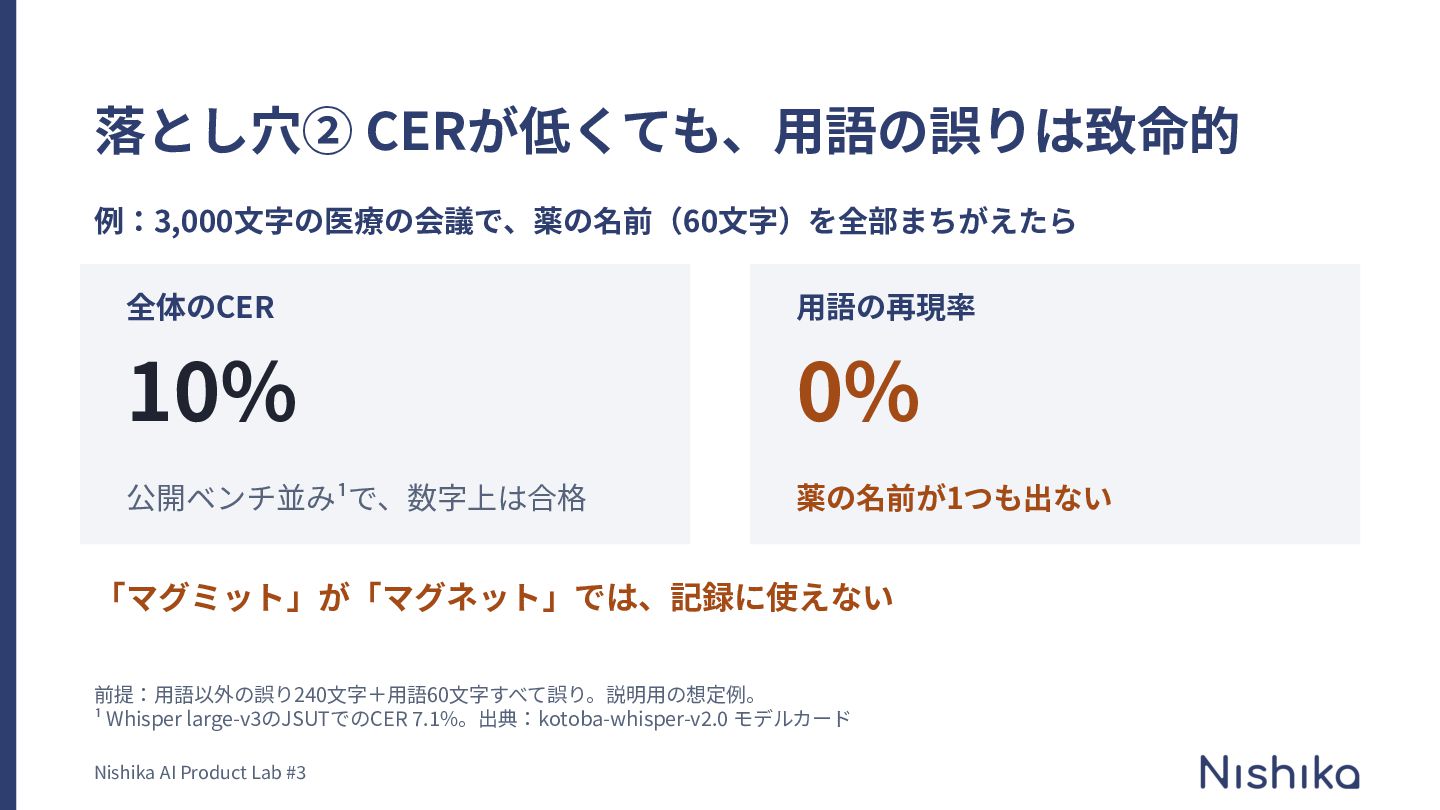
落とし⽳② CERが低くても、⽤語の誤りは致命的 例:3,000⽂字の医療の会議で、薬の名前(60⽂字)を全部まちがえたら 全体のCER ⽤語の再現率 10% 0% 公開ベンチ並み¹で、数字上は合格 薬の名前が1つも出ない 「マグミット」が「マグネット」では、記録に使えない
前提:⽤語以外の誤り240⽂字+⽤語60⽂字すべて誤り。説明⽤の想定例。 ¹ Whisper large-v3のJSUTでのCER 7.1%。出典:kotoba-whisper-v2.0 モデルカード Nishika AI Product Lab #3
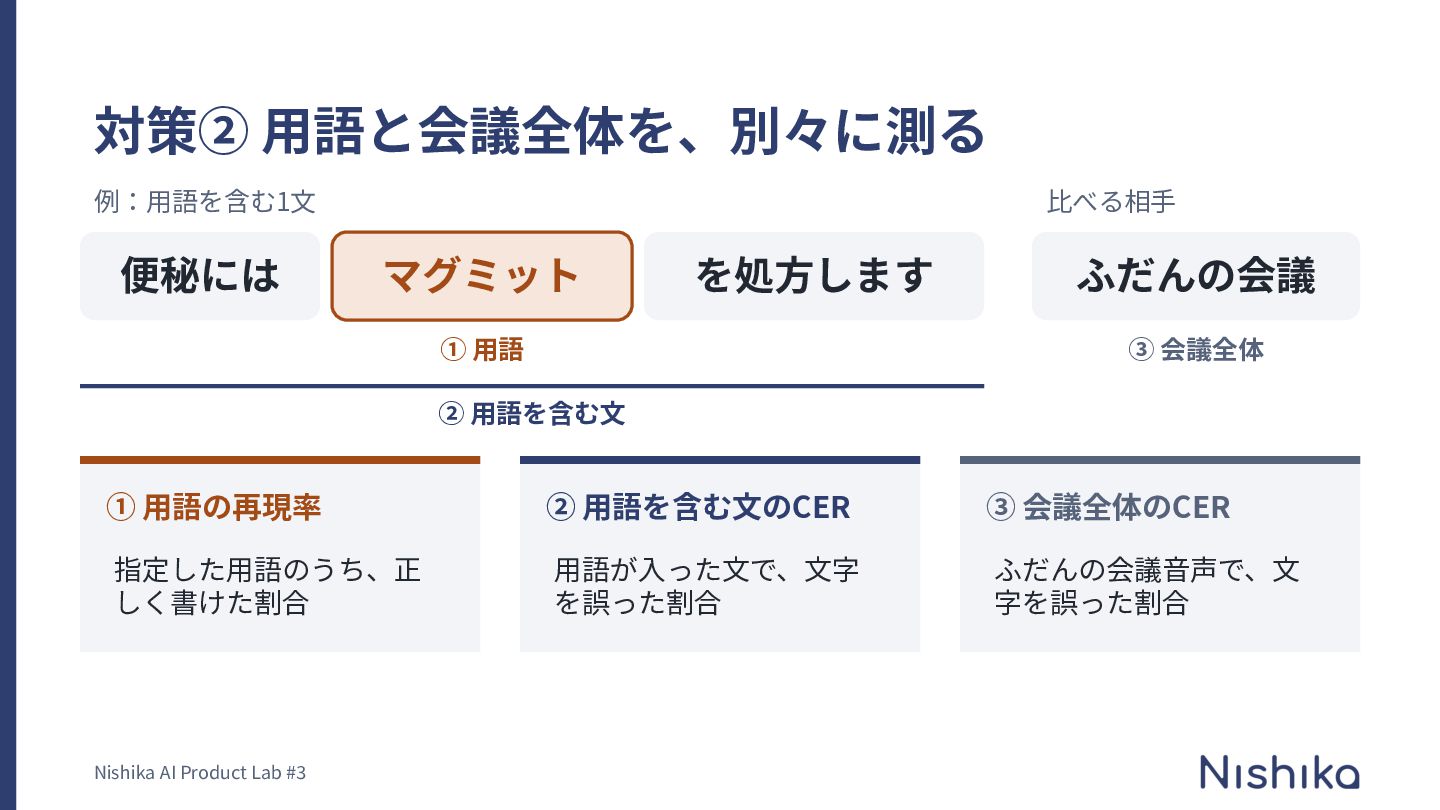
対策② ⽤語と会議全体を、別々に測る 例:⽤語を含む1⽂ 便秘には ⽐べる相⼿ マグミット を処⽅します ① ⽤語 ふだんの会議
③ 会議全体 ② ⽤語を含む⽂ ① ⽤語の再現率 ② ⽤語を含む⽂のCER ③ 会議全体のCER 指定した⽤語のうち、正 しく書けた割合 ⽤語が⼊った⽂で、⽂字 を誤った割合 ふだんの会議⾳声で、⽂ 字を誤った割合 Nishika AI Product Lab #3
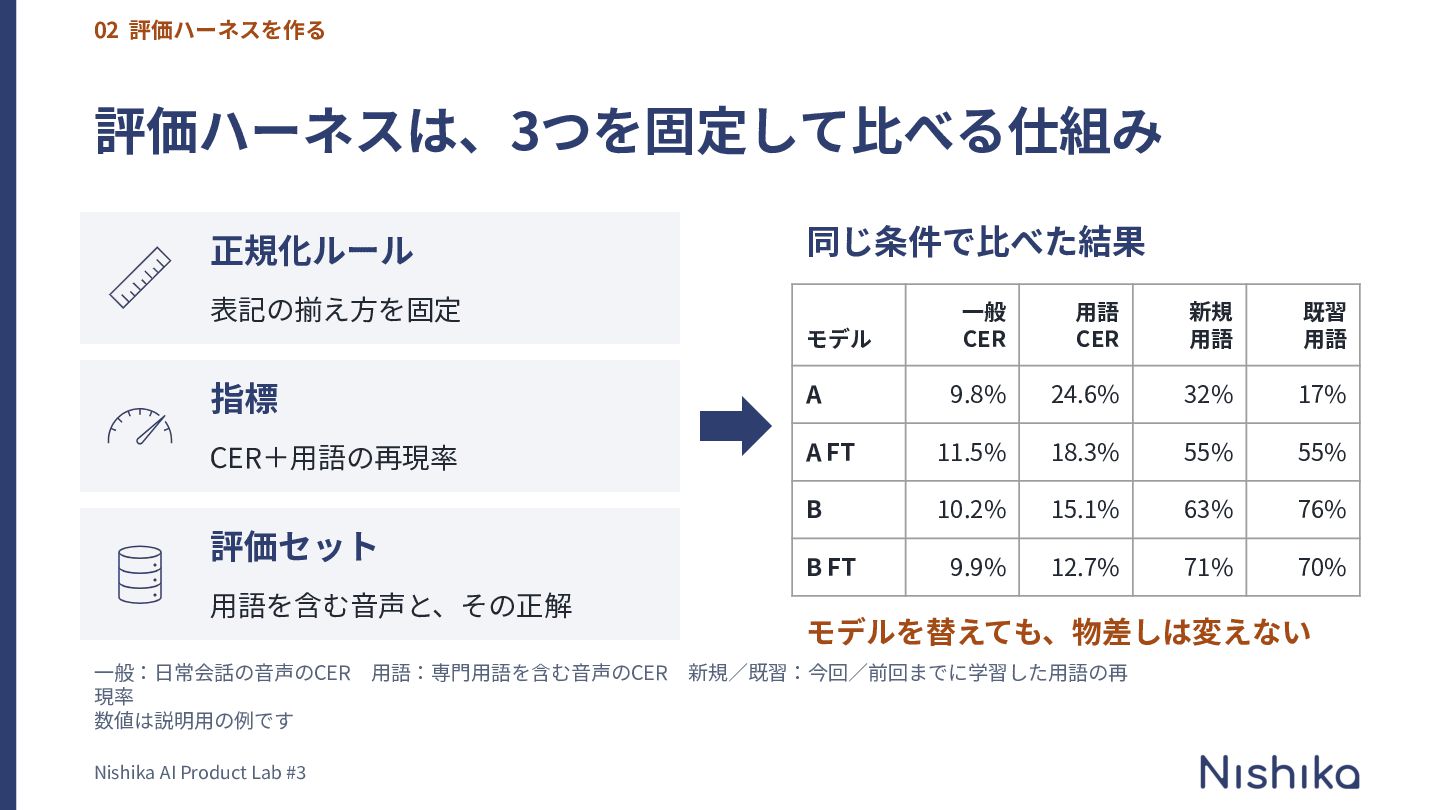
02 評価ハーネスを作る 評価ハーネスは、3つを固定して⽐べる仕組み 正規化ルール 同じ条件で⽐べた結果 表記の揃え⽅を固定 モデル ⼀般 CER ⽤語
CER 新規 ⽤語 既習 ⽤語 指標 A 9.8% 24.6% 32% 17% CER+⽤語の再現率 A FT 11.5% 18.3% 55% 55% B 10.2% 15.1% 63% 76% B FT 9.9% 12.7% 71% 70% 評価セット ⽤語を含む⾳声と、その正解 ⼀般:⽇常会話の⾳声のCER 現率 数値は説明⽤の例です Nishika AI Product Lab #3 ⽤語:専⾨⽤語を含む⾳声のCER モデルを替えても、物差しは変えない 新規∕既習:今回∕前回までに学習した⽤語の再
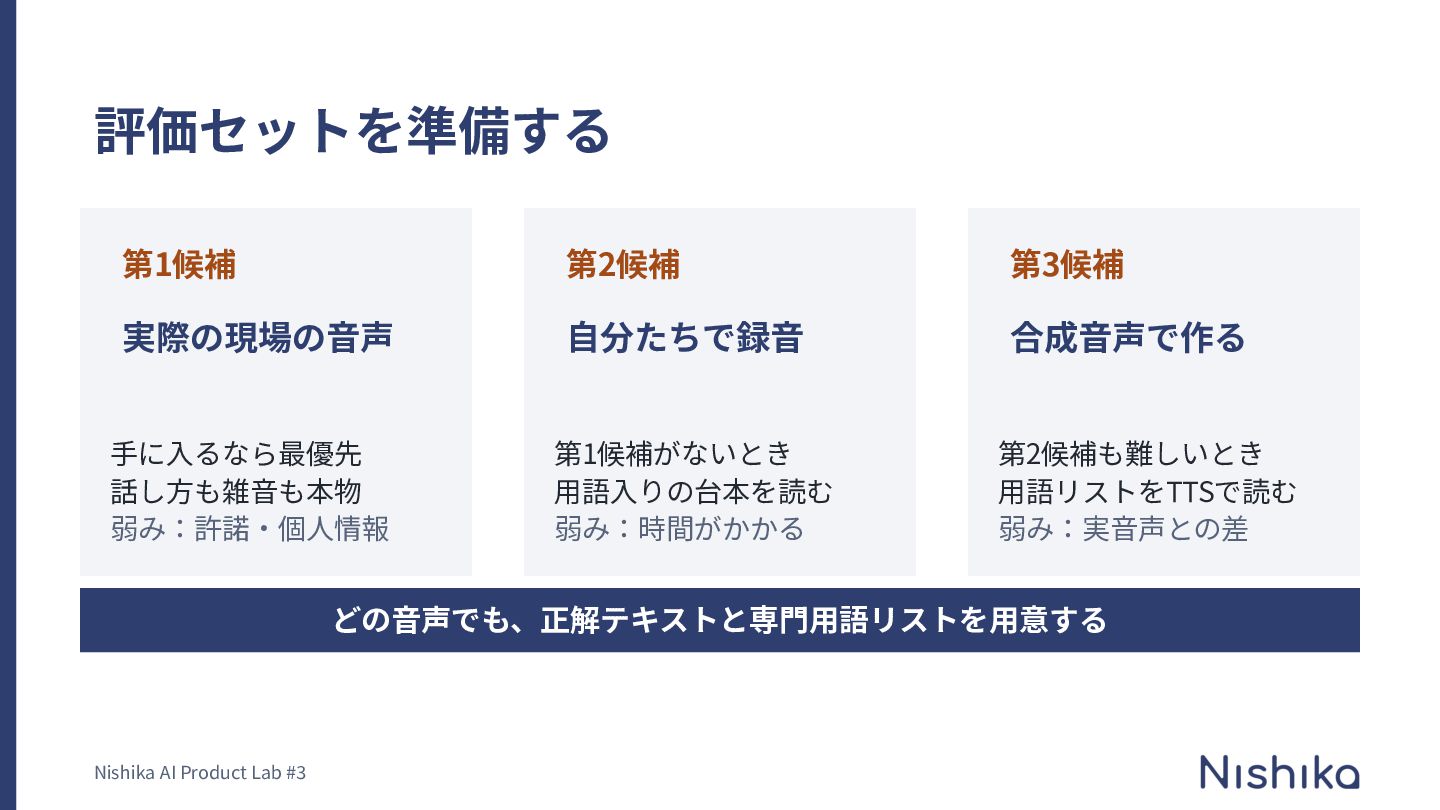
評価セットを準備する 第1候補 第2候補 第3候補 実際の現場の⾳声 ⾃分たちで録⾳ 合成⾳声で作る ⼿に⼊るなら最優先 話し⽅も雑⾳も本物 弱み:許諾‧個⼈情報
第1候補がないとき ⽤語⼊りの台本を読む 弱み:時間がかかる 第2候補も難しいとき ⽤語リストをTTSで読む 弱み:実⾳声との差 どの⾳声でも、正解テキストと専⾨⽤語リストを⽤意する Nishika AI Product Lab #3
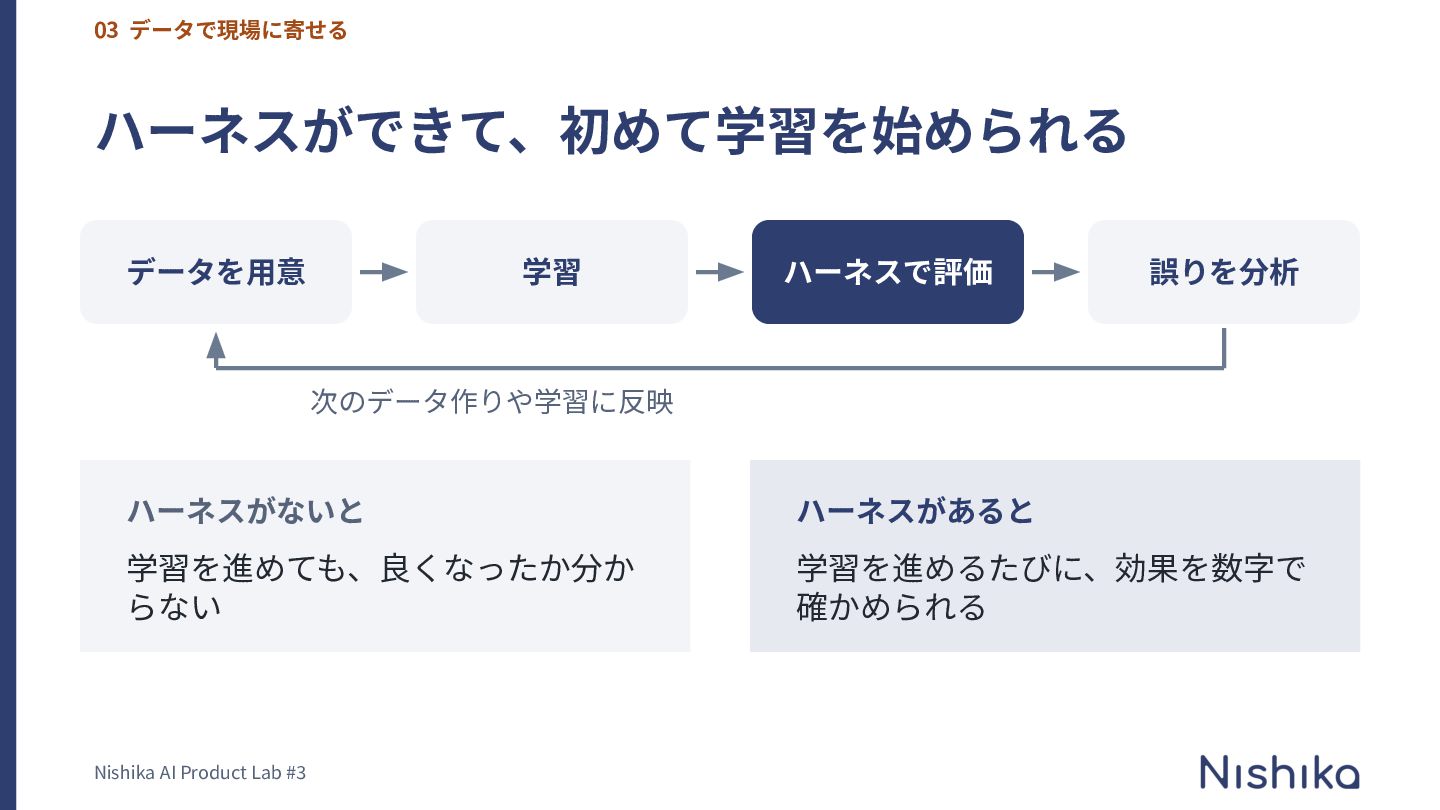
03 データで現場に寄せる ハーネスができて、初めて学習を始められる データを⽤意 学習 ハーネスで評価 誤りを分析 次のデータ作りや学習に反映 ハーネスがないと ハーネスがあると
学習を進めても、良くなったか分か らない 学習を進めるたびに、効果を数字で 確かめられる Nishika AI Product Lab #3
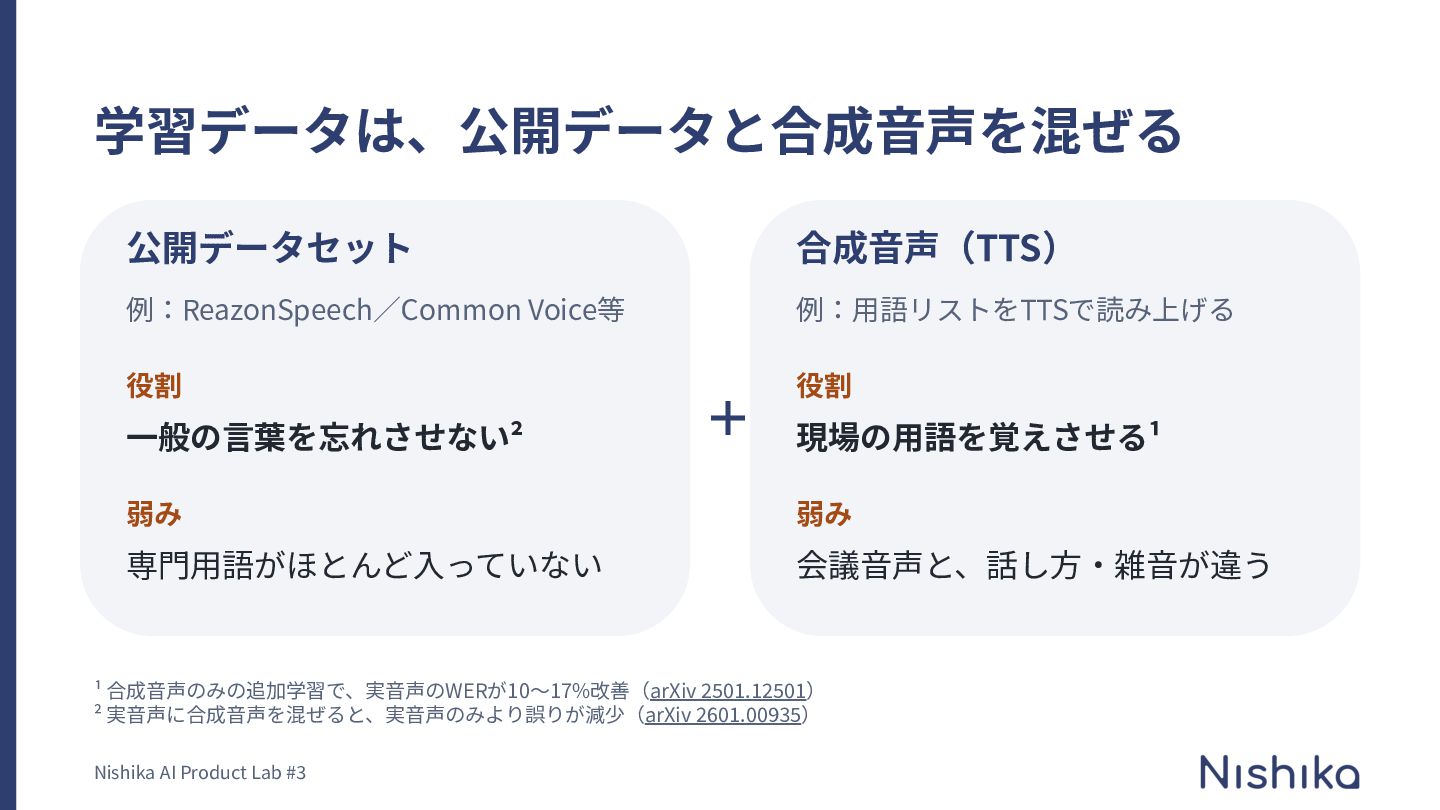
学習データは、公開データと合成⾳声を混ぜる 公開データセット 合成⾳声(TTS) 例:ReazonSpeech∕Common Voice等 例:⽤語リストをTTSで読み上げる 役割 役割 ⼀般の⾔葉を忘れさせない² +
現場の⽤語を覚えさせる¹ 弱み 弱み 専⾨⽤語がほとんど⼊っていない 会議⾳声と、話し⽅‧雑⾳が違う ¹ 合成⾳声のみの追加学習で、実⾳声のWERが10〜17%改善(arXiv 2501.12501) ² 実⾳声に合成⾳声を混ぜると、実⾳声のみより誤りが減少(arXiv 2601.00935) Nishika AI Product Lab #3
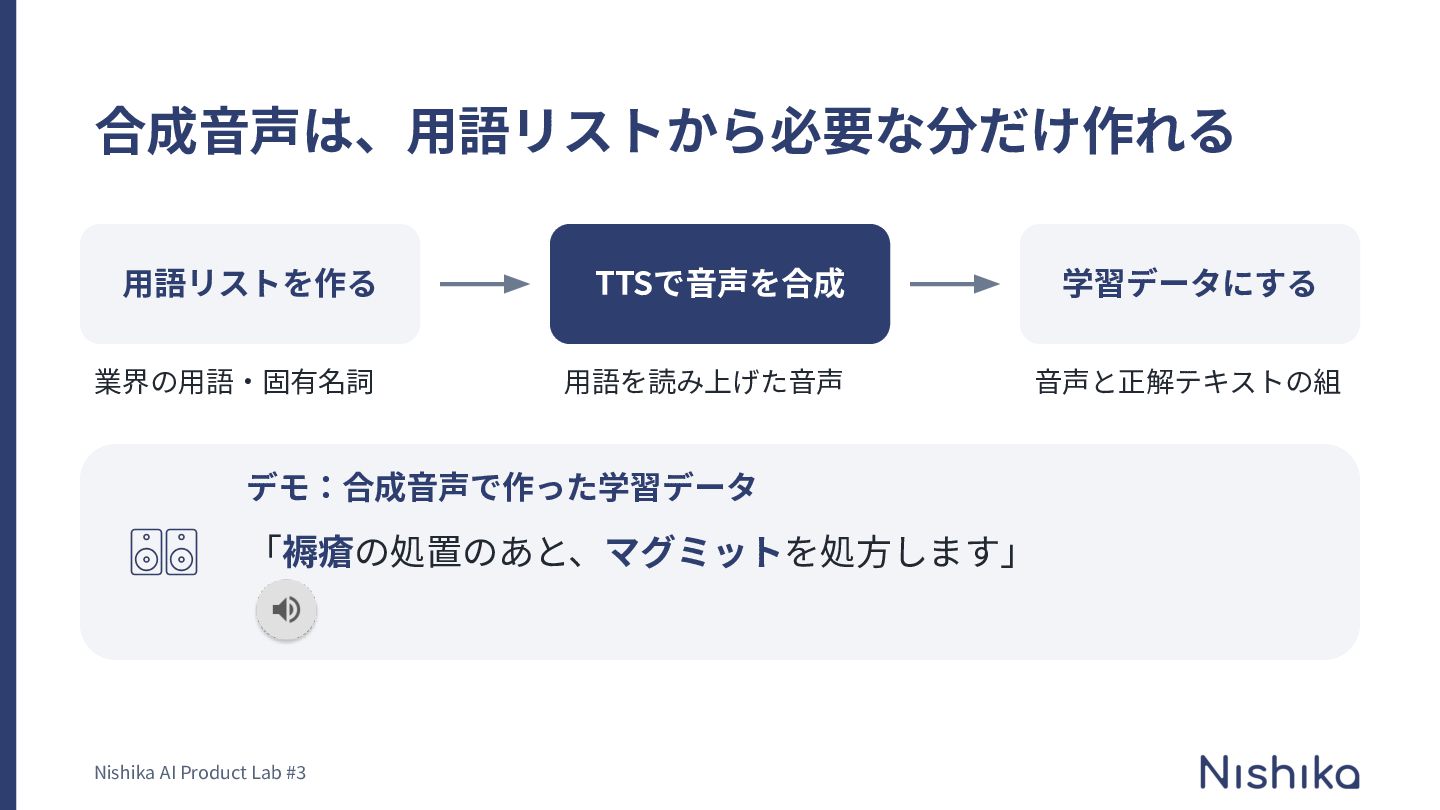
合成⾳声は、⽤語リストから必要な分だけ作れる ⽤語リストを作る TTSで⾳声を合成 学習データにする 業界の⽤語‧固有名詞 ⽤語を読み上げた⾳声 ⾳声と正解テキストの組 デモ:合成⾳声で作った学習データ 「褥瘡の処置のあと、マグミットを処⽅します」 Nishika
AI Product Lab #3
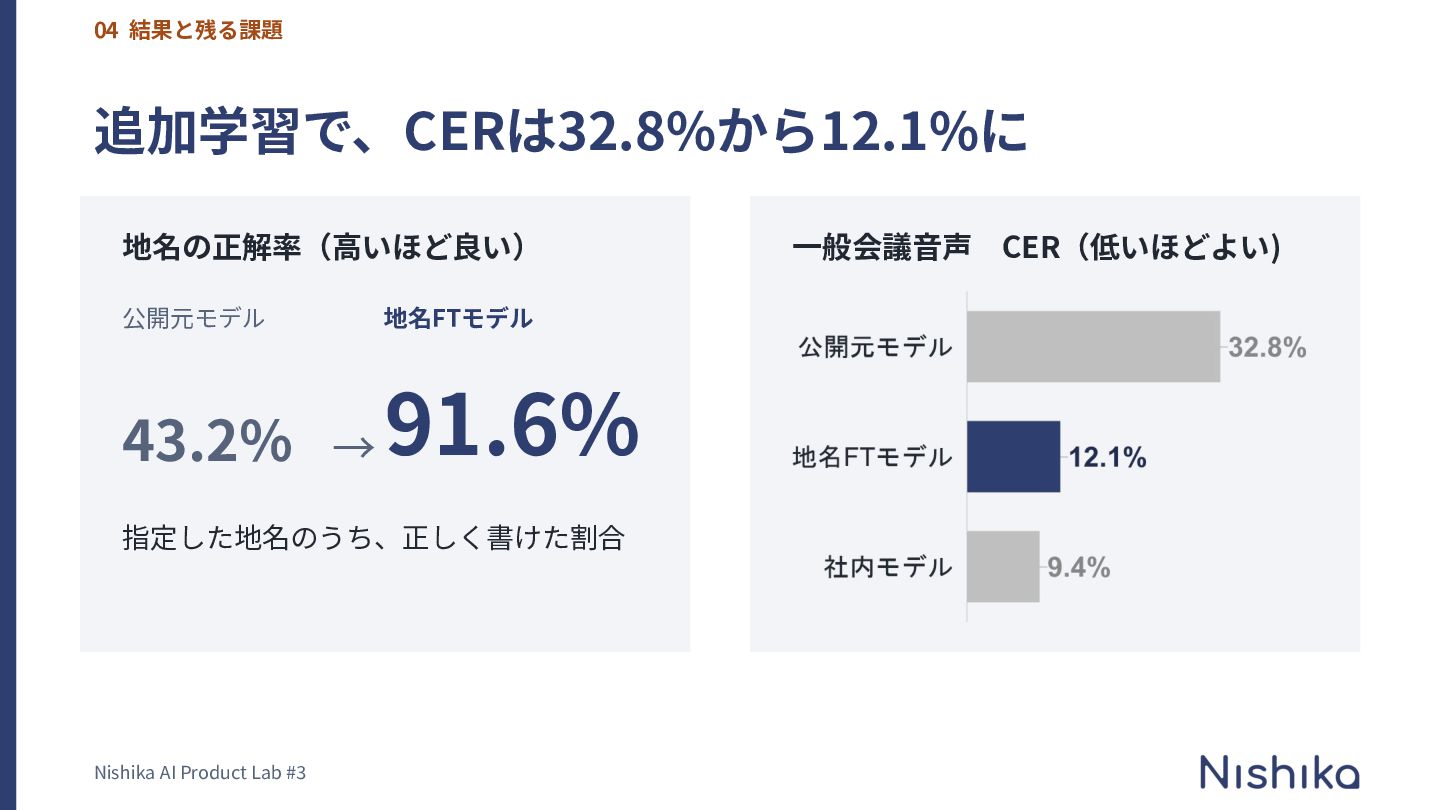
04 結果と残る課題 追加学習で、CERは32.8%から12.1%に 地名の正解率(⾼いほど良い) 公開元モデル 地名FTモデル 43.2% → 91.6% 指定した地名のうち、正しく書けた割合
Nishika AI Product Lab #3 ⼀般会議⾳声 CER(低いほどよい)
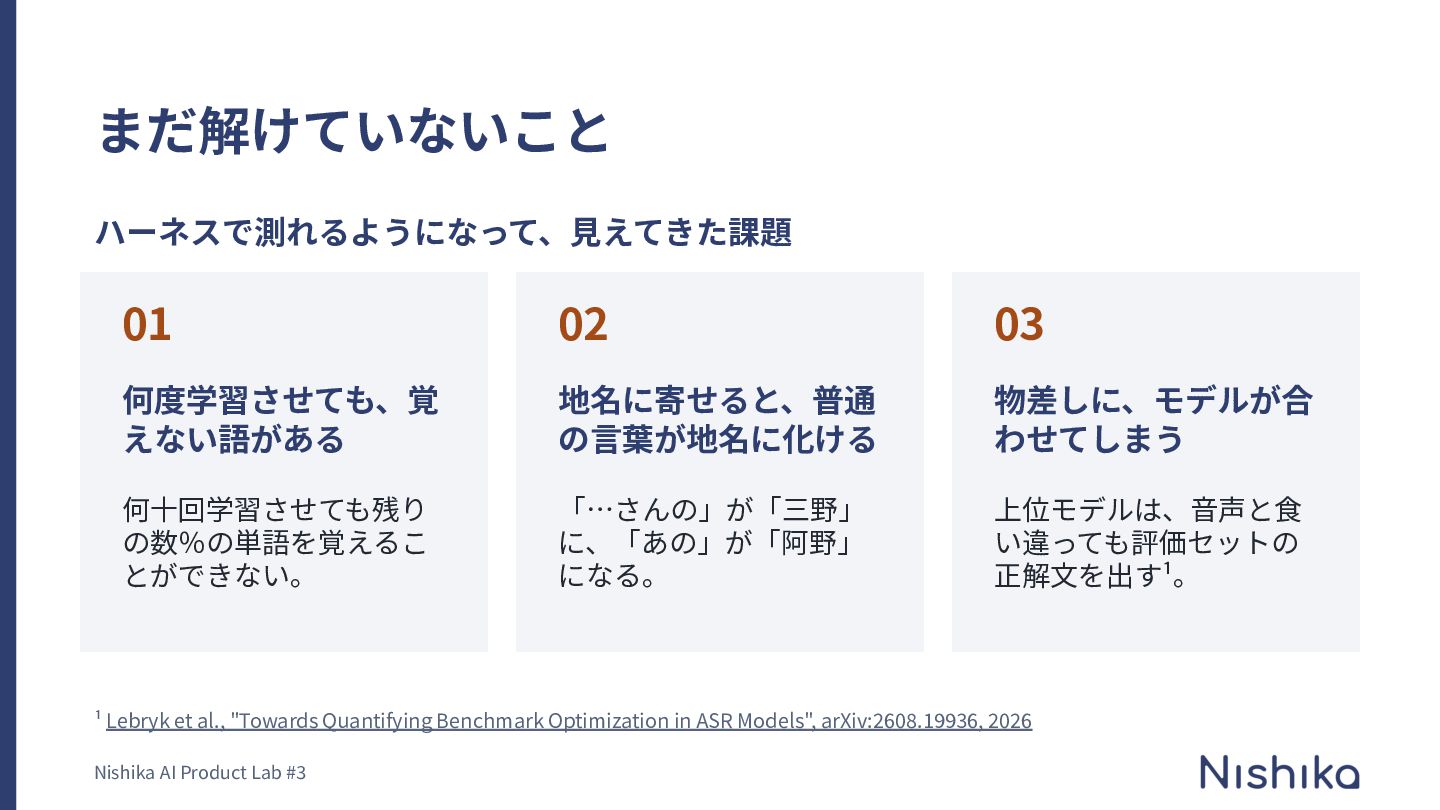
まだ解けていないこと ハーネスで測れるようになって、⾒えてきた課題 01 02 03 何度学習させても、覚 えない語がある 地名に寄せると、普通 の⾔葉が地名に化ける 物差しに、モデルが合
わせてしまう 何⼗回学習させても残り の数%の単語を覚えるこ とができない。 「…さんの」が「三野」 に、「あの」が「阿野」 になる。 上位モデルは、⾳声と⾷ い違っても評価セットの 正解⽂を出す¹。 ¹ Lebryk et al., "Towards Quantifying Benchmark Optimization in ASR Models", arXiv:2608.19936, 2026 Nishika AI Product Lab #3
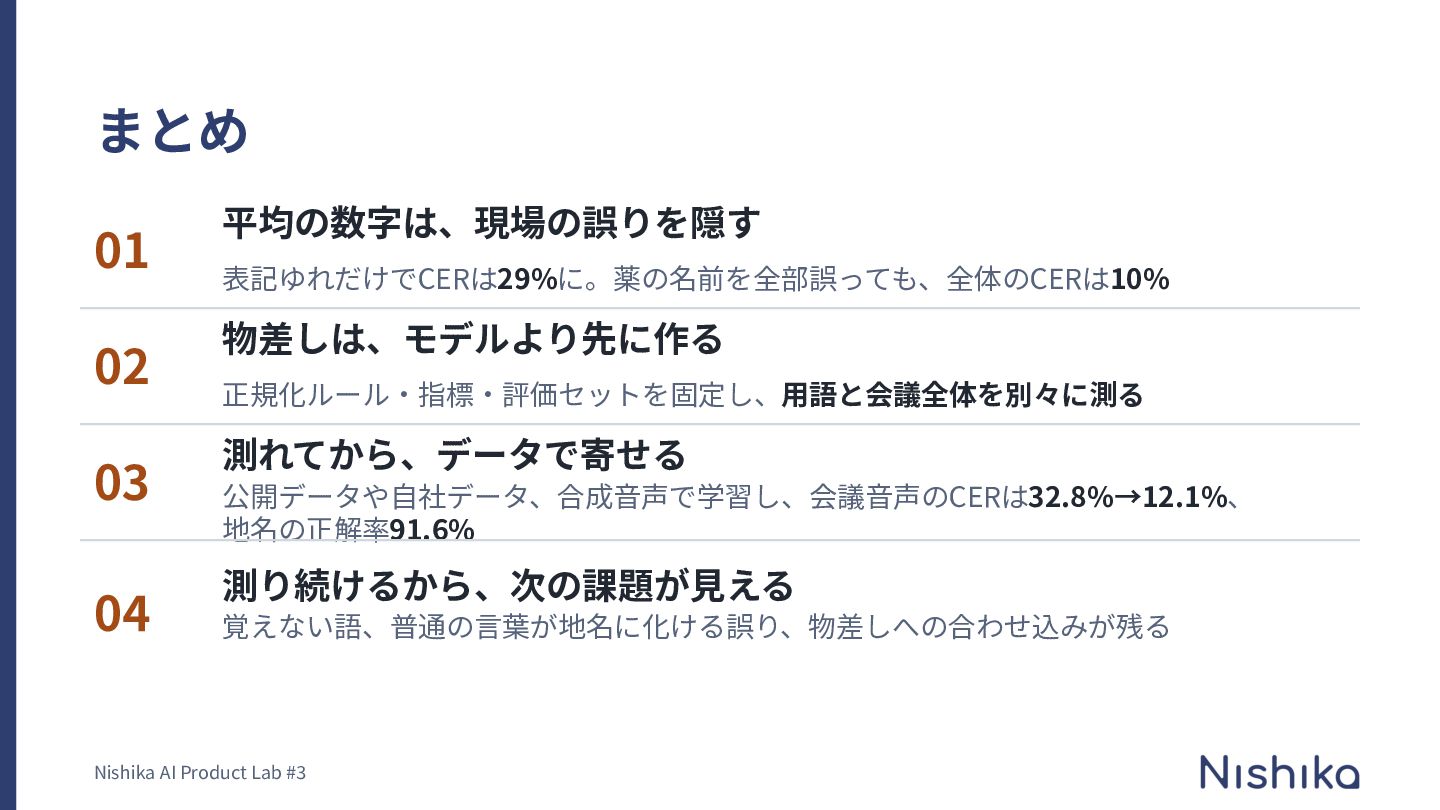
まとめ 01 02 03 04 平均の数字は、現場の誤りを隠す 表記ゆれだけでCERは29%に。薬の名前を全部誤っても、全体のCERは10% 物差しは、モデルより先に作る 正規化ルール‧指標‧評価セットを固定し、⽤語と会議全体を別々に測る 測れてから、データで寄せる
公開データや⾃社データ、合成⾳声で学習し、会議⾳声のCERは32.8%→12.1%、 地名の正解率91.6% 測り続けるから、次の課題が⾒える 覚えない語、普通の⾔葉が地名に化ける誤り、物差しへの合わせ込みが残る Nishika AI Product Lab #3
ご清聴ありがとうございました Nishika AI Product Lab #3 Nishika AI Product Lab
#3
More Decks by Nishika-Inc
See All by Nishika-Inc
話者分離を例とした_UX改善のための評価指標_データセット作成の重要性_山口_.pdf
nishikainc
0
34
Slack + Notion + AIで作る不具合対応ワークフロー
nishikainc
0
48
AIプロダクト開発におけるClaudeCode活用ガイド
nishikainc
0
64
会議AIエージェント「SecureMemo」シリーズ紹介 − なぜ私たちは精度に一番こだわるのか
nishikainc
0
99
会議AIエージェントに話者認識AIを乗せる難しさと重要性
nishikainc
0
160
ASRは精度だけでは足りない − 専門用語の誤認識にどう向き合うか
nishikainc
0
160
Nishika_テックチーム_ご紹介資料 / Nishika_TechTeam_Introduction
nishikainc
0
2.1k
Nishika_Bussei_大好きオフトゥン_1st_solution.pdf
nishikainc
0
250
Nishika_Bussei_mi-solution_3rd_solution.pdf
nishikainc
0
460
Featured
See All Featured
Evolving SEO for Evolving Search Engines
ryanjones
0
360
A Tale of Four Properties
chriscoyier
163
24k
Build your cross-platform service in a week with App Engine
jlugia
234
19k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
680
Keith and Marios Guide to Fast Websites
keithpitt
413
23k
Intergalactic Javascript Robots from Outer Space
tanoku
273
28k
Cheating the UX When There Is Nothing More to Optimize - PixelPioneers
stephaniewalter
287
14k
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
1
610
Color Theory Basics | Prateek | Gurzu
gurzu
1
520
The Spectacular Lies of Maps
axbom
PRO
1
1.1k
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
121
130k


 nishikainc
 ryanjones
 chriscoyier
 jlugia
 samlambert
 reverentgeek
 keithpitt
 tanoku
 stephaniewalter
 baasie
 gurzu
 axbom
 twada