Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ACL読み会2026@名大:ReTraceQA: Evaluating Reasoning T...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Ryoji Osaki
September 24, 2026
Research
56
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ACL読み会2026@名大:ReTraceQA: Evaluating Reasoning Traces of Small Language Models in Commonsense Question Answering
Ryoji Osaki
September 24, 2026
Other Decks in Research
See All in Research
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
390
Santé et fertilité des sols : ce que nous disent les pratiques dans les systèmes de polyculture-élevage
institutdelelevage
PRO
0
130
敵対生成プロンプト同時探索による内省型プロンプト最適化
kinoue_smarthr
0
440
第64回CV・PRML勉強会 論文紹介:Linguistic Priors for Visual Decoupling: Towards Symmetric Vision-Brain Alignment
sokikatayama
0
250
J-STAGEの現況と全文XML登載必須化について
xspa2012
0
340
Language and AI
ayaniwa
0
320
Les émissions de méthane entérique en élevage laitier : Enjeux et travaux menés en Afrique de l’Ouest et en France
institutdelelevage
PRO
0
130
Byzantine Eventual Consistency for Reliable Local-First Software
ept
0
220
GeoAgent勉強会 論文紹介と強い推論モデルが与えるインパクト
satai
5
360
PHTalks Bengaluru - SSRF When All Else Fails
dk999
0
1.2k
VRID: View-Invariant Representation through Dual-Axis Transformation for Cross-iew Pose Estimation
satai
3
120
OWASP AISVS - C7
shiell
2
830
Featured
See All Featured
The Illustrated Guide to Node.js - THAT Conference 2024
reverentgeek
1
570
The Pragmatic Product Professional
lauravandoore
37
7.5k
CoffeeScript is Beautiful & I Never Want to Write Plain JavaScript Again
sstephenson
162
16k
ラッコキーワード サービス紹介資料
rakko
1
5.3M
Groundhog Day: Seeking Process in Gaming for Health
codingconduct
0
410
Claude Code のすすめ
schroneko
67
230k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
930
Optimizing for Happiness
mojombo
378
71k
Rails Girls Zürich Keynote
gr2m
96
14k
Site-Speed That Sticks
csswizardry
13
1.6k
Sharpening the Axe: The Primacy of Toolmaking
bcantrill
46
3k
New Earth Scene 8
popppiees
4
2.7k
Transcript
※図表は論文・発表スライドより引用 ACL 2026読み会@名大 読み手:大崎 稜司(豊田工業大学 知識データ工学研究室 M1)
論⽂概要 • 概要: • Small Language Models (SLMs, 1〜8B程度の⾔語モデル) の常識推論
における推論過程の妥当性を評価 • ⼿法: • 推論過程評価のベンチマークReTraceQAを提案 • 推論内のエラー箇所と種類をアノテーションしLLMの性能を測定 • 選定理由: • RLVRにおける推論過程の評価の重要性を強調したい • 推論そのものの研究に興味を持って欲しい 2
背景 (1/2) |推論評価の現状と課題 • 推論モデルの学習においてRLVRが⽤いられる • 最終回答を⾃動的に照合することで報酬を計算 • 例:DeepSeek-R1では正答率と<think>の有無のみ •
性能評価においても正答率を使⽤ ↔最終回答のみの評価では推論過程の妥当性を無視 →推論の内容に対する評価が必要 3
背景 (2/2) |プロセスベースの評価指標 • 推論過程の評価にはProcess Reward Models (PRMs) や LLM-as-a-Judgeを使⽤
• PRMs:推論の各ステップの正しさを判定するモデルを学習 • LLM-as-a-Judge:LLMを⽤いて推論の正しさを判定 4
既存⼿法の課題 • 数学や科学などのSTEM領域における評価に偏重 • 例:ProcessBench (数学) ,MR-Ben (学術) など •
常識推論における評価は⼆値にとどまる • CriticBench:推論の正誤のみ評価,推論の失敗位置を扱わない →常識推論において推論過程を評価する⼿段は限定的 5
⽬的 • RQ1:既存⼿法は常識推論における推論過程をどの程度評価出 来るか? • RQ2:回答のみの指標と過程を含めた指標ではSLMの評価結果 がどの程度変わるか? 6
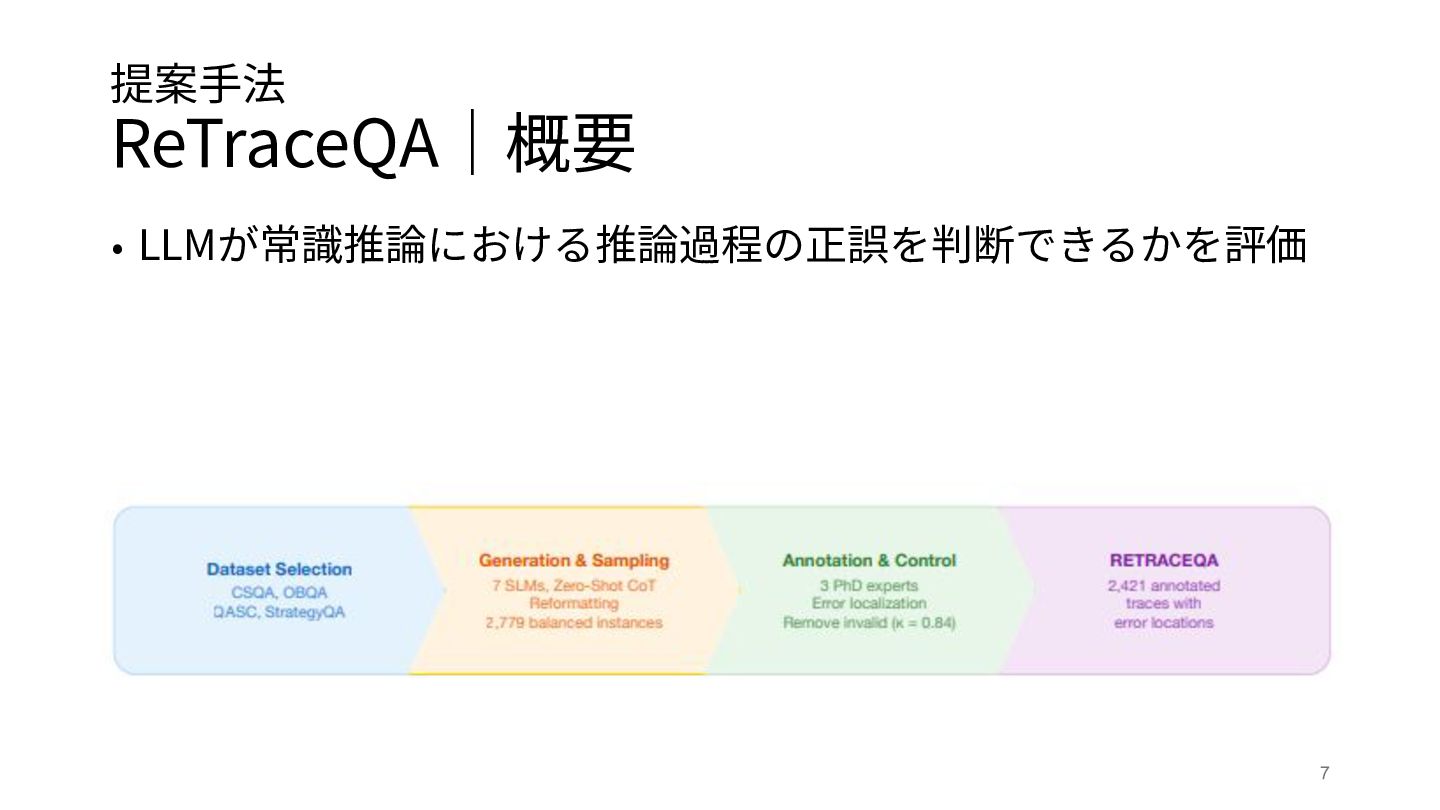
提案⼿法 ReTraceQA|概要 • LLMが常識推論における推論過程の正誤を判断できるかを評価 7
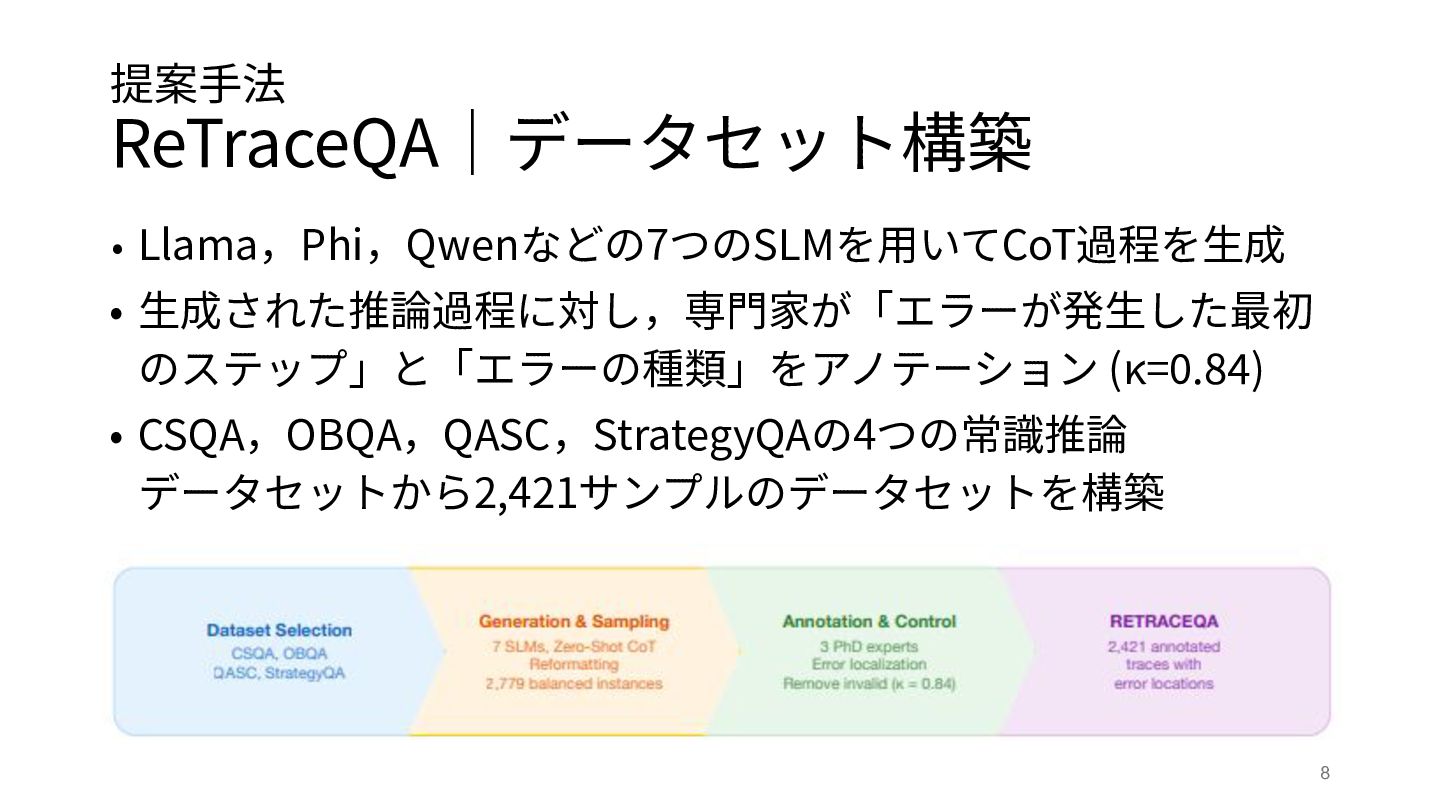
提案⼿法 ReTraceQA|データセット構築 • Llama,Phi,Qwenなどの7つのSLMを⽤いてCoT過程を⽣成 • ⽣成された推論過程に対し,専⾨家が「エラーが発⽣した最初 のステップ」と「エラーの種類」をアノテーション (κ=0.84) • CSQA,OBQA,QASC,StrategyQAの4つの常識推論
データセットから2,421サンプルのデータセットを構築 8
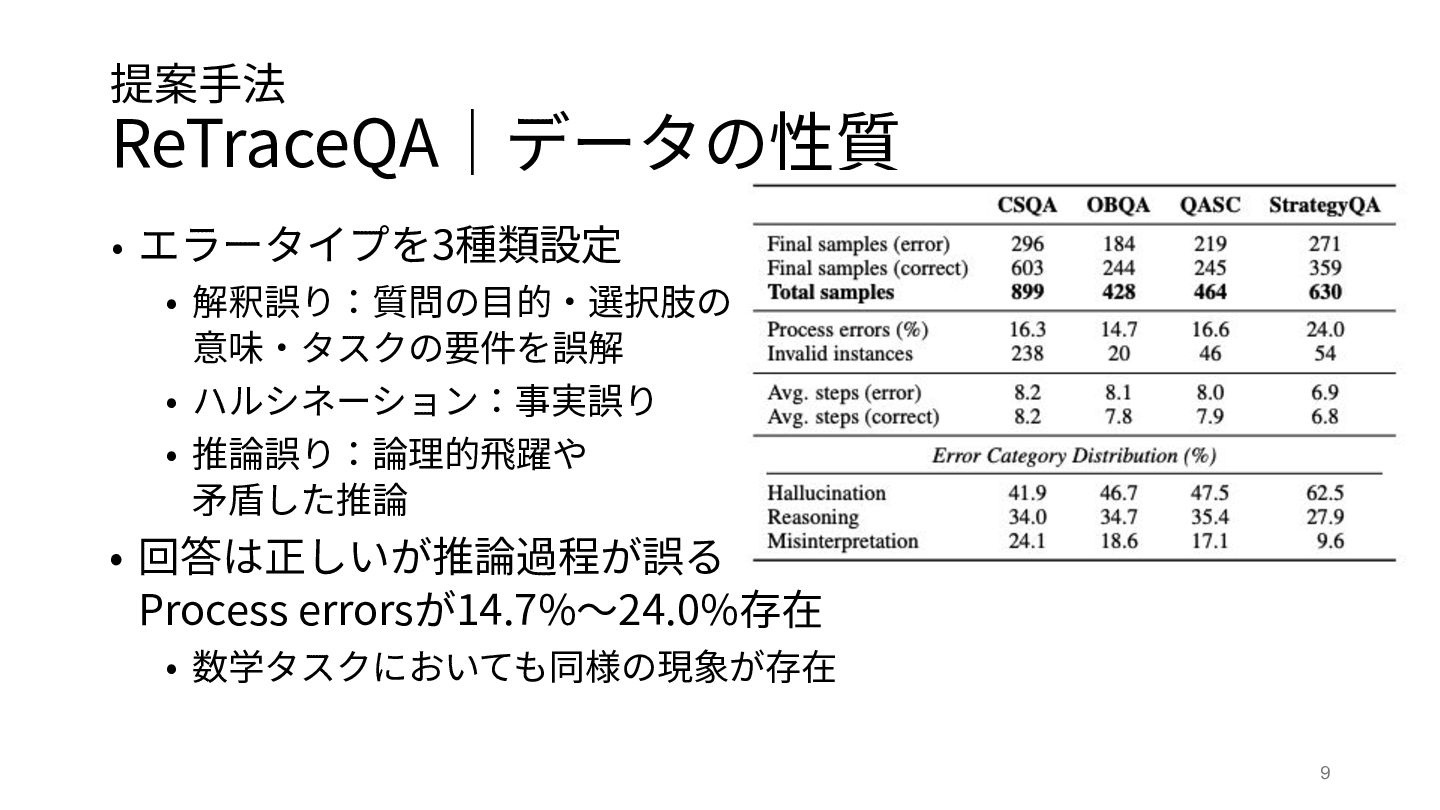
提案⼿法 ReTraceQA|データの性質 • エラータイプを3種類設定 • 解釈誤り:質問の⽬的‧選択肢の 意味‧タスクの要件を誤解 • ハルシネーション:事実誤り •
推論誤り:論理的⾶躍や ⽭盾した推論 • 回答は正しいが推論過程が誤る Process errorsが14.7%〜24.0%存在 • 数学タスクにおいても同様の現象が存在 9
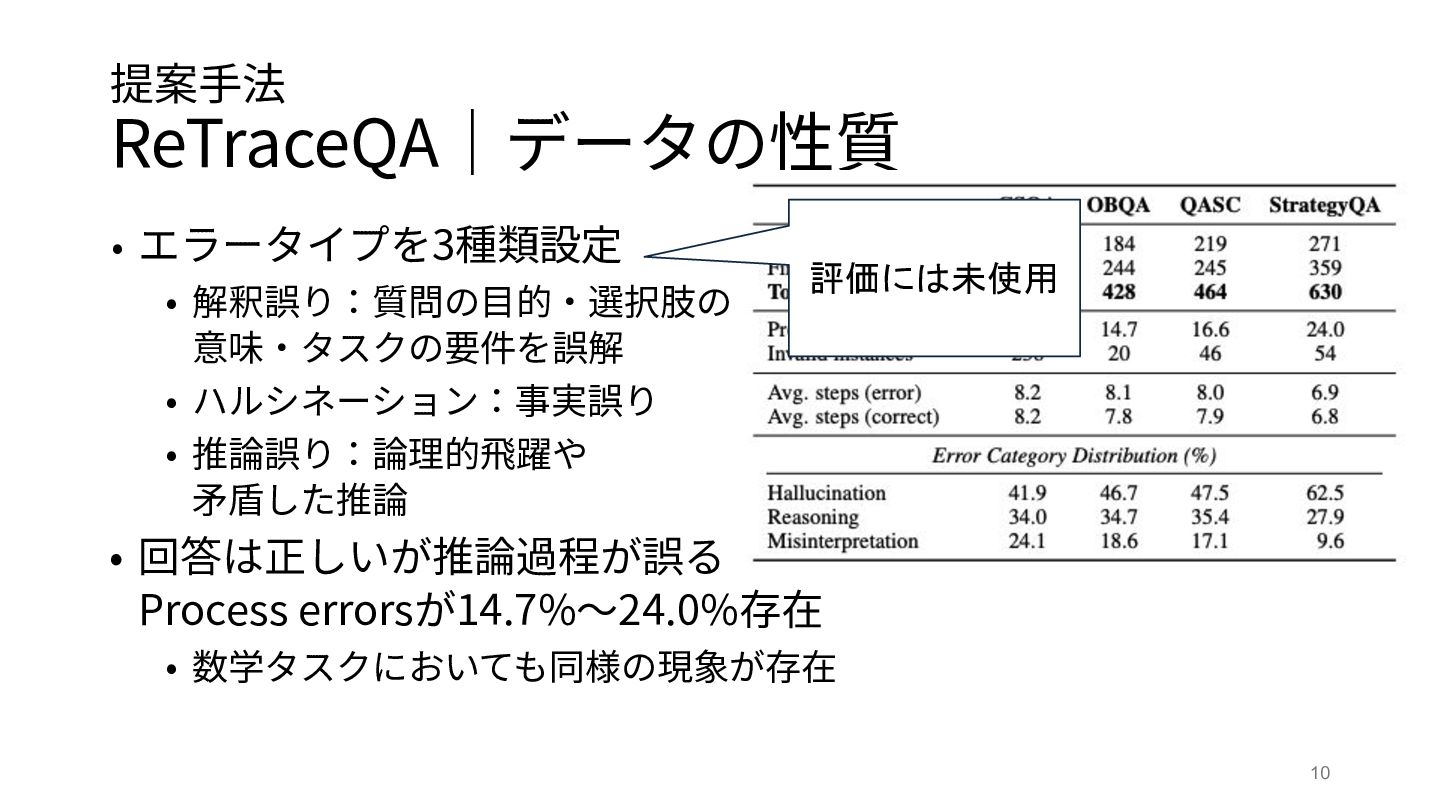
提案⼿法 ReTraceQA|データの性質 • エラータイプを3種類設定 • 解釈誤り:質問の⽬的‧選択肢の 意味‧タスクの要件を誤解 • ハルシネーション:事実誤り •
推論誤り:論理的⾶躍や ⽭盾した推論 評価には未使用 • 回答は正しいが推論過程が誤る Process errorsが14.7%〜24.0%存在 • 数学タスクにおいても同様の現象が存在 10
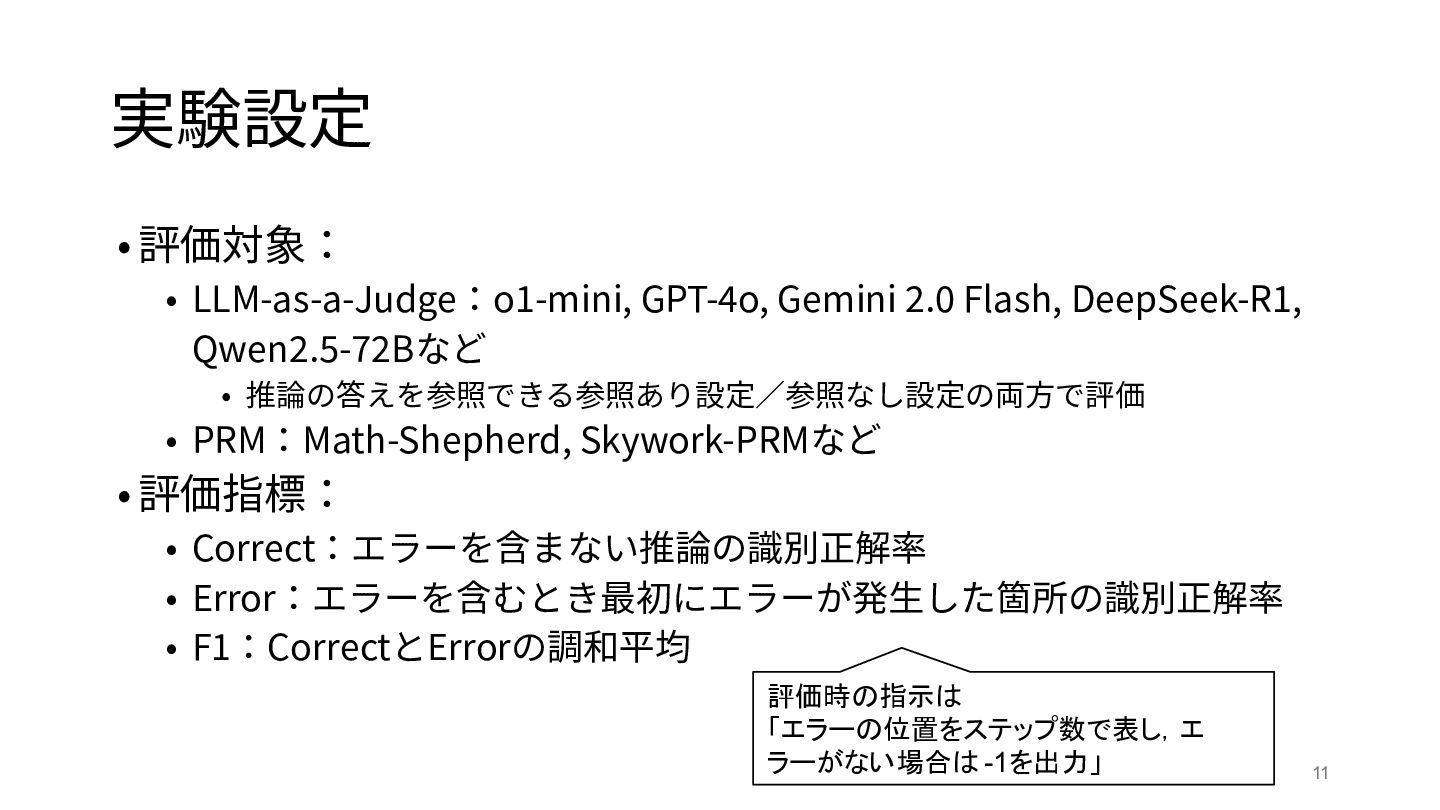
実験設定 • 評価対象: • LLM-as-a-Judge:o1-mini, GPT-4o, Gemini 2.0 Flash, DeepSeek-R1,
Qwen2.5-72Bなど • 推論の答えを参照できる参照あり設定∕参照なし設定の両⽅で評価 • PRM:Math-Shepherd, Skywork-PRMなど • 評価指標: • Correct:エラーを含まない推論の識別正解率 • Error:エラーを含むとき最初にエラーが発⽣した箇所の識別正解率 • F1:CorrectとErrorの調和平均 評価時の指示は 「エラーの位置をステップ数で表し,エ ラーがない場合は -1を出力」 11
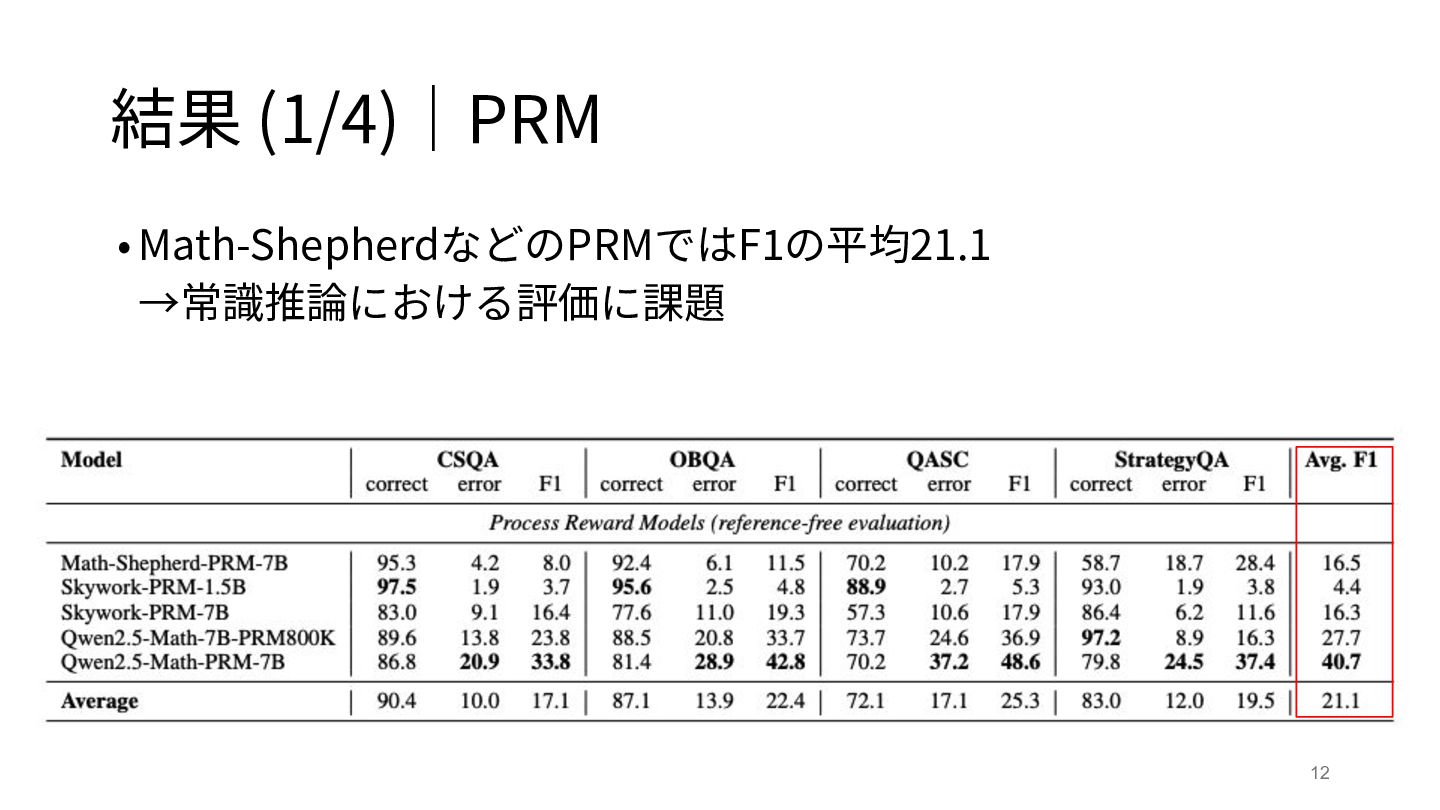
結果 (1/4)|PRM • Math-ShepherdなどのPRMではF1の平均21.1 →常識推論における評価に課題 12
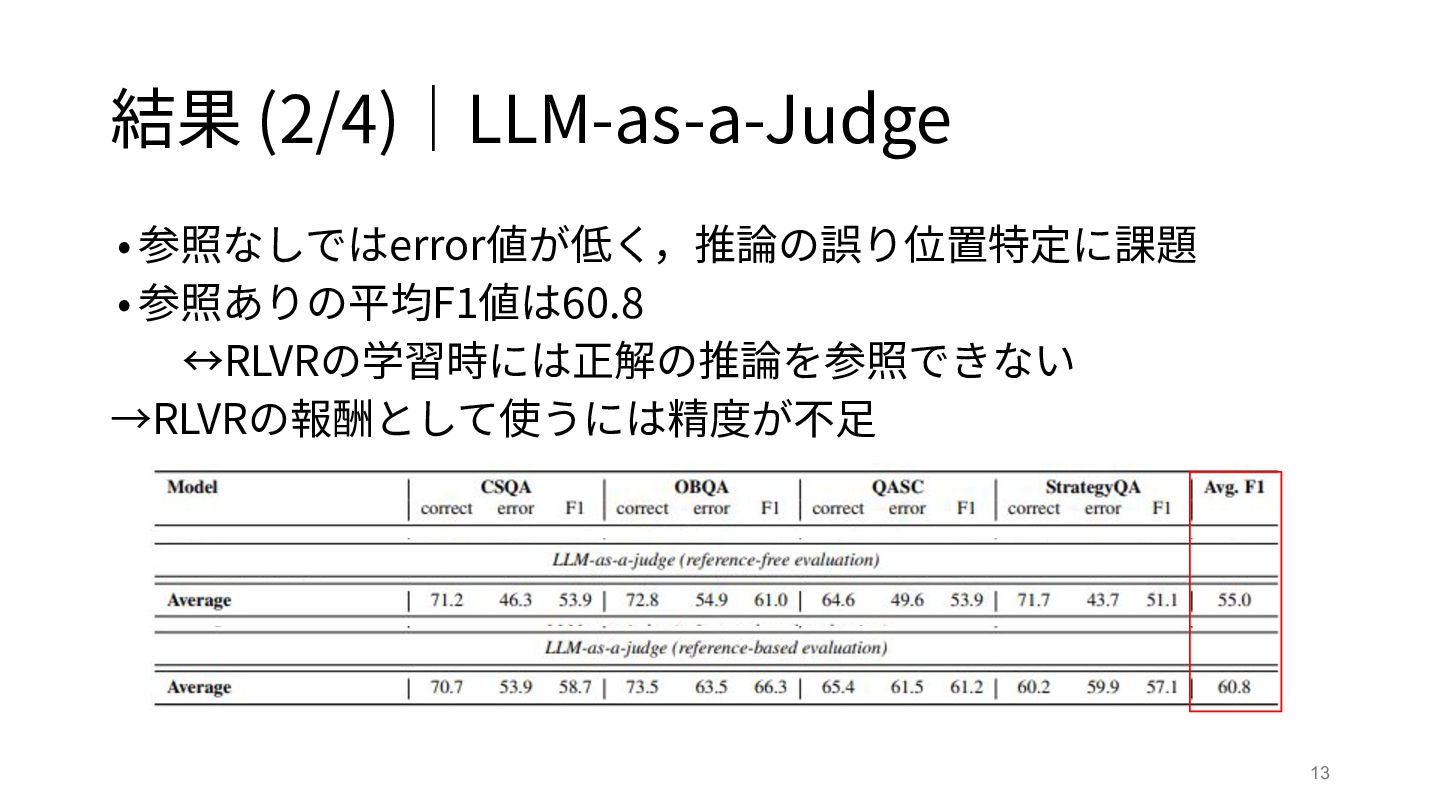
結果 (2/4)|LLM-as-a-Judge • 参照なしではerror値が低く,推論の誤り位置特定に課題 • 参照ありの平均F1値は60.8 ↔RLVRの学習時には正解の推論を参照できない →RLVRの報酬として使うには精度が不⾜ 13
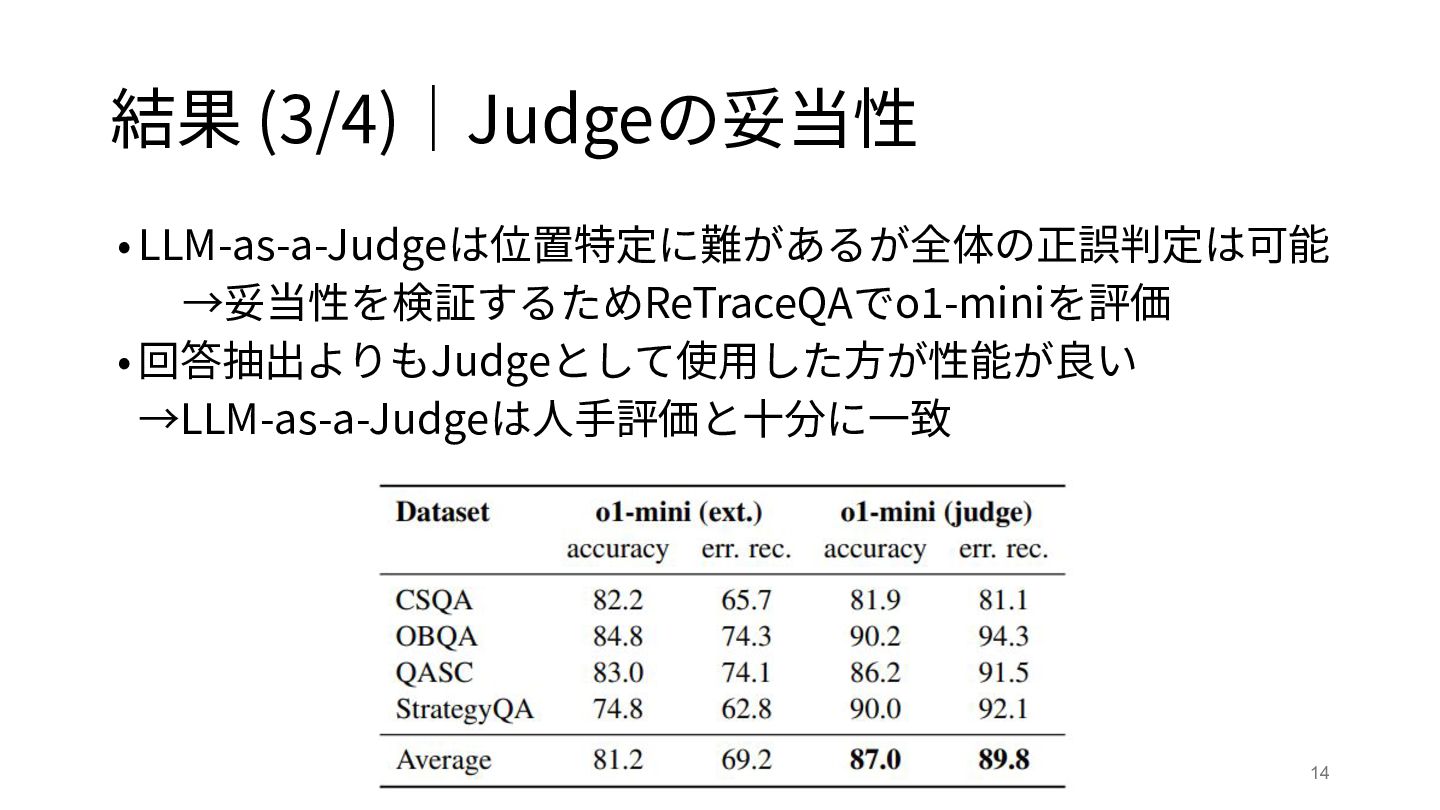
結果 (3/4)|Judgeの妥当性 • LLM-as-a-Judgeは位置特定に難があるが全体の正誤判定は可能 →妥当性を検証するためReTraceQAでo1-miniを評価 • 回答抽出よりもJudgeとして使⽤した⽅が性能が良い →LLM-as-a-Judgeは⼈⼿評価と⼗分に⼀致 14
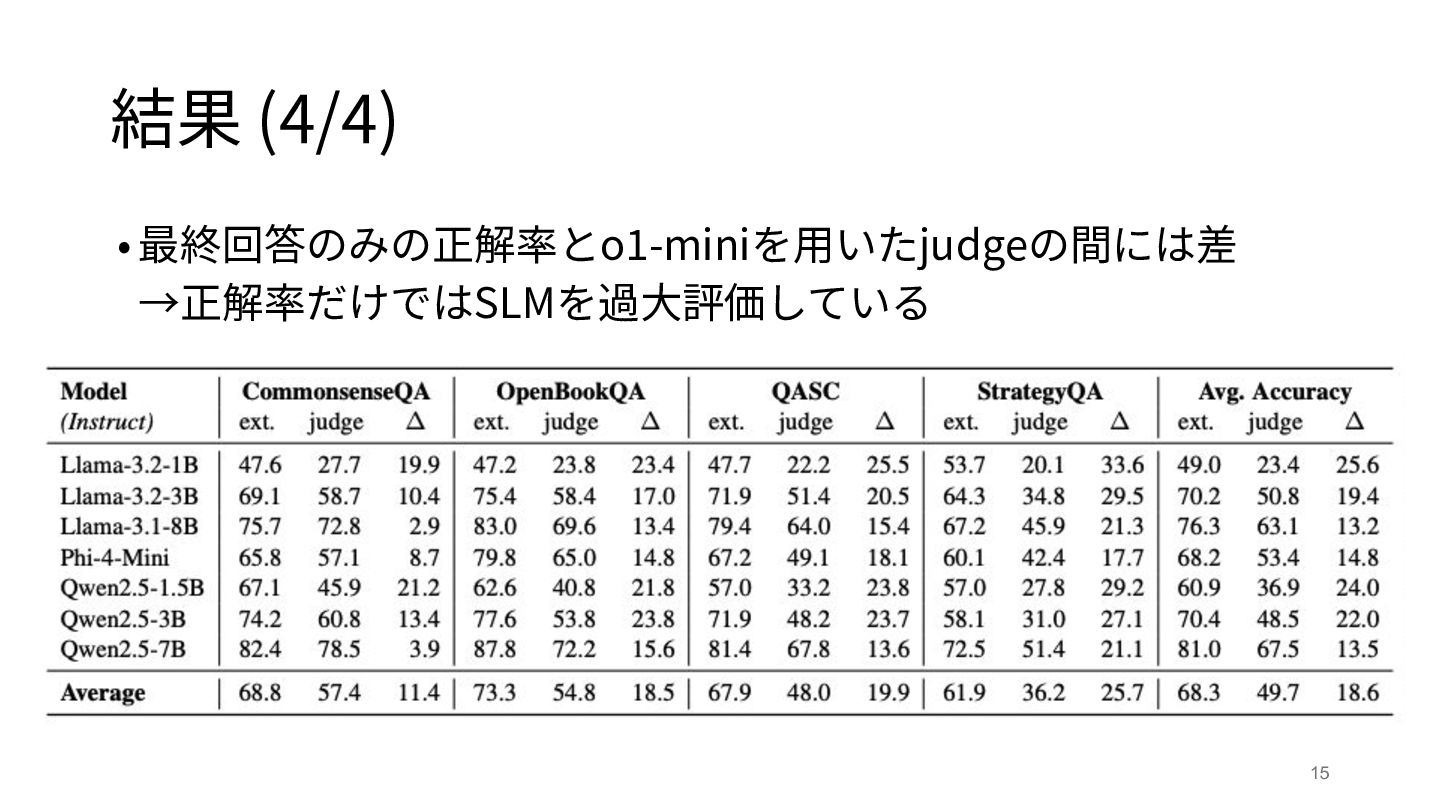
結果 (4/4) • 最終回答のみの正解率とo1-miniを⽤いたjudgeの間には差 →正解率だけではSLMを過⼤評価している 15
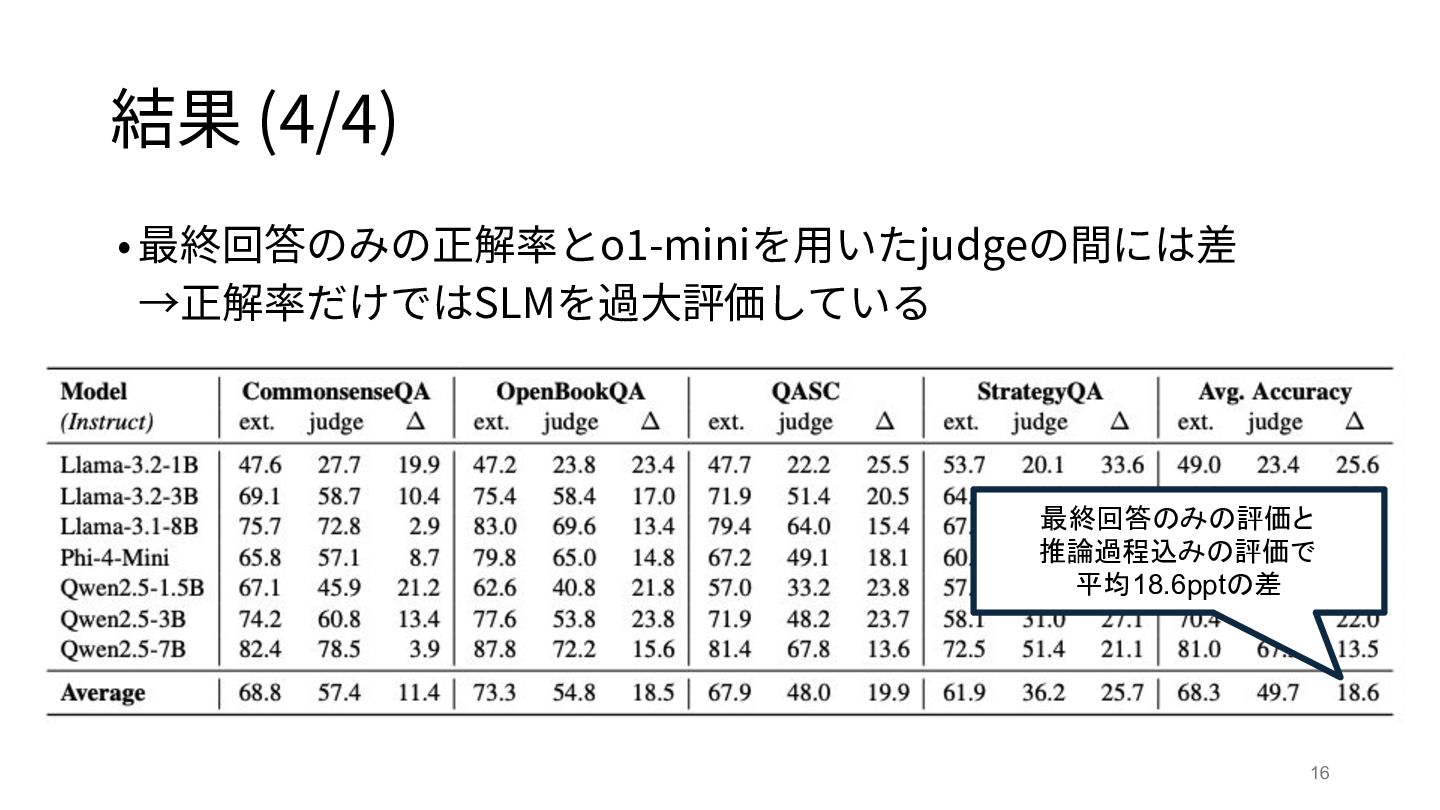
結果 (4/4) • 最終回答のみの正解率とo1-miniを⽤いたjudgeの間には差 →正解率だけではSLMを過⼤評価している 最終回答のみの評価と 推論過程込みの評価で 平均18.6pptの差 16
まとめ • 課題:SLMの推論過程に対する評価⼿法が⼗分でない • 検証:ReTraceQAを構築し,推論過程中のエラー分析を実施 • 結果:SLMは事実誤認や誤った推論を含みつつ正解している • 最終回答のみの評価ではSLMの性能を過⼤評価 •
結論:推論過程全体を考慮した評価が必要 • STEM領域だけでなく,常識推論におけるPRMの作成が必要 17
所感 • こうした分析の⾃動化が進めば推論性能も向上させられそう • 気になった点 • 推論過程が間違っても正解できる理由に対する考察がない • 関連:CoTの忠実性の問題 •
間違った推論から持ち直して正解した場合を対象外としている • ProcessBenchもこの設計だが妥当性に疑問 • 3種類⽤意したエラーラベルを評価に使⽤していない • このラベル⾃体強化学習時に適⽤できるのか不明なので必要性に疑問 18


 rfujii
 institutdelelevage
 kinoue_smarthr
 sokikatayama
 xspa2012
 ayaniwa
 ept
 satai
 dk999
 shiell
 reverentgeek
 lauravandoore
 sstephenson
 rakko
 codingconduct
 schroneko
 katarinadahlin
 mojombo
 gr2m
 csswizardry
 bcantrill
 popppiees