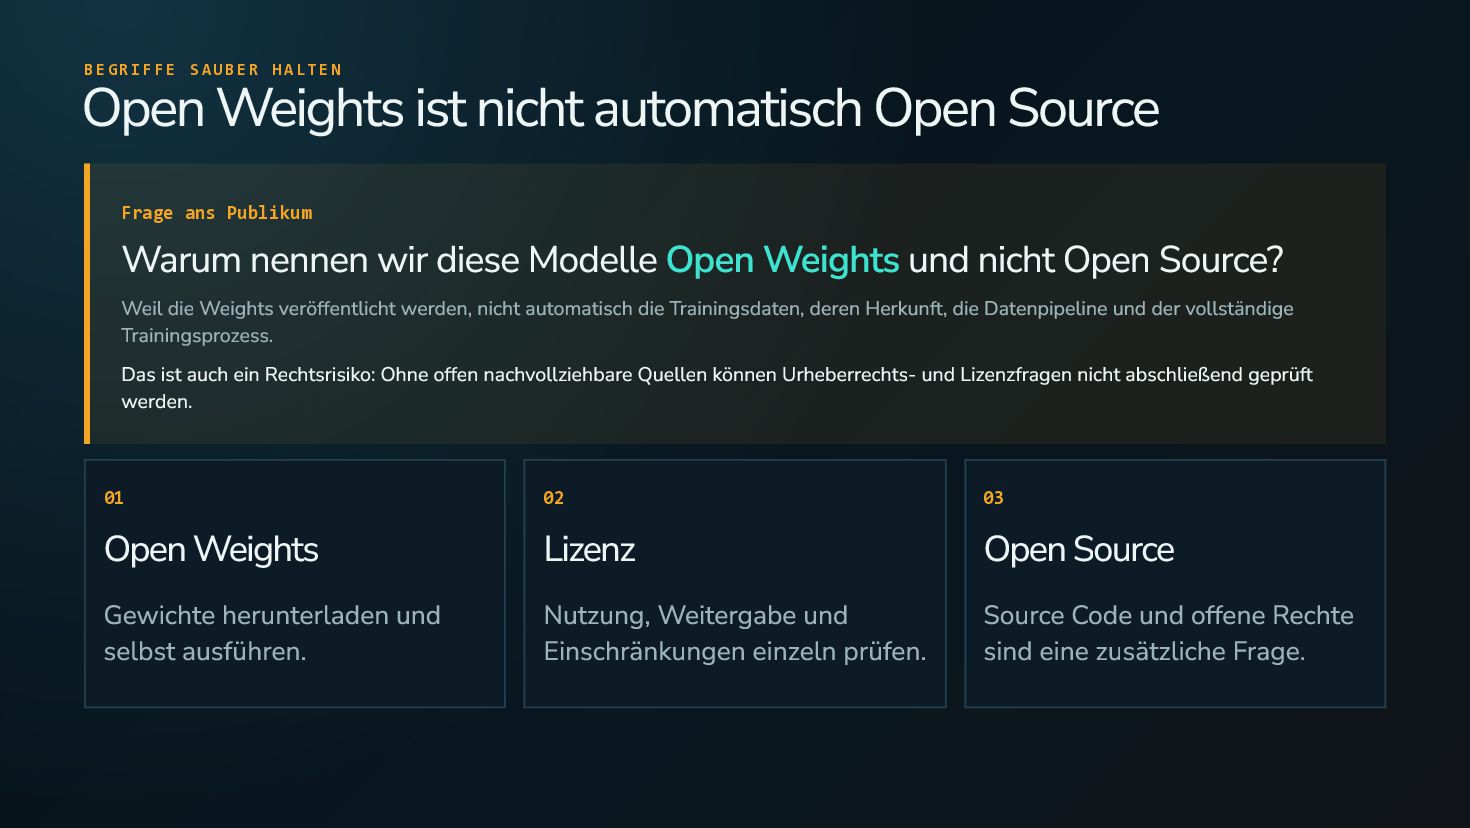
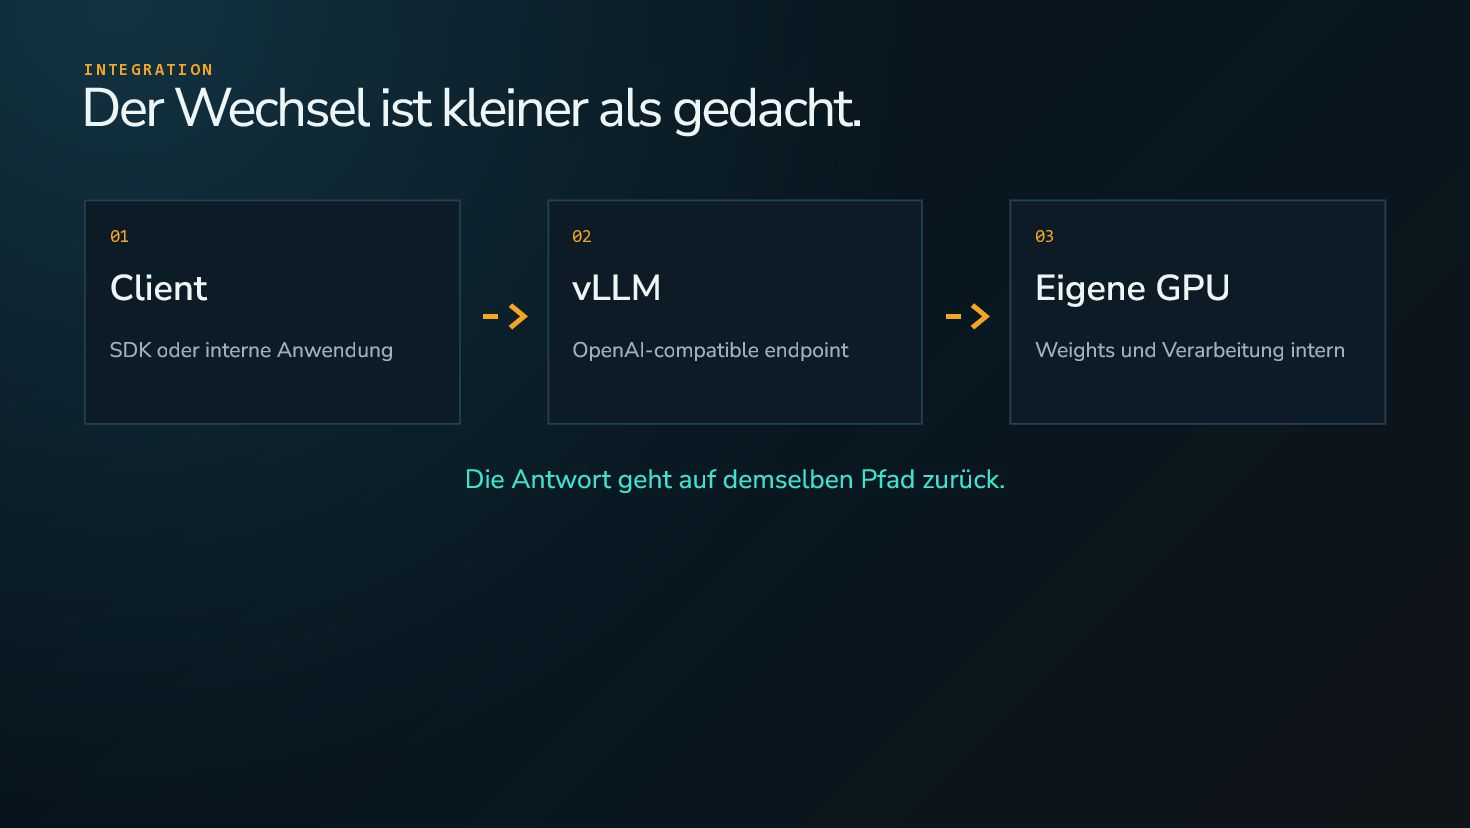
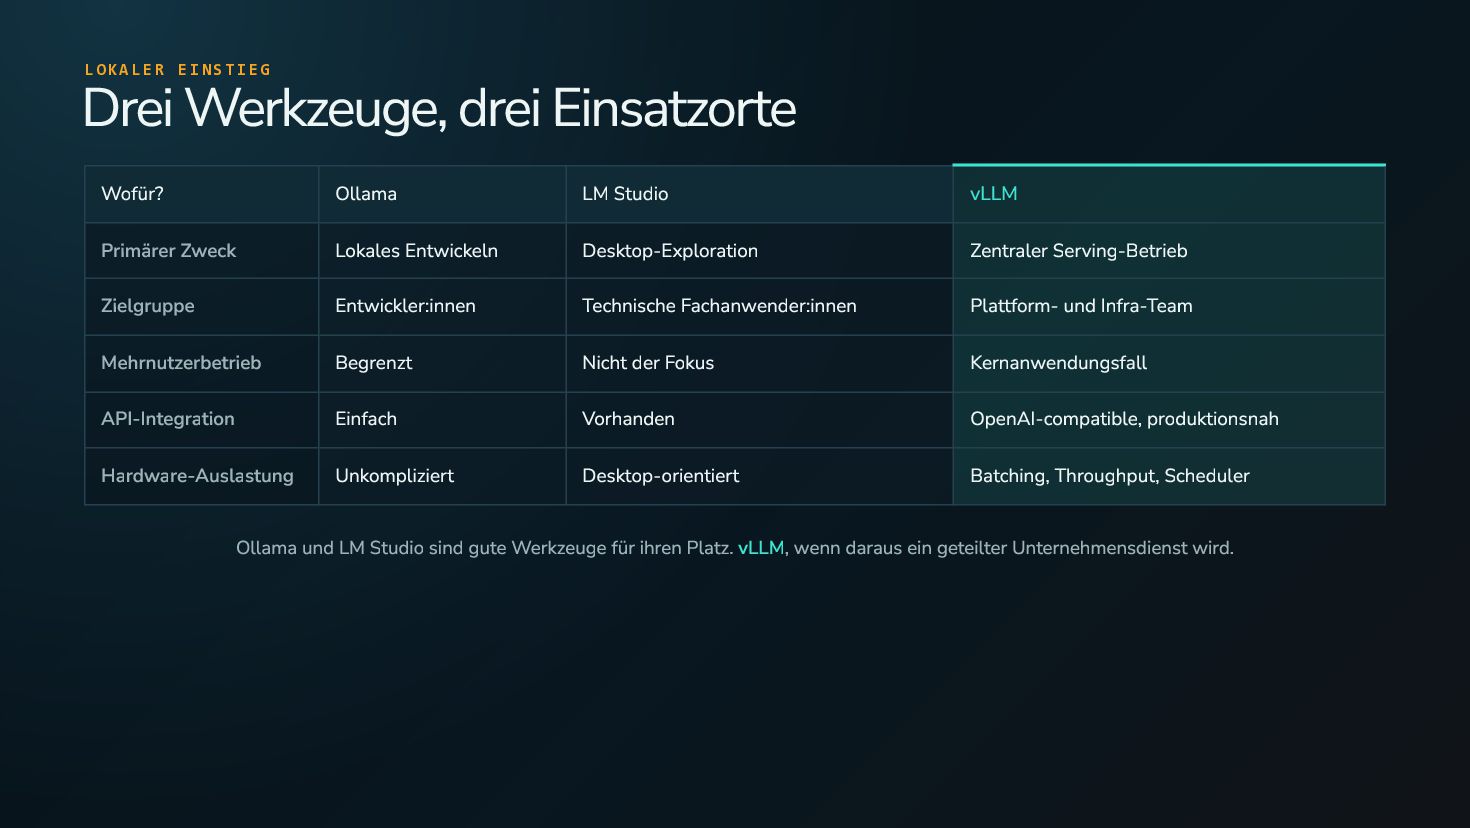
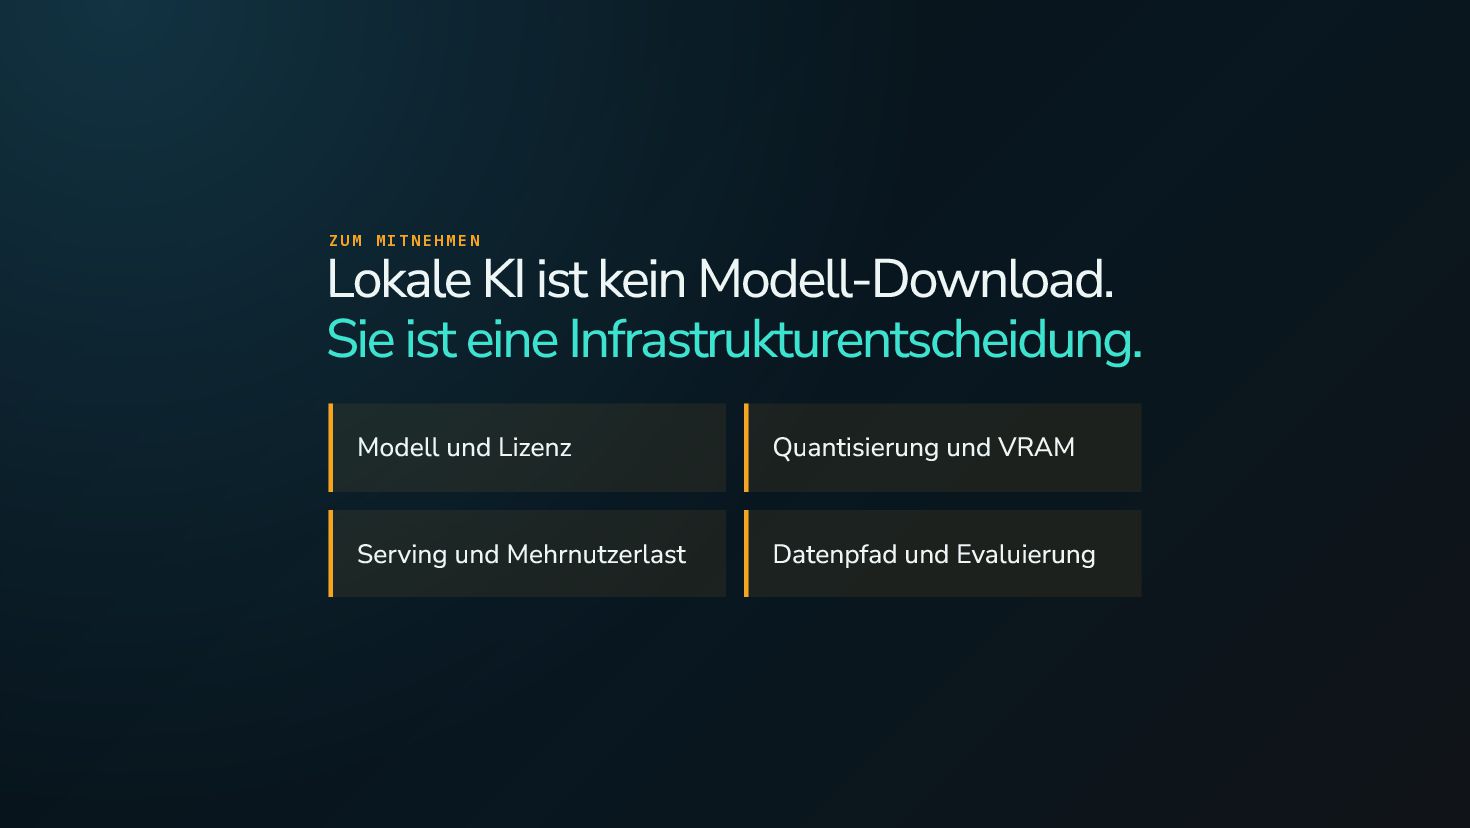
Wie betreibt ein Unternehmen Open-Weights-Modelle auf eigener Hardware und bietet sie über eine OpenAI-kompatible API an? Der Vortrag zeigt den Weg von Ollama und LM Studio für lokales Entwickeln bis zu vLLM als zentralem Serving-Dienst für viele Nutzer.
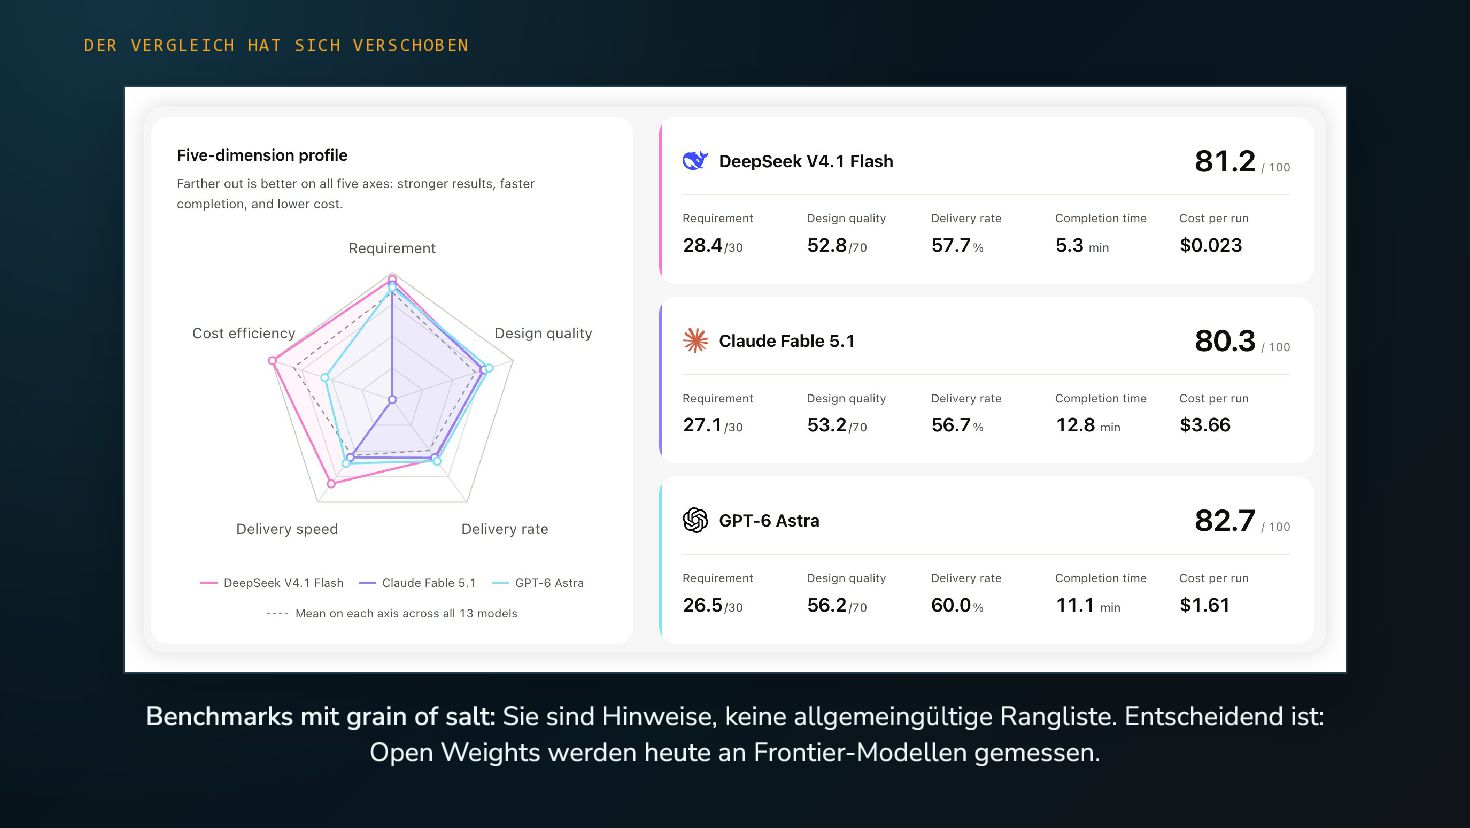
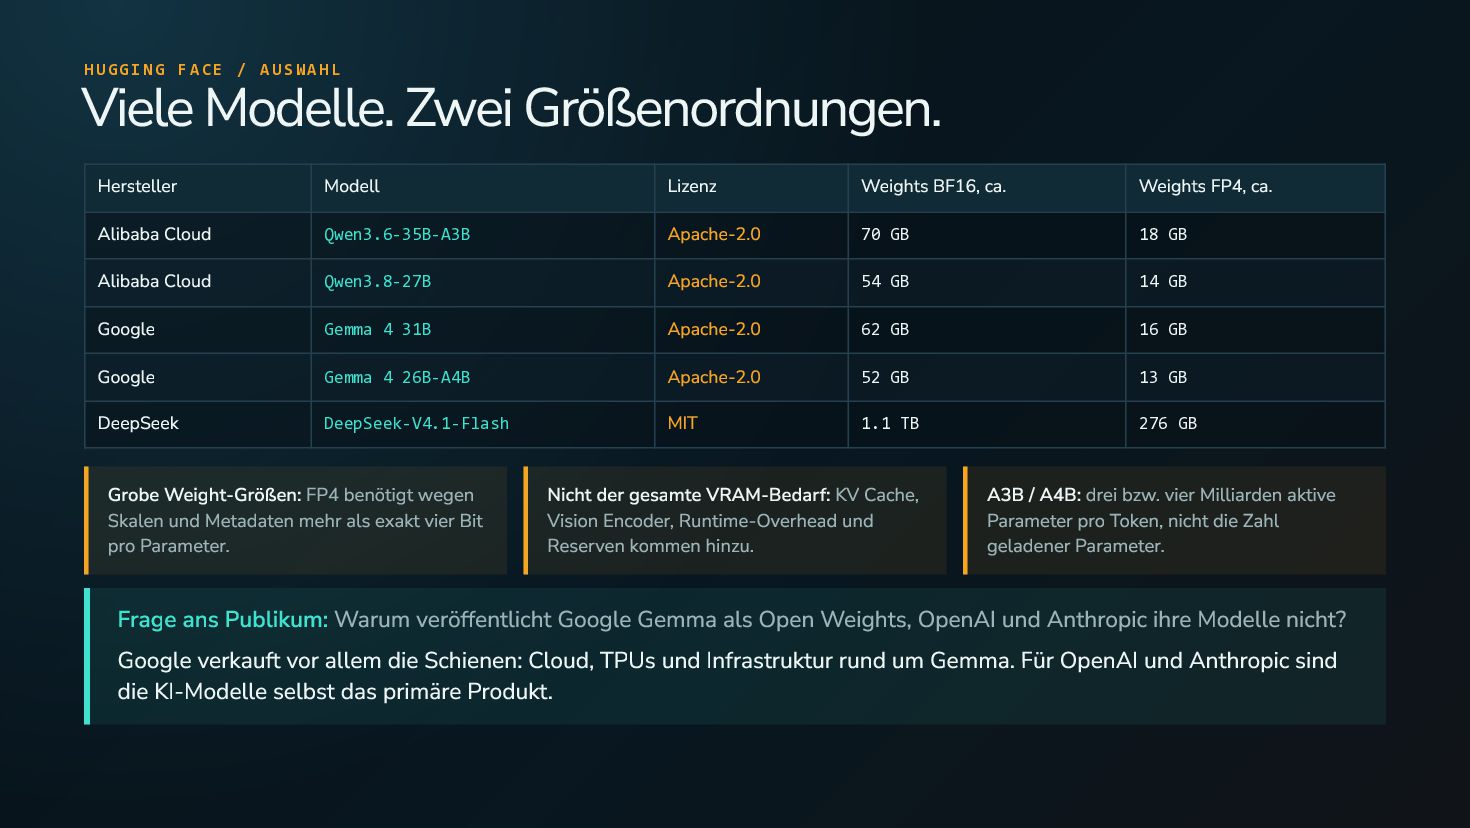
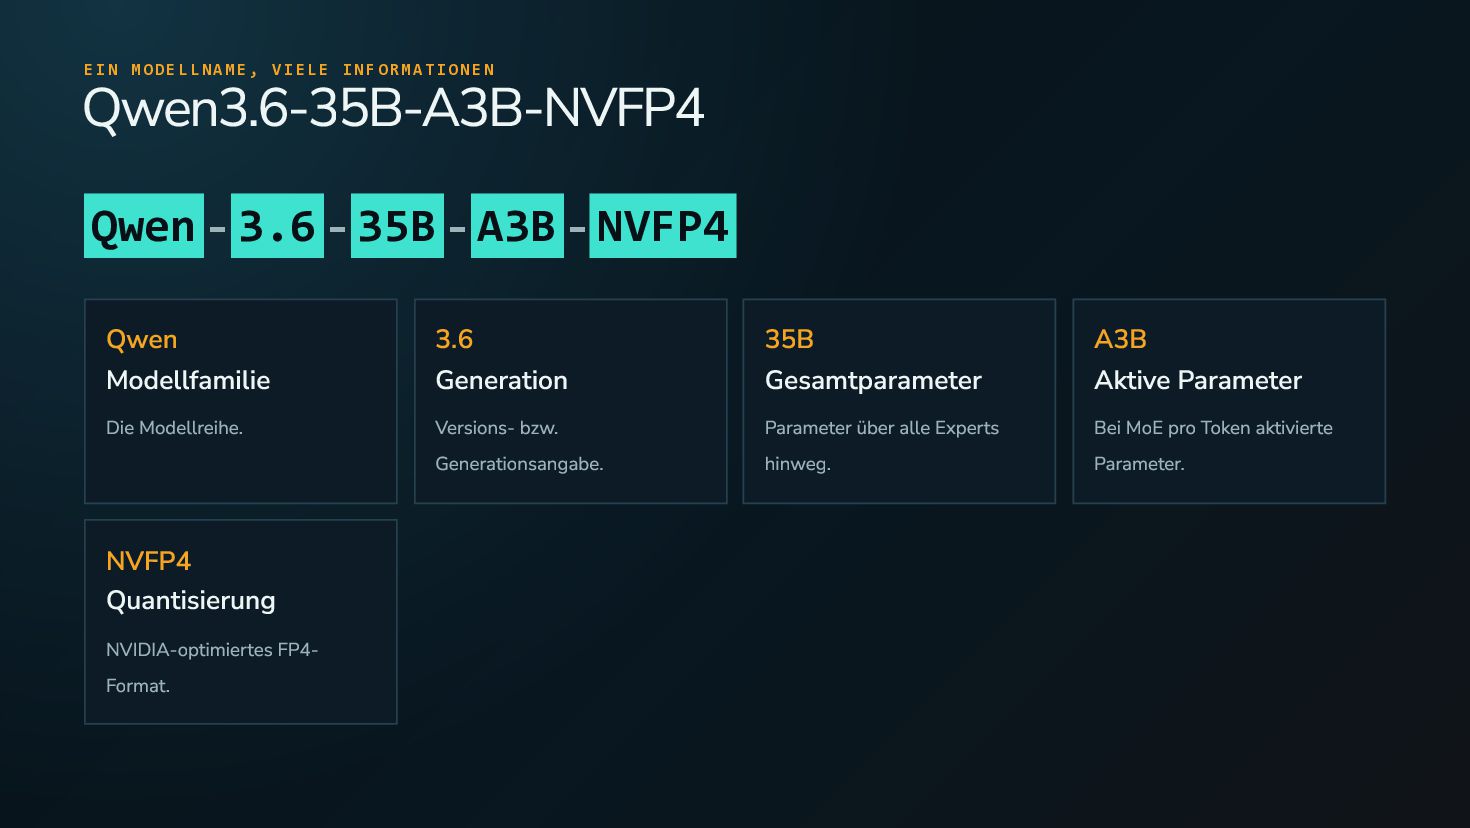
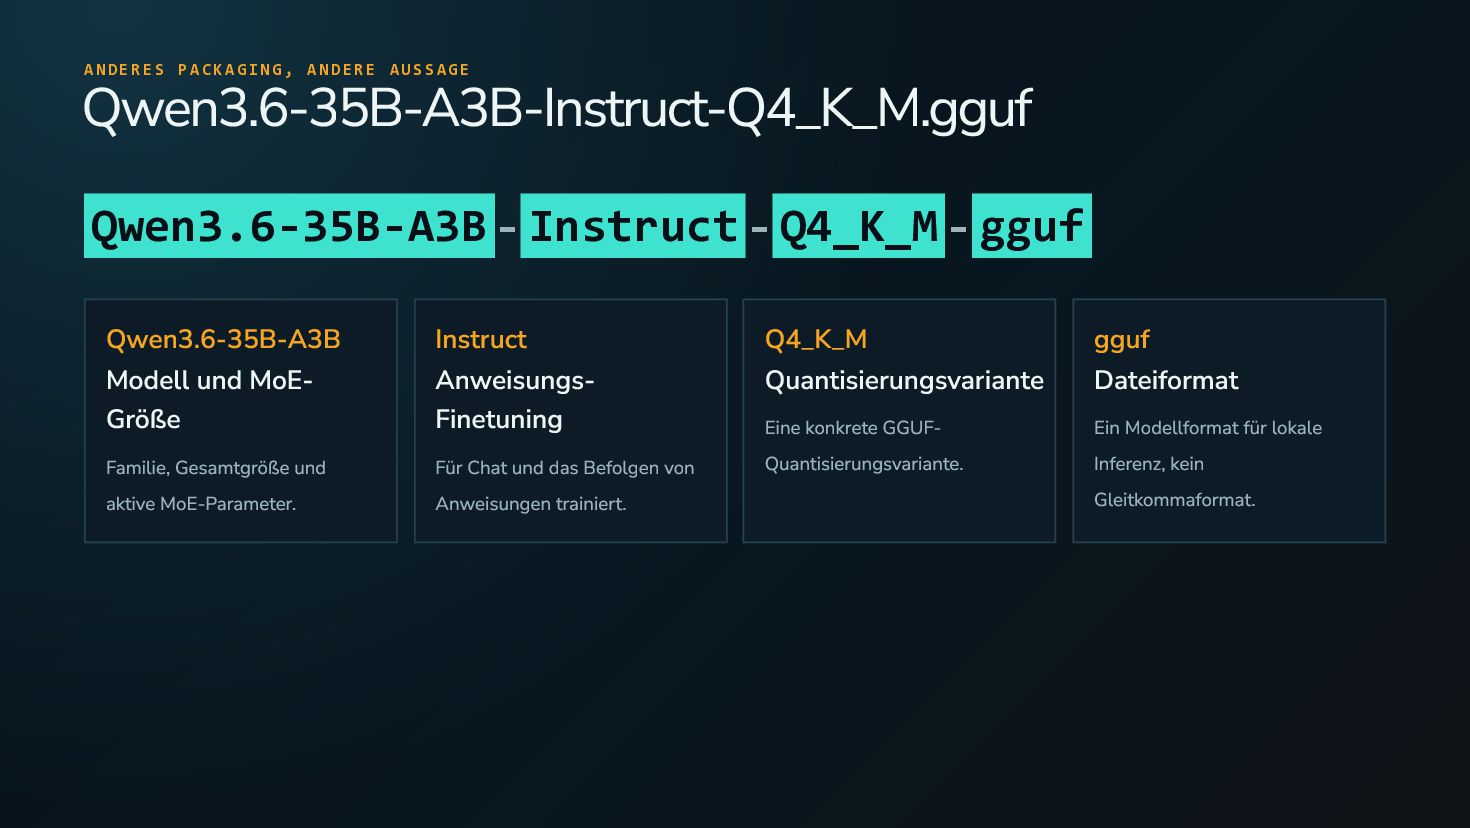
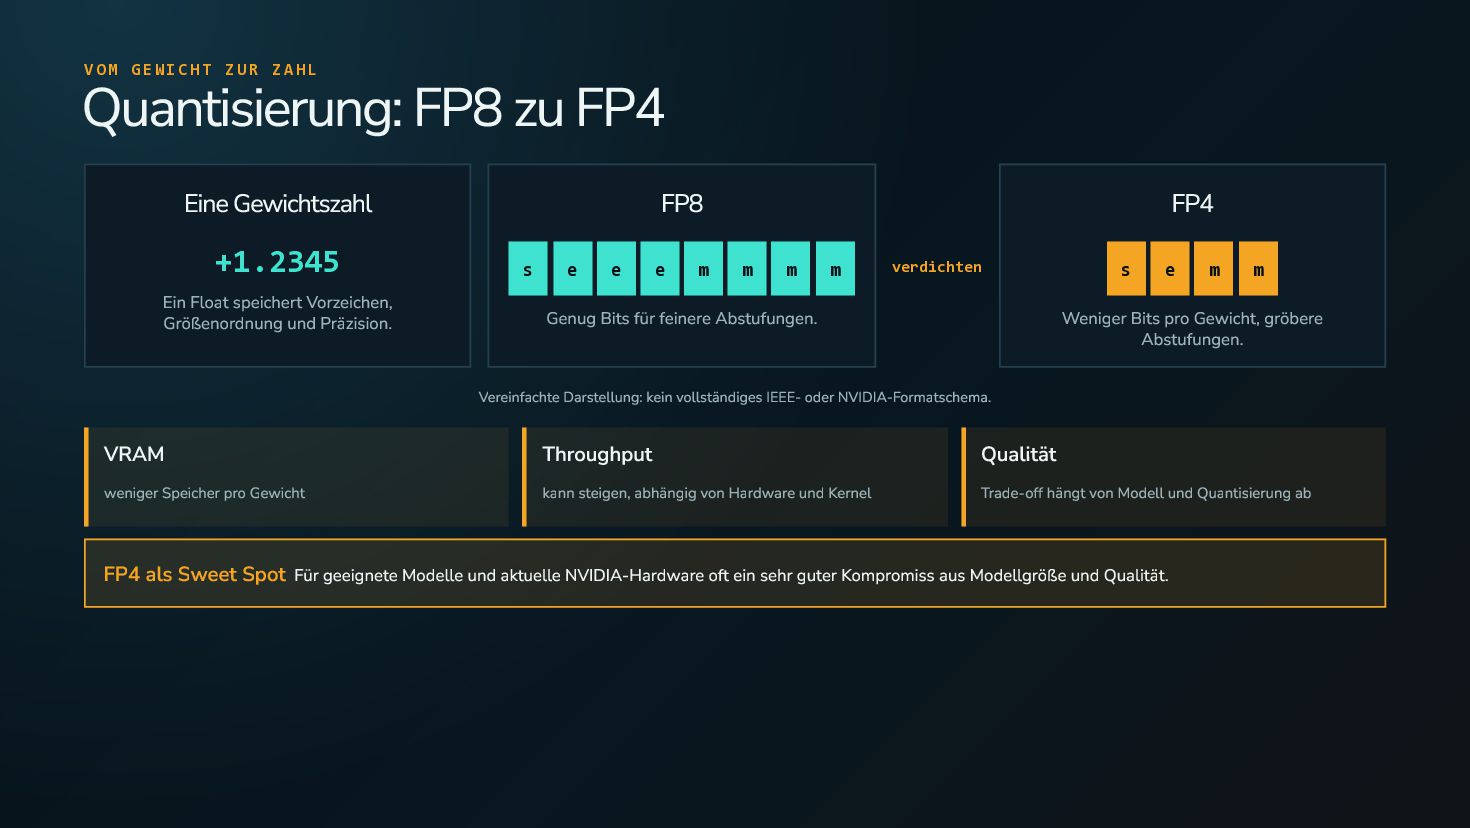
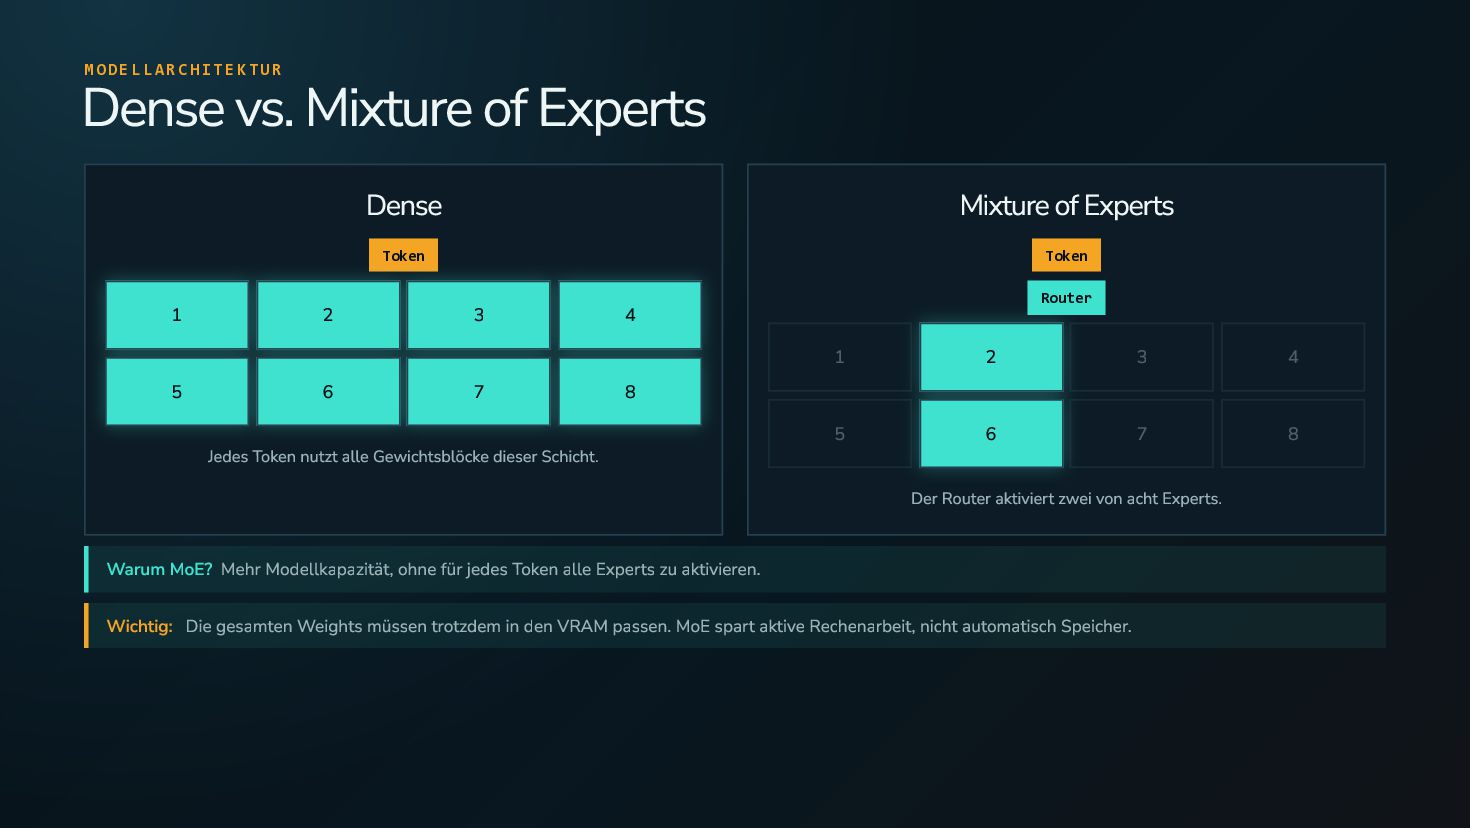
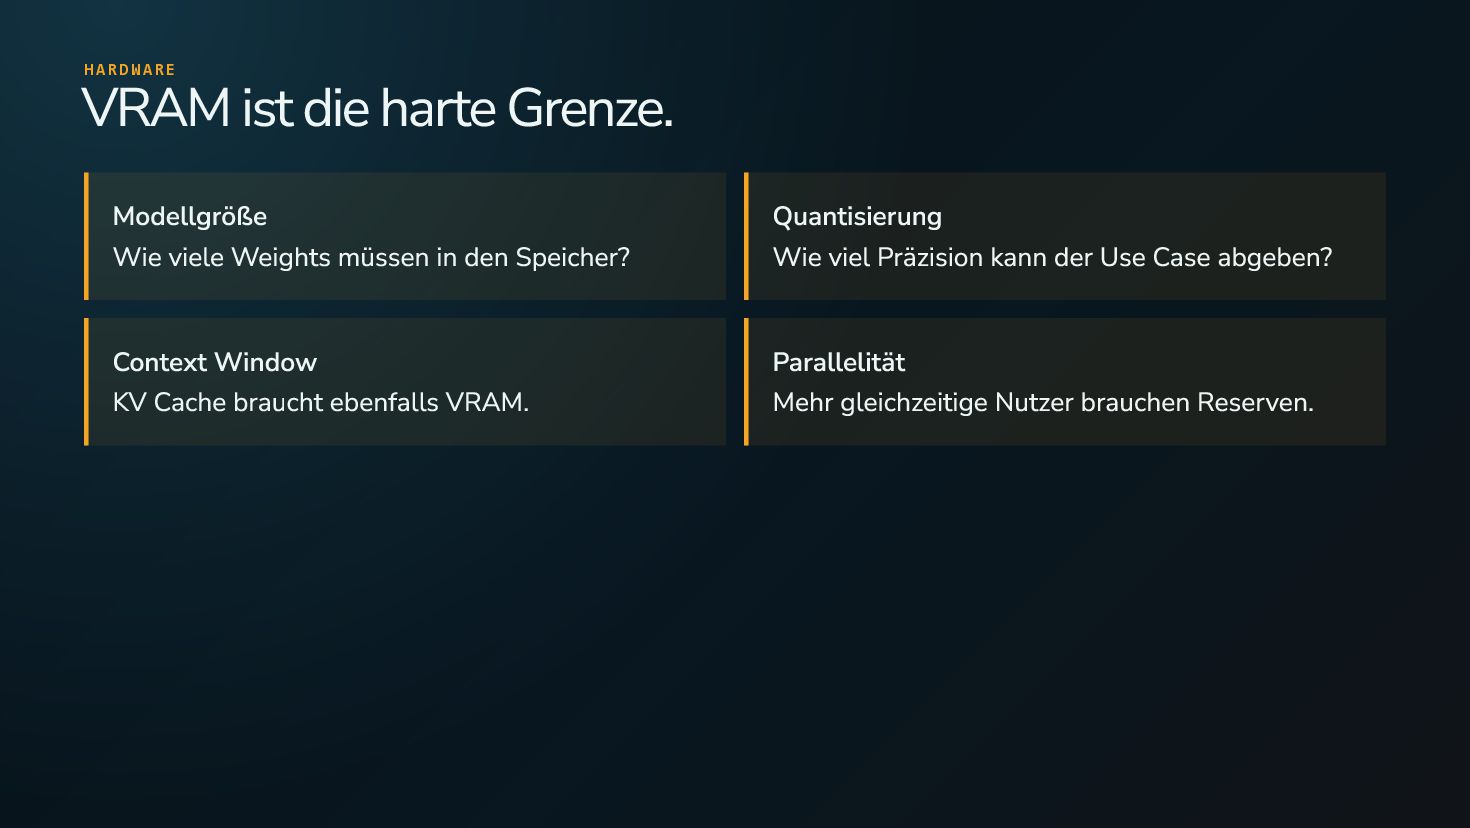
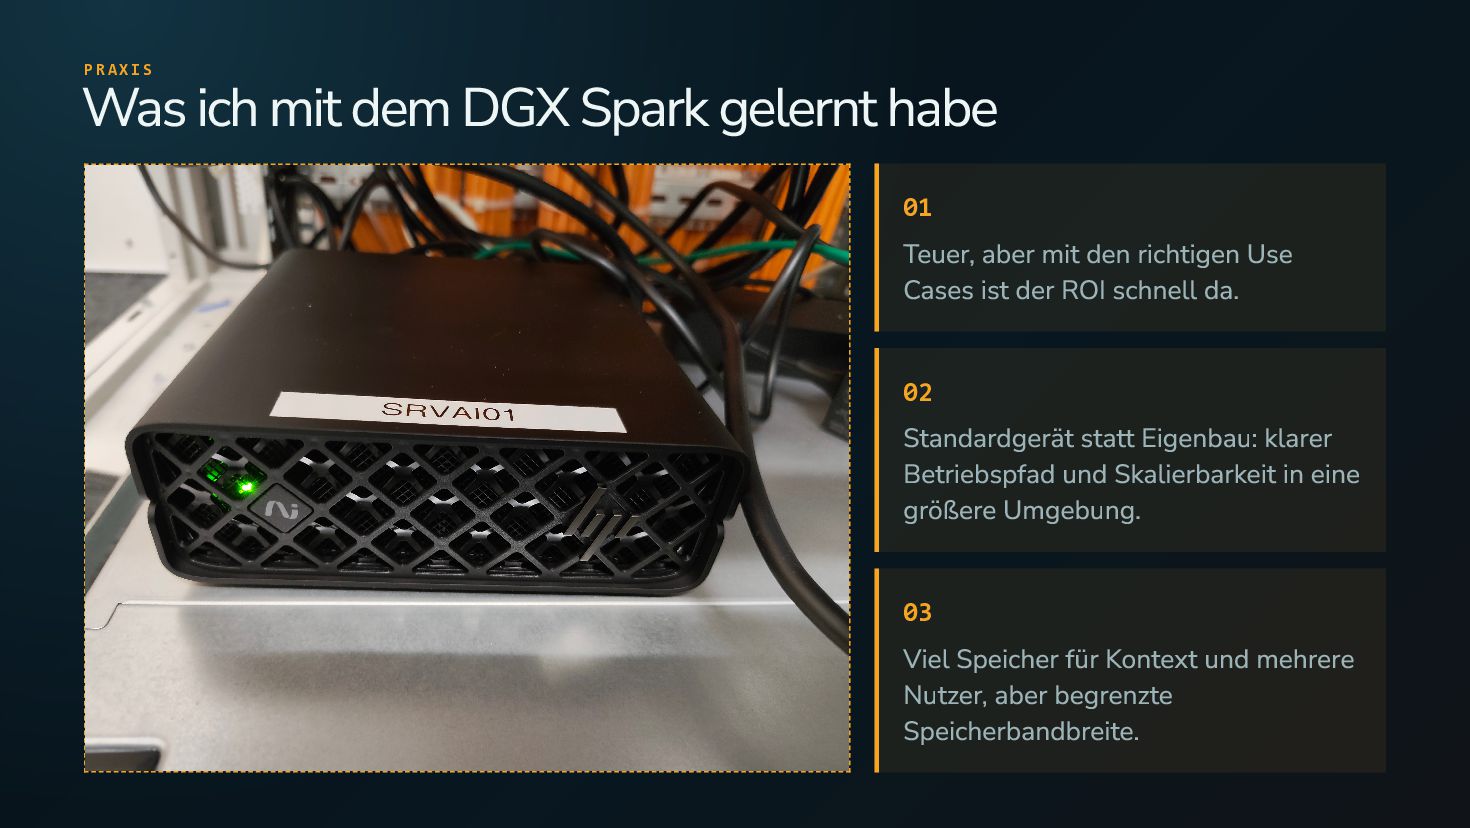
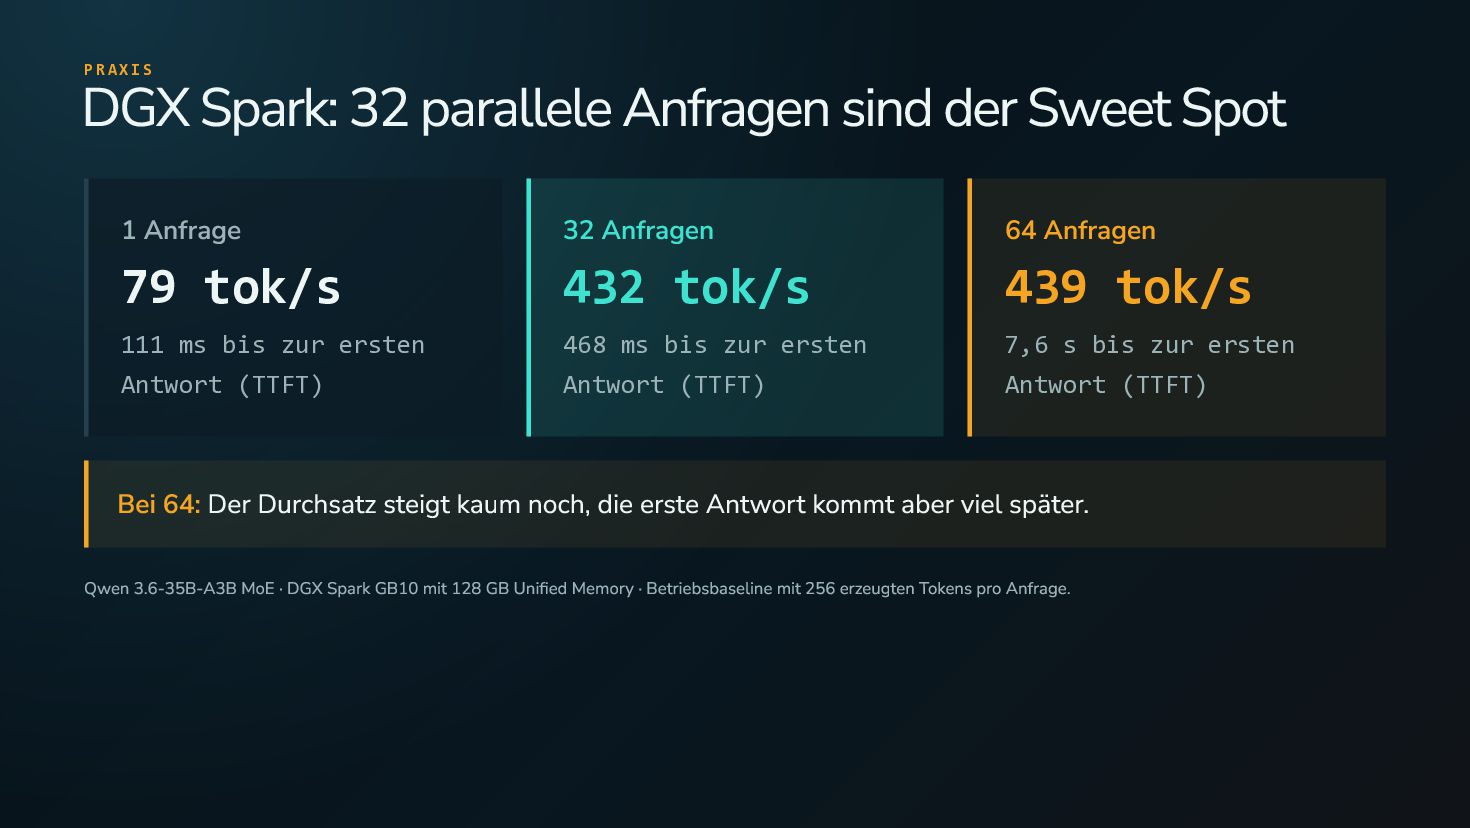
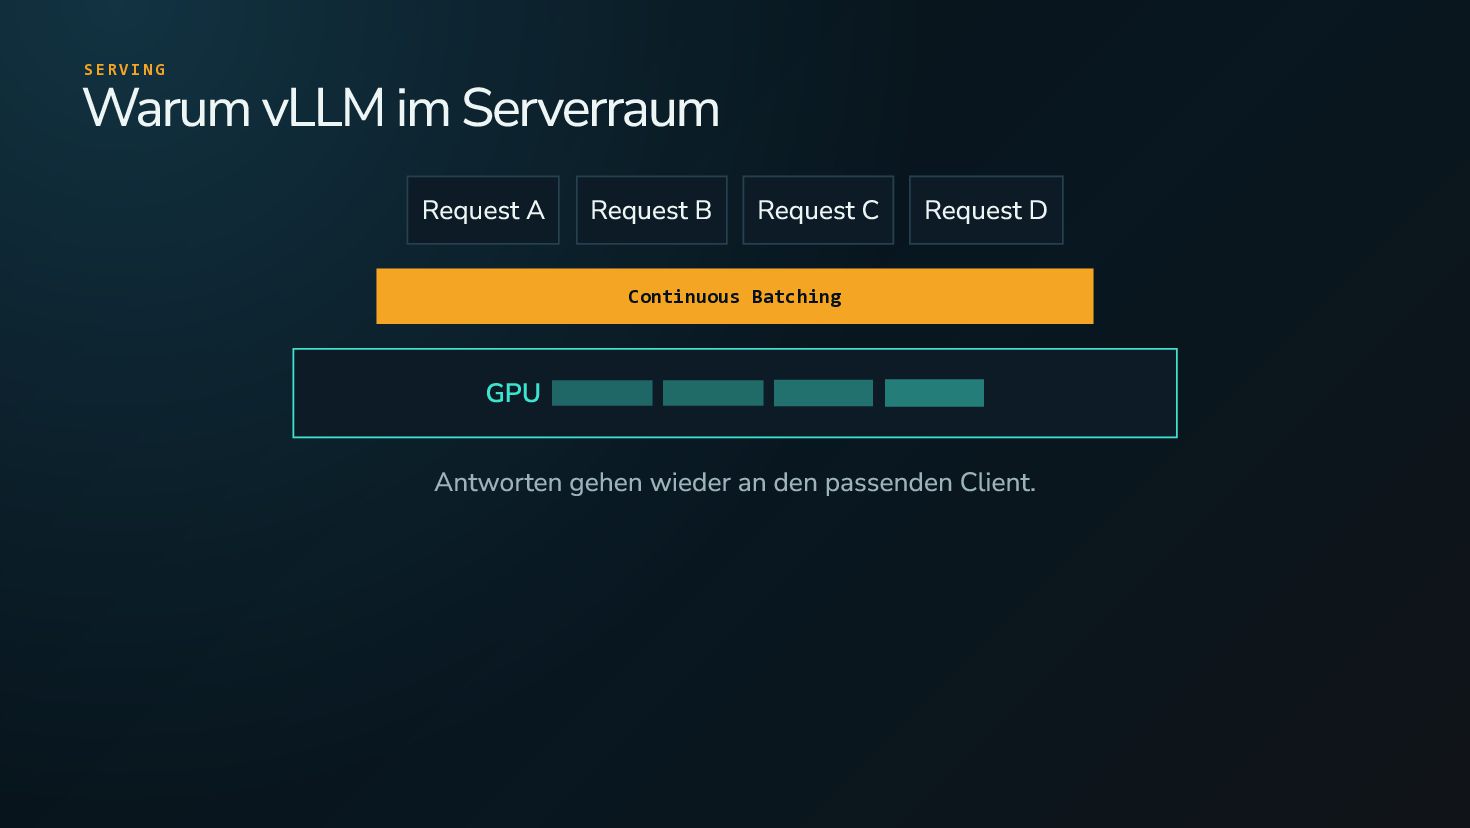
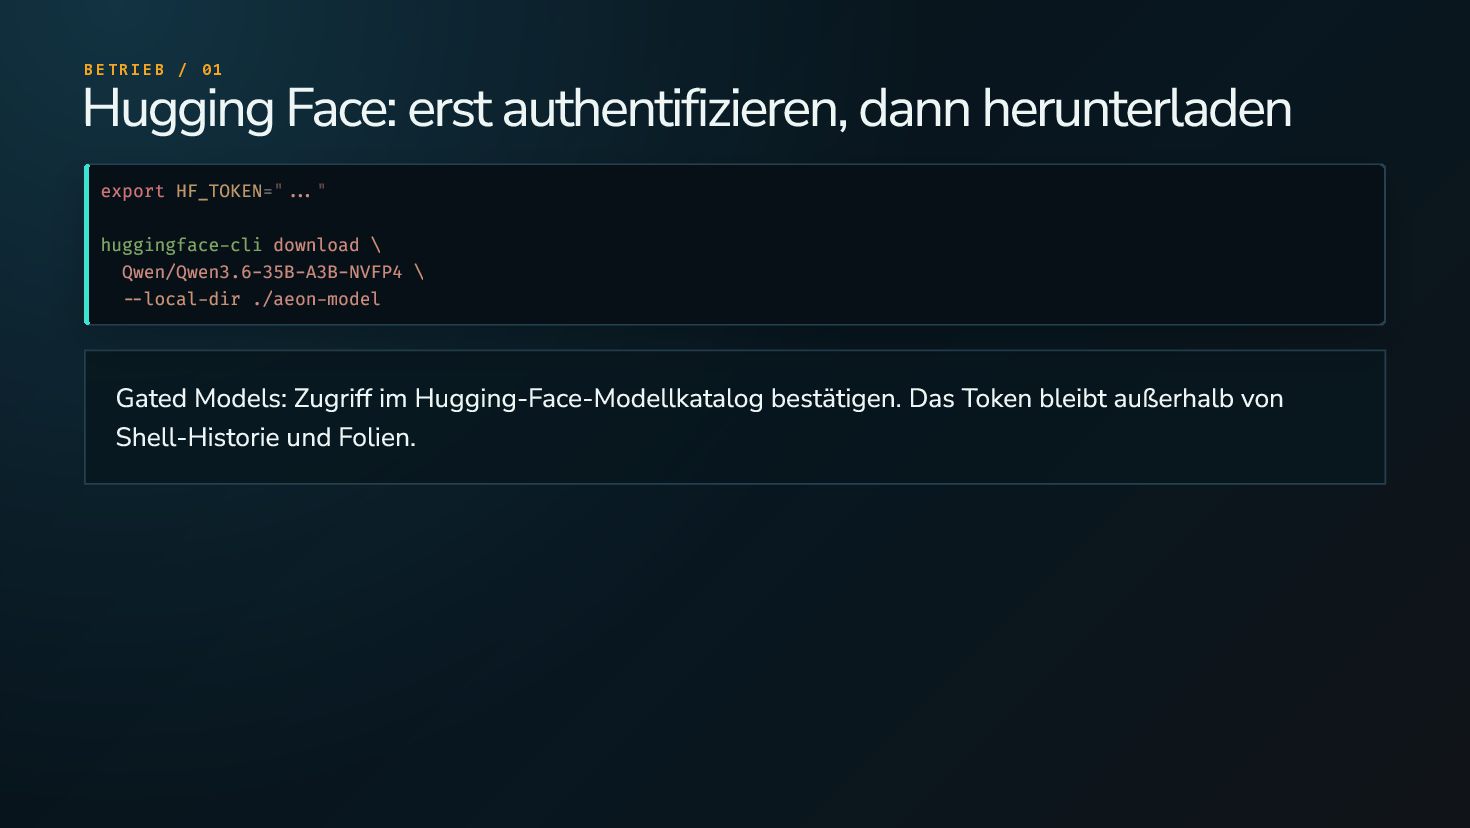
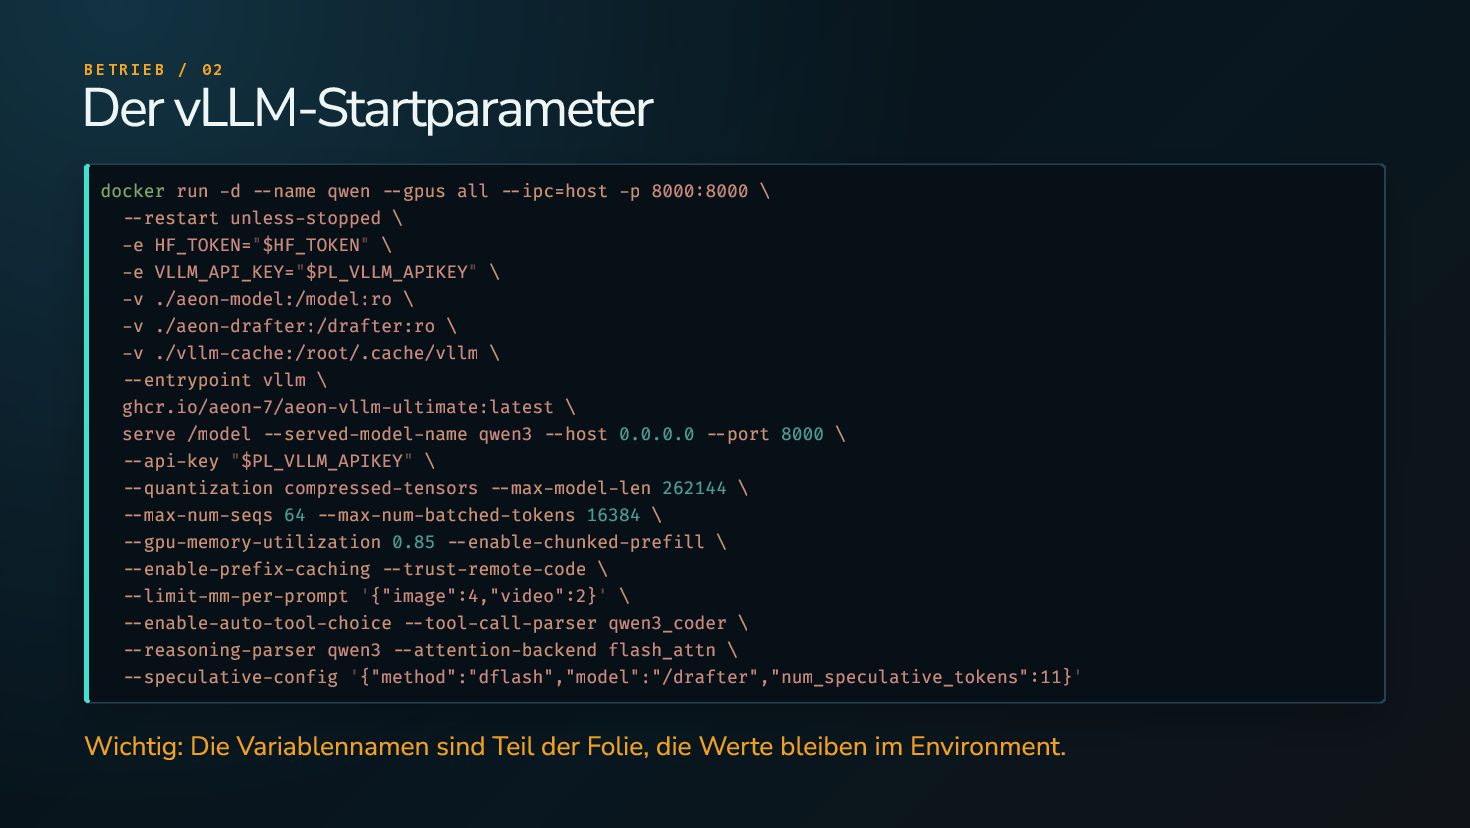
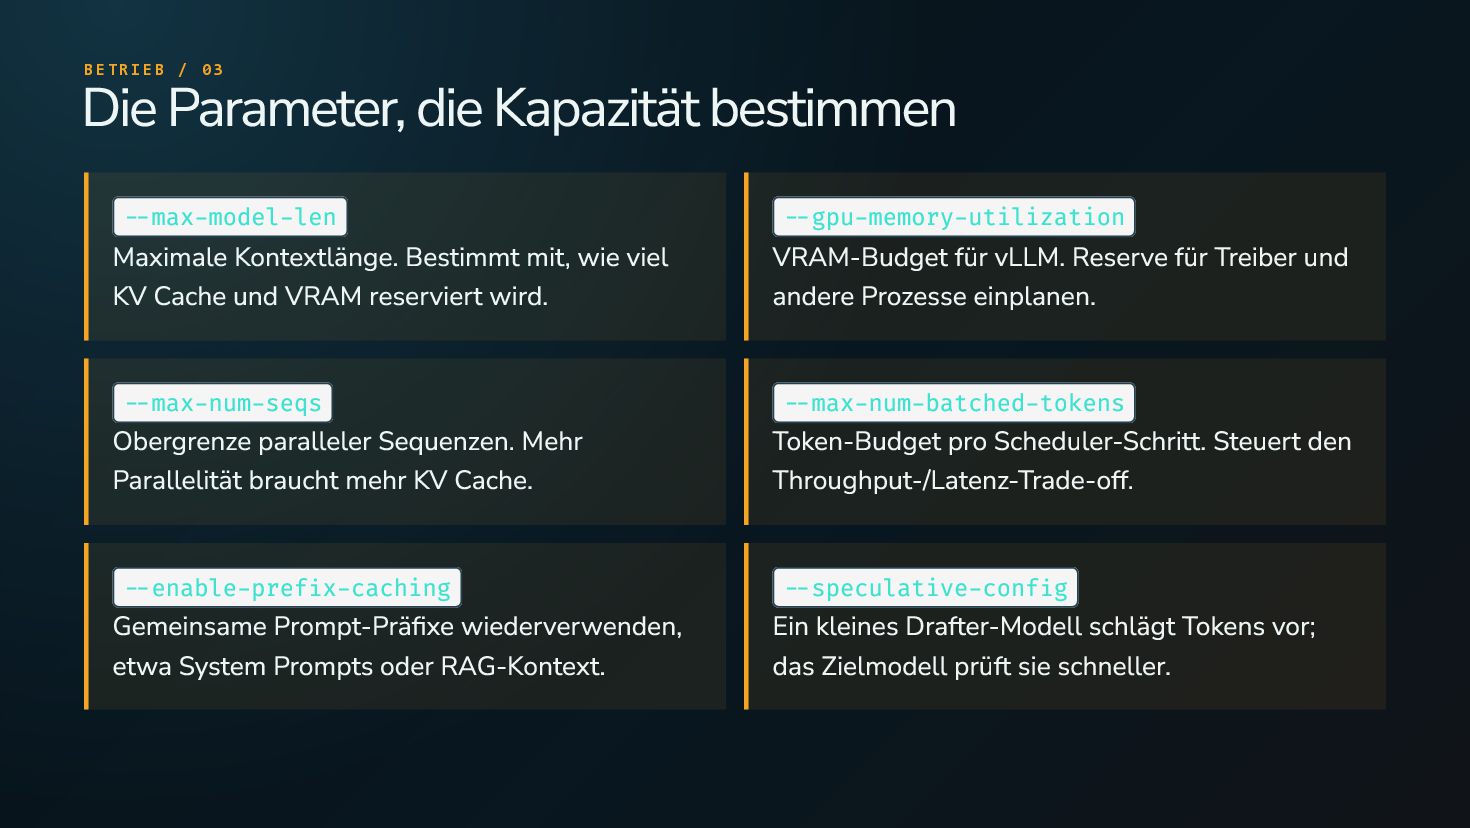
Themen: Open Weights und Modellnamen, Dense vs. MoE, Quantisierung (FP8/FP4), Continuous Batching, Benchmarks auf dem NVIDIA DGX Spark (GB10, 128 GB Unified Memory) sowie der Betrieb mit Hugging Face, Docker und den wichtigsten vLLM-Startparametern.
https://www.linkedin.com/in/marco-wagner-551562b2


 sh_fk2
 riyaamemiya
 codmoninc
 gree_tech
 kzkhykw1991
 raspython3
 bengo4com
 ezaki
 satoshi7
 pfn
 genda
 finengine
 samanthasiow
 marketingsoph
 wayneb77
 sferik
 cromwellryan
 addyosmani
 orderedlist
 quramy
 jonoalderson
 bermonpainter
 skipperchong
 brad_frost