Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ストリーム処理基盤のFlink移行検証と適材適所の実践
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Recruit
PRO
June 09, 2026
Technology
160
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ストリーム処理基盤のFlink移行検証と適材適所の実践
2026/6/2に、Data Streaming World Tour 2026で発表した田村の資料になります。
Recruit
PRO
June 09, 2026
More Decks by Recruit
See All by Recruit
実体験から学ぶ分析エージェントの開発と運⽤
recruitengineers
PRO
8
2.4k
大規模フロントエンド開発におけるmonorepoという選択肢
recruitengineers
PRO
2
87
自律型 AI をセキュアに実装!Gemini と MIG で作る動的コード実行環境
recruitengineers
PRO
1
260
Google Cloud Next Tokyo 26登壇時のスクリプト
recruitengineers
PRO
0
250
つくって納得、つかって実感! 大規模言語モデルことはじめ ver2.0
recruitengineers
PRO
6
2.7k
ブラウザ研修 2026
recruitengineers
PRO
8
2k
事業価値と Engineering 2026年度版
recruitengineers
PRO
59
30k
トヨタ⽣産⽅式(TPS)⼊⾨
recruitengineers
PRO
3
1.5k
JavaScript 研修 (2026)
recruitengineers
PRO
2
960
Other Decks in Technology
See All in Technology
Claude の新機能を、 出た日に触って社内に届けるまで
rfdnxbro
1
160
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
5
4.8k
20261017福岡devIO 「AIは"良いダッシュボード"を作れるか?
jtakeda
0
110
AI導入は済んだ。次は統制を作り替える番だ_AI×開発組織 Summit 2026
techtekt
PRO
0
190
AI × アーキテクト 第1・2章|生成AIの課題とアーキテクトの素養
daidaidai
0
140
Railsで挑む大量データ永続化 〜600億件を永続化するための設計とボトルネックとの戦い〜
occhi
1
570
アウトプット初心者、半年間のふりかえり
4o1sobblue
0
430
ブラウザとサーバーから考えるAI時代のフロントエンド監視
shogo4131
3
930
AI駆動開発の時代になったのでトヨタ生産方式から見直す
terurou
7
6k
PagerDuty Tech Hub-鳴らすけれど、人は動かない
ezaki
0
160
初海外で注意すべきこと12選!!!安全快適なre:invent生活にするために
yuuuuuuu168
1
140
『SAR衛星データ解析入門』の ご紹介とその応用
syuchimu
0
120
Featured
See All Featured
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
280
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Become a Pro
speakerdeck
PRO
31
6.3k
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
820
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
We Analyzed 250 Million AI Search Results: Here's What I Found
joshbly
2
2k
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
3
3.9k
Lightning Talk: Beautiful Slides for Beginners
inesmontani
PRO
2
730
Sam Torres - BigQuery for SEOs
techseoconnect
PRO
0
580
YesSQL, Process and Tooling at Scale
rocio
174
15k
Transcript
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved ストリーム処理基盤の
Flink移行検証と適材適所の実践 株式会社インディードリクルートテクノロジーズ プロダクト統括本部 データ データソリューションユニット データエンジニアリング部 田村 優友 2026/06/02 Data Streaming World Tour 2026: Tokyo
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 株式会社インディードリクルートテクノロジーズ
プロダクト統括本部 データ データソリューションユニット データエンジニアリング部 2015-2021 大手メーカーでWebアプリケーションの開発に従事 2021-2024 株式会社リクルートにキャリア入社 HRプロダクトのデータエンジニアとして データ基盤やAPI、ETLパイプラインの開発を担当 2025-現在 組織再編に伴い株式会社インディードリクルート テクノロジーズへ出向 引き続きHRプロダクトのデータエンジニアとして従事 田村 優友 Tamura Yusuke 写真 Profile 経歴 所属 2
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 3
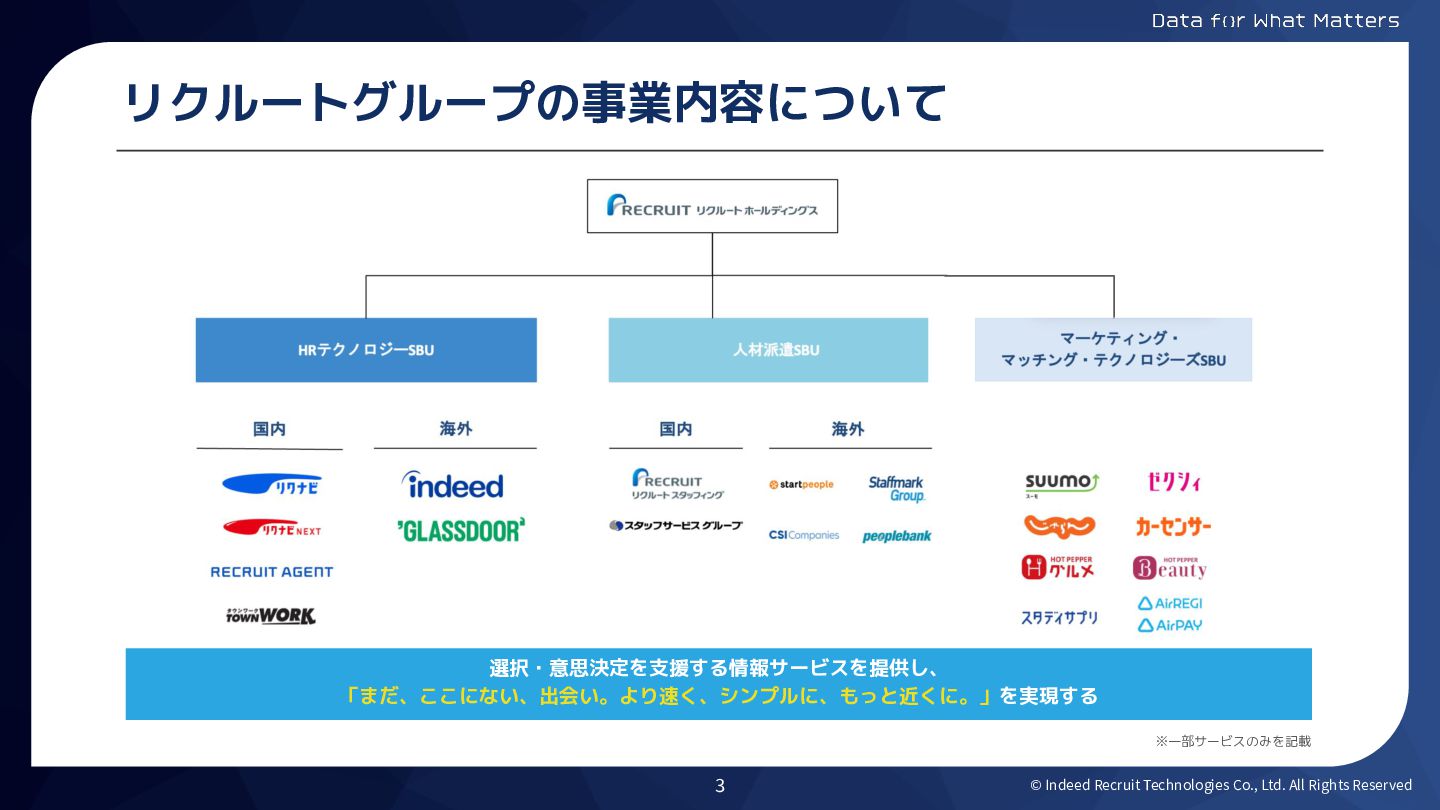
リクルートグループの事業内容について 選択・意思決定を支援する情報サービスを提供し、 「まだ、ここにない、出会い。より速く、シンプルに、もっと近くに。」を実現する ※一部サービスのみを記載
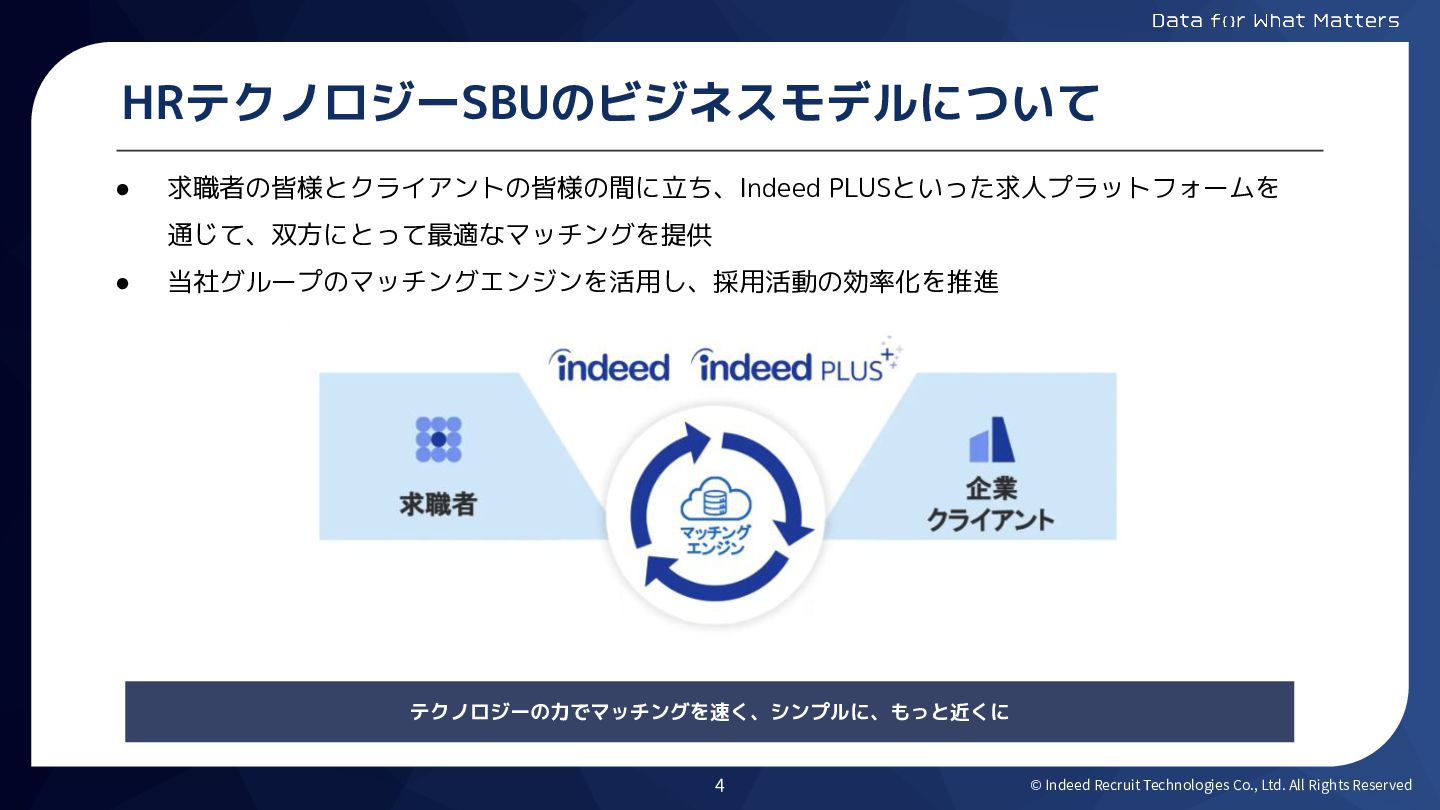
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved HRテクノロジーSBUのビジネスモデルについて
テクノロジーの力でマッチングを速く、シンプルに、もっと近くに • 求職者の皆様とクライアントの皆様の間に立ち、Indeed PLUSといった求人プラットフォームを 通じて、双方にとって最適なマッチングを提供 • 当社グループのマッチングエンジンを活用し、採用活動の効率化を推進 4
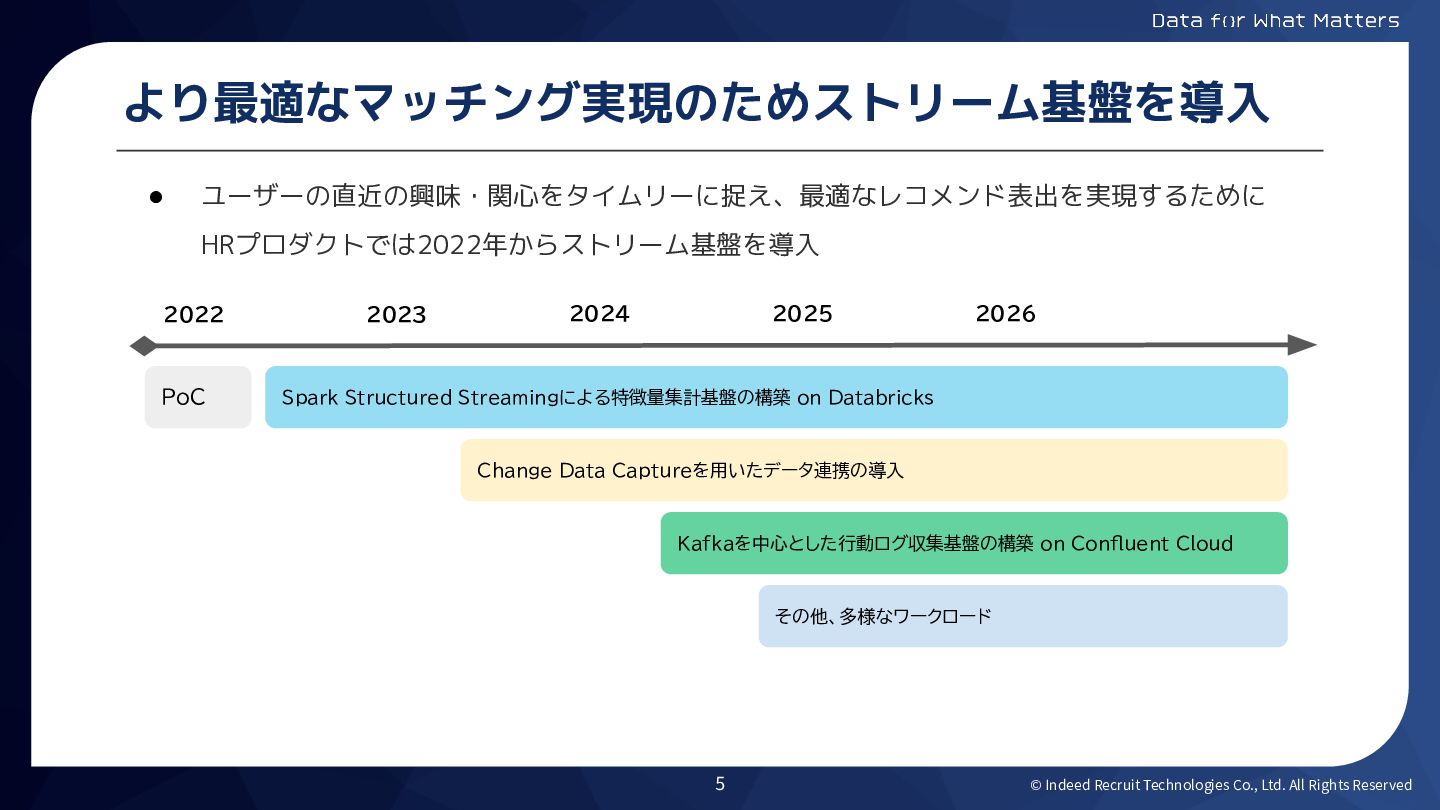
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved より最適なマッチング実現のためストリーム基盤を導入
• ユーザーの直近の興味・関心をタイムリーに捉え、最適なレコメンド表出を実現するために HRプロダクトでは2022年からストリーム基盤を導入 2022 PoC Spark Structured Streamingによる特徴量集計基盤の構築 on Databricks Change Data Captureを用いたデータ連携の導入 Kafkaを中心とした行動ログ収集基盤の構築 on Confluent Cloud 2023 2024 2025 2026 その他、多様なワークロード 5
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 本日の内容
6 • Spark Structured Streaming を用いた現行の機械学習モデル向けの特徴量集計基盤が抱える レイテンシとコストの課題 • 上記の Confluent Cloud for Apache Flink への移行検証プロセス • ワークロードの特性に応じた Flink と Spark の使い分けと判断基準
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 移行検証
概要
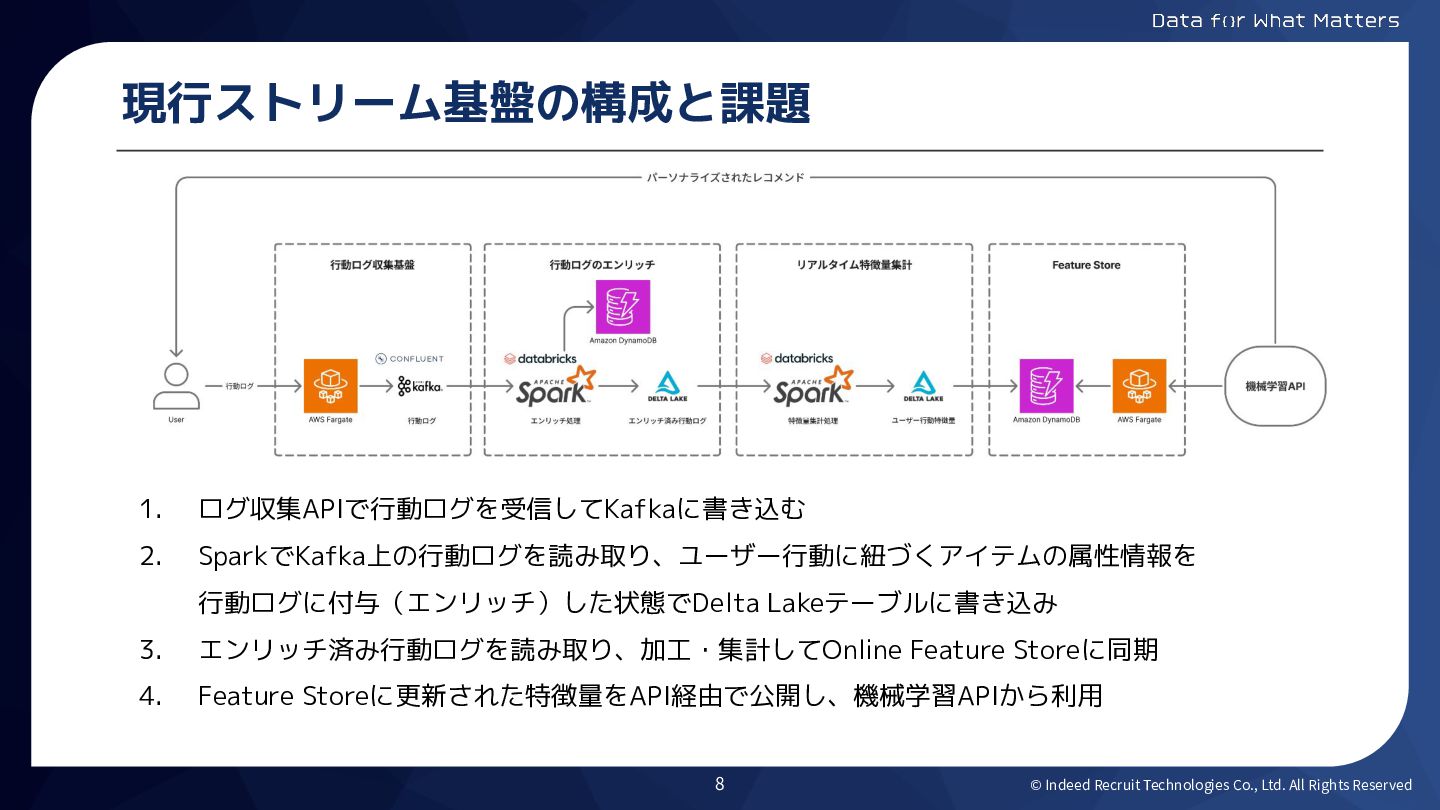
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 現行ストリーム基盤の構成と課題
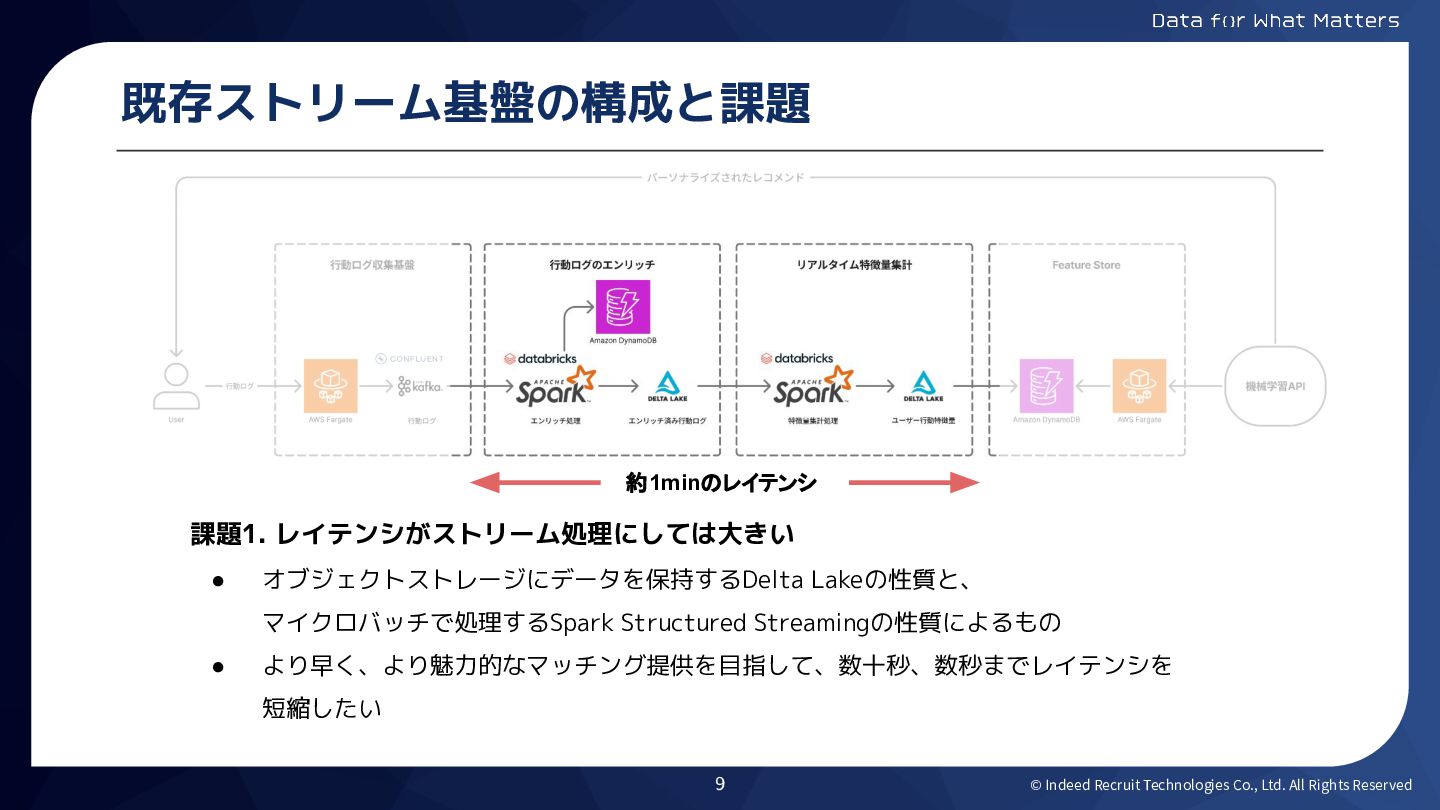
1. ログ収集APIで行動ログを受信してKafkaに書き込む 2. SparkでKafka上の行動ログを読み取り、ユーザー行動に紐づくアイテムの属性情報を 行動ログに付与(エンリッチ)した状態でDelta Lakeテーブルに書き込み 3. エンリッチ済み行動ログを読み取り、加工・集計してOnline Feature Storeに同期 4. Feature Storeに更新された特徴量をAPI経由で公開し、機械学習APIから利用 8
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 既存ストリーム基盤の構成と課題
約1minのレイテンシ 課題1. レイテンシがストリーム処理にしては大きい • オブジェクトストレージにデータを保持するDelta Lakeの性質と、 マイクロバッチで処理するSpark Structured Streamingの性質によるもの • より早く、より魅力的なマッチング提供を目指して、数十秒、数秒までレイテンシを 短縮したい 9
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 既存ストリーム基盤の構成と課題
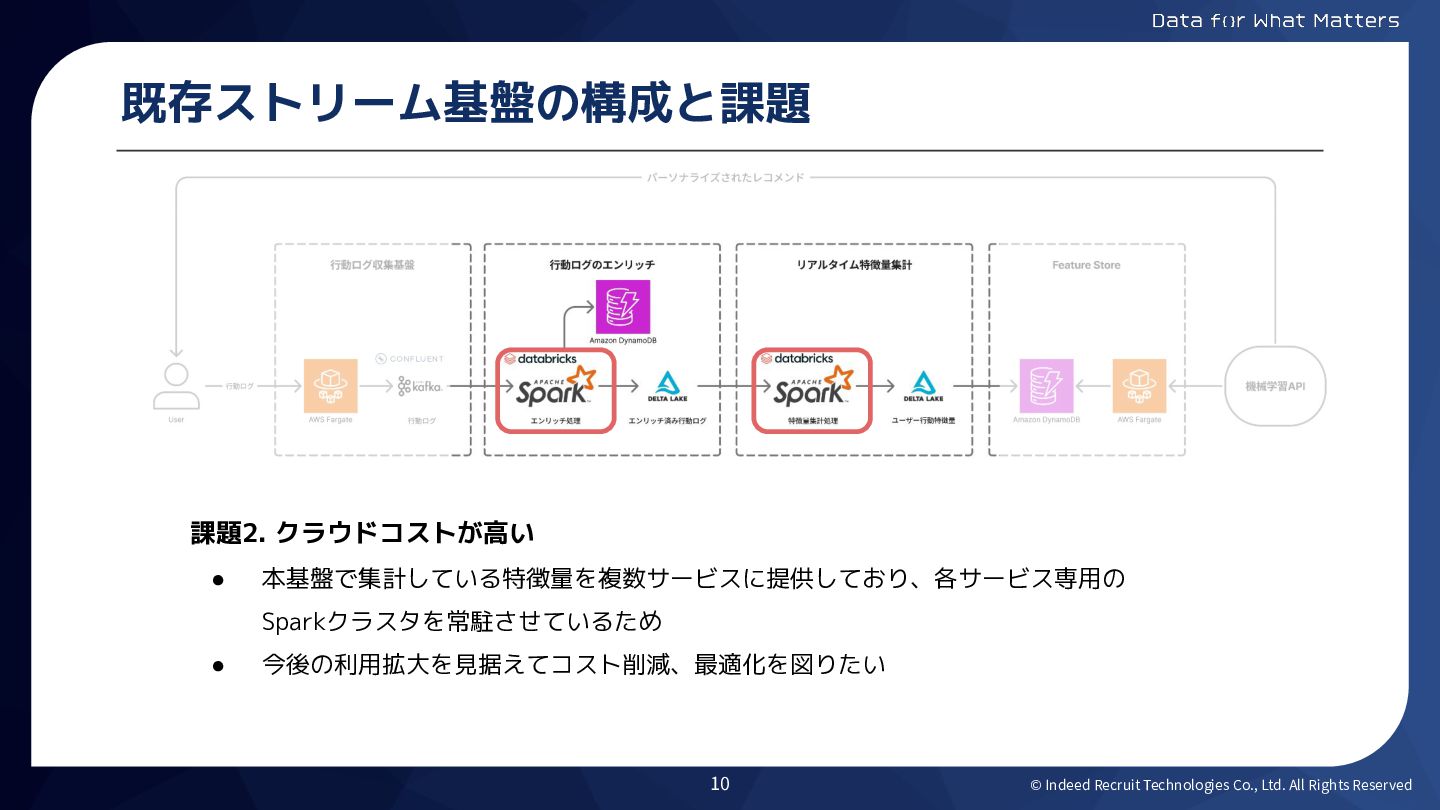
課題2. クラウドコストが高い • 本基盤で集計している特徴量を複数サービスに提供しており、各サービス専用の Sparkクラスタを常駐させているため • 今後の利用拡大を見据えてコスト削減、最適化を図りたい 10
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved Flink移行検証の目的とスコープ
スコープ • 行動ログのエンリッチ処理 • リアルタイム特徴量集計処理 目的 • Confluent Cloud for Apache Flink の採用により、前述したレイテンシとコストの課題が 解決できるかを見定める ◦ Confluent Cloud for Apache Flink がフルマネージドかつサーバーレスであるため、 副次的効果として運用コストの削減も狙う • 現行基盤(Spark Structured Streaming + DeltaTable)との比較を通して、 HRプロダクトにおけるストリーム処理の実装方針を定める 11
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 行動ログのエンリッチ処理の移行
検証 1
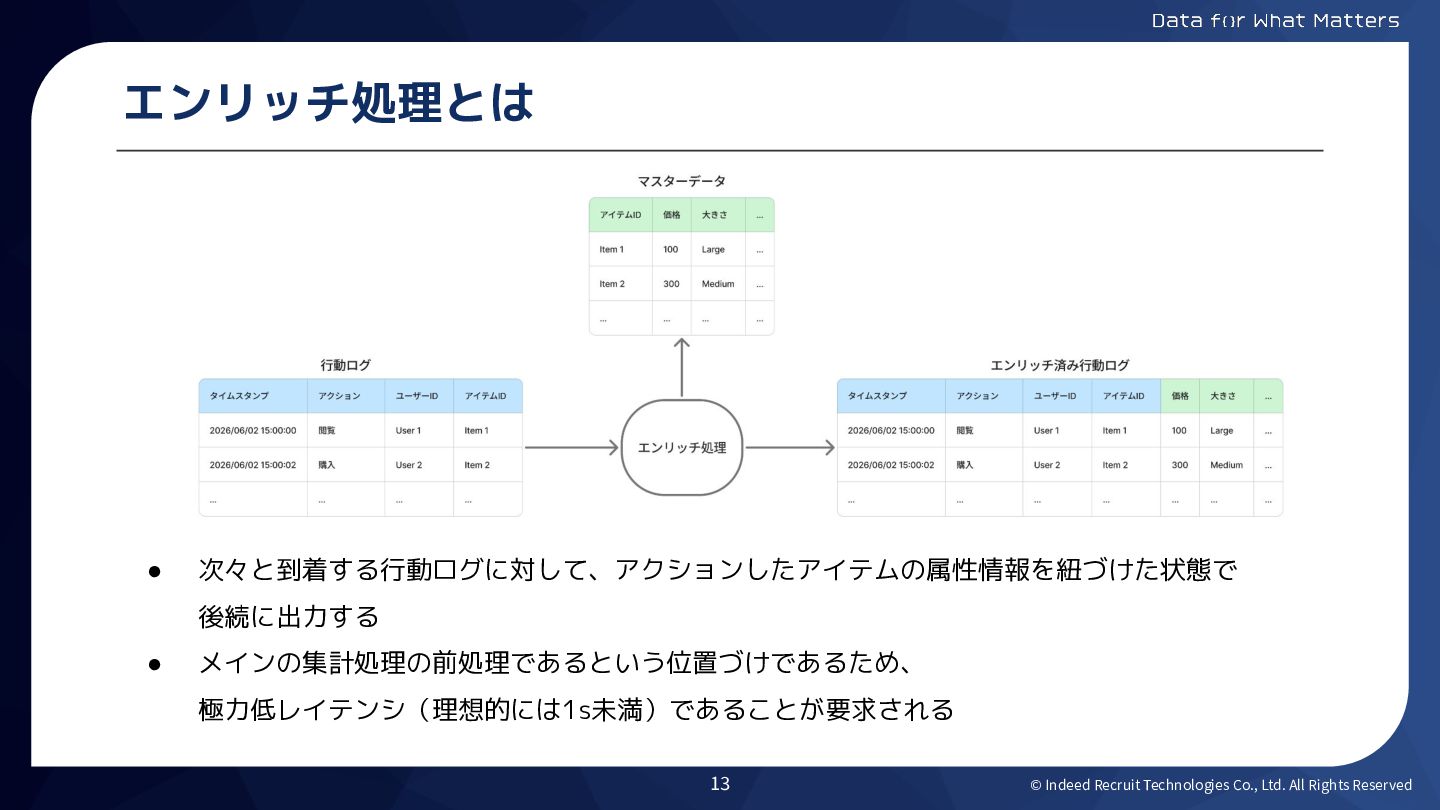
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved エンリッチ処理とは
• 次々と到着する行動ログに対して、アクションしたアイテムの属性情報を紐づけた状態で 後続に出力する • メインの集計処理の前処理であるという位置づけであるため、 極力低レイテンシ(理想的には1s未満)であることが要求される 13
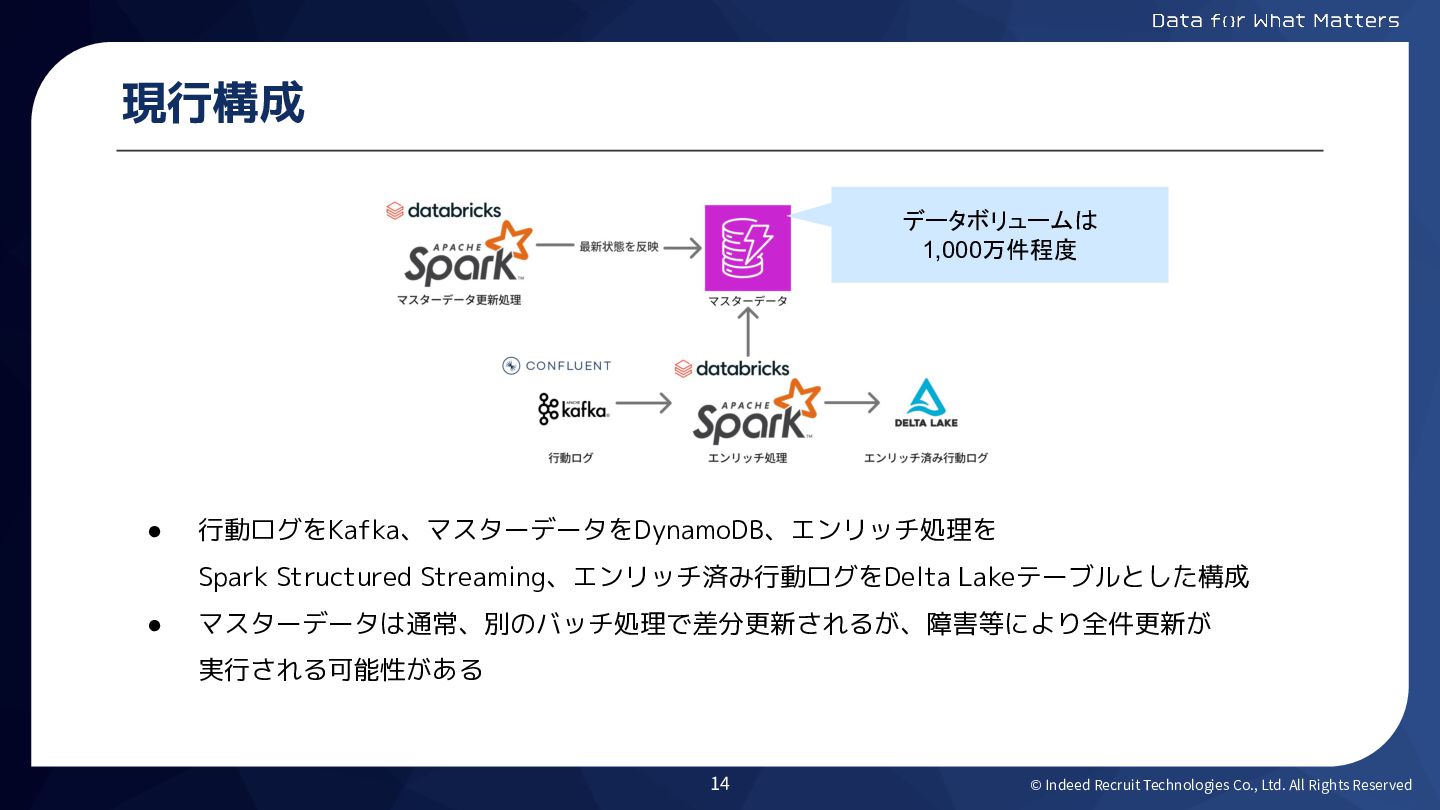
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 現行構成
• 行動ログをKafka、マスターデータをDynamoDB、エンリッチ処理を Spark Structured Streaming、エンリッチ済み行動ログをDelta Lakeテーブルとした構成 • マスターデータは通常、別のバッチ処理で差分更新されるが、障害等により全件更新が 実行される可能性がある データボリュームは 1,000万件程度 14
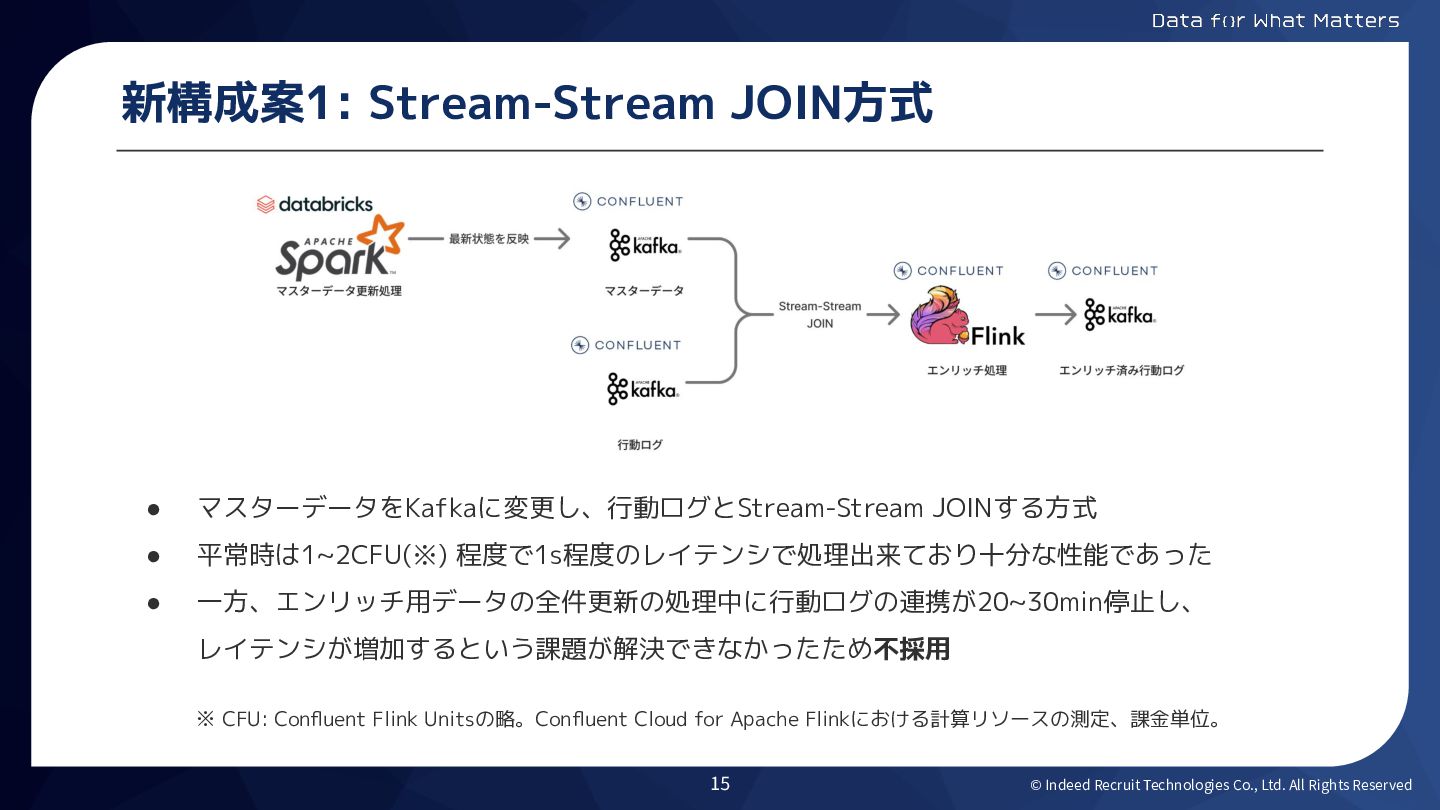
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 新構成案1:
Stream-Stream JOIN方式 • マスターデータをKafkaに変更し、行動ログとStream-Stream JOINする方式 • 平常時は1~2CFU(※) 程度で1s程度のレイテンシで処理出来ており十分な性能であった • 一方、エンリッチ用データの全件更新の処理中に行動ログの連携が20~30min停止し、 レイテンシが増加するという課題が解決できなかったため不採用 15 ※ CFU: Confluent Flink Unitsの略。Confluent Cloud for Apache Flinkにおける計算リソースの測定、課金単位。
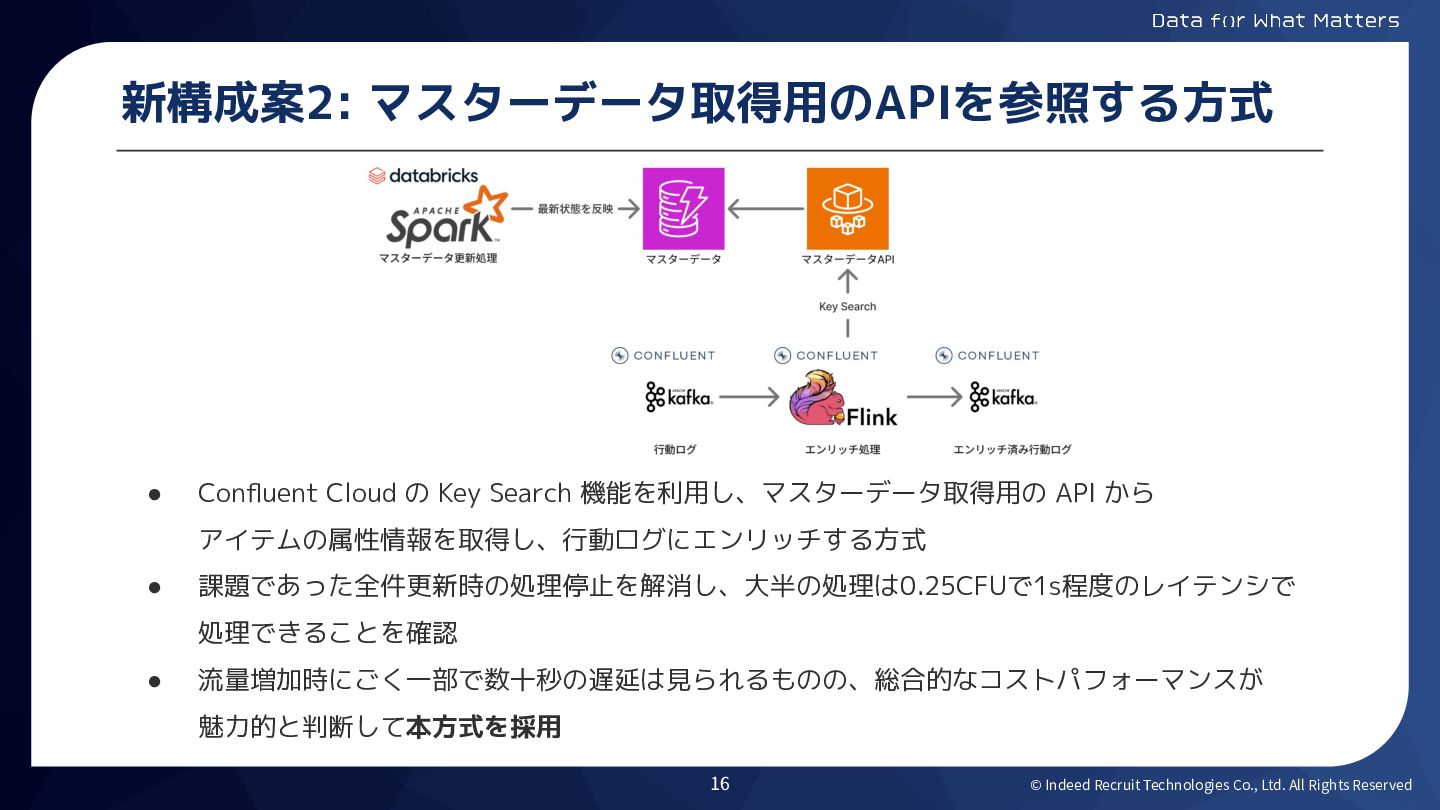
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 新構成案2:
マスターデータ取得用のAPIを参照する方式 • Confluent Cloud の Key Search 機能を利用し、マスターデータ取得用の API から アイテムの属性情報を取得し、行動ログにエンリッチする方式 • 課題であった全件更新時の処理停止を解消し、大半の処理は0.25CFUで1s程度のレイテンシで 処理できることを確認 • 流量増加時にごく一部で数十秒の遅延は見られるものの、総合的なコストパフォーマンスが 魅力的と判断して本方式を採用 16
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 特徴量集計処理の移行
検証 2
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 特徴量集計処理とは
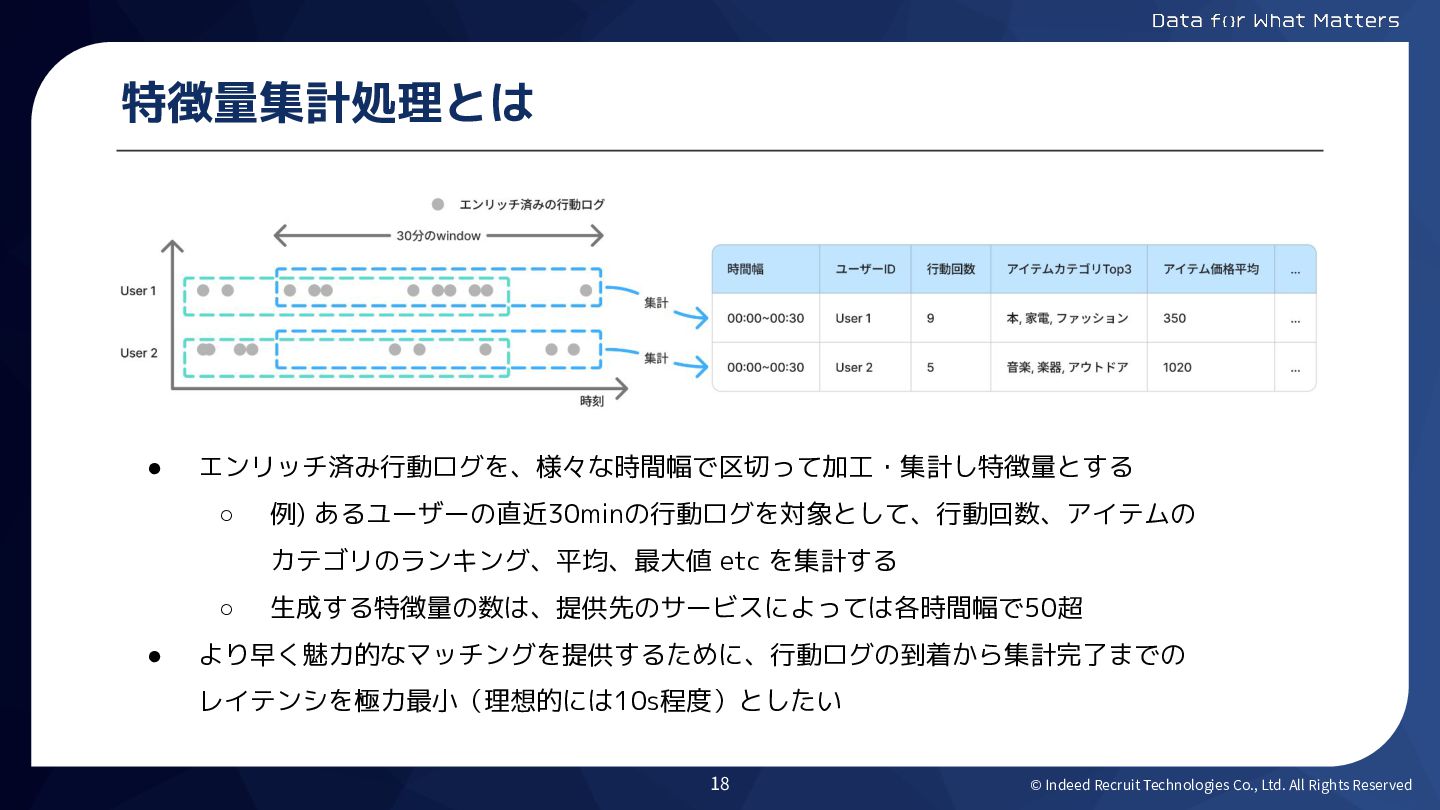
• エンリッチ済み行動ログを、様々な時間幅で区切って加工・集計し特徴量とする ◦ 例) あるユーザーの直近30minの行動ログを対象として、行動回数、アイテムの カテゴリのランキング、平均、最大値 etc を集計する ◦ 生成する特徴量の数は、提供先のサービスによっては各時間幅で50超 • より早く魅力的なマッチングを提供するために、行動ログの到着から集計完了までの レイテンシを極力最小(理想的には10s程度)としたい 18
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 現行構成
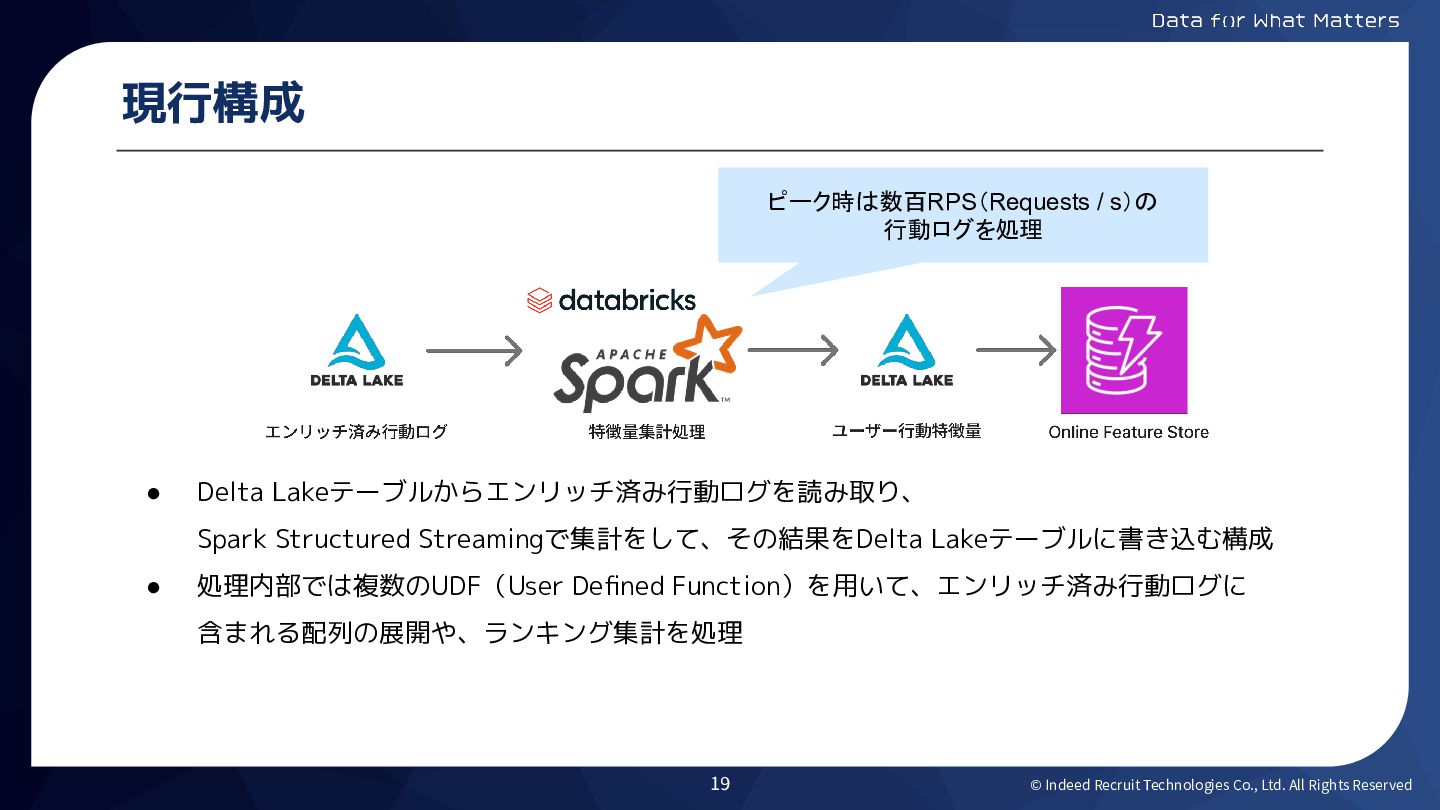
• Delta Lakeテーブルからエンリッチ済み行動ログを読み取り、 Spark Structured Streamingで集計をして、その結果をDelta Lakeテーブルに書き込む構成 • 処理内部では複数のUDF(User Defined Function)を用いて、エンリッチ済み行動ログに 含まれる配列の展開や、ランキング集計を処理 ピーク時は数百RPS(Requests / s)の 行動ログを処理 19
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 現行の特徴量集計処理の内訳
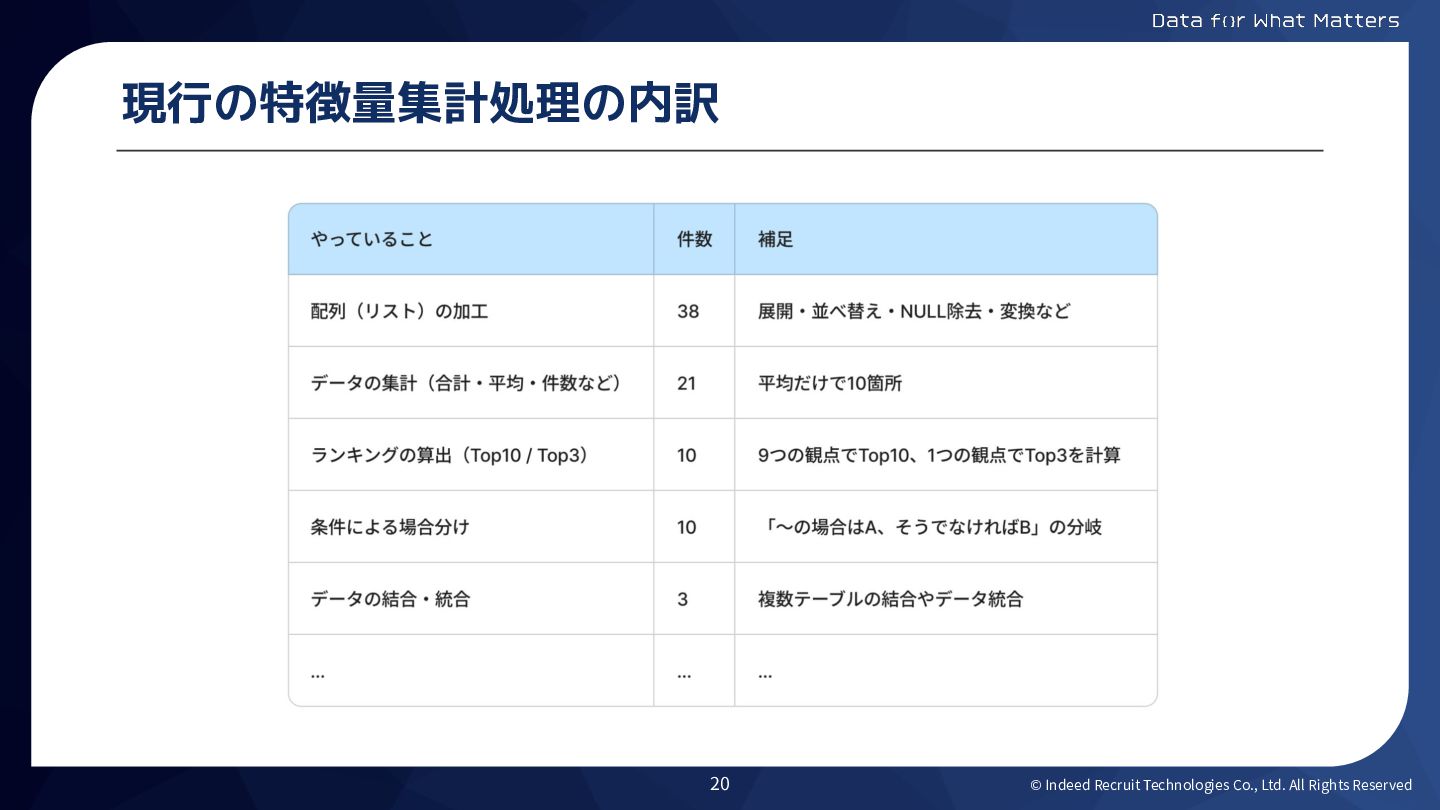
20
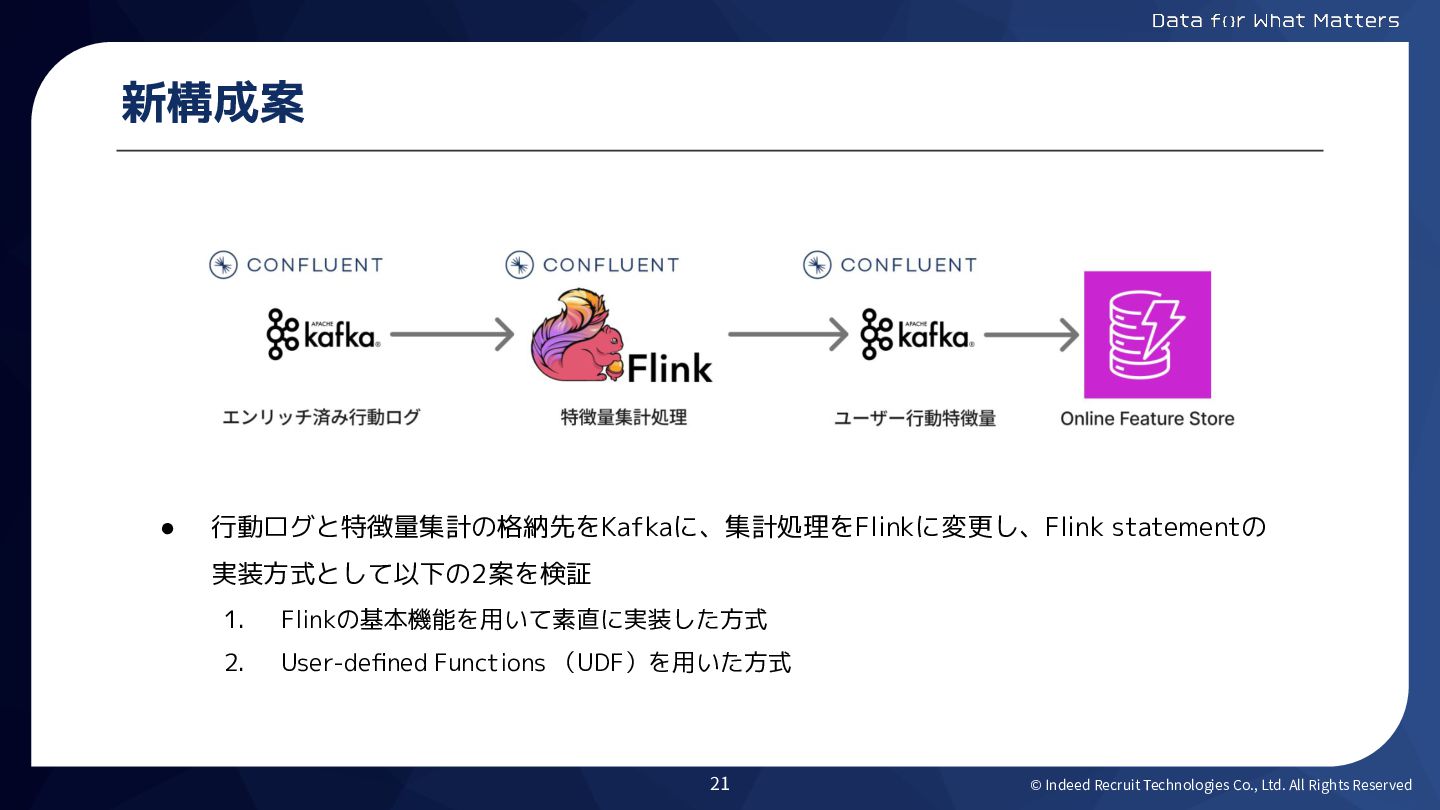
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 新構成案
• 行動ログと特徴量集計の格納先をKafkaに、集計処理をFlinkに変更し、Flink statementの 実装方式として以下の2案を検証 1. Flinkの基本機能を用いて素直に実装した方式 2. User-defined Functions (UDF)を用いた方式 21
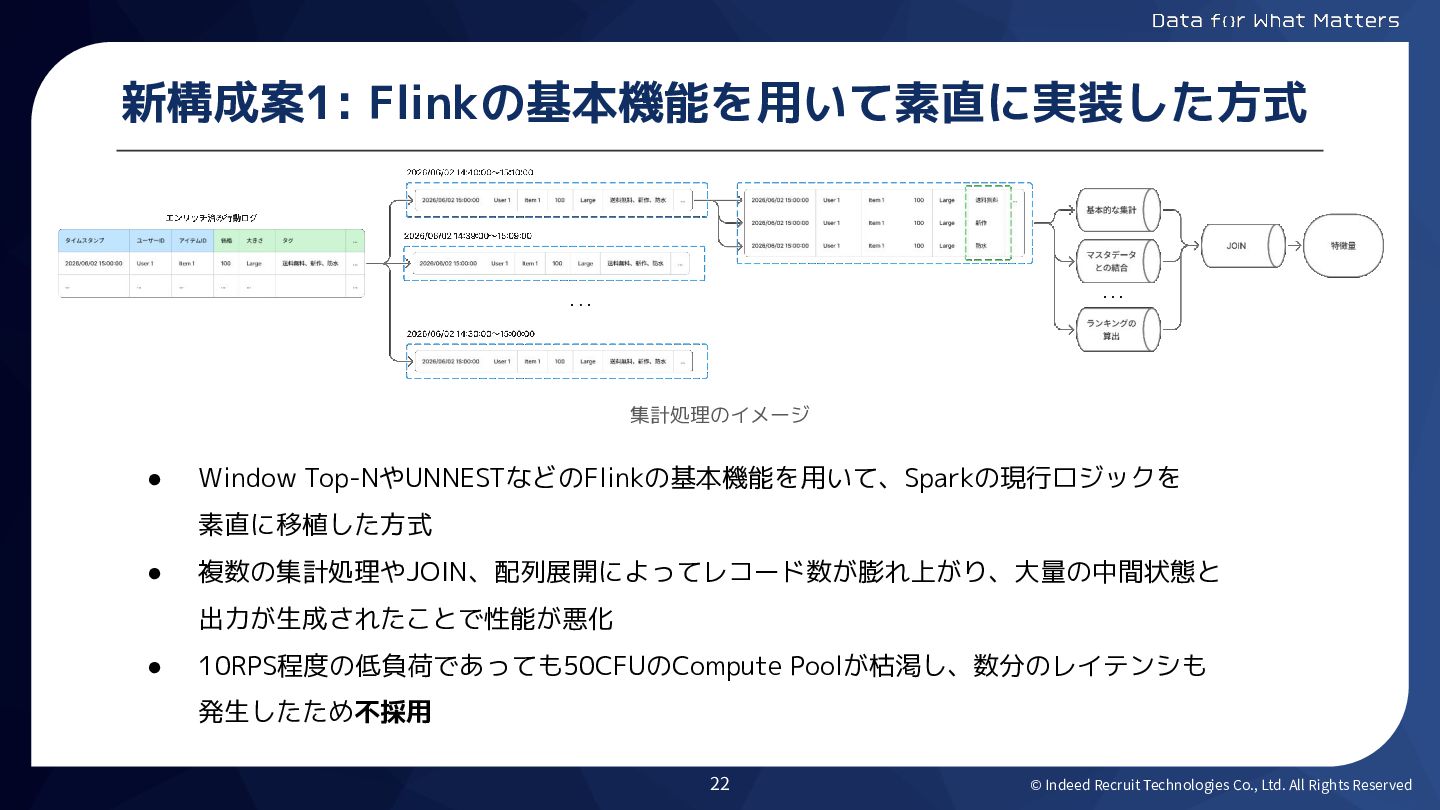
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 新構成案1:
Flinkの基本機能を用いて素直に実装した方式 • Window Top-NやUNNESTなどのFlinkの基本機能を用いて、Sparkの現行ロジックを 素直に移植した方式 • 複数の集計処理やJOIN、配列展開によってレコード数が膨れ上がり、大量の中間状態と 出力が生成されたことで性能が悪化 • 10RPS程度の低負荷であっても50CFUのCompute Poolが枯渇し、数分のレイテンシも 発生したため不採用 集計処理のイメージ 22
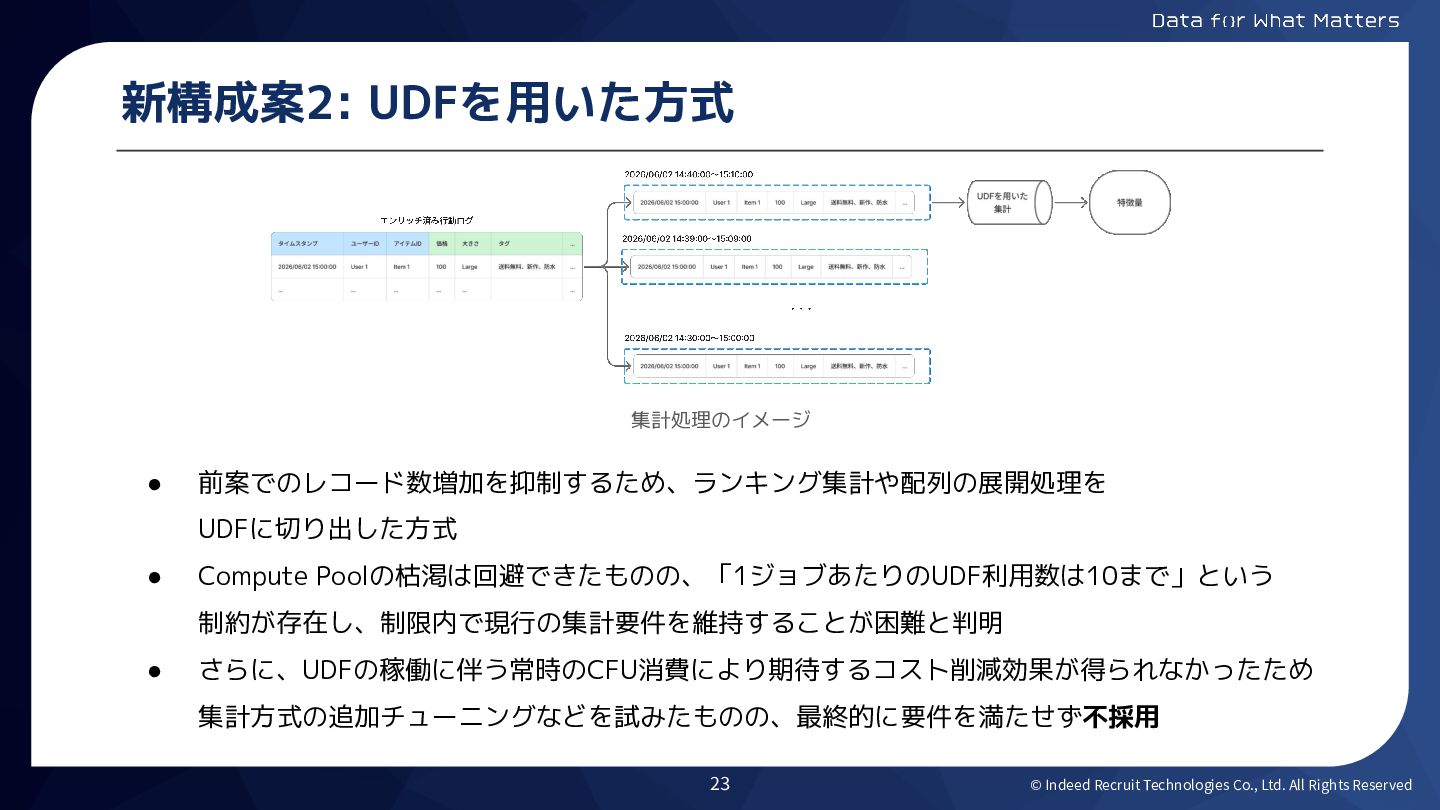
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 新構成案2:
UDFを用いた方式 • 前案でのレコード数増加を抑制するため、ランキング集計や配列の展開処理を UDFに切り出した方式 • Compute Poolの枯渇は回避できたものの、「1ジョブあたりのUDF利用数は10まで」という 制約が存在し、制限内で現行の集計要件を維持することが困難と判明 • さらに、UDFの稼働に伴う常時のCFU消費により期待するコスト削減効果が得られなかったため 集計方式の追加チューニングなどを試みたものの、最終的に要件を満たせず不採用 集計処理のイメージ 23
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved まとめ
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 結論
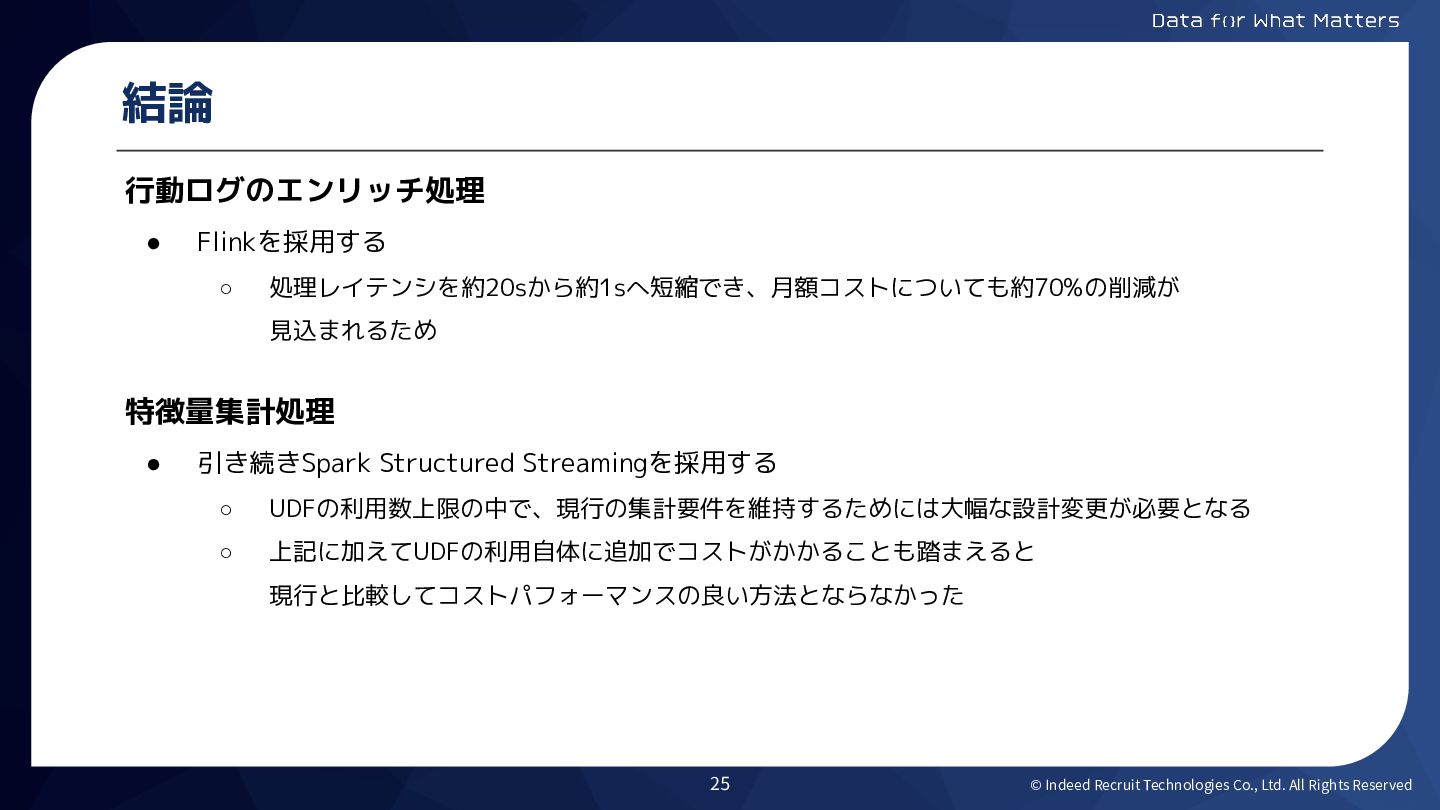
行動ログのエンリッチ処理 • Flinkを採用する ◦ 処理レイテンシを約20sから約1sへ短縮でき、月額コストについても約70%の削減が 見込まれるため 特徴量集計処理 • 引き続きSpark Structured Streamingを採用する ◦ UDFの利用数上限の中で、現行の集計要件を維持するためには大幅な設計変更が必要となる ◦ 上記に加えてUDFの利用自体に追加でコストがかかることも踏まえると 現行と比較してコストパフォーマンスの良い方法とならなかった 25
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved FlinkとSparkの使い分け
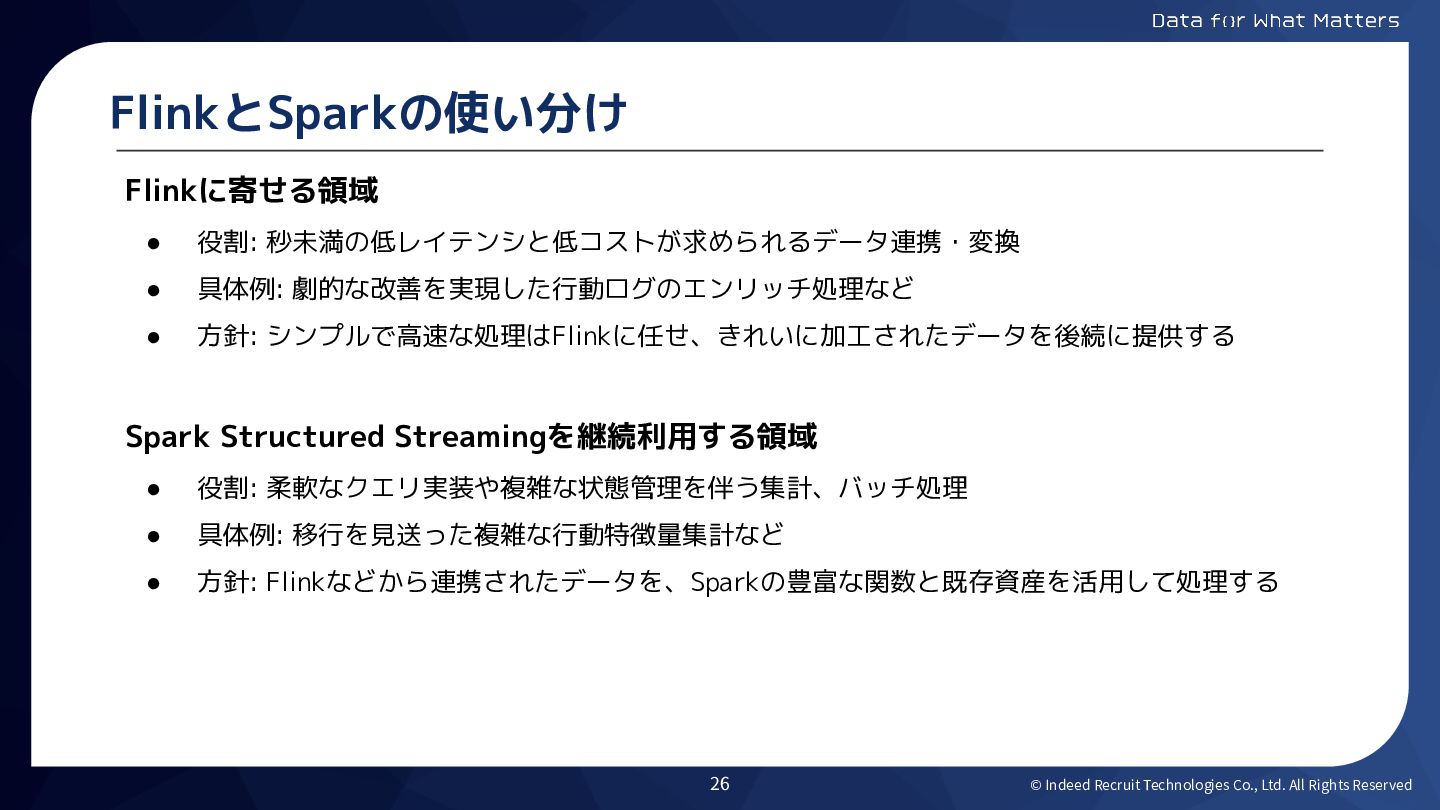
Flinkに寄せる領域 • 役割: 秒未満の低レイテンシと低コストが求められるデータ連携・変換 • 具体例: 劇的な改善を実現した行動ログのエンリッチ処理など • 方針: シンプルで高速な処理はFlinkに任せ、きれいに加工されたデータを後続に提供する Spark Structured Streamingを継続利用する領域 • 役割: 柔軟なクエリ実装や複雑な状態管理を伴う集計、バッチ処理 • 具体例: 移行を見送った複雑な行動特徴量集計など • 方針: Flinkなどから連携されたデータを、Sparkの豊富な関数と既存資産を活用して処理する 26
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 今後の展望
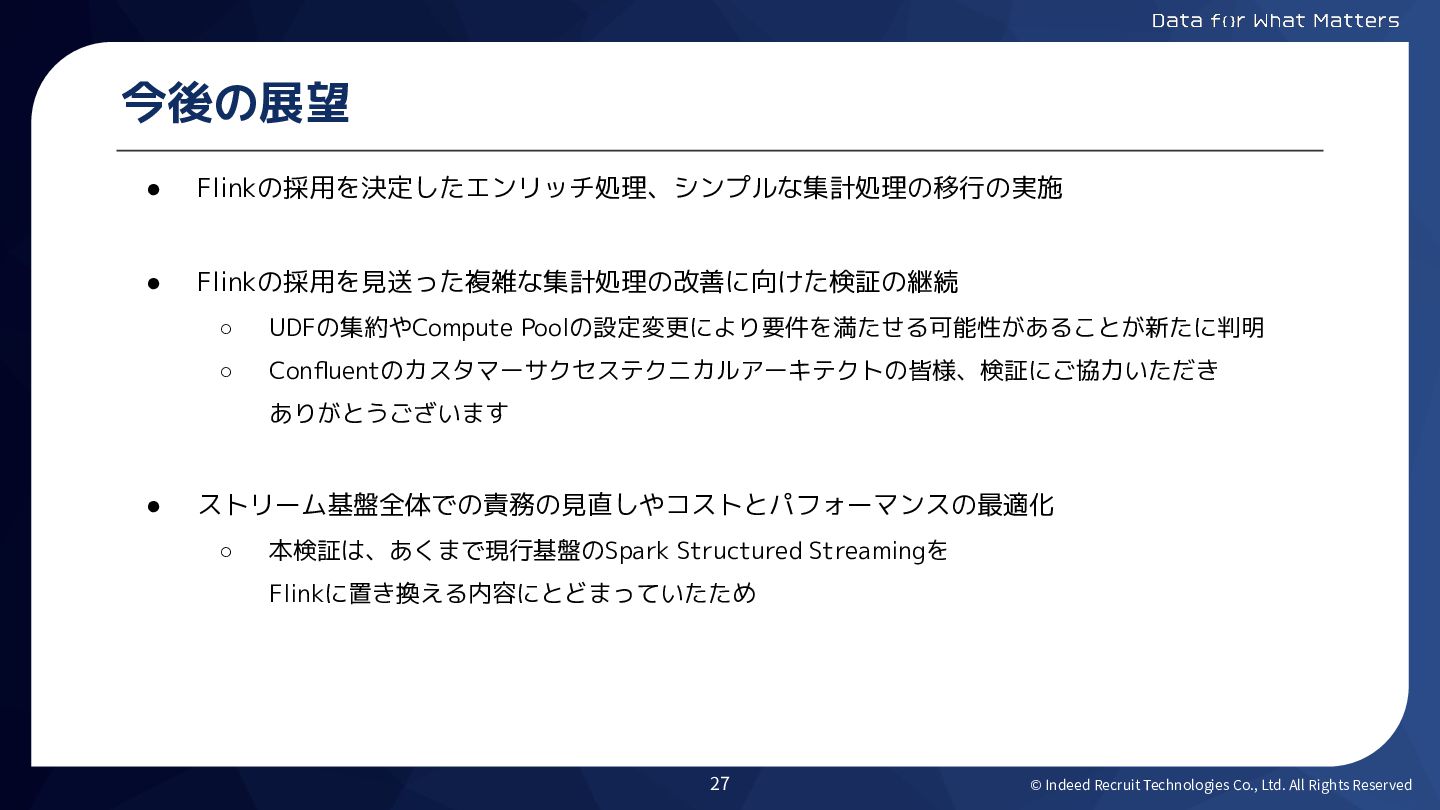
• Flinkの採用を決定したエンリッチ処理、シンプルな集計処理の移行の実施 • Flinkの採用を見送った複雑な集計処理の改善に向けた検証の継続 ◦ UDFの集約やCompute Poolの設定変更により要件を満たせる可能性があることが新たに判明 ◦ Confluentのカスタマーサクセステクニカルアーキテクトの皆様、検証にご協力いただき ありがとうございます • ストリーム基盤全体での責務の見直しやコストとパフォーマンスの最適化 ◦ 本検証は、あくまで現行基盤のSpark Structured Streamingを Flinkに置き換える内容にとどまっていたため 27
© Indeed Recruit Technologies Co., Ltd. All Rights Reserved 28
We are hiring! カジュアル面談はこちらより お申し込みください データサイエンティスト 機械学習エンジニア データエンジニア アナリティクスエンジニア R&Dエンジニア データアプリケーションエンジニア クラウドエンジニア


 recruitengineers
 rfdnxbro
 iktakahiro
 jtakeda
 techtekt
 daidaidai
 occhi
 4o1sobblue
 shogo4131
 terurou
 ezaki
 yuuuuuuu168
 syuchimu
 davidcarrasco
 tammyeverts
 danielanewman
 speakerdeck
 marcoroth
 maggiecrowley
 joshbly
 katarinadahlin
 inesmontani
 techseoconnect
 rocio