Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
第十章-教師なし学習【数学嫌いと学ぶデータサイエンス・統計的学習入門】
Search
Ringa_hyj
July 22, 2020
Technology
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
第十章-教師なし学習【数学嫌いと学ぶデータサイエンス・統計的学習入門】
第十章【数学嫌いと学ぶデータサイエンス・統計的学習入門】
Ringa_hyj
July 22, 2020
More Decks by Ringa_hyj
See All by Ringa_hyj
DVCによるデータバージョン管理
ringa_hyj
0
470
deeplakeによる大規模データのバージョン管理と深層学習フレームワークとの接続
ringa_hyj
0
120
Hydraを使った設定ファイル管理とoptunaプラグインでのパラメータ探索
ringa_hyj
0
250
ClearMLで行うAIプロジェクトの管理(レポート,最適化,再現,デプロイ,オーケストレーション)
ringa_hyj
0
300
Catching up with the tidymodels.[Japan.R 2021 LT]
ringa_hyj
3
890
多次元尺度法MDS
ringa_hyj
0
470
因子分析(仮)
ringa_hyj
0
230
階層、非階層クラスタリング
ringa_hyj
0
170
tidymodels紹介「モデリング過程料理で表現できる説」
ringa_hyj
0
700
Other Decks in Technology
See All in Technology
AI 時代のスタートアップエコシステ厶から考究する技術的負債との向き合い方
m3m0r7
PRO
3
2.6k
アクセスキーこわい やめかたと漏らさない工夫
sassssan68
1
730
Mastering Agentic Development: Harness Engineering for Effective Coding Agents
konippi
3
490
サーバーレスをどこまで使う? WebRTC対戦ゲームで選んだVPSとの共存設計
kaidouji85
0
400
リアーキテクチャ後の障害ゼロを目指したShadow Testingの取り組み
nihonbuson
PRO
1
180
Deployment の 先にある AI Agent 基盤 - kagent vNext、Agent Substrate、Hermes から読み解く Agent Runtime の現在地 / k8s-matsuri-2-ai-agent-platform-amsy810
masayaaoyama
5
720
「どのログを見ればいい?」 から始めた サーバーレス障害解析
y_waka1
1
140
AIエージェントを最高のパートナーに育てる方法|評価と判断軸を育てる5つのステップ
koichiaoki
1
160
現場で役立つ技術負債の効果的な返済方法
masuda220
PRO
11
5.2k
Railsのように考える: See through the Master
snoozer05
PRO
5
1.3k
え、こんなに早く改修できるの?──新人エンジニアとスクラムマスターの2人が語る、AI×アジャイル開発の現場
ysasago
2
720
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
16
120k
Featured
See All Featured
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
22k
How to make the Groovebox
asonas
2
2.5k
Visualization
eitanlees
153
17k
Joys of Absence: A Defence of Solitary Play
codingconduct
1
530
We Are The Robots
honzajavorek
0
380
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
310
Fantastic passwords and where to find them - at NoRuKo
philnash
52
3.9k
SEO for Brand Visibility & Recognition
aleyda
0
4.7k
Building AI with AI
inesmontani
PRO
1
1.2k
Claude Code のすすめ
schroneko
67
230k
How Software Deployment tools have changed in the past 20 years
geshan
1
34k
Testing 201, or: Great Expectations
jmmastey
46
8.3k
Transcript
@Ringa_hyj 日本一の数学嫌いと学ぶ データサイエンス ~第十章:教師なし学習~
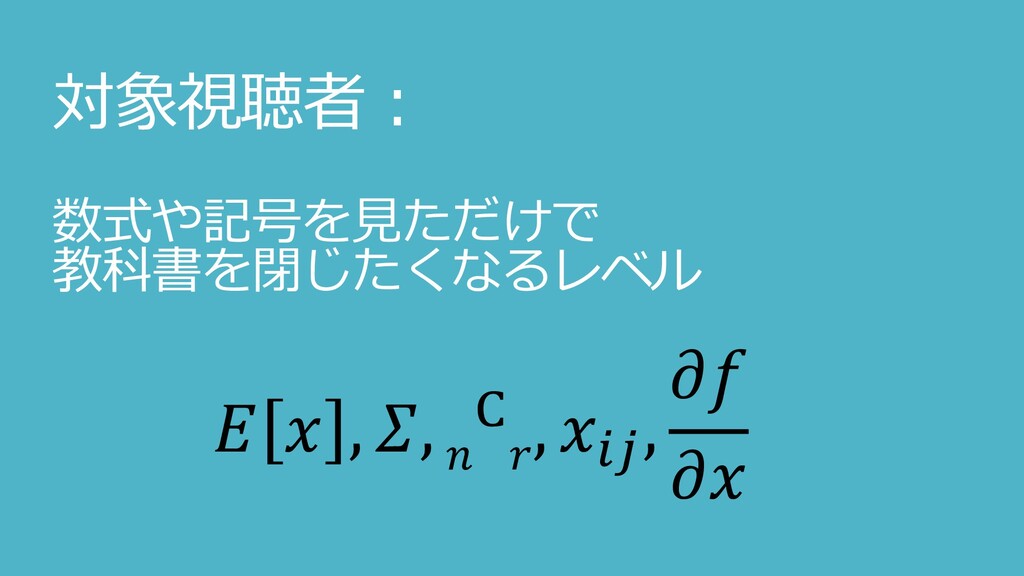
対象視聴者: 数式や記号を見ただけで 教科書を閉じたくなるレベル , , C , ,
教師なし学習 ・主成分分析 ・寄与度 ・クラスタリング ・k平均 ・階層的
教師なし学習
・教師なし学習 教師なし学習とは 教師ありと違い精度を確かめる方法がない データから知見を引き出すために使われる しかし、テストでの性能を測れないので汎化性に期待はできない 教師なし学習としては ・主成分分析 ・クラスタリング が有名である
主成分分析
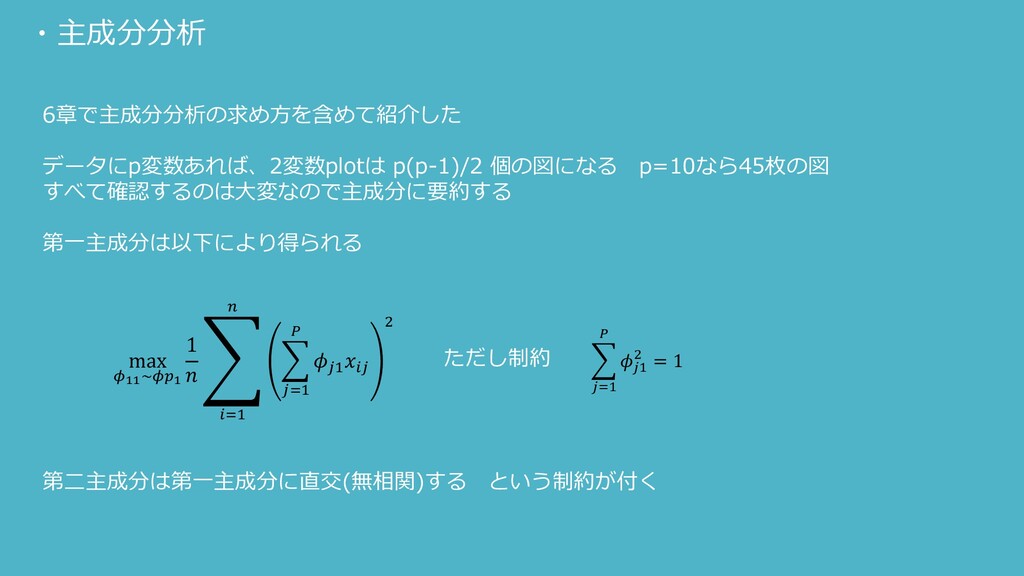
・主成分分析 6章で主成分分析の求め方を含めて紹介した データにp変数あれば、2変数plotは p(p-1)/2 個の図になる p=10なら45枚の図 すべて確認するのは大変なので主成分に要約する 第一主成分は以下により得られる max 11~1
1 ා =1 =1 1 2 =1 1 2 = 1 ただし制約 第二主成分は第一主成分に直交(無相関)する という制約が付く
・主成分分析 ・主成分が最良のM次元近似である 主成分とは、各データから近いように近似していく方法 1~M次元の主成分ベクトルと係数ベクトルは最良のM次元近似である Mを大きくしていけばp次元データに同じようになっていく ・標準化 主成分分析は事前に中心化する手法である 標準化すべきか、という議論については、単位が異なるならば行うことが推奨 単位が等しい中で標準化するのは比較できなくなるのでNG ・パッケージによる出力の違い
係数ベクトル、主成分スコアベクトルの符号がパッケージによって異なるが、 これは主成分軸の方向を表すものであり、符号以外は一致する このことを「符号を除いた一意性を持つ」という
寄与度
・主成分分析 どれだけ情報が失われているか 分散の割合 寄与率 によって考える データセット全体の分散の総和 =1 Var =
ා =1 1 =1 2 第m主成分での分散の総和は 1 =1 2 = 1 ා =1 =1 2 以上から第m主成分が全体から抽出できた情報量は以下 =1 =1 2 =1 =1 2
クラスタリング k平均
・クラスタリング クラスタリングには有名なものに ・K平均クラスタリング・・・クラスタを指定 ・階層的クラスタリングがある・・・デンドログラムからクラスタ数を決める
・クラスタリング ・K平均クラスタリング データはKクラスのいずれかに属する C1 ⋁ C2 ⋁ … Ck =
(1~n) 一つのデータの所属クラスが重複することはない K≠K’ で Ck ∧ Ck’ = ∅ iがCkのデータであるとき、 i∉Ck と表示する
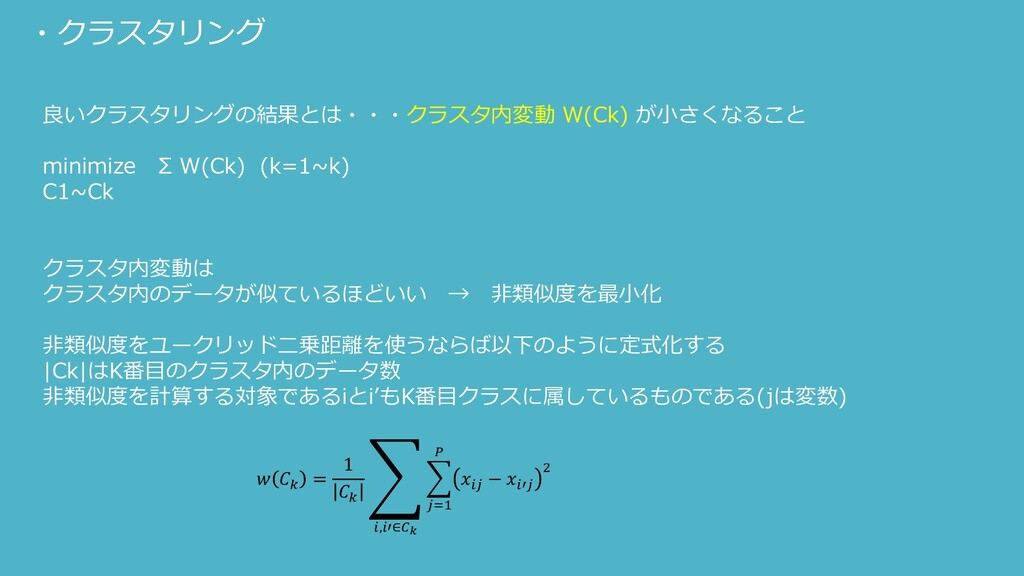
・クラスタリング 良いクラスタリングの結果とは・・・クラスタ内変動 W(Ck) が小さくなること minimize Σ W(Ck) (k=1~k) C1~Ck クラスタ内変動は
クラスタ内のデータが似ているほどいい → 非類似度を最小化 非類似度をユークリッド二乗距離を使うならば以下のように定式化する |Ck|はK番目のクラスタ内のデータ数 非類似度を計算する対象であるiとi’もK番目クラスに属しているものである(jは変数) = 1 ා ,′∈ =1 − ′ 2
・クラスタリング 全データを全クラスに割り当てて調べる場合、 n個をK個のクラスに分割するのは Kn通り 局所的最適解に陥るが以下の方法を繰りかえすことが主流 ①Kをいくつにするか決める 各データに1~kのクラスをランダムに割り当てる ②各クラスタの重心を求める ③各データと各重心のユークリッド距離を計算し、最も距離の近いクラスに割り当てなおす ②③を重心が変動しなくなるまで繰り返す。
この繰り返しは単調減少の性質を持つことを数式で表現する = 2 ා ∈ =1 − ҧ 2 = 1 ා ,′∈ =1 − ′ 2 クラス内変動が重心からの距離であると考えれば 重心は各データから最も近くなるまで移動するので、 この繰り返しによりクラスタ内変動は減少する ҧ = 1 ∈
クラスタリング 階層的クラスタリング
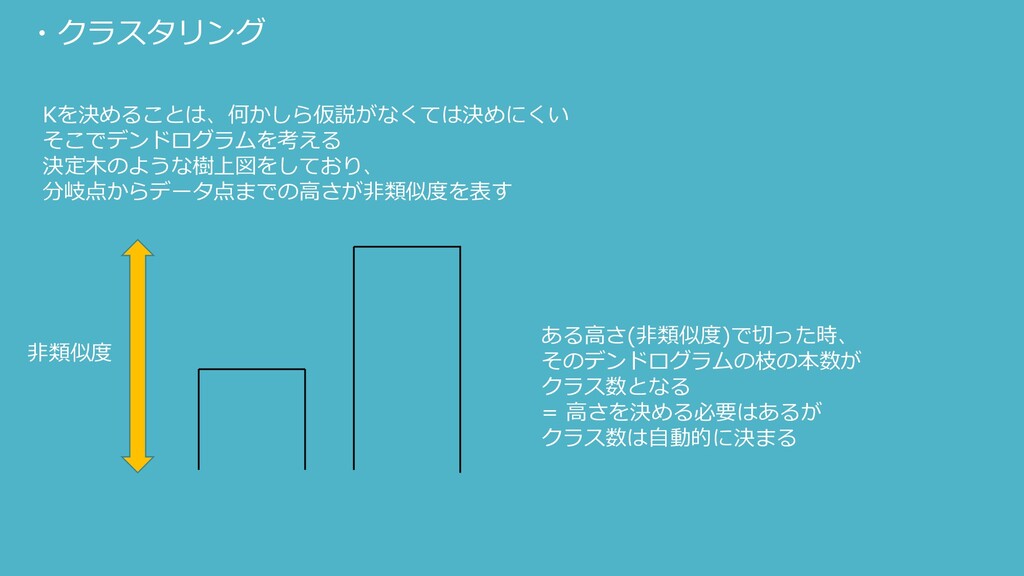
・クラスタリング Kを決めることは、何かしら仮説がなくては決めにくい そこでデンドログラムを考える 決定木のような樹上図をしており、 分岐点からデータ点までの高さが非類似度を表す 非類似度 ある高さ(非類似度)で切った時、 そのデンドログラムの枝の本数が クラス数となる =
高さを決める必要はあるが クラス数は自動的に決まる
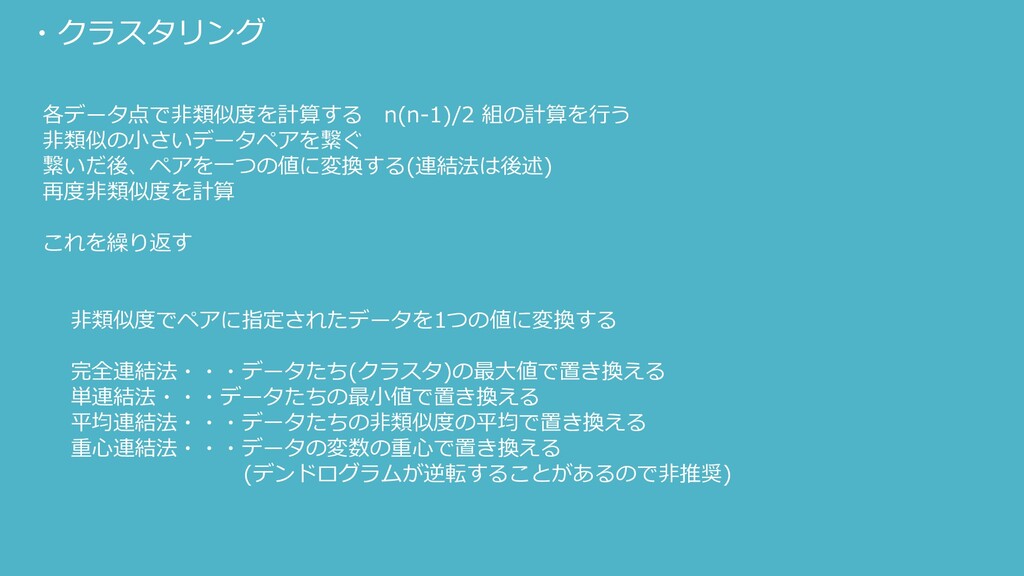
・クラスタリング 各データ点で非類似度を計算する n(n-1)/2 組の計算を行う 非類似の小さいデータペアを繋ぐ 繋いだ後、ペアを一つの値に変換する(連結法は後述) 再度非類似度を計算 これを繰り返す 非類似度でペアに指定されたデータを1つの値に変換する 完全連結法・・・データたち(クラスタ)の最大値で置き換える
単連結法・・・データたちの最小値で置き換える 平均連結法・・・データたちの非類似度の平均で置き換える 重心連結法・・・データの変数の重心で置き換える (デンドログラムが逆転することがあるので非推奨)
・クラスタリング 非類似度にどんな計算を使うか?(今回ユークリッド) 目的によっては距離でなく、相関をとらえる計算を行うべき クラスタリングには複数の決定すべき項目がある(正解はない) 中心化するか、標準化すべきか、類似度の関数、連結法、切断の高さ、初期クラスタ数 その項目によって結果(割り当てられたクラス)の解釈が変化してしまう クラスタにp値を割り当てるクラスタリングや 外れ値に強い混合モデルクラスタリングなどもある。
None
None


 ringa_hyj
 m3m0r7
 sassssan68
 konippi
 kaidouji85
 nihonbuson
 masayaaoyama
 y_waka1
 koichiaoki
 masuda220
 snoozer05
 ysasago
 oracle4engineer
 smashingmag
 asonas
 eitanlees
 codingconduct
 honzajavorek
 gurzu
 philnash
 aleyda
 inesmontani
 schroneko
 geshan
 jmmastey