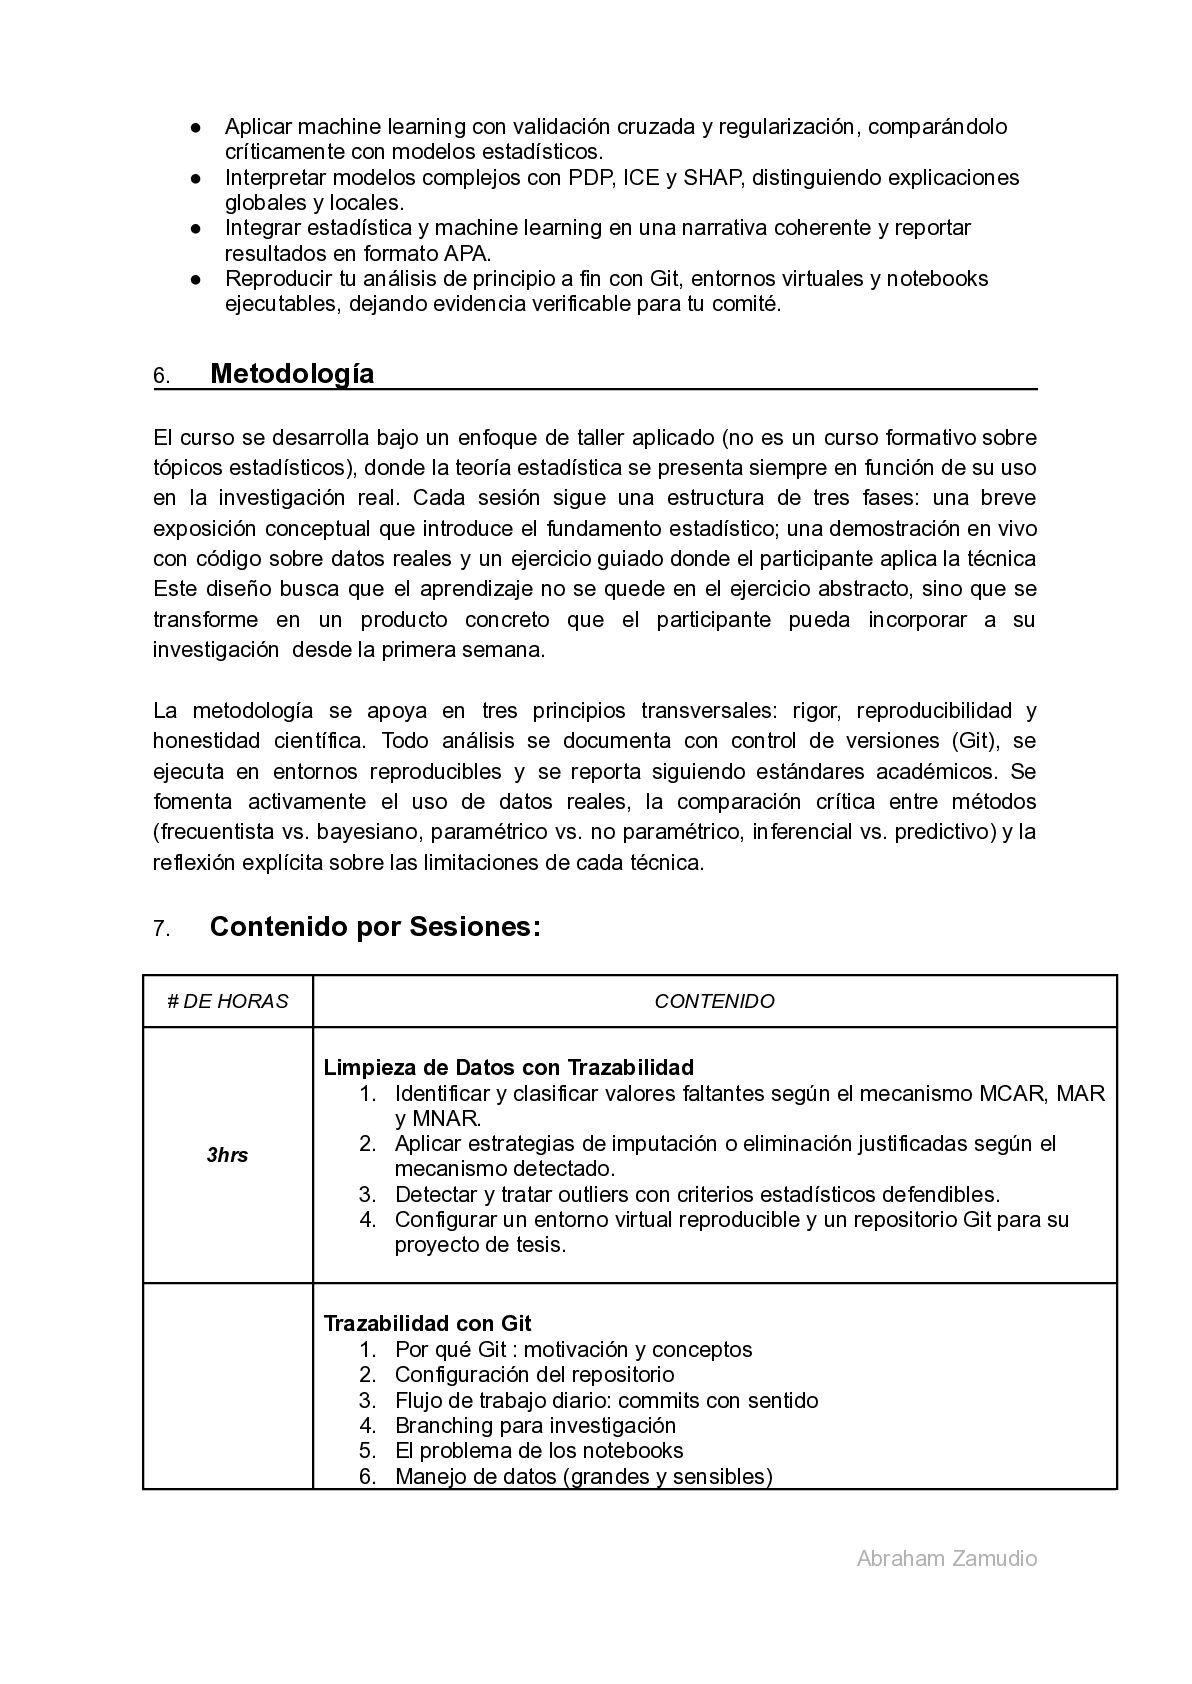
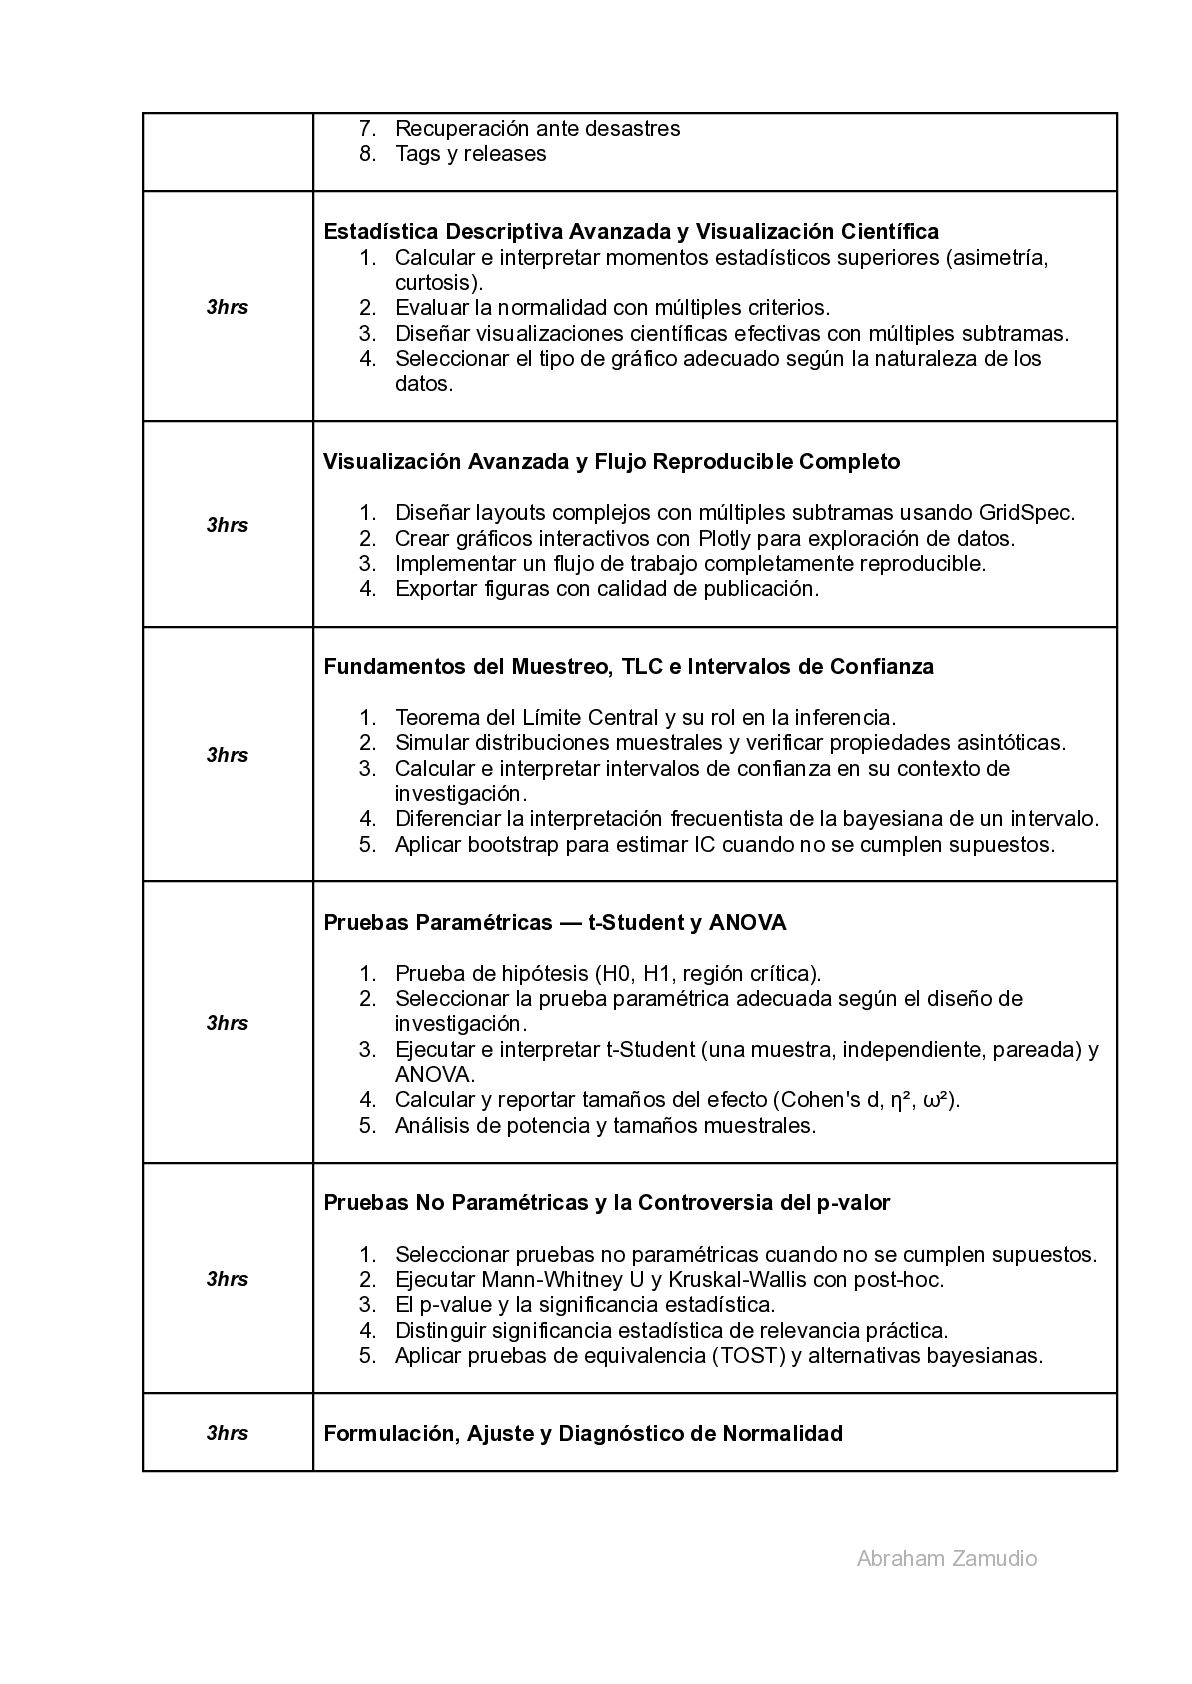
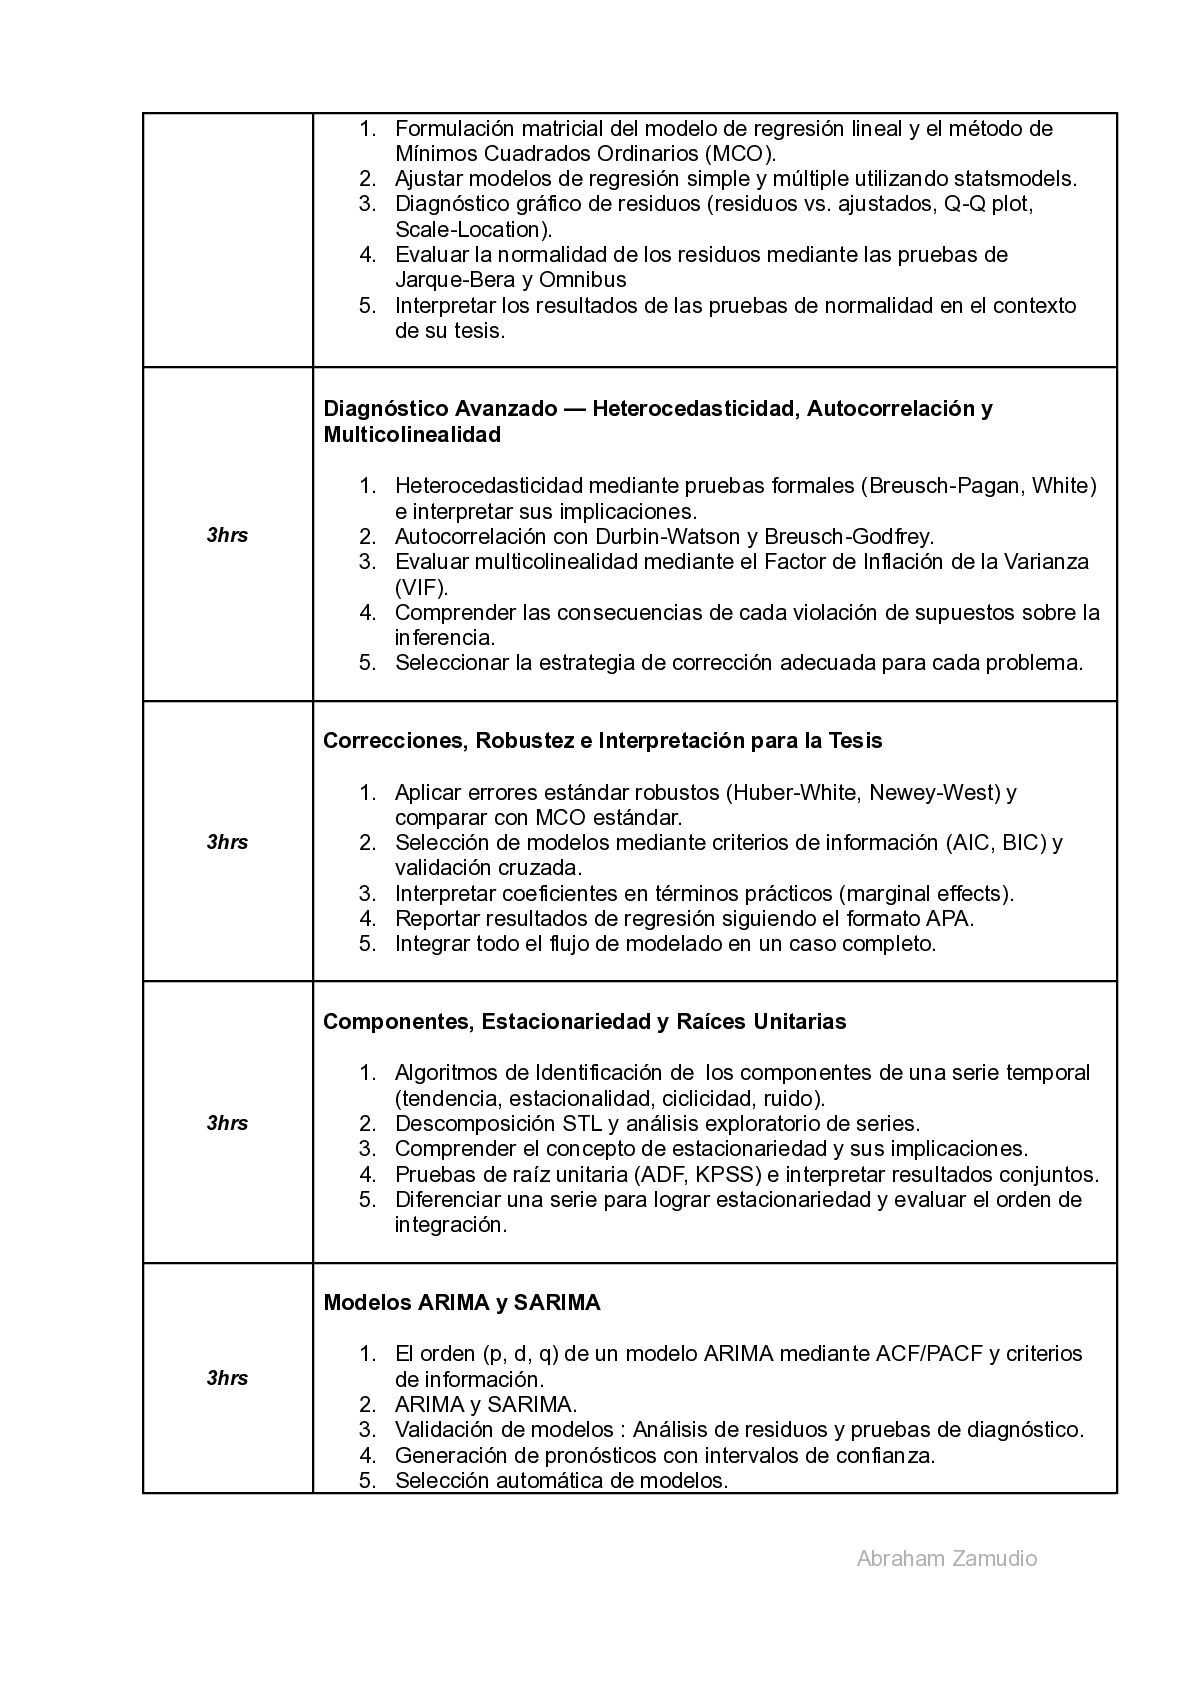
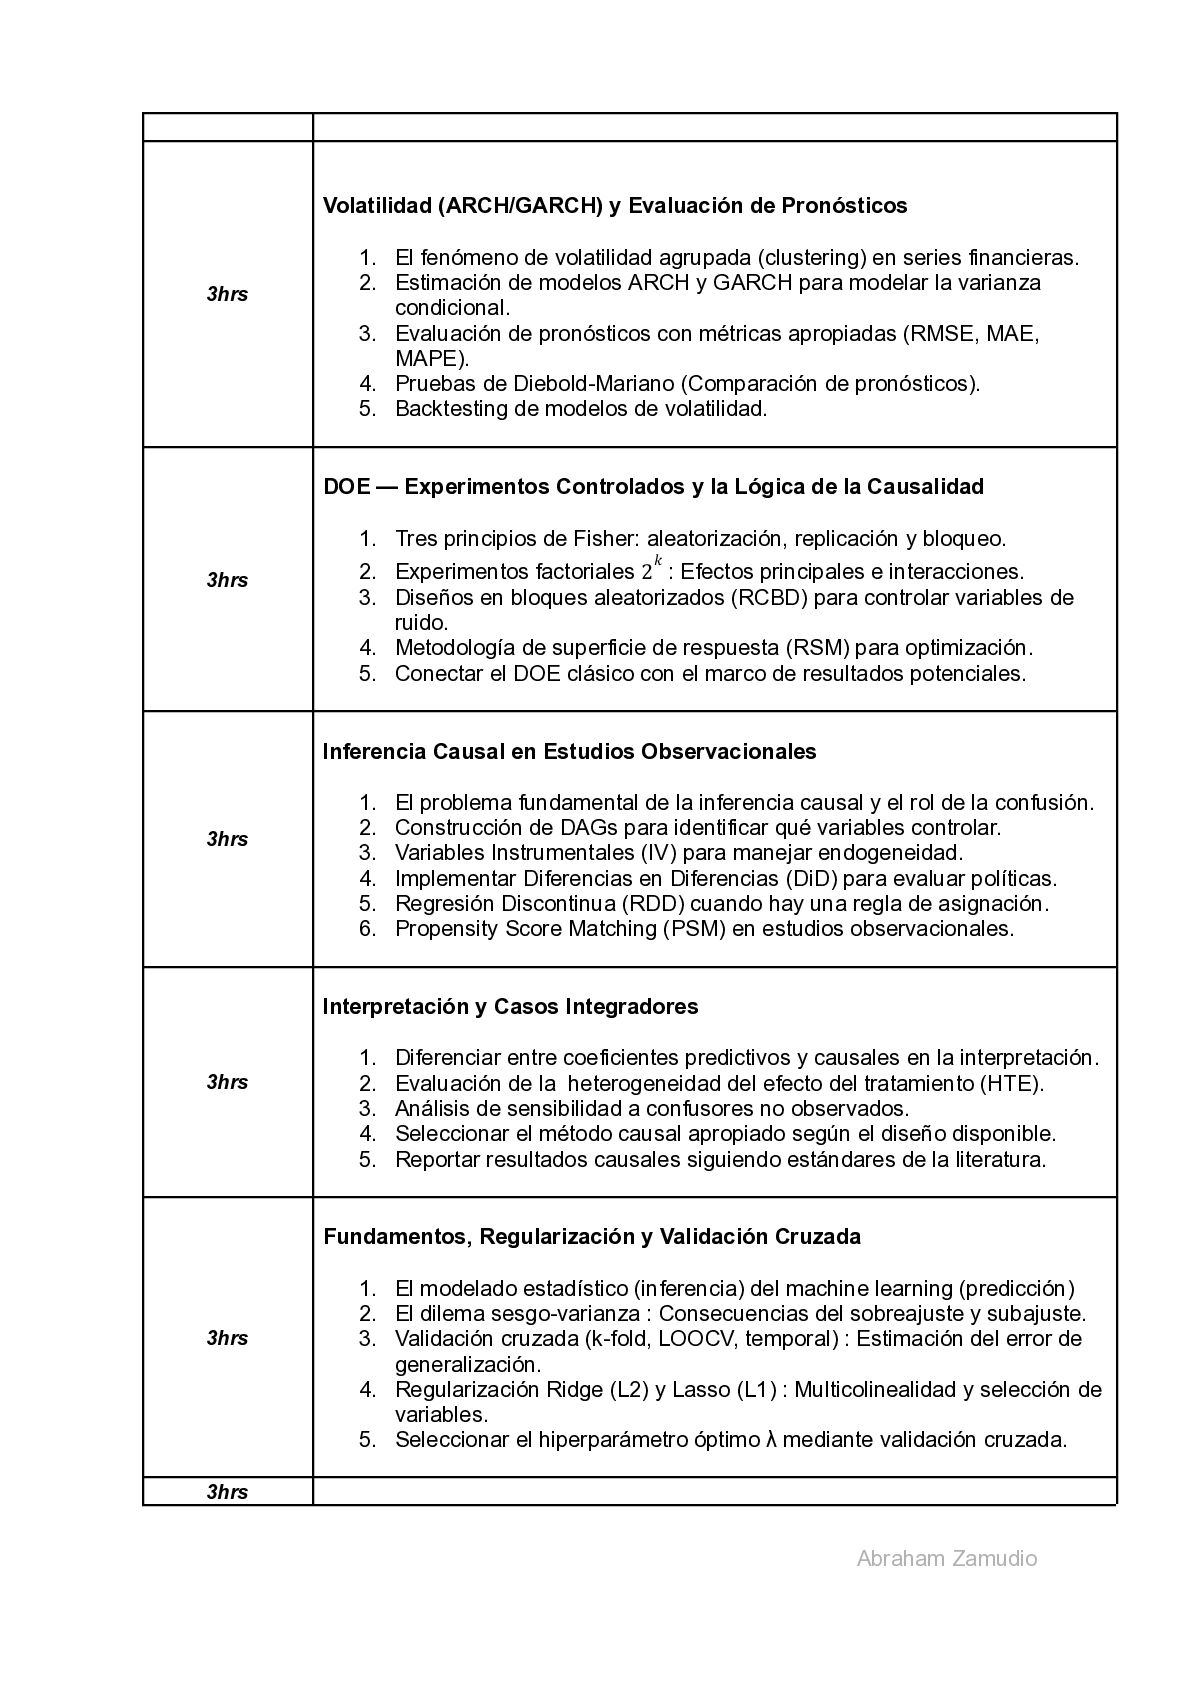
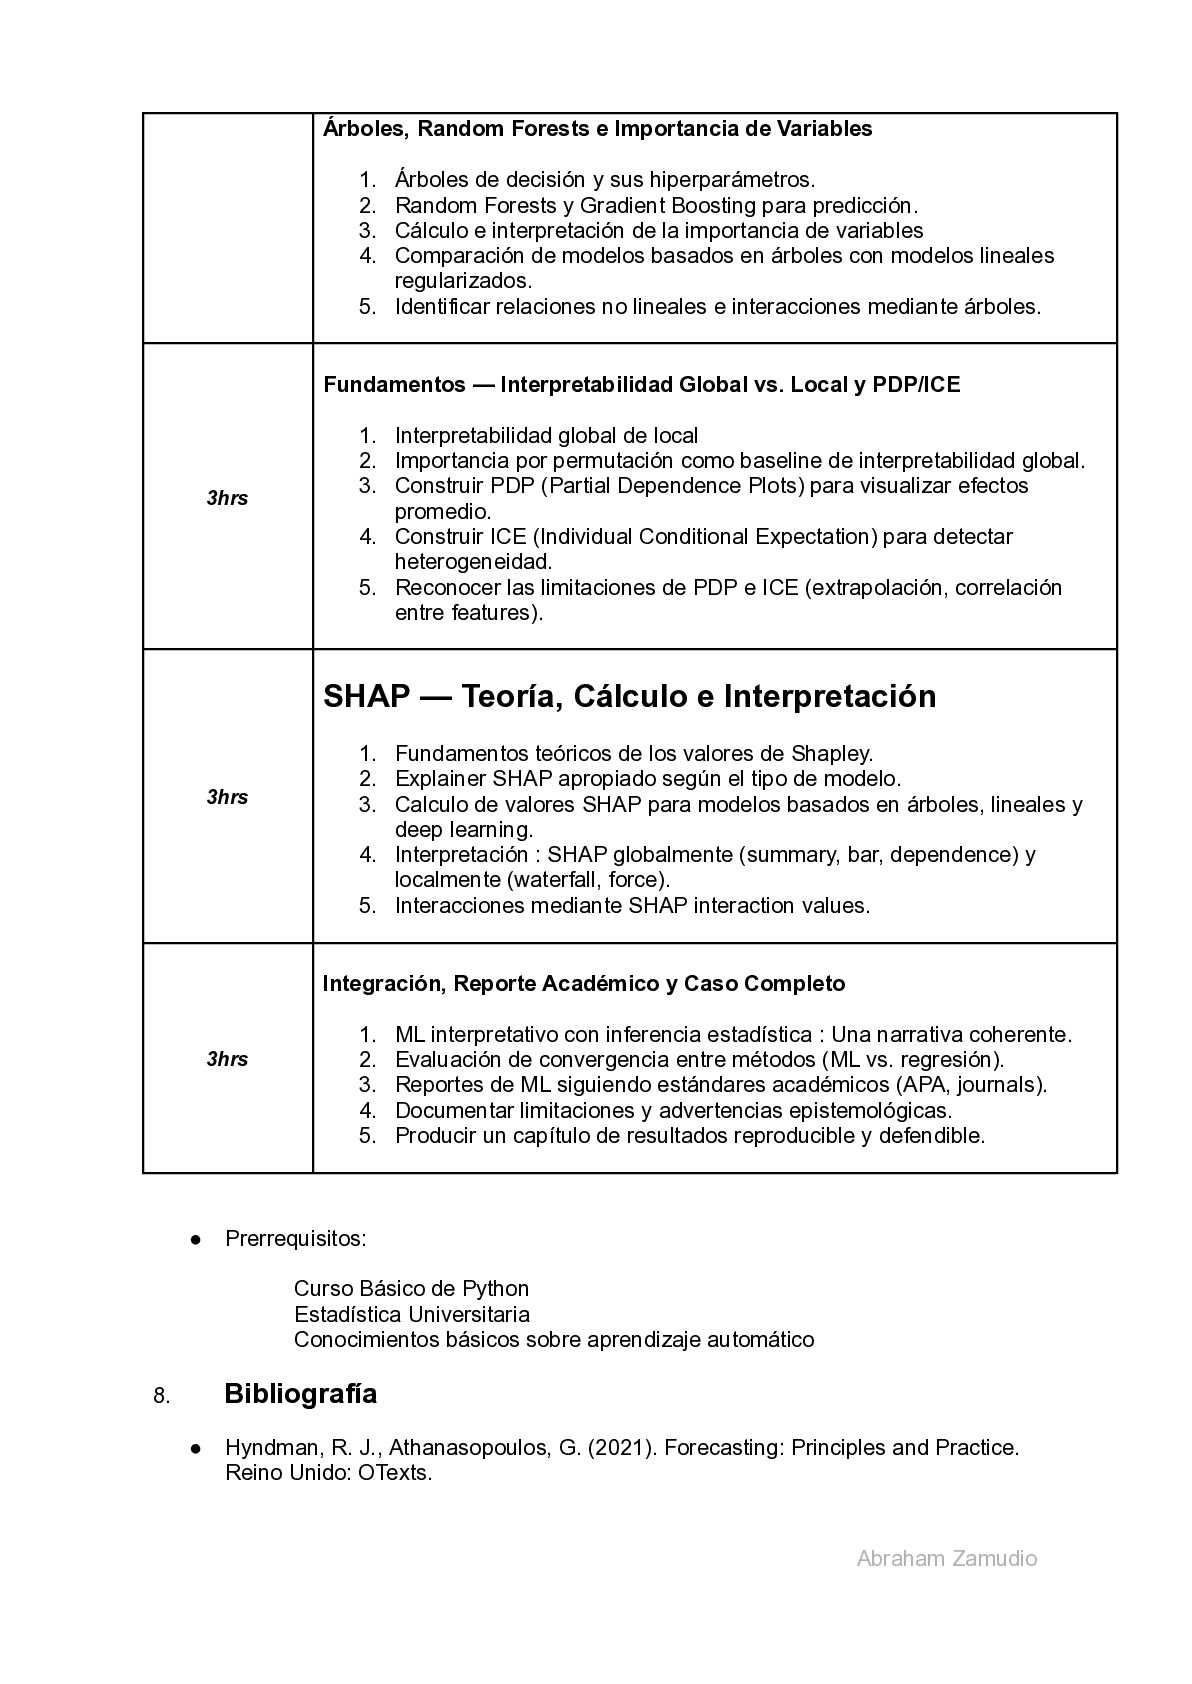
mediante el VIF. Pero la verdadera riqueza de este tramo reside en las correcciones: cuando los supuestos fallan, no te quedarás de brazos cruzados. Aprenderás a aplicar errores estándar robustos, a comparar modelos con criterios de información y a reportar resultados en formato APA con transparencia total. Un modelo no termina cuando obtienes coeficientes significativos: termina cuando has verificado que los supuestos se cumplen, has corregido lo que no, y has comunicado con claridad tanto los hallazgos como sus limitaciones. El curso amplía después el horizonte hacia dos territorios que distinguen a las tesis ambiciosas: el análisis de series temporales y la inferencia causal. En el primero, aprenderás a modelar datos dependientes del tiempo —cruciales en economía, finanzas e ingeniería— identificando componentes de tendencia, estacionalidad, ciclicidad y ruido, aplicando pruebas de raíz unitaria e implementando modelos ARIMA, SARIMA y ARCH/GARCH para pronóstico y modelado de volatilidad. Este tramo te prepara para investigaciones donde el orden temporal importa y donde la dependencia entre observaciones exige un marco distinto al clásico. En el segundo, darás el salto de la correlación a la causalidad: construirás DAGs, aplicarás variables instrumentales, diferencias en diferencias, regresión discontinua y propensity score matching, y aprenderás a evaluar la heterogeneidad del efecto del tratamiento y a realizar análisis de sensibilidad a confusores no observados. La transformación es profunda: dejarás de describir asociaciones y comenzarás a explicar mecanismos causales, con el rigor que exige la investigación científica contemporánea. A este recorrido se incorporan las técnicas predictivas modernas, siempre con un enfoque que pocos cursos ofrecen: sin sacrificar la interpretabilidad. Aprenderás a diferenciar el modelado estadístico del machine learning, a comprender el dilema sesgo-varianza, a implementar validación cruzada rigurosa, y a aplicar regularización Ridge, Lasso y Elastic Net para manejar multicolinealidad y seleccionar variables. Explorarás árboles de decisión, Random Forests y Gradient Boosting, y aprenderás a calcular e interpretar la importancia de variables con métodos robustos. Pero la lección más significativa de este tramo es que te enseña a usar el machine learning como complemento de la inferencia, no como sustituto. Un modelo predictivo puede revelar relaciones no lineales e interacciones que un modelo lineal no captura, pero en una tesis debe dialogar con la teoría, no reemplazarla. El cierre del curso es el que convierte un análisis técnico en un hallazgo científico comunicable. Aprenderás a distinguir entre interpretabilidad global y local, a construir Partial Dependence Plots e ICE para visualizar relaciones no lineales y heterogeneidad, y a calcular valores SHAP para atribuir contribuciones tanto a nivel global como individual. La lección más profunda de este tramo es que te enseña a integrar machine learning e inferencia en una narrativa coherente: a evaluar la convergencia entre métodos, a interpretar divergencias, y a reportar resultados siguiendo estándares académicos con transparencia total. Aprenderás a documentar limitaciones con honestidad epistemológica, a distinguir entre lo que el modelo describe y lo que la realidad causal implica, y a producir un capítulo de resultados reproducible y defendible. Al terminar, no solo sabrás analizar datos: sabrás contar la historia que esos datos cuentan, con el lenguaje que la ciencia exige. Cada uno de estos tramos aporta una pieza distinta al rompecabezas de una tesis rigurosa. Juntos construyen un perfil de investigador que no teme a los datos, no improvisa decisiones, no oculta limitaciones y no confunde correlación con causalidad. Este curso no promete convertirte en estadístico profesional en pocas semanas, pero sí promete algo más valioso: darte las competencias, las herramientas y, sobre todo, la mentalidad de un investigador que trata sus datos con respeto, sus métodos con rigor y Abraham Zamudio


 robintux
 pawan_pharm
 juanmartin2026
 eller86
 uranoken
 matleenalaakso
 terasawat
 ainischool
 ishii_mit
 frievea
 aokiplayer
 soudai
 chriscoyier
 tamaranovitovic
 mraible
 katarinadahlin
 codingconduct
 nikkihalliwell
 bkeepers
 emna__ayadi
 asonas
 maggiecrowley
 helenjbeal
 inesmontani