Upgrade to Pro — share decks privately, control downloads, hide ads and more …

うちなーぐちが認識できるなら、秋田弁もいけるはず!? Amazon Transcribe方言チ...

Avatar for ryouto715 ryouto715
November 07, 2026

うちなーぐちが認識できるなら、秋田弁もいけるはず!? Amazon Transcribe方言チューニング検証

JAWS FESTA 2026 in AKITA で登壇した資料です!
https://jawsfesta2026.jaws-ug.jp/timetable/f4301d3c-eac4-4b1c-9389-8f7ff94199a9

Avatar for ryouto715

ryouto715

November 07, 2026

Other Decks in Technology

Transcript

  1. なんで面白そうだと思ったか? たわた りょうと 多和田 涼人 沖縄出身 業務内容 株式会社Relic のエンジニアとして @RTawata64610

    Copyright © 2026 Relic Inc. All Rights Reserv ed. 新規事業のアイデア創出 SaaS「IDEATION Cloud」を開発 5
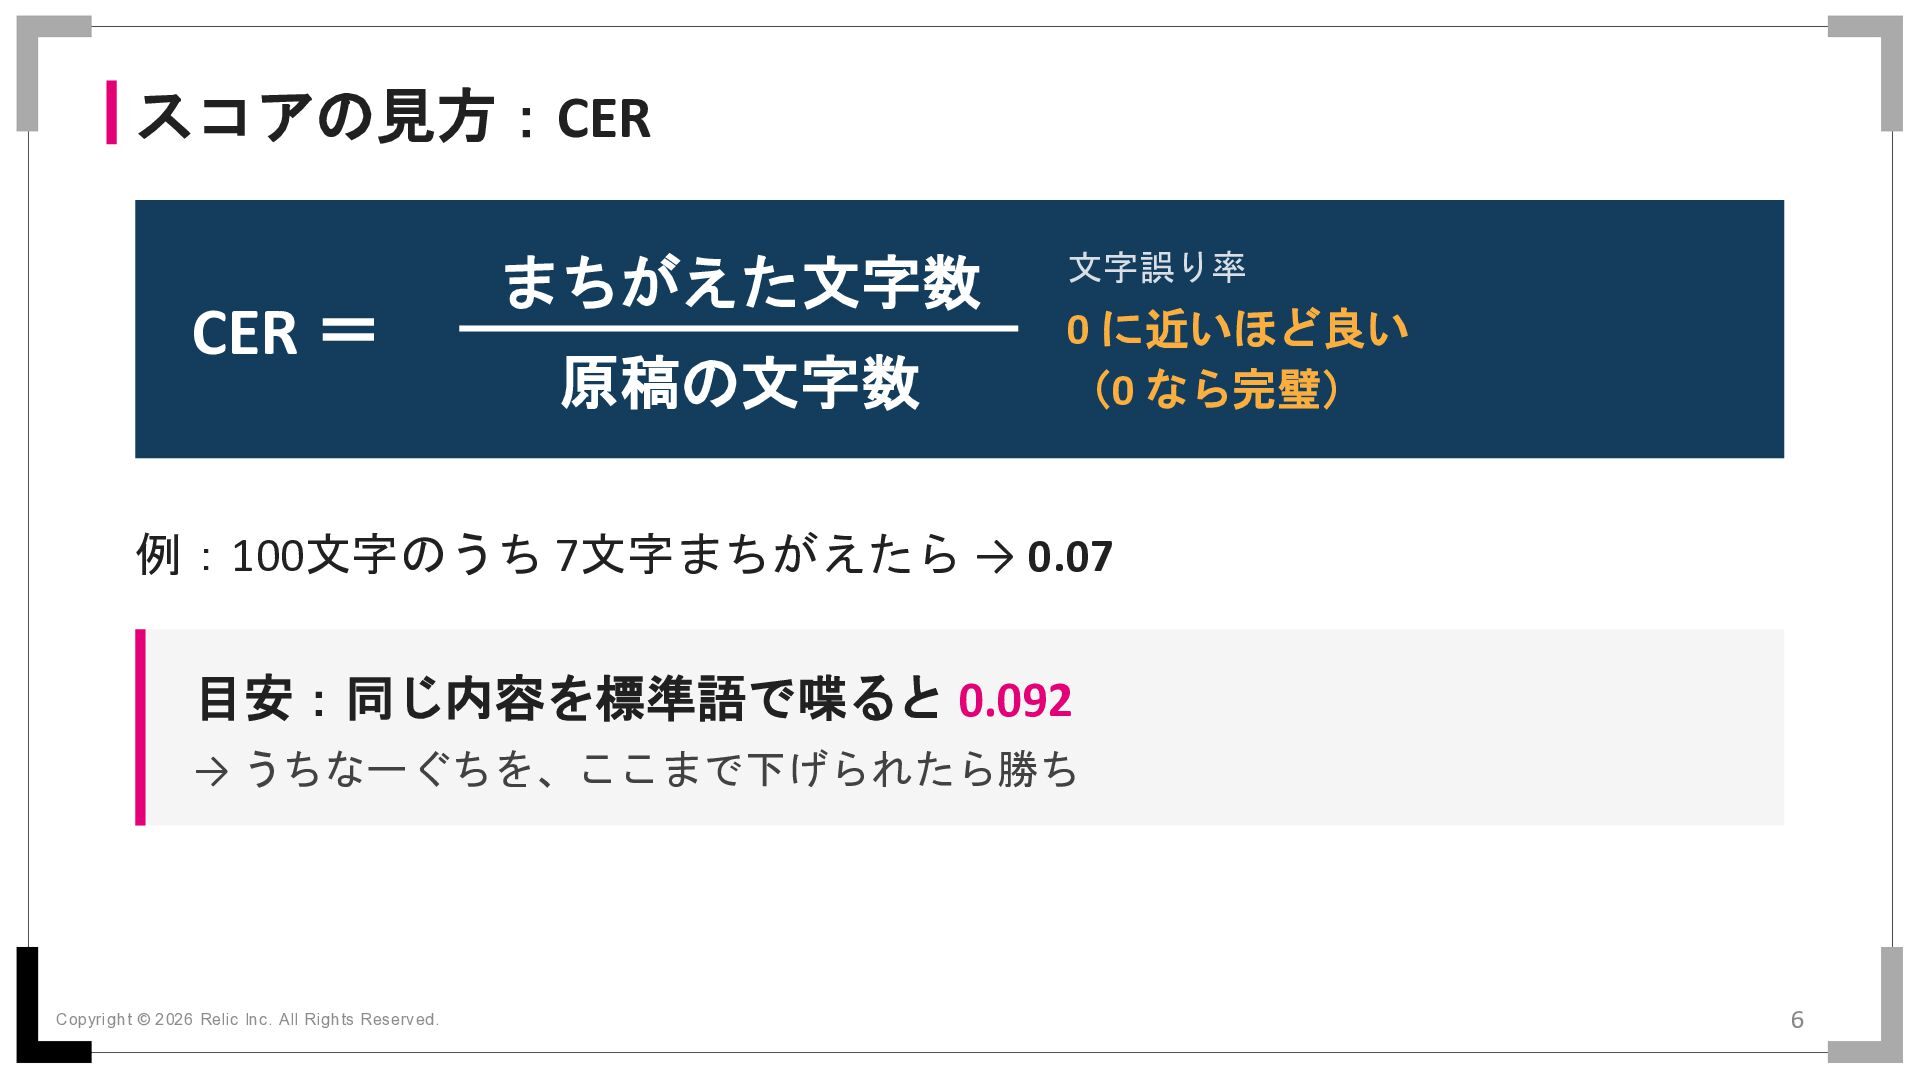
  2. スコアの見方:CER CER = まちがえた文字数 原稿の文字数 文字誤り率 0 に近いほど良い (0 なら完璧)

    例:100文字のうち 7文字まちがえたら → 0.07 目安:同じ内容を標準語で喋ると 0.092 → うちなーぐちを、ここまで下げられたら勝ち Copyright © 2026 Relic Inc. All Rights Reserv ed. 6
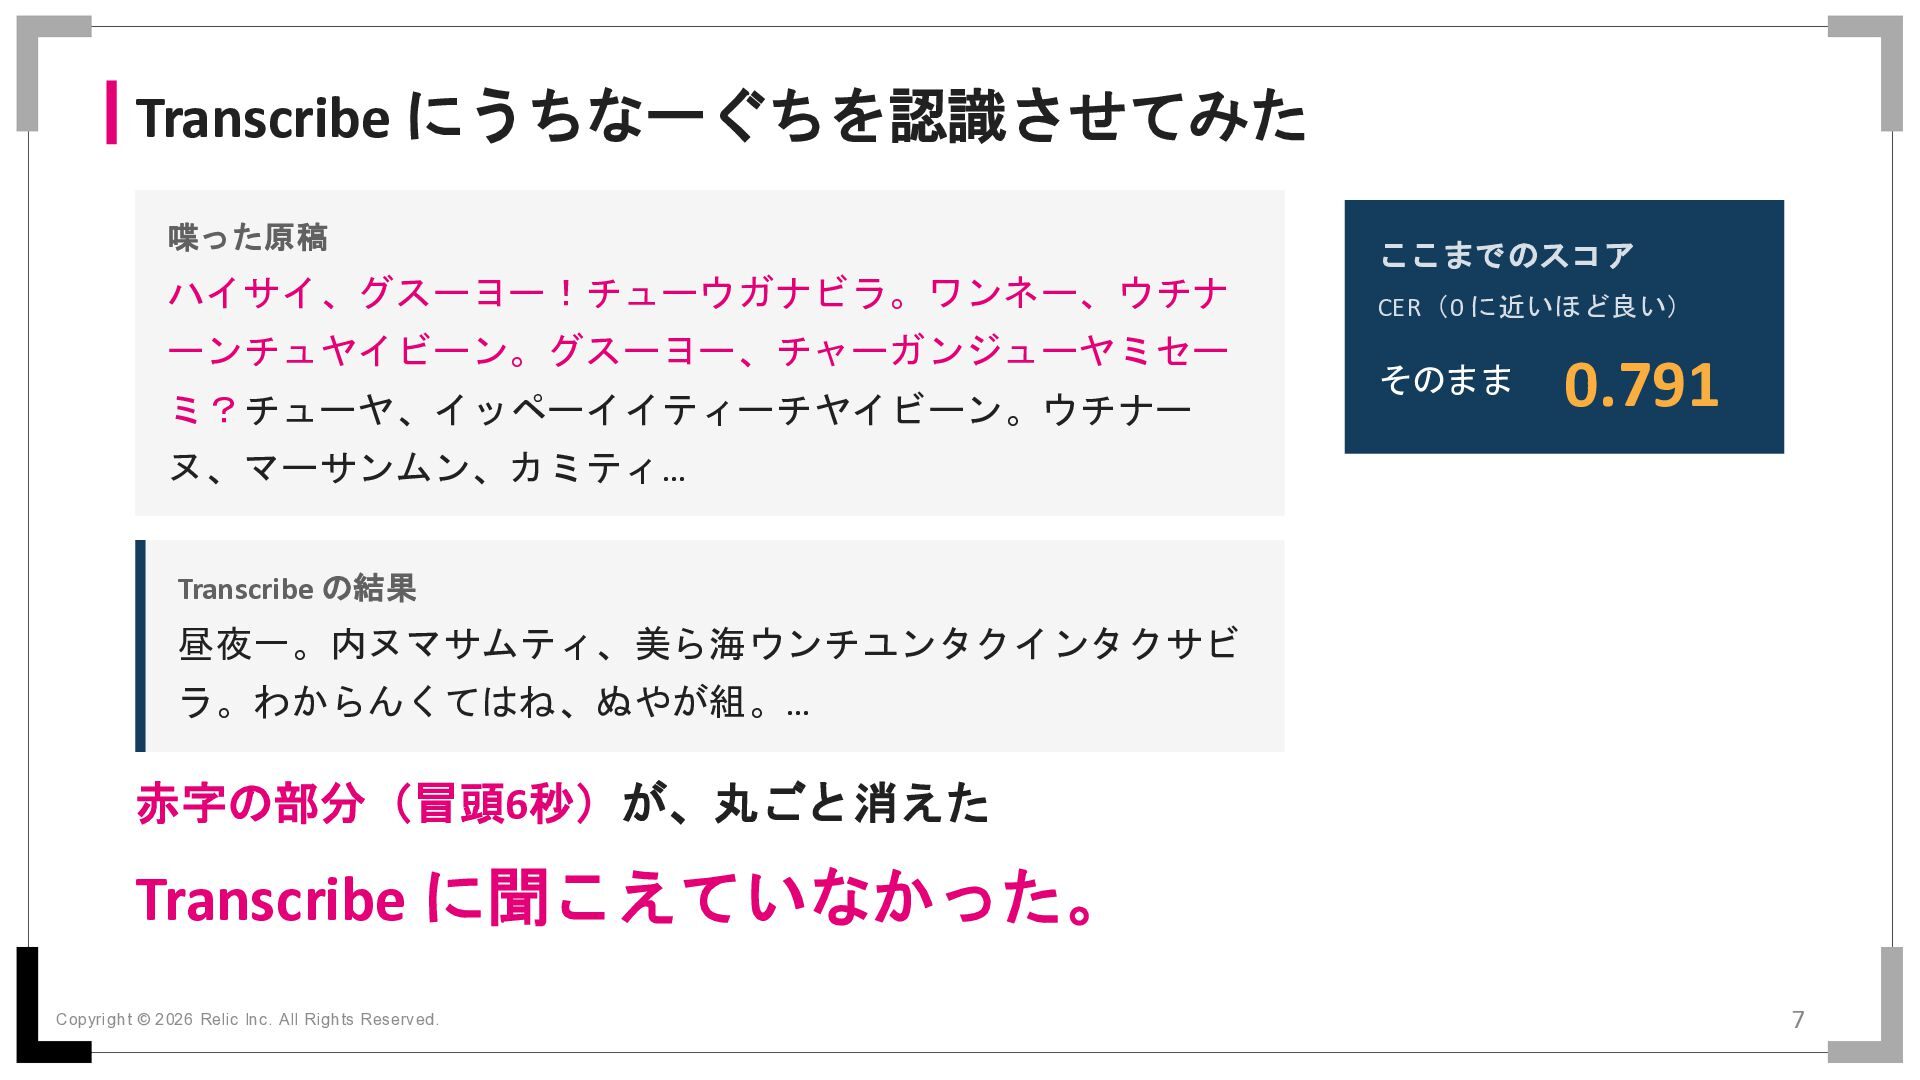
  3. Transcribe にうちなーぐちを認識させてみた 喋った原稿 ハイサイ、グスーヨー!チューウガナビラ。ワンネー、ウチナ ーンチュヤイビーン。グスーヨー、チャーガンジューヤミセー ミ?チューヤ、イッペーイイティーチヤイビーン。ウチナー ここまでのスコア CER(0 に近いほど良い) そのまま

    0.791 ヌ、マーサンムン、カミティ… Transcribe の結果 昼夜一。内ヌマサムティ、美ら海ウンチユンタクインタクサビ ラ。わからんくてはね、ぬやが組。… 赤字の部分(冒頭6秒)が、丸ごと消えた Transcribe に聞こえていなかった。 Copyright © 2026 Relic Inc. All Rights Reserv ed. 7
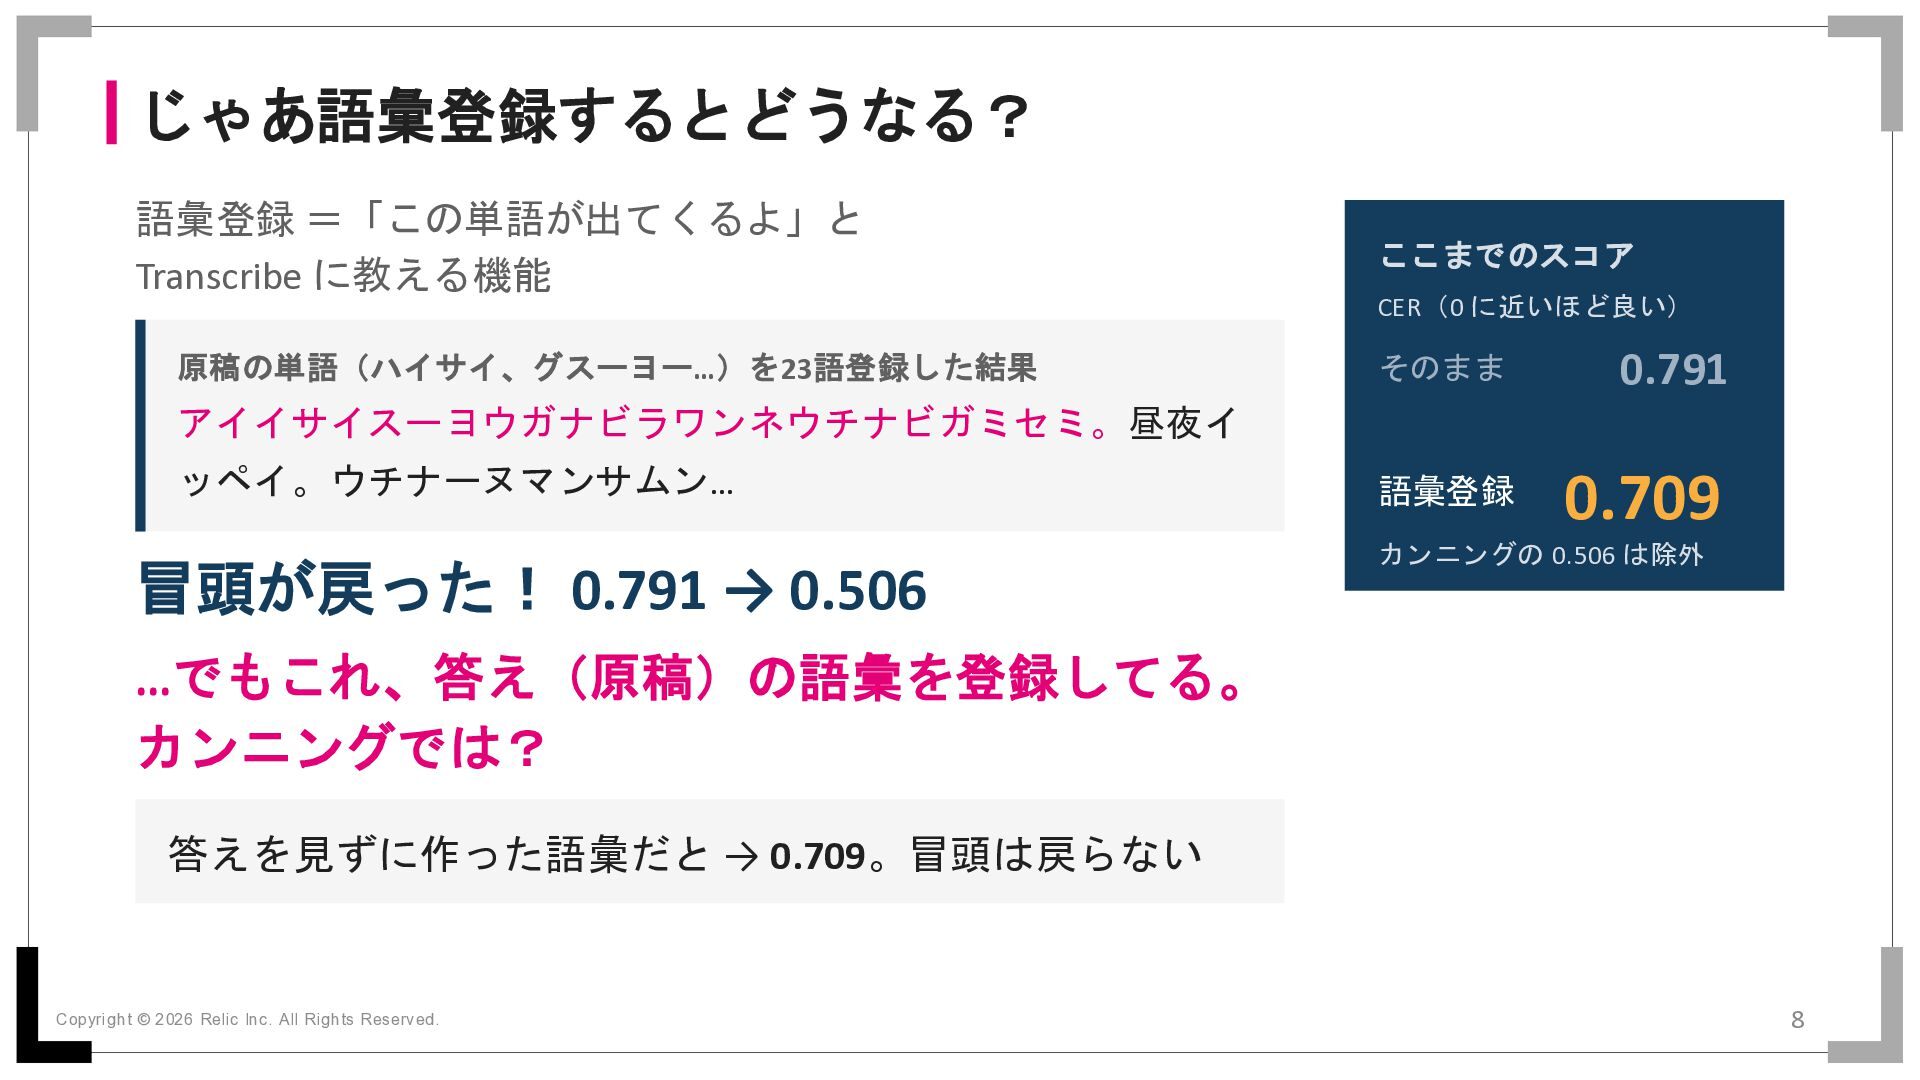
  4. じゃあ語彙登録するとどうなる? 語彙登録 =「この単語が出てくるよ」と Transcribe に教える機能 原稿の単語(ハイサイ、グスーヨー…)を23語登録した結果 ここまでのスコア CER(0 に近いほど良い) そのまま

    0.791 語彙登録 0.709 アイイサイスーヨウガナビラワンネウチナビガミセミ。昼夜イ ッペイ。ウチナーヌマンサムン… 冒頭が戻った! 0.791 → 0.506 カンニングの 0.506 は除外 …でもこれ、答え(原稿)の語彙を登録してる。 カンニングでは? 答えを見ずに作った語彙だと → 0.709。冒頭は戻らない Copyright © 2026 Relic Inc. All Rights Reserv ed. 8
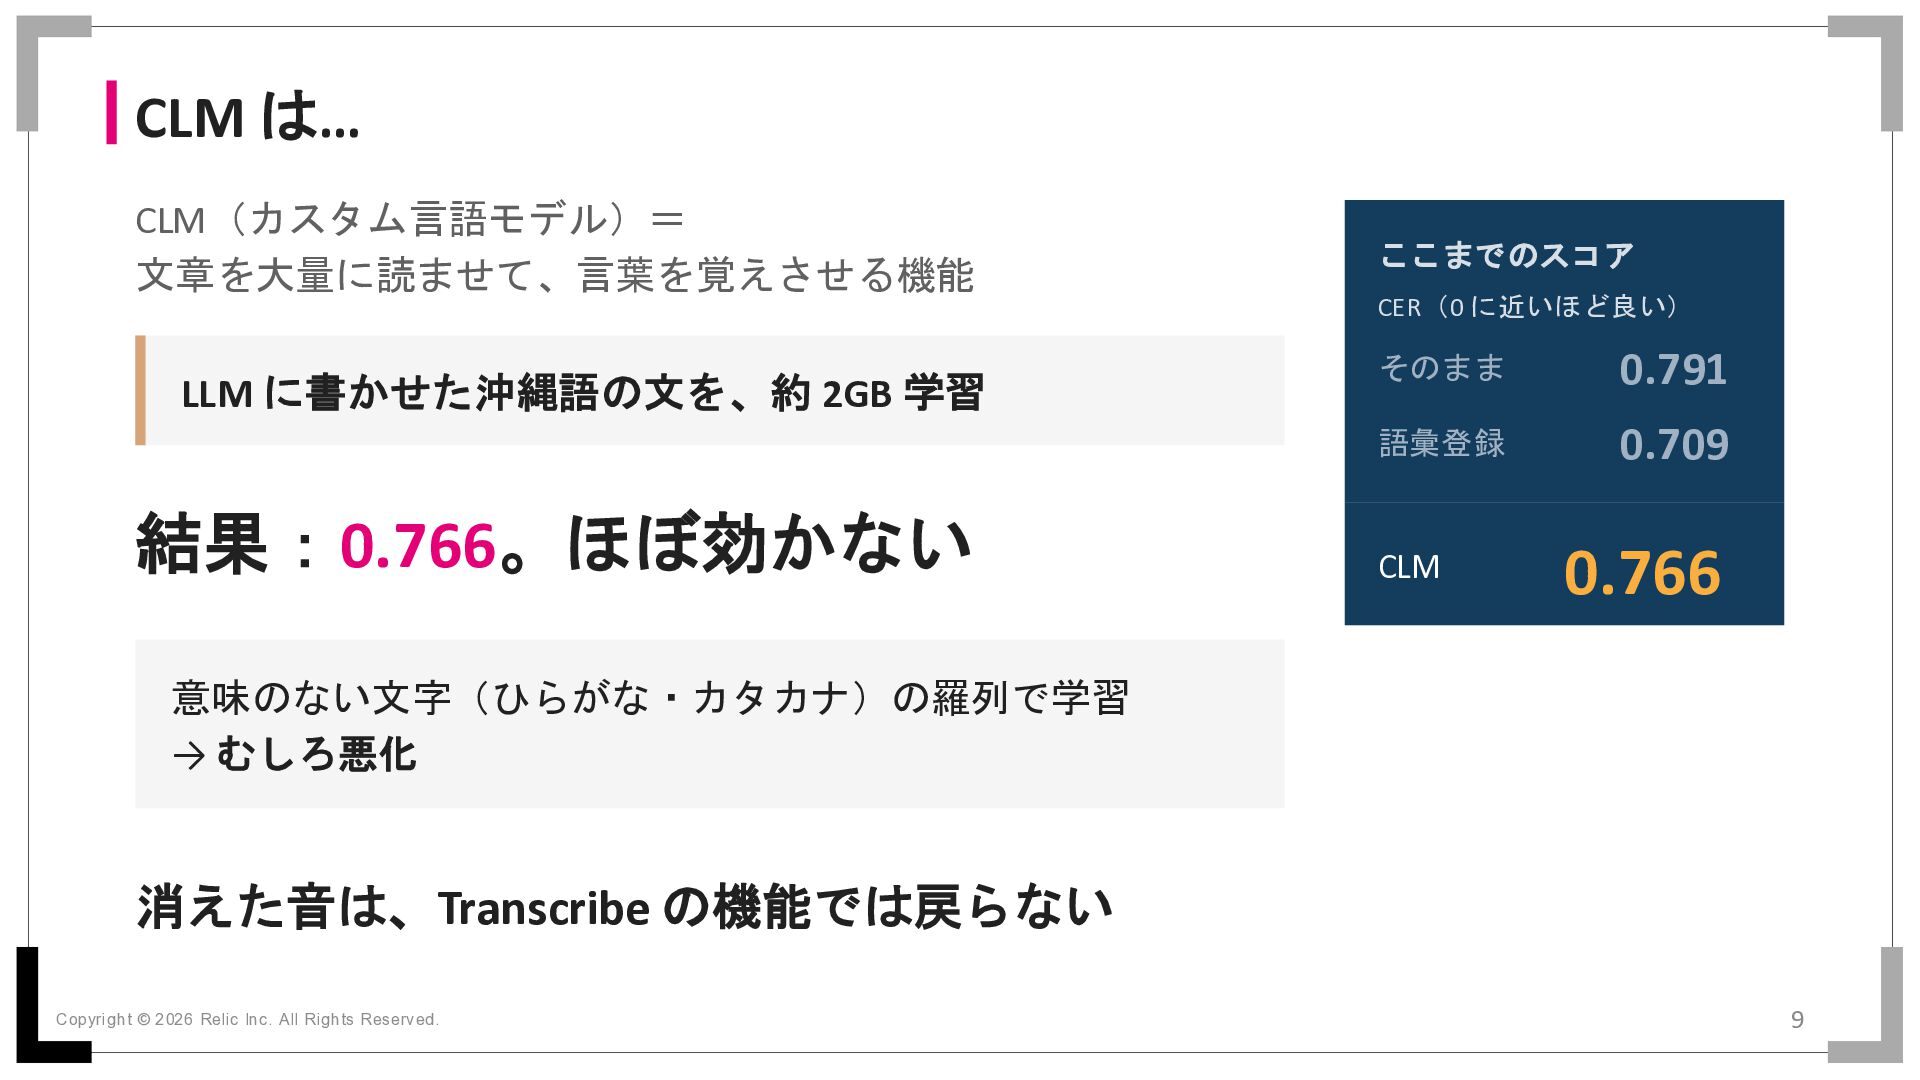
  5. CLM は… CLM(カスタム言語モデル)= 文章を大量に読ませて、言葉を覚えさせる機能 LLM に書かせた沖縄語の文を、約 2GB 学習 結果:0.766。ほぼ効かない ここまでのスコア

    CER(0 に近いほど良い) そのまま 0.791 語彙登録 0.709 CLM 0.766 意味のない文字(ひらがな・カタカナ)の羅列で学習 → むしろ悪化 消えた音は、Transcribe の機能では戻らない Copyright © 2026 Relic Inc. All Rights Reserv ed. 9
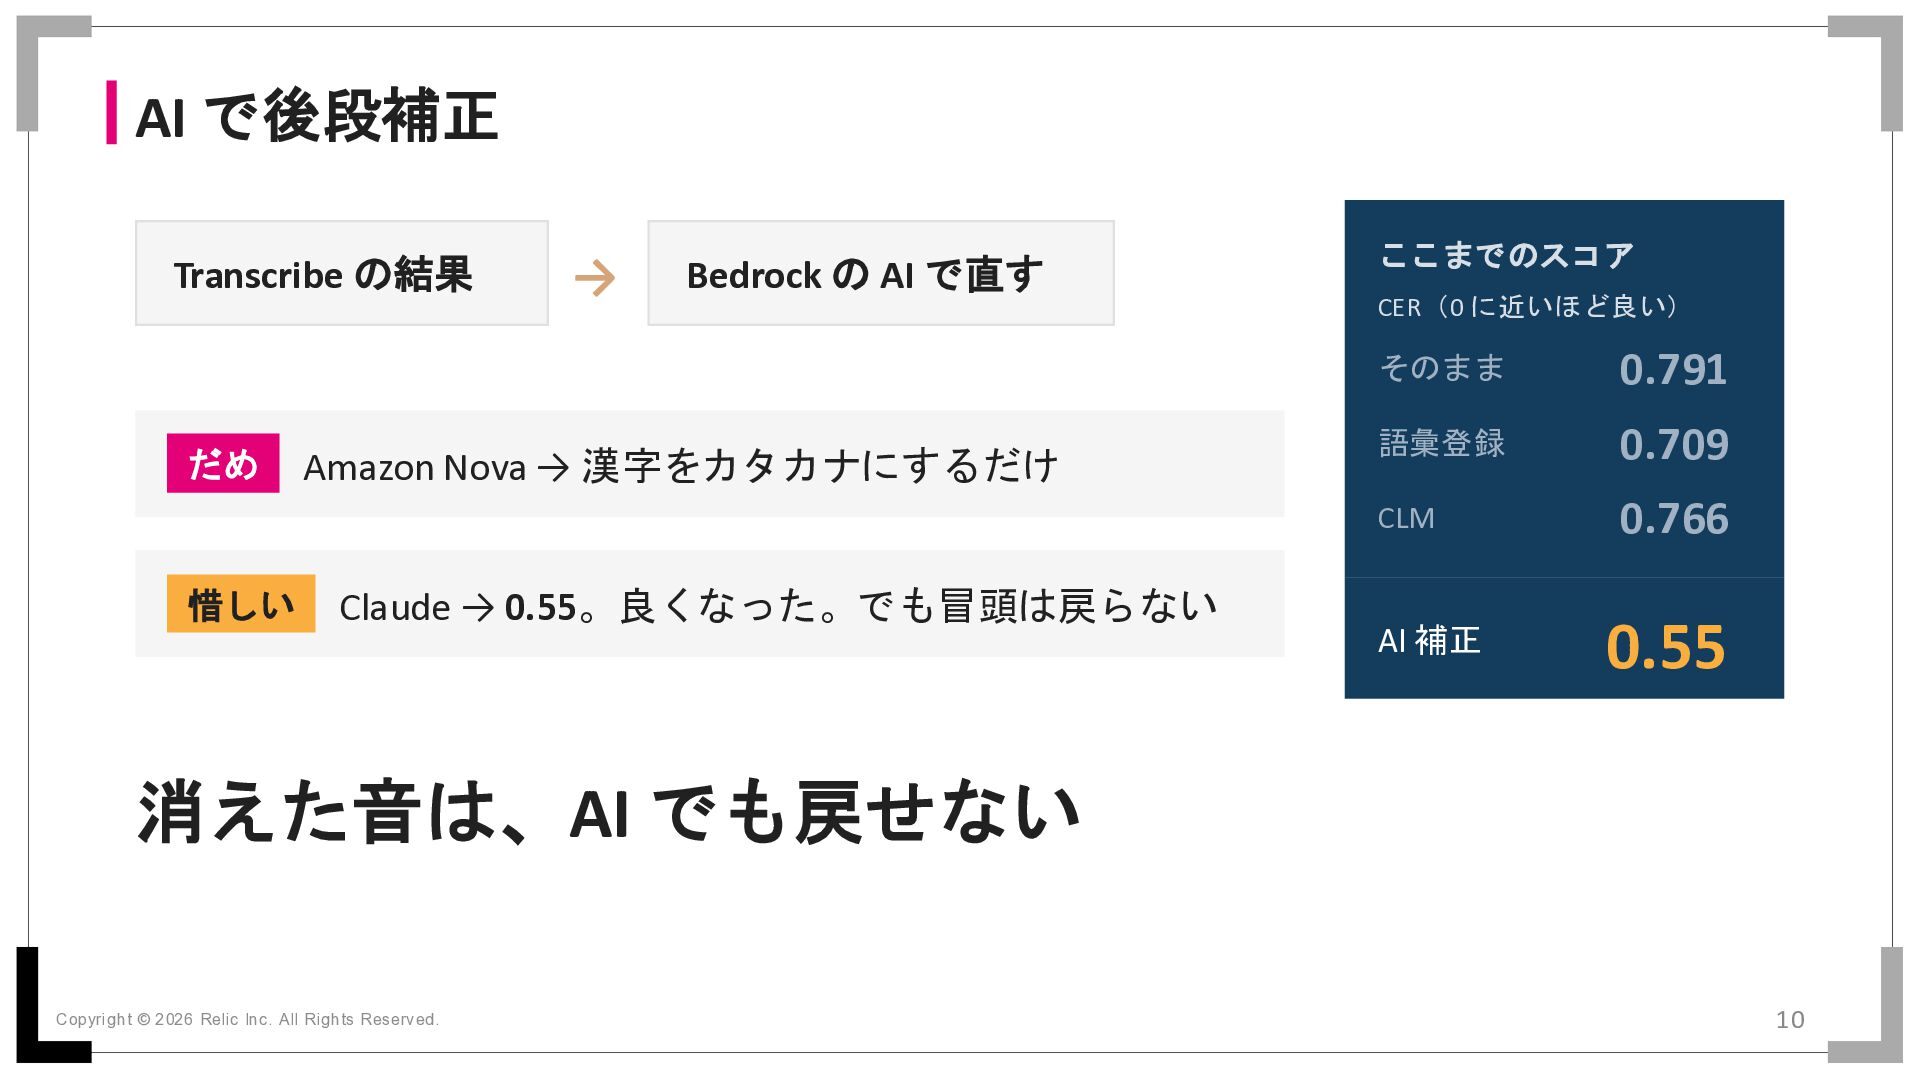
  6. AI で後段補正 Transcribe の結果 だめ 惜しい → Bedrock の AI

    で直す Amazon Nova → 漢字をカタカナにするだけ Claude → 0.55。良くなった。でも冒頭は戻らない ここまでのスコア CER(0 に近いほど良い) そのまま 0.791 語彙登録 0.709 CLM 0.766 AI 補正 0.55 消えた音は、AI でも戻せない Copyright © 2026 Relic Inc. All Rights Reserv ed. 10
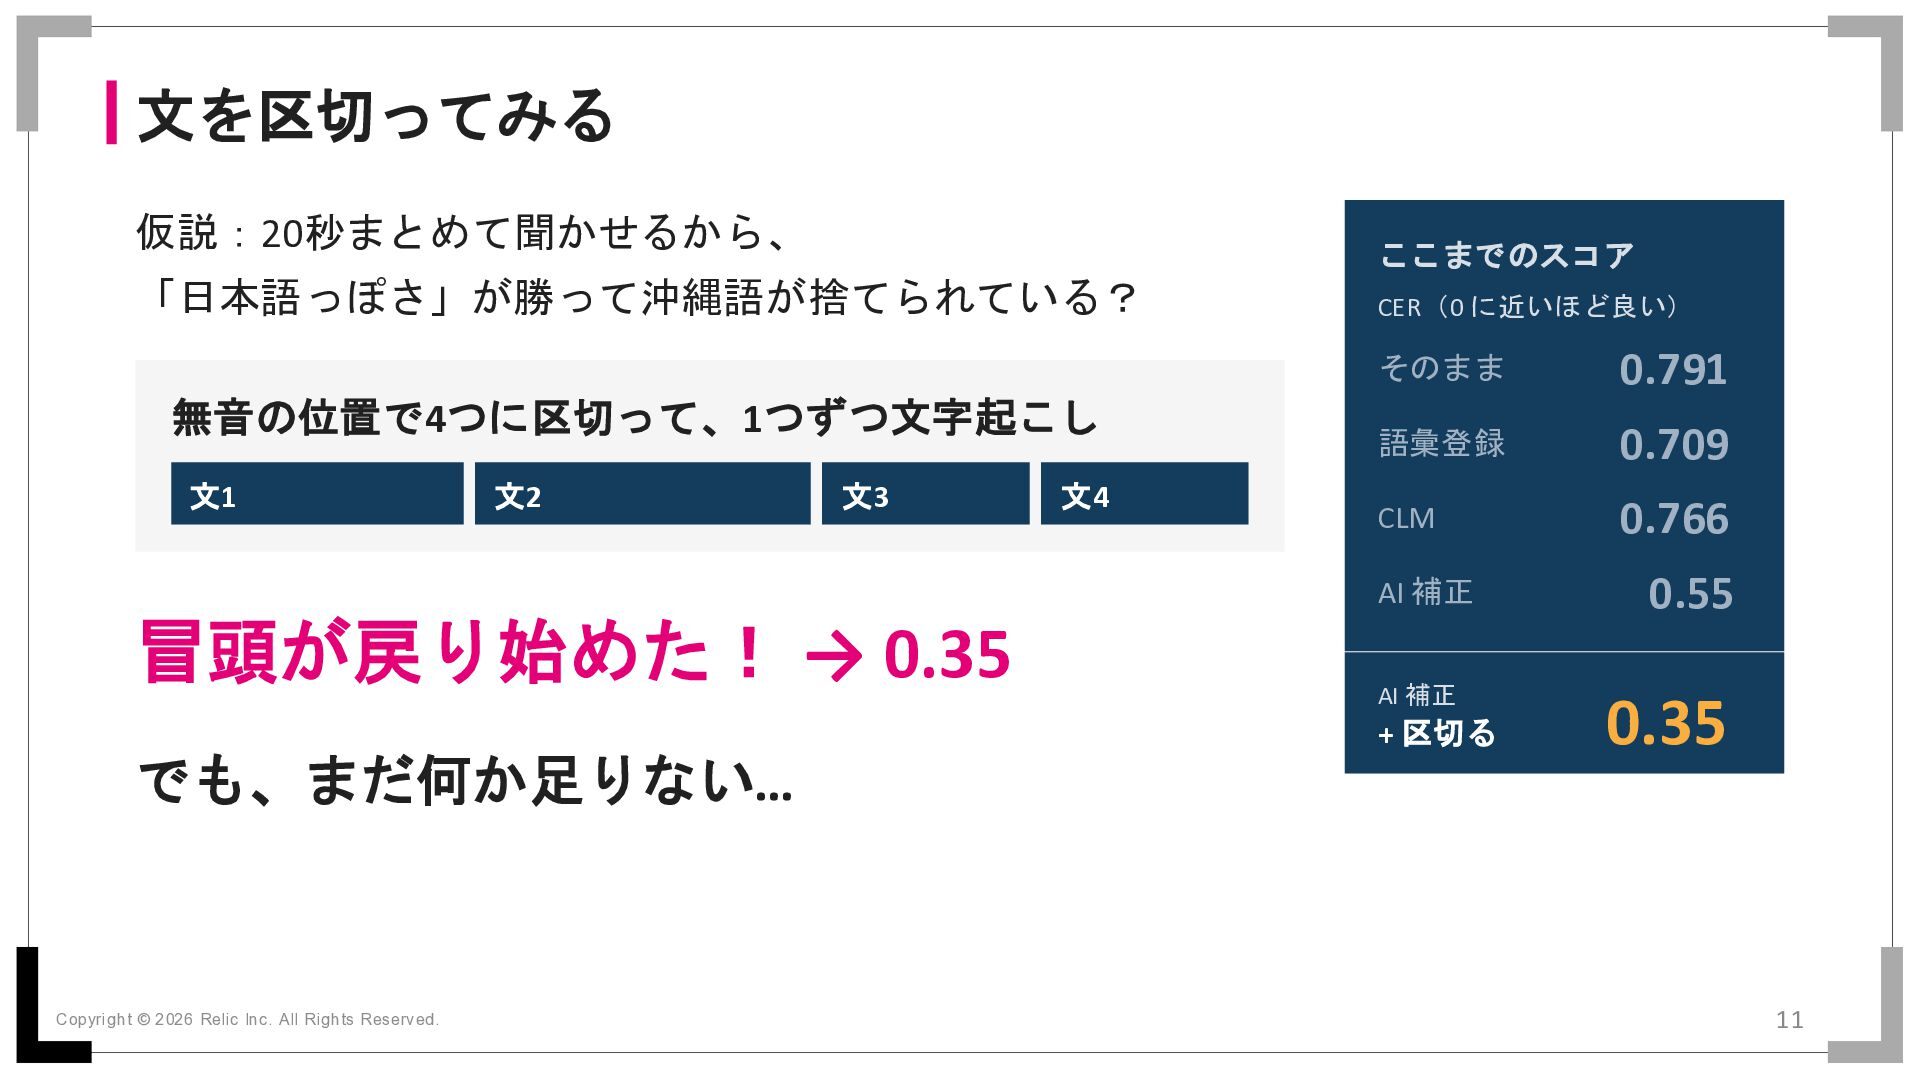
  7. 文を区切ってみる 仮説:20秒まとめて聞かせるから、 ここまでのスコア 「日本語っぽさ」が勝って沖縄語が捨てられている? 無音の位置で4つに区切って、1つずつ文字起こし 文1 文2 文3 冒頭が戻り始めた! →

    0.35 でも、まだ何か足りない… Copyright © 2026 Relic Inc. All Rights Reserv ed. 文4 CER(0 に近いほど良い) そのまま 0.791 語彙登録 0.709 CLM 0.766 AI 補正 0.55 AI 補正 0.35 + 区切る 11
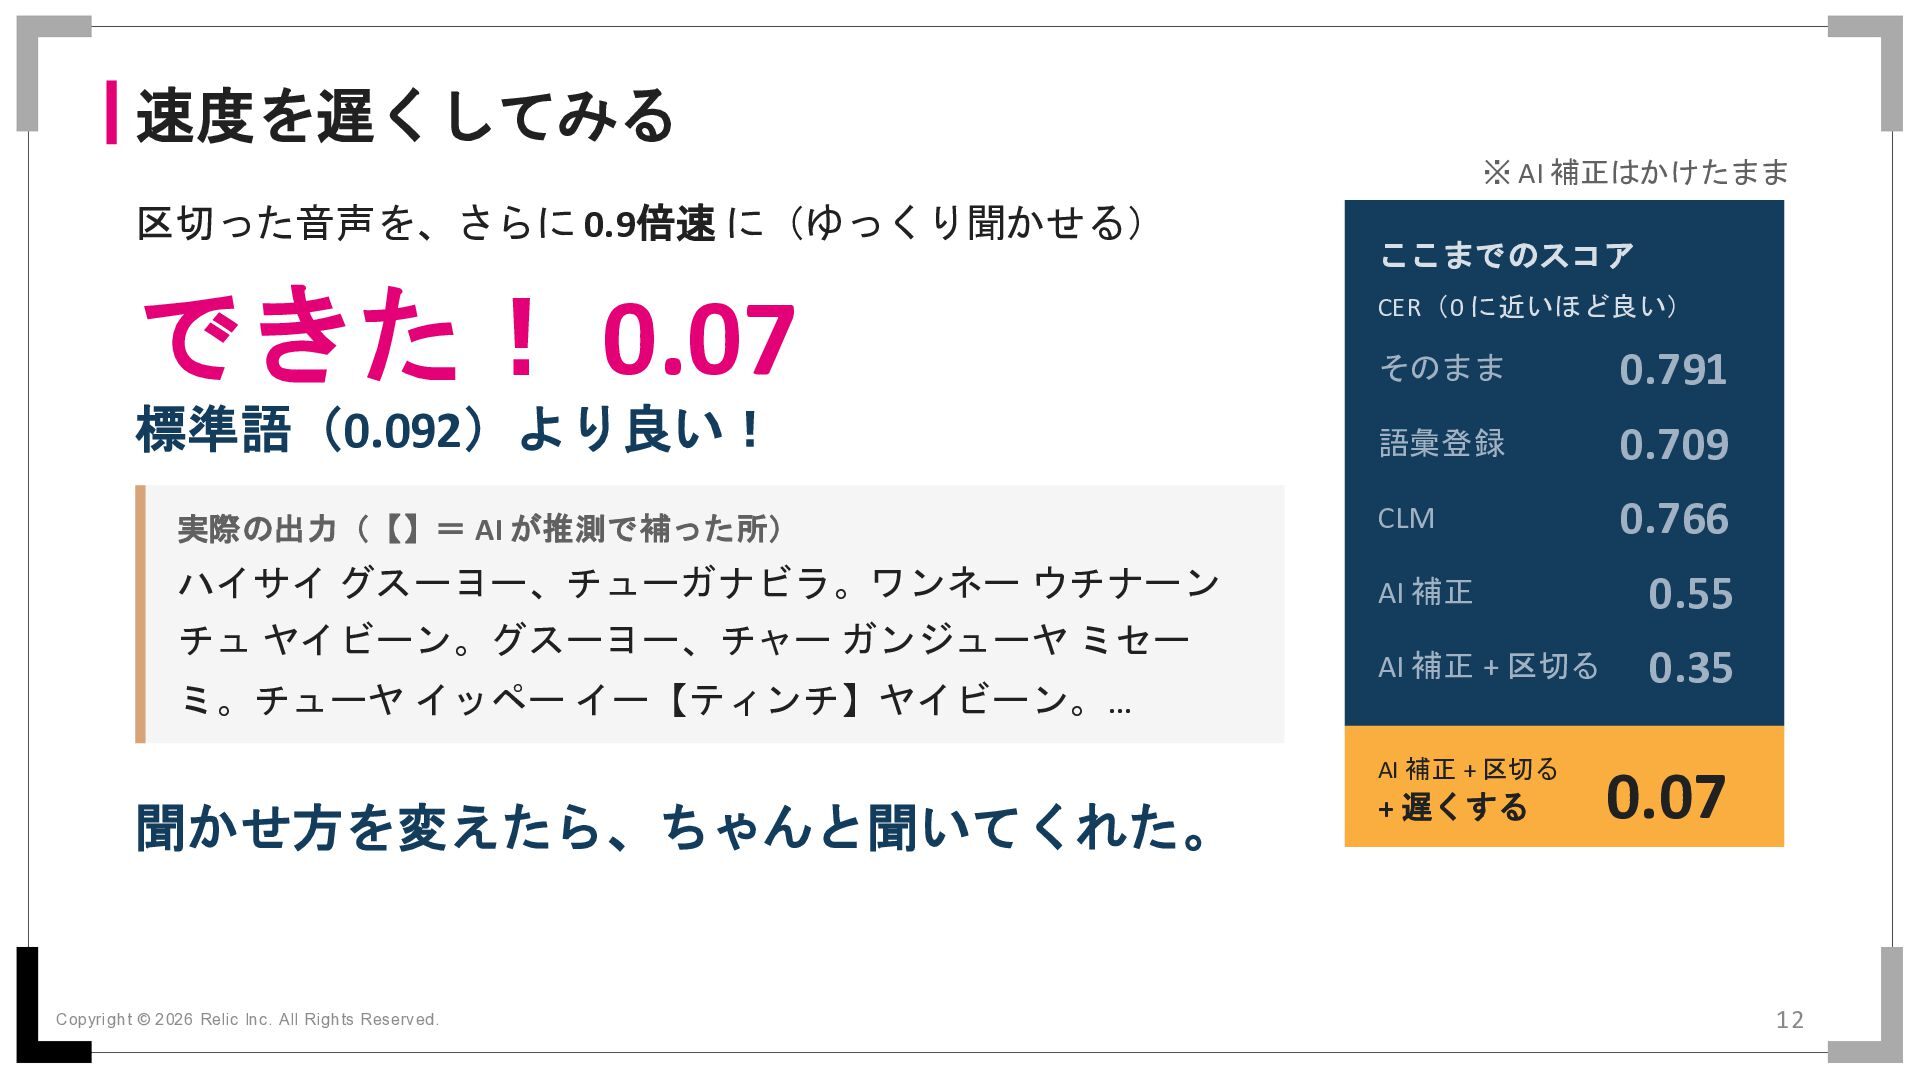
  8. 速度を遅くしてみる ※ AI 補正はかけたまま 区切った音声を、さらに 0.9倍速 に(ゆっくり聞かせる) できた! 0.07 ここまでのスコア

    CER(0 に近いほど良い) そのまま 0.791 語彙登録 0.709 実際の出力(【】= AI が推測で補った所) CLM 0.766 ハイサイ グスーヨー、チューガナビラ。ワンネー ウチナーン AI 補正 0.55 AI 補正 + 区切る 0.35 標準語(0.092)より良い! チュ ヤイビーン。グスーヨー、チャー ガンジューヤ ミセー ミ。チューヤ イッペー イー【ティンチ】ヤイビーン。… AI 補正 + 区切る 聞かせ方を変えたら、ちゃんと聞いてくれた。 Copyright © 2026 Relic Inc. All Rights Reserv ed. + 遅くする 0.07 12
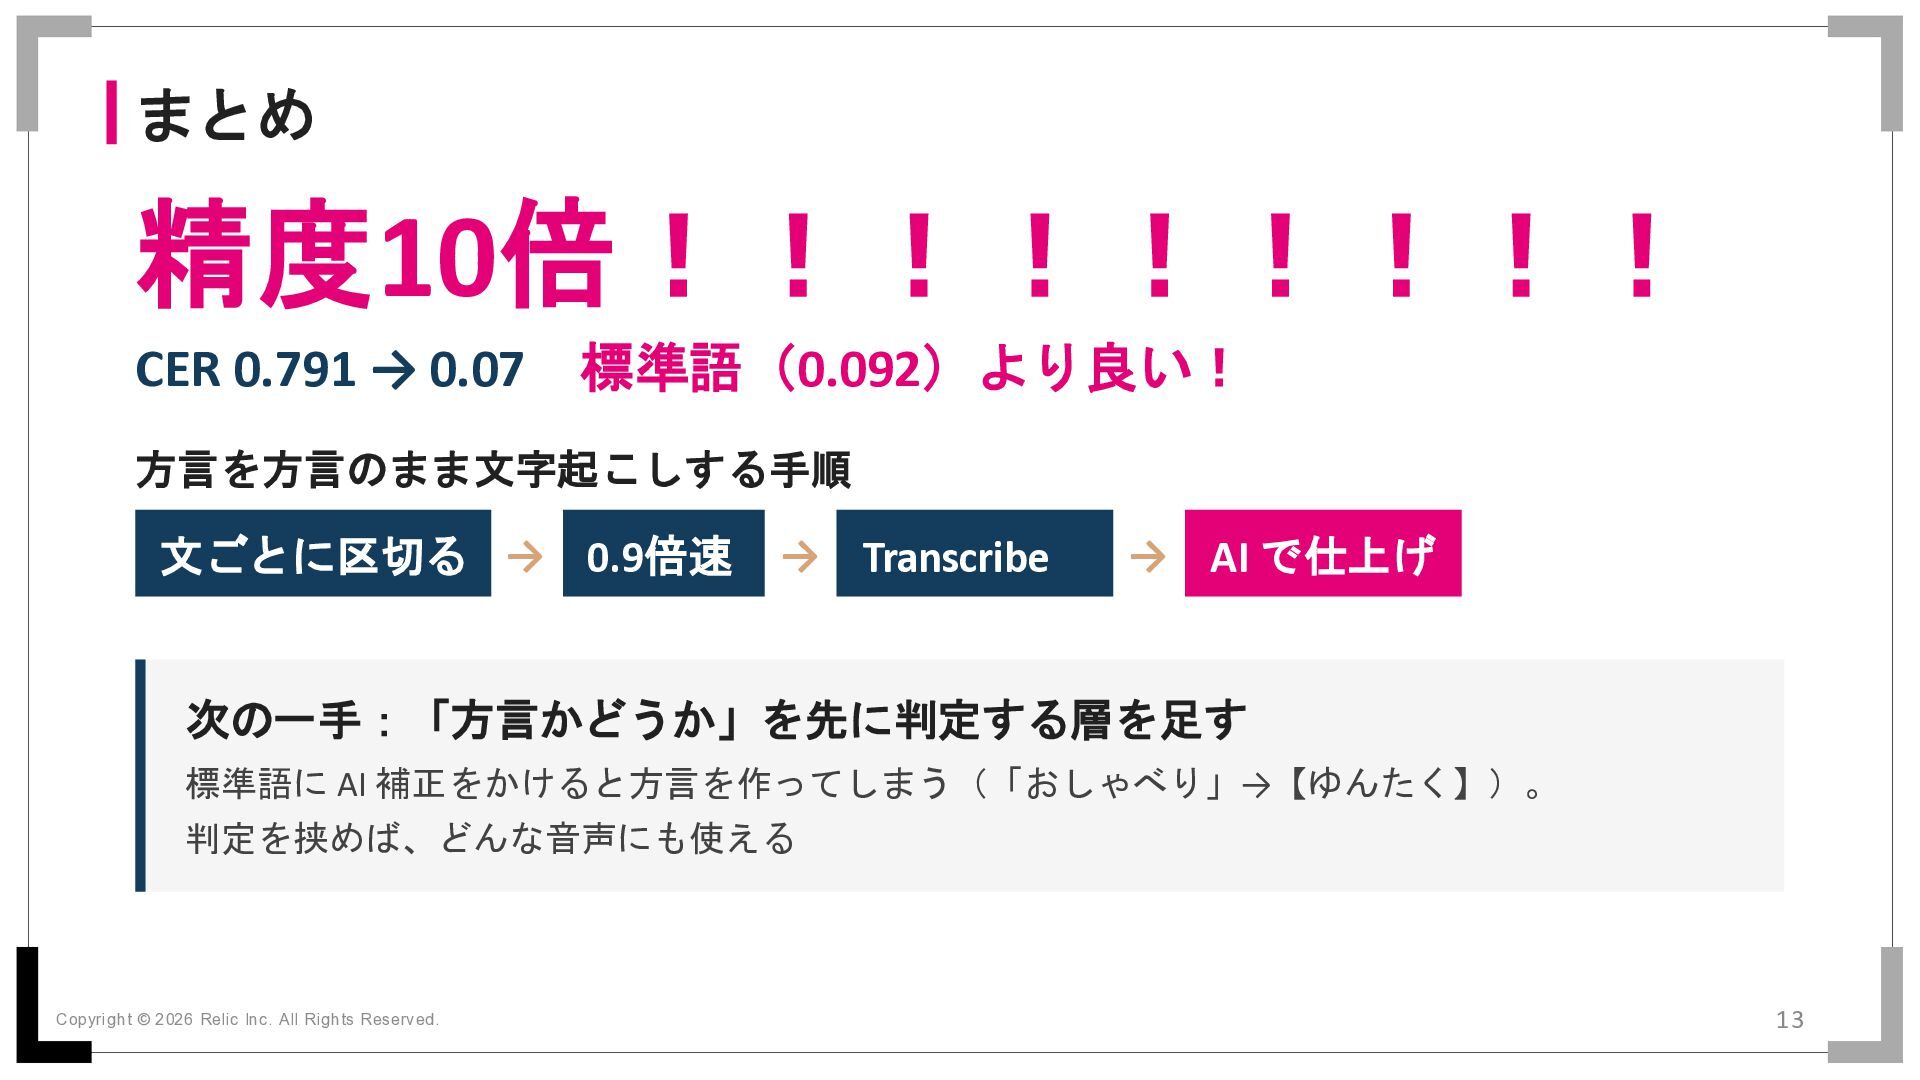
  9. まとめ 精度10倍!!!!!!!!! CER 0.791 → 0.07 標準語(0.092)より良い! 方言を方言のまま文字起こしする手順 文ごとに区切る →

    0.9倍速 → Transcribe → AI で仕上げ 次の一手:「方言かどうか」を先に判定する層を足す 標準語に AI 補正をかけると方言を作ってしまう(「おしゃべり」→【ゆんたく】)。 判定を挟めば、どんな音声にも使える Copyright © 2026 Relic Inc. All Rights Reserv ed. 13