Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Perceiver: General Perception with Iterative [輪...
Search
shibutani
June 22, 2022
Research
150
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Perceiver: General Perception with Iterative [輪講発表資料]
Perceiver: General Perception with Iterativeに関する輪講発表資料
shibutani
June 22, 2022
More Decks by shibutani
See All by shibutani
AIで進めるQA自動化の現在地 - E2Eリグレッションテストの整備と維持 -
shibukazu
9
4.1k
越境するAIのために、境界を取り払う - AI 時代の開発体験向上に向けたリポジトリ統合の取り組み -
shibukazu
1
770
メッセージキュー型の非同期処理から Temporal 移行へ
shibukazu
4
5.9k
はじめてのOSS開発からみえたGo言語の強み
shibukazu
4
1.6k
全自動コードレビューの夢 〜実際に活用されるAIコードレビューの実現に向けて〜
shibukazu
11
5.8k
Hybrid Autoregressive Transducer [輪講発表資料]
shibukazu
0
510
Other Decks in Research
See All in Research
The Conductor Pattern -Multi-Granularity Feedback for Creative Agents-
shibuiwilliam
2
120
Bilan travail en élevage : première restitution des enquêtes 2025-2026
institutdelelevage
PRO
0
270
Top 4セキュリティ会議に一通り論文が採択されるまでの道のりと展望 / Top 4 Security Grand Slam
takaomurakami
0
1.1k
Santé et fertilité des sols : ce que nous disent les pratiques dans les systèmes de polyculture-élevage
institutdelelevage
PRO
0
220
SLAMはどこまで解決されたのか?
tomonom
0
1.6k
論文読み会 SNLP2026 Tau2-Bench: Evaluating Conversational Agents in a Dual-Control Environment
s_mizuki_nlp
0
330
Vers un système bovin allaitant multiperformant :leviers actionnés et trajectoire de réduction de l'empreinte carbone à travers 4 années d'expérimentation à FERM'INOV
institutdelelevage
PRO
0
140
[IEICE-Soceity-Conf2026] セマンティック通信を見据えたマルチスケールセンシングと 学習の融合によるデジタルツイン基盤 / Digital Twin Infrastructure via the Fusion of Multi-Scale Sensing and Learning toward Semantic Communications
pman0214
0
140
La génomique au service de la fromageabilité du lait grâce aux spectres MIR
institutdelelevage
PRO
0
210
Détecter les vulnérabilités dans un environnement souverain
hellosct1
0
120
HackSick vol.7 LT資料【LLMアーキテクチャ入門・事前学習時の躓き所解説】 スパースなAttention・状態空間モデル
rikkabotan7
0
230
論文紹介: Understanding Epistemic Language with a Language-augmented Bayesian Theory of Mind
hisaokatsumi
0
210
Featured
See All Featured
Everyday Curiosity
cassininazir
0
390
From Legacy to Launchpad: Building Startup-Ready Communities
dugsong
0
370
WCS-LA-2024
lcolladotor
0
970
The Cost Of JavaScript in 2023
addyosmani
56
10k
Docker and Python
trallard
47
4.2k
Connecting the Dots Between Site Speed, User Experience & Your Business [WebExpo 2025]
tammyeverts
11
1.1k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
560
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
450
What Being in a Rock Band Can Teach Us About Real World SEO
427marketing
0
1.1k
4 Signs Your Business is Dying
shpigford
187
23k
Rails Girls Zürich Keynote
gr2m
96
14k
Building Better People: How to give real-time feedback that sticks.
wjessup
371
20k
Transcript
Perceiver: General Perception with Iterative Attention [Jaegle, Gimeno+ 2020] 京都大学
音声メディア研究室 M1 渋谷和樹 1
これまではモダリティに依存したアーキテクチャが主流 ⇒アーキテクチャがモダリティにロックインされる Transformerはモダリティに依存しない Transformerの計算量は入力インデックスの二乗に比例 任意の入力長に対応できるTransformerベースのアーキテクチャが必要 ⇒Perceiverの登場 Introduction 2
Perceiver 3
Transformerベースのモダリティ非依存アーキテクチャ CrossAttentionによってTransformerの計算量を削減 画像・音声・点群において優れた性能 Perceiver 4
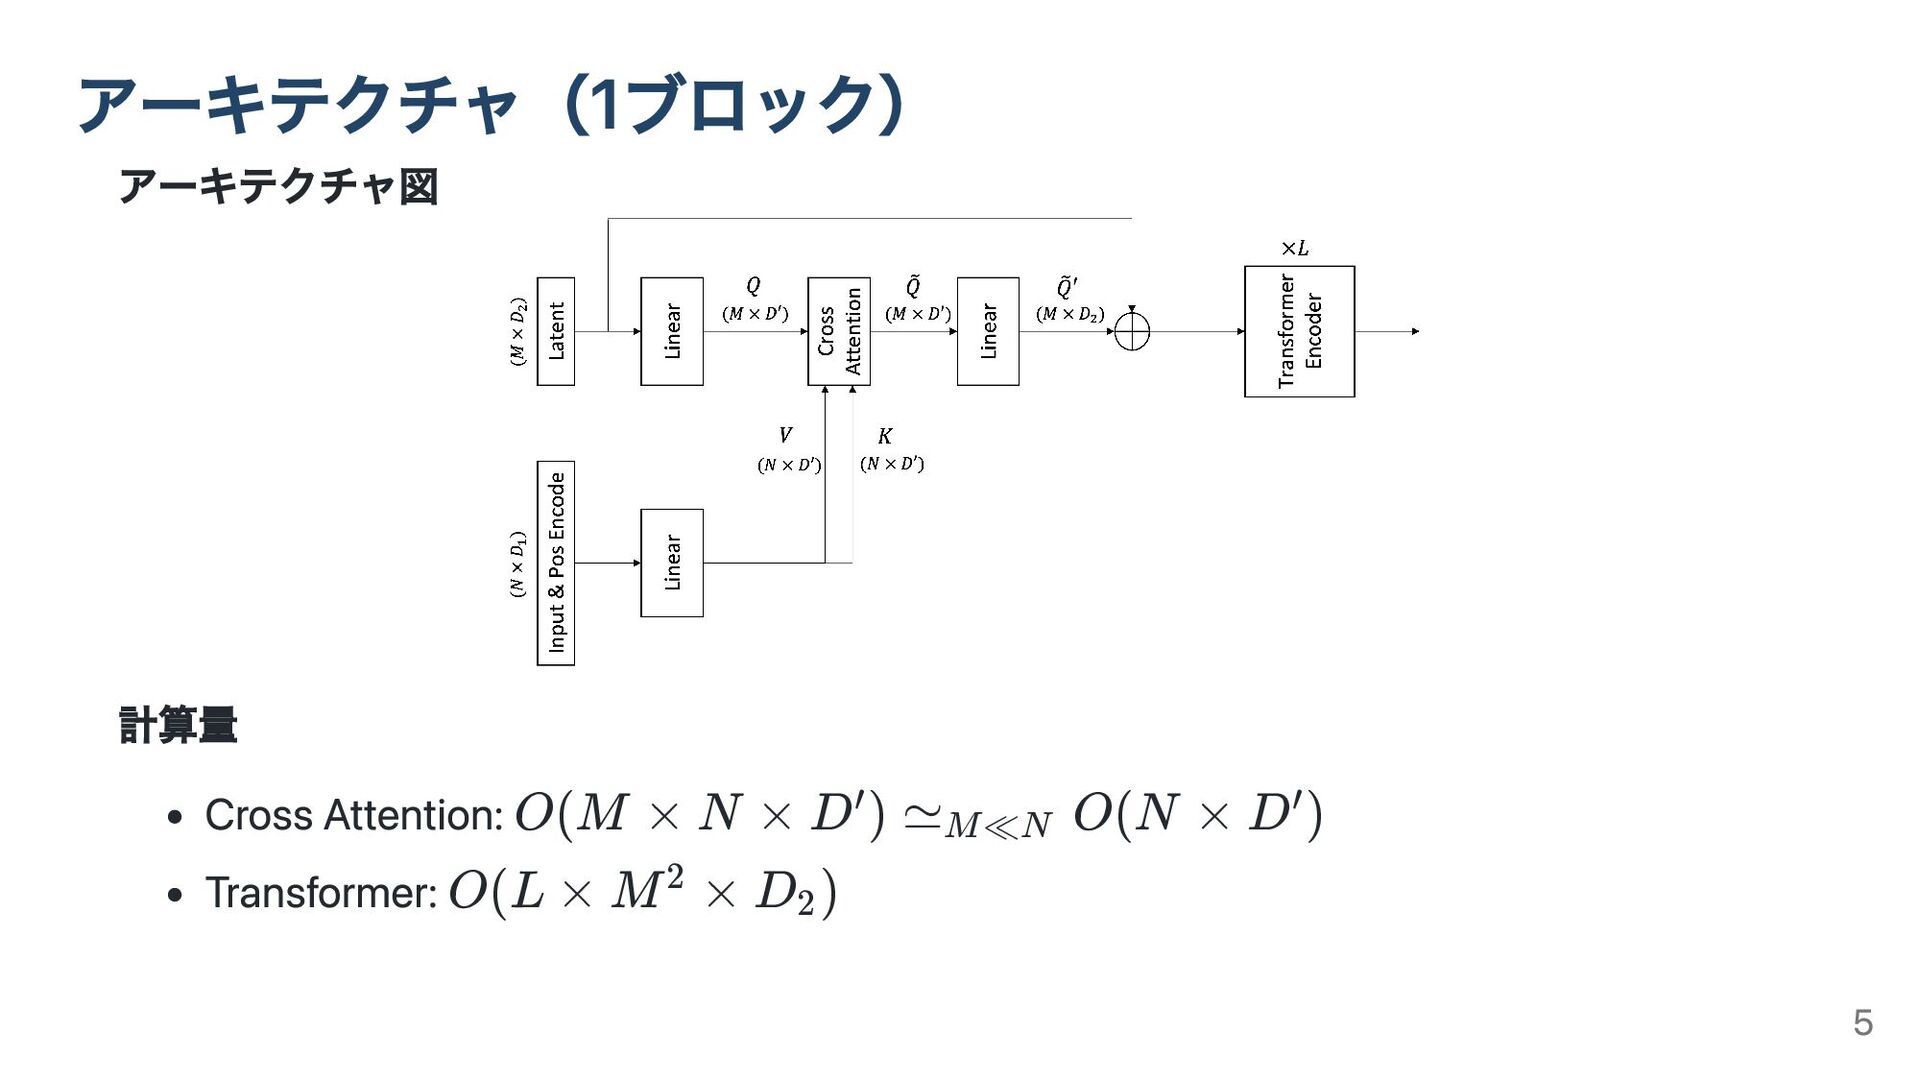
アーキテクチャ図 計算量 Cross Attention: Transformer: アーキテクチャ(1ブロック) O(M × N ×
D ) ≃ ′ M≪N O(N × D ) ′ O(L × M × 2 D ) 2 5
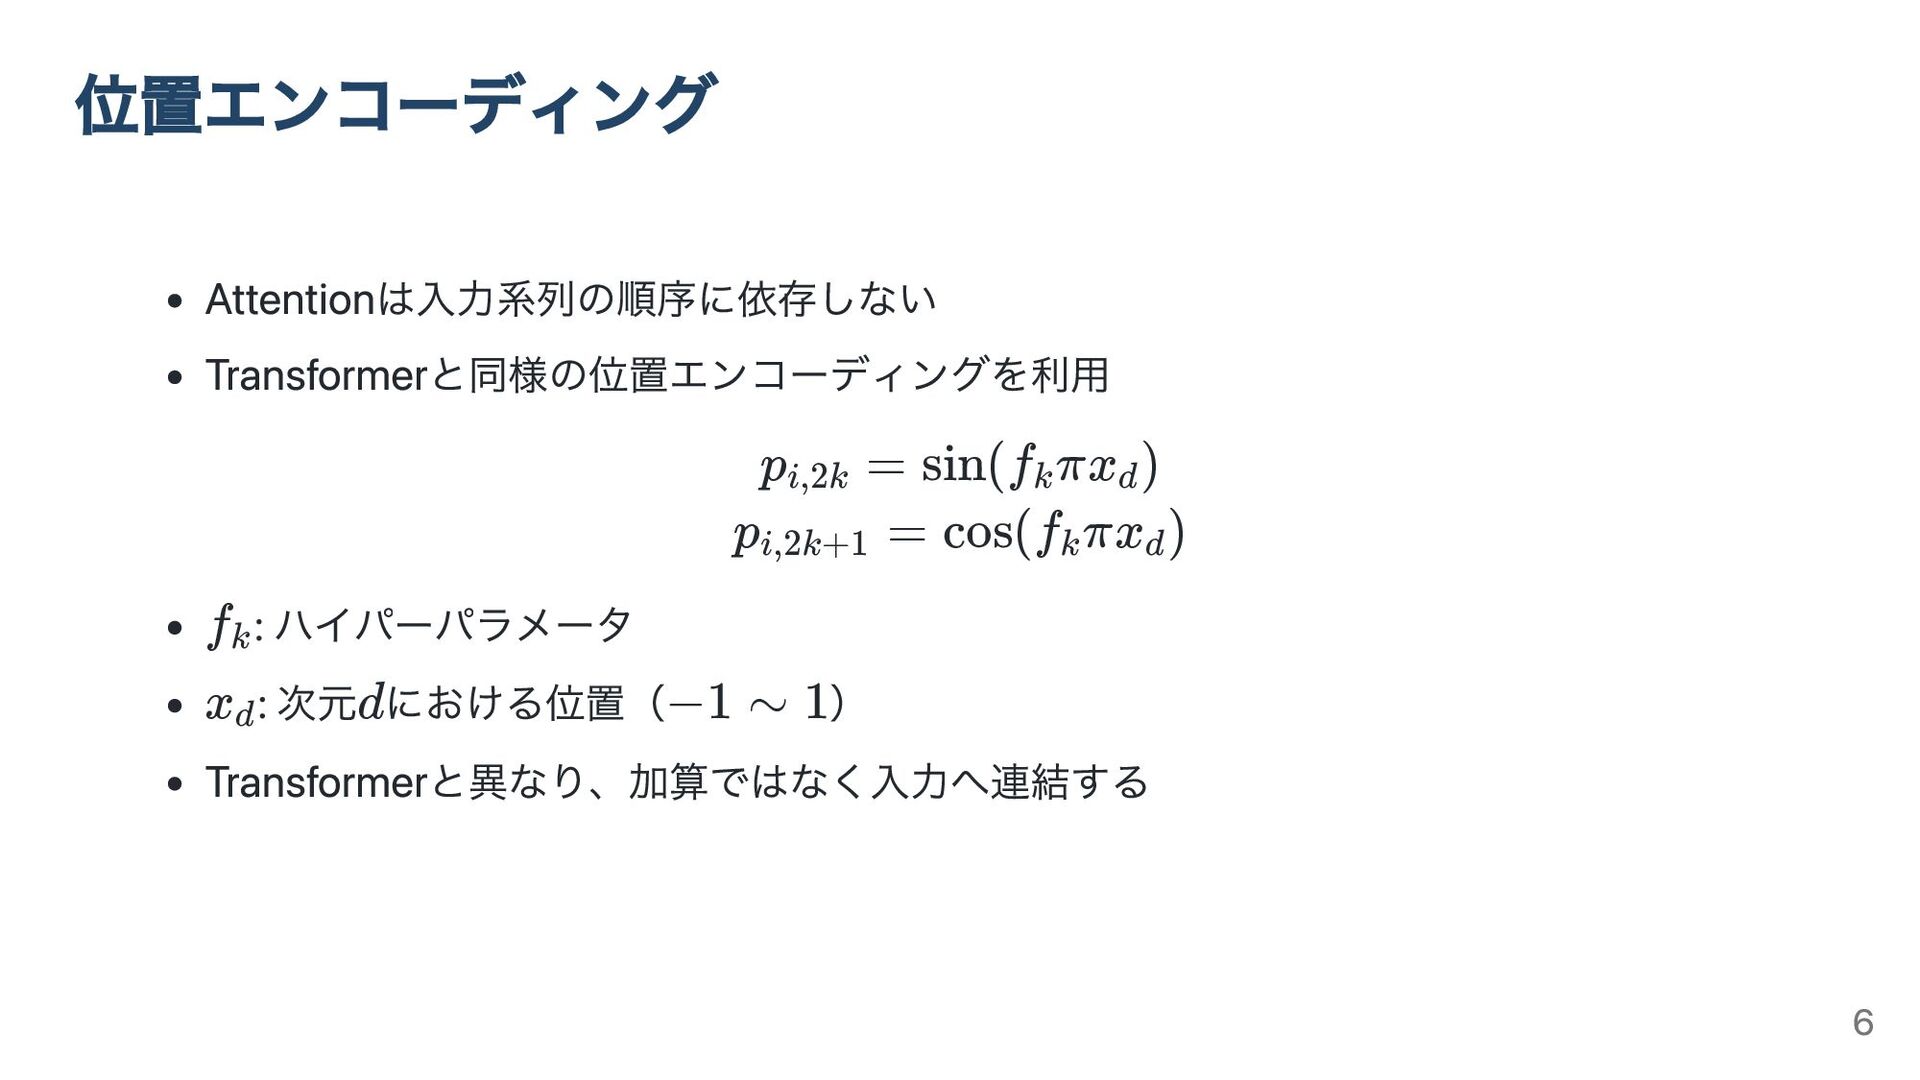
Attentionは入力系列の順序に依存しない Transformerと同様の位置エンコーディングを利用 p = i,2k sin(f πx
) k d p = i,2k+1 cos(f πx ) k d : ハイパーパラメータ : 次元 における位置( ) Transformerと異なり、加算ではなく入力へ連結する 位置エンコーディング f k x d d −1 ∼ 1 6
結果(Image) 7
実験設定 データセット: ImageNet ピクセルレベルの並び替えあり・並び替えなしで実験 評価指標: 予測ラベルの正解率 アーキテクチャ: (CrossAttention + TransformerEncoder
* 6) * 8 入力ベクトル: 50176x3 潜在ベクトル: 512x1024 結果(Image) 8
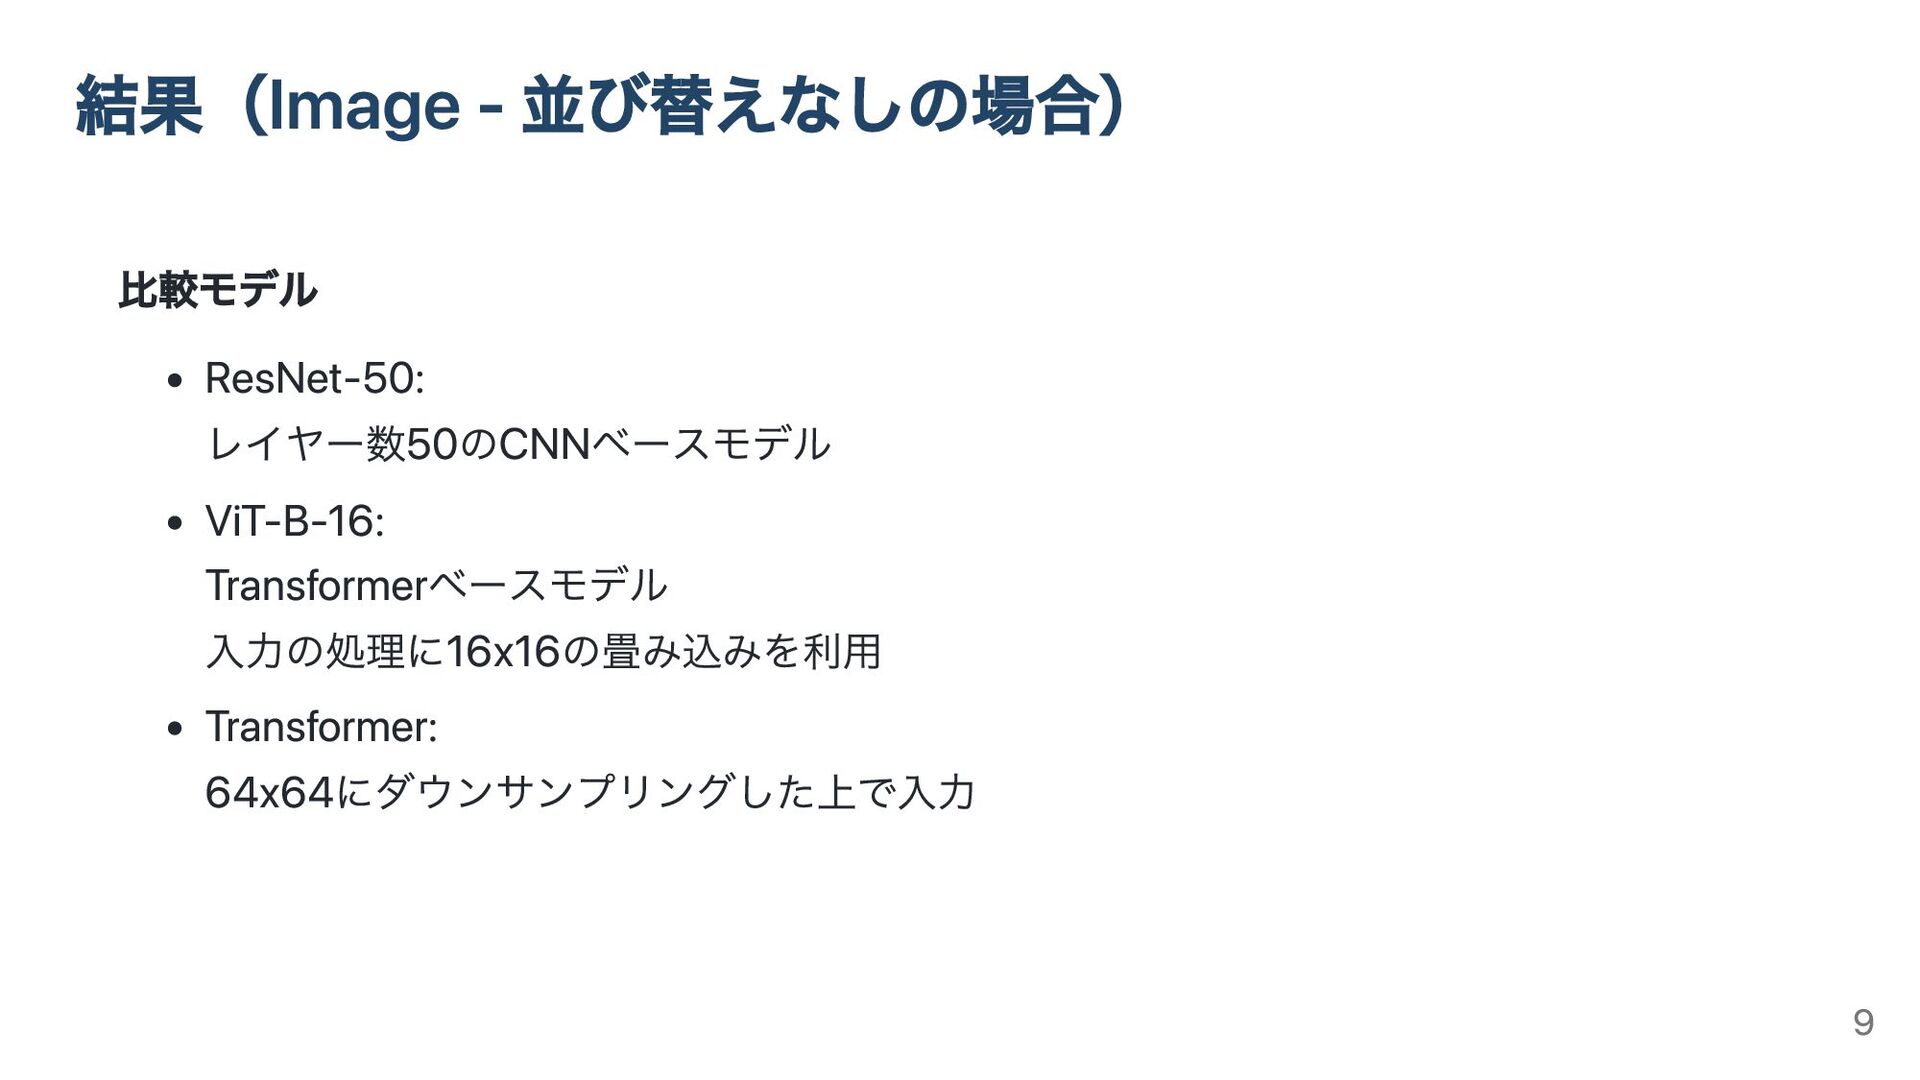
比較モデル ResNet-50: レイヤー数50のCNNベースモデル ViT-B-16: Transformerベースモデル 入力の処理に16x16の畳み込みを利用 Transformer: 64x64にダウンサンプリングした上で入力 結果(Image -
並び替えなしの場合) 9
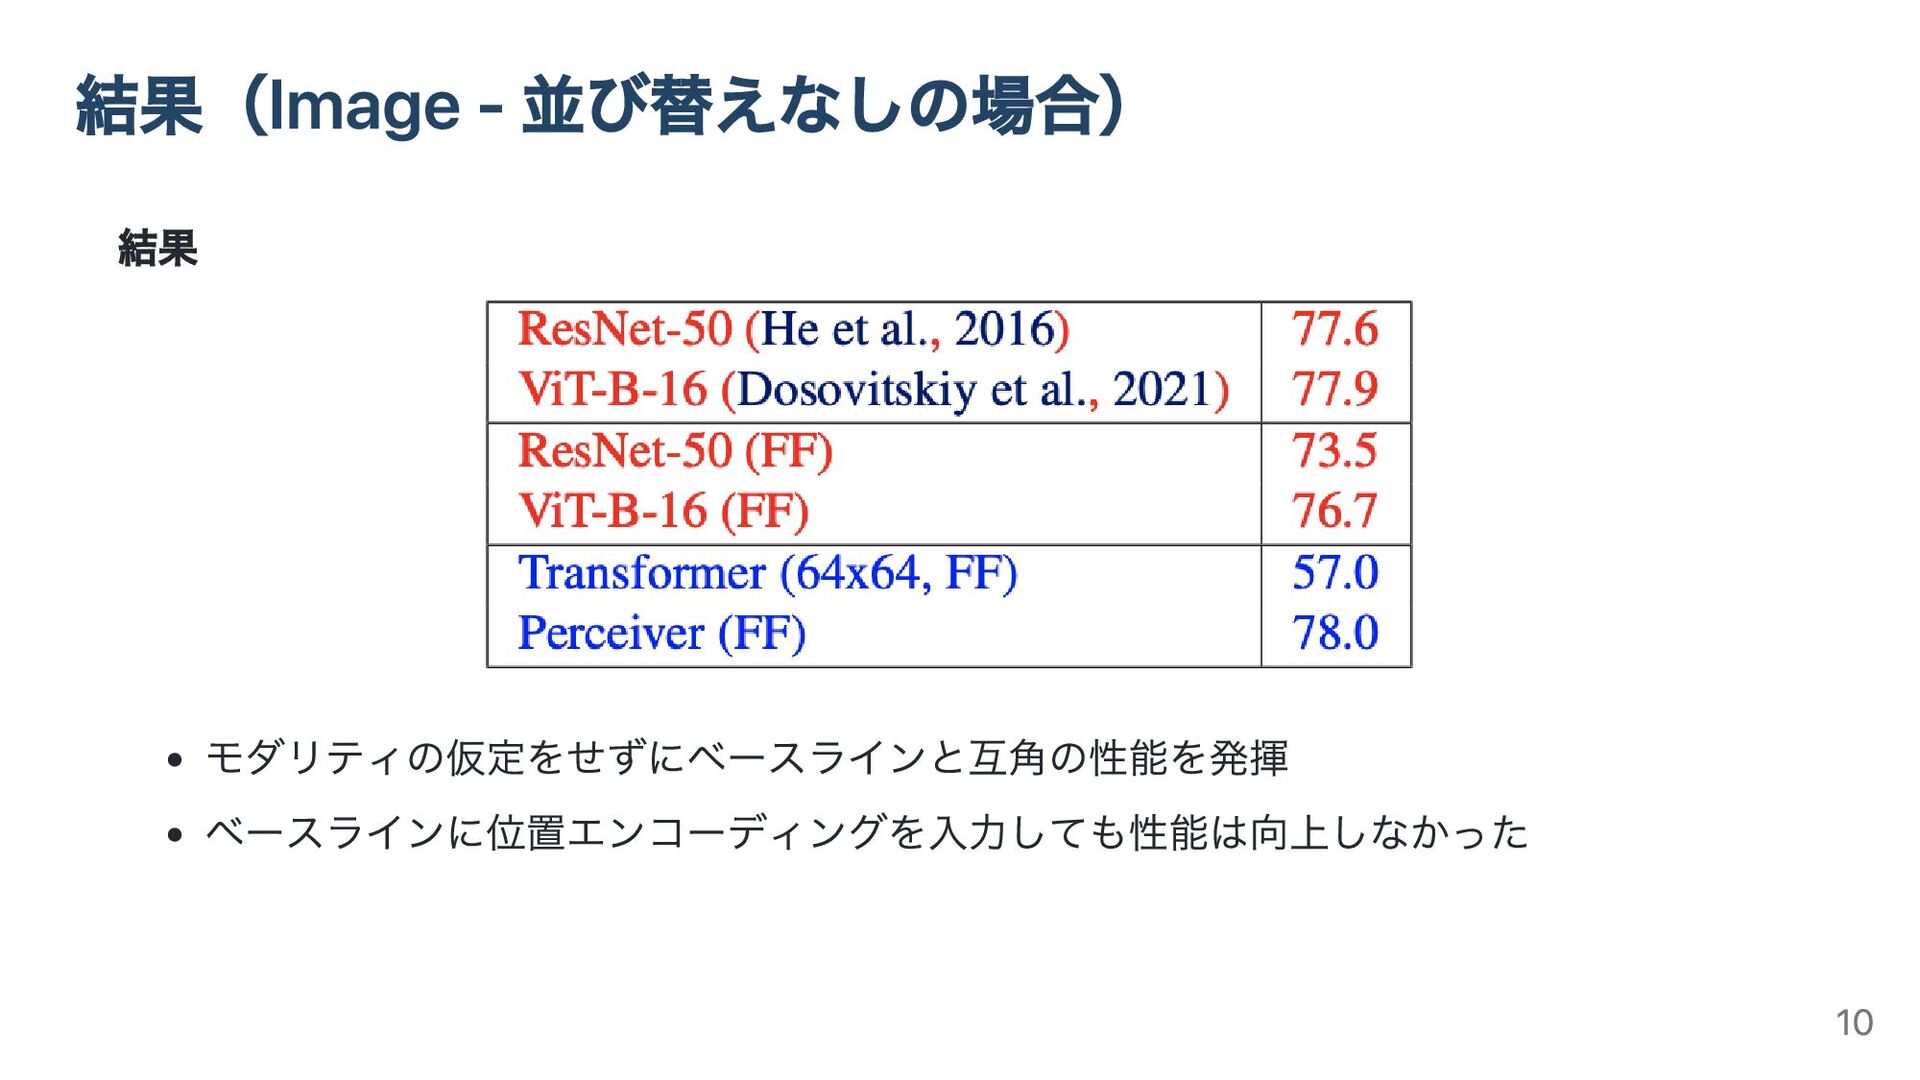
結果 モダリティの仮定をせずにベースラインと互角の性能を発揮 ベースラインに位置エンコーディングを入力しても性能は向上しなかった 結果(Image - 並び替えなしの場合) 10
設定 各画像内のピクセルを同一の規則に従って並び替える 帰納バイアスの利用を防ぐ 並び替え前に位置エンコーディングを行う 位置エンコーディングからピクセル同士の関連は学習可能 Learned pos: 位置エンコーディングを学習する inputRF: 入力レイヤーにおける受容野の大きさ
結果(Image - 並び替えありの場合) 11
結果 モダリティを仮定しないTransformerやPerceiverでは性能が悪化しなかった ViTは性能が劣化しづらかった ViTで採用されている畳み込みフィルターはResNet50より大きいから? 最終的にTransformerでパッチ間の関係を見ていることも関係してそう? 結果(Image - 並び替えありの場合) 12
結果(Audio and Video) 13
実験設定 データセット: AudioSet Audio, Video, Audio&Videoで実験 評価指標: meanAveragePrecision アーキテクチャ: (CrossAttention+TransformerEncoder*8)*2
入力ベクトル 生音声: 480x128 メルスペクトログラム: 4800x1 動画: 12544x128 潜在ベクトル: サイズ記載なし 結果(Audio and Video) 14
結果 いずれの入力パターンでもほとんどの比較手法と同等以上の性能 CNN-14に関してはbalancingおよびmixupなどの前処理を除くと性能が下回った Attention AV-fusionとの違いは今後の調査課題 結果(Audio and Video) 15
結果(Point clouds) 16
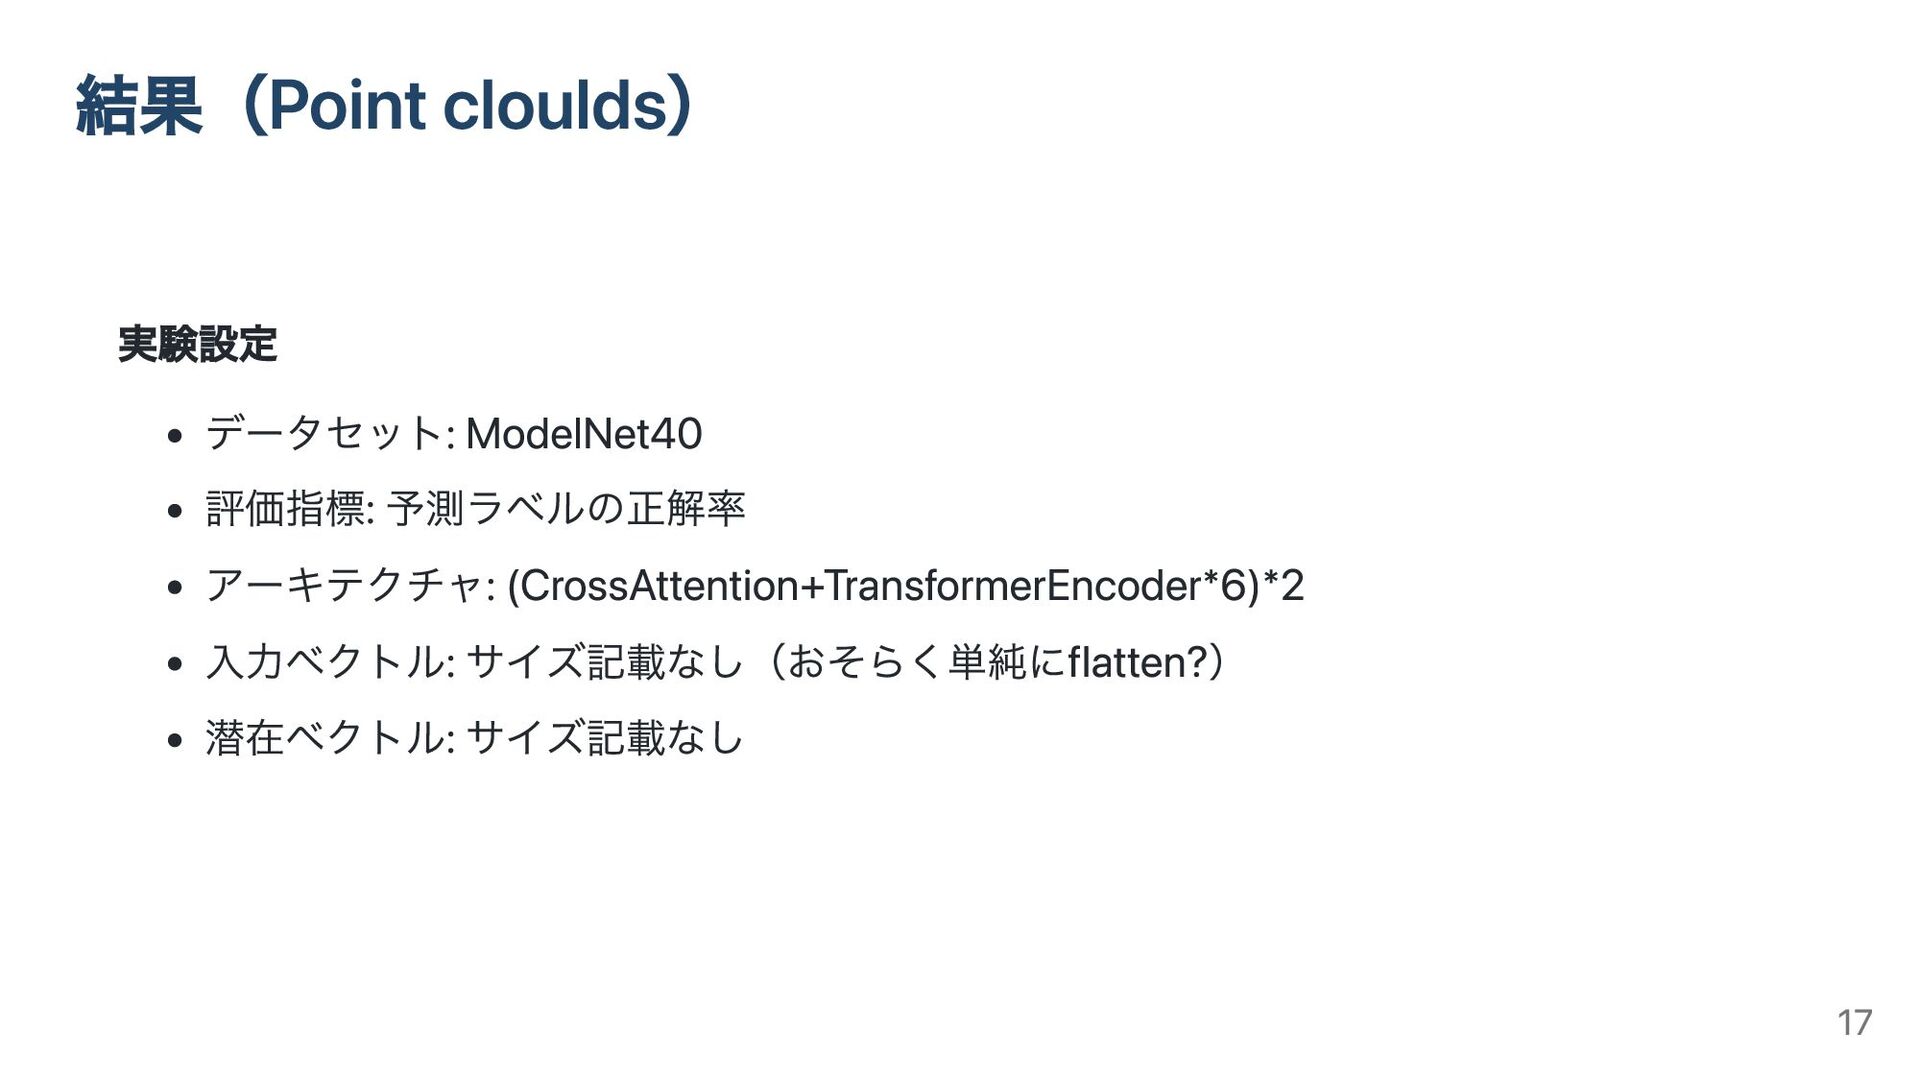
実験設定 データセット: ModelNet40 評価指標: 予測ラベルの正解率 アーキテクチャ: (CrossAttention+TransformerEncoder*6)*2 入力ベクトル: サイズ記載なし(おそらく単純にflatten?) 潜在ベクトル:
サイズ記載なし 結果(Point cloulds) 17
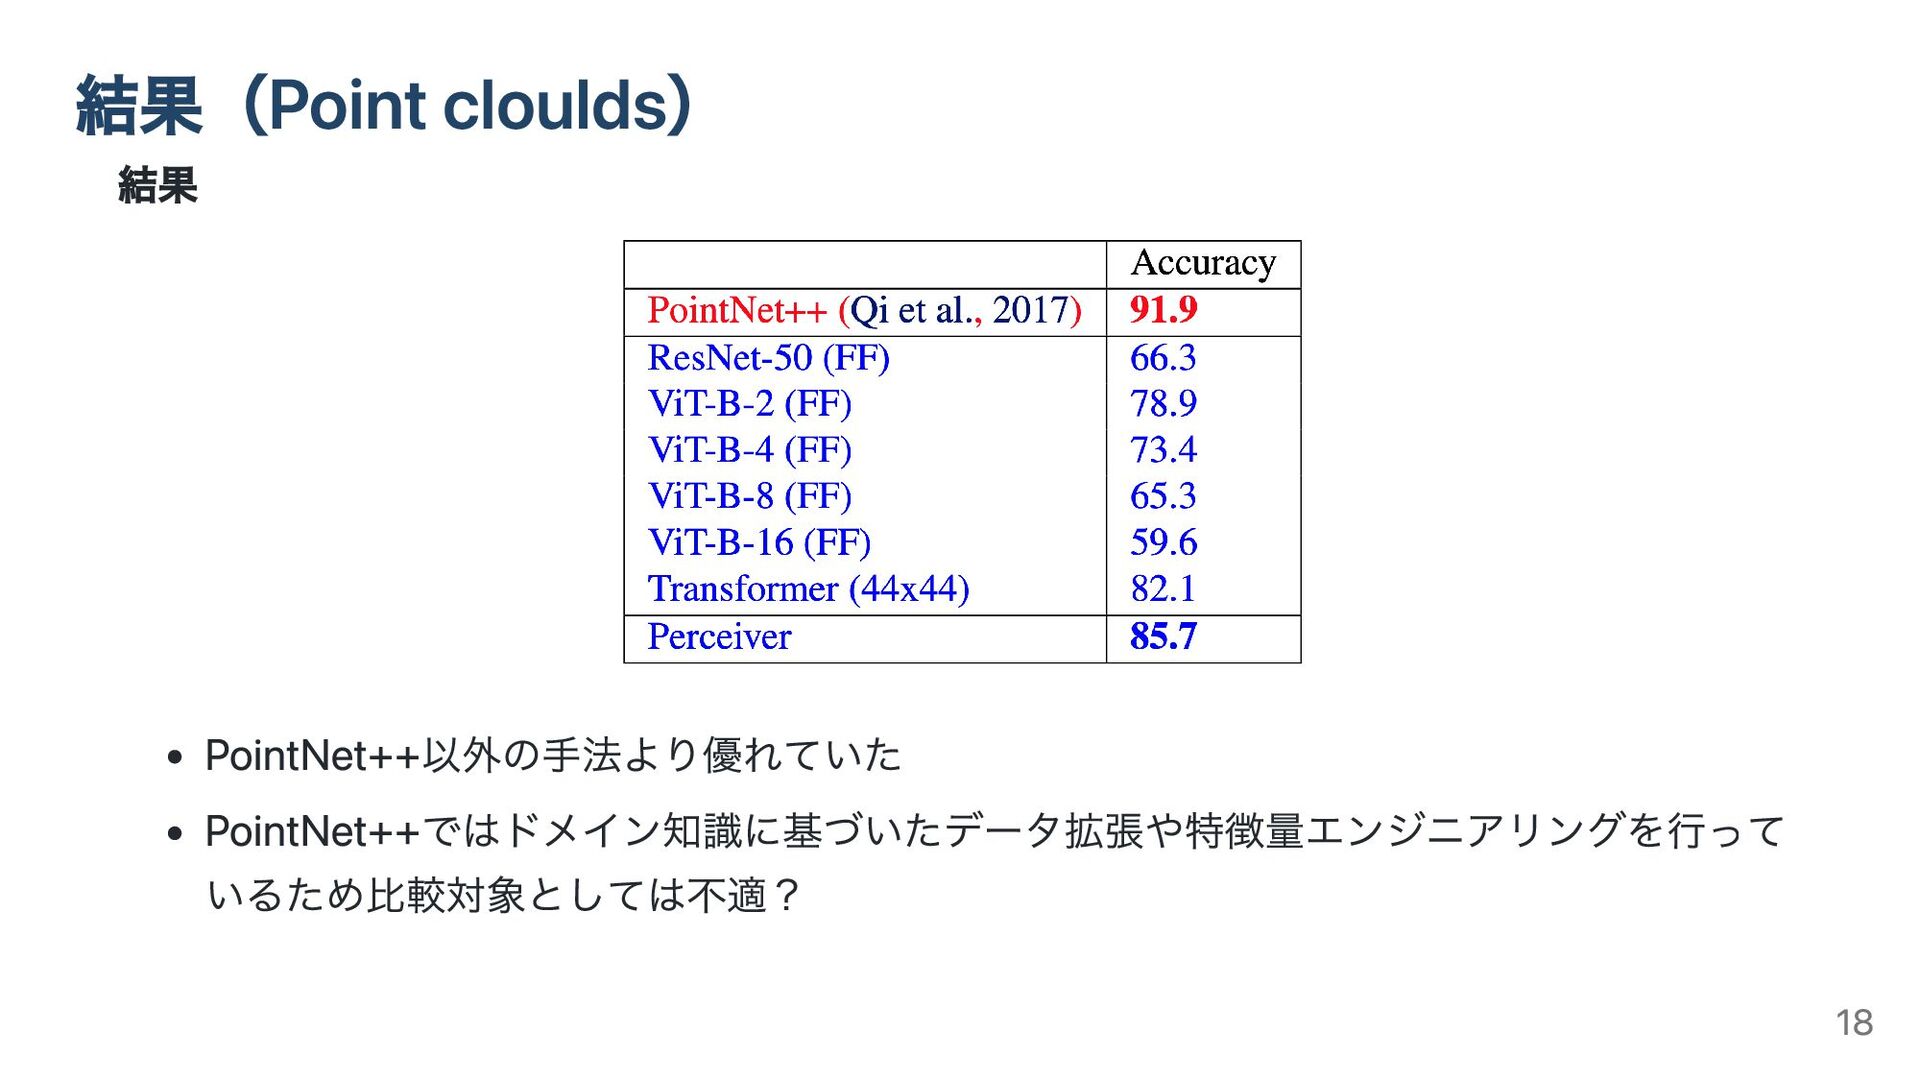
結果 PointNet++以外の手法より優れていた PointNet++ではドメイン知識に基づいたデータ拡張や特徴量エンジニアリングを行って いるため比較対象としては不適? 結果(Point cloulds) 18
まとめ 19
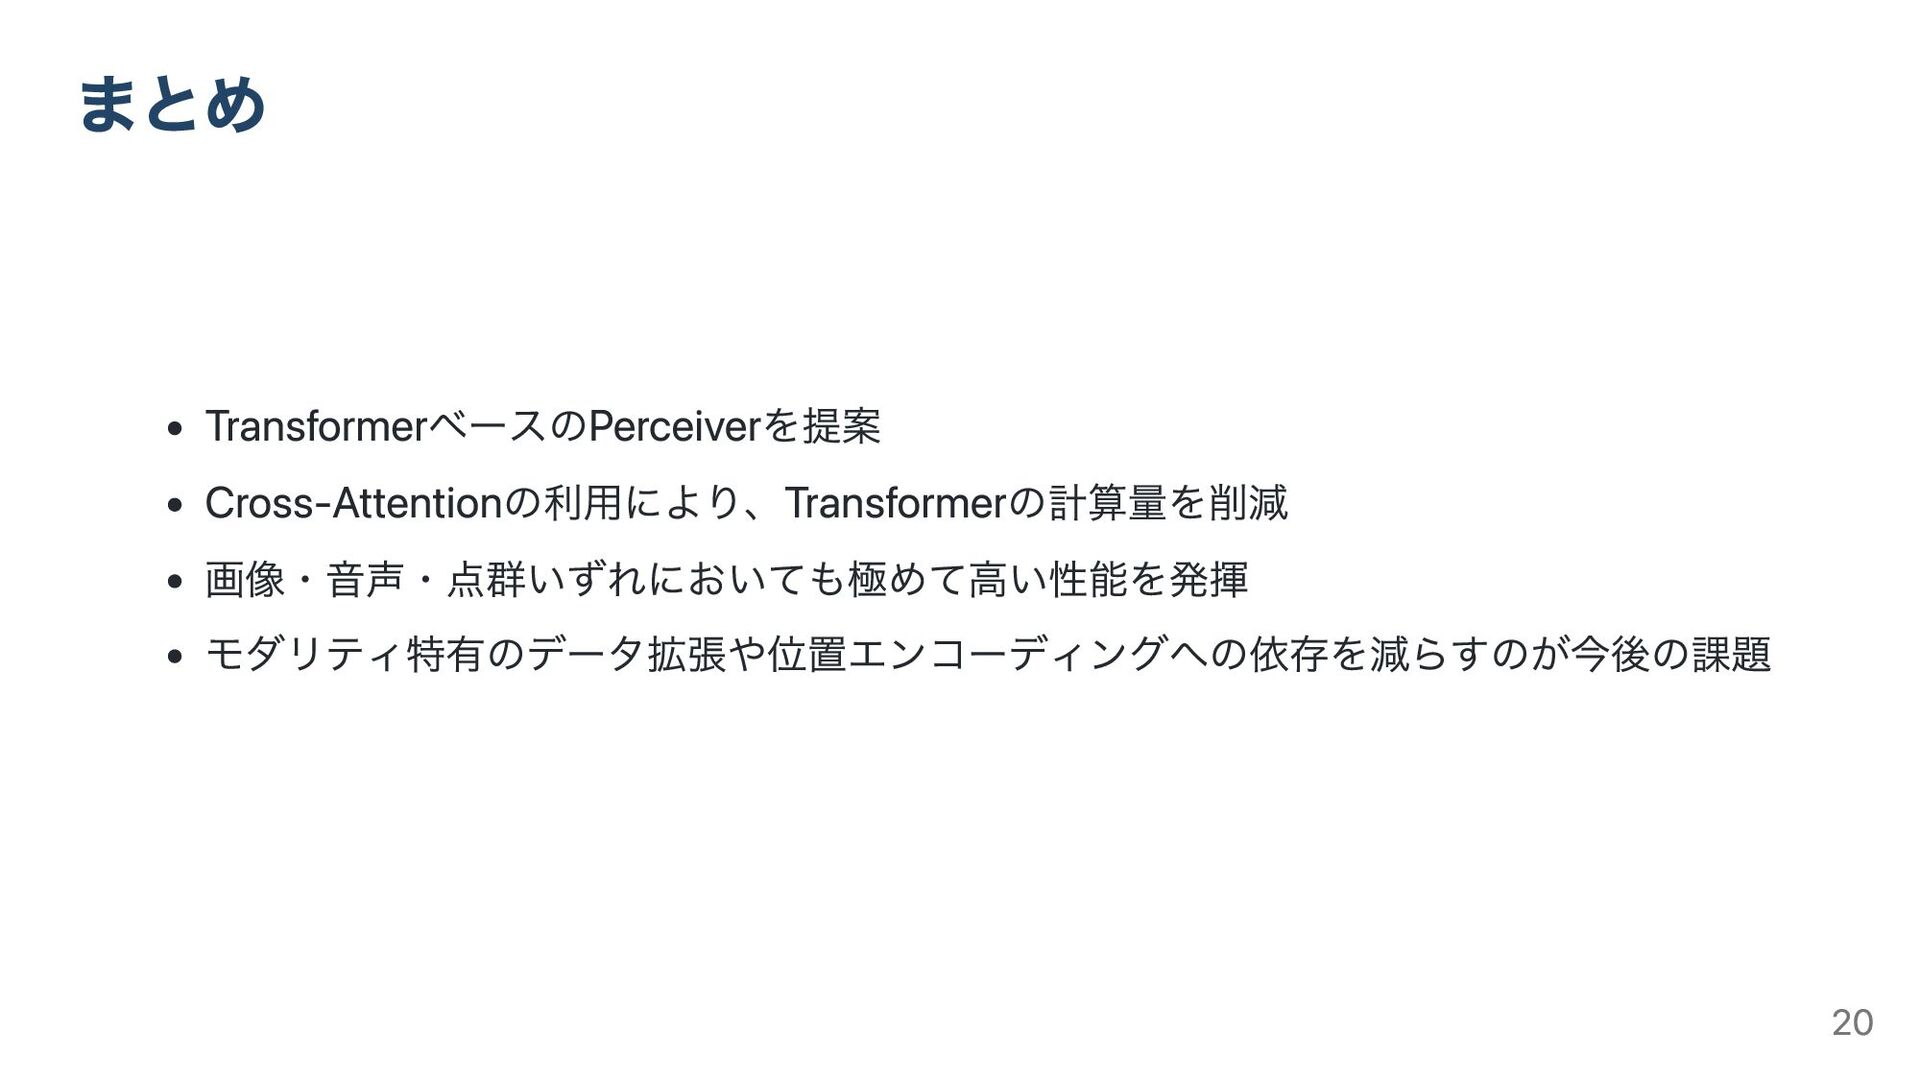
TransformerベースのPerceiverを提案 Cross-Attentionの利用により、Transformerの計算量を削減 画像・音声・点群いずれにおいても極めて高い性能を発揮 モダリティ特有のデータ拡張や位置エンコーディングへの依存を減らすのが今後の課題 まとめ 20


 shibukazu
 shibuiwilliam
 institutdelelevage
 takaomurakami
 tomonom
 s_mizuki_nlp
 pman0214
 hellosct1
 rikkabotan7
 hisaokatsumi
 cassininazir
 dugsong
 lcolladotor
 addyosmani
 trallard
 tammyeverts
 jct
 marketingsoph
 427marketing
 shpigford
 gr2m
 wjessup