Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
ShigeruOda
February 08, 2026
Technology
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
ShigeruOda
February 08, 2026
More Decks by ShigeruOda
See All by ShigeruOda
Amazon S3 Tablesに全部任せてみた結果——コンパクション/スナップショット管理は本当に手放せるか
shigeruoda
1
830
AWS re:Invent 2025 Apache Iceberg Recap
shigeruoda
1
130
Amazon Athena で JSON・Parquet・Iceberg のデータを検索し、性能を比較してみた
shigeruoda
1
650
Amazon S3標準/ S3 Tables/S3 Express One Zoneを使ったログ分析
shigeruoda
6
1k
CFP選定とタイムテーブル決めについて
shigeruoda
0
220
今年前半のAWSアップデートを振り返り
shigeruoda
0
160
#31 JAWS-UG主催 週刊AWSキャッチアップ (2024/5/6週)
shigeruoda
0
250
#30 JAWS-UG主催 週刊AWSキャッチアップ(2024/4/29週)
shigeruoda
0
200
#28 JAWS-UG主催 週刊AWSキャッチアップ(2024/4/15週)
shigeruoda
0
230
Other Decks in Technology
See All in Technology
React改造してみた
tsukina_7mochi
0
120
M5Stackで作る BLEマウス GPSログの世界
tomokusaba
PRO
0
440
Post AI時代のリファクタリング実践記 / Refactoring in the post AI era
kaminashi
1
290
その Valkey 使いこなしていますか?
onk
PRO
5
1.6k
スキマバイトという雇用形態は存在しないので、雇用期間1日のアルバイト契約を事業者とワーカーが結ぶ手続きを支えるのがタイミーなんです
akitoshiga
0
210
フィンテック養成勉強会#68
finengine
0
150
Webの常識が通じないHTMLメールのダークモード
teamlab
PRO
0
130
V8のArray.prototype.flatを最大約20倍速くするまでと、巨大OSSへの大規模コミットの道のり
riyaamemiya
0
310
AI時代のPRレビューにどう向き合うか?
kairim0
1
240
実践!Cloud Run ハンズオン!! / Cloud Run handson
y0hgi
2
300
Claude の新機能を、 出た日に触って社内に届けるまで
rfdnxbro
1
190
脆弱性診断って、何をしているの? 〜弱点を見つけて、会社の改善につなげるまで〜
keeg
0
930
Featured
See All Featured
KATA
mclloyd
PRO
35
16k
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1.2k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
Skip the Path - Find Your Career Trail
mkilby
1
260
16th Malabo Montpellier Forum Presentation
akademiya2063
PRO
0
410
Building Adaptive Systems
keathley
44
3.3k
Heart Work Chapter 1 - Part 1
lfama
PRO
10
37k
Cheating the UX When There Is Nothing More to Optimize - PixelPioneers
stephaniewalter
287
14k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
The B2B funnel & how to create a winning content strategy
katarinadahlin
PRO
1
570
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Jess Joyce - The Pitfalls of Following Frameworks
techseoconnect
PRO
1
450
Transcript
AWS re:Invent 2025 Apache Iceberg Recap JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
2025.02.08 1
自己紹介 Name Shigeru Oda Community Japan AWS User Group Beginner's
Branch AWS Community Hero Role Product Infrastructure Technical Lead at Sansan, Inc. 2
お伝えすること Apache Iceberg の基礎 AWS re:Invent 2025 で発表された Apache Iceberg
関連アップデート 3
Apache Iceberg ってなに? Apache Iceberg は「データレイク用のテーブルフォーマット」 S3などのオブジェクトストレージで構成される巨大かつ複雑なテーブルを分散エンジン (Spark、Trino、Flink、Hiveなどから効率良く扱える仕組みを提供します 具体的な機能としては ▪
ACID 保証: トランザクション制御 ▪ スキーマ進化: カラム追加・変更が安全 ▪ タイムトラベル: 過去の状態に遡れる ▪ 高速なメタデータ操作: パーティション管理が効率的 4
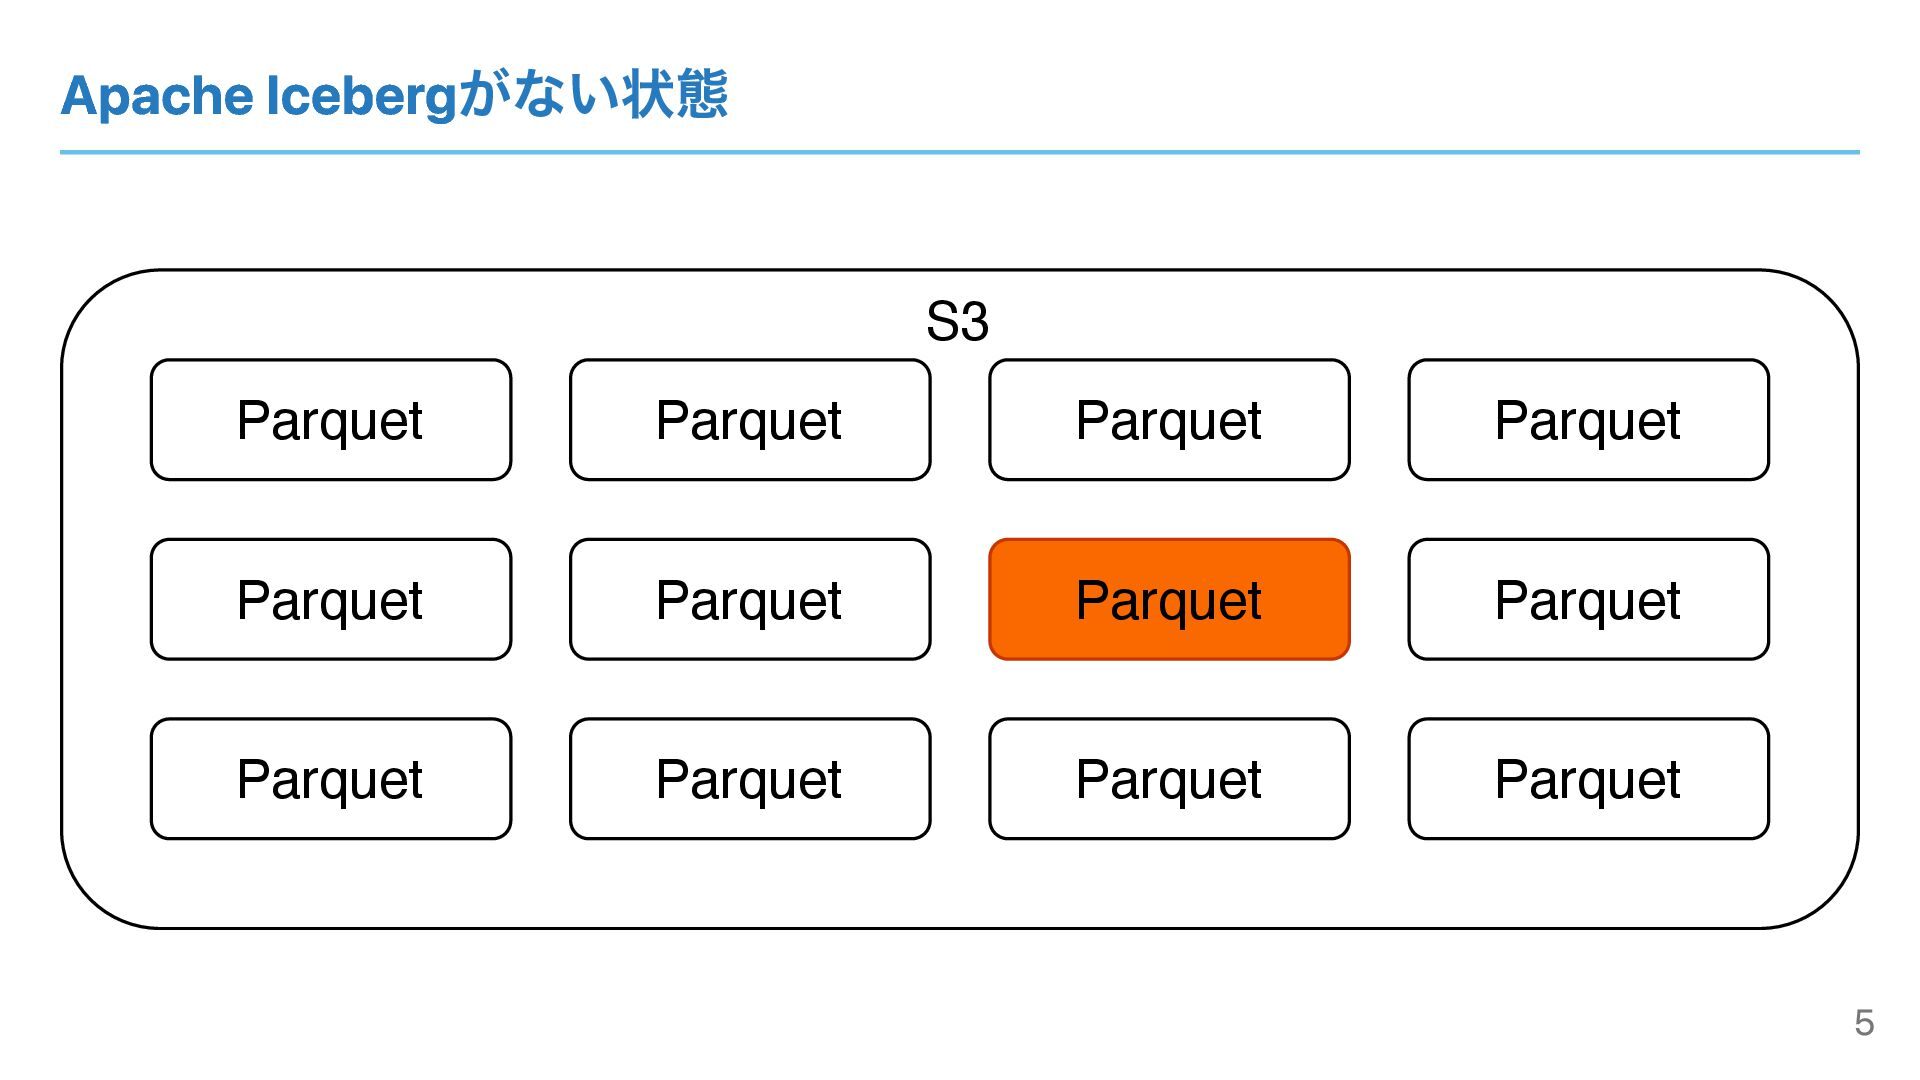
Apache Icebergがない状態 S3 Parquet Parquet Parquet Parquet Parquet Parquet Parquet
Parquet Parquet Parquet Parquet Parquet 5
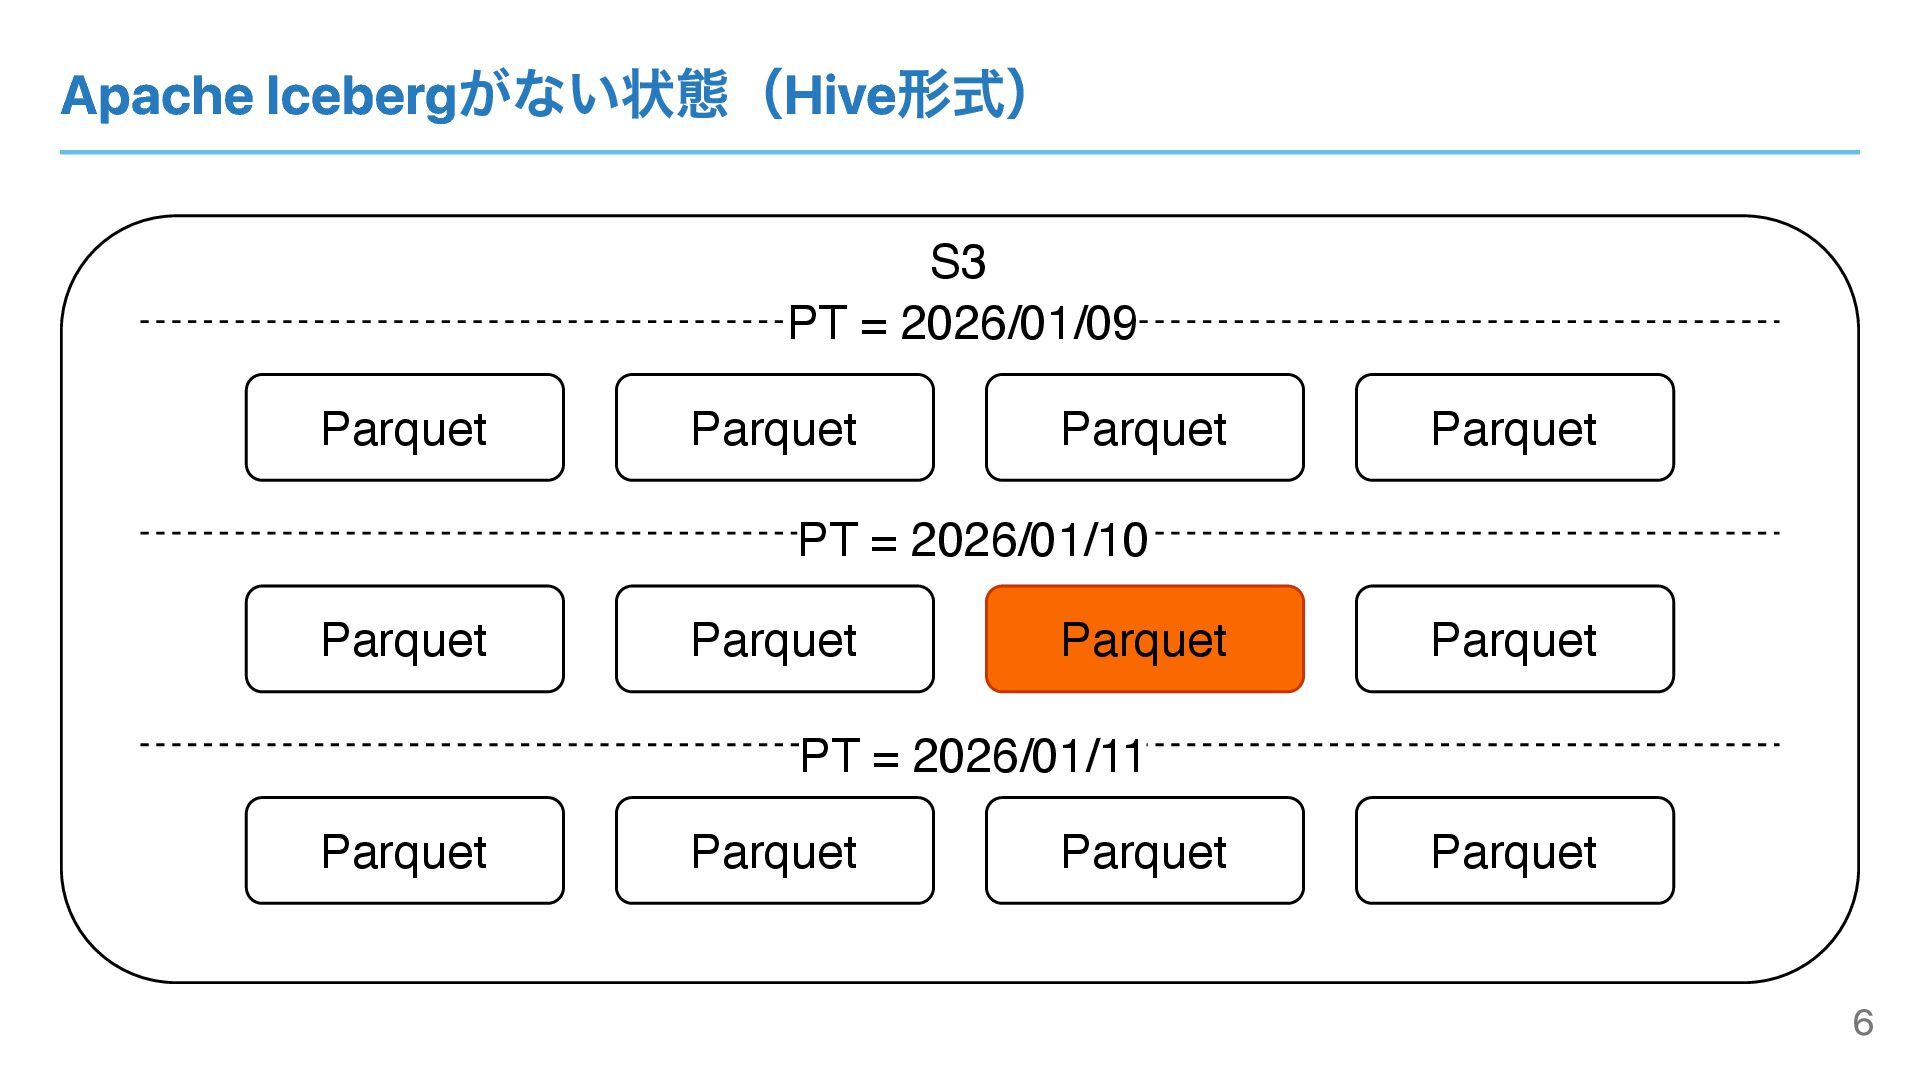
Apache Icebergがない状態(Hive形式) S3 Parquet Parquet Parquet Parquet Parquet Parquet Parquet
Parquet Parquet Parquet Parquet Parquet PT = 2026/01/10 PT = 2026/01/11 PT = 2026/01/09 6
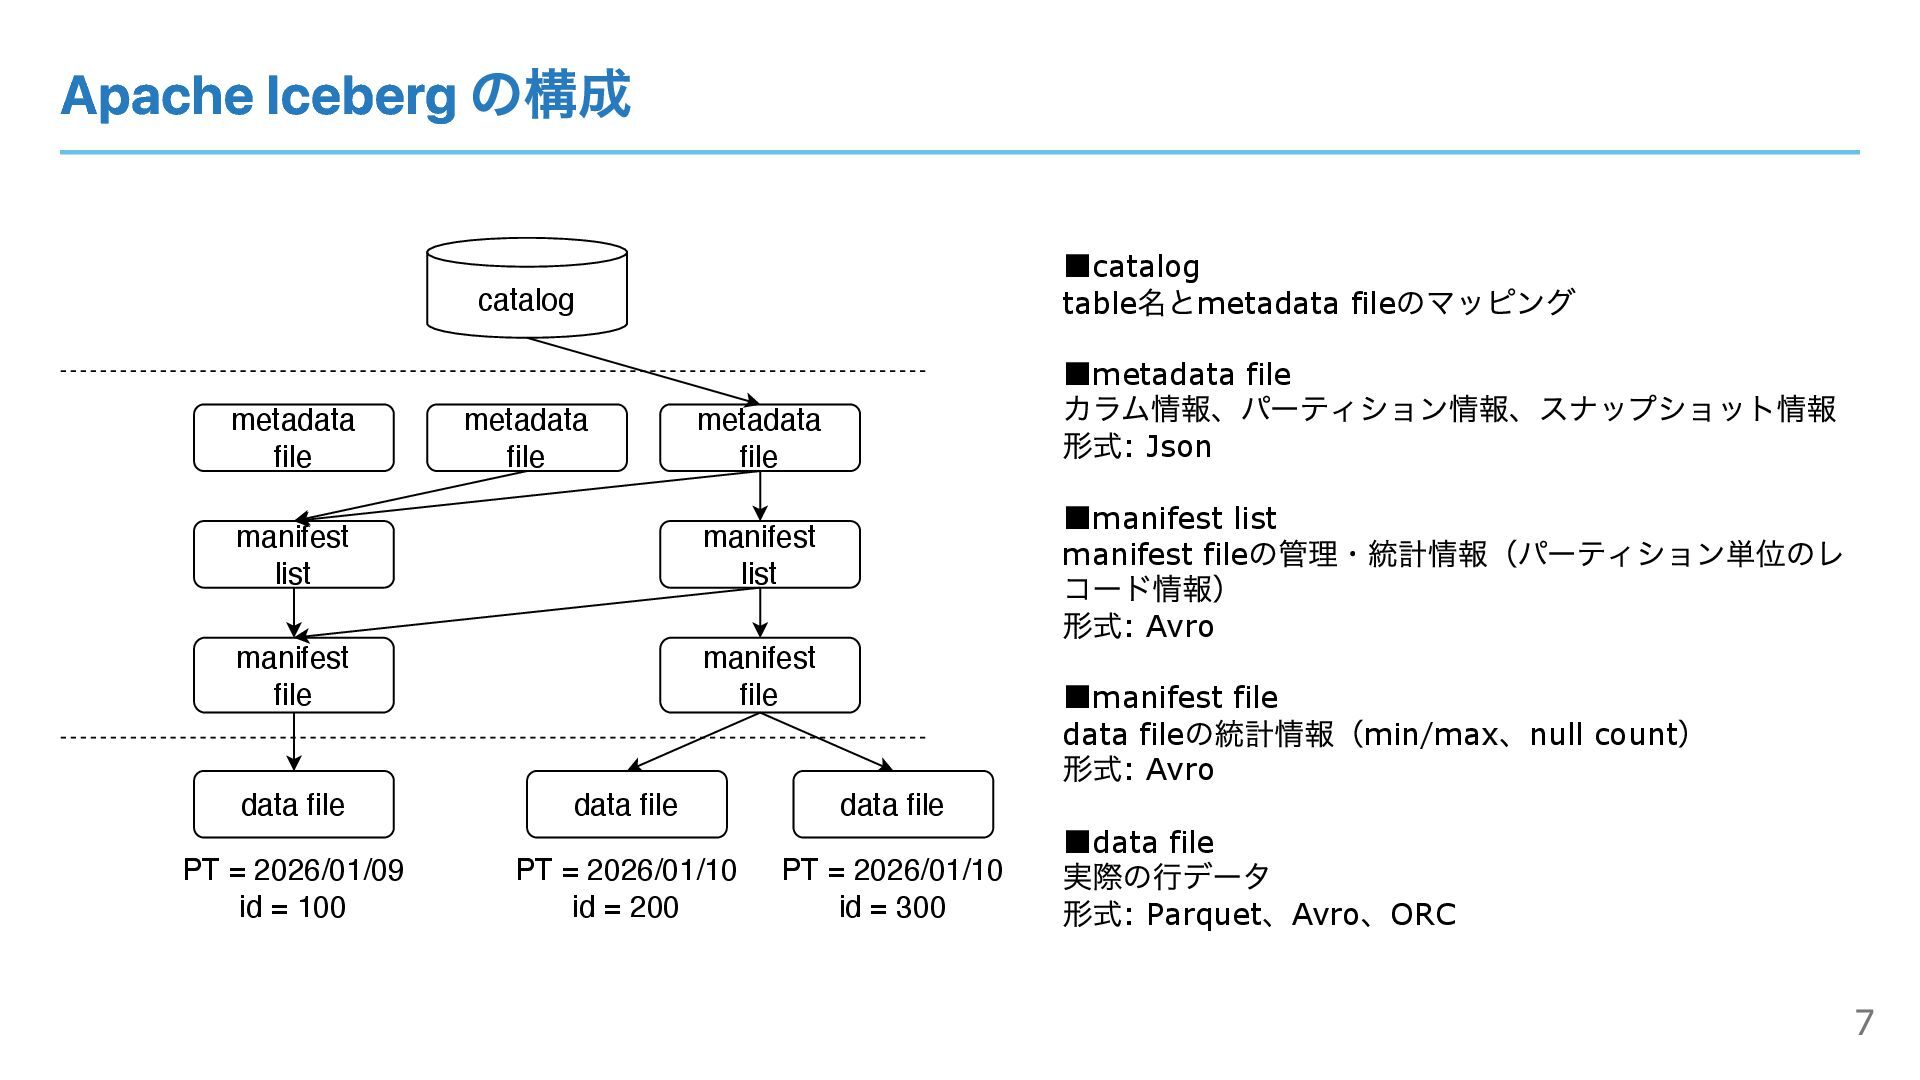
Apache Iceberg の構成 catalog metadata file manifest list manifest file
data file ▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC data file manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 PT = 2026/01/10 id = 200 PT = 2026/01/10 id = 300 metadata file 7
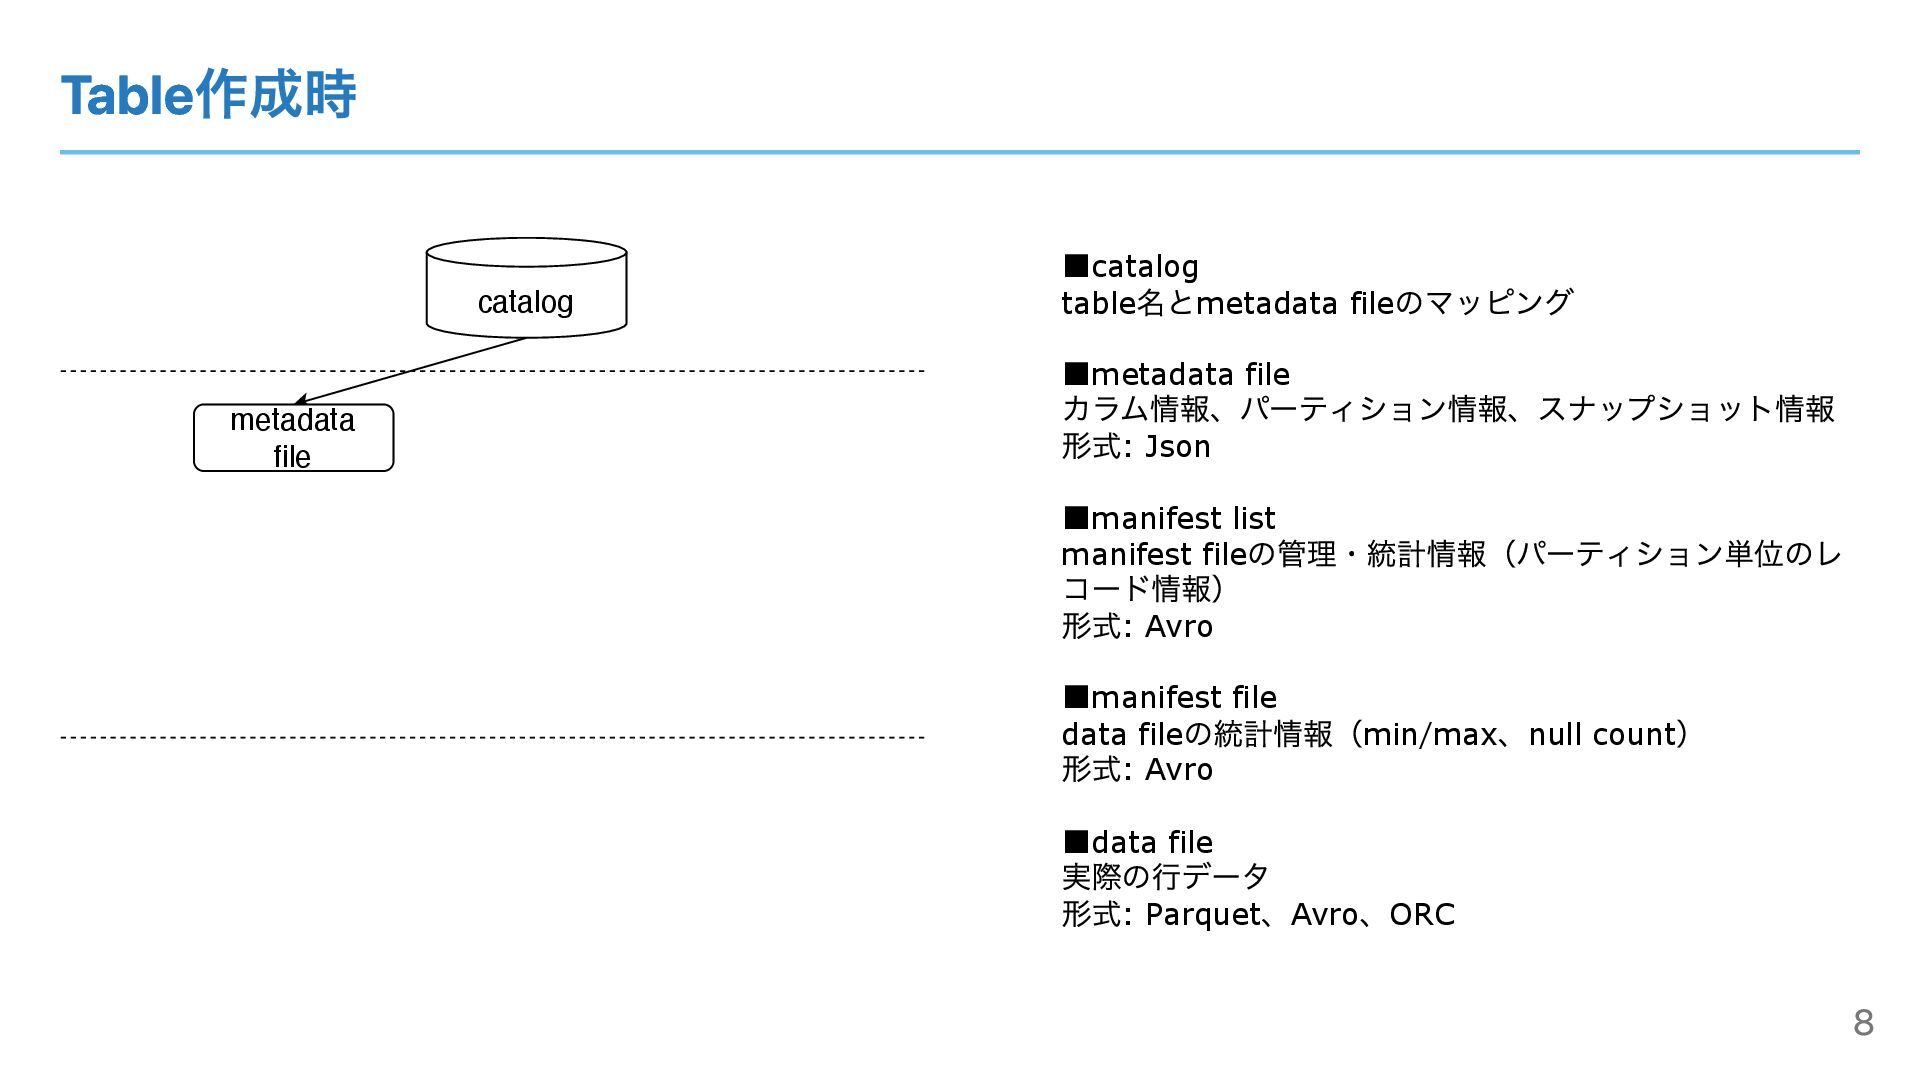
Table作成時 catalog ▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報
形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC metadata file 8
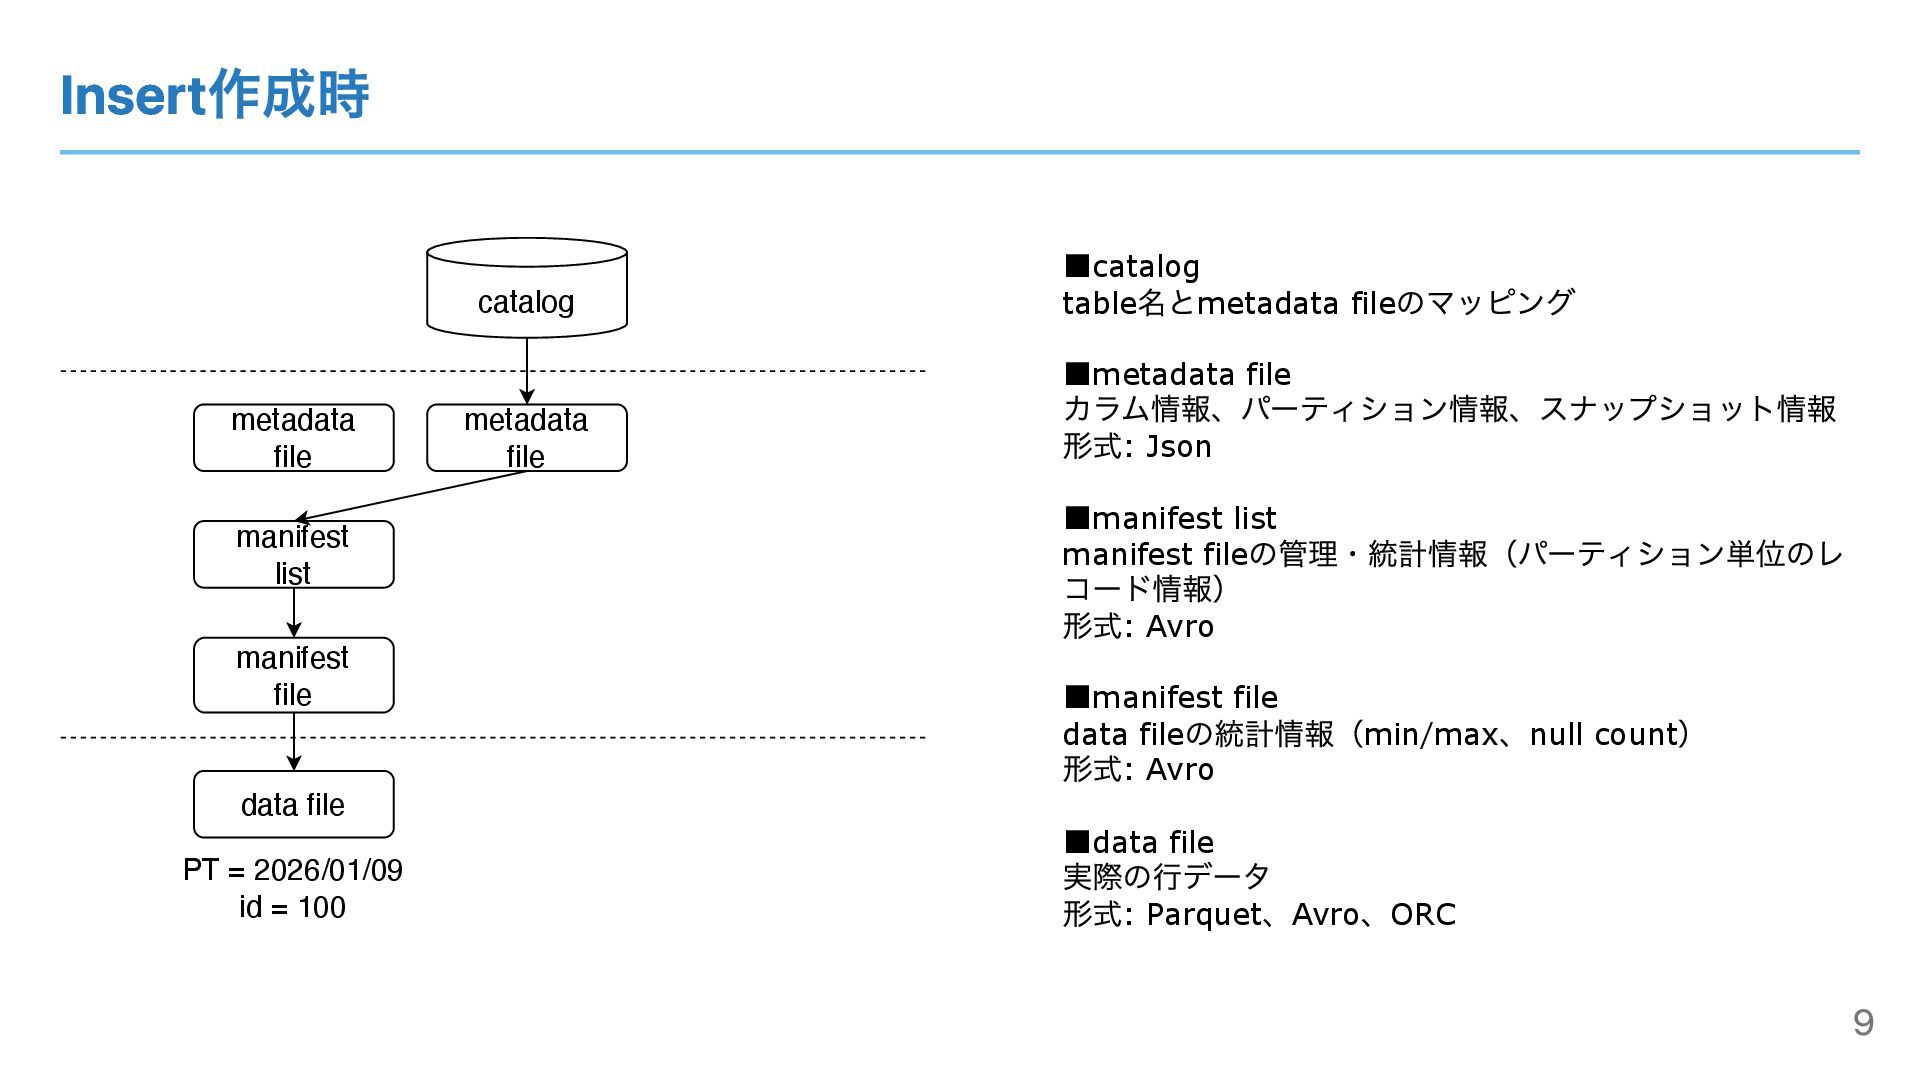
Insert作成時 catalog metadata file ▪catalog table 名とmetadata file のマッピング ▪metadata
file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 9
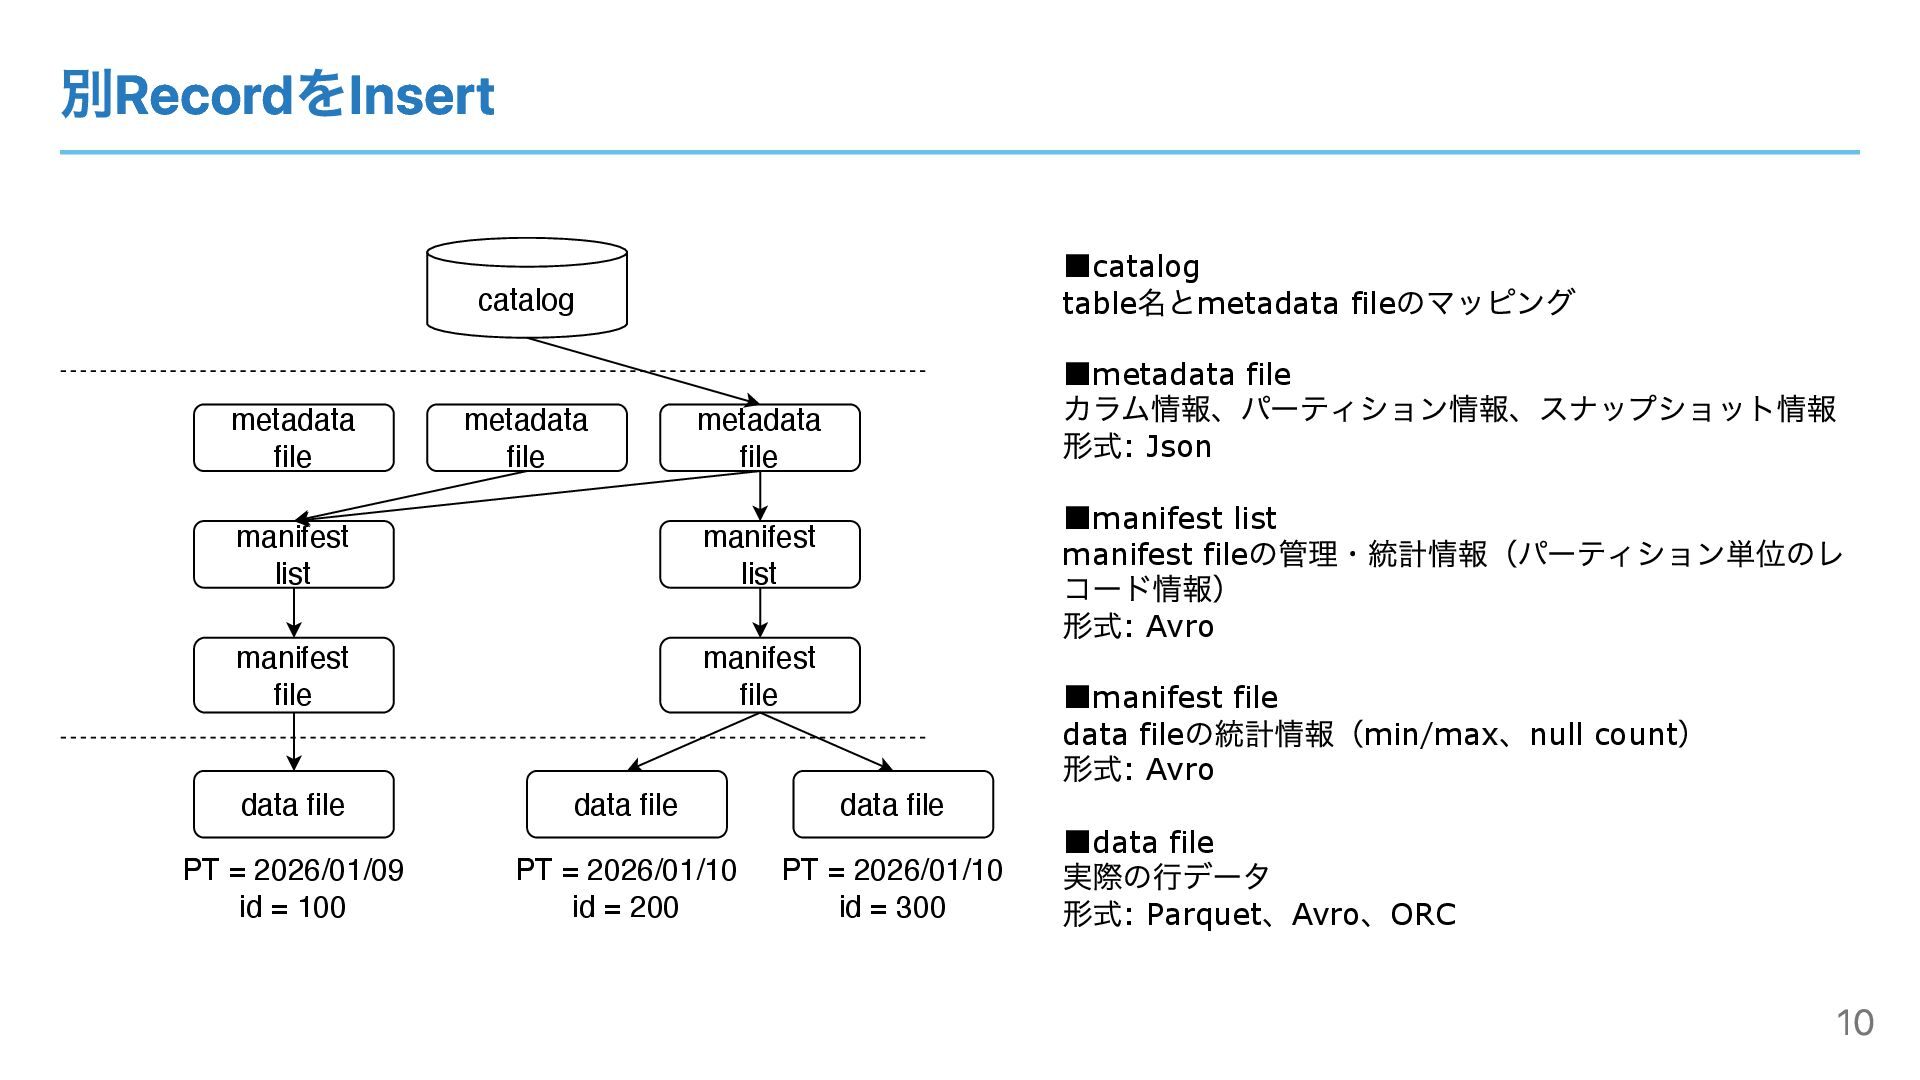
別RecordをInsert catalog metadata file manifest list manifest file data file
▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC data file manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 PT = 2026/01/10 id = 200 metadata file PT = 2026/01/10 id = 300 10
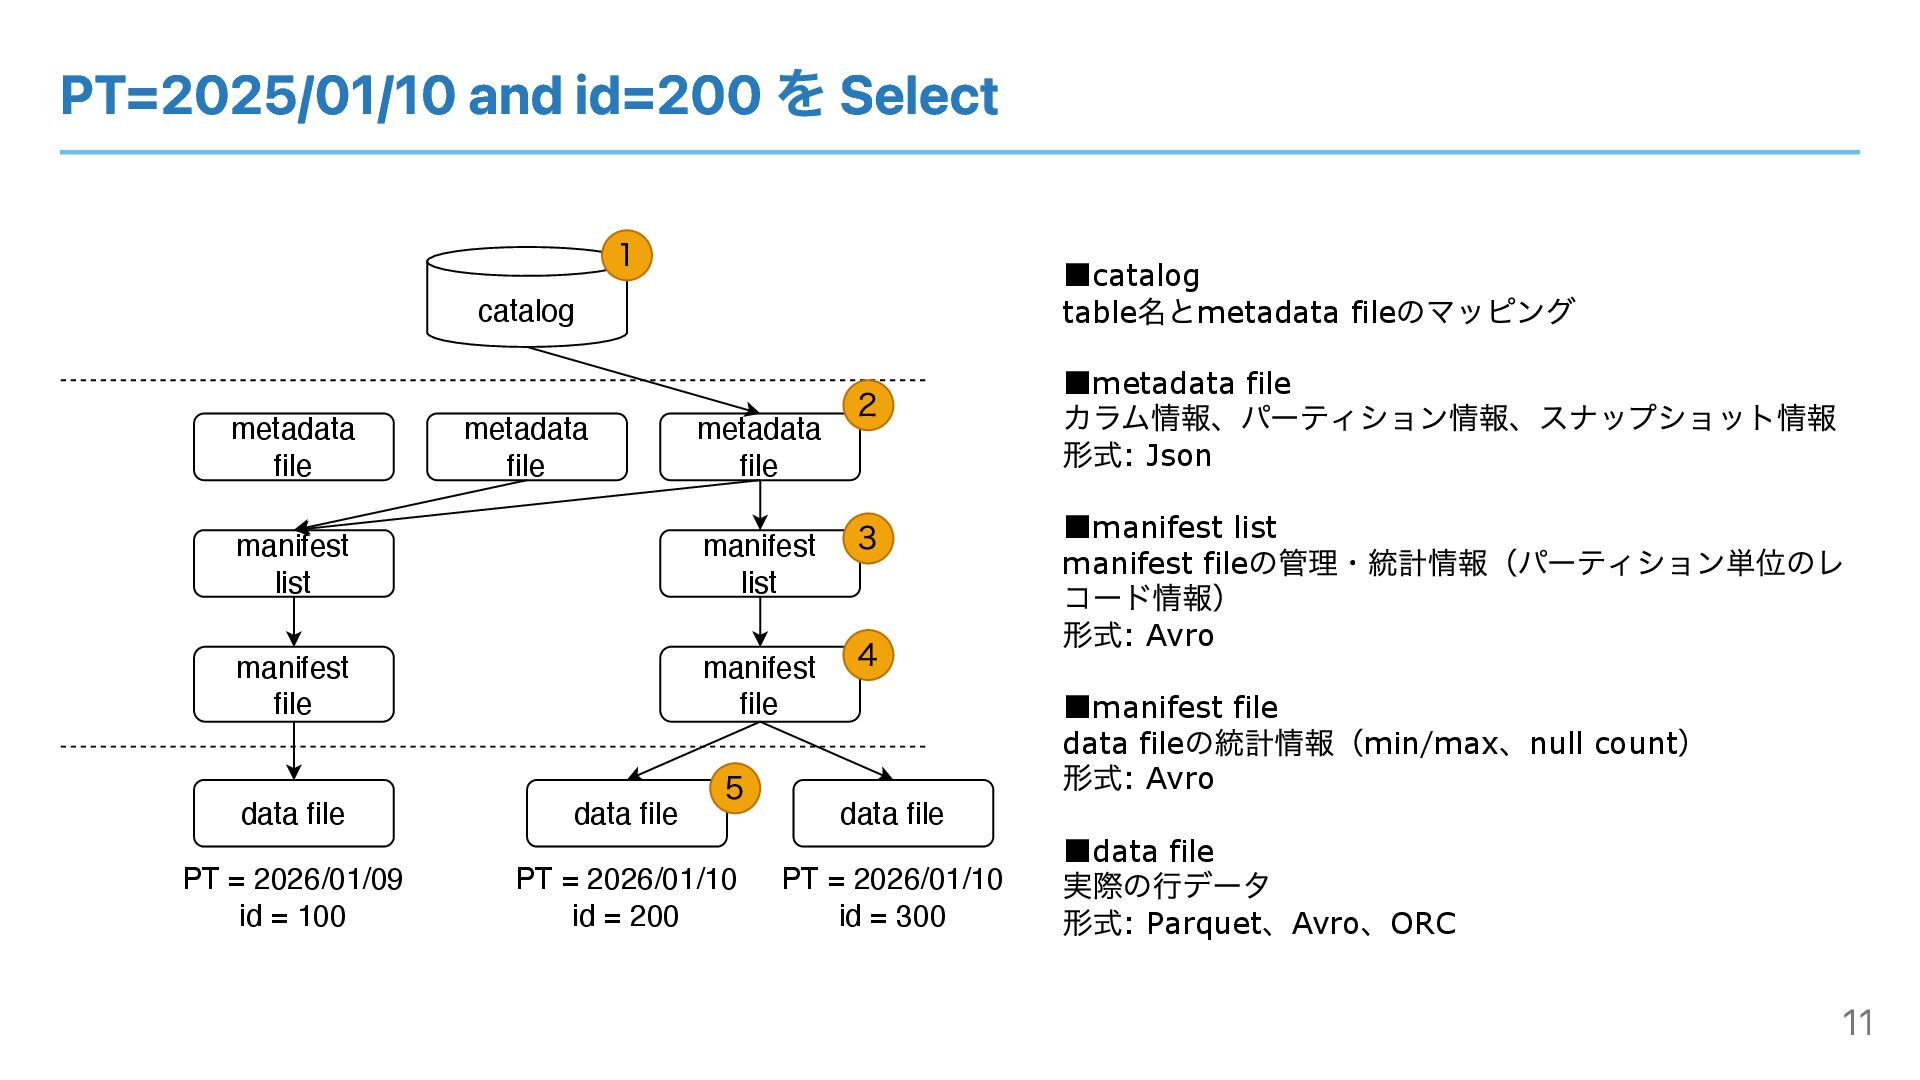
PT=2025/01/10 and id=200 を Select catalog metadata file manifest list
manifest file data file ▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC data file manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 PT = 2026/01/10 id = 200 PT = 2026/01/10 id = 300 metadata file 1 2 3 4 5 11
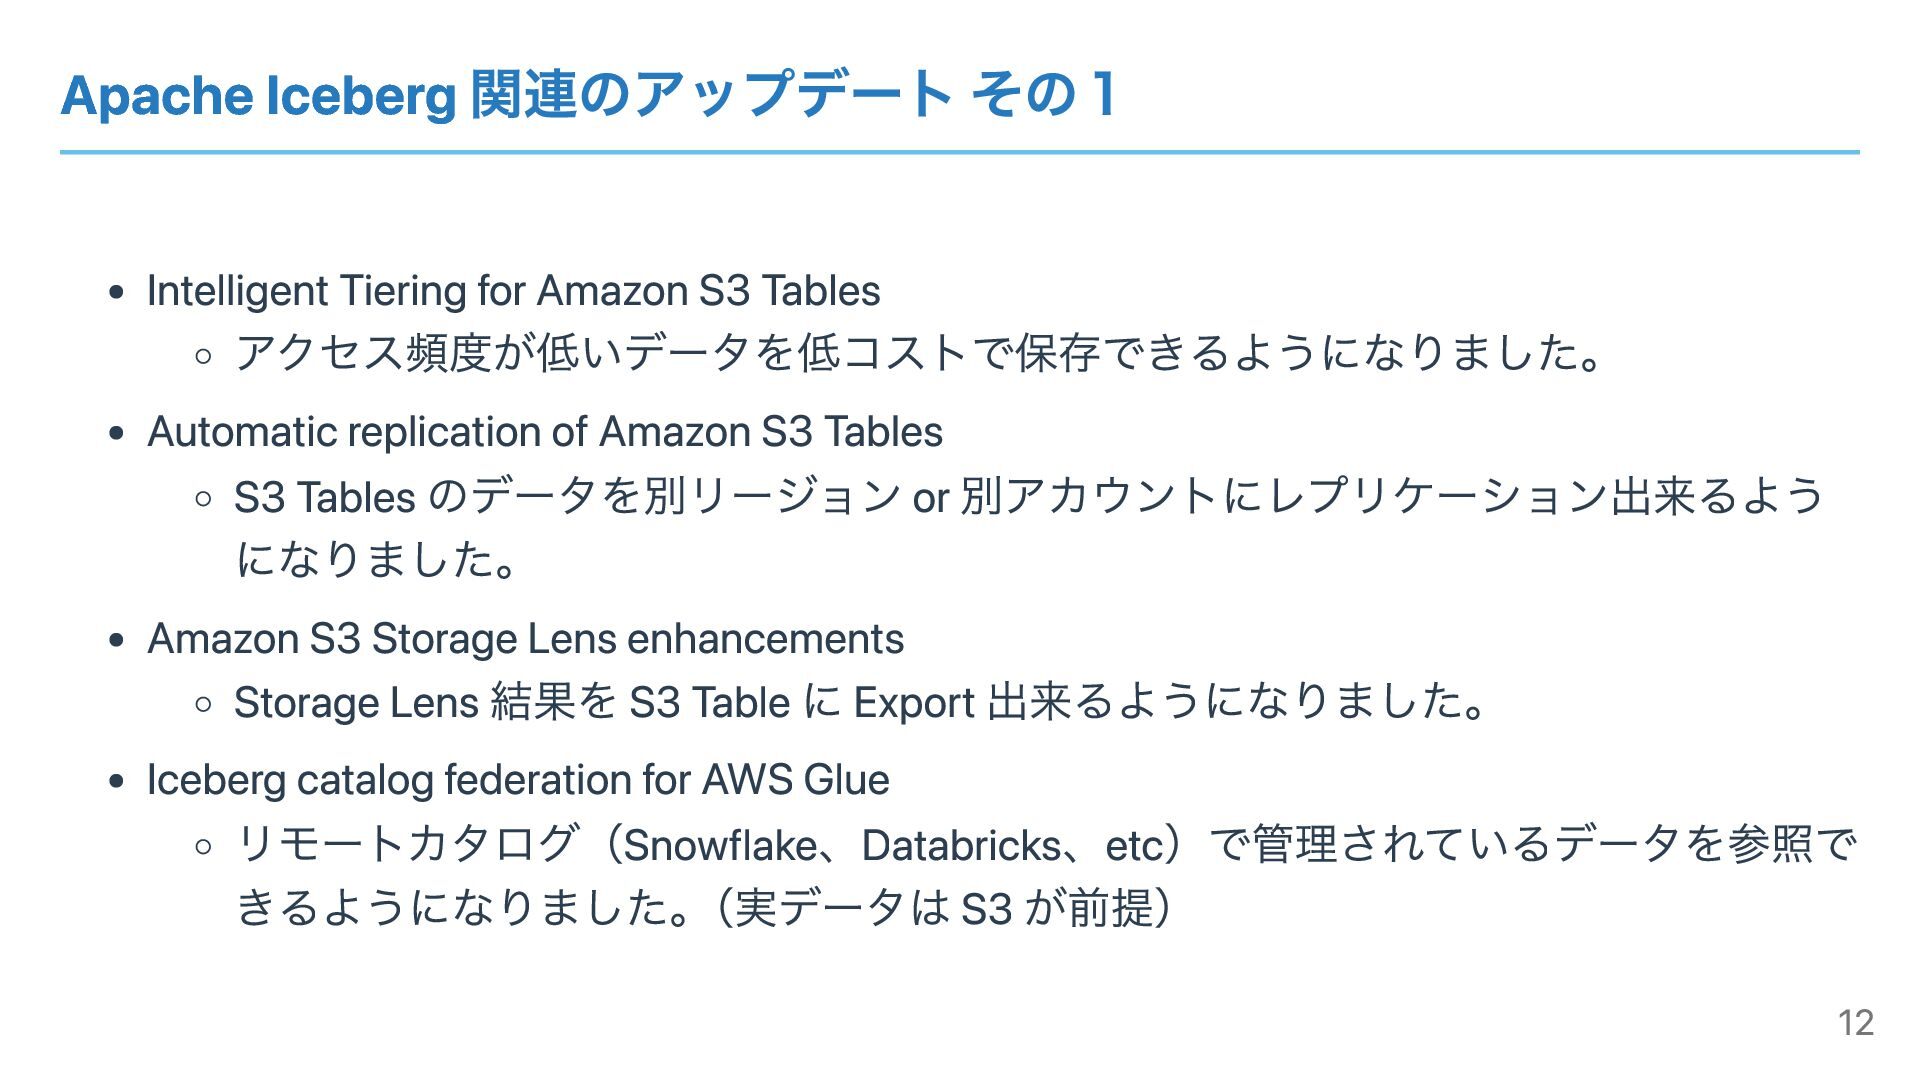
Apache Iceberg 関連のアップデート その1 Intelligent Tiering for Amazon S3 Tables
アクセス頻度が低いデータを低コストで保存できるようになりました。 Automatic replication of Amazon S3 Tables S3 Tables のデータを別リージョン or 別アカウントにレプリケーション出来るよう になりました。 Amazon S3 Storage Lens enhancements Storage Lens 結果を S3 Table に Export 出来るようになりました。 Iceberg catalog federation for AWS Glue リモートカタログ(Snowflake、Databricks、etc)で管理されているデータを参照で きるようになりました。 (実データは S3 が前提) 12
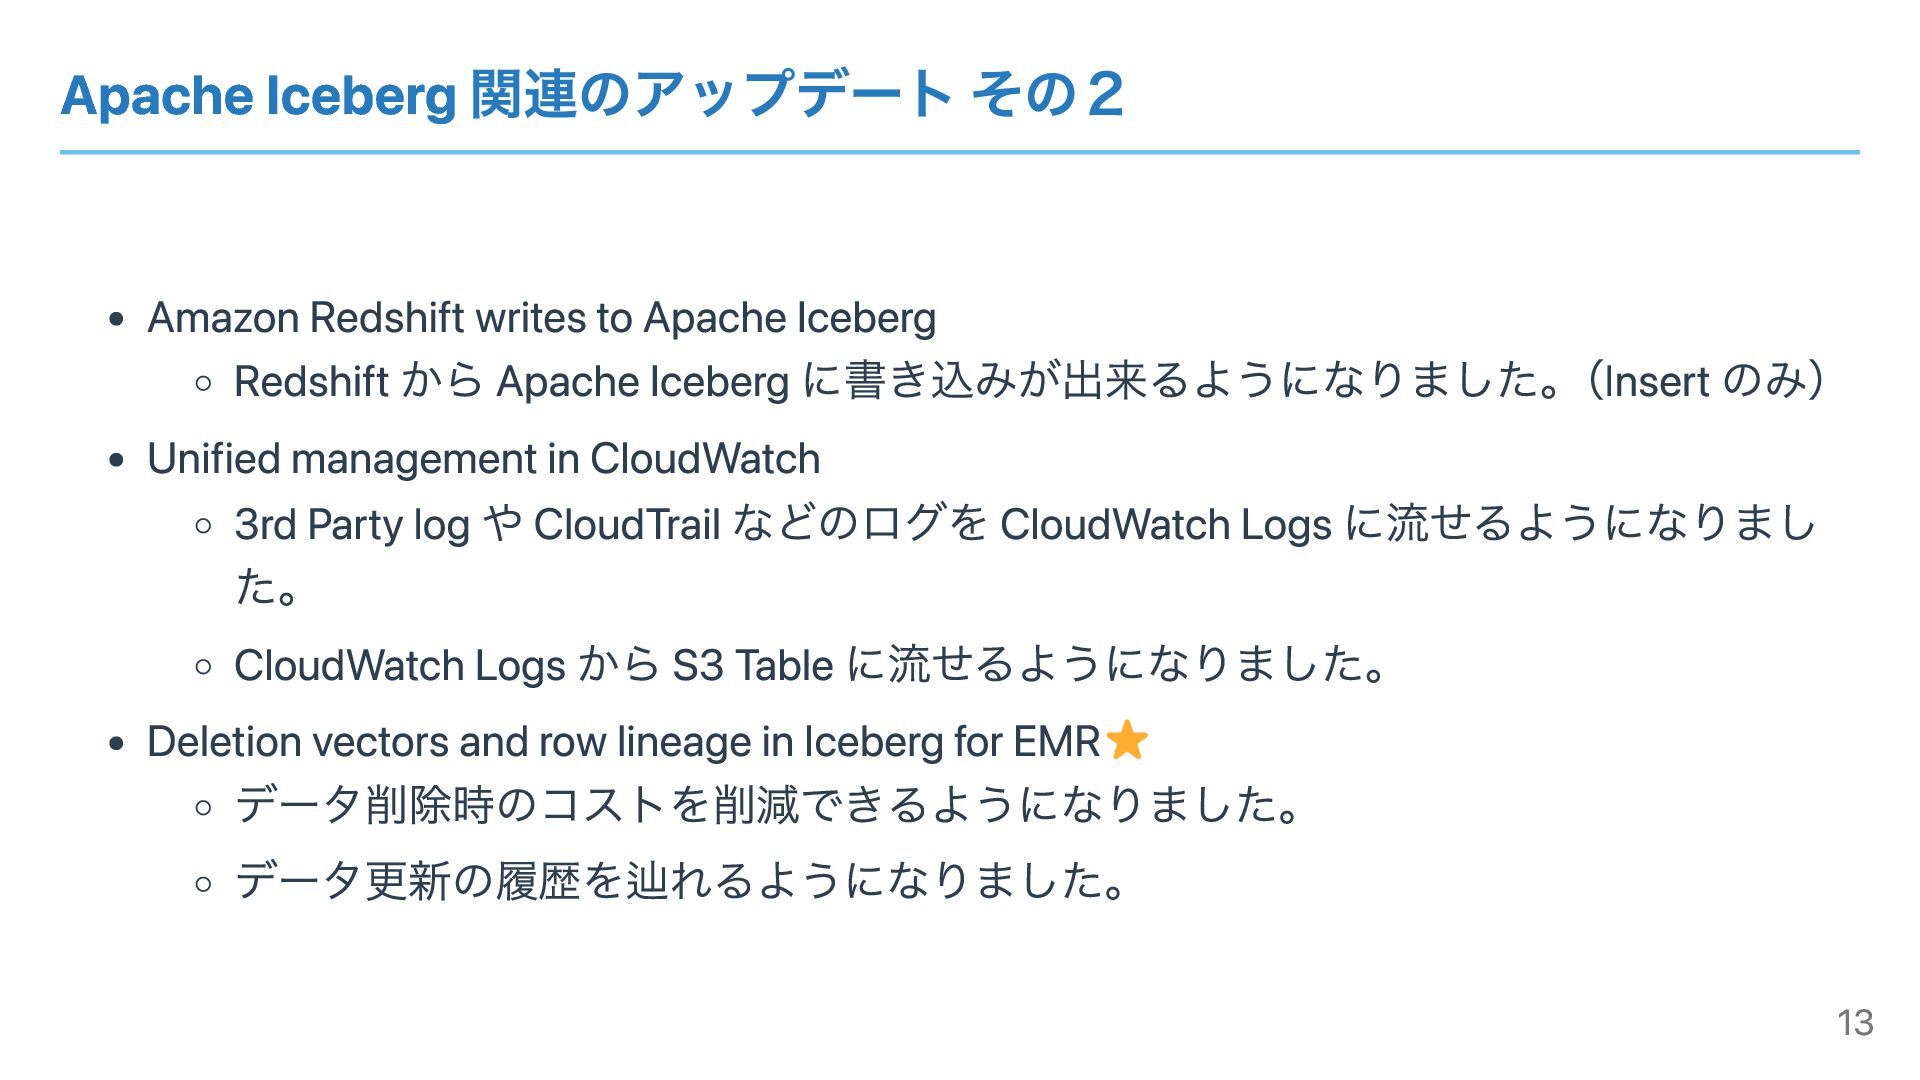
Apache Iceberg 関連のアップデート その2 Amazon Redshift writes to Apache Iceberg
Redshift から Apache Iceberg に書き込みが出来るようになりました。 (Insert のみ) Unified management in CloudWatch 3rd Party log や CloudTrail などのログを CloudWatch Logs に流せるようになりまし た。 CloudWatch Logs から S3 Table に流せるようになりました。 Deletion vectors and row lineage in Iceberg for EMR データ削除時のコストを削減できるようになりました。 データ更新の履歴を辿れるようになりました。 13
deletion vectors 削除ベクトル 14
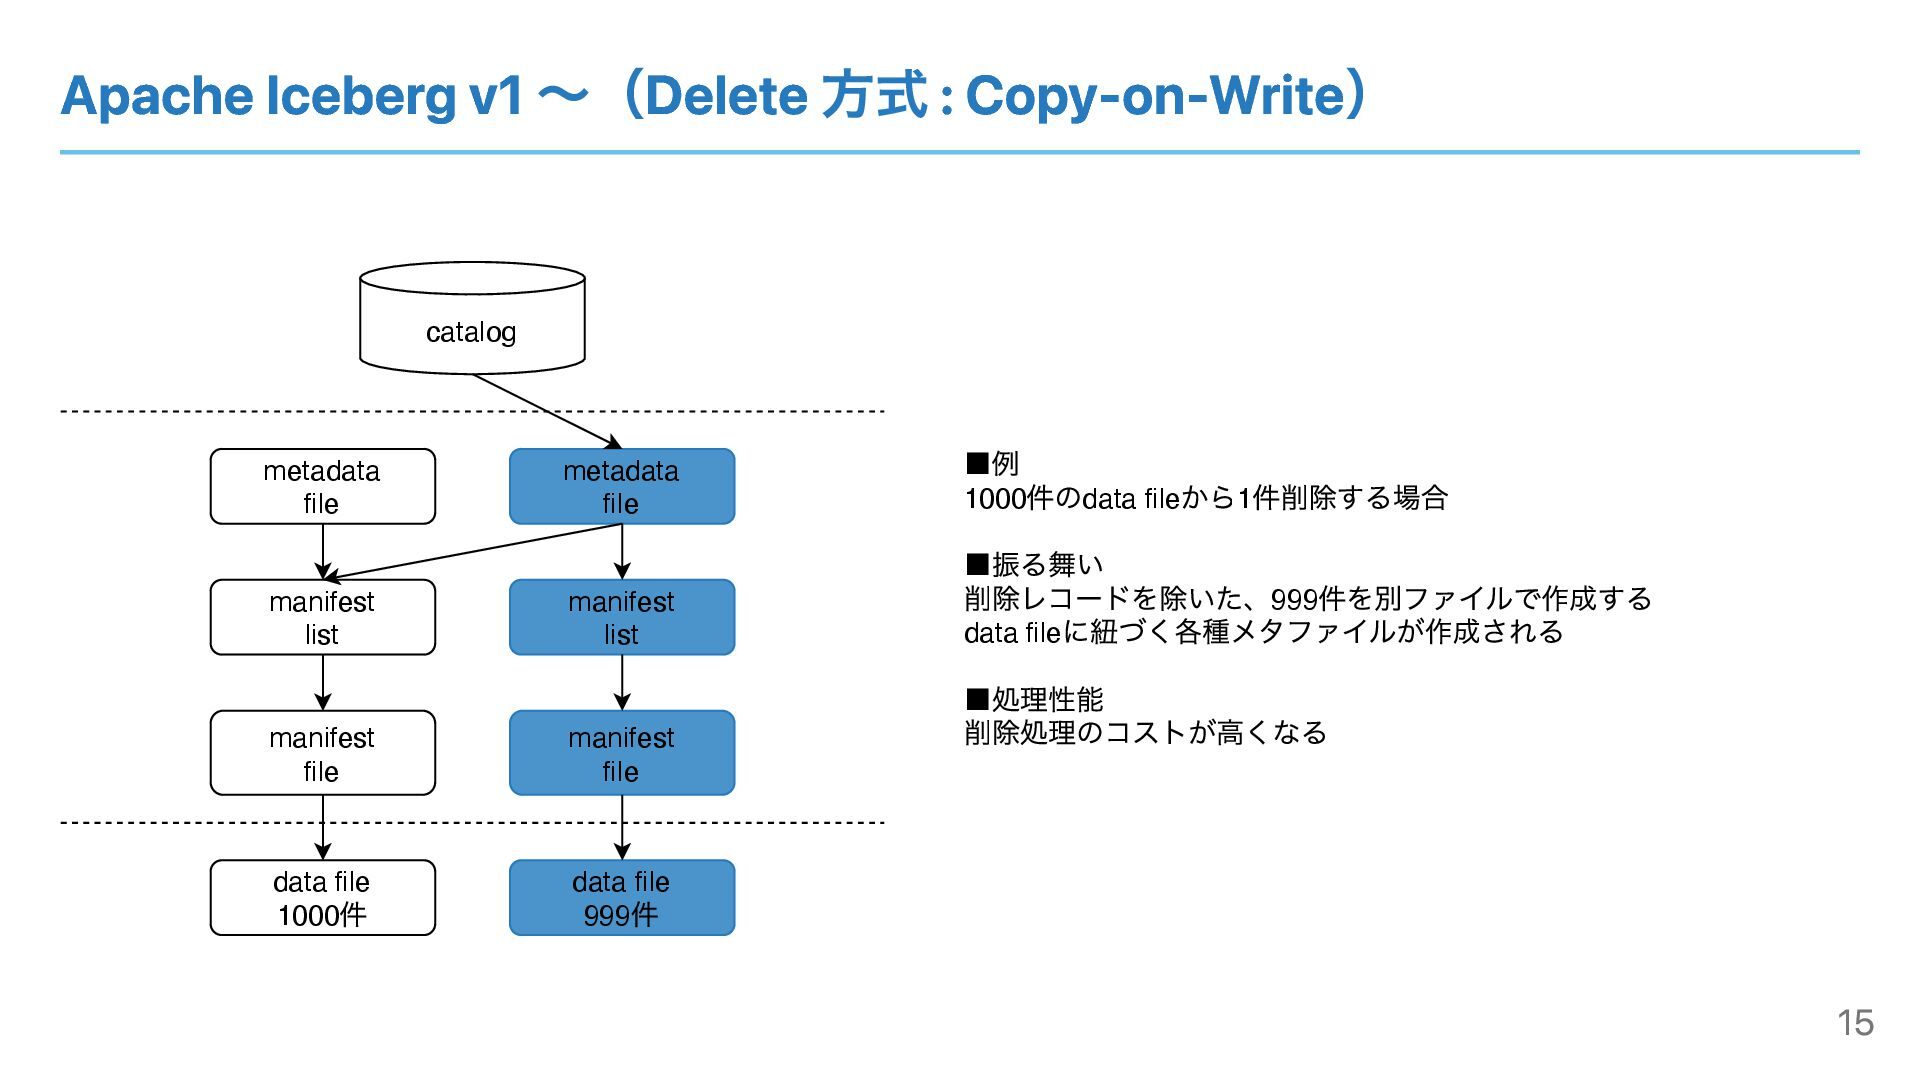
Apache Iceberg v1 〜(Delete 方式 : Copy-on-Write) catalog metadata file
manifest list manifest file data file 1000 件 ▪例 1000 件のdata file から1 件削除する場合 ▪振る舞い 削除レコードを除いた、999 件を別ファイルで作成する data file に紐づく各種メタファイルが作成される ▪処理性能 削除処理のコストが⾼くなる data file 999 件 metadata file manifest list manifest file 15
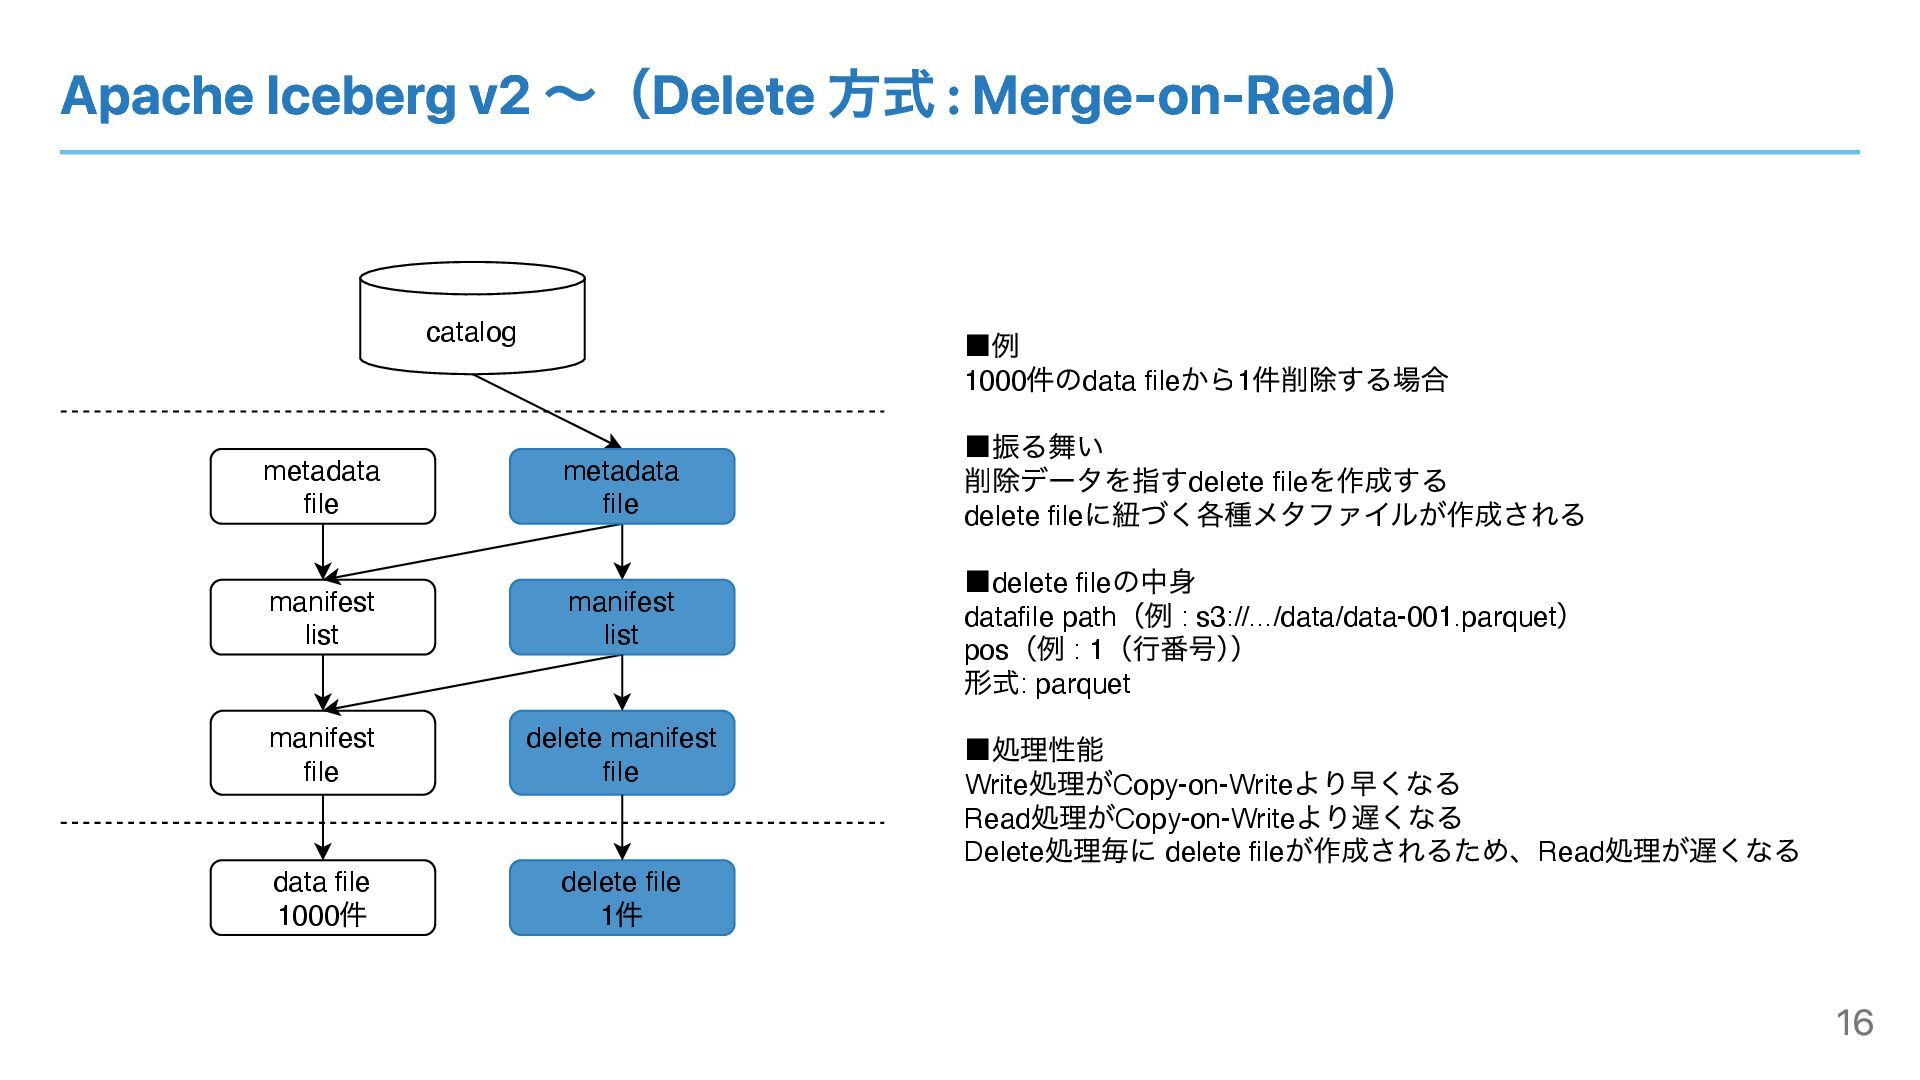
Apache Iceberg v2 〜(Delete 方式 : Merge-on-Read) catalog metadata file
manifest list manifest file data file 1000 件 ▪例 1000 件のdata file から1 件削除する場合 ▪振る舞い 削除データを指すdelete file を作成する delete file に紐づく各種メタファイルが作成される ▪delete file の中⾝ datafile path (例 : s3://.../data/data-001.parquet ) pos (例 : 1 (⾏番号) ) 形式: parquet ▪処理性能 Write 処理がCopy-on-Write より早くなる Read 処理がCopy-on-Write より遅くなる Delete 処理毎に delete file が作成されるため、Read 処理が遅くなる delete file 1 件 metadata file manifest list delete manifest file 16
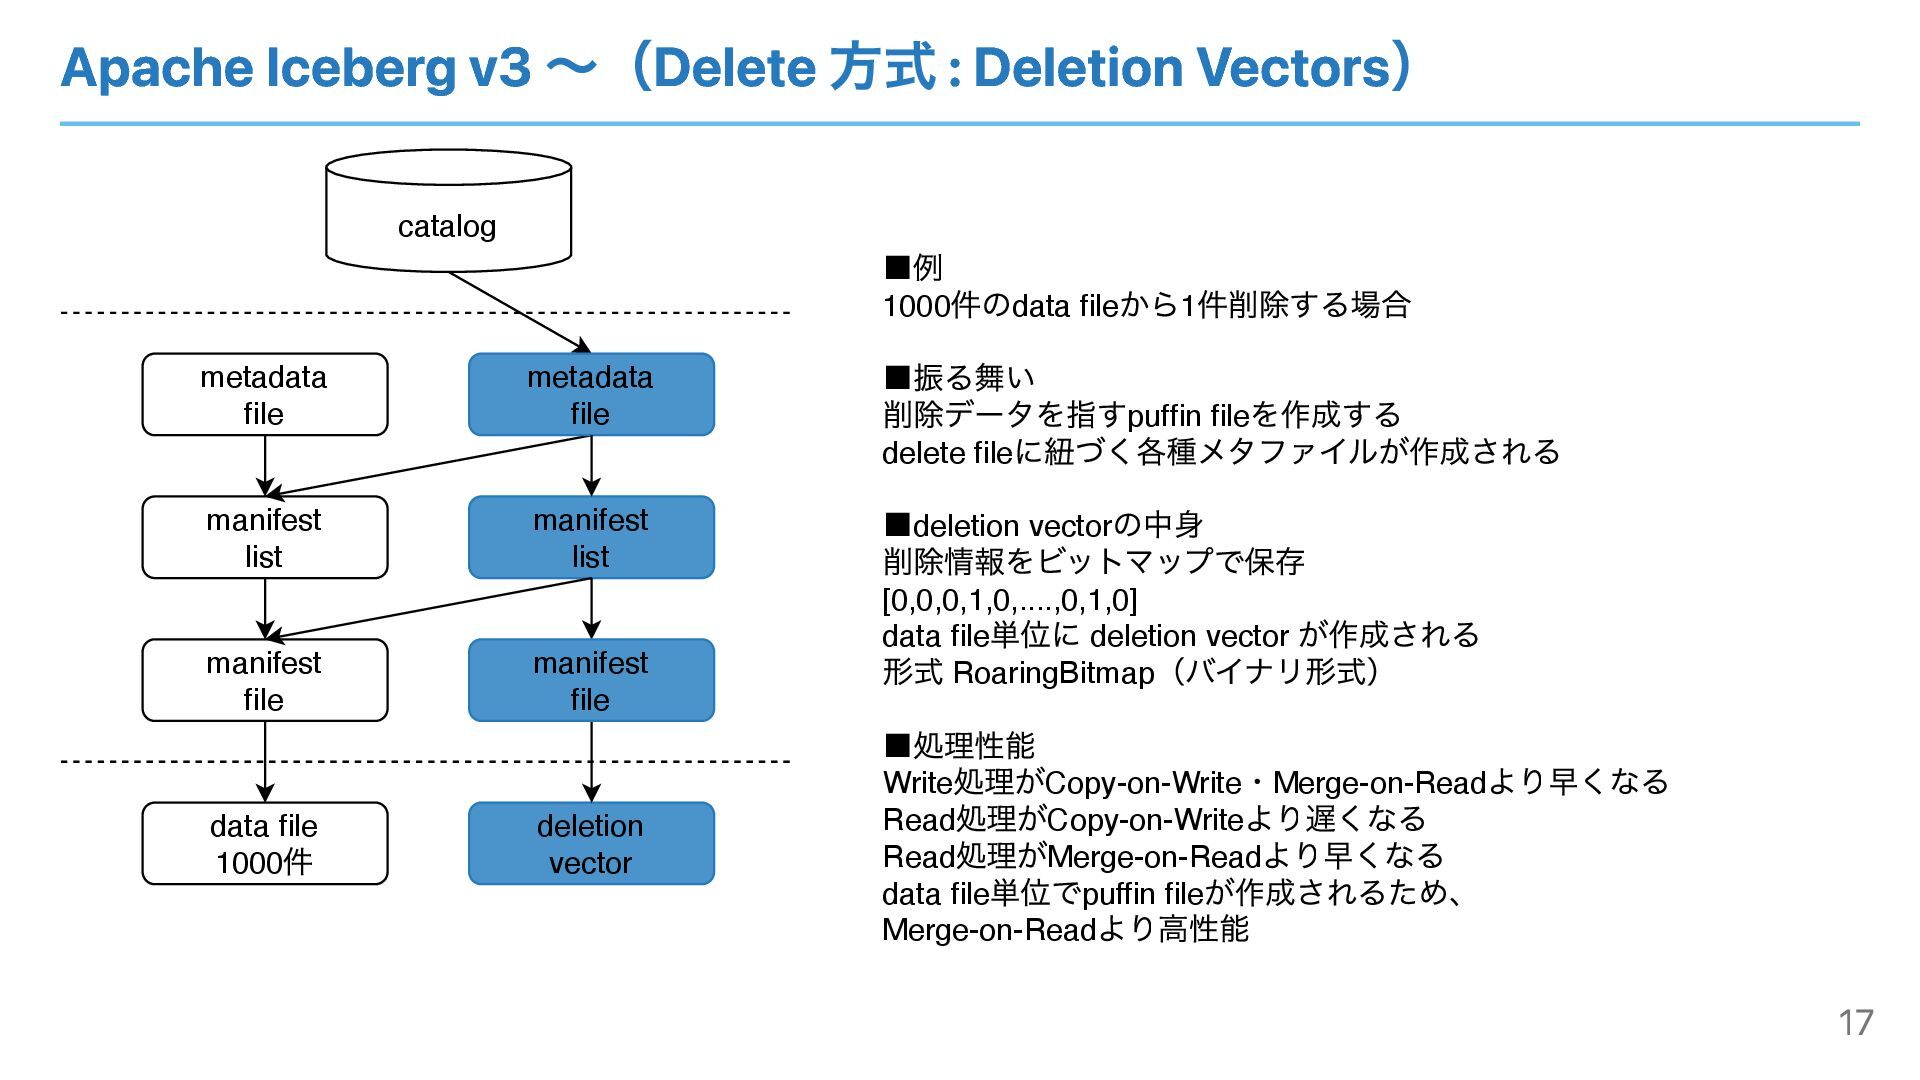
Apache Iceberg v3 〜(Delete 方式 : Deletion Vectors) catalog metadata
file manifest list manifest file data file 1000 件 deletion vector metadata file manifest list ▪例 1000 件のdata file から1 件削除する場合 ▪振る舞い 削除データを指すpuffin file を作成する delete file に紐づく各種メタファイルが作成される ▪deletion vector の中⾝ 削除情報をビットマップで保存 [0,0,0,1,0,....,0,1,0] data file 単位に deletion vector が作成される 形式 RoaringBitmap (バイナリ形式) ▪処理性能 Write 処理がCopy-on-Write ・Merge-on-Read より早くなる Read 処理がCopy-on-Write より遅くなる Read 処理がMerge-on-Read より早くなる data file 単位でpuffin file が作成されるため、 Merge-on-Read より⾼性能 manifest file 17
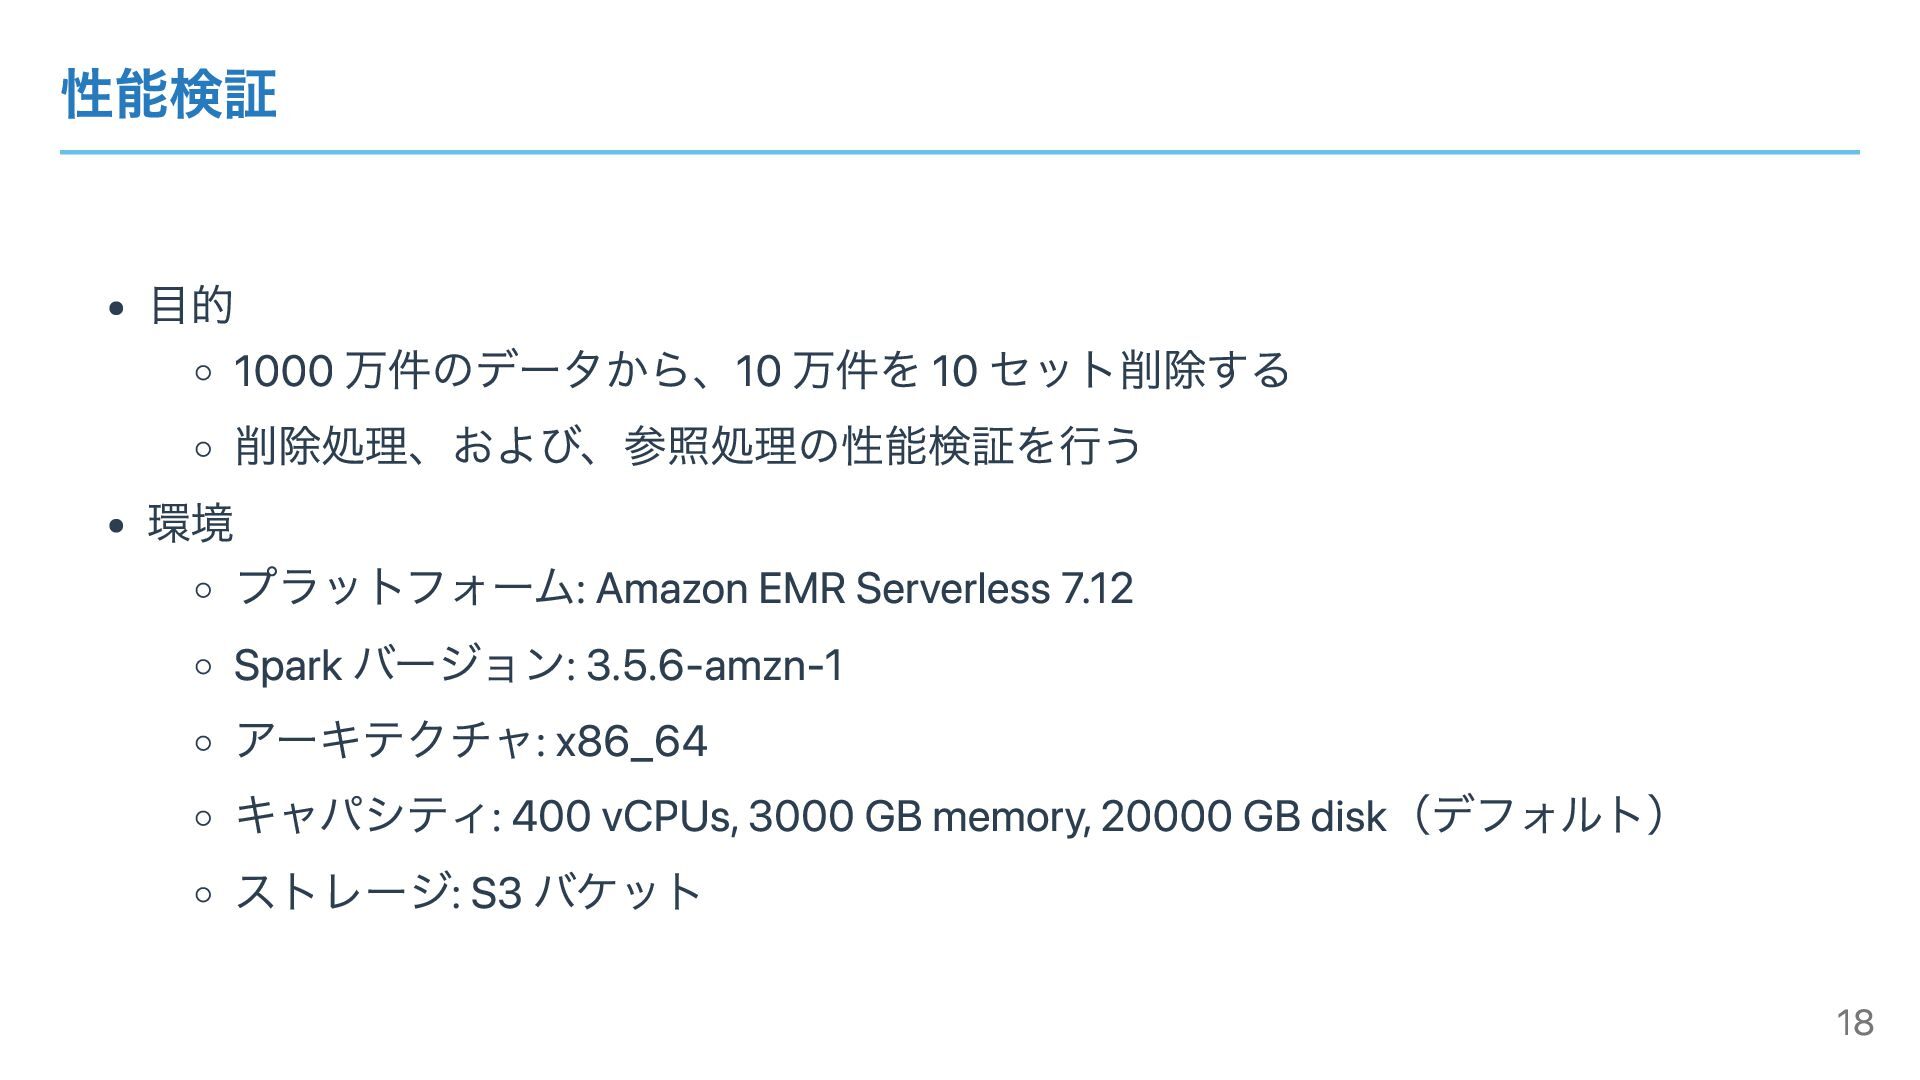
性能検証 目的 1000 万件のデータから、10 万件を 10 セット削除する 削除処理、および、参照処理の性能検証を行う 環境 プラットフォーム:
Amazon EMR Serverless 7.12 Spark バージョン: 3.5.6-amzn-1 アーキテクチャ: x86_64 キャパシティ: 400 vCPUs, 3000 GB memory, 20000 GB disk(デフォルト) ストレージ: S3 バケット 18
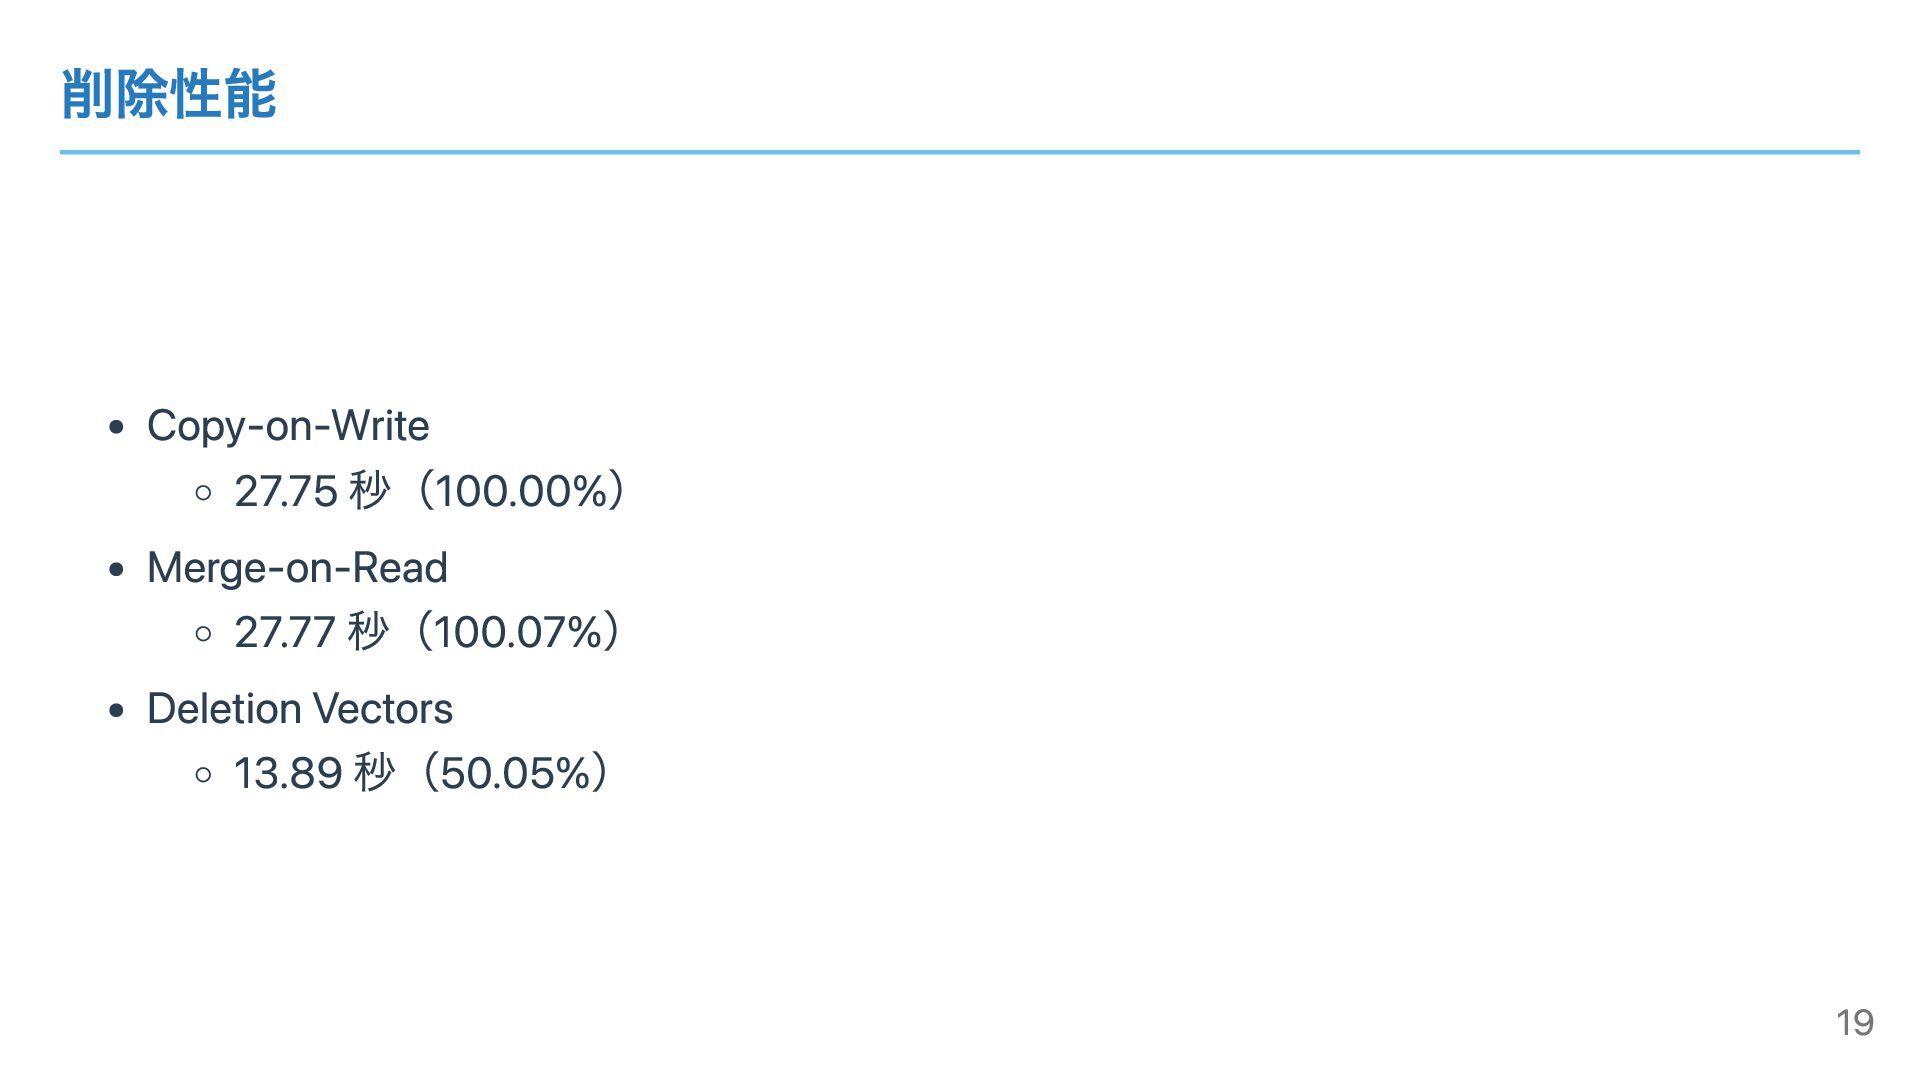
削除性能 Copy-on-Write 27.75 秒(100.00%) Merge-on-Read 27.77 秒(100.07%) Deletion Vectors 13.89
秒(50.05%) 19
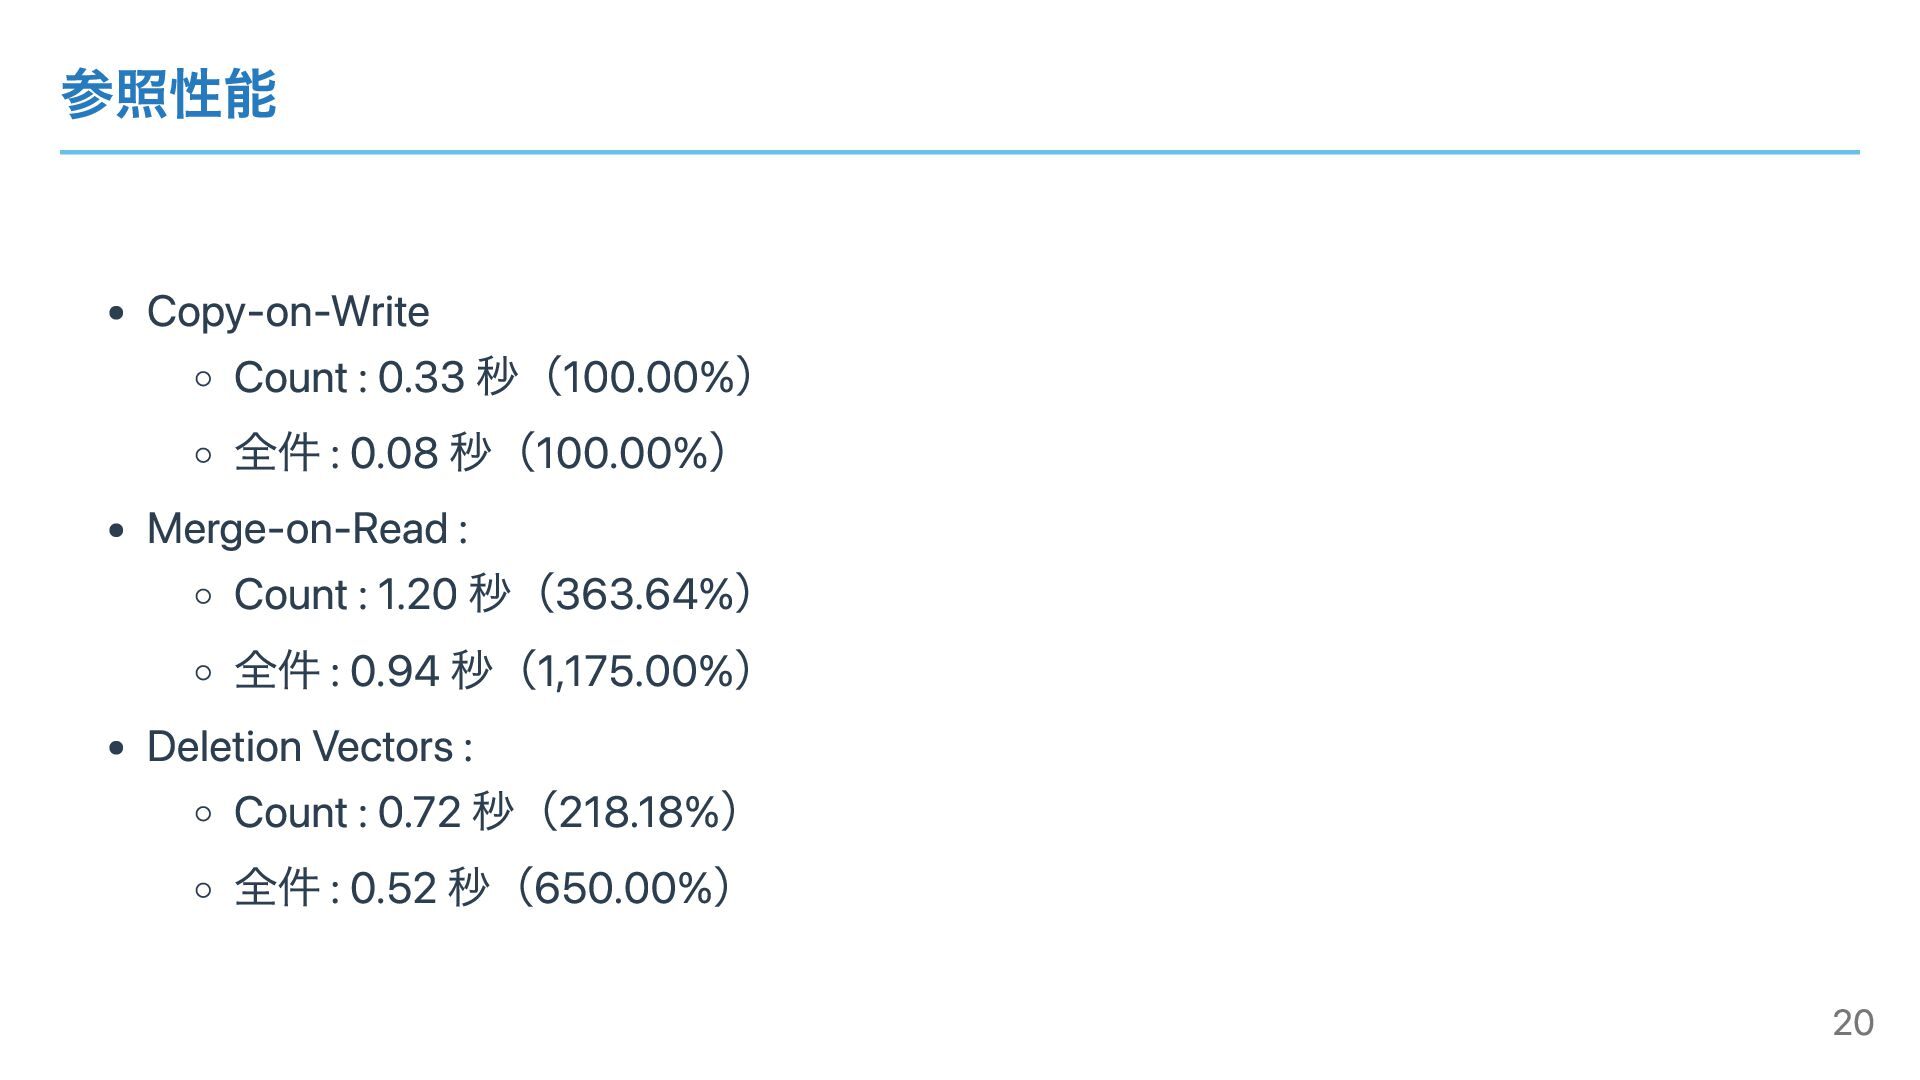
参照性能 Copy-on-Write Count : 0.33 秒(100.00%) 全件 : 0.08 秒(100.00%)
Merge-on-Read : Count : 1.20 秒(363.64%) 全件 : 0.94 秒(1,175.00%) Deletion Vectors : Count : 0.72 秒(218.18%) 全件 : 0.52 秒(650.00%) 20
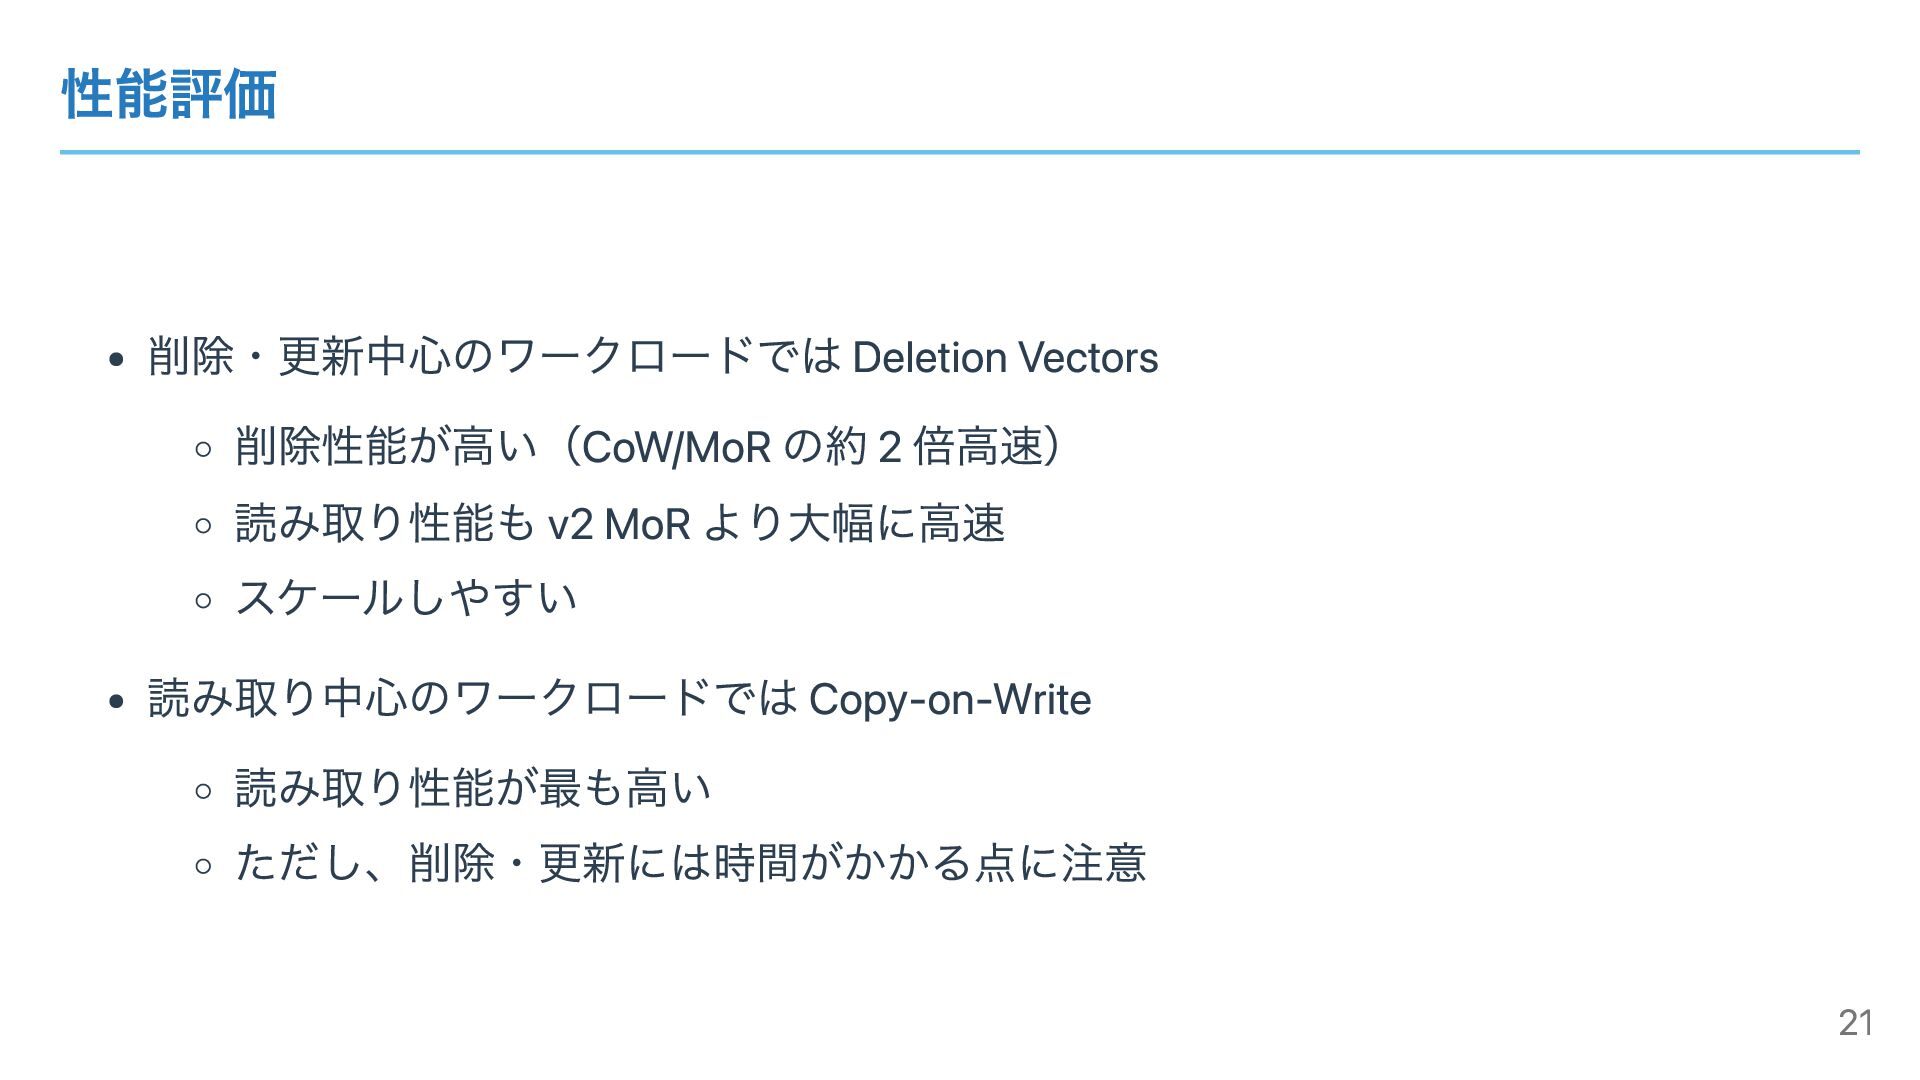
性能評価 削除・更新中心のワークロードでは Deletion Vectors 削除性能が高い(CoW/MoR の約 2 倍高速) 読み取り性能も v2
MoR より大幅に高速 スケールしやすい 読み取り中心のワークロードでは Copy-on-Write 読み取り性能が最も高い ただし、削除・更新には時間がかかる点に注意 21
最後に 今後も Apache Iceberg を中心とした Data Lake 整備が進んで行くと考えています。 データ整備の1案としてご利用ください 22


 shigeruoda
 tsukina_7mochi
 tomokusaba
 kaminashi
 onk
 akitoshiga
 finengine
 teamlab
 riyaamemiya
 kairim0
 y0hgi
 rfdnxbro
 keeg
 mclloyd
 jnunemaker
 samlambert
 mkilby
 akademiya2063
 keathley
 lfama
 stephaniewalter
 maggiecrowley
 katarinadahlin
 lindahogenes
 techseoconnect