Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Amazon DocumentDB入門
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
shinadaa_1717
August 30, 2026
Technology
69
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Amazon DocumentDB入門
shinadaa_1717
August 30, 2026
More Decks by shinadaa_1717
See All by shinadaa_1717
構成を理解するWAF入門
shinadaa1717
0
33
Other Decks in Technology
See All in Technology
DWH の限界突破! AI エージェント向け爆速リアルタイムデータ基盤 ClickHouse
jozono
1
470
無理せず続ける、子育てエンジニアの学び
codmoninc
PRO
0
860
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
130
Running Kotlin + Quarkus with Lambda
nealle
1
3.7k
AIカンパニーへの転換を支えた、エンジニアの仕事の再定義
kworkdev
PRO
2
1.2k
Gemini Intelligence 入門 ― AppFunctions と Gemini Nano
takuroabe
0
250
フロントエンドカンファレンス関西2026 - 速すぎるUIに、待ち時間を
teamlab
PRO
0
130
re:Invent初参加で変わったこと、2回目にやってみたいこと(JAWS-UG彩の国埼玉 #12)
mhrtech
2
220
継続的なAIコスト最適化
bgpat
1
340
DGX Spark でどこまでハッキングができるのか?
kash1064
3
1.3k
AI コーディングと人間の認知スループット / CTO Night & Day 2026 Morning Session / AI Coding and Human Cognitive Throughput
prog893
4
1k
『SAR衛星データ解析入門』の ご紹介とその応用
syuchimu
0
120
Featured
See All Featured
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3.2k
Product Roadmaps are Hard
iamctodd
55
13k
How to build a perfect <img>
jonoalderson
1
6.1k
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
Code Reviewing Like a Champion
maltzj
529
40k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
<Decoding/> the Language of Devs - We Love SEO 2024
nikkihalliwell
1
360
The World Runs on Bad Software
bkeepers
PRO
72
12k
HDC tutorial
michielstock
2
960
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Building AI with AI
inesmontani
PRO
1
1.3k
Transcript
Amazon DocumentDB入門 ToyoStar☆ 品田遵詞
Amazon DocumentDB入門 アジェンダ 今回は入門ということで、 1. ドキュメント指向DBとは 2. MongoDBとは 3. DocumentDBはMongDB互換のDBサービス
4. DocumentDBのインフラストラクチャー 1/15
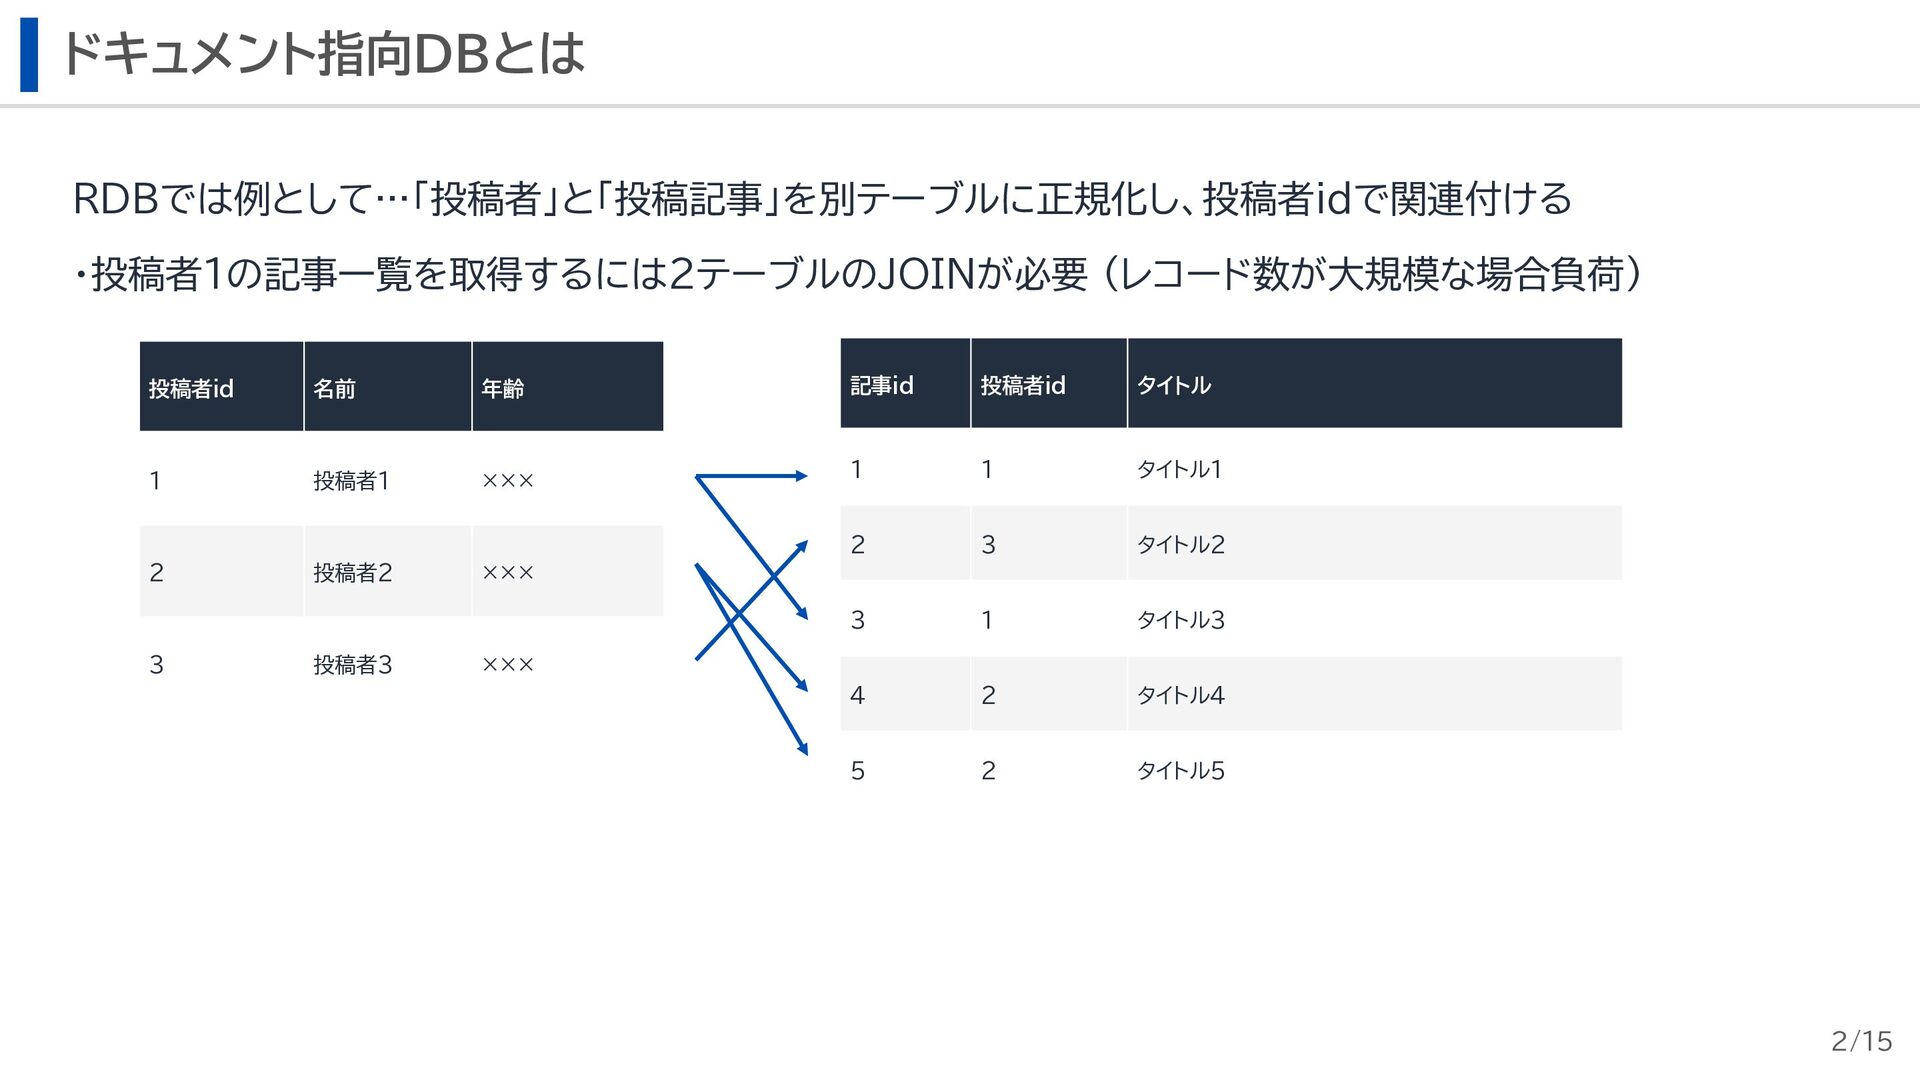
ドキュメント指向DBとは RDBでは例として…「投稿者」と「投稿記事」を別テーブルに正規化し、投稿者idで関連付ける ・投稿者1の記事一覧を取得するには2テーブルのJOINが必要 (レコード数が大規模な場合負荷) 投稿者id 名前 年齢 1 投稿者1 ×××
2 3 投稿者2 投稿者3 記事id 投稿者id タイトル 1 1 タイトル1 2 3 タイトル2 3 1 タイトル3 4 2 タイトル4 5 2 タイトル5 ××× ××× 2/15
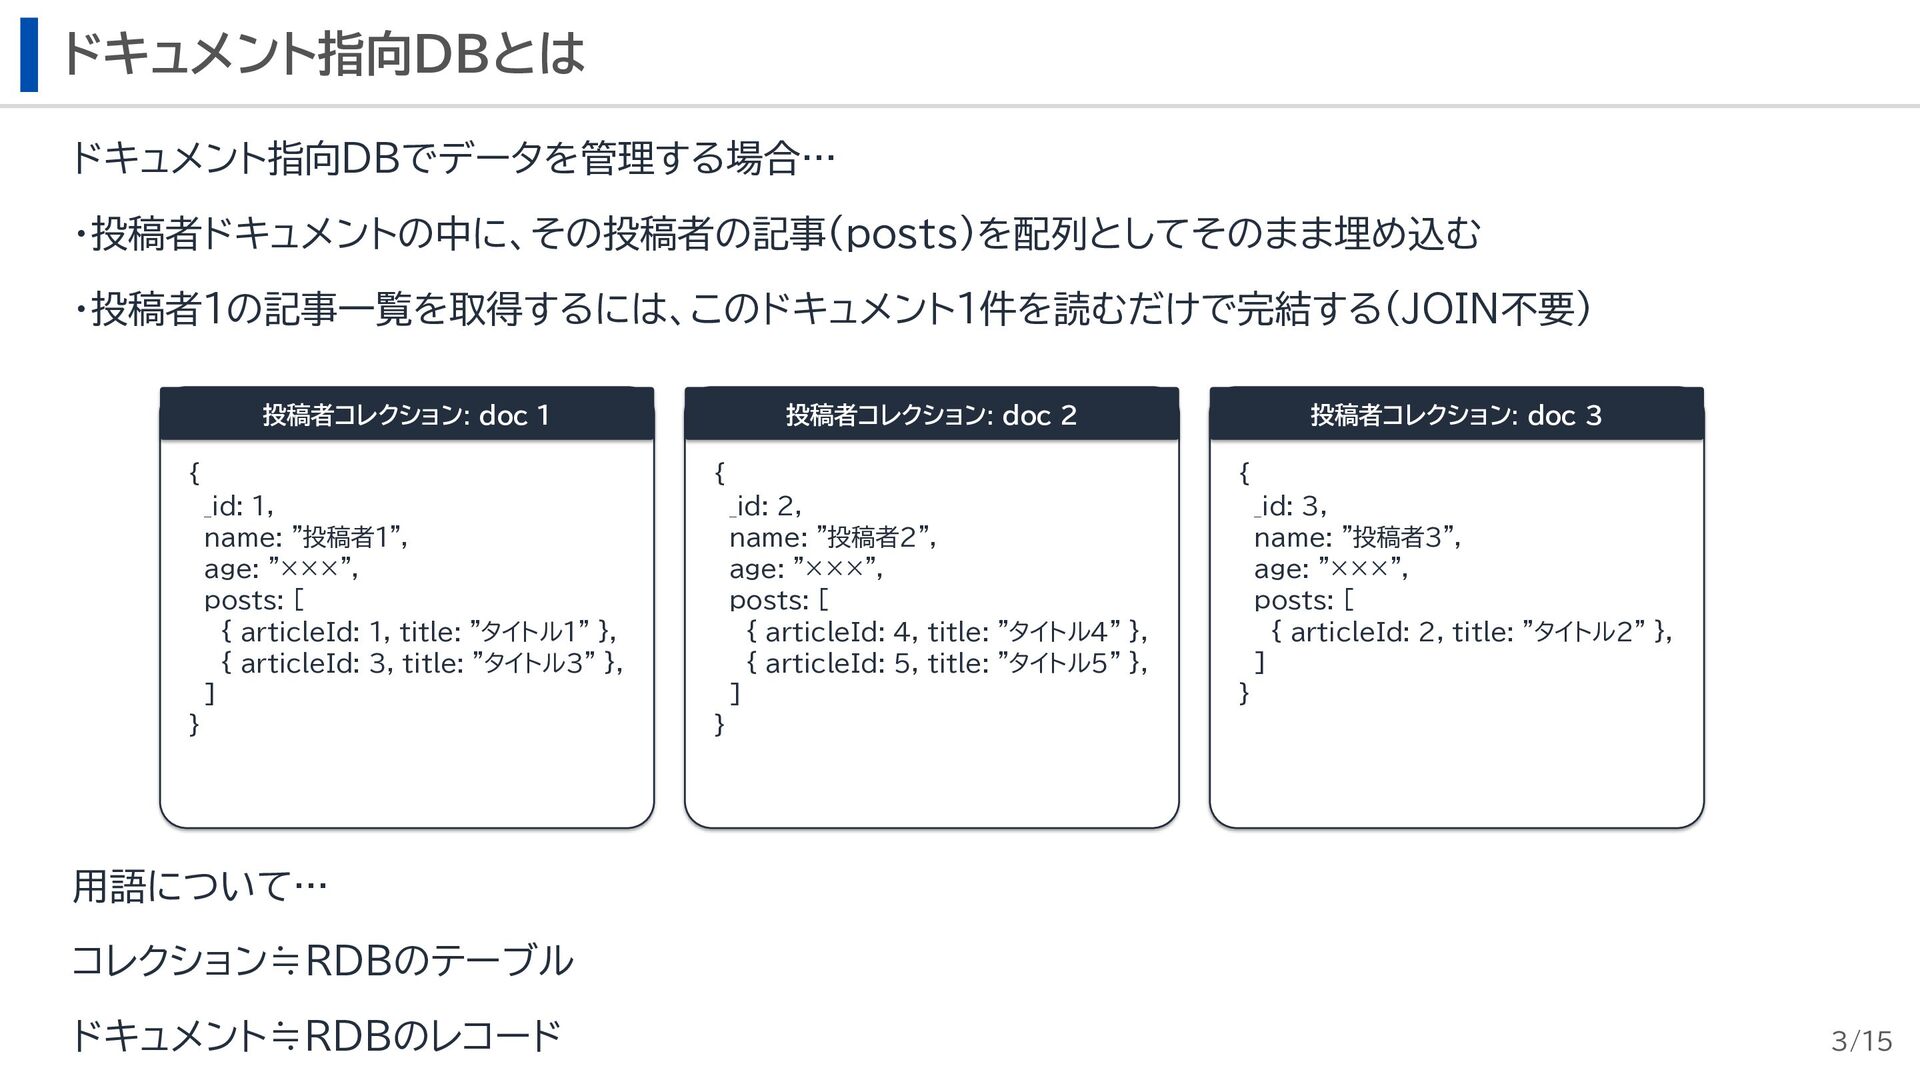
ドキュメント指向DBとは ドキュメント指向DBでデータを管理する場合… ・投稿者ドキュメントの中に、その投稿者の記事(posts)を配列としてそのまま埋め込む ・投稿者1の記事一覧を取得するには、このドキュメント1件を読むだけで完結する(JOIN不要) 投稿者コレクション: doc 1 { 投稿者コレクション: doc
2 { _id: 1, name: "投稿者1", age: "×××", posts: [ { articleId: 1, title: "タイトル1" }, { articleId: 3, title: "タイトル3" }, ] } 投稿者コレクション: doc 3 { _id: 2, name: "投稿者2", age: "×××", posts: [ { articleId: 4, title: "タイトル4" }, { articleId: 5, title: "タイトル5" }, ] _id: 3, name: "投稿者3", age: "×××", posts: [ { articleId: 2, title: "タイトル2" }, ] } } 用語について… コレクション≒RDBのテーブル ドキュメント≒RDBのレコード 3/15
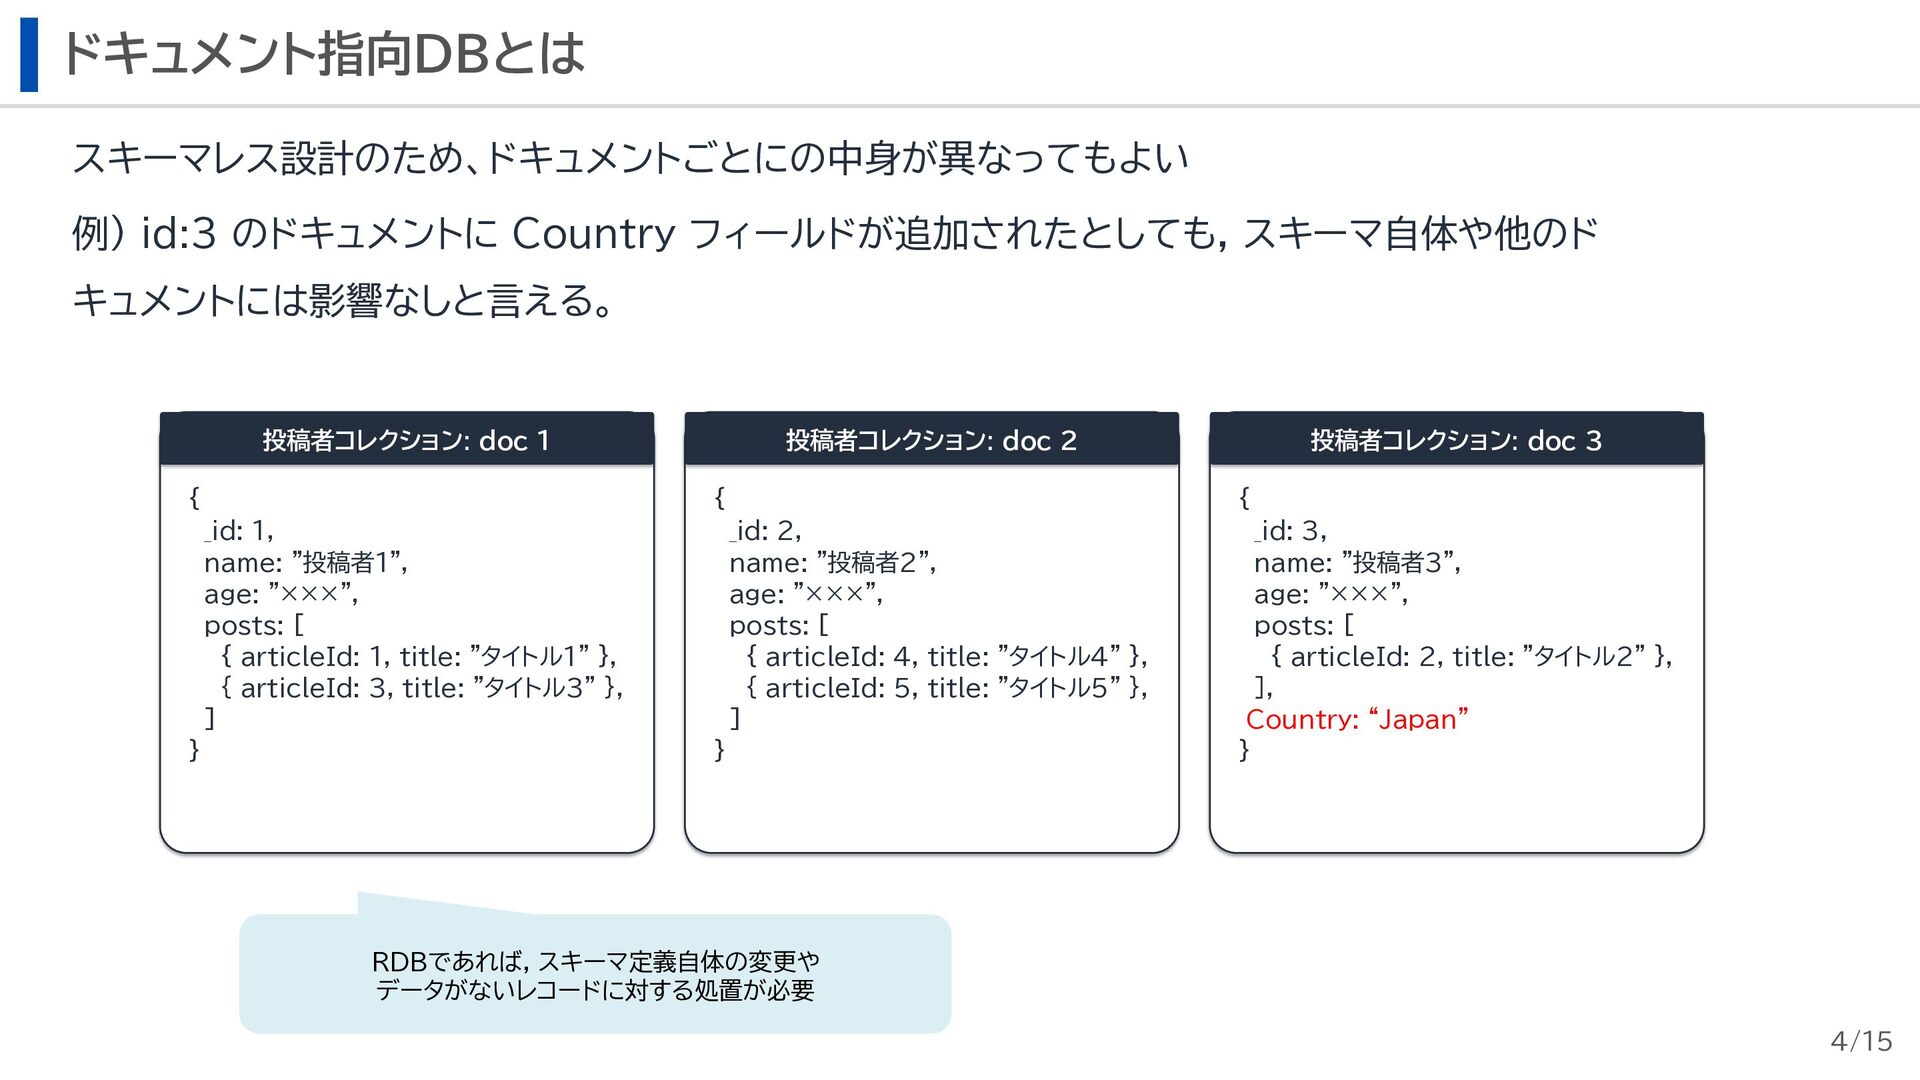
ドキュメント指向DBとは スキーマレス設計のため、ドキュメントごとにの中身が異なってもよい 例) id:3 のドキュメントに Country フィールドが追加されたとしても, スキーマ自体や他のド キュメントには影響なしと言える。 投稿者コレクション:
doc 1 { 投稿者コレクション: doc 2 { _id: 1, name: "投稿者1", age: "×××", posts: [ { articleId: 1, title: "タイトル1" }, { articleId: 3, title: "タイトル3" }, ] } 投稿者コレクション: doc 3 { _id: 2, name: "投稿者2", age: "×××", posts: [ { articleId: 4, title: "タイトル4" }, { articleId: 5, title: "タイトル5" }, ] } _id: 3, name: "投稿者3", age: "×××", posts: [ { articleId: 2, title: "タイトル2" }, ], Country: “Japan” } RDBであれば, スキーマ定義自体の変更や データがないレコードに対する処置が必要 4/15
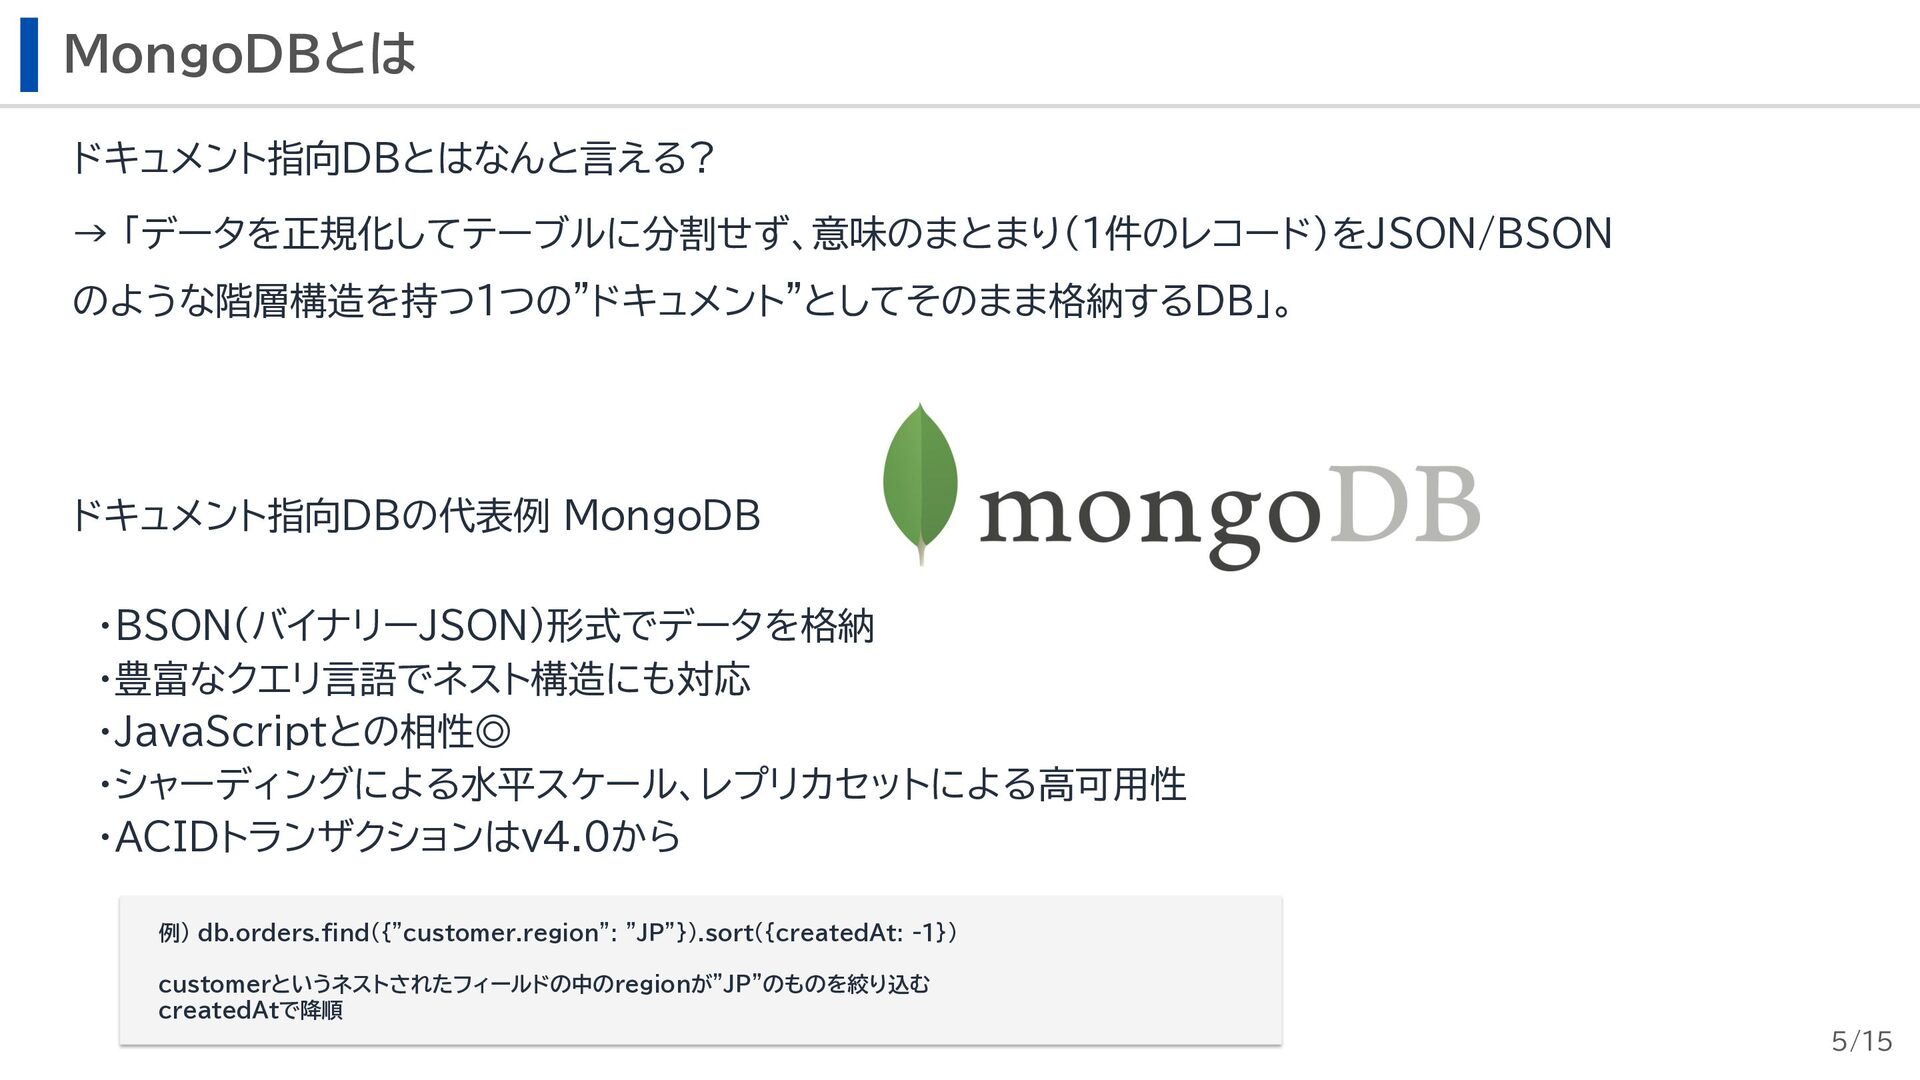
MongoDBとは ドキュメント指向DBとはなんと言える? → 「データを正規化してテーブルに分割せず、意味のまとまり(1件のレコード)をJSON/BSON のような階層構造を持つ1つの"ドキュメント"としてそのまま格納するDB」。 ドキュメント指向DBの代表例 MongoDB ・BSON(バイナリーJSON)形式でデータを格納 ・豊富なクエリ言語でネスト構造にも対応 ・JavaScriptとの相性◎
・シャーディングによる水平スケール、レプリカセットによる高可用性 ・ACIDトランザクションはv4.0から 例) db.orders.find({"customer.region": "JP"}).sort({createdAt: -1}) customerというネストされたフィールドの中のregionが"JP"のものを絞り込む createdAtで降順 5/15
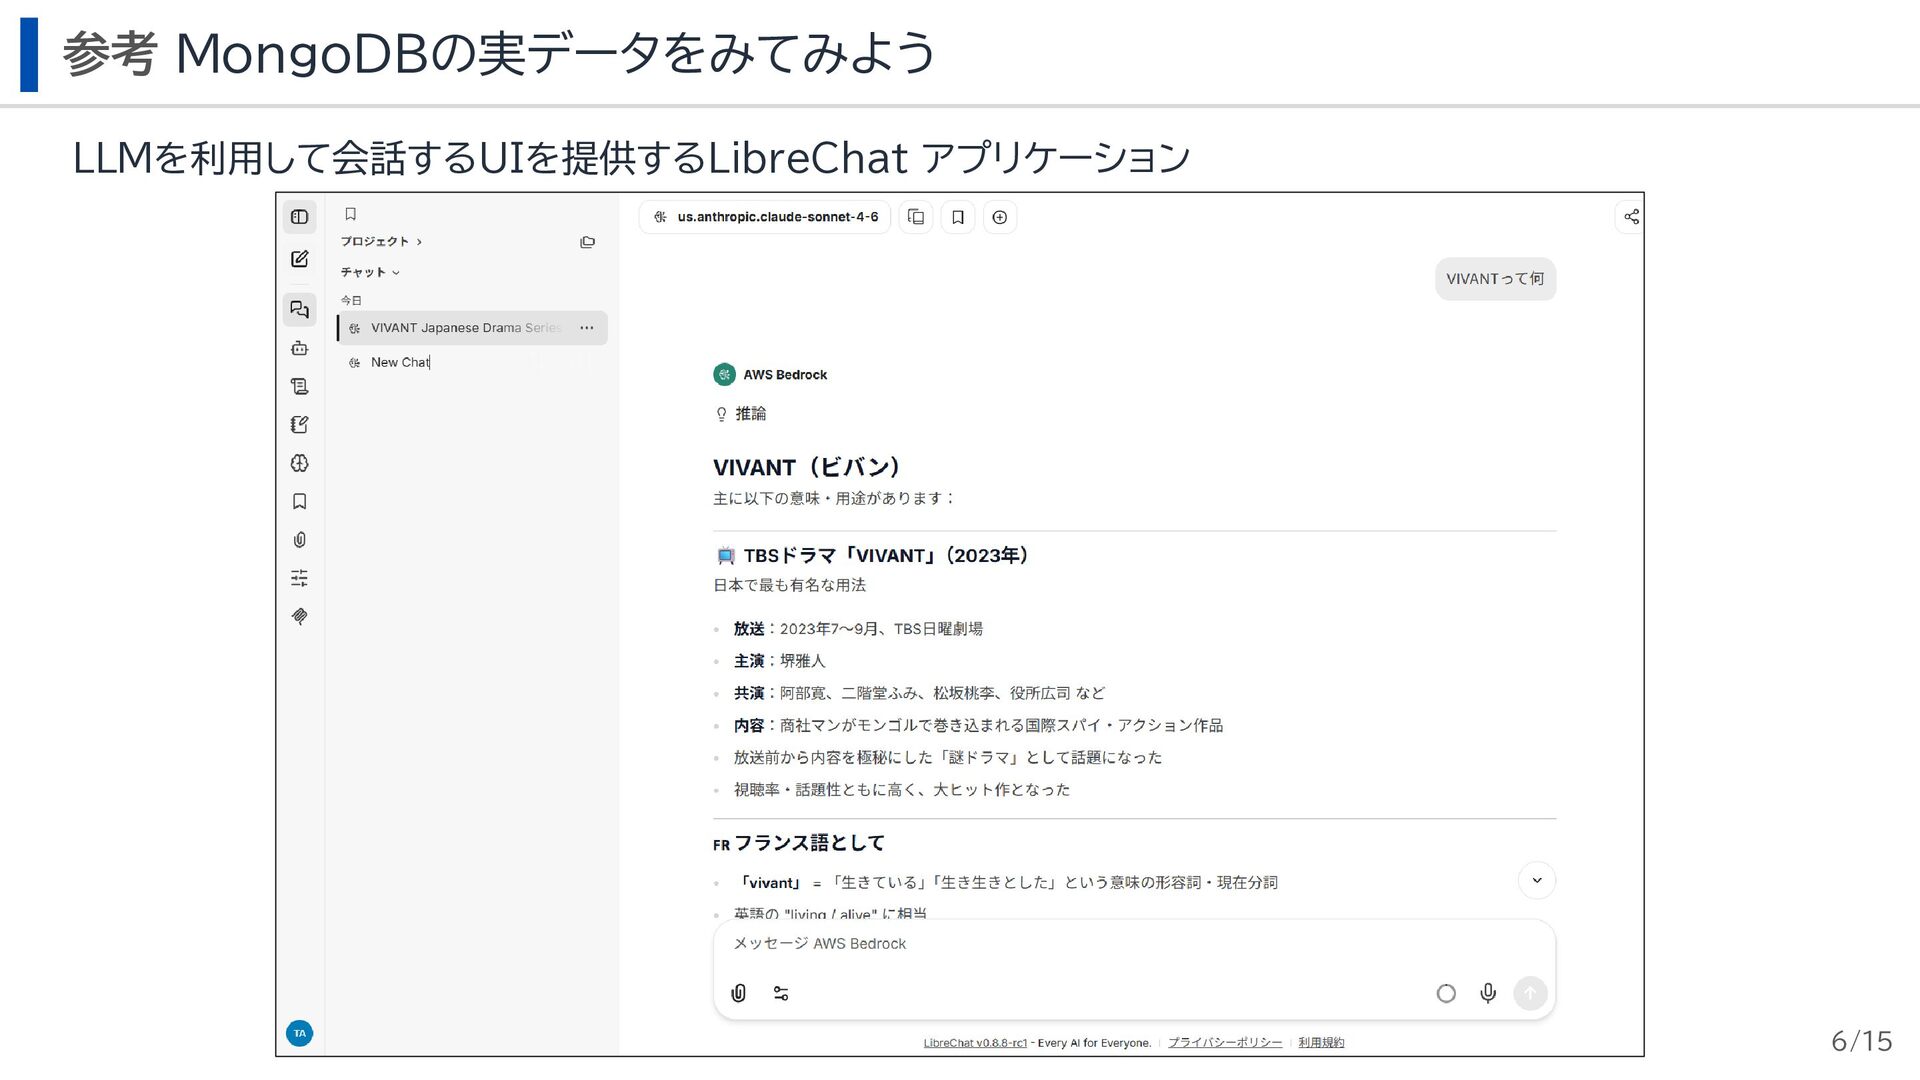
参考 MongoDBの実データをみてみよう LLMを利用して会話するUIを提供するLibreChat アプリケーション 6/15
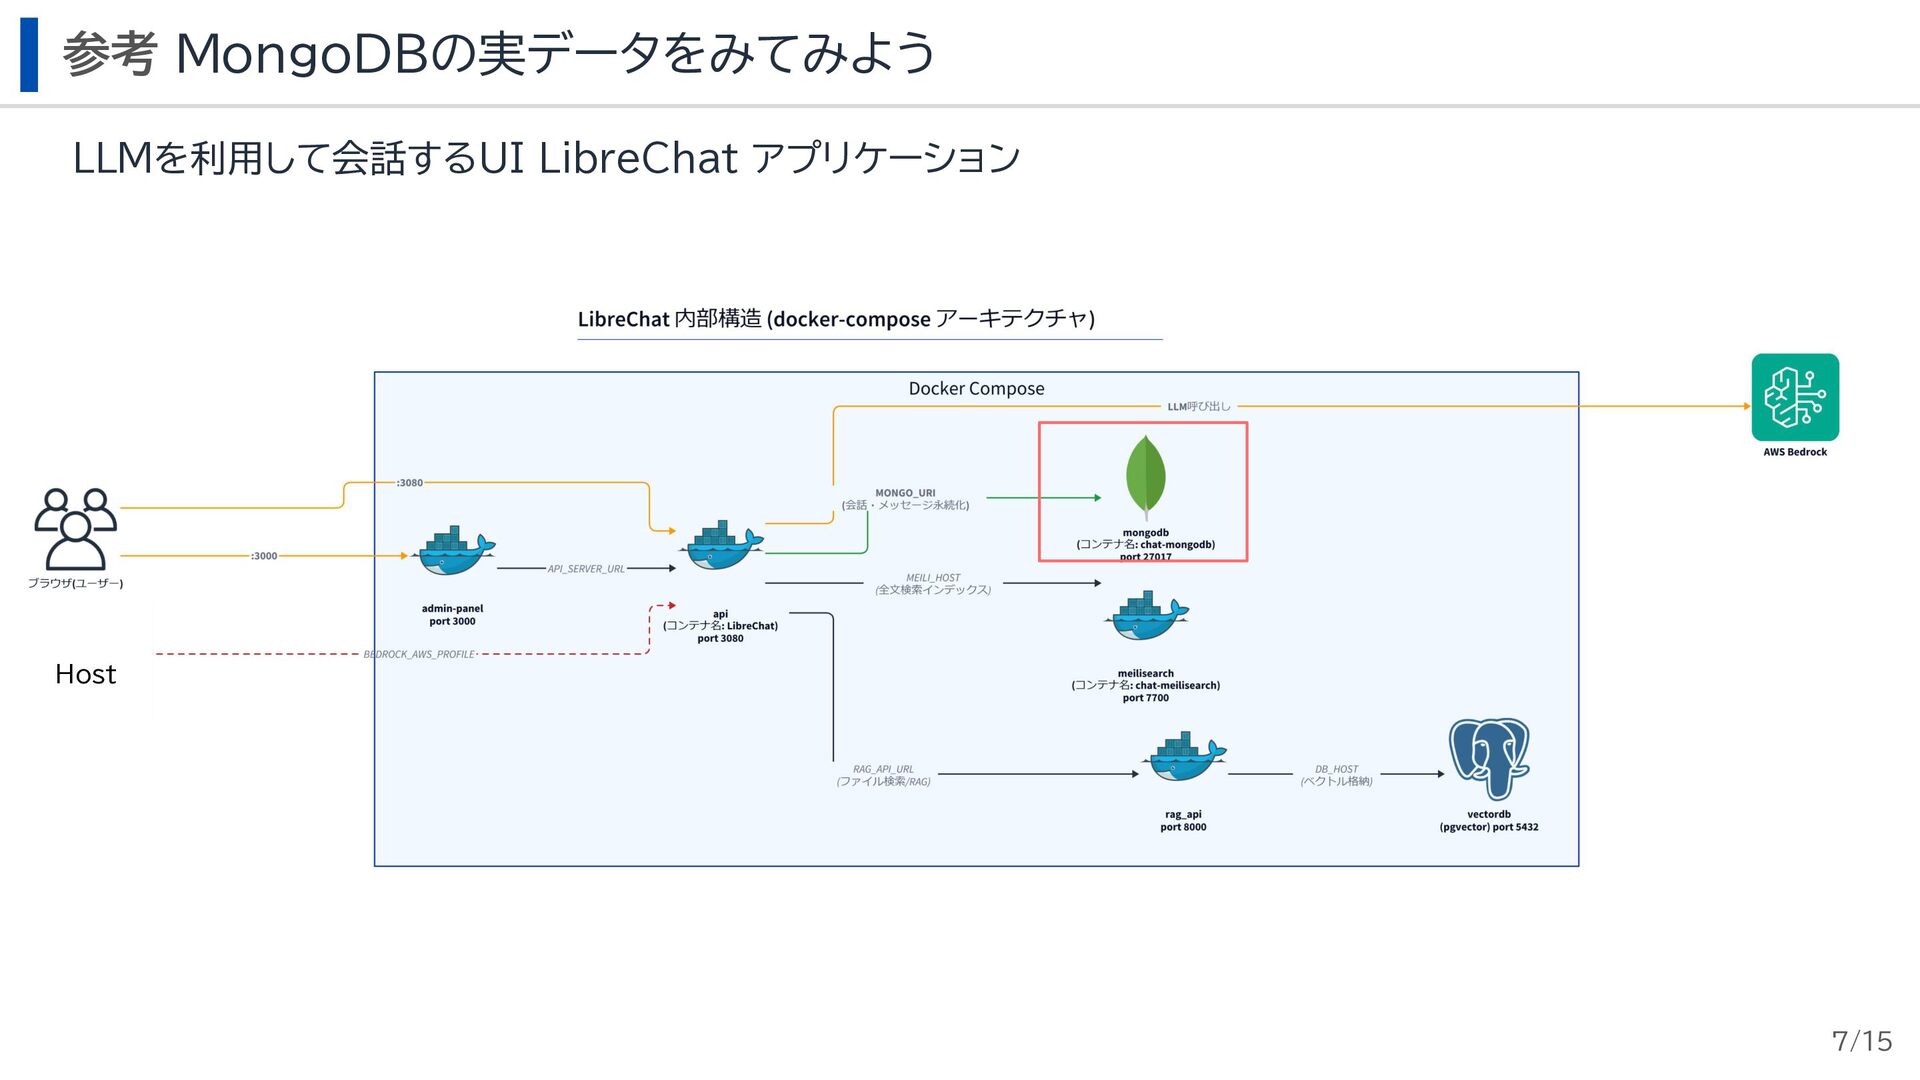
参考 MongoDBの実データをみてみよう LLMを利用して会話するUI LibreChat アプリケーション Host 7/15
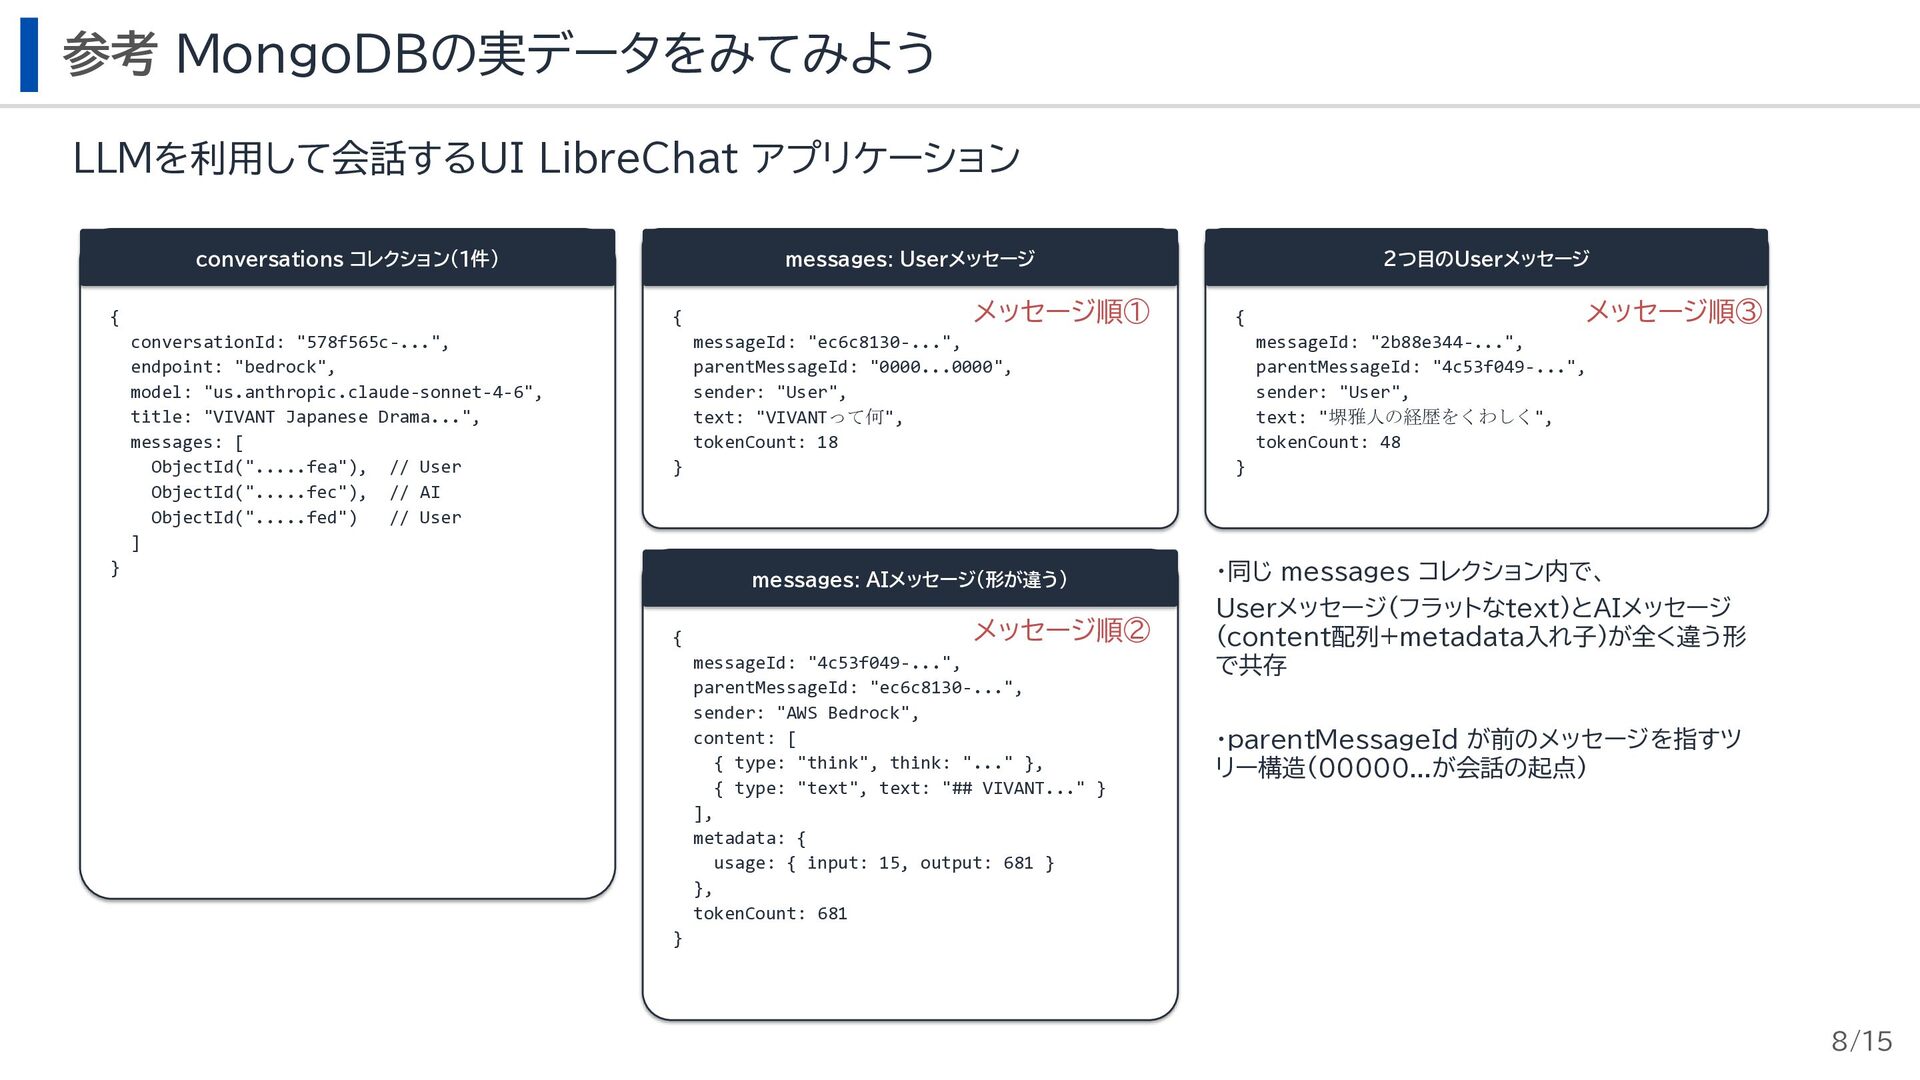
参考 MongoDBの実データをみてみよう LLMを利用して会話するUI LibreChat アプリケーション conversations コレクション(1件) { messages: Userメッセージ
{ conversationId: "578f565c-...", endpoint: "bedrock", model: "us.anthropic.claude-sonnet-4-6", title: "VIVANT Japanese Drama...", messages: [ ObjectId(".....fea"), // User ObjectId(".....fec"), // AI ObjectId(".....fed") // User ] メッセージ順① 2つ目のUserメッセージ { messageId: "ec6c8130-...", parentMessageId: "0000...0000", sender: "User", text: "VIVANTって何", tokenCount: 18 } } messageId: "2b88e344-...", parentMessageId: "4c53f049-...", sender: "User", text: "堺雅人の経歴をくわしく", tokenCount: 48 } messages: AIメッセージ(形が違う) { メッセージ順③ メッセージ順② messageId: "4c53f049-...", parentMessageId: "ec6c8130-...", sender: "AWS Bedrock", content: [ { type: "think", think: "..." }, { type: "text", text: "## VIVANT..." } ], metadata: { usage: { input: 15, output: 681 } }, tokenCount: 681 ・同じ messages コレクション内で、 Userメッセージ(フラットなtext)とAIメッセージ (content配列+metadata入れ子)が全く違う形 で共存 ・parentMessageId が前のメッセージを指すツ リー構造(00000...が会話の起点) } 8/15
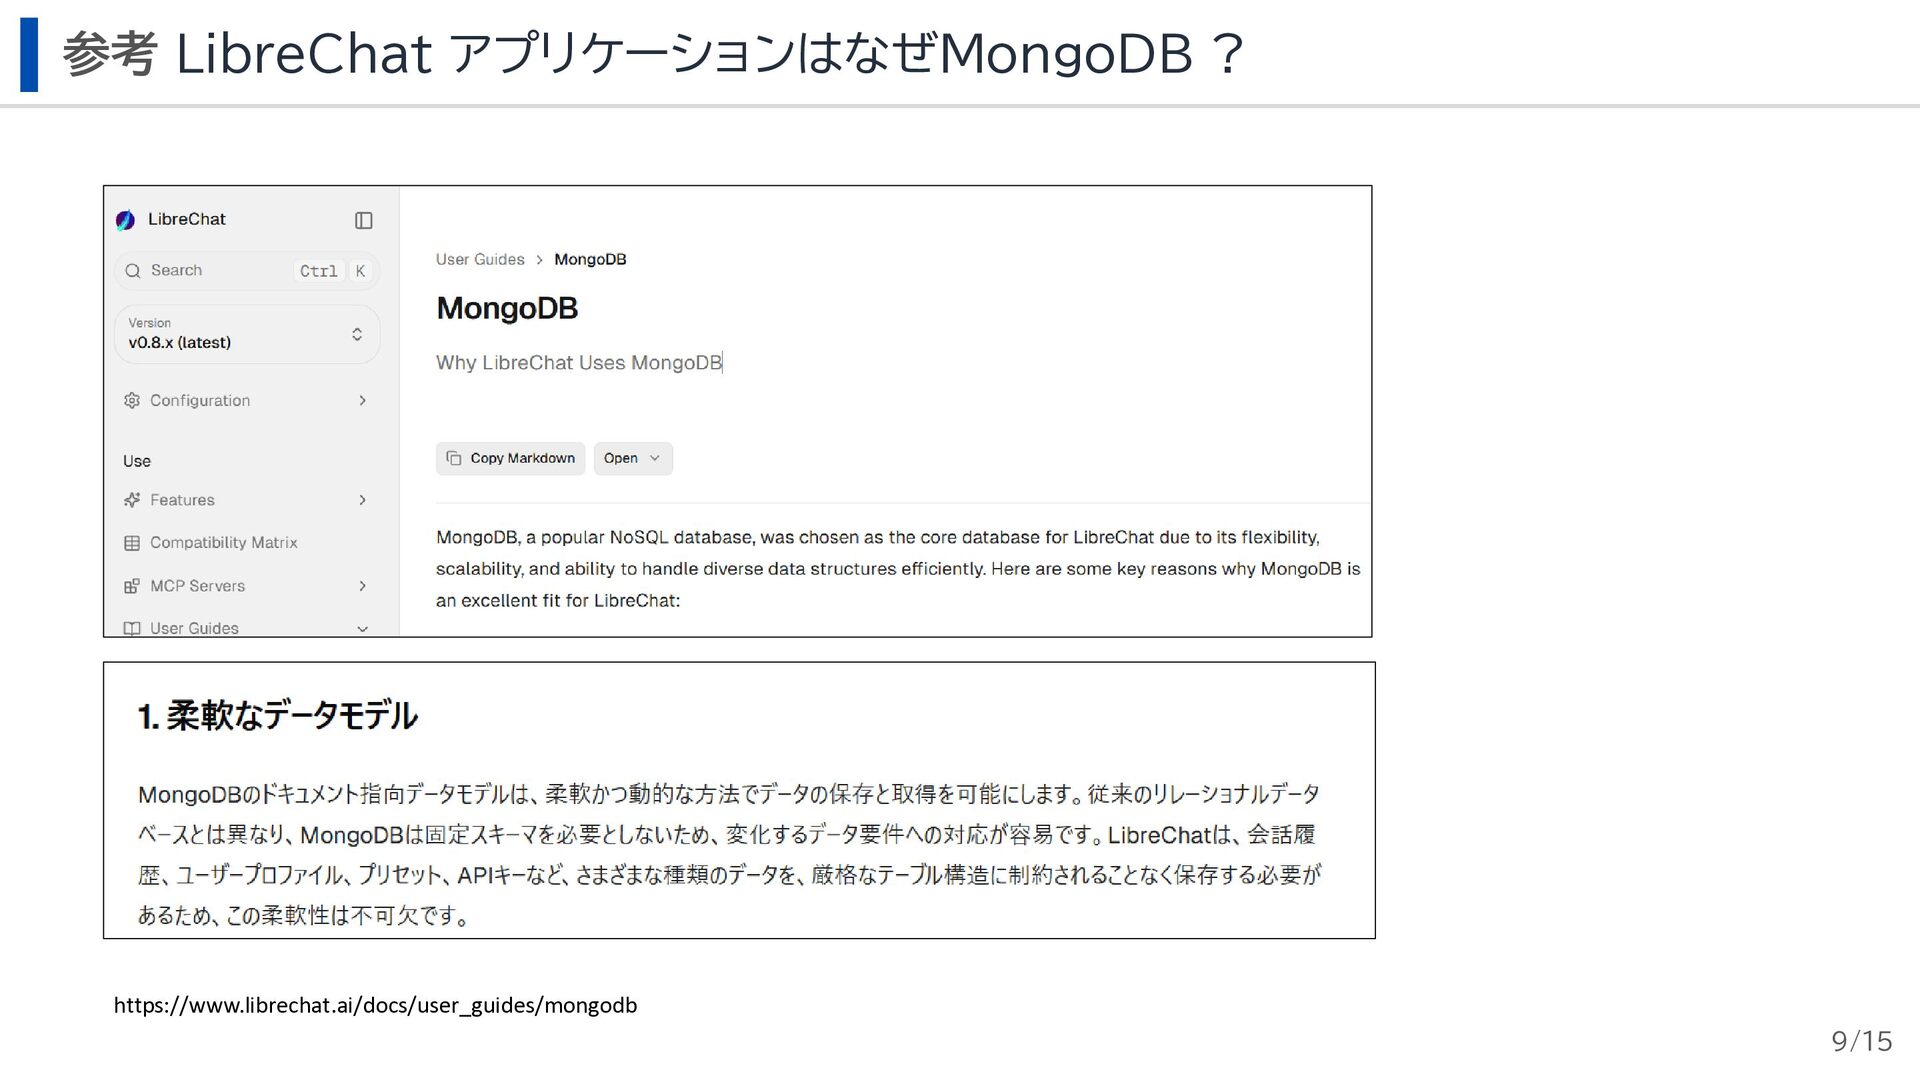
参考 LibreChat アプリケーションはなぜMongoDB ? https://www.librechat.ai/docs/user_guides/mongodb 9/15
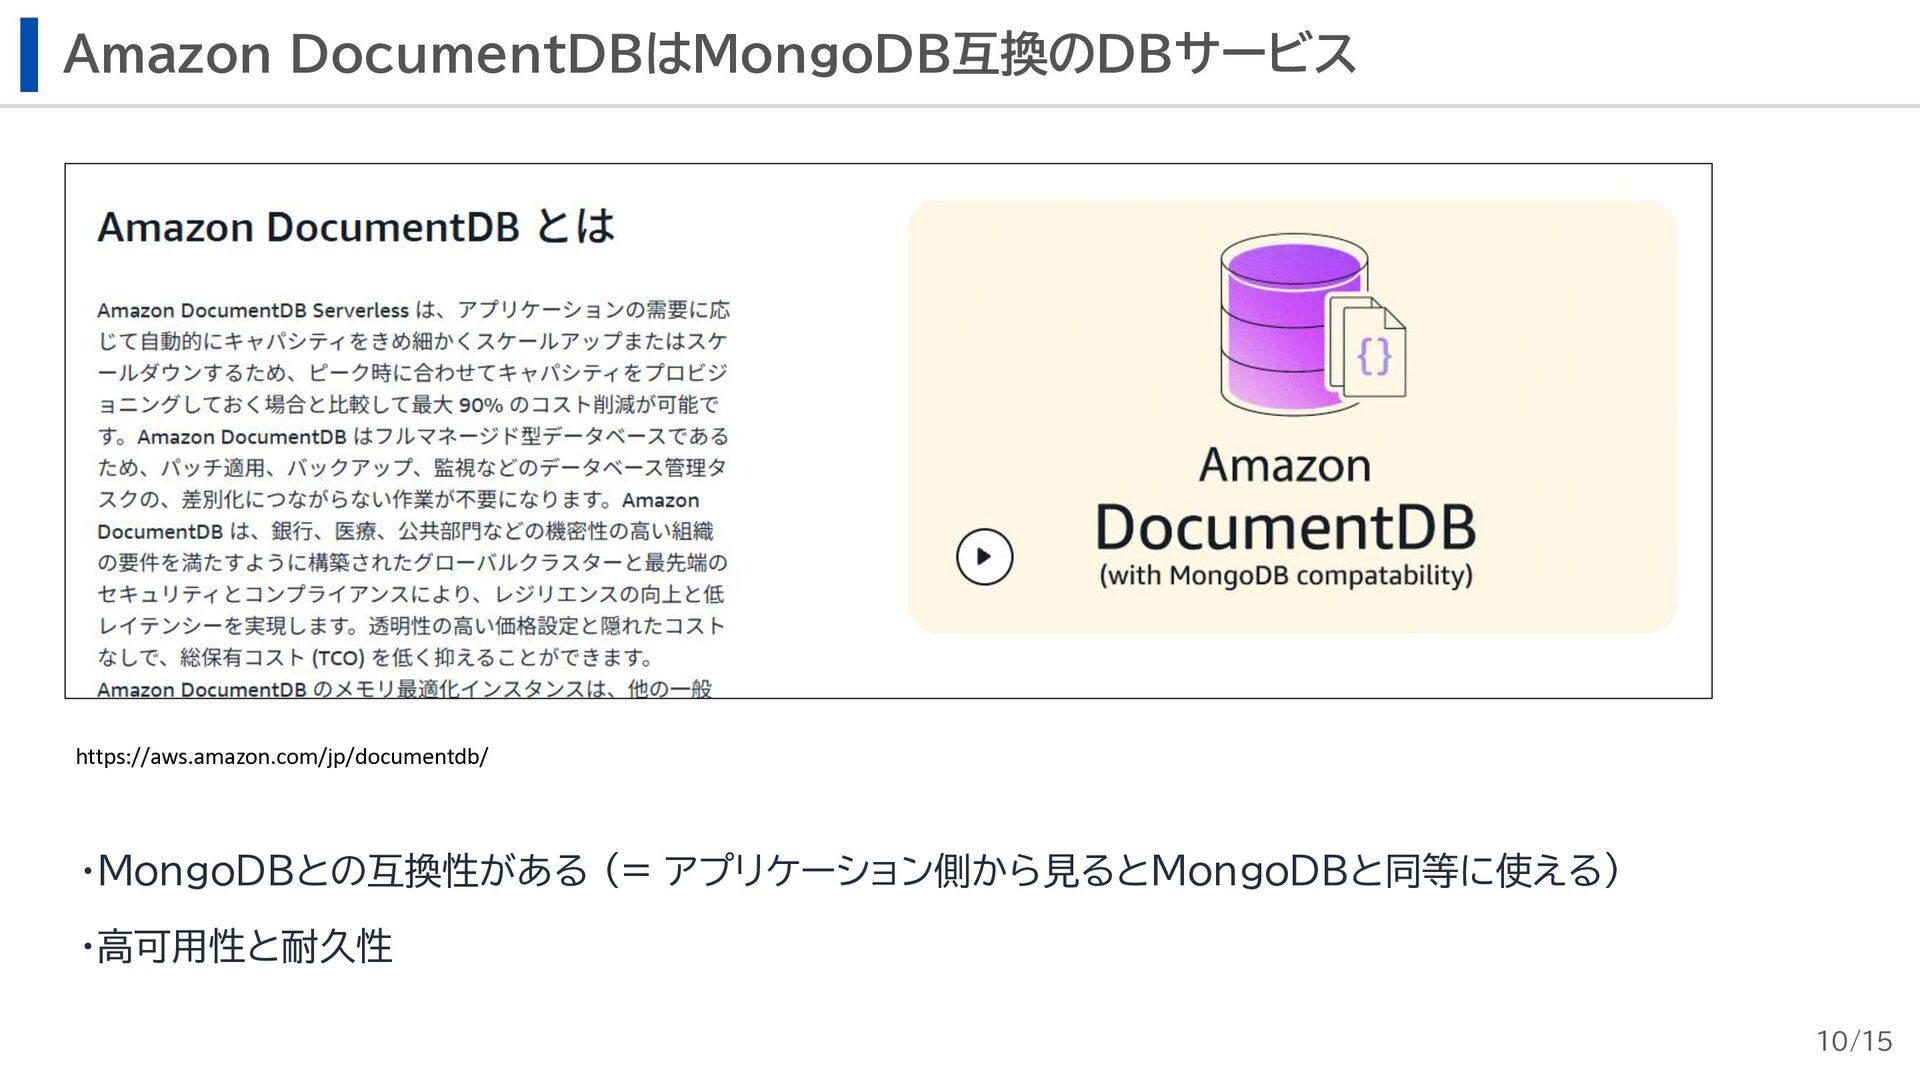
Amazon DocumentDBはMongoDB互換のDBサービス https://aws.amazon.com/jp/documentdb/ ・MongoDBとの互換性がある (= アプリケーション側から見るとMongoDBと同等に使える) ・高可用性と耐久性 10/15
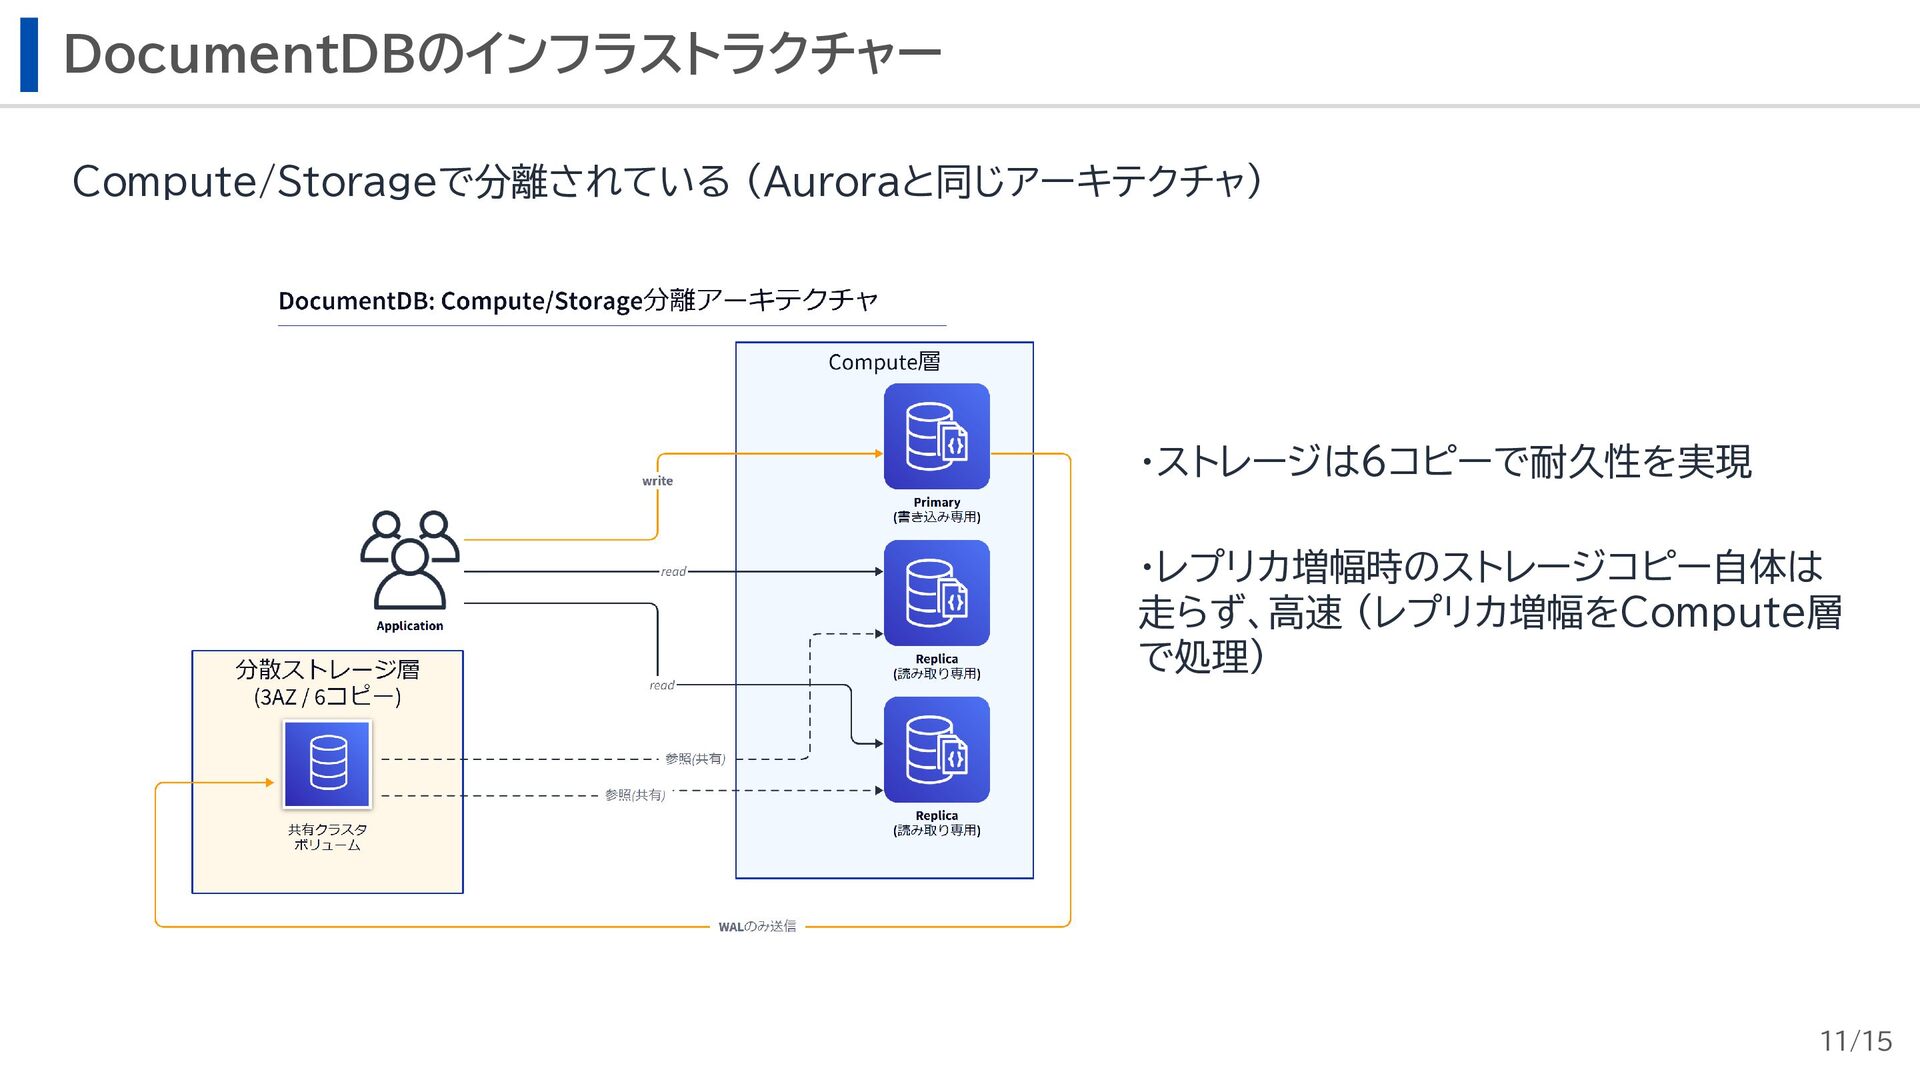
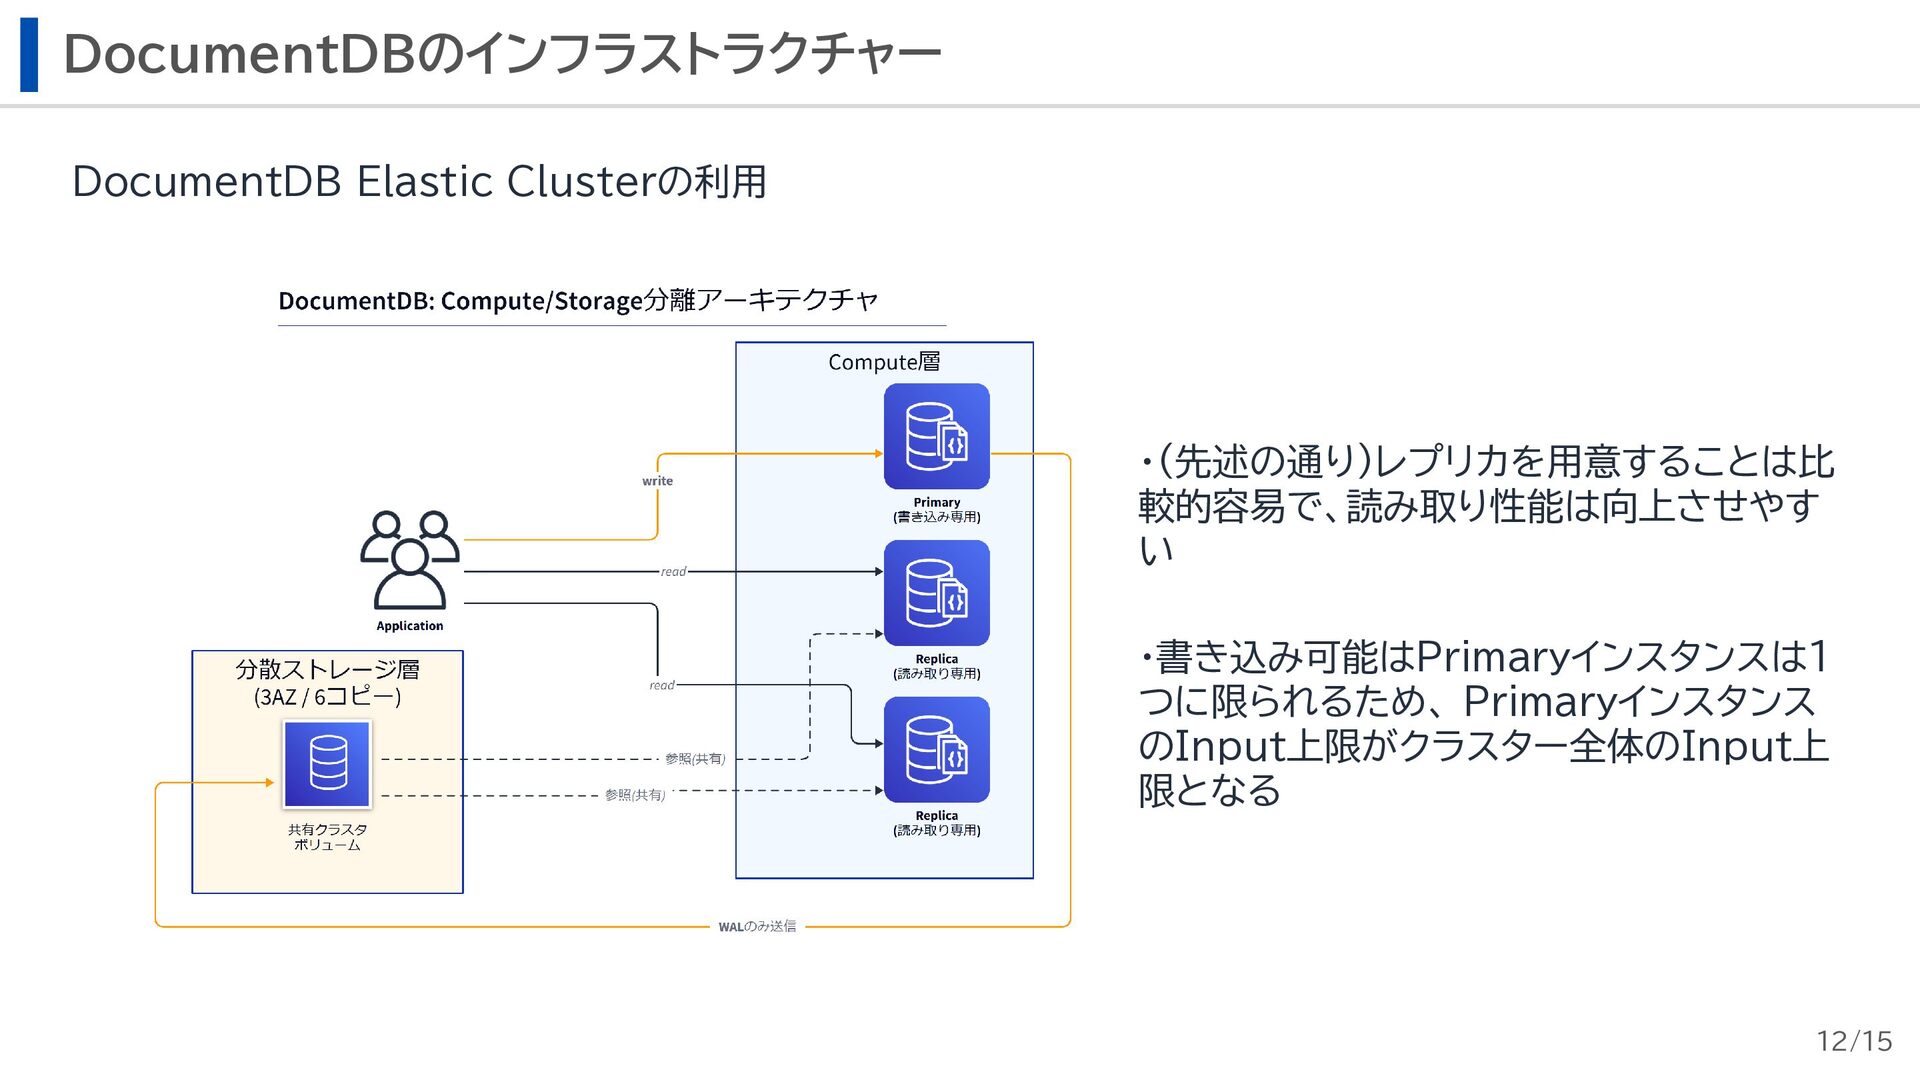
DocumentDBのインフラストラクチャー Compute/Storageで分離されている (Auroraと同じアーキテクチャ) ・ストレージは6コピーで耐久性を実現 ・レプリカ増幅時のストレージコピー自体は 走らず、高速 (レプリカ増幅をCompute層 で処理) 11/15
DocumentDBのインフラストラクチャー DocumentDB Elastic Clusterの利用 ・(先述の通り)レプリカを用意することは比 較的容易で、読み取り性能は向上させやす い ・書き込み可能はPrimaryインスタンスは1 つに限られるため、 Primaryインスタンス
のInput上限がクラスター全体のInput上 限となる 12/15
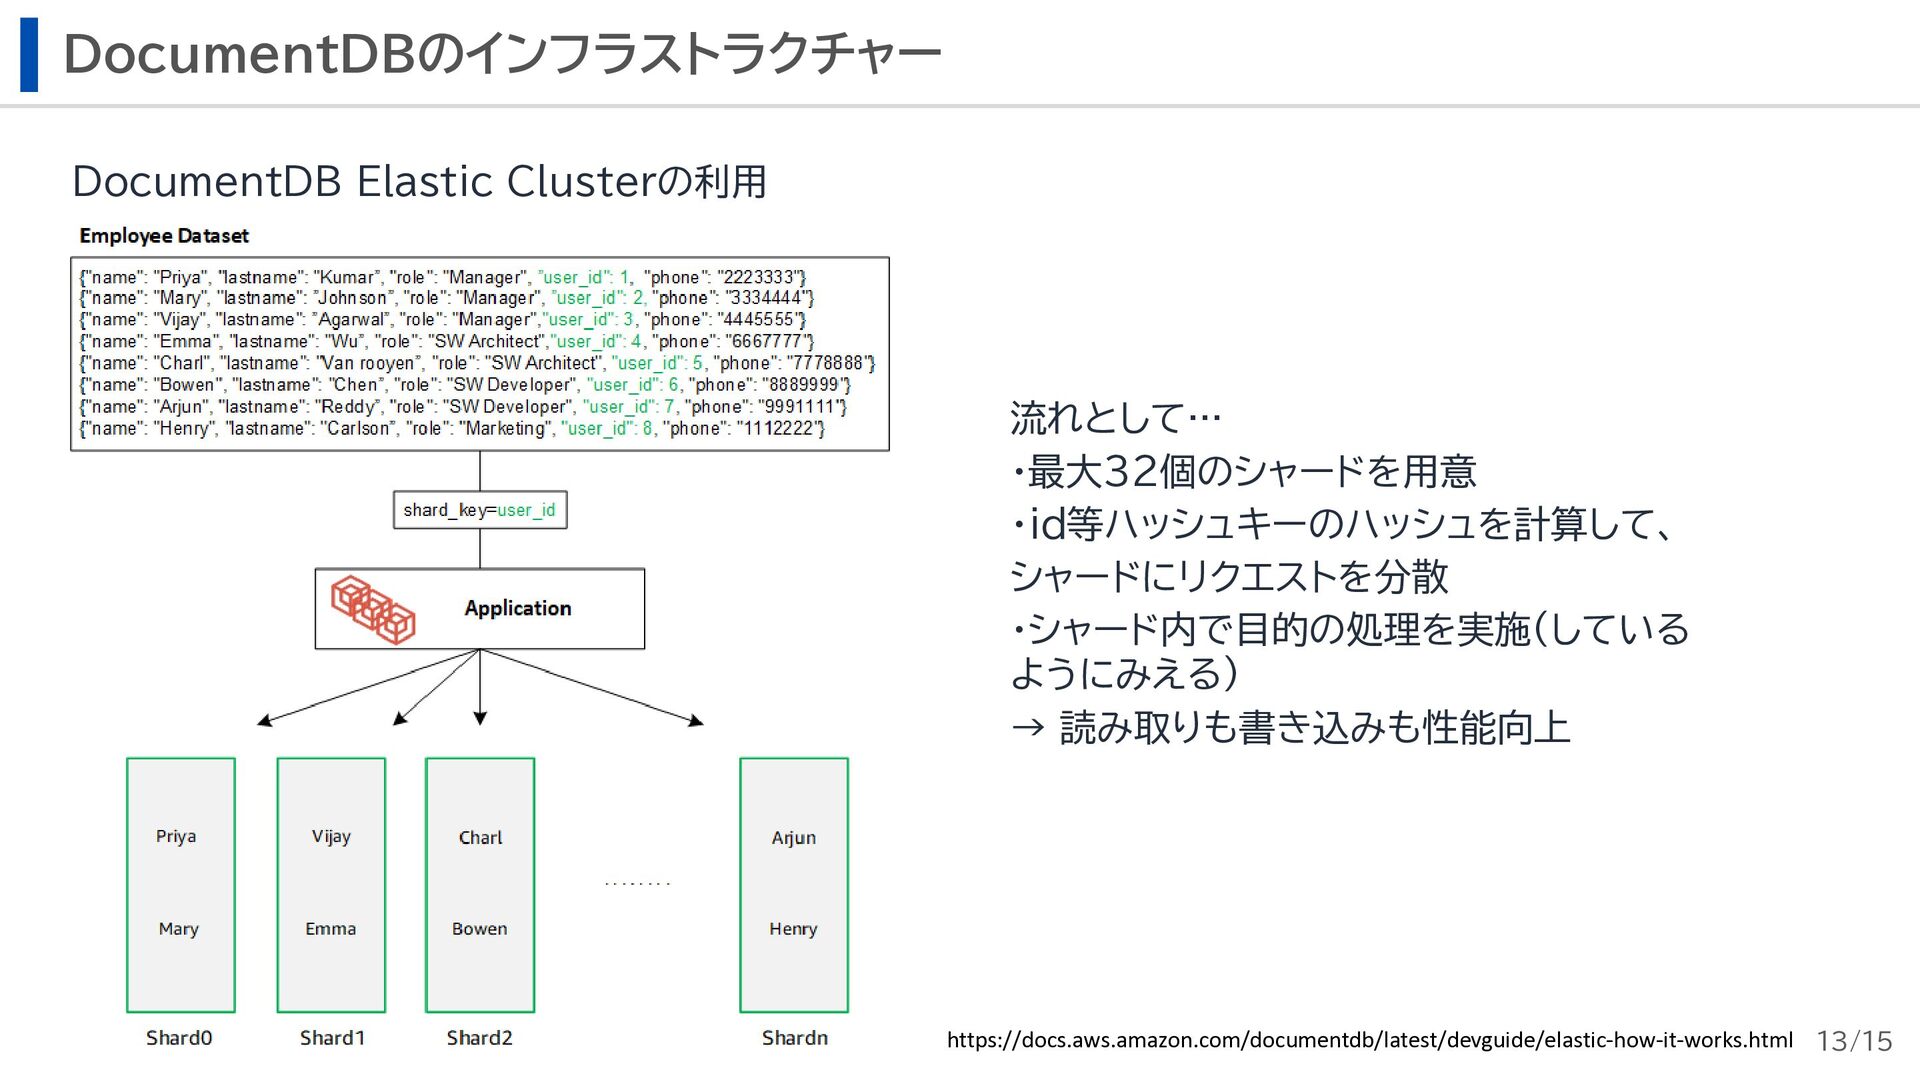
DocumentDBのインフラストラクチャー DocumentDB Elastic Clusterの利用 流れとして… ・最大32個のシャードを用意 ・id等ハッシュキーのハッシュを計算して、 シャードにリクエストを分散 ・シャード内で目的の処理を実施(している ようにみえる)
→ 読み取りも書き込みも性能向上 https://docs.aws.amazon.com/documentdb/latest/devguide/elastic-how-it-works.html 13/15
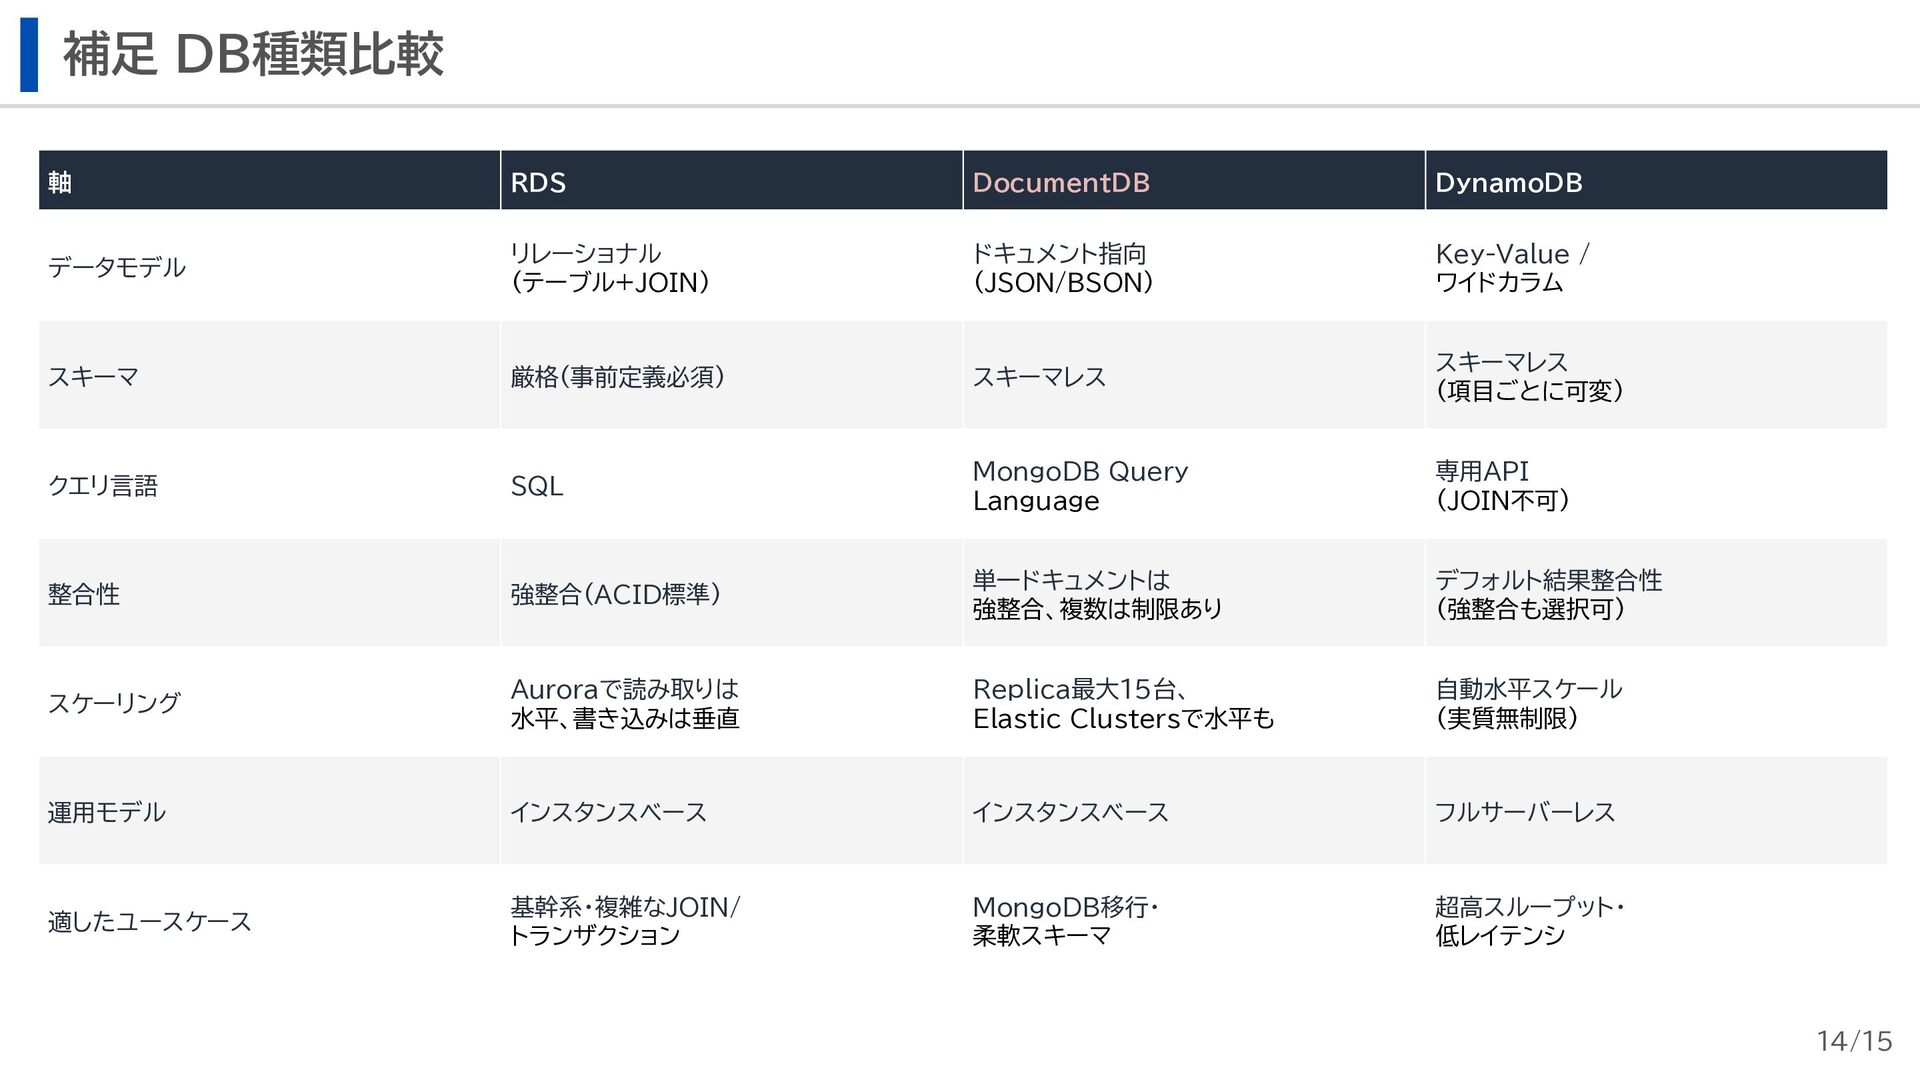
補足 DB種類比較 軸 RDS DocumentDB DynamoDB データモデル リレーショナル (テーブル+JOIN) ドキュメント指向
(JSON/BSON) Key-Value / ワイドカラム スキーマ 厳格(事前定義必須) スキーマレス スキーマレス (項目ごとに可変) クエリ言語 SQL MongoDB Query Language 専用API (JOIN不可) 整合性 強整合(ACID標準) 単一ドキュメントは 強整合、複数は制限あり デフォルト結果整合性 (強整合も選択可) スケーリング Auroraで読み取りは 水平、書き込みは垂直 Replica最大15台、 Elastic Clustersで水平も 自動水平スケール (実質無制限) 運用モデル インスタンスベース インスタンスベース フルサーバーレス 適したユースケース 基幹系・複雑なJOIN/ トランザクション MongoDB移行・ 柔軟スキーマ 超高スループット・ 低レイテンシ 14/15
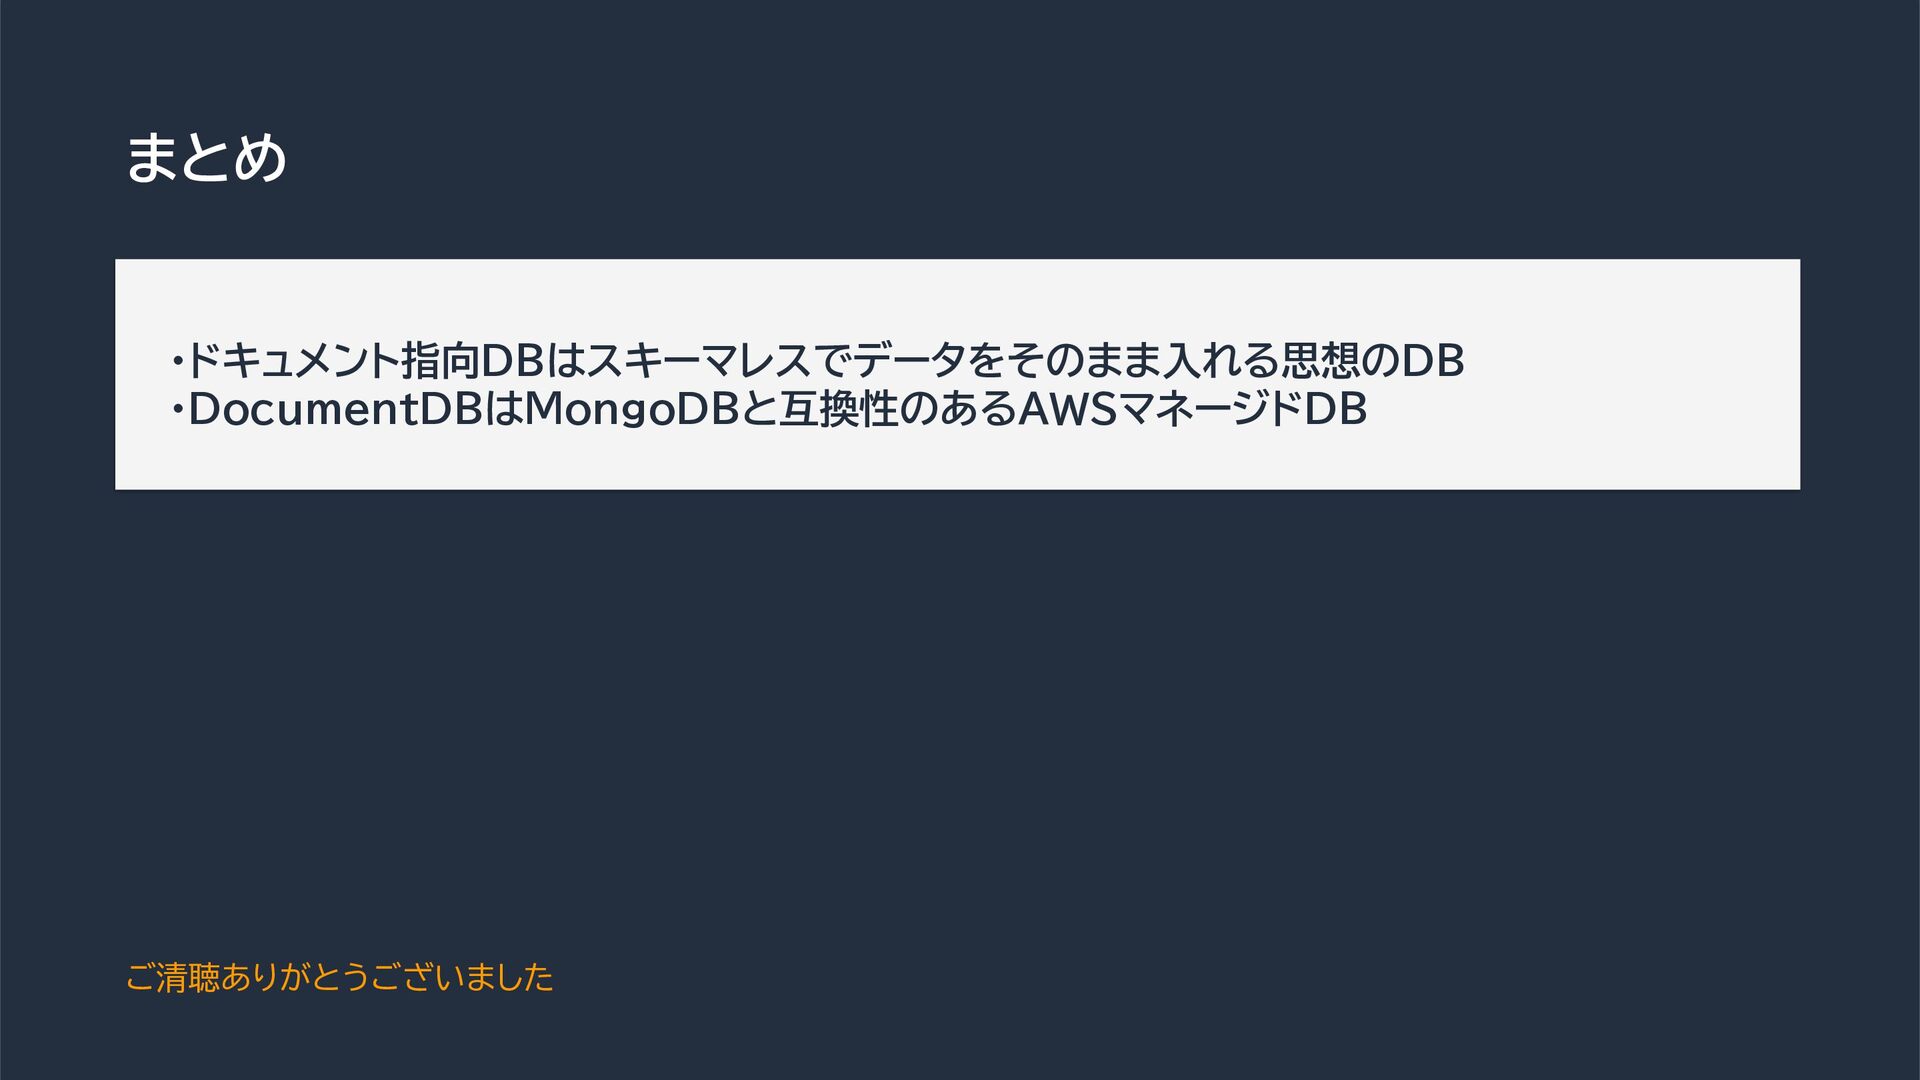
まとめ ・ドキュメント指向DBはスキーマレスでデータをそのまま入れる思想のDB ・DocumentDBはMongoDBと互換性のあるAWSマネージドDB ご清聴ありがとうございました
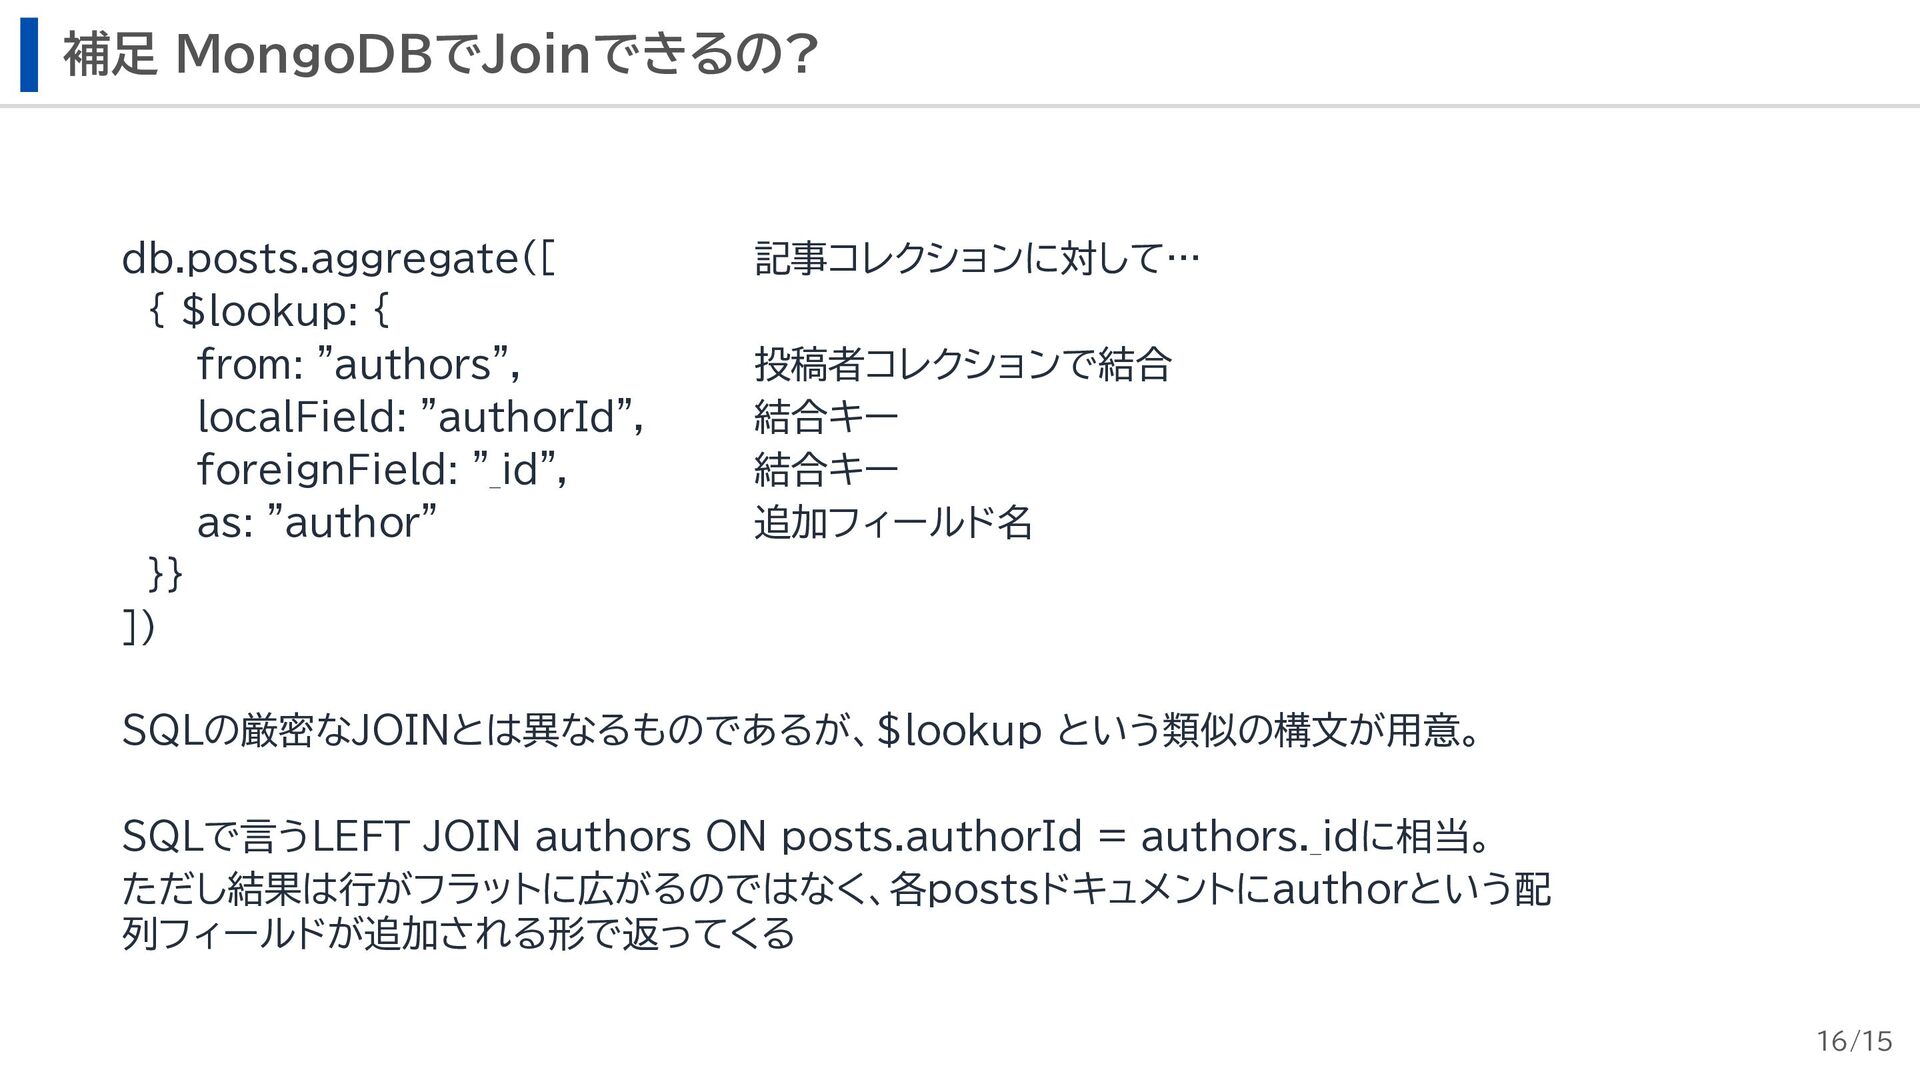
補足 MongoDBでJoinできるの? db.posts.aggregate([ { $lookup: { from: "authors", localField: "authorId",
foreignField: "_id", as: "author" }} ]) 記事コレクションに対して… 投稿者コレクションで結合 結合キー 結合キー 追加フィールド名 SQLの厳密なJOINとは異なるものであるが、$lookup という類似の構文が用意。 SQLで言うLEFT JOIN authors ON posts.authorId = authors._idに相当。 ただし結果は行がフラットに広がるのではなく、各postsドキュメントにauthorという配 列フィールドが追加される形で返ってくる 16/15


 shinadaa1717
 jozono
 codmoninc
 pfn
 nealle
 kworkdev
 takuroabe
 teamlab
 mhrtech
 bgpat
 kash1064
 prog893
 syuchimu
 lynnandtonic
 inesmontani
 iamctodd
 jonoalderson
 keavy
 maltzj
 reverentgeek
 nikkihalliwell
 bkeepers
 michielstock
 aarron