Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
【データベース】統計情報の収集【第2回】
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Shin
September 14, 2024
Programming
57
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
【データベース】統計情報の収集【第2回】
使用したデータは以下
https://www.notion.so/85c3816ea99840249be0b9104f15ab04
Shin
September 14, 2024
More Decks by Shin
See All by Shin
【DWH】Snowflakeのクラスタリングキーについて
sk8er_boi_shin
0
24
【DWH】Snowflakeで等価条件なのにコストが変わる理由
sk8er_boi_shin
0
27
【DWH】 PostgreSQLとSnowFlake_設計思想とデータ管理の違い
sk8er_boi_shin
0
34
【PostgreSQL】メンテナンス系コマンドの種類
sk8er_boi_shin
0
38
【データベース】統計情報と物理順序
sk8er_boi_shin
0
82
【データベース】RedisとPostgreSQL
sk8er_boi_shin
0
210
【データベース】統計情報と単一カラムのヒストグラム
sk8er_boi_shin
0
38
【データベース】制約の種類と速度検証
sk8er_boi_shin
0
42
【データベース】インデックスの種類と役割
sk8er_boi_shin
0
28
Other Decks in Programming
See All in Programming
UPDATE をやめる — EF Core でマスタをバージョン管理する
panda728
PRO
0
1.2k
AmebaブログはKMPから卒業します
kmars0605
0
200
作れる、でも消せるか?──安全に「枯らして消す」機能削除術 / Drain, Then Delete
chobishiba
2
800
コードで差別化できない時代の ソフトウェアエンジニアリング / Software Engineering in an Era Where Code Doesn’t Differentiate
kishida
2
180
sbt 2.0: takeoff
eed3si9n
0
160
Findy - エンジニア向け会社紹介/Findy Company Deck
findyinc
6
400k
[2026-09-26]空論ジェネリックプロセス~テスト資産とAIで紡ぐ、再現可能なパフォーマンスチューニングの話~
tosite
0
270
KiroのSpecで「五目並べ」を作ってみる
satoshi256kbyte
1
380
GemmaをJevのように使ってみる / Use Gemma like Jev
kishida
5
800
Kotlinの15年とServer-Side Kotlin
n_takehata
1
150
複雑なUIコンポーネントとの ⻑い付き合い⽅:波及するバグからテスト戦略を経て、安全な再設計へ
mixplace
0
430
JIS keyboard support in Omarchy
lef237
0
130
Featured
See All Featured
Testing 201, or: Great Expectations
jmmastey
46
8.3k
Odyssey Design
rkendrick25
PRO
2
880
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
Rails Girls Zürich Keynote
gr2m
96
14k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
280
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
950
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
540
Site-Speed That Sticks
csswizardry
13
1.6k
KATA
mclloyd
PRO
35
16k
Thoughts on Productivity
jonyablonski
76
5.4k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
300
Bash Introduction
62gerente
615
220k
Transcript
【データベース】 統計情報の収集
目次 1. 統計情報とは 2. サンプリングと完全スキャンの特性 3. サンプリングと完全スキャンの選択基準 4. サンプリング又は完全スキャンを使用しているサービス 5.
【検証】統計情報が不適切な場合のリスク 6. 各製品ごとに統計情報が古いとされる基準 7. まとめ
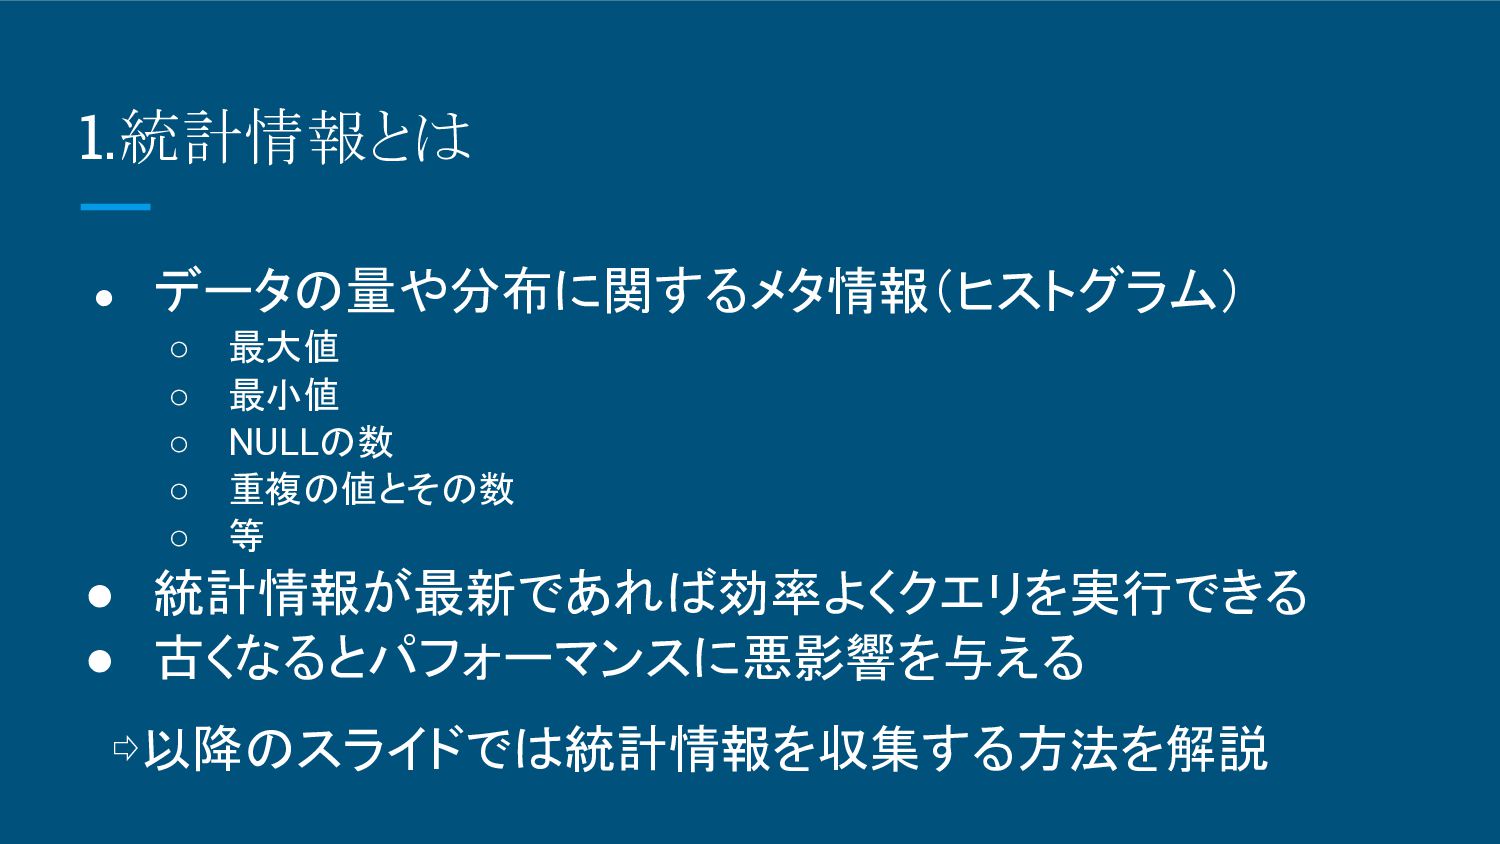
1.統計情報とは • データの量や分布に関するメタ情報(ヒストグラム) ◦ 最大値 ◦ 最小値 ◦ NULLの数 ◦
重複の値とその数 ◦ 等 • 統計情報が最新であれば効率よくクエリを実行できる • 古くなるとパフォーマンスに悪影響を与える ⇨以降のスライドでは統計情報を収集する方法を解説
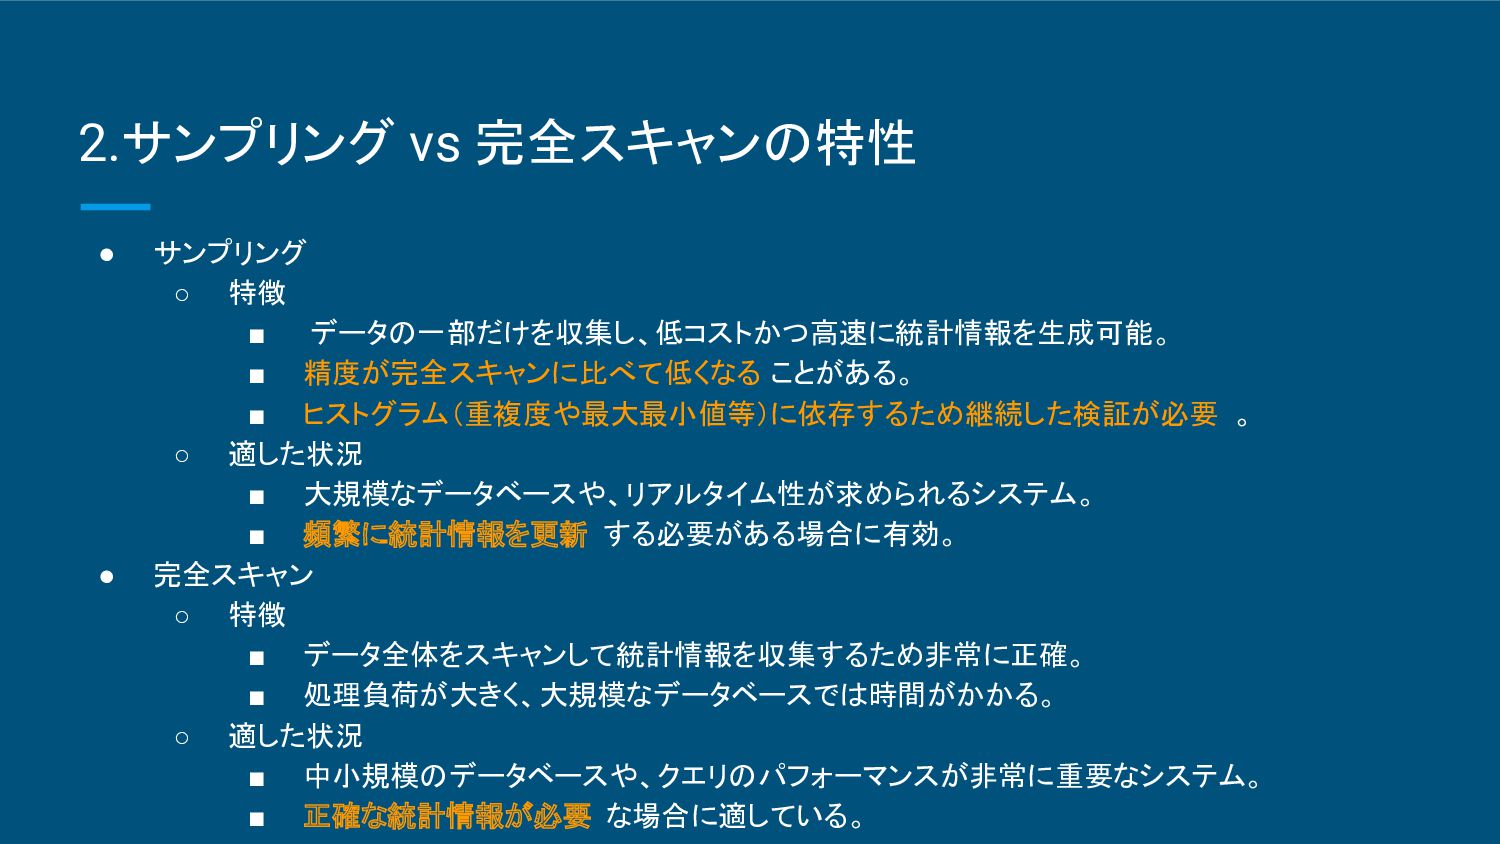
2.サンプリング vs 完全スキャンの特性 • サンプリング ◦ 特徴 ▪ データの一部だけを収集し、低コストかつ高速に統計情報を生成可能。 ▪
精度が完全スキャンに比べて低くなる ことがある。 ▪ ヒストグラム(重複度や最大最小値等)に依存するため継続した検証が必要 。 ◦ 適した状況 ▪ 大規模なデータベースや、リアルタイム性が求められるシステム。 ▪ 頻繁に統計情報を更新 する必要がある場合に有効。 • 完全スキャン ◦ 特徴 ▪ データ全体をスキャンして統計情報を収集するため非常に正確。 ▪ 処理負荷が大きく、大規模なデータベースでは時間がかかる。 ◦ 適した状況 ▪ 中小規模のデータベースや、クエリのパフォーマンスが非常に重要なシステム。 ▪ 正確な統計情報が必要 な場合に適している。
3.サンプリングと完全スキャンの選択基準 • データ量 ◦ サンプリング ▪ データが非常に大規模で、全体をスキャンするのが非効率な場合。 ◦ 完全スキャン ▪
データ量が少ない場合や、中規模データベースで正確さが重視される場合。 • データの変動頻度 ◦ サンプリング ▪ データが頻繁に更新されるシステム。 ◦ 完全スキャン ▪ データの更新があまり頻繁でない場合や、構造が安定している場合。
3.サンプリングと完全スキャンの選択基準 • クエリパフォーマンスの重要度 ◦ サンプリング ▪ すべてのクエリで極端に高いパフォーマンスが求められない場合。 ◦ 完全スキャン ▪
特定のクエリや業務で非常に高いパフォーマンスが求められる場合。 • データの分布 ◦ サンプリング ▪ データの分布が均一である場合は、サンプリングでも統計情報が十分に正確になる。 ◦ 完全スキャン ▪ データに偏りがある場合 (各カラムの一意性が高い場合等 )は完全スキャンが必要。
3.サンプリングと完全スキャンの選択基準 • サンプリングを選ぶケース ◦ リアルタイム性が求められる ▪ 例: eコマース、SNSフィード ▪ 理由:
頻繁なデータ更新で統計情報の迅速な更新が必要。 ◦ 大規模データベース ▪ 例: ビッグデータ分析、データウェアハウス ▪ 理由: データ量が膨大な場合、完全スキャンが非現実的。 • 完全スキャンを選ぶケース ◦ クエリパフォーマンスが非常に重要 ▪ 例: 金融取引システム ▪ 理由: 統計情報の正確さがパフォーマンスに直結。 ◦ 中小規模データベース ▪ 例: 社内システム、小規模業務アプリケーション ▪ 理由: データ量が少なく、完全スキャンの負荷が軽い。
3.サンプリングと完全スキャンの選択基準 • そもそもサンプリングを多用するべきか? ◦ 頻繁にサンプリングが必要ならRDS以外も検討 ▪ 理由: RDSは自動化が便利だが、統計情報の管理には制限がある。 ◦ 他の選択肢
▪ オンプレミスDB: より柔軟なチューニングが可能。 ▪ NoSQL: 統計情報管理が不要な場合もあり。
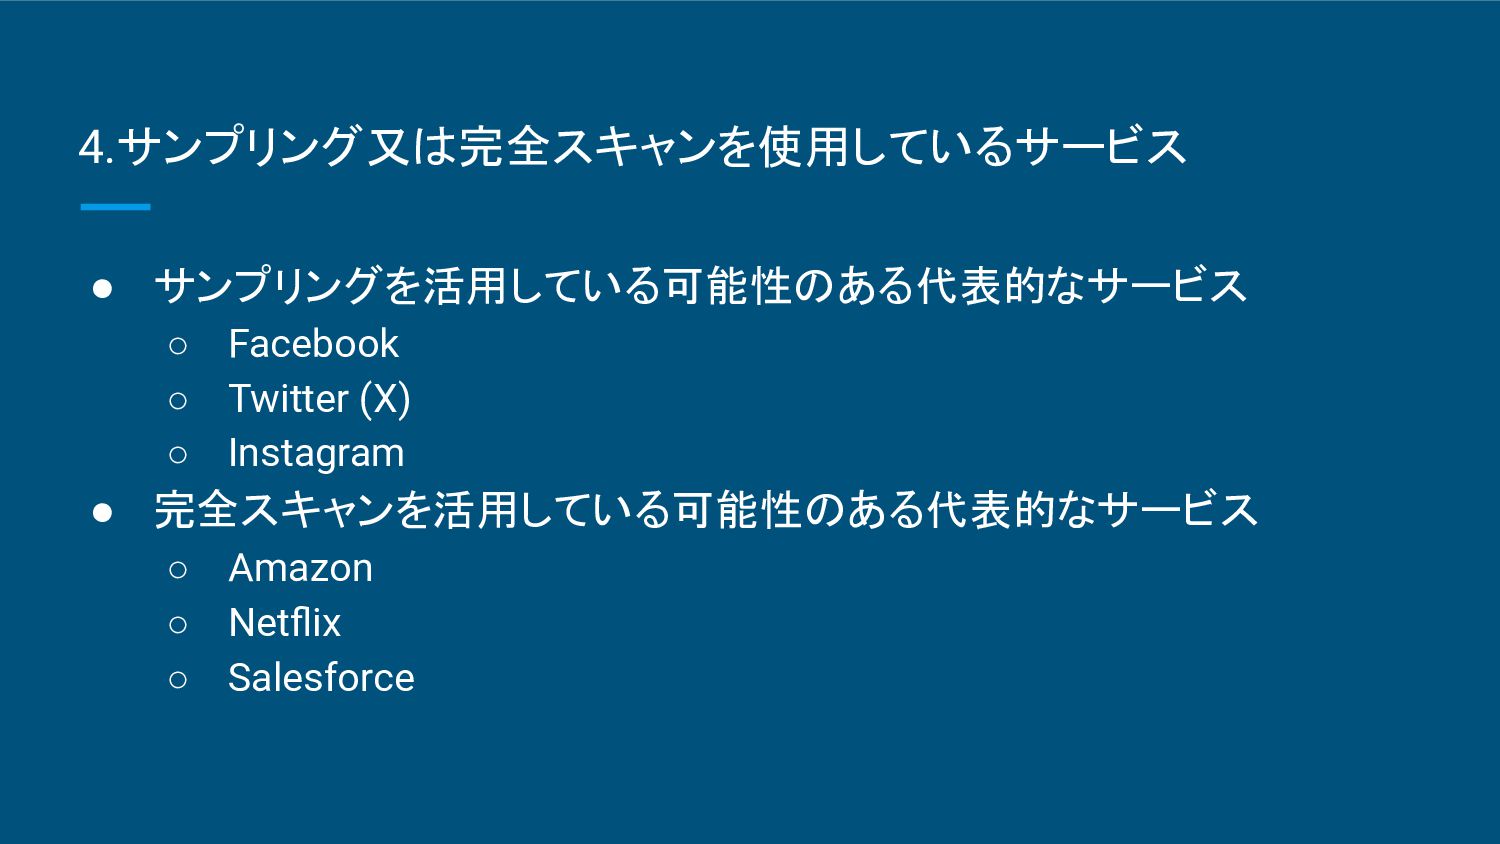
4.サンプリング又は完全スキャンを使用しているサービス • サンプリングを活用している可能性のある代表的なサービス ◦ Facebook ◦ Twitter (X) ◦ Instagram
• 完全スキャンを活用している可能性のある代表的なサービス ◦ Amazon ◦ Netflix ◦ Salesforce
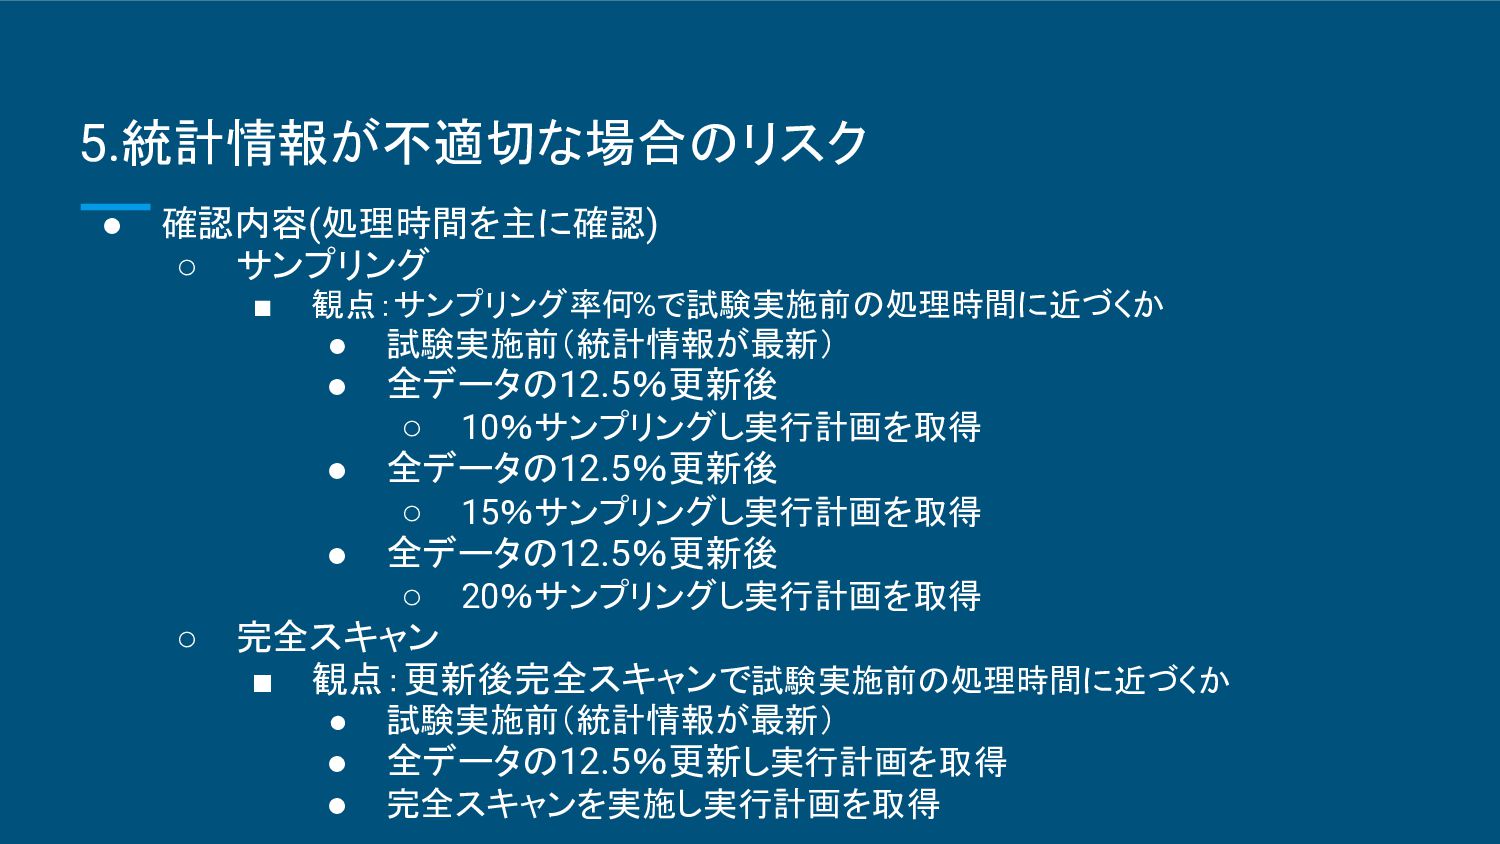
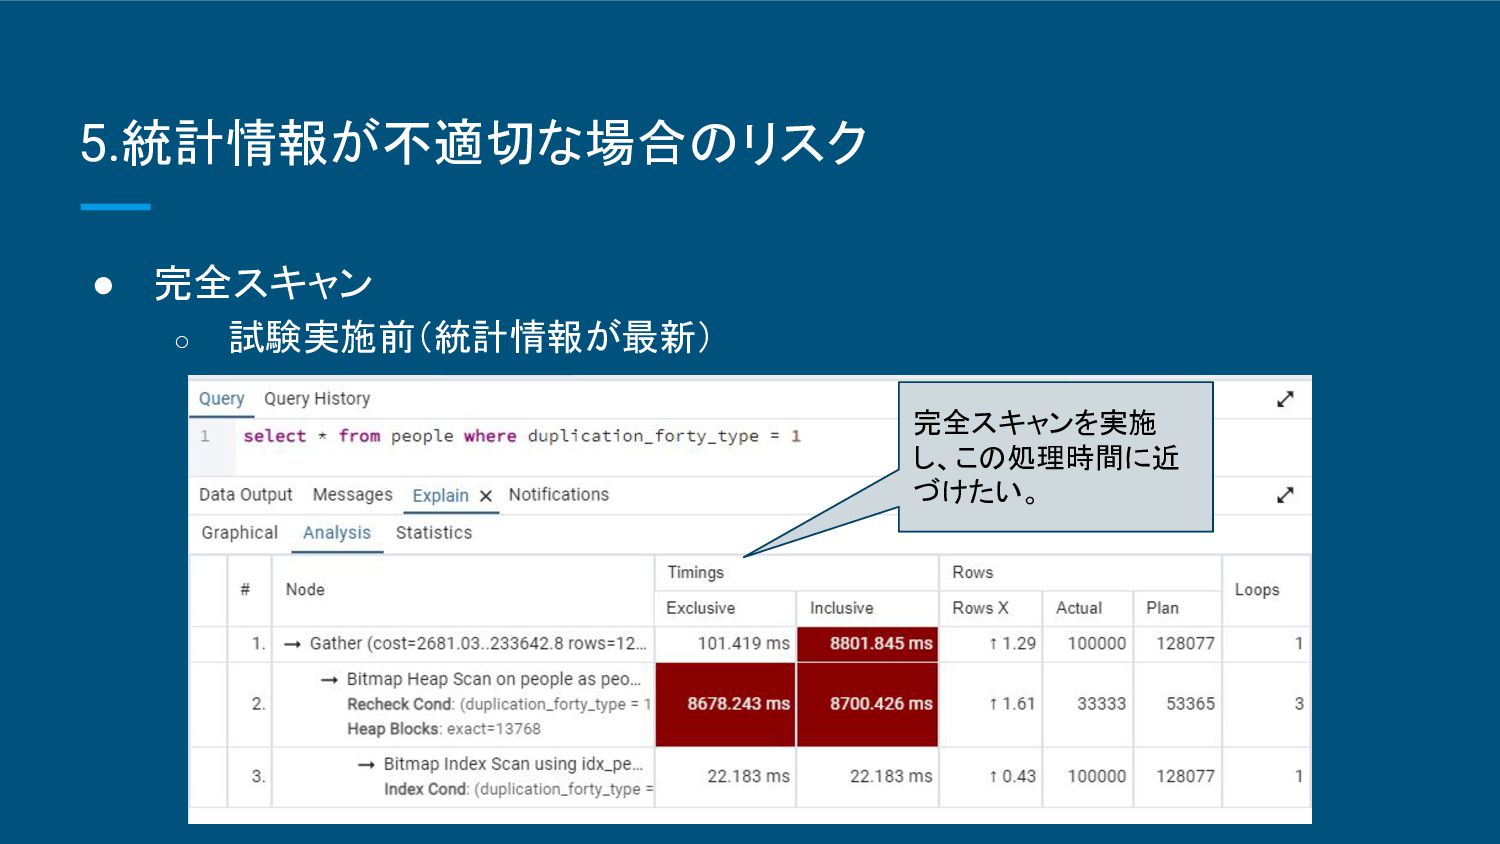
5.統計情報が不適切な場合のリスク • 確認内容(処理時間を主に確認) ◦ サンプリング ▪ 観点:サンプリング率何%で試験実施前の処理時間に近づくか • 試験実施前(統計情報が最新) •
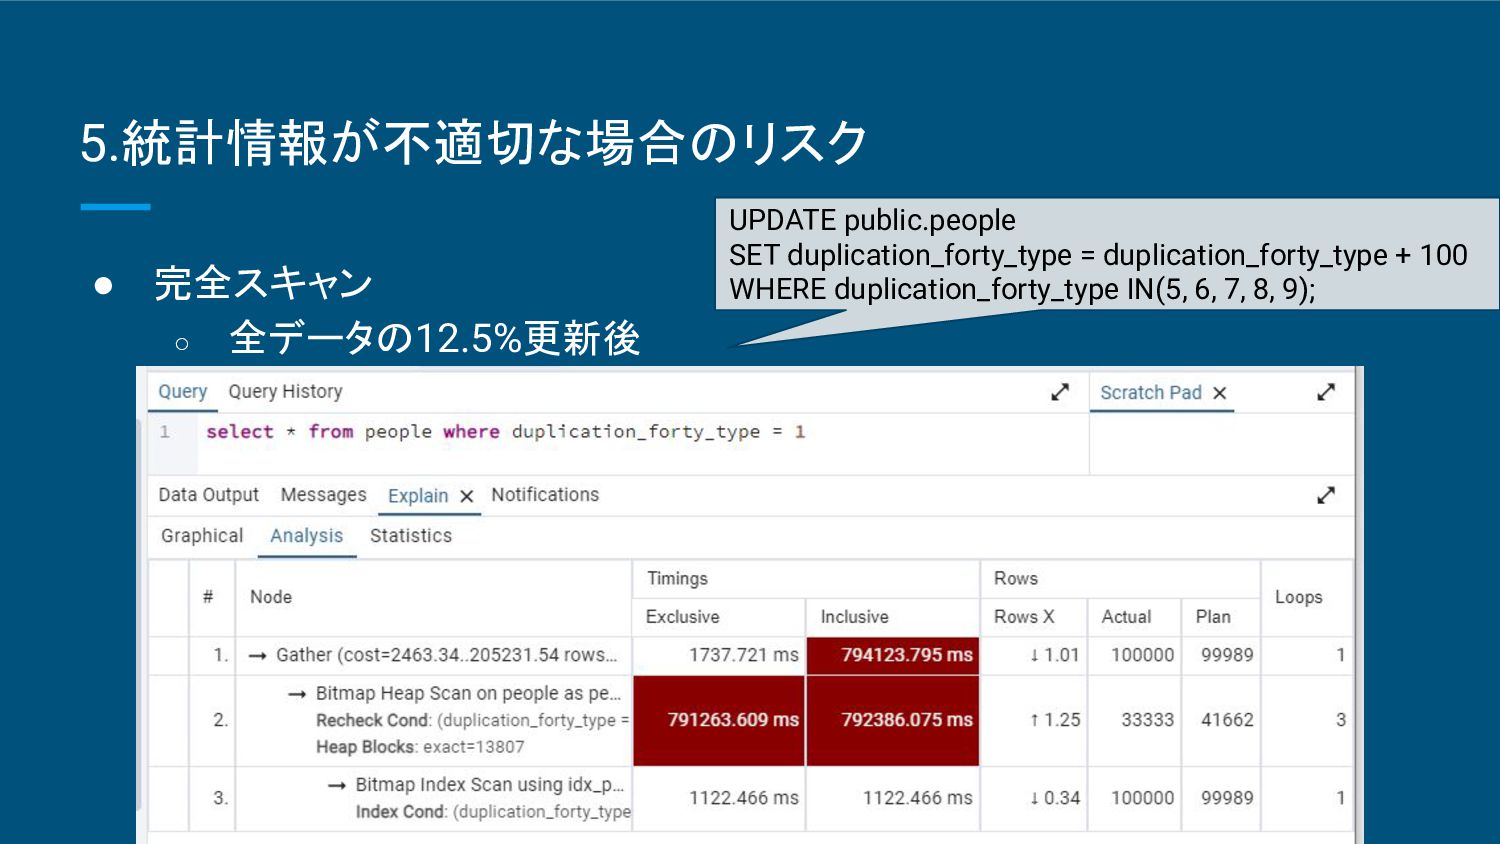
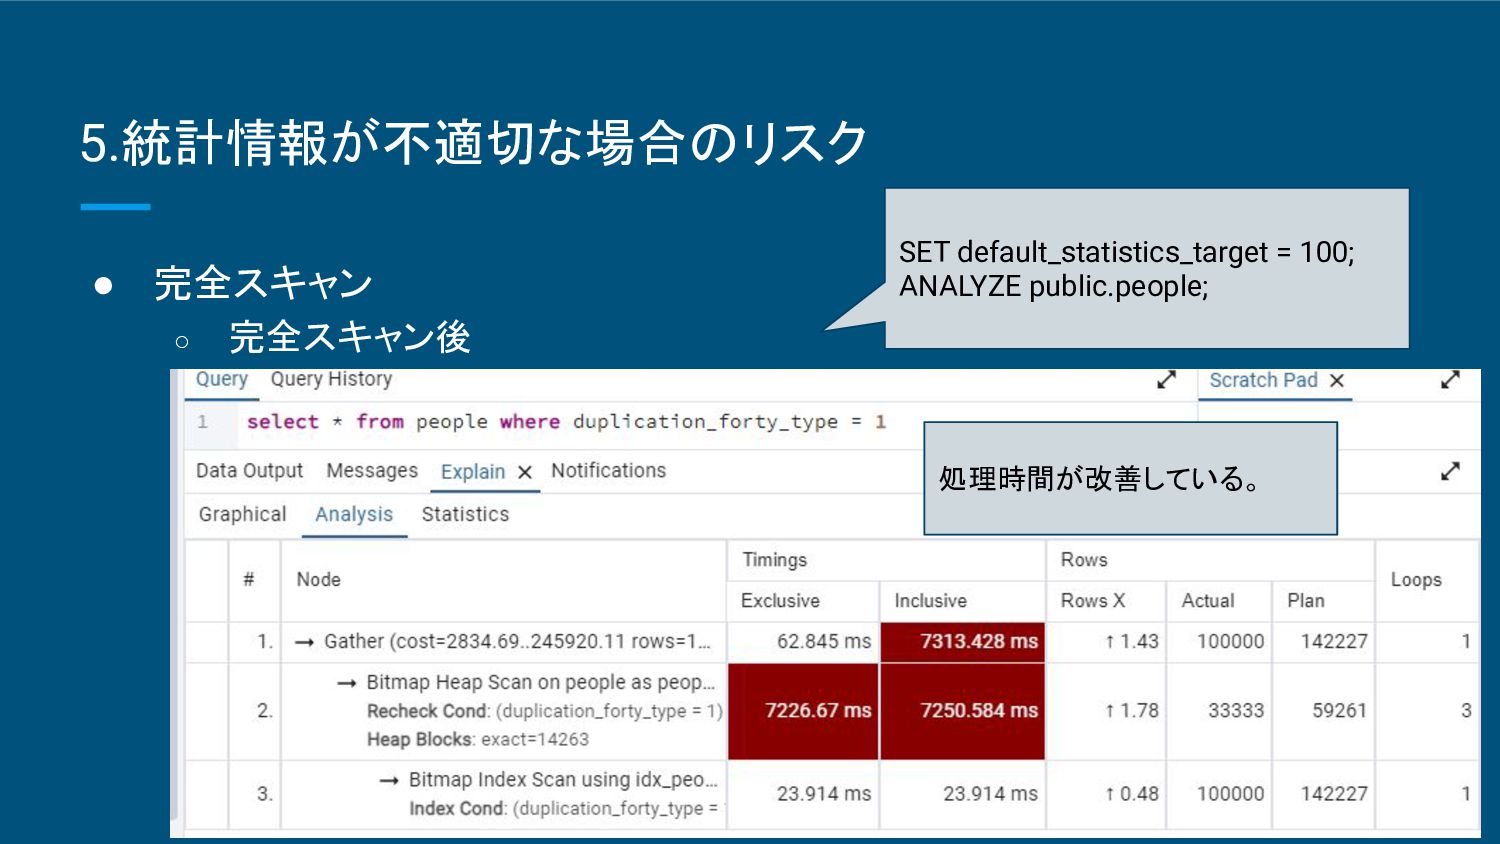
全データの12.5%更新後 ◦ 10%サンプリングし実行計画を取得 • 全データの12.5%更新後 ◦ 15%サンプリングし実行計画を取得 • 全データの12.5%更新後 ◦ 20%サンプリングし実行計画を取得 ◦ 完全スキャン ▪ 観点:更新後完全スキャンで試験実施前の処理時間に近づくか • 試験実施前(統計情報が最新) • 全データの12.5%更新し実行計画を取得 • 完全スキャンを実施し実行計画を取得
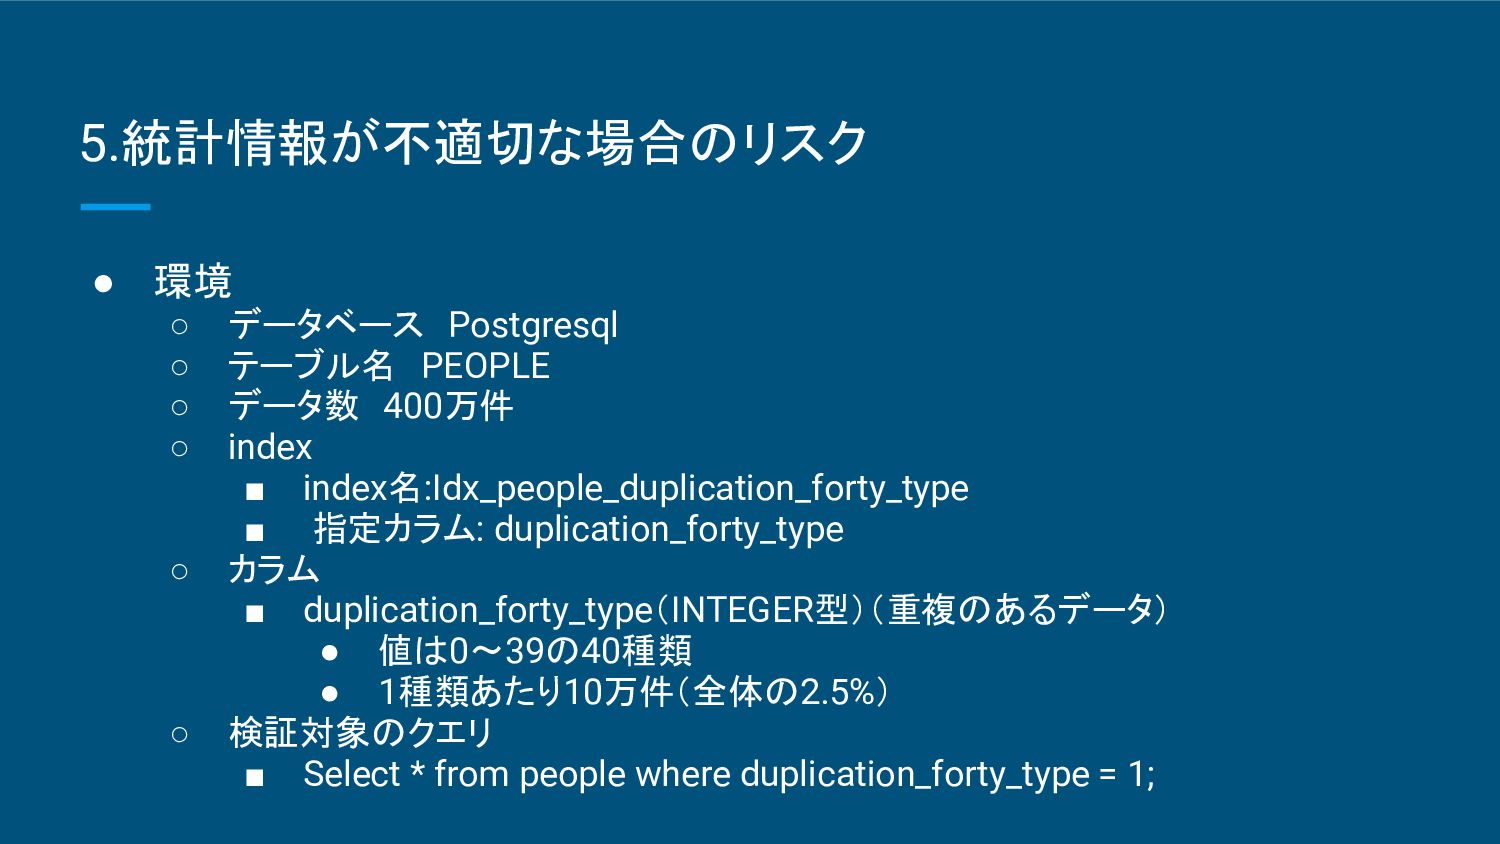
5.統計情報が不適切な場合のリスク • 環境 ◦ データベース Postgresql ◦ テーブル名 PEOPLE ◦ データ数 400万件 ◦
index ▪ index名:Idx_people_duplication_forty_type ▪ 指定カラム: duplication_forty_type ◦ カラム ▪ duplication_forty_type(INTEGER型)(重複のあるデータ) • 値は0~39の40種類 • 1種類あたり10万件(全体の2.5%) ◦ 検証対象のクエリ ▪ Select * from people where duplication_forty_type = 1;
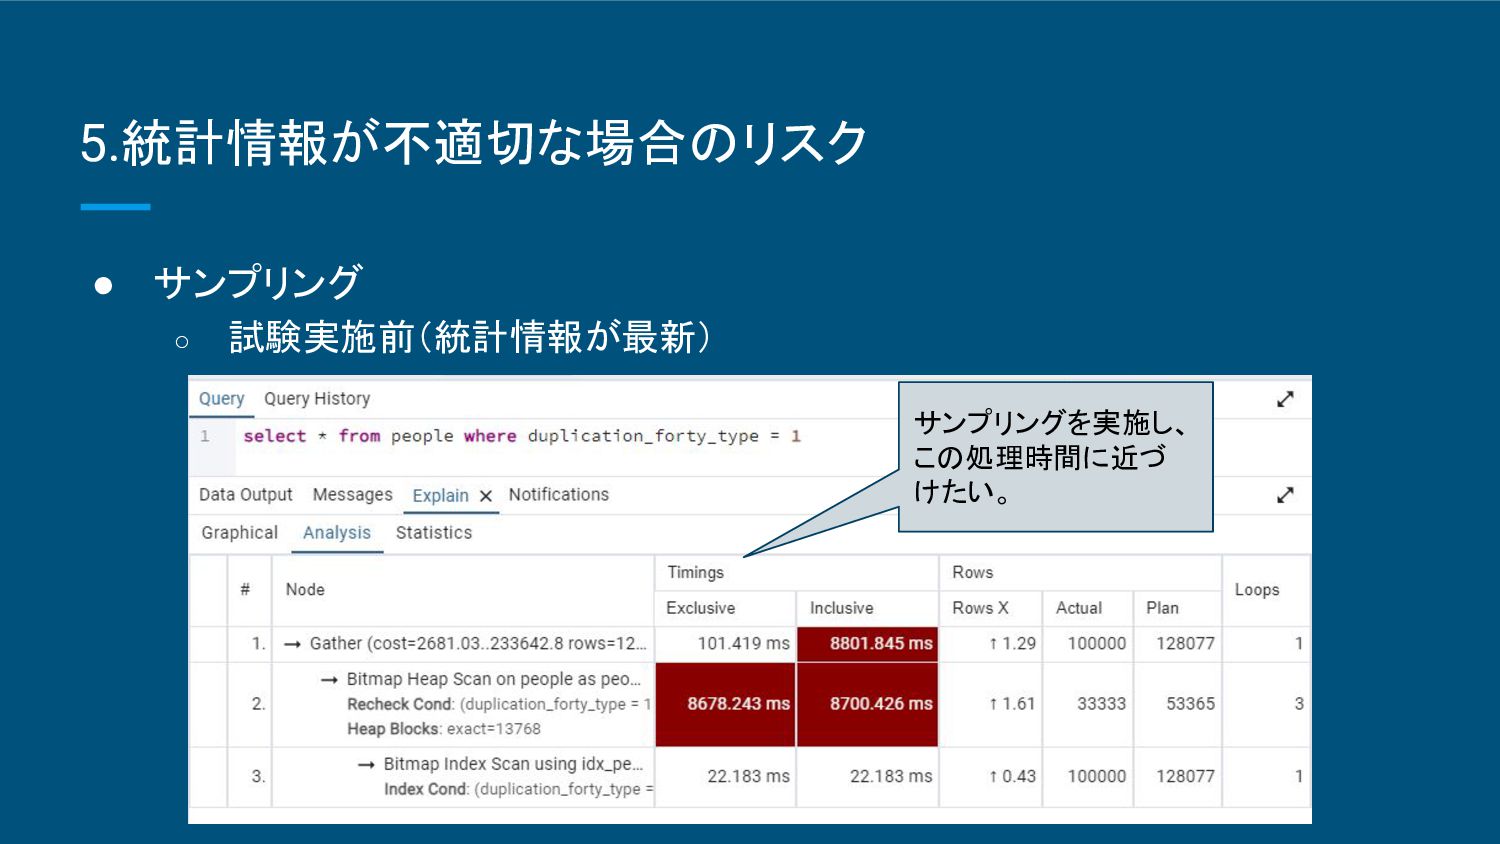
5.統計情報が不適切な場合のリスク • サンプリング ◦ 試験実施前(統計情報が最新) サンプリングを実施し、 この処理時間に近づ けたい。
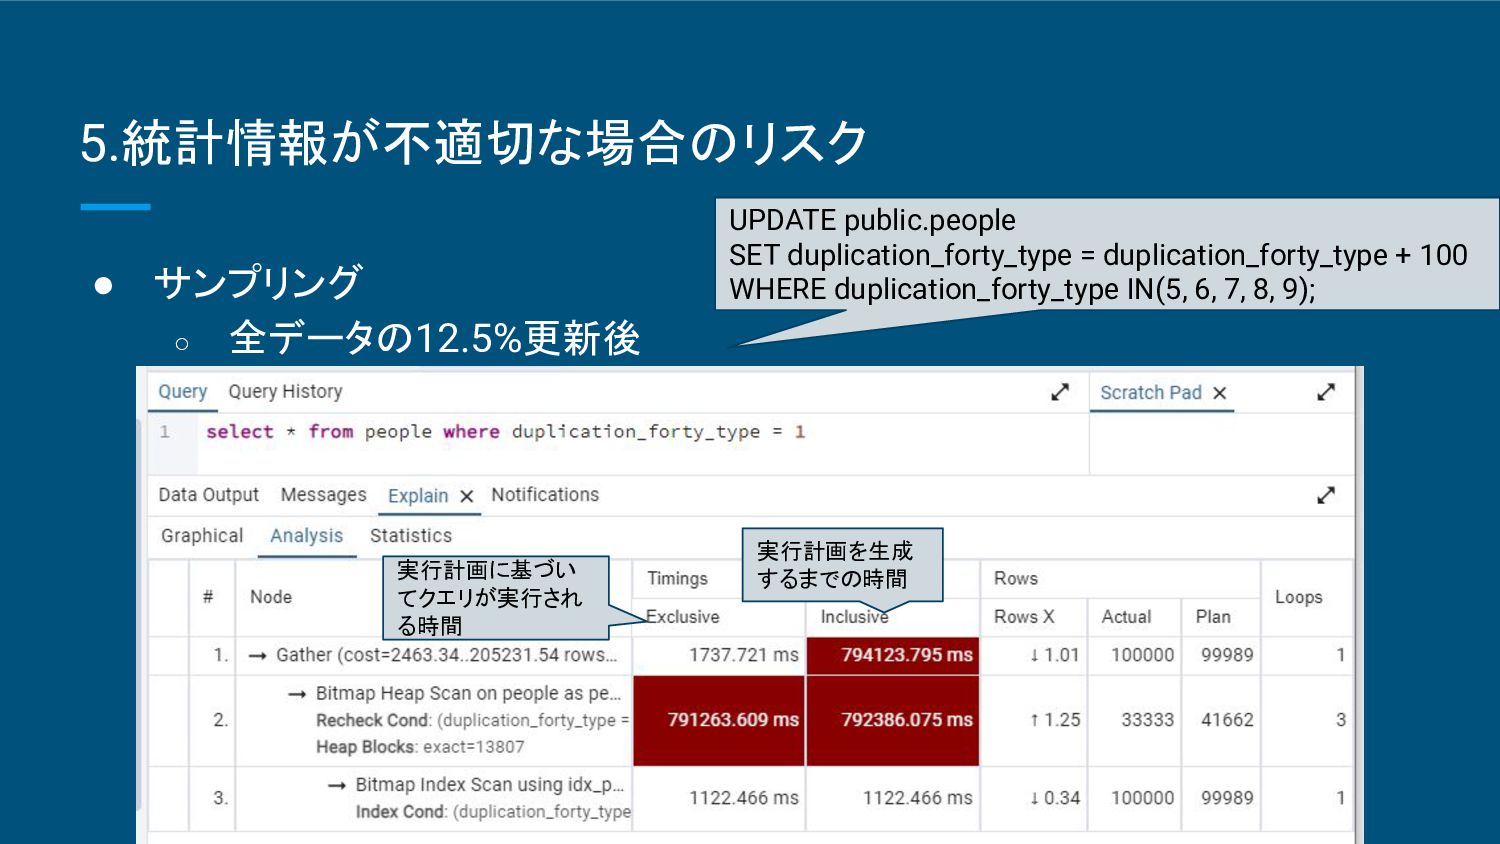
5.統計情報が不適切な場合のリスク • サンプリング ◦ 全データの12.5%更新後 UPDATE public.people SET duplication_forty_type =
duplication_forty_type + 100 WHERE duplication_forty_type IN(5, 6, 7, 8, 9); 実行計画を生成 するまでの時間 実行計画に基づい てクエリが実行され る時間
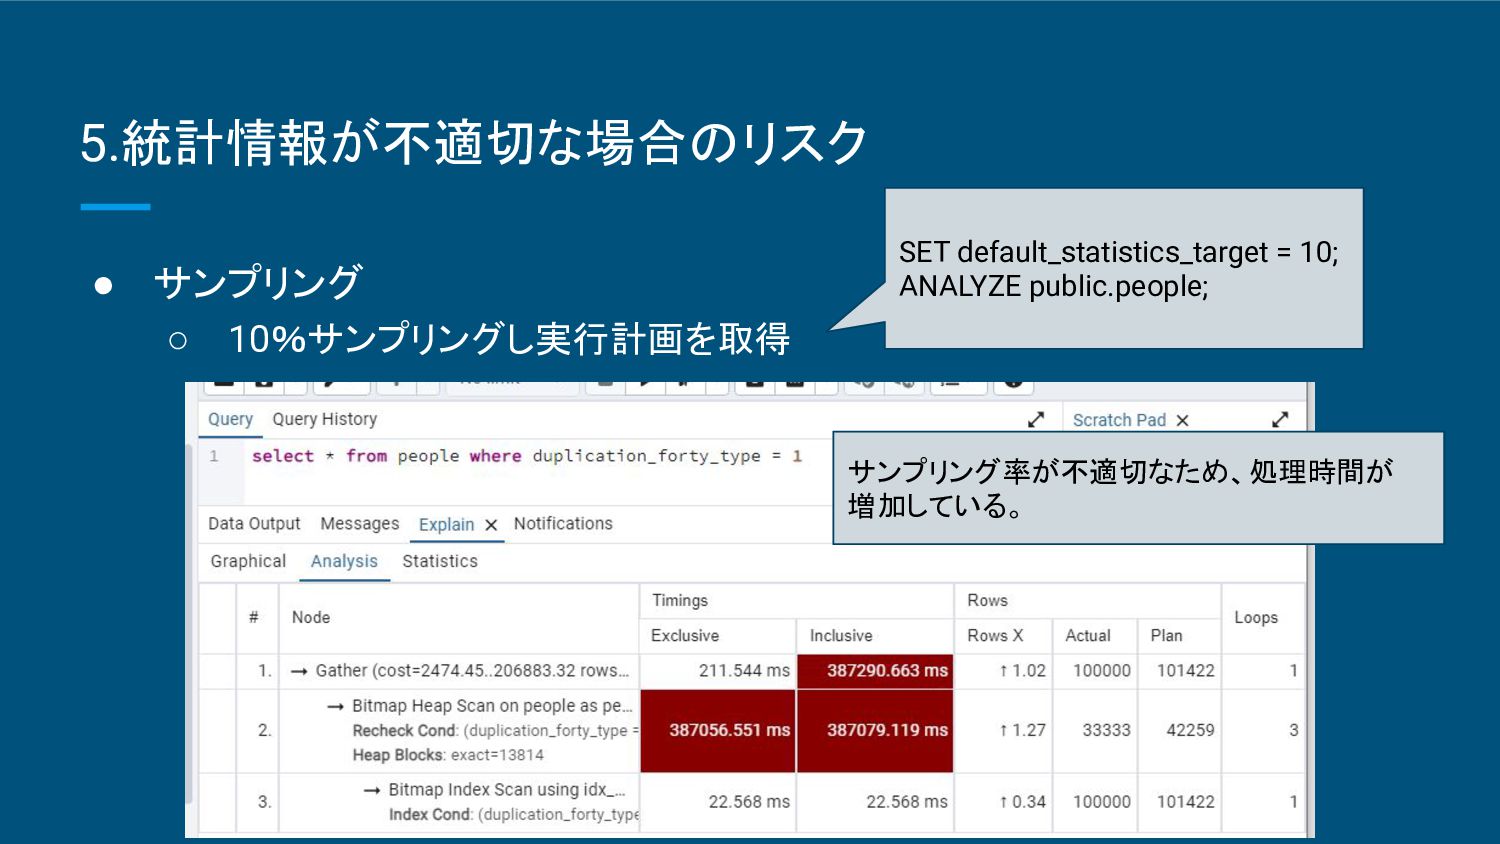
5.統計情報が不適切な場合のリスク • サンプリング ◦ 10%サンプリングし実行計画を取得 SET default_statistics_target = 10; ANALYZE
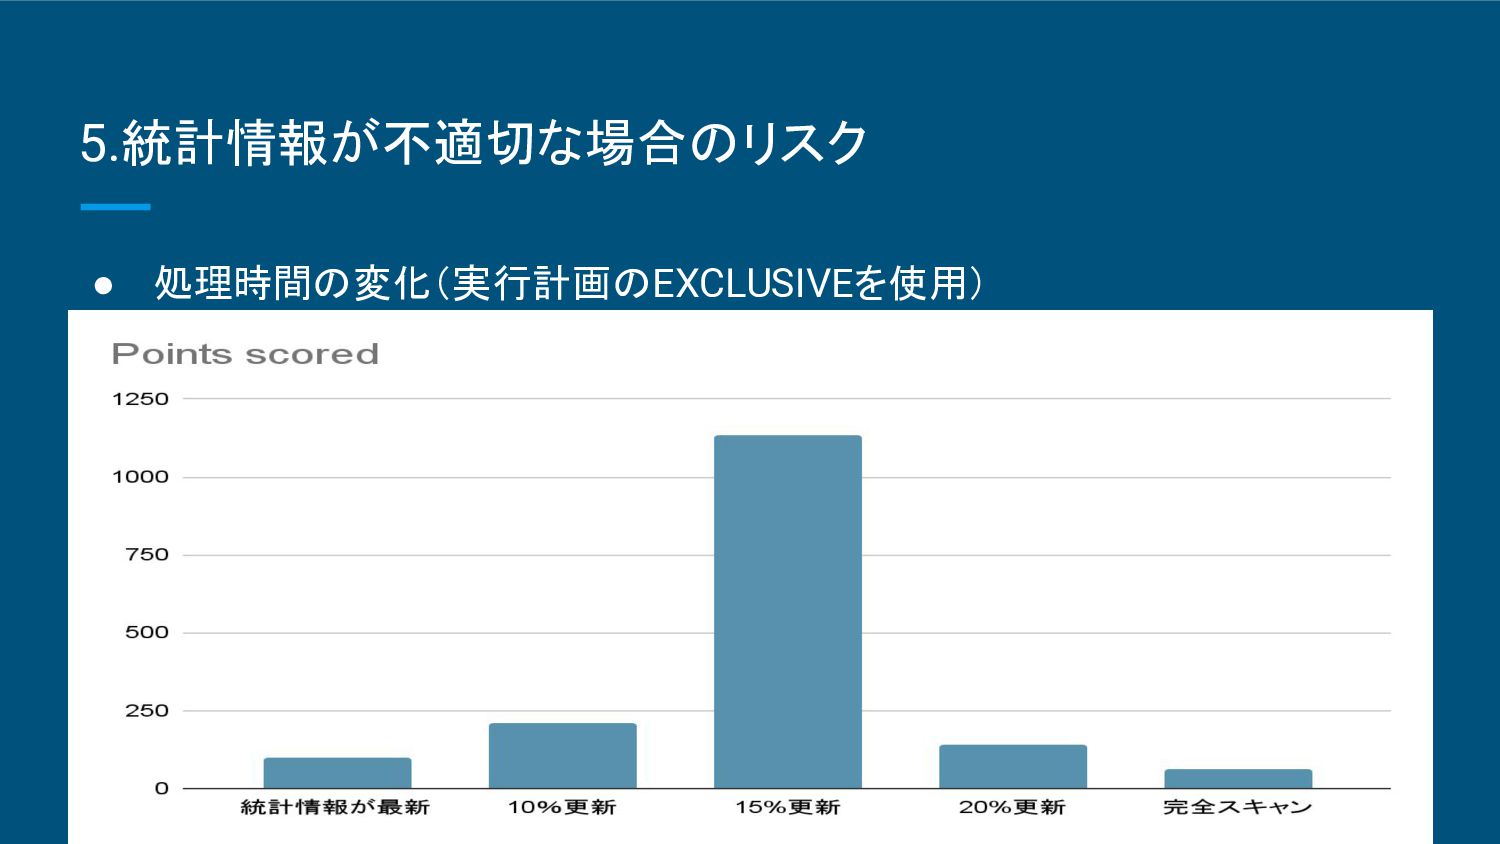
public.people; サンプリング率が不適切なため、処理時間が 増加している。
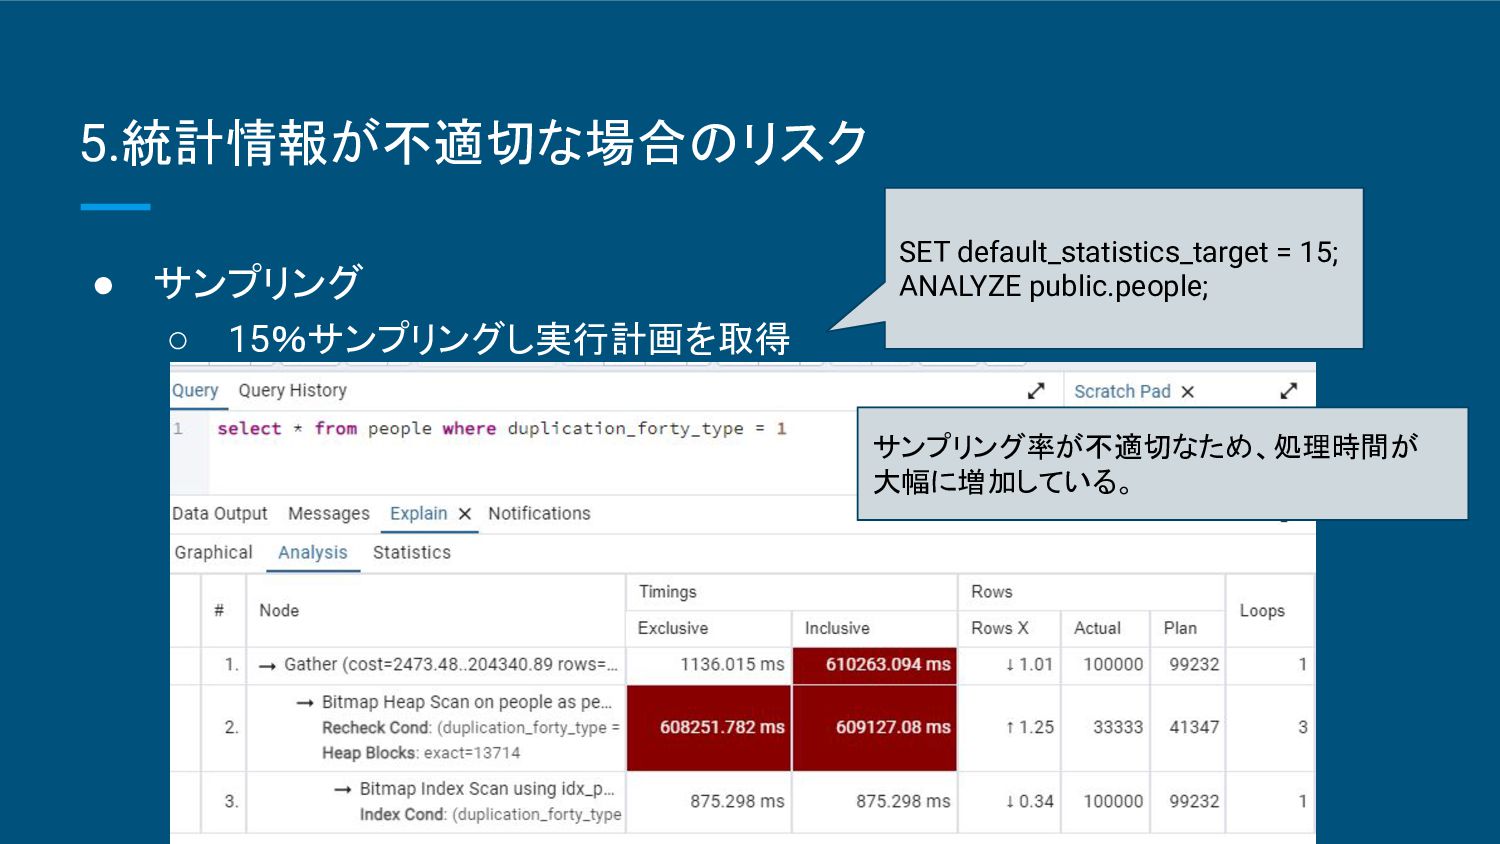
5.統計情報が不適切な場合のリスク • サンプリング ◦ 15%サンプリングし実行計画を取得 SET default_statistics_target = 15; ANALYZE
public.people; サンプリング率が不適切なため、処理時間が 大幅に増加している。
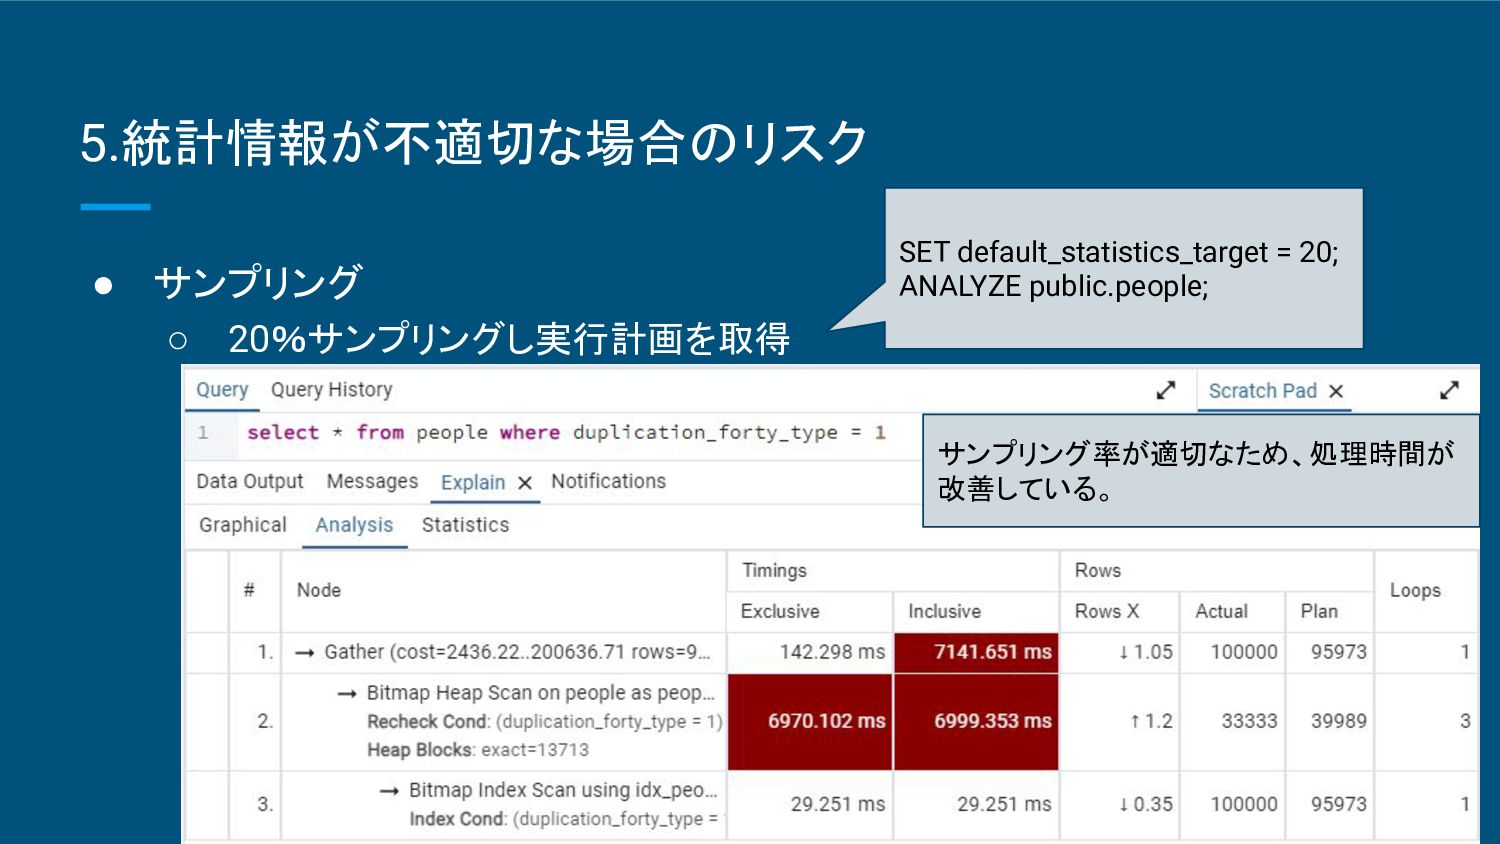
5.統計情報が不適切な場合のリスク • サンプリング ◦ 20%サンプリングし実行計画を取得 SET default_statistics_target = 20; ANALYZE
public.people; サンプリング率が適切なため、処理時間が 改善している。
5.統計情報が不適切な場合のリスク • 完全スキャン ◦ 試験実施前(統計情報が最新) 完全スキャンを実施 し、この処理時間に近 づけたい。
5.統計情報が不適切な場合のリスク • 完全スキャン ◦ 全データの12.5%更新後 UPDATE public.people SET duplication_forty_type =
duplication_forty_type + 100 WHERE duplication_forty_type IN(5, 6, 7, 8, 9);
5.統計情報が不適切な場合のリスク • 完全スキャン ◦ 完全スキャン後 SET default_statistics_target = 100; ANALYZE
public.people; 処理時間が改善している。
5.統計情報が不適切な場合のリスク • 処理時間の変化(実行計画のEXCLUSIVEを使用)
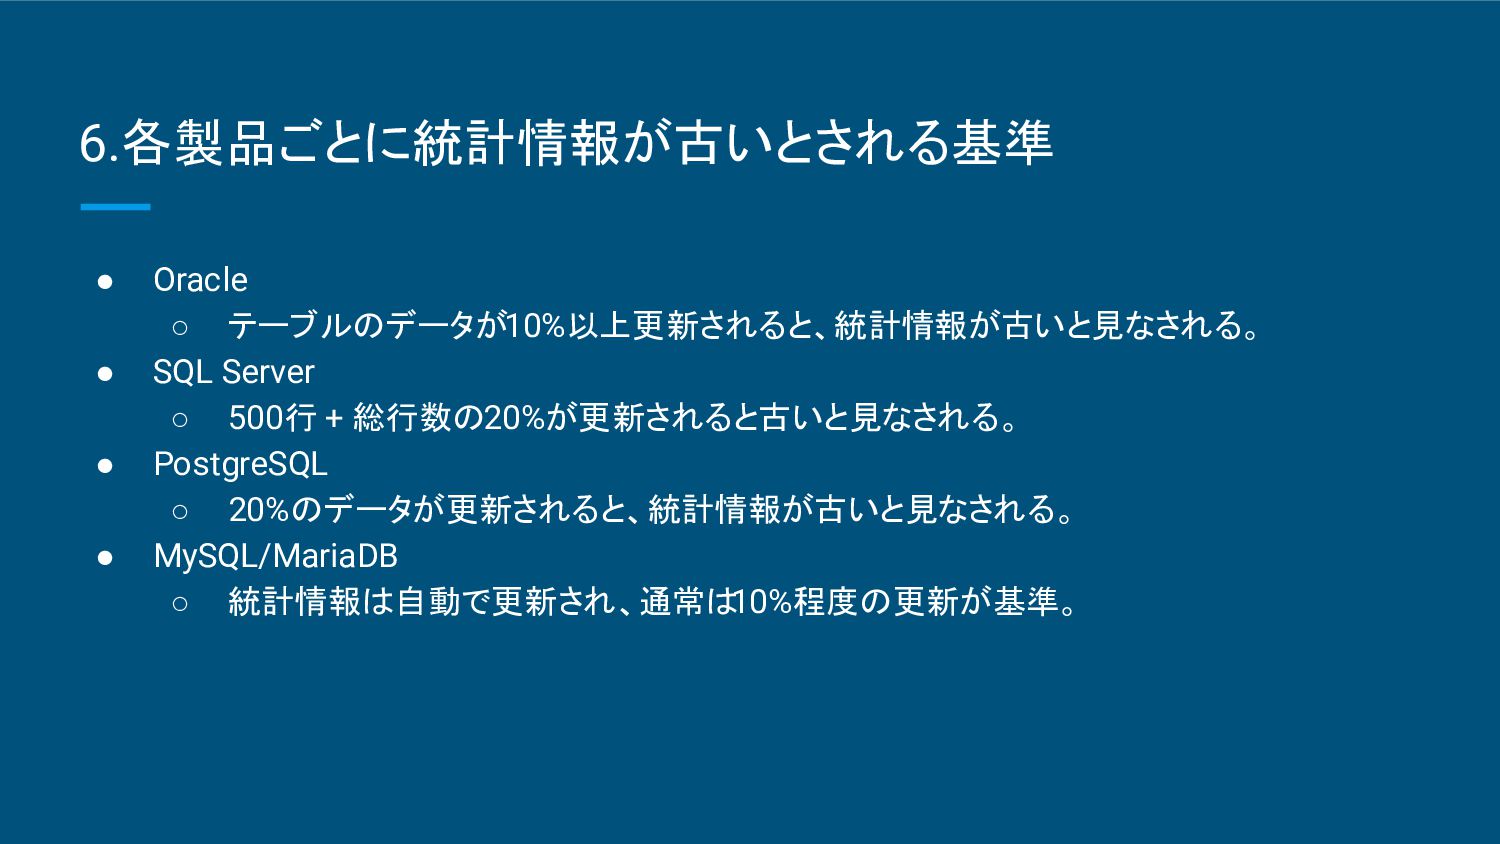
6.各製品ごとに統計情報が古いとされる基準 • Oracle ◦ テーブルのデータが10%以上更新されると、統計情報が古いと見なされる。 • SQL Server ◦ 500行
+ 総行数の20%が更新されると古いと見なされる。 • PostgreSQL ◦ 20%のデータが更新されると、統計情報が古いと見なされる。 • MySQL/MariaDB ◦ 統計情報は自動で更新され、通常は 10%程度の更新が基準。
7.まとめ • 統計情報の重要性 クエリパフォーマンス最適化には、統計情報の定期的な更新が不可欠。 • サンプリング vs 完全スキャン システム規模や要件に応じて、適切な方法を選択することが重要。


 sk8er_boi_shin
 panda728
 kmars0605
 chobishiba
 kishida
 eed3si9n
 findyinc
 tosite
 satoshi256kbyte
 n_takehata
 mixplace
 lef237
 jmmastey
 rkendrick25
 twada
 gr2m
 davidcarrasco
 nmsamuel
 jacobtomlinson
 csswizardry
 mclloyd
 jonyablonski
 sabderemane
 62gerente