Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
大規模言語モデルにおける分野横断的な知識信頼性の評価
Search
老兵は死なず、ただハックするのみ
September 10, 2026
8
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
大規模言語モデルにおける分野横断的な知識信頼性の評価
老兵は死なず、ただハックするのみ
September 10, 2026
More Decks by 老兵は死なず、ただハックするのみ
See All by 老兵は死なず、ただハックするのみ
京橋もくもく組_20261019_v00i.pdf
snoopy0806
0
7
AIエージェント公開前に 押さえておきたい法務
snoopy0806
0
30
AI_Agent_Journey_11月度_全体図.pdf
snoopy0806
0
9
AI_Agent_Journey_10月度_全体図
snoopy0806
0
56
京橋もくもく組11月回案内
snoopy0806
0
6
AI_Agent_Journey全体図
snoopy0806
0
17
人は知らないうちに行動経済学に動かされている
snoopy0806
0
32
HubSpotとLPの基本
snoopy0806
0
34
大本営参謀の情報戦記
snoopy0806
0
39
Featured
See All Featured
Accessibility Awareness
sabderemane
1
250
Heart Work Chapter 1 - Part 1
lfama
PRO
10
37k
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
370
Bioeconomy Workshop: Dr. Julius Ecuru, Opportunities for a Bioeconomy in West Africa
akademiya2063
PRO
1
410
Bash Introduction
62gerente
615
220k
[Rails World 2026] Durable orchestration on Rails: from continuation to workflow
palkan
1
750
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
260
Paper Plane (Part 1)
katiecoart
PRO
2
12k
Visualization
eitanlees
153
17k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
Google's AI Overviews - The New Search
badams
0
1.6k
What does AI have to do with Human Rights?
axbom
PRO
1
2.5k
Transcript
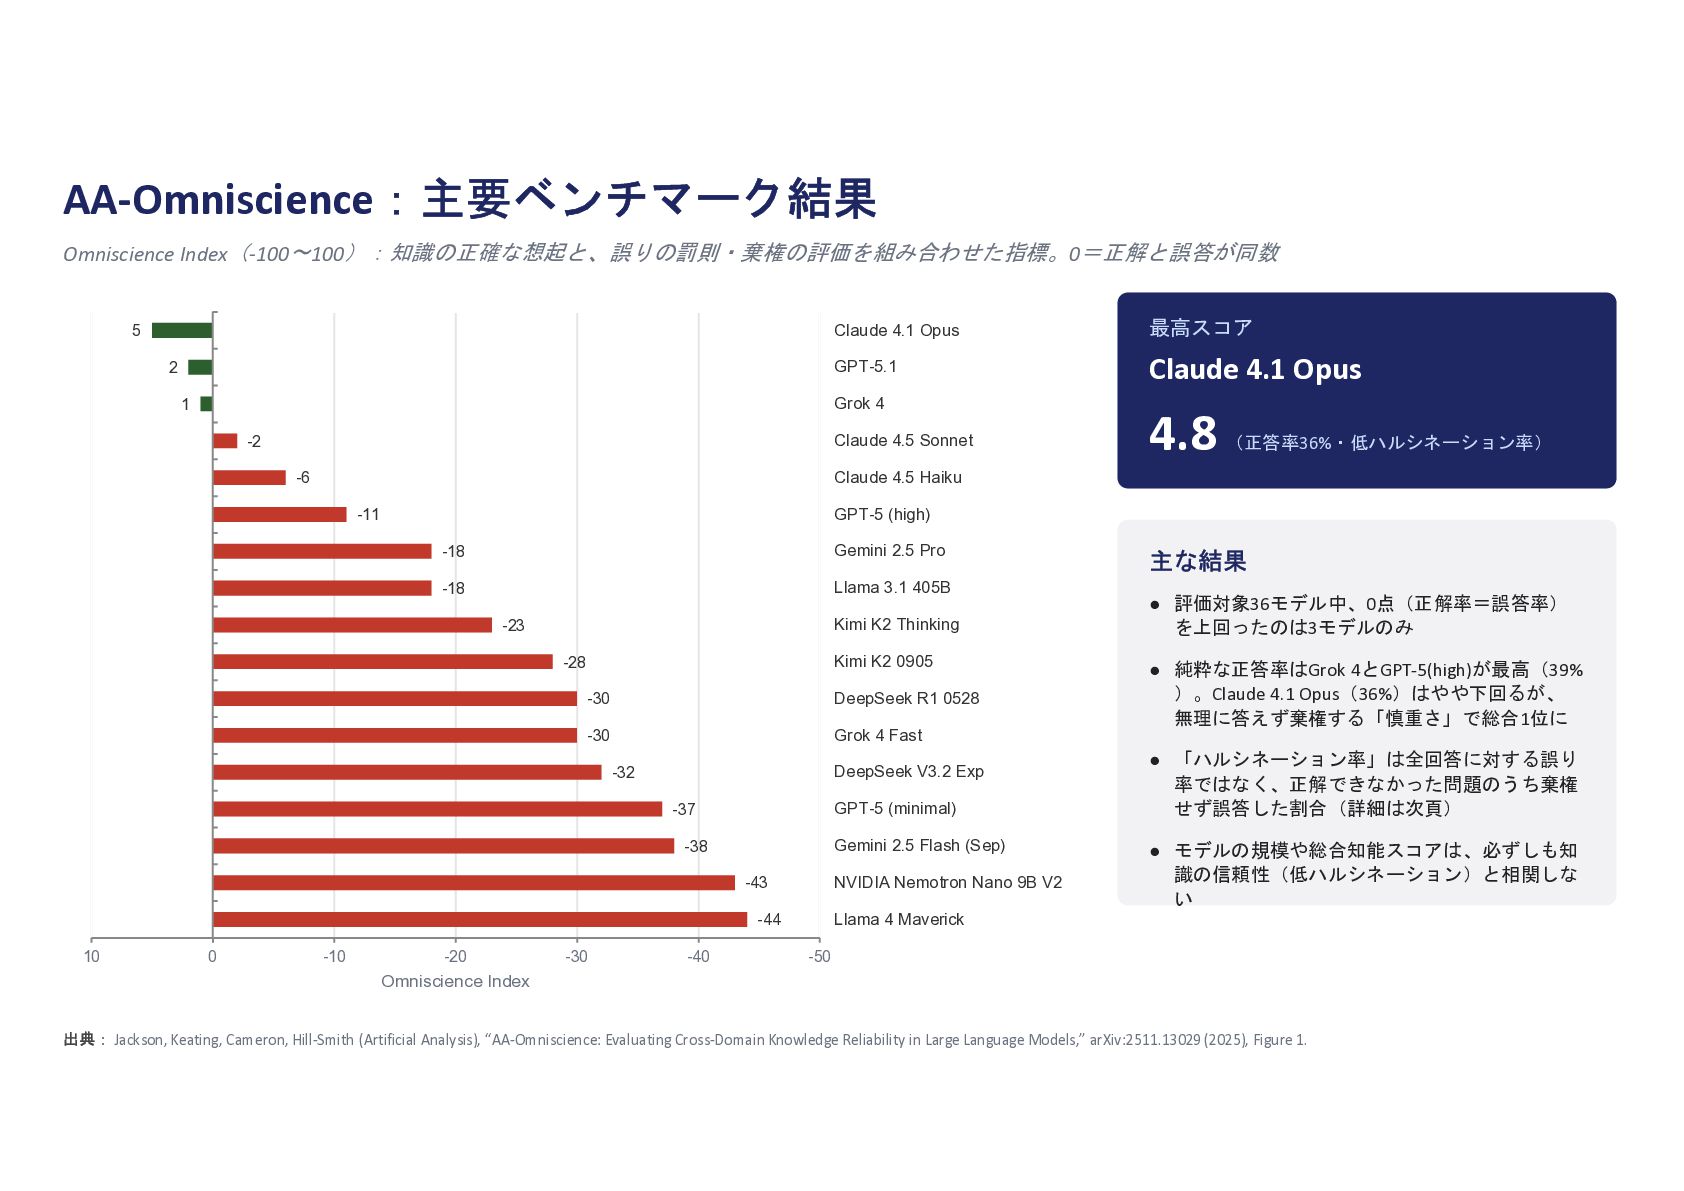
AA-Omniscience:主要ベンチマーク結果 Omniscience Index(-100〜100):知識の正確な想起と、誤りの罰則・棄権の評価を組み合わせた指標。0=正解と誤答が同数 5 2 最高スコア GPT-5.1 Claude 4.1 Opus
Grok 4 1 Claude 4.5 Sonnet -2 (正答率36%・低ハルシネーション率) GPT-5 (high) -11 -18 Gemini 2.5 Pro -18 Llama 3.1 405B Kimi K2 Thinking -23 Kimi K2 0905 -28 -30 DeepSeek R1 0528 -30 Grok 4 Fast DeepSeek V3.2 Exp -32 GPT-5 (minimal) -37 Gemini 2.5 Flash (Sep) -38 NVIDIA Nemotron Nano 9B V2 -43 -10 -20 -30 -40 主な結果 • 評価対象36モデル中、0点(正解率=誤答率) を上回ったのは3モデルのみ • 純粋な正答率はGrok 4とGPT-5(high)が最高(39% )。Claude 4.1 Opus(36%)はやや下回るが、 無理に答えず棄権する「慎重さ」で総合1位に • 「ハルシネーション率」は全回答に対する誤り 率ではなく、正解できなかった問題のうち棄権 せず誤答した割合(詳細は次頁) • モデルの規模や総合知能スコアは、必ずしも知 識の信頼性(低ハルシネーション)と相関しな い Llama 4 Maverick -44 0 4.8 Claude 4.5 Haiku -6 10 Claude 4.1 Opus -50 Omniscience Index 出典: Jackson, Keating, Cameron, Hill-Smith (Artificial Analysis), “AA-Omniscience: Evaluating Cross-Domain Knowledge Reliability in Large Language Models,” arXiv:2511.13029 (2025), Figure 1.
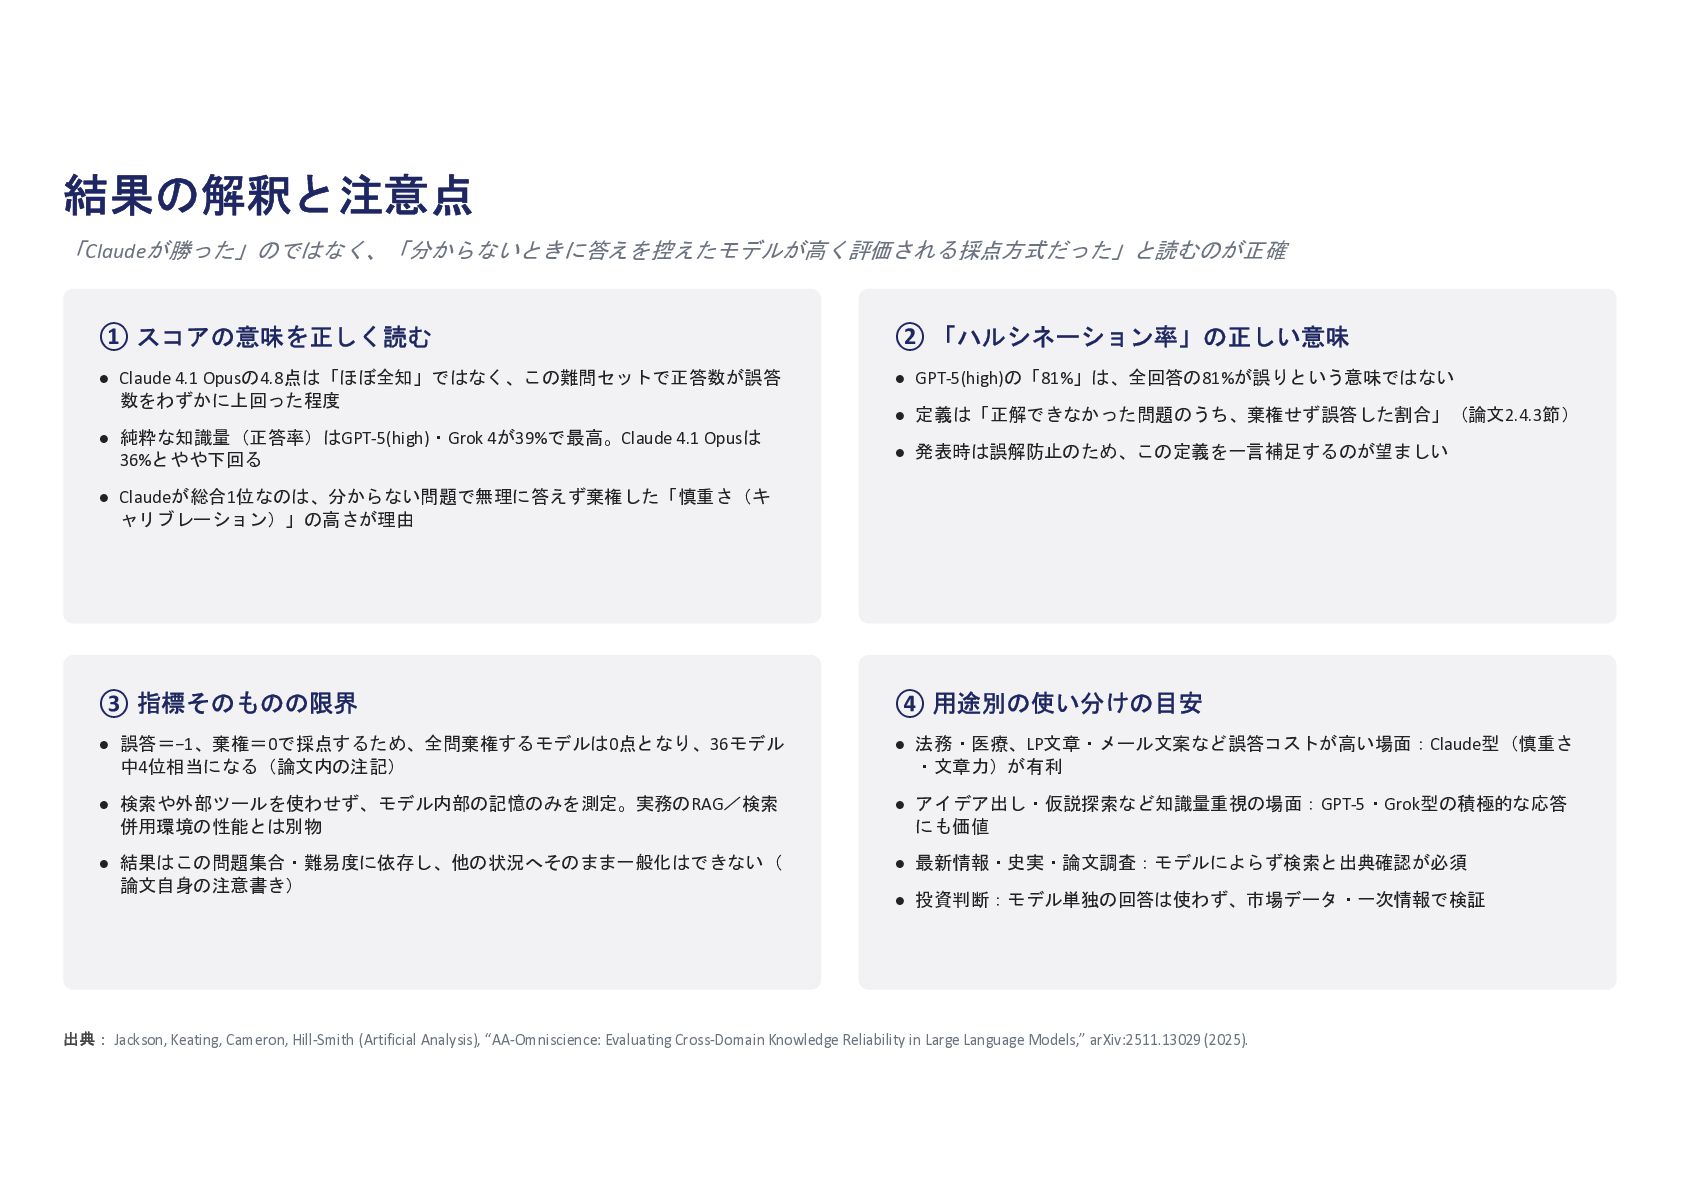
結果の解釈と注意点 「Claudeが勝った」のではなく、「分からないときに答えを控えたモデルが高く評価される採点方式だった」と読むのが正確 ① スコアの意味を正しく読む ② 「ハルシネーション率」の正しい意味 • Claude 4.1 Opusの4.8点は「ほぼ全知」ではなく、この難問セットで正答数が誤答
数をわずかに上回った程度 • GPT-5(high)の「81%」は、全回答の81%が誤りという意味ではない • 純粋な知識量(正答率)はGPT-5(high)・Grok 4が39%で最高。Claude 4.1 Opusは 36%とやや下回る • 定義は「正解できなかった問題のうち、棄権せず誤答した割合」(論文2.4.3節) • 発表時は誤解防止のため、この定義を一言補足するのが望ましい • Claudeが総合1位なのは、分からない問題で無理に答えず棄権した「慎重さ(キ ャリブレーション)」の高さが理由 ③ 指標そのものの限界 ④ 用途別の使い分けの目安 • 誤答=−1、棄権=0で採点するため、全問棄権するモデルは0点となり、36モデル 中4位相当になる(論文内の注記) • 法務・医療、LP文章・メール文案など誤答コストが高い場面:Claude型(慎重さ ・文章力)が有利 • 検索や外部ツールを使わせず、モデル内部の記憶のみを測定。実務のRAG/検索 併用環境の性能とは別物 • アイデア出し・仮説探索など知識量重視の場面:GPT-5・Grok型の積極的な応答 にも価値 • 結果はこの問題集合・難易度に依存し、他の状況へそのまま一般化はできない( 論文自身の注意書き) • 最新情報・史実・論文調査:モデルによらず検索と出典確認が必須 • 投資判断:モデル単独の回答は使わず、市場データ・一次情報で検証 出典: Jackson, Keating, Cameron, Hill-Smith (Artificial Analysis), “AA-Omniscience: Evaluating Cross-Domain Knowledge Reliability in Large Language Models,” arXiv:2511.13029 (2025).


 snoopy0806
 sabderemane
 lfama
 greggifford
 akademiya2063
 62gerente
 palkan
 davidcarrasco
 katiecoart
 eitanlees
 reverentgeek
 badams
 axbom