Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Volcamp_2022_-_Testez_vos_data_pipelines.pdf

 Volcamp_2022_-_Testez_vos_data_pipelines.pdf

Avatar for Stéphanie Baltus-Bergamo

Stéphanie Baltus-Bergamo

October 18, 2022

Other Decks in Programming

Transcript

  1. Airflow, idempotence, rejouabilité Population vs Pollution, un lien ? Pourquoi

    la vie, pourquoi les tests Pourquoi ?! Quelques concepts clé Présentation du cas 01 02 03 Table of contents
  2. Stéphanie B 13+ années dans la data Consulting, Leboncoin, Algolia,

    … Baigne dans le “big” data depuis 2013 Kanop depuis Juillet 2022 Accroc aux tests et au TDD stéphanie-baltus steph_baltus
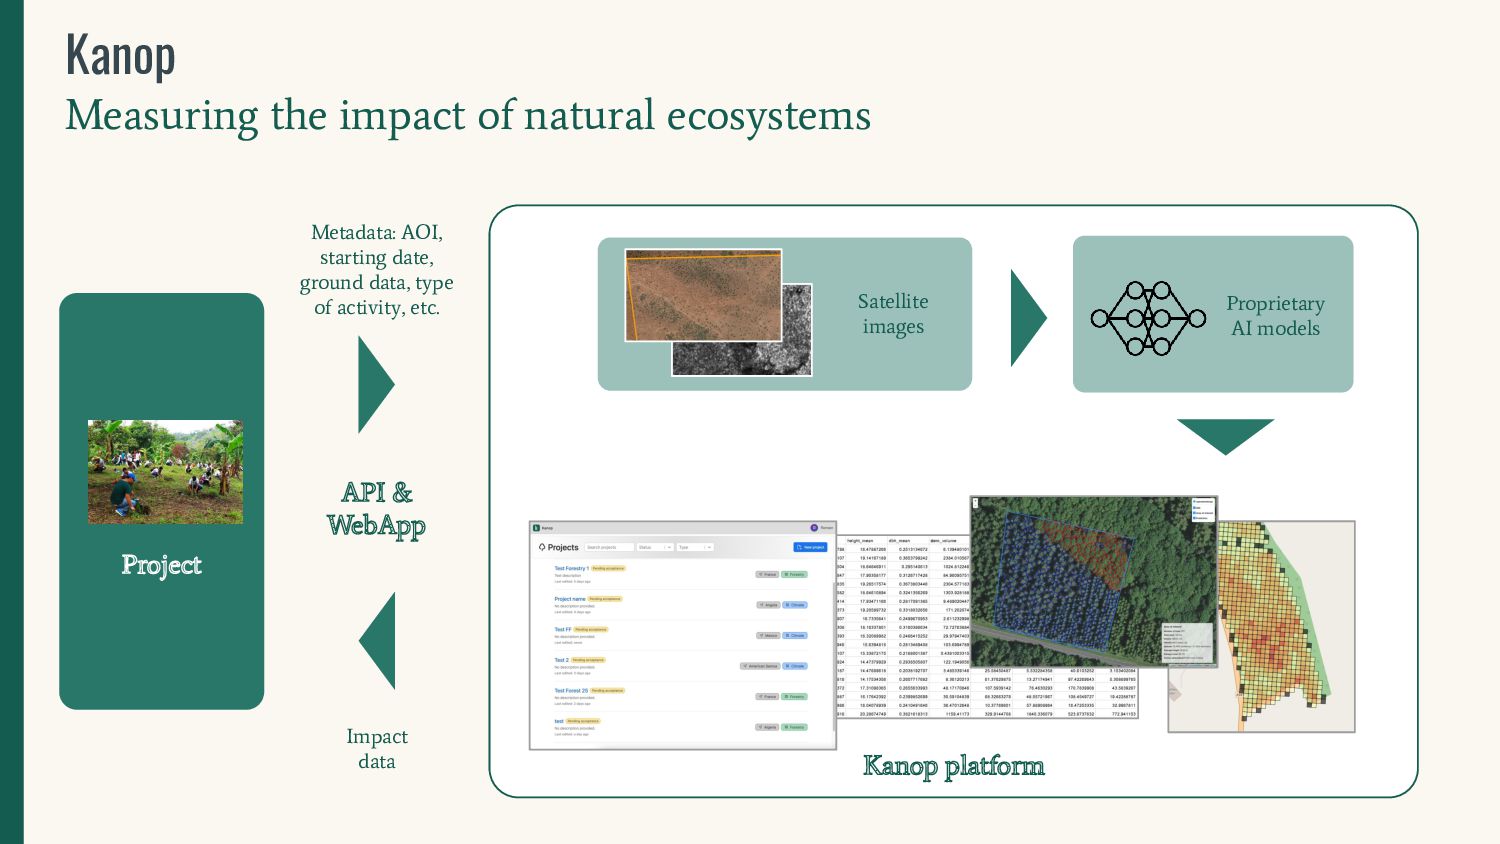
  3. Measuring the impact of natural ecosystems Kanop Satellite images Proprietary

    AI models Project Metadata: AOI, starting date, ground data, type of activity, etc. Impact data API & WebApp Kanop platform
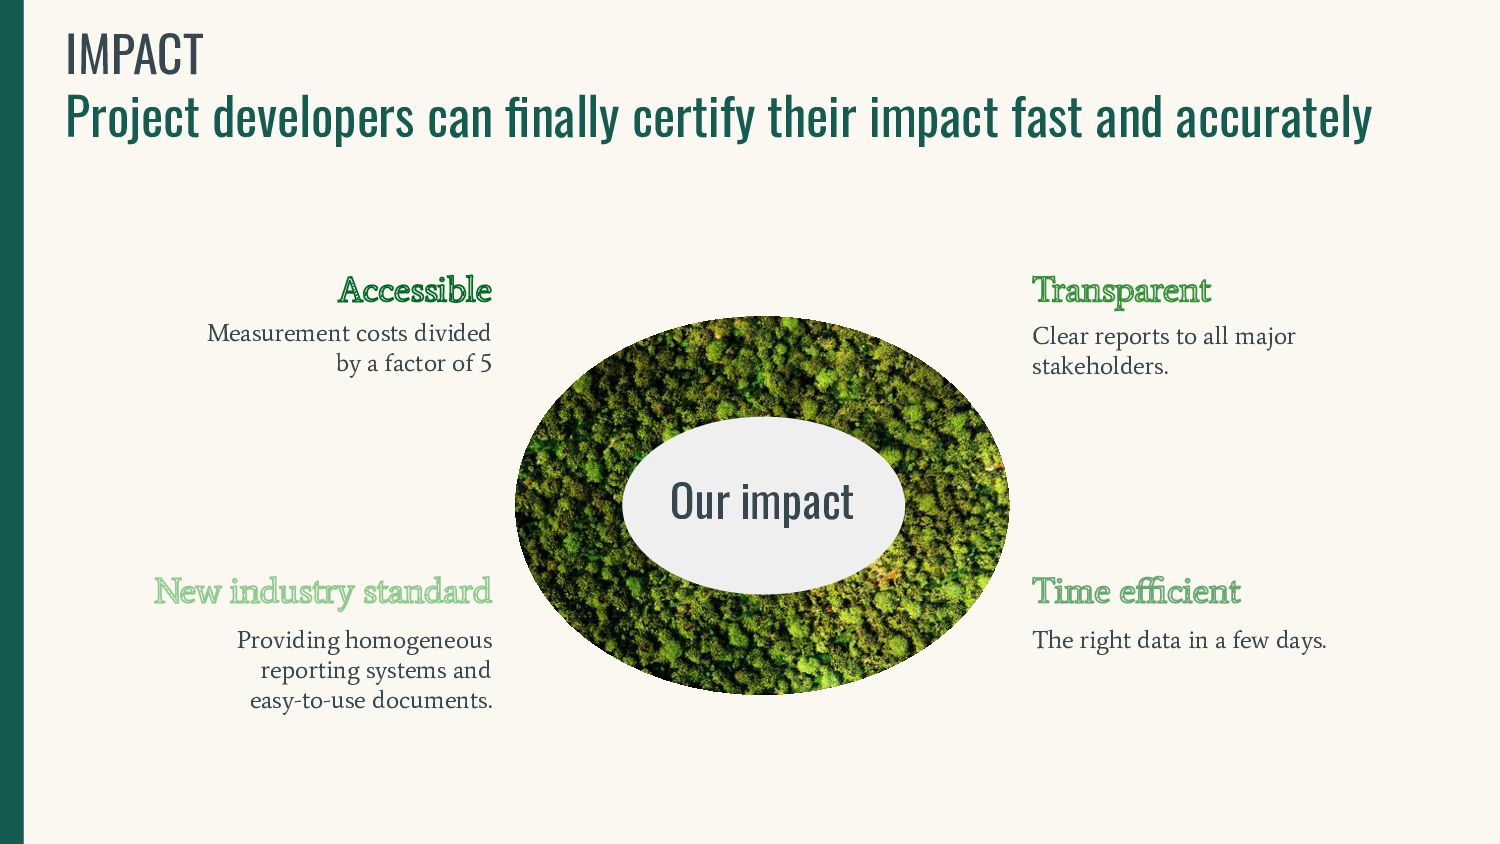
  4. Clear reports to all major stakeholders. Transparent The right data

    in a few days. Time efficient Measurement costs divided by a factor of 5 Accessible Providing homogeneous reporting systems and easy-to-use documents. New industry standard Our impact IMPACT Project developers can finally certify their impact fast and accurately
  5. Pourquoi on est là ? (Pour tester des data pipelines

    🤭) • Le test fait peu partie de la culture data eng / scientist • De prime abord, la tâche n’est pas triviale • On a tous•tes eu des soucis de qualité de la donnée • On n’est pas maître•sse de la donnée qu’on reçoit
  6. Et pourquoi on teste ? • Augmenter la qualité du

    code • Faciliter le refactoring
  7. Et pourquoi on teste ? • Augmenter la qualité du

    code • Faciliter le refactoring • Améliorer le design du code
  8. Et pourquoi on teste ? • Augmenter la qualité du

    code • Faciliter le refactoring • Améliorer le design du code • Encourager la réutilisation de composants
  9. Certes, mais y’a plein de solutions • Découpage de code

    -> tests unitaires + lib (moto, hypothesis,...) • Tests d’intégration -> testscontainers, minio • Tests de qualité -> greatexpectations, deequ
  10. Mais qu’est-ce qu’on teste d’abord ? • Les DAGs: ajoutés

    au DagBag ? Valides ? • Les helpers: font-ils ce qu’on attends ? • Les fonctions / classes de transformation de données • Les Operators customs • Quand les choses ne se passent pas comme prévu
  11. On ne teste pas • Airflow : si un DAG

    est OK, pas besoin de tester l’orchestration • Le bon fonctionnement des dépendances
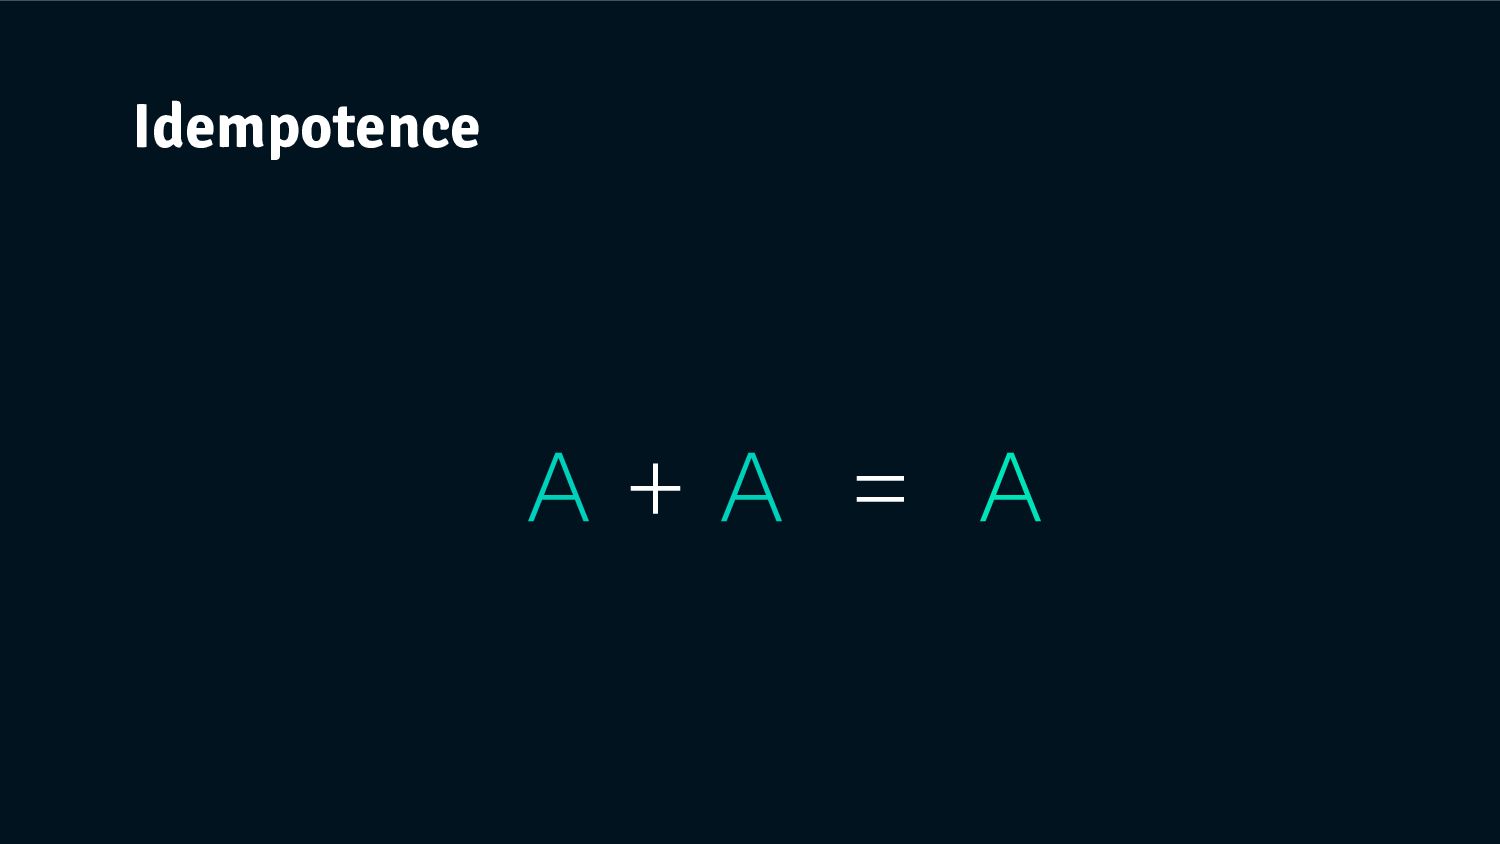
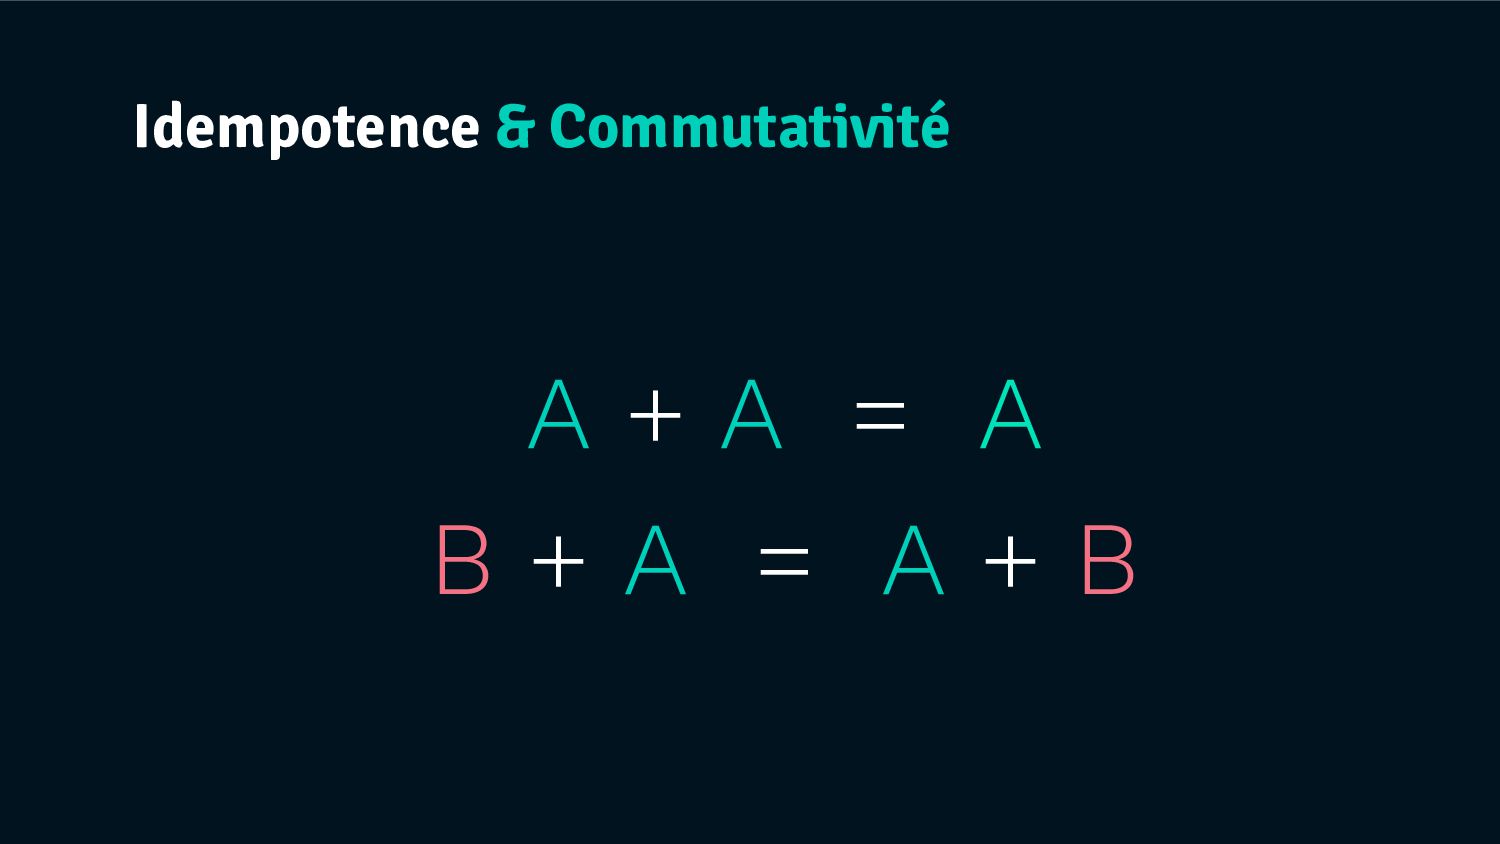
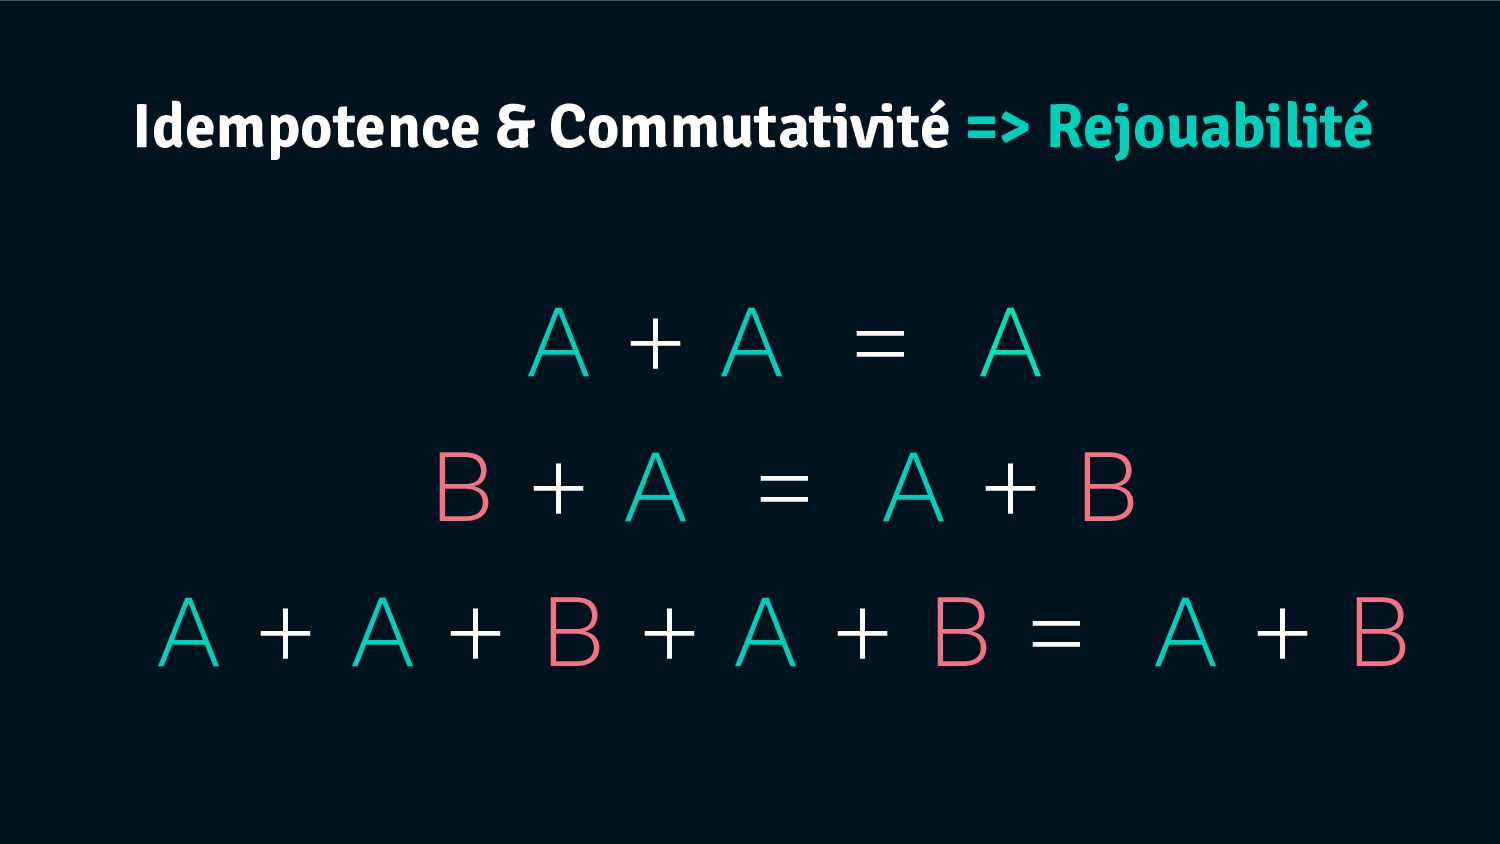
  12. Idempotence & Commutativité => Rejouabilité A + A = A

    B + A = A + B A + A + B + A + B = A + B
  13. Rejouabilité = respect des ressources • Capacité à ne rejouer

    que ce qui est nécessaire ◦ Rate limiting ◦ Call API payants ◦ Coût d’egress par les fournisseurs cloud
  14. Cas pratique 03 De la donnée pour analyser la relation

    entre densité de population & pollution en france
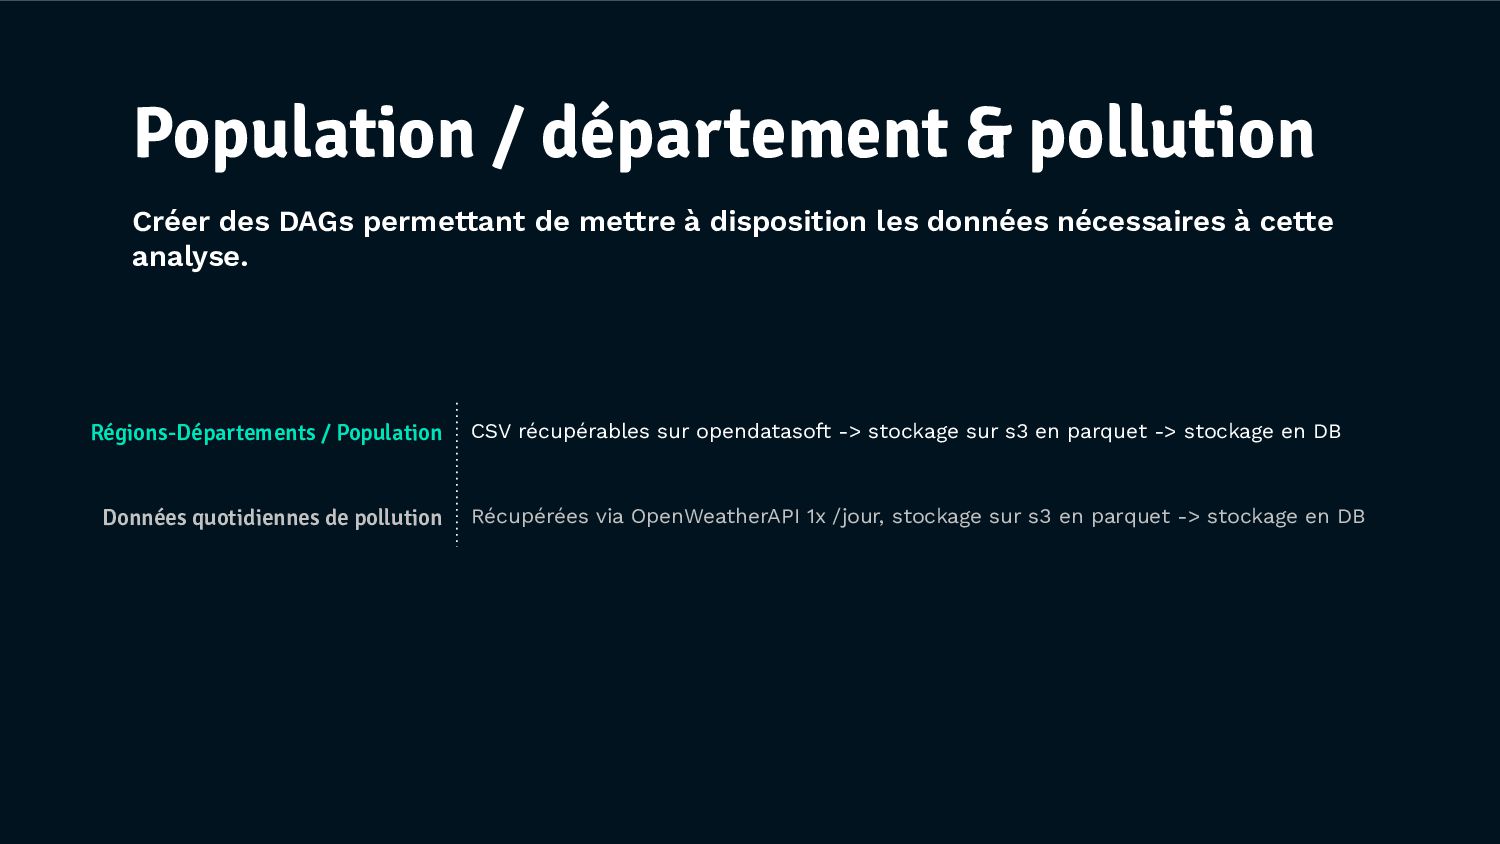
  15. Créer des DAGs permettant de mettre à disposition les données

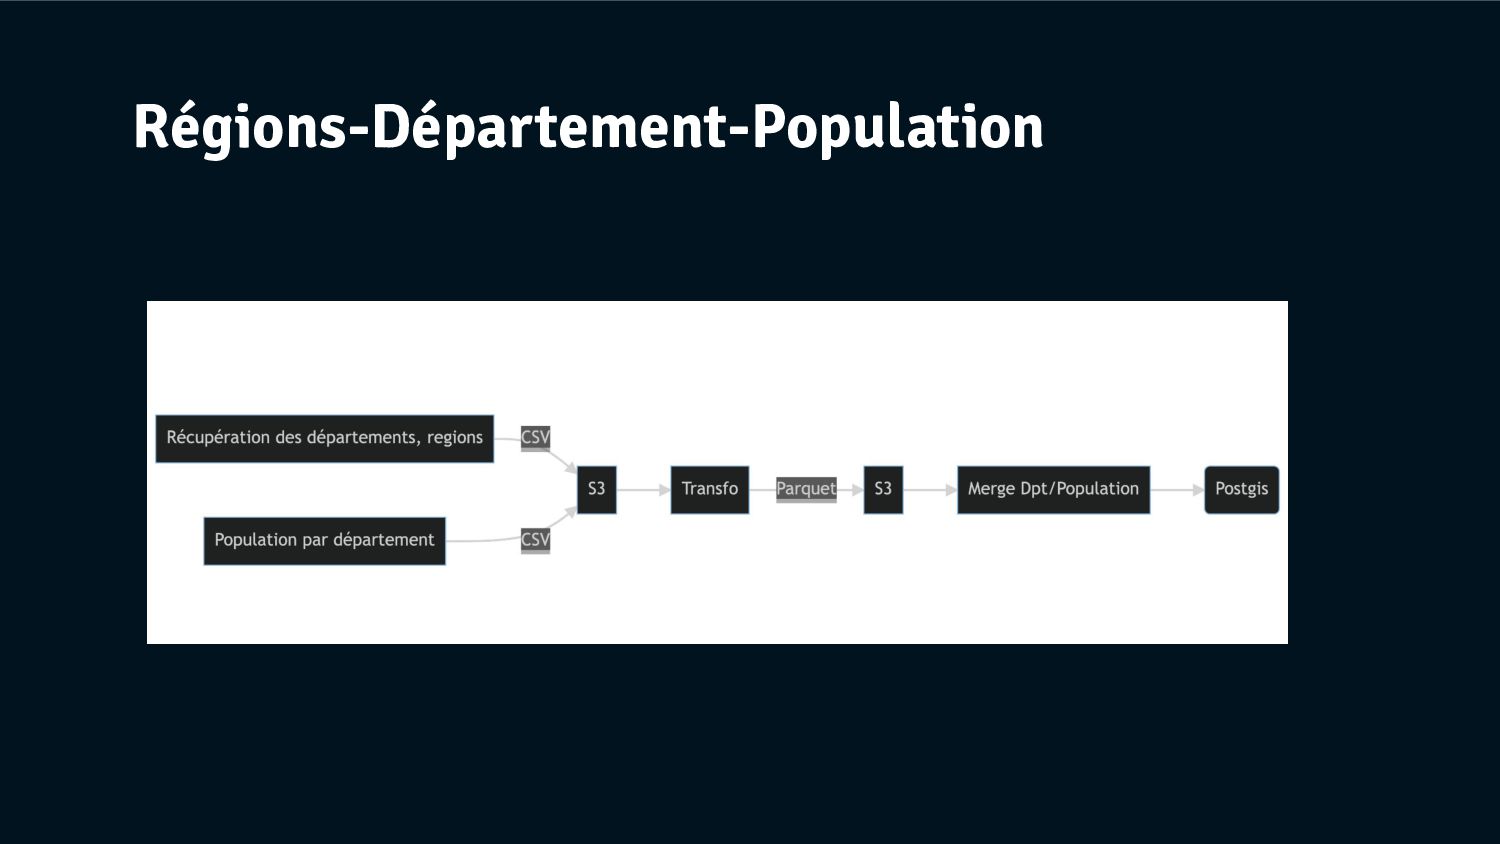
    nécessaires à cette analyse. Population / département & pollution Régions-Départements / Population CSV récupérables sur opendatasoft -> stockage sur s3 en parquet -> stockage en DB Données quotidiennes de pollution Récupérées via OpenWeatherAPI 1x /jour, stockage sur s3 en parquet -> stockage en DB
  16. A votre dispo - Le DAG déjà créé, avec toutes

    les étapes ETL - Toutes les lib nécessaires: - Pytest, pytest-mock, requests-mock - Testcontainers - Hypothesis - Quelques dataset de tests - Pensez aux fixtures !
  17. Step by step - HTTP to S3 - Department Processor

    - Population Processor - Department and Population Merger
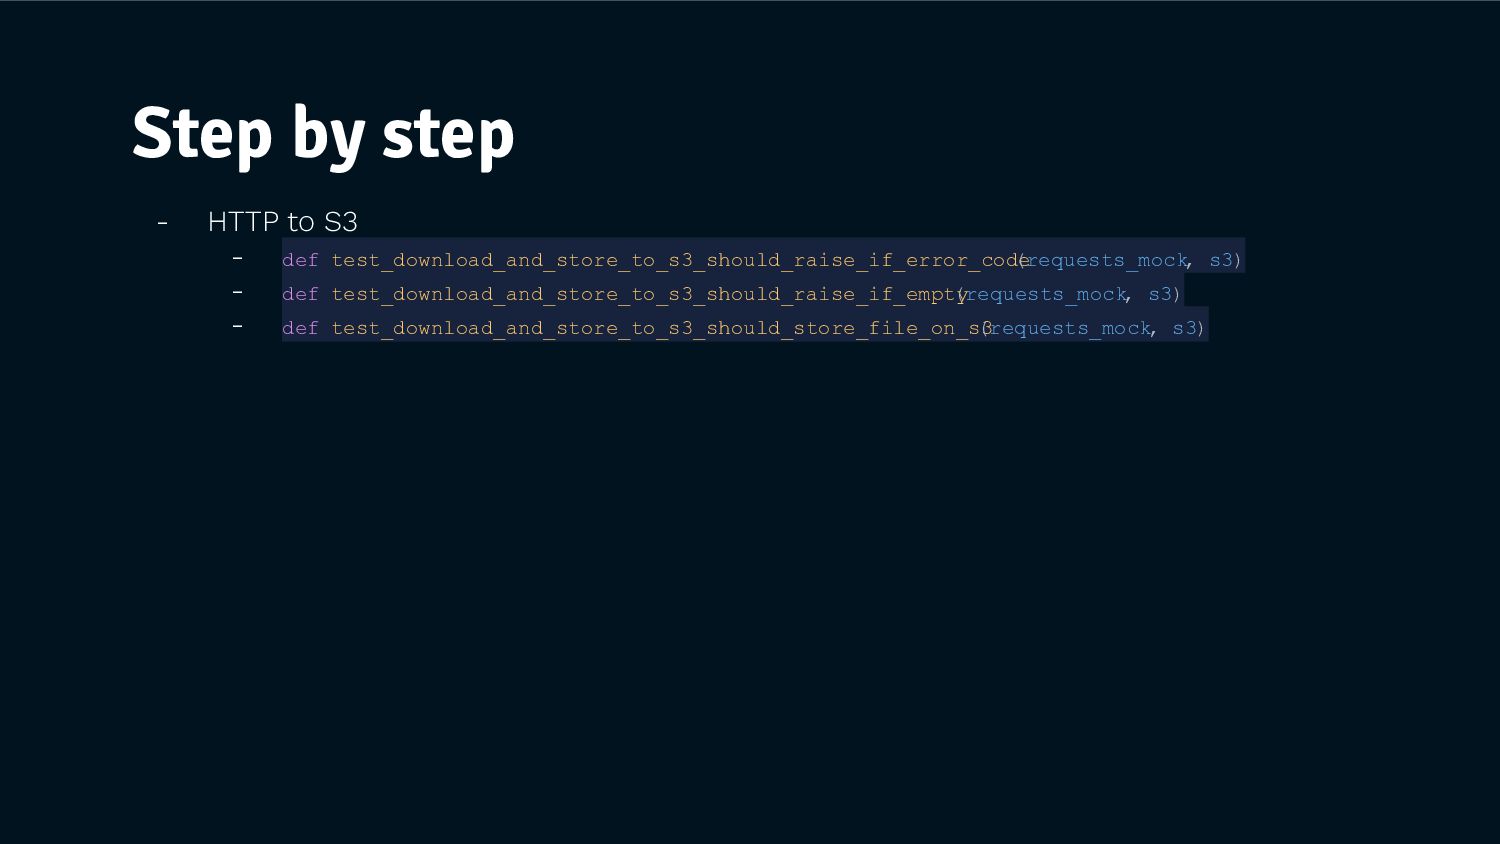
  18. Step by step - HTTP to S3 - def test_download_and_store_to_s3_should_raise_if_error_code

    (requests_mock, s3) - def test_download_and_store_to_s3_should_raise_if_empty (requests_mock, s3) - def test_download_and_store_to_s3_should_store_file_on_s3 (requests_mock, s3)
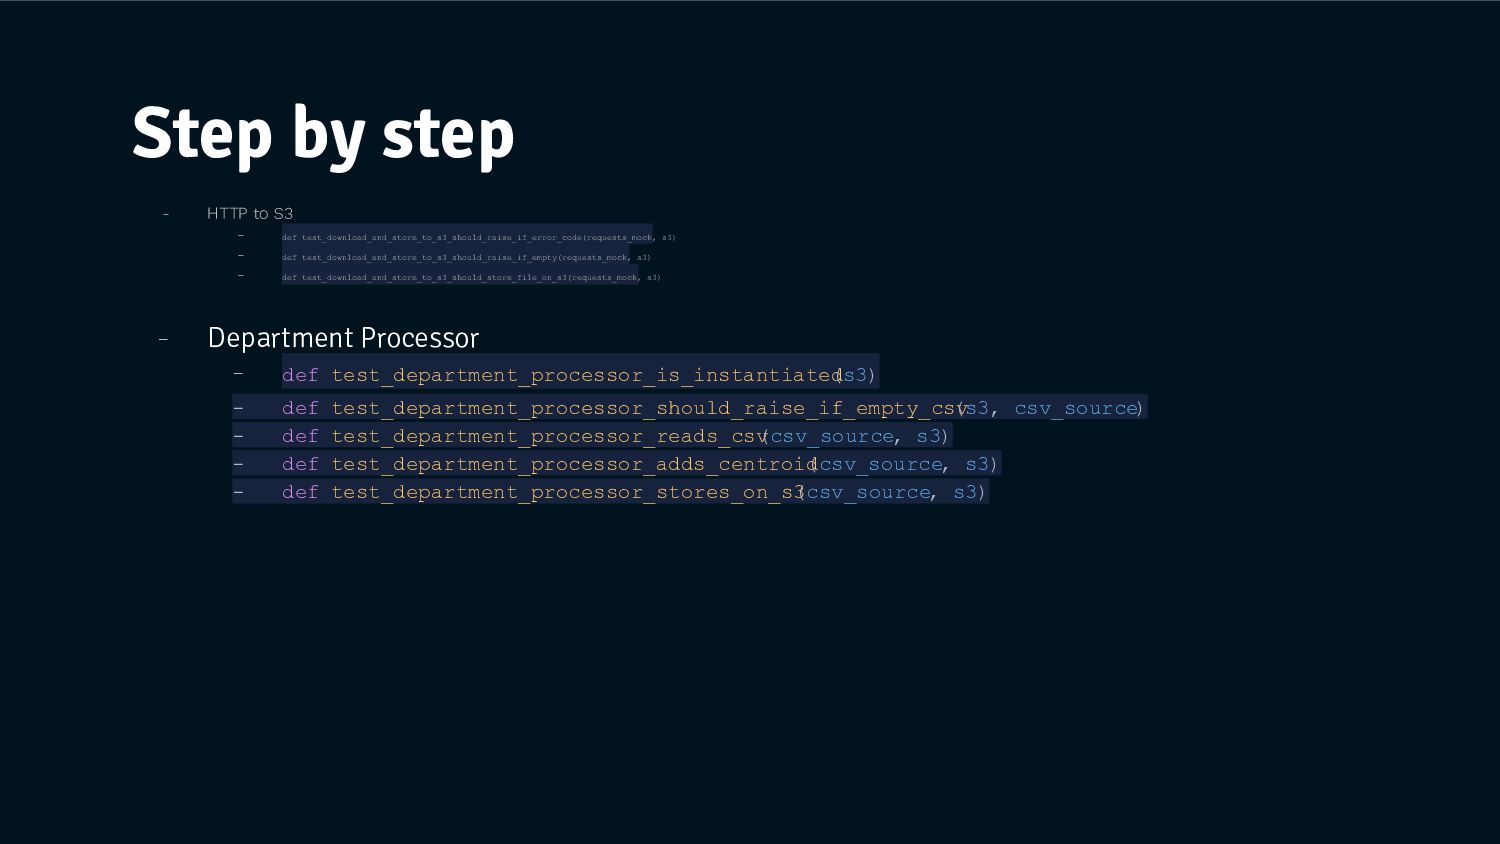
  19. Step by step - HTTP to S3 - def test_download_and_store_to_s3_should_raise_if_error_code(requests_mock,

    s3) - def test_download_and_store_to_s3_should_raise_if_empty(requests_mock, s3) - def test_download_and_store_to_s3_should_store_file_on_s3(requests_mock, s3) - Department Processor - def test_department_processor_is_instantiated (s3) - def test_department_processor_should_raise_if_empty_csv (s3, csv_source) - def test_department_processor_reads_csv (csv_source, s3) - def test_department_processor_adds_centroid (csv_source, s3) - def test_department_processor_stores_on_s3 (csv_source, s3)
  20. Step by step - HTTP to S3 - def test_download_and_store_to_s3_should_raise_if_error_code(requests_mock,

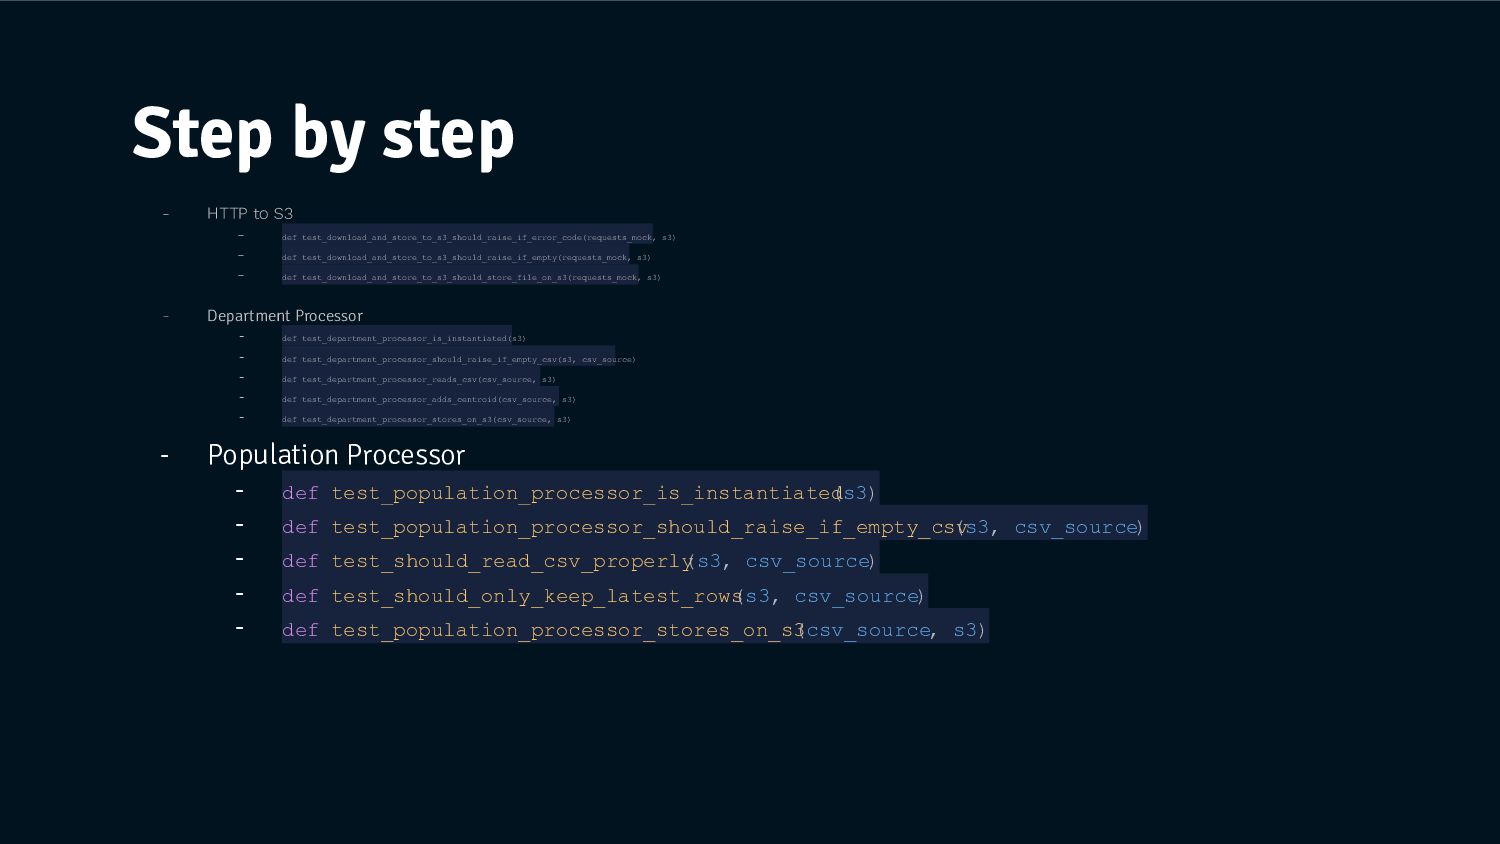
    s3) - def test_download_and_store_to_s3_should_raise_if_empty(requests_mock, s3) - def test_download_and_store_to_s3_should_store_file_on_s3(requests_mock, s3) - Department Processor - def test_department_processor_is_instantiated(s3) - def test_department_processor_should_raise_if_empty_csv(s3, csv_source) - def test_department_processor_reads_csv(csv_source, s3) - def test_department_processor_adds_centroid(csv_source, s3) - def test_department_processor_stores_on_s3(csv_source, s3) - Population Processor - def test_population_processor_is_instantiated (s3) - def test_population_processor_should_raise_if_empty_csv (s3, csv_source) - def test_should_read_csv_properly (s3, csv_source) - def test_should_only_keep_latest_rows (s3, csv_source) - def test_population_processor_stores_on_s3 (csv_source, s3)
  21. Step by step - HTTP to S3 - def test_download_and_store_to_s3_should_raise_if_error_code(requests_mock,

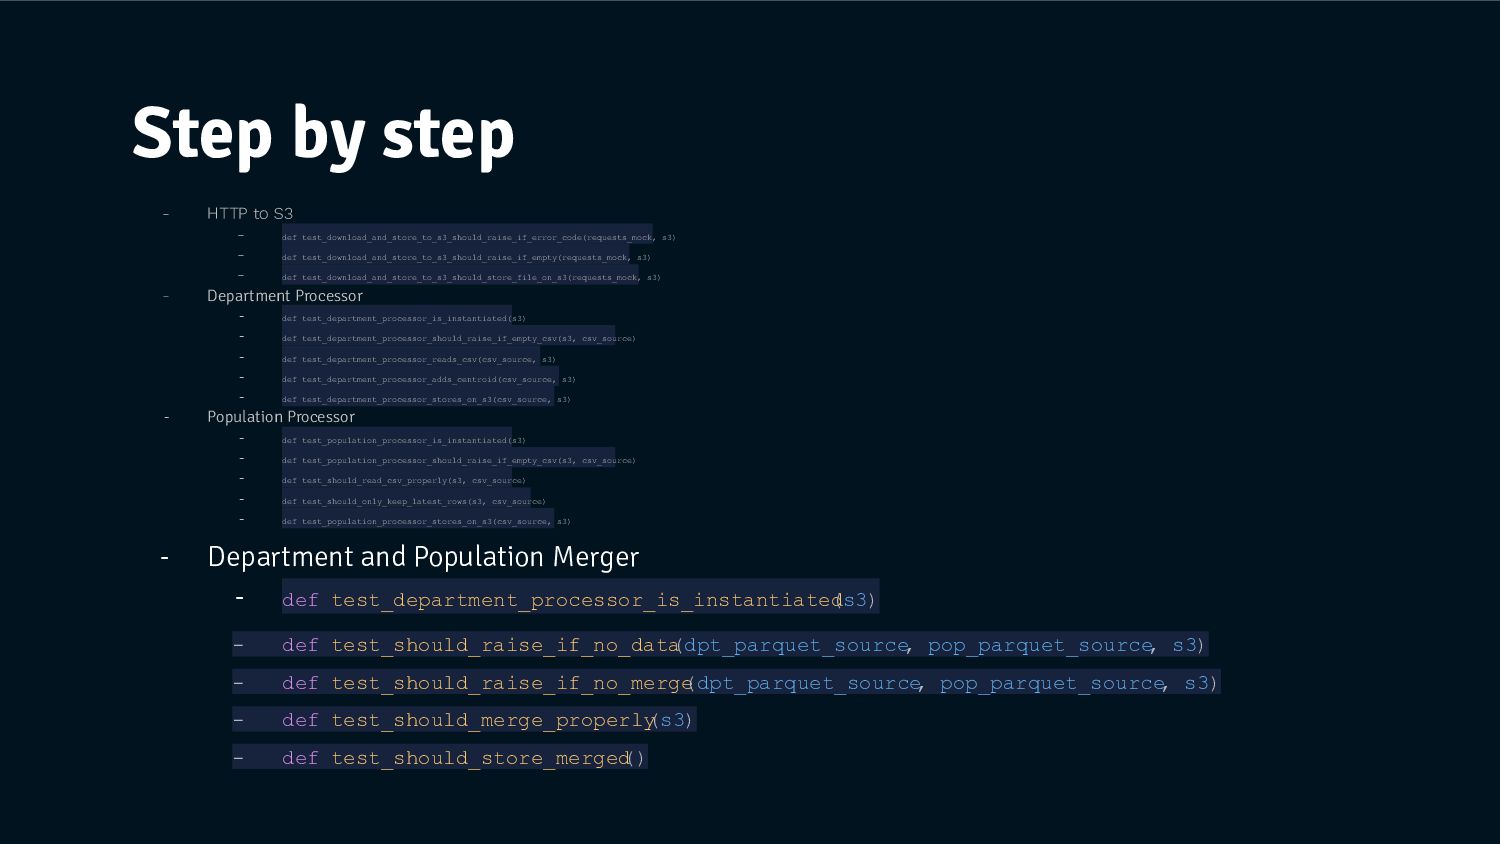
    s3) - def test_download_and_store_to_s3_should_raise_if_empty(requests_mock, s3) - def test_download_and_store_to_s3_should_store_file_on_s3(requests_mock, s3) - Department Processor - def test_department_processor_is_instantiated(s3) - def test_department_processor_should_raise_if_empty_csv(s3, csv_source) - def test_department_processor_reads_csv(csv_source, s3) - def test_department_processor_adds_centroid(csv_source, s3) - def test_department_processor_stores_on_s3(csv_source, s3) - Population Processor - def test_population_processor_is_instantiated(s3) - def test_population_processor_should_raise_if_empty_csv(s3, csv_source) - def test_should_read_csv_properly(s3, csv_source) - def test_should_only_keep_latest_rows(s3, csv_source) - def test_population_processor_stores_on_s3(csv_source, s3) - Department and Population Merger - def test_department_processor_is_instantiated (s3) - def test_should_raise_if_no_data (dpt_parquet_source , pop_parquet_source , s3) - def test_should_raise_if_no_merge (dpt_parquet_source , pop_parquet_source , s3) - def test_should_merge_properly (s3) - def test_should_store_merged ()
  22. Énormément d’outils disponibles - Pytest & parameterized tests - Faker,

    mocker, request_mock et plein d’autres fixtures - Testscontainers pour les DB, Kafka, …
  23. Property based testing - Ne pas limiter les tests à

    l’imagination de l’auteur•e - Happy path + tous les edge cases - N’hésitez pas à tester hypothesis
  24. Contract Testing - S’appuyer sur la documentation OpenAPI avec Prism

    pour tester les API source https://github.com/stoplightio/prism - Générateurs de testcase basés sur des contrats d’interface