Upgrade to Pro — share decks privately, control downloads, hide ads and more …

⼤規模⾔語モデル事前学習の安定化(IBIS2026企画セッション講演) / IBIS2026_...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Sho Takase Sho Takase
November 02, 2026
300

⼤規模⾔語モデル事前学習の安定化(IBIS2026企画セッション講演) / IBIS2026_organized_session3

Avatar for Sho Takase

Sho Takase

November 02, 2026

Transcript

  1. ⾼瀬の⾃⼰紹介 • 経歴 – – – – – – •

    • 2008-2017︓東北⼤学(学⼠-博⼠) 2017-2018︓NTT CS研(ポスドク) 2018-2022︓東⼯⼤(研究員・助教) 2022-2025︓LINE → LINEヤフー/SB Intuitions 2024︓東北⼤学(特任准教授(客員)) 2025︓サイバーエージェント ⾃然⾔語処理の研究に従事(特に翻訳・要約・⾔語モデル) ⼤規模⾔語モデル周辺の仕事 – LINE,SB Intuitionsでそれぞれ⼤規模事前学習を担当,モデルを公開 – 主著︓COLM 25, ACL Findings 25, AACL 26 – 共著︓ICML 25, COLM 25, ICLR 26, EMNLP 26 • ⾃然⾔語処理周辺の研究で⼤規模⾔語モデルが関連しないことの⽅が珍しくなってる説あり 2
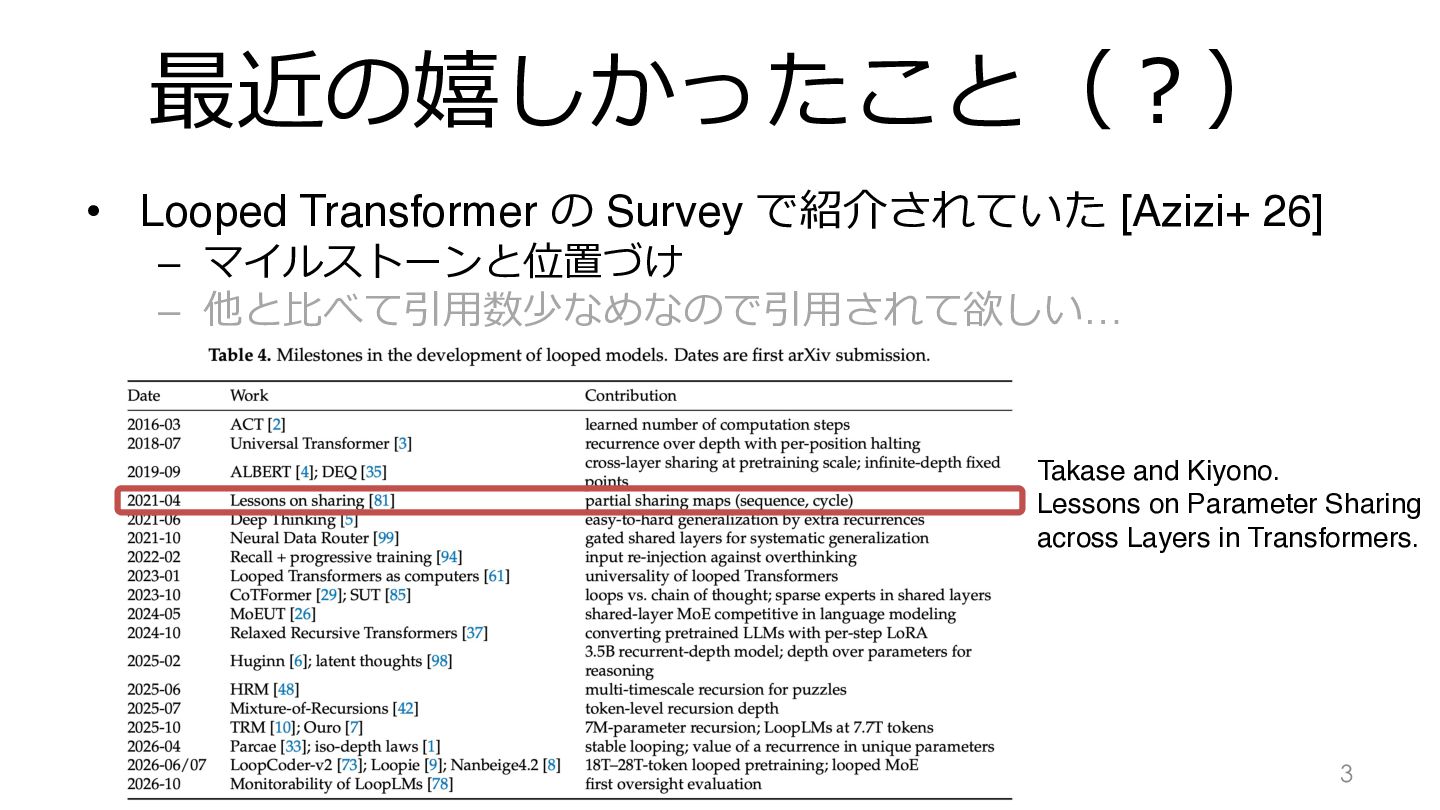
  2. 最近の嬉しかったこと(︖) • Looped Transformer の Survey で紹介されていた [Azizi+ 26] –

    マイルストーンと位置づけ – 他と⽐べて引⽤数少なめなので引⽤されて欲しい… Takase and Kiyono. Lessons on Parameter Sharing across Layers in Transformers. 3
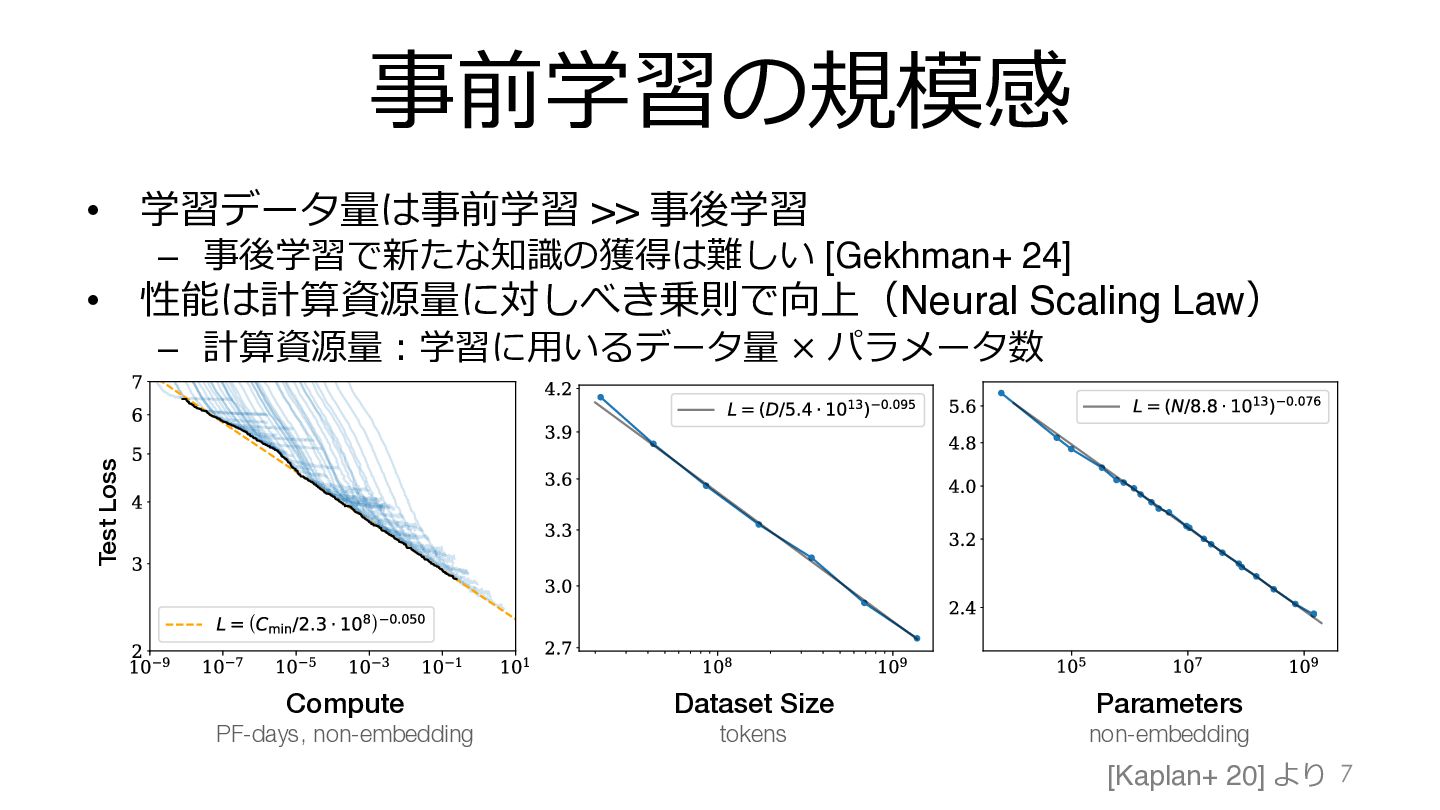
  3. 事前学習の規模感 • 学習データ量は事前学習 >> 事後学習 • 性能は計算資源量に対しべき乗則で向上(Neural Scaling Law) –

    事後学習で新たな知識の獲得は難しい [Gekhman+ 24] Test Loss – 計算資源量︓学習に⽤いるデータ量 × パラメータ数 Compute Dataset Size Parameters PF-days, non-embedding tokens non-embedding [Kaplan+ 20] より 7 Figure 1 Language modeling performance improves smoothly as we increase the model size, datasetset
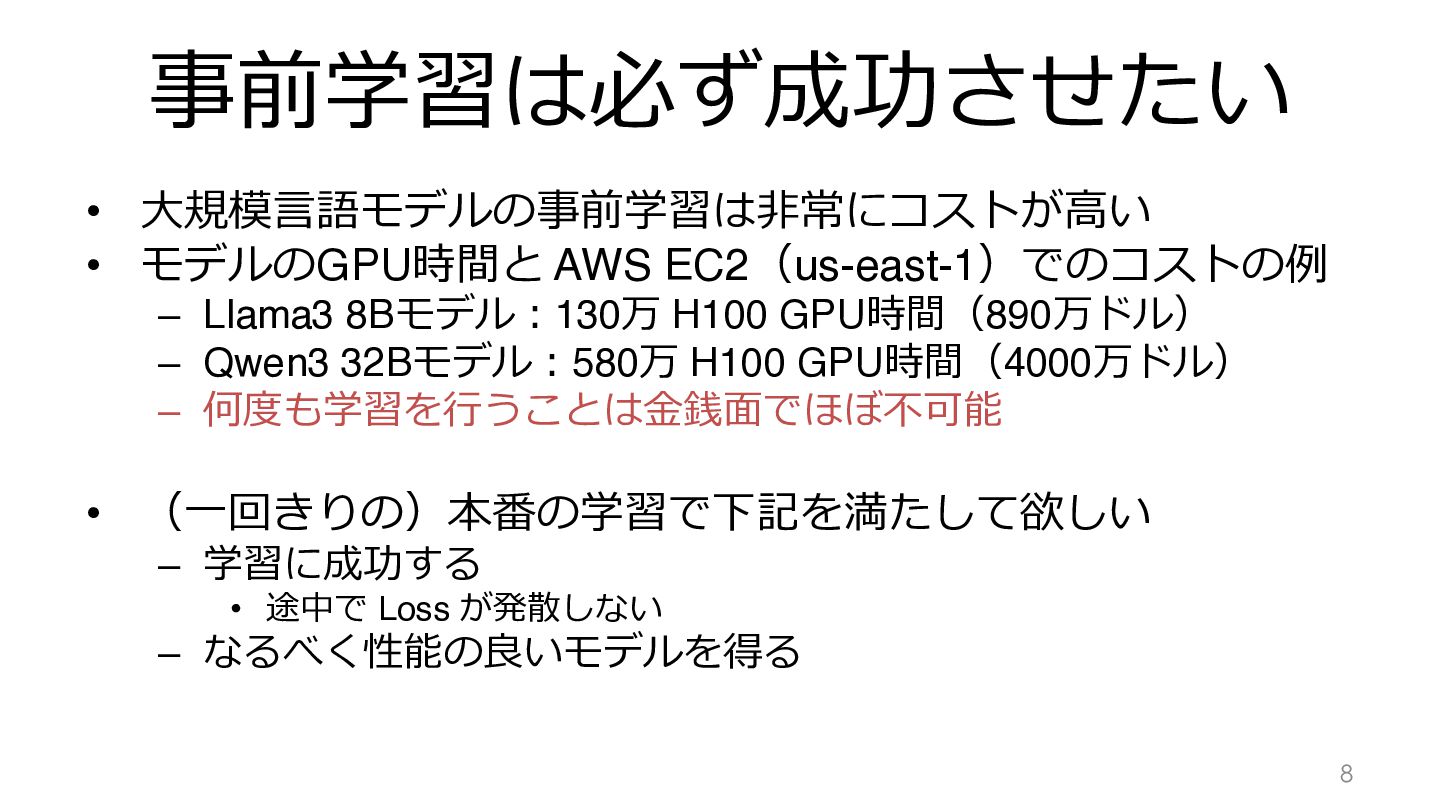
  4. 事前学習は必ず成功させたい • ⼤規模⾔語モデルの事前学習は⾮常にコストが⾼い • モデルのGPU時間と AWS EC2(us-east-1)でのコストの例 – Llama3 8Bモデル︓130万

    H100 GPU時間(890万ドル) – Qwen3 32Bモデル︓580万 H100 GPU時間(4000万ドル) – 何度も学習を⾏うことは⾦銭⾯でほぼ不可能 • (⼀回きりの)本番の学習で下記を満たして欲しい – 学習に成功する • 途中で Loss が発散しない – なるべく性能の良いモデルを得る 8
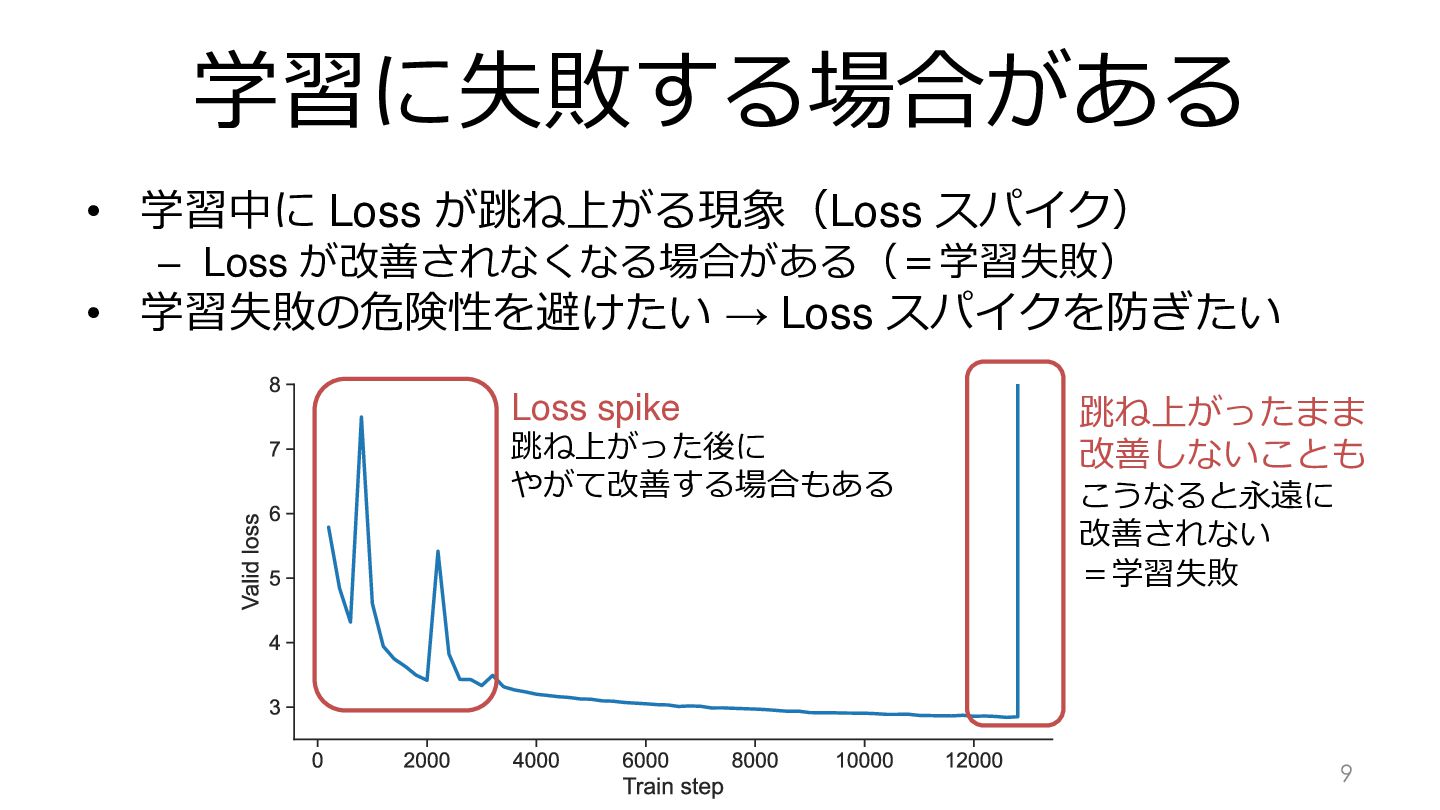
  5. 学習に失敗する場合がある • 学習中に Loss が跳ね上がる現象(Loss スパイク) – Loss が改善されなくなる場合がある(=学習失敗) •

    学習失敗の危険性を避けたい → Loss スパイクを防ぎたい Loss spike 跳ね上がった後に やがて改善する場合もある 跳ね上がったまま 改善しないことも こうなると永遠に 改善されない =学習失敗 9
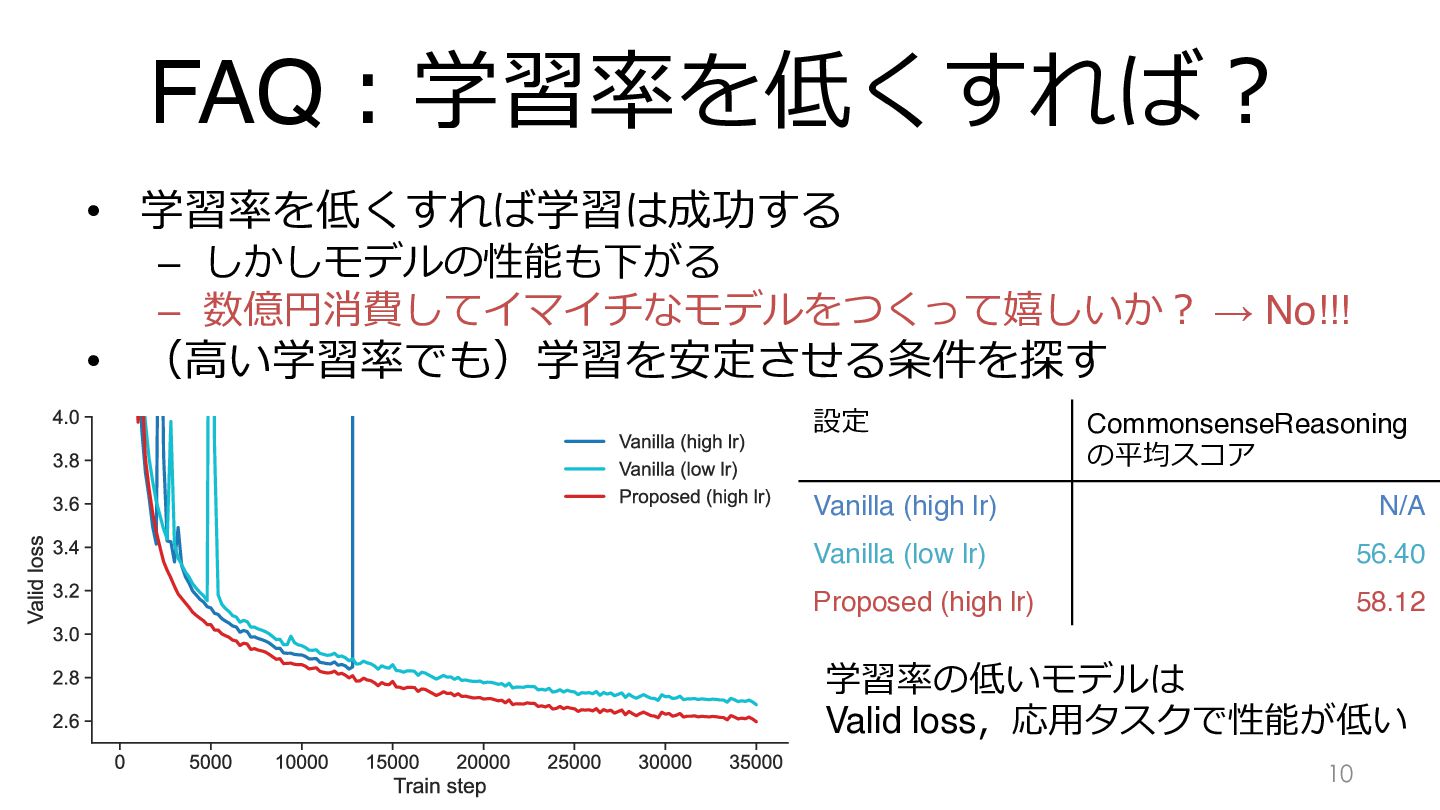
  6. FAQ︓学習率を低くすれば︖ • 学習率を低くすれば学習は成功する – しかしモデルの性能も下がる – 数億円消費してイマイチなモデルをつくって嬉しいか︖ → No!!! •

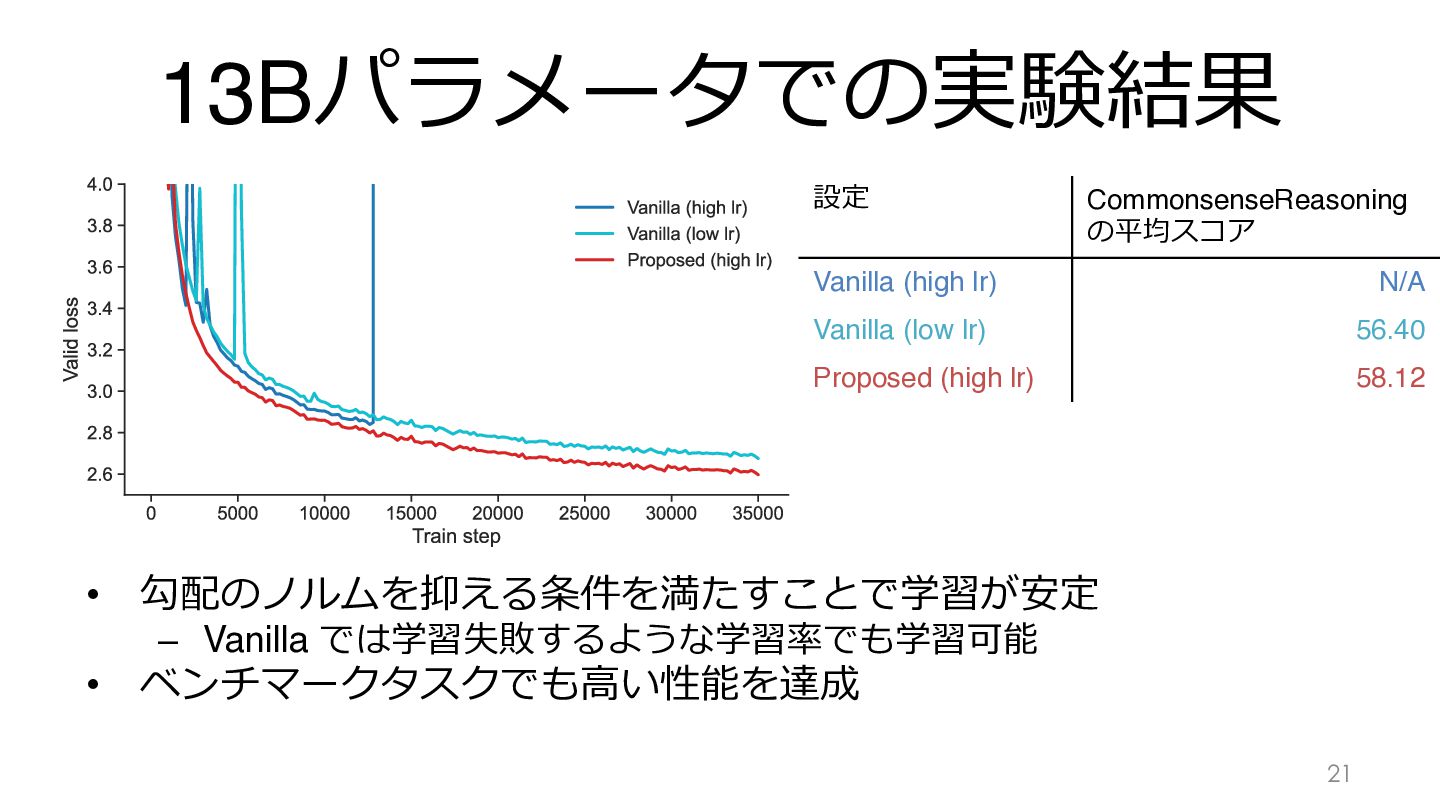
    (⾼い学習率でも)学習を安定させる条件を探す 設定 CommonsenseReasoning の平均スコア Vanilla (high lr) N/A Vanilla (low lr) 56.40 Proposed (high lr) 58.12 学習率の低いモデルは Valid loss,応⽤タスクで性能が低い 10
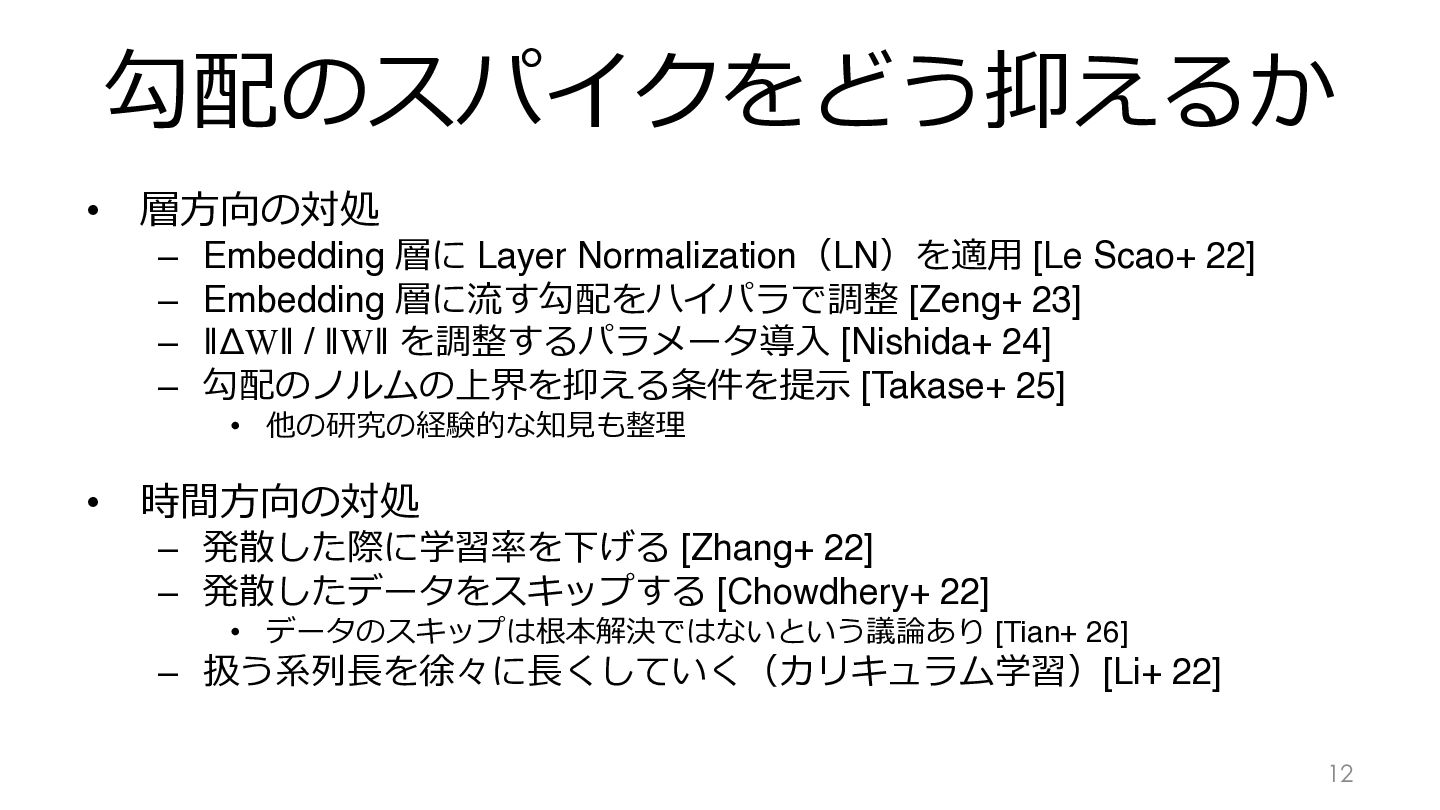
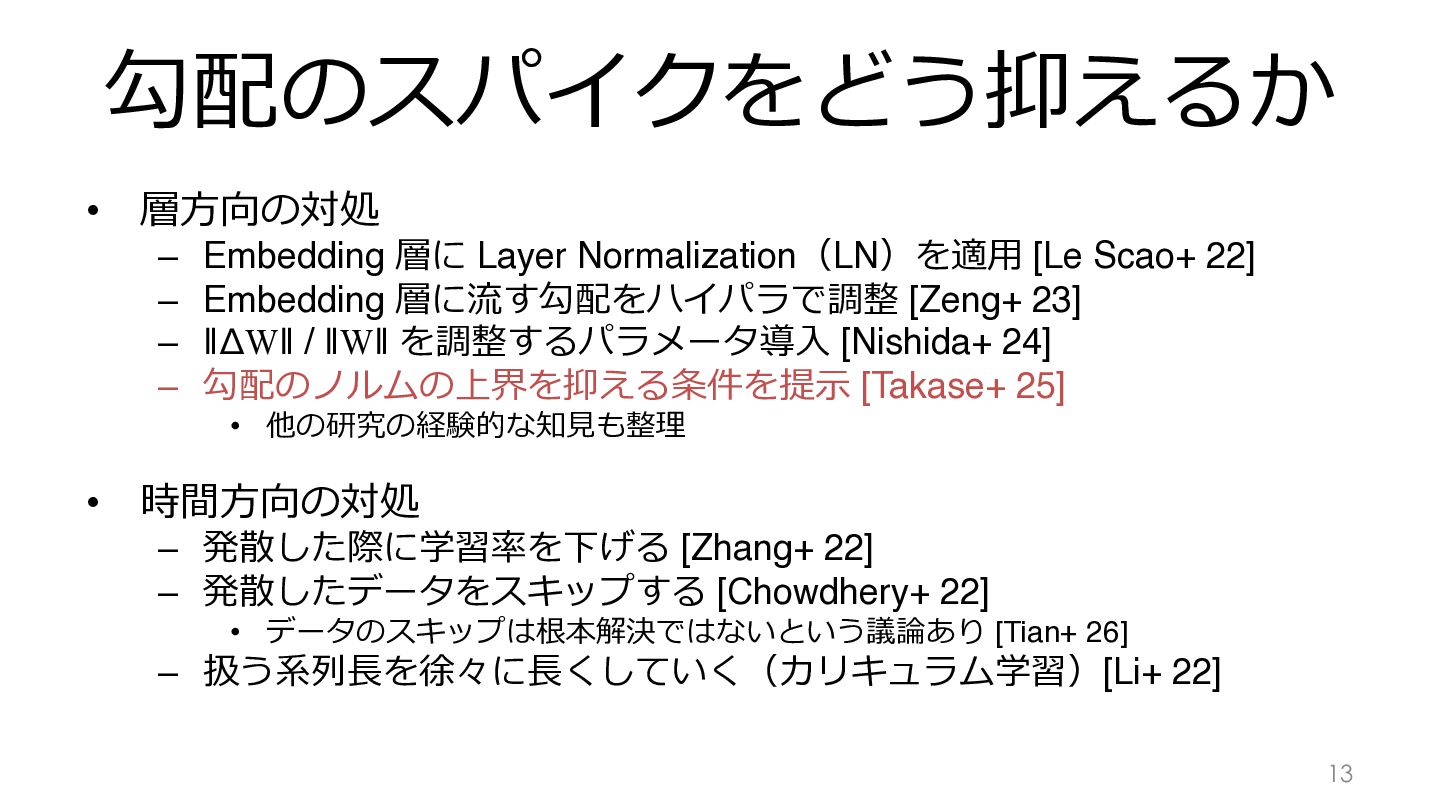
  7. 勾配のスパイクをどう抑えるか • 層⽅向の対処 – Embedding 層に Layer Normalization(LN)を適⽤ [Le Scao+

    22] – Embedding 層に流す勾配をハイパラで調整 [Zeng+ 23] – ‖ΔW‖ / ‖W‖ を調整するパラメータ導⼊ [Nishida+ 24] – 勾配のノルムの上界を抑える条件を提⽰ [Takase+ 25] • 他の研究の経験的な知⾒も整理 • 時間⽅向の対処 – 発散した際に学習率を下げる [Zhang+ 22] – 発散したデータをスキップする [Chowdhery+ 22] • データのスキップは根本解決ではないという議論あり [Tian+ 26] – 扱う系列⻑を徐々に⻑くしていく(カリキュラム学習)[Li+ 22] 12
  8. 勾配のスパイクをどう抑えるか • 層⽅向の対処 – Embedding 層に Layer Normalization(LN)を適⽤ [Le Scao+

    22] – Embedding 層に流す勾配をハイパラで調整 [Zeng+ 23] – ‖ΔW‖ / ‖W‖ を調整するパラメータ導⼊ [Nishida+ 24] – 勾配のノルムの上界を抑える条件を提⽰ [Takase+ 25] • 他の研究の経験的な知⾒も整理 • 時間⽅向の対処 – 発散した際に学習率を下げる [Zhang+ 22] – 発散したデータをスキップする [Chowdhery+ 22] • データのスキップは根本解決ではないという議論あり [Tian+ 26] – 扱う系列⻑を徐々に⻑くしていく(カリキュラム学習)[Li+ 22] 13
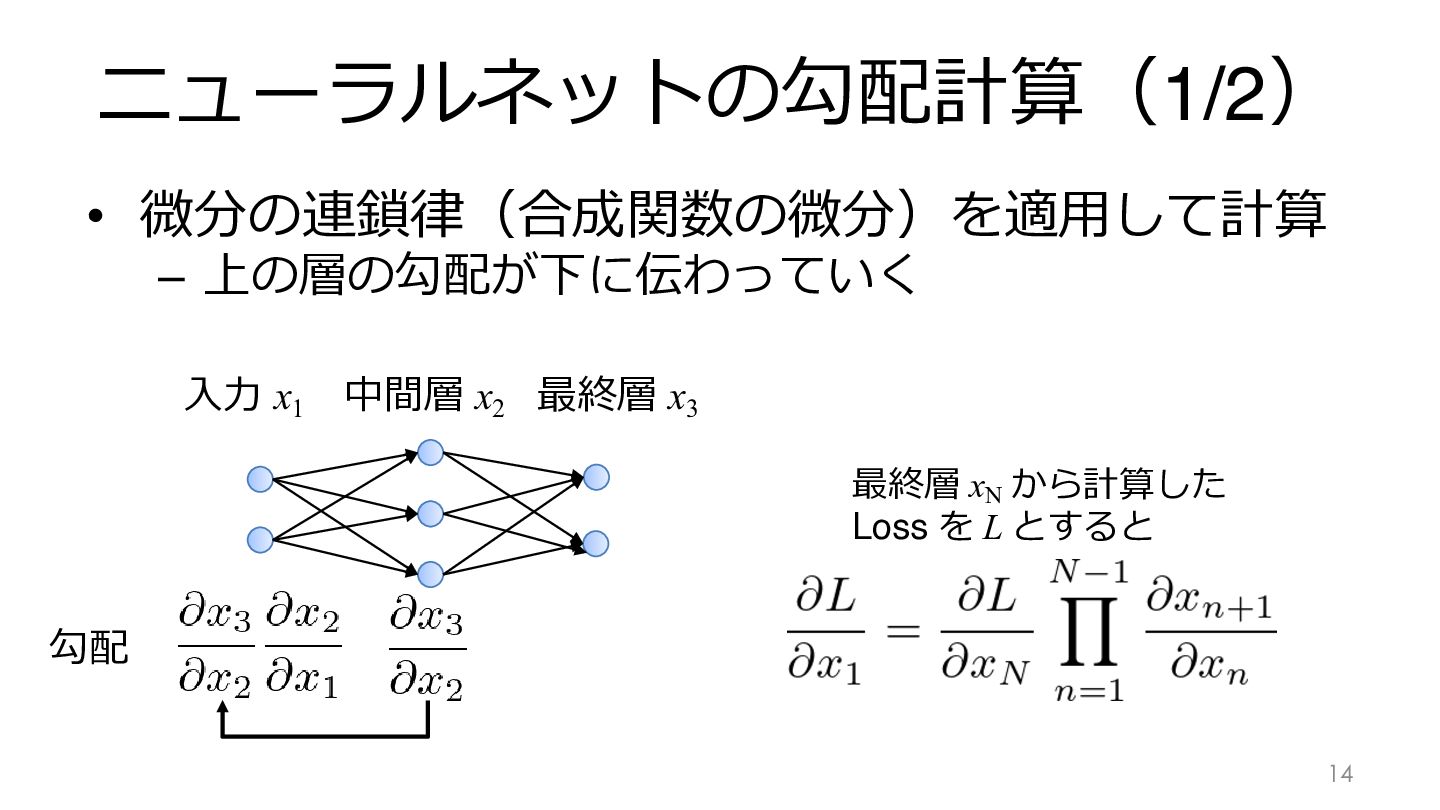
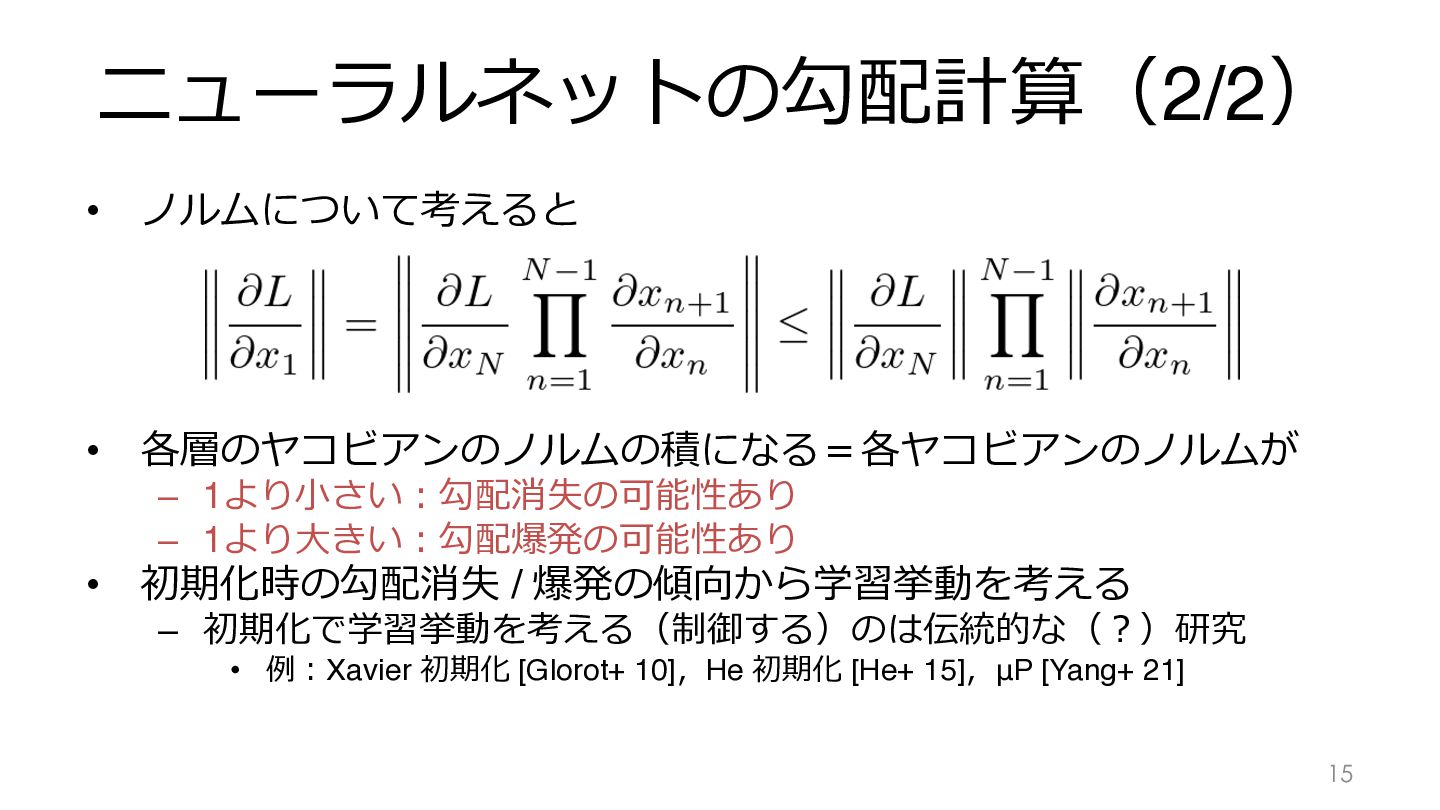
  9. ニューラルネットの勾配計算(2/2) • ノルムについて考えると • 各層のヤコビアンのノルムの積になる=各ヤコビアンのノルムが – 1より⼩さい︓勾配消失の可能性あり – 1より⼤きい︓勾配爆発の可能性あり •

    初期化時の勾配消失 / 爆発の傾向から学習挙動を考える – 初期化で学習挙動を考える(制御する)のは伝統的な(︖)研究 • 例︓Xavier 初期化 [Glorot+ 10],He 初期化 [He+ 15],μP [Yang+ 21] 15
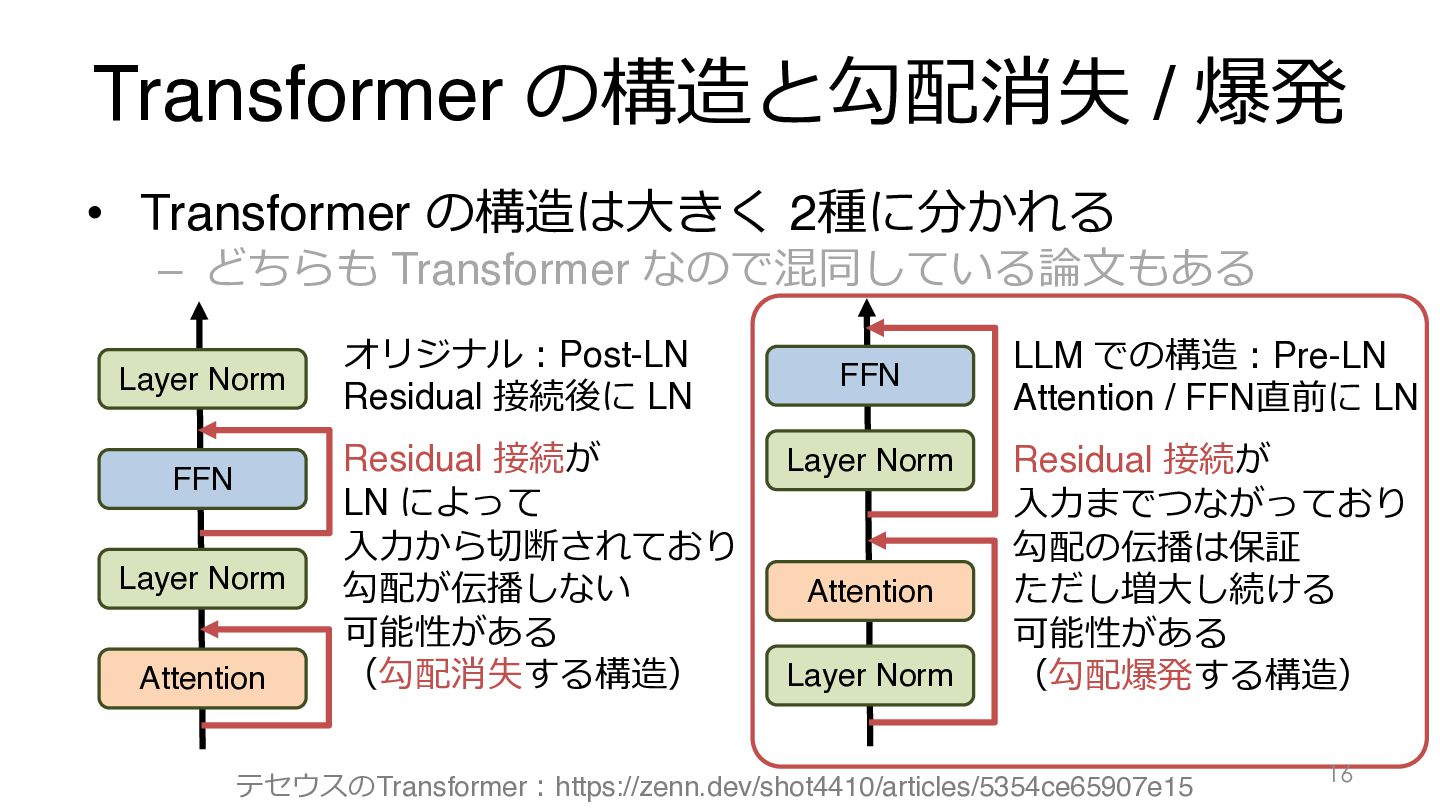
  10. Transformer の構造と勾配消失 / 爆発 • Transformer の構造は⼤きく 2種に分かれる – どちらも

    Transformer なので混同している論⽂もある Layer Norm FFN Layer Norm Attention オリジナル︓Post-LN Residual 接続後に LN Residual 接続が LN によって ⼊⼒から切断されており 勾配が伝播しない 可能性がある (勾配消失する構造) FFN Layer Norm Attention Layer Norm LLM での構造︓Pre-LN Attention / FFN直前に LN Residual 接続が ⼊⼒までつながっており 勾配の伝播は保証 ただし増⼤し続ける 可能性がある (勾配爆発する構造) テセウスのTransformer︓https://zenn.dev/shot4410/articles/5354ce65907e15 16
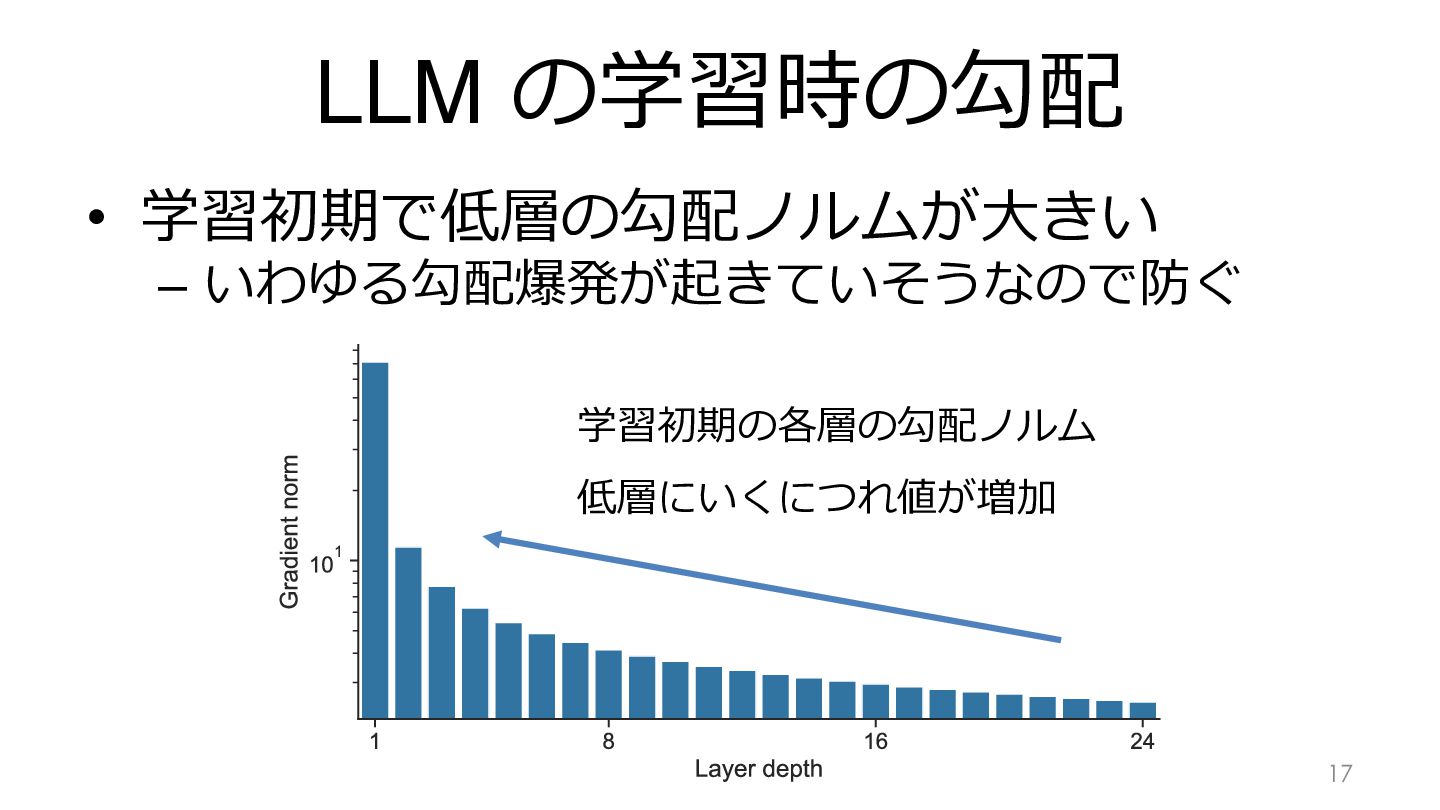
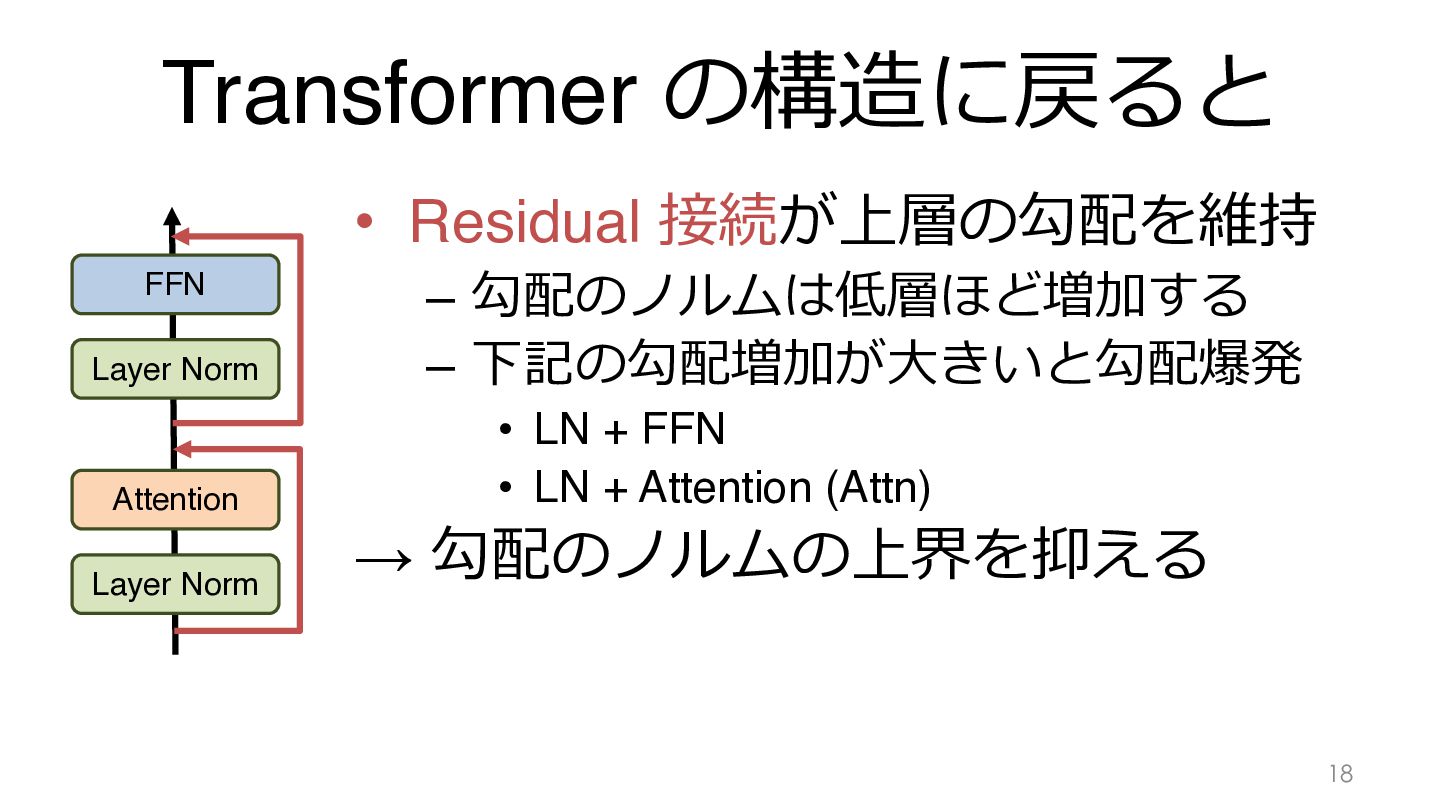
  11. Transformer の構造に戻ると • Residual 接続が上層の勾配を維持 FFN Layer Norm Attention Layer

    Norm – 勾配のノルムは低層ほど増加する – 下記の勾配増加が⼤きいと勾配爆発 • LN + FFN • LN + Attention (Attn) → 勾配のノルムの上界を抑える 18
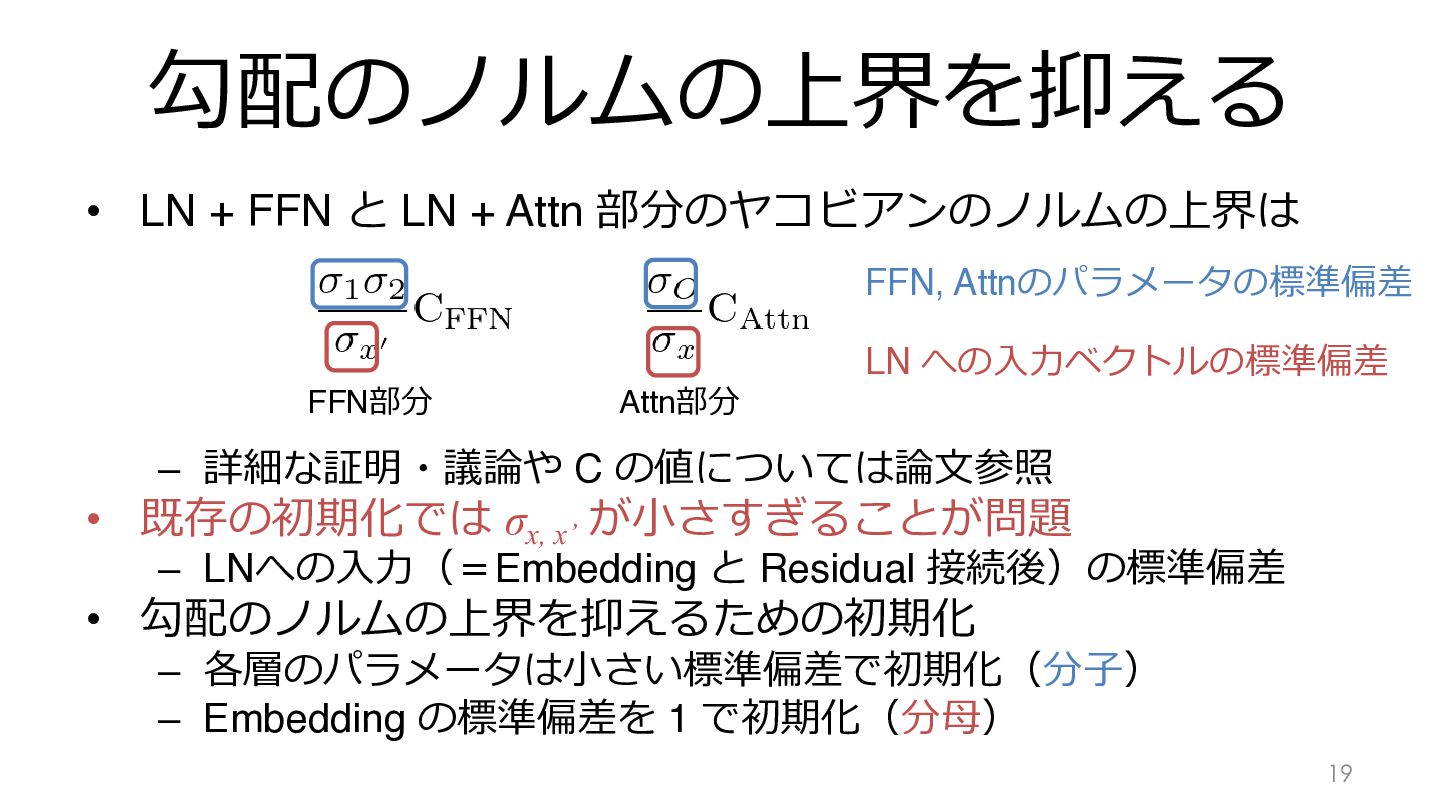
  12. 勾配のノルムの上界を抑える • LN + FFN と LN + Attn 部分のヤコビアンのノルムの上界は

    FFN, Attnのパラメータの標準偏差 FFN部分 Attn部分 LN への⼊⼒ベクトルの標準偏差 – 詳細な証明・議論や C の値については論⽂参照 • 既存の初期化では σx, x’ が⼩さすぎることが問題 – LNへの⼊⼒(=Embedding と Residual 接続後)の標準偏差 • 勾配のノルムの上界を抑えるための初期化 – 各層のパラメータは⼩さい標準偏差で初期化(分⼦) – Embedding の標準偏差を 1 で初期化(分⺟) 19
  13. 13Bパラメータでの実験結果 設定 CommonsenseReasoning の平均スコア Vanilla (high lr) N/A Vanilla (low

    lr) 56.40 Proposed (high lr) 58.12 • 勾配のノルムを抑える条件を満たすことで学習が安定 • ベンチマークタスクでも⾼い性能を達成 – Vanilla では学習失敗するような学習率でも学習可能 21
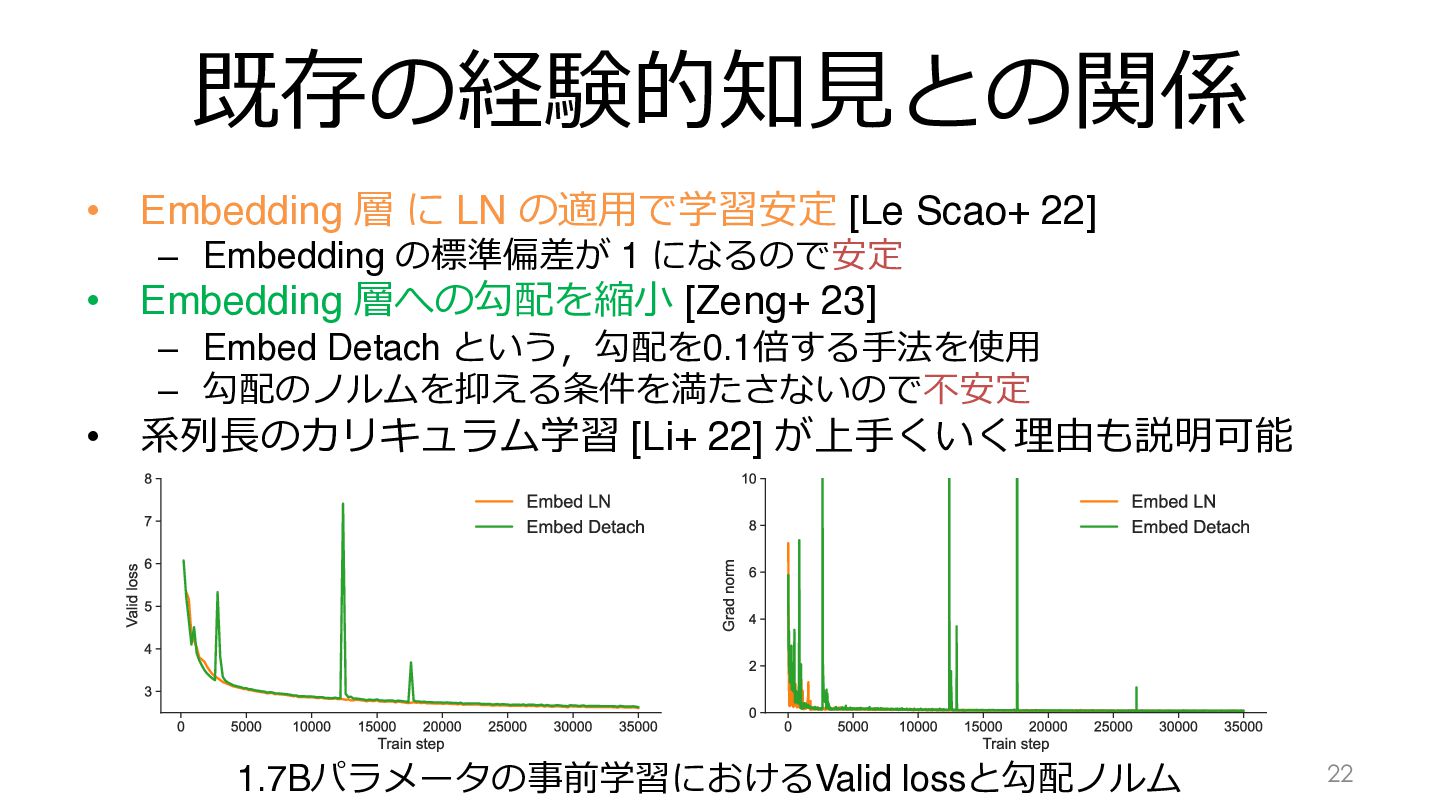
  14. 既存の経験的知⾒との関係 • Embedding 層 に LN の適⽤で学習安定 [Le Scao+ 22]

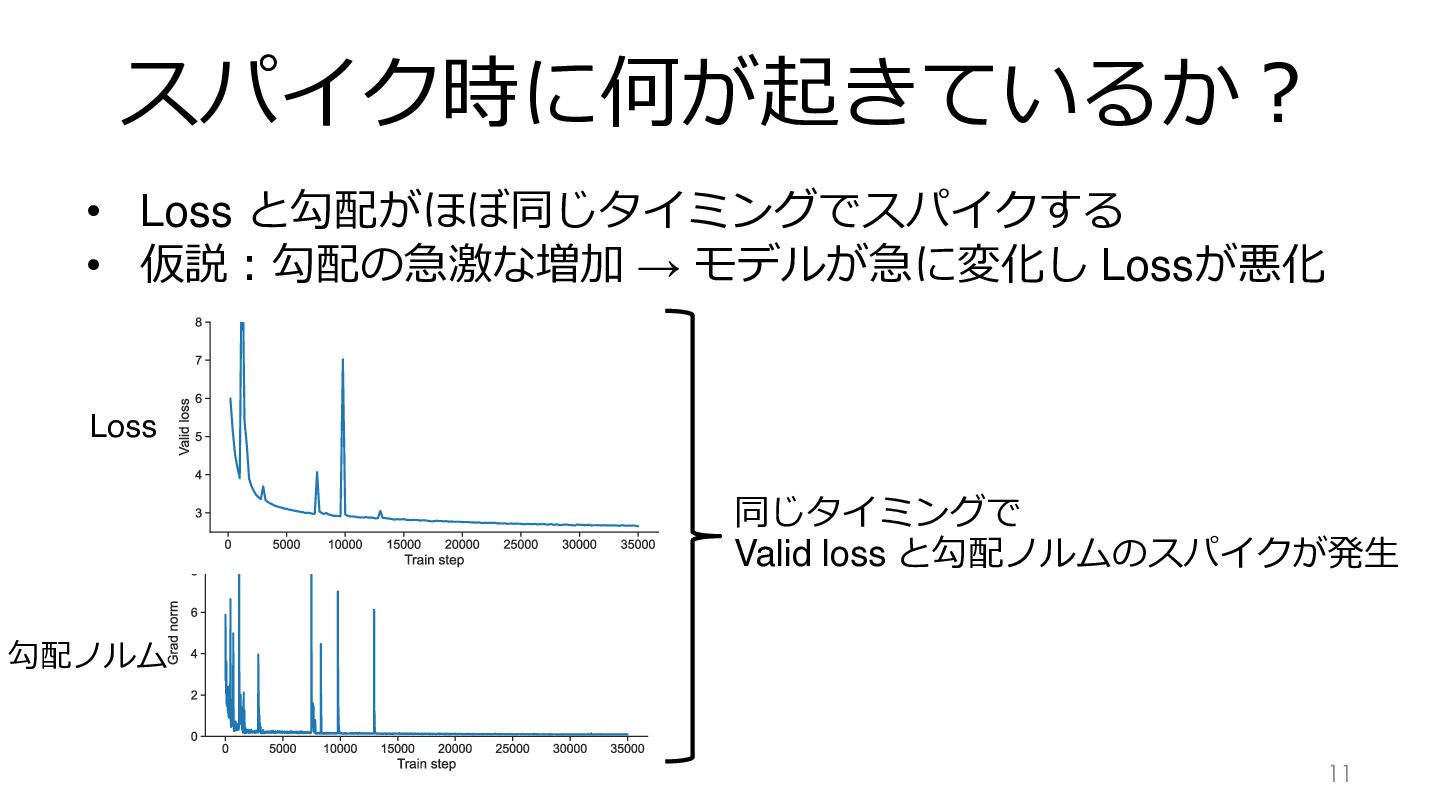
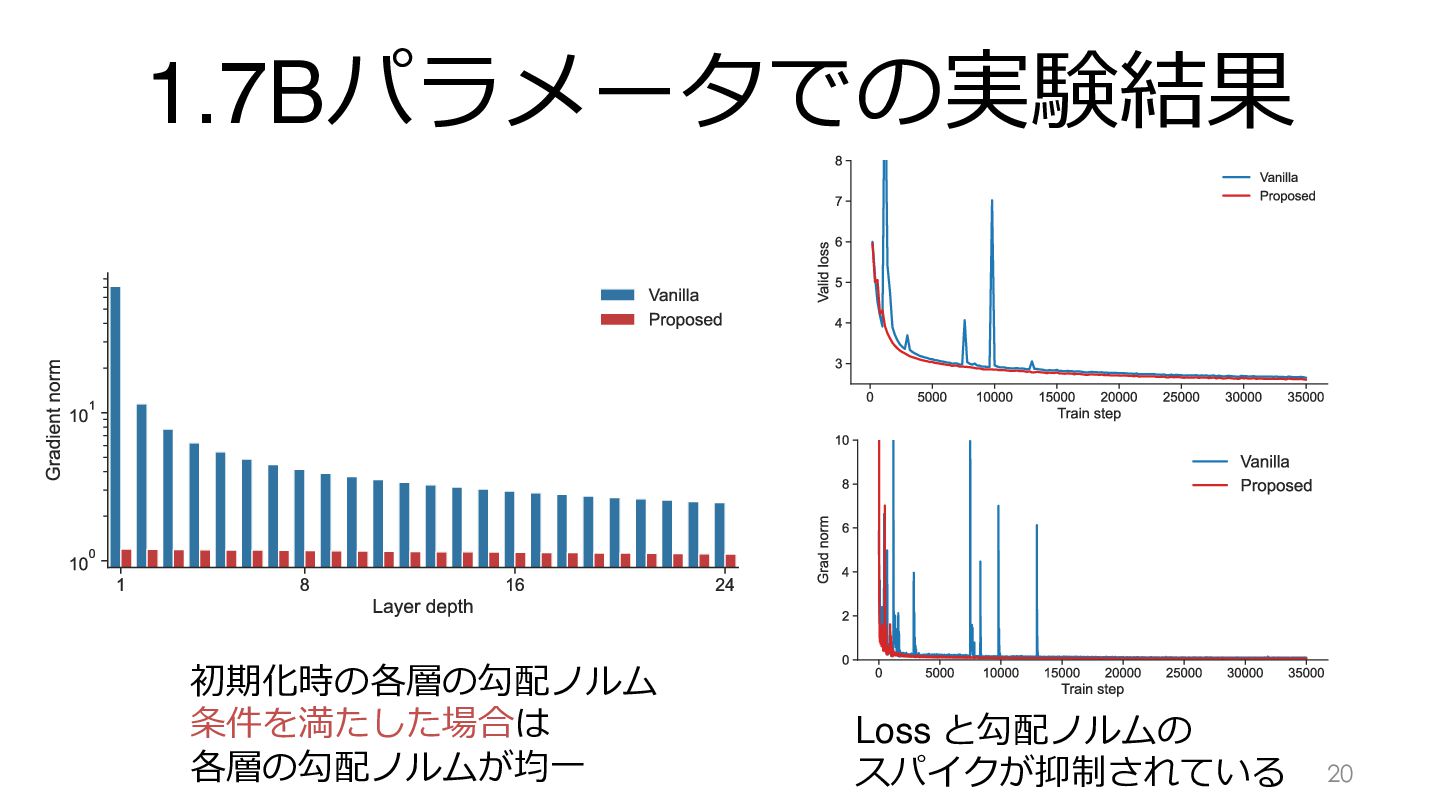
    • Embedding 層への勾配を縮⼩ [Zeng+ 23] • 系列⻑のカリキュラム学習 [Li+ 22] が上⼿くいく理由も説明可能 – Embedding の標準偏差が 1 になるので安定 – Embed Detach という,勾配を0.1倍する⼿法を使⽤ – 勾配のノルムを抑える条件を満たさないので不安定 1.7Bパラメータの事前学習におけるValid lossと勾配ノルム 22
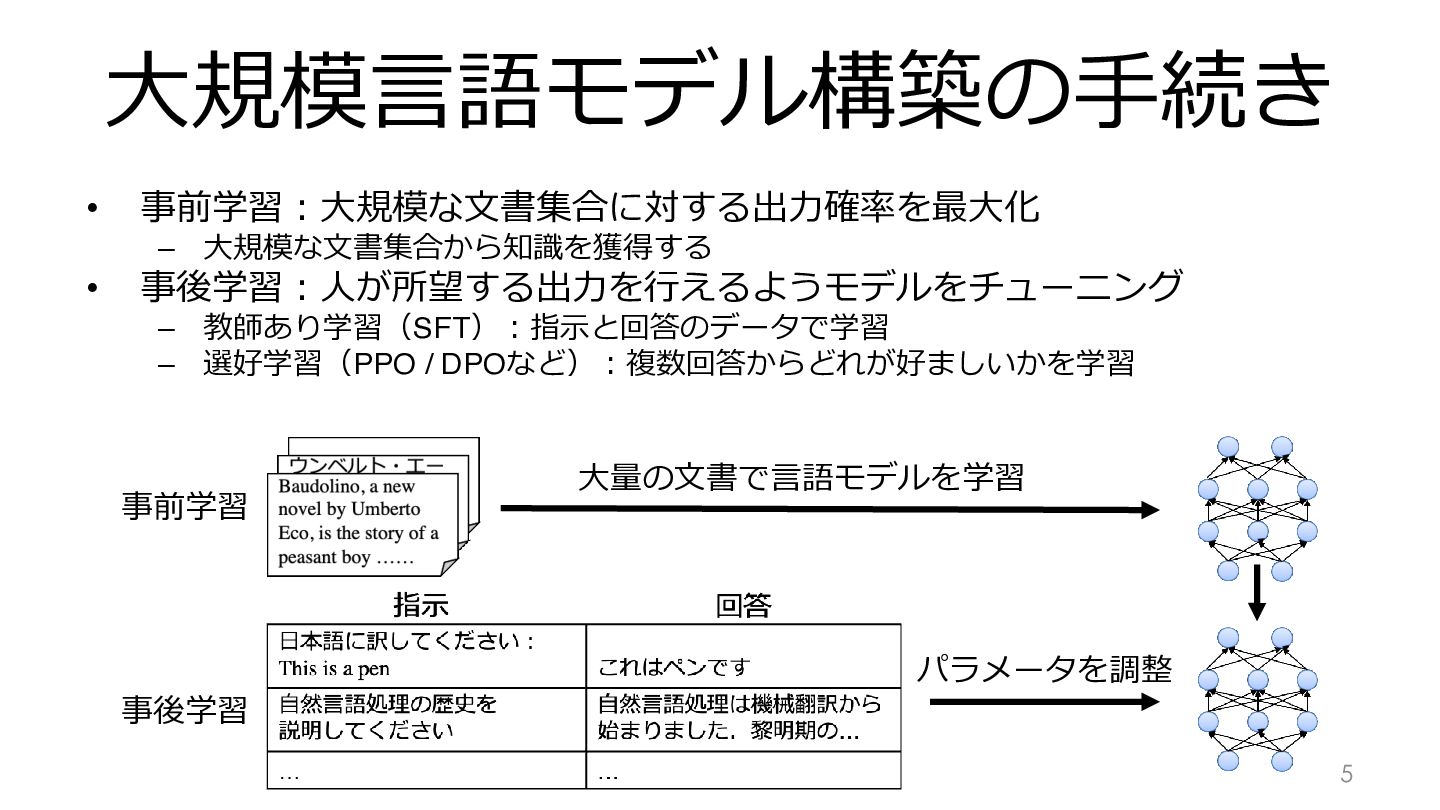
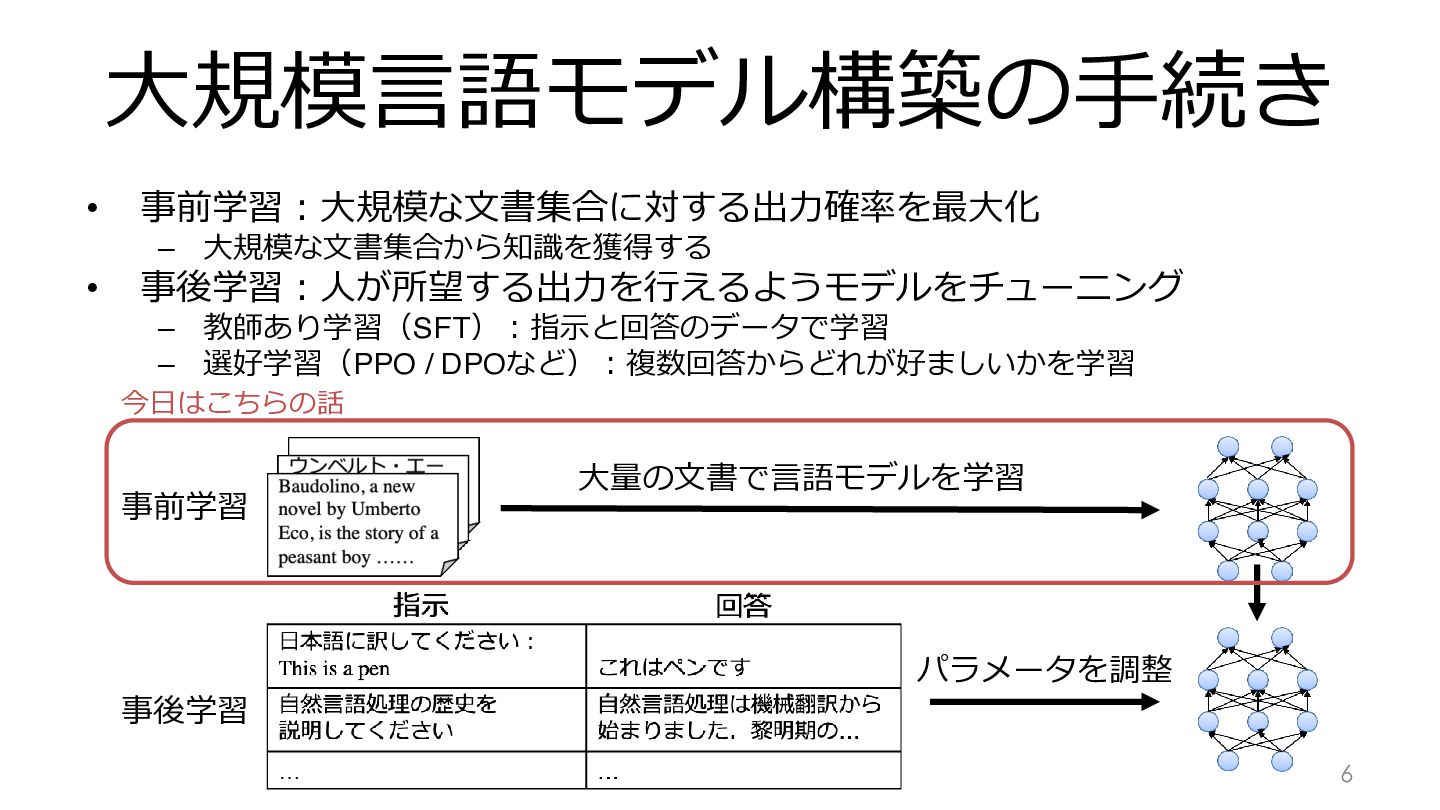
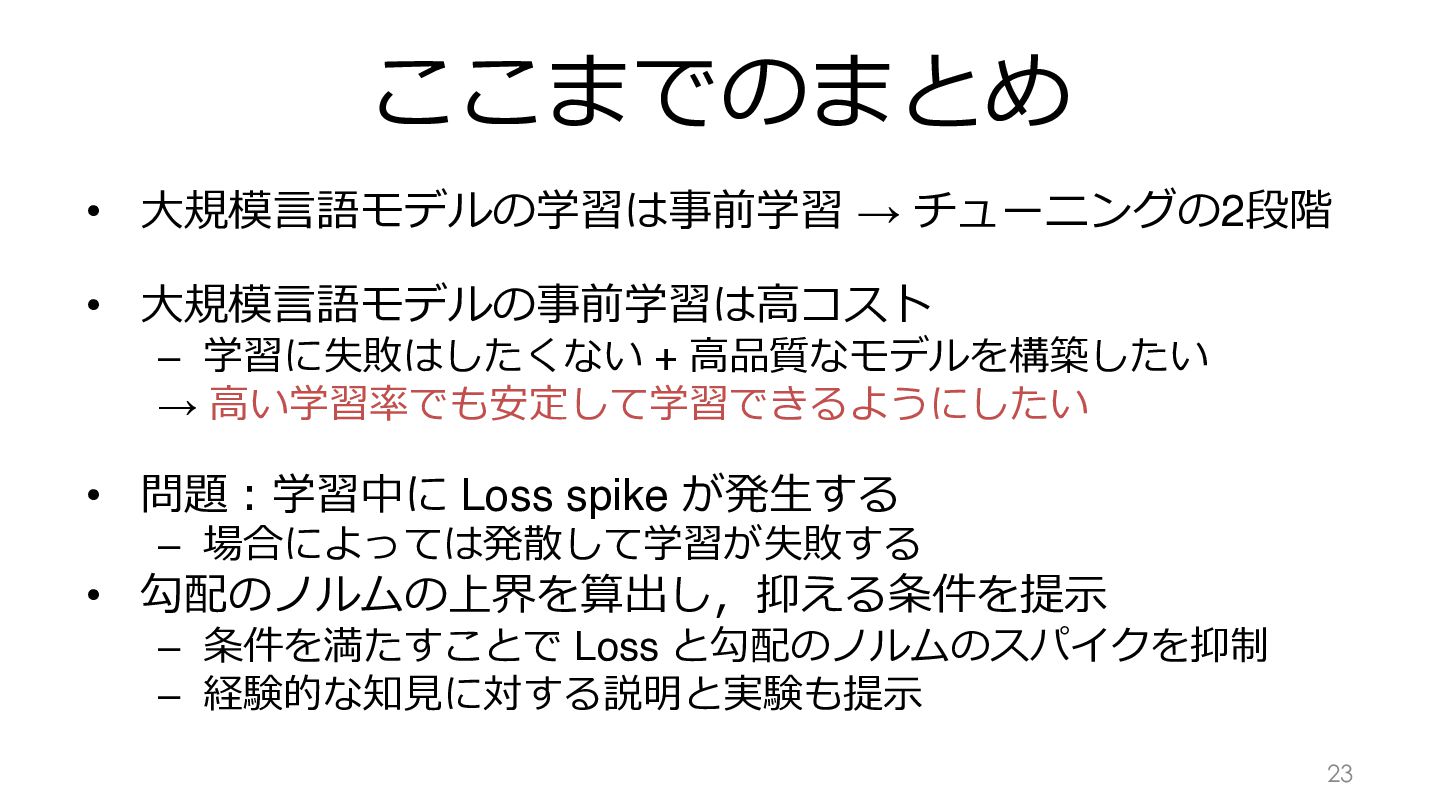
  15. ここまでのまとめ • ⼤規模⾔語モデルの学習は事前学習 → チューニングの2段階 • ⼤規模⾔語モデルの事前学習は⾼コスト – 学習に失敗はしたくない +

    ⾼品質なモデルを構築したい → ⾼い学習率でも安定して学習できるようにしたい • 問題︓学習中に Loss spike が発⽣する – 場合によっては発散して学習が失敗する • 勾配のノルムの上界を算出し,抑える条件を提⽰ – 条件を満たすことで Loss と勾配のノルムのスパイクを抑制 – 経験的な知⾒に対する説明と実験も提⽰ 23
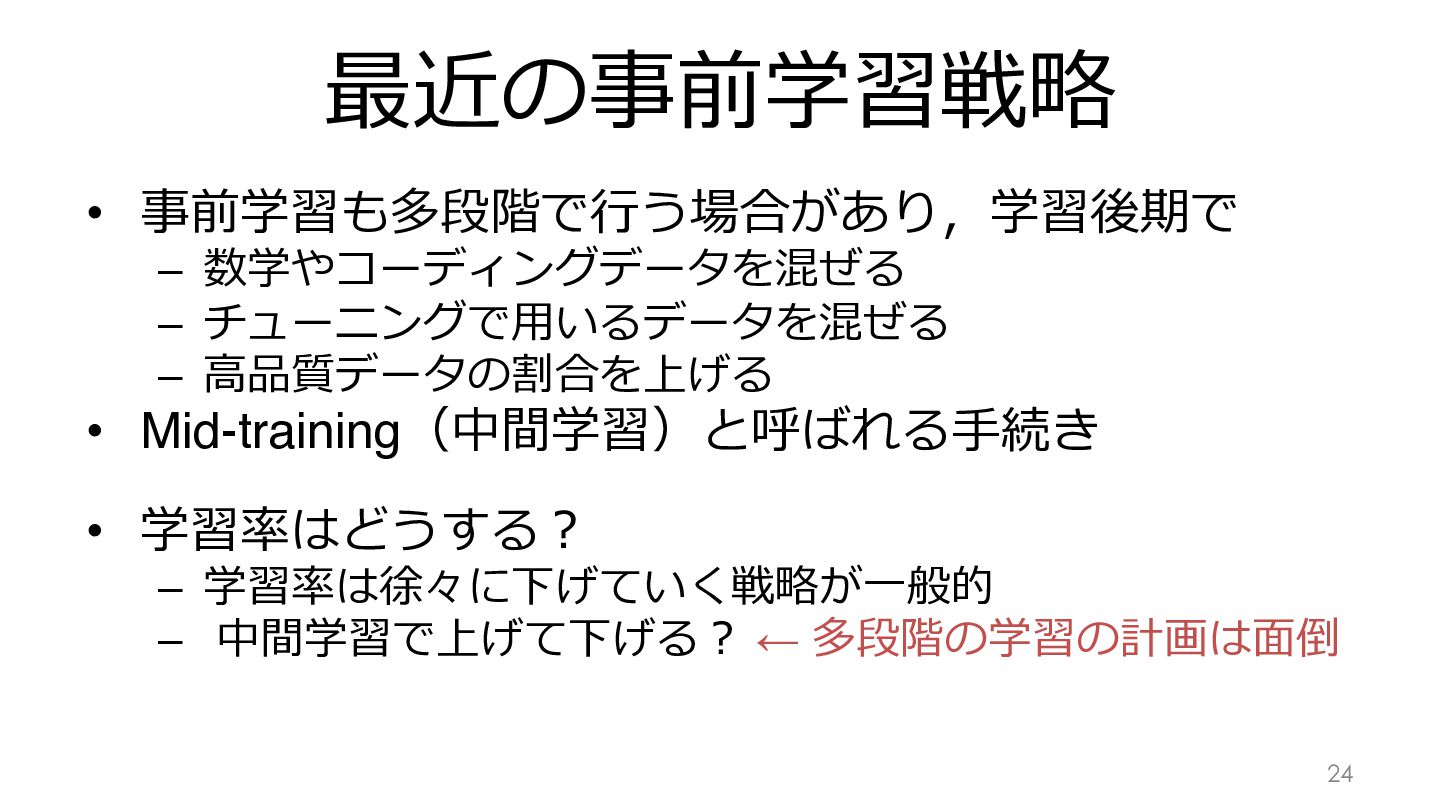
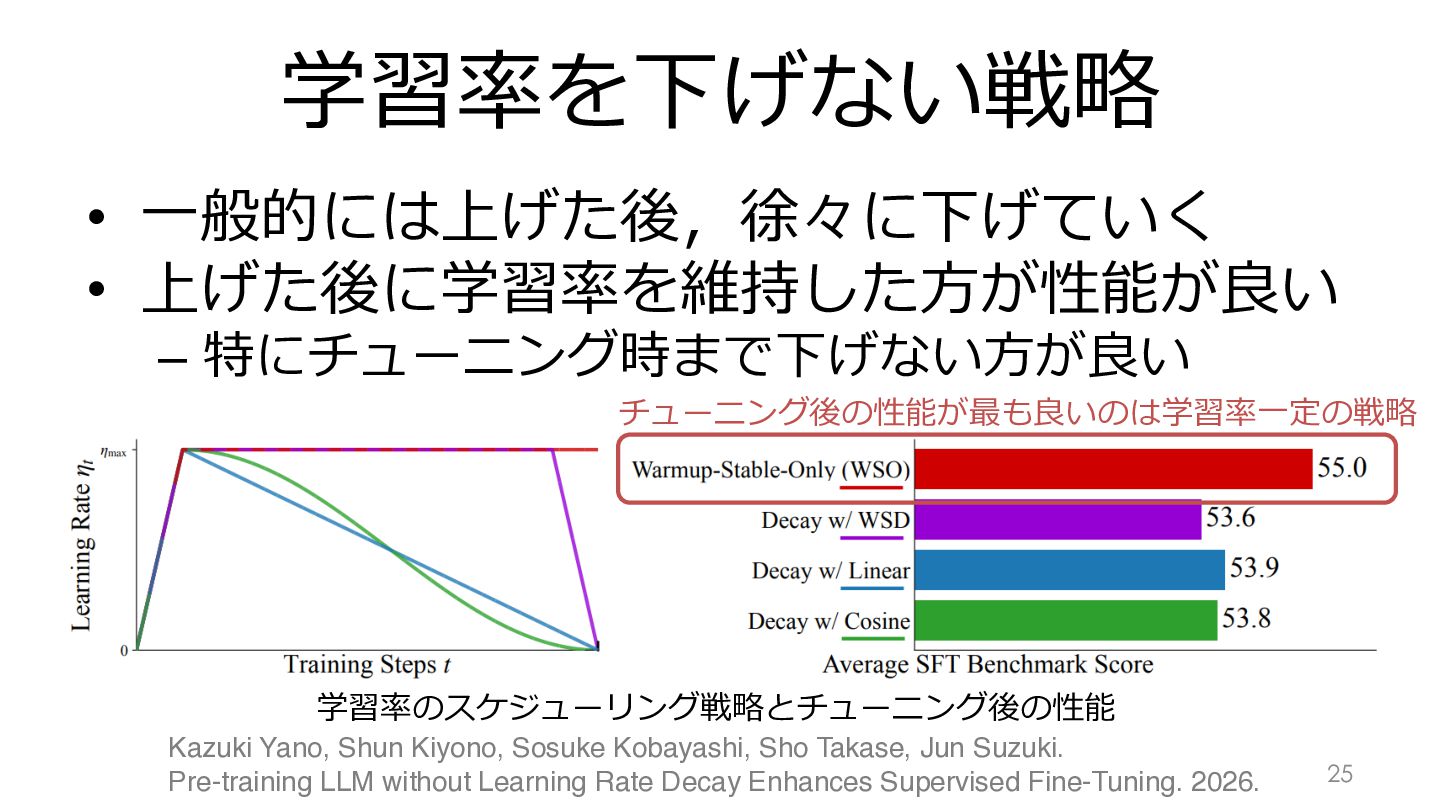
  16. 最近の事前学習戦略 • 事前学習も多段階で⾏う場合があり,学習後期で – 数学やコーディングデータを混ぜる – チューニングで⽤いるデータを混ぜる – ⾼品質データの割合を上げる •

    Mid-training(中間学習)と呼ばれる⼿続き • 学習率はどうする︖ – 学習率は徐々に下げていく戦略が⼀般的 – 中間学習で上げて下げる︖ ← 多段階の学習の計画は⾯倒 24
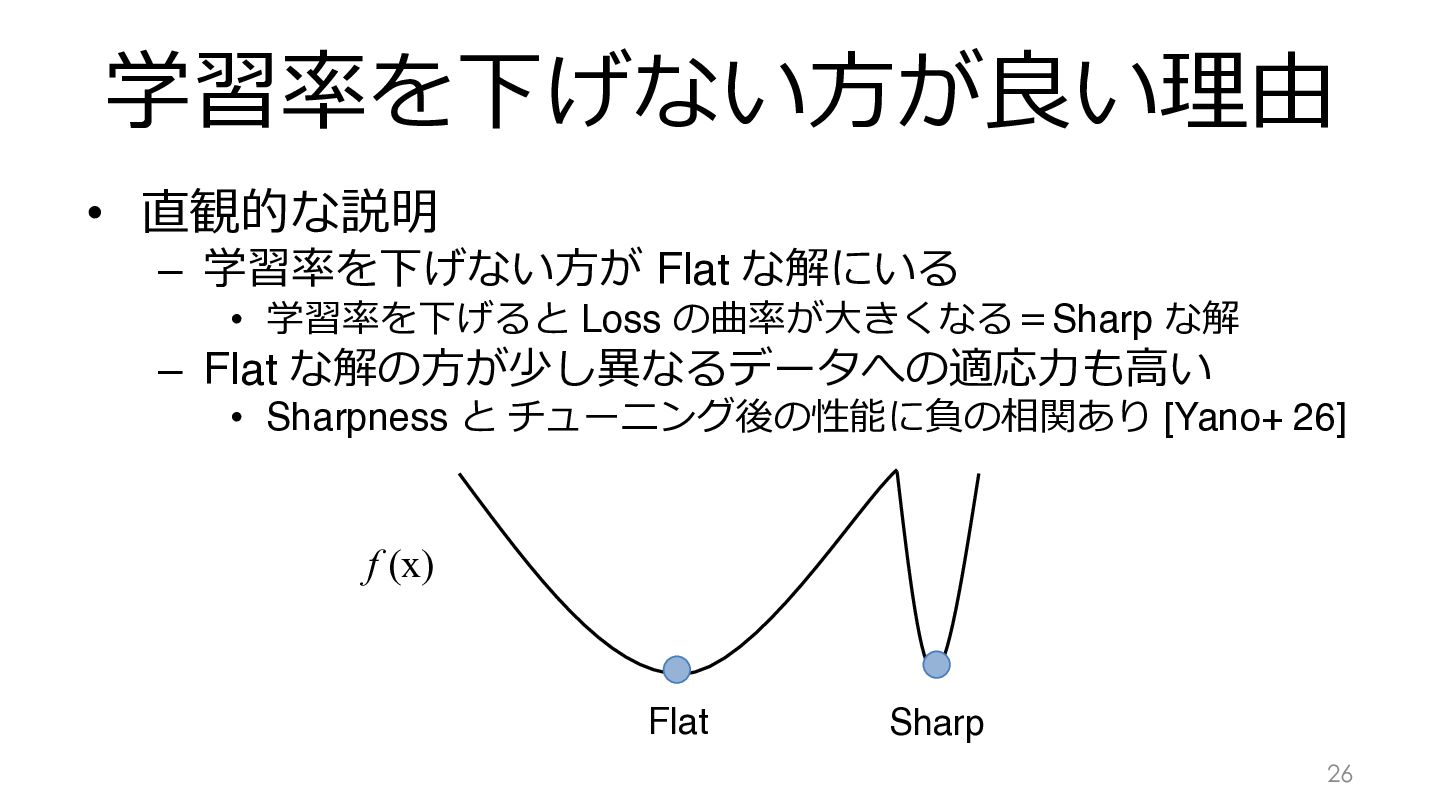
  17. 学習率を下げない⽅が良い理由 • 直観的な説明 – 学習率を下げない⽅が Flat な解にいる • 学習率を下げると Loss

    の曲率が⼤きくなる=Sharp な解 – Flat な解の⽅が少し異なるデータへの適応⼒も⾼い • Sharpness と チューニング後の性能に負の相関あり [Yano+ 26] f (x) Flat Sharp 26
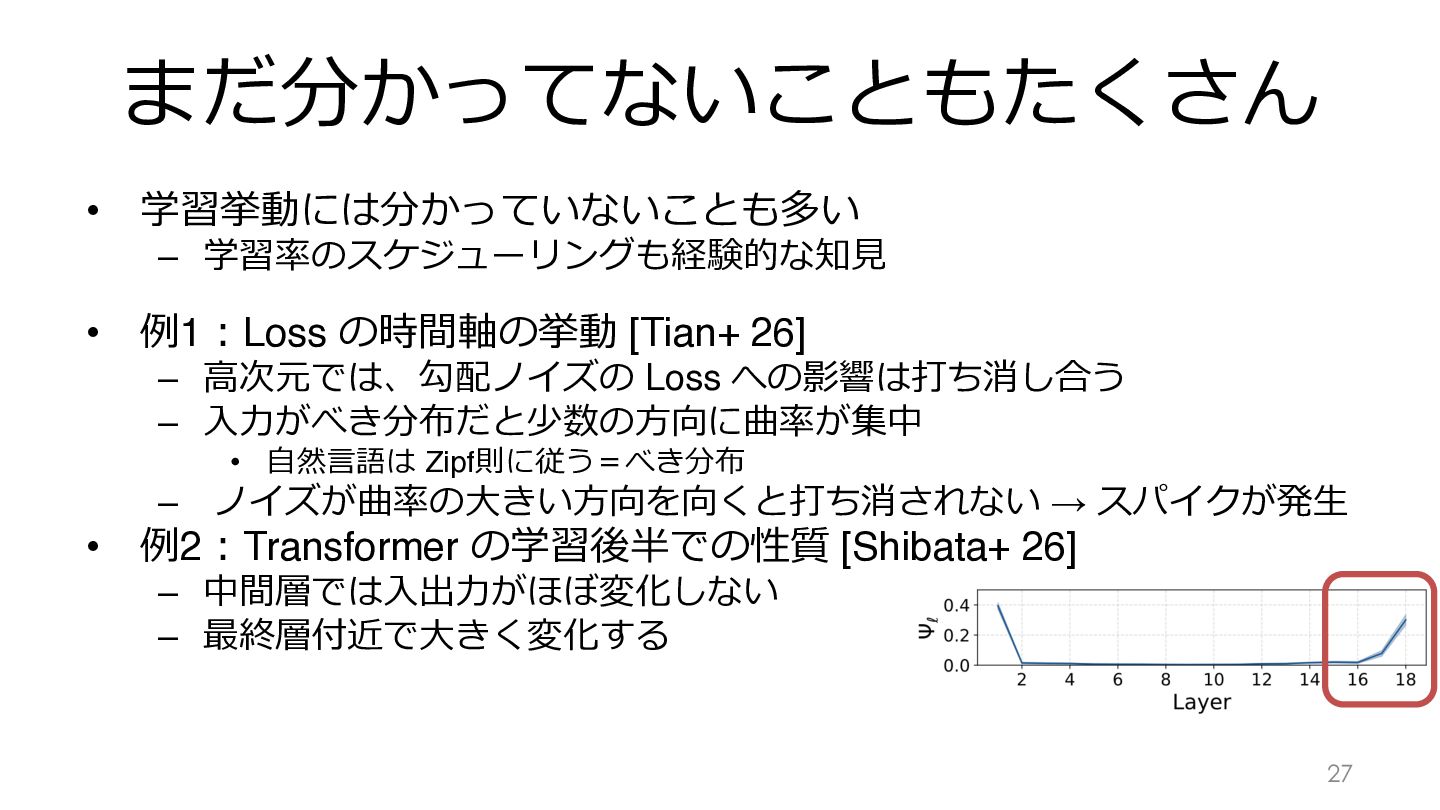
  18. まだ分かってないこともたくさん • 学習挙動には分かっていないことも多い • 例1︓Loss の時間軸の挙動 [Tian+ 26] – 学習率のスケジューリングも経験的な知⾒

    – ⾼次元では、勾配ノイズの Loss への影響は打ち消し合う – ⼊⼒がべき分布だと少数の⽅向に曲率が集中 • ⾃然⾔語は Zipf則に従う=べき分布 • – ノイズが曲率の⼤きい⽅向を向くと打ち消されない → スパイクが発⽣ 例2︓Transformer の学習後半での性質 [Shibata+ 26] – 中間層では⼊出⼒がほぼ変化しない – 最終層付近で⼤きく変化する 27
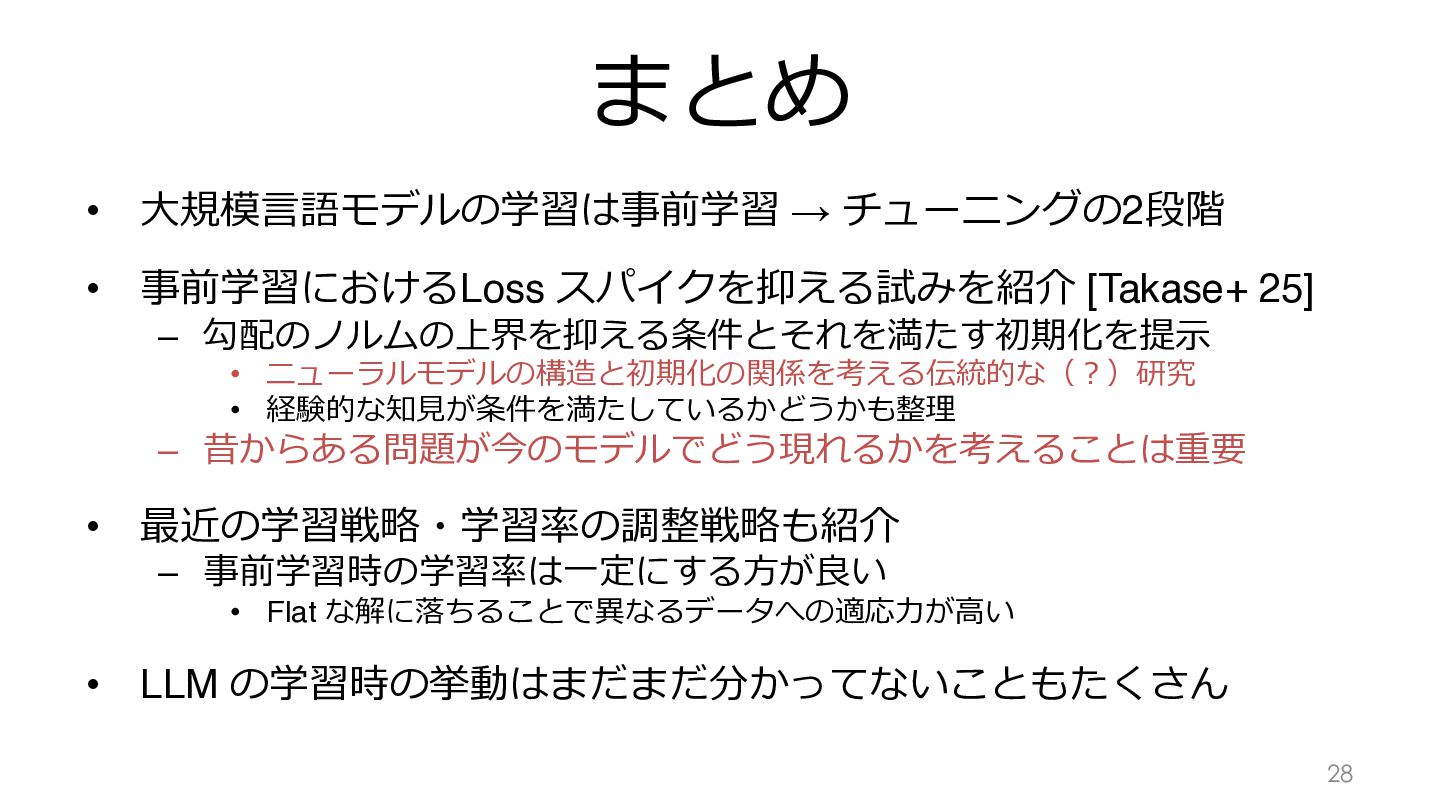
  19. まとめ • ⼤規模⾔語モデルの学習は事前学習 → チューニングの2段階 • 事前学習におけるLoss スパイクを抑える試みを紹介 [Takase+ 25]

    – 勾配のノルムの上界を抑える条件とそれを満たす初期化を提⽰ • ニューラルモデルの構造と初期化の関係を考える伝統的な(︖)研究 • 経験的な知⾒が条件を満たしているかどうかも整理 – 昔からある問題が今のモデルでどう現れるかを考えることは重要 • 最近の学習戦略・学習率の調整戦略も紹介 – 事前学習時の学習率は⼀定にする⽅が良い • Flat な解に落ちることで異なるデータへの適応⼒が⾼い • LLM の学習時の挙動はまだまだ分かってないこともたくさん 28
  20. 参考⽂献(1/2) • • • • • • • • •

    [Azizi+ 26] Looped Language Models: A Survey and Meta-Analysis of Recurrent-Depth Transformers [Takase and Kiyono] Lessons on Parameter Sharing across Layers in Transformers [Gekhman+ 24] Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations? [Kaplan+ 20] Scaling Laws for Neural Language Models [Le Scao+ 22] What Language Model to Train if You Have One Million GPU Hours? [Zeng+ 23] GLM-130B: An Open Bilingual Pre-trained Model [Nishida+ 24] Initialization of Large Language Models via Reparameterization to Mitigate Loss Spikes [Takase+ 25] Spike No More: Stabilizing the Pre-training of Large Language Models [Zhang+ 22] OPT: Open Pre-trained Transformer Language Models 29
  21. 参考⽂献(2/2) • • • • • • • • [Chowdhery+

    22] PaLM: Scaling Language Modeling with Pathways [Tian+ 26] Simulating Training Spikes of Deep Neural Networks by Layer-wise Random Feature Models [Li+ 22] The Stability-Efficiency Dilemma: Investigating Sequence Length Warmup for Training GPT Models [Glorot+ 10] Understanding the Difficulty of Training Deep Feedforward Neural Networks [He+ 15] Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification [Yang+ 21] Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer [Yano+ 26] Pre-training LLM without Learning Rate Decay Enhances Supervised FineTuning [Shibata+ 26] Suppressing Final Layer Hidden State Jumps in Transformer Pretraining 30