Share
Embed
Point Cloud as a Foreign Language for Multi-modal Large Language Model
第67回コンピュータビジョン勉強会@関東「CVPR2026読み会」(後編)発表資料
https://kantocv.connpass.com/event/397925/
Takuya MINAGAWA
August 28, 2026
Transcript
26 slides
-
第67回 CV勉強会@関東「CVPR2026読み会(後編)」 Point Cloud as a Foreign Language for Multi-modal
Large Language Model 2026/08/29 takmin -
自己紹介 株式会社ビジョン&ITラボ 代表取締役 皆川 卓也(みながわ たくや) 博士(工学) 「コンピュータビジョン勉強会@関東」主催 株式会社フューチャースタンダード 技術顧問
略歴: 1999-2003年 日本HP(後にアジレント・テクノロジーへ分社)にて、ITエンジニアとしてシステム構築、プリ セールス、プロジェクトマネジメント、サポート等の業務に従事 2004-2009年 コンピュータビジョンを用いたシステム/アプリ/サービス開発等に従事 2007-2010年 慶應義塾大学大学院 後期博士課程にて、コンピュータビジョンを専攻 単位取得退学後、博士号取得(2014年) 2009年-現在 フリーランスとして、コンピュータビジョンのコンサル/研究/開発等に従事(2018年法人化) 2 http://visitlab.jp -
紹介する論文 Point Cloud as a Foreign Language for Multi-modal
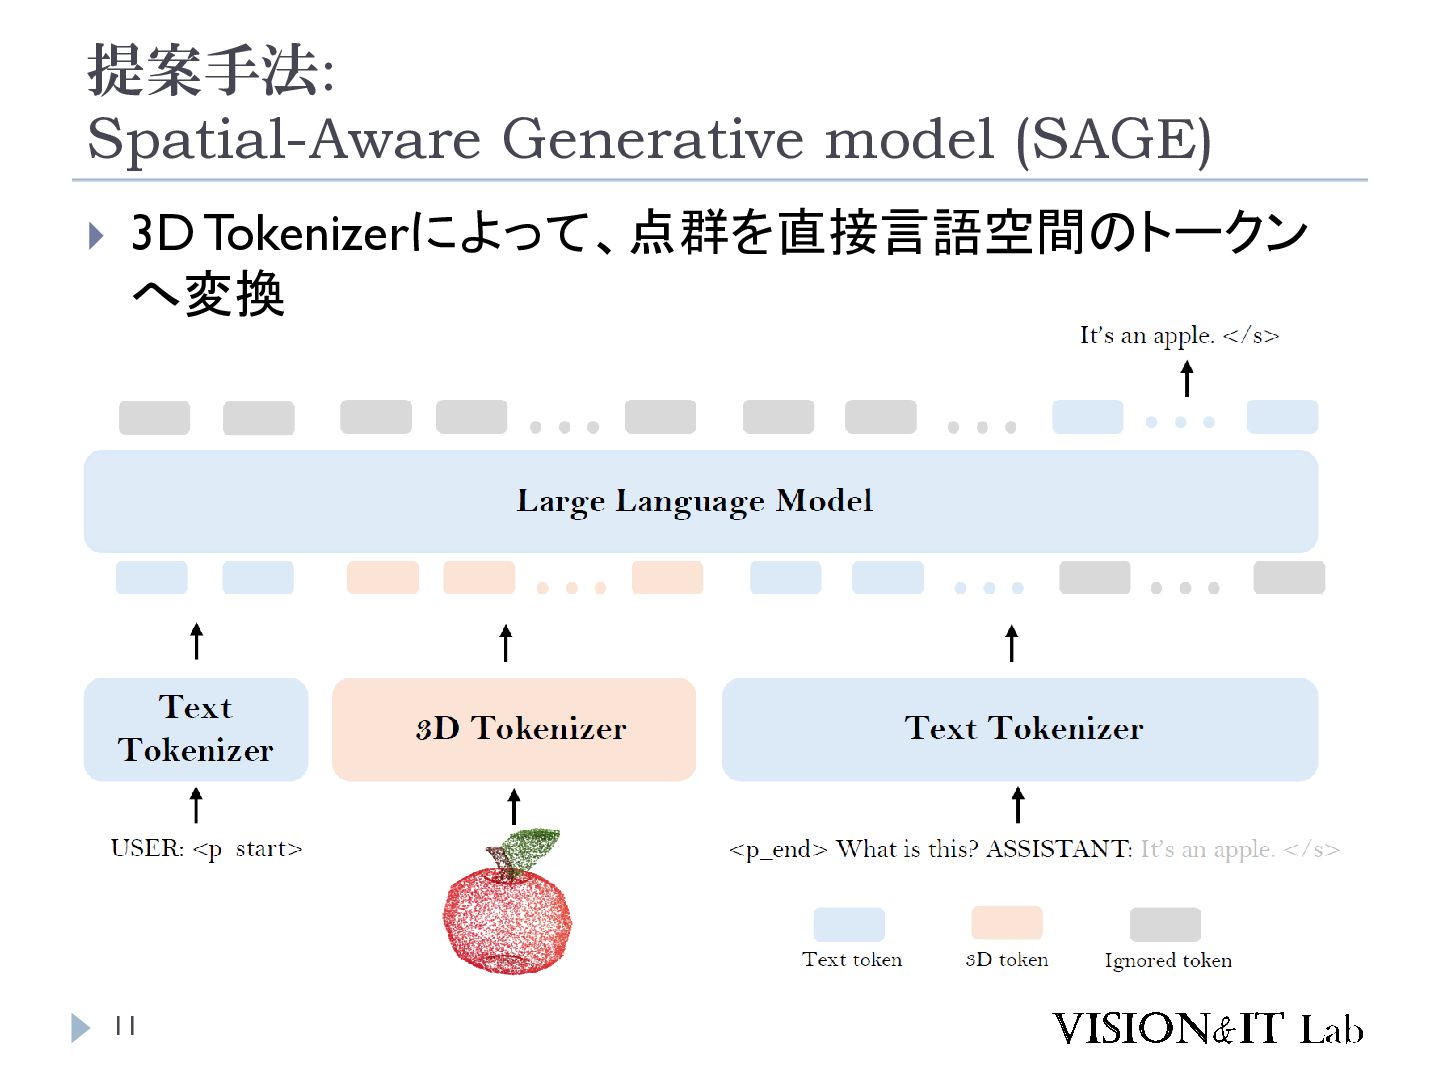
Large Language Model Sneha Paul, Zachary Patterson, Nizar Bouguila Concordia University, Canada 従来の3D Multi-model LLMに対して、事前学習済みの 巨大な3Dエンコーダーを使用せず、生の点群を「外国 語」のように扱うことで、End-to-Endで直接LLMへのマッ ピングを学習するSAGE (Spatial-Aware GEnerative model)を提案 3 -
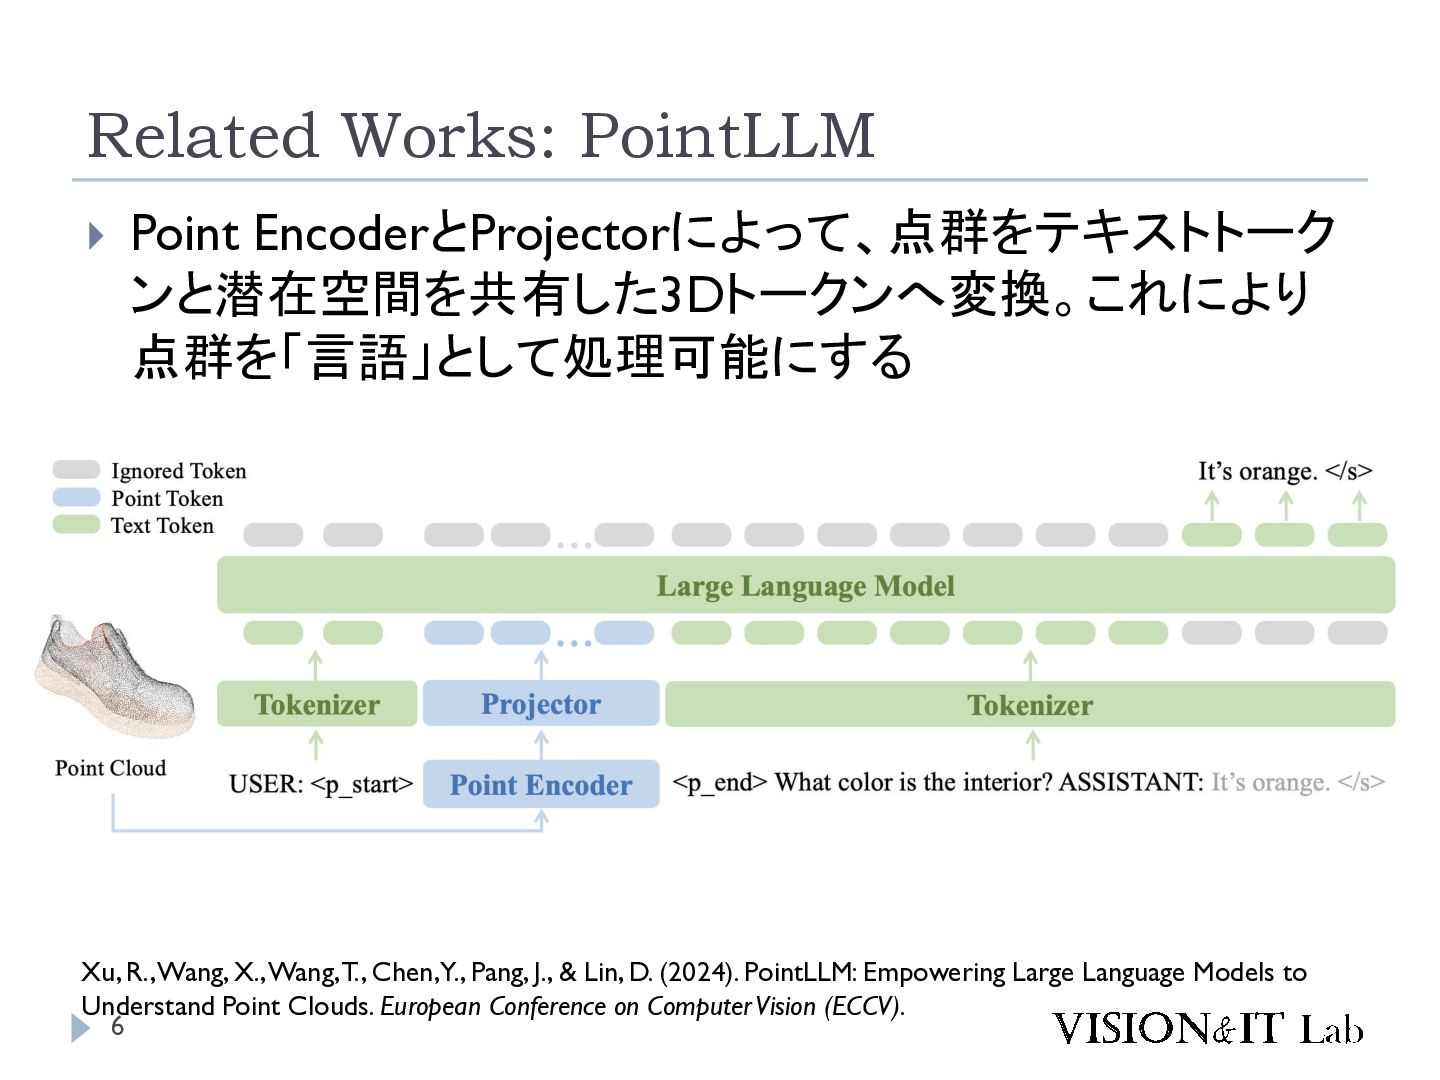
Related Works: PointLLM Point EncoderとProjectorによって、点群をテキストトーク ンと潜在空間を共有した3Dトークンへ変換。これにより 点群を「言語」として処理可能にする Xu, R.,
Wang, X., Wang, T., Chen,Y., Pang, J., & Lin, D. (2024). PointLLM: Empowering Large Language Models to Understand Point Clouds. European Conference on Computer Vision (ECCV). 6 -
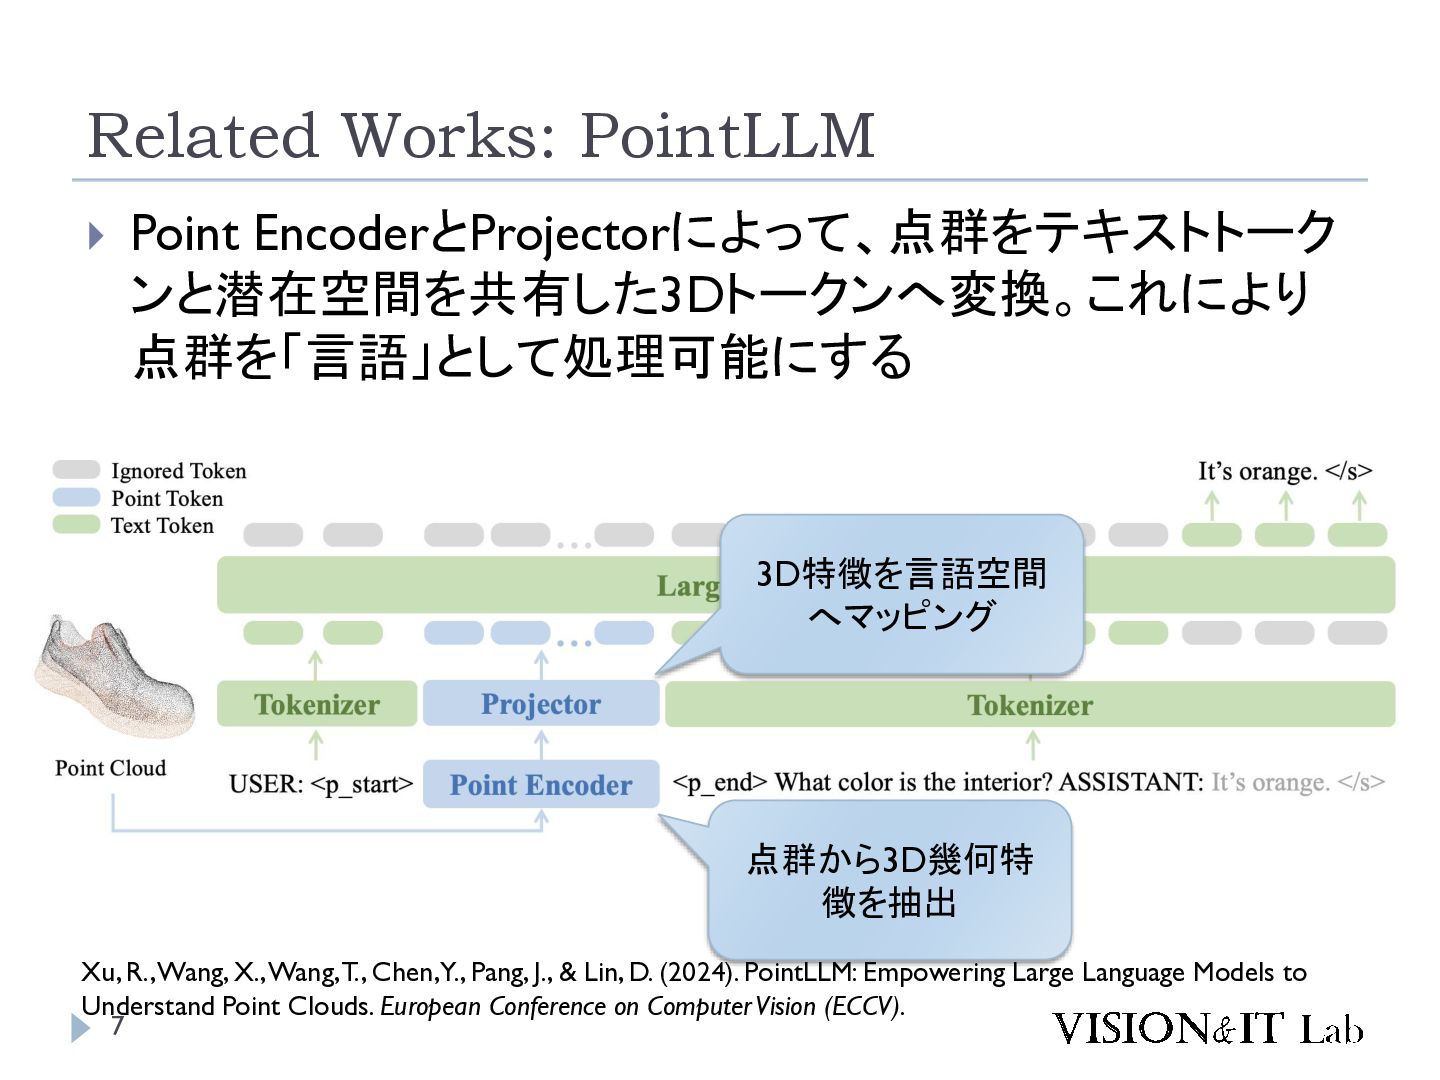
Related Works: PointLLM Point EncoderとProjectorによって、点群をテキストトーク ンと潜在空間を共有した3Dトークンへ変換。これにより 点群を「言語」として処理可能にする 3D特徴を言語空間 へマッピング
点群から3D幾何特 徴を抽出 Xu, R., Wang, X., Wang, T., Chen,Y., Pang, J., & Lin, D. (2024). PointLLM: Empowering Large Language Models to Understand Point Clouds. European Conference on Computer Vision (ECCV). 7 -
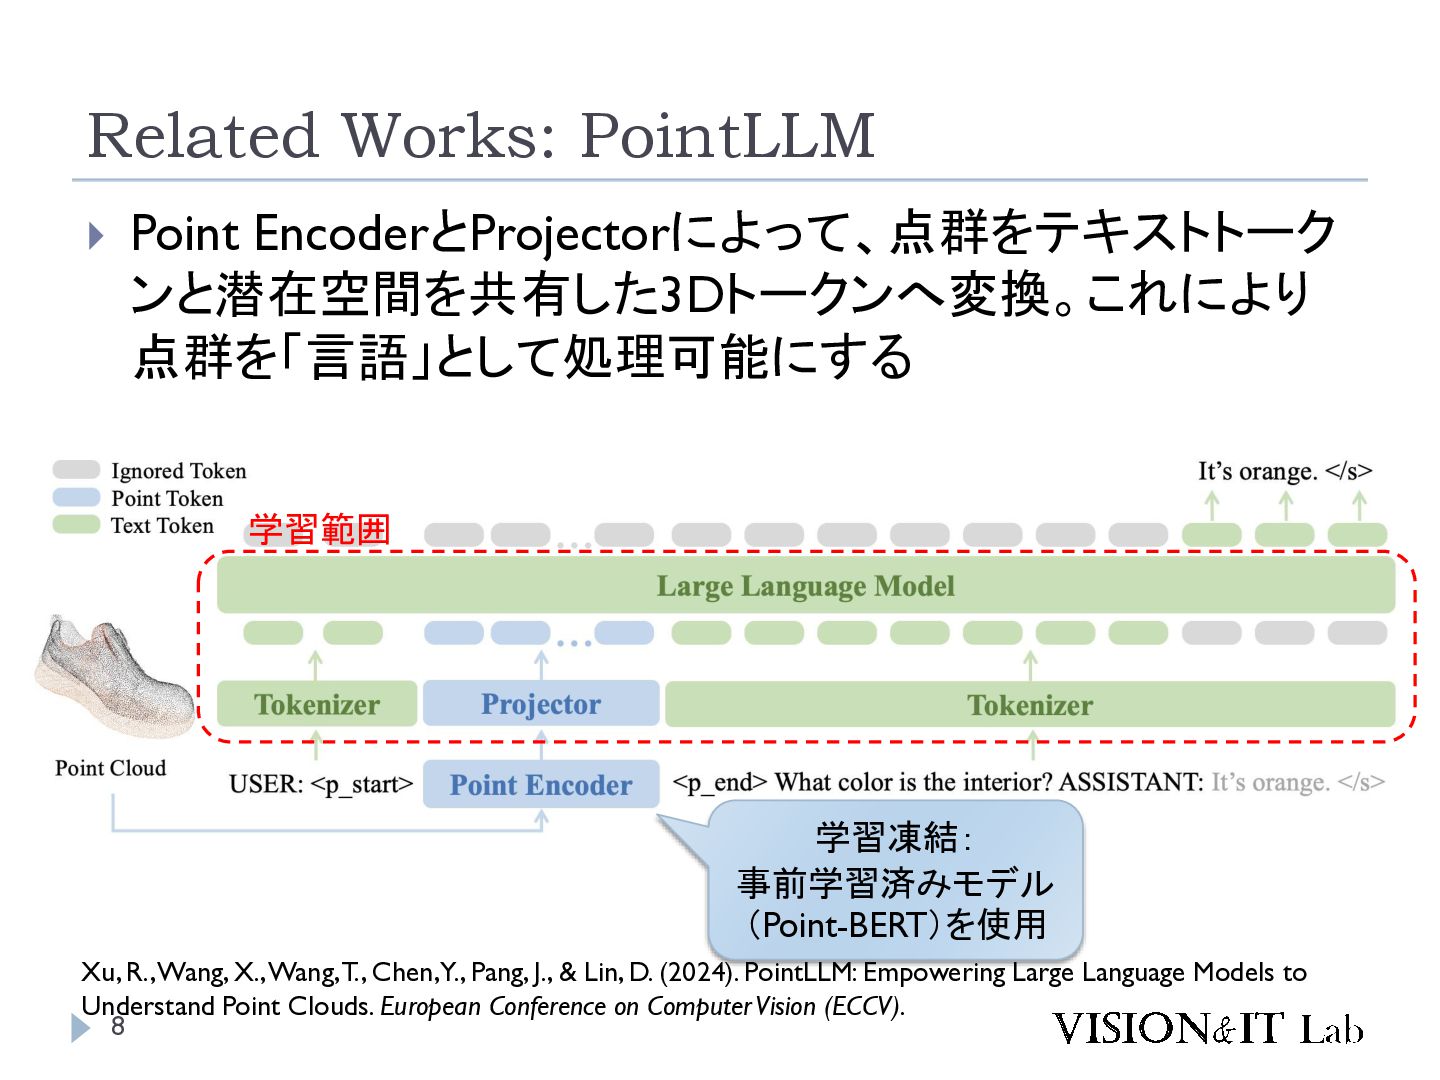
Related Works: PointLLM Point EncoderとProjectorによって、点群をテキストトーク ンと潜在空間を共有した3Dトークンへ変換。これにより 点群を「言語」として処理可能にする 学習範囲 学習凍結:
事前学習済みモデル (Point-BERT)を使用 Xu, R., Wang, X., Wang, T., Chen,Y., Pang, J., & Lin, D. (2024). PointLLM: Empowering Large Language Models to Understand Point Clouds. European Conference on Computer Vision (ECCV). 8 -
事前学習済みエンコーダーの限界 セマンティックな不一致 幾何的な問題を解くように訓練されたエンコーダの情報は、言 語問題を解くためには最適化されていない 解像度のミスマッチ エンコーダの入力は固定サイズが前提のため、巨大な点群で
は詳細が切り落とされ、小さな点群では余計な補間がされて しまう。 膨大な計算コスト 9 巨大なエンコーダによる前処理が、高速な推論を行うにあ たってのボトルネックになる。 -
事前学習済みエンコーダーの限界 セマンティックな不一致 幾何的な問題を解くように訓練されたエンコーダの情報は、言 語問題を解くためには最適化されていない 解像度のミスマッチ 軽量な3D
Tokenizerで、LLMへの入力 エンコーダの入力は固定サイズが前提のため、巨大な点群で は詳細が切り落とされ、小さな点群では余計な補間がされて となる離散トークンを直接推定! しまう。 膨大な計算コスト 10 巨大なエンコーダによる前処理が、高速な推論を行うにあ たってのボトルネックになる。 -
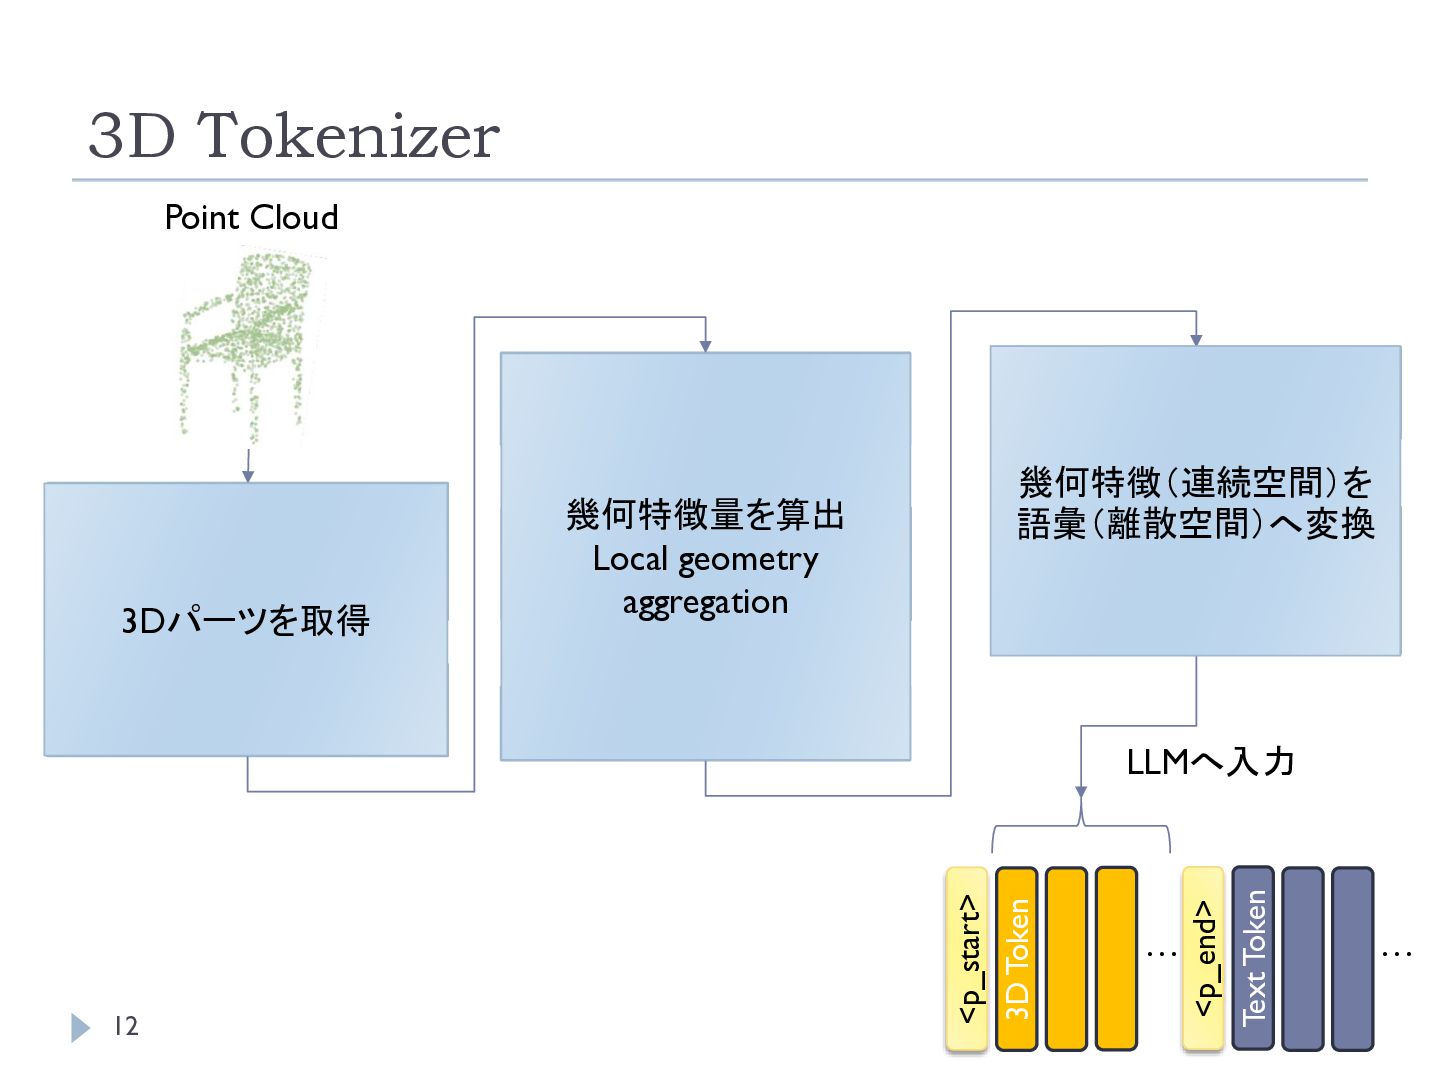
3D Tokenizer Point Cloud LLM空間へ投影 (Linear) 相対位置埋め込み 12 LLMへ入力 …
Text Token Max-Pooling <p_end> K近傍点取得 (学習可能なコードブック を用いたベクトル量子化) 3D Token 幾何特徴量を算出 幾何特徴空間へ投影 Local geometry (Linear) aggregation <p_start> 点のサンプリング (Farthest Point Sampling) 3Dパーツを取得 幾何特徴(連続空間)を 語彙(離散空間)へ変換 3D Tokenへ変換 … -
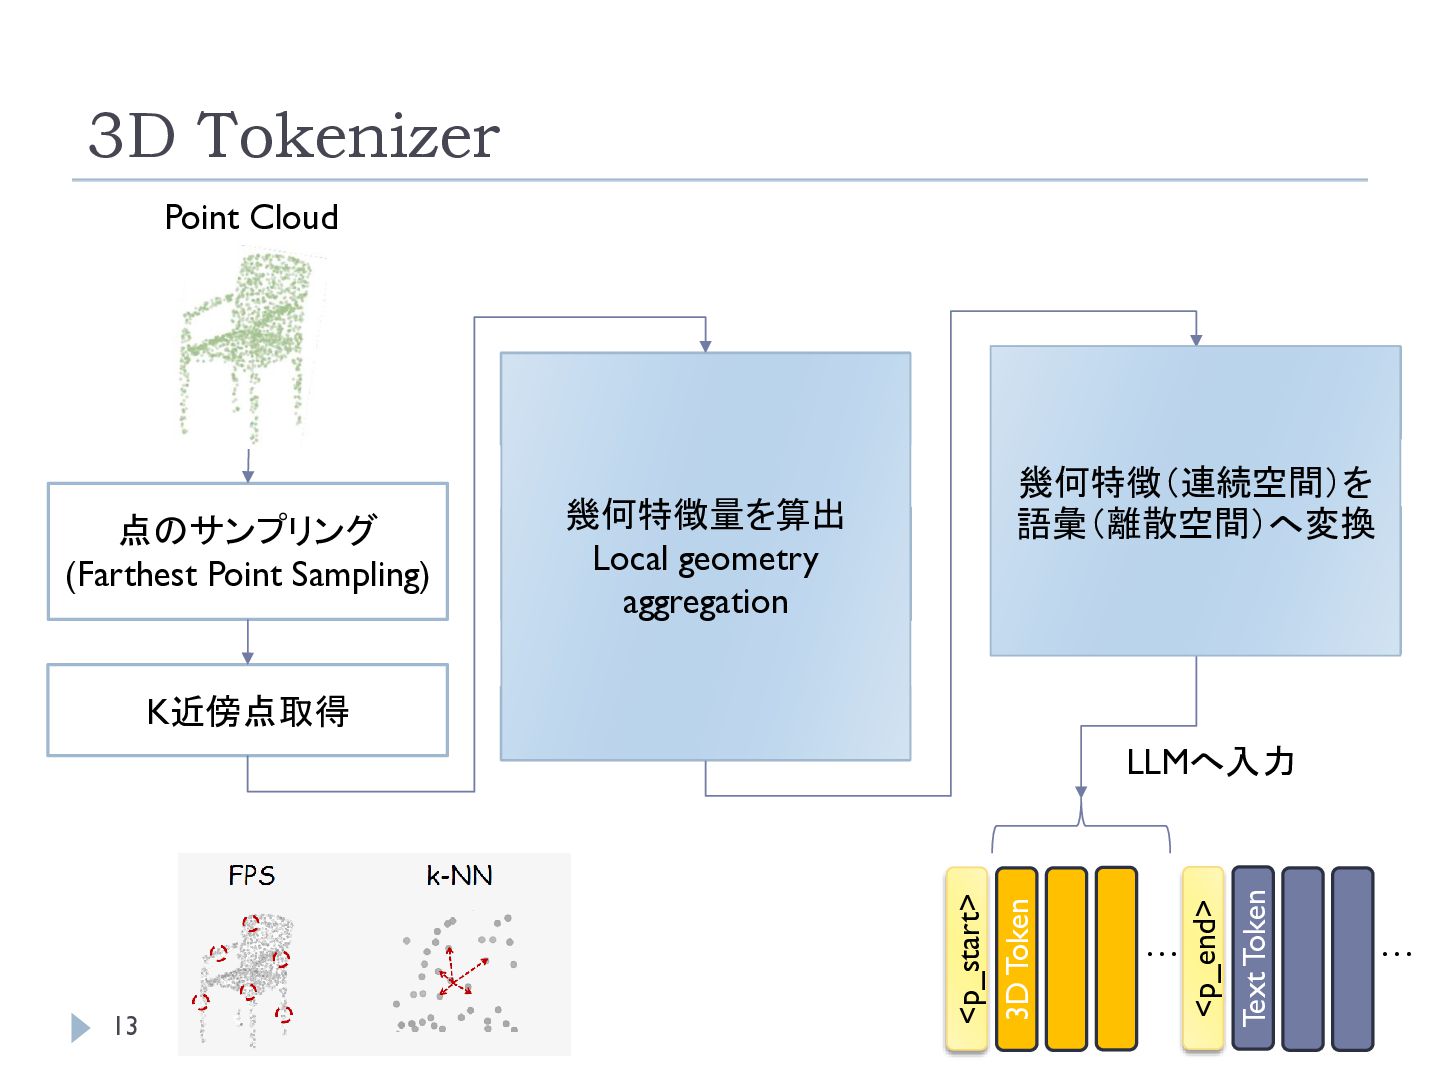
3D Tokenizer Point Cloud LLM空間へ投影 (Linear) 相対位置埋め込み 13 LLMへ入力 …
Text Token Max-Pooling <p_end> K近傍点取得 (学習可能なコードブック を用いたベクトル量子化) 3D Token 幾何特徴量を算出 幾何特徴空間へ投影 Local geometry (Linear) aggregation <p_start> 点のサンプリング (Farthest Point Sampling) 幾何特徴(連続空間)を 語彙(離散空間)へ変換 3D Tokenへ変換 … -
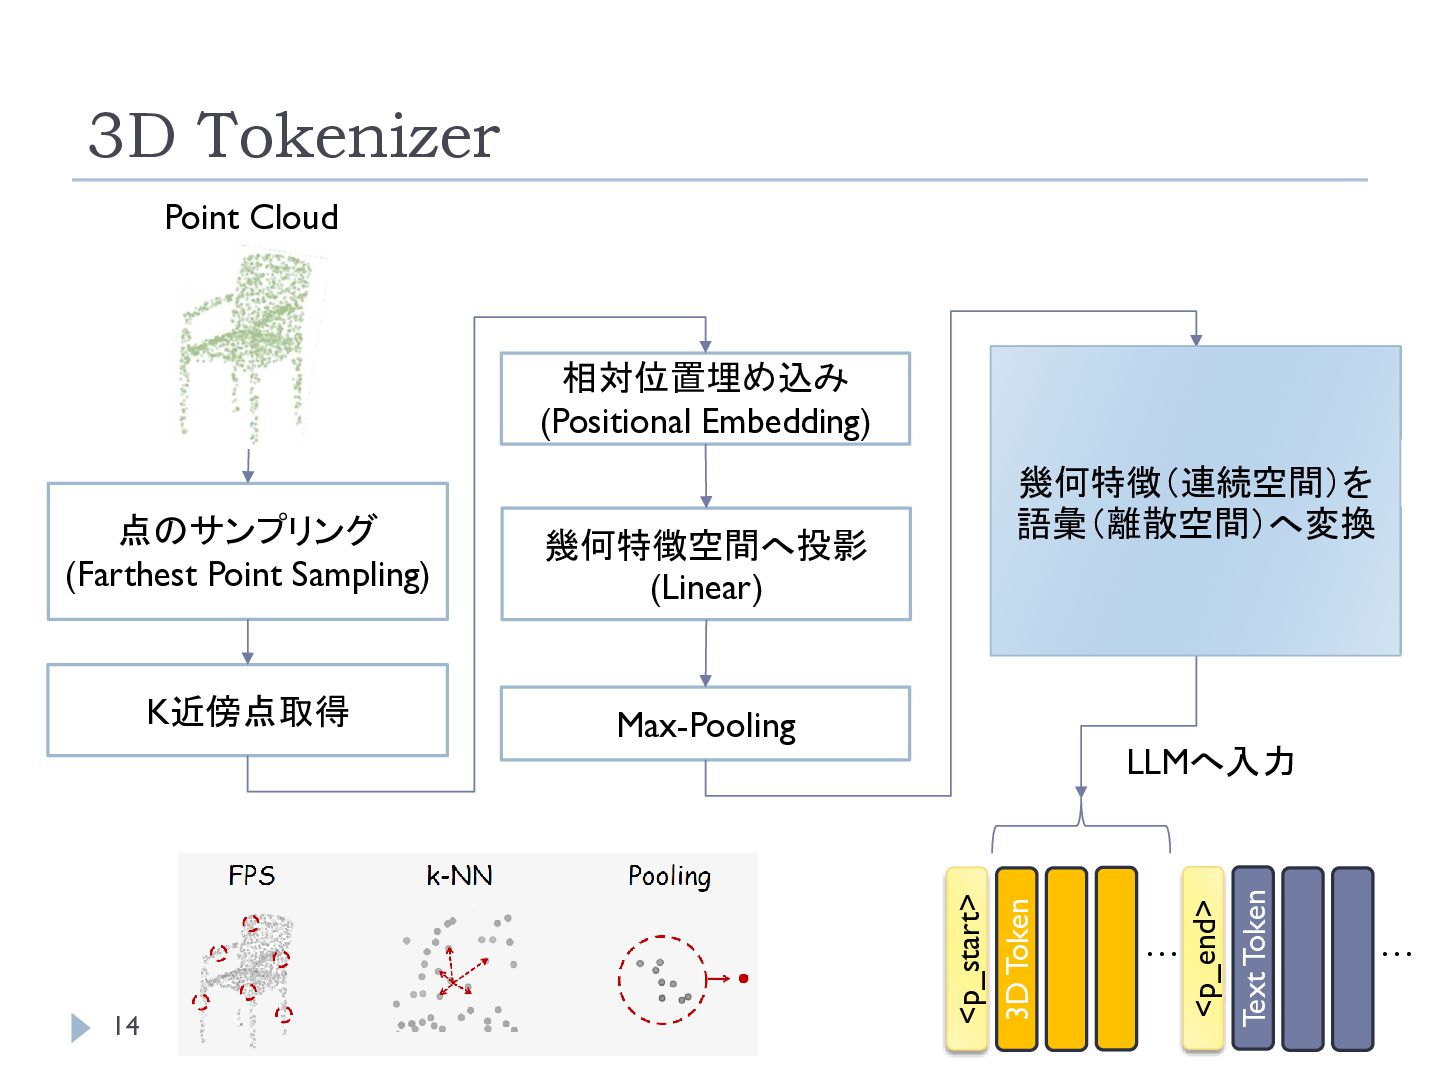
3D Tokenizer Point Cloud LLM空間へ投影 (Linear) 相対位置埋め込み (Positional Embedding) 14
LLMへ入力 … Text Token Max-Pooling <p_end> K近傍点取得 (学習可能なコードブック を用いたベクトル量子化) 3D Token 幾何特徴空間へ投影 (Linear) <p_start> 点のサンプリング (Farthest Point Sampling) 幾何特徴(連続空間)を 語彙(離散空間)へ変換 3D Tokenへ変換 … -
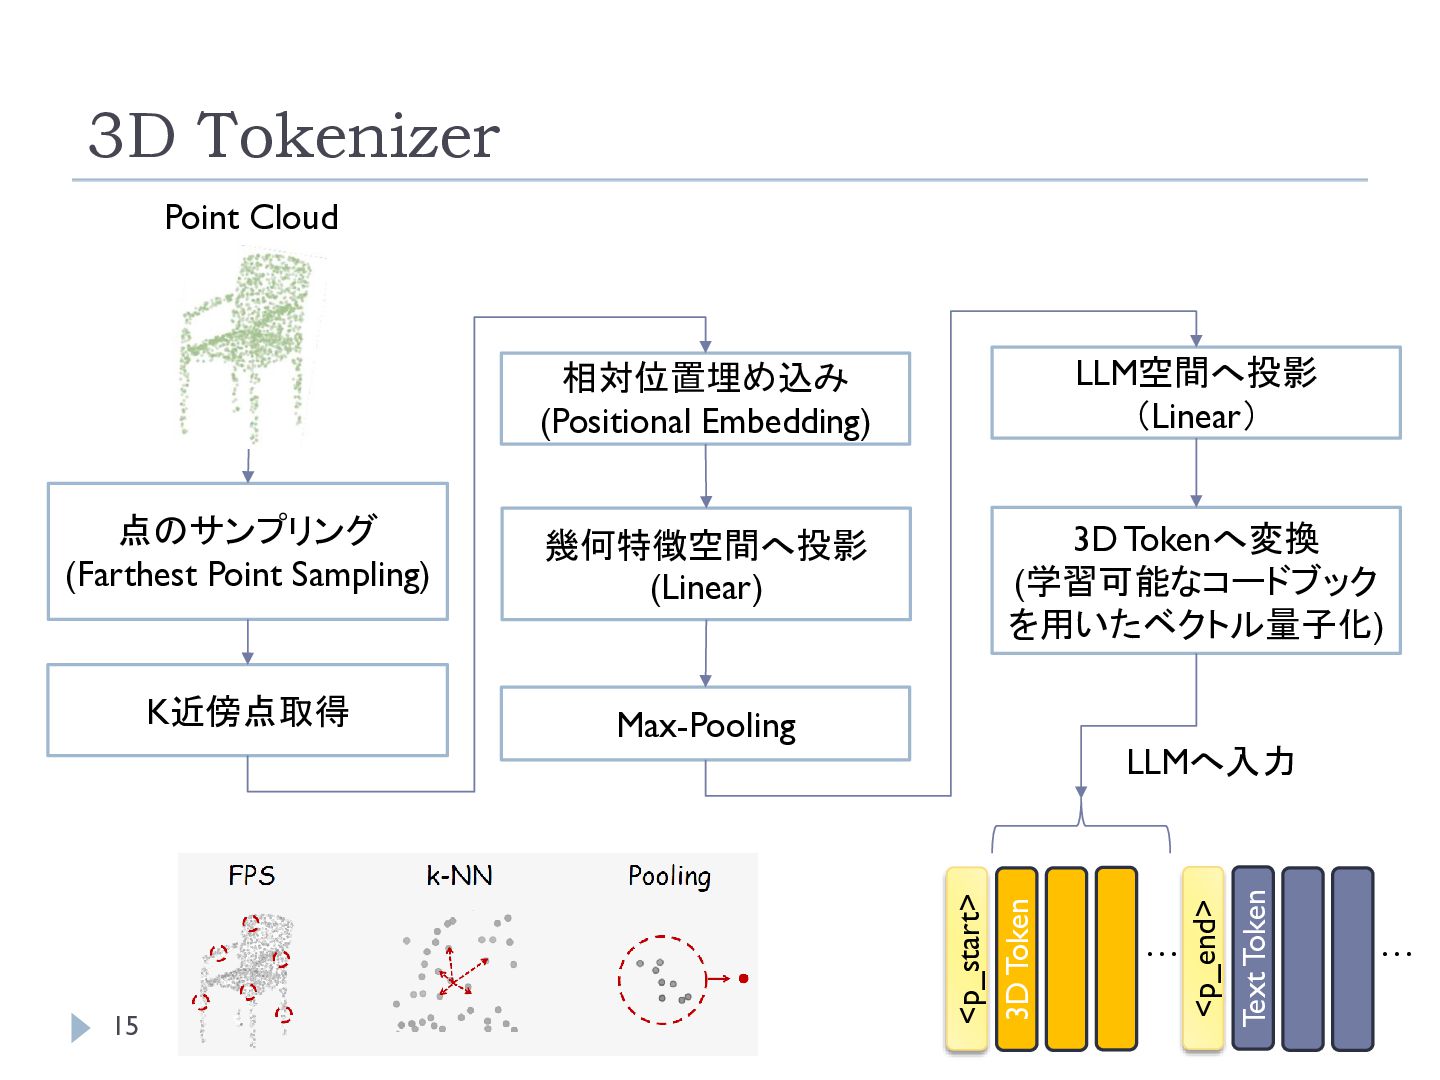
3D Tokenizer Point Cloud 相対位置埋め込み (Positional Embedding) LLM空間へ投影 (Linear) 点のサンプリング
(Farthest Point Sampling) 幾何特徴空間へ投影 (Linear) 3D Tokenへ変換 (学習可能なコードブック を用いたベクトル量子化) K近傍点取得 Max-Pooling Text Token … <p_end> 3D Token <p_start> 15 LLMへ入力 … -
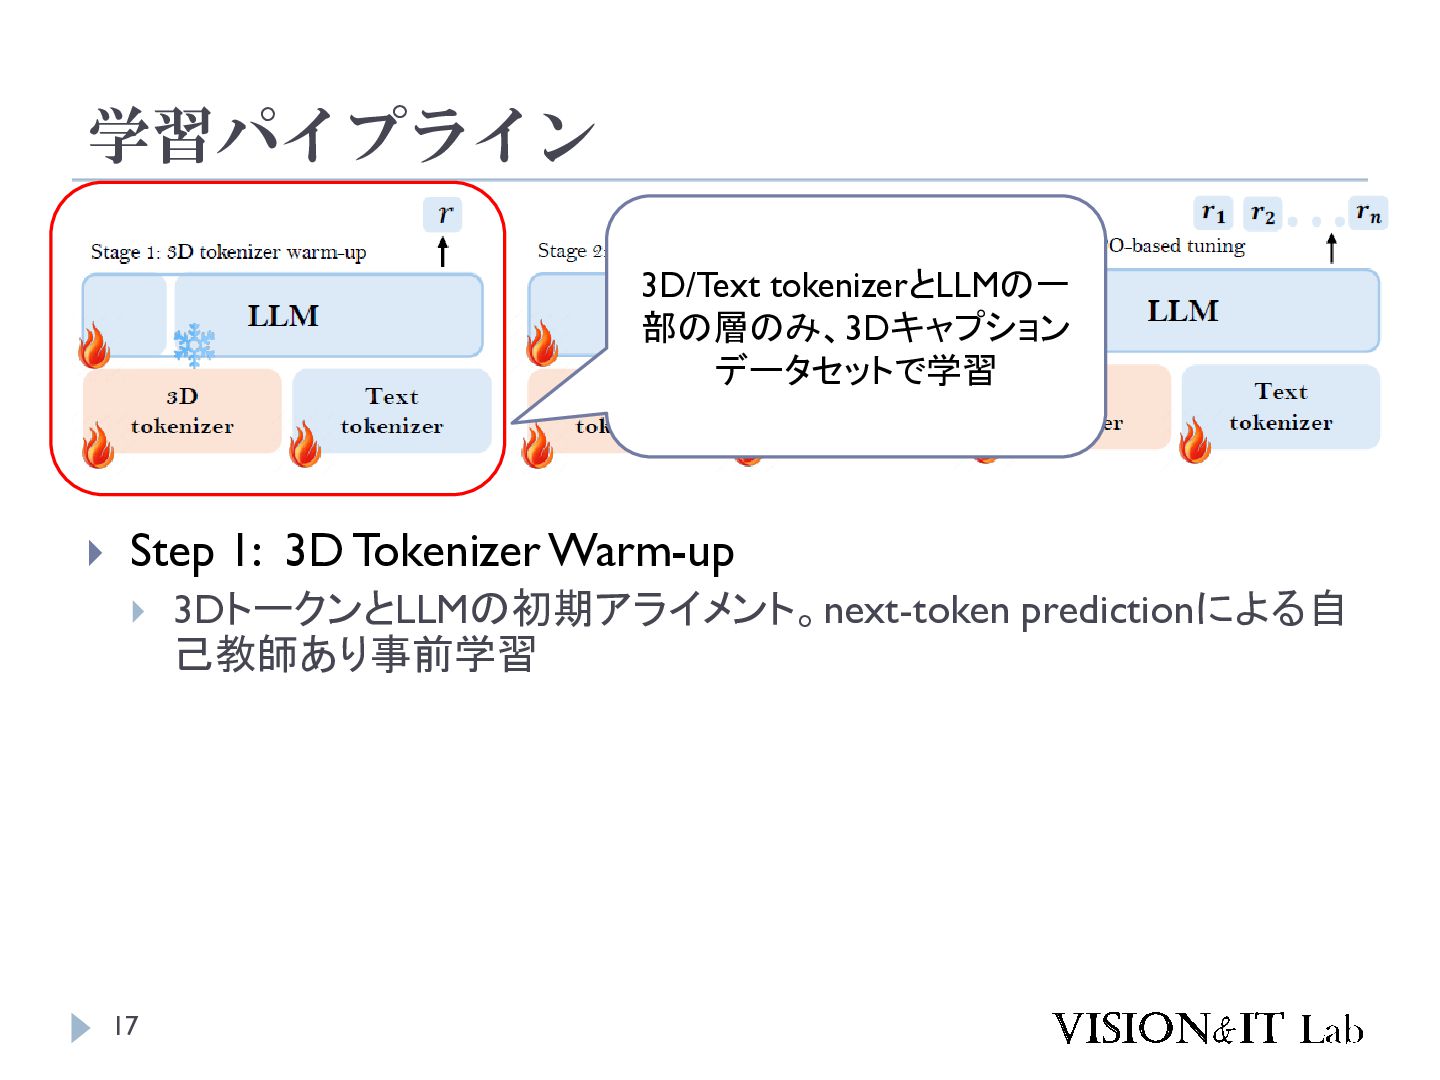
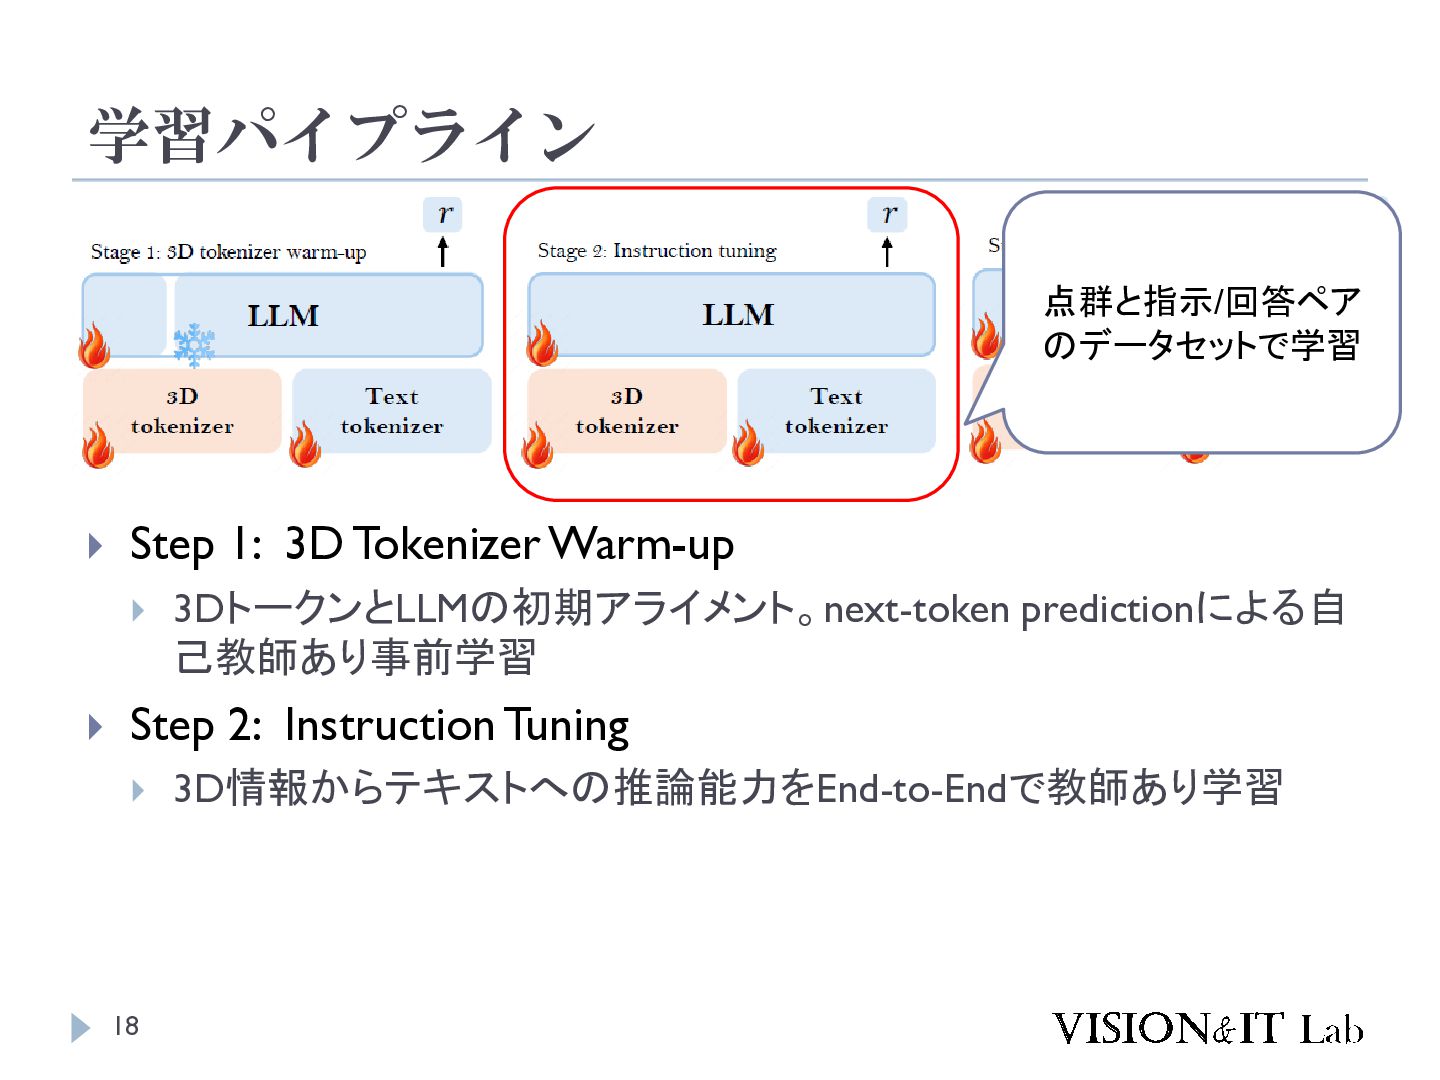
学習パイプライン 3D/Text tokenizerとLLMの一 部の層のみ、3Dキャプション データセットで学習 Step 1: 3D Tokenizer
Warm-up 17 3DトークンとLLMの初期アライメント。next-token predictionによる自 己教師あり事前学習 -
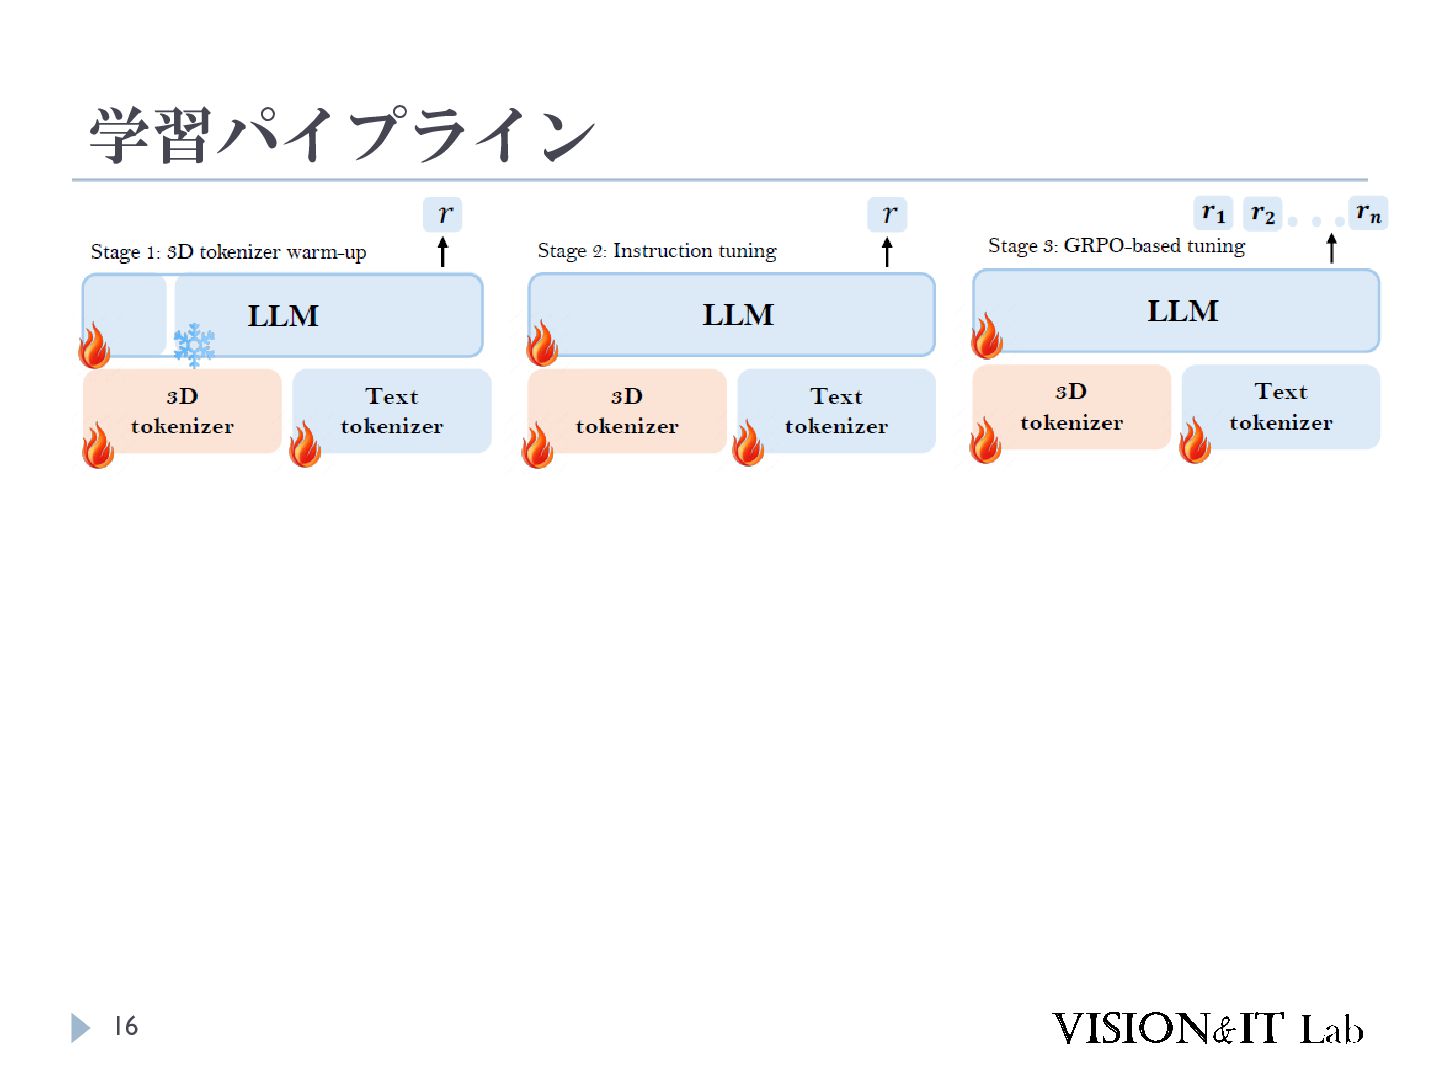
学習パイプライン 点群と指示/回答ペア のデータセットで学習 Step 1: 3D Tokenizer Warm-up
3DトークンとLLMの初期アライメント。next-token predictionによる自 己教師あり事前学習 Step 2: Instruction Tuning 18 3D情報からテキストへの推論能力をEnd-to-Endで教師あり学習 -
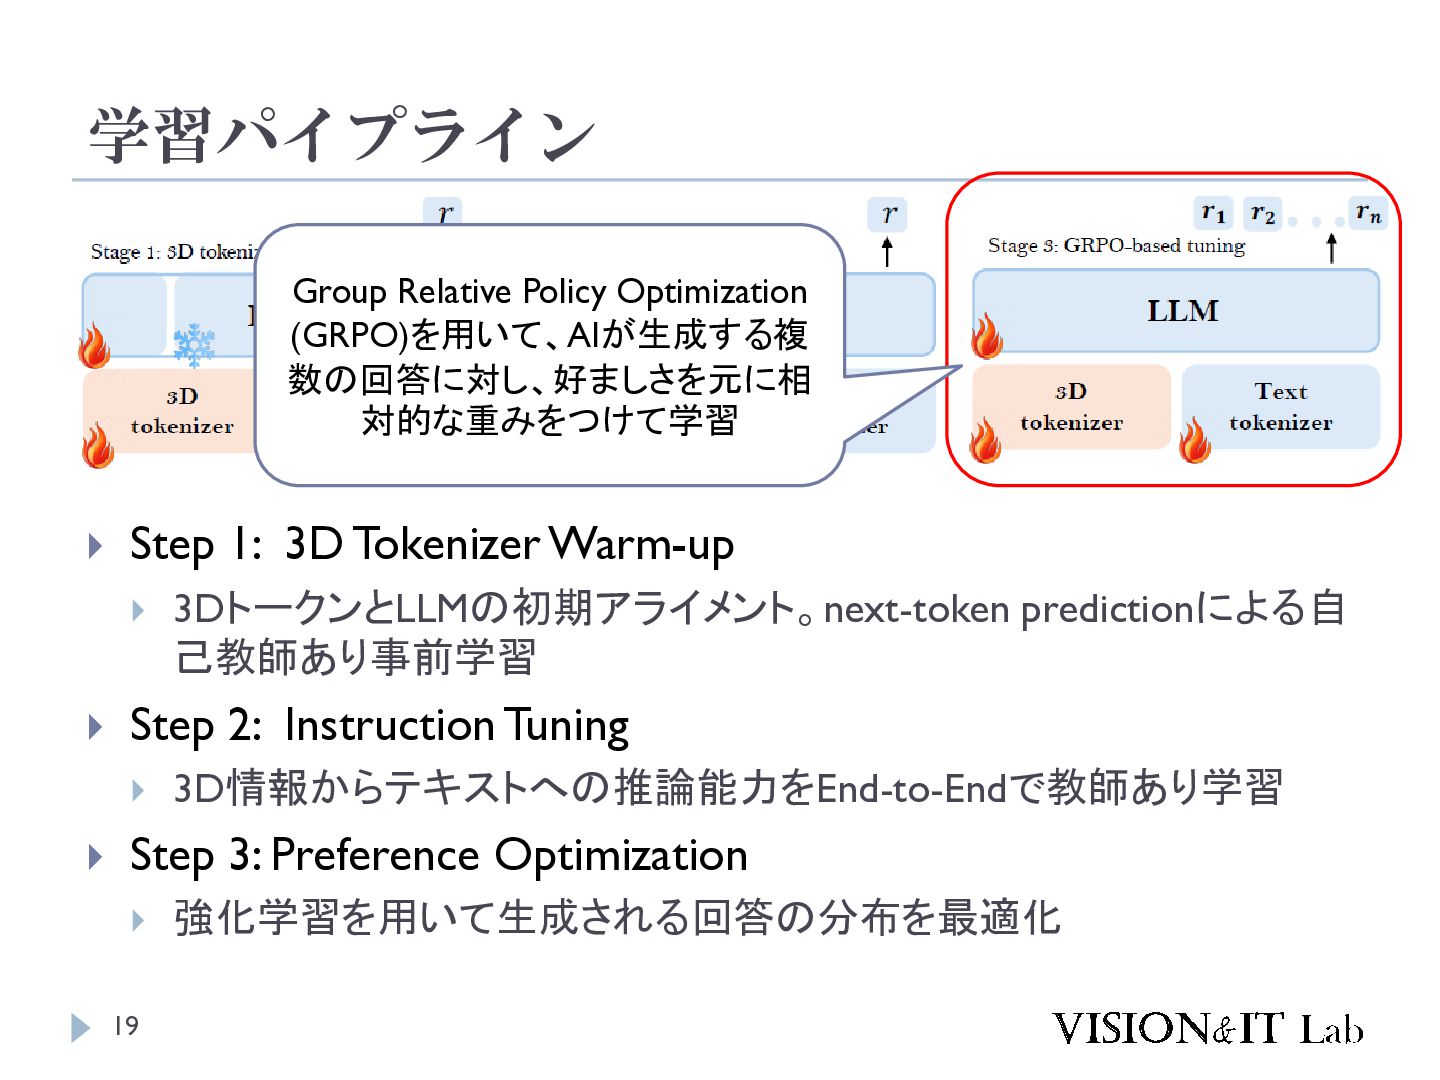
学習パイプライン Group Relative Policy Optimization (GRPO)を用いて、AIが生成する複 数の回答に対し、好ましさを元に相 対的な重みをつけて学習 Step
1: 3D Tokenizer Warm-up 3DトークンとLLMの初期アライメント。next-token predictionによる自 己教師あり事前学習 Step 2: Instruction Tuning 3D情報からテキストへの推論能力をEnd-to-Endで教師あり学習 Step 3: Preference Optimization 19 強化学習を用いて生成される回答の分布を最適化 -
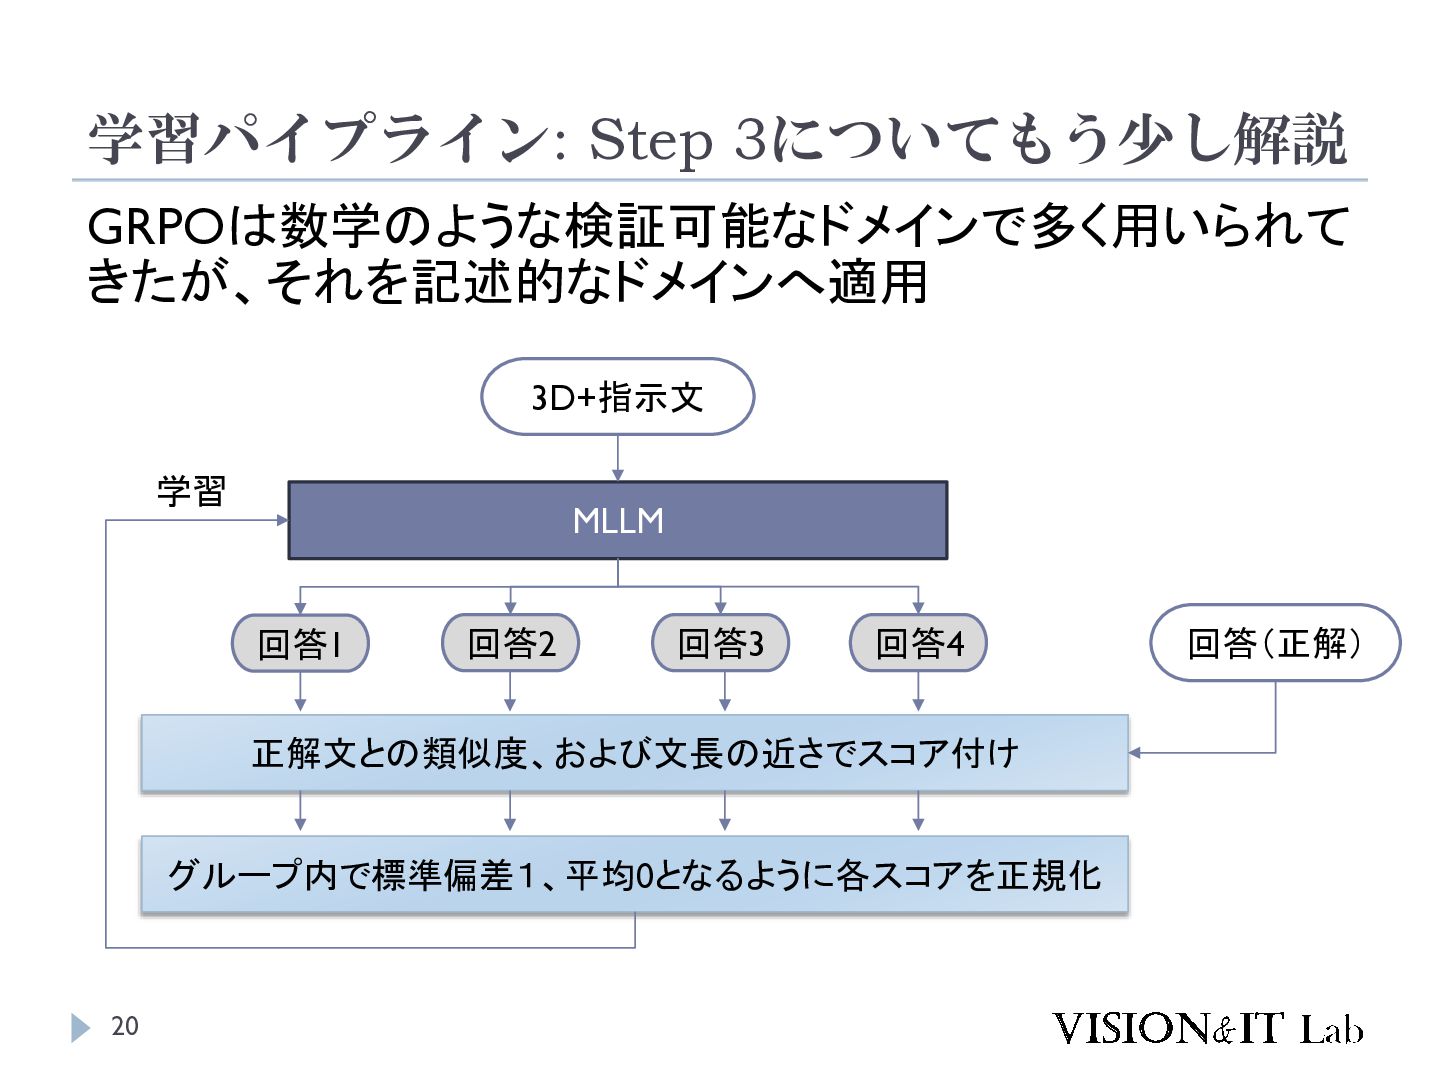
学習パイプライン: Step 3についてもう少し解説 GRPOは数学のような検証可能なドメインで多く用いられて きたが、それを記述的なドメインへ適用 3D+指示文 学習 MLLM 回答1 回答2
回答3 回答4 正解文との類似度、および文長の近さでスコア付け グループ内で標準偏差1、平均0となるように各スコアを正規化 20 回答(正解) -
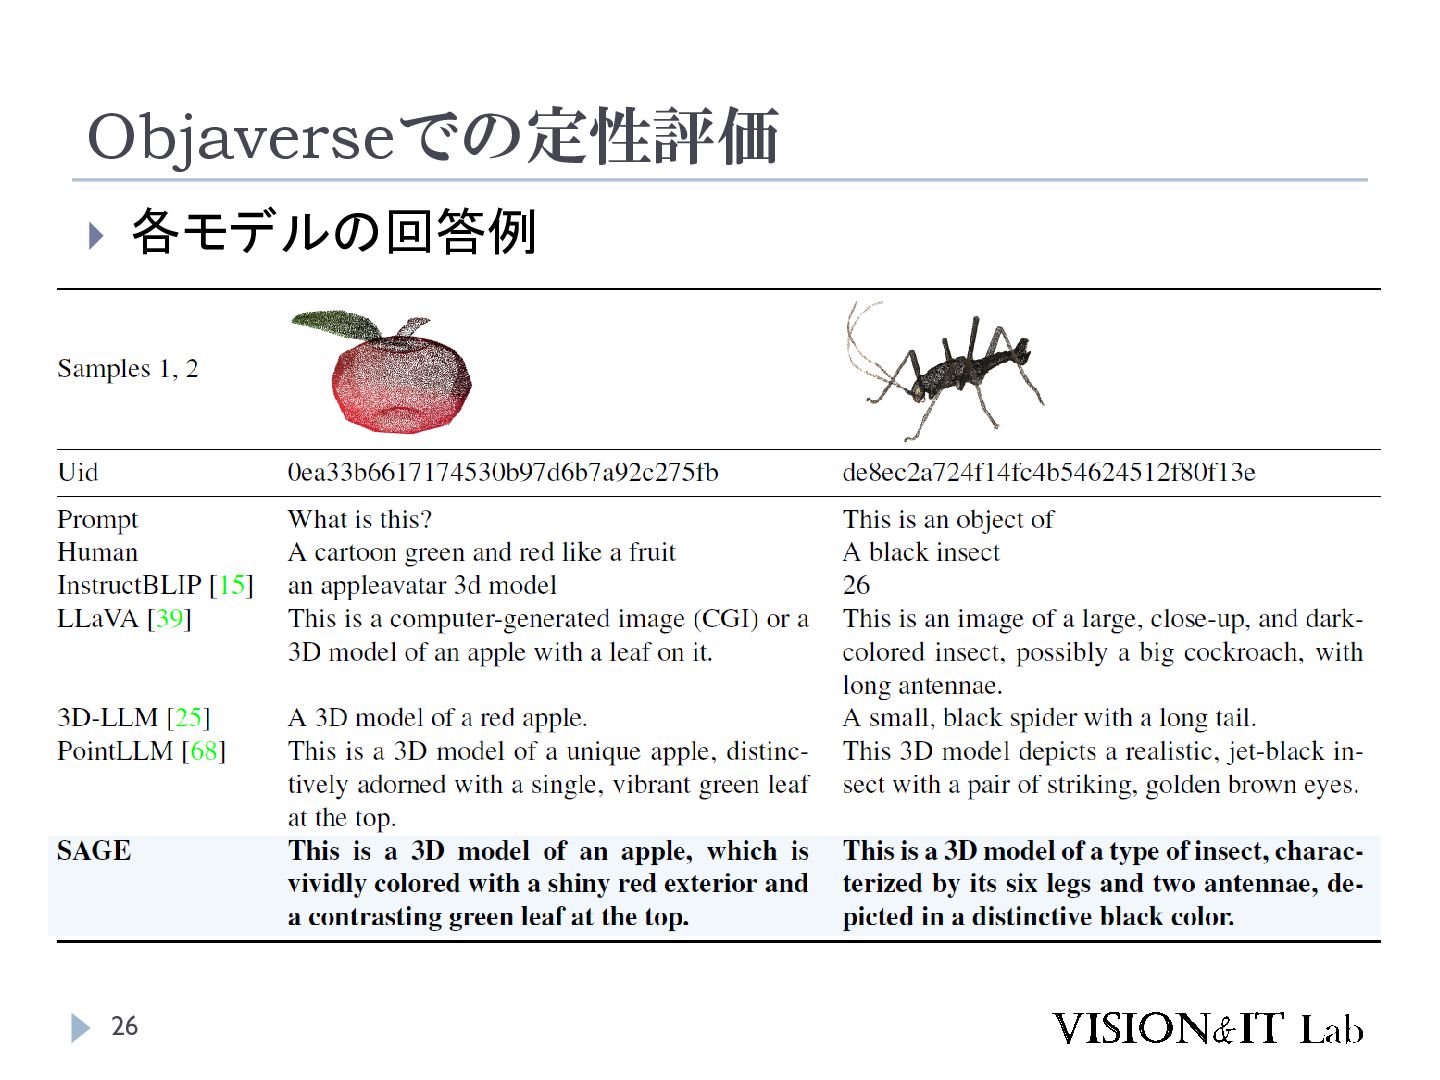
実験:学習データセット PointLLMで提案された大規模な点群-テキスト指示学習 データセットを利用 規模: 73万件以上(>730K)の点群-テキストのペア 対象: Objaverse から収集された約66万個(~660K)のユ
ニークな3Dオブジェクト 内訳: 簡易キャプションデータ(約66万件) Step 1の学習に利用 複雑な指示サンプル(約7万件) Step 2,3の学習に利用 21 -
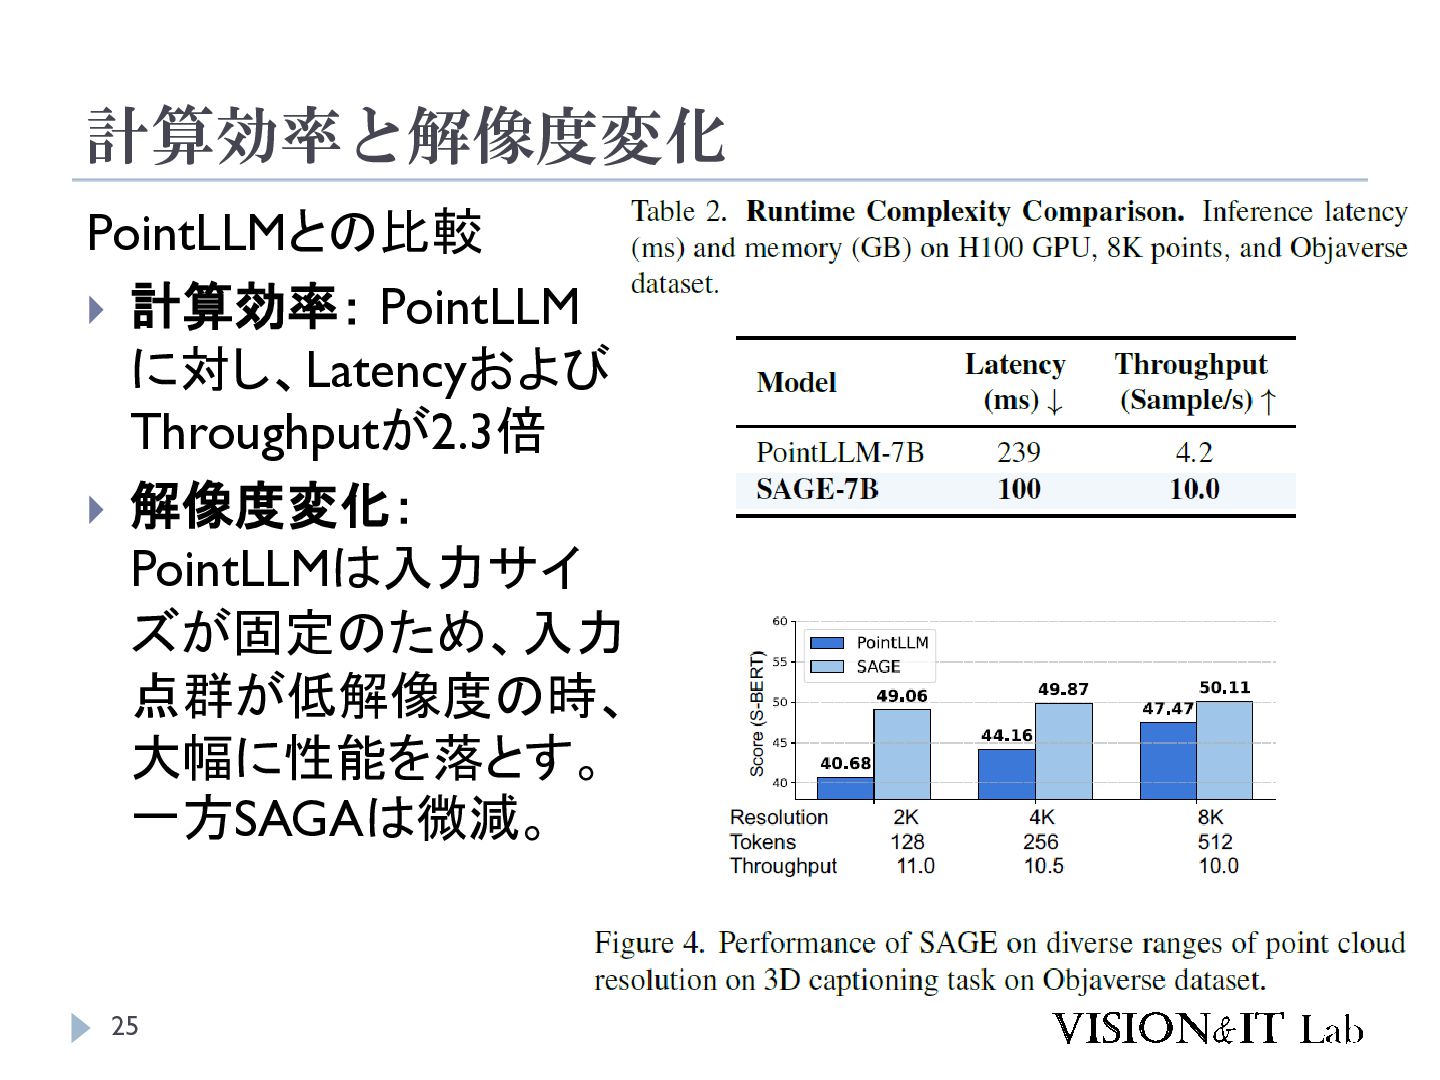
計算効率と解像度変化 PointLLMとの比較 計算効率: PointLLM に対し、Latencyおよび Throughputが2.3倍 解像度変化: PointLLMは入力サイ
ズが固定のため、入力 点群が低解像度の時、 大幅に性能を落とす。 一方SAGAは微減。 25 -
結論 事前学習済みの3Dエンコーダーなしで、直接点群から 言語空間用のトークンを生成するSAGEを提案。 3D点群を、言語空間を拡張して、あたかも「外国語」かのよう にシームレス統合できる マルチステージの学習パイプラインによって、3Dについ ての高い推論能力を実現。
精度面だけでなく、計算効率や、入力点群密度に対して の柔軟性などを実現 27