Share
Embed
Transcript
42 slides
-
1 NIKKEI Tech Talk #1 日本経済新聞社 技術戦略ユニット 清水 赳 2022年11月17日
SRE in NIKKEI -
2 自己紹介 清水 赳 (Shimizu, Takeru) • 技術戦略ユニット SREチーム ◦
兼 クラウドセキュリティチーム • SRE, Observability, Cloud Security • Google Cloud Professional Cloud Architect • 新卒2年目 • 鳥取県鳥取市 出身 • 香川県高松市にも数年住んでました • 好きなOSSはPrometheus • 銭湯めぐりとうどん屋さんが大好き -
4 SRE: Site Reliability Engineeringとは? • Google 社が提唱した概念 ◦ https://sre.google
• Reliability (信頼性) ◦ 求められた機能を、定められた条件下で 定められた期間、障害なく実行する性能 • サイトの信頼性に主眼を置くエンジニアリング ◦ 稼働率・可用性の向上や保証 ◦ サービスの運用サポート ◦ 基盤・インフラの運用 などなど Ref: Betsy Beyer et al., “Site Reliability Engineering - HOW GOOGLE RUNS PRODUCTION SYSTEMS -,” 2016. -
5 SRE: Site Reliability Engineeringとは? “My explanation is simple: SRE
is what happens when you ask a software engineer to design an operation team.” Google - Site Reliability Engineering Ref: Betsy Beyer et al., “Site Reliability Engineering - HOW GOOGLE RUNS PRODUCTION SYSTEMS -,” 2016. • ソフトウェアエンジニアに運用チームの設計を依頼し たときにできあがるもの • SREチームは単なるインフラチームでも 運用チームでもない -
6 システム運用の辛さ • システムは作ったら終わり、ではない ◦ 機器が壊れた・古くなった: 機器の交換 ◦ 負荷が増えた・減った: リソースの調整
◦ ミドルウェアが最新になった: ソフトウェアの更新 ◦ セキュリティホールがあった: パッチの適用 • このような作業は大量に発生し、しばしば辛く苦しいものになる ソフトウェア・エンジニアリングで削減できないか? -
7 システムは成長すべきか、安定すべきか • システムは成長する ◦ よりよいビジネスを目指し、システムは機能追加や改善が常に行われる ◦ 一方でシステムが壊れるのは、変更や機能追加があったときがほとんど ◦ 運用チームとしては、システムの安定運用のため、変更を最小限にしたい
▪ 機能追加や変更のスピードは遅くなってしまう ▪ 守りの運用 (守りの信頼性) ▪ ビジネスのあり方として好ましいか? ソフトウェア・エンジニアリングで両立・最適化できないだろうか -
8 Site Reliability Engineering の主眼 SREの主眼はあくまでソフトウェア・エンジニアリングで課題解決を図ること • 信頼性とシステム変更速度を両立させる ◦ 従来の運用では、安定を求めるとシステム変更速度を落とさざるを得ない
◦ 脆弱性の放置、遅いシステムの塩漬け、追加されない新機能… ◦ 信頼できるシステムとは言えない ◦ 変更は迅速に、運用は安定している仕組みが必要 ◦ 守りの信頼性から、攻めの信頼性へ -
9 Site Reliability Engineering の主眼 SREの主眼はあくまでソフトウェア・エンジニアリングで課題解決を図ること • 信頼性を担保する仕組みを作る ◦ 運用をソフトウェアで自動化:
運用の労苦 (toil) を削減する ◦ 共通基盤を開発・提供: システムの変更も運用も容易に ◦ 監視の仕組みを作る: 信頼性の担保をしやすくする -
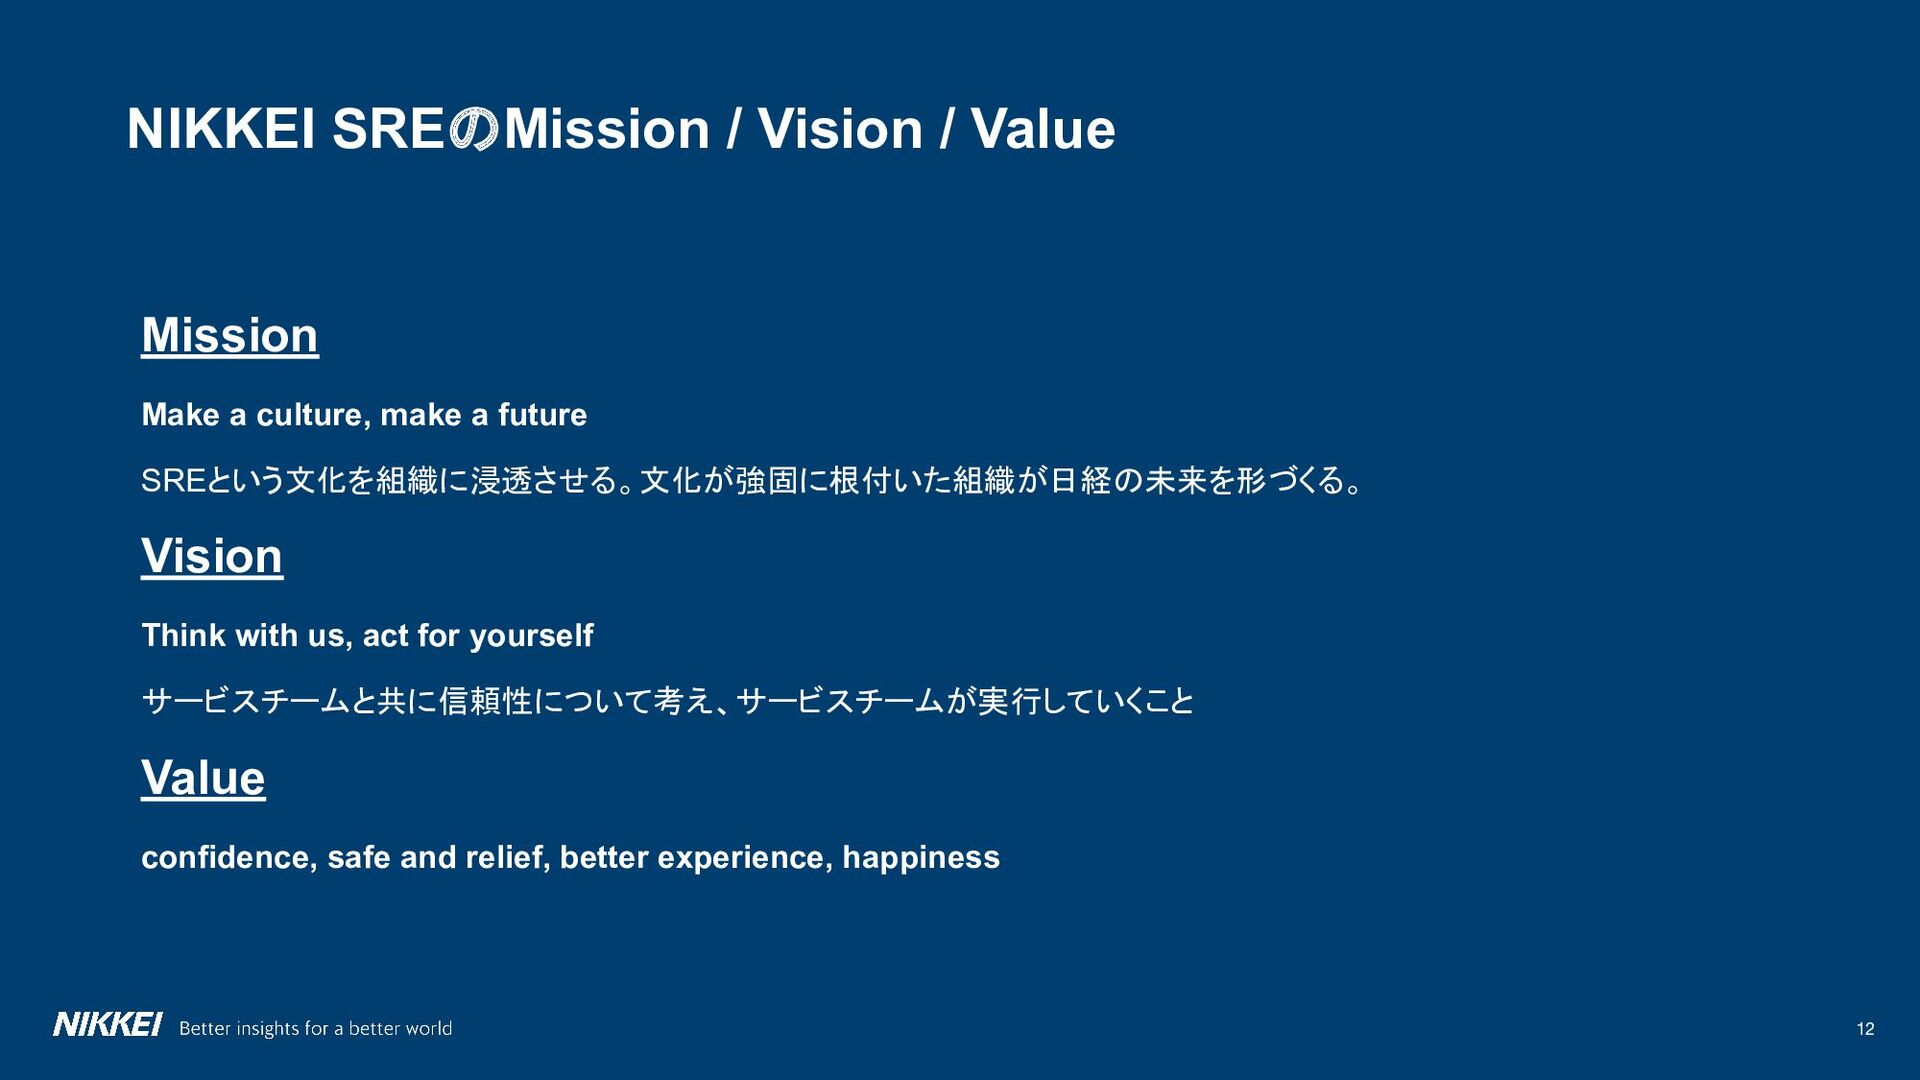
12 NIKKEI SREのMission / Vision / Value Mission Make a
culture, make a future SREという文化を組織に浸透させる。文化が強固に根付いた組織が日経の未来を形づくる。 Vision Think with us, act for yourself サービスチームと共に信頼性について考え、サービスチームが実行していくこと Value confidence, safe and relief, better experience, happiness -
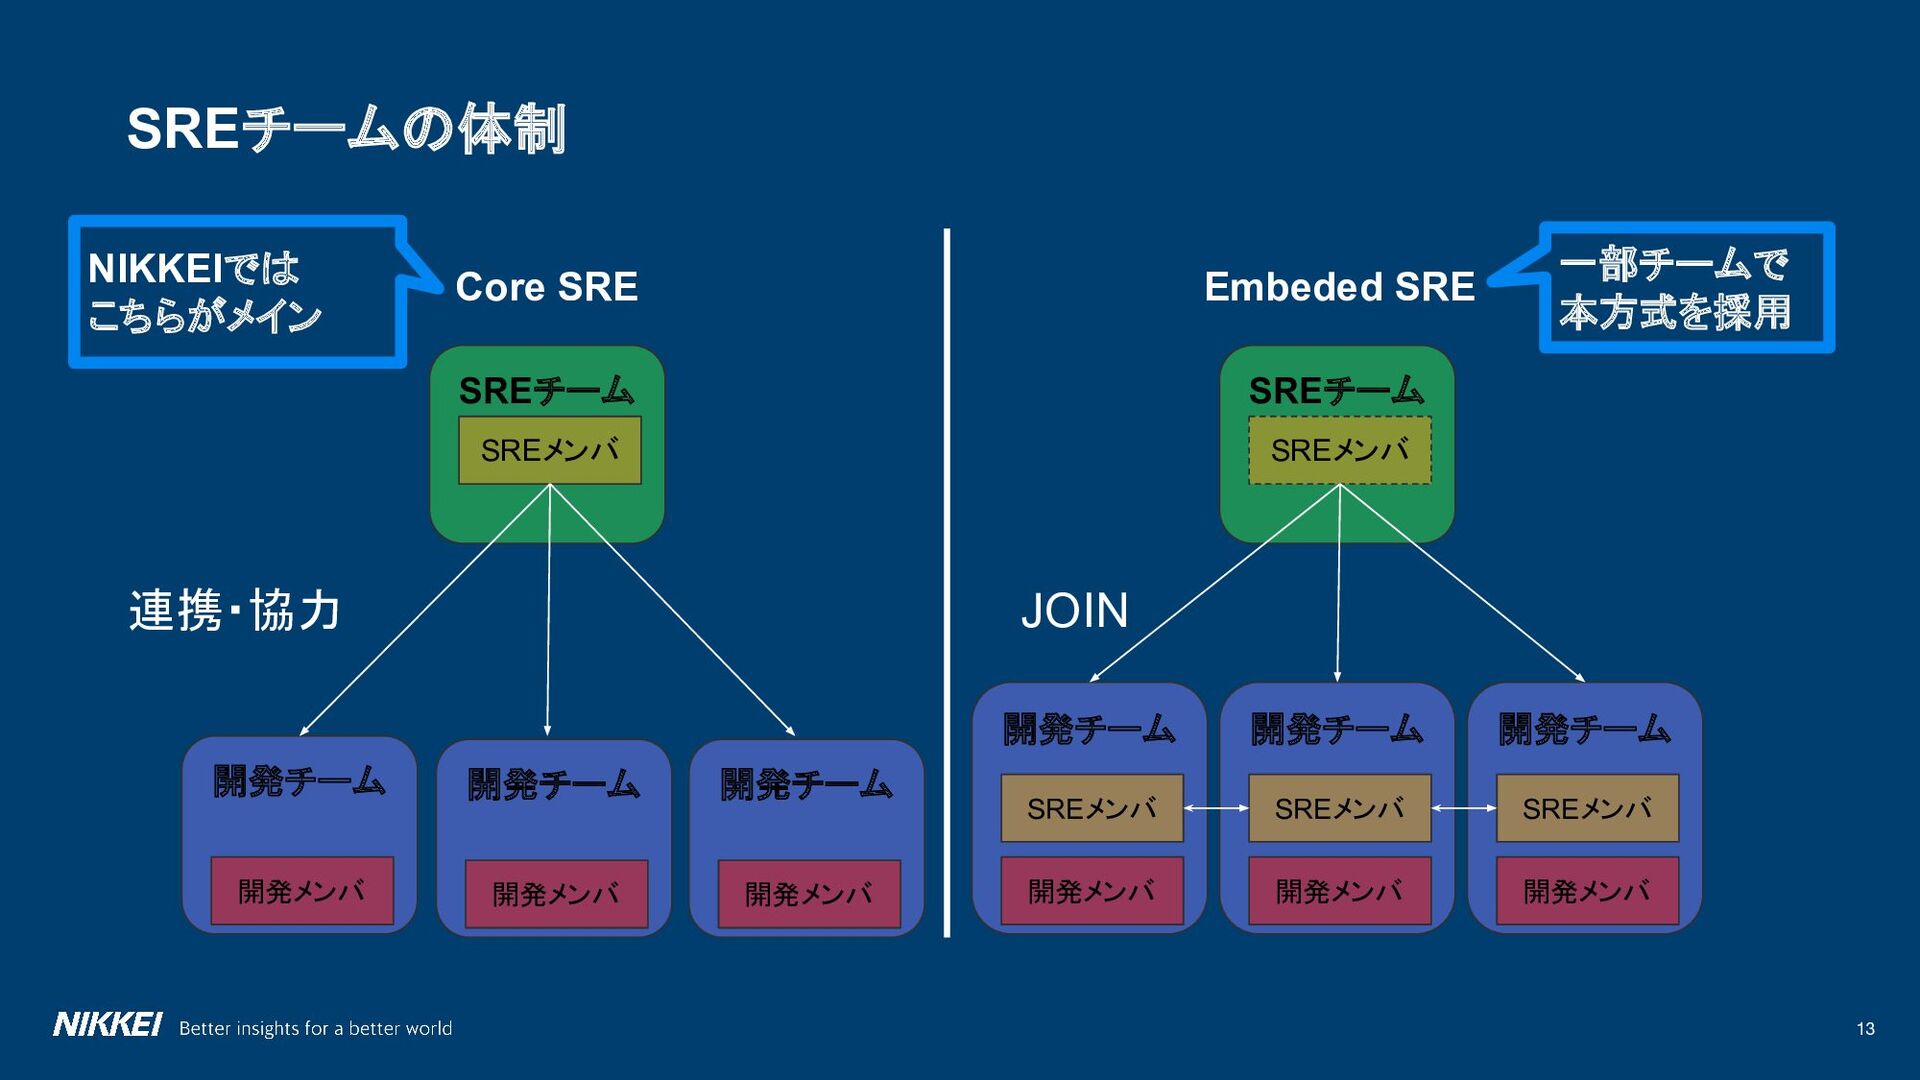
13 Core SRE 開発チーム SREチーム SREメンバ 開発メンバ 連携・協力 Embeded SRE
開発チーム 開発チーム 開発チーム SREチーム SREメンバ 開発メンバ 開発メンバ 開発メンバ JOIN SREメンバ SREメンバ SREメンバ SREチームの体制 NIKKEIでは こちらがメイン 一部チームで 本方式を採用 開発チーム 開発メンバ 開発チーム 開発メンバ -
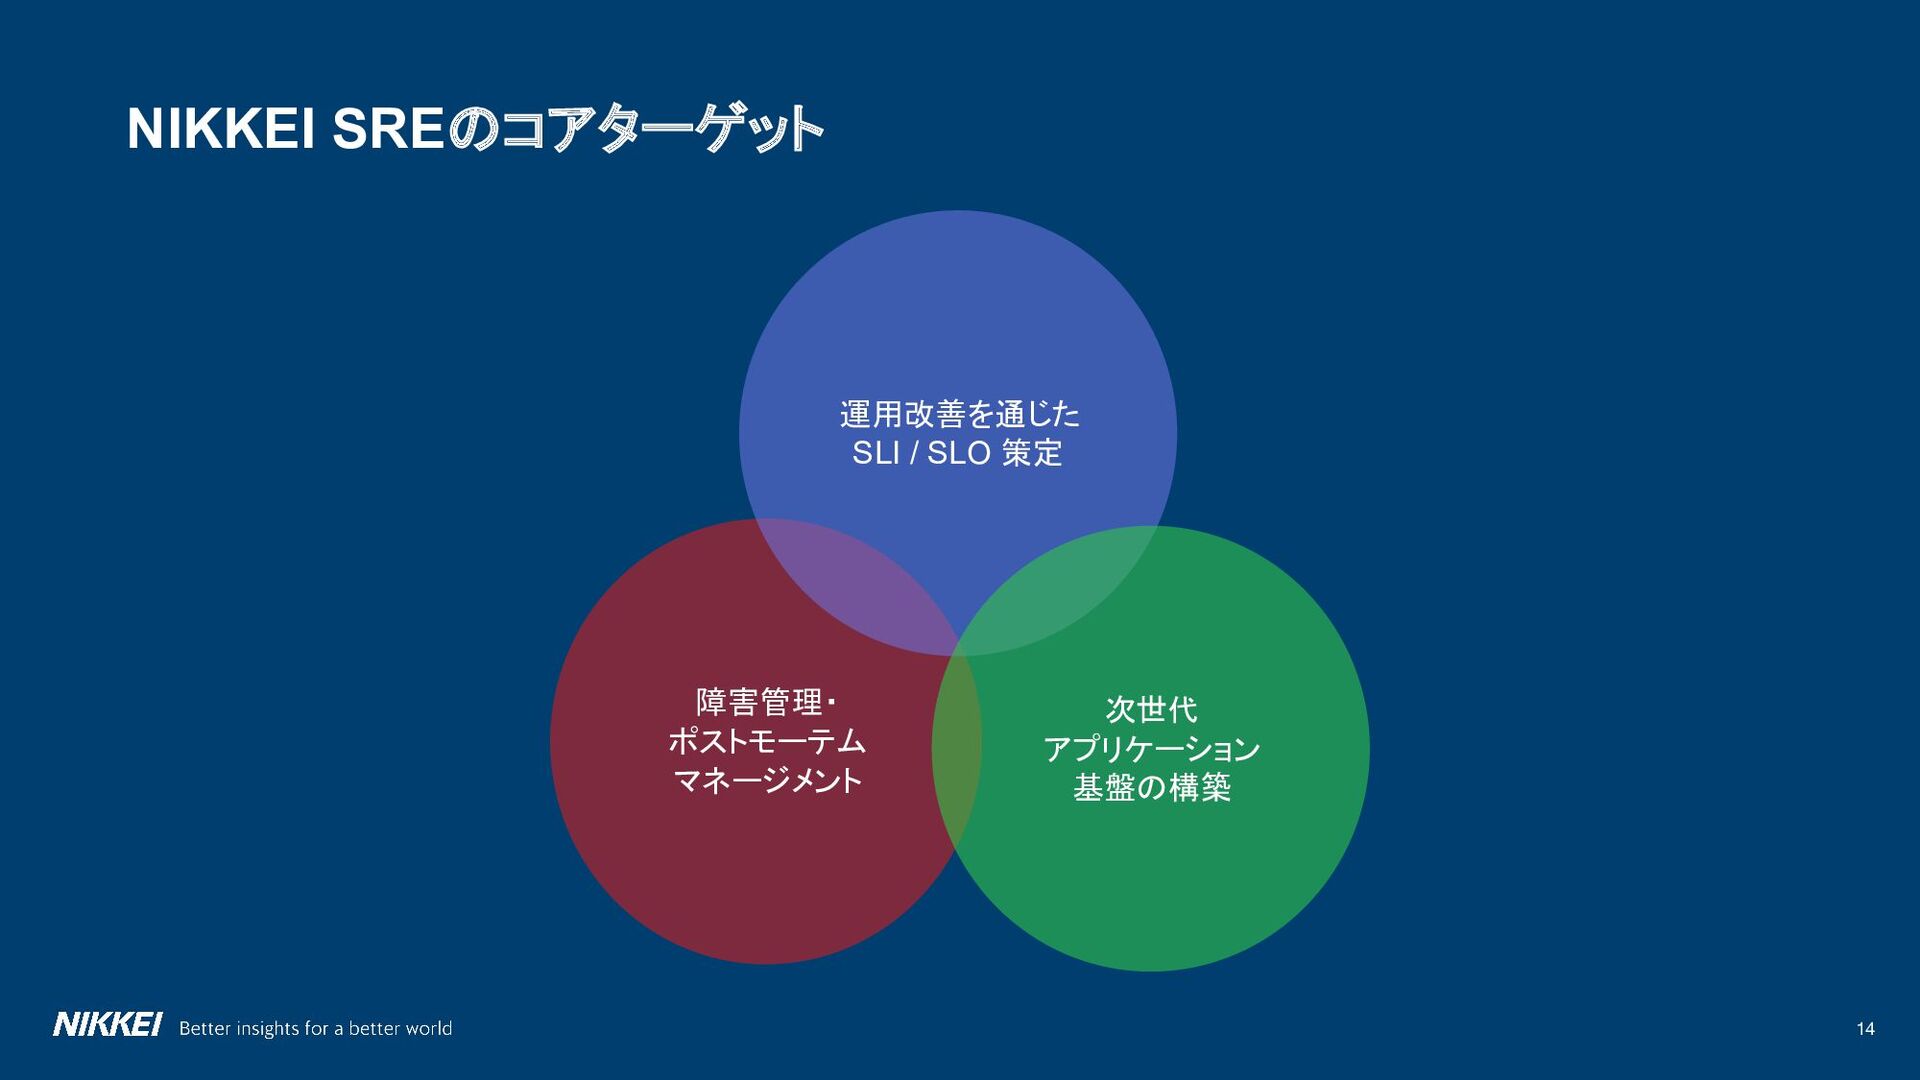
14 NIKKEI SREのコアターゲット 障害管理・ ポストモーテム マネージメント 運用改善を通じた SLI / SLO
策定 次世代 アプリケーション 基盤の構築 -
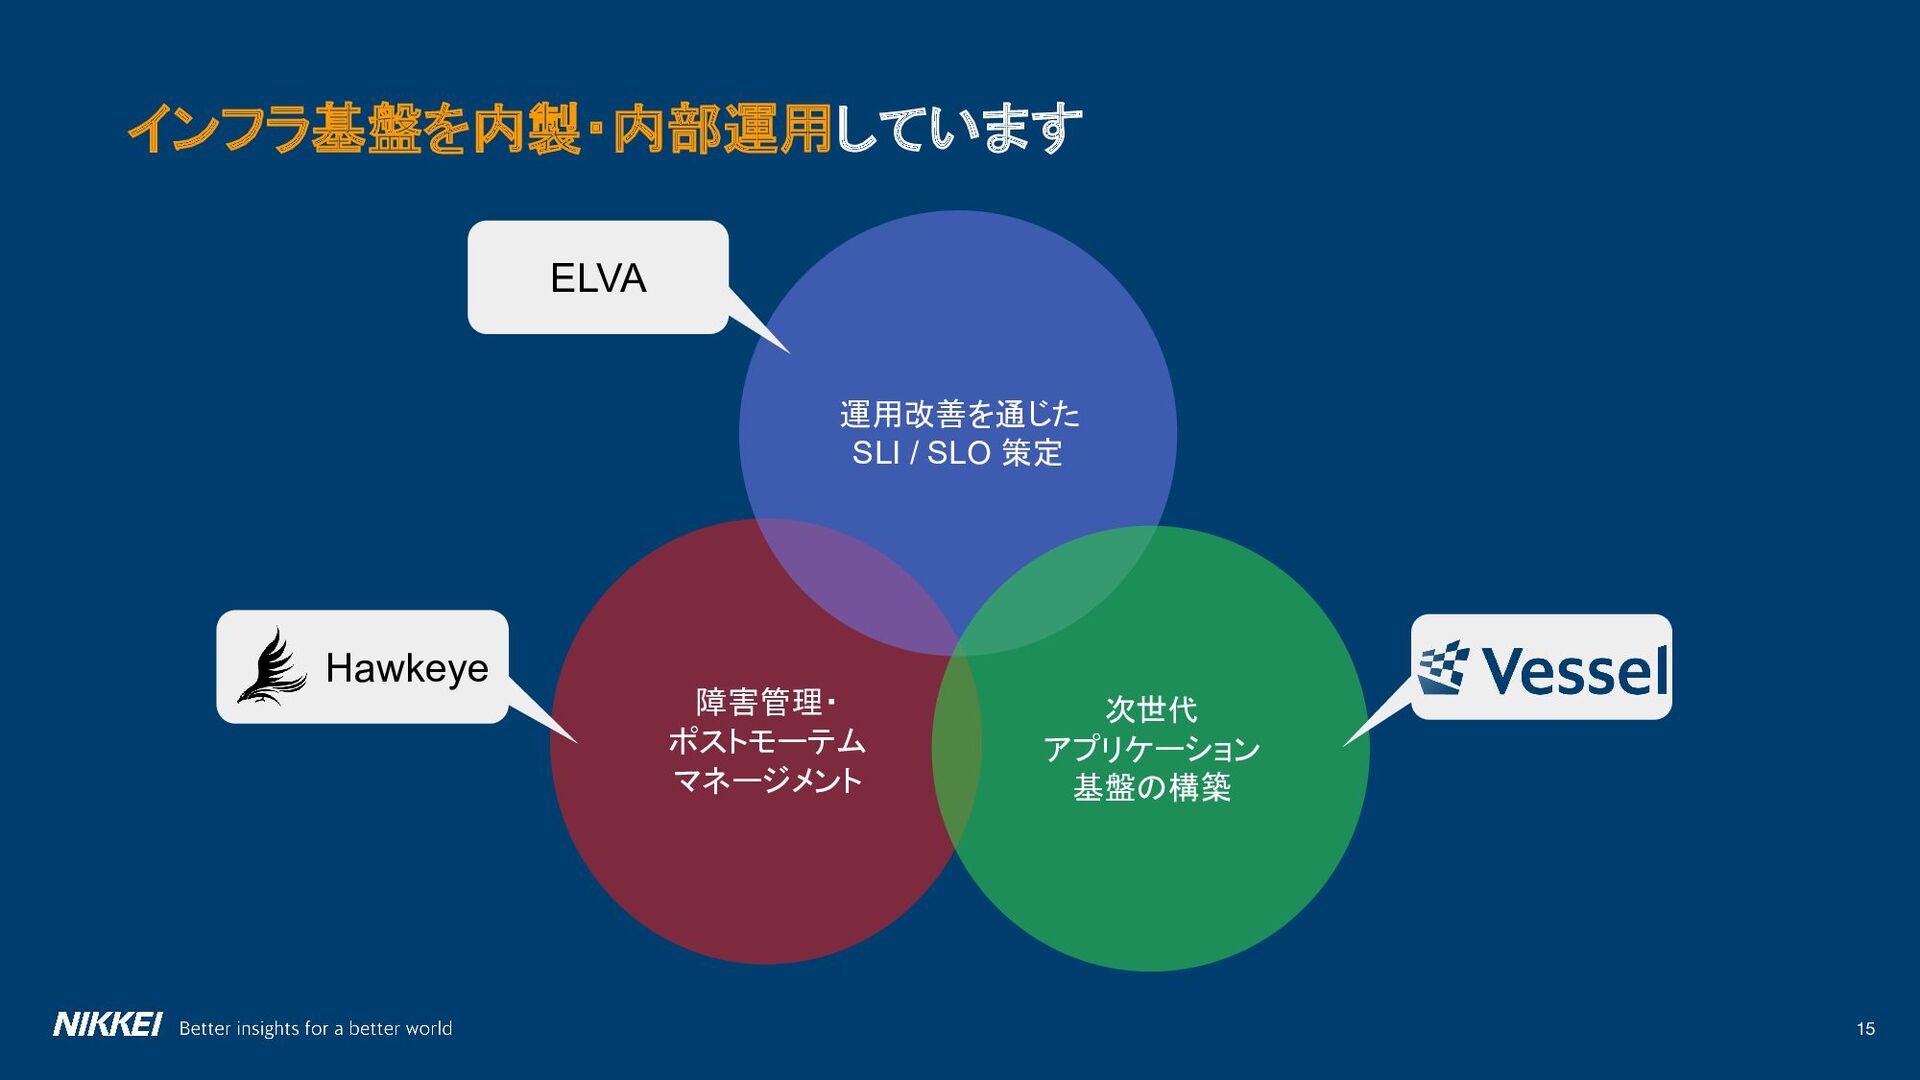
15 インフラ基盤を内製・内部運用しています 障害管理・ ポストモーテム マネージメント 運用改善を通じた SLI / SLO 策定
次世代 アプリケーション 基盤の構築 ELVA Hawkeye -
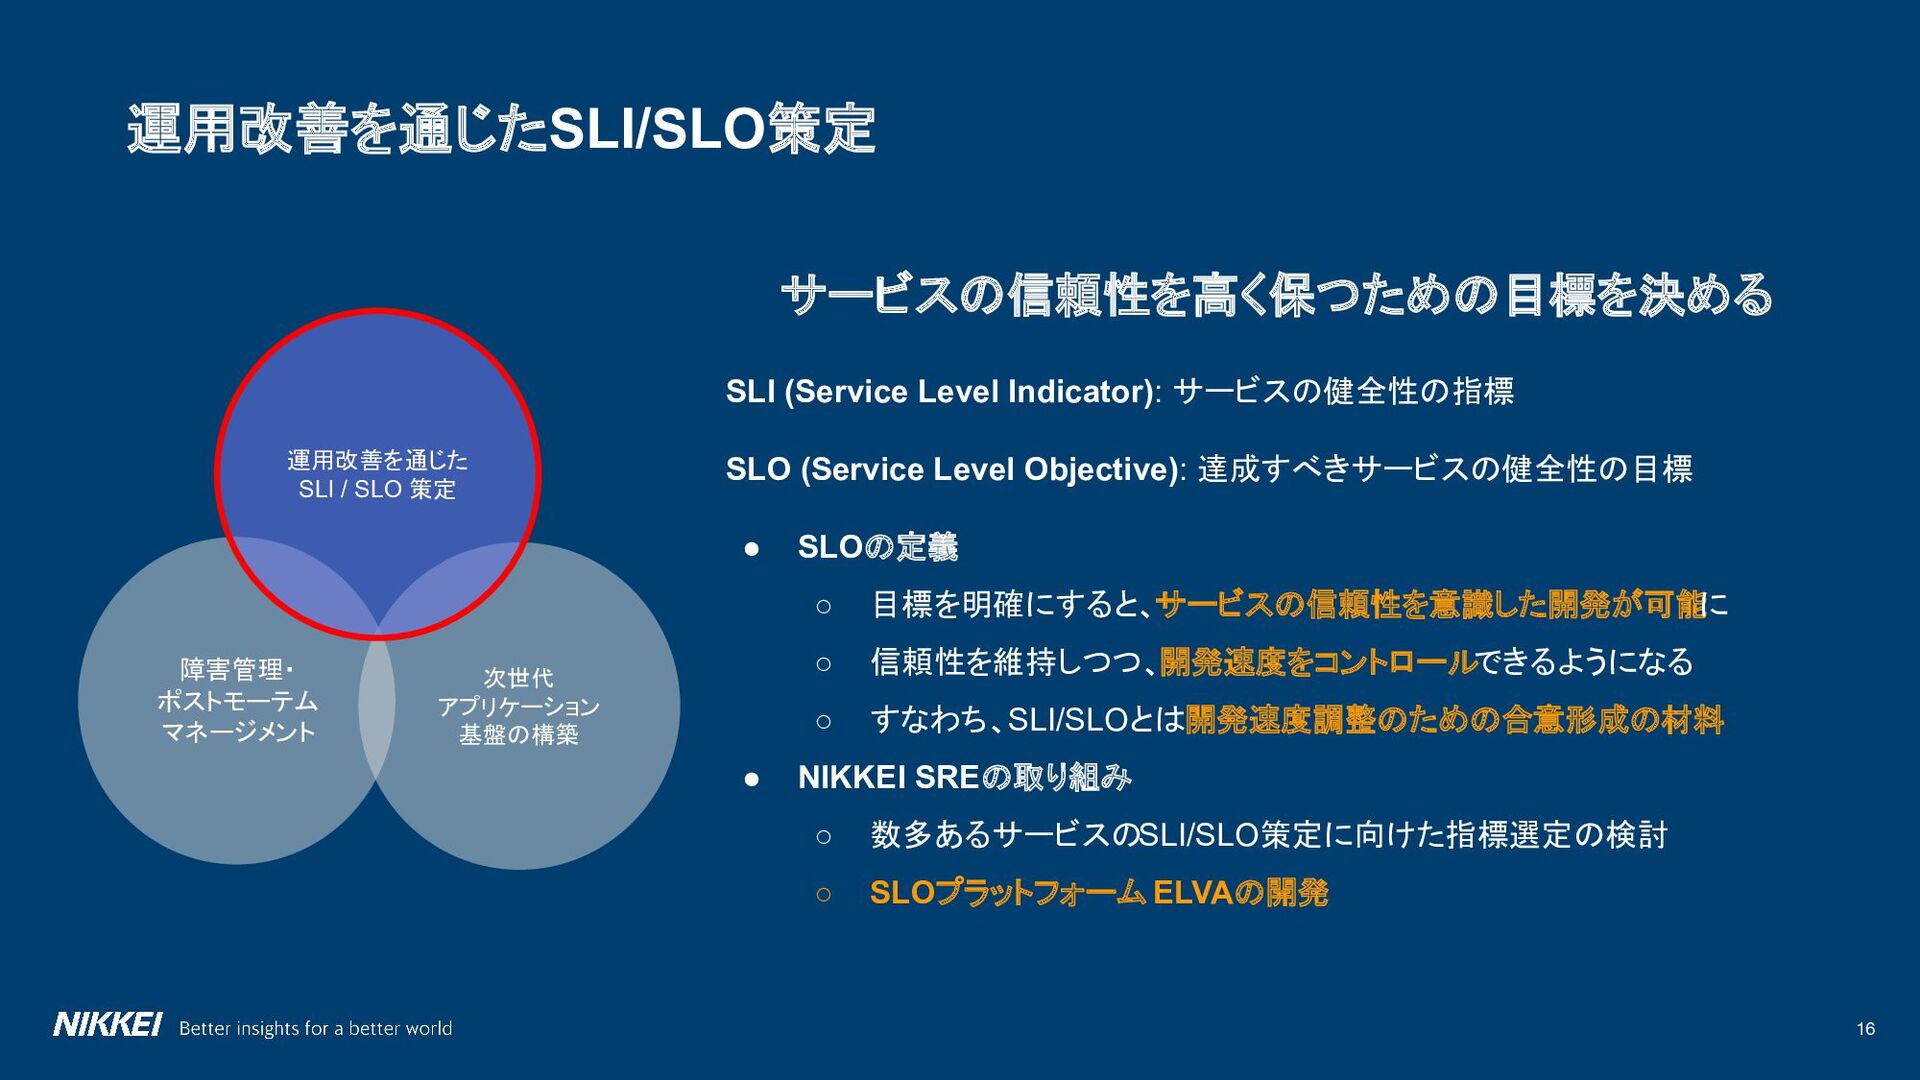
16 運用改善を通じたSLI/SLO策定 サービスの信頼性を高く保つための目標を決める SLI (Service Level Indicator): サービスの健全性の指標 SLO (Service
Level Objective): 達成すべきサービスの健全性の目標 • SLOの定義 ◦ 目標を明確にすると、サービスの信頼性を意識した開発が可能 に ◦ 信頼性を維持しつつ、開発速度をコントロールできるようになる ◦ すなわち、SLI/SLOとは開発速度調整のための合意形成の材料 • NIKKEI SREの取り組み ◦ 数多あるサービスのSLI/SLO策定に向けた指標選定の検討 ◦ SLOプラットフォーム ELVAの開発 障害管理・ ポストモーテム マネージメント 次世代 アプリケーション 基盤の構築 運用改善を通じた SLI / SLO 策定 -
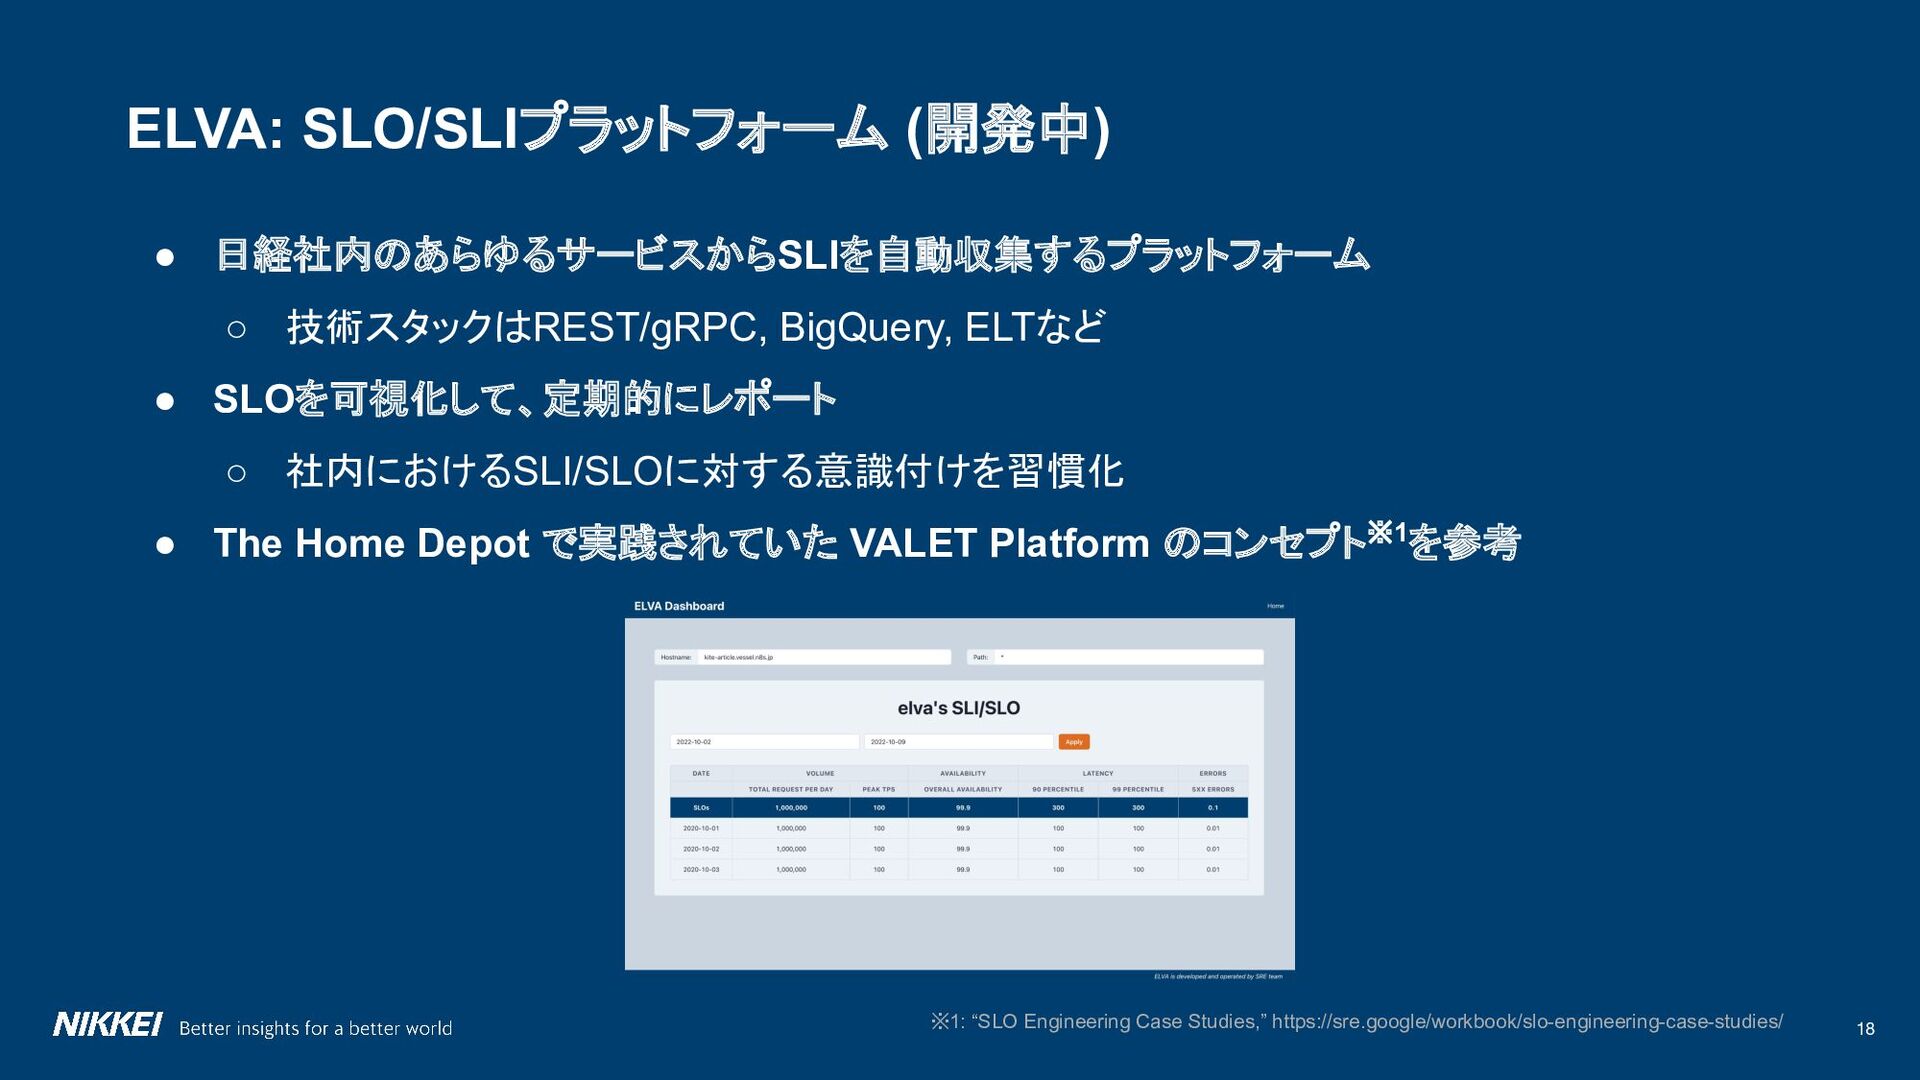
18 ELVA: SLO/SLIプラットフォーム (開発中) • 日経社内のあらゆるサービスからSLIを自動収集するプラットフォーム ◦ 技術スタックはREST/gRPC, BigQuery, ELTなど
• SLOを可視化して、定期的にレポート ◦ 社内におけるSLI/SLOに対する意識付けを習慣化 • The Home Depot で実践されていた VALET Platform のコンセプト※1を参考 ※1: “SLO Engineering Case Studies,” https://sre.google/workbook/slo-engineering-case-studies/ -
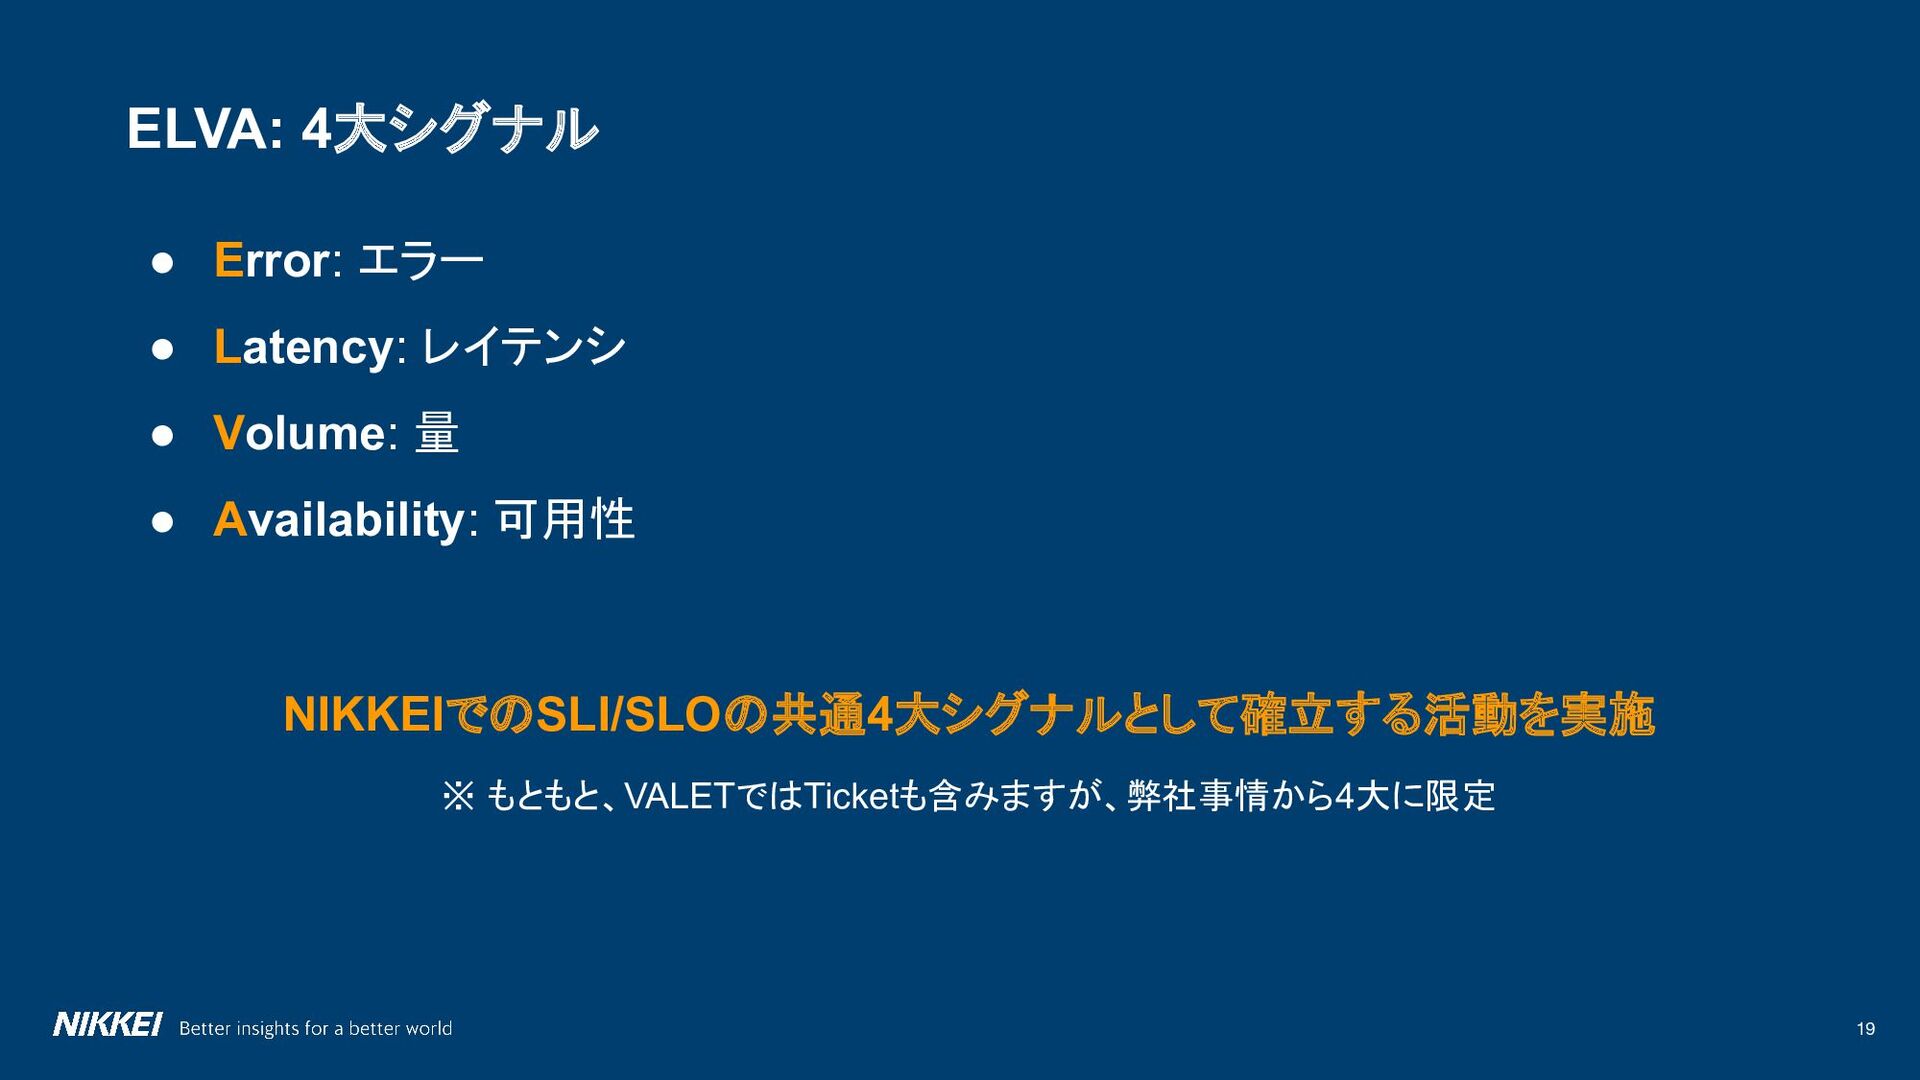
19 ELVA: 4大シグナル • Error: エラー • Latency: レイテンシ •
Volume: 量 • Availability: 可用性 NIKKEIでのSLI/SLOの共通4大シグナルとして確立する活動を実施 ※ もともと、VALETではTicketも含みますが、弊社事情から4大に限定 -
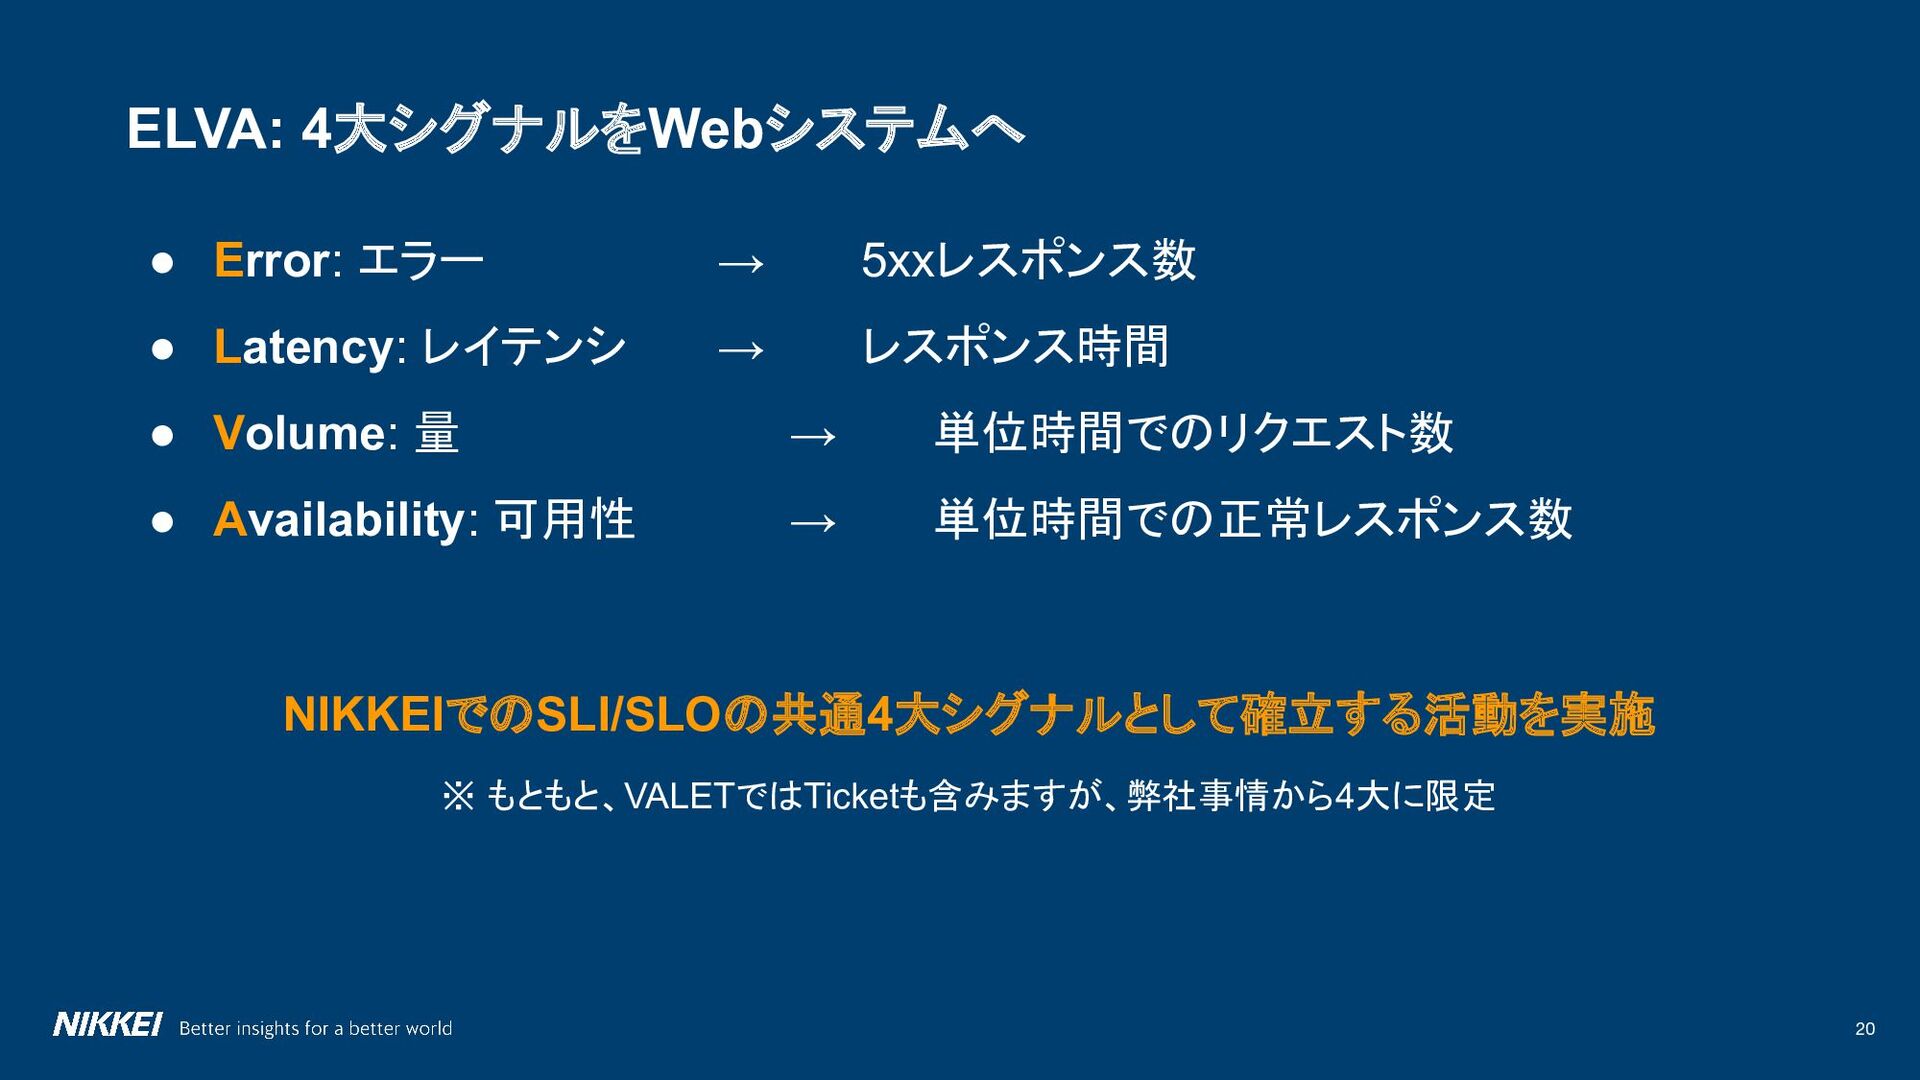
20 ELVA: 4大シグナルをWebシステムへ • Error: エラー → 5xxレスポンス数 • Latency:
レイテンシ → レスポンス時間 • Volume: 量 → 単位時間でのリクエスト数 • Availability: 可用性 → 単位時間での正常レスポンス数 NIKKEIでのSLI/SLOの共通4大シグナルとして確立する活動を実施 ※ もともと、VALETではTicketも含みますが、弊社事情から4大に限定 -
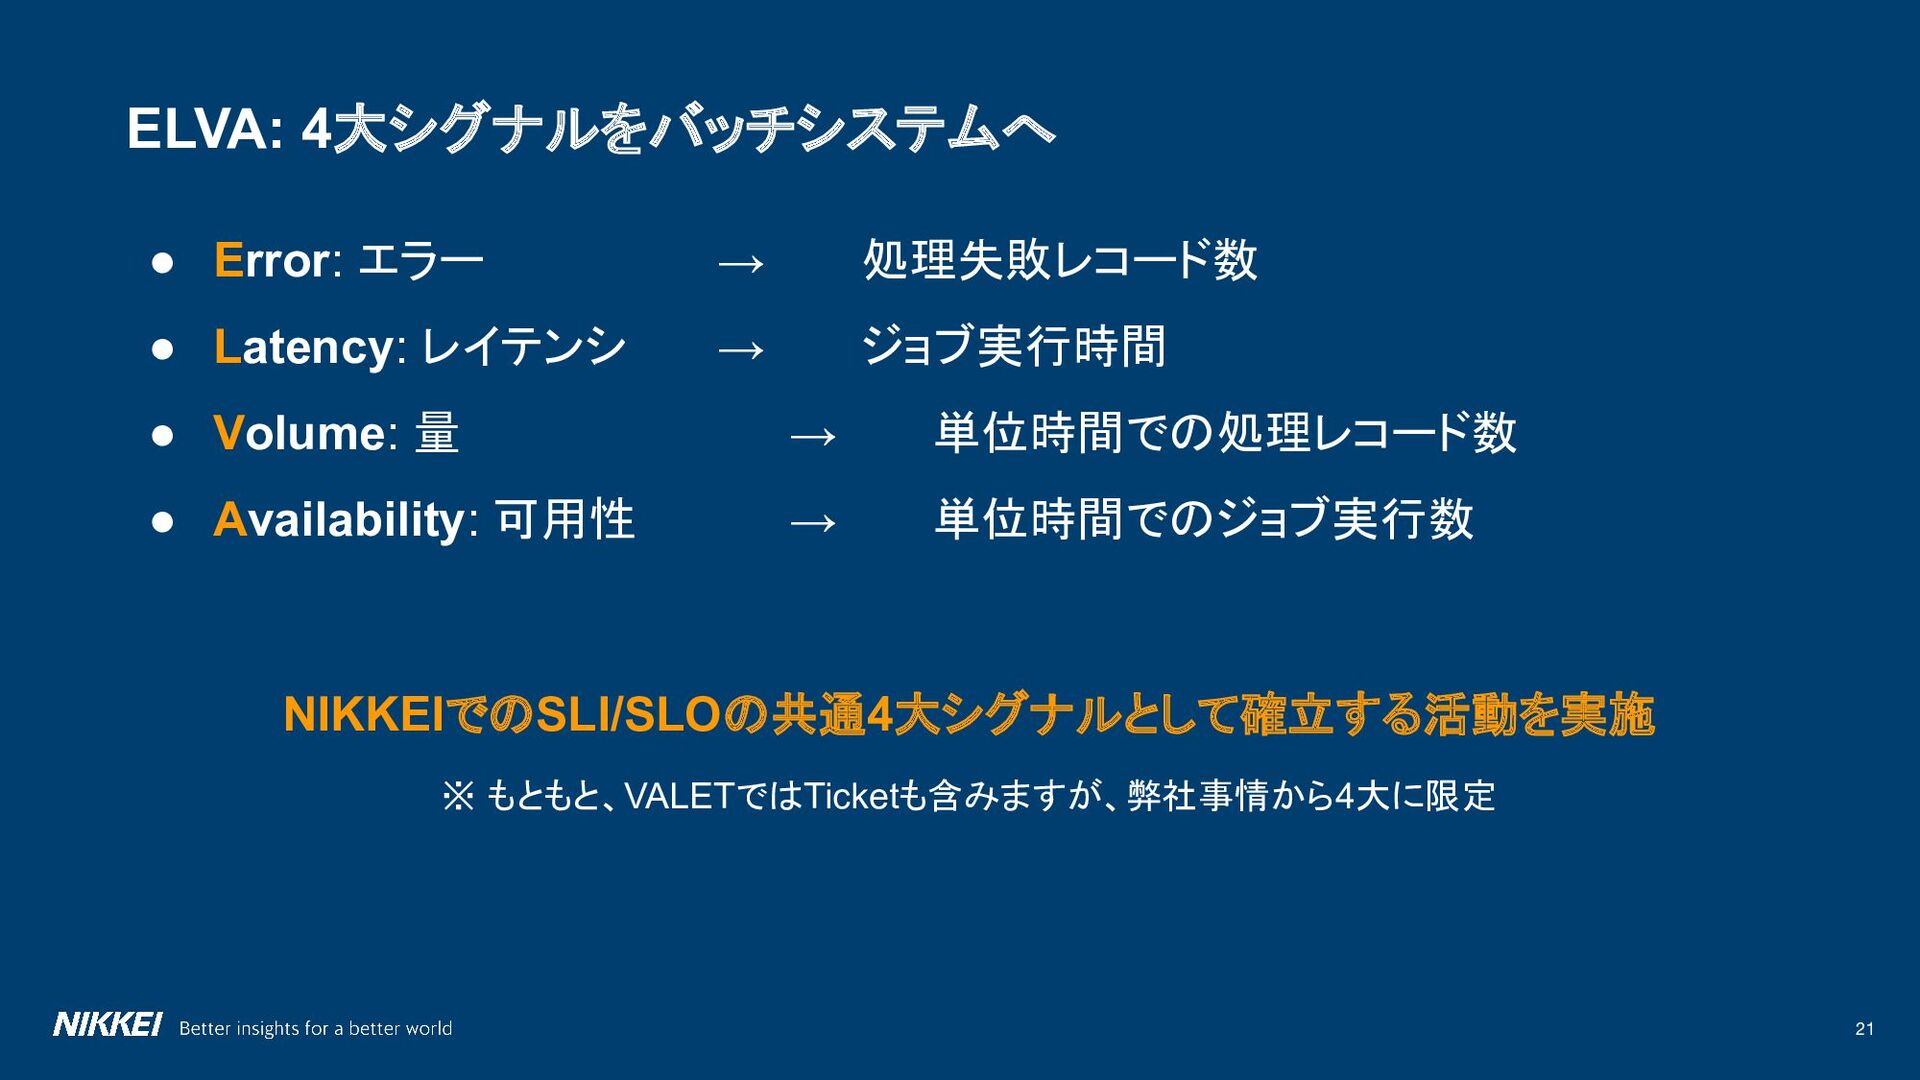
21 ELVA: 4大シグナルをバッチシステムへ • Error: エラー → 処理失敗レコード数 • Latency:
レイテンシ → ジョブ実行時間 • Volume: 量 → 単位時間での処理レコード数 • Availability: 可用性 → 単位時間でのジョブ実行数 NIKKEIでのSLI/SLOの共通4大シグナルとして確立する活動を実施 ※ もともと、VALETではTicketも含みますが、弊社事情から4大に限定 -
22 ELVAは何をめざすか? • NIKKEIにSLO文化を浸透させる ◦ 技術者以外でも信頼性が議論されるNIKKEIへ ◦ 施策実施の根拠のひとつに信頼性があるNIKKEIの姿を目指す • 開発リソースを適切に配置する
◦ SLOは開発速度を適切に調整するための合意形成の手段 ◦ SLO/SLIがリソース配置の根拠として利用される未来を作る -
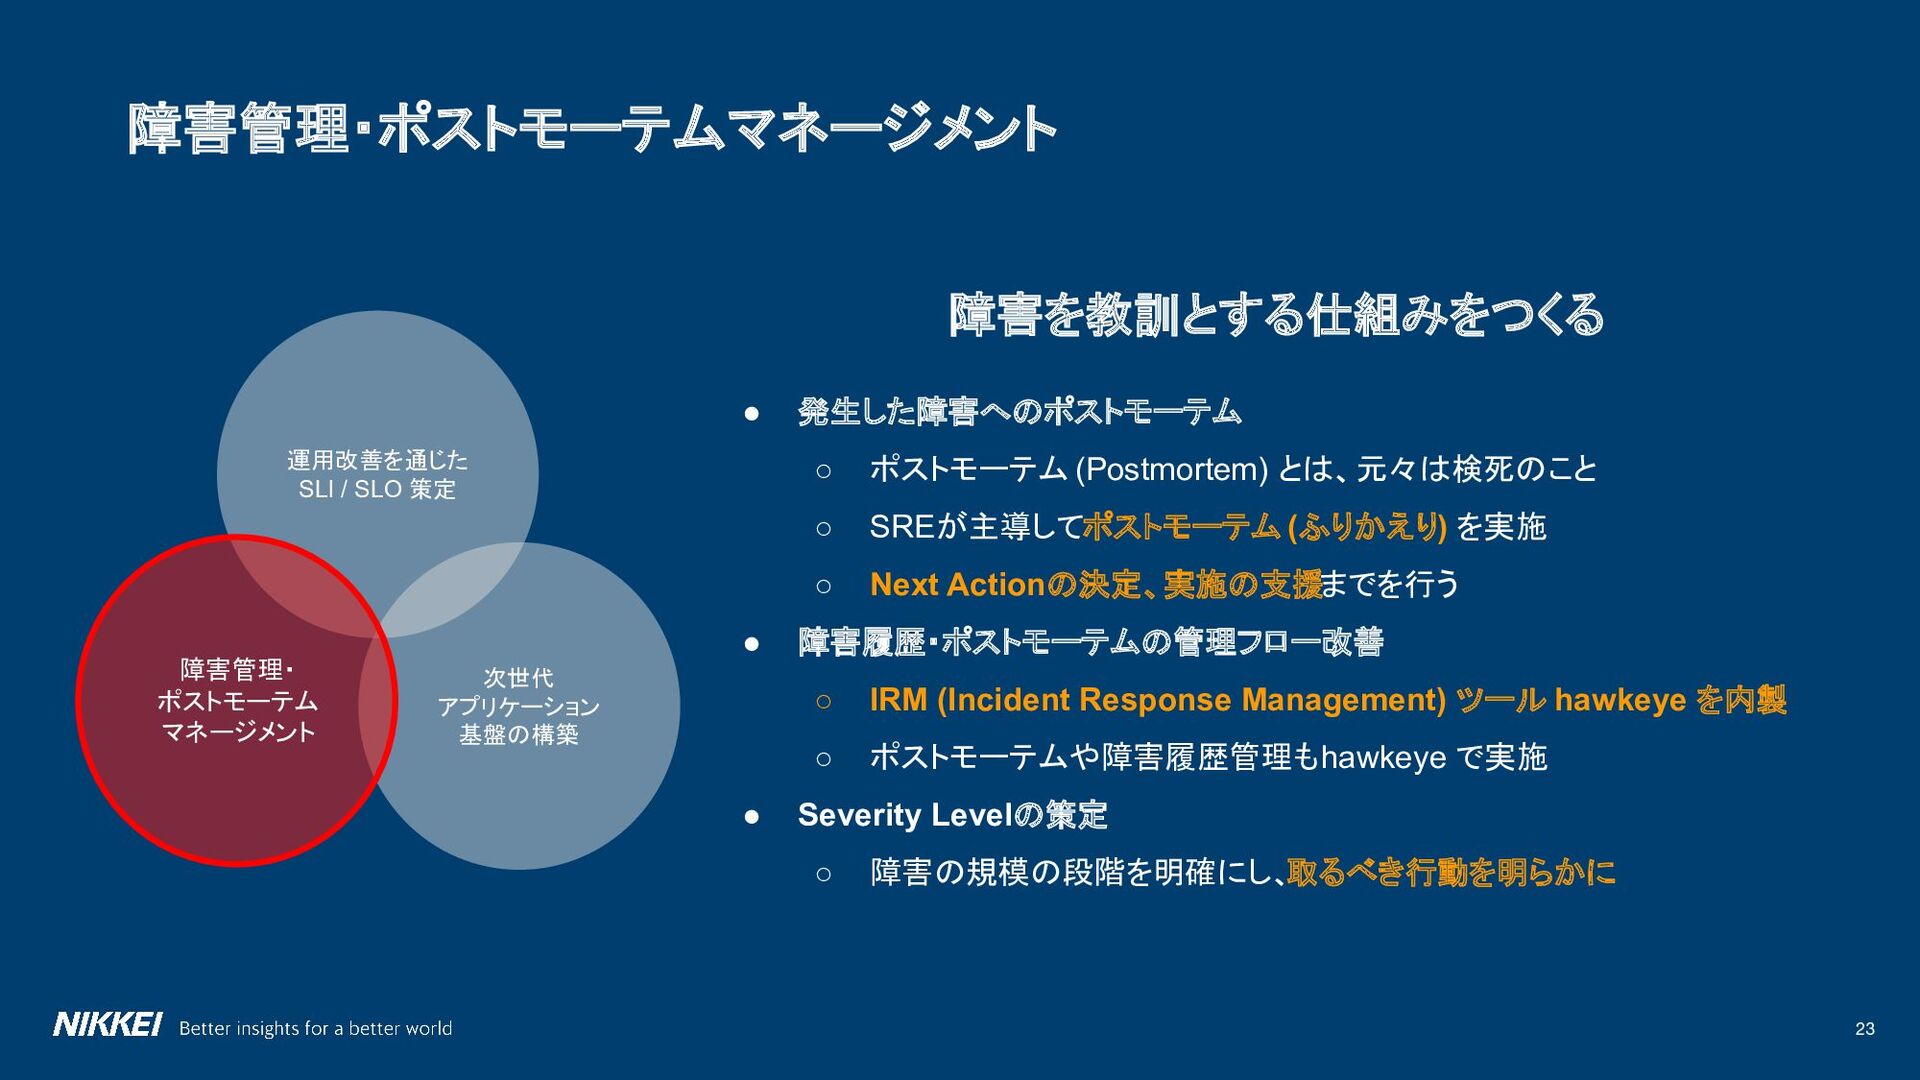
23 障害管理・ポストモーテムマネージメント 障害を教訓とする仕組みをつくる • 発生した障害へのポストモーテム ◦ ポストモーテム (Postmortem) とは、元々は検死のこと ◦
SREが主導してポストモーテム (ふりかえり) を実施 ◦ Next Actionの決定、実施の支援までを行う • 障害履歴・ポストモーテムの管理フロー改善 ◦ IRM (Incident Response Management) ツール hawkeye を内製 ◦ ポストモーテムや障害履歴管理も hawkeye で実施 • Severity Levelの策定 ◦ 障害の規模の段階を明確にし、 取るべき行動を明らかに 次世代 アプリケーション 基盤の構築 運用改善を通じた SLI / SLO 策定 障害管理・ ポストモーテム マネージメント -
25 Hawkeye: Incident Response Management ツール • IRM (Incident Response
Management) ツール ◦ 障害の対応状況を管理し、円滑な障害対応を管理する • 障害サマリの限界 ◦ NIKKEIでは、もともと障害発生時はチケットによる対応管理が行われていた ◦ これをベースに障害時間や稼働率を算出するのは限界がある • 障害対応から学ぶ ◦ システムを監視項目を拡充する、次からもっと早く気付けるように ◦ IaaSやPaaSも落ちるときは落ちる、落ちたときの対策を考えるきっかけに ◦ 暫定対応で解決した問題の恒久対応を考える -
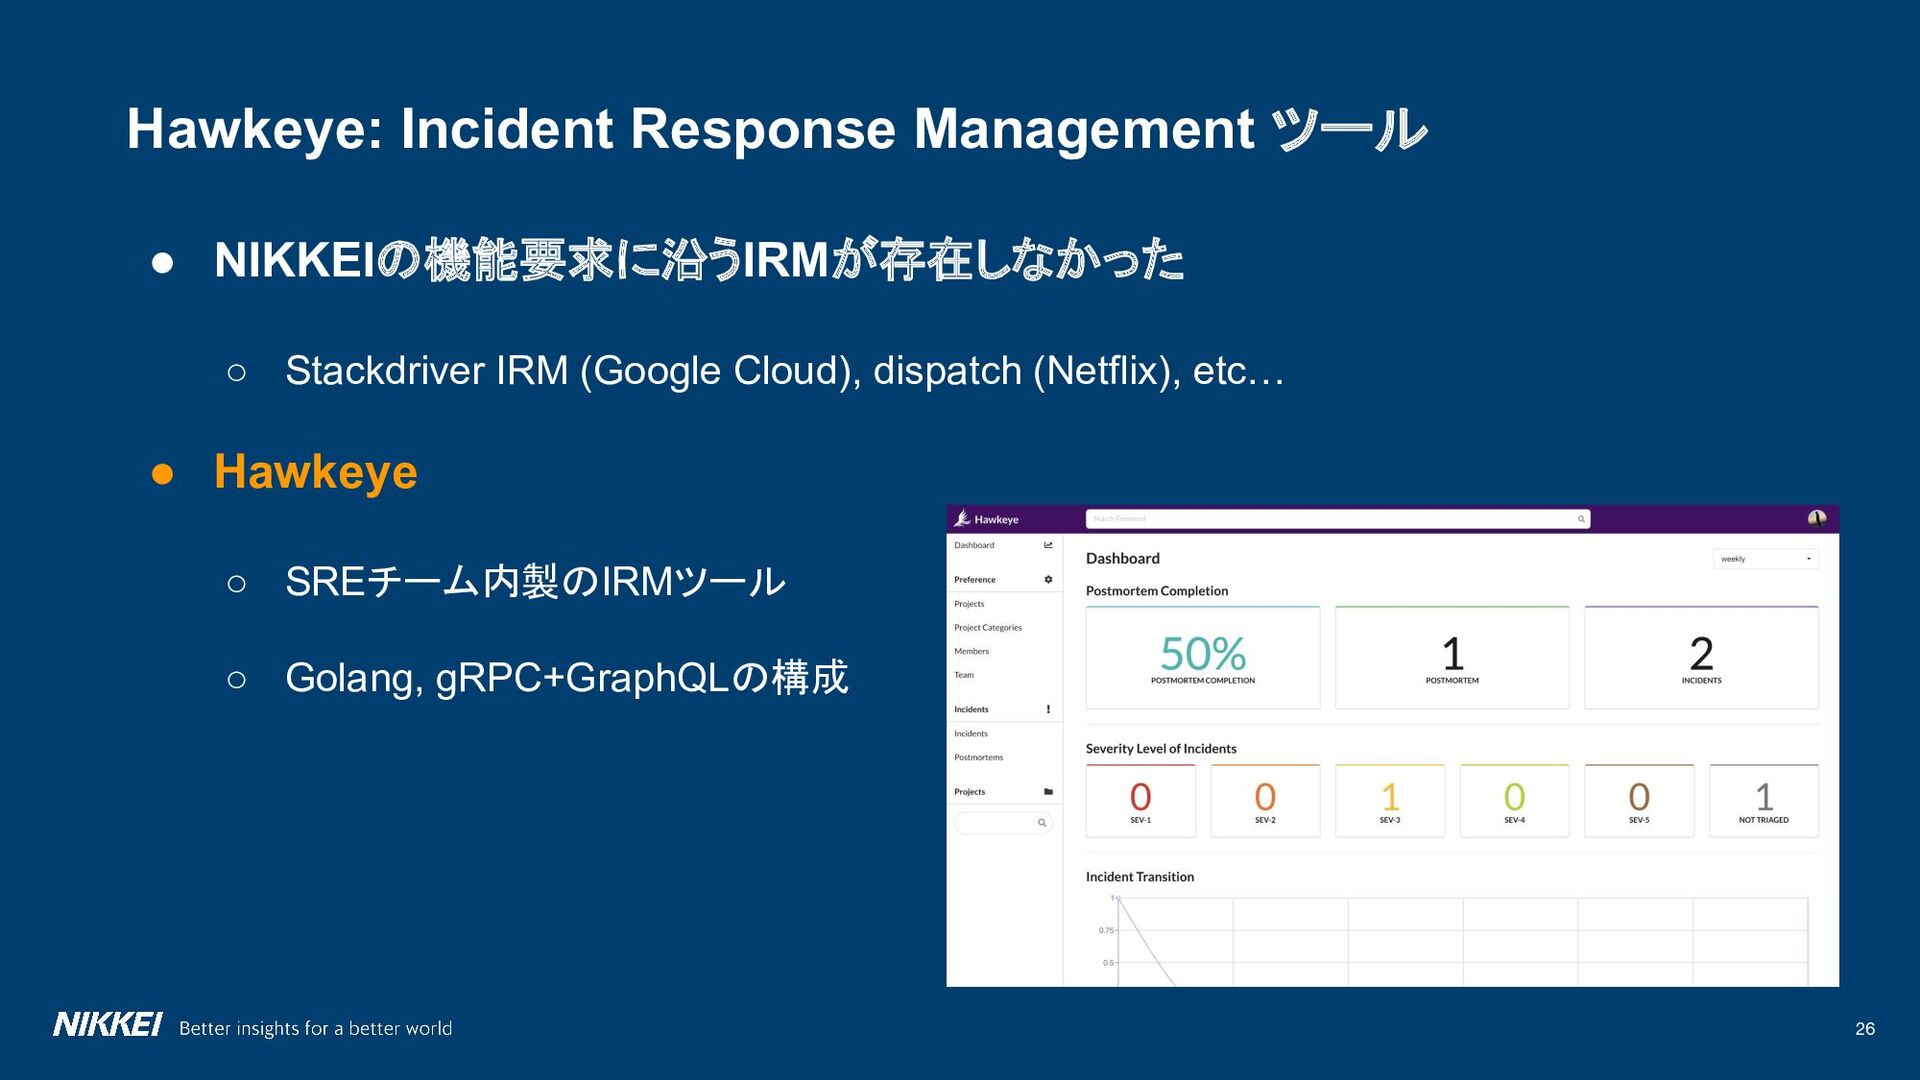
26 Hawkeye: Incident Response Management ツール • NIKKEIの機能要求に沿うIRMが存在しなかった ◦ Stackdriver
IRM (Google Cloud), dispatch (Netflix), etc… • Hawkeye ◦ SREチーム内製のIRMツール ◦ Golang, gRPC+GraphQLの構成 -
27 Hawkeye: Incident Response Management ツール • 障害の自治とオープン化の推進 ◦ 障害やを教訓に、同じ事態を引き起こさない強いNIKKEIへ
◦ 誰もがナレッジにアクセスできることが第一歩 • ポストモーテムの文化を作る ◦ 障害は教訓であり、教科書である ◦ 正しく振り返れば、同じ事態は未然に防げるはず -
28 次世代アプリケーション基盤の開発 NIKKEIのあたらしい汎用基盤をつくる • アプリケーション基盤 Vessel ◦ 基盤運用の共通部分をSREが開発・管理、迅速な開発活動に寄与 ◦ 信頼性の部分を共通化し、コストを下げつつ信頼性向上
• ログ基盤・メトリクス基盤 ◦ Elasticsearchによるログ収集基盤を運用 ◦ Prometheusベースのメトリクス集約基盤を開発中 • 新技術の検証・導入 ◦ 新技術も積極的に検証・導入 次世代 アプリケーション 基盤の構築 運用改善を通じた SLI / SLO 策定 障害管理・ ポストモーテム マネージメント -
30 Vessel: NIKKEIのアプリケーション基盤の課題 • 基盤運用の労苦 ◦ アプリケーション開発チームによって基盤の構築・運用手順が異なる場合もある ◦ 基盤スタックが個々のチームで異なる場合も …
• 高い信頼性の要求 ◦ 報道機関は高い信頼性が求められる ◦ 有事や災害時においてもサービスの継続を求められる • 最新への追従 ◦ 基盤のミドルウェアを最新に追従するのが手間 ◦ ソフトウェアの更新時でさえ、報道機関はダウンタイムが許されない -
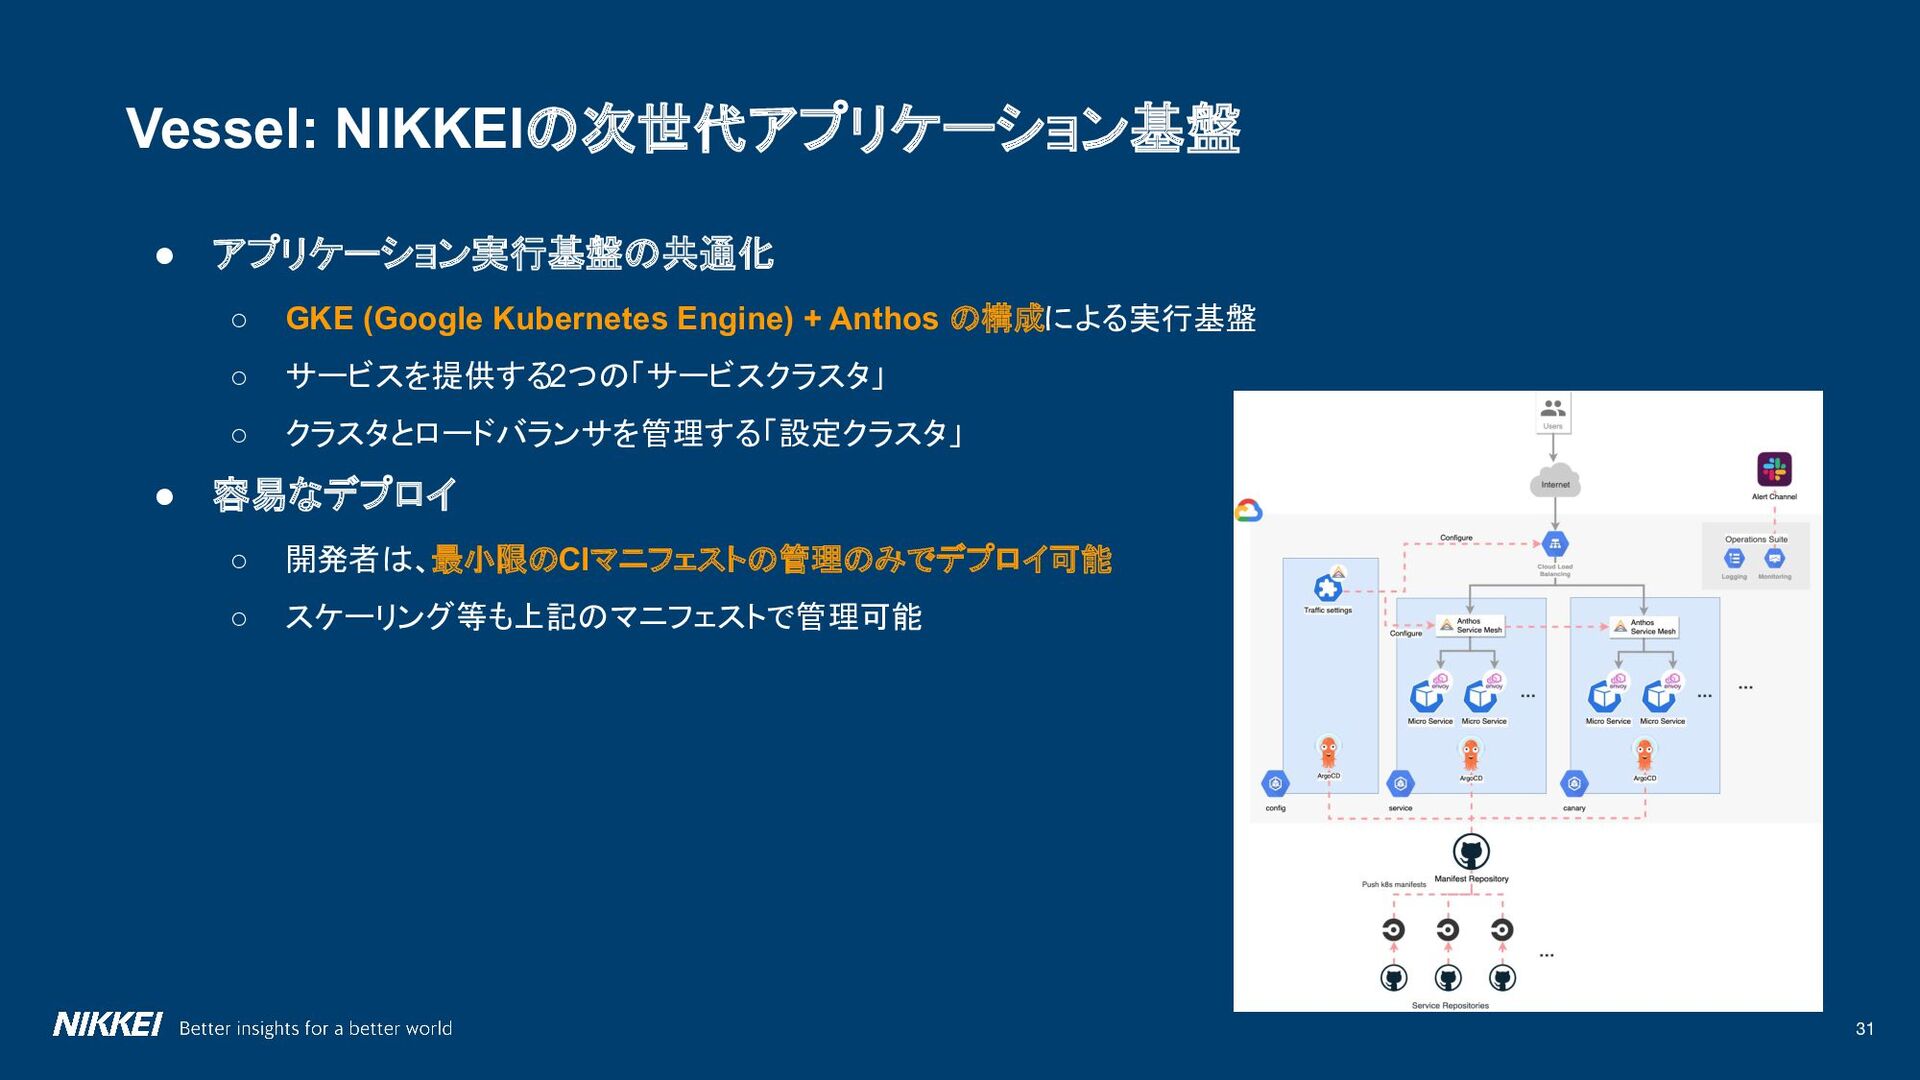
31 Vessel: NIKKEIの次世代アプリケーション基盤 • アプリケーション実行基盤の共通化 ◦ GKE (Google Kubernetes Engine)
+ Anthos の構成による実行基盤 ◦ サービスを提供する2つの「サービスクラスタ」 ◦ クラスタとロードバランサを管理する「設定クラスタ」 • 容易なデプロイ ◦ 開発者は、最小限のCIマニフェストの管理のみでデプロイ可能 ◦ スケーリング等も上記のマニフェストで管理可能 -
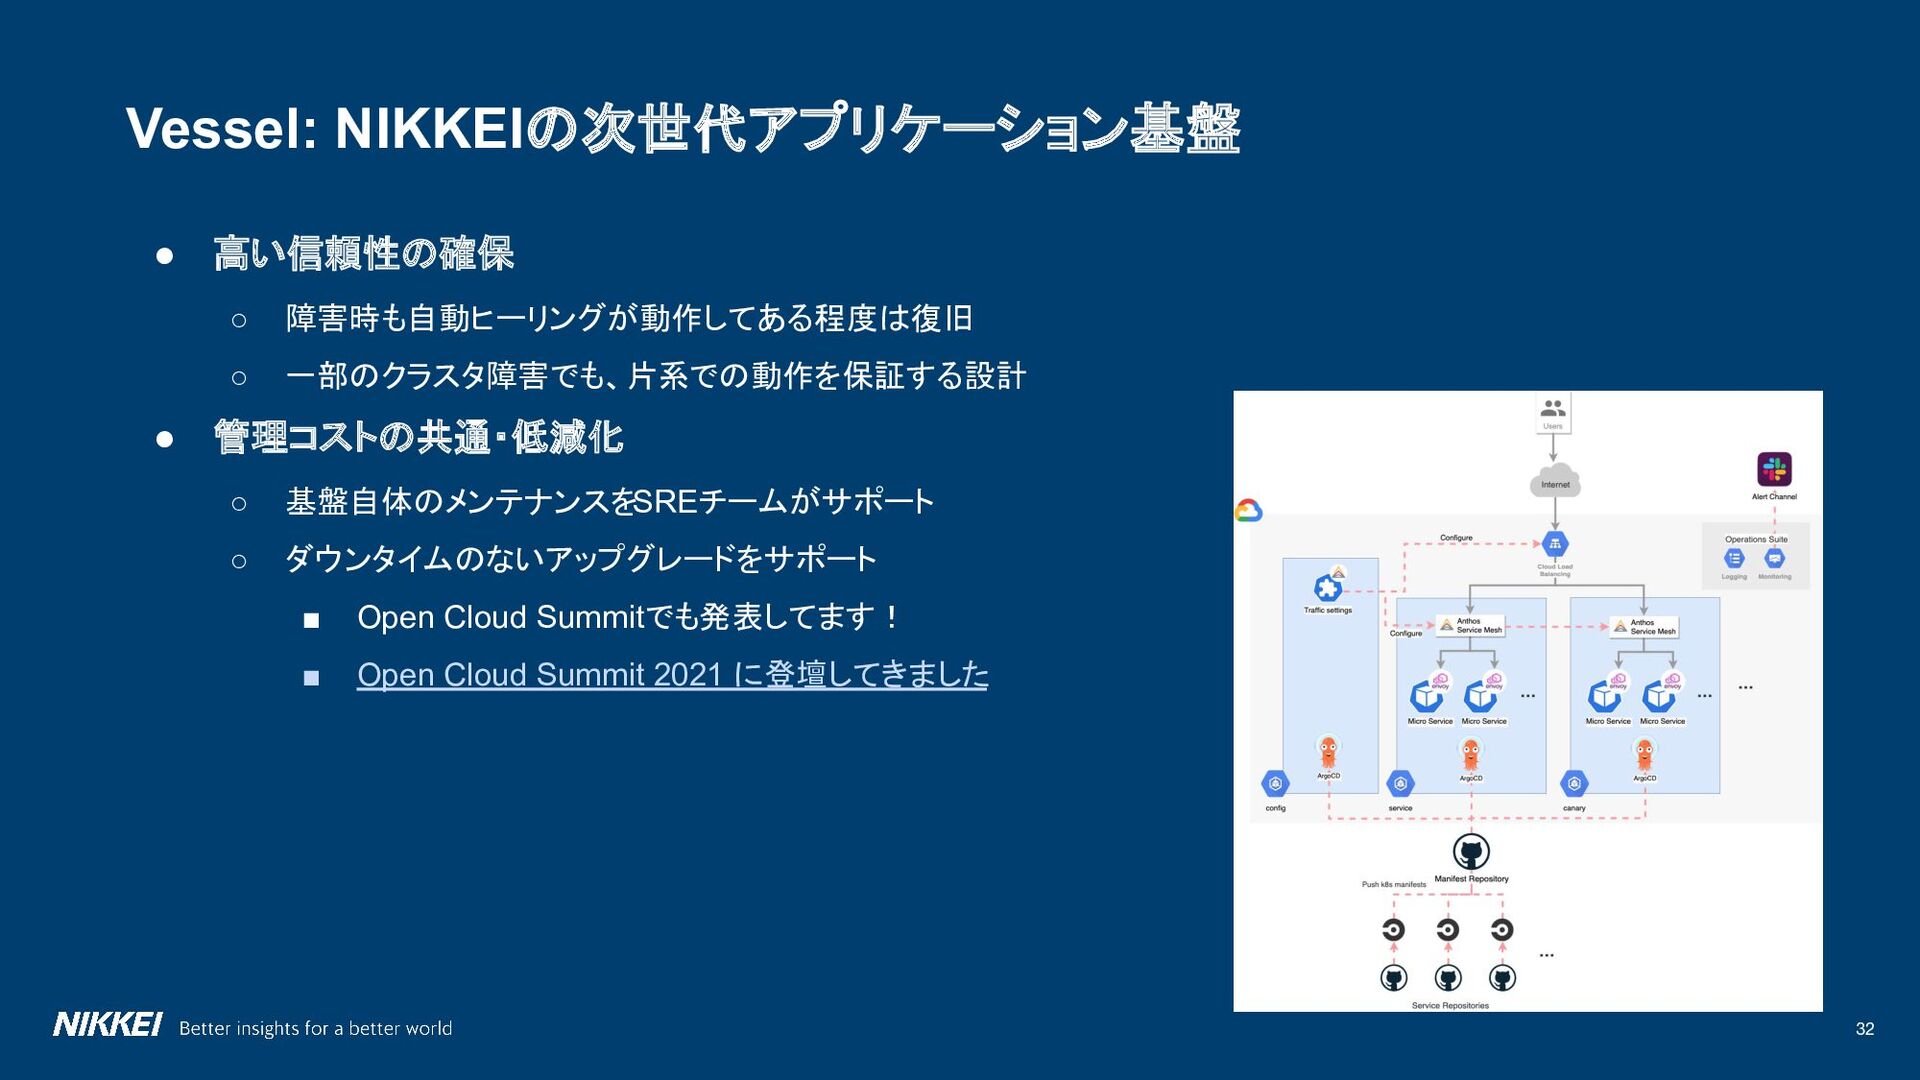
32 Vessel: NIKKEIの次世代アプリケーション基盤 • 高い信頼性の確保 ◦ 障害時も自動ヒーリングが動作してある程度は復旧 ◦ 一部のクラスタ障害でも、片系での動作を保証する設計 •
管理コストの共通・低減化 ◦ 基盤自体のメンテナンスをSREチームがサポート ◦ ダウンタイムのないアップグレードをサポート ▪ Open Cloud Summitでも発表してます! ▪ Open Cloud Summit 2021 に登壇してきました -
33 Vessel: 運用体制をつくる・新技術をとりいれる • 運用体制の整備 ◦ 自動的に回復する構成の採用 ◦ もしものときのための行動基準やドキュメントの整備を常に実施 •
障害訓練・運用トレーニング ◦ 開発環境への障害注入を行い、対応を確認 ◦ 障害に対応するだけではなく、障害対応時の連絡や報告、事後対応もレビュー ◦ 障害注入を通じて、障害が生じる可能性のあるコンポーネントを特定 ◦ 訓練の様子は Hack The NIKKEI でも公開中です! ▪ GKEベースのアプリケーション基盤 Vessel での障害訓練の取り組み • 新技術への挑戦 ◦ 安定運用は重視しつつ、最新技術も惜しみなく投入 -
34 信頼性をつくる汎用基盤たち NIKKEI の SREチームでは以下も内製・内部運用しています • アプリケーション基盤 (Cloud Runベース) ◦
Streamlitや小規模なアプリケーション等を簡単にデプロイできる • 負荷計測基盤 ◦ デプロイしたアプリケーションに対する負荷を発生させ、実際の耐性を計測 • ログ基盤 ◦ Elasticsearchを利用したログ収集基盤で、可視化をするKibana環境も提供 • メトリクス基盤 (開発中) ◦ 大量のメトリクスを集中管理し、長期間かつ安価なメトリクスの保管を可能に -
36 SRE Office Hours • 信頼性に関する相談事をざっくばらんに持ち込んでもらう時間 ◦ 月2回・毎回1時間の実施 ◦ SlackのHuddleを常設して入退室自由で来てもらう
◦ アジェンダも不要にしており、参加者のハードルも低く ◦ 毎回10名程度が参加 • ときには信頼性以外の相談事も… ◦ 大歓迎! ◦ 例えば…最近の重大脅威について、Terraformのベストプラクティスなどなど ◦ まずは議論を重要視し、信頼性に関する課題を拾い上げる -
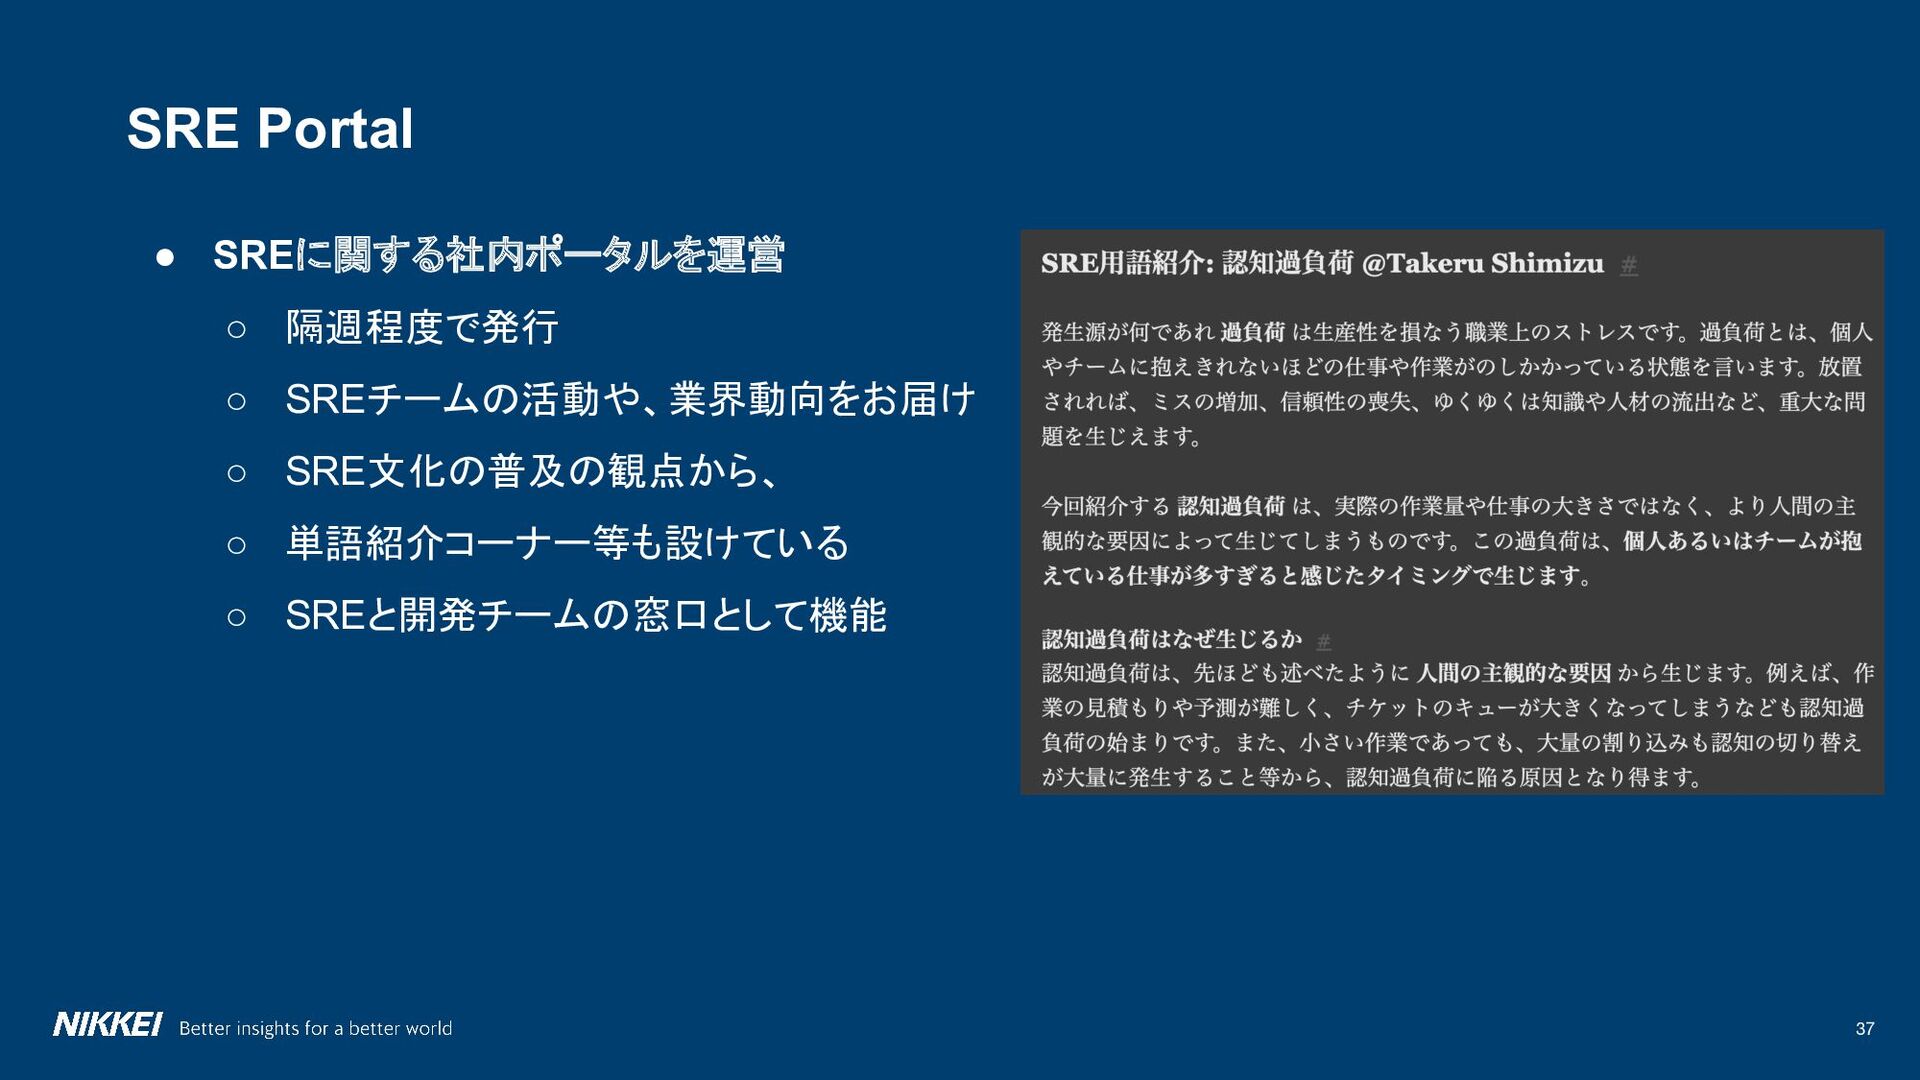
37 SRE Portal • SREに関する社内ポータルを運営 ◦ 隔週程度で発行 ◦ SREチームの活動や、業界動向をお届け ◦
SRE文化の普及の観点から、 ◦ 単語紹介コーナー等も設けている ◦ SREと開発チームの窓口として機能 -
38 まとめ - 私たちのミッション Mission make a culture, make a
future SREという文化を組織に浸透させる。文化が強固に根付いた組織が日経の未来を形づくる。 Vision Think with us, act for yourself サービスチームと共に信頼性について考え、サービスチームが実行していくこと Value confidence, safe and relief, better experience, happiness -
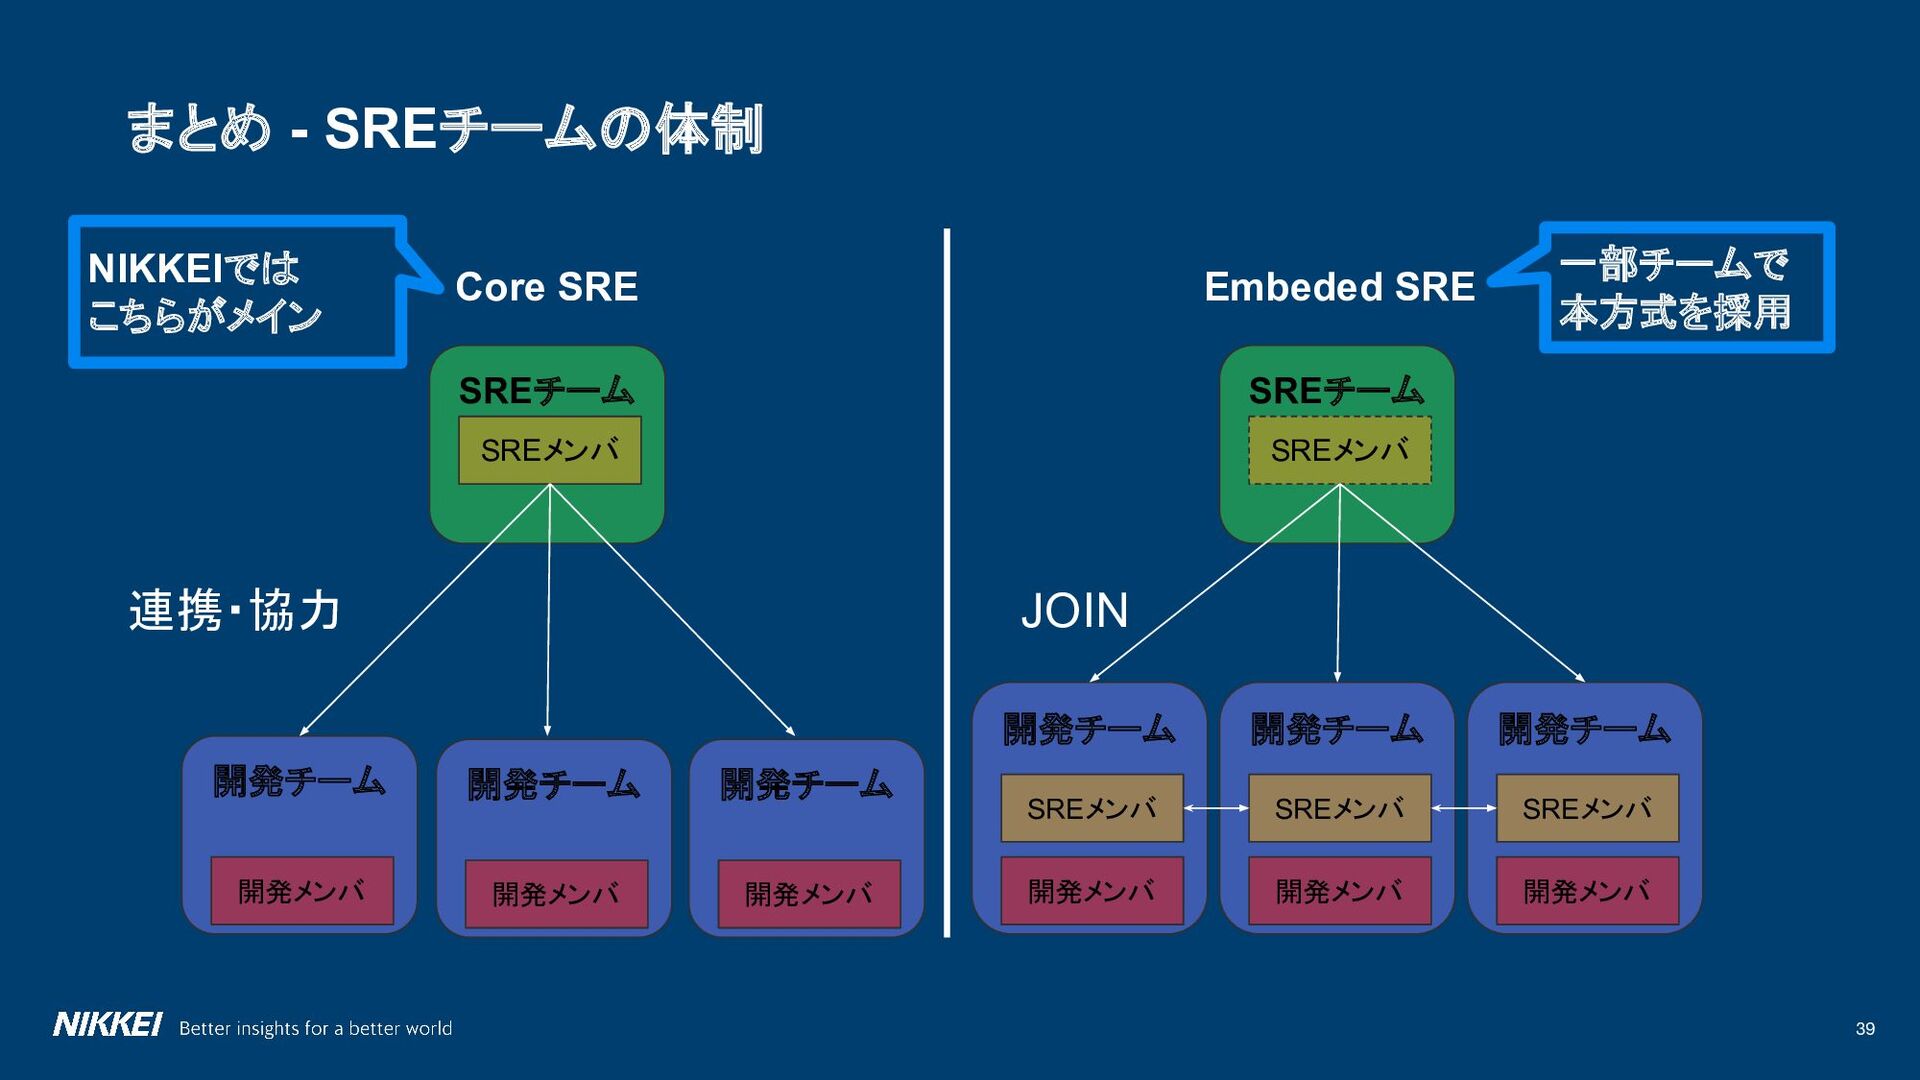
39 Core SRE 開発チーム SREチーム SREメンバ 開発メンバ 連携・協力 Embeded SRE
開発チーム 開発チーム 開発チーム SREチーム SREメンバ 開発メンバ 開発メンバ 開発メンバ JOIN SREメンバ SREメンバ SREメンバ まとめ - SREチームの体制 NIKKEIでは こちらがメイン 一部チームで 本方式を採用 開発チーム 開発メンバ 開発チーム 開発メンバ -
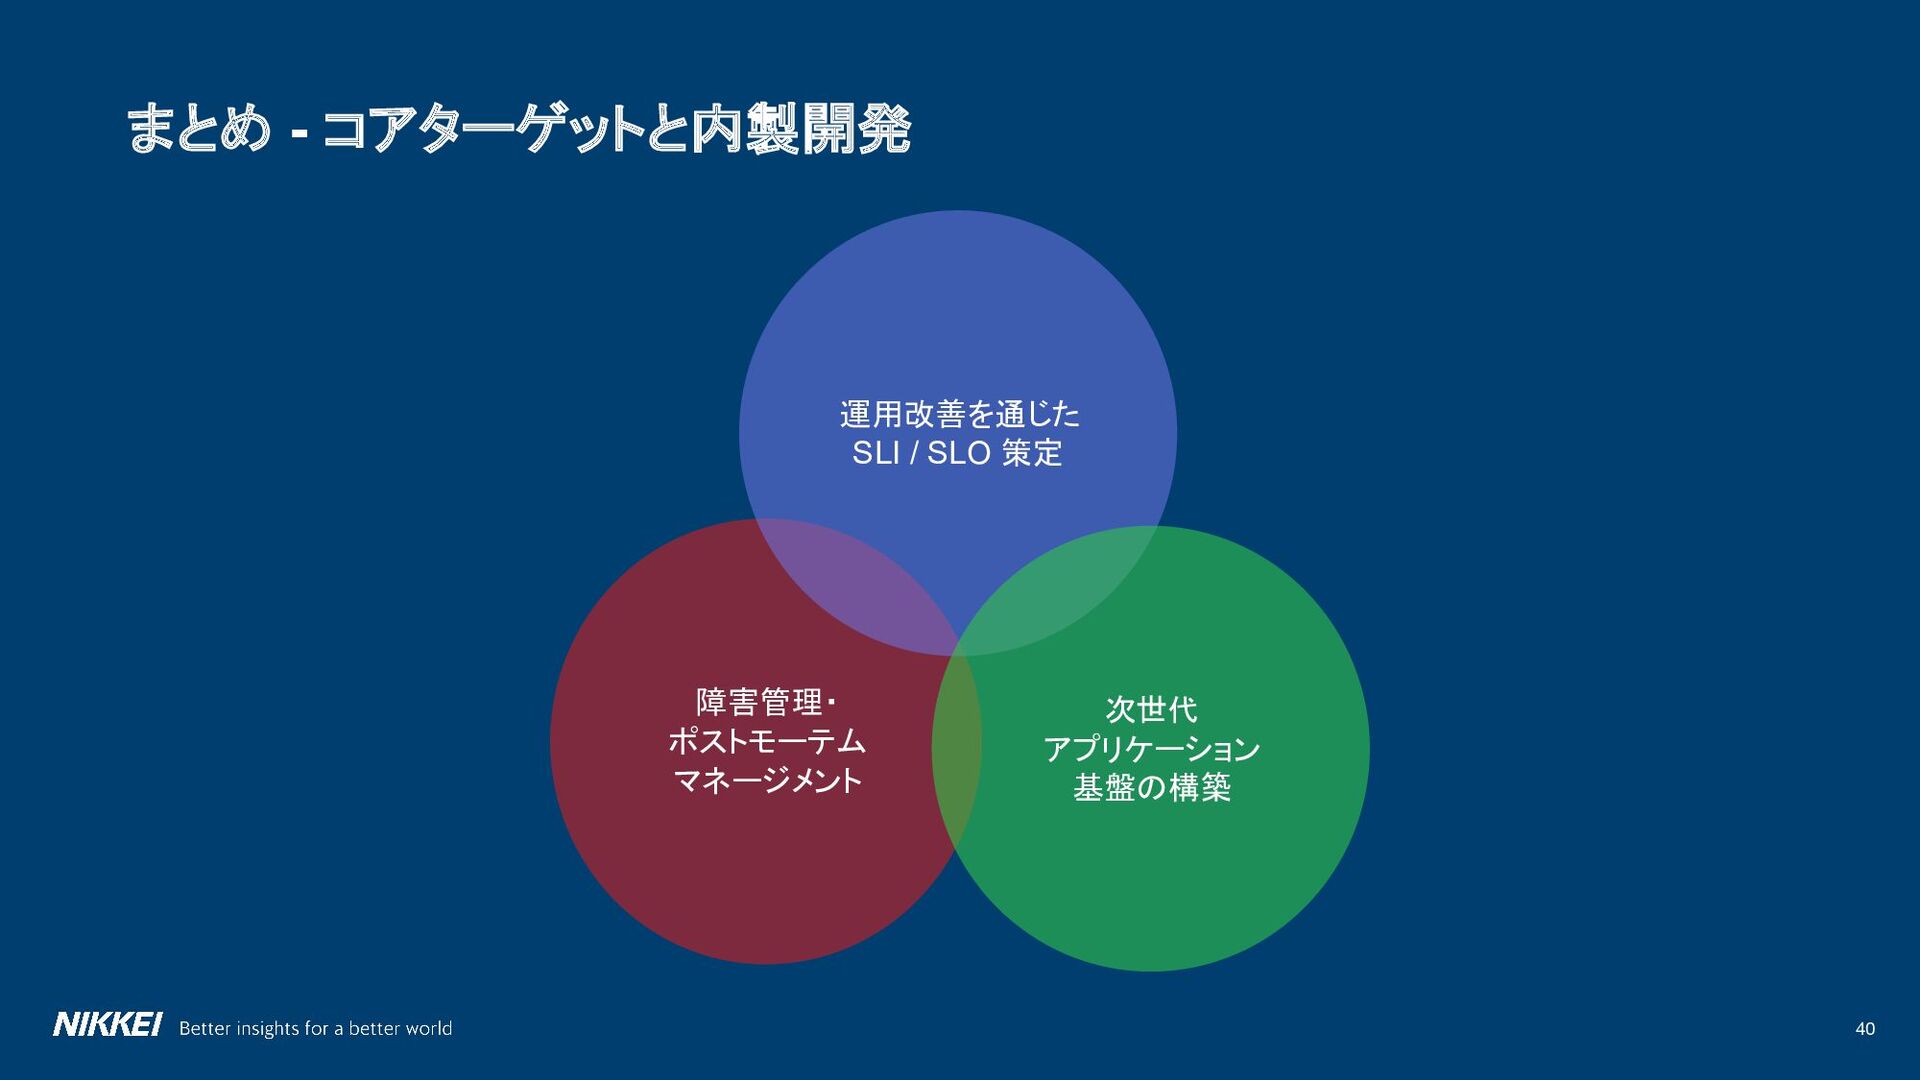
40 まとめ - コアターゲットと内製開発 障害管理・ ポストモーテム マネージメント 運用改善を通じた SLI /
SLO 策定 次世代 アプリケーション 基盤の構築