Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
TiUG #1 HBaseからTiDBへの移行を選んだ理由
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
nori
April 03, 2024
Technology
650
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
TiUG #1 HBaseからTiDBへの移行を選んだ理由
https://tiug.connpass.com/event/310114/
nori
April 03, 2024
Transcript
47 slides
HBaseからTiDBへの移行を選 んだ理由 株式会社サイバーエージェント 渡邉 敬之 1
自己紹介 • 名前:渡邉 敬之(わたなべ のりゆき) • 出身:千葉県 • 経歴:2019年サイバーエージェント新卒入社 •所属:グループIT推進本部
> データプロダクトユニット (DPU) • 興味あるもの:データベース 2
1.部署の紹介 2.HBaseの運用者・利用者視点の課題 3.TiDBを選定した理由 4.TiDB検証 5.今後の課題とまとめ 3
部署の紹介 4
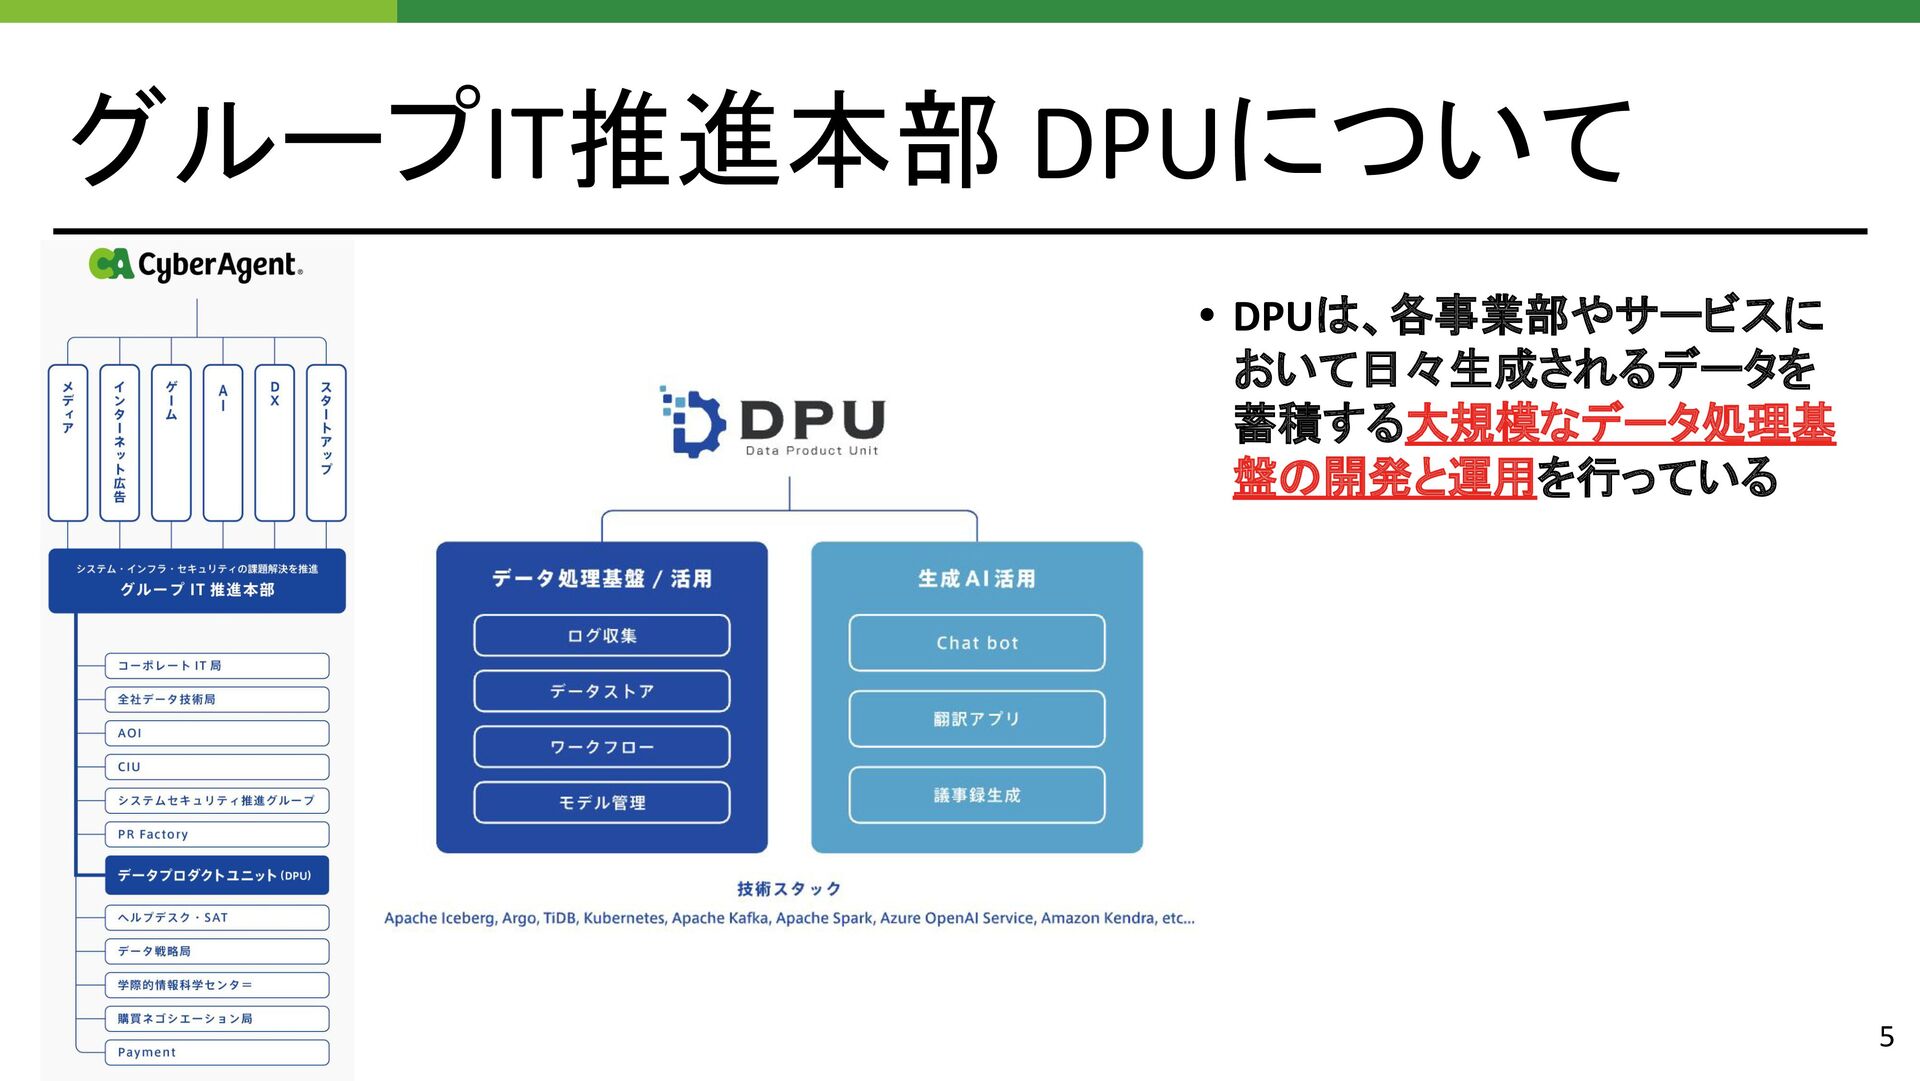
グループIT推進本部 DPUについて • DPUは、各事業部やサービスに おいて日々生成されるデータを 蓄積する大規模なデータ処理基 盤の開発と運用を行っている 5
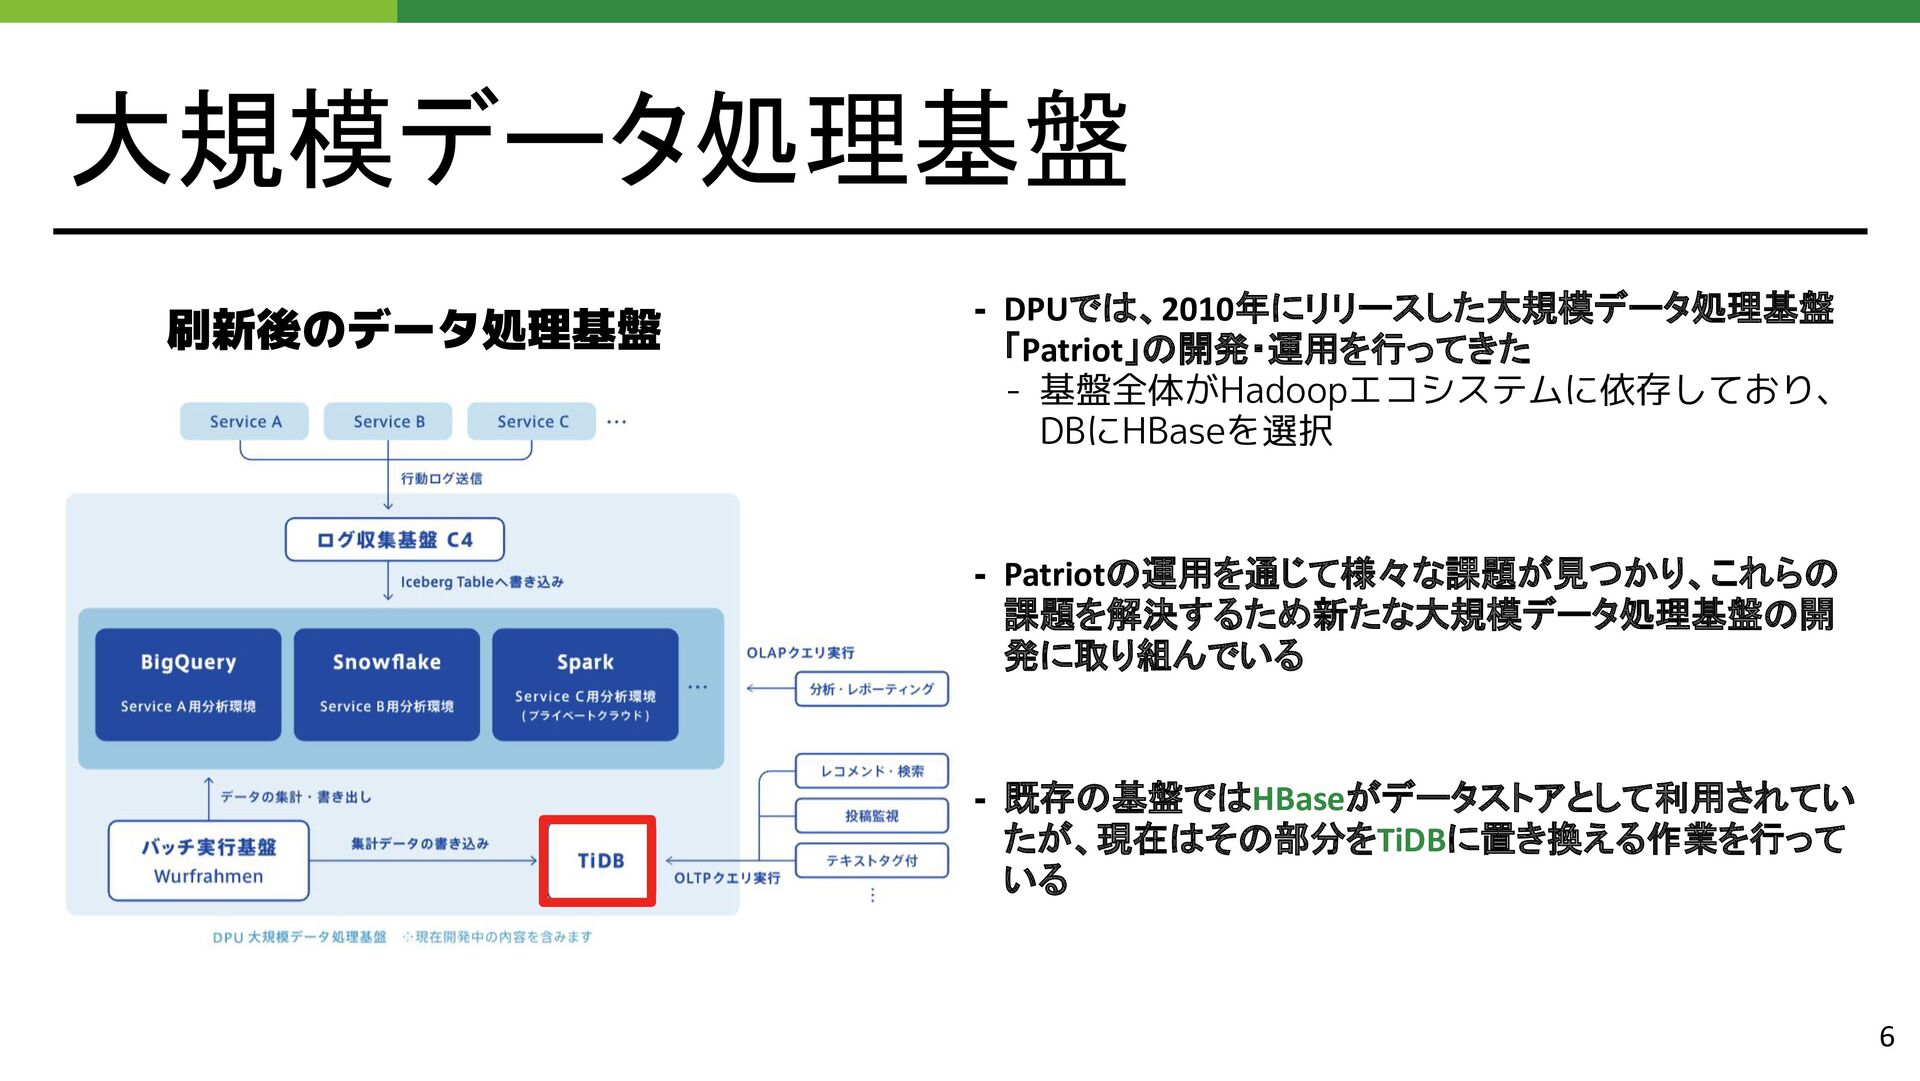
大規模データ処理基盤 6 - DPUでは、2010年にリリースした大規模データ処理基盤 「Patriot」の開発・運用を行ってきた - 基盤全体がHadoopエコシステムに依存しており、 DBにHBaseを選択 - Patriotの運用を通じて様々な課題が見つかり、これらの
課題を解決するため新たな大規模データ処理基盤の開 発に取り組んでいる - 既存の基盤ではHBaseがデータストアとして利用されてい たが、現在はその部分をTiDBに置き換える作業を行って いる 刷新後のデータ処理基盤
HBaseの運用者・利用者視点の課題 7
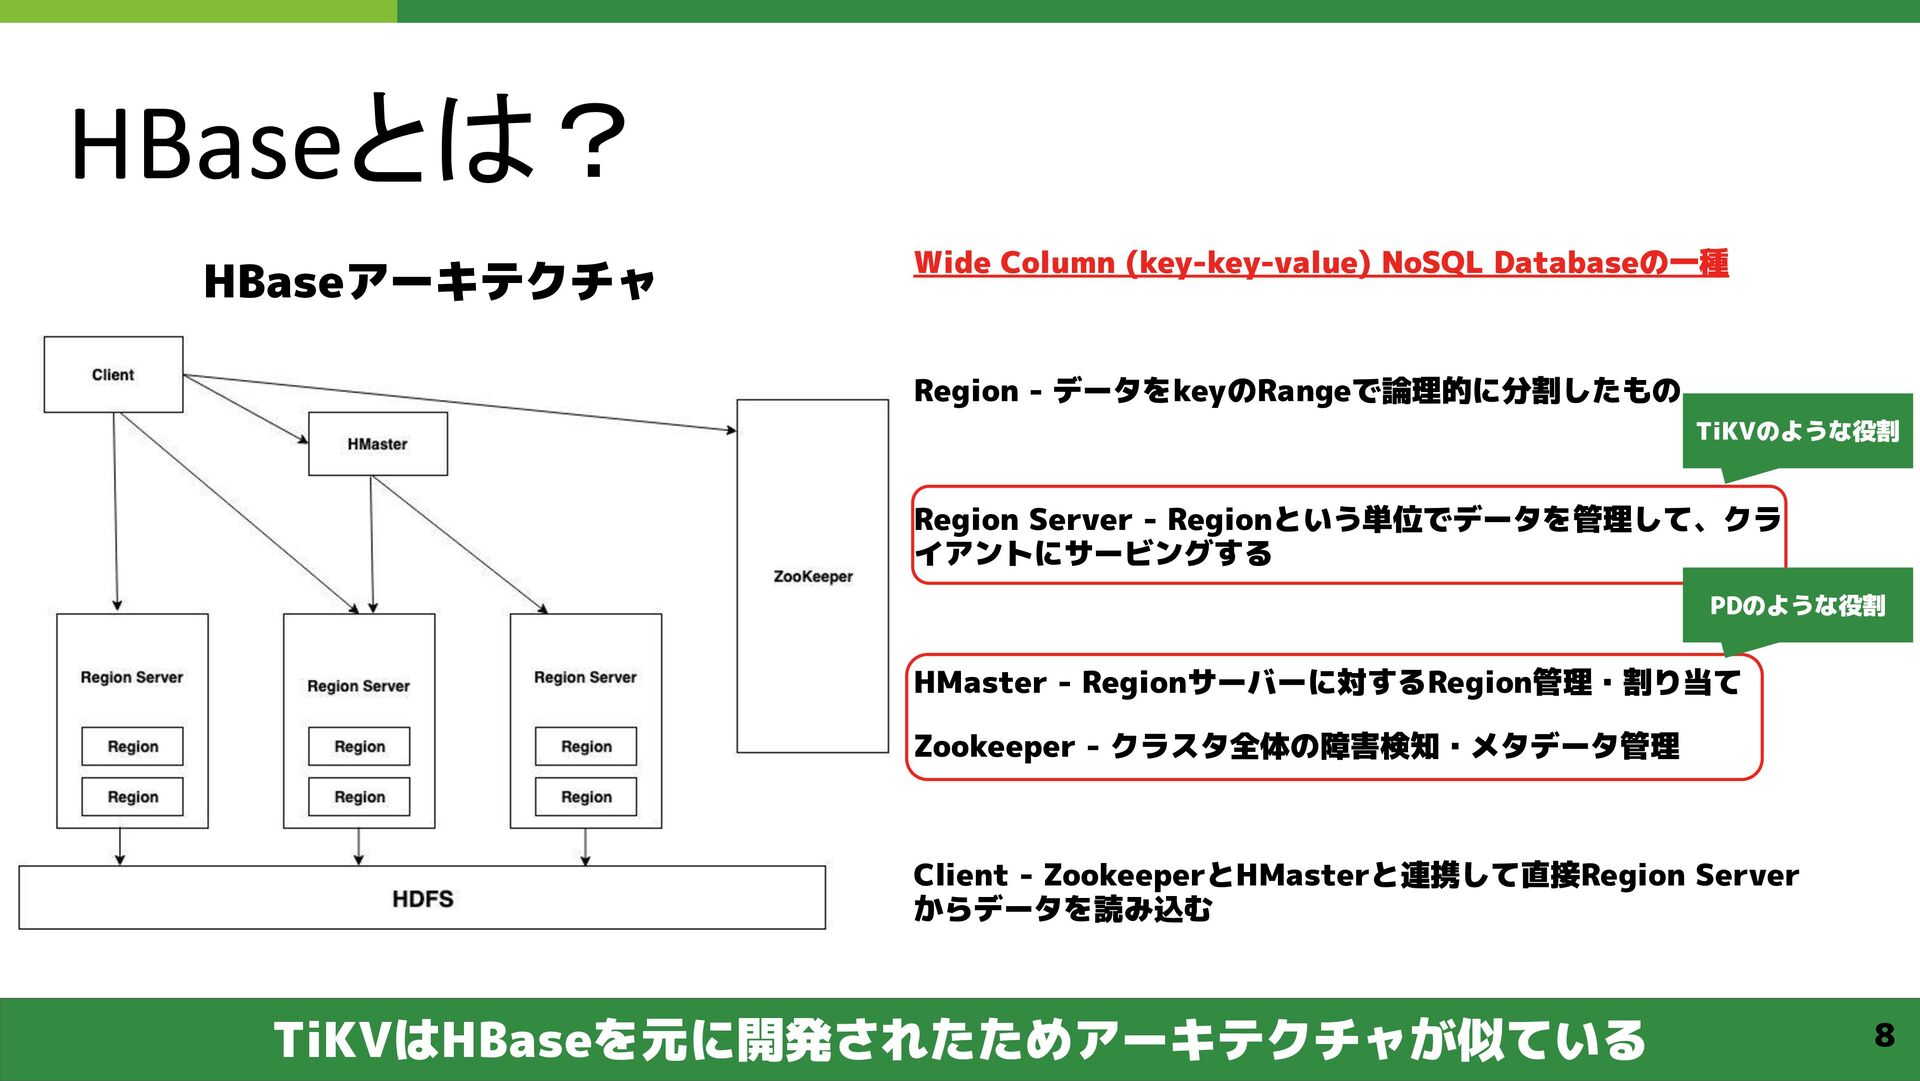
Wide Column (key-key-value) NoSQL Databaseの一種 Region - データをkeyのRangeで論理的に分割したもの Region Server
- Regionという単位でデータを管理して、クラ イアントにサービングする HMaster - Regionサーバーに対するRegion管理・割り当て Zookeeper - クラスタ全体の障害検知・メタデータ管理 Client - ZookeeperとHMasterと連携して直接Region Server からデータを読み込む TiKVはHBaseを元に開発されたためアーキテクチャが似ている HBaseとは? HBaseアーキテクチャ 8 TiKVのような役割 PDのような役割
現状のHBase運用環境 9 • プライベートクラウドのVM上でクラスタを構築 • クラスタは1台でマルチテナントで運用 • テーブルの中にどのようなデータが入っているかはスキーマがないのでHBase管理者側では 管理できていない •
ユーザ管理できておらず誰でも全てのテーブルにアクセスできる状態
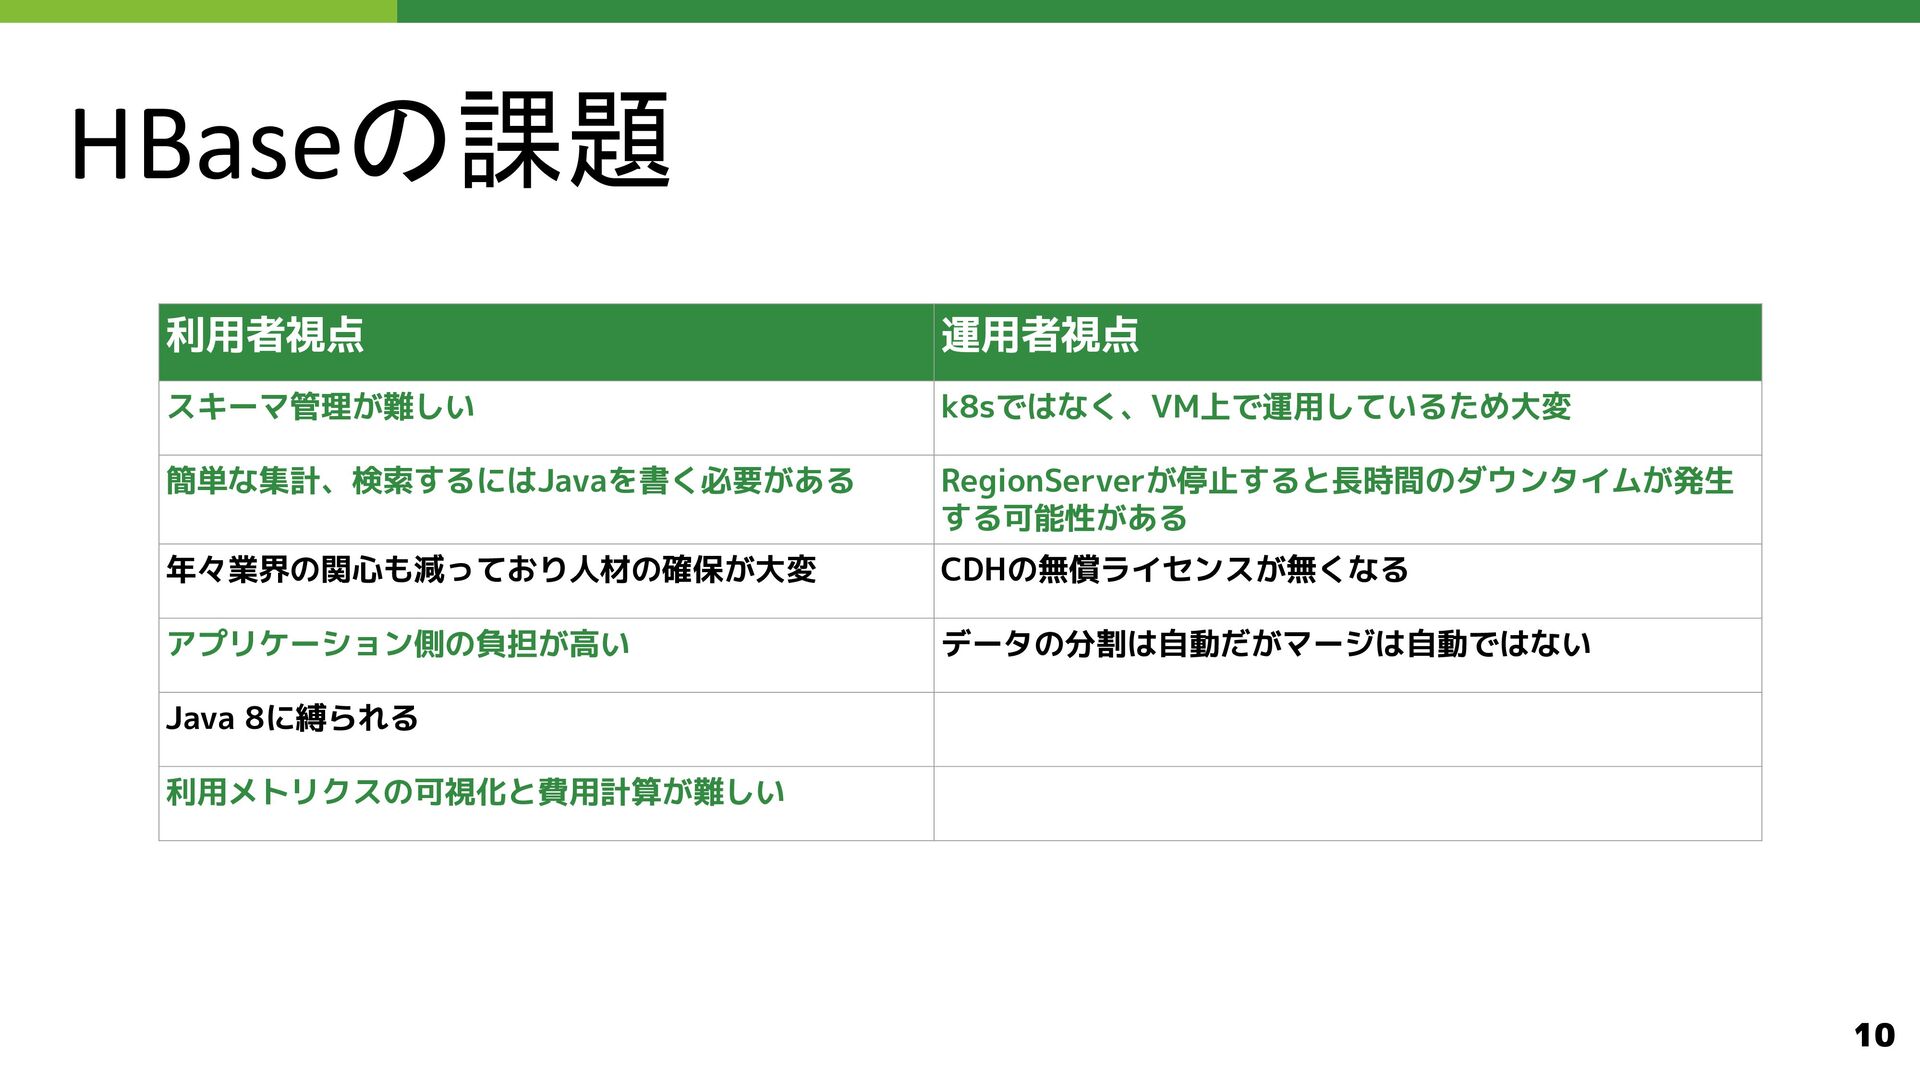
HBaseの課題 利用者視点 運用者視点 スキーマ管理が難しい k8sではなく、VM上で運用しているため大変 簡単な集計、検索するにはJavaを書く必要がある RegionServerが停止すると長時間のダウンタイムが発生 する可能性がある 年々業界の関心も減っており人材の確保が大変 CDHの無償ライセンスが無くなる
アプリケーション側の負担が高い データの分割は自動だがマージは自動ではない Java 8に縛られる 利用メトリクスの可視化と費用計算が難しい 10
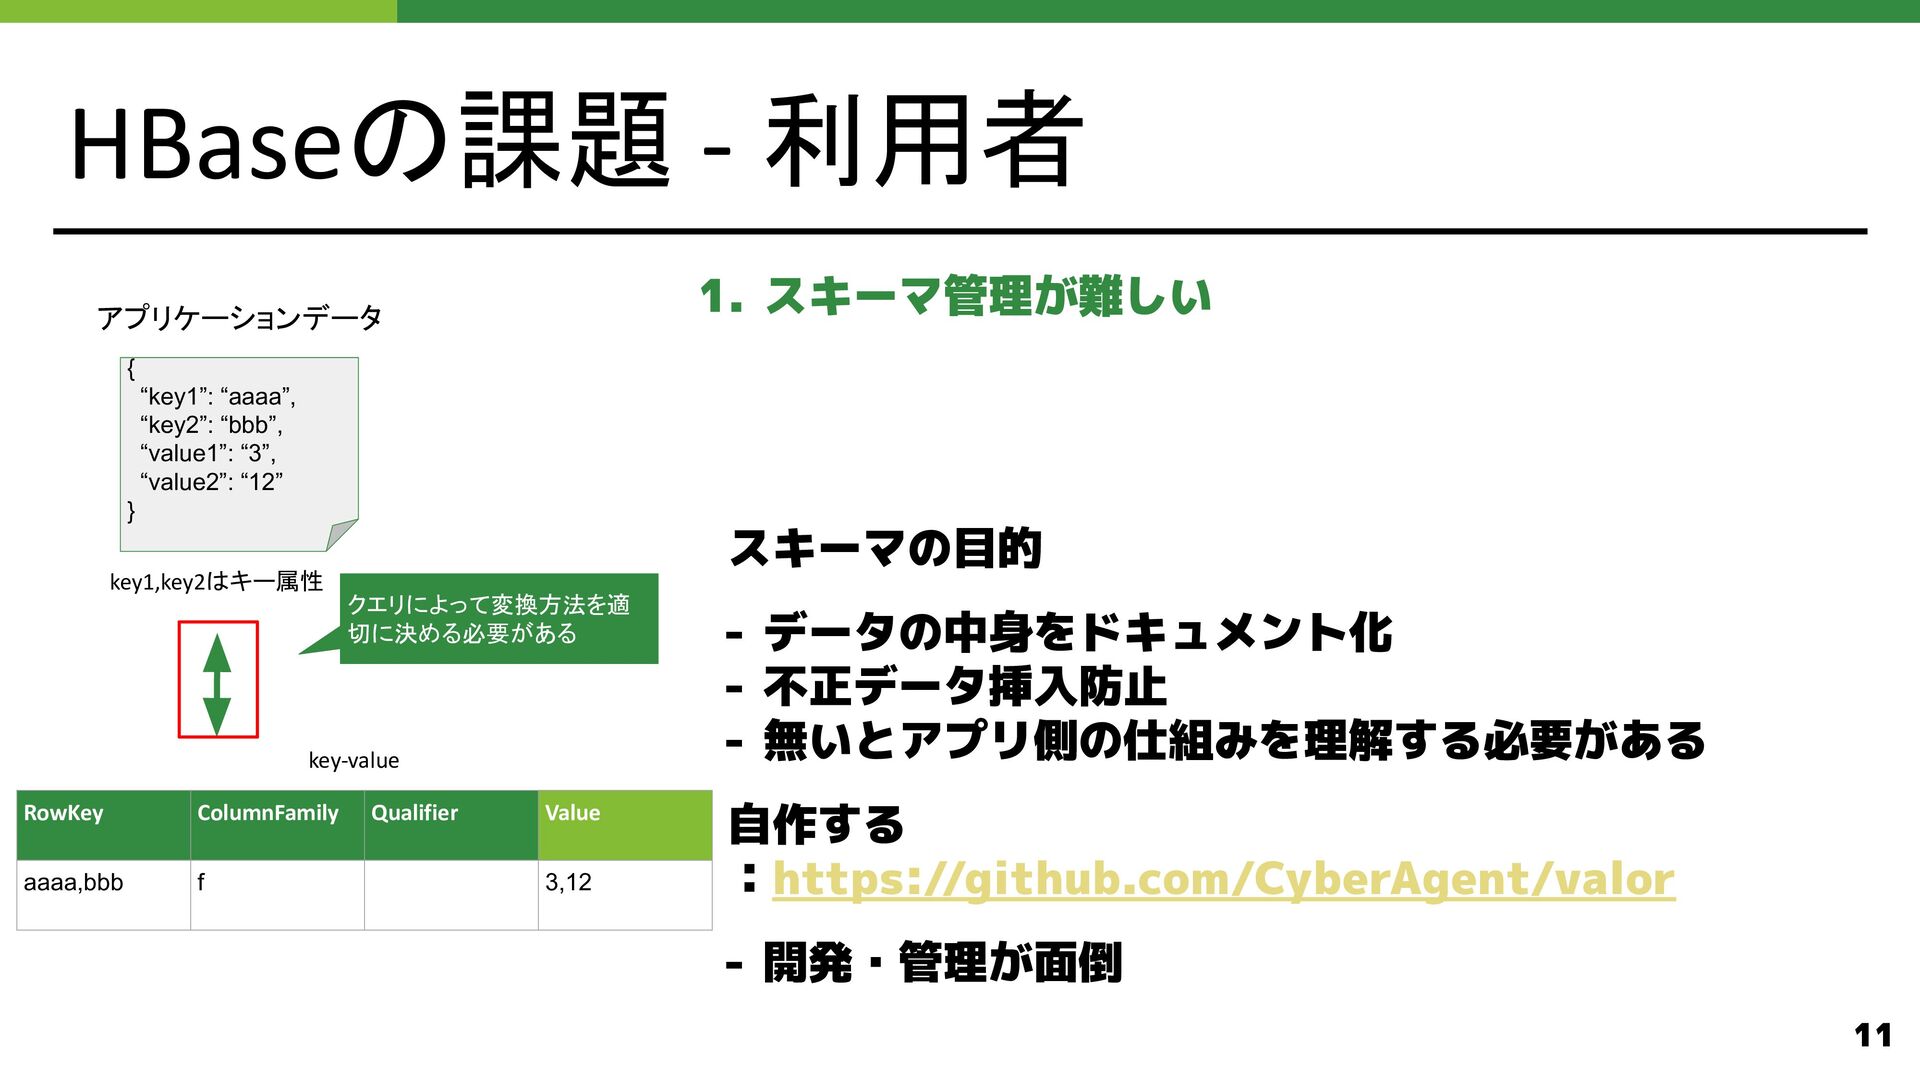
HBaseの課題 - 利用者 1. スキーマ管理が難しい スキーマの目的 - データの中身をドキュメント化 - 不正データ挿入防止
- 無いとアプリ側の仕組みを理解する必要がある 自作する :https://github.com/CyberAgent/valor - 開発・管理が面倒 11 { “key1”: “aaaa”, “key2”: “bbb”, “value1”: “3”, “value2”: “12” } RowKey ColumnFamily Qualifier Value aaaa,bbb f 3,12 key1,key2はキー属性 アプリケーションデータ key-value クエリによって変換方法を適 切に決める必要がある
HBaseの課題 - 利用者 1. スキーマ管理が難しい 2. アプリケーション側の負荷が高い - 複雑なクエリが実行できない -
セカンダリインデックスがない - アプリケーション側で一貫性を保証する必要がある 12
HBaseの課題 - 利用者 1. スキーマ管理が難しい 2. アプリケーション側の負荷が高い 3. 簡単な集計、検索するにはJavaを書く必要がある Hbase
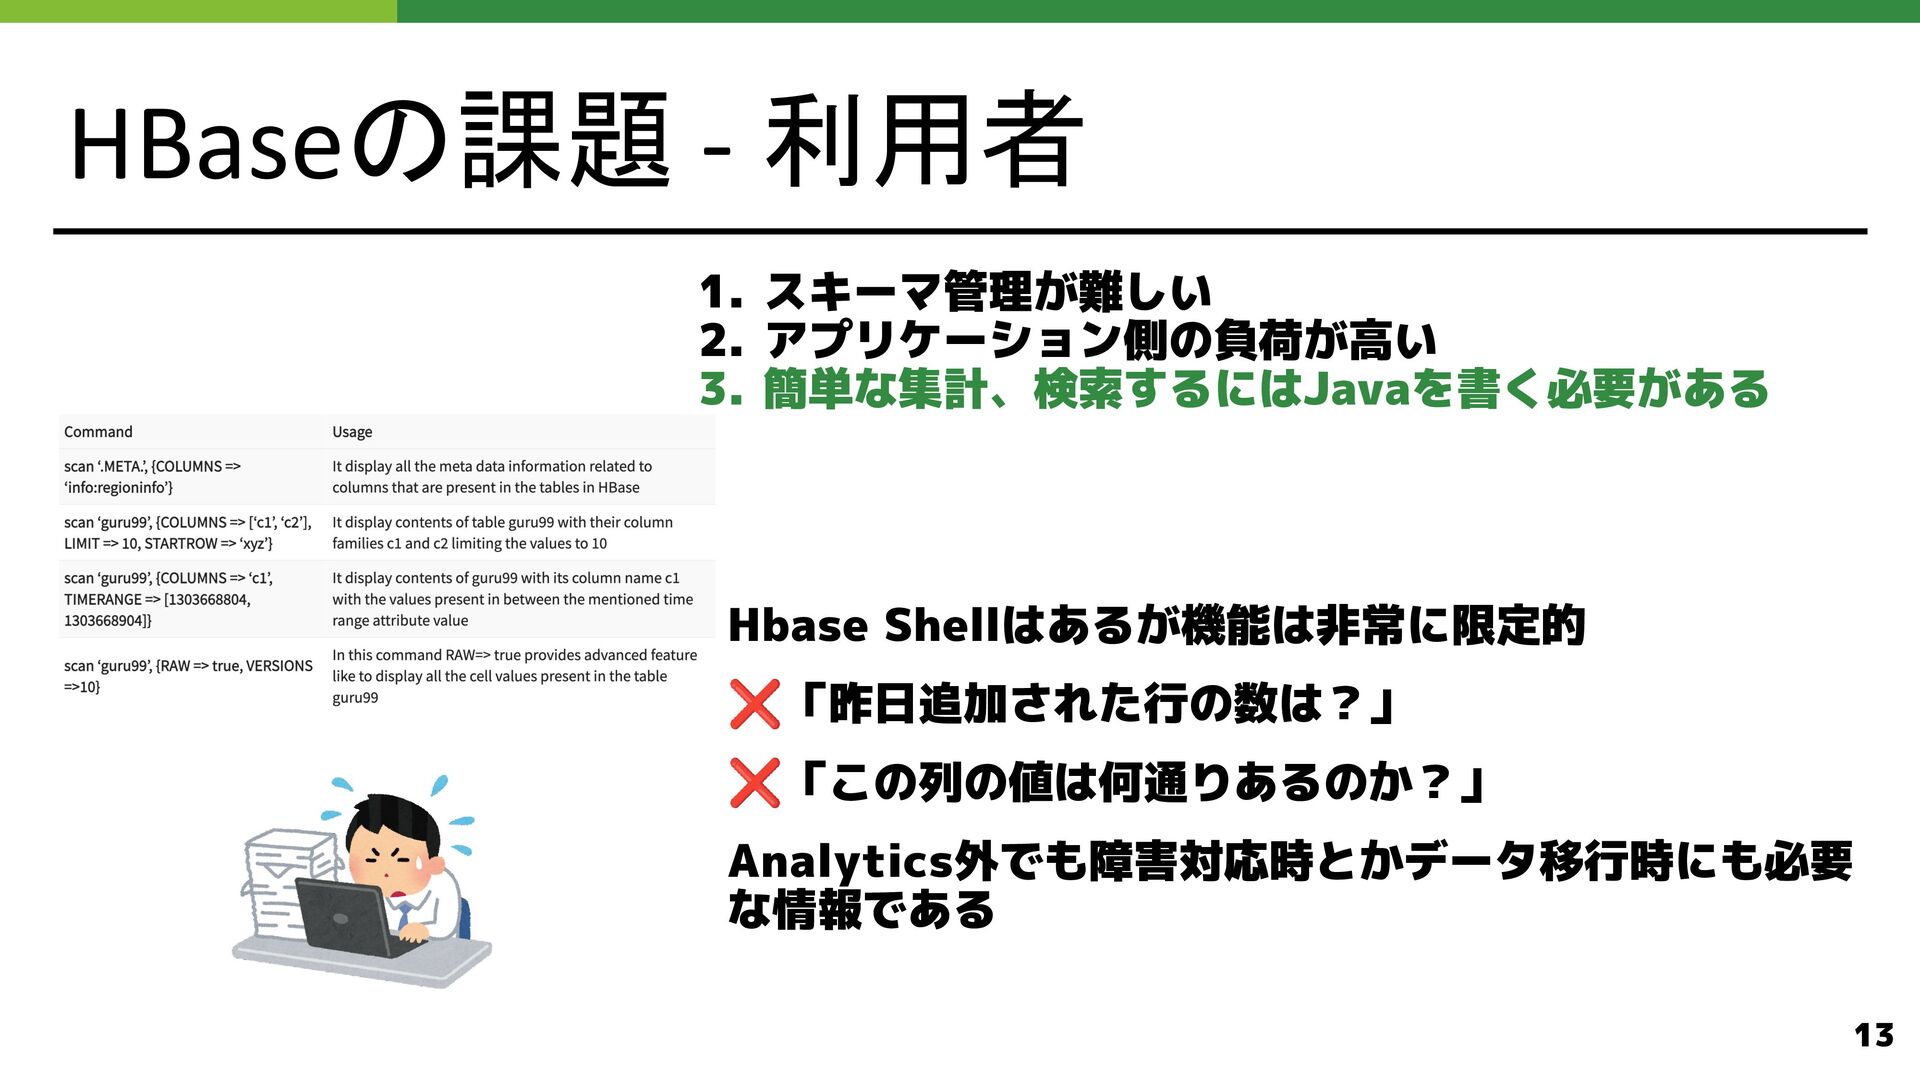
Shellはあるが機能は非常に限定的 ❌「昨日追加された行の数は?」 ❌「この列の値は何通りあるのか?」 Analytics外でも障害対応時とかデータ移行時にも必要 な情報である 13
HBaseの課題 - 利用者 1. スキーマ管理が難しい 2. アプリケーション側の負荷が高い 3. 簡単な集計、検索するにはJavaを書く必要がある 4.
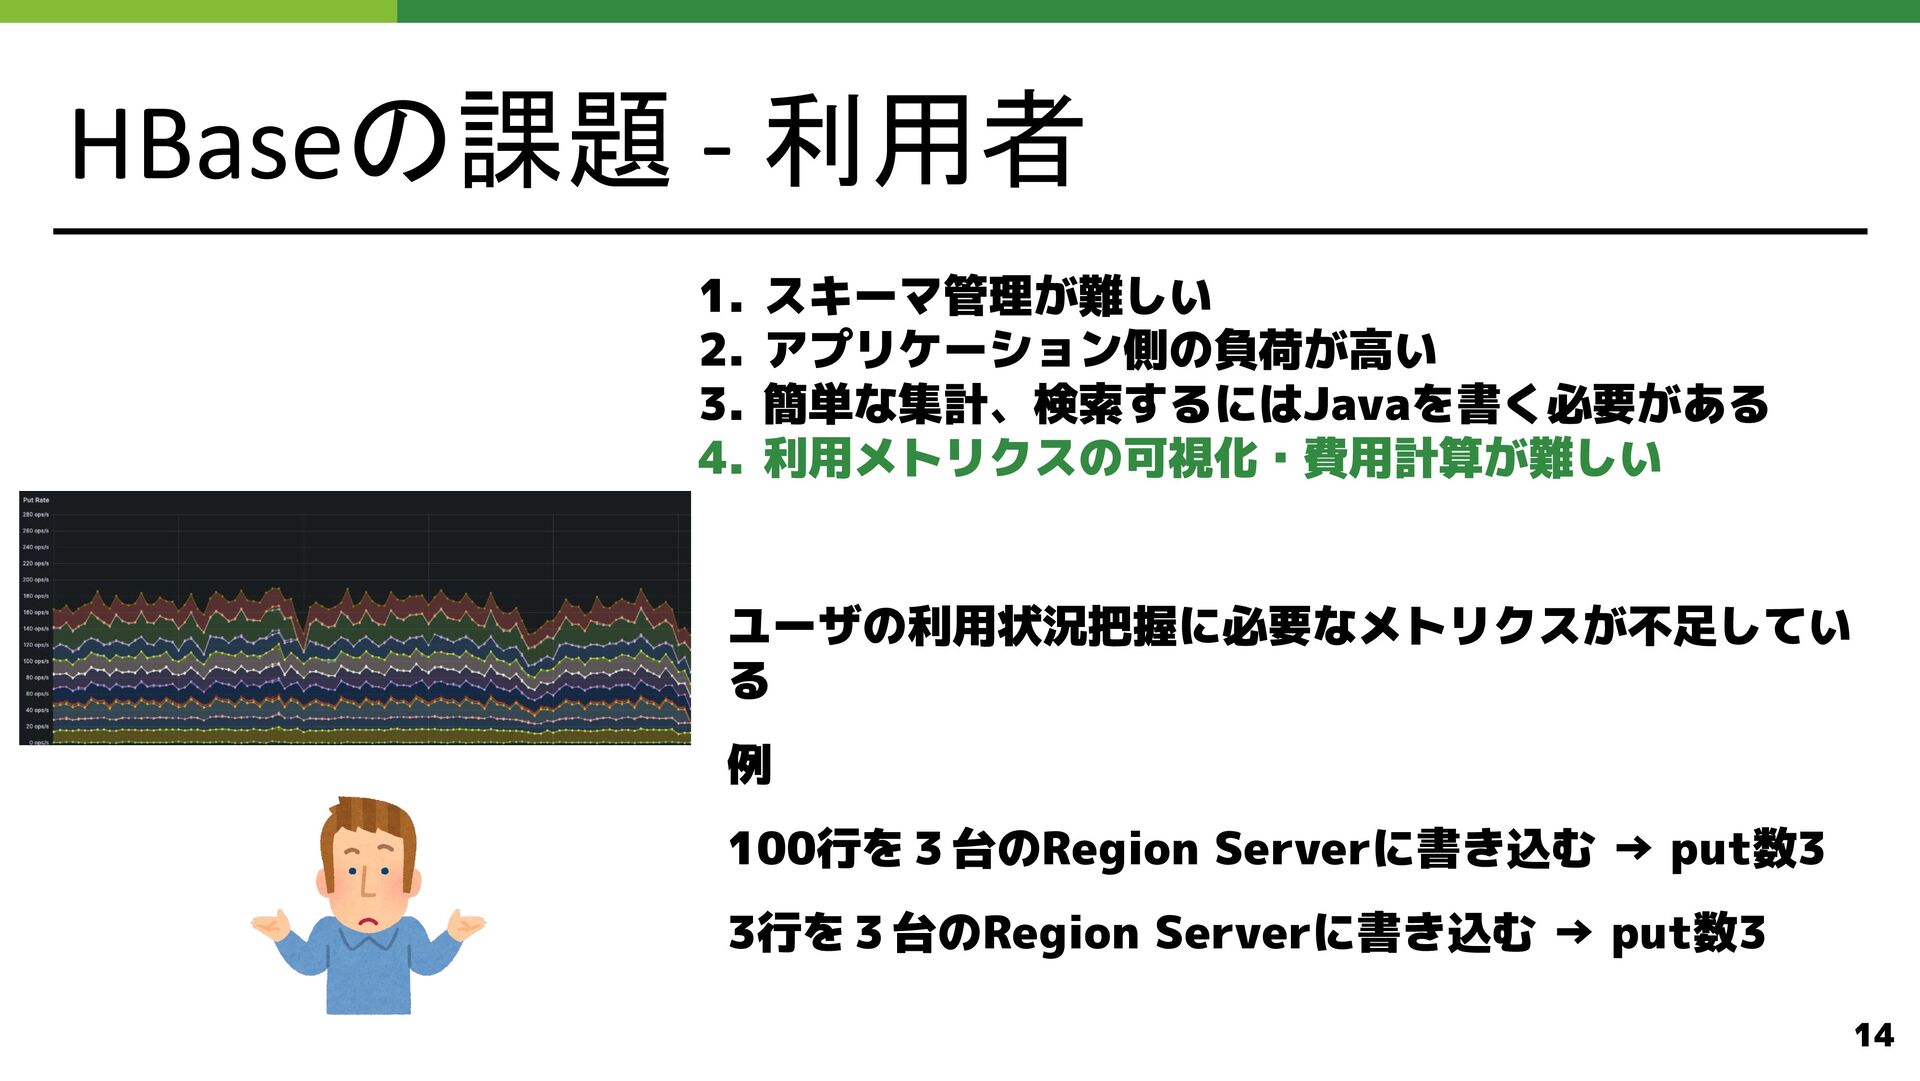
利用メトリクスの可視化・費用計算が難しい ユーザの利用状況把握に必要なメトリクスが不足してい る 例 100行を3台のRegion Serverに書き込む → put数3 3行を3台のRegion Serverに書き込む → put数3 14
HBaseの課題 - 運用者 1. スキーマ管理が難しい 2. アプリケーション側の負荷が高い 3. 簡単な集計、検索するにはJavaを書く必要がある 4.
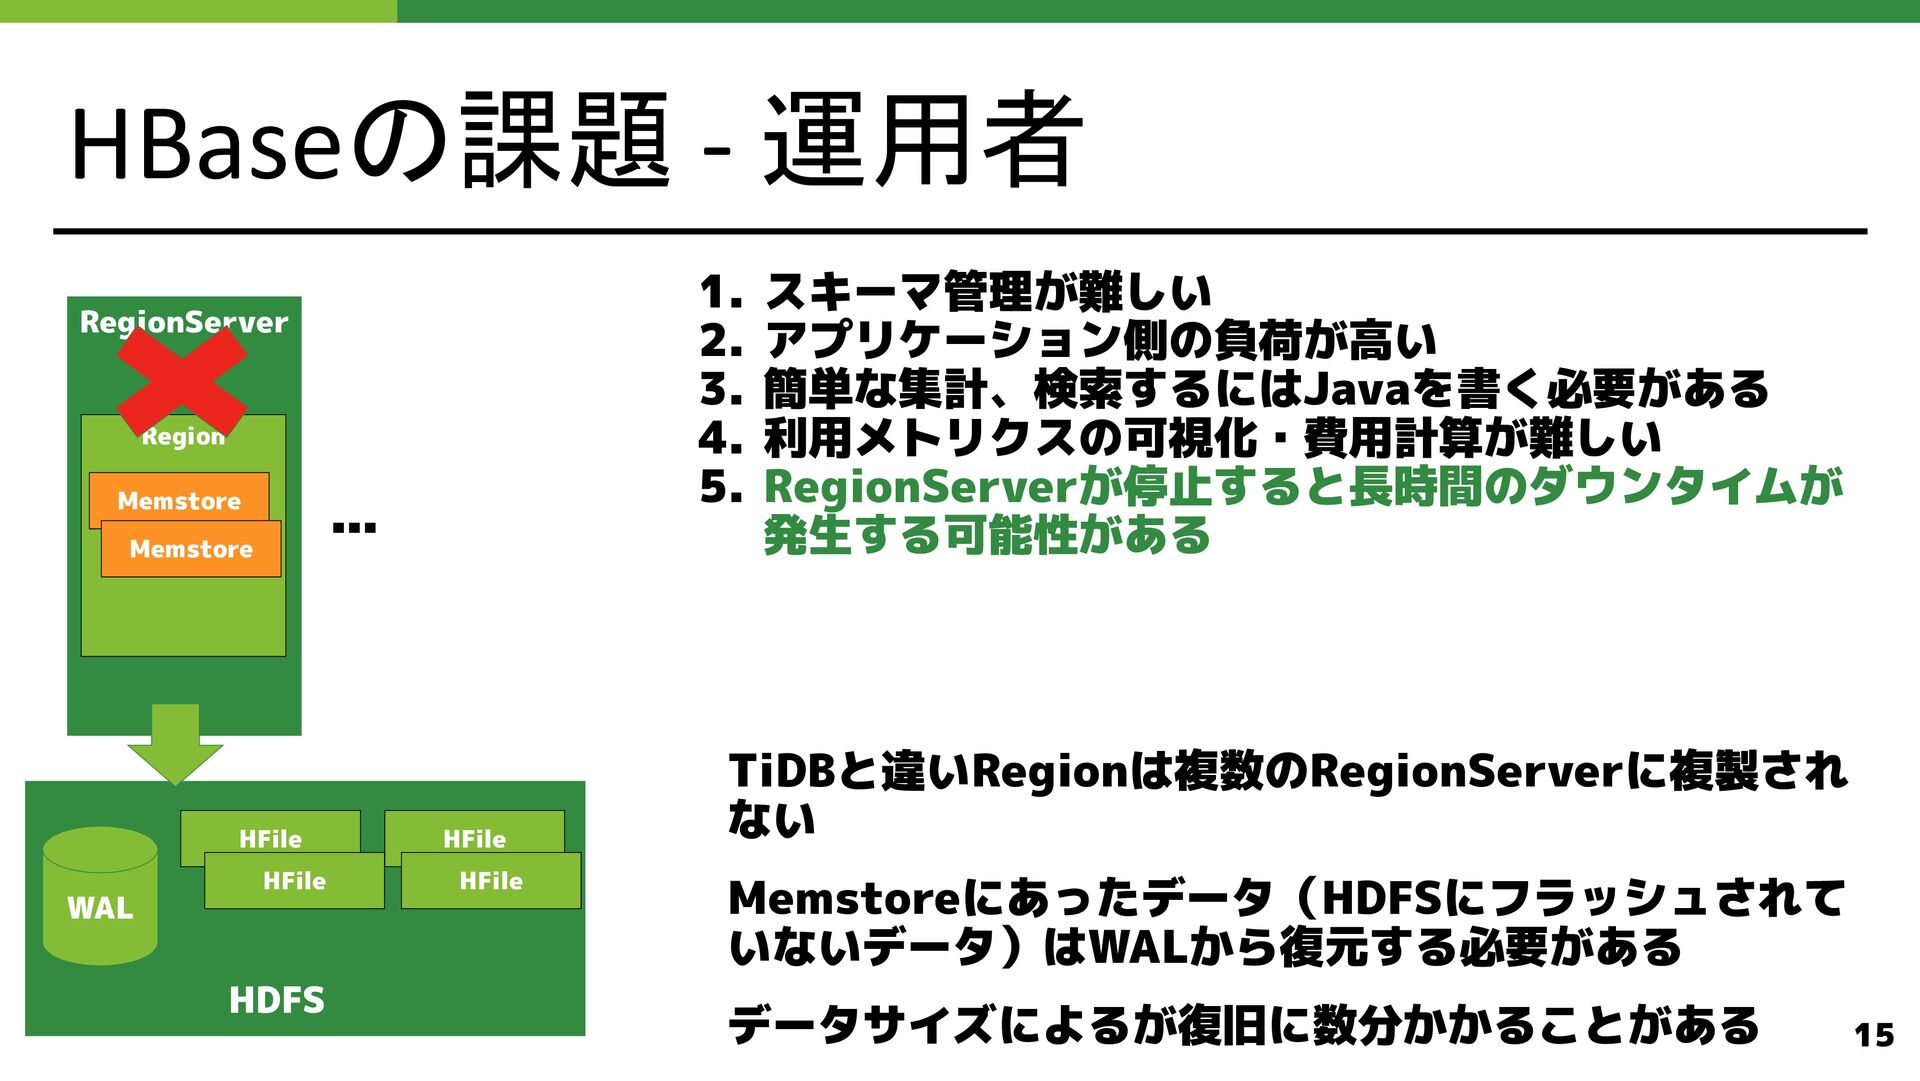
利用メトリクスの可視化・費用計算が難しい 5. RegionServerが停止すると長時間のダウンタイムが 発生する可能性がある TiDBと違いRegionは複数のRegionServerに複製され ない Memstoreにあったデータ(HDFSにフラッシュされて いないデータ)はWALから復元する必要がある データサイズによるが復旧に数分かかることがある 15 WAL HDFS HFile HFile HFile HFile RegionServer Region Memstore Memstore …
HBaseの課題 - 運用者 1. スキーマ管理が難しい 2. アプリケーション側の負荷が高い 3. 簡単な集計、検索するにはJavaを書く必要がある 4.
利用メトリクスの可視化・費用計算が難しい 5. RegionServerが停止すると長時間のダウンタイムが 発生する可能性がある 6. k8sではなく、VM上で運用しているため大変 部署内で運用しているシステムは基本的にk8s上で構築 されている DBもk8sで管理したいがHBaseはk8sで管理されるこ とが前提で作られていないため導入が大変 16
その他の要件 • シンプルなクエリで99%ileのレイテンシが100ms以内 • プライベートクラウドで運用 • HBaseと同様のスケーラビリティ • computeとstorageが分離 17
TiDBの選定理由 18
ユーザ側の実装負荷が低い • MySQL互換であるため習得が容易 • 複雑なクエリが実行できる • データの一貫性がデータベース側で確保されるため、アプリケーション側での処理が単純化さ れる • スキーマがあるため、データの意味や型が明確になる
19 アプリ開発者は本来の機能実装に専念できる
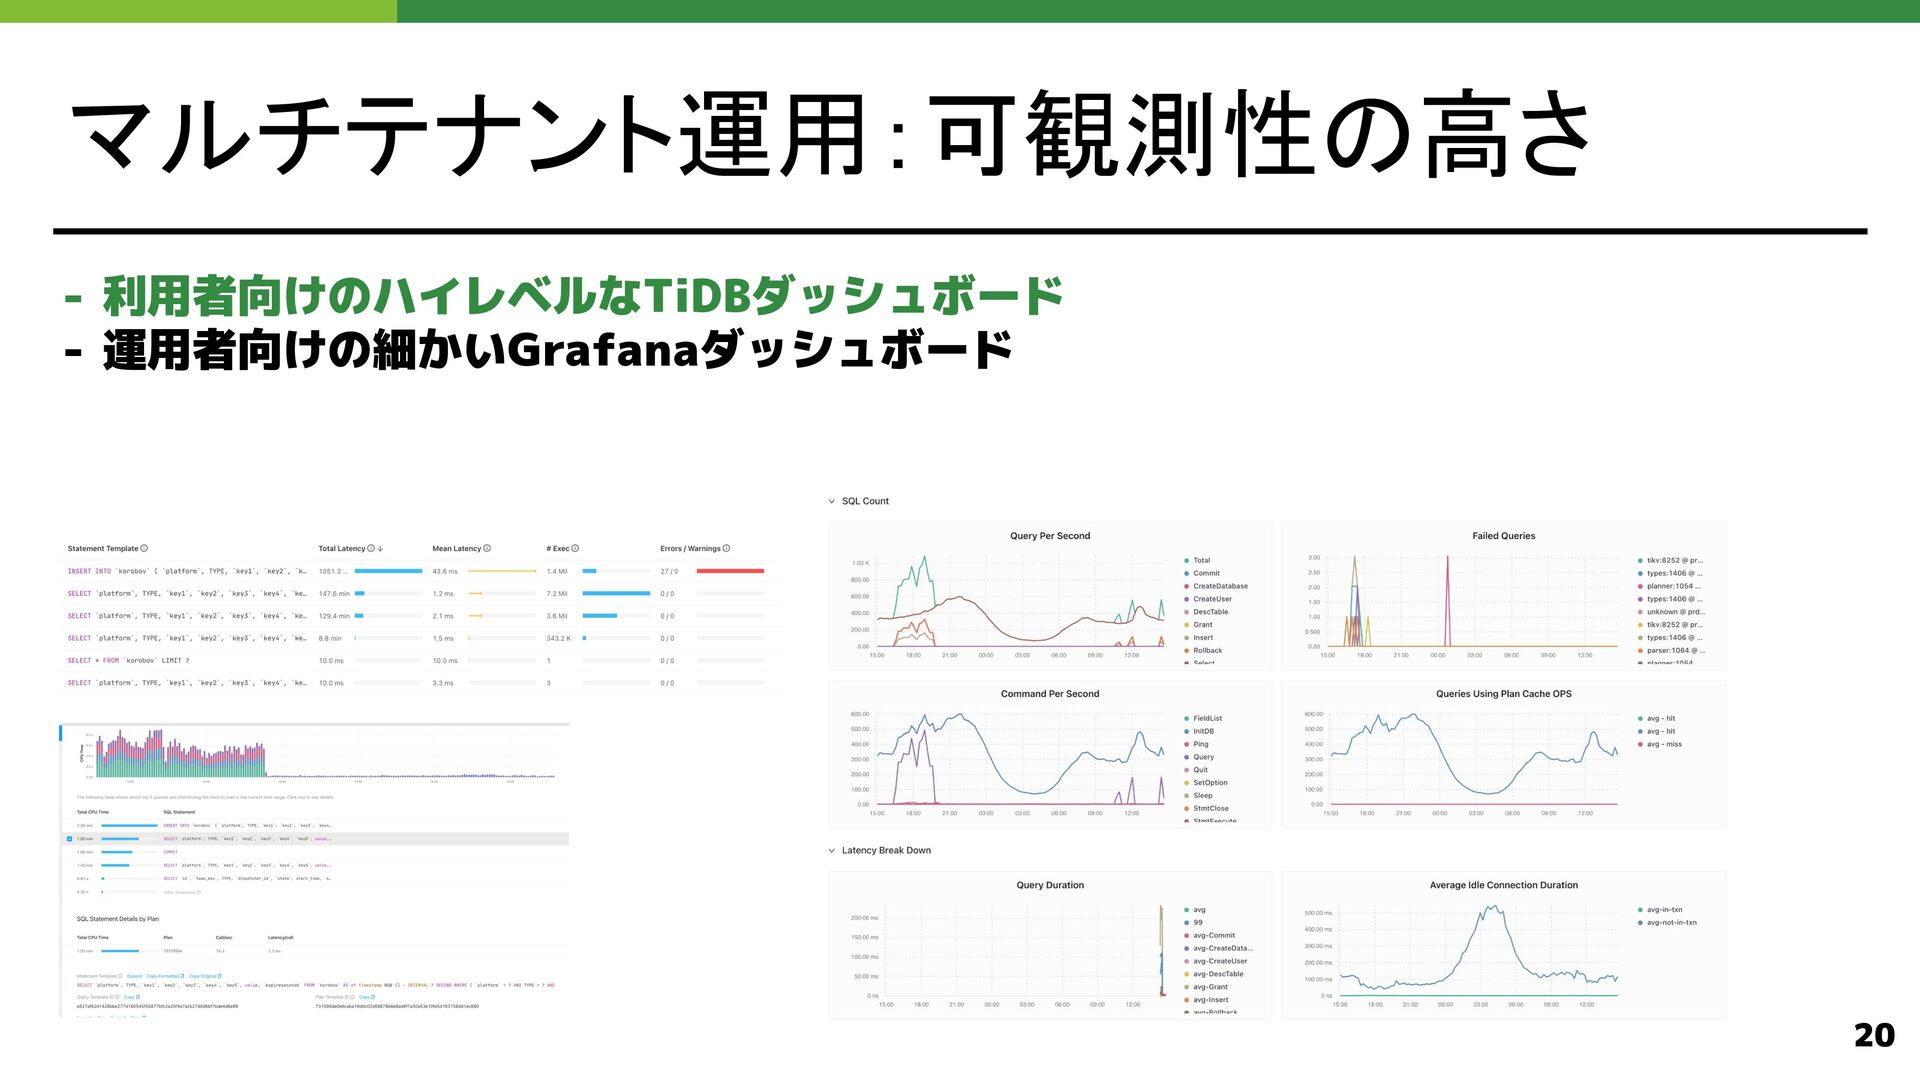
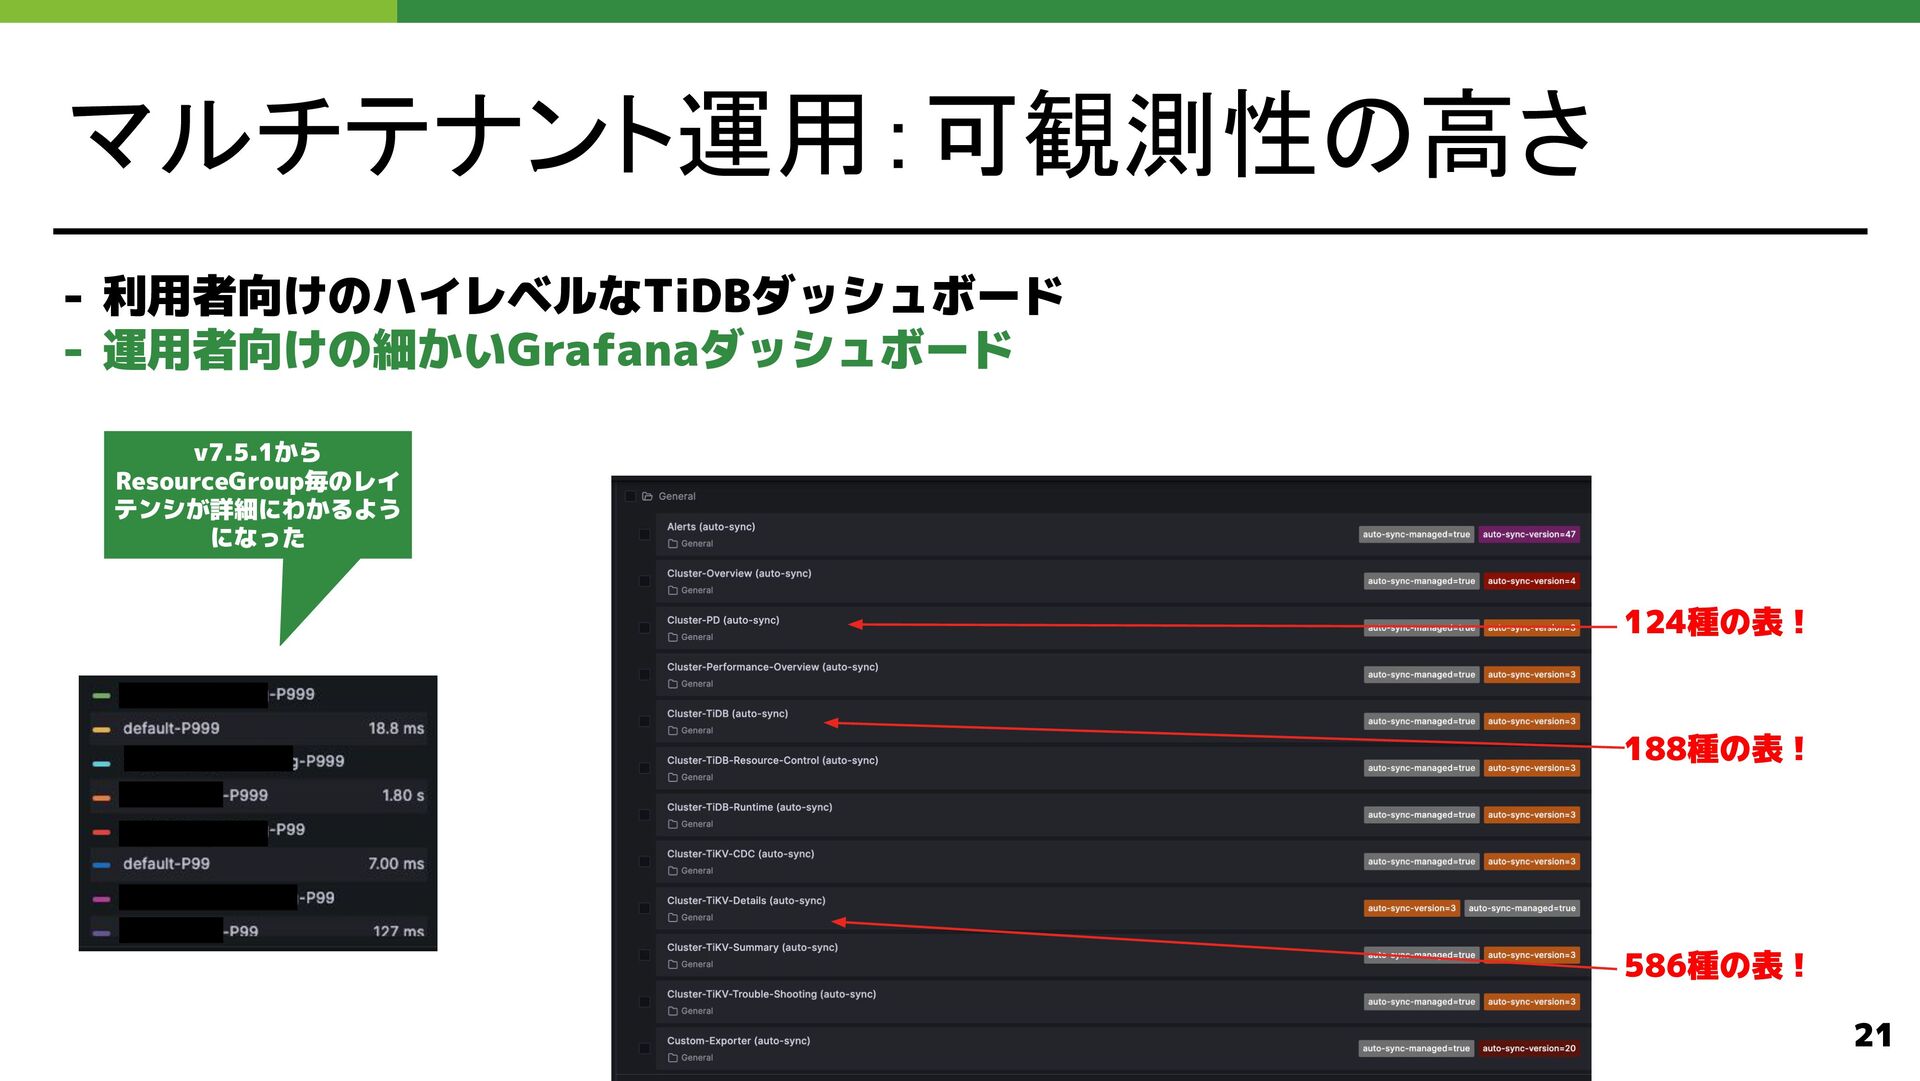
マルチテナント運用:可観測性の高さ - 利用者向けのハイレベルなTiDBダッシュボード - 運用者向けの細かいGrafanaダッシュボード 20
マルチテナント運用:可観測性の高さ - 利用者向けのハイレベルなTiDBダッシュボード - 運用者向けの細かいGrafanaダッシュボード 188種の表! 586種の表! 124種の表! 21 ç
ç ç ç ç ç v7.5.1から ResourceGroup毎のレイ テンシが詳細にわかるよう になった
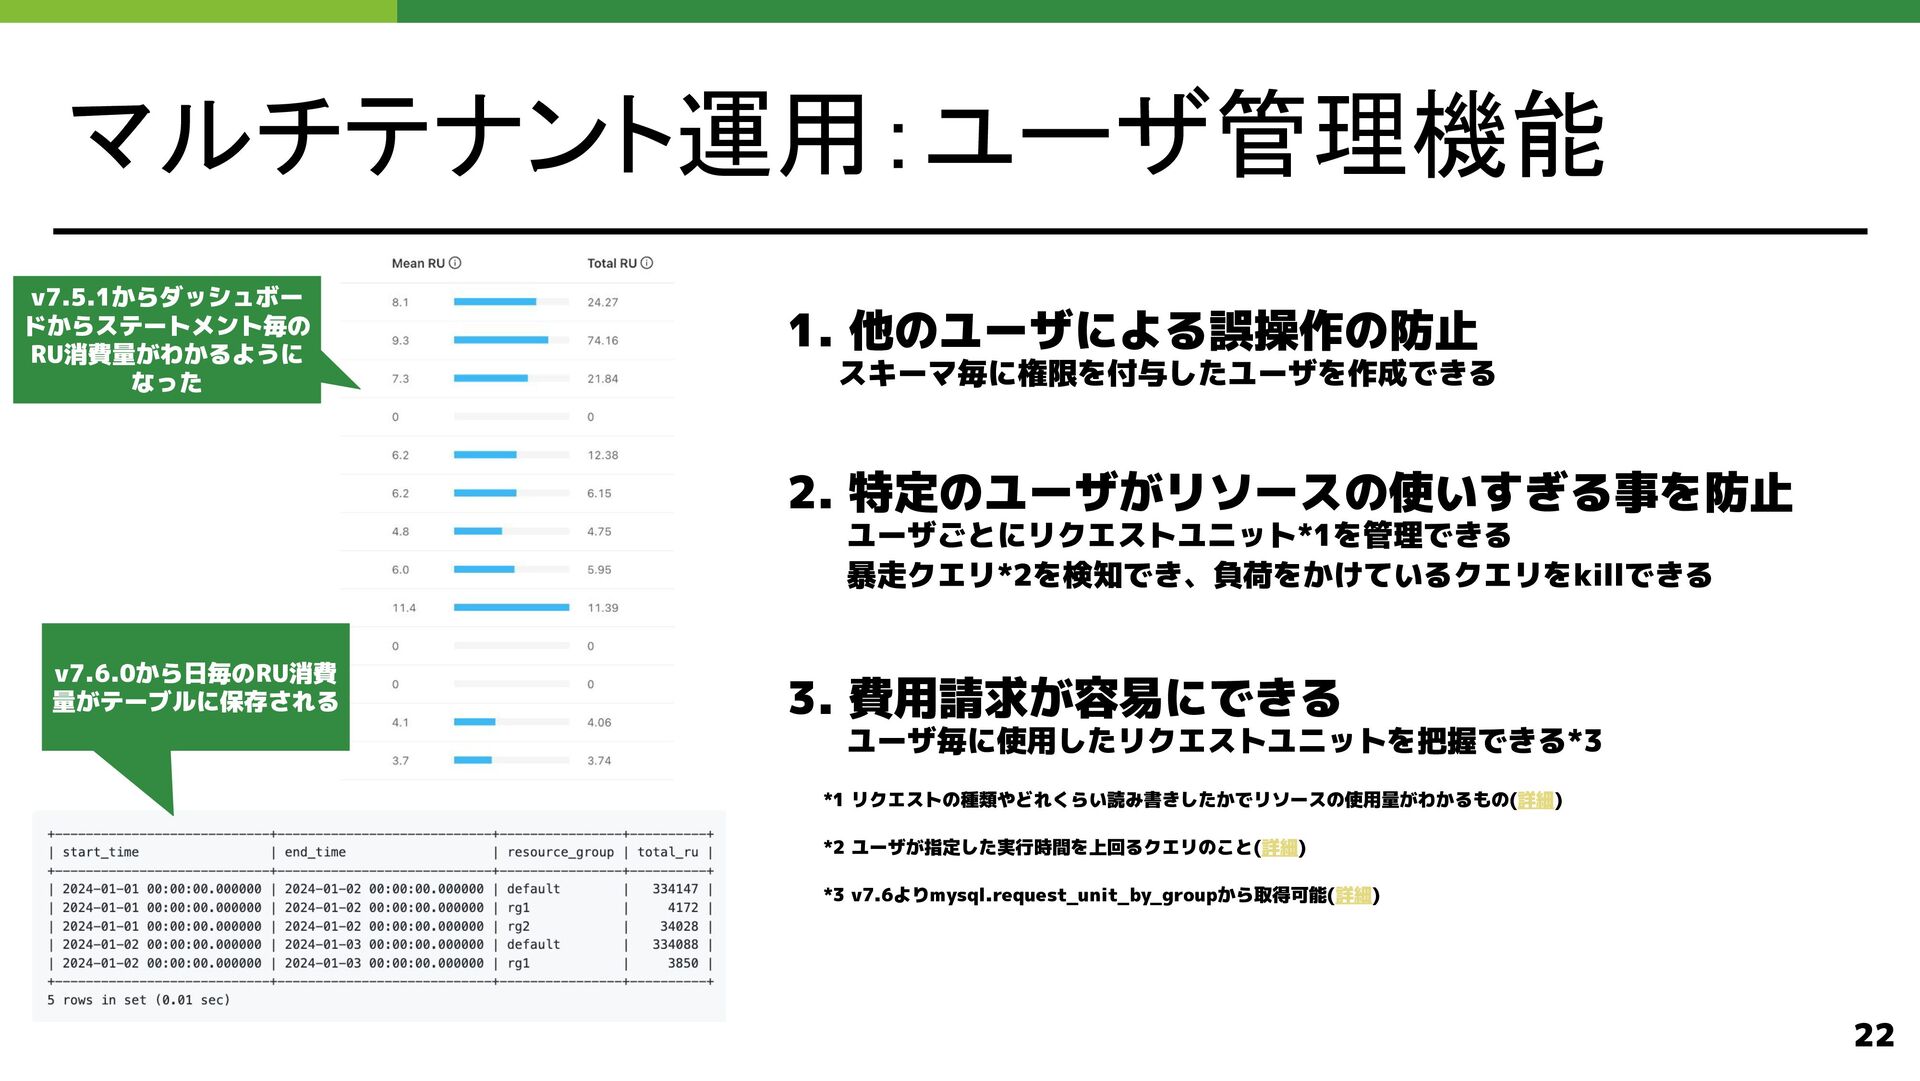
マルチテナント運用:ユーザ管理機能 1. 他のユーザによる誤操作の防止 スキーマ毎に権限を付与したユーザを作成できる 2. 特定のユーザがリソースの使いすぎる事を防止 ユーザごとにリクエストユニット*1を管理できる 暴走クエリ*2を検知でき、負荷をかけているクエリをkillできる 3. 費用請求が容易にできる
ユーザ毎に使用したリクエストユニットを把握できる*3 *1 リクエストの種類やどれくらい読み書きしたかでリソースの使用量がわかるもの(詳細) *2 ユーザが指定した実行時間を上回るクエリのこと(詳細) *3 v7.6よりmysql.request_unit_by_groupから取得可能(詳細) 22 v7.5.1からダッシュボー ドからステートメント毎の RU消費量がわかるように なった v7.6.0から日毎のRU消費 量がテーブルに保存される
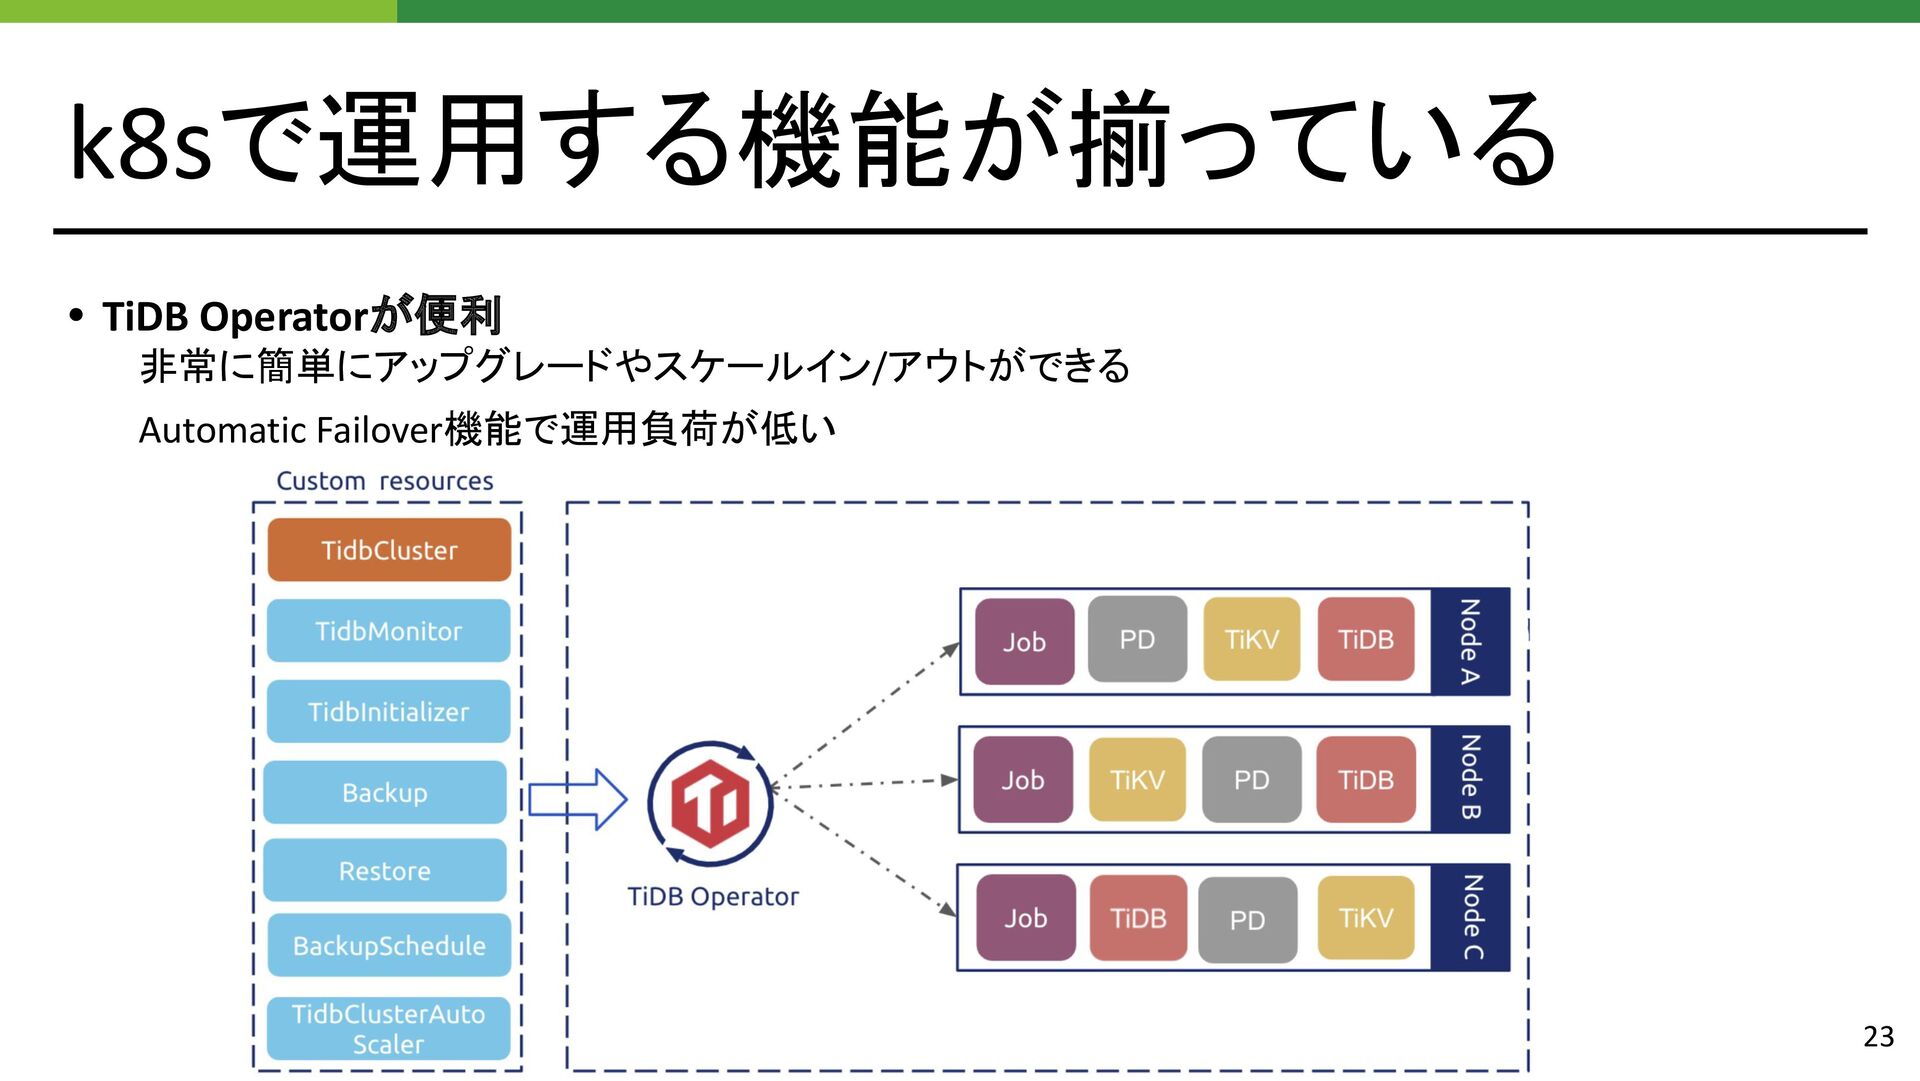
k8sで運用する機能が揃っている • TiDB Operatorが便利 非常に簡単にアップグレードやスケールイン/アウトができる Automatic Failover機能で運用負荷が低い 23
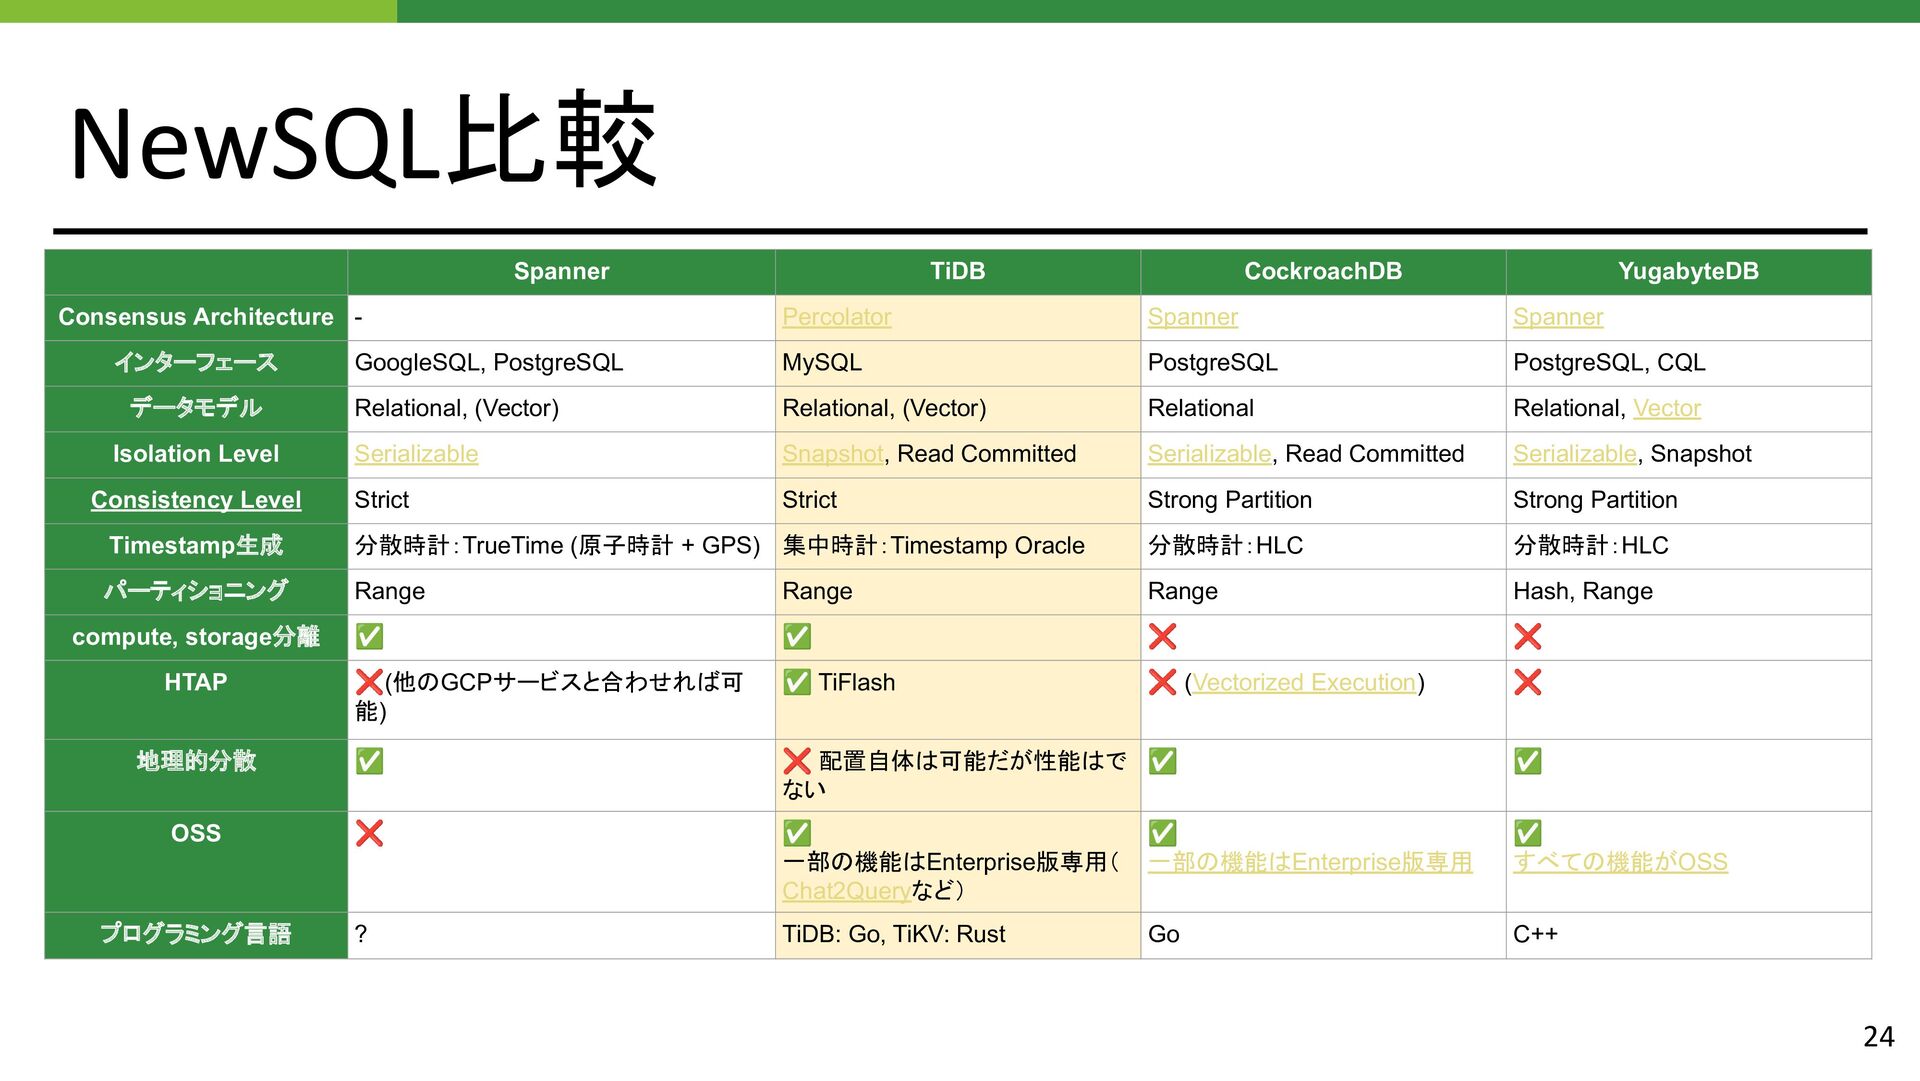
NewSQL比較 Spanner TiDB CockroachDB YugabyteDB Consensus Architecture - Percolator Spanner
Spanner インターフェース GoogleSQL, PostgreSQL MySQL PostgreSQL PostgreSQL, CQL データモデル Relational, (Vector) Relational, (Vector) Relational Relational, Vector Isolation Level Serializable Snapshot, Read Committed Serializable, Read Committed Serializable, Snapshot Consistency Level Strict Strict Strong Partition Strong Partition Timestamp生成 分散時計:TrueTime (原子時計 + GPS) 集中時計:Timestamp Oracle 分散時計:HLC 分散時計:HLC パーティショニング Range Range Range Hash, Range compute, storage分離 ✅ ✅ ❌ ❌ HTAP ❌(他のGCPサービスと合わせれば可 能) ✅ TiFlash ❌ (Vectorized Execution) ❌ 地理的分散 ✅ ❌ 配置自体は可能だが性能はで ない ✅ ✅ OSS ❌ ✅ 一部の機能はEnterprise版専用( Chat2Queryなど) ✅ 一部の機能はEnterprise版専用 ✅ すべての機能がOSS プログラミング言語 ? TiDB: Go, TiKV: Rust Go C++ 24
TiDB検証 25
検証項目 1. HBaseからTiDBへのデータ移行 問題なく移行が可能かの検証 2. 障害検証 障害発生しても問題なく動作するか(運用負荷がどれくらいか) 3. 性能検証 HBaseと比較してQPSとレイテンシがどれくらい劣化するか
26
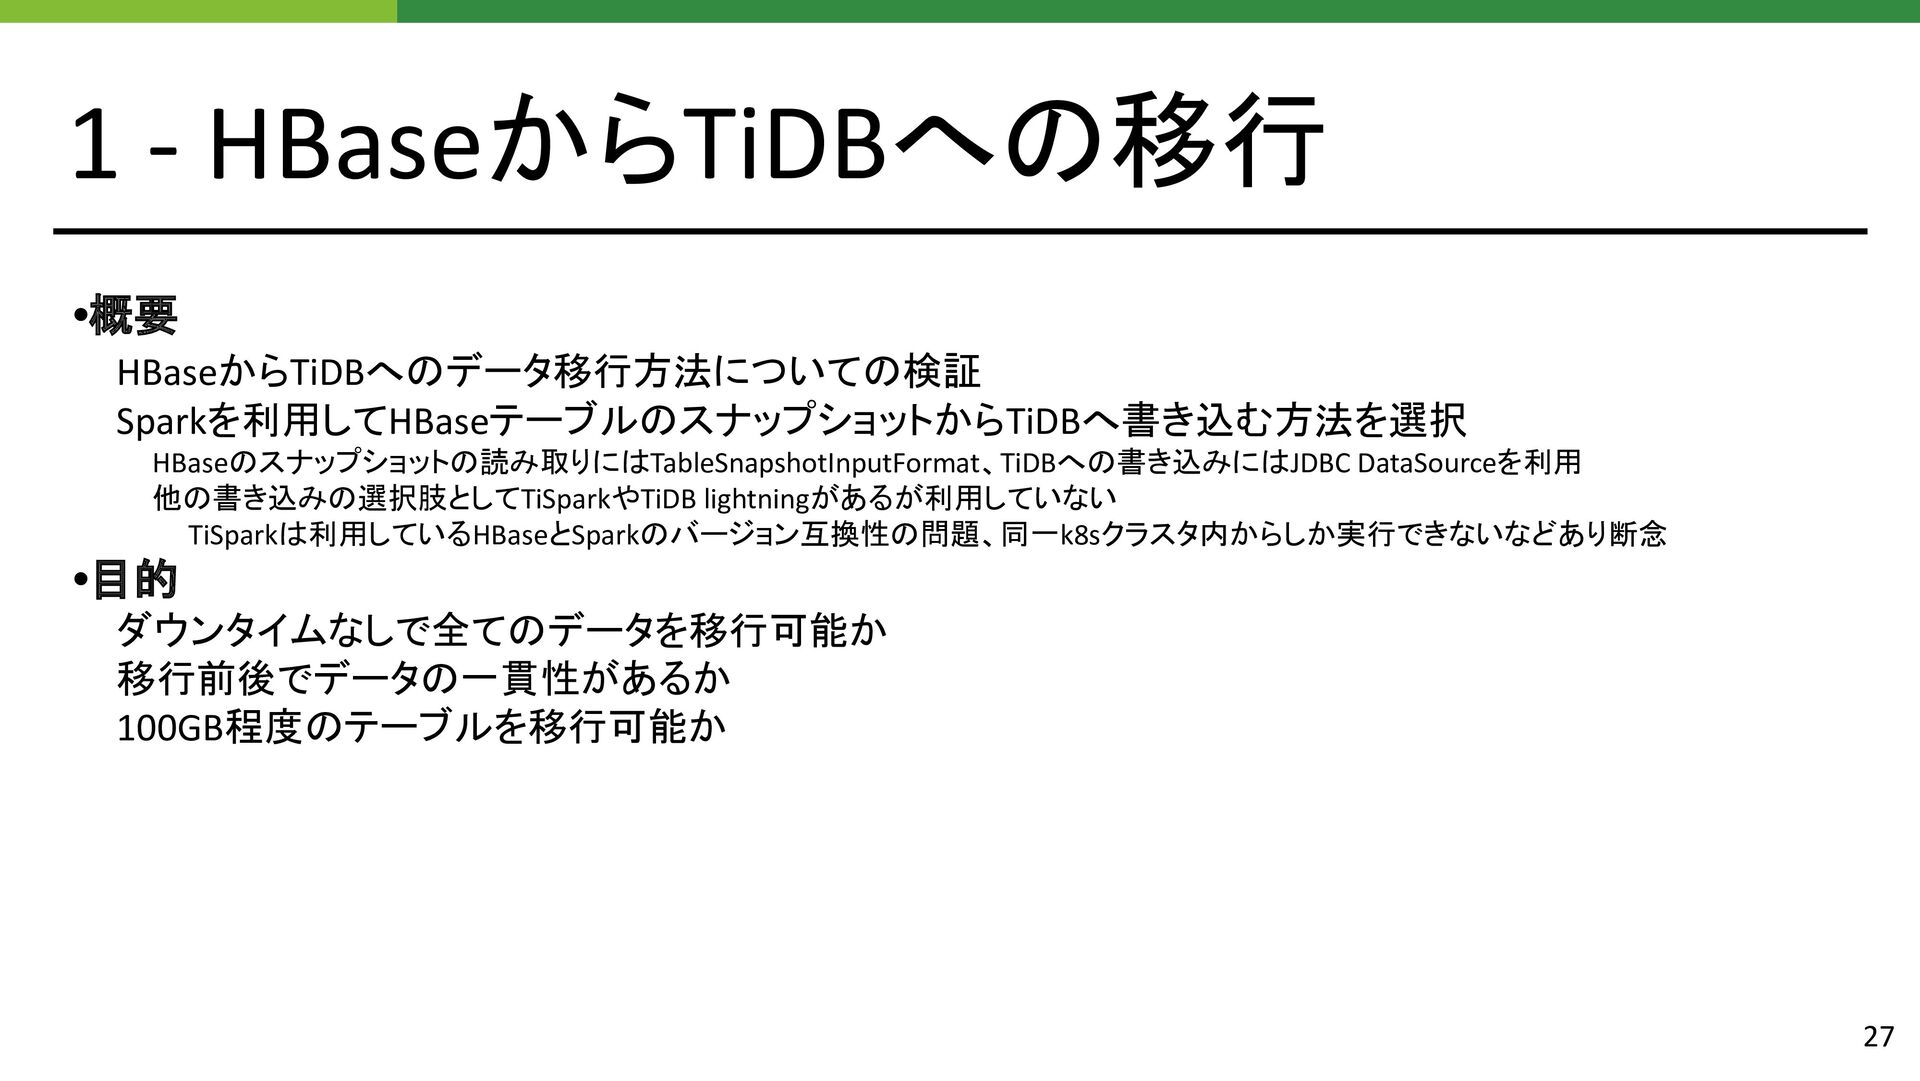
1 - HBaseからTiDBへの移行 •概要 HBaseからTiDBへのデータ移行方法についての検証 Sparkを利用してHBaseテーブルのスナップショットからTiDBへ書き込む方法を選択 HBaseのスナップショットの読み取りにはTableSnapshotInputFormat、TiDBへの書き込みにはJDBC DataSourceを利用 他の書き込みの選択肢としてTiSparkやTiDB lightningがあるが利用していない
TiSparkは利用しているHBaseとSparkのバージョン互換性の問題、同一k8sクラスタ内からしか実行できないなどあり断念 •目的 ダウンタイムなしで全てのデータを移行可能か 移行前後でデータの一貫性があるか 100GB程度のテーブルを移行可能か 27
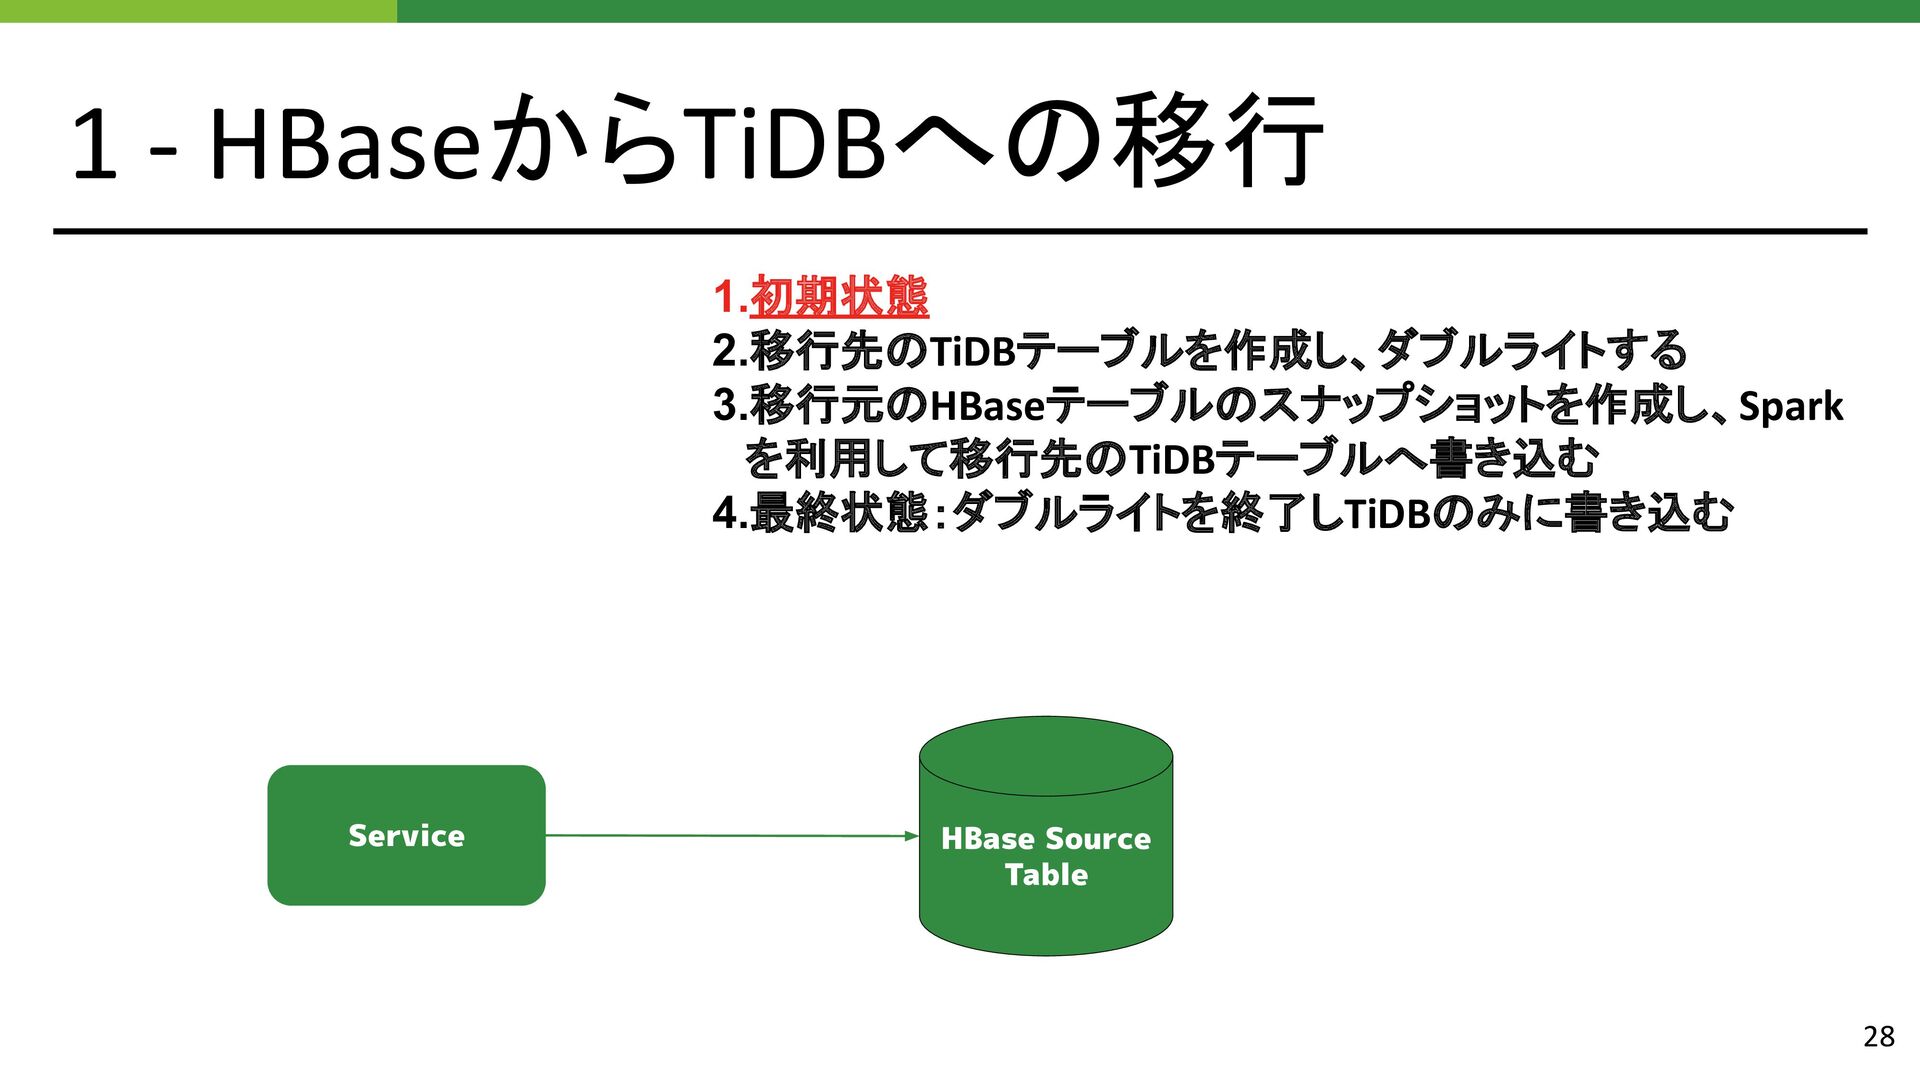
1 - HBaseからTiDBへの移行 1.初期状態 2.移行先のTiDBテーブルを作成し、ダブルライトする 3.移行元のHBaseテーブルのスナップショットを作成し、Spark を利用して移行先のTiDBテーブルへ書き込む 4.最終状態:ダブルライトを終了しTiDBのみに書き込む Service HBase
Source Table 28
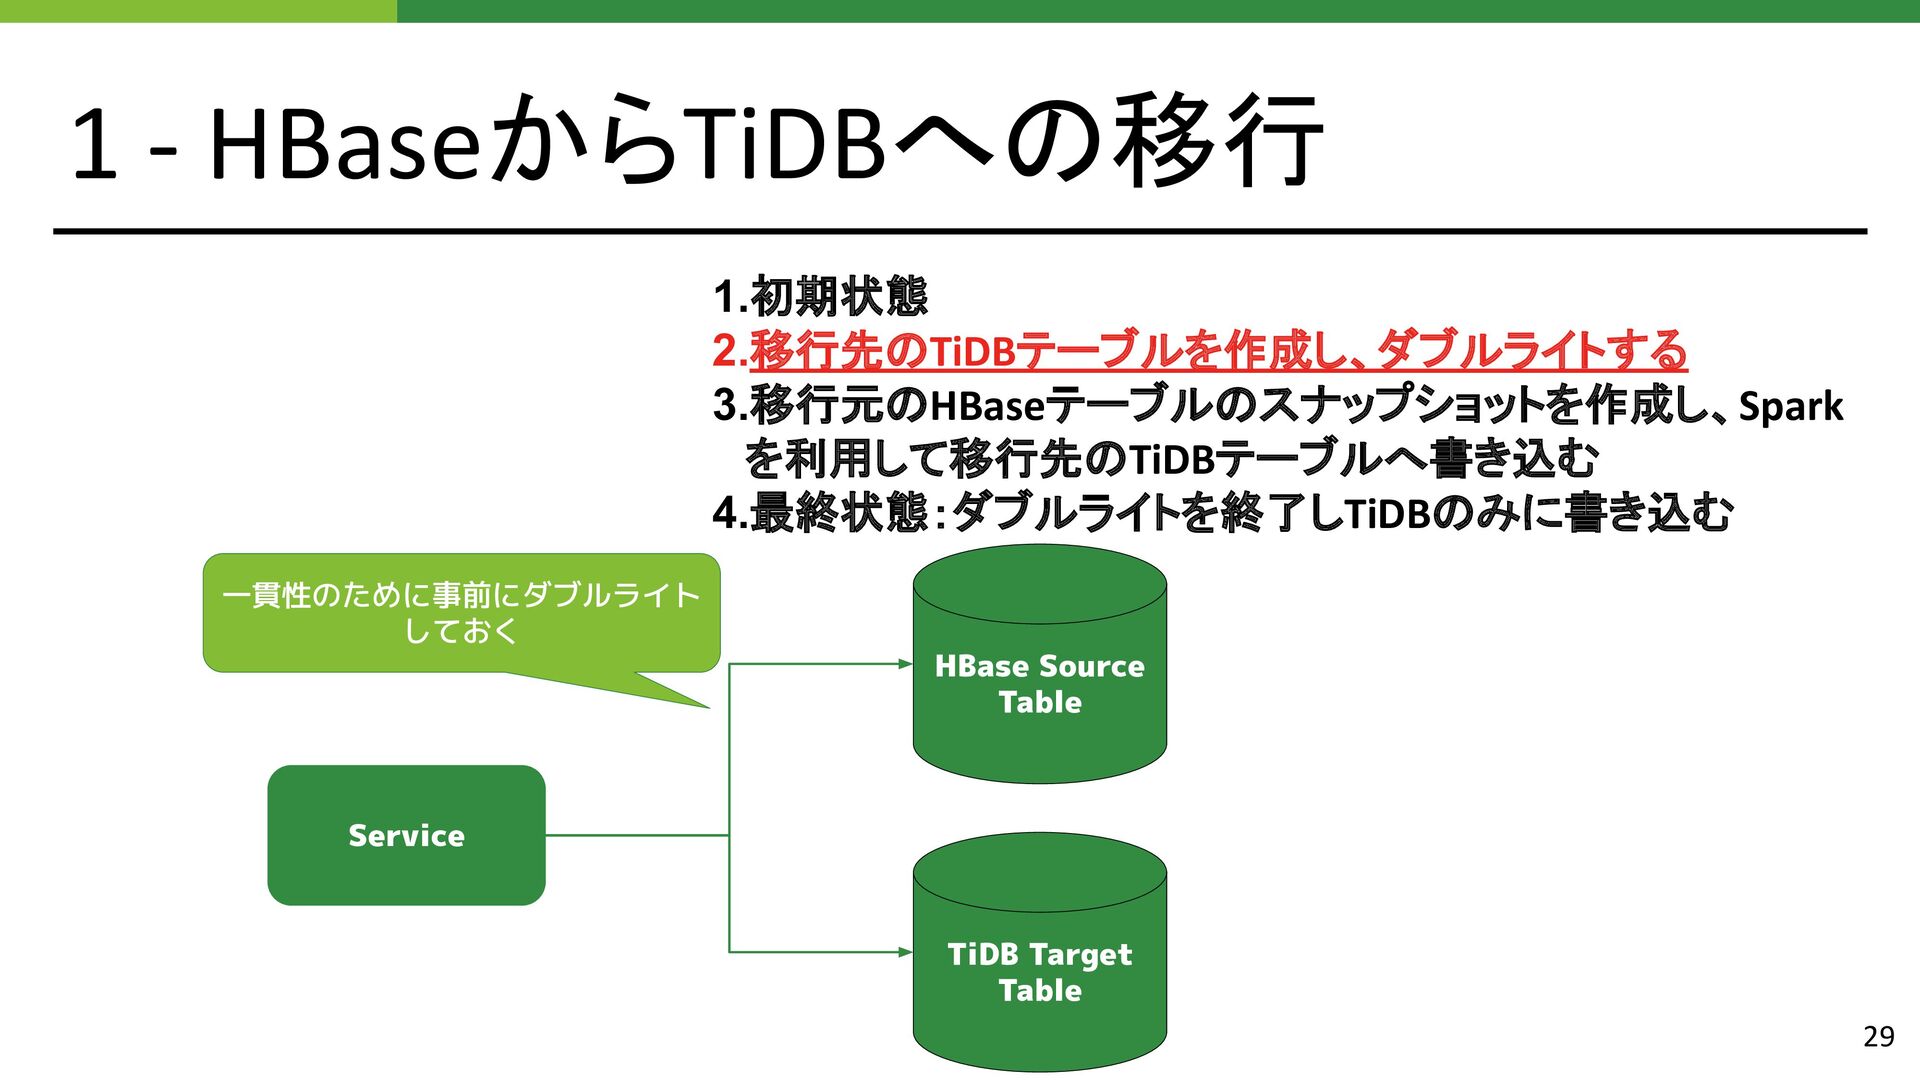
1 - HBaseからTiDBへの移行 1.初期状態 2.移行先のTiDBテーブルを作成し、ダブルライトする 3.移行元のHBaseテーブルのスナップショットを作成し、Spark を利用して移行先のTiDBテーブルへ書き込む 4.最終状態:ダブルライトを終了しTiDBのみに書き込む HBase Source
Table Service TiDB Target Table 29 一貫性のために事前にダブルライト しておく
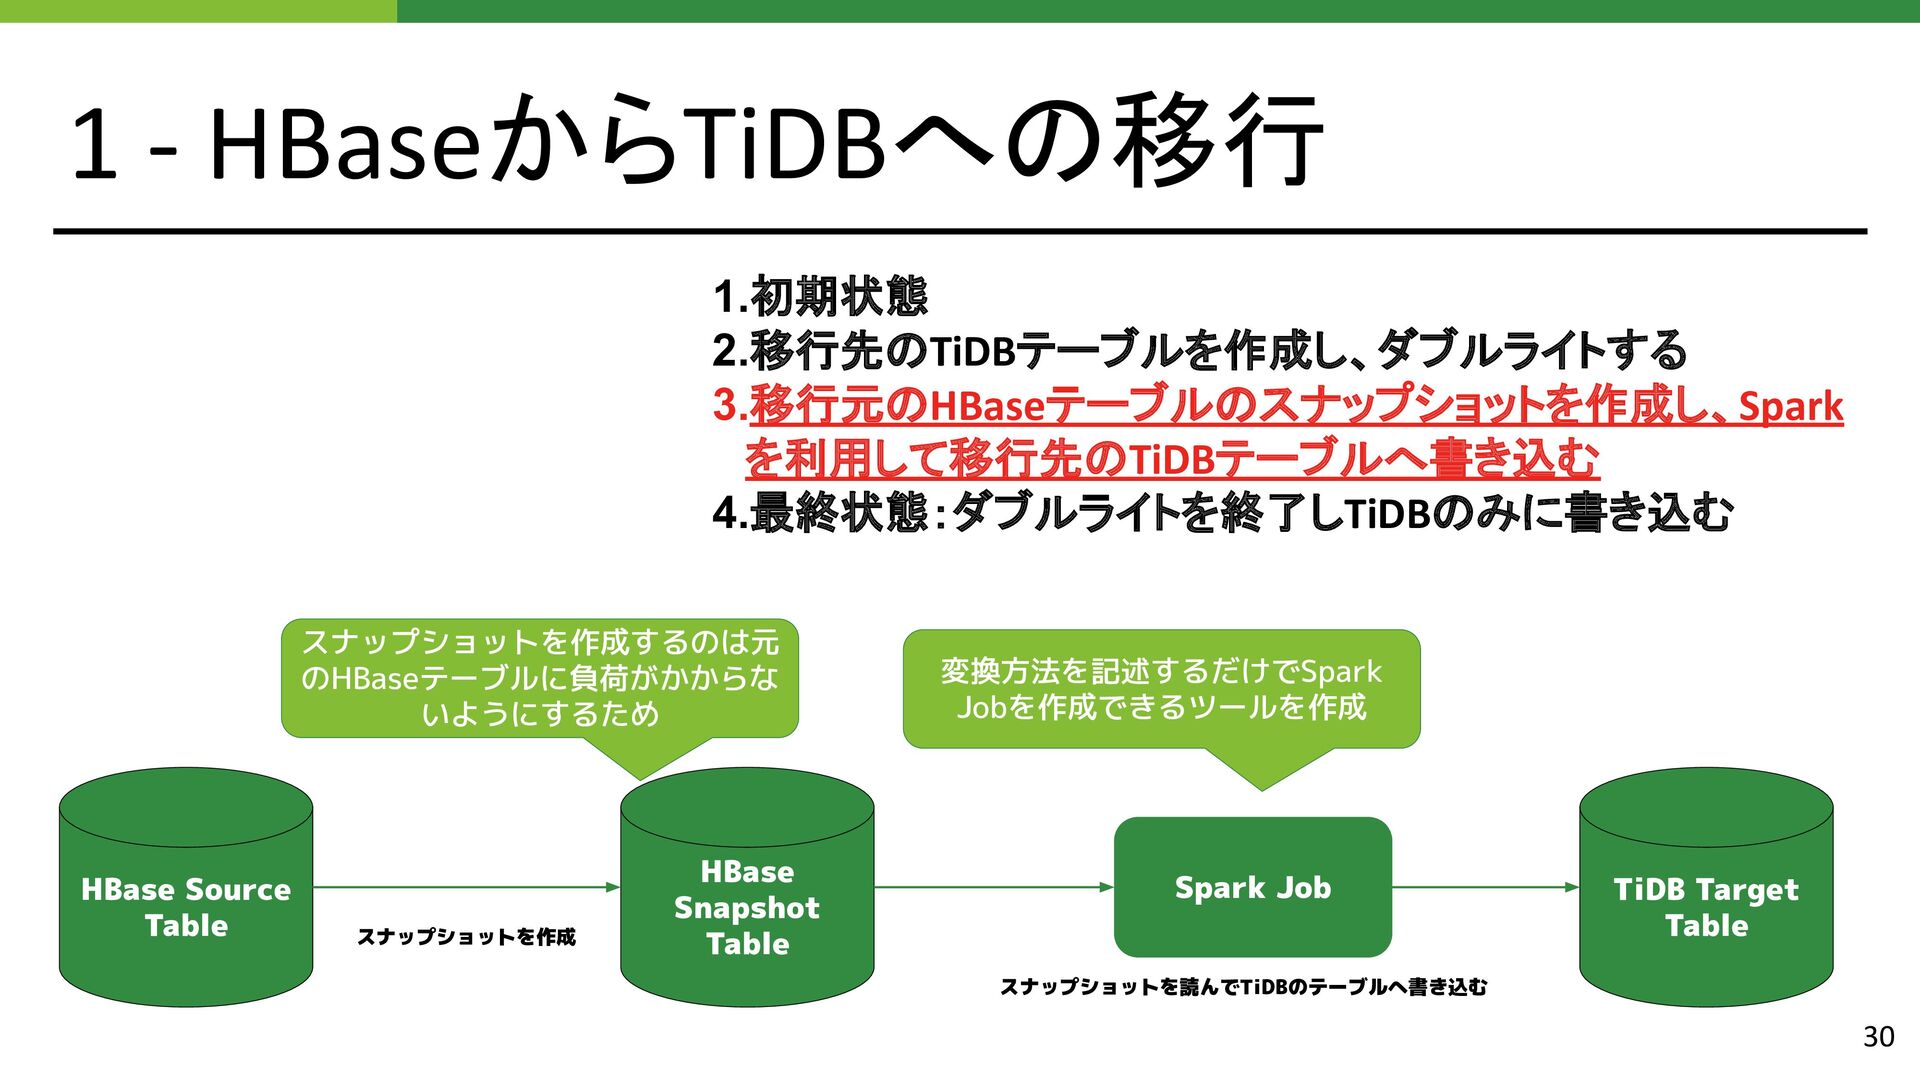
1 - HBaseからTiDBへの移行 1.初期状態 2.移行先のTiDBテーブルを作成し、ダブルライトする 3.移行元のHBaseテーブルのスナップショットを作成し、Spark を利用して移行先のTiDBテーブルへ書き込む 4.最終状態:ダブルライトを終了しTiDBのみに書き込む HBase Source
Table TiDB Target Table HBase Snapshot Table Spark Job スナップショットを作成 スナップショットを読んでTiDBのテーブルへ書き込む スナップショットを作成するのは元 のHBaseテーブルに負荷がかからな いようにするため 変換方法を記述するだけでSpark Jobを作成できるツールを作成 30
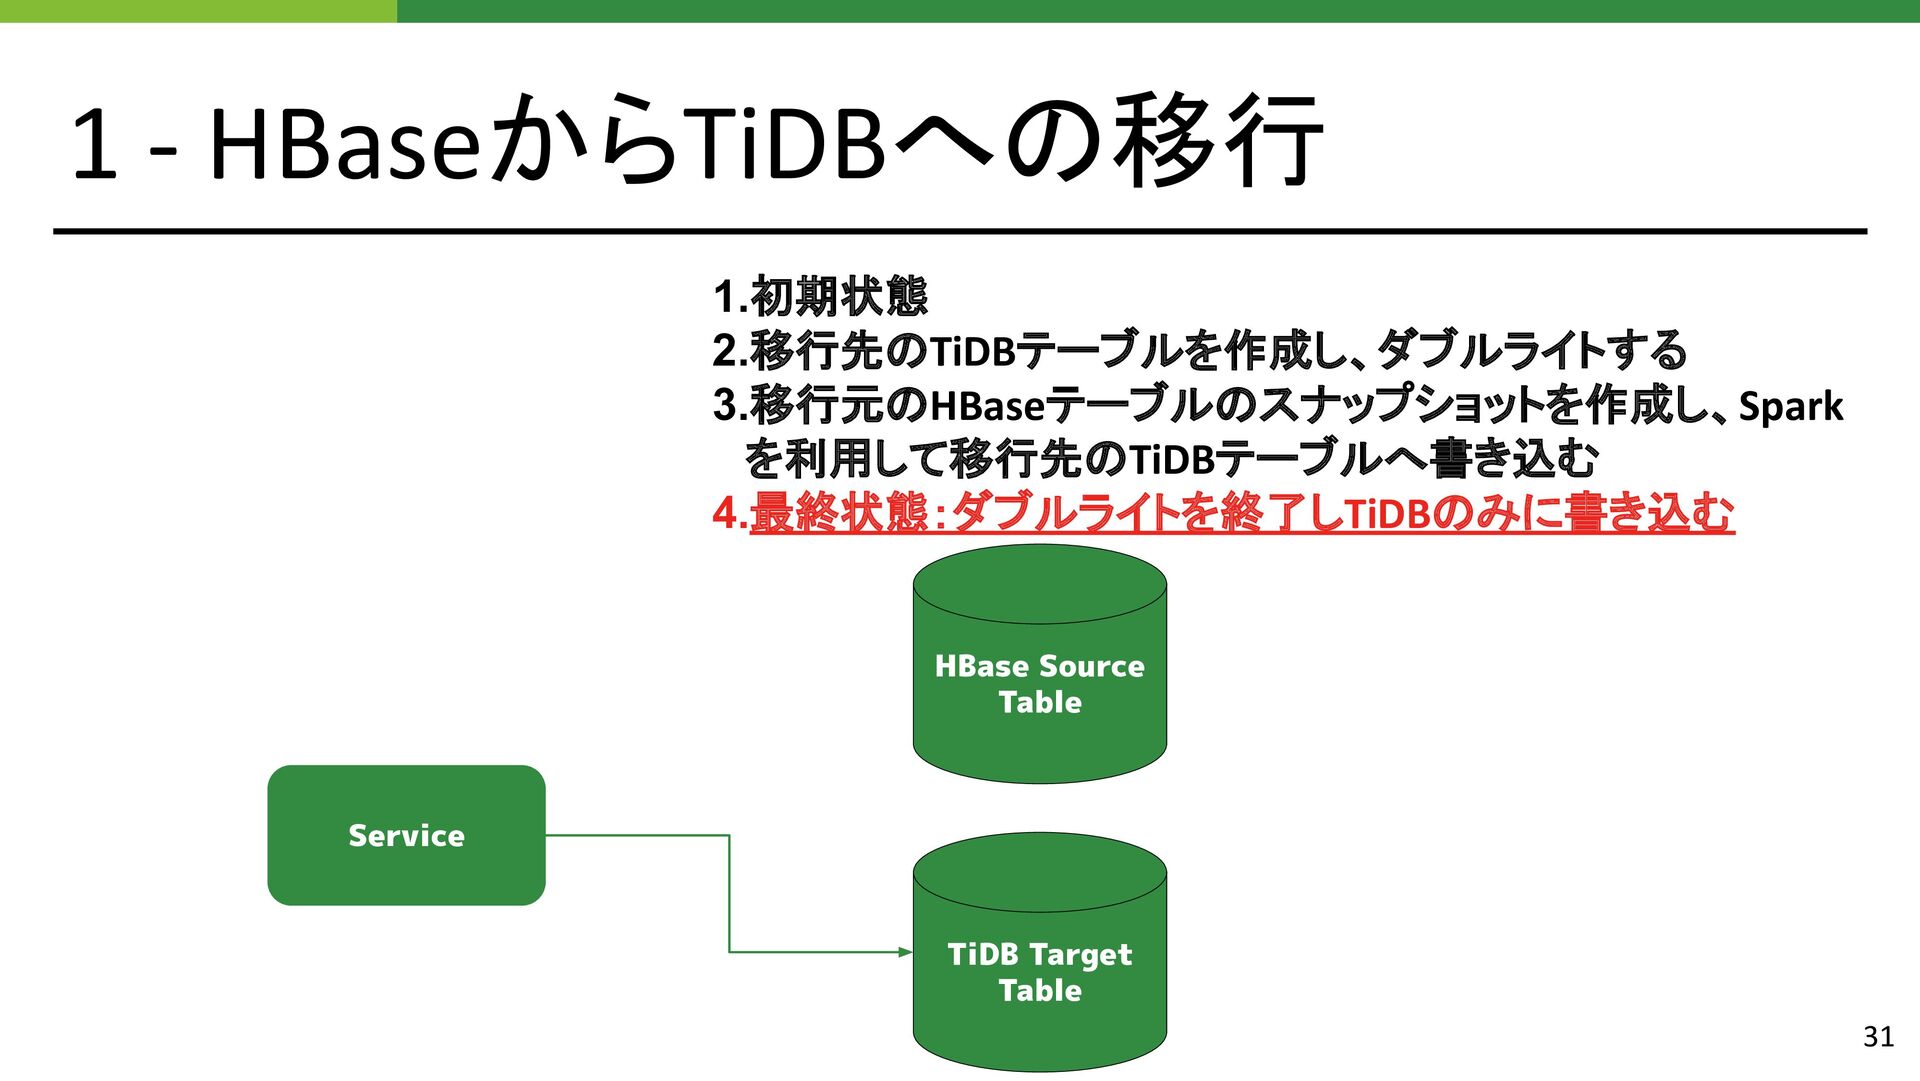
1 - HBaseからTiDBへの移行 1.初期状態 2.移行先のTiDBテーブルを作成し、ダブルライトする 3.移行元のHBaseテーブルのスナップショットを作成し、Spark を利用して移行先のTiDBテーブルへ書き込む 4.最終状態:ダブルライトを終了しTiDBのみに書き込む HBase Source
Table Service TiDB Target Table 31
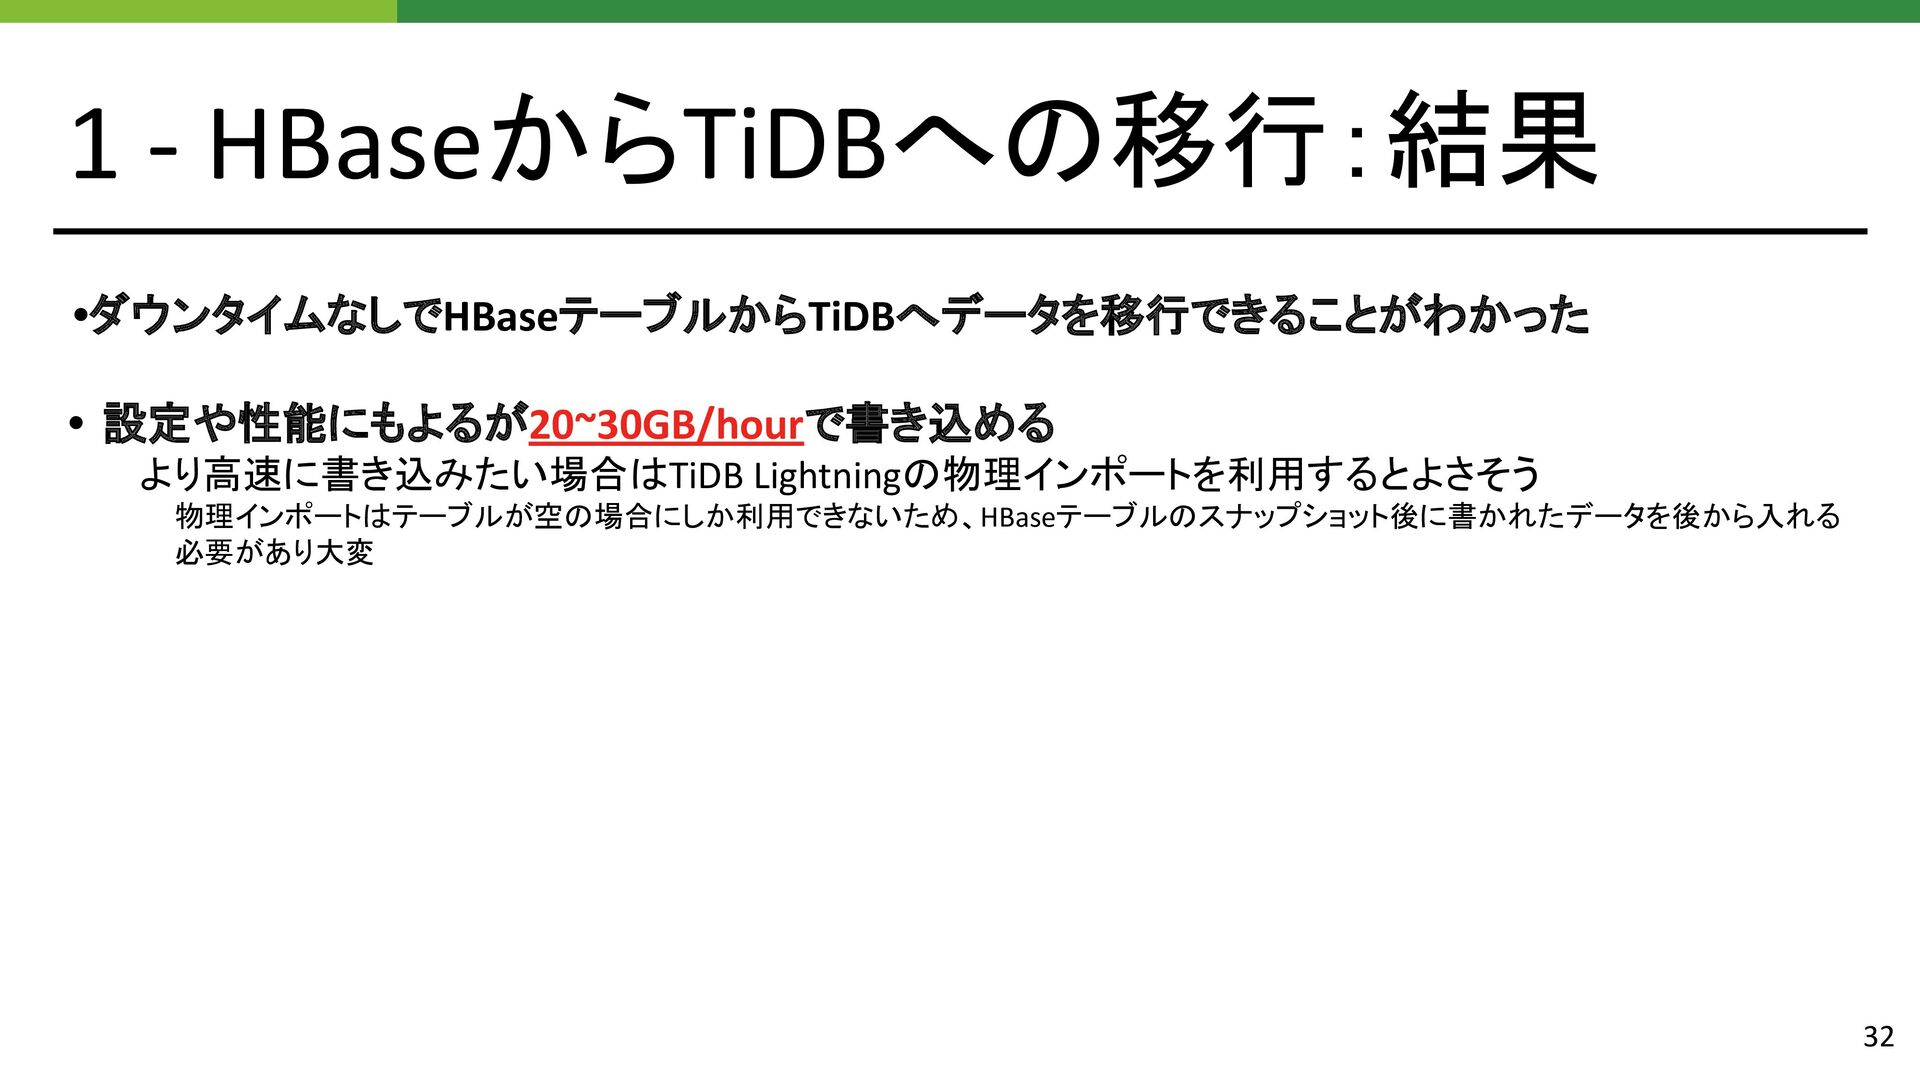
1 - HBaseからTiDBへの移行:結果 •ダウンタイムなしでHBaseテーブルからTiDBへデータを移行できることがわかった • 設定や性能にもよるが20~30GB/hourで書き込める より高速に書き込みたい場合はTiDB Lightningの物理インポートを利用するとよさそう 物理インポートはテーブルが空の場合にしか利用できないため、HBaseテーブルのスナップショット後に書かれたデータを後から入れる 必要があり大変
32
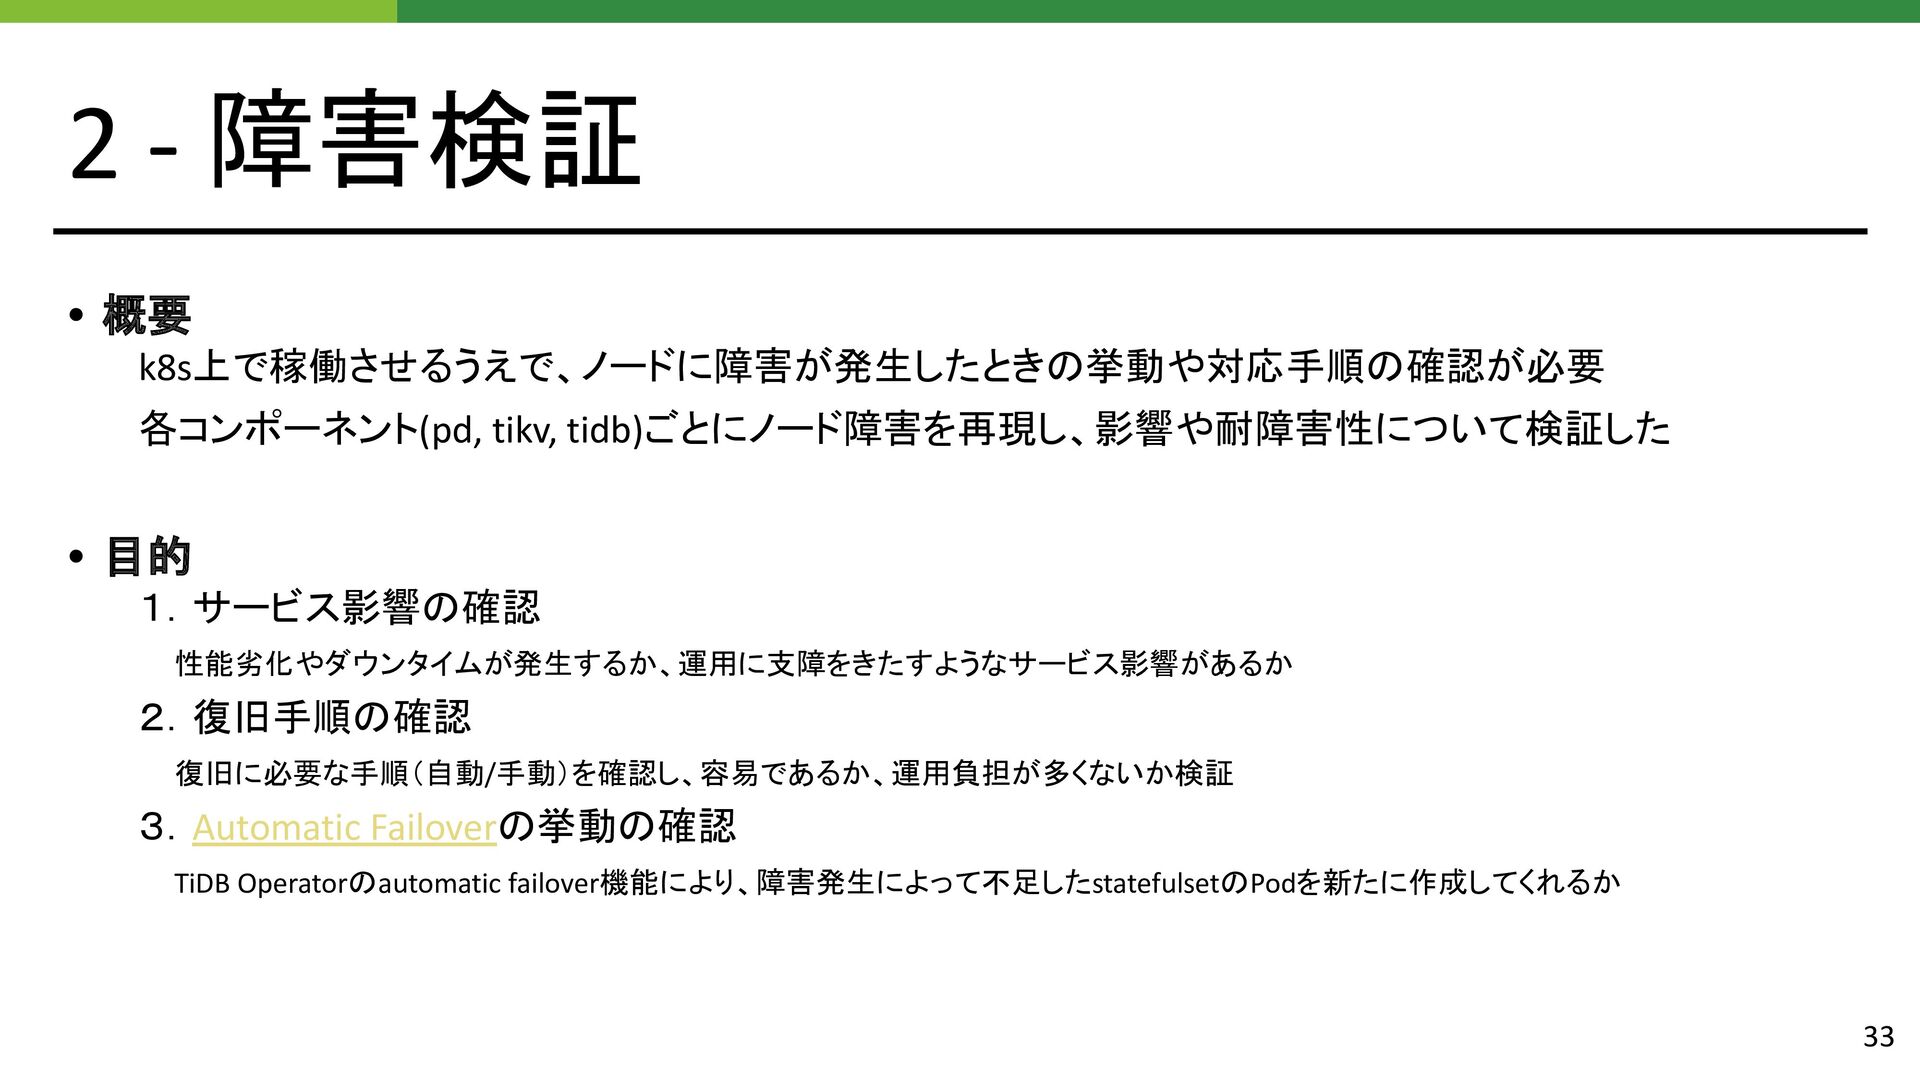
2 - 障害検証 • 概要 k8s上で稼働させるうえで、ノードに障害が発生したときの挙動や対応手順の確認が必要 各コンポーネント(pd, tikv, tidb)ごとにノード障害を再現し、影響や耐障害性について検証した •
目的 1.サービス影響の確認 性能劣化やダウンタイムが発生するか、運用に支障をきたすようなサービス影響があるか 2.復旧手順の確認 復旧に必要な手順(自動/手動)を確認し、容易であるか、運用負担が多くないか検証 3.Automatic Failoverの挙動の確認 TiDB Operatorのautomatic failover機能により、障害発生によって不足したstatefulsetのPodを新たに作成してくれるか 33
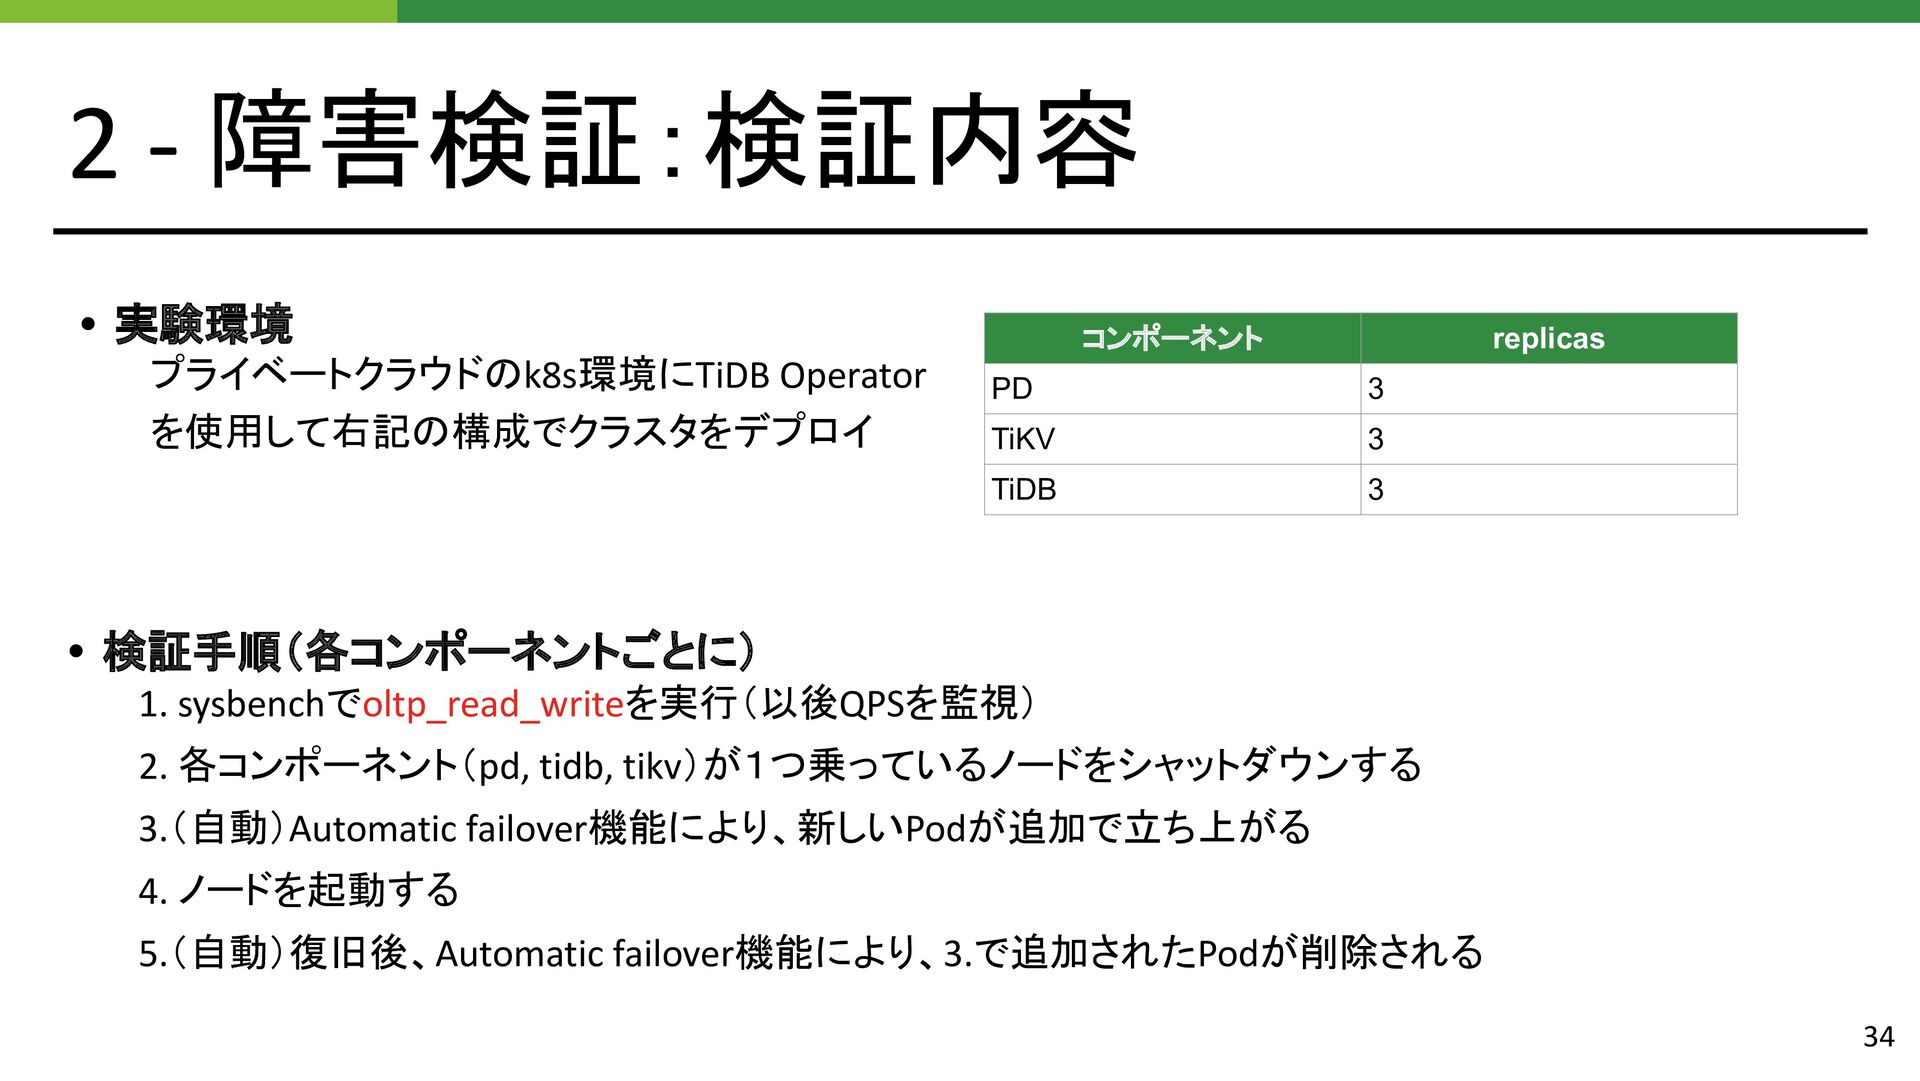
2 - 障害検証:検証内容 • 検証手順(各コンポーネントごとに) 1. sysbenchでoltp_read_writeを実行(以後QPSを監視) 2. 各コンポーネント(pd, tidb,
tikv)が1つ乗っているノードをシャットダウンする 3.(自動)Automatic failover機能により、新しいPodが追加で立ち上がる 4. ノードを起動する 5.(自動)復旧後、Automatic failover機能により、3.で追加されたPodが削除される コンポーネント replicas PD 3 TiKV 3 TiDB 3 34 • 実験環境 プライベートクラウドのk8s環境にTiDB Operator を使用して右記の構成でクラスタをデプロイ
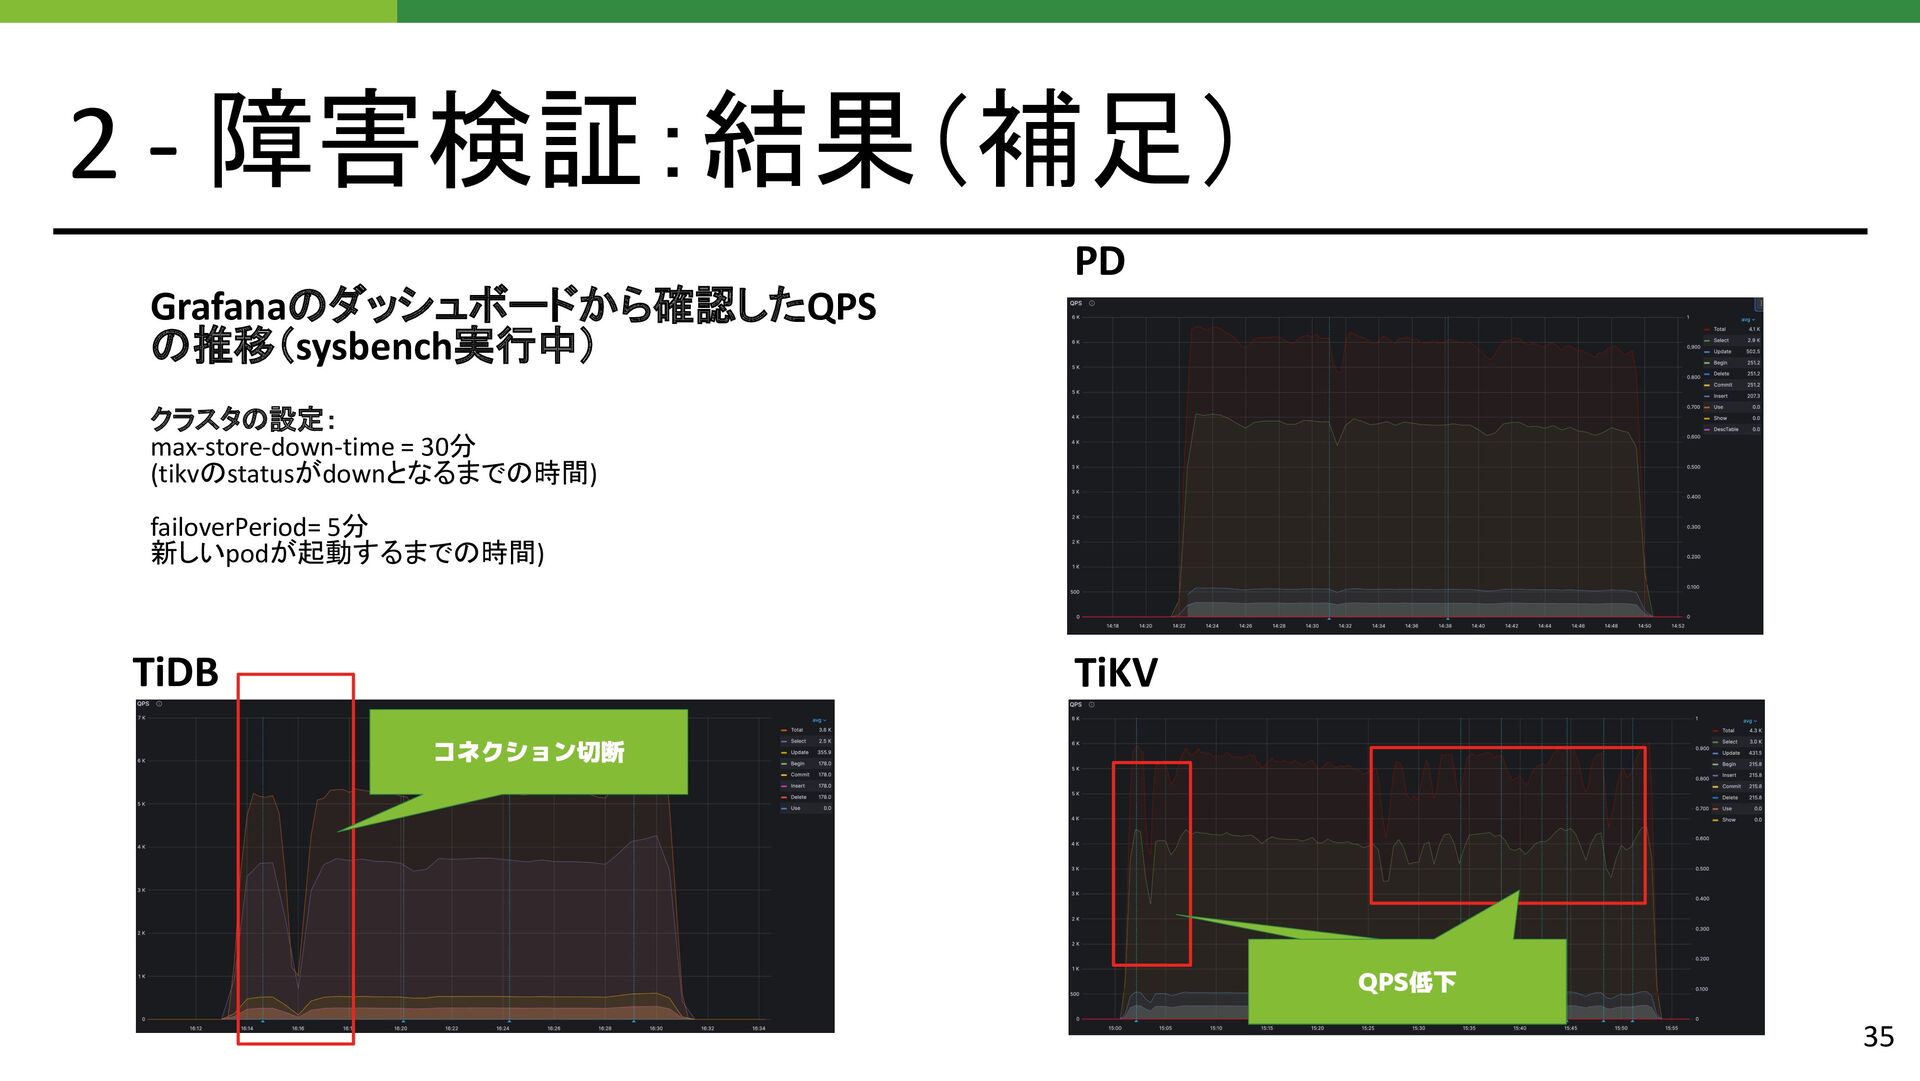
2 - 障害検証:結果(補足) ① ② 35 Grafanaのダッシュボードから確認したQPS の推移(sysbench実行中) クラスタの設定: max-store-down-time
= 30分 (tikvのstatusがdownとなるまでの時間) failoverPeriod= 5分 新しいpodが起動するまでの時間) TiDB PD TiKV コネクション切断 QPS低下 QPS低下
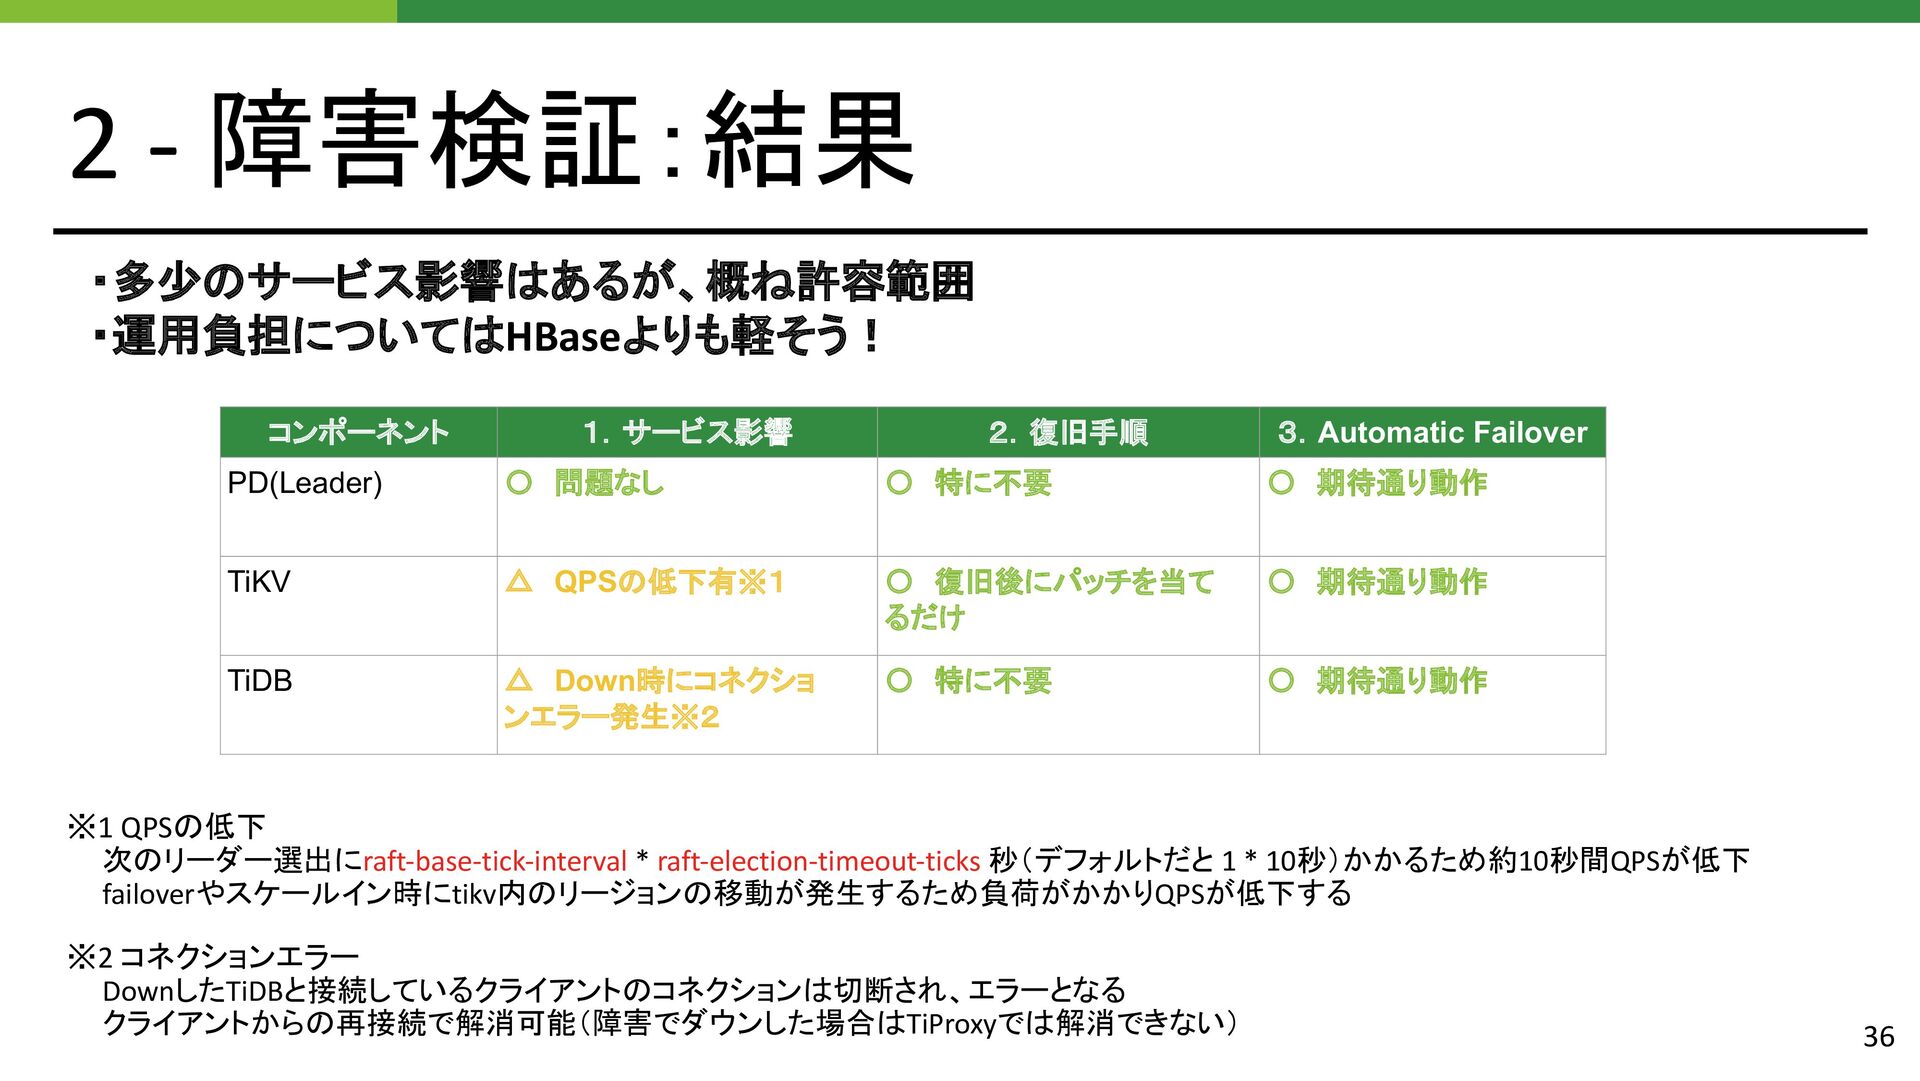
2 - 障害検証:結果 ※1 QPSの低下 次のリーダー選出にraft-base-tick-interval * raft-election-timeout-ticks 秒(デフォルトだと 1
* 10秒)かかるため約10秒間QPSが低下 failoverやスケールイン時にtikv内のリージョンの移動が発生するため負荷がかかりQPSが低下する ※2 コネクションエラー DownしたTiDBと接続しているクライアントのコネクションは切断され、エラーとなる クライアントからの再接続で解消可能(障害でダウンした場合はTiProxyでは解消できない) 36 コンポーネント 1.サービス影響 2.復旧手順 3.Automatic Failover PD(Leader) 〇 問題なし 〇 特に不要 〇 期待通り動作 TiKV △ QPSの低下有※1 〇 復旧後にパッチを当て るだけ 〇 期待通り動作 TiDB △ Down時にコネクショ ンエラー発生※2 〇 特に不要 〇 期待通り動作 ・多少のサービス影響はあるが、概ね許容範囲 ・運用負担についてはHBaseよりも軽そう!
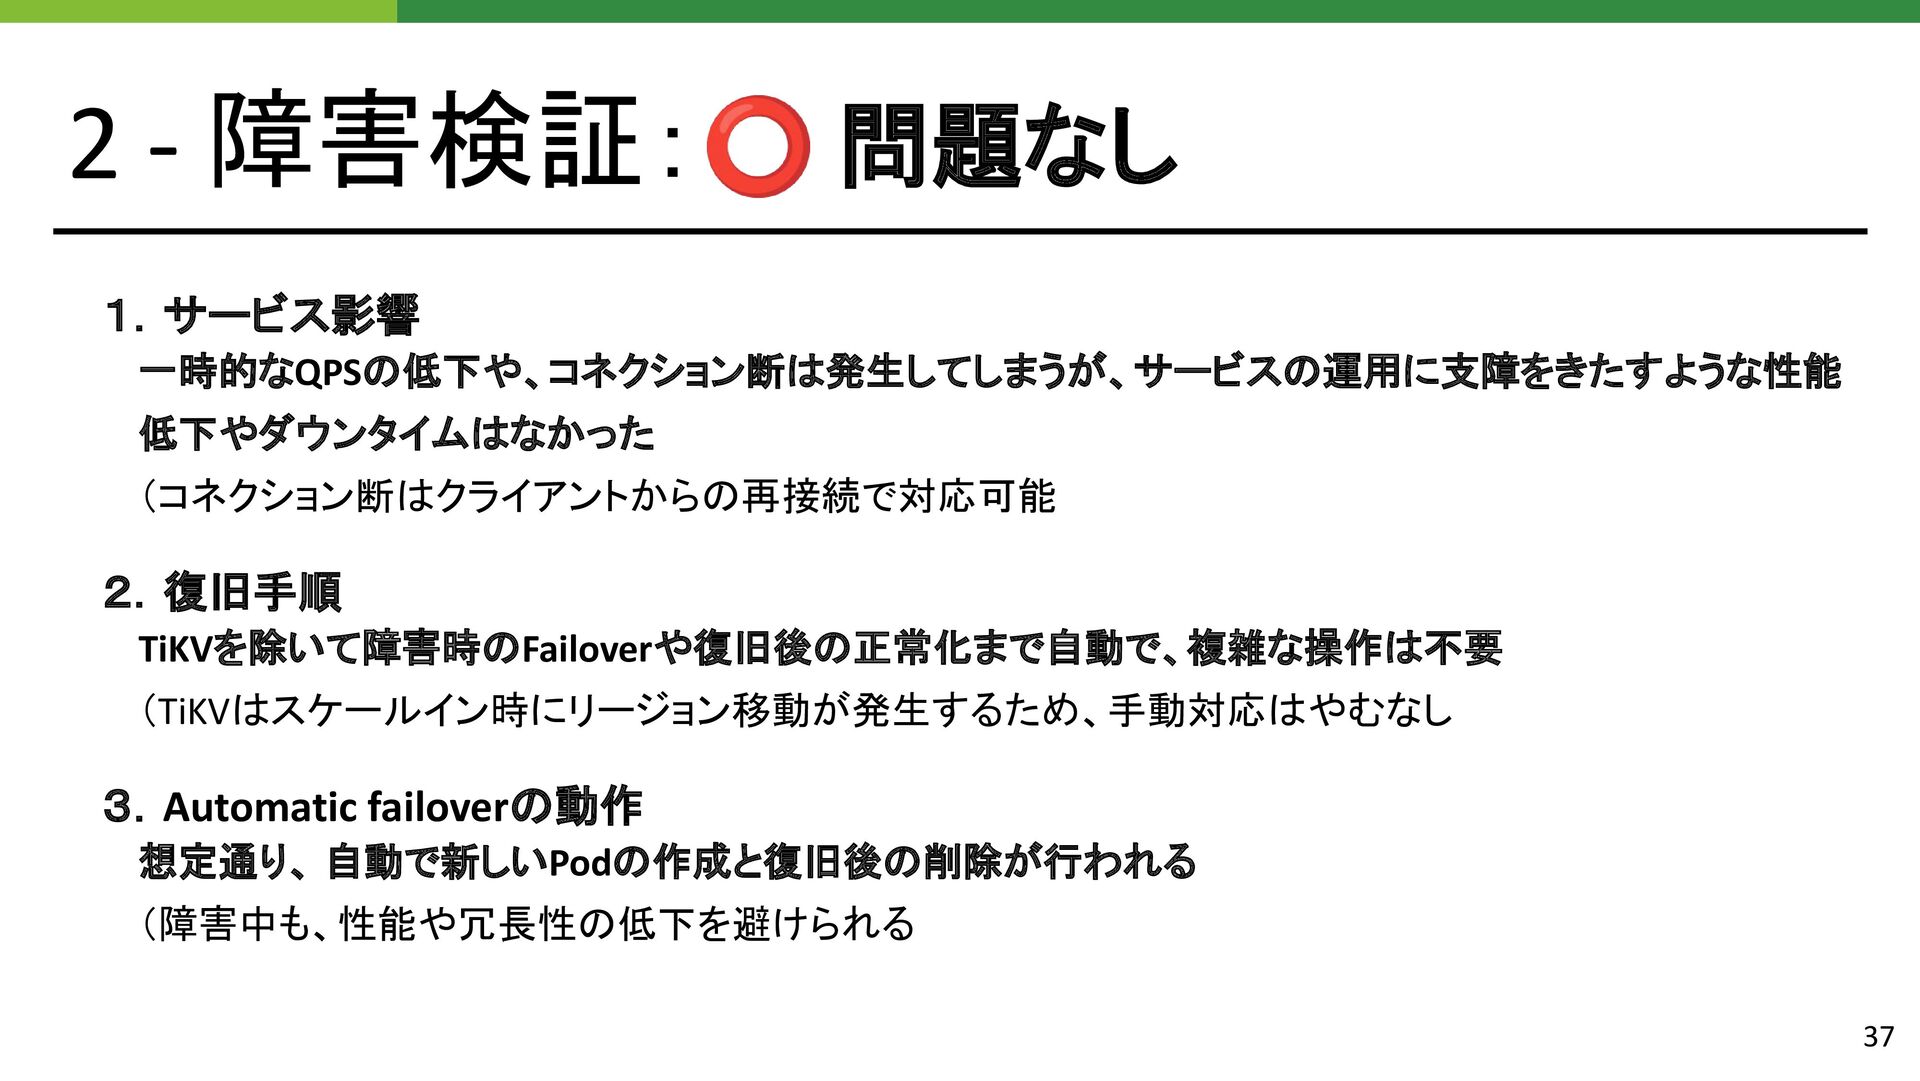
2 - 障害検証:⭕ 問題なし 1.サービス影響 一時的なQPSの低下や、コネクション断は発生してしまうが、サービスの運用に支障をきたすような性能 低下やダウンタイムはなかった (コネクション断はクライアントからの再接続で対応可能 2.復旧手順 TiKVを除いて障害時のFailoverや復旧後の正常化まで自動で、複雑な操作は不要
(TiKVはスケールイン時にリージョン移動が発生するため、手動対応はやむなし 3.Automatic failoverの動作 想定通り、 自動で新しいPodの作成と復旧後の削除が行われる (障害中も、性能や冗長性の低下を避けられる 37
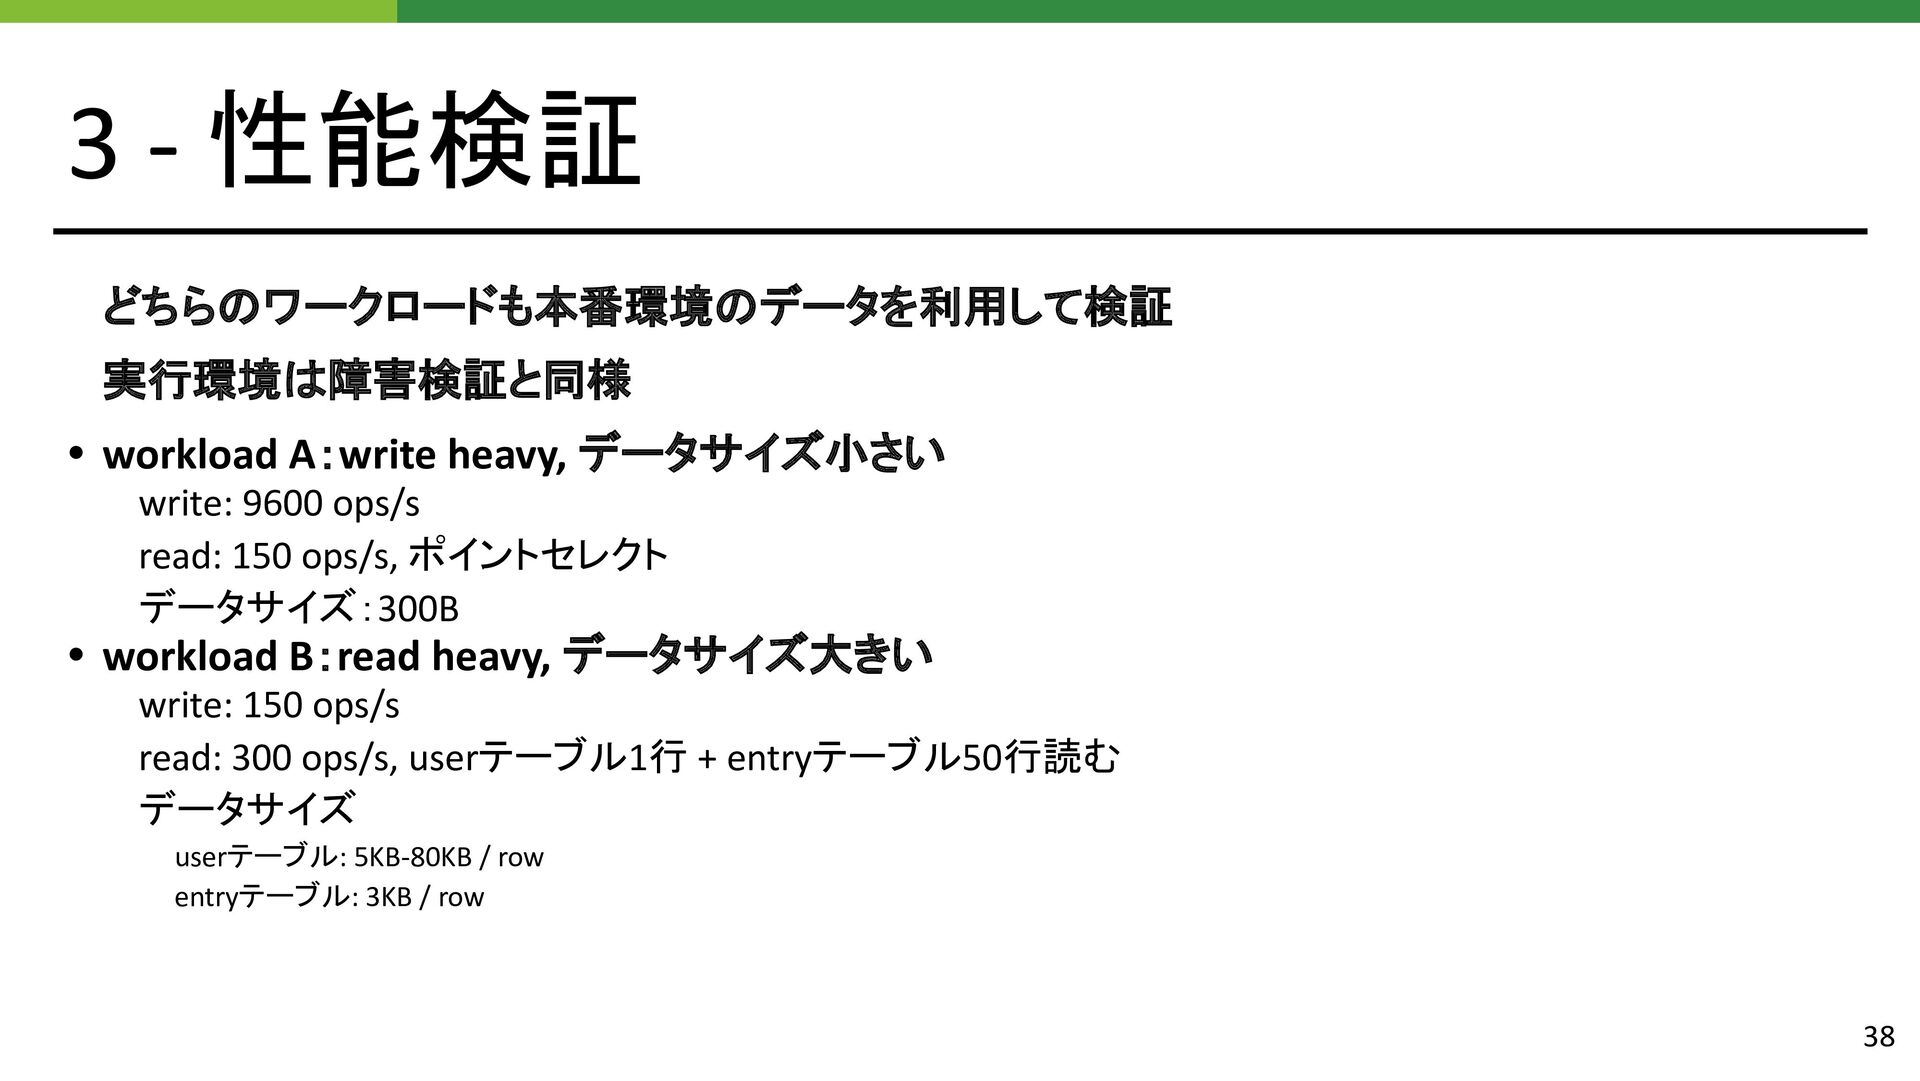
3 - 性能検証 どちらのワークロードも本番環境のデータを利用して検証 実行環境は障害検証と同様 • workload A:write heavy, データサイズ小さい
write: 9600 ops/s read: 150 ops/s, ポイントセレクト データサイズ:300B • workload B:read heavy, データサイズ大きい write: 150 ops/s read: 300 ops/s, userテーブル1行 + entryテーブル50行読む データサイズ userテーブル: 5KB-80KB / row entryテーブル: 3KB / row 38
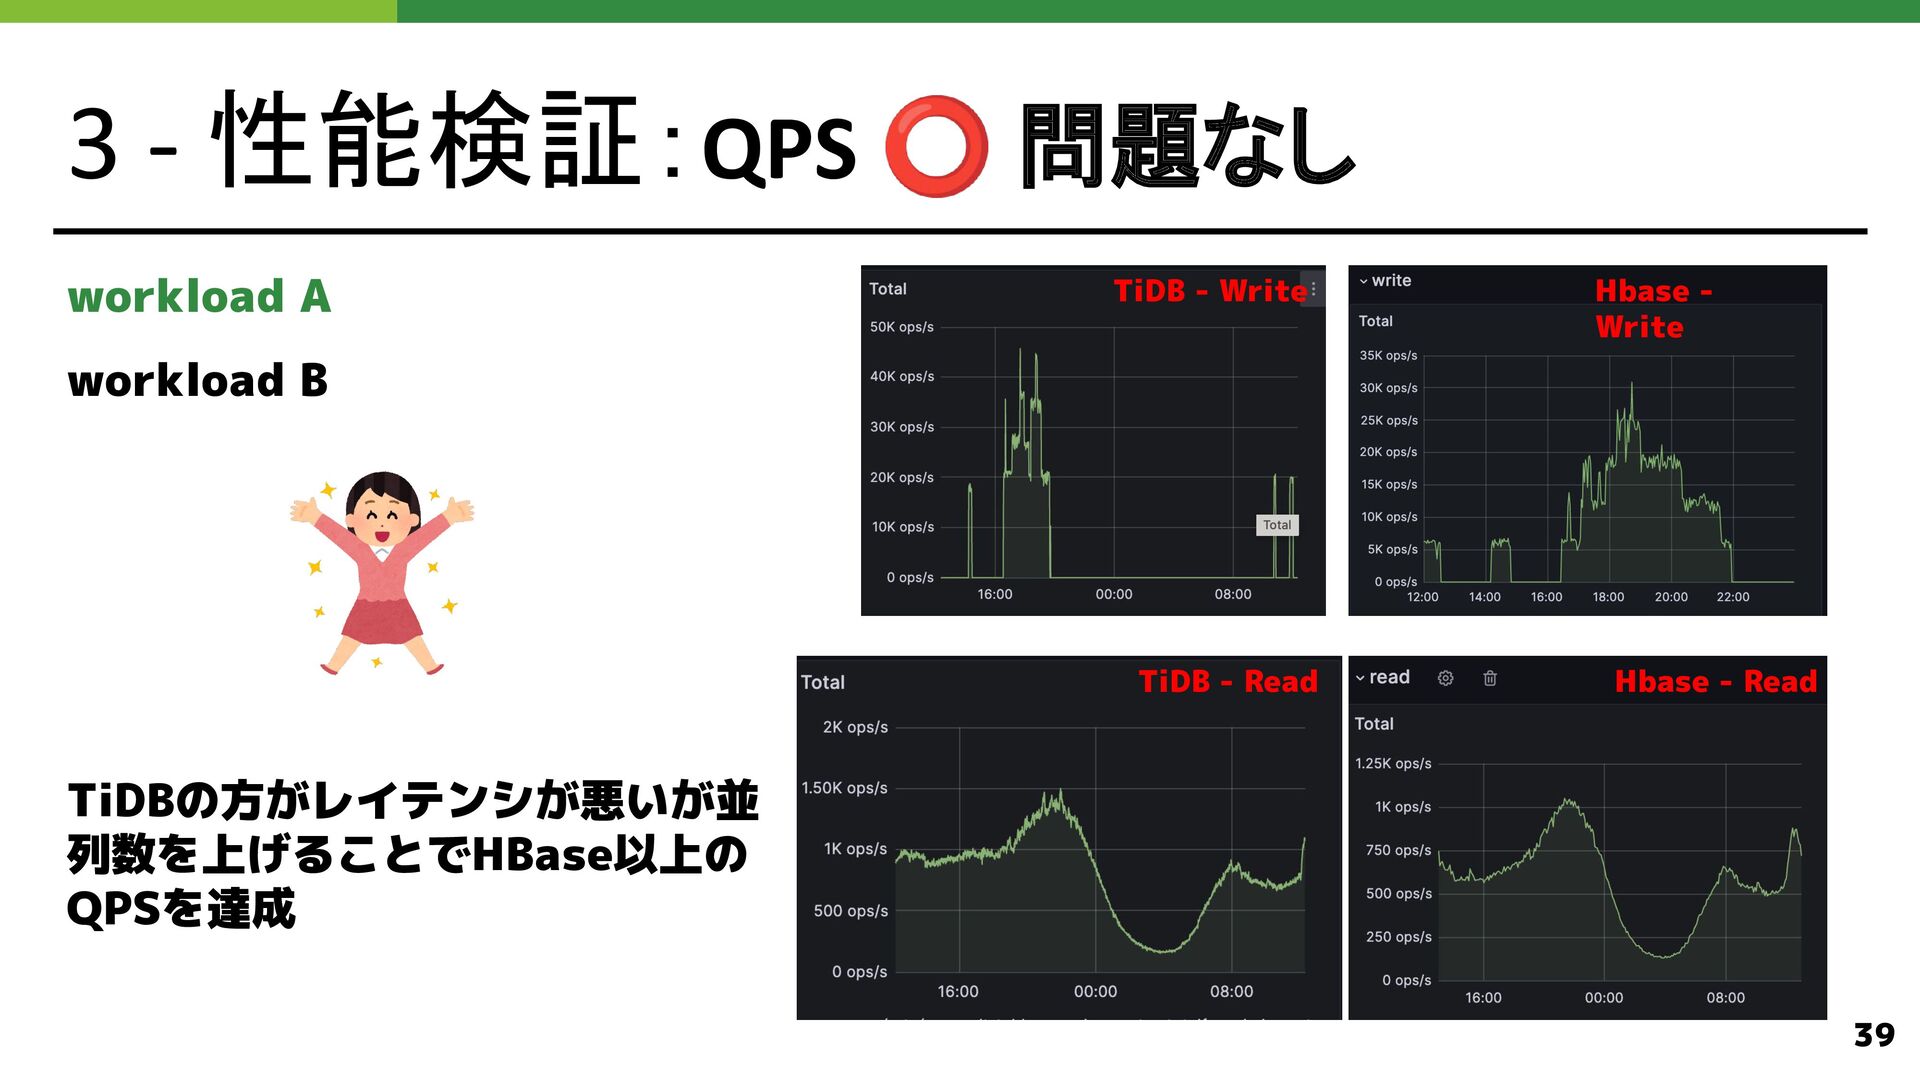
3 - 性能検証:QPS ⭕ 問題なし workload A workload B TiDBの方がレイテンシが悪いが並
列数を上げることでHBase以上の QPSを達成 Hbase - Write Hbase - Read TiDB - Read TiDB - Write 39
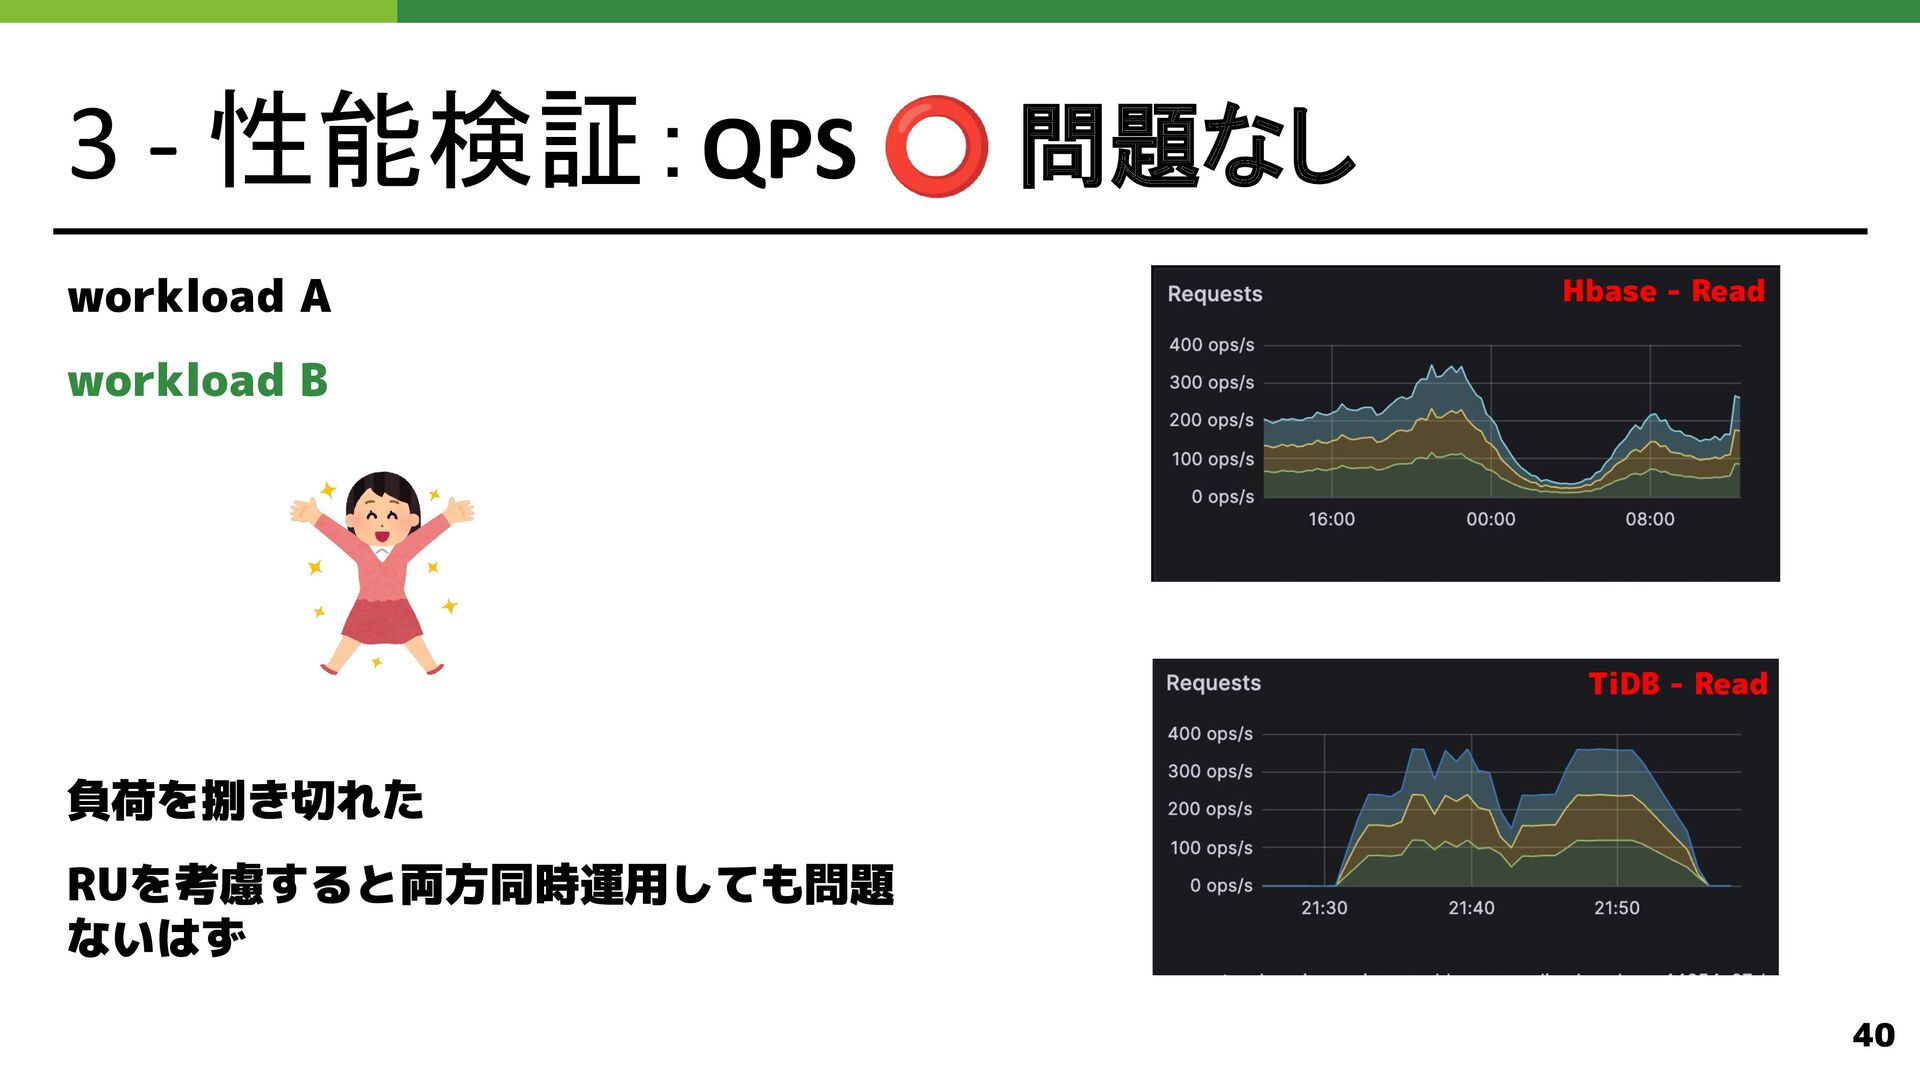
3 - 性能検証:QPS ⭕ 問題なし workload A workload B 負荷を捌き切れた
RUを考慮すると両方同時運用しても問題 ないはず TiDB - Read Hbase - Read 40
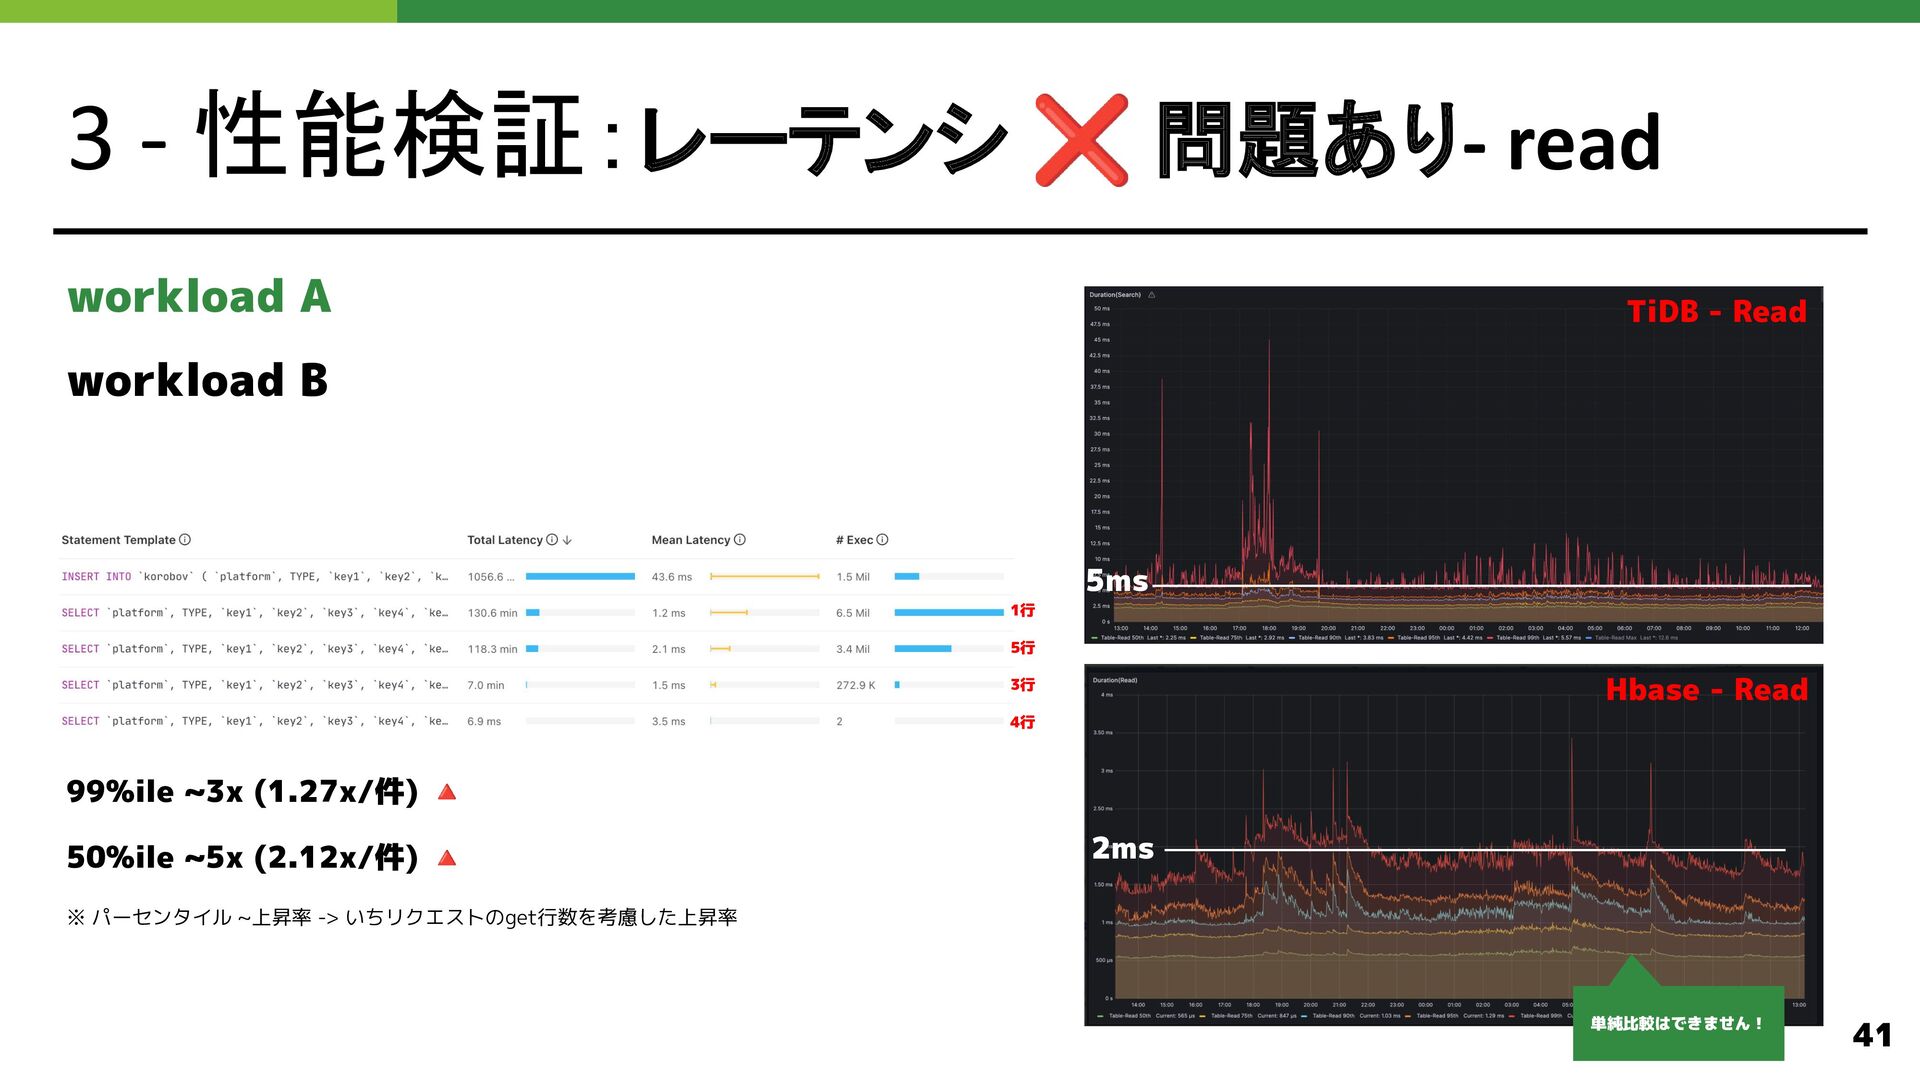
3 - 性能検証:レーテンシ ❌ 問題あり- read workload A workload B
99%ile ~3x (1.27x/件) 🔺 50%ile ~5x (2.12x/件) 🔺 ※ パーセンタイル ~上昇率 -> いちリクエストのget行数を考慮した上昇率 TiDB - Read Hbase - Read 単純比較はできません! 1行 5行 3行 4行 41 2ms 5ms
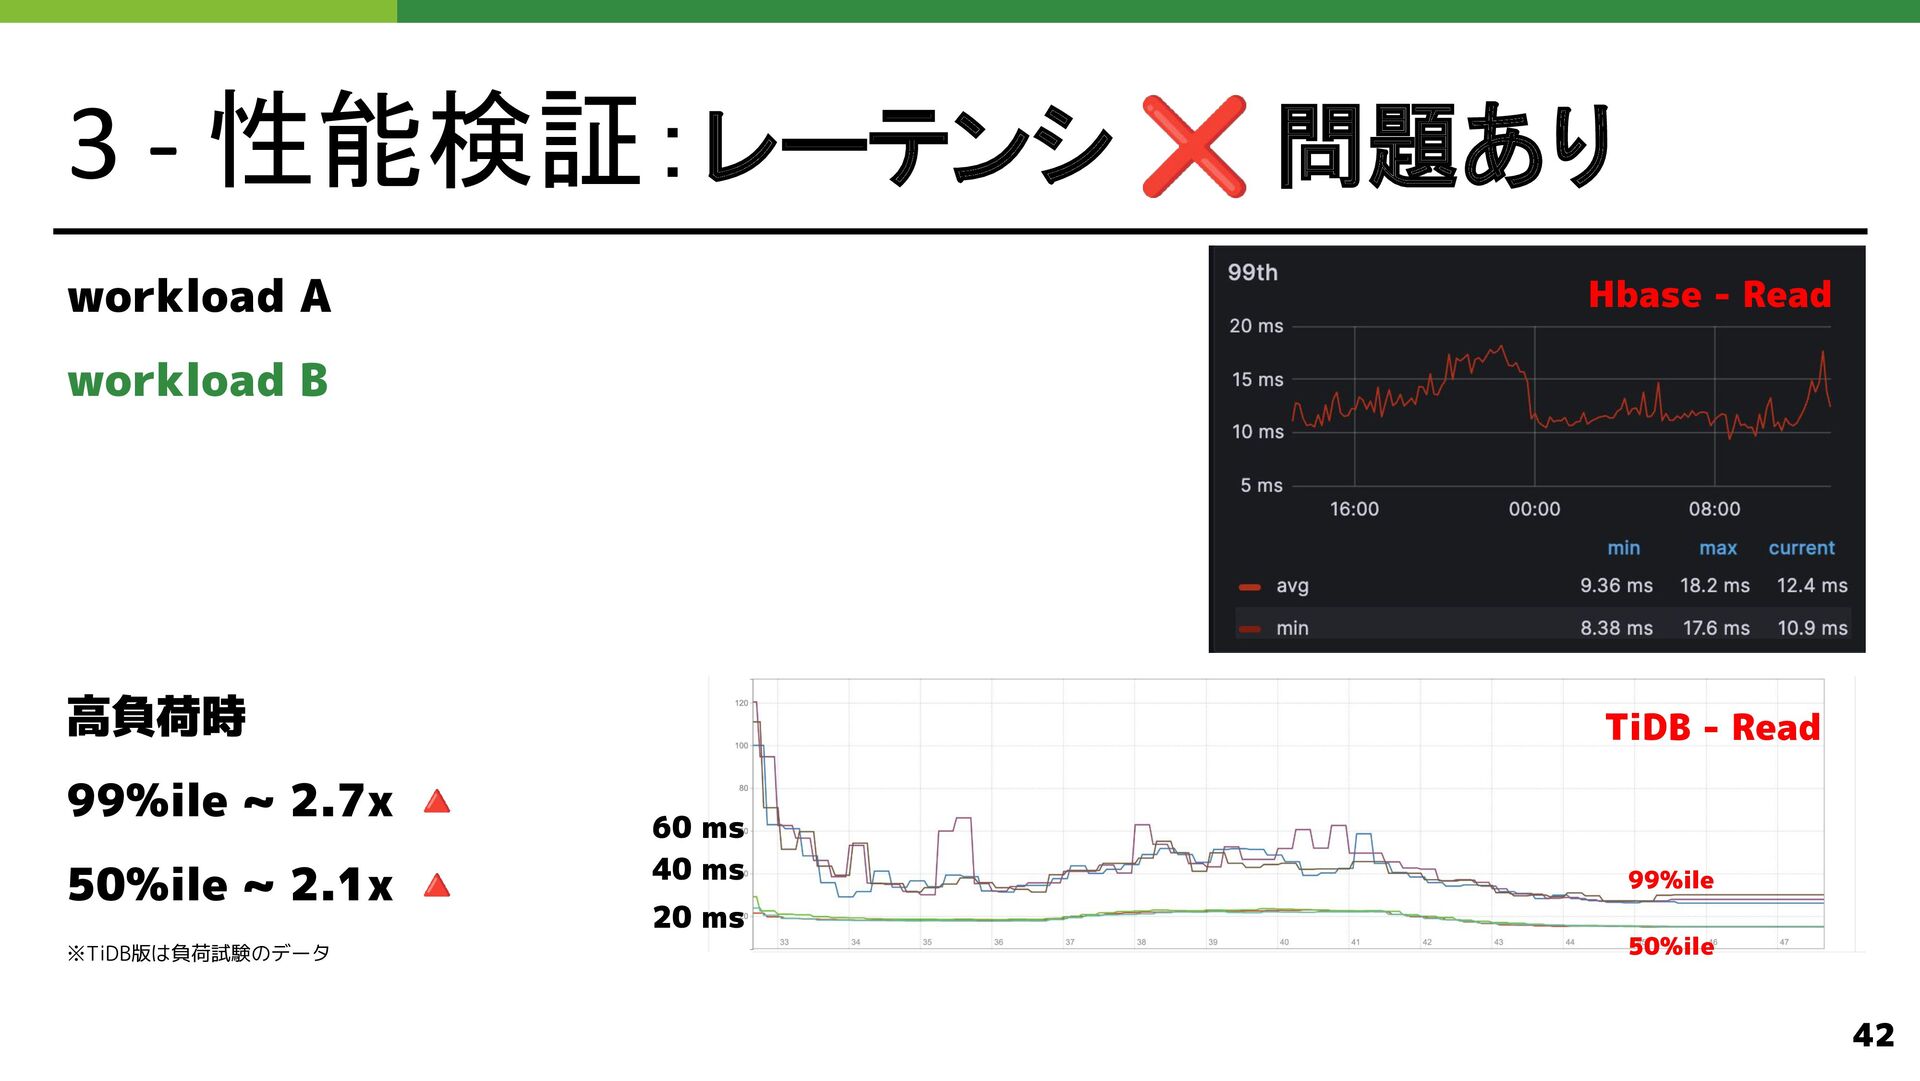
3 - 性能検証:レーテンシ ❌ 問題あり workload A workload B 高負荷時
99%ile ~ 2.7x 🔺 50%ile ~ 2.1x 🔺 ※TiDB版は負荷試験のデータ 50%ile 99%ile TiDB - Read Hbase - Read 42 20 ms 40 ms 60 ms
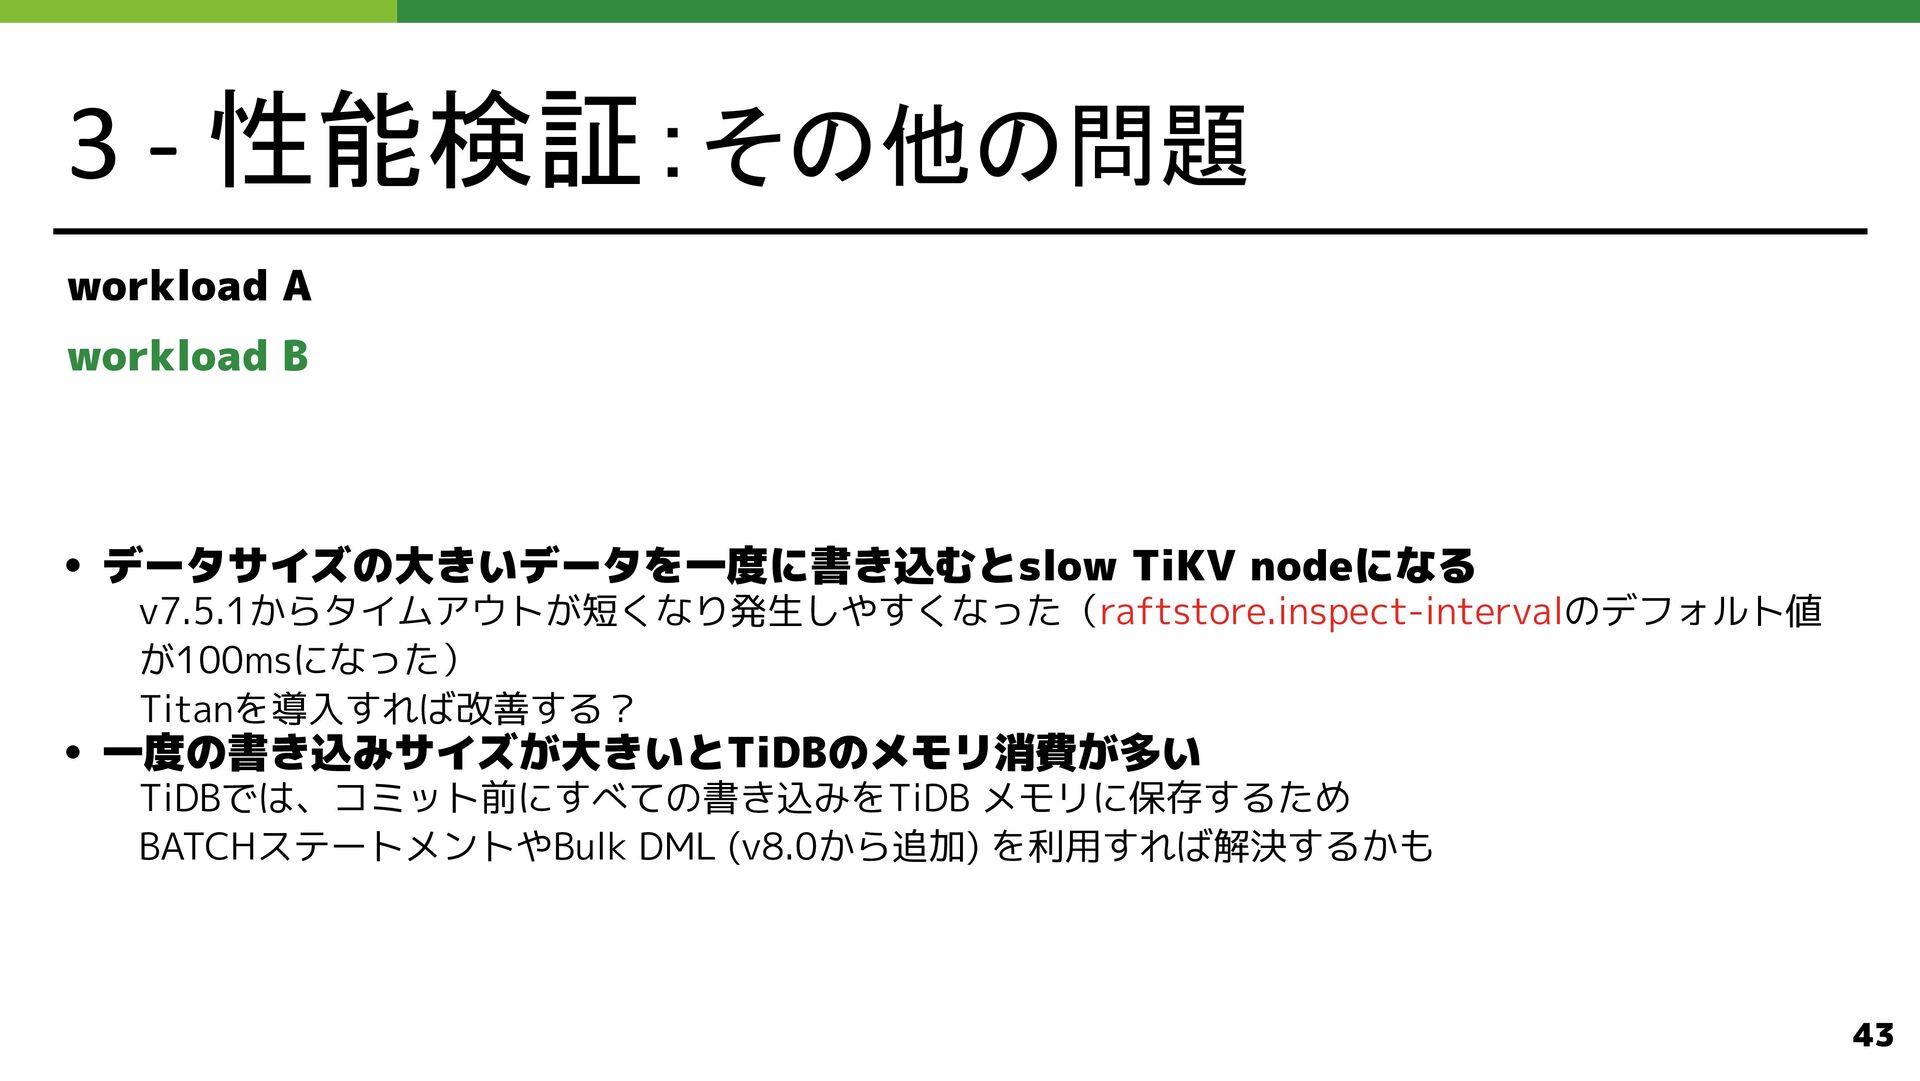
3 - 性能検証:その他の問題 workload A workload B • データサイズの大きいデータを一度に書き込むとslow TiKV
nodeになる v7.5.1からタイムアウトが短くなり発生しやすくなった(raftstore.inspect-intervalのデフォルト値 が100msになった) Titanを導入すれば改善する? • 一度の書き込みサイズが大きいとTiDBのメモリ消費が多い TiDBでは、コミット前にすべての書き込みをTiDB メモリに保存するため BATCHステートメントやBulk DML (v8.0から追加) を利用すれば解決するかも 43
今後の課題とまとめ 44
今後の課題 •オートスケーリング機能がない TiDB Cloudだとある •より低レイテンシが求められるワークロードの対応 TiKVを直接利用する? •Vector Search機能使いたい 45
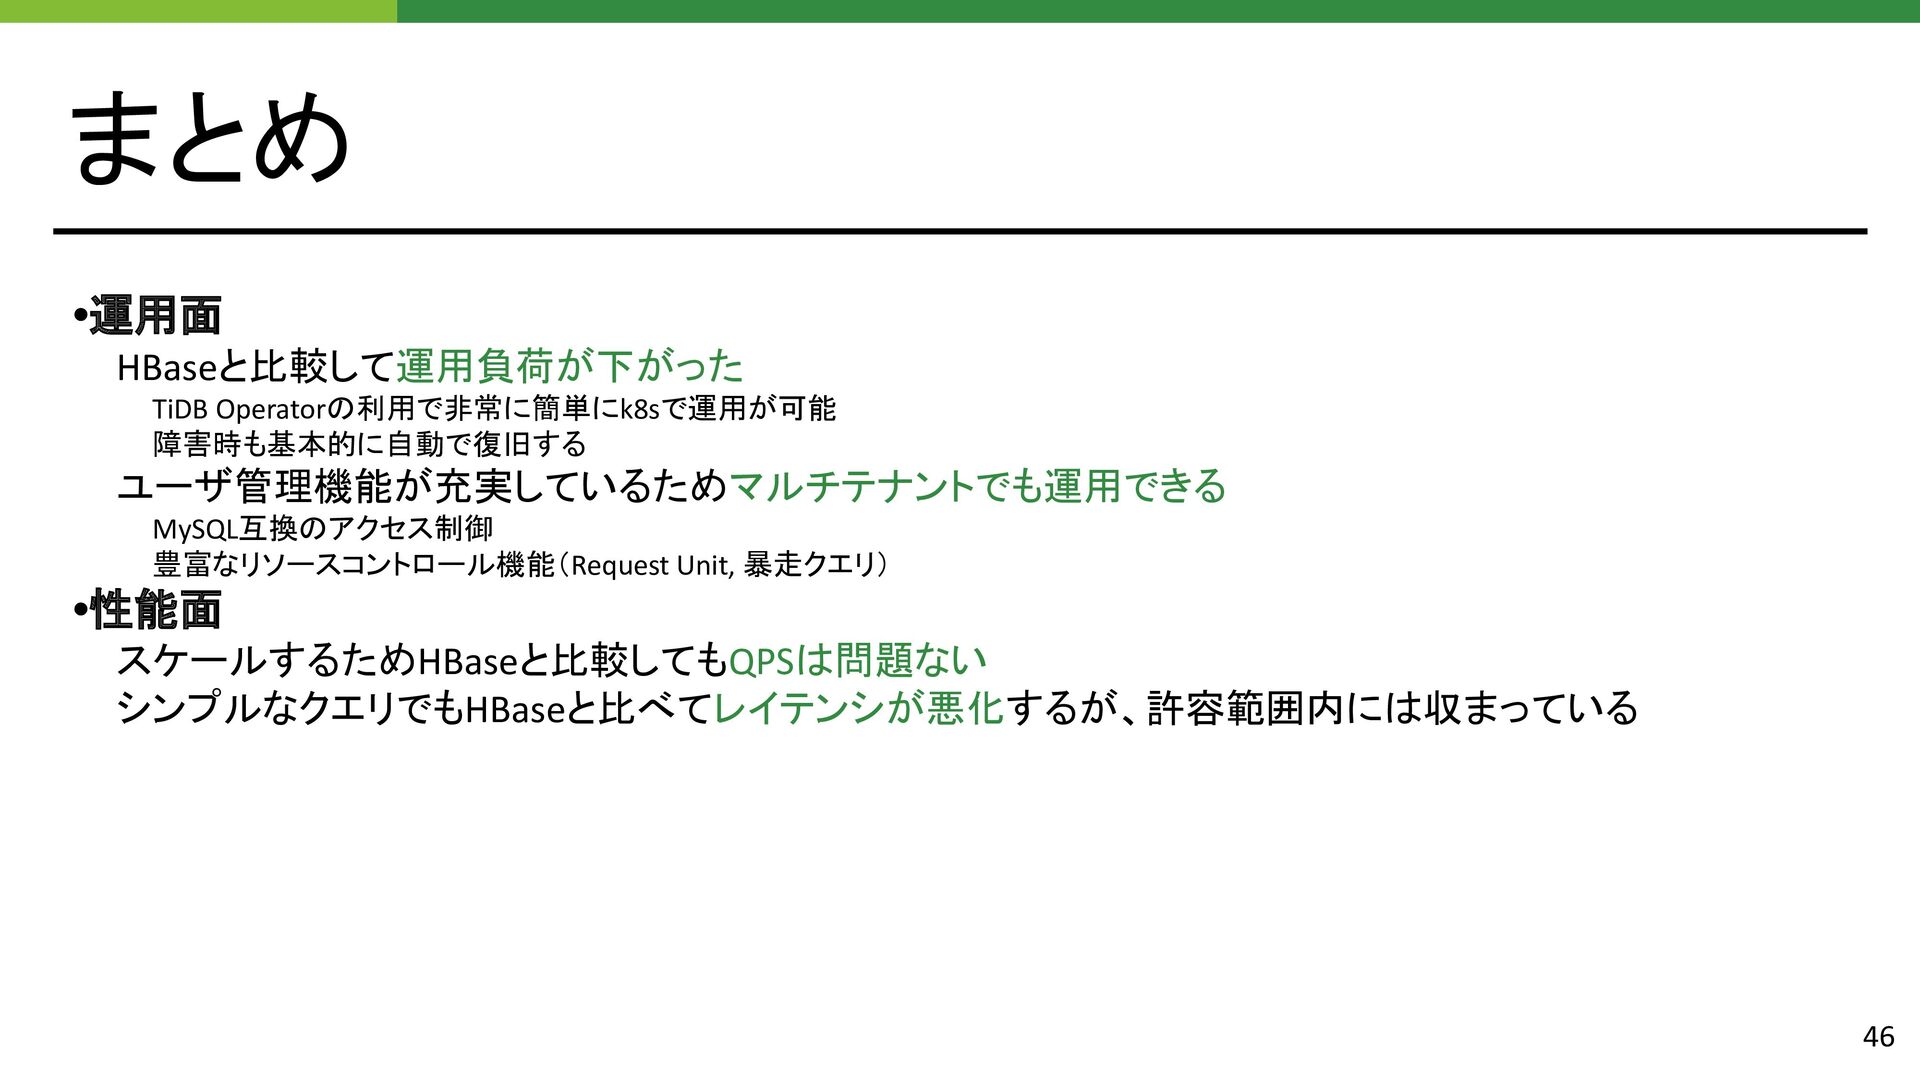
まとめ •運用面 HBaseと比較して運用負荷が下がった TiDB Operatorの利用で非常に簡単にk8sで運用が可能 障害時も基本的に自動で復旧する ユーザ管理機能が充実しているためマルチテナントでも運用できる MySQL互換のアクセス制御 豊富なリソースコントロール機能(Request Unit,
暴走クエリ) •性能面 スケールするためHBaseと比較してもQPSは問題ない シンプルなクエリでもHBaseと比べてレイテンシが悪化するが、許容範囲内には収まっている 46
ありがとうございました 47
More Decks by nori
See All by nori
TiUG #5 TiDBベクトル検索の活用事例
watanori
0
34
TiDB User Day 2024 大規模データ処理基盤におけるHBaseからTiDBへの移行事例
watanori
0
94
Other Decks in Technology
See All in Technology
Biohub - Cell Tracking During Development 5th place solution
rist
0
150
Shared Signals Framework 仕様解説
oidfj
0
430
Steering と Hook (チームの決まりを守らせる) | 目指せ Kiro マスター 06
inariku
PRO
2
120
「AIチャットからもできないの?」と言われたら ~業務アプリをMCP対応するときの認証・認可の勘所
oidfj
0
330
異夢同船〜異なる夢でも同じ船でなんとかする〜
fortegp05
0
210
Linuxネットワークスタック進化の軌跡: 過去10年の歩みと最新トレンド
orimanabu
3
610
ゼロから作るWebアプリの新定番!?Amplify Gen 2 × AWS Blocksで実現する「開発速度とRDBの柔軟性のいいとこ取り」
amixedcolor
1
250
プロダクションコードにおける encoding/json から encoding/json/v2 へのスムーズな移行
sansantech
PRO
1
410
Kiro 入門 (1 つのエージェントを、どの画面からでも) | 目指せ Kiro マスター 01
inariku
PRO
6
1.7k
大江戸Ruby会議でデータベース クライアントの話をするのは 間違っているだろうか
yahonda
1
120
Gifu WordPress Meetup #200 に向けて、私たちには何ができるだろうか?/ 2026-11-07 Gifu WordPress Meetup
torounit
0
290
evcc & Home Assistant
naltatis
0
710
Featured
See All Featured
Raft: Consensus for Rubyists
vanstee
143
7.9k
Between Models and Reality
mayunak
4
580
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.9k
Un-Boring Meetings
codingconduct
0
490
Organizational Design Perspectives: An Ontology of Organizational Design Elements
kimpetersen
PRO
1
880
Large-scale JavaScript Application Architecture
addyosmani
516
110k
The Web Performance Landscape in 2024 [PerfNow 2024]
tammyeverts
12
1.4k
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
Leading Effective Engineering Teams in the AI Era
addyosmani
9
2.9k
Leveraging Curiosity to Care for An Aging Population
cassininazir
1
560
How To Speak Unicorn (iThemes Webinar)
marktimemedia
1
630
The SEO identity crisis: Don't let AI make you average
varn
0
630


 watanori
 rist
 oidfj
 inariku
 fortegp05
 orimanabu
 amixedcolor
 sansantech
 yahonda
 torounit
 naltatis
 vanstee
 mayunak
 rmw
 codingconduct
 kimpetersen
 addyosmani
 tammyeverts
 garrettdimon
 cassininazir
 marktimemedia
 varn