Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Automating and Democratizing with Cortex AI & C...

Avatar for Matsubara Matsubara
September 16, 2026

Automating and Democratizing with Cortex AI & CoCo: DOCOMO’s Accelerating Data Mesh Foundation

題名:Cortex AIとCoCoによる自動化・民主化:加速するドコモのData Mesh基盤
運用負担を下げ生産性を高めるアプローチ

Snowflake World Tour Tokyo 2026

Avatar for Matsubara

Matsubara

September 16, 2026

More Decks by Matsubara

Other Decks in Technology

Transcript

  1. Profile 松原 侑哉 安田 匠吾 幡 祐輔 今里 淳平 株式会社NTTドコモ

    株式会社NTTドコモ 株式会社NTTドコモ Snowflake合同会社 R&Dイノベーション本部 サービスイノベーション部ビッグデータ基盤 兼 ネットワーク本部 ネットワーク業務改革推進部 構造改革推進室 R&Dイノベーション本部 サービスイノベーション部ビッグデータ基盤 兼 ネットワーク本部 ネットワーク業務改革推進部 構造改革推進室 R&Dイノベーション本部 サービスイノベーション部ビッグデータ基盤 Principal Technical Architect Principal Data Engineer Data Engineer © NTT DOCOMO, INC. All rights reserved. Data Engineer
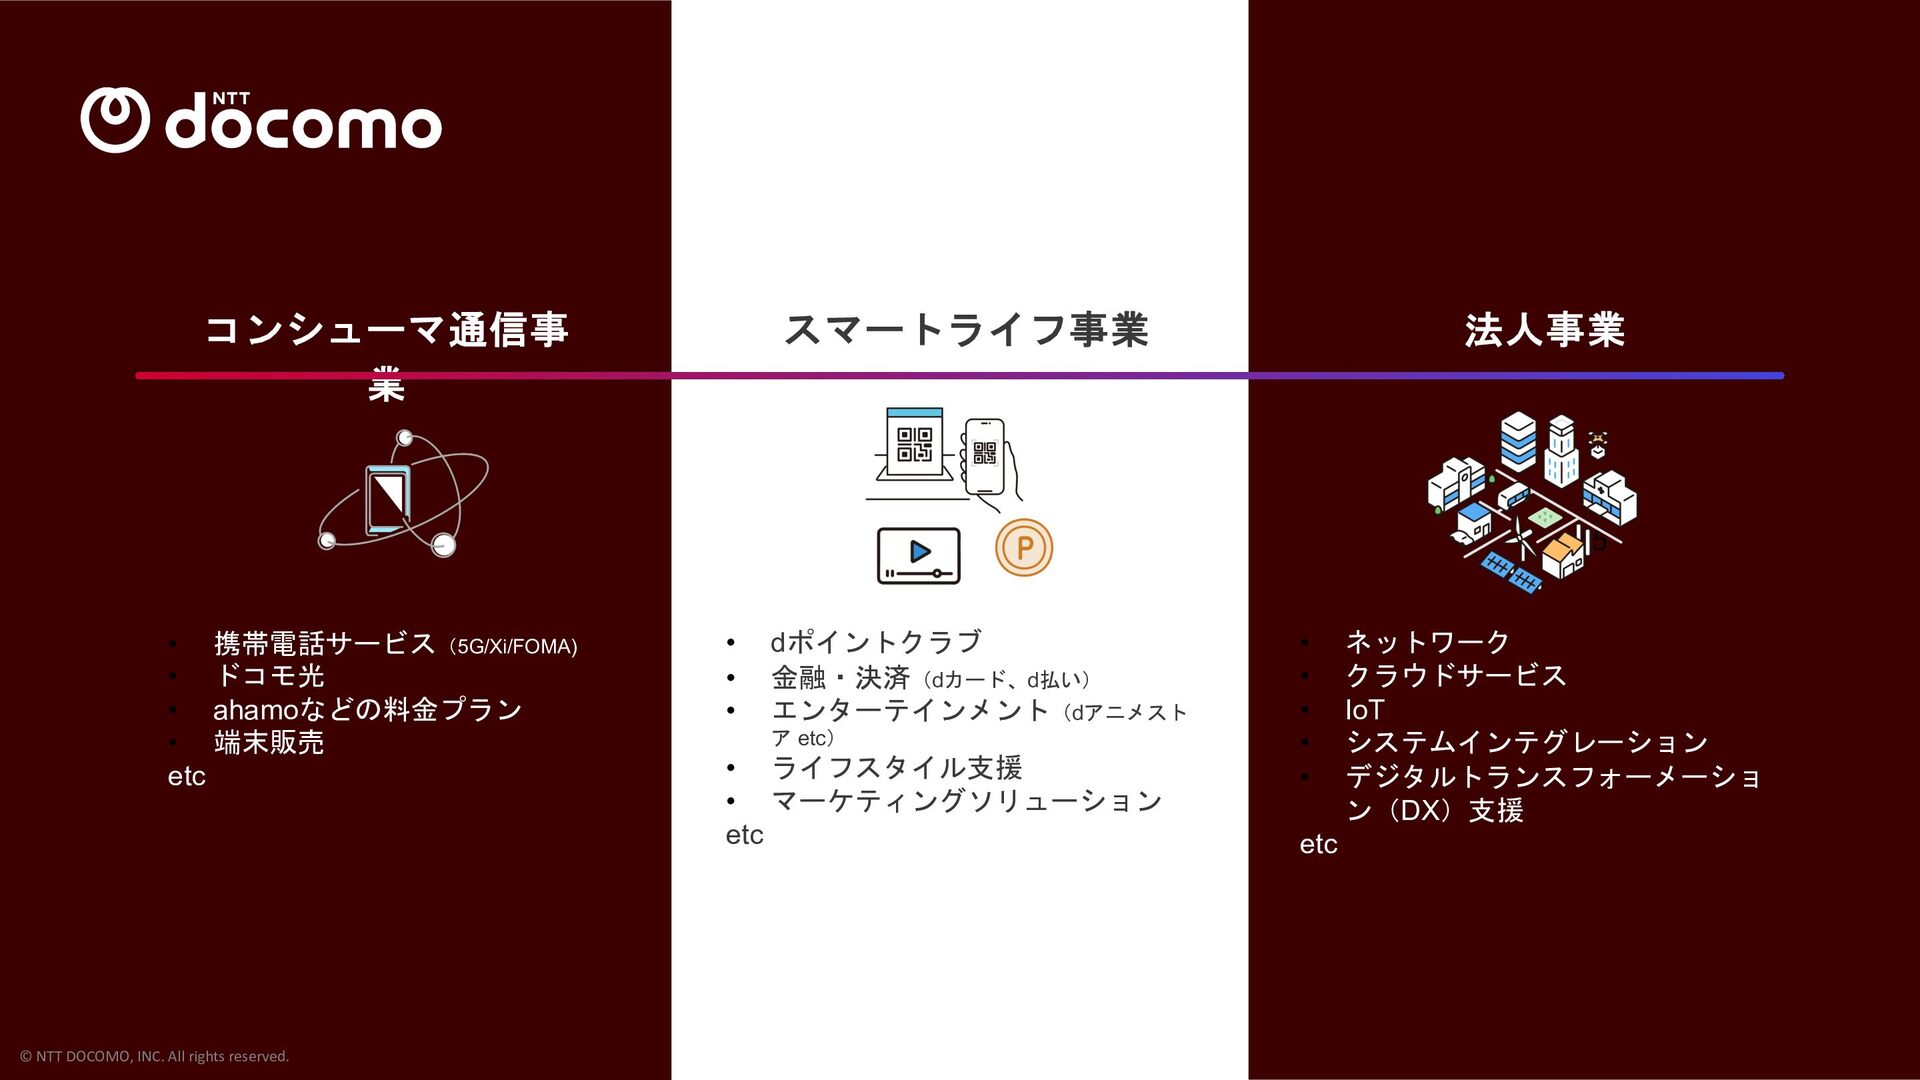
  2. コンシューマ通信事 業 スマートライフ事業 法人事業 ea5 • 携帯電話サービス(5G/Xi/FOMA) • ドコモ光 •

    ahamoなどの料金プラン • 端末販売 etc © NTT DOCOMO, INC. All rights reserved. • • • dポイントクラブ 金融・決済(dカード、d払い) エンターテインメント(dアニメスト ア etc) • ライフスタイル支援 • マーケティングソリューション etc • • • • • etc ネットワーク クラウドサービス IoT システムインテグレーション デジタルトランスフォーメーショ ン(DX)支援
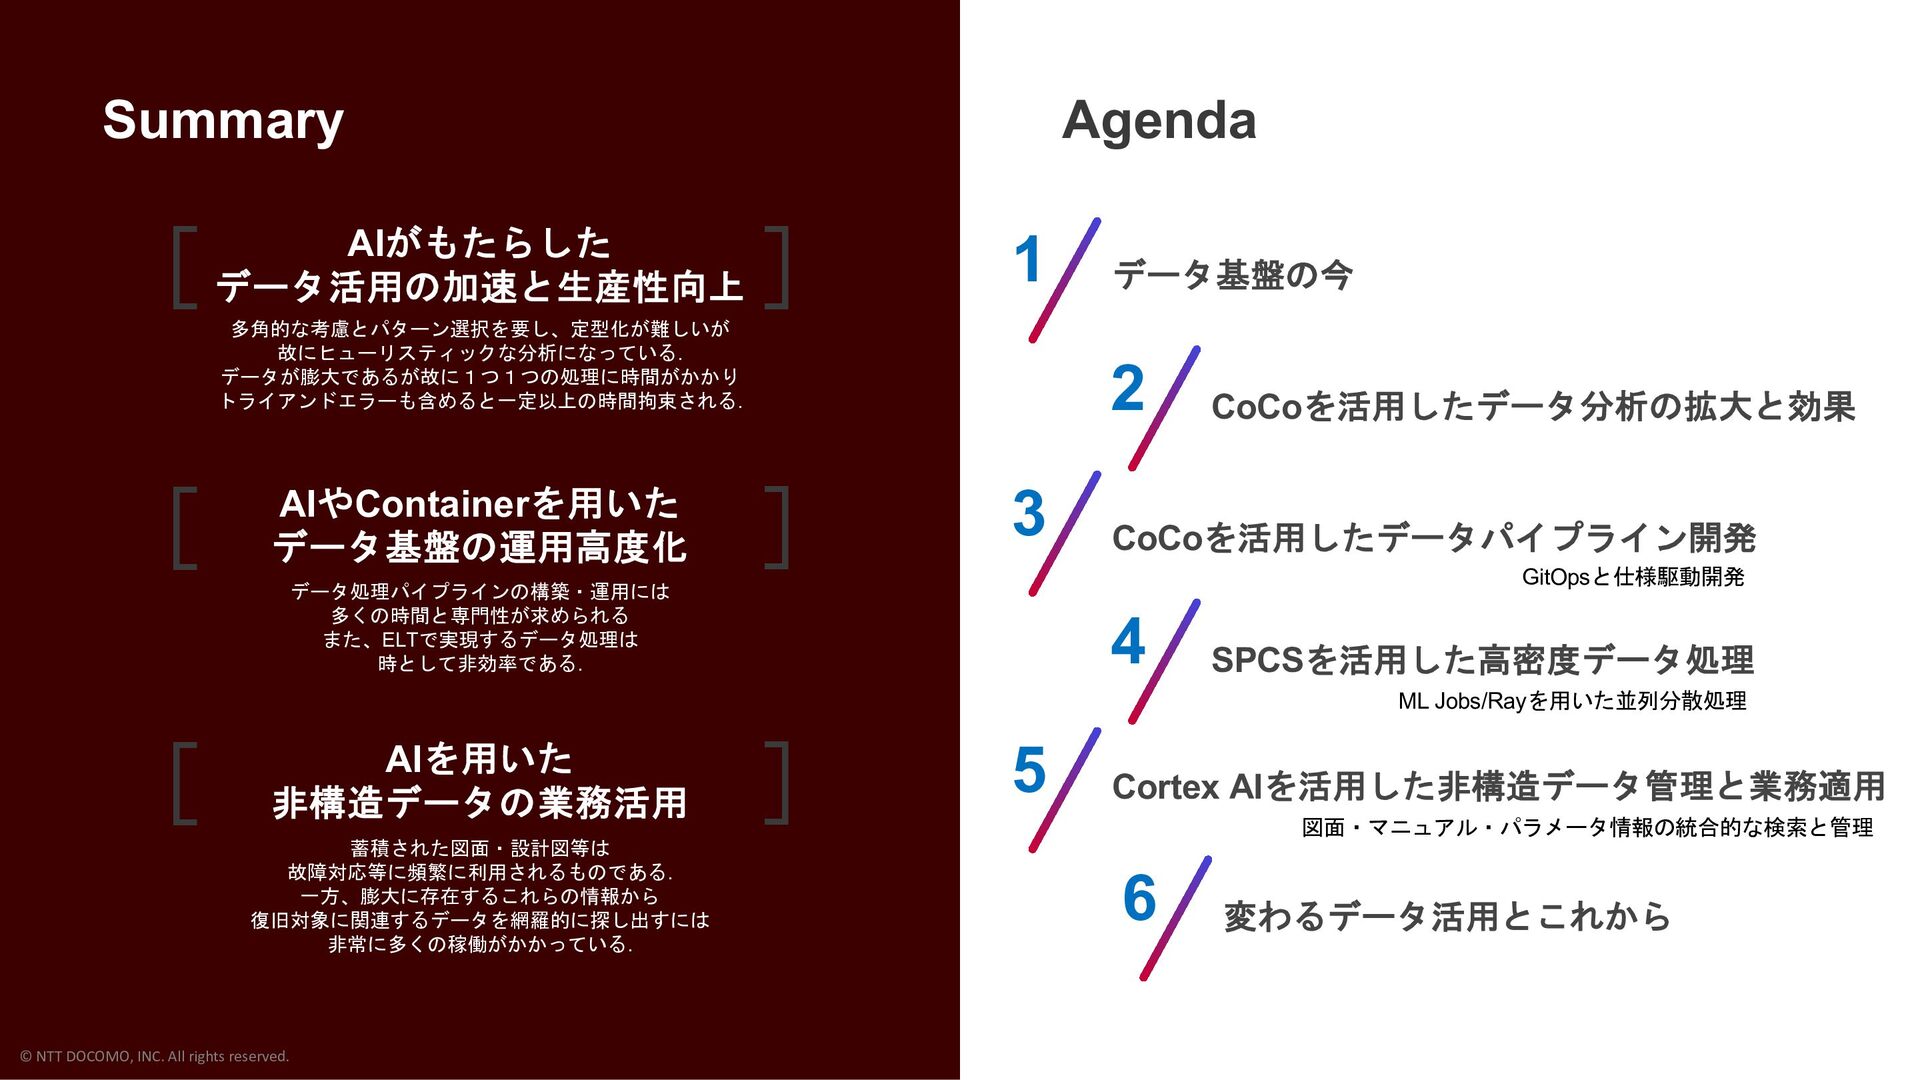
  3. Summary [ AIがもたらした データ活用の加速と生産性向上 Agenda ] 1 多角的な考慮とパターン選択を要し、定型化が難しいが 故にヒューリスティックな分析になっている. データが膨大であるが故に1つ1つの処理に時間がかかり

    トライアンドエラーも含めると一定以上の時間拘束される. [ AIやContainerを用いた データ基盤の運用高度化 データ基盤の今 2 ] 3 CoCoを活用したデータ分析の拡大と効果 CoCoを活用したデータパイプライン開発 GitOpsと仕様駆動開発 データ処理パイプラインの構築・運用には 多くの時間と専門性が求められる また、ELTで実現するデータ処理は 時として非効率である. 4 SPCSを活用した高密度データ処理 ML Jobs/Rayを用いた並列分散処理 [ AIを用いた 非構造データの業務活用 蓄積された図面・設計図等は 故障対応等に頻繁に利用されるものである. 一方、膨大に存在するこれらの情報から 復旧対象に関連するデータを網羅的に探し出すには 非常に多くの稼働がかかっている. © NTT DOCOMO, INC. All rights reserved. ] 5 Cortex AIを活用した非構造データ管理と業務適用 図面・マニュアル・パラメータ情報の統合的な検索と管理 6 変わるデータ活用とこれから
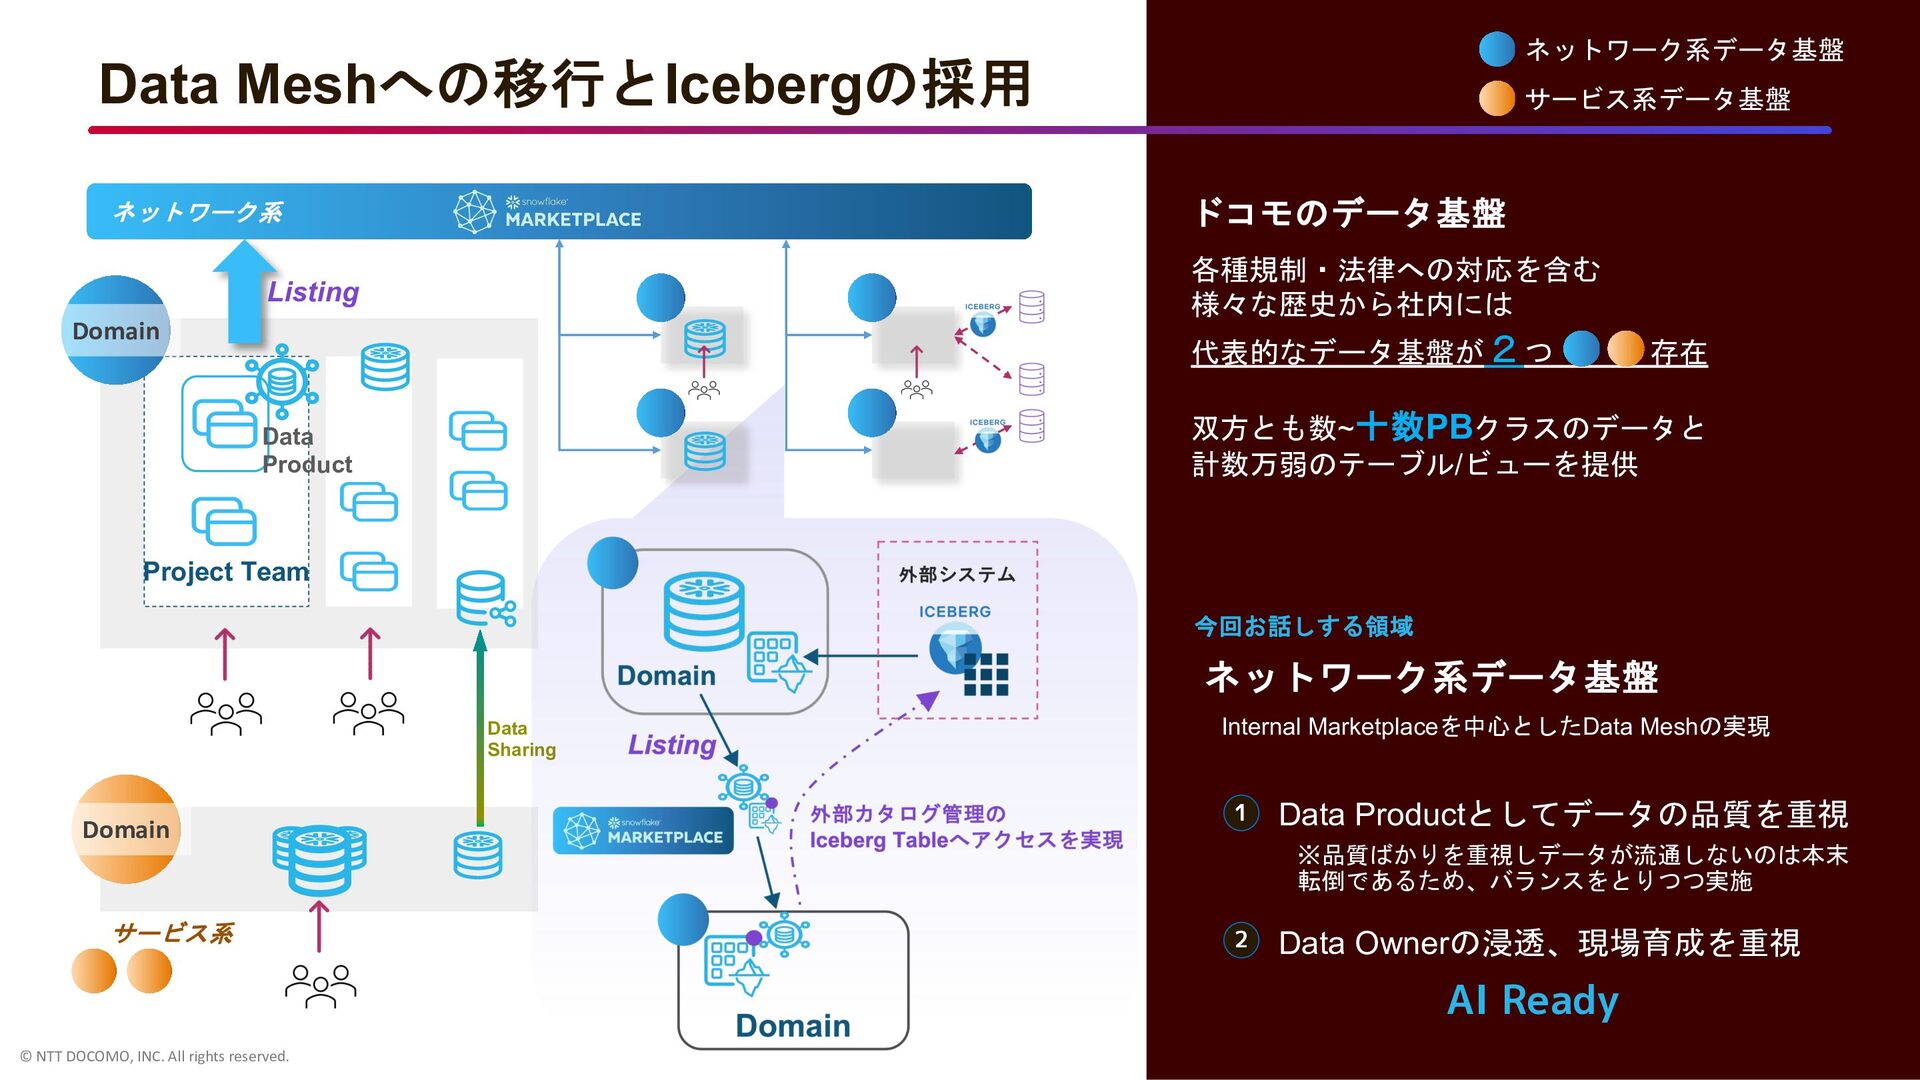
  4. ネットワーク系データ基盤 Data Meshへの移行とIcebergの採用 サービス系データ基盤 ドコモのデータ基盤 ネットワーク系 各種規制・法律への対応を含む 様々な歴史から社内には Listing Domain

    代表的なデータ基盤が2つ 存在 双方とも数~十数PBクラスのデータと 計数万弱のテーブル/ビューを提供 Data Product Project Team 今回お話しする領域 ネットワーク系データ基盤 Data Sharing Domain サービス系 Internal Marketplaceを中心としたData Meshの実現 1 Data Productとしてデータの品質を重視 ※品質ばかりを重視しデータが流通しないのは本末 転倒であるため、バランスをとりつつ実施 2 Data Ownerの浸透、現場育成を重視 AI Ready © NTT DOCOMO, INC. All rights reserved.
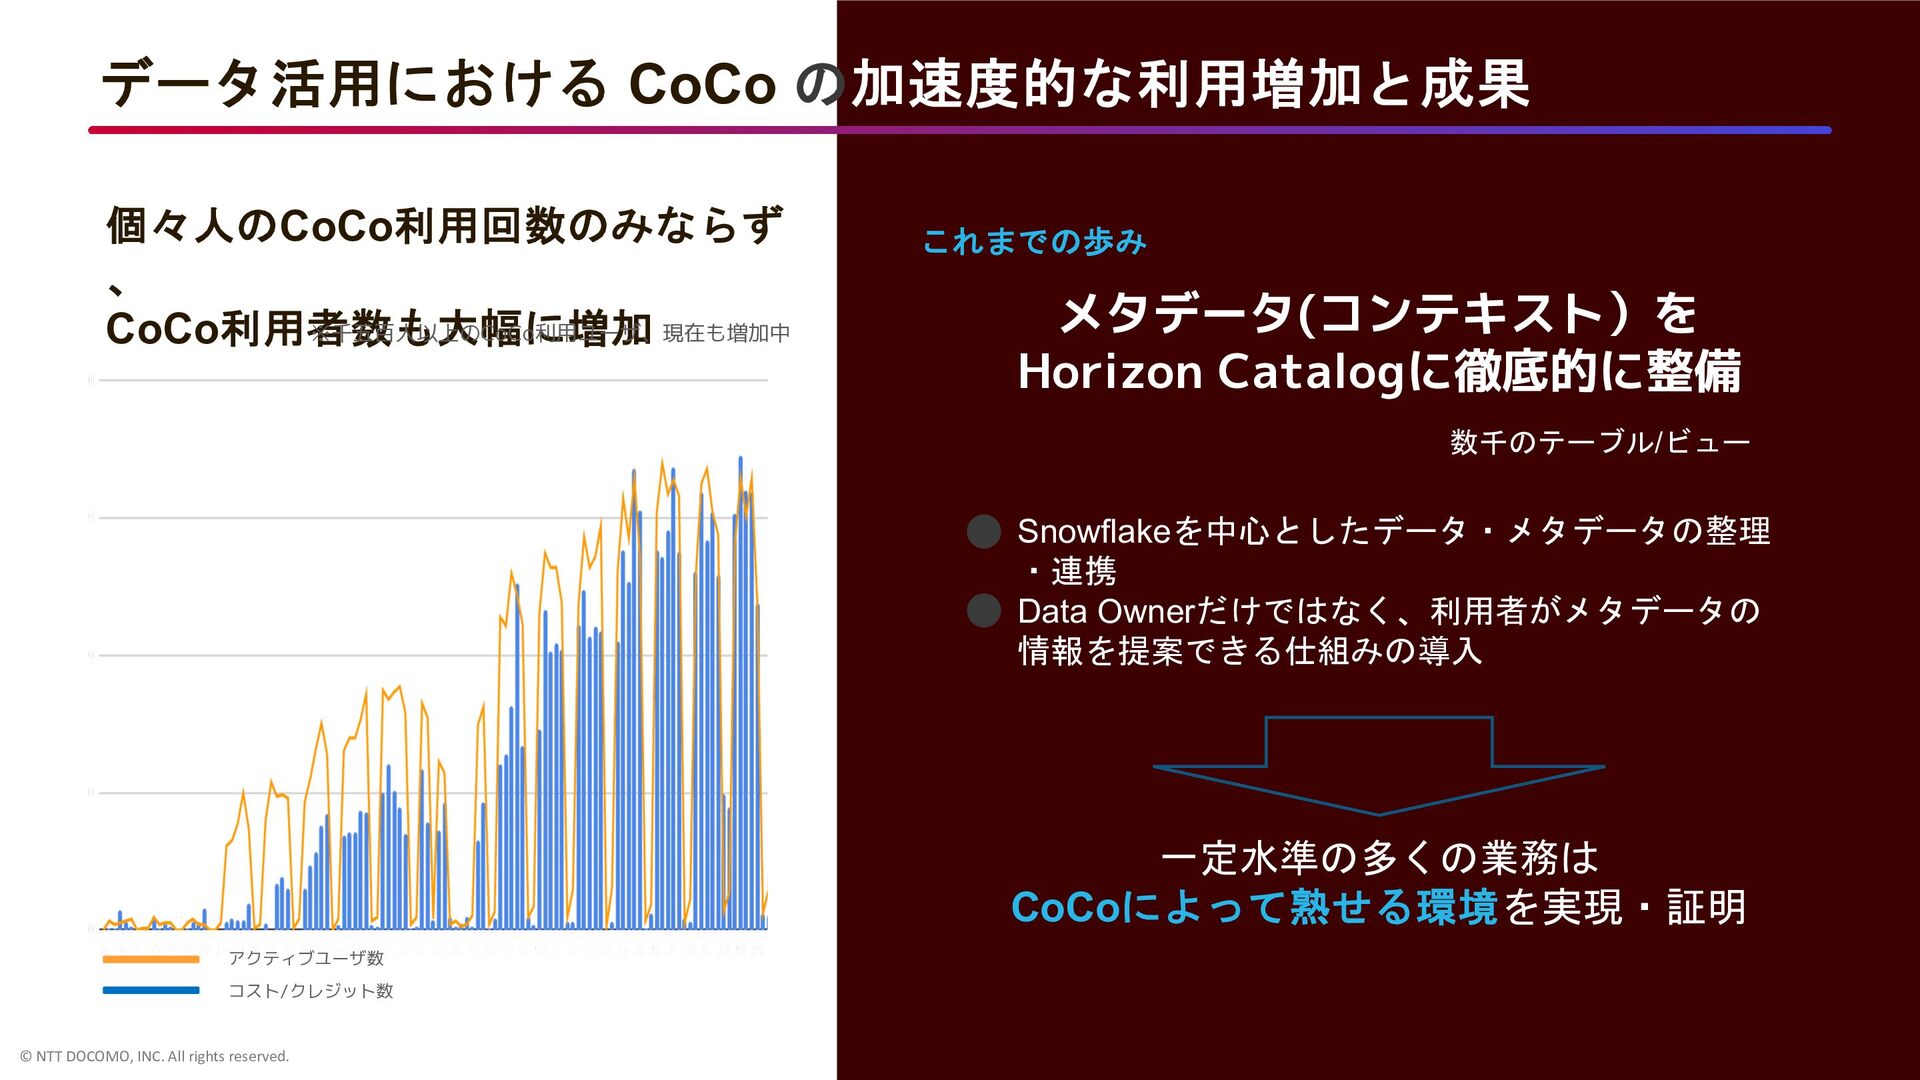
  5. データ活用における CoCo の加速度的な利用増加と成果 個々人のCoCo利用回数のみならず 、 ※千五百人以上のCoCo利用ユーザ、現在も増加中 CoCo利用者数も大幅に増加 これまでの歩み メタデータ(コンテキスト)を Horizon

    Catalogに徹底的に整備 数千のテーブル/ビュー • Snowflakeを中心としたデータ・メタデータの整理 ・連携 • Data Ownerだけではなく、利用者がメタデータの 情報を提案できる仕組みの導入 一定水準の多くの業務は CoCoによって熟せる環境を実現・証明 アクティブユーザ数 コスト/クレジット数 © NTT DOCOMO, INC. All rights reserved.
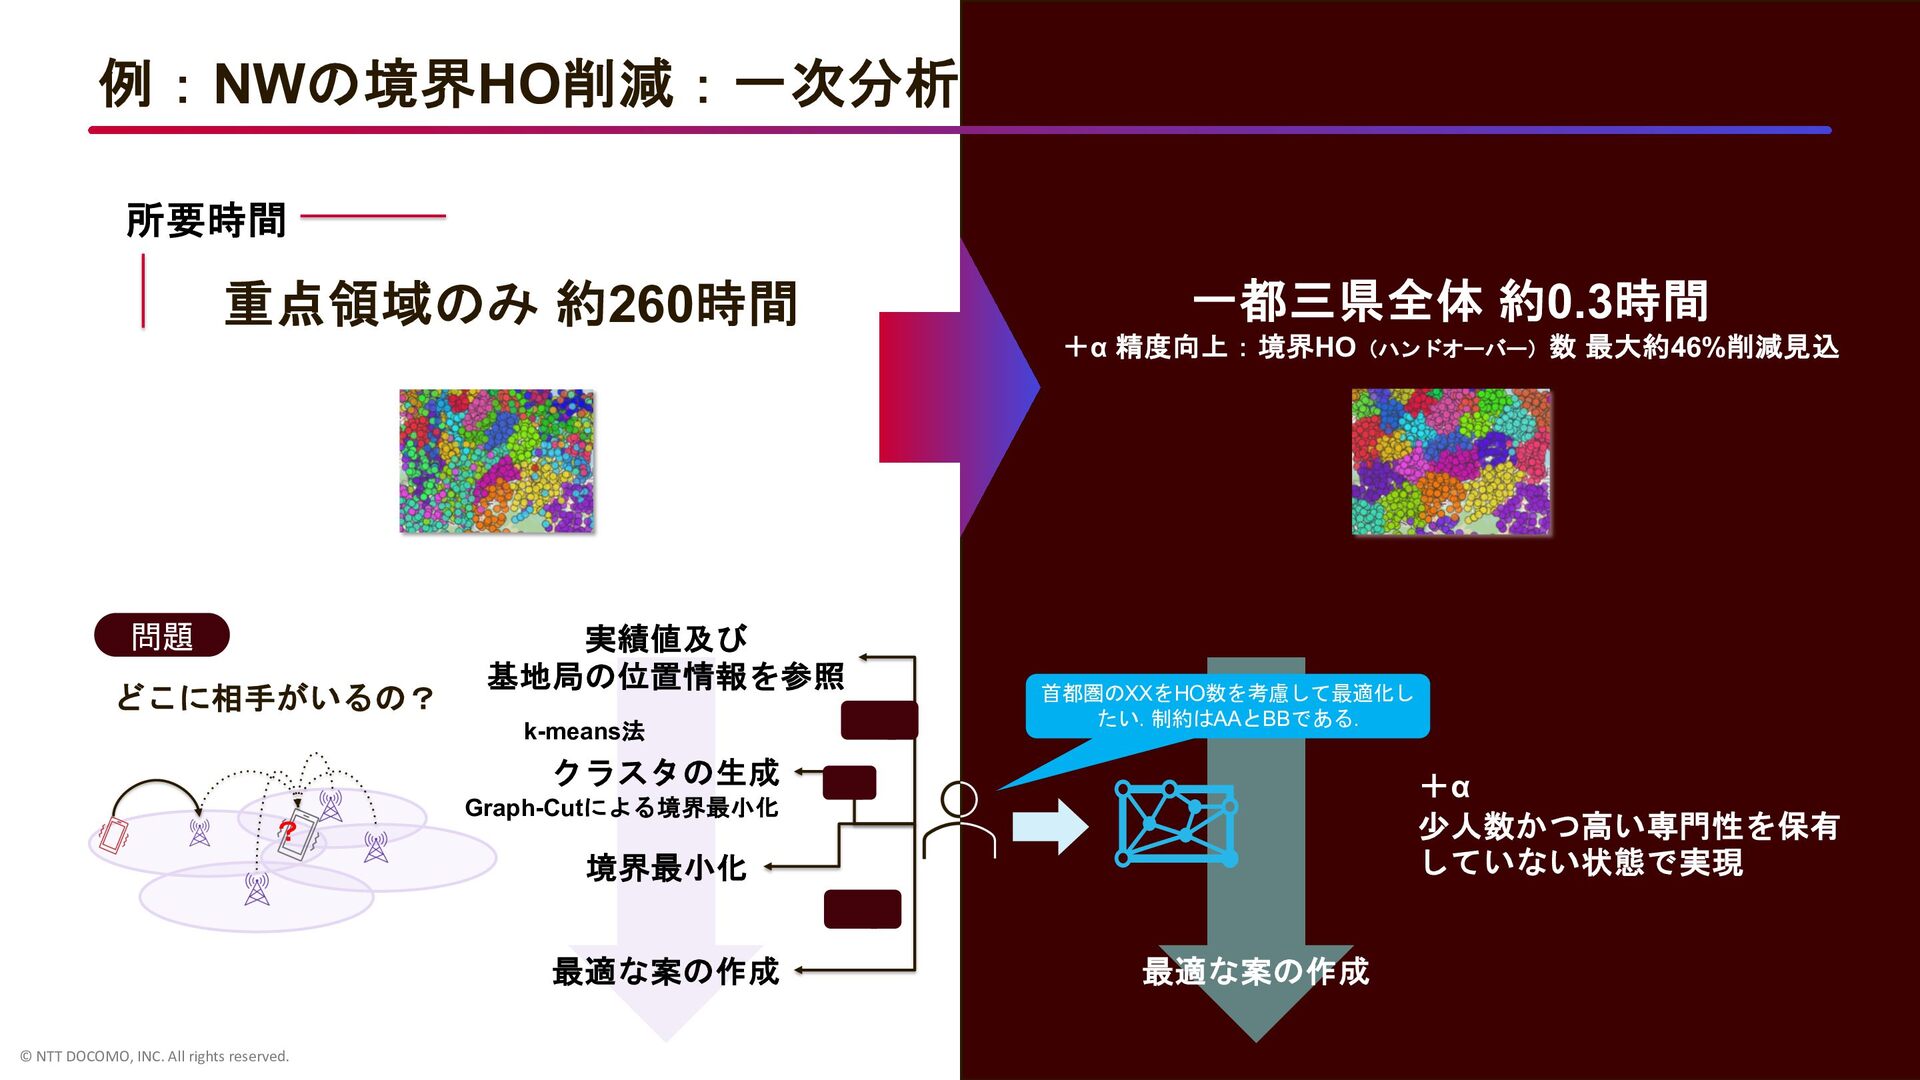
  6. 例:NWの境界HO削減:一次分析 所要時間 重点領域のみ 約260時間 問題 どこに相手がいるの? 実績値及び 基地局の位置情報を参照 k-means法 一都三県全体

    約0.3時間 +α 精度向上:境界HO(ハンドオーバー)数 最大約46%削減見込 首都圏のXXをHO数を考慮して最適化し たい. 制約はAAとBBである. クラスタの生成 ? +α 少人数かつ高い専門性を保有 していない状態で実現 Graph-Cutによる境界最小化 境界最小化 最適な案の作成 © NTT DOCOMO, INC. All rights reserved. 最適な案の作成
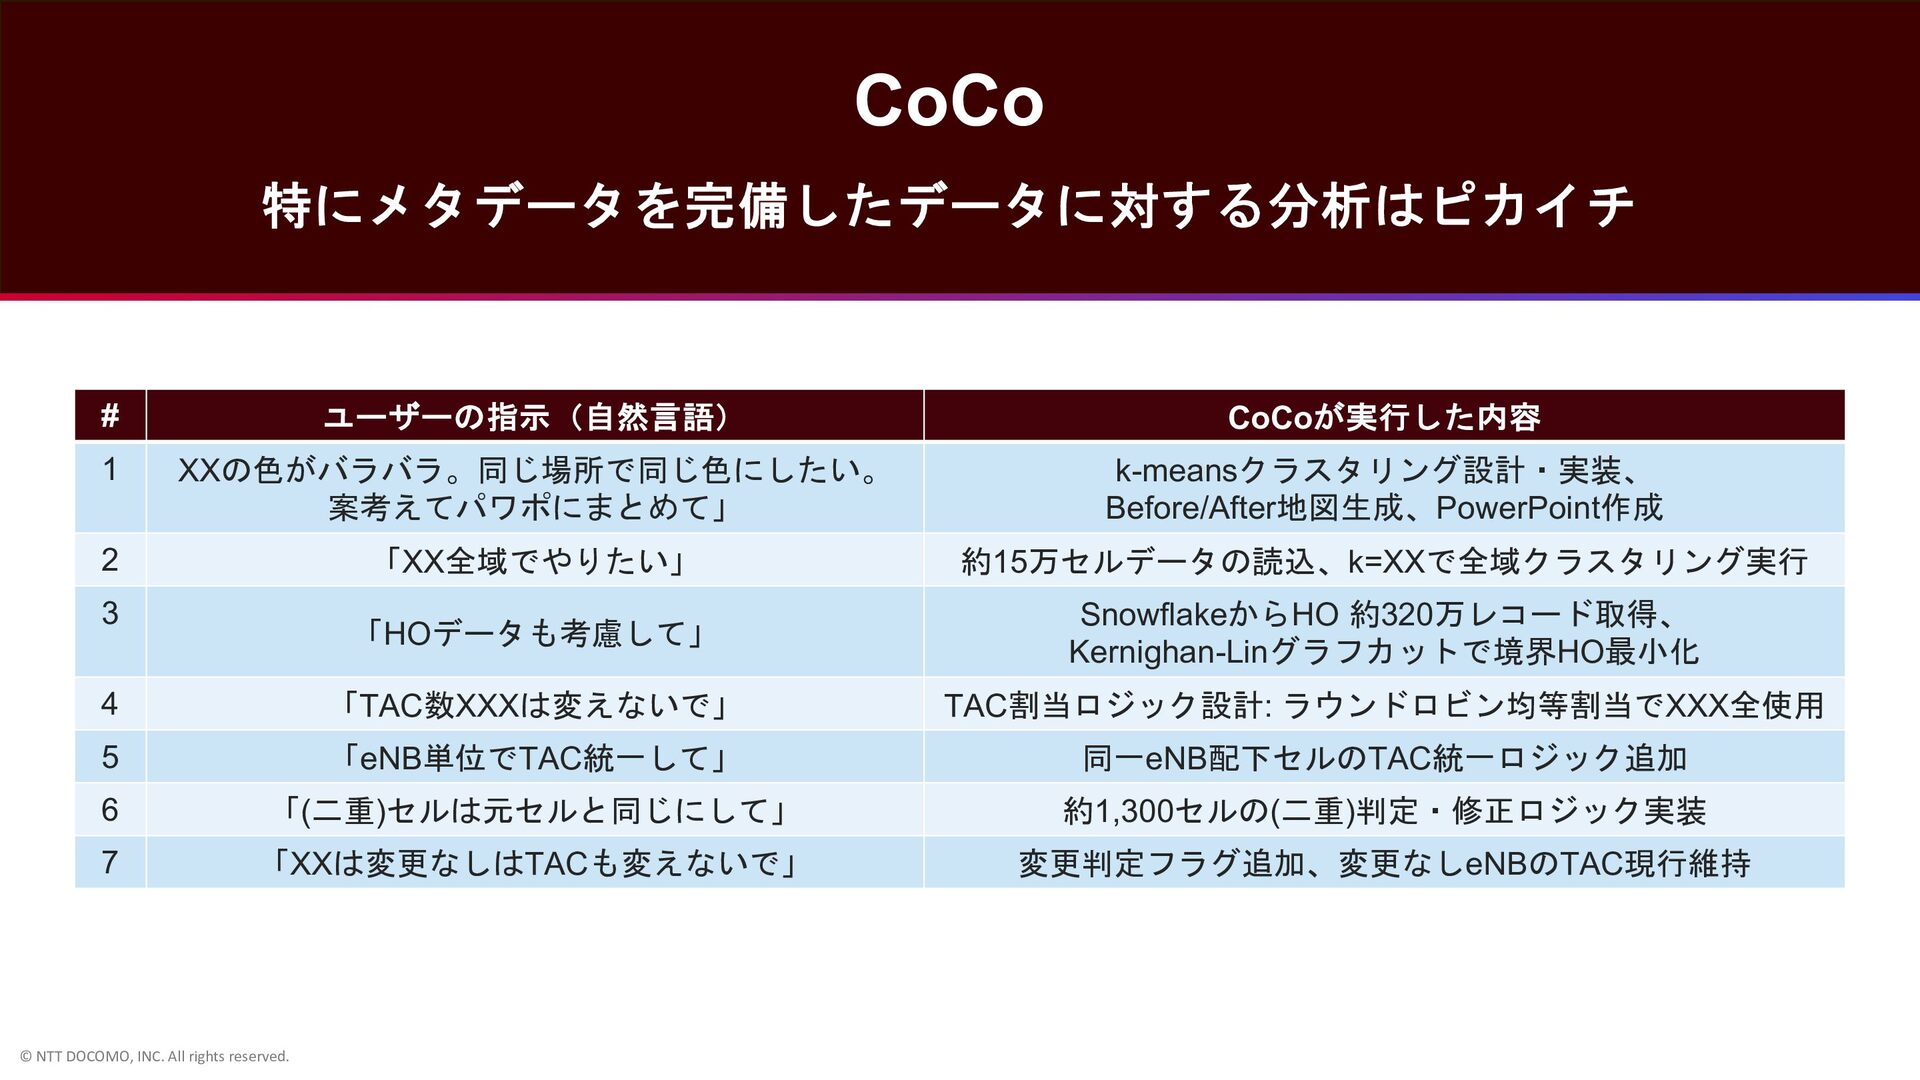
  7. CoCo 特にメタデータを完備したデータに対する分析はピカイチ # ユーザーの指示(自然言語) CoCoが実行した内容 1 XXの色がバラバラ。同じ場所で同じ色にしたい。 案考えてパワポにまとめて」 k-meansクラスタリング設計・実装、 Before/After地図生成、PowerPoint作成

    2 「XX全域でやりたい」 約15万セルデータの読込、k=XXで全域クラスタリング実行 「HOデータも考慮して」 SnowflakeからHO 約320万レコード取得、 Kernighan-Linグラフカットで境界HO最小化 4 「TAC数XXXは変えないで」 TAC割当ロジック設計: ラウンドロビン均等割当でXXX全使用 5 「eNB単位でTAC統一して」 同一eNB配下セルのTAC統一ロジック追加 6 「(二重)セルは元セルと同じにして」 約1,300セルの(二重)判定・修正ロジック実装 7 「XXは変更なしはTACも変えないで」 変更判定フラグ追加、変更なしeNBのTAC現行維持 3 © NTT DOCOMO, INC. All rights reserved.
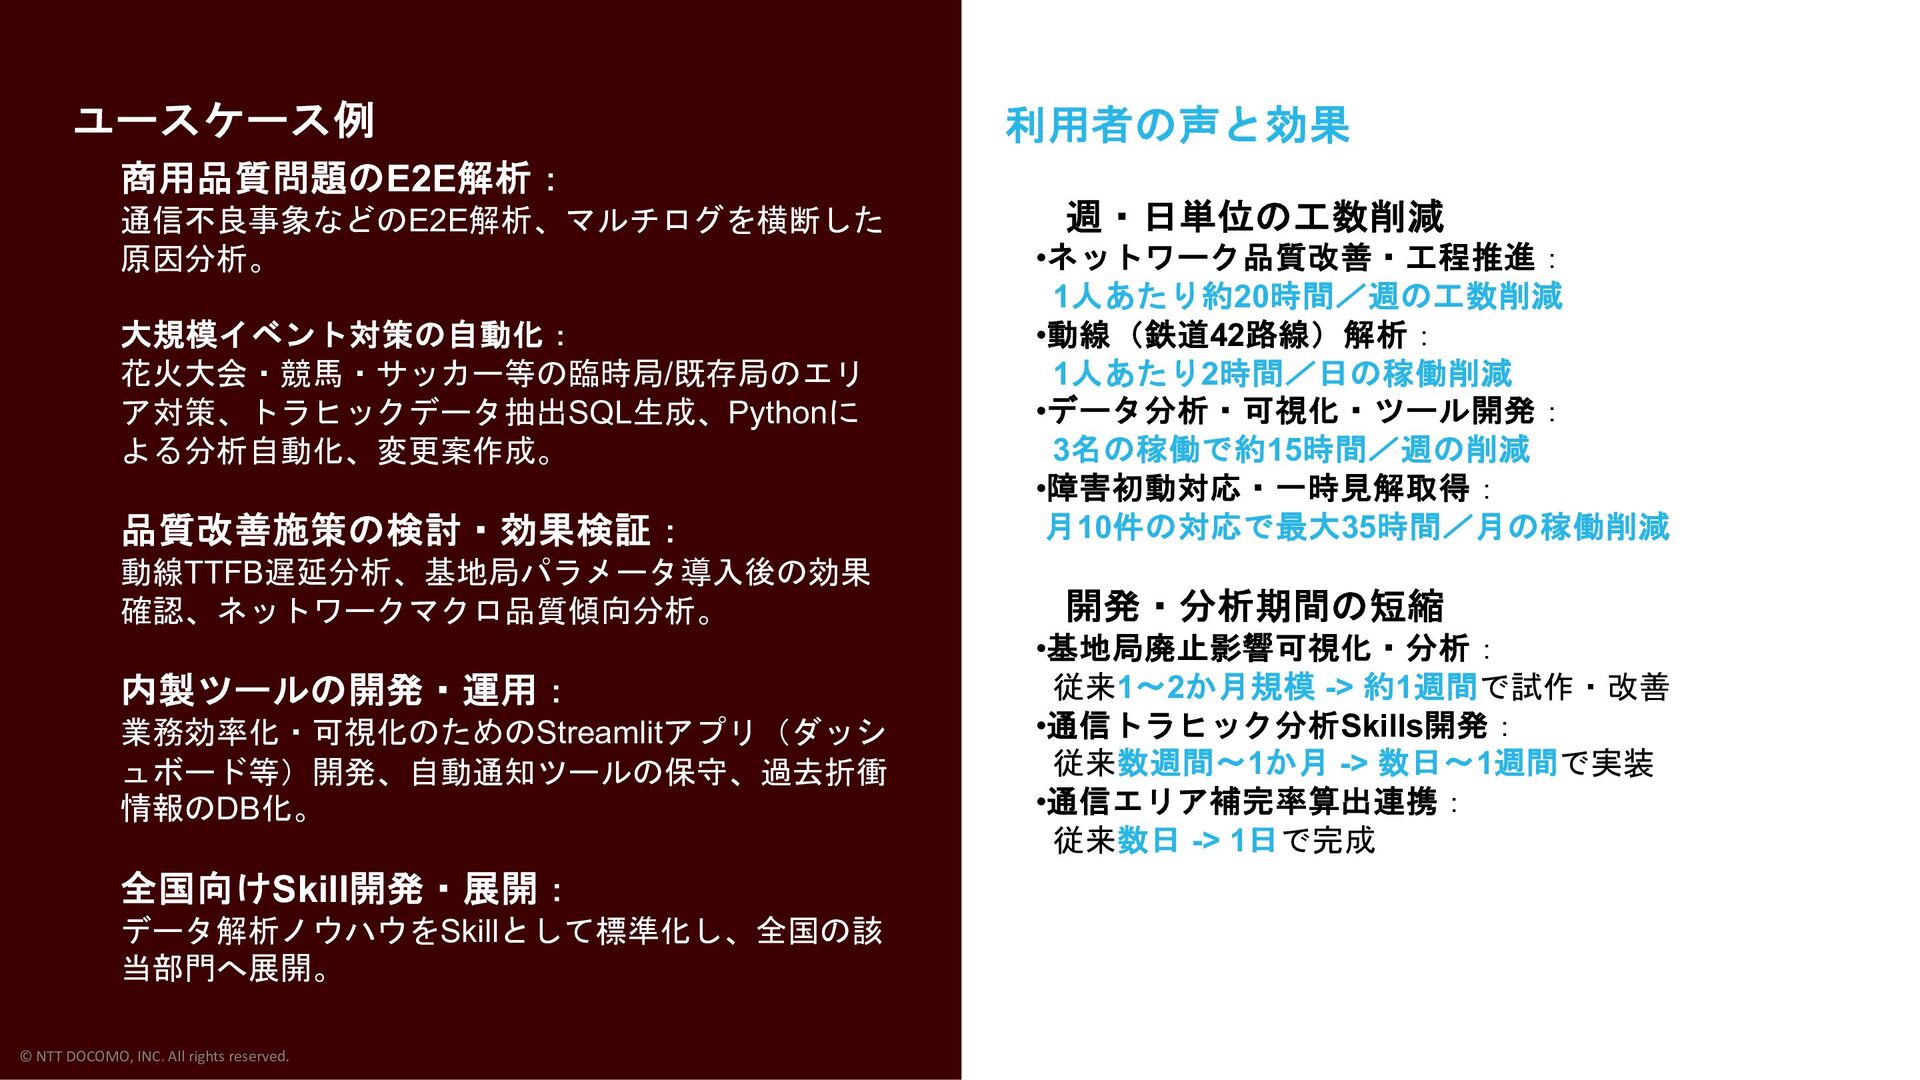
  8. ユースケース例 商用品質問題のE2E解析: 通信不良事象などのE2E解析、マルチログを横断した 原因分析。 大規模イベント対策の自動化: 花火大会・競馬・サッカー等の臨時局/既存局のエリ ア対策、トラヒックデータ抽出SQL生成、Pythonに よる分析自動化、変更案作成。 品質改善施策の検討・効果検証: 動線TTFB遅延分析、基地局パラメータ導入後の効果

    確認、ネットワークマクロ品質傾向分析。 内製ツールの開発・運用: 業務効率化・可視化のためのStreamlitアプリ(ダッシ ュボード等)開発、自動通知ツールの保守、過去折衝 情報のDB化。 全国向けSkill開発・展開: データ解析ノウハウをSkillとして標準化し、全国の該 当部門へ展開。 © NTT DOCOMO, INC. All rights reserved. 利用者の声と効果 週・日単位の工数削減 •ネットワーク品質改善・工程推進: 1人あたり約20時間/週の工数削減 •動線(鉄道42路線)解析: 1人あたり2時間/日の稼働削減 •データ分析・可視化・ツール開発: 3名の稼働で約15時間/週の削減 •障害初動対応・一時見解取得: 月10件の対応で最大35時間/月の稼働削減 開発・分析期間の短縮 •基地局廃止影響可視化・分析: 従来1〜2か月規模 -> 約1週間で試作・改善 •通信トラヒック分析Skills開発: 従来数週間〜1か月 -> 数日〜1週間で実装 •通信エリア補完率算出連携: 従来数日 -> 1日で完成
  9. 3 CoCoを活用した データパイプライン開発 GitOpsと仕様駆動開発 © NTT DOCOMO, INC. All rights

    reserved. [ AIやContainerを用いた データ基盤の運用高度化 データ処理パイプラインの構築・運用には 多くの時間と専門性が求められる. また、ELTで実現するデータ処理は 時として非効率である. ]
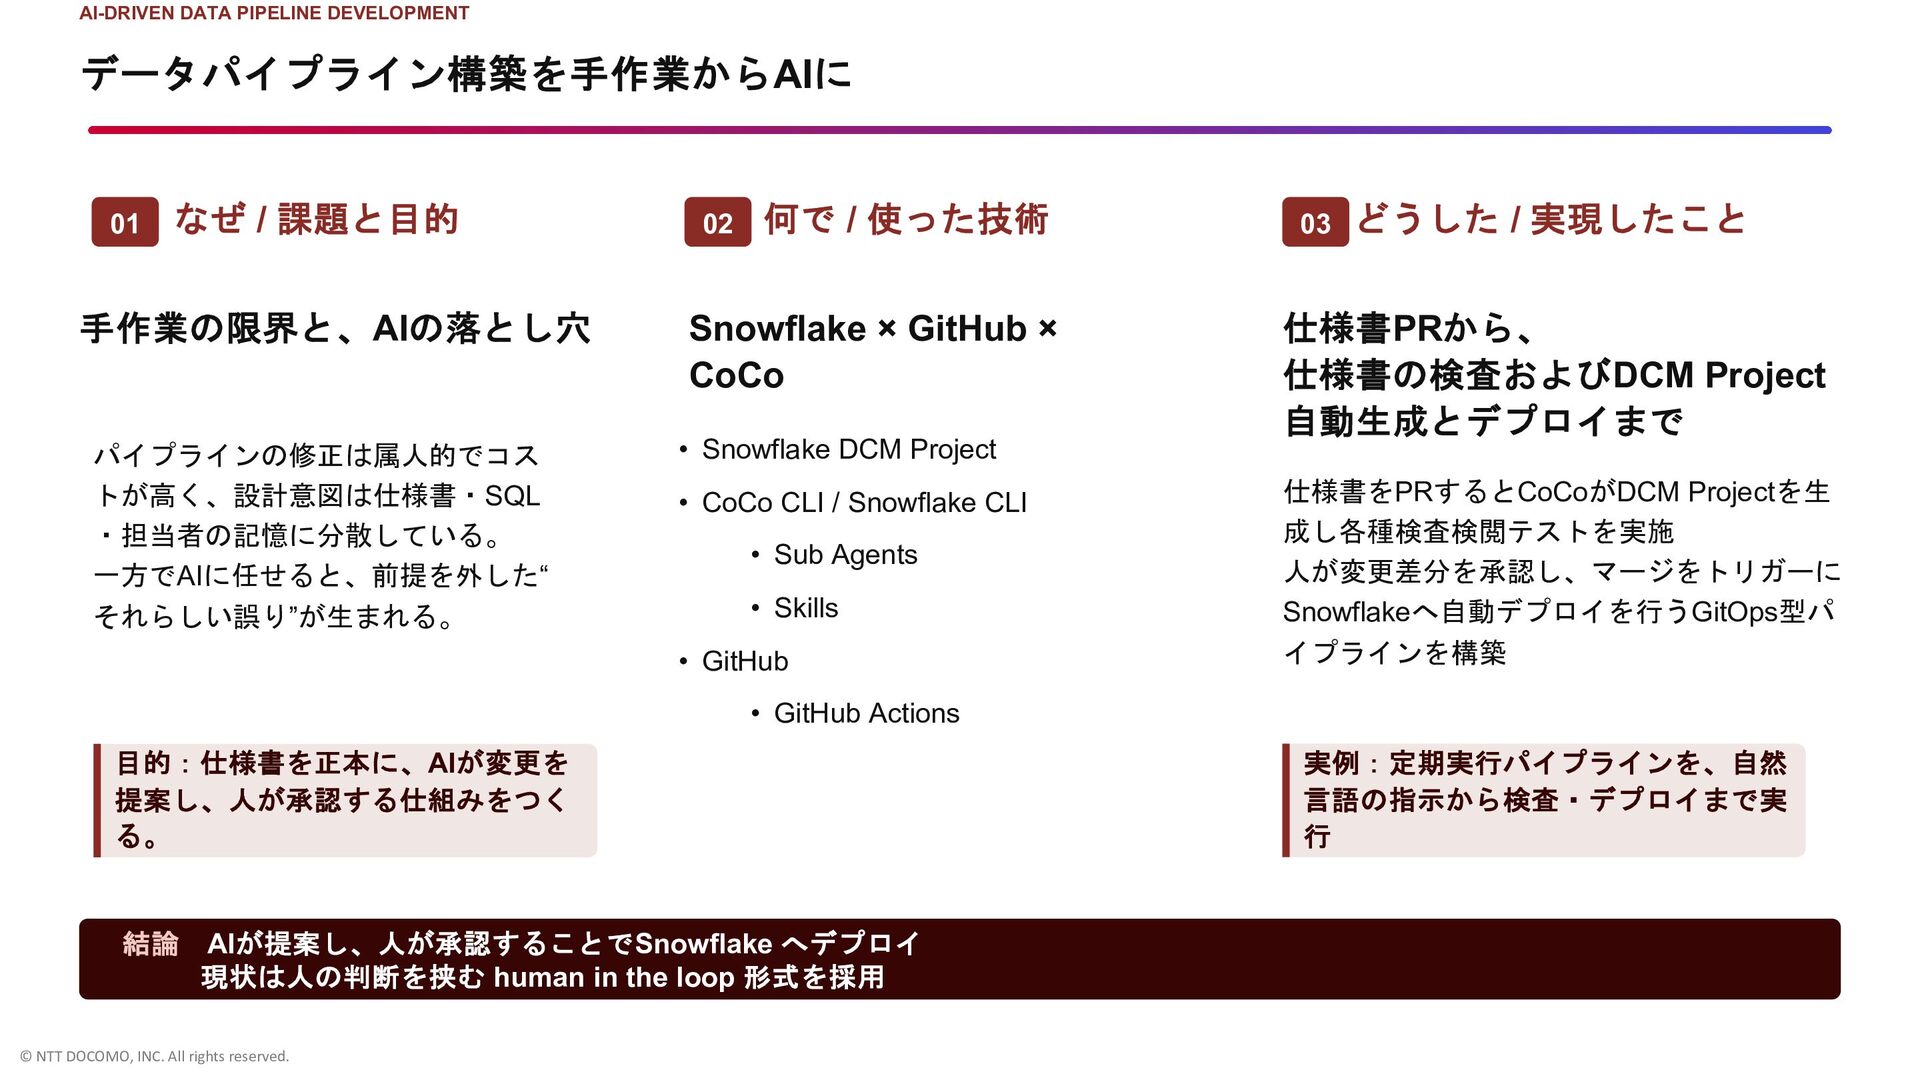
  10. AI-DRIVEN DATA PIPELINE DEVELOPMENT データパイプライン構築を手作業からAIに 01 なぜ / 課題と目的 02

    何で / 使った技術 手作業の限界と、AIの落とし穴 Snowflake × GitHub × CoCo パイプラインの修正は属人的でコス トが高く、設計意図は仕様書・SQL ・担当者の記憶に分散している。 一方でAIに任せると、前提を外した“ それらしい誤り”が生まれる。 • Snowflake DCM Project • CoCo CLI / Snowflake CLI • Sub Agents • Skills • GitHub 03 どうした / 実現したこと 仕様書PRから、 仕様書の検査およびDCM Project 自動生成とデプロイまで 仕様書をPRするとCoCoがDCM Projectを生 成し各種検査検閲テストを実施 人が変更差分を承認し、マージをトリガーに Snowflakeへ自動デプロイを行うGitOps型パ イプラインを構築 • GitHub Actions 目的:仕様書を正本に、AIが変更を 提案し、人が承認する仕組みをつく る。 結論 AIが提案し、人が承認することでSnowflake へデプロイ 現状は人の判断を挟む human in the loop 形式を採用 © NTT DOCOMO, INC. All rights reserved. 実例:定期実行パイプラインを、自然 言語の指示から検査・デプロイまで実 行
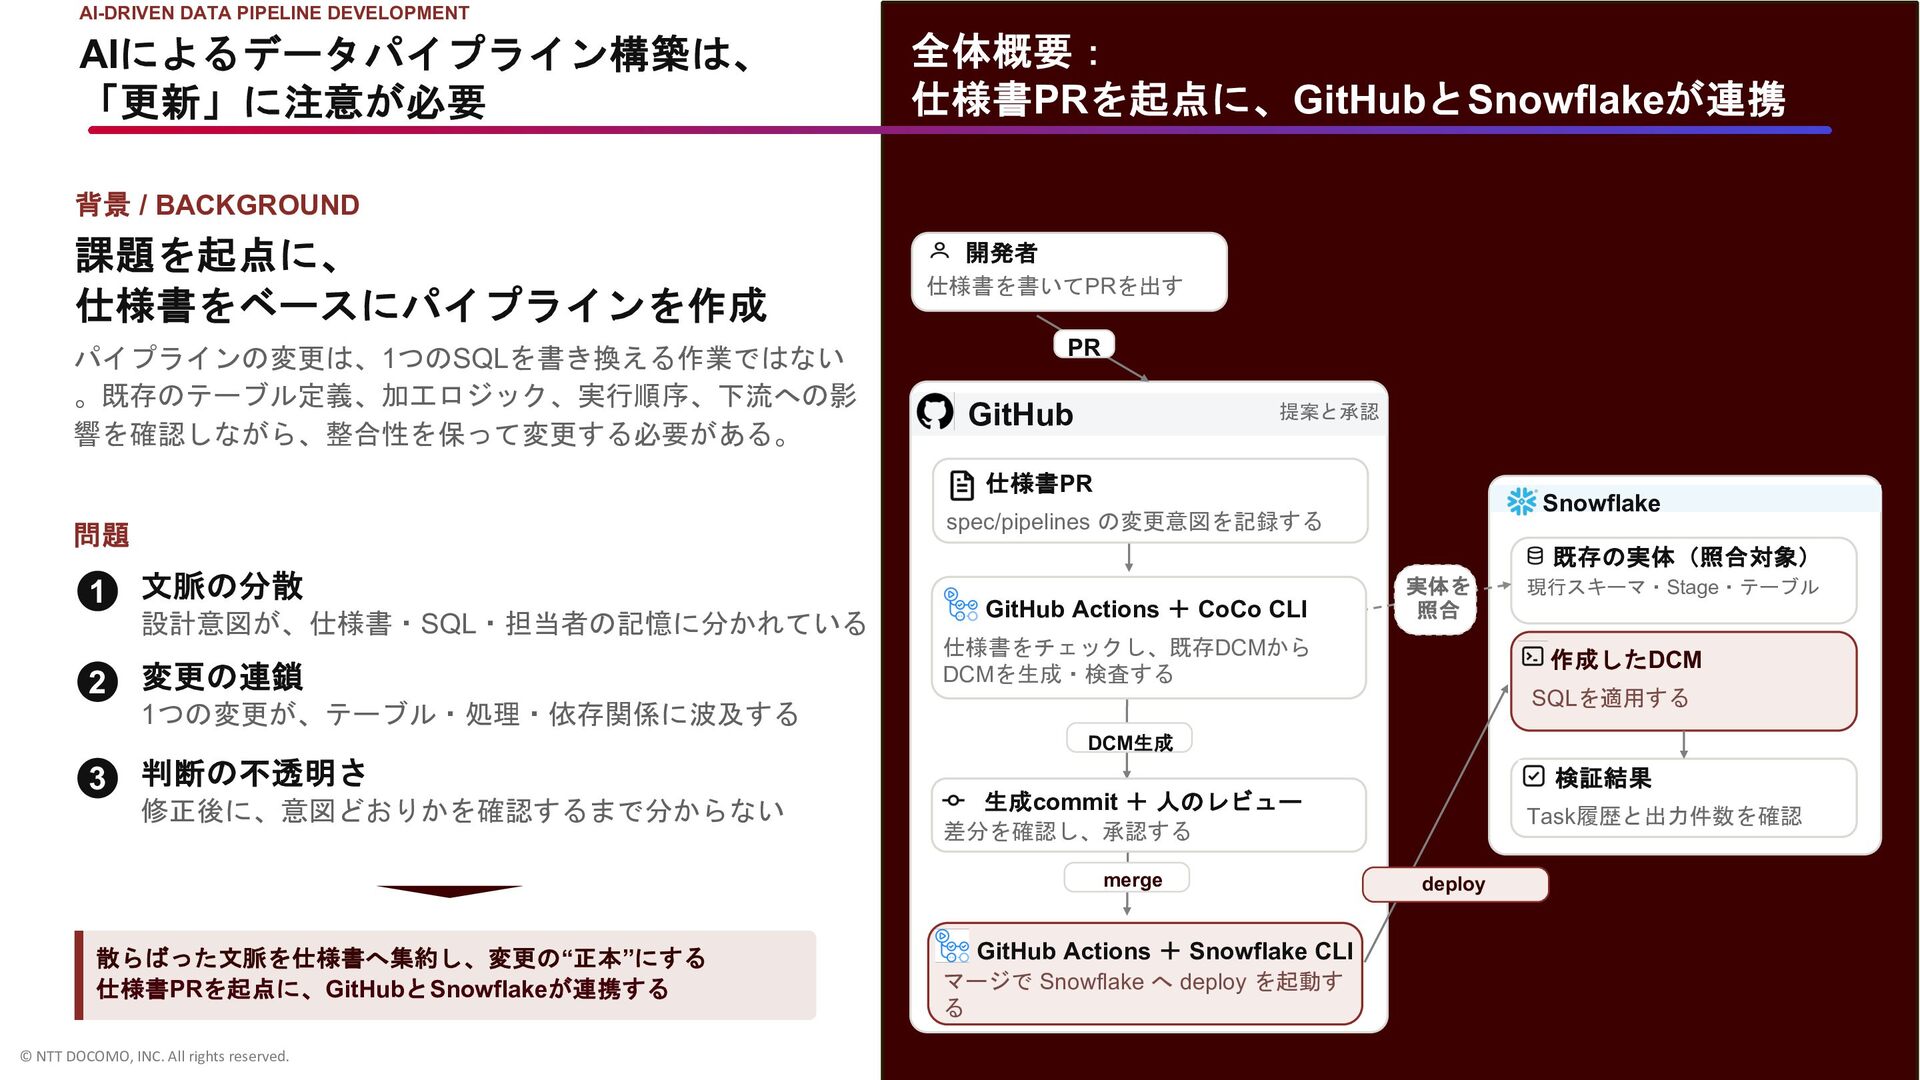
  11. AI-DRIVEN DATA PIPELINE DEVELOPMENT AIによるデータパイプライン構築は、 「更新」に注意が必要 全体概要: 仕様書PRを起点に、GitHubとSnowflakeが連携 背景 /

    BACKGROUND 課題を起点に、 仕様書をベースにパイプラインを作成 パイプラインの変更は、1つのSQLを書き換える作業ではない 。既存のテーブル定義、加工ロジック、実行順序、下流への影 響を確認しながら、整合性を保って変更する必要がある。 開発者 仕様書を書いてPRを出す PR GitHub 提案と承認 仕様書PR spec/pipelines の変更意図を記録する 問題 1 2 Snowflake 既存の実体(照合対象) 文脈の分散 設計意図が、仕様書・SQL・担当者の記憶に分かれている 変更の連鎖 GitHub Actions + CoCo CLI 実体を 照合 仕様書をチェックし、既存DCMから DCMを生成・検査する 現行スキーマ・Stage・テーブル 作成したDCM SQLを適用する 1つの変更が、テーブル・処理・依存関係に波及する DCM生成 3 判断の不透明さ 修正後に、意図どおりかを確認するまで分からない 生成commit + 人のレビュー 差分を確認し、承認する merge 散らばった文脈を仕様書へ集約し、変更の“正本”にする 仕様書PRを起点に、GitHubとSnowflakeが連携する © NTT DOCOMO, INC. All rights reserved. 検証結果 GitHub Actions + Snowflake CLI マージで Snowflake へ deploy を起動す る Task履歴と出力件数を確認 deploy
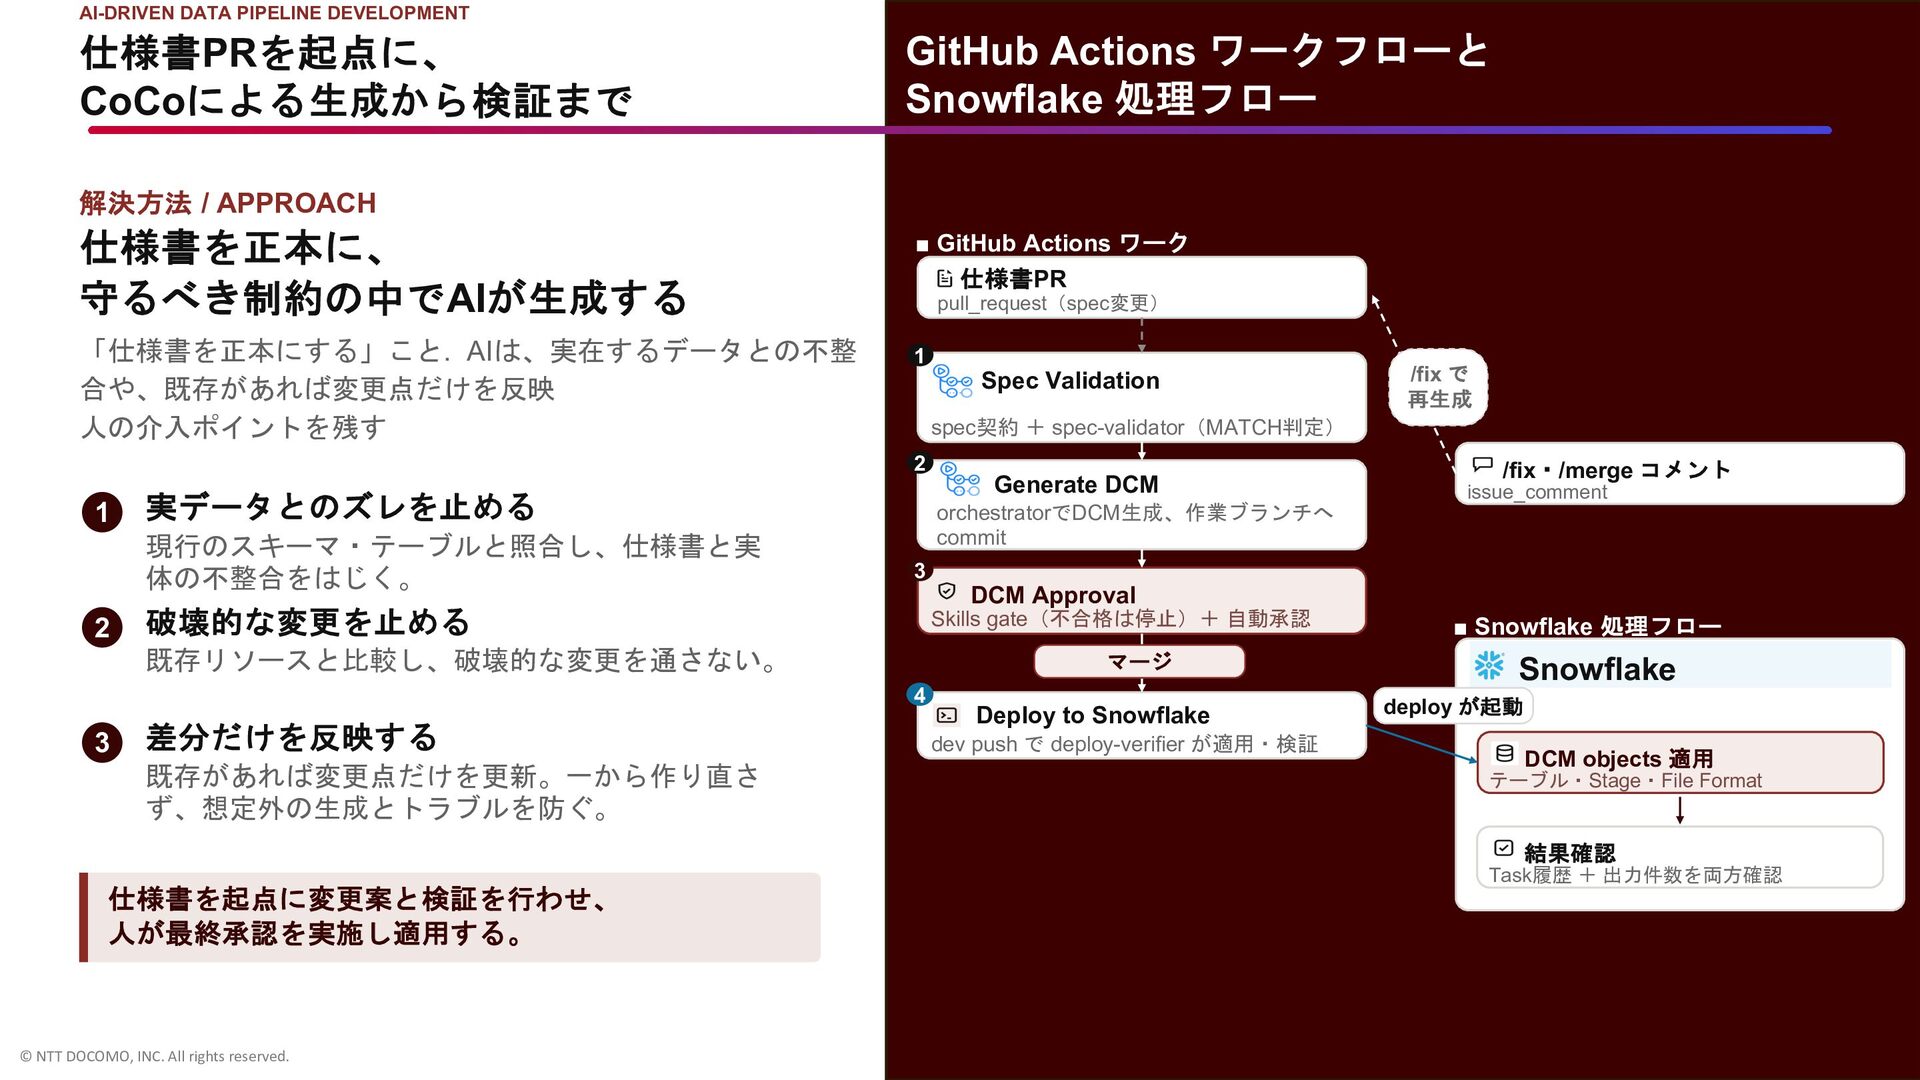
  12. AI-DRIVEN DATA PIPELINE DEVELOPMENT 仕様書PRを起点に、 CoCoによる生成から検証まで GitHub Actions ワークフローと Snowflake

    処理フロー 解決方法 / APPROACH 仕様書を正本に、 守るべき制約の中でAIが生成する ▪ GitHub Actions ワーク フロー 仕様書PR 「仕様書を正本にする」こと. AIは、実在するデータとの不整 合や、既存があれば変更点だけを反映 人の介入ポイントを残す 1 pull_request(spec変更) 実データとのズレを止める 現行のスキーマ・テーブルと照合し、仕様書と実 体の不整合をはじく。 2 3 破壊的な変更を止める 既存があれば変更点だけを更新。一から作り直さ ず、想定外の生成とトラブルを防ぐ。 /fix・/merge コメント issue_comment DCM Approval Skills gate(不合格は停止)+ 自動承認 マージ 4 差分だけを反映する Generate DCM orchestratorでDCM生成、作業ブランチへ commit 既存リソースと比較し、破壊的な変更を通さない。 3 /fix で 再生成 spec契約 + spec-validator(MATCH判定) 2 1 Spec Validation Deploy to Snowflake dev push で deploy-verifier が適用・検証 ▪ Snowflake 処理フロー Snowflake deploy が起動 DCM objects 適用 テーブル・Stage・File Format 結果確認 仕様書を起点に変更案と検証を行わせ、 人が最終承認を実施し適用する。 © NTT DOCOMO, INC. All rights reserved. Task履歴 + 出力件数を両方確認
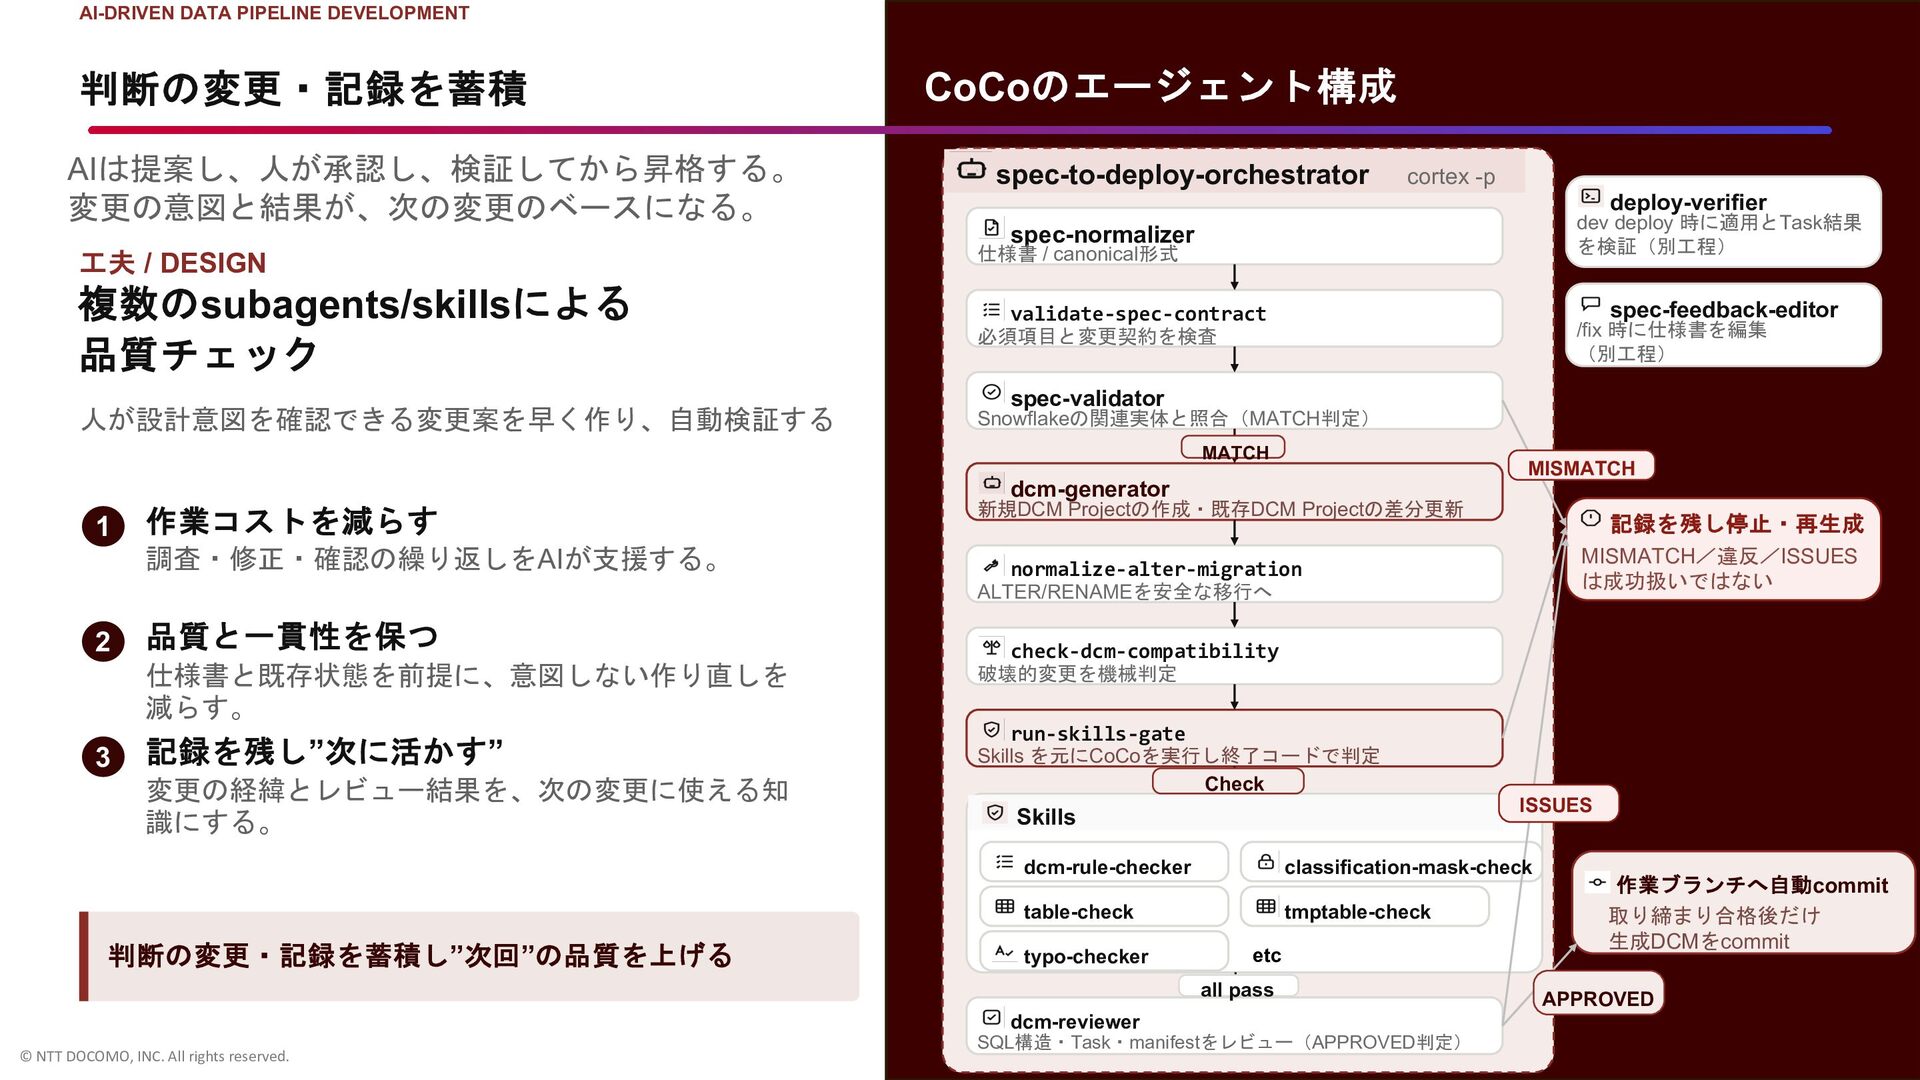
  13. AI-DRIVEN DATA PIPELINE DEVELOPMENT 判断の変更・記録を蓄積 AIは提案し、人が承認し、検証してから昇格する。 変更の意図と結果が、次の変更のベースになる。 工夫 / DESIGN

    CoCoのエージェント構成 spec-to-deploy-orchestrator cortex -p dev deploy 時に適用とTask結果 を検証(別工程) spec-normalizer 仕様書 / canonical形式 複数のsubagents/skillsによる 品質チェック 必須項目と変更契約を検査 人が設計意図を確認できる変更案を早く作り、自動検証する Snowflakeの関連実体と照合(MATCH判定) spec-feedback-editor validate-spec-contract /fix 時に仕様書を編集 (別工程) spec-validator MATCH MISMATCH dcm-generator 1 作業コストを減らす 調査・修正・確認の繰り返しをAIが支援する。 deploy-verifier 新規DCM Projectの作成・既存DCM Projectの差分更新 記録を残し停止・再生成 MISMATCH/違反/ISSUES は成功扱いではない normalize-alter-migration ALTER/RENAMEを安全な移行へ 2 品質と一貫性を保つ 仕様書と既存状態を前提に、意図しない作り直しを 減らす。 3 記録を残し”次に活かす” 変更の経緯とレビュー結果を、次の変更に使える知 識にする。 判断の変更・記録を蓄積し”次回”の品質を上げる check-dcm-compatibility 破壊的変更を機械判定 run-skills-gate Skills を元にCoCoを実行し終了コードで判定 Check Skills dcm-rule-checker classification-mask-check table-check tmptable-check typo-checker etc all pass dcm-reviewer © NTT DOCOMO, INC. All rights reserved. ISSUES SQL構造・Task・manifestをレビュー(APPROVED判定) 作業ブランチへ自動commit 取り締まり合格後だけ 生成DCMをcommit APPROVED
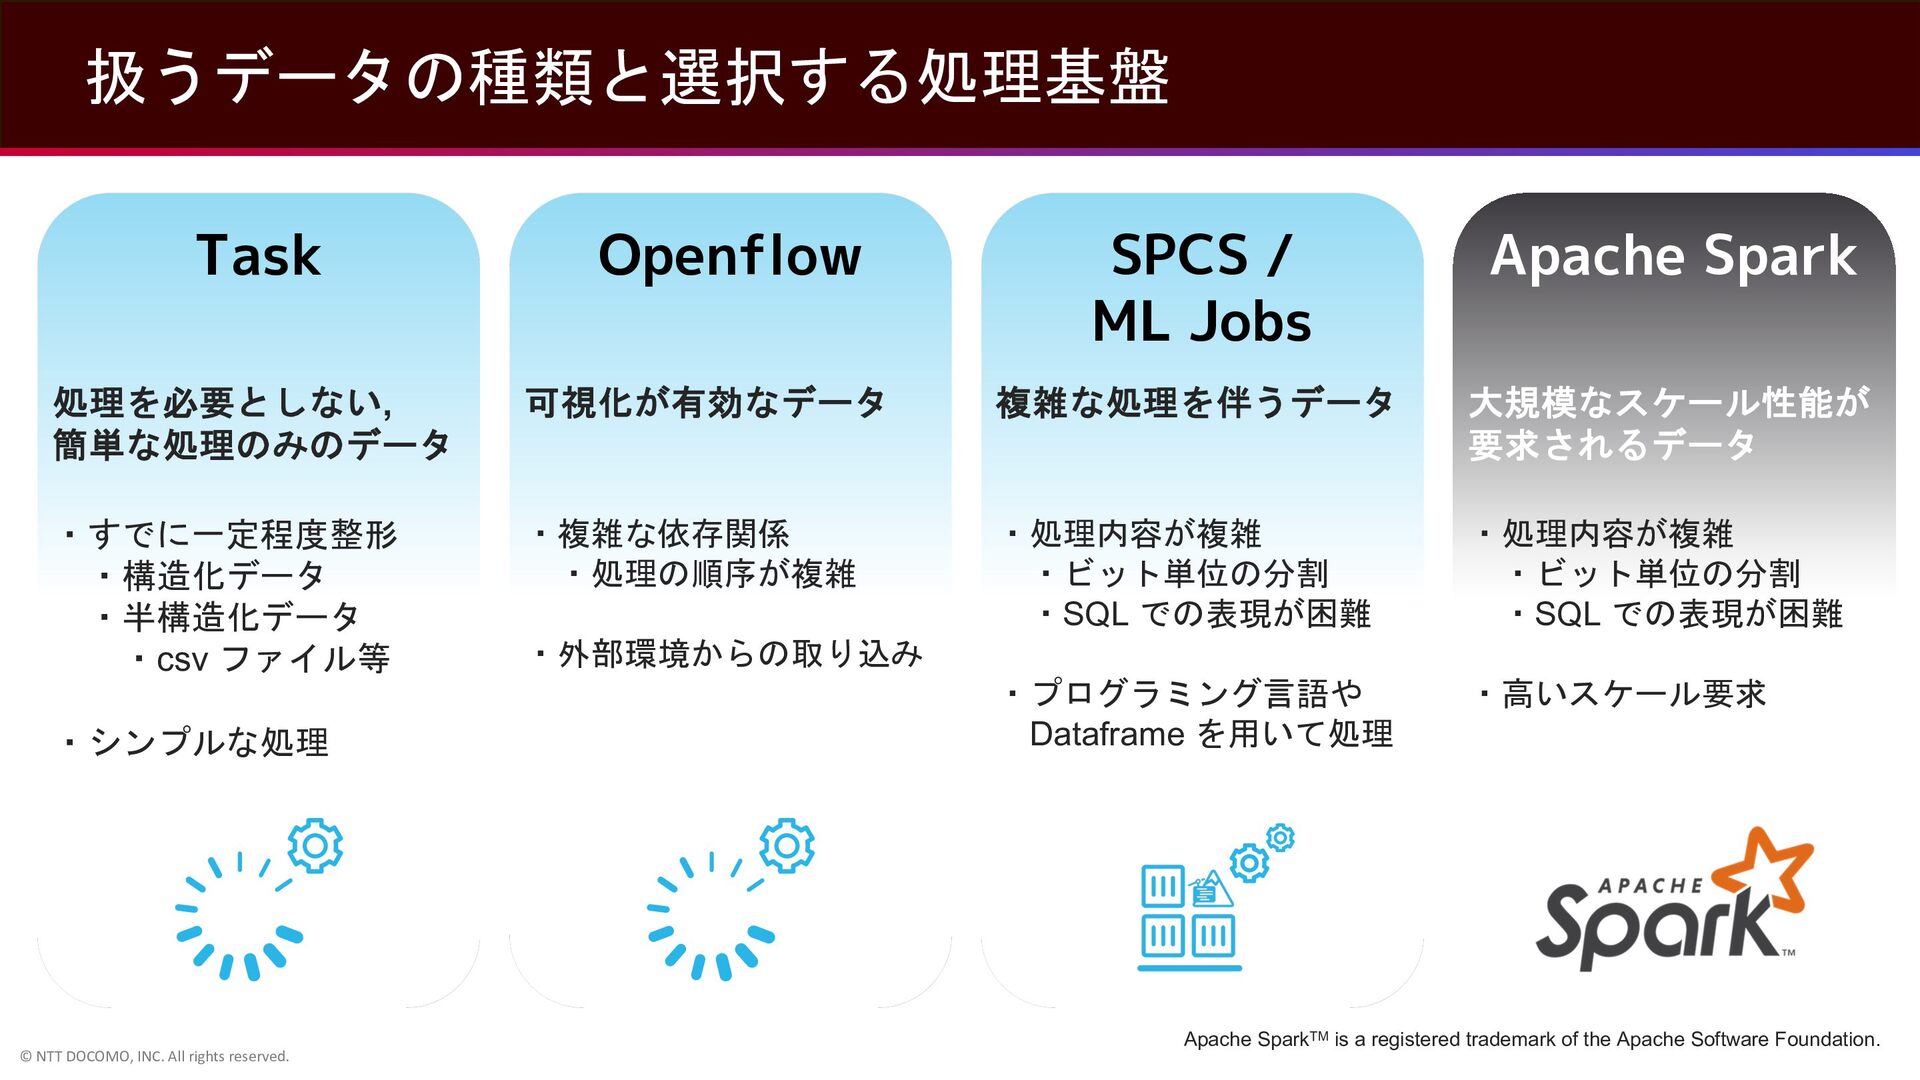
  14. 扱うデータの種類と選択する処理基盤 Task Openflow SPCS / ML Jobs Apache Spark 処理を必要としない,

    簡単な処理のみのデータ 可視化が有効なデータ 複雑な処理を伴うデータ 大規模なスケール性能が 要求されるデータ ・すでに一定程度整形 ・構造化データ ・半構造化データ ・csv ファイル等 ・複雑な依存関係 ・処理の順序が複雑 ・処理内容が複雑 ・ビット単位の分割 ・SQL での表現が困難 ・処理内容が複雑 ・ビット単位の分割 ・SQL での表現が困難 ・プログラミング言語や Dataframe を用いて処理 ・高いスケール要求 ・シンプルな処理 © NTT DOCOMO, INC. All rights reserved. ・外部環境からの取り込み Apache SparkTM is a registered trademark of the Apache Software Foundation.
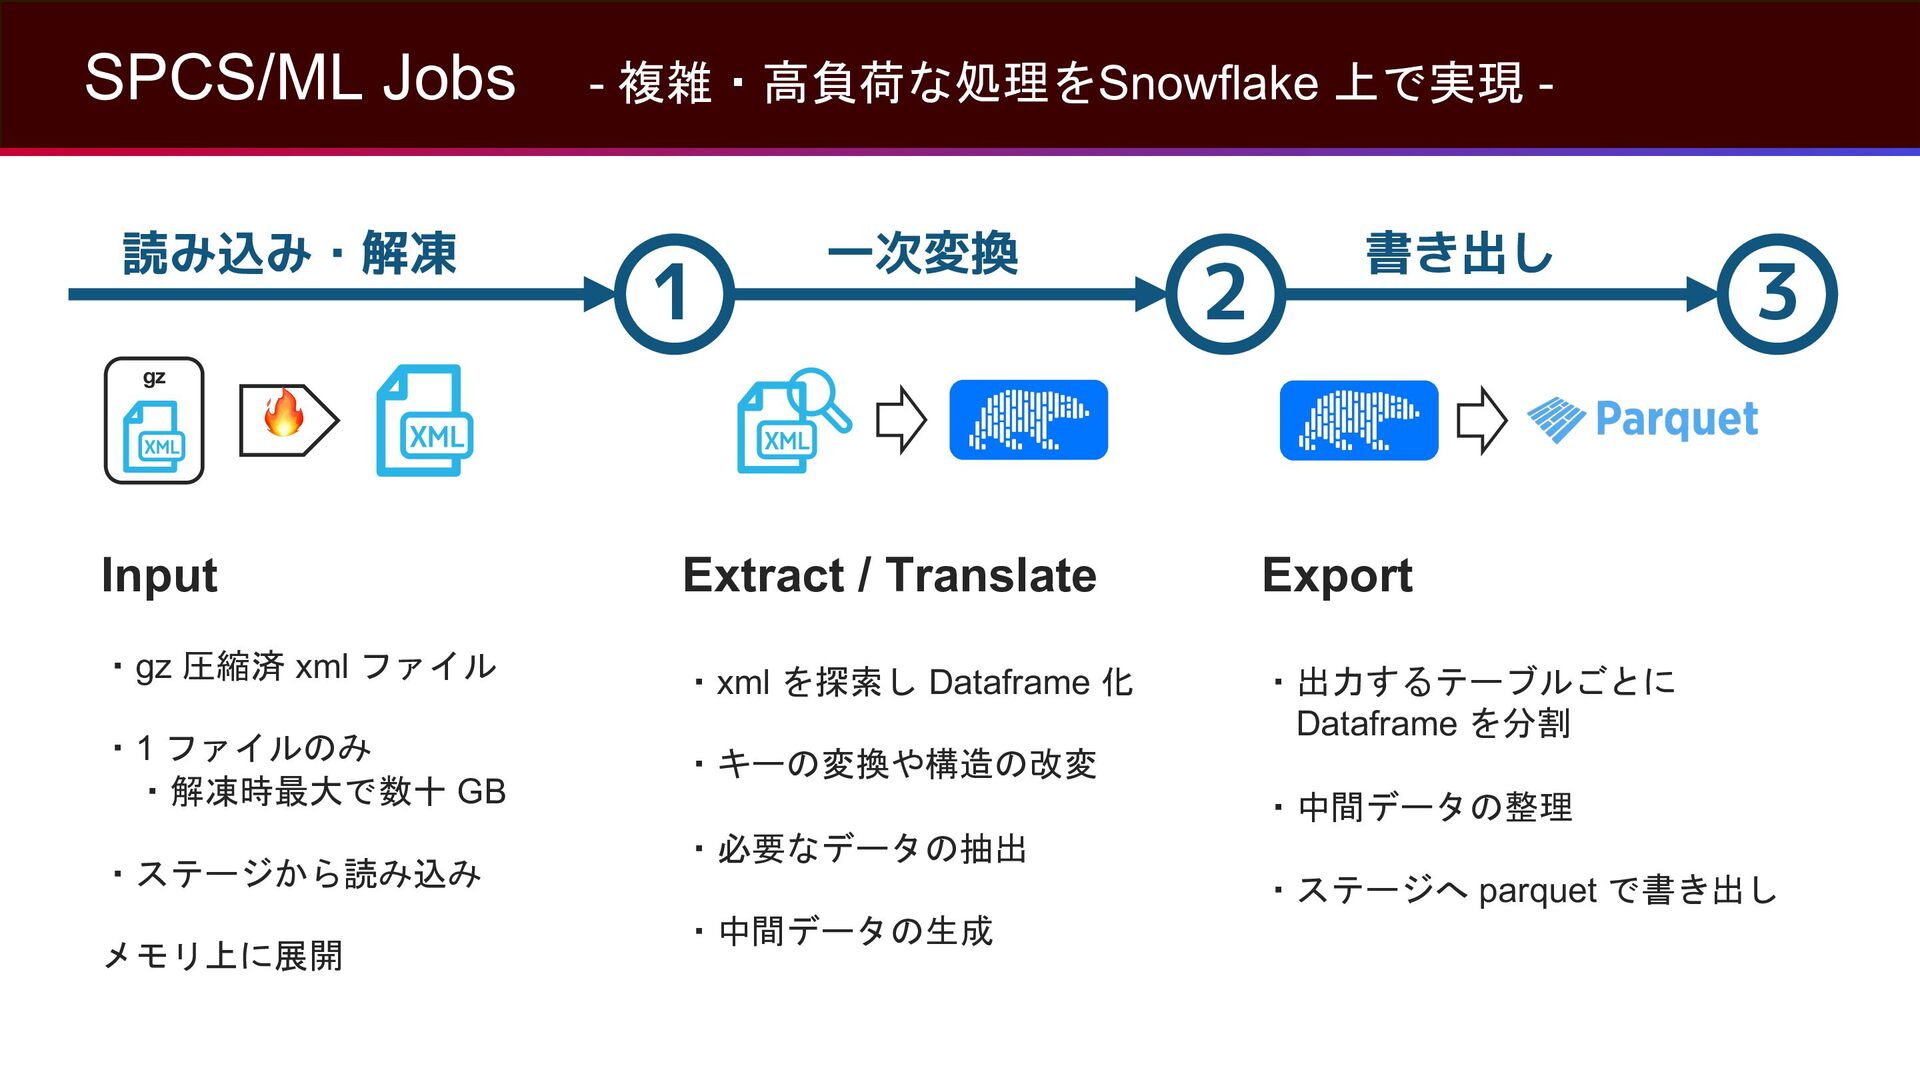
  15. SPCS/ML Jobs 読み込み・解凍 - 複雑・高負荷な処理をSnowflake 上で実現 - 1 一次変換 2

    書き出し 3 gz 🔥 Input Extract / Translate Export ・gz 圧縮済 xml ファイル ・xml を探索し Dataframe 化 ・1 ファイルのみ ・解凍時最大で数十 GB ・出力するテーブルごとに Dataframe を分割 ・キーの変換や構造の改変 ・ステージから読み込み メモリ上に展開 ・中間データの整理 ・必要なデータの抽出 ・ステージへ parquet で書き出し ・中間データの生成
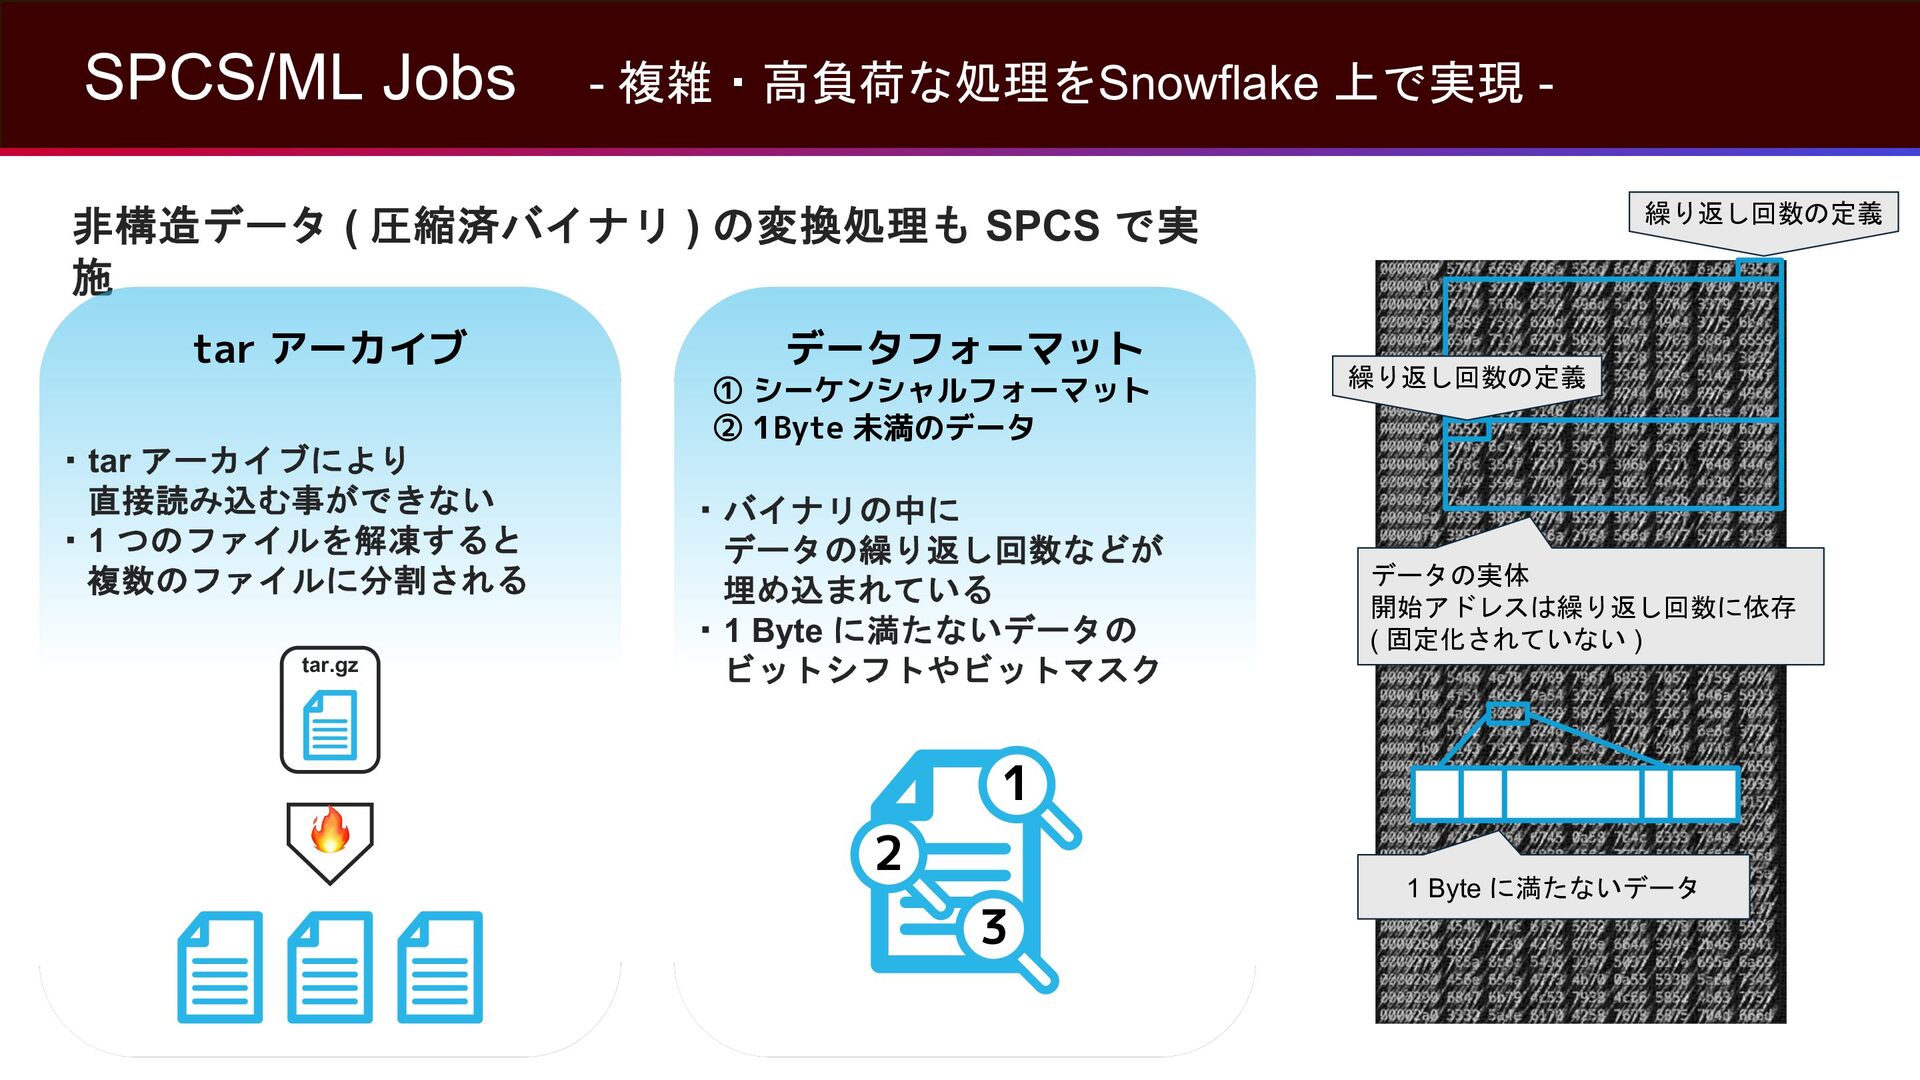
  16. SPCS/ML Jobs - 複雑・高負荷な処理をSnowflake 上で実現 繰り返し回数の定義 非構造データ ( 圧縮済バイナリ )

    の変換処理も SPCS で実 施 tar アーカイブ ・tar アーカイブにより 直接読み込む事ができない ・1 つのファイルを解凍すると 複数のファイルに分割される tar.gz 🔥 データフォーマット ① シーケンシャルフォーマット ② 1Byte 未満のデータ ・バイナリの中に データの繰り返し回数などが 埋め込まれている ・1 Byte に満たないデータの ビットシフトやビットマスク 繰り返し回数の定義 データの実体 開始アドレスは繰り返し回数に依存 ( 固定化されていない ) 1 2 3 1 Byte に満たないデータ
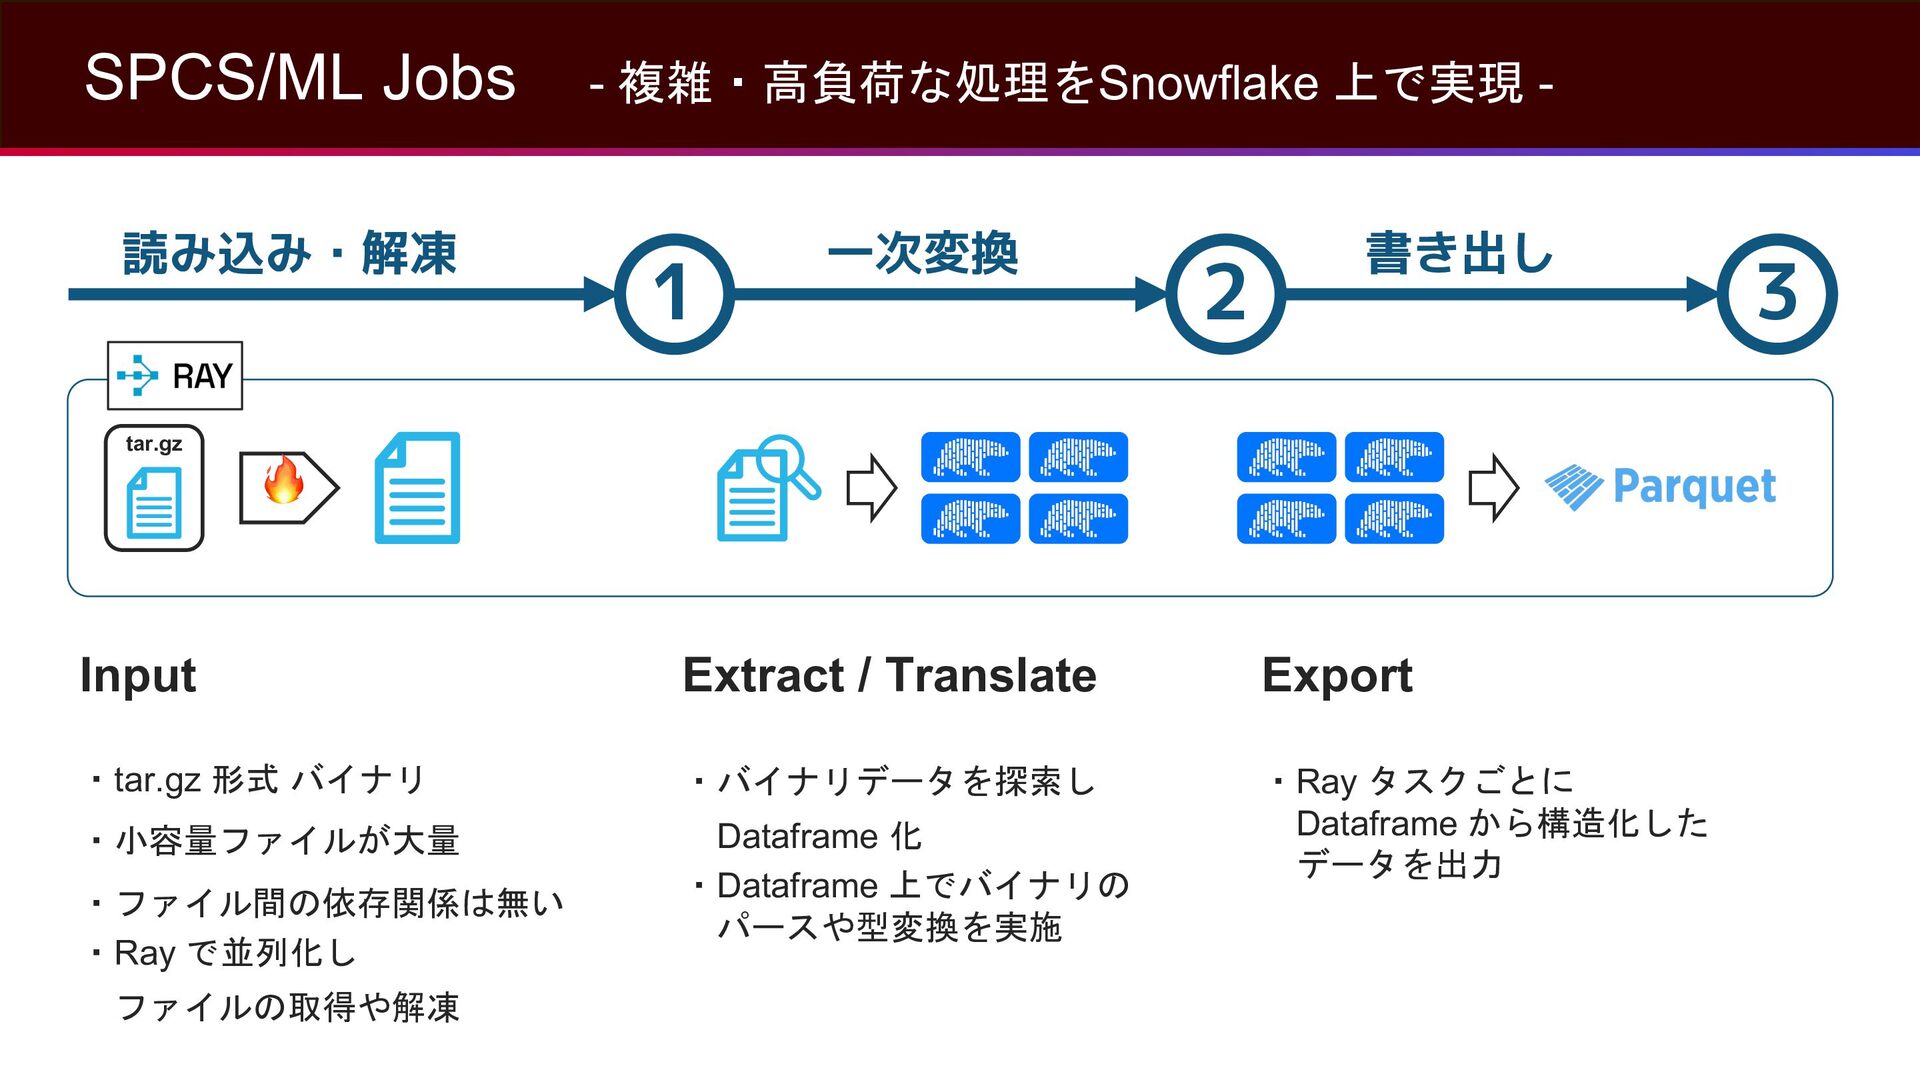
  17. SPCS/ML Jobs 読み込み・解凍 - 複雑・高負荷な処理をSnowflake 上で実現 - 1 一次変換 2

    書き出し tar.gz 🔥 Input Extract / Translate Export ・tar.gz 形式 バイナリ ・バイナリデータを探索し ・小容量ファイルが大量 Dataframe 化 ・Dataframe 上でバイナリの パースや型変換を実施 ・Ray タスクごとに Dataframe から構造化した データを出力 ・ファイル間の依存関係は無い ・Ray で並列化し ファイルの取得や解凍 3
  18. 5 Cortex AIを活用した 非構造データ管理と 業務適用 図面・マニュアル・パラメータ情報 の 統合的な検索と管理 © NTT

    DOCOMO, INC. All rights reserved. [ AIを用いた 非構造データの業務活用 蓄積された図面・設計図等は 故障対応等に頻繁に利用されるものである. 一方、膨大に存在するこれらの情報から 復旧対象に関連するデータを網羅的に探し出すには 非常に多くの稼働がかかっている. ]
  19. REV 12.16.25 セーフハーバーおよび免責事項 歴史的事実に関する記述を除き、これらの資料および付随する口頭解説(以下、総称し て「資料」といいます)に含まれるすべての記述は、改正1933年証券法第27A条および 改正1934年証券取引法第21E条の意味における将来の見通しに関する記述であり、(i )Snowflakeのビジネス戦略、計画、機会または優先事項、(ii)Snowflakeの新しい または強化された製品、サービス、および技術提供物(開発中のもの、一般向けに提供 されていないものを含む)、(iii)市場の規模および成長、トレンド、および競争上の 考慮事項、(iv)人工知能(以下「AI」といいます)、Snowpark、Snowflakeマーケッ

    トプレイス、AIデータクラウド、および特定の産業および製品カテゴリーのためのAIデ ータクラウドに関連するSnowflakeのビジョン、戦略および予想される利点(AIデータ クラウドの予想される利点とネットワーク効果を含む)、および(v)サードパーティの プラットフォームまたは製品との、またはサードパーティのプラットフォームまたは製 品上でのSnowflakeの製品、サービス、または技術提供物の統合、相互運用性、および 可用性(パブリッククラウドプラットフォームを含む)に関する記述を含みます。これ らの将来の見通しに関する記述は、Snowflakeが証券取引委員会に提出するフォーム 10-Kの年次報告書およびフォーム10-Qの四半期報告書の「リスク要因」の見出しの下 およびその他の箇所に適宜記載されているものを含む多くの既知または未知のリスク、 不確実性および仮定事項による影響を受けます。これらのリスク、不確実性、および仮 定事項が存在することから、資料において概説されている将来のイベントや傾向は発生 しない場合があり、実際の結果は将来の見通しに関する記述において表現または示唆さ れたものと大幅にかつ不利に異なる場合があります。よって、将来の見通しに関する記 述を将来の出来事の予測として信頼することはお控えください。将来の見通しに関する 記述は、当該記述が最初に行われた日時点の見解のみを述べたものであり、当該記述が 行われた時点でSnowflakeが入手可能な情報、または当該時点における経営陣の誠実な 信念に基づくものです。法律で義務付けられている場合を除き、当社にはこれらの資料 内の将来の見通しに関する記述を更新する義務はなく、また更新する意図もありません 。 将来の製品またはロードマップの情報(以下、総称して「ロードマップ」といい ます) は、製品の一般的な方向性を示すことを目的としています。ロードマッ プは、Snowflake が将来の製品、機能、または機能性を提供することに対する コミットメント、約束、および法的義務を生じさせるものではなく、いかなる契 約にも組み込まれることを意図しておらず、契約に組み込まれるものとみなされ てはなりません。最終的にご利用が可能となる製品、機能、または機能性の実際 のタイミングは、ロードマップに示されているものとは異なる場合があります。 ご購入を決定される際にロードマップ情報を使用することはご遠慮ください。資 料に含まれる情報と Snowflake の公式文書との間に矛盾が見られる場合は、 Snowflake の公式文書がこれらの資料に優先するものとします。また、 Snowflake は、最終的にご利用が可能になる可能性のある将来の製品、機能ま たは機能性に関する別途料金のご請求の有無については決定していませんのでご 了承ください。Snowflake は独自の裁量により、最終的にご利用が可能となる 将来の製品、機能、または機能性の提供に関し、別途料金をご請求する場合があ ります。 資料には、第三者によって提供された情報が含まれる場合があります。 Snowflake はこの情報について独自の検証を行っておらず、この情報の使用は 、Snowflake がこの情報を独自のものとして採用したこと、またはその正確性 を独自に検証したことを意味するものではありません。 非公開 © 2026 Snowflake Inc. All rights reserved. Snowflake、Snowflakeのロゴ、および資料に記載されているその他のSnowflakeの製品、機能およびサービス名は、米国および その他の国におけるSnowflake © 2026 Snowflake Inc. All RightsInc.の登録商標または商標です。資料に記載または使用されているその他のブランド名またはロゴは、識別のみを目的としたものであり、各権利 Reserved 者の商標である場合があります。Snowflakeは、そのような各権利者と提携関係にあるとは限らず、また、スポンサーシップや推奨を受けているとは限りません。 23
  20. 非構造化ドキュメントを自然言語で横断検索・分析 Excel・PDF・設計図面を横断し、根拠となる原本を示して回答 対象ドキュメント ユーザーからの質問 & 探索要求 回答結果 & 提示される原本の根拠 質問例

    「G-DBSV-Fラックは何階 にある?」 多様な非構造化データ • Excel設定表 • ラック実装図 • フロア配置図 • PDF手順書 原本画像データ 設計図面のビジュアル情 報(画像データ含む) © 2026 Snowflake Inc. All Rights Reserved 信頼性の高い回答結果 Agentが 探索 非公開 Cortex Agentによる自動処理ステ ップ 複数ファイルからの探す・読む・照合す る煩雑な作業を100%自動化 「3階のAエリアにあります 」 回答生成 提示される原本・回答根拠 該当フロア:3F西側エリア • 関連設備:G-DBSV-Fラッ ク 等 • 25
  21. 非構造化ドキュメントを自然言語で横断検索・分析 非構造化データの取り込み/活用時の課題について 01 データ構造の課題 02 データファイルの課題 03 情報分散の課題 神Excel(Excel方眼紙) 埋め込み画像データ

    複数ファイル間の検索 設計書や重要な設定値が、人間 が読むためだけに整形された「 Excel方眼紙」に記載されている ケースが多く含まれた。 PDFやExcelシートの内部に、フ ロア配置図、アンテナ図面など の重要なビジュアル情報が「画 像」として含まれていた。 必要な情報が単一ではなく複数 のファイルに跨って記録されて いる。 非公開 (従来のテキストベースの AI_PARSE_DOCUMENTの OCR/LAYOUTモードによる処理 だけでは、画像内の設備関係性 や物理配置などを抽出・理解す ることが困難だった。) © 2026 Snowflake Inc. All Rights Reserved 複数ファイルの情報検索、要約 作業が必要だった。 26
  22. RAG & AI分析 詳細パイプライン処理フロー 重要ポイント 非構造化ファイルからメタデータ・ドキュメントを自動解析 1. Ingestion (取り込み) 2.

    Extraction (AI抽出・変換) 3. Indexing (検索データ生成) ① 非構造化ファイル投入 ④ AI_COMPLETE / AI_PARSE_DOCUMENT ⑦ CHUNK_DOCUMENTS ② @DOCUMENT_STORE Snowflake内部ステージ (Stage)へ保存 • Office系: AI_COMPLETE(マル チモーダル)で全シート・図表を Markdown化 • PDF/PPTX系: AI_PARSE_DOCUMENTで構造化抽 出 検索精度を引き出すチャンク化 • 適切な文字数やセクションによ る粒度分割 • 各チャンクへカテゴリ/拠点/原 本情報を付加 ⑤ AI Vision分析 & 分類 ⑧ Cortex Search Services ③DOCUMENT_REGISTRY • 版管理/メタデータ登録 ファイル情報、パス、新規/更新/ 削除、現行バージョン、拠点、カ テゴリ、フロア等の情報を一元管 理 非公開 • 図面判定、機器配置のテキスト 文脈化 ⑥ AIによるメタデータ付与 • カテゴリ、拠点、要約等の属性 情報を各ドキュメントに自動付加 © 2026 Snowflake Inc. All Rights Reserved • Cortex Search チャンク単位でのベクトル/キー ワード検索、属性フィルタリン グに対応 • Cortex Search(Analytical Search) 文書全体を対象に、横断検索を 実行 4. Analysis (質問・分析) ⑨ Cortex Agents • Cortex Search 自然文による内容検索、 ピンポイント・精密なQA 応答を提供 27
  23. RAG & AI分析 詳細パイプライン処理フロー 工夫ポイント 精度を低下させる課題 検索・分析品質を高める実装上の工夫 1.マルチモーダル解析:情報抽出の網羅性を向上 <神Excel|データ構造> 方眼紙・セル結合で表の行列対応が崩れる

    設定値が断片化し「どの設備の値か」が失 われる <埋め込み画像|データファイル > テキスト抽出のみでは図面が本文に現れな い 設備の物理配置・接続関係が読み取れない <情報分散|複数ファイル> 単発の類似検索では必要な情報を拾い切れ ない © 2026 Snowflake Inc. All Rights Reserved 品質 向上 ・文書形式に応じてAI_COMPLETE(マルチモーダル)と AI_PARSE_DOCUMENTを使い分け ・適切なチャンク、Markdown化やHTML化(表の場合)してAIが理解しや すくする 非公開 1.メタデータ付与:AIに業務文脈を提供 ・Excel全シートや文書内の図面を原本から直接解析してパースする ・画像データのDescriptionをメタデータとして格納 ・拠点・カテゴリ・設備・フロア・検索キーワードを付与 1.検索方式の最適化 ・キーワード検索とベクトル検索を組み合わせ ・RAG検索・Analytical Searchを目的に応じて使い分け 28
  24. CoCoを活用した高速開発 本取り組みの進め方 1. 開発期間の短縮 2. フィードバック反映の高速化 3. 自然言語でチューニングを反復 ▪ 数日の工数で大部分を高速実装

    ▪ 実データ・実質問による即時評価 ▪ PoCアカウント上での共同開発 要件定義からプロトタイプ構築ま での開発日数を圧縮。アイデアの 具現化プロセスを大幅に効率化。 非構造化ファイルも含めて本番相当の データを使用。検索漏れや回答精度、 抽出揺らぎ等の問題点を早期に検出し 、細かいチューニングを実施。 AIの精度改善はメタデータの整備 、パラメータ調整、チャンク分割 の見直しといった試行錯誤の回数 が必要で、CoCoでは各種修正を自 然言語の指示で実施できるため、 限られた期間でも試行回数を確保 できた。 非公開 エージェントやパイプラインの変更時 は Cortex Agents Evaluation で評価 し、改善を定量で確認。 従来のプロフェッショナルサービスのアドバイザリーサービスに留まらない顧客が実現したいことをCoCoと一緒に 実現! © 2026 Snowflake Inc. All Rights Reserved 29
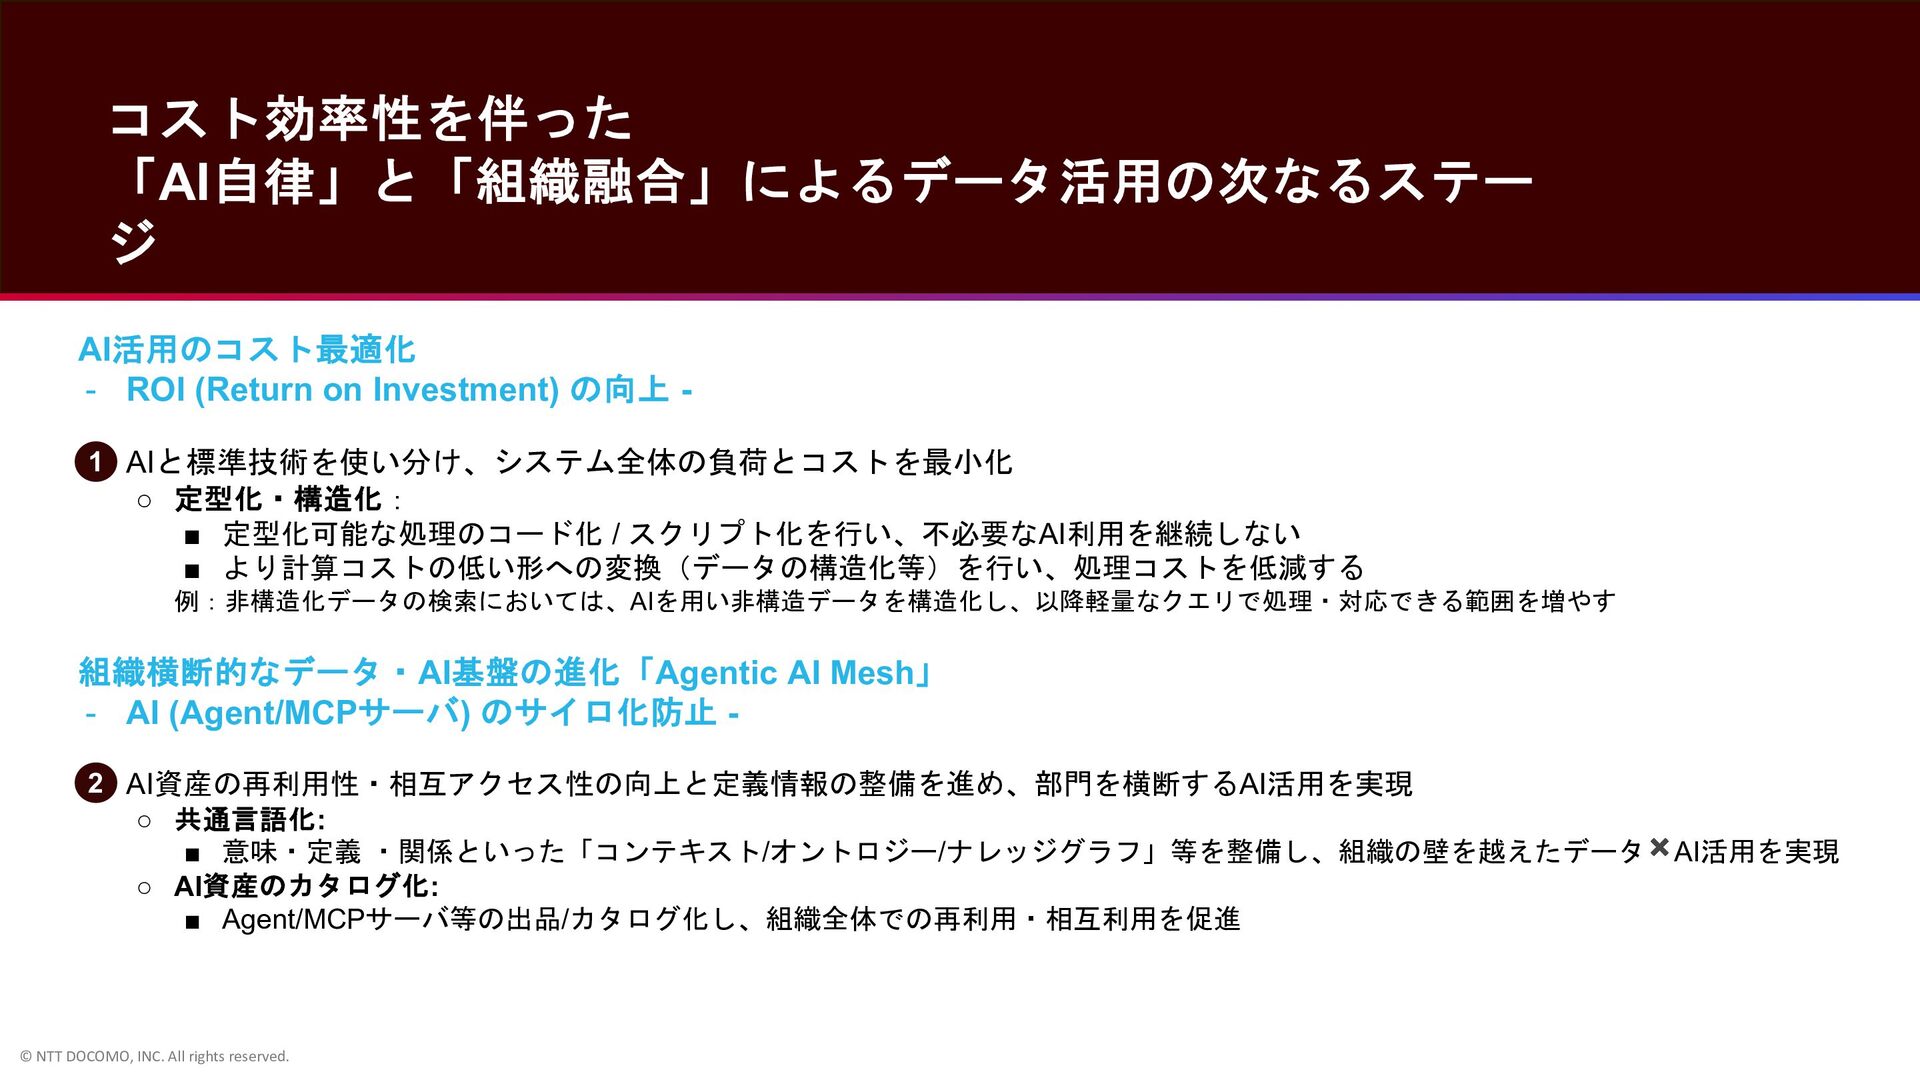
  25. コスト効率性を伴った 「AI自律」と「組織融合」によるデータ活用の次なるステー ジ AI活用のコスト最適化 - ROI (Return on Investment) の向上

    1 AIと標準技術を使い分け、システム全体の負荷とコストを最小化 • ◦ 定型化・構造化: ▪ 定型化可能な処理のコード化 / スクリプト化を行い、不必要なAI利用を継続しない ▪ より計算コストの低い形への変換(データの構造化等)を行い、処理コストを低減する 例:非構造化データの検索においては、AIを用い非構造データを構造化し、以降軽量なクエリで処理・対応できる範囲を増やす 組織横断的なデータ・AI基盤の進化「Agentic AI Mesh」 - AI (Agent/MCPサーバ) のサイロ化防止 2 AI資産の再利用性・相互アクセス性の向上と定義情報の整備を進め、部門を横断するAI活用を実現 • ◦ 共通言語化: ▪ 意味・定義 ・関係といった「コンテキスト/オントロジー/ナレッジグラフ」等を整備し、組織の壁を越えたデータ✖AI活用を実現 ◦ AI資産のカタログ化: ▪ Agent/MCPサーバ等の出品/カタログ化し、組織全体での再利用・相互利用を促進 © NTT DOCOMO, INC. All rights reserved.