Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
はじめての文字認識_改
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
yasu
June 18, 2019
Technology
520
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
はじめての文字認識_改
scikit-learnを使って手書き文字認識をやってみました。
yasu
June 18, 2019
More Decks by yasu
See All by yasu
Docker 危険のキ!/Docker the beginning of danger
yasu8899
1
270
Dockerとは
yasu8899
1
910
ML基本のキの一筆目
yasu8899
0
92
rancheros-in-raspberrypi
yasu8899
2
490
5分で説明する RancherOS+Rancher2インストール / rancherosinstall
yasu8899
0
730
Other Decks in Technology
See All in Technology
GitHub Agentic Workflows を触ってみる
htkym
2
920
検証フェーズはAIの回答を判断するための学習機会
toru_kubota
2
430
大阪オフィスに Unitree Go2 がやってきたので Physical AI やってみた
dafujii
0
250
TiDBファミリーにDWHが新登場!! TiDB最新情報 / TiDB update 202609
yoshiakiyamasaki
0
190
KanaAI
shreyas1009
0
140
SREでアラート疲れを 解決しよう!
kairim0
1
110
自律型 AI をセキュアに実装!Gemini と MIG で作る動的コード実行環境
recruitengineers
PRO
1
110
組み立てて楽しむ AWS Blocks 入門
kmiya84377
0
150
The seven pitfalls of AI (revised version)
ufried
0
220
Snowflake Horizon Catalog と Apache Iceberg で作る オープンなデータ基盤
kitagawaz
0
390
Execution in the Kingdom of Agents: Reflections on Abstraction and Complexity
bcantrill
0
770
3人で1000GPU超を統合運用する?マルチクラウド&オンプレを跨ぐ、構築と運用のリアル!
kazukun0716
2
820
Featured
See All Featured
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.5k
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Templates, Plugins, & Blocks: Oh My! Creating the theme that thinks of everything
marktimemedia
31
2.9k
We Have a Design System, Now What?
morganepeng
55
8.3k
No one is an island. Learnings from fostering a developers community.
thoeni
21
3.8k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
[SF Ruby Conf 2025] Rails X
palkan
3
1.4k
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
Exploring anti-patterns in Rails
aemeredith
4
520
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
350
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
760
Transcript
はじめての文字認識 改 oda@sendai 令和元年 6月18日
環境 Python 3.7.3 JupyterLab 0.35.4 scikit-learn 0.20.3 matplotlib 3.0.3 opencv-python
4.1.0.25
JupyterLab ・ブラウザ上でPythonのプログラミングができるツール ・プラグインを入れれば、JavaやRも使用できる https://github.com/jupyterlab/jupyterlab
JupyterLab
scikit-learn ・Pythonのオープンソース機械学習ライブラリ ・サポートベクターマシン(SVM)のサポート ・1797個の8x8サイズ 手書き数字イメージサンプル有り http://scikit-learn.org/ https://ja.wikipedia.org/wiki/Scikit-learn
matplotlib ・グラフ描画ライブラリ http://matplotlib.org/ https://ja.wikipedia.org/wiki/Matplotlib
opencv-python ・画像処理ライブラリ https://opencv.org https://ja.wikipedia.org/wiki/OpenCV
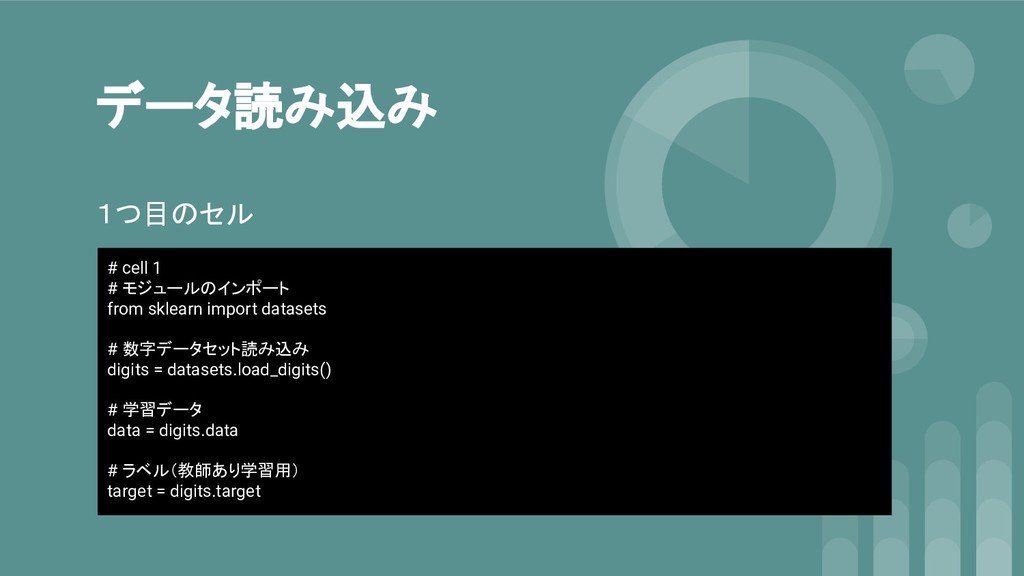
データ読み込み 1つ目のセル # cell 1 # モジュールのインポート from sklearn import
datasets # 数字データセット読み込み digits = datasets.load_digits() # 学習データ data = digits.data # ラベル(教師あり学習用) target = digits.target
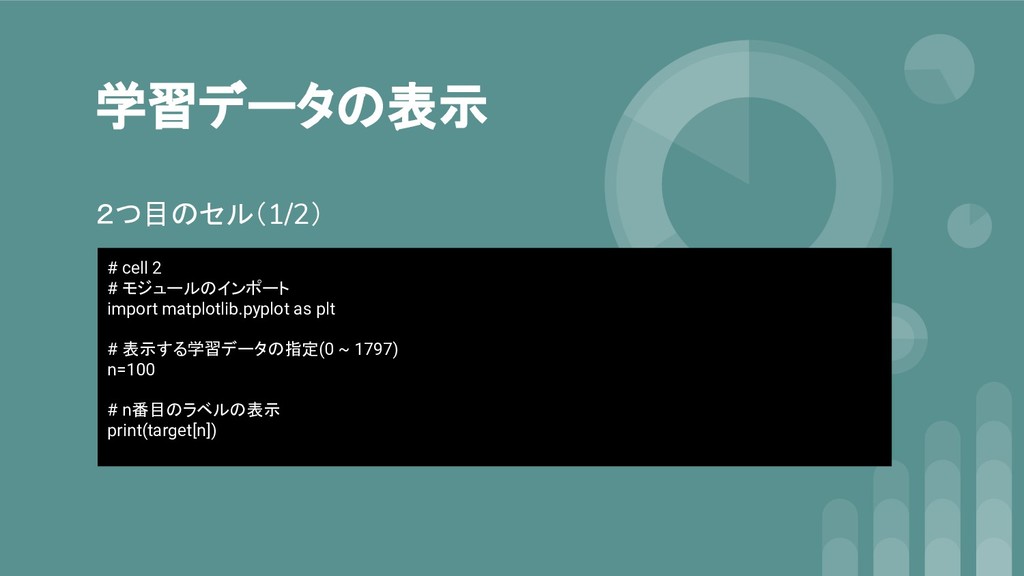
学習データの表示 2つ目のセル(1/2) # cell 2 # モジュールのインポート import matplotlib.pyplot as
plt # 表示する学習データの指定(0 ~ 1797) n=100 # n番目のラベルの表示 print(target[n])
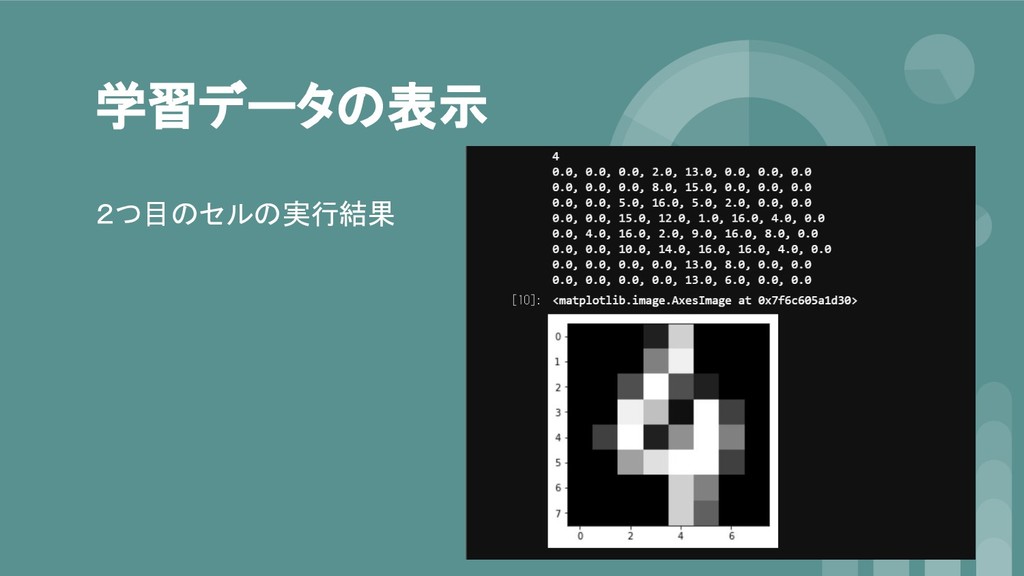
学習データの表示 2つ目のセル(2/2) # n番目の学習データの表示 i=0 for j in data[n]: if
i<7: print(j, end='') print(", ", end='') i+=1 else: print(j) i=0 # n番目の学習データを画像表示 plt.imshow(digits.images[n], cmap='Greys')
学習データの表示 2つ目のセルの実行結果
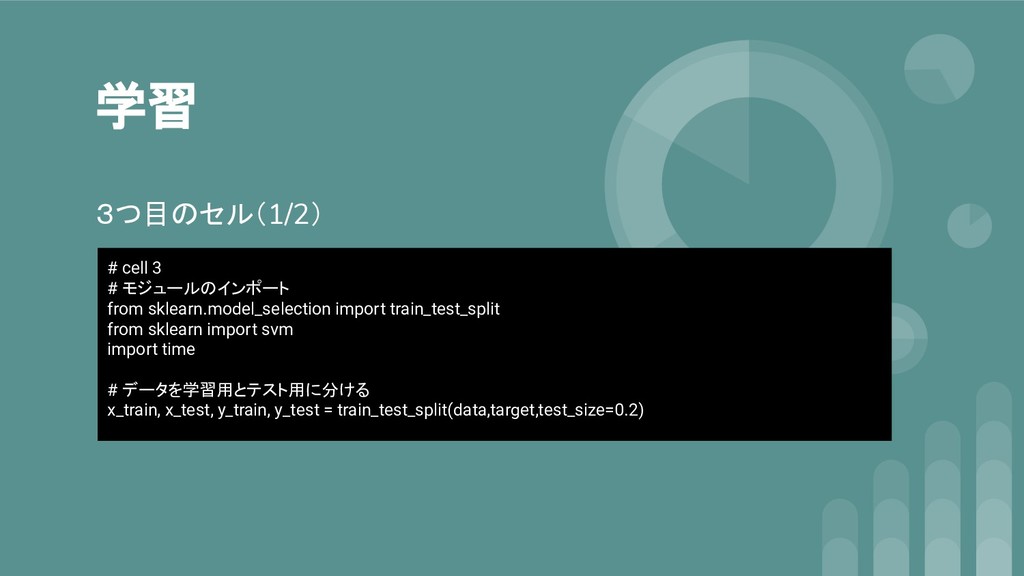
学習 3つ目のセル(1/2) # cell 3 # モジュールのインポート from sklearn.model_selection import
train_test_split from sklearn import svm import time # データを学習用とテスト用に分ける x_train, x_test, y_train, y_test = train_test_split(data,target,test_size=0.2)
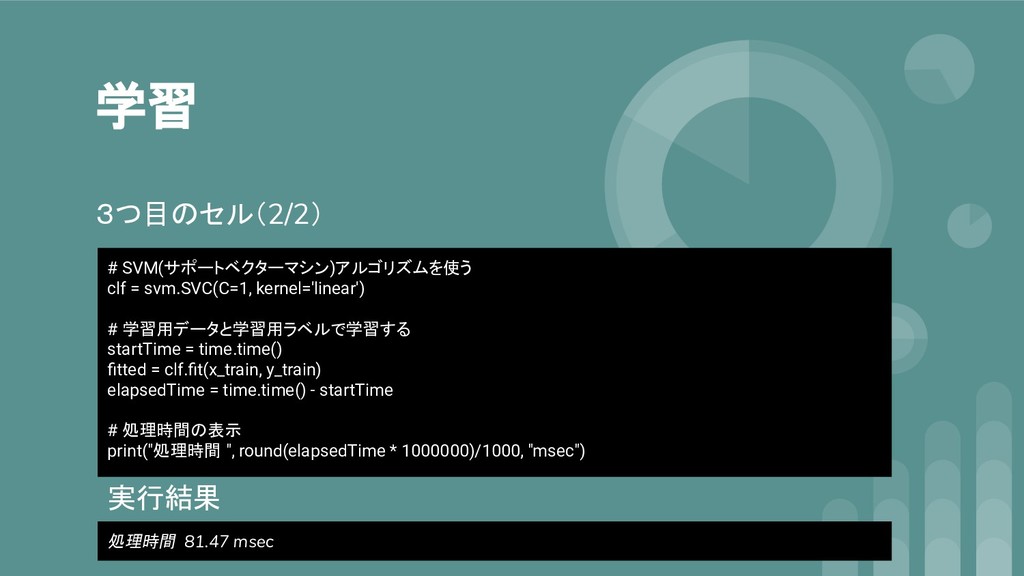
学習 3つ目のセル(2/2) # SVM(サポートベクターマシン)アルゴリズムを使う clf = svm.SVC(C=1, kernel='linear') # 学習用データと学習用ラベルで学習する
startTime = time.time() fitted = clf.fit(x_train, y_train) elapsedTime = time.time() - startTime # 処理時間の表示 print("処理時間 ", round(elapsedTime * 1000000)/1000, "msec") 実行結果 処理時間 81.47 msec
データを学習用とテスト用に分ける ・学習用データとテスト用データが同じなら、 正解率が100%に近くなるため分ける。 ・ここでは、学習用データを8割・テスト用データを2割 にしている。 train_test_splitが良しなにしてくれる。
SVM(サポートベクターマシン) ・教師あり学習を用いるパターン認識モデル。 ・線形分類が得意。
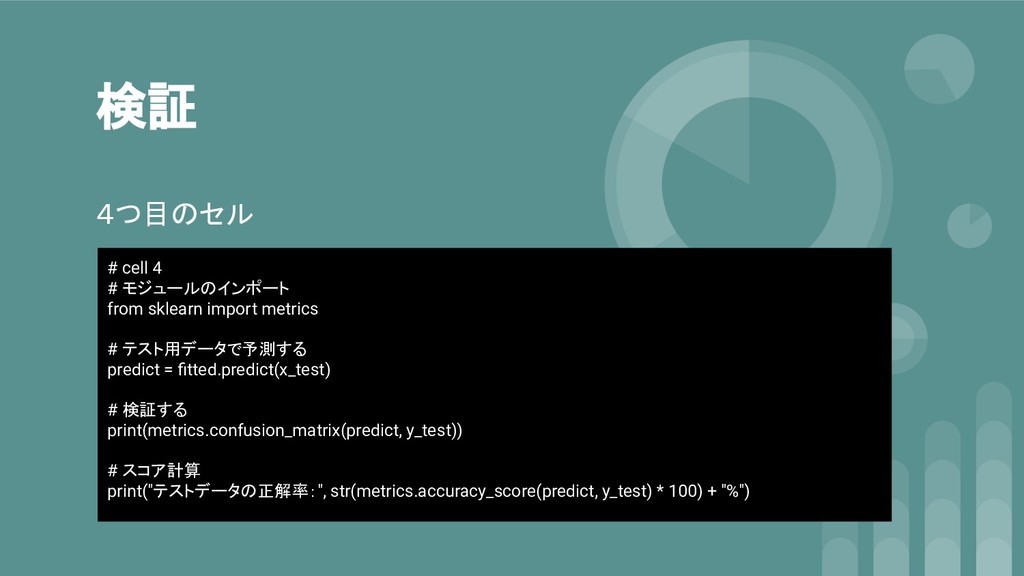
検証 4つ目のセル # cell 4 # モジュールのインポート from sklearn import
metrics # テスト用データで予測する predict = fitted.predict(x_test) # 検証する print(metrics.confusion_matrix(predict, y_test)) # スコア計算 print("テストデータの正解率:", str(metrics.accuracy_score(predict, y_test) * 100) + "%")
検証結果 横軸が検証結果 縦軸がテスト用ラベル [[33 0 0 0 0 0 0
0 0 0] [ 0 35 0 0 0 0 0 0 0 0] [ 0 0 44 0 0 0 0 0 0 0] [ 0 0 0 35 0 0 0 0 0 0] [ 1 0 0 0 39 0 0 0 0 0] [ 0 0 0 1 0 24 0 0 0 0] [ 0 0 0 0 0 1 38 0 0 0] [ 0 0 0 0 0 0 0 47 0 0] [ 0 0 0 1 0 0 0 0 30 0] [ 0 0 0 1 0 0 0 0 0 30]] テストデータの正解率: 98.61111111111111%
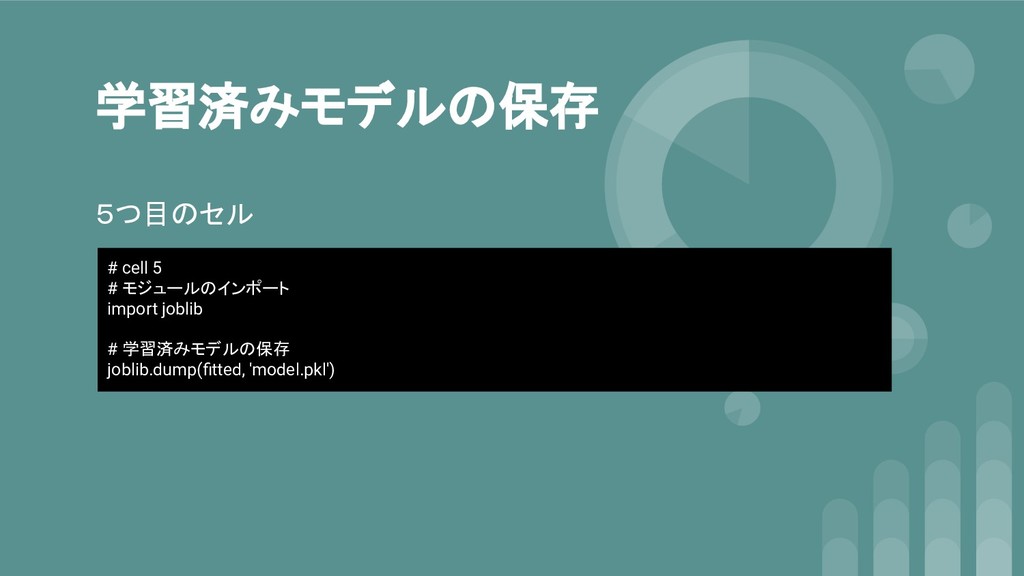
学習済みモデルの保存 5つ目のセル # cell 5 # モジュールのインポート import joblib #
学習済みモデルの保存 joblib.dump(fitted, 'model.pkl')
手書き数字の判定 6つ目のセル(1/3) # cell 6 # モジュールのインポート import cv2 from
sklearn.externals import joblib from IPython.display import display, Image # 読み込む画像ファイル名 filename="7.png" # 画像の表示 def display_cv_image(image, format='.png'): decoded_bytes = cv2.imencode(format, image)[1].tobytes() display(Image(data=decoded_bytes))
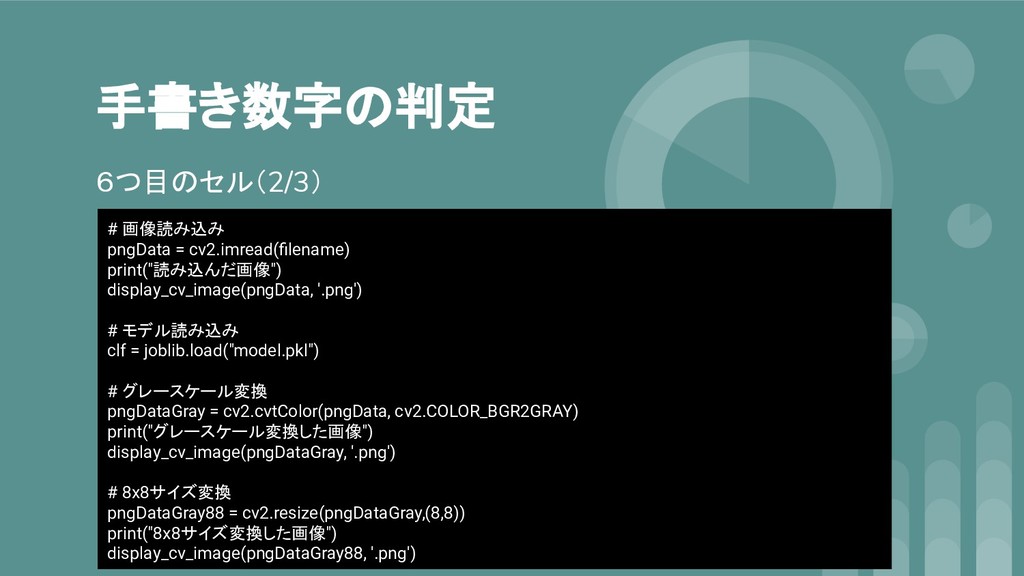
手書き数字の判定 6つ目のセル(2/3) # 画像読み込み pngData = cv2.imread(filename) print("読み込んだ画像") display_cv_image(pngData, '.png')
# モデル読み込み clf = joblib.load("model.pkl") # グレースケール変換 pngDataGray = cv2.cvtColor(pngData, cv2.COLOR_BGR2GRAY) print("グレースケール変換した画像") display_cv_image(pngDataGray, '.png') # 8x8サイズ変換 pngDataGray88 = cv2.resize(pngDataGray,(8,8)) print("8x8サイズ変換した画像") display_cv_image(pngDataGray88, '.png')
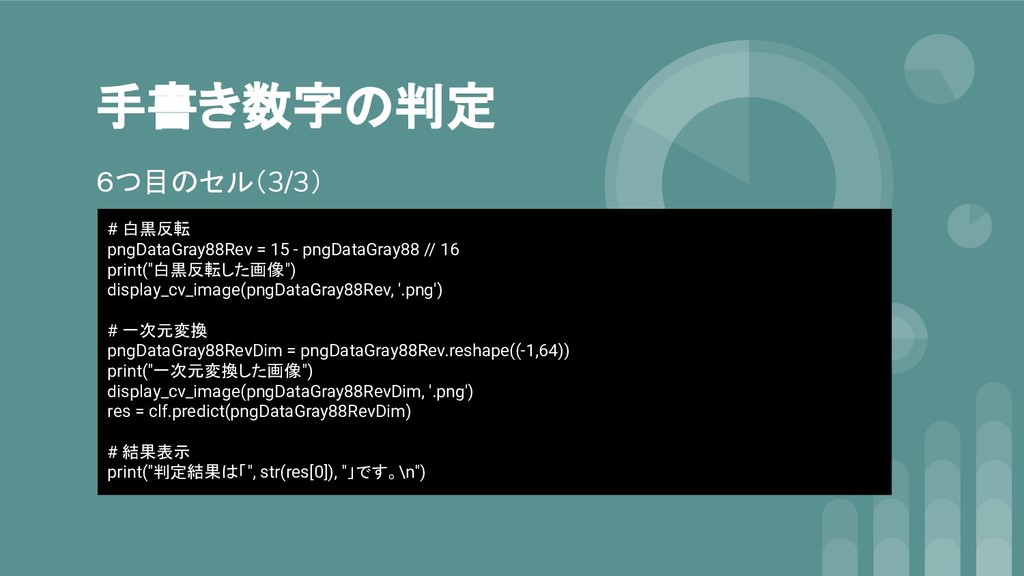
手書き数字の判定 6つ目のセル(3/3) # 白黒反転 pngDataGray88Rev = 15 - pngDataGray88 //
16 print("白黒反転した画像") display_cv_image(pngDataGray88Rev, '.png') # 一次元変換 pngDataGray88RevDim = pngDataGray88Rev.reshape((-1,64)) print("一次元変換した画像") display_cv_image(pngDataGray88RevDim, '.png') res = clf.predict(pngDataGray88RevDim) # 結果表示 print("判定結果は「", str(res[0]), "」です。\n")
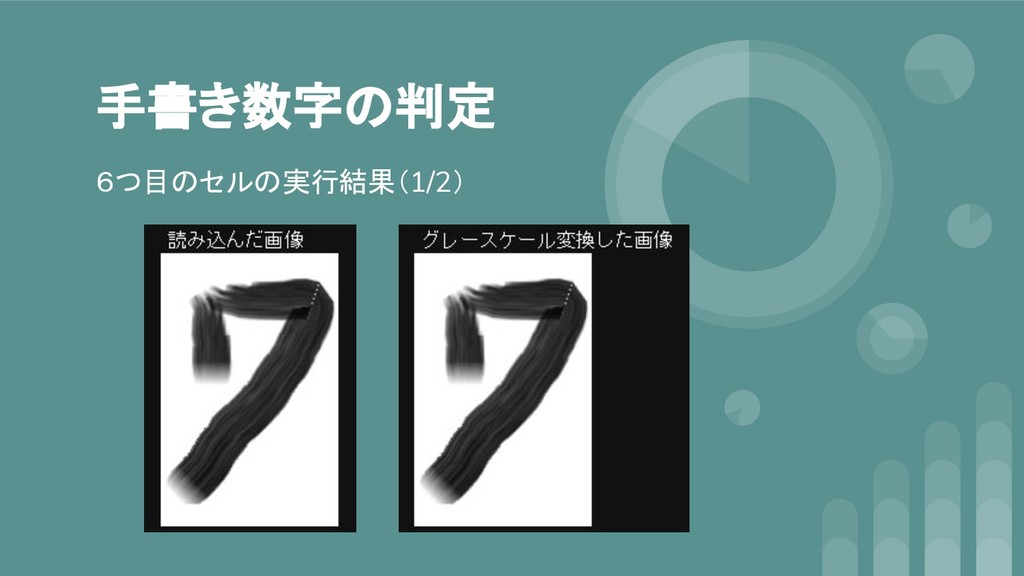
手書き数字の判定 6つ目のセルの実行結果(1/2)
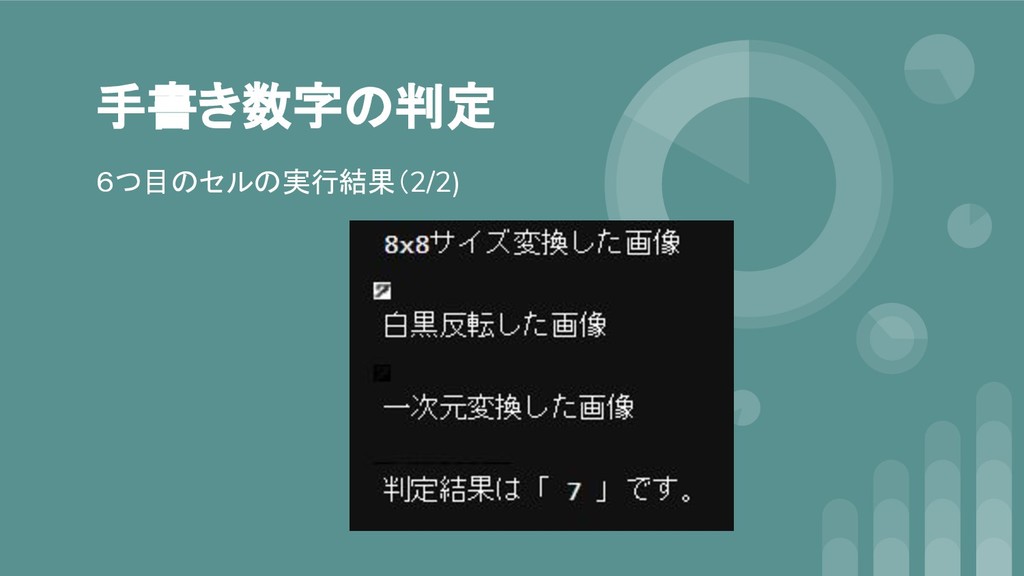
手書き数字の判定 6つ目のセルの実行結果(2/2)
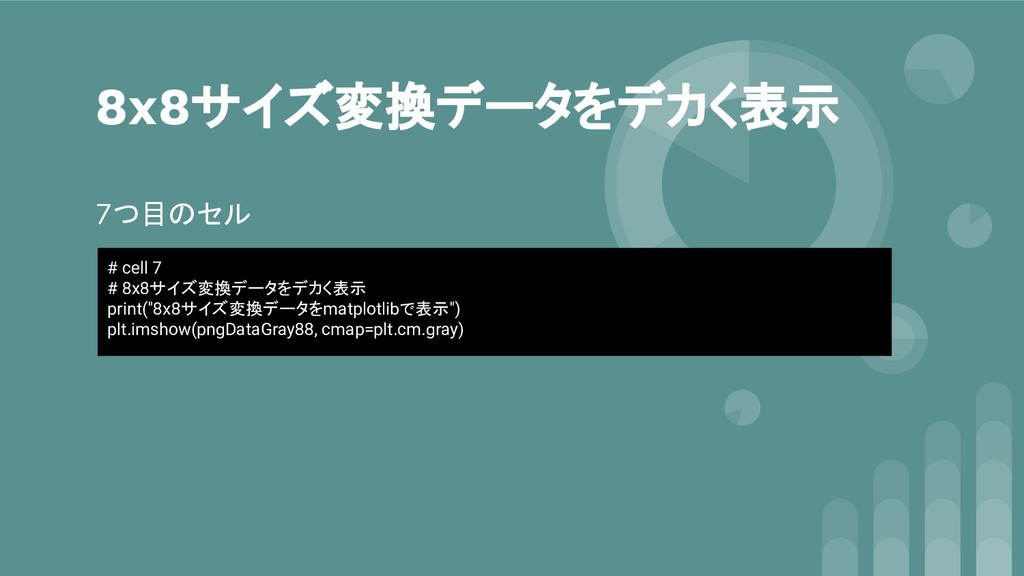
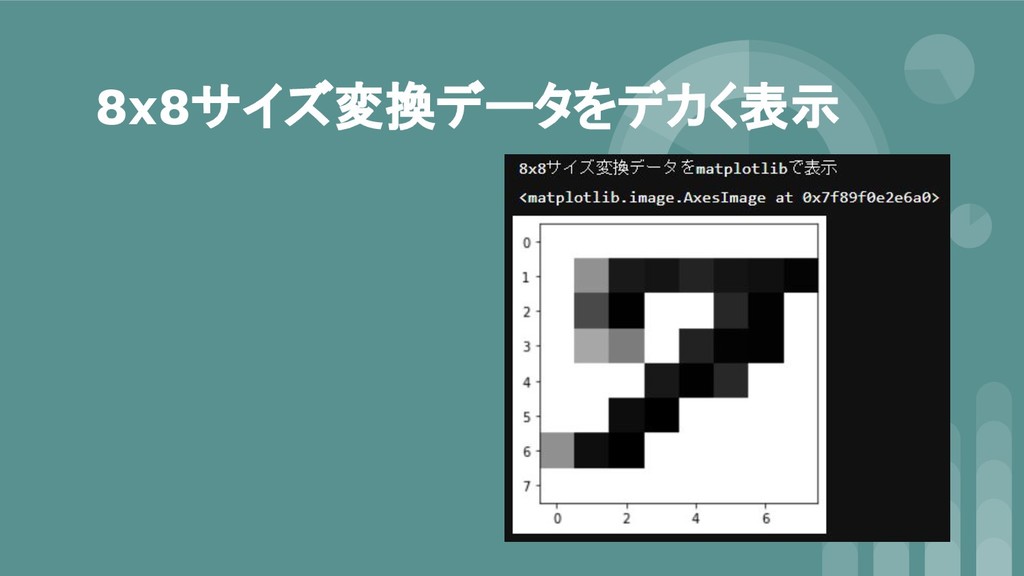
8x8サイズ変換データをデカく表示 7つ目のセル # cell 7 # 8x8サイズ変換データをデカく表示 print("8x8サイズ変換データをmatplotlibで表示") plt.imshow(pngDataGray88, cmap=plt.cm.gray)
8x8サイズ変換データをデカく表示
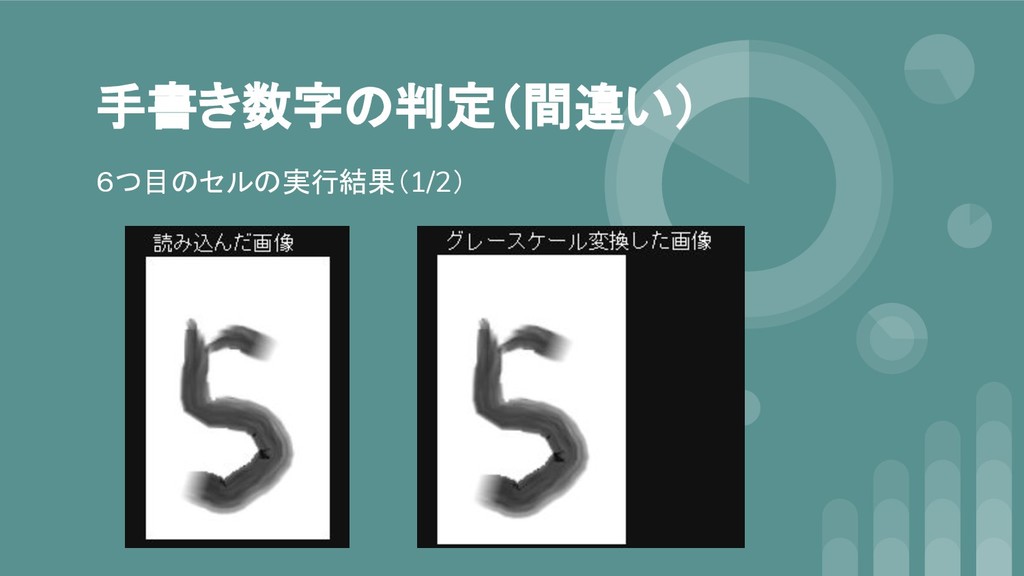
手書き数字の判定(間違い) 6つ目のセルの実行結果(1/2)
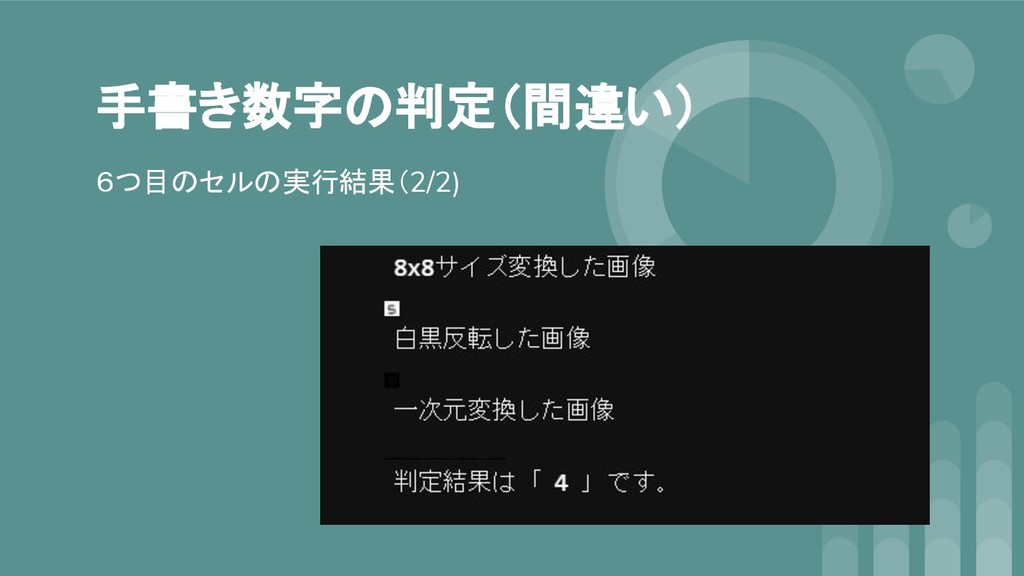
手書き数字の判定(間違い) 6つ目のセルの実行結果(2/2)
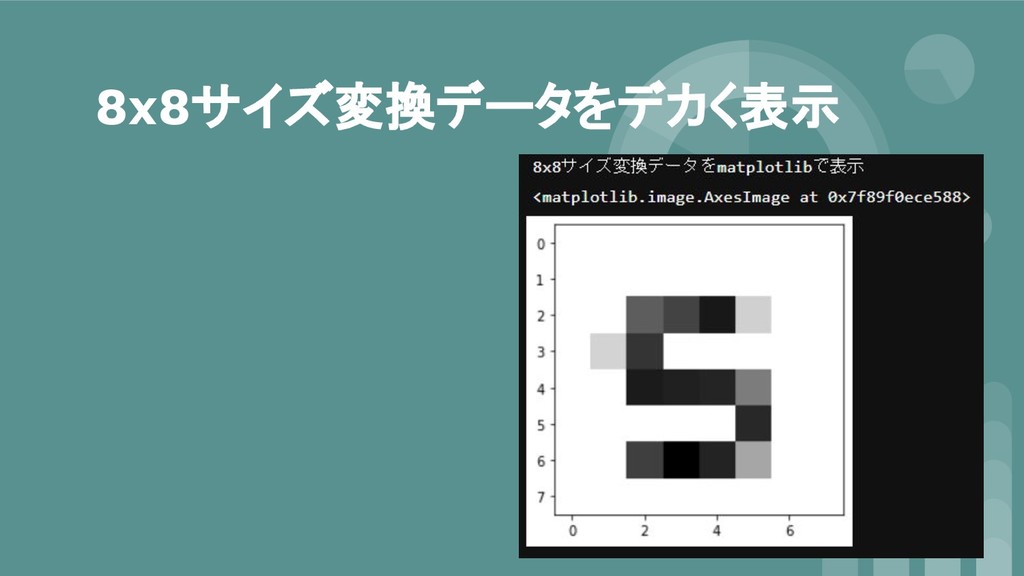
8x8サイズ変換データをデカく表示
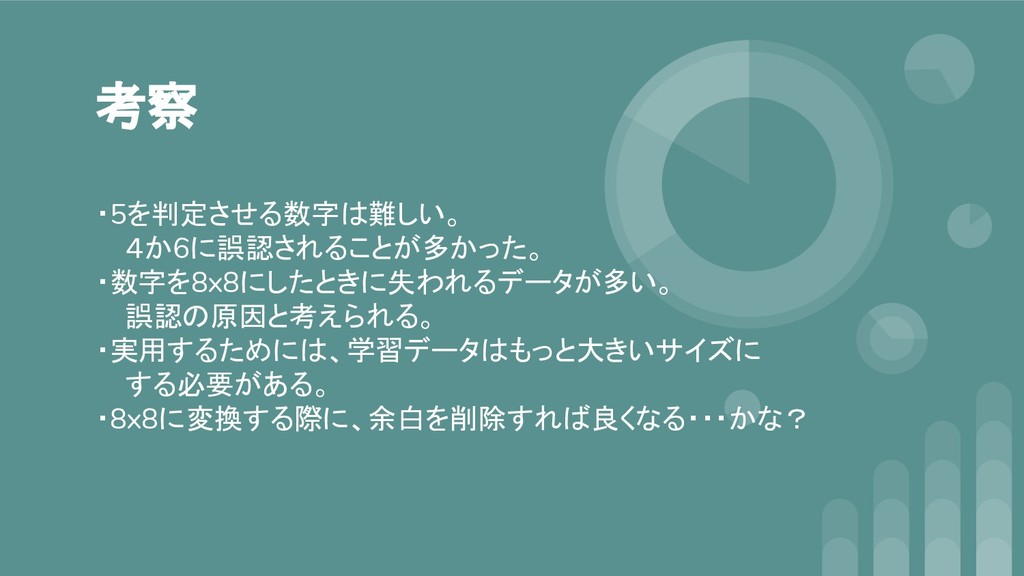
考察 ・5を判定させる数字は難しい。 4か6に誤認されることが多かった。 ・数字を8x8にしたときに失われるデータが多い。 誤認の原因と考えられる。 ・実用するためには、学習データはもっと大きいサイズに する必要がある。 ・8x8に変換する際に、余白を削除すれば良くなる・・・かな?
参考ページ ・scikit-learn Tutorials https://scikit-learn.org/stable/tutorial/index.html ・【Python】scikit-learnで手書き数字を判定してみた https://ymgsapo.com/2018/12/03/hand-digits-test/ ・sklearnで手書き文字認識 http://akiniwa.hatenablog.jp/entry/2013/12/20/120734
はじめての文字認識 END


 yasu8899
 htkym
 toru_kubota
 dafujii
 yoshiakiyamasaki
 shreyas1009
 kairim0
 recruitengineers
 kmiya84377
 ufried
 kitagawaz
 bcantrill
 kazukun0716
 inesmontani
 aleyda
 marktimemedia
 morganepeng
 thoeni
 lindahogenes
 palkan
 eileencodes
 reverentgeek
 aemeredith
 greggifford
 marcoroth



![検証結果 横軸が検証結果 縦軸がテスト用ラベル [[33 0 0 0 0 0 0](https://files.speakerdeck.com/presentations/fdae44e6a2fd4b7ab337a6ec6be9bf73/slide_16.jpg)