Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
データ基盤統合への歩み - ハッカーズチャンプルー2025前夜祭
Search
Yuji Takaesu
August 01, 2025
Programming
59
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
データ基盤統合への歩み - ハッカーズチャンプルー2025前夜祭
Yuji Takaesu
August 01, 2025
Transcript
19 slides
Hackers Champloo 2025 前夜祭 データ基盤統合への歩み RedshiftからBigQueryへ
⾼江洲 祐治 (たかえす ゆうじ) X: https://x.com/takaesu_ug 沖縄在住 リモートワーク歴 8年 ランニング(NAHAマラソン)
クラフトビール 【経歴】 - 2020年に⼊社してからトクバイ(チラシ‧買物情報 プラットフォーム)の開発 - https://tokubai.co.jp/ - 主にRailsやReactを⽤いた開発 - 今年からプラットフォーム開発部 - データ基盤などの開発を主軸 - ID統合や開発標準化 - データエンジニアリングとしては初⼼者
なぜデータ基盤統合するのか?!
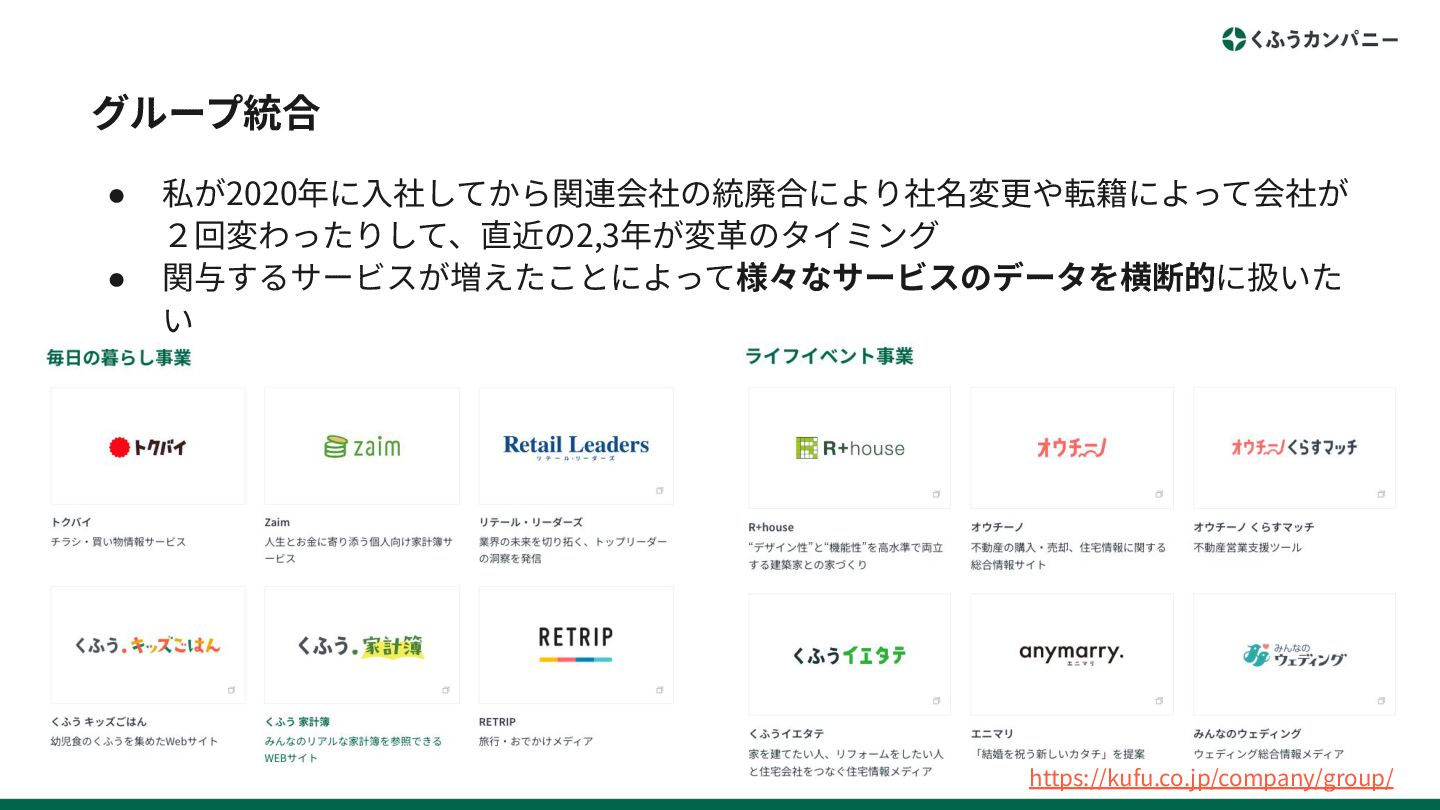
グループ統合 • 私が2020年に⼊社してから関連会社の統廃合により社名変更や転籍によって会社が 2回変わったりして、直近の2,3年が変⾰のタイミング • 関与するサービスが増えたことによって様々なサービスのデータを横断的に扱いた い https://kufu.co.jp/company/group/
データ基盤がサービス毎に最適化されて横展開が難しい • グループ内の各種サービス毎にデータ基盤を活⽤している ◦ 主にRedshift とBigQuery、またサービス内のDBが⼊り混じっている • データの取り込み、変換、活⽤などそれぞれが最適な⼿段を適⽤しているため、 サービス毎にバラバラな状態 ◦
独⾃実装のデータ取り込み⽤のツール ◦ Embulkによる定期的な取り込み ◦ Railsのアプリケーション側のバッチ処理
データ品質に関して⼀貫性や担保が難しい • 共通化可能な条件が集計クエリ毎に定義されている ◦ クエリごとに条件が統⼀されておらず結果の担保や⼀貫性が難しい ◦ (例) 不要なBotのログを除外する条件など • 集計処理の状況把握や追跡がやりづらい
◦ どこで、どの分析基盤のテーブルを利⽤しているの分かりづらい ◦ 集計処理などをコード管理して、⼀貫性のある状態で追跡可能にしたい
⽬指す理想像
None
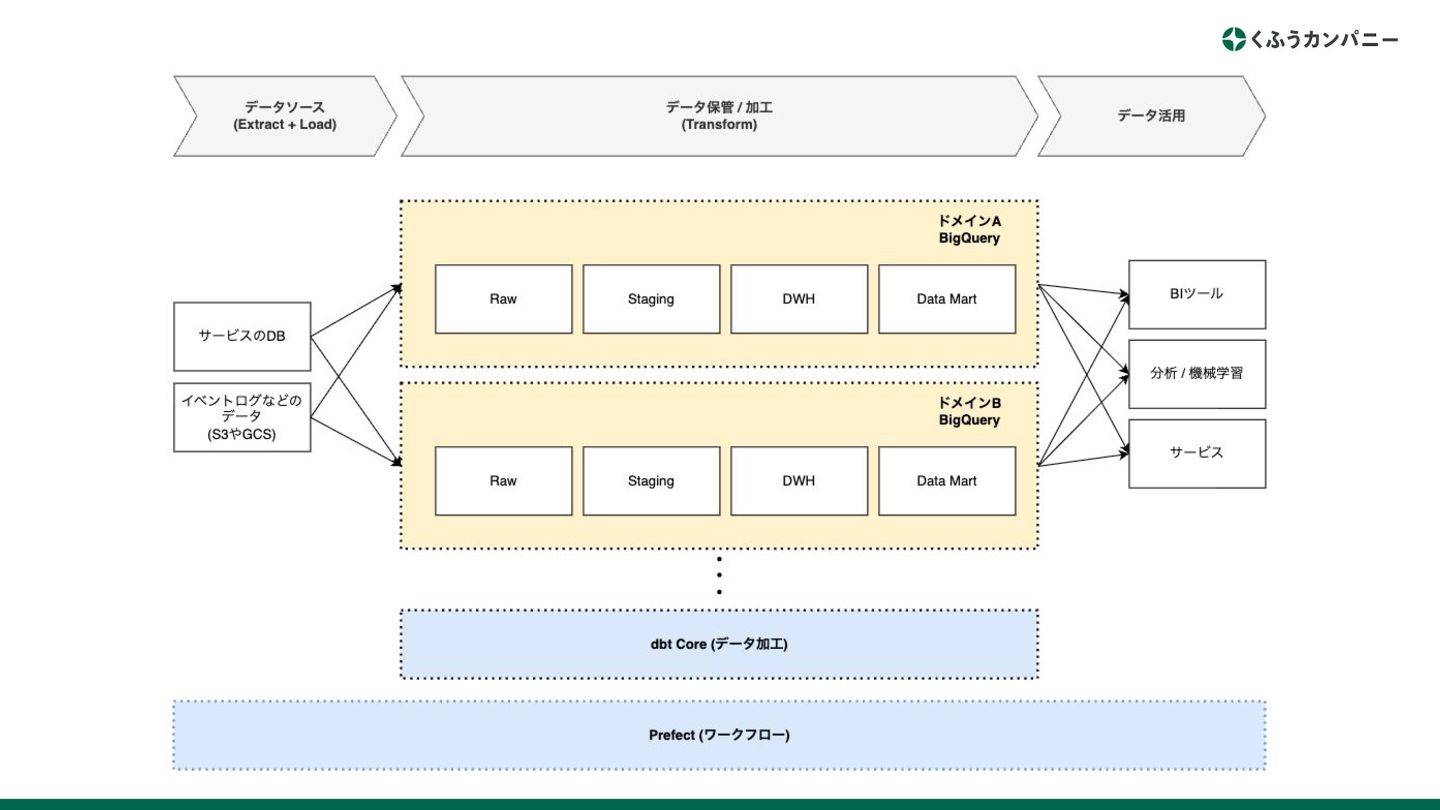
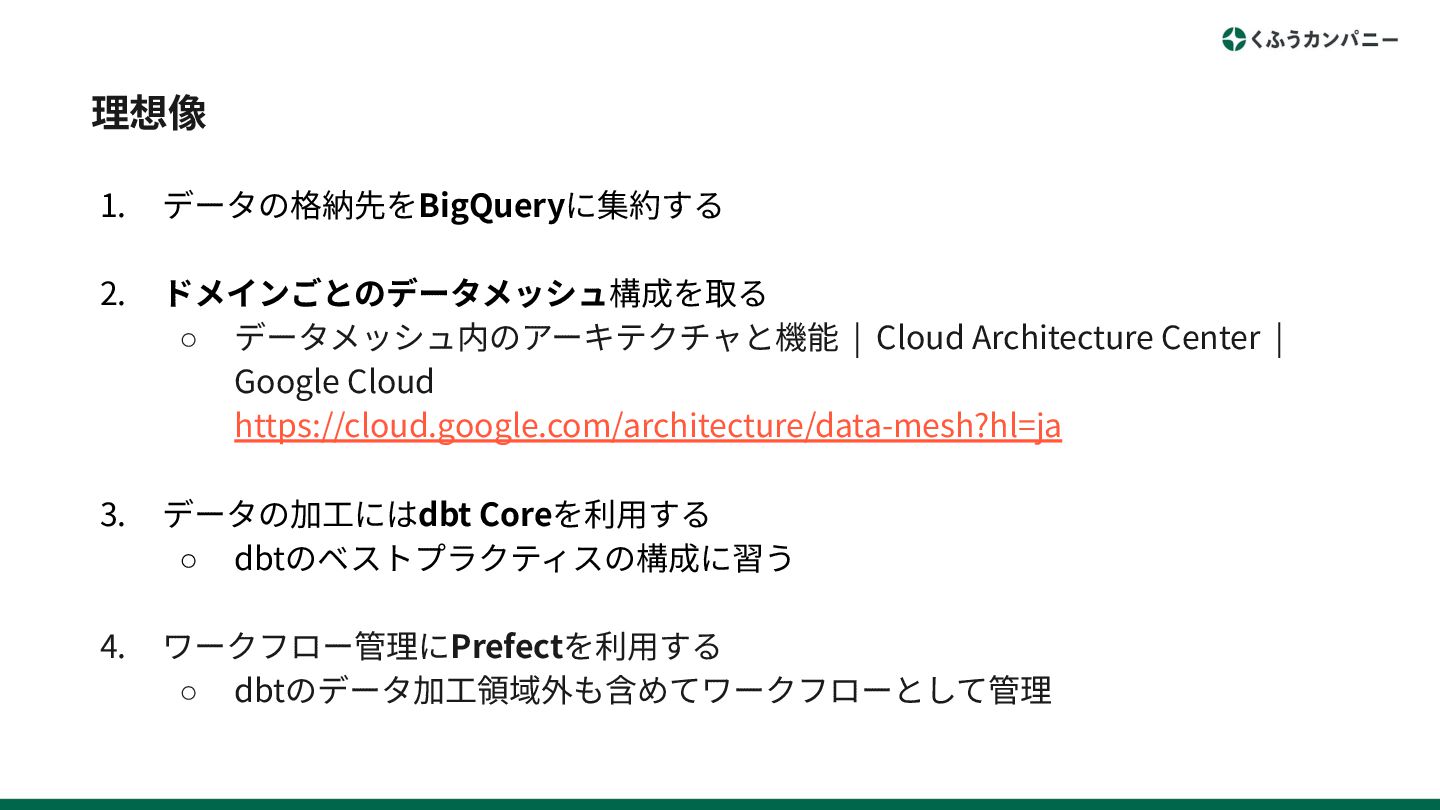
理想像 1. データの格納先をBigQueryに集約する 2. ドメインごとのデータメッシュ構成を取る ◦ データメッシュ内のアーキテクチャと機能 | Cloud Architecture
Center | Google Cloud https://cloud.google.com/architecture/data-mesh?hl=ja 3. データの加⼯にはdbt Coreを利⽤する ◦ dbtのベストプラクティスの構成に習う 4. ワークフロー管理にPrefectを利⽤する ◦ dbtのデータ加⼯領域外も含めてワークフローとして管理
現状やっていることの ⼀部を紹介します
データの格納先をBigQueryに集約する (Redshift廃⽌)
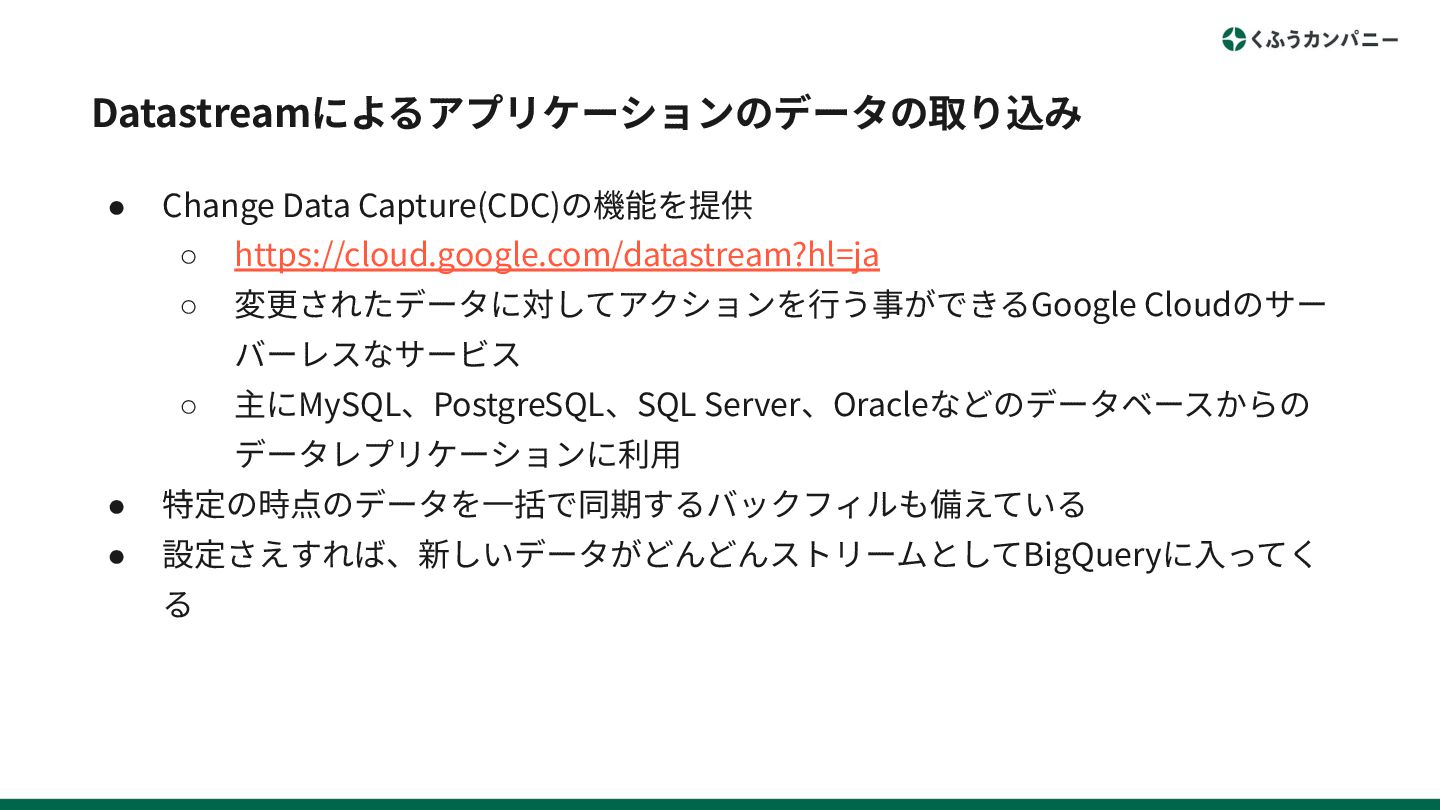
Datastreamによるアプリケーションのデータの取り込み • Change Data Capture(CDC)の機能を提供 ◦ https://cloud.google.com/datastream?hl=ja ◦ 変更されたデータに対してアクションを⾏う事ができるGoogle Cloudのサー
バーレスなサービス ◦ 主にMySQL、PostgreSQL、SQL Server、Oracleなどのデータベースからの データレプリケーションに利⽤ • 特定の時点のデータを⼀括で同期するバックフィルも備えている • 設定さえすれば、新しいデータがどんどんストリームとしてBigQueryに⼊ってく る
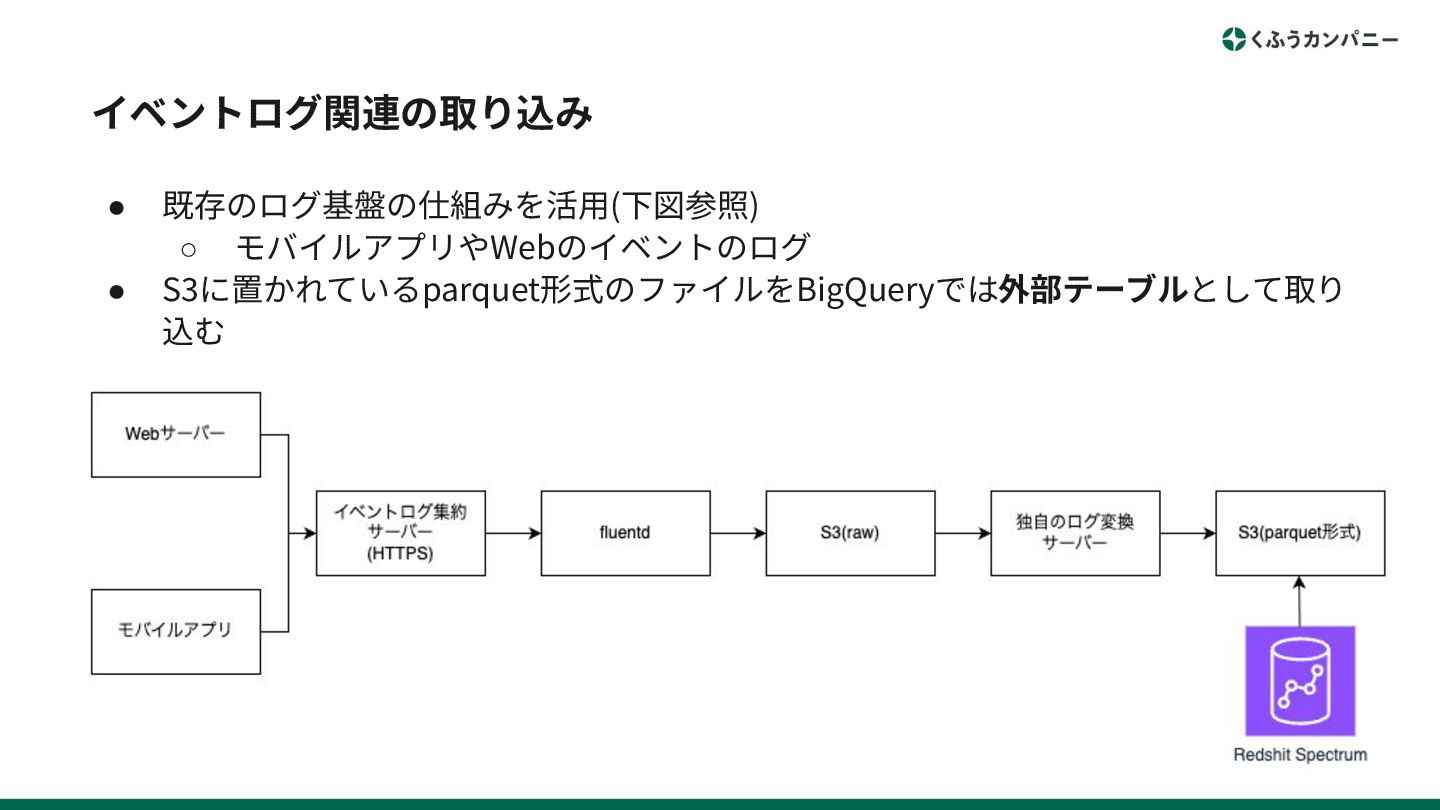
イベントログ関連の取り込み • 既存のログ基盤の仕組みを活⽤(下図参照) ◦ モバイルアプリやWebのイベントのログ • S3に置かれているparquet形式のファイルをBigQueryでは外部テーブルとして取り 込む
アプリケーション側に実装されたアドホックなバッチ処理 • ⽇次や週次の様々な集計バッチをRedshiftからBigQueryに向けるように変更 ◦ PV集計やUU集計など • ここにいくつかつらみがある ◦ TimeStamp型のTimeZone ◦
RailsのActiveRecordの依存を除く
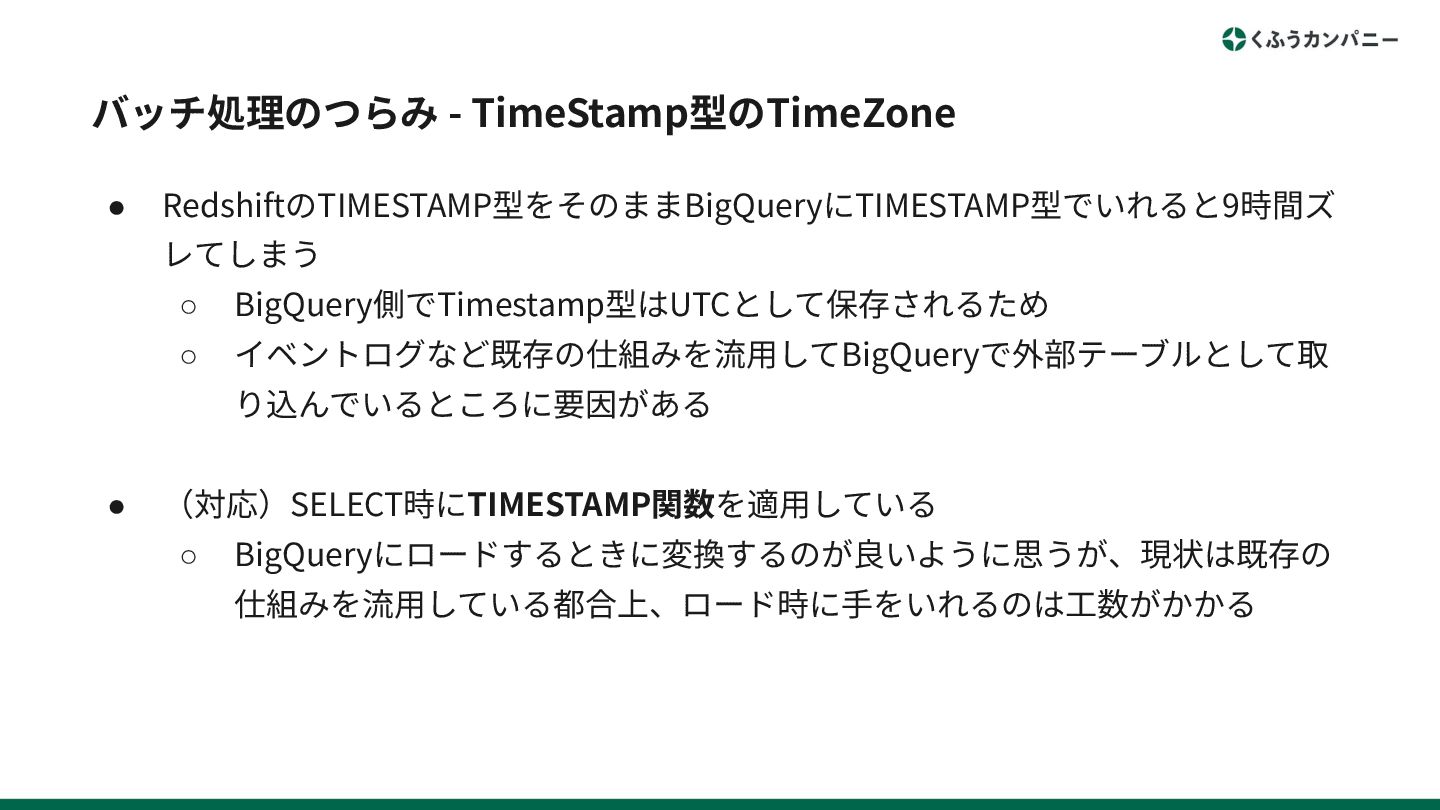
バッチ処理のつらみ - TimeStamp型のTimeZone • RedshiftのTIMESTAMP型をそのままBigQueryにTIMESTAMP型でいれると9時間ズ レてしまう ◦ BigQuery側でTimestamp型はUTCとして保存されるため ◦ イベントログなど既存の仕組みを流⽤してBigQueryで外部テーブルとして取
り込んでいるところに要因がある • (対応)SELECT時にTIMESTAMP関数を適⽤している ◦ BigQueryにロードするときに変換するのが良いように思うが、現状は既存の 仕組みを流⽤している都合上、ロード時に⼿をいれるのは⼯数がかかる
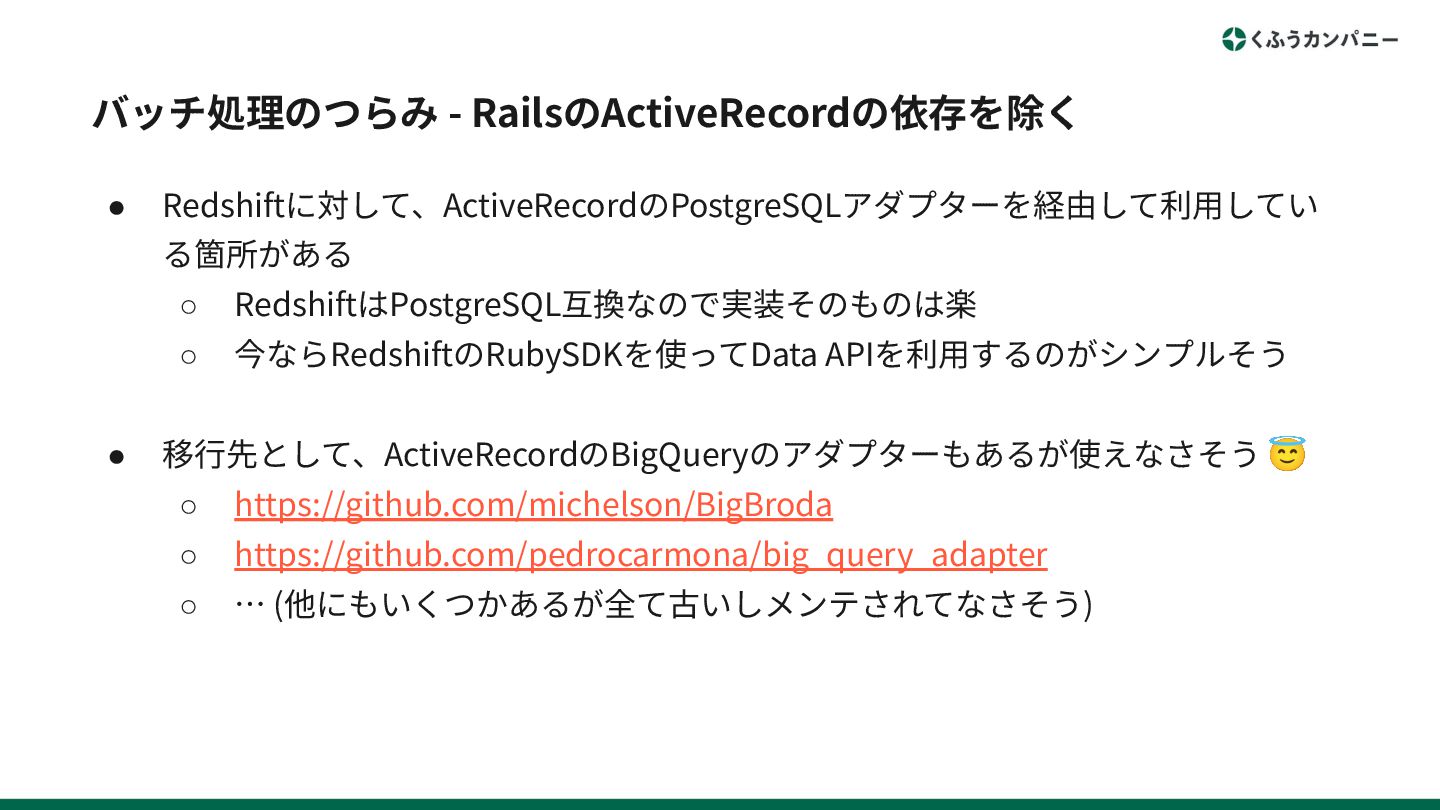
バッチ処理のつらみ - RailsのActiveRecordの依存を除く • Redshiftに対して、ActiveRecordのPostgreSQLアダプターを経由して利⽤してい る箇所がある ◦ RedshiftはPostgreSQL互換なので実装そのものは楽 ◦ 今ならRedshiftのRubySDKを使ってData
APIを利⽤するのがシンプルそう • 移⾏先として、ActiveRecordのBigQueryのアダプターもあるが使えなさそう 😇 ◦ https://github.com/michelson/BigBroda ◦ https://github.com/pedrocarmona/big_query_adapter ◦ … (他にもいくつかあるが全て古いしメンテされてなさそう)
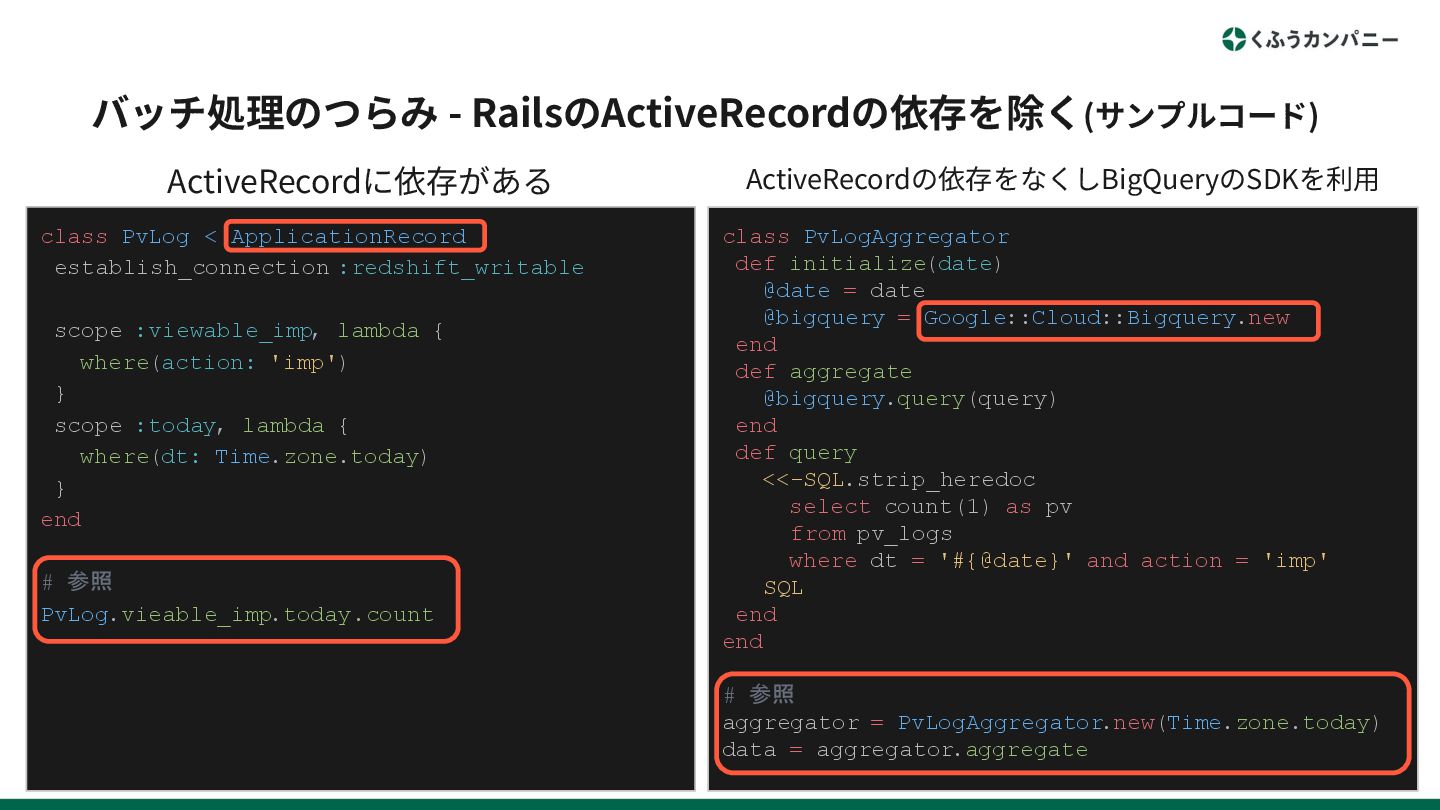
バッチ処理のつらみ - RailsのActiveRecordの依存を除く(サンプルコード) class PvLog < ApplicationRecord establish_connection :redshift_writable scope
:viewable_imp, lambda { where(action: 'imp') } scope :today, lambda { where(dt: Time.zone.today) } end # 参照 PvLog.vieable_imp.today.count class PvLogAggregator def initialize(date) @date = date @bigquery = Google::Cloud::Bigquery.new end def aggregate @bigquery.query(query) end def query <<-SQL.strip_heredoc select count(1) as pv from pv_logs where dt = '#{@date}' and action = 'imp' SQL end end # 参照 aggregator = PvLogAggregator.new(Time.zone.today) data = aggregator.aggregate ActiveRecordに依存がある ActiveRecordの依存をなくしBigQueryのSDKを利⽤
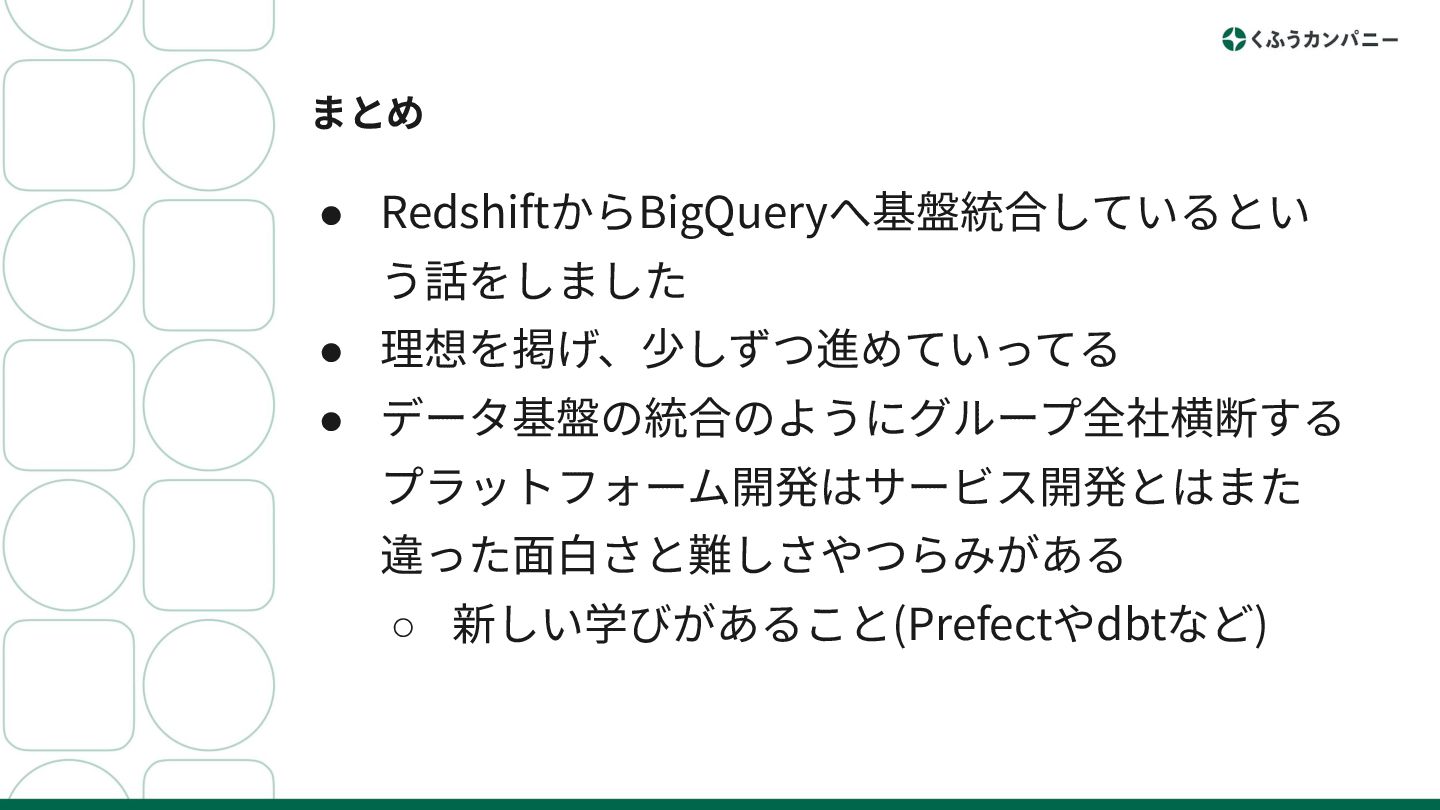
まとめ • RedshiftからBigQueryへ基盤統合しているとい う話をしました • 理想を掲げ、少しずつ進めていってる • データ基盤の統合のようにグループ全社横断する プラットフォーム開発はサービス開発とはまた 違った⾯⽩さと難しさやつらみがある
◦ 新しい学びがあること(Prefectやdbtなど)
Fin. ありがとうございました!!
More Decks by Yuji Takaesu
See All by Yuji Takaesu
サーバーレスのテストを取り巻く環境
yusabana
0
970
IT筋トレを続けるための技術
yusabana
0
290
テスト導入支援
yusabana
0
130
社内向けgyazo
yusabana
0
210
社内開発環境/テスト環境
yusabana
0
140
hubotを使ったチャット環境
yusabana
0
94
Other Decks in Programming
See All in Programming
React Native経験者が Flutterを30⽇間触って驚いたこと
3saito
0
200
[DroidKnights 2026] Workflow AX 적용기 — 자동 정책 정리부터 E2E까지
dayeon
0
120
Kotlin Fest 2026: Kotlin コンパイラに Contribute してみよう! - Kotlin/Wasm で深い再帰を書けるようにした話
ternbusty
1
400
RaspberryPi 5で軽くはじめるk3sとtailscaleを用いたホームサーバー構築 (1)
nasum
0
420
TS 7.0 で baseUrl が使えなくなった今、パスエイリアスをどうするか
bicstone
2
770
Proxmox x Talos Linux x Terraform で実現するなんかいい感じの Kubernetes クラスタ / A Sleek Kubernetes Cluster Powered by Proxmox, Talos Linux, and Terraform
nnaka2992
0
280
SFCで実現する病院・医療システムの動的組み立て式UI
koukimiura
1
190
Web3Dライブラリを作ってVue Custom Rendererの仕組みを理解しよう / lets learn vue custom renderer by making 3d library
drumath2237
1
140
AIがコードを書いてくれる時代、我々は何を確かめるのか
yosuke_furukawa
PRO
13
6.1k
なぜ私たちは「現時点では」KMPの導入を見送ったのか
chigichan24
1
480
Goコンパイラを作ってGoをもっと理解する / Build a Go compiler to better understand Go
ikura_hamu
0
130
Getting Started with Vibe Coding
miccheng
0
240
Featured
See All Featured
Money Talks: Using Revenue to Get Sh*t Done
nikkihalliwell
0
570
HDC tutorial
michielstock
2
1k
Everyday Curiosity
cassininazir
0
410
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
70
69k
Bootstrapping a Software Product
garrettdimon
PRO
306
120k
[RailsConf 2023 Opening Keynote] The Magic of Rails
eileencodes
31
10k
How STYLIGHT went responsive
nonsquared
100
6.4k
Build The Right Thing And Hit Your Dates
maggiecrowley
39
3.5k
It's Worth the Effort
3n
188
29k
Code Review Best Practice
trishagee
74
20k
How to make the Groovebox
asonas
2
2.6k
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k


 yusabana
 3saito
 dayeon
 ternbusty
 nasum
 bicstone
 nnaka2992
 koukimiura
 drumath2237
 yosuke_furukawa
 chigichan24
 ikura_hamu
 miccheng
 nikkihalliwell
 michielstock
 cassininazir
 madoxten
 garrettdimon
 eileencodes
 nonsquared
 maggiecrowley
 3n
 trishagee
 asonas
 destraynor