Upgrade to Pro — share decks privately, control downloads, hide ads and more …

【AIニュース】Muse Spark Open とは何か

【AIニュース】Muse Spark Open とは何か

Avatar for 赤神青空

赤神青空 PRO

October 22, 2026

Video

More Decks by 赤神青空

Other Decks in Programming

Transcript

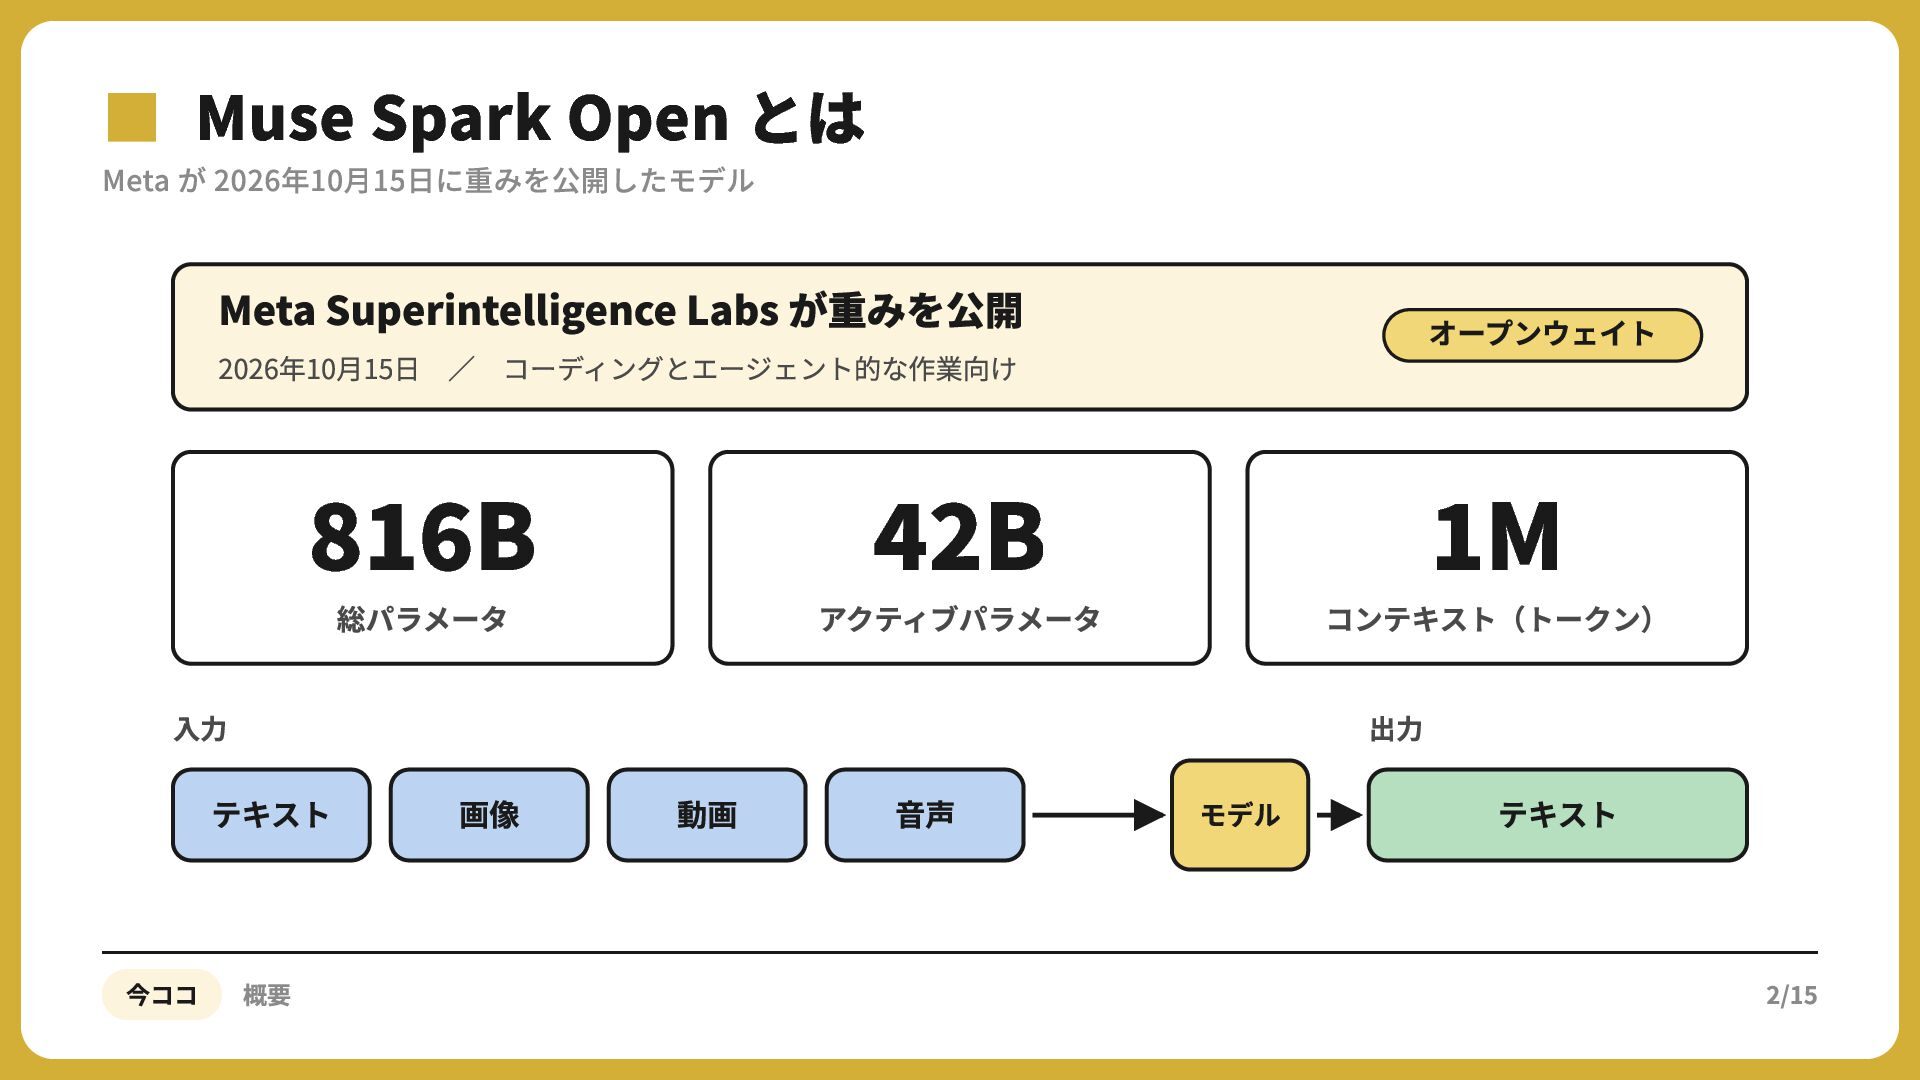
  1. ▪Meta がMuse Spark Open とは 2026年10月15日に重みを公開したモデル Meta Superintelligence Labs が重みを公開

    オープンウェイト 2026年10⽉15⽇ ∕ コーディングとエージェント的な作業向け B B 総パラメータ M アクティブパラメータ コンテキスト(トークン) ⼊⼒ テキスト 今ココ 概要 出⼒ 画像 動画 ⾳声 モデル テキスト 2/15
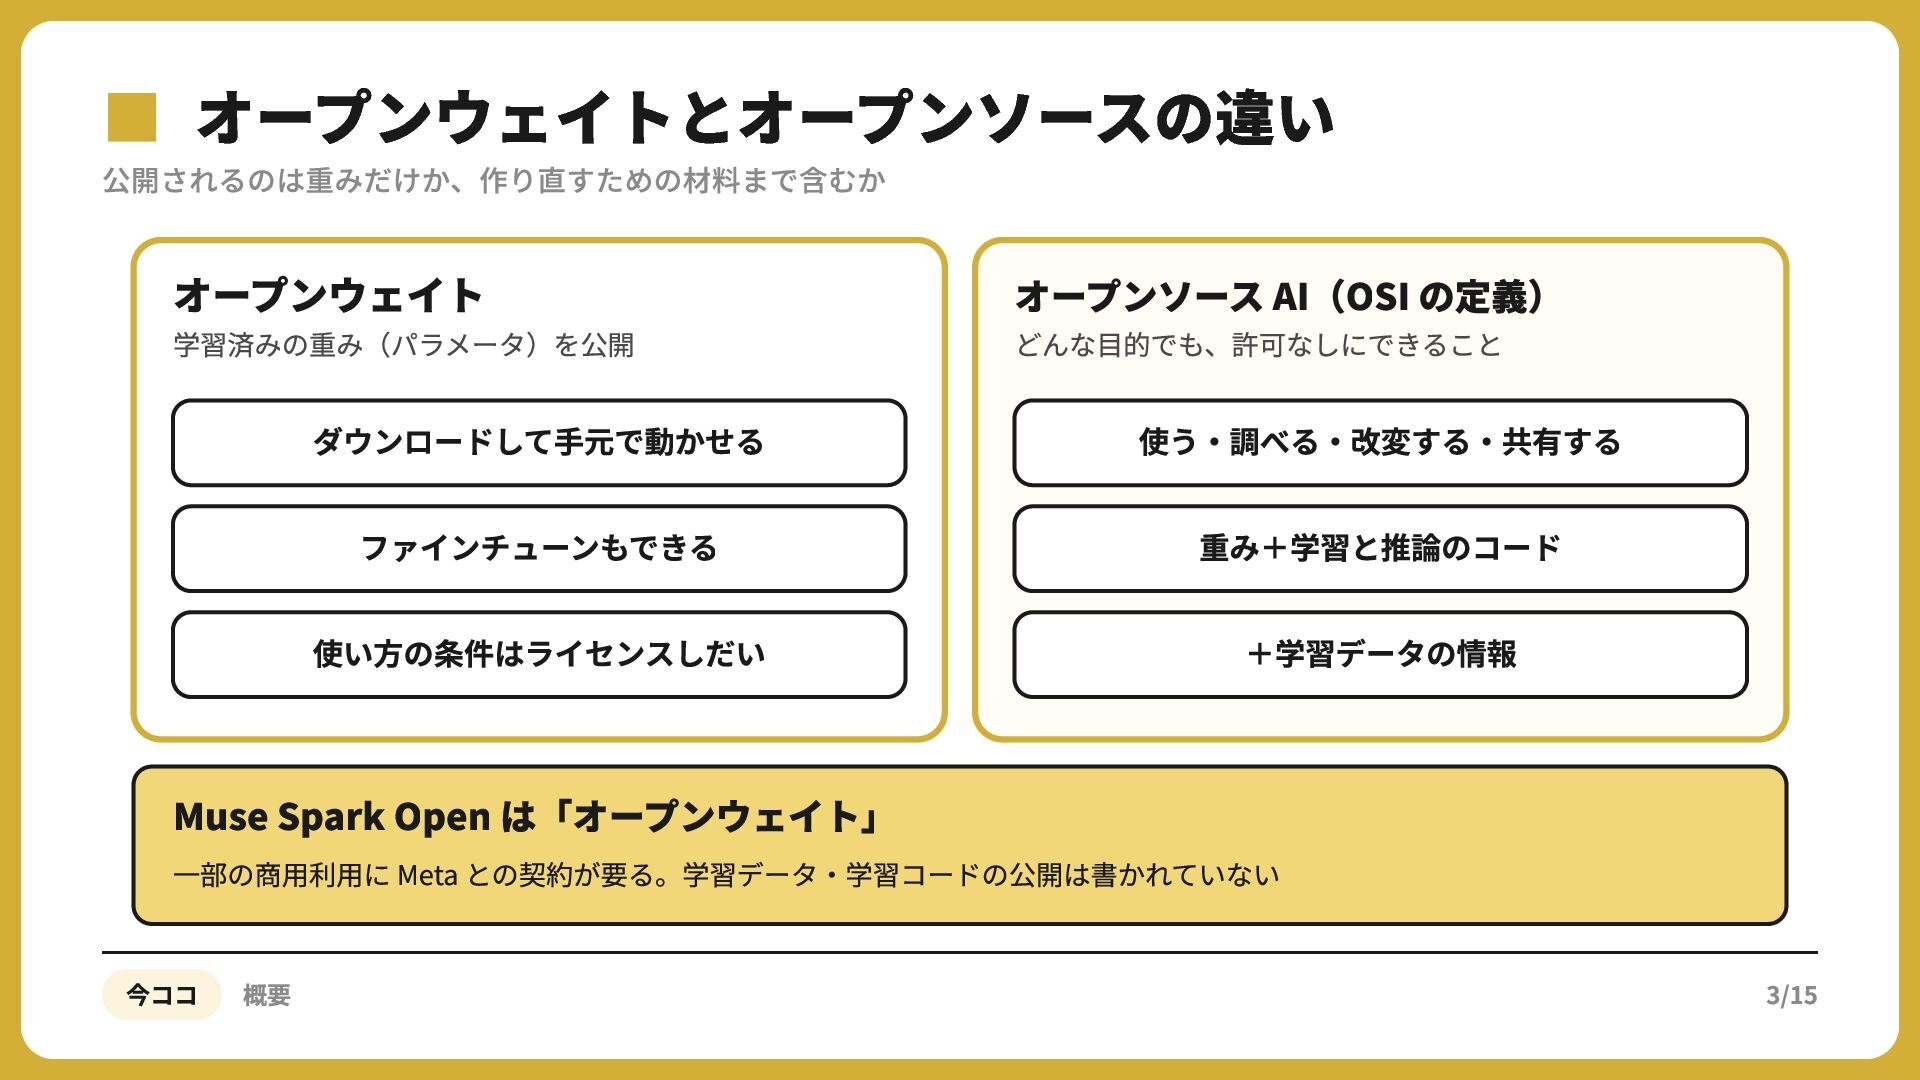
  2. ▪公開されるのは重みだけか、作り直すための材料まで含むか オープンウェイトとオープンソースの違い オープンウェイト 学習済みの重み(パラメータ)を公開 オープンソース AI(OSI の定義) どんな⽬的でも、許可なしにできること ダウンロードして⼿元で動かせる 使う‧調べる‧改変する‧共有する

    ファインチューンもできる 重み+学習と推論のコード 使い⽅の条件はライセンスしだい +学習データの情報 Muse Spark Open は「オープンウェイト」 ⼀部の商⽤利⽤に Meta との契約が要る。学習データ‧学習コードの公開は書かれていない 今ココ 概要 3/15
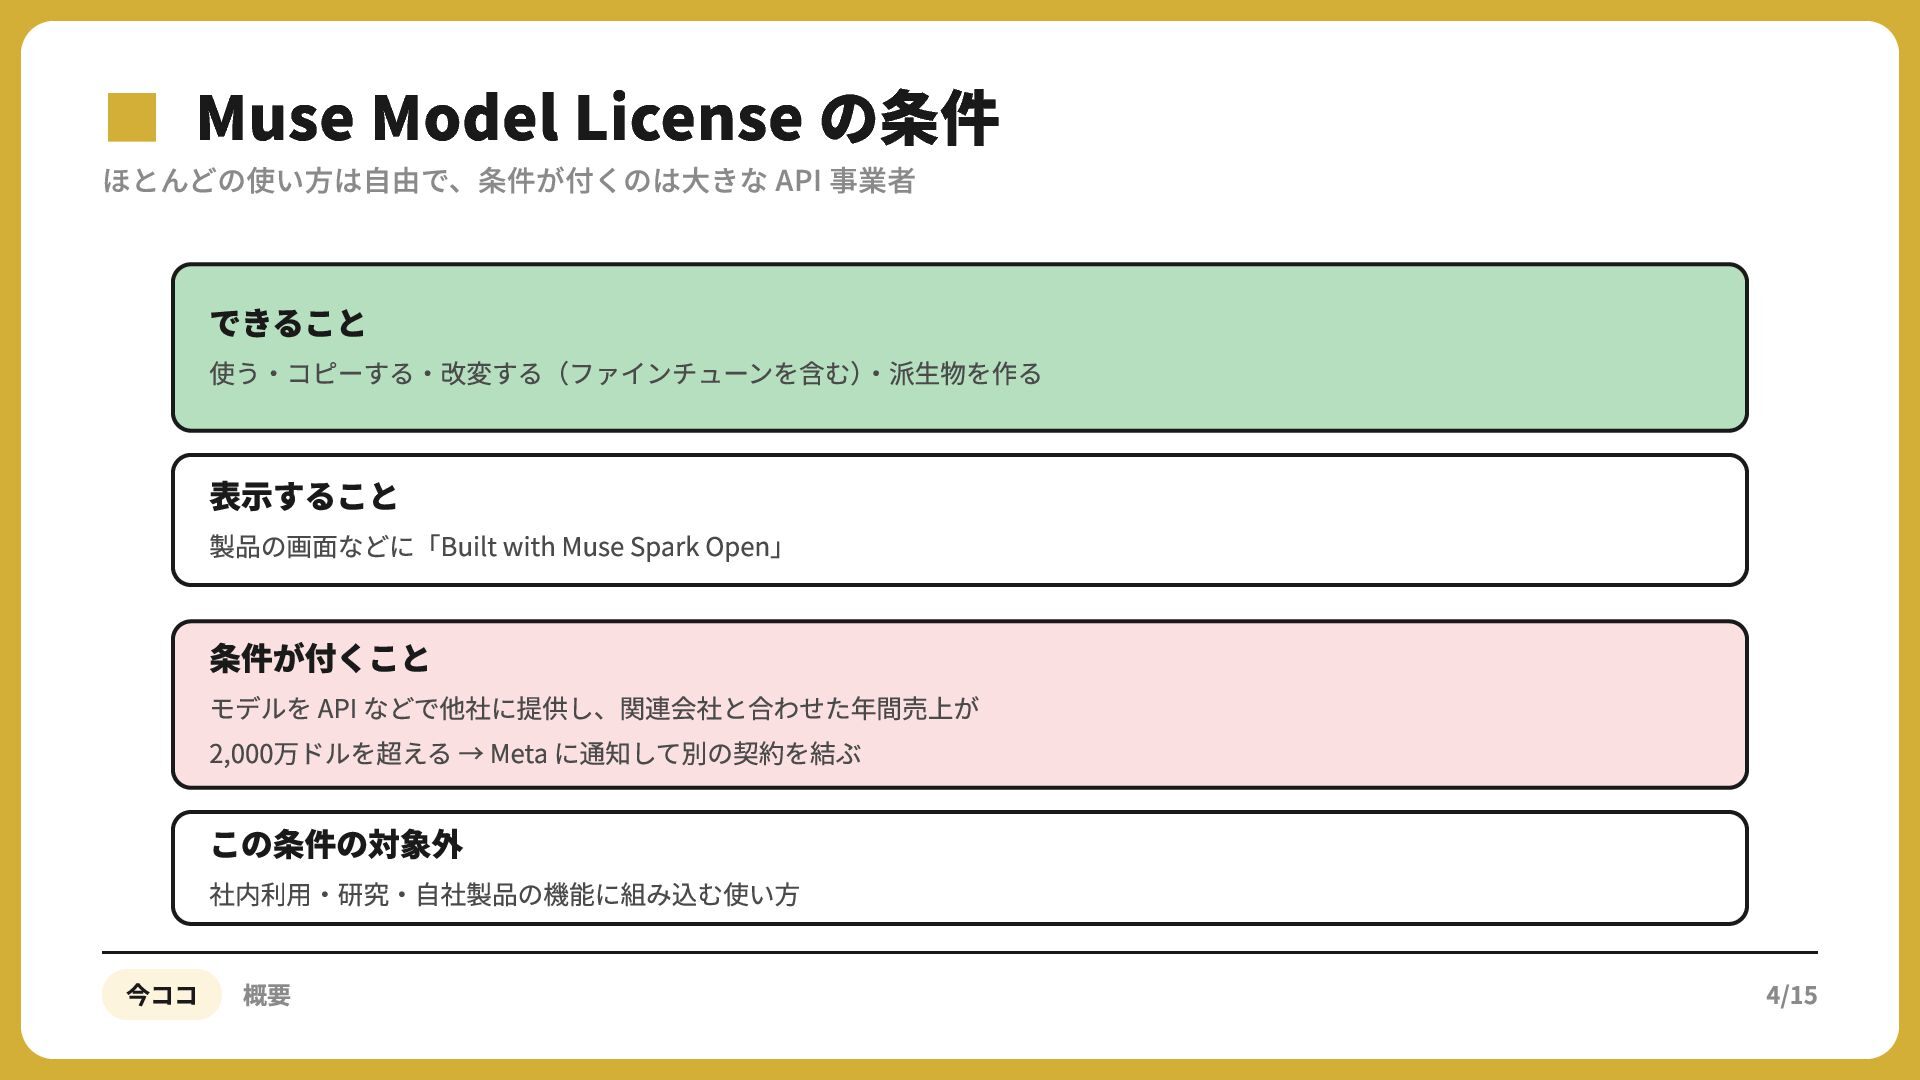
  3. ▪ほとんどの使い方は自由で、条件が付くのは大きな Muse Model LicenseAPIの条件 事業者 できること 使う‧コピーする‧改変する(ファインチューンを含む)‧派⽣物を作る 表⽰すること 製品の画⾯などに「Built with

    Muse Spark Open」 条件が付くこと モデルを API などで他社に提供し、関連会社と合わせた年間売上が 2,000万ドルを超える → Meta に通知して別の契約を結ぶ この条件の対象外 社内利⽤‧研究‧⾃社製品の機能に組み込む使い⽅ 今ココ 概要 4/15
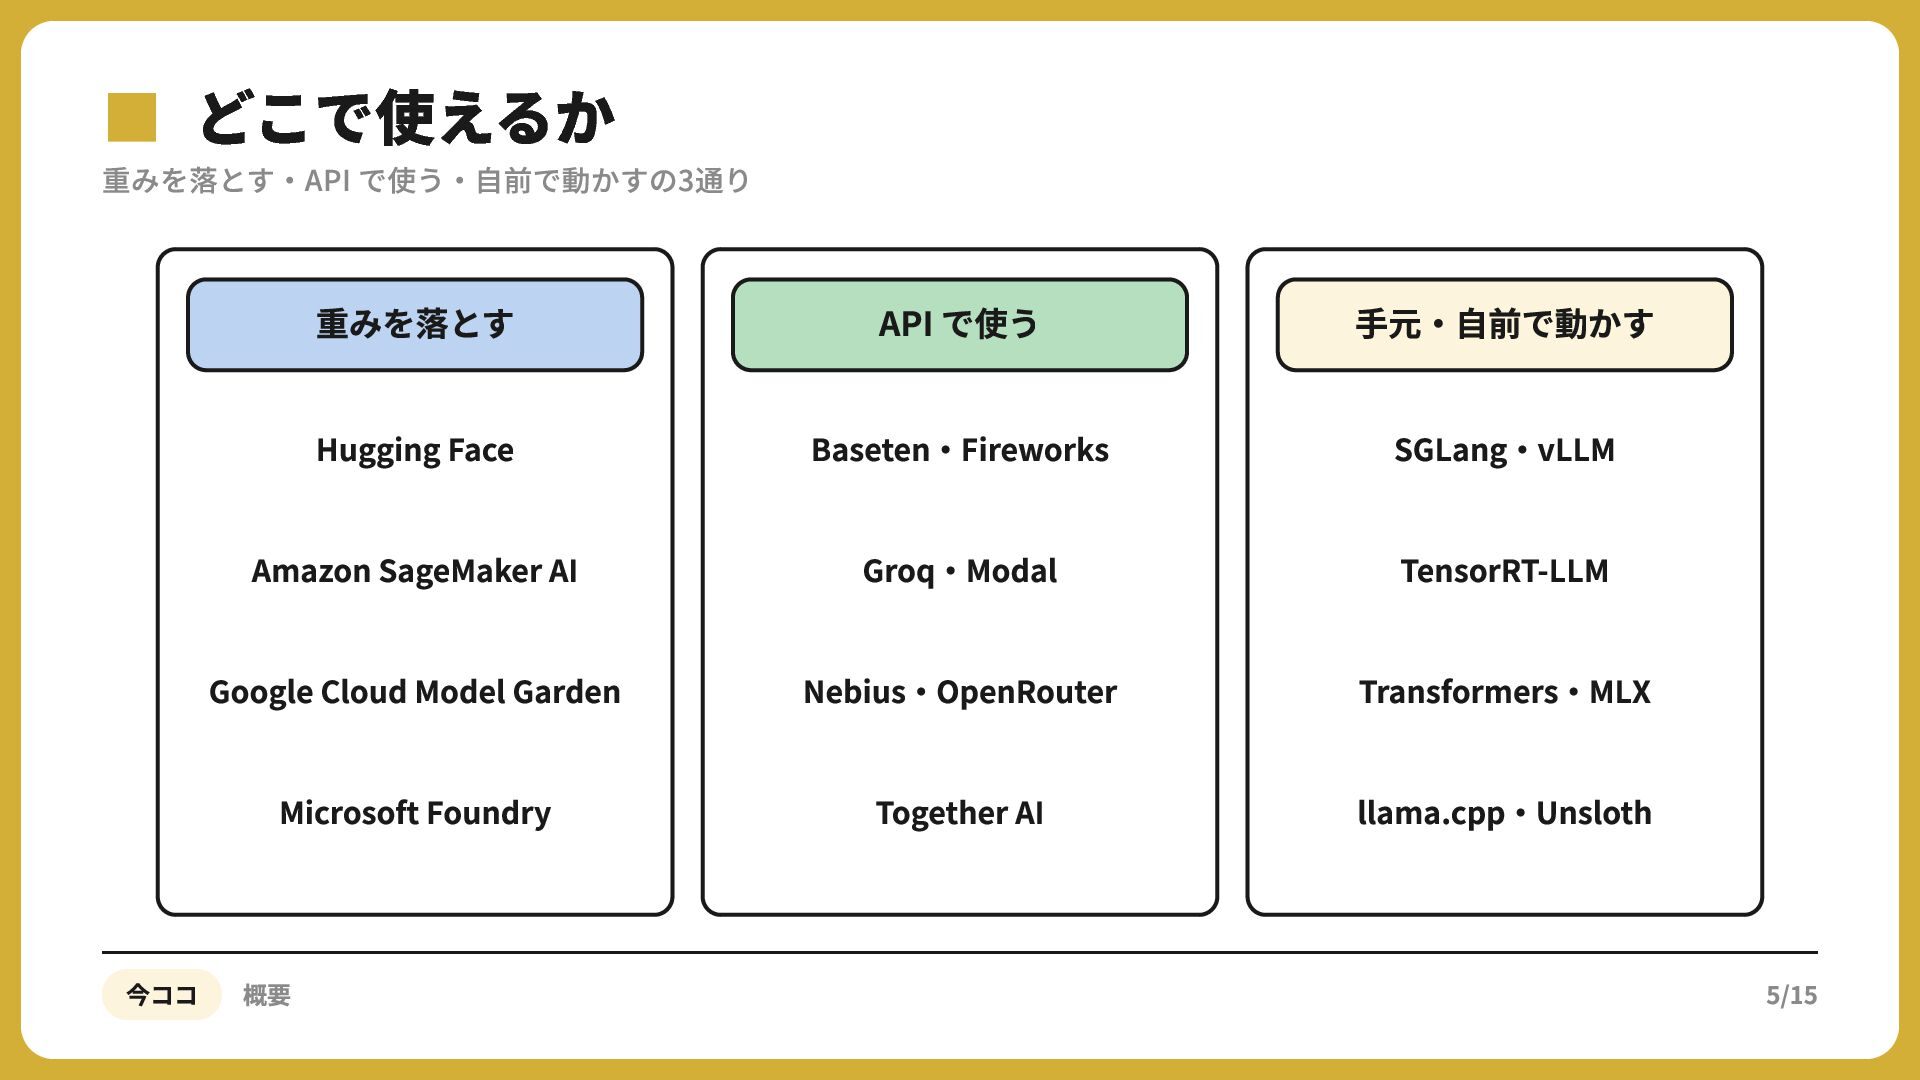
  4. ▪重みを落とす・API どこで使えるか で使う・自前で動かすの3通り 重みを落とす API で使う ⼿元‧⾃前で動かす Hugging Face Baseten‧Fireworks

    SGLang‧vLLM Amazon SageMaker AI Groq‧Modal TensorRT-LLM Google Cloud Model Garden Nebius‧OpenRouter Transformers‧MLX Microsoft Foundry Together AI llama.cpp‧Unsloth 今ココ 概要 5/15
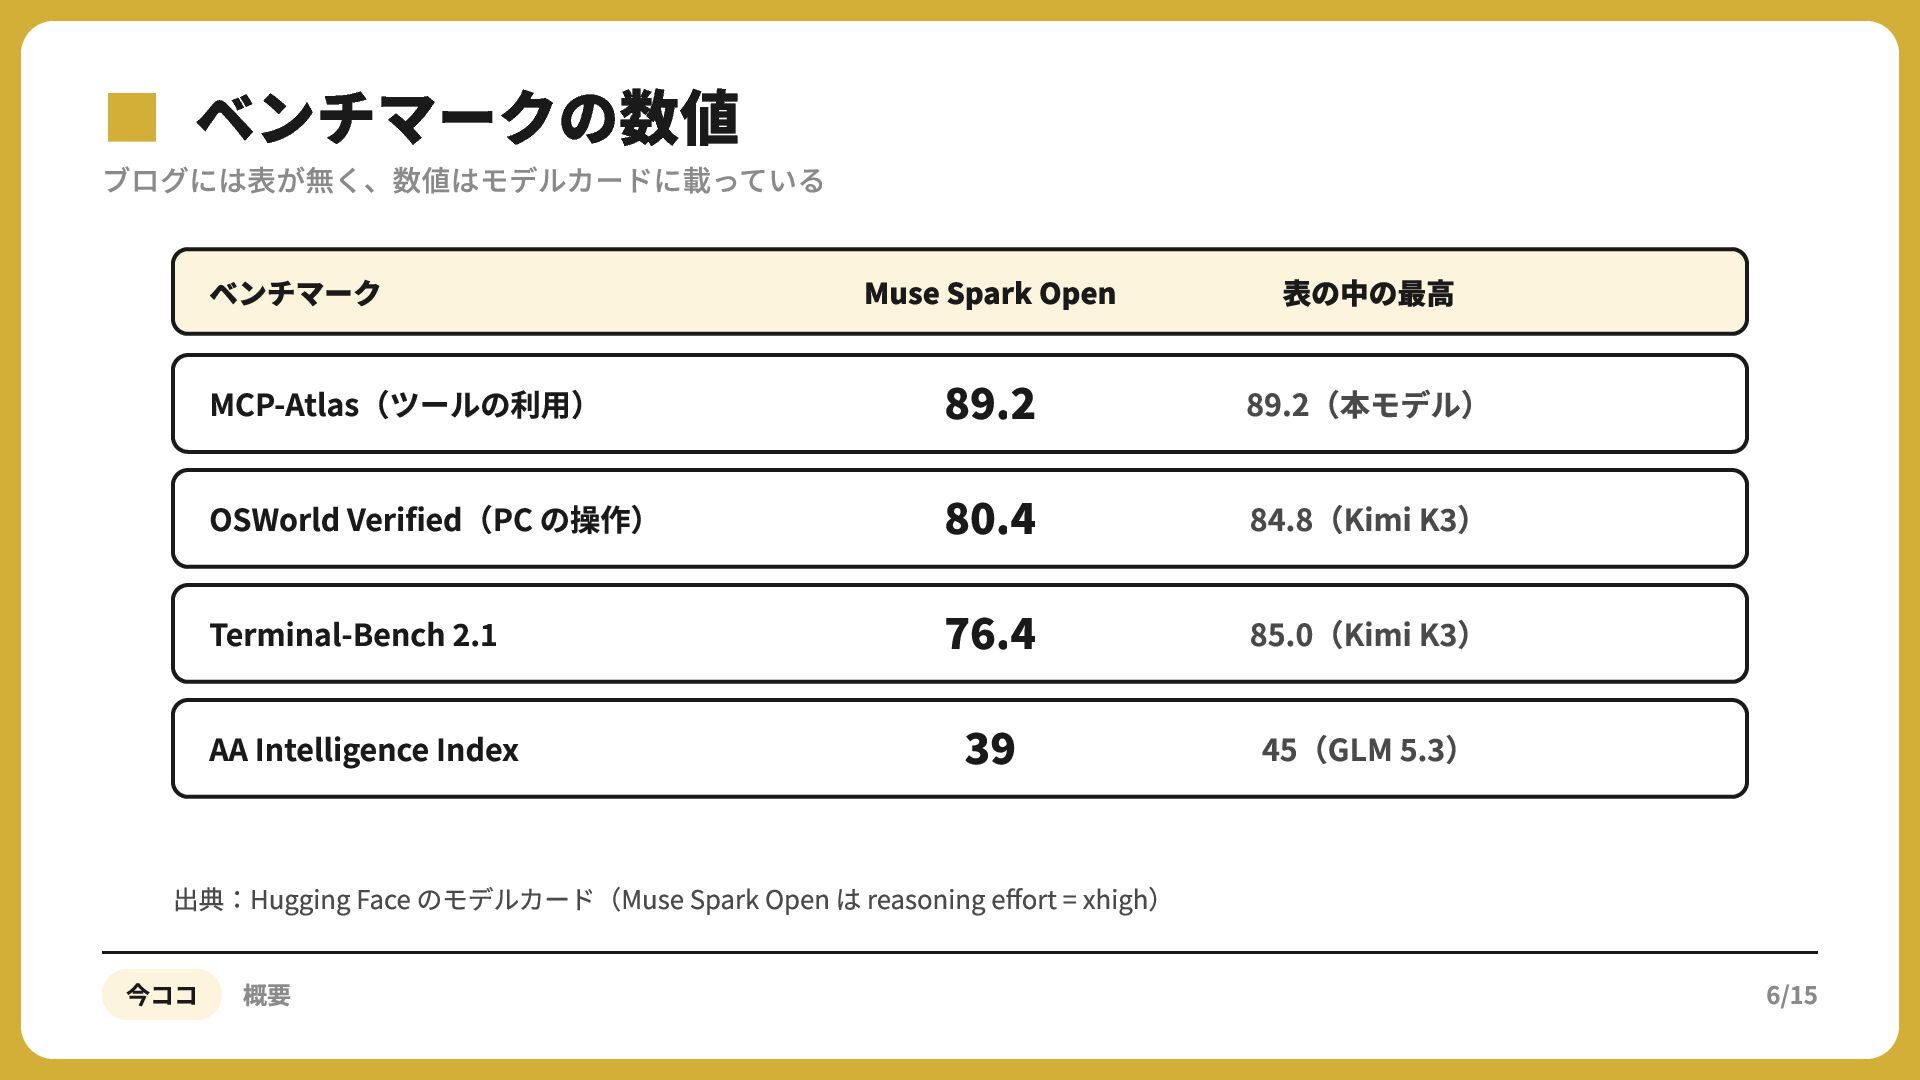
  5. ▪ブログには表が無く、数値はモデルカードに載っている ベンチマークの数値 ベンチマーク MCP-Atlas(ツールの利⽤) OSWorld Verified(PC の操作) Terminal-Bench . Muse

    Spark Open 表の中の最⾼ . . . 89.2(本モデル) AA Intelligence Index 84.8(Kimi K ) 85.0(Kimi K ) 45(GLM . ) 出典:Hugging Face のモデルカード(Muse Spark Open は reasoning effort = xhigh) 今ココ 概要 6/15
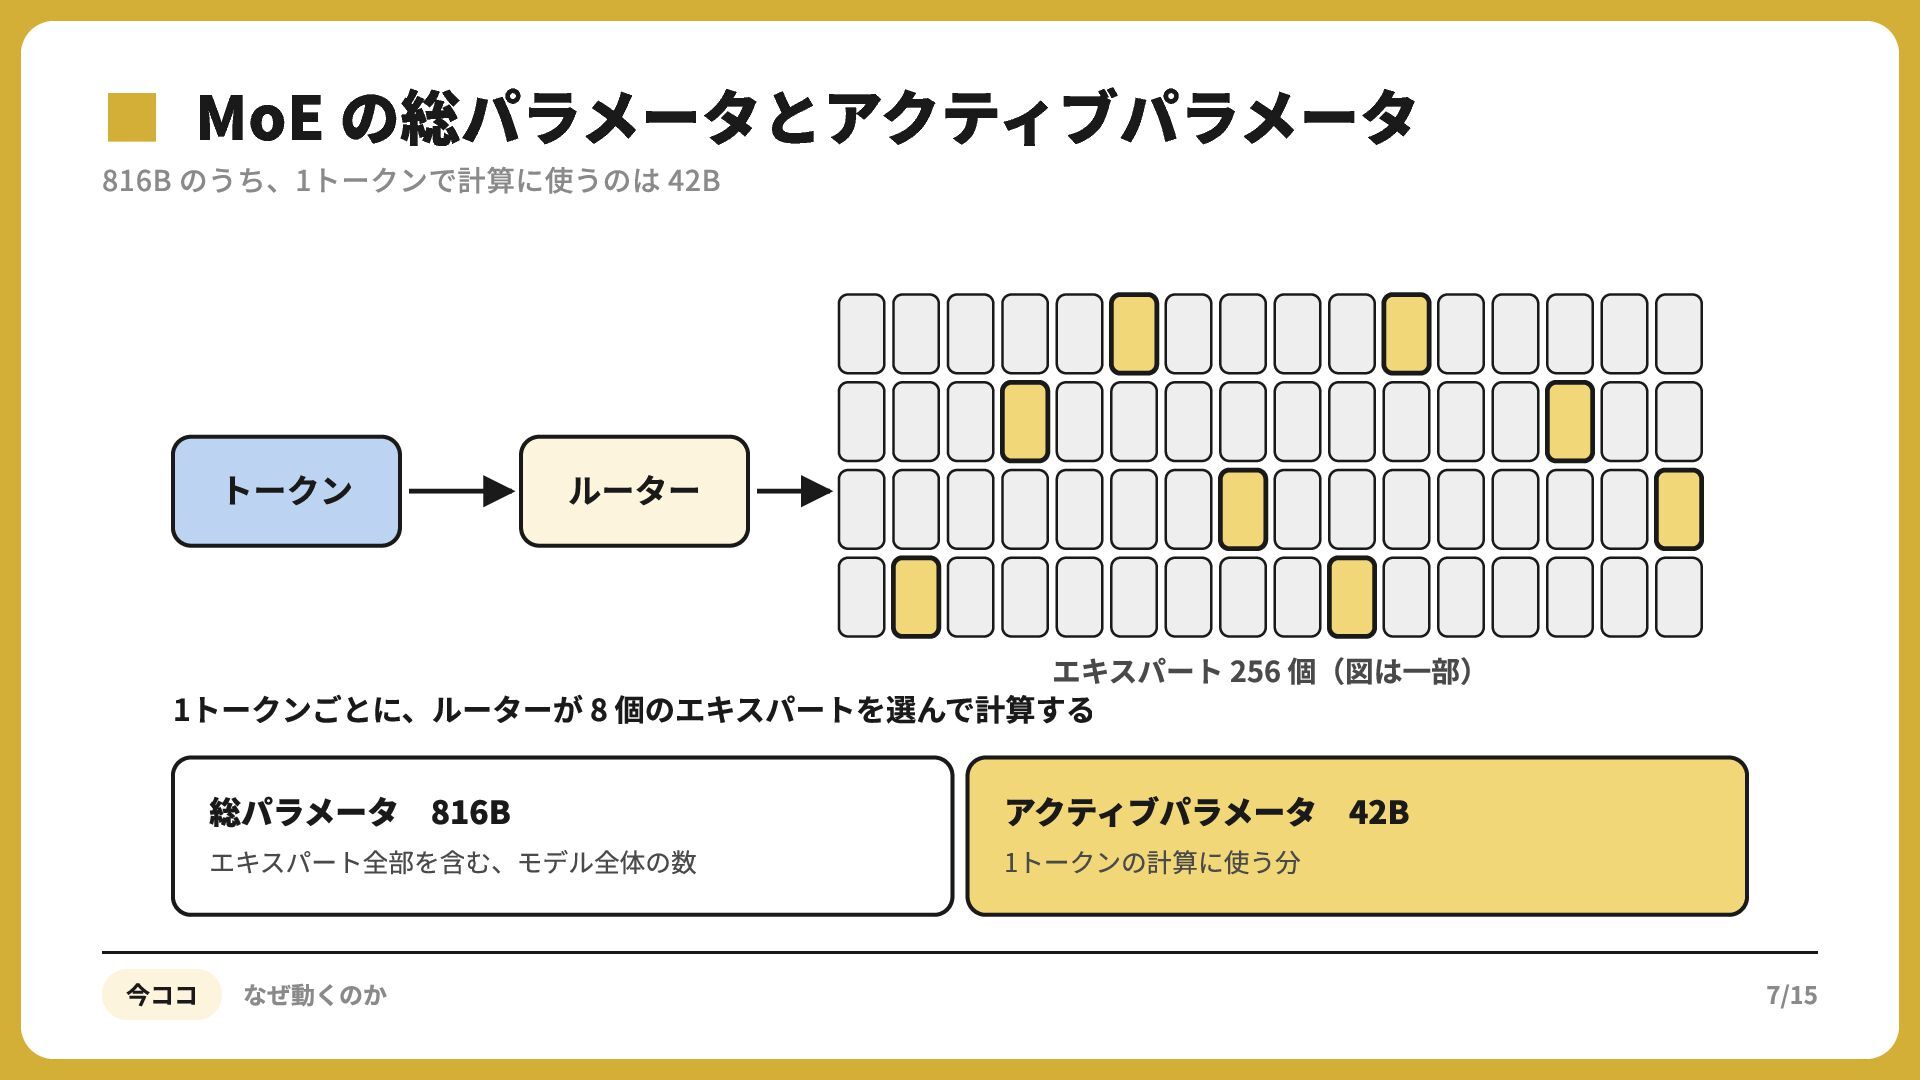
  6. ▪816B のうち、1トークンで計算に使うのは MoE の総パラメータとアクティブパラメータ 42B トークン ルーター エキスパート 256 個(図は⼀部)

    1トークンごとに、ルーターが 8 個のエキスパートを選んで計算する 総パラメータ 816B エキスパート全部を含む、モデル全体の数 今ココ なぜ動くのか アクティブパラメータ 42B 1トークンの計算に使う分 7/15
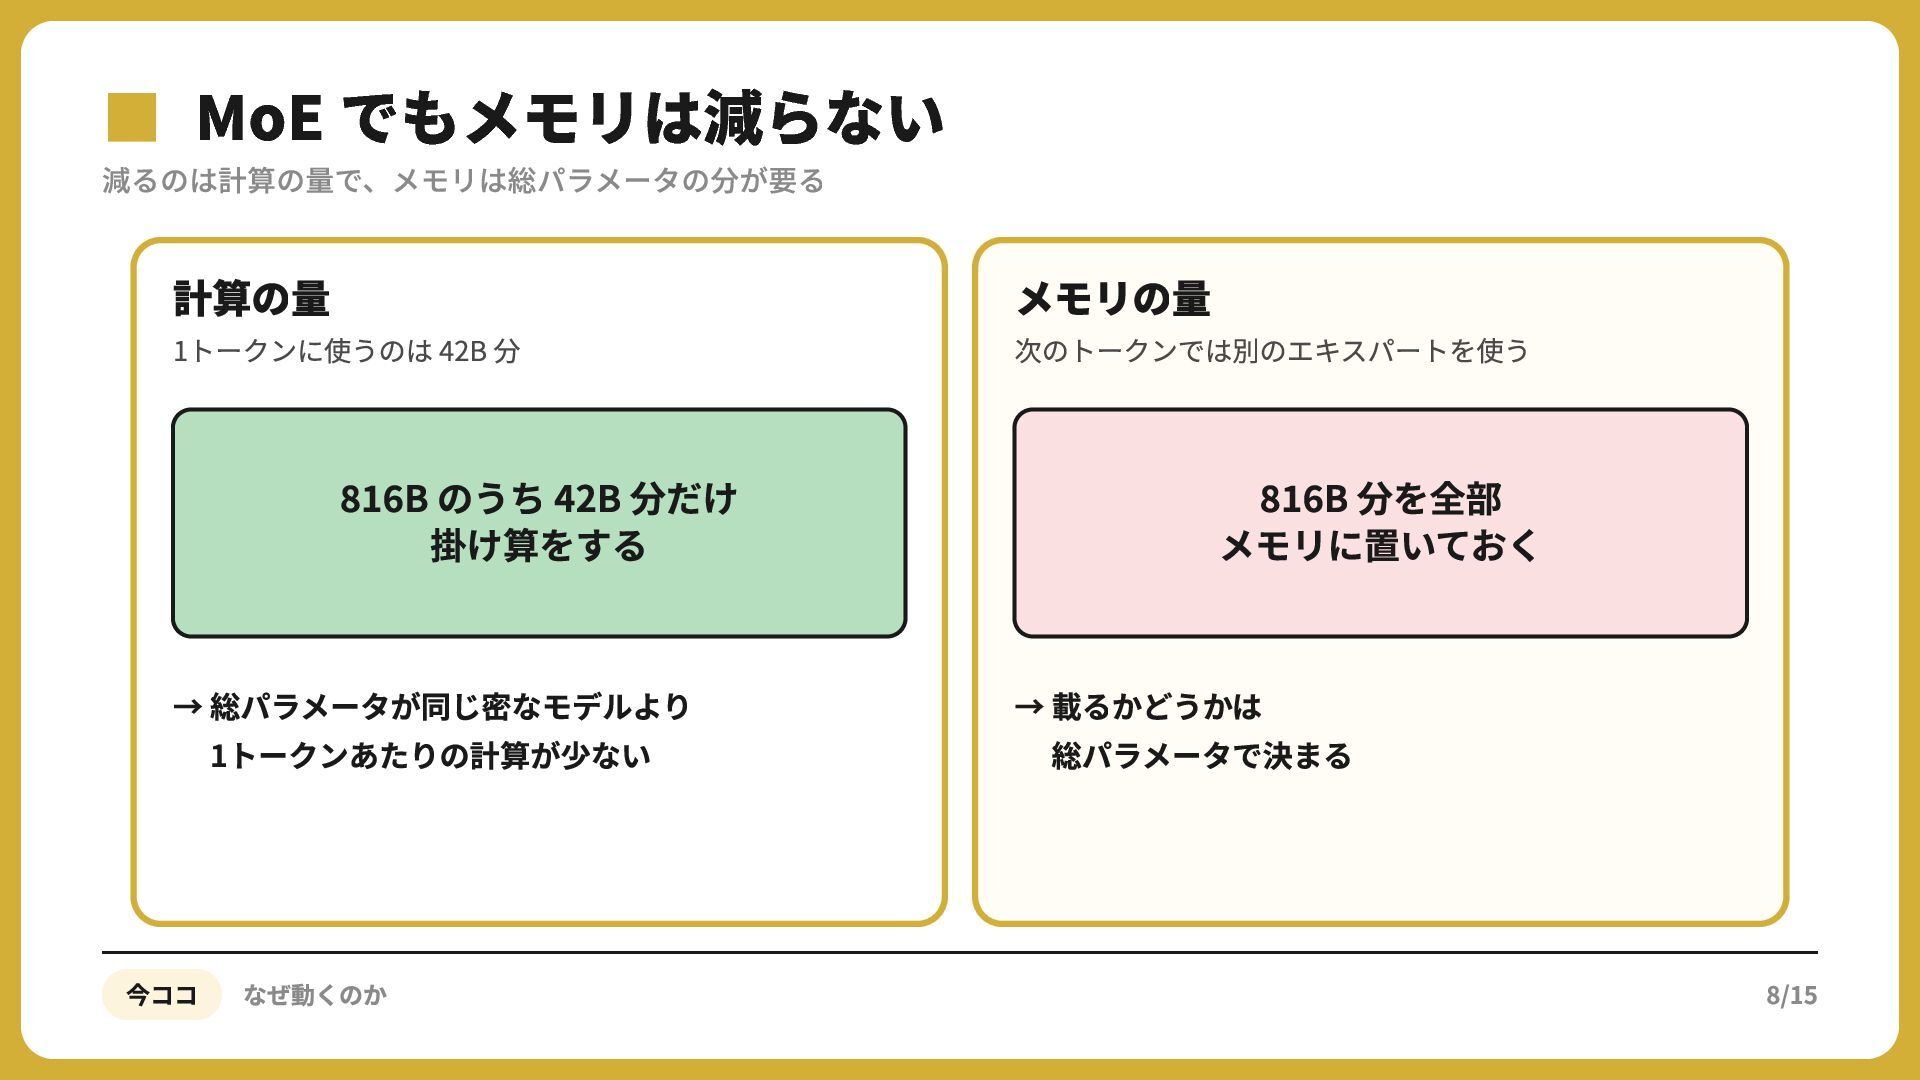
  7. ▪減るのは計算の量で、メモリは総パラメータの分が要る MoE でもメモリは減らない 計算の量 1トークンに使うのは 42B 分 B のうち 42B

    分だけ 掛け算をする → 総パラメータが同じ密なモデルより 1トークンあたりの計算が少ない 今ココ なぜ動くのか メモリの量 次のトークンでは別のエキスパートを使う B 分を全部 メモリに置いておく → 載るかどうかは 総パラメータで決まる 8/15
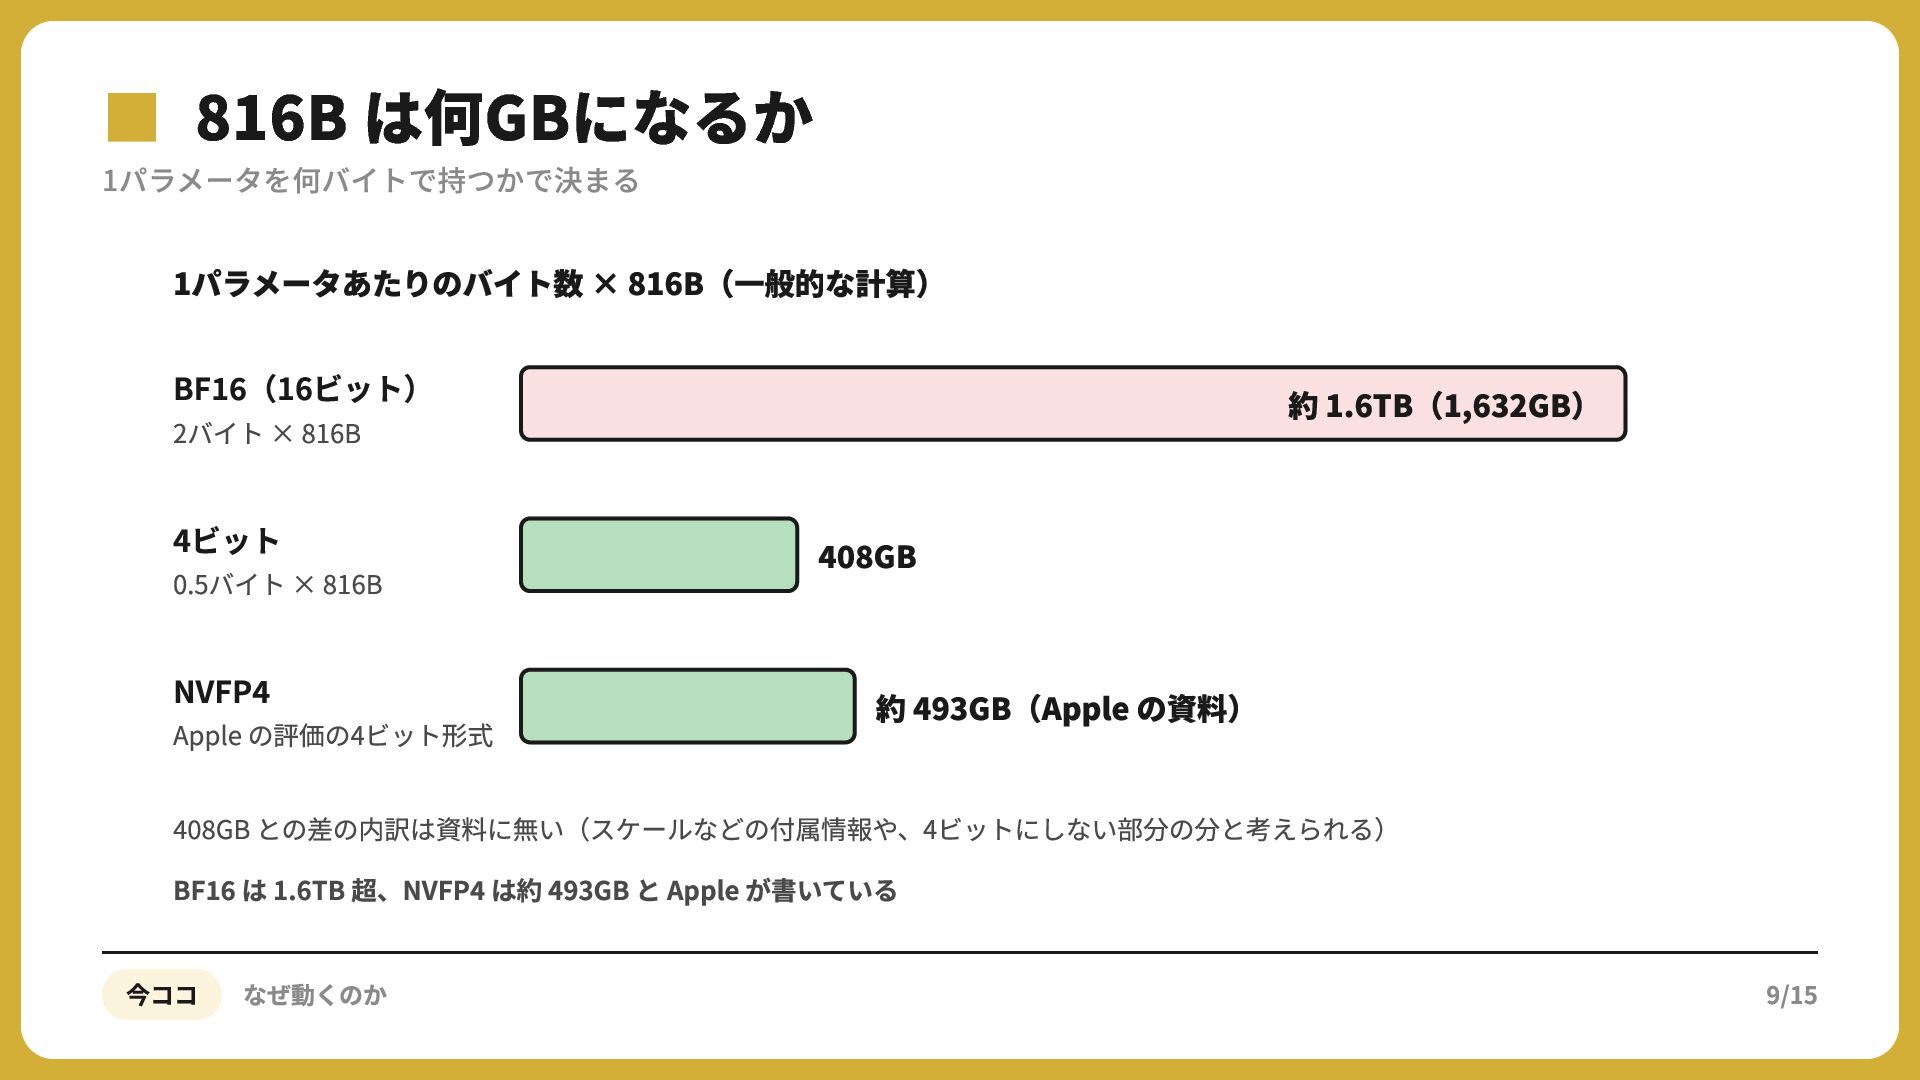
  8. ▪1パラメータを何バイトで持つかで決まる 816B は何GBになるか 1パラメータあたりのバイト数 × 816B(⼀般的な計算) BF (16ビット) 約 1.6TB(1,632GB)

    2バイト × 816B 4ビット 0.5バイト × 816B GB NVFP 約 493GB(Apple の資料) Apple の評価の4ビット形式 GB との差の内訳は資料に無い(スケールなどの付属情報や、4ビットにしない部分の分と考えられる) BF は 1.6TB 超、NVFP は約 493GB と Apple が書いている 今ココ なぜ動くのか 9/15
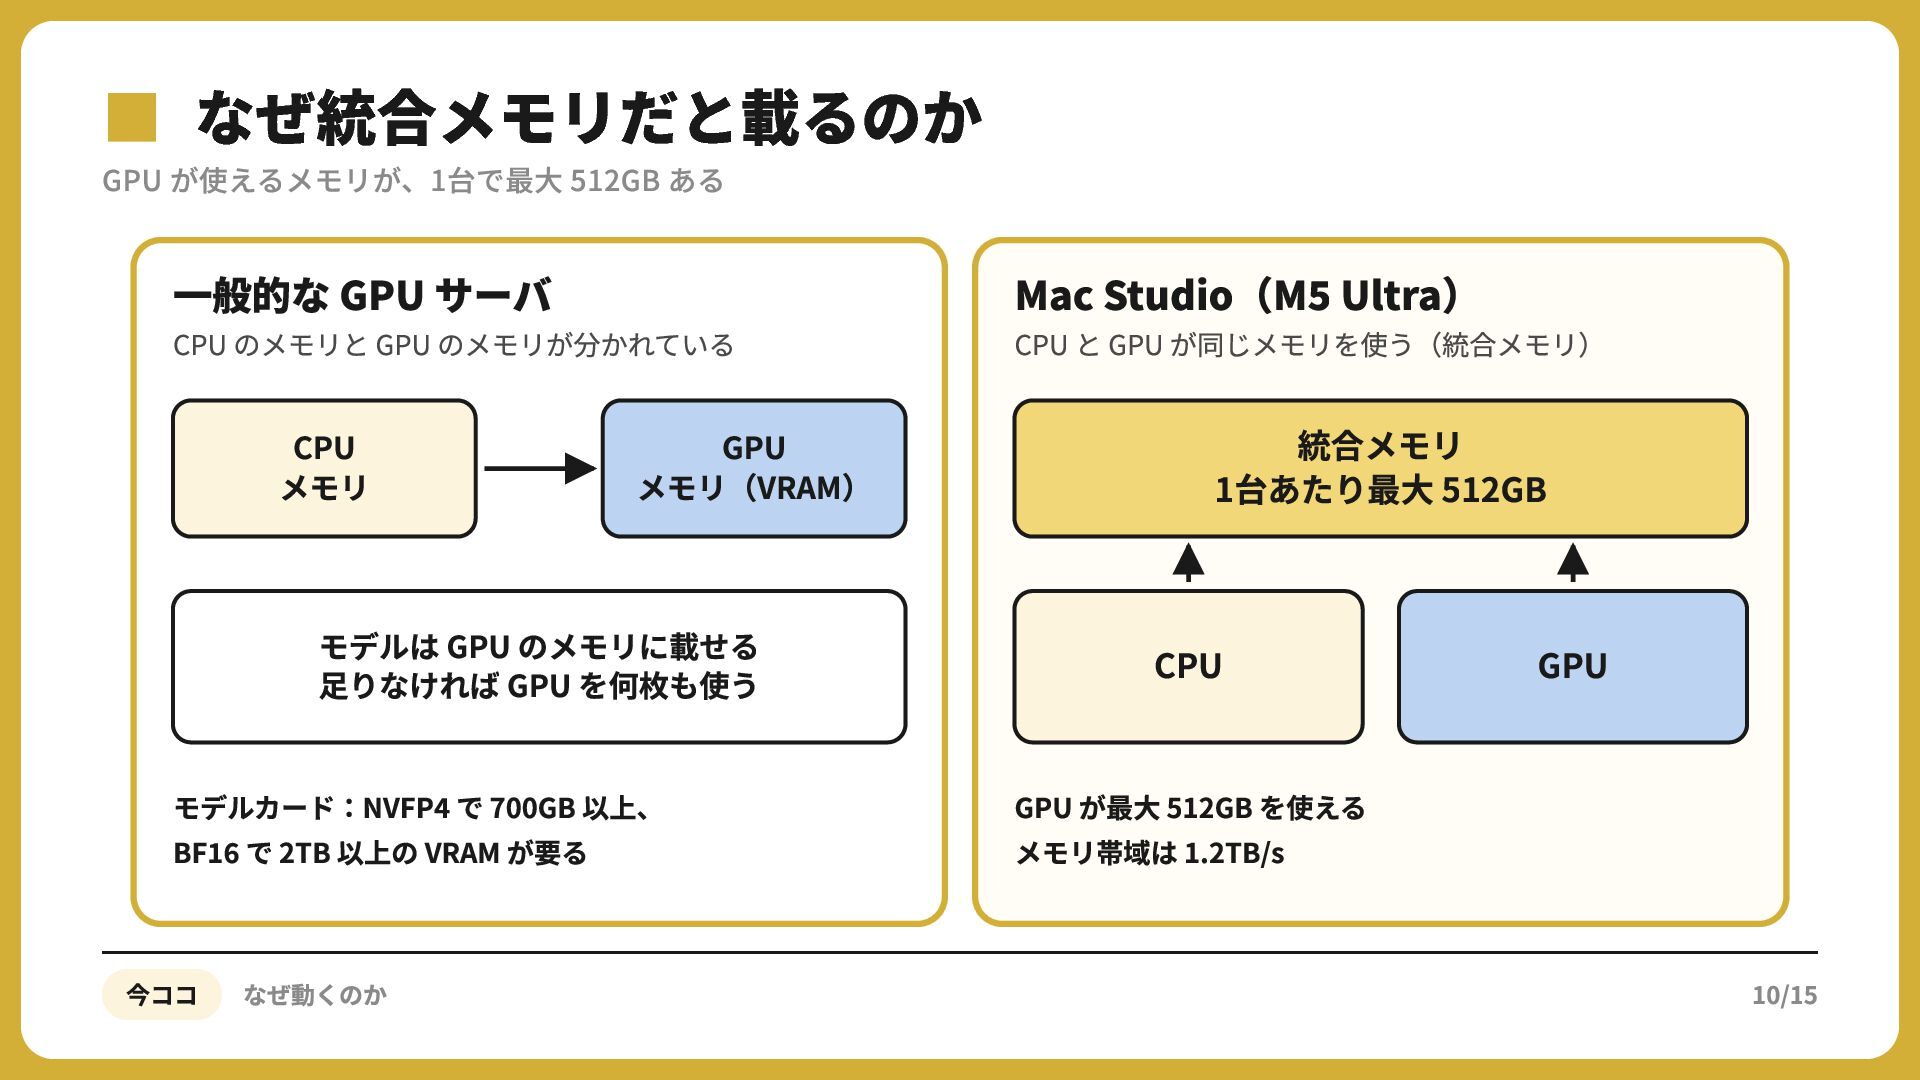
  9. ▪GPU が使えるメモリが、1台で最大 なぜ統合メモリだと載るのか 512GB ある ⼀般的な GPU サーバ CPU のメモリと

    GPU のメモリが分かれている CPU メモリ GPU メモリ(VRAM) モデルは GPU のメモリに載せる ⾜りなければ GPU を何枚も使う モデルカード:NVFP で 700GB 以上、 BF で 2TB 以上の VRAM が要る 今ココ なぜ動くのか Mac Studio(M Ultra) CPU と GPU が同じメモリを使う(統合メモリ) 統合メモリ 1台あたり最⼤ 512GB CPU GPU GPU が最⼤ 512GB を使える メモリ帯域は 1.2TB/s 10/15
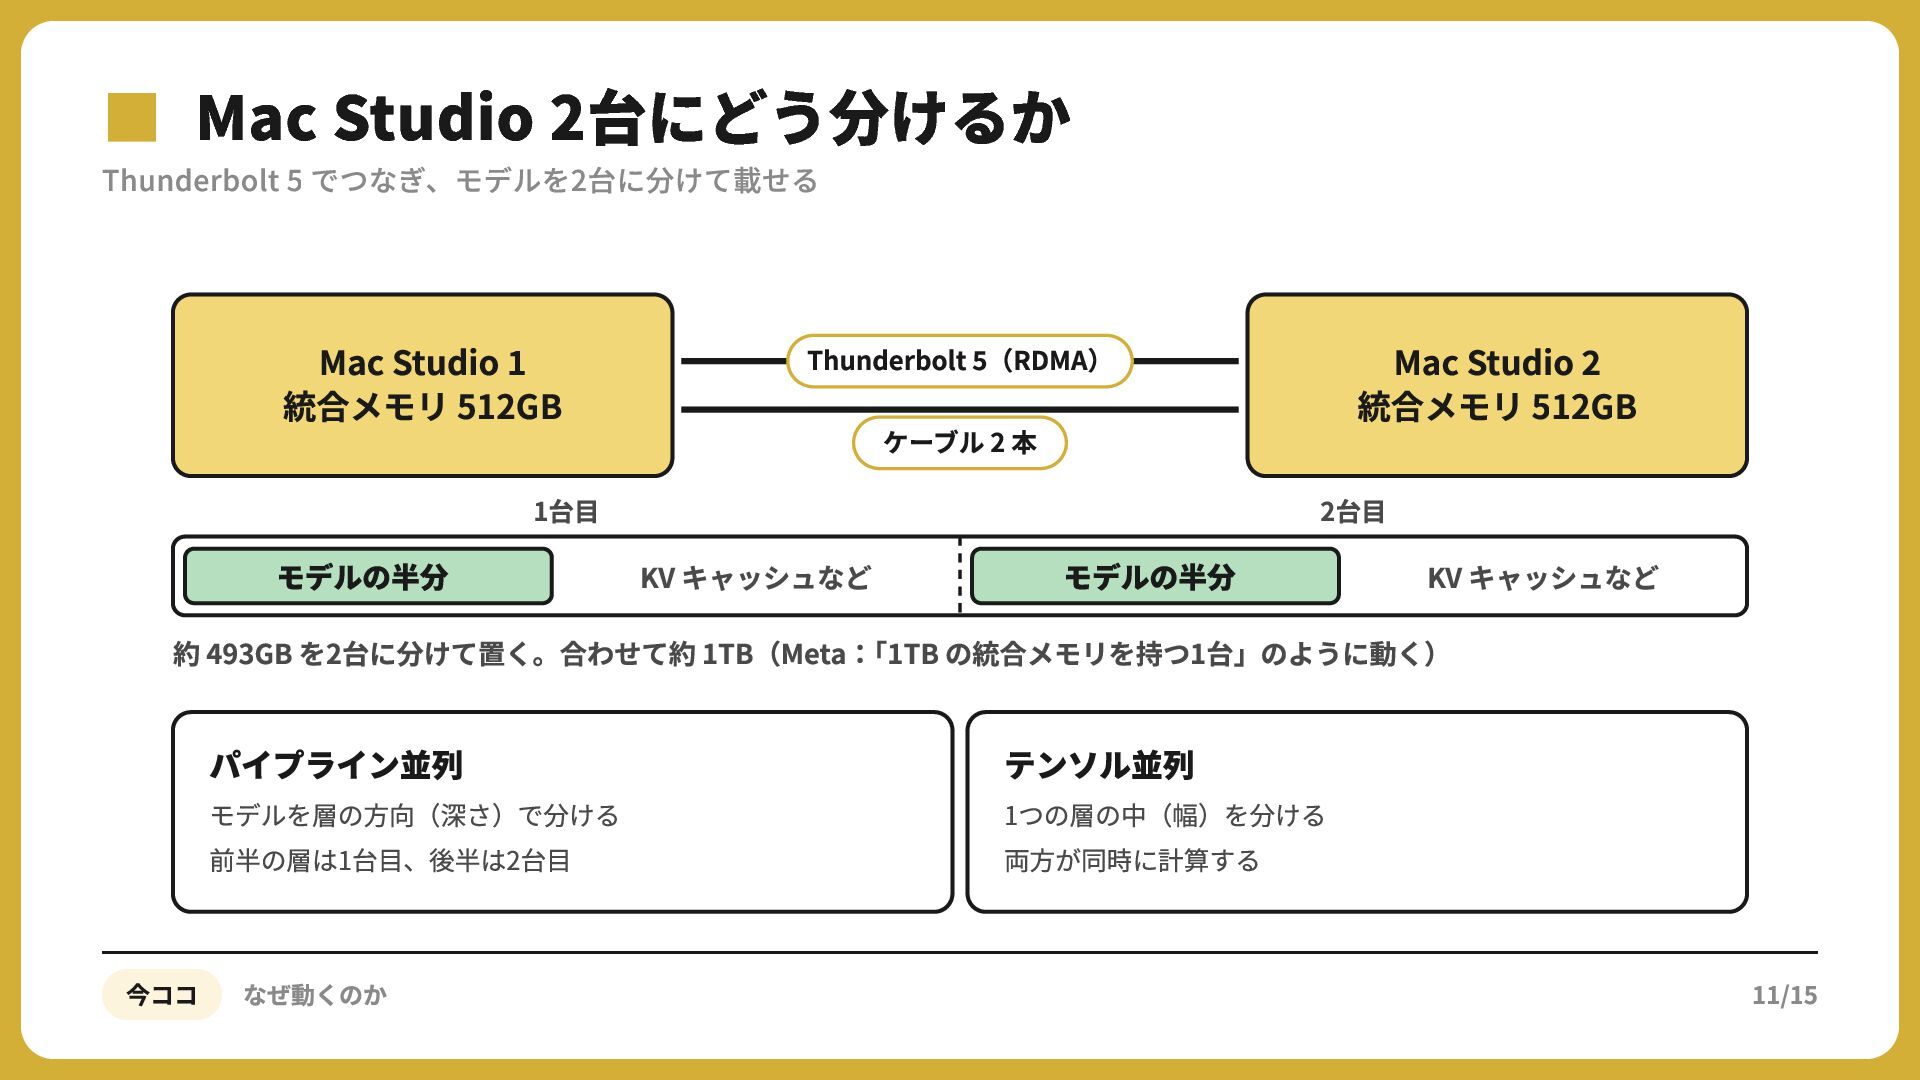
  10. ▪Thunderbolt Mac5 でつなぎ、モデルを2台に分けて載せる Studio 2台にどう分けるか Mac Studio 統合メモリ 512GB モデルの半分

    Mac Studio 統合メモリ 512GB Thunderbolt (RDMA) ケーブル 2 本 1台⽬ 2台⽬ KV キャッシュなど モデルの半分 KV キャッシュなど 約 493GB を2台に分けて置く。合わせて約 1TB(Meta:「1TB の統合メモリを持つ1台」のように動く) パイプライン並列 モデルを層の⽅向(深さ)で分ける 前半の層は1台⽬、後半は2台⽬ 今ココ なぜ動くのか テンソル並列 1つの層の中(幅)を分ける 両⽅が同時に計算する 11/15
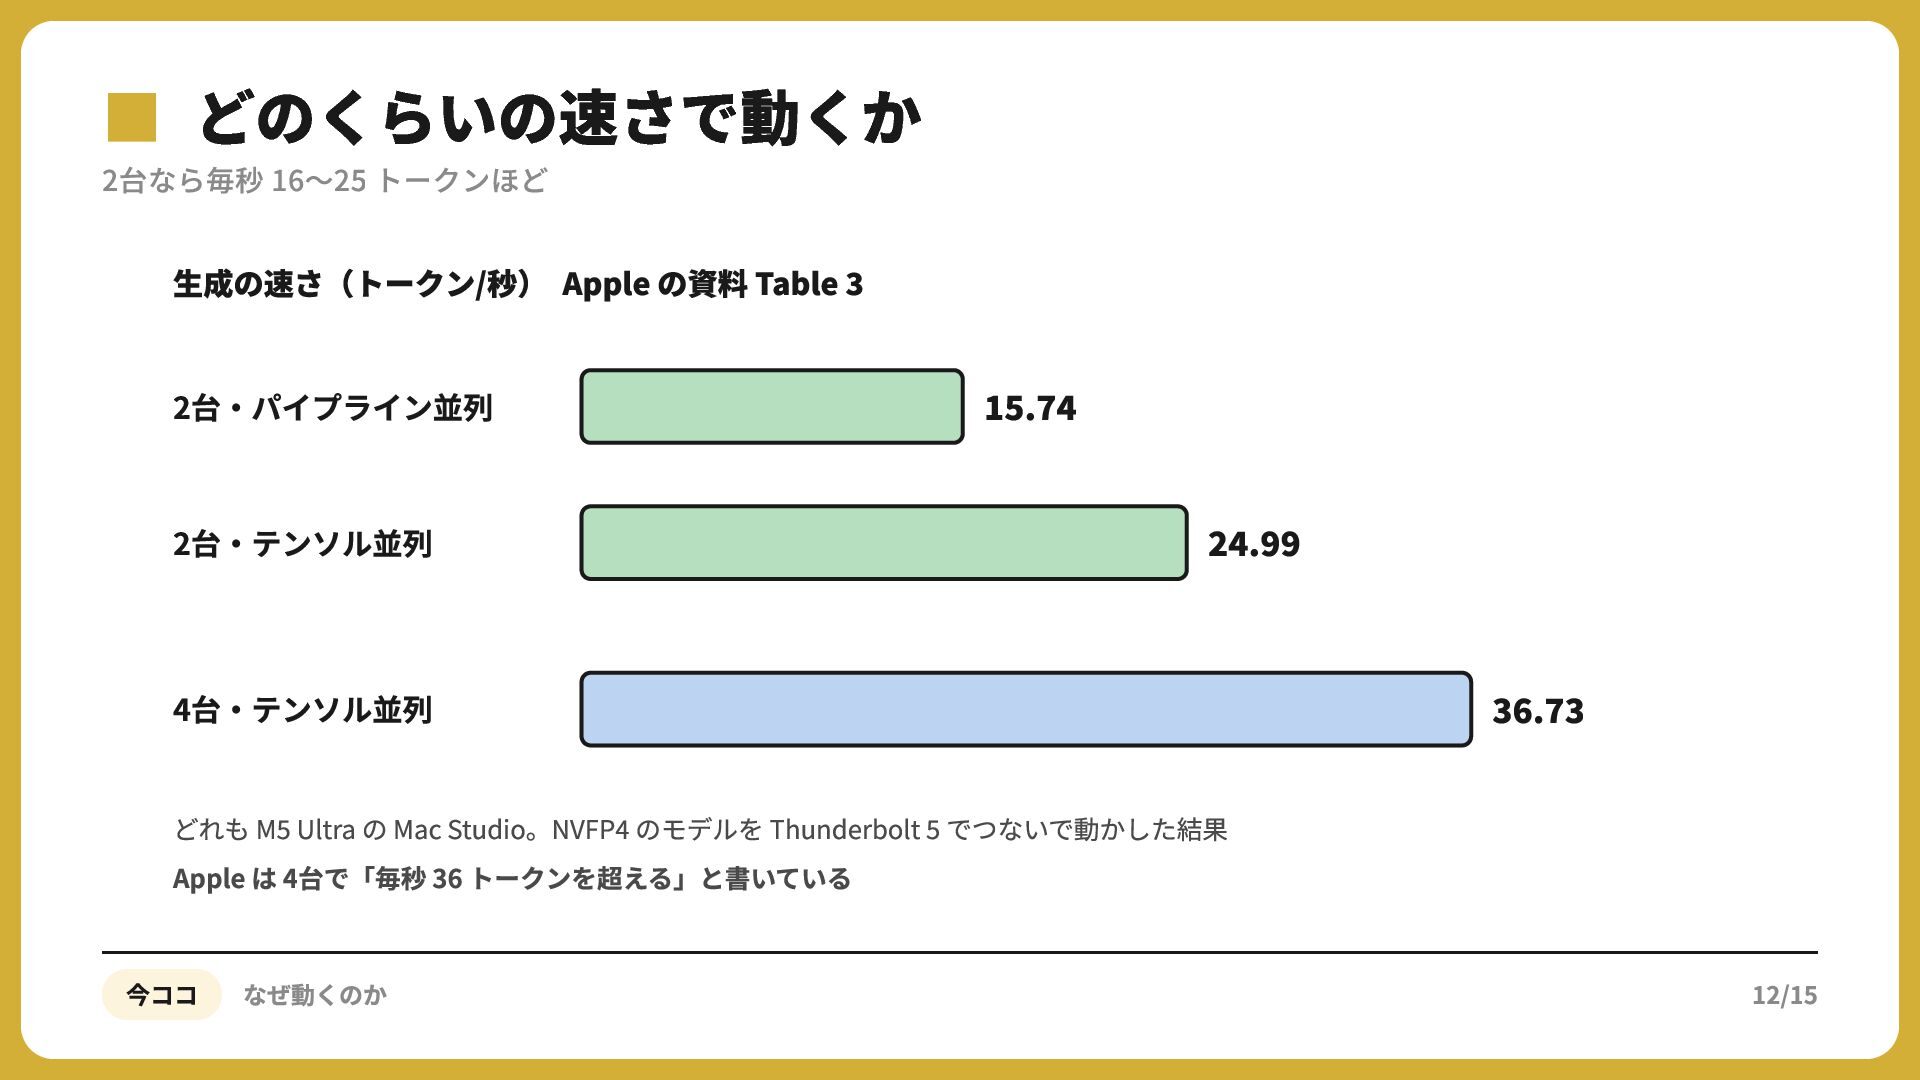
  11. ▪2台なら毎秒 どのくらいの速さで動くか 16〜25 トークンほど ⽣成の速さ(トークン/秒) Apple の資料 Table 2台‧パイプライン並列 .

    2台‧テンソル並列 4台‧テンソル並列 . . どれも M Ultra の Mac Studio。NVFP のモデルを Thunderbolt でつないで動かした結果 Apple は 4台で「毎秒 36 トークンを超える」と書いている 今ココ なぜ動くのか 12/15
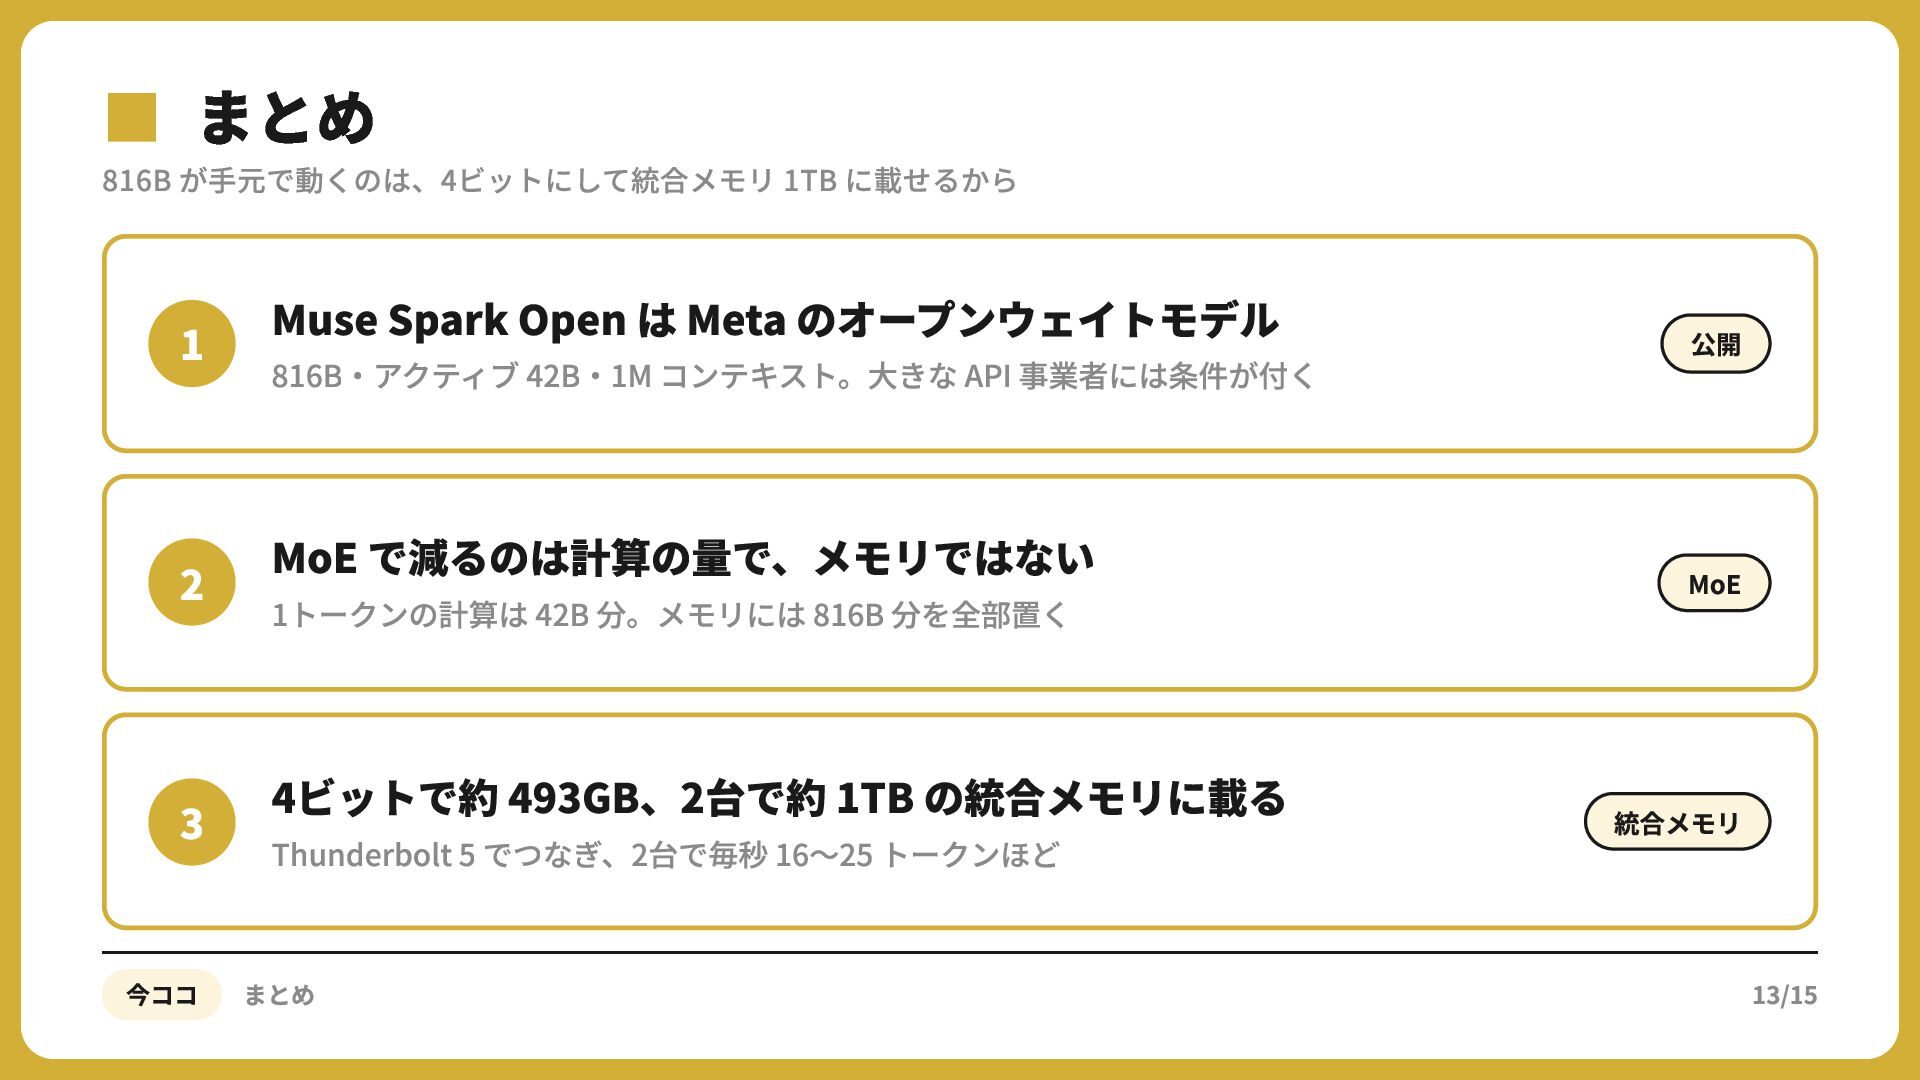
  12. ▪816B が手元で動くのは、4ビットにして統合メモリ まとめ 1TB に載せるから Spark Open は Meta のオープンウェイトモデル

    1 Muse 816B・アクティブ 42B・1M コンテキスト。大きな API 事業者には条件が付く 公開 で減るのは計算の量で、メモリではない 2 MoE 1トークンの計算は 42B 分。メモリには 816B 分を全部置く MoE 493GB、2台で約 1TB の統合メモリに載る 3 4ビットで約 Thunderbolt 5 でつなぎ、2台で毎秒 16〜25 トークンほど 今ココ まとめ 統合メモリ 13/15
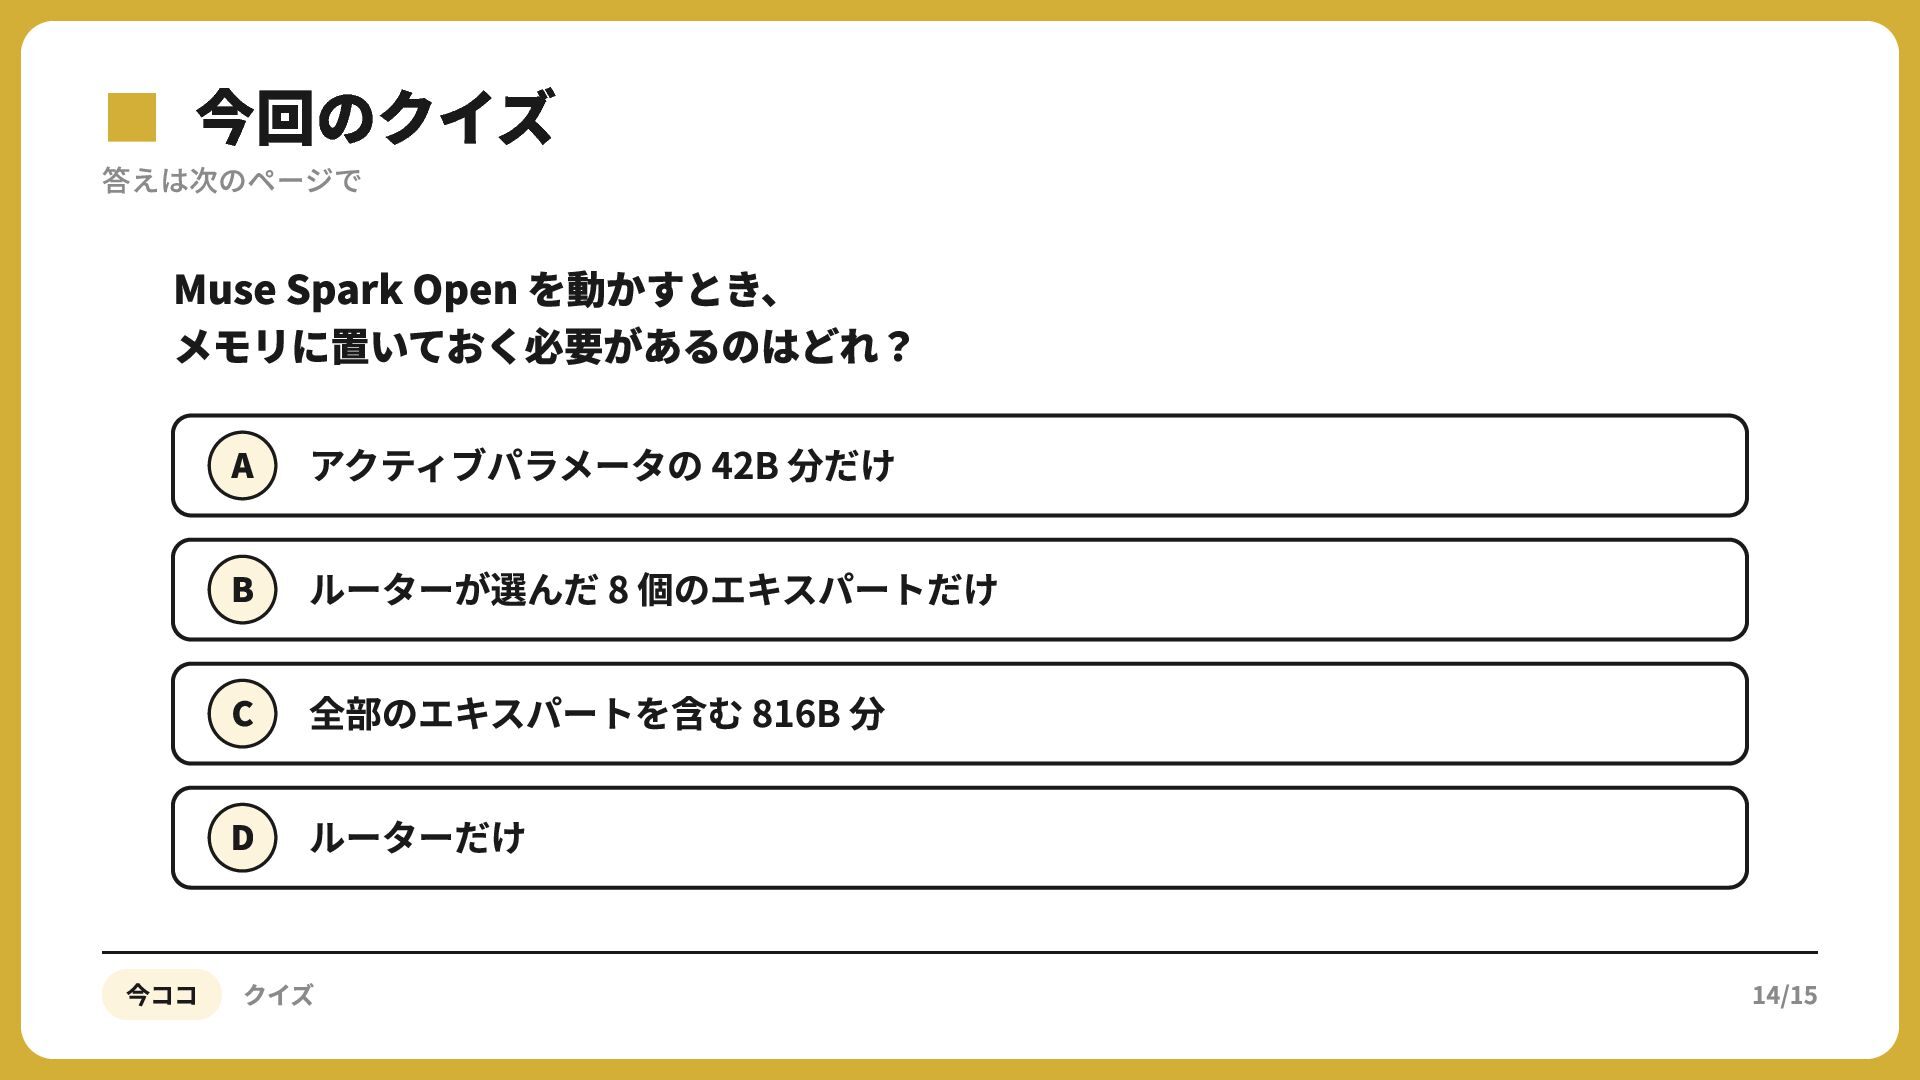
  13. ▪答えは次のページで 今回のクイズ Muse Spark Open を動かすとき、 メモリに置いておく必要があるのはどれ? A アクティブパラメータの 42B

    分だけ B ルーターが選んだ 8 個のエキスパートだけ C 全部のエキスパートを含む 816B 分 D ルーターだけ 今ココ クイズ 14/15
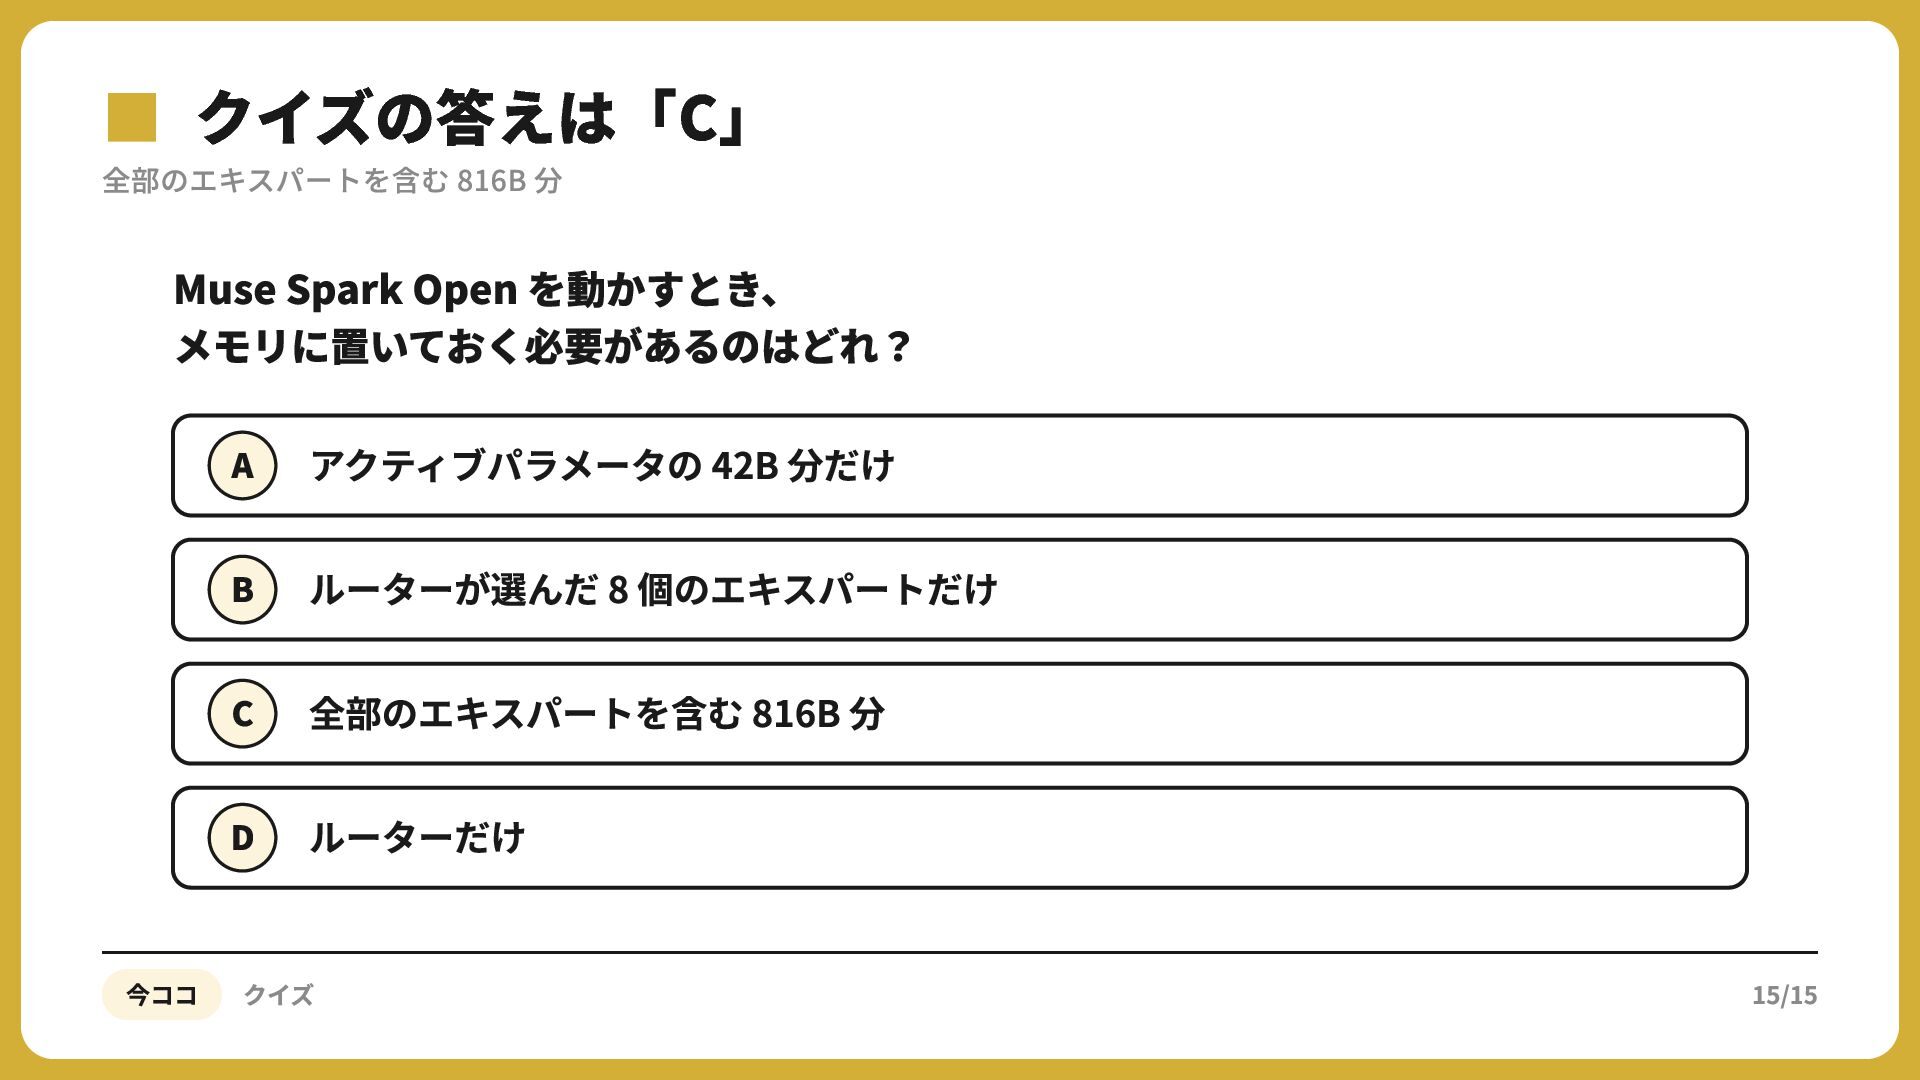
  14. ▪全部のエキスパートを含む クイズの答えは「C」 816B 分 Muse Spark Open を動かすとき、 メモリに置いておく必要があるのはどれ? A

    アクティブパラメータの 42B 分だけ B ルーターが選んだ 8 個のエキスパートだけ C 全部のエキスパートを含む 816B 分 D ルーターだけ 今ココ クイズ 15/15