Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
量と質のバランス取れてないよ
Search
Daisuke Akagawa (Akasan)
November 16, 2026
Programming
43
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
量と質のバランス取れてないよ
Daisuke Akagawa (Akasan)
November 16, 2026
Transcript
34 slides
量と質のバランス取れてないよ AIを紡ぐ者たち #4 ~AIに振り回された人間たちの慰労会~ 株式会社スリーシェイク Sreake事業部 赤川 大空 Copyright ©
3-shake, Inc. All Rights Reserved.
自己紹介 - 赤川大空(Akasan) - 株式会社スリーシェイク Sreake事業部 アプリチームの中で、特にML領域を担当 - - MLOpsの構築支援や生成AIアプリケーションの実装
- NVIDIA NPN Solution Advisor としての活動のリード 最近の興味 - MLOps - ML/AI - クラウド(Google Cloudを中心) 2
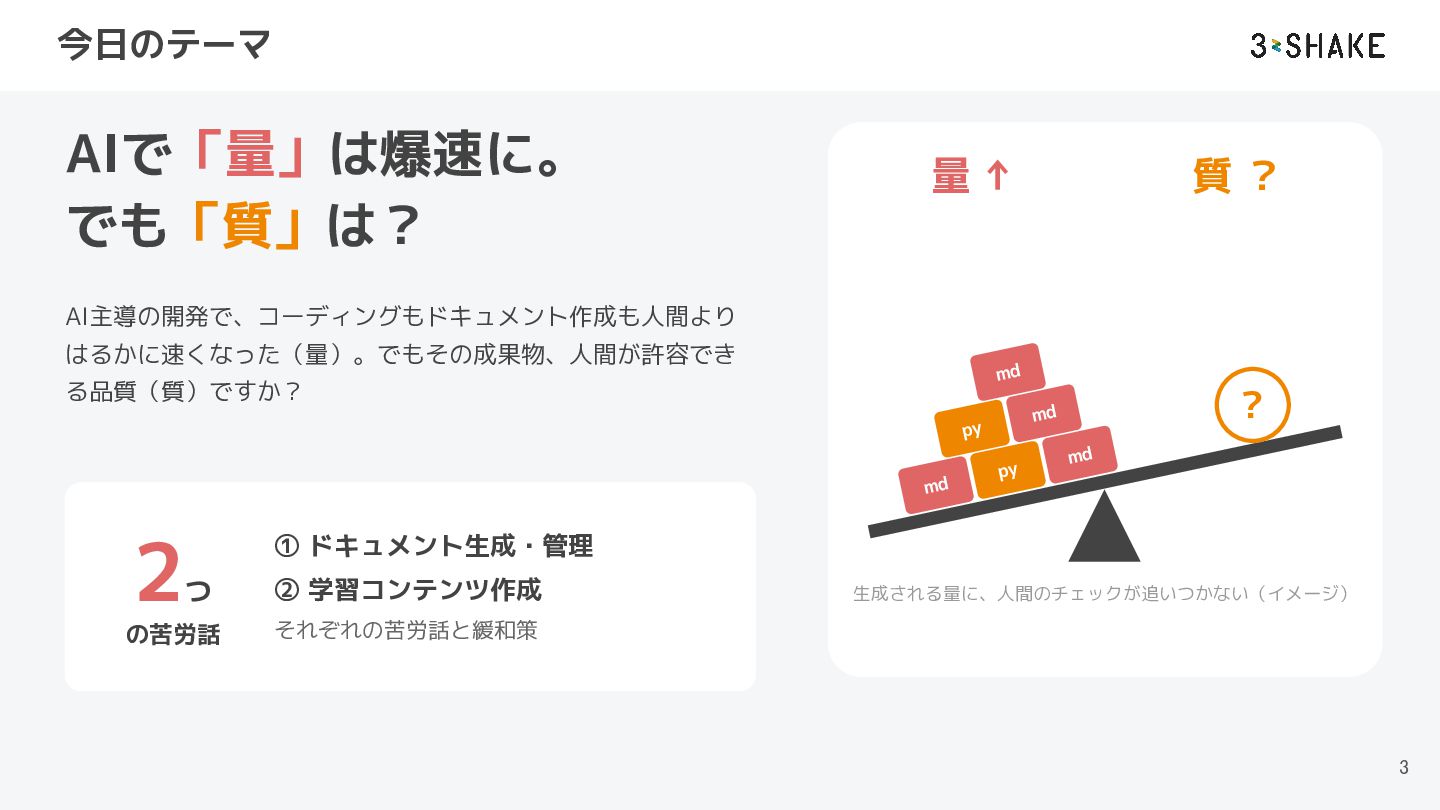
今日のテーマ AIで「量」は爆速に。 でも「質」は? 量↑ 質? AI主導の開発で、コーディングもドキュメント作成も人間より はるかに速くなった(量)。でもその成果物、人間が許容でき md る品質(質)ですか? md
2 ① ドキュメント生成・管理 つ ② 学習コンテンツ作成 の苦労話 それぞれの苦労話と緩和策 ? md py py md 生成される量に、人間のチェックが追いつかない(イメージ) 3
01 ユースケース1:ドキュメント生成・管理 AIにドキュメントを書かせたら… 書くのは一瞬。でも、その後どうなった? Copyright © 3-shake, Inc. All Rights
Reserved. 4
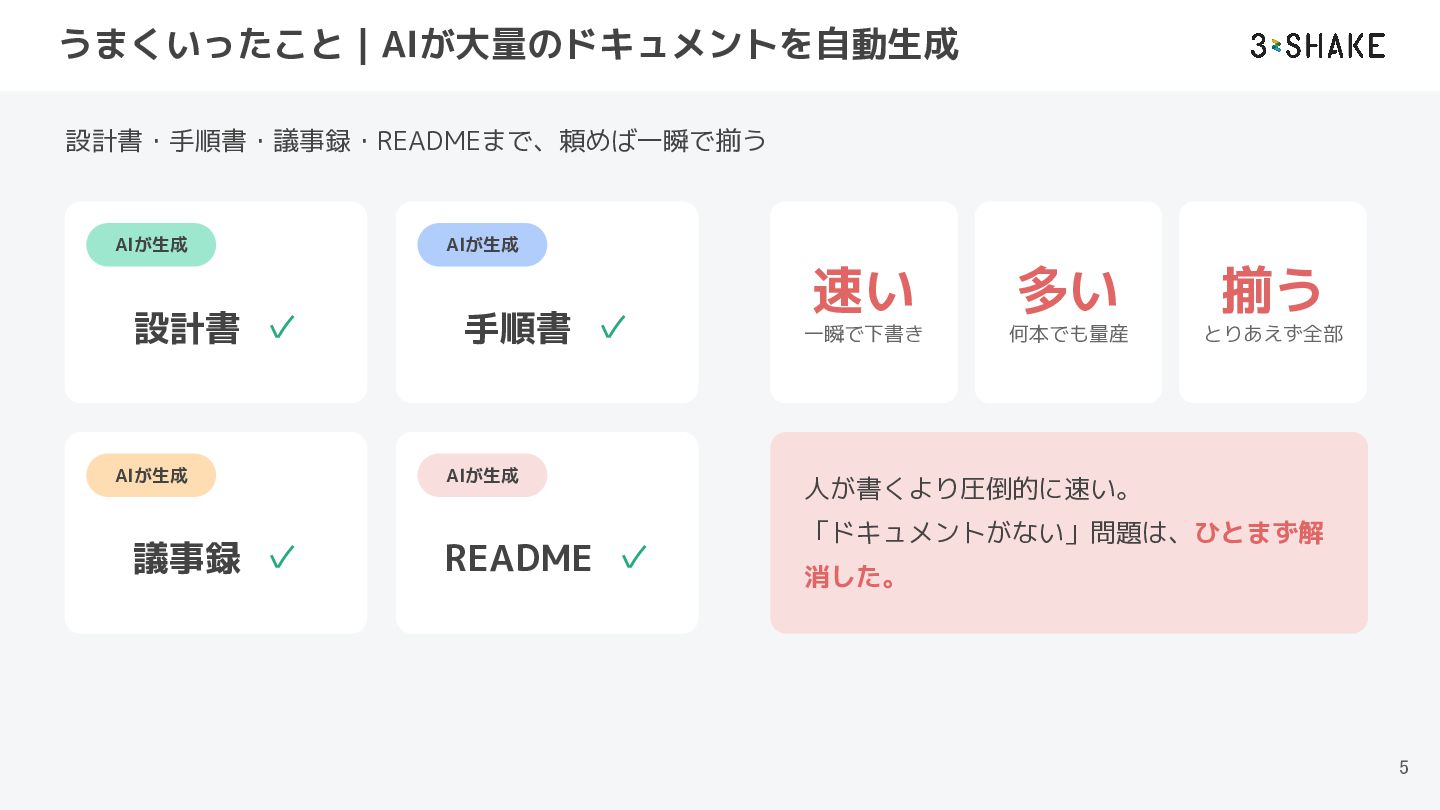
うまくいったこと|AIが大量のドキュメントを自動生成 設計書・手順書・議事録・READMEまで、頼めば一瞬で揃う AIが生成 設計書 ✓ AIが生成 議事録 ✓ AIが生成 手順書
✓ AIが生成 README ✓ 速い 多い 揃う 一瞬で下書き 何本でも量産 とりあえず全部 人が書くより圧倒的に速い。 「ドキュメントがない」問題は、ひとまず解 消した。 5
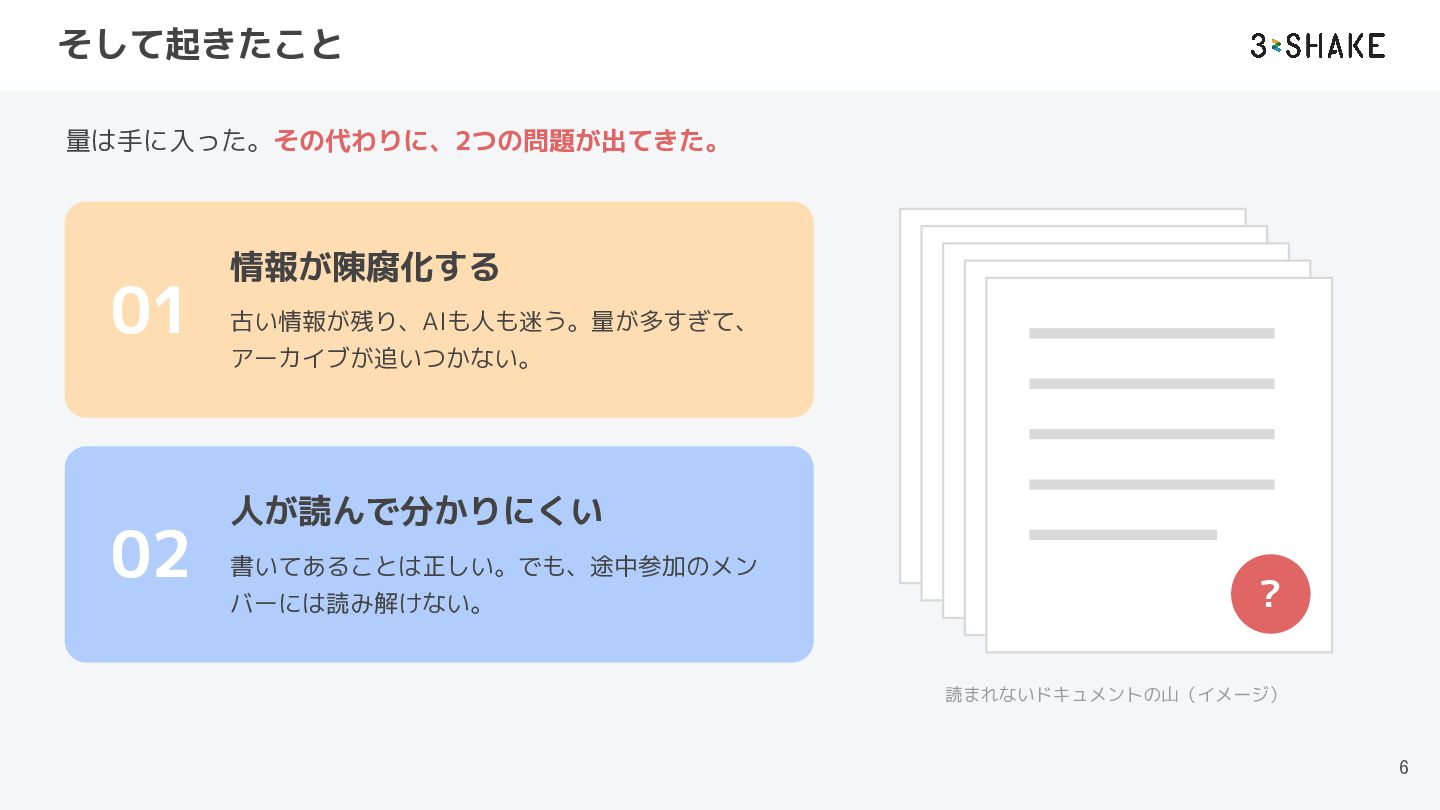
そして起きたこと 量は手に入った。その代わりに、2つの問題が出てきた。 01 情報が陳腐化する 古い情報が残り、AIも人も迷う。量が多すぎて、 アーカイブが追いつかない。 02 人が読んで分かりにくい 書いてあることは正しい。でも、途中参加のメン バーには読み解けない。
? 読まれないドキュメントの山(イメージ) 6
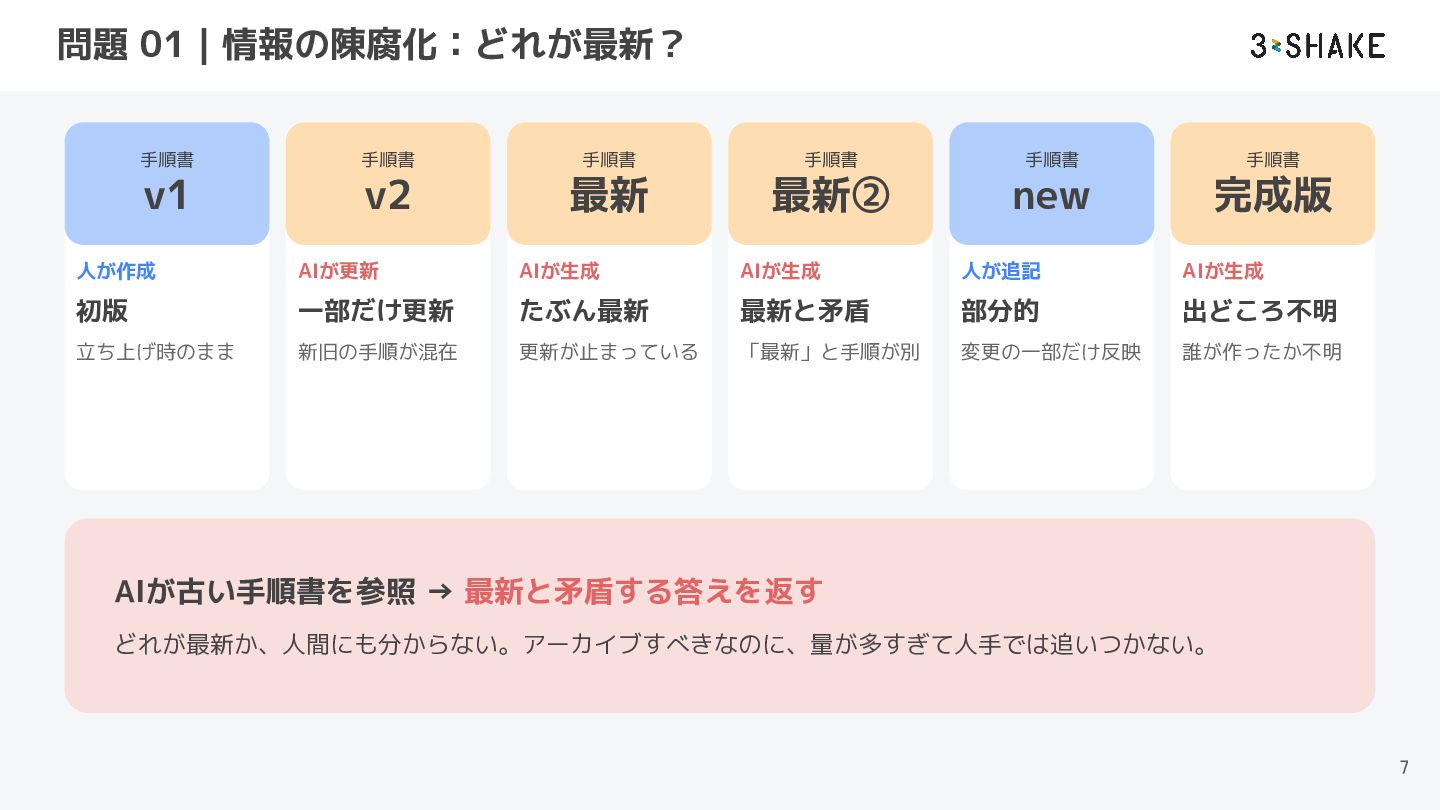
問題 01|情報の陳腐化:どれが最新? 手順書 手順書 手順書 手順書 手順書 手順書 v1 v2
最新 最新② new 完成版 人が作成 AIが更新 AIが生成 AIが生成 人が追記 AIが生成 初版 一部だけ更新 たぶん最新 最新と矛盾 部分的 出どころ不明 立ち上げ時のまま 新旧の手順が混在 更新が止まっている 「最新」と手順が別 変更の一部だけ反映 誰が作ったか不明 AIが古い手順書を参照 → 最新と矛盾する答えを返す どれが最新か、人間にも分からない。アーカイブすべきなのに、量が多すぎて人手では追いつかない。 7
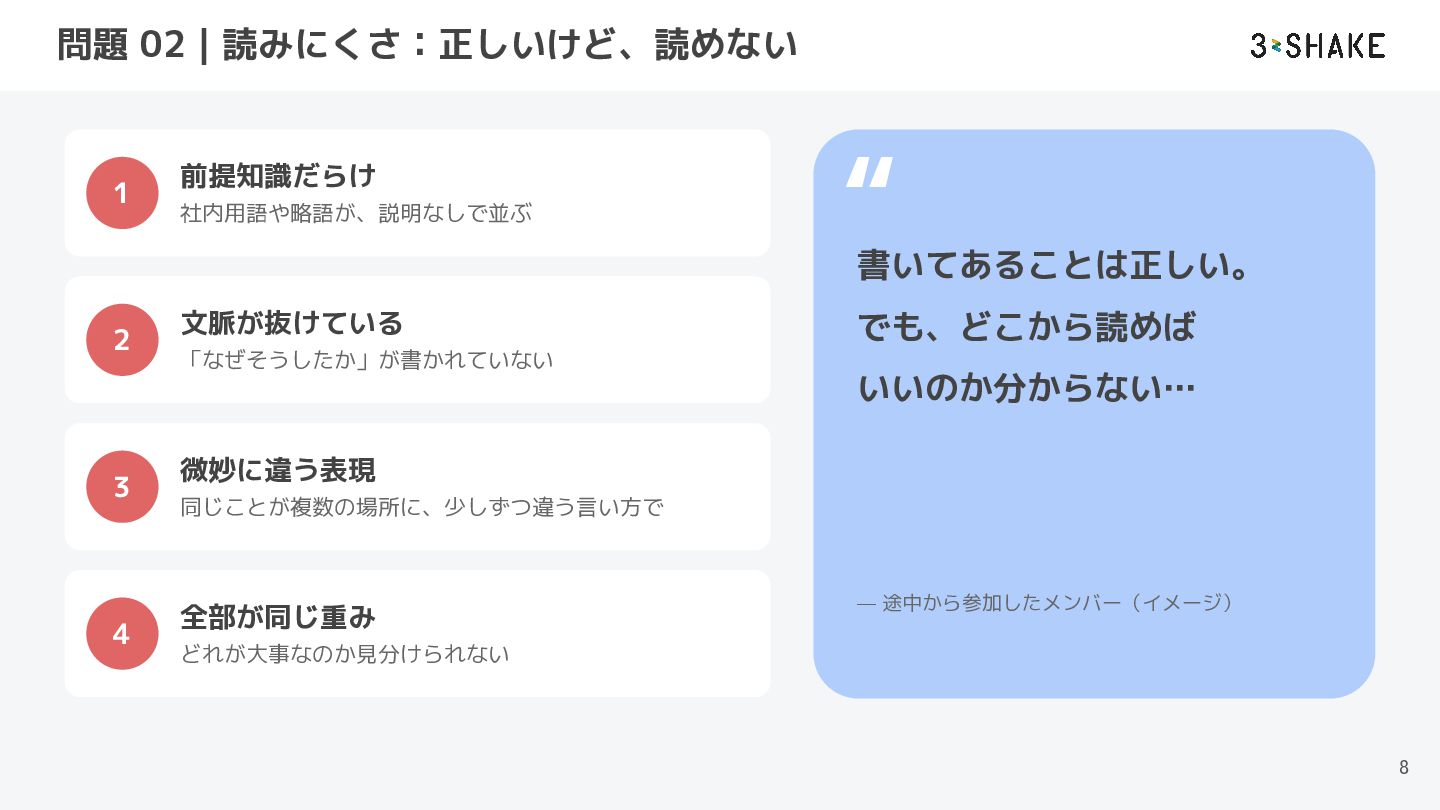
問題 02|読みにくさ:正しいけど、読めない 1 前提知識だらけ 社内用語や略語が、説明なしで並ぶ “ 書いてあることは正しい。 2 3 4
文脈が抜けている 「なぜそうしたか」が書かれていない でも、どこから読めば いいのか分からない… 微妙に違う表現 同じことが複数の場所に、少しずつ違う言い方で 全部が同じ重み — 途中から参加したメンバー(イメージ) どれが大事なのか見分けられない 8
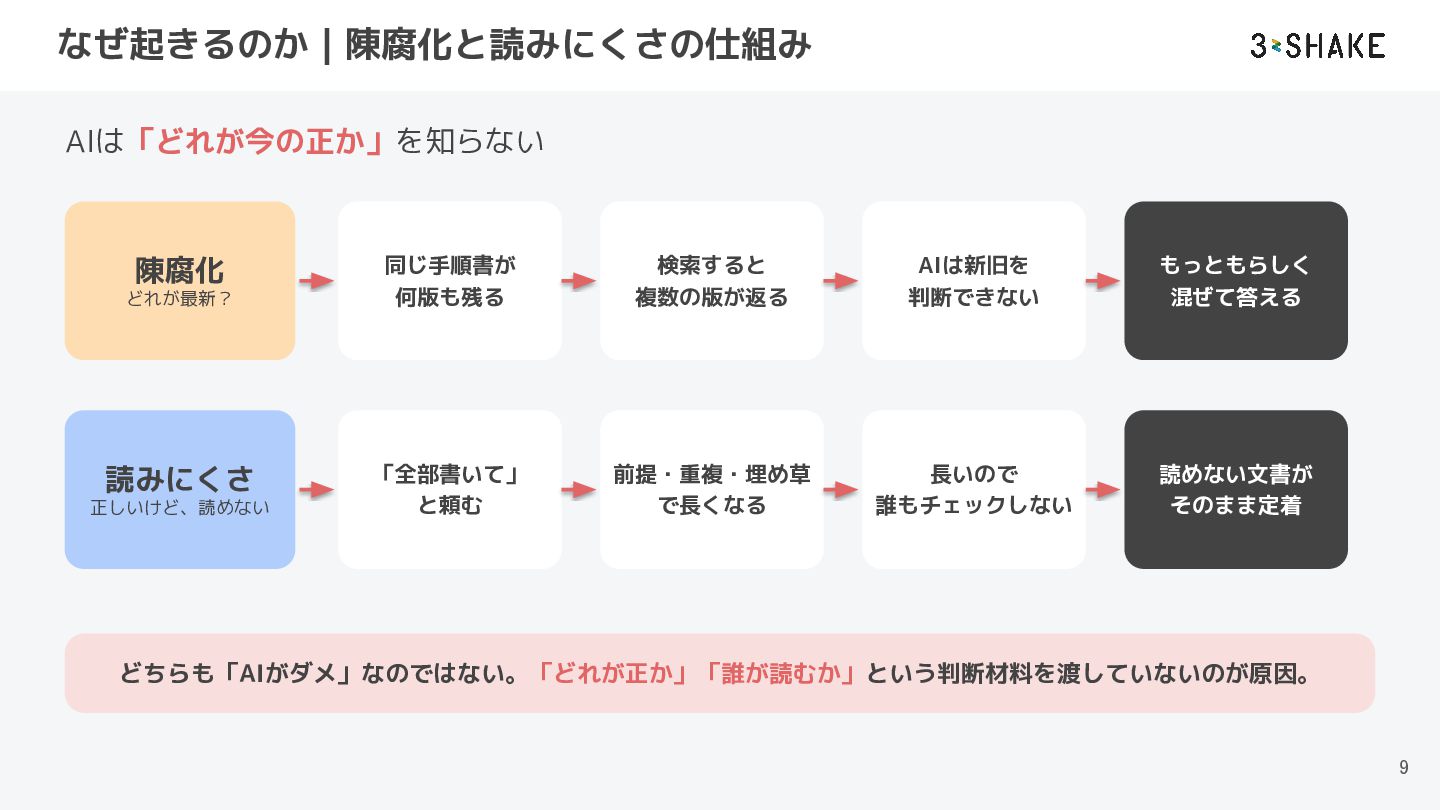
なぜ起きるのか|陳腐化と読みにくさの仕組み AIは「どれが今の正か」を知らない 陳腐化 どれが最新? 読みにくさ 正しいけど、読めない 同じ手順書が 何版も残る 検索すると 複数の版が返る
AIは新旧を 判断できない もっともらしく 混ぜて答える 「全部書いて」 と頼む 前提・重複・埋め草 で長くなる 長いので 誰もチェックしない 読めない文書が そのまま定着 どちらも「AIがダメ」なのではない。「どれが正か」「誰が読むか」という判断材料を渡していないのが原因。 9
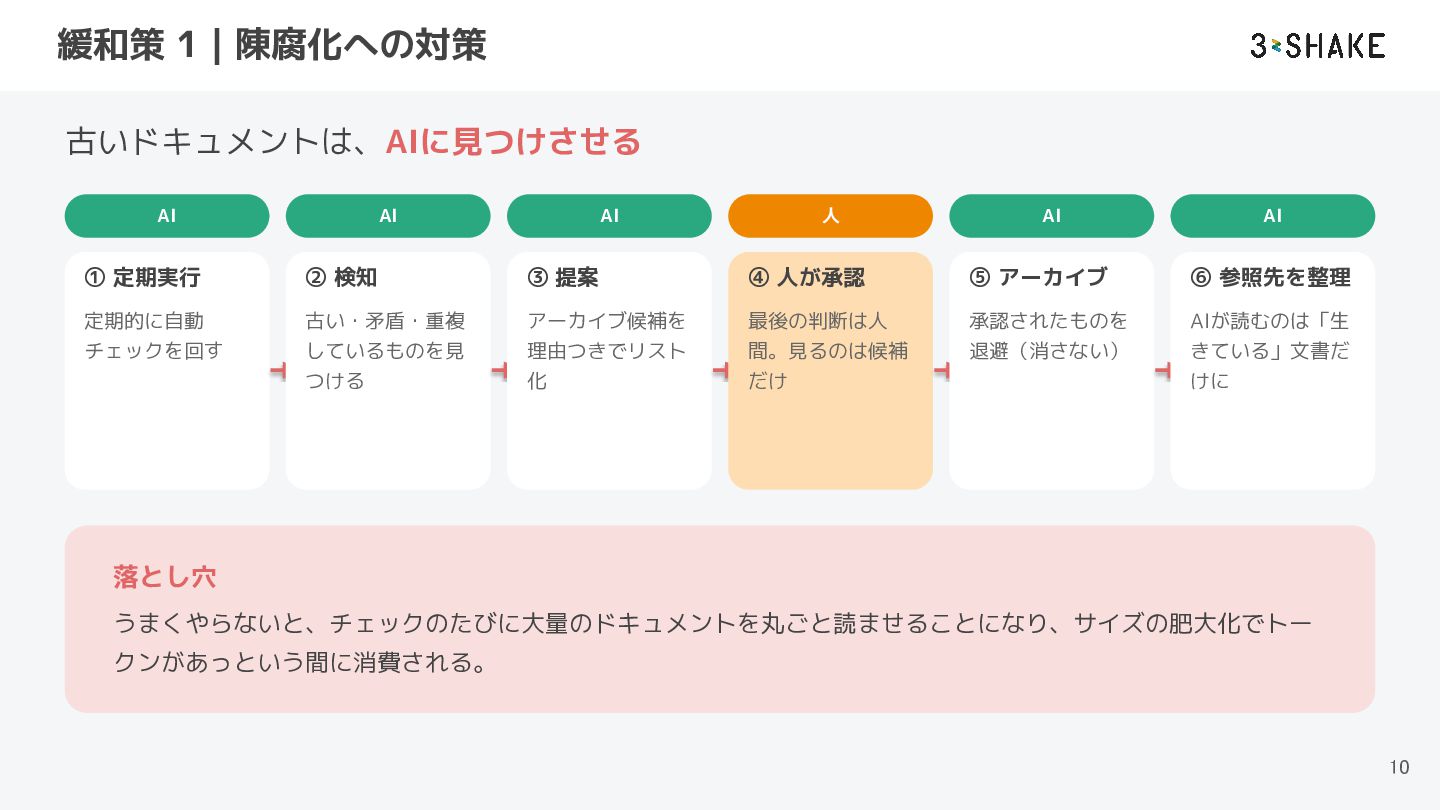
緩和策 1|陳腐化への対策 古いドキュメントは、AIに見つけさせる AI AI AI 人 AI AI ①
定期実行 ② 検知 ③ 提案 ④ 人が承認 ⑤ アーカイブ ⑥ 参照先を整理 定期的に自動 古い・矛盾・重複 アーカイブ候補を 最後の判断は人 承認されたものを AIが読むのは「生 チェックを回す しているものを見 理由つきでリスト 間。見るのは候補 退避(消さない) きている」文書だ つける 化 だけ けに 落とし穴 うまくやらないと、チェックのたびに大量のドキュメントを丸ごと読ませることになり、サイズの肥大化でトー クンがあっという間に消費される。 10
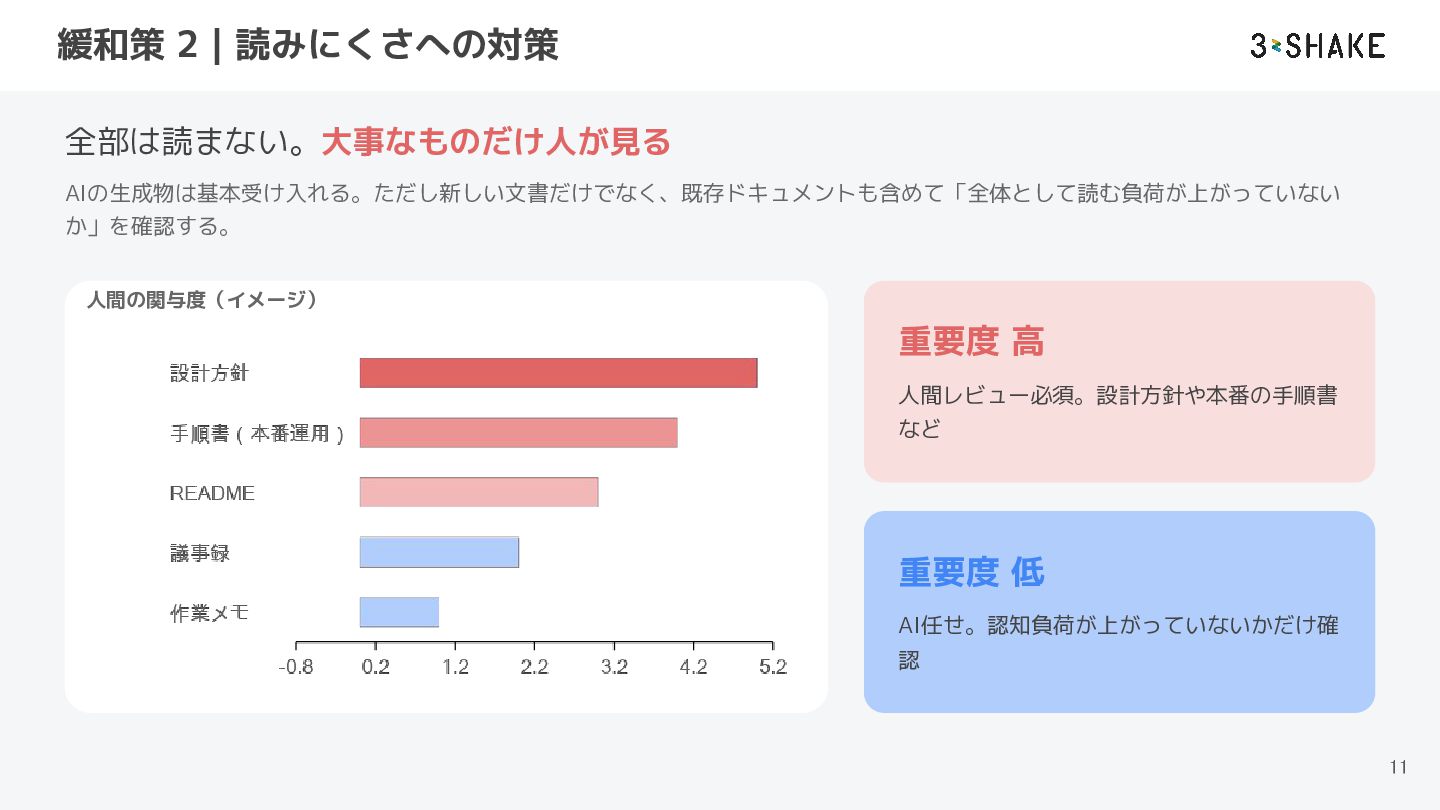
緩和策 2|読みにくさへの対策 全部は読まない。大事なものだけ人が見る AIの生成物は基本受け入れる。ただし新しい文書だけでなく、既存ドキュメントも含めて「全体として読む負荷が上がっていない か」を確認する。 人間の関与度(イメージ) 重要度 高 人間レビュー必須。設計方針や本番の手順書 など
重要度 低 AI任せ。認知負荷が上がっていないかだけ確 認 11
02 ユースケース2:学習コンテンツ作成 研修資料も問題集もAIに任せたら… 作るのは一瞬。でも、学ぶ人には届いた? Copyright © 3-shake, Inc. All Rights
Reserved. 12
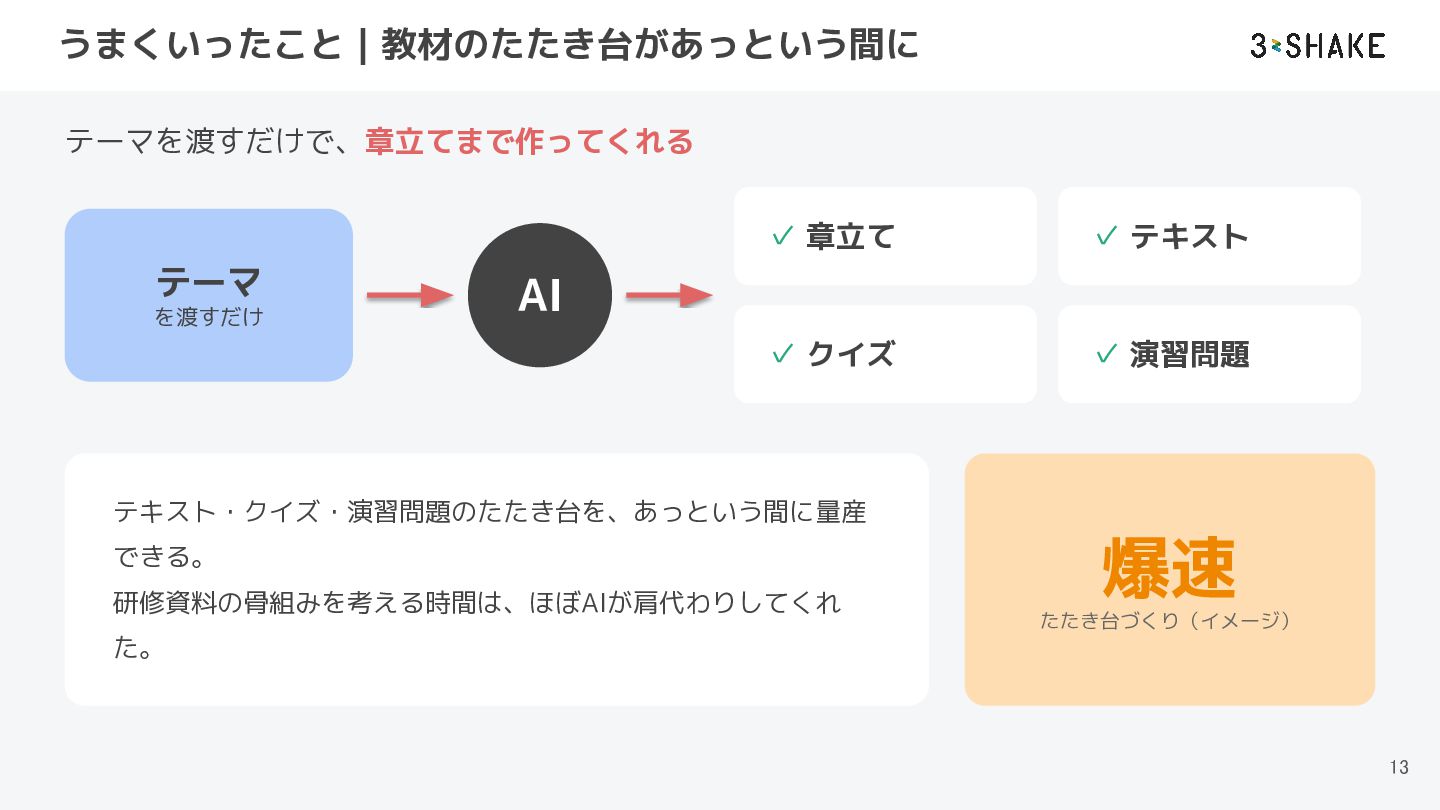
うまくいったこと|教材のたたき台があっという間に テーマを渡すだけで、章立てまで作ってくれる テーマ を渡すだけ ✓ 章立て ✓ テキスト ✓ クイズ
✓ 演習問題 AI テキスト・クイズ・演習問題のたたき台を、あっという間に量産 できる。 研修資料の骨組みを考える時間は、ほぼAIが肩代わりしてくれ 爆速 たたき台づくり(イメージ) た。 13
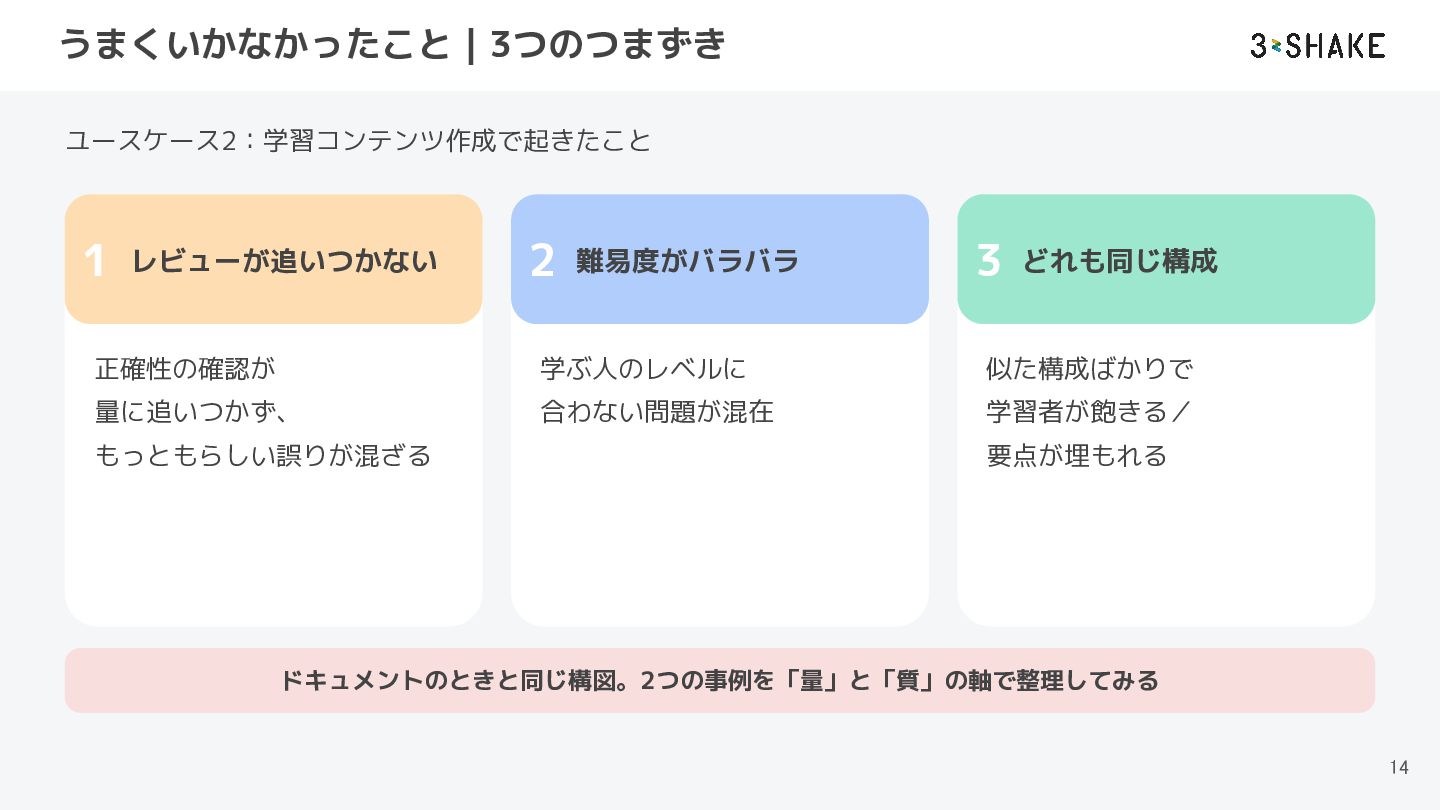
うまくいかなかったこと|3つのつまずき ユースケース2:学習コンテンツ作成で起きたこと 1 レビューが追いつかない 2 難易度がバラバラ 3 どれも同じ構成 正確性の確認が 学ぶ人のレベルに
似た構成ばかりで 量に追いつかず、 合わない問題が混在 学習者が飽きる/ もっともらしい誤りが混ざる 要点が埋もれる ドキュメントのときと同じ構図。2つの事例を「量」と「質」の軸で整理してみる 14
03 量 vs 質 2つの事例を「量」と「質」の軸で分解する Copyright © 3-shake, Inc. All
Rights Reserved. 15
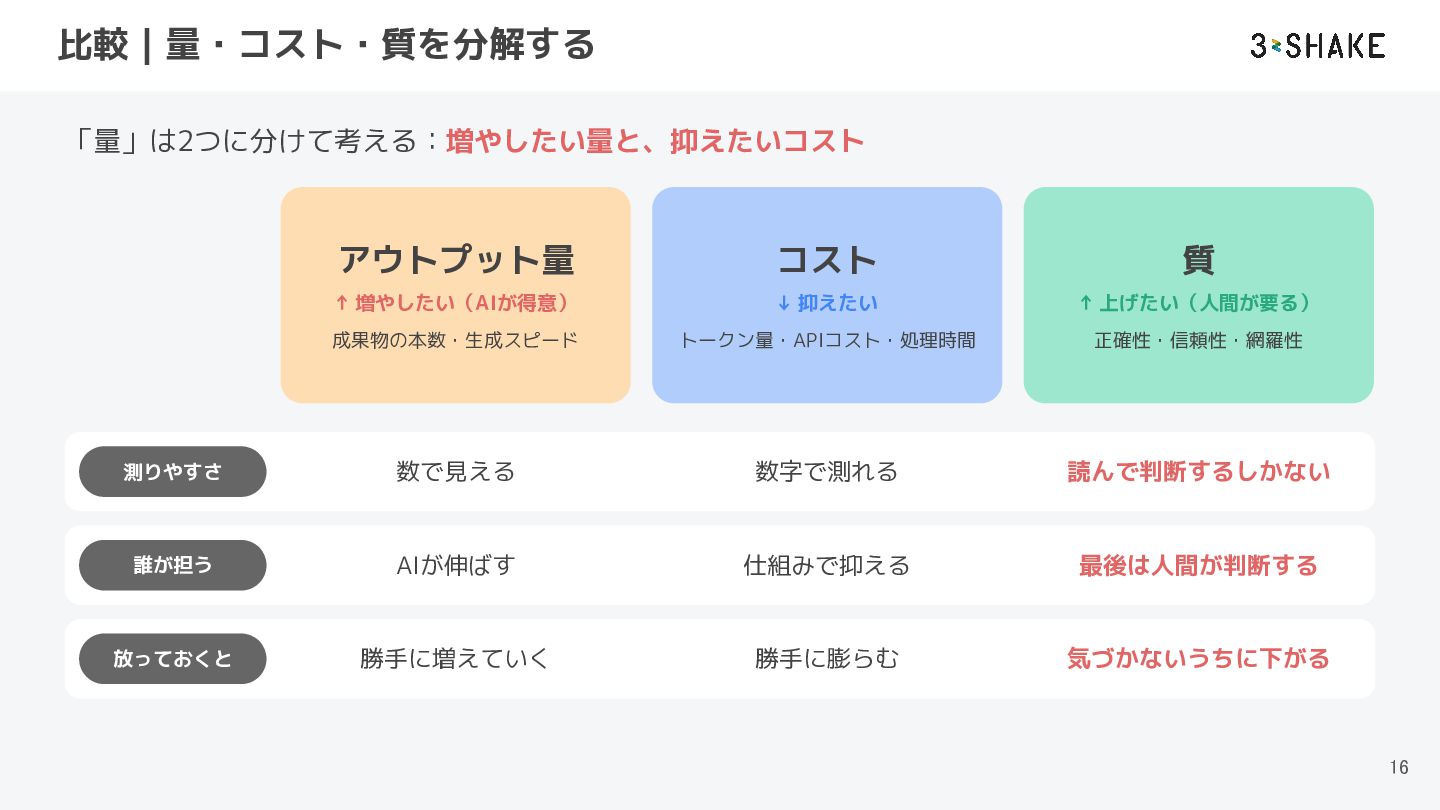
比較|量・コスト・質を分解する 「量」は2つに分けて考える:増やしたい量と、抑えたいコスト アウトプット量 コスト 質 ↑ 増やしたい(AIが得意) ↓ 抑えたい ↑
上げたい(人間が要る) 成果物の本数・生成スピード トークン量・APIコスト・処理時間 正確性・信頼性・網羅性 測りやすさ 数で見える 数字で測れる 読んで判断するしかない 誰が担う AIが伸ばす 仕組みで抑える 最後は人間が判断する 放っておくと 勝手に増えていく 勝手に膨らむ 気づかないうちに下がる 16
量と質の四象限 高品質 横軸:アウトプット量 少量・高品質 大量・高品質 人力の職人芸 目指す場所 丁寧。でも遅い AIの速さ ×
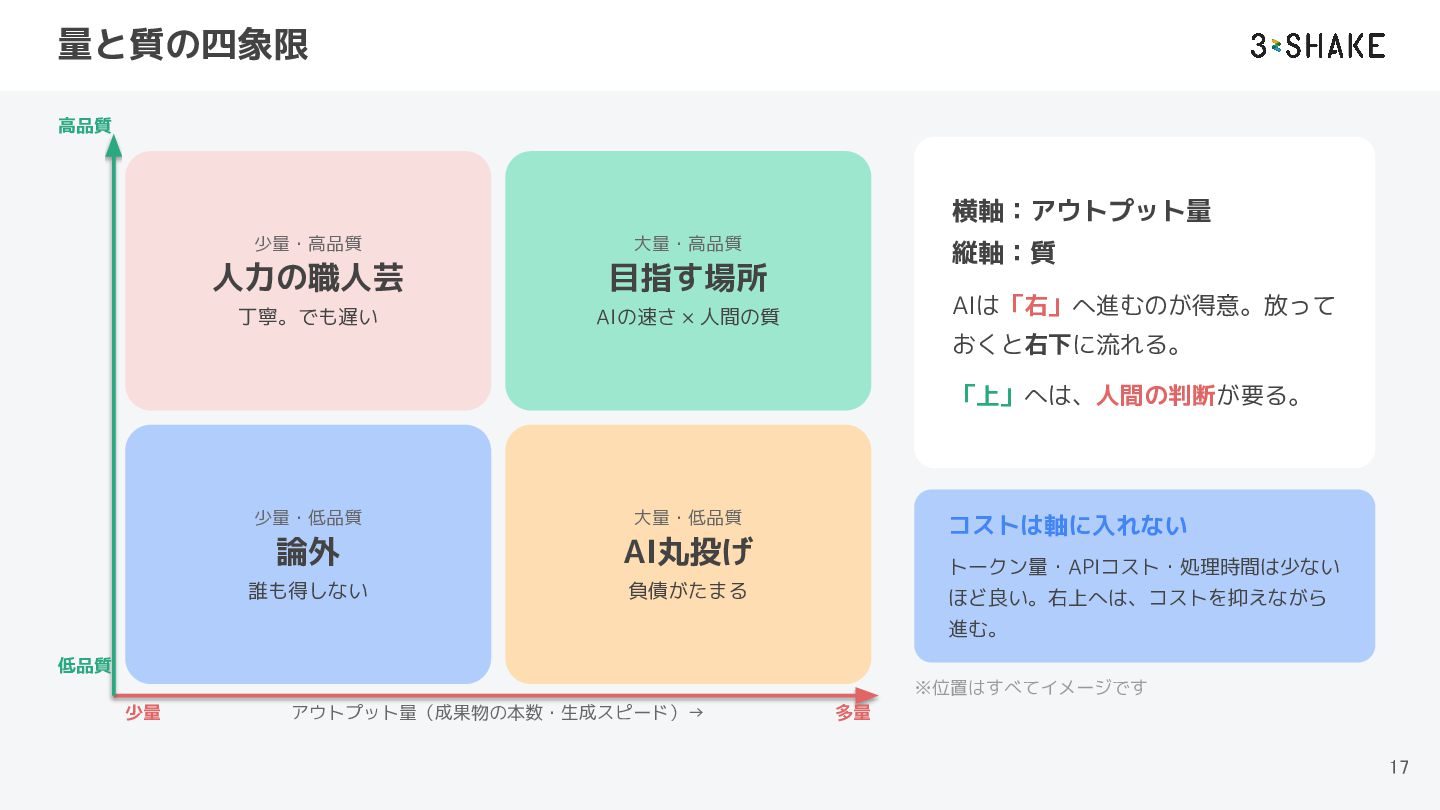
人間の質 縦軸:質 AIは「右」へ進むのが得意。放って おくと右下に流れる。 「上」へは、人間の判断が要る。 少量・低品質 大量・低品質 論外 AI丸投げ 誰も得しない 負債がたまる コストは軸に入れない トークン量・APIコスト・処理時間は少ない ほど良い。右上へは、コストを抑えながら 進む。 低品質 ※位置はすべてイメージです 少量 アウトプット量(成果物の本数・生成スピード)→ 多量 17
トレードオフ ①|コストの中にも綱引きがある 「コスト」も1本のつまみじゃない 安い・小さいモデルにする 単価を下げたい バッチ処理・キャッシュ 早く終わらせたい APIコスト ↓ る。処理時間も延びがち
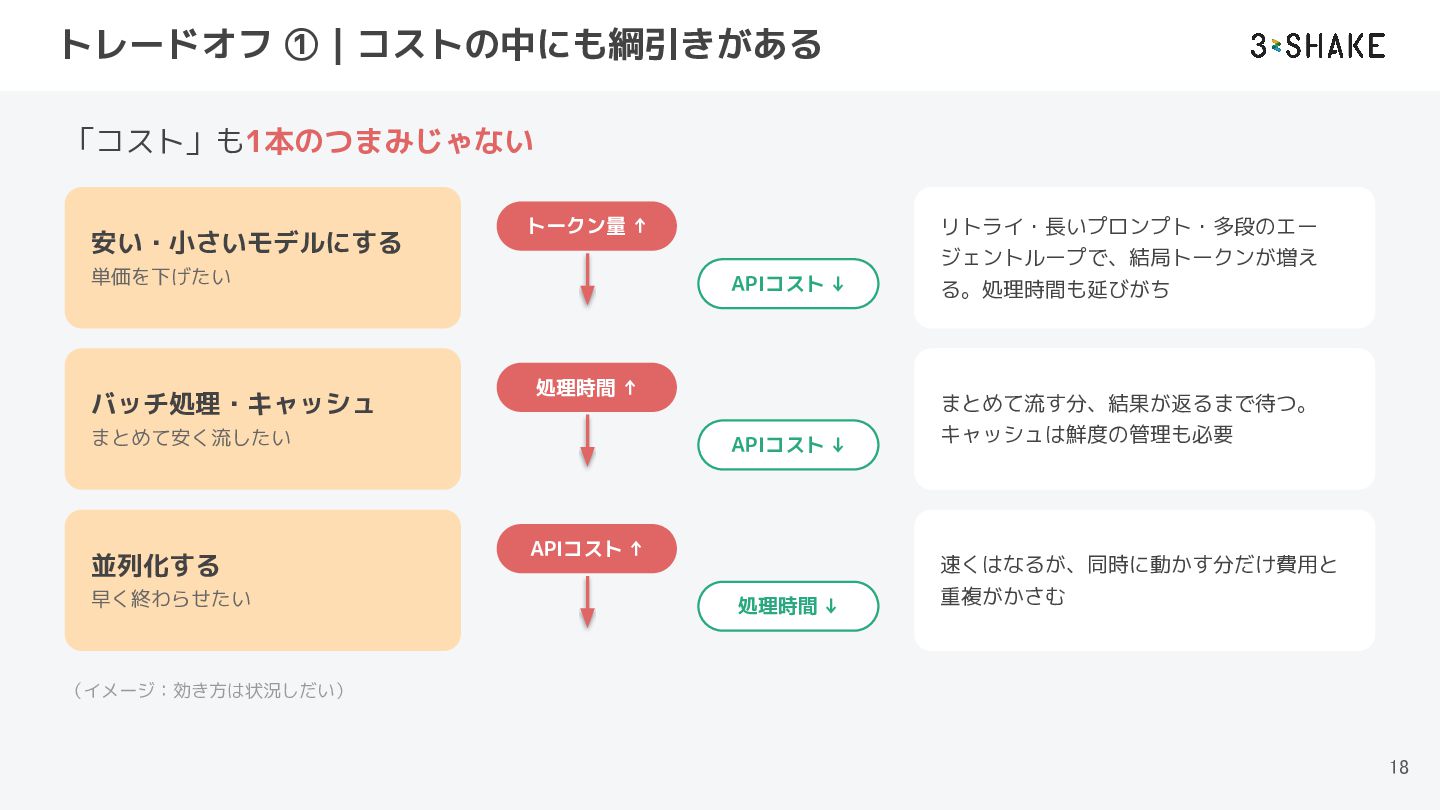
APIコスト ↓ まとめて流す分、結果が返るまで待つ。 キャッシュは鮮度の管理も必要 処理時間 ↓ 速くはなるが、同時に動かす分だけ費用と 重複がかさむ 処理時間 ↑ まとめて安く流したい 並列化する リトライ・長いプロンプト・多段のエー ジェントループで、結局トークンが増え トークン量 ↑ APIコスト ↑ (イメージ:効き方は状況しだい) 18
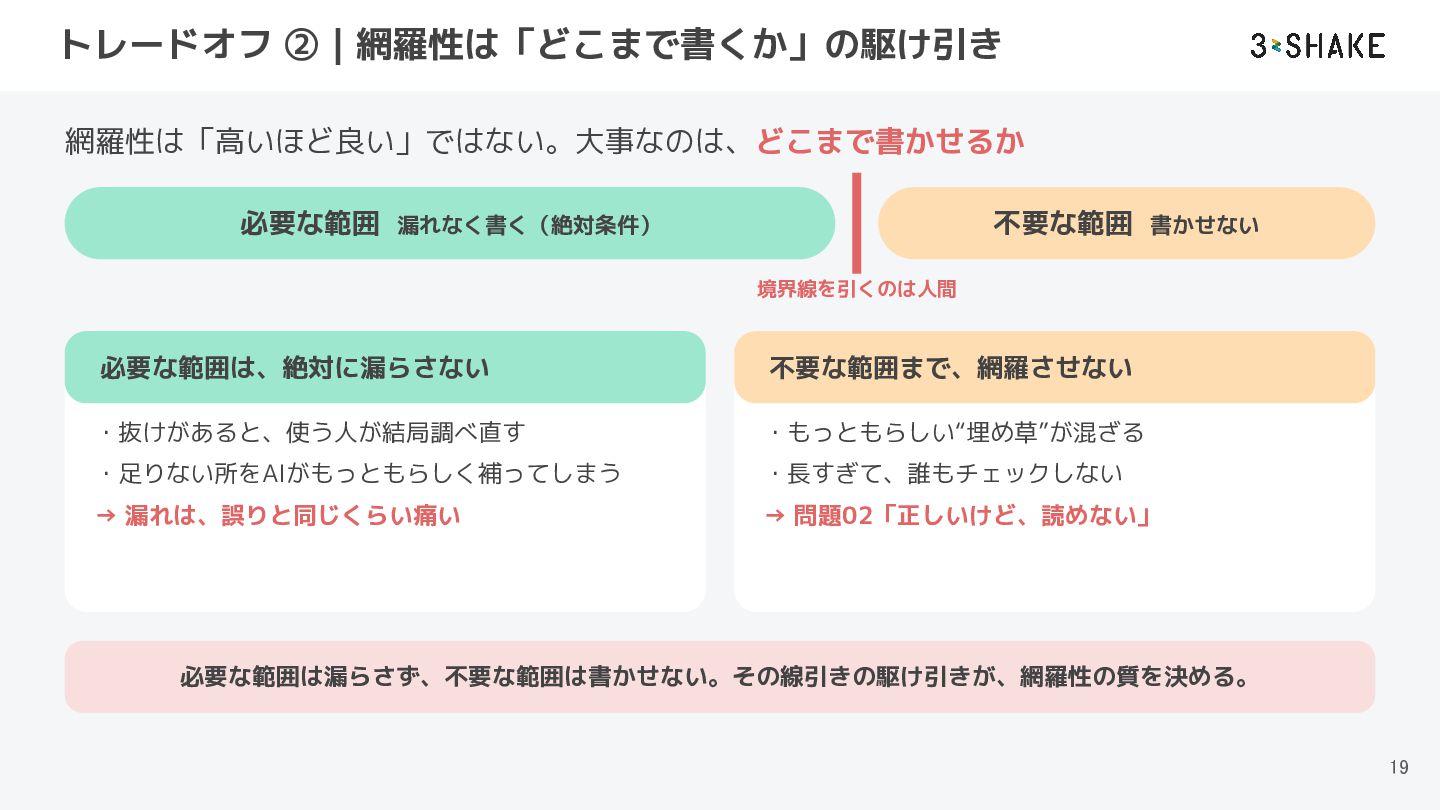
トレードオフ ②|網羅性は「どこまで書くか」の駆け引き 網羅性は「高いほど良い」ではない。大事なのは、どこまで書かせるか 必要な範囲 漏れなく書く(絶対条件) 不要な範囲 書かせない 境界線を引くのは人間 必要な範囲は、絶対に漏らさない 不要な範囲まで、網羅させない
・抜けがあると、使う人が結局調べ直す ・もっともらしい“埋め草”が混ざる ・足りない所をAIがもっともらしく補ってしまう ・長すぎて、誰もチェックしない → 漏れは、誤りと同じくらい痛い → 問題02「正しいけど、読めない」 必要な範囲は漏らさず、不要な範囲は書かせない。その線引きの駆け引きが、網羅性の質を決める。 19
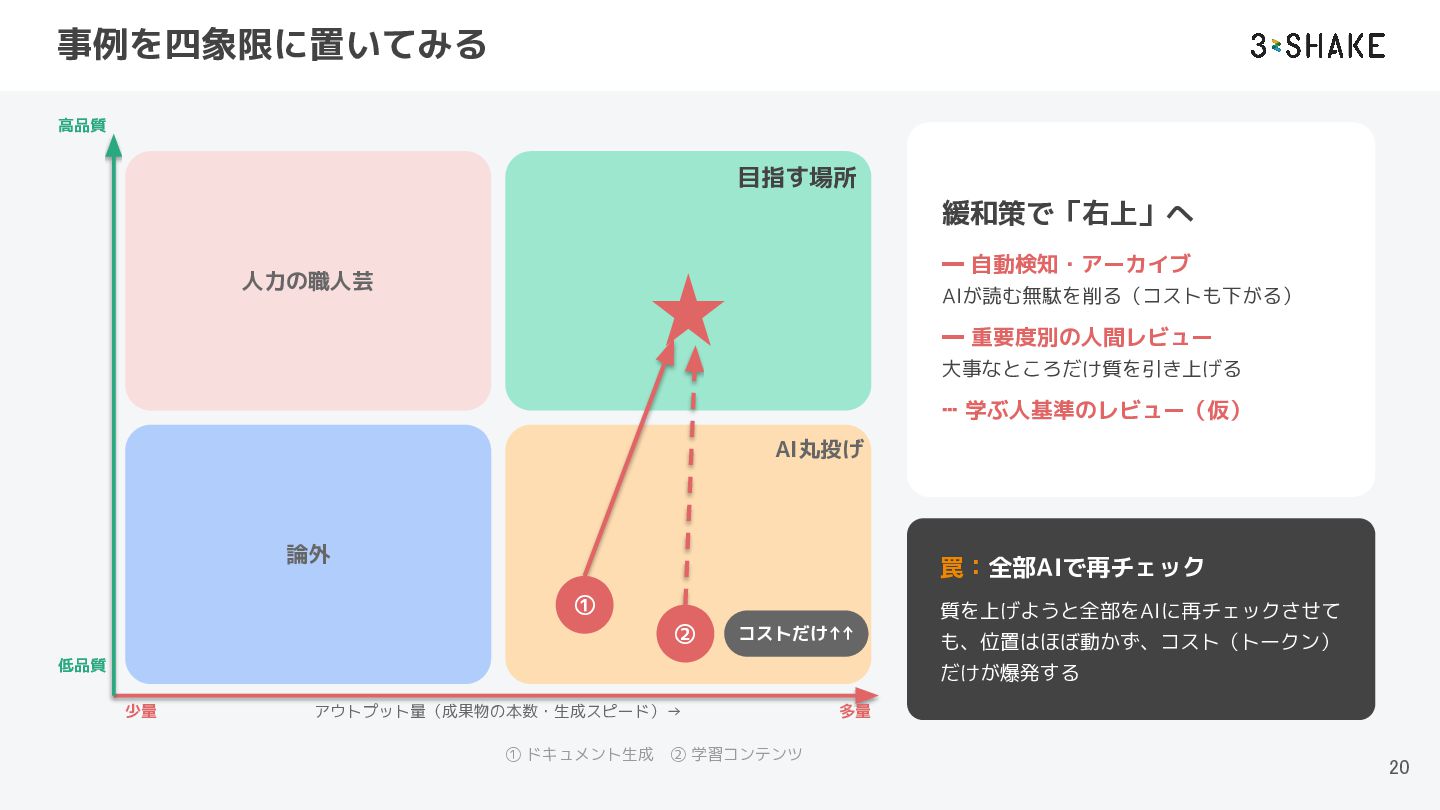
事例を四象限に置いてみる 高品質 目指す場所 緩和策で「右上」へ ━ 自動検知・アーカイブ 人力の職人芸 AIが読む無駄を削る(コストも下がる) ━ 重要度別の人間レビュー
大事なところだけ質を引き上げる ┅ 学ぶ人基準のレビュー(仮) AI丸投げ 論外 罠:全部AIで再チェック ① 質を上げようと全部をAIに再チェックさせて ② コストだけ↑↑ 低品質 も、位置はほぼ動かず、コスト(トークン) だけが爆発する 少量 アウトプット量(成果物の本数・生成スピード)→ ① ドキュメント生成 ② 学習コンテンツ 多量 20
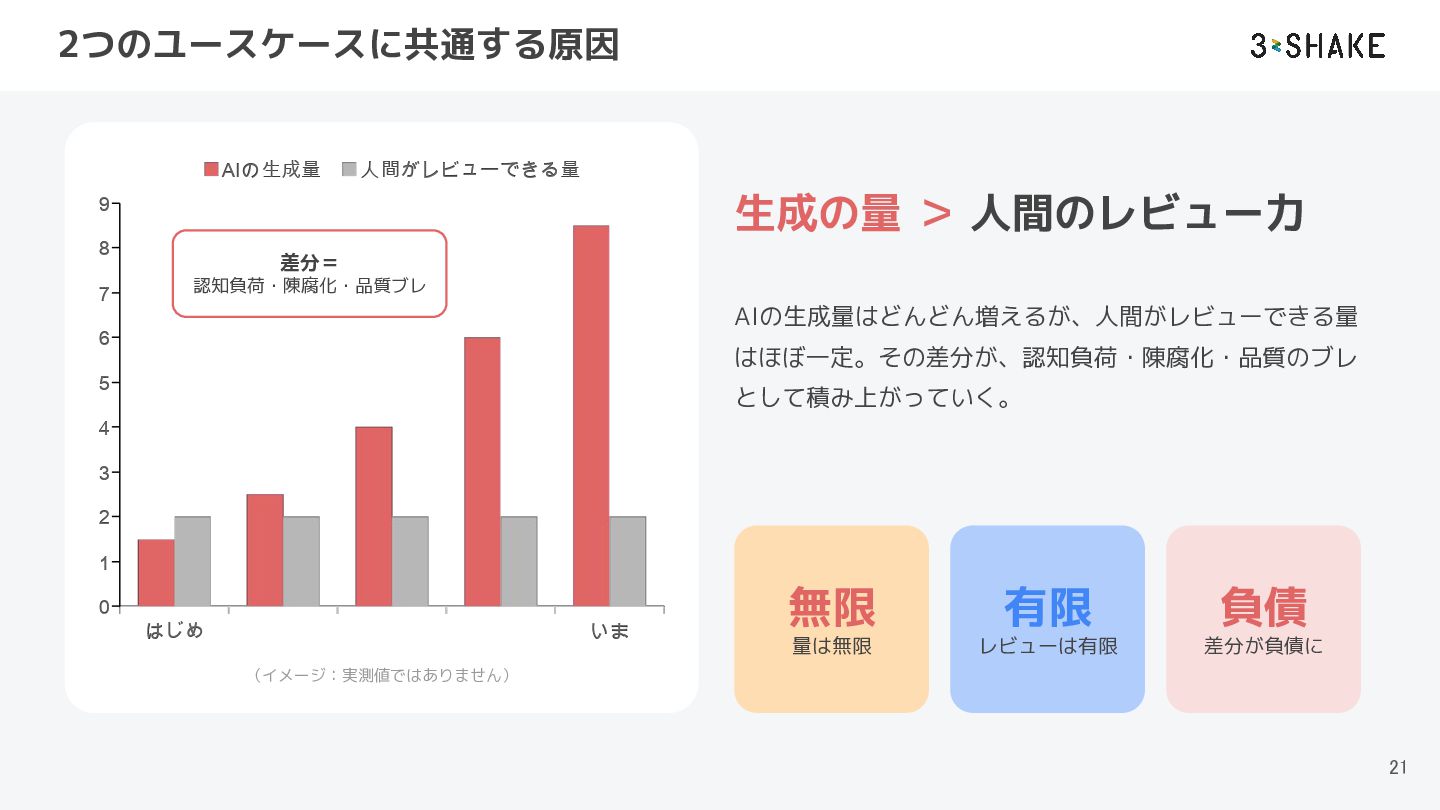
2つのユースケースに共通する原因 生成の量 > 人間のレビュー力 差分= 認知負荷・陳腐化・品質ブレ AIの生成量はどんどん増えるが、人間がレビューできる量 はほぼ一定。その差分が、認知負荷・陳腐化・品質のブレ として積み上がっていく。 無限
有限 負債 量は無限 レビューは有限 差分が負債に (イメージ:実測値ではありません) 21
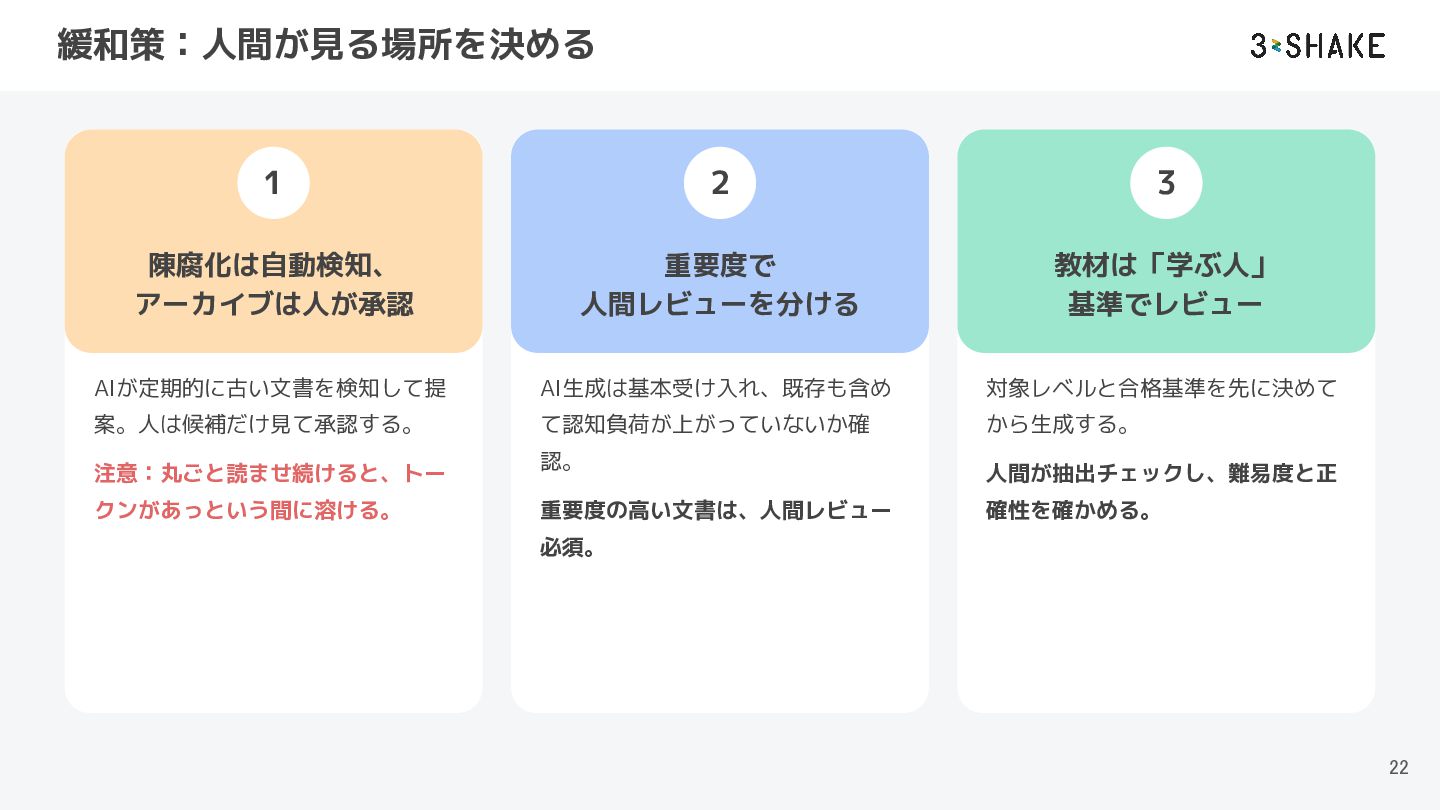
緩和策:人間が見る場所を決める 1 2 3 陳腐化は自動検知、 アーカイブは人が承認 重要度で 人間レビューを分ける 教材は「学ぶ人」 基準でレビュー
AIが定期的に古い文書を検知して提 AI生成は基本受け入れ、既存も含め 対象レベルと合格基準を先に決めて 案。人は候補だけ見て承認する。 て認知負荷が上がっていないか確 から生成する。 注意:丸ごと読ませ続けると、トー クンがあっという間に溶ける。 認。 重要度の高い文書は、人間レビュー 人間が抽出チェックし、難易度と正 確性を確かめる。 必須。 22
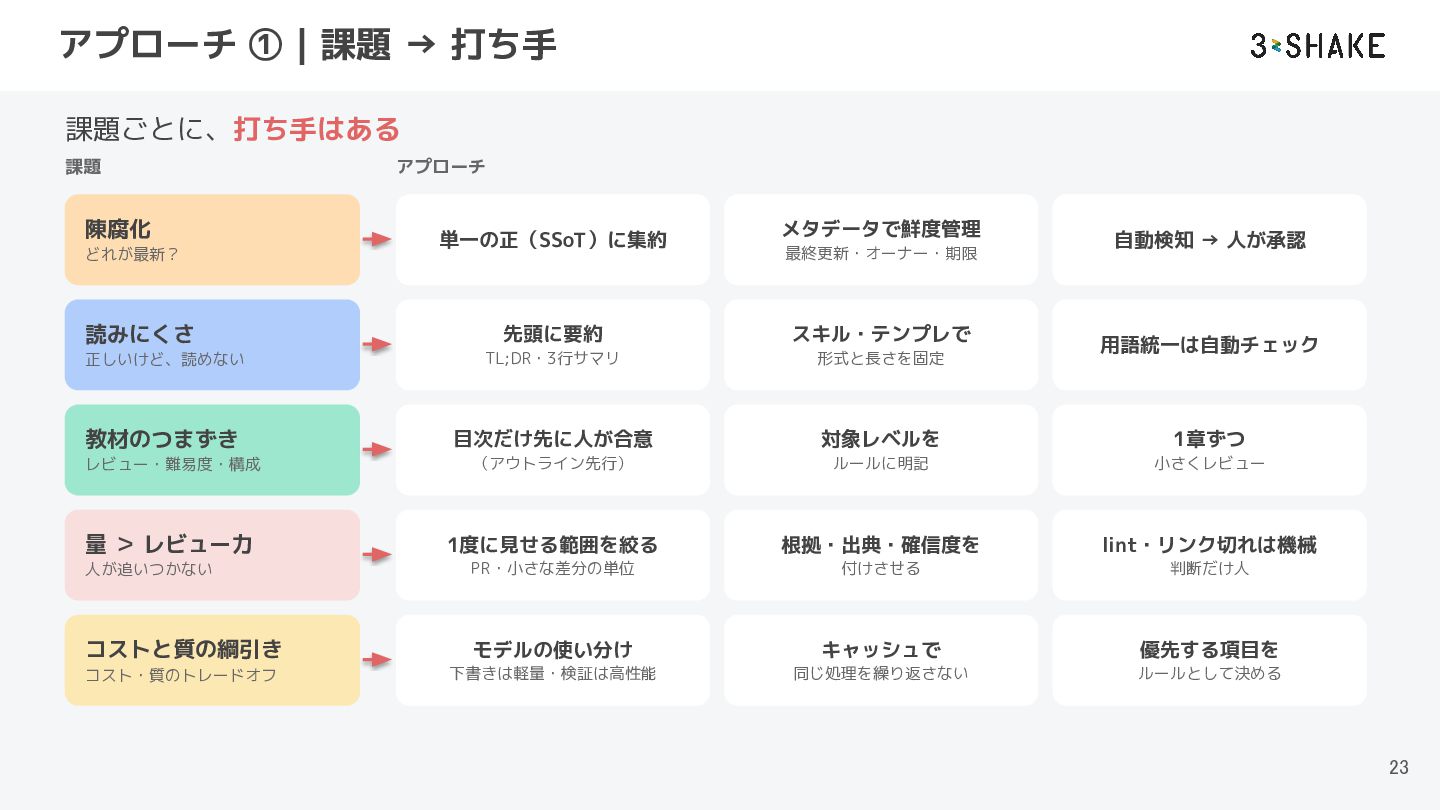
アプローチ ①|課題 → 打ち手 課題ごとに、打ち手はある 課題 陳腐化 どれが最新? 読みにくさ アプローチ
単一の正(SSoT)に集約 メタデータで鮮度管理 最終更新・オーナー・期限 自動検知 → 人が承認 先頭に要約 スキル・テンプレで 正しいけど、読めない TL;DR・3行サマリ 形式と長さを固定 教材のつまずき 目次だけ先に人が合意 対象レベルを 1章ずつ レビュー・難易度・構成 (アウトライン先行) ルールに明記 小さくレビュー 量 > レビュー力 1度に見せる範囲を絞る 根拠・出典・確信度を lint・リンク切れは機械 PR・小さな差分の単位 付けさせる 判断だけ人 人が追いつかない 用語統一は自動チェック コストと質の綱引き モデルの使い分け キャッシュで 優先する項目を コスト・質のトレードオフ 下書きは軽量・検証は高性能 同じ処理を繰り返さない ルールとして決める 23
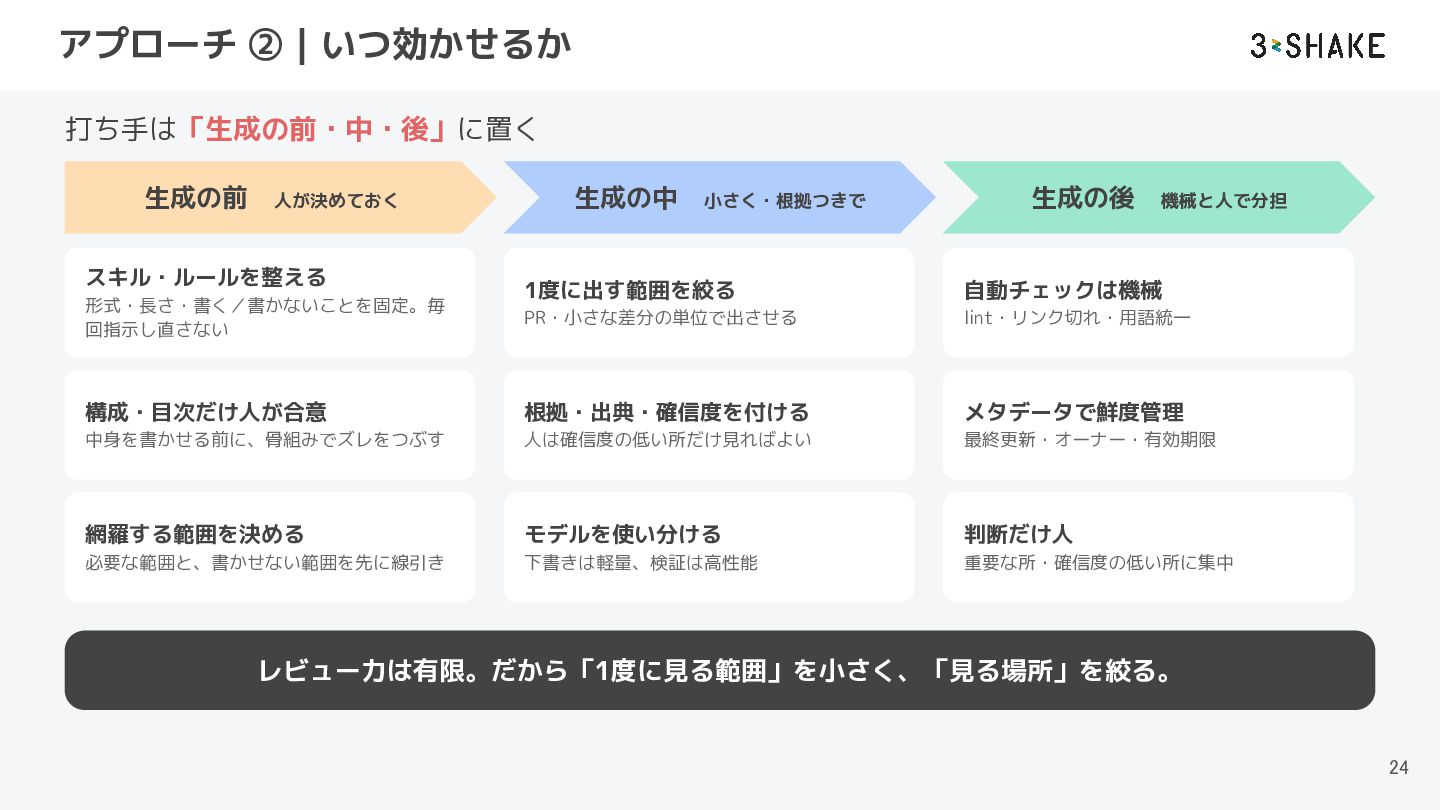
アプローチ ②|いつ効かせるか 打ち手は「生成の前・中・後」に置く 生成の前 人が決めておく スキル・ルールを整える 生成の中 小さく・根拠つきで 生成の後 機械と人で分担
1度に出す範囲を絞る 自動チェックは機械 PR・小さな差分の単位で出させる lint・リンク切れ・用語統一 構成・目次だけ人が合意 根拠・出典・確信度を付ける メタデータで鮮度管理 中身を書かせる前に、骨組みでズレをつぶす 人は確信度の低い所だけ見ればよい 最終更新・オーナー・有効期限 網羅する範囲を決める モデルを使い分ける 判断だけ人 必要な範囲と、書かせない範囲を先に線引き 下書きは軽量、検証は高性能 重要な所・確信度の低い所に集中 形式・長さ・書く/書かないことを固定。毎 回指示し直さない レビュー力は有限。だから「1度に見る範囲」を小さく、「見る場所」を絞る。 24
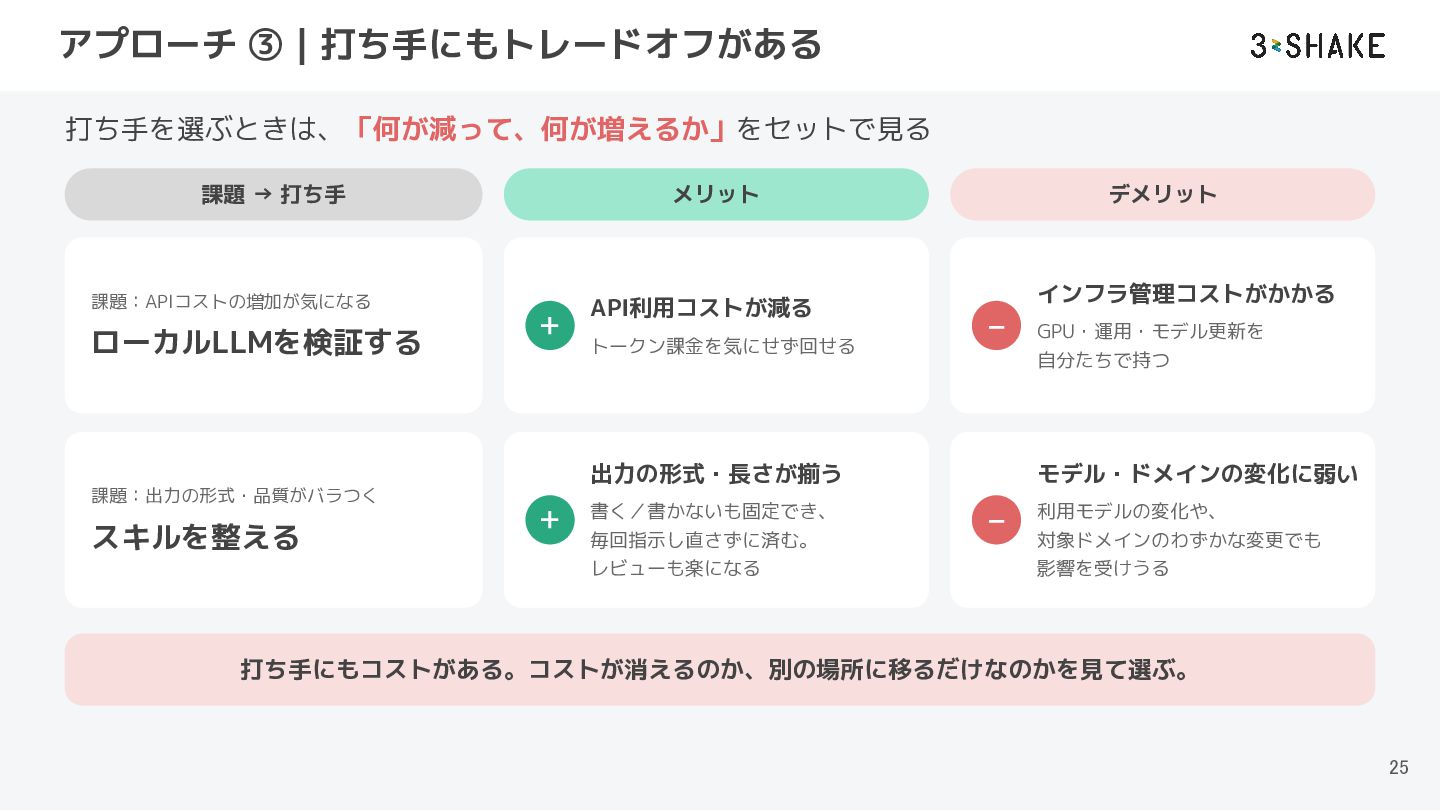
アプローチ ③|打ち手にもトレードオフがある 打ち手を選ぶときは、「何が減って、何が増えるか」をセットで見る 課題 → 打ち手 メリット 課題:APIコストの増加が気になる ローカルLLMを検証する +
API利用コストが減る トークン課金を気にせず回せる デメリット インフラ管理コストがかかる − 自分たちで持つ 出力の形式・長さが揃う 課題:出力の形式・品質がバラつく スキルを整える + 書く/書かないも固定でき、 毎回指示し直さずに済む。 レビューも楽になる GPU・運用・モデル更新を モデル・ドメインの変化に弱い − 利用モデルの変化や、 対象ドメインのわずかな変更でも 影響を受けうる 打ち手にもコストがある。コストが消えるのか、別の場所に移るだけなのかを見て選ぶ。 25
04 気づき:よく聞く話の、その先 「人がレビューすればいい」で終わらせない 3つの気づき:レビュー・ループ・引き算 Copyright © 3-shake, Inc. All Rights
Reserved. 26
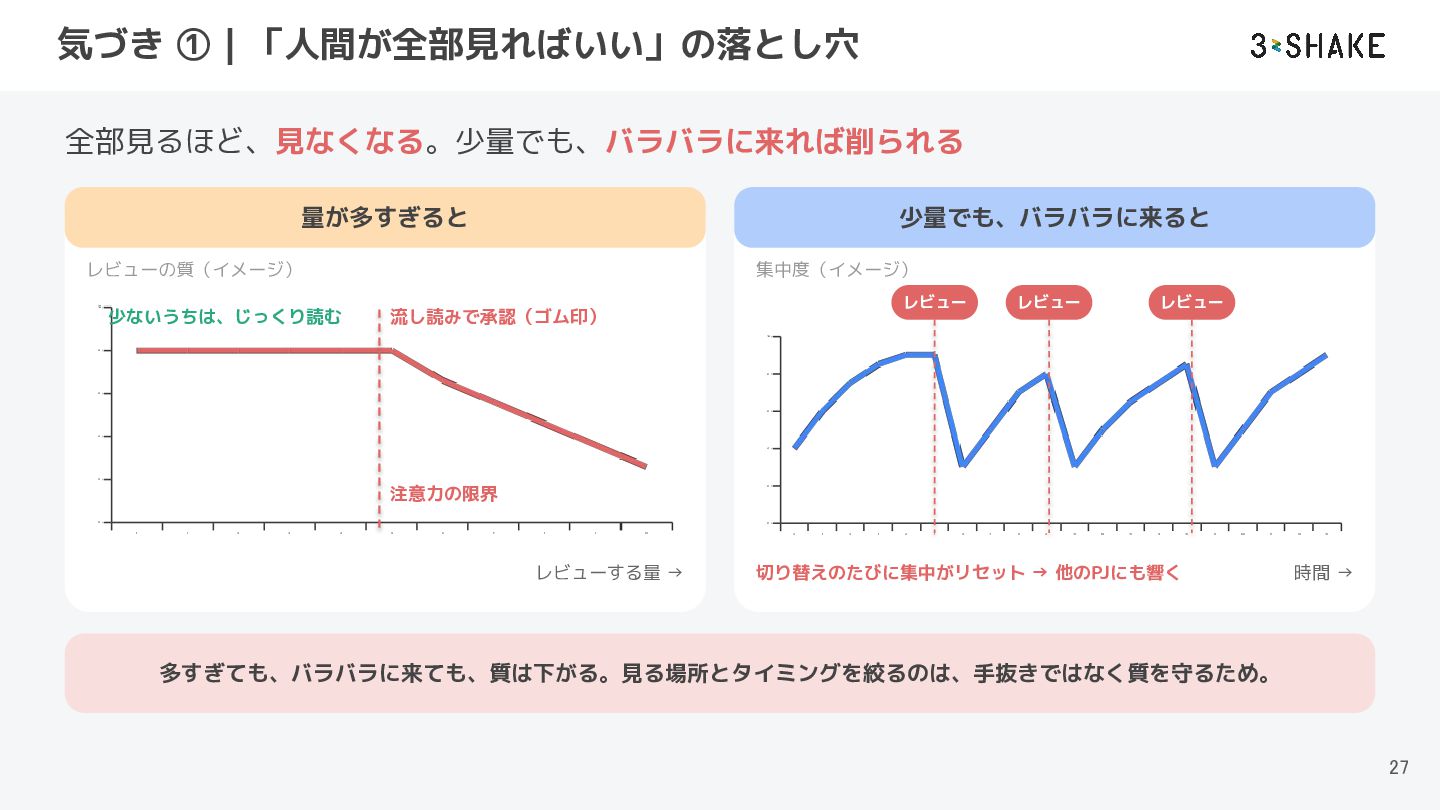
気づき ①|「人間が全部見ればいい」の落とし穴 全部見るほど、見なくなる。少量でも、バラバラに来れば削られる 量が多すぎると 少量でも、バラバラに来ると レビューの質(イメージ) 少ないうちは、じっくり読む 集中度(イメージ) 流し読みで承認(ゴム印) レビュー
レビュー レビュー 注意力の限界 レビューする量 → 切り替えのたびに集中がリセット → 他のPJにも響く 時間 → 多すぎても、バラバラに来ても、質は下がる。見る場所とタイミングを絞るのは、手抜きではなく質を守るため。 27
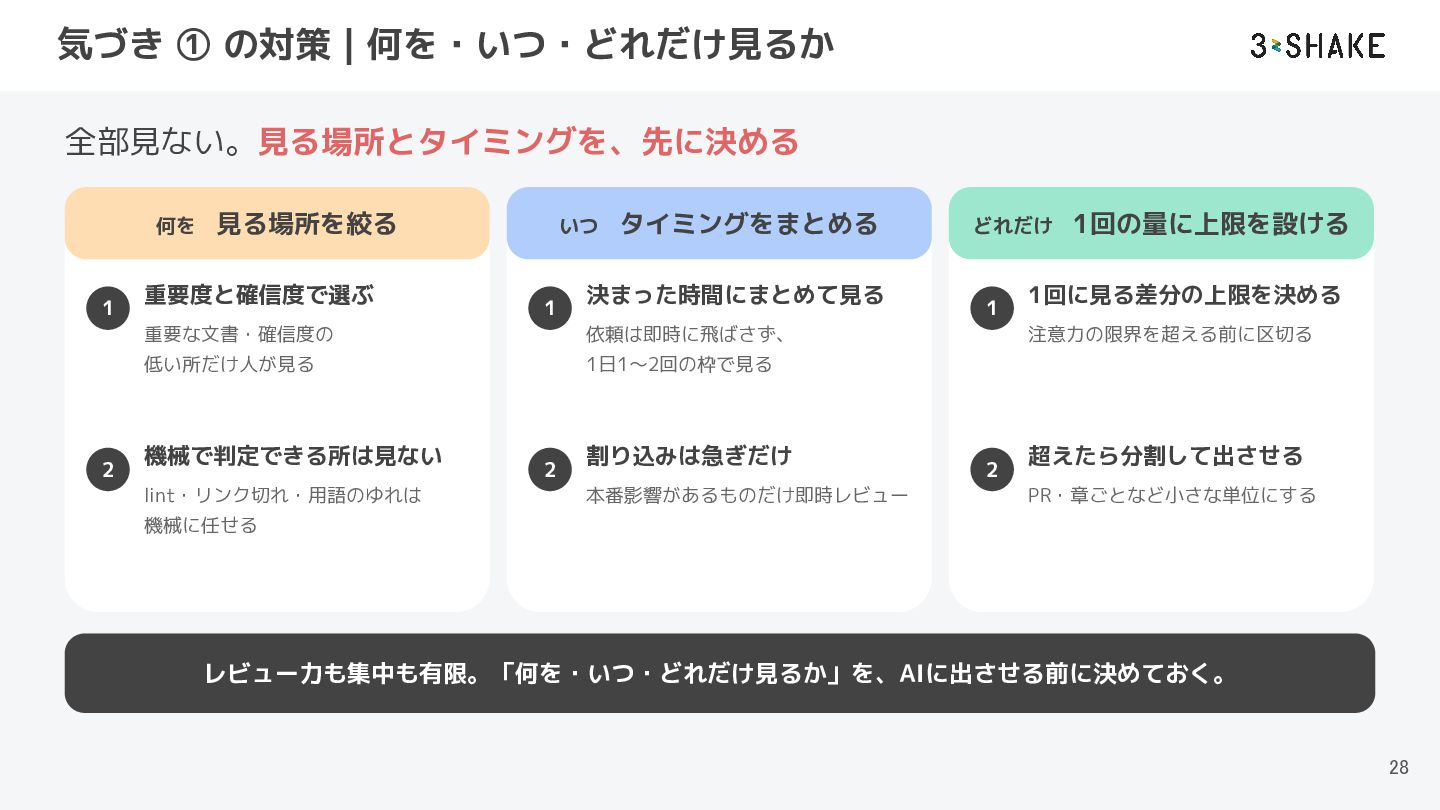
気づき ① の対策|何を・いつ・どれだけ見るか 全部見ない。見る場所とタイミングを、先に決める 何を 1 2 見る場所を絞る 重要度と確信度で選ぶ いつ
1 タイミングをまとめる 決まった時間にまとめて見る 重要な文書・確信度の 依頼は即時に飛ばさず、 低い所だけ人が見る 1日1〜2回の枠で見る 機械で判定できる所は見ない lint・リンク切れ・用語のゆれは 2 割り込みは急ぎだけ 本番影響があるものだけ即時レビュー どれだけ 1 1回の量に上限を設ける 1回に見る差分の上限を決める 注意力の限界を超える前に区切る 2 超えたら分割して出させる PR・章ごとなど小さな単位にする 機械に任せる レビュー力も集中も有限。「何を・いつ・どれだけ見るか」を、AIに出させる前に決めておく。 28
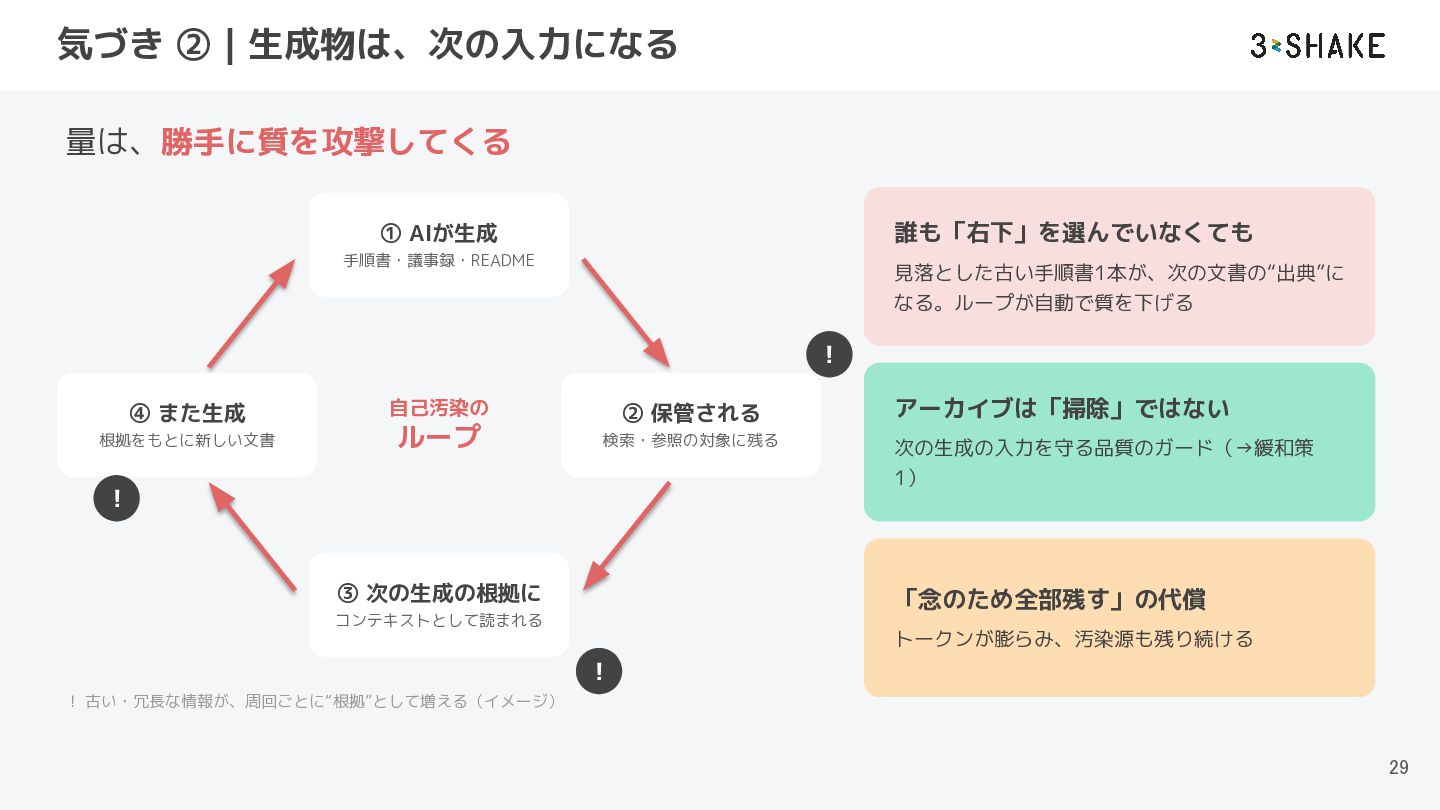
気づき ②|生成物は、次の入力になる 量は、勝手に質を攻撃してくる 誰も「右下」を選んでいなくても ① AIが生成 手順書・議事録・README 見落とした古い手順書1本が、次の文書の“出典”に なる。ループが自動で質を下げる !
④ また生成 根拠をもとに新しい文書 自己汚染の ループ ② 保管される 検索・参照の対象に残る アーカイブは「掃除」ではない 次の生成の入力を守る品質のガード(→緩和策 1) ! ③ 次の生成の根拠に 「念のため全部残す」の代償 コンテキストとして読まれる トークンが膨らみ、汚染源も残り続ける ! ! 古い・冗長な情報が、周回ごとに“根拠”として増える(イメージ) 29
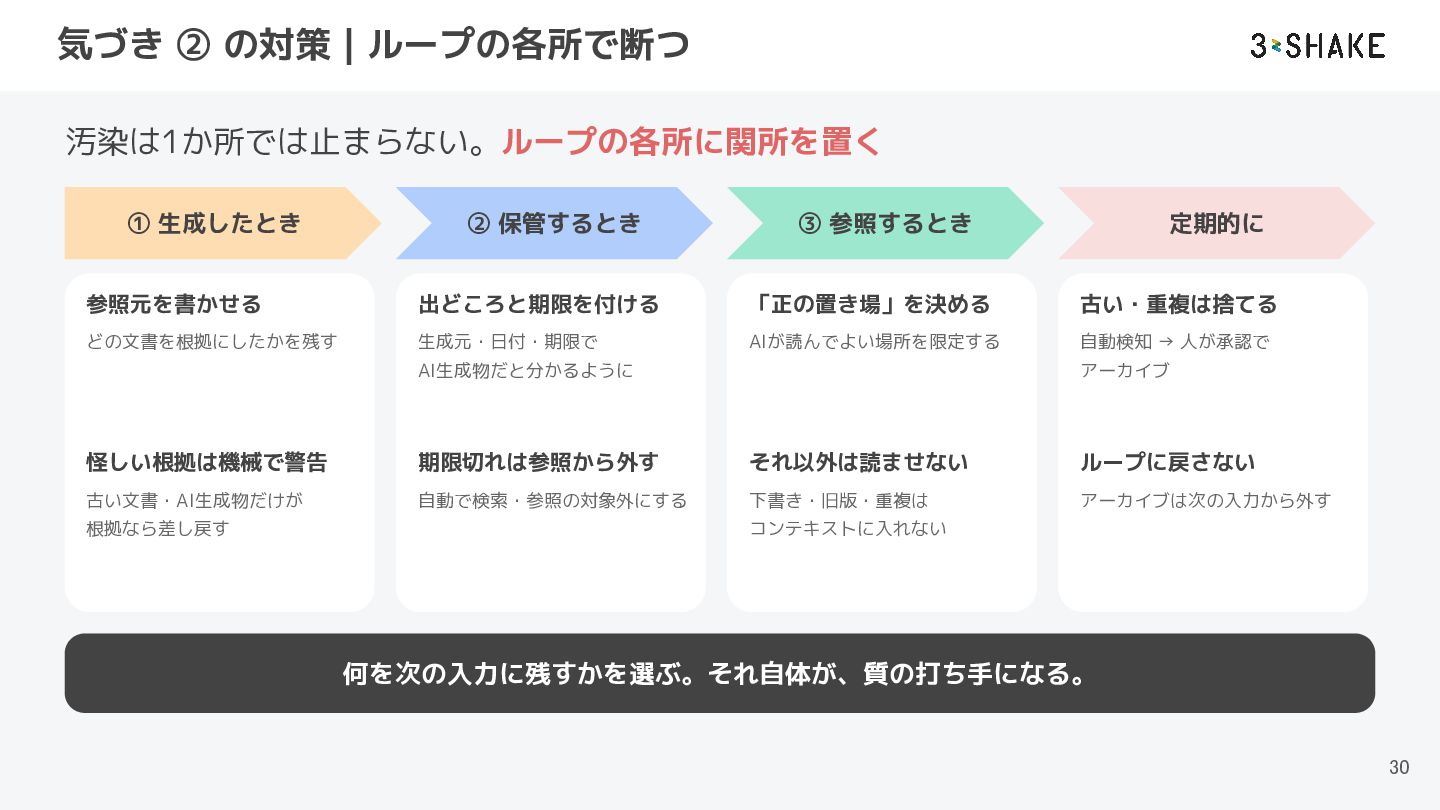
気づき ② の対策|ループの各所で断つ 汚染は1か所では止まらない。ループの各所に関所を置く ① 生成したとき ② 保管するとき ③ 参照するとき
定期的に 参照元を書かせる 出どころと期限を付ける 「正の置き場」を決める 古い・重複は捨てる どの文書を根拠にしたかを残す 生成元・日付・期限で AIが読んでよい場所を限定する 自動検知 → 人が承認で AI生成物だと分かるように アーカイブ 怪しい根拠は機械で警告 期限切れは参照から外す それ以外は読ませない ループに戻さない 古い文書・AI生成物だけが 自動で検索・参照の対象外にする 下書き・旧版・重複は アーカイブは次の入力から外す 根拠なら差し戻す コンテキストに入れない 何を次の入力に残すかを選ぶ。それ自体が、質の打ち手になる。 30
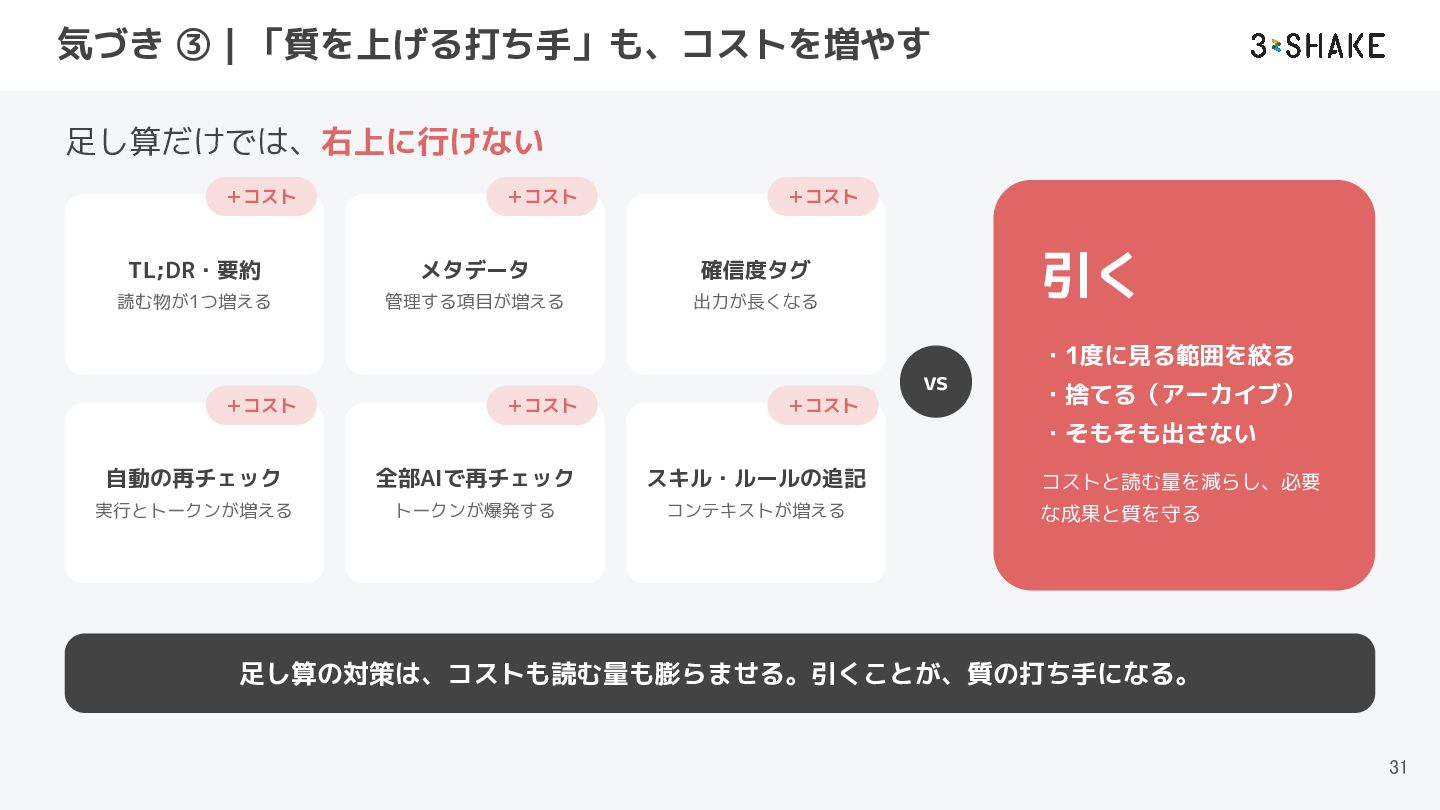
気づき ③|「質を上げる打ち手」も、コストを増やす 足し算だけでは、右上に行けない +コスト +コスト +コスト TL;DR・要約 メタデータ 確信度タグ 読む物が1つ増える
管理する項目が増える 出力が長くなる 引く ・1度に見る範囲を絞る vs +コスト +コスト +コスト ・捨てる(アーカイブ) ・そもそも出さない 自動の再チェック 全部AIで再チェック スキル・ルールの追記 実行とトークンが増える トークンが爆発する コンテキストが増える コストと読む量を減らし、必要 な成果と質を守る 足し算の対策は、コストも読む量も膨らませる。引くことが、質の打ち手になる。 31
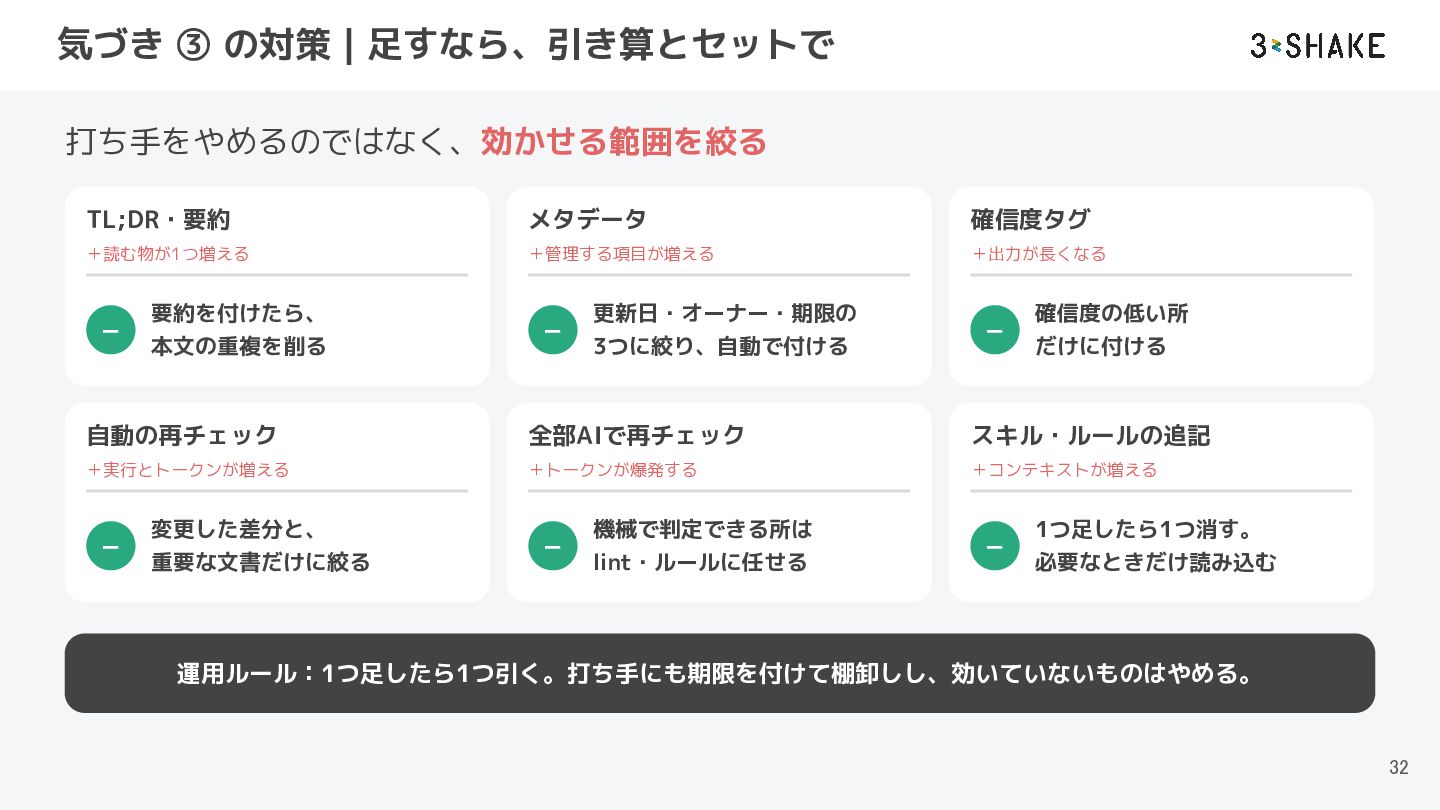
気づき ③ の対策|足すなら、引き算とセットで 打ち手をやめるのではなく、効かせる範囲を絞る TL;DR・要約 メタデータ 確信度タグ +読む物が1つ増える +管理する項目が増える +出力が長くなる
− 要約を付けたら、 本文の重複を削る − 更新日・オーナー・期限の 3つに絞り、自動で付ける − 確信度の低い所 だけに付ける 自動の再チェック 全部AIで再チェック スキル・ルールの追記 +実行とトークンが増える +トークンが爆発する +コンテキストが増える − 変更した差分と、 重要な文書だけに絞る − 機械で判定できる所は lint・ルールに任せる − 1つ足したら1つ消す。 必要なときだけ読み込む 運用ルール:1つ足したら1つ引く。打ち手にも期限を付けて棚卸しし、効いていないものはやめる。 32
まとめ Copyright © 3-shake, Inc. All Rights Reserved. 33
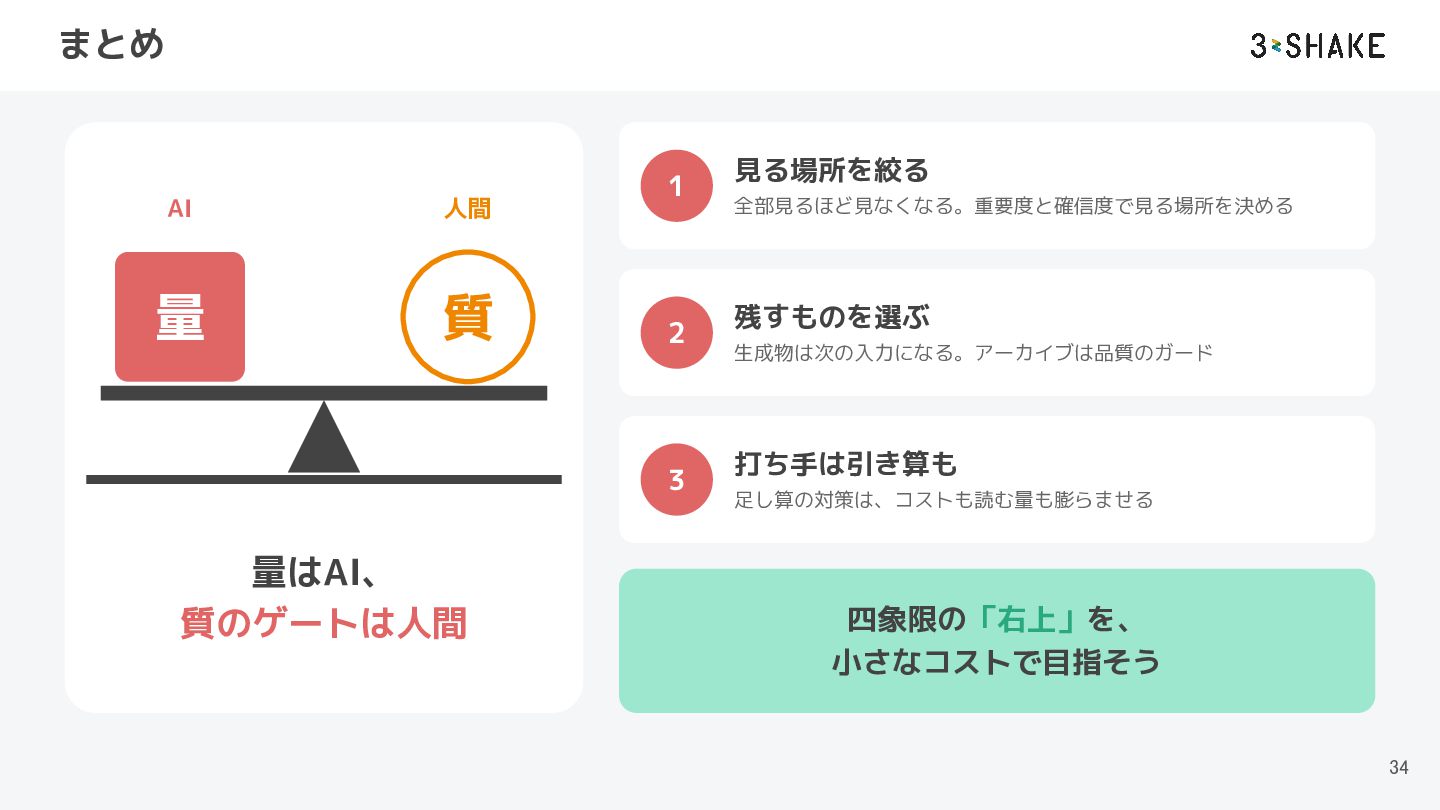
まとめ AI 人間 量 質 1 2 3 量はAI、 質のゲートは人間
見る場所を絞る 全部見るほど見なくなる。重要度と確信度で見る場所を決める 残すものを選ぶ 生成物は次の入力になる。アーカイブは品質のガード 打ち手は引き算も 足し算の対策は、コストも読む量も膨らませる 四象限の「右上」を、 小さなコストで目指そう 34
More Decks by Daisuke Akagawa (Akasan)
See All by Daisuke Akagawa (Akasan)
Grok Botと共存するために苦労した話
akasan
0
11
GKE上でオセロの強化学習やってみた
akasan
0
130
バランスって大事だね
akasan
1
170
生成AI時代のエンジニア育成について考えてみた
akasan
0
290
How_to_create_MLOps_Team.pdf
akasan
0
62
MLOps導入のための組織作りの第一歩
akasan
0
780
NVIDIA GTC2026 AI技術トレンドレポート
akasan
0
170
NVIDIA NIMによるモデルのサービングと NVIDIA NeMo Guardrailsによる安全性の担保
akasan
0
300
言語モデルに対する攻撃とその予防策について
akasan
0
61
Other Decks in Programming
See All in Programming
Coding with AI: How to trust the storyteller (AWS Community Day Adria, Ljubljana 2026)
slobodan
0
150
将来の標準フォーマッター?ktfmtを深堀る
t45k
0
220
手の動かし方がわからなかった私が個人開発者になるまで
usagi0920_pochi
0
300
高橋メソッドでCVE解説シリーズ 〜CVE-2026-112816〜
hakkadaikon
0
270
우리의 Nitro Modules는 당신의 Turbo Modules보다 아름답다
l2hyunwoo
0
270
Rails初心者がパスキーを実装してみて大変だったこと
ktombow
0
220
Proxmox x Talos Linux x Terraform で実現するなんかいい感じの Kubernetes クラスタ / A Sleek Kubernetes Cluster Powered by Proxmox, Talos Linux, and Terraform
nnaka2992
0
270
ローカルLLMの基本と近況 2611 / Local LLM basics and recent situation 2611
kishida
3
600
Debian JP Projectのサーバー構成
uwabami
1
140
作れるエンジニアから、価値を届けるエンジニアへ
ryunakayama
1
310
LLM 101: Exploring LLMs, Starting with Tokens.
dalinaum
0
120
React Native에 현대적인 빌드 도구 더하기: Rollipop 구현기
leegeunhyeok
0
190
Featured
See All Featured
Measuring & Analyzing Core Web Vitals
bluesmoon
9
1.1k
Un-Boring Meetings
codingconduct
0
500
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
570
VelocityConf: Rendering Performance Case Studies
addyosmani
331
25k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.9k
CSS Pre-Processors: Stylus, Less & Sass
bermonpainter
360
31k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.4k
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
480
Everyday Curiosity
cassininazir
0
400
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
The Illustrated Guide to Node.js - THAT Conference 2024
reverentgeek
1
610
The Art of Programming - Codeland 2020
erikaheidi
57
15k


 akasan
 slobodan
 t45k
 usagi0920_pochi
 hakkadaikon
 l2hyunwoo
 ktombow
 nnaka2992
 kishida
 uwabami
 ryunakayama
 dalinaum
 leegeunhyeok
 bluesmoon
 codingconduct
 ks91
 addyosmani
 rmw
 bermonpainter
 minecr
 cassininazir
 marcduiker
 reverentgeek
 erikaheidi