Upgrade to Pro — share decks privately, control downloads, hide ads and more …

dbt Semantic Layerで進めるenechainのデータ民主化

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for Aki Zhou Aki Zhou
October 22, 2026

dbt Semantic Layerで進めるenechainのデータ民主化

enechainでは、dbt Semantic Layerを中心に社員が自然言語で社内のデータに問い合わせられる仕組みを運用しています。利用が広がるにつれて問いの幅も広がり、モデル開発の速さが課題となります。本セッションでは、dbt Semantic Layerを軸にしたデータ民主化の進め方とモデル開発を速くするための工夫について紹介します。

Avatar for Aki Zhou

Aki Zhou

October 22, 2026

More Decks by Aki Zhou

Other Decks in Technology

Transcript

  1. dbt Semantic Layer で進める enechain のデータ⺠主化 dbt World Tour 東京

    | 2026-10-20 Data Platform Desk 周 晟聡 ∕ 菱沼 拓未
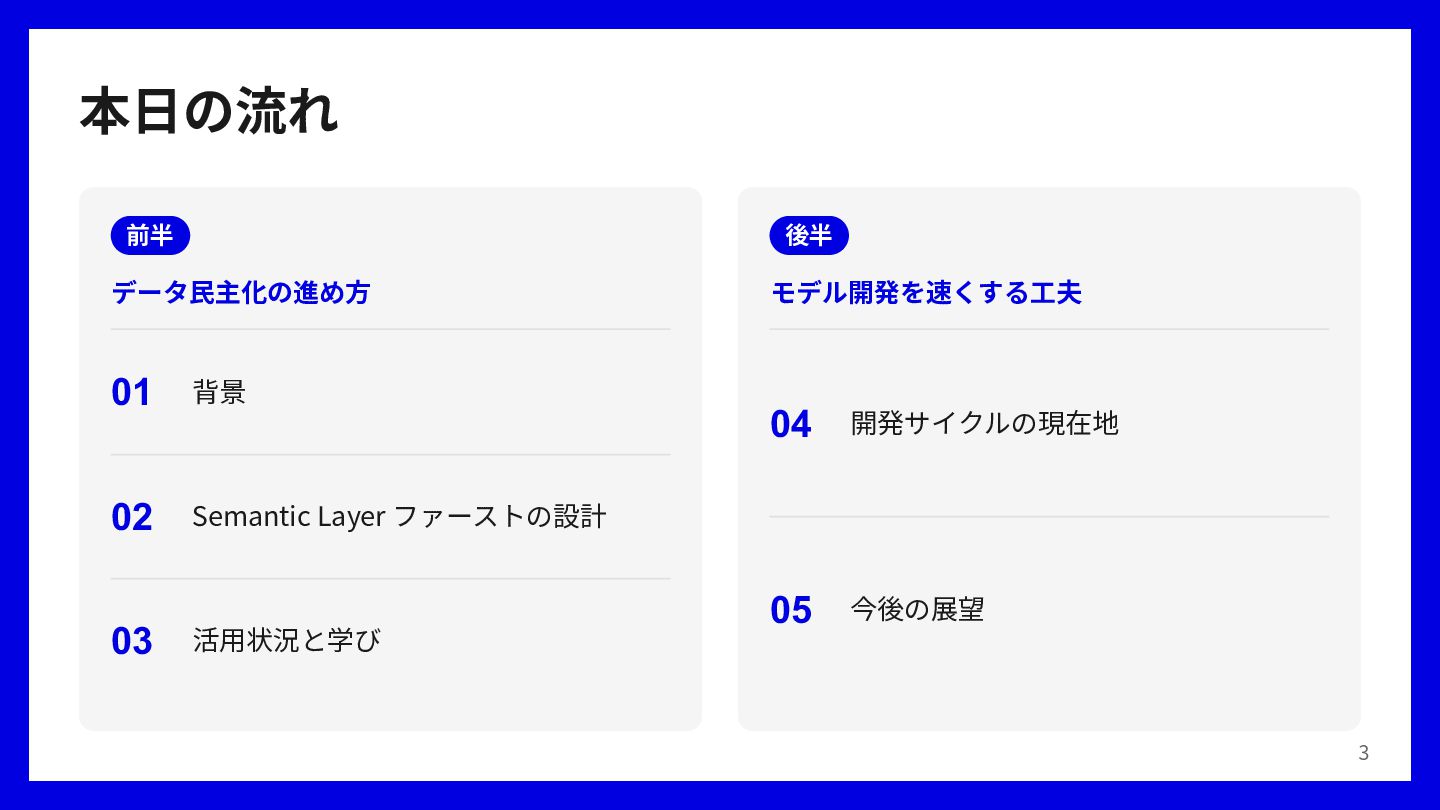
  2. 本⽇の流れ 前半 後半 データ⺠主化の進め⽅ モデル開発を速くする⼯夫 01 背景 02 Semantic Layer

    ファーストの設計 03 活⽤状況と学び 04 開発サイクルの現在地 05 今後の展望 3
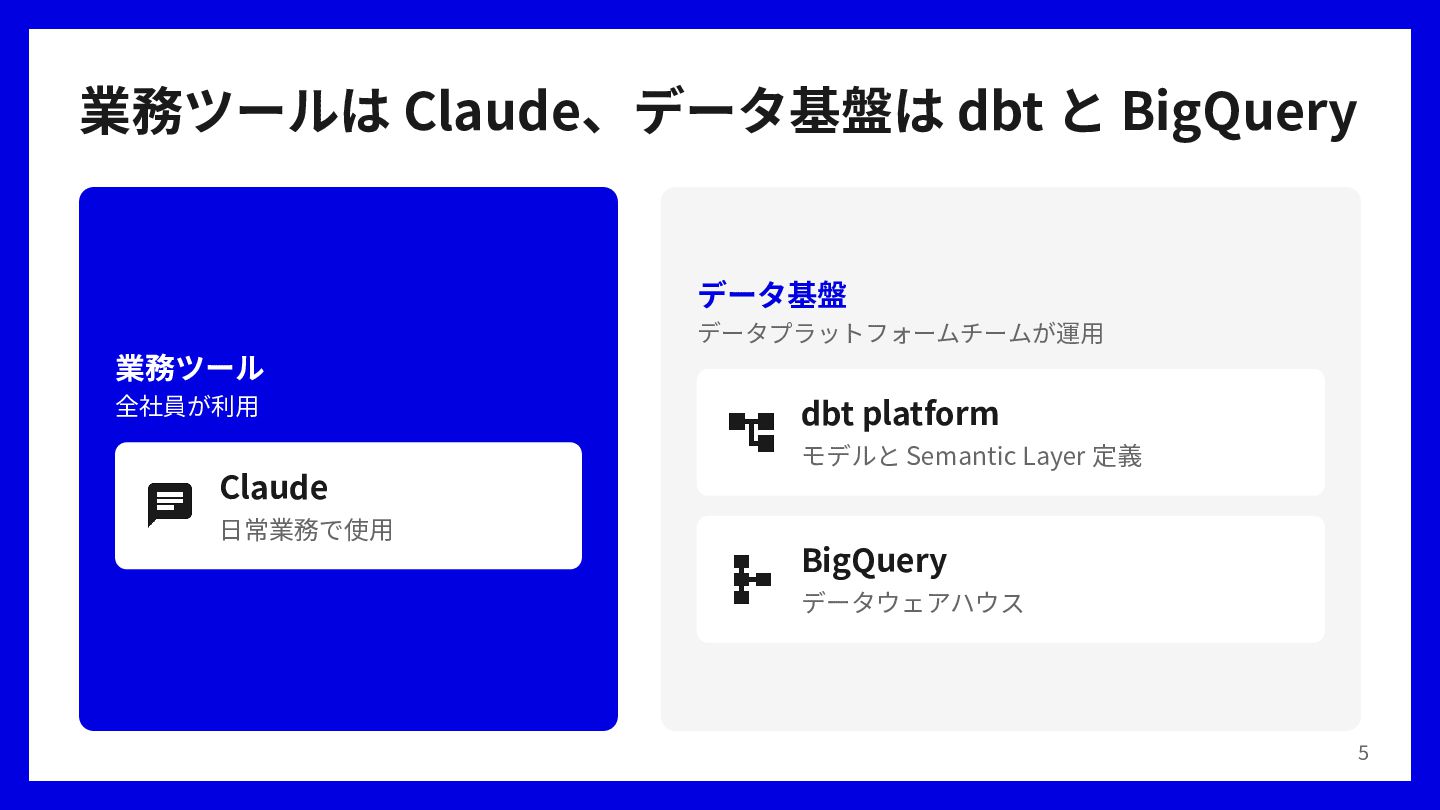
  3. 業務ツールは Claude、データ基盤は dbt と BigQuery データ基盤 データプラットフォームチームが運⽤ 業務ツール 全社員が利⽤ dbt

    platform モデルと Semantic Layer 定義 Claude ⽇常業務で使⽤ BigQuery データウェアハウス 5
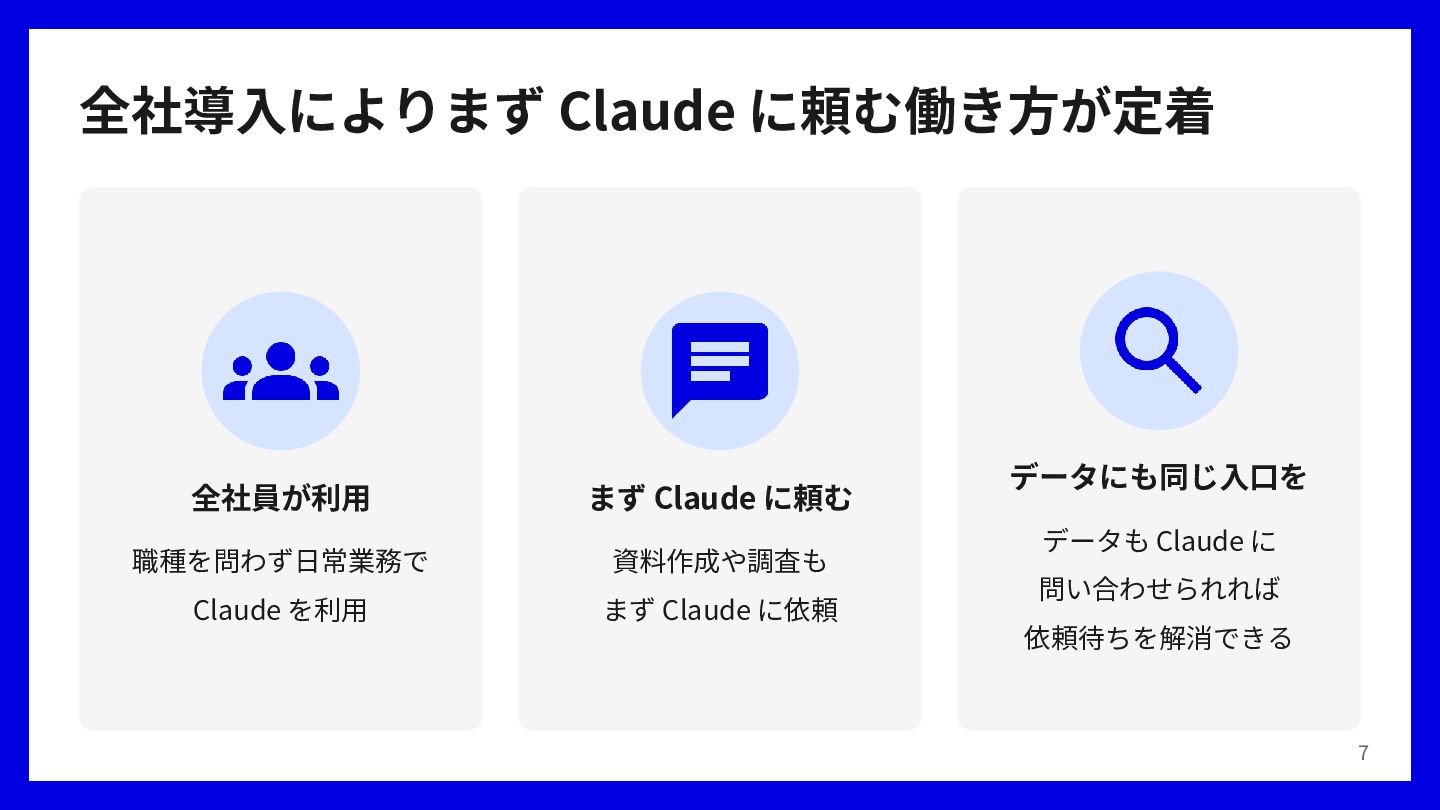
  4. 全社導⼊によりまず Claude に頼む働き⽅が定着 全社員が利⽤ まず Claude に頼む 職種を問わず⽇常業務で 資料作成や調査も Claude

    を利⽤ まず Claude に依頼 データにも同じ⼊⼝を データも Claude に 問い合わせられれば 依頼待ちを解消できる 7
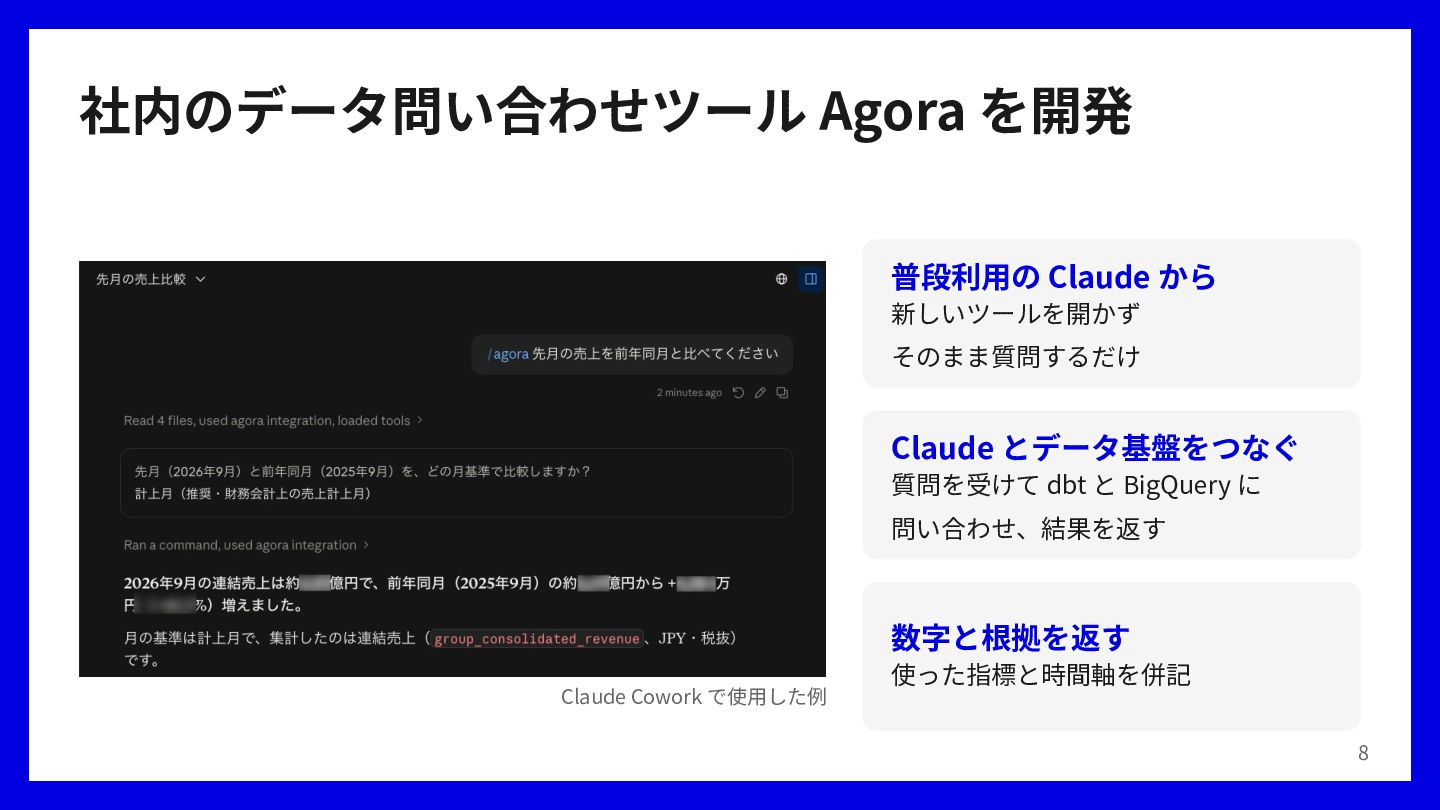
  5. 社内のデータ問い合わせツール Agora を開発 普段利⽤の Claude から 新しいツールを開かず そのまま質問するだけ Claude とデータ基盤をつなぐ

    質問を受けて dbt と BigQuery に 問い合わせ、結果を返す 数字と根拠を返す Claude Cowork で使⽤した例 使った指標と時間軸を併記 8
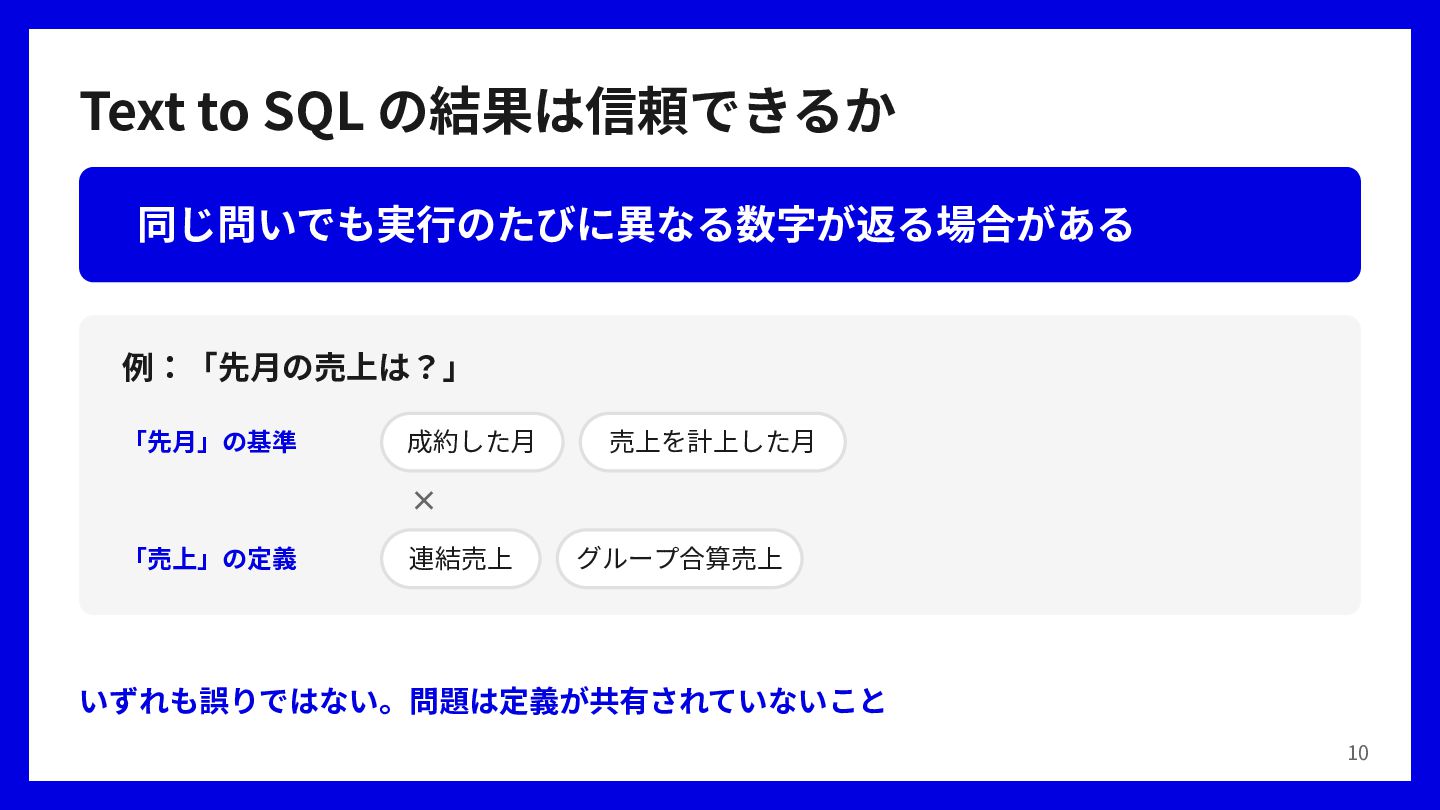
  6. Text to SQL の結果は信頼できるか 同じ問いでも実⾏のたびに異なる数字が返る場合がある 例:「先⽉の売上は?」 「先⽉」の基準 成約した⽉ 売上を計上した⽉ ×

    「売上」の定義 連結売上 グループ合算売上 いずれも誤りではない。問題は定義が共有されていないこと 10
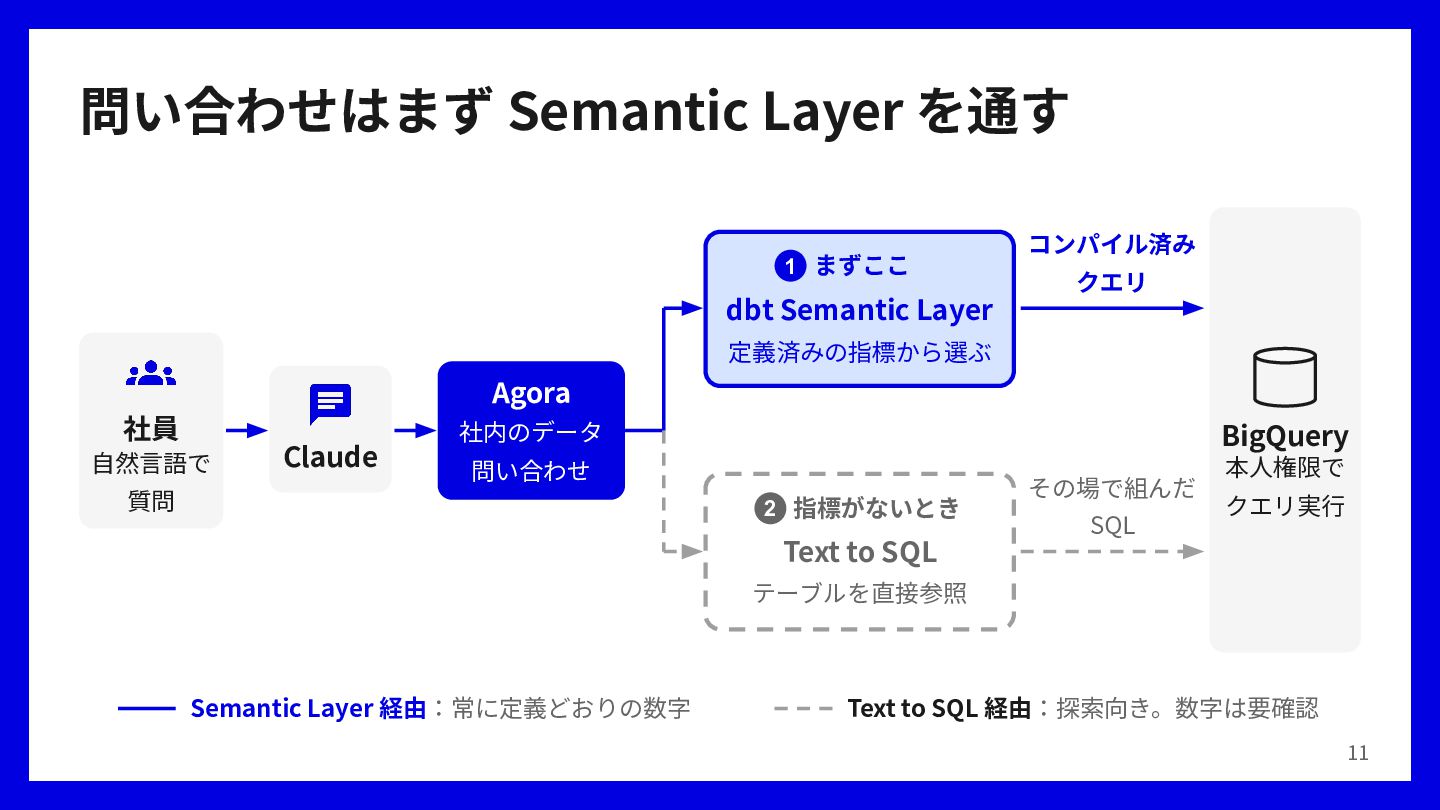
  7. 問い合わせはまず Semantic Layer を通す 1 まずここ コンパイル済み クエリ dbt Semantic

    Layer 定義済みの指標から選ぶ Agora 社員 ⾃然⾔語で Claude 社内のデータ BigQuery 問い合わせ 質問 2 指標がないとき Text to SQL その場で組んだ SQL 本⼈権限で クエリ実⾏ テーブルを直接参照 Semantic Layer 経由:常に定義どおりの数字 Text to SQL 経由:探索向き。数字は要確認 11
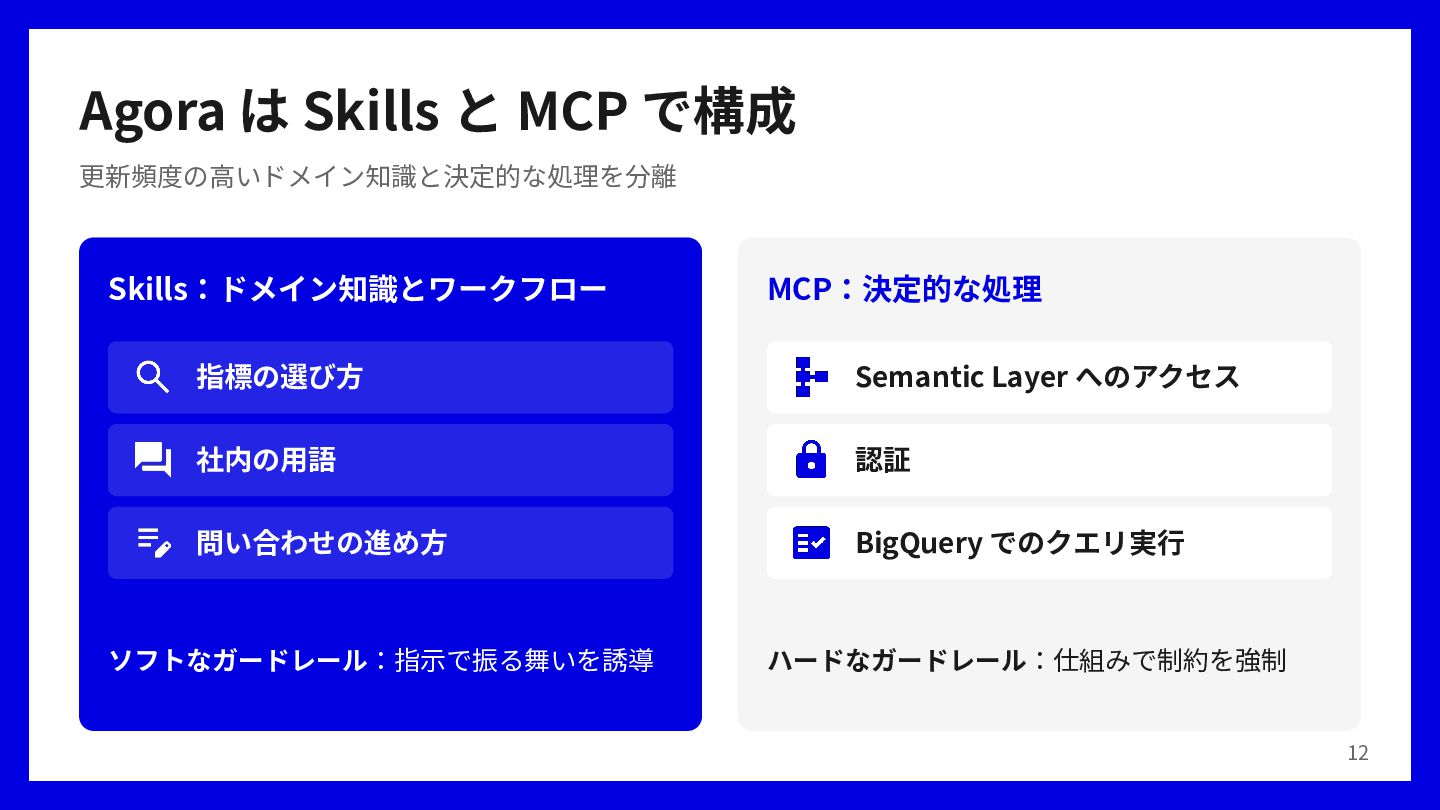
  8. Agora は Skills と MCP で構成 更新頻度の⾼いドメイン知識と決定的な処理を分離 Skills:ドメイン知識とワークフロー MCP:決定的な処理 指標の選び⽅

    Semantic Layer へのアクセス 社内の⽤語 認証 問い合わせの進め⽅ BigQuery でのクエリ実⾏ ソフトなガードレール:指⽰で振る舞いを誘導 ハードなガードレール:仕組みで制約を強制 12
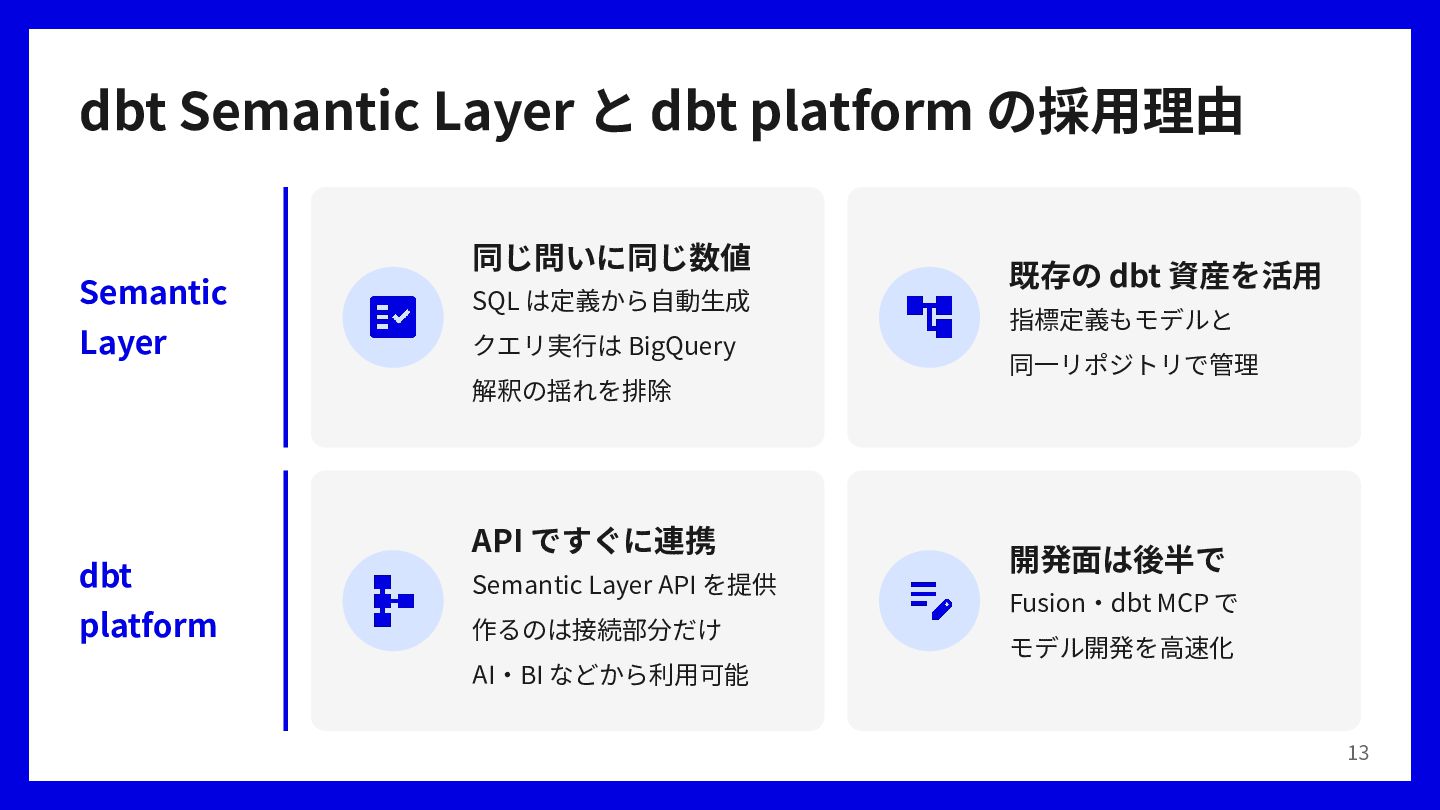
  9. dbt Semantic Layer と dbt platform の採⽤理由 同じ問いに同じ数値 Semantic SQL

    は定義から⾃動⽣成 Layer クエリ実⾏は BigQuery 既存の dbt 資産を活⽤ 指標定義もモデルと 同⼀リポジトリで管理 解釈の揺れを排除 API ですぐに連携 dbt Semantic Layer API を提供 platform 作るのは接続部分だけ 開発⾯は後半で Fusion‧dbt MCP で モデル開発を⾼速化 AI‧BI などから利⽤可能 13
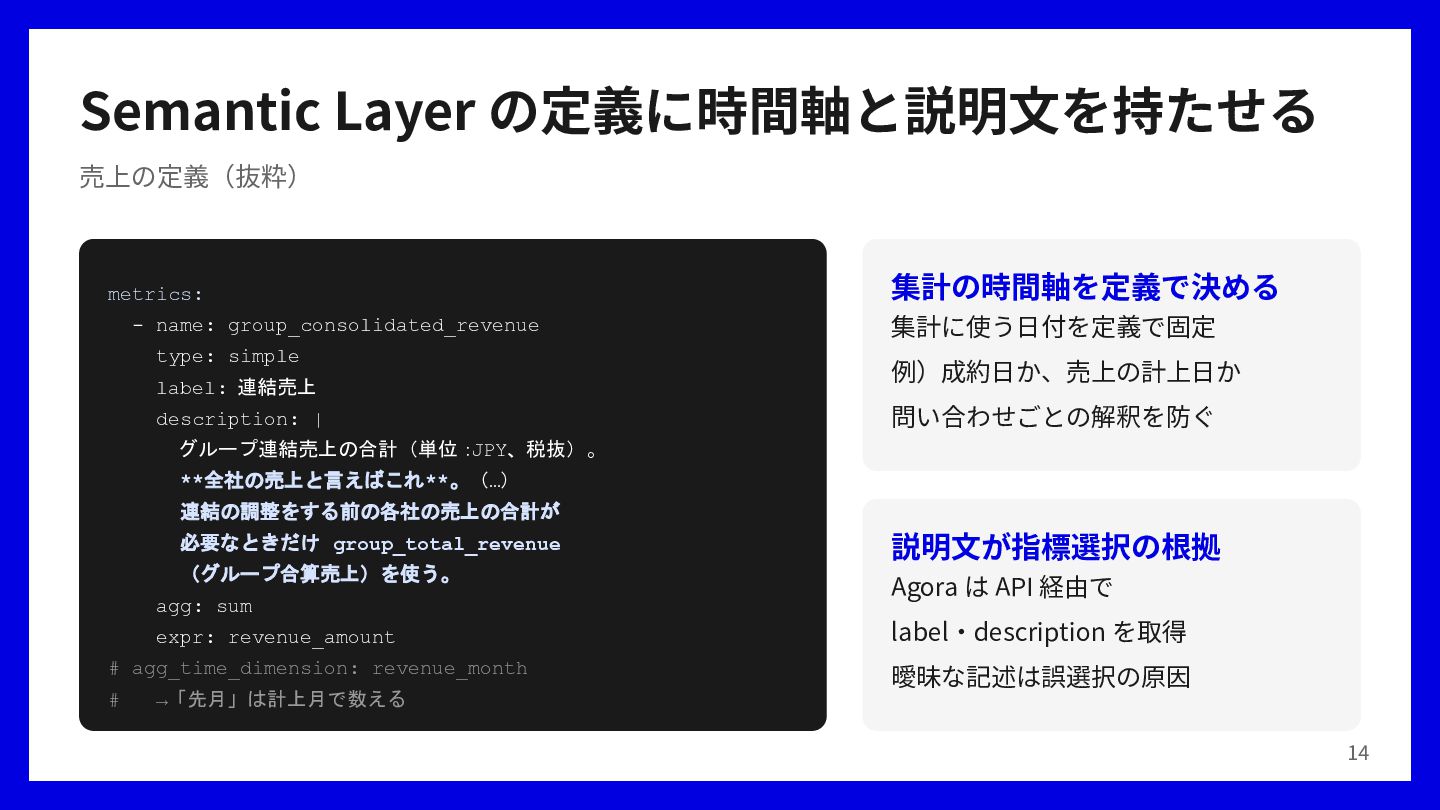
  10. Semantic Layer の定義に時間軸と説明⽂を持たせる 売上の定義(抜粋) metrics: - name: group_consolidated_revenue type: simple

    label: 連結売上 description: | 集計の時間軸を定義で決める 集計に使う⽇付を定義で固定 例)成約⽇か、売上の計上⽇か 問い合わせごとの解釈を防ぐ グループ連結売上の合計(単位:JPY、税抜)。 **全社の売上と言えばこれ**。(…) 連結の調整をする前の各社の売上の合計が 必要なときだけ group_total_revenue (グループ合算売上)を使う。 説明⽂が指標選択の根拠 Agora は API 経由で agg: sum expr: revenue_amount # agg_time_dimension: revenue_month # label‧description を取得 曖昧な記述は誤選択の原因 →「先月」は計上月で数える 14
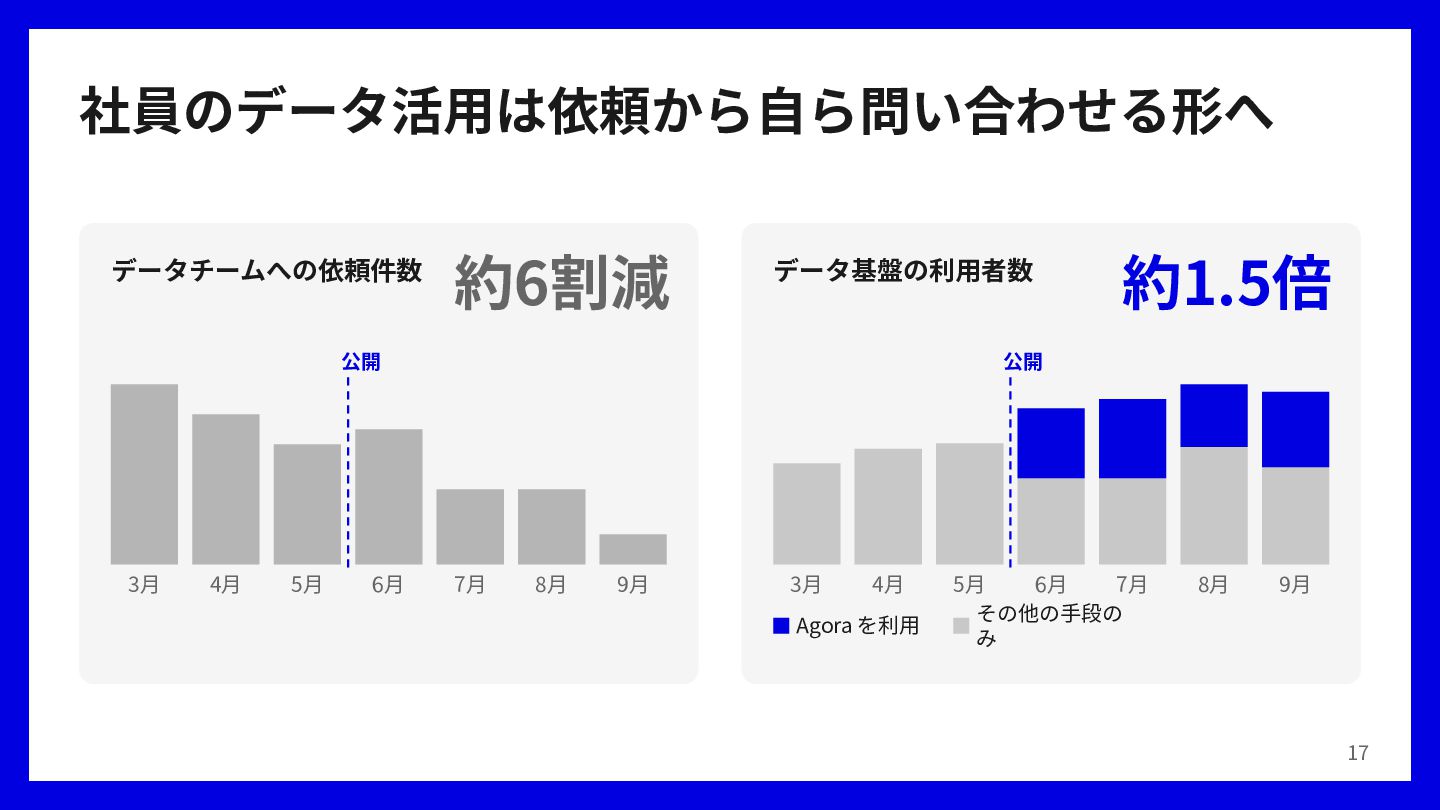
  11. まず公開し、計測して整備先を決める 1 データチーム Agora をまず公開 社員が⽇常的に使う 2 Agora が⾃動で 公開初⽇から利⽤を記録

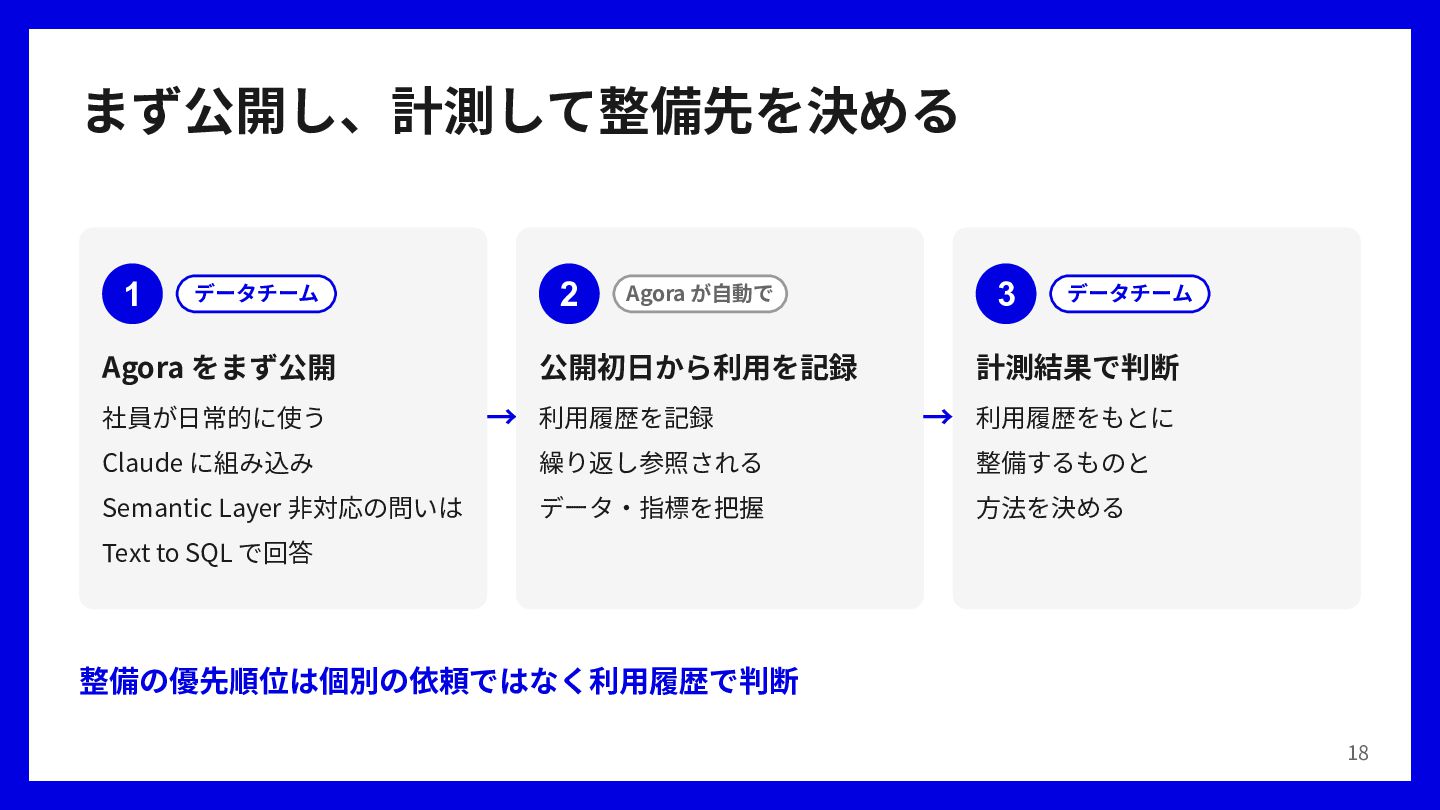
    → 利⽤履歴を記録 3 データチーム 計測結果で判断 → 利⽤履歴をもとに Claude に組み込み 繰り返し参照される 整備するものと Semantic Layer ⾮対応の問いは データ‧指標を把握 ⽅法を決める Text to SQL で回答 整備の優先順位は個別の依頼ではなく利⽤履歴で判断 18
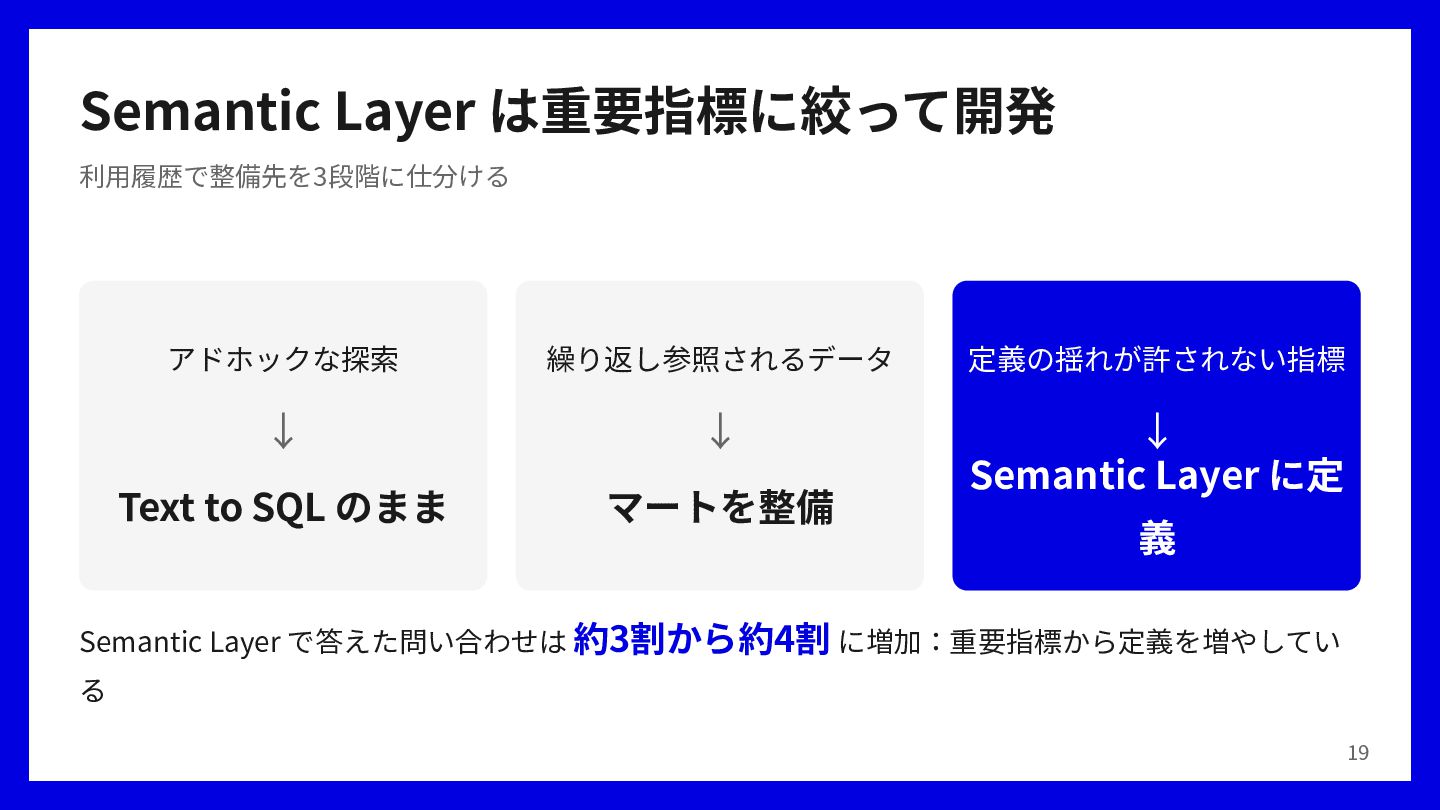
  12. Semantic Layer は重要指標に絞って開発 利⽤履歴で整備先を3段階に仕分ける アドホックな探索 繰り返し参照されるデータ 定義の揺れが許されない指標 ↓ ↓ Text

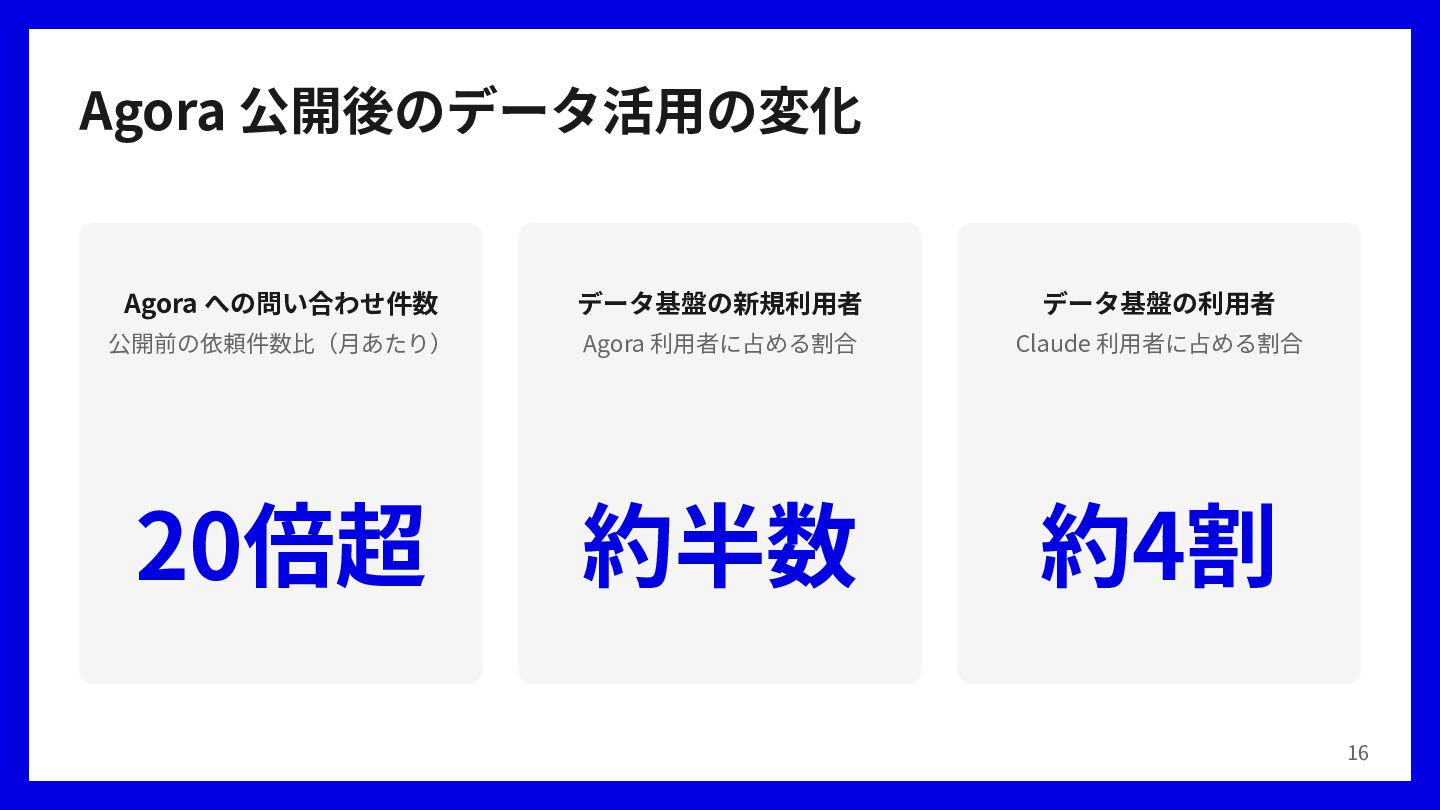
    to SQL のまま マートを整備 ↓ Semantic Layer に定 義 Semantic Layer で答えた問い合わせは 約3割から約4割 に増加:重要指標から定義を増やしてい る 19
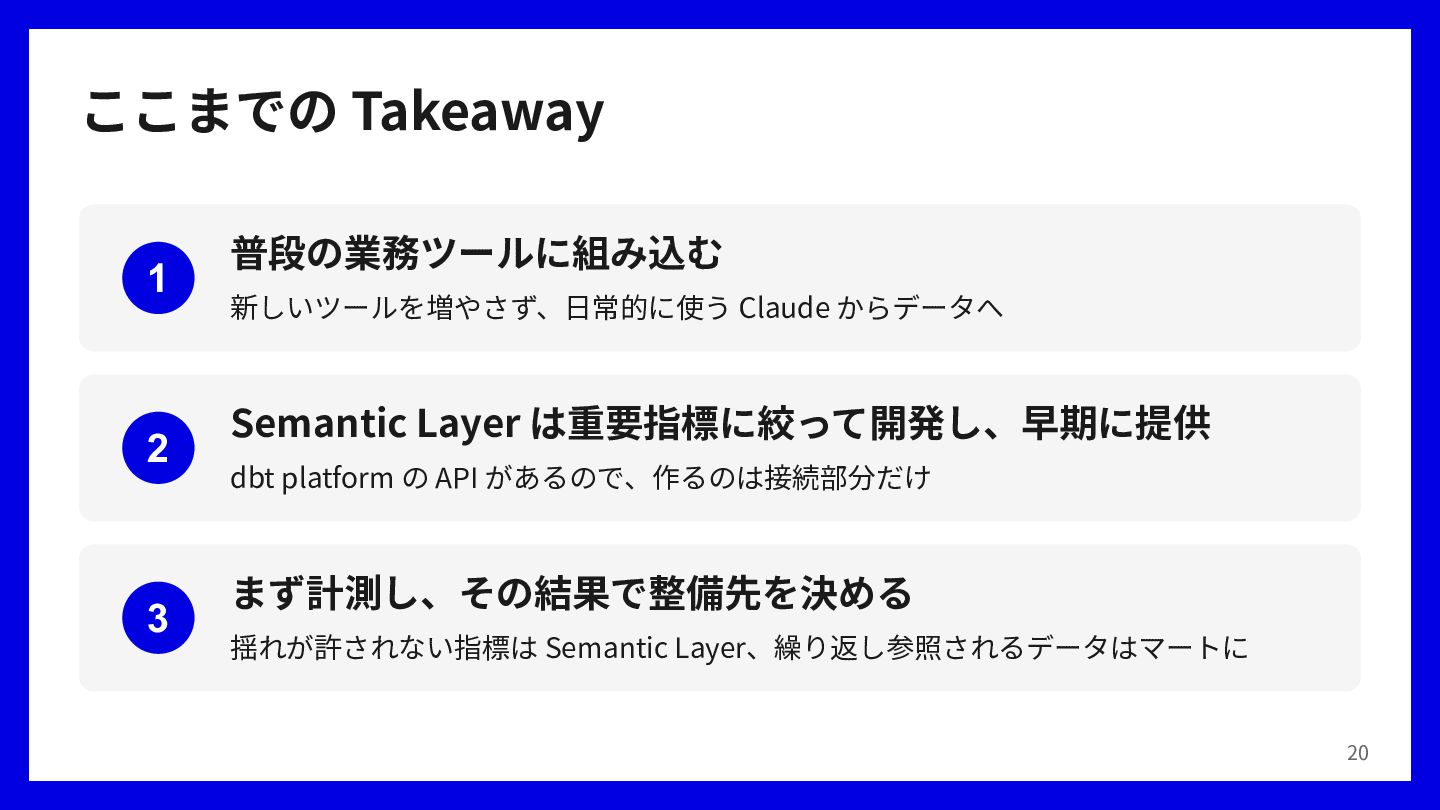
  13. ここまでの Takeaway 1 2 3 普段の業務ツールに組み込む 新しいツールを増やさず、⽇常的に使う Claude からデータへ Semantic

    Layer は重要指標に絞って開発し、早期に提供 dbt platform の API があるので、作るのは接続部分だけ まず計測し、その結果で整備先を決める 揺れが許されない指標は Semantic Layer、繰り返し参照されるデータはマートに 20
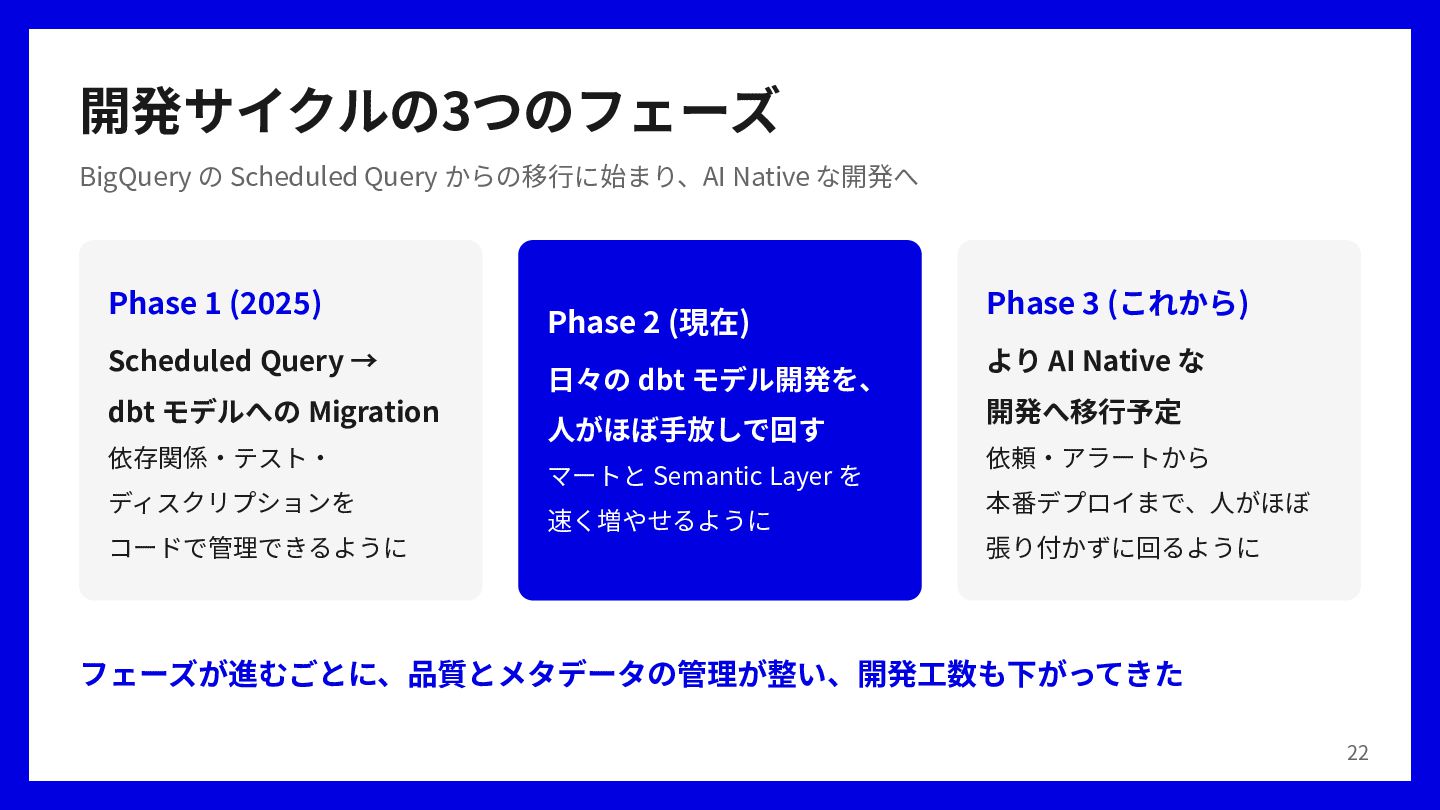
  14. 開発サイクルの3つのフェーズ BigQuery の Scheduled Query からの移⾏に始まり、AI Native な開発へ Phase 1

    (2025) Scheduled Query → dbt モデルへの Migration 依存関係‧テスト‧ ディスクリプションを コードで管理できるように Phase 2 (現在) ⽇々の dbt モデル開発を、 ⼈がほぼ⼿放しで回す マートと Semantic Layer を 速く増やせるように Phase 3 (これから) より AI Native な 開発へ移⾏予定 依頼‧アラートから 本番デプロイまで、⼈がほぼ 張り付かずに回るように フェーズが進むごとに、品質とメタデータの管理が整い、開発⼯数も下がってきた 22
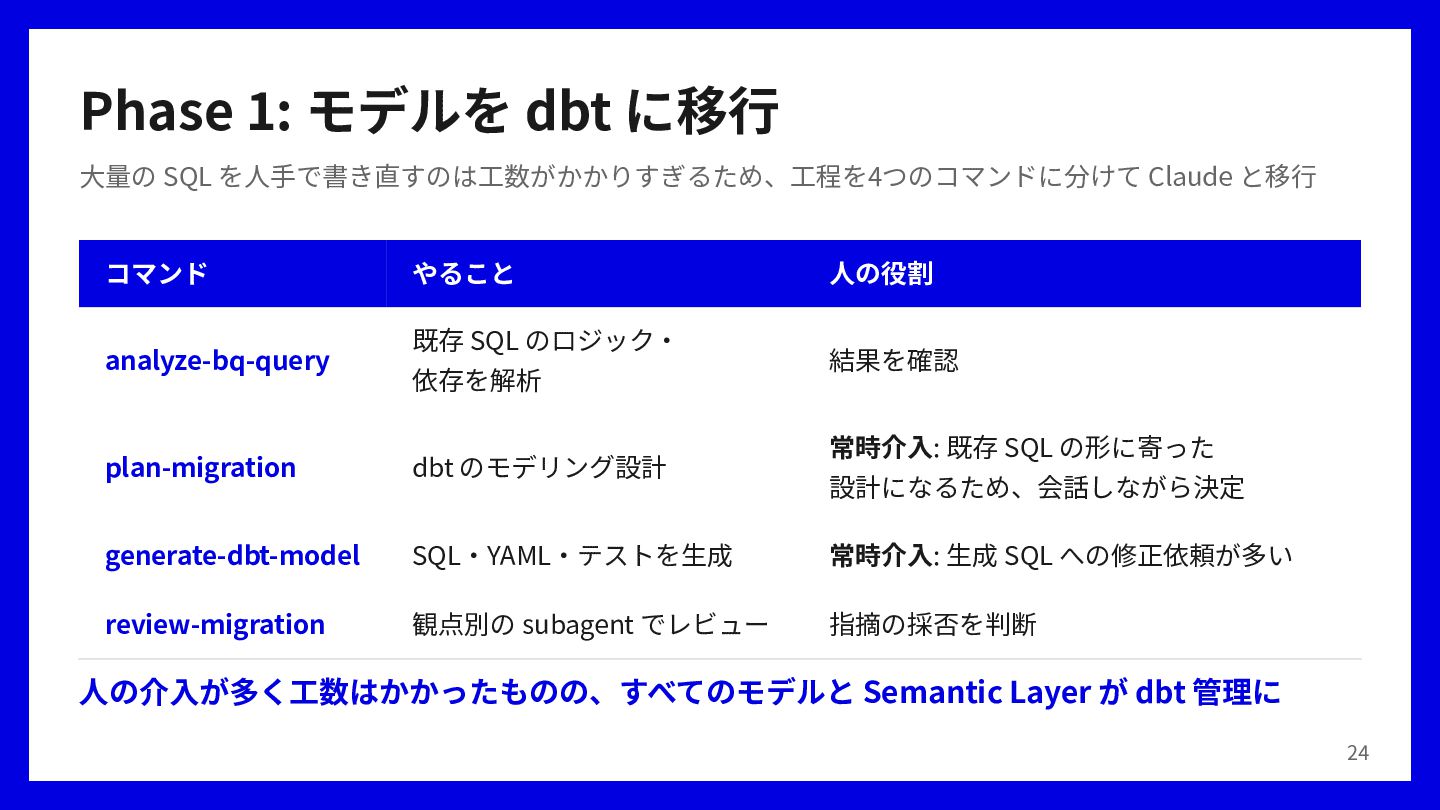
  15. Phase 1: モデルを dbt に移⾏ ⼤量の SQL を⼈⼿で書き直すのは⼯数がかかりすぎるため、⼯程を4つのコマンドに分けて Claude と移⾏

    コマンド analyze-bq-query やること 既存 SQL のロジック‧ 依存を解析 ⼈の役割 結果を確認 常時介⼊: 既存 SQL の形に寄った plan-migration dbt のモデリング設計 generate-dbt-model SQL‧YAML‧テストを⽣成 常時介⼊: ⽣成 SQL への修正依頼が多い review-migration 観点別の subagent でレビュー 指摘の採否を判断 設計になるため、会話しながら決定 ⼈の介⼊が多く⼯数はかかったものの、すべてのモデルと Semantic Layer が dbt 管理に 24
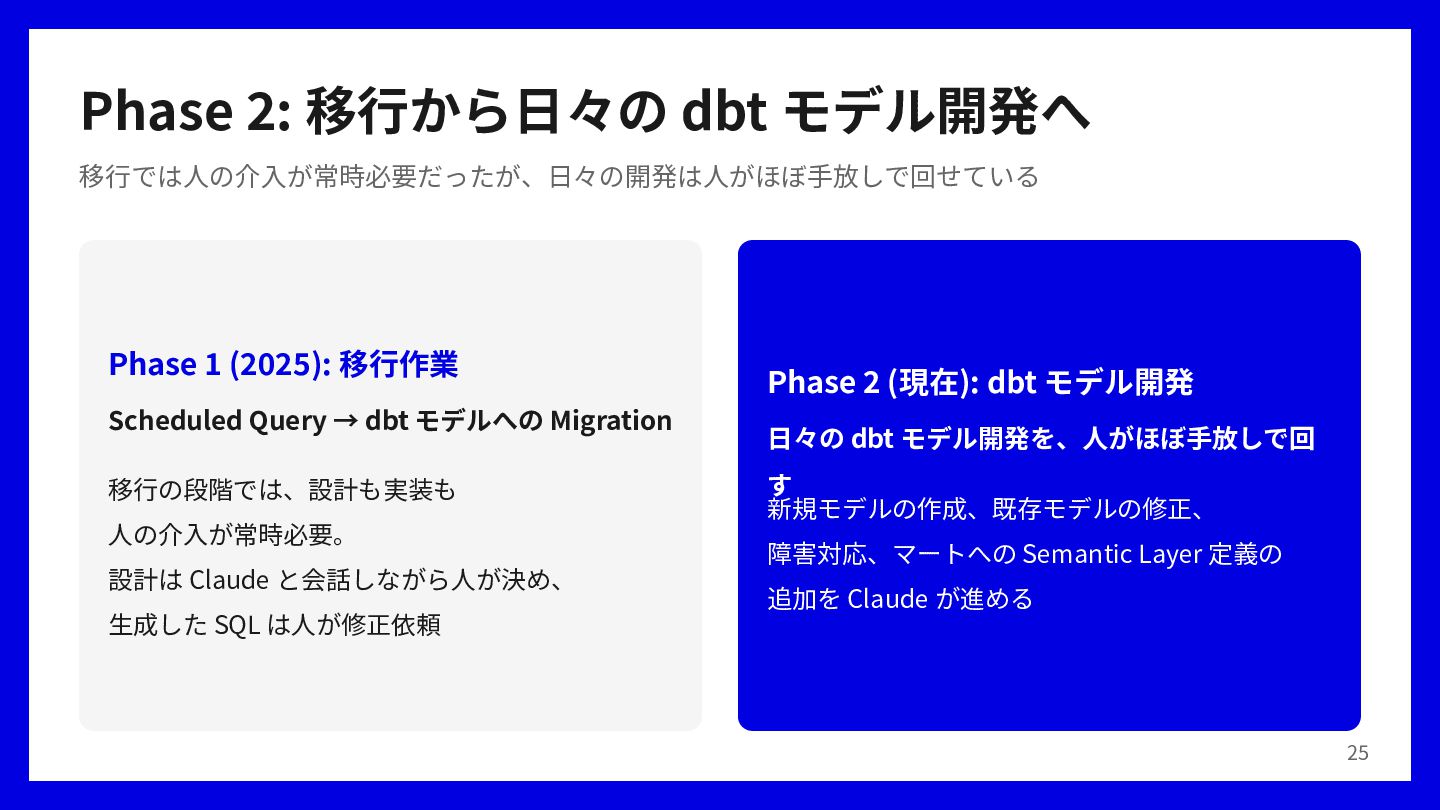
  16. Phase 2: 移⾏から⽇々の dbt モデル開発へ 移⾏では⼈の介⼊が常時必要だったが、⽇々の開発は⼈がほぼ⼿放しで回せている Phase 1 (2025): 移⾏作業

    Scheduled Query → dbt モデルへの Migration 移⾏の段階では、設計も実装も ⼈の介⼊が常時必要。 設計は Claude と会話しながら⼈が決め、 Phase 2 (現在): dbt モデル開発 ⽇々の dbt モデル開発を、⼈がほぼ⼿放しで回 す 新規モデルの作成、既存モデルの修正、 障害対応、マートへの Semantic Layer 定義の 追加を Claude が進める ⽣成した SQL は⼈が修正依頼 25
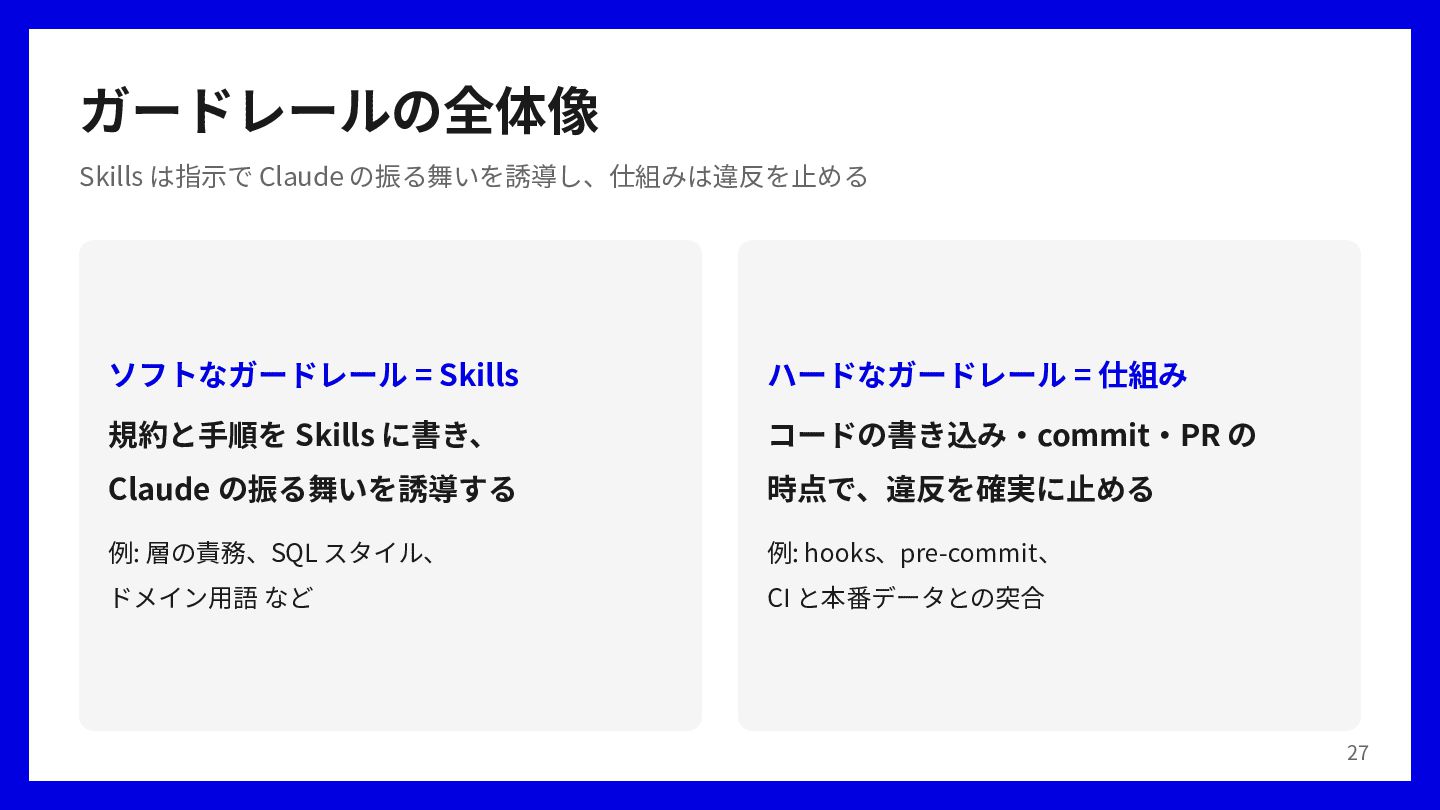
  17. ガードレールの全体像 Skills は指⽰で Claude の振る舞いを誘導し、仕組みは違反を⽌める ソフトなガードレール = Skills ハードなガードレール =

    仕組み 規約と⼿順を Skills に書き、 コードの書き込み‧commit‧PR の Claude の振る舞いを誘導する 時点で、違反を確実に⽌める 例: 層の責務、SQL スタイル、 例: hooks、pre-commit、 ドメイン⽤語 など CI と本番データとの突合 27
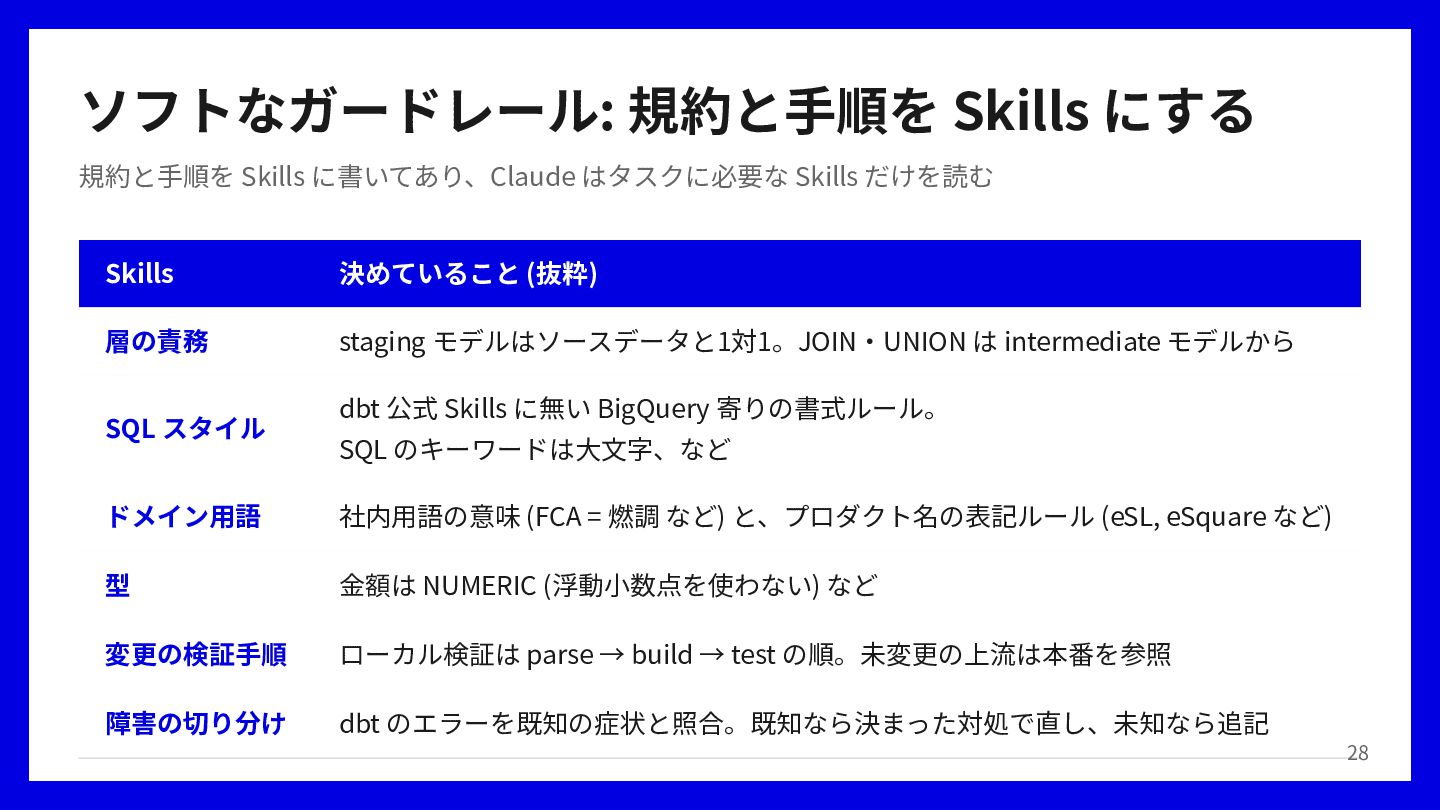
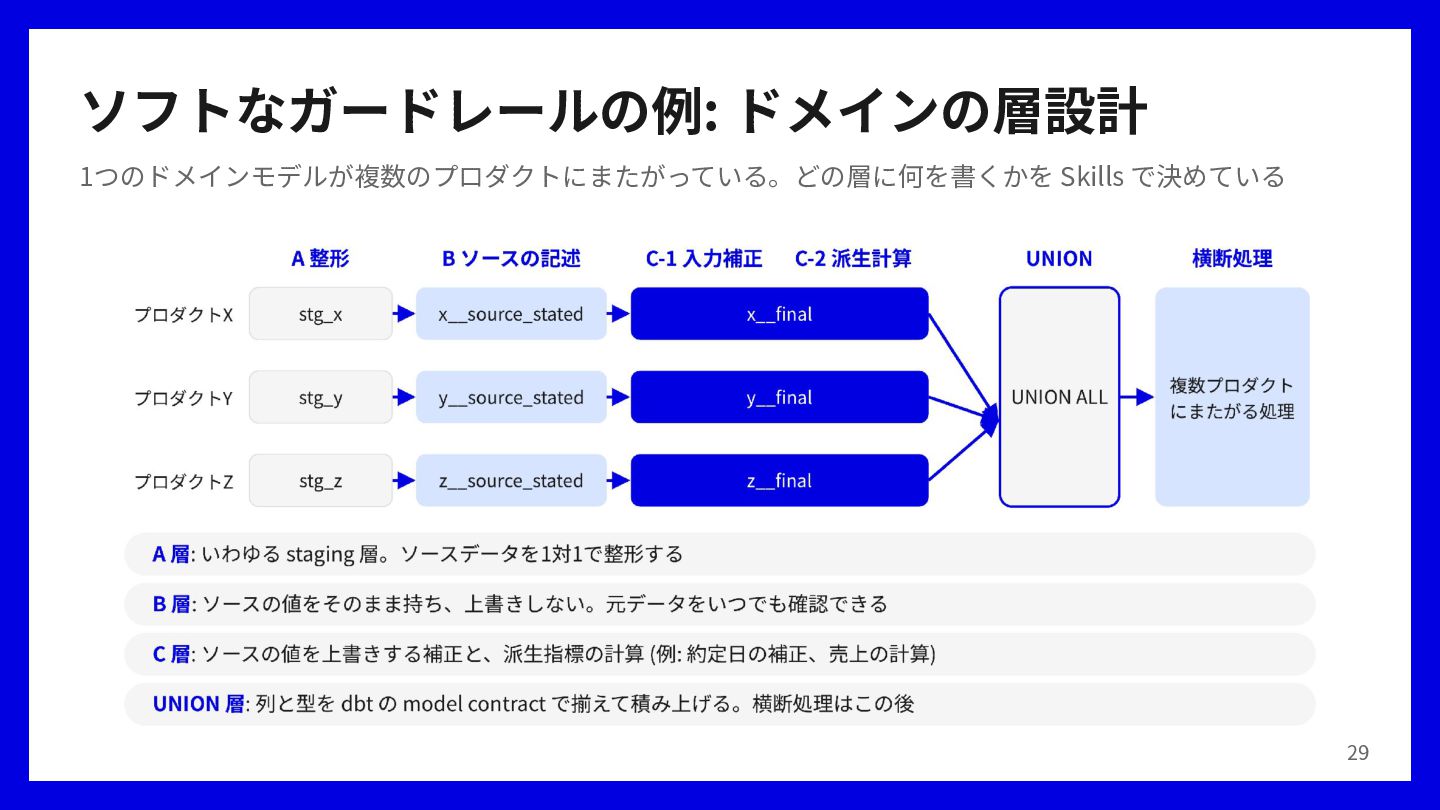
  18. ソフトなガードレール: 規約と⼿順を Skills にする 規約と⼿順を Skills に書いてあり、Claude はタスクに必要な Skills だけを読む

    Skills 決めていること (抜粋) 層の責務 staging モデルはソースデータと1対1。JOIN‧UNION は intermediate モデルから SQL スタイル dbt 公式 Skills に無い BigQuery 寄りの書式ルール。 SQL のキーワードは⼤⽂字、など ドメイン⽤語 社内⽤語の意味 (FCA = 燃調 など) と、プロダクト名の表記ルール (eSL, eSquare など) 型 ⾦額は NUMERIC (浮動⼩数点を使わない) など 変更の検証⼿順 ローカル検証は parse → build → test の順。未変更の上流は本番を参照 障害の切り分け dbt のエラーを既知の症状と照合。既知なら決まった対処で直し、未知なら追記 28
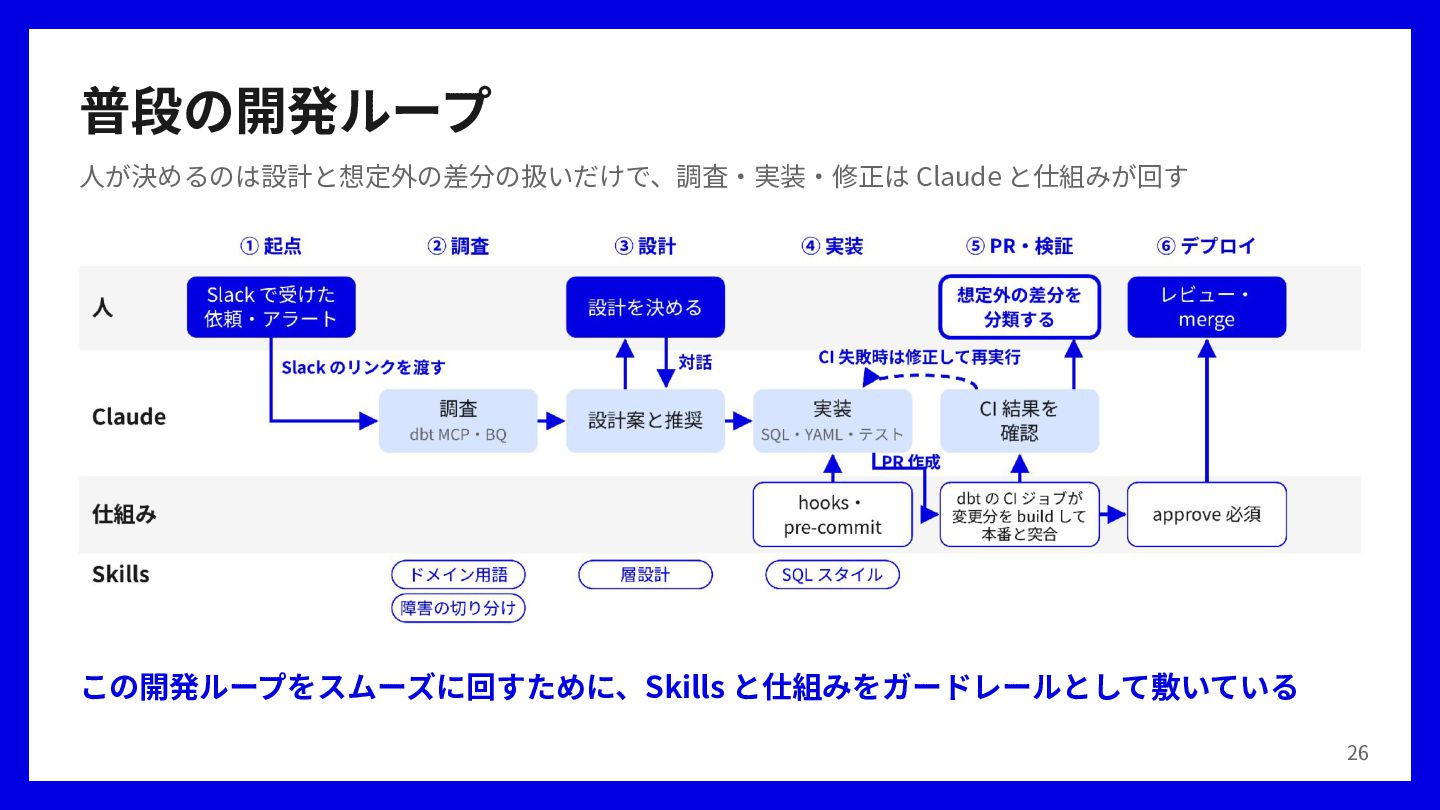
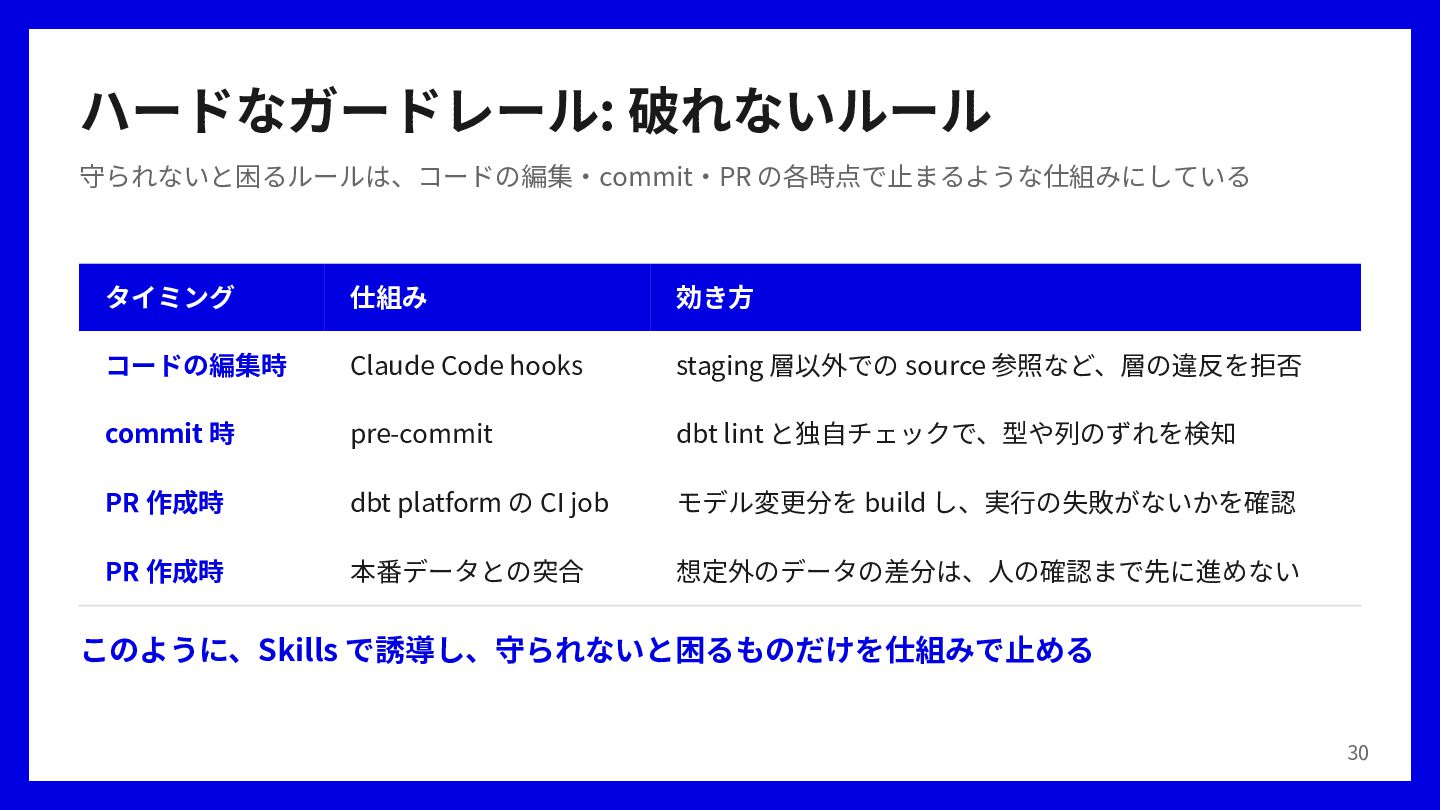
  19. ハードなガードレール: 破れないルール 守られないと困るルールは、コードの編集‧commit‧PR の各時点で⽌まるような仕組みにしている タイミング 仕組み 効き⽅ コードの編集時 Claude Code

    hooks staging 層以外での source 参照など、層の違反を拒否 commit 時 pre-commit dbt lint と独⾃チェックで、型や列のずれを検知 PR 作成時 dbt platform の CI job モデル変更分を build し、実⾏の失敗がないかを確認 PR 作成時 本番データとの突合 想定外のデータの差分は、⼈の確認まで先に進めない このように、Skills で誘導し、守られないと困るものだけを仕組みで⽌める 30
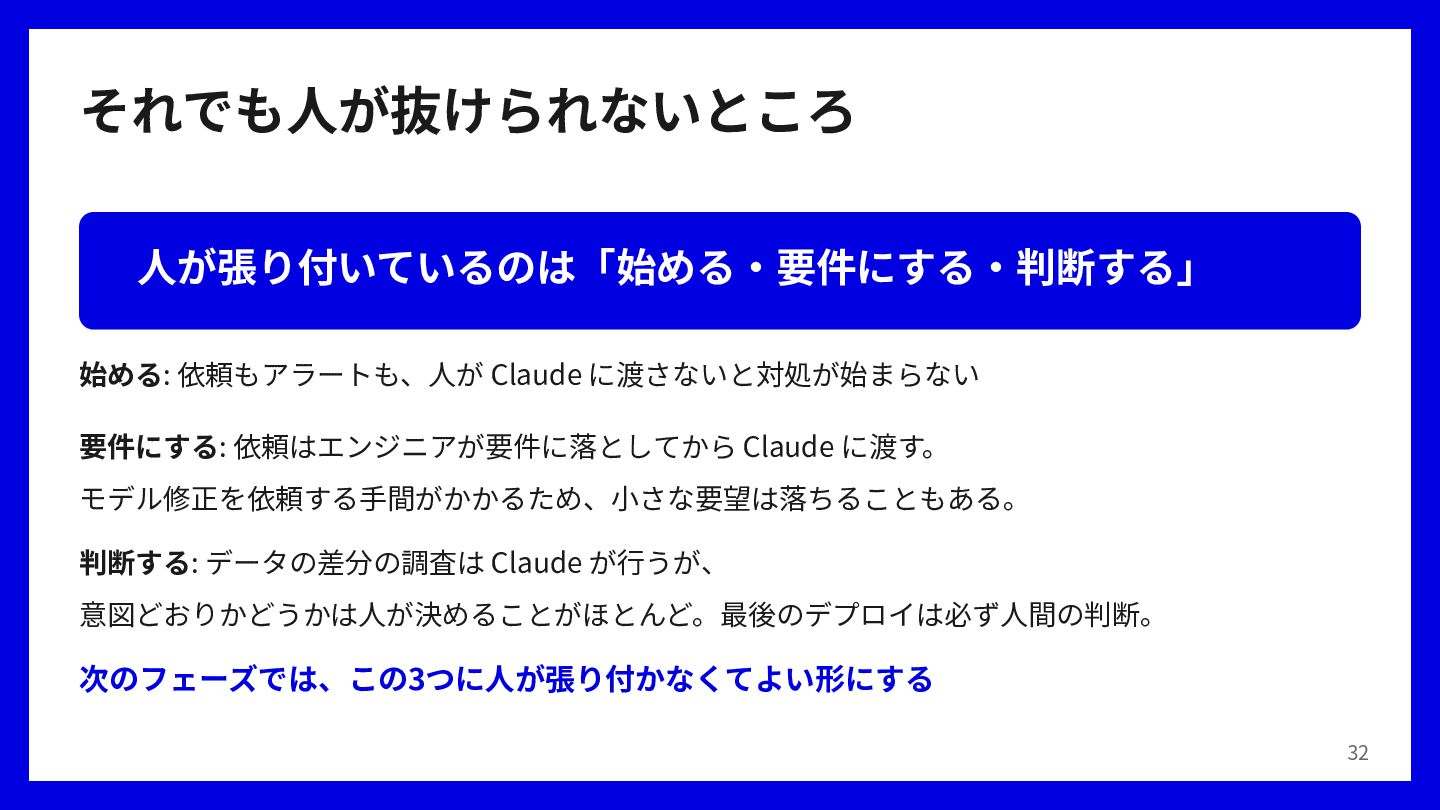
  20. それでも⼈が抜けられないところ ⼈が張り付いているのは「始める‧要件にする‧判断する」 始める: 依頼もアラートも、⼈が Claude に渡さないと対処が始まらない 要件にする: 依頼はエンジニアが要件に落としてから Claude に渡す。

    モデル修正を依頼する⼿間がかかるため、⼩さな要望は落ちることもある。 判断する: データの差分の調査は Claude が⾏うが、 意図どおりかどうかは⼈が決めることがほとんど。最後のデプロイは必ず⼈間の判断。 次のフェーズでは、この3つに⼈が張り付かなくてよい形にする 32
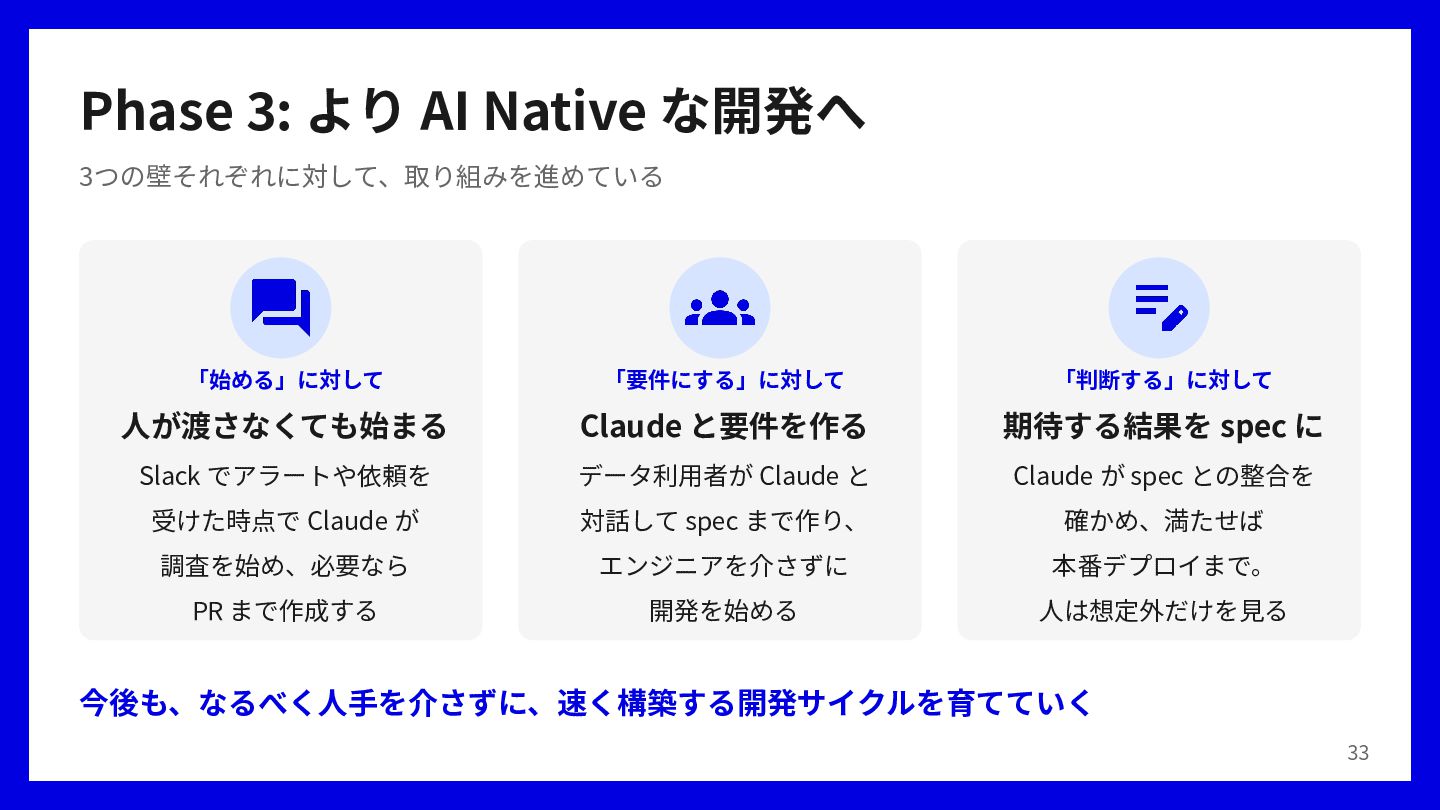
  21. Phase 3: より AI Native な開発へ 3つの壁それぞれに対して、取り組みを進めている 「始める」に対して 「要件にする」に対して 「判断する」に対して

    ⼈が渡さなくても始まる Claude と要件を作る 期待する結果を spec に Slack でアラートや依頼を データ利⽤者が Claude と Claude が spec との整合を 受けた時点で Claude が 対話して spec まで作り、 確かめ、満たせば 調査を始め、必要なら エンジニアを介さずに 本番デプロイまで。 PR まで作成する 開発を始める ⼈は想定外だけを⾒る 今後も、なるべく⼈⼿を介さずに、速く構築する開発サイクルを育てていく 33