Share
Embed
EthreumのPoWアルゴリズム Ethash
GBECの解説動画の資料です。
https://goblockchain.network/2020/09/ethash/
shigeyuki azuchi
September 28, 2020
Transcript
8 slides
-
1 Ethashとは? Ethereumで採用されているASIC耐性を持たせるよう設計されたProof of Workアルゴリズム https://eth.wiki/en/concepts/ethash/ethash • マイニングに大量のメモリの展開を必要とさせることでASIC耐性を持たせる
(2020年9月時点で約3.8GB) • ProgPoWの導入が見送られたことから現在でもEthereumのPoWアルゴリズム • EthashをサポートするASICは既に発売されている。 Bitcoinのように極端な効率の向上ではなく、GPUマイニングに比べて現状数倍 • 将来的には別のアルゴリズムに移行? -
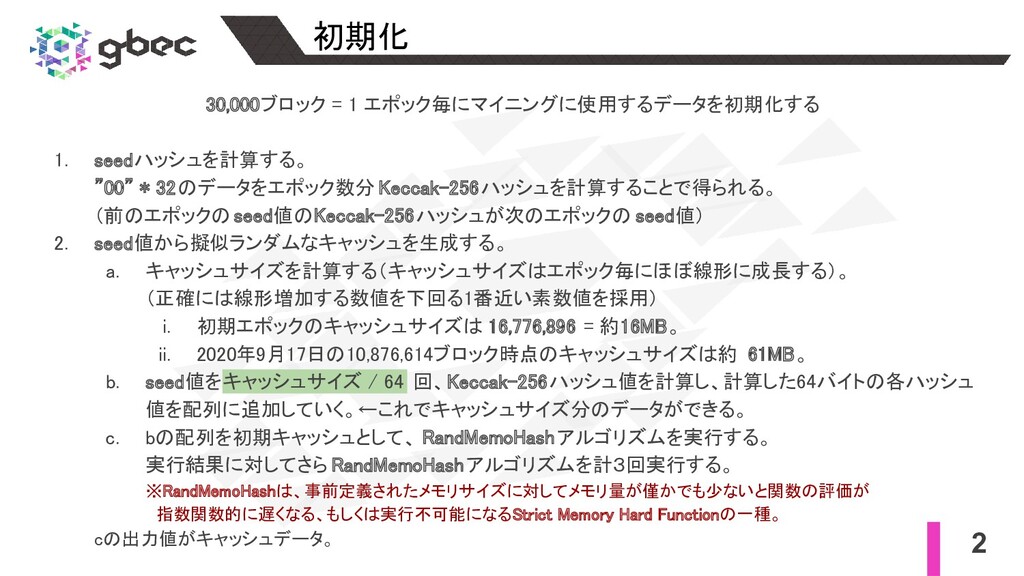
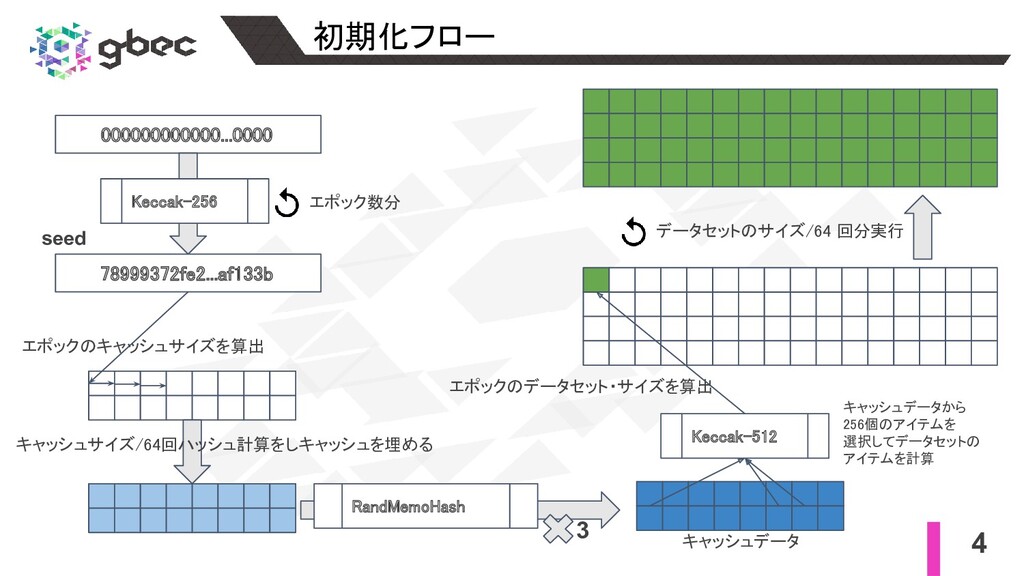
2 初期化 30,000ブロック = 1 エポック毎にマイニングに使用するデータを初期化する 1. seedハッシュを計算する。
”00” * 32のデータをエポック数分 Keccak-256ハッシュを計算することで得られる。 (前のエポックのseed値のKeccak-256ハッシュが次のエポックの seed値) 2. seed値から擬似ランダムなキャッシュを生成する。 a. キャッシュサイズを計算する(キャッシュサイズはエポック毎にほぼ線形に成長する)。 (正確には線形増加する数値を下回る1番近い素数値を採用) i. 初期エポックのキャッシュサイズは 16,776,896 = 約16MB。 ii. 2020年9月17日の10,876,614ブロック時点のキャッシュサイズは約 61MB。 b. seed値をキャッシュサイズ / 64 回、Keccak-256ハッシュ値を計算し、計算した64バイトの各ハッシュ 値を配列に追加していく。←これでキャッシュサイズ分のデータができる。 c. bの配列を初期キャッシュとして、 RandMemoHashアルゴリズムを実行する。 実行結果に対してさら RandMemoHashアルゴリズムを計3回実行する。 ※RandMemoHashは、事前定義されたメモリサイズに対してメモリ量が僅かでも少ないと関数の評価が 指数関数的に遅くなる、もしくは実行不可能になるStrict Memory Hard Functionの一種。 cの出力値がキャッシュデータ。 -
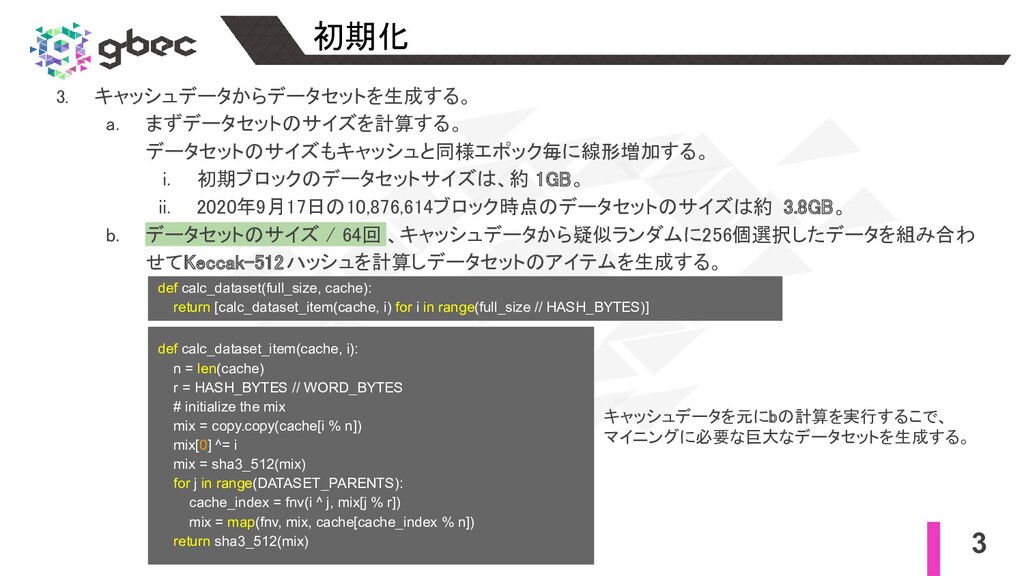
3 初期化 3. キャッシュデータからデータセットを生成する。 a. まずデータセットのサイズを計算する。 データセットのサイズもキャッシュと同様エポック毎に線形増加する。
i. 初期ブロックのデータセットサイズは、約 1GB。 ii. 2020年9月17日の10,876,614ブロック時点のデータセットのサイズは約 3.8GB。 b. データセットのサイズ / 64回 、キャッシュデータから疑似ランダムに256個選択したデータを組み合わ せてKeccak-512ハッシュを計算しデータセットのアイテムを生成する。 def calc_dataset_item(cache, i): n = len(cache) r = HASH_BYTES // WORD_BYTES # initialize the mix mix = copy.copy(cache[i % n]) mix[0] ^= i mix = sha3_512(mix) for j in range(DATASET_PARENTS): cache_index = fnv(i ^ j, mix[j % r]) mix = map(fnv, mix, cache[cache_index % n]) return sha3_512(mix) def calc_dataset(full_size, cache): return [calc_dataset_item(cache, i) for i in range(full_size // HASH_BYTES)] キャッシュデータを元にbの計算を実行するこで、 マイニングに必要な巨大なデータセットを生成する。 -
4 初期化フロー 000000000000...0000 78999372fe2...af133b seed Keccak-256 エポック数分 エポックのキャッシュサイズを算出
キャッシュサイズ/64回ハッシュ計算をしキャッシュを埋める RandMemoHash 3 キャッシュデータ エポックのデータセット・サイズを算出 Keccak-512 キャッシュデータから 256個のアイテムを 選択してデータセットの アイテムを計算 データセットのサイズ/64 回分実行 -
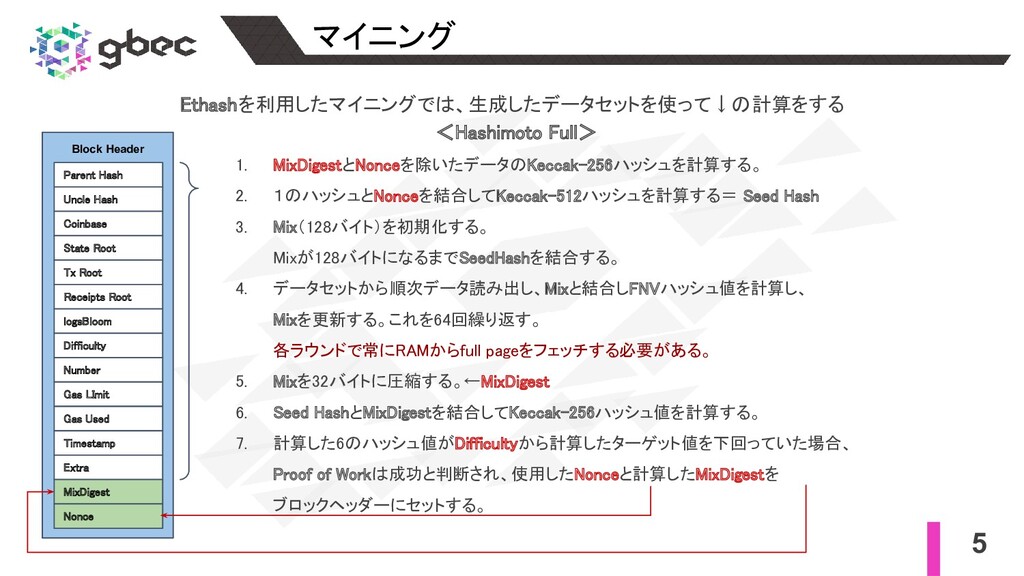
Block Header 5 マイニング Ethashを利用したマイニングでは、生成したデータセットを使って↓の計算をする <Hashimoto Full>
Parent Hash Uncle Hash Coinbase State Root Tx Root Receipts Root logsBloom Difficulty Number Gas LImit Gas Used Timestamp Extra MixDigest Nonce 1. MixDigestとNonceを除いたデータのKeccak-256ハッシュを計算する。 2. 1のハッシュとNonceを結合してKeccak-512ハッシュを計算する= Seed Hash 3. Mix(128バイト)を初期化する。 Mixが128バイトになるまでSeedHashを結合する。 4. データセットから順次データ読み出し、Mixと結合しFNVハッシュ値を計算し、 Mixを更新する。これを64回繰り返す。 各ラウンドで常にRAMからfull pageをフェッチする必要がある。 5. Mixを32バイトに圧縮する。←MixDigest 6. Seed HashとMixDigestを結合してKeccak-256ハッシュ値を計算する。 7. 計算した6のハッシュ値がDifficultyから計算したターゲット値を下回っていた場合、 Proof of Workは成功と判断され、使用したNonceと計算したMixDigestを ブロックヘッダーにセットする。 -
Block Header 6 Proof of Workの検証 EthashのPoWを検証するには2通りの方法がある
Parent Hash Uncle Hash Coinbase State Root Tx Root Receipts Root logsBloom Difficulty Number Gas LImit Gas Used Timestamp Extra MixDigest Nonce • Full Client向け マイニング時と同様、各エポックで必要なデータセットをメモリ上に展開して、 ブロックヘッダーのNonceを使ってマイニング時と同じ計算Hashimoto Fullを実行する。 高速なPoWの検証が可能。※ これを実行しているのはGethではFull Syncの場合のみ。 • Light Client向け スマートフォンなどの軽量デバイスで大量のメモリを使用したPoWの検証は難しい。 Light Clientでは各エポックで必要なキャッシュのみをメモリ上に展開し、 Hashimoto Fullで必要になるデータセットからのデータの読み出しをメモリからではなく、 都度データセットのアイテムを計算する。<Hashimoto Lite> このため、Light Clientの方がPoWの検証スピードは遅い。ただし必要なメモリ量は低。 ※ GethではLightモード以外に、デフォルトのFast Syncでもこの方法を採用。 -
7 まとめ • EthashはASIC耐性を持たせるために設計されたProof of Workのアルゴリズム • エポック毎に決定論的にキャッシュ、データセットを生成 • キャッシュ、データセットのサイズはエポック毎に線形増加する
• 高速にマイニングするためにデータセットをメモリ上に展開しておく必要がある • データセットがメモリ上に展開されていると検証も高速 • Light Clientはキャッシュのみをメモリ上に展開し、PoWの検証で必要な データセットのアイテムを都度計算するため、PoWの検証は遅い • PoWアルゴリズムを設計する上でのトレードオフは重要なポイント