Upgrade to Pro — share decks privately, control downloads, hide ads and more …

CData Sync v26.3 アップデート徹底解説

CData Sync v26.3 アップデート徹底解説

データパイプラインツールCData Sync v26.3 の新機能を徹底解説するウェビナーです。

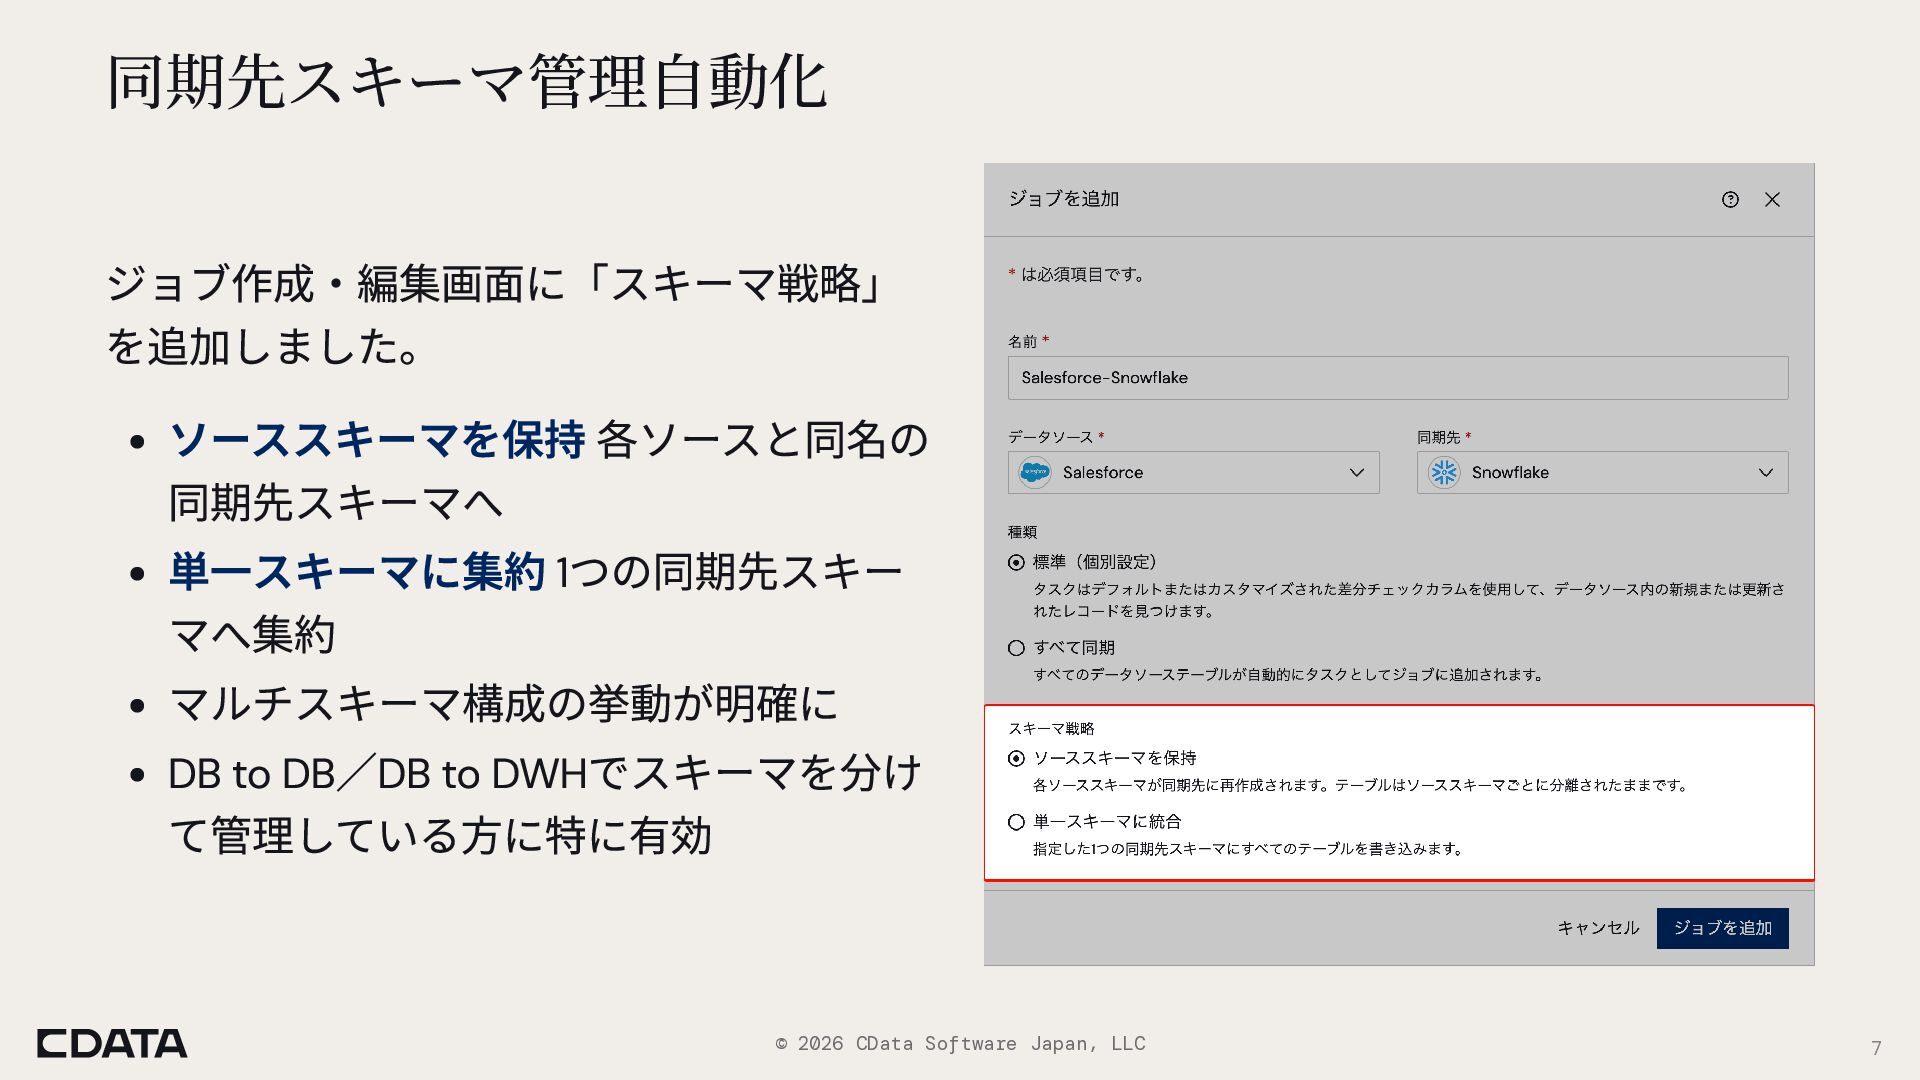
デスティネーションスキーマ管理の自動化やライブ件数表示による運用効率化、パイプライン並列実行やバルクロード性能改善によるパフォーマンス向上、SQL Server/SAP HANA/DB2 for iのCDCスキーマ変更対応強化、Apache Doris・Kafka連携強化まで、既存ユーザーの日々の運用に直結する改善が数多く含まれています。
本セミナーでは、これらのアップデート内容を分かりやすくデモも交えながらご紹介します。

▼ 本動画で紹介する主な内容
✅ 運用効率化
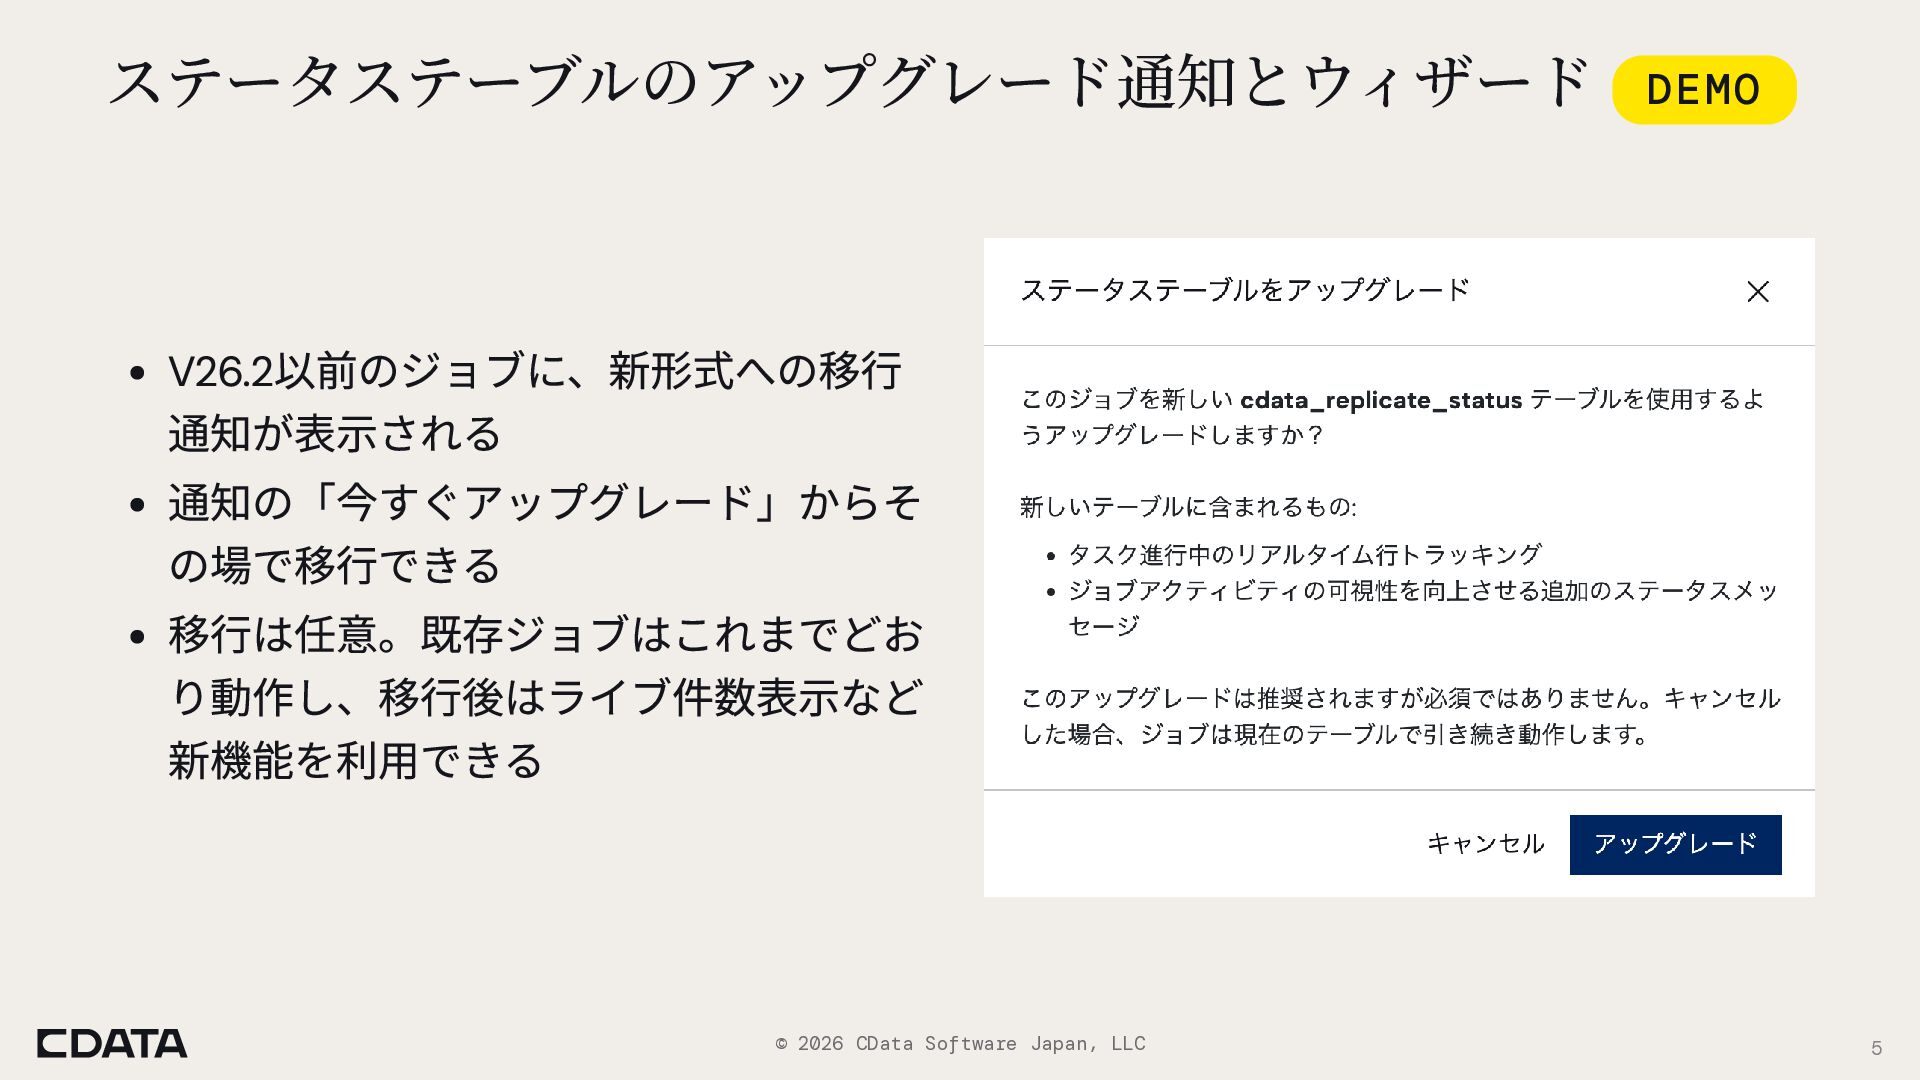
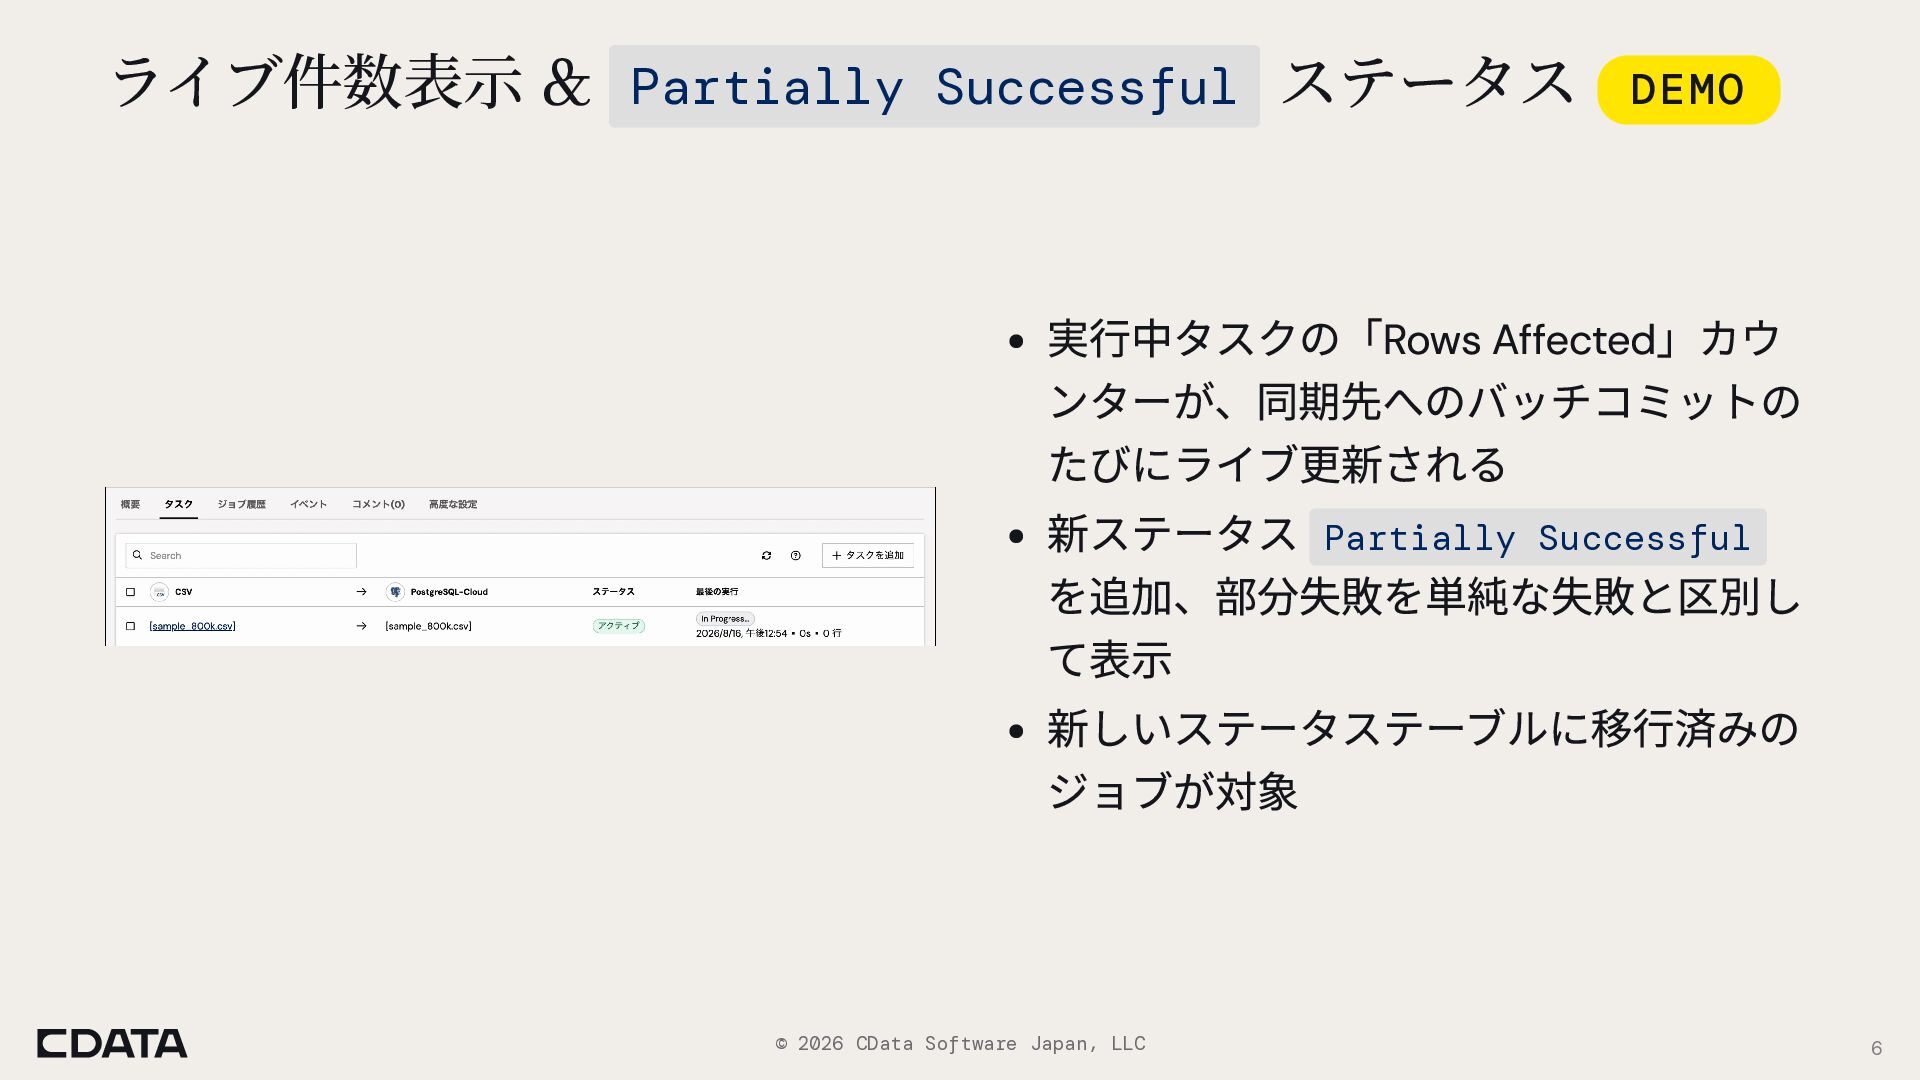
 → デスティネーションスキーマ管理の自動化、実行中タスクのライブ件数表示、新ステータス「Partially Successful」、ステータステーブル移行(デモあり)

✅ パフォーマンス改善
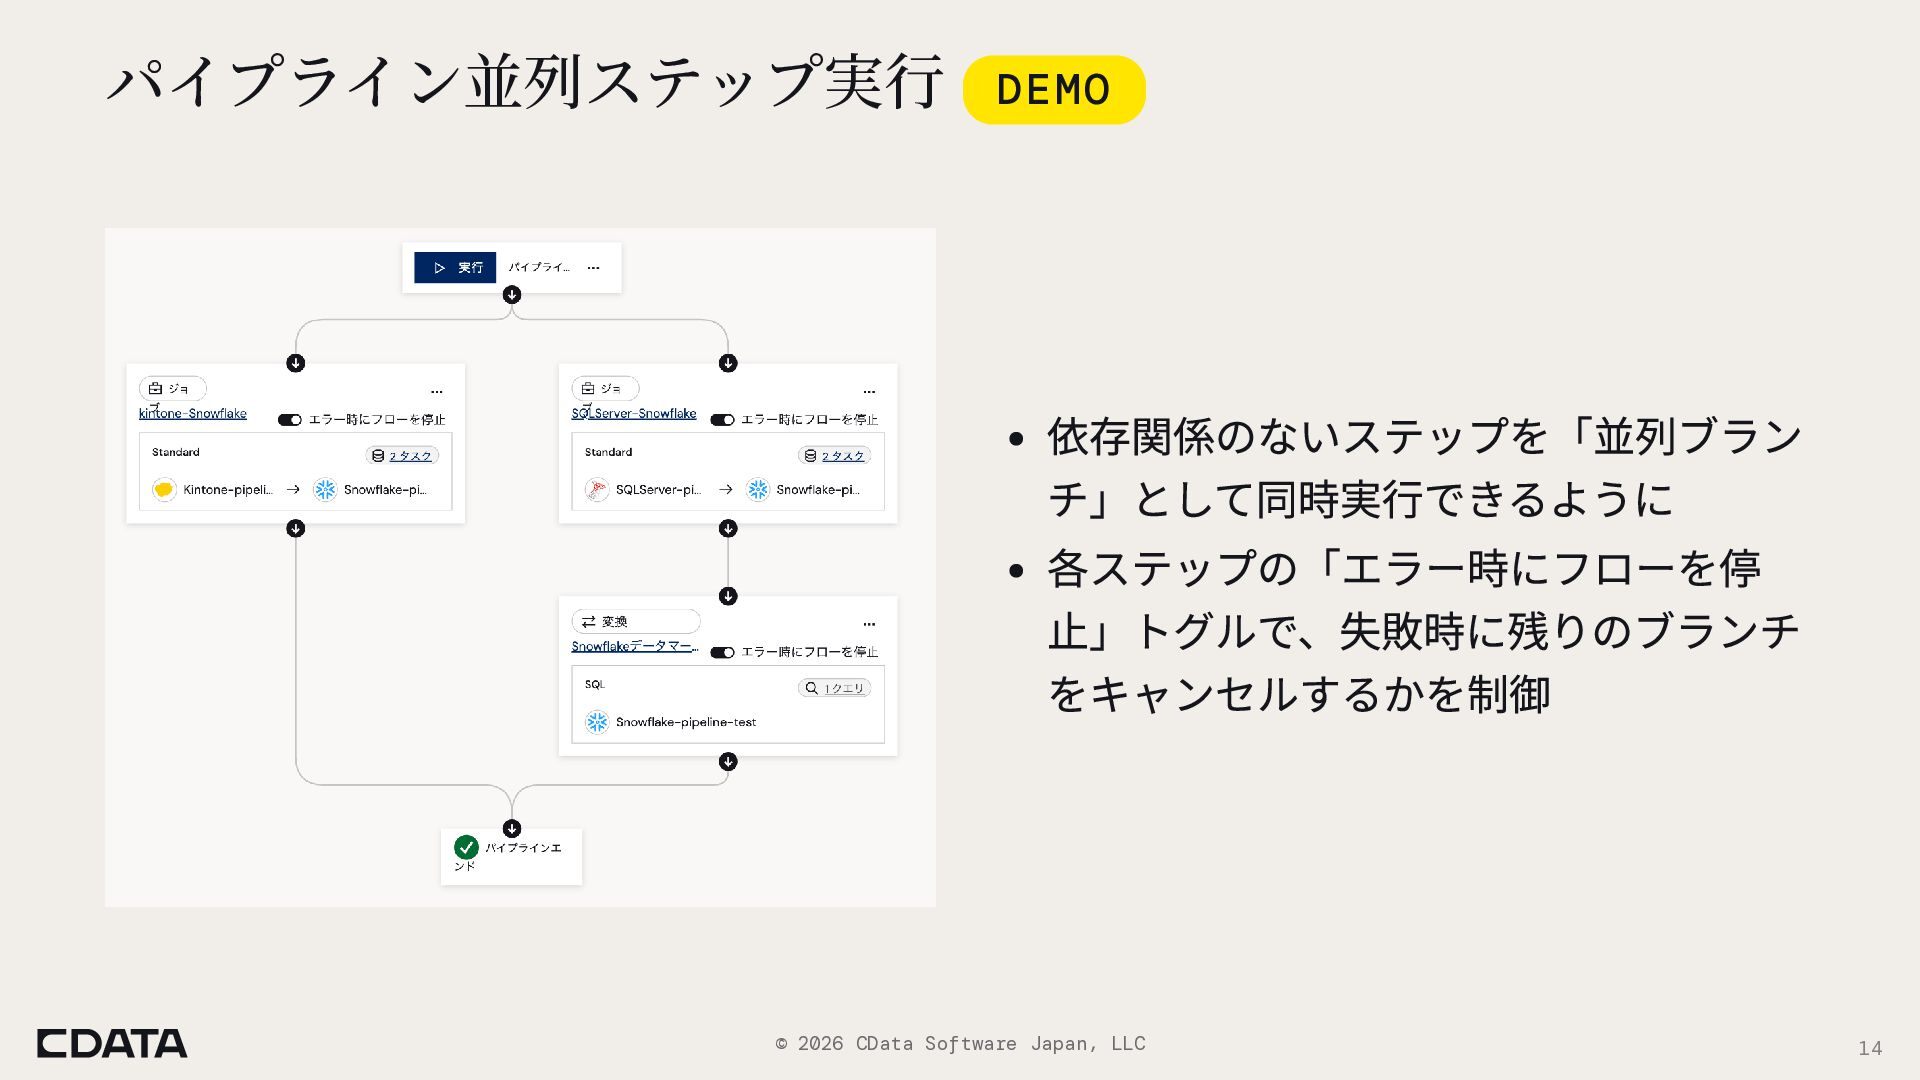
 → パイプライン内の複数ステップを並列実行(デモあり)、主要8同期先へのバルクロードが設定変更なしで最大約2.2倍、PostgreSQL 同期先への書き込みが最大約3倍高速化

✅ CDCの安定性・継続性強化
 → SQL Server/SAP HANA/DB2 for i の CDC で、ソース側のスキーマ変更が起きてもジョブを止めずに自動復旧

✅ その他機能強化・改善点
 → Apache Doris が新規デスティネーションとして追加、Kafka Destination は Schema Registry が任意化されトピックルーティングも柔軟に、パイプライン変数で環境をまたいだ再利用が容易に

⏱ チャプター
0:00 オープニング・v26.3リリース概要
2:35 【第1部】運用効率化:スキーマ管理自動化・ライブ件数表示・ステータステーブル移行(デモ)
15:30 【第2部】パフォーマンス改善:パイプライン並列実行・バルクロード性能改善(デモ)
21:23 【第3部】CDCの安定性・継続性強化:SQL Server/SAP HANA/DB2 for i
28:58 【第4部】その他機能強化・改善点:Apache Doris・Kafka連携強化・パイプライン変数
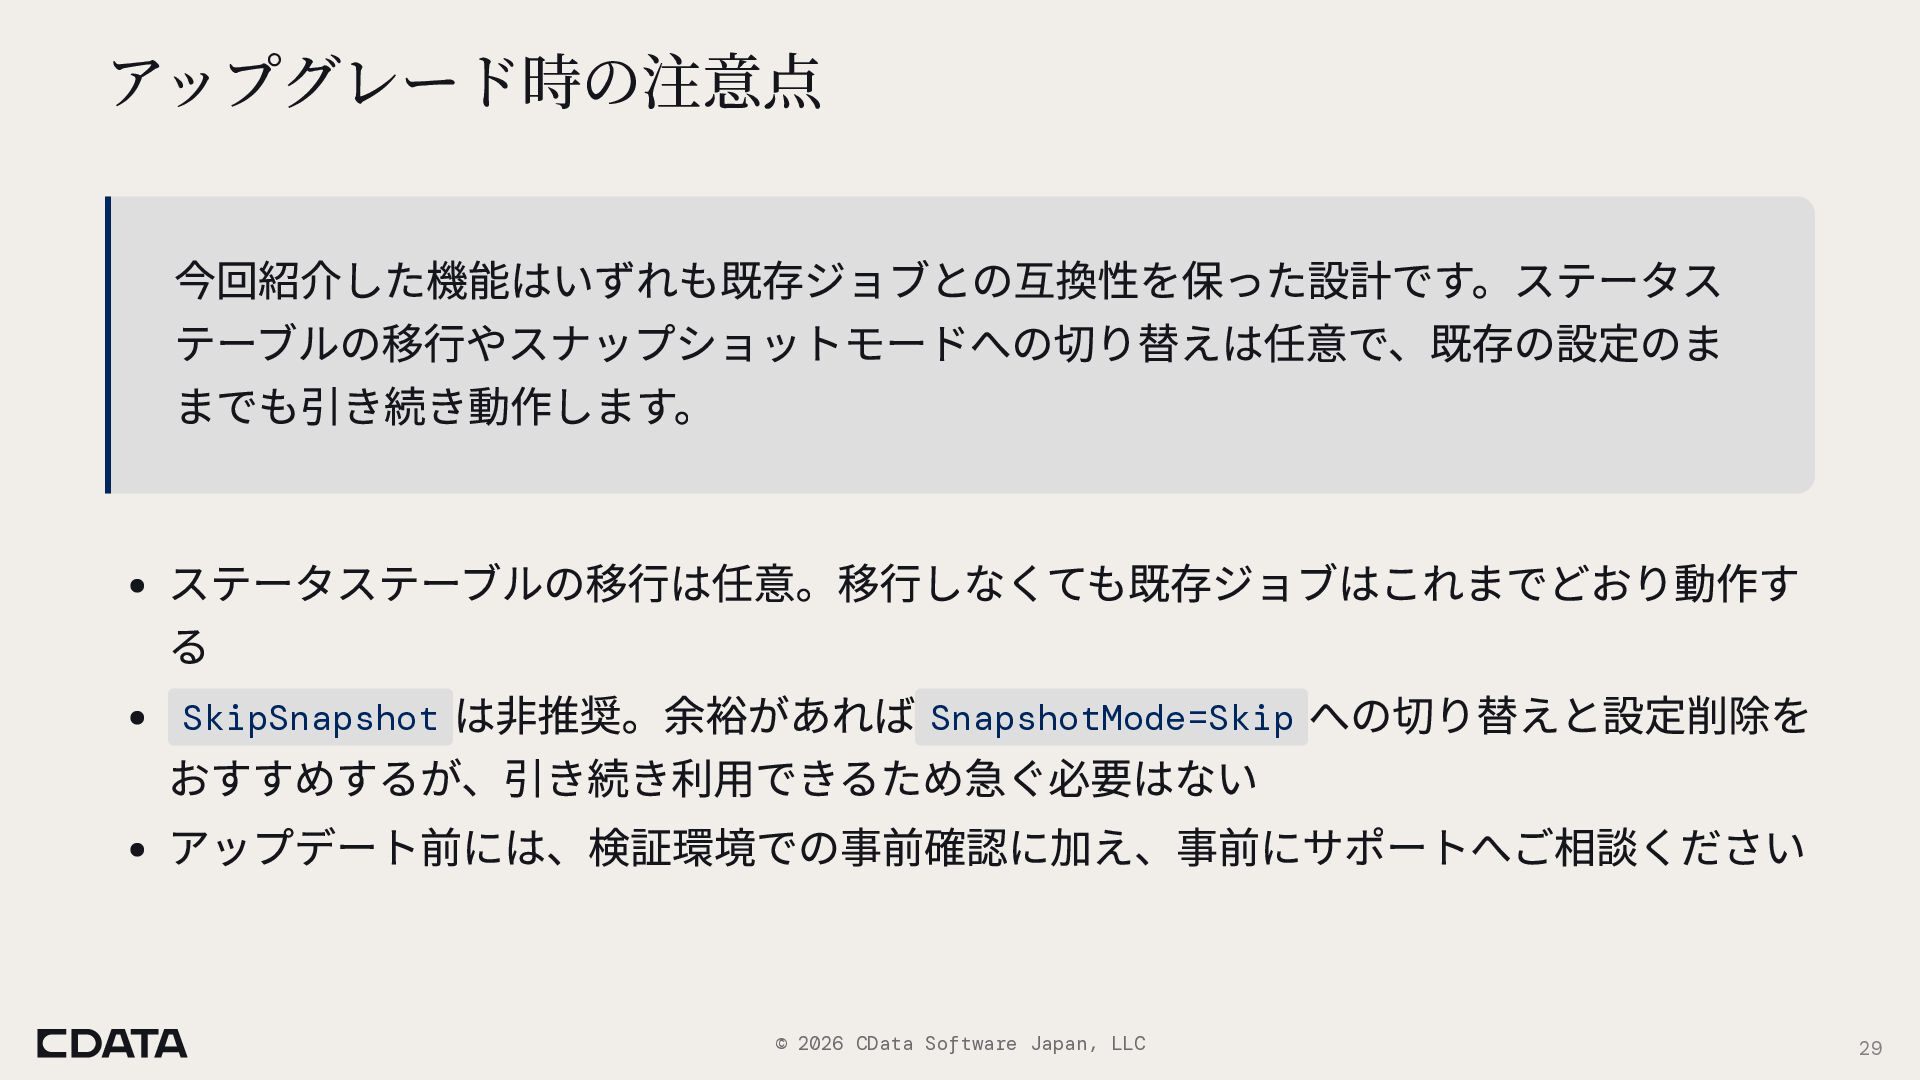
34:05 【第5部】まとめ・アップグレード時の注意点

📝 関連ブログ記事
▼ CData Sync v26.3 アップデート詳細解説
・CData Sync 26.3 リリース:新機能のご紹介 
https://jp.cdata.com/blog/cdata-sync-26-3-whats-new

・CData Sync V26.3 UI Updates:ステータステーブル移行・スキーマ管理・実行状況の可視化 
https://www.cdata.com/jp/blog/cdata-sync-v26-3-ui-updates/

・CData Sync V26.3 アップデート時のステータステーブルのアップグレードについて 
https://www.cdata.com/jp/blog/cdata-sync-v26-3-status-table-upgrade/

・CData Sync V26.3 Updates:主要同期先のバルクロードを最大約2.2倍に高速化 
https://www.cdata.com/jp/blog/cdata-sync-v26-3-bulk-load-performance/

・CData Sync V26.3 Updates:SQL Server CDC がスキーマ変更に対応 
https://www.cdata.com/jp/blog/sql-server-cdc-schema-change/

・CData Sync V26.3 新機能:同期先 Apache Doris 対応で業務データを高速分析基盤へ連携 
https://www.cdata.com/jp/blog/cdata-sync-v26-apache-doris-destination/

・CData Sync V26.3 新機能:パイプラインのステップ並列実行とパイプライン変数 
https://www.cdata.com/jp/blog/cdata-sync-v26-pipeline-parallel-variables/

▼ CDC・パイプラインの基礎知識(あわせて読みたい)
・Change Data Capture(CDC)とは?CDC の基本から仕組み、各種手法を完全解説 
https://www.cdata.com/jp/blog/db-cdc-sync/

・CData Sync:標準ジョブと CDC ジョブの違いとは。仕組み・メリット・使い分けを徹底解説 
https://www.cdata.com/jp/blog/standard-job-vs-cdc-job/

・ジョブからワークフローへ:データチームが CData Sync にパイプラインを必要とした理由 
https://www.cdata.com/jp/blog/pipelines-in-cdata-sync-coordinating-data-workflows/

・CData Sync のアップデートとロールバック ─ 安全にアップデートするための2つのアプローチ 
https://www.cdata.com/jp/blog/sync-update-practices/

🔗 関連リンク
・CData Sync 製品ページ:https://jp.cdata.com/sync/
・CData Sync 無料トライアル:https://jp.cdata.com/sync/trial/
・CData Software Japan 公式サイト:https://jp.cdata.com/

#CData #CDataSync #データ連携 #ETL #CDC #データパイプライン #ApacheDoris #Kafka #データエンジニアリング #DWH #データウェアハウス

CData Software Japan

August 24, 2026

Transcript

29 slides
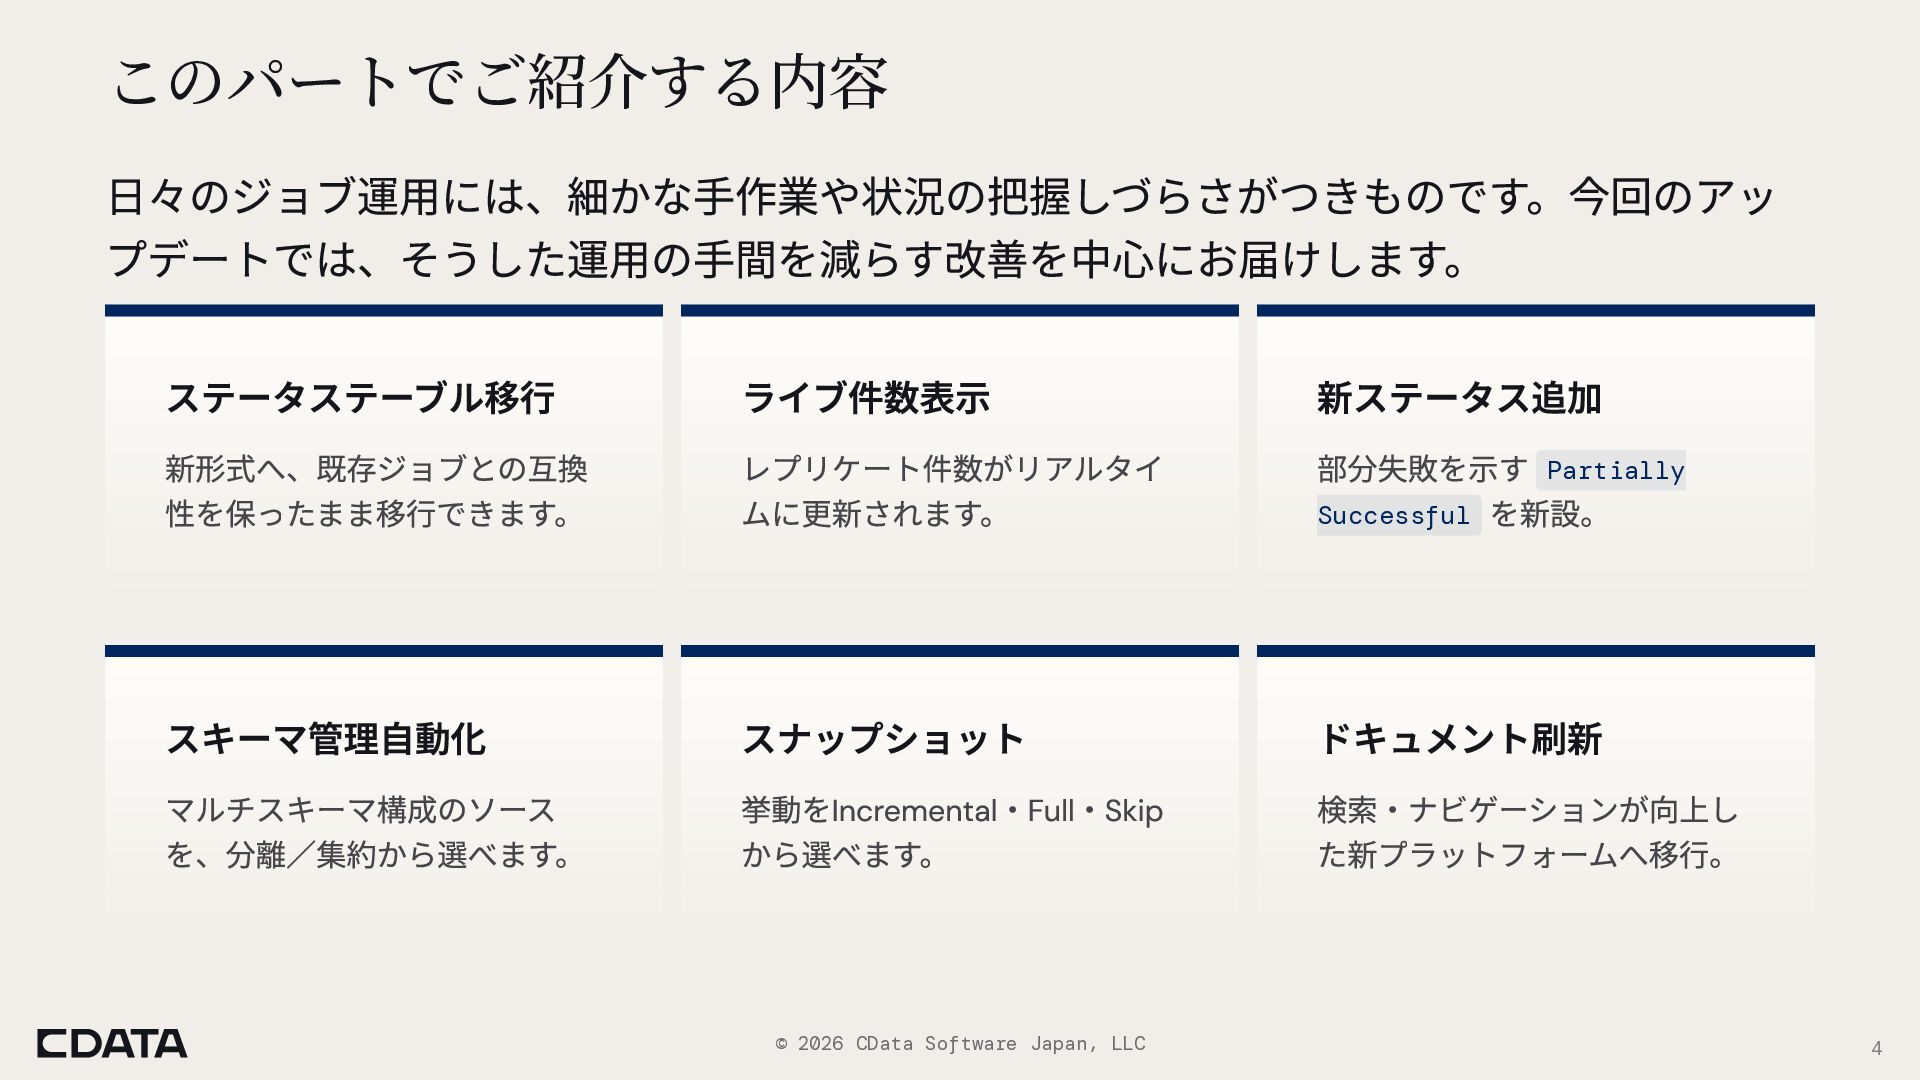
  1. このパートでご紹介する内容 日々のジョブ運用には、細かな手作業や状況の把握しづらさがつきものです。今回のアッ プデートでは、そうした運用の手間を減らす改善を中心にお届けします。 ステータステーブル移行 ライブ件数表示 新ステータス追加 スキーマ管理自動化 スナップショット ドキュメント刷新 新形式へ、既存ジョブとの互換

    性を保ったまま移行できます。 マルチスキーマ構成のソース を、分離/集約から選べます。 レプリケート件数がリアルタイ ムに更新されます。 挙動をIncremental・Full・Skip から選べます。 © 2026 CData Software Japan, LLC 部分失敗を示す Partially Successful を新設。 検索・ナビゲーションが向上し た新プラットフォームへ移行。 4
  2. ライブ件数表示 & Partially Successful ステータス DEMO 実行中タスクの「Rows Affected」カウ ンターが、同期先へのバッチコミットの たびにライブ更新される

    新ステータス Partially Successful を追加、部分失敗を単純な失敗と区別し て表示 新しいステータステーブルに移行済みの ジョブが対象 © 2026 CData Software Japan, LLC 6
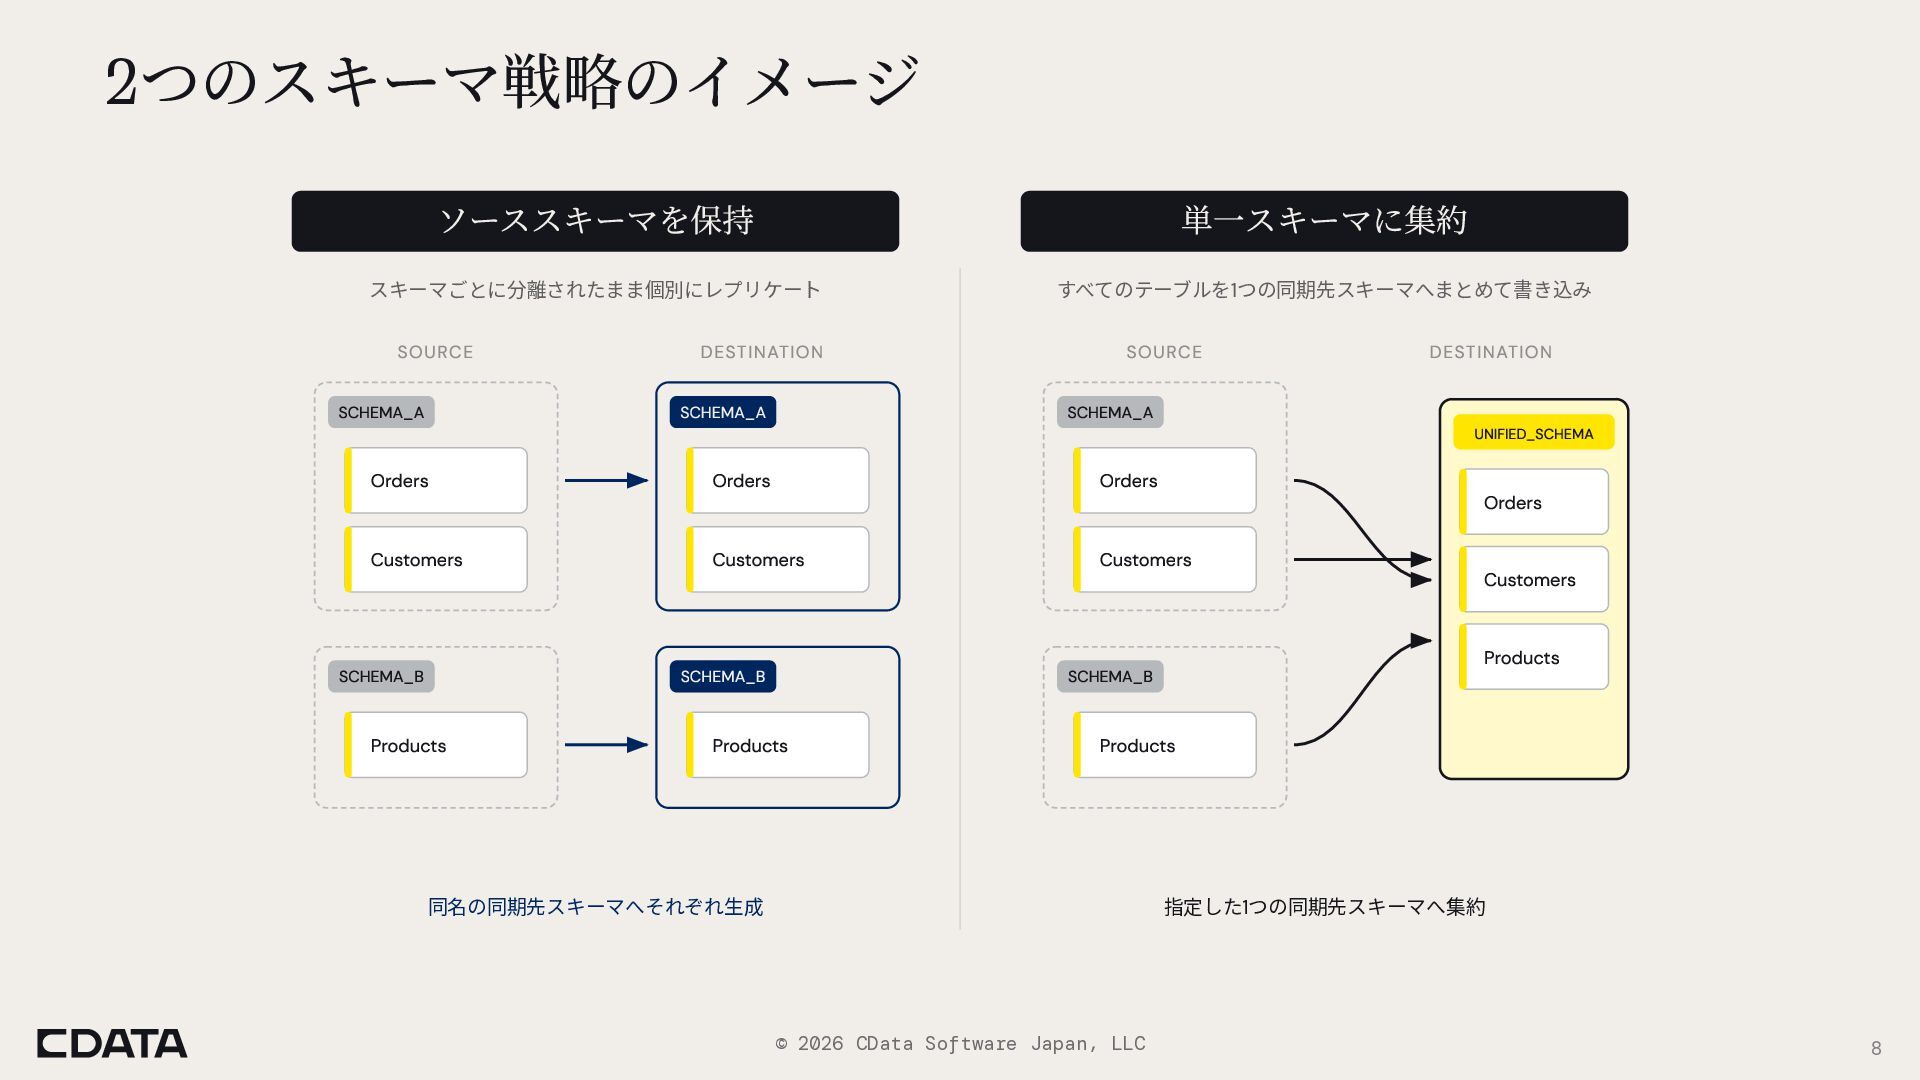
  3. 2つのスキーマ戦略のイメージ ソーススキーマを保持 単⼀スキーマに集約 スキーマごとに分離されたまま個別にレプリケート すべてのテーブルを1つの同期先スキーマへまとめて書き込み SOURCE DESTINATION SOURCE SCHEMA_A SCHEMA_A

    SCHEMA_A Orders Orders Orders Customers Customers Customers SCHEMA_B SCHEMA_B Products UNIFIED_SCHEMA Orders Customers Products SCHEMA_B Products DESTINATION Products 同名の同期先スキーマへそれぞれ⽣成 指定した1つの同期先スキーマへ集約 © 2026 CData Software Japan, LLC 8
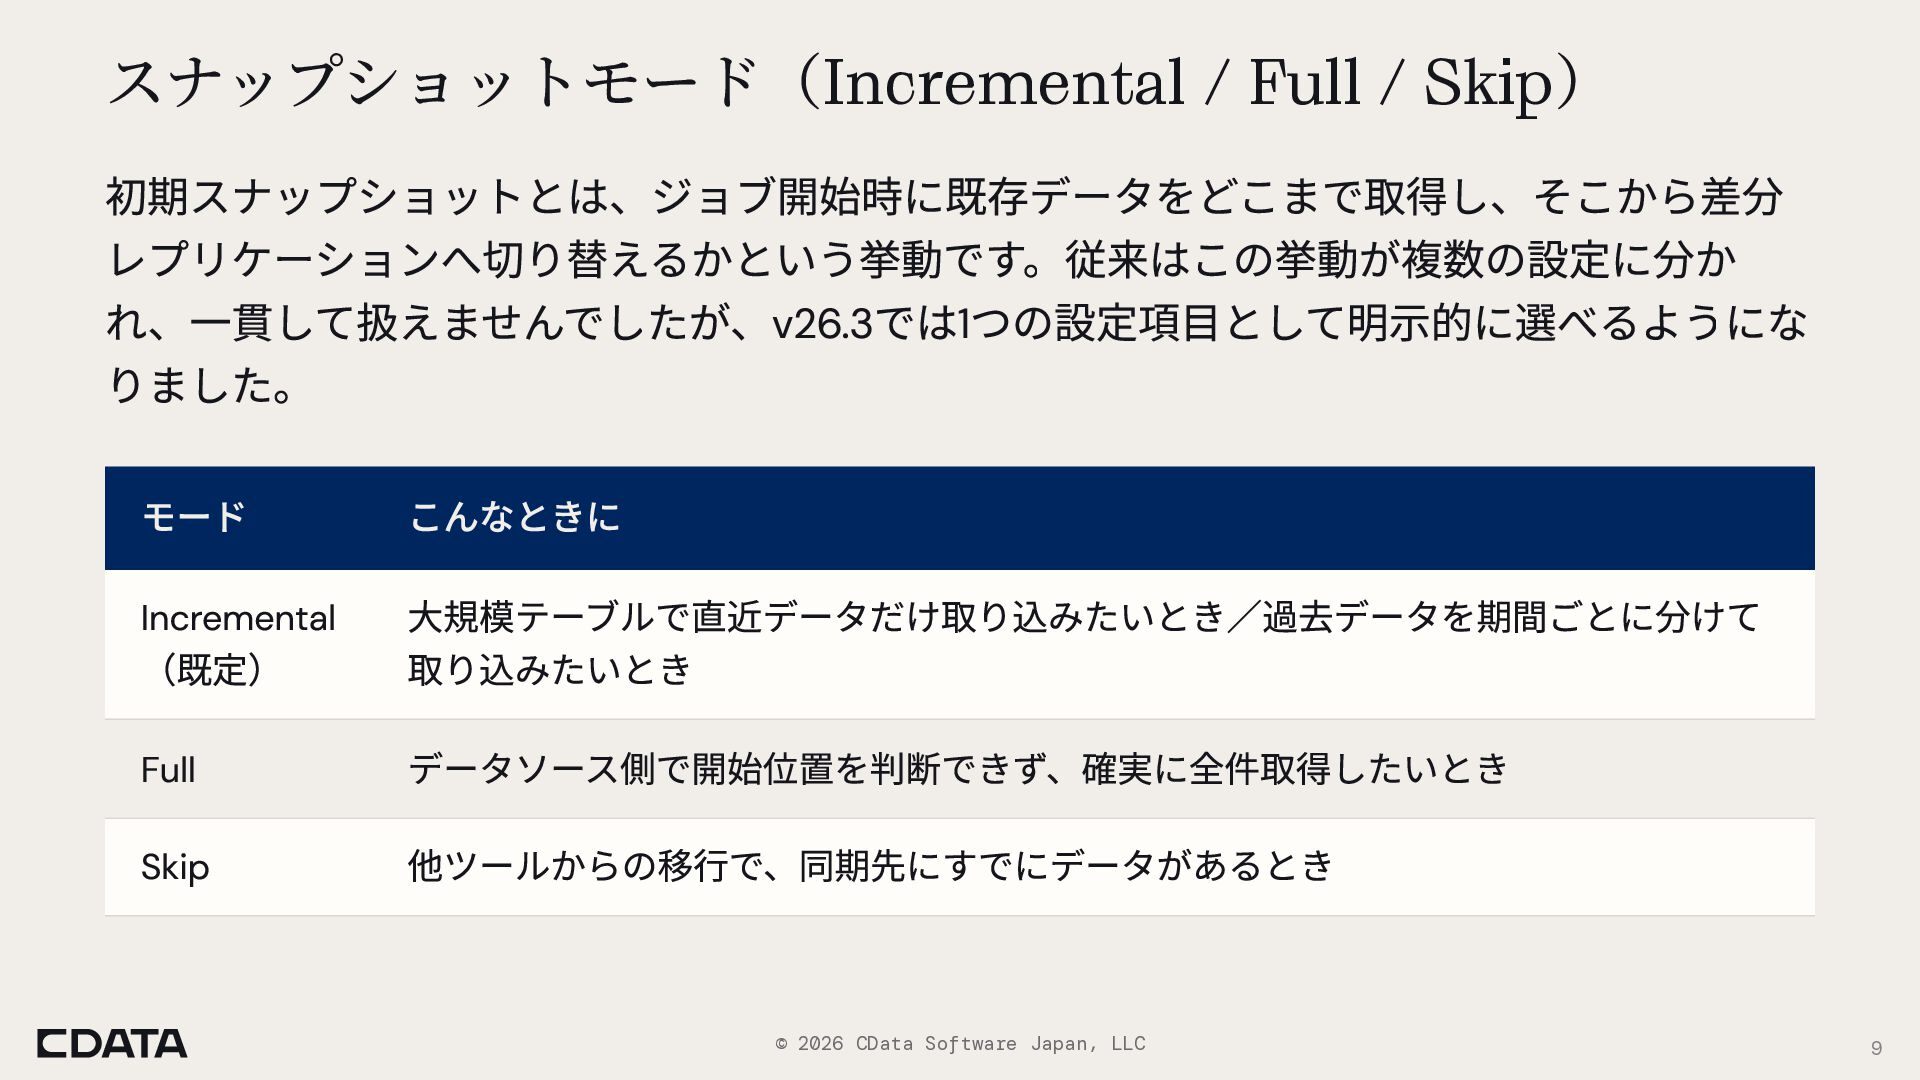
  4. スナップショットモード(Incremental / Full / Skip) 初期スナップショットとは、ジョブ開始時に既存データをどこまで取得し、そこから差分 レプリケーションへ切り替えるかという挙動です。従来はこの挙動が複数の設定に分か れ、一貫して扱えませんでしたが、v26.3では1つの設定項目として明示的に選べるようにな りました。 モード

    Incremental (既定) Full Skip こんなときに 大規模テーブルで直近データだけ取り込みたいとき/過去データを期間ごとに分けて 取り込みたいとき データソース側で開始位置を判断できず、確実に全件取得したいとき 他ツールからの移行で、同期先にすでにデータがあるとき © 2026 CData Software Japan, LLC 9
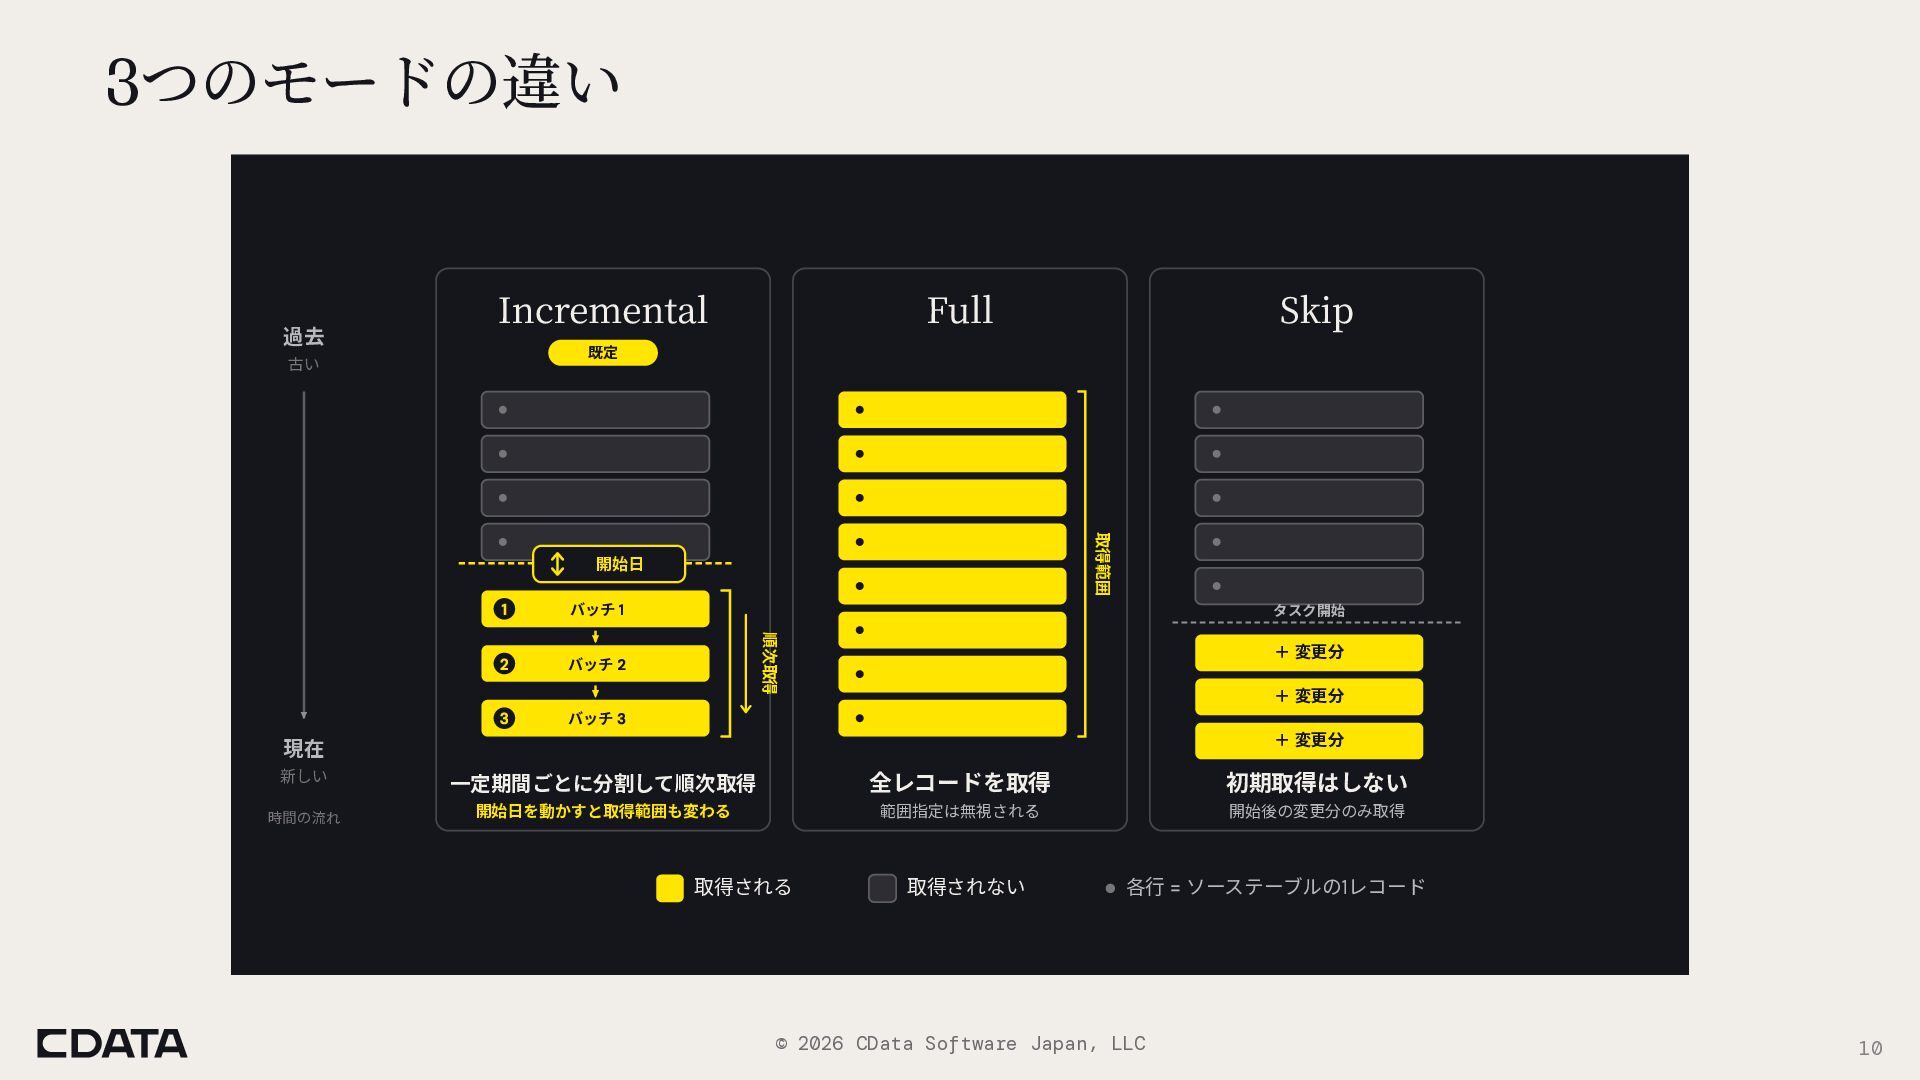
  5. 3つのモードの違い 過去 Incremental Full 既定 古い 取得範囲 開始⽇ バッチ 1

    2 バッチ 2 3 バッチ 3 タスク開始 順次取得 1 Skip + 変更分 + 変更分 + 変更分 現在 新しい ⼀定期間ごとに分割して順次取得 全レコードを取得 初期取得はしない 時間の流れ 開始⽇を動かすと取得範囲も変わる 範囲指定は無視される 開始後の変更分のみ取得 取得される 取得されない 各⾏ = ソーステーブルの1レコード © 2026 CData Software Japan, LLC 10
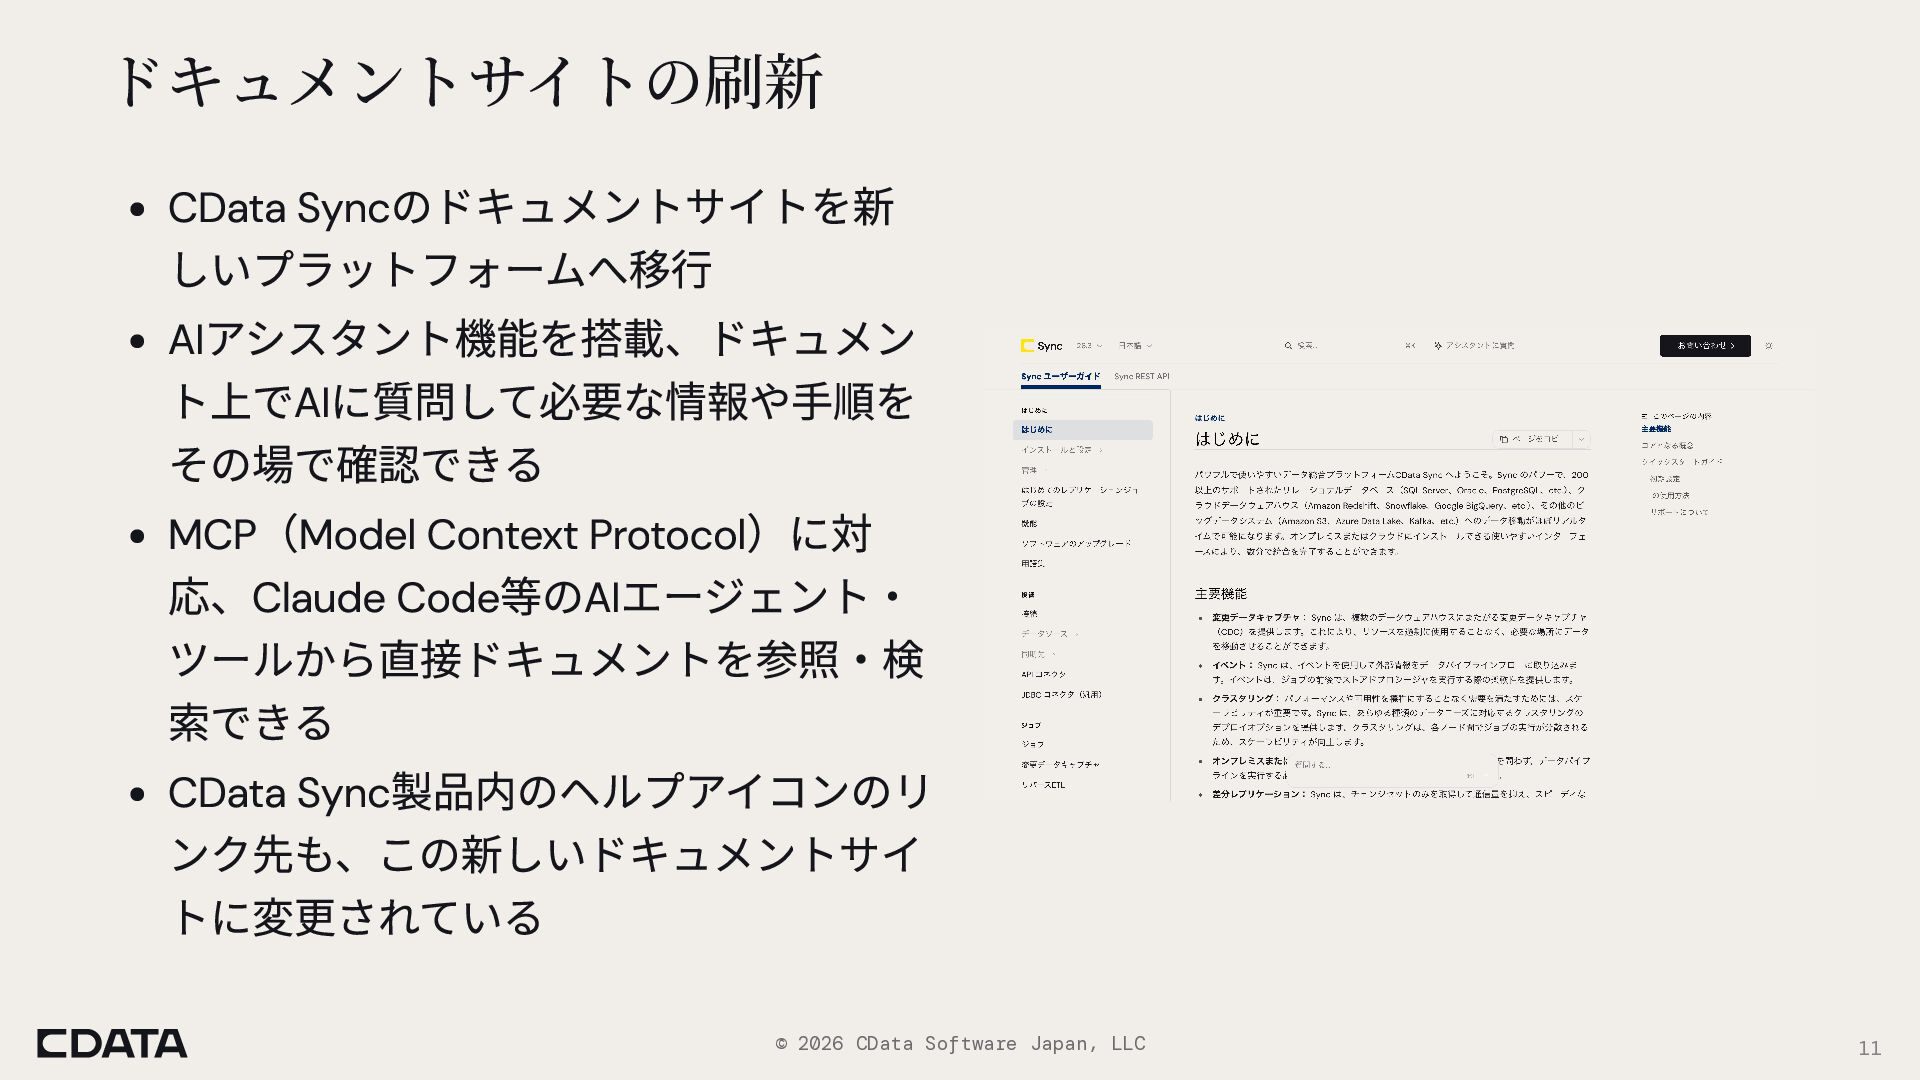
  6. ドキュメントサイトの刷新 のドキュメントサイトを新 しいプラットフォームへ移行 AIアシスタント機能を搭載、ドキュメン ト上でAIに質問して必要な情報や手順を その場で確認できる MCP(Model Context Protocol)に対 応、Claude

    Code等のAIエージェント・ ツールから直接ドキュメントを参照・検 索できる CData Sync製品内のヘルプアイコンのリ ンク先も、この新しいドキュメントサイ トに変更されている CData Sync © 2026 CData Software Japan, LLC 11
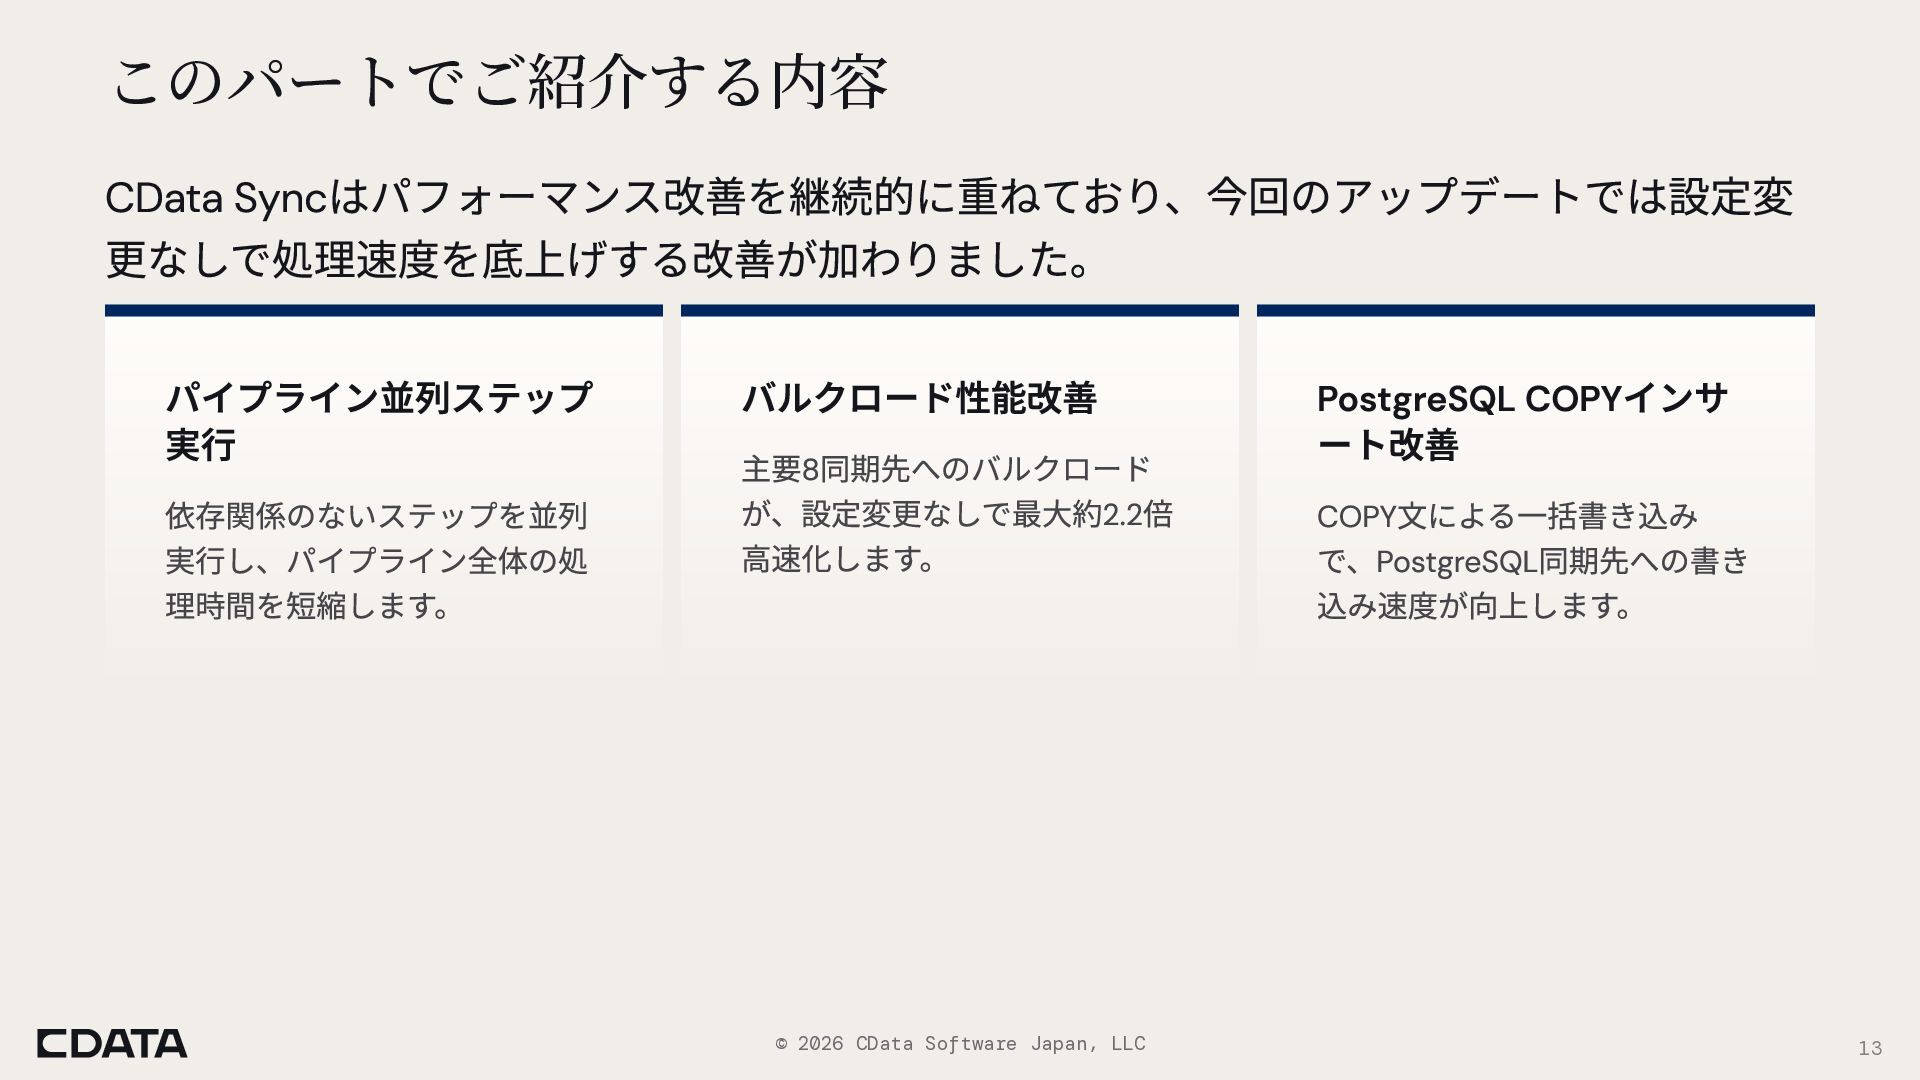
  7. このパートでご紹介する内容 はパフォーマンス改善を継続的に重ねており、今回のアップデートでは設定変 更なしで処理速度を底上げする改善が加わりました。 CData Sync パイプライン並列ステップ 実行 依存関係のないステップを並列 実行し、パイプライン全体の処 理時間を短縮します。

    バルクロード性能改善 主要8同期先へのバルクロード が、設定変更なしで最大約2.2倍 高速化します。 © 2026 CData Software Japan, LLC インサ PostgreSQL COPY ート改善 文による一括書き込み で、 同期先への書き 込み速度が向上します。 COPY PostgreSQL 13
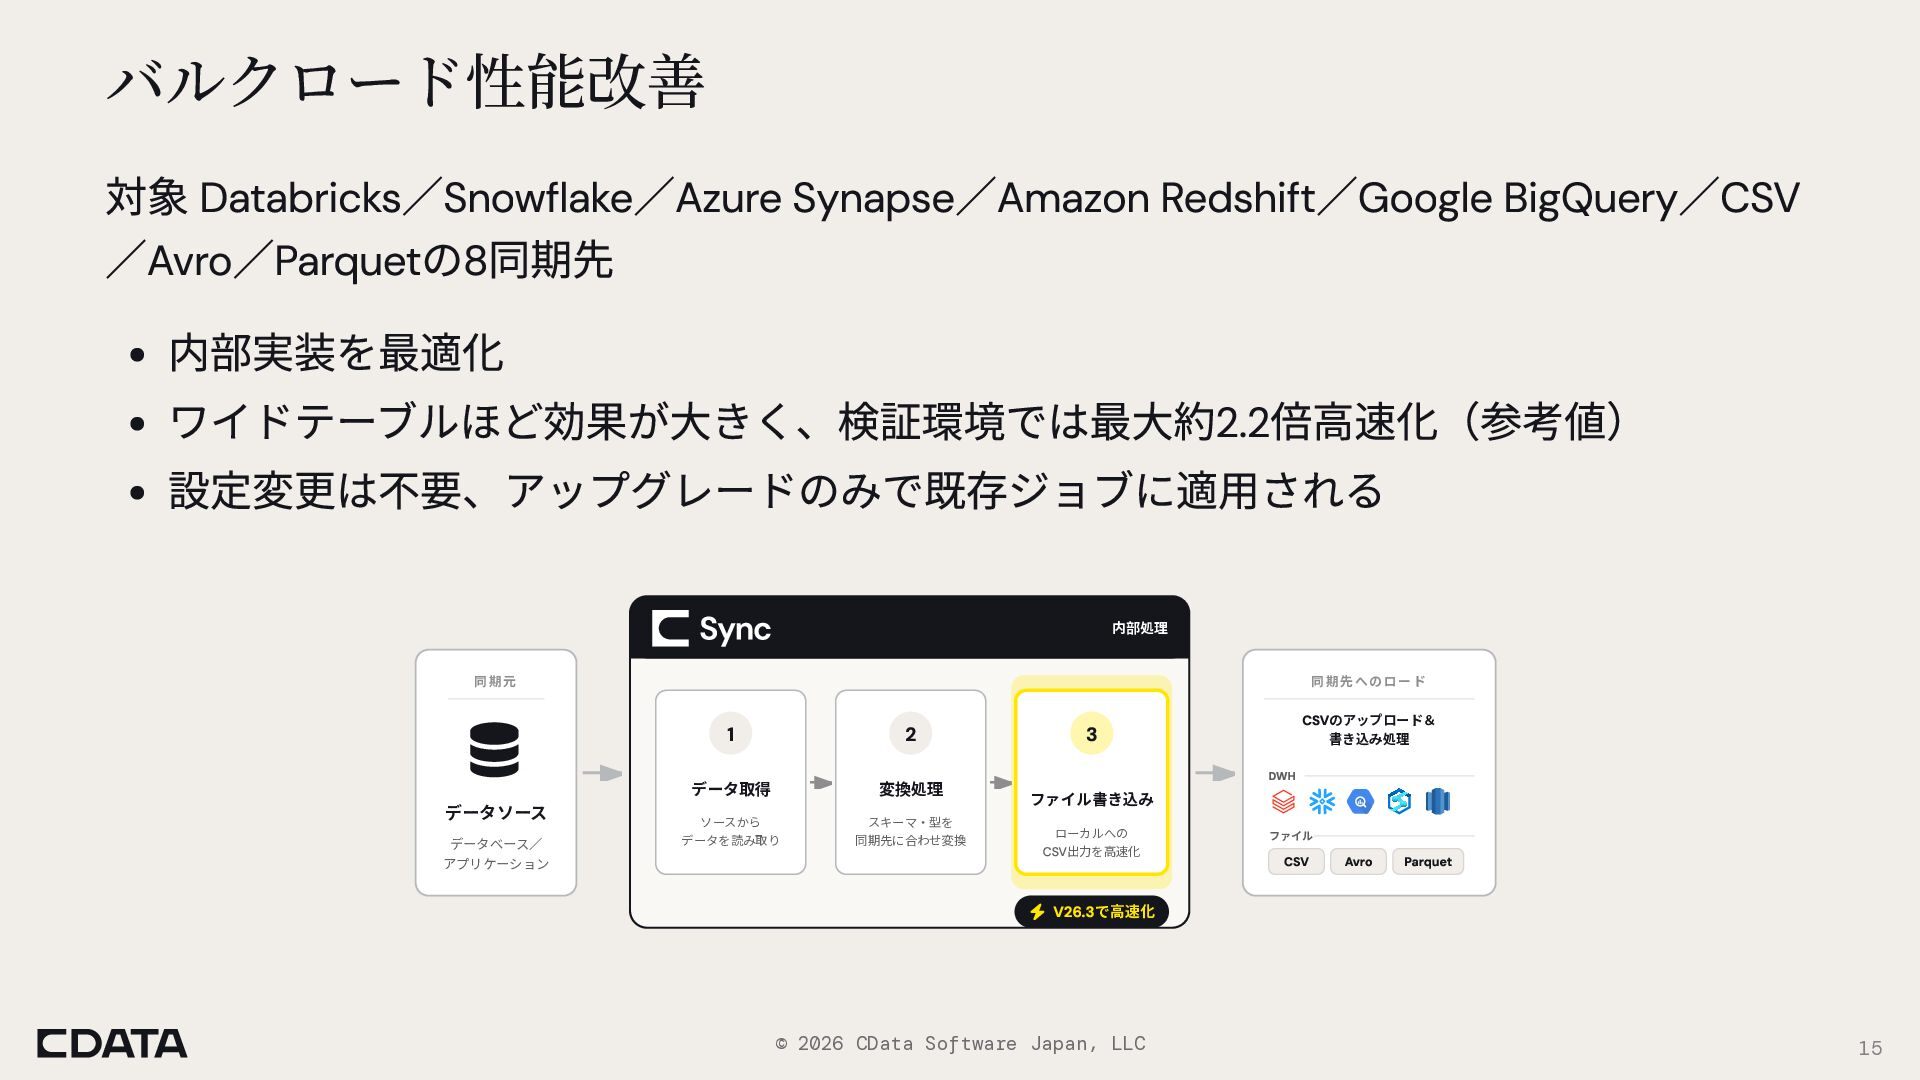
  8. バルクロード性能改善 対象 Databricks/Snowflake/Azure Synapse/Amazon Redshift/Google BigQuery/CSV /Avro/Parquetの8同期先 内部実装を最適化 ワイドテーブルほど効果が大きく、検証環境では最大約2.2倍高速化(参考値) 設定変更は不要、アップグレードのみで既存ジョブに適用される

    内部処理 同期元 データソース データベース∕ アプリケーション 同期先へのロード 1 2 データ取得 変換処理 ソースから データを読み取り スキーマ‧型を 同期先に合わせ変換 CSVのアップロード& 3 書き込み処理 DWH ファイル書き込み ローカルへの CSV出⼒を⾼速化 ファイル CSV Avro Parquet V26.3で⾼速化 © 2026 CData Software Japan, LLC 15
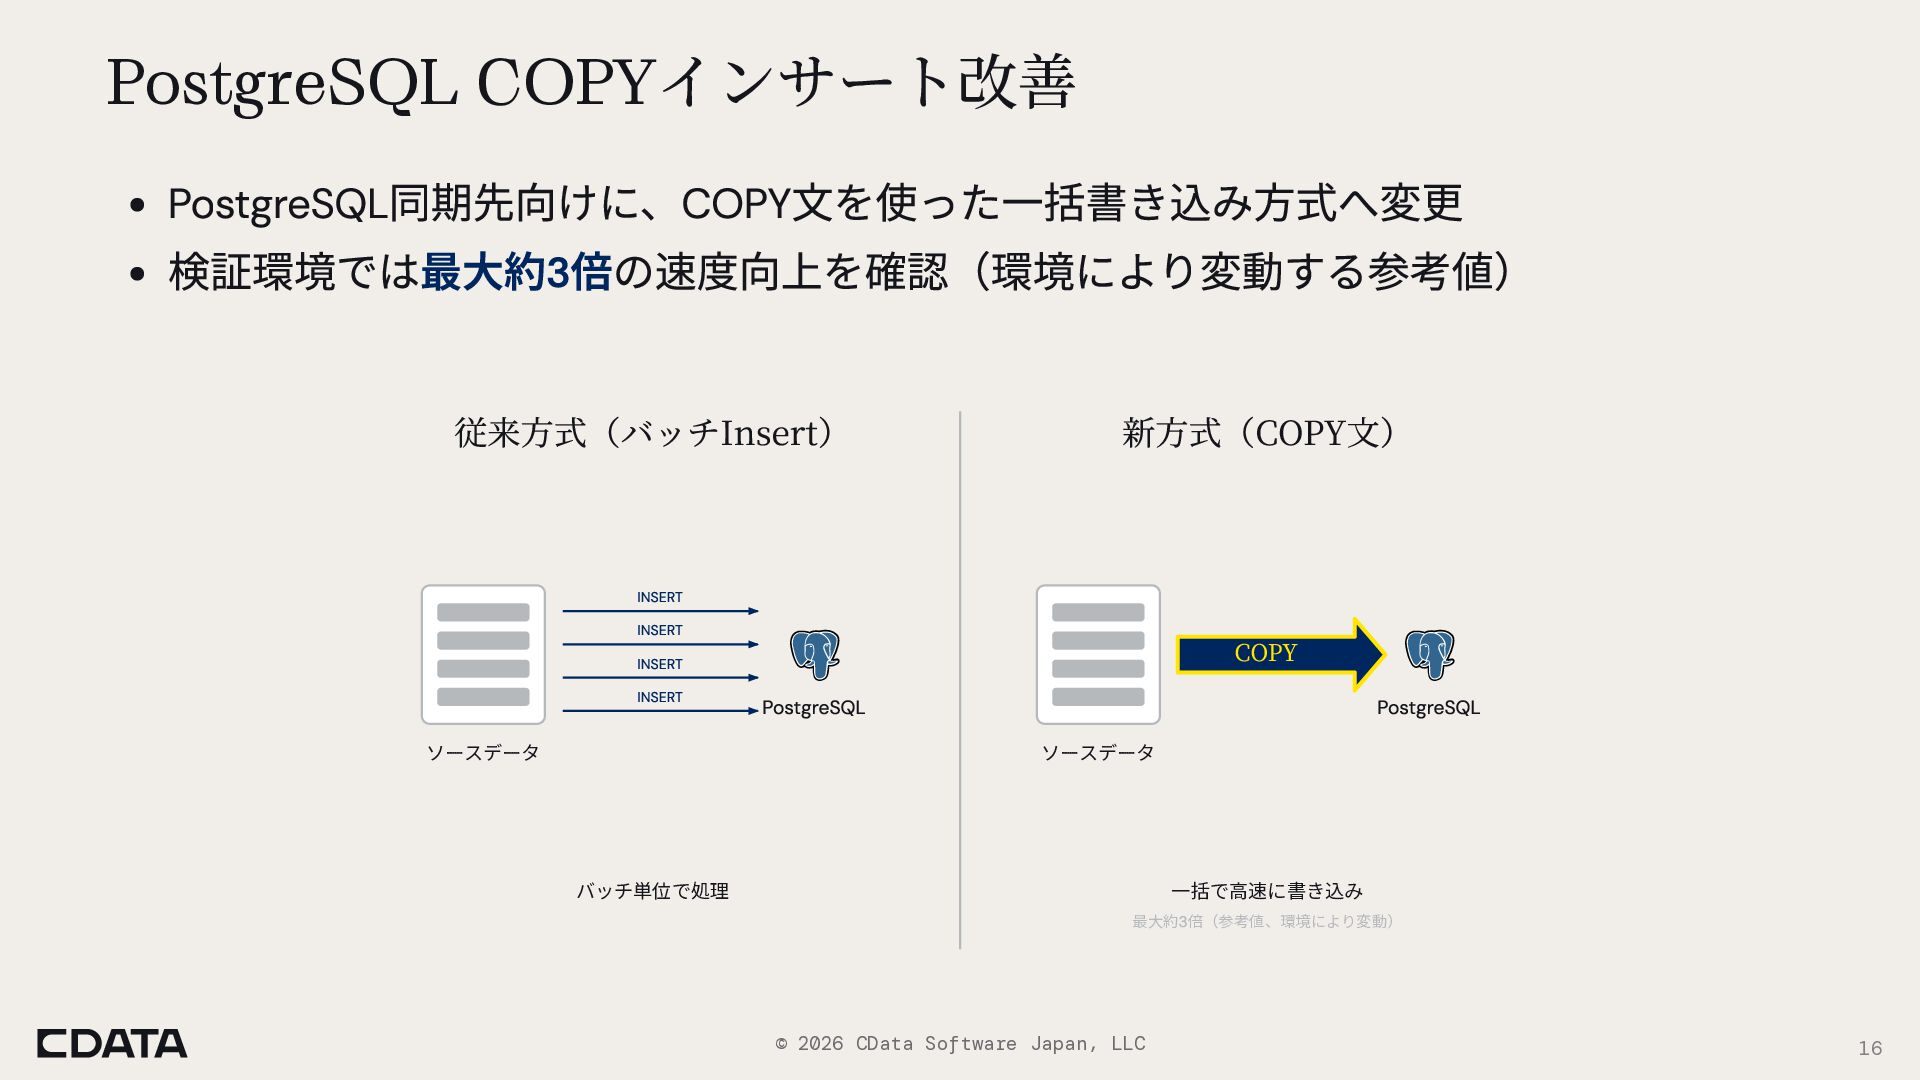
  9. PostgreSQL COPYインサート改善 同期先向けに、COPY文を使った一括書き込み方式へ変更 検証環境では最大約3倍の速度向上を確認(環境により変動する参考値) PostgreSQL 従来⽅式(バッチInsert) 新⽅式(COPY⽂) INSERT COPY INSERT

    INSERT INSERT ソースデータ PostgreSQL PostgreSQL ソースデータ バッチ単位で処理 ⼀括で⾼速に書き込み 最⼤約3倍(参考値、環境により変動) © 2026 CData Software Japan, LLC 16
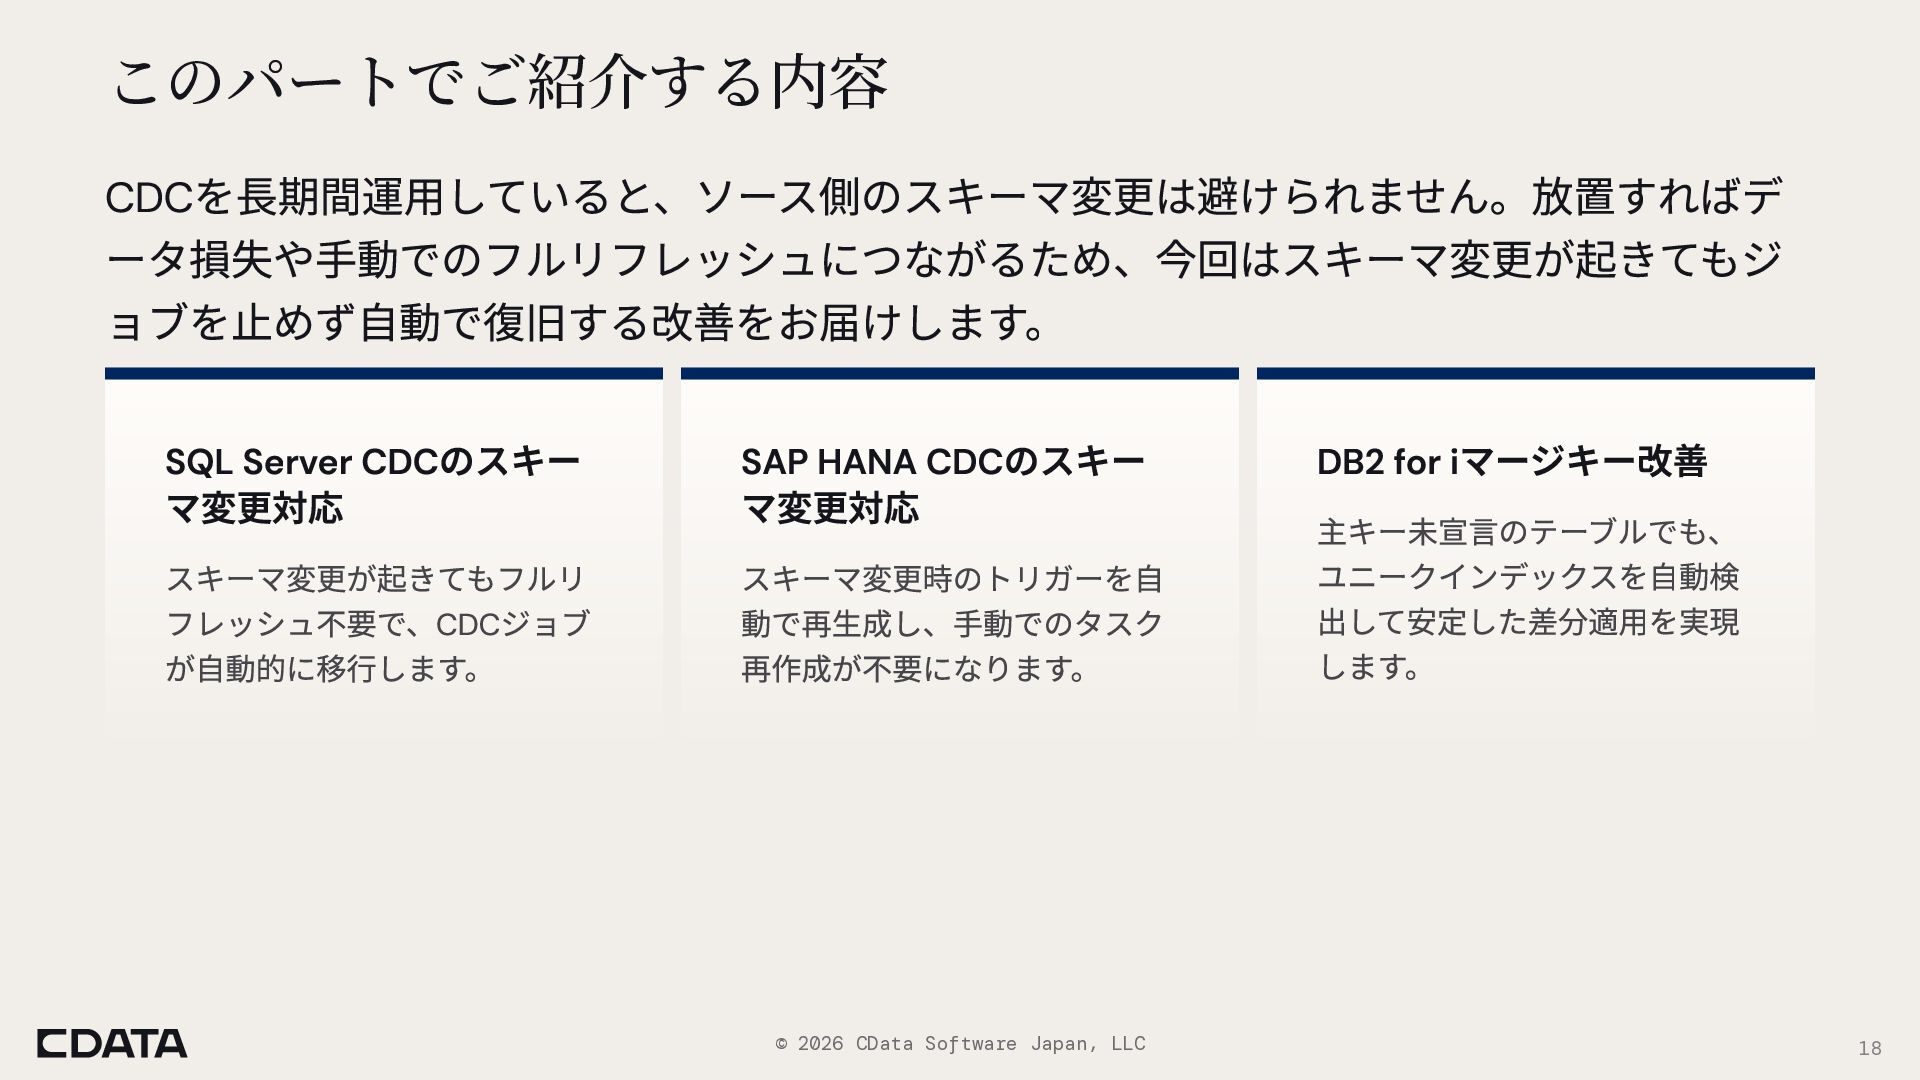
  10. このパートでご紹介する内容 を長期間運用していると、ソース側のスキーマ変更は避けられません。放置すればデ ータ損失や手動でのフルリフレッシュにつながるため、今回はスキーマ変更が起きてもジ ョブを止めず自動で復旧する改善をお届けします。 CDC のスキー のスキー SQL Server CDC

    SAP HANA CDC スキーマ変更が起きてもフルリ フレッシュ不要で、CDCジョブ が自動的に移行します。 スキーマ変更時のトリガーを自 動で再生成し、手動でのタスク 再作成が不要になります。 マ変更対応 マ変更対応 © 2026 CData Software Japan, LLC マージキー改善 DB2 for i 主キー未宣言のテーブルでも、 ユニークインデックスを自動検 出して安定した差分適用を実現 します。 18
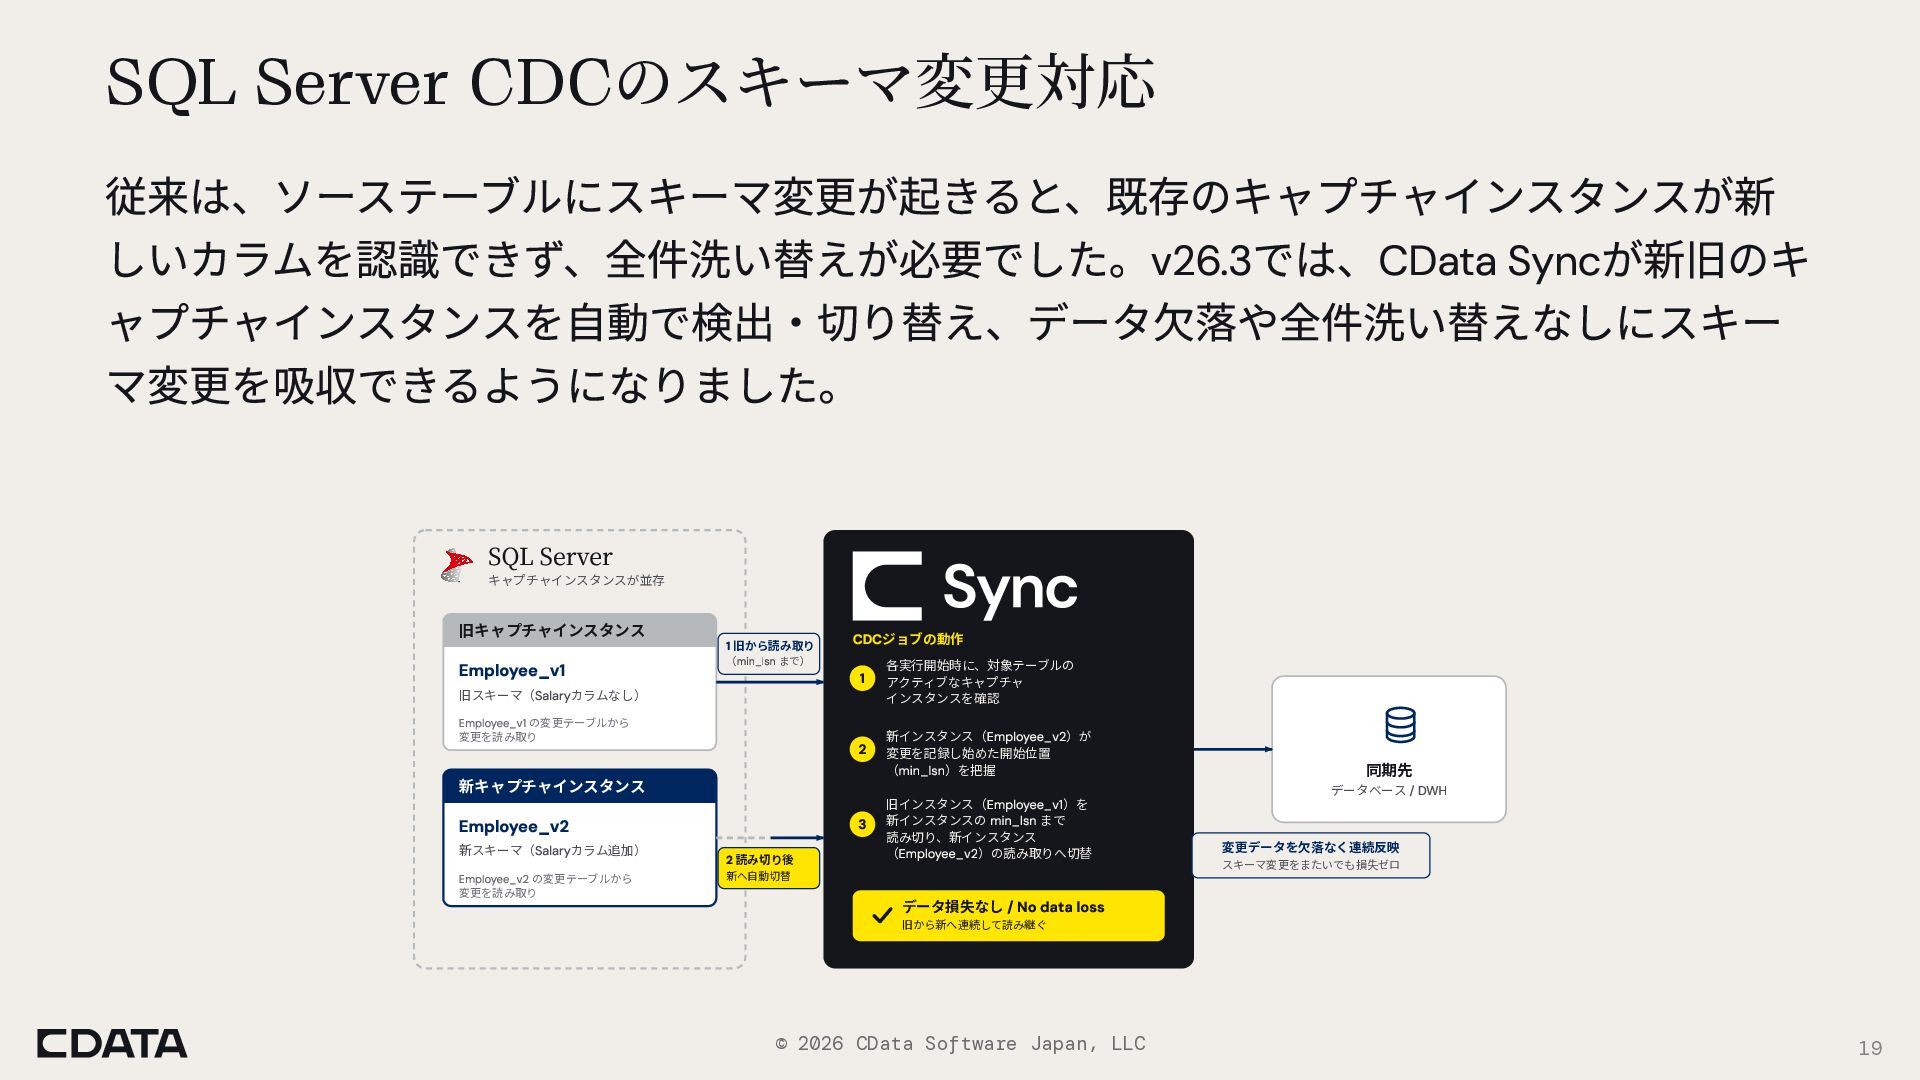
  11. SQL Server CDCのスキーマ変更対応 従来は、ソーステーブルにスキーマ変更が起きると、既存のキャプチャインスタンスが新 しいカラムを認識できず、全件洗い替えが必要でした。v26.3では、CData Syncが新旧のキ ャプチャインスタンスを自動で検出・切り替え、データ欠落や全件洗い替えなしにスキー マ変更を吸収できるようになりました。 SQL Server

    キャプチャインスタンスが並存 旧キャプチャインスタンス Employee_v1 1 旧から読み取り (min_lsn まで) 旧スキーマ(Salaryカラムなし) CDCジョブの動作 1 各実⾏開始時に、対象テーブルの アクティブなキャプチャ インスタンスを確認 2 新インスタンス(Employee_v2)が 変更を記録し始めた開始位置 (min_lsn)を把握 Employee_v1 の変更テーブルから 変更を読み取り 新キャプチャインスタンス Employee_v2 新スキーマ(Salaryカラム追加) Employee_v2 の変更テーブルから 変更を読み取り 3 2 読み切り後 旧インスタンス(Employee_v1)を 新インスタンスの min_lsn まで 読み切り、新インスタンス (Employee_v2)の読み取りへ切替 新へ⾃動切替 同期先 データベース / DWH 変更データを⽋落なく連続反映 スキーマ変更をまたいでも損失ゼロ データ損失なし / No data loss 旧から新へ連続して読み継ぐ © 2026 CData Software Japan, LLC 19
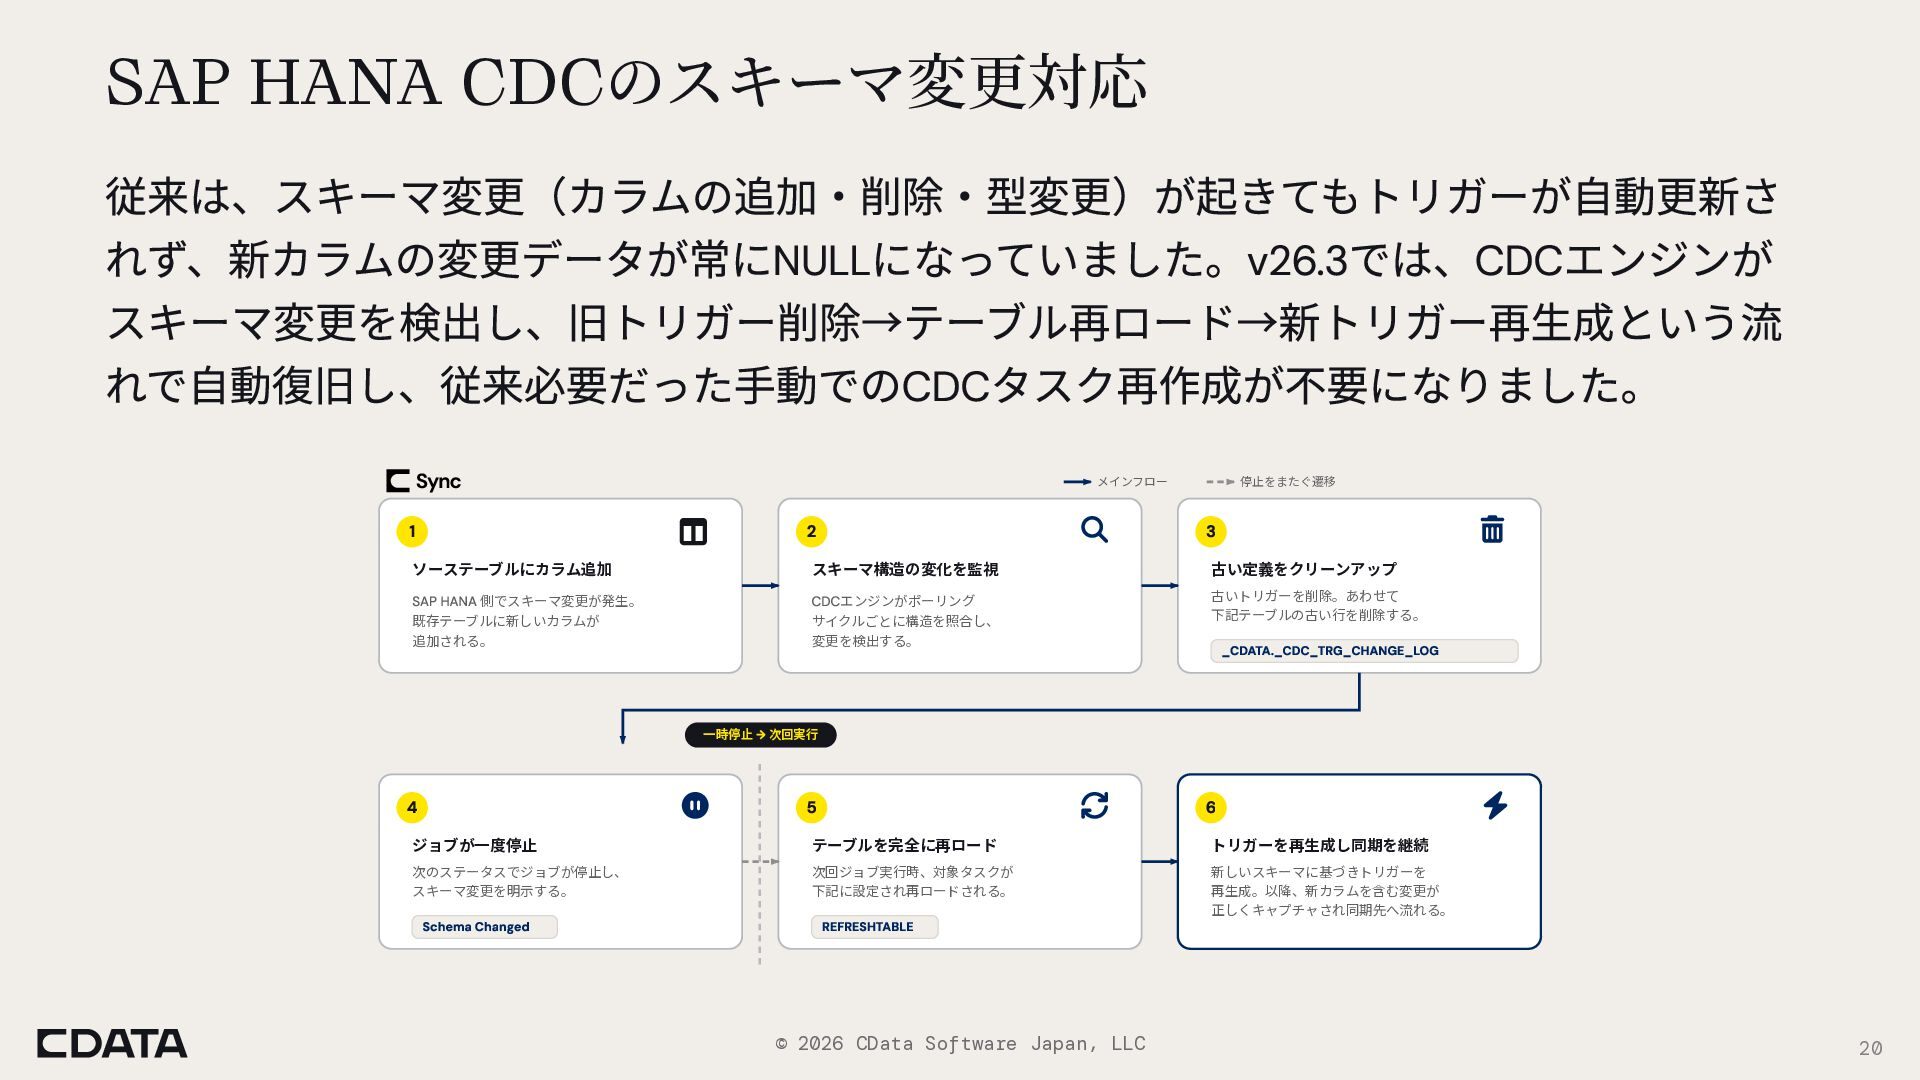
  12. SAP HANA CDCのスキーマ変更対応 従来は、スキーマ変更(カラムの追加・削除・型変更)が起きてもトリガーが自動更新さ れず、新カラムの変更データが常にNULLになっていました。v26.3では、CDCエンジンが スキーマ変更を検出し、旧トリガー削除→テーブル再ロード→新トリガー再生成という流 れで自動復旧し、従来必要だった手動でのCDCタスク再作成が不要になりました。 メインフロー 停⽌をまたぐ遷移 1

    2 3 ソーステーブルにカラム追加 スキーマ構造の変化を監視 古い定義をクリーンアップ SAP HANA 側でスキーマ変更が発⽣。 CDCエンジンがポーリング 古いトリガーを削除。あわせて 下記テーブルの古い⾏を削除する。 既存テーブルに新しいカラムが 追加される。 サイクルごとに構造を照合し、 変更を検出する。 _CDATA._CDC_TRG_CHANGE_LOG ⼀時停⽌ → 次回実⾏ 4 5 6 ジョブが⼀度停⽌ テーブルを完全に再ロード トリガーを再⽣成し同期を継続 次のステータスでジョブが停⽌し、 スキーマ変更を明⽰する。 次回ジョブ実⾏時、対象タスクが 下記に設定され再ロードされる。 新しいスキーマに基づきトリガーを 再⽣成。以降、新カラムを含む変更が 正しくキャプチャされ同期先へ流れる。 Schema Changed REFRESHTABLE © 2026 CData Software Japan, LLC 20
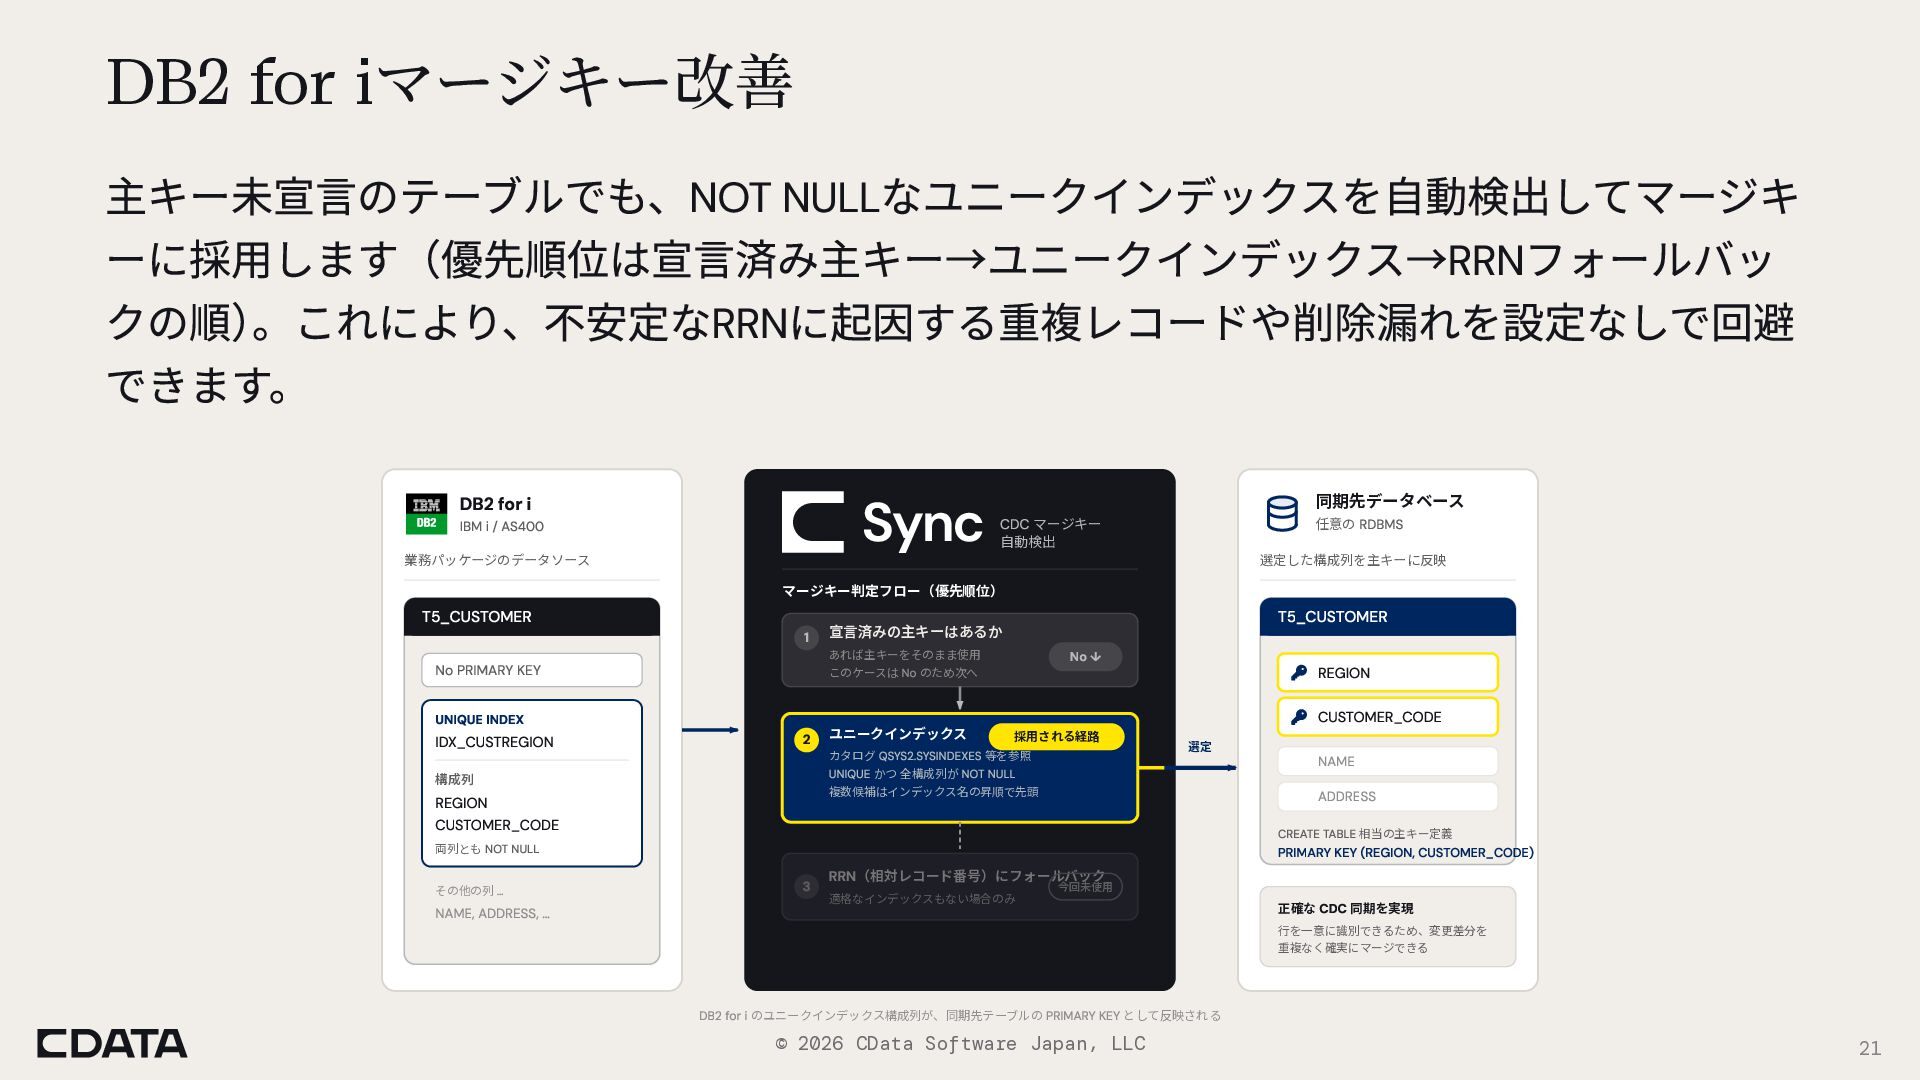
  13. DB2 for iマージキー改善 主キー未宣言のテーブルでも、NOT NULLなユニークインデックスを自動検出してマージキ ーに採用します(優先順位は宣言済み主キー→ユニークインデックス→RRNフォールバッ クの順)。これにより、不安定なRRNに起因する重複レコードや削除漏れを設定なしで回避 できます。 同期先データベース DB2

    for i CDC マージキー IBM i / AS400 任意の RDBMS ⾃動検出 業務パッケージのデータソース 選定した構成列を主キーに反映 マージキー判定フロー(優先順位) T5_CUSTOMER 1 No PRIMARY KEY あれば主キーをそのまま使⽤ No ↓ このケースは No のため次へ UNIQUE INDEX IDX_CUSTREGION T5_CUSTOMER 宣⾔済みの主キーはあるか 2 ユニークインデックス 採⽤される経路 カタログ QSYS2.SYSINDEXES 等を参照 REGION CUSTOMER_CODE 選定 UNIQUE かつ 全構成列が NOT NULL 構成列 複数候補はインデックス名の昇順で先頭 REGION CUSTOMER_CODE ADDRESS CREATE TABLE 相当の主キー定義 両列とも NOT NULL その他の列 … NAME, ADDRESS, … NAME PRIMARY KEY (REGION, CUSTOMER_CODE) 3 RRN(相対レコード番号)にフォールバック 適格なインデックスもない場合のみ 今回未使⽤ 正確な CDC 同期を実現 ⾏を⼀意に識別できるため、変更差分を 重複なく確実にマージできる DB2 for i のユニークインデックス構成列が、同期先テーブルの PRIMARY KEY として反映される © 2026 CData Software Japan, LLC 21
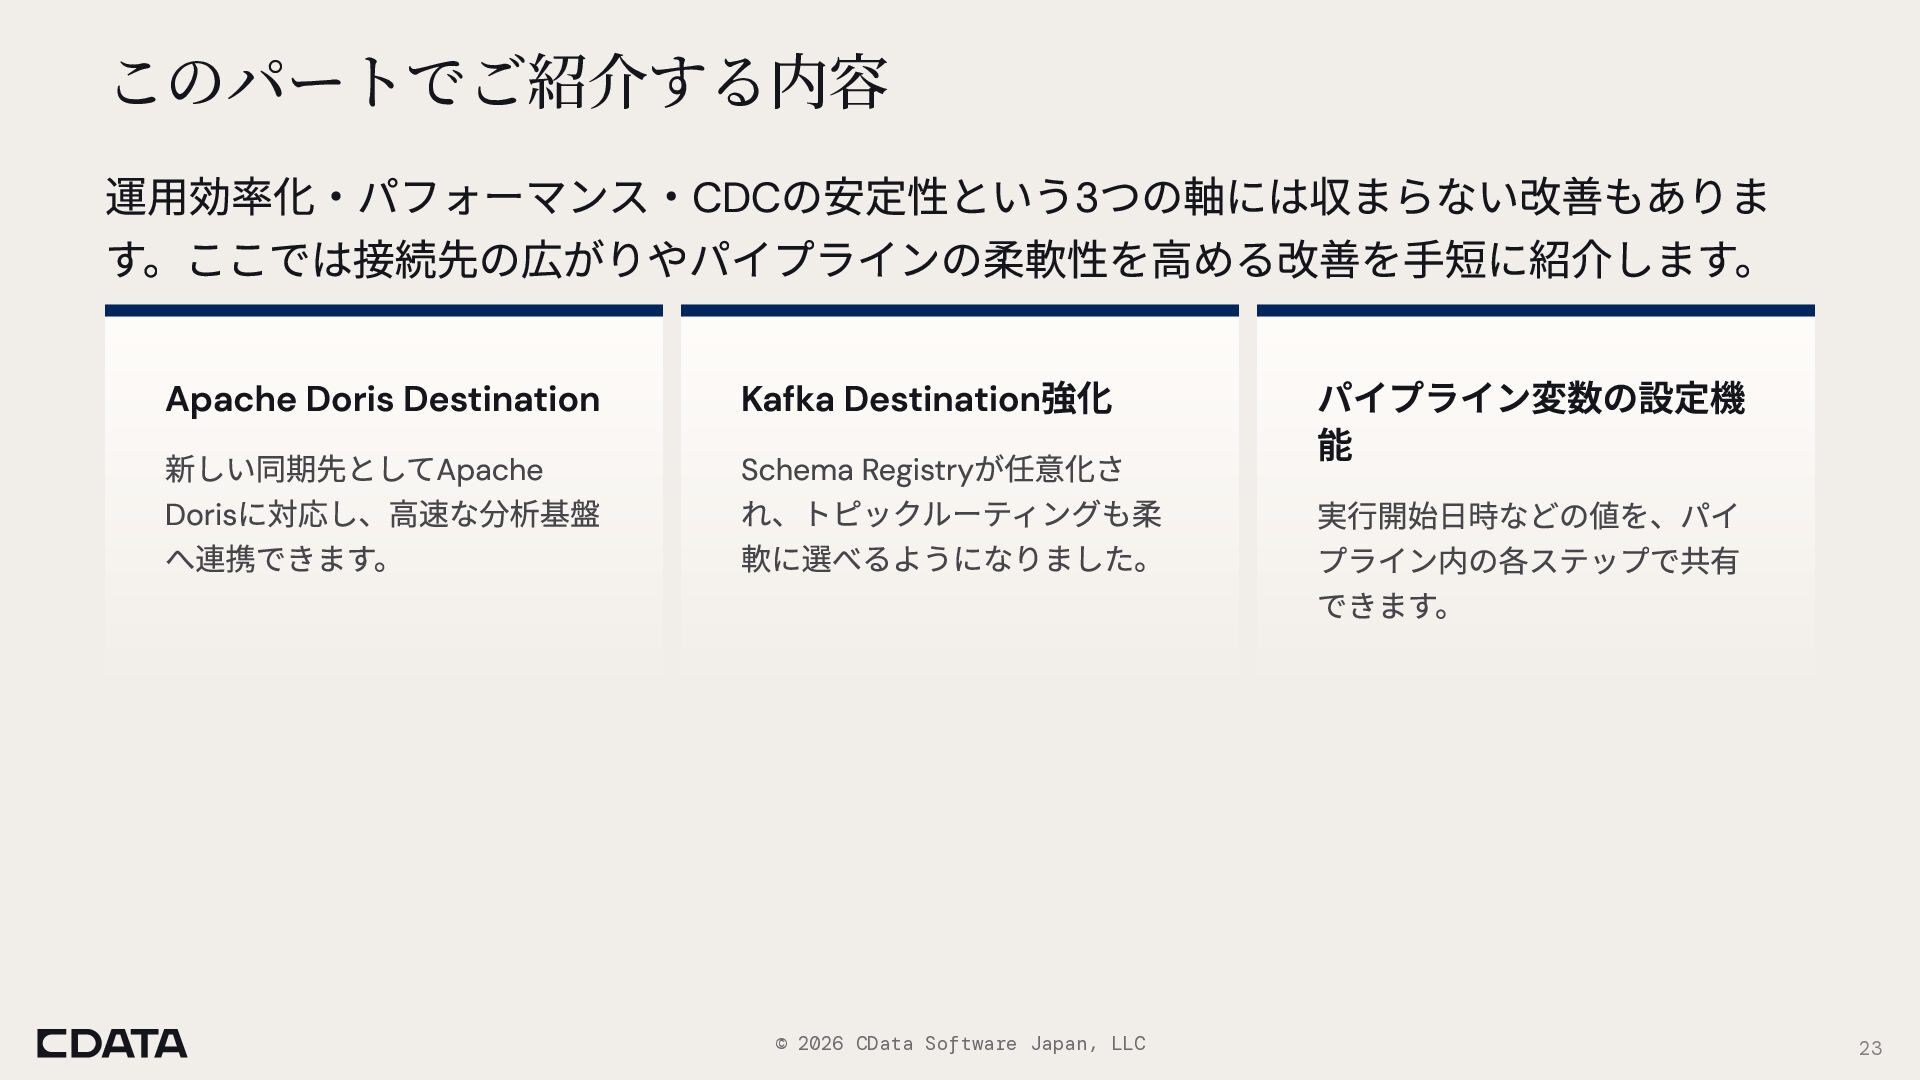
  14. このパートでご紹介する内容 運用効率化・パフォーマンス・CDCの安定性という3つの軸には収まらない改善もありま す。ここでは接続先の広がりやパイプラインの柔軟性を高める改善を手短に紹介します。 Apache Doris Destination 新しい同期先としてApache Dorisに対応し、高速な分析基盤 へ連携できます。 強化

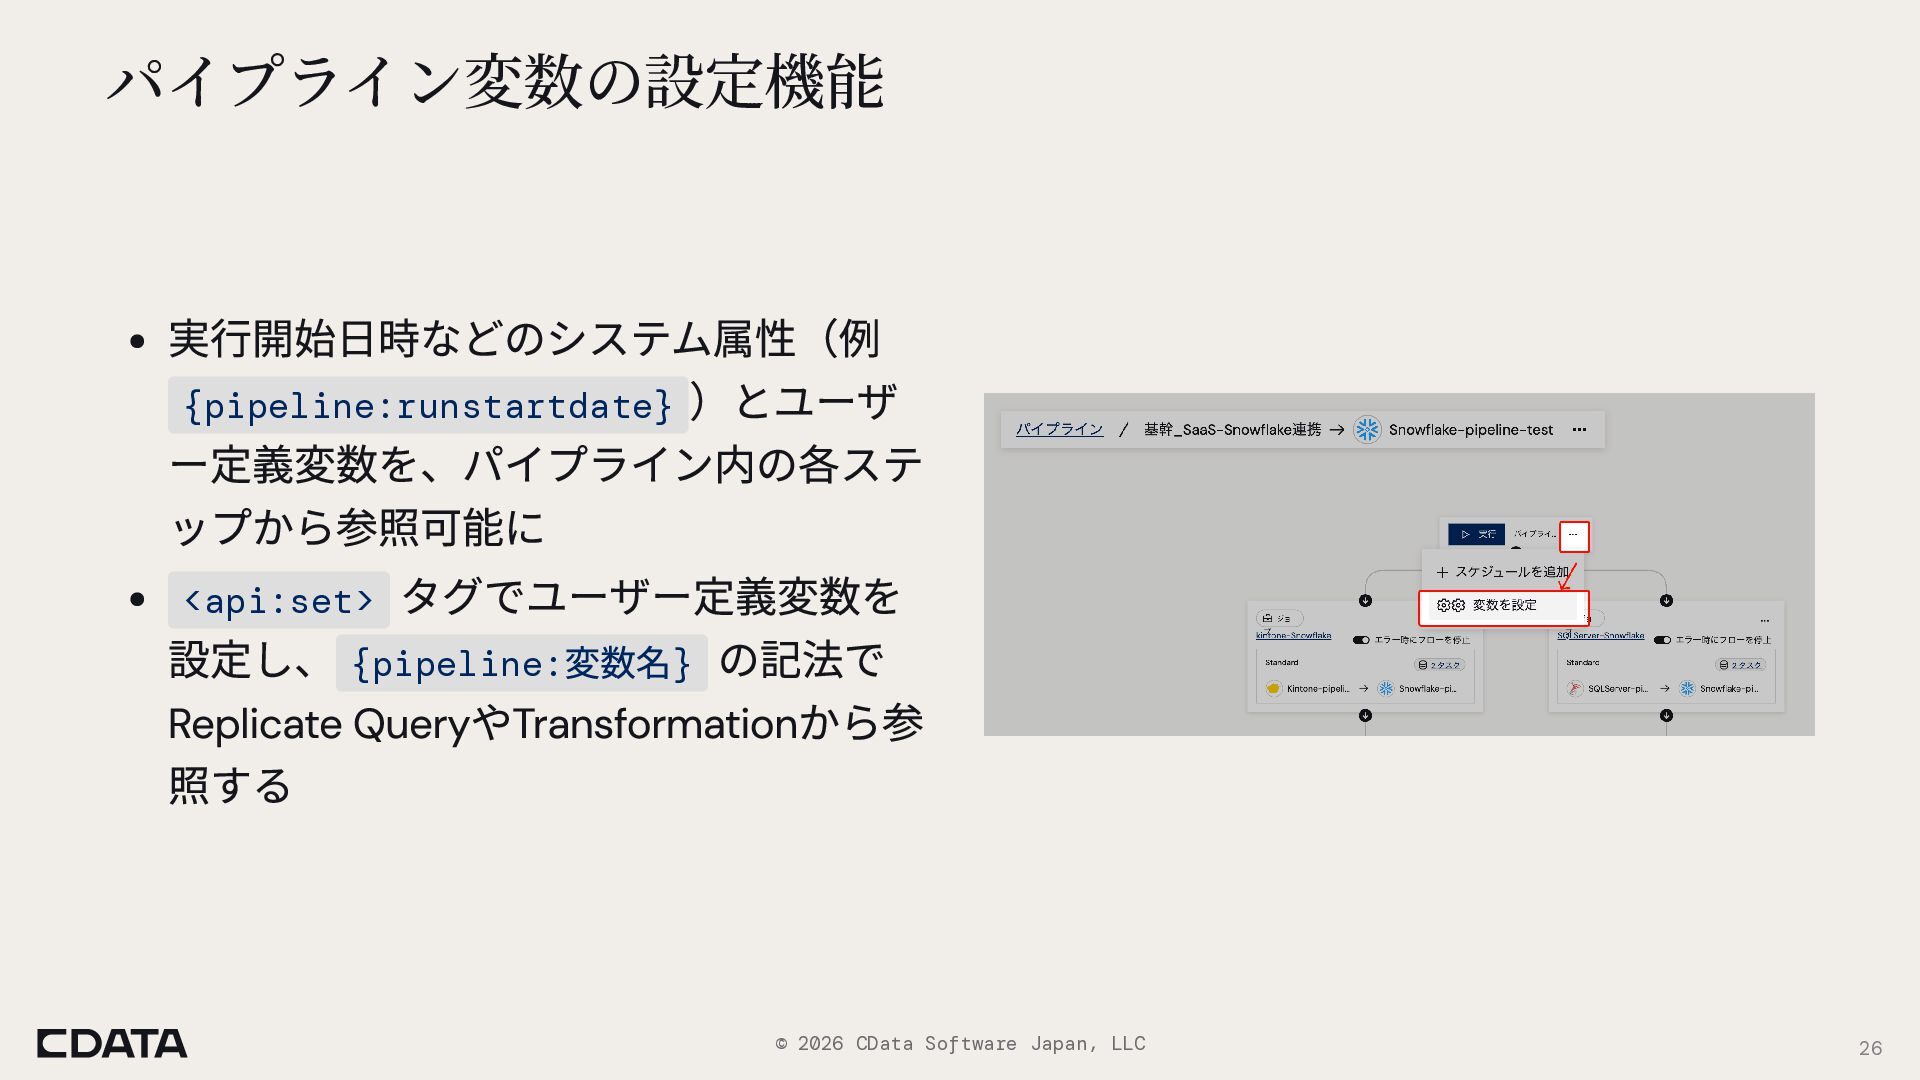
    Kafka Destination が任意化さ れ、トピックルーティングも柔 軟に選べるようになりました。 Schema Registry © 2026 CData Software Japan, LLC パイプライン変数の設定機 能 実行開始日時などの値を、パイ プライン内の各ステップで共有 できます。 23
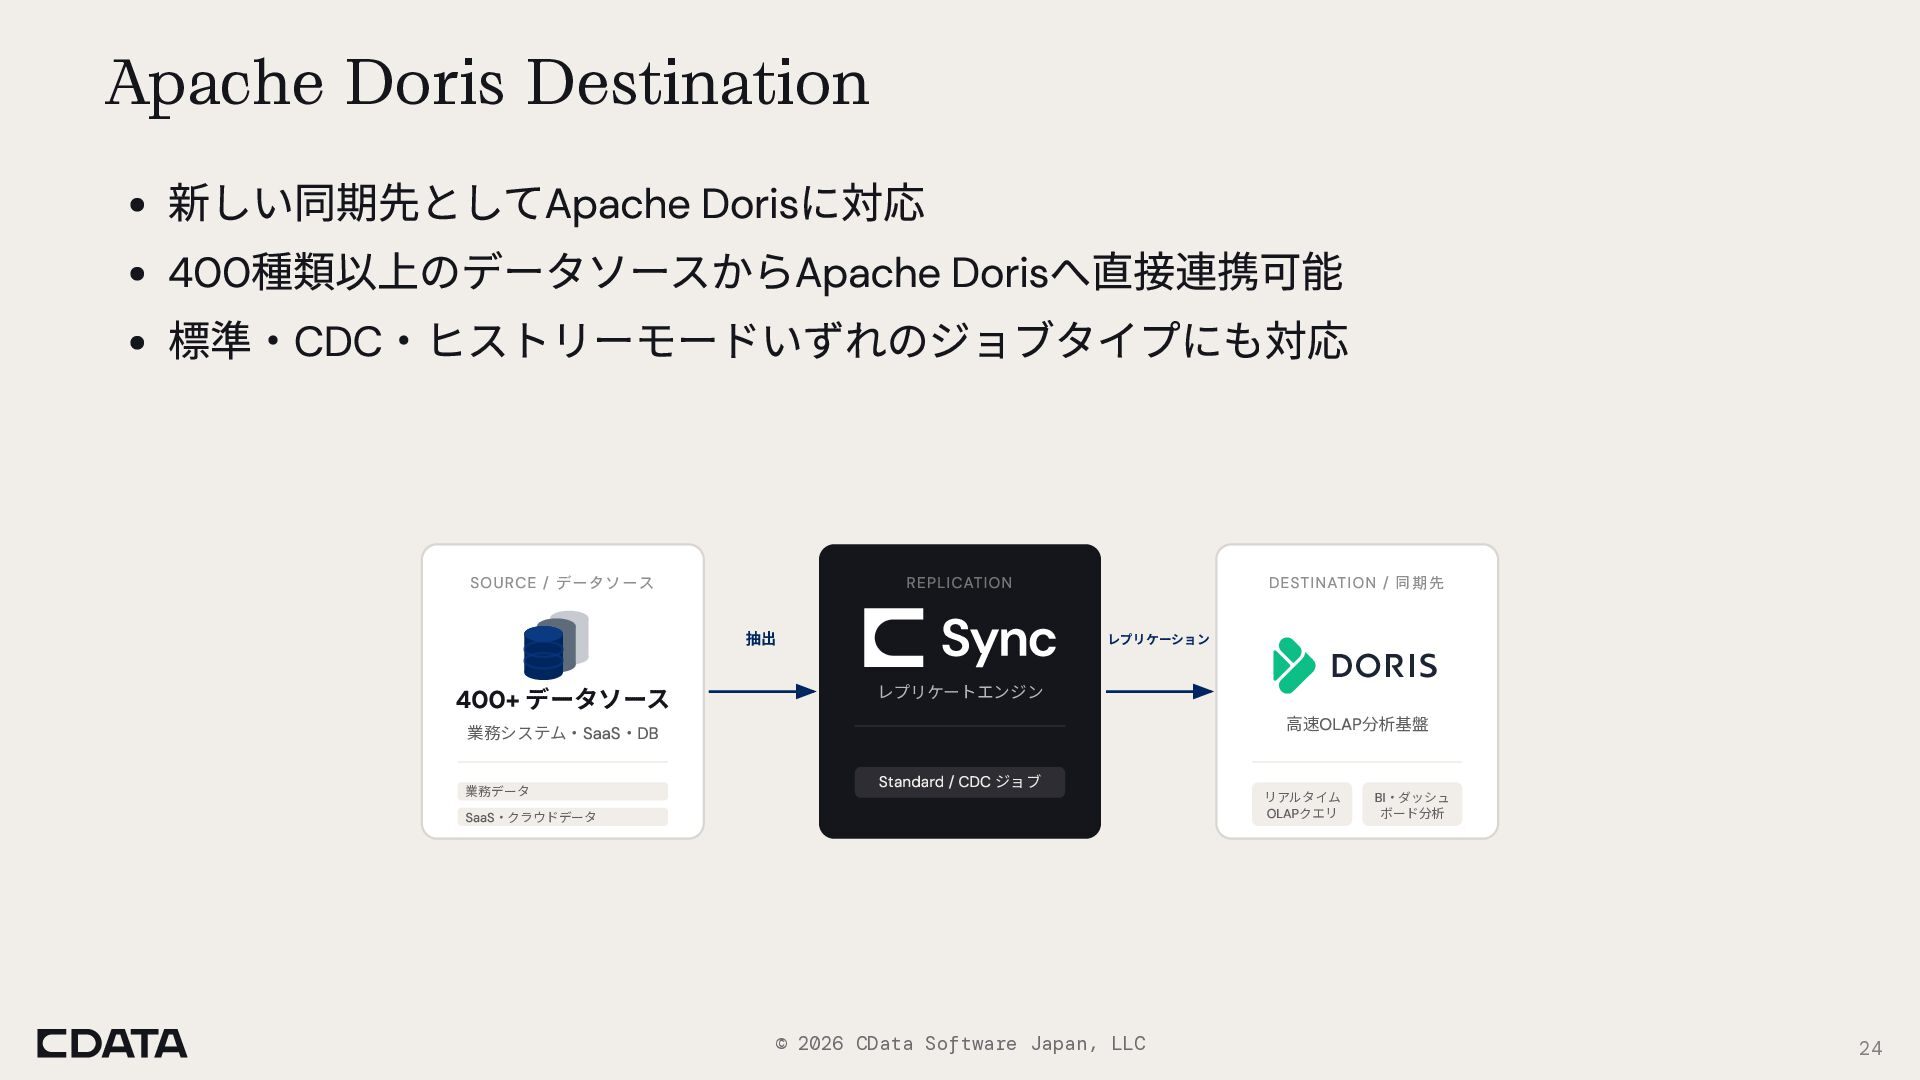
  15. Apache Doris Destination 新しい同期先としてApache Dorisに対応 400種類以上のデータソースからApache Dorisへ直接連携可能 標準・CDC・ヒストリーモードいずれのジョブタイプにも対応 SOURCE /

    データソース REPLICATION 抽出 400+ データソース DESTINATION / 同期先 レプリケーション レプリケートエンジン ⾼速OLAP分析基盤 業務システム‧SaaS‧DB 業務データ Standard / CDC ジョブ SaaS‧クラウドデータ © 2026 CData Software Japan, LLC リアルタイム OLAPクエリ BI‧ダッシュ ボード分析 24
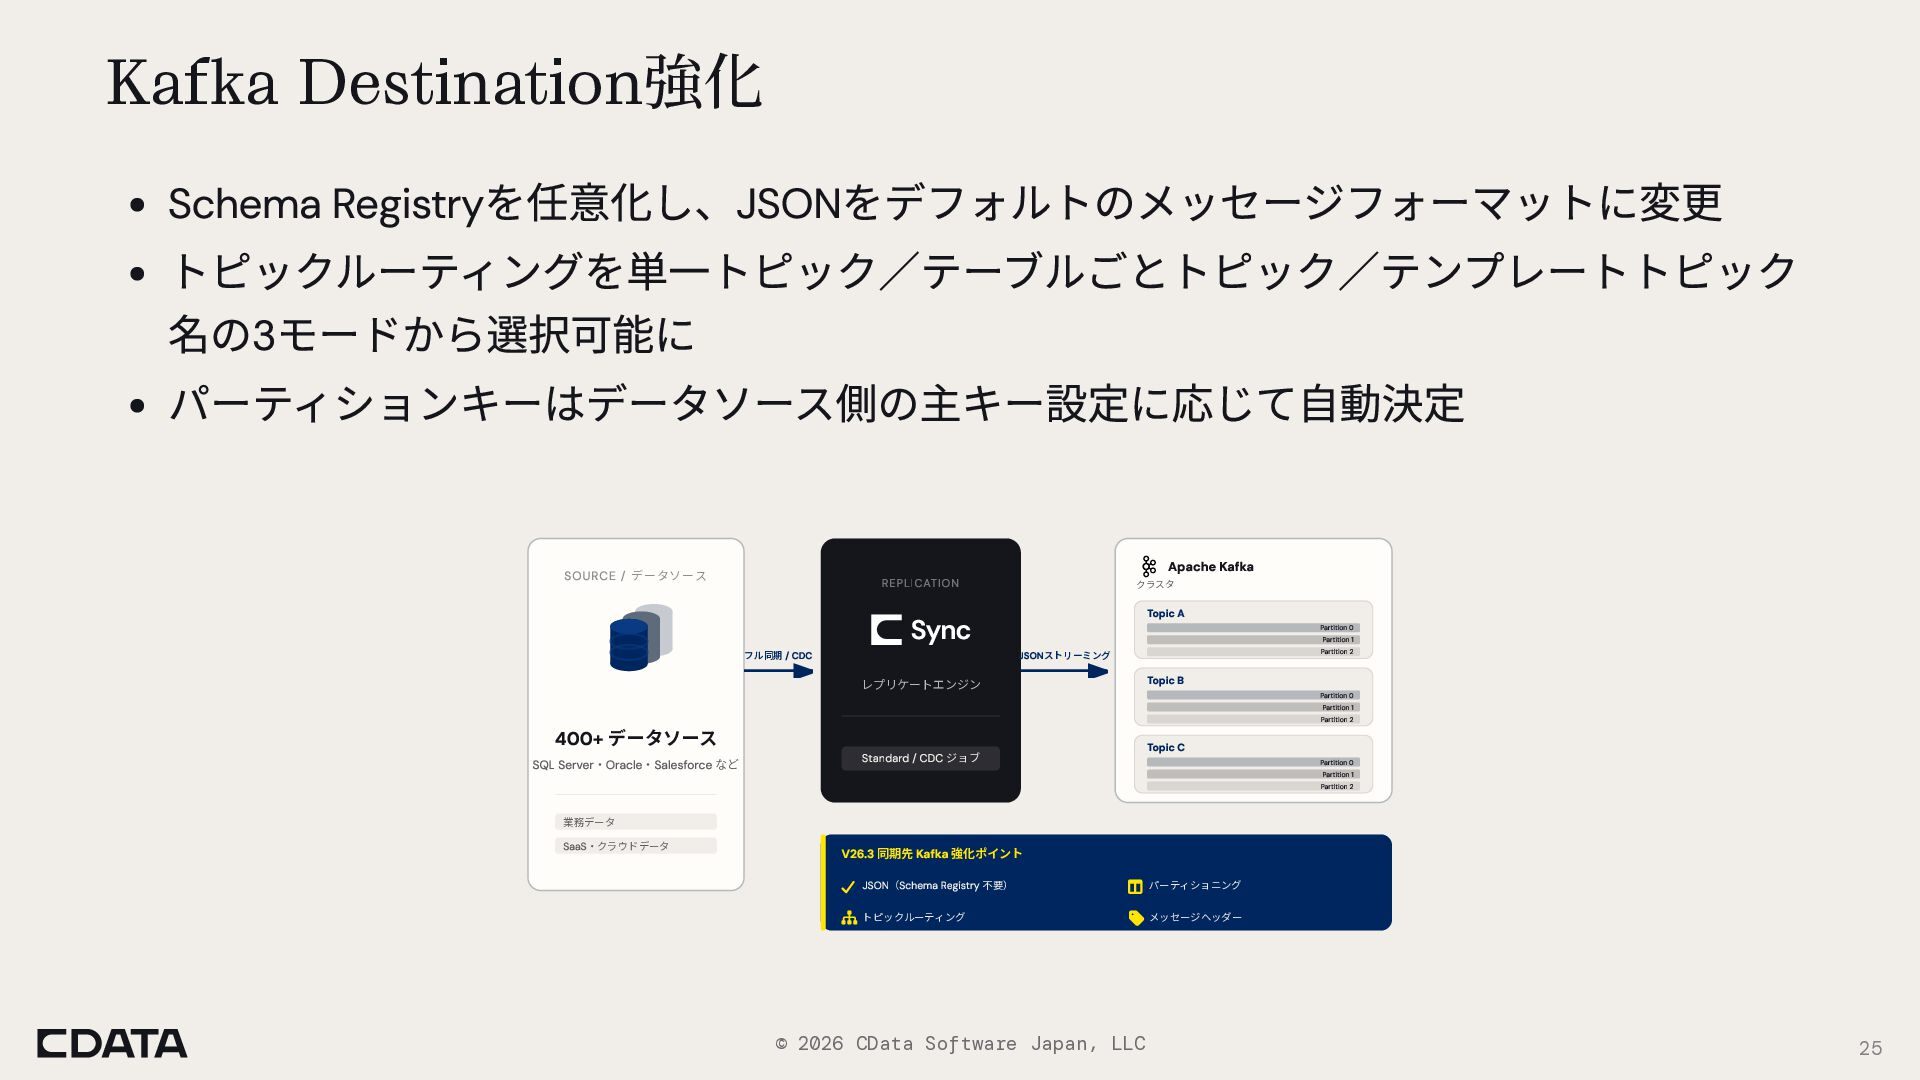
  16. Kafka Destination強化 を任意化し、JSONをデフォルトのメッセージフォーマットに変更 トピックルーティングを単一トピック/テーブルごとトピック/テンプレートトピック 名の3モードから選択可能に パーティションキーはデータソース側の主キー設定に応じて自動決定 Schema Registry SOURCE /

    データソース Apache Kafka REPLICATION クラスタ Topic A Partition 0 Partition 1 フル同期 / CDC Partition 2 JSONストリーミング レプリケートエンジン Topic B Partition 0 Partition 1 400+ データソース SQL Server‧Oracle‧Salesforce など Partition 2 Standard / CDC ジョブ Topic C Partition 0 Partition 1 Partition 2 業務データ SaaS‧クラウドデータ V26.3 同期先 Kafka 強化ポイント JSON(Schema Registry 不要) パーティショニング トピックルーティング メッセージヘッダー © 2026 CData Software Japan, LLC 25
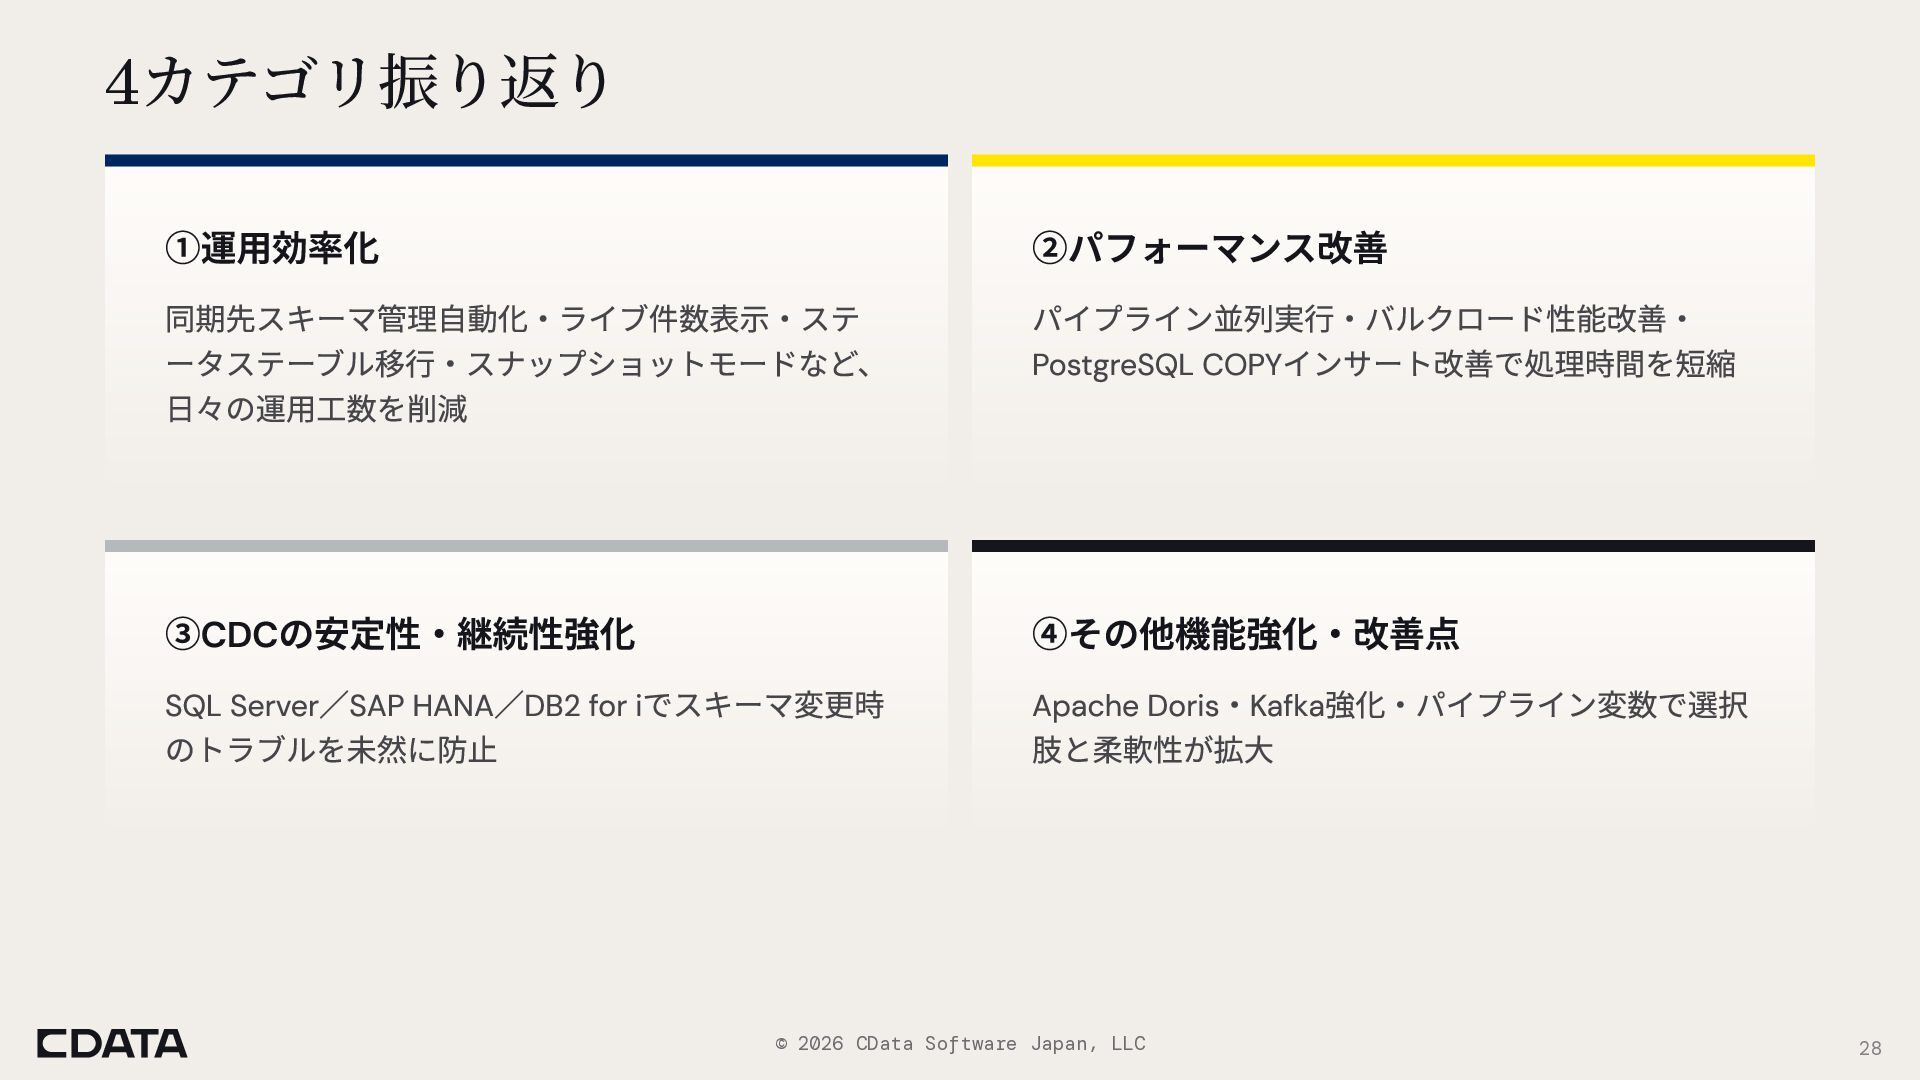
  17. 4カテゴリ振り返り ①運用効率化 ②パフォーマンス改善 ③CDCの安定性・継続性強化 ④その他機能強化・改善点 同期先スキーマ管理自動化・ライブ件数表示・ステ ータステーブル移行・スナップショットモードなど、 日々の運用工数を削減 / /

    のトラブルを未然に防止 でスキーマ変更時 SQL Server SAP HANA DB2 for i パイプライン並列実行・バルクロード性能改善・ PostgreSQL COPYインサート改善で処理時間を短縮 ・ 強化・パイプライン変数で選択 肢と柔軟性が拡大 Apache Doris Kafka © 2026 CData Software Japan, LLC 28

More Decks by CData Software Japan

Other Decks in Technology