Share
Embed
ゼロから作るDeep Learning読書会 7章 畳み込みニューラルネットワーク
「7章 畳み込みニューラルネットワーク」の内容をまとめました
Takuya Kitamura
October 02, 2017
Transcript
22 slides
-
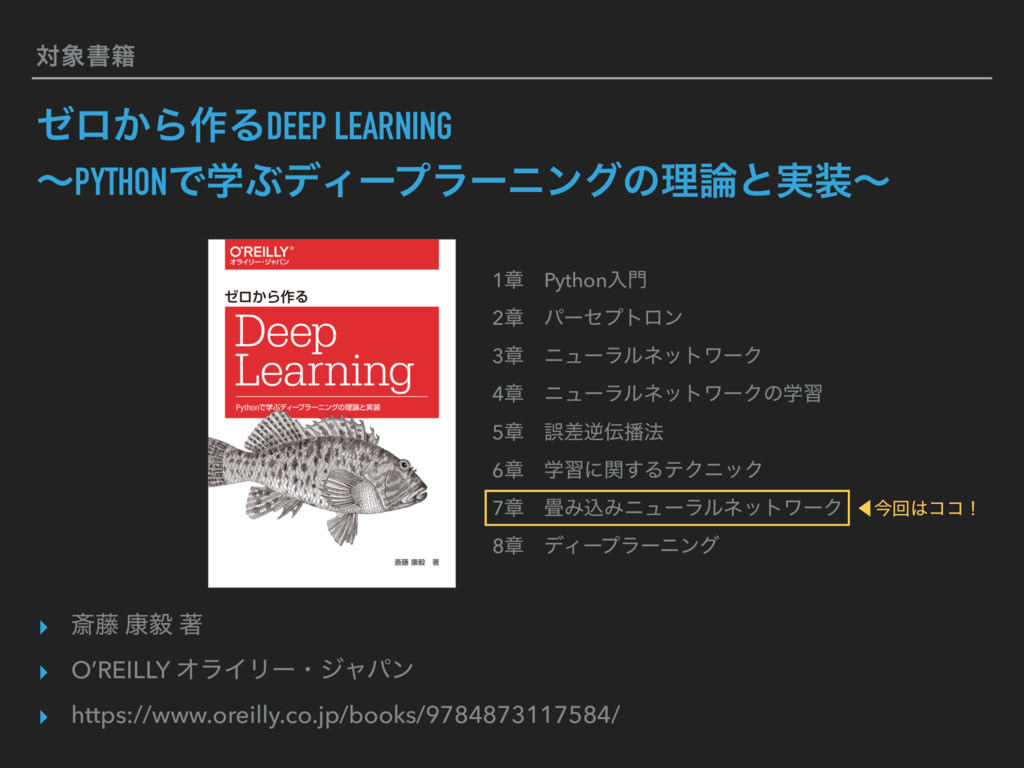
ରॻ੶ θϩ͔Β࡞ΔDEEP LEARNING ʙPYTHONͰֶͿσΟʔϓϥʔχϯάͷཧͱ࣮ʙ ▸ ࡈ౻ ߁ؽ ஶ ▸ O’REILLY
ΦϥΠϦʔɾδϟύϯ ▸ https://www.oreilly.co.jp/books/9784873117584/ 1ষɹPythonೖ 2ষɹύʔηϓτϩϯ 3ষɹχϡʔϥϧωοτϫʔΫ 4ষɹχϡʔϥϧωοτϫʔΫͷֶश 5ষɹޡࠩٯ๏ 6ষɹֶशʹؔ͢ΔςΫχοΫ 7ষɹΈࠐΈχϡʔϥϧωοτϫʔΫ 8ষɹσΟʔϓϥʔχϯά ⾢ࠓճίίʂ -
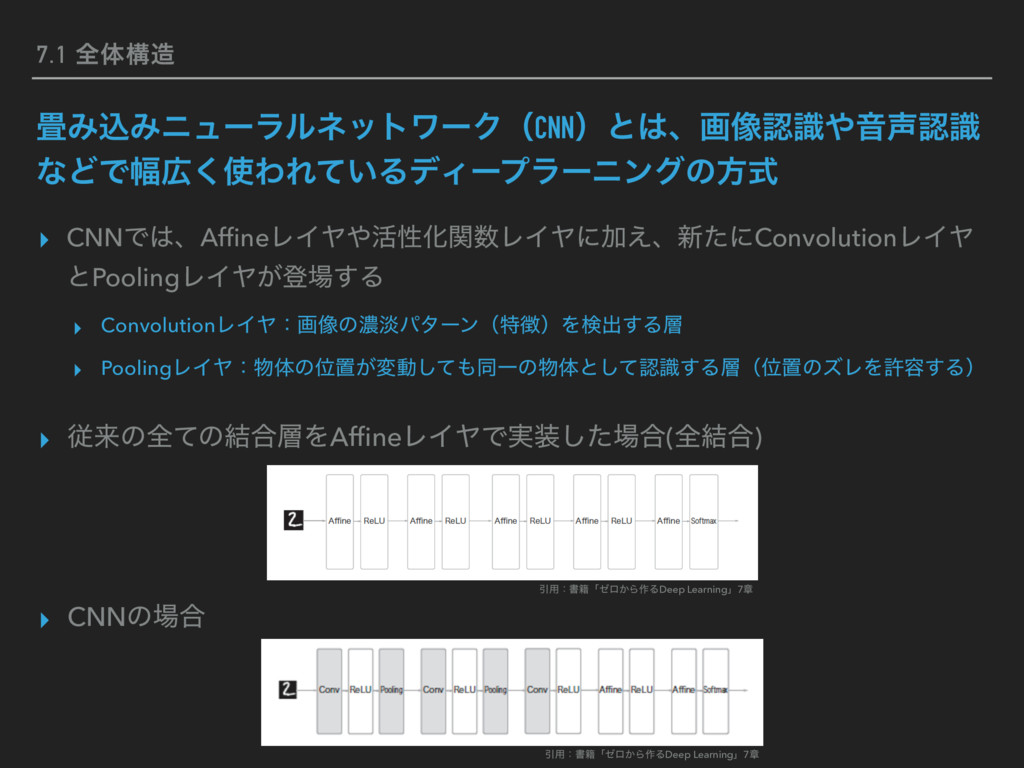
7.1 શମߏ ΈࠐΈχϡʔϥϧωοτϫʔΫʢCNNʣͱɺը૾ೝࣝԻೝࣝ ͳͲͰ෯͘ΘΕ͍ͯΔσΟʔϓϥʔχϯάͷํࣜ ▸ CNNͰɺAffineϨΠϠ׆ੑԽؔϨΠϠʹՃ͑ɺ৽ͨʹConvolutionϨΠϠ ͱPoolingϨΠϠ͕ొ͢Δ ▸ ConvolutionϨΠϠɿը૾ͷೱ୶ύλʔϯʢಛʣΛݕग़͢Δ ▸
PoolingϨΠϠɿମͷҐஔ͕มಈͯ͠ಉҰͷମͱͯ͠ೝࣝ͢ΔʢҐஔͷζϨΛڐ༰͢Δʣ ▸ ैདྷͷશͯͷ݁߹ΛAffineϨΠϠͰ࣮ͨ͠߹(શ݁߹) ▸ CNNͷ߹ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
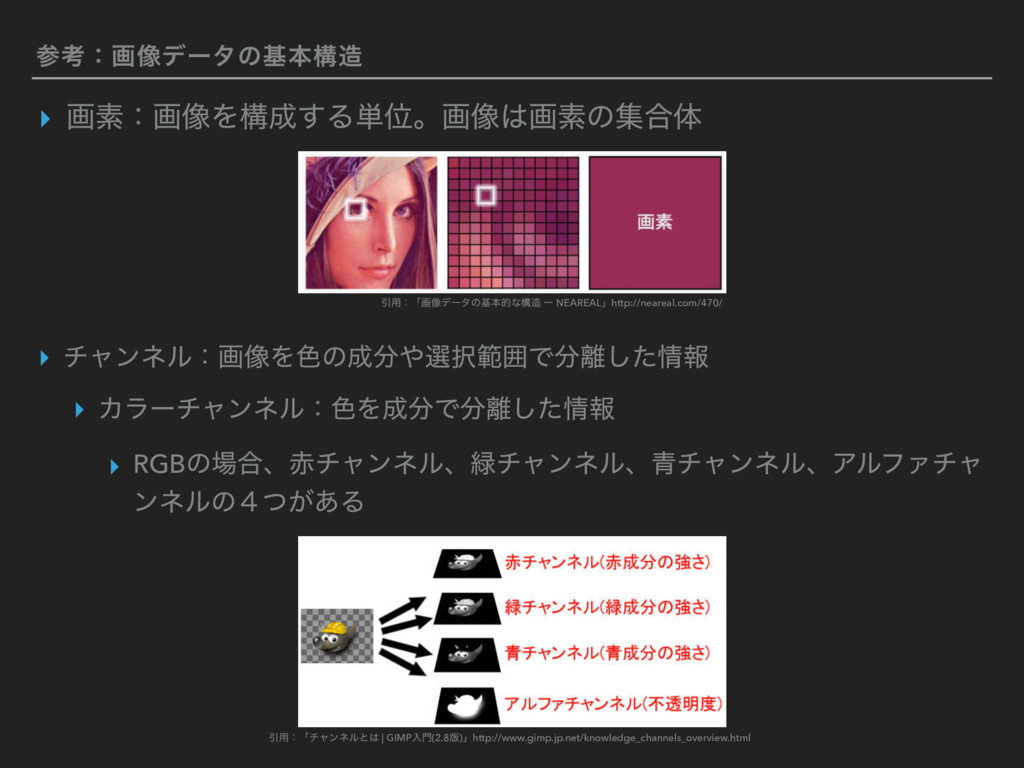
ࢀߟɿը૾σʔλͷجຊߏ ▸ ըૉɿը૾Λߏ͢Δ୯Ґɻը૾ըૉͷू߹ମ ▸ νϟϯωϧɿը૾Λ৭ͷબൣғͰͨ͠ใ ▸ Χϥʔνϟϯωϧɿ৭ΛͰͨ͠ใ ▸ RGBͷ߹ɺνϟϯωϧɺνϟϯωϧɺ੨νϟϯωϧɺΞϧϑΝνϟ ϯωϧͷ͕̐ͭ͋Δ
Ҿ༻ɿʮը૾σʔλͷجຊతͳߏ ʔ NEAREALʯhttp://neareal.com/470/ Ҿ༻ɿʮνϟϯωϧͱ | GIMPೖ(2.8൛)ʯhttp://www.gimp.jp.net/knowledge_channels_overview.html -
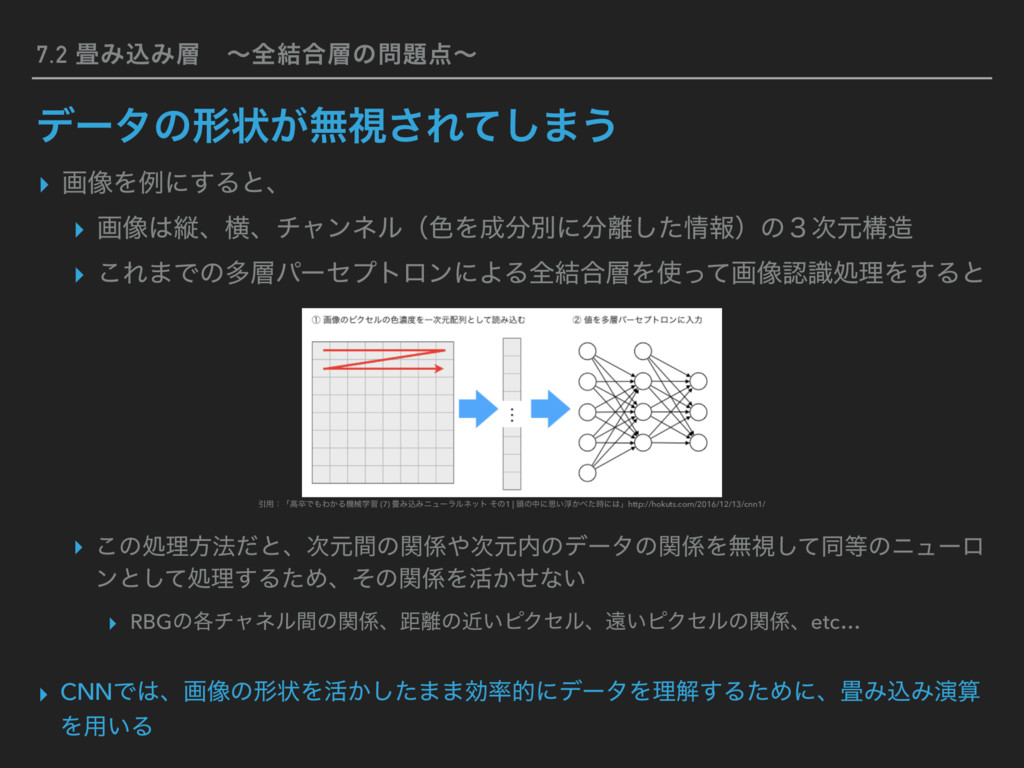
7.2 ΈࠐΈɹʙશ݁߹ͷʙ σʔλͷܗঢ়͕ແࢹ͞Εͯ͠·͏ ▸ ը૾Λྫʹ͢Δͱɺ ▸ ը૾ॎɺԣɺνϟϯωϧʢ৭Λผʹͨ͠ใʣͷ̏࣍ݩߏ ▸ ͜Ε·ͰͷଟύʔηϓτϩϯʹΑΔશ݁߹Λͬͯը૾ೝࣝॲཧΛ͢Δͱ ▸
͜ͷॲཧํ๏ͩͱɺ࣍ݩؒͷؔ࣍ݩͷσʔλͷؔΛແࢹͯ͠ಉͷχϡʔϩ ϯͱͯ͠ॲཧ͢ΔͨΊɺͦͷؔΛ׆͔ͤͳ͍ ▸ RBGͷ֤νϟωϧؒͷؔɺڑͷ͍ۙϐΫηϧɺԕ͍ϐΫηϧͷؔɺetc… ▸ CNNͰɺը૾ͷܗঢ়Λ׆͔ͨ͠··ޮతʹσʔλΛཧղ͢ΔͨΊʹɺΈࠐΈԋࢉ Λ༻͍Δ Ҿ༻ɿʮߴଔͰΘ͔Δػցֶश (7) ΈࠐΈχϡʔϥϧωοτ ͦͷ1 | ಄ͷதʹࢥ͍ු͔ͨ࣌ʹʯhttp://hokuts.com/2016/12/13/cnn1/ -
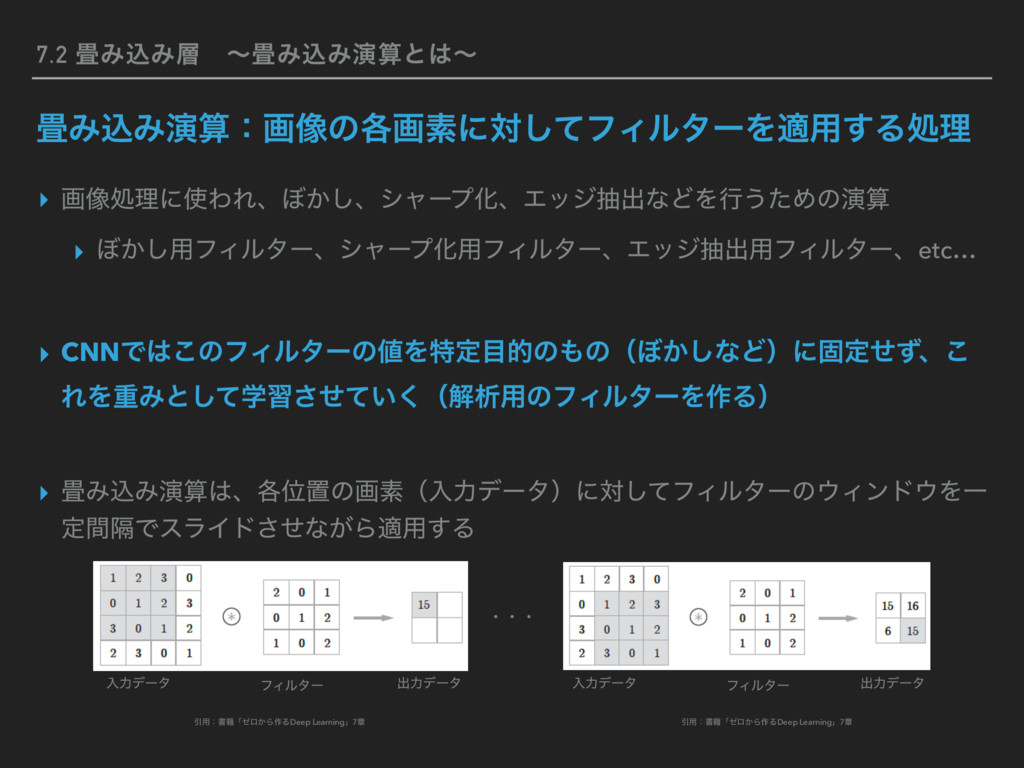
7.2 ΈࠐΈɹʙΈࠐΈԋࢉͱʙ ΈࠐΈԋࢉɿը૾ͷ֤ըૉʹରͯ͠ϑΟϧλʔΛద༻͢Δॲཧ ▸ ը૾ॲཧʹΘΕɺ΅͔͠ɺγϟʔϓԽɺΤοδநग़ͳͲΛߦ͏ͨΊͷԋࢉ ▸ ΅͔͠༻ϑΟϧλʔɺγϟʔϓԽ༻ϑΟϧλʔɺΤοδநग़༻ϑΟϧλʔɺetc… ▸ CNNͰ͜ͷϑΟϧλʔͷΛಛఆతͷͷʢ΅͔͠ͳͲʣʹݻఆͤͣɺ͜ ΕΛॏΈͱֶͯ͠श͍ͤͯ͘͞ʢղੳ༻ͷϑΟϧλʔΛ࡞Δʣ
▸ ΈࠐΈԋࢉɺ֤Ґஔͷըૉʢೖྗσʔλʣʹରͯ͠ϑΟϧλʔͷΟϯυΛҰ ఆִؒͰεϥΠυͤ͞ͳ͕Βద༻͢Δ ɾɾɾ ೖྗσʔλ ϑΟϧλʔ ग़ྗσʔλ ೖྗσʔλ ϑΟϧλʔ ग़ྗσʔλ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
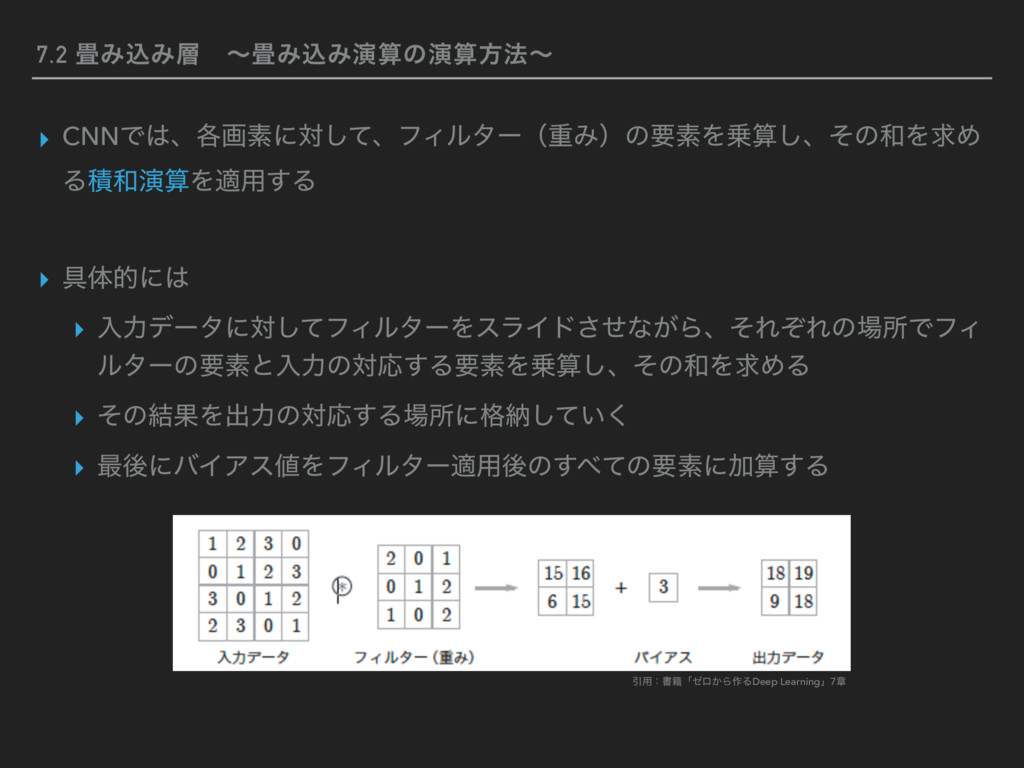
7.2 ΈࠐΈɹʙΈࠐΈԋࢉͷԋࢉํ๏ʙ ▸ CNNͰɺ֤ըૉʹରͯ͠ɺϑΟϧλʔʢॏΈʣͷཁૉΛࢉ͠ɺͦͷΛٻΊ ΔੵԋࢉΛద༻͢Δ ▸ ۩ମతʹ ▸ ೖྗσʔλʹରͯ͠ϑΟϧλʔΛεϥΠυͤ͞ͳ͕ΒɺͦΕͧΕͷॴͰϑΟ ϧλʔͷཁૉͱೖྗͷରԠ͢ΔཁૉΛࢉ͠ɺͦͷΛٻΊΔ
▸ ͦͷ݁ՌΛग़ྗͷରԠ͢Δॴʹ֨ೲ͍ͯ͘͠ ▸ ࠷ޙʹόΠΞεΛϑΟϧλʔద༻ޙͷͯ͢ͷཁૉʹՃࢉ͢Δ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
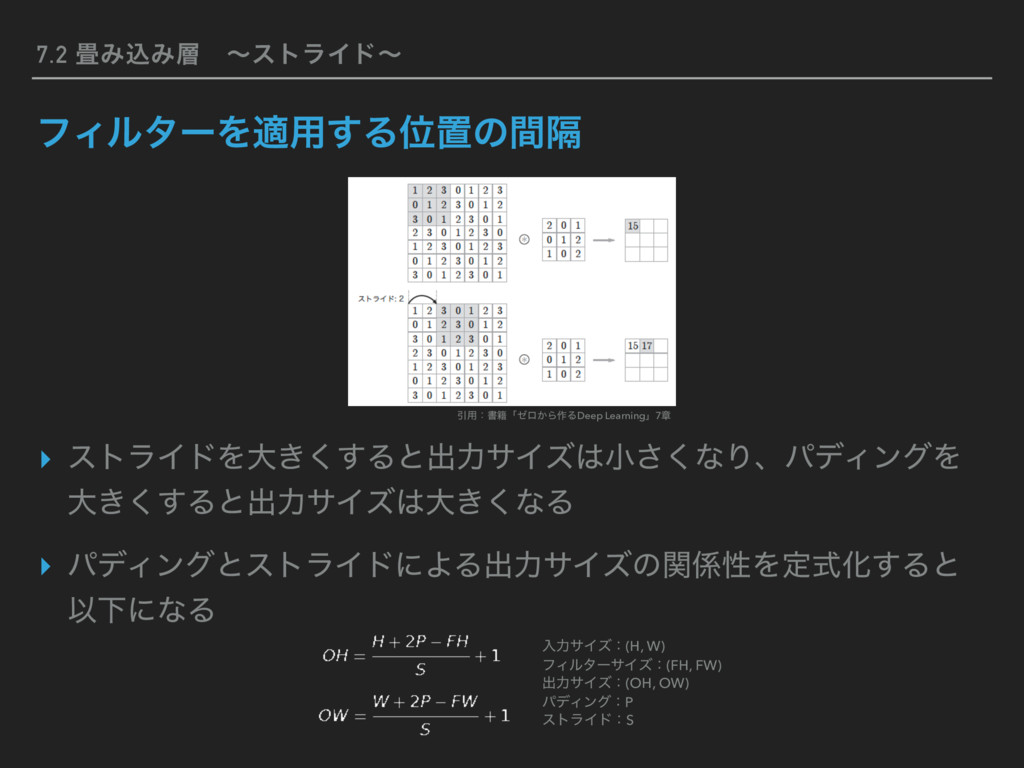
7.2 ΈࠐΈɹʙετϥΠυʙ ϑΟϧλʔΛద༻͢ΔҐஔͷִؒ ▸ ετϥΠυΛେ͖͘͢Δͱग़ྗαΠζখ͘͞ͳΓɺύσΟϯάΛ େ͖͘͢Δͱग़ྗαΠζେ͖͘ͳΔ ▸ ύσΟϯάͱετϥΠυʹΑΔग़ྗαΠζͷؔੑΛఆࣜԽ͢Δͱ ҎԼʹͳΔ ೖྗαΠζɿ(H,
W) ϑΟϧλʔαΠζɿ(FH, FW) ग़ྗαΠζɿ(OH, OW) ύσΟϯάɿP ετϥΠυɿS Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
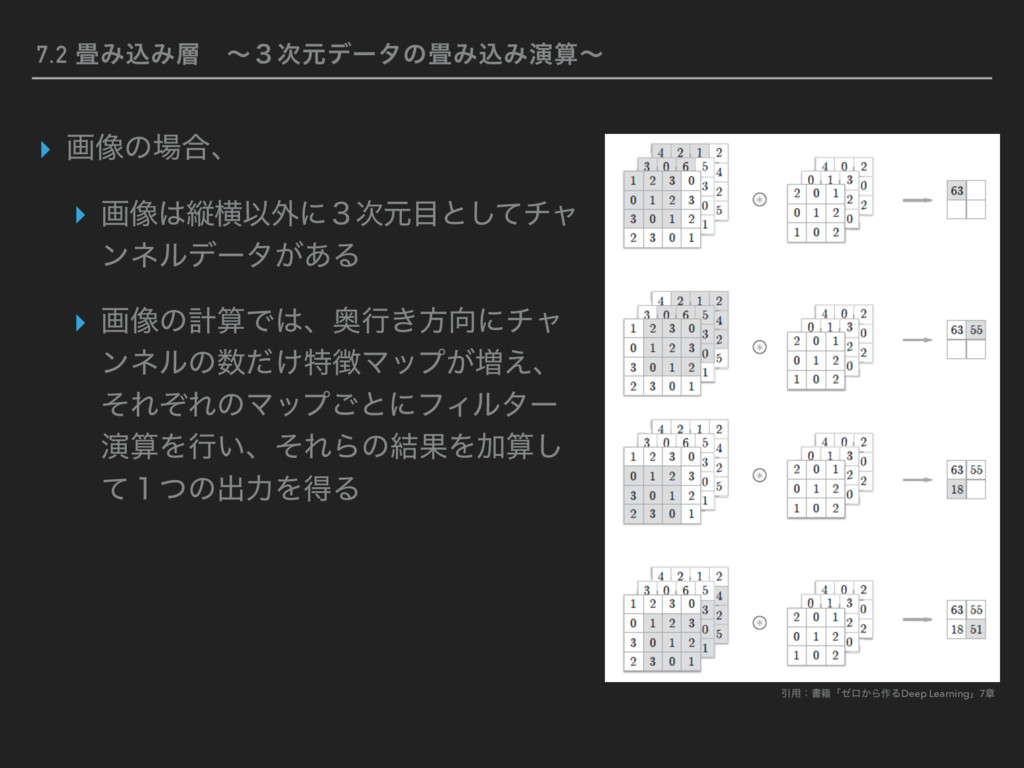
7.2 ΈࠐΈɹʙ̏࣍ݩσʔλͷΈࠐΈԋࢉʙ ▸ ը૾ͷ߹ɺ ▸ ը૾ॎԣҎ֎ʹ̏࣍ݩͱͯ͠νϟ ϯωϧσʔλ͕͋Δ ▸ ը૾ͷܭࢉͰɺԞߦ͖ํʹνϟ ϯωϧͷ͚ͩಛϚοϓ͕૿͑ɺ
ͦΕͧΕͷϚοϓ͝ͱʹϑΟϧλʔ ԋࢉΛߦ͍ɺͦΕΒͷ݁ՌΛՃࢉ͠ ͯ̍ͭͷग़ྗΛಘΔ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
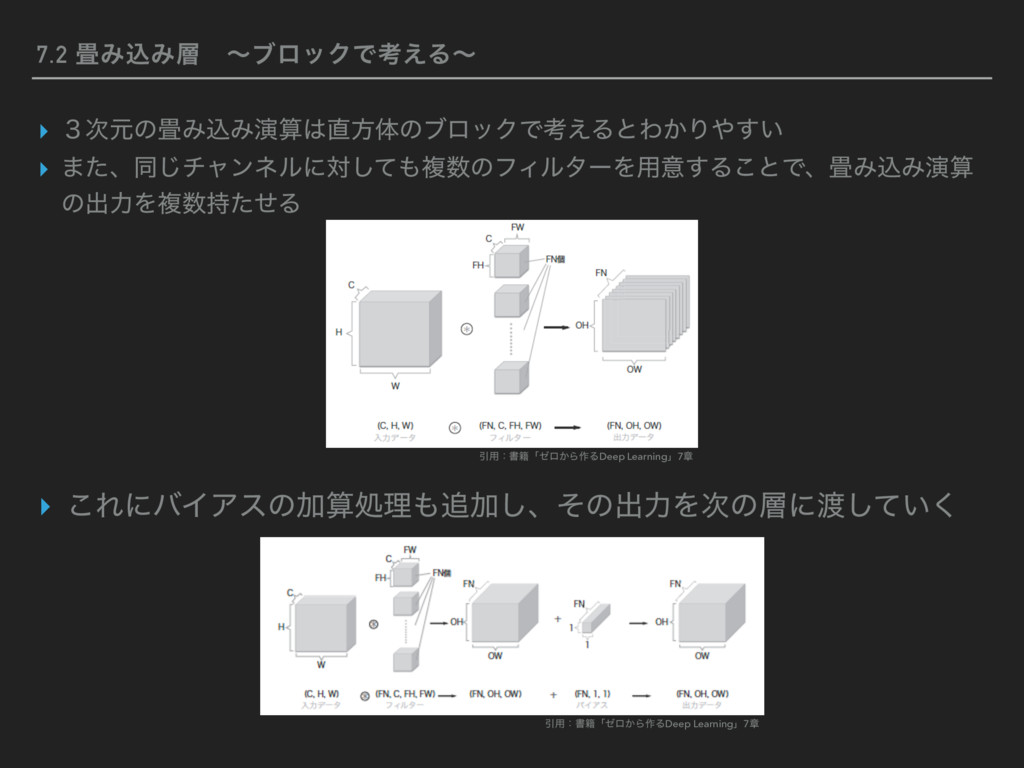
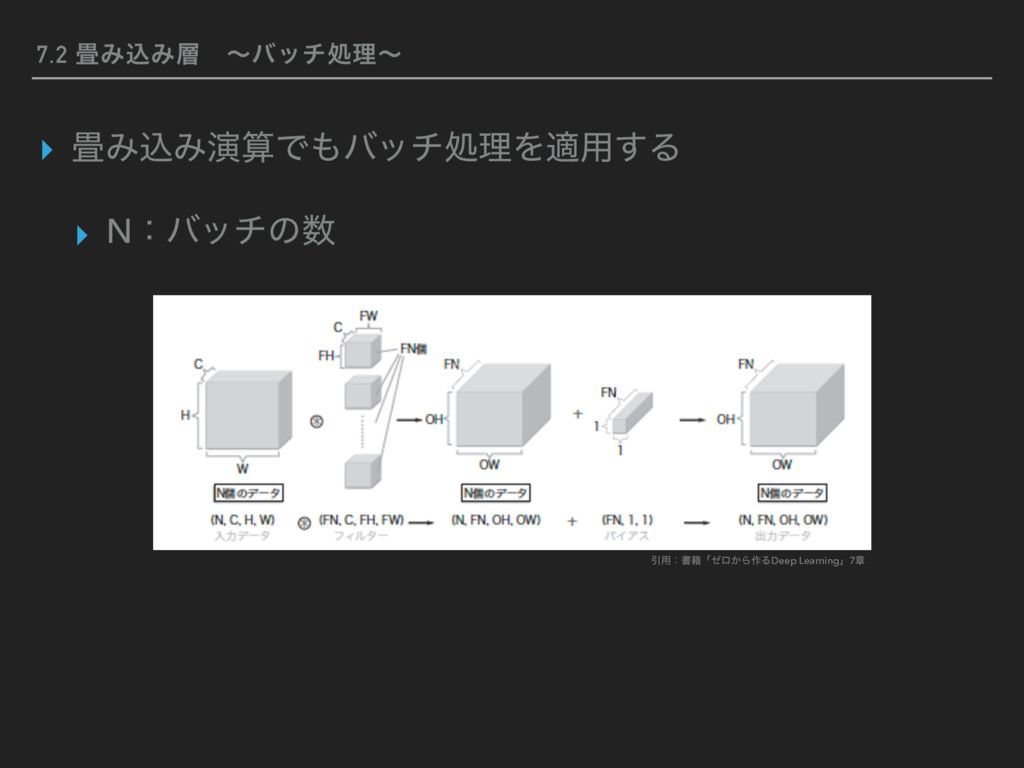
7.2 ΈࠐΈɹʙϒϩοΫͰߟ͑Δʙ ▸ ̏࣍ݩͷΈࠐΈԋࢉํମͷϒϩοΫͰߟ͑ΔͱΘ͔Γ͍͢ ▸ ·ͨɺಉ͡νϟϯωϧʹରͯ͠ෳͷϑΟϧλʔΛ༻ҙ͢Δ͜ͱͰɺΈࠐΈԋࢉ ͷग़ྗΛෳ࣋ͨͤΔ ▸ ͜ΕʹόΠΞεͷՃࢉॲཧՃ͠ɺͦͷग़ྗΛ࣍ͷʹ͍ͯ͘͠ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep
Learningʯ7ষ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
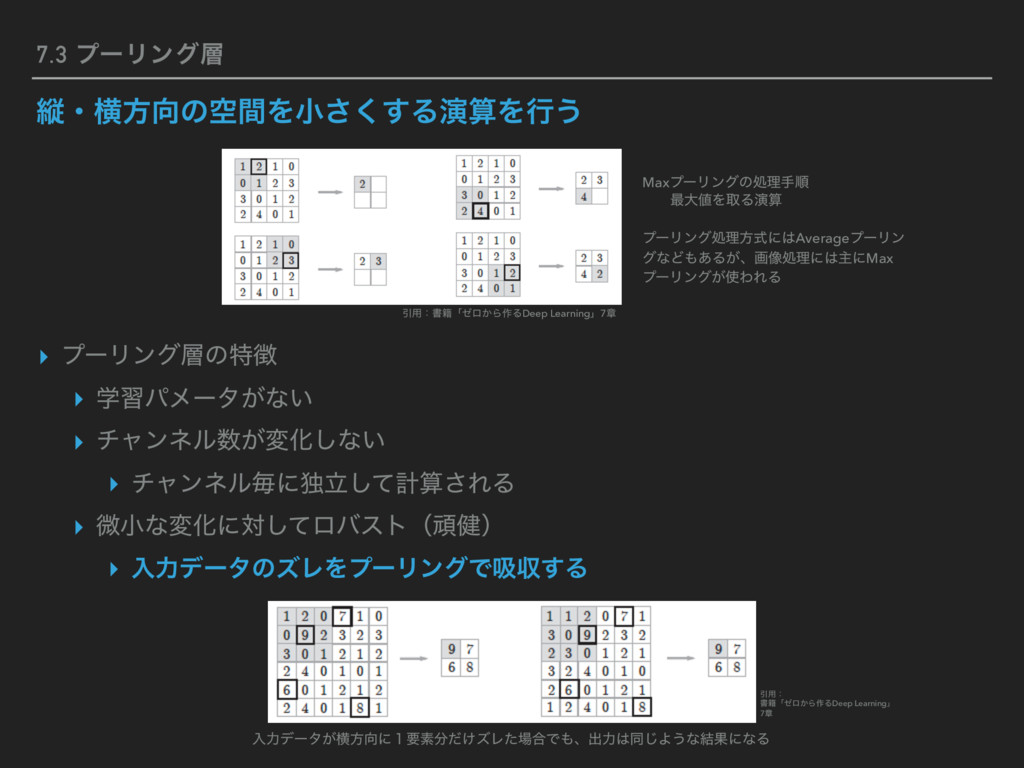
7.3 ϓʔϦϯά ॎɾԣํͷۭؒΛখ͘͢͞ΔԋࢉΛߦ͏ ▸ ϓʔϦϯάͷಛ ▸ ֶशύϝʔλ͕ͳ͍ ▸ νϟϯωϧ͕มԽ͠ͳ͍ ▸
νϟϯωϧຖʹಠཱͯ͠ܭࢉ͞ΕΔ ▸ ඍখͳมԽʹରͯ͠ϩόετʢؤ݈ʣ ▸ ೖྗσʔλͷζϨΛϓʔϦϯάͰٵऩ͢Δ ೖྗσʔλ͕ԣํʹ̍ཁૉ͚ͩζϨͨ߹Ͱɺग़ྗಉ͡Α͏ͳ݁ՌʹͳΔ MaxϓʔϦϯάͷॲཧखॱ ɹɹ࠷େΛऔΔԋࢉ ϓʔϦϯάॲཧํࣜʹAverageϓʔϦϯ άͳͲ͋Δ͕ɺը૾ॲཧʹओʹMax ϓʔϦϯά͕ΘΕΔ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ Ҿ༻ɿ ॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ 7ষ -
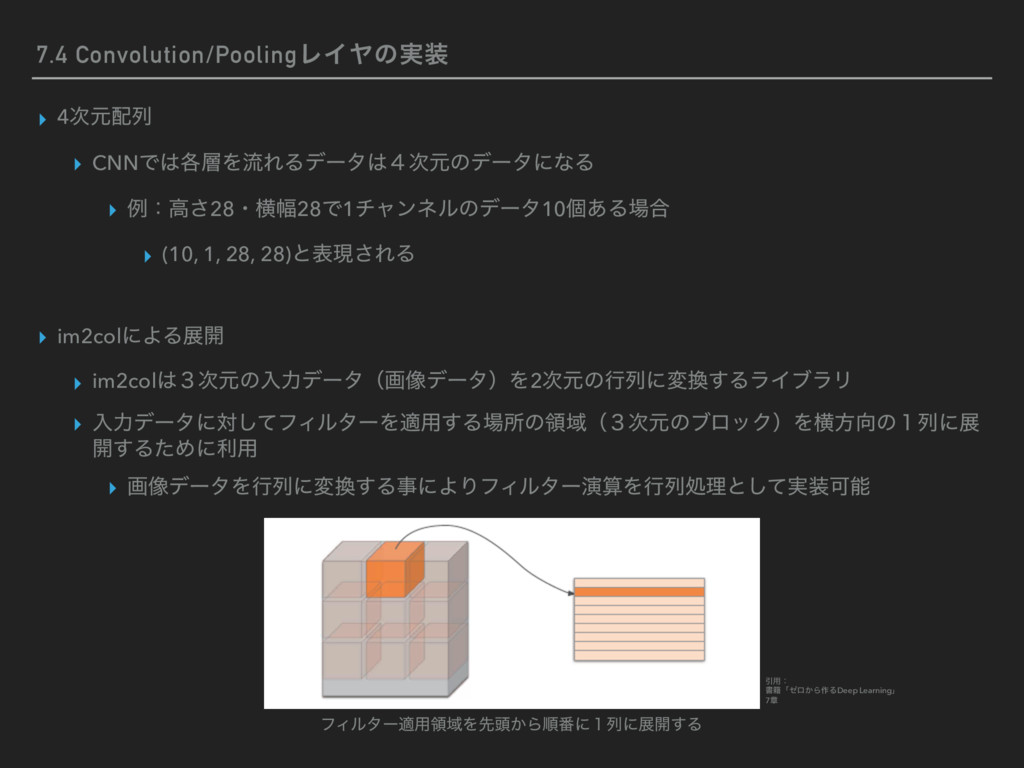
7.4 Convolution/PoolingϨΠϠͷ࣮ ▸ 4࣍ݩྻ ▸ CNNͰ֤ΛྲྀΕΔσʔλ̐࣍ݩͷσʔλʹͳΔ ▸ ྫɿߴ͞28ɾԣ෯28Ͱ1νϟϯωϧͷσʔλ10ݸ͋Δ߹ ▸ (10,
1, 28, 28)ͱදݱ͞ΕΔ ▸ im2colʹΑΔల։ ▸ im2col̏࣍ݩͷೖྗσʔλʢը૾σʔλʣΛ2࣍ݩͷߦྻʹม͢ΔϥΠϒϥϦ ▸ ೖྗσʔλʹରͯ͠ϑΟϧλʔΛద༻͢ΔॴͷྖҬʢ̏࣍ݩͷϒϩοΫʣΛԣํͷ̍ྻʹల ։͢ΔͨΊʹར༻ ▸ ը૾σʔλΛߦྻʹม͢ΔࣄʹΑΓϑΟϧλʔԋࢉΛߦྻॲཧͱ࣮ͯ͠Մೳ ϑΟϧλʔద༻ྖҬΛઌ಄͔Βॱ൪ʹ̍ྻʹల։͢Δ Ҿ༻ɿ ॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ 7ষ -
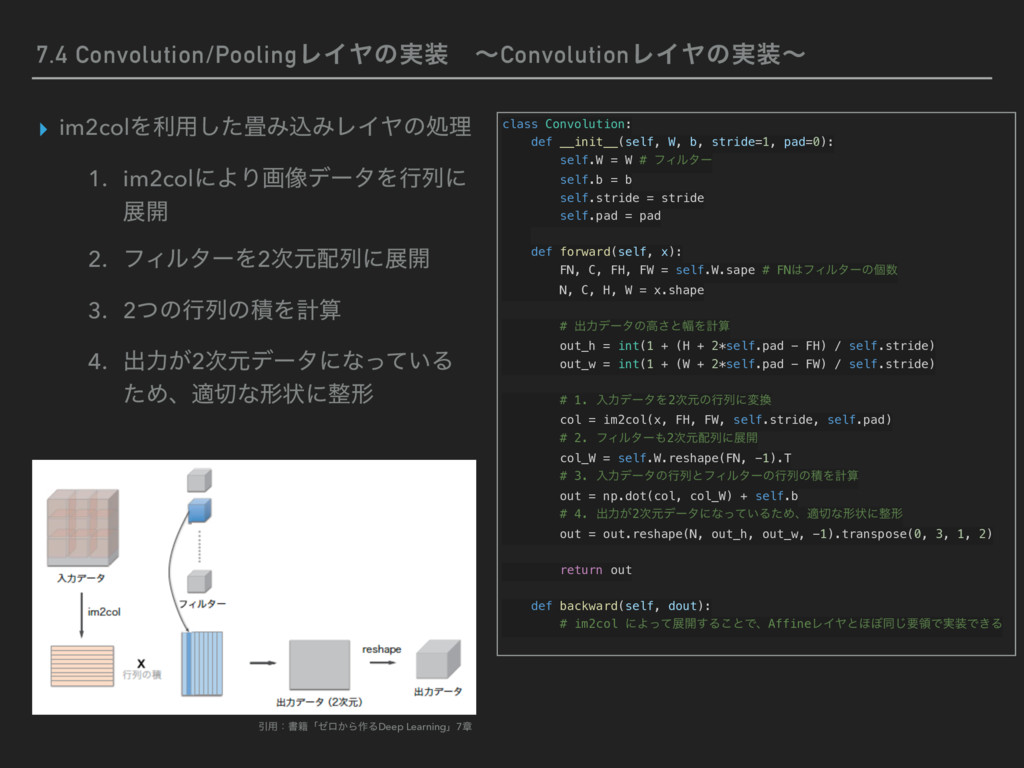
7.4 Convolution/PoolingϨΠϠͷ࣮ɹʙConvolutionϨΠϠͷ࣮ʙ ▸ im2colΛར༻ͨ͠ΈࠐΈϨΠϠͷॲཧ 1. im2colʹΑΓը૾σʔλΛߦྻʹ ల։ 2. ϑΟϧλʔΛ2࣍ݩྻʹల։ 3.
2ͭͷߦྻͷੵΛܭࢉ 4. ग़ྗ͕2࣍ݩσʔλʹͳ͍ͬͯΔ ͨΊɺదͳܗঢ়ʹܗ class Convolution: def __init__(self, W, b, stride=1, pad=0): self.W = W # ϑΟϧλʔ self.b = b self.stride = stride self.pad = pad def forward(self, x): FN, C, FH, FW = self.W.sape # FNϑΟϧλʔͷݸ N, C, H, W = x.shape # ग़ྗσʔλͷߴ͞ͱ෯Λܭࢉ out_h = int(1 + (H + 2*self.pad - FH) / self.stride) out_w = int(1 + (W + 2*self.pad - FW) / self.stride) # 1. ೖྗσʔλΛ2࣍ݩͷߦྻʹม col = im2col(x, FH, FW, self.stride, self.pad) # 2. ϑΟϧλʔ2࣍ݩྻʹల։ col_W = self.W.reshape(FN, -1).T # 3. ೖྗσʔλͷߦྻͱϑΟϧλʔͷߦྻͷੵΛܭࢉ out = np.dot(col, col_W) + self.b # 4. ग़ྗ͕2࣍ݩσʔλʹͳ͍ͬͯΔͨΊɺదͳܗঢ়ʹܗ out = out.reshape(N, out_h, out_w, -1).transpose(0, 3, 1, 2) return out def backward(self, dout): # im2col ʹΑͬͯల։͢Δ͜ͱͰɺAffineϨΠϠͱ΄΅ಉ͡ཁྖͰ࣮Ͱ͖Δ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
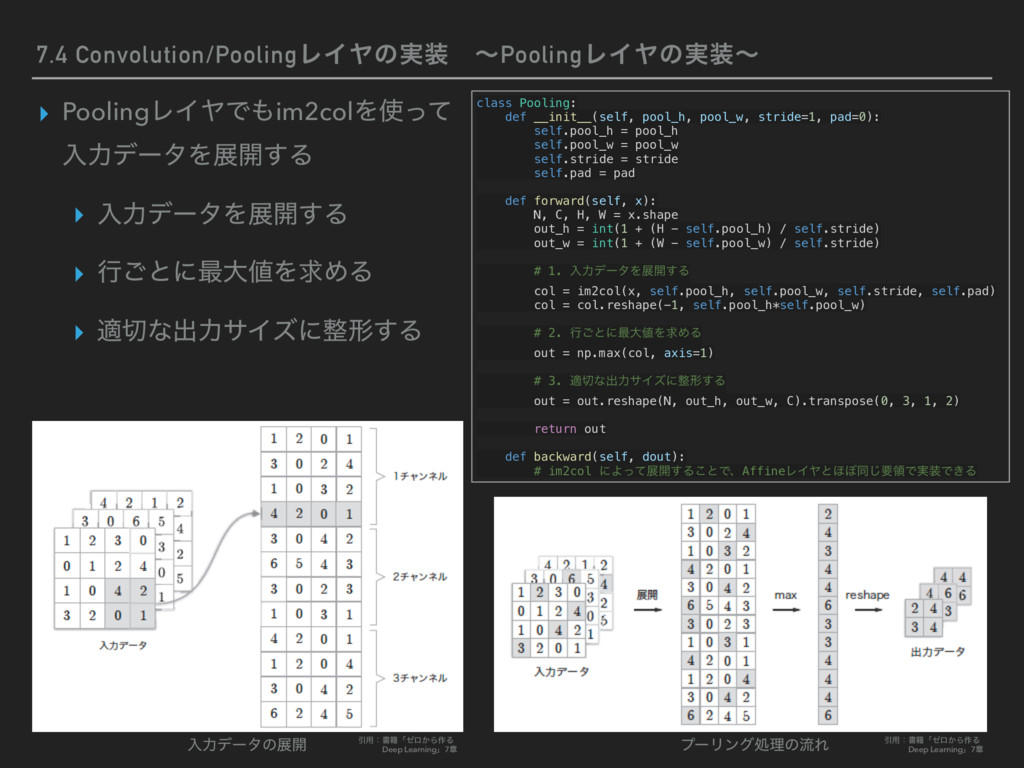
7.4 Convolution/PoolingϨΠϠͷ࣮ɹʙPoolingϨΠϠͷ࣮ʙ ▸ PoolingϨΠϠͰim2colΛͬͯ ೖྗσʔλΛల։͢Δ ▸ ೖྗσʔλΛల։͢Δ ▸ ߦ͝ͱʹ࠷େΛٻΊΔ ▸
దͳग़ྗαΠζʹܗ͢Δ class Pooling: def __init__(self, pool_h, pool_w, stride=1, pad=0): self.pool_h = pool_h self.pool_w = pool_w self.stride = stride self.pad = pad def forward(self, x): N, C, H, W = x.shape out_h = int(1 + (H - self.pool_h) / self.stride) out_w = int(1 + (W - self.pool_w) / self.stride) # 1. ೖྗσʔλΛల։͢Δ col = im2col(x, self.pool_h, self.pool_w, self.stride, self.pad) col = col.reshape(-1, self.pool_h*self.pool_w) # 2. ߦ͝ͱʹ࠷େΛٻΊΔ out = np.max(col, axis=1) # 3. దͳग़ྗαΠζʹܗ͢Δ out = out.reshape(N, out_h, out_w, C).transpose(0, 3, 1, 2) return out def backward(self, dout): # im2col ʹΑͬͯల։͢Δ͜ͱͰɺAffineϨΠϠͱ΄΅ಉ͡ཁྖͰ࣮Ͱ͖Δ ೖྗσʔλͷల։ ϓʔϦϯάॲཧͷྲྀΕ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞Δ ɹɹɹDeep Learningʯ7ষ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞Δ ɹɹɹDeep Learningʯ7ষ -
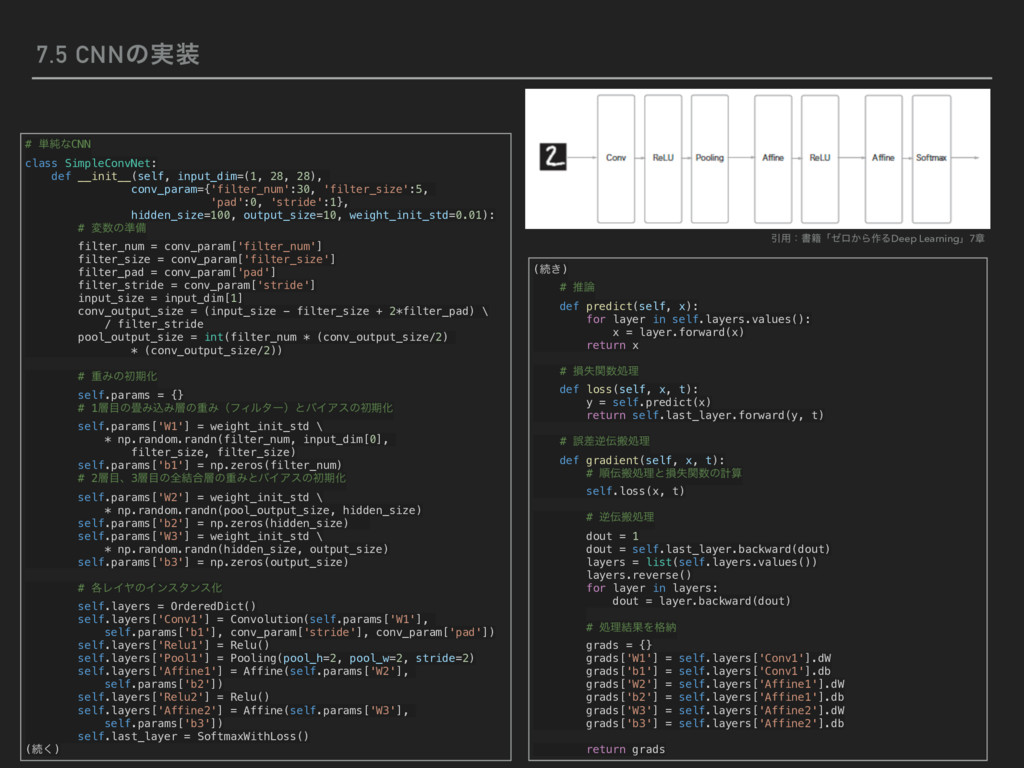
7.5 CNNͷ࣮ # ୯७ͳCNN class SimpleConvNet: def __init__(self, input_dim=(1, 28,
28), conv_param={'filter_num':30, 'filter_size':5, 'pad':0, 'stride':1}, hidden_size=100, output_size=10, weight_init_std=0.01): # มͷ४උ filter_num = conv_param['filter_num'] filter_size = conv_param['filter_size'] filter_pad = conv_param['pad'] filter_stride = conv_param['stride'] input_size = input_dim[1] conv_output_size = (input_size - filter_size + 2*filter_pad) \ / filter_stride pool_output_size = int(filter_num * (conv_output_size/2) * (conv_output_size/2)) # ॏΈͷॳظԽ self.params = {} # 1ͷΈࠐΈͷॏΈʢϑΟϧλʔʣͱόΠΞεͷॳظԽ self.params['W1'] = weight_init_std \ * np.random.randn(filter_num, input_dim[0], filter_size, filter_size) self.params['b1'] = np.zeros(filter_num) # 2ɺ3ͷશ݁߹ͷॏΈͱόΠΞεͷॳظԽ self.params['W2'] = weight_init_std \ * np.random.randn(pool_output_size, hidden_size) self.params['b2'] = np.zeros(hidden_size) self.params['W3'] = weight_init_std \ * np.random.randn(hidden_size, output_size) self.params['b3'] = np.zeros(output_size) # ֤ϨΠϠͷΠϯελϯεԽ self.layers = OrderedDict() self.layers['Conv1'] = Convolution(self.params['W1'], self.params['b1'], conv_param['stride'], conv_param['pad']) self.layers['Relu1'] = Relu() self.layers['Pool1'] = Pooling(pool_h=2, pool_w=2, stride=2) self.layers['Affine1'] = Affine(self.params['W2'], self.params['b2']) self.layers['Relu2'] = Relu() self.layers['Affine2'] = Affine(self.params['W3'], self.params['b3']) self.last_layer = SoftmaxWithLoss() (ଓ͘) (ଓ͖) # ਪ def predict(self, x): for layer in self.layers.values(): x = layer.forward(x) return x # ଛࣦؔॲཧ def loss(self, x, t): y = self.predict(x) return self.last_layer.forward(y, t) # ޡࠩٯൖॲཧ def gradient(self, x, t): # ॱൖॲཧͱଛࣦؔͷܭࢉ self.loss(x, t) # ٯൖॲཧ dout = 1 dout = self.last_layer.backward(dout) layers = list(self.layers.values()) layers.reverse() for layer in layers: dout = layer.backward(dout) # ॲཧ݁ՌΛ֨ೲ grads = {} grads['W1'] = self.layers['Conv1'].dW grads['b1'] = self.layers['Conv1'].db grads['W2'] = self.layers['Affine1'].dW grads['b2'] = self.layers['Affine1'].db grads['W3'] = self.layers['Affine2'].dW grads['b3'] = self.layers['Affine2'].db return grads Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
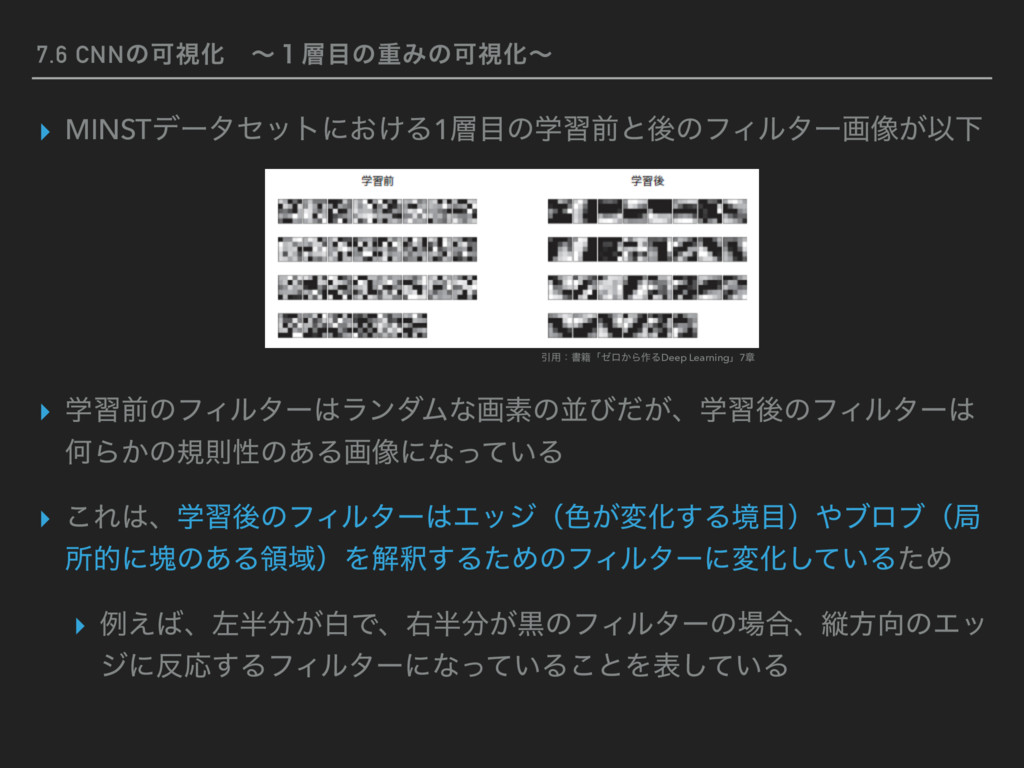
7.6 CNNͷՄࢹԽɹʙ̍ͷॏΈͷՄࢹԽʙ ▸ MINSTσʔληοτʹ͓͚Δ1ͷֶशલͱޙͷϑΟϧλʔը૾͕ҎԼ ▸ ֶशલͷϑΟϧλʔϥϯμϜͳըૉͷฒͼ͕ͩɺֶशޙͷϑΟϧλʔ ԿΒ͔ͷنଇੑͷ͋Δը૾ʹͳ͍ͬͯΔ ▸ ͜ΕɺֶशޙͷϑΟϧλʔΤοδʢ৭͕มԽ͢Δڥʣϒϩϒʢہ ॴతʹմͷ͋ΔྖҬʣΛղऍ͢ΔͨΊͷϑΟϧλʔʹมԽ͍ͯ͠ΔͨΊ
▸ ྫ͑ɺࠨ͕നͰɺӈ͕ࠇͷϑΟϧλʔͷ߹ɺॎํͷΤο δʹԠ͢ΔϑΟϧλʔʹͳ͍ͬͯΔ͜ͱΛද͍ͯ͠Δ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
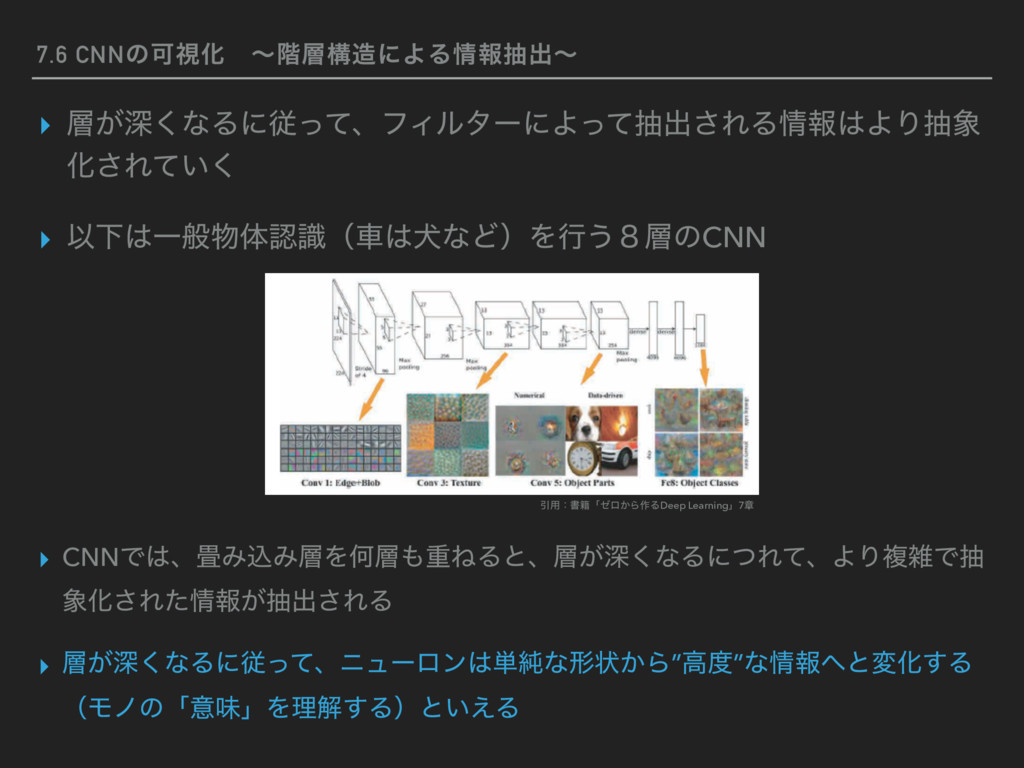
7.6 CNNͷՄࢹԽɹʙ֊ߏʹΑΔใநग़ʙ ▸ ͕ਂ͘ͳΔʹैͬͯɺϑΟϧλʔʹΑͬͯநग़͞ΕΔใΑΓந Խ͞Ε͍ͯ͘ ▸ ҎԼҰൠମೝࣝʢंݘͳͲʣΛߦ͏̔ͷCNN ▸ CNNͰɺΈࠐΈΛԿॏͶΔͱɺ͕ਂ͘ͳΔʹͭΕͯɺΑΓෳࡶͰந Խ͞Εͨใ͕நग़͞ΕΔ
▸ ͕ਂ͘ͳΔʹैͬͯɺχϡʔϩϯ୯७ͳܗঢ়͔Β”ߴ”ͳใͱมԽ͢Δ ʢϞϊͷʮҙຯʯΛཧղ͢Δʣͱ͍͑Δ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
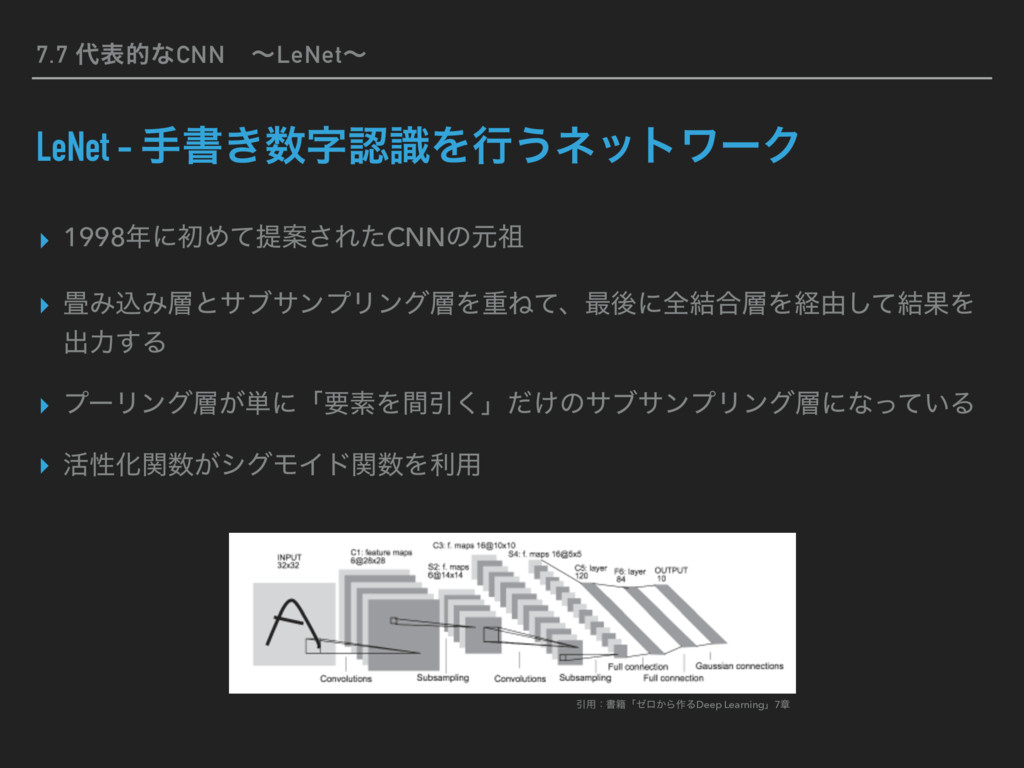
7.7 දతͳCNNɹʙLeNetʙ LeNet - खॻ͖ࣈೝࣝΛߦ͏ωοτϫʔΫ ▸ 1998ʹॳΊͯఏҊ͞ΕͨCNNͷݩ ▸ ΈࠐΈͱαϒαϯϓϦϯάΛॏͶͯɺ࠷ޙʹશ݁߹Λܦ༝ͯ݁͠ՌΛ ग़ྗ͢Δ
▸ ϓʔϦϯά͕୯ʹʮཁૉΛؒҾ͘ʯ͚ͩͷαϒαϯϓϦϯάʹͳ͍ͬͯΔ ▸ ׆ੑԽ͕ؔγάϞΠυؔΛར༻ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
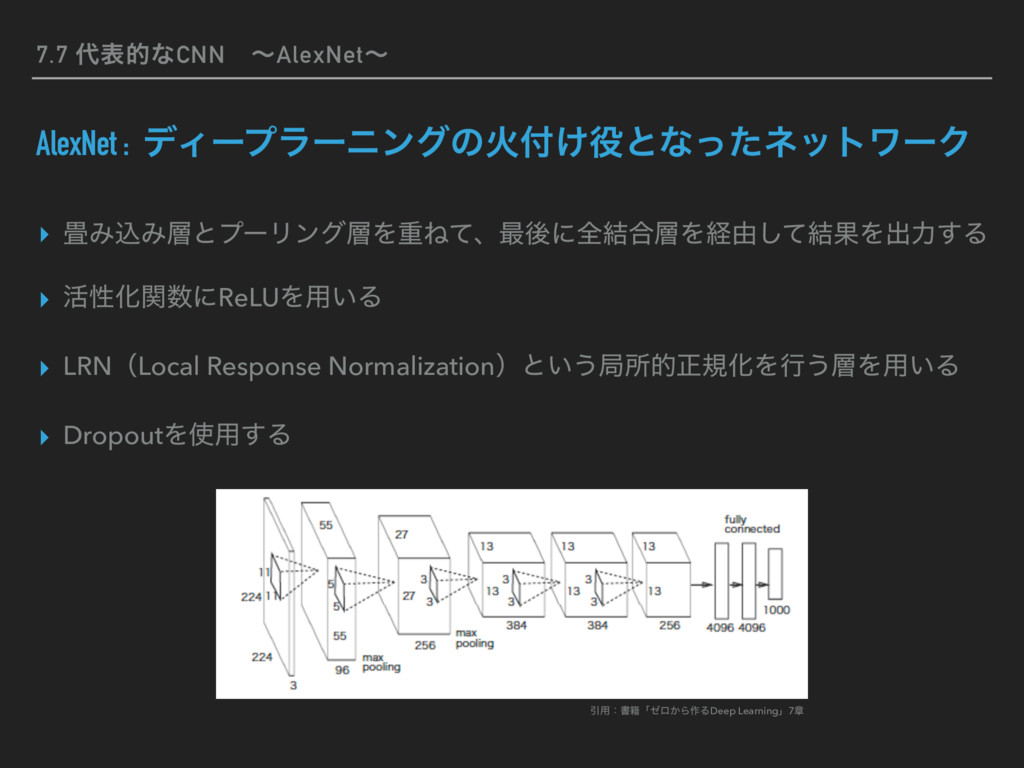
7.7 දతͳCNNɹʙAlexNetʙ AlexNet : σΟʔϓϥʔχϯάͷՐ͚ͱͳͬͨωοτϫʔΫ ▸ ΈࠐΈͱϓʔϦϯάΛॏͶͯɺ࠷ޙʹશ݁߹Λܦ༝ͯ݁͠ՌΛग़ྗ͢Δ ▸ ׆ੑԽؔʹReLUΛ༻͍Δ ▸
LRNʢLocal Response Normalizationʣͱ͍͏ہॴతਖ਼نԽΛߦ͏Λ༻͍Δ ▸ DropoutΛ༻͢Δ Ҿ༻ɿॻ੶ʮθϩ͔Β࡞ΔDeep Learningʯ7ষ -
ࢀߟจݙ 1. θϩ͔Β࡞ΔDeep LearningʙPythonͰֶͿσΟʔϓϥʔχϯάͷཧͱ࣮ʙ ࡈ౻ ߁ؽ ஶʗO’REILLY ΦϥΠϦʔɾδϟύϯ https://www.oreilly.co.jp/books/9784873117584/ 2.
ը૾σʔλͷجຊతͳߏ ʔ NEAREAL http://neareal.com/470/ 3. νϟϯωϧͱ | GIMPೖ(2.8൛) http://www.gimp.jp.net/knowledge_channels_overview.html 4. ߴଔͰΘ͔Δػցֶश (7) ΈࠐΈχϡʔϥϧωοτ ͦͷ1 | ಄ͷதʹࢥ͍ු͔ͨ࣌ʹ http://hokuts.com/2016/12/13/cnn1/