Share
Embed
ゼロから作るDeep Learning読書会 4章 ニューラルネットワークの学習
「4章 ニューラルネットワークの学習」の内容をまとめました

Takuya Kitamura
August 06, 2017
Transcript
17 slides
-
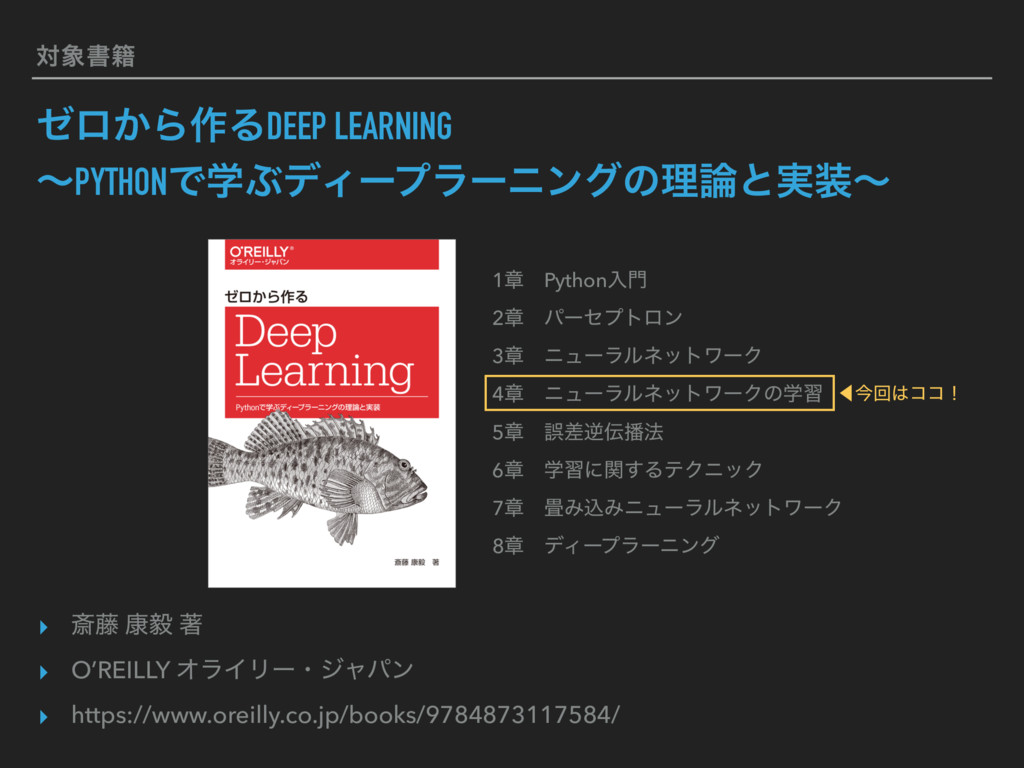
ରॻ੶ θϩ͔Β࡞ΔDEEP LEARNING ʙPYTHONͰֶͿσΟʔϓϥʔχϯάͷཧͱ࣮ʙ ▸ ࡈ౻ ߁ؽ ஶ ▸ O’REILLY
ΦϥΠϦʔɾδϟύϯ ▸ https://www.oreilly.co.jp/books/9784873117584/ 1ষɹPythonೖ 2ষɹύʔηϓτϩϯ 3ষɹχϡʔϥϧωοτϫʔΫ 4ষɹχϡʔϥϧωοτϫʔΫͷֶश 5ষɹޡࠩٯ๏ 6ষɹֶशʹؔ͢ΔςΫχοΫ 7ষɹΈࠐΈχϡʔϥϧωοτϫʔΫ 8ষɹσΟʔϓϥʔχϯά ⾢ࠓճίίʂ -
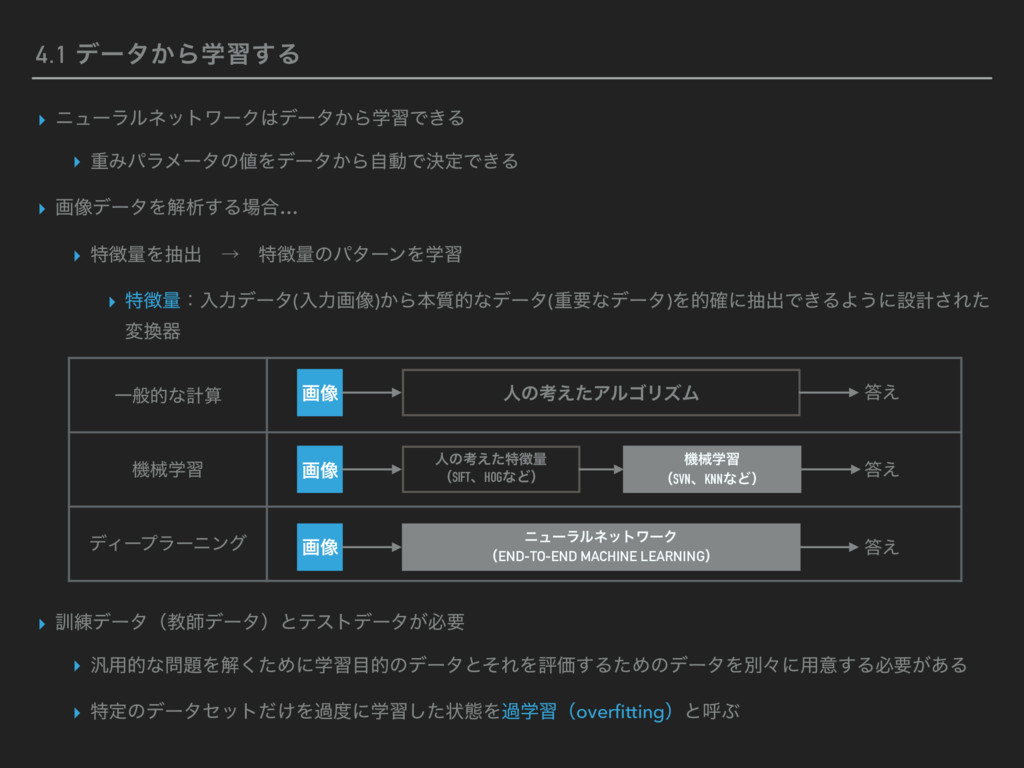
4.1 σʔλ͔Βֶश͢Δ ▸ χϡʔϥϧωοτϫʔΫσʔλ͔ΒֶशͰ͖Δ ▸ ॏΈύϥϝʔλͷΛσʔλ͔ΒࣗಈͰܾఆͰ͖Δ ▸ ը૾σʔλΛղੳ͢Δ߹… ▸ ಛྔΛநग़ɹˠɹಛྔͷύλʔϯΛֶश
▸ ಛྔɿೖྗσʔλ(ೖྗը૾)͔Βຊ࣭తͳσʔλ(ॏཁͳσʔλ)Λత֬ʹநग़Ͱ͖ΔΑ͏ʹઃܭ͞Εͨ มث ▸ ܇࿅σʔλʢڭࢣσʔλʣͱςετσʔλ͕ඞཁ ▸ ൚༻తͳΛղͨ͘ΊʹֶशతͷσʔλͱͦΕΛධՁ͢ΔͨΊͷσʔλΛผʑʹ༻ҙ͢Δඞཁ͕͋Δ ▸ ಛఆͷσʔληοτ͚ͩΛաʹֶशͨ͠ঢ়ଶΛաֶशʢoverfittingʣͱݺͿ Ұൠతͳܭࢉ ػցֶश σΟʔϓϥʔχϯά ը૾ ը૾ ը૾ ਓͷߟ͑ͨΞϧΰϦζϜ ਓͷߟ͑ͨಛྔ ʢSIFTɺHOGͳͲʣ ػցֶश ʢSVNɺKNNͳͲʣ χϡʔϥϧωοτϫʔΫ ʢEND-TO-END MACHINE LEARNINGʣ ͑ ͑ ͑ -
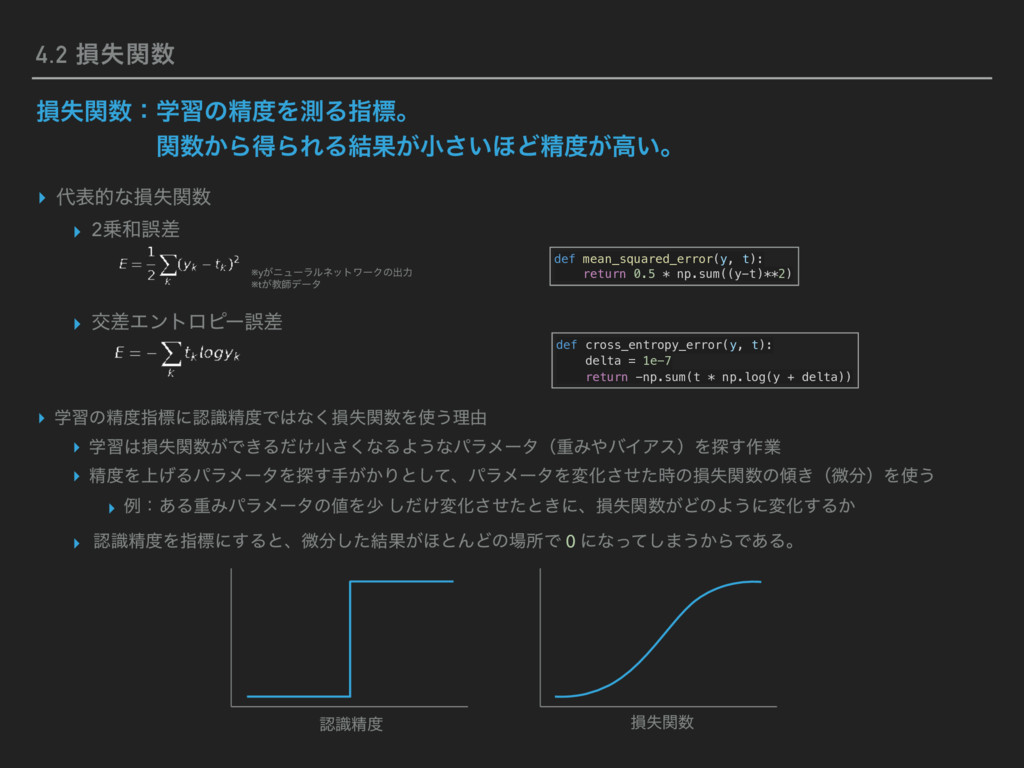
▸ දతͳଛࣦؔ ▸ 2ޡࠩ ▸ ަࠩΤϯτϩϐʔޡࠩ ଛࣦؔɿֶशͷਫ਼ΛଌΔࢦඪɻ ɹɹɹɹɹ͔ؔΒಘΒΕΔ݁Ռ͕খ͍͞΄Ͳਫ਼͕ߴ͍ɻ 4.2 ଛࣦؔ
def mean_squared_error(y, t): return 0.5 * np.sum((y-t)**2) def cross_entropy_error(y, t): delta = 1e-7 return -np.sum(t * np.log(y + delta)) ※y͕χϡʔϥϧωοτϫʔΫͷग़ྗ ※t͕ڭࢣσʔλ ▸ ֶशͷਫ਼ࢦඪʹೝࣝਫ਼Ͱͳ͘ଛࣦؔΛ͏ཧ༝ ▸ ֶशଛࣦ͕ؔͰ͖Δ͚ͩখ͘͞ͳΔΑ͏ͳύϥϝʔλʢॏΈόΠΞεʣΛ୳͢࡞ۀ ▸ ਫ਼Λ্͛ΔύϥϝʔλΛ୳͢ख͕͔Γͱͯ͠ɺύϥϝʔλΛมԽͤͨ࣌͞ͷଛࣦؔͷ͖ʢඍʣΛ͏ ▸ ྫɿ͋ΔॏΈύϥϝʔλͷΛগ ͚ͩ͠มԽͤͨ͞ͱ͖ʹɺଛࣦ͕ؔͲͷΑ͏ʹมԽ͢Δ͔ ▸ ೝࣝਫ਼Λࢦඪʹ͢Δͱɺඍͨ݁͠Ռ͕΄ͱΜͲͷॴͰ 0 ʹͳͬͯ͠·͏͔ΒͰ͋Δɻ ଛࣦؔ ೝࣝਫ਼ -
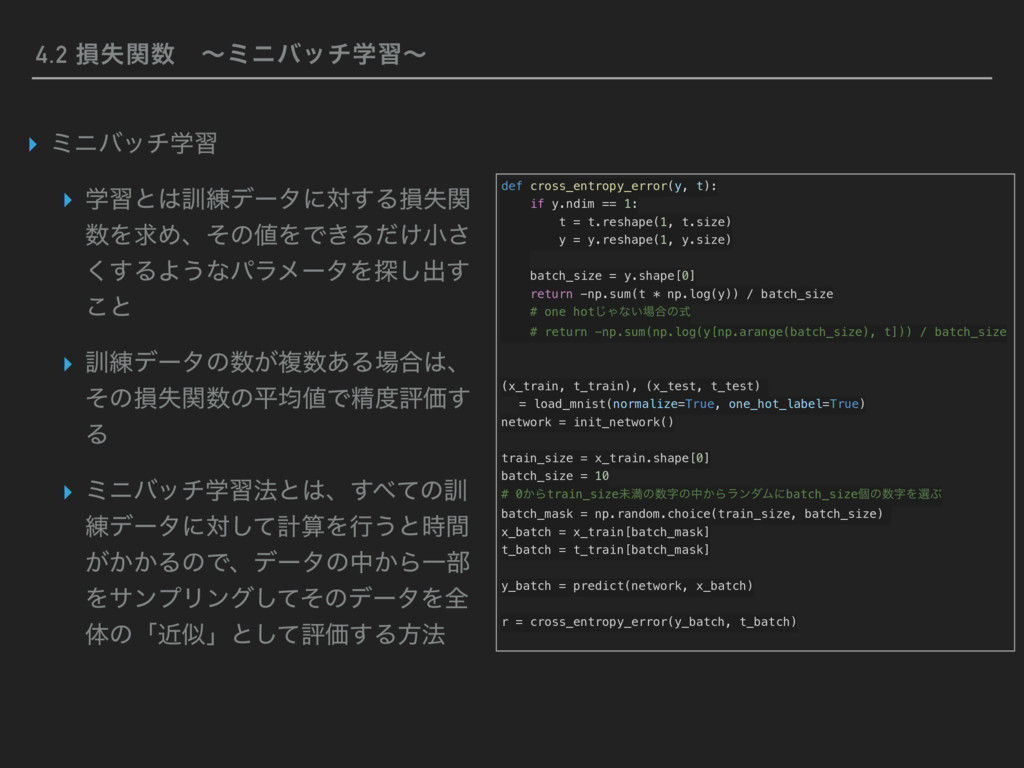
4.2 ଛࣦؔɹʙϛχόονֶशʙ ▸ ϛχόονֶश ▸ ֶशͱ܇࿅σʔλʹର͢Δଛࣦؔ ΛٻΊɺͦͷΛͰ͖Δ͚ͩখ͞ ͘͢ΔΑ͏ͳύϥϝʔλΛ୳͠ग़͢ ͜ͱ ▸
܇࿅σʔλͷ͕ෳ͋Δ߹ɺ ͦͷଛࣦؔͷฏۉͰਫ਼ධՁ͢ Δ ▸ ϛχόονֶश๏ͱɺͯ͢ͷ܇ ࿅σʔλʹରͯ͠ܭࢉΛߦ͏ͱ࣌ؒ ͕͔͔ΔͷͰɺσʔλͷத͔ΒҰ෦ ΛαϯϓϦϯάͯͦ͠ͷσʔλΛશ ମͷʮۙࣅʯͱͯ͠ධՁ͢Δํ๏ def cross_entropy_error(y, t): if y.ndim == 1: t = t.reshape(1, t.size) y = y.reshape(1, y.size) batch_size = y.shape[0] return -np.sum(t * np.log(y)) / batch_size # one hot͡Όͳ͍߹ͷࣜ # return -np.sum(np.log(y[np.arange(batch_size), t])) / batch_size (x_train, t_train), (x_test, t_test) = load_mnist(normalize=True, one_hot_label=True) network = init_network() train_size = x_train.shape[0] batch_size = 10 # 0͔Βtrain_sizeະຬͷࣈͷத͔ΒϥϯμϜʹbatch_sizeݸͷࣈΛબͿ batch_mask = np.random.choice(train_size, batch_size) x_batch = x_train[batch_mask] t_batch = t_train[batch_mask] y_batch = predict(network, x_batch) r = cross_entropy_error(y_batch, t_batch) -
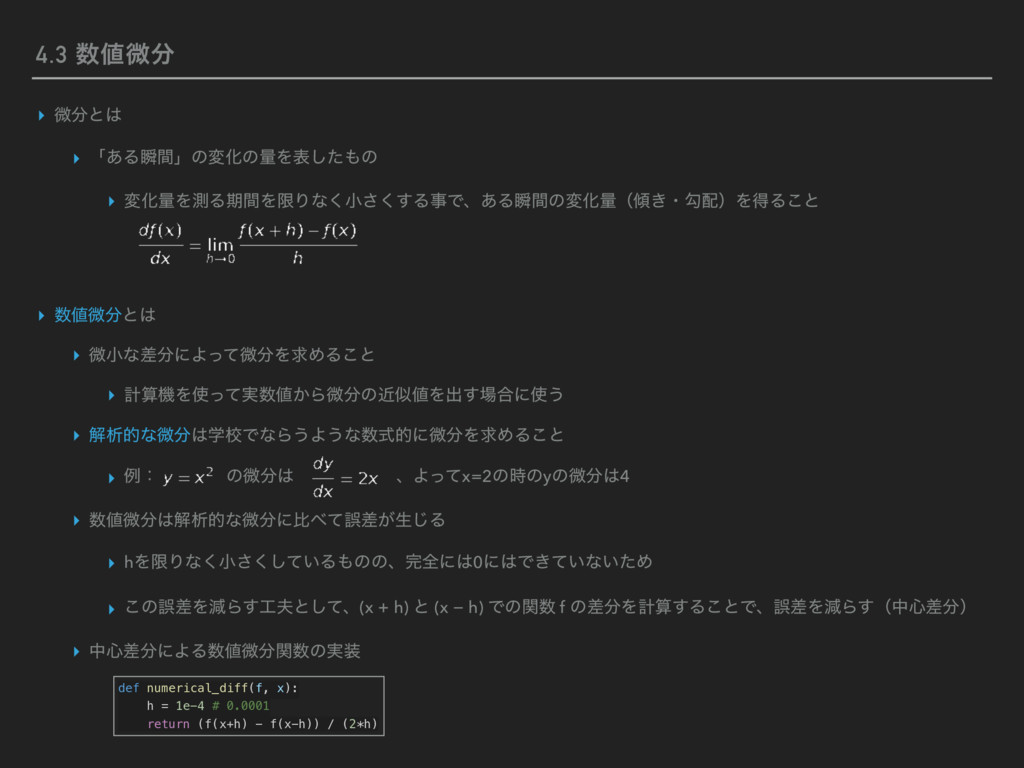
4.3 ඍ ▸ ඍͱ ▸ ʮ͋ΔॠؒʯͷมԽͷྔΛදͨ͠ͷ ▸ มԽྔΛଌΔظؒΛݶΓͳ͘খ͘͢͞ΔࣄͰɺ͋ΔॠؒͷมԽྔʢ͖ɾޯʣΛಘΔ͜ͱ ▸ ඍͱ
▸ ඍখͳࠩʹΑͬͯඍΛٻΊΔ͜ͱ ▸ ܭࢉػΛ࣮͔ͬͯΒඍͷۙࣅΛग़͢߹ʹ͏ ▸ ղੳతͳඍֶߍͰͳΒ͏Α͏ͳࣜతʹඍΛٻΊΔ͜ͱ ▸ ྫɿɹɹɹɹͷඍɹɹɹɹɹɹɺΑͬͯx=2ͷ࣌ͷyͷඍ4 ▸ ඍղੳతͳඍʹൺͯޡ͕ࠩੜ͡Δ ▸ hΛݶΓͳ͘খ͍ͯ͘͞͠Δͷͷɺશʹ0ʹͰ͖͍ͯͳ͍ͨΊ ▸ ͜ͷޡࠩΛݮΒ͢ͱͯ͠ɺ(x + h) ͱ (x − h) Ͱͷؔ f ͷࠩΛܭࢉ͢Δ͜ͱͰɺޡࠩΛݮΒ͢ʢத৺ࠩʣ ▸ த৺ࠩʹΑΔඍؔͷ࣮ def numerical_diff(f, x): h = 1e-4 # 0.0001 return (f(x+h) - f(x-h)) / (2*h) -
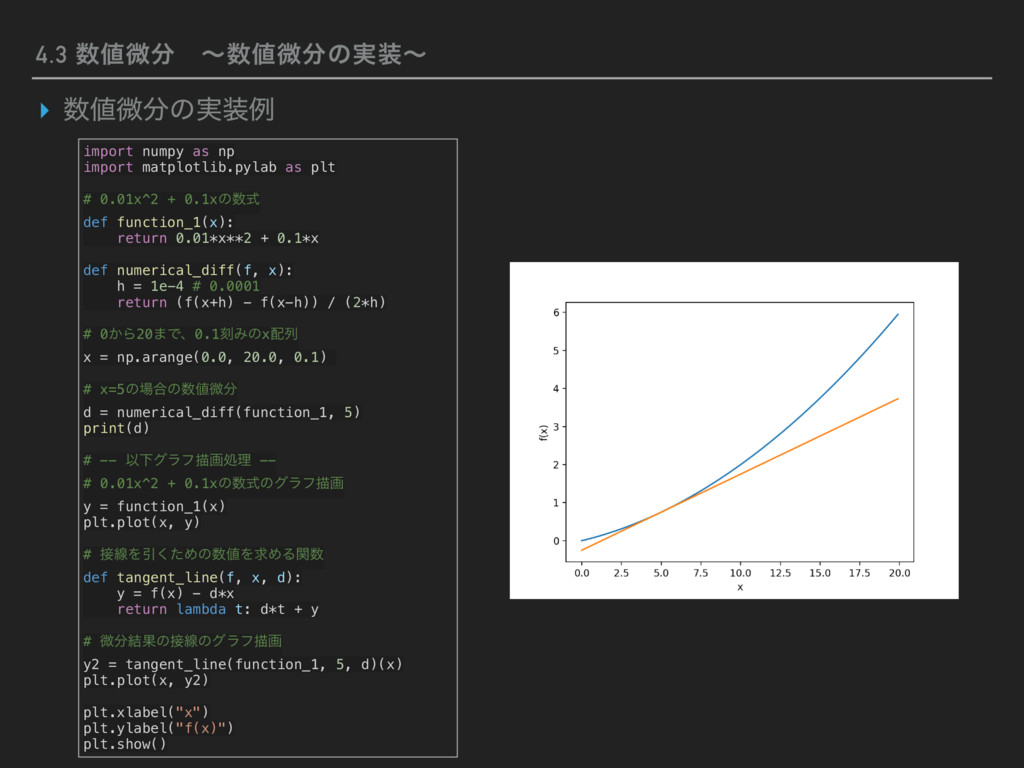
4.3 ඍɹʙඍͷ࣮ʙ ▸ ඍͷ࣮ྫ import numpy as np import matplotlib.pylab
as plt # 0.01x^2 + 0.1xͷࣜ def function_1(x): return 0.01*x**2 + 0.1*x def numerical_diff(f, x): h = 1e-4 # 0.0001 return (f(x+h) - f(x-h)) / (2*h) # 0͔Β20·Ͱɺ0.1ࠁΈͷxྻ x = np.arange(0.0, 20.0, 0.1) # x=5ͷ߹ͷඍ d = numerical_diff(function_1, 5) print(d) # -- ҎԼάϥϑඳըॲཧ -- # 0.01x^2 + 0.1xͷࣜͷάϥϑඳը y = function_1(x) plt.plot(x, y) # ઢΛҾͨ͘ΊͷΛٻΊΔؔ def tangent_line(f, x, d): y = f(x) - d*x return lambda t: d*t + y # ඍ݁Ռͷઢͷάϥϑඳը y2 = tangent_line(function_1, 5, d)(x) plt.plot(x, y2) plt.xlabel("x") plt.ylabel("f(x)") plt.show() -
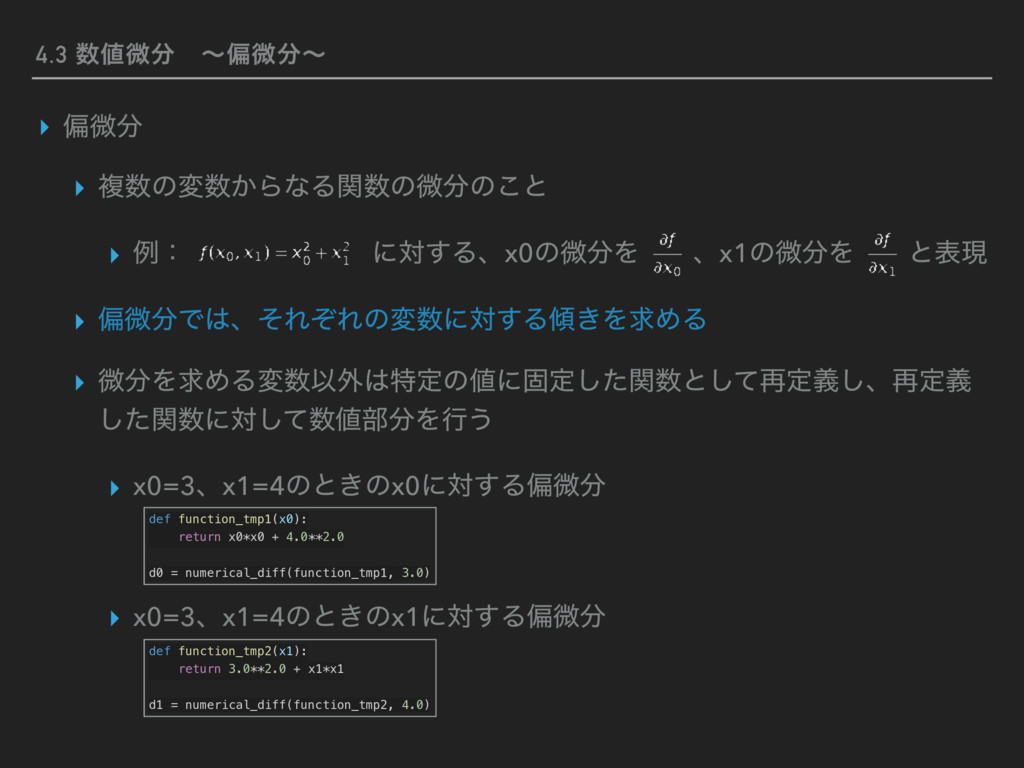
4.3 ඍɹʙภඍʙ ▸ ภඍ ▸ ෳͷม͔ΒͳΔؔͷඍͷ͜ͱ ▸ ྫɿɹɹɹɹɹɹɹʹର͢Δɺx0ͷඍΛɹɹɺx1ͷඍΛɹɹͱදݱ ▸ ภඍͰɺͦΕͧΕͷมʹର͢Δ͖ΛٻΊΔ
▸ ඍΛٻΊΔมҎ֎ಛఆͷʹݻఆͨؔ͠ͱͯ͠࠶ఆٛ͠ɺ࠶ఆٛ ͨؔ͠ʹରͯ͠෦Λߦ͏ ▸ x0=3ɺx1=4ͷͱ͖ͷx0ʹର͢Δภඍ ▸ x0=3ɺx1=4ͷͱ͖ͷx1ʹର͢Δภඍ def function_tmp1(x0): return x0*x0 + 4.0**2.0 d0 = numerical_diff(function_tmp1, 3.0) def function_tmp2(x1): return 3.0**2.0 + x1*x1 d1 = numerical_diff(function_tmp2, 4.0) -
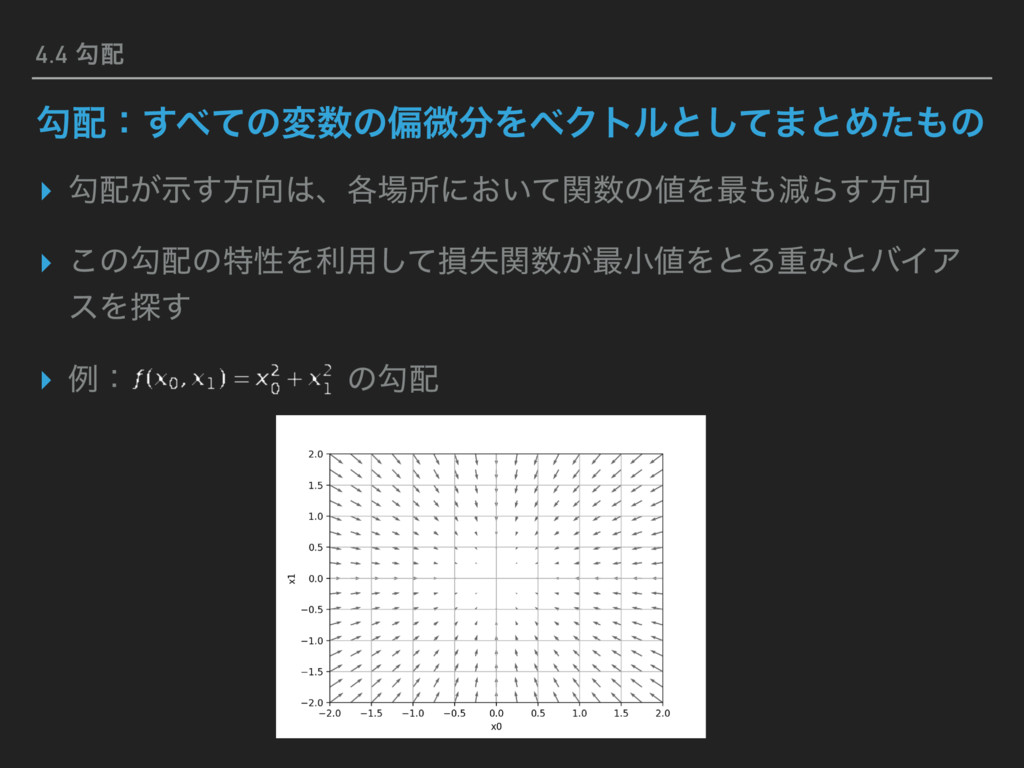
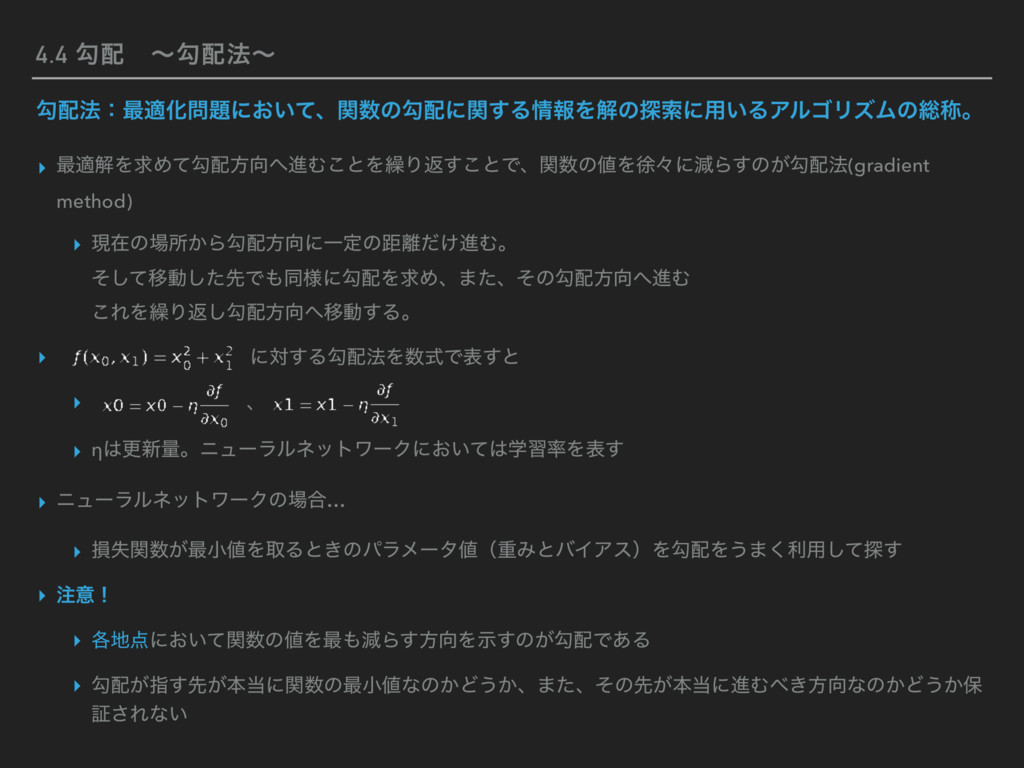
4.4 ޯɹʙޯ๏ʙ ޯ๏ɿ࠷దԽʹ͓͍ͯɺؔͷޯʹؔ͢ΔใΛղͷ୳ࡧʹ༻͍ΔΞϧΰϦζϜͷ૯শɻ ▸ ࠷దղΛٻΊͯޯํਐΉ͜ͱΛ܁Γฦ͢͜ͱͰɺؔͷΛঃʑʹݮΒ͢ͷ͕ޯ๏(gradient method) ▸ ݱࡏͷॴ͔ΒޯํʹҰఆͷڑ͚ͩਐΉɻ ͦͯ͠Ҡಈͨ͠ઌͰಉ༷ʹޯΛٻΊɺ·ͨɺͦͷޯํਐΉ ͜ΕΛ܁Γฦ͠ޯํҠಈ͢Δɻ
▸ ɹɹɹɹɹɹɹɹɹɹʹର͢Δޯ๏ΛࣜͰද͢ͱ ▸ ɹɹɹɹɹɹɹɹɺ ▸ ηߋ৽ྔɻχϡʔϥϧωοτϫʔΫʹֶ͓͍ͯशΛද͢ ▸ χϡʔϥϧωοτϫʔΫͷ߹… ▸ ଛࣦ͕ؔ࠷খΛऔΔͱ͖ͷύϥϝʔλʢॏΈͱόΠΞεʣΛޯΛ͏·͘ར༻ͯ͠୳͢ ▸ ҙʂ ▸ ֤ʹ͓͍ͯؔͷΛ࠷ݮΒ͢ํΛࣔ͢ͷ͕ޯͰ͋Δ ▸ ޯ͕ࢦ͢ઌ͕ຊʹؔͷ࠷খͳͷ͔Ͳ͏͔ɺ·ͨɺͦͷઌ͕ຊʹਐΉ͖ํͳͷ͔Ͳ͏͔อ ূ͞Εͳ͍ -
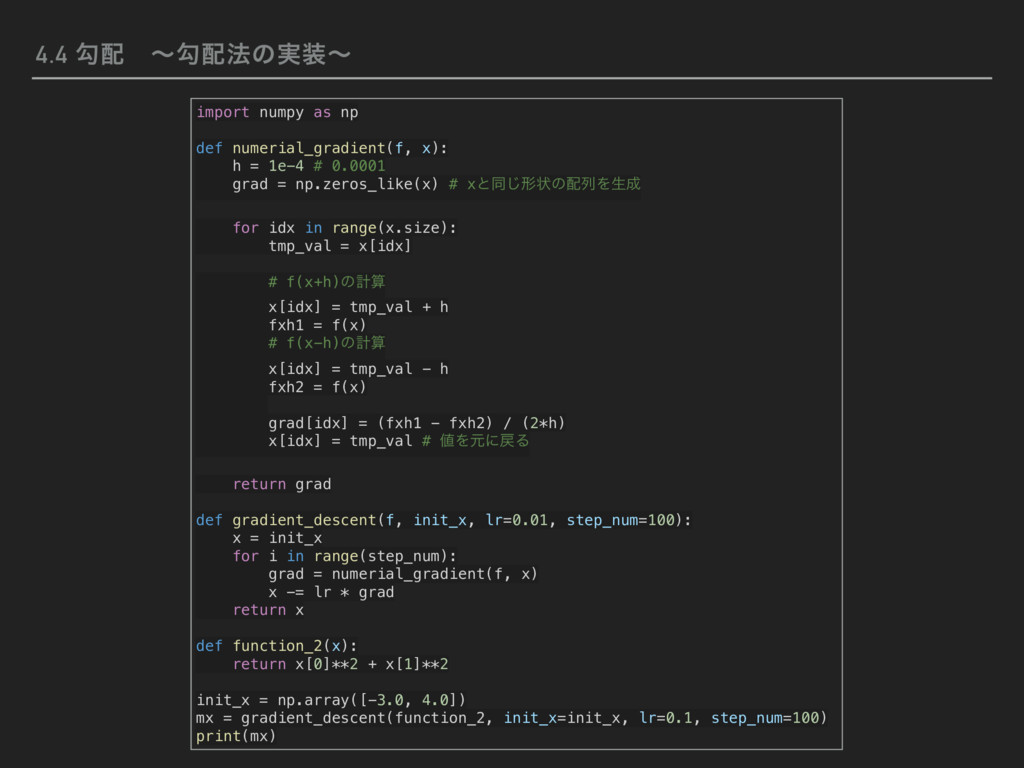
4.4 ޯɹʙޯ๏ͷ࣮ʙ import numpy as np def numerial_gradient(f, x): h
= 1e-4 # 0.0001 grad = np.zeros_like(x) # xͱಉ͡ܗঢ়ͷྻΛੜ for idx in range(x.size): tmp_val = x[idx] # f(x+h)ͷܭࢉ x[idx] = tmp_val + h fxh1 = f(x) # f(x-h)ͷܭࢉ x[idx] = tmp_val - h fxh2 = f(x) grad[idx] = (fxh1 - fxh2) / (2*h) x[idx] = tmp_val # ΛݩʹΔ return grad def gradient_descent(f, init_x, lr=0.01, step_num=100): x = init_x for i in range(step_num): grad = numerial_gradient(f, x) x -= lr * grad return x def function_2(x): return x[0]**2 + x[1]**2 init_x = np.array([-3.0, 4.0]) mx = gradient_descent(function_2, init_x=init_x, lr=0.1, step_num=100) print(mx) -
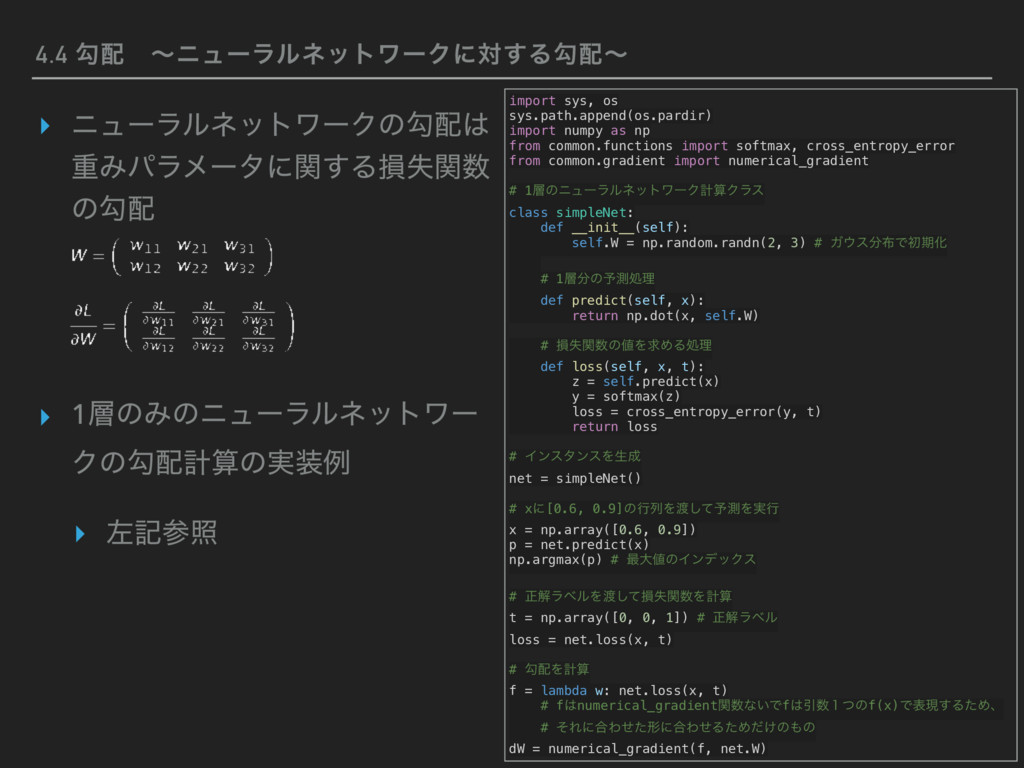
4.4 ޯɹʙχϡʔϥϧωοτϫʔΫʹର͢Δޯʙ ▸ χϡʔϥϧωοτϫʔΫͷޯ ॏΈύϥϝʔλʹؔ͢Δଛࣦؔ ͷޯ ▸ 1ͷΈͷχϡʔϥϧωοτϫʔ Ϋͷޯܭࢉͷ࣮ྫ ▸
ࠨهࢀর import sys, os sys.path.append(os.pardir) import numpy as np from common.functions import softmax, cross_entropy_error from common.gradient import numerical_gradient # 1ͷχϡʔϥϧωοτϫʔΫܭࢉΫϥε class simpleNet: def __init__(self): self.W = np.random.randn(2, 3) # ΨεͰॳظԽ # 1ͷ༧ଌॲཧ def predict(self, x): return np.dot(x, self.W) # ଛࣦؔͷΛٻΊΔॲཧ def loss(self, x, t): z = self.predict(x) y = softmax(z) loss = cross_entropy_error(y, t) return loss # ΠϯελϯεΛੜ net = simpleNet() # xʹ[0.6, 0.9]ͷߦྻΛͯ͠༧ଌΛ࣮ߦ x = np.array([0.6, 0.9]) p = net.predict(x) np.argmax(p) # ࠷େͷΠϯσοΫε # ਖ਼ղϥϕϧΛͯ͠ଛࣦؔΛܭࢉ t = np.array([0, 0, 1]) # ਖ਼ղϥϕϧ loss = net.loss(x, t) # ޯΛܭࢉ f = lambda w: net.loss(x, t) # fnumerical_gradientؔͳ͍ͰfҾ̍ͭͷf(x)Ͱදݱ͢ΔͨΊɺ # ͦΕʹ߹Θͤͨܗʹ߹ΘͤΔͨΊ͚ͩͷͷ dW = numerical_gradient(f, net.W) -
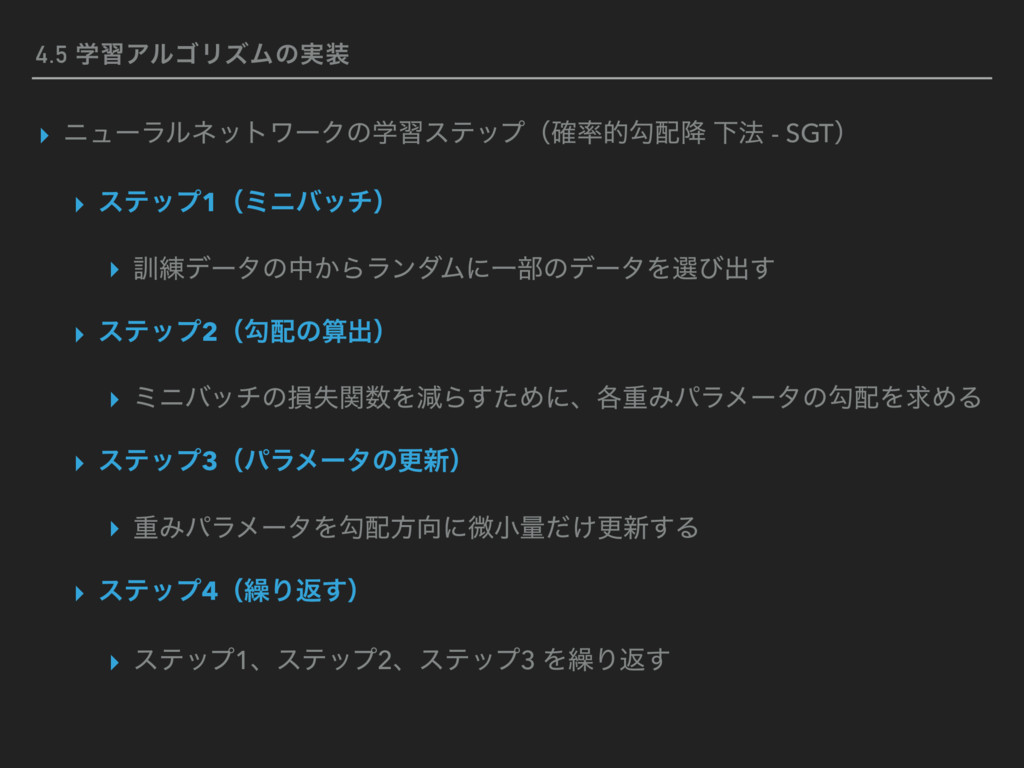
4.5 ֶशΞϧΰϦζϜͷ࣮ ▸ χϡʔϥϧωοτϫʔΫͷֶशεςοϓʢ֬తޯ߱ Լ๏ - SGTʣ ▸ εςοϓ1ʢϛχόονʣ ▸
܇࿅σʔλͷத͔ΒϥϯμϜʹҰ෦ͷσʔλΛબͼग़͢ ▸ εςοϓ2ʢޯͷࢉग़ʣ ▸ ϛχόονͷଛࣦؔΛݮΒͨ͢Ίʹɺ֤ॏΈύϥϝʔλͷޯΛٻΊΔ ▸ εςοϓ3ʢύϥϝʔλͷߋ৽ʣ ▸ ॏΈύϥϝʔλΛޯํʹඍখྔ͚ͩߋ৽͢Δ ▸ εςοϓ4ʢ܁Γฦ͢ʣ ▸ εςοϓ1ɺεςοϓ2ɺεςοϓ3 Λ܁Γฦ͢ -
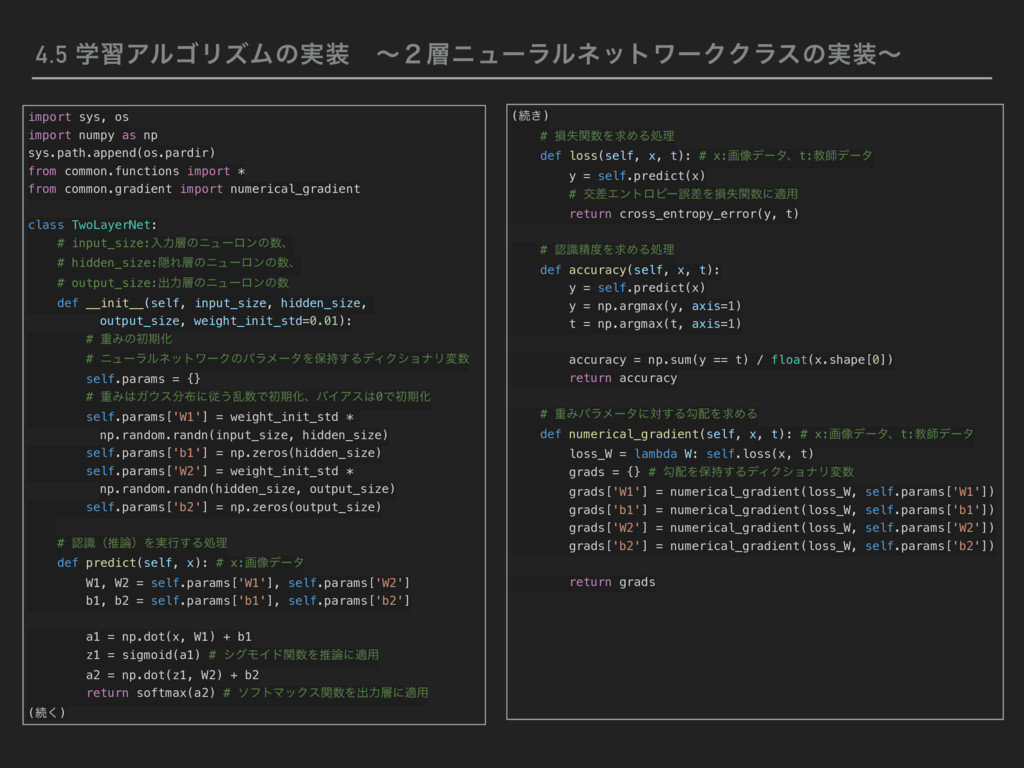
4.5 ֶशΞϧΰϦζϜͷ࣮ɹʙ̎χϡʔϥϧωοτϫʔΫΫϥεͷ࣮ʙ import sys, os import numpy as np sys.path.append(os.pardir)
from common.functions import * from common.gradient import numerical_gradient class TwoLayerNet: # input_size:ೖྗͷχϡʔϩϯͷɺ # hidden_size:ӅΕͷχϡʔϩϯͷɺ # output_size:ग़ྗͷχϡʔϩϯͷ def __init__(self, input_size, hidden_size, output_size, weight_init_std=0.01): # ॏΈͷॳظԽ # χϡʔϥϧωοτϫʔΫͷύϥϝʔλΛอ࣋͢ΔσΟΫγϣφϦม self.params = {} # ॏΈΨεʹै͏ཚͰॳظԽɺόΠΞε0ͰॳظԽ self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size) self.params['b1'] = np.zeros(hidden_size) self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size) self.params['b2'] = np.zeros(output_size) # ೝࣝʢਪʣΛ࣮ߦ͢Δॲཧ def predict(self, x): # x:ը૾σʔλ W1, W2 = self.params['W1'], self.params['W2'] b1, b2 = self.params['b1'], self.params['b2'] a1 = np.dot(x, W1) + b1 z1 = sigmoid(a1) # γάϞΠυؔΛਪʹద༻ a2 = np.dot(z1, W2) + b2 return softmax(a2) # ιϑτϚοΫεؔΛग़ྗʹద༻ (ଓ͘) (ଓ͖) # ଛࣦؔΛٻΊΔॲཧ def loss(self, x, t): # x:ը૾σʔλɺt:ڭࢣσʔλ y = self.predict(x) # ަࠩΤϯτϩϐʔޡࠩΛଛࣦؔʹద༻ return cross_entropy_error(y, t) # ೝࣝਫ਼ΛٻΊΔॲཧ def accuracy(self, x, t): y = self.predict(x) y = np.argmax(y, axis=1) t = np.argmax(t, axis=1) accuracy = np.sum(y == t) / float(x.shape[0]) return accuracy # ॏΈύϥϝʔλʹର͢ΔޯΛٻΊΔ def numerical_gradient(self, x, t): # x:ը૾σʔλɺt:ڭࢣσʔλ loss_W = lambda W: self.loss(x, t) grads = {} # ޯΛอ࣋͢ΔσΟΫγϣφϦม grads['W1'] = numerical_gradient(loss_W, self.params['W1']) grads['b1'] = numerical_gradient(loss_W, self.params['b1']) grads['W2'] = numerical_gradient(loss_W, self.params['W2']) grads['b2'] = numerical_gradient(loss_W, self.params['b2']) return grads -
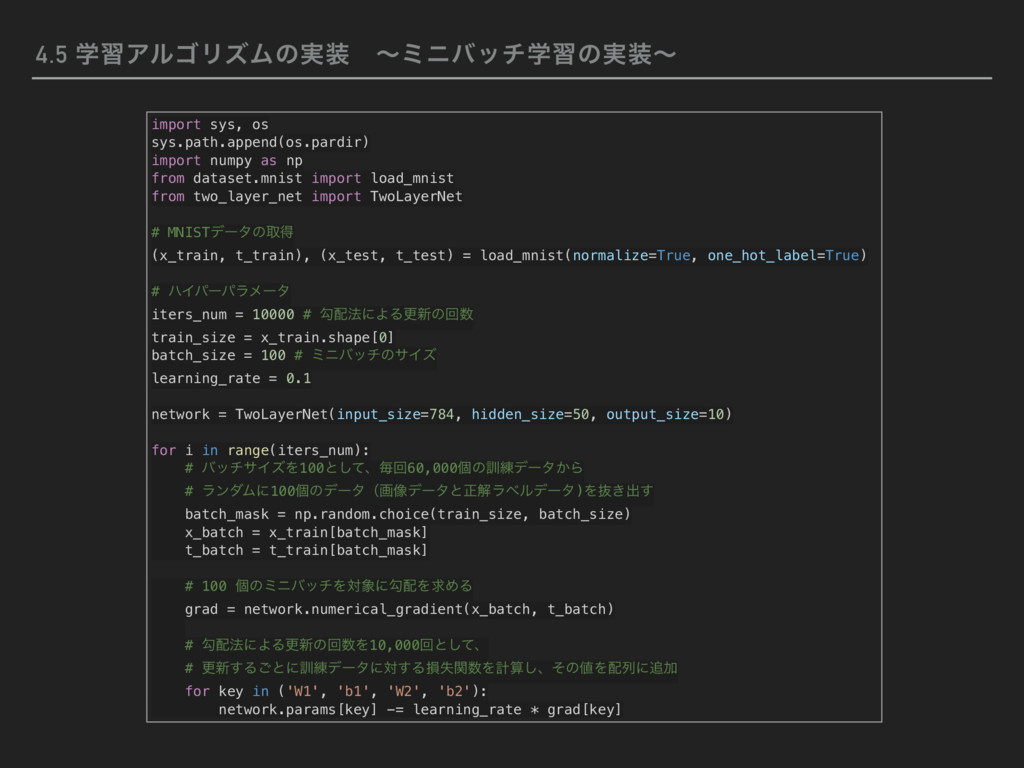
4.5 ֶशΞϧΰϦζϜͷ࣮ɹʙϛχόονֶशͷ࣮ʙ import sys, os sys.path.append(os.pardir) import numpy as np
from dataset.mnist import load_mnist from two_layer_net import TwoLayerNet # MNISTσʔλͷऔಘ (x_train, t_train), (x_test, t_test) = load_mnist(normalize=True, one_hot_label=True) # ϋΠύʔύϥϝʔλ iters_num = 10000 # ޯ๏ʹΑΔߋ৽ͷճ train_size = x_train.shape[0] batch_size = 100 # ϛχόονͷαΠζ learning_rate = 0.1 network = TwoLayerNet(input_size=784, hidden_size=50, output_size=10) for i in range(iters_num): # όοναΠζΛ100ͱͯ͠ɺຖճ60,000ݸͷ܇࿅σʔλ͔Β # ϥϯμϜʹ100ݸͷσʔλʢը૾σʔλͱਖ਼ղϥϕϧσʔλ)Λൈ͖ग़͢ batch_mask = np.random.choice(train_size, batch_size) x_batch = x_train[batch_mask] t_batch = t_train[batch_mask] # 100 ݸͷϛχόονΛରʹޯΛٻΊΔ grad = network.numerical_gradient(x_batch, t_batch) # ޯ๏ʹΑΔߋ৽ͷճΛ10,000ճͱͯ͠ɺ # ߋ৽͢Δ͝ͱʹ܇࿅σʔλʹର͢ΔଛࣦؔΛܭࢉ͠ɺͦͷΛྻʹՃ for key in ('W1', 'b1', 'W2', 'b2'): network.params[key] -= learning_rate * grad[key] -
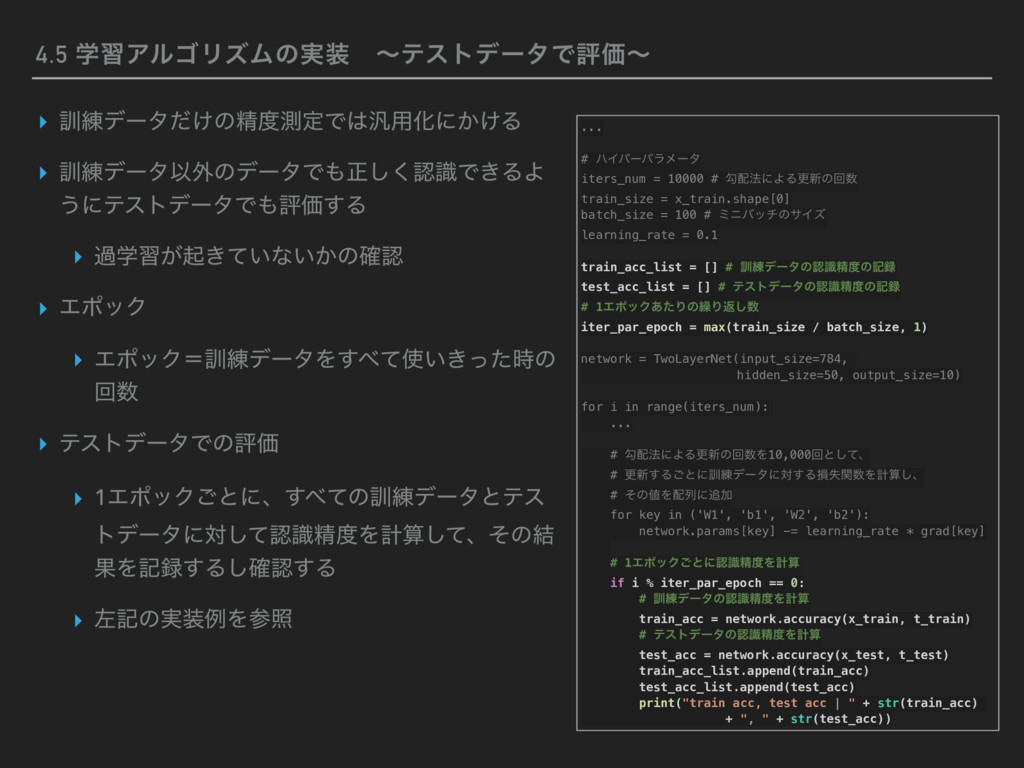
4.5 ֶशΞϧΰϦζϜͷ࣮ɹʙςετσʔλͰධՁʙ ▸ ܇࿅σʔλ͚ͩͷਫ਼ଌఆͰ൚༻Խʹ͔͚Δ ▸ ܇࿅σʔλҎ֎ͷσʔλͰਖ਼͘͠ೝࣝͰ͖ΔΑ ͏ʹςετσʔλͰධՁ͢Δ ▸ աֶश͕ى͖͍ͯͳ͍͔ͷ֬ೝ ▸
ΤϙοΫ ▸ ΤϙοΫʹ܇࿅σʔλΛ͍͖ͯͬͨ࣌͢ͷ ճ ▸ ςετσʔλͰͷධՁ ▸ 1ΤϙοΫ͝ͱʹɺͯ͢ͷ܇࿅σʔλͱςε τσʔλʹରͯ͠ೝࣝਫ਼Λܭࢉͯ͠ɺͦͷ݁ ՌΛه͢Δ֬͠ೝ͢Δ ▸ ࠨهͷ࣮ྫΛࢀর ... # ϋΠύʔύϥϝʔλ iters_num = 10000 # ޯ๏ʹΑΔߋ৽ͷճ train_size = x_train.shape[0] batch_size = 100 # ϛχόονͷαΠζ learning_rate = 0.1 train_acc_list = [] # ܇࿅σʔλͷೝࣝਫ਼ͷه test_acc_list = [] # ςετσʔλͷೝࣝਫ਼ͷه # 1ΤϙοΫ͋ͨΓͷ܁Γฦ͠ iter_par_epoch = max(train_size / batch_size, 1) network = TwoLayerNet(input_size=784, ɹɹɹɹɹɹɹɹɹɹɹɹɹhidden_size=50, output_size=10) for i in range(iters_num): ... # ޯ๏ʹΑΔߋ৽ͷճΛ10,000ճͱͯ͠ɺ # ߋ৽͢Δ͝ͱʹ܇࿅σʔλʹର͢ΔଛࣦؔΛܭࢉ͠ɺ # ͦͷΛྻʹՃ for key in ('W1', 'b1', 'W2', 'b2'): network.params[key] -= learning_rate * grad[key] # 1ΤϙοΫ͝ͱʹೝࣝਫ਼Λܭࢉ if i % iter_par_epoch == 0: # ܇࿅σʔλͷೝࣝਫ਼Λܭࢉ train_acc = network.accuracy(x_train, t_train) # ςετσʔλͷೝࣝਫ਼Λܭࢉ test_acc = network.accuracy(x_test, t_test) train_acc_list.append(train_acc) test_acc_list.append(test_acc) print("train acc, test acc | " + str(train_acc) + ", " + str(test_acc))
 chipstar_light
 110y
 amarelo_n24
 wind111
 takuyay0ne
 kazzpapa3
 nealle
 tammyeverts
 knwoop
 akihiro0038
 daishukojima
 sat
 shotashiratori
 kastner
 ipullrank
 mza
 addyosmani
 michielstock
 codingconduct
 ammeep
 marcduiker
 jonoalderson
 csswizardry
 watany
 oripsolob