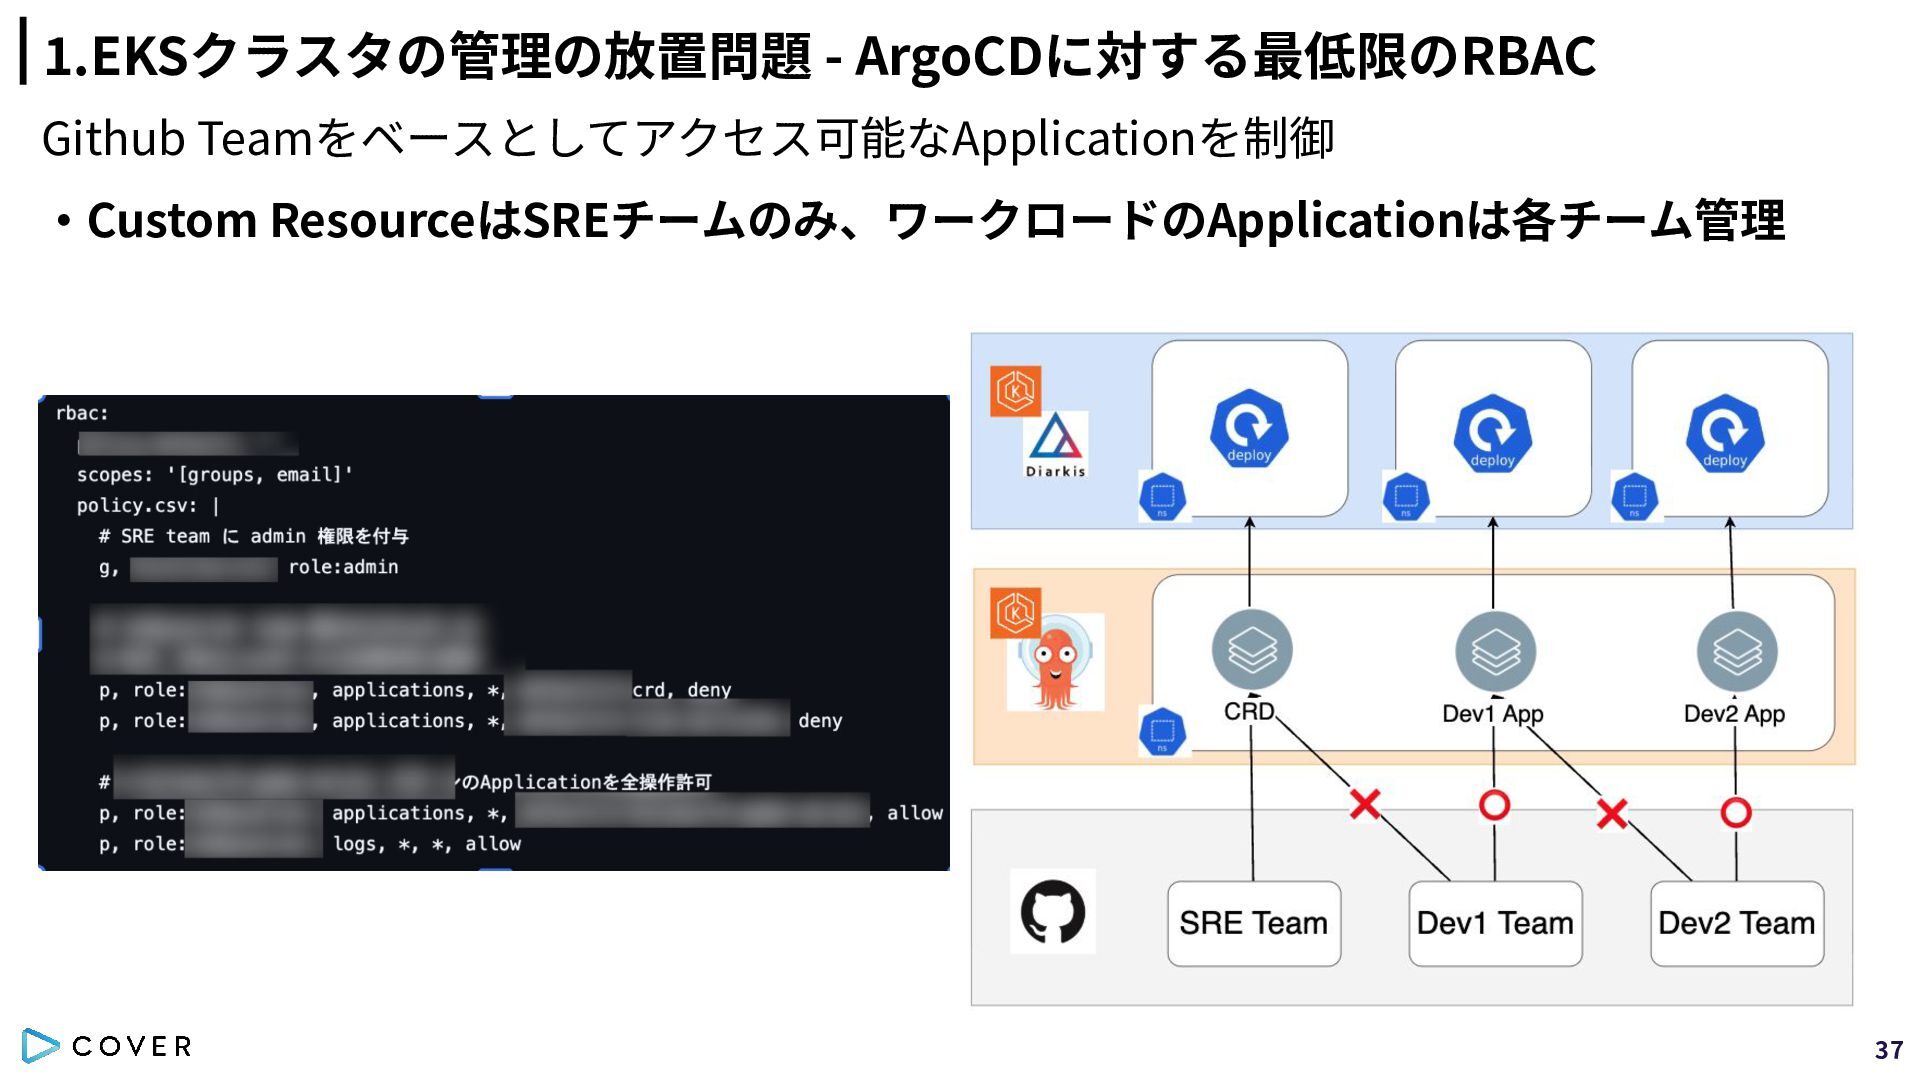
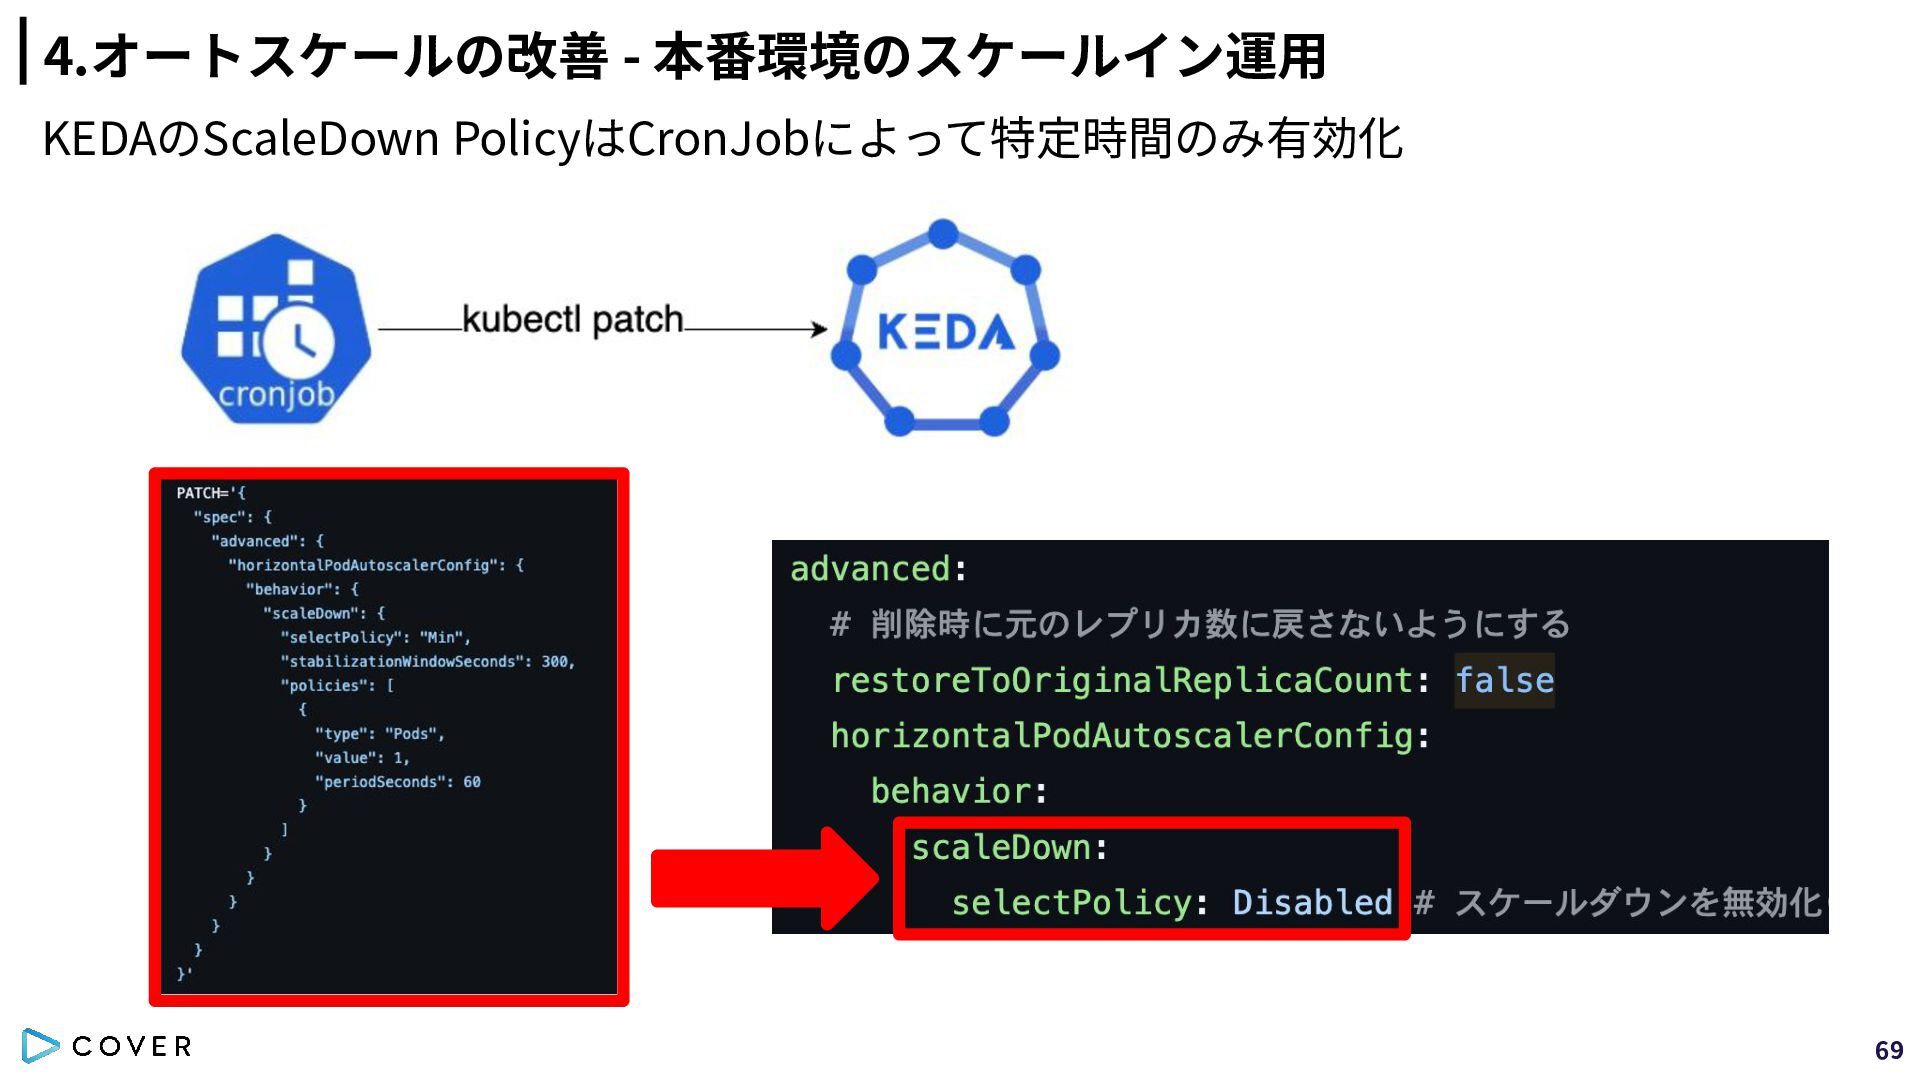
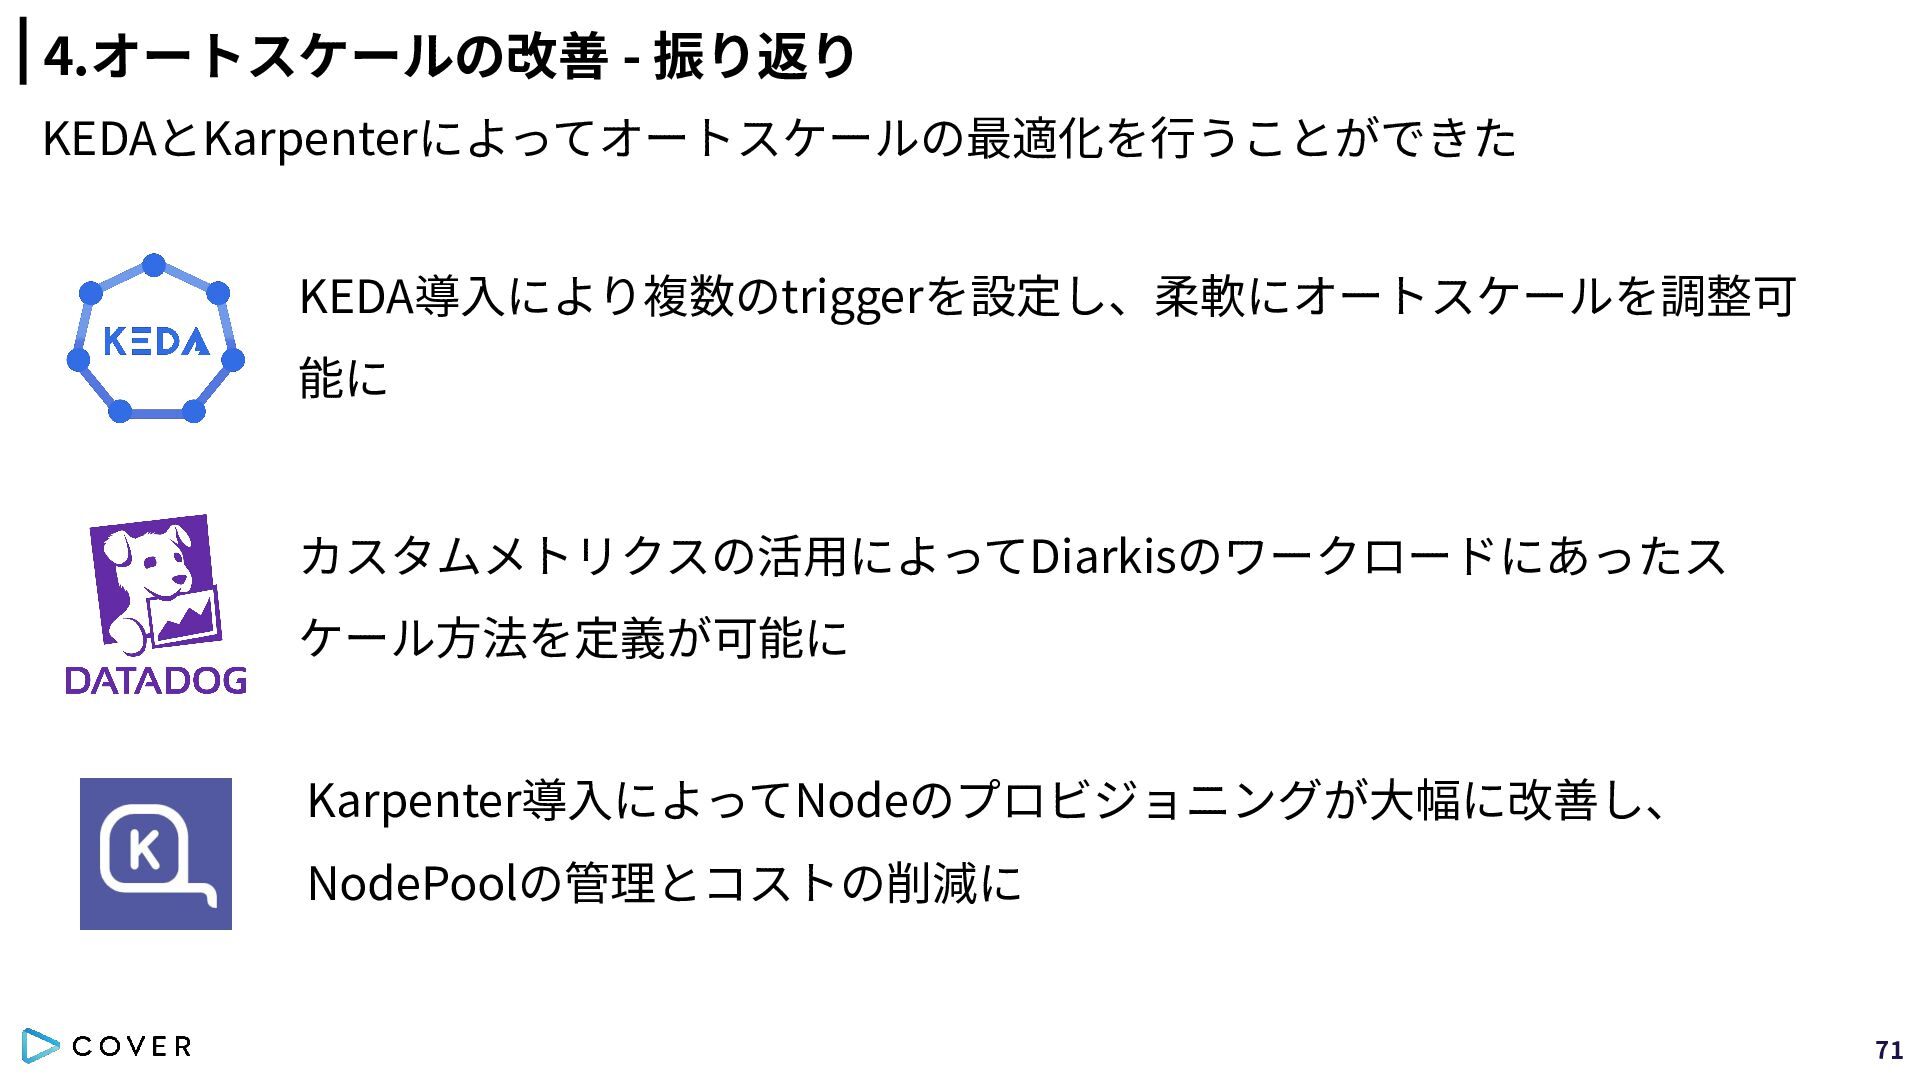
リアルタイムサーバー運用改善 〜メタバースプラットフォームにおけるEKS運用とDatadog活...

Share
Embed

Transcript
92 slides
-
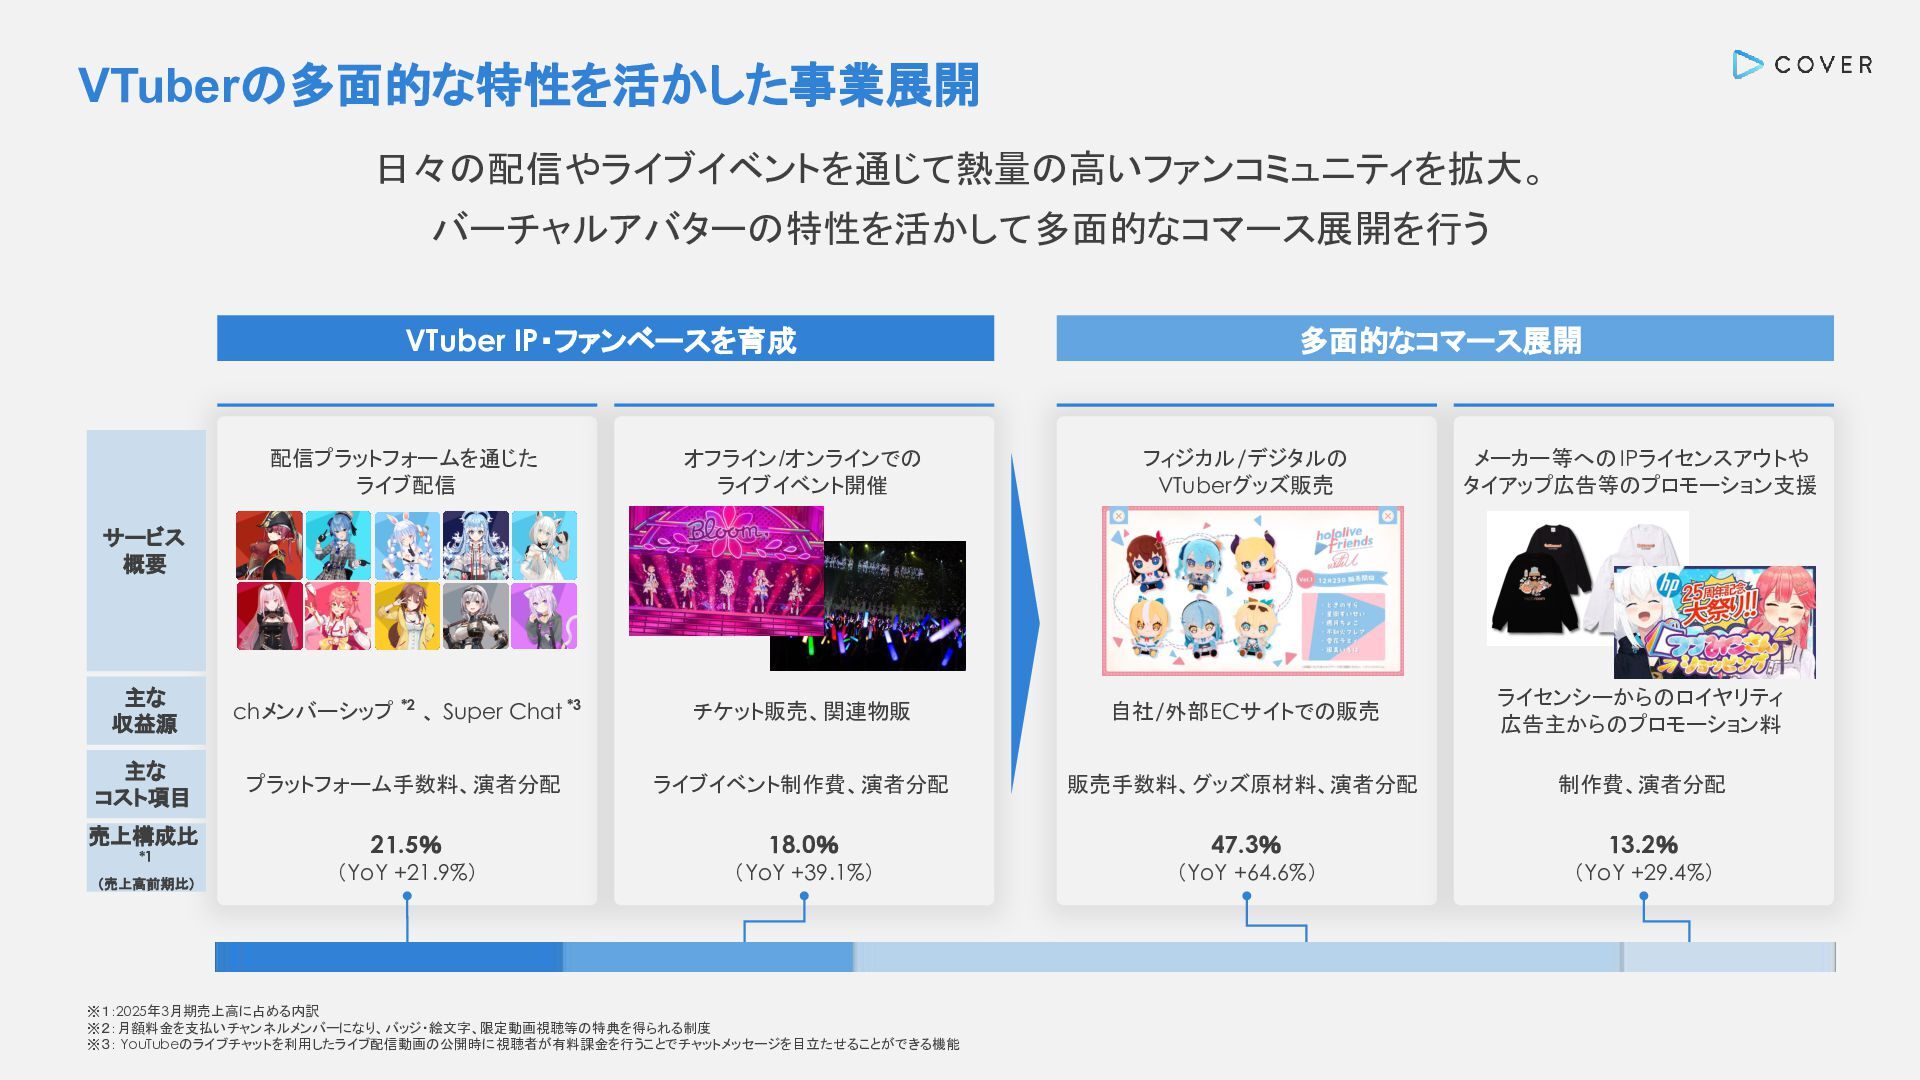
VTuberの多面的な特性を活かした事業展開 日々の配信やライブイベントを通じて熱量の高いファンコミュニティを拡大。 バーチャルアバターの特性を活かして多面的なコマース展開を行う 多面的なコマース展開 VTuber IP・ファンベースを育成 配信プラットフォームを通じた ライブ配信 オフライン/オンラインでの ライブイベント開催
フィジカル/デジタルの VTuberグッズ販売 メーカー等への IPライセンスアウトや タイアップ広告等のプロモーション支援 主な 収益源 chメンバーシップ *2 、 Super Chat *3 チケット販売、関連物販 自社/外部ECサイトでの販売 ライセンシーからのロイヤリティ 広告主からのプロモーション料 主な コスト項目 プラットフォーム手数料、演者分配 ライブイベント制作費、演者分配 販売手数料、グッズ原材料、演者分配 制作費、演者分配 サービス 概要 売上構成比 *1 (売上高前期比) 21.5% 18.0% 47.3% 13.2% (YoY +21.9%) (YoY +39.1%) (YoY +64.6%) (YoY +29.4%) ※1:2025年3月期売上高に占める内訳 ※2:月額料金を支払いチャンネルメンバーになり、バッジ・絵文字、限定動画視聴等の特典を得られる制度 ※3: YouTubeのライブチャットを利用したライブ配信動画の公開時に視聴者が有料課金を行うことでチャットメッセージを目立たせることができる機能 -
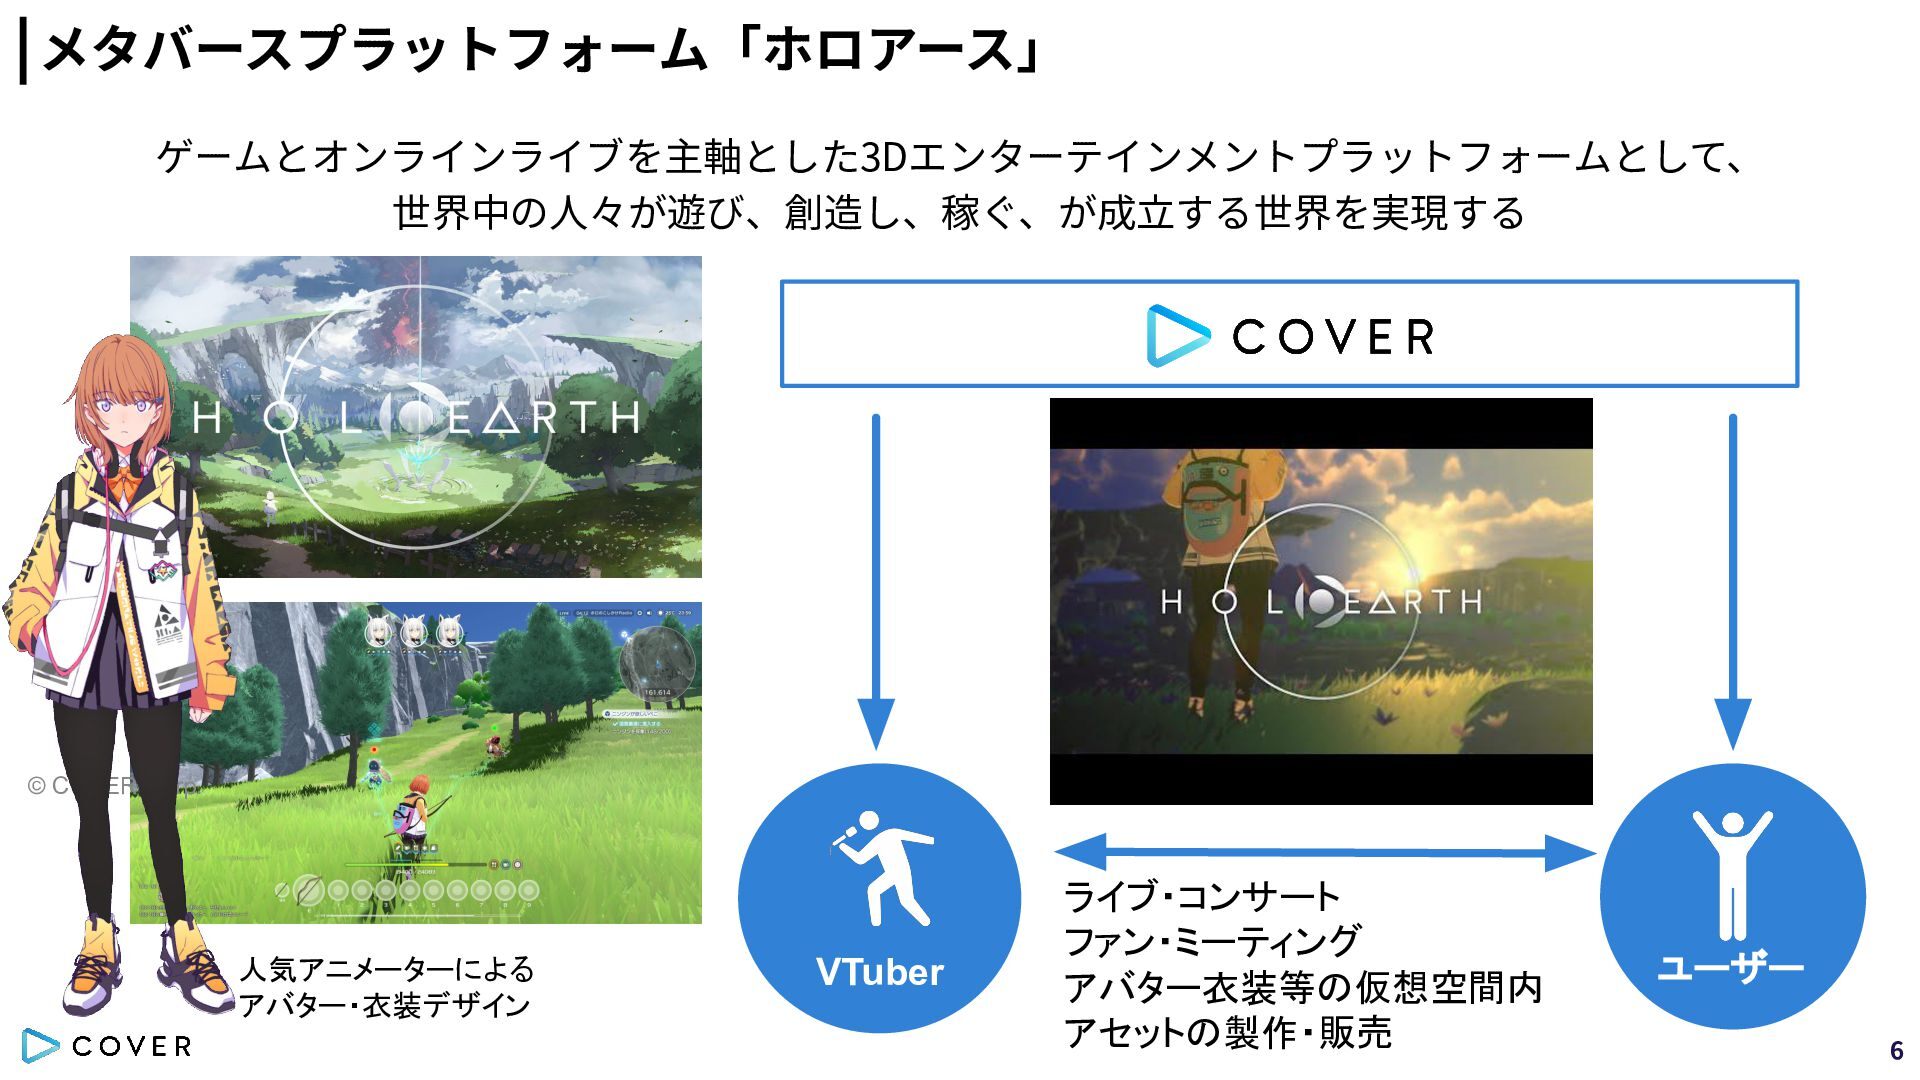
メタバースプラットフォーム「ホロアース」 ゲームとオンラインライブを主軸とした3Dエンターテインメントプラットフォームとして、 世界中の⼈々が遊び、創造し、稼ぐ、が成⽴する世界を実現する © COVER Corp. 人気アニメーターによる アバター・衣装デザイン VTuber ライブ・コンサート
ファン・ミーティング アバター衣装等の仮想空間内 アセットの製作・販売 ユーザー 6 -
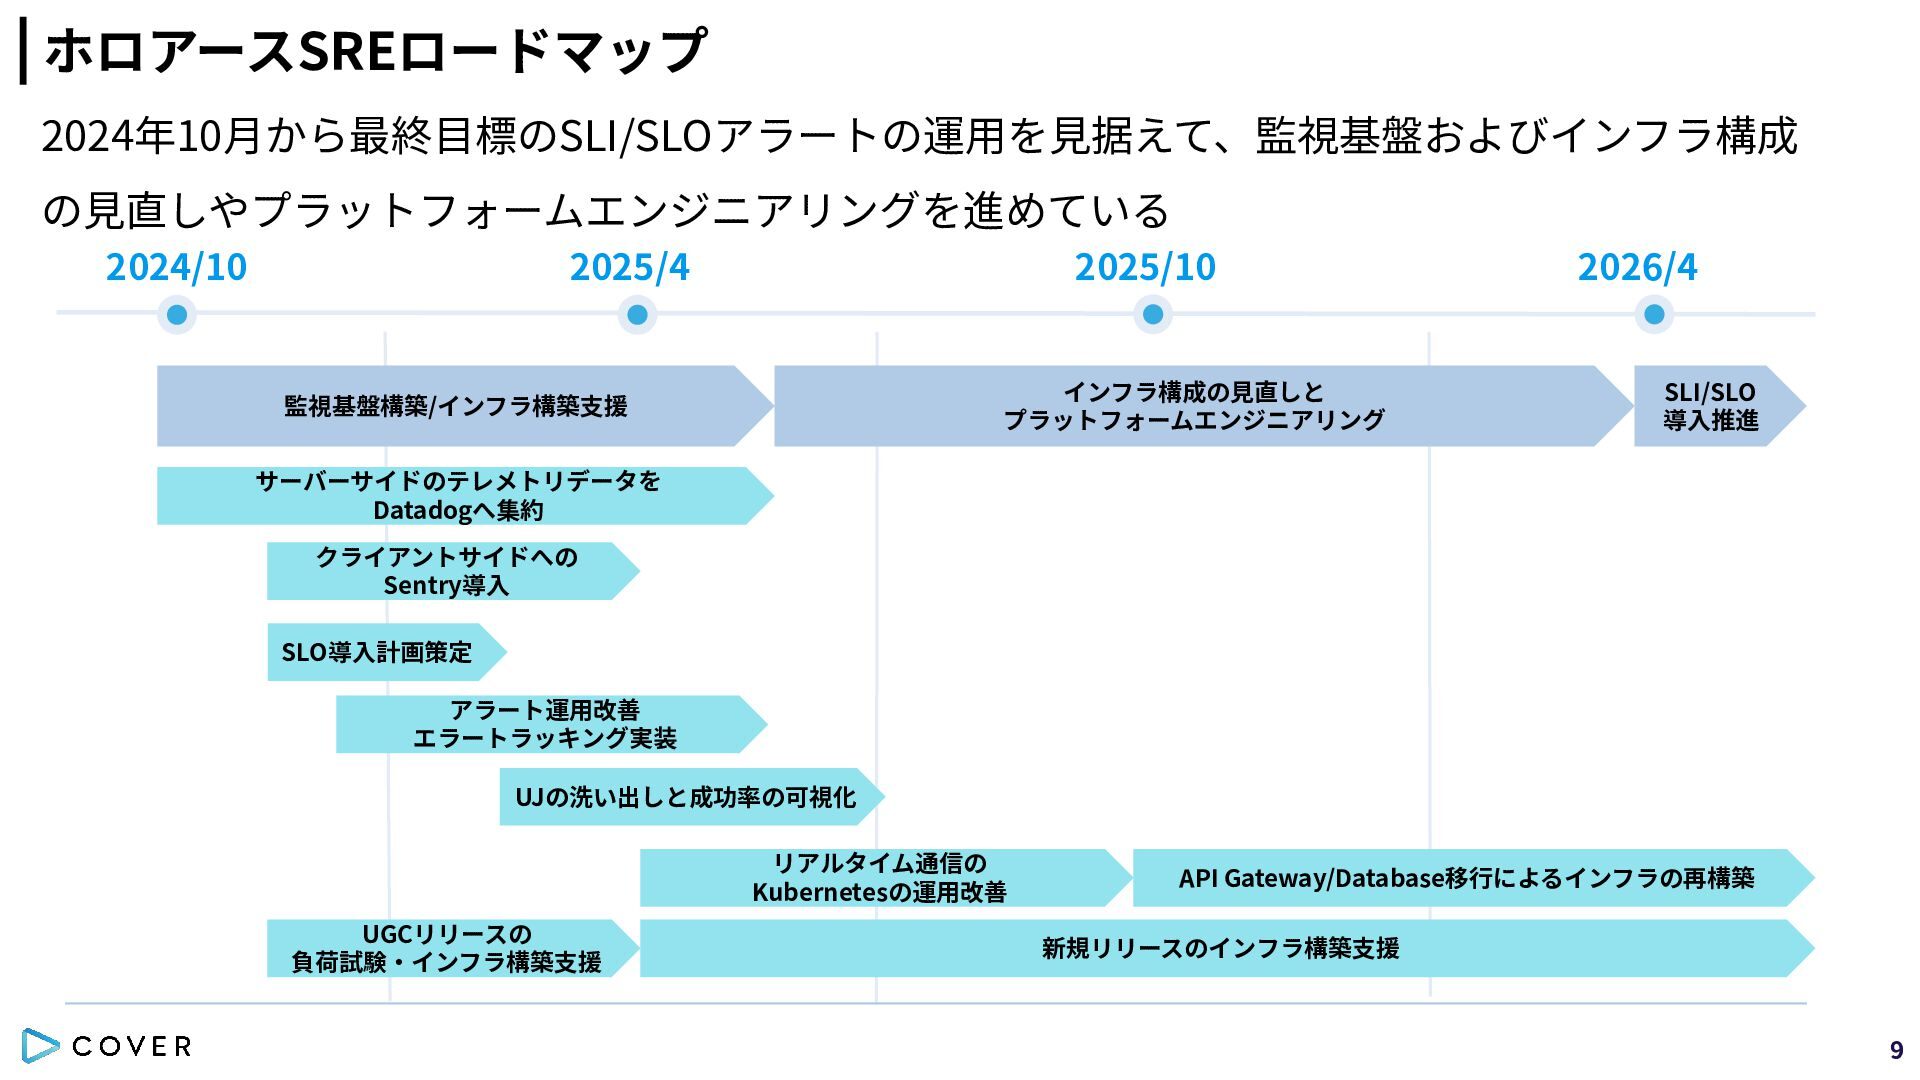
ホロアースSREロードマップ 2024年10⽉から最終⽬標のSLI/SLOアラートの運⽤を⾒据えて、監視基盤およびインフラ構成 の⾒直しやプラットフォームエンジニアリングを進めている 2024/10 2025/4 2025/10 インフラ構成の⾒直しと プラットフォームエンジニアリング 監視基盤構築/インフラ構築⽀援 2026/4
SLI/SLO 導⼊推進 サーバーサイドのテレメトリデータを Datadogへ集約 クライアントサイドへの Sentry導⼊ SLO導⼊計画策定 アラート運⽤改善 エラートラッキング実装 UJの洗い出しと成功率の可視化 リアルタイム通信の Kubernetesの運⽤改善 UGCリリースの 負荷試験‧インフラ構築⽀援 API Gateway/Database移⾏によるインフラの再構築 新規リリースのインフラ構築⽀援 9 -
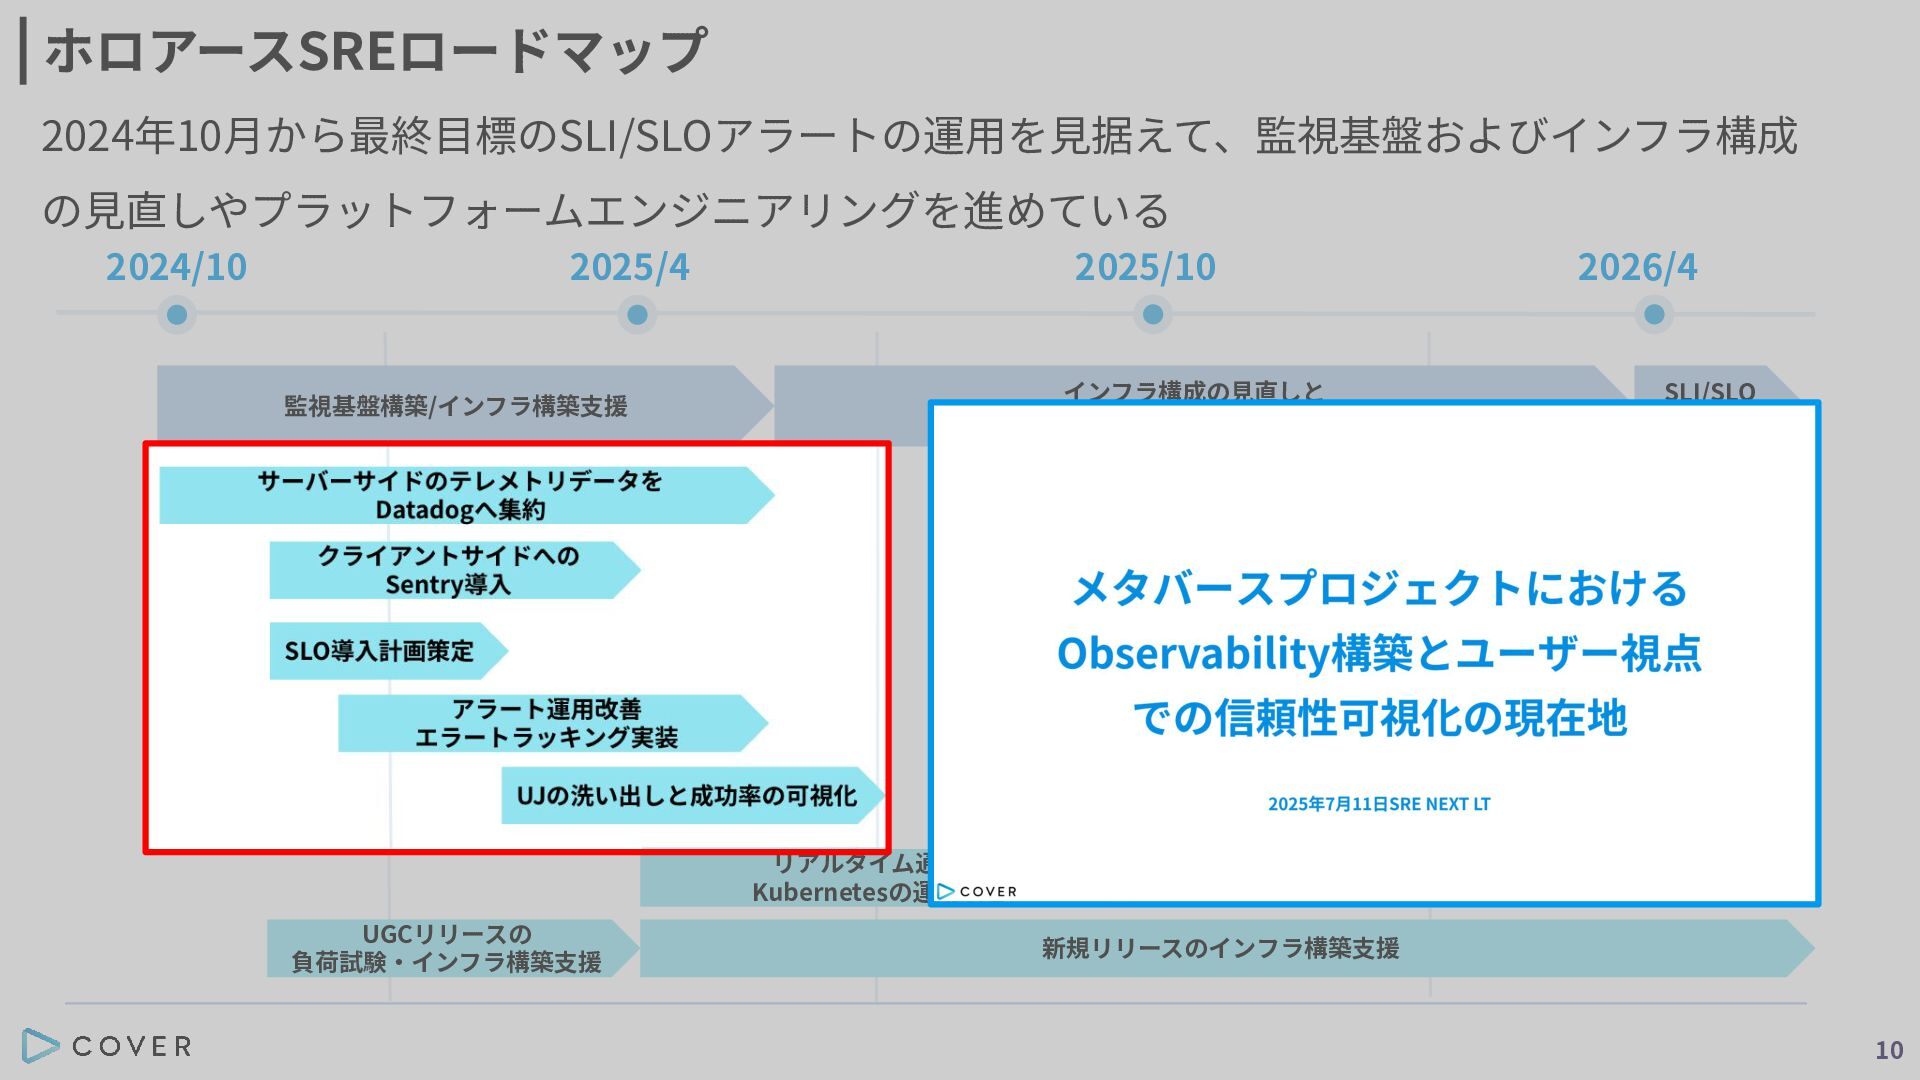
ホロアースSREロードマップ 2024年10⽉から最終⽬標のSLI/SLOアラートの運⽤を⾒据えて、監視基盤およびインフラ構成 の⾒直しやプラットフォームエンジニアリングを進めている 2024/10 2025/4 2025/10 インフラ構成の⾒直しと プラットフォームエンジニアリング 監視基盤構築/インフラ構築⽀援 2026/4
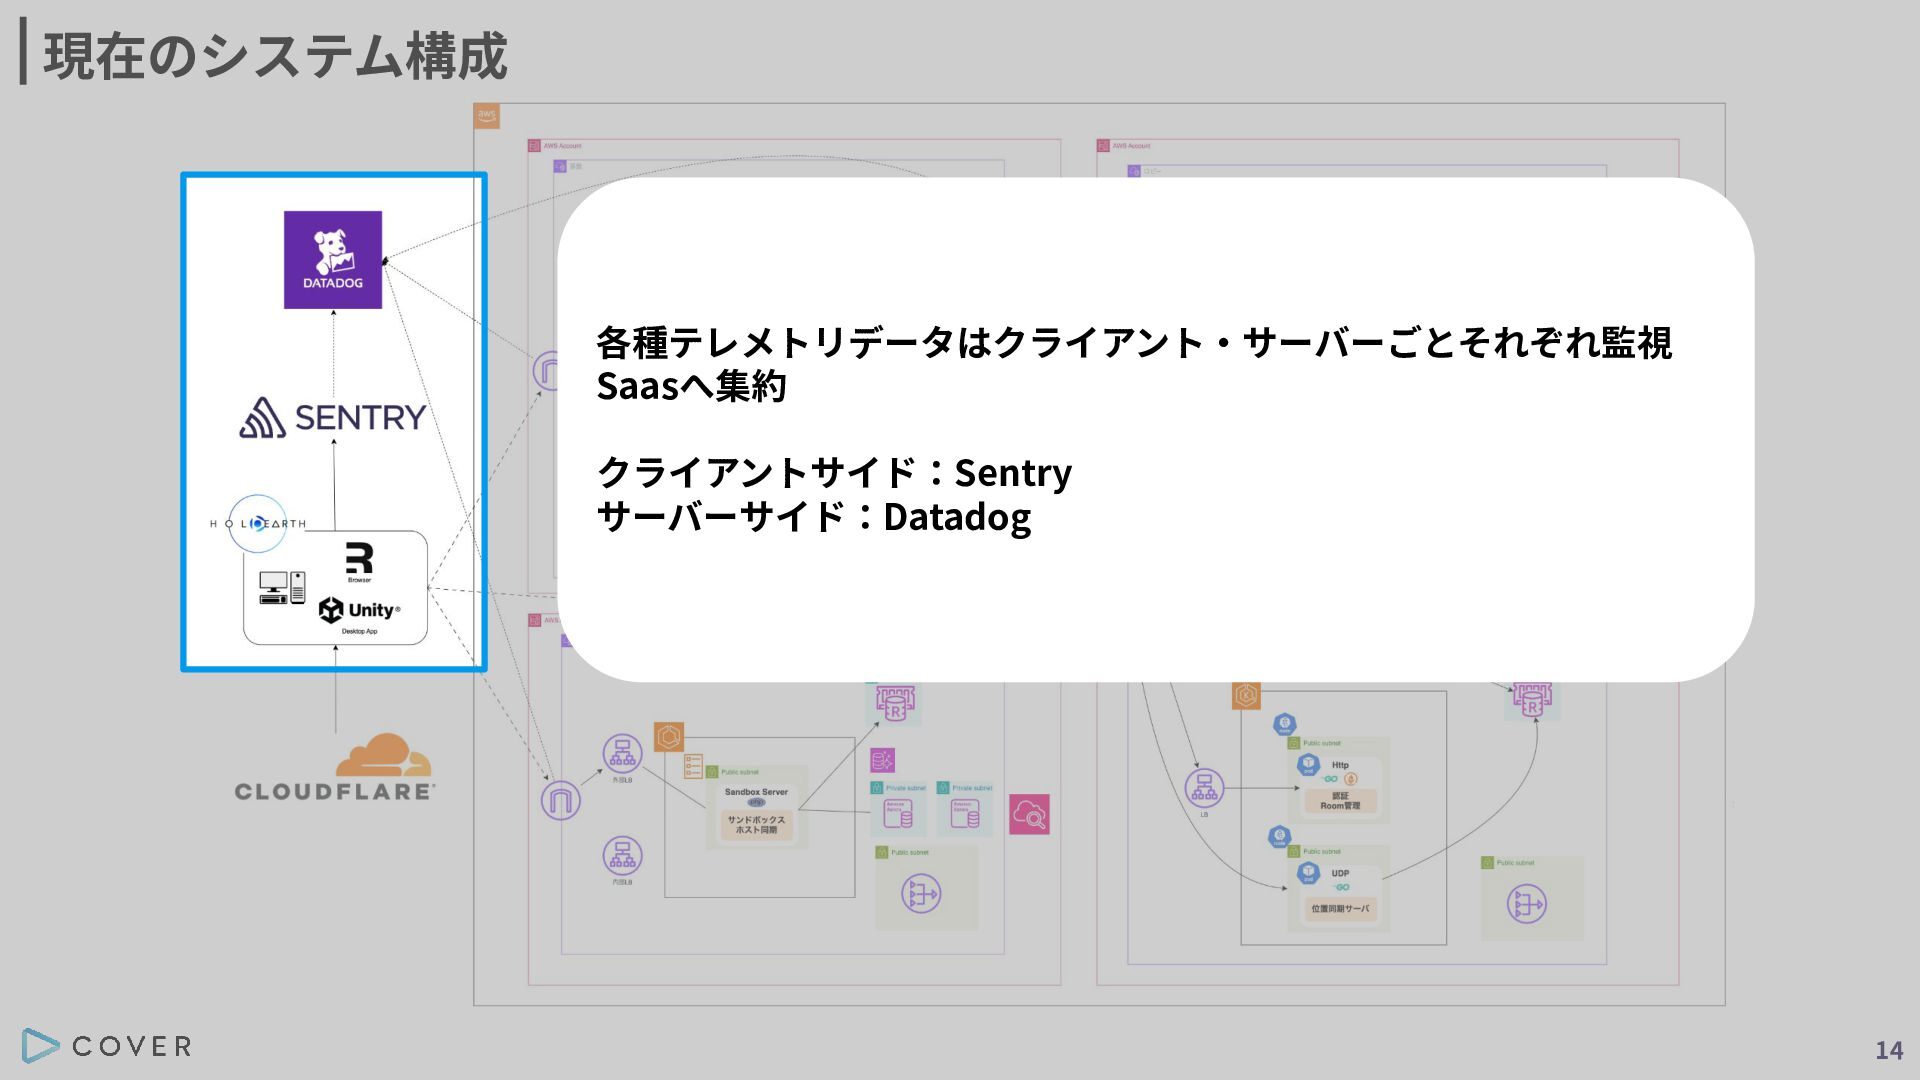
SLI/SLO 導⼊推進 サーバーサイドのテレメトリデータを Datadogへ集約 クライアントサイドへの Sentry導⼊ SLO導⼊計画策定 アラート運⽤改善 エラートラッキング実装 UJの洗い出しと成功率の可視化 リアルタイム通信の Kubernetesの運⽤改善 UGCリリースの 負荷試験‧インフラ構築⽀援 API Gateway/Database移⾏によるインフラの再構築 新規リリースのインフラ構築⽀援 10 -
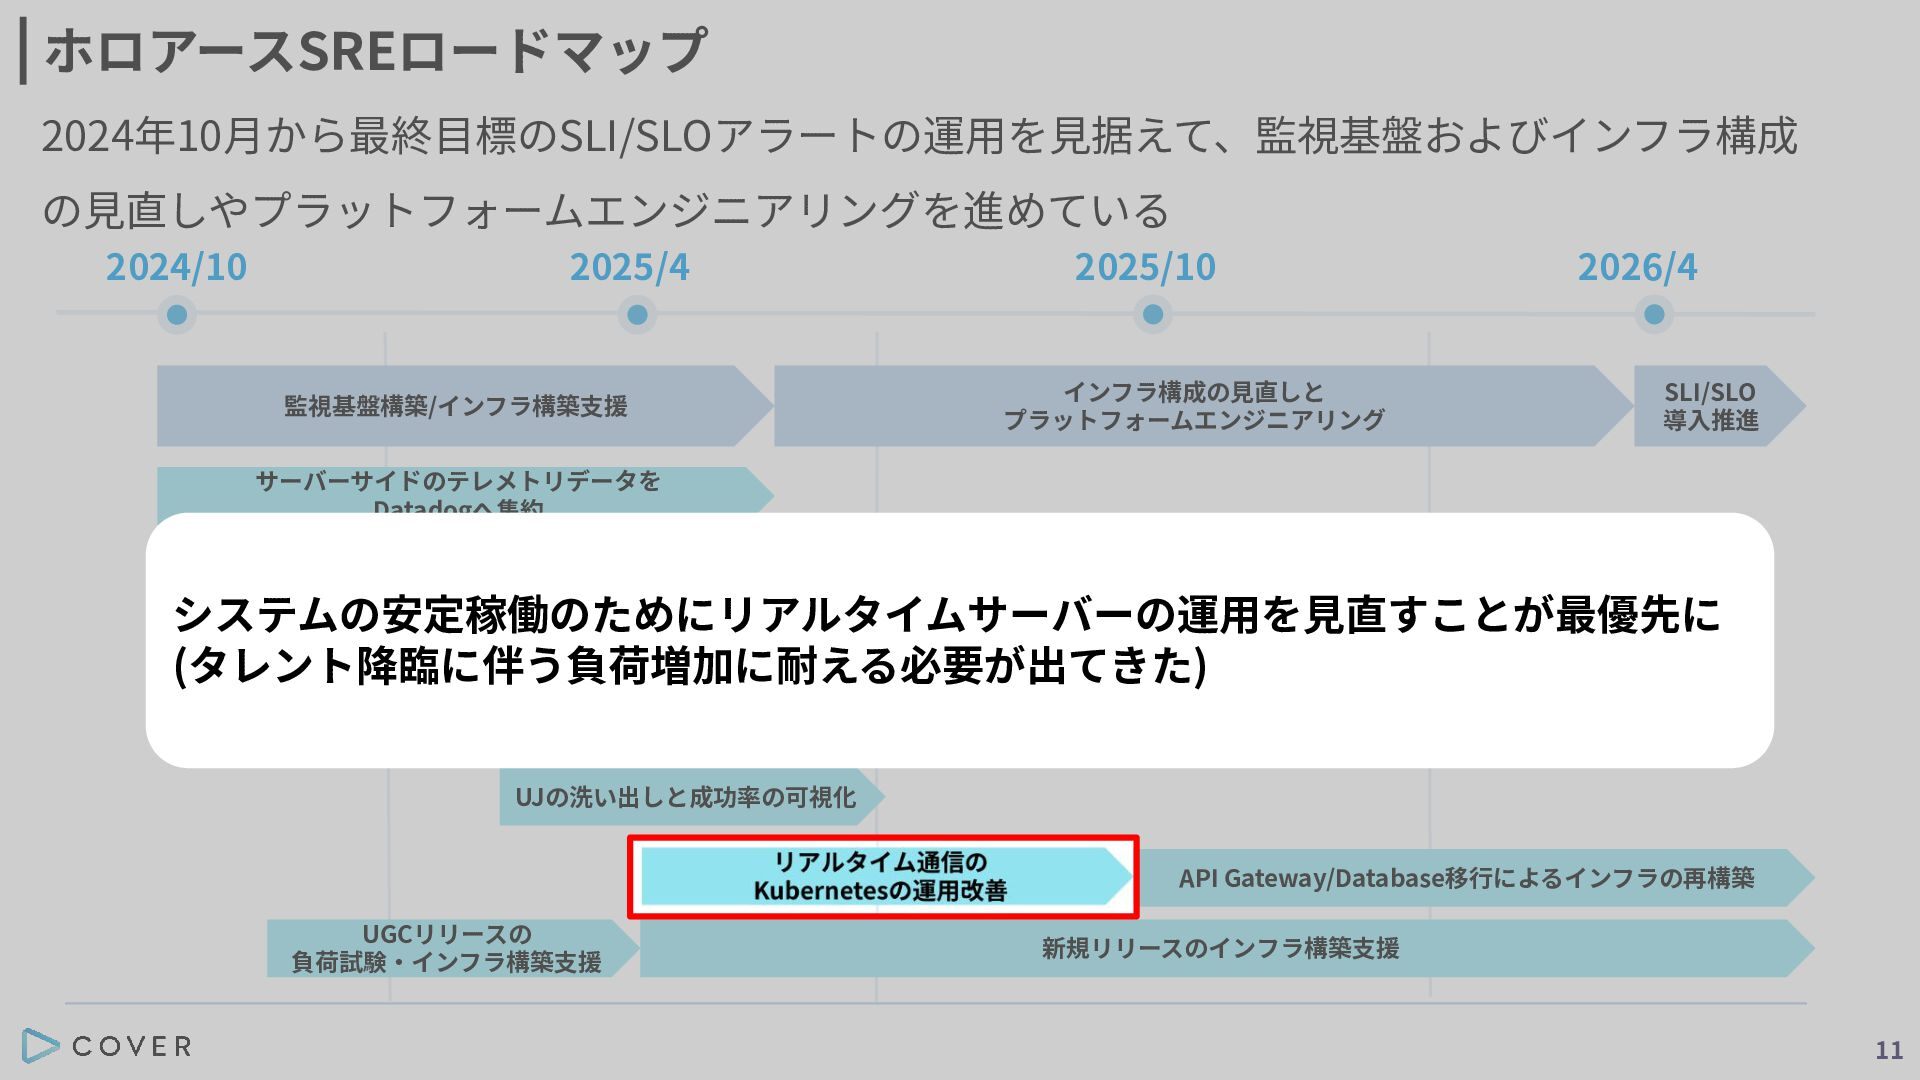
ホロアースSREロードマップ 2024年10⽉から最終⽬標のSLI/SLOアラートの運⽤を⾒据えて、監視基盤およびインフラ構成 の⾒直しやプラットフォームエンジニアリングを進めている 2024/10 2025/4 2025/10 インフラ構成の⾒直しと プラットフォームエンジニアリング 監視基盤構築/インフラ構築⽀援 2026/4
SLI/SLO 導⼊推進 サーバーサイドのテレメトリデータを Datadogへ集約 クライアントサイドへの Sentry導⼊ システムの安定稼働のためにリアルタイムサーバーの運⽤を⾒直すことが最優先に SLO導⼊計画策定 (タレント降臨に伴う負荷増加に耐える必要が出てきた) アラート運⽤改善 エラートラッキング実装 UJの洗い出しと成功率の可視化 リアルタイム通信の Kubernetesの運⽤改善 UGCリリースの 負荷試験‧インフラ構築⽀援 API Gateway/Database移⾏によるインフラの再構築 新規リリースのインフラ構築⽀援 11 -
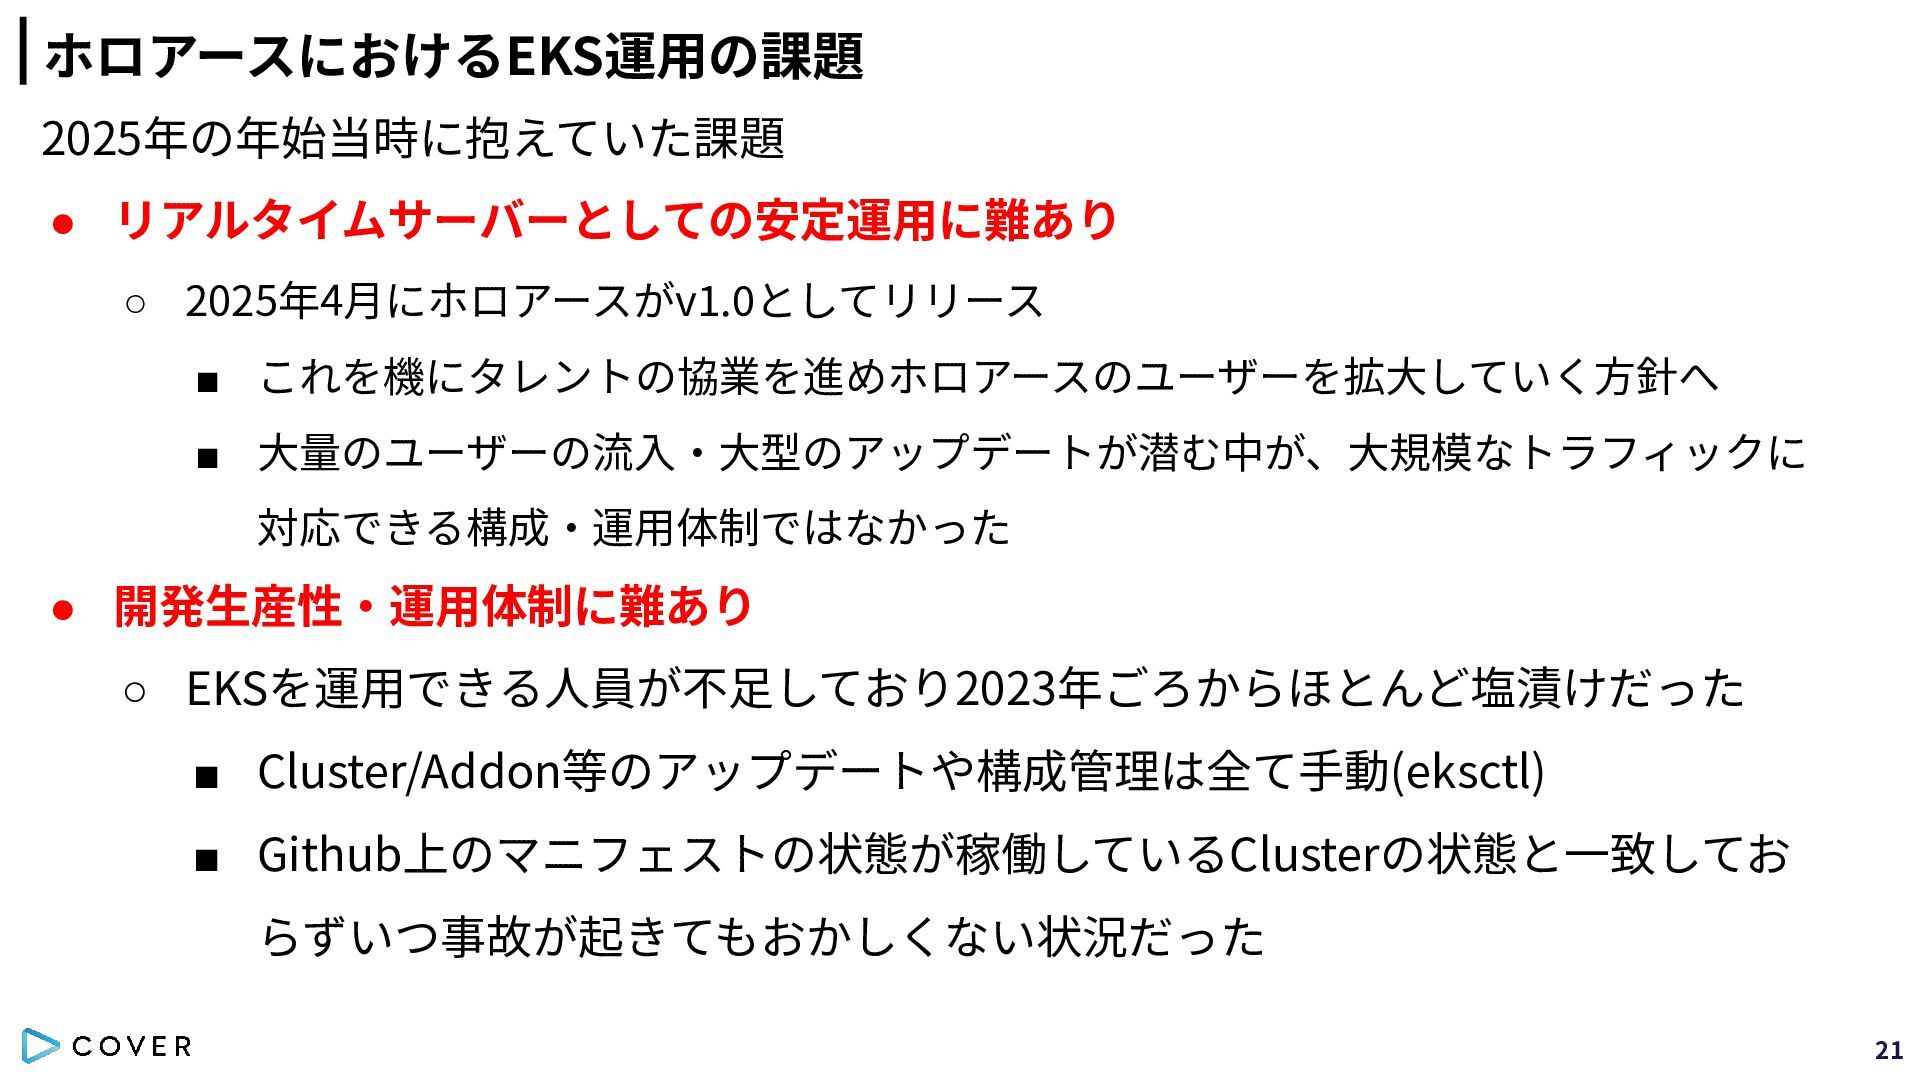
ホロアースにおけるEKS運⽤の課題 2025年の年始当時に抱えていた課題 • リアルタイムサーバーとしての安定運⽤に難あり ◦ 2025年4⽉にホロアースがv1.0としてリリース ▪ これを機にタレントの協業を進めホロアースのユーザーを拡⼤していく⽅針へ ▪ ⼤量のユーザーの流⼊‧⼤型のアップデートが潜む中が、⼤規模なトラフィックに
対応できる構成‧運⽤体制ではなかった • 開発⽣産性‧運⽤体制に難あり ◦ EKSを運⽤できる⼈員が不⾜しており2023年ごろからほとんど塩漬けだった ▪ Cluster/Addon等のアップデートや構成管理は全て⼿動(eksctl) ▪ Github上のマニフェストの状態が稼働しているClusterの状態と⼀致してお らずいつ事故が起きてもおかしくない状況だった 21 -
ホロアースにおけるEKS運⽤の課題 2025年の年始当時に抱えていた課題 • リアルタイムサーバーとしての安定運⽤に難あり ◦ 2025年4⽉にホロアースがv1.0としてリリース ▪ これを機にタレントの協業を進めホロアースのユーザーを拡⼤していく⽅針へ ▪ ⼤量のユーザーの流⼊‧⼤型のアップデートが潜む中が、⼤規模なトラフィックに
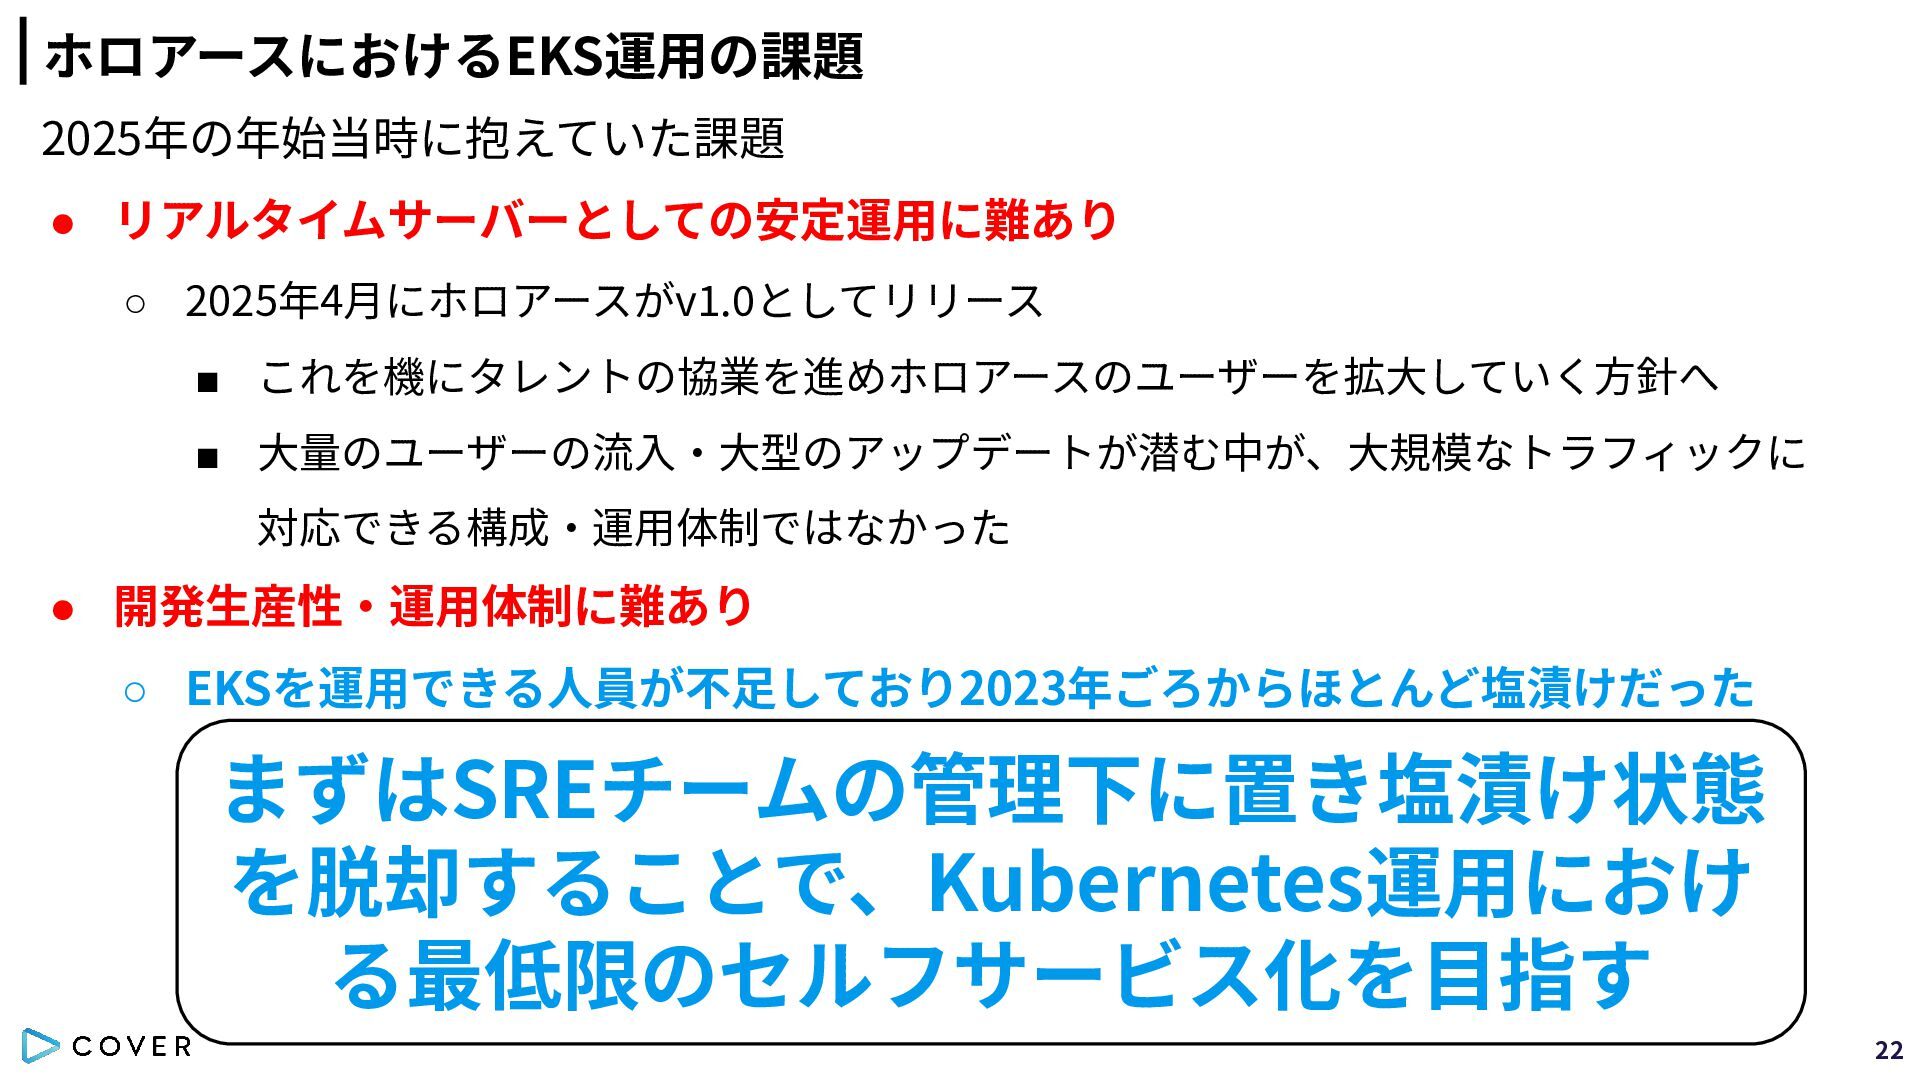
対応できる構成‧運⽤体制ではなかった • 開発⽣産性‧運⽤体制に難あり ◦ EKSを運⽤できる⼈員が不⾜しており2023年ごろからほとんど塩漬けだった ▪ Cluster/Addon等のアップデートや構成管理は全て⼿動(eksctl) まずはSREチームの管理下に置き塩漬け状態 ▪ Github上のマニフェストの状態が稼働しているClusterの状態と⼀致してお を脱却することで、Kubernetes運⽤におけ らずいつ事故が起きてもおかしくない状況だった る最低限のセルフサービス化を⽬指す 22 -
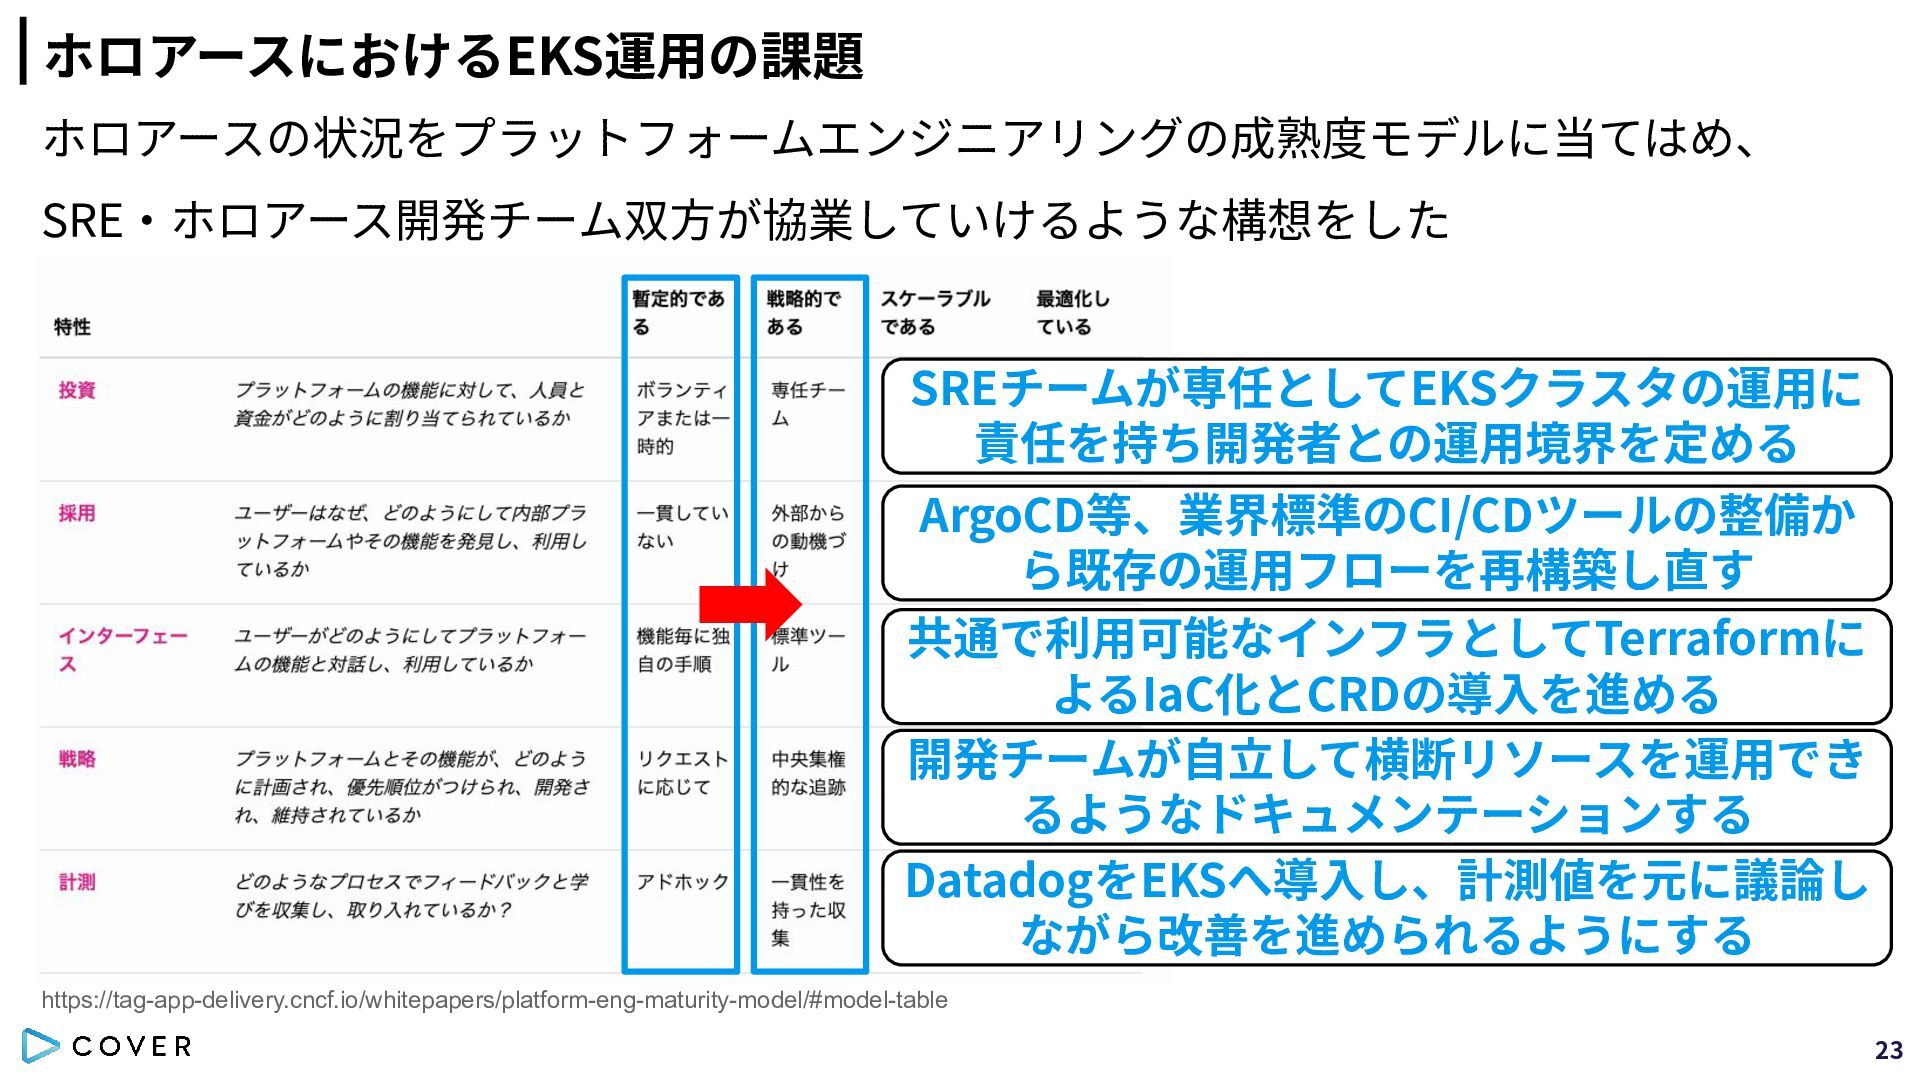
ホロアースにおけるEKS運⽤の課題 ホロアースの状況をプラットフォームエンジニアリングの成熟度モデルに当てはめ、 SRE‧ホロアース開発チーム双⽅が協業していけるような構想をした SREチームが専任としてEKSクラスタの運⽤に 責任を持ち開発者との運⽤境界を定める ArgoCD等、業界標準のCI/CDツールの整備か ら既存の運⽤フローを再構築し直す 共通で利⽤可能なインフラとしてTerraformに よるIaC化とCRDの導⼊を進める 開発チームが⾃⽴して横断リソースを運⽤でき
るようなドキュメンテーションする DatadogをEKSへ導⼊し、計測値を元に議論し ながら改善を進められるようにする https://tag-app-delivery.cncf.io/whitepapers/platform-eng-maturity-model/#model-table 23 -
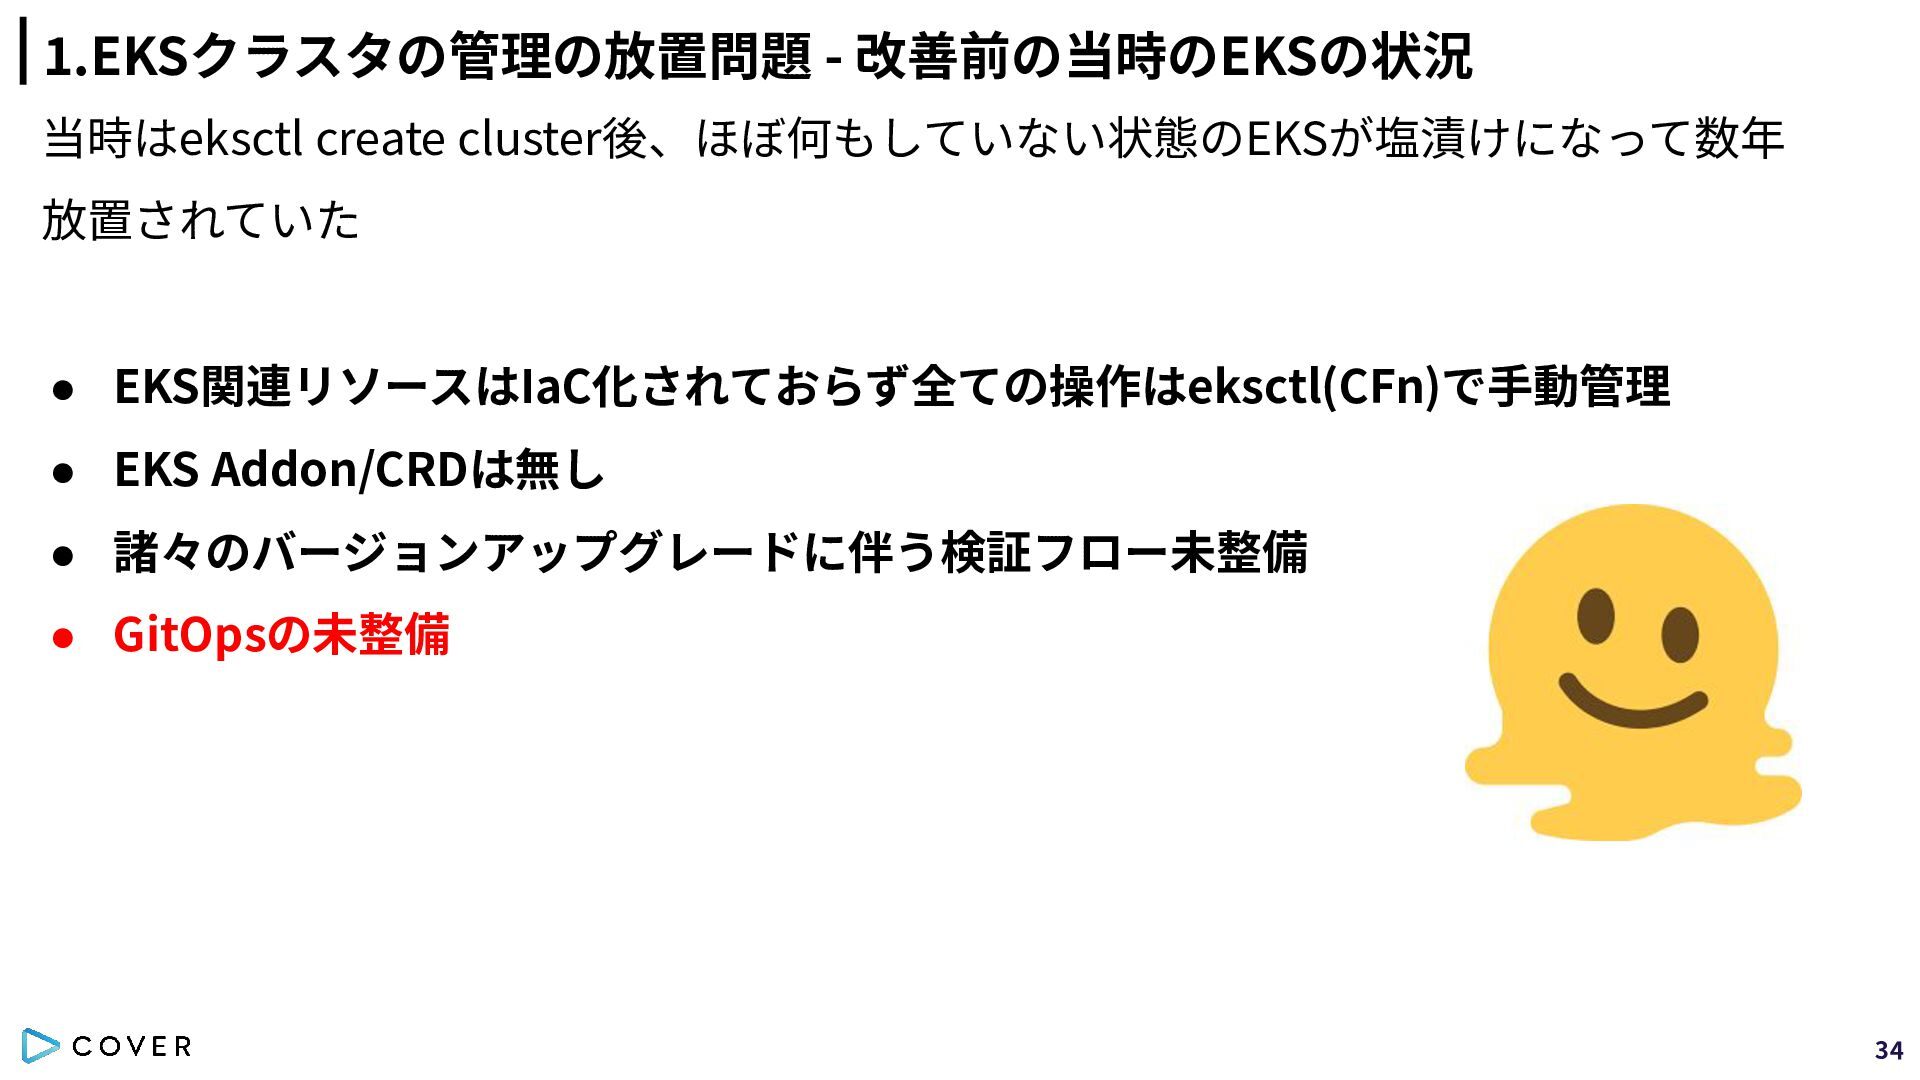
1.EKSクラスタの管理の放置問題 - 改善前の当時のEKSの状況 当時はeksctl create cluster後、ほぼ何もしていない状態のEKSが塩漬けになって数年 放置されていた • EKS関連リソースはIaC化されておらず全ての操作はeksctl(CFn)で⼿動管理 •
EKS Addon/CRDは無し • 諸々のバージョンアップグレードに伴う検証フロー未整備 • GitOpsの未整備 27 -
1.EKSクラスタの管理の放置問題 - 改善前の当時のEKSの状況 当時はeksctl create cluster後、ほぼ何もしていない状態のEKSが塩漬けになって数年 放置されていた • EKS関連リソースはIaC化されておらず全ての操作はeksctl(CFn)で⼿動管理 •
EKS Addon/CRDは無し • 諸々のバージョンアップグレードに伴う検証フロー未整備 • GitOpsの未整備 29 -
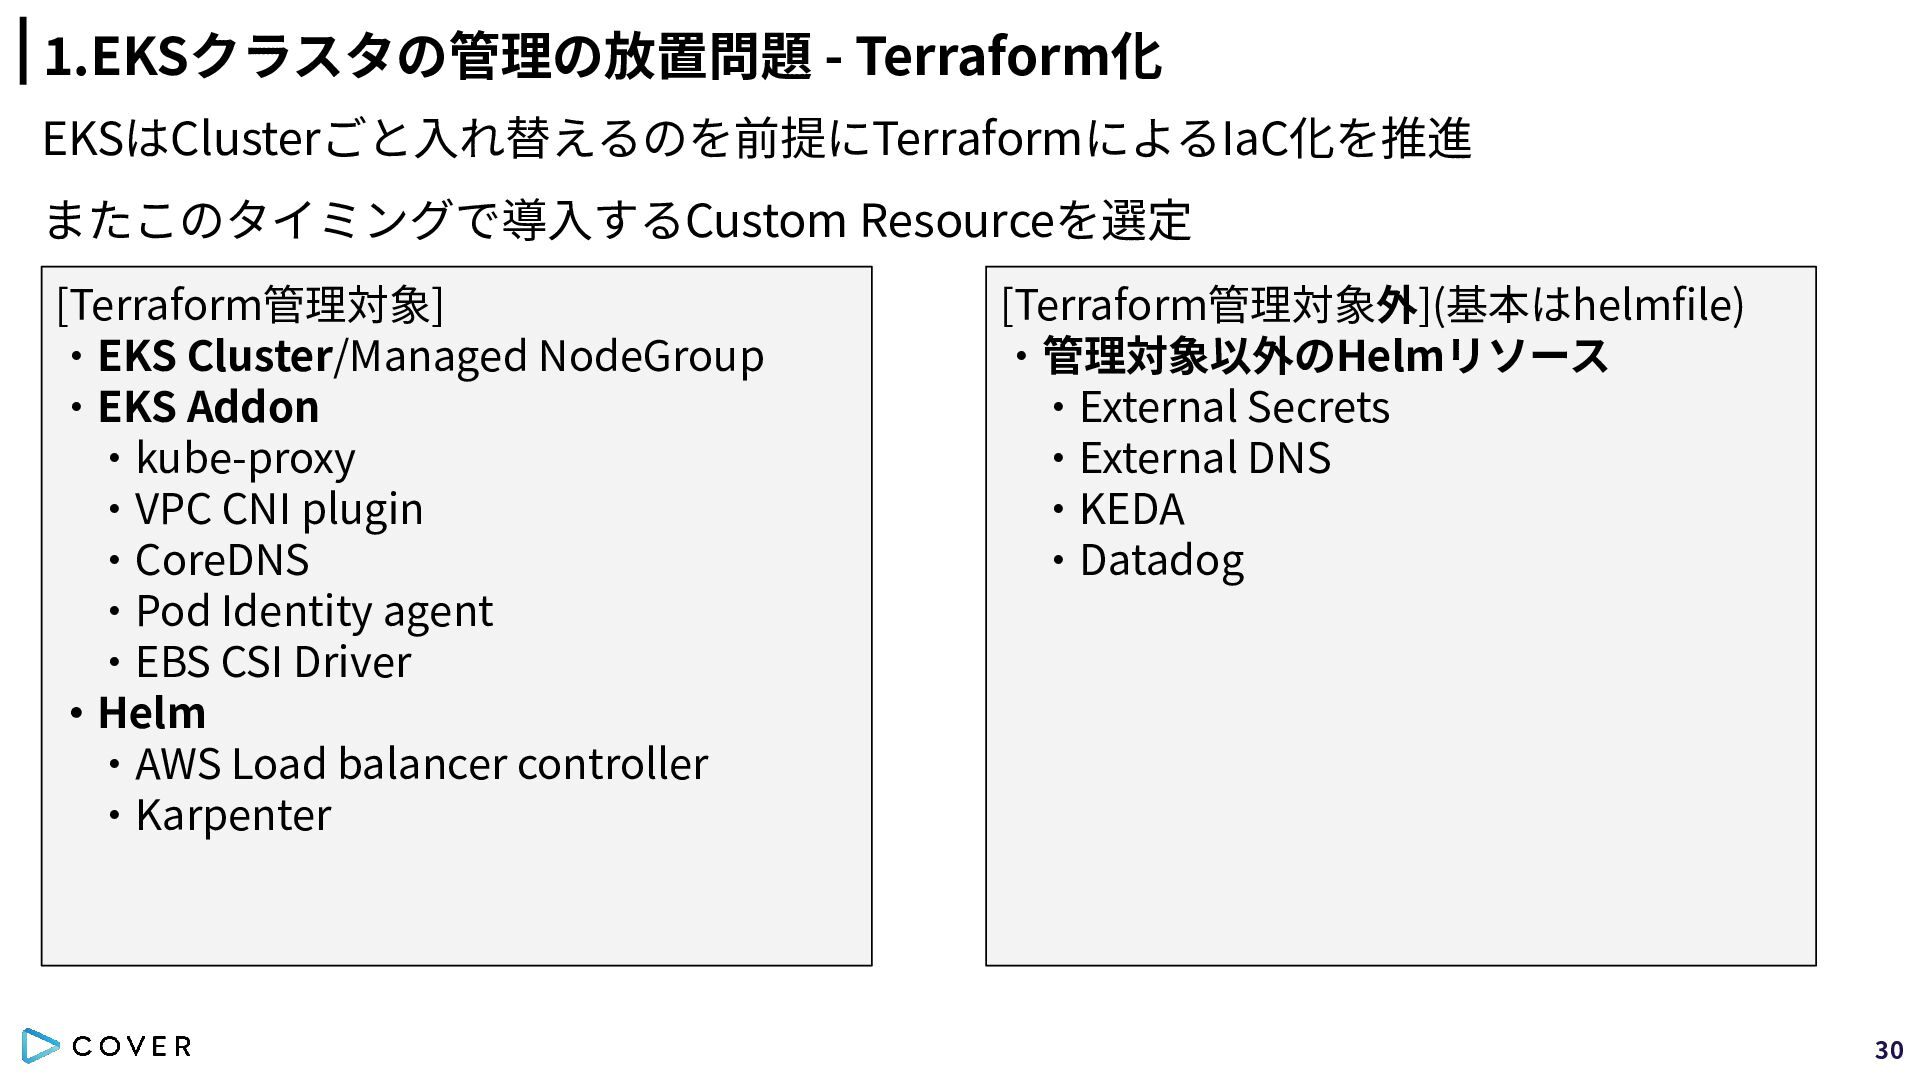
1.EKSクラスタの管理の放置問題 - Terraform化 EKSはClusterごと⼊れ替えるのを前提にTerraformによるIaC化を推進 またこのタイミングで導⼊するCustom Resourceを選定 [Terraform管理対象] ‧EKS Cluster/Managed NodeGroup
‧EKS Addon ‧kube-proxy ‧VPC CNI plugin ‧CoreDNS ‧Pod Identity agent ‧EBS CSI Driver ‧Helm ‧AWS Load balancer controller ‧Karpenter [Terraform管理対象外](基本はhelmfile) ‧管理対象以外のHelmリソース ‧External Secrets ‧External DNS ‧KEDA ‧Datadog 30 -
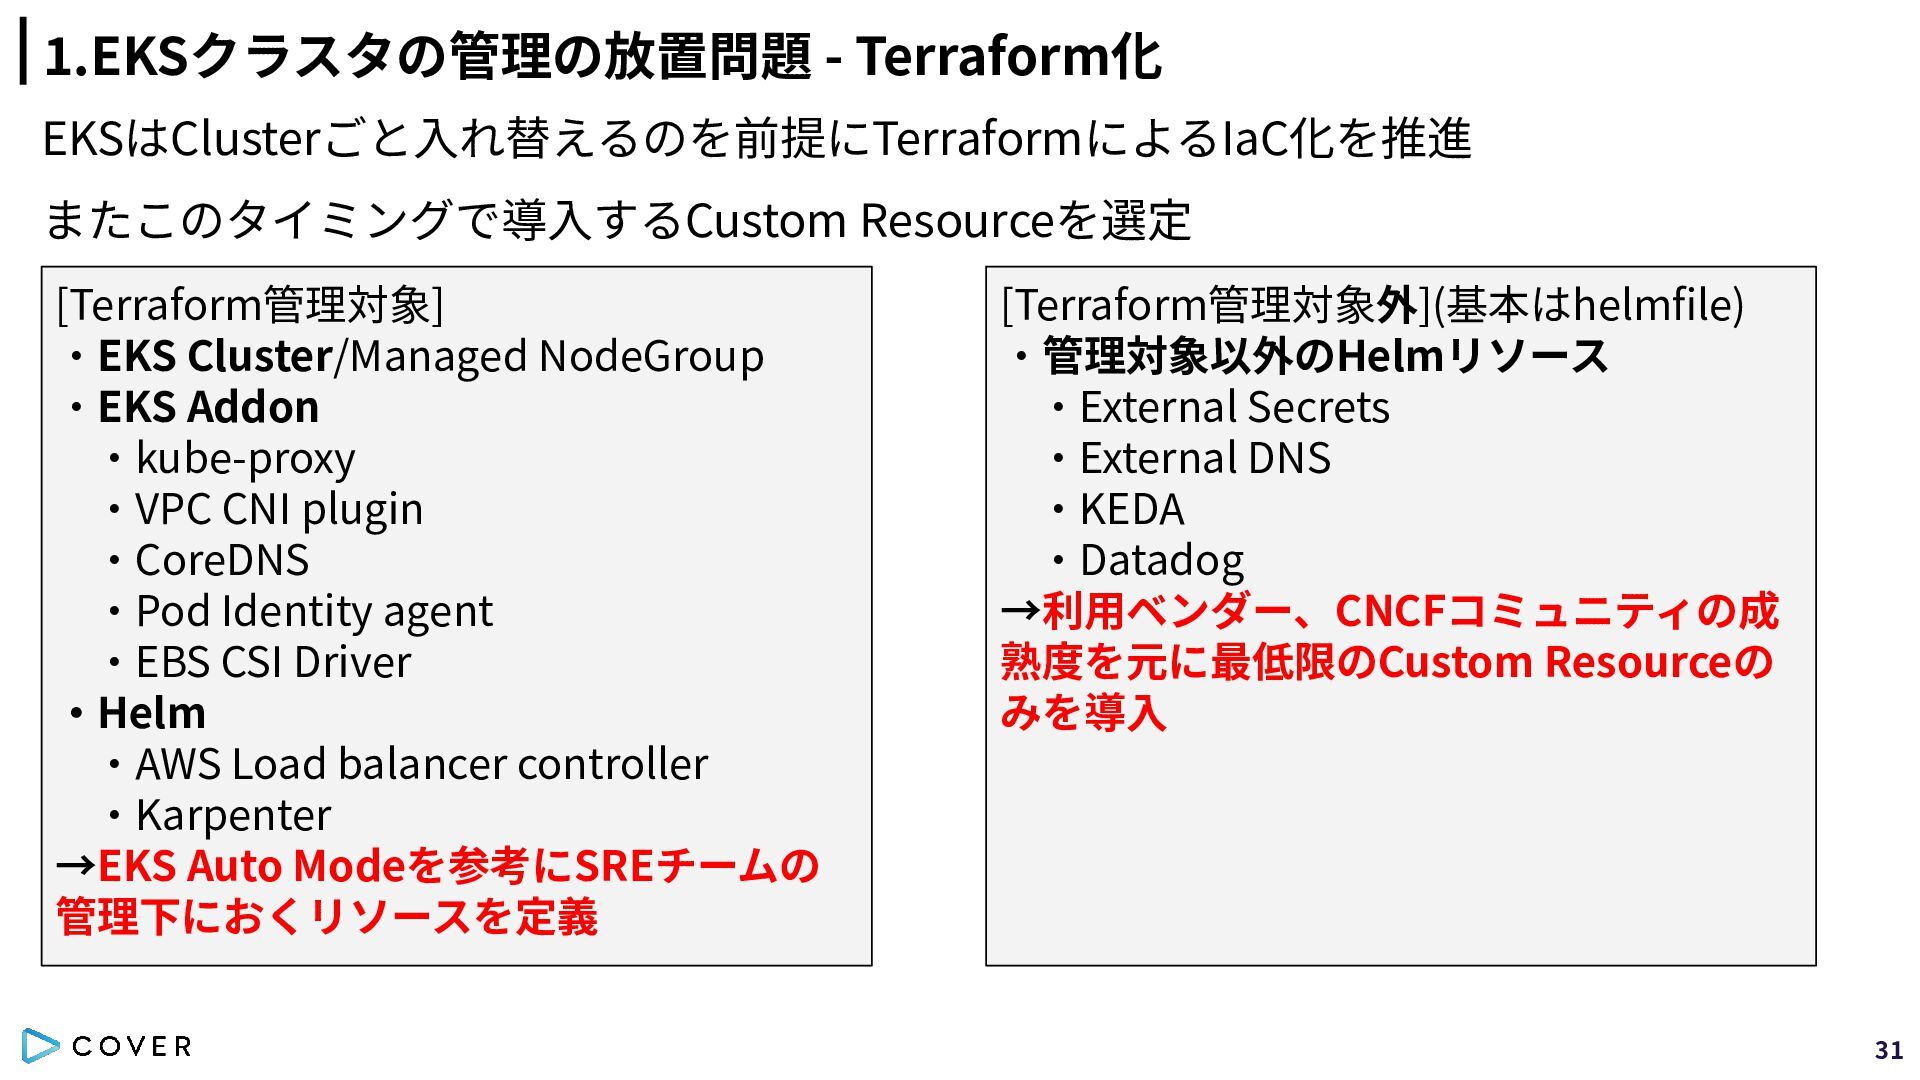
1.EKSクラスタの管理の放置問題 - Terraform化 EKSはClusterごと⼊れ替えるのを前提にTerraformによるIaC化を推進 またこのタイミングで導⼊するCustom Resourceを選定 [Terraform管理対象] ‧EKS Cluster/Managed NodeGroup
‧EKS Addon ‧kube-proxy ‧VPC CNI plugin ‧CoreDNS ‧Pod Identity agent ‧EBS CSI Driver ‧Helm ‧AWS Load balancer controller ‧Karpenter →EKS Auto Modeを参考にSREチームの 管理下におくリソースを定義 [Terraform管理対象外](基本はhelmfile) ‧管理対象以外のHelmリソース ‧External Secrets ‧External DNS ‧KEDA ‧Datadog →利⽤ベンダー、CNCFコミュニティの成 熟度を元に最低限のCustom Resourceの みを導⼊ 31 -
1.EKSクラスタの管理の放置問題 - 改善前の当時のEKSの状況 当時はeksctl create cluster後、ほぼ何もしていない状態のEKSが塩漬けになって数年 放置されていた • EKS関連リソースはIaC化されておらず全ての操作はeksctl(CFn)で⼿動管理 •
EKS Addon/CRDは無し • 諸々のバージョンアップグレードに伴う検証フロー未整備 • GitOpsの未整備 34 -
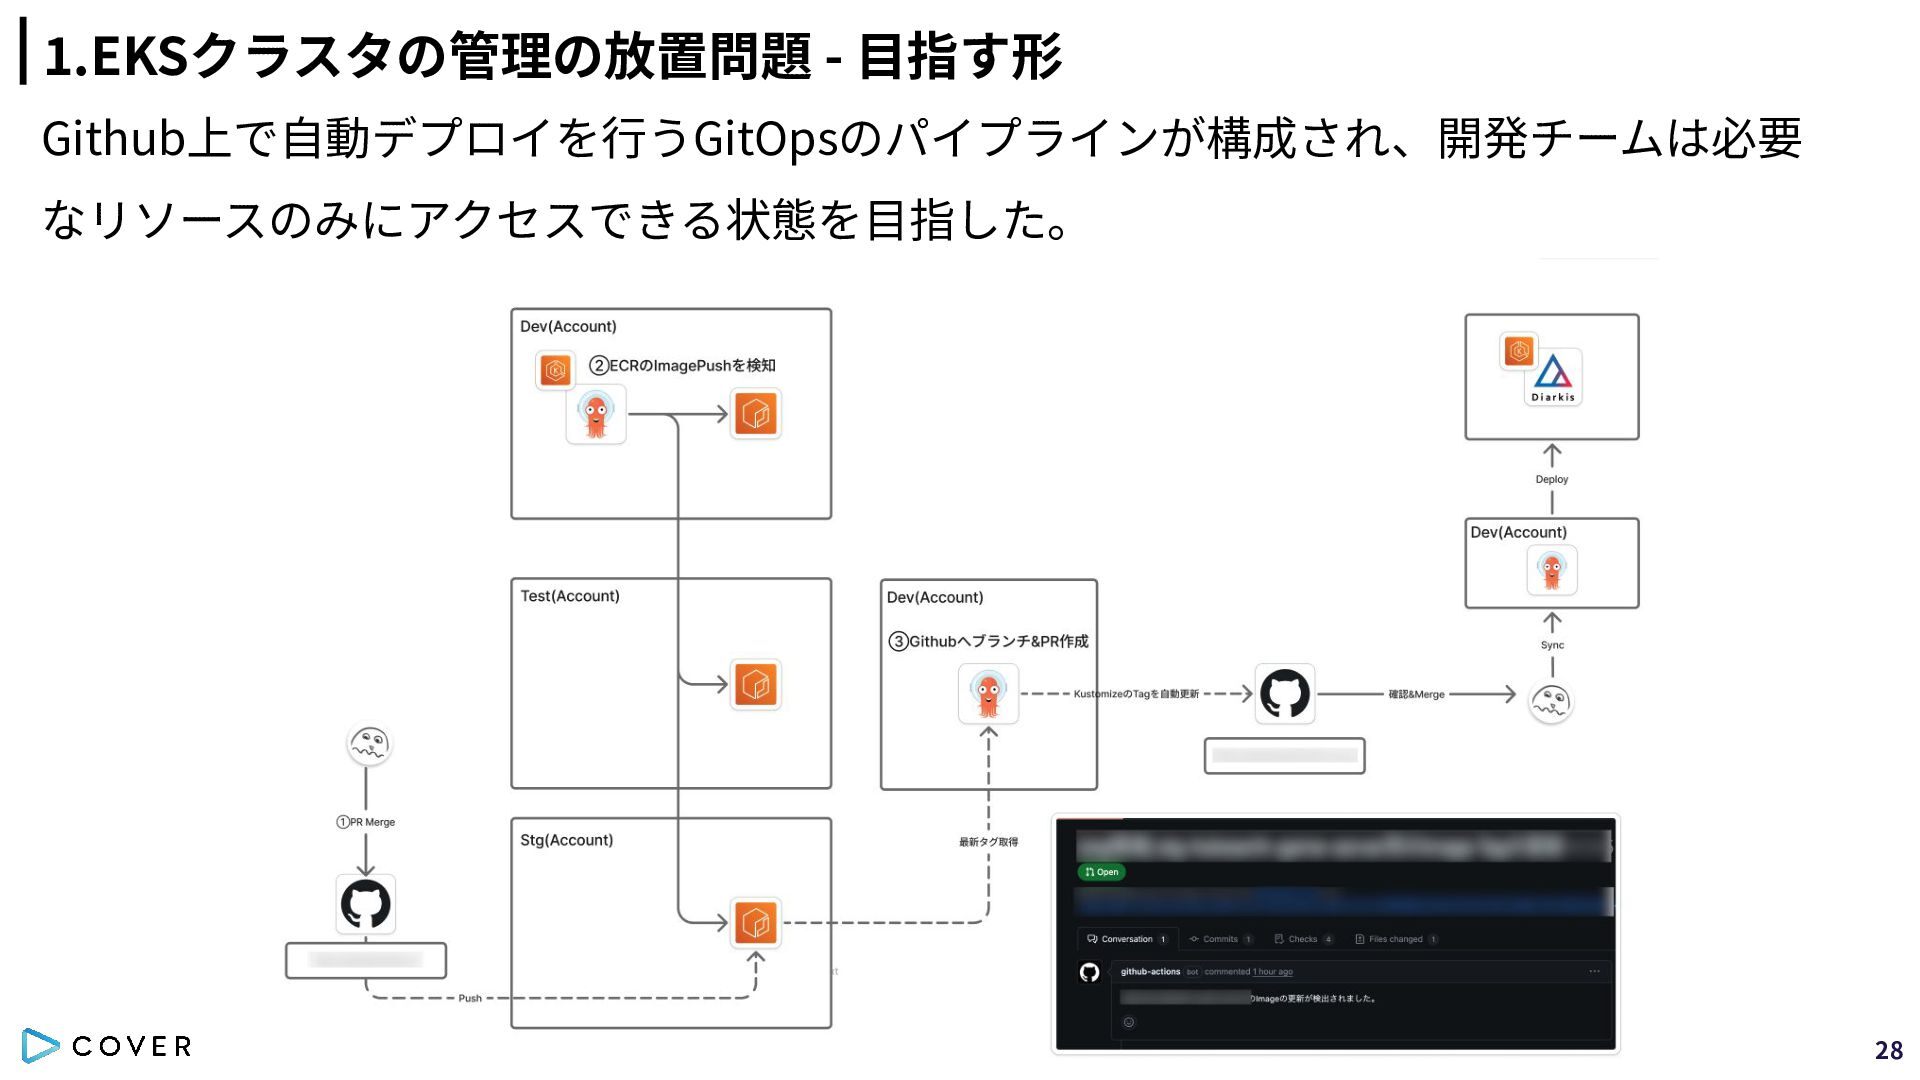
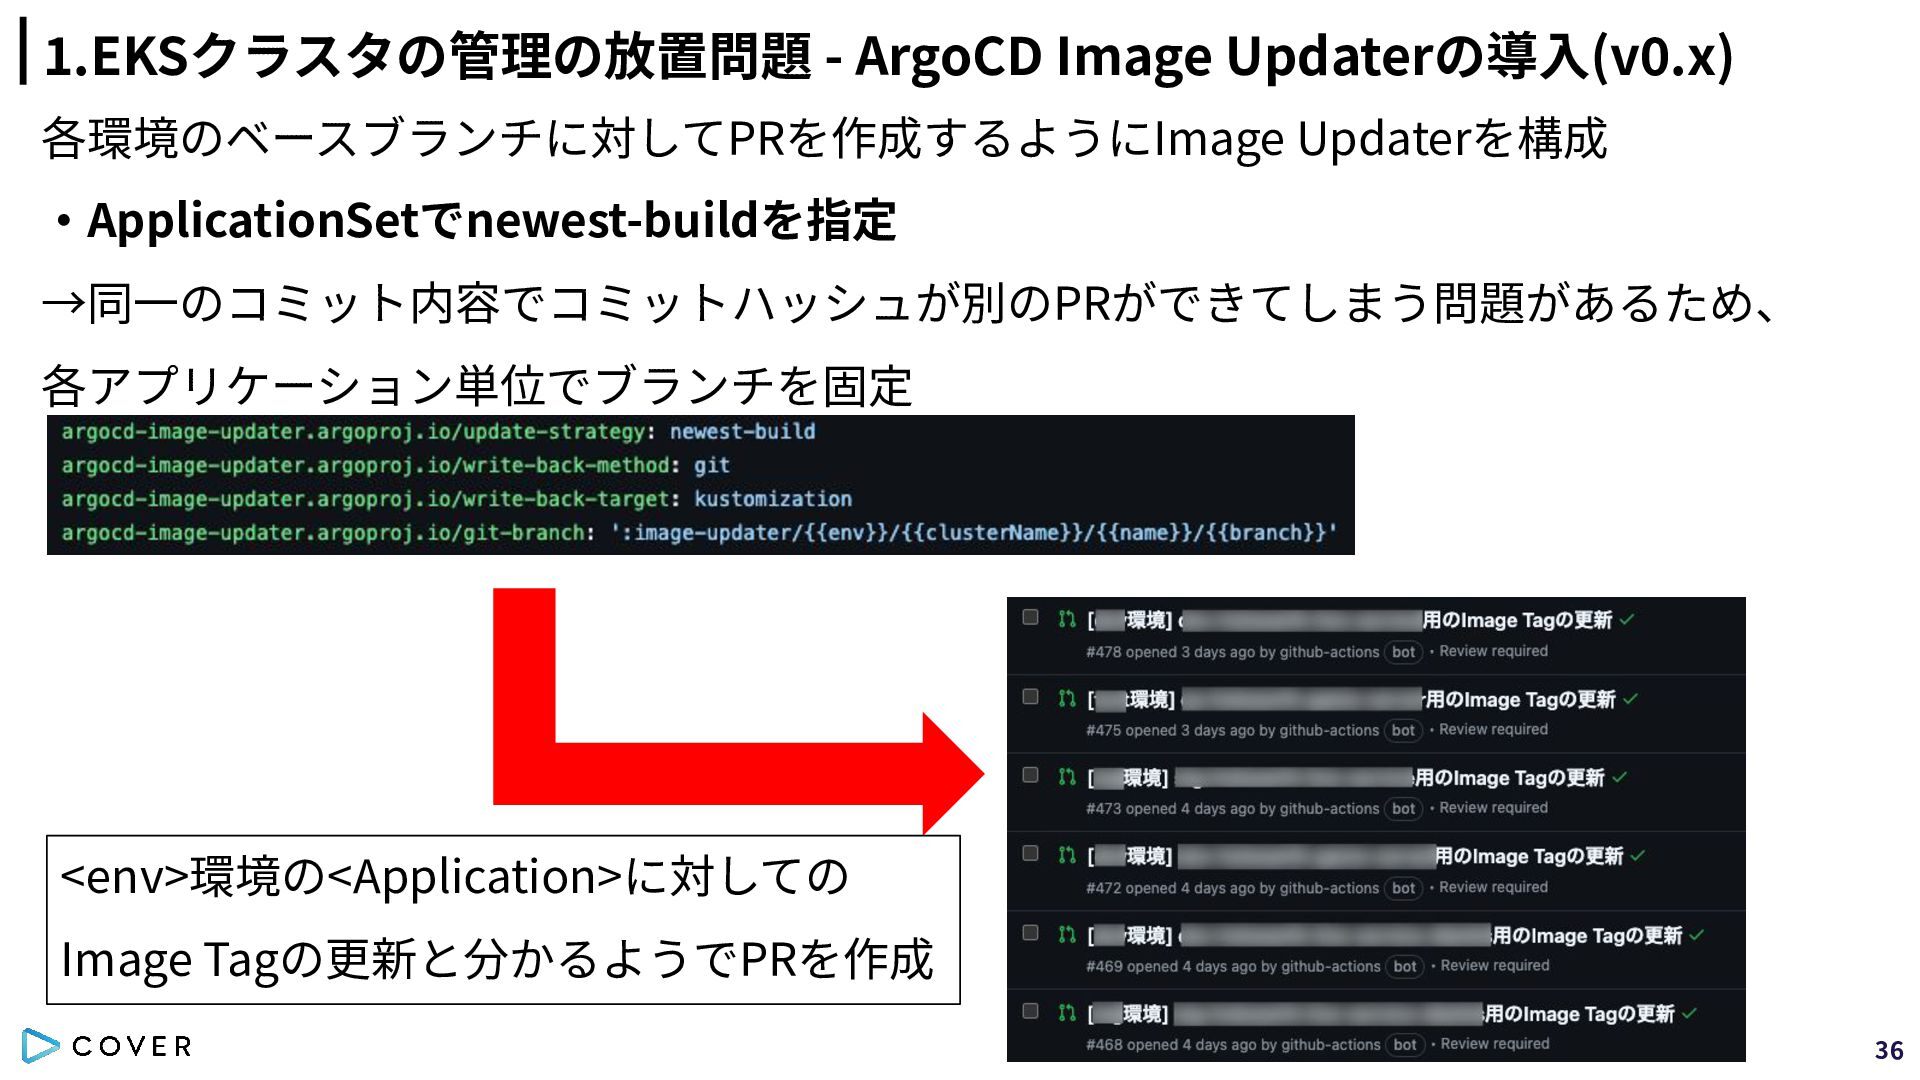
1.EKSクラスタの管理の放置問題 - ArgoCD Image Updaterの導⼊(v0.x) 各環境のベースブランチに対してPRを作成するようにImage Updaterを構成 ‧ApplicationSetでnewest-buildを指定 →同⼀のコミット内容でコミットハッシュが別のPRができてしまう問題があるため、 各アプリケーション単位でブランチを固定
<env>環境の<Application>に対しての Image Tagの更新と分かるようでPRを作成 36 -
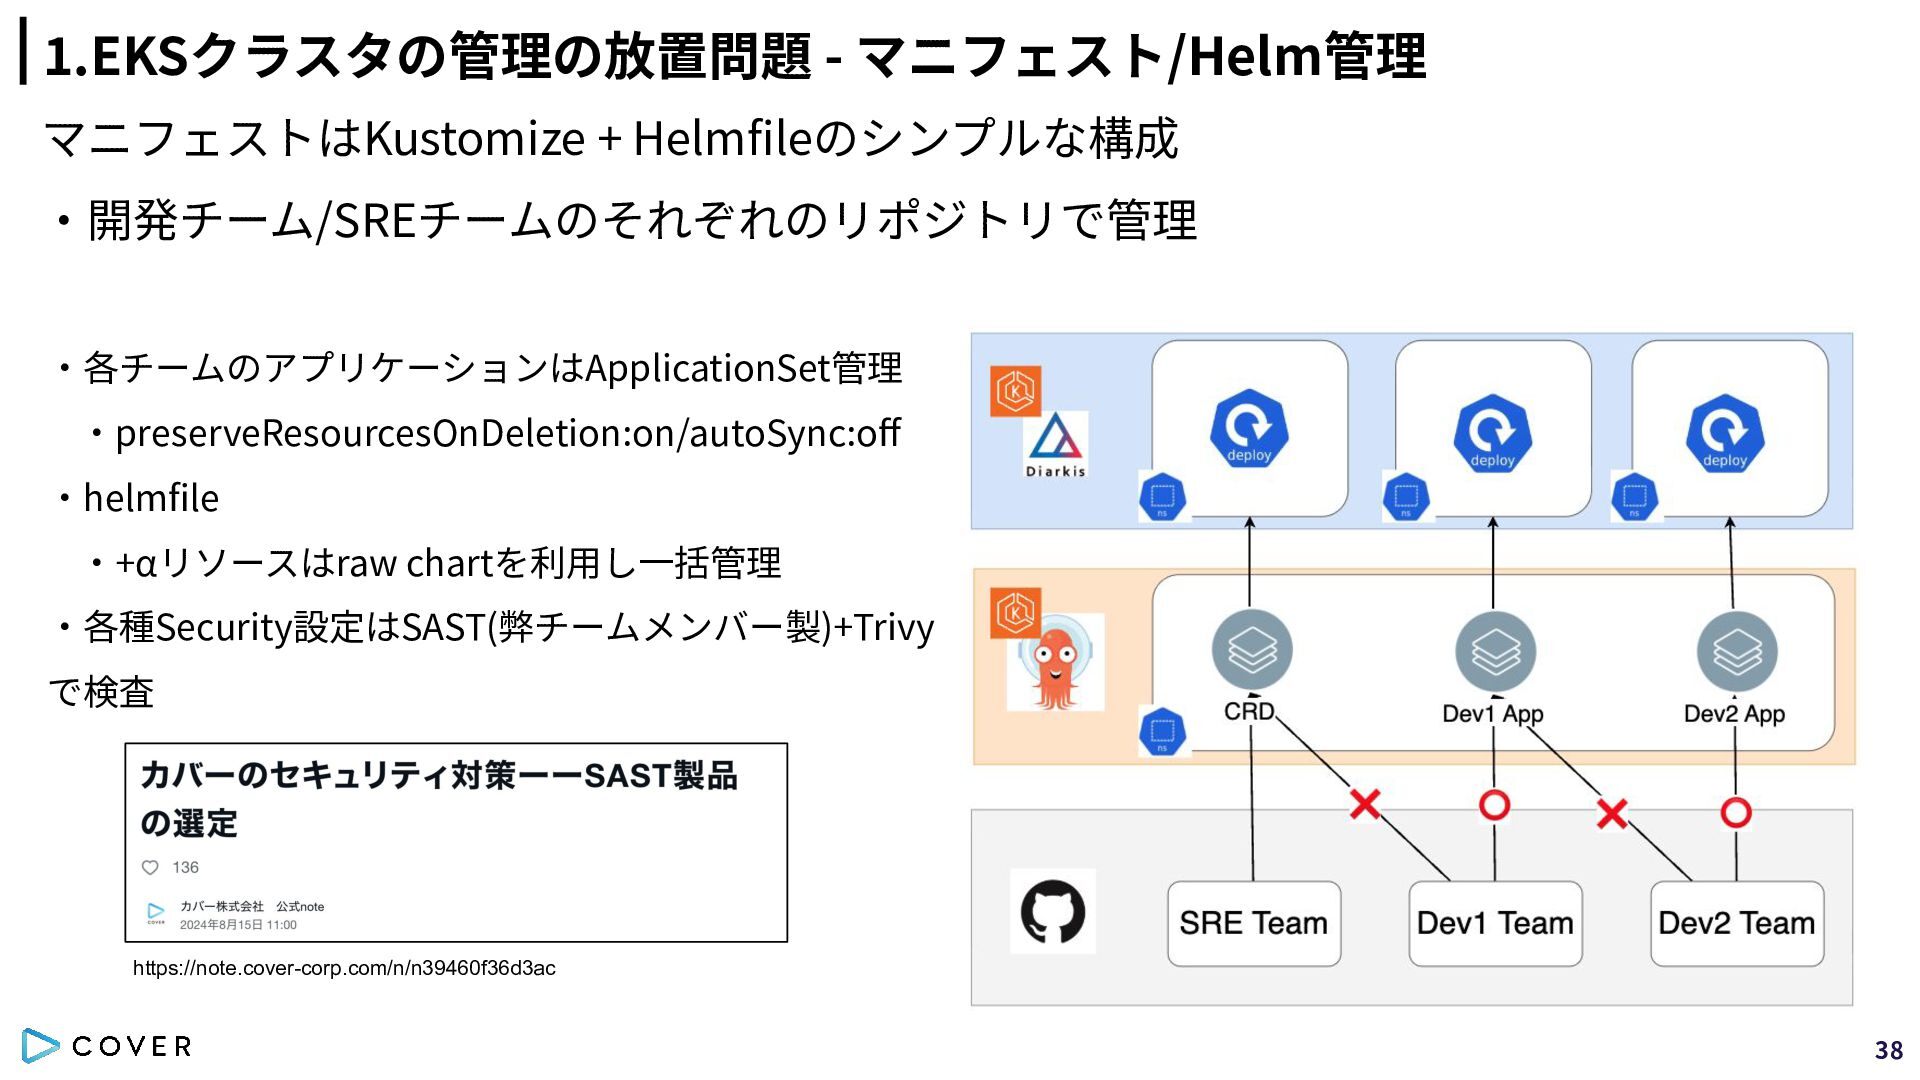
1.EKSクラスタの管理の放置問題 - マニフェスト/Helm管理 マニフェストはKustomize + Helmfileのシンプルな構成 ‧開発チーム/SREチームのそれぞれのリポジトリで管理 ‧各チームのアプリケーションはApplicationSet管理 ‧preserveResourcesOnDeletion:on/autoSync:off ‧helmfile
‧+αリソースはraw chartを利⽤し⼀括管理 ‧各種Security設定はSAST(弊チームメンバー製)+Trivy で検査 https://note.cover-corp.com/n/n39460f36d3ac 38 -
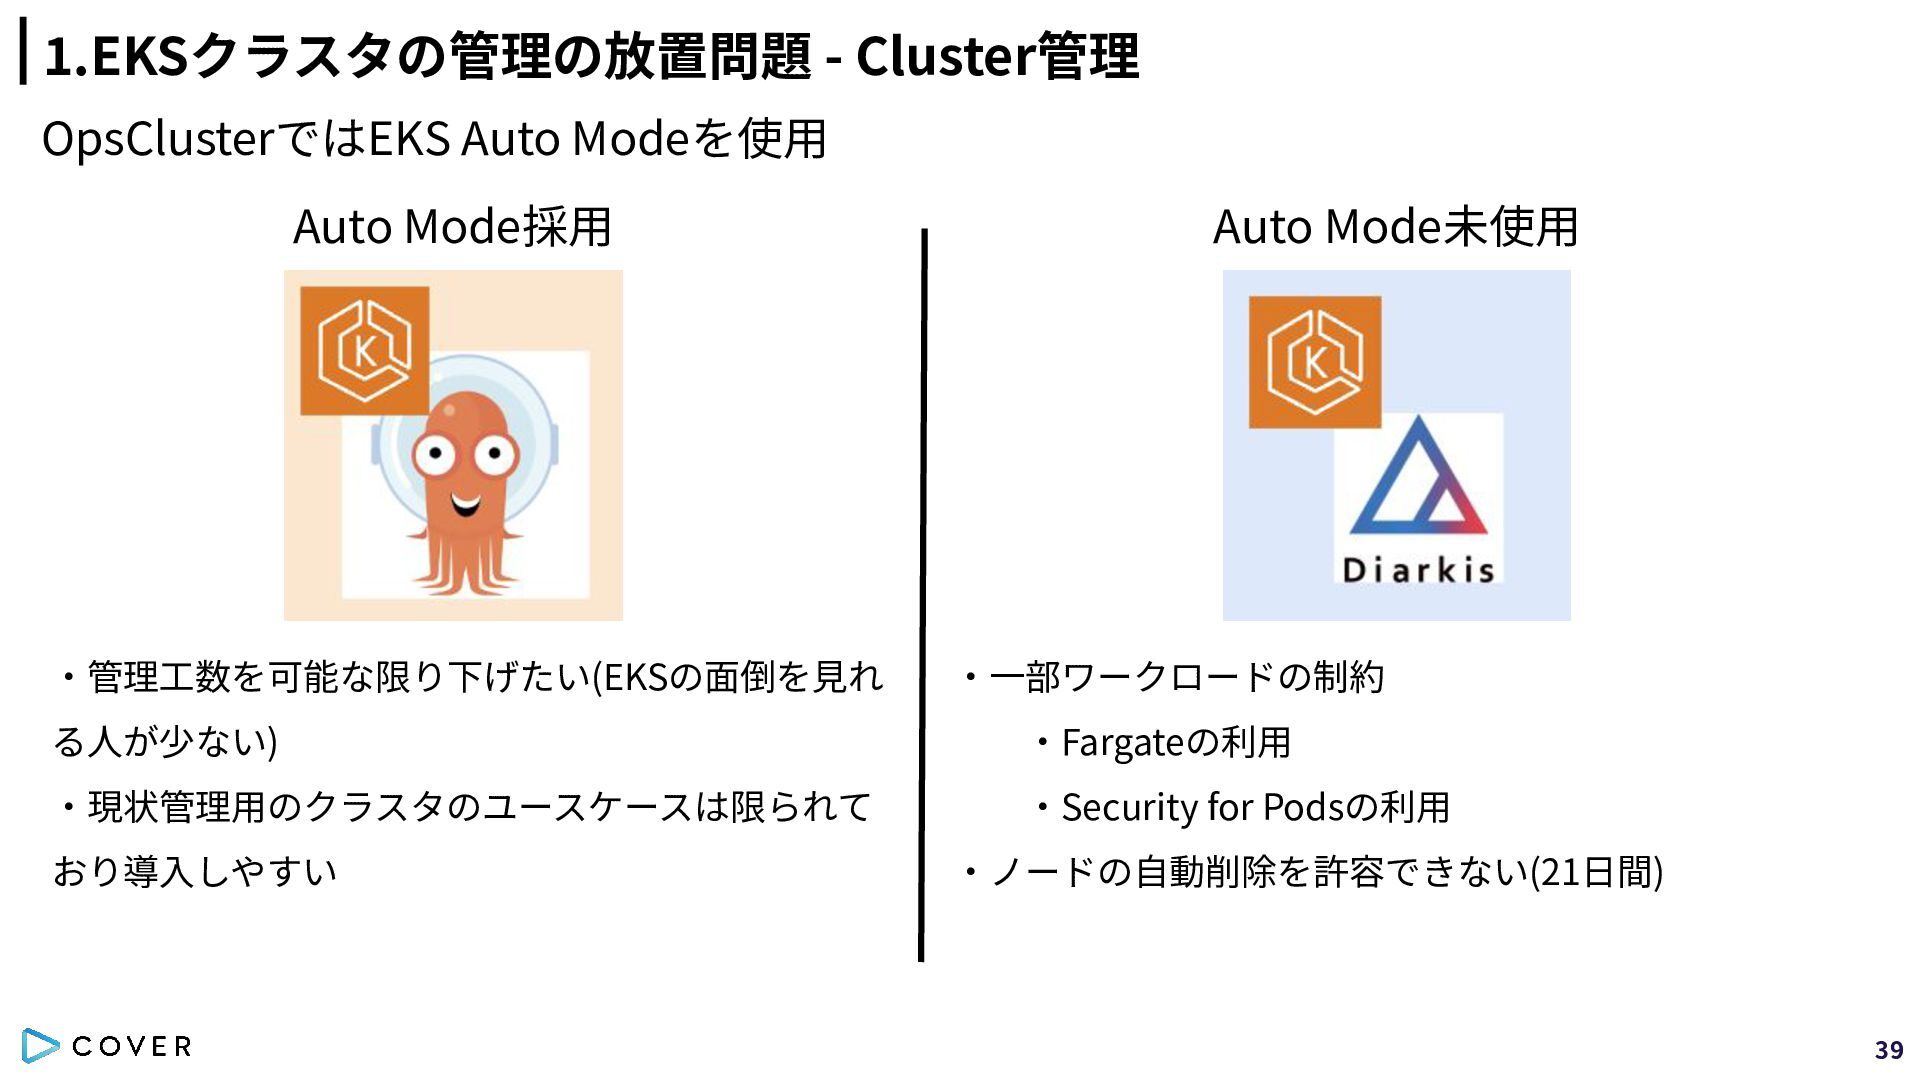
1.EKSクラスタの管理の放置問題 - Cluster管理 OpsClusterではEKS Auto Modeを使⽤ Auto Mode採⽤ ‧管理⼯数を可能な限り下げたい(EKSの⾯倒を⾒れ Auto
Mode未使⽤ ‧⼀部ワークロードの制約 る⼈が少ない) ‧Fargateの利⽤ ‧現状管理⽤のクラスタのユースケースは限られて ‧Security for Podsの利⽤ おり導⼊しやすい ‧ノードの⾃動削除を許容できない(21⽇間) 39 -
1.EKSクラスタの管理の放置問題 - 振り返り 変更容易性を⼿に⼊れワークロードクラスタに対してテコ⼊れがしやすくなった Terraformでリソースを管理を統⼀できたことで、マルチアカウントの EKSクラスタ、アドオンのバージョンを容易に統⼀可能に Org横断で利⽤可能なRenovateやtfactionのReusable Workflowの定義に より、簡単なセットアップでセキュリティ、バージョン管理が可能に Custom
Resourceはhelmfileで管理し、ManifestはArgoCD管理下に置く ことでGithubをSSoTとしたデプロイ基盤を構築 40 -
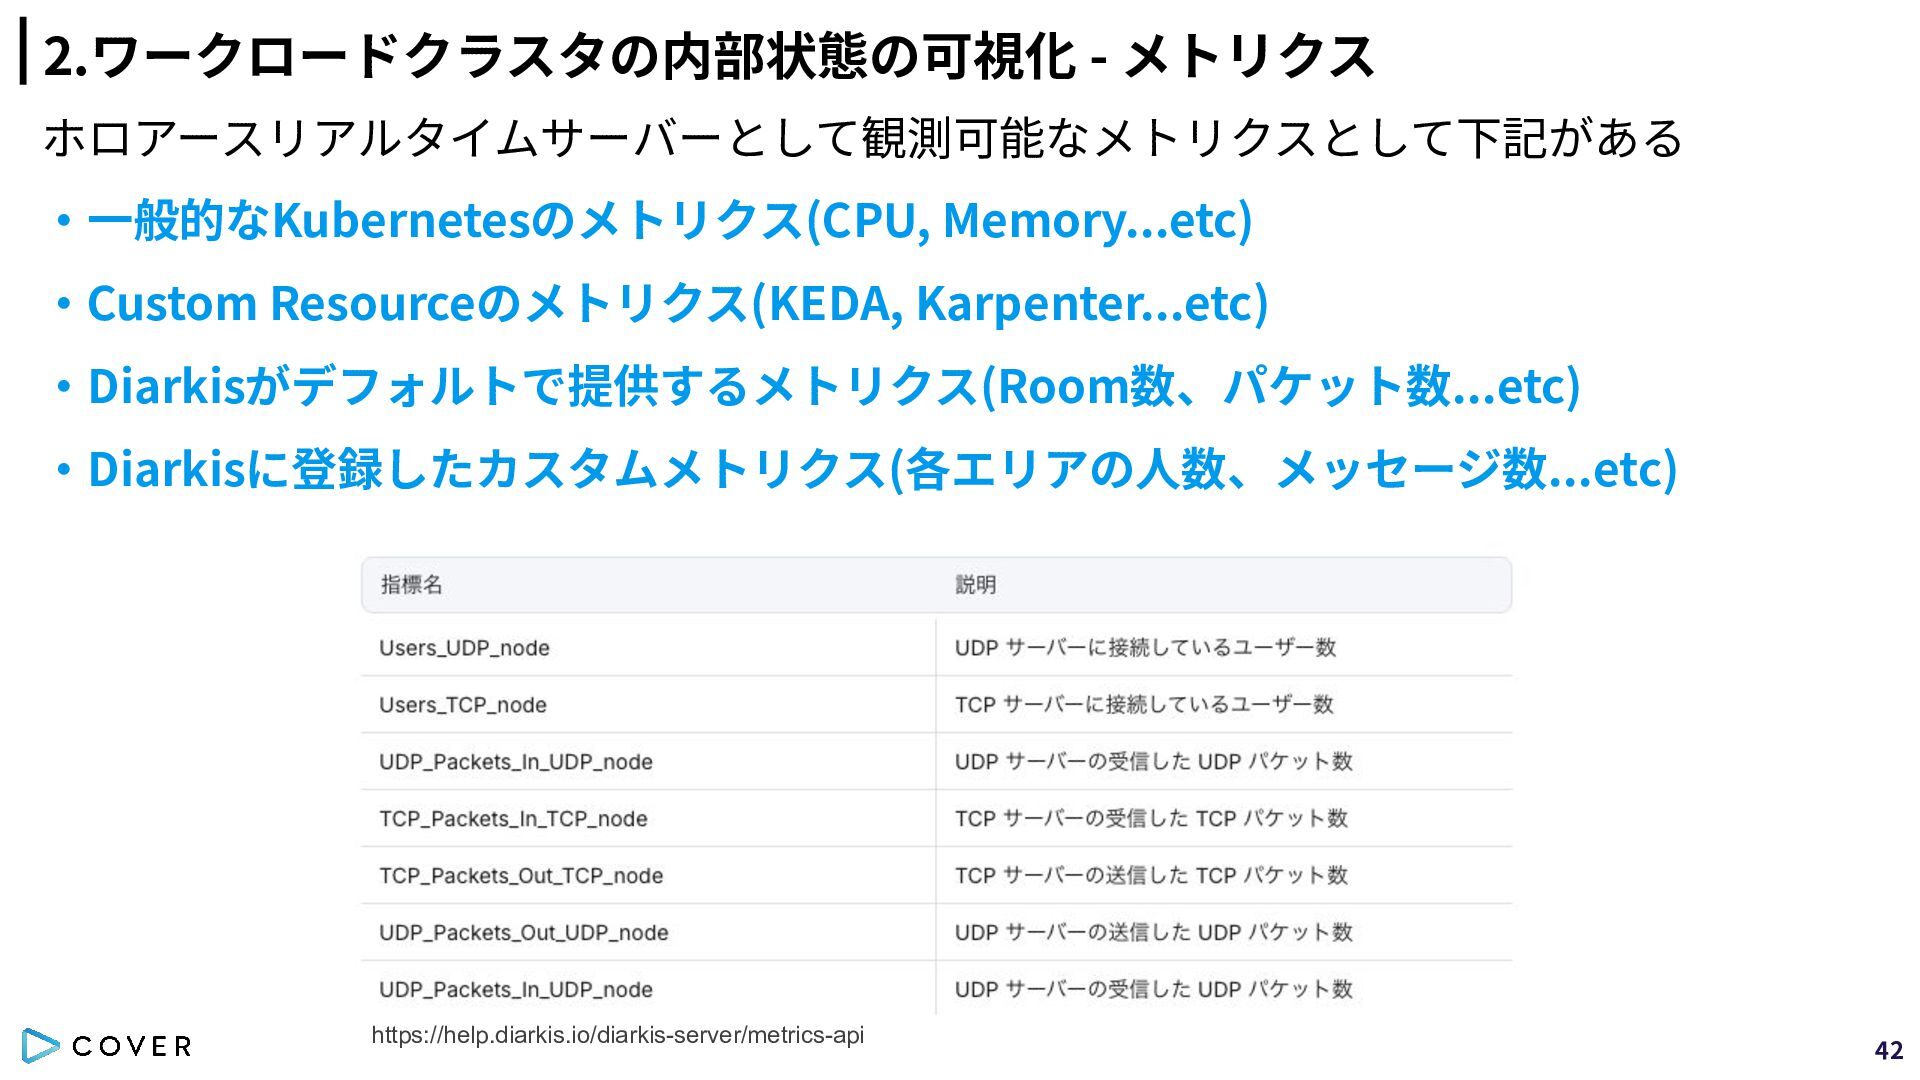
2.ワークロードクラスタの内部状態の可視化 - メトリクス ホロアースリアルタイムサーバーとして観測可能なメトリクスとして下記がある ‧⼀般的なKubernetesのメトリクス(CPU, Memory...etc) ‧Custom Resourceのメトリクス(KEDA, Karpenter...etc) ‧Diarkisがデフォルトで提供するメトリクス(Room数、パケット数...etc)
‧Diarkisに登録したカスタムメトリクス(各エリアの⼈数、メッセージ数...etc) https://help.diarkis.io/diarkis-server/metrics-api 42 -
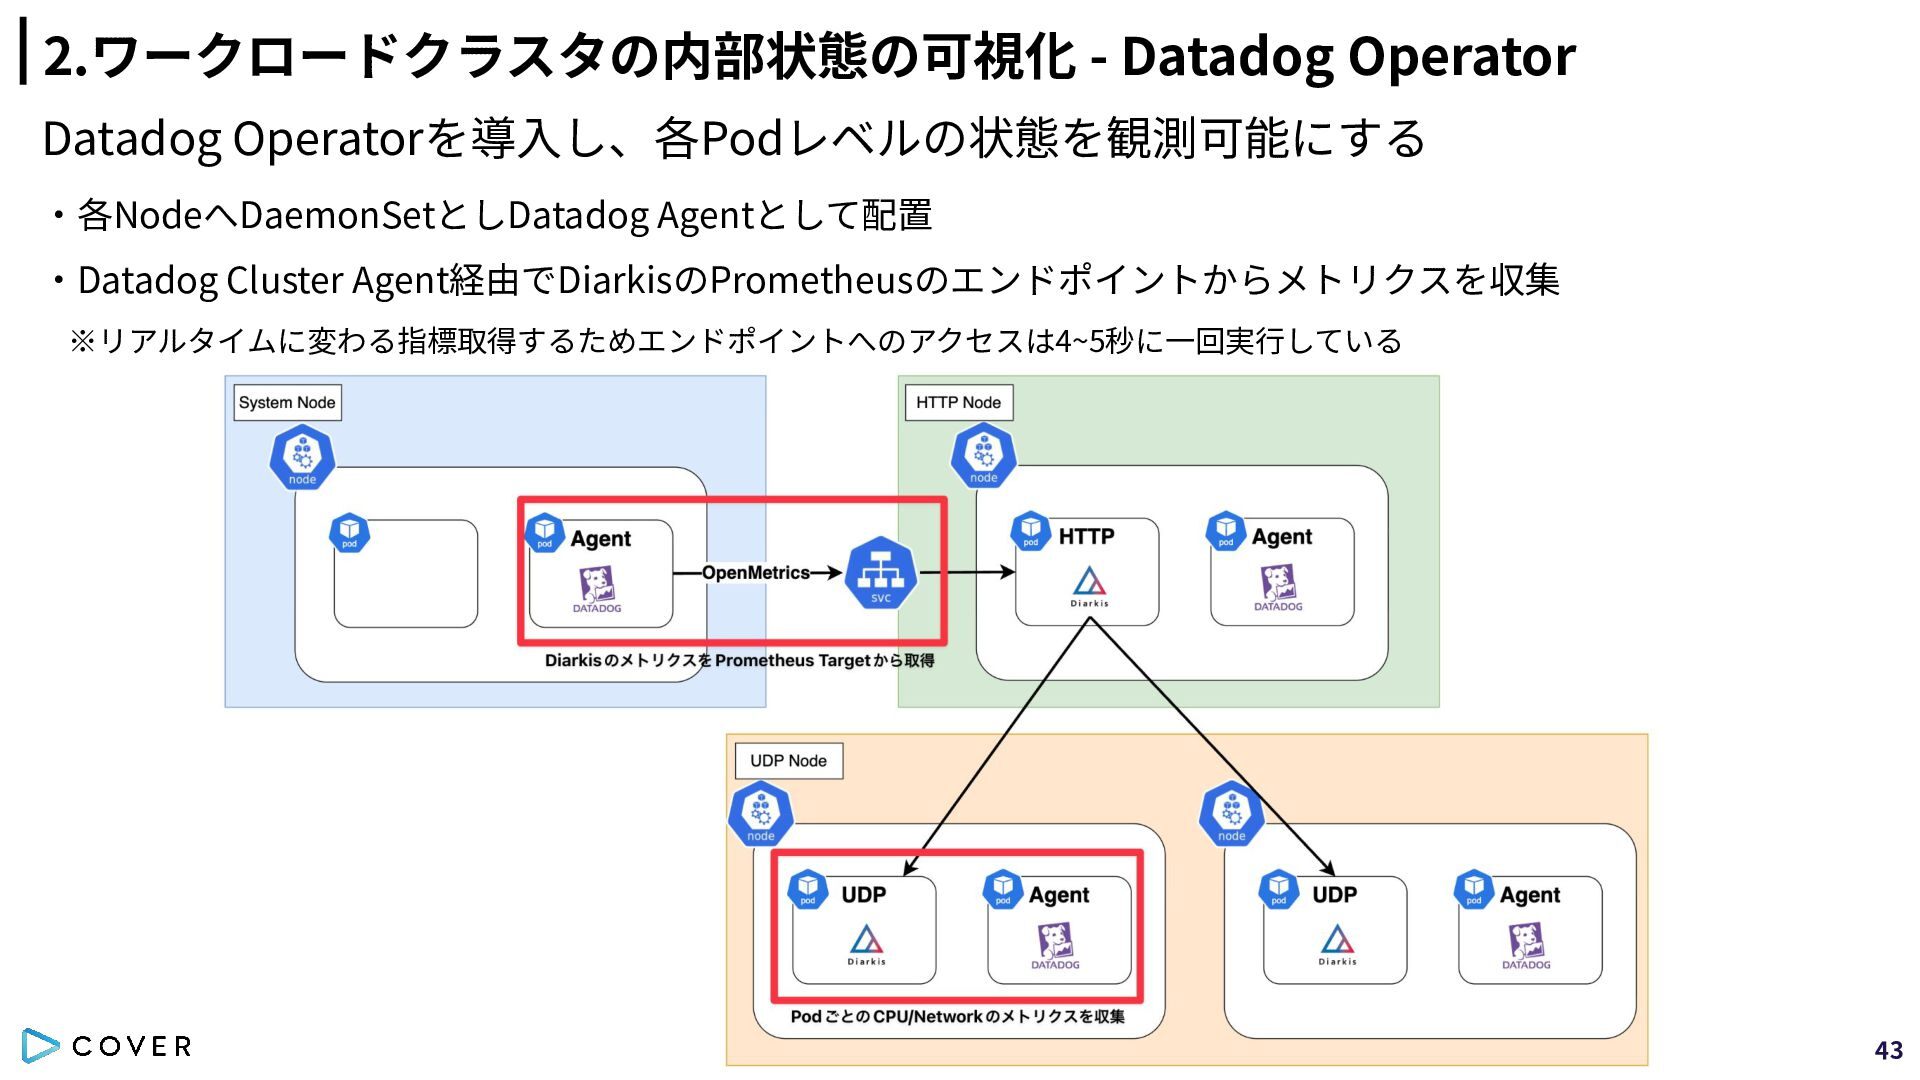
2.ワークロードクラスタの内部状態の可視化 - Datadog Operator Datadog Operatorを導⼊し、各Podレベルの状態を観測可能にする ‧各NodeへDaemonSetとしDatadog Agentとして配置 ‧Datadog Cluster
Agent経由でDiarkisのPrometheusのエンドポイントからメトリクスを収集 ※リアルタイムに変わる指標取得するためエンドポイントへのアクセスは4~5秒に⼀回実⾏している 43 -
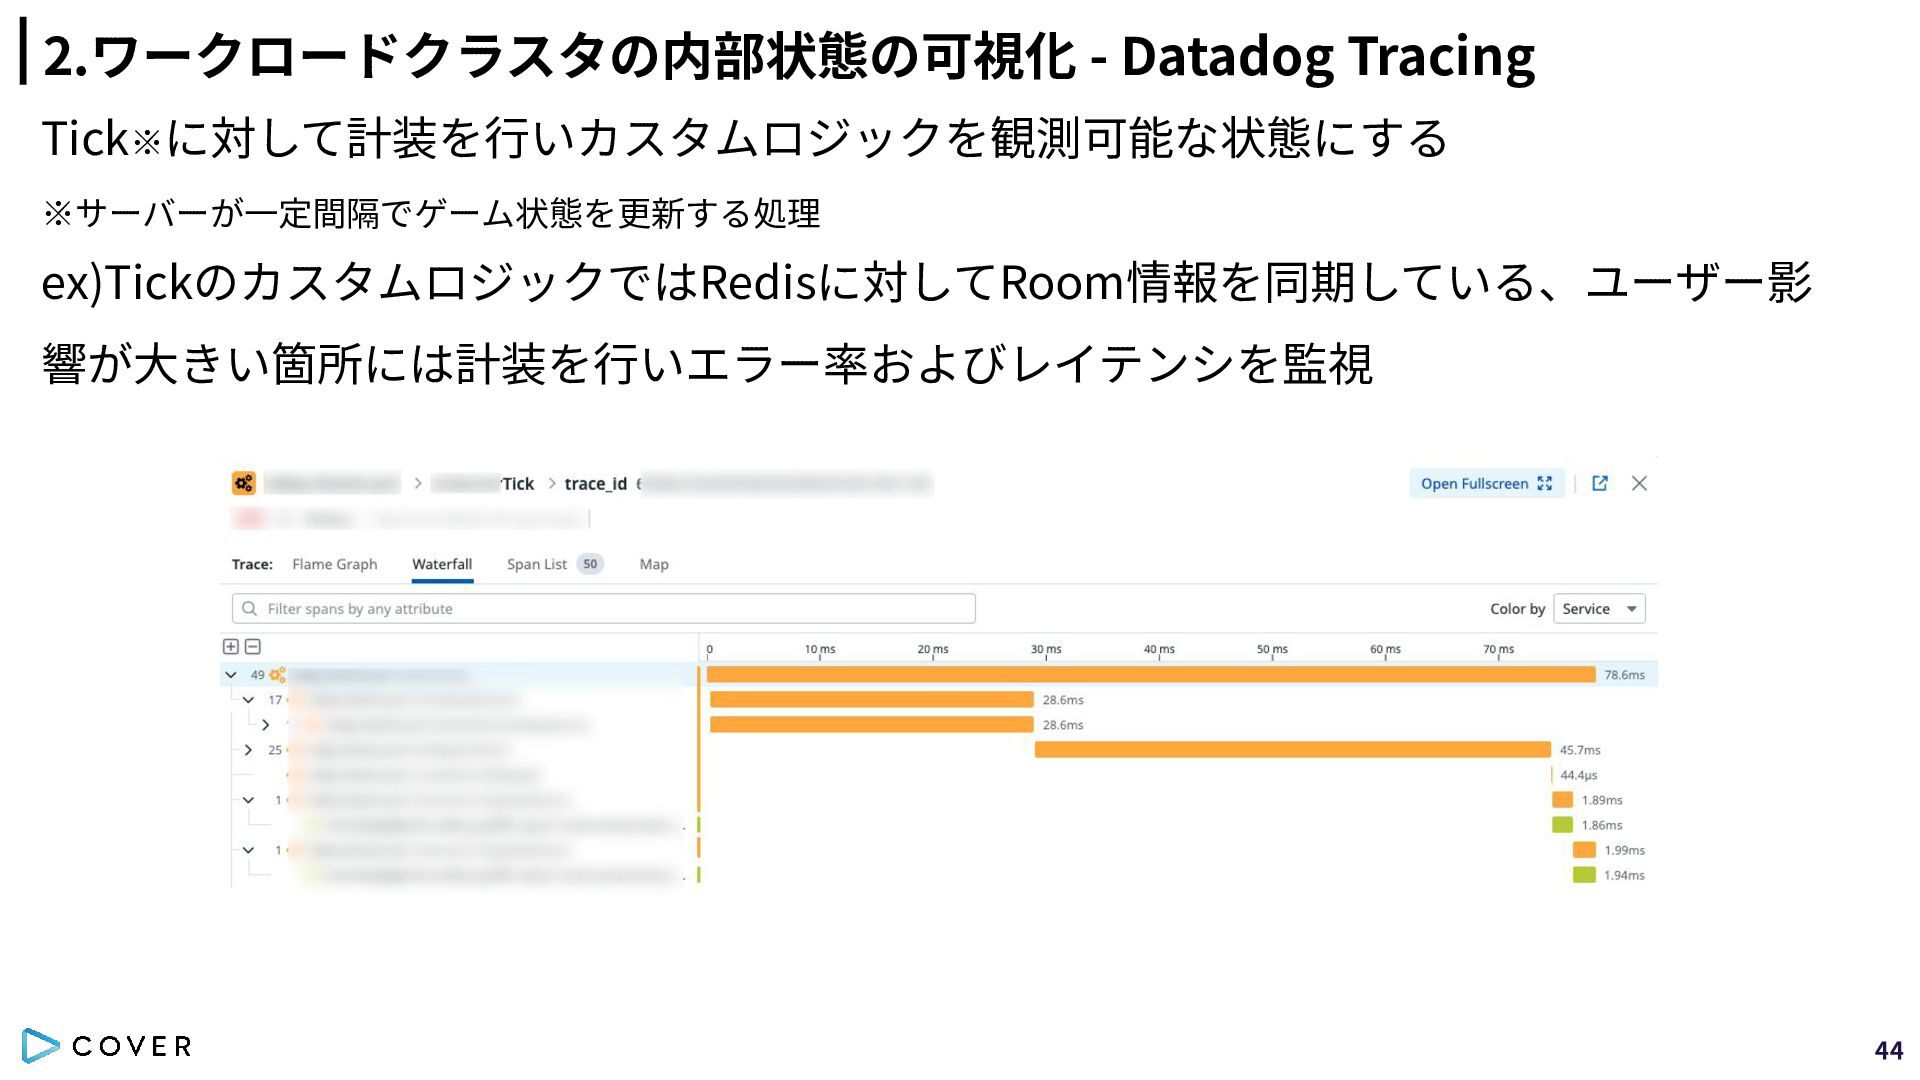
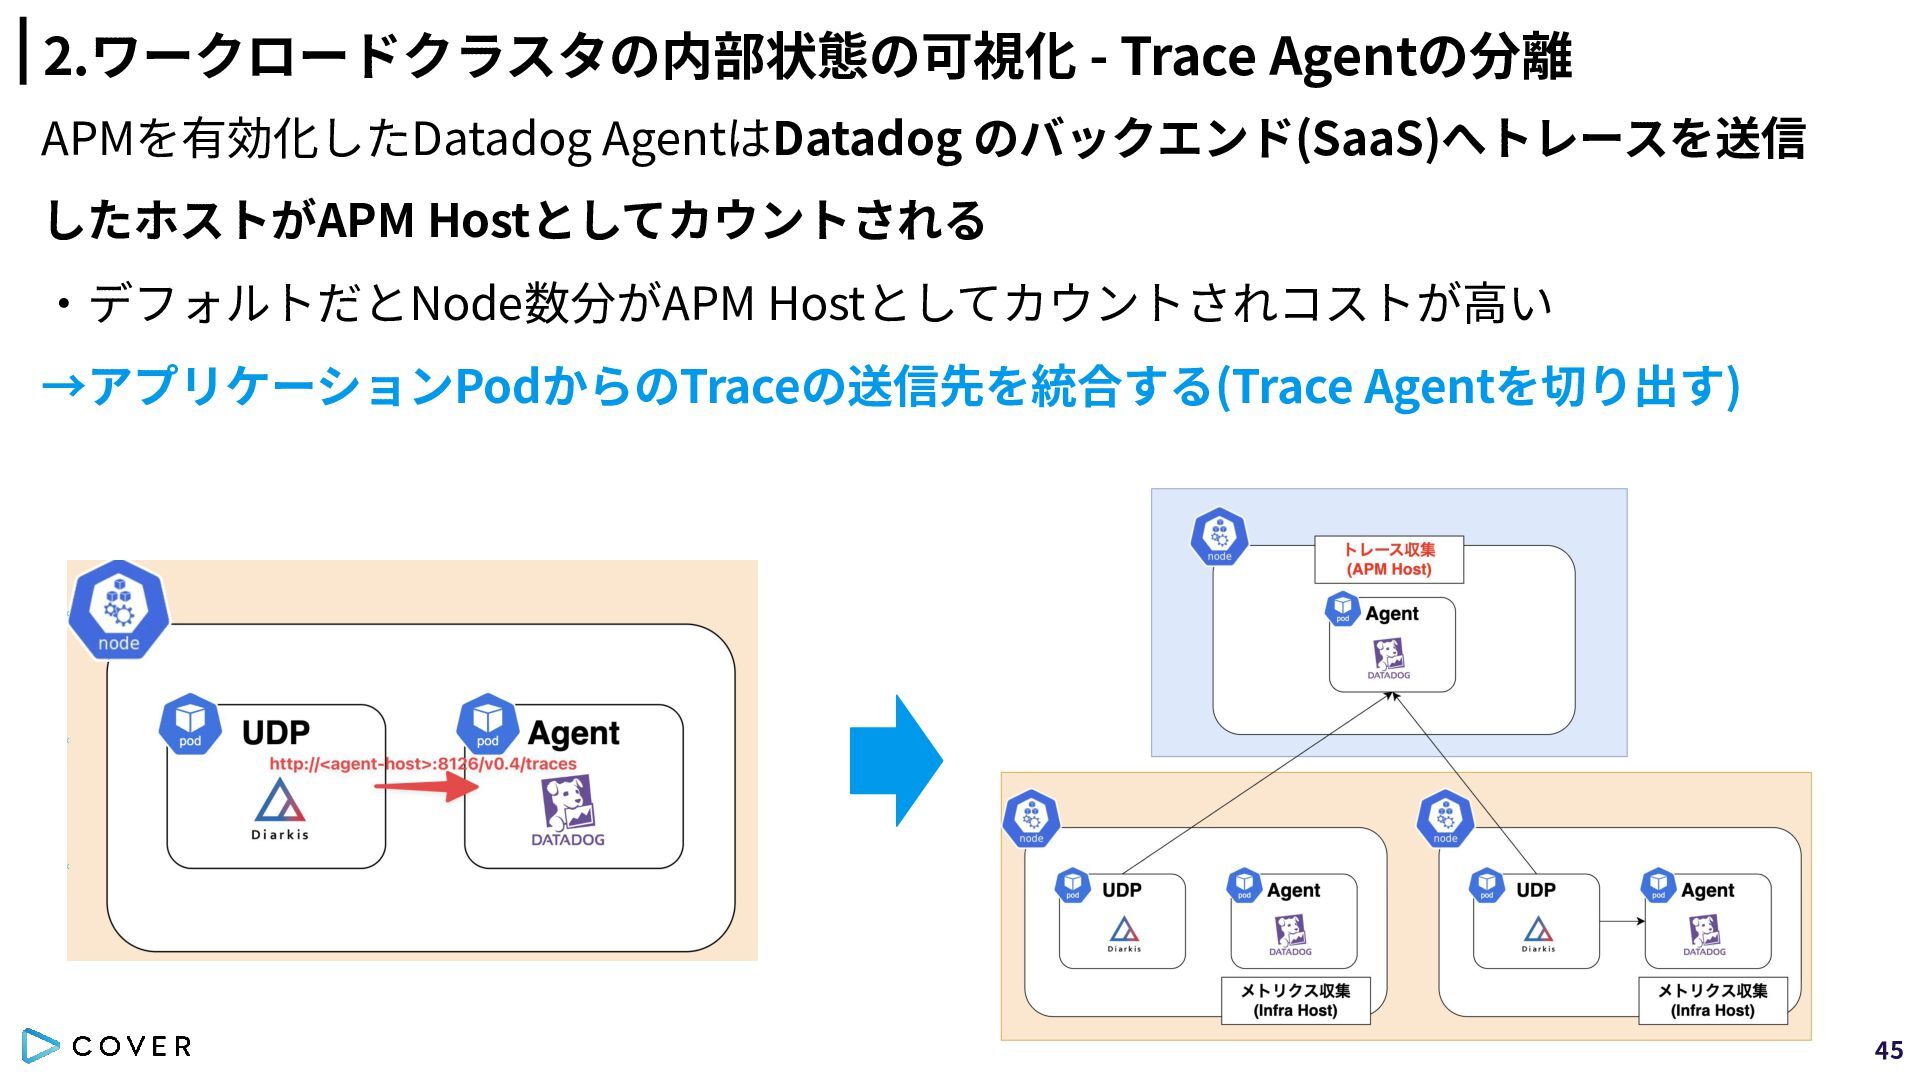
2.ワークロードクラスタの内部状態の可視化 - Trace Agentの分離 APMを有効化したDatadog AgentはDatadog のバックエンド(SaaS)へトレースを送信 したホストがAPM Hostとしてカウントされる ‧デフォルトだとNode数分がAPM
Hostとしてカウントされコストが⾼い →アプリケーションPodからのTraceの送信先を統合する(Trace Agentを切り出す) 45 -
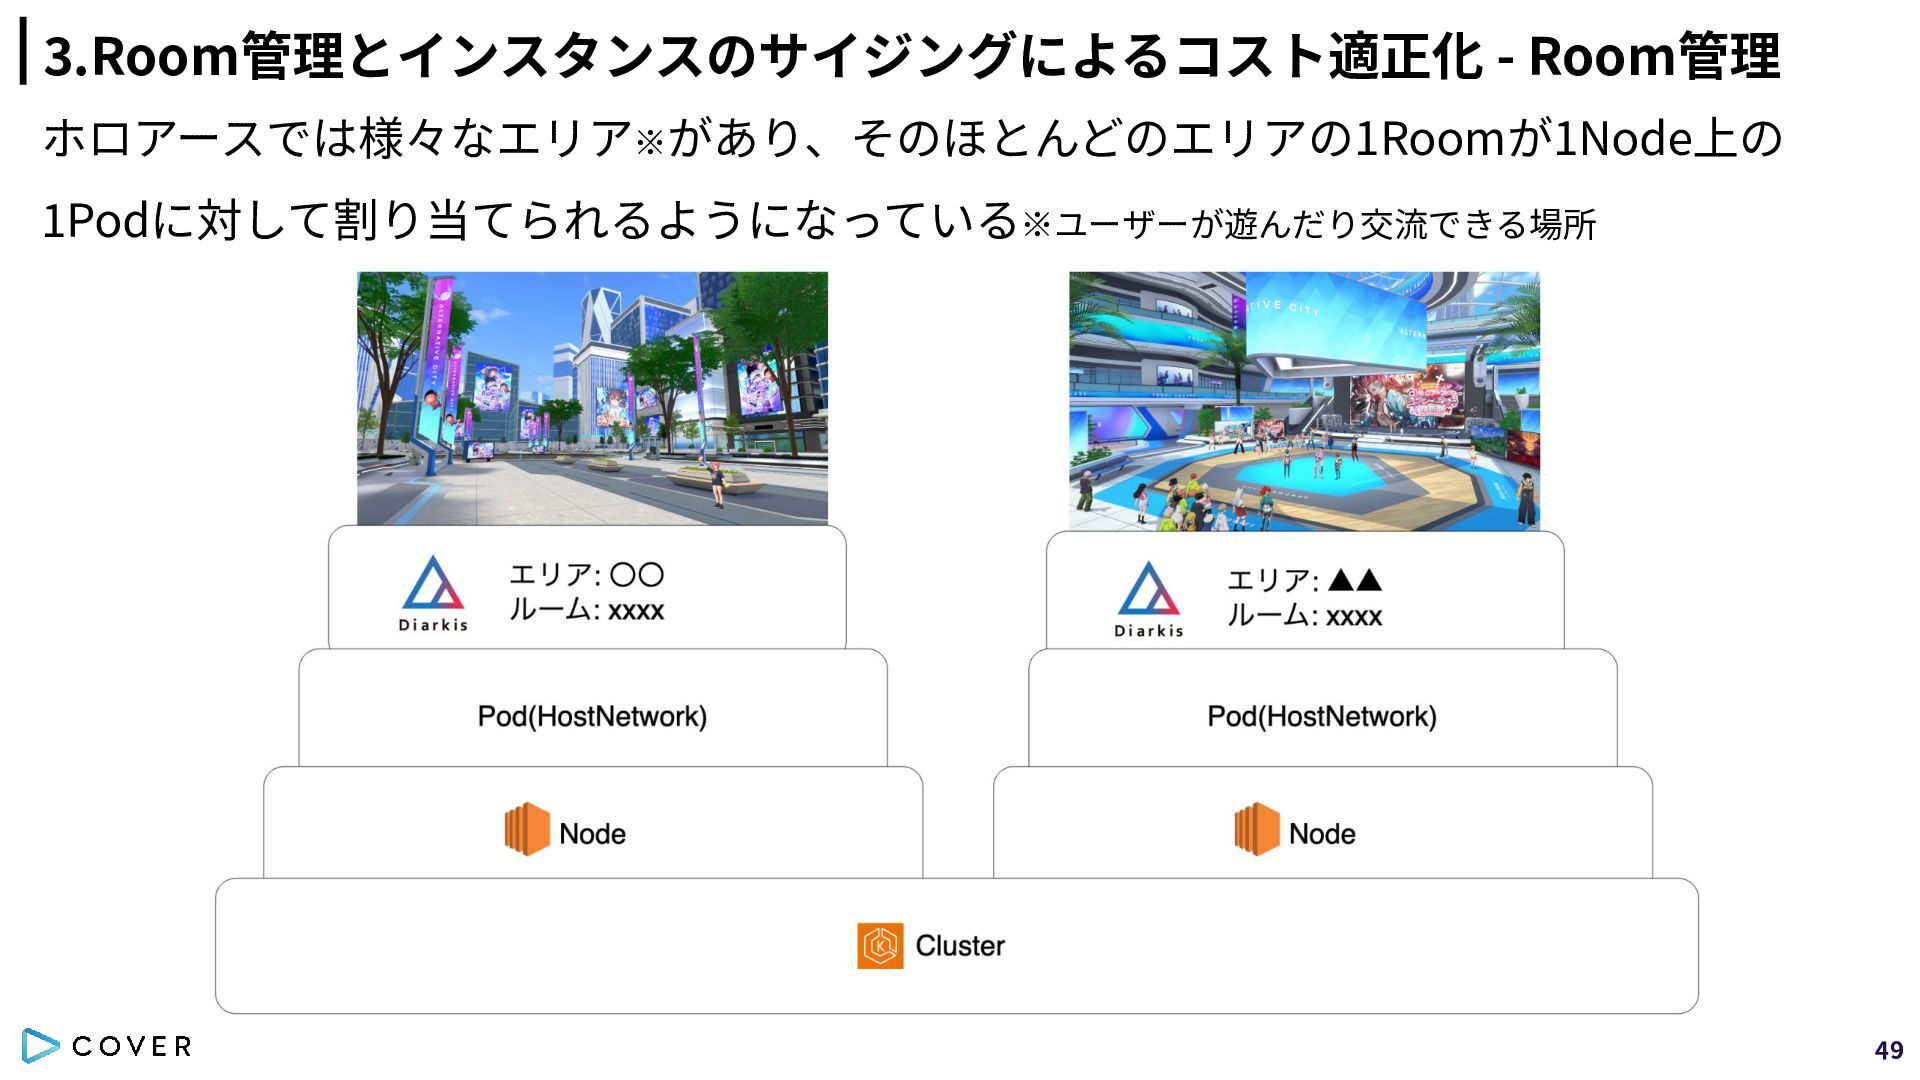
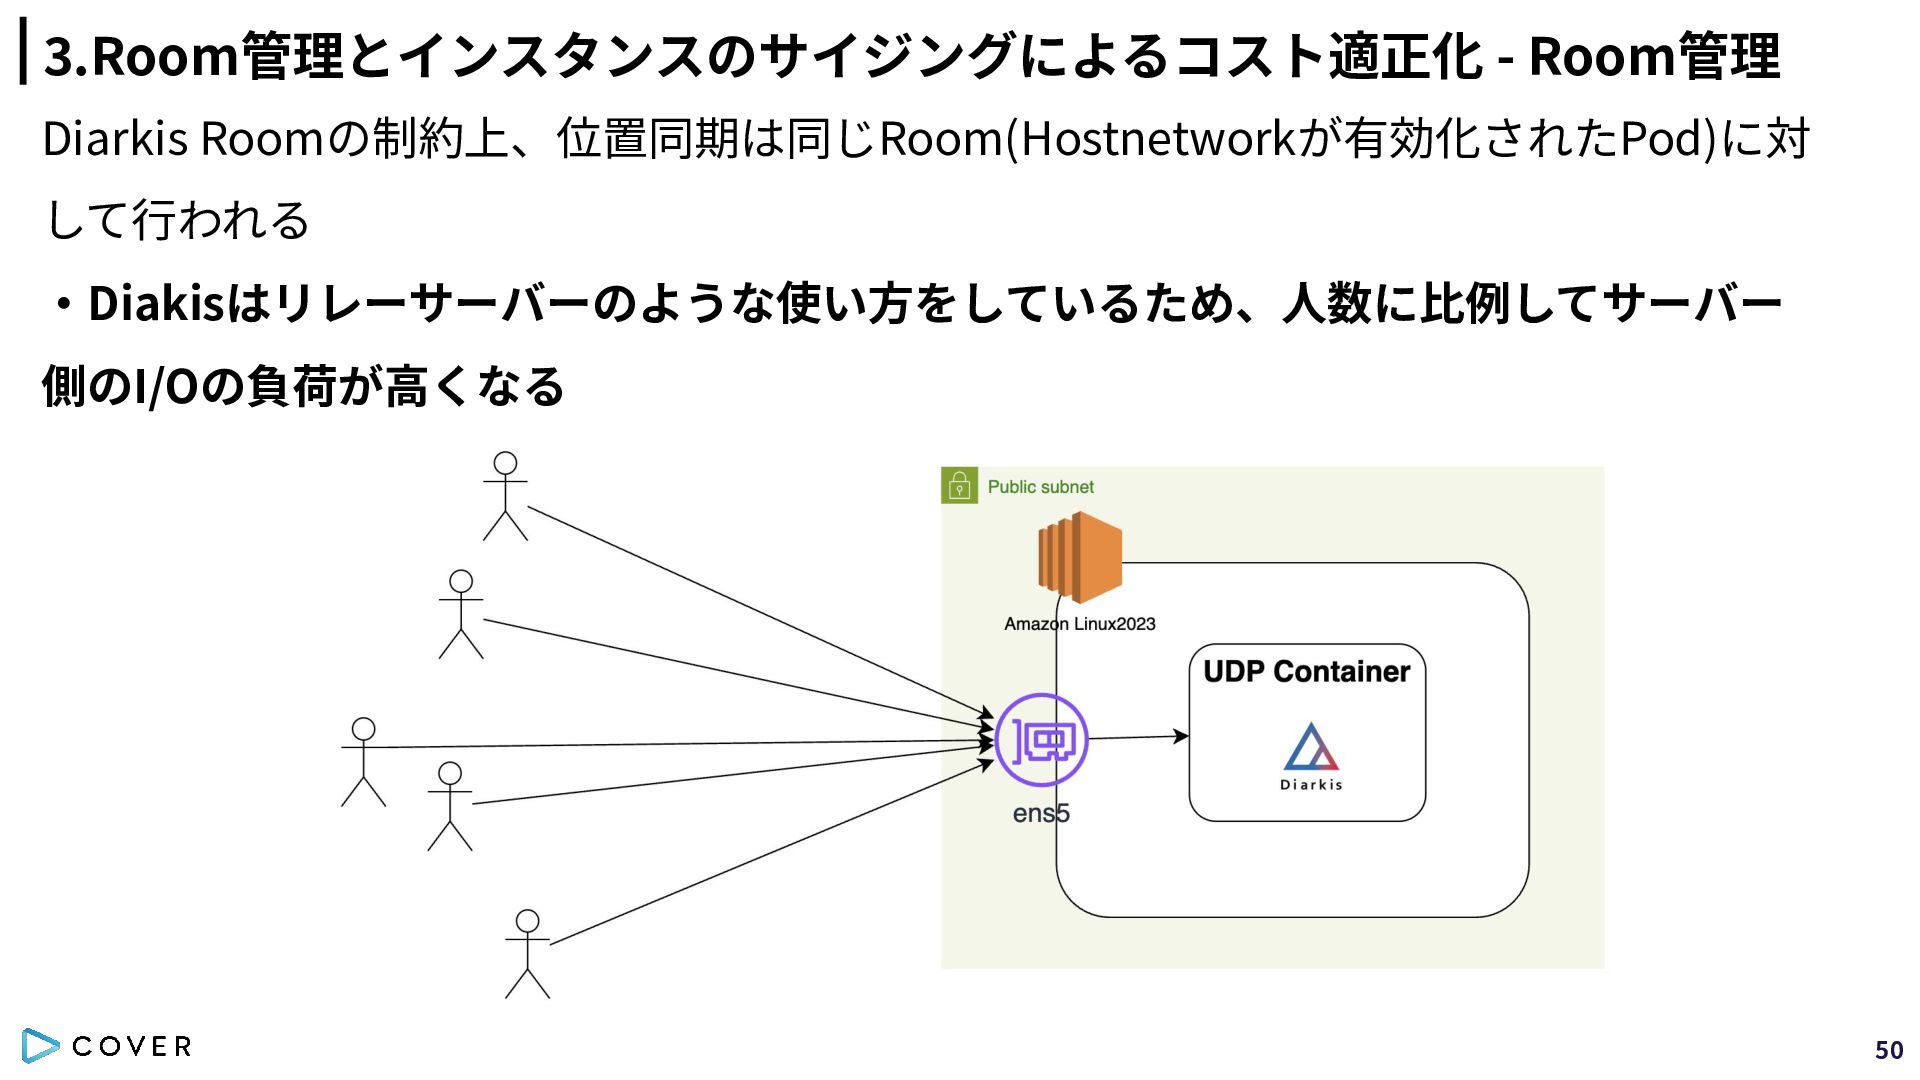
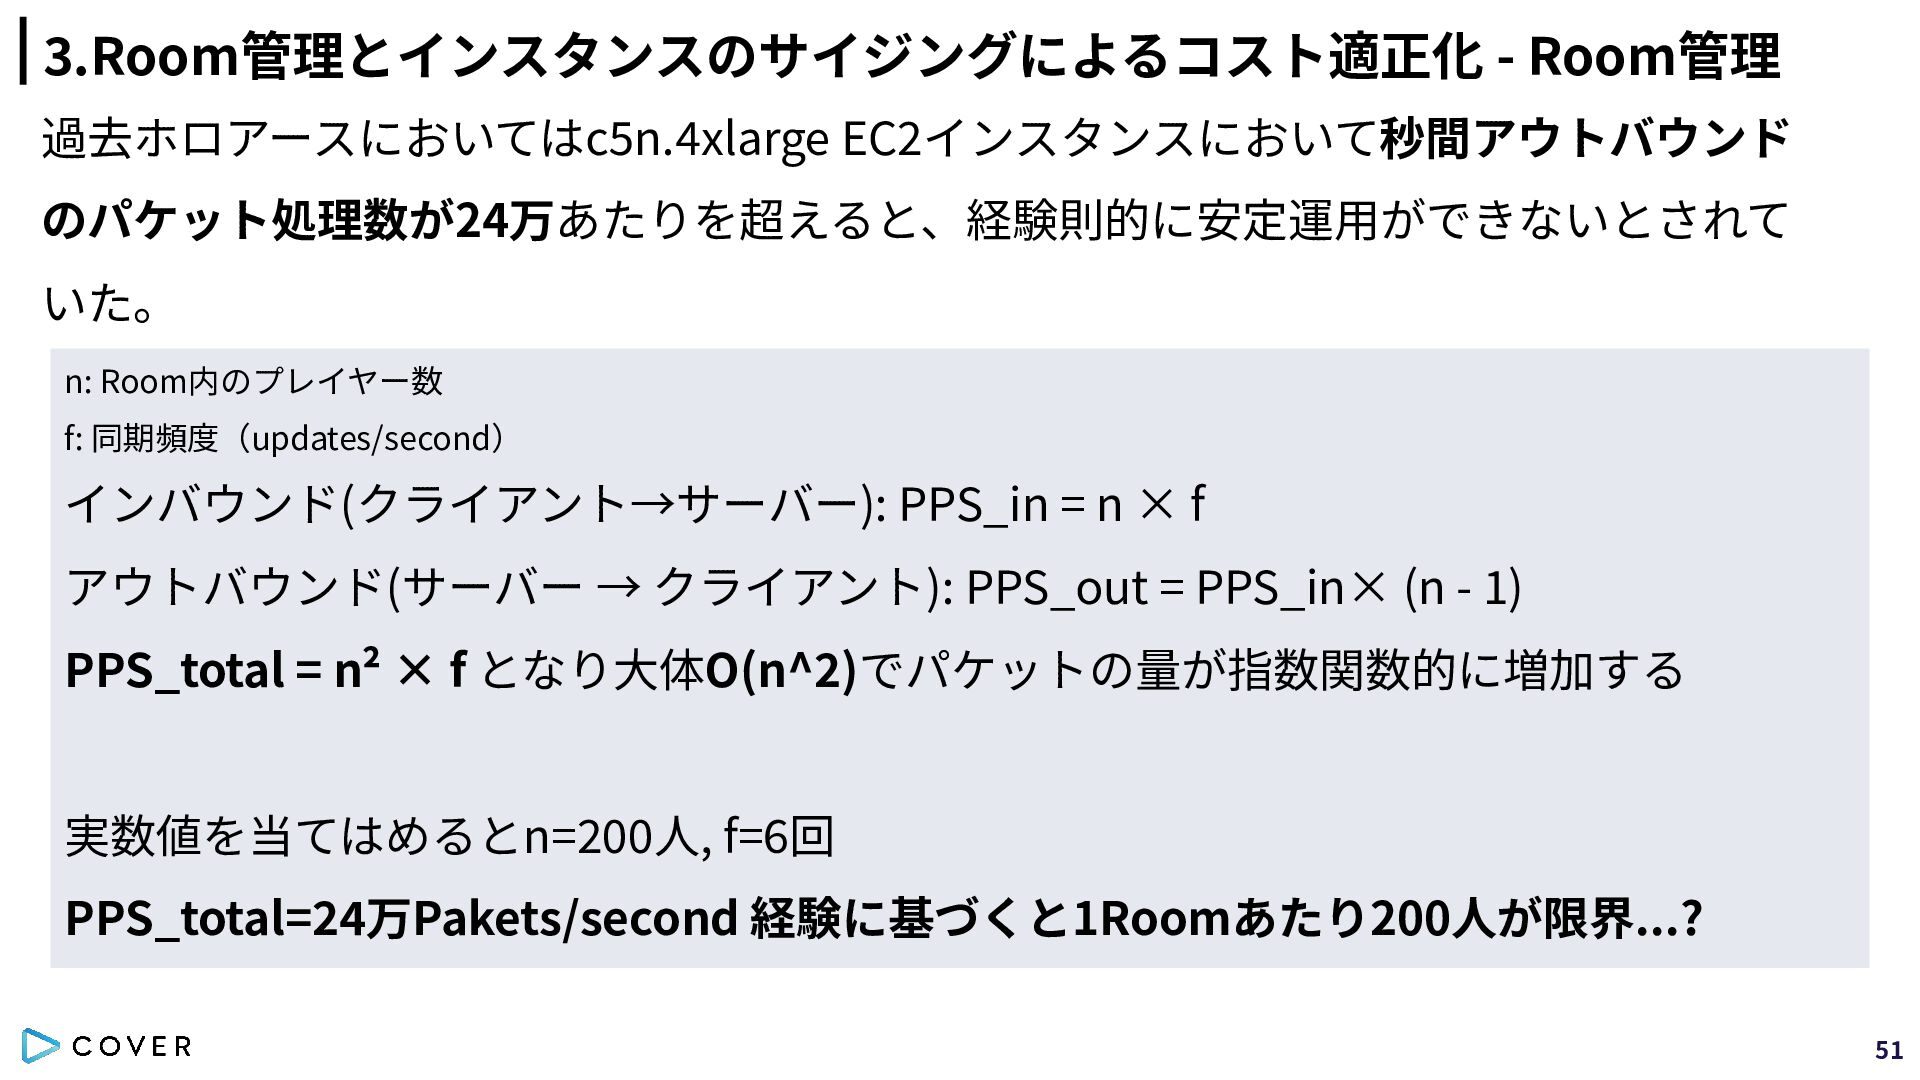
3.Room管理とインスタンスのサイジングによるコスト適正化 - Room管理 過去ホロアースにおいてはc5n.4xlarge EC2インスタンスにおいて秒間アウトバウンド のパケット処理数が24万あたりを超えると、経験則的に安定運⽤ができないとされて いた。 n: Room内のプレイヤー数 f:
同期頻度(updates/second) インバウンド(クライアント→サーバー): PPS_in = n × f アウトバウンド(サーバー → クライアント): PPS_out = PPS_in× (n - 1) PPS_total = n² × f となり⼤体O(n^2)でパケットの量が指数関数的に増加する 実数値を当てはめるとn=200⼈, f=6回 PPS_total=24万Pakets/second 経験に基づくと1Roomあたり200⼈が限界...? 51 -
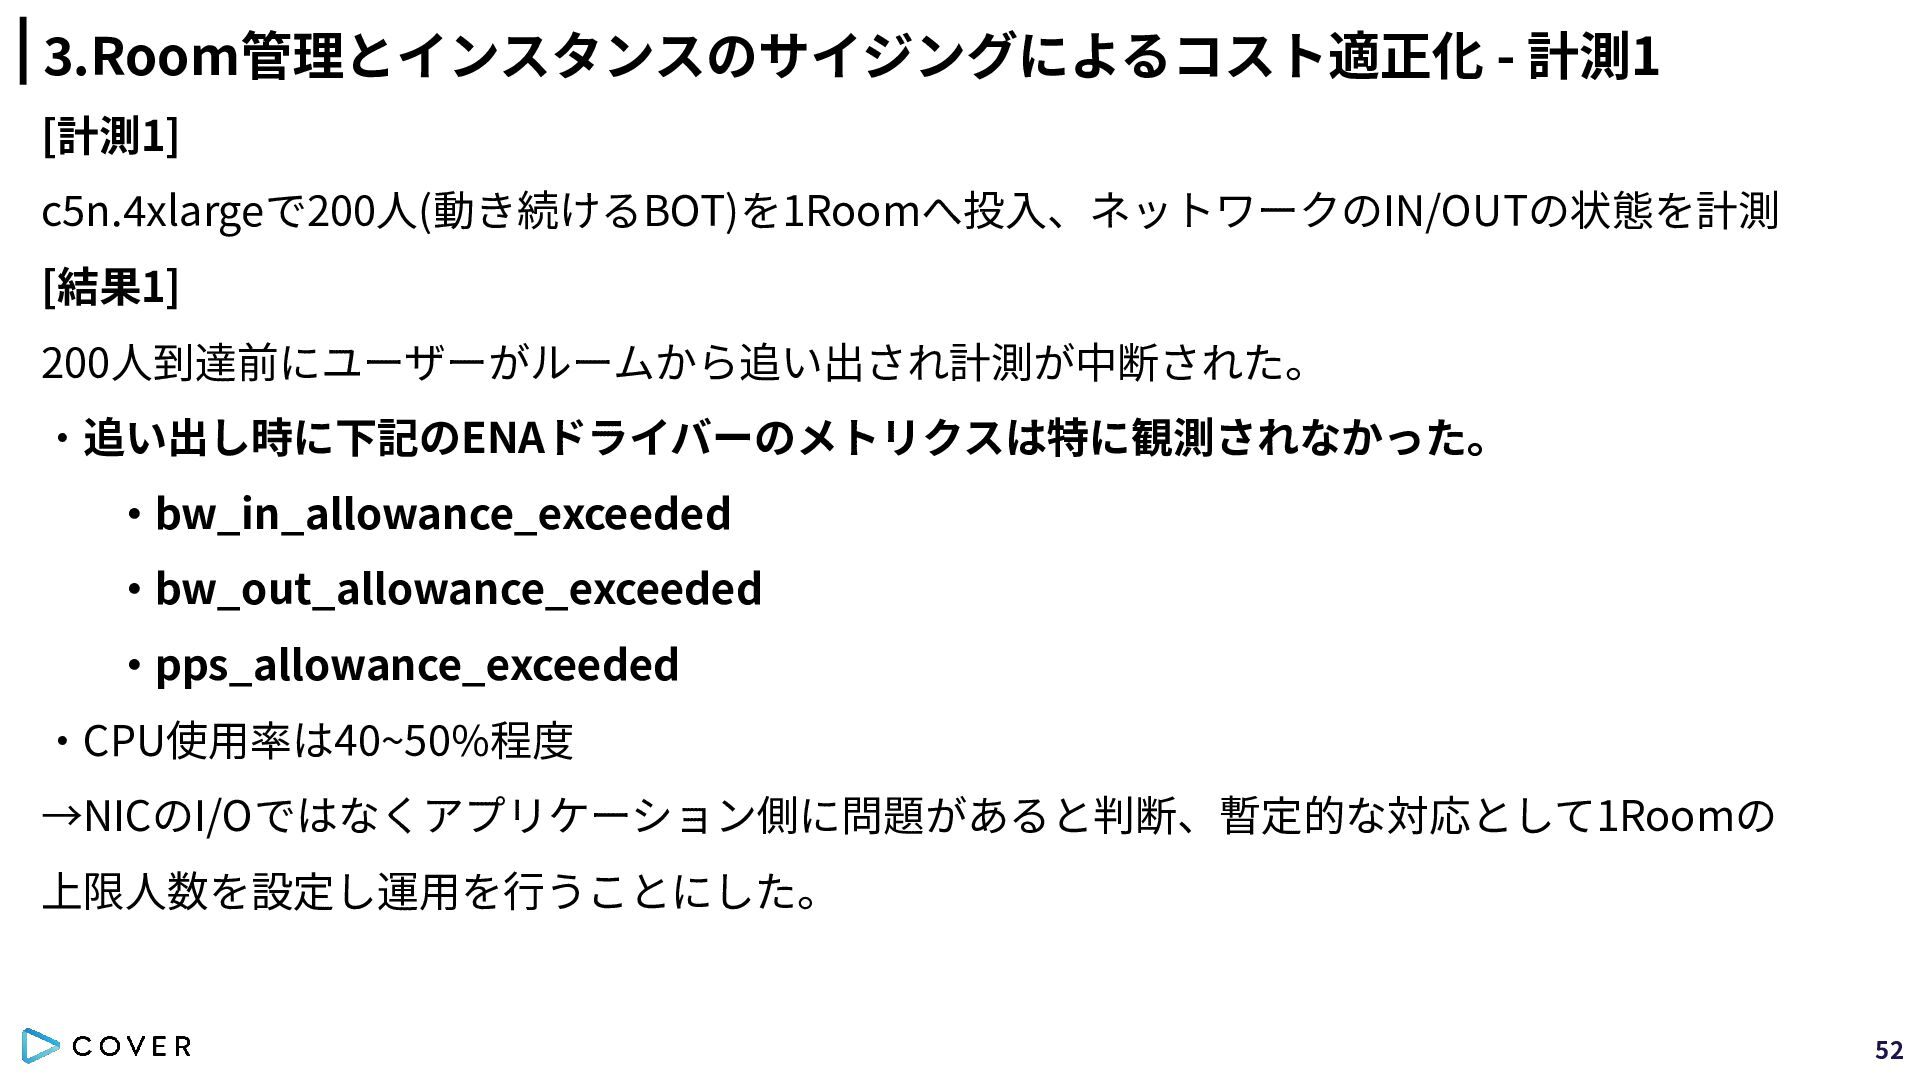
3.Room管理とインスタンスのサイジングによるコスト適正化 - 計測1 [計測1] c5n.4xlargeで200⼈(動き続けるBOT)を1Roomへ投⼊、ネットワークのIN/OUTの状態を計測 [結果1] 200⼈到達前にユーザーがルームから追い出され計測が中断された。 ‧追い出し時に下記のENAドライバーのメトリクスは特に観測されなかった。 ‧bw_in_allowance_exceeded ‧bw_out_allowance_exceeded
‧pps_allowance_exceeded ‧CPU使⽤率は40~50%程度 →NICのI/Oではなくアプリケーション側に問題があると判断、暫定的な対応として1Roomの 上限⼈数を設定し運⽤を⾏うことにした。 52 -
3.Room管理とインスタンスのサイジングによるコスト適正化 - 計測2 [計測2] c5n.4xlarge ~ c5n.xlargeで100⼈(動き続けるBOT)を投⼊、ネットワークのIN/OUTの状態を計測 [結果2] ‧どのパターンも下記のENAドライバーのメトリクスは特に観測されなかった。 ‧bw_in_allowance_exceeded
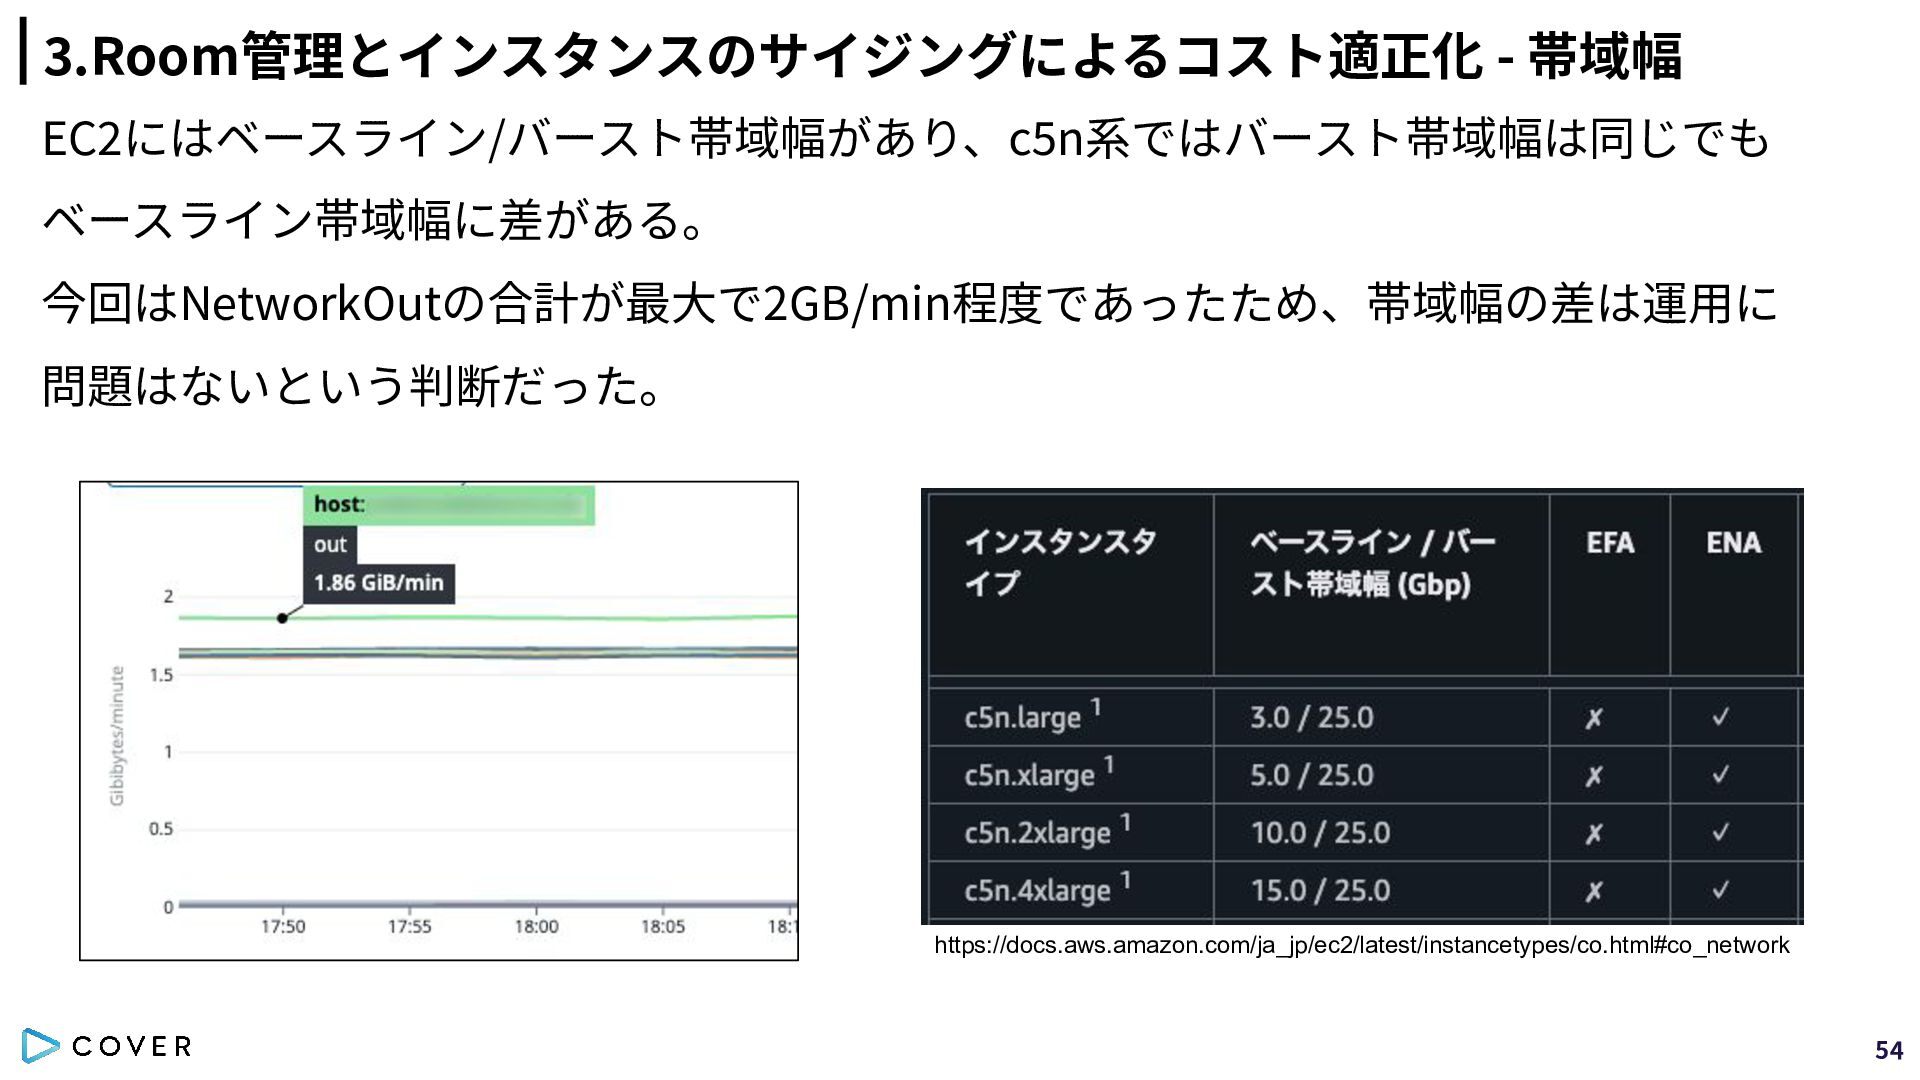
‧bw_out_allowance_exceeded ‧pps_allowance_exceeded ‧CPU使⽤率は4xlarge:5%, 2xlarge:10%, xlarge:20%とコア数に対してほぼ線形に推移して いた。 →Diarkis社と相談しピークのCPU使⽤率が20%程度で運⽤するのが良いと判断したため、 1Room 100⼈を上限としてc5n.xlargeでUDPサーバーのインスタンスで運⽤を決断 53 -
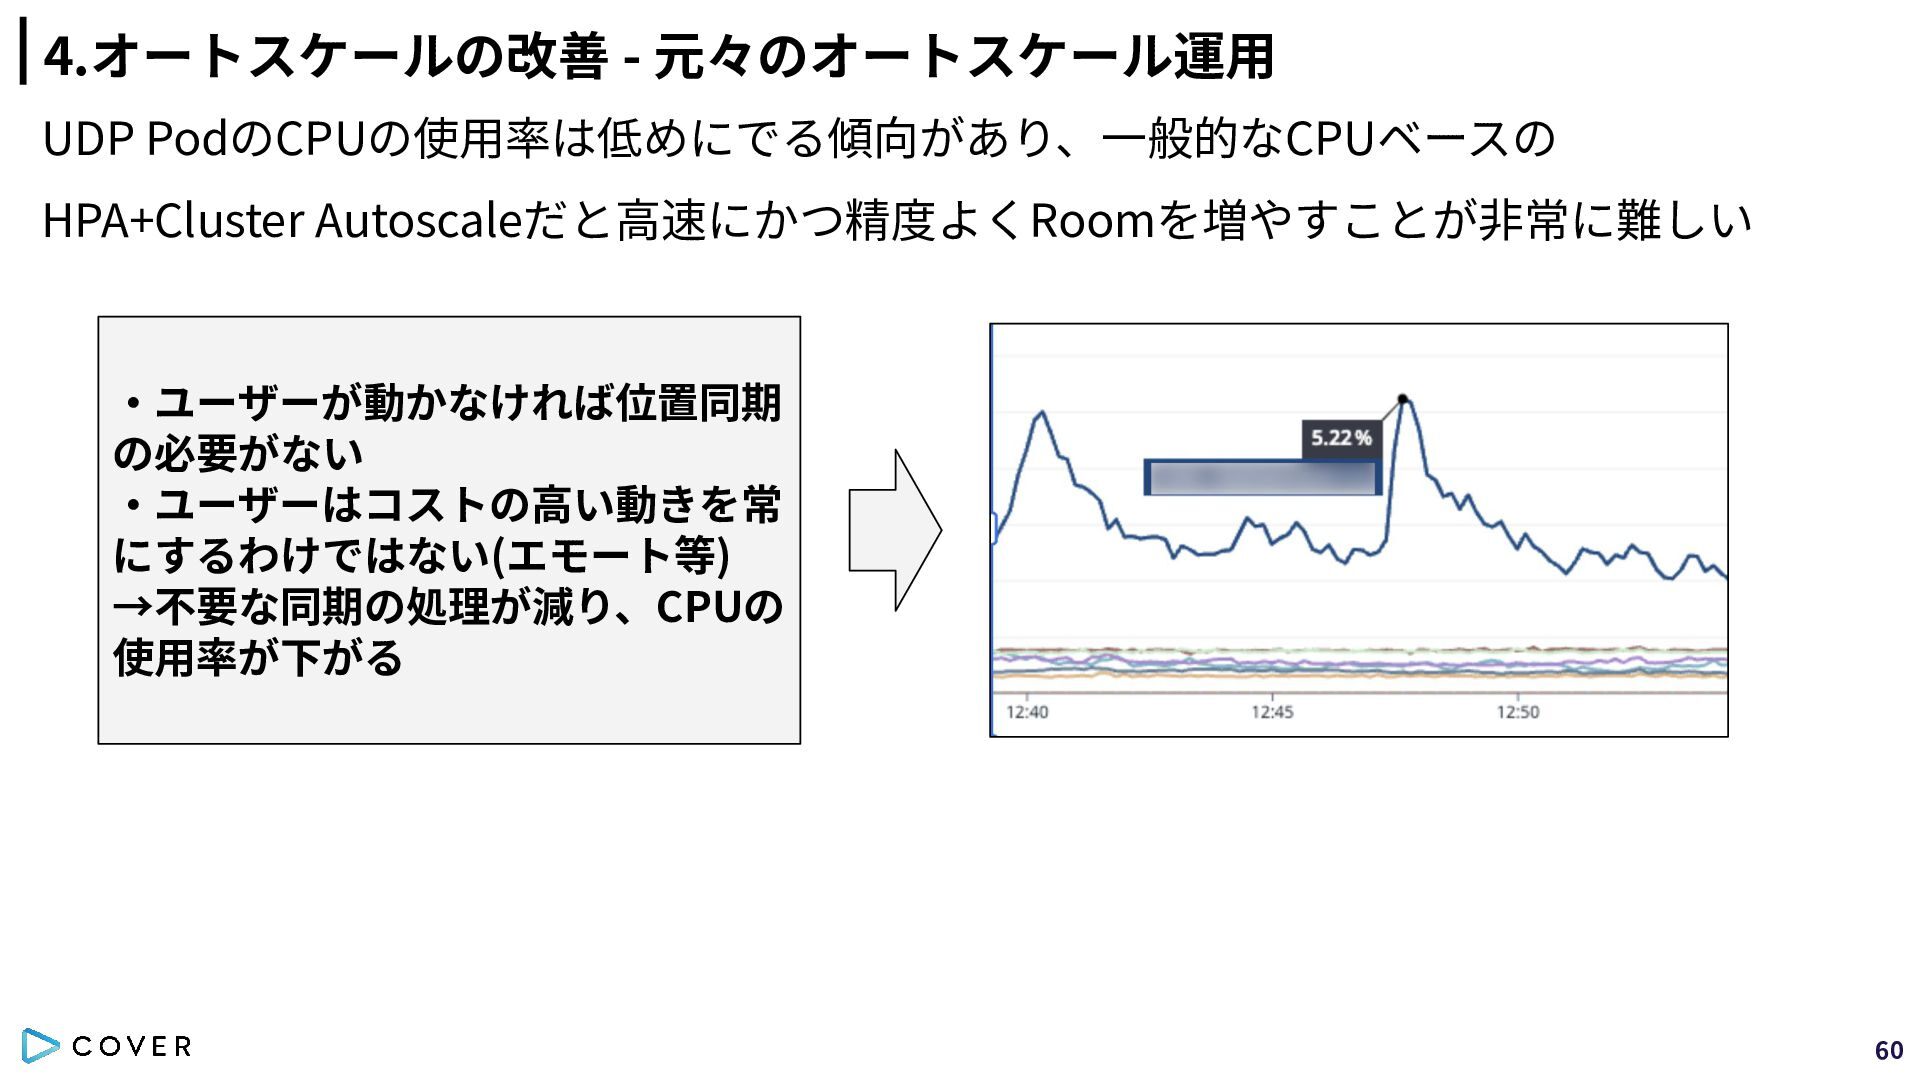
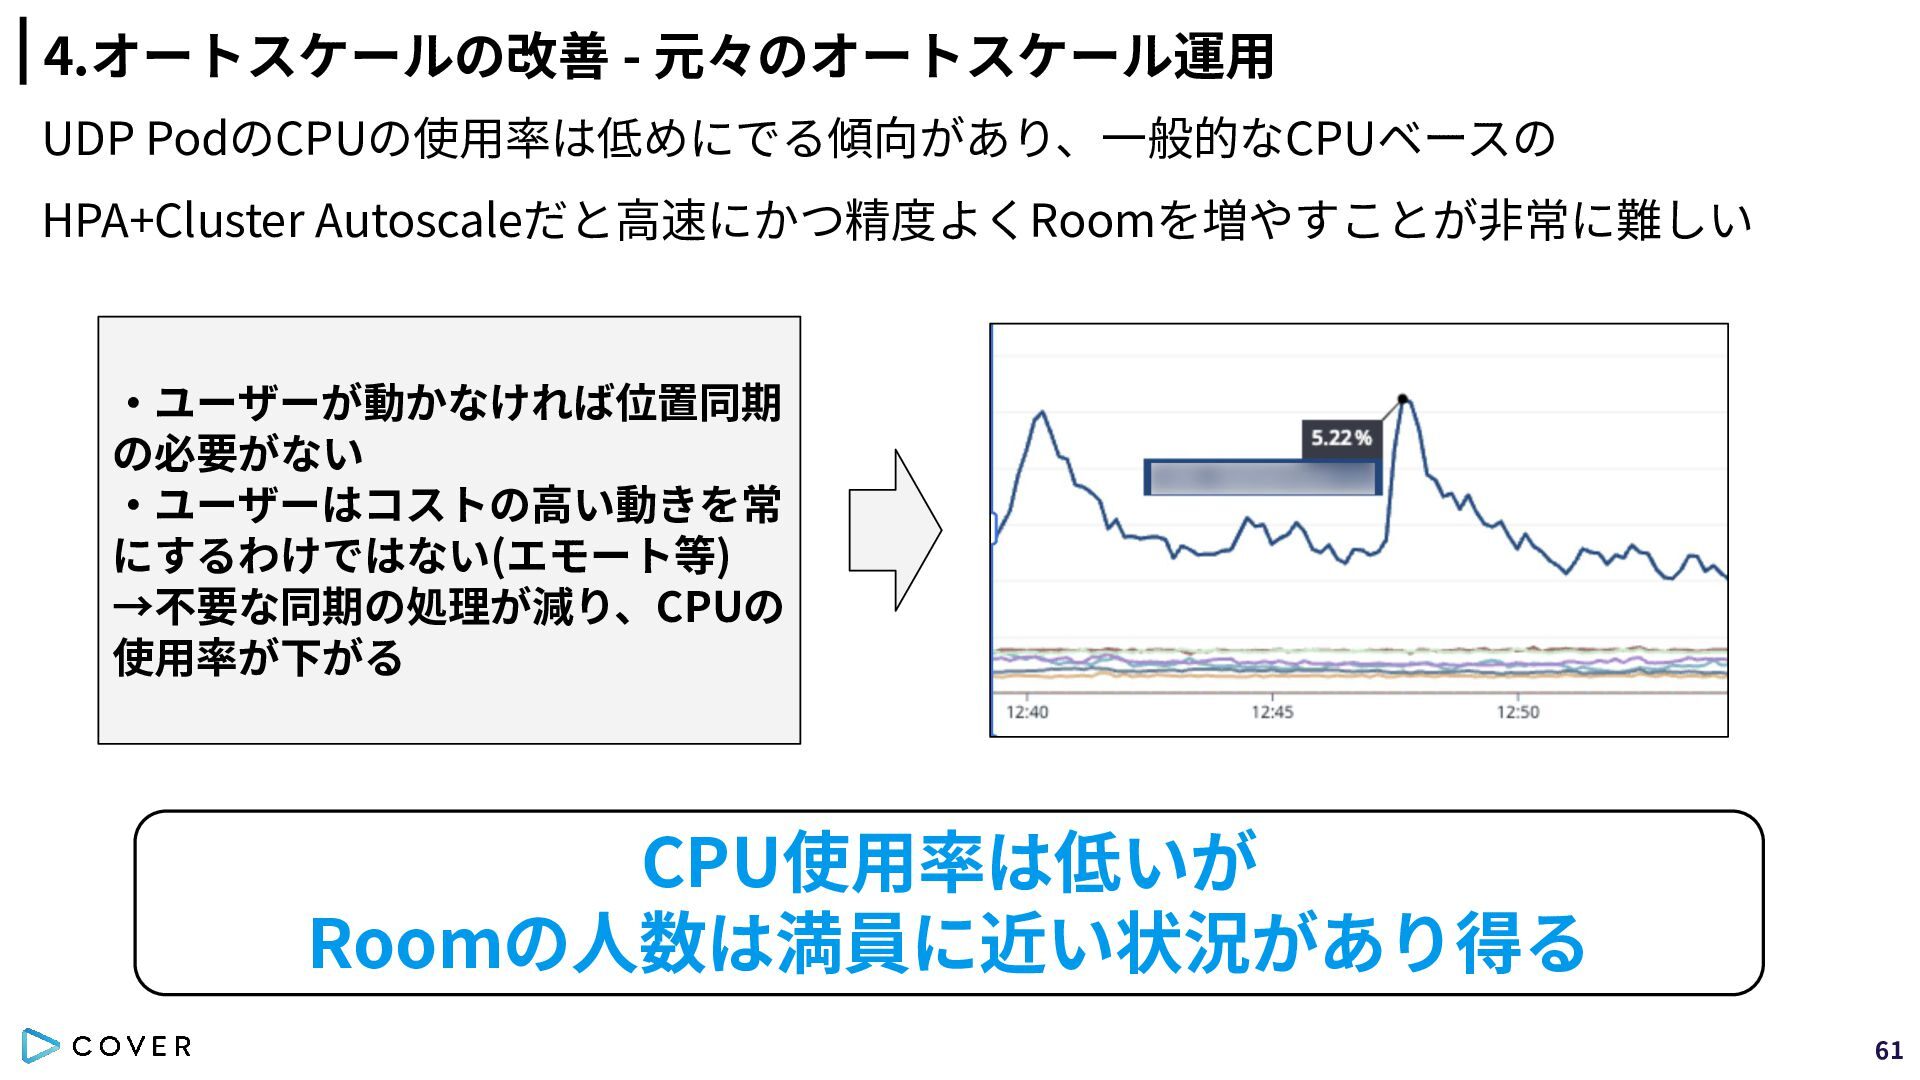
4.オートスケールの改善 - 元々のオートスケール運⽤ UDP PodのCPUの使⽤率は低めにでる傾向があり、⼀般的なCPUベースの HPA+Cluster Autoscaleだと⾼速にかつ精度よくRoomを増やすことが⾮常に難しい ‧ユーザーが動かなければ位置同期 の必要がない ‧ユーザーはコストの⾼い動きを常
にするわけではない(エモート等) →不要な同期の処理が減り、CPUの 使⽤率が下がる 60 -
4.オートスケールの改善 - 元々のオートスケール運⽤ UDP PodのCPUの使⽤率は低めにでる傾向があり、⼀般的なCPUベースの HPA+Cluster Autoscaleだと⾼速にかつ精度よくRoomを増やすことが⾮常に難しい ‧ユーザーが動かなければ位置同期 の必要がない ‧ユーザーはコストの⾼い動きを常
にするわけではない(エモート等) →不要な同期の処理が減り、CPUの 使⽤率が下がる CPU使⽤率は低いが Roomの⼈数は満員に近い状況があり得る 61 -
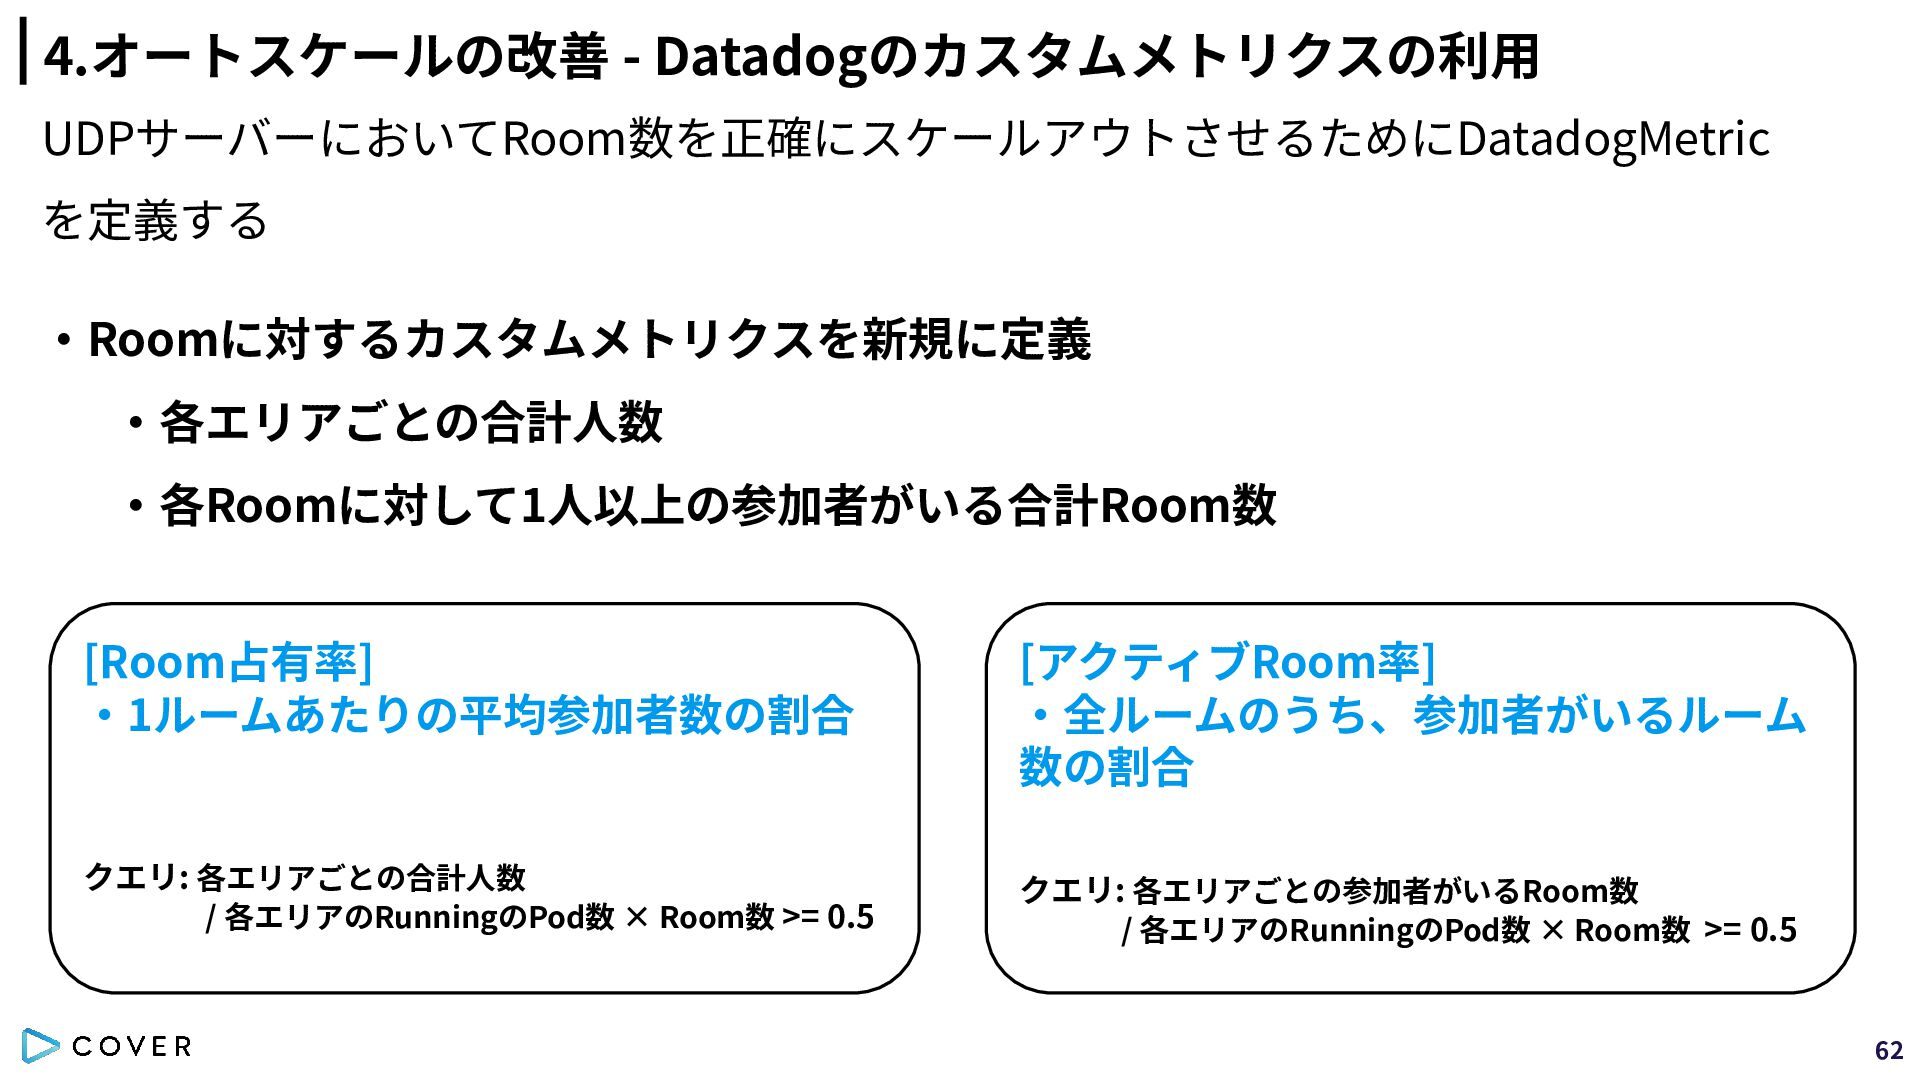
4.オートスケールの改善 - Datadogのカスタムメトリクスの利⽤ UDPサーバーにおいてRoom数を正確にスケールアウトさせるためにDatadogMetric を定義する ‧Roomに対するカスタムメトリクスを新規に定義 ‧各エリアごとの合計⼈数 ‧各Roomに対して1⼈以上の参加者がいる合計Room数 [Room占有率] ‧1ルームあたりの平均参加者数の割合
[アクティブRoom率] ‧全ルームのうち、参加者がいるルーム 数の割合 クエリ: 各エリアごとの合計⼈数 クエリ: 各エリアごとの参加者がいるRoom数 / 各エリアのRunningのPod数 × Room数 >= 0.5 / 各エリアのRunningのPod数 × Room数 >= 0.5 62 -
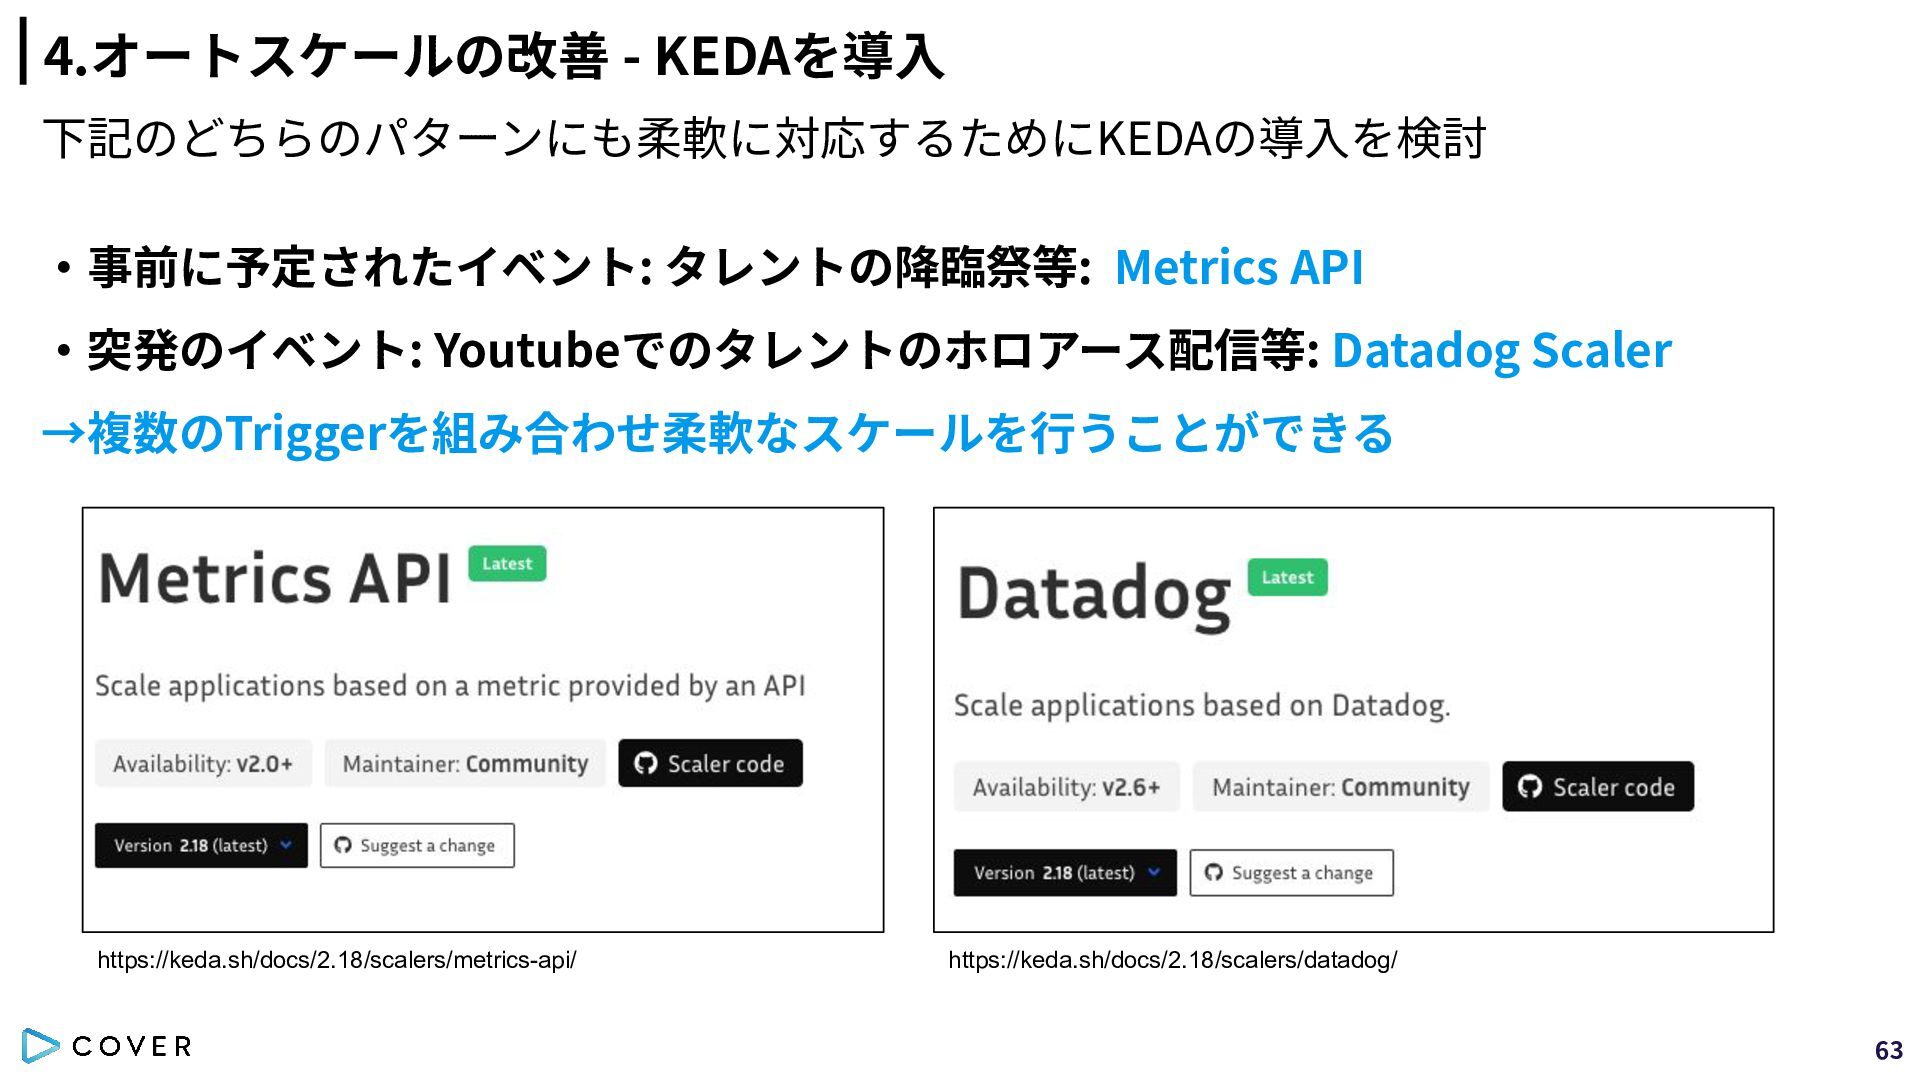
4.オートスケールの改善 - KEDAを導⼊ 下記のどちらのパターンにも柔軟に対応するためにKEDAの導⼊を検討 ‧事前に予定されたイベント: タレントの降臨祭等: Metrics API ‧突発のイベント: Youtubeでのタレントのホロアース配信等:
Datadog Scaler →複数のTriggerを組み合わせ柔軟なスケールを⾏うことができる https://keda.sh/docs/2.18/scalers/metrics-api/ https://keda.sh/docs/2.18/scalers/datadog/ 63 -
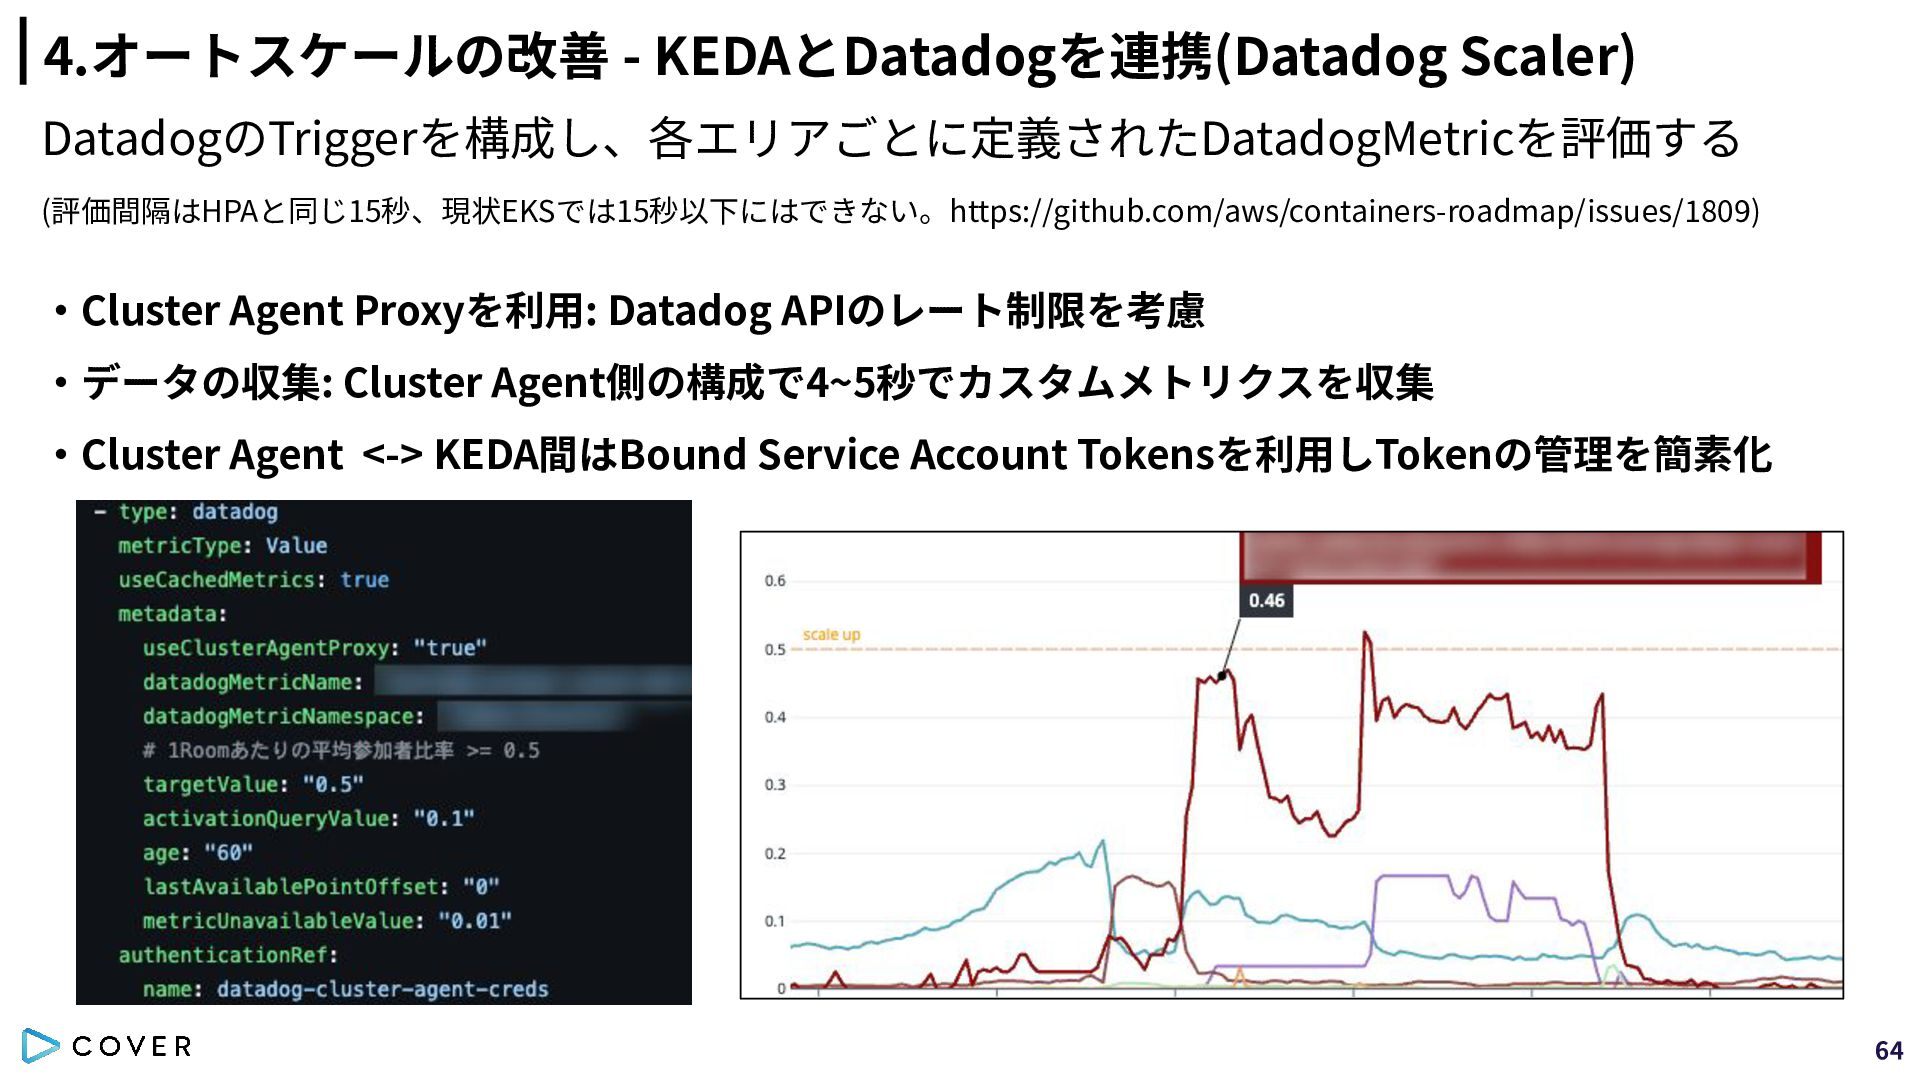
4.オートスケールの改善 - KEDAとDatadogを連携(Datadog Scaler) DatadogのTriggerを構成し、各エリアごとに定義されたDatadogMetricを評価する (評価間隔はHPAと同じ15秒、現状EKSでは15秒以下にはできない。https://github.com/aws/containers-roadmap/issues/1809) ‧Cluster Agent Proxyを利⽤: Datadog
APIのレート制限を考慮 ‧データの収集: Cluster Agent側の構成で4~5秒でカスタムメトリクスを収集 ‧Cluster Agent <-> KEDA間はBound Service Account Tokensを利⽤しTokenの管理を簡素化 64 -
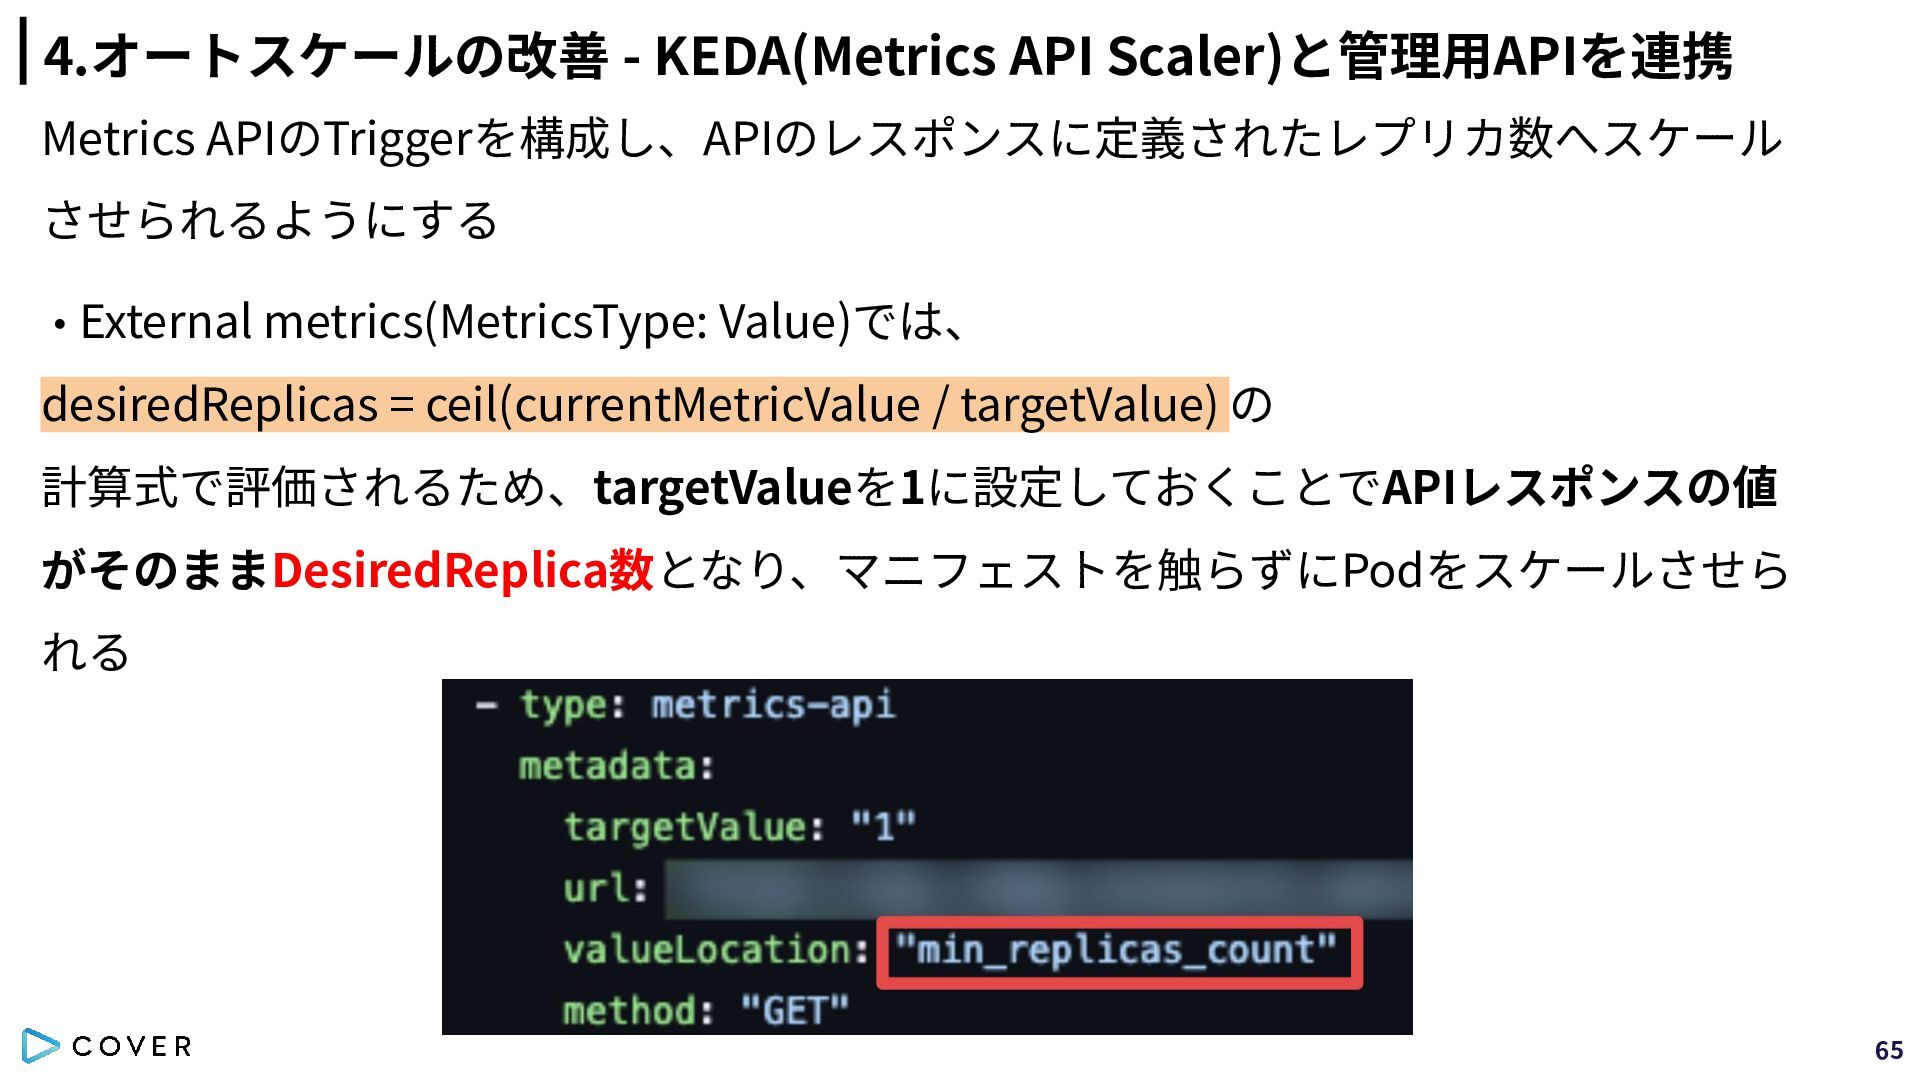
4.オートスケールの改善 - KEDA(Metrics API Scaler)と管理⽤APIを連携 Metrics APIのTriggerを構成し、APIのレスポンスに定義されたレプリカ数へスケール させられるようにする ‧External metrics(MetricsType:
Value)では、 desiredReplicas = ceil(currentMetricValue / targetValue) の 計算式で評価されるため、targetValueを1に設定しておくことでAPIレスポンスの値 がそのままDesiredReplica数となり、マニフェストを触らずにPodをスケールさせら れる 65 -
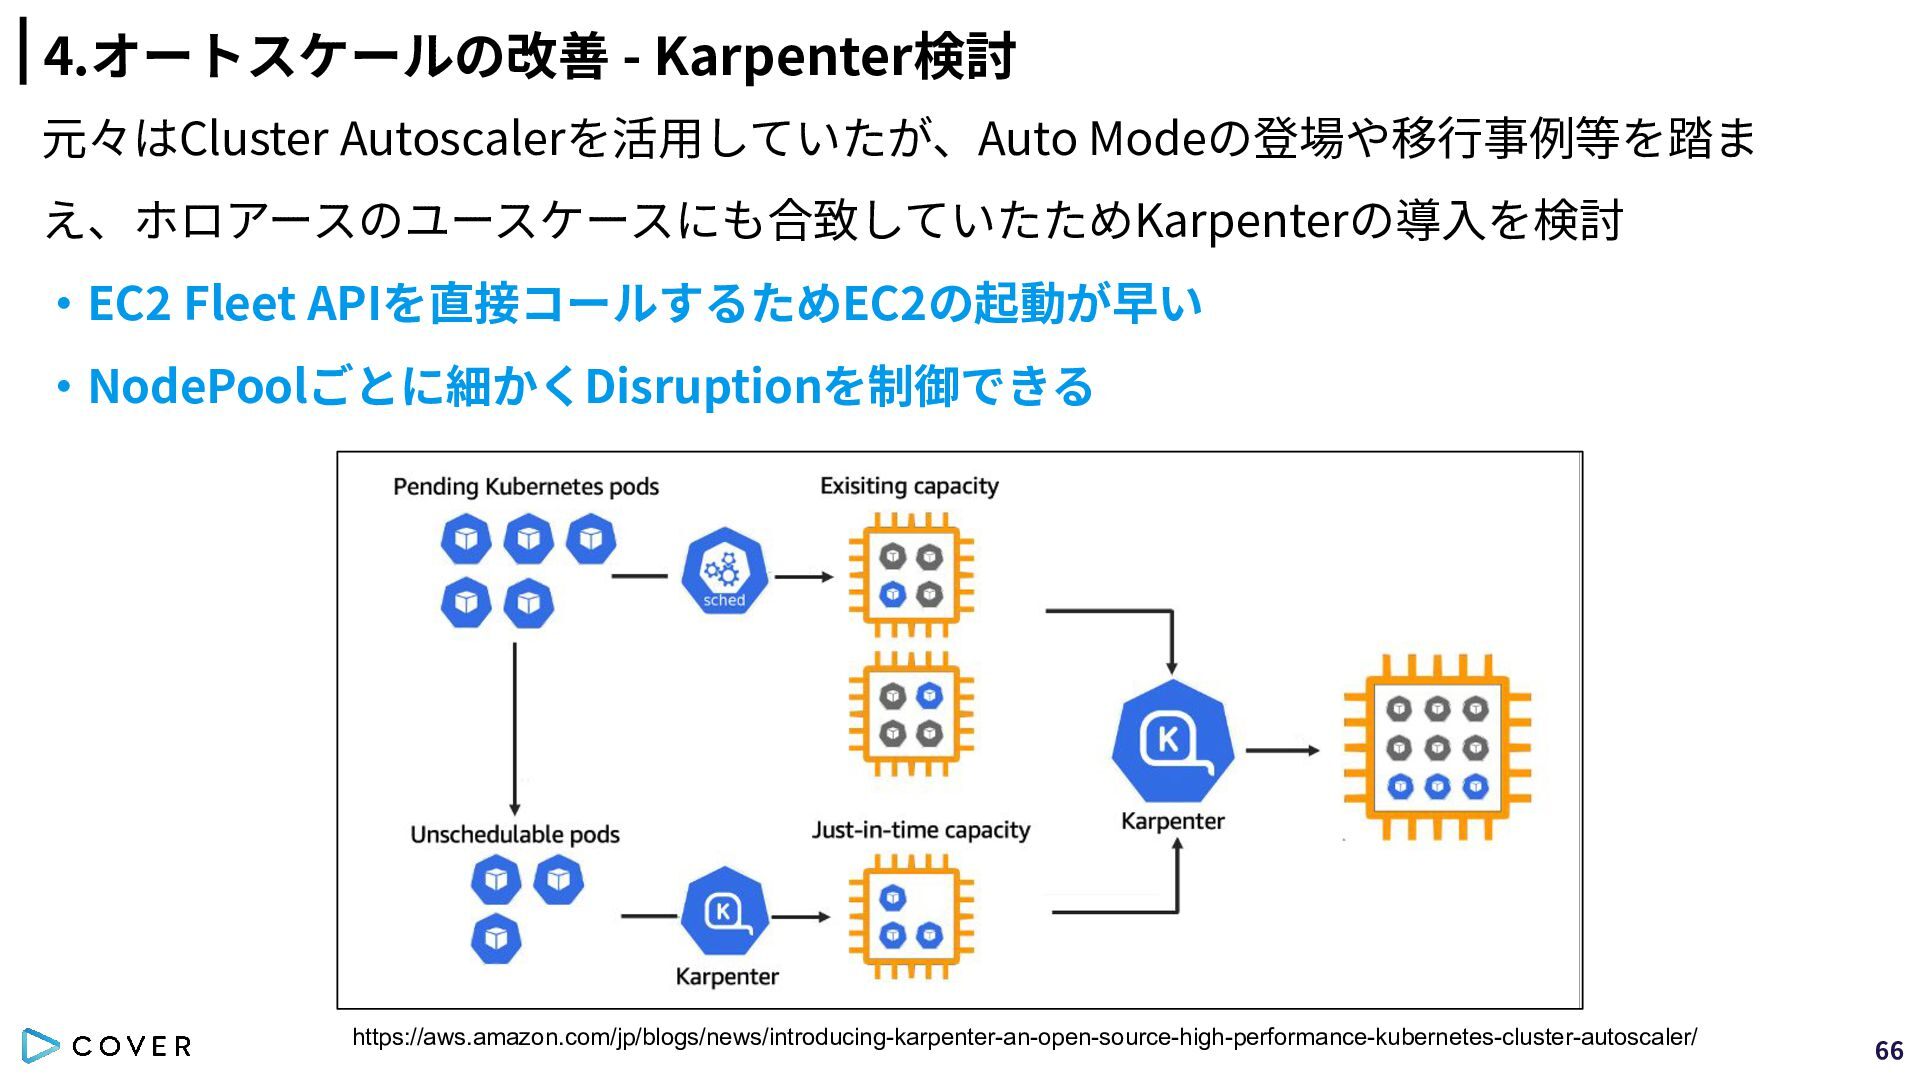
4.オートスケールの改善 - Karpenter検討 元々はCluster Autoscalerを活⽤していたが、Auto Modeの登場や移⾏事例等を踏ま え、ホロアースのユースケースにも合致していたためKarpenterの導⼊を検討 ‧EC2 Fleet APIを直接コールするためEC2の起動が早い
‧NodePoolごとに細かくDisruptionを制御できる https://aws.amazon.com/jp/blogs/news/introducing-karpenter-an-open-source-high-performance-kubernetes-cluster-autoscaler/ 66 -
4.オートスケールの改善 - Karpenter導⼊ ホロアースにおいてはNodeの管理コストを下げ、細かい中断制御を⾏うために Karpenterを全てのクラスタへ導⼊を⾏なった [導⼊背景] 管理⾯ ‧ UDP⽤のNodeGroupがエリアごとに定義されておりManaged NogeGroupの管理が煩雑になっ
ていた コスト⾯ ‧開発環境でSpotインスタンスが活⽤できていなかった その他 ‧UDPサーバーはNode単位のスケールアウトとなるため、EC2の起動速度を改善させたかった ‧本番環境の中断時間を細かく制御したかった 67 -
4.オートスケールの改善 - Karpenter運⽤考慮点 NodeClass ‧IMDSを利⽤しているためホップカウントを2に設定 ‧AMIを固定(AMIの更新AL2→AL2023でNIC名が変更) ‧[開発環境]maxPodsを調整しIPの割り当て数を増加(VPC CNI のPrefix Delegationを有効化)
NodePool ‧[開発環境]Spot Instanceを優先的に使⽤ ‧Diarkisの各コンポーネントごとにNodePoolを分割しインスタンスタイプを割り当てる ‧expireAfter: Neverで運⽤、イベント時にNodeの⼊れ替えが起きないようにしている ※AutoModeでは21⽇の⽣存期間があるが、メンテナンス時間をコントロールできず導⼊を断念した ‧[本番環境]DisruptionはDiarkisのWorkload Podが存在しない場合 & ピーク時間以外のみ⾏う ‧consolidationPolicy: WhenEmpty ‧budgets: 特定時間内のみ許可、nodeは1台ずつ減らす(それ以外は0台) 68 -
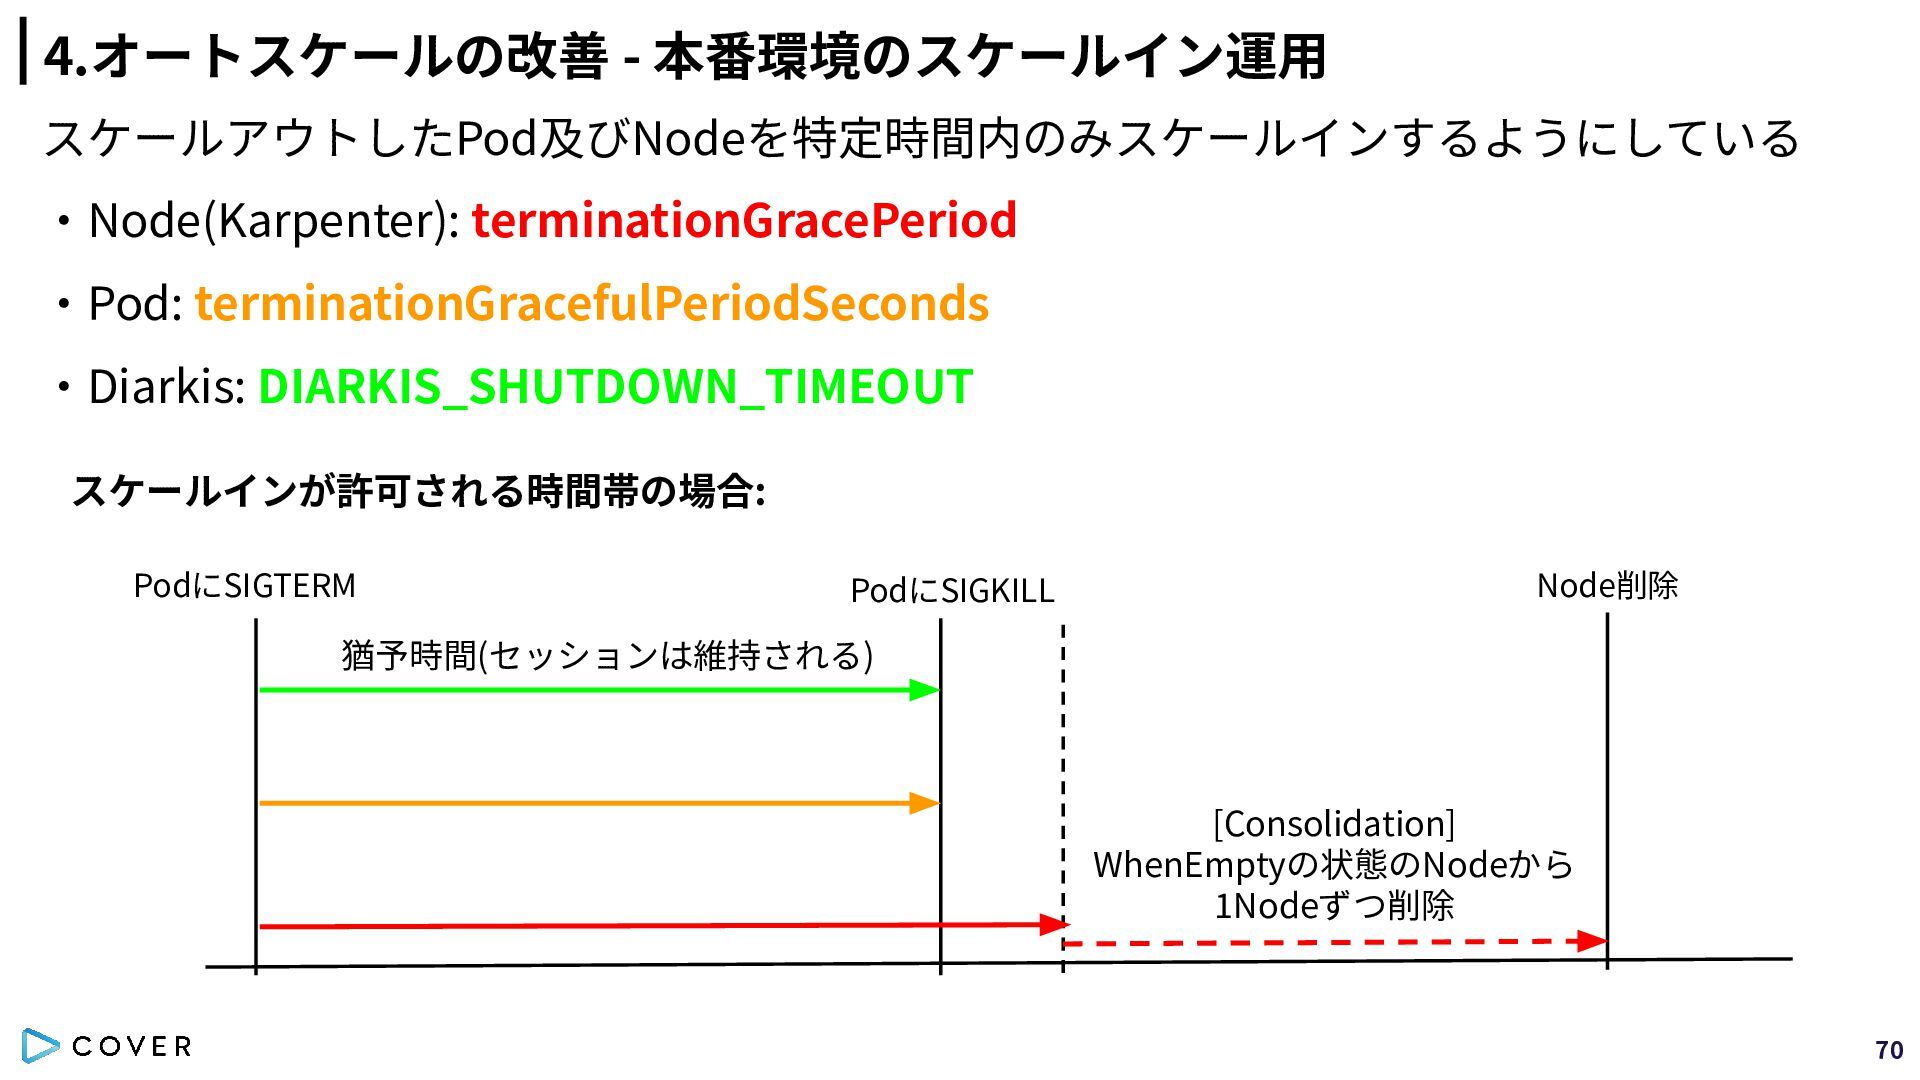
4.オートスケールの改善 - 本番環境のスケールイン運⽤ スケールアウトしたPod及びNodeを特定時間内のみスケールインするようにしている ‧Node(Karpenter): terminationGracePeriod ‧Pod: terminationGracefulPeriodSeconds ‧Diarkis: DIARKIS_SHUTDOWN_TIMEOUT
スケールインが許可される時間帯の場合: PodにSIGTERM PodにSIGKILL Node削除 猶予時間(セッションは維持される) [Consolidation] WhenEmptyの状態のNodeから 1Nodeずつ削除 70 -
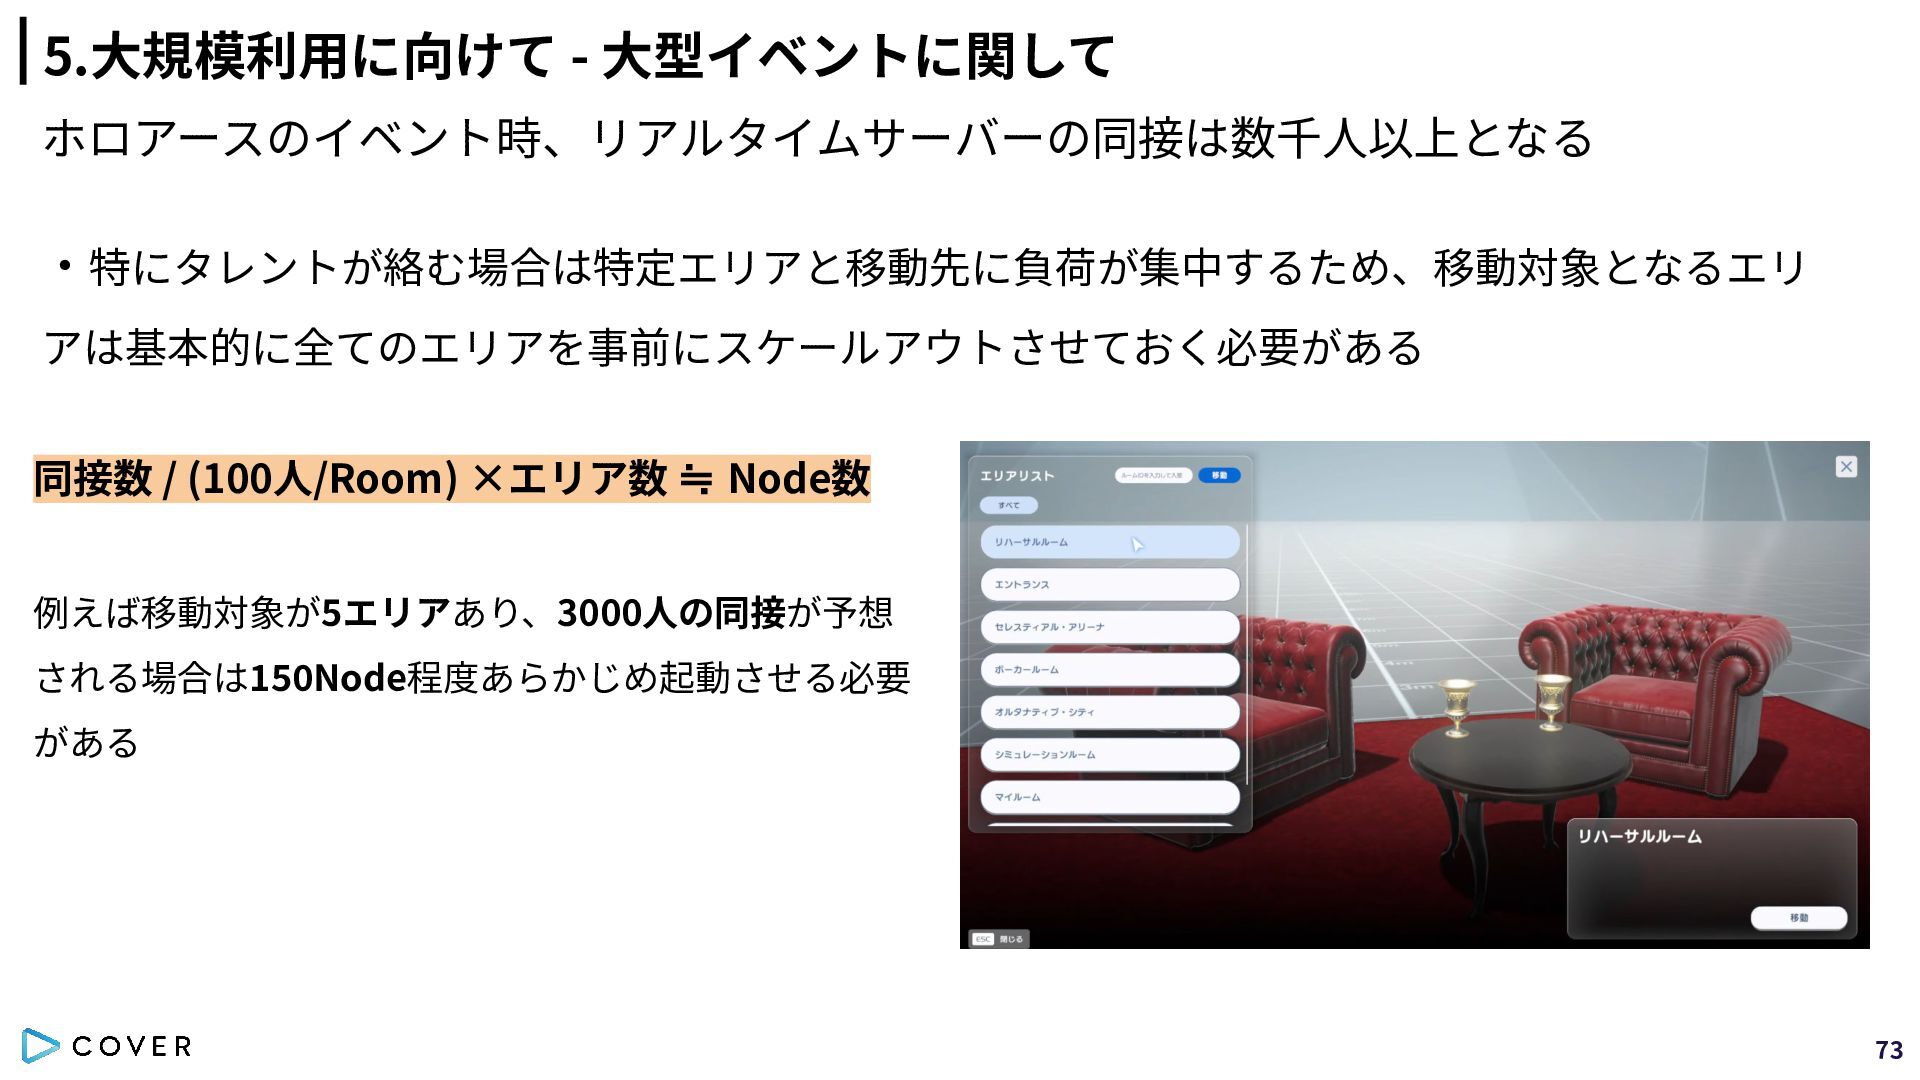
5.⼤規模利⽤に向けて - ⼤型イベントに関して ホロアースのイベント時、リアルタイムサーバーの同接は数千⼈以上となる ‧特にタレントが絡む場合は特定エリアと移動先に負荷が集中するため、移動対象となるエリ アは基本的に全てのエリアを事前にスケールアウトさせておく必要がある 同接数 / (100⼈/Room) ×エリア数
≒ Node数 例えば移動対象が5エリアあり、3000⼈の同接が予想 される場合は150Node程度あらかじめ起動させる必要 がある 73 -
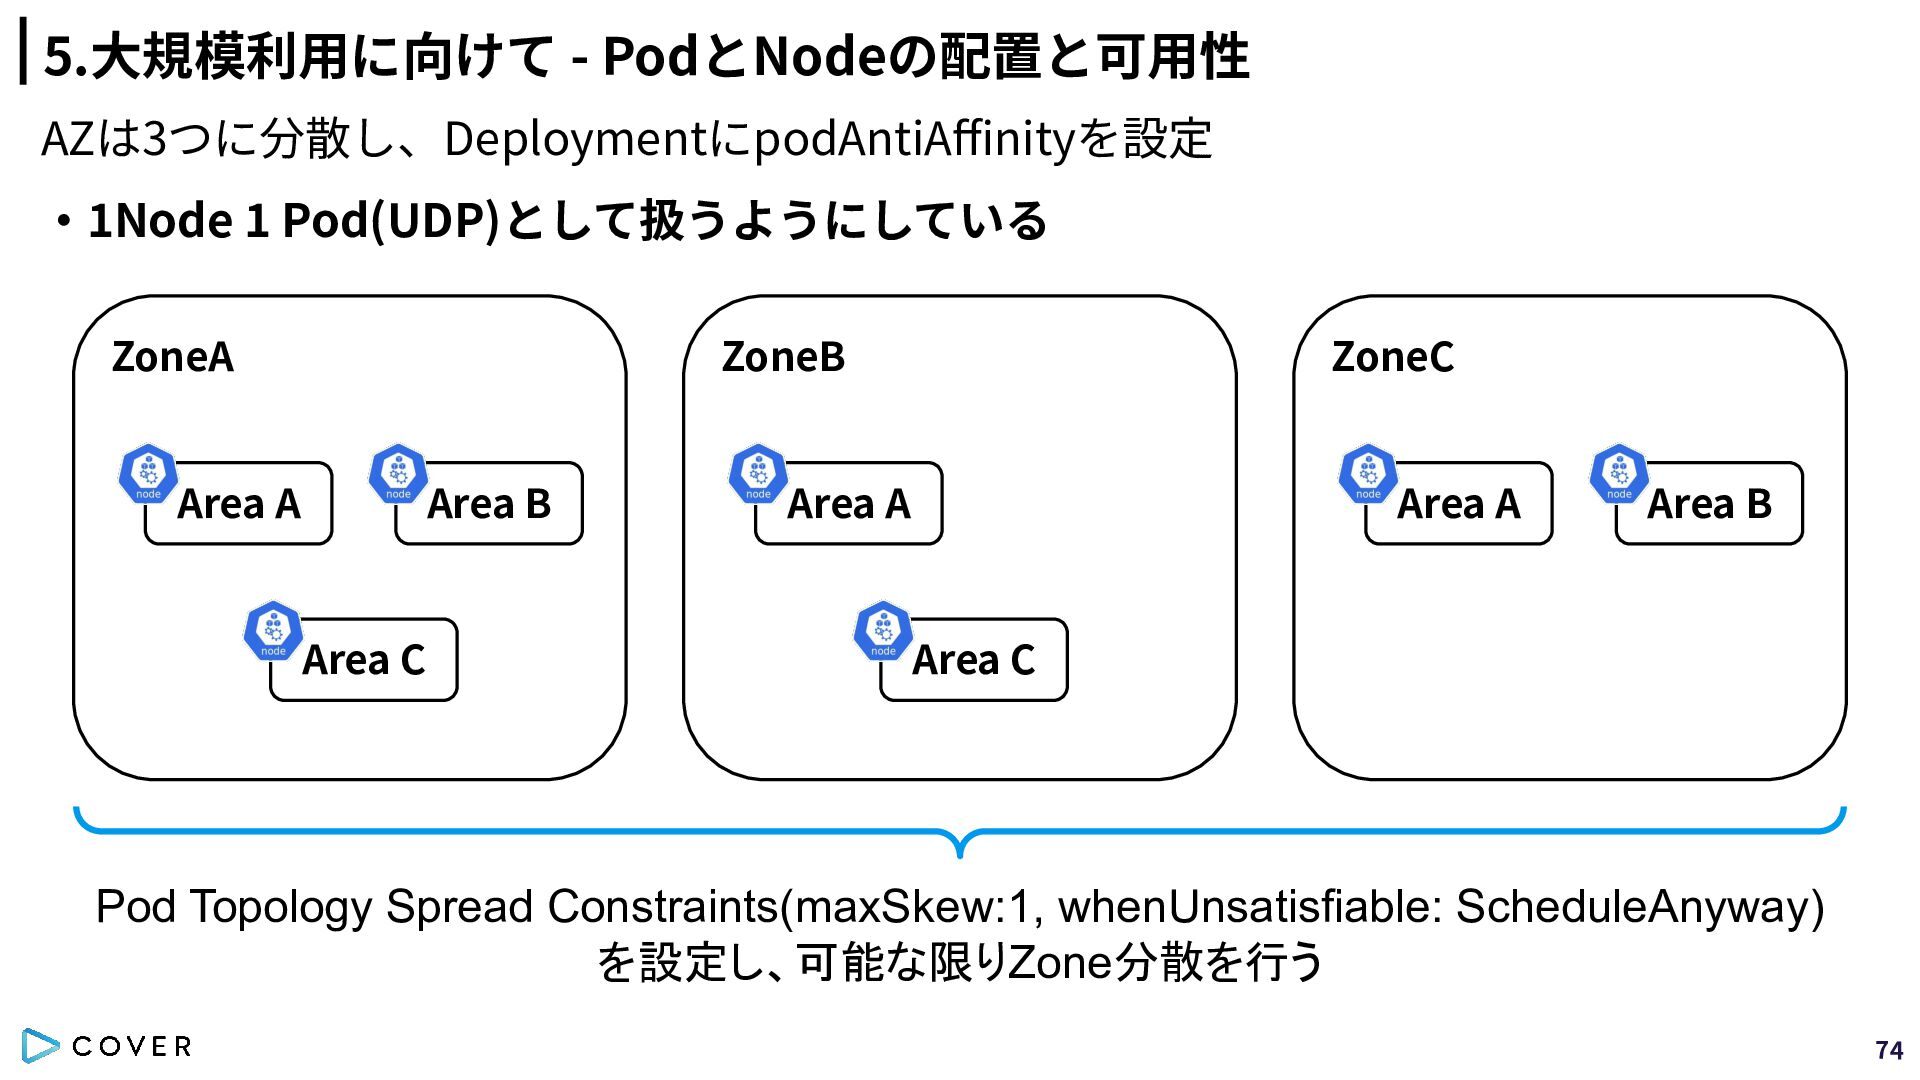
5.⼤規模利⽤に向けて - PodとNodeの配置と可⽤性 AZは3つに分散し、DeploymentにpodAntiAffinityを設定 ‧1Node 1 Pod(UDP)として扱うようにしている ZoneA ZoneB Area
A Area B Area C ZoneC Area A Area A Area B Area C Pod Topology Spread Constraints(maxSkew:1, whenUnsatisfiable: ScheduleAnyway) を設定し、可能な限りZone分散を行う 74 -
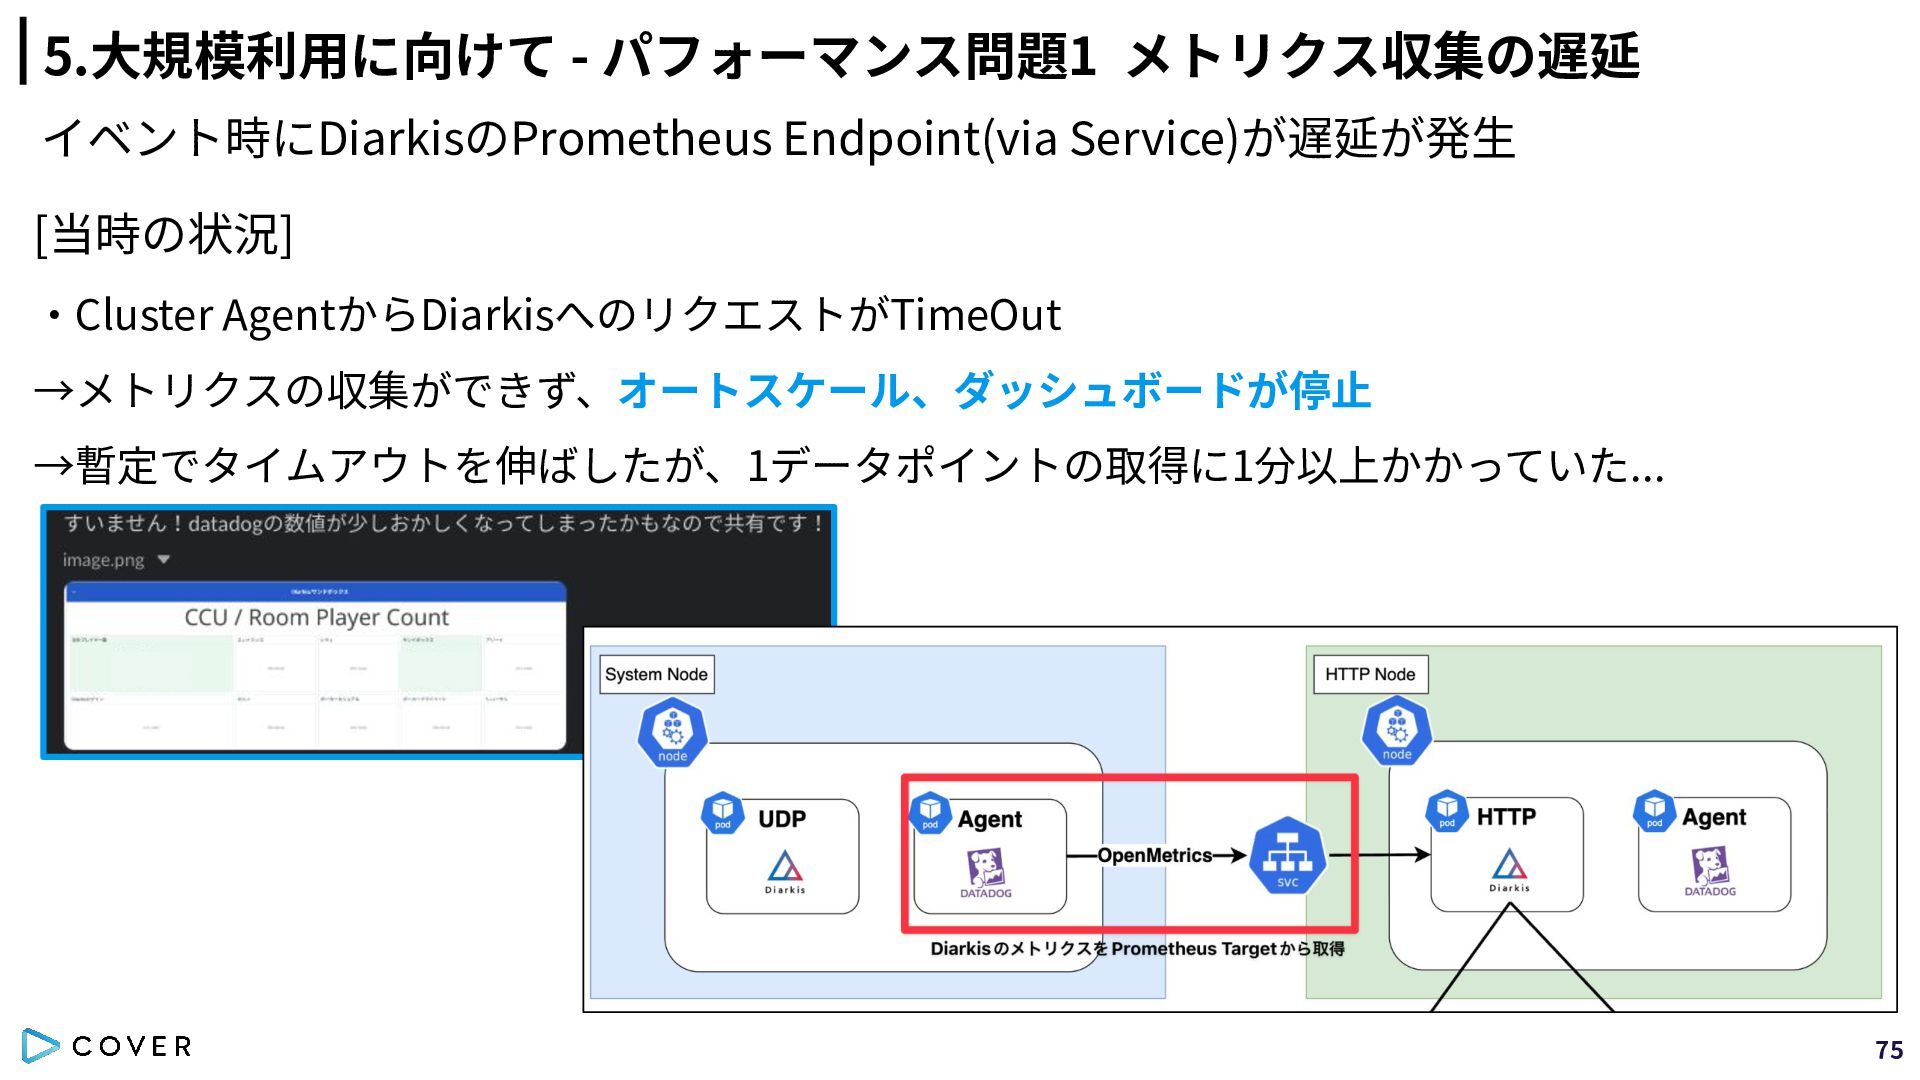
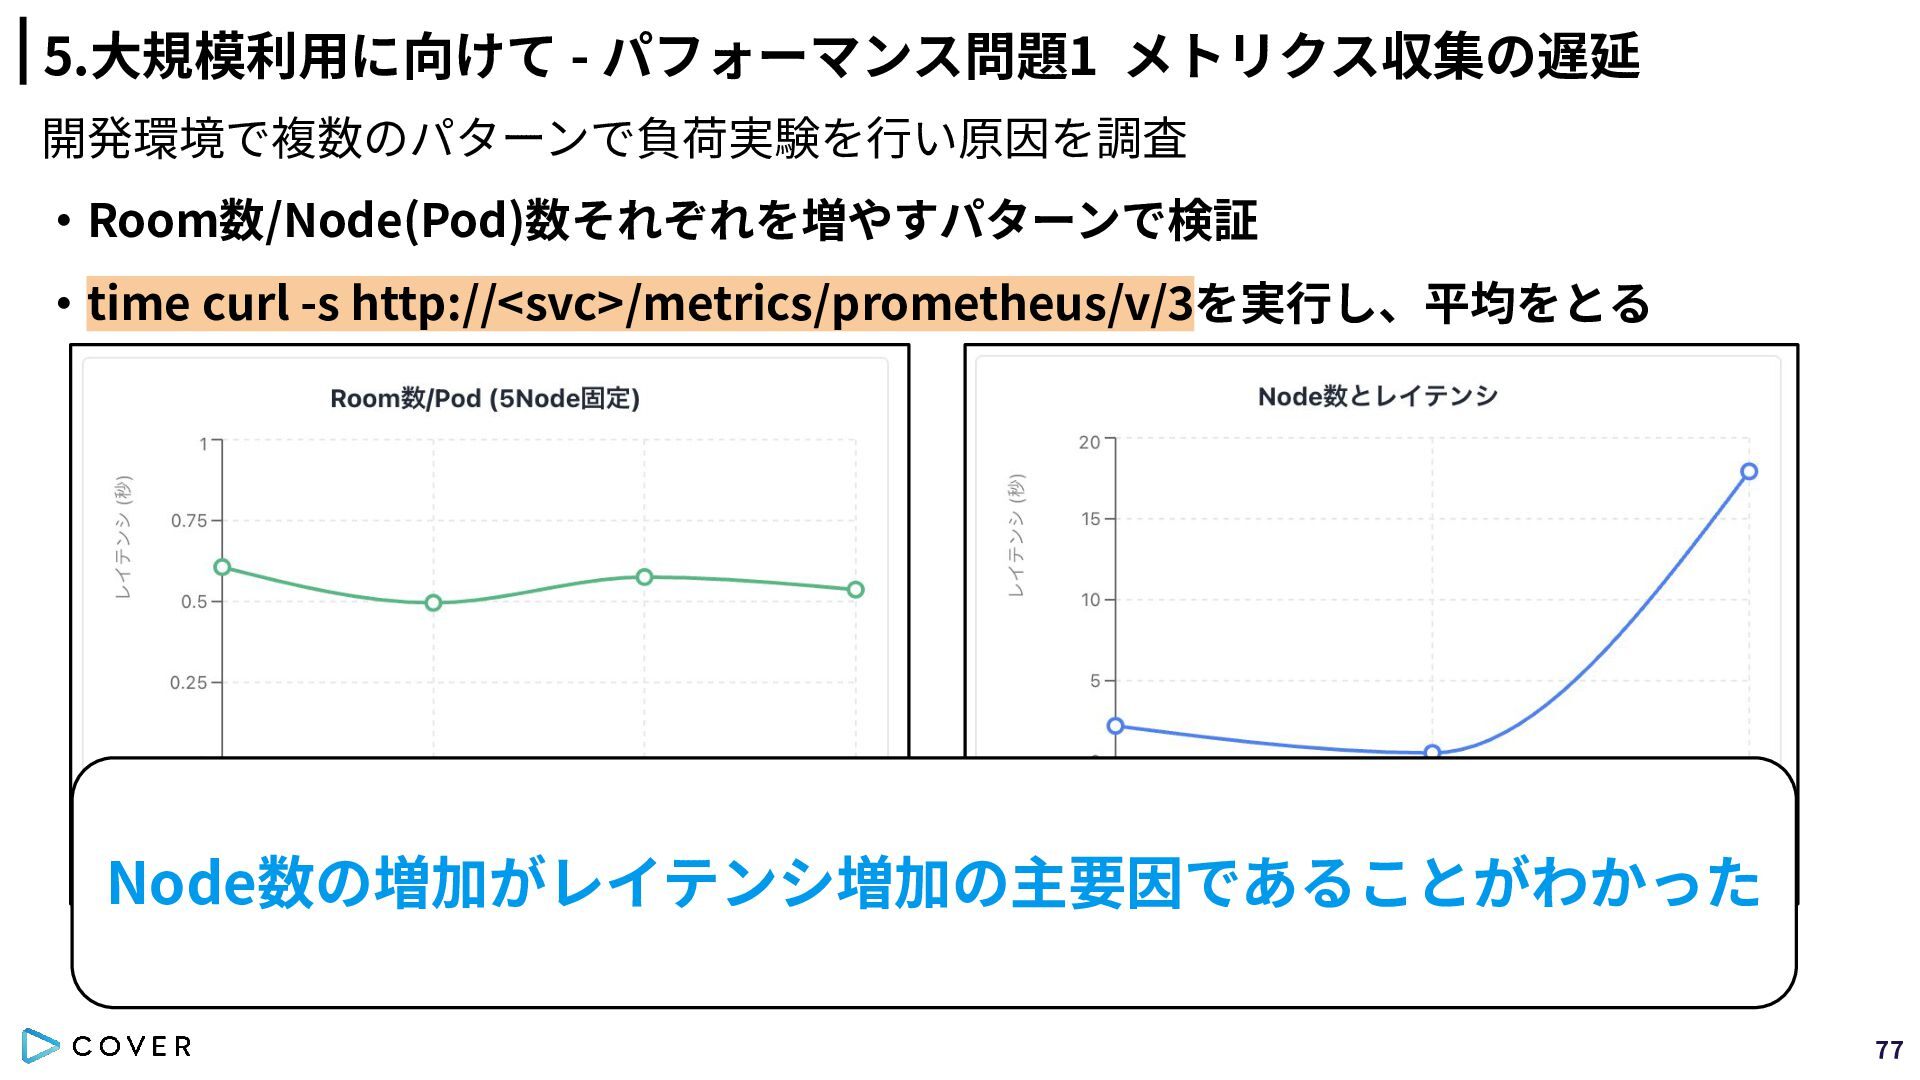
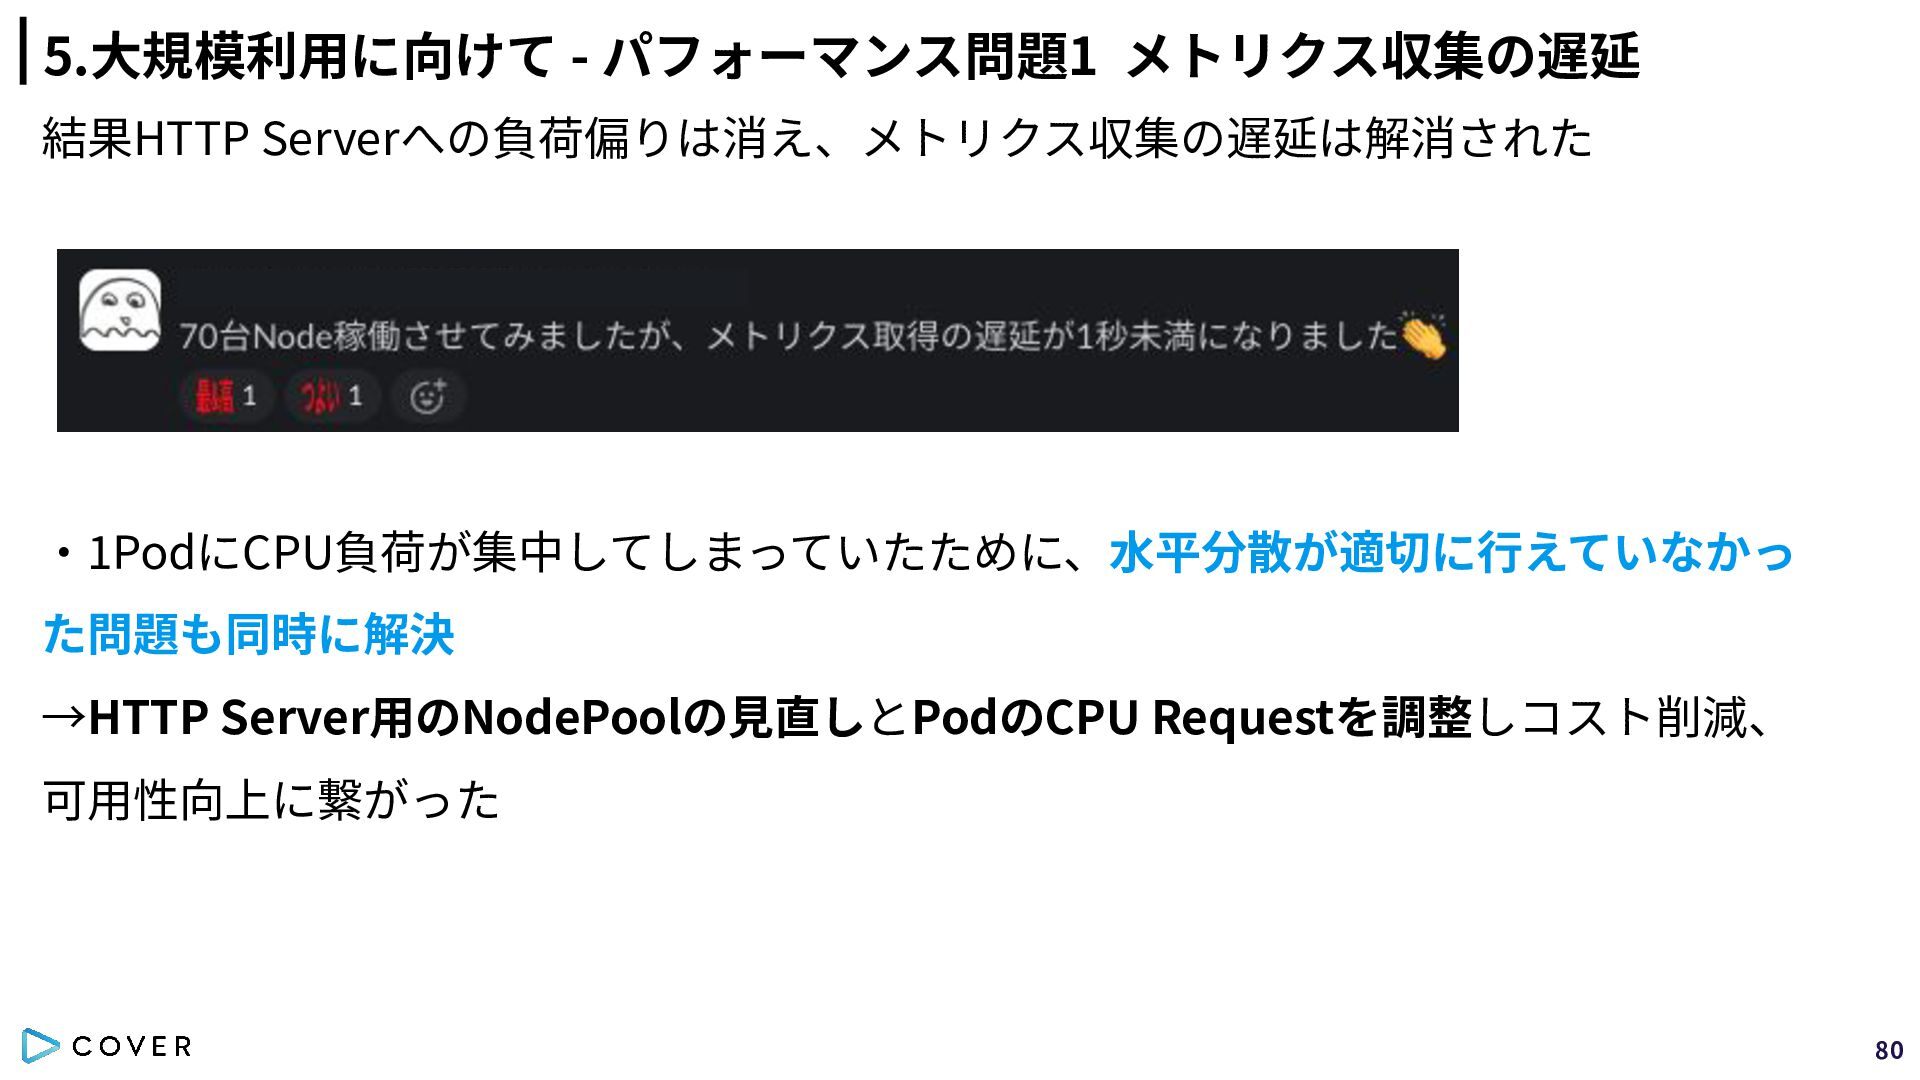
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 イベント時にDiarkisのPrometheus Endpoint(via Service)が遅延が発⽣ [当時の状況] ‧Cluster AgentからDiarkisへのリクエストがTimeOut
→メトリクスの収集ができず、オートスケール、ダッシュボードが停⽌ →暫定でタイムアウトを伸ばしたが、1データポイントの取得に1分以上かかっていた... 75 -
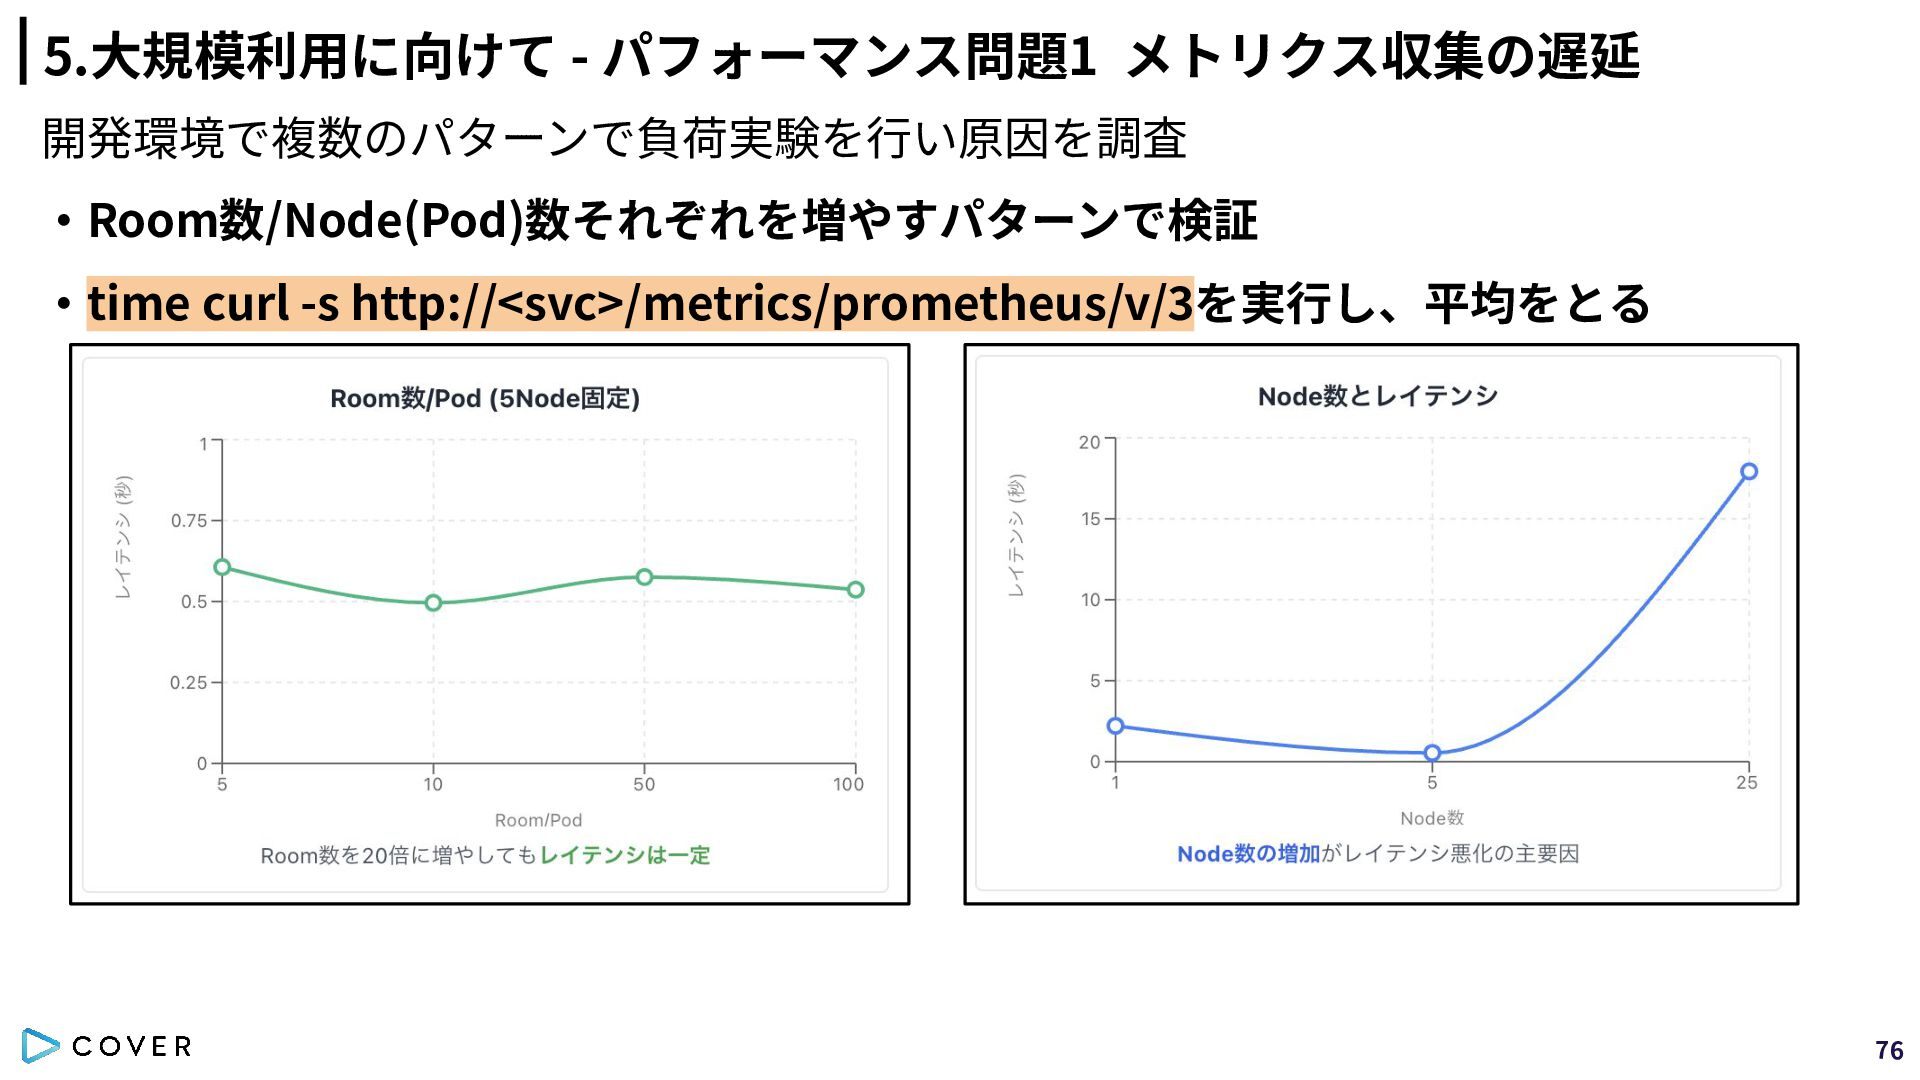
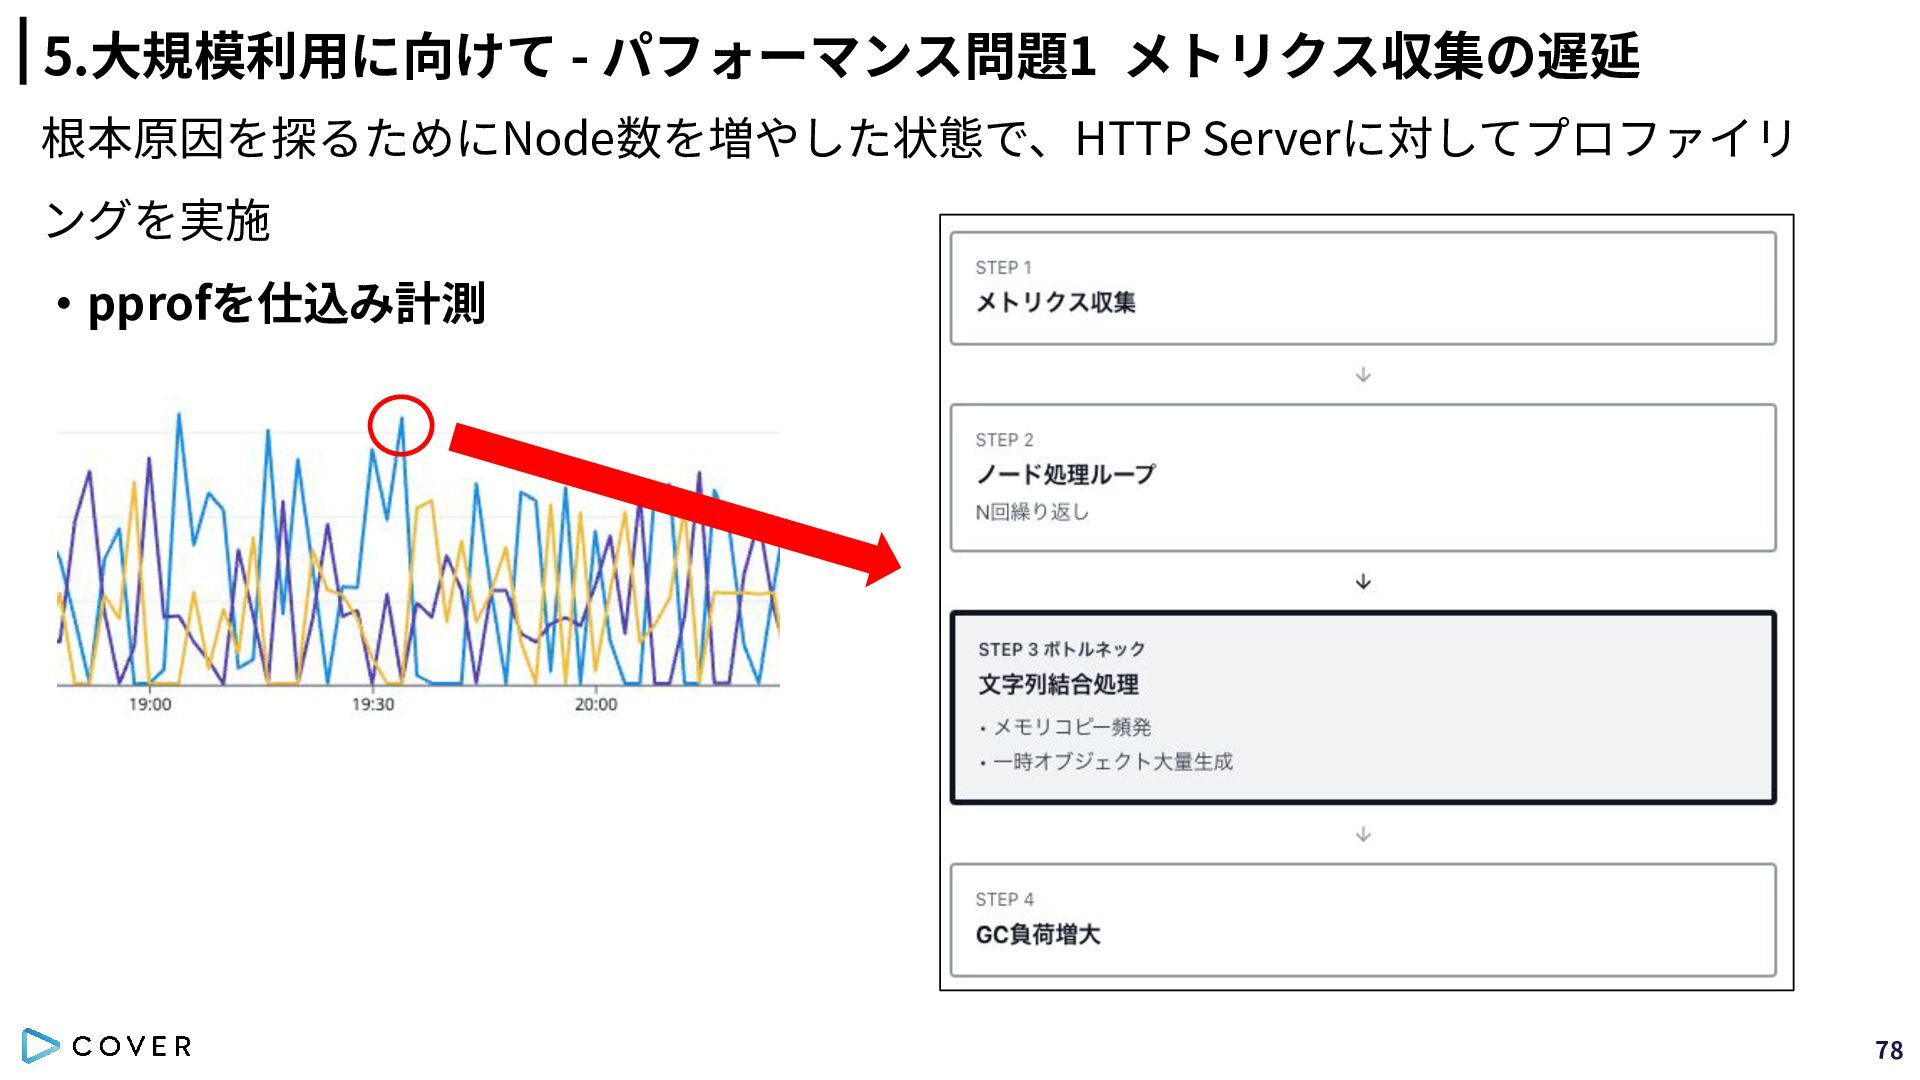
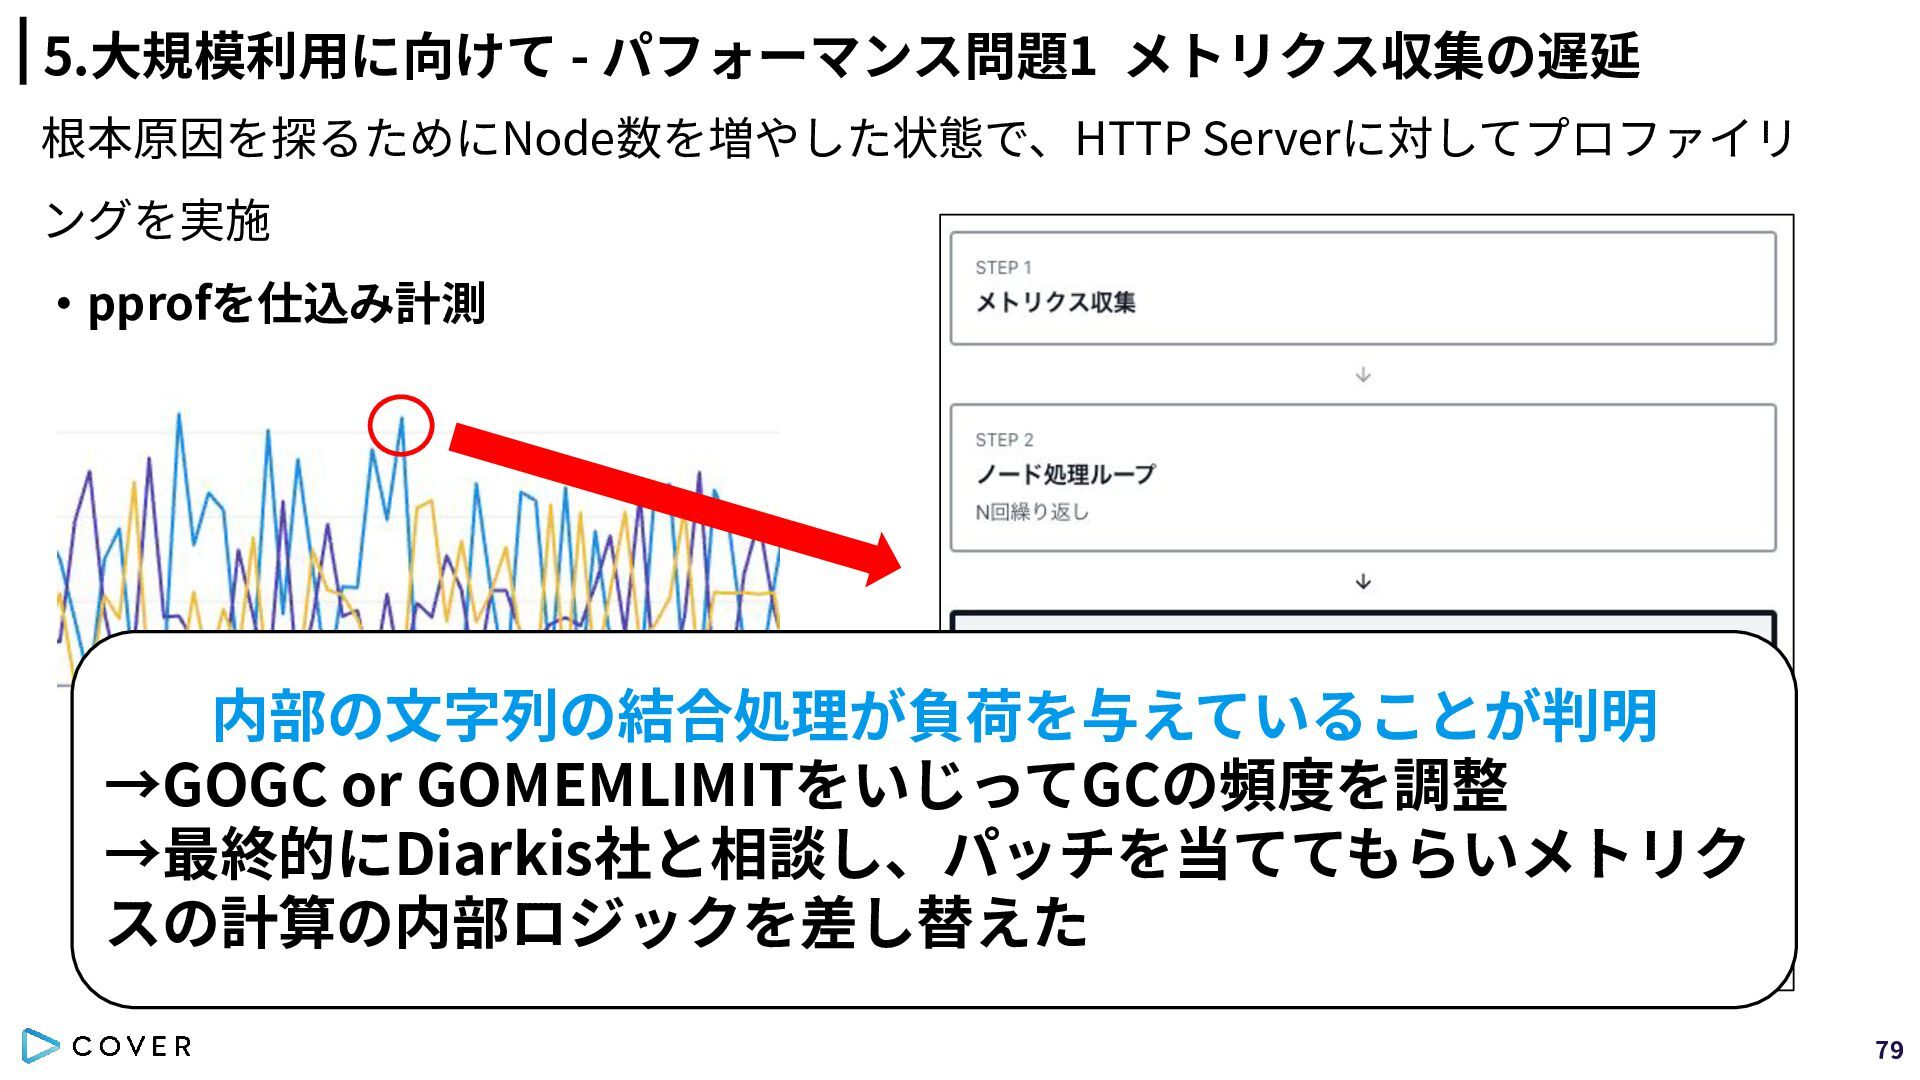
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 根本原因を探るためにNode数を増やした状態で、HTTP Serverに対してプロファイリ ングを実施 ‧pprofを仕込み計測 内部の⽂字列の結合処理が負荷を与えていることが判明 →GOGC
or GOMEMLIMITをいじってGCの頻度を調整 →最終的にDiarkis社と相談し、パッチを当ててもらいメトリク スの計算の内部ロジックを差し替えた 79 -
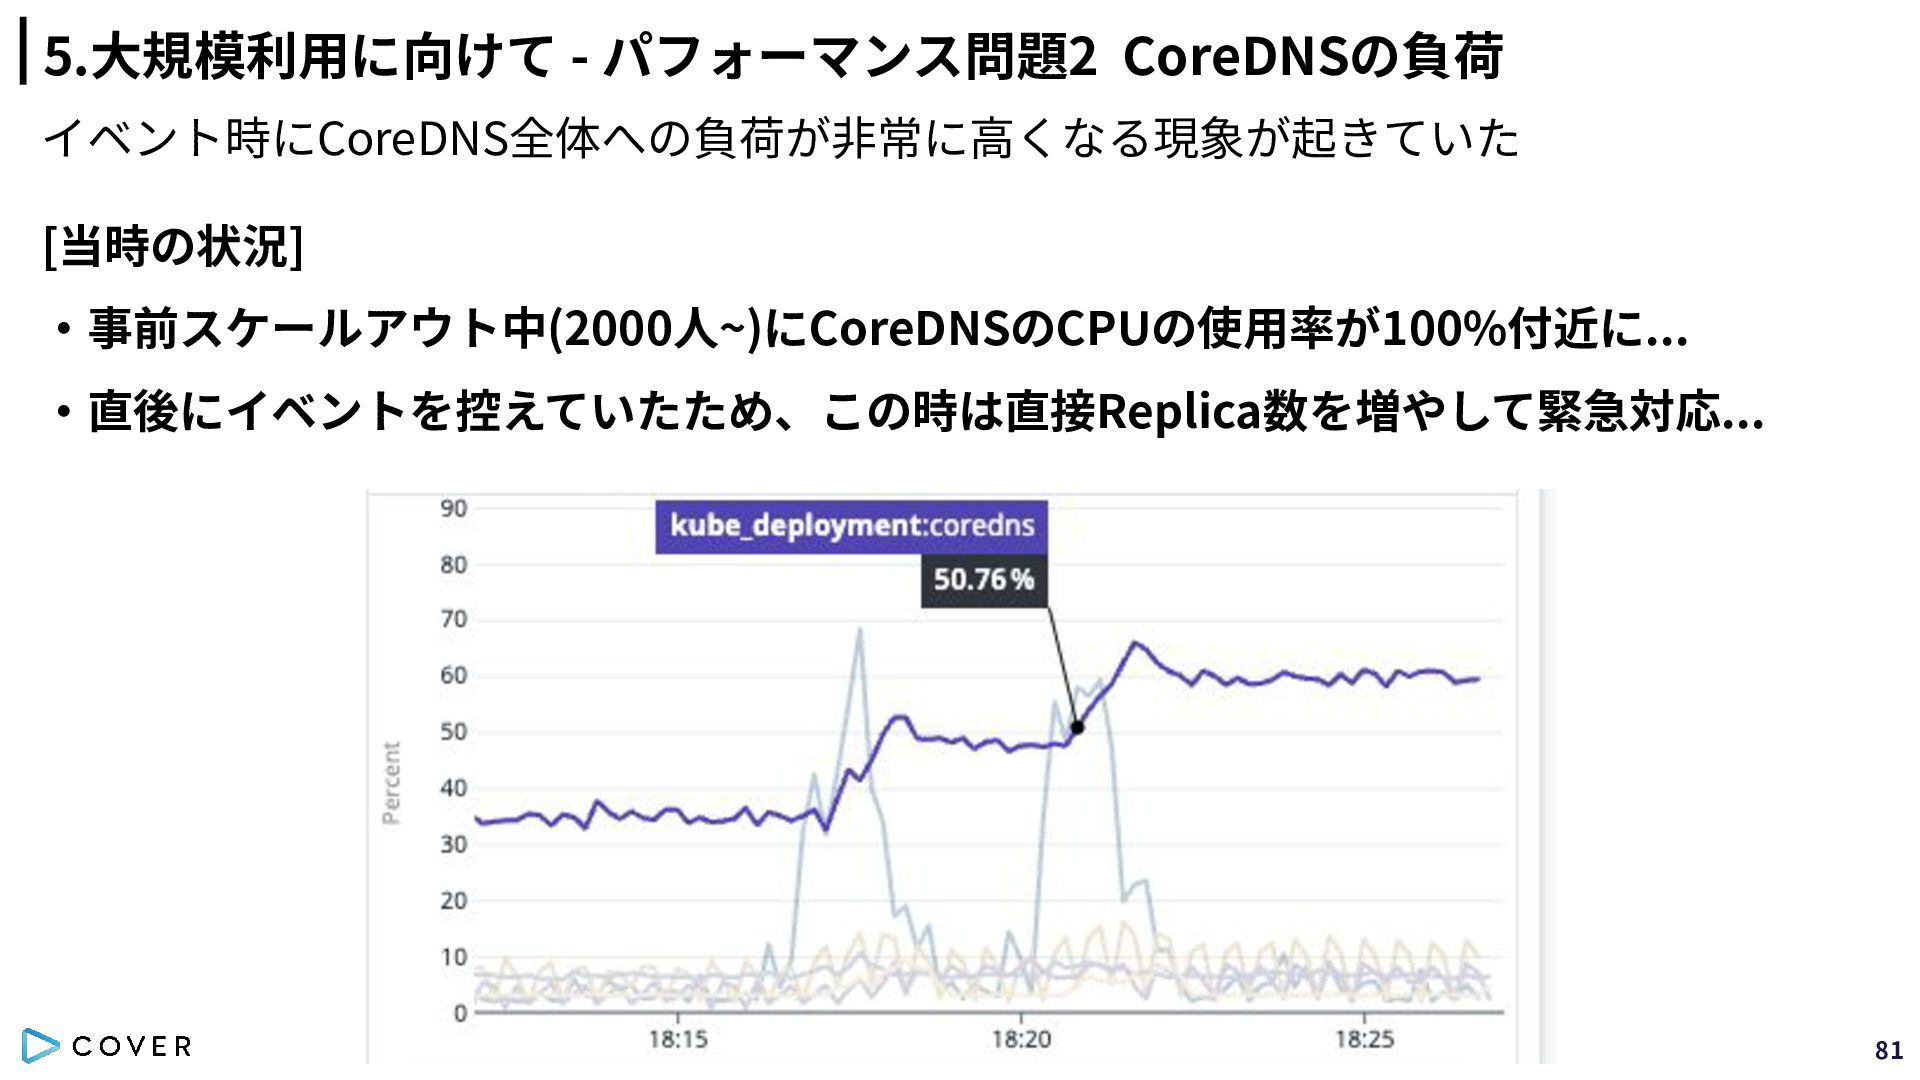
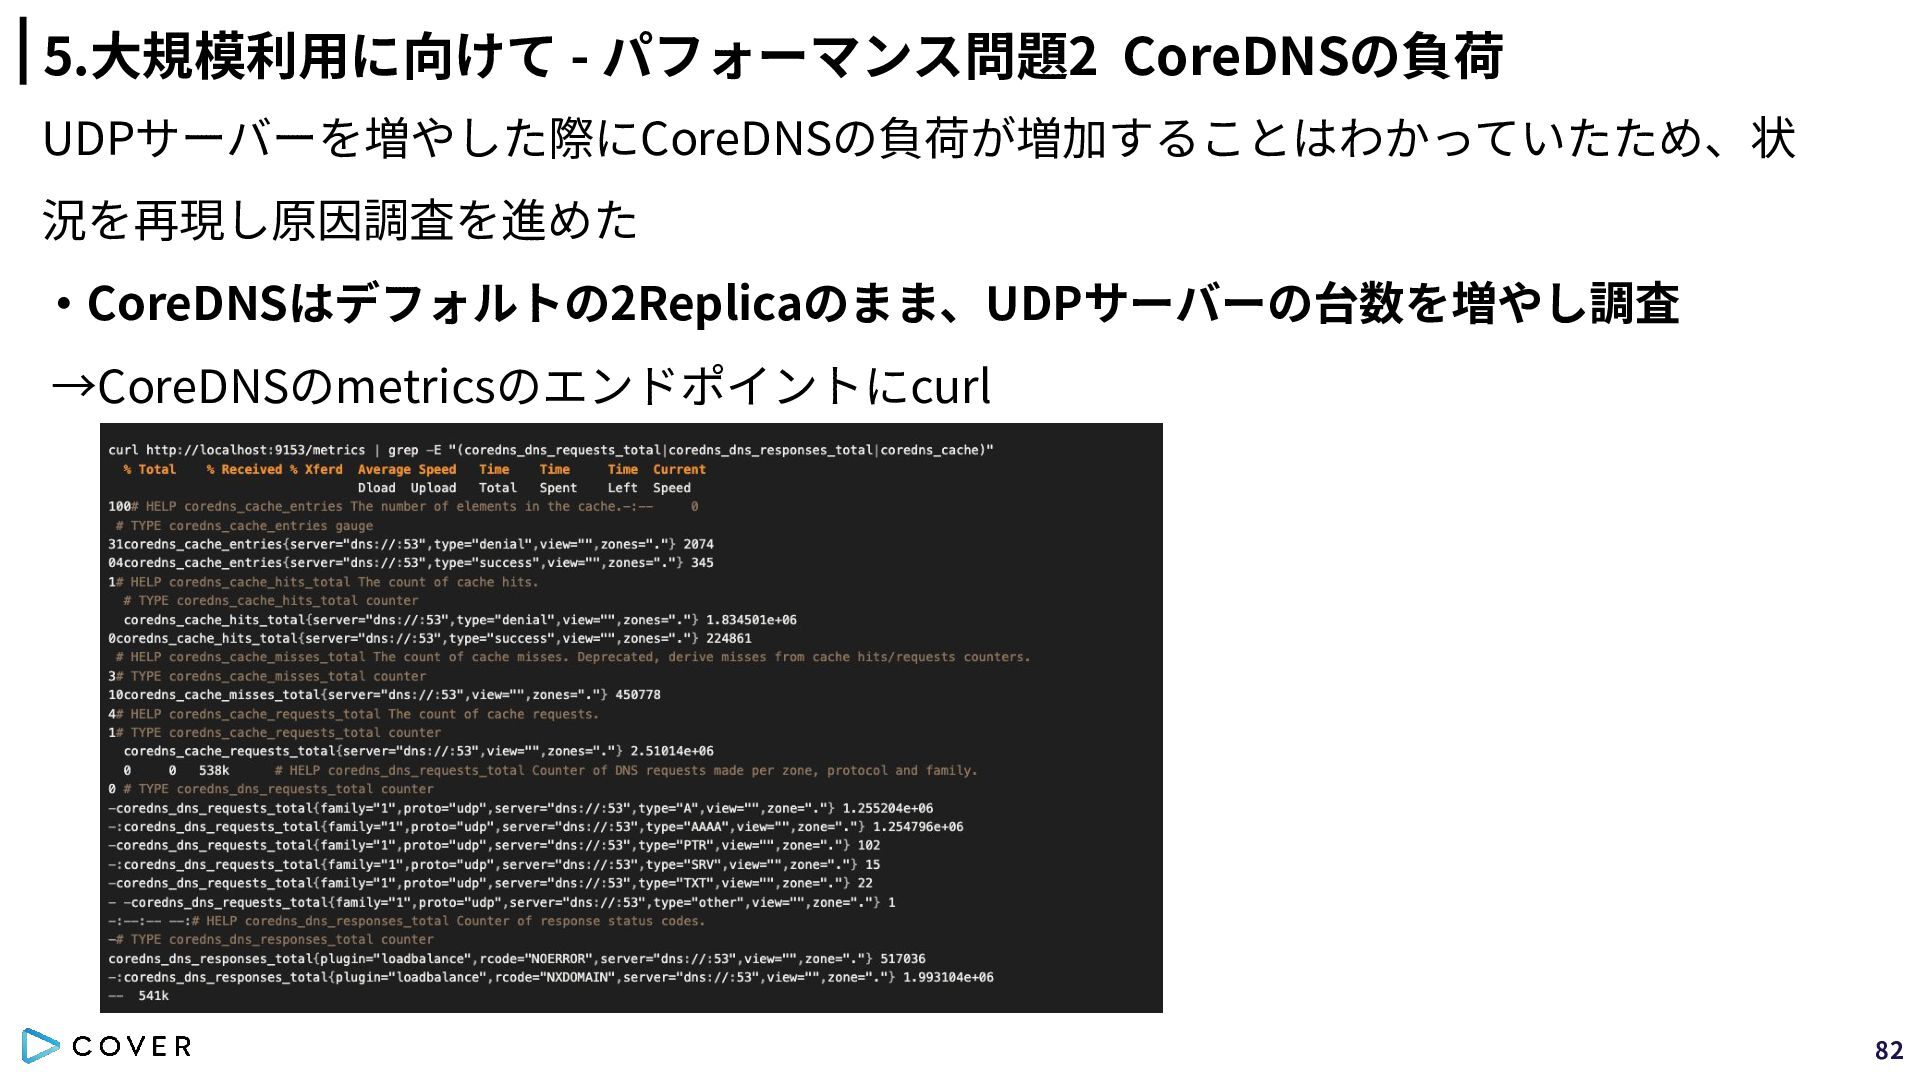
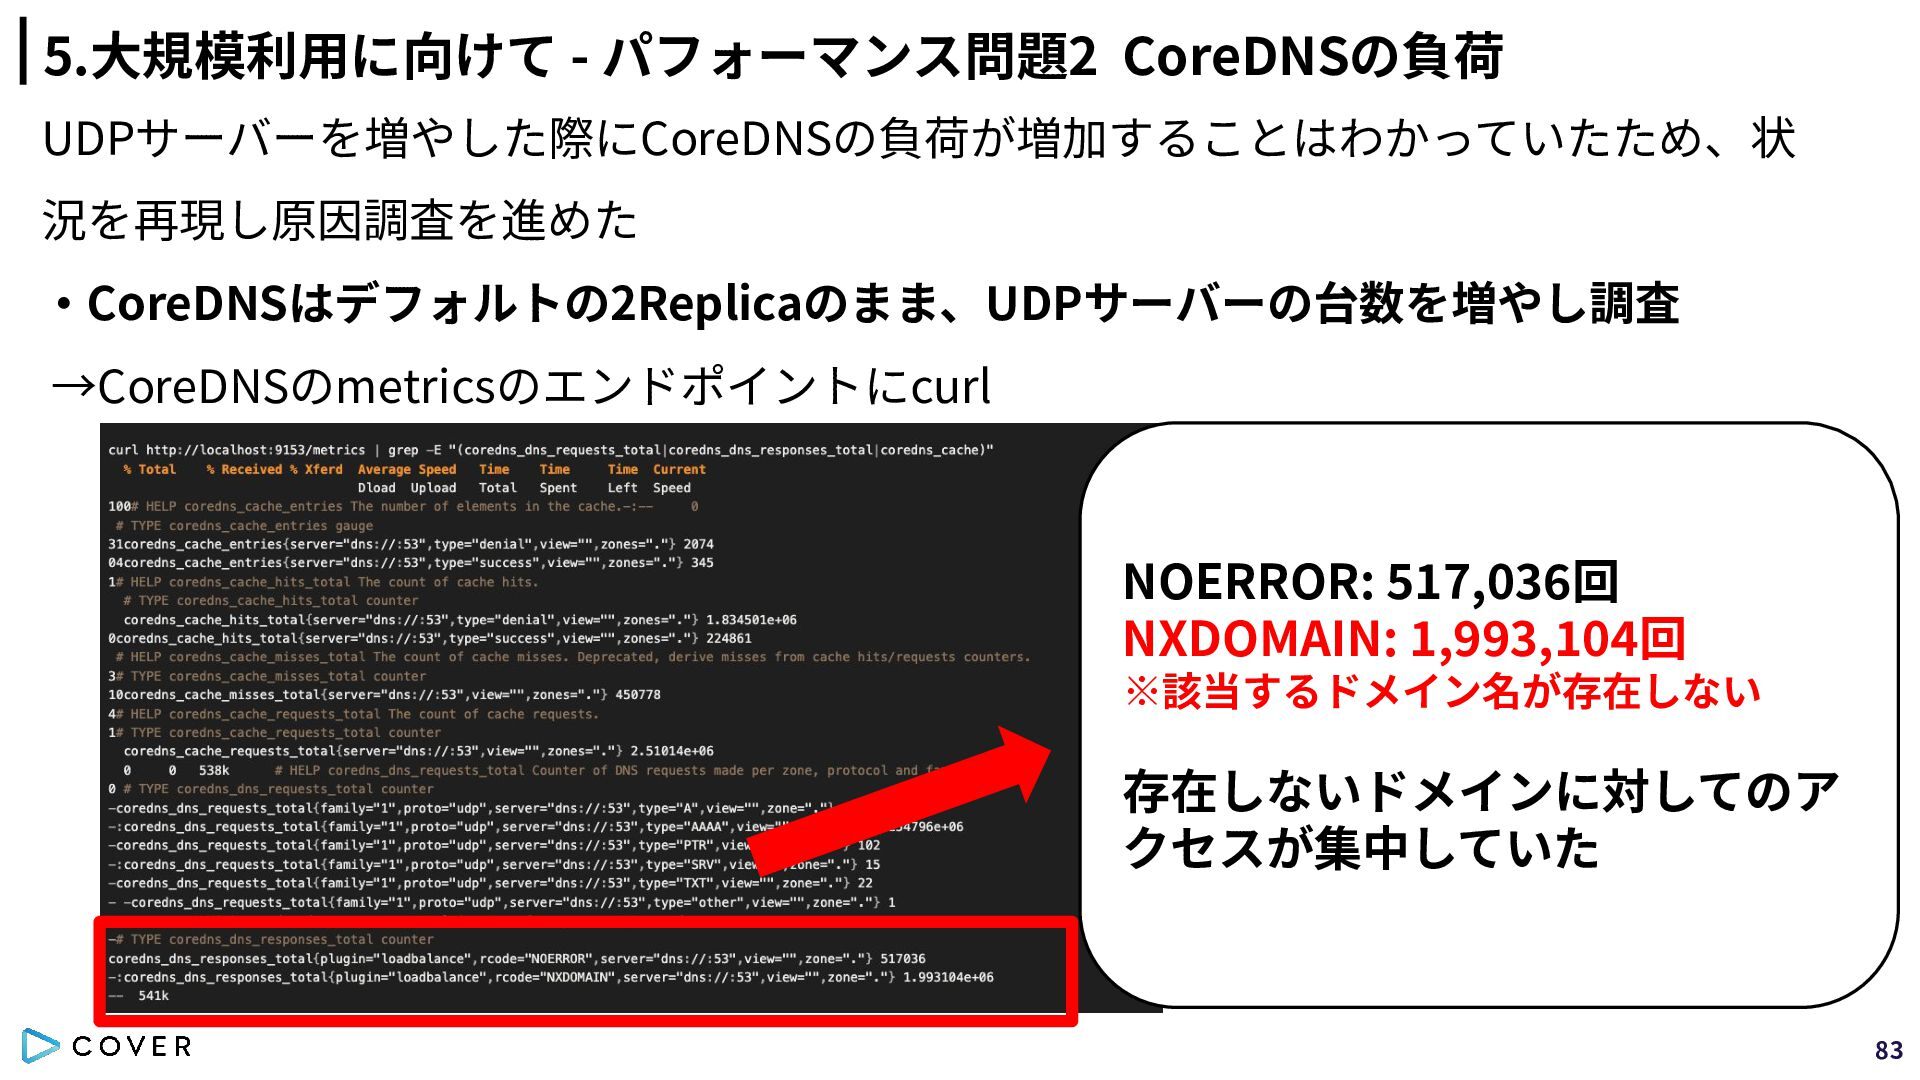
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 UDPサーバーを増やした際にCoreDNSの負荷が増加することはわかっていたため、状 況を再現し原因調査を進めた ‧CoreDNSはデフォルトの2Replicaのまま、UDPサーバーの台数を増やし調査 →CoreDNSのmetricsのエンドポイントにcurl NOERROR: 517,036回
NXDOMAIN: 1,993,104回 ※該当するドメイン名が存在しない 存在しないドメインに対してのア クセスが集中していた 83 -
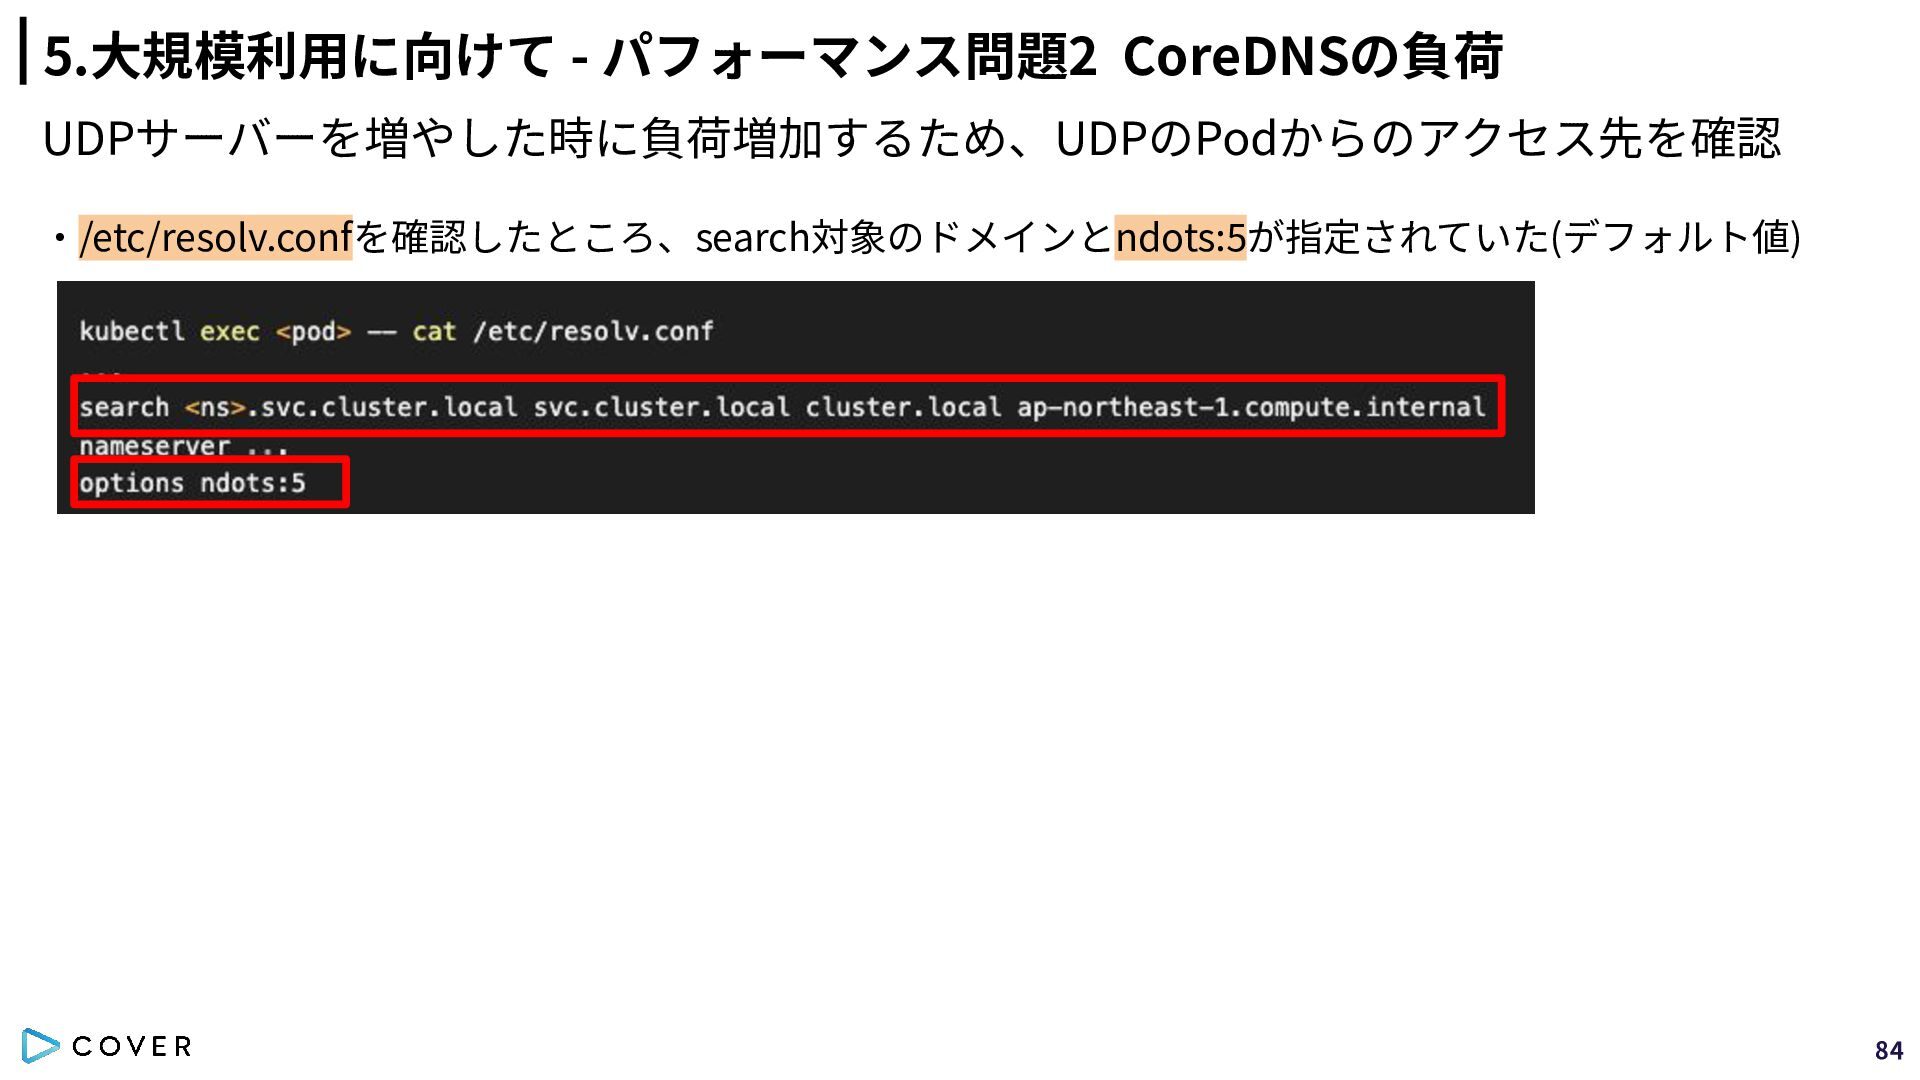
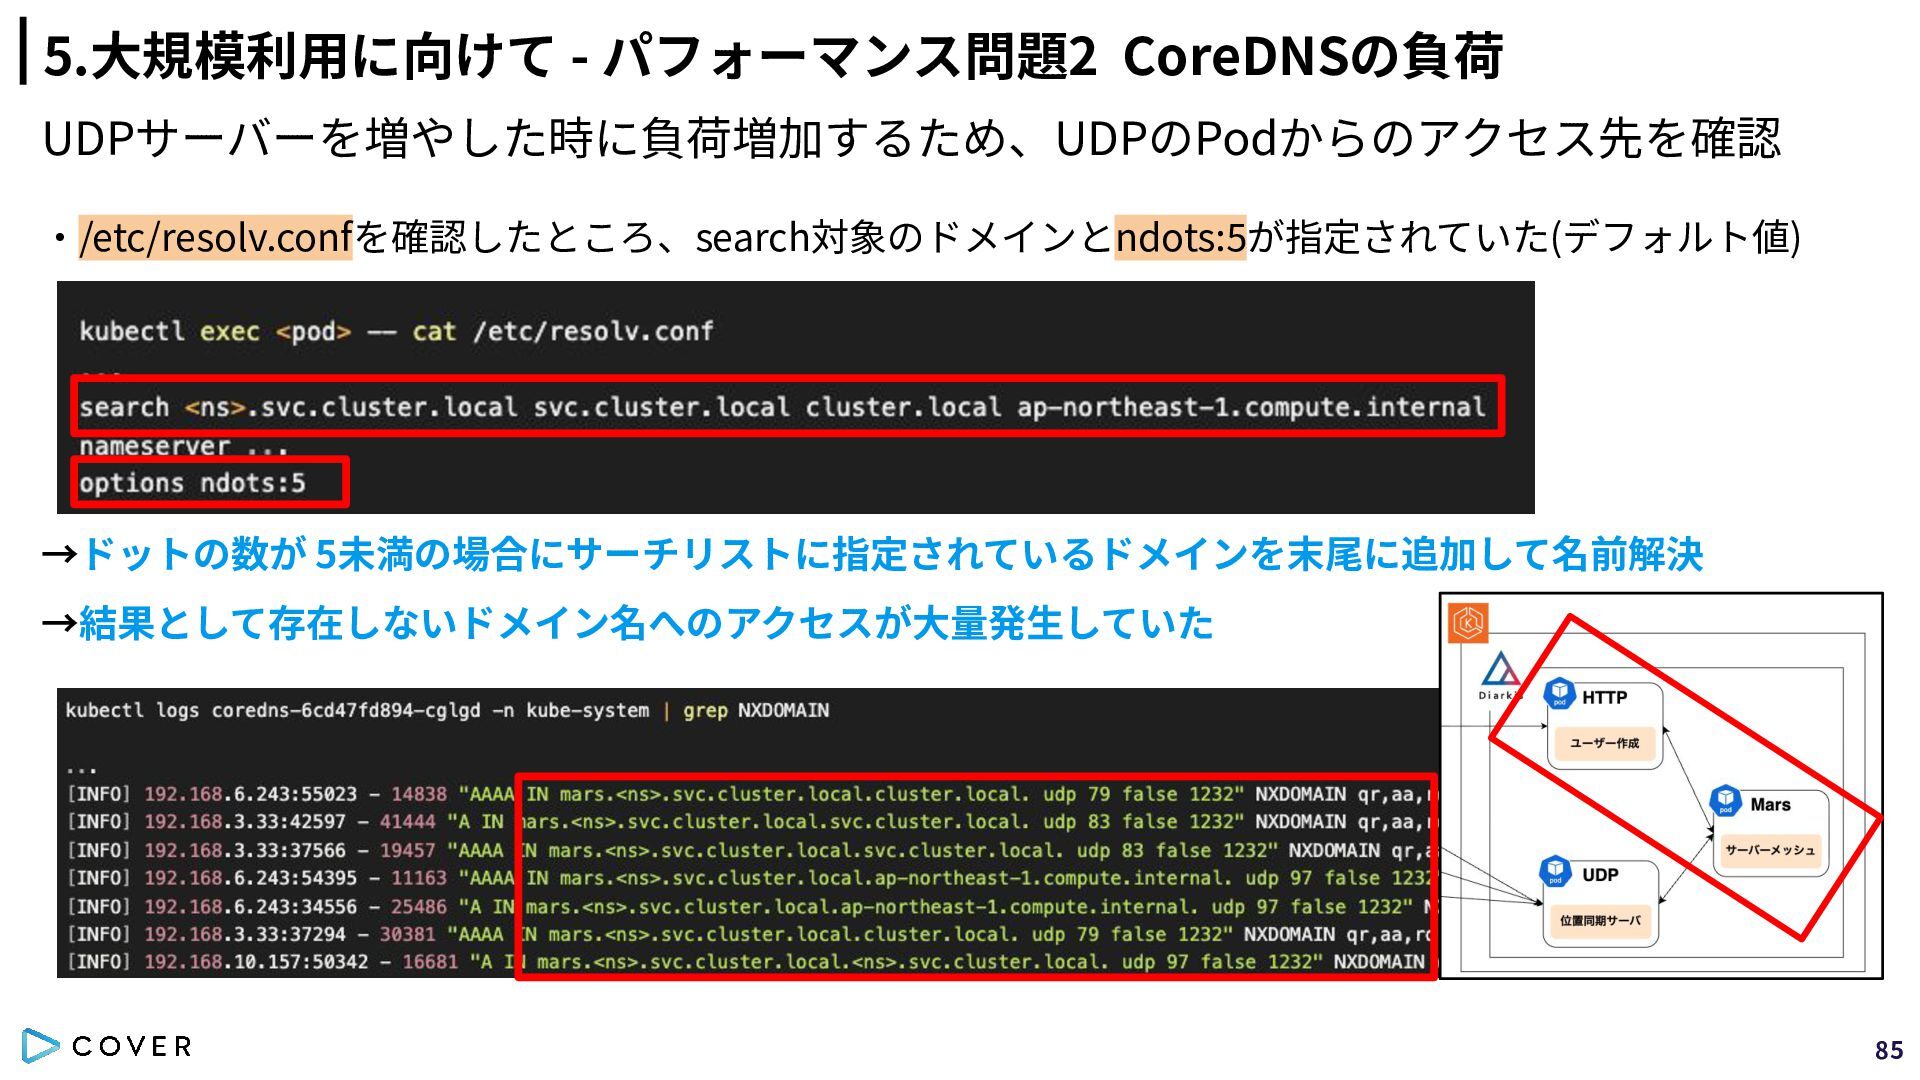
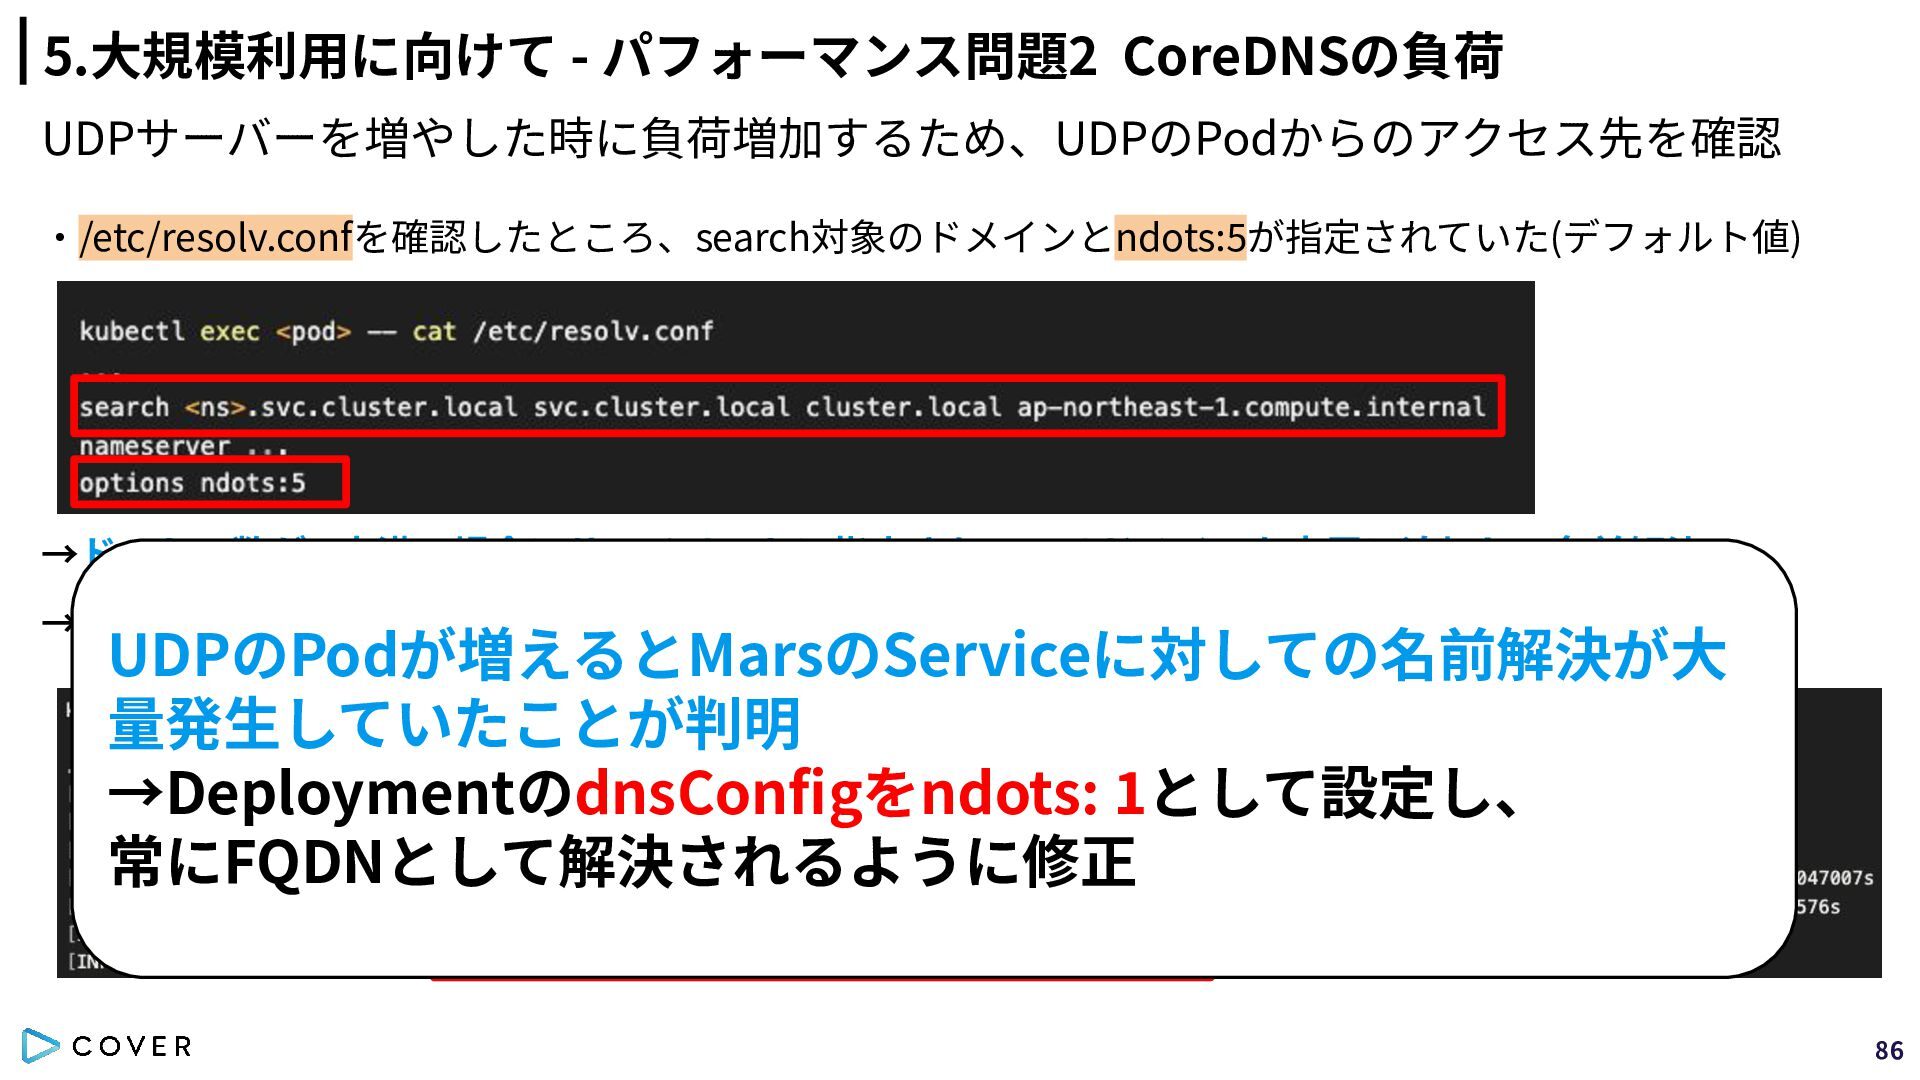
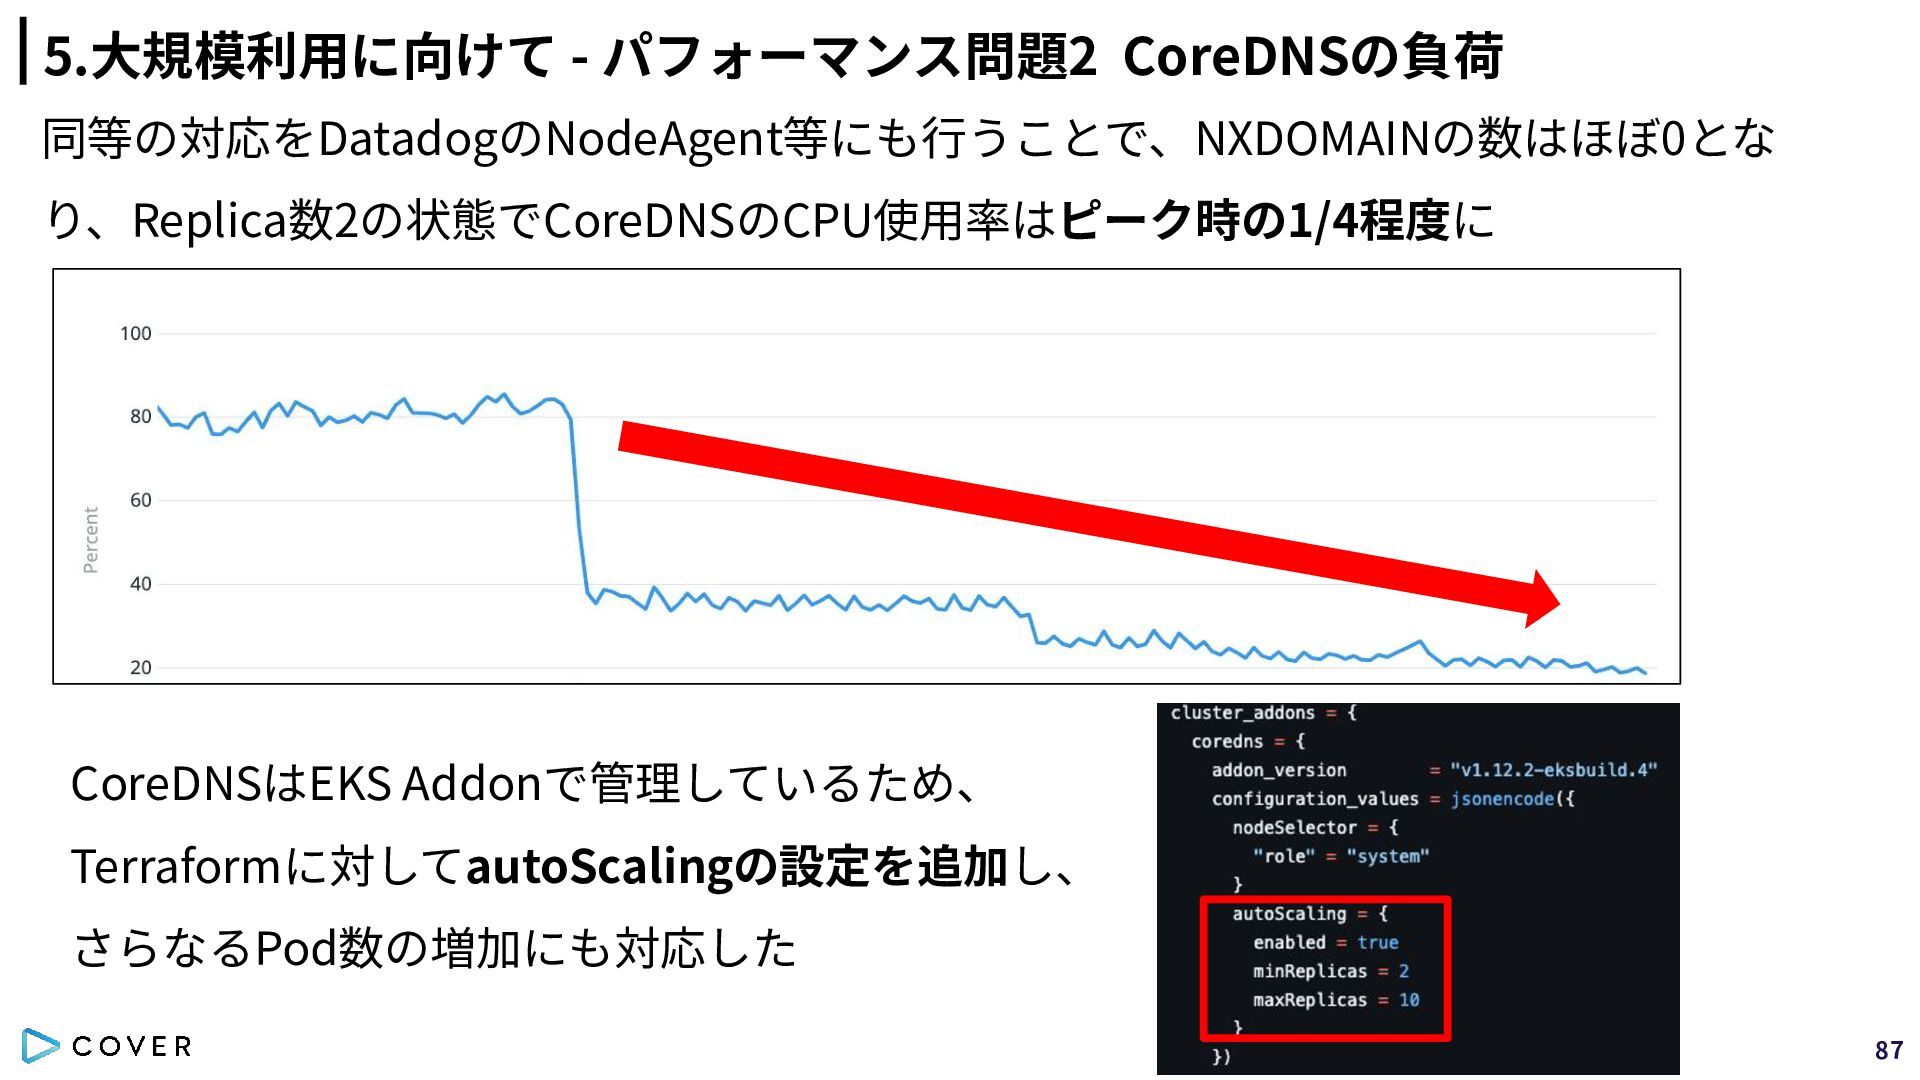
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 UDPサーバーを増やした時に負荷増加するため、UDPのPodからのアクセス先を確認 ‧/etc/resolv.confを確認したところ、search対象のドメインとndots:5が指定されていた(デフォルト値) →ドットの数が 5未満の場合にサーチリストに指定されているドメインを末尾に追加して名前解決 →結果として存在しないドメイン名へのアクセスが⼤量発⽣していた UDPのPodが増えるとMarsのServiceに対しての名前解決が⼤
量発⽣していたことが判明 →DeploymentのdnsConfigをndots: 1として設定し、 常にFQDNとして解決されるように修正 86
 covercorp
 nakamizu
 nearme_tech
 seike460
 ikura_hamu
 omatty198
 michaelsimons
 ostk0069
 nokonoko1203
 takahirosunaga
 usagi0920_pochi
 steliosf
 umigishiaoi
 deanohume
 keathley
 yeseniaperezcruz
 frankvandijk
 palkan
 tmiket
 lara
 inesmontani
 szymonslowik
 mfonobong
 aleyda
 ipullrank