Share
Embed

Transcript
139 slides
-
鬼海 雄太 Yuta Kikai •メディア統括本部サービスリライアビリティグループ (メディア事業 横断SRE組織) 2012年 サイバーエージェント中途入社 コミュニティサービスやソーシャルゲームの インフラやデータベースを担当
現在は横断SRE組織である現チームで AmebaのDBREとして従事 チームブログであるSRGポータルに毎月記事執筆中 https://ca-srg.dev 2025年~ AWS Community Builders (Category: Data) -
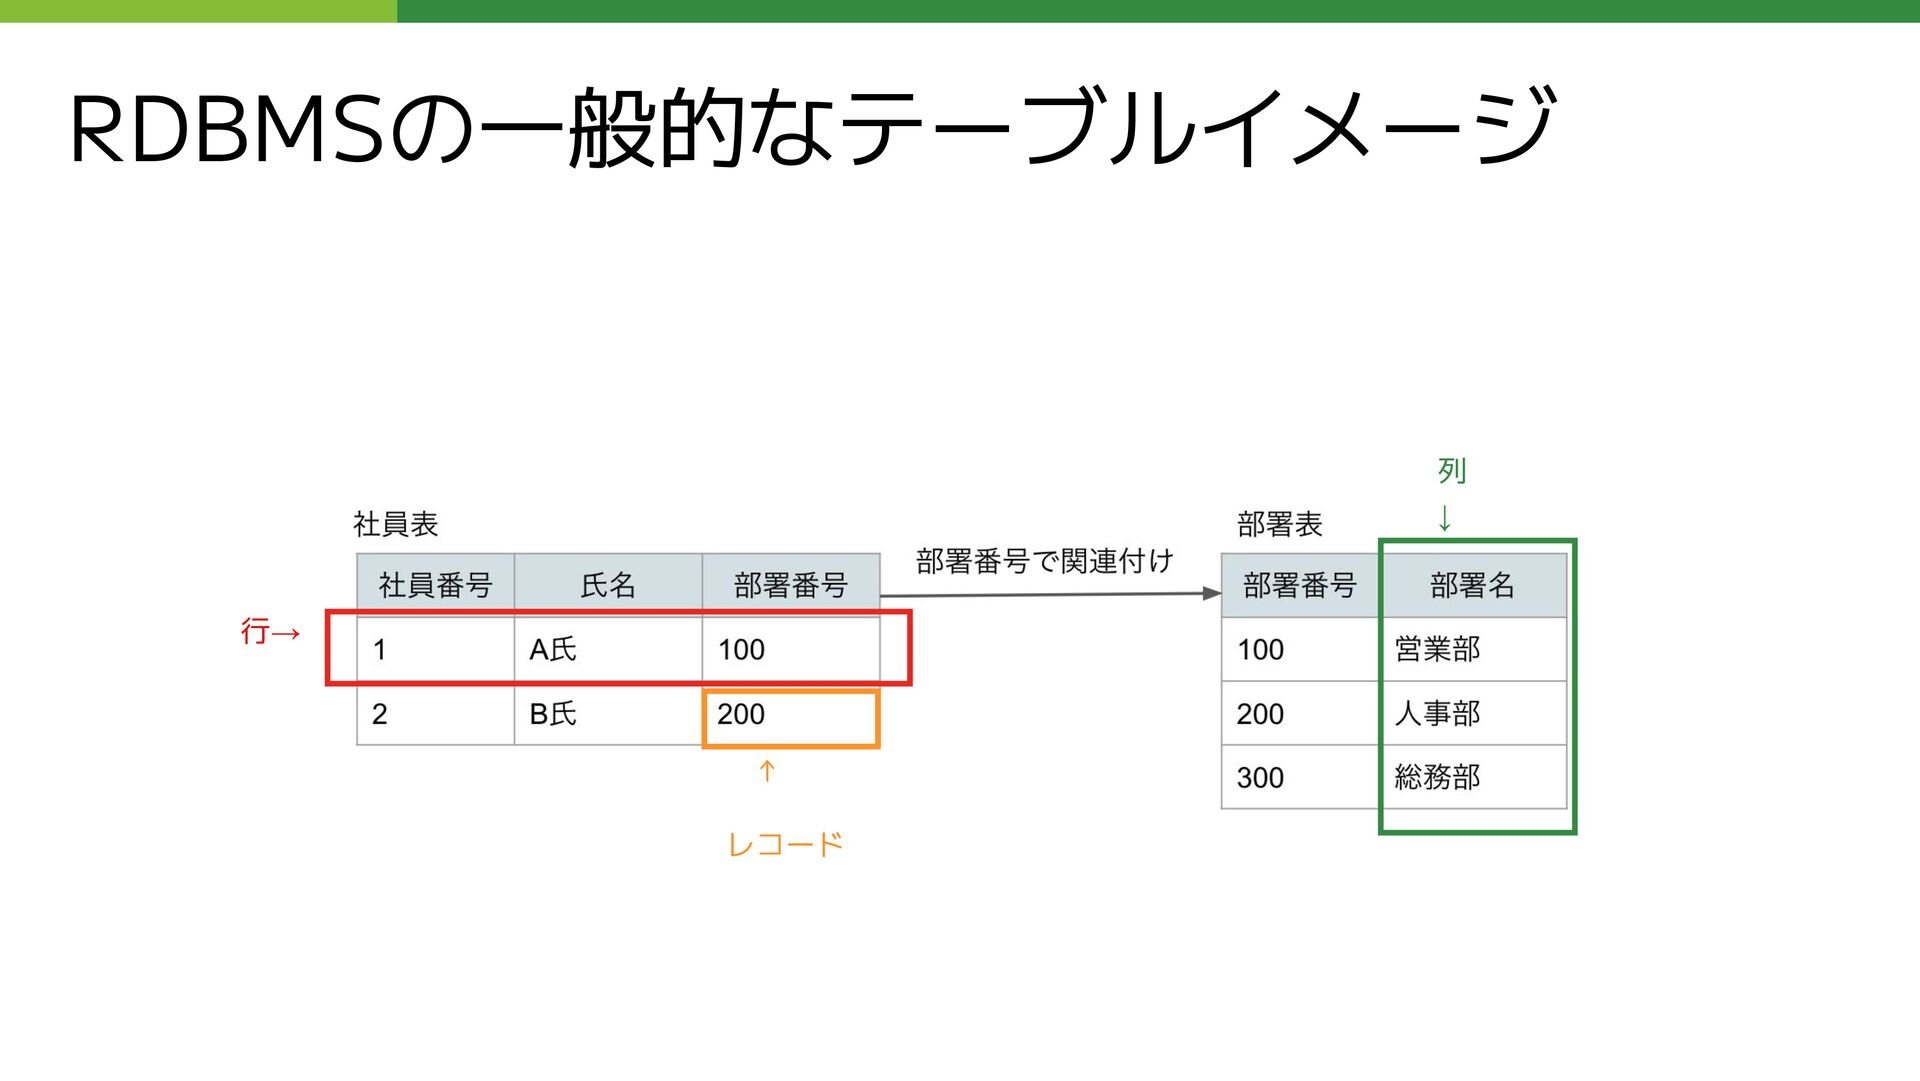
リレーショナルデータベース •表(テーブル)を利用してデータを格納 テーブルは行( row )と列( column )で構成 • テーブル同士が 関係・関連(
リレーション )をもつ • SQL( Structured Query Language )というデータ操作言語でデータを管理 • データの一貫性、整合性を担保するために厳格な制約 • 代表的なリレーショナルデータベース管理システム( RDBMS ) Oracle Database, MySQL , SQL Server , PostgreSQL -
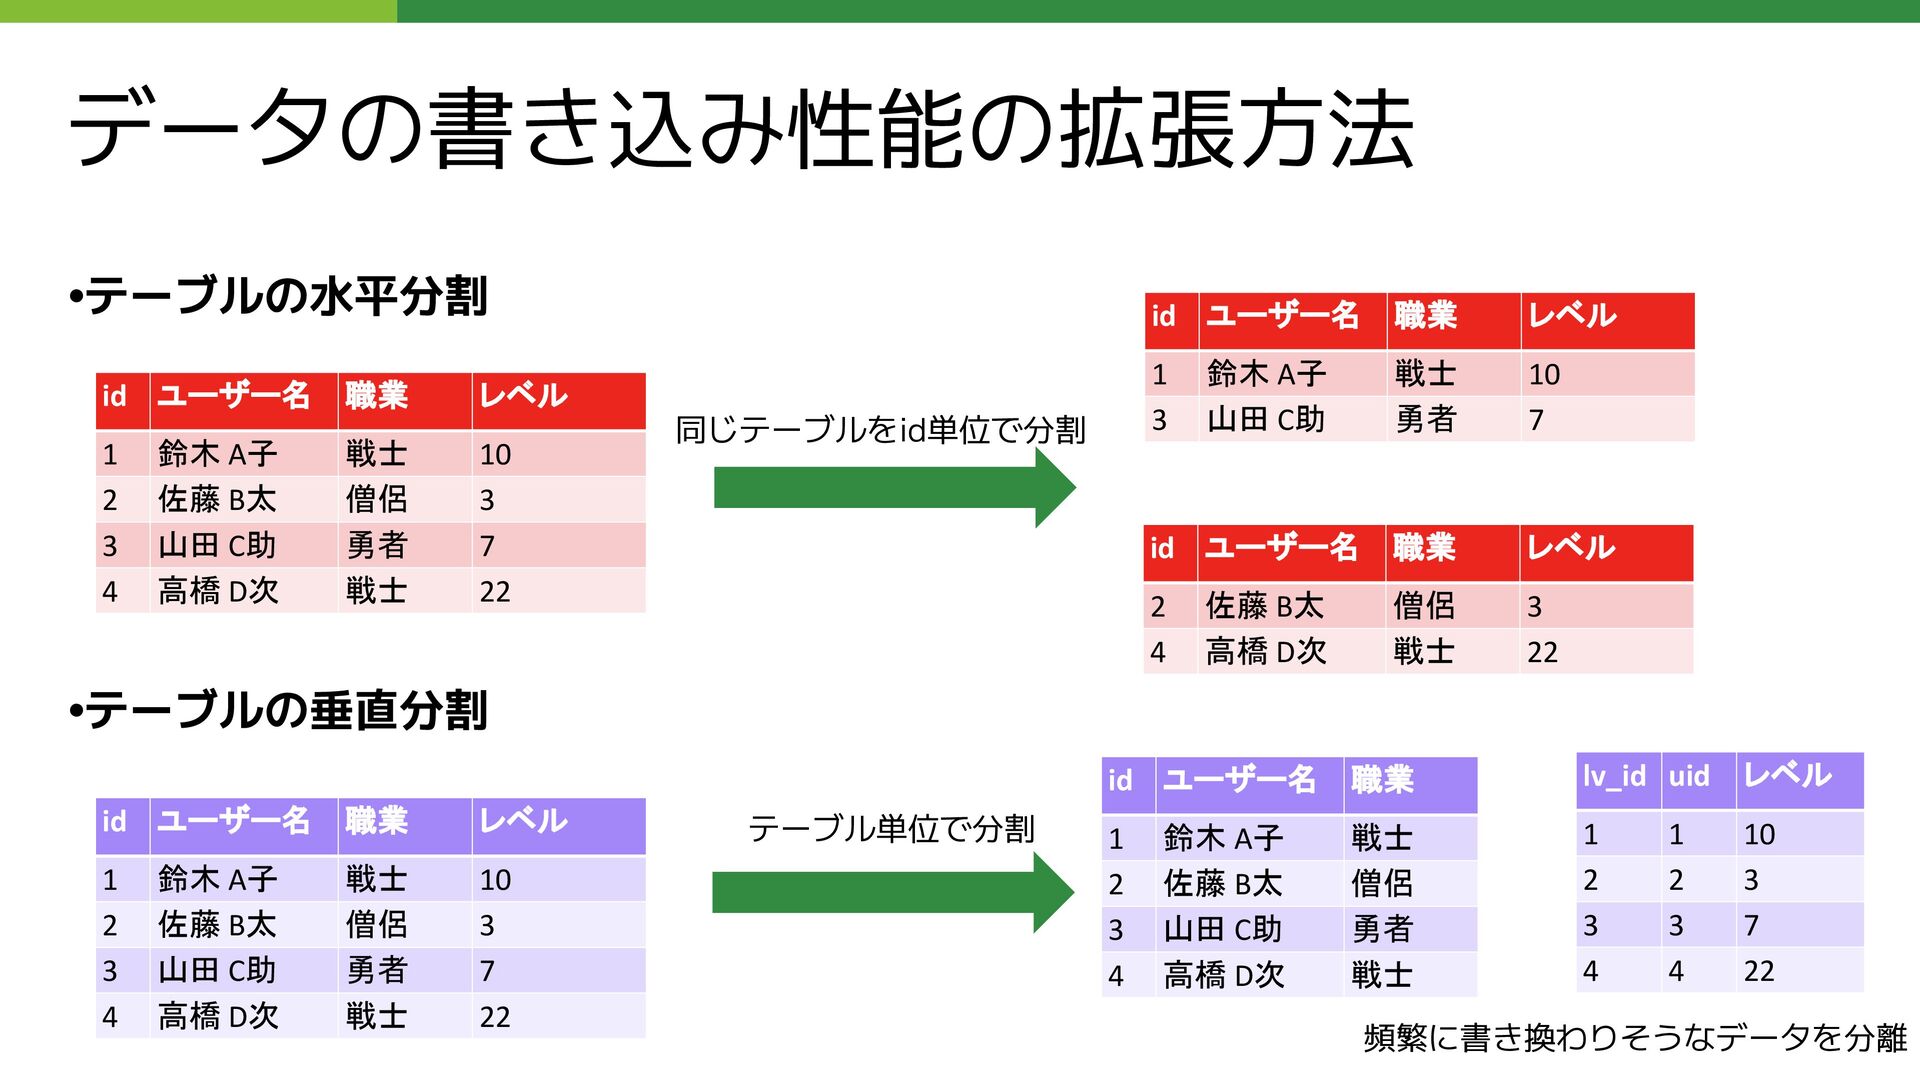
データの書き込み性能の拡張方法 •テーブルの水平分割 •テーブルの垂直分割 id ユーザー名 職業 レベル 1 鈴木 A子
戦士 10 2 佐藤 B太 僧侶 3 3 山田 C助 勇者 7 4 高橋 D次 戦士 22 id ユーザー名 職業 レベル 1 鈴木 A子 戦士 10 3 山田 C助 勇者 7 id ユーザー名 職業 レベル 2 佐藤 B太 僧侶 3 4 高橋 D次 戦士 22 id ユーザー名 職業 レベル 1 鈴木 A子 戦士 10 2 佐藤 B太 僧侶 3 3 山田 C助 勇者 7 4 高橋 D次 戦士 22 id ユーザー名 職業 1 鈴木 A子 戦士 2 佐藤 B太 僧侶 3 山田 C助 勇者 4 高橋 D次 戦士 lv_id uid レベル 1 1 10 2 2 3 3 3 7 4 4 22 同じテーブルをid単位で分割 テーブル単位で分割 頻繁に書き換わりそうなデータを分離 -
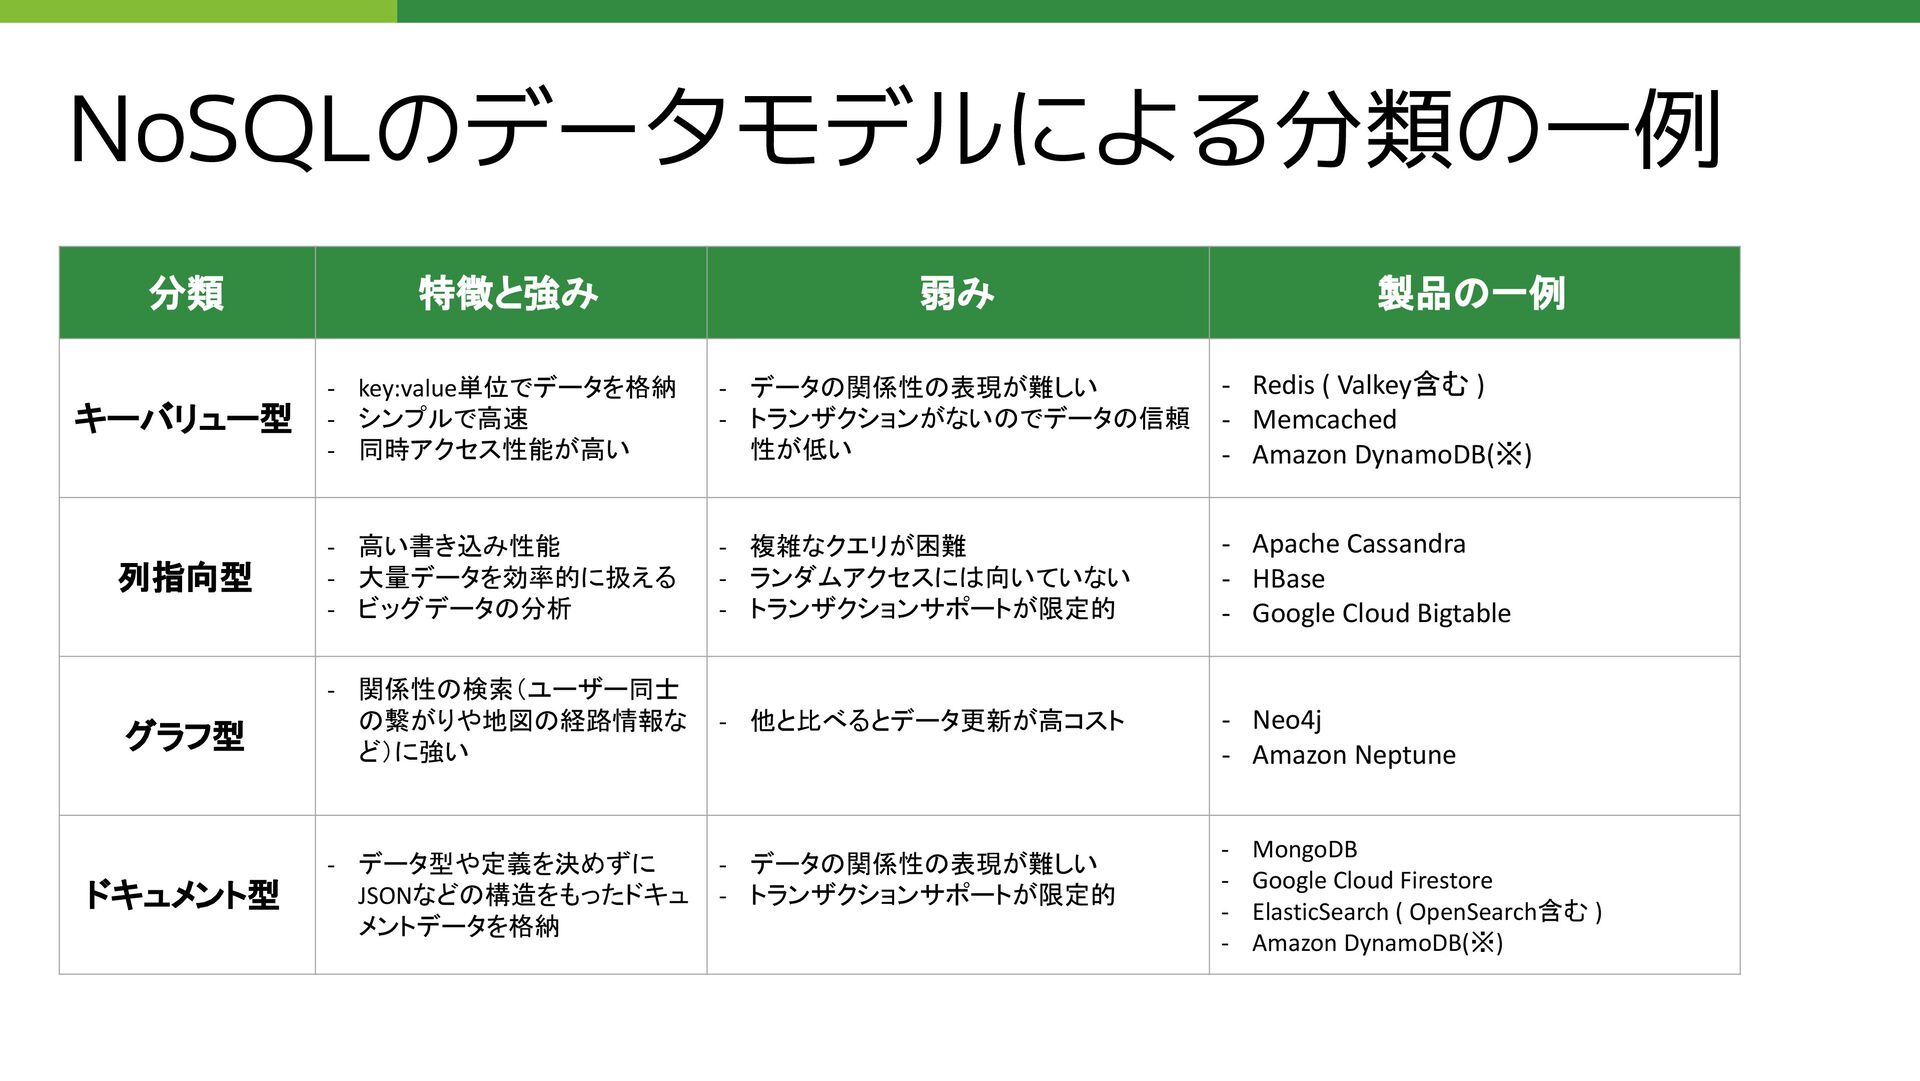
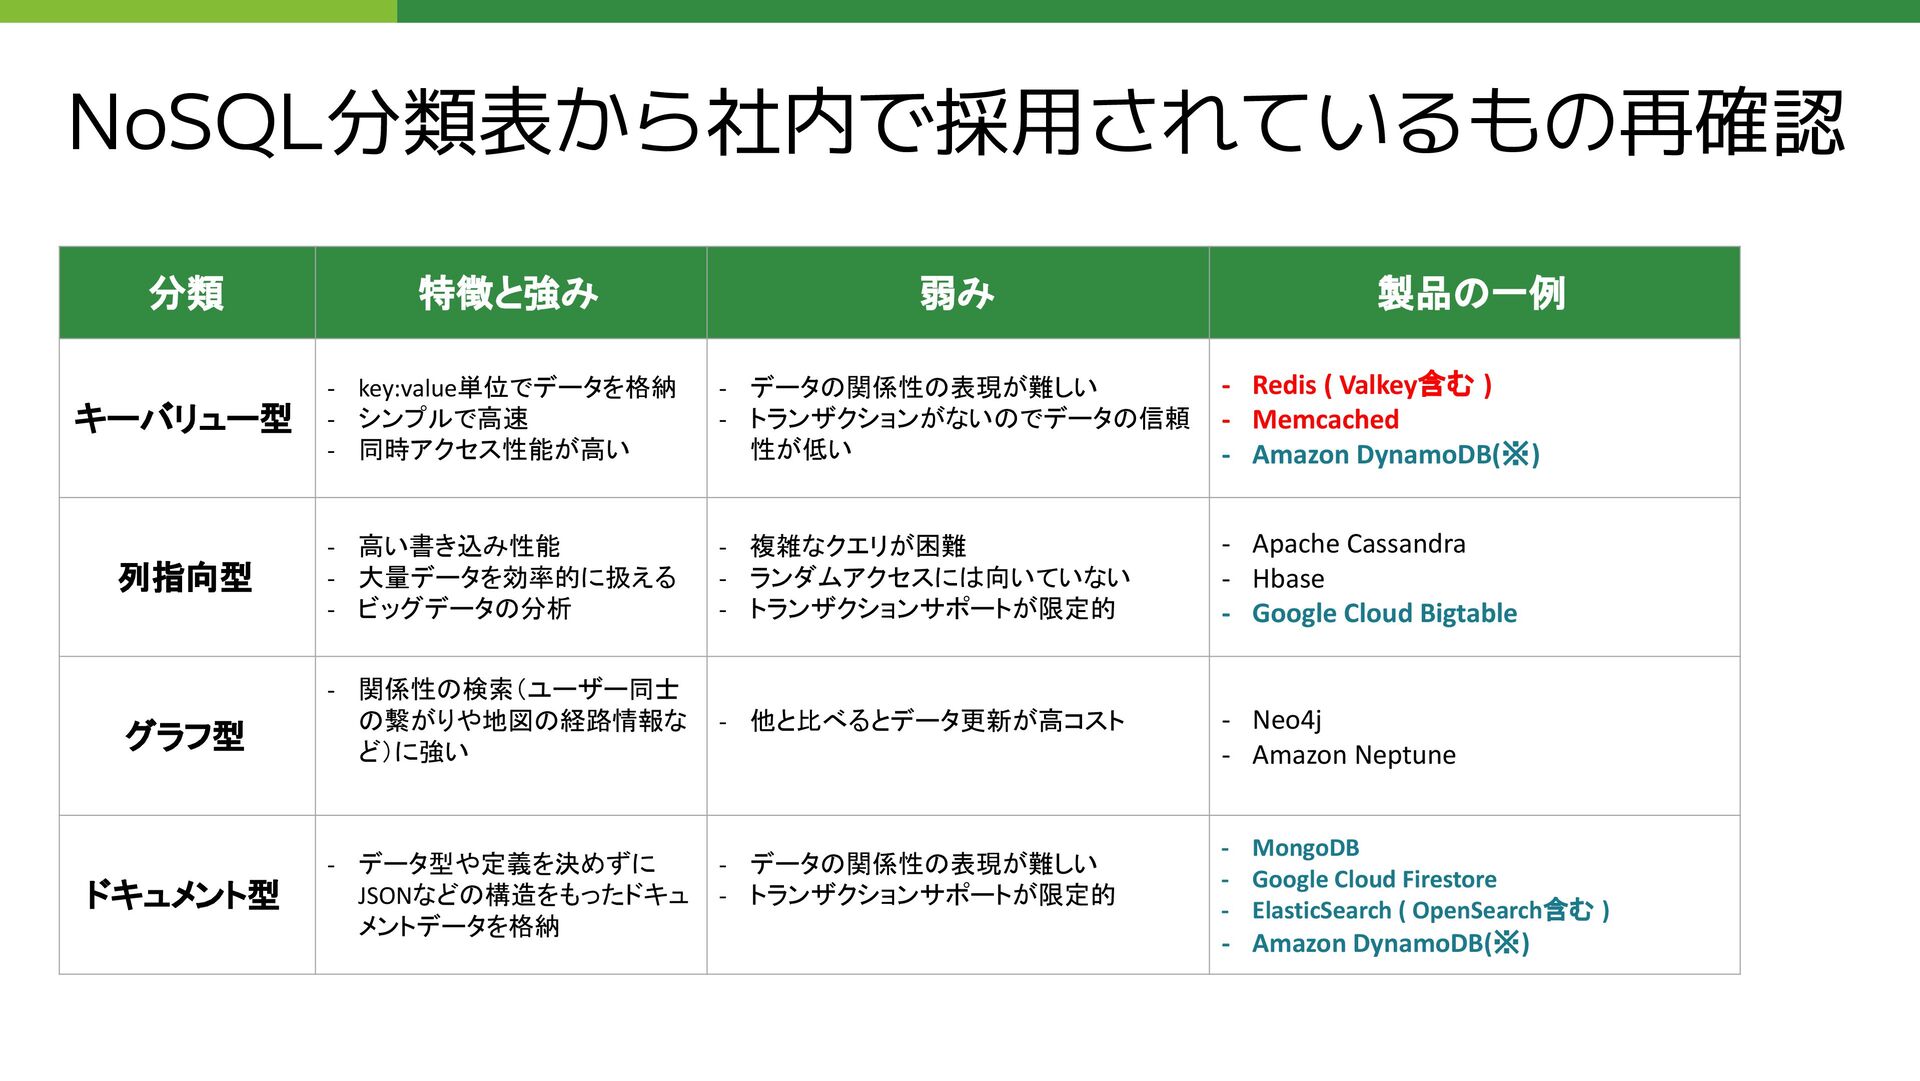
NoSQLのデータモデルによる分類の一例 分類 特徴と強み 弱み 製品の一例 キーバリュー型 - key:value単位でデータを格納 - シンプルで高速
- 同時アクセス性能が高い - データの関係性の表現が難しい - トランザクションがないのでデータの信頼 性が低い - Redis ( Valkey含む ) - Memcached - Amazon DynamoDB(※) 列指向型 - 高い書き込み性能 - 大量データを効率的に扱える - ビッグデータの分析 - 複雑なクエリが困難 - ランダムアクセスには向いていない - トランザクションサポートが限定的 - Apache Cassandra - HBase - Google Cloud Bigtable グラフ型 - 関係性の検索(ユーザー同士 の繋がりや地図の経路情報な ど)に強い - 他と比べるとデータ更新が高コスト - Neo4j - Amazon Neptune ドキュメント型 - データ型や定義を決めずに JSONなどの構造をもったドキュ メントデータを格納 - データの関係性の表現が難しい - トランザクションサポートが限定的 - MongoDB - Google Cloud Firestore - ElasticSearch ( OpenSearch含む ) - Amazon DynamoDB(※) -
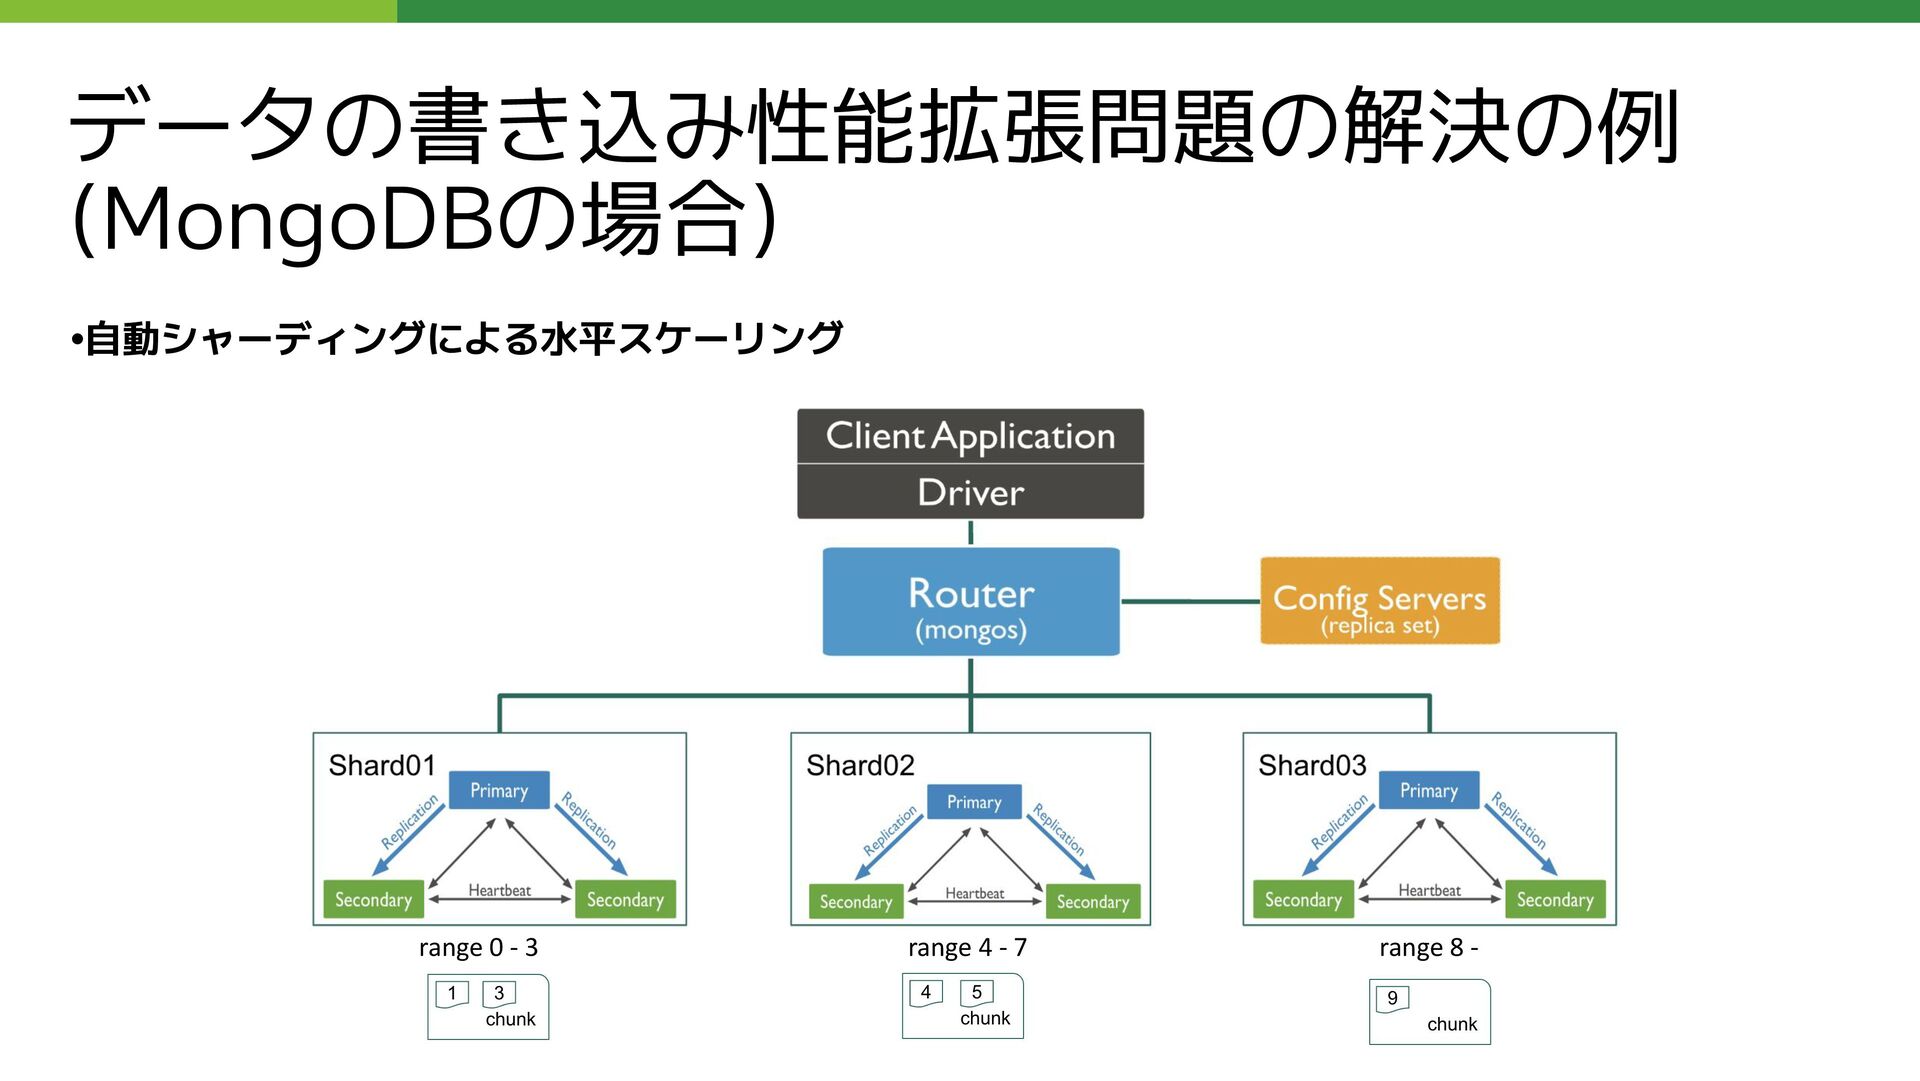
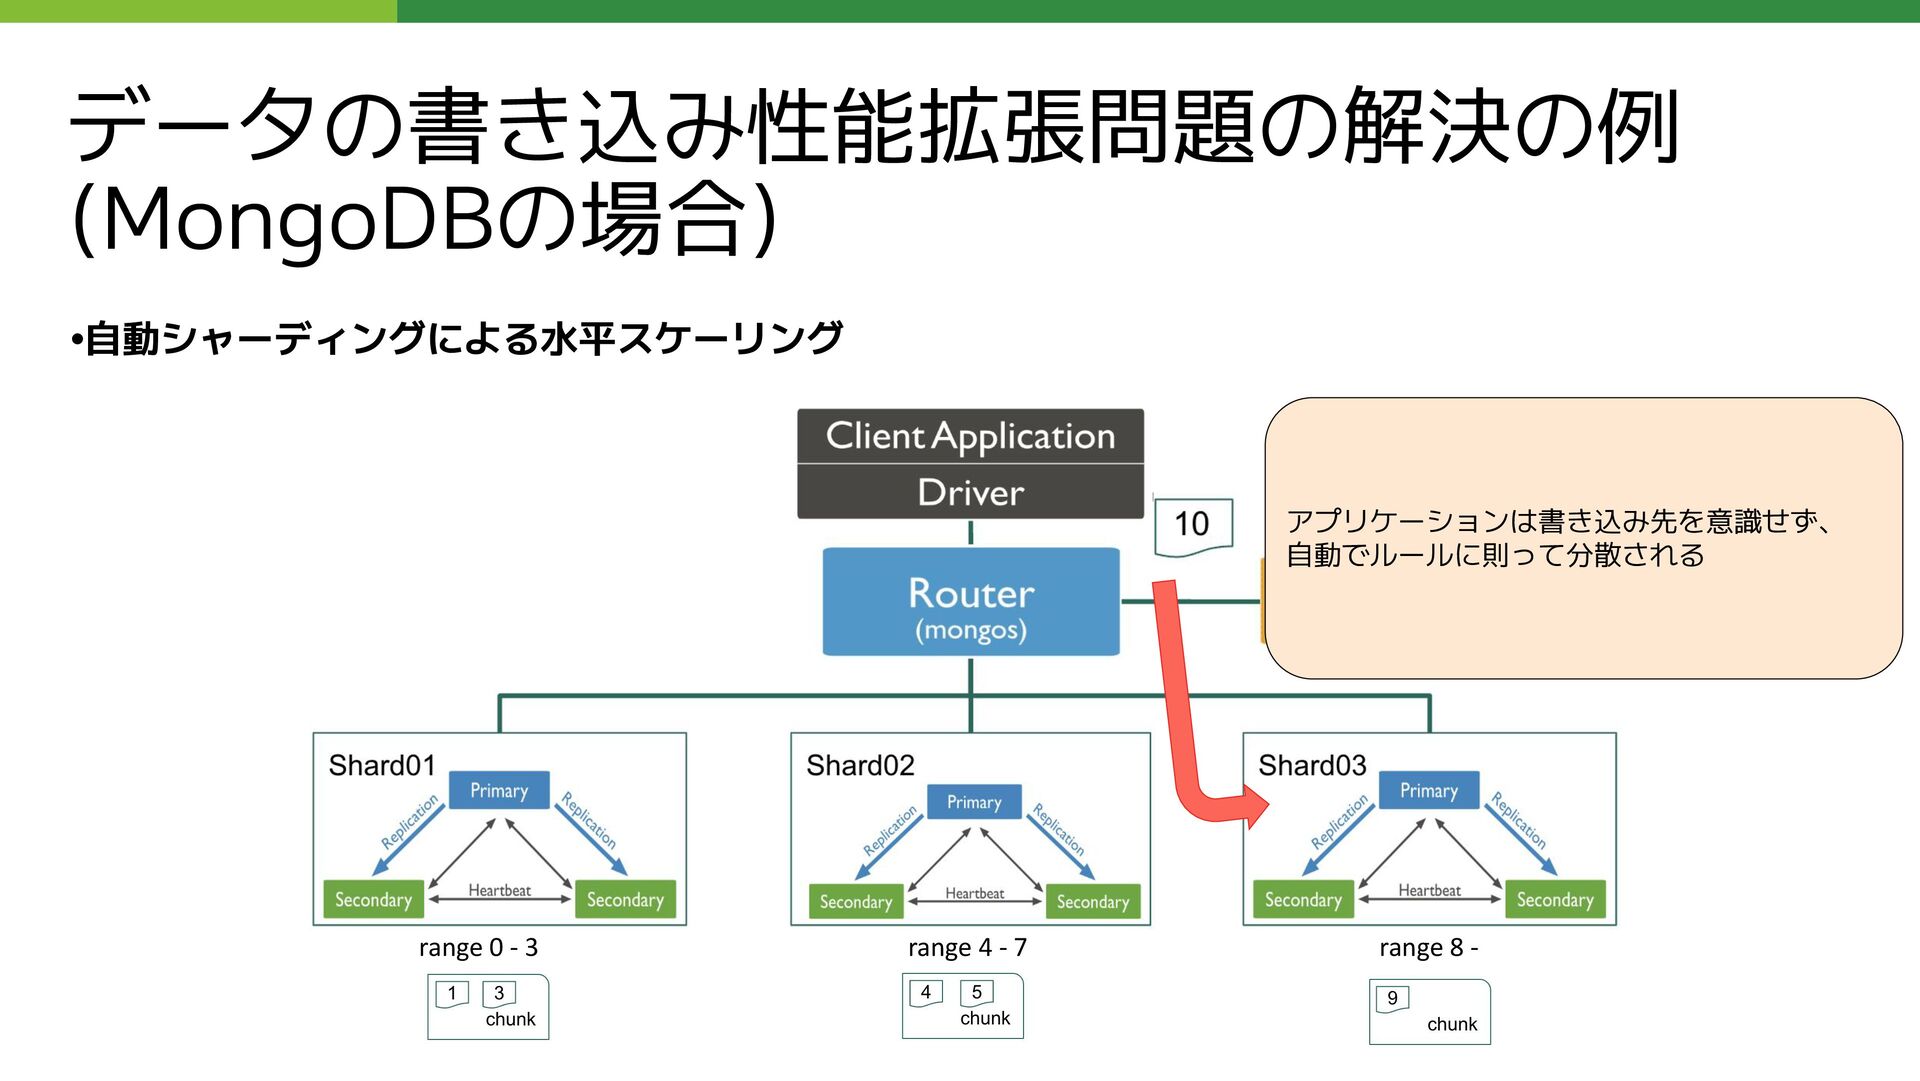
データの書き込み性能拡張問題の解決の例 (MongoDBの場合) •自動シャーディングによる水平スケーリング range 0 - 3 range 4 -
7 range 8 - アプリケーションは書き込み先を意識せず、 自動でルールに則って分散される -
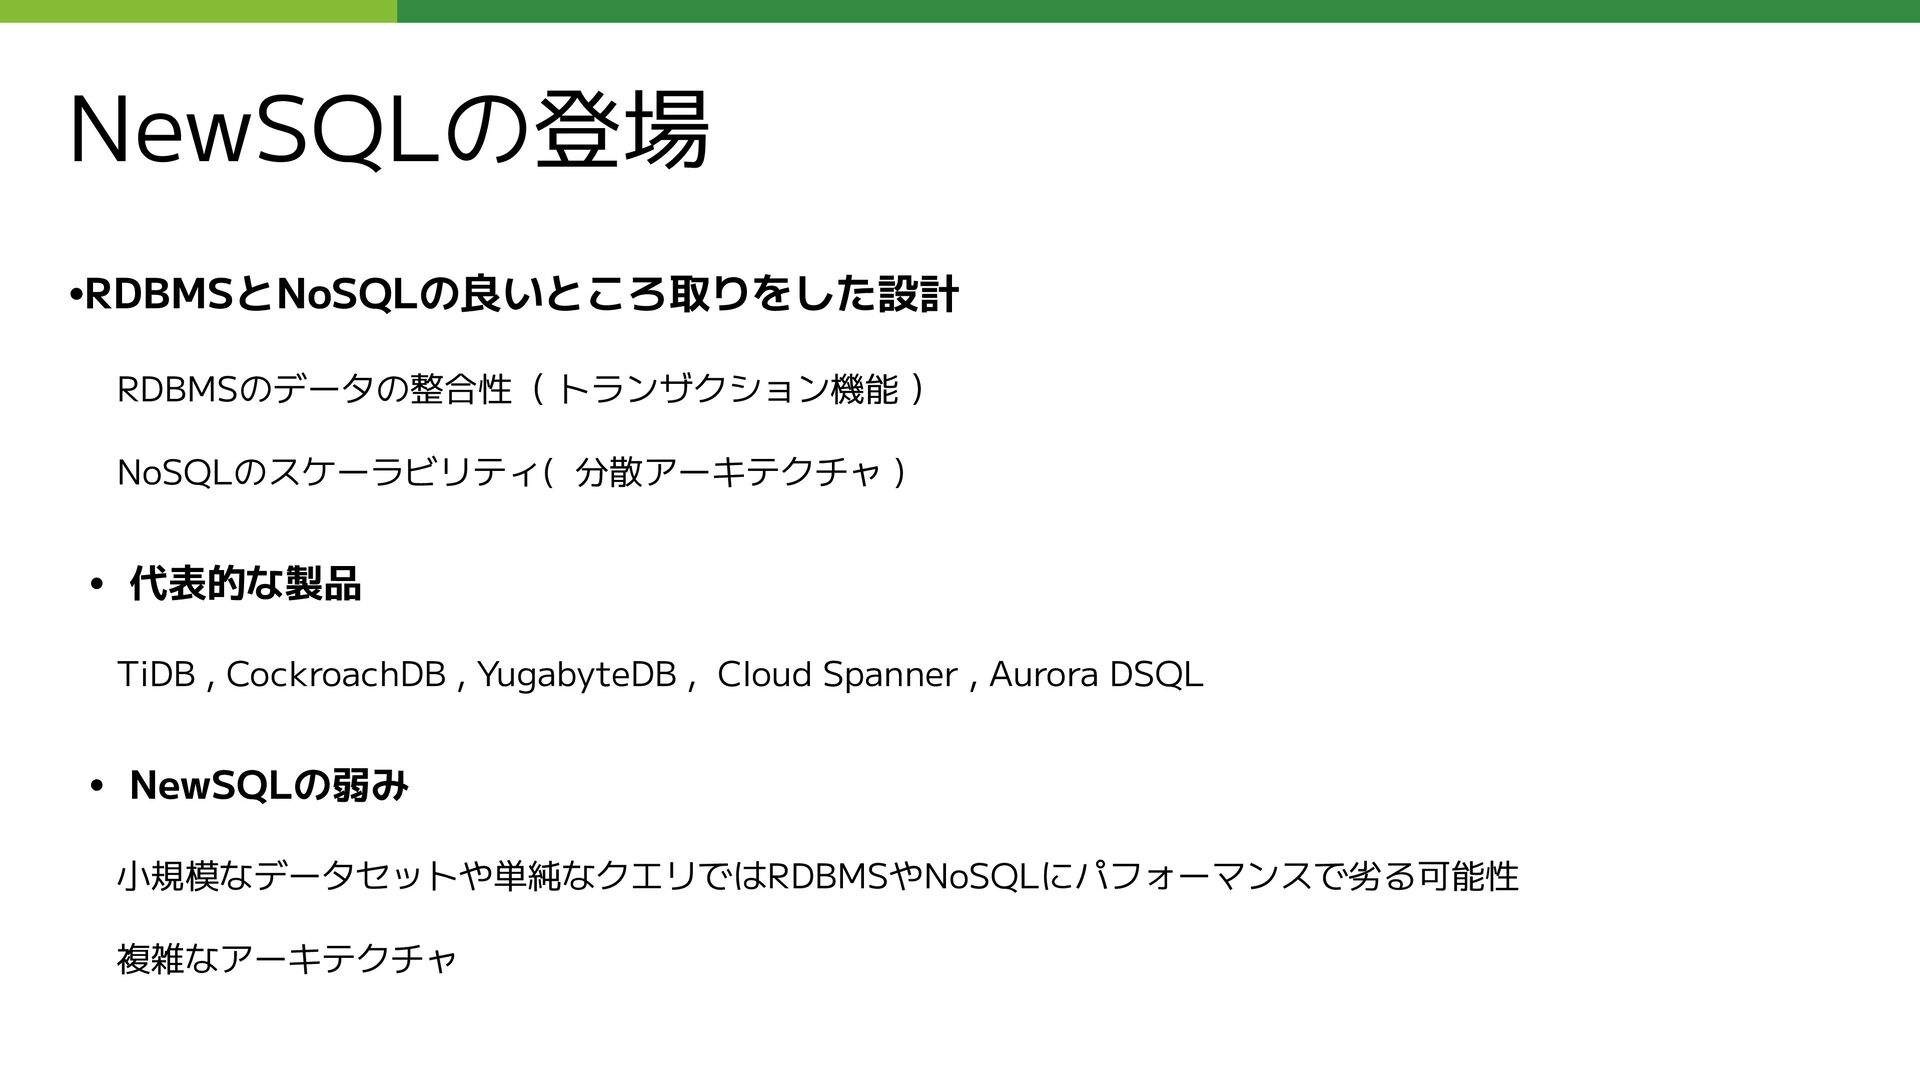
NewSQLの登場 •RDBMSとNoSQLの良いところ取りをした設計 RDBMSのデータの整合性( トランザクション機能 ) NoSQLのスケーラビリティ( 分散アーキテクチャ ) • 代表的な製品
TiDB , CockroachDB , YugabyteDB , Cloud Spanner , Aurora DSQL • NewSQLの弱み 小規模なデータセットや単純なクエリではRDBMSやNoSQLにパフォーマンスで劣る可能性 複雑なアーキテクチャ -
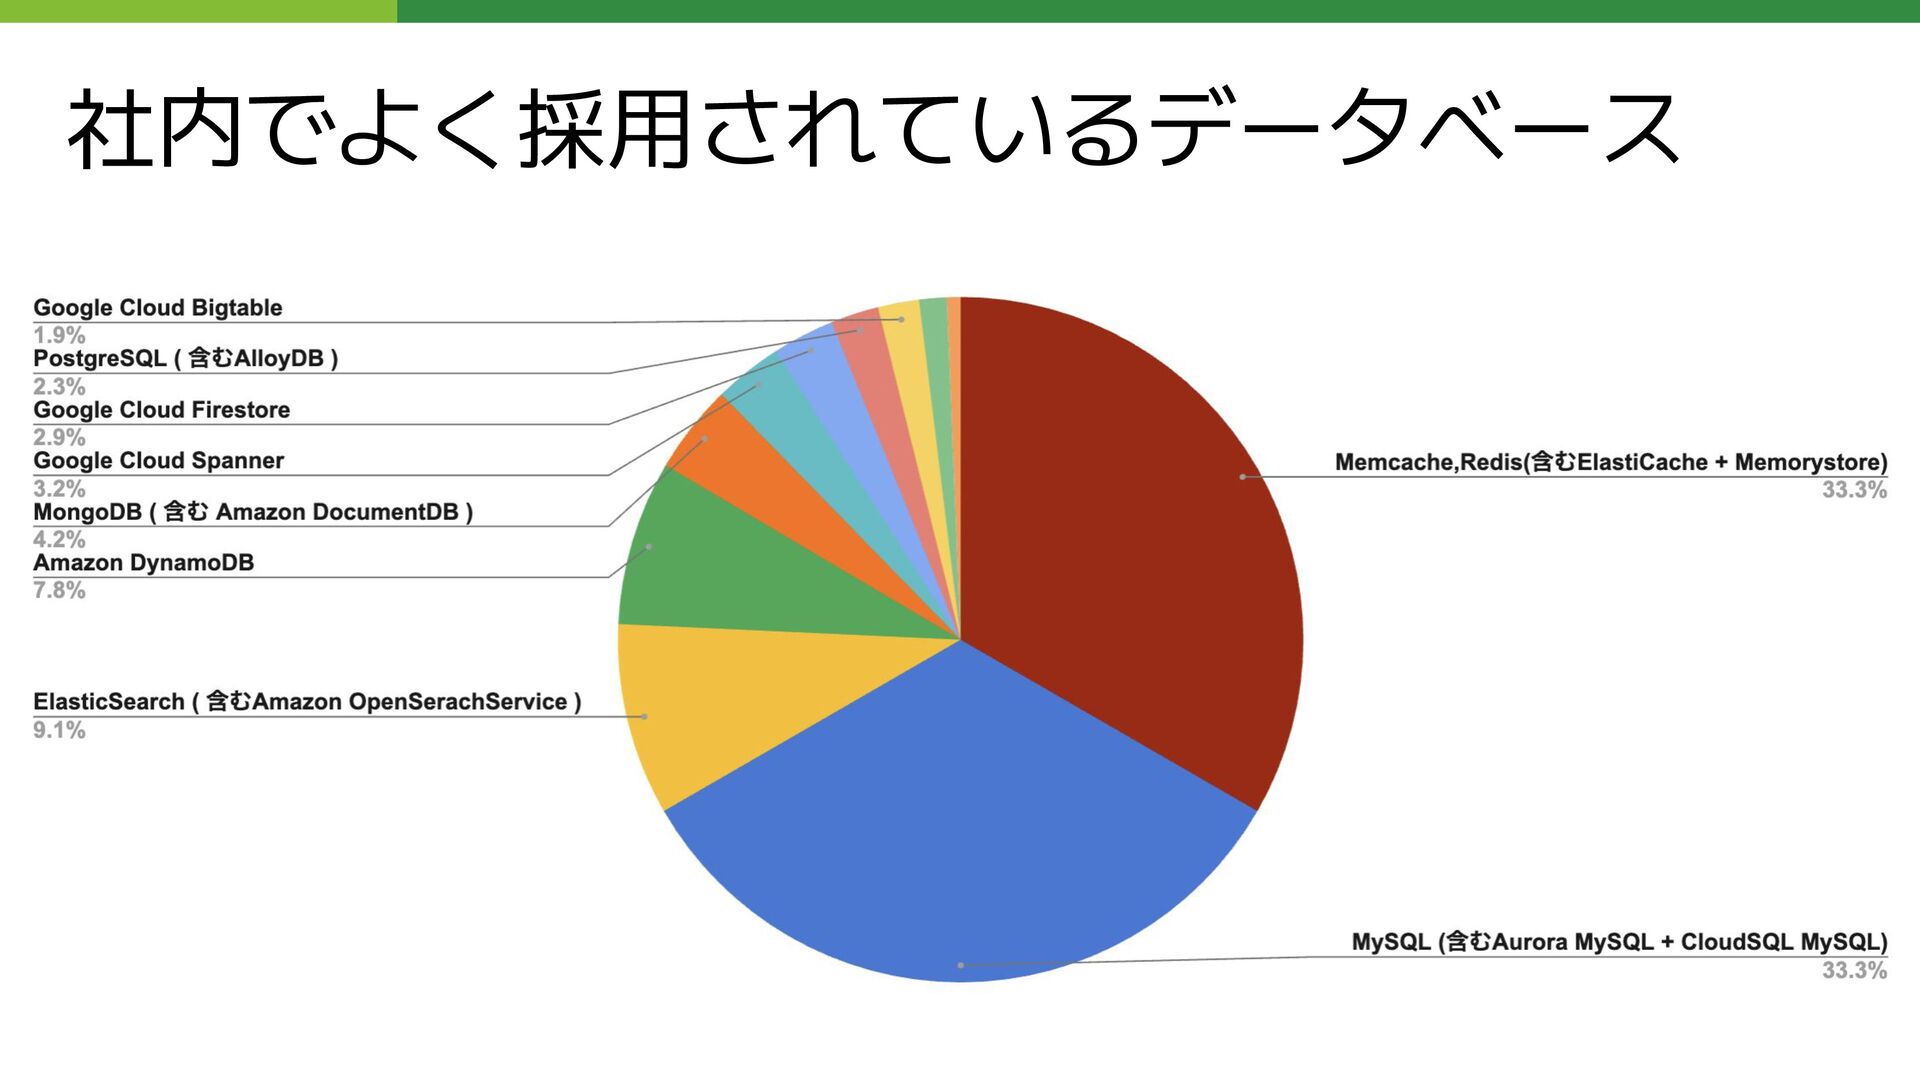
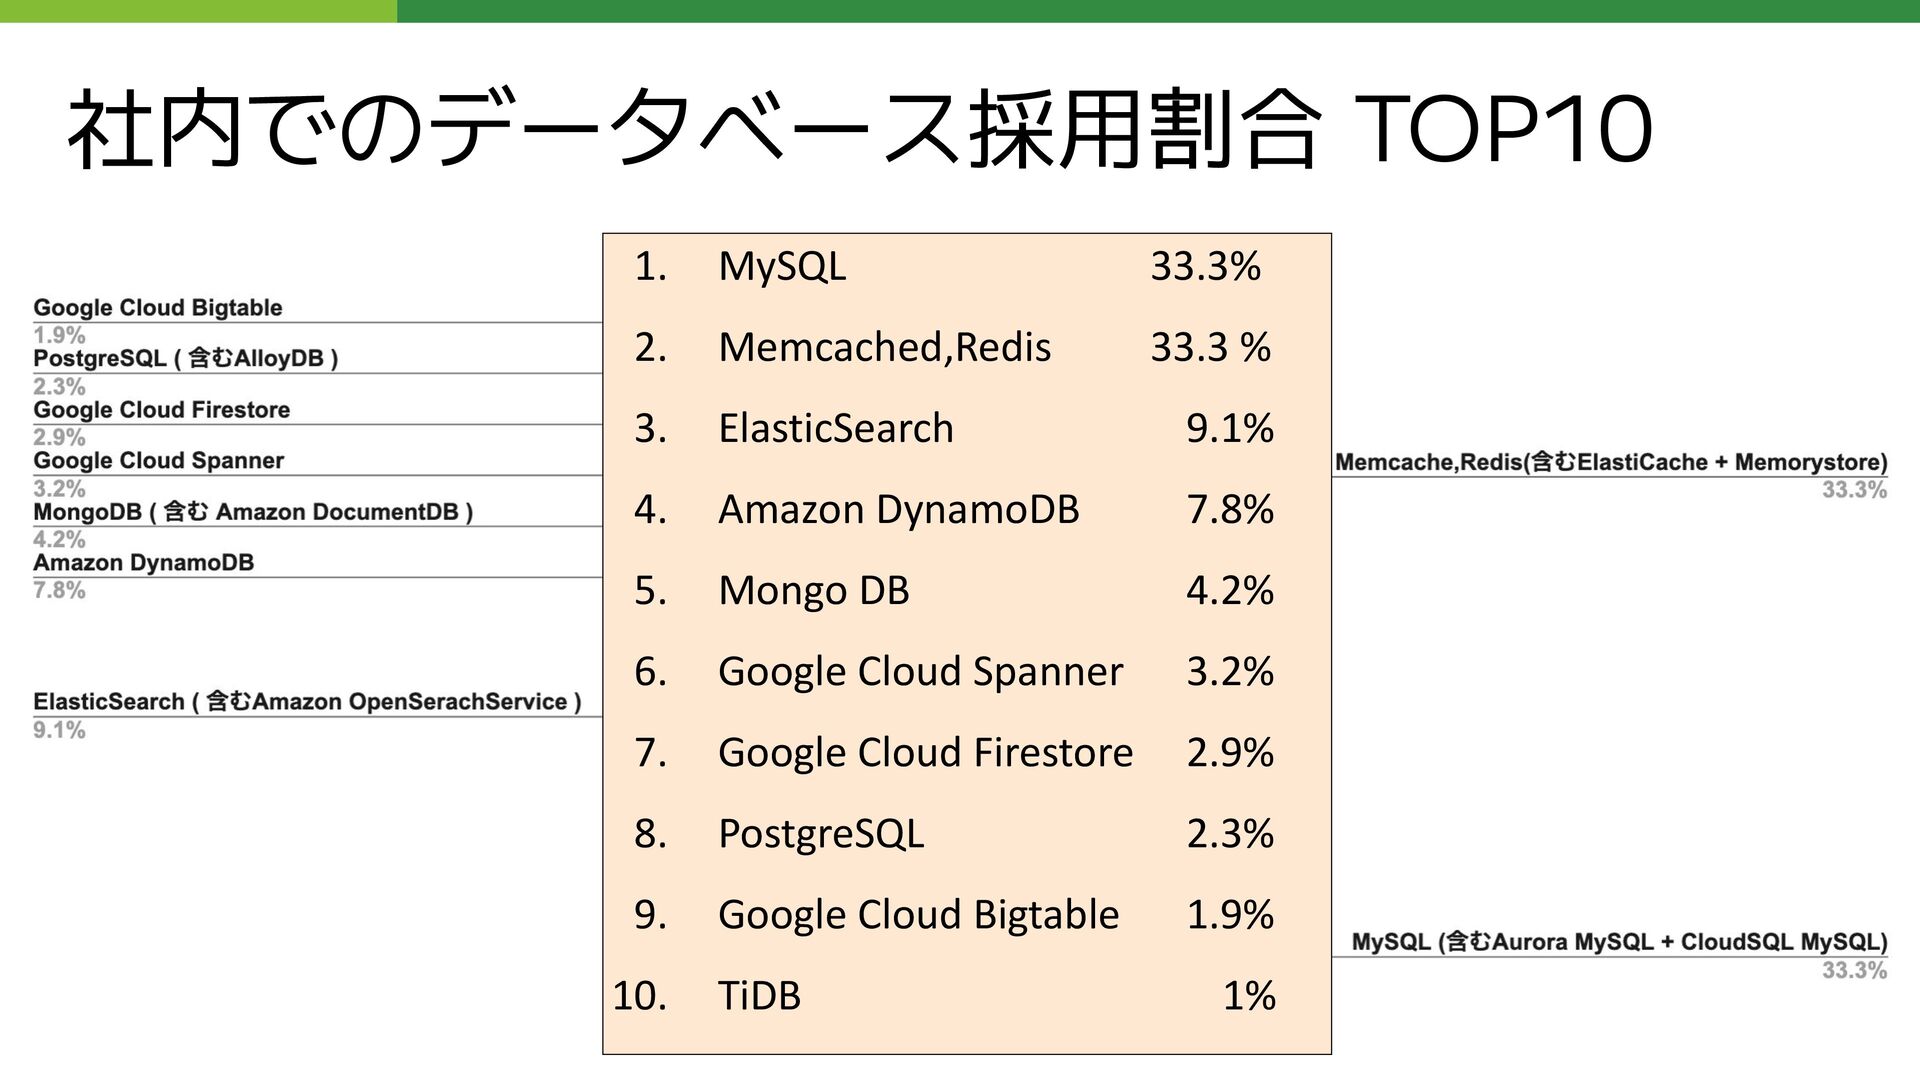
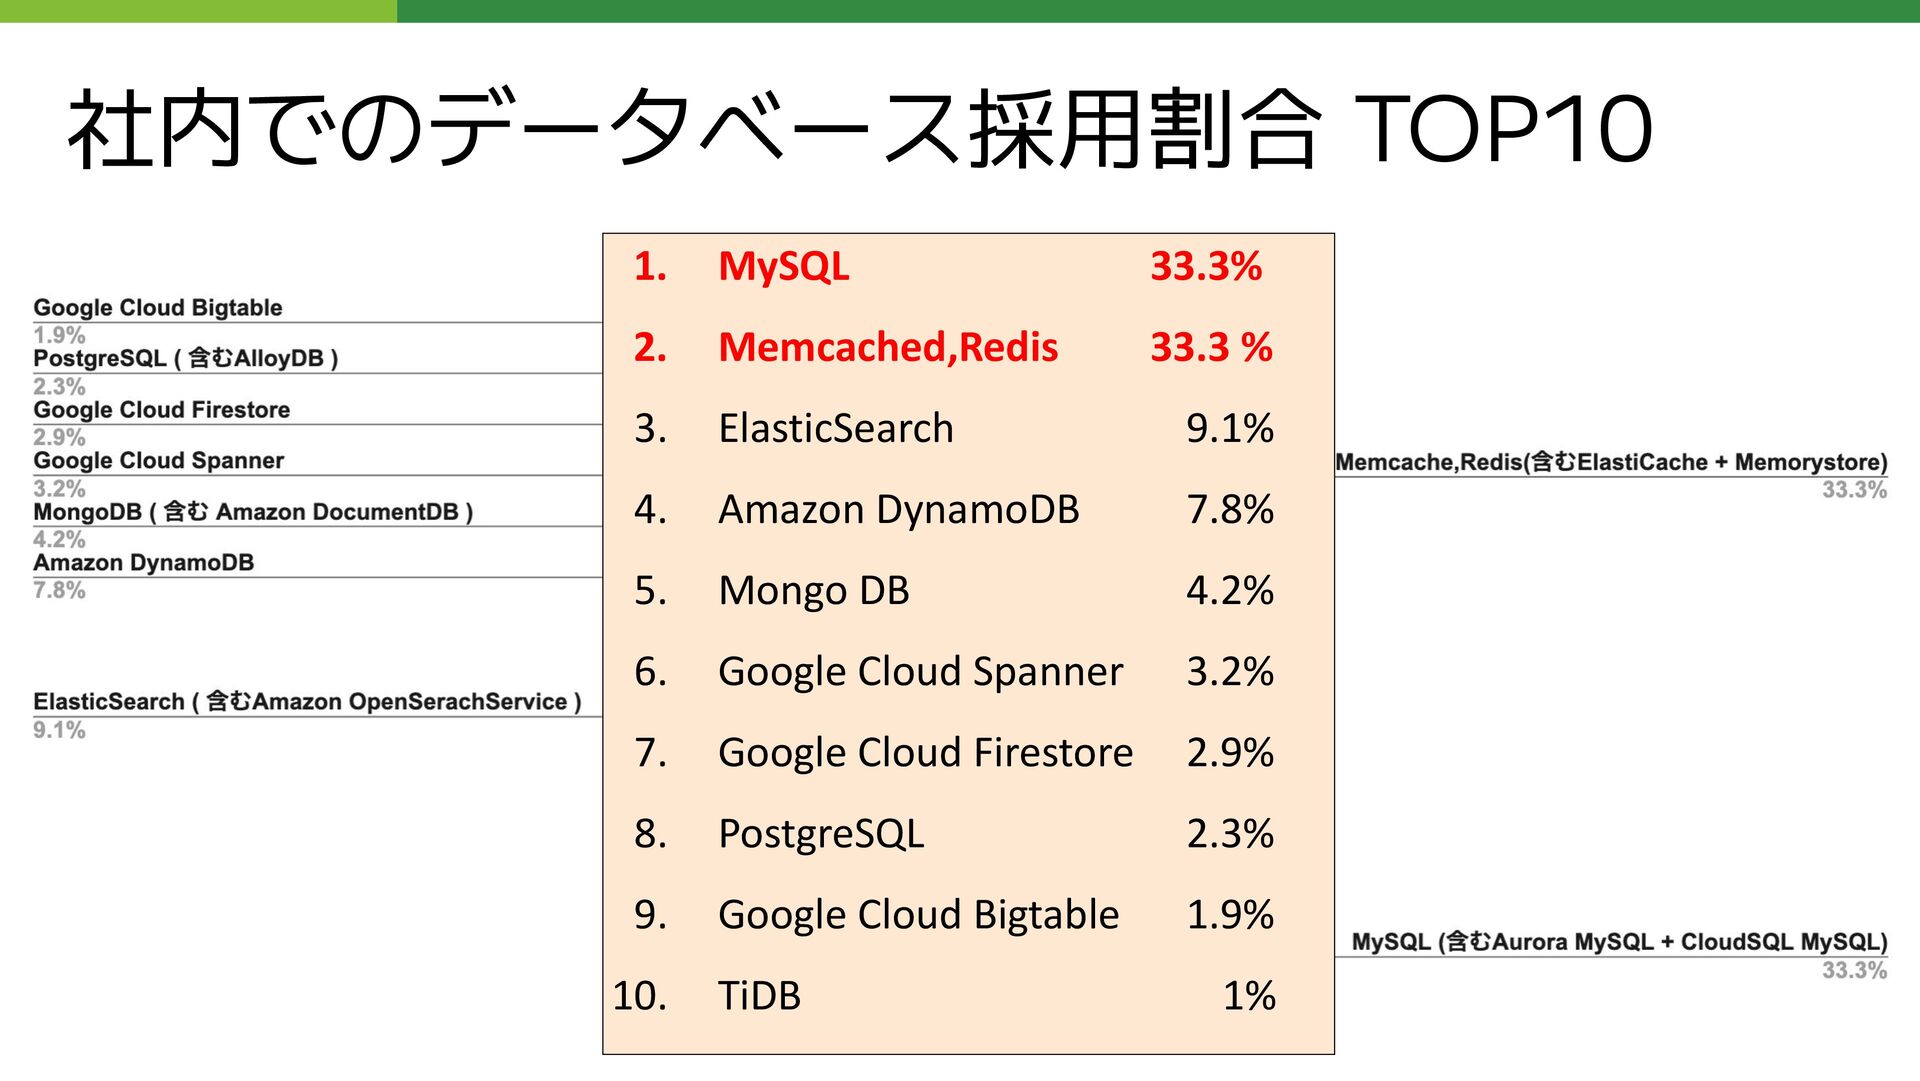
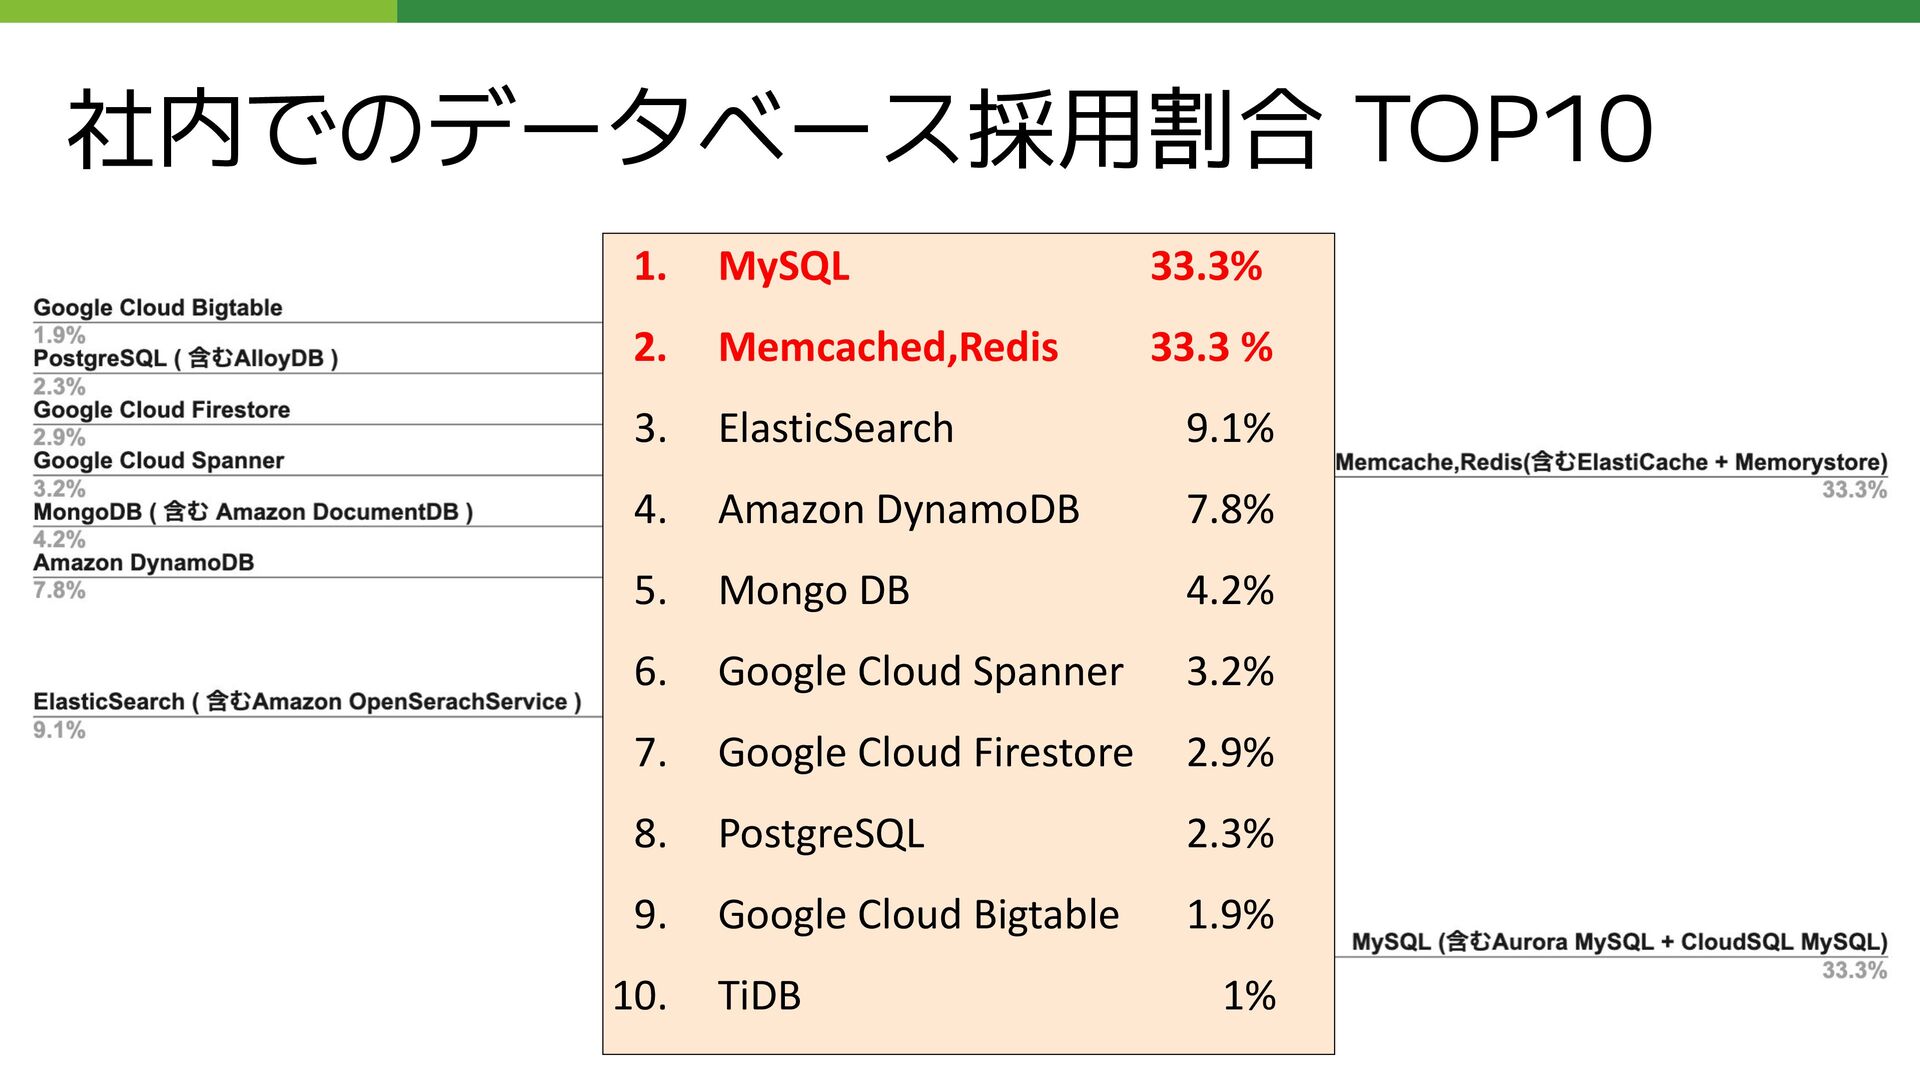
社内でのデータベース採用割合 TOP10 1. MySQL 33.3% 2. Memcached,Redis 33.3 % 3.
ElasticSearch 9.1% 4. Amazon DynamoDB 7.8% 5. Mongo DB 4.2% 6. Google Cloud Spanner 3.2% 7. Google Cloud Firestore 2.9% 8. PostgreSQL 2.3% 9. Google Cloud Bigtable 1.9% 10. TiDB 1% -
社内でのデータベース採用割合 TOP10 1. MySQL 33.3% 2. Memcached,Redis 33.3 % 3.
ElasticSearch 9.1% 4. Amazon DynamoDB 7.8% 5. Mongo DB 4.2% 6. Google Cloud Spanner 3.2% 7. Google Cloud Firestore 2.9% 8. PostgreSQL 2.3% 9. Google Cloud Bigtable 1.9% 10. TiDB 1% -
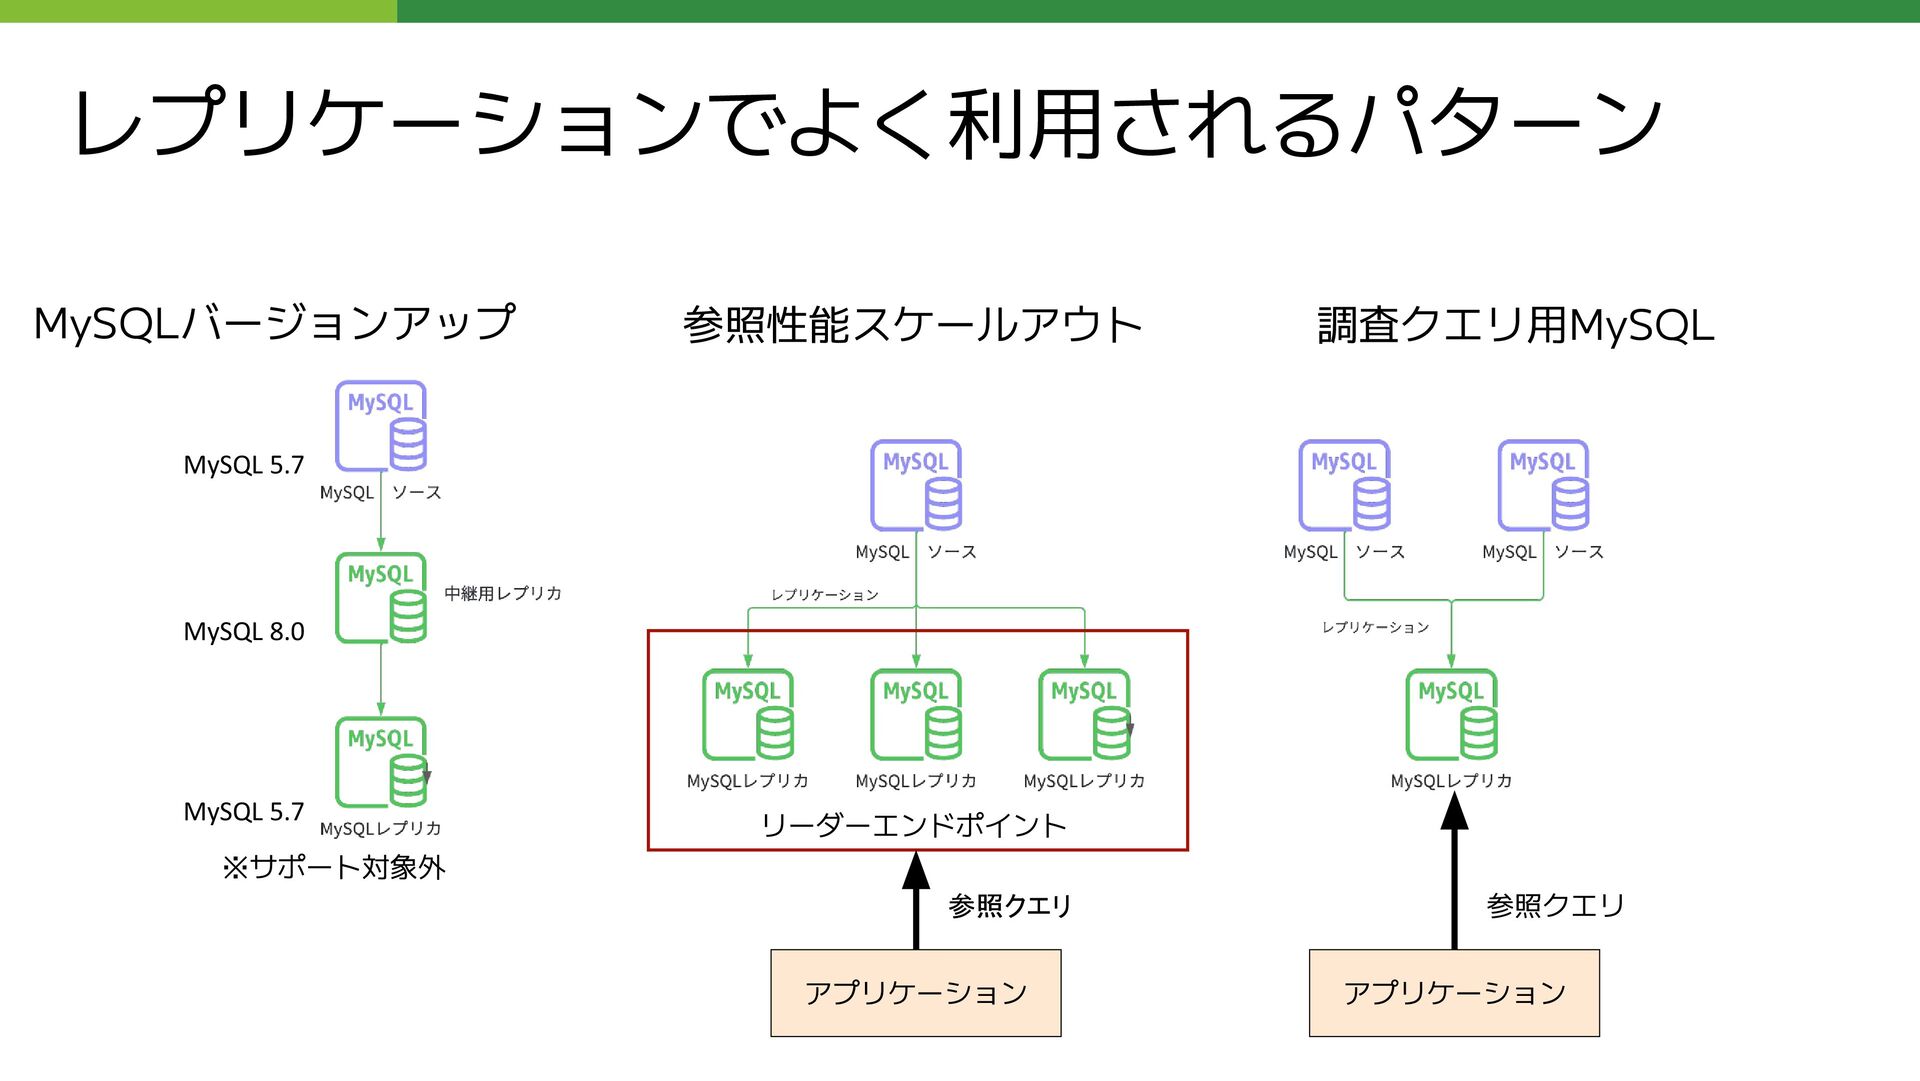
レプリケーションでよく利用されるパターン MySQLバージョンアップ 参照性能スケールアウト 調査クエリ用MySQL MySQL 5.7 MySQL 8.0 MySQL 5.7
リーダーエンドポイント アプリケーション 参照クエリ アプリケーション 参照クエリ ※サポート対象外 -
NoSQL分類表から社内で採用されているもの再確認 分類 特徴と強み 弱み 製品の一例 キーバリュー型 - key:value単位でデータを格納 - シンプルで高速
- 同時アクセス性能が高い - データの関係性の表現が難しい - トランザクションがないのでデータの信頼 性が低い - Redis ( Valkey含む ) - Memcached - Amazon DynamoDB(※) 列指向型 - 高い書き込み性能 - 大量データを効率的に扱える - ビッグデータの分析 - 複雑なクエリが困難 - ランダムアクセスには向いていない - トランザクションサポートが限定的 - Apache Cassandra - Hbase - Google Cloud Bigtable グラフ型 - 関係性の検索(ユーザー同士 の繋がりや地図の経路情報な ど)に強い - 他と比べるとデータ更新が高コスト - Neo4j - Amazon Neptune ドキュメント型 - データ型や定義を決めずに JSONなどの構造をもったドキュ メントデータを格納 - データの関係性の表現が難しい - トランザクションサポートが限定的 - MongoDB - Google Cloud Firestore - ElasticSearch ( OpenSearch含む ) - Amazon DynamoDB(※) -
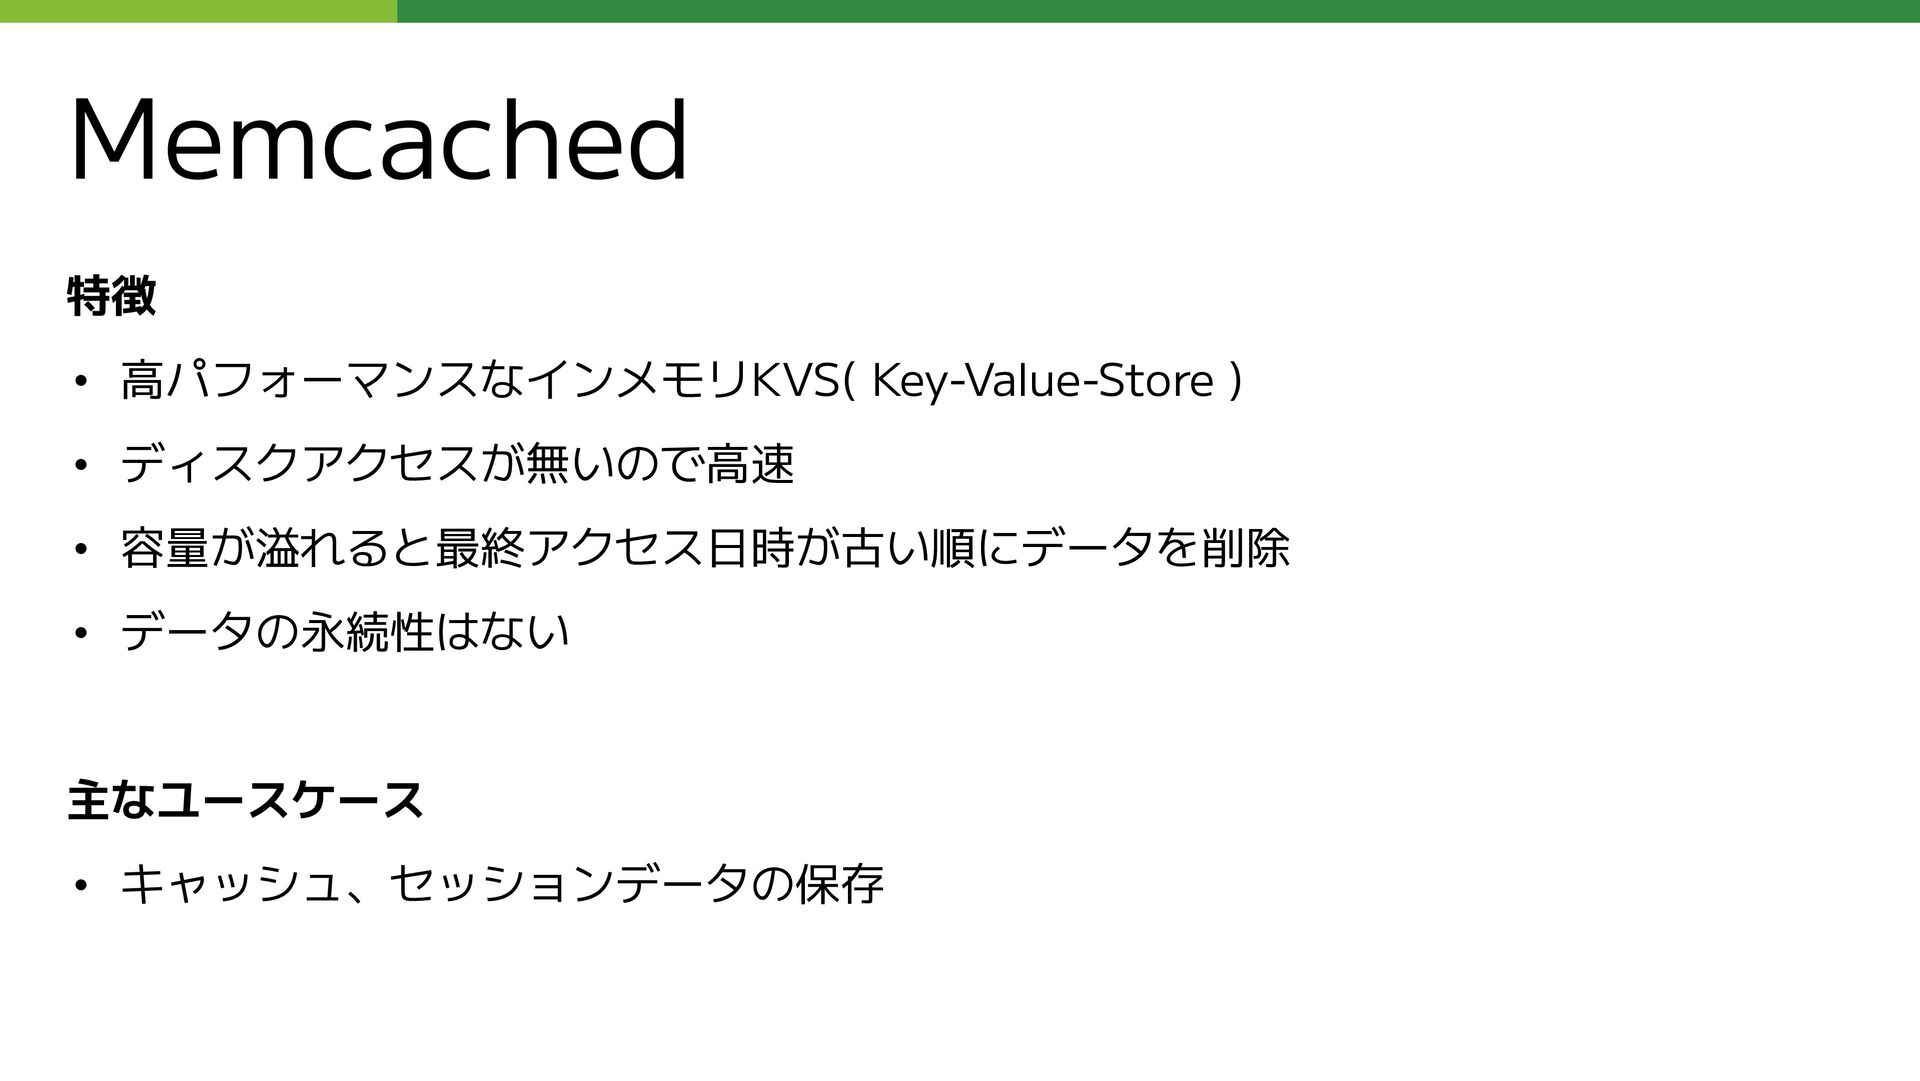
Memcached 特徴 • 高パフォーマンスなインメモリKVS( Key-Value-Store ) • ディスクアクセスが無いので高速 • 容量が溢れると最終アクセス日時が古い順にデータを削除
• データの永続性はない 主なユースケース • キャッシュ、セッションデータの保存 -
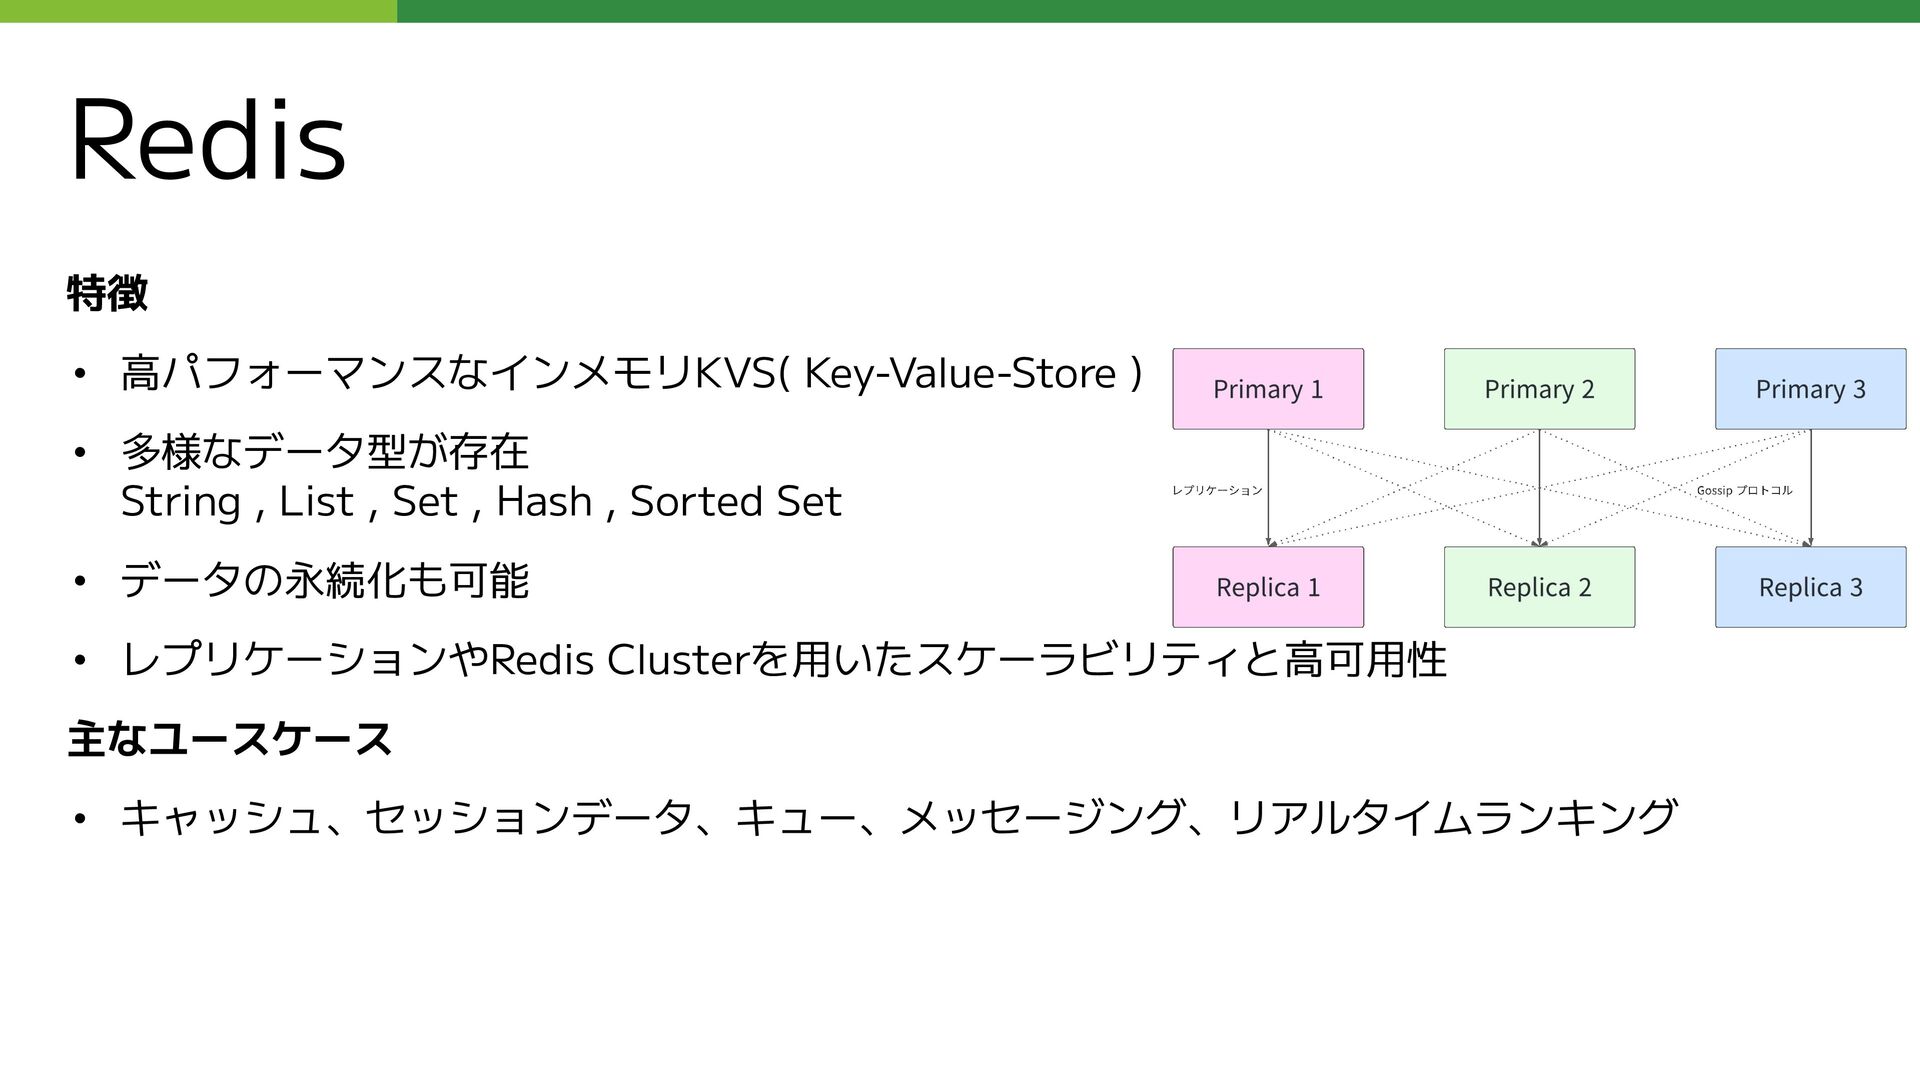
Redis 特徴 • 高パフォーマンスなインメモリKVS( Key-Value-Store ) • 多様なデータ型が存在 String ,
List , Set , Hash , Sorted Set • データの永続化も可能 • レプリケーションやRedis Clusterを用いたスケーラビリティと高可用性 主なユースケース • キャッシュ、セッションデータ、キュー、メッセージング、リアルタイムランキング -
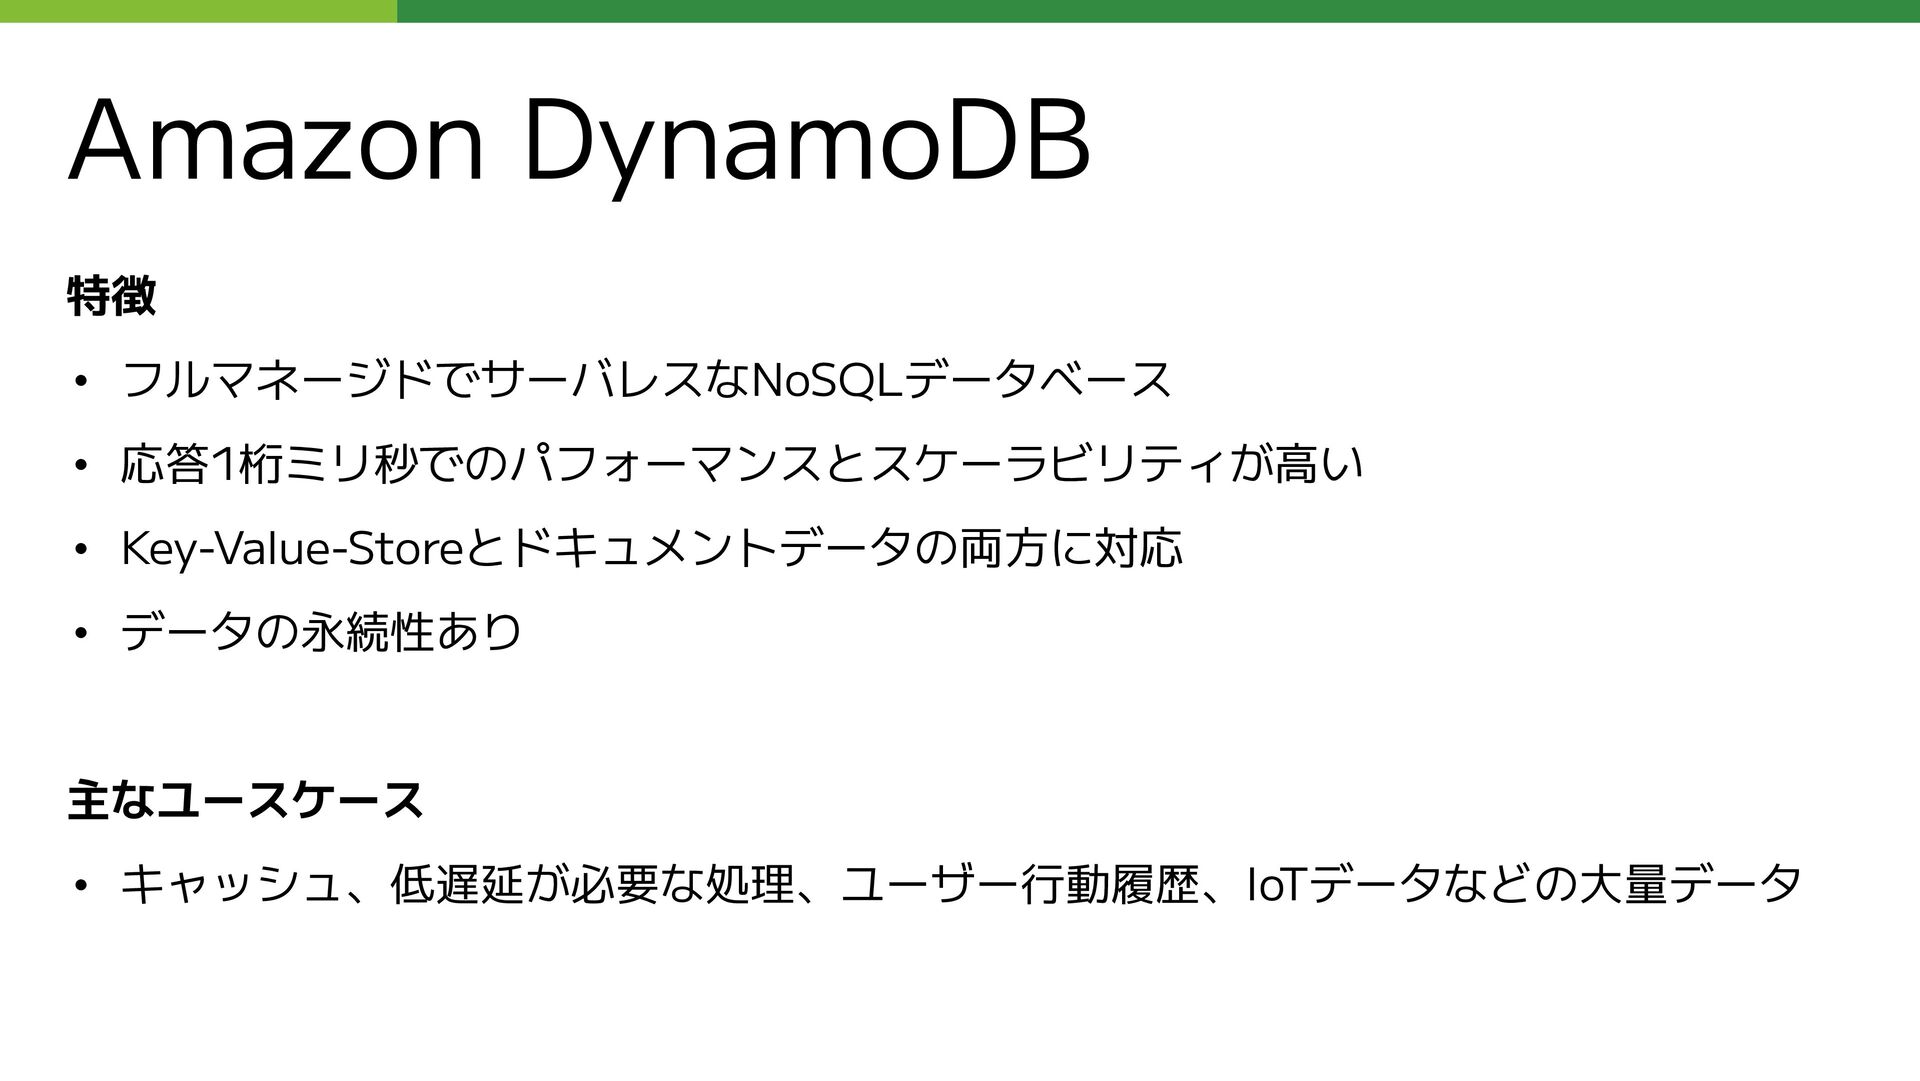
特徴 • フルマネージドでサーバレスなNoSQLデータベース • 応答1桁ミリ秒でのパフォーマンスとスケーラビリティが高い • Key-Value-Storeとドキュメントデータの両方に対応 • データの永続性あり 主なユースケース
• キャッシュ、低遅延が必要な処理、ユーザー行動履歴、IoTデータなどの大量データ Amazon DynamoDB -
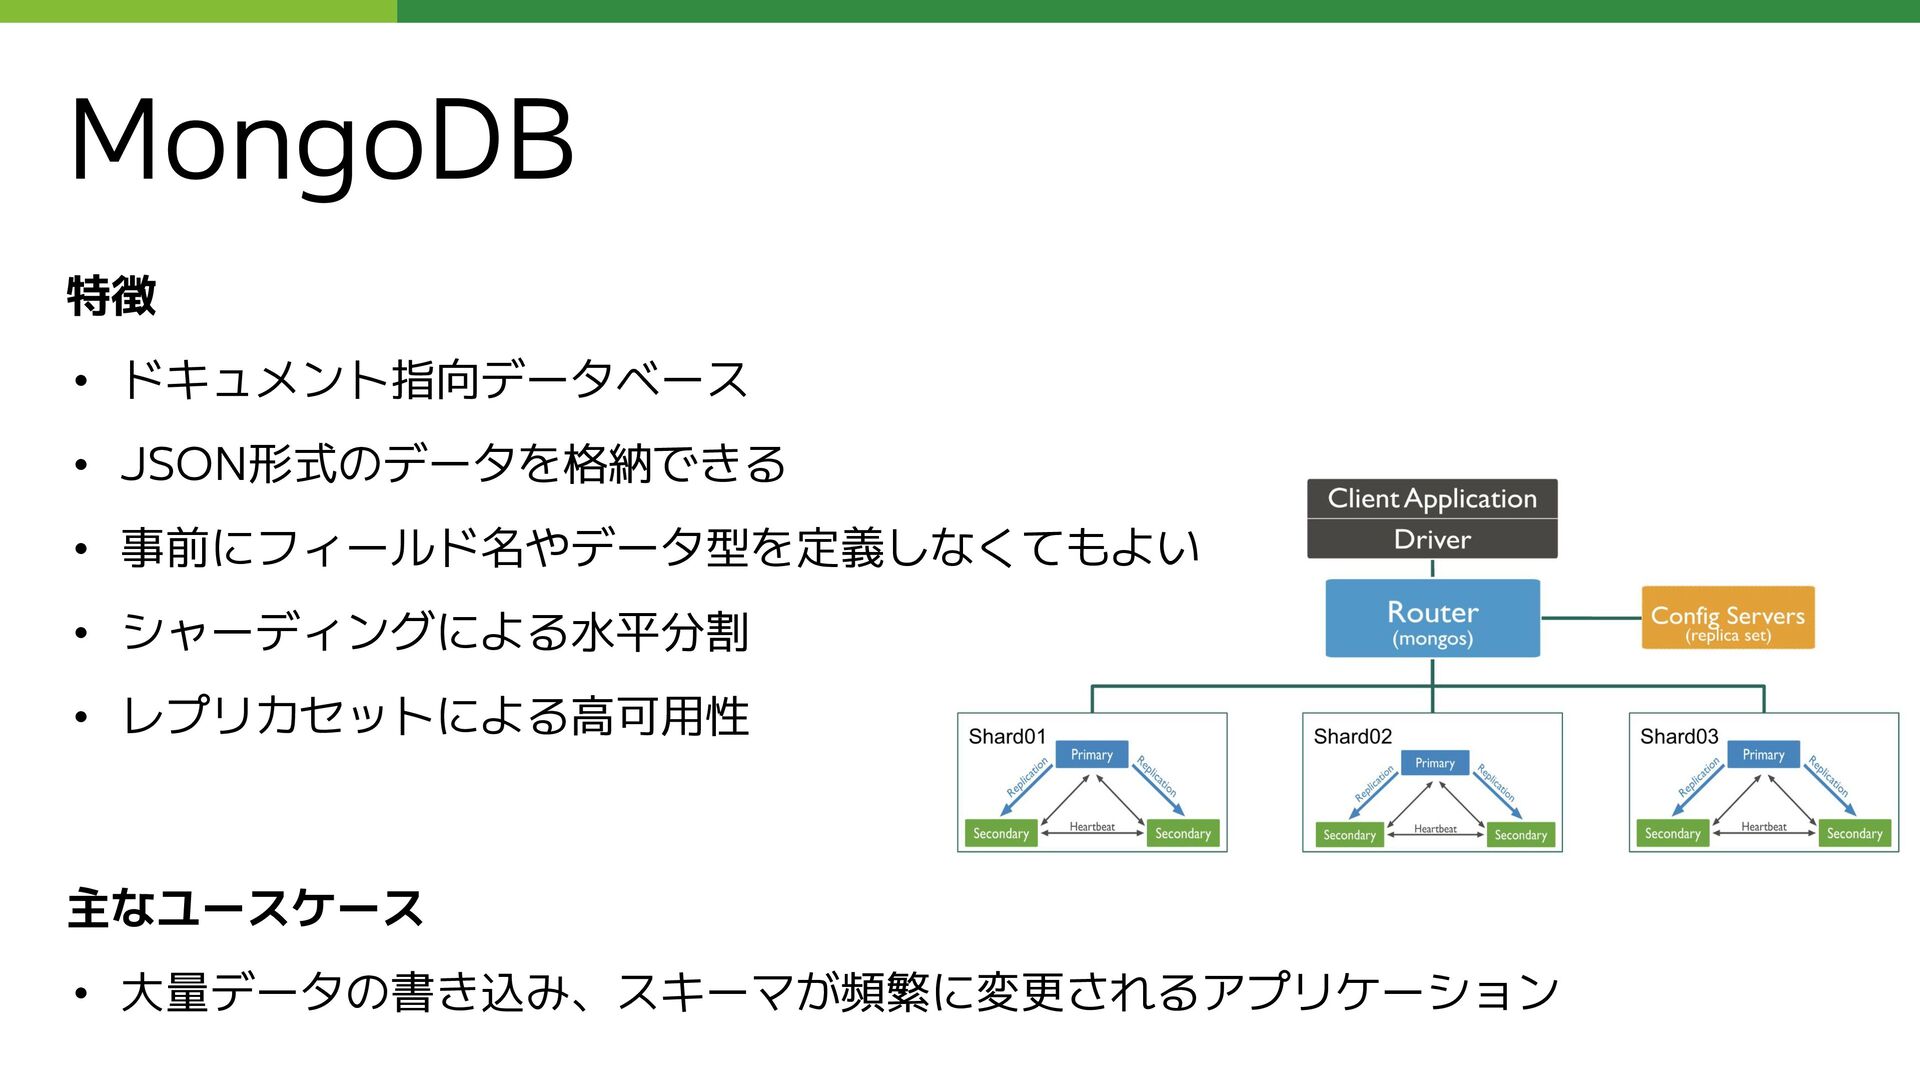
特徴 • ドキュメント指向データベース • JSON形式のデータを格納できる • 事前にフィールド名やデータ型を定義しなくてもよい • シャーディングによる水平分割 •
レプリカセットによる高可用性 主なユースケース • 大量データの書き込み、スキーマが頻繁に変更されるアプリケーション MongoDB -
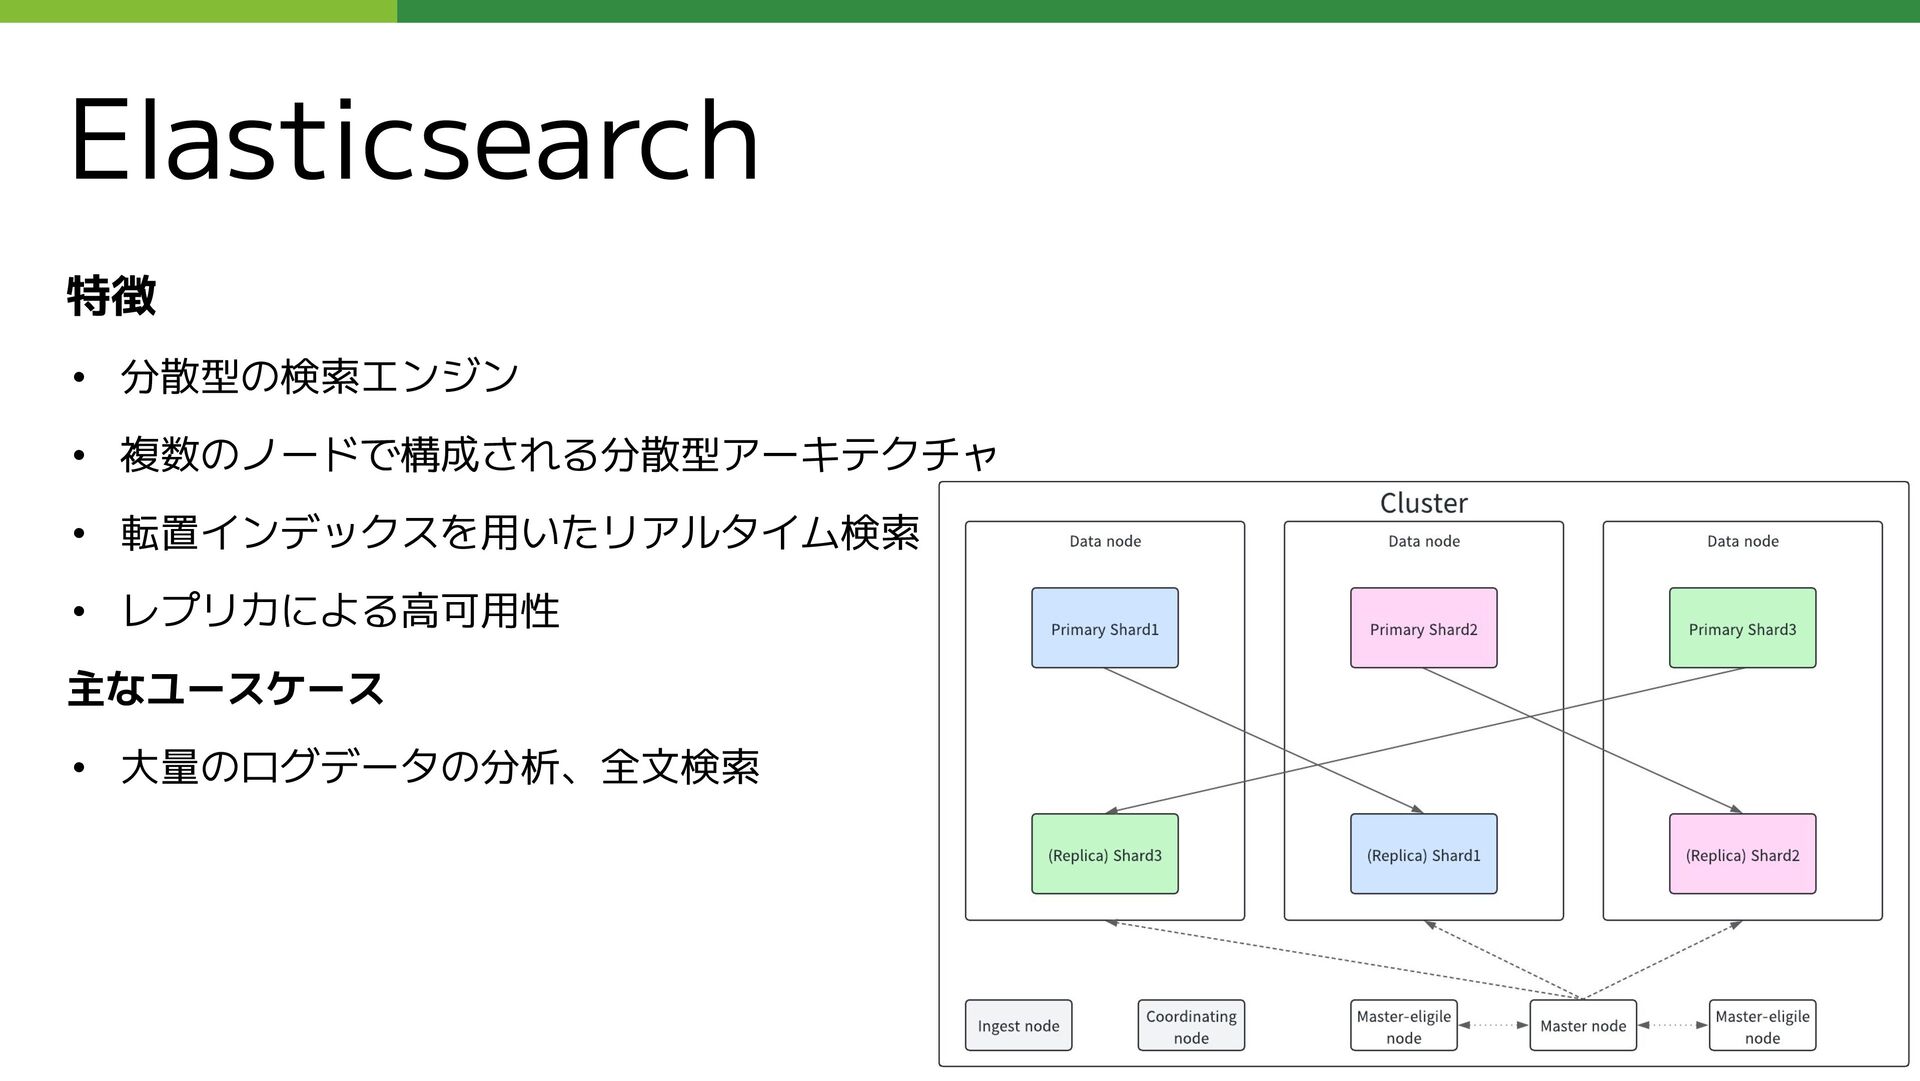
特徴 • 分散型の検索エンジン • 複数のノードで構成される分散型アーキテクチャ • 転置インデックスを用いたリアルタイム検索 • レプリカによる高可用性 主なユースケース
• 大量のログデータの分析、全文検索 Elasticsearch -
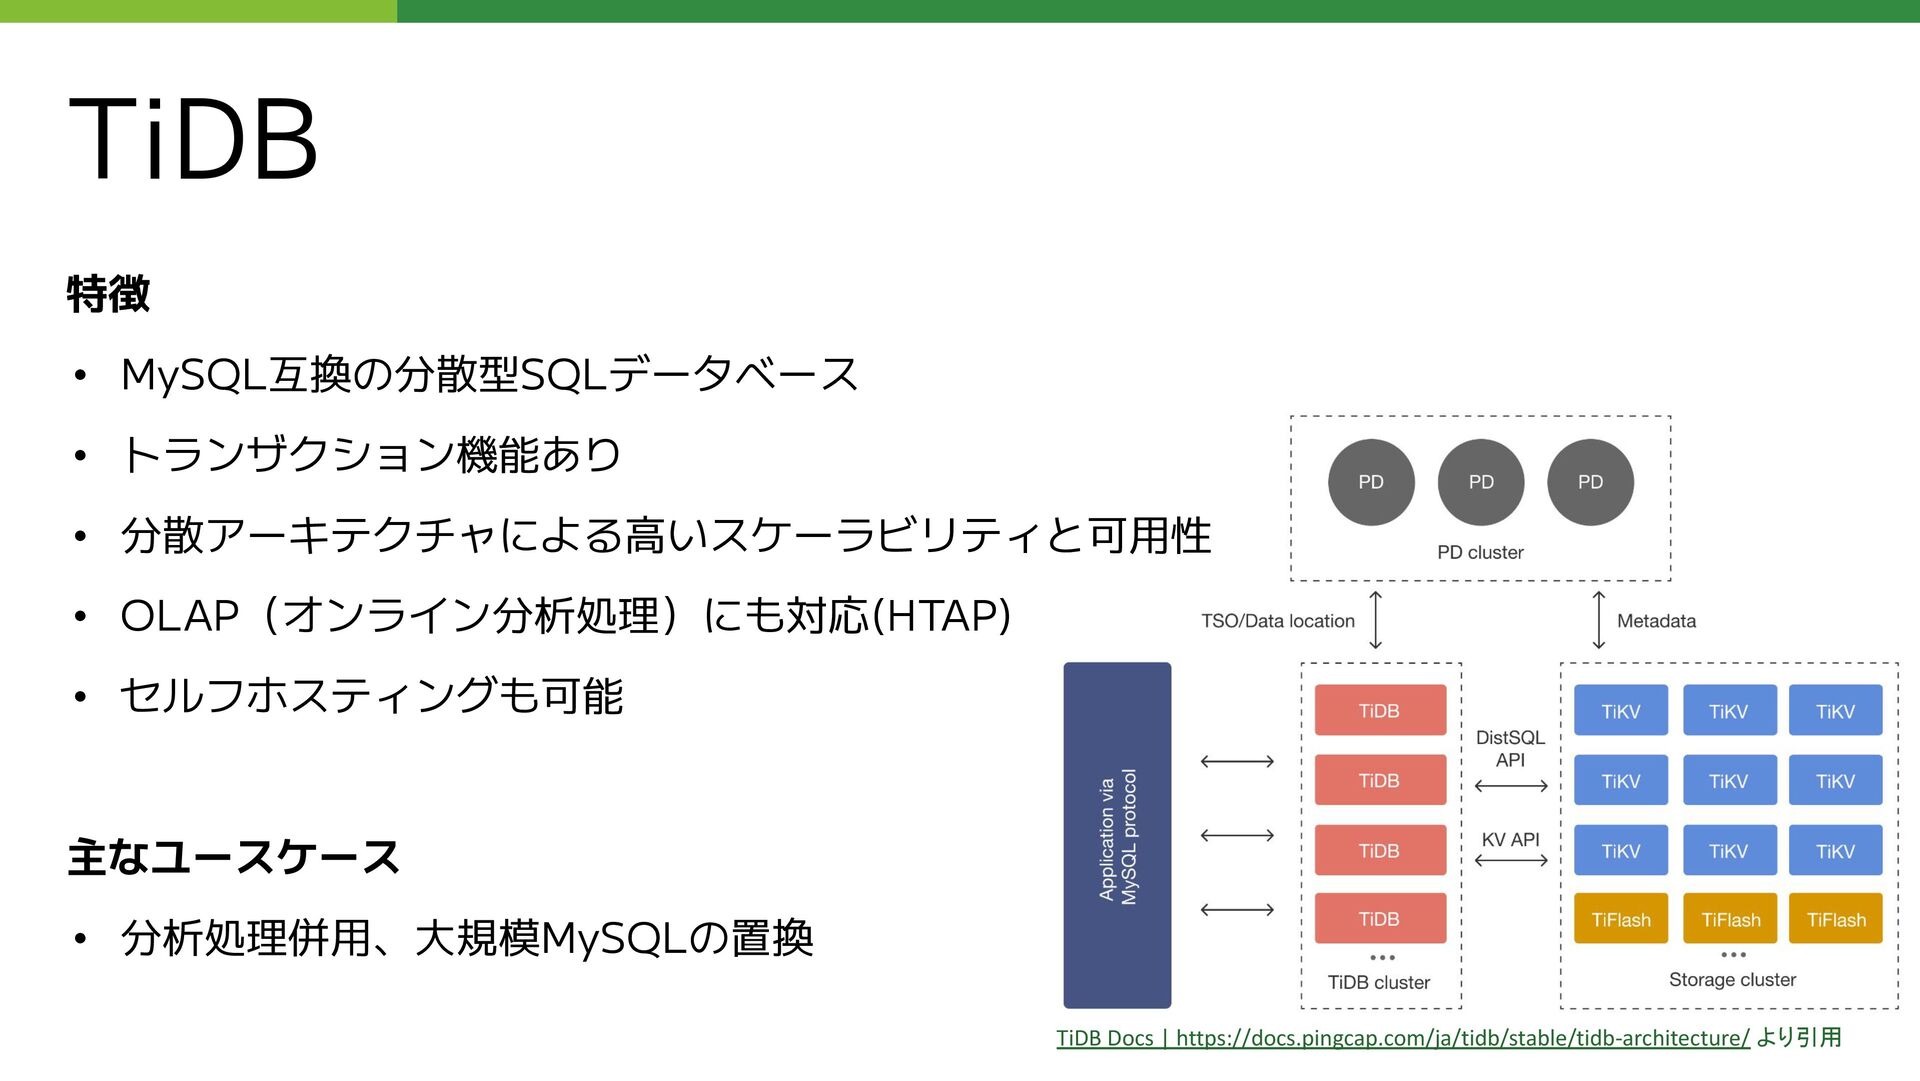
特徴 • MySQL互換の分散型SQLデータベース • トランザクション機能あり • 分散アーキテクチャによる高いスケーラビリティと可用性 • OLAP(オンライン分析処理)にも対応(HTAP) •
セルフホスティングも可能 主なユースケース • 分析処理併用、大規模MySQLの置換 TiDB TiDB Docs | https://docs.pingcap.com/ja/tidb/stable/tidb-architecture/ より引用 -
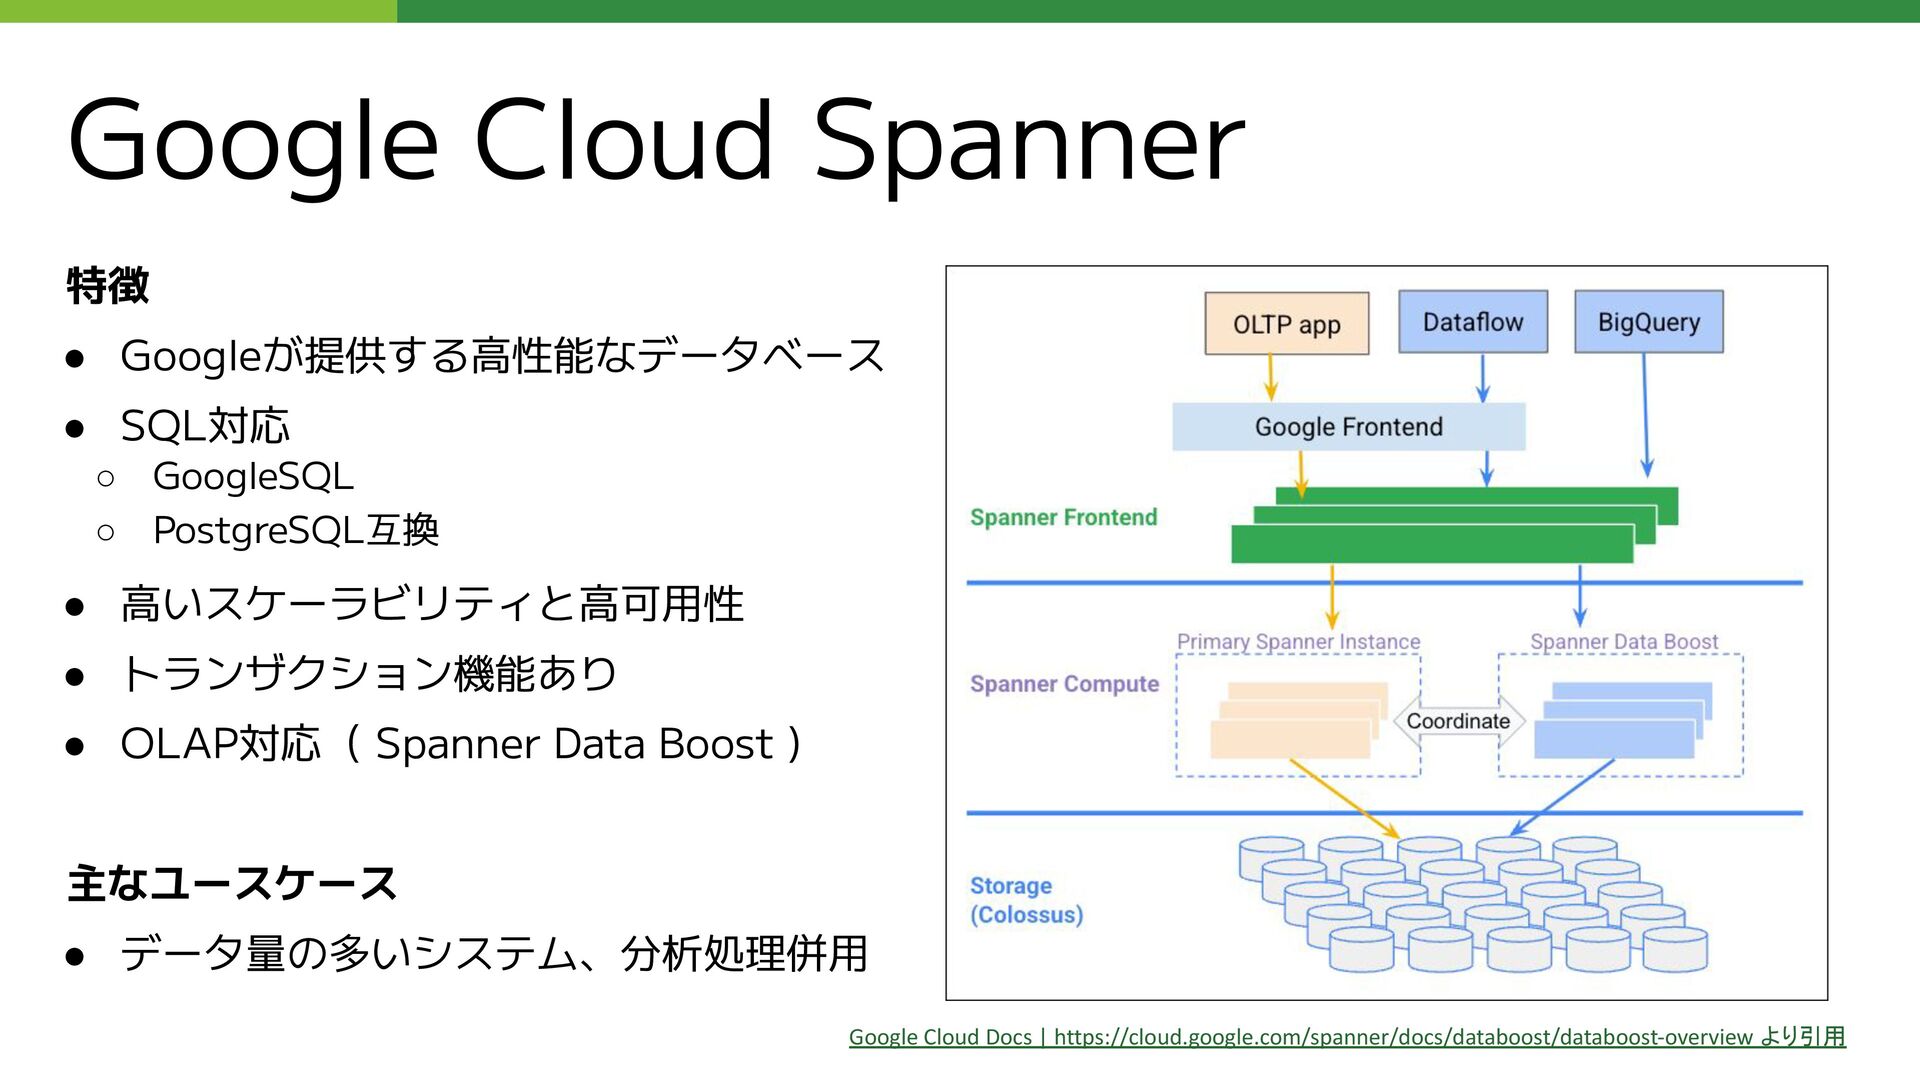
特徴 • Googleが提供する高性能なデータベース • SQL対応 ◦ GoogleSQL ◦ PostgreSQL互換 •
高いスケーラビリティと高可用性 • トランザクション機能あり • OLAP対応( Spanner Data Boost ) 主なユースケース • データ量の多いシステム、分析処理併用 Google Cloud Spanner Google Cloud Docs | https://cloud.google.com/spanner/docs/databoost/databoost-overview より引用 -
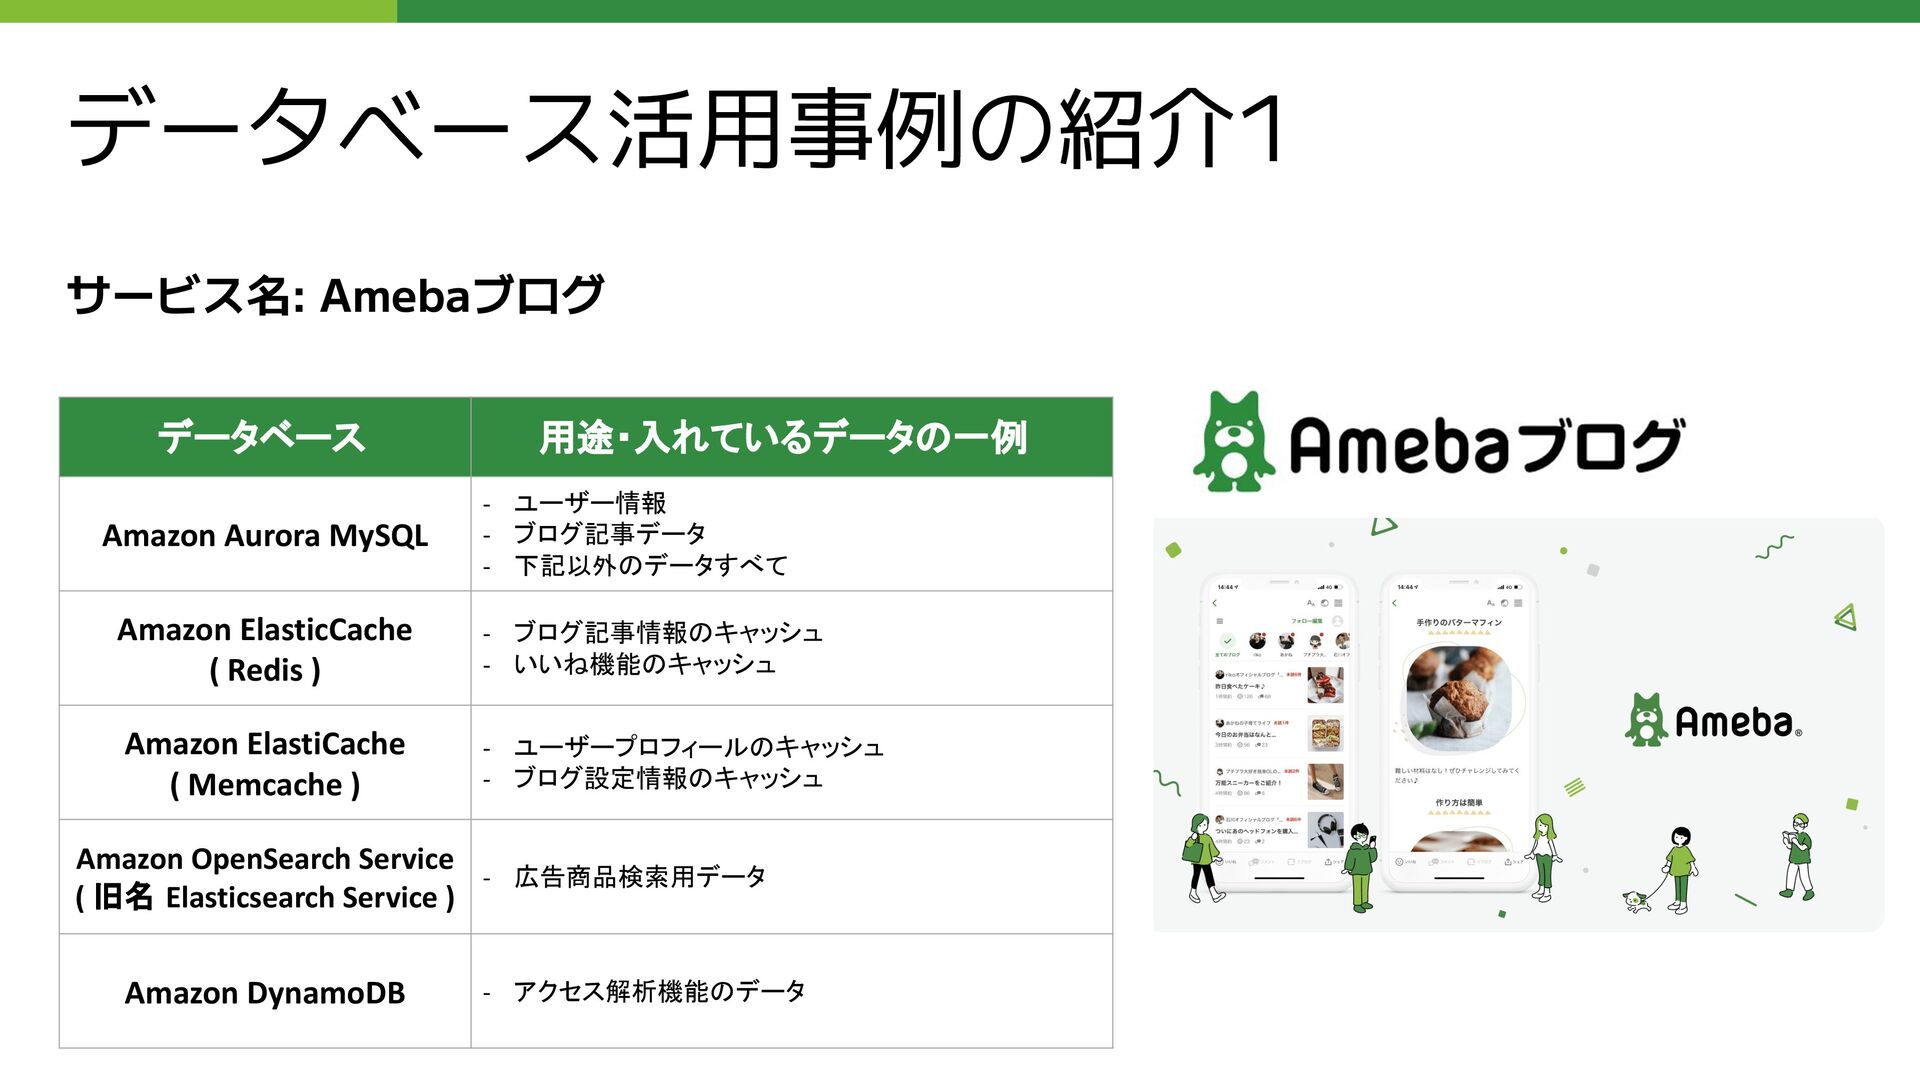
データベース活用事例の紹介1 サービス名: Amebaブログ データベース 用途・入れているデータの一例 Amazon Aurora MySQL - ユーザー情報
- ブログ記事データ - 下記以外のデータすべて Amazon ElasticCache ( Redis ) - ブログ記事情報のキャッシュ - いいね機能のキャッシュ Amazon ElastiCache ( Memcache ) - ユーザープロフィールのキャッシュ - ブログ設定情報のキャッシュ Amazon OpenSearch Service ( 旧名 Elasticsearch Service ) - 広告商品検索用データ Amazon DynamoDB - アクセス解析機能のデータ -
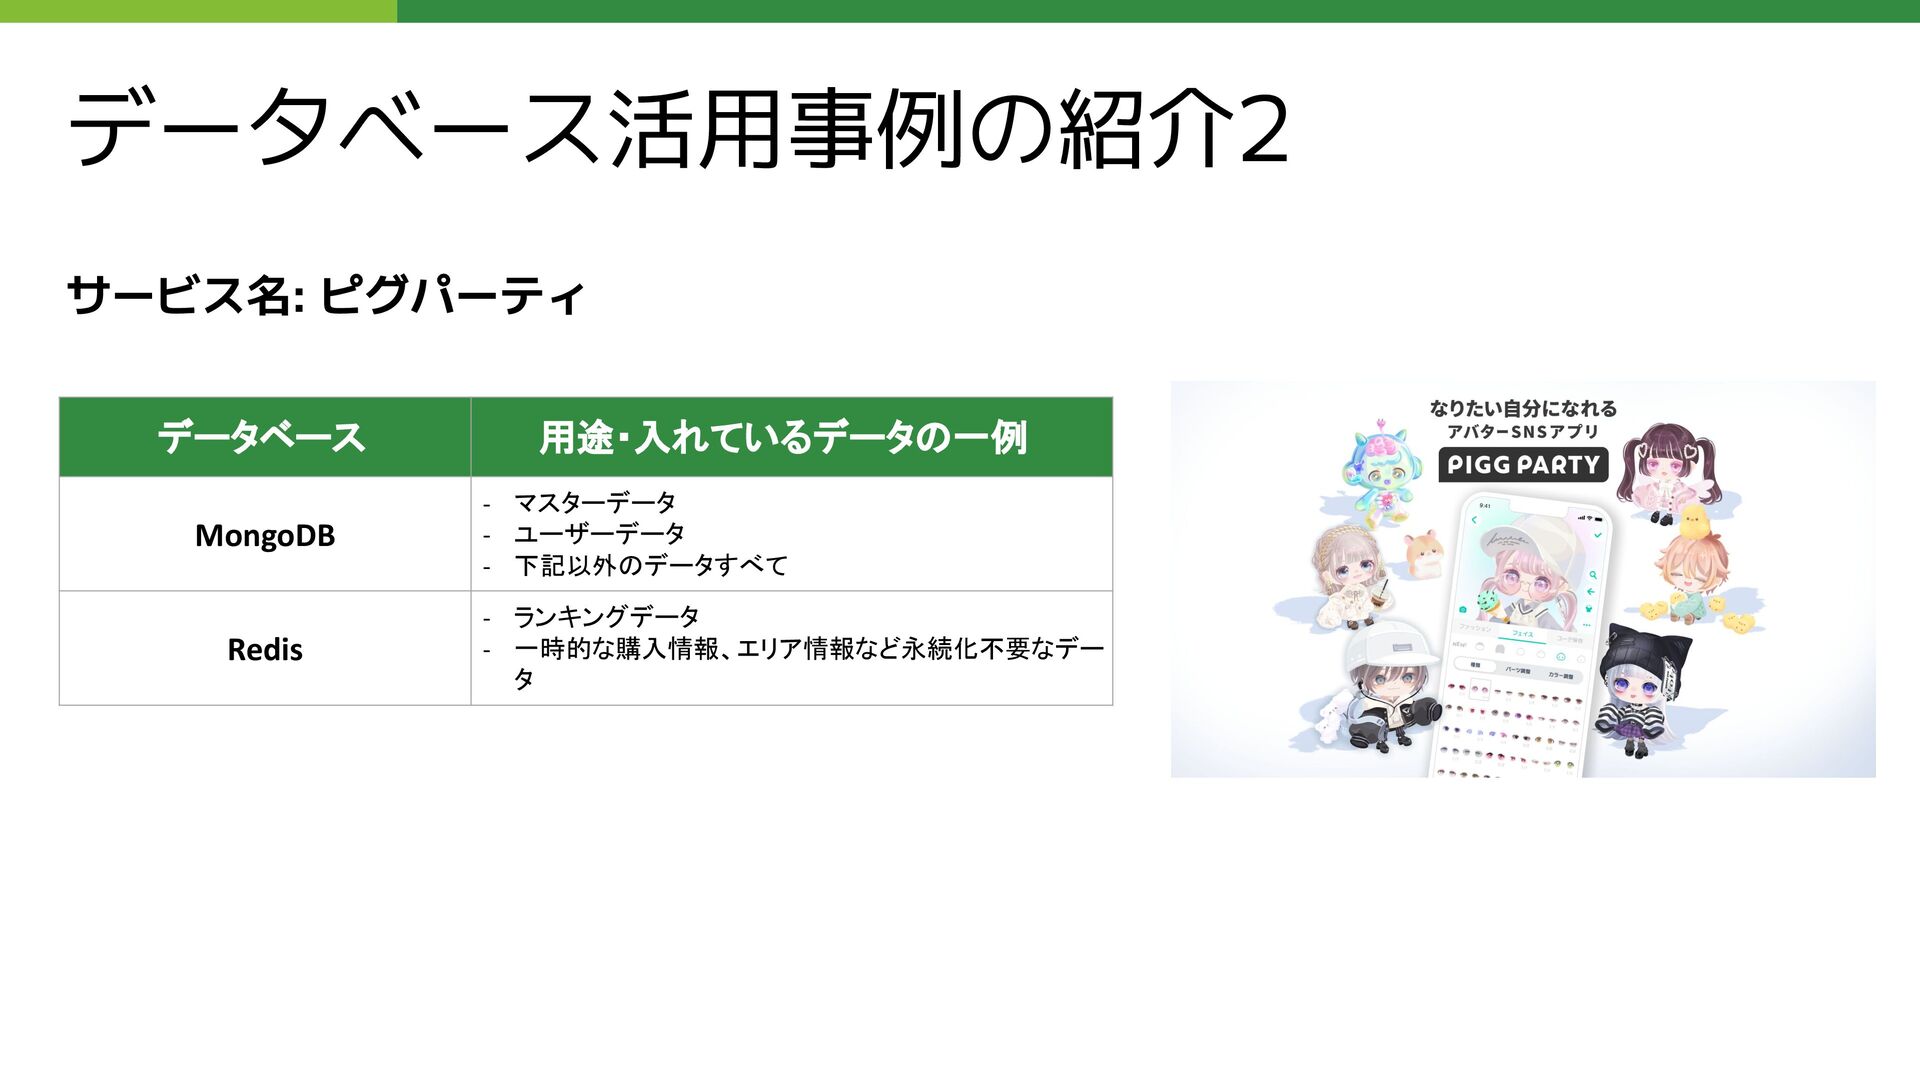
データベース活用事例の紹介2 サービス名: ピグパーティ データベース 用途・入れているデータの一例 MongoDB - マスターデータ - ユーザーデータ
- 下記以外のデータすべて Redis - ランキングデータ - 一時的な購入情報、エリア情報など永続化不要なデー タ -
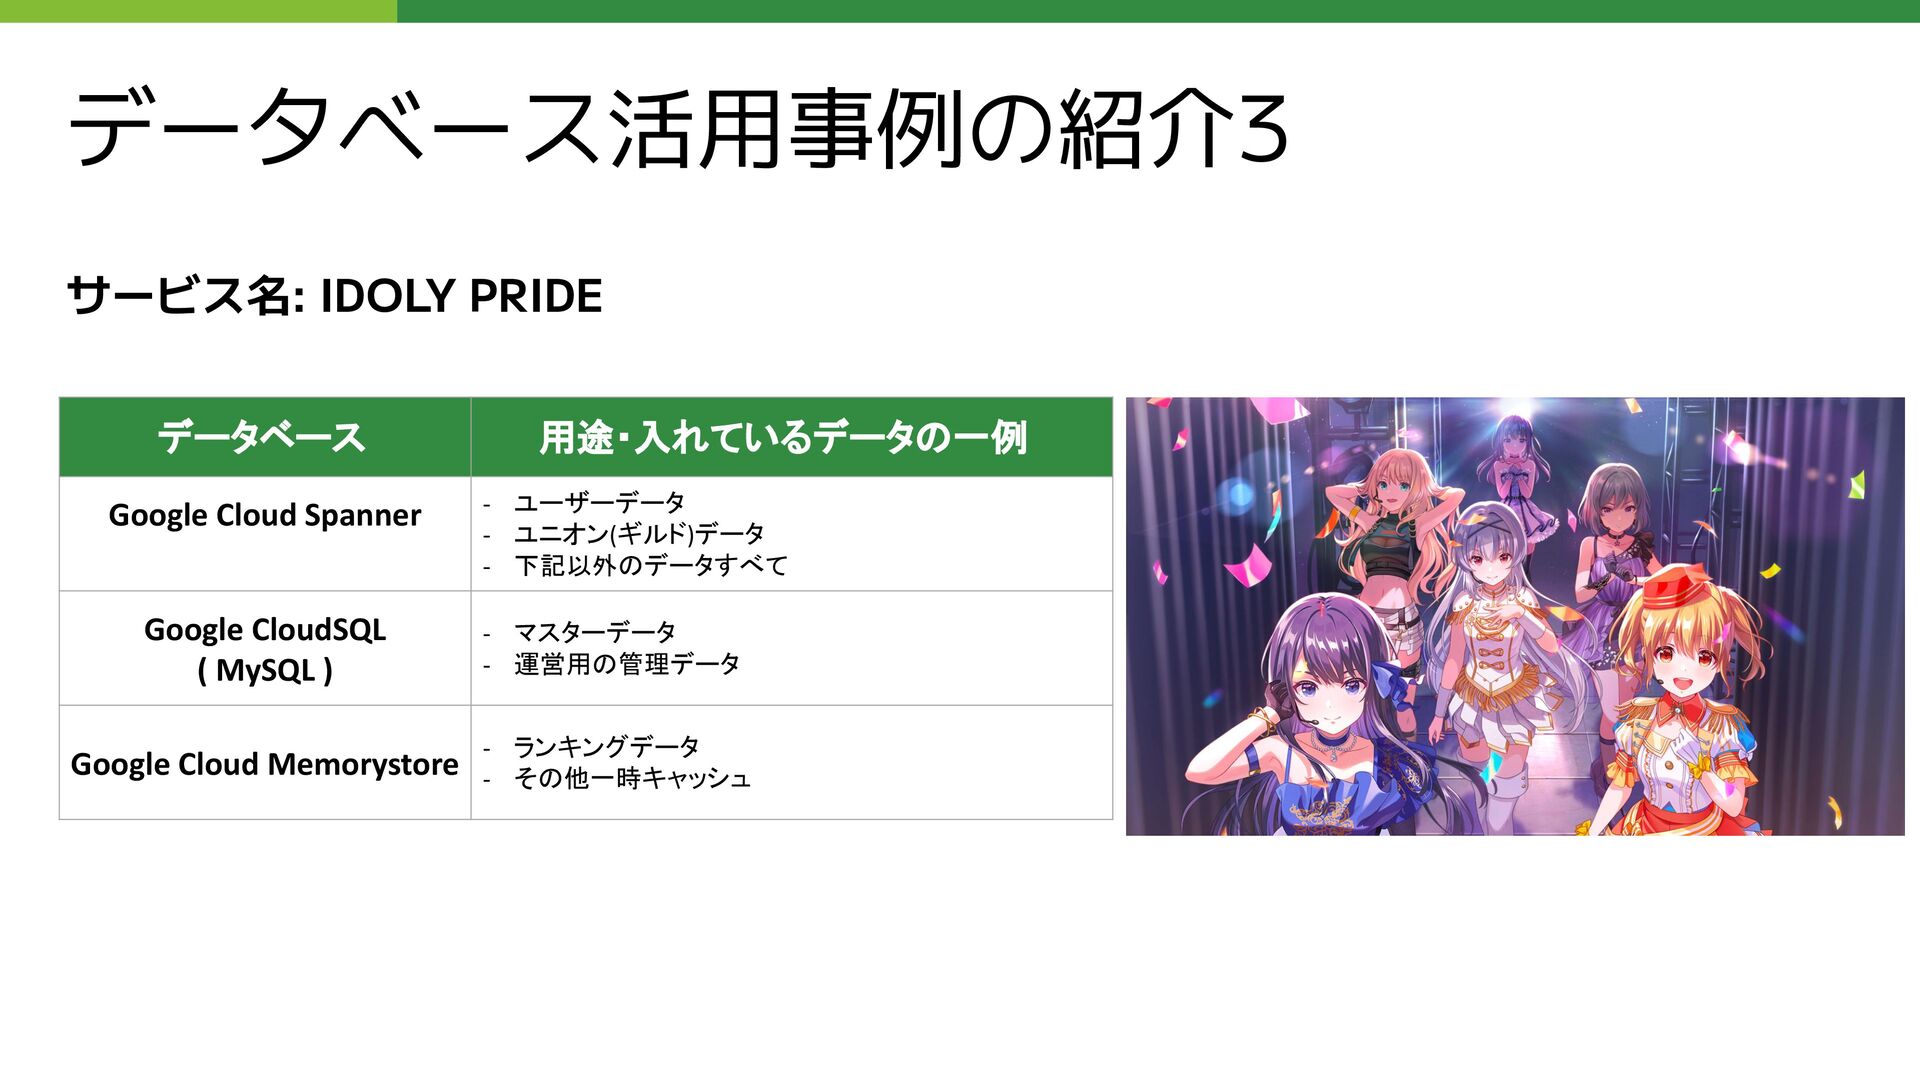
データベース活用事例の紹介3 サービス名: IDOLY PRIDE データベース 用途・入れているデータの一例 Google Cloud Spanner -
ユーザーデータ - ユニオン(ギルド)データ - 下記以外のデータすべて Google CloudSQL ( MySQL ) - マスターデータ - 運営用の管理データ Google Cloud Memorystore - ランキングデータ - その他一時キャッシュ -
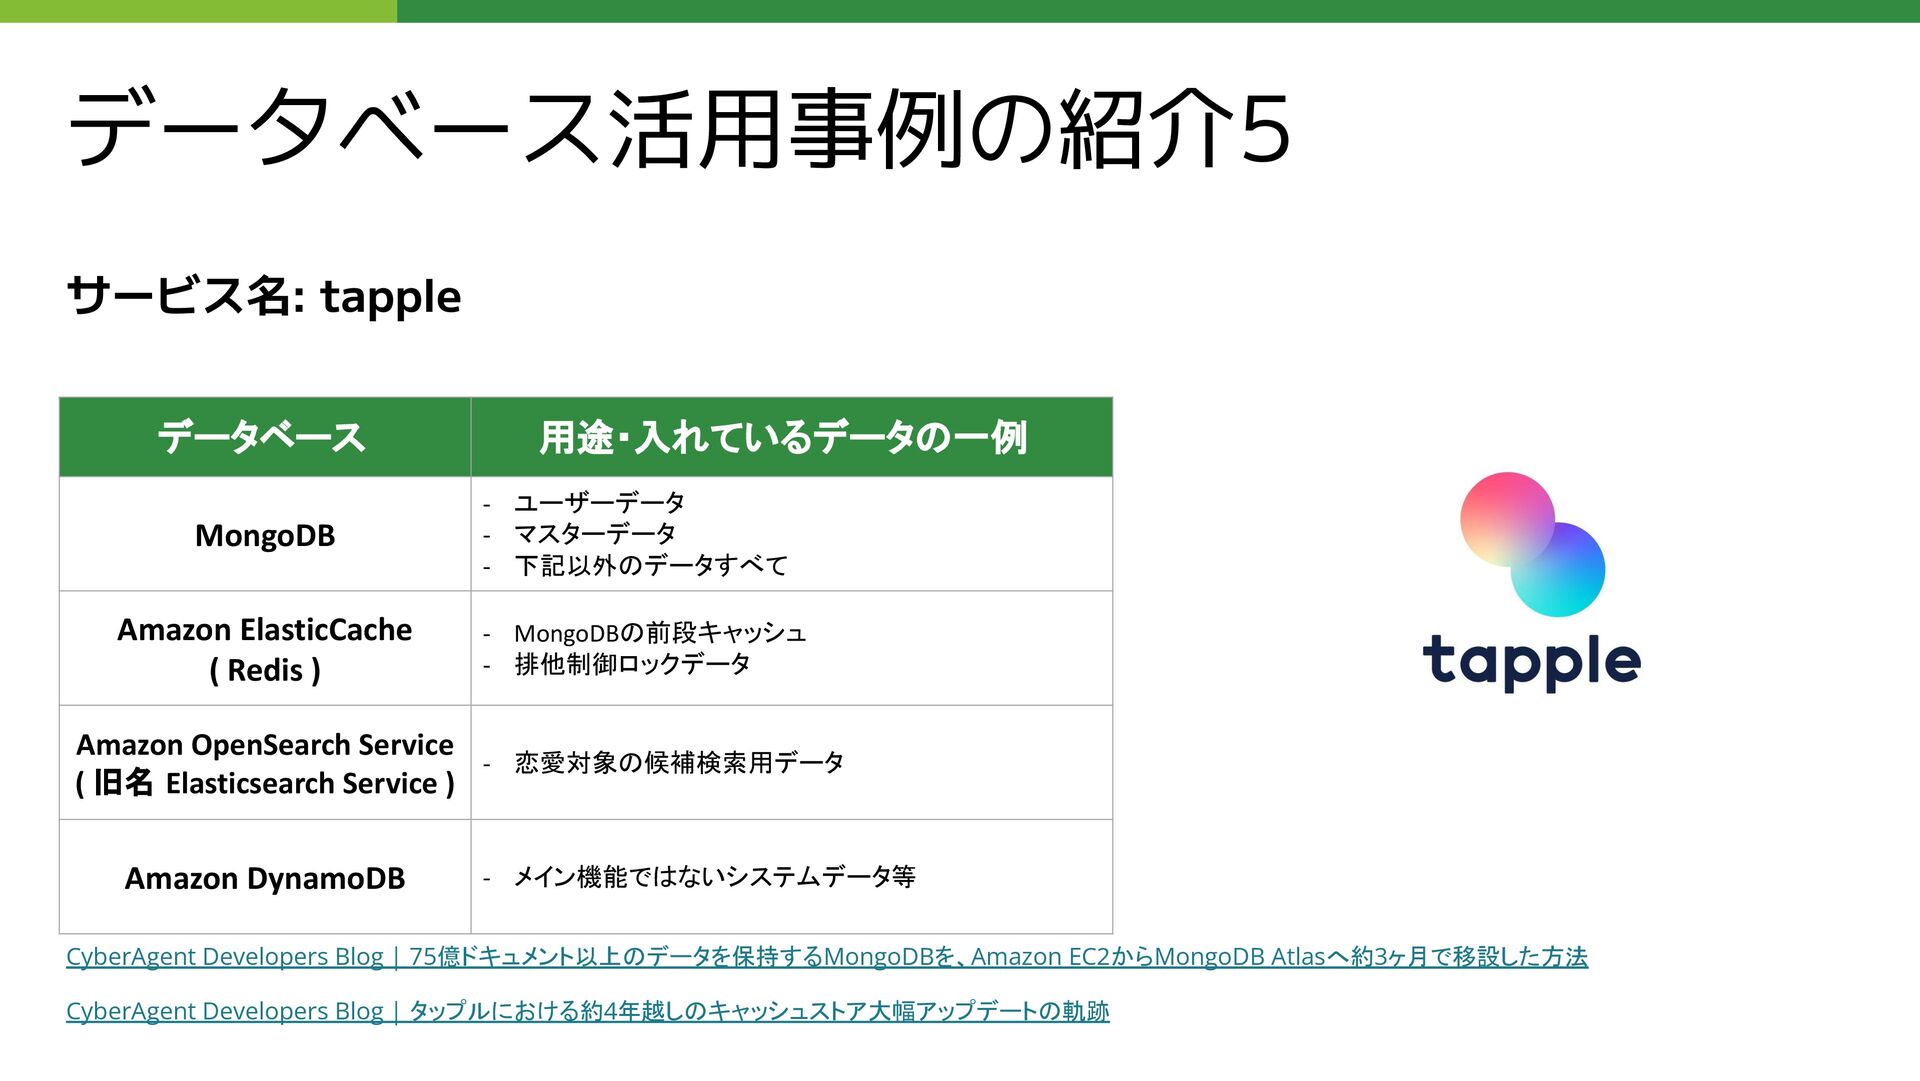
データベース活用事例の紹介5 サービス名: tapple CyberAgent Developers Blog | 75億ドキュメント以上のデータを保持するMongoDBを、Amazon EC2からMongoDB Atlasへ約3ヶ月で移設した方法
CyberAgent Developers Blog | タップルにおける約4年越しのキャッシュストア大幅アップデートの軌跡 データベース 用途・入れているデータの一例 MongoDB - ユーザーデータ - マスターデータ - 下記以外のデータすべて Amazon ElasticCache ( Redis ) - MongoDBの前段キャッシュ - 排他制御ロックデータ Amazon OpenSearch Service ( 旧名 Elasticsearch Service ) - 恋愛対象の候補検索用データ Amazon DynamoDB - メイン機能ではないシステムデータ等 -
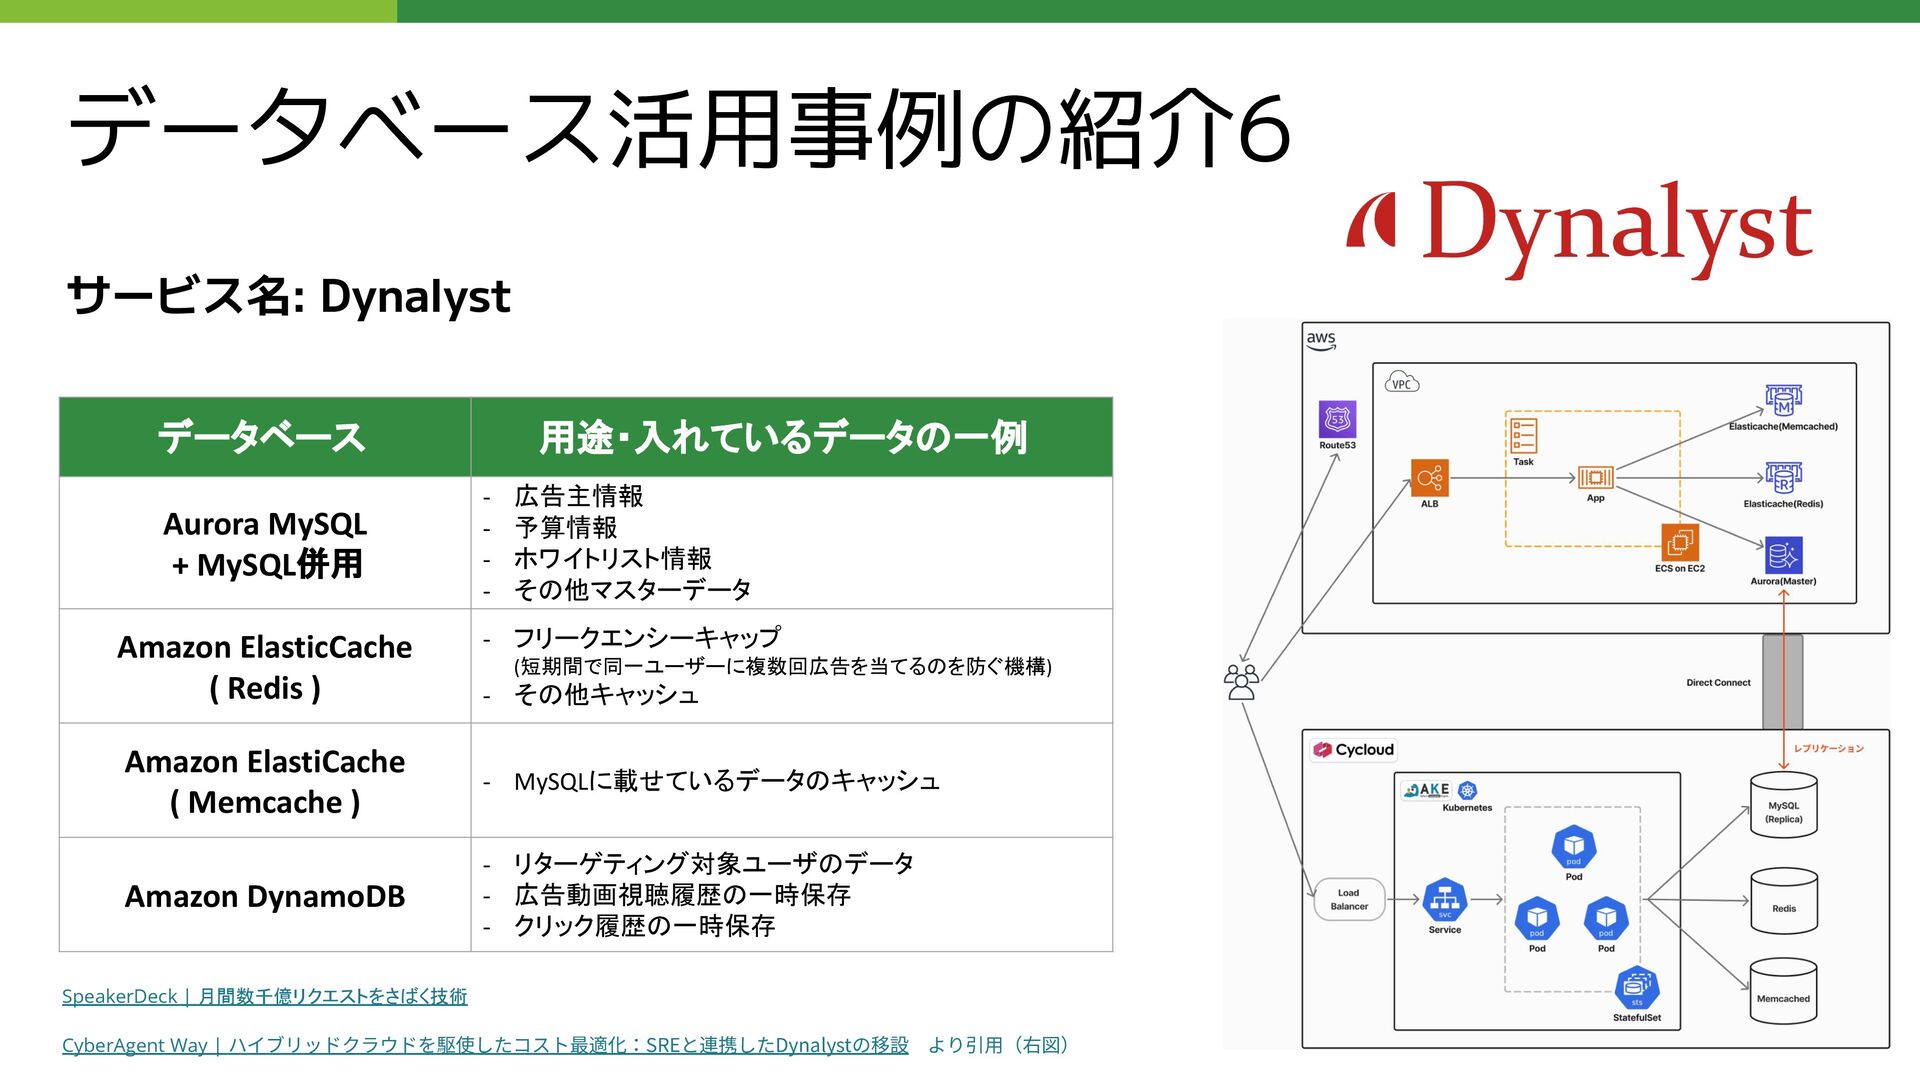
データベース活用事例の紹介6 サービス名: Dynalyst データベース 用途・入れているデータの一例 Aurora MySQL + MySQL併用 -
広告主情報 - 予算情報 - ホワイトリスト情報 - その他マスターデータ Amazon ElasticCache ( Redis ) - フリークエンシーキャップ (短期間で同一ユーザーに複数回広告を当てるのを防ぐ機構) - その他キャッシュ Amazon ElastiCache ( Memcache ) - MySQLに載せているデータのキャッシュ Amazon DynamoDB - リターゲティング対象ユーザのデータ - 広告動画視聴履歴の一時保存 - クリック履歴の一時保存 SpeakerDeck | 月間数千億リクエストをさばく技術 CyberAgent Way | ハイブリッドクラウドを駆使したコスト最適化:SREと連携したDynalystの移設 より引⽤(右図) -
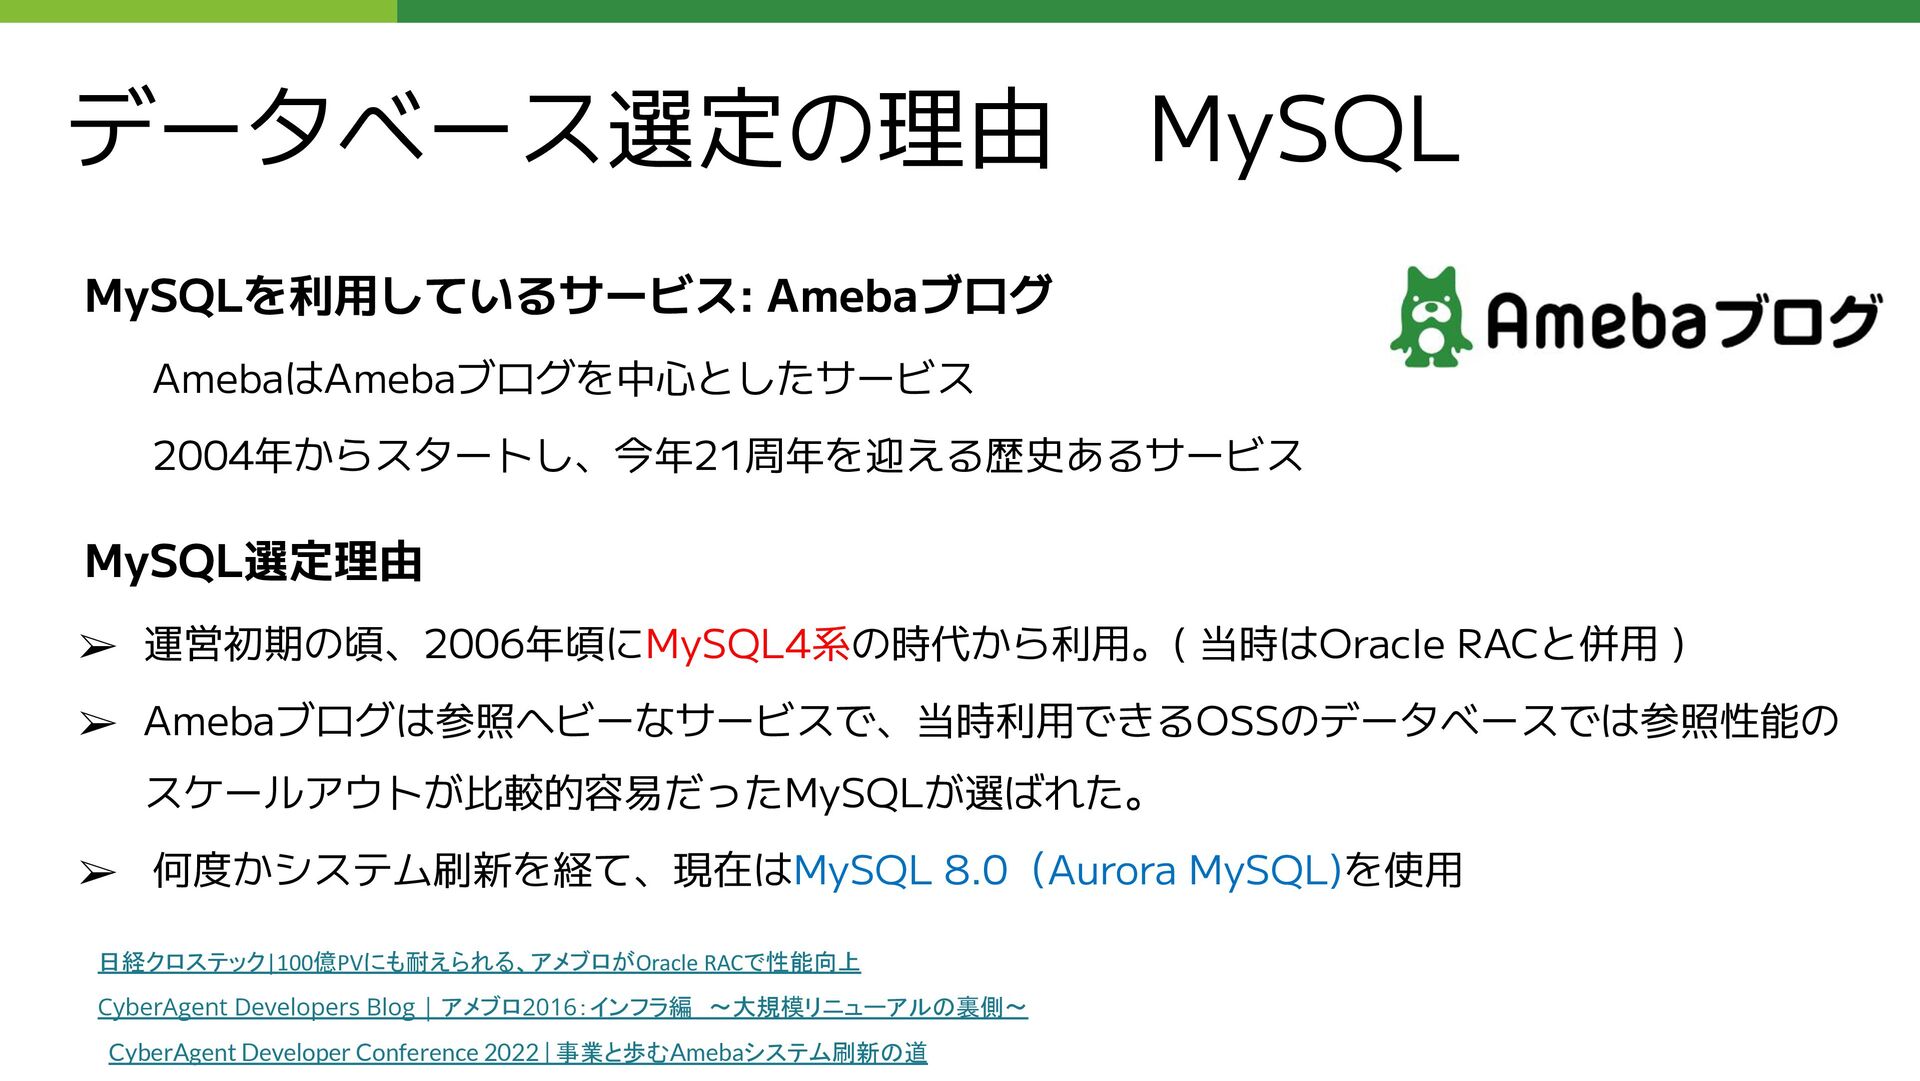
データベース選定の理由 MySQL MySQLを利用しているサービス: Amebaブログ AmebaはAmebaブログを中心としたサービス 2004年からスタートし、今年21周年を迎える歴史あるサービス MySQL選定理由 ➢ 運営初期の頃、2006年頃にMySQL4系の時代から利用。( 当時はOracle RACと併用
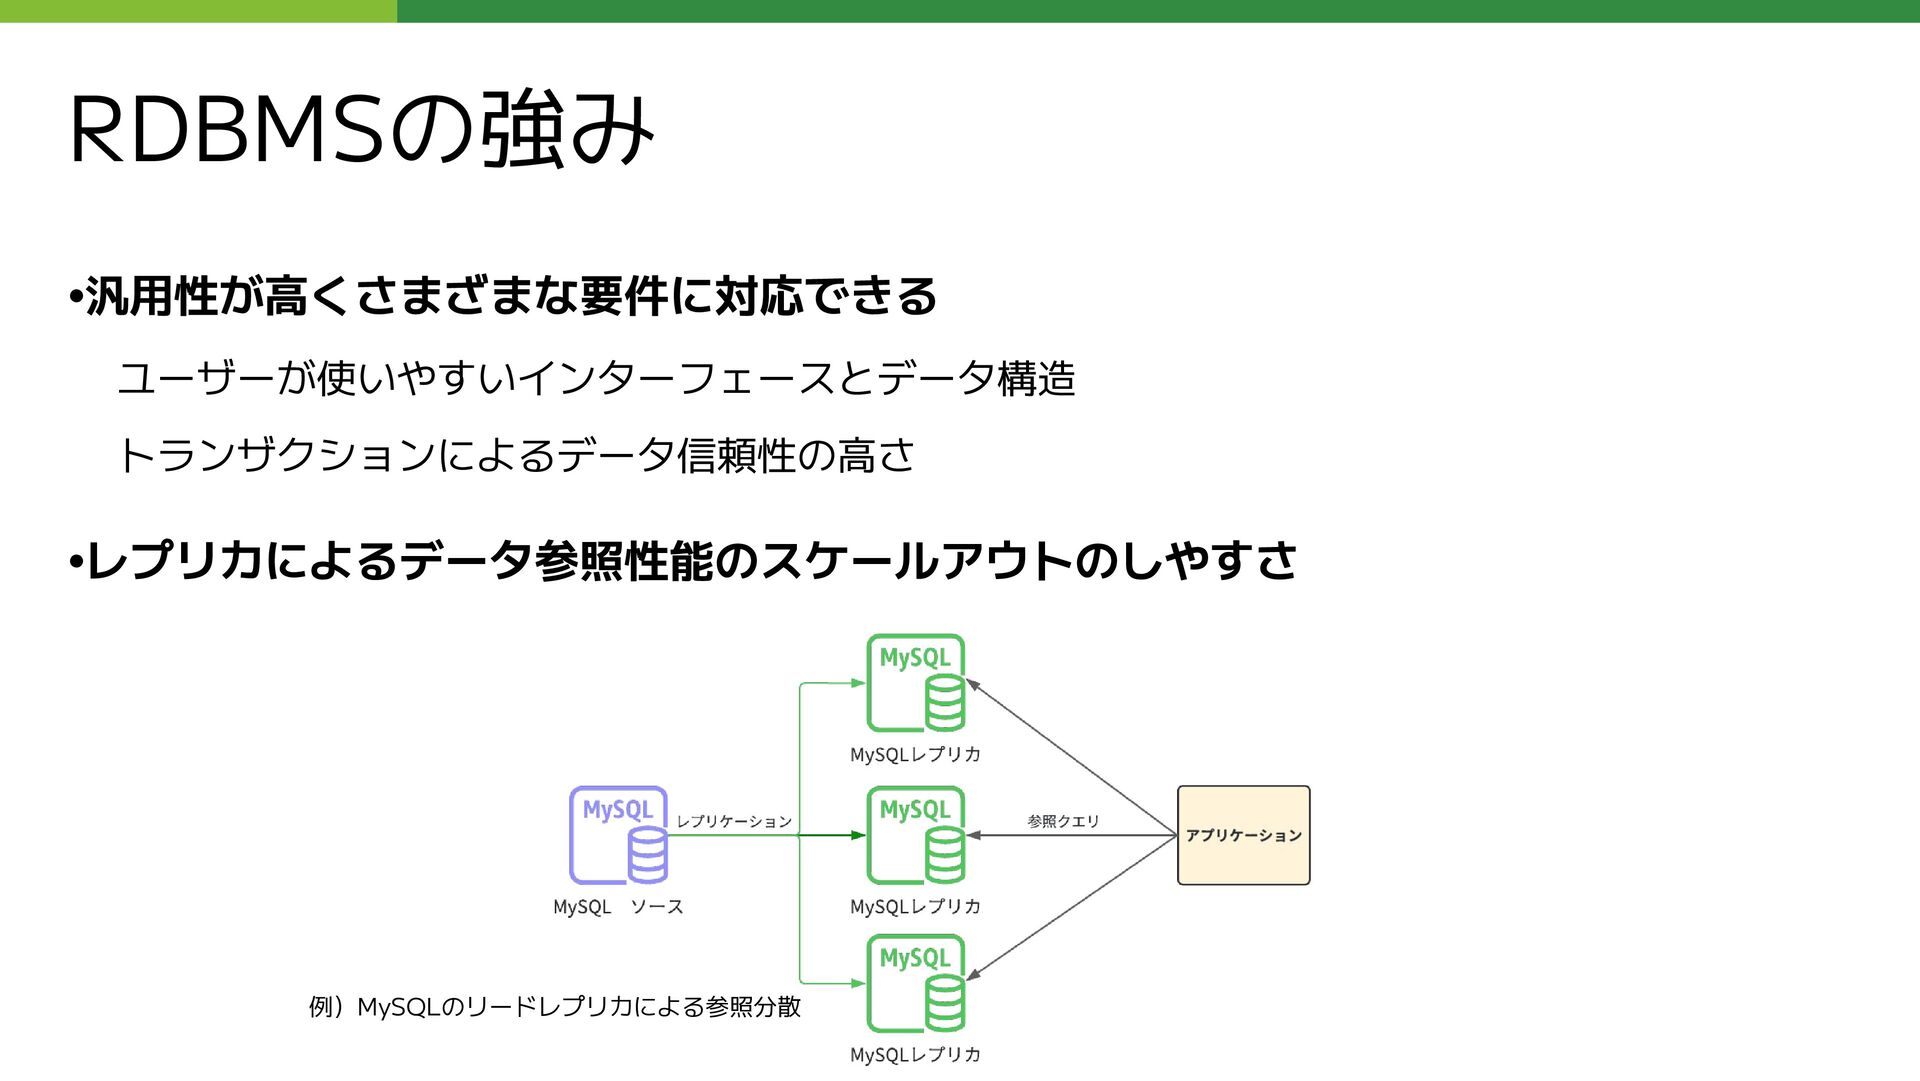
) ➢ Amebaブログは参照ヘビーなサービスで、当時利用できるOSSのデータベースでは参照性能の スケールアウトが比較的容易だったMySQLが選ばれた。 ➢ 何度かシステム刷新を経て、現在はMySQL 8.0(Aurora MySQL)を使用 CyberAgent Developers Blog | アメブロ2016:インフラ編 〜大規模リニューアルの裏側〜 CyberAgent Developer Conference 2022 | 事業と歩むAmebaシステム刷新の道 日経クロステック|100億PVにも耐えられる、アメブロがOracle RACで性能向上 -
データベース選定の理由 MongoDB MongoDBを利用しているサービス:ピグパーティ 仮想空間内でアバター( ピグ )を使って着せ替えや部屋の模様替えを楽しむアバターSNS MongoDB 選定理由 ➢ サーバサイドにNode.jsを採用していて、JSONをそのまま格納できるMongoDBと相性が良い ➢
柔軟なスキーマ設計により仕様変更が多いゲーム開発にマッチ ➢ 自動シャーディングによる負荷分散とレプリケーションによる高可用性 ➢ ピグパーティより前に運営開始したピグライフでもMongoDBを採用しており知見があった Slideshare | MongoDB + node.js で作るソーシャルゲーム Speakerdeck | ピグパーティにおけるMongoDB CommunityバージョンからAtlasへの移行事例 -
データベース選定の理由 Elasticsearch Elasticsearchを利用しているサービス:tapple tappleは2014年にサービス開始したマッチングサービス 共通の趣味を通して異性との交流や出会いのきっかけを提供 Elasticsearch選定理由 ➢ リリース当初はユーザー検索機能もメインDBであるMongoDBを利用してきた ➢ MongoDBは検索に強いわけではないので、ユーザー数の増加により性能が悪化してきた ➢
ユーザー検索機能を大規模データの検索に強みのあるElasticsearchに切り替えた Speakerdeck | タップル誕生における、事業成長に合わせた継続的なシステム改善について ※サービス名称が変更されたAmazon OpenSearch Service 利用中。名称変更については下記記事を参照 Publickey | 「Amazon Elasticsearch Service」の名称が「Amazon OpenSearch Service」に変更。ElasticsearchからフォークしたOpenSearchも採 用 -
データベース選定の理由 Cloud Spanner Cloud Spannerを利用しているサービス:IDOLY PRIDE IDOLY PRIDEはアイドルマネジメントRPGのゲーム 2021年リリース ゲーム開発と運営はSGEのQualiArtsが担当 Cloud Spanner選定理由
➢ 過去の別ゲームではMySQLやMongoDBを採用してきた ➢ MySQLでは高負荷なゲームの書き込みの分散で苦労していた ➢ MongoDBは当時トランザクションがなかったり、MongoDBクラスタの運用に苦労していた ➢ Cloud Spannerはフルマネージドで、自動水平分割機能やトランザクション機能をもっていた speakerdeck | ゲーム「IDOLY PRIDE」を構成するGCPアーキテクチャの全貌 「IDOLY PRIDE」におけるGoogle Cloud Spannerの活用 -
データベース選定の理由 TiDB TiDBを利用しているサービス:大規模データ処理基盤 サイバーエージェント内で横断的に利用される大規模データ処理基盤 以前は基盤全体がHadoopエコシステムに依存していて、データストアにHBaseを利用していた TiDB選定理由 ➢ HBaseの利用と運用の面から複数の課題があった ▪ 簡単な集計、検索にもJavaでコードを書く必要がある ▪
HBaseはプライベートクラウドのVM上で運用していて手間が多かった ➢ TiDBはMySQL互換であるため利用者が使いやすく、複雑なクエリの実行も可能 ➢ TiDB OperatorによってKubernetes上でTiDBを運用可能 speakerdeck |TiUG #1 HBaseからTiDBへの移行を選んだ理由 -
社内でのデータベース採用割合 TOP10 1. MySQL 33.3% 2. Memcached,Redis 33.3 % 3.
ElasticSearch 9.1% 4. Amazon DynamoDB 7.8% 5. Mongo DB 4.2% 6. Google Cloud Spanner 3.2% 7. Google Cloud Firestore 2.9% 8. PostgreSQL 2.3% 9. Google Cloud Bigtable 1.9% 10. TiDB 1% -
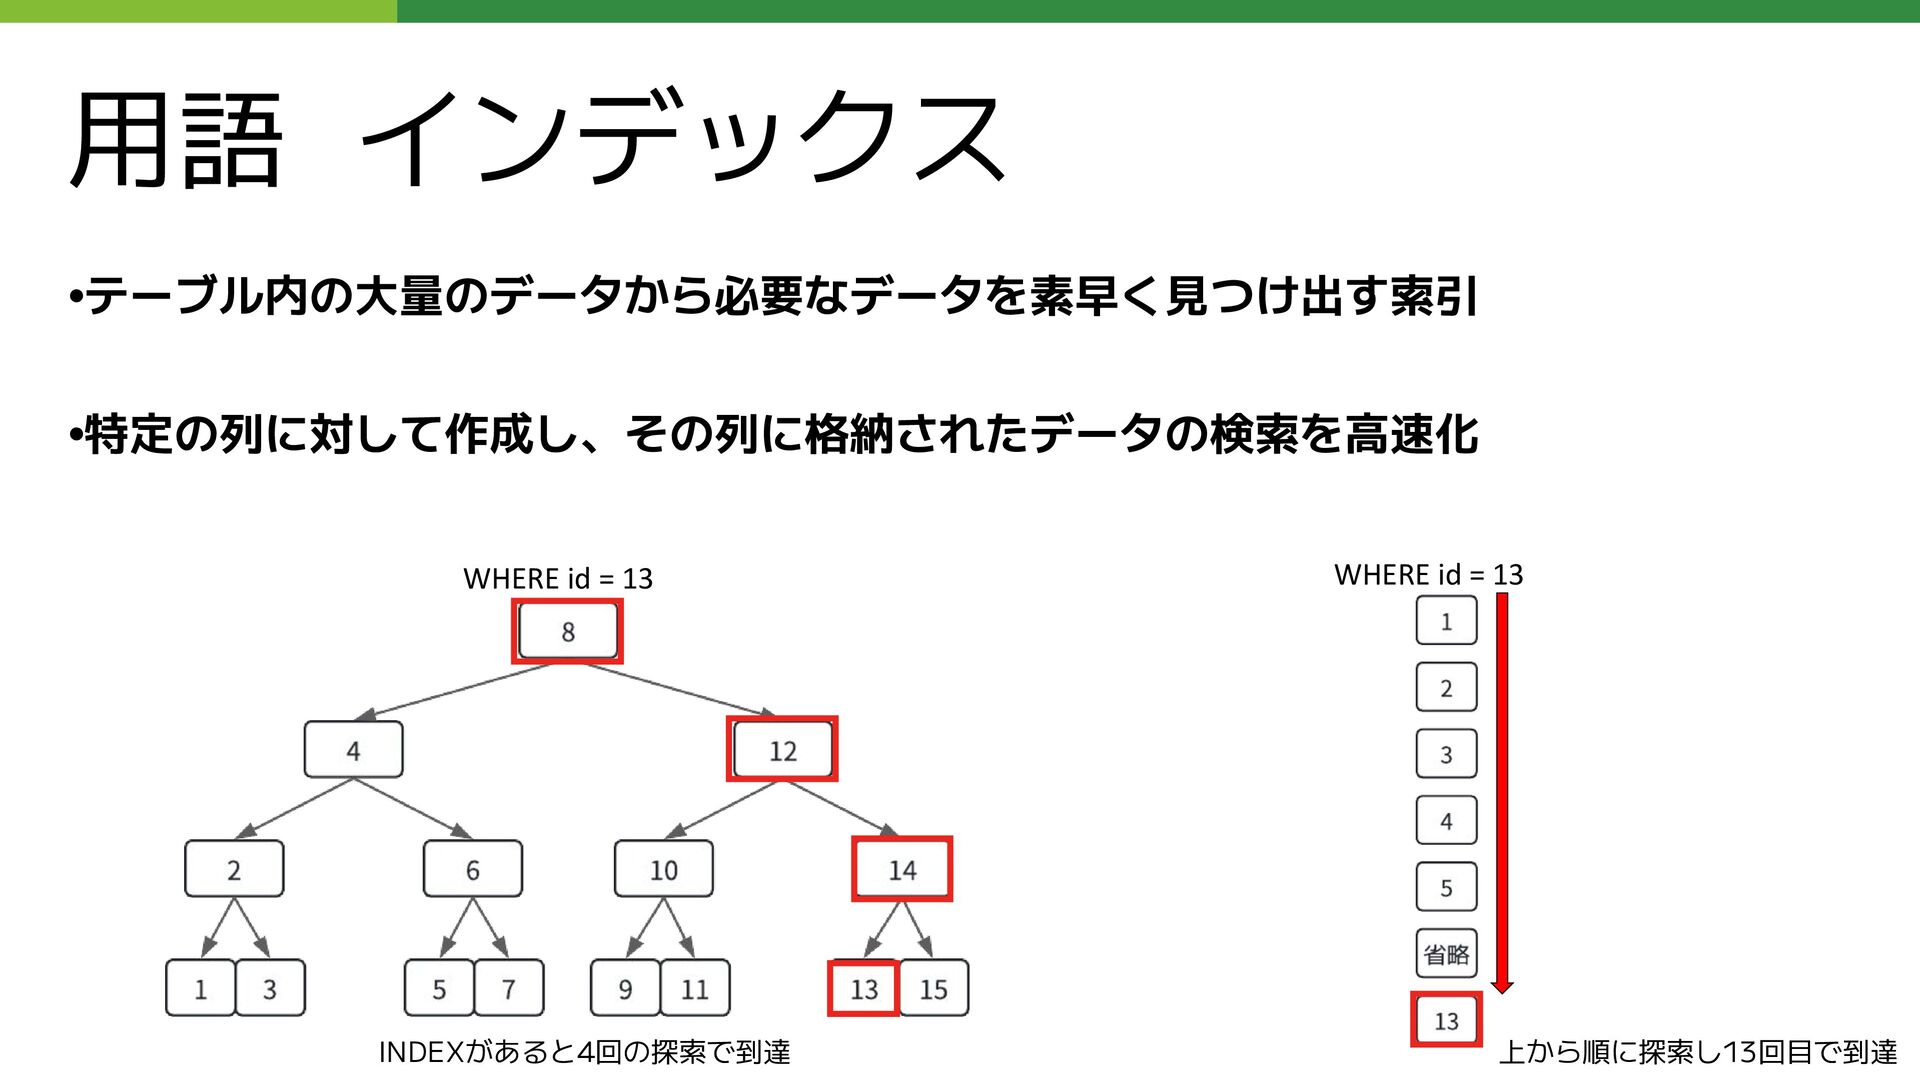
用語 インデックス •テーブル内の大量のデータから必要なデータを素早く見つけ出す索引 •特定の列に対して作成し、その列に格納されたデータの検索を高速化 WHERE id = 13 WHERE id
= 13 INDEXがあると4回の探索で到達 上から順に探索し13回目で到達 -
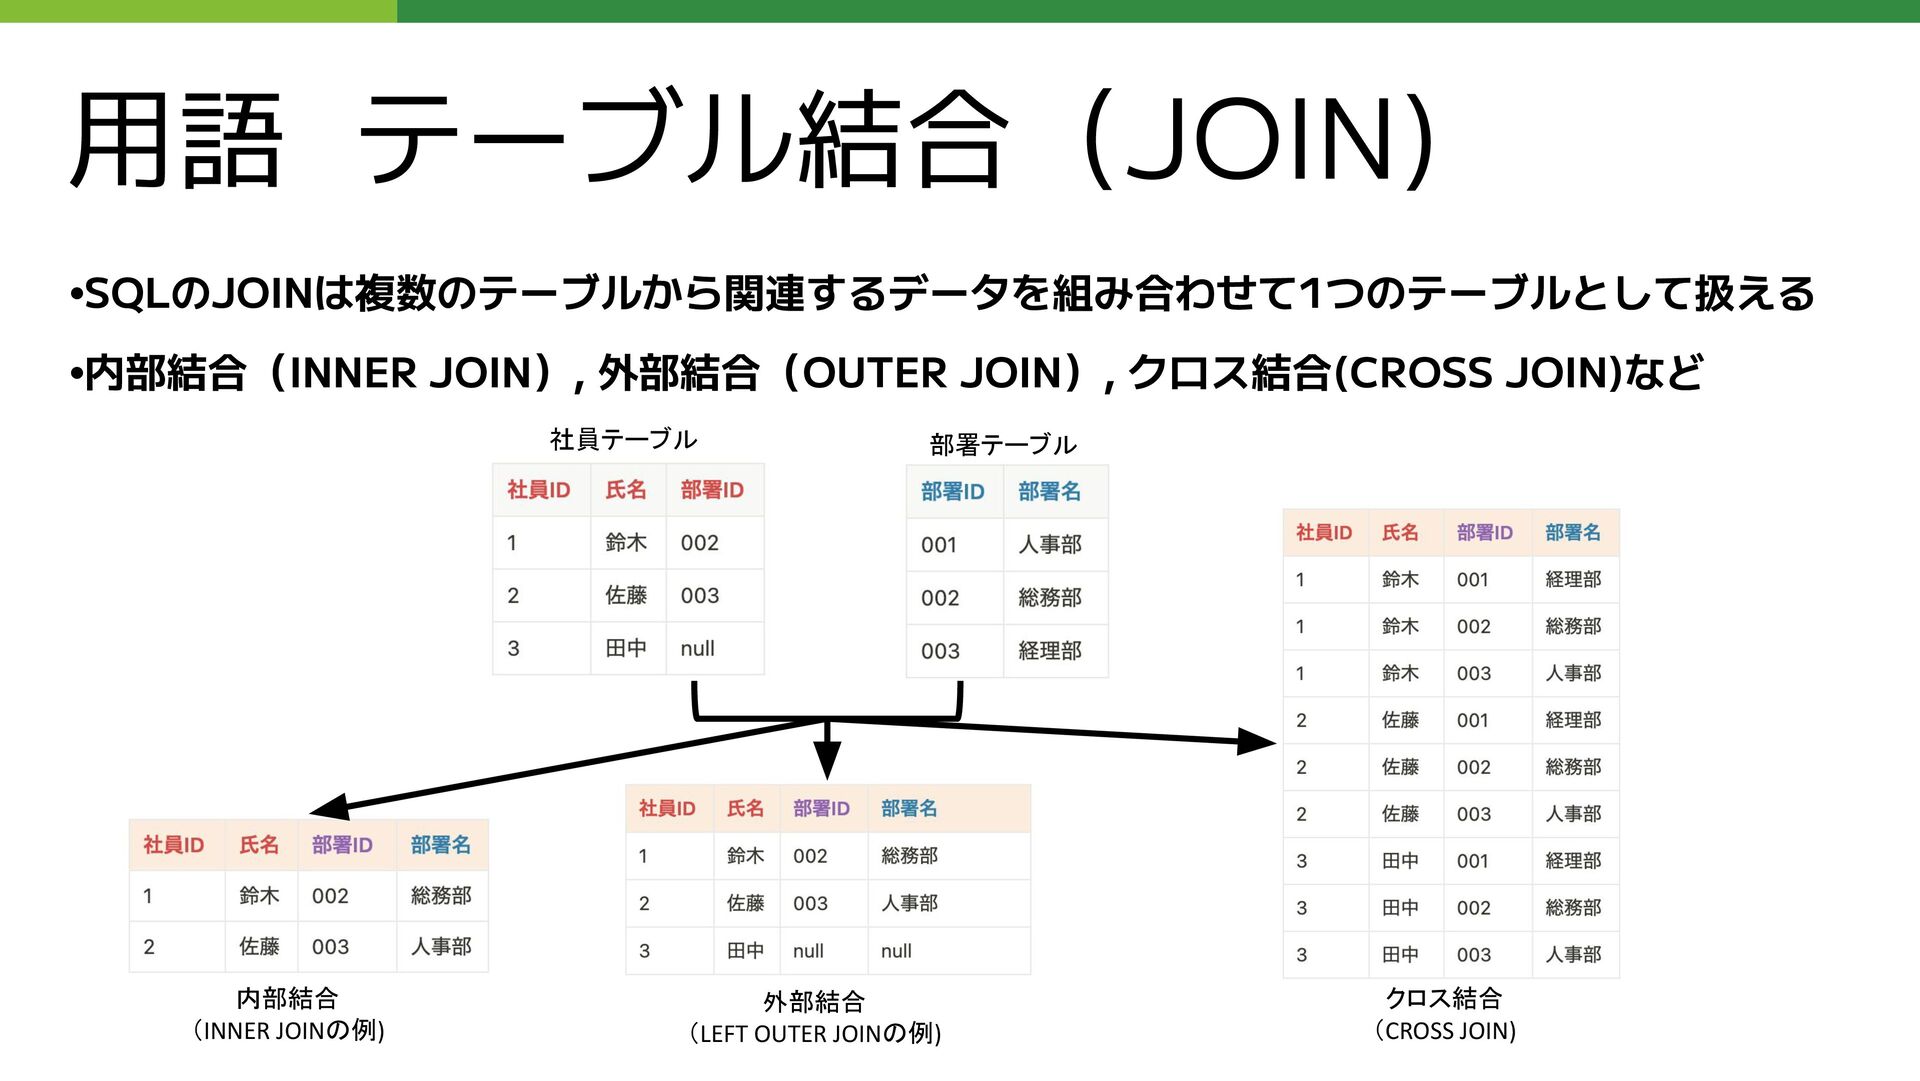
用語 テーブル結合(JOIN) •SQLのJOINは複数のテーブルから関連するデータを組み合わせて1つのテーブルとして扱える •内部結合(INNER JOIN), 外部結合(OUTER JOIN), クロス結合(CROSS JOIN)など 社員テーブル
部署テーブル 内部結合 (INNER JOINの例) 外部結合 (LEFT OUTER JOINの例) クロス結合 (CROSS JOIN) -
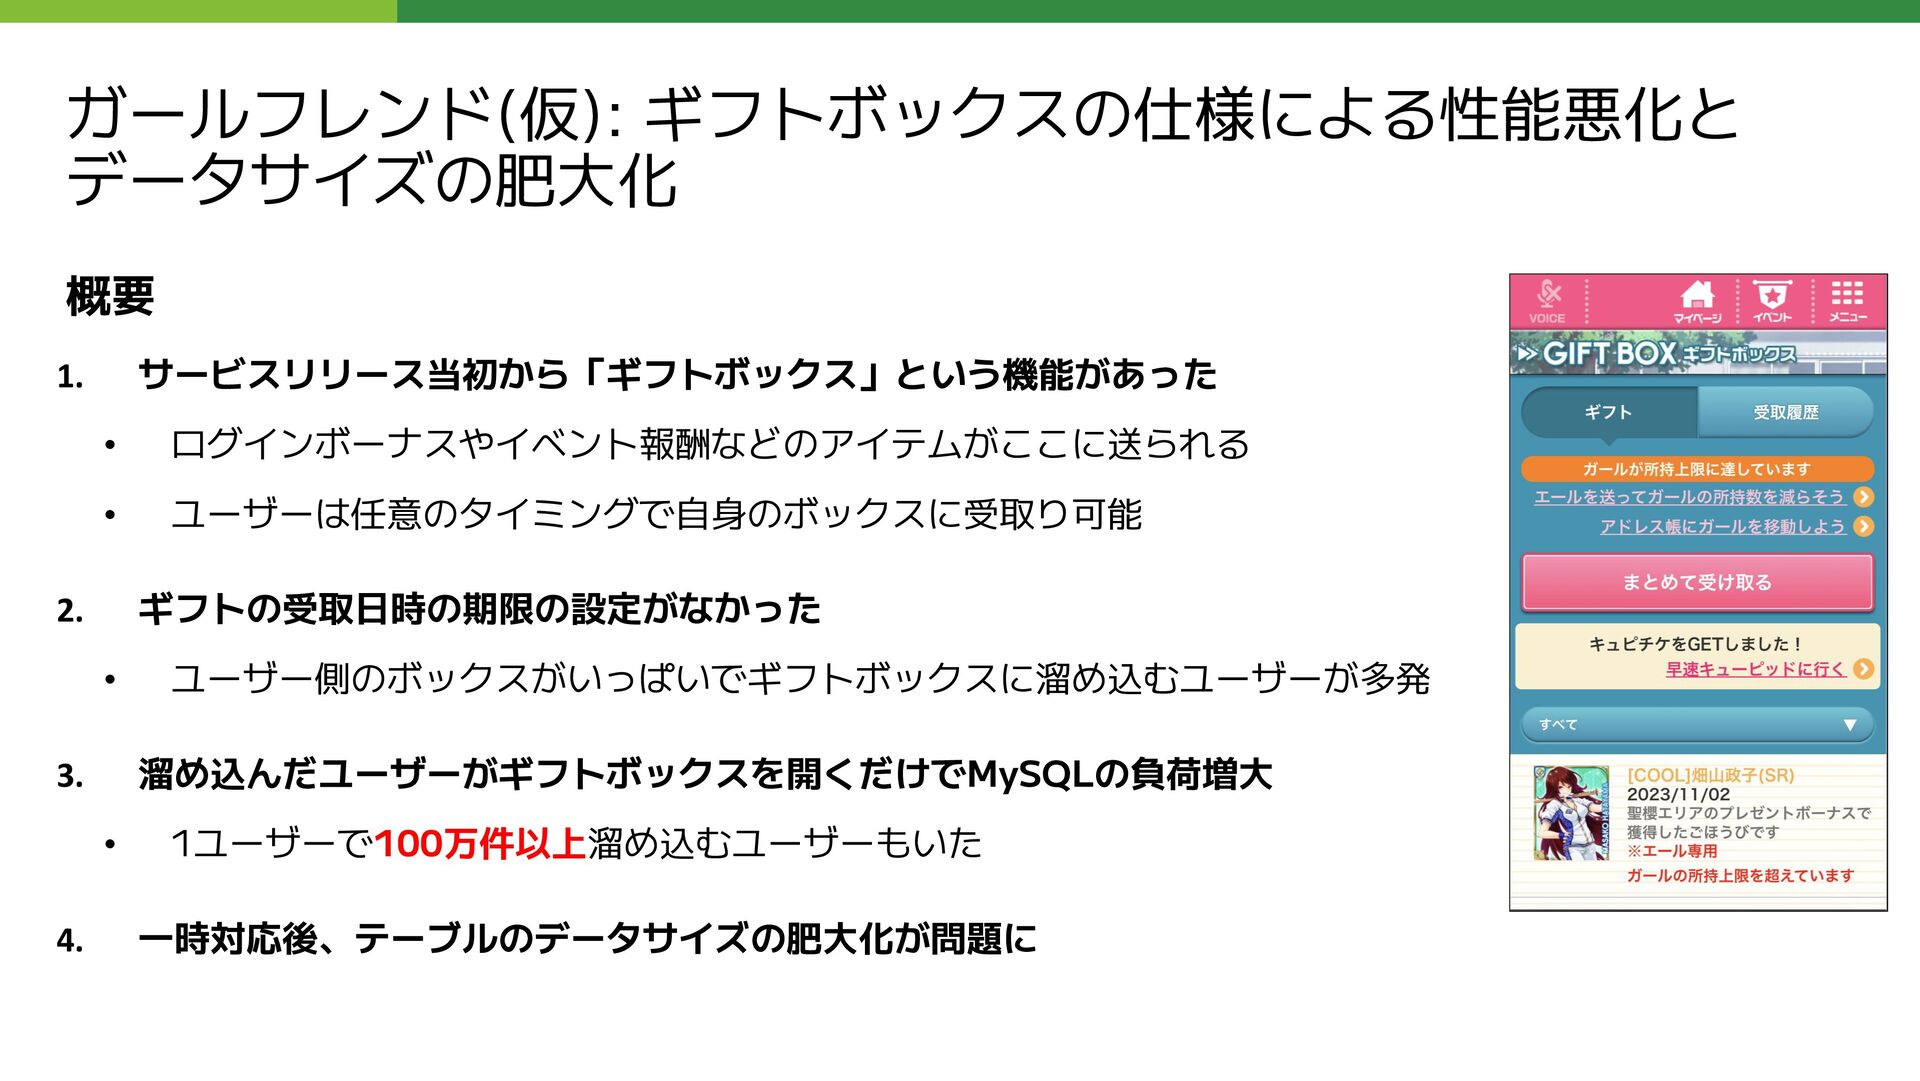
ガールフレンド(仮): ギフトボックスの仕様による性能悪化と データサイズの肥大化 概要 1. サービスリリース当初から「ギフトボックス」という機能があった • ログインボーナスやイベント報酬などのアイテムがここに送られる • ユーザーは任意のタイミングで自身のボックスに受取り可能
2. ギフトの受取日時の期限の設定がなかった • ユーザー側のボックスがいっぱいでギフトボックスに溜め込むユーザーが多発 3. 溜め込んだユーザーがギフトボックスを開くだけでMySQLの負荷増大 • 1ユーザーで100万件以上溜め込むユーザーもいた 4. 一時対応後、テーブルのデータサイズの肥大化が問題に -
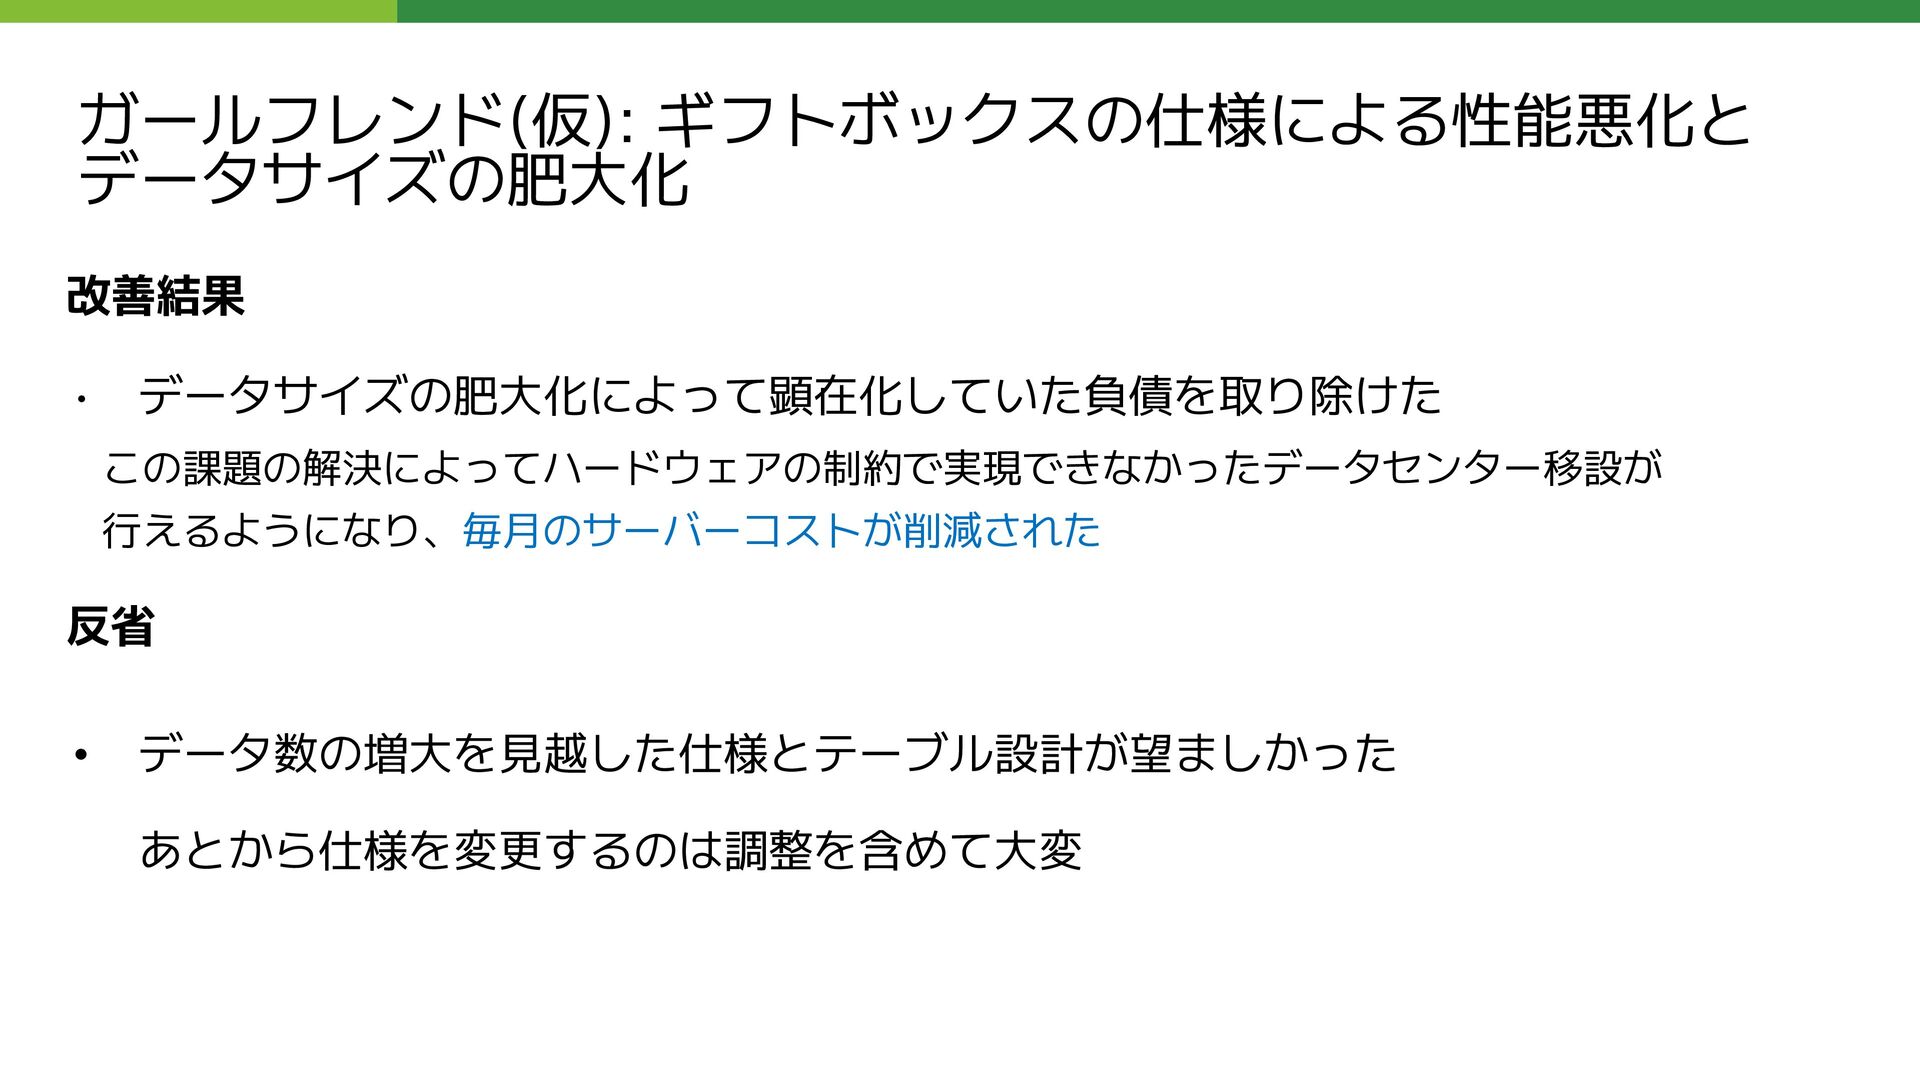
根本対応 1. ギフトボックスの仕様変更によるレコード件数の大幅削減 ギフトボックスの一部アイテムをポイント(数値)に変換する仕様を追加 1アイテム = 1レコードだったので集約できる ユーザーの不利にならないような一定ルールで一括変換 2. 複合インデックスの削除
レコード件数が減ったことで複合インデックスを削除しても影響が出なくなった レコード件数削減と複合インデックス削除によりテーブルのデータサイズは半減した ガールフレンド(仮): ギフトボックスの仕様による性能悪化と データサイズの肥大化 -
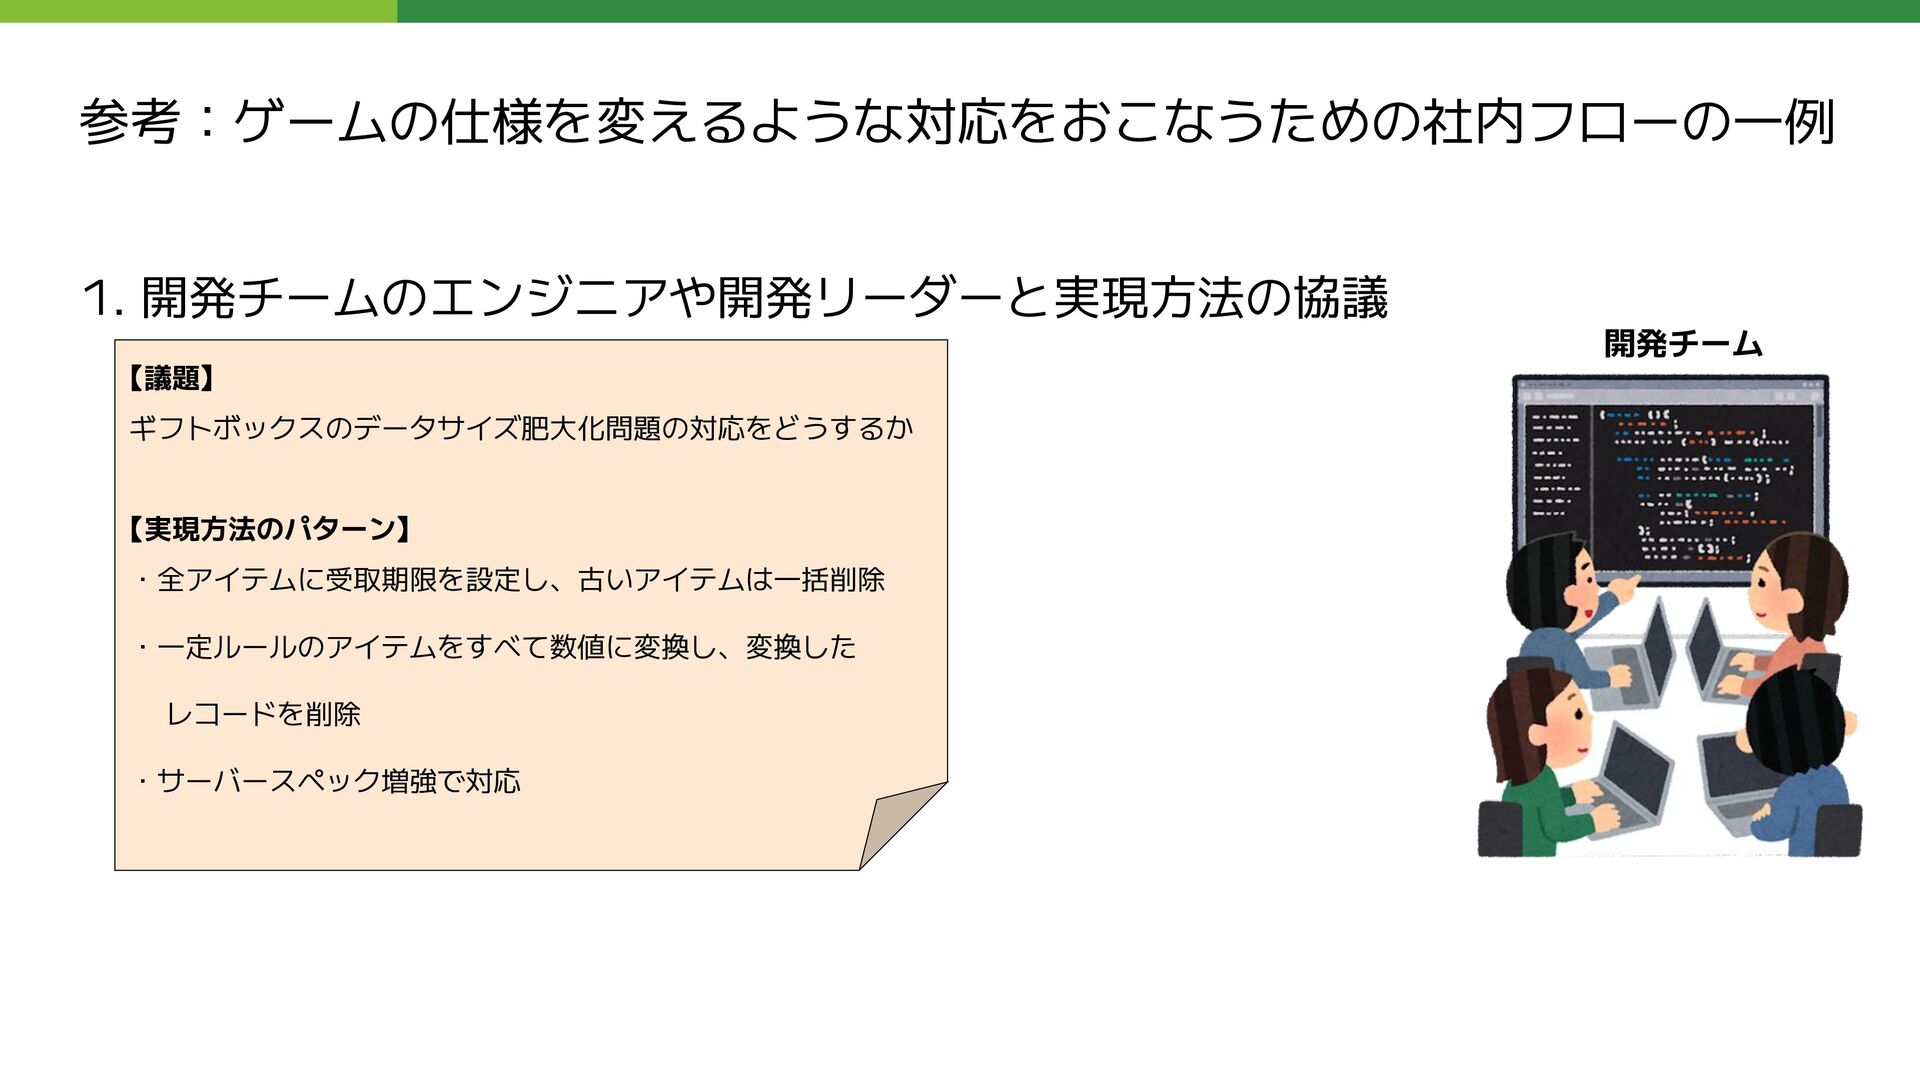
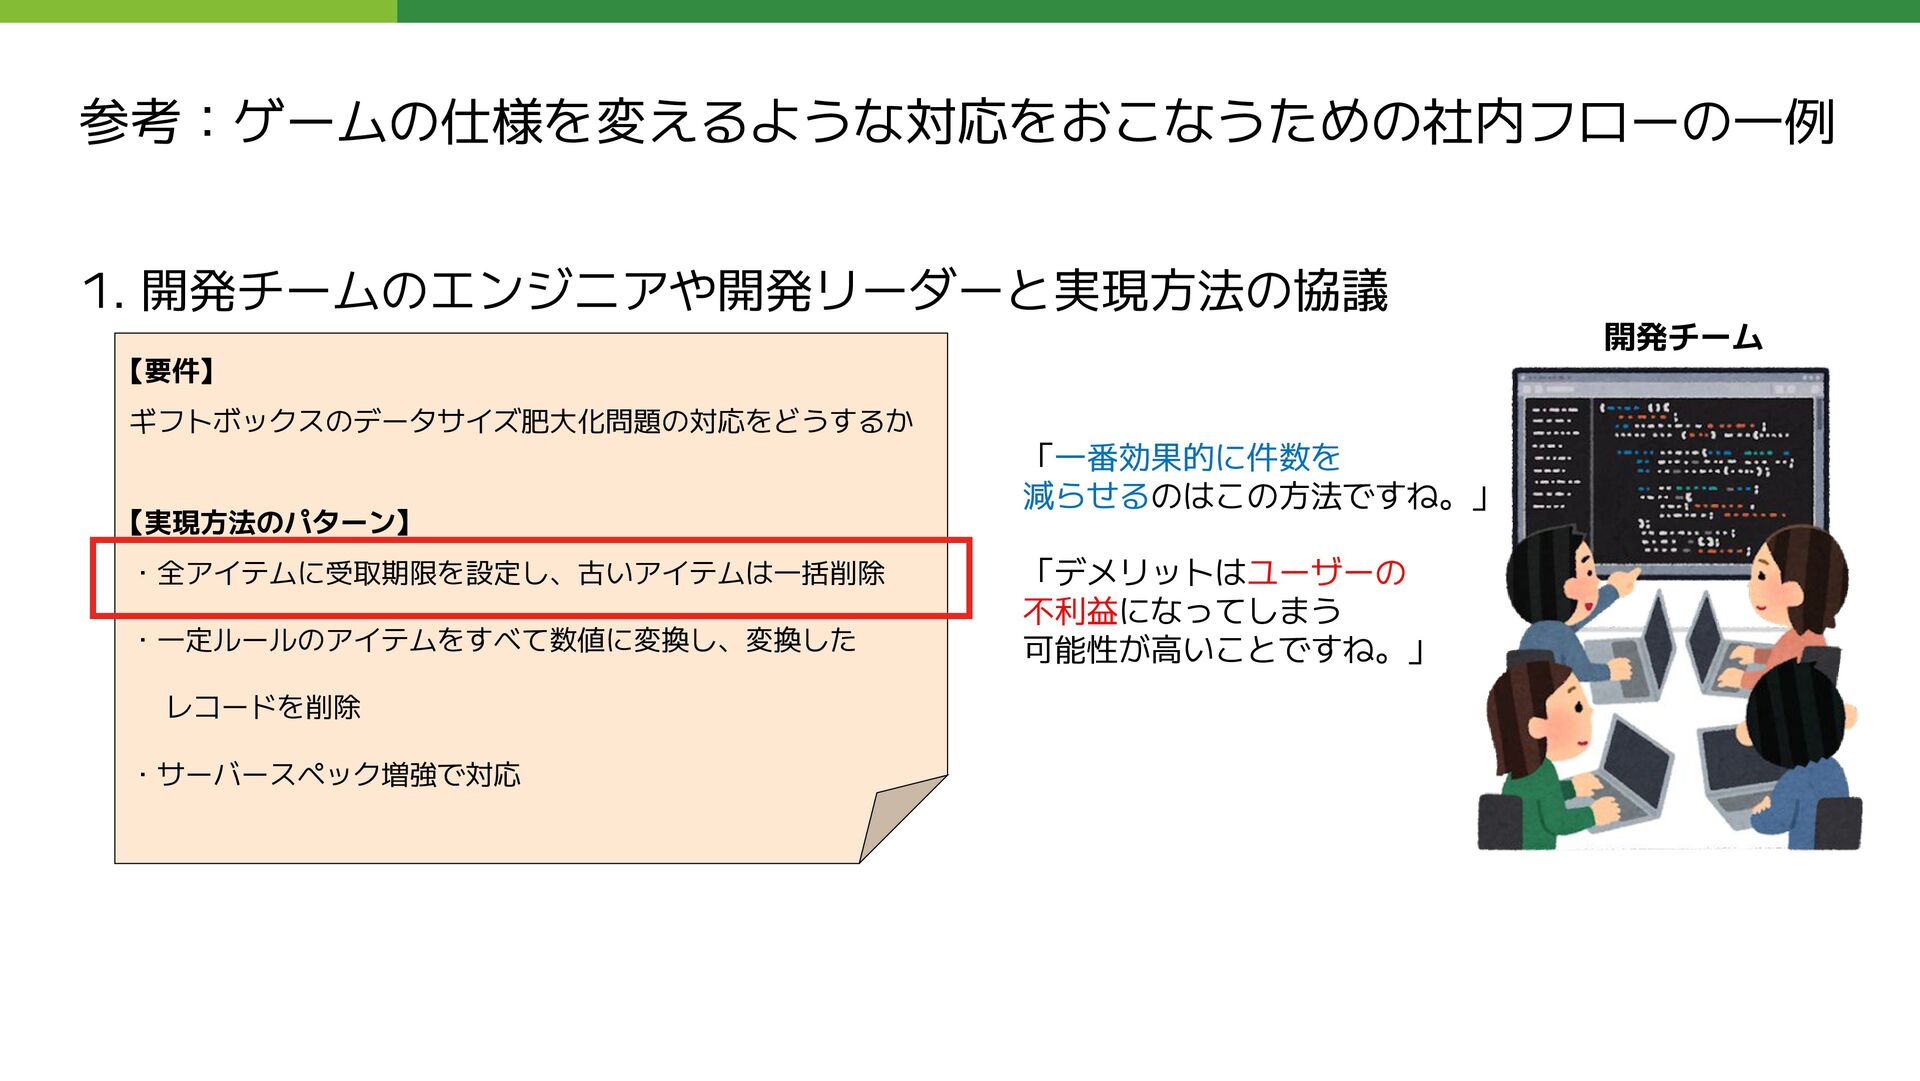
【要件】 ギフトボックスのデータサイズ肥大化問題の対応をどうするか 【実現方法のパターン】 ・全アイテムに受取期限を設定し、古いアイテムは一括削除 ・一定ルールのアイテムをすべて数値に変換し、変換した レコードを削除 ・サーバースペック増強で対応 1. 開発チームのエンジニアや開発リーダーと実現方法の協議 「一番効果的に件数を
減らせるのはこの方法ですね。」 「デメリットはユーザーの 不利益になってしまう 可能性が高いことですね。」 開発チーム 参考:ゲームの仕様を変えるような対応をおこなうための社内フローの一例 -
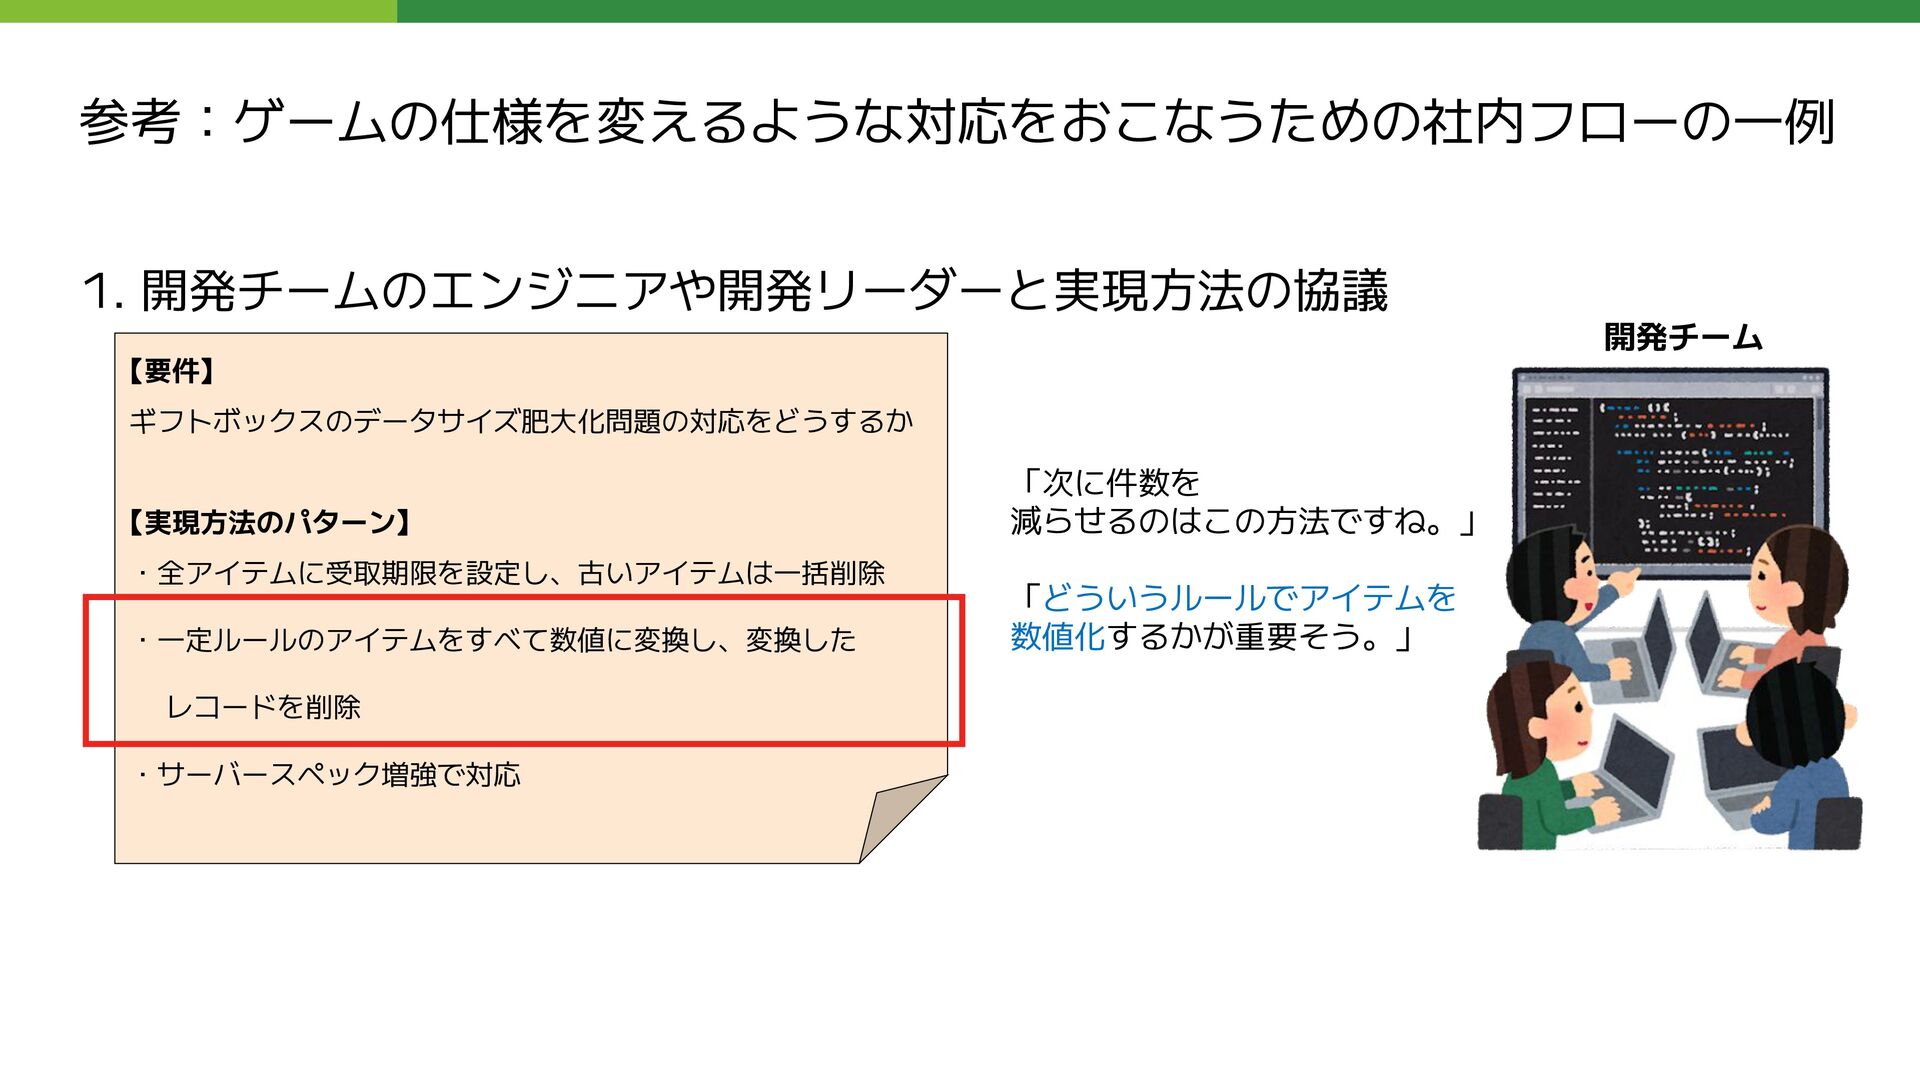
【要件】 ギフトボックスのデータサイズ肥大化問題の対応をどうするか 【実現方法のパターン】 ・全アイテムに受取期限を設定し、古いアイテムは一括削除 ・一定ルールのアイテムをすべて数値に変換し、変換した レコードを削除 ・サーバースペック増強で対応 1. 開発チームのエンジニアや開発リーダーと実現方法の協議 開発チーム
参考:ゲームの仕様を変えるような対応をおこなうための社内フローの一例 「次に件数を 減らせるのはこの方法ですね。」 「どういうルールでアイテムを 数値化するかが重要そう。」 -
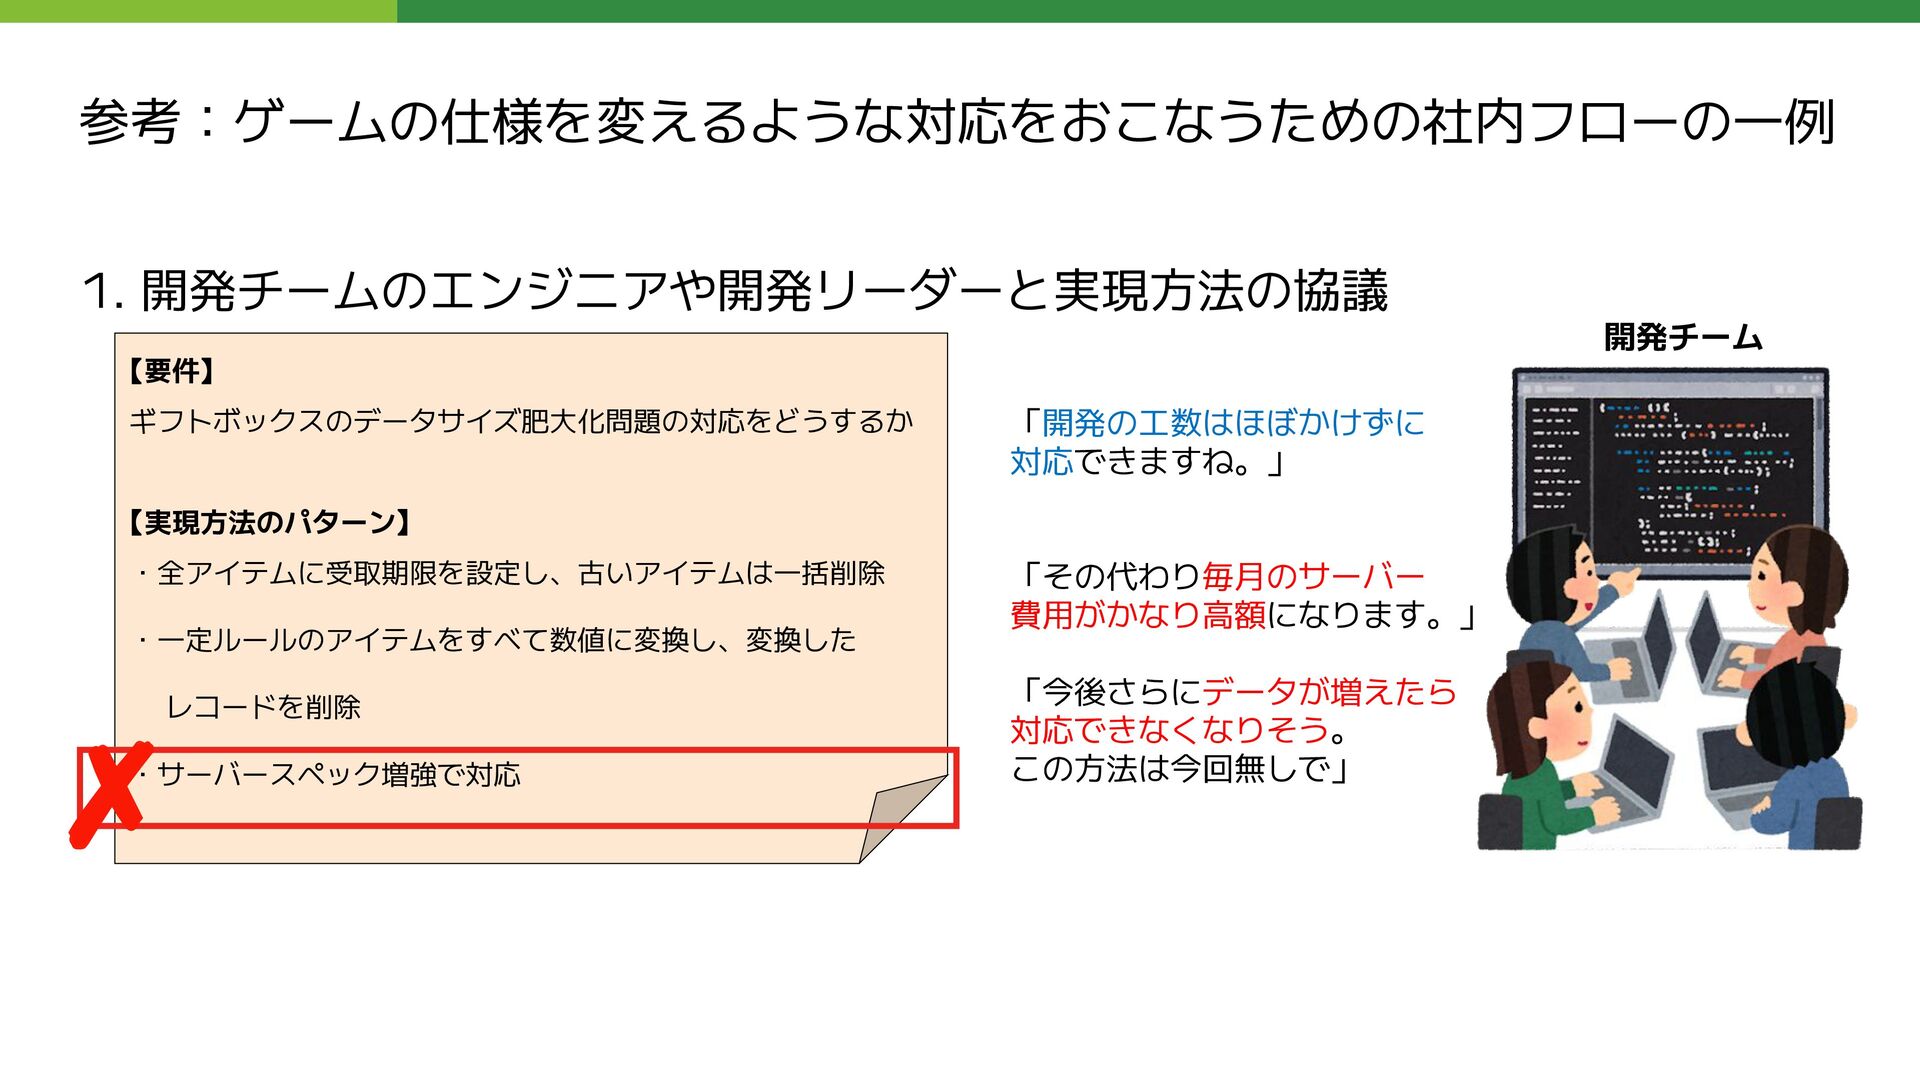
【要件】 ギフトボックスのデータサイズ肥大化問題の対応をどうするか 【実現方法のパターン】 ・全アイテムに受取期限を設定し、古いアイテムは一括削除 ・一定ルールのアイテムをすべて数値に変換し、変換した レコードを削除 ・サーバースペック増強で対応 1. 開発チームのエンジニアや開発リーダーと実現方法の協議 開発チーム
参考:ゲームの仕様を変えるような対応をおこなうための社内フローの一例 「開発の工数はほぼかけずに 対応できますね。」 「その代わり毎月のサーバー 費用がかなり高額になります。」 「今後さらにデータが増えたら 対応できなくなりそう。 この方法は今回無しで」 ✗ -
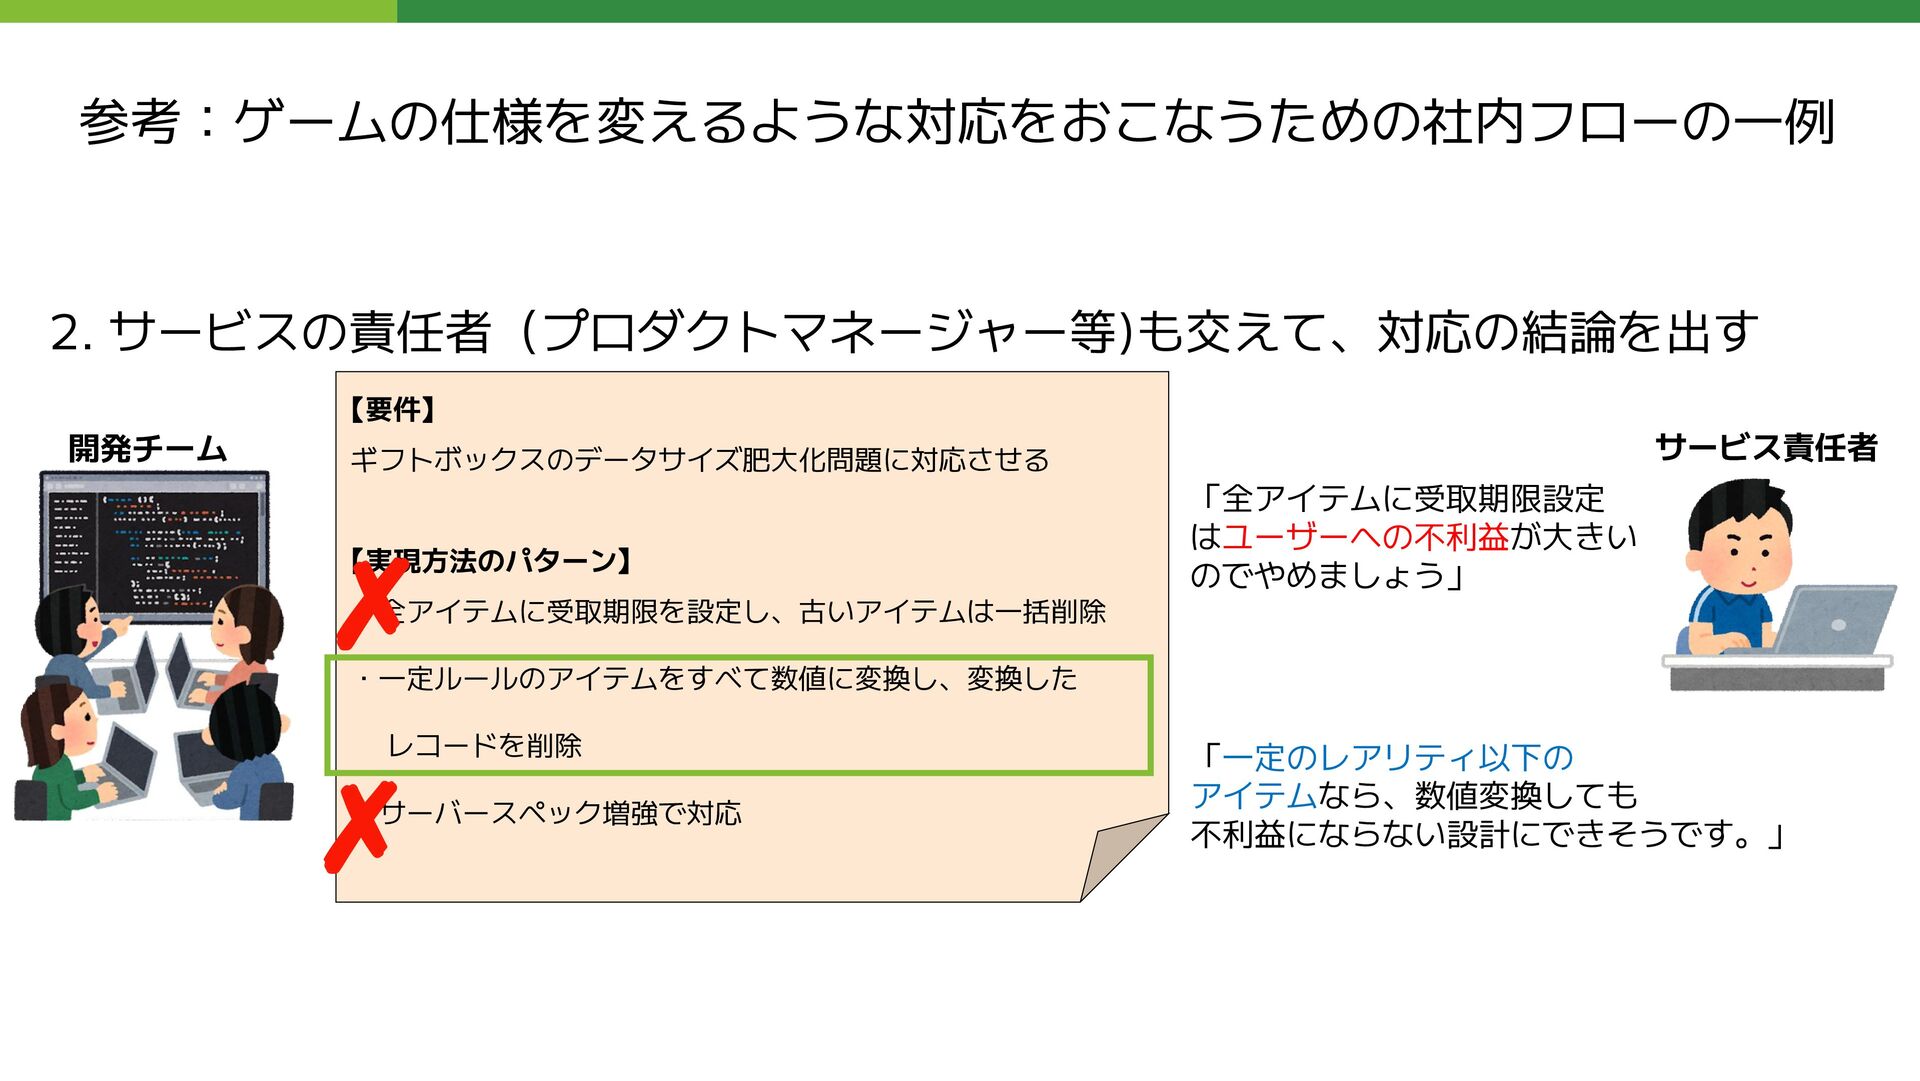
【要件】 ギフトボックスのデータサイズ肥大化問題に対応させる 【実現方法のパターン】 ・全アイテムに受取期限を設定し、古いアイテムは一括削除 ・一定ルールのアイテムをすべて数値に変換し、変換した レコードを削除 ・サーバースペック増強で対応 2. サービスの責任者(プロダクトマネージャー等)も交えて、対応の結論を出す サービス責任者
開発チーム 「全アイテムに受取期限設定 はユーザーへの不利益が大きい のでやめましょう」 「一定のレアリティ以下の アイテムなら、数値変換しても 不利益にならない設計にできそうです。」 参考:ゲームの仕様を変えるような対応をおこなうための社内フローの一例 ✗ ✗ -
Amebaブログ: コメント返信通知機能追加による性能悪化 概要 1. Amebaブログのコメント機能は昔からある機能だが、後から返信機能が実装された • 返信機能では元のコメント用テーブルではなく、他の複数テーブルと情報を組み合わせて 作成した仮想テーブルを参照するように改修されていた。 2. 数年後、コメント返信時に通知する機能を追加実装
• 先ほどの仮想テーブルを参照するようにして機能を追加実装した 3. 機能リリース後、APIサーバーの応答速度が悪化 • 一部ユーザーへの応答速度が極端に悪化していることが判明 -
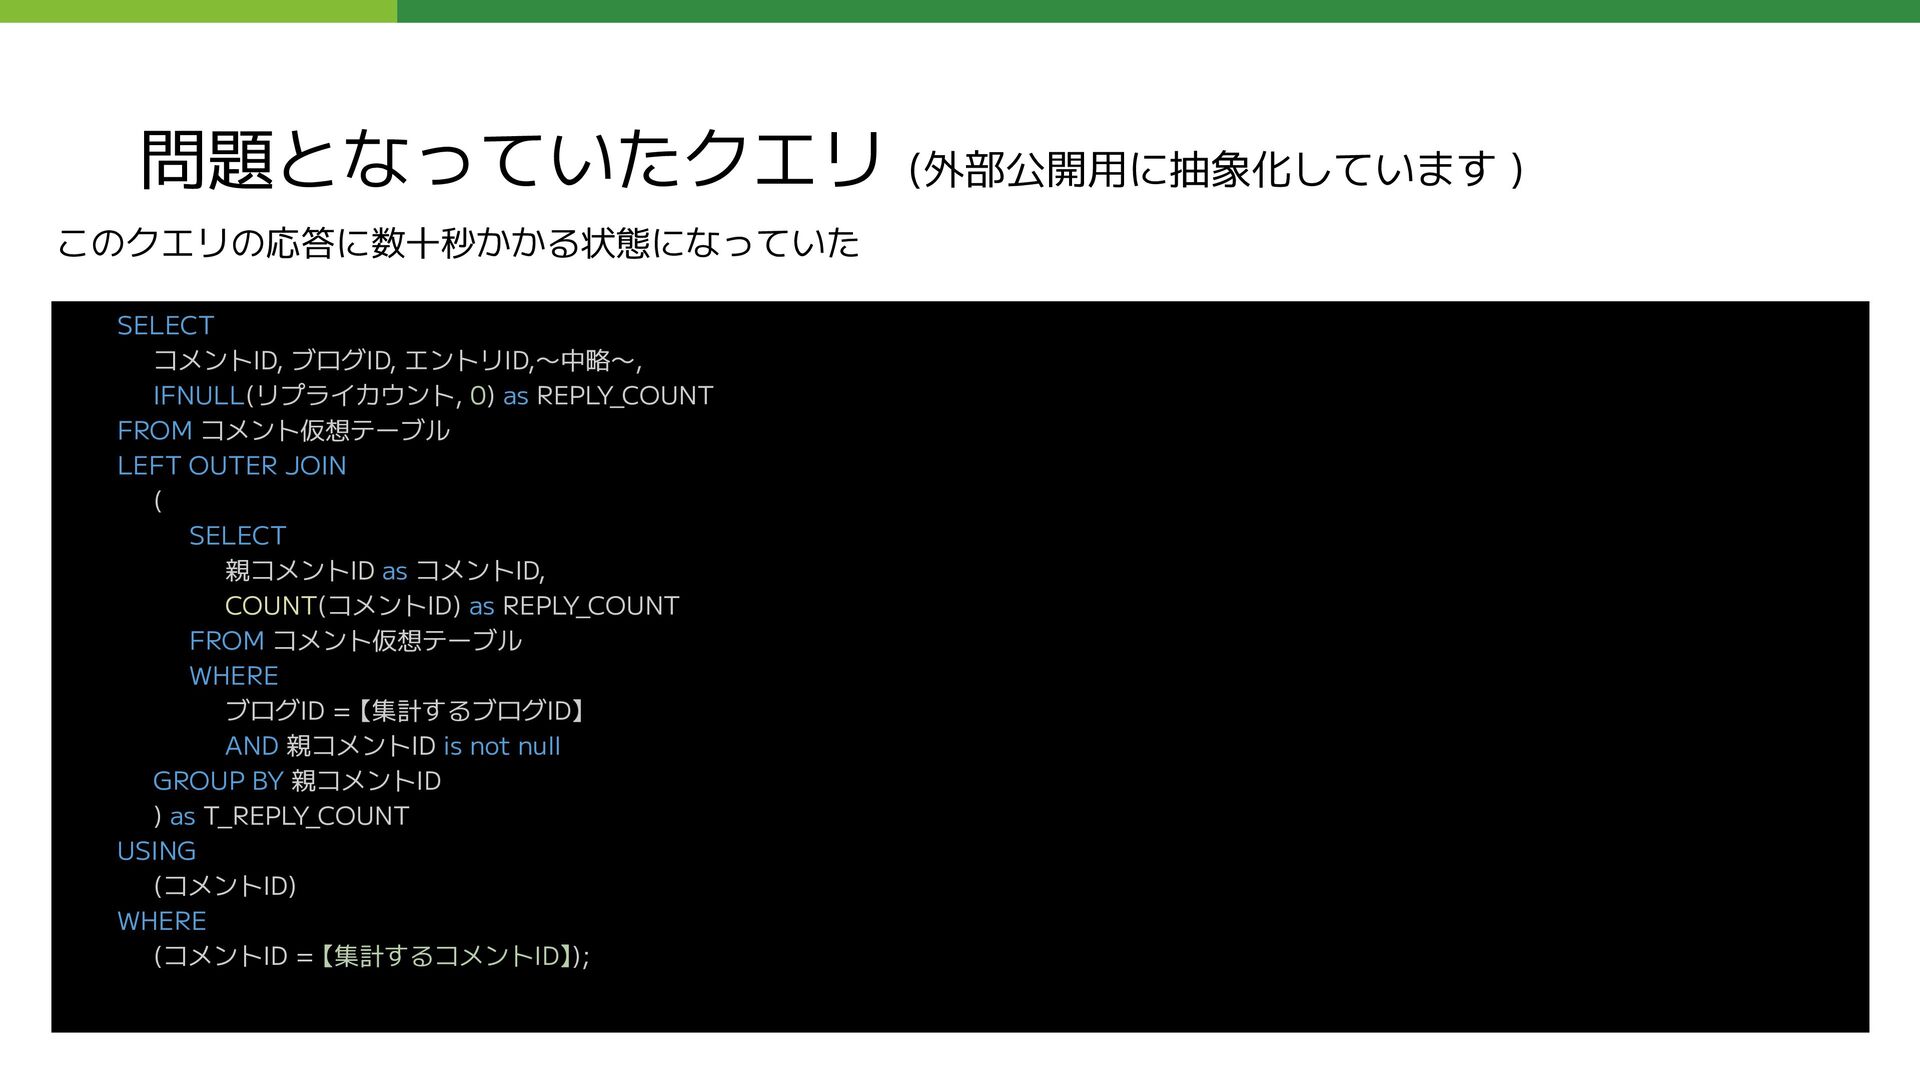
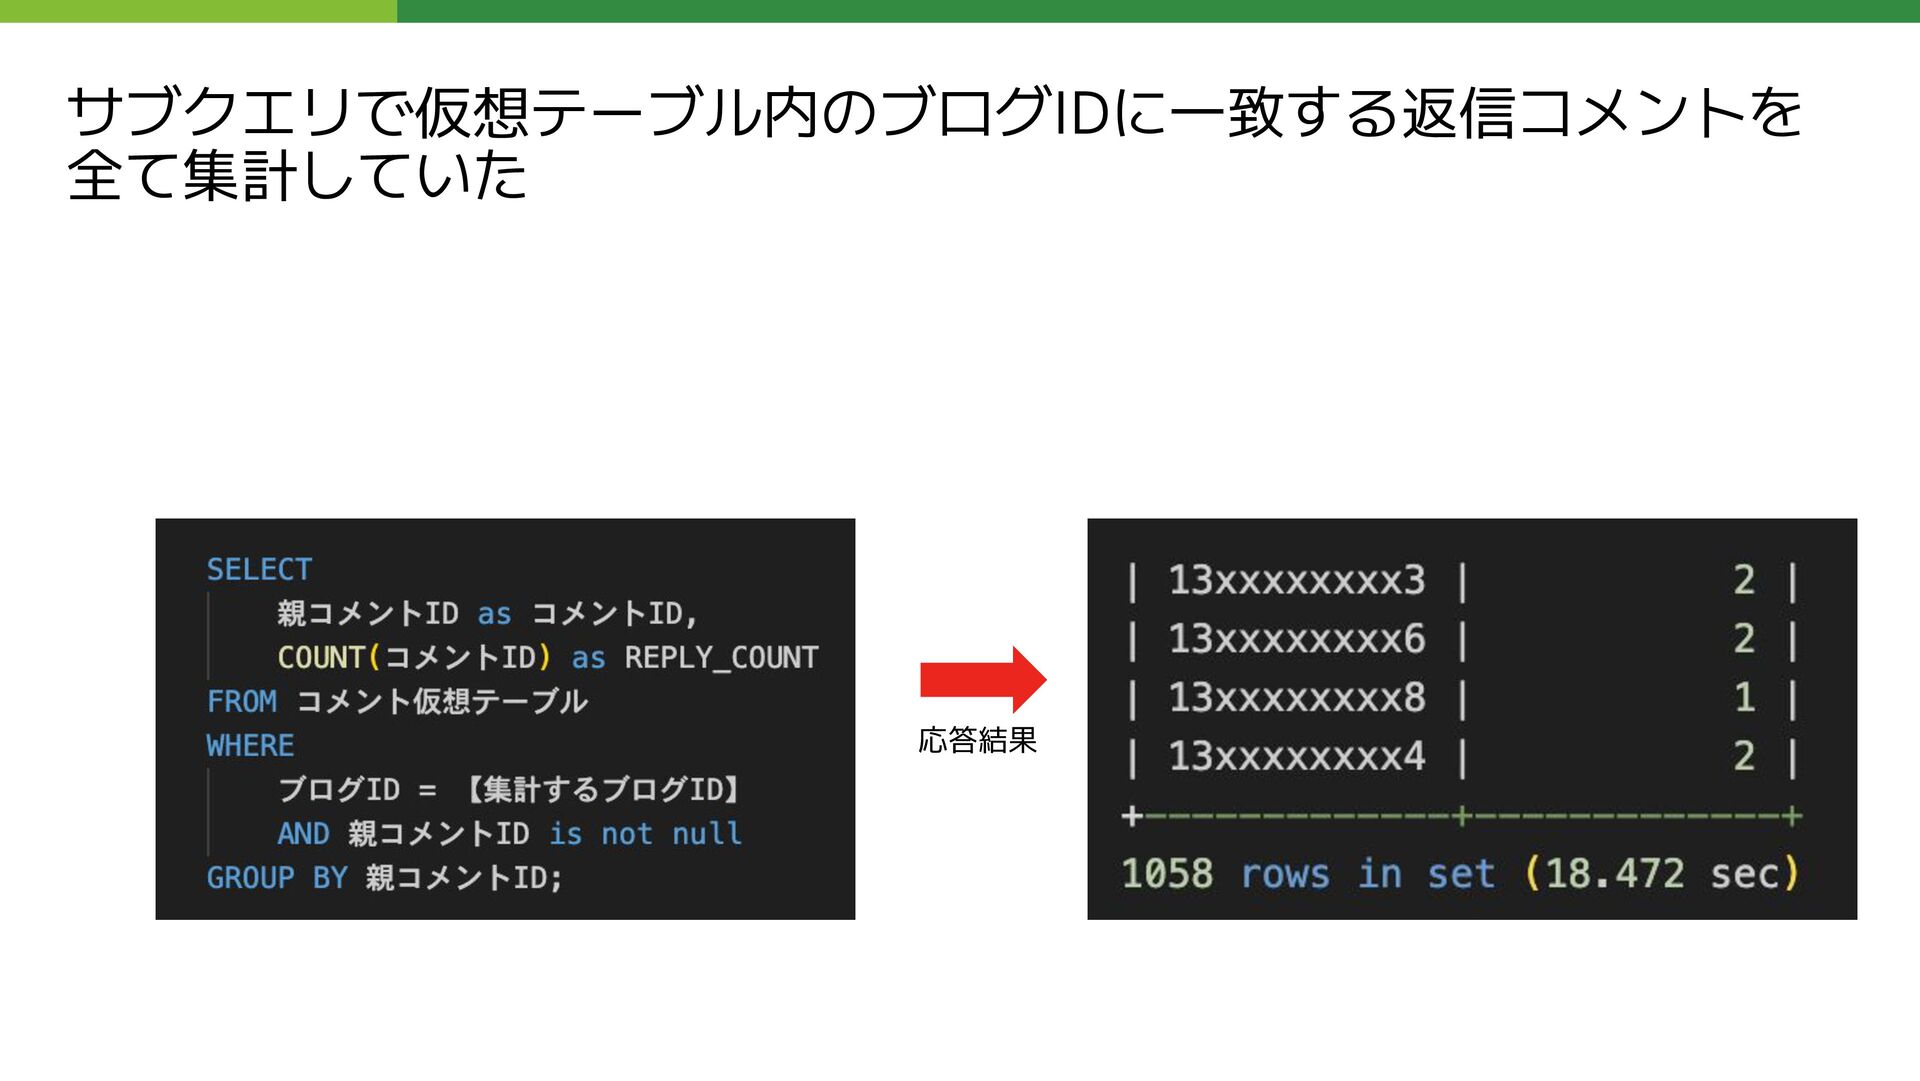
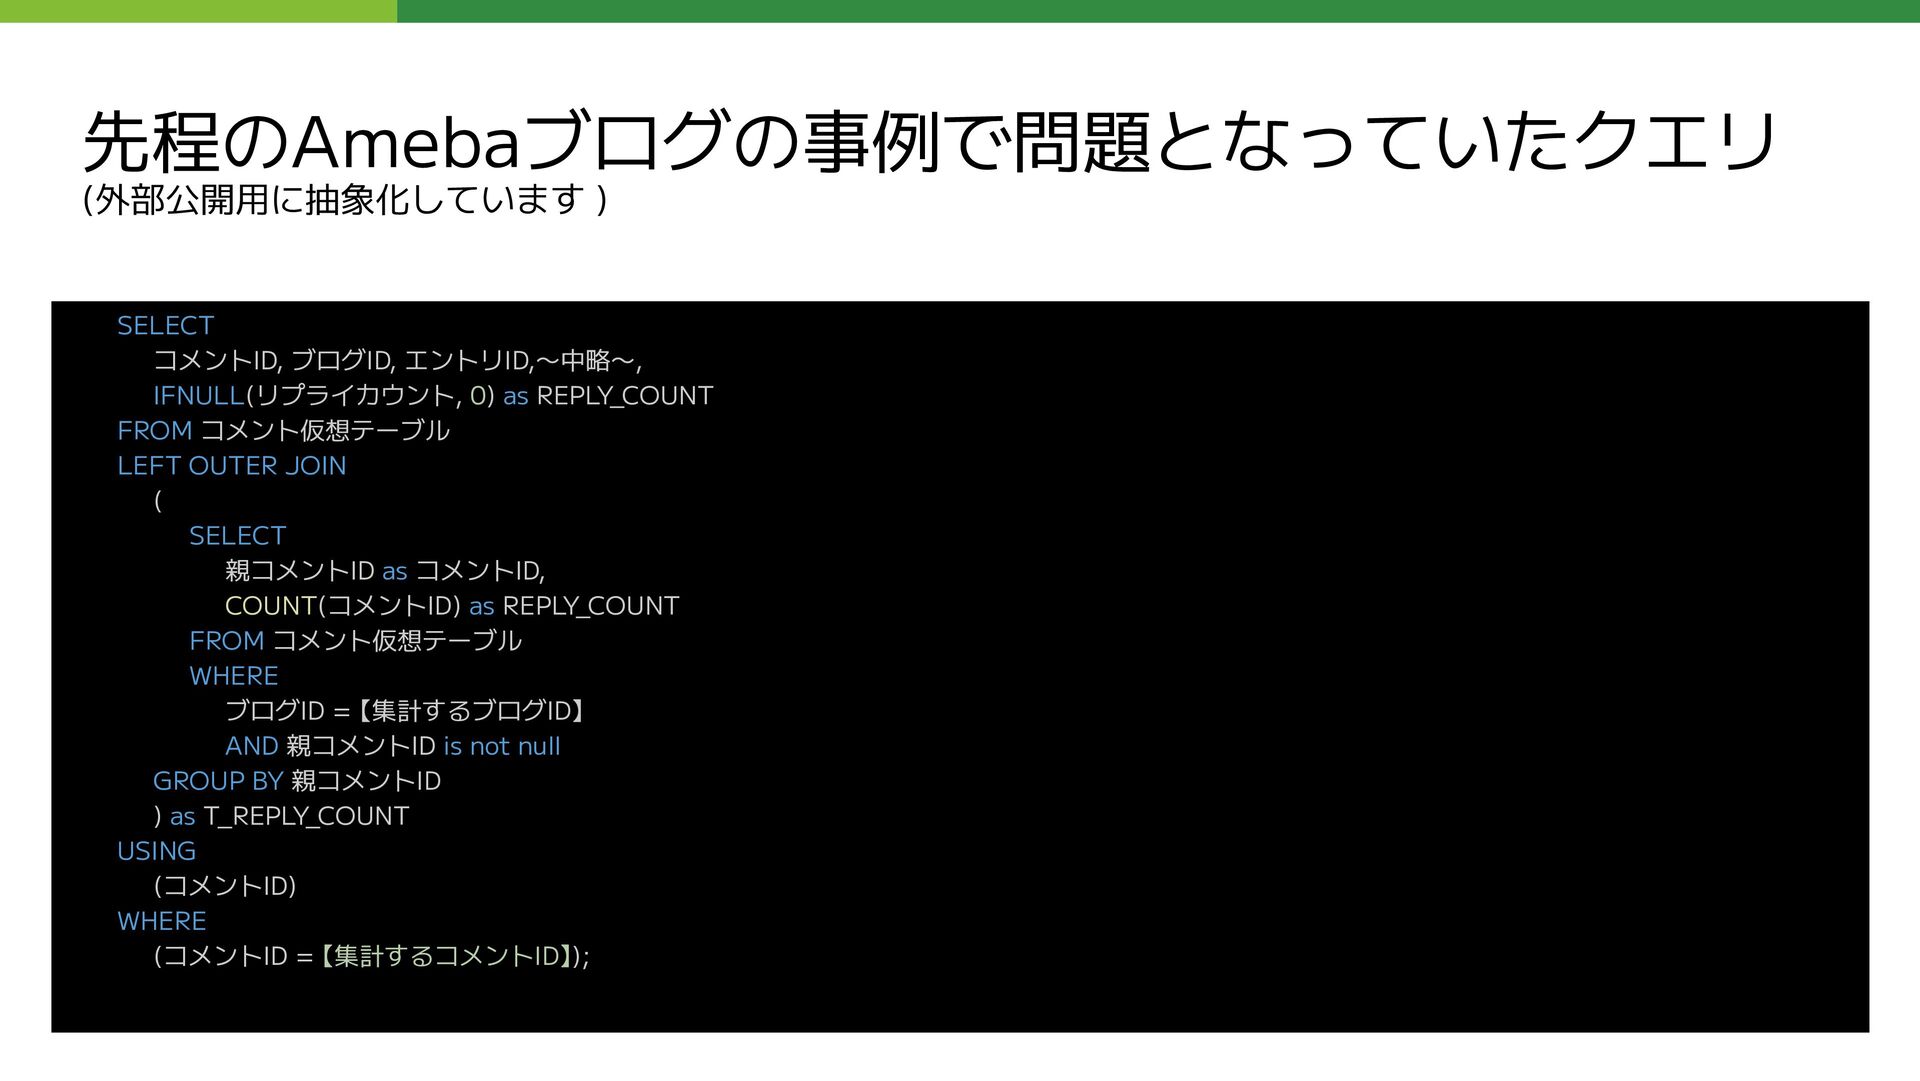
問題となっていたクエリ (外部公開用に抽象化しています ) SELECT コメントID, ブログID, エントリID,〜中略〜, IFNULL(リプライカウント, 0) as
REPLY_COUNT FROM コメント仮想テーブル LEFT OUTER JOIN ( SELECT 親コメントID as コメントID, COUNT(コメントID) as REPLY_COUNT FROM コメント仮想テーブル WHERE ブログID = 【集計するブログID】 AND 親コメントID is not null GROUP BY 親コメントID ) as T_REPLY_COUNT USING (コメントID) WHERE (コメントID = 【集計するコメントID】); このクエリの応答に数十秒かかる状態になっていた -
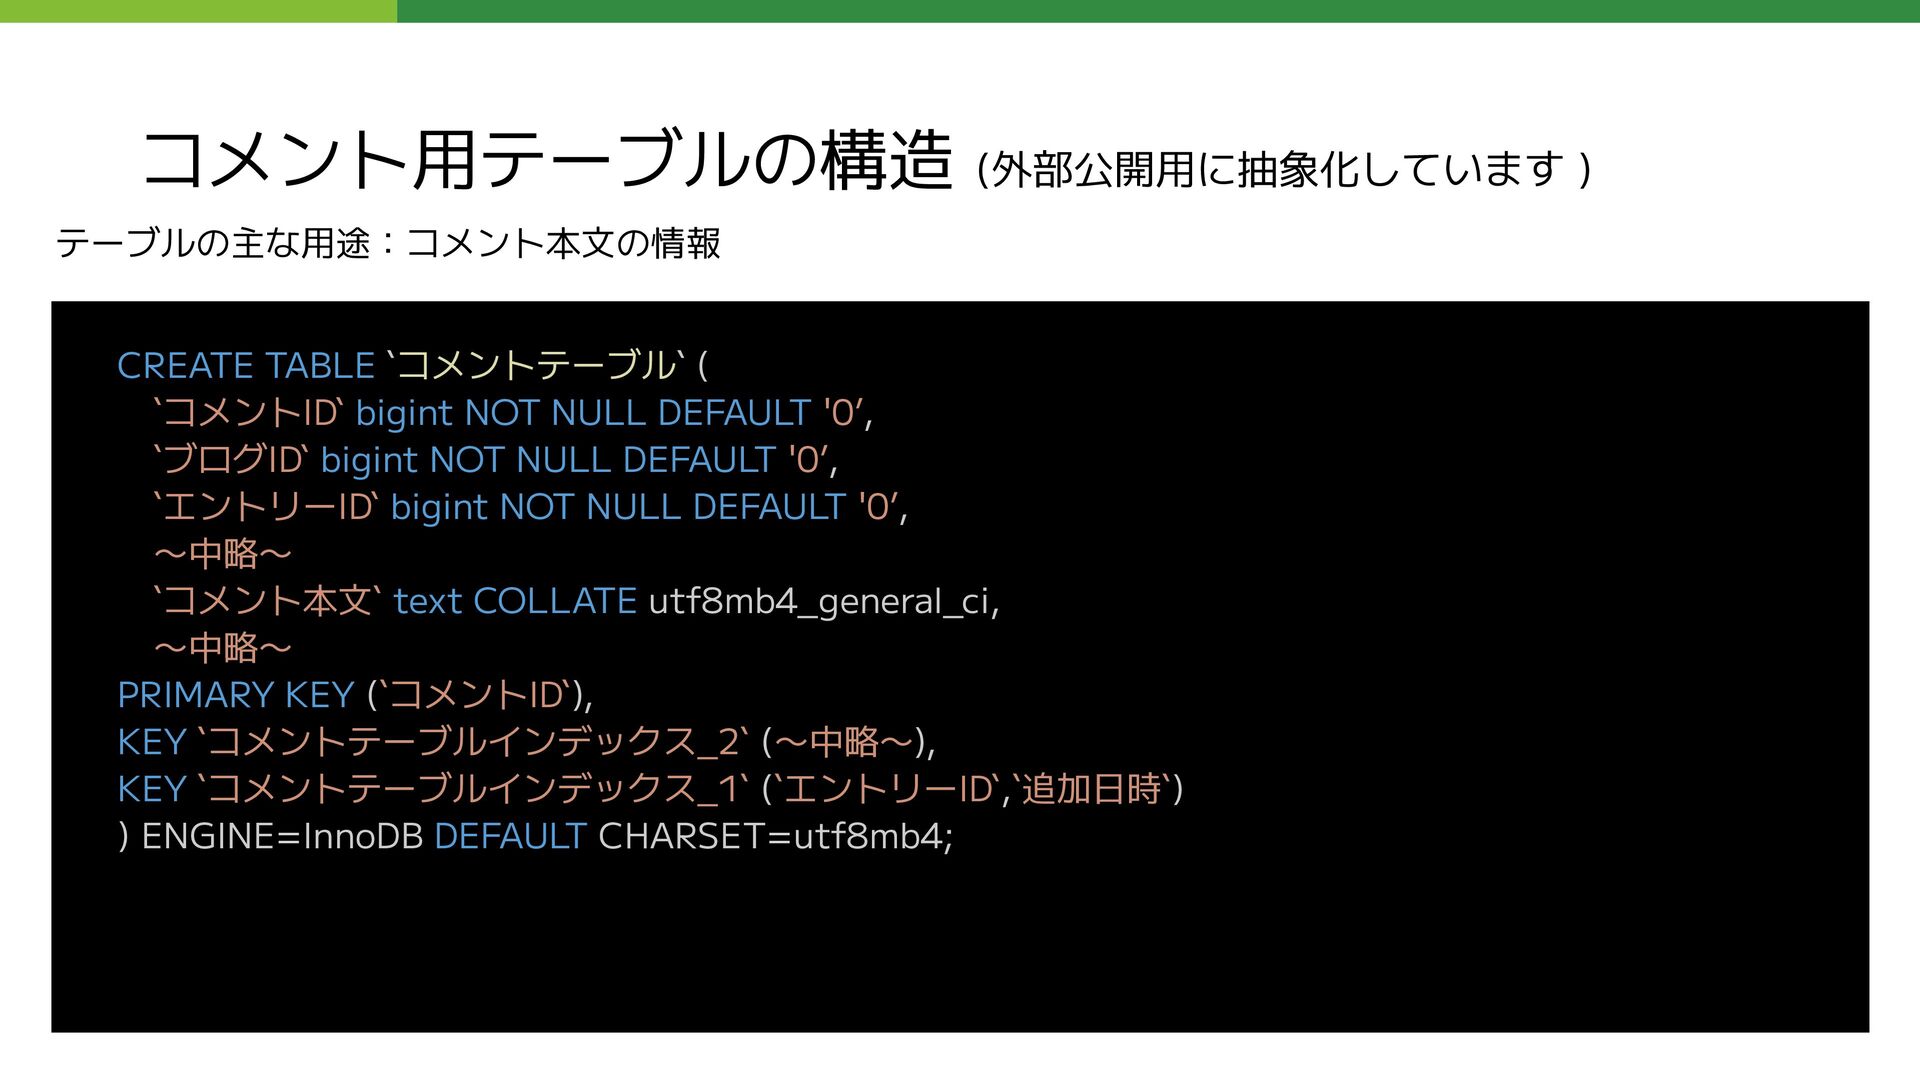
コメント用テーブルの構造 (外部公開用に抽象化しています ) CREATE TABLE `コメントテーブル` ( `コメントID` bigint NOT
NULL DEFAULT '0’, `ブログID` bigint NOT NULL DEFAULT '0’, `エントリーID` bigint NOT NULL DEFAULT '0’, 〜中略〜 `コメント本文` text COLLATE utf8mb4_general_ci, 〜中略〜 PRIMARY KEY (`コメントID`), KEY `コメントテーブルインデックス_2` (〜中略〜), KEY `コメントテーブルインデックス_1` (`エントリーID`,`追加日時`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4; テーブルの主な用途:コメント本文の情報 -
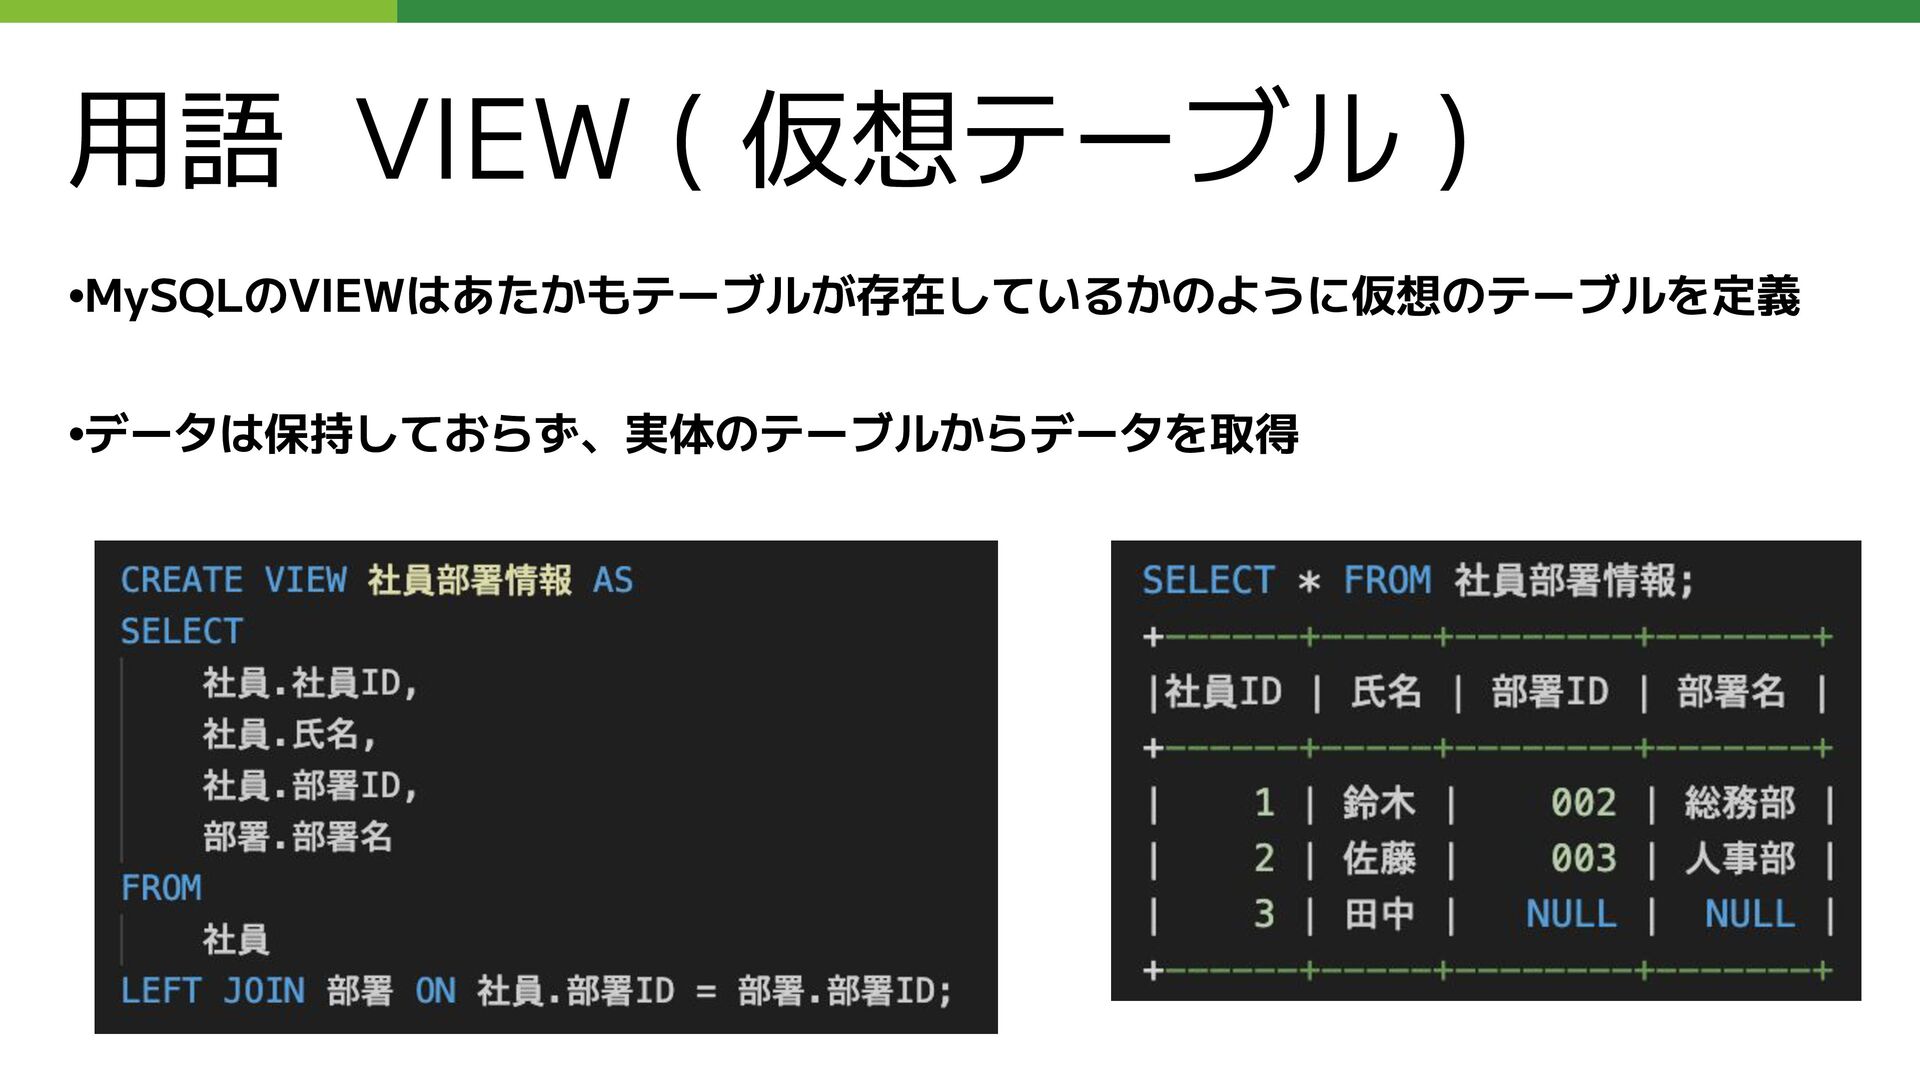
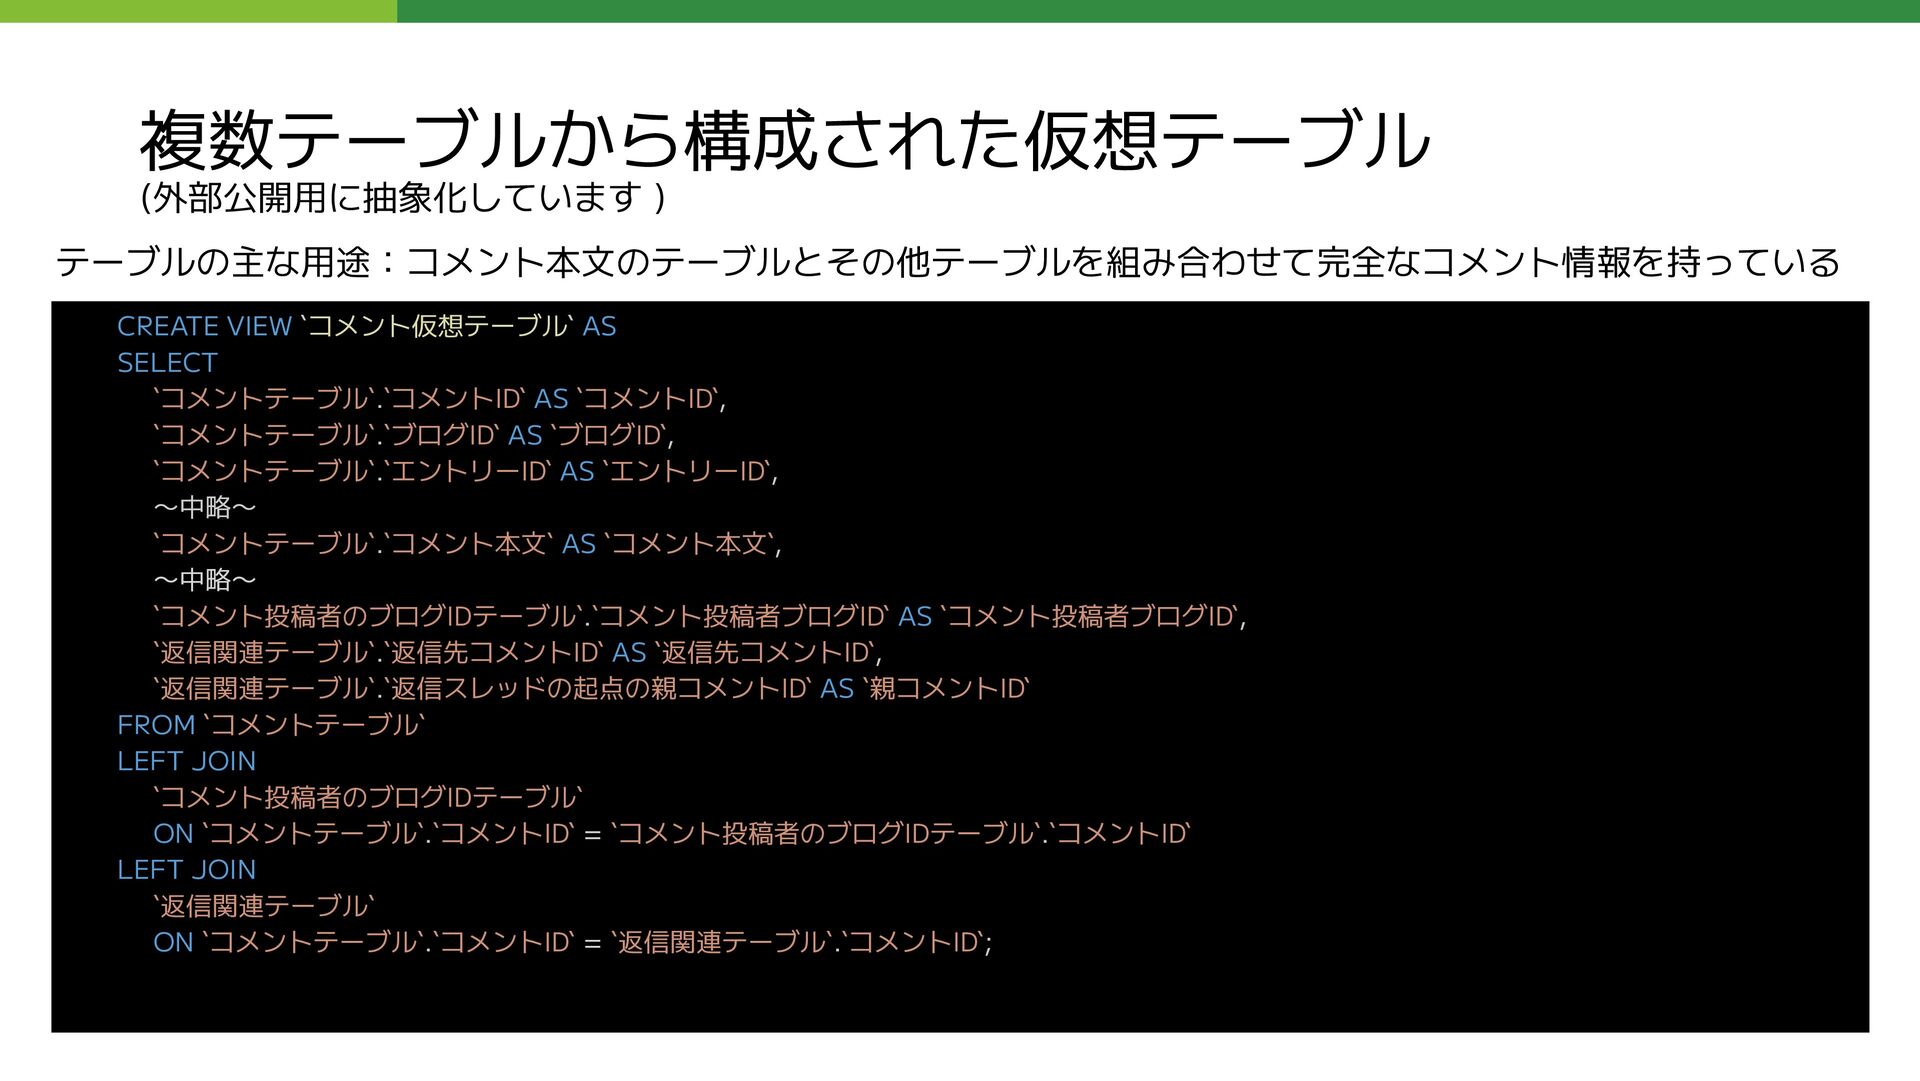
複数テーブルから構成された仮想テーブル (外部公開用に抽象化しています ) CREATE VIEW `コメント仮想テーブル` AS SELECT `コメントテーブル`.`コメントID` AS
`コメントID`, `コメントテーブル`.`ブログID` AS `ブログID`, `コメントテーブル`.`エントリーID` AS `エントリーID`, 〜中略〜 `コメントテーブル`.`コメント本文` AS `コメント本文`, 〜中略〜 `コメント投稿者のブログIDテーブル`.`コメント投稿者ブログID` AS `コメント投稿者ブログID`, `返信関連テーブル`.`返信先コメントID` AS `返信先コメントID`, `返信関連テーブル`.`返信スレッドの起点の親コメントID` AS `親コメントID` FROM `コメントテーブル` LEFT JOIN `コメント投稿者のブログIDテーブル` ON `コメントテーブル`.`コメントID` = `コメント投稿者のブログIDテーブル`.`コメントID` LEFT JOIN `返信関連テーブル` ON `コメントテーブル`.`コメントID` = `返信関連テーブル`.`コメントID`; テーブルの主な用途:コメント本文のテーブルとその他テーブルを組み合わせて完全なコメント情報を持っている -
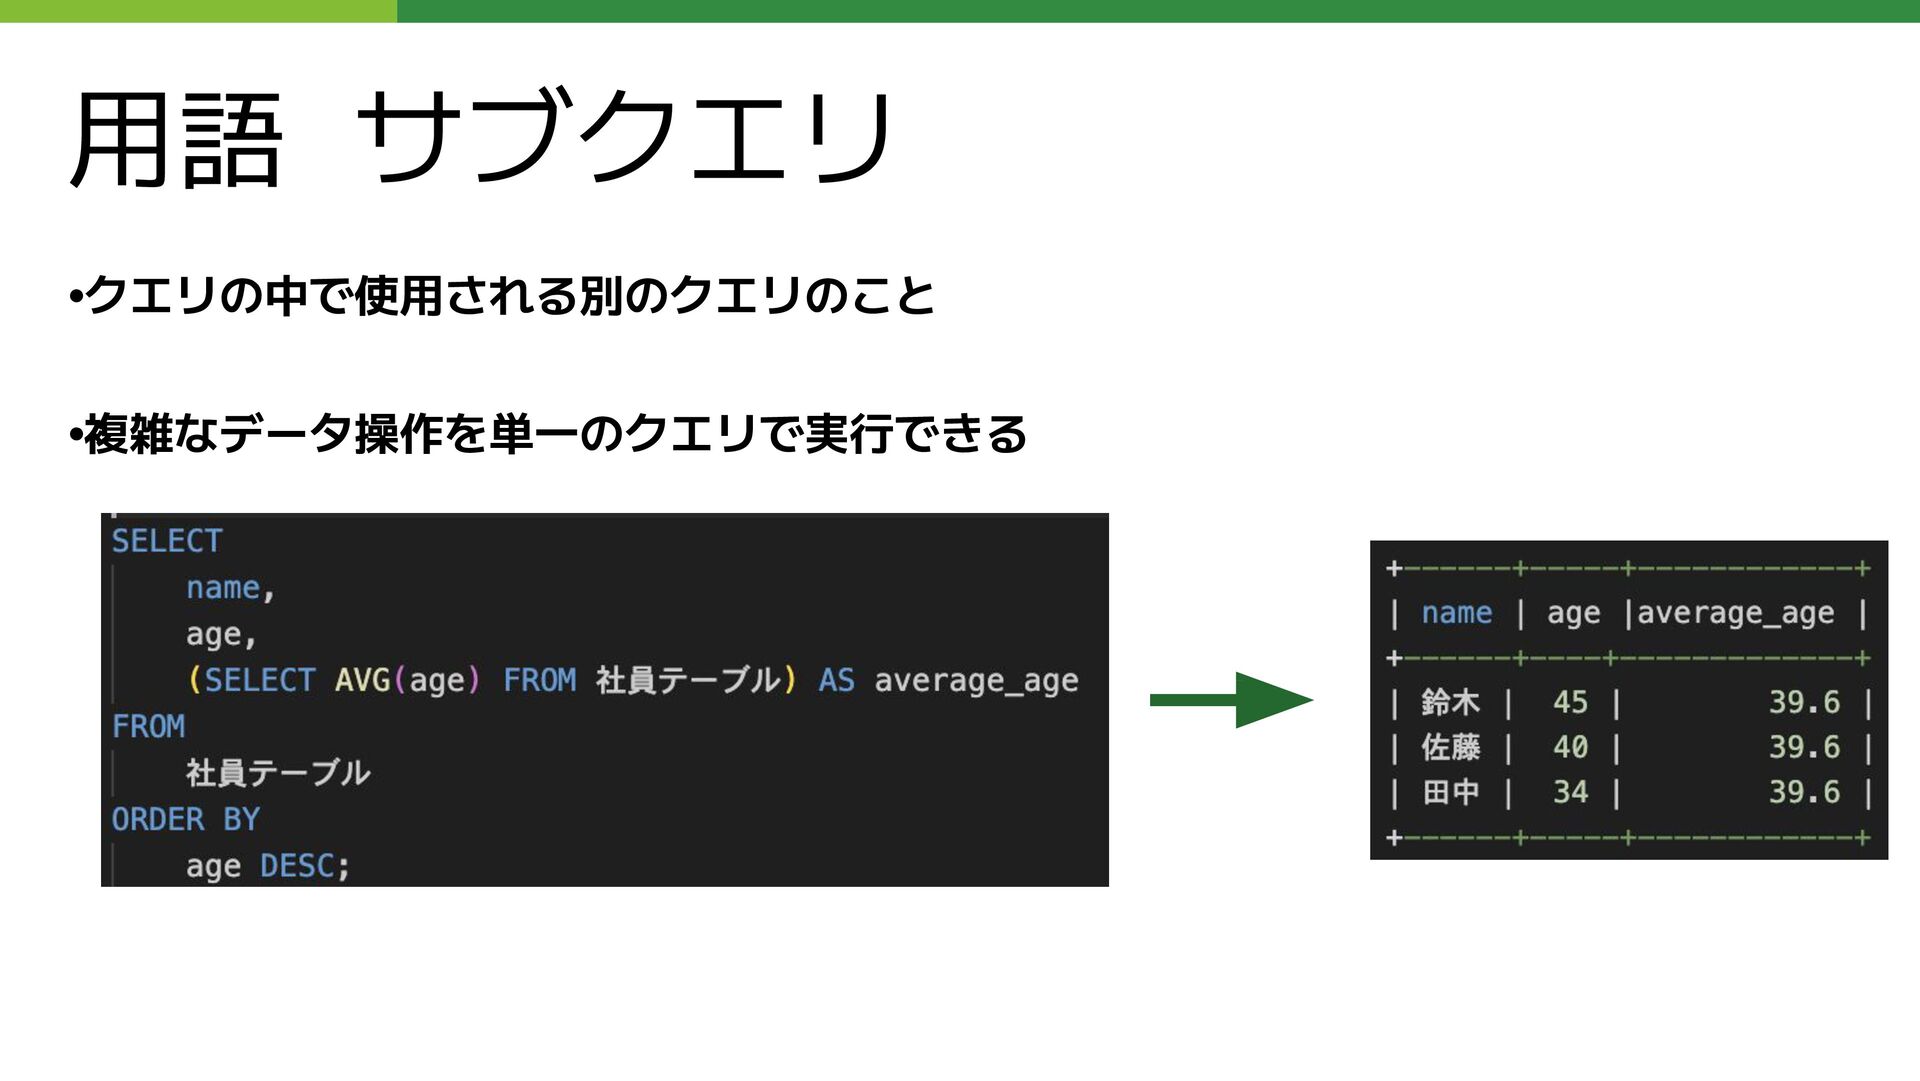
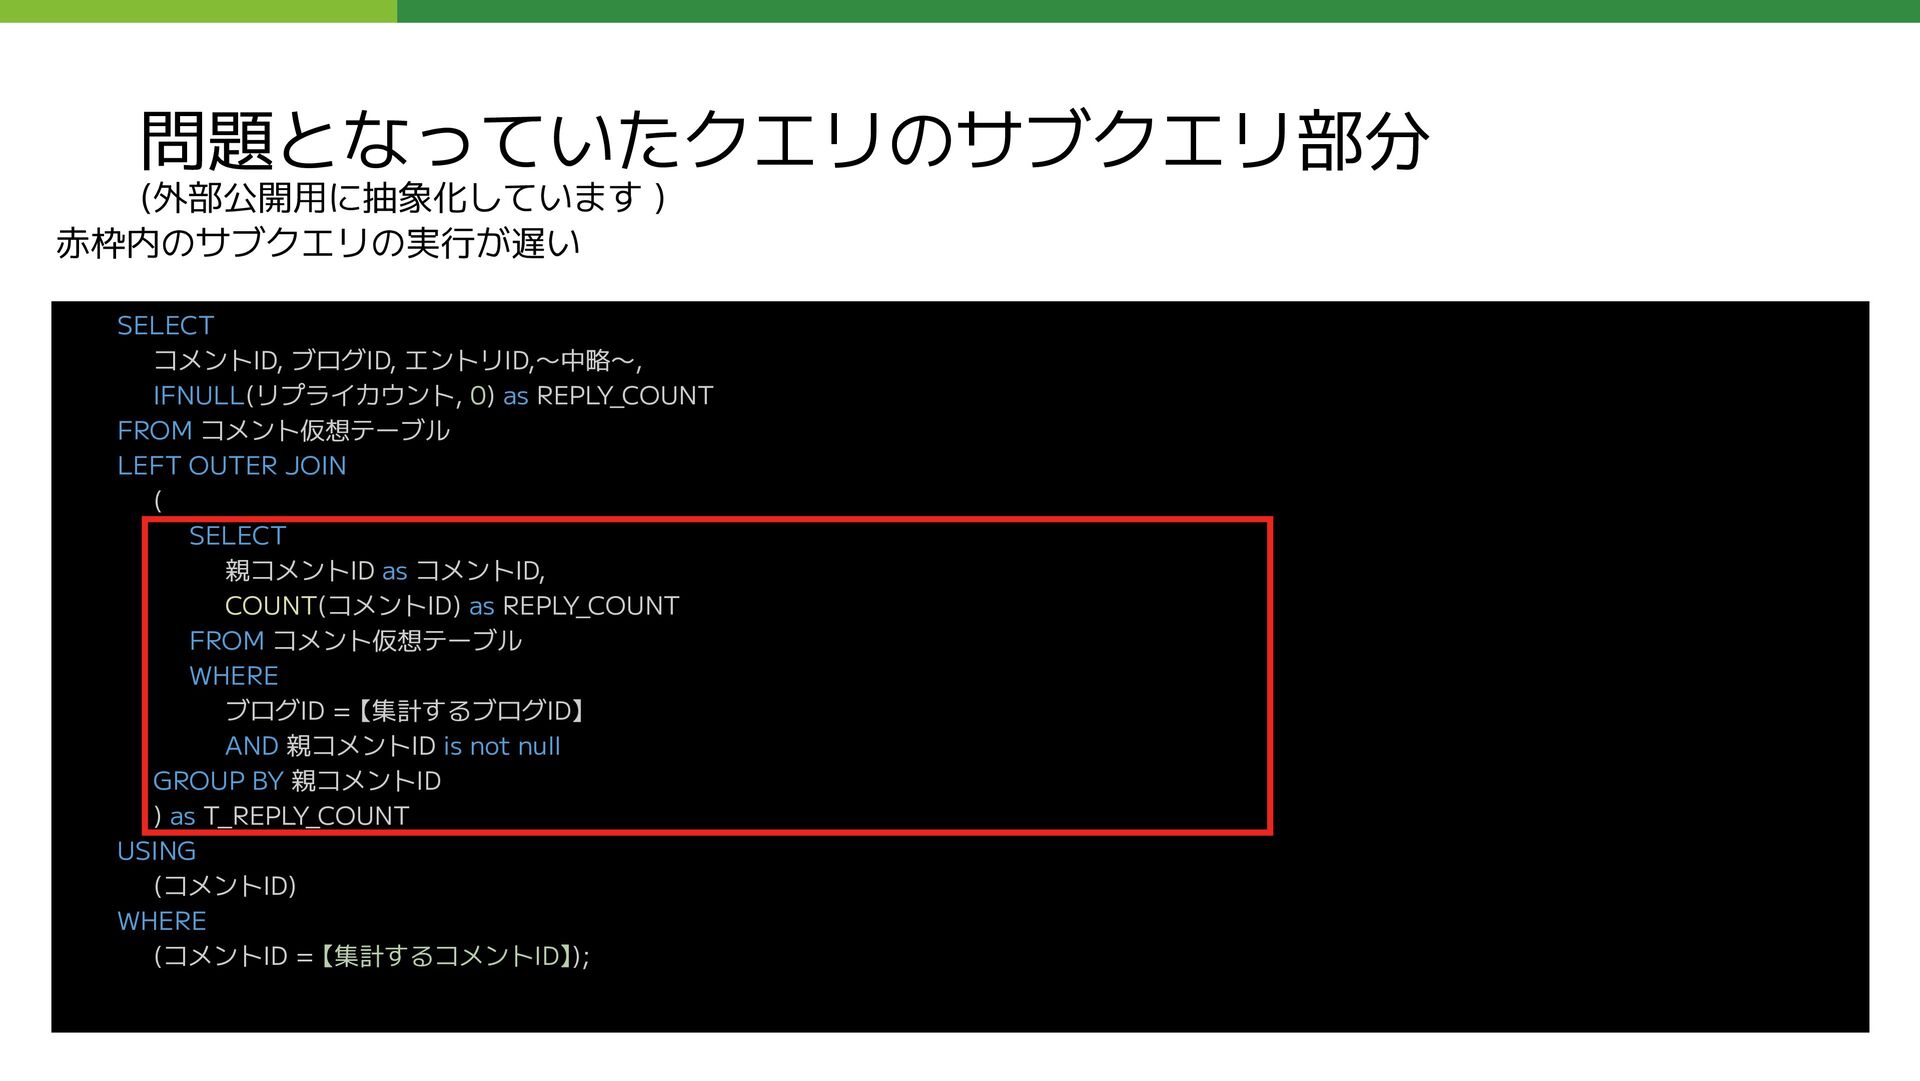
SELECT コメントID, ブログID, エントリID,〜中略〜, IFNULL(リプライカウント, 0) as REPLY_COUNT FROM コメント仮想テーブル
LEFT OUTER JOIN ( SELECT 親コメントID as コメントID, COUNT(コメントID) as REPLY_COUNT FROM コメント仮想テーブル WHERE ブログID = 【集計するブログID】 AND 親コメントID is not null GROUP BY 親コメントID ) as T_REPLY_COUNT USING (コメントID) WHERE (コメントID = 【集計するコメントID】); 問題となっていたクエリのサブクエリ部分 (外部公開用に抽象化しています ) 赤枠内のサブクエリの実行が遅い -
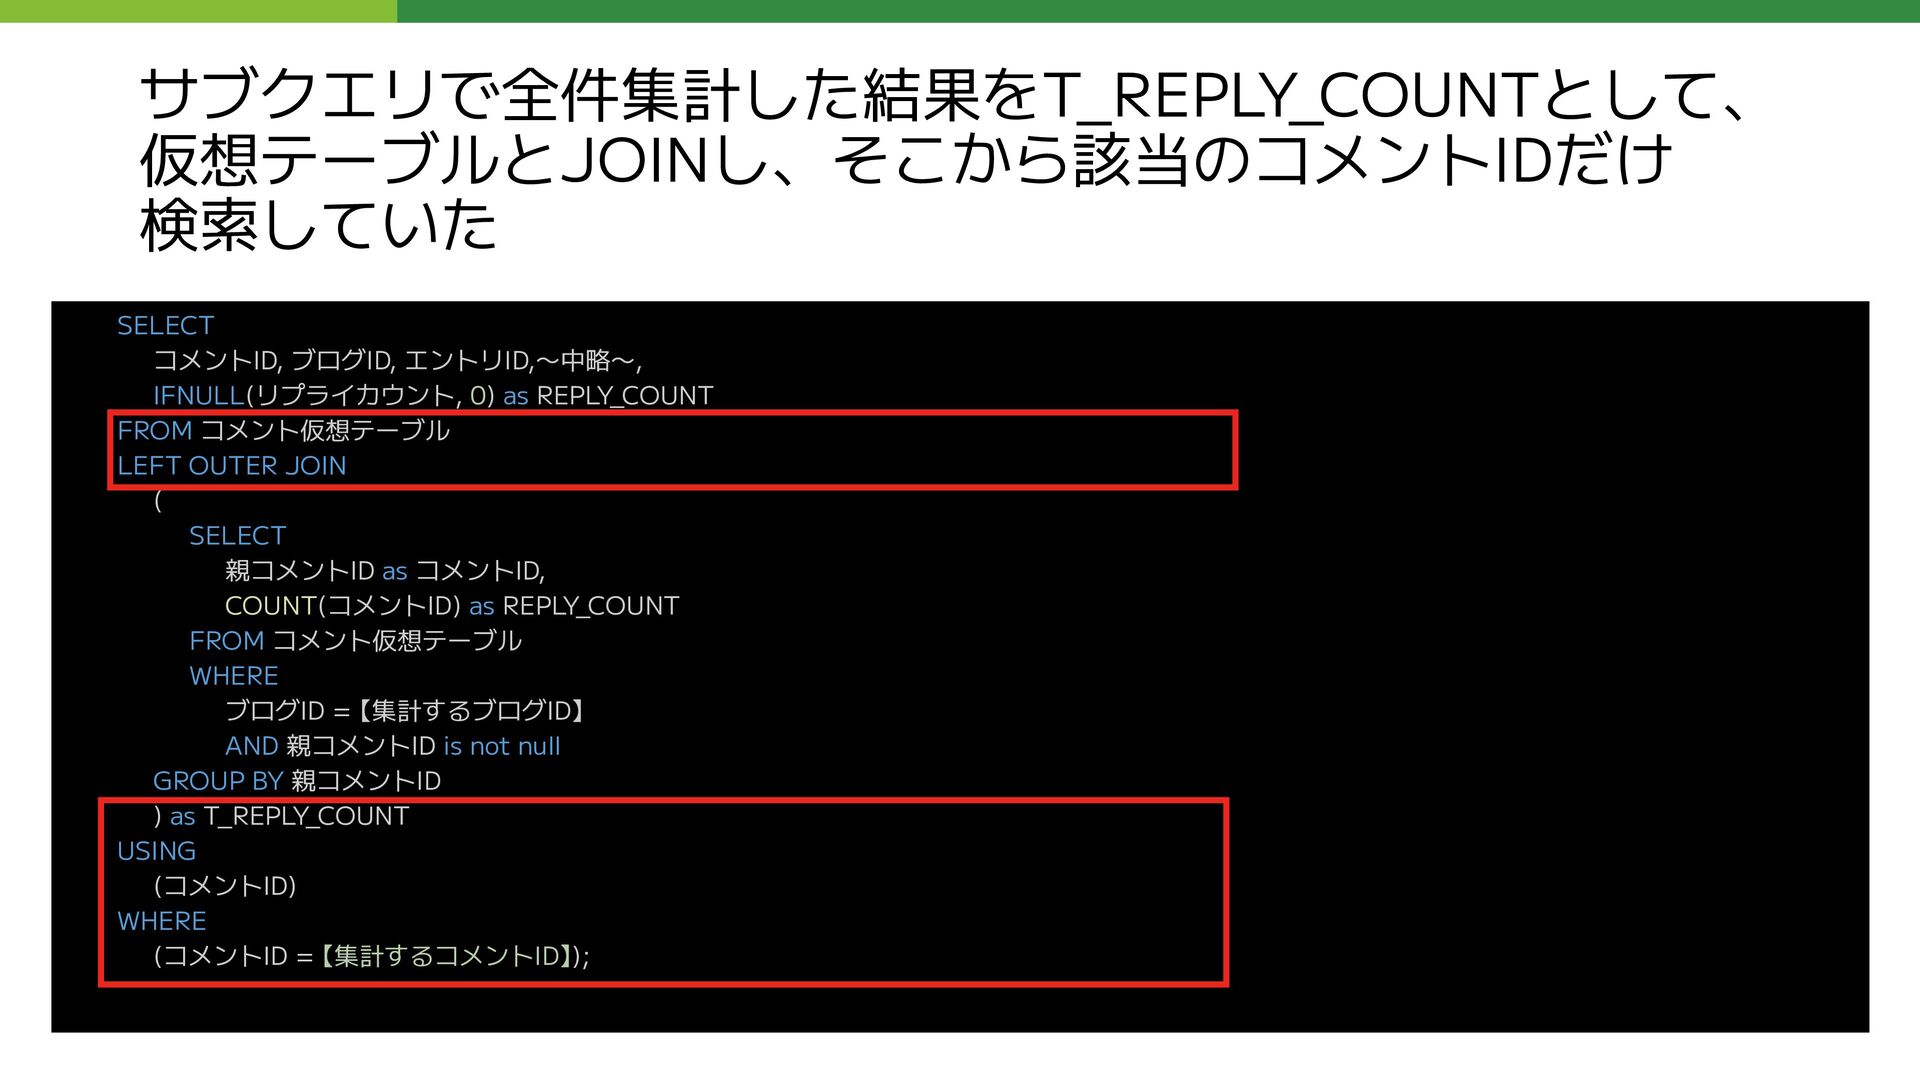
サブクエリで全件集計した結果をT_REPLY_COUNTとして、 仮想テーブルとJOINし、そこから該当のコメントIDだけ 検索していた SELECT コメントID, ブログID, エントリID,〜中略〜, IFNULL(リプライカウント, 0) as
REPLY_COUNT FROM コメント仮想テーブル LEFT OUTER JOIN ( SELECT 親コメントID as コメントID, COUNT(コメントID) as REPLY_COUNT FROM コメント仮想テーブル WHERE ブログID = 【集計するブログID】 AND 親コメントID is not null GROUP BY 親コメントID ) as T_REPLY_COUNT USING (コメントID) WHERE (コメントID = 【集計するコメントID】); -
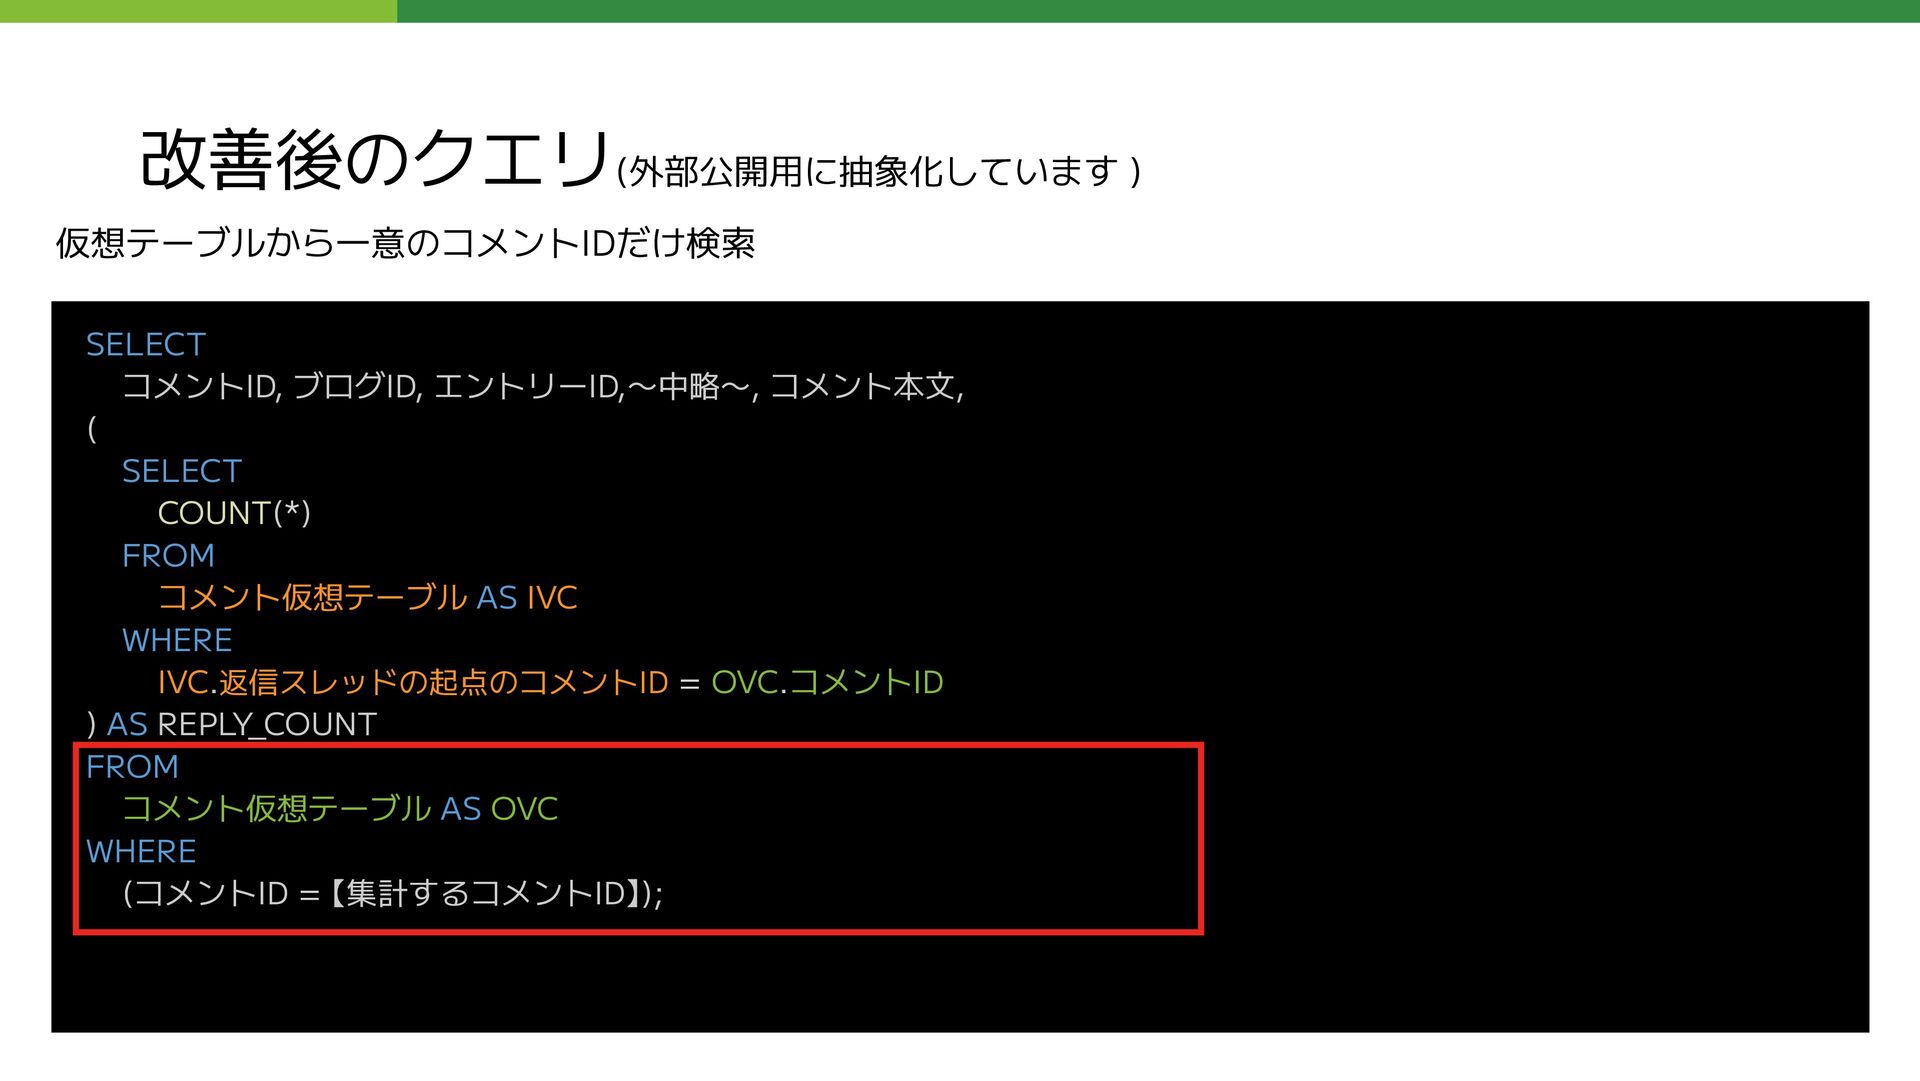
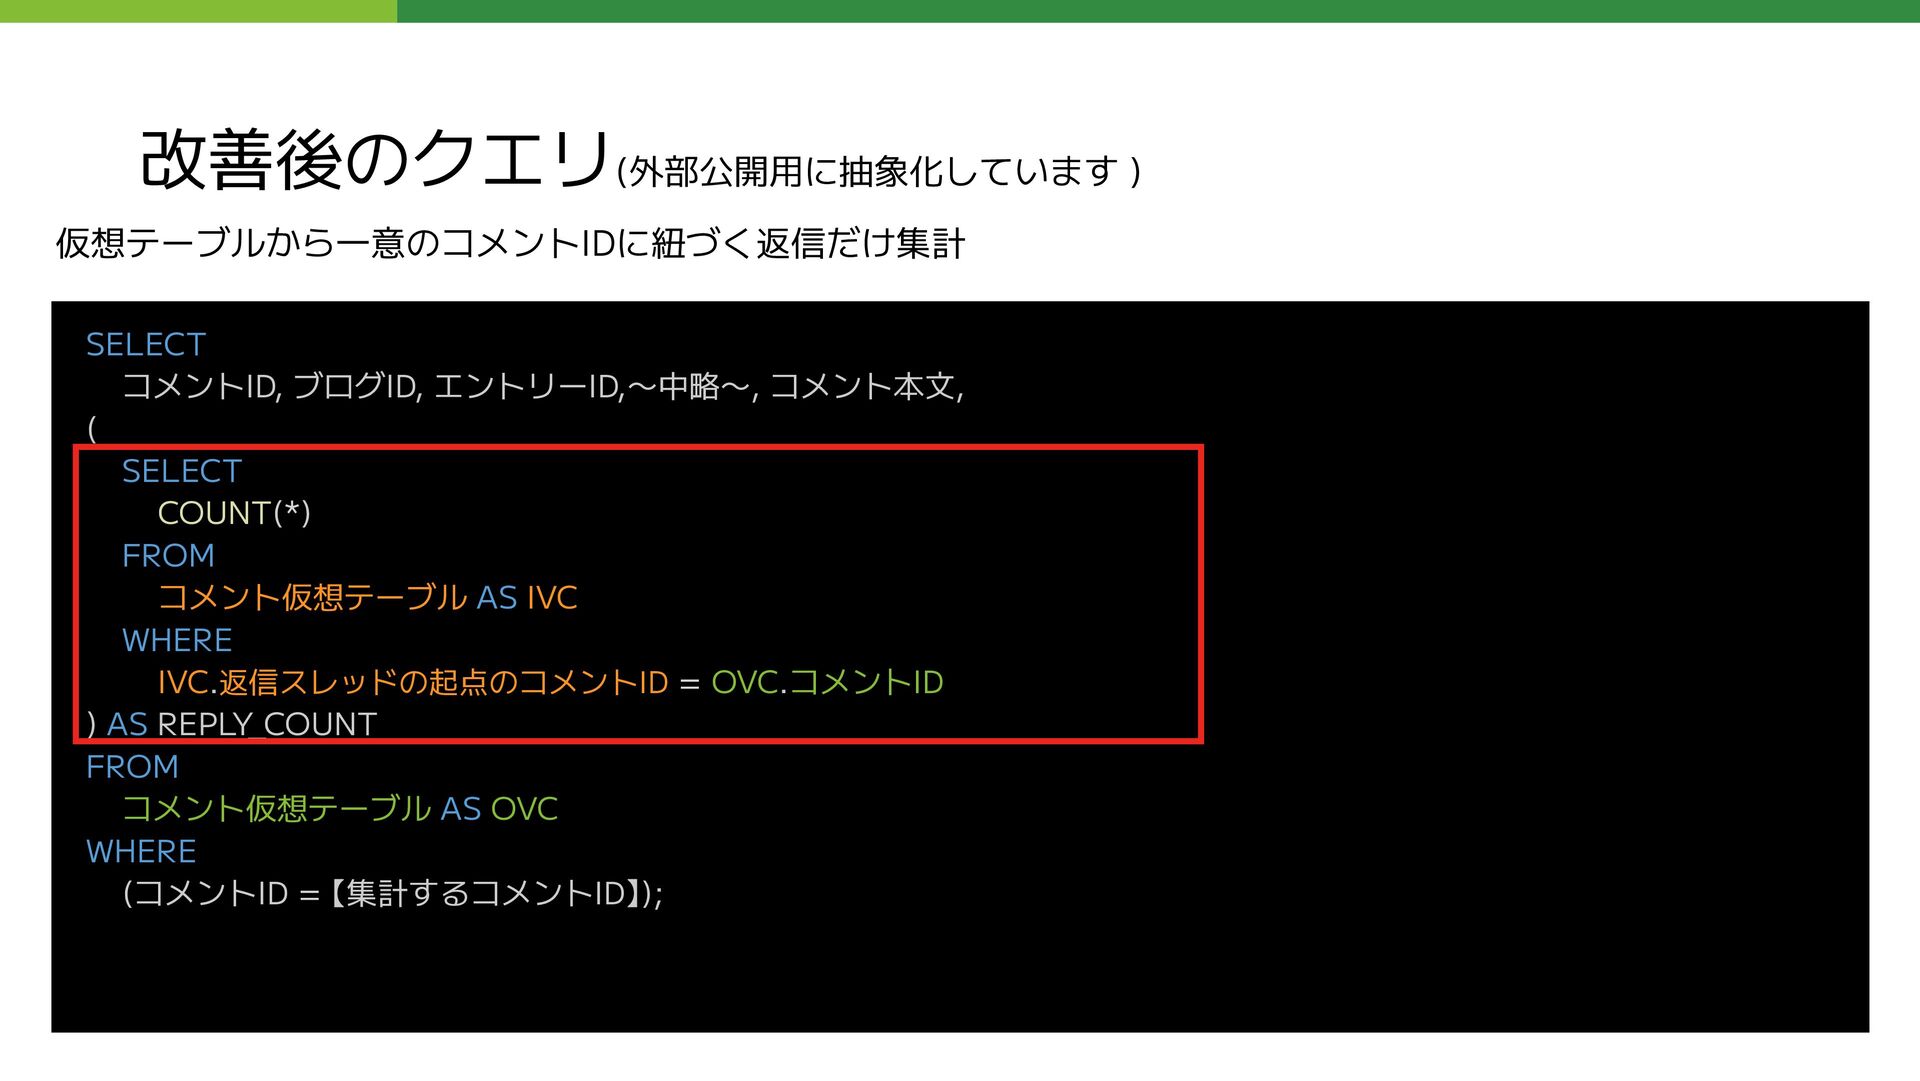
改善後のクエリ(外部公開用に抽象化しています ) SELECT コメントID, ブログID, エントリーID,〜中略〜, コメント本文, ( SELECT COUNT(*)
FROM コメント仮想テーブル AS IVC WHERE IVC.返信スレッドの起点のコメントID = OVC.コメントID ) AS REPLY_COUNT FROM コメント仮想テーブル AS OVC WHERE (コメントID = 【集計するコメントID】); 仮想テーブルから一意のコメントIDだけ検索 -
改善後のクエリ(外部公開用に抽象化しています ) 仮想テーブルから一意のコメントIDに紐づく返信だけ集計 SELECT コメントID, ブログID, エントリーID,〜中略〜, コメント本文, ( SELECT
COUNT(*) FROM コメント仮想テーブル AS IVC WHERE IVC.返信スレッドの起点のコメントID = OVC.コメントID ) AS REPLY_COUNT FROM コメント仮想テーブル AS OVC WHERE (コメントID = 【集計するコメントID】); -
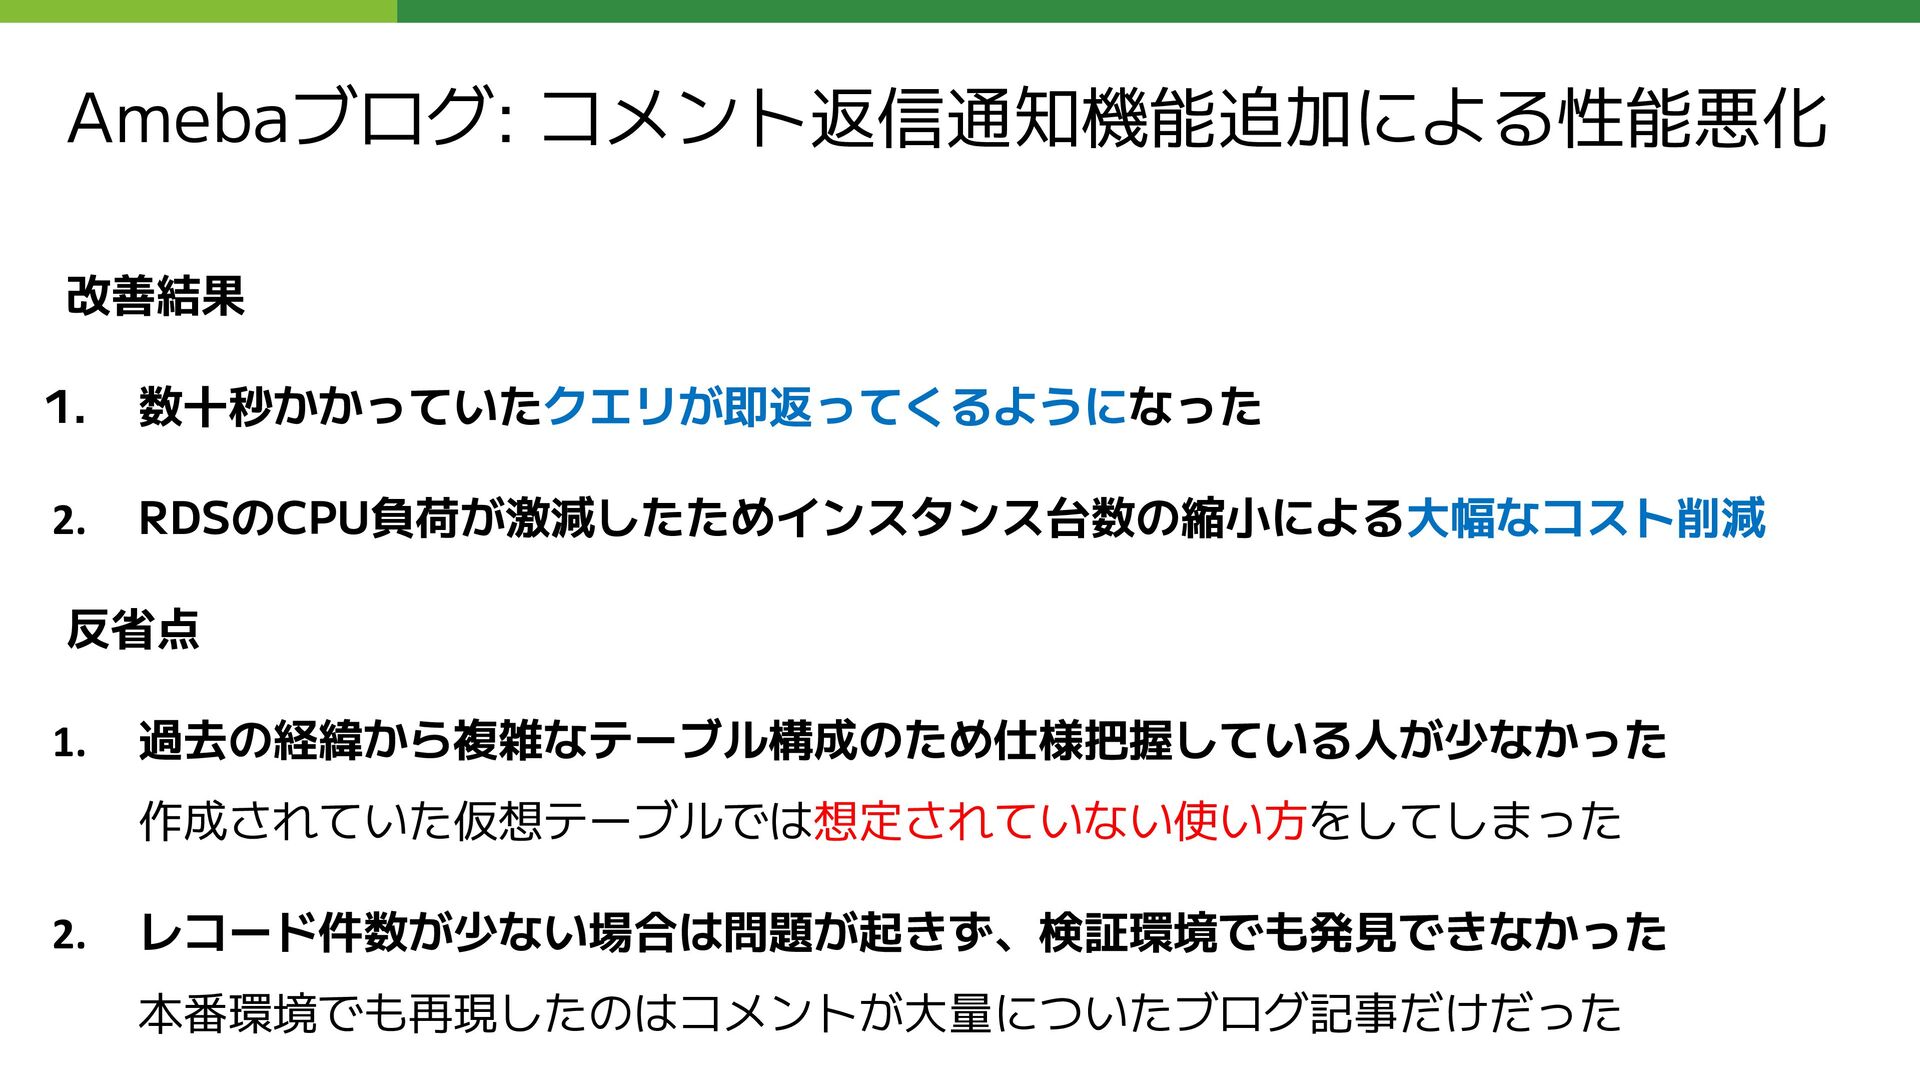
Amebaブログ: コメント返信通知機能追加による性能悪化 改善結果 1. 数十秒かかっていたクエリが即返ってくるようになった 2. RDSのCPU負荷が激減したためインスタンス台数の縮小による大幅なコスト削減 反省点 1. 過去の経緯から複雑なテーブル構成のため仕様把握している人が少なかった
作成されていた仮想テーブルでは想定されていない使い方をしてしまった 2. レコード件数が少ない場合は問題が起きず、検証環境でも発見できなかった 本番環境でも再現したのはコメントが大量についたブログ記事だけだった -
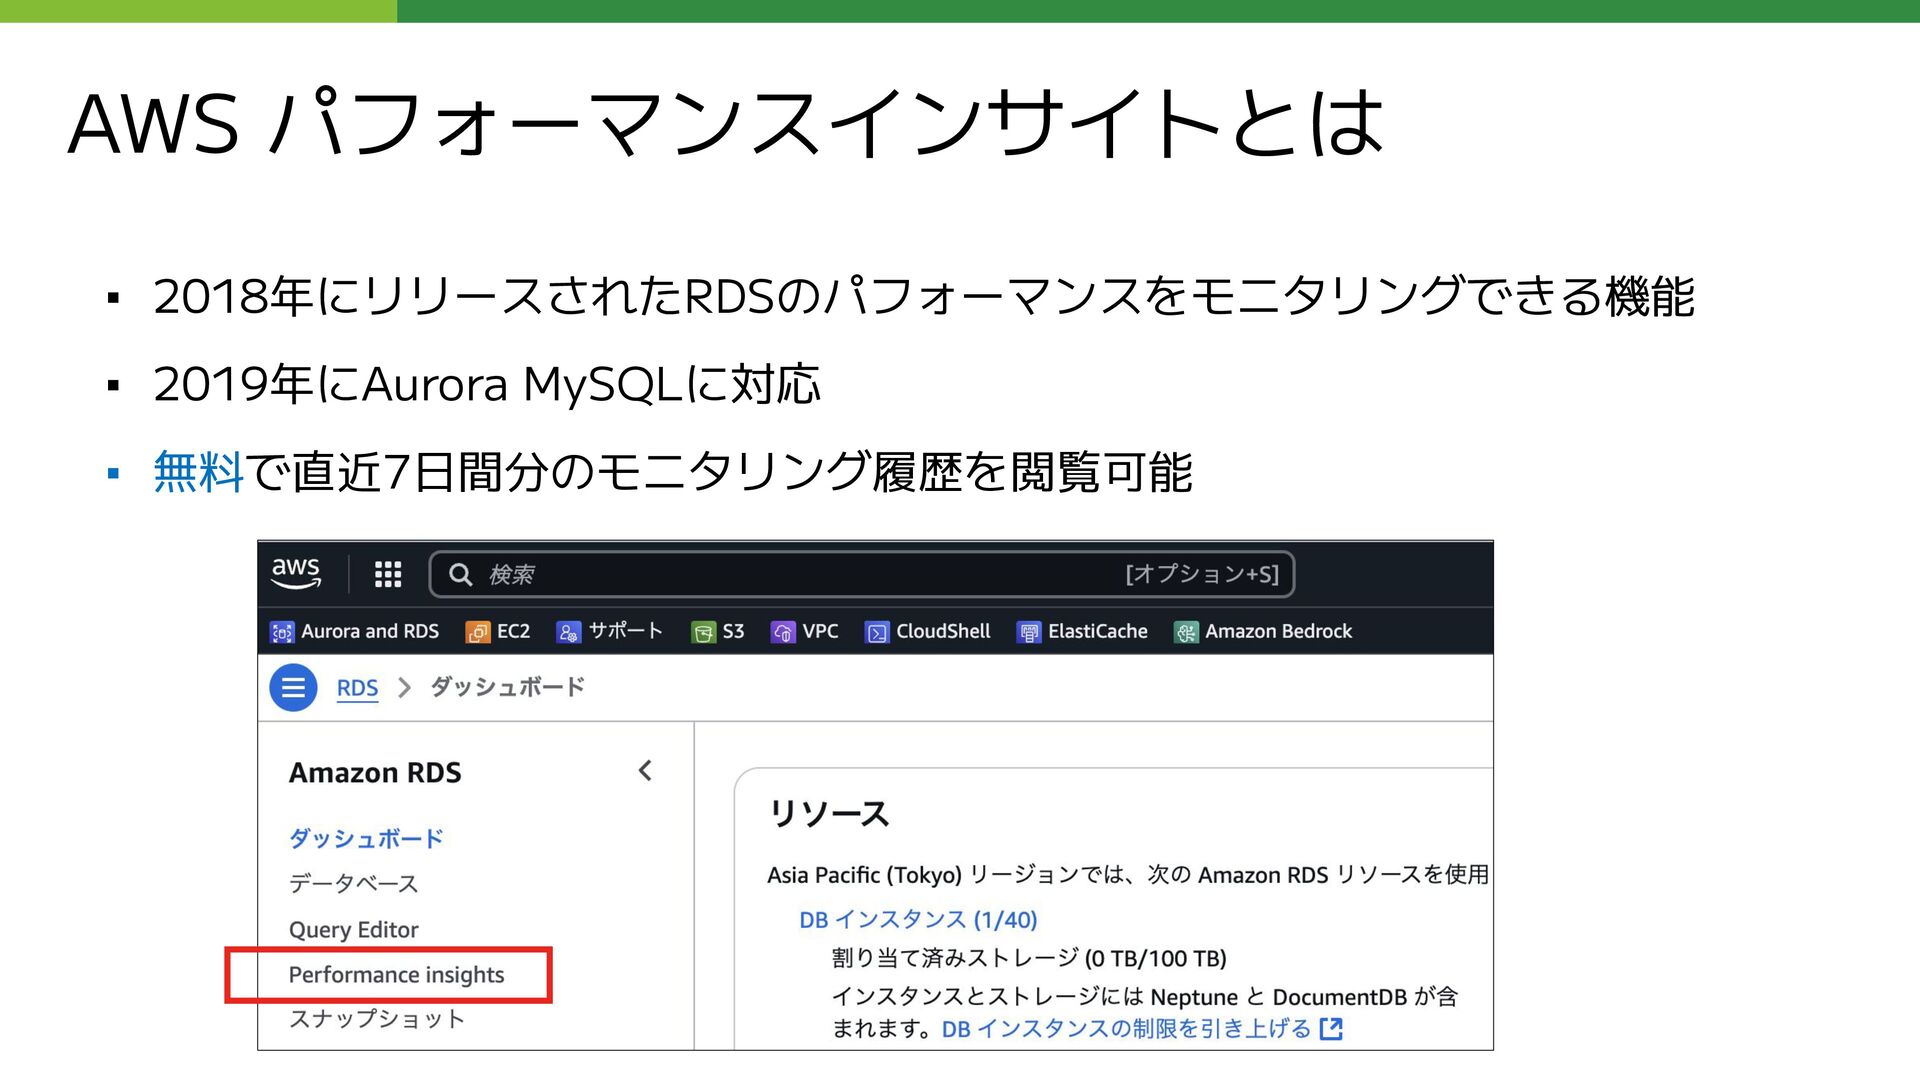
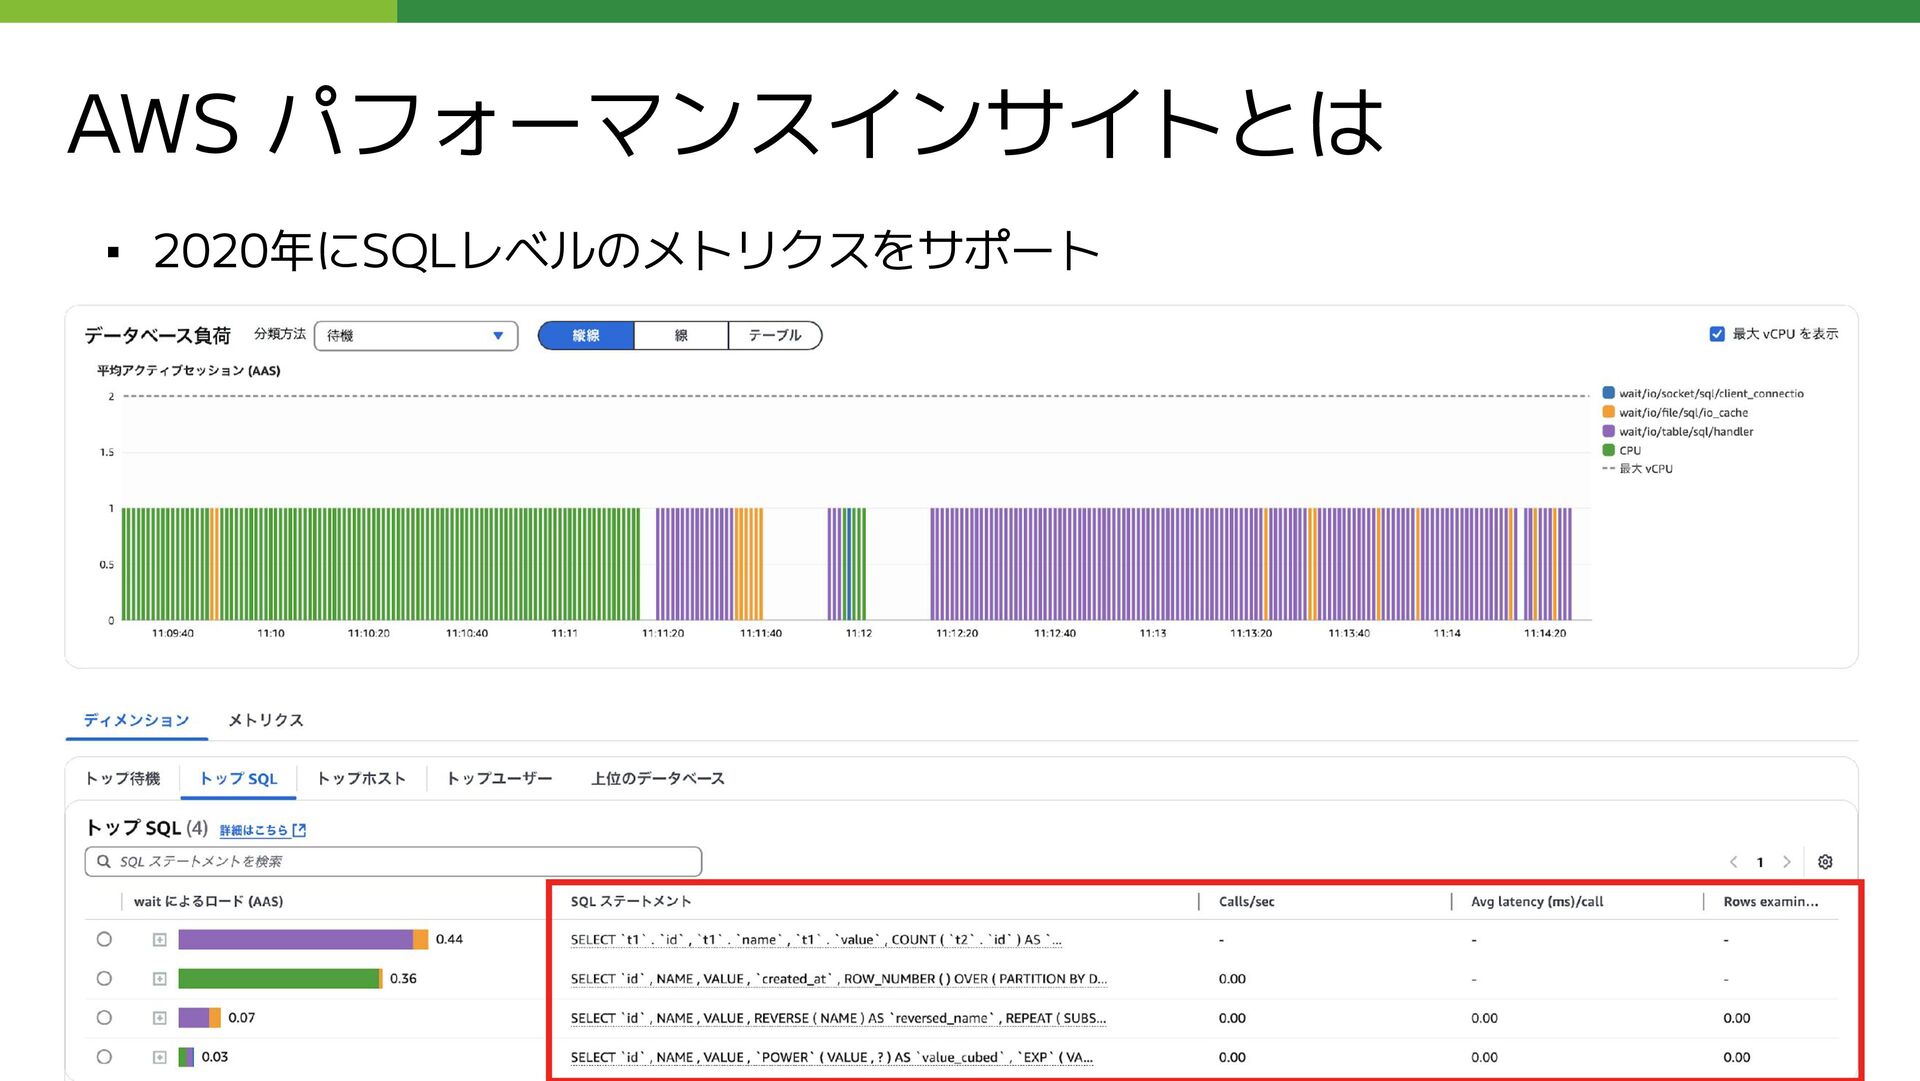
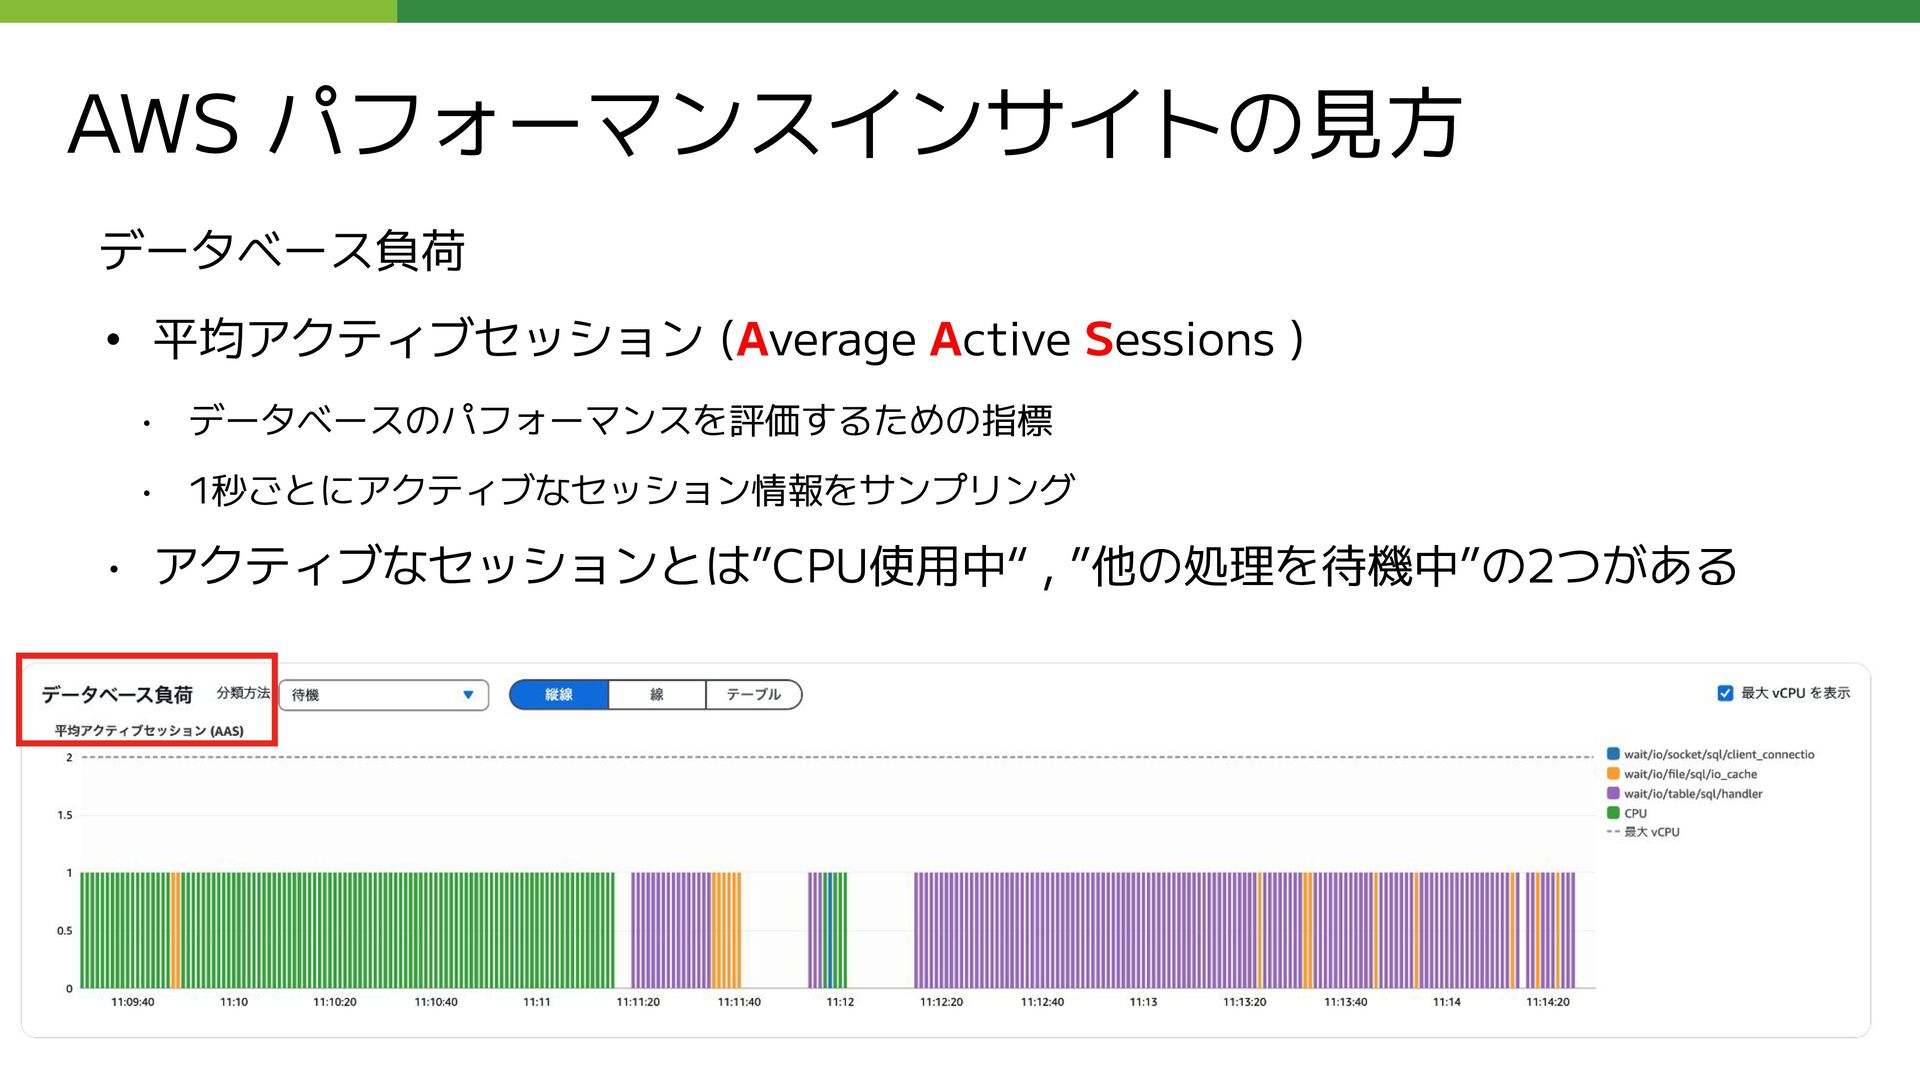
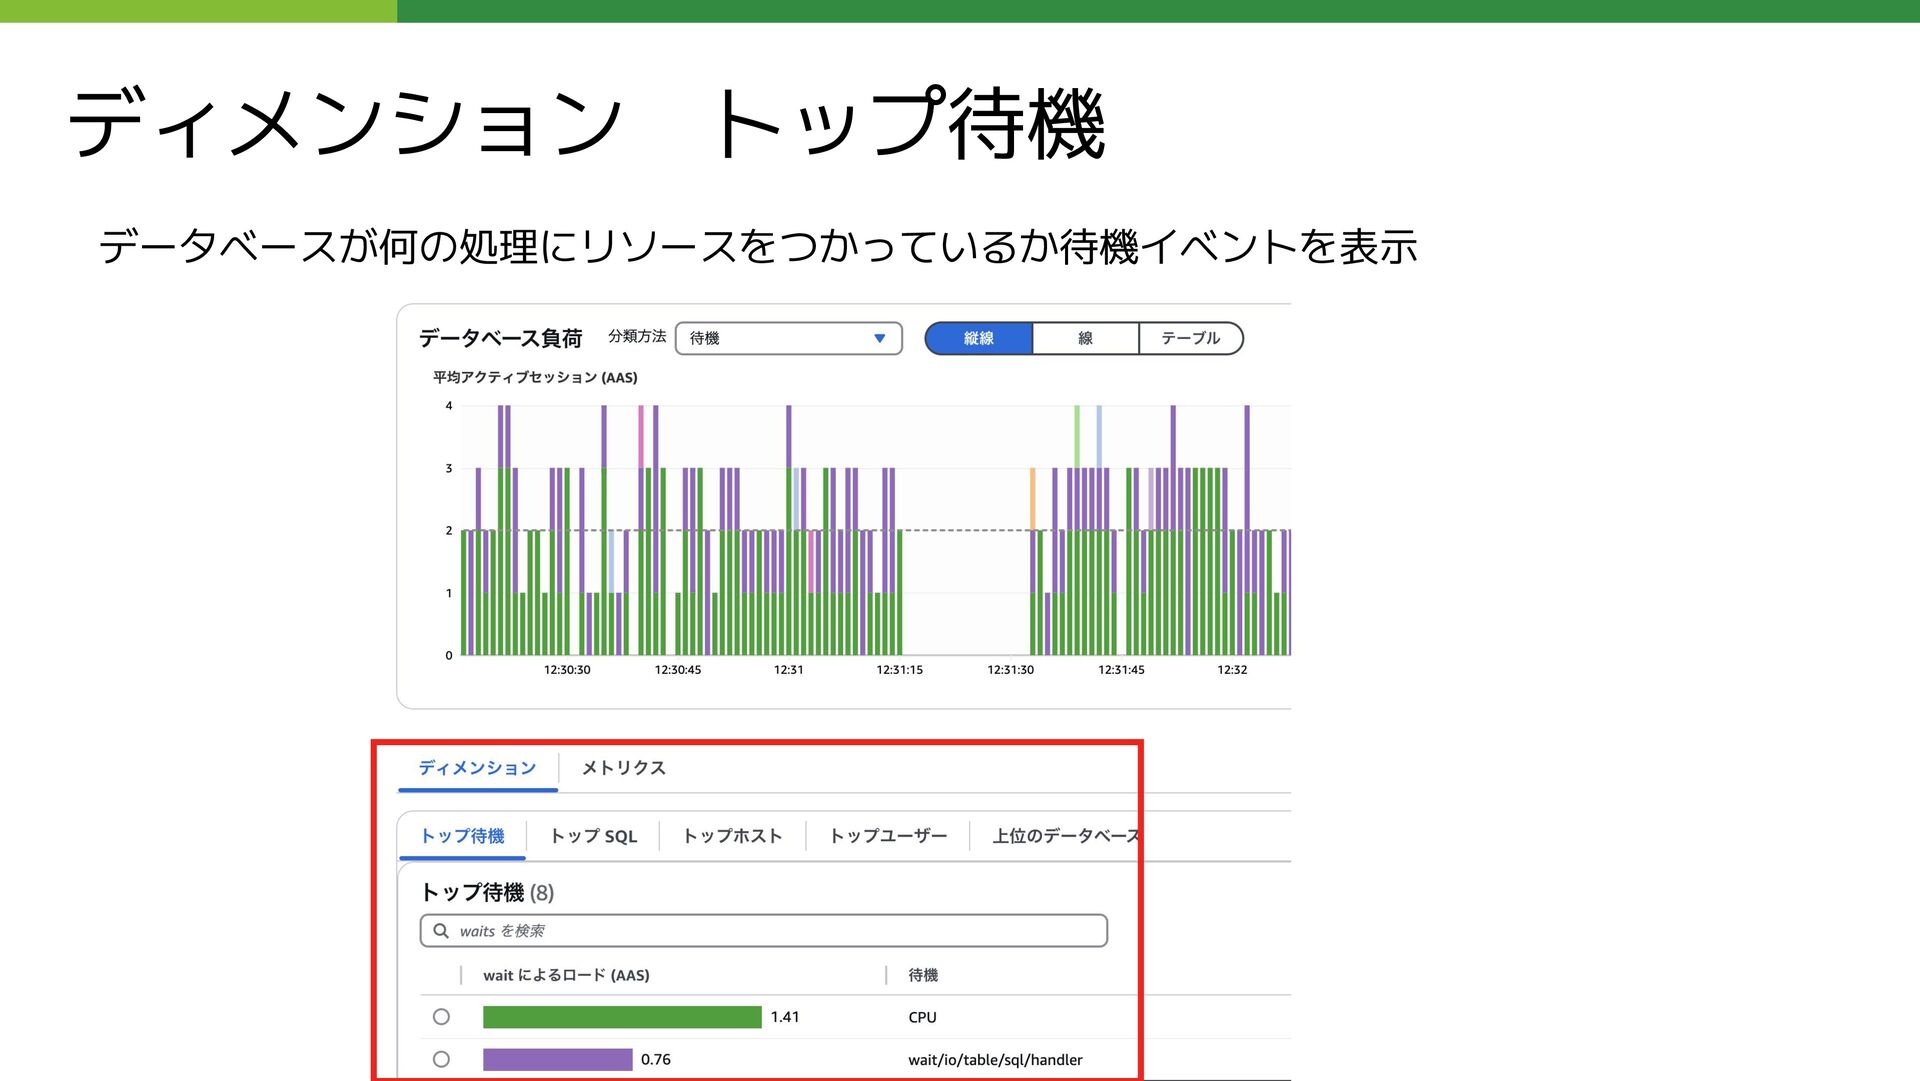
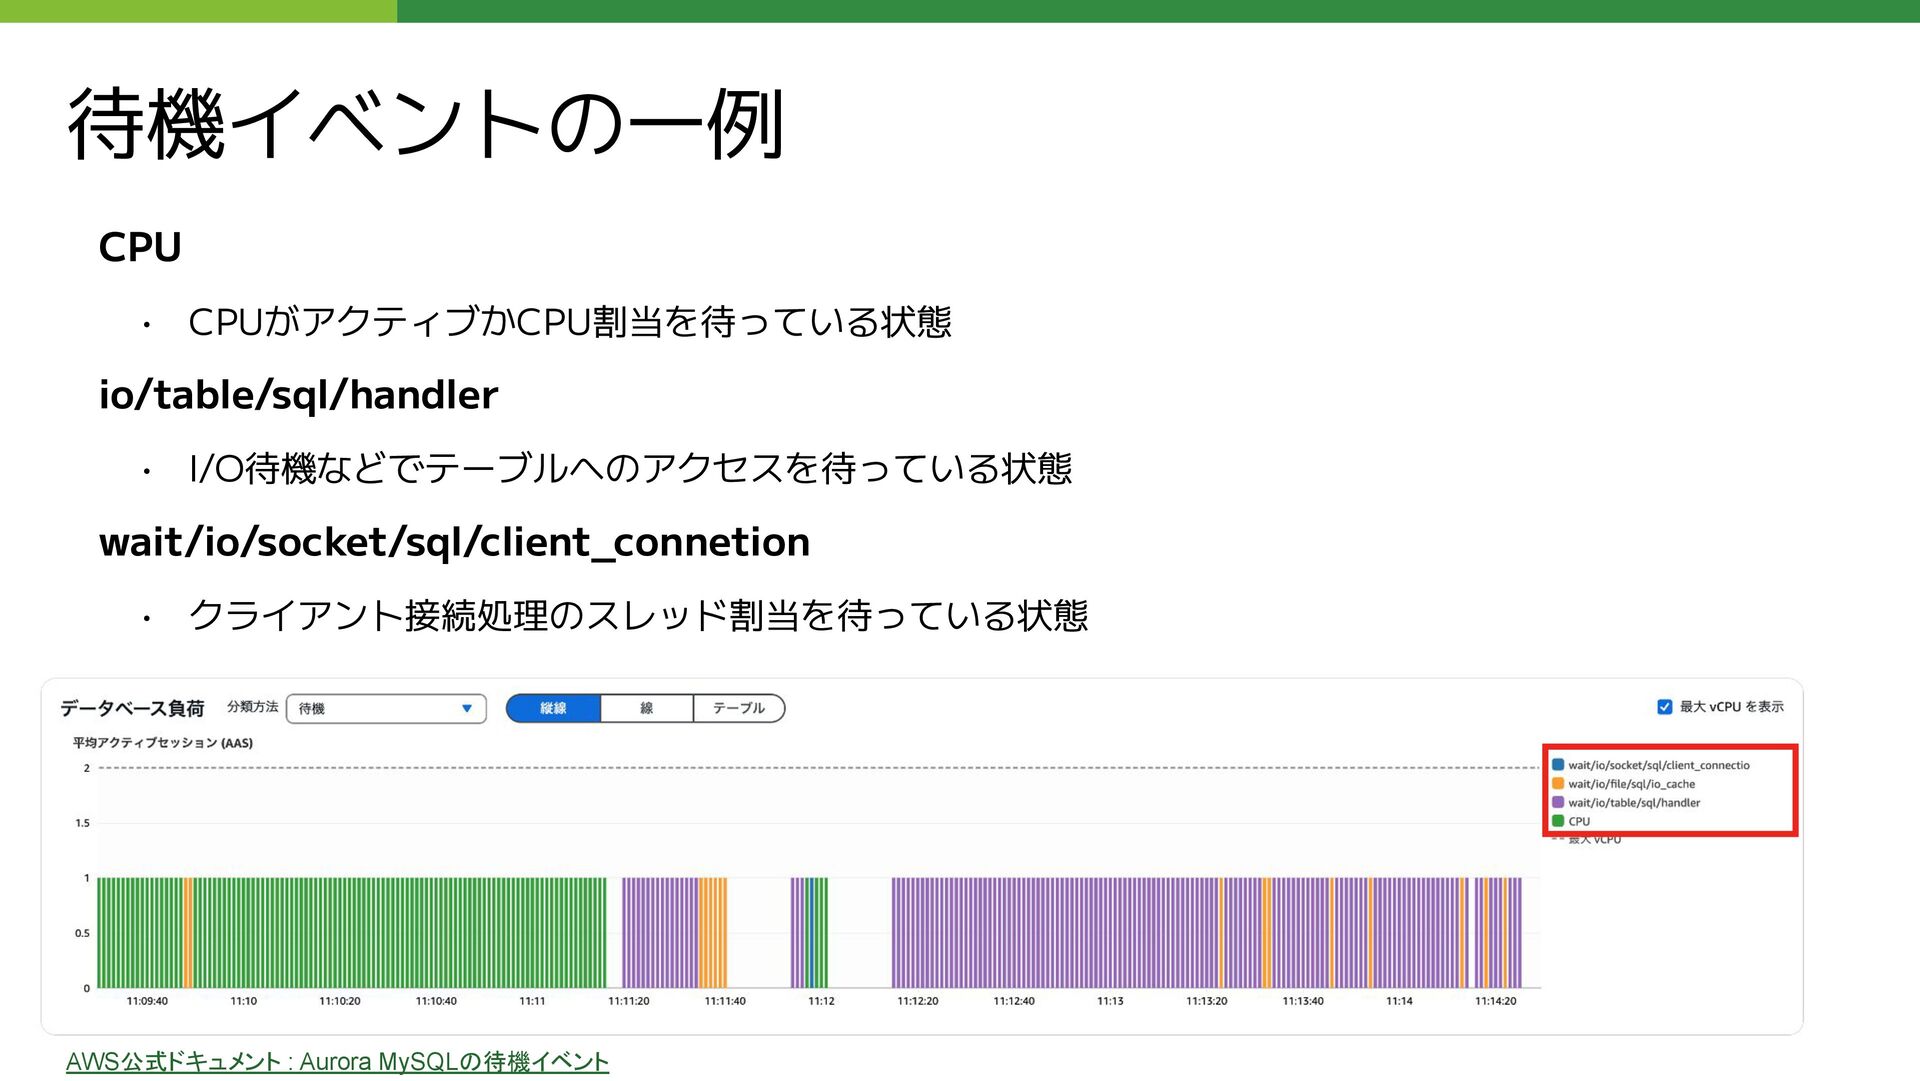
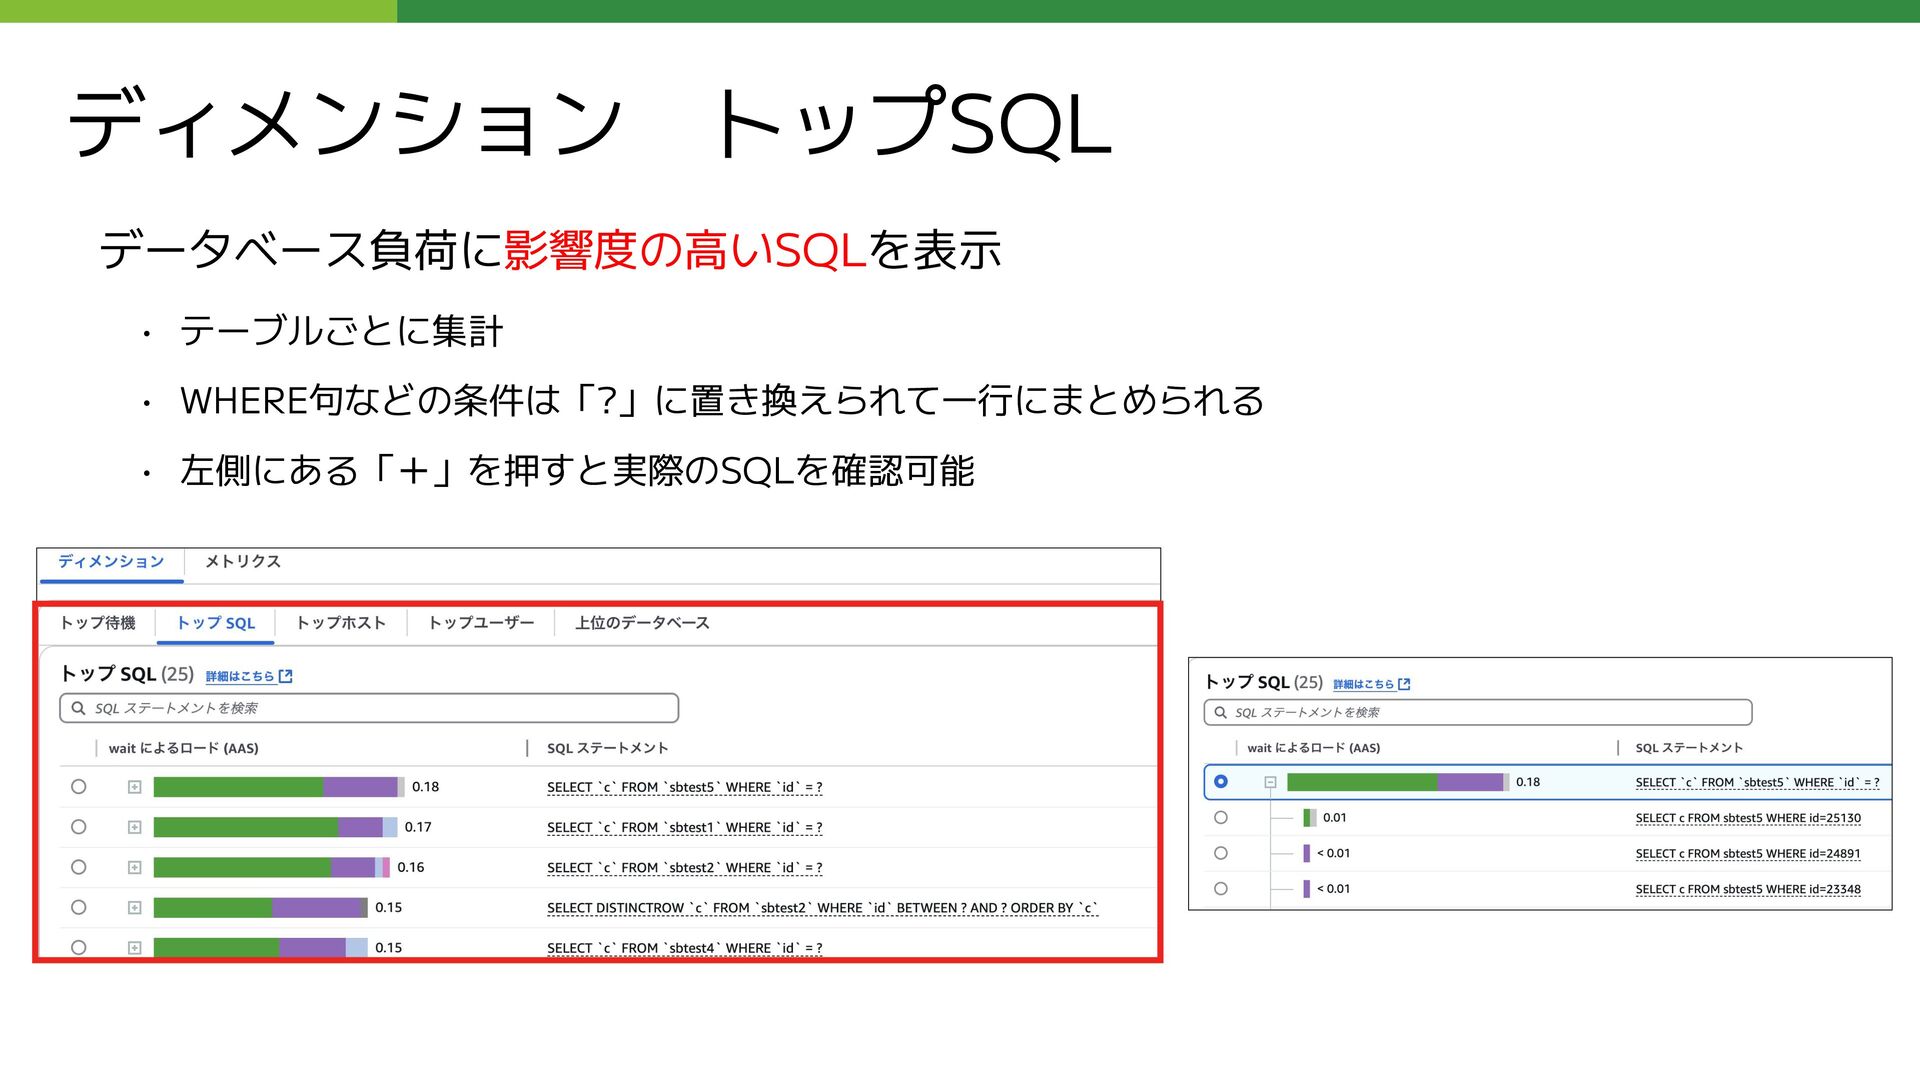
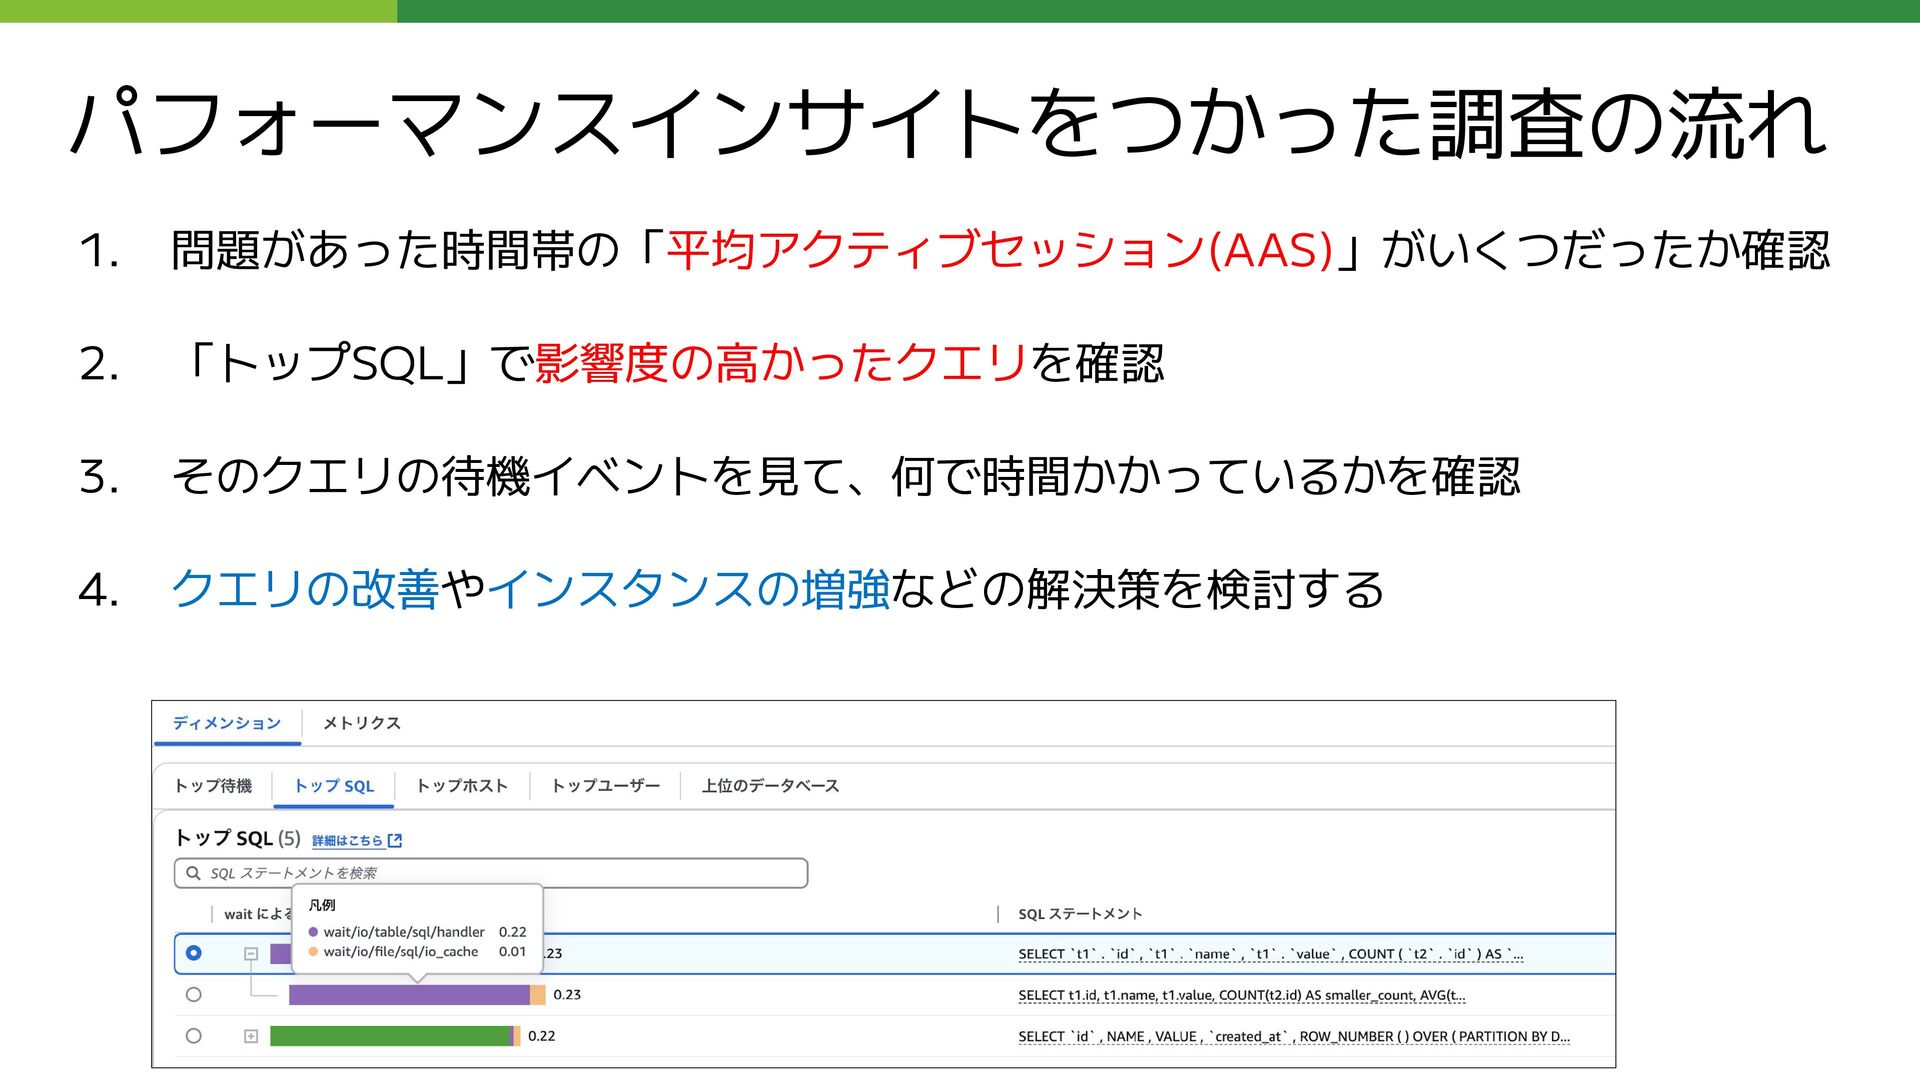
AWS パフォーマンスインサイトの見方 データベース負荷 • 平均アクティブセッション (Average Active Sessions ) •
データベースのパフォーマンスを評価するための指標 • 1秒ごとにアクティブなセッション情報をサンプリング • アクティブなセッションとは”CPU使用中“ , ”他の処理を待機中”の2つがある -
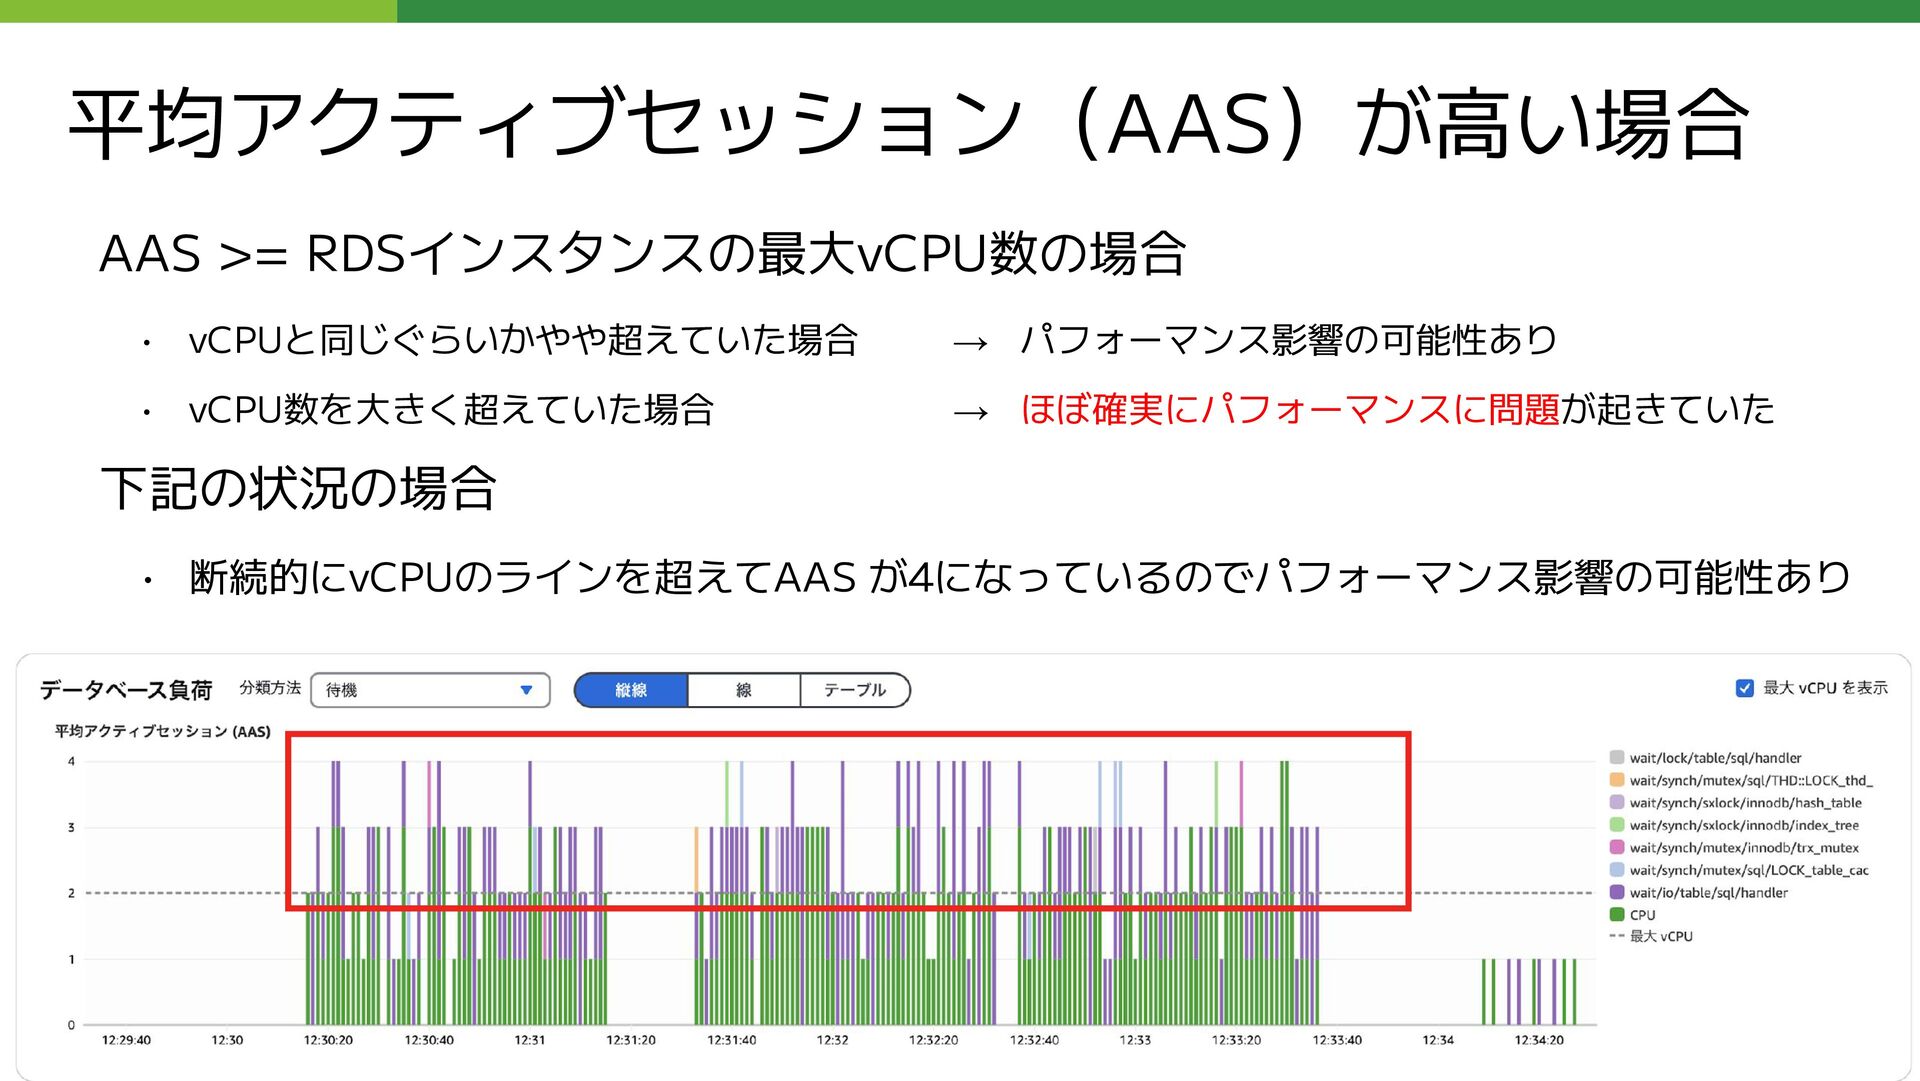
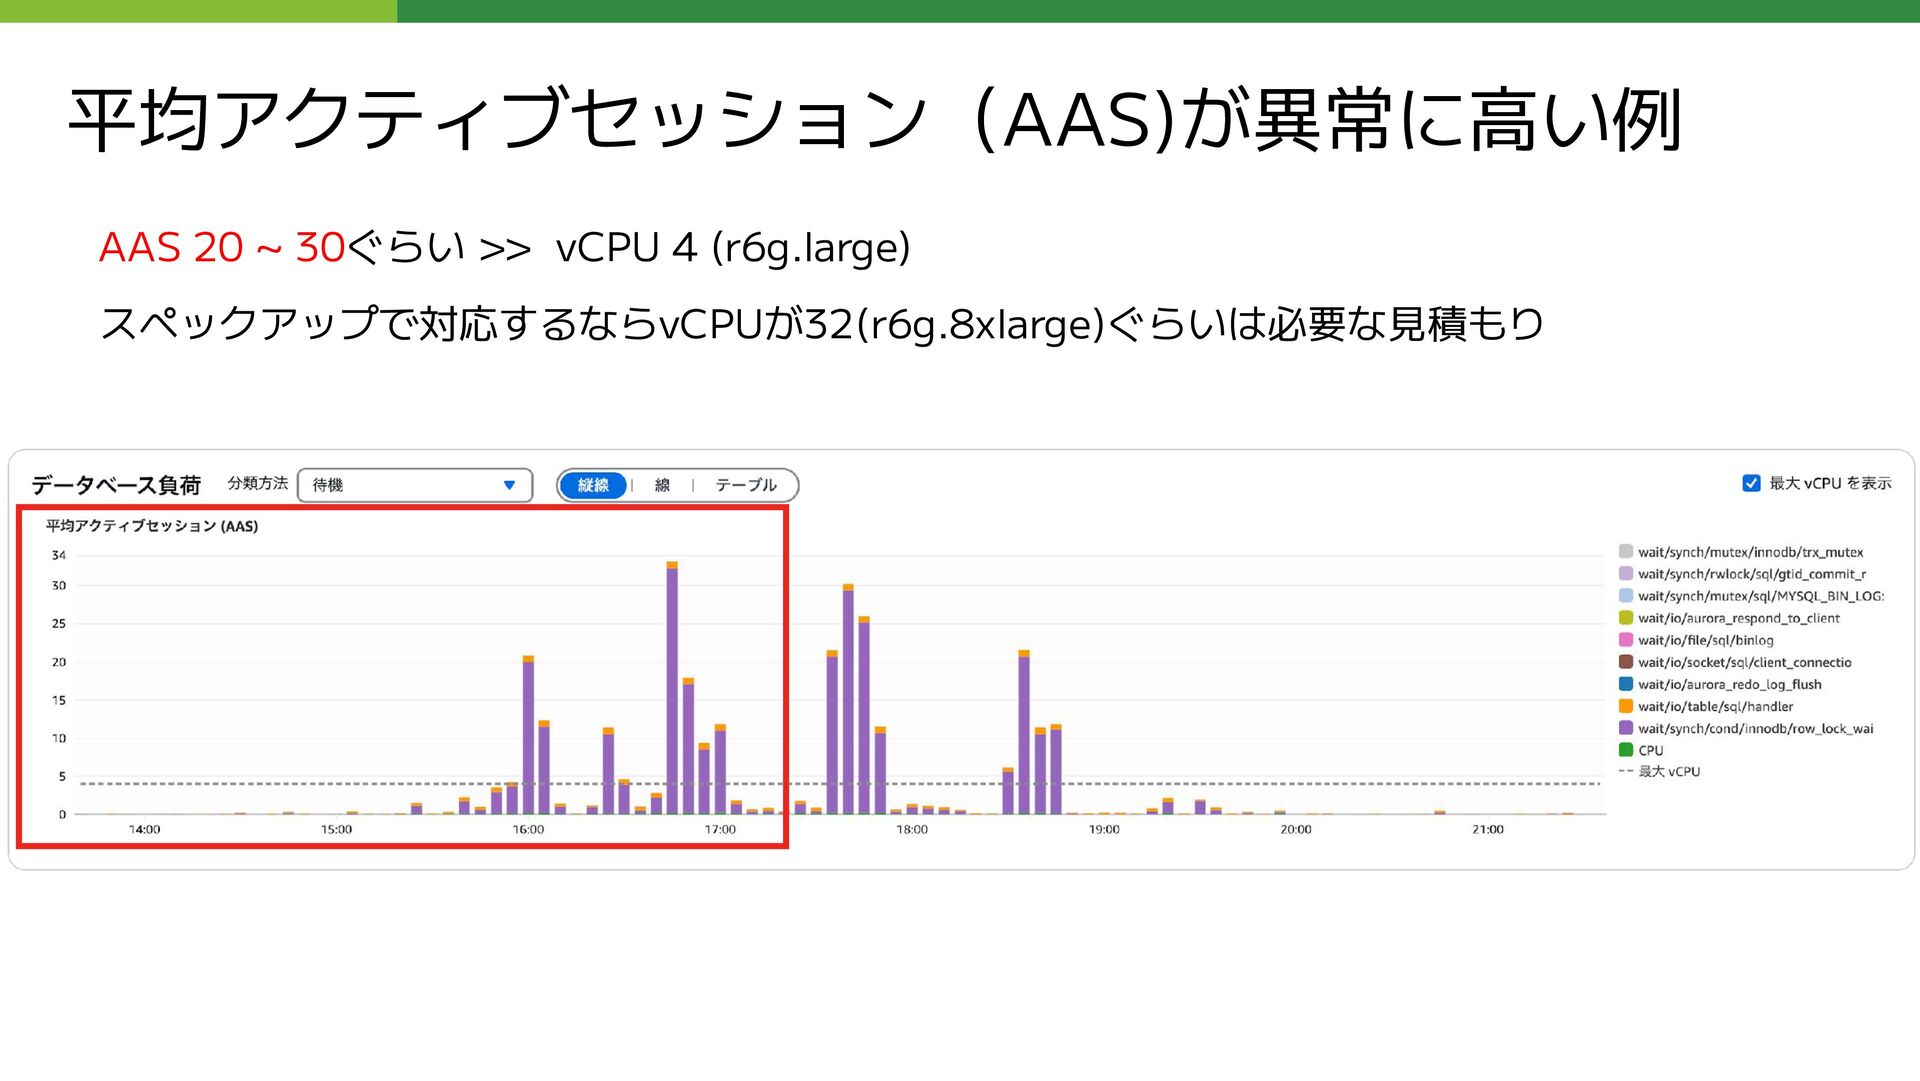
平均アクティブセッション(AAS)が高い場合 AAS >= RDSインスタンスの最大vCPU数の場合 • vCPUと同じぐらいかやや超えていた場合 → パフォーマンス影響の可能性あり • vCPU数を大きく超えていた場合
→ ほぼ確実にパフォーマンスに問題が起きていた 下記の状況の場合 • 断続的にvCPUのラインを超えてAAS が4になっているのでパフォーマンス影響の可能性あり -
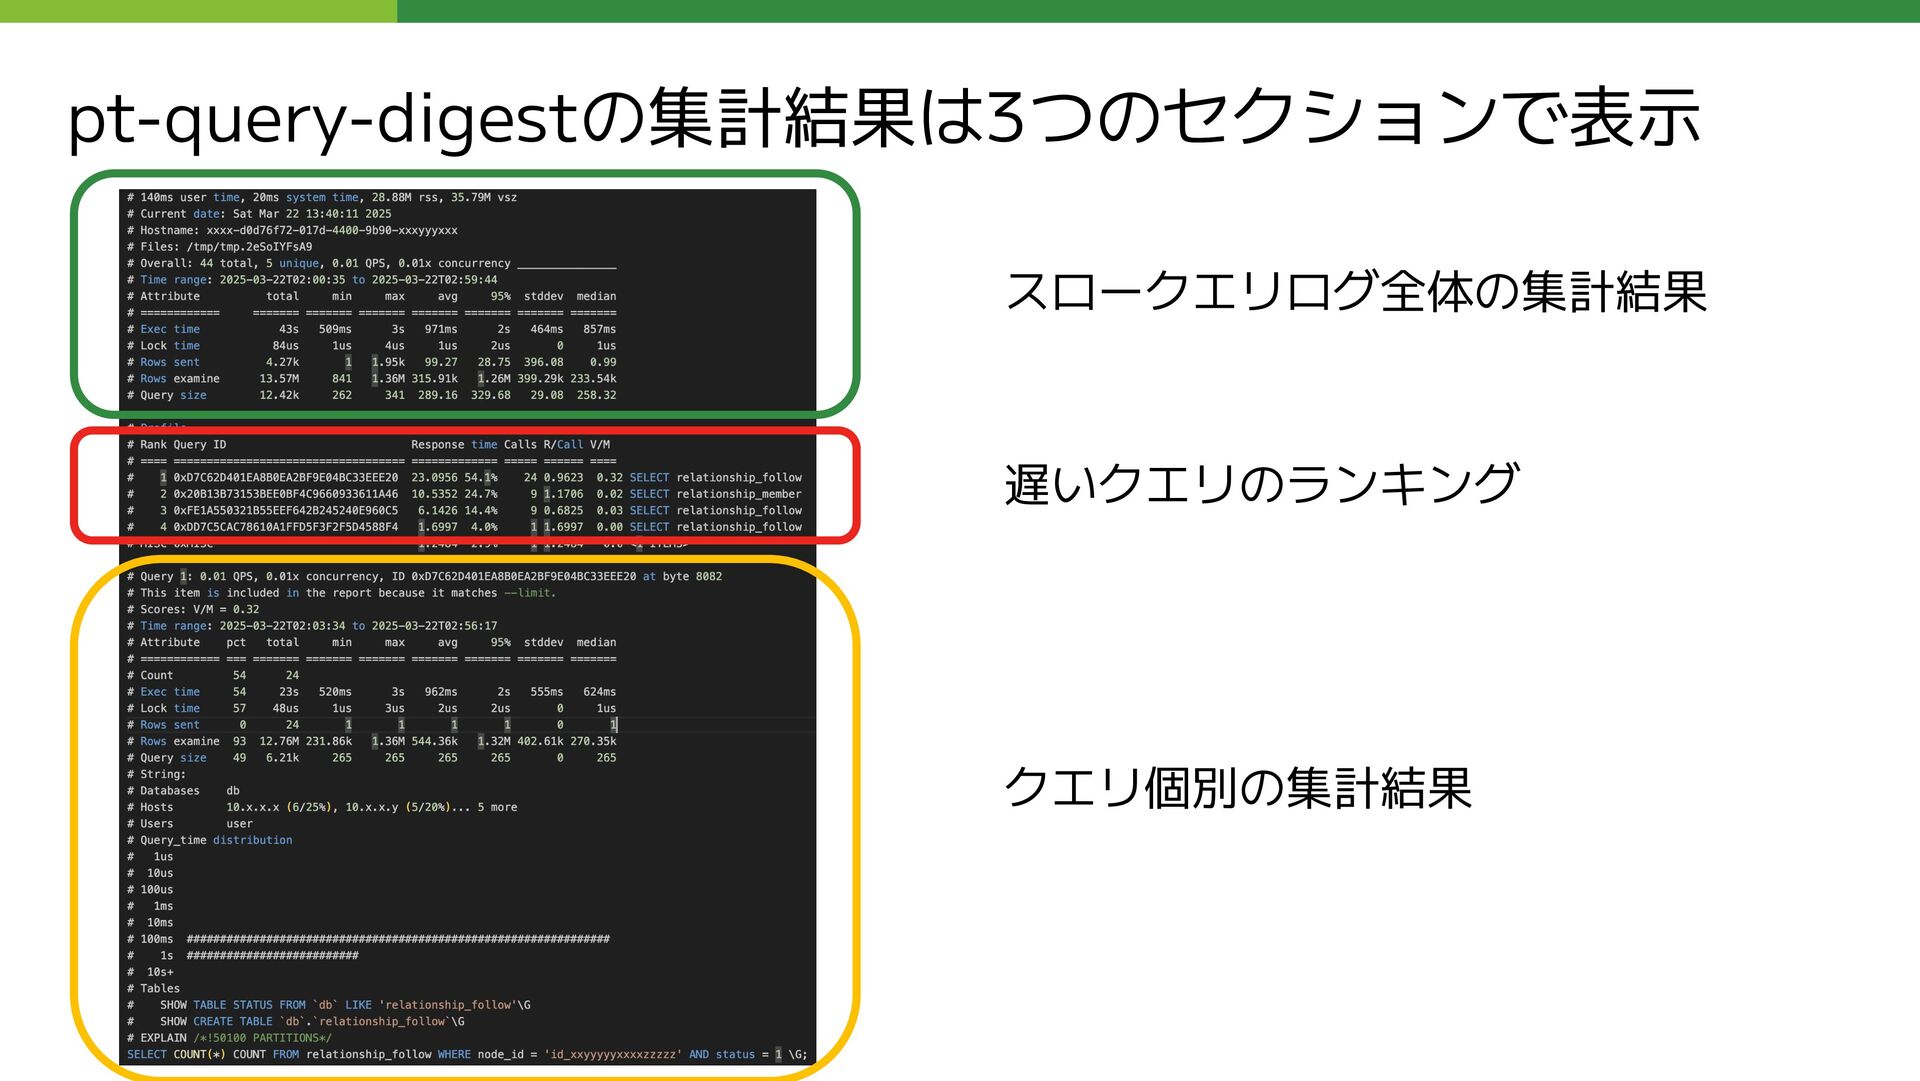
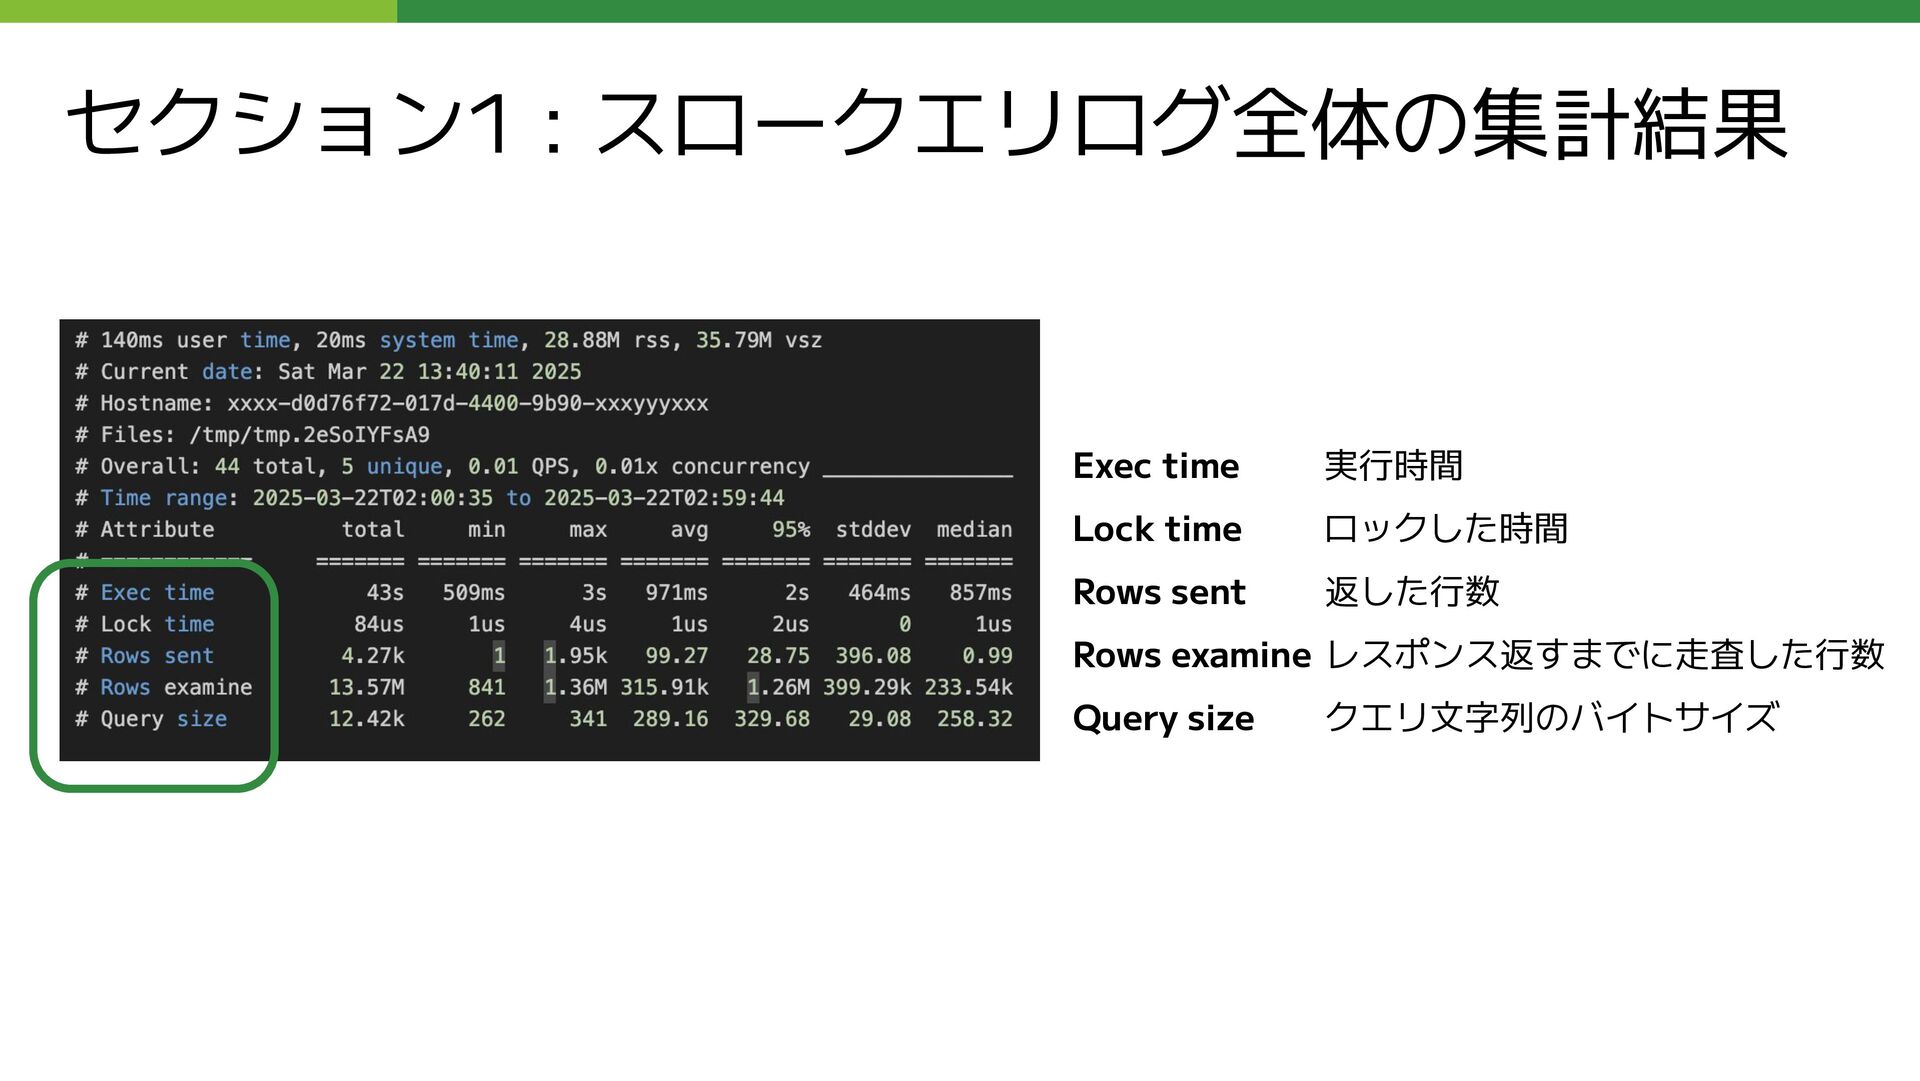
セクション1 : スロークエリログ全体の集計結果 Exec time 実行時間 Lock time ロックした時間 Rows
sent 返した行数 Rows examine レスポンス返すまでに走査した行数 Query size クエリ文字列のバイトサイズ -
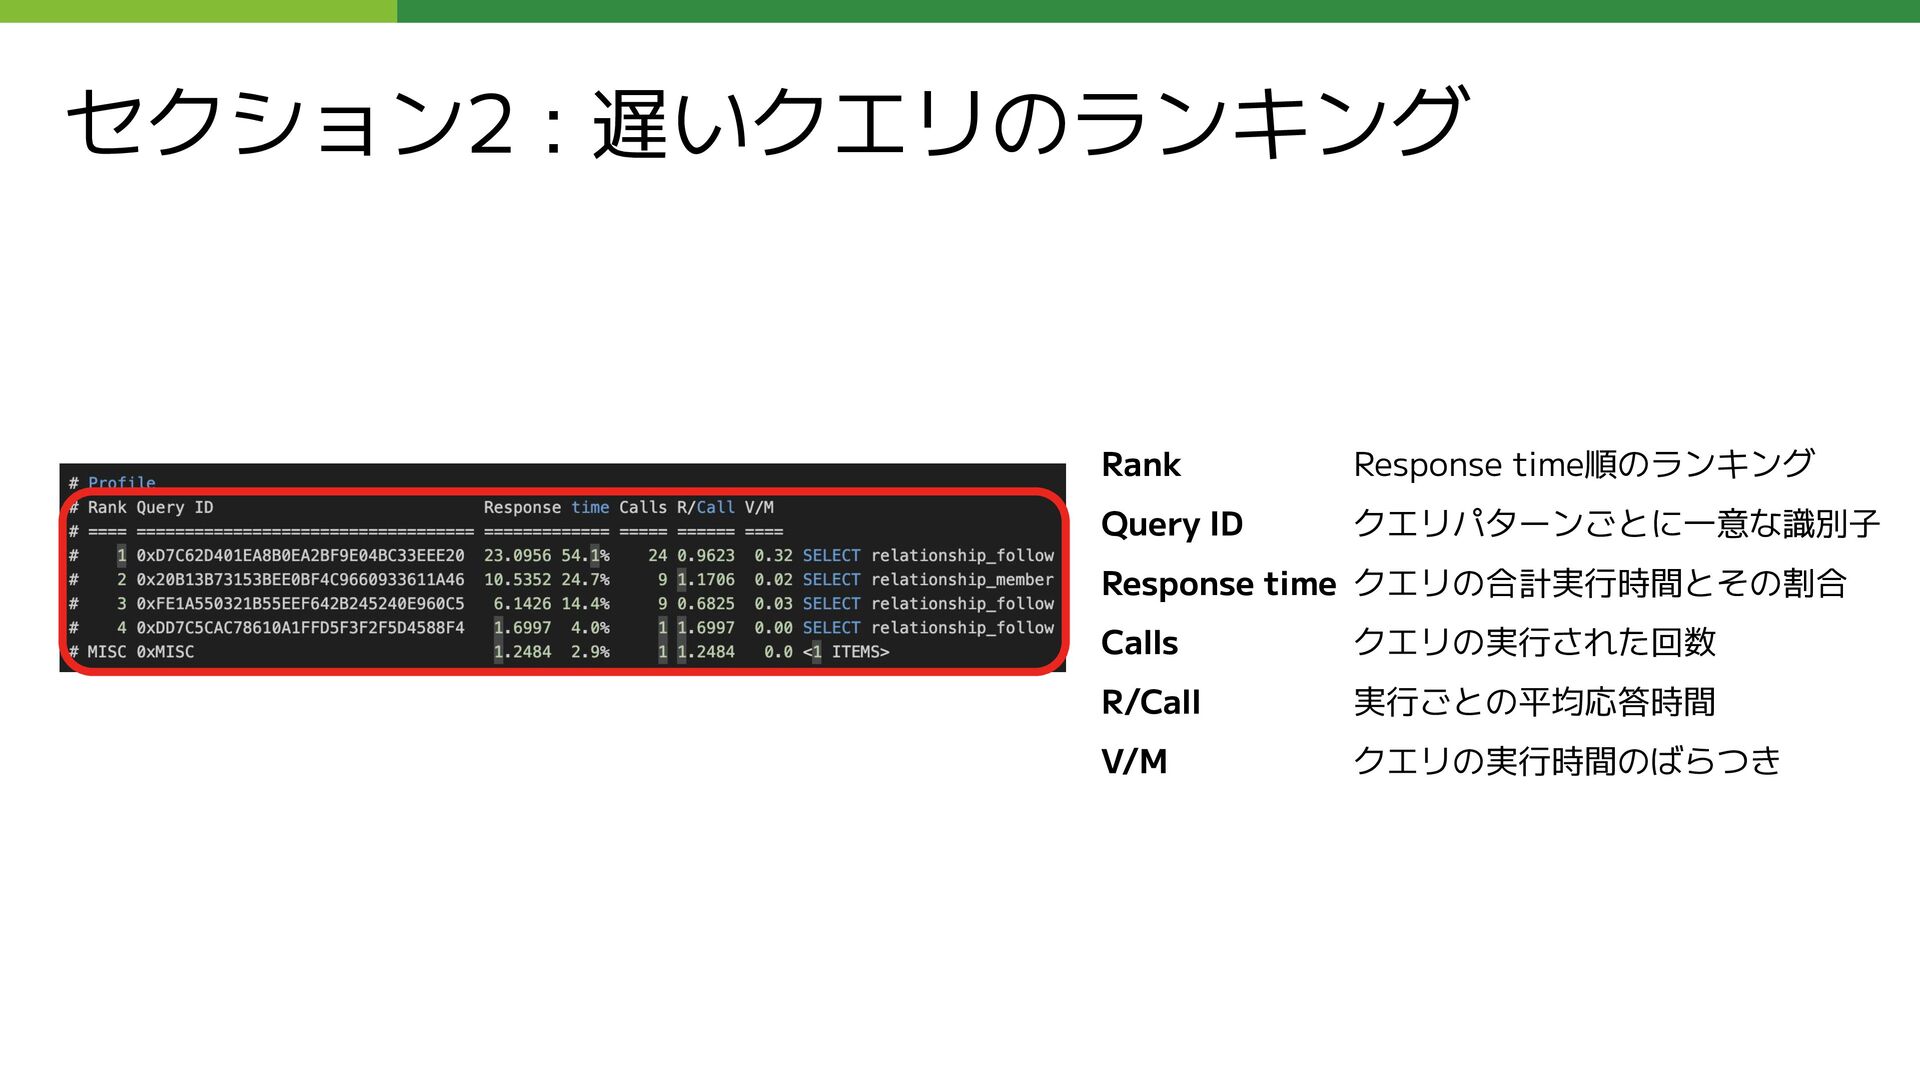
セクション2 : 遅いクエリのランキング Rank Response time順のランキング Query ID クエリパターンごとに一意な識別子 Response
time クエリの合計実行時間とその割合 Calls クエリの実行された回数 R/Call 実行ごとの平均応答時間 V/M クエリの実行時間のばらつき -
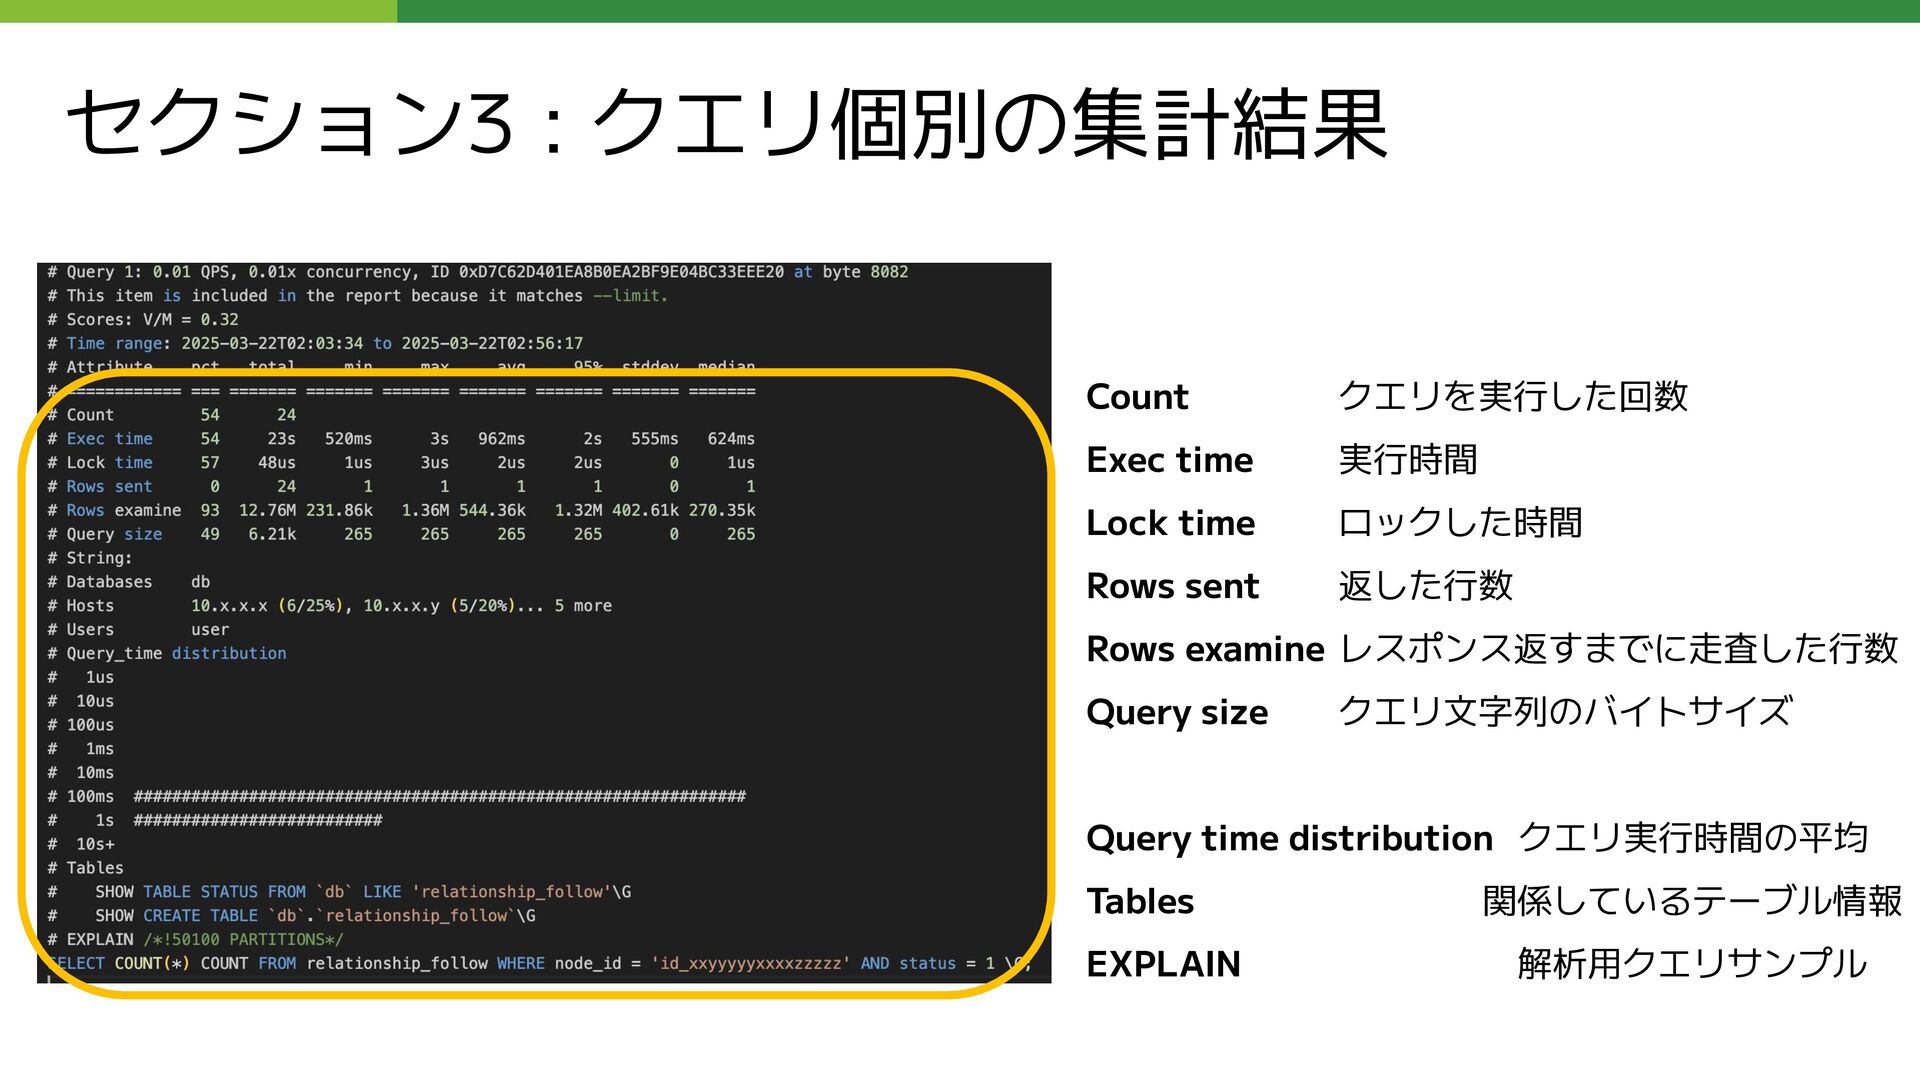
セクション3 : クエリ個別の集計結果 Count クエリを実行した回数 Exec time 実行時間 Lock time
ロックした時間 Rows sent 返した行数 Rows examine レスポンス返すまでに走査した行数 Query size クエリ文字列のバイトサイズ Query time distribution クエリ実行時間の平均 Tables 関係しているテーブル情報 EXPLAIN 解析用クエリサンプル -
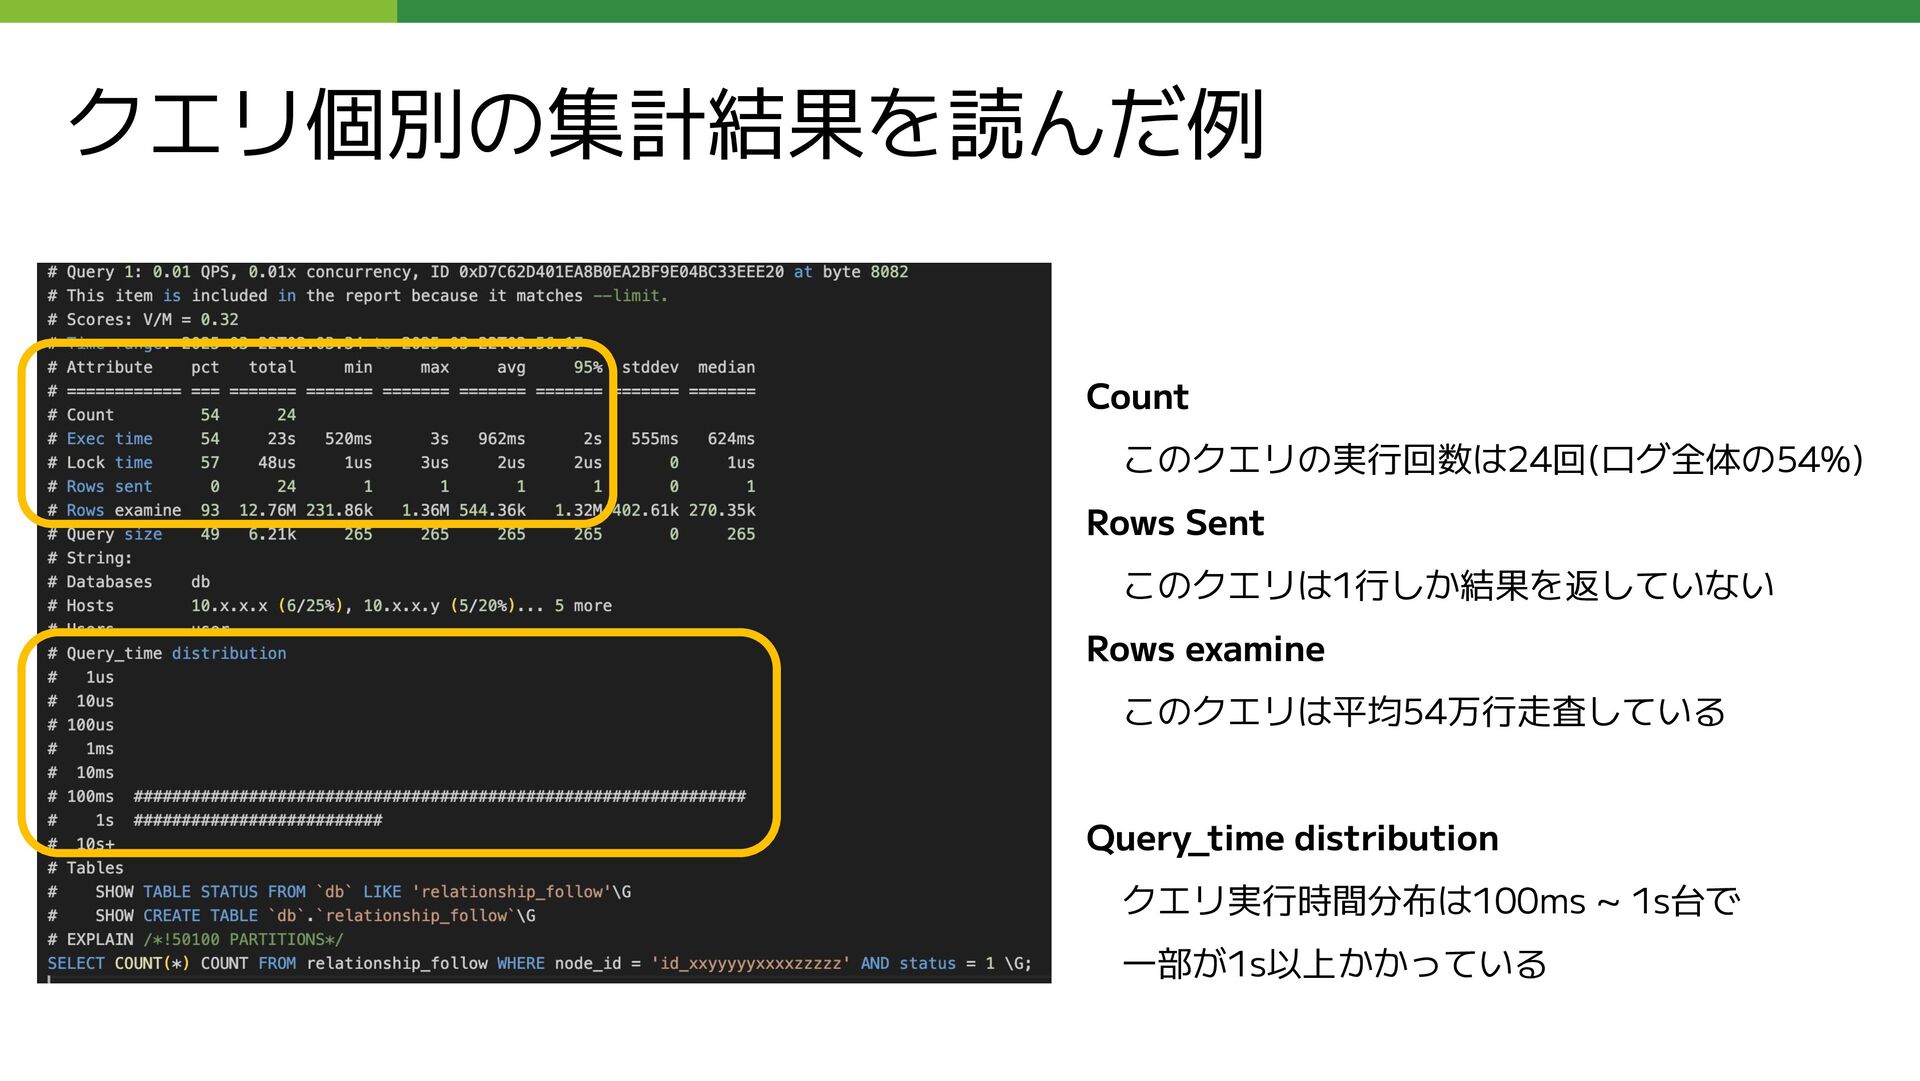
クエリ個別の集計結果を読んだ例 Count このクエリの実行回数は24回(ログ全体の54%) Rows Sent このクエリは1行しか結果を返していない Rows examine このクエリは平均54万行走査している Query_time
distribution クエリ実行時間分布は100ms ~ 1s台で 一部が1s以上かかっている -
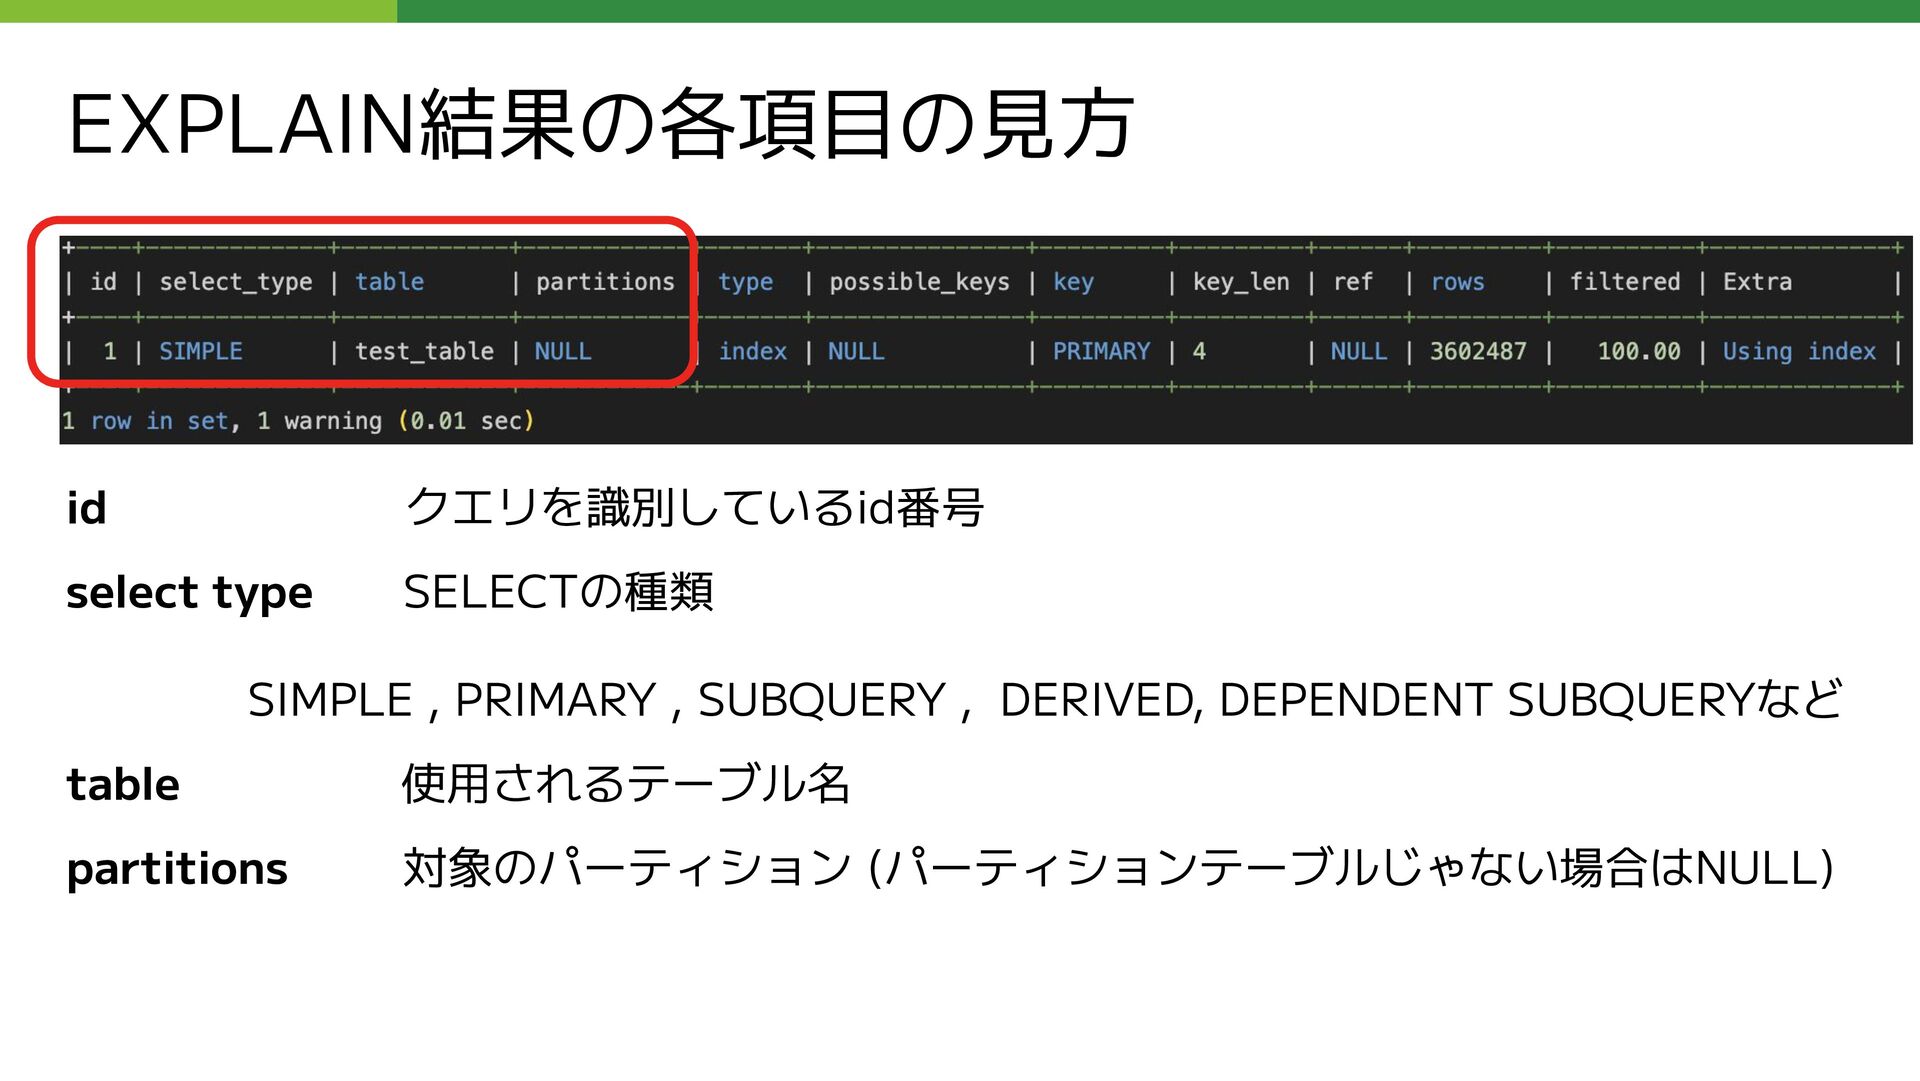
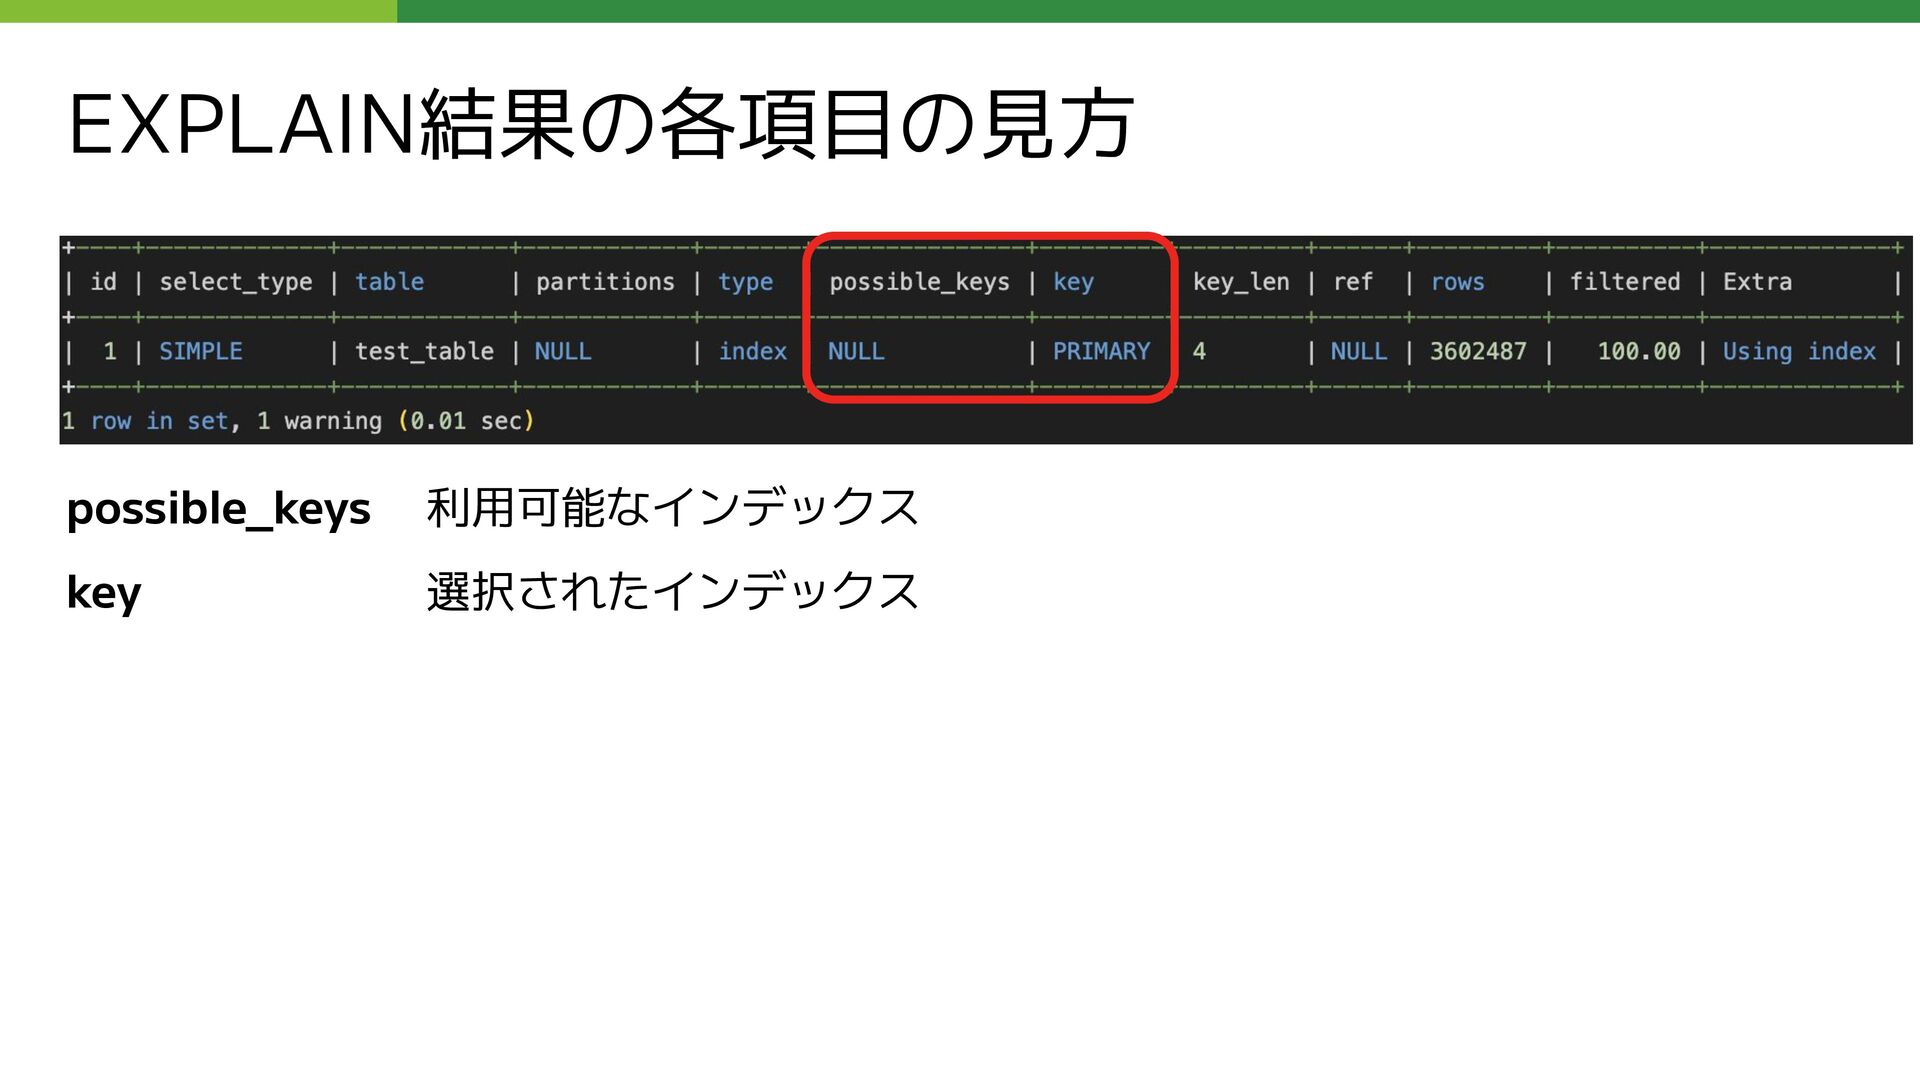
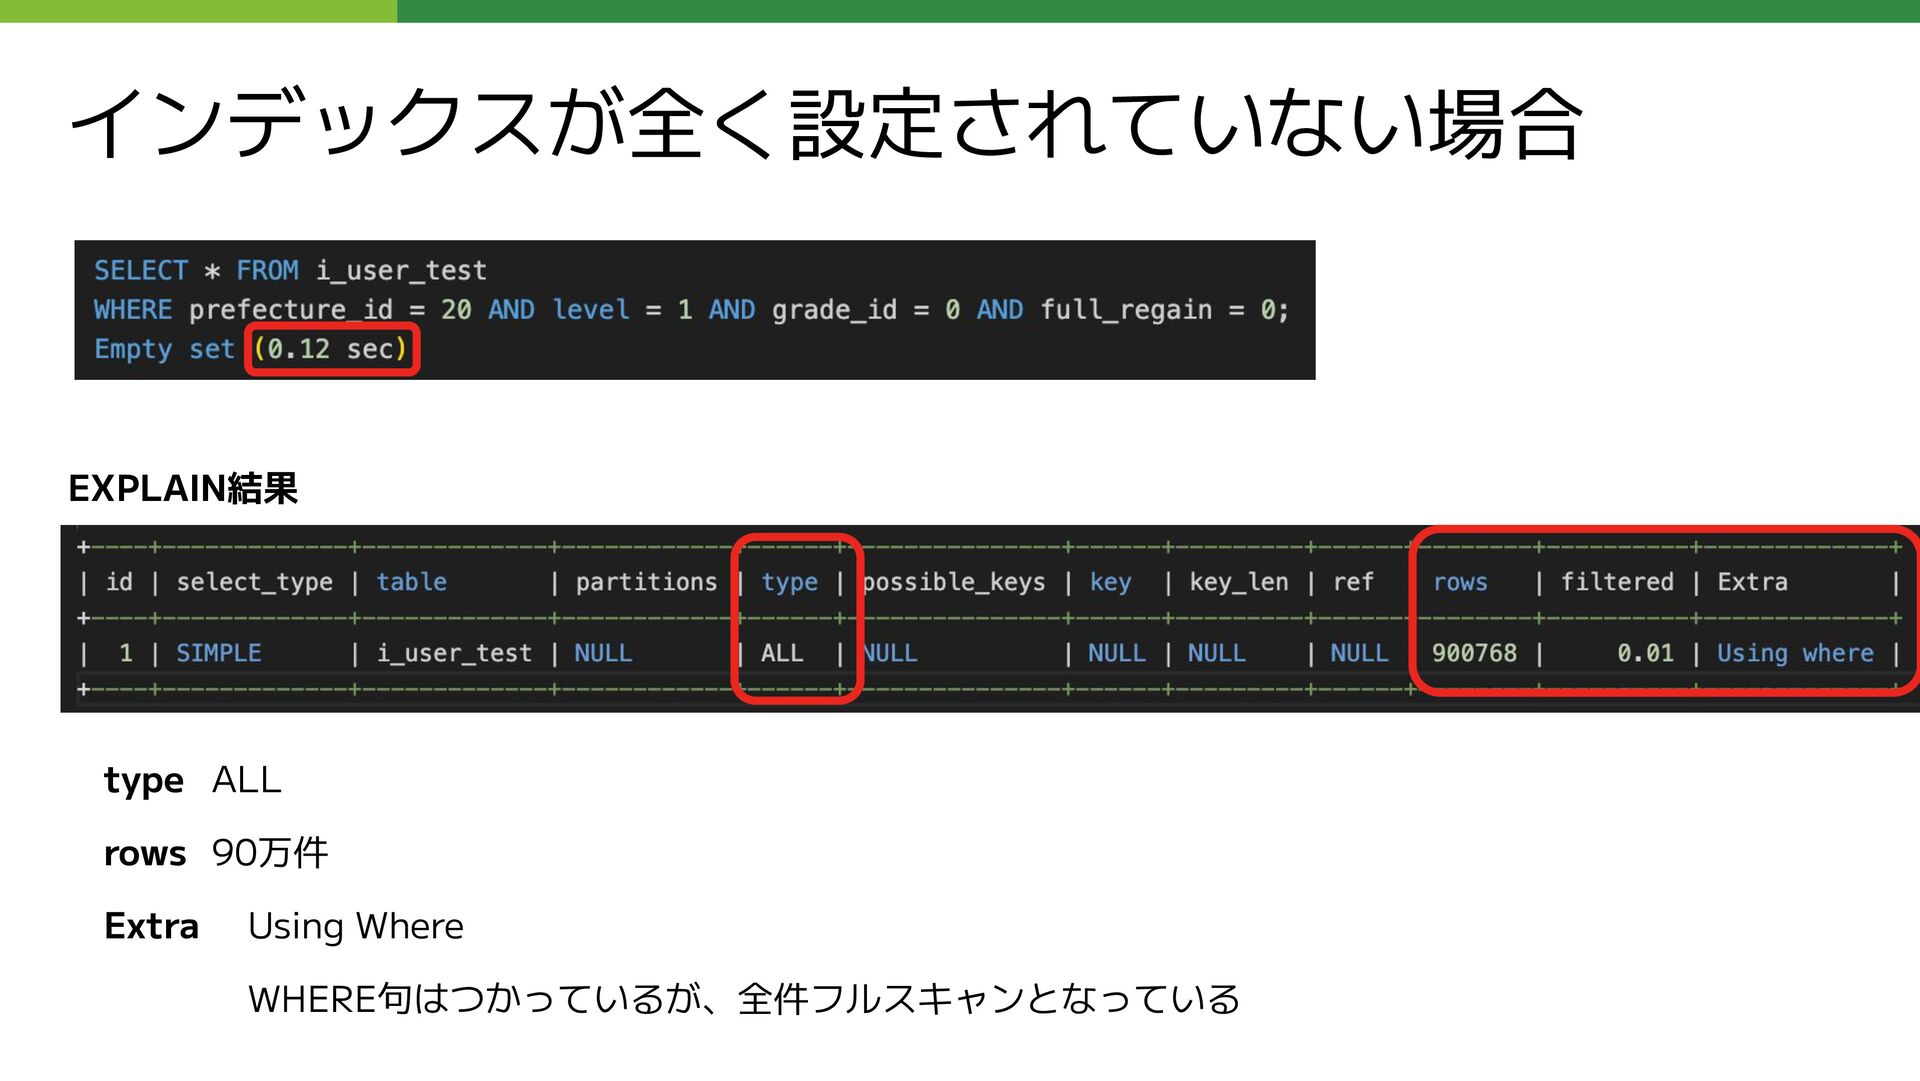
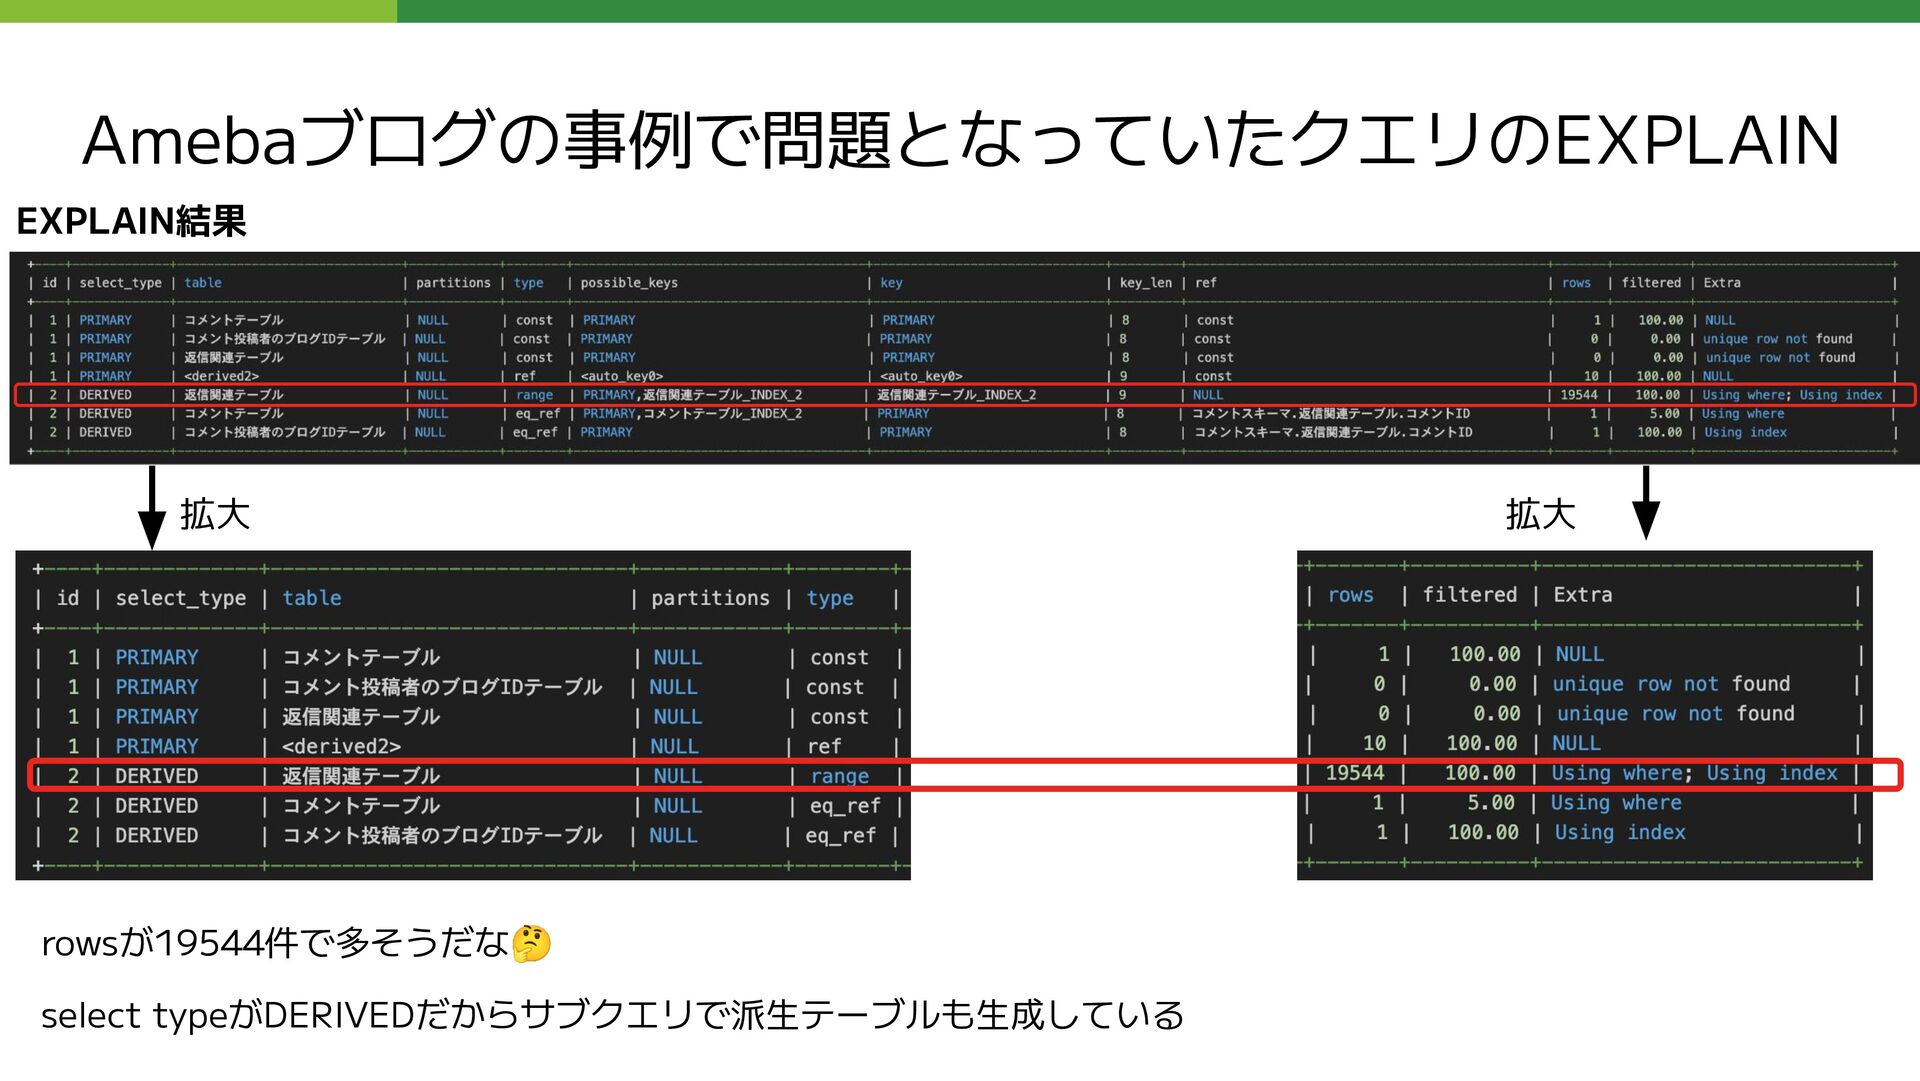
EXPLAIN結果の各項目の見方 id クエリを識別しているid番号 select type SELECTの種類 SIMPLE , PRIMARY
, SUBQUERY , DERIVED, DEPENDENT SUBQUERYなど table 使用されるテーブル名 partitions 対象のパーティション (パーティションテーブルじゃない場合はNULL) -
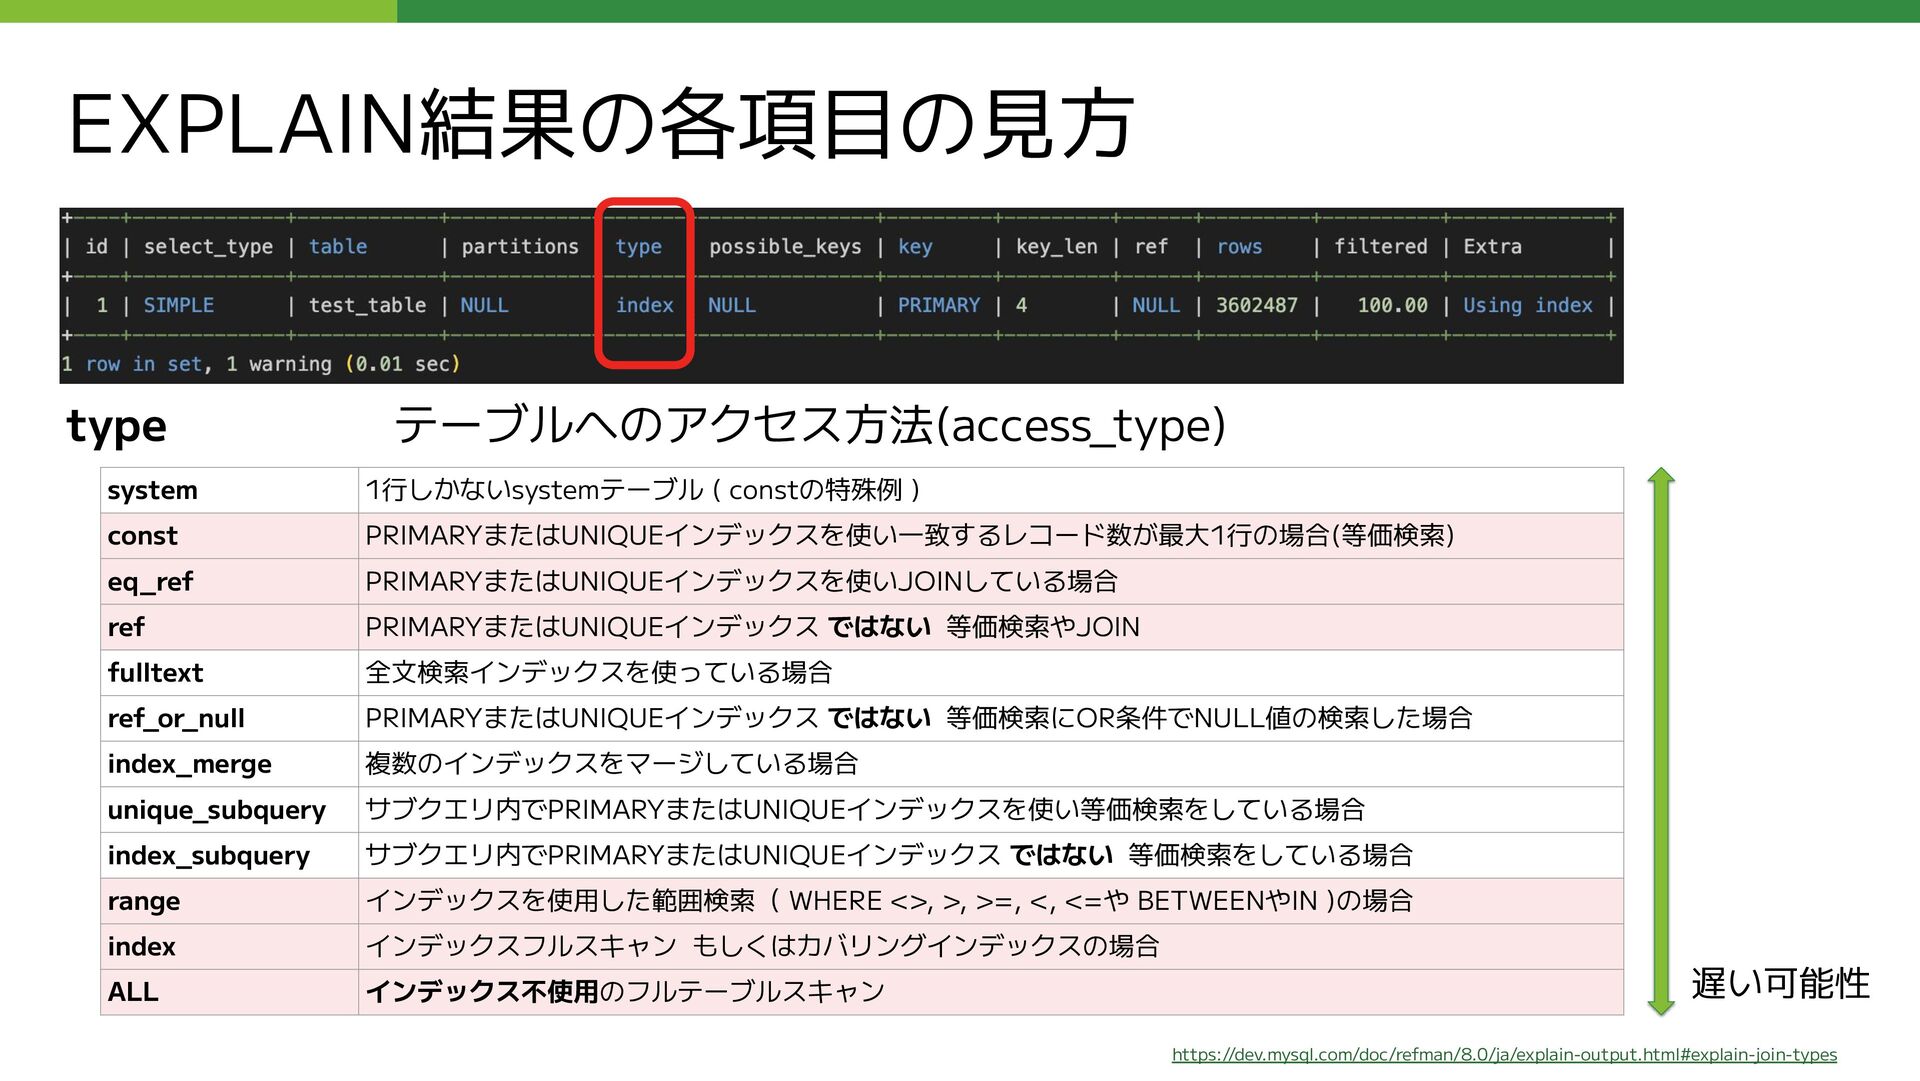
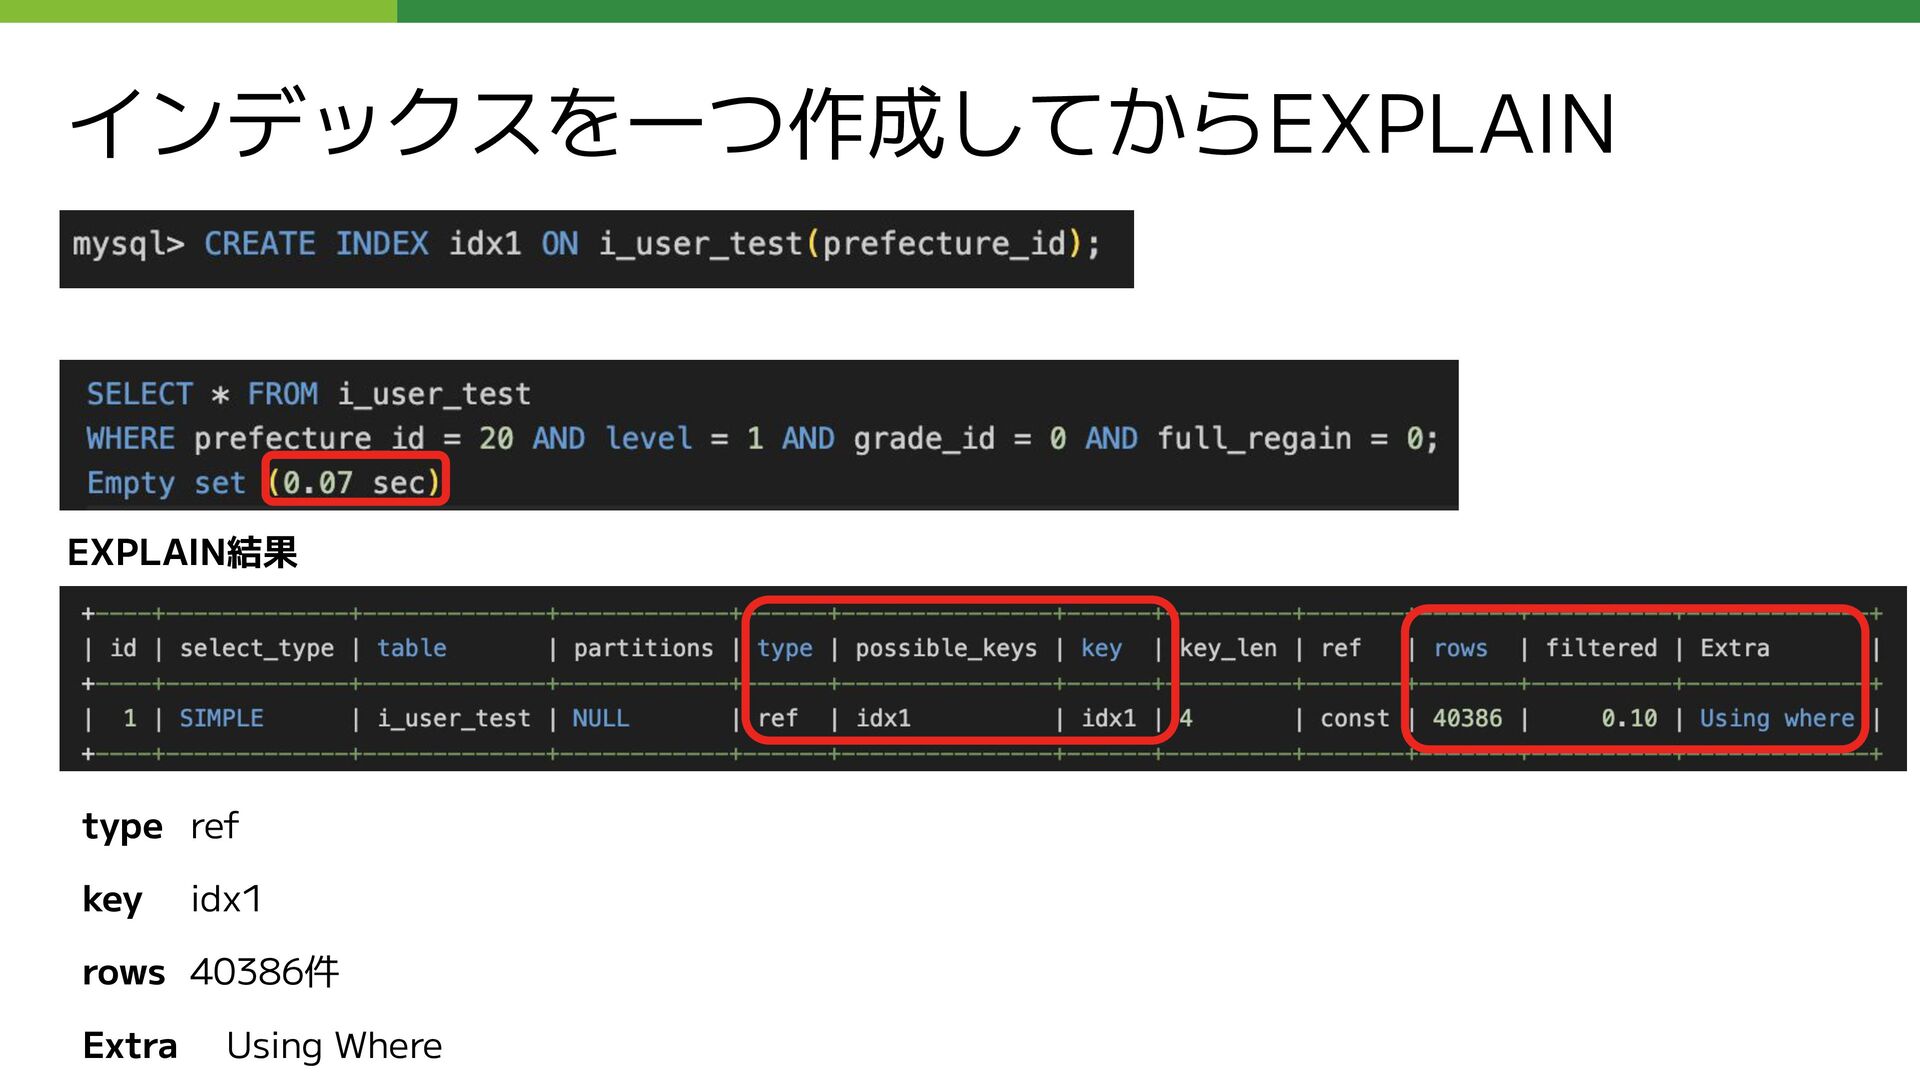
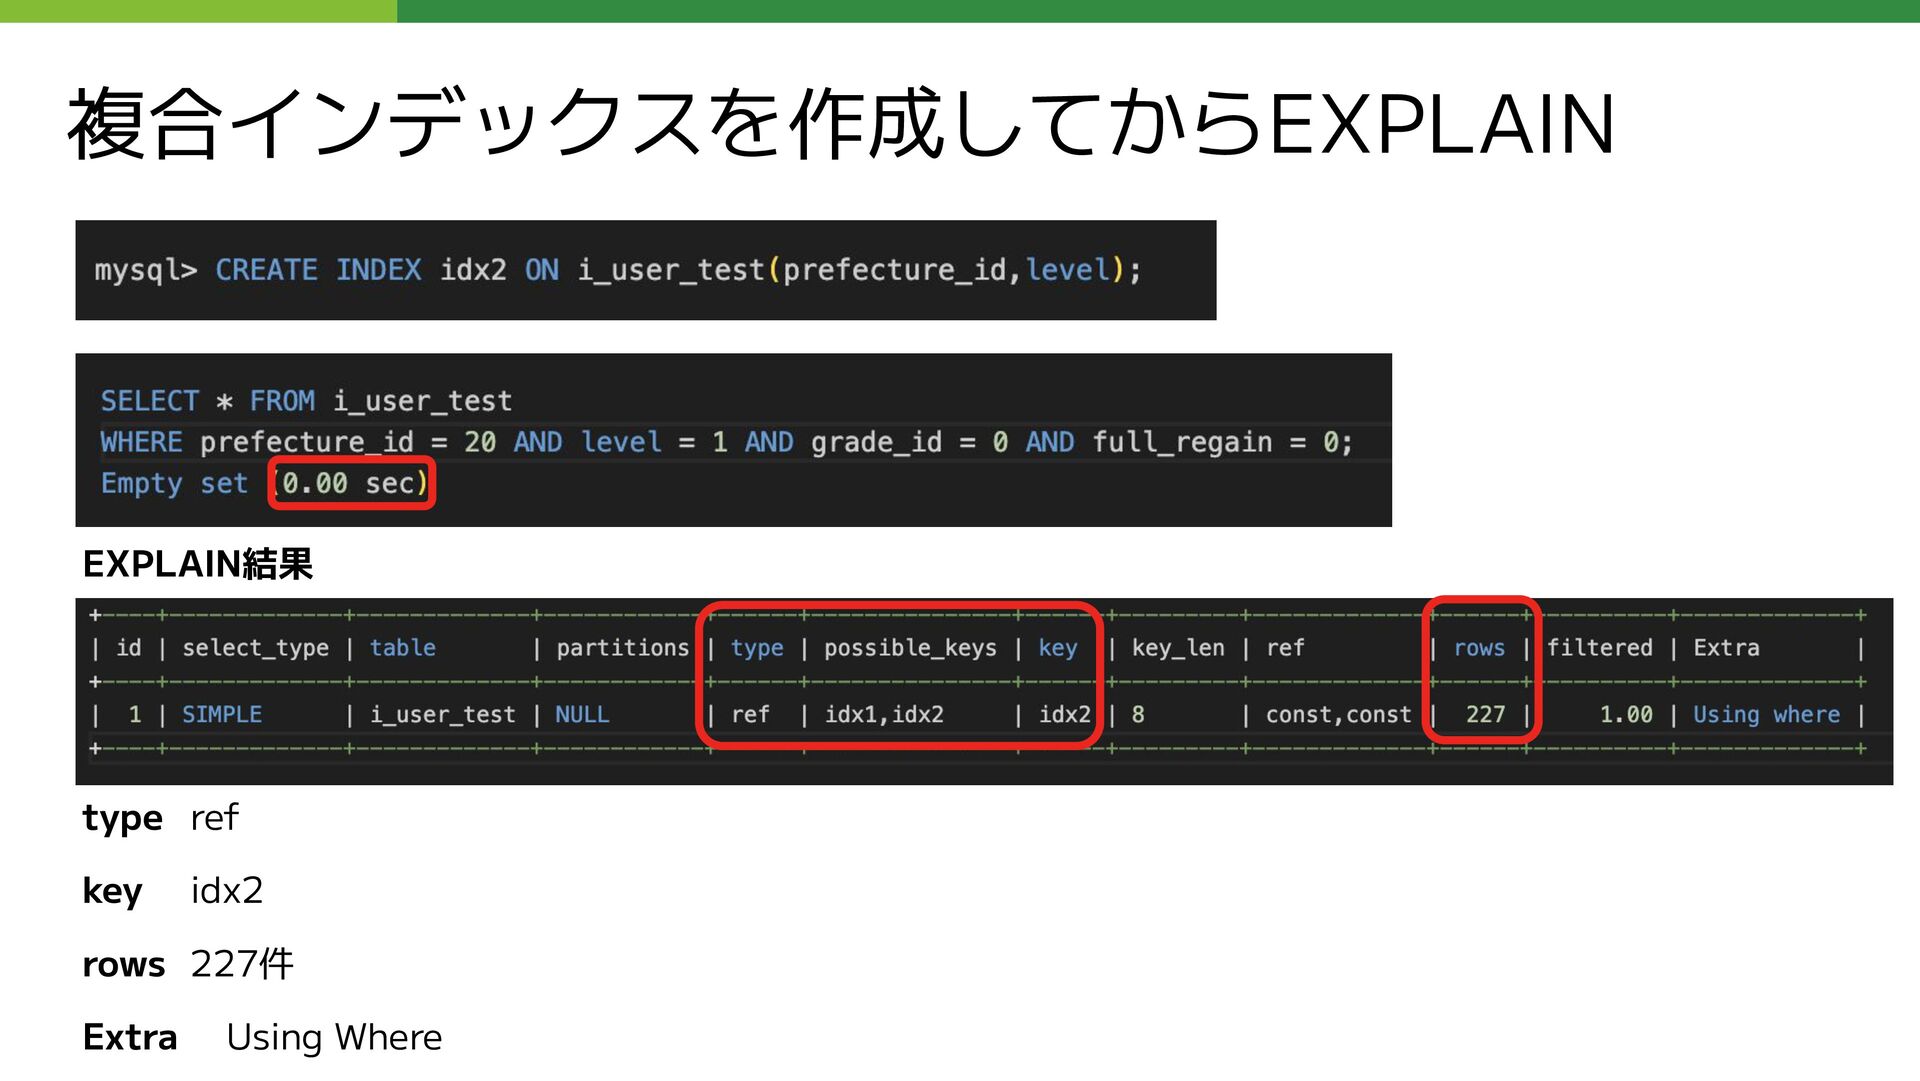
EXPLAIN結果の各項目の見方 type テーブルへのアクセス方法(access_type) system 1行しかないsystemテーブル ( constの特殊例 )
const PRIMARYまたはUNIQUEインデックスを使い一致するレコード数が最大1行の場合(等価検索) eq_ref PRIMARYまたはUNIQUEインデックスを使いJOINしている場合 ref PRIMARYまたはUNIQUEインデックス ではない 等価検索やJOIN fulltext 全文検索インデックスを使っている場合 ref_or_null PRIMARYまたはUNIQUEインデックス ではない 等価検索にOR条件でNULL値の検索した場合 index_merge 複数のインデックスをマージしている場合 unique_subquery サブクエリ内でPRIMARYまたはUNIQUEインデックスを使い等価検索をしている場合 index_subquery サブクエリ内でPRIMARYまたはUNIQUEインデックス ではない 等価検索をしている場合 range インデックスを使用した範囲検索( WHERE <>, >, >=, <, <=や BETWEENやIN )の場合 index インデックスフルスキャン もしくはカバリングインデックスの場合 ALL インデックス不使用のフルテーブルスキャン https://dev.mysql.com/doc/refman/8.0/ja/explain-output.html#explain-join-types 遅い可能性 -
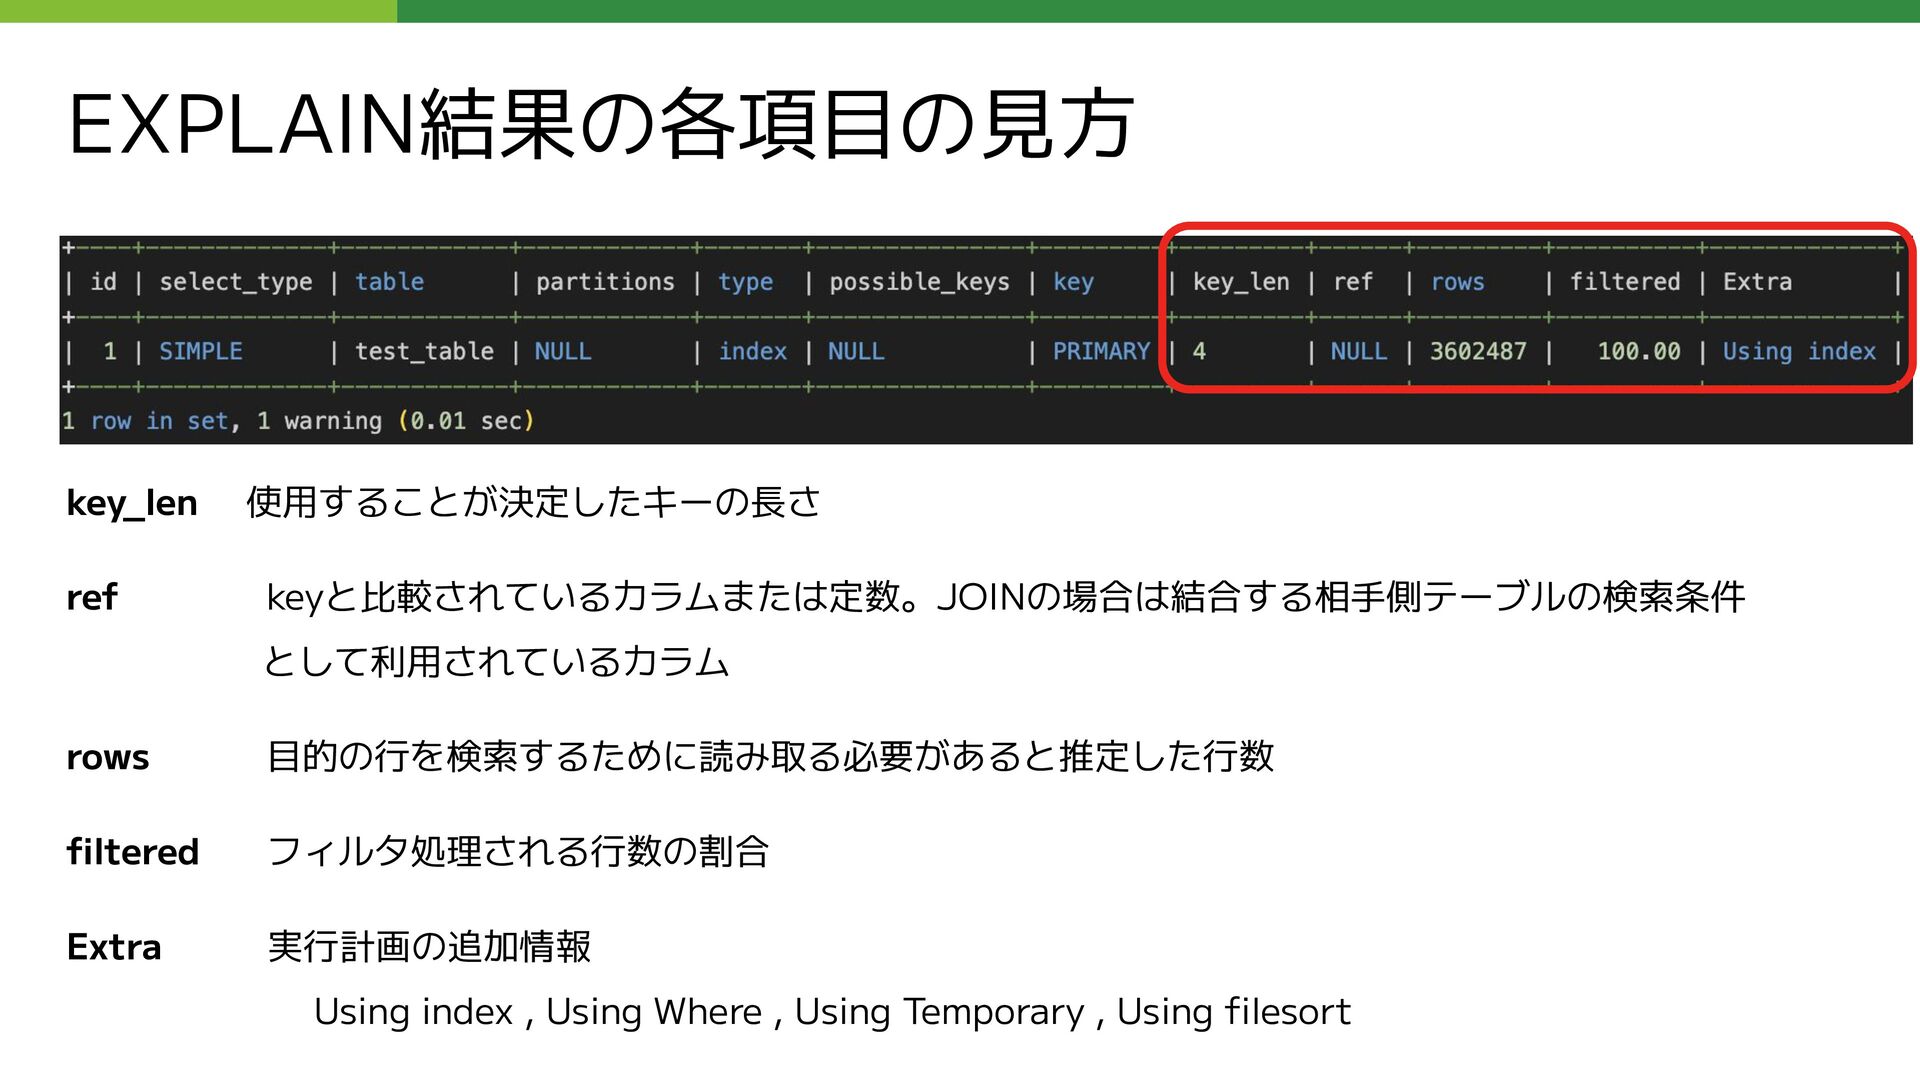
EXPLAIN結果の各項目の見方 key_len 使用することが決定したキーの長さ ref keyと比較されているカラムまたは定数。JOINの場合は結合する相手側テーブルの検索条件 として利用されているカラム rows 目的の行を検索するために読み取る必要があると推定した行数 filtered フィルタ処理される行数の割合
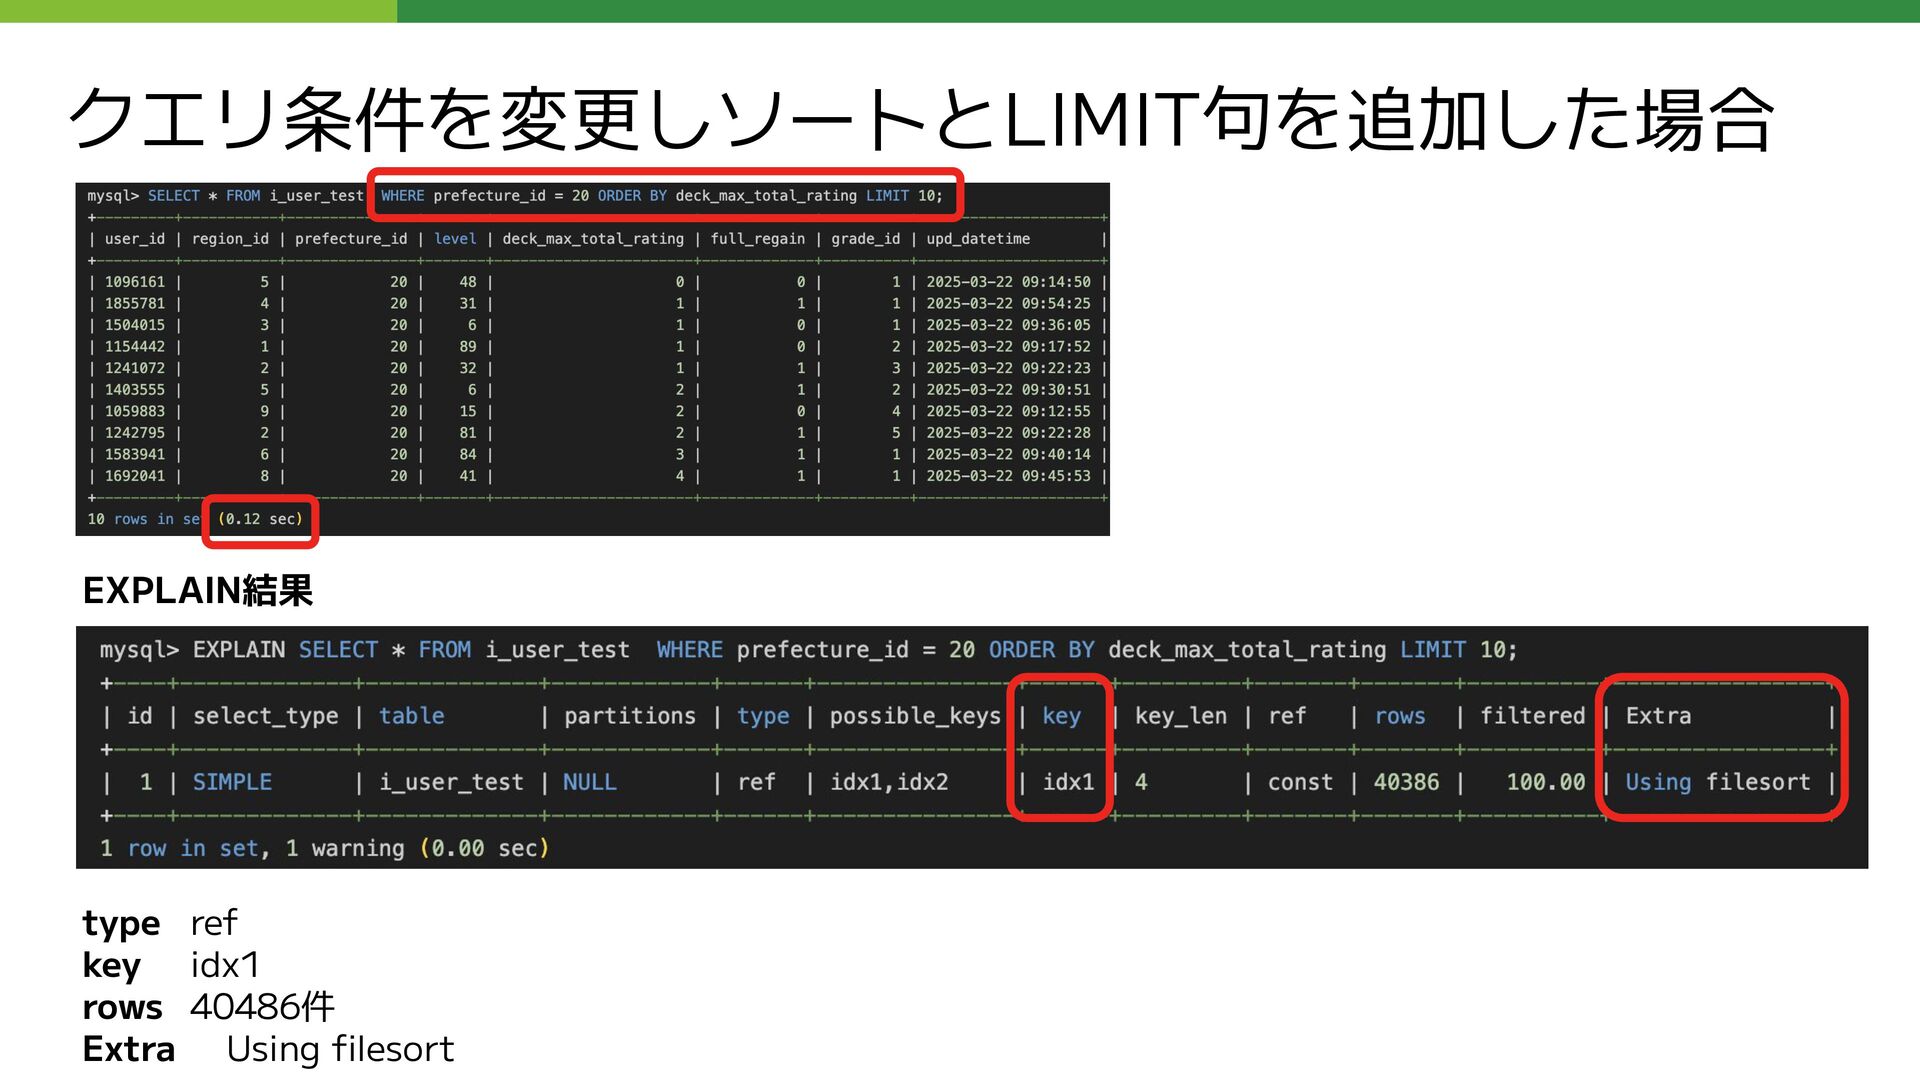
Extra 実行計画の追加情報 Using index , Using Where , Using Temporary , Using filesort -
ソート対象のカラムを含めた複合インデックス作成 type ref key idx3 rows 40486件 Extra NULL ←
Using Filesortが消えた。インデックスからLIMITの10件分取り出して終了するので高速 EXPLAIN結果 -
先程のAmebaブログの事例で問題となっていたクエリ (外部公開用に抽象化しています ) SELECT コメントID, ブログID, エントリID,〜中略〜, IFNULL(リプライカウント, 0) as
REPLY_COUNT FROM コメント仮想テーブル LEFT OUTER JOIN ( SELECT 親コメントID as コメントID, COUNT(コメントID) as REPLY_COUNT FROM コメント仮想テーブル WHERE ブログID = 【集計するブログID】 AND 親コメントID is not null GROUP BY 親コメントID ) as T_REPLY_COUNT USING (コメントID) WHERE (コメントID = 【集計するコメントID】); -
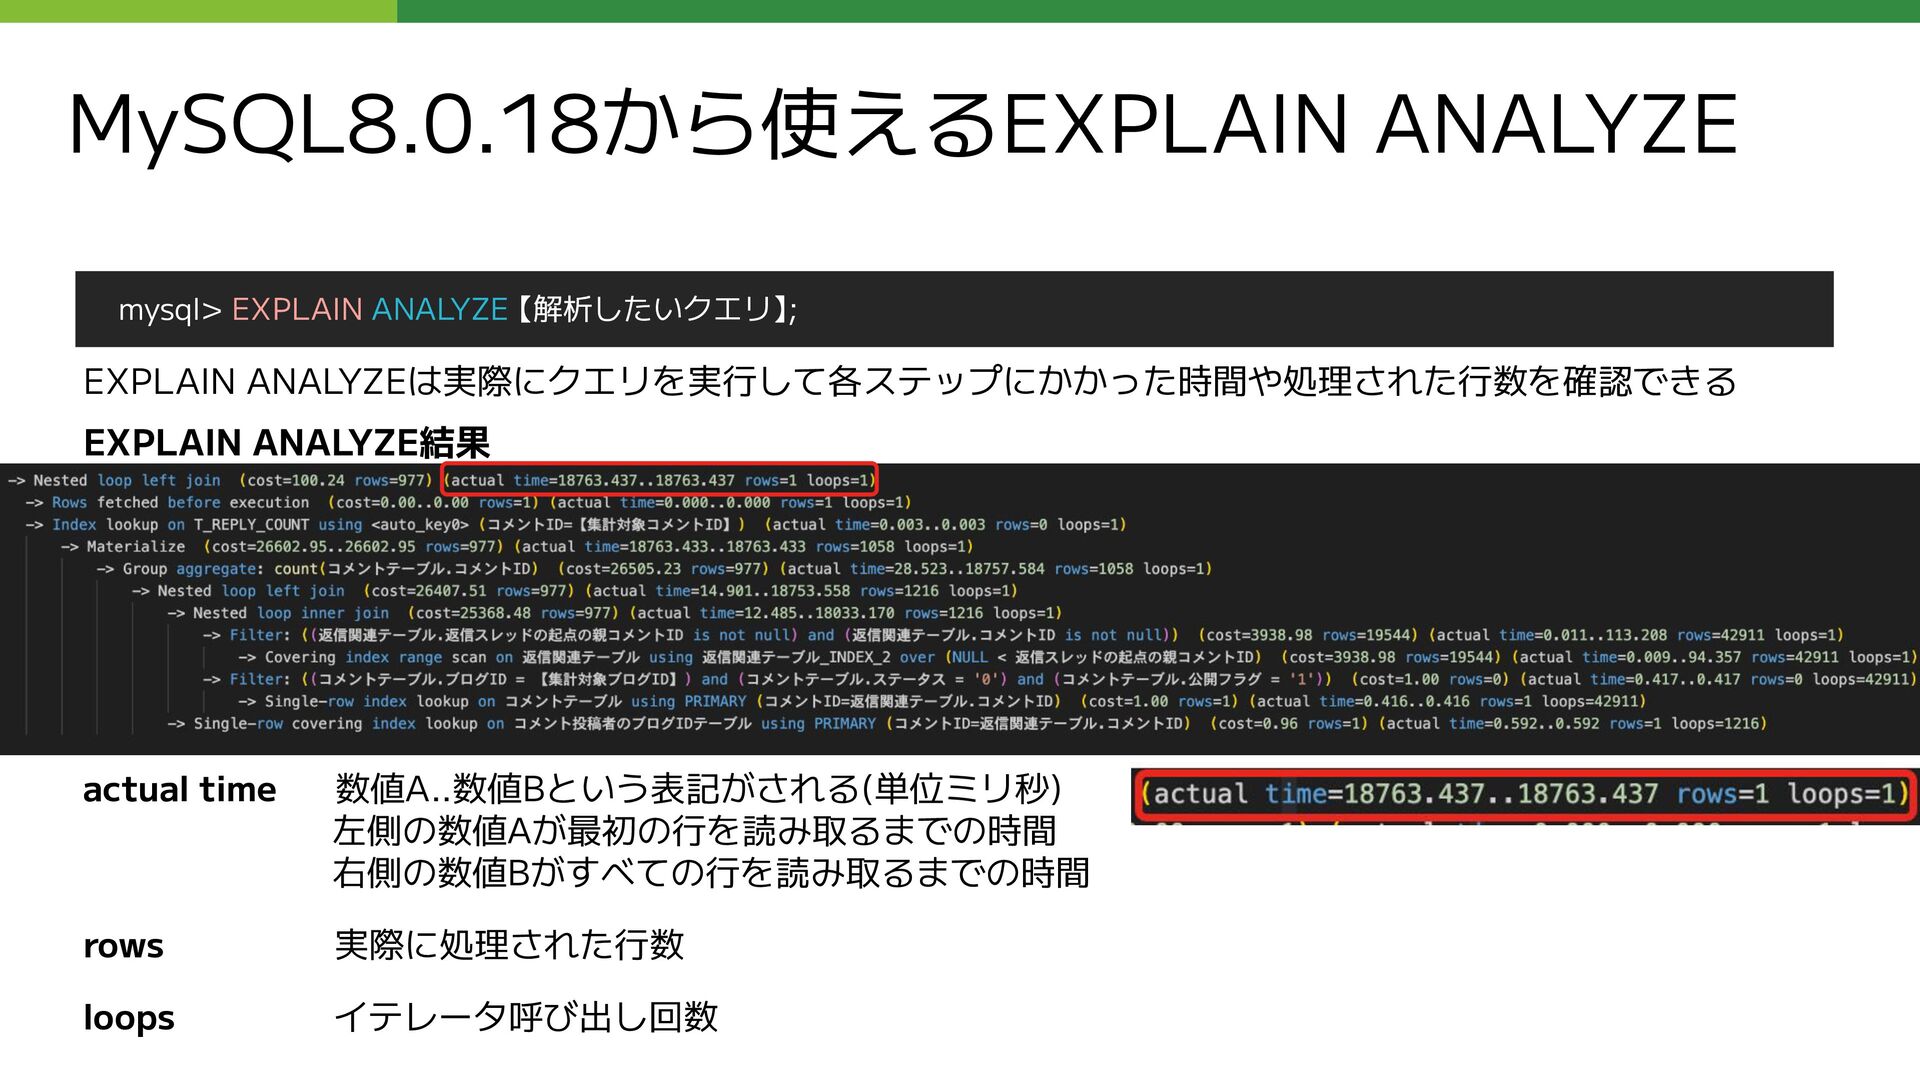
MySQL8.0.18から使えるEXPLAIN ANALYZE actual time 数値A..数値Bという表記がされる(単位ミリ秒) 左側の数値Aが最初の行を読み取るまでの時間 右側の数値Bがすべての行を読み取るまでの時間 rows 実際に処理された行数 loops
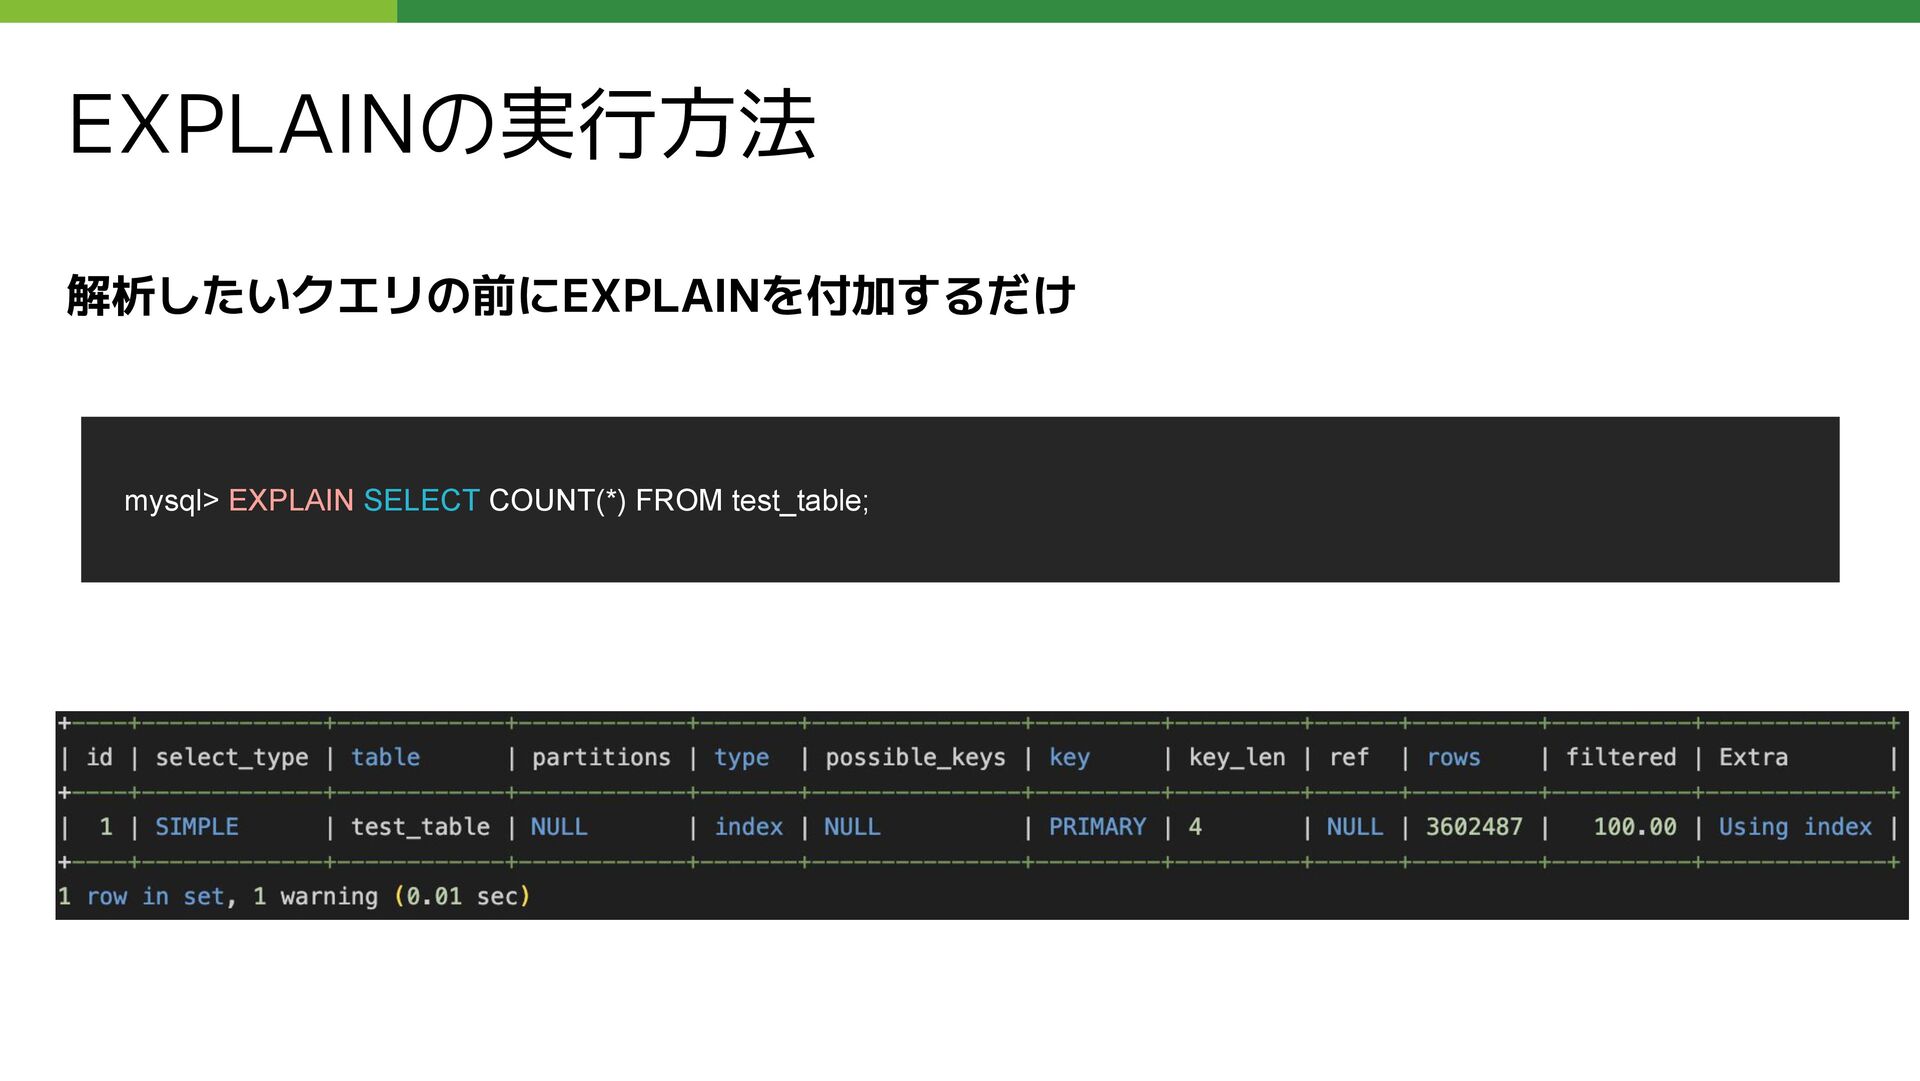
イテレータ呼び出し回数 EXPLAIN ANALYZE結果 mysql> EXPLAIN ANALYZE 【解析したいクエリ】; EXPLAIN ANALYZEは実際にクエリを実行して各ステップにかかった時間や処理された行数を確認できる -
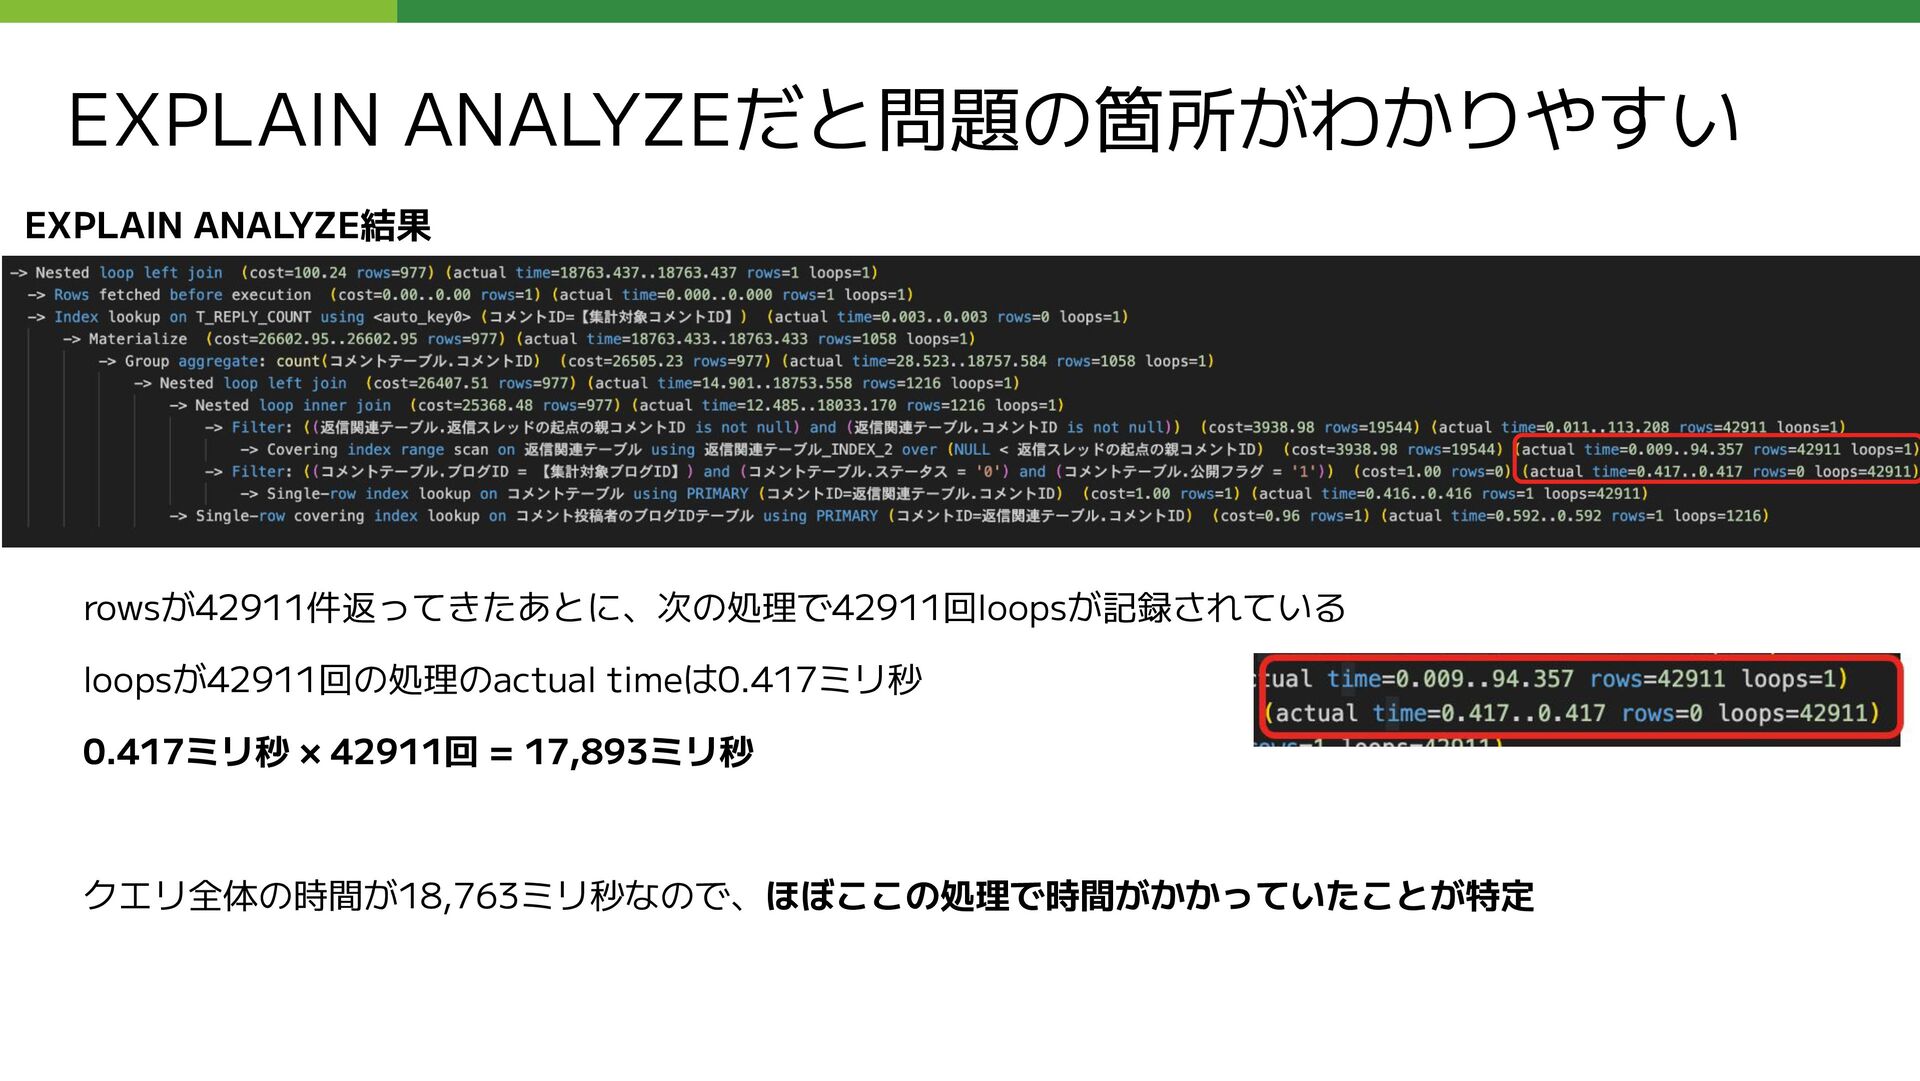
EXPLAIN ANALYZEだと問題の箇所がわかりやすい rowsが42911件返ってきたあとに、次の処理で42911回loopsが記録されている loopsが42911回の処理のactual timeは0.417ミリ秒 0.417ミリ秒 × 42911回 = 17,893ミリ秒
クエリ全体の時間が18,763ミリ秒なので、ほぼここの処理で時間がかかっていたことが特定 EXPLAIN ANALYZE結果 -
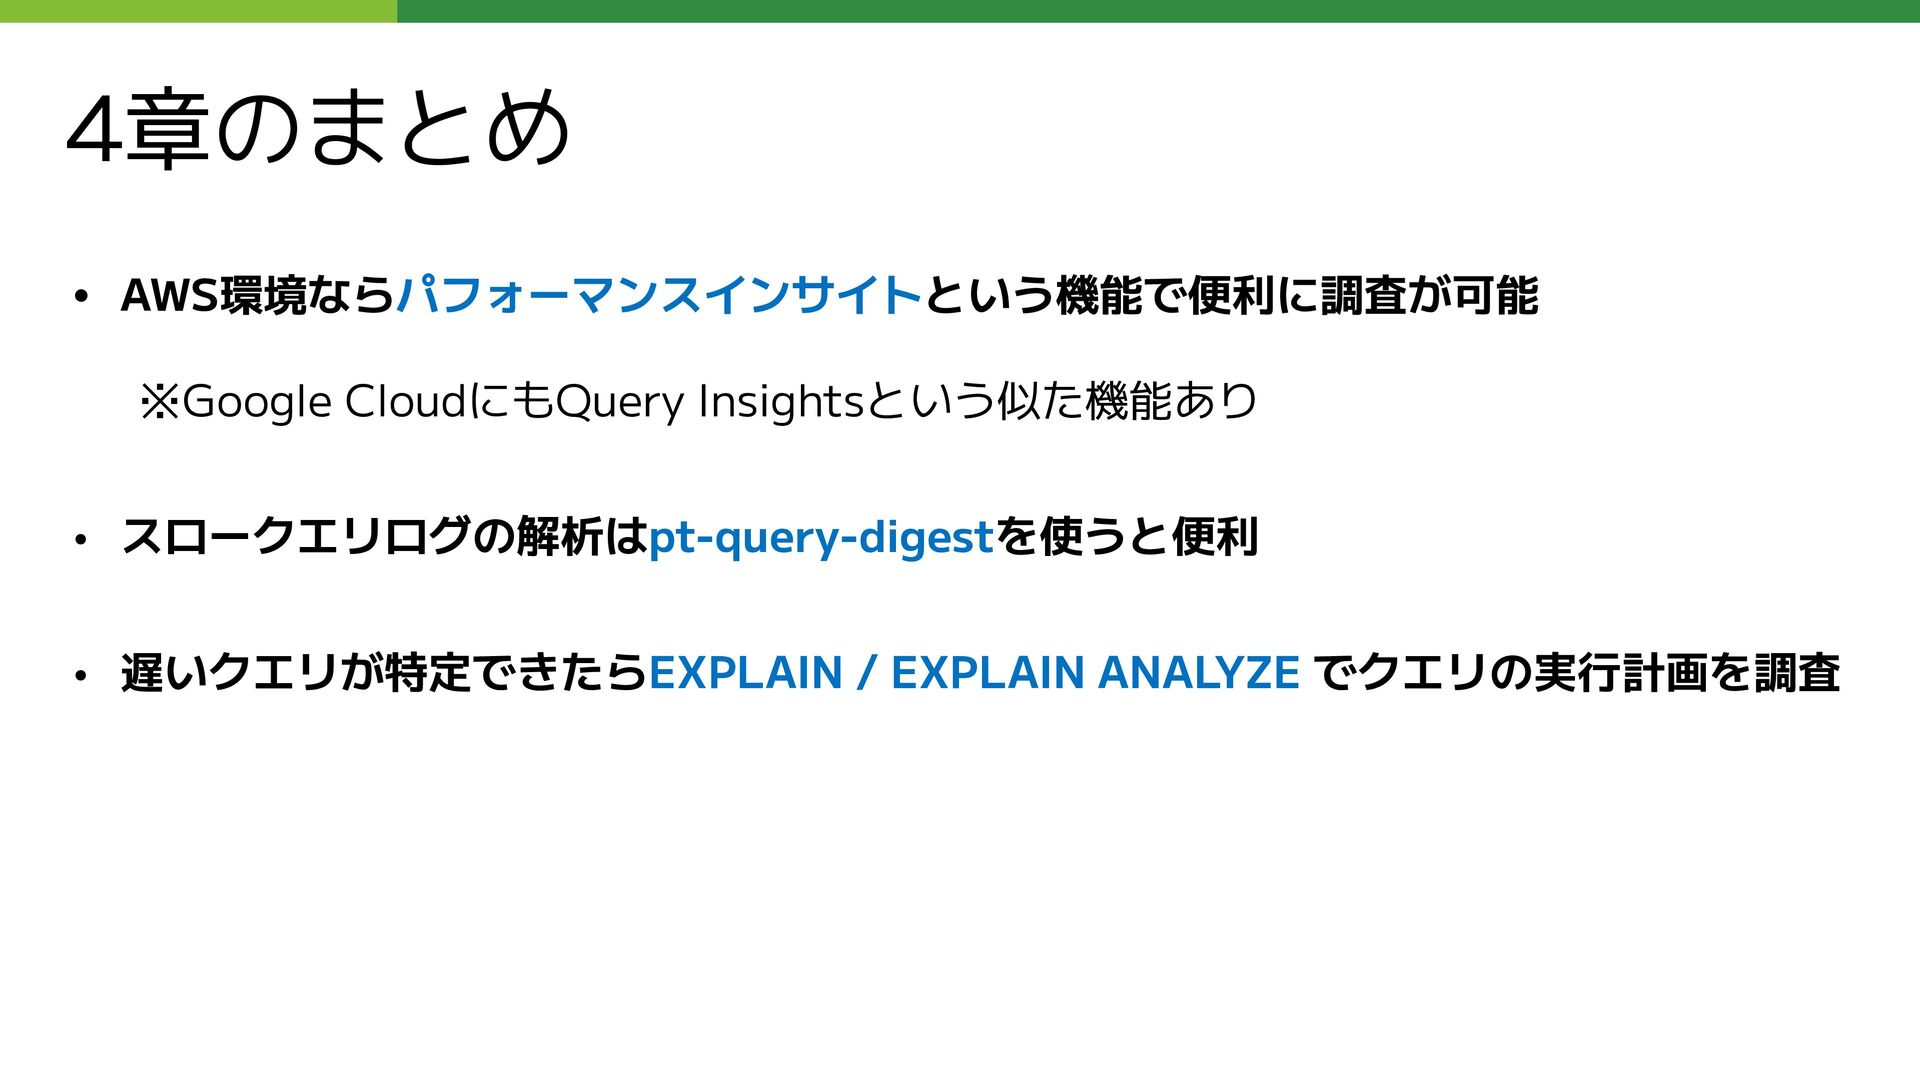
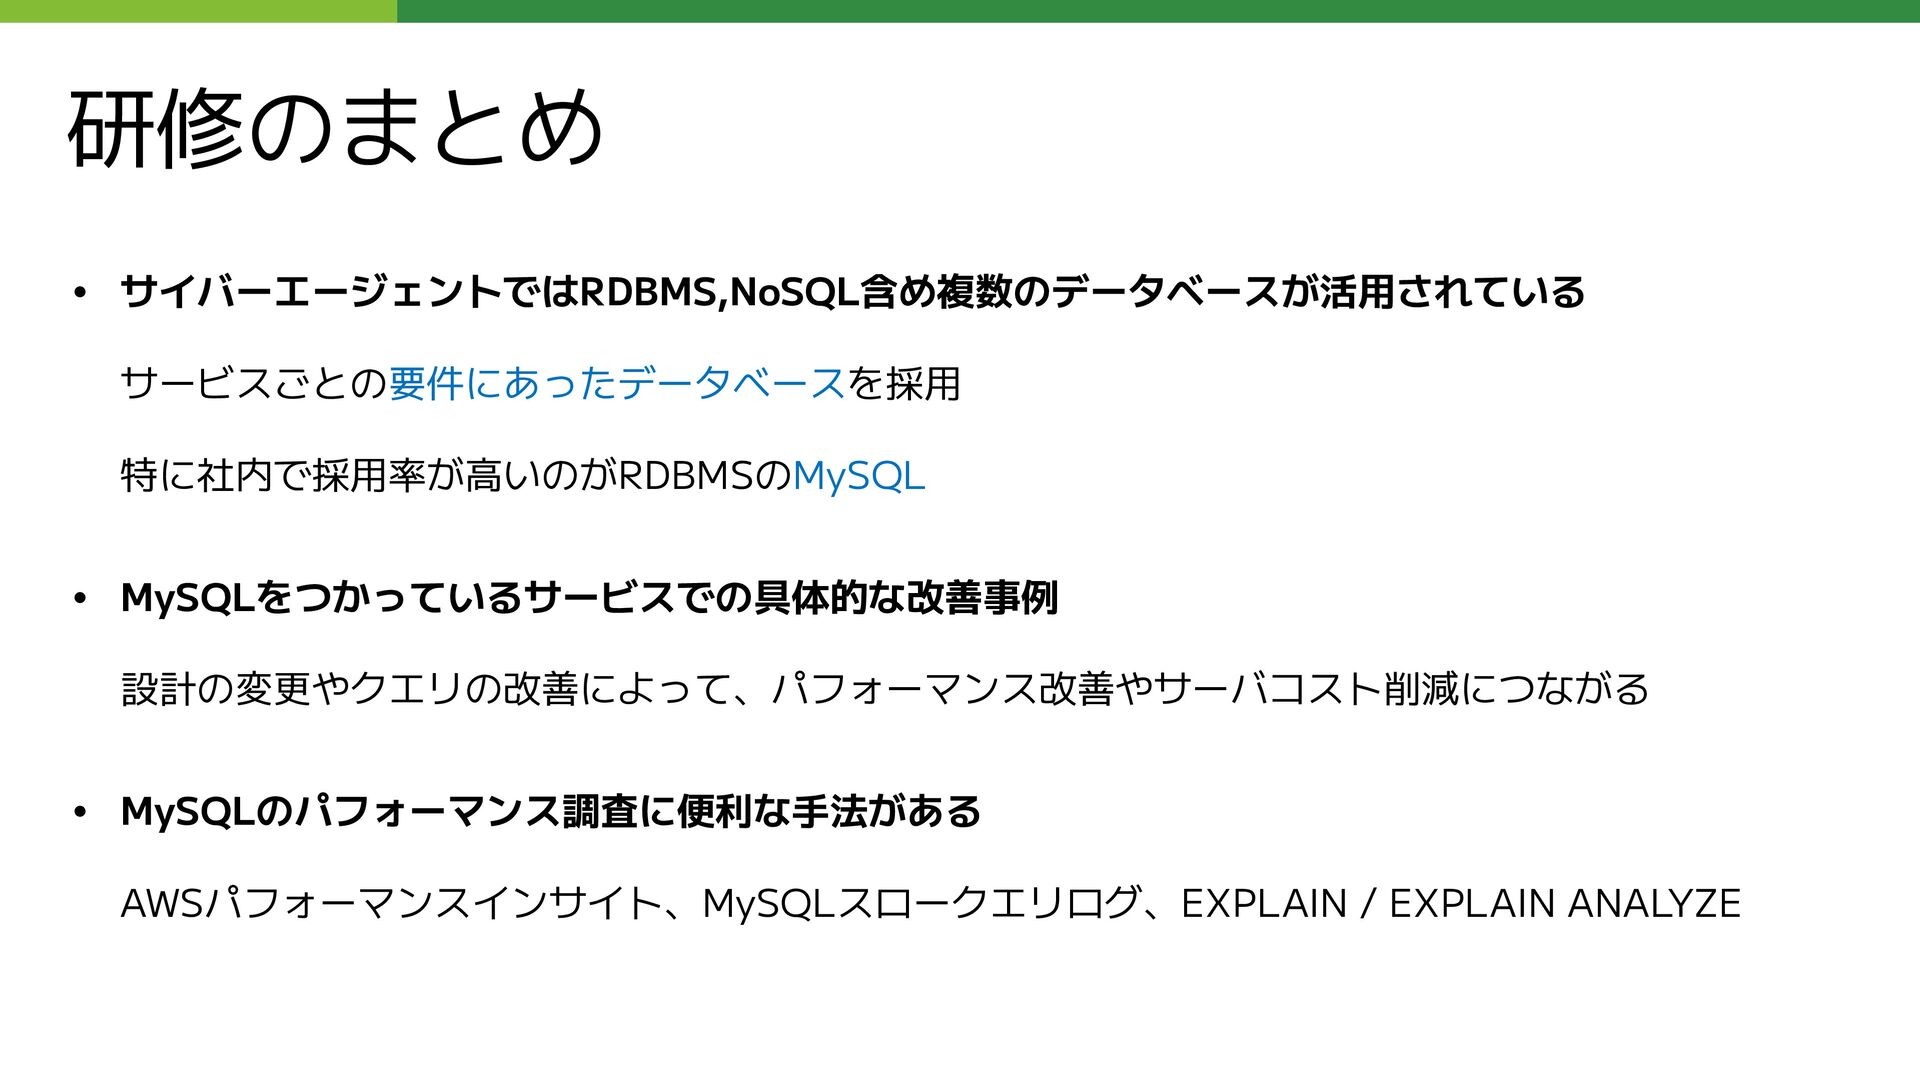
研修のまとめ • サイバーエージェントではRDBMS,NoSQL含め複数のデータベースが活用されている サービスごとの要件にあったデータベースを採用 特に社内で採用率が高いのがRDBMSのMySQL • MySQLをつかっているサービスでの具体的な改善事例 設計の変更やクエリの改善によって、パフォーマンス改善やサーバコスト削減につながる • MySQLのパフォーマンス調査に便利な手法がある
AWSパフォーマンスインサイト、MySQLスロークエリログ、EXPLAIN / EXPLAIN ANALYZE
 cyberagentdevelopers
 knwoop
 a_suenami
 silmin_
 nejumi
 jacopen
 sat
 nealle
 ivry_presentationmaterials
 grimoh
 minorun365
 ykimi
 sansantech
 auna
 uxyall
 helenjbeal
 eitanlees
 ipullrank
 pwiseman
 lemiorhan
 irinanazarova
 palkan
 sarafernandez
 honnibal
 soysaucechin