Share
Embed
いち機械学習エンジニアが考える、 広告効果予測プロダクトへの 価値提供と貢献の仕方 / Providing value to products that predict advertising effectiveness, as considered by ML engineers
CyberAgent PRO
October 05, 2023
Transcript
44 slides
-
自己紹介 • 2017/12〜 アドテク本部 CA DyVE • 2019/09〜 AI事業本部 極TD
基本属性はフルスタックエンジニア サイバーエージェント入社後、Data & MLに も領域を広げる 西村 政輝 -
今日話すこと&話す人の属性 話す人の属性: • 仕事始めて約15年間:Webエンジニア・サーバーサイドエンジニア • 直近4年間:MLエンジニアに転向 話せること: • MLE以前の経験を活かすことで転向後にどのような成果に繋がったか =>
過去から現在までの担当システムの技術要件やシステム構成に関する話 (ビジネス貢献の話や所属プロダクトのMLモデルに関する話は薄いです) -
MLプロダクト開発・運用(MLOps) 一般的なプロダクト開発と比べMLプロダクト特有の概念やタスクが増える ただし、プロダクトの開発・運用という文脈では大枠は同じ ML未経験からでも、MLを学びながら開発・運用の方面で貢献可能 企画・設計 • 要件定義 • DWHの整備 •
PoC 開発 • モデルの訓練 • 実験管理 • モデルのサービング 運用・保守 • 監視 • 効果検証 • プロダクト改善 -
目次 • 簡単な前提知識の共有(プロダクト紹介とMLOps) • MLプロダクト開発においてサーバーサイド経験が活きた例 ◦ 極TD立ち上げ初期のDataOps整備 ◦ 予測モデルの効果検証のためのABnテスト基盤 ◦
Dataflowによるアセット組み合わせ大規模バッチ推論 ◦ LLM API活用 TDオンデマンド生成サーバー開発 • 最後に -
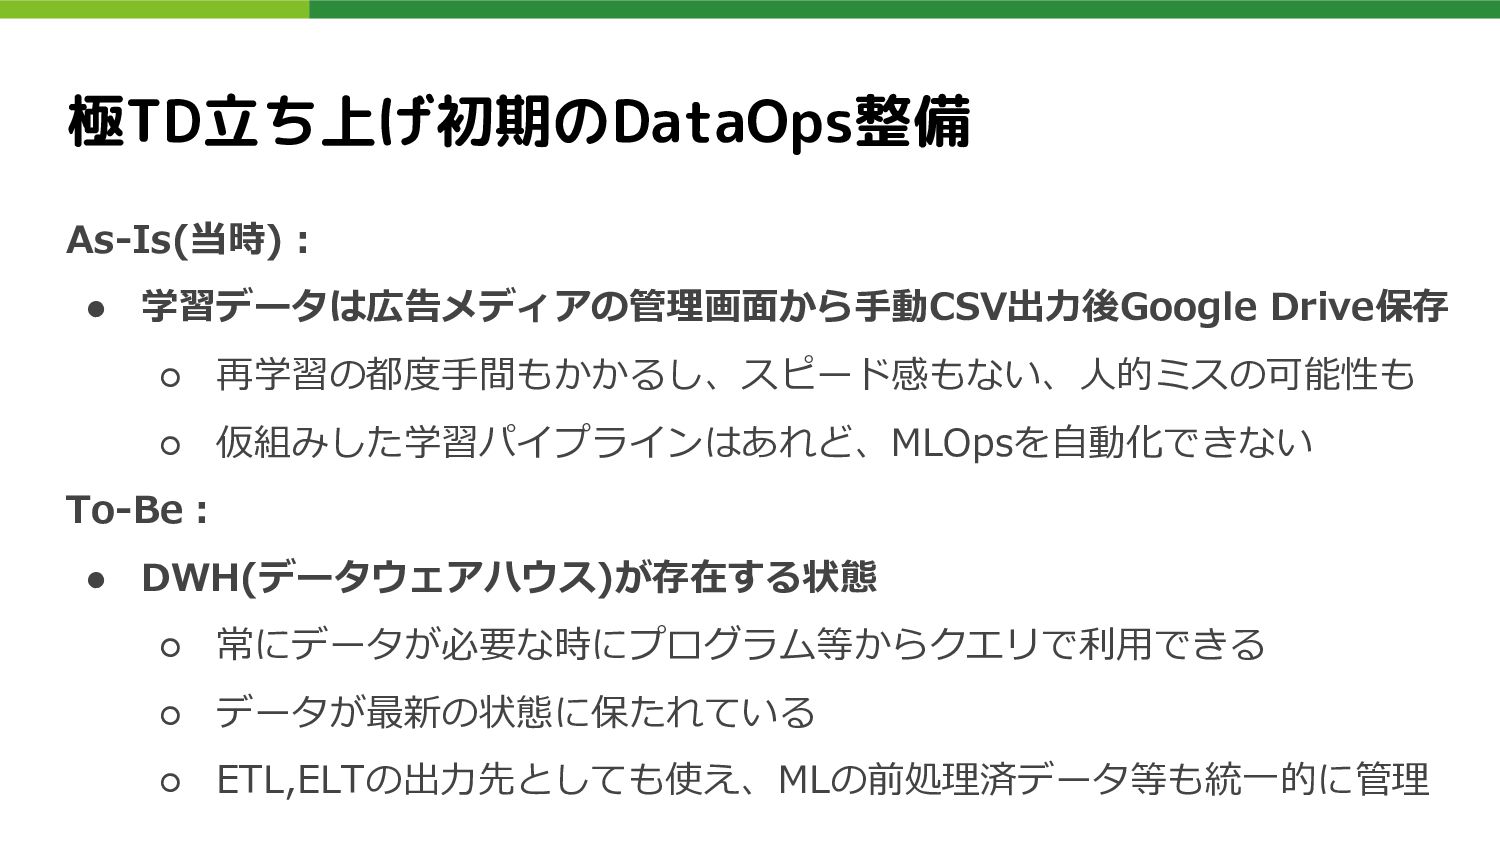
極TD立ち上げ初期のDataOps整備 As-Is(当時): • 学習データは広告メディアの管理画面から手動CSV出力後Google Drive保存 ◦ 再学習の都度手間もかかるし、スピード感もない、人的ミスの可能性も ◦ 仮組みした学習パイプラインはあれど、MLOpsを自動化できない To-Be:
• DWH(データウェアハウス)が存在する状態 ◦ 常にデータが必要な時にプログラム等からクエリで利用できる ◦ データが最新の状態に保たれている ◦ ETL,ELTの出力先としても使え、MLの前処理済データ等も統一的に管理 -
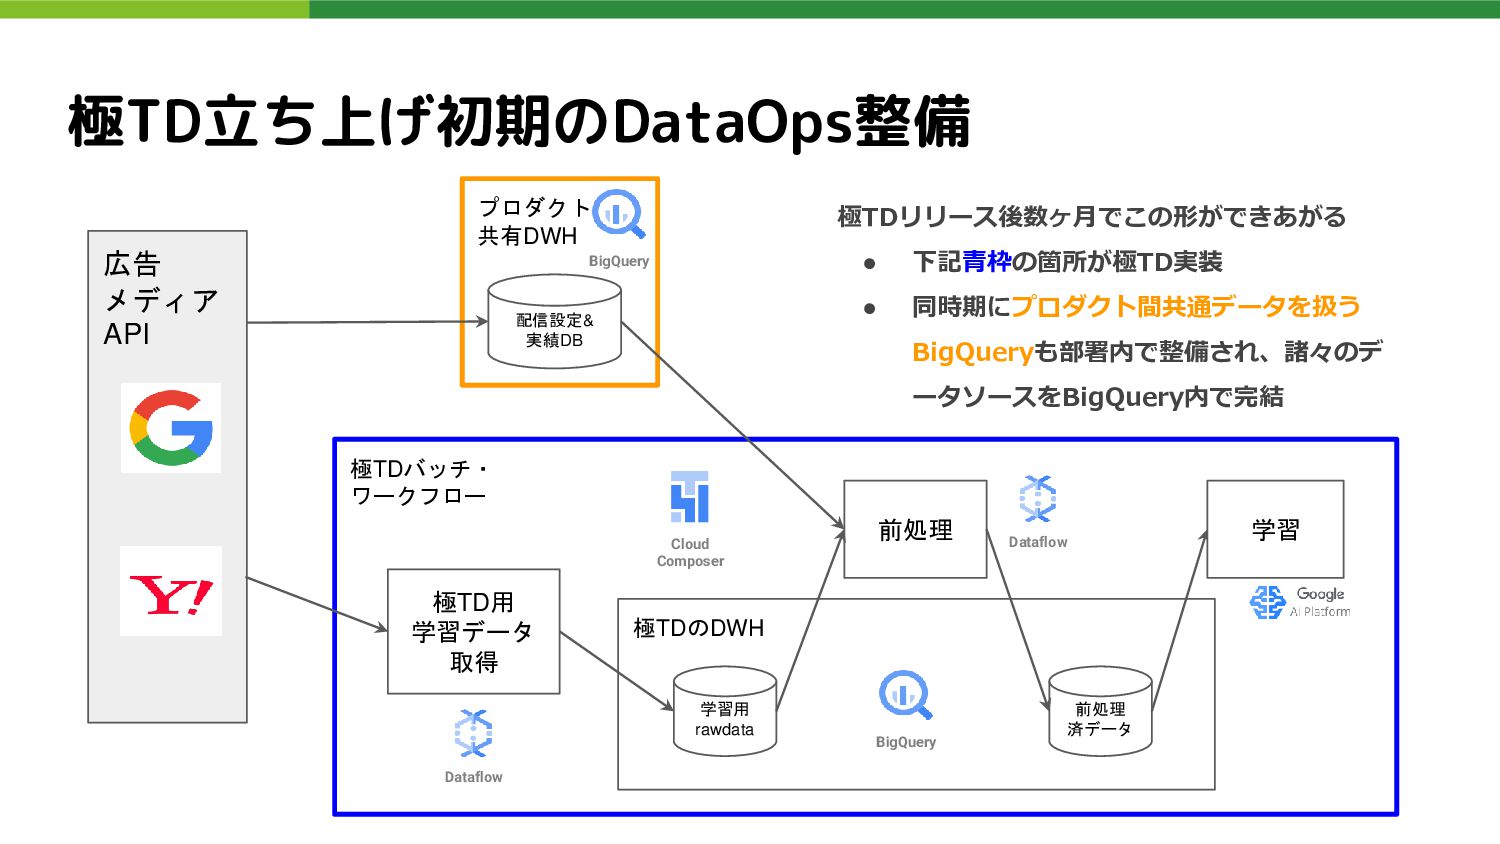
極TDバッチ・ ワークフロー 極TDのDWH 極TD立ち上げ初期のDataOps整備 プロダクト 共有DWH 広告 メディア API BigQuery
配信設定& 実績DB 学習用 rawdata 前処理 済データ 前処理 BigQuery 極TD用 学習データ 取得 Dataflow Dataflow Cloud Composer 極TDリリース後数ヶ月でこの形ができあがる • 下記青枠の箇所が極TD実装 • 同時期にプロダクト間共通データを扱う BigQueryも部署内で整備され、諸々のデ ータソースをBigQuery内で完結 学習 -
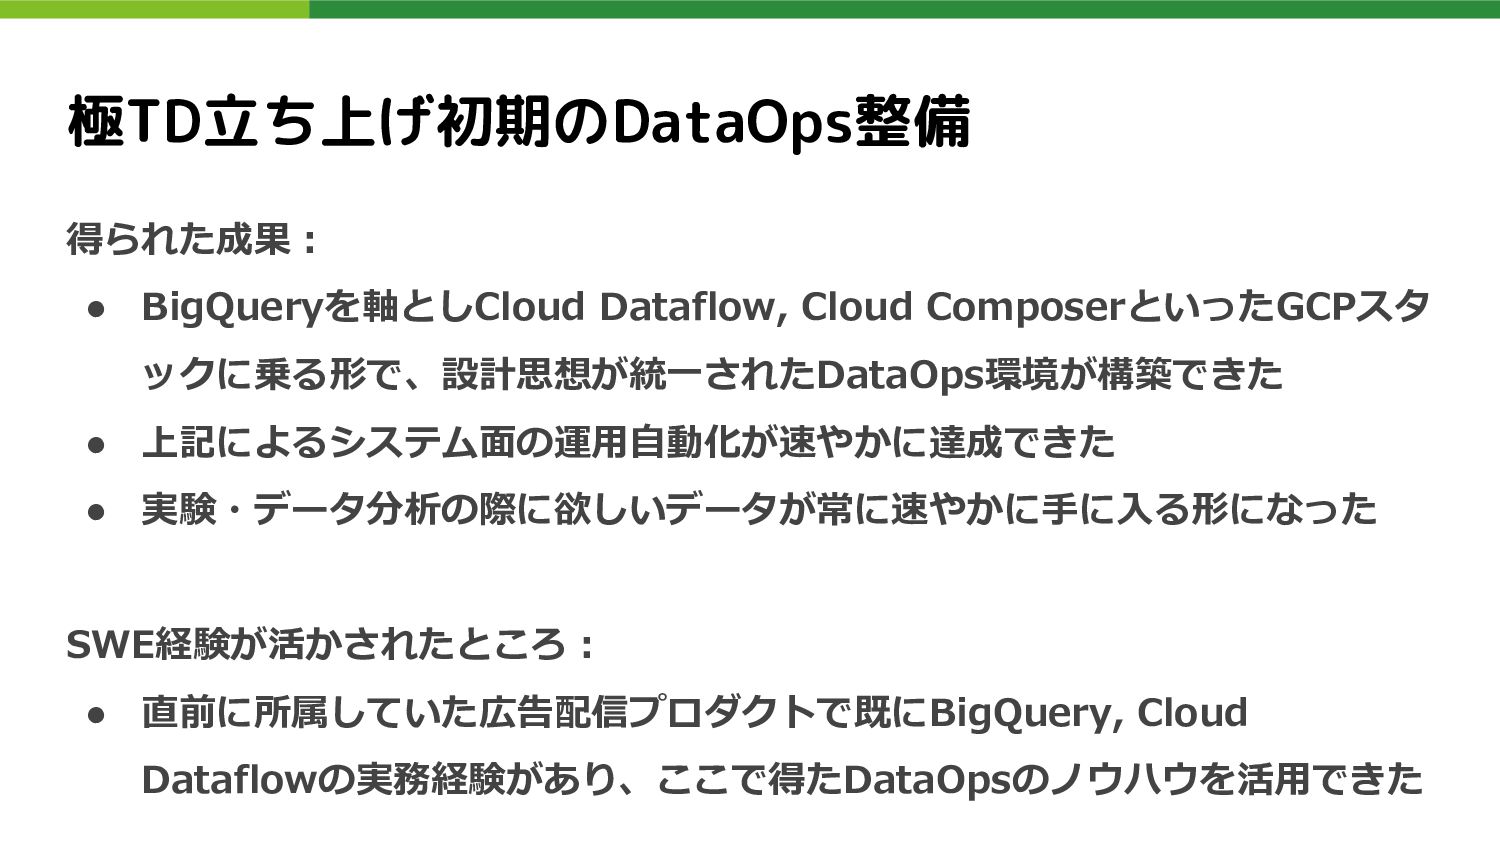
極TD立ち上げ初期のDataOps整備 得られた成果: • BigQueryを軸としCloud Dataflow, Cloud ComposerといったGCPスタ ックに乗る形で、設計思想が統一されたDataOps環境が構築できた • 上記によるシステム面の運用自動化が速やかに達成できた
• 実験・データ分析の際に欲しいデータが常に速やかに手に入る形になった SWE経験が活かされたところ: • 直前に所属していた広告配信プロダクトで既にBigQuery, Cloud Dataflowの実務経験があり、ここで得たDataOpsのノウハウを活用できた -
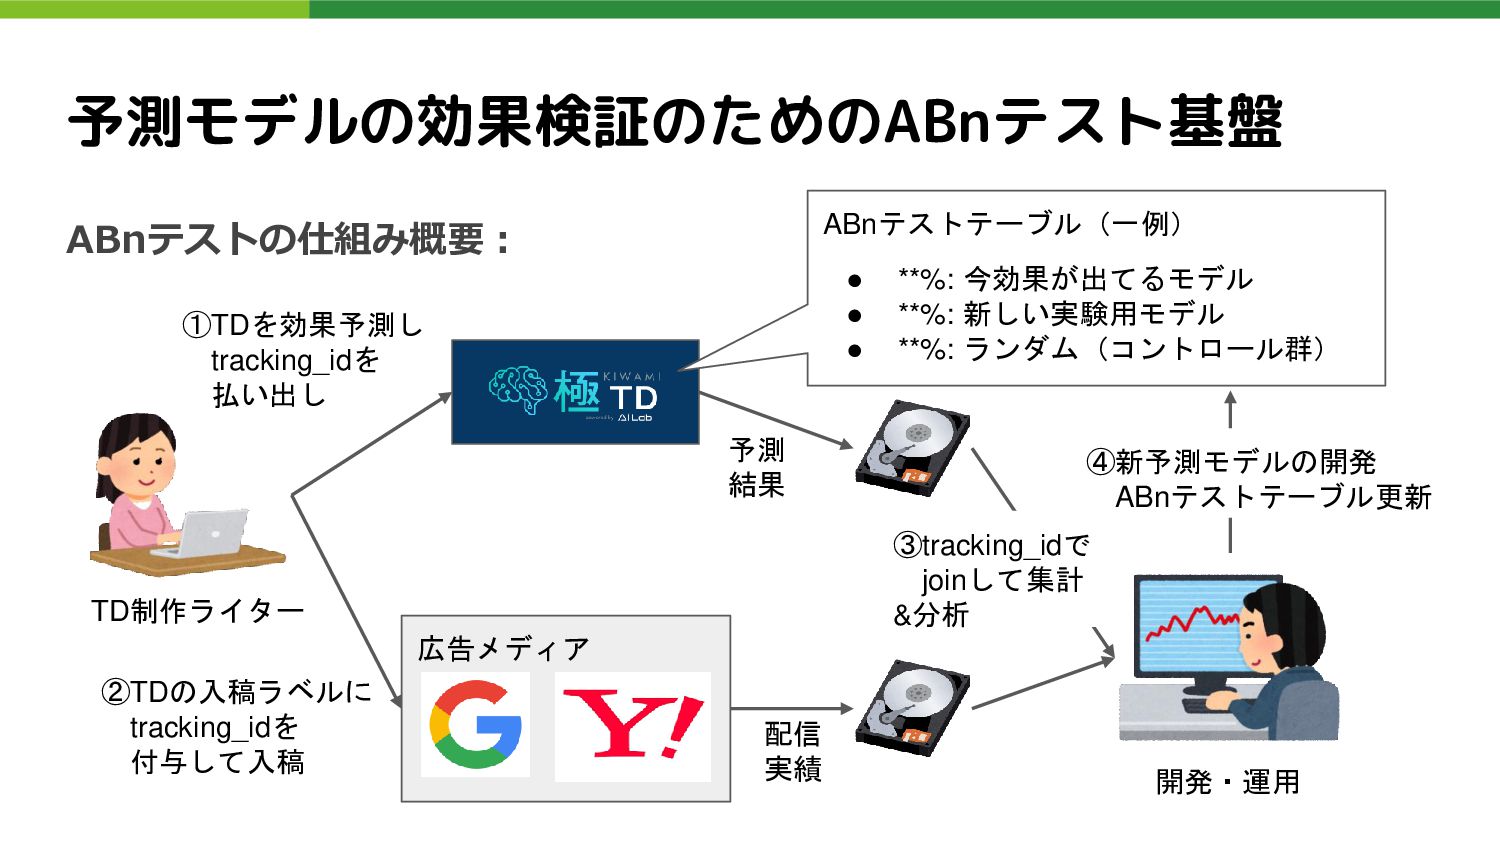
予測モデルの効果検証のためのABnテスト基盤 要求/要件: • 予測モデル単体の正しい貢献度を測定できること ◦ PoC、実験コード上のオフライン評価で優秀なモデルができたとしても それがオンライン上で正しく寄与できているというエビデンスが必要 配 信 実
績 時系列 導入前 導入後 外部要因(何もしなくても上がってた) 予測モデルが寄与した分 ← これを明るみに 極予測TDを用いた制作プロセス自身が寄与した分 -
広告メディア ABnテストテーブル(一例) • **%: 今効果が出てるモデル • **%: 新しい実験用モデル • **%:
ランダム(コントロール群) ①TDを効果予測し tracking_idを 払い出し ②TDの入稿ラベルに tracking_idを 付与して入稿 予測 結果 配信 実績 TD制作ライター 開発・運用 ④新予測モデルの開発 ABnテストテーブル更新 ③tracking_idで joinして集計 &分析 予測モデルの効果検証のためのABnテスト基盤 ABnテストの仕組み概要: -
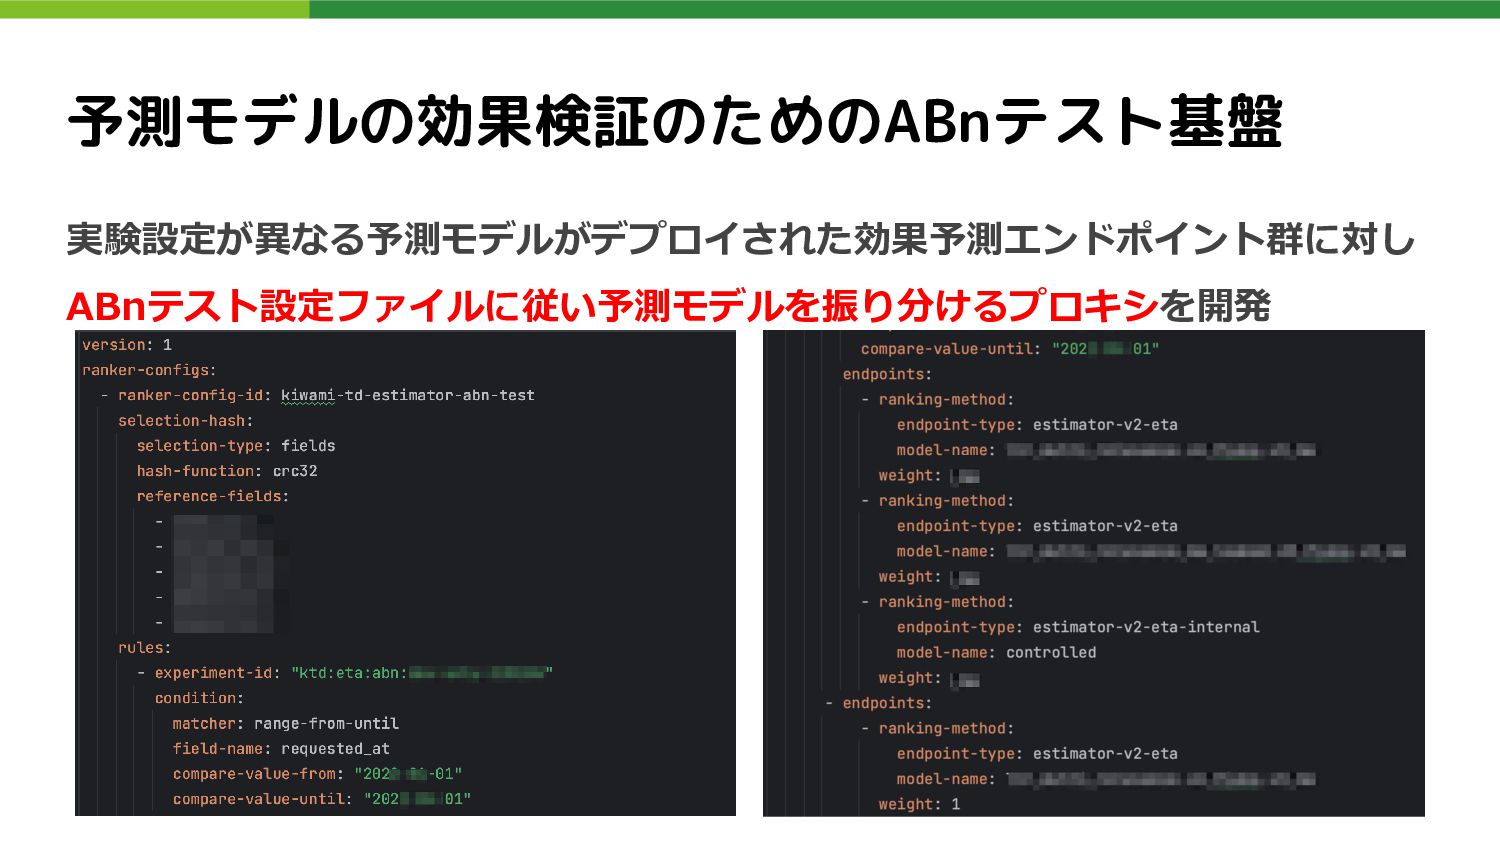
予測モデルの効果検証のためのABnテスト基盤 実験設定が異なる予測モデルがデプロイされた効果予測エンドポイント群に対し ABnテスト設定ファイルに従い予測モデルを振り分けるプロキシを開発 極予測TD 制作画面 estimator- proxy estimator-v1 estimator-v2 estimator-v3
{ campaign_id: “...”, adgroup_id: “…”, title: “...”, description: “...” } { endpoint: “...”, model_name:“...”, pred_score: “...”, } proxy- config .yaml request response -
予測モデルの効果検証のためのABnテスト基盤 得られた成果: • オンラインで得られたデータをもとにT検定が実施できるようになった • ランダム化比較試験ができるようになった ◦ 配信実績で強いリフトが得られる予測モデルが発見できた • ダッシュボードでモデル間の性能差を確認できるようになった
• 複数モデル間の性能差を明るみにし、有効なモデルのみ残すPDCAサイクル を回すことができるようになった -
予測モデルの効果検証のためのABnテスト基盤 SWE経験が活かされたところ: • TDの入稿ラベルにトラッキングIDを与え配信実績を追跡する設計上の着想 は、SWEとして分散トレーシングが馴染み深かったことから得られた • 今回の要件にあったプロキシサーバの実装難易度は高めだが実装力でカバー ◦ ABnテストのyaml定義ファイルをプログラムに落とし込む ▪
Interpriter, Decorator, Chain Of Responsibility @ GoFデザパタ ◦ 非同期プログラミング、ノンブロッキングIOの意味と特性を理解した上 での分散・並行リクエスト (Pytyonならコルーチン・Async/Await) ◦ 諸々の複雑寄りの実装を支えるためのコンストラクタDIとテスト実装 -
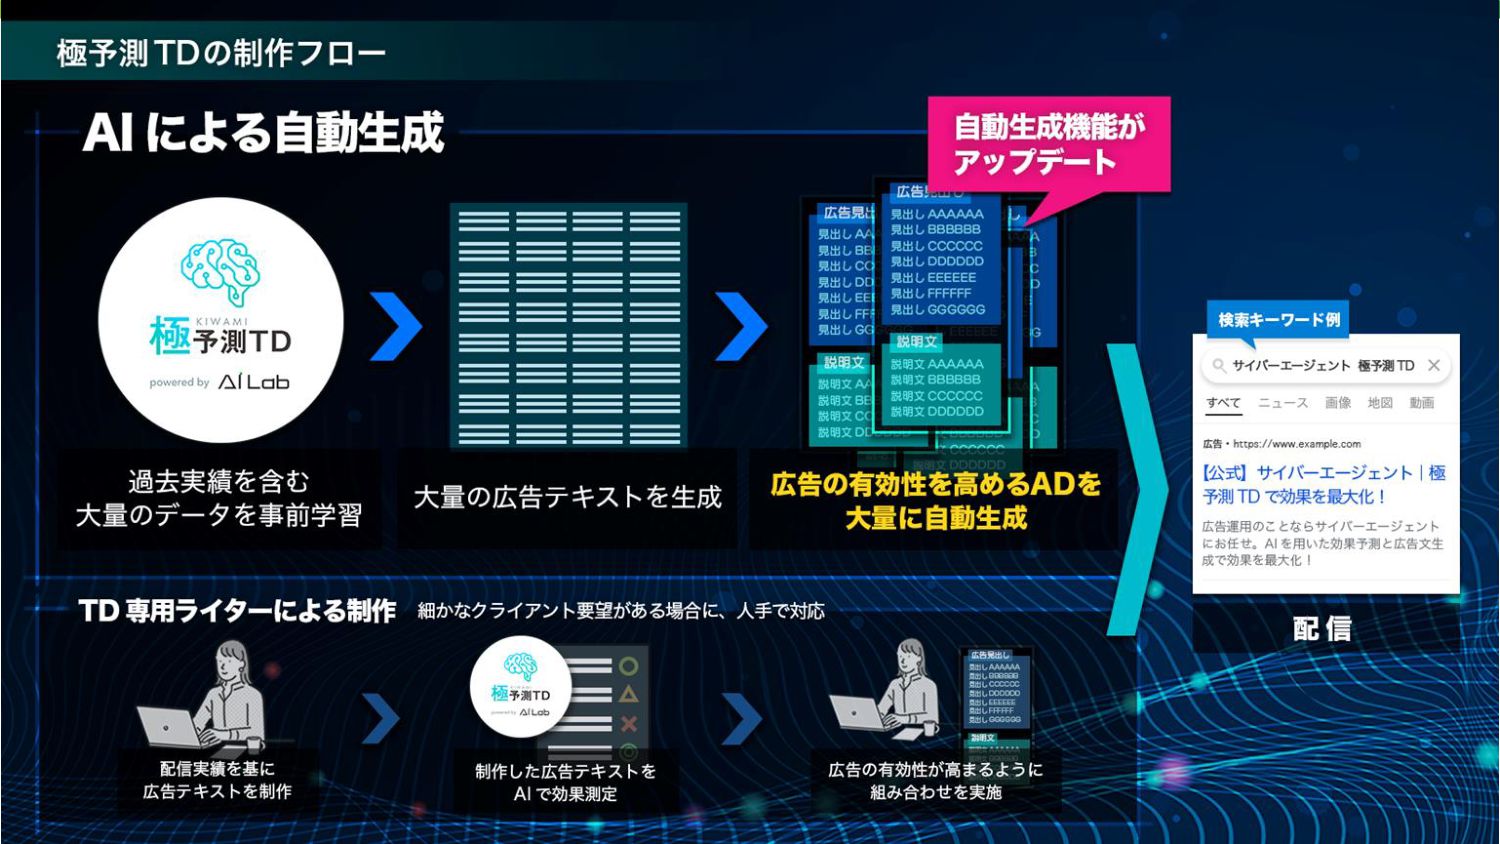
Dataflowによるアセット組み合わせ大規模バッチ推論 技術要件: • 1実行あたり、数億の自動生成アセットの組み合わせパターンに対して推論 ◦ 各adに対し広告アセットの最適な組み合わせを探索するバッチ ▪ 広告数 x 組み合わせ各nパターンずつ推論を試行
• 1実行あたりの推論コストは決して低くない ◦ モデル側の推論はともかく、NLP絡みの前処理が少し重い • 予測対象増加やモデルアップデートに備え、処理能力をスケール可能 -
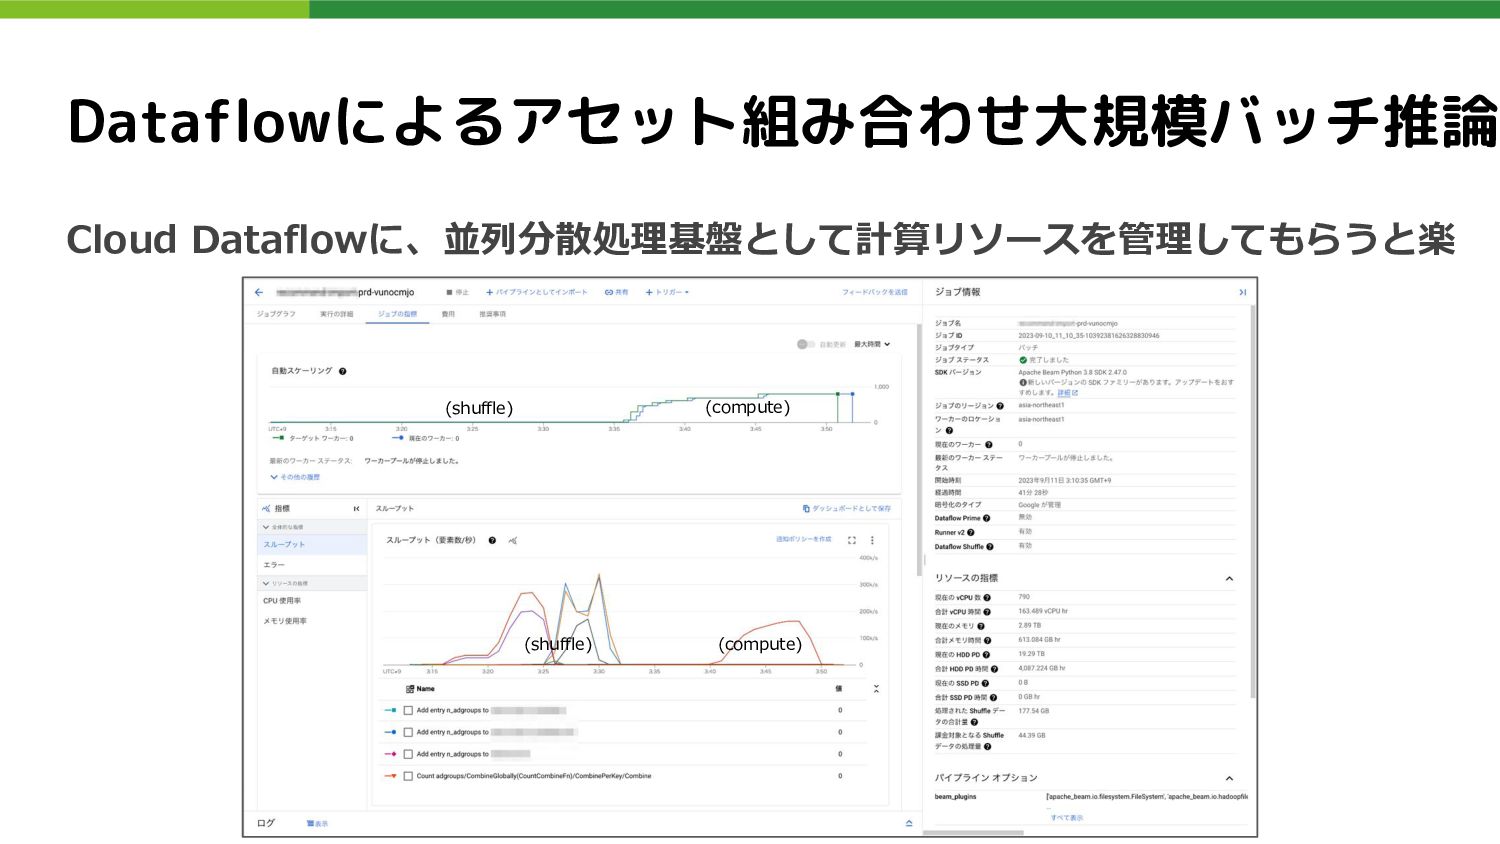
Dataflowによるアセット組み合わせ大規模バッチ推論 得られた成果: • 数億件単位の前処理と推論を1時間以内で完了させる ◦ PCollection操作でデータを適切な粒度にシャーディング ◦ 各シャードに対し最大1,000ワーカーで並列分散処理を行い推論 SWE経験が活かされたところ: •
分散処理自体はここに至るまでたまに携わっていたことが活きた • Cloud Dataflow(Apache Beam)使用歴は前プロダクトから5年程あり、 このような用途に適性がある事を予め知っていた -
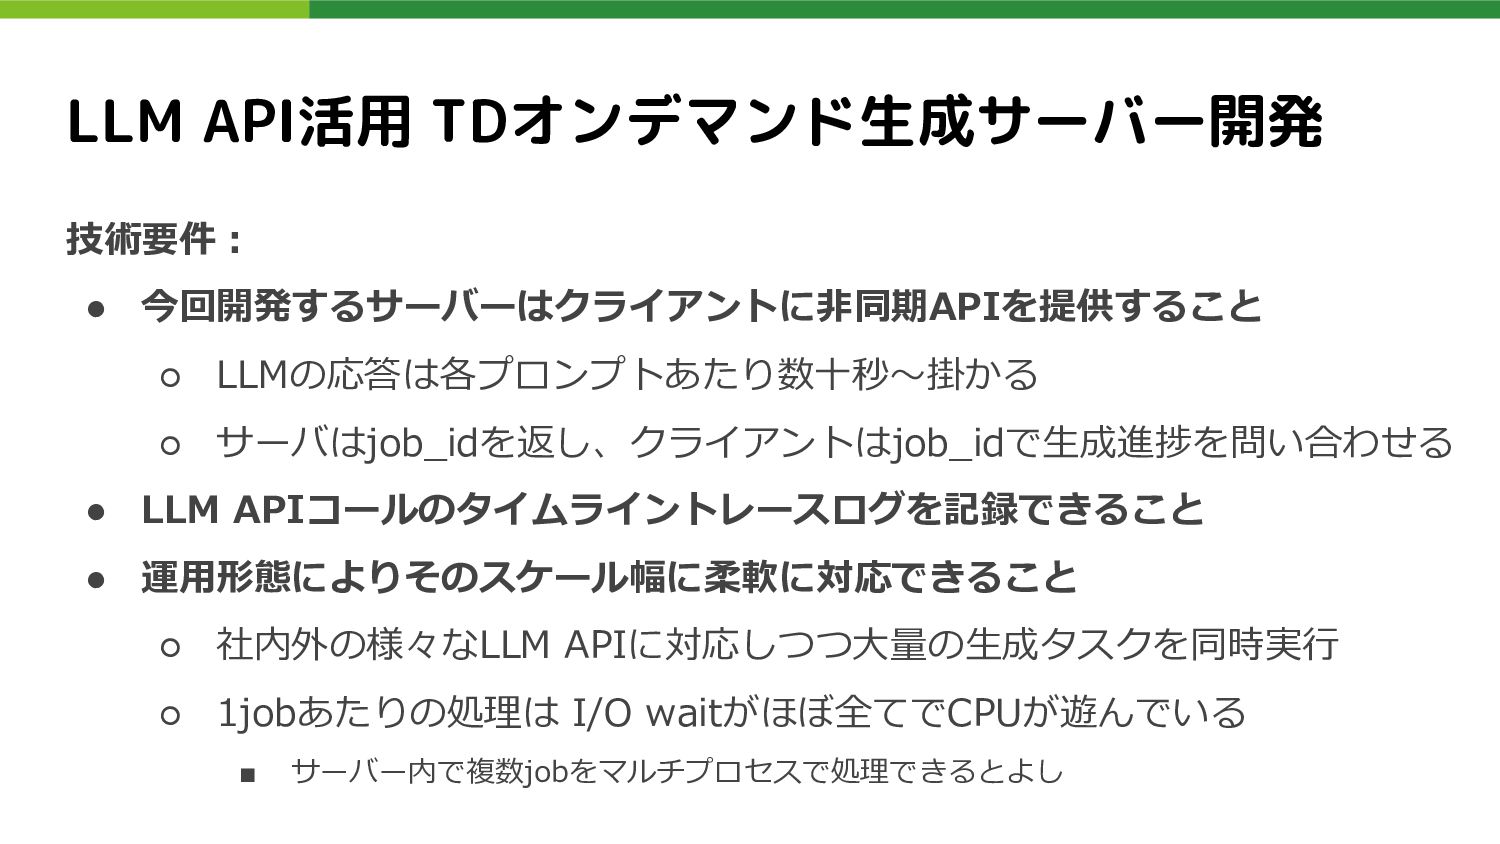
LLM API活用 TDオンデマンド生成サーバー開発 技術要件: • 今回開発するサーバーはクライアントに非同期APIを提供すること ◦ LLMの応答は各プロンプトあたり数十秒〜掛かる ◦ サーバはjob_idを返し、クライアントはjob_idで生成進捗を問い合わせる
• LLM APIコールのタイムライントレースログを記録できること • 運用形態によりそのスケール幅に柔軟に対応できること ◦ 社内外の様々なLLM APIに対応しつつ大量の生成タスクを同時実行 ◦ 1jobあたりの処理は I/O waitがほぼ全てでCPUが遊んでいる ▪ サーバー内で複数jobをマルチプロセスで処理できるとよし -
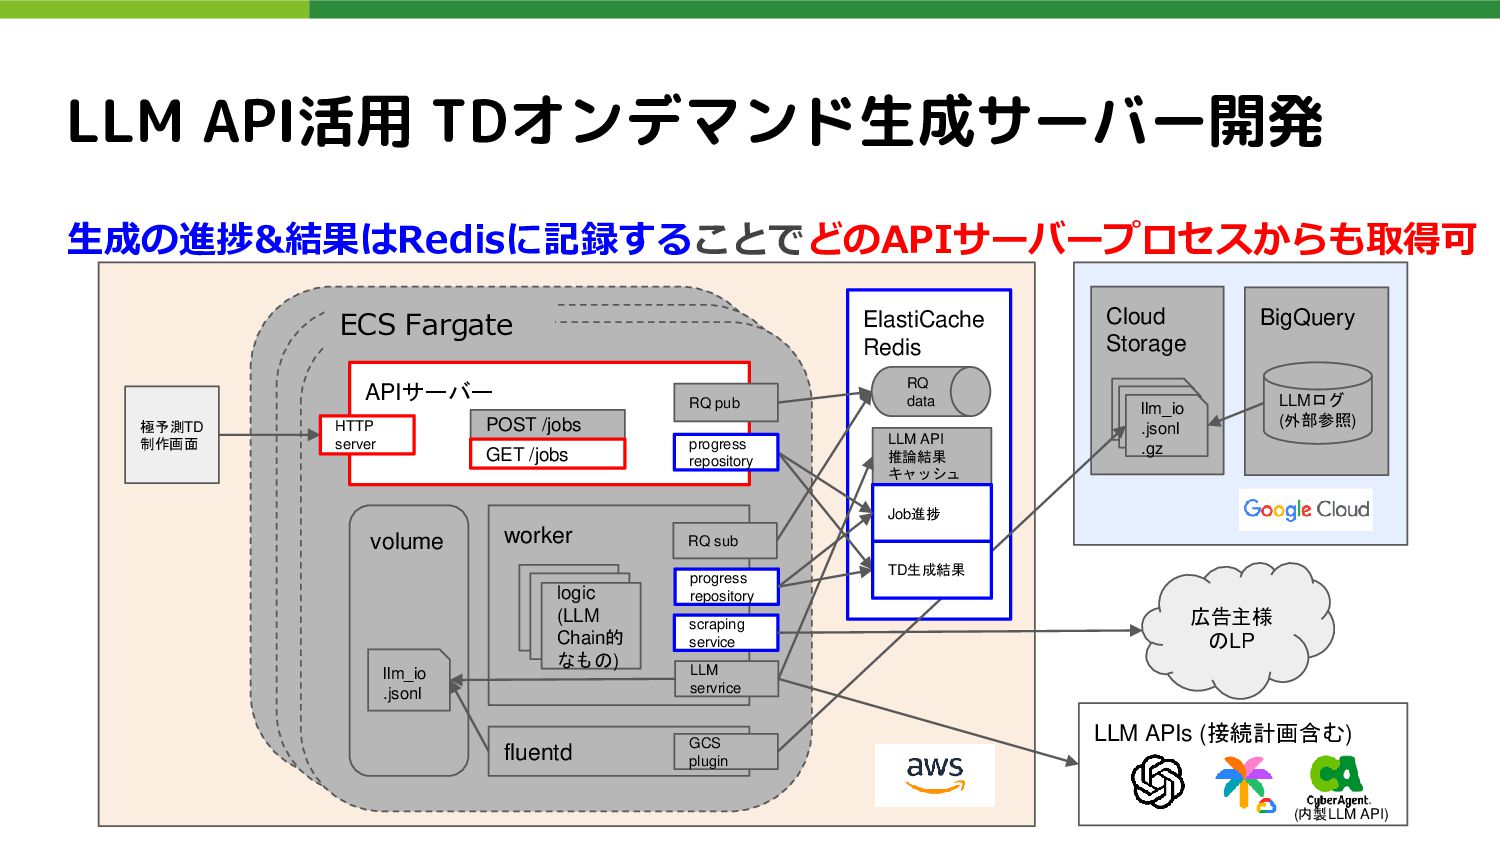
BigQuery Cloud Storage worker ElastiCache Redis LLM API 推論結果 キャッシュ
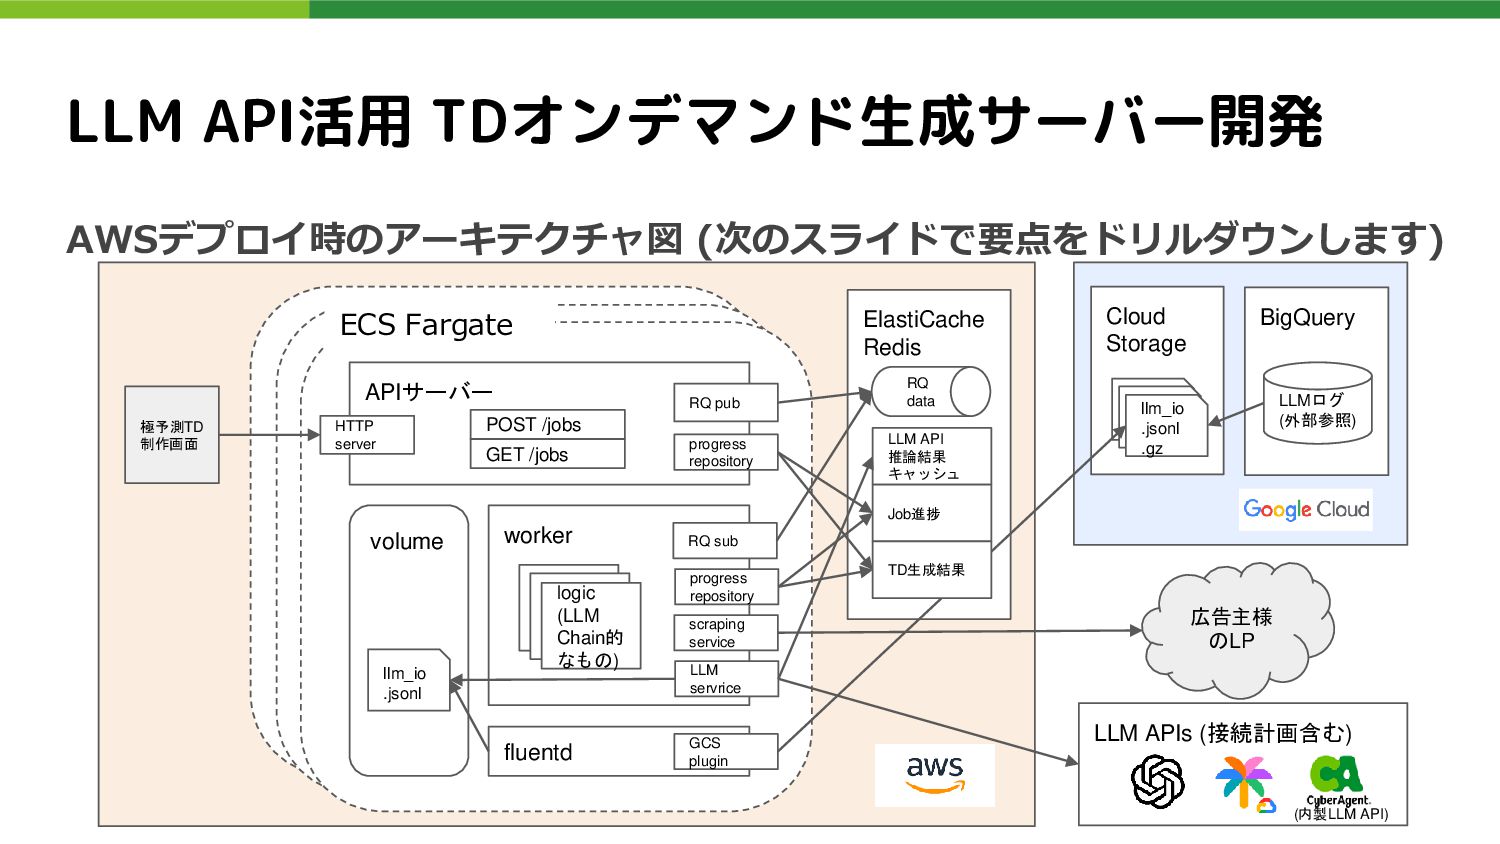
Job進捗 RQ data RQ sub LLM servrice volume llm_io .jsonl scraping service logic (LLM Chain的 なもの) fluentd progress repository GCS plugin 広告主様 のLP LLM APIs (接続計画含む) llm_io .jsonl llm_io .jsonl llm_io .jsonl .gz TD生成結果 極予測TD 制作画面 LLM API活用 TDオンデマンド生成サーバー開発 LLMログ (外部参照) ECS Fargate APIサーバー RQ pub progress repository HTTP server POST /jobs GET /jobs AWSデプロイ時のアーキテクチャ図 (次のスライドで要点をドリルダウンします) (内製LLM API) -
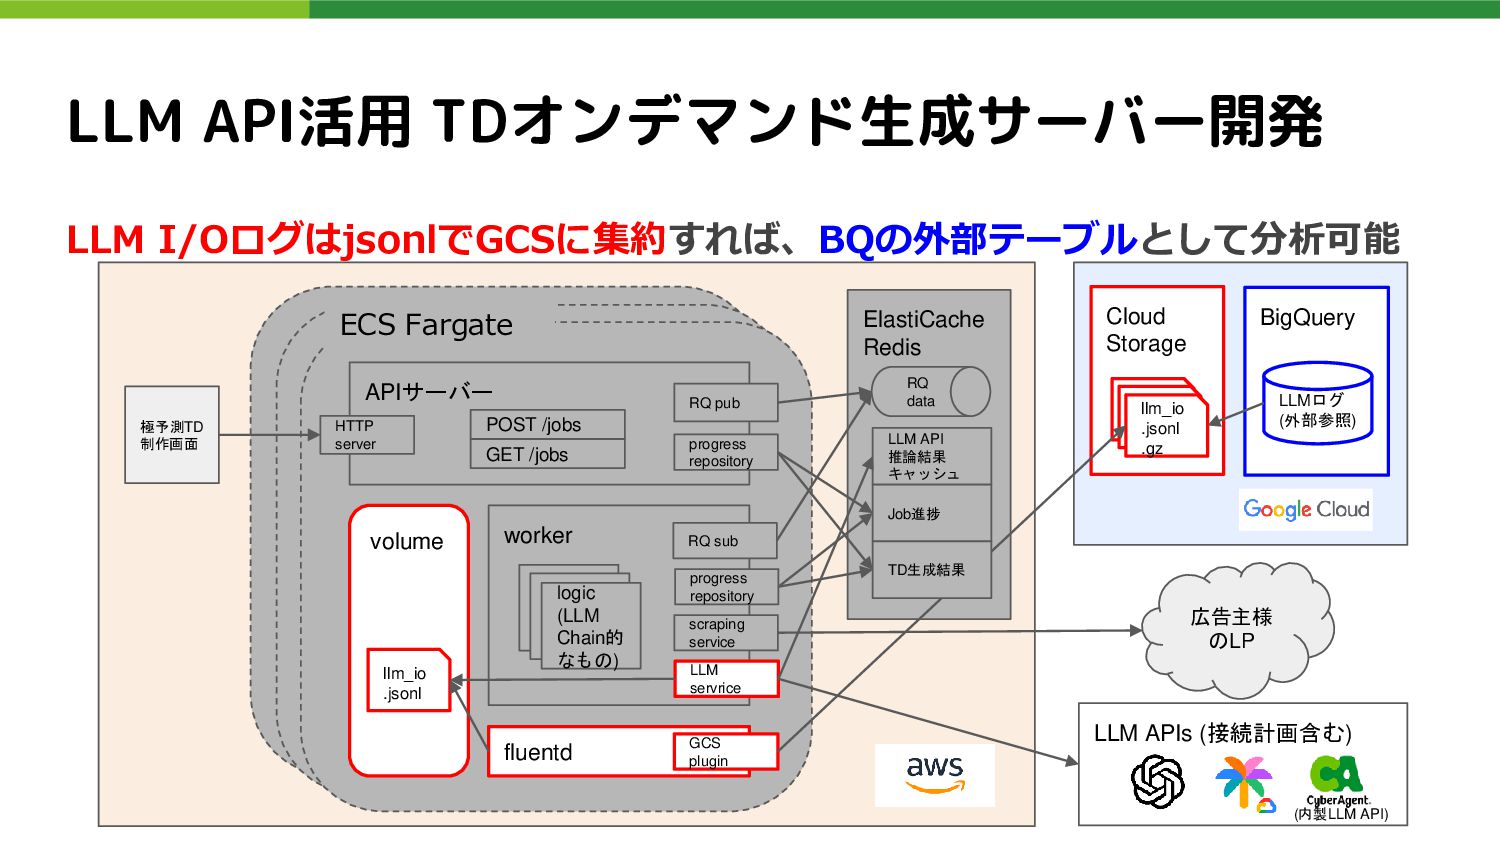
BigQuery Cloud Storage worker ElastiCache Redis LLM API 推論結果 キャッシュ
Job進捗 RQ data RQ sub LLM servrice volume llm_io .jsonl scraping service logic (LLM Chain的 なもの) fluentd progress repository GCS plugin 広告主様 のLP LLM APIs (接続計画含む) llm_io .jsonl llm_io .jsonl llm_io .jsonl .gz TD生成結果 極予測TD 制作画面 LLM API活用 TDオンデマンド生成サーバー開発 LLMログ (外部参照) ECS Fargate APIサーバー RQ pub progress repository HTTP server GET /jobs サーバーとワーカーを分離し、MQ(今回はRQ)経由でjobを配布することでスケール POST /jobs (内製LLM API) -
BigQuery Cloud Storage worker ElastiCache Redis LLM API 推論結果 キャッシュ
Job進捗 RQ data RQ sub LLM servrice volume llm_io .jsonl scraping service logic (LLM Chain的 なもの) fluentd progress repository GCS plugin 広告主様 のLP LLM APIs (接続計画含む) llm_io .jsonl llm_io .jsonl llm_io .jsonl .gz TD生成結果 極予測TD 制作画面 LLM API活用 TDオンデマンド生成サーバー開発 LLMログ (外部参照) ECS Fargate APIサーバー RQ pub progress repository HTTP server POST /jobs GET /jobs 生成の進捗&結果はRedisに記録することでどのAPIサーバープロセスからも取得可 (内製LLM API) -
BigQuery Cloud Storage worker ElastiCache Redis LLM API 推論結果 キャッシュ
Job進捗 RQ data RQ sub LLM servrice volume llm_io .jsonl scraping service logic (LLM Chain的 なもの) fluentd progress repository GCS plugin 広告主様 のLP LLM APIs (接続計画含む) llm_io .jsonl llm_io .jsonl llm_io .jsonl .gz TD生成結果 極予測TD 制作画面 LLM API活用 TDオンデマンド生成サーバー開発 LLMログ (外部参照) ECS Fargate APIサーバー RQ pub progress repository HTTP server POST /jobs GET /jobs LLM I/OログはjsonlでGCSに集約すれば、BQの外部テーブルとして分析可能 (内製LLM API) -
LLM API活用 TDオンデマンド生成サーバー開発 得られた成果: • あらゆる実行環境に適応できるコンパクトかつelasticなシステムとなった ◦ ローカルでDocker Compose等で小さく起動 ◦
極TD画面からの1APIサービスとして起動 ◦ バッチ実行向けに大きくスケールアウト(OpenAIのTPMリミットに注意) SWE経験が活かされたところ: • 非同期仕様のAPIはたまによく作るもの。今回もその延長線上にあり • クリーンアーキテクチャで実装し、コードの運用・保守性を担保