Share
Embed
PLaMoの事後学習を支える技術 / PFN LLMセミナー
PLaMo を人の役に立つ形に Fine-Tuning していく事後学習の全体像と、そこで使われている技術について、データ生成・学習・評価などの各プロセスを掘り下げてご紹介します。
イベントサイト: https://preferred-networks.connpass.com/event/368829/
Preferred Networks PRO
October 01, 2025
Transcript
24 slides
-
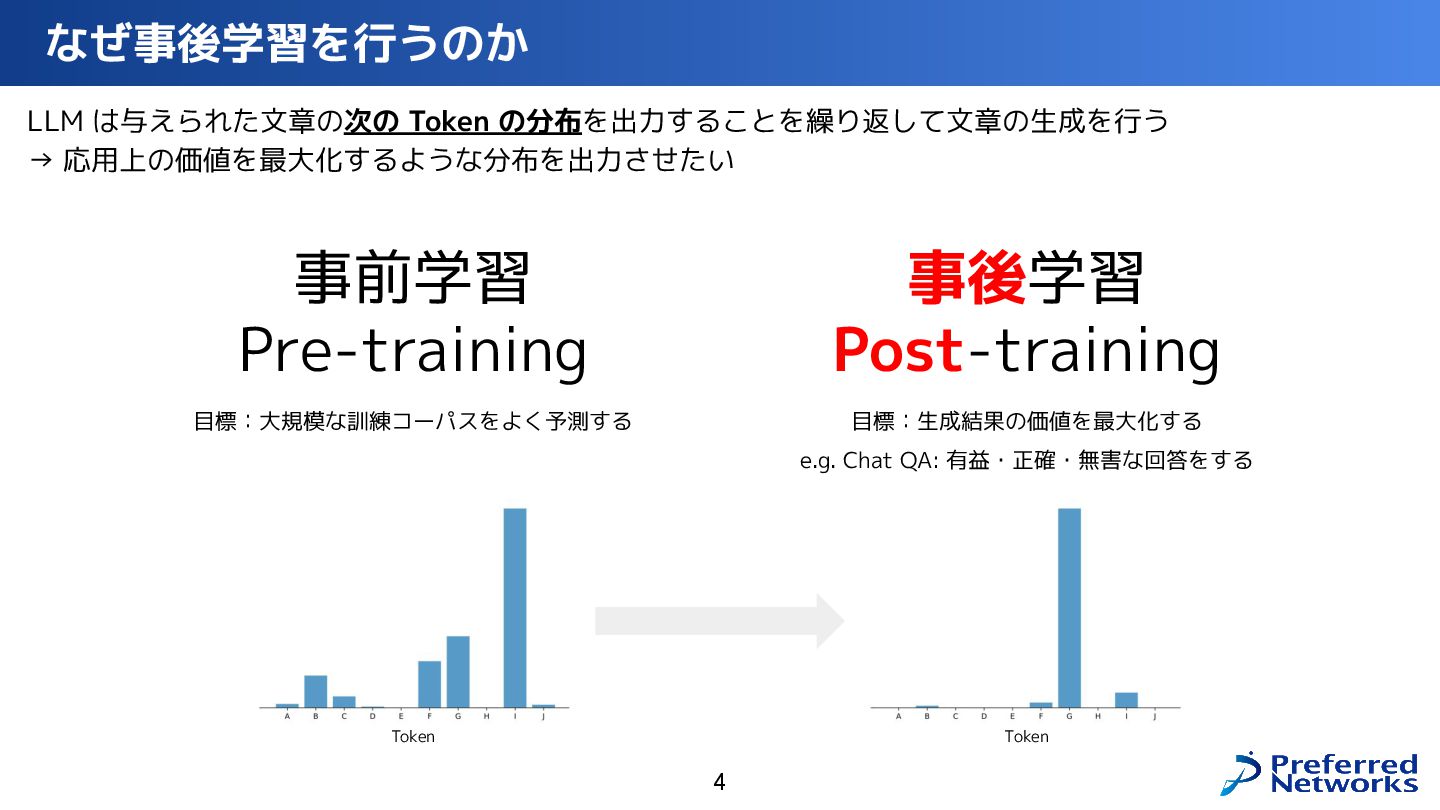
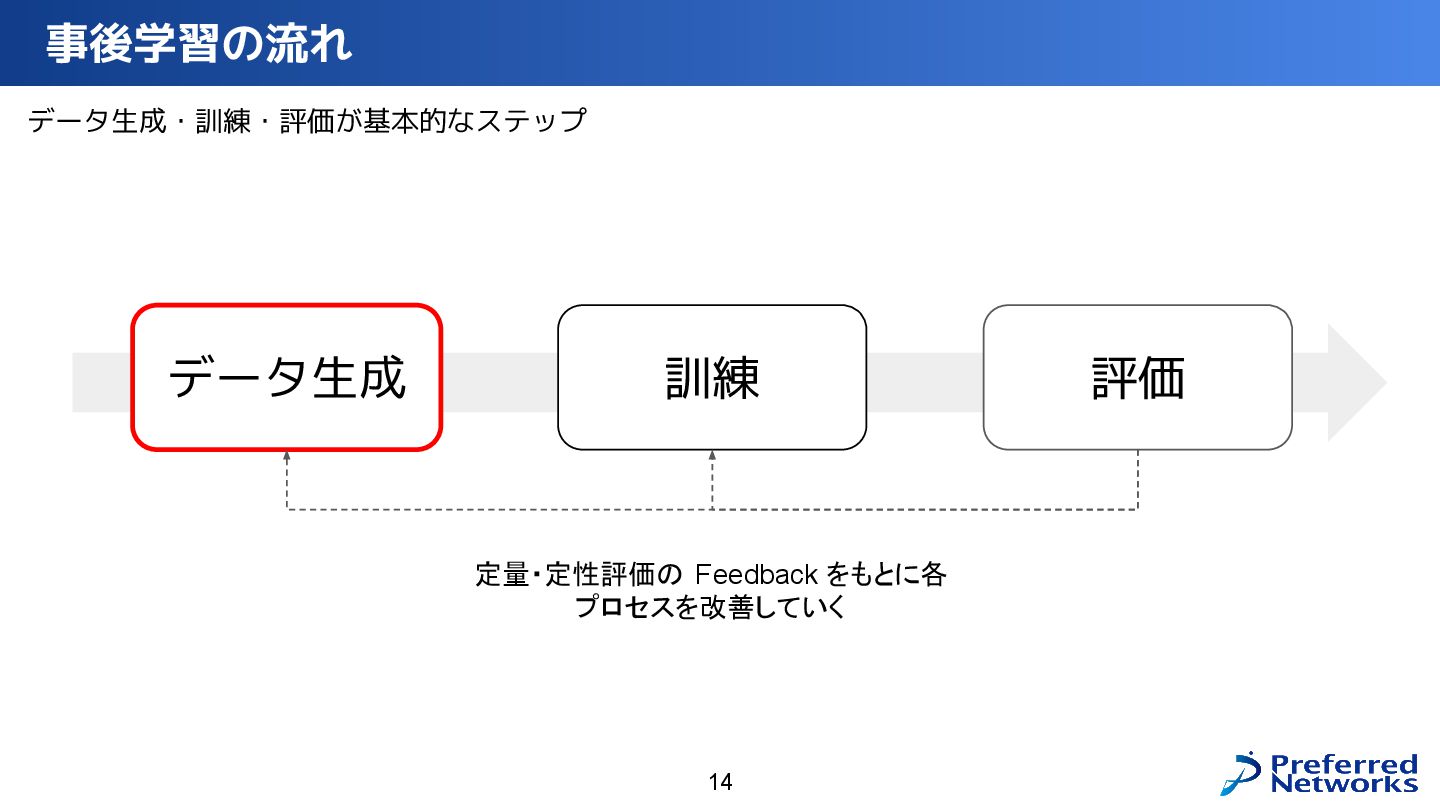
なぜ事後学習を行うのか 4 LLM は与えられた文章の次の Token の分布を出力することを繰り返して文章の生成を行う → 応用上の価値を最大化するような分布を出力させたい 事前学習 Pre-training
事後学習 Post-training 目標:大規模な訓練コーパスをよく予測する 目標:生成結果の価値を最大化する e.g. Chat QA: 有益・正確・無害な回答をする Token Token -
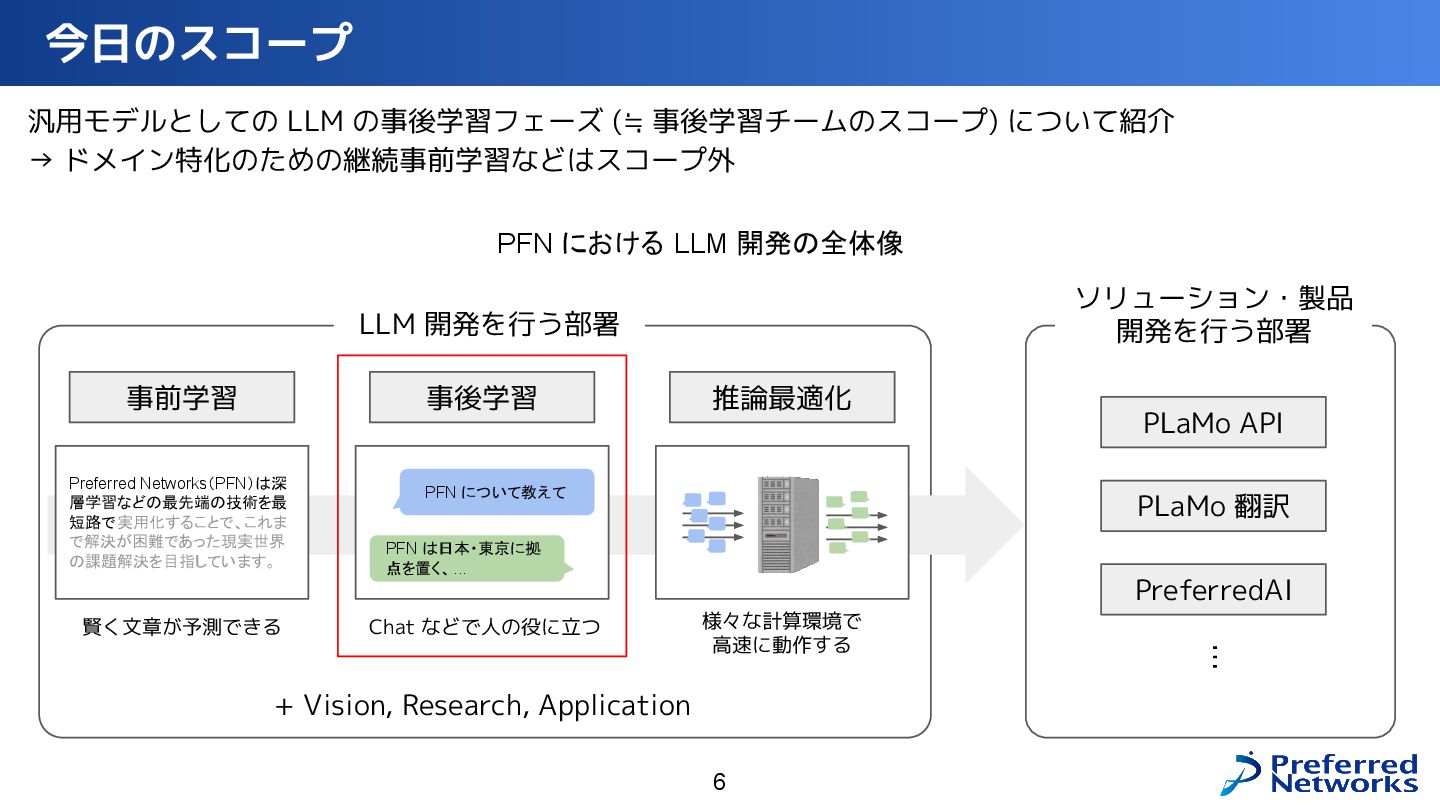
今日のスコープ 6 事前学習 事後学習 推論最適化 PLaMo API PLaMo 翻訳 PreferredAI
賢く文章が予測できる Chat などで人の役に立つ 様々な計算環境で 高速に動作する Preferred Networks(PFN)は深 層学習などの最先端の技術を最 短路で実用化することで、これま で解決が困難であった現実世界 の課題解決を目指しています。 PFN について教えて PFN は日本・東京に拠 点を置く、... LLM 開発を行う部署 ソリューション・製品 開発を行う部署 … 汎用モデルとしての LLM の事後学習フェーズ (≒ 事後学習チームのスコープ) について紹介 → ドメイン特化のための継続事前学習などはスコープ外 + Vision, Research, Application PFN における LLM 開発の全体像 -
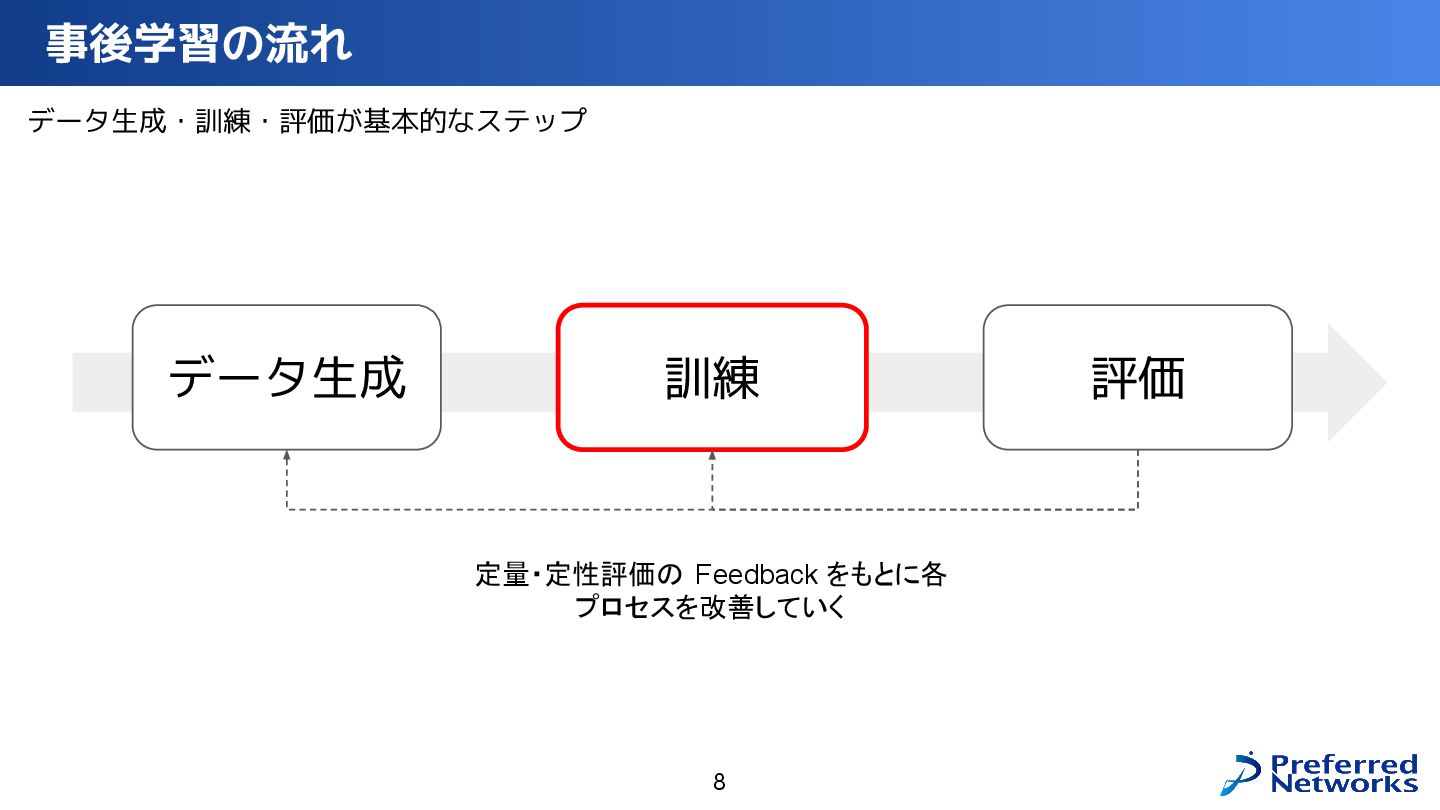
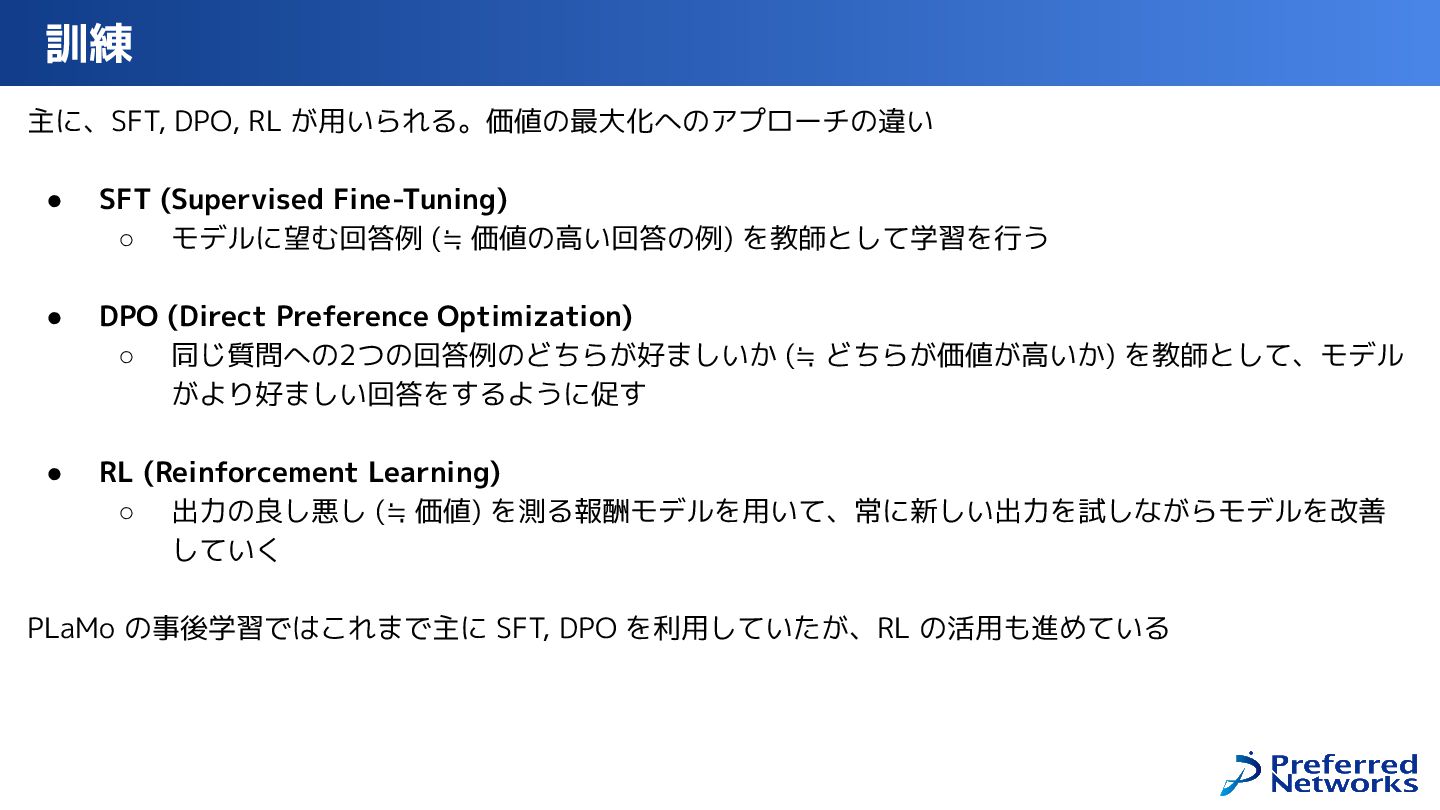
訓練 主に、SFT, DPO, RL が用いられる。価値の最大化へのアプローチの違い • SFT (Supervised Fine-Tuning) ◦
モデルに望む回答例 (≒ 価値の高い回答の例) を教師として学習を行う • DPO (Direct Preference Optimization) ◦ 同じ質問への2つの回答例のどちらが好ましいか (≒ どちらが価値が高いか) を教師として、モデル がより好ましい回答をするように促す • RL (Reinforcement Learning) ◦ 出力の良し悪し (≒ 価値) を測る報酬モデルを用いて、常に新しい出力を試しながらモデルを改善 していく PLaMo の事後学習ではこれまで主に SFT, DPO を利用していたが、RL の活用も進めている -
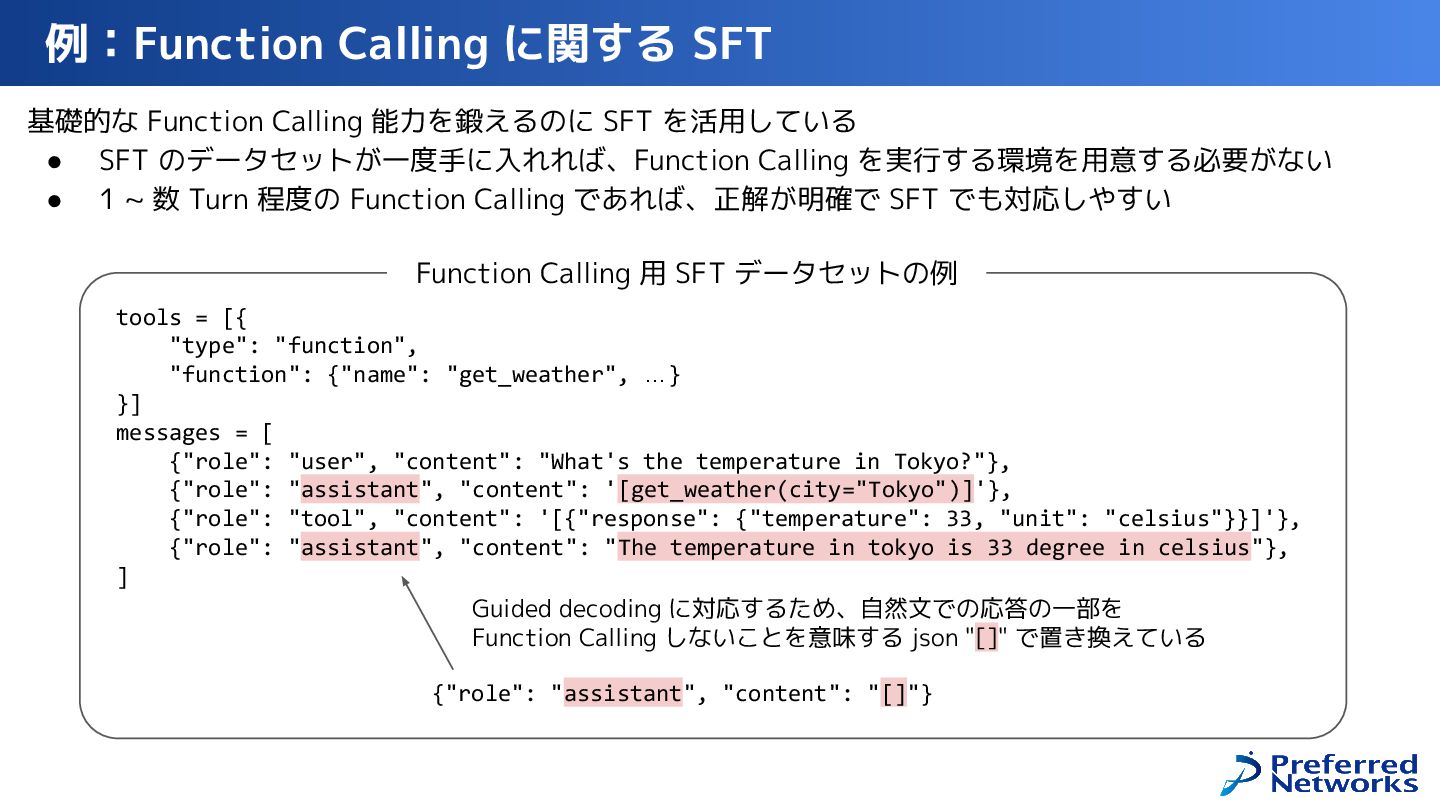
例:Function Calling に関する SFT 基礎的な Function Calling 能力を鍛えるのに SFT を活用している
• SFT のデータセットが一度手に入れれば、Function Calling を実行する環境を用意する必要がない • 1 ~ 数 Turn 程度の Function Calling であれば、正解が明確で SFT でも対応しやすい tools = [{ "type": "function", "function": {"name": "get_weather", …} }] messages = [ {"role": "user", "content": "What's the temperature in Tokyo?"}, {"role": "assistant", "content": '[get_weather(city="Tokyo")]'}, {"role": "tool", "content": '[{"response": {"temperature": 33, "unit": "celsius"}}]'}, {"role": "assistant", "content": "The temperature in tokyo is 33 degree in celsius"}, ] {"role": "assistant", "content": "[]"} Guided decoding に対応するため、自然文での応答の一部を Function Calling しないことを意味する json "[]" で置き換えている Function Calling 用 SFT データセットの例 -
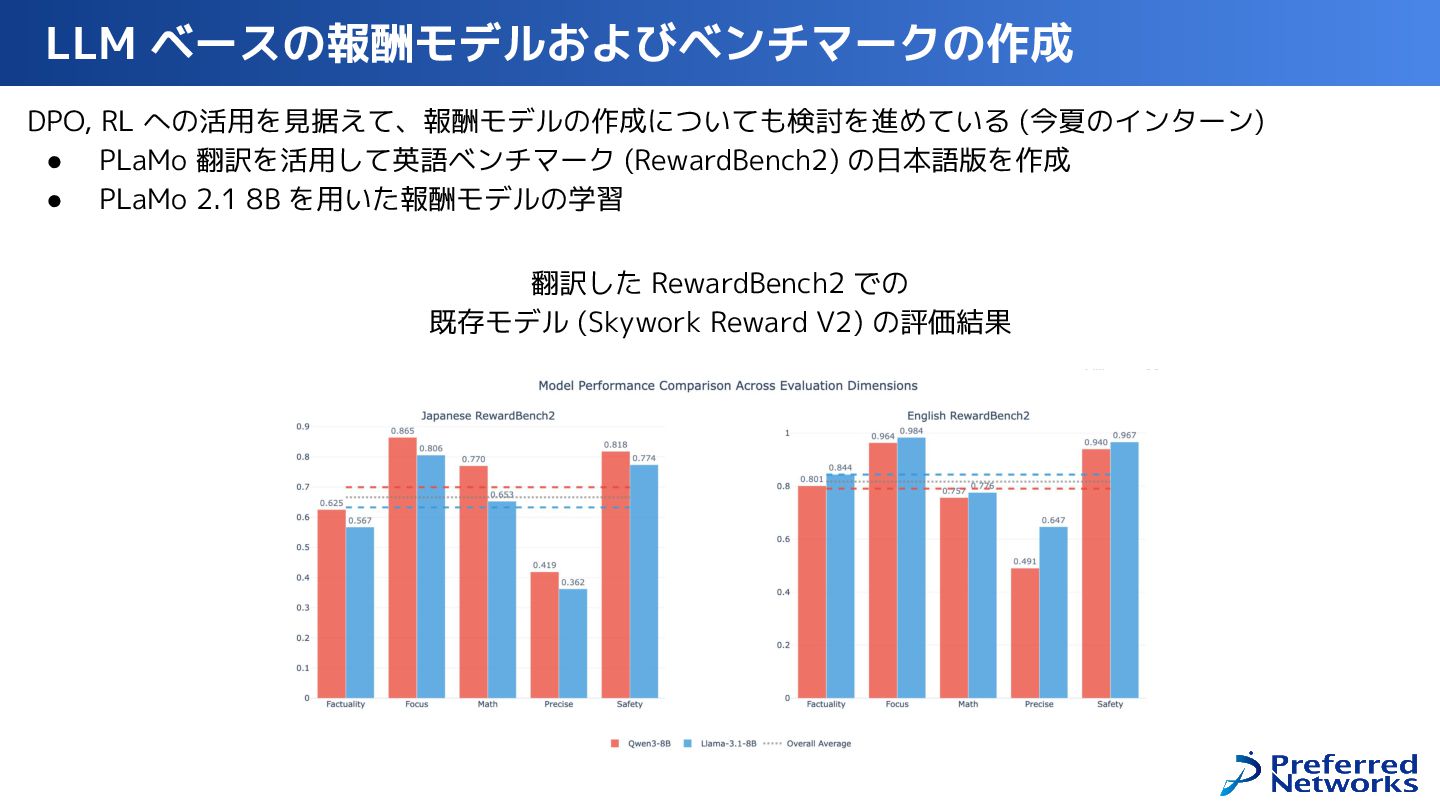
LLM ベースの報酬モデルおよびベンチマークの作成 DPO, RL への活用を見据えて、報酬モデルの作成についても検討を進めている (今夏のインターン) • PLaMo 翻訳を活用して英語ベンチマーク (RewardBench2)
の日本語版を作成 • PLaMo 2.1 8B を用いた報酬モデルの学習 翻訳した RewardBench2 での 既存モデル (Skywork Reward V2) の評価結果 -
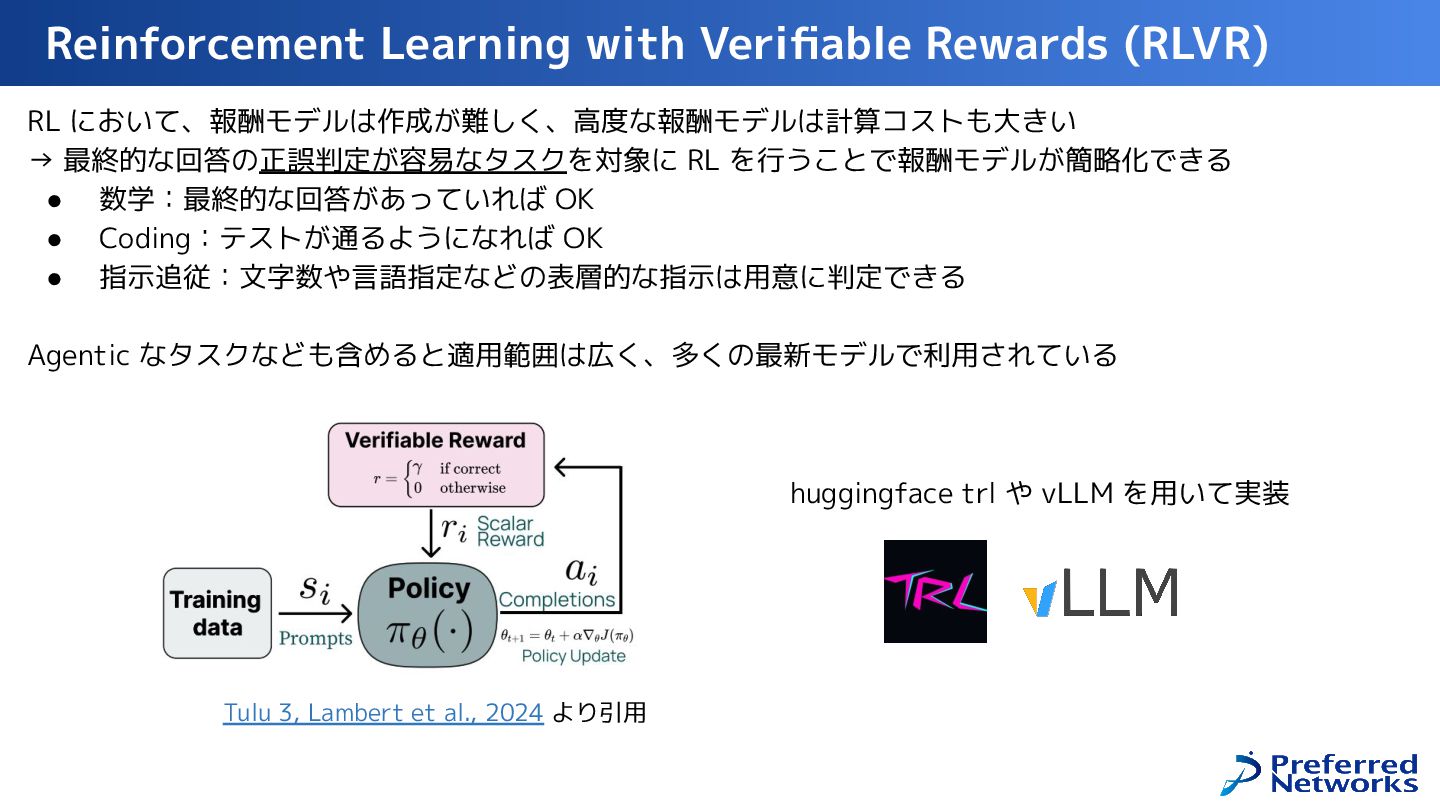
Reinforcement Learning with Verifiable Rewards (RLVR) RL において、報酬モデルは作成が難しく、高度な報酬モデルは計算コストも大きい → 最終的な回答の正誤判定が容易なタスクを対象に
RL を行うことで報酬モデルが簡略化できる • 数学:最終的な回答があっていれば OK • Coding:テストが通るようになれば OK • 指示追従:文字数や言語指定などの表層的な指示は用意に判定できる Agentic なタスクなども含めると適用範囲は広く、多くの最新モデルで利用されている Tulu 3, Lambert et al., 2024 より引用 huggingface trl や vLLM を用いて実装 -
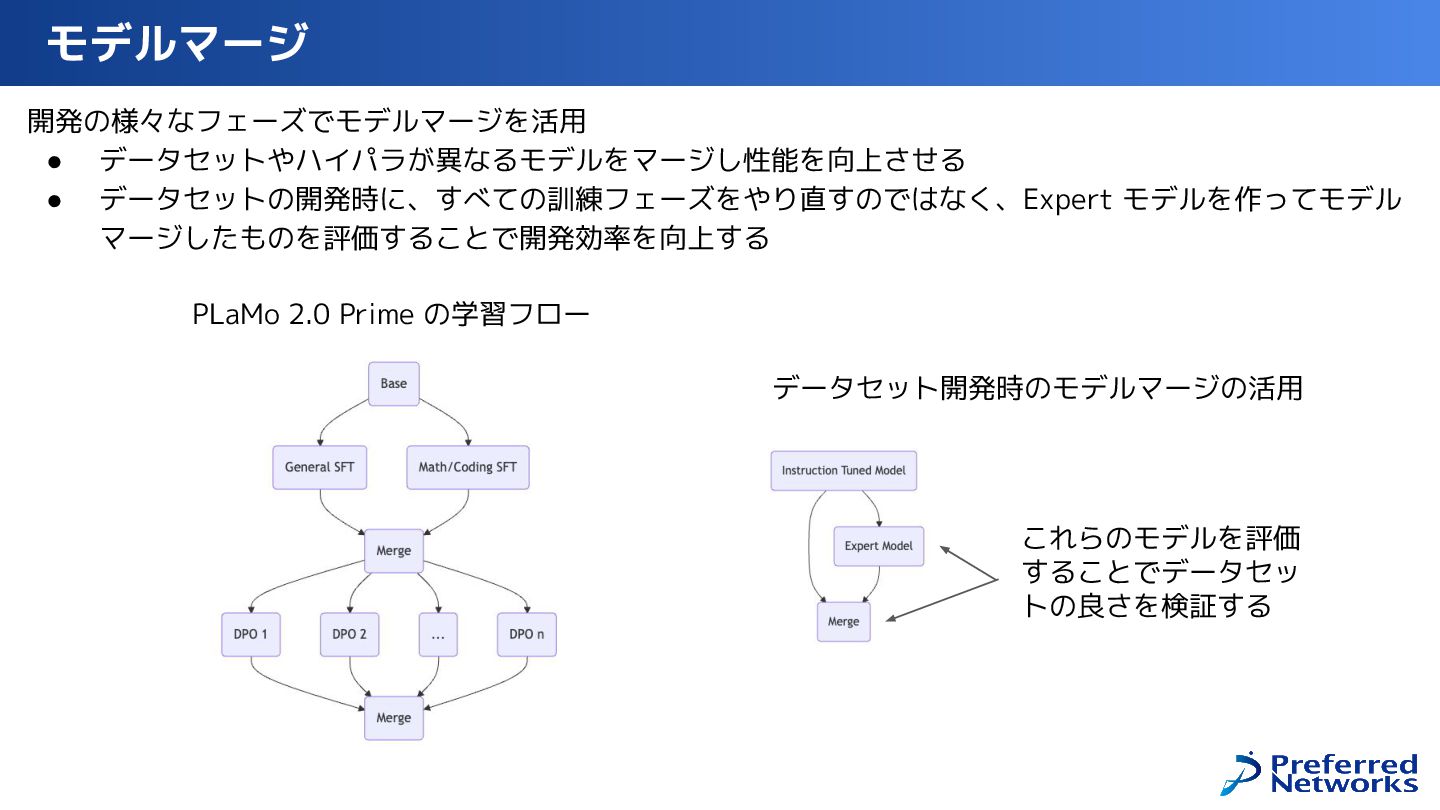
モデルマージ 開発の様々なフェーズでモデルマージを活用 • データセットやハイパラが異なるモデルをマージし性能を向上させる • データセットの開発時に、すべての訓練フェーズをやり直すのではなく、Expert モデルを作ってモデル マージしたものを評価することで開発効率を向上する PLaMo 2.0
Prime の学習フロー データセット開発時のモデルマージの活用 これらのモデルを評価 することでデータセッ トの良さを検証する -
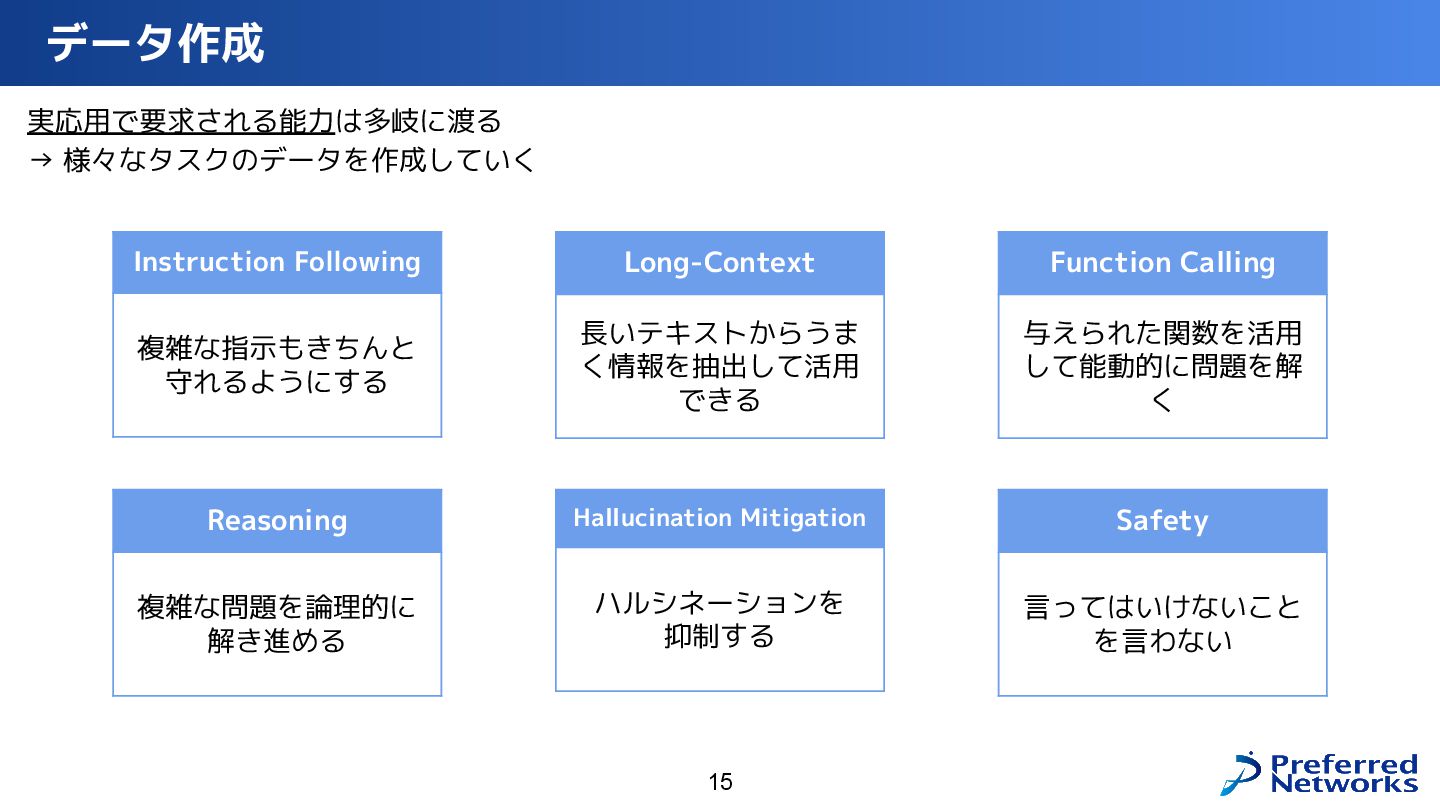
データ作成 15 Long-Context 長いテキストからうま く情報を抽出して活用 できる Instruction Following 複雑な指示もきちんと 守れるようにする
Function Calling 与えられた関数を活用 して能動的に問題を解 く Hallucination Mitigation ハルシネーションを 抑制する Reasoning 複雑な問題を論理的に 解き進める Safety 言ってはいけないこと を言わない 実応用で要求される能力は多岐に渡る → 様々なタスクのデータを作成していく -
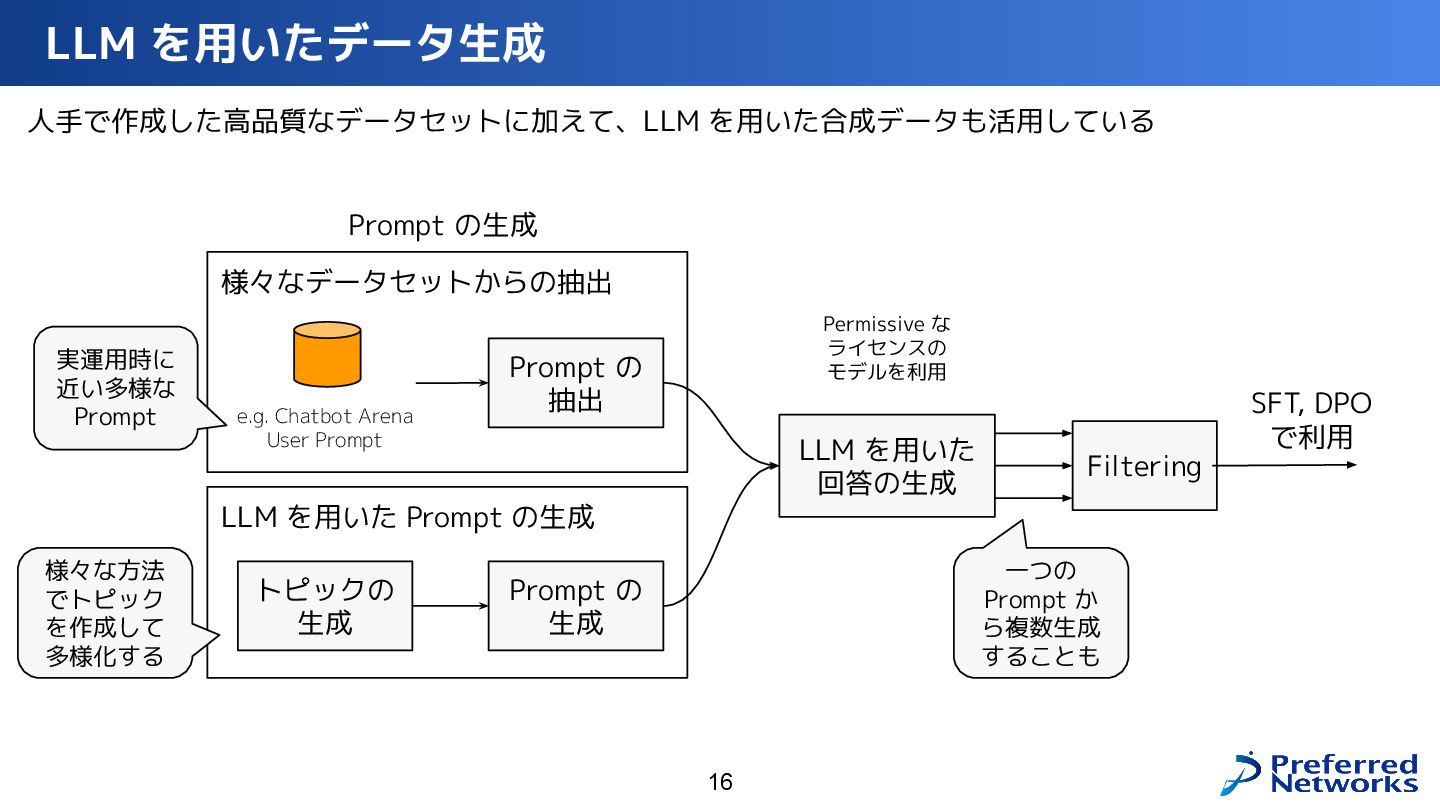
LLM を用いたデータ生成 16 人手で作成した高品質なデータセットに加えて、LLM を用いた合成データも活用している 様々なデータセットからの抽出 LLM を用いた Prompt の生成
トピックの 生成 Prompt の 生成 LLM を用いた 回答の生成 Filtering Prompt の 抽出 e.g. Chatbot Arena User Prompt Permissive な ライセンスの モデルを利用 Prompt の生成 実運用時に 近い多様な Prompt 様々な方法 でトピック を作成して 多様化する 一つの Prompt か ら複数生成 することも SFT, DPO で利用 -
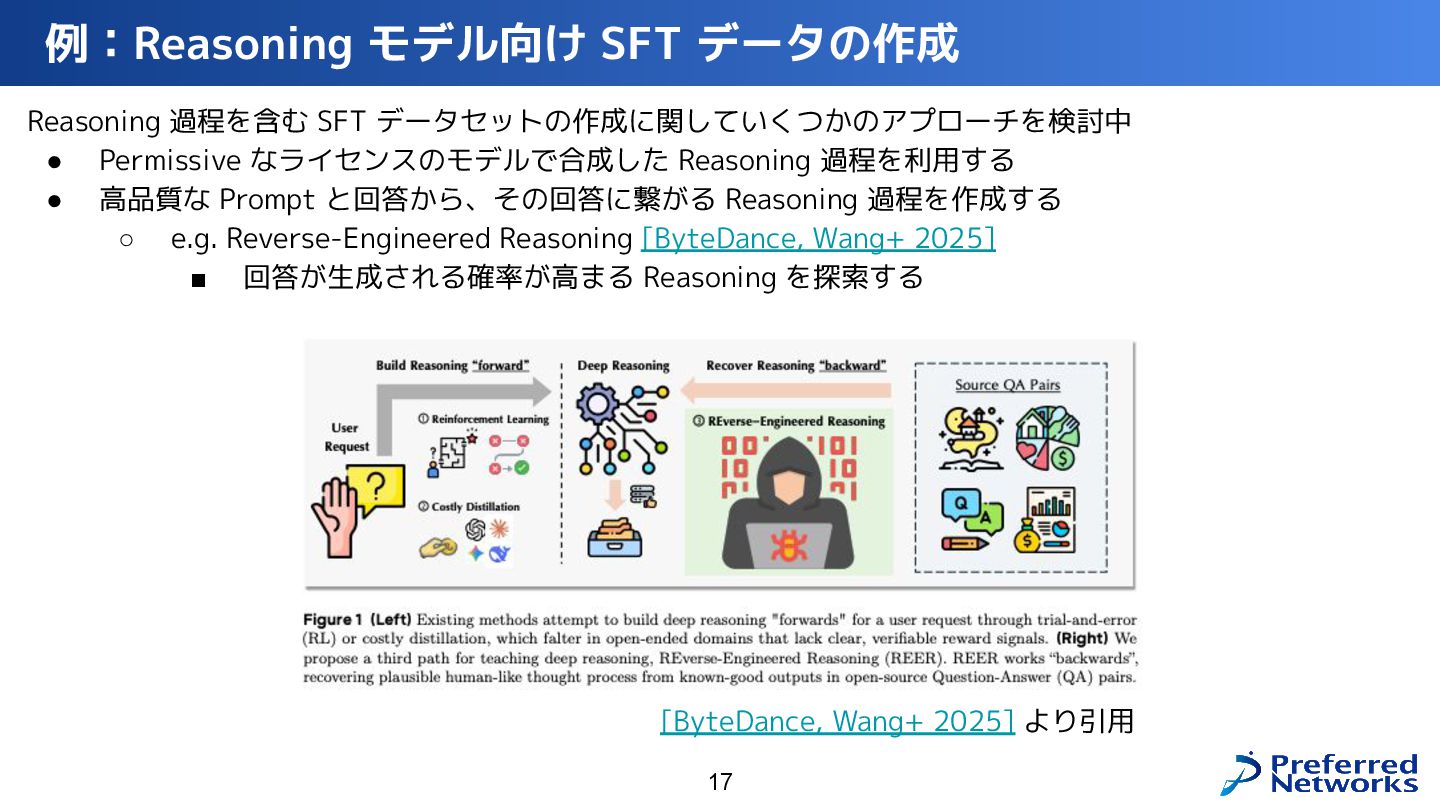
例:Reasoning モデル向け SFT データの作成 17 Reasoning 過程を含む SFT データセットの作成に関していくつかのアプローチを検討中 •
Permissive なライセンスのモデルで合成した Reasoning 過程を利用する • 高品質な Prompt と回答から、その回答に繋がる Reasoning 過程を作成する ◦ e.g. Reverse-Engineered Reasoning [ByteDance, Wang+ 2025] ▪ 回答が生成される確率が高まる Reasoning を探索する [ByteDance, Wang+ 2025] より引用 -
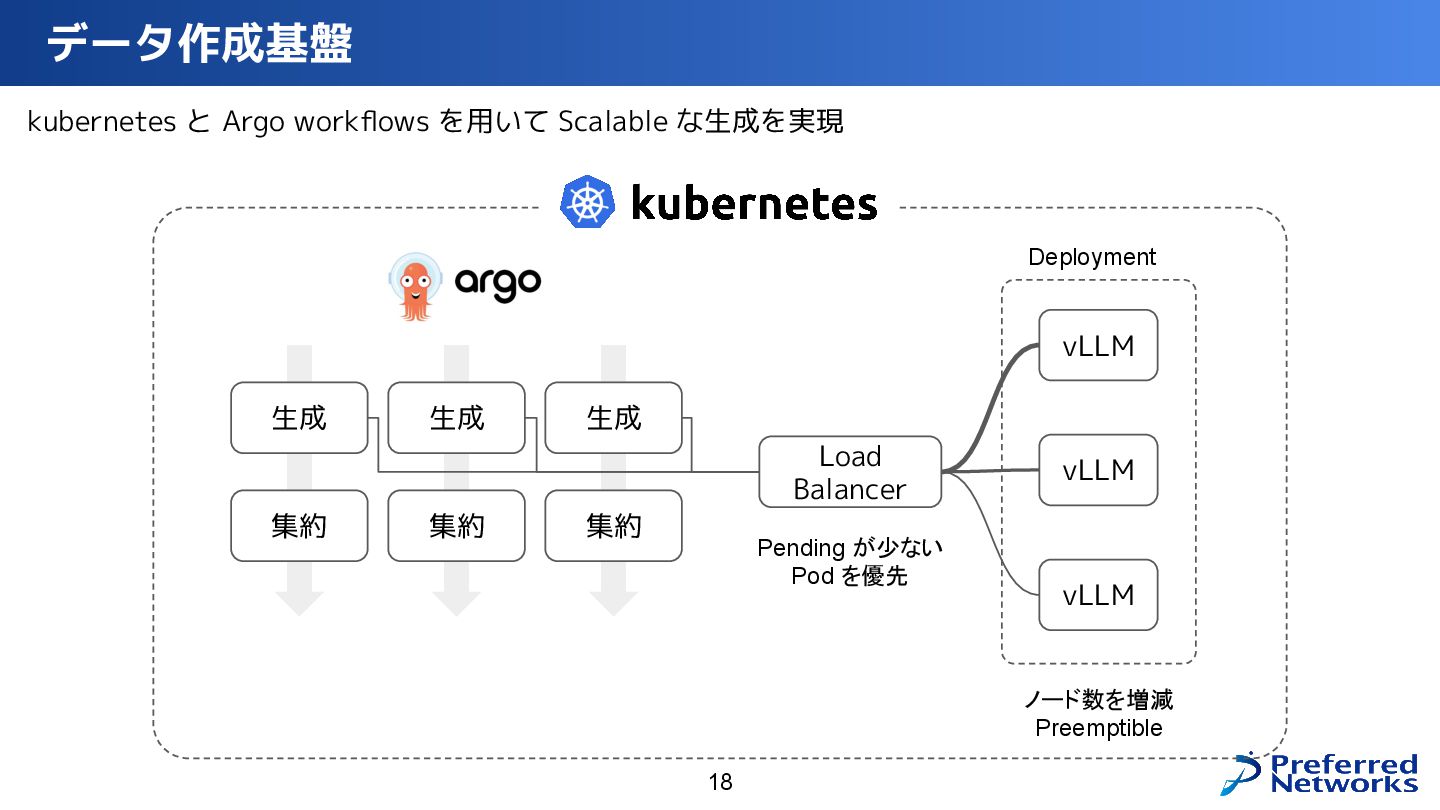
データ作成基盤 18 kubernetes と Argo workflows を用いて Scalable な生成を実現 生成
生成 集約 Load Balancer vLLM vLLM vLLM Deployment 集約 集約 生成 Pending が少ない Pod を優先 ノード数を増減 Preemptible -
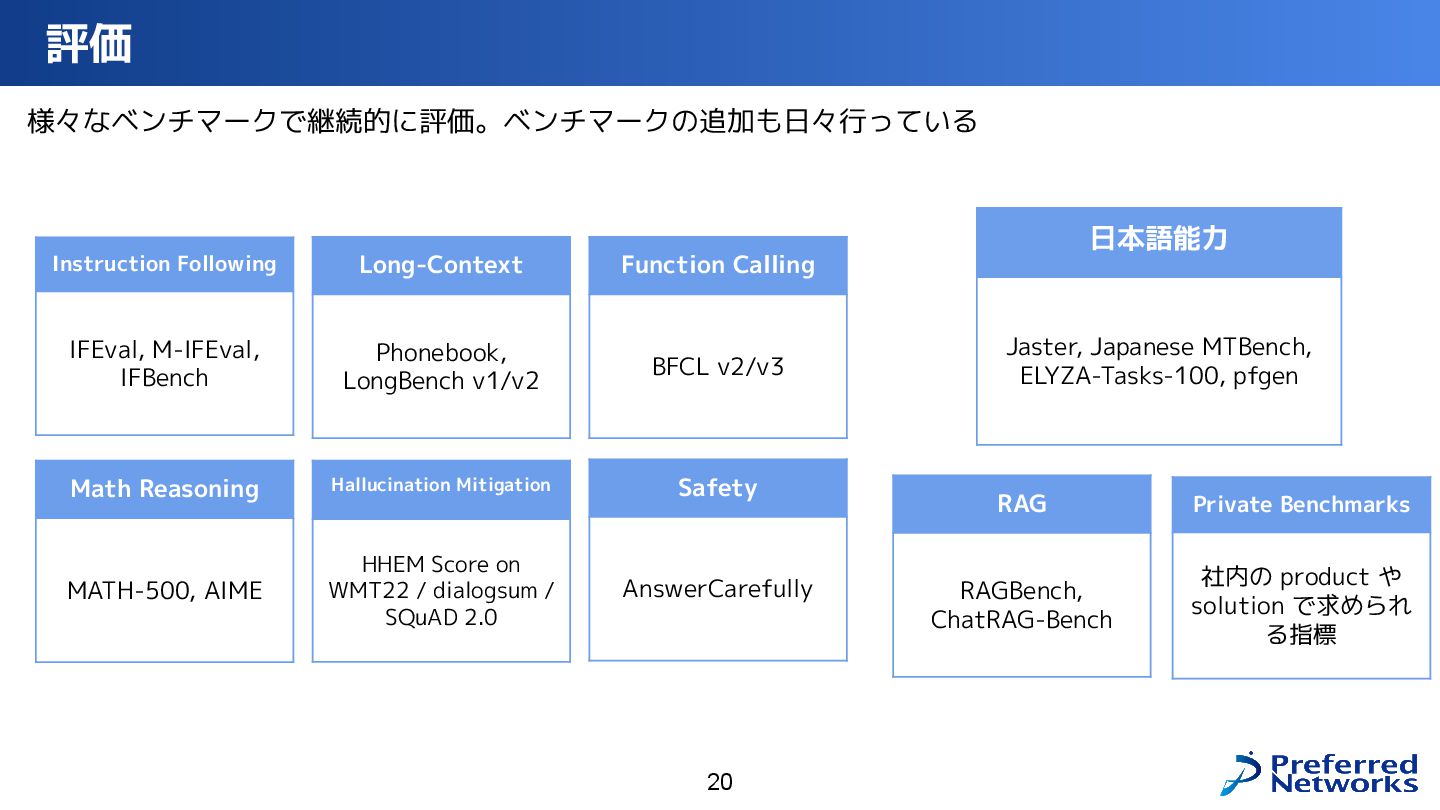
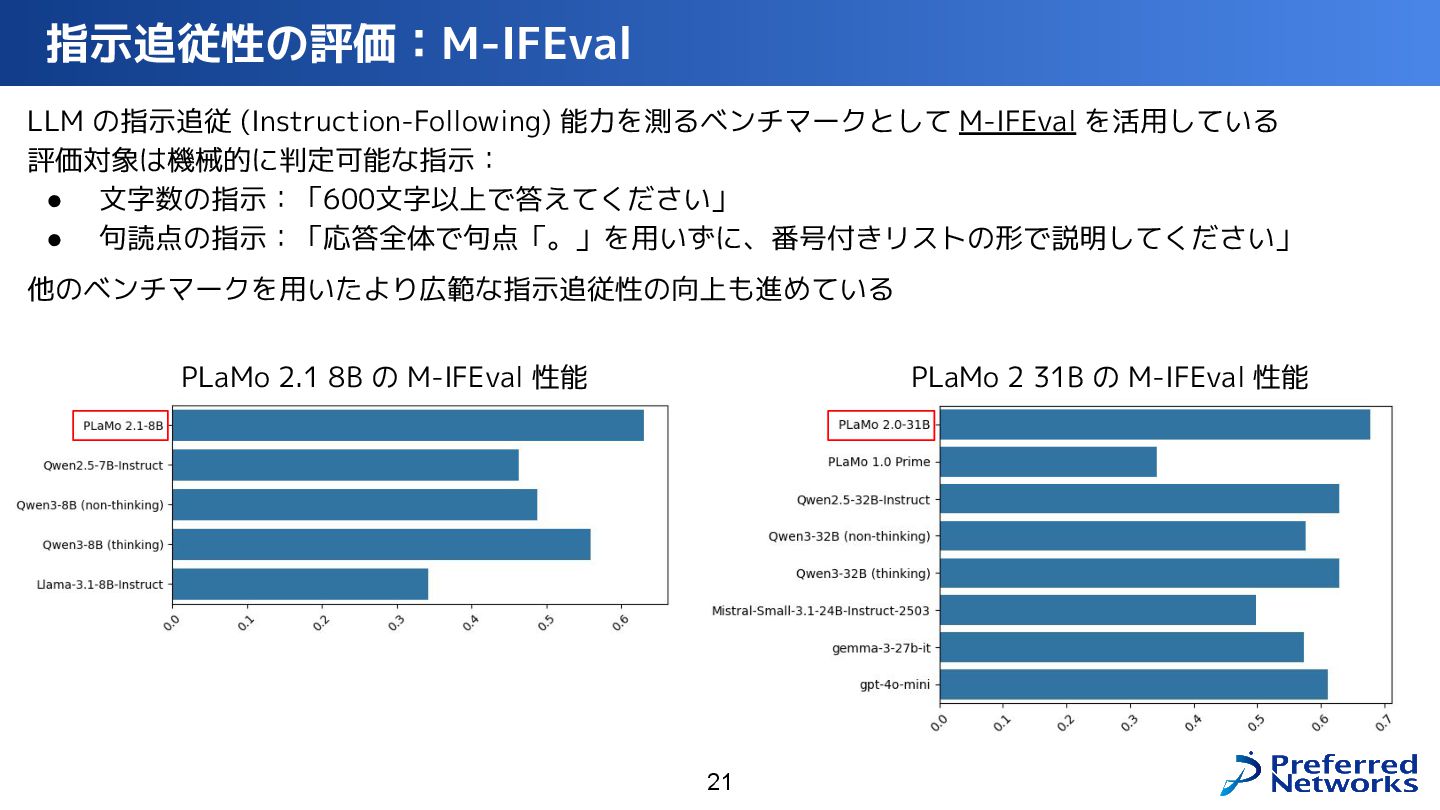
様々なベンチマークで継続的に評価。ベンチマークの追加も日々行っている 評価 20 Long-Context Phonebook, LongBench v1/v2 Instruction Following IFEval,
M-IFEval, IFBench Function Calling BFCL v2/v3 Hallucination Mitigation HHEM Score on WMT22 / dialogsum / SQuAD 2.0 Math Reasoning MATH-500, AIME Safety AnswerCarefully 日本語能力 Jaster, Japanese MTBench, ELYZA-Tasks-100, pfgen Private Benchmarks 社内の product や solution で求められ る指標 RAG RAGBench, ChatRAG-Bench -
指示追従性の評価:M-IFEval 21 LLM の指示追従 (Instruction-Following) 能力を測るベンチマークとして M-IFEval を活用している 評価対象は機械的に判定可能な指示: •
文字数の指示:「600文字以上で答えてください」 • 句読点の指示:「応答全体で句点「。」を用いずに、番号付きリストの形で説明してください」 他のベンチマークを用いたより広範な指示追従性の向上も進めている PLaMo 2.1 8B の M-IFEval 性能 PLaMo 2 31B の M-IFEval 性能 -
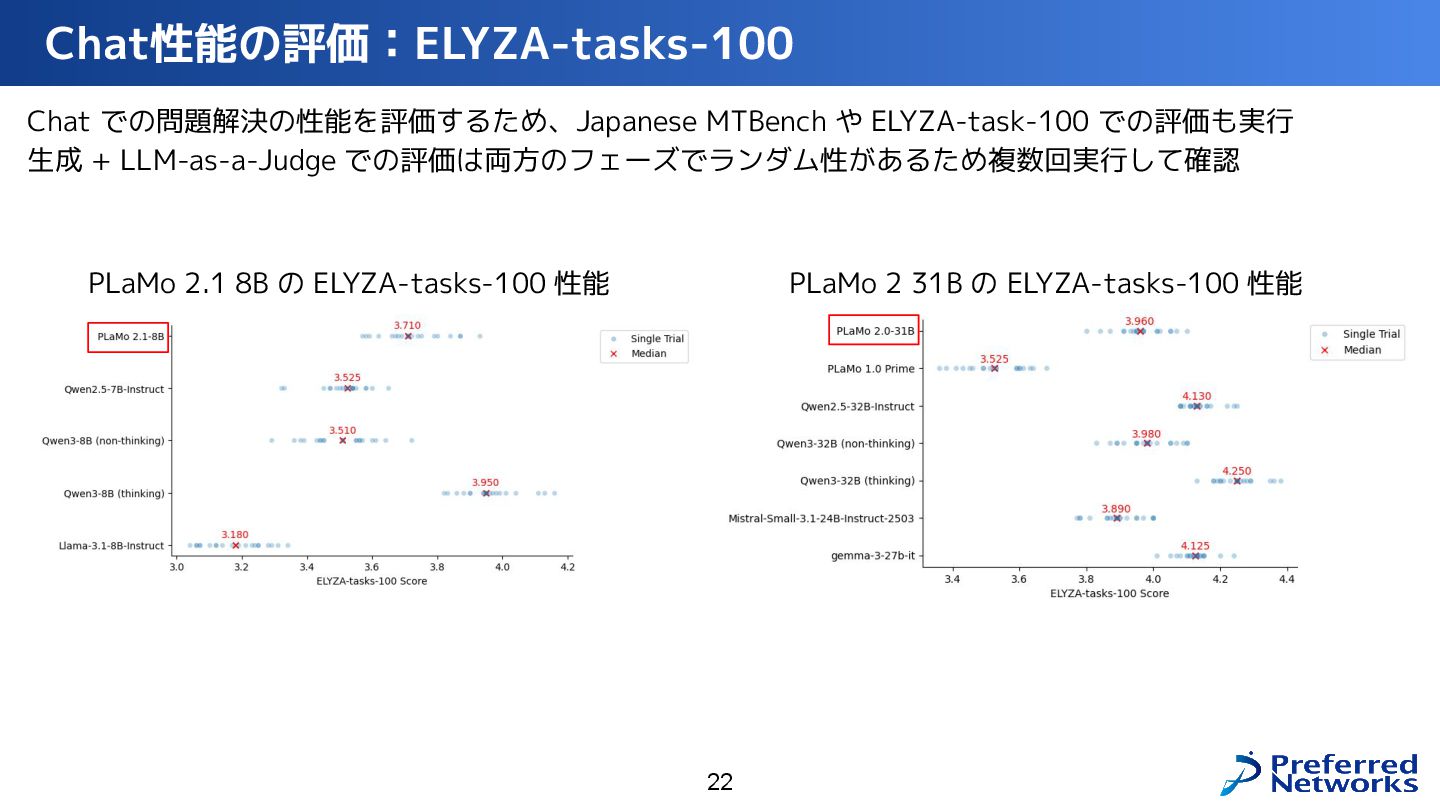
Chat性能の評価:ELYZA-tasks-100 22 Chat での問題解決の性能を評価するため、Japanese MTBench や ELYZA-task-100 での評価も実行 生成 +
LLM-as-a-Judge での評価は両方のフェーズでランダム性があるため複数回実行して確認 PLaMo 2.1 8B の ELYZA-tasks-100 性能 PLaMo 2 31B の ELYZA-tasks-100 性能 -
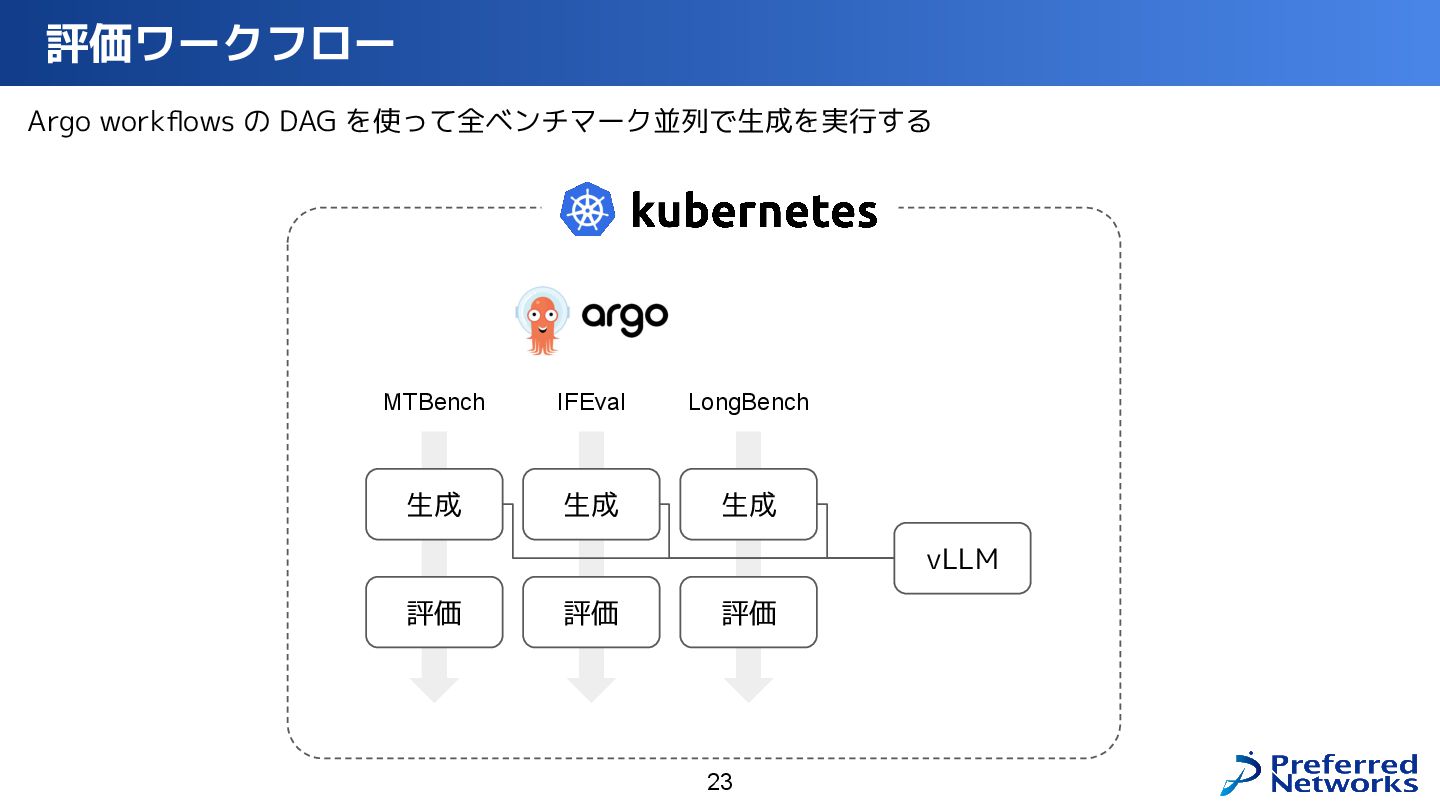
評価ワークフロー 23 Argo workflows の DAG を使って全ベンチマーク並列で生成を実行する 生成 生成 評価
vLLM 評価 評価 生成 MTBench IFEval LongBench -
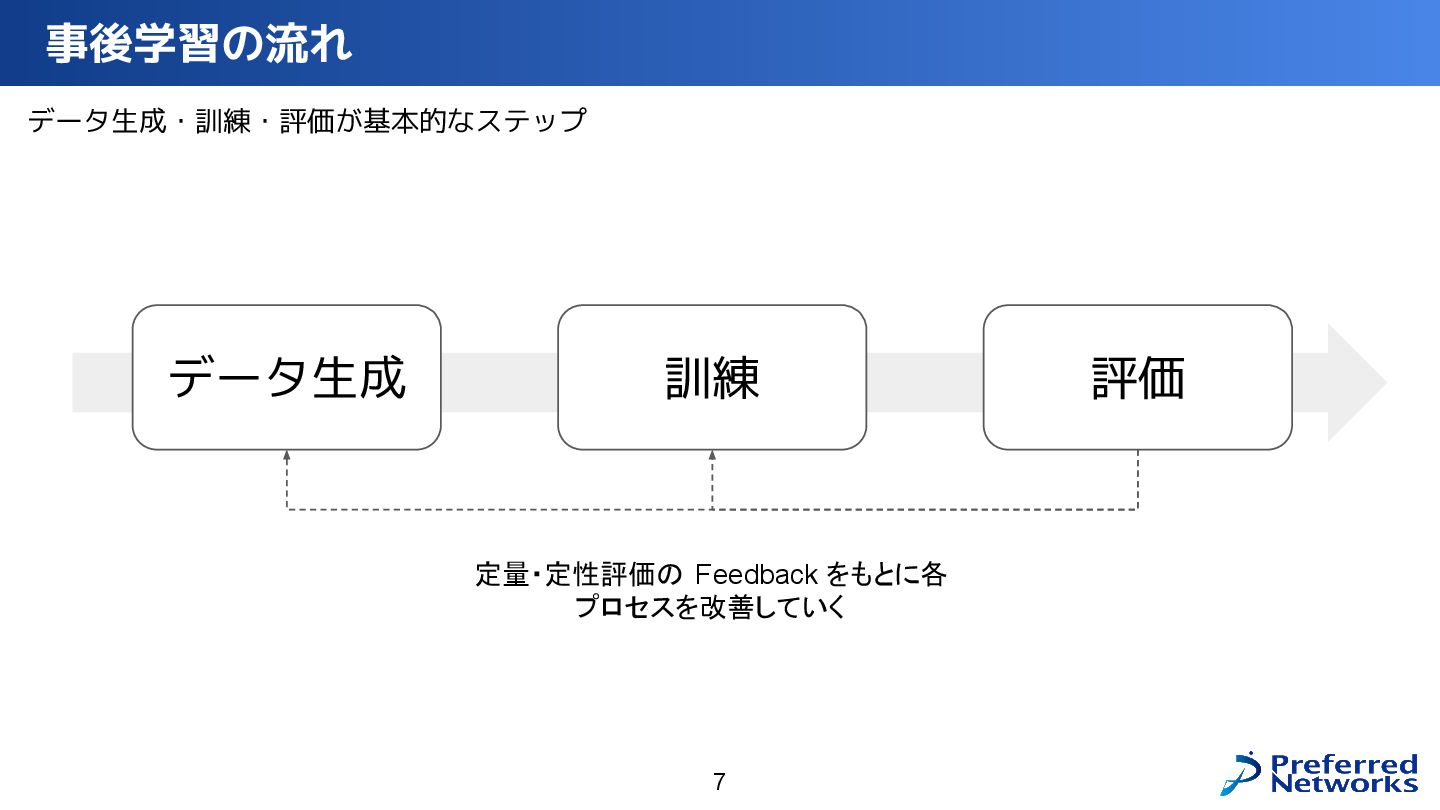
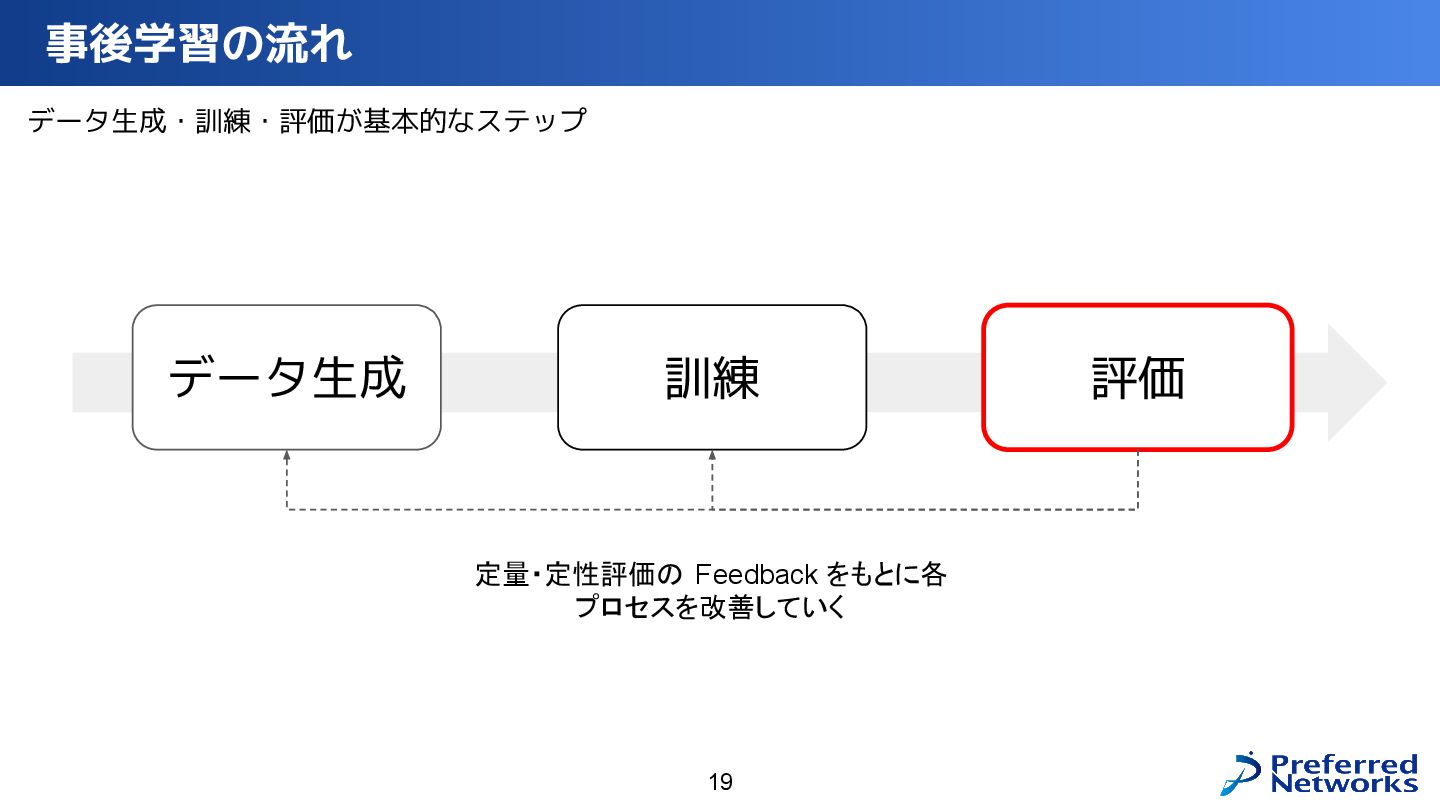
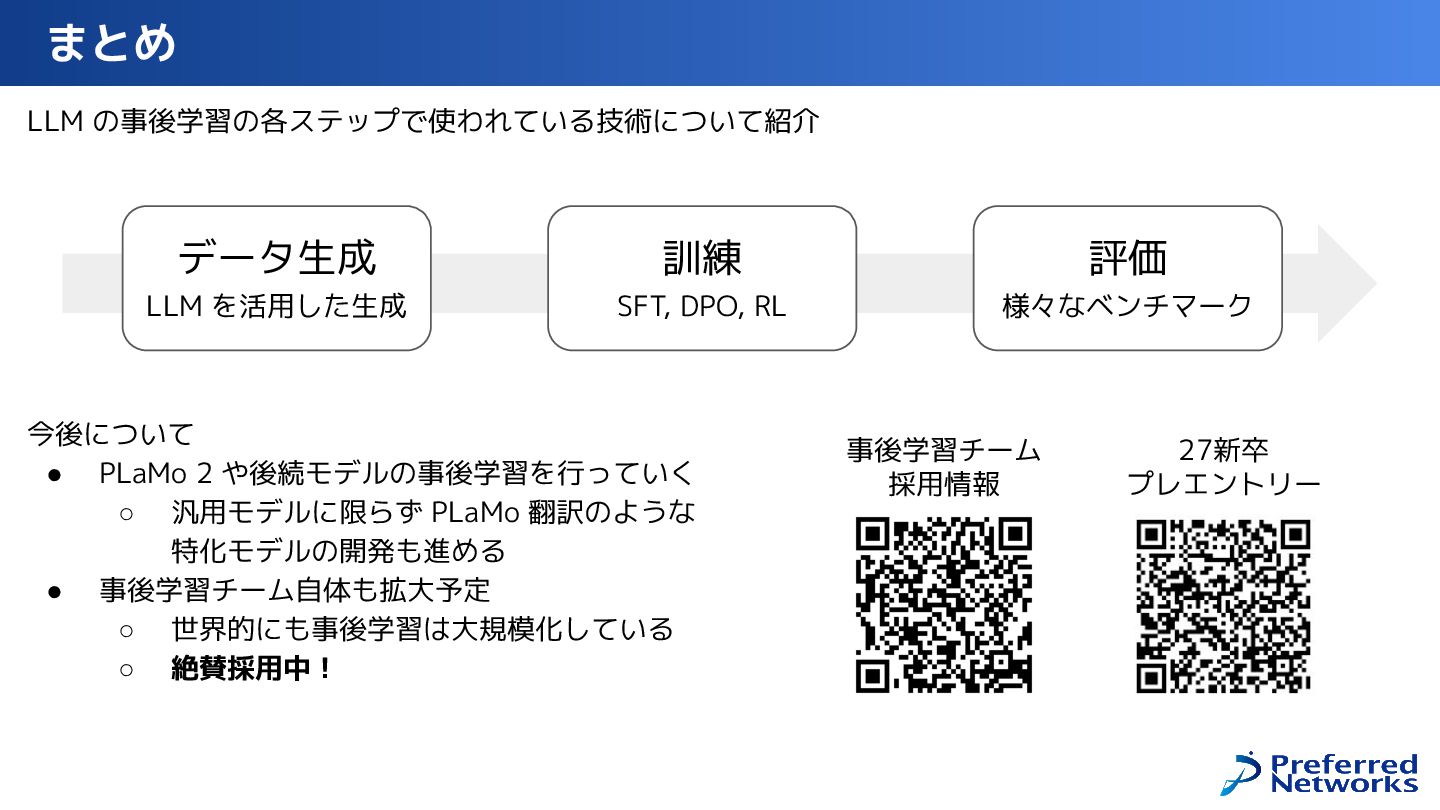
LLM の事後学習の各ステップで使われている技術について紹介 まとめ データ生成 LLM を活用した生成 訓練 SFT, DPO, RL
評価 様々なベンチマーク 今後について • PLaMo 2 や後続モデルの事後学習を行っていく ◦ 汎用モデルに限らず PLaMo 翻訳のような 特化モデルの開発も進める • 事後学習チーム自体も拡大予定 ◦ 世界的にも事後学習は大規模化している ◦ 絶賛採用中! 事後学習チーム 採用情報 27新卒 プレエントリー