Share
Embed
Semi-supervised Learning for Word Sense Disambiguation
Original title in Spanish: Desambiguación de Palabras Polisémicas mediante Aprendizaje Semi-supervisado
Date: September 20, 2013
Venue: Córdoba, Argentina. 42nd JAIIO - Argentine Journals of Informatics and Operating Research (JAIIO '13)
Please cite, link to or credit this presentation when using it or part of it in your work.
#ML #MachineLearning #NLP #NaturalLanguageProcessing #SemiSupervisedLearning #WordSenseDisambiguation #WSD
Darío Garigliotti
September 20, 2013
Transcript
29 slides
-
Desambiguación de palabras polisémicas mediante aprendizaje semi-supervisado Darío Garigliotti FAMAF
– UNC 42 JAIIO – EST – Trabajo de Cátedra 20 de septiembre de 2013 -
1 - La tarea de la desambiguación de sentidos 2
- Presentación del trabajo 3 - Algoritmo de listas de decisión 4 - Experimentos con factores 5 - ¿Cuán bien desambigua? Resumen de la presentación -
1 - La tarea de la desambiguación de sentidos 2
- Presentación del trabajo 3 - Algoritmo de listas de decisión 4 - Experimentos con factores 5 - ¿Cuán bien desambigua? Resumen de la presentación -
1 - Desambiguación de sentidos • Una palabra presenta polisemia
cuando posee más de un sentido 1 significante → 2+ significados : ambigüedad banco := crédito | asiento | estrato | peces manzana:= fruta | superficie movimiento:= desplazamiento | corriente ¿Qué es la polisemia? -
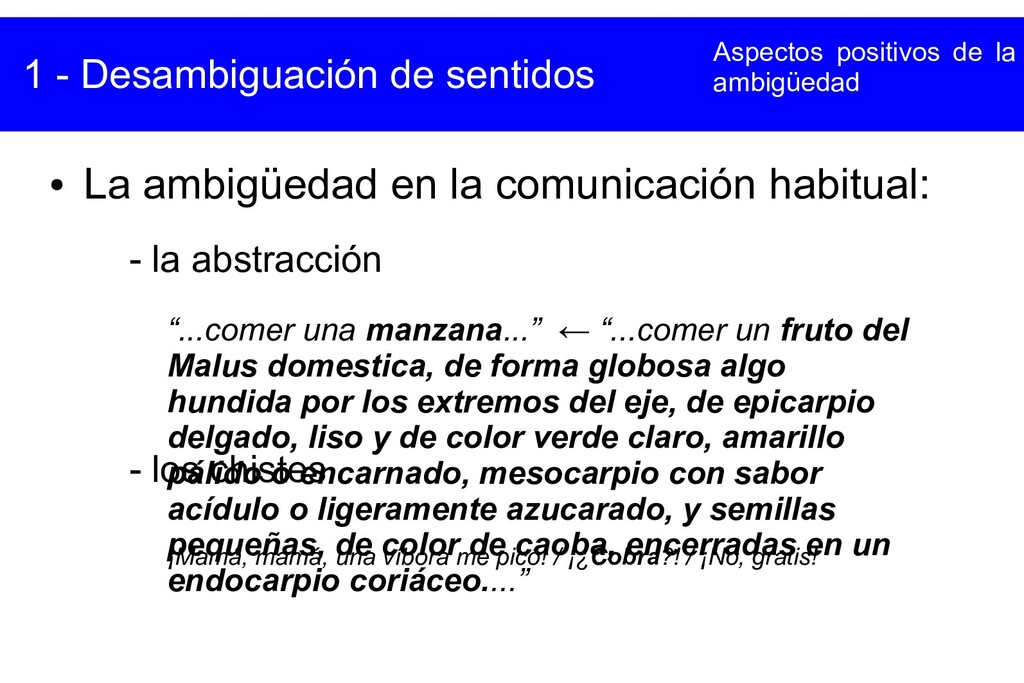
1 - Desambiguación de sentidos • La ambigüedad en la
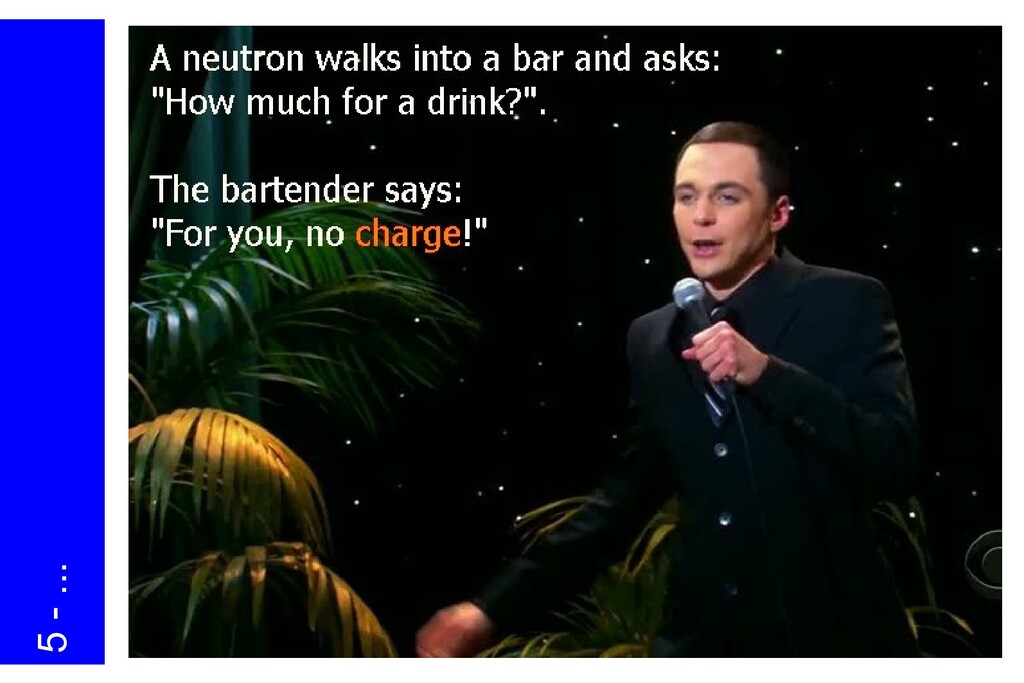
comunicación habitual: - la abstracción - los chistes Aspectos positivos de la ambigüedad “...comer una manzana...” ← “...comer un fruto del Malus domestica, de forma globosa algo hundida por los extremos del eje, de epicarpio delgado, liso y de color verde claro, amarillo pálido o encarnado, mesocarpio con sabor acídulo o ligeramente azucarado, y semillas pequeñas, de color de caoba, encerradas en un endocarpio coriáceo....” ¡Mamá, mamá, una víbora me picó! / ¡¿Cobra?! / ¡No, gratis! -
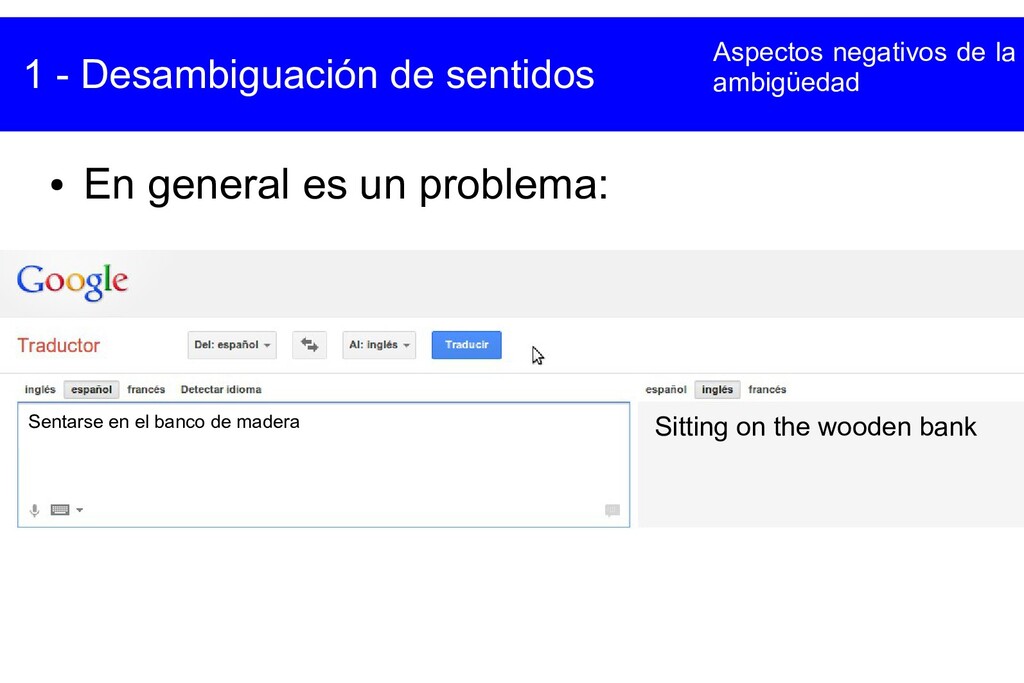
1 - Desambiguación de sentidos • En general es un
problema: Aspectos negativos de la ambigüedad Sitting on the wooden bank Sentarse en el banco de madera -
2 - Presentación del trabajo • En este trabajo lo
que se hizo fue... - estudiar un algoritmo de desambiguación de sentidos - identificar factores relevantes - valorar / proponer criterios y parámetros a los factores - implementar una versión simplificada del algoritmo con estas decisiones - observar su comportamiento y evaluar su desempeño -
2 - Presentación del trabajo • Más precisamente: - Algoritmo
de Yarowsky: bootstrapping iterativo, training inicial con semillas “no supervisadas”. - Tarea de desambiguar las ocurrencias de una palabra fija target en un texto (lexical sample task). - Preprocesamos un corpus para obtener un conjunto de instancias -oraciones- a etiquetar con un sentido, cada una con ocurrencia del target y representada por un vector con valores para cada atributo del lexicón. -
[…] En este caso, la causa de los movimientos sísmicos
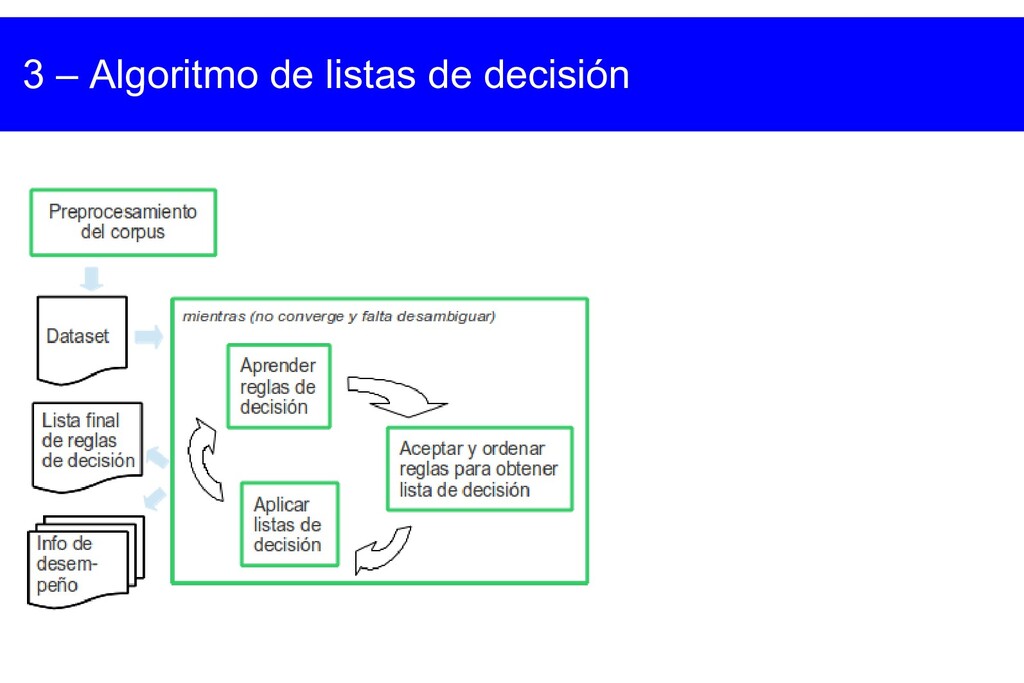
es la acción de una base de misiles nucleares.[...] 3 – Algoritmo de listas de decisión En en SPS00 1 este este DD0MS0 0.956743 caso caso NCMS000 0.990741 , , Fc 1 la el DA0FS0 0.972146 causa causa NCFS000 0.794872 de de SPS00 0.999919 los el DA0MP0 0.97623 movimientos movimiento NCMP000 1 sísmicos sísmico AQ0MP0 1 es ser VSIP3S0 1 la el DA0FS0 0.972146 acción acción NCFS000 1 de de SPS00 0.999919 una uno DI0FS0 0.951241 base base NCCS000 0.955882 de de SPS00 0.999919 misiles misil NCMP000 1 nucleares nuclear AQ0CP0 1 . . Fp 1 caso caso NCMS000 0.990741 causa causa NCFS000 0.794872 movimientos movimiento NCMP000 1 sísmicos sísmico AQ0MP0 1 acción acción NCFS000 1 base base NCCS000 0.955882 misiles misil NCMP000 1 nucleares nuclear AQ0CP0 1 . . Fp 1 m ovim iento POS-tagging tener hacer acción caso base sísm ico causa .... .... .... .... … … 1 0 0 ...... 1 ....... 1 ..... 1 ..... 1 .... 1 .... Filtrado por palabras de contenido Construcción de lexicón + tuplas: Preprocesamiento del corpus -
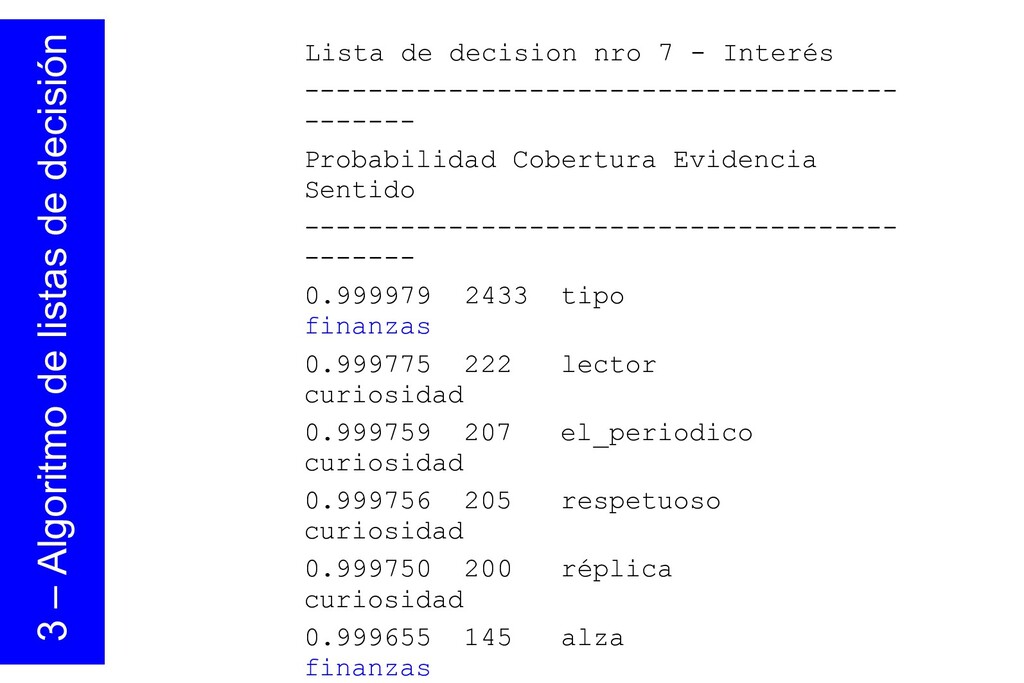
Lista de decision nro 7 - Interés ------------------------------------- ------- Probabilidad
Cobertura Evidencia Sentido ------------------------------------- ------- 0.999979 2433 tipo finanzas 0.999775 222 lector curiosidad 0.999759 207 el_periodico curiosidad 0.999756 205 respetuoso curiosidad 0.999750 200 réplica curiosidad 0.999655 145 alza finanzas 3 – Algoritmo de listas de decisión -
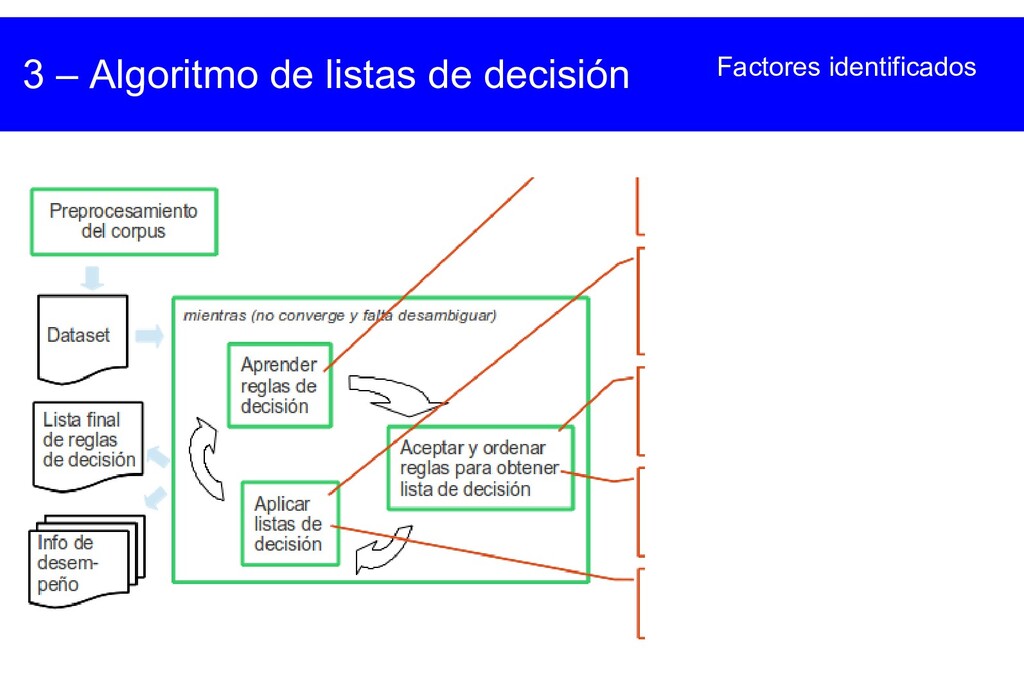
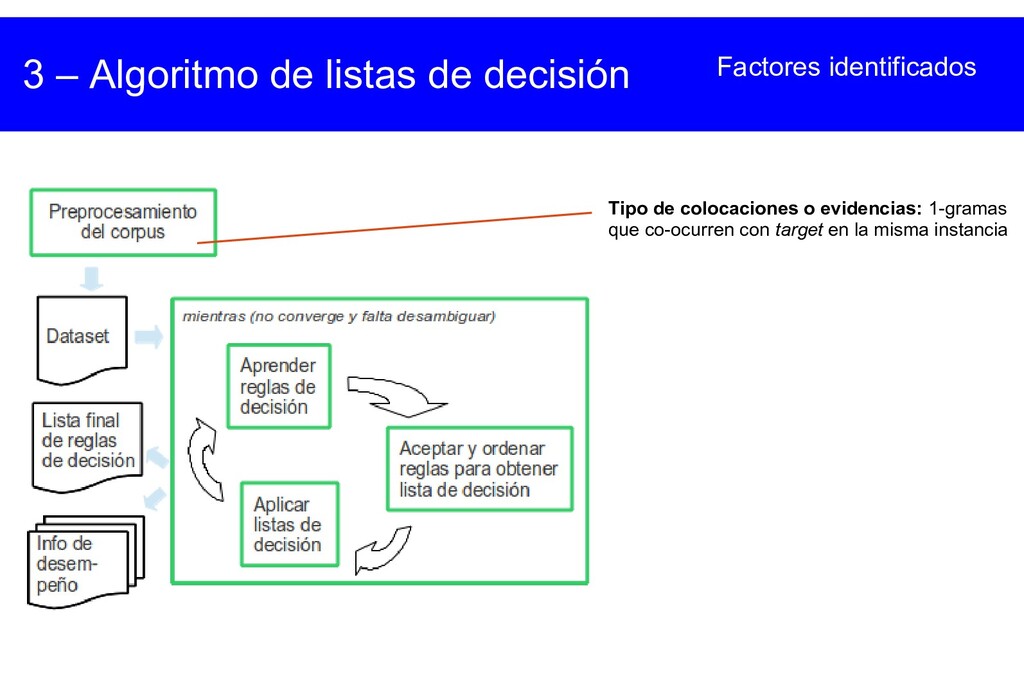
3 – Algoritmo de listas de decisión Tipo de colocaciones
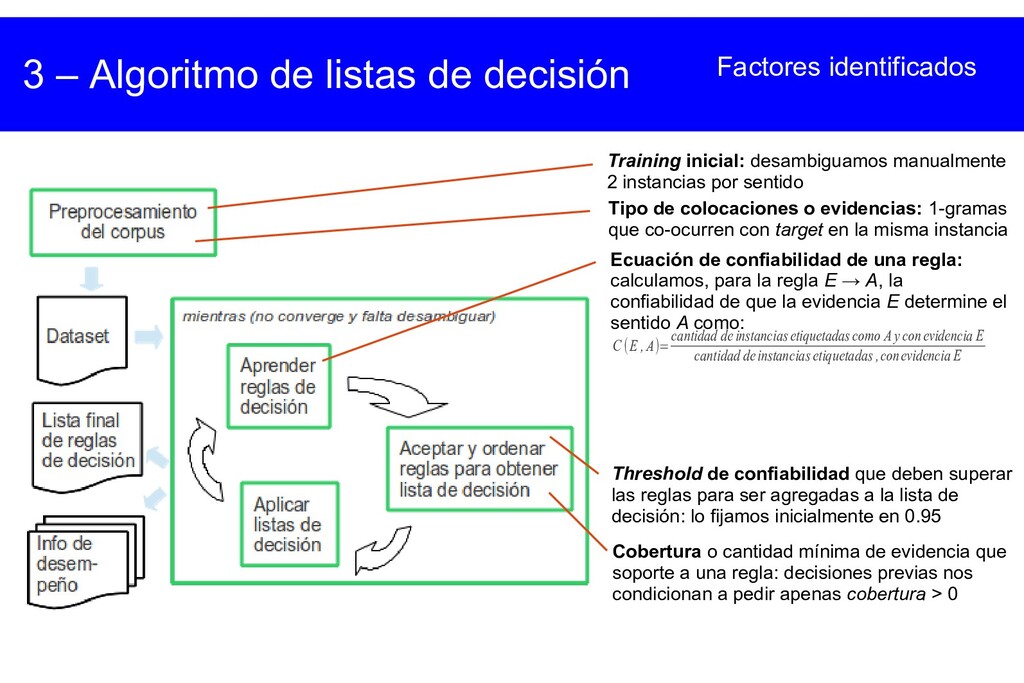
o evidencias: 1-gramas que co-ocurren con target en la misma instancia Factores identificados -
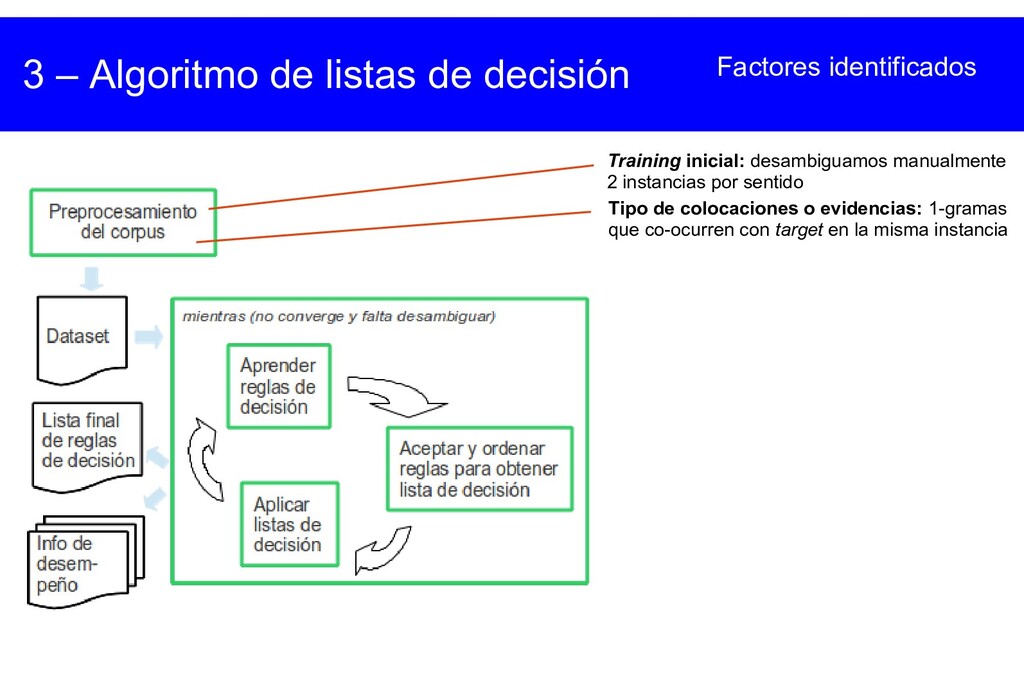
3 – Algoritmo de listas de decisión Tipo de colocaciones
o evidencias: 1-gramas que co-ocurren con target en la misma instancia Training inicial: desambiguamos manualmente 2 instancias por sentido Factores identificados -
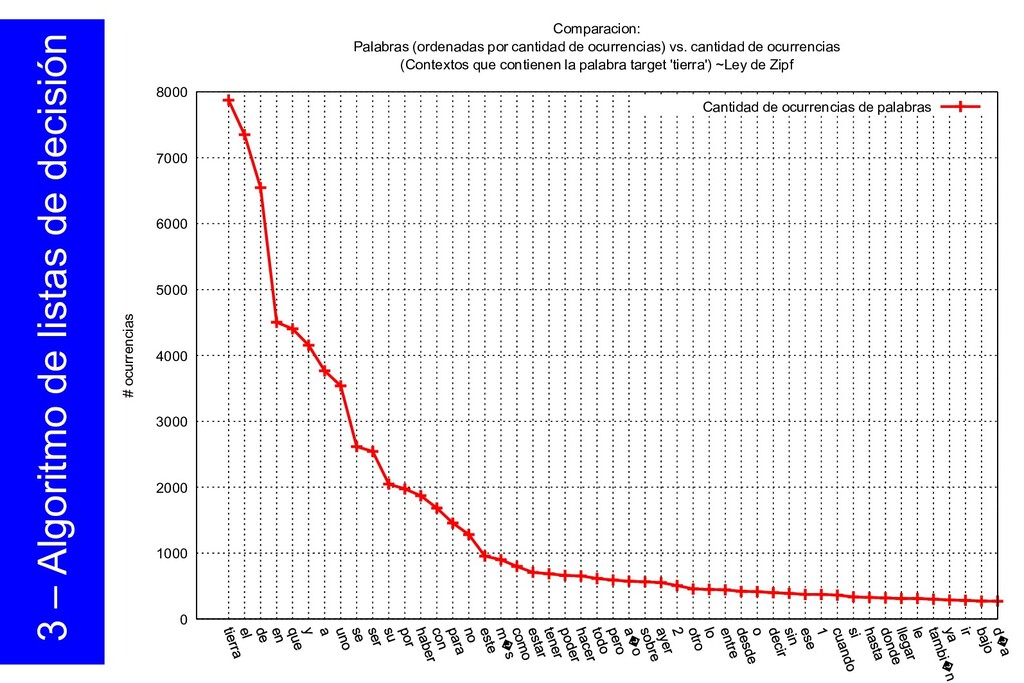
3 – Algoritmo de listas de decisión 0 1000 2000
3000 4000 5000 6000 7000 8000 # ocurrencias Comparacion: Palabras (ordenadas por cantidad de ocurrencias) vs. cantidad de ocurrencias (Contextos que contienen la palabra target 'tierra') ~Ley de Zipf Cantidad de ocurrencias de palabras -
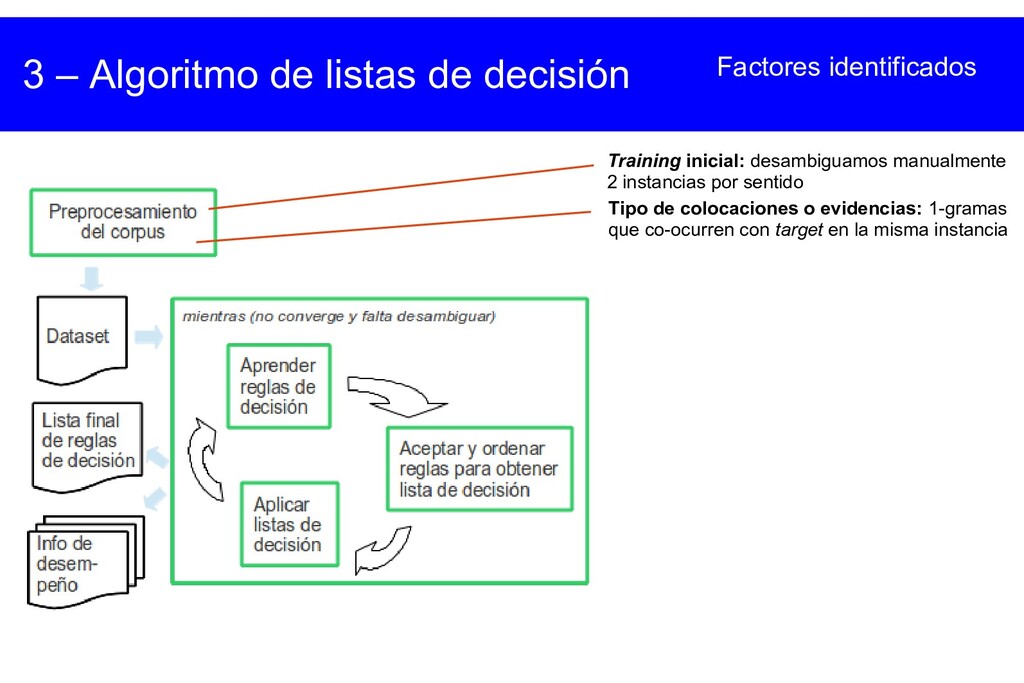
3 – Algoritmo de listas de decisión Tipo de colocaciones
o evidencias: 1-gramas que co-ocurren con target en la misma instancia Training inicial: desambiguamos manualmente 2 instancias por sentido Factores identificados -
3 – Algoritmo de listas de decisión Tipo de colocaciones
o evidencias: 1-gramas que co-ocurren con target en la misma instancia Training inicial: desambiguamos manualmente 2 instancias por sentido Ecuación de confiabilidad de una regla: calculamos, para la regla E → A, la confiabilidad de que la evidencia E determine el sentido A como: Cobertura o cantidad mínima de evidencia que soporte a una regla: decisiones previas nos condicionan a pedir apenas cobertura > 0 Threshold de confiabilidad que deben superar las reglas para ser agregadas a la lista de decisión: lo fijamos inicialmente en 0.95 C(E , A)= cantidad de instanciasetiquetadas como A yconevidencia E cantidad deinstanciasetiquetadas ,conevidenciaE Factores identificados -
3 – Algoritmo de listas de decisión Tipo de colocaciones
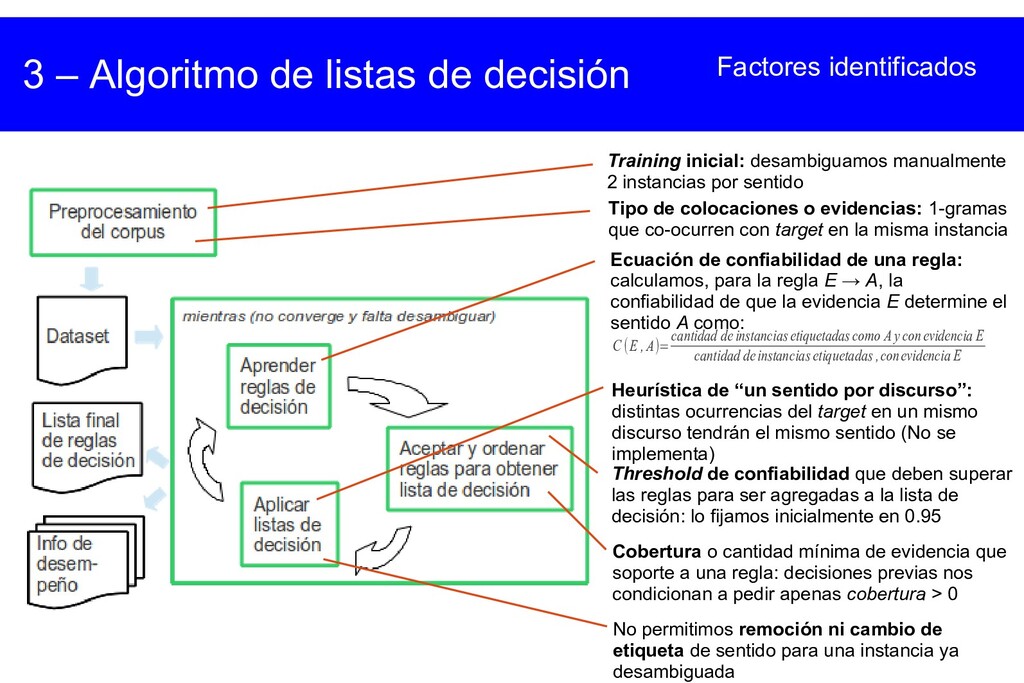
o evidencias: 1-gramas que co-ocurren con target en la misma instancia Training inicial: desambiguamos manualmente 2 instancias por sentido Heurística de “un sentido por discurso”: distintas ocurrencias del target en un mismo discurso tendrán el mismo sentido (No se implementa) Ecuación de confiabilidad de una regla: calculamos, para la regla E → A, la confiabilidad de que la evidencia E determine el sentido A como: Cobertura o cantidad mínima de evidencia que soporte a una regla: decisiones previas nos condicionan a pedir apenas cobertura > 0 No permitimos remoción ni cambio de etiqueta de sentido para una instancia ya desambiguada Threshold de confiabilidad que deben superar las reglas para ser agregadas a la lista de decisión: lo fijamos inicialmente en 0.95 C(E , A)= cantidad de instanciasetiquetadas como A yconevidencia E cantidad deinstanciasetiquetadas ,conevidenciaE Factores identificados -
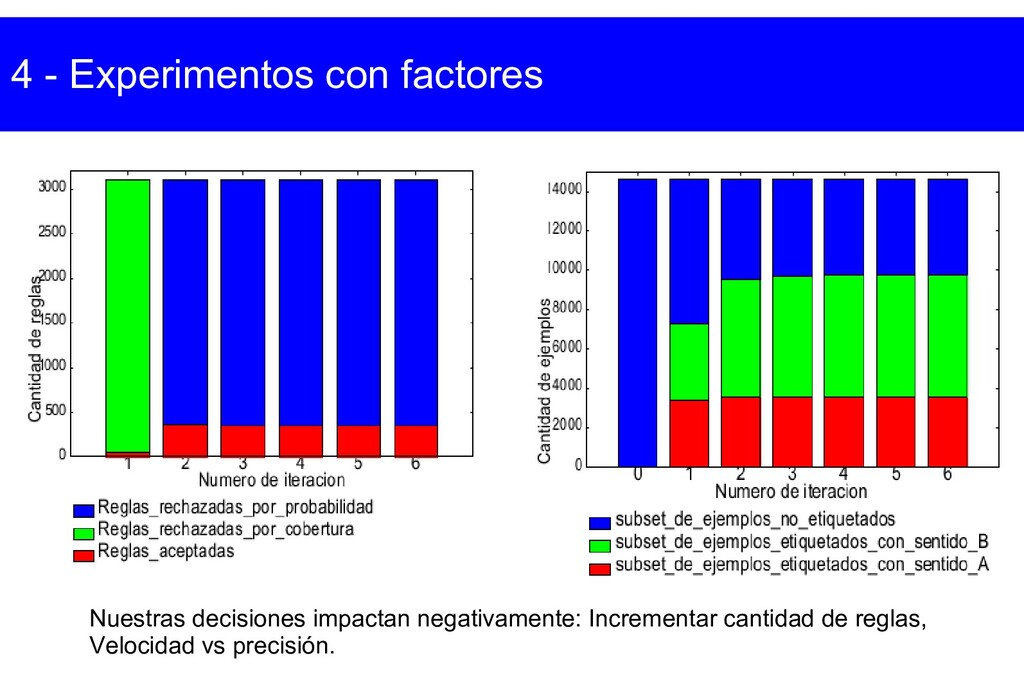
4 - Experimentos con factores Nuestras decisiones impactan negativamente: Incrementar
cantidad de reglas, Velocidad vs precisión. -
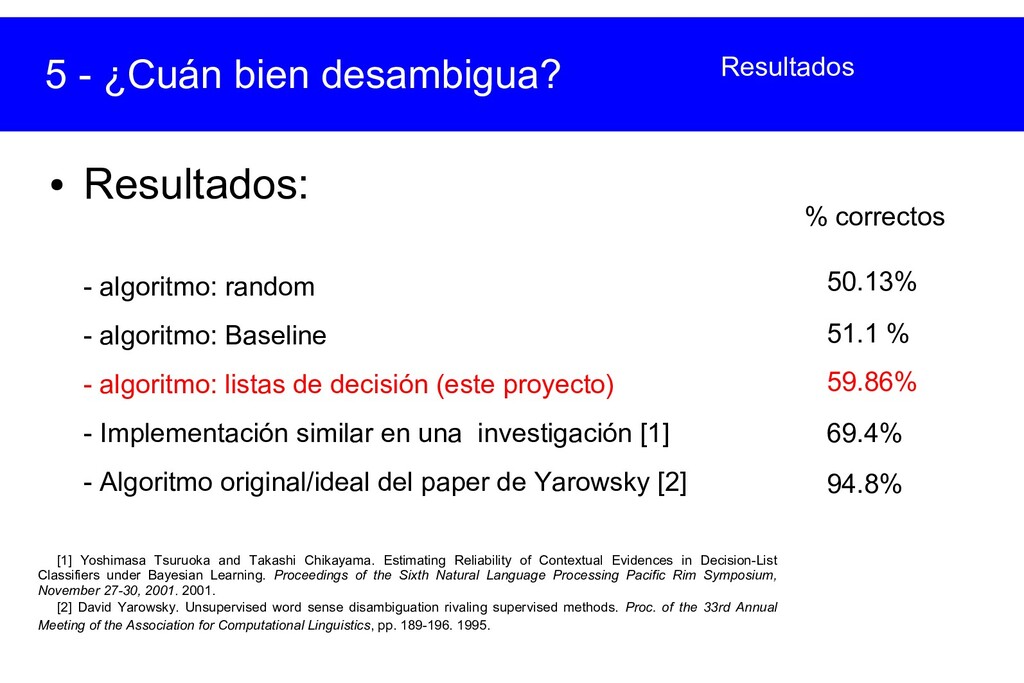
5 - ¿Cuán bien desambigua? • Evaluación clásica: tomar muchos
ejemplos etiquetados y aplicarles el algoritmo - costoso obtenerlos - problema del acuerdo entre humanos • ¿Alternativa disponible? - Y que además evalúa la independencia del algoritmo respecto al lenguaje - La polisemia ocurre no sólo en español -
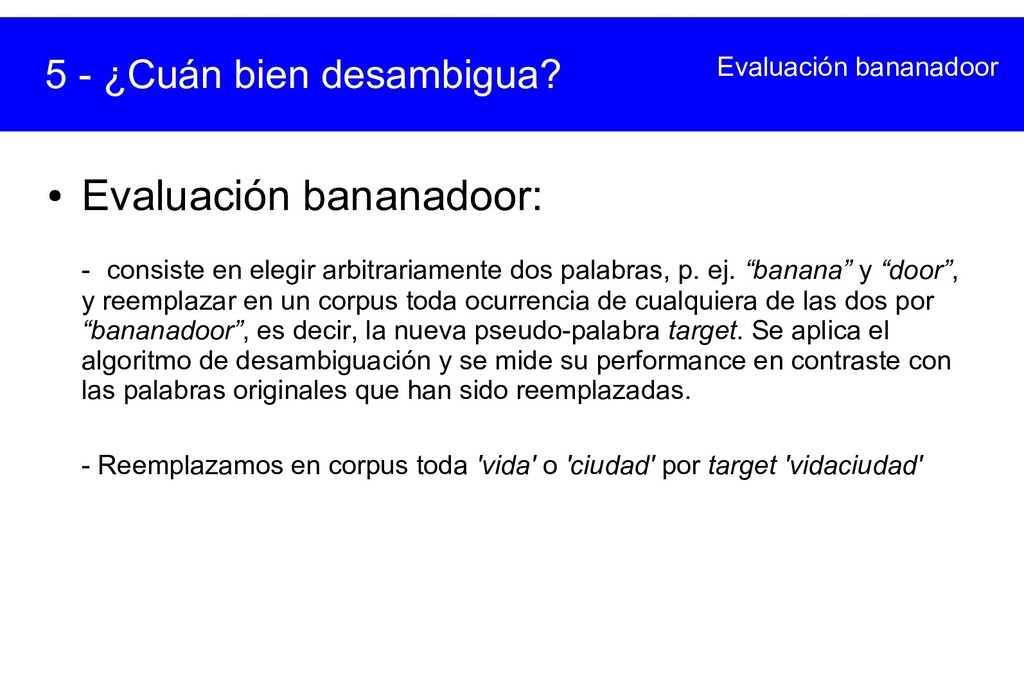
5 - ¿Cuán bien desambigua? Evaluación bananadoor • Evaluación bananadoor:
- consiste en elegir arbitrariamente dos palabras, p. ej. “banana” y “door”, y reemplazar en un corpus toda ocurrencia de cualquiera de las dos por “bananadoor”, es decir, la nueva pseudo-palabra target. Se aplica el algoritmo de desambiguación y se mide su performance en contraste con las palabras originales que han sido reemplazadas. - Reemplazamos en corpus toda 'vida' o 'ciudad' por target 'vidaciudad' -
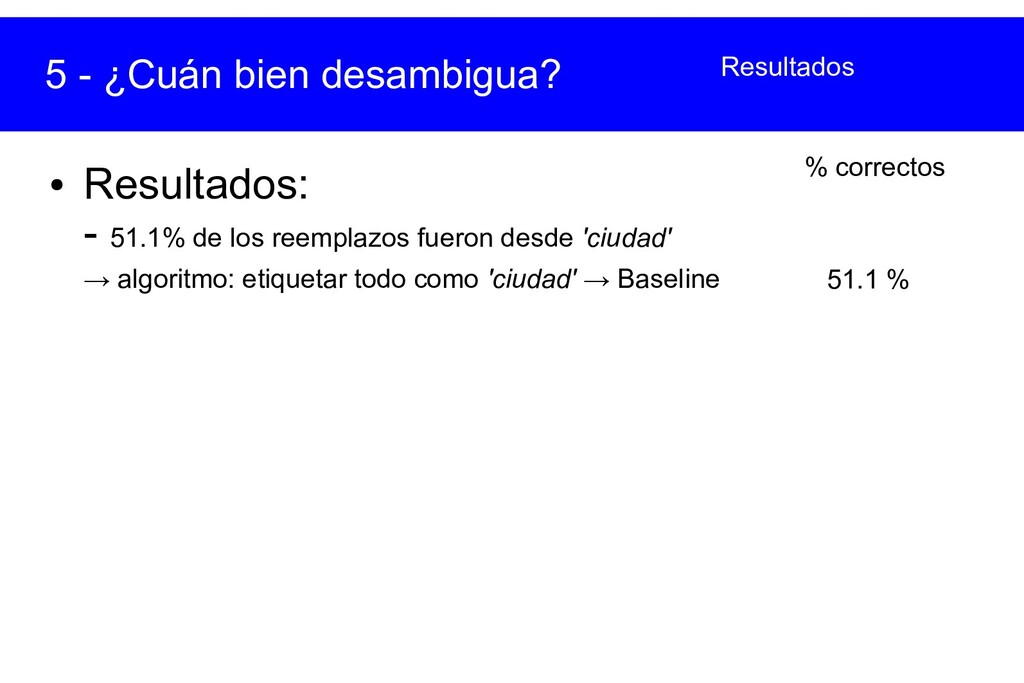
5 - ¿Cuán bien desambigua? • Resultados: - 51.1% de
los reemplazos fueron desde 'ciudad' → algoritmo: etiquetar todo como 'ciudad' → Baseline Resultados % correctos 51.1 % -
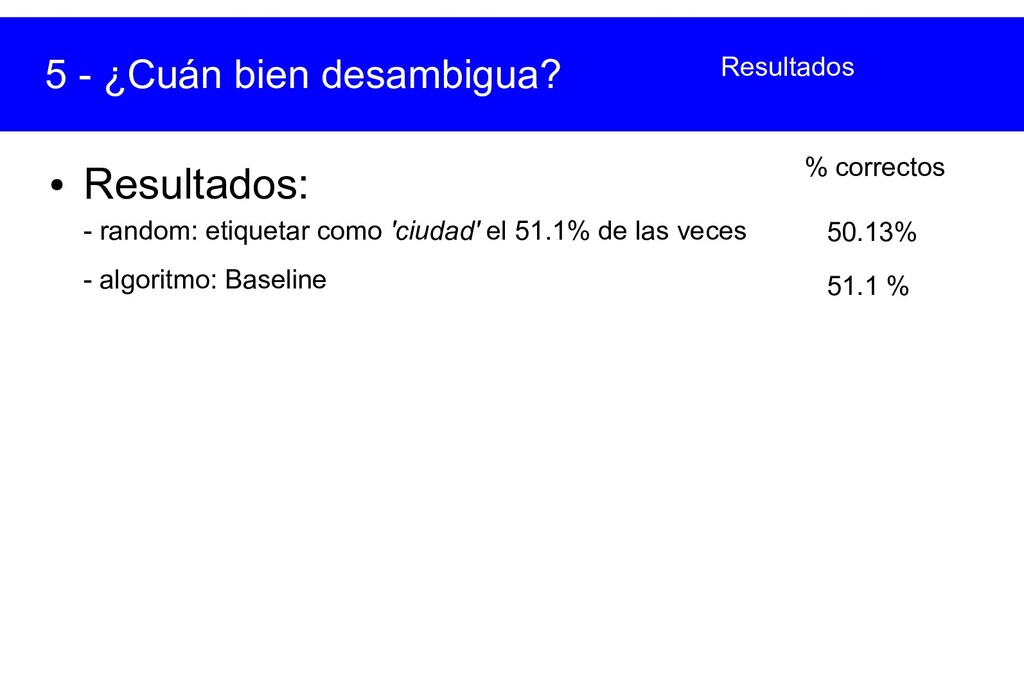
5 - ¿Cuán bien desambigua? • Resultados: - random: etiquetar
como 'ciudad' el 51.1% de las veces - algoritmo: Baseline Resultados % correctos 50.13% 51.1 % -
5 - ¿Cuán bien desambigua? • Resultados: - algoritmo: random
- algoritmo: Baseline - algoritmo: listas de decisión (este proyecto) - Implementación similar en una investigación [1] - Algoritmo original/ideal del paper de Yarowsky [2] [1] Yoshimasa Tsuruoka and Takashi Chikayama. Estimating Reliability of Contextual Evidences in Decision-List Classifiers under Bayesian Learning. Proceedings of the Sixth Natural Language Processing Pacific Rim Symposium, November 27-30, 2001. 2001. [2] David Yarowsky. Unsupervised word sense disambiguation rivaling supervised methods. Proc. of the 33rd Annual Meeting of the Association for Computational Linguistics, pp. 189-196. 1995. Resultados % correctos 50.13% 51.1 % 59.86% 69.4% 94.8% -
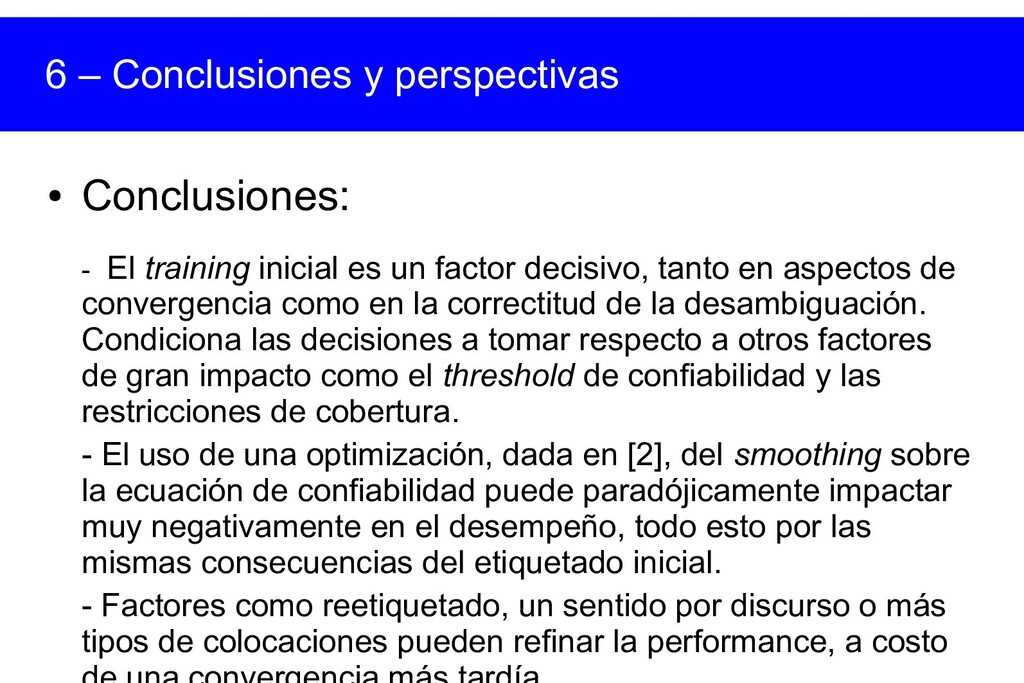
6 – Conclusiones y perspectivas • Conclusiones: - El training
inicial es un factor decisivo, tanto en aspectos de convergencia como en la correctitud de la desambiguación. Condiciona las decisiones a tomar respecto a otros factores de gran impacto como el threshold de confiabilidad y las restricciones de cobertura. - El uso de una optimización, dada en [2], del smoothing sobre la ecuación de confiabilidad puede paradójicamente impactar muy negativamente en el desempeño, todo esto por las mismas consecuencias del etiquetado inicial. - Factores como reetiquetado, un sentido por discurso o más tipos de colocaciones pueden refinar la performance, a costo -
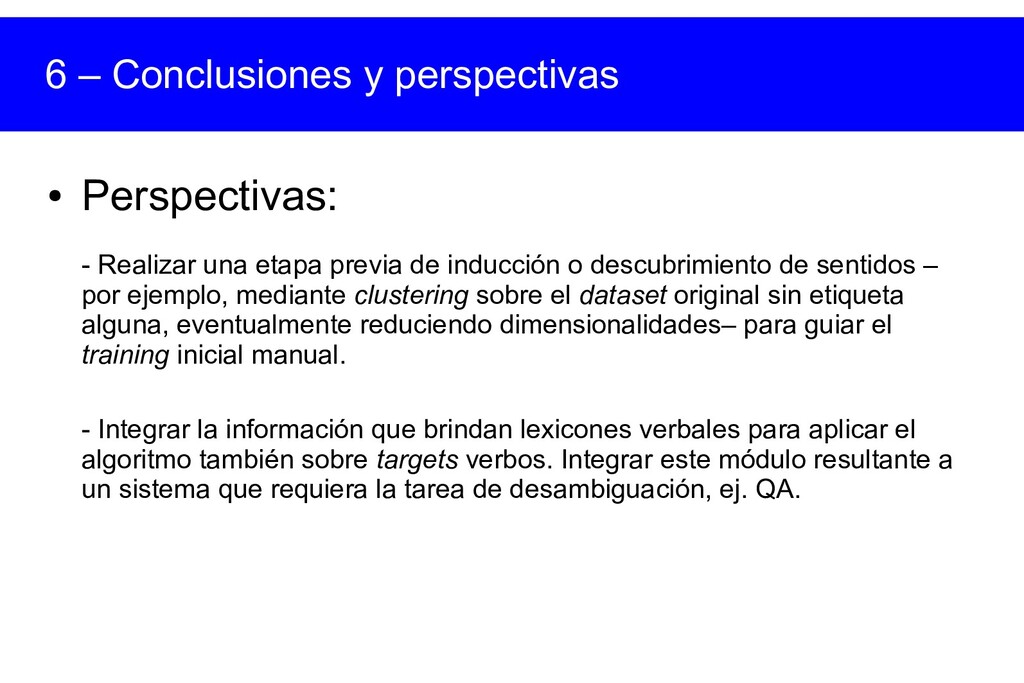
6 – Conclusiones y perspectivas • Perspectivas: - Realizar una
etapa previa de inducción o descubrimiento de sentidos – por ejemplo, mediante clustering sobre el dataset original sin etiqueta alguna, eventualmente reduciendo dimensionalidades– para guiar el training inicial manual. - Integrar la información que brindan lexicones verbales para aplicar el algoritmo también sobre targets verbos. Integrar este módulo resultante a un sistema que requiera la tarea de desambiguación, ej. QA.