Share
Embed
Anonymisation
Histoire des définitions et méthodes. Illustrations sur les données de santé.
Entrepreneurs d'intérêt général
April 04, 2019
Transcript
35 slides
-
Anonymisation Histoire des définitions et méthodes Illustrations sur les données
de santé Etalab Talk - 2019.04.04 Pierre-Alain Jachiet - Lab Santé - OpenChronic -
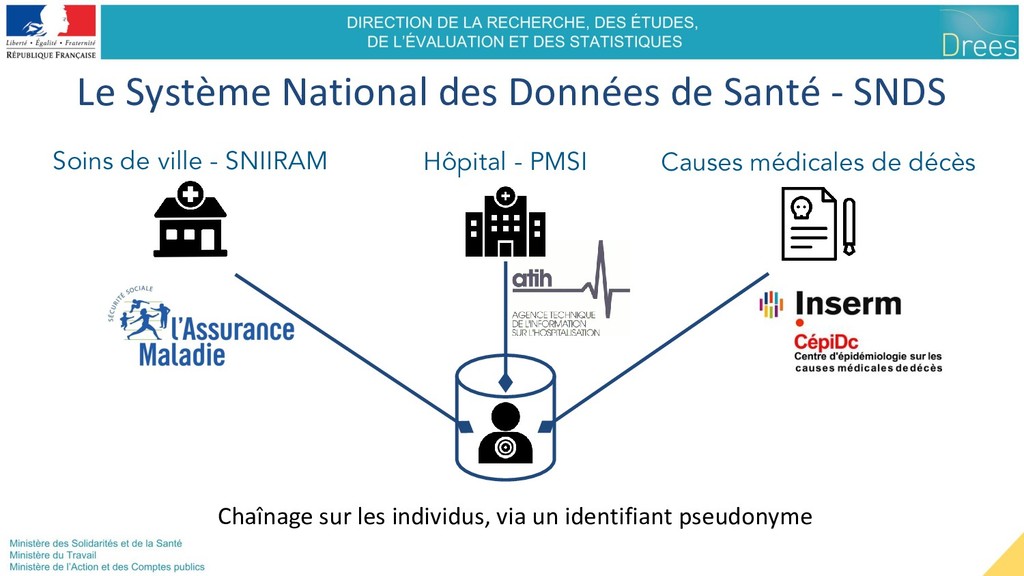
Chaînage sur les individus, via un identifiant pseudonyme Soins de
ville - SNIIRAM Hôpital - PMSI Causes médicales de décès Le Système National des Données de Santé - SNDS -
La tension Utilité ↔ Sensibilité => Les contraintes de sécurité
freinent l’utilisation => Les données sorties doivent être “anonymes” Loi création SNDS Utilité : Meilleure santé - Connaissance médicale - Épidémiologie - Suivi de la qualité des soins - IA médical, etc. Ouverture des données Sensibilité : Causer du tort aux individus - Réidentification - violation secret médical - Discrimination statistique - volontaire ou non Référentiel de sécurité -
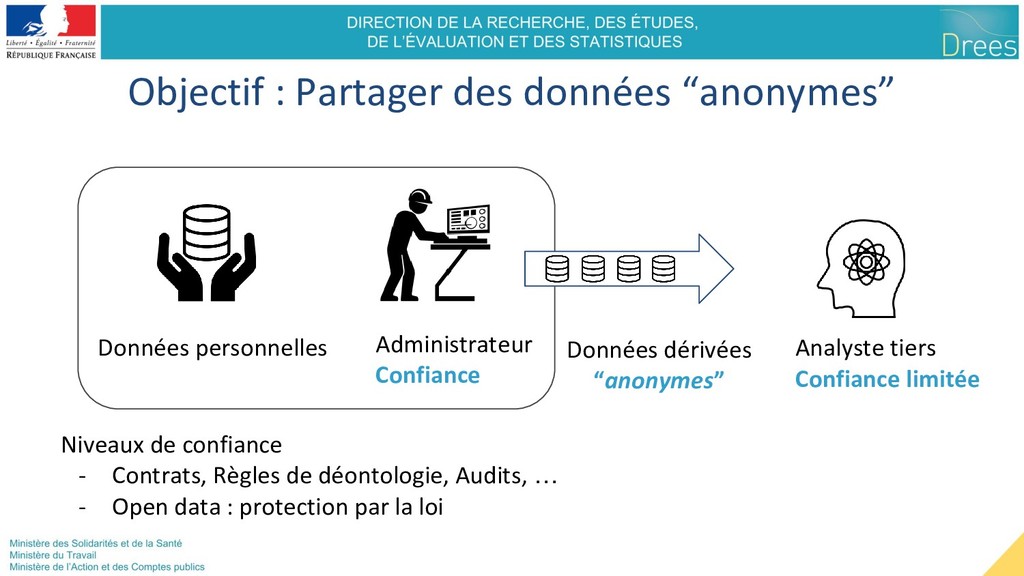
Objectif : Partager des données “anonymes” Données personnelles Administrateur Confiance
Analyste tiers Confiance limitée Données dérivées “anonymes” Niveaux de confiance - Contrats, Règles de déontologie, Audits, … - Open data : protection par la loi -
L’anonymisation : un art de spécialistes ? ➔ Nombreuses méthodes
➔ “Inventions” régulières ➔ Analyses de risques complexes => Repartons des définitions -
Sources Blog de Damien Desfontaines (nb Copier-Collers) - ingénieur logiciel
à Google, équipe « Privacy » - doctorant à l'ETH Zürich Cf autres sources commentaires Plan présentation Histoire définitions #1 Pseudonymisation #2 K-anonymat #3 L-Diversité #4 Confidentialité différentielle -
#1 Pseudonymisation : Définition Objectif Empêcher d’identifier directement des personnes
Définition Pas d’informations directement identifiantes dans les données nom prénom, adresse, numéro de téléphone, identifiant, etc -
#1 Pseudonymisation : Méthode Méthode - Déterminer les données directement
ou quasi-identifiantes - Retirer ces valeurs (dé-identification) - Ou remplacer ces valeurs par un pseudonyme non-réversible - aléatoire ou hash avec secret Exemples - Recherche manuelle ou automatique d’entités - compte rendus médicaux, textes de loi, etc. - Pseudonymisation à 2 niveaux dans le SNDS (FOIN) -
#1 Pseudonymisation : Limites Exemple historique : 1997 - Massachusetts
Publication Open Data médical dé-identifié - contient code postal, sexe, date de naissance Latanya Sweeney, doctorante - Achète le registre électoral avec données démographiques - Attage par couplage => Identifie le gouverneur Limite Pseudonymisation + Données auxiliaire => Réidentification -
#1 Pseudonymisation : Limites Exemple historique bis : 1991 -
France Résumé de Sortie Anonyme des hospitalisations (PMSI) - définition avec la CNIL - diffusion libre Données retirées - nom, NIR - dates de naissance et d’hospitalisation => mois année - code géographique de moins de mille habitants 1996 et 1998 : Réalisation des possibilités de croisement → Diffusion limitée, chapitres IX et X LIL -
Objectif : Empêcher la ré-identification avec données auxiliaires Définition (1998)
: Toute combinaison de quasi-identifiants* concerne plus de K individus #2 K-anonymisation : Définition Table 2-anonyme *Quasi-identifiants : sexe, âge, adresse, … dépend du contexte et de l’attaquant desfontain.es/privacy/k-anonymity.html -
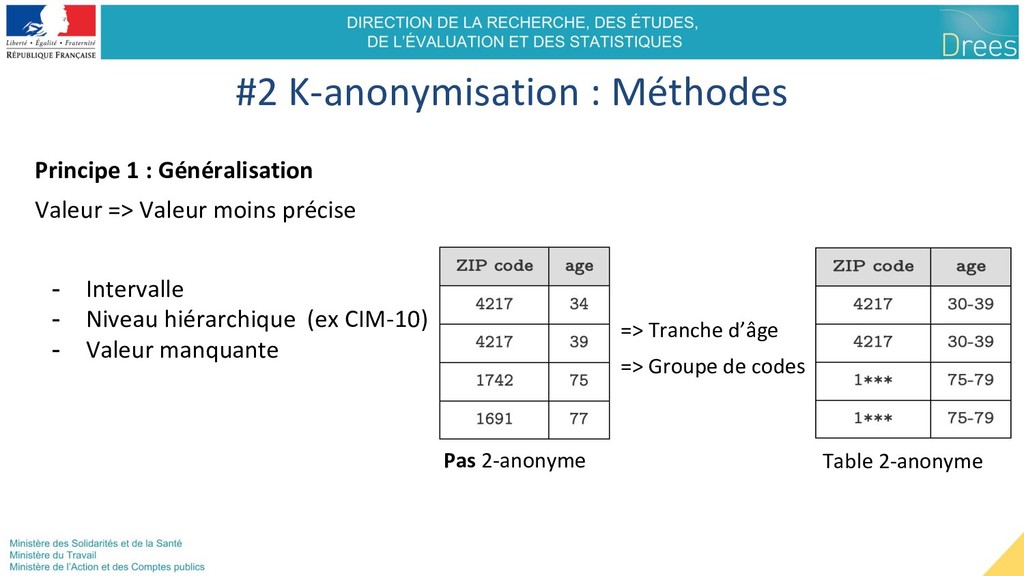
Principe 1 : Généralisation Valeur => Valeur moins précise -
Intervalle - Niveau hiérarchique (ex CIM-10) - Valeur manquante #2 K-anonymisation : Méthodes Pas 2-anonyme Table 2-anonyme => Tranche d’âge => Groupe de codes -
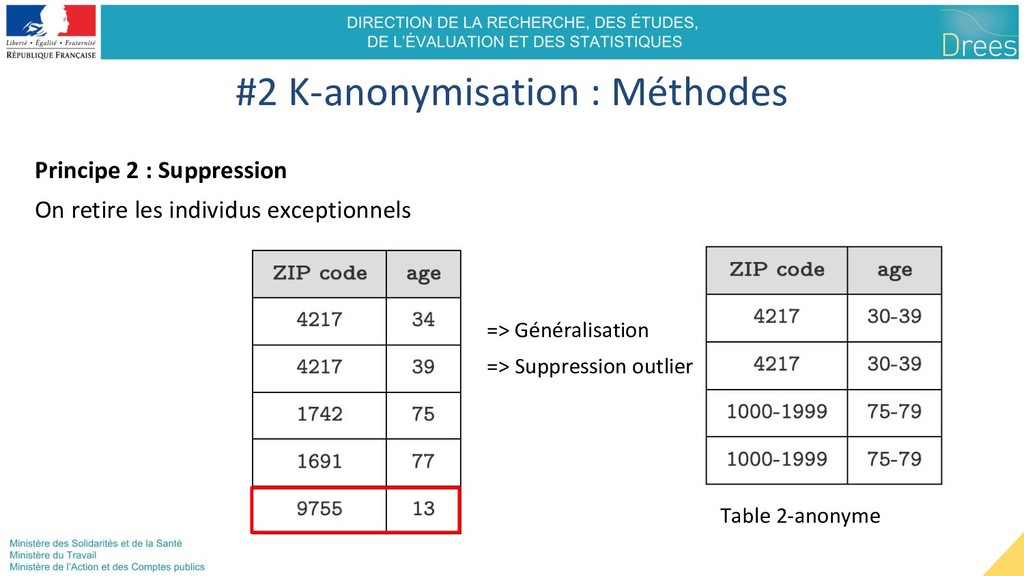
Principe 2 : Suppression On retire les individus exceptionnels #2
K-anonymisation : Méthodes => Généralisation => Suppression outlier Table 2-anonyme -
#1 K-anonymisation : Pratique En pratique - Définition simple et
très utilisée Exemple : secret statistique - Quel sont les quasi-identifiants / variables sensibles ? - Plus de quasi-identifiants => plus de généralisation et suppression Outils - Principalement ARX (Open-Source) - Souvent implémentations spécifiques au sujet -
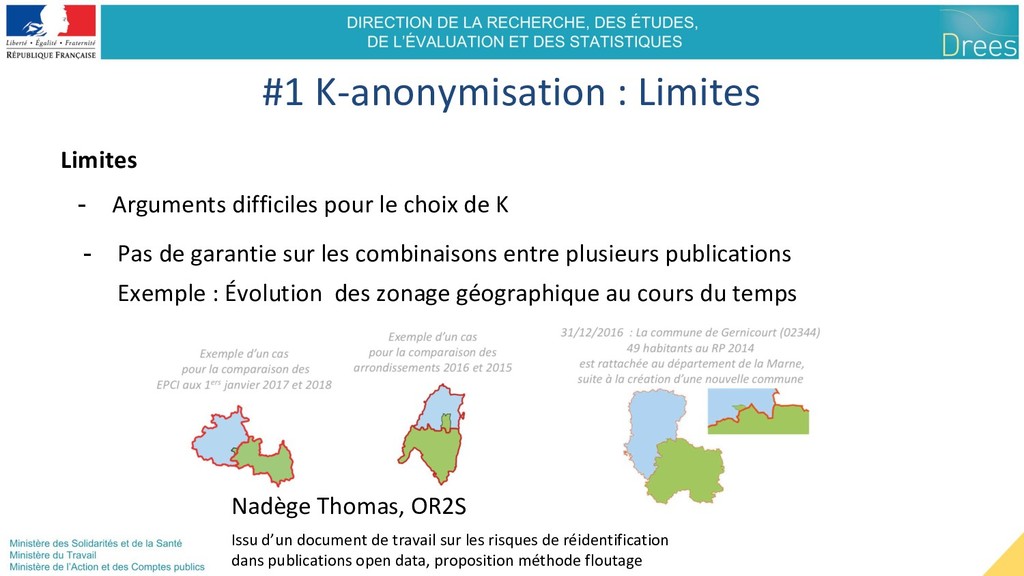
#1 K-anonymisation : Limites Limites - Arguments difficiles pour le
choix de K Nadège Thomas, OR2S Issu d’un document de travail sur les risques de réidentification dans publications open data, proposition méthode floutage - Pas de garantie sur les combinaisons entre plusieurs publications Exemple : Évolution des zonage géographique au cours du temps -
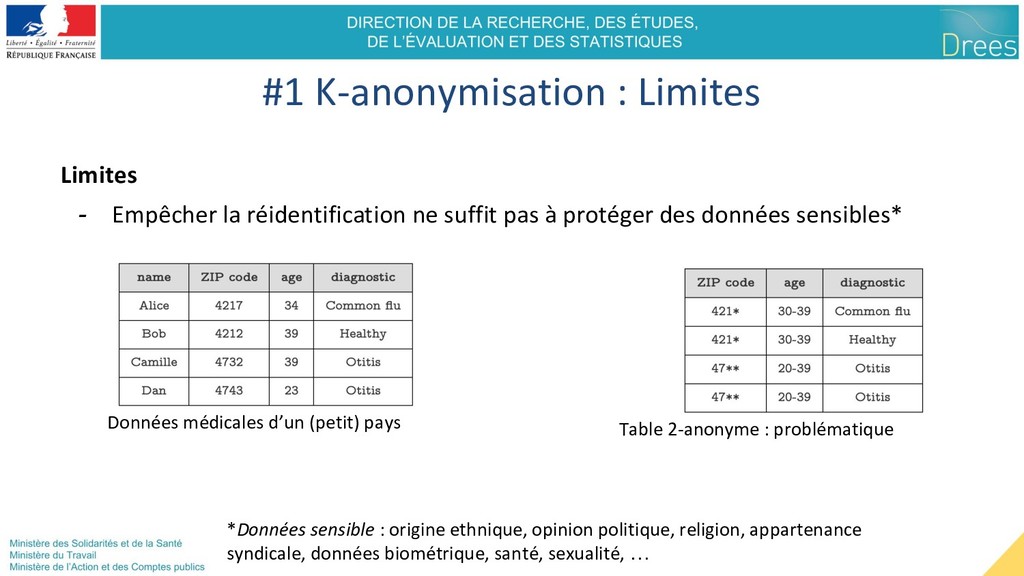
#1 K-anonymisation : Limites Limites - Empêcher la réidentification ne
suffit pas à protéger des données sensibles* *Données sensible : origine ethnique, opinion politique, religion, appartenance syndicale, données biométrique, santé, sexualité, … Données médicales d’un (petit) pays Table 2-anonyme : problématique -
Objectif : correctif à k-anonymisation Empêcher l’apprentissage déterministe d’une information
sensible sur un individu, à partir de ses quasi-identifiants Définition (2006) : Tout groupe de quasi-identifiants doit comprendre + de L valeurs sensibles distinctes #3 L-diversité : Définition Table 2-anonyme problématique Table 2-diverse => Généralisation (=> Suppression) Méthodes : Similaire K-anonymisation -
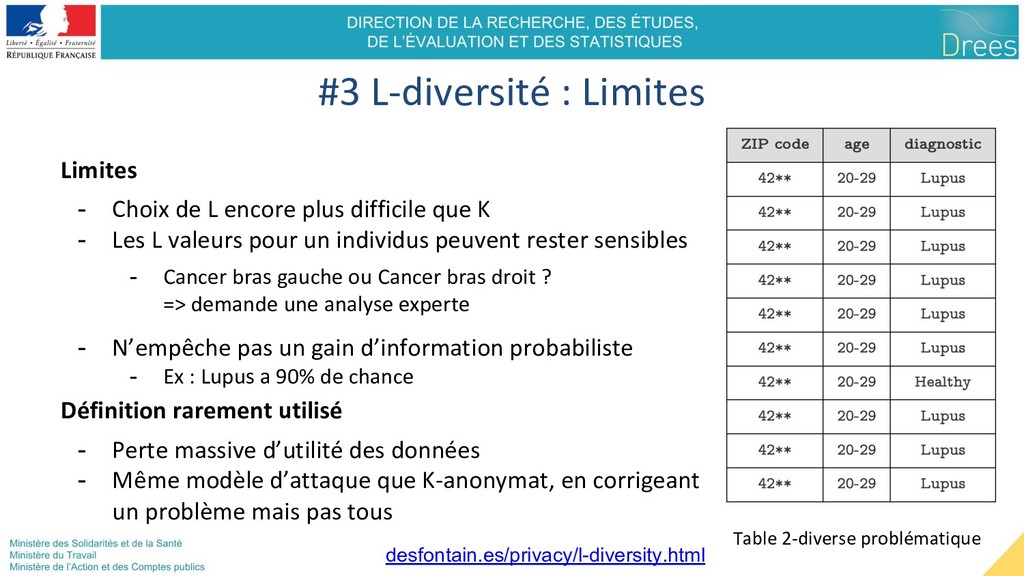
#3 L-diversité : Limites Limites - Choix de L encore
plus difficile que K - Les L valeurs pour un individus peuvent rester sensibles - Cancer bras gauche ou Cancer bras droit ? => demande une analyse experte - N’empêche pas un gain d’information probabiliste - Ex : Lupus a 90% de chance Table 2-diverse problématique Définition rarement utilisé - Perte massive d’utilité des données - Même modèle d’attaque que K-anonymat, en corrigeant un problème mais pas tous desfontain.es/privacy/l-diversity.html -
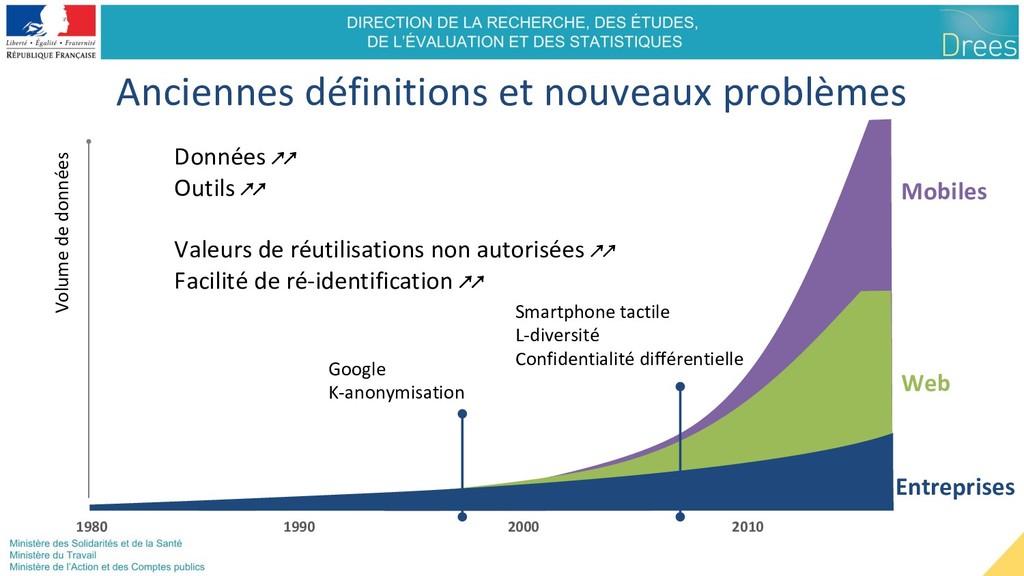
Anciennes définitions et nouveaux problèmes 1990 2000 2010 Entreprises Web
Volume de données Mobiles Google K-anonymisation 1980 Smartphone tactile L-diversité Confidentialité différentielle Données ↗↗ Outils ↗↗ Valeurs de réutilisations non autorisées ↗↗ Facilité de ré-identification ↗↗ -
À la recherche d'une meilleure définition Idée de définition: On
ne doit rien pouvoir apprendre sur un individu avec les données produites Problème de cette idée : Si les données permettent d’apprendre un lien statistique “fumer => cancer”, on apprend une information sur les fumeurs, qui peut leur nuire. Objectif : Résoudre ce paradoxe - Apprendre des informations statistiques sur une population - Ne rien apprendre de spécifique à un individu -
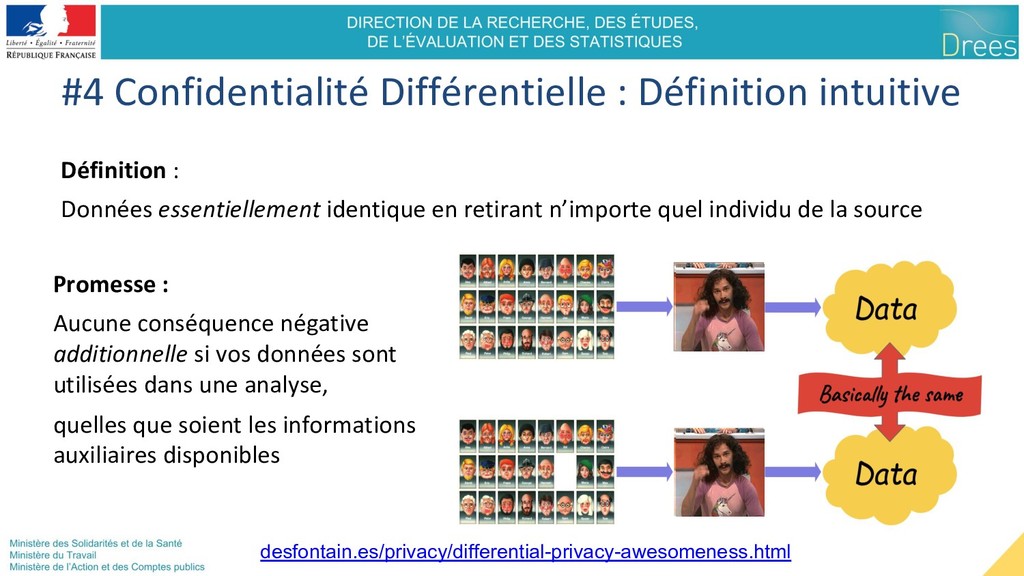
Définition : Données essentiellement identique en retirant n’importe quel individu
de la source #4 Confidentialité Différentielle : Définition intuitive Promesse : Aucune conséquence négative additionnelle si vos données sont utilisées dans une analyse, quelles que soient les informations auxiliaires disponibles desfontain.es/privacy/differential-privacy-awesomeness.html -
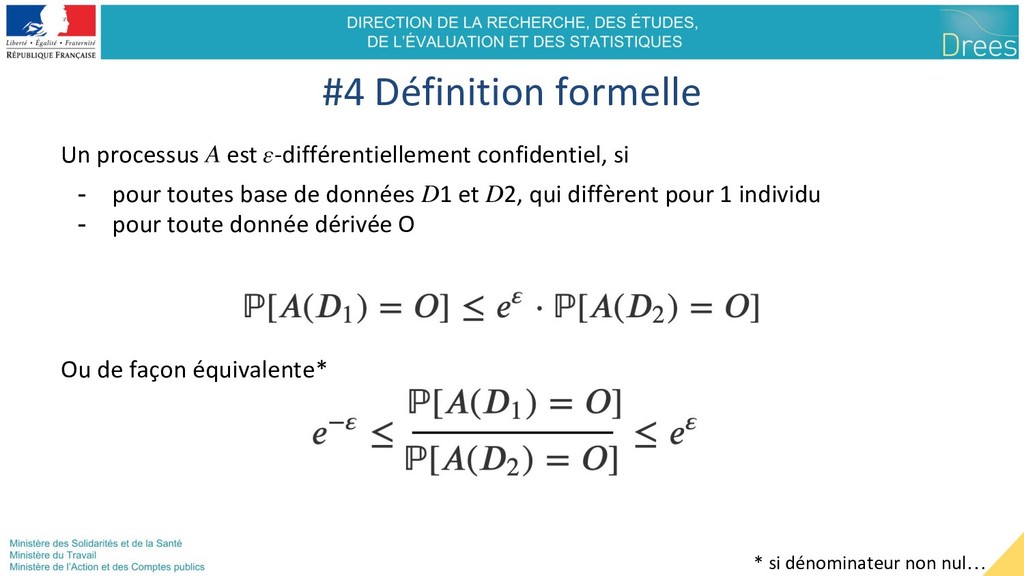
#4 Définition formelle Un processus est -différentiellement confidentiel, si -
pour toutes base de données 1 et 2, qui diffèrent pour 1 individu - pour toute donnée dérivée O Ou de façon équivalente* * si dénominateur non nul… -
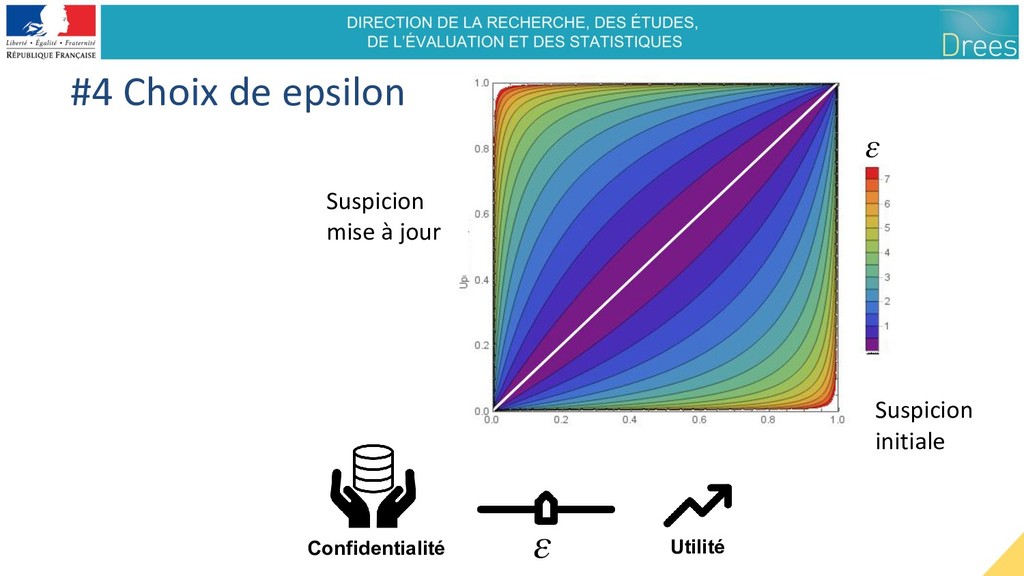
#4 Epsilon : une borne sur le gain d’information Suspicion
initiale Suspicion mise à jour https://desfontain.es/privacy/differential-privacy-in-more-detail.html = 1.1 -
#4 Choix de epsilon Suspicion initiale Suspicion mise à jour
Utilité Confidentialité -
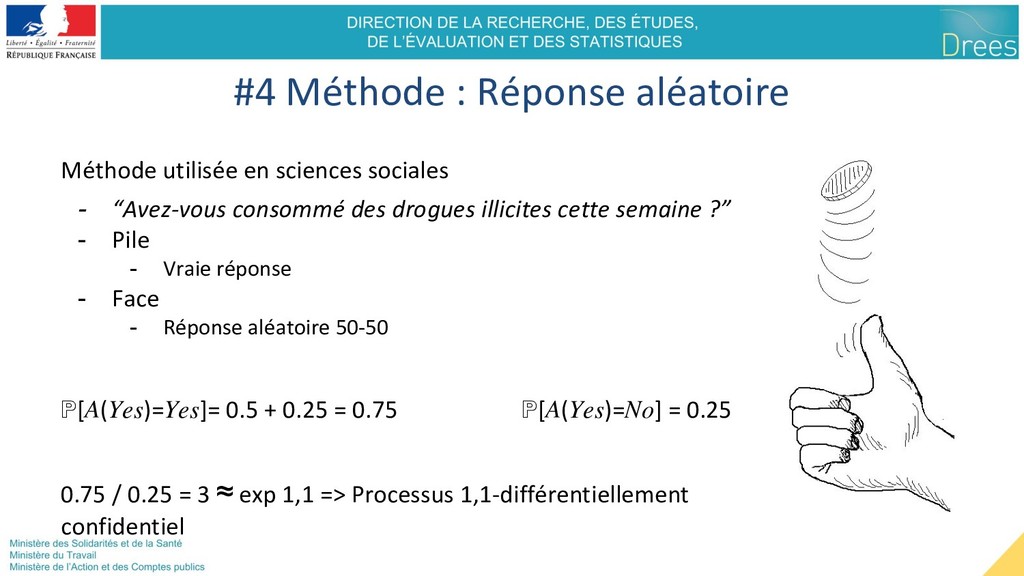
#4 Méthode : Réponse aléatoire Méthode utilisée en sciences sociales
- “Avez-vous consommé des drogues illicites cette semaine ?” - Pile - Vraie réponse - Face - Réponse aléatoire 50-50 ℙ[()=]= 0.5 + 0.25 = 0.75 ℙ[()=] = 0.25 0.75 / 0.25 = 3 ≈ exp 1,1 => Processus 1,1-différentiellement confidentiel -
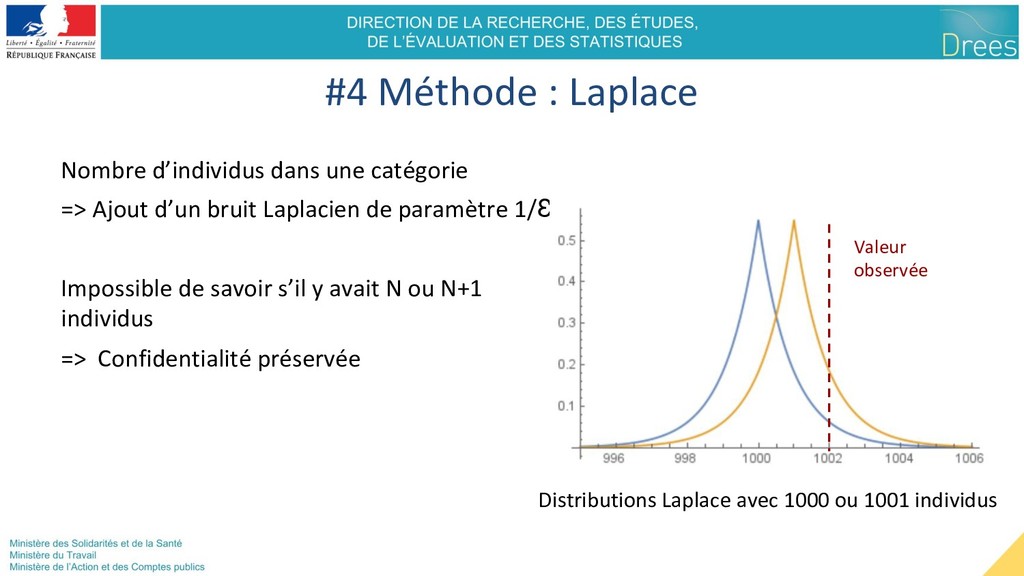
#4 Méthode : Laplace Nombre d’individus dans une catégorie =>
Ajout d’un bruit Laplacien de paramètre 1/Ɛ Impossible de savoir s’il y avait N ou N+1 individus => Confidentialité préservée Distributions Laplace avec 1000 ou 1001 individus Valeur observée -
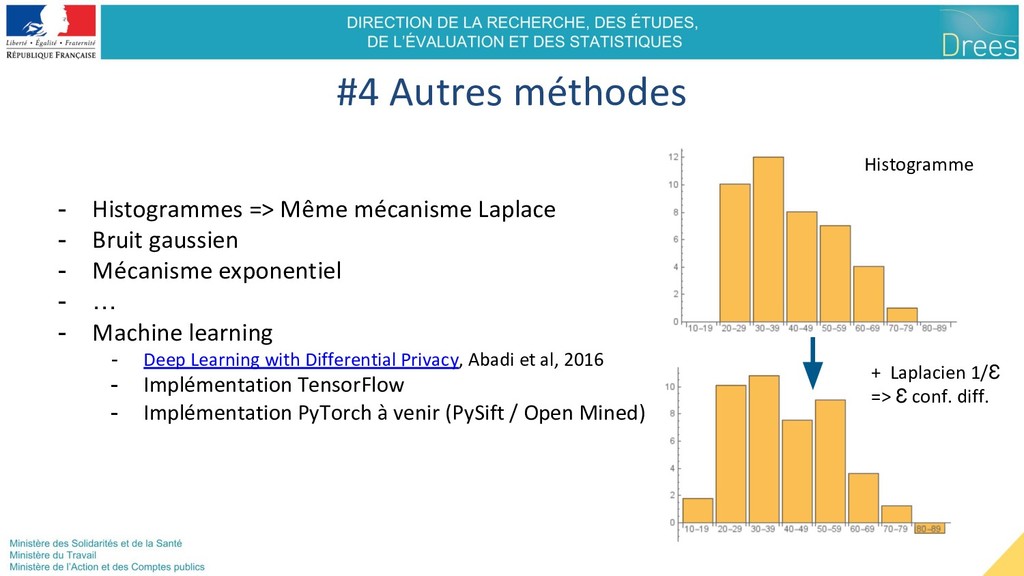
- Histogrammes => Même mécanisme Laplace - Bruit gaussien -
Mécanisme exponentiel - … - Machine learning - Deep Learning with Differential Privacy, Abadi et al, 2016 - Implémentation TensorFlow - Implémentation PyTorch à venir (PySift / Open Mined) #4 Autres méthodes Histogramme + Laplacien 1/Ɛ => Ɛ conf. diff. -
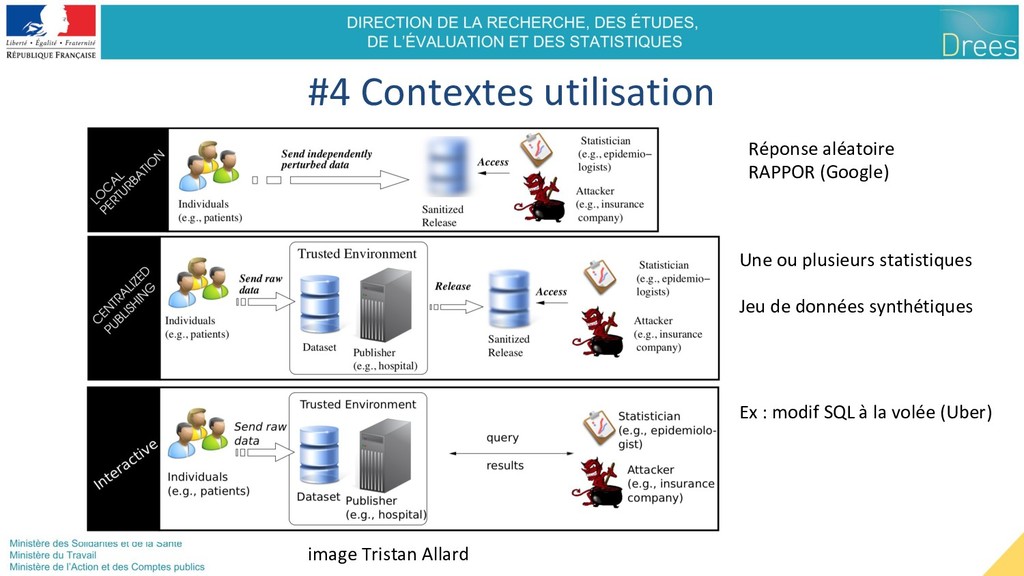
#4 Contextes utilisation image Tristan Allard Réponse aléatoire RAPPOR (Google)
Une ou plusieurs statistiques Jeu de données synthétiques Ex : modif SQL à la volée (Uber) -
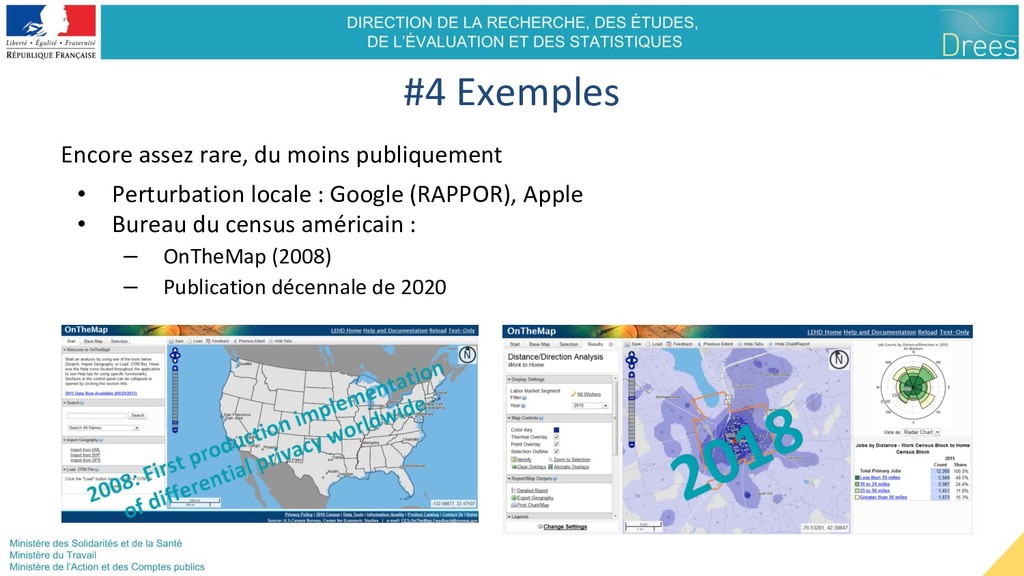
#4 Exemples Encore assez rare, du moins publiquement • Perturbation
locale : Google (RAPPOR), Apple • Bureau du census américain : – OnTheMap (2008) – Publication décennale de 2020 -
#4 Confidentialité Différentielle : Intérêts • Plus besoin de modèle
d’attaque – Protège n’importe quelle type d’information à propos d’un individu – Futur proof : données auxiliaires, méthodes, outils, puissance de calcul • Quantification claire de la perte de secret privé, avec paramètre Ɛ • Possibilité de quantifier la combinaison de plusieurs informations dérivées – 4 fois Ɛ => au pire 4 Ɛ -
#4 Confidentialité Différentielle : Limites Une définition encore peu adoptée
• Manque d’experts => Méthodes avancées, Subtilité, Pièges • Manque de vulgarisation • Manque d’implémentations Des garanties parfois trop fortes ? • Pas de nuancée selon le contexte • Ne permet pas de publier des micro-données à l’échelle individuelle Peu d'expériences sur la mise en oeuvre • Utilisation des données bruitées • Gestion du budget de privacy • Choix par les décideurs de epsilon -
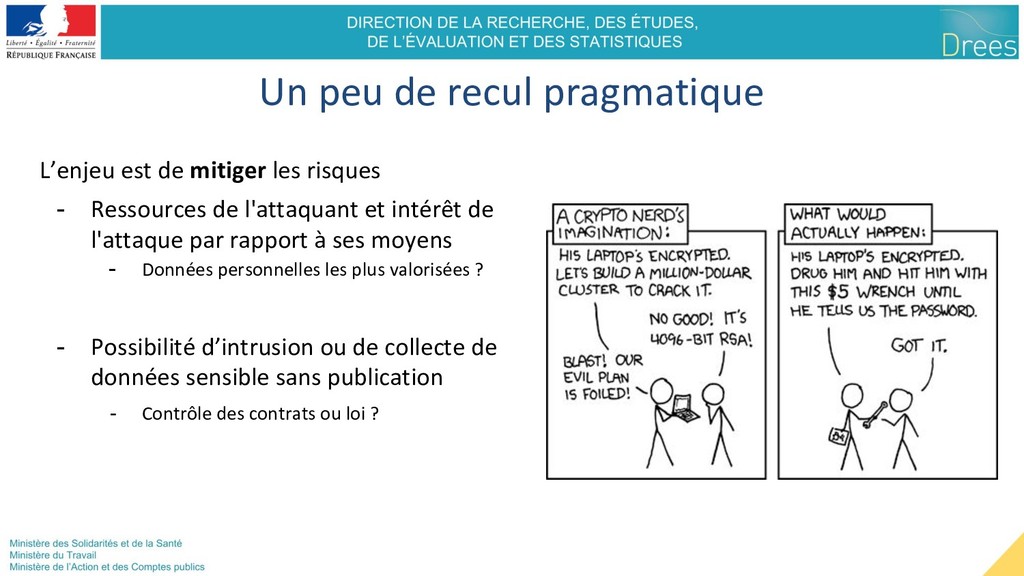
Un peu de recul pragmatique L’enjeu est de mitiger les
risques - Ressources de l'attaquant et intérêt de l'attaque par rapport à ses moyens - Données personnelles les plus valorisées ? - Possibilité d’intrusion ou de collecte de données sensible sans publication - Contrôle des contrats ou loi ? -
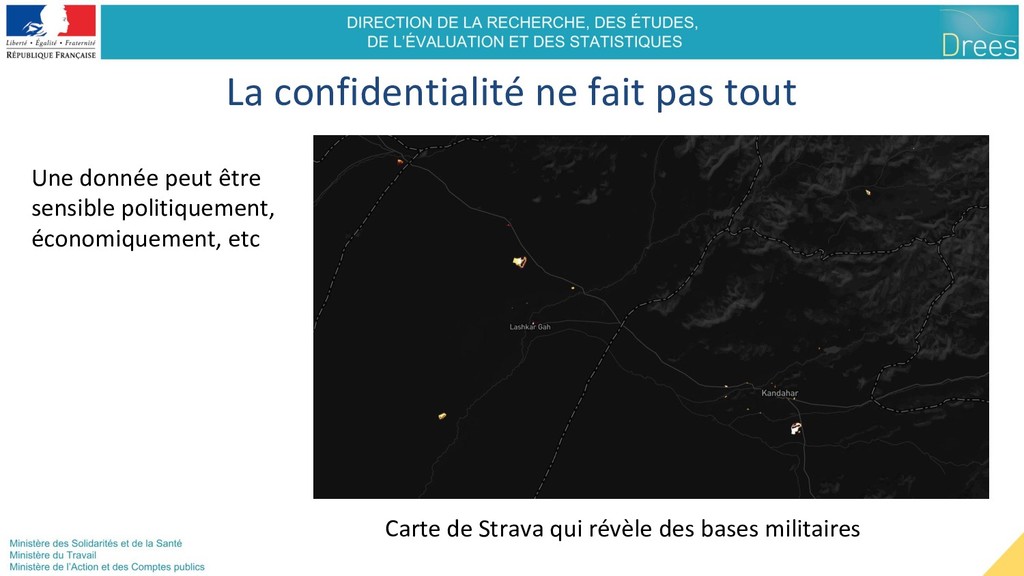
La confidentialité ne fait pas tout Une donnée peut être
sensible politiquement, économiquement, etc Carte de Strava qui révèle des bases militaires -
Vos questions ? Anonymisation Histoire des définitions et méthodes Illustration
sur les données de santé Artem Maltsev