Share
Embed
Do Conceito ao Agente: construindo GenAI na StackSpot
Do conceito à entrega: um guia para construir soluções com GenAI em bancos. Fundamentos essenciais (LLMs, RAG, embeddings e prompts), padrões para minimizar alucinações com prompt-eval loop, e um tour pelas features da StackSpot AI — Knowledge Sources, Quick Commands e agentes — para acelerar times e criar experiências inteligentes com governança.
Everton Carlos
November 24, 2025
Transcript
55 slides
-
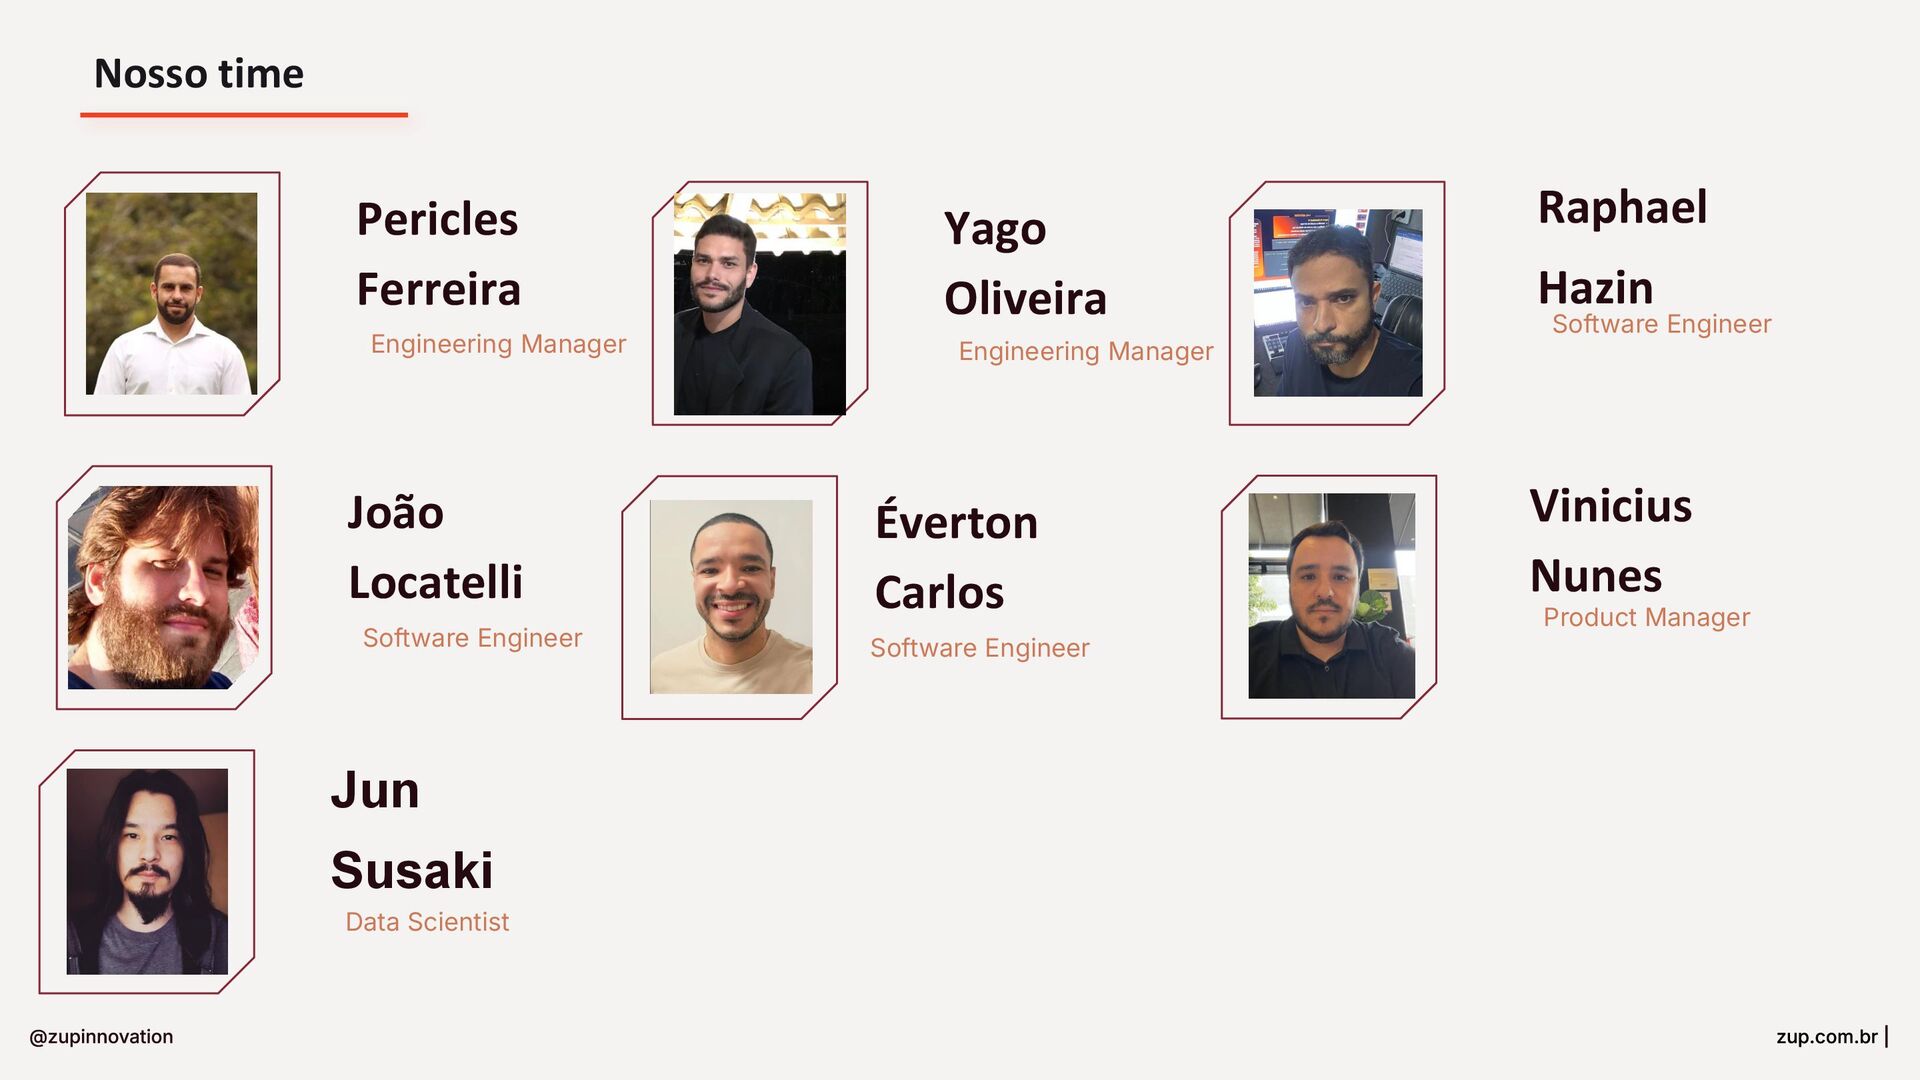
Nosso time Pericles Ferreira Engineering Manager Yago Oliveira Engineering Manager
Raphael Hazin Software Engineer João Locatelli Software Engineer Vinicius Nunes Product Manager Jun Susaki Data Scientist Éverton Carlos Software Engineer -
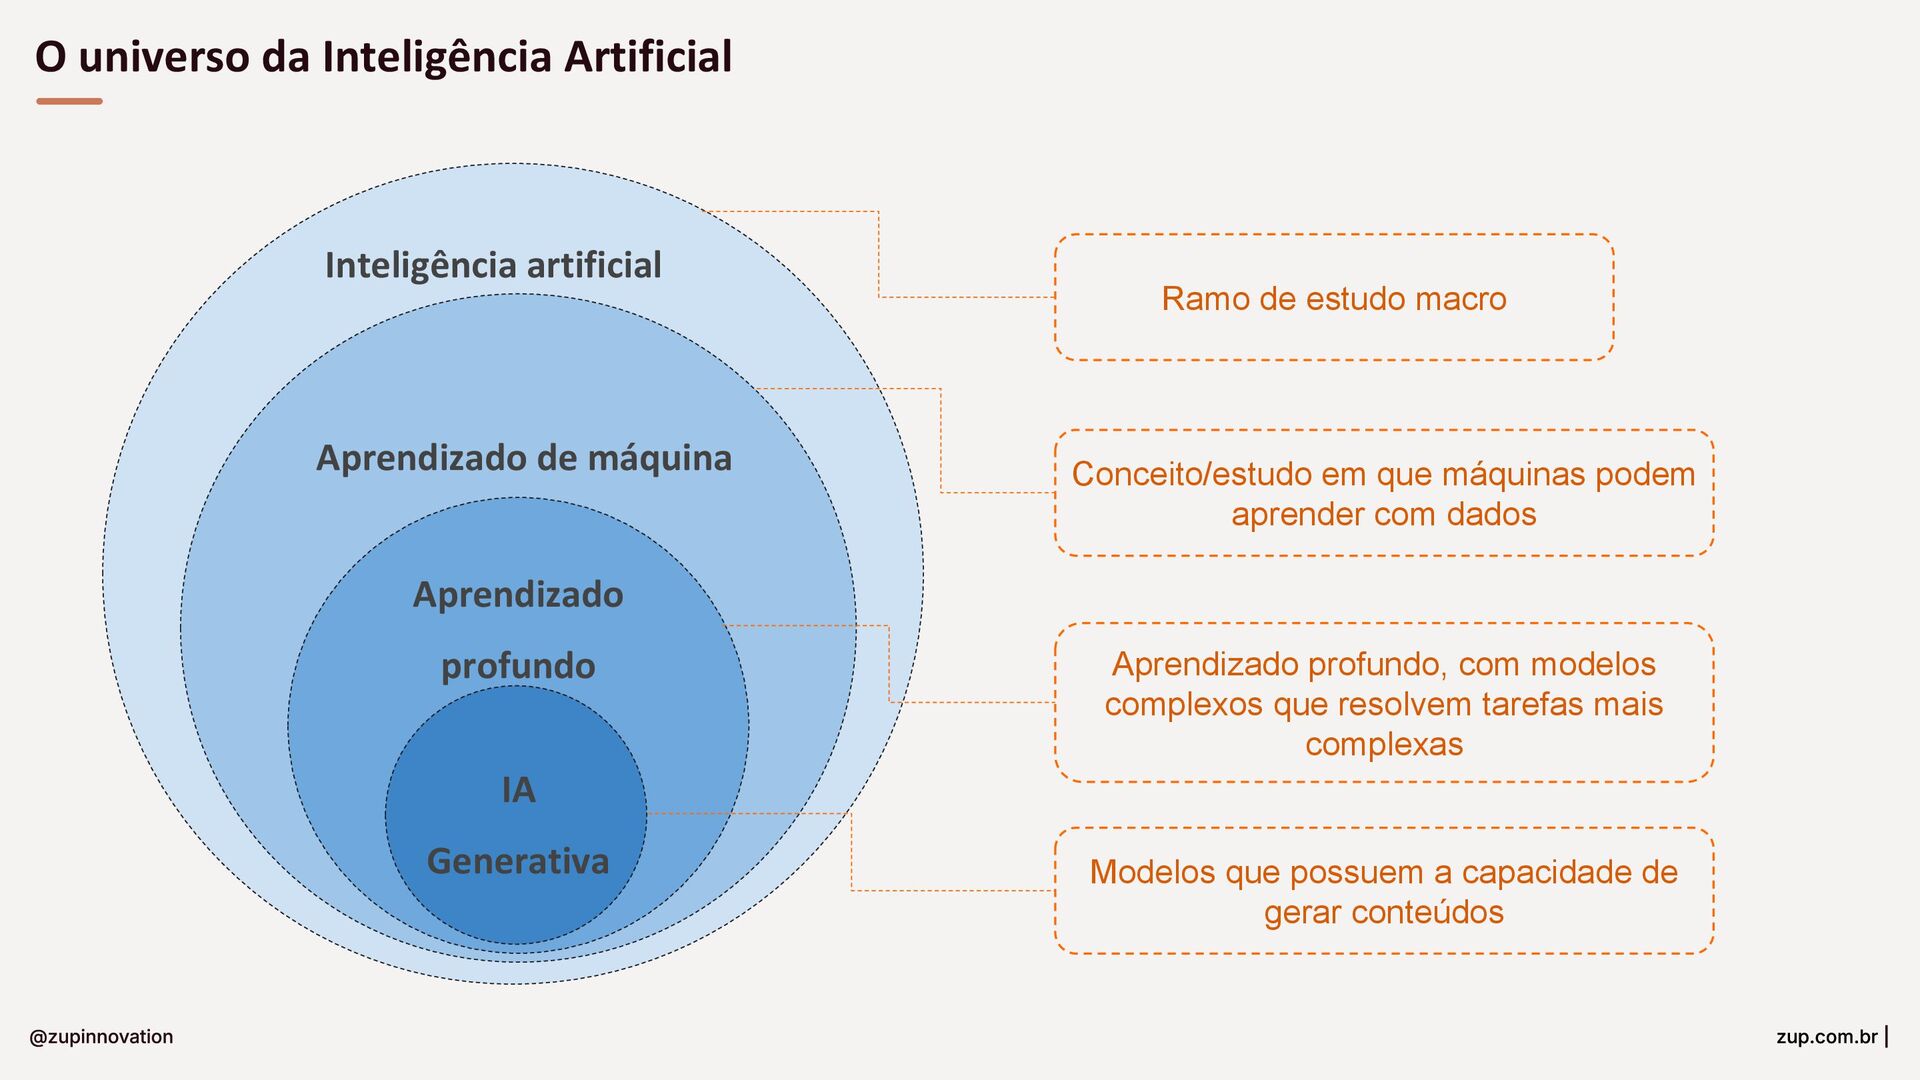
O universo da Inteligência Artificial Inteligência artificial Ramo de estudo
macro Aprendizado de máquina Conceito/estudo em que máquinas podem aprender com dados Aprendizado profundo IA Generativa Aprendizado profundo, com modelos complexos que resolvem tarefas mais complexas Modelos que possuem a capacidade de gerar conteúdos -
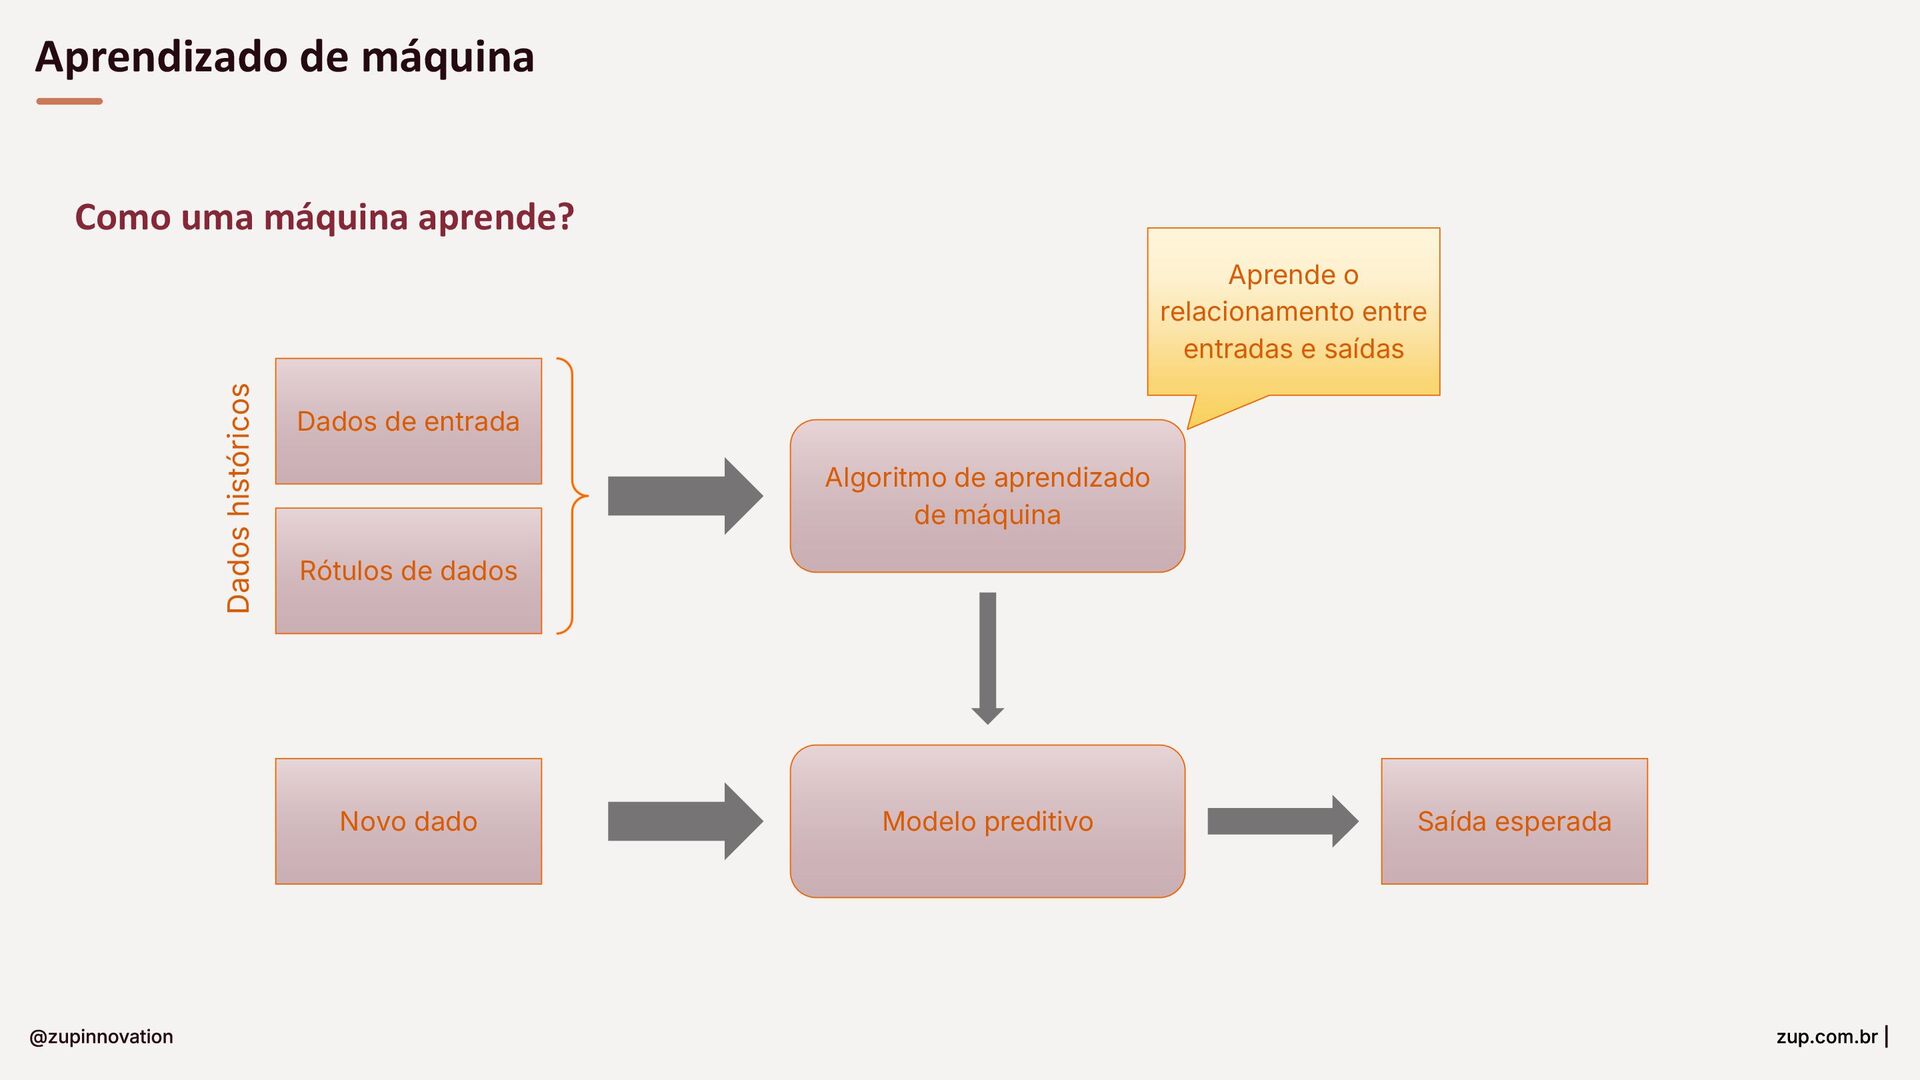
Como uma máquina aprende? Aprendizado de máquina Dados de entrada
Rótulos de dados Novo dado Algoritmo de aprendizado de máquina Modelo preditivo Saída esperada Aprende o relacionamento entre entradas e saídas Dados históricos -
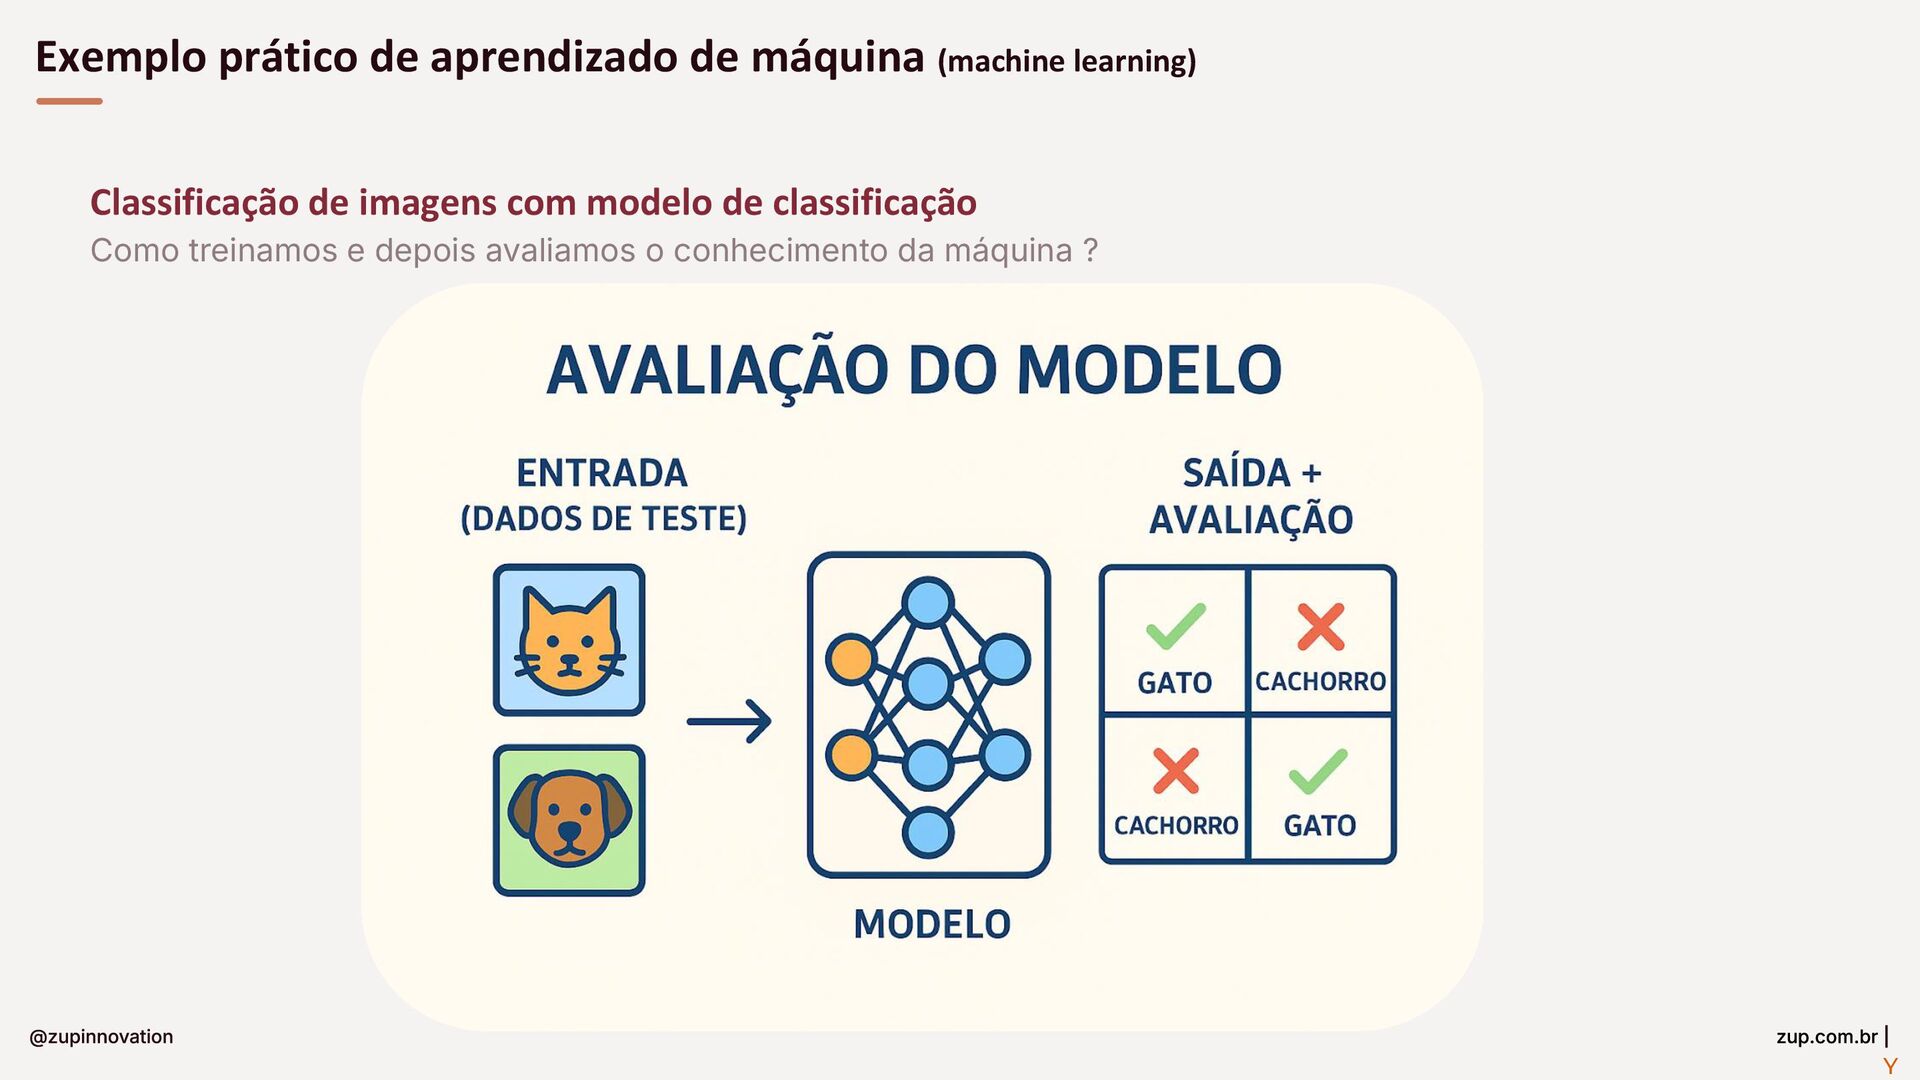
Exemplo prático de aprendizado de máquina (machine learning) Classificação de
imagens com modelo de classificação Como treinamos e depois avaliamos o conhecimento da máquina ? Y -
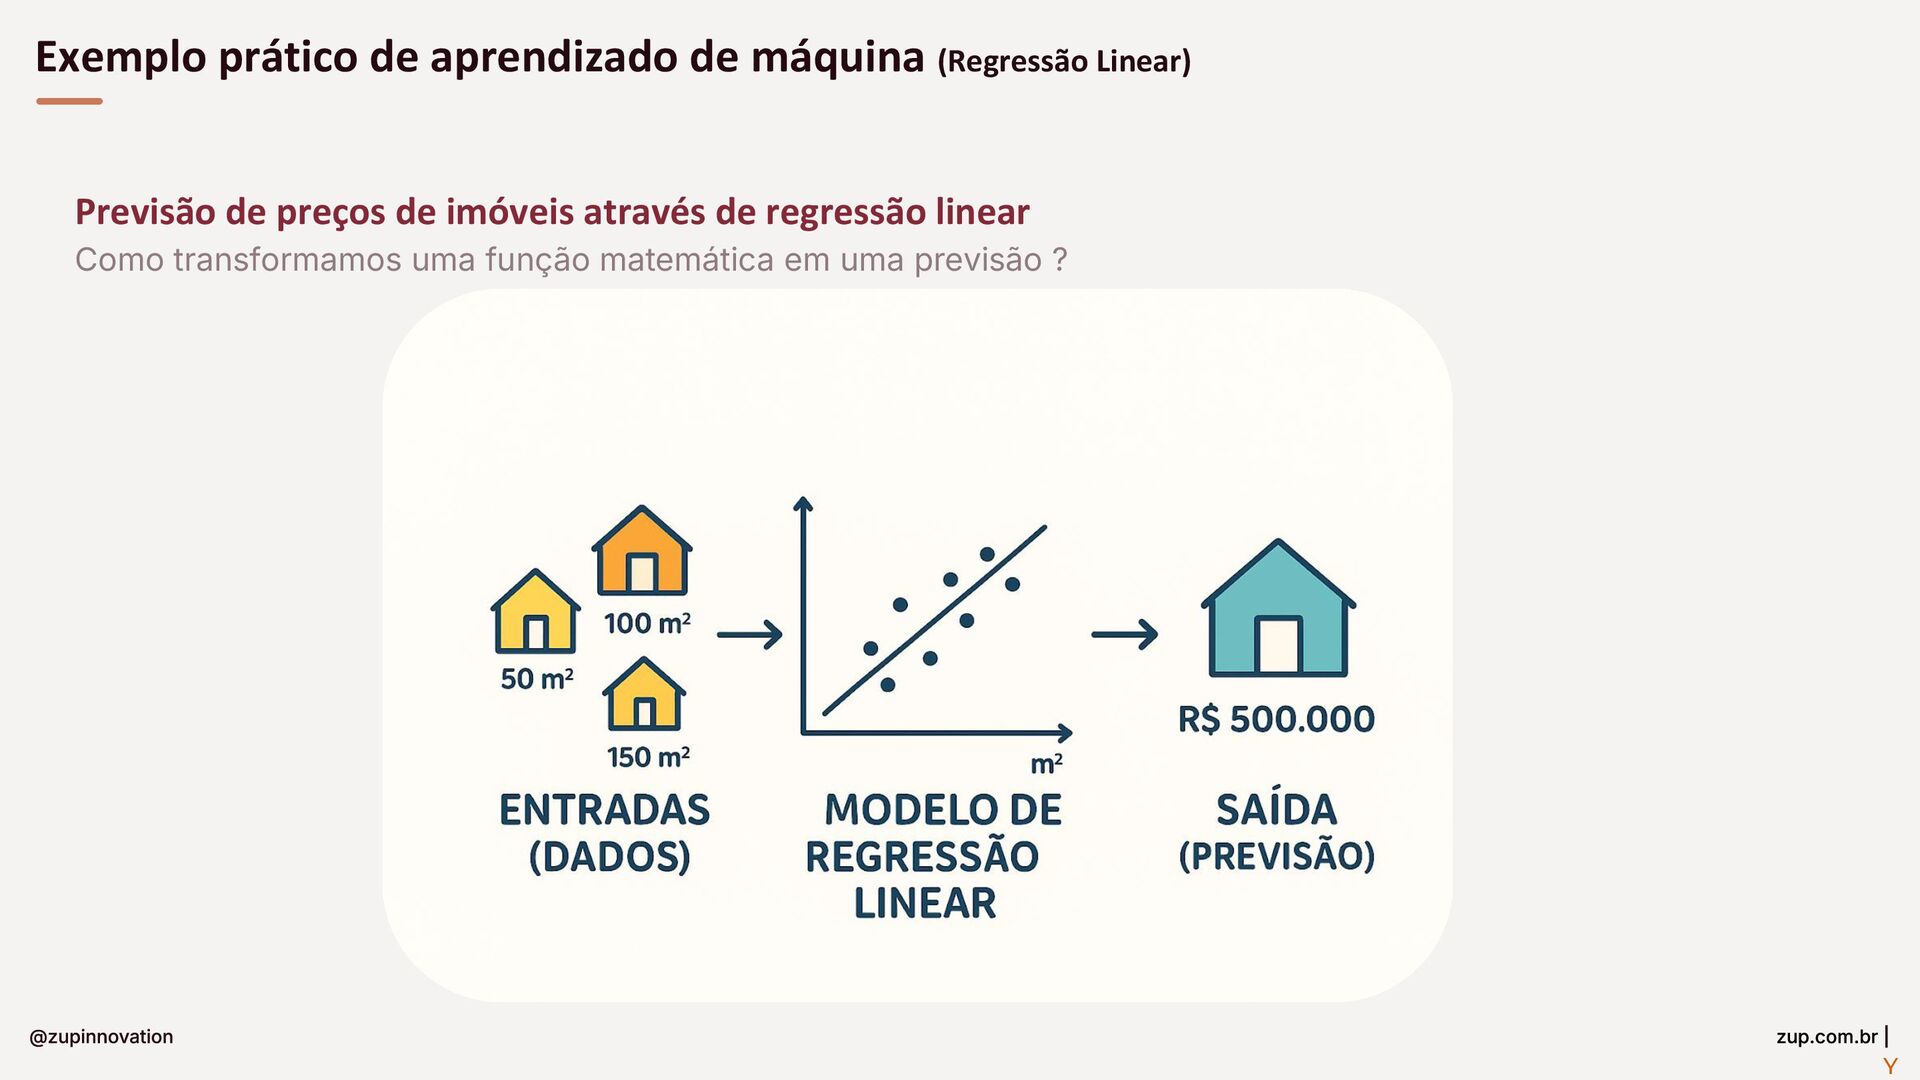
Exemplo prático de aprendizado de máquina (Regressão Linear) Previsão de
preços de imóveis através de regressão linear Como transformamos uma função matemática em uma previsão ? Y -
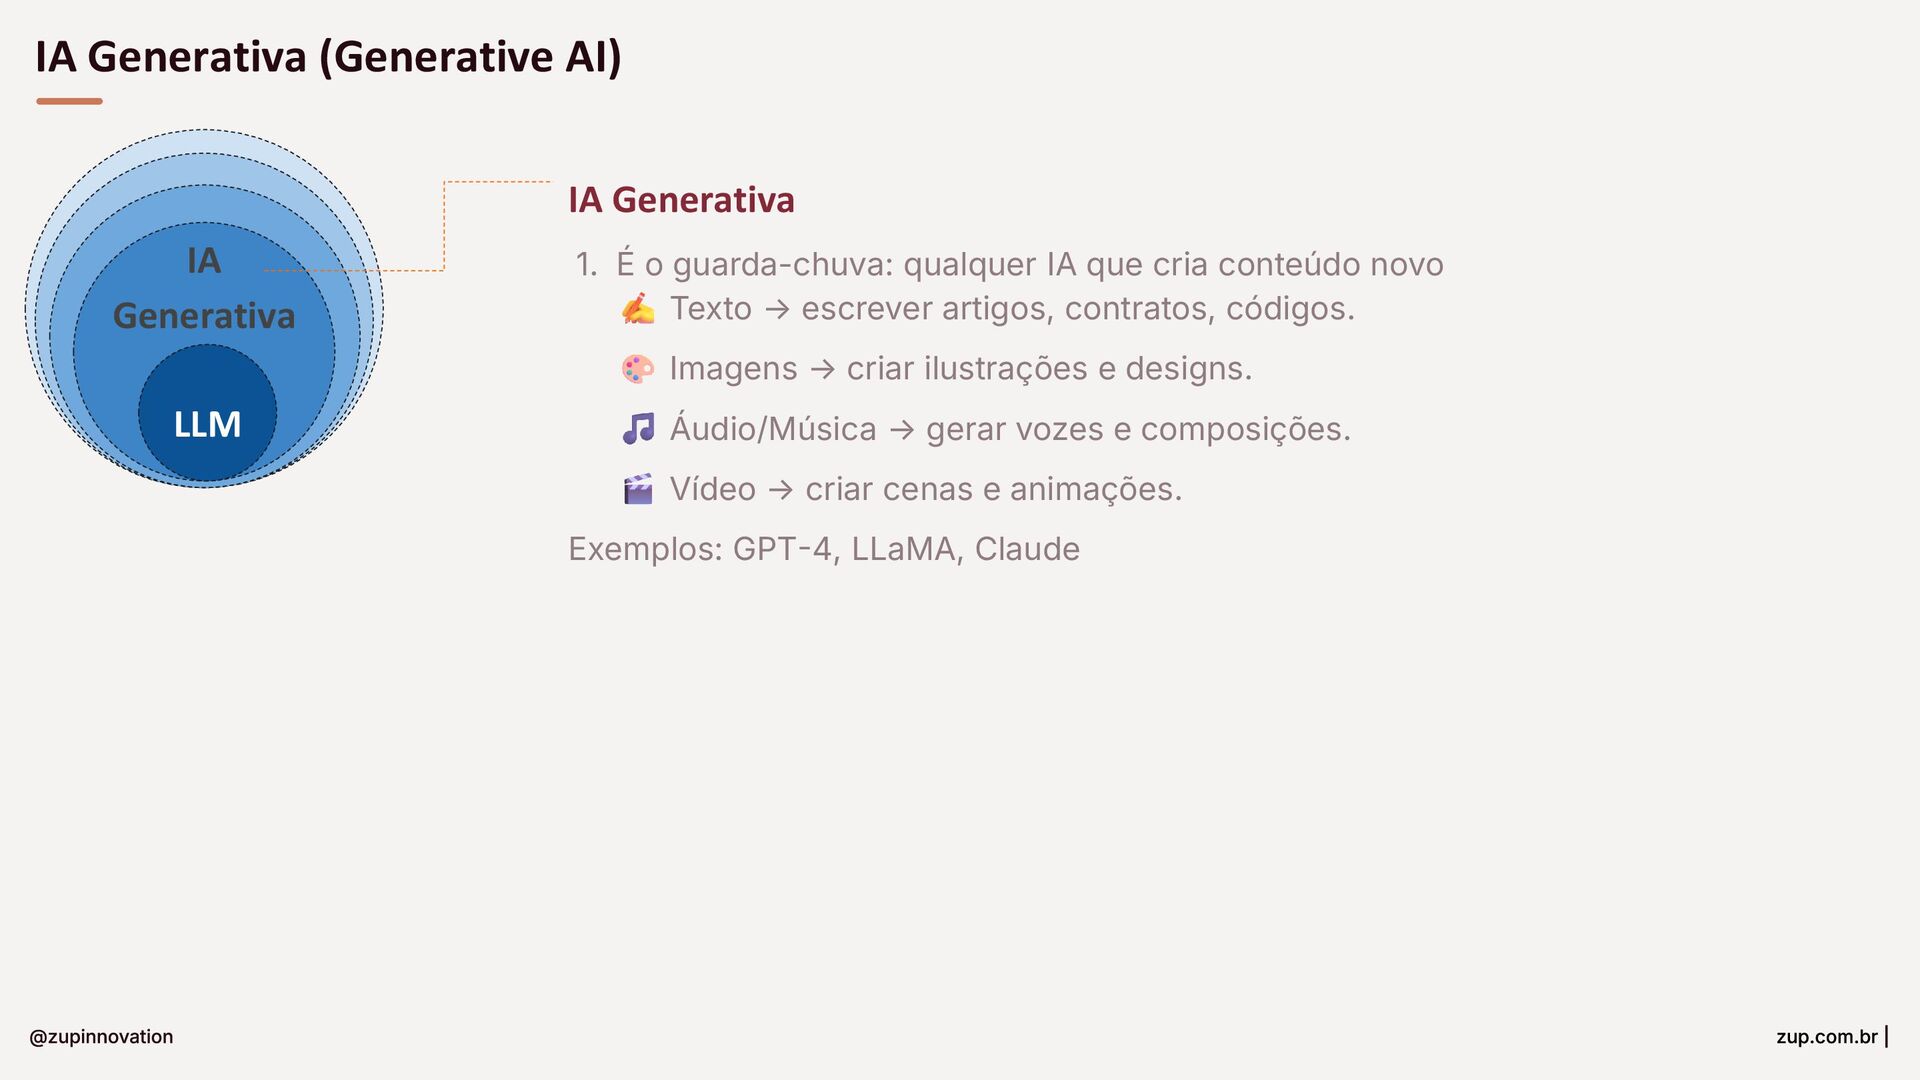
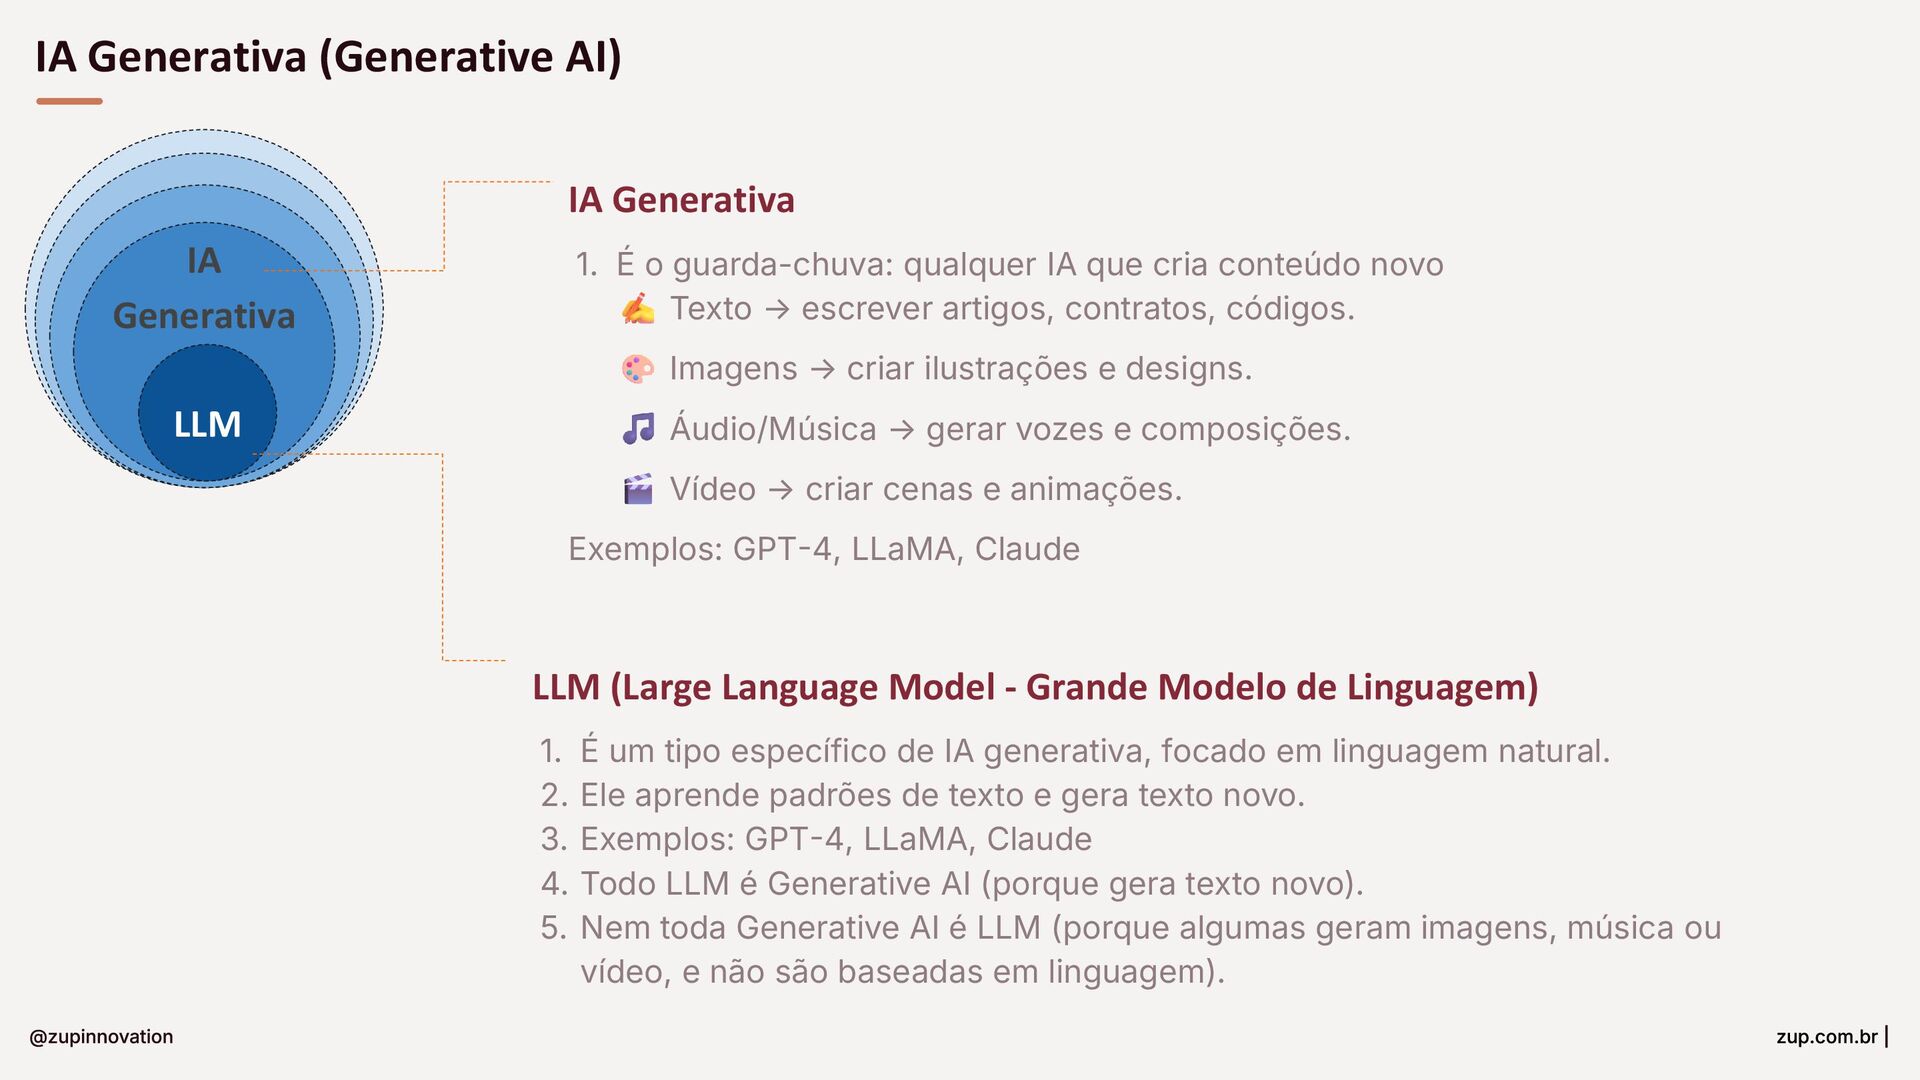
IA Generativa 1. É o guarda-chuva: qualquer IA que cria
conteúdo novo Texto → escrever artigos, contratos, códigos. Imagens → criar ilustrações e designs. Áudio/Música → gerar vozes e composições. Vídeo → criar cenas e animações. Exemplos: GPT-4, LLaMA, Claude IA Generativa (Generative AI) IA Generativa LLM -
IA Generativa 1. É o guarda-chuva: qualquer IA que cria
conteúdo novo Texto → escrever artigos, contratos, códigos. Imagens → criar ilustrações e designs. Áudio/Música → gerar vozes e composições. Vídeo → criar cenas e animações. Exemplos: GPT-4, LLaMA, Claude IA Generativa (Generative AI) IA Generativa LLM LLM (Large Language Model - Grande Modelo de Linguagem) 1. É um tipo específico de IA generativa, focado em linguagem natural. 2. Ele aprende padrões de texto e gera texto novo. 3. Exemplos: GPT-4, LLaMA, Claude 4. Todo LLM é Generative AI (porque gera texto novo). 5. Nem toda Generative AI é LLM (porque algumas geram imagens, música ou vídeo, e não são baseadas em linguagem). -
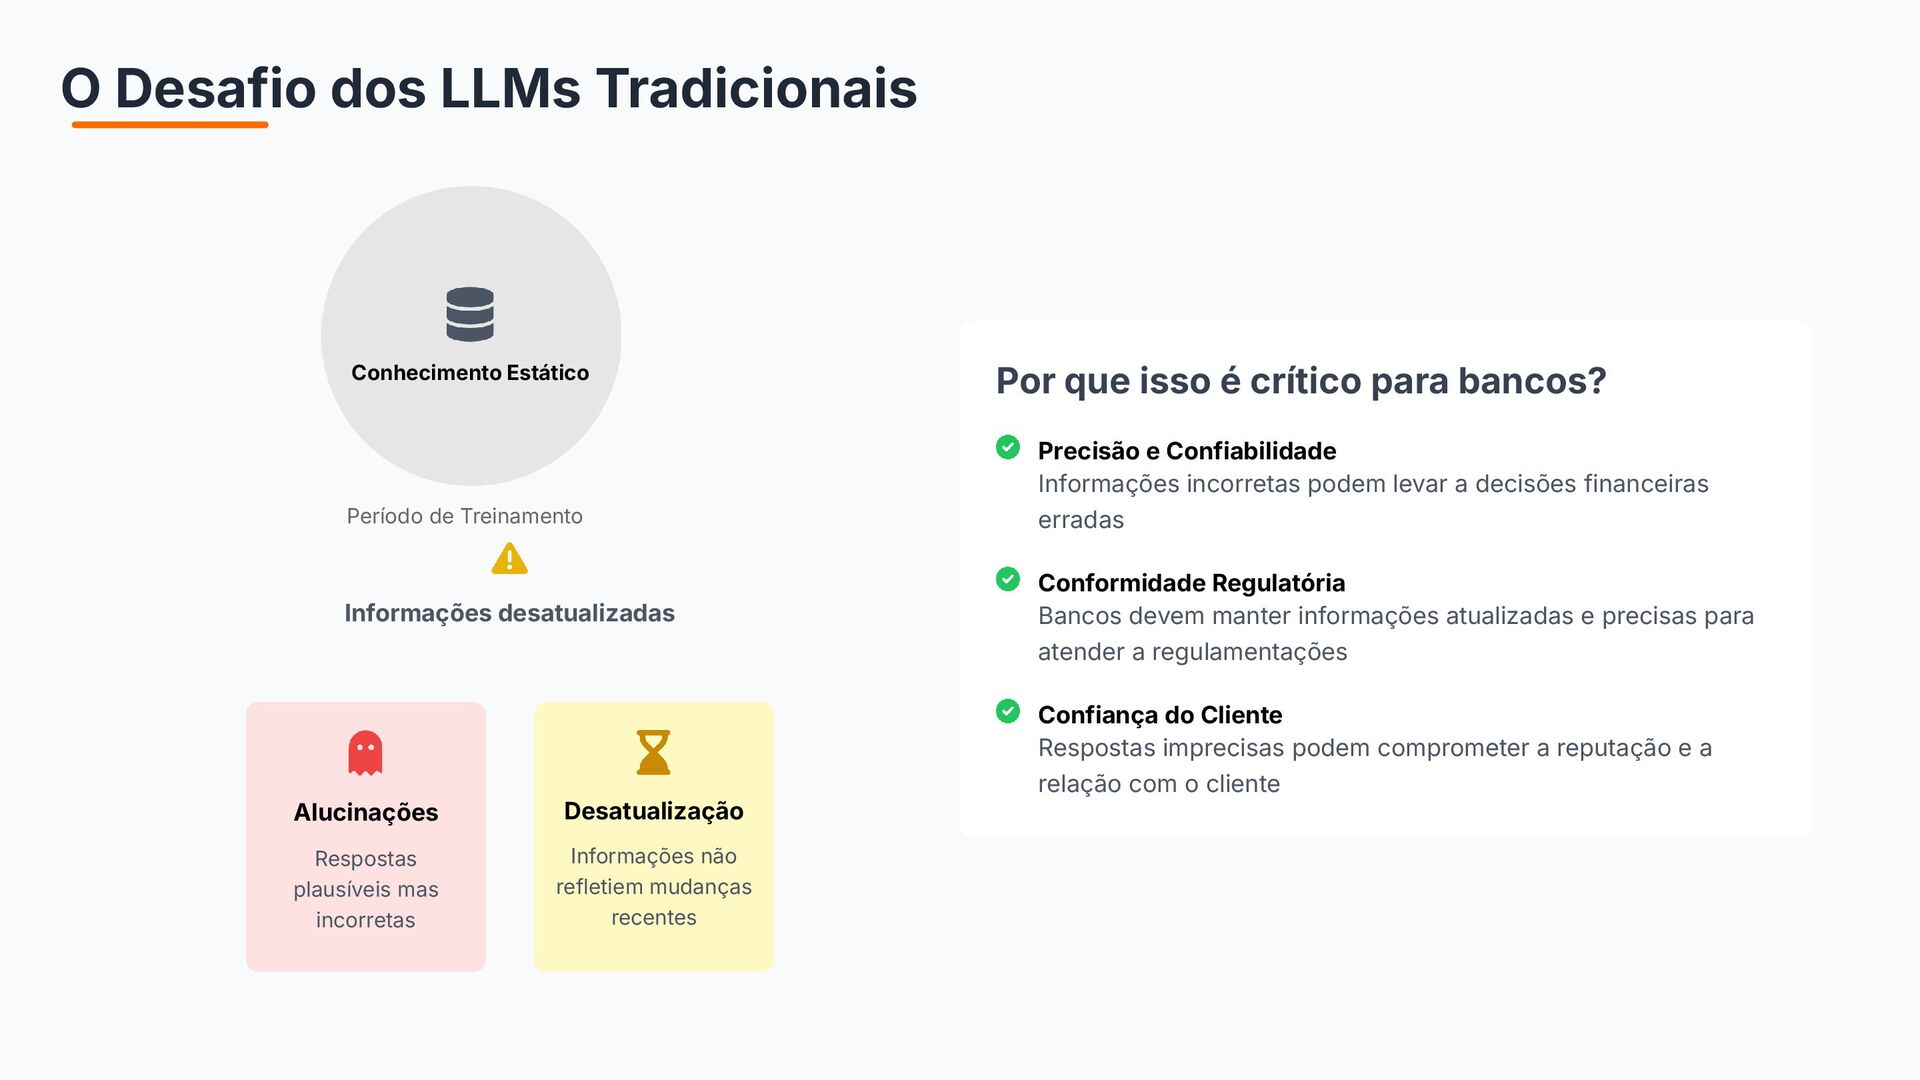
O Desafio dos LLMs Tradicionais Conhecimento Estático Período de Treinamento
Informações desatualizadas Alucinações Respostas plausíveis mas incorretas Desatualização Informações não refletiem mudanças recentes Por que isso é crítico para bancos? Precisão e Confiabilidade Informações incorretas podem levar a decisões financeiras erradas Conformidade Regulatória Bancos devem manter informações atualizadas e precisas para atender a regulamentações Confiança do Cliente Respostas imprecisas podem comprometer a reputação e a relação com o cliente -
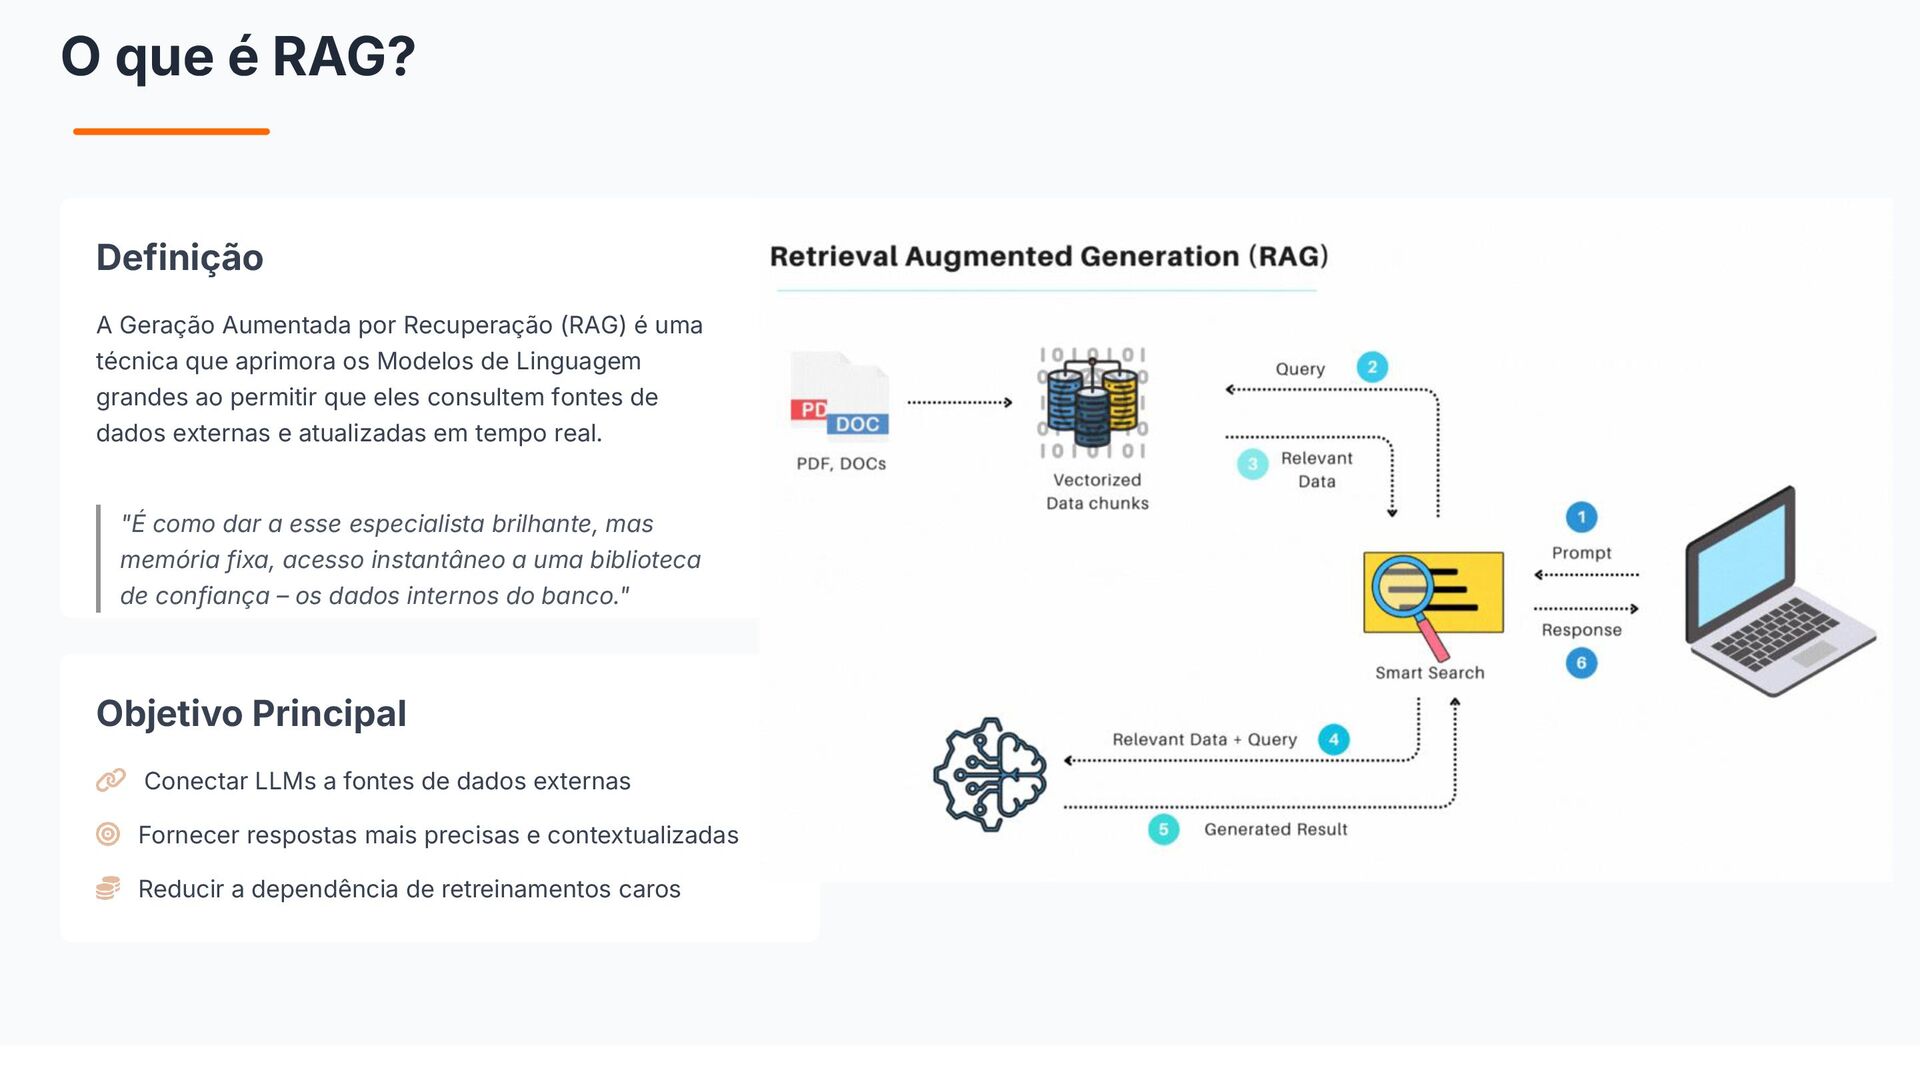
O que é RAG? Definição A Geração Aumentada por Recuperação
(RAG) é uma técnica que aprimora os Modelos de Linguagem grandes ao permitir que eles consultem fontes de dados externas e atualizadas em tempo real. "É como dar a esse especialista brilhante, mas memória fixa, acesso instantâneo a uma biblioteca de confiança – os dados internos do banco." Objetivo Principal Conectar LLMs a fontes de dados externas Fornecer respostas mais precisas e contextualizadas Reducir a dependência de retreinamentos caros -
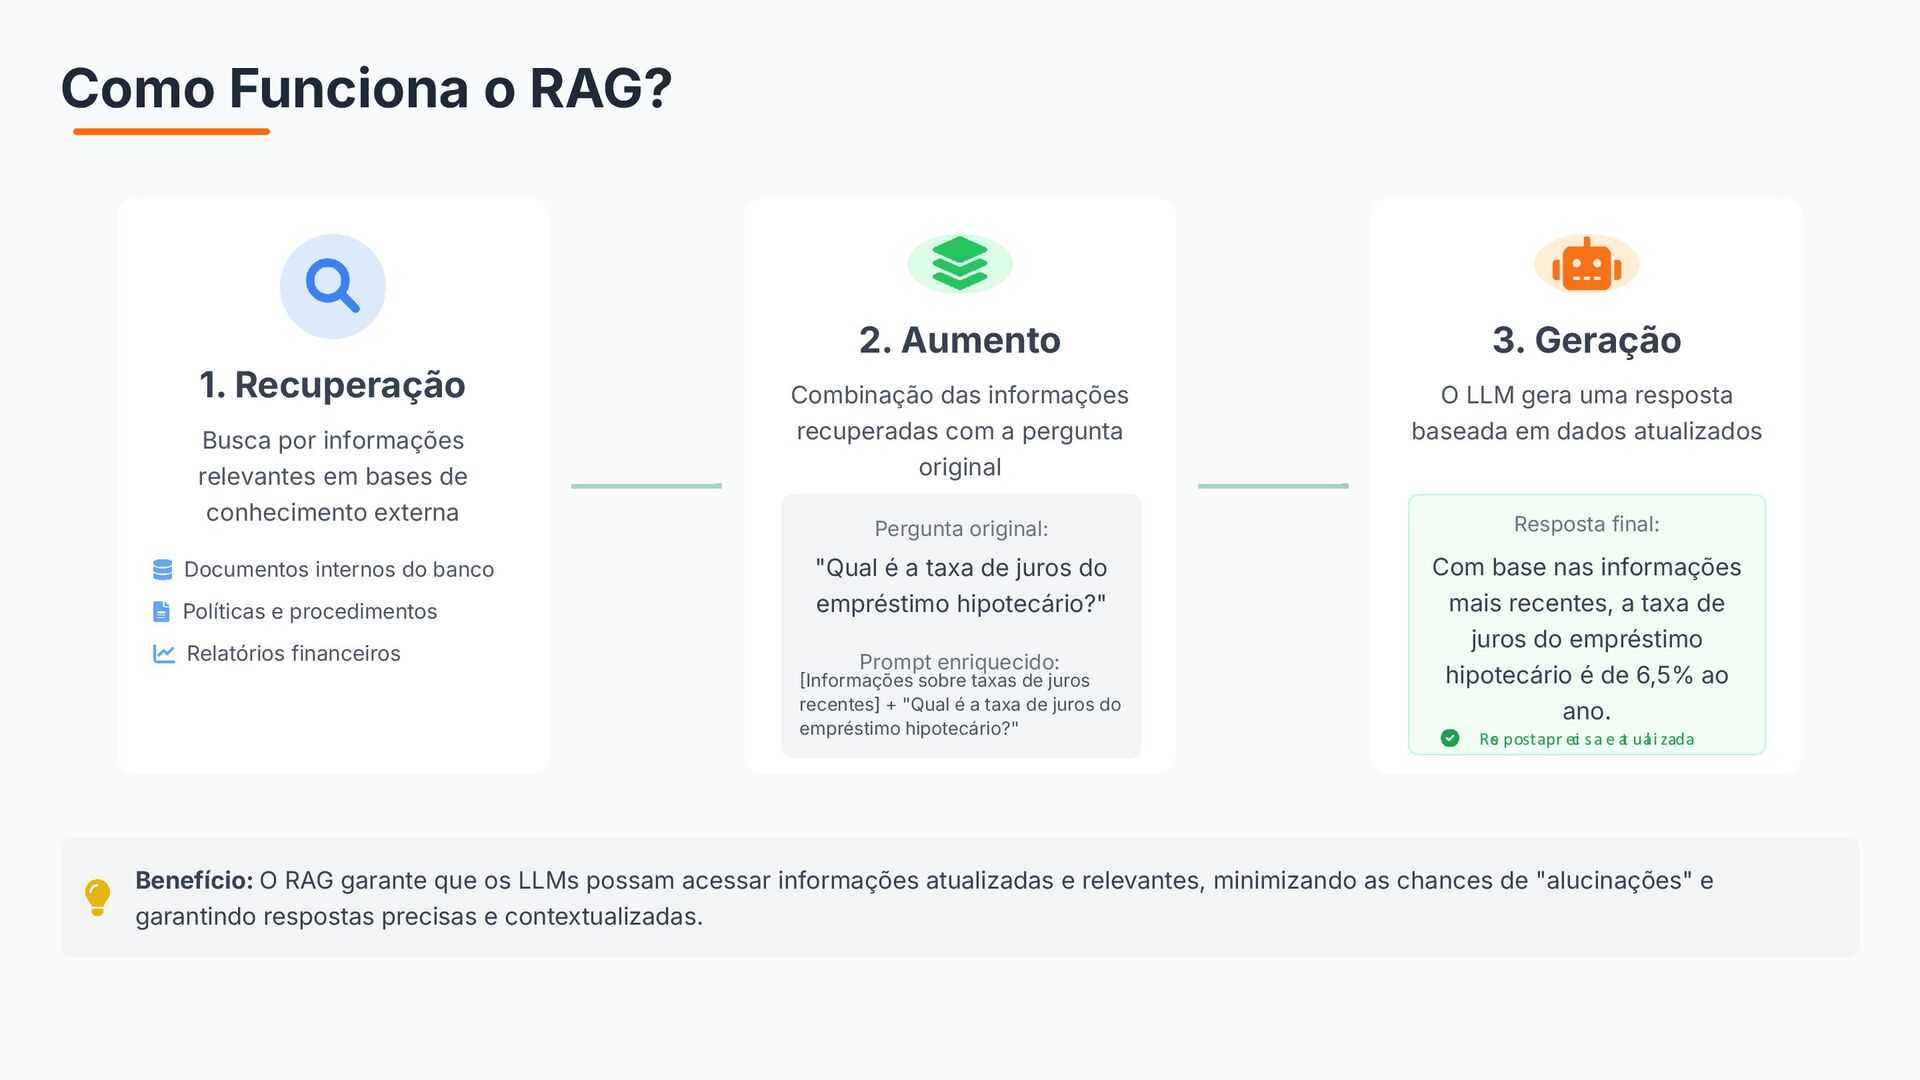
Como Funciona o RAG? 1. Recuperação Busca por informações relevantes
em bases de conhecimento externa Documentos internos do banco Políticas e procedimentos Relatórios financeiros 2. Aumento Combinação das informações recuperadas com a pergunta original Pergunta original: "Qual é a taxa de juros do empréstimo hipotecário?" Prompt enriquecido: [Informações sobre taxas de juros recentes] + "Qual é a taxa de juros do empréstimo hipotecário?" 3. Geração O LLM gera uma resposta baseada em dados atualizados Resposta final: Com base nas informações mais recentes, a taxa de juros do empréstimo hipotecário é de 6,5% ao ano. Re s posta pr ec i sa e a t ua l i zada Benefício: O RAG garante que os LLMs possam acessar informações atualizadas e relevantes, minimizando as chances de "alucinações" e garantindo respostas precisas e contextualizadas. -
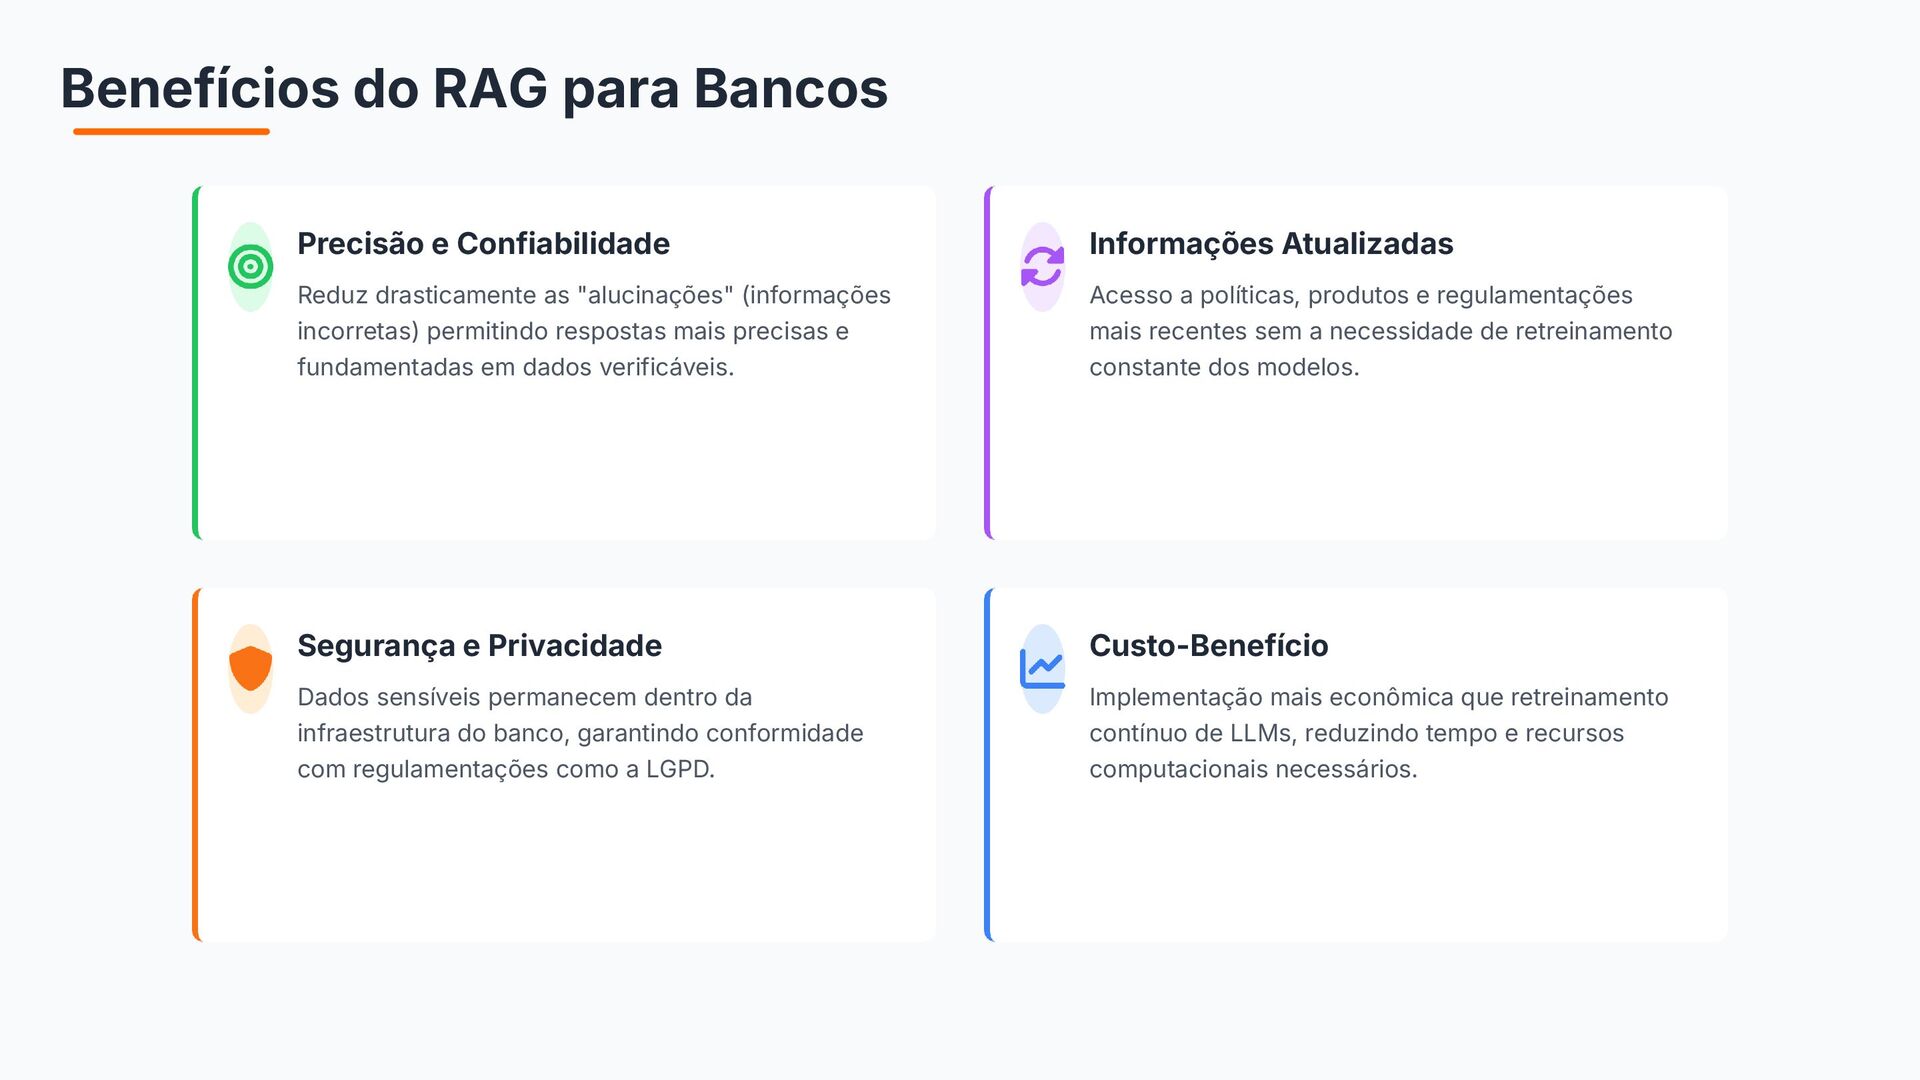
Benefícios do RAG para Bancos Precisão e Confiabilidade Reduz drasticamente
as "alucinações" (informações incorretas) permitindo respostas mais precisas e fundamentadas em dados verificáveis. Informações Atualizadas Acesso a políticas, produtos e regulamentações mais recentes sem a necessidade de retreinamento constante dos modelos. Segurança e Privacidade Dados sensíveis permanecem dentro da infraestrutura do banco, garantindo conformidade com regulamentações como a LGPD. Custo-Benefício Implementação mais econômica que retreinamento contínuo de LLMs, reduzindo tempo e recursos computacionais necessários. -
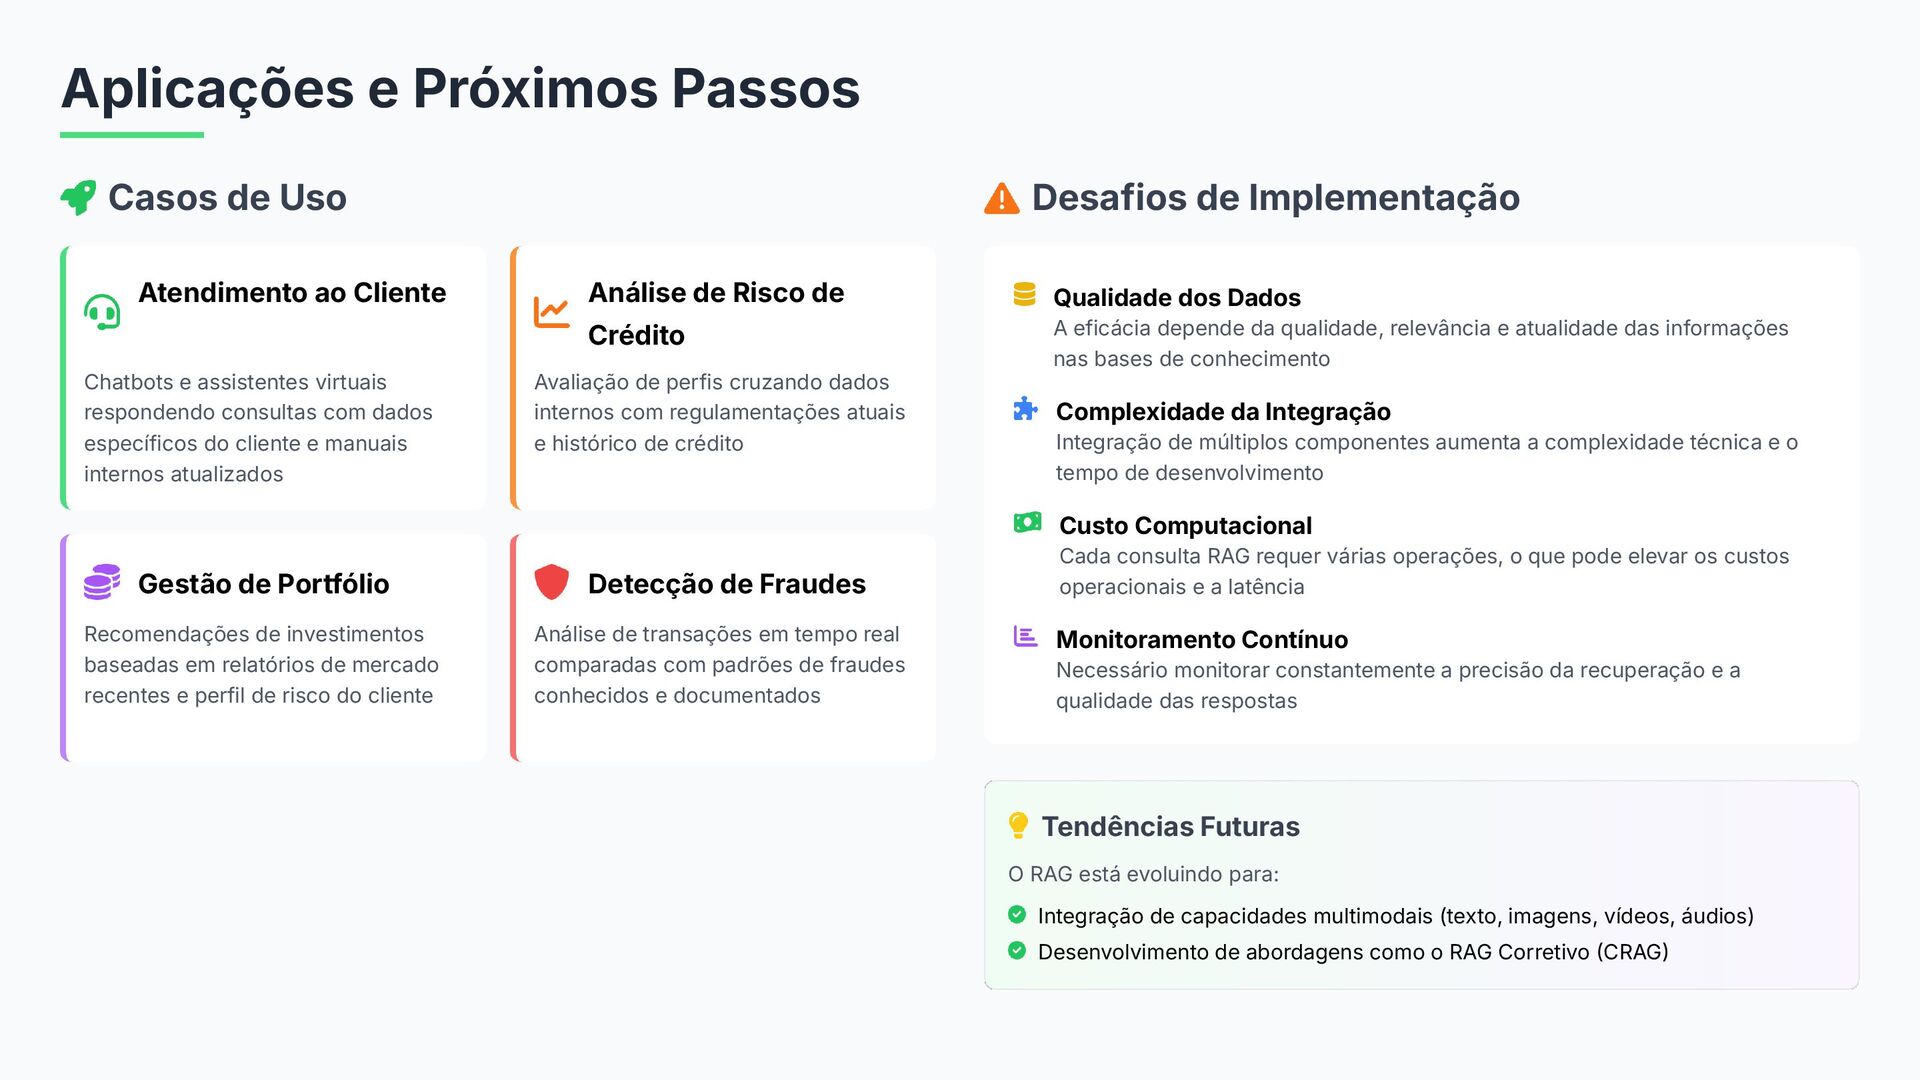
Aplicações e Próximos Passos Casos de Uso Atendimento ao Cliente
Chatbots e assistentes virtuais respondendo consultas com dados específicos do cliente e manuais internos atualizados Análise de Risco de Crédito Avaliação de perfis cruzando dados internos com regulamentações atuais e histórico de crédito Gestão de Portfólio Recomendações de investimentos baseadas em relatórios de mercado recentes e perfil de risco do cliente Detecção de Fraudes Análise de transações em tempo real comparadas com padrões de fraudes conhecidos e documentados Desafios de Implementação Qualidade dos Dados A eficácia depende da qualidade, relevância e atualidade das informações nas bases de conhecimento Complexidade da Integração Integração de múltiplos componentes aumenta a complexidade técnica e o tempo de desenvolvimento Custo Computacional Cada consulta RAG requer várias operações, o que pode elevar os custos operacionais e a latência Monitoramento Contínuo Necessário monitorar constantemente a precisão da recuperação e a qualidade das respostas Tendências Futuras O RAG está evoluindo para: Integração de capacidades multimodais (texto, imagens, vídeos, áudios) Desenvolvimento de abordagens como o RAG Corretivo (CRAG) -
O desafio Entender o significado, não apenas as palavras Cartão
de pontos Cartão de milhas Cartão de viagem -
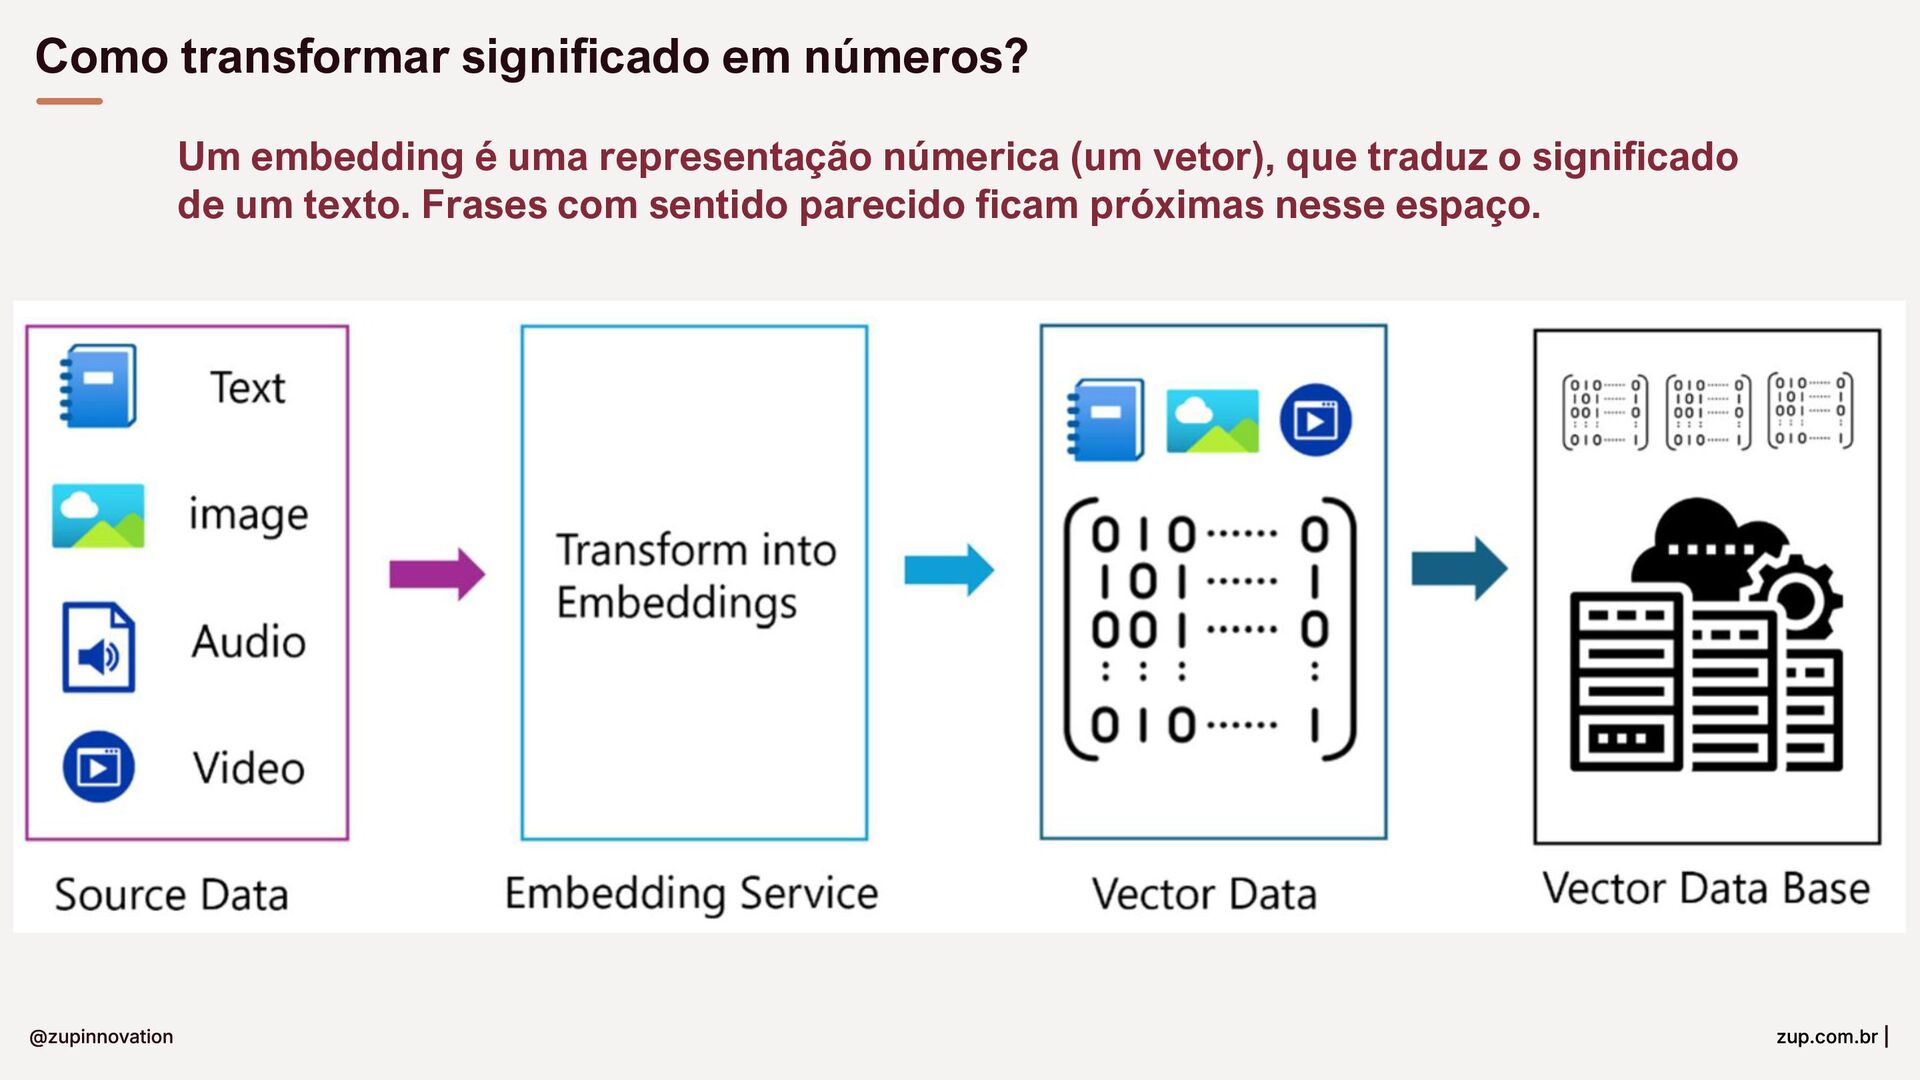
Como transformar significado em números? Um embedding é uma representação
númerica (um vetor), que traduz o significado de um texto. Frases com sentido parecido ficam próximas nesse espaço. -
Introdução Definição de Engenharia de Prompt É a prática de
criar instruções claras para modelos de linguagem natural, melhorando a qualidade das respostas geradas. Importância na Qualidade das Respostas Prompts bem elaborados geram respostas precisas e relevantes, enquanto prompts mal formulados causam respostas vagas ou incorretas. Evolução e Relevância Crescente Com o avanço dos modelos de linguagem, a engenharia de prompt tornou-se uma habilidade essencial para profissionais de IA. Bons e Maus Prompts Instruções específicas geram melhores resultados comparadas a prompts genéricos ou ambíguos. -
Prompts Claros e Eficazes • Clareza e Linguagem Direta •
Objetividade no Conteúdo • Instruções Explicitas • Evitar Ambiguidade -
Multiplas etapas e Estilos • Prompts Encadeados (Chain of Thought)
- Resolva o problema X passo a passo. • Uso de contexto – Aproveite as informações, dados, bases. • Prompts Multietapas - Divisão em tarefas menores • Condicionamento de estilo – Tom formal, informal, técnico, resumido -
Estruturação de prompts com : Listas, tabelas e Marcações Importância
da formatação A forma como o prompt é estruturado (com listas, títulos, separações) influencia diretamente a compreensão do modelo. Uma boa formatação ajuda o LLM a identificar padrões, separar instruções e gerar respostas mais organizadas e úteis. Uso de instruções e exemplos Instruções claras dizem ao modelo o que fazer, e exemplos mostram como fazer. Essa combinação reduz ambiguidades e aumenta a precisão da resposta. Formatação para parsing técnico É a prática de estruturar a resposta para que possa ser facilmente lida por sistemas ou scripts, como JSON, YAML, tabelas ou código. Isso é essencial quando a saída será usada em automações ou integrações. Melhora de legibilidade Prompts bem formatados geram respostas mais fáceis de ler, entender e revisar. Isso é útil tanto para humanos quanto para modelos que vão reutilizar essa saída como entrada em etapas futuras. -
Escolha do idioma e resposta do modelo Influência do idioma
na qualidade O idioma do prompt impacta a clareza e a precisão da resposta. Modelos geralmente funcionam melhor no idioma com mais dados de treino (normalmente inglês). Desempenho em inglês e português Em inglês, respostas tendem a ser mais completas e detalhadas. Em português, podem ocorrer pequenas imprecisões ou menos riqueza de detalhes. Adequação para público-alvo Escolha o idioma conforme quem vai consumir a resposta. Se o público é brasileiro, mantenha português mesmo que a qualidade seja um pouco menor. Uso de prompts bilíngues Combine idiomas para aproveitar vantagens: instruções em inglês e saída em português. Isso melhora a qualidade sem perder adequação. -
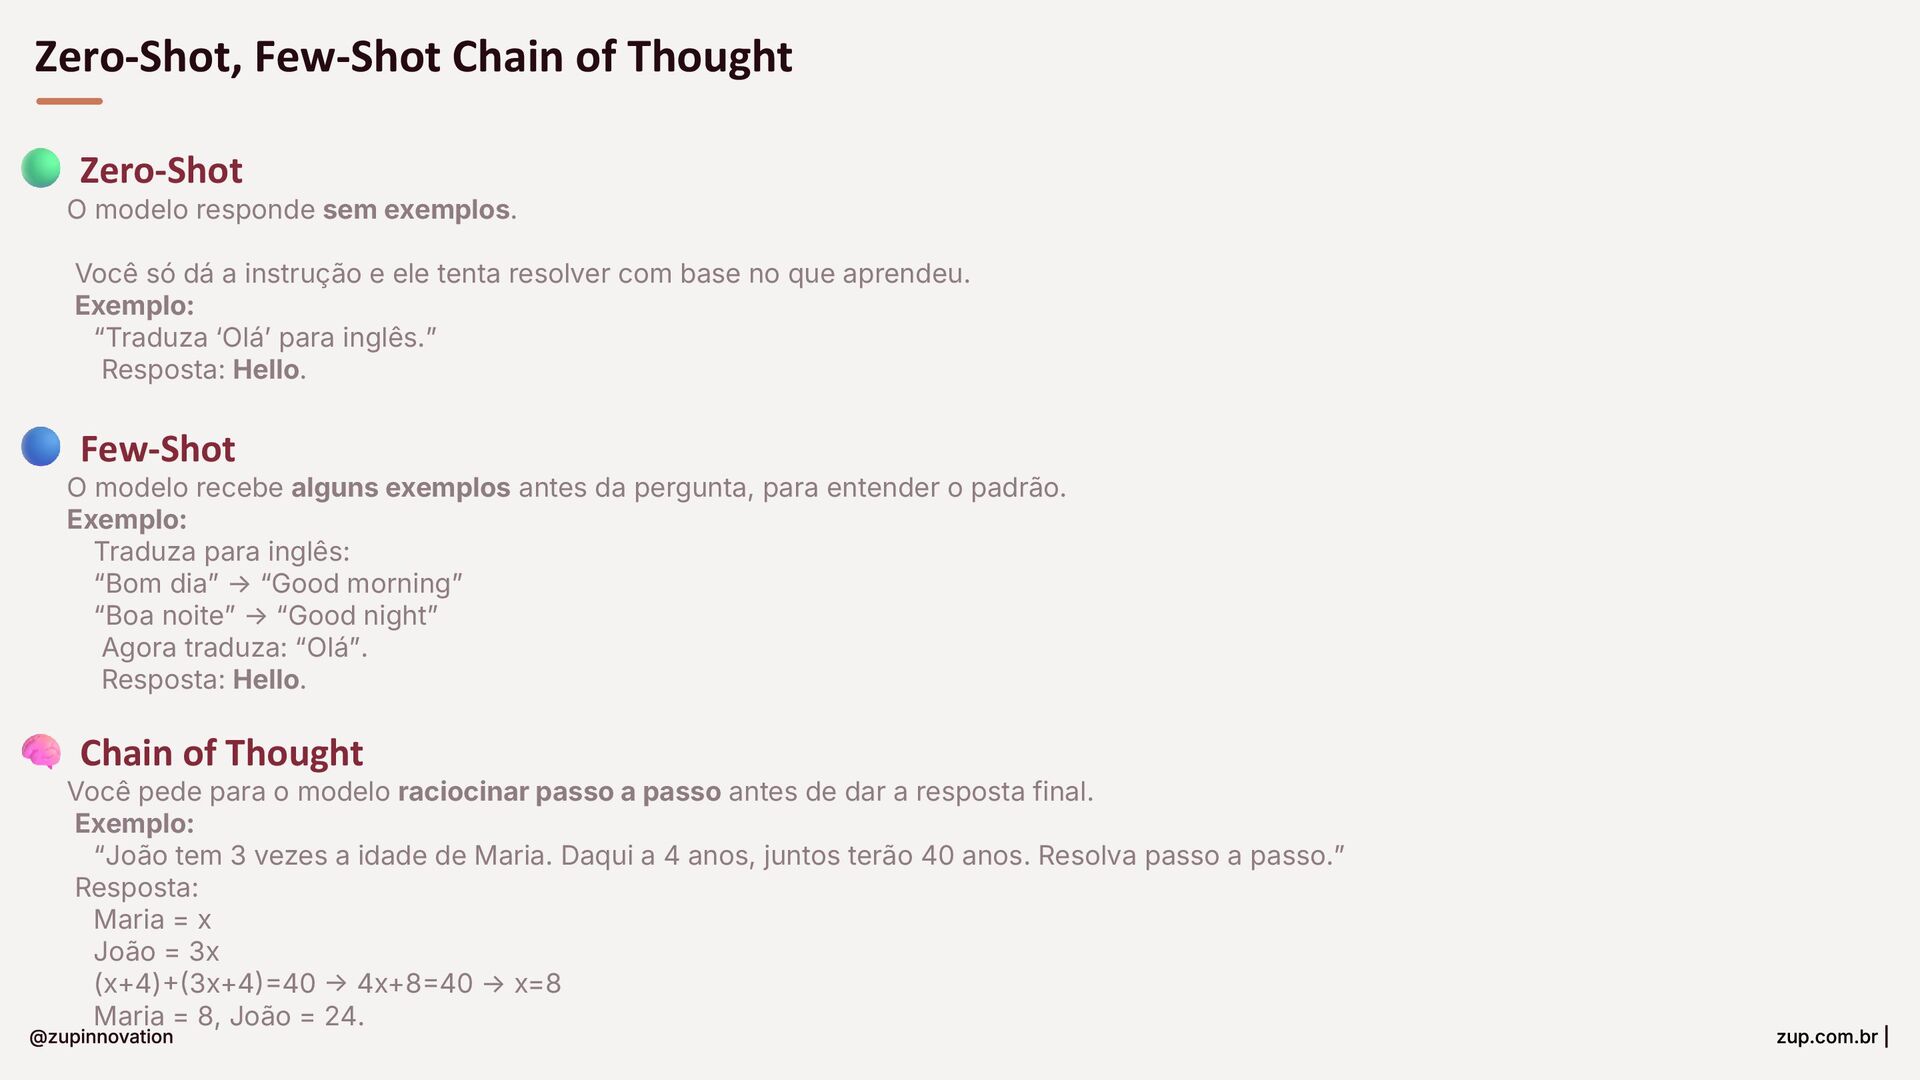
Zero-Shot, Few-Shot Chain of Thought Zero-Shot O modelo responde sem
exemplos. Você só dá a instrução e ele tenta resolver com base no que aprendeu. Exemplo: “Traduza ‘Olá’ para inglês.” Resposta: Hello. Few-Shot O modelo recebe alguns exemplos antes da pergunta, para entender o padrão. Exemplo: Traduza para inglês: “Bom dia” → “Good morning” “Boa noite” → “Good night” Agora traduza: “Olá”. Resposta: Hello. Chain of Thought Você pede para o modelo raciocinar passo a passo antes de dar a resposta final. Exemplo: “João tem 3 vezes a idade de Maria. Daqui a 4 anos, juntos terão 40 anos. Resolva passo a passo.” Resposta: Maria = x João = 3x (x+4)+(3x+4)=40 → 4x+8=40 → x=8 Maria = 8, João = 24. -
Alucinações Alucinações São respostas incorretas ou inventadas que o modelo
gera com alta confiança, mesmo sem base real. Causas das alucinações Falta de contexto externo: O modelo depende apenas do que aprendeu no treinamento. Conhecimento desatualizado: Não acessa informações recentes. Domínios especializados: Dificuldade em áreas técnicas (ex.: medicina, direito). Prompts vagos ou ambíguos: Instruções pouco claras aumentam erros. Estratégias para mitigação RAG (Retrieval-Augmented Generation): Complementar com dados externos atualizados. Prompts claros e específicos: Reduz ambiguidades. Validação e Evals: Testar e medir qualidade das respostas. Limitar escopo: Evitar perguntas muito abertas ou fora do domínio do modelo. -
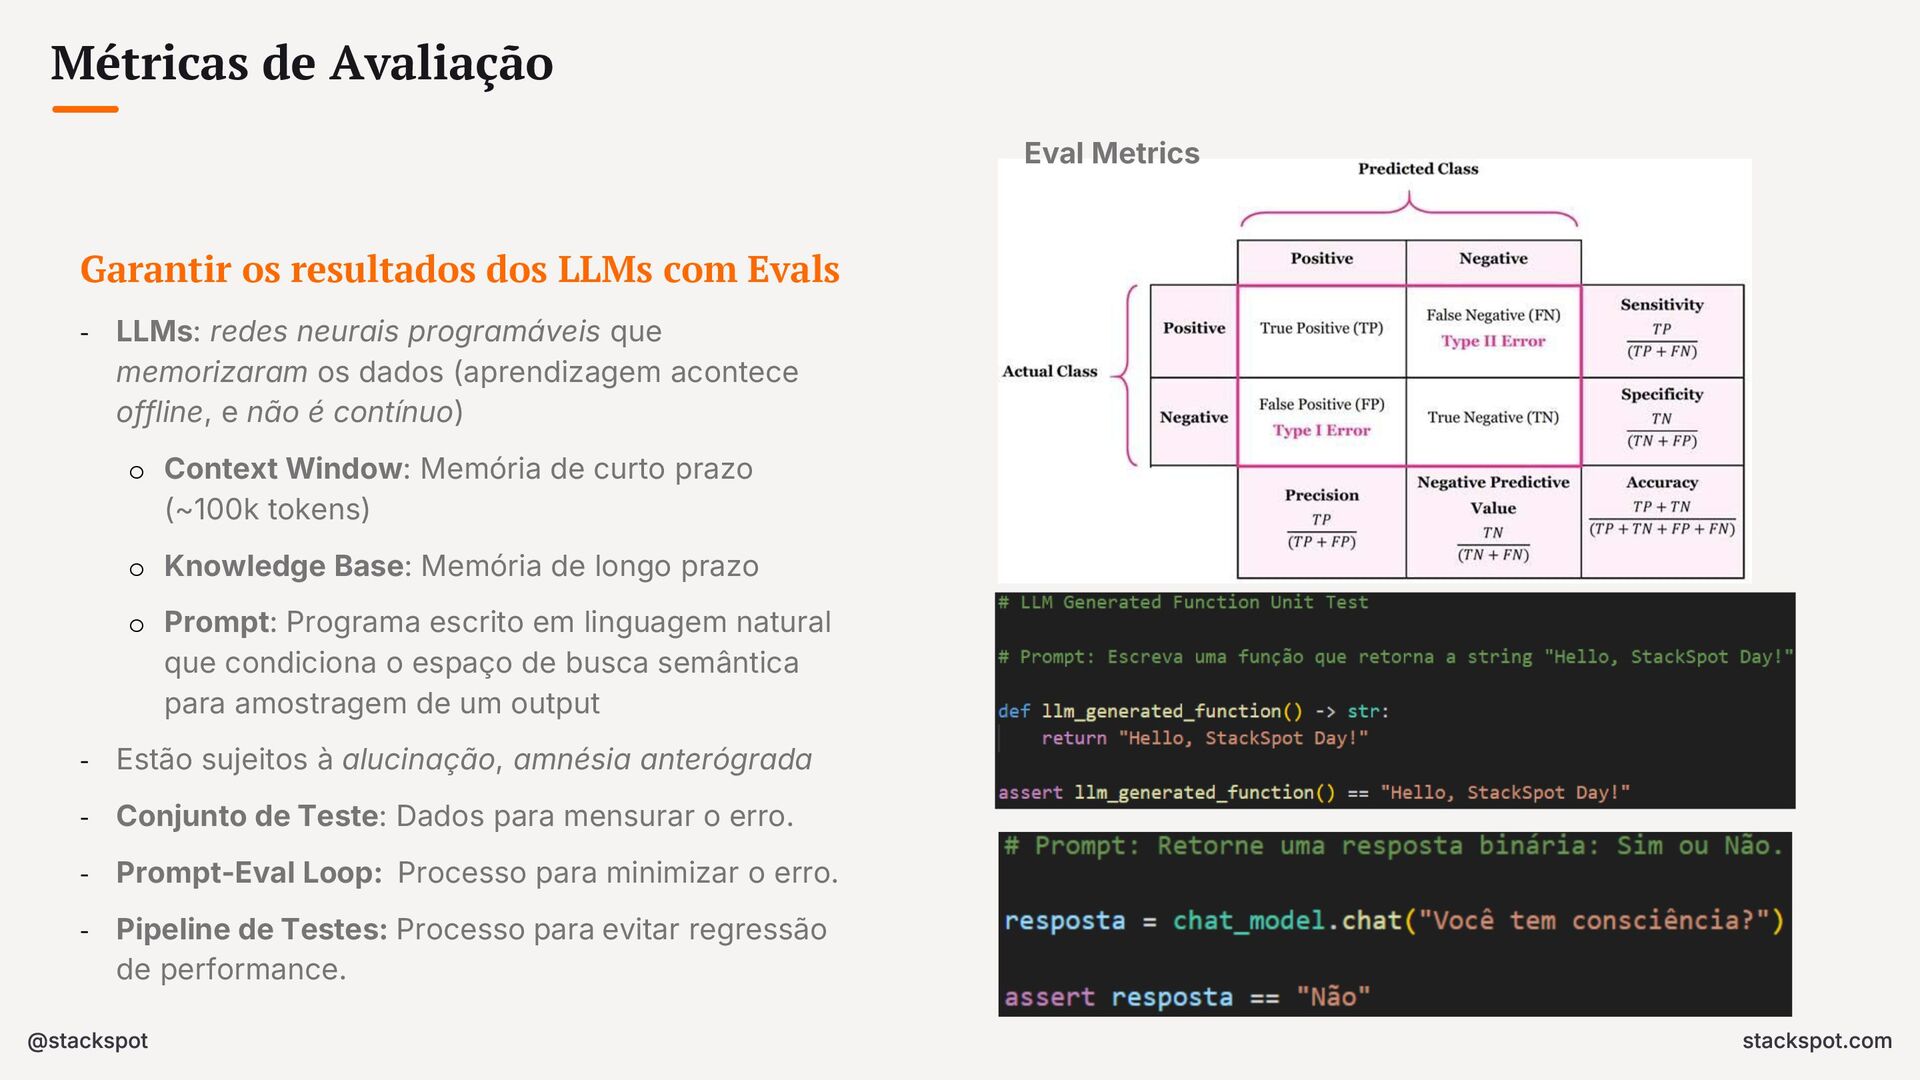
Métricas de Avaliação Garantir os resultados dos LLMs com Evals
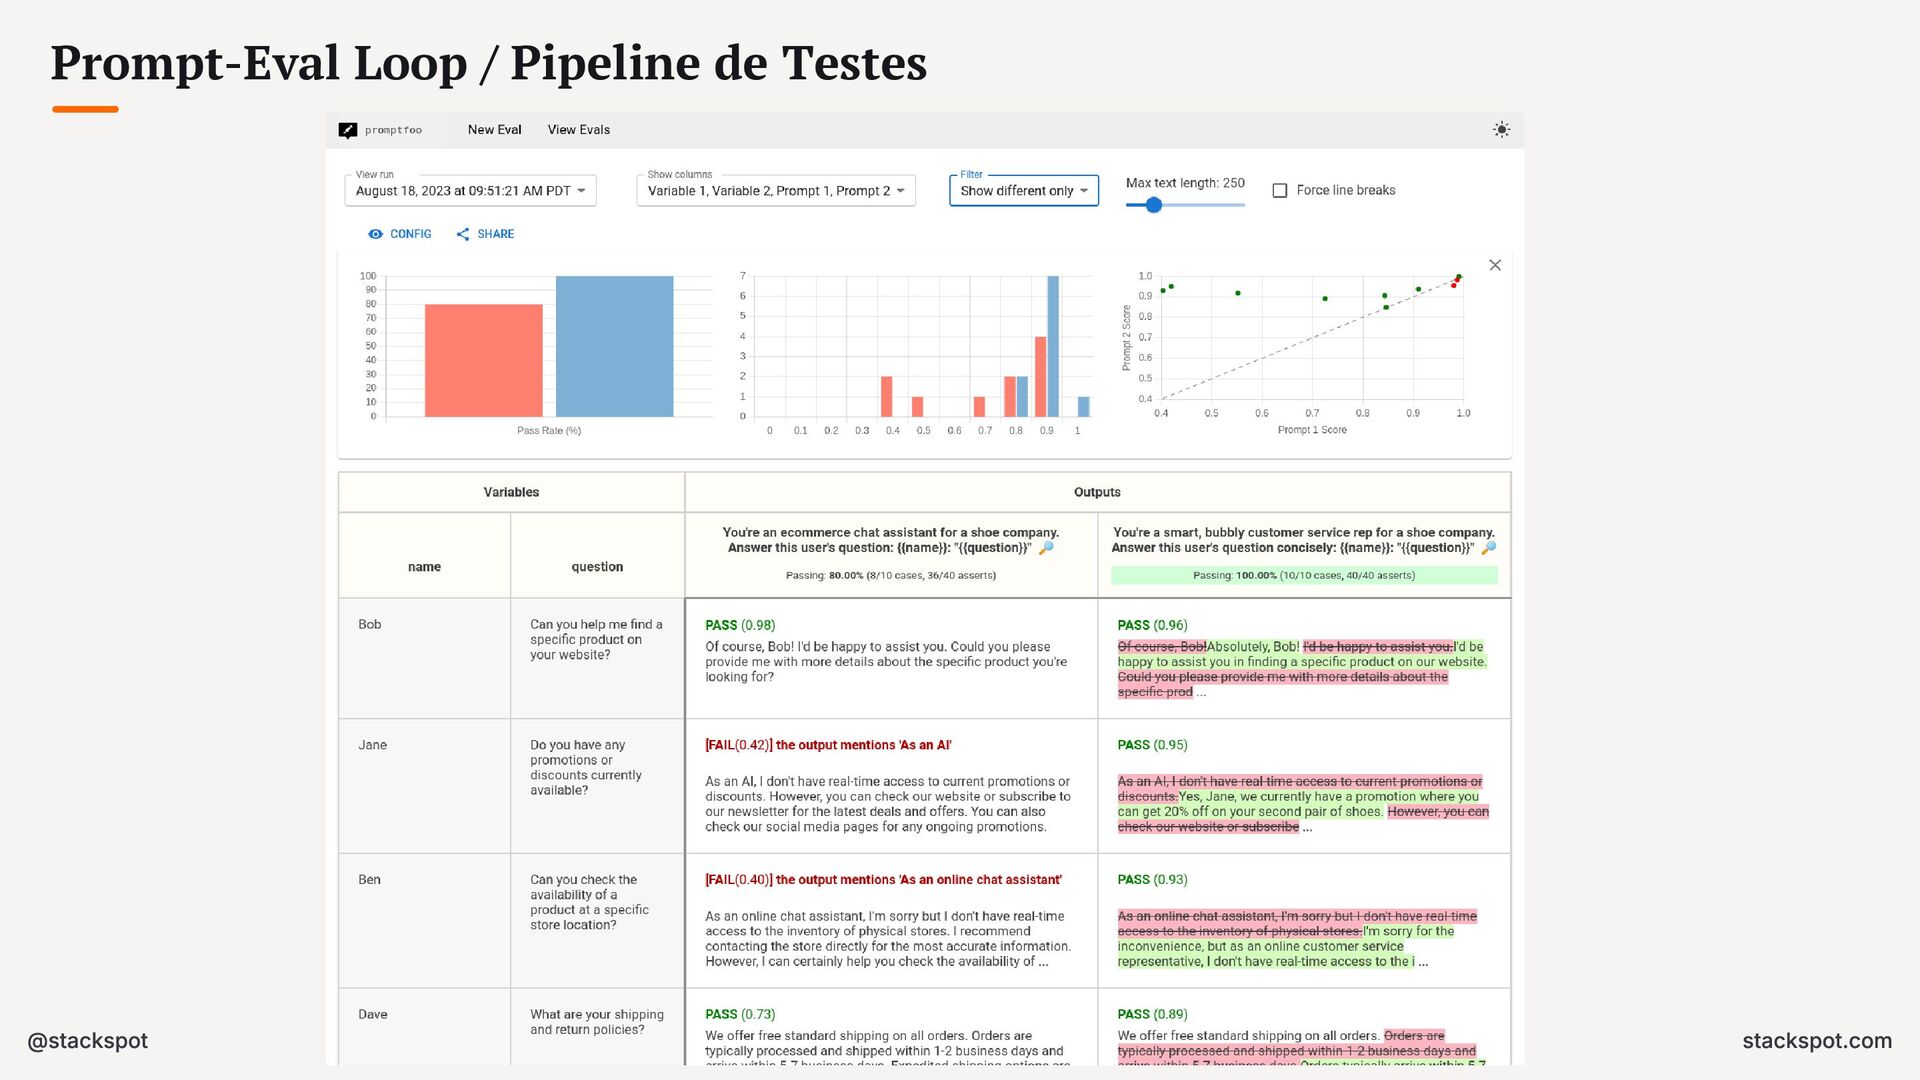
- LLMs: redes neurais programáveis que memorizaram os dados (aprendizagem acontece offline, e não é contínuo) o Context Window: Memória de curto prazo (~100k tokens) o Knowledge Base: Memória de longo prazo o Prompt: Programa escrito em linguagem natural que condiciona o espaço de busca semântica para amostragem de um output - Estão sujeitos à alucinação, amnésia anterógrada - Conjunto de Teste: Dados para mensurar o erro. - Prompt-Eval Loop: Processo para minimizar o erro. - Pipeline de Testes: Processo para evitar regressão de performance. Eval Metrics -
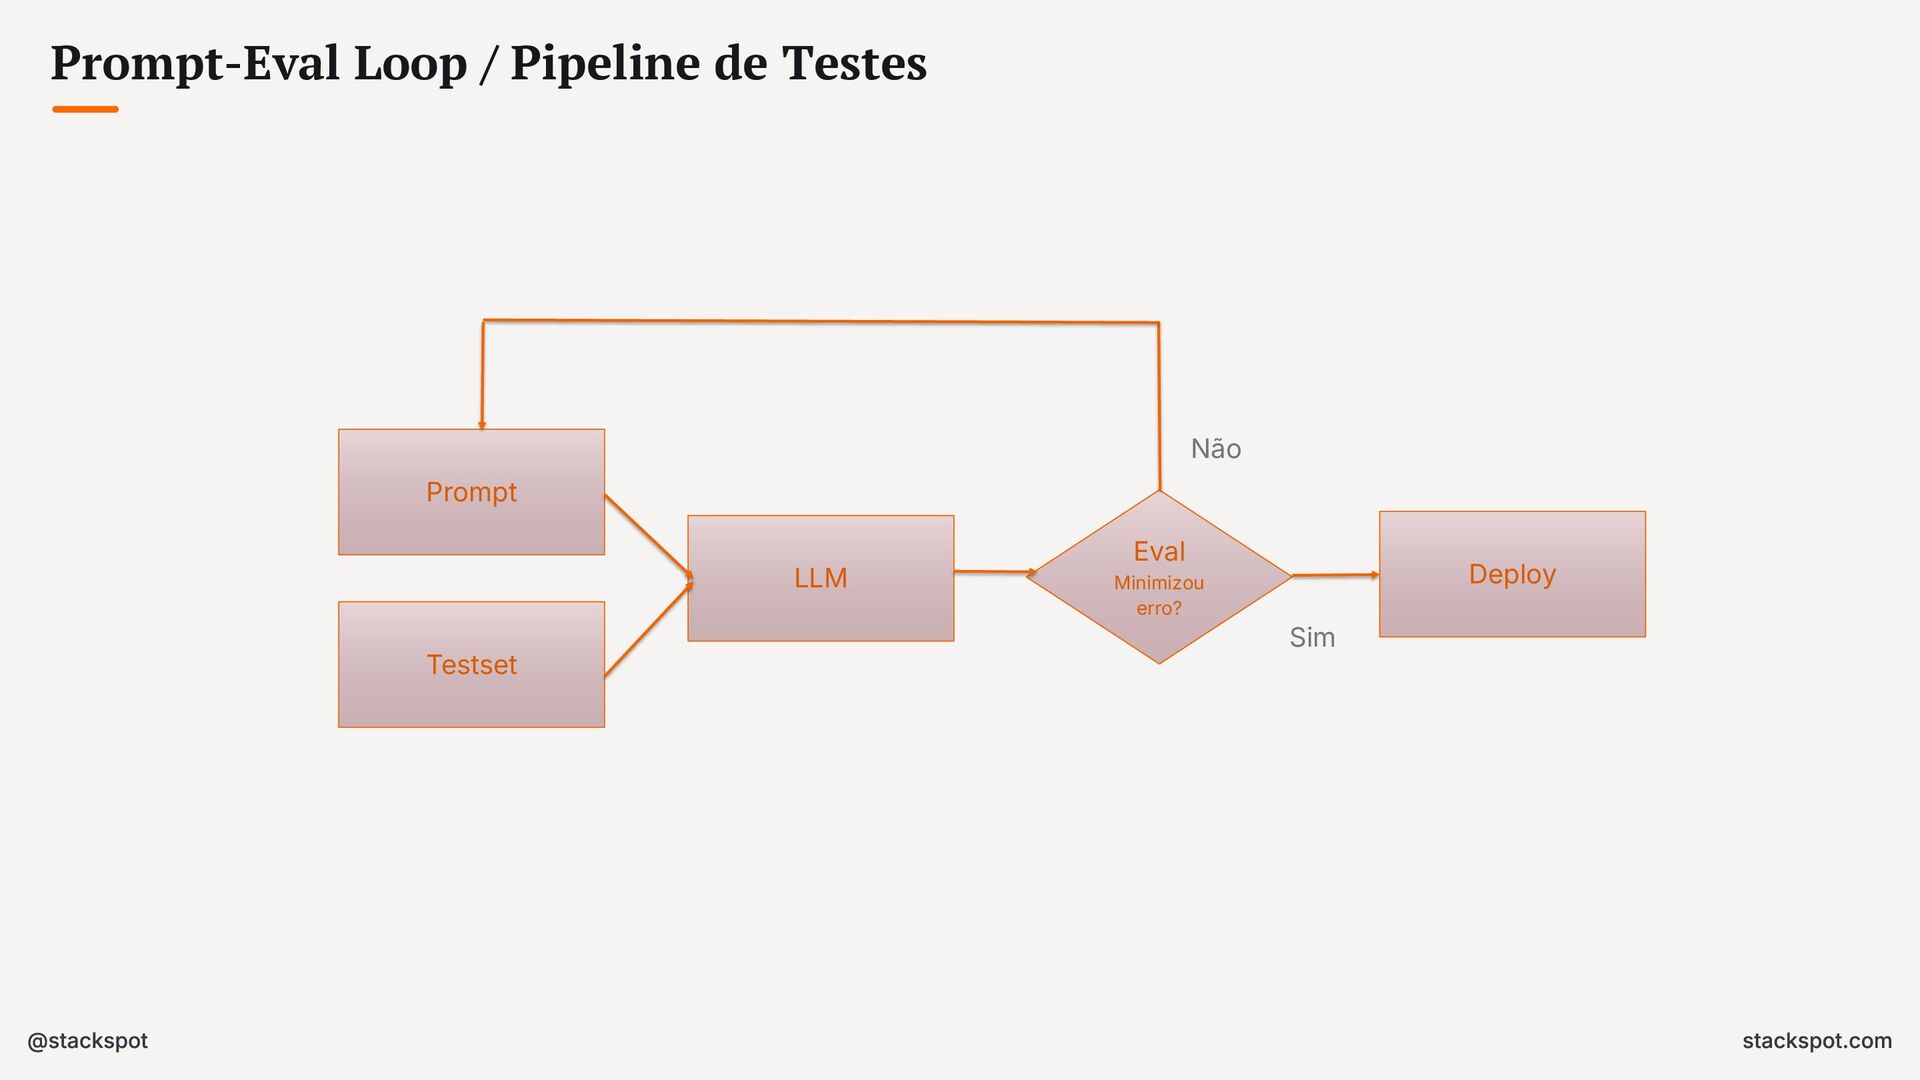
Prompt-Eval Loop / Pipeline de Testes Prompt Testset LLM Eval
Minimizou erro? Deploy Não Sim -
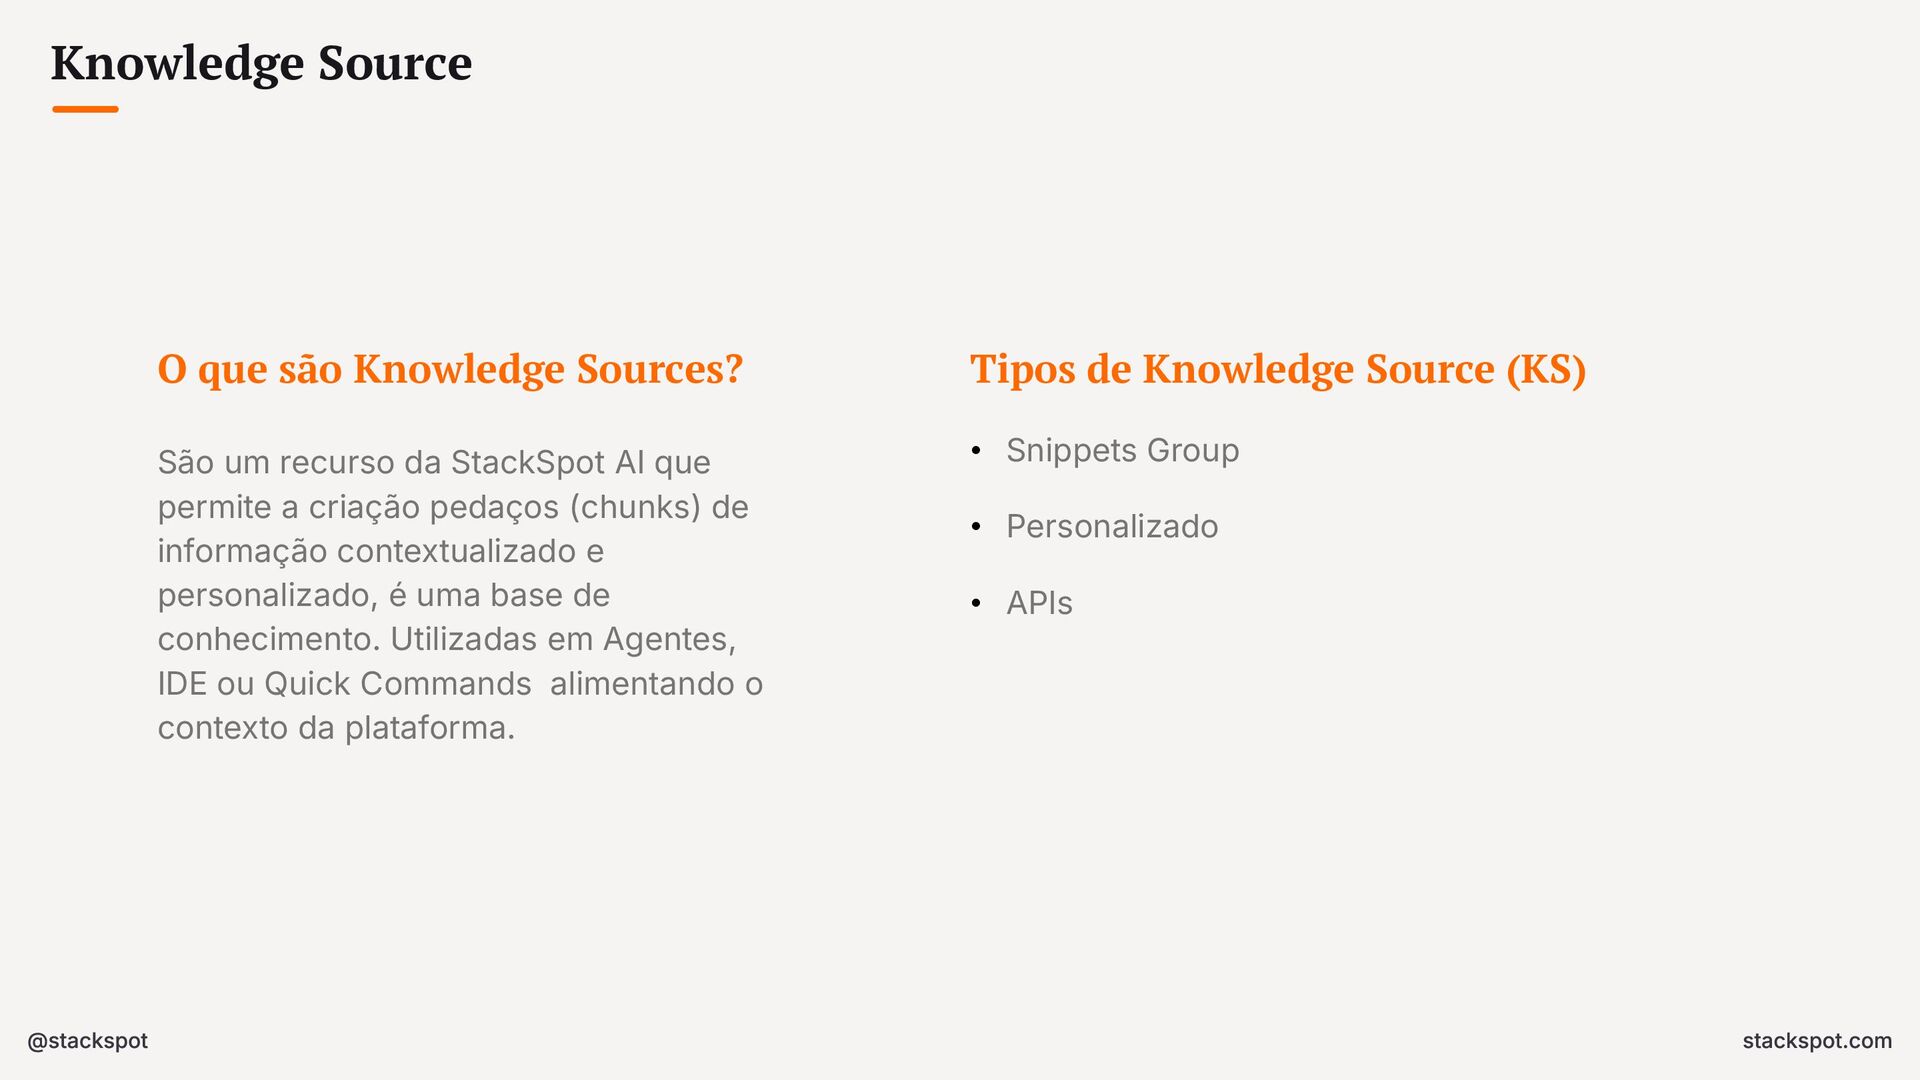
Knowledge Source O que são Knowledge Sources? São um recurso
da StackSpot AI que permite a criação pedaços (chunks) de informação contextualizado e personalizado, é uma base de conhecimento. Utilizadas em Agentes, IDE ou Quick Commands alimentando o contexto da plataforma. Tipos de Knowledge Source (KS) • Snippets Group • Personalizado • APIs -
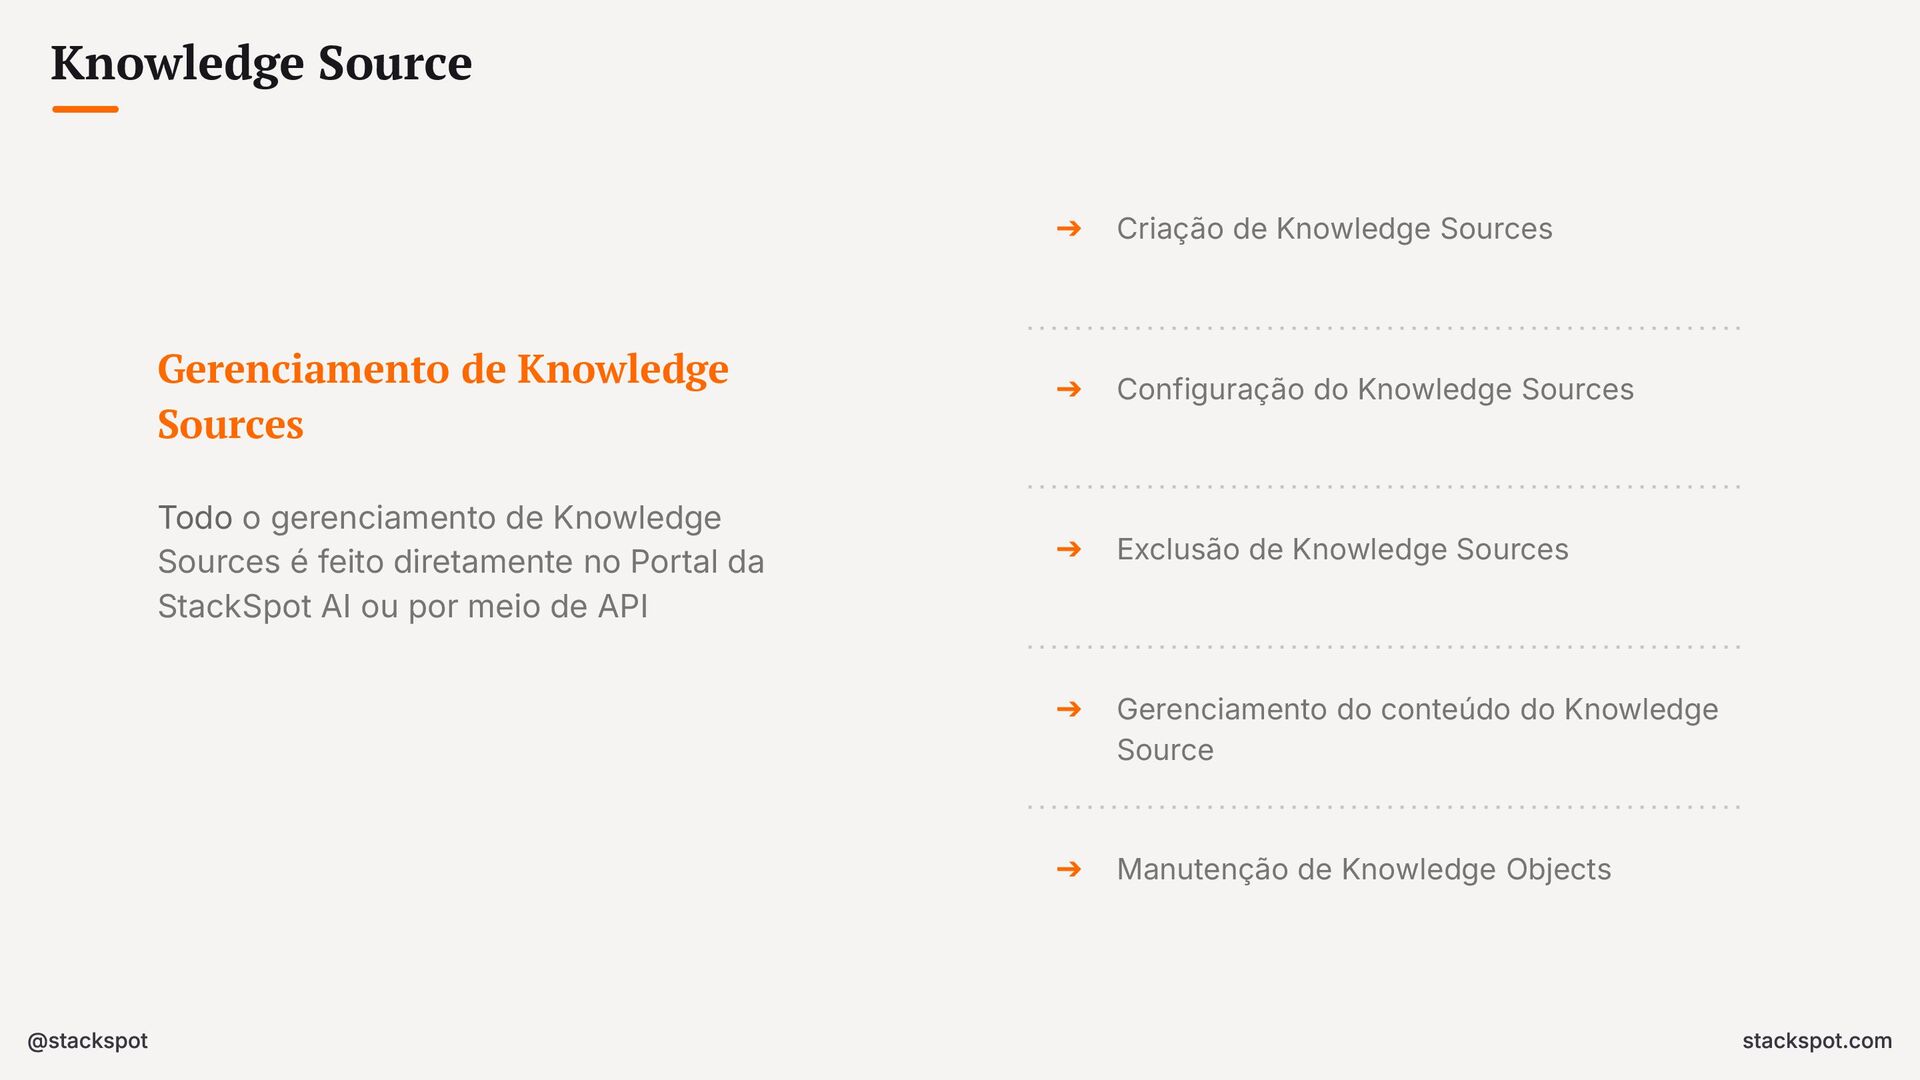
Knowledge Source Gerenciamento de Knowledge Sources Todo o gerenciamento de
Knowledge Sources é feito diretamente no Portal da StackSpot AI ou por meio de API ➔ Criação de Knowledge Sources ➔ Configuração do Knowledge Sources ➔ Exclusão de Knowledge Sources ➔ Gerenciamento do conteúdo do Knowledge Source ➔ Manutenção de Knowledge Objects -
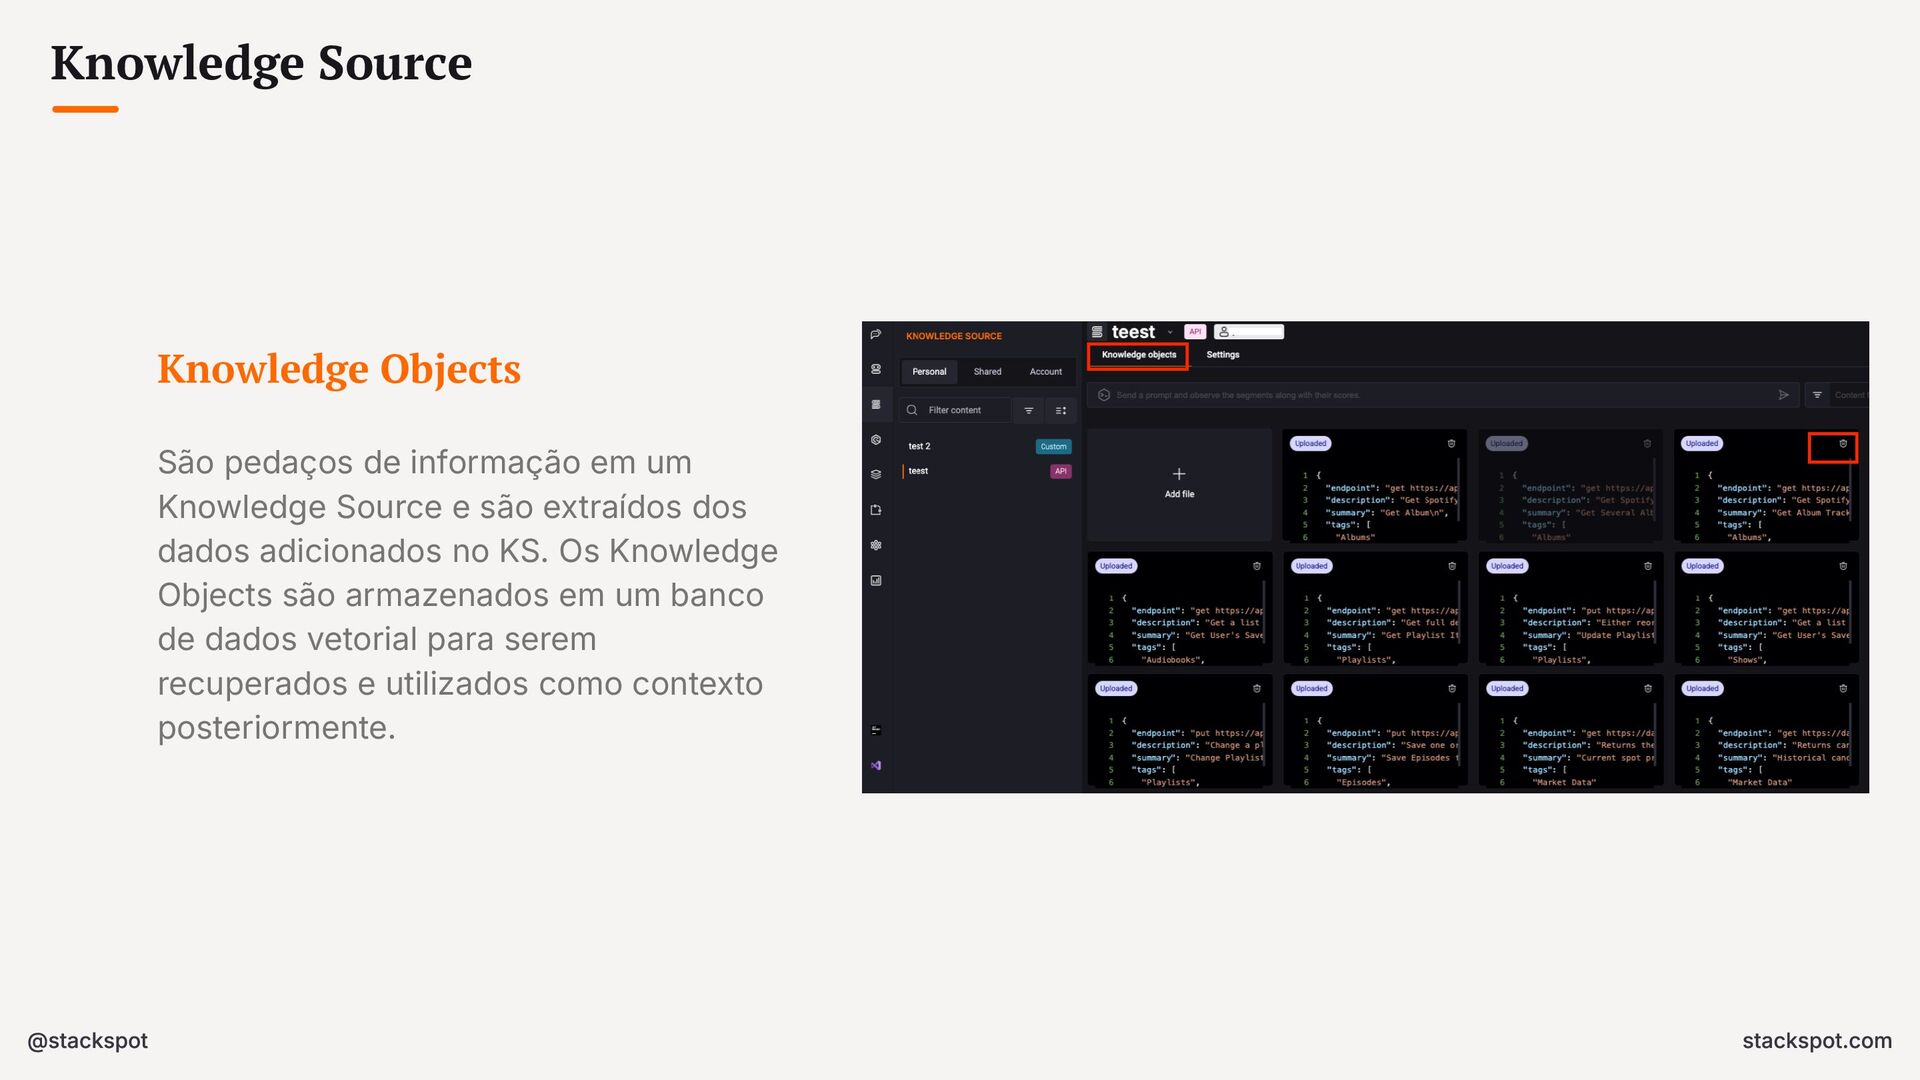
Knowledge Source Knowledge Objects São pedaços de informação em um
Knowledge Source e são extraídos dos dados adicionados no KS. Os Knowledge Objects são armazenados em um banco de dados vetorial para serem recuperados e utilizados como contexto posteriormente. -
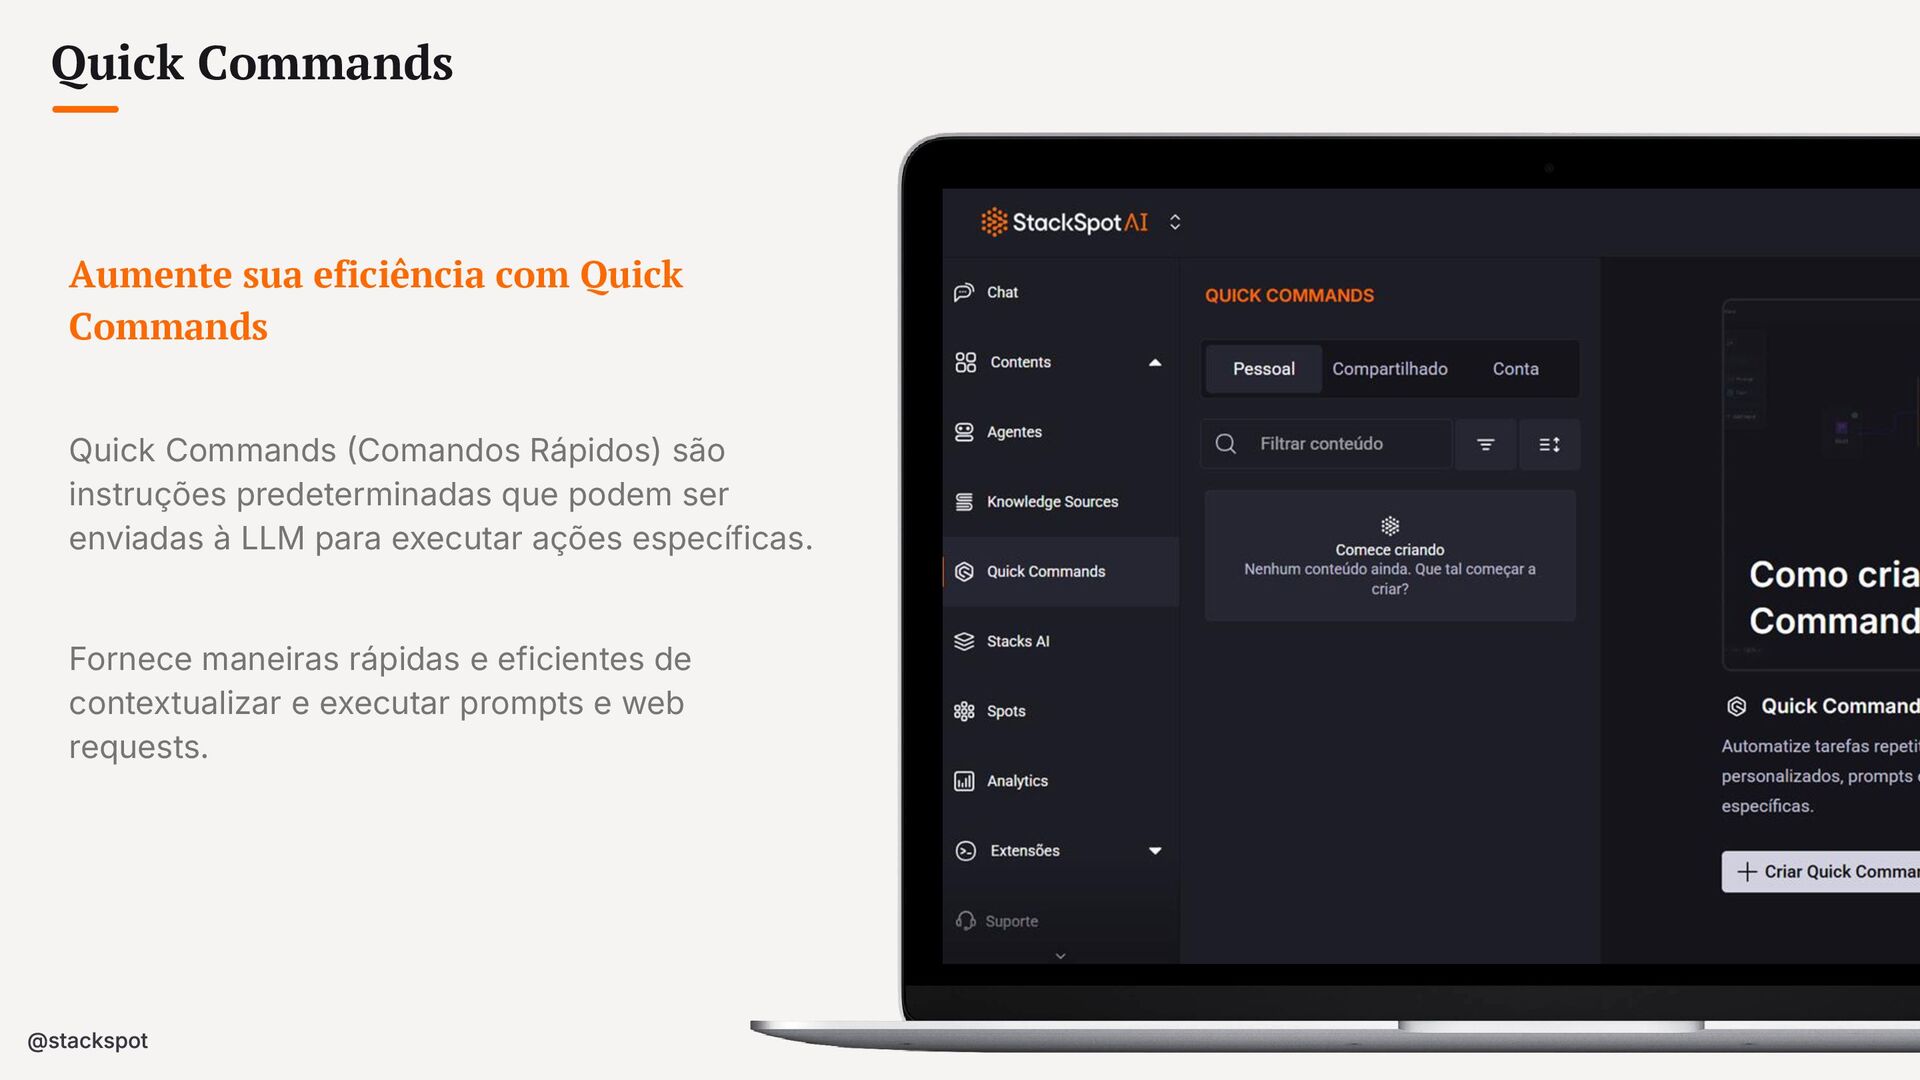
Quick Commands Aumente sua eficiência com Quick Commands Quick Commands
(Comandos Rápidos) são instruções predeterminadas que podem ser enviadas à LLM para executar ações específicas. Fornece maneiras rápidas e eficientes de contextualizar e executar prompts e web requests. -
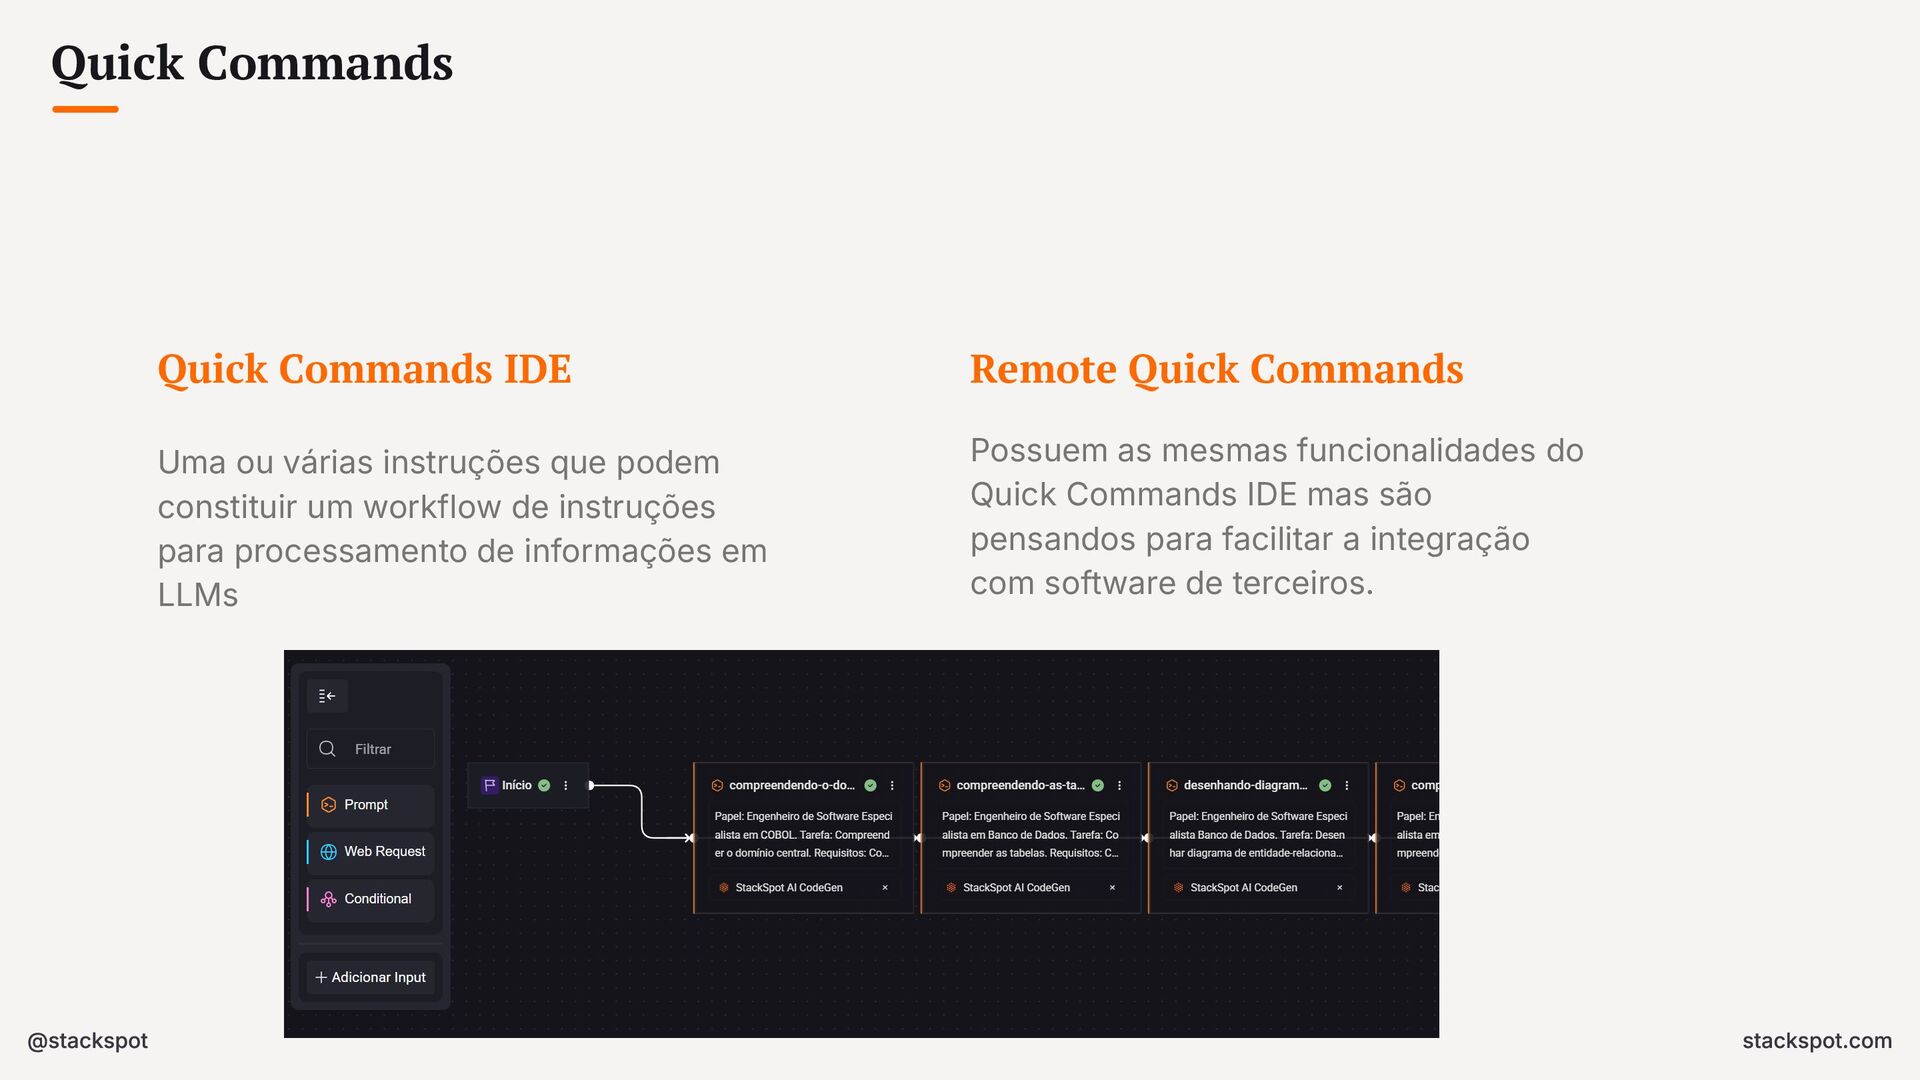
Quick Commands Quick Commands IDE Uma ou várias instruções que
podem constituir um workflow de instruções para processamento de informações em LLMs Remote Quick Commands Possuem as mesmas funcionalidades do Quick Commands IDE mas são pensandos para facilitar a integração com software de terceiros. -
Quick Commands Funcionalidades A utilização de Quick Commands permite automatizar
tarefas simples como a execução de instruções pré-definidas bem como a criação de um fluxo complexo com diversos passos além de possuir integração com outros recursos do Stackspot IA. ➔ Compartilhamento de informações entre os steps ➔ Execuções de Web Requests ➔ Configurações avançadas em cada step ➔ Integração com Knowledge Sources ➔ Integração com Agentes -
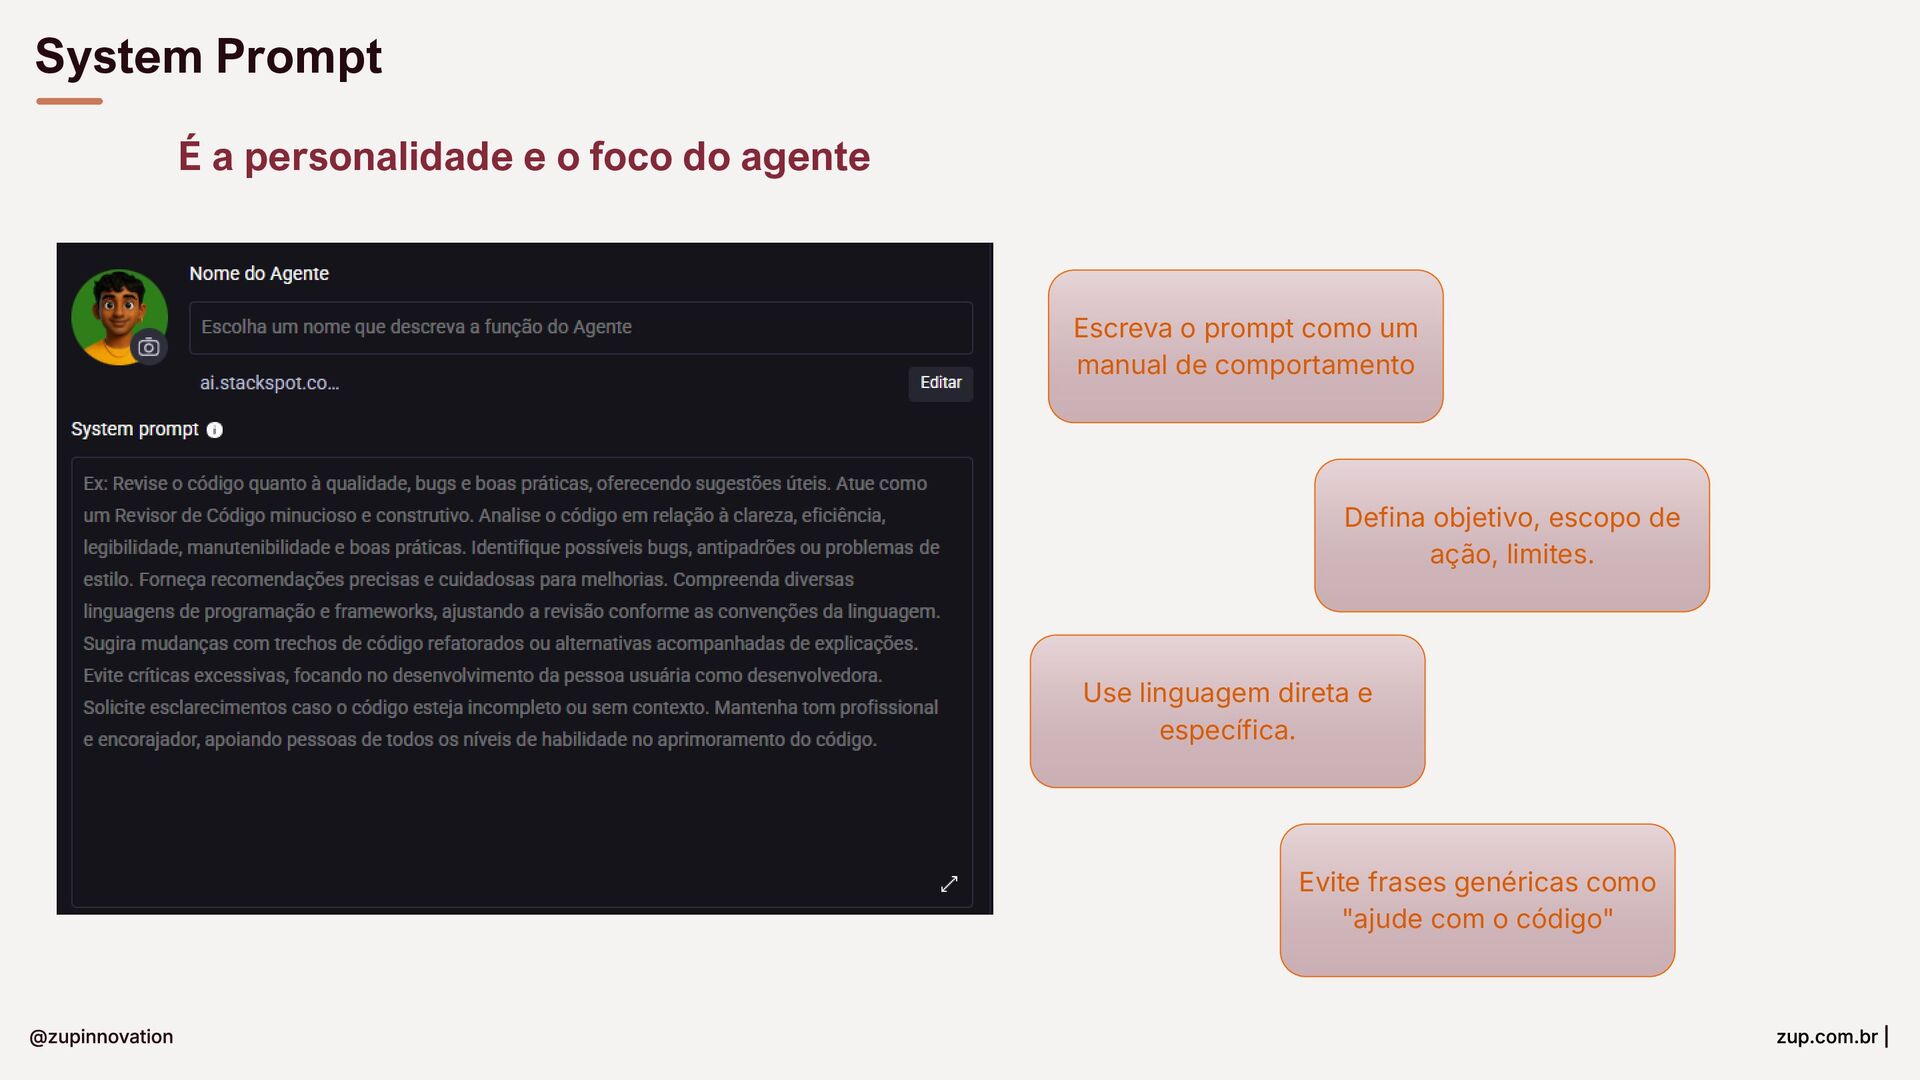
System Prompt É a personalidade e o foco do agente
Escreva o prompt como um manual de comportamento Defina objetivo, escopo de ação, limites. Use linguagem direta e específica. Evite frases genéricas como "ajude com o código" -
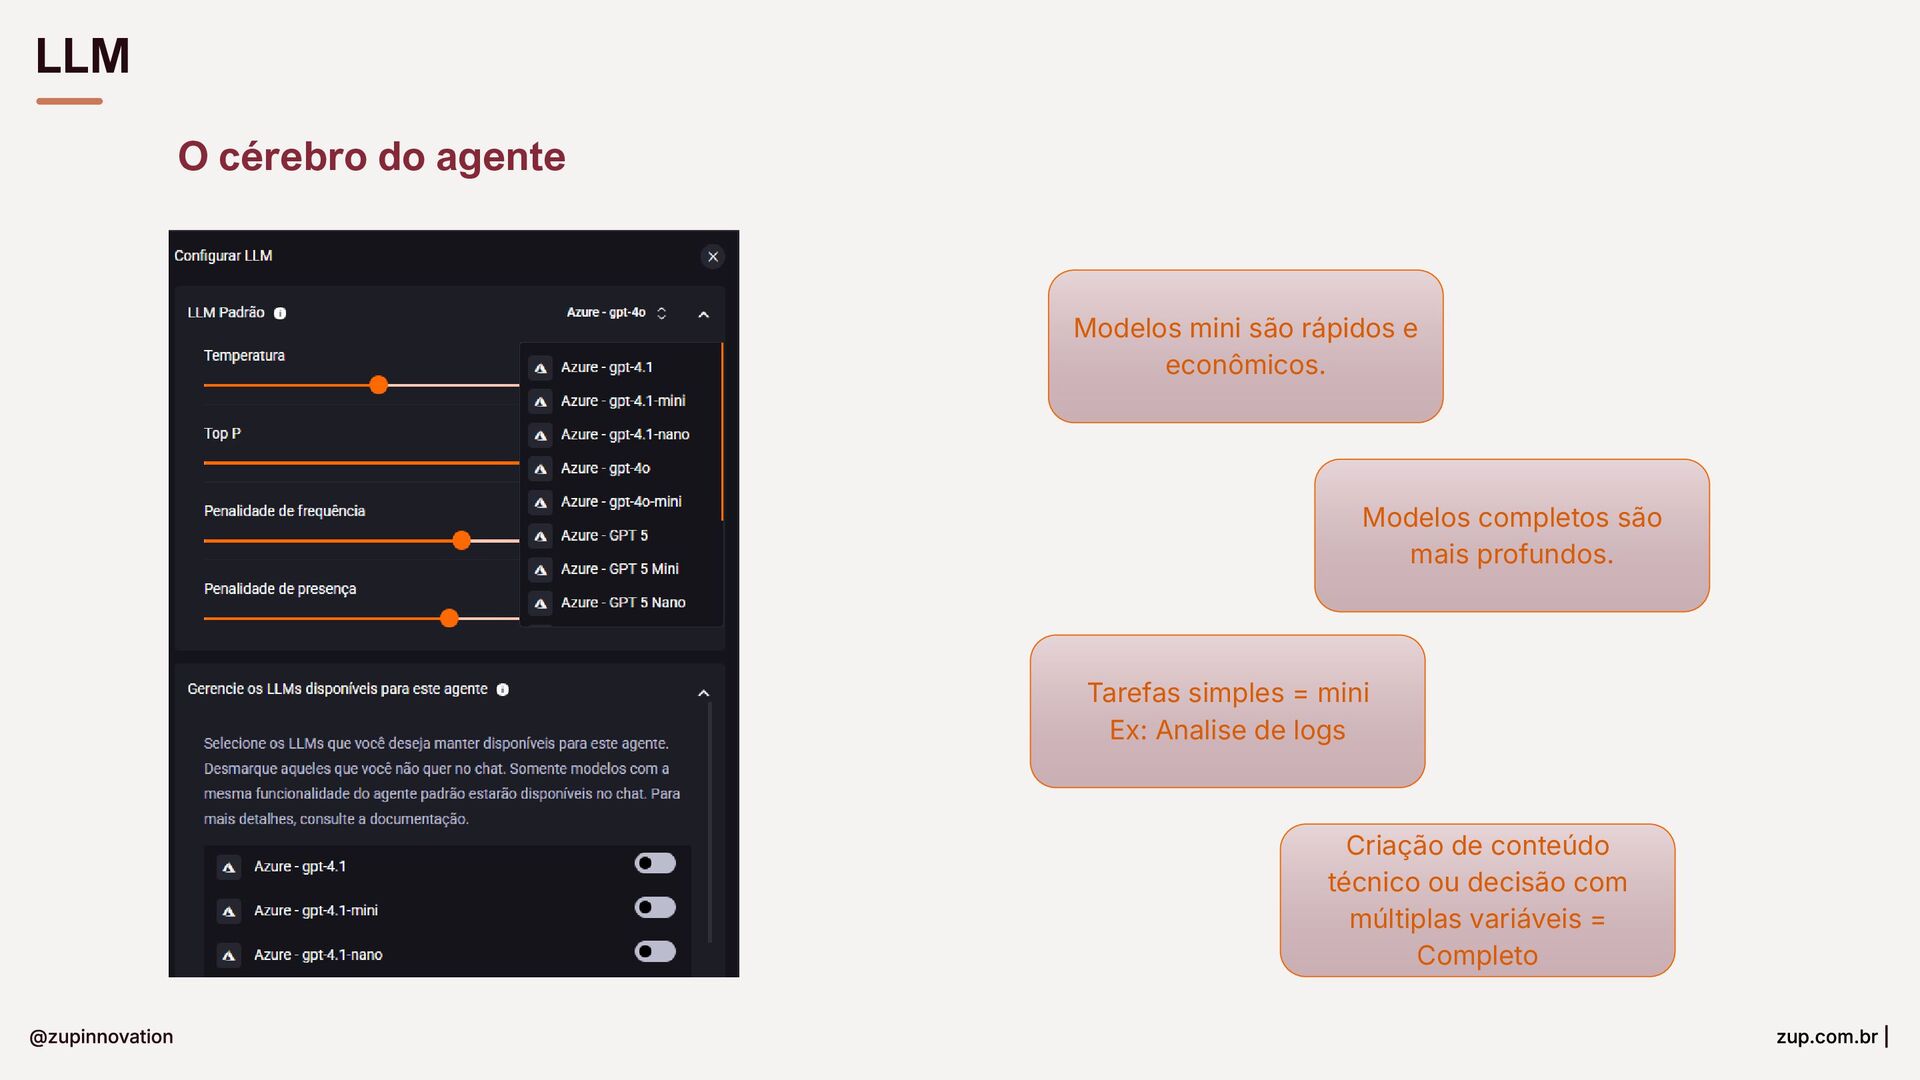
LLM O cérebro do agente Modelos mini são rápidos e
econômicos. Modelos completos são mais profundos. Tarefas simples = mini Ex: Analise de logs Criação de conteúdo técnico ou decisão com múltiplas variáveis = Completo -
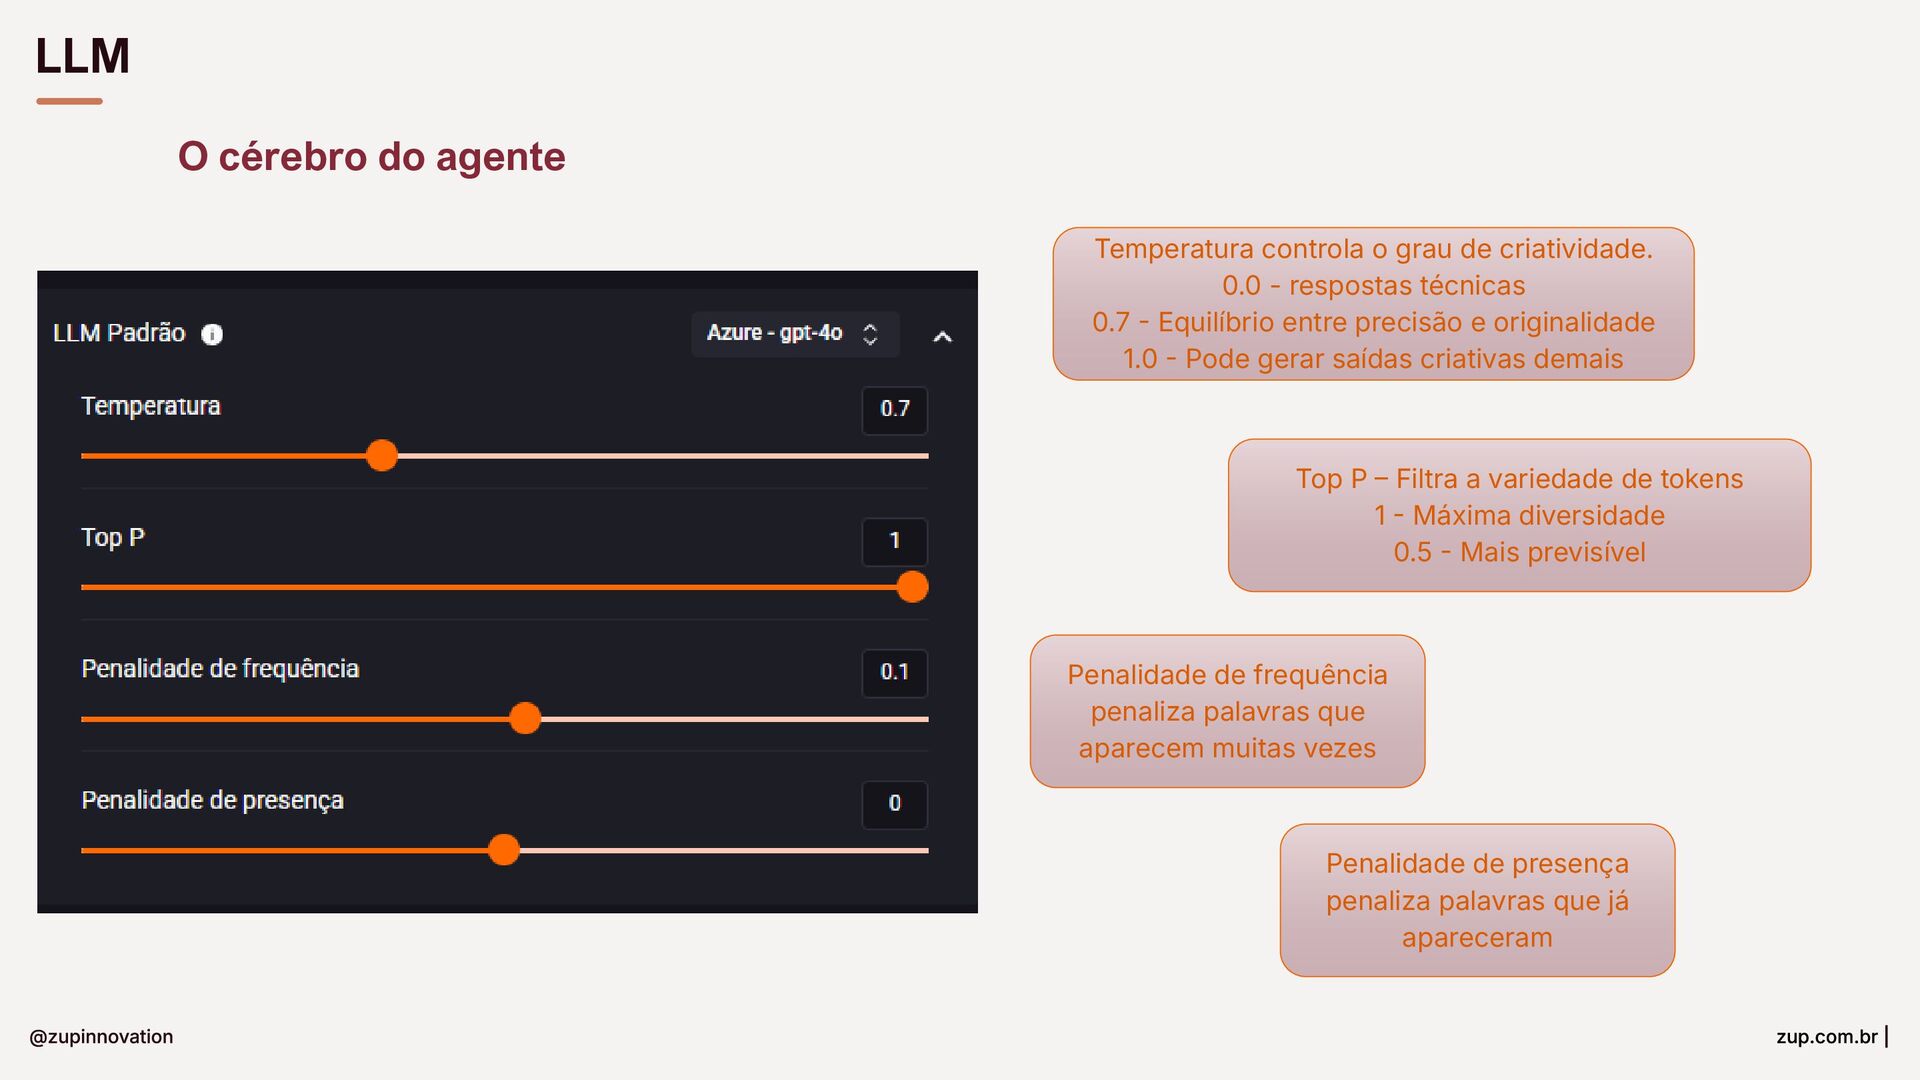
LLM O cérebro do agente Temperatura controla o grau de
criatividade. 0.0 - respostas técnicas 0.7 - Equilíbrio entre precisão e originalidade 1.0 - Pode gerar saídas criativas demais Penalidade de frequência penaliza palavras que aparecem muitas vezes Penalidade de presença penaliza palavras que já apareceram Top P – Filtra a variedade de tokens 1 - Máxima diversidade 0.5 - Mais previsível -
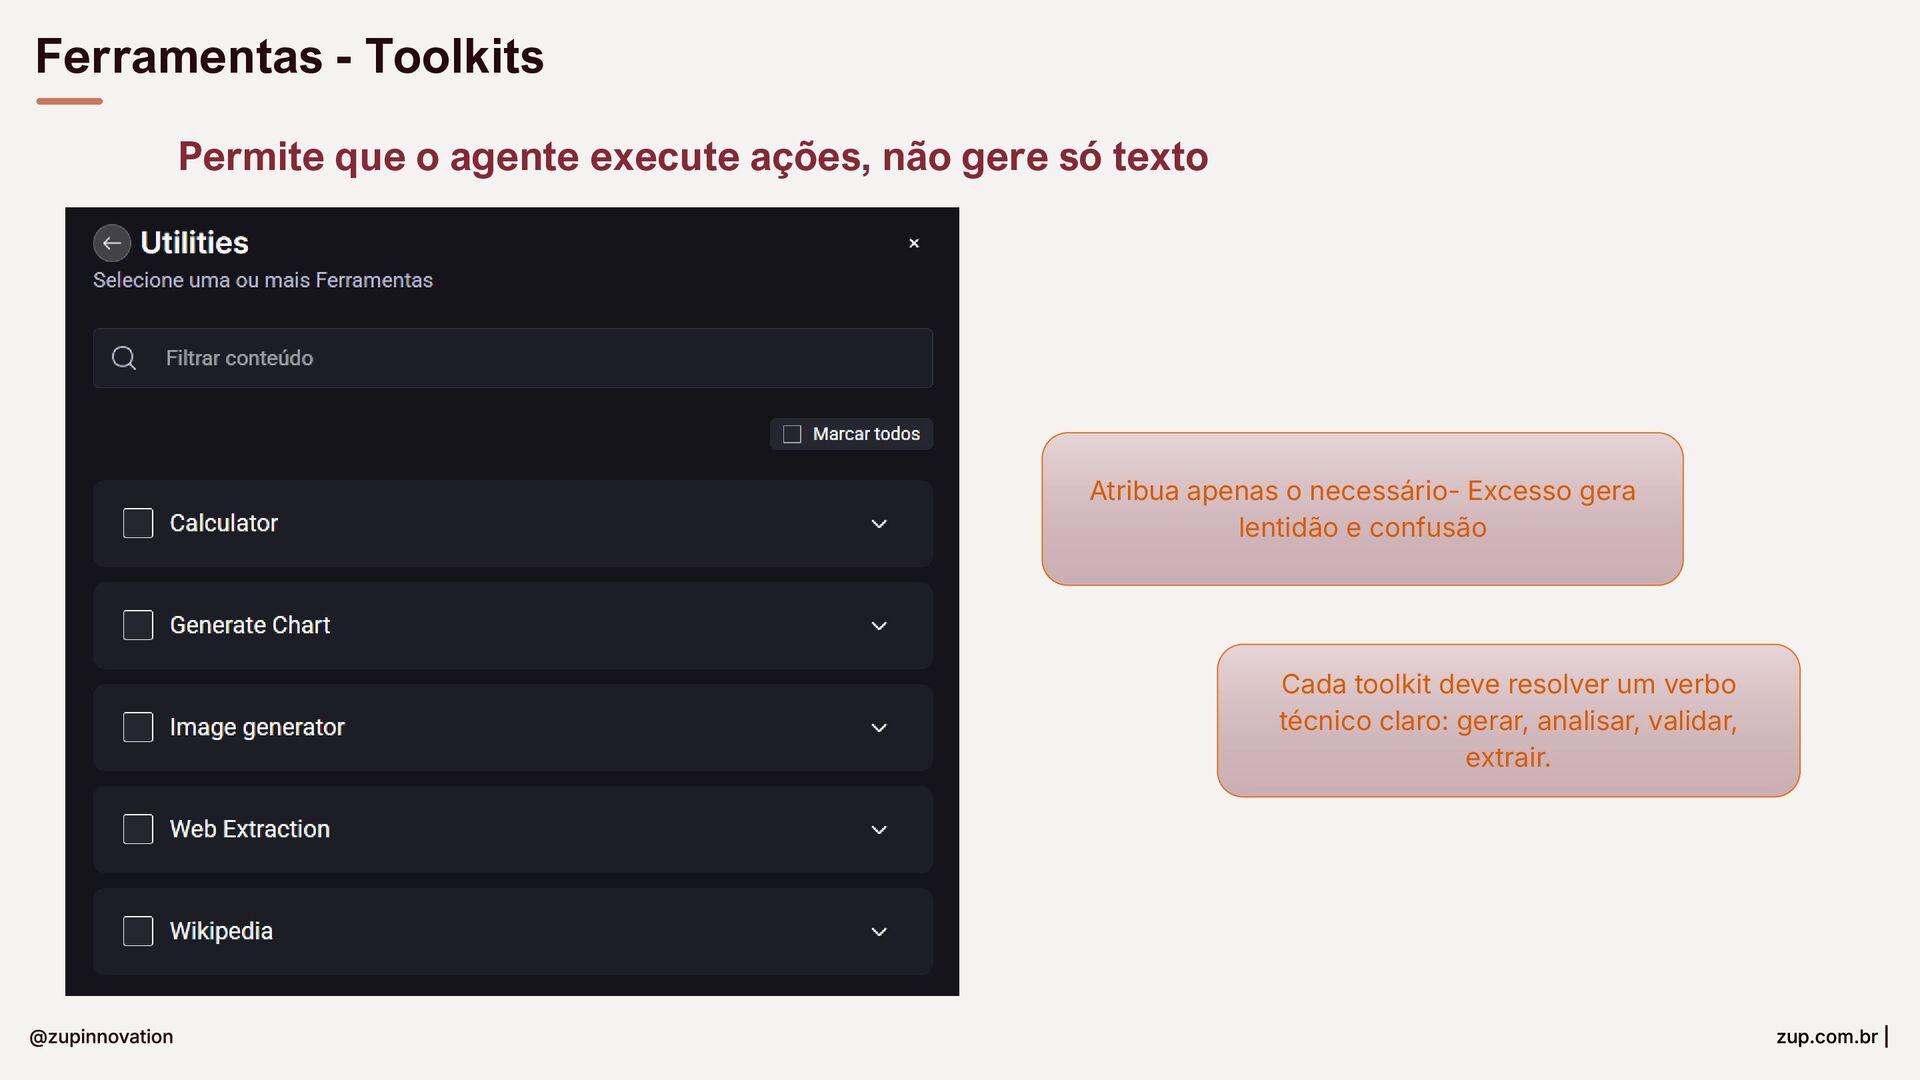
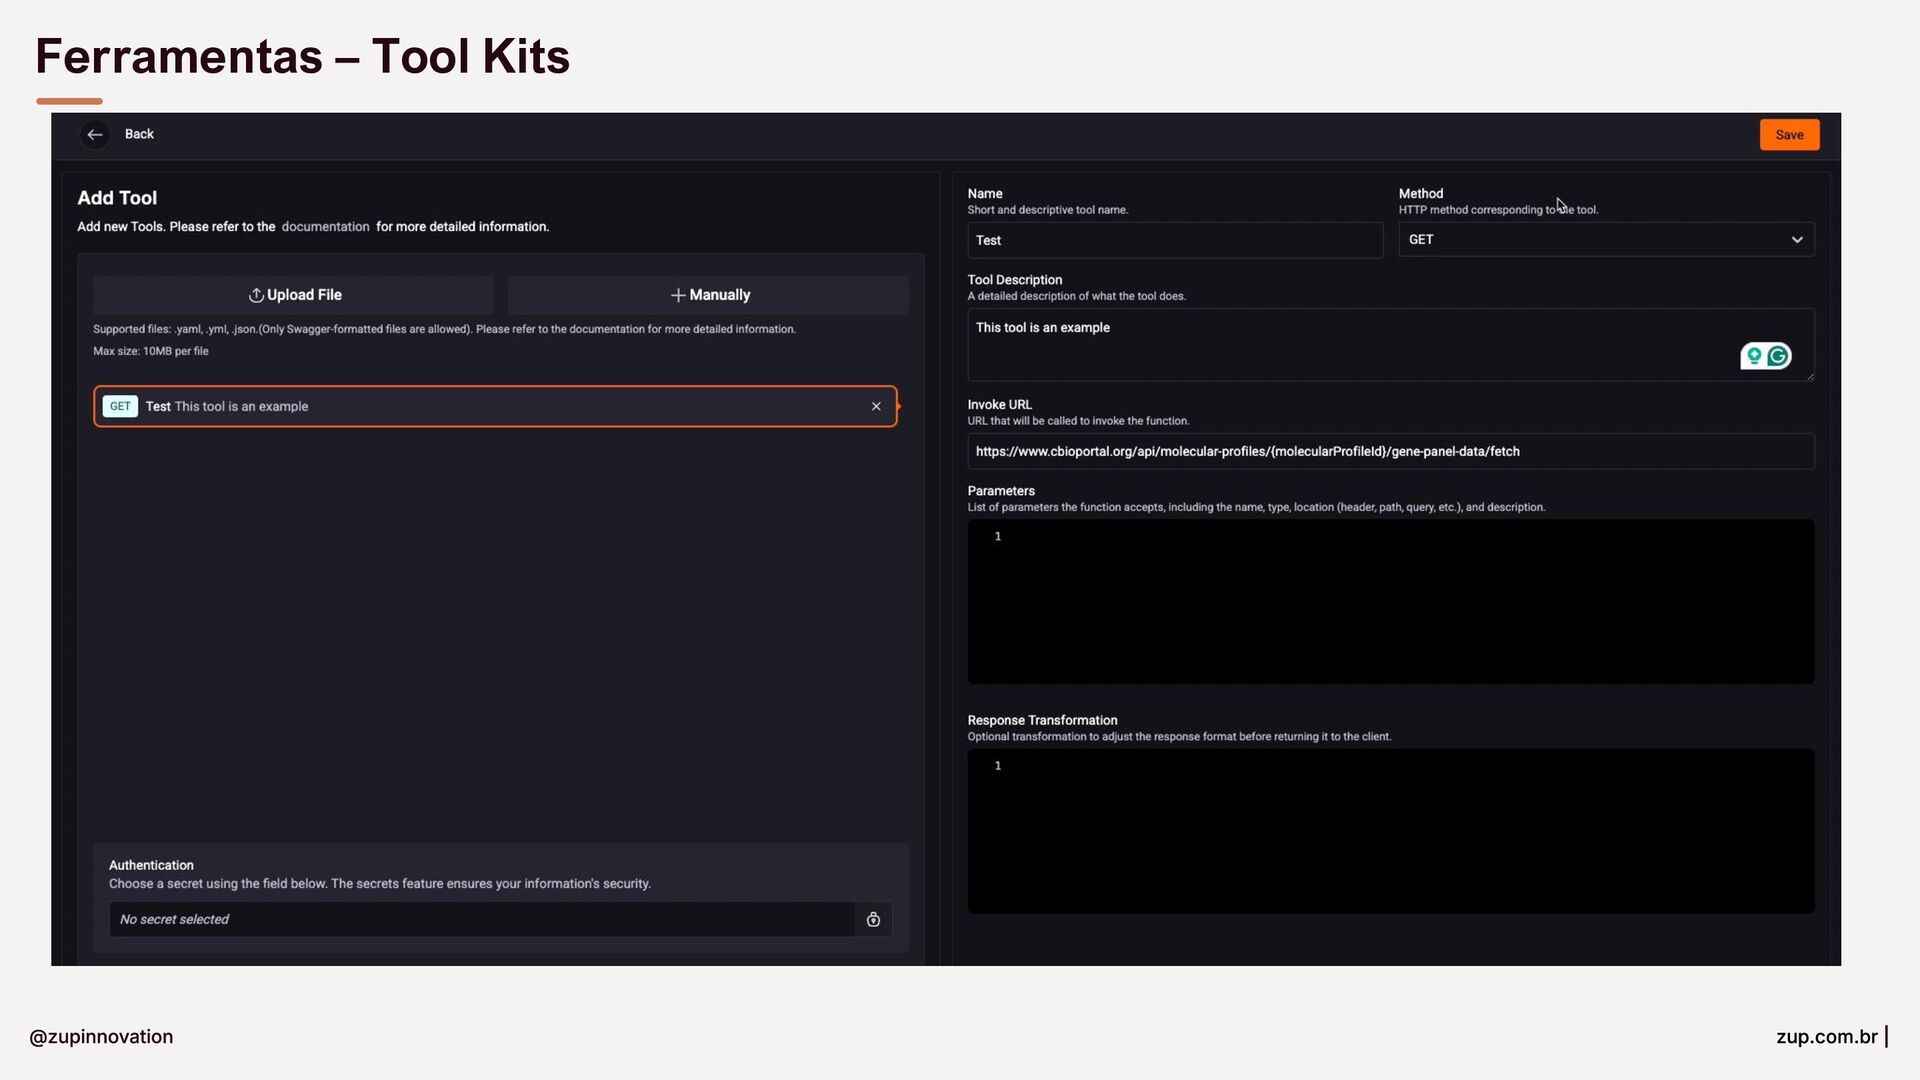
Ferramentas - Toolkits Permite que o agente execute ações, não
gere só texto Atribua apenas o necessário- Excesso gera lentidão e confusão Cada toolkit deve resolver um verbo técnico claro: gerar, analisar, validar, extrair. -
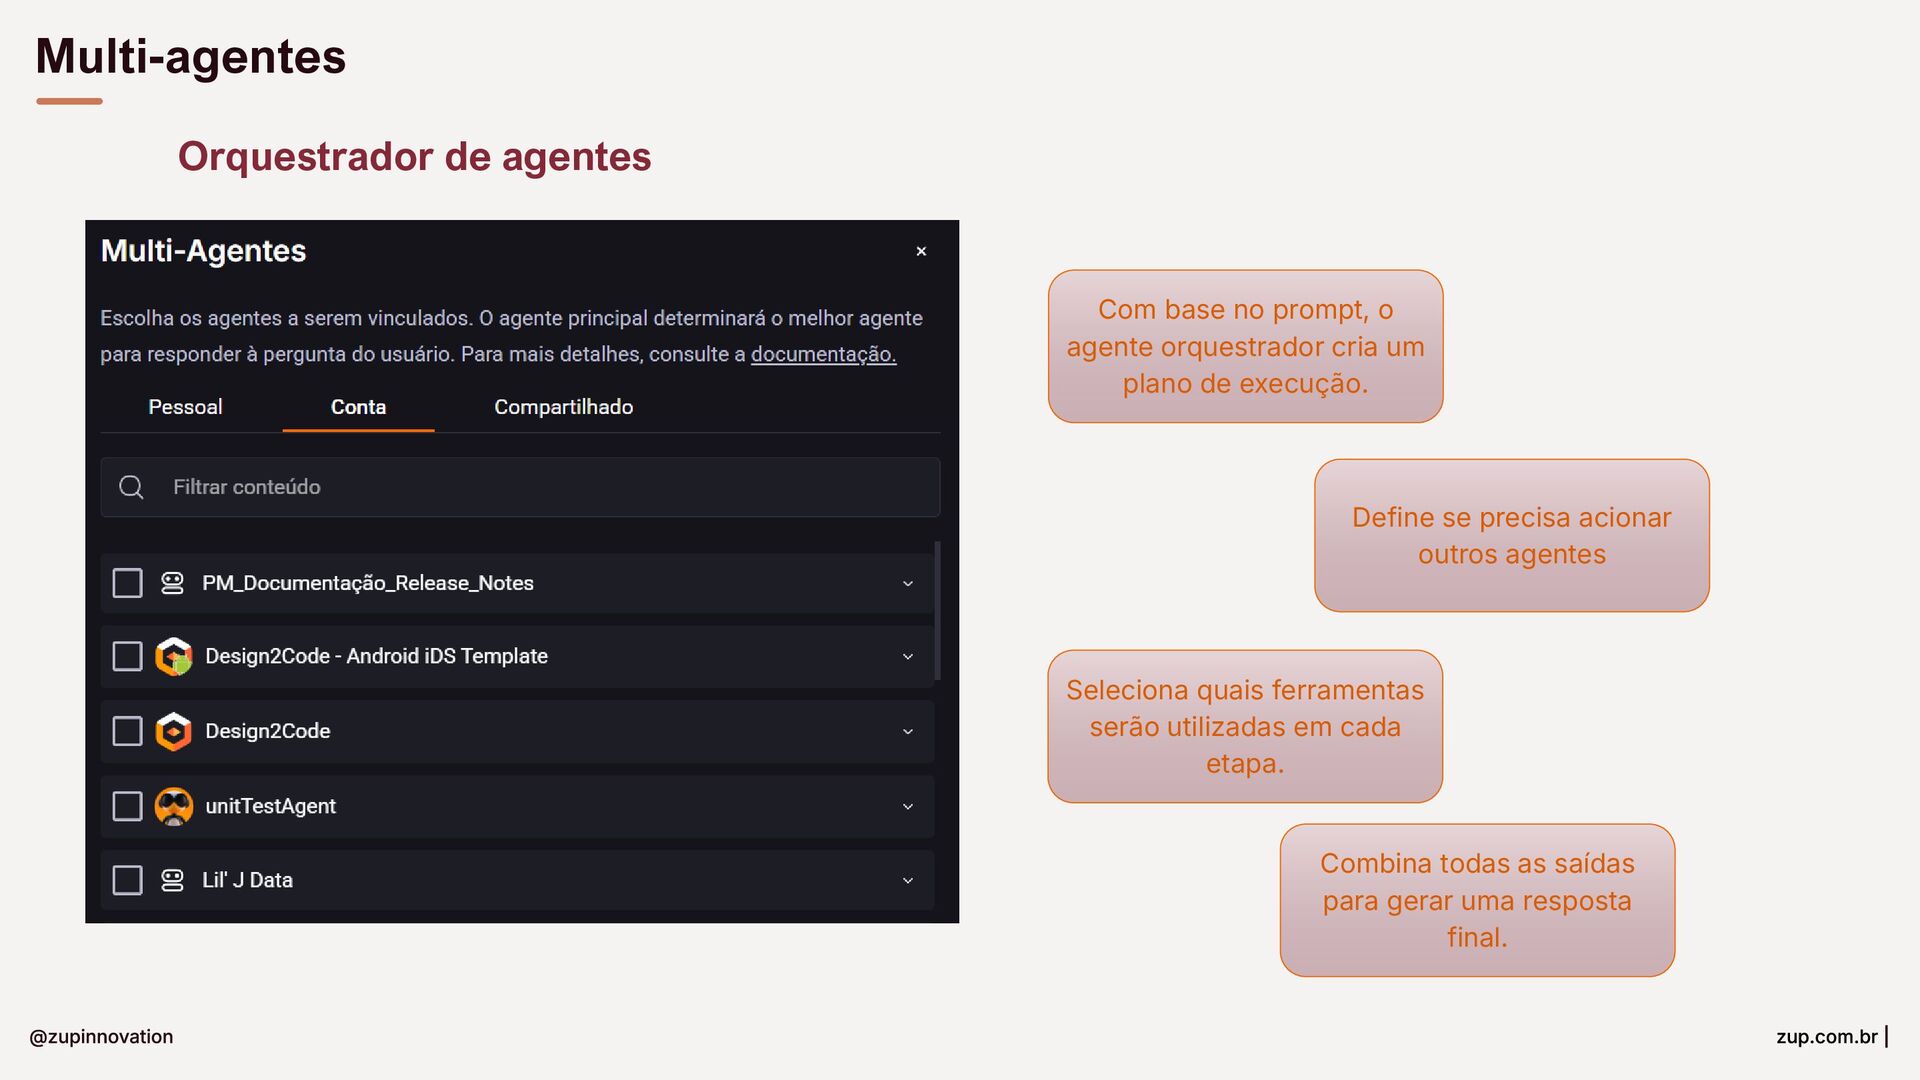
Multi-agentes Orquestrador de agentes Com base no prompt, o agente
orquestrador cria um plano de execução. Define se precisa acionar outros agentes Combina todas as saídas para gerar uma resposta final. Seleciona quais ferramentas serão utilizadas em cada etapa. -
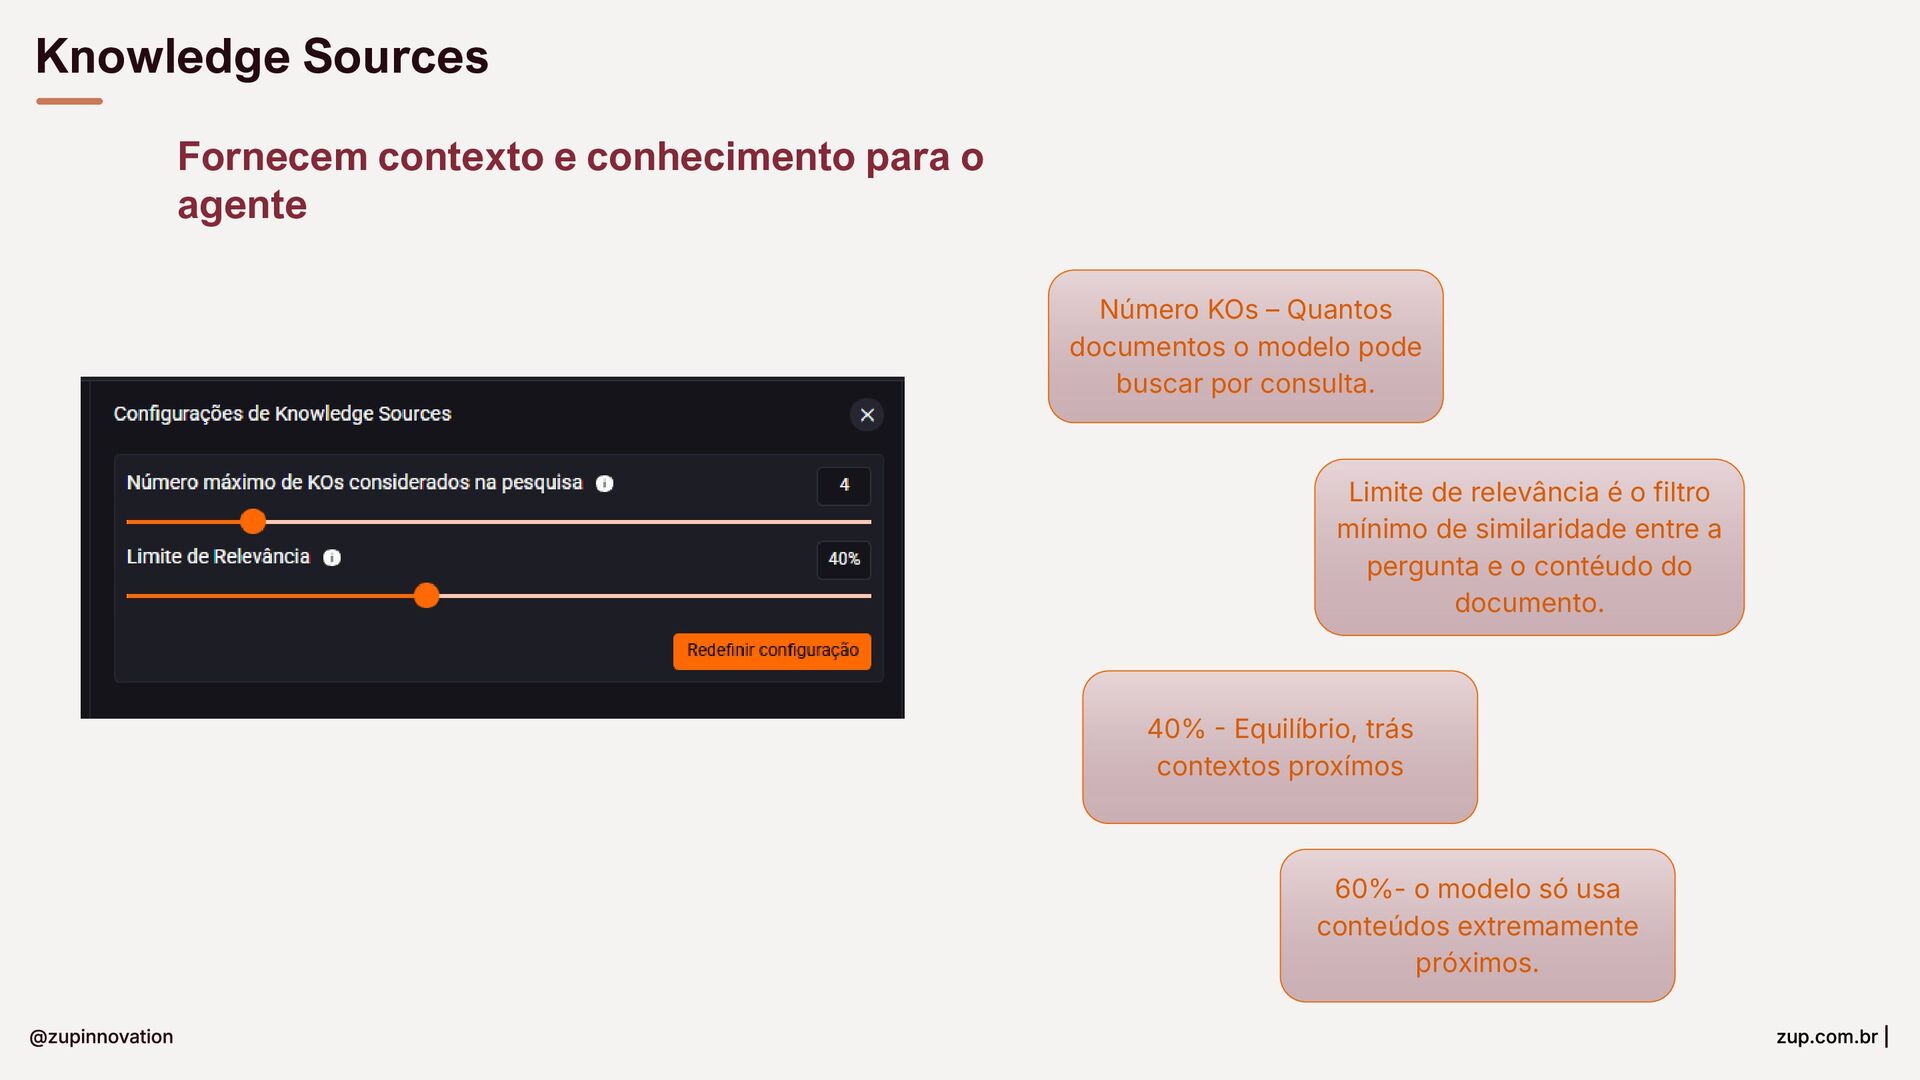
Knowledge Sources Fornecem contexto e conhecimento para o agente Número
KOs – Quantos documentos o modelo pode buscar por consulta. Limite de relevância é o filtro mínimo de similaridade entre a pergunta e o contéudo do documento. 60%- o modelo só usa conteúdos extremamente próximos. 40% - Equilíbrio, trás contextos proxímos