Share
Embed
NewSQL_ ストレージ分離と分散合意を用いたスケーラブルアーキテクチャ
2026/3/12『Database Engineering Meetup #9: NewSQL』
プリンシパル分散システムエンジニア 上田 義明(bootjp)
P41の動画リンク
https://docs.google.com/file/d/1Eu8rRDMxl3LQy6KM6MRuJrvhobe3AF9c/preview
P42の動画リンク
https://docs.google.com/file/d/1XbJWAKTabMQJqrPPWn6LNi1IYA6omfGh/preview
hacomono Inc. PRO
March 13, 2026
Transcript
53 slides
-
2 今日の発表の流れ • 本発表について/自己紹介 • 基盤技術①:コンピュートとストレージの分離 ◦ ストレージ分離のアーキテクチャの実例 ◦ ストレージ分離の背景
◦ 「The Log Is The Database」とログ適用型ストレージへの進化 • 基盤技術②:分散合意アルゴリズム (Raft) ◦ Raftの動作についてざっくり理解する ◦ スケールの壁を越える工夫:「Multi-Raft」 ◦ レイテンシを削る工夫:「Leader Lease」と「HLC」 • NewSQLの運用上の「落とし穴」を知る -
3 対象 • 分散システムやNewSQLの内部アーキテクチャ、運用に関心のある人 この発表が終わったときに目指す状態 • なぜコンピュート・ストレージを分離しているのか、その背景を知る • NewSQLが使っているRaftについてざっくり仕組みを理解する ◦
Raftがなぜ必要なのか/Raftはなにをしてくれるのか ◦ Raftは何が得意で、何が苦手なのかを整理する • NewSQLが行っている最適化について知る • NewSQLの運用上の「落とし穴」を知る 本発表について -
4 SNS: @bootjp Yoshiaki UEDA 自己紹介 経歴(前略) ◦ 2018年~2021年: Supership株式会社
スマホ向け大量配信システムの開発/運用 検索・検索連動広告 開発/運用 ◦ 2021年~2023年: 株式会社プレイド 大量配信システムのリプレース 分散システムの相談窓口 ◦ 2023年~2024年: btj.systems合同会社 Raftを用いた分散ストレージの研究/開発 ◦ 2024年~現在: 株式会社hacomono プリンシパルエンジニア(分散システム) 基盤本部にて社内共通基盤を設計/開発 株式会社hacomno プリンシパルエンジニア (分散システム) -
5 @bootjp Yoshiaki UEDA 自己紹介 経歴(前略) ◦ 2018年~2021年: Supership株式会社 スマホ向け大量配信システムの開発/運用
検索・検索連動広告 開発/運用 ◦ 2021年~2023年: 株式会社プレイド 大量配信システムのリプレース 分散システムの相談窓口 ◦ 2023年~2024年: btj.systems合同会社 Raftを用いた分散ストレージの研究/開発 ◦ 2024年~現在: 株式会社hacomono プリンシパルエンジニア(分散システム) 基盤本部にて社内共通基盤を設計/開発 株式会社hacomno プリンシパルエンジニア (分散システム) -
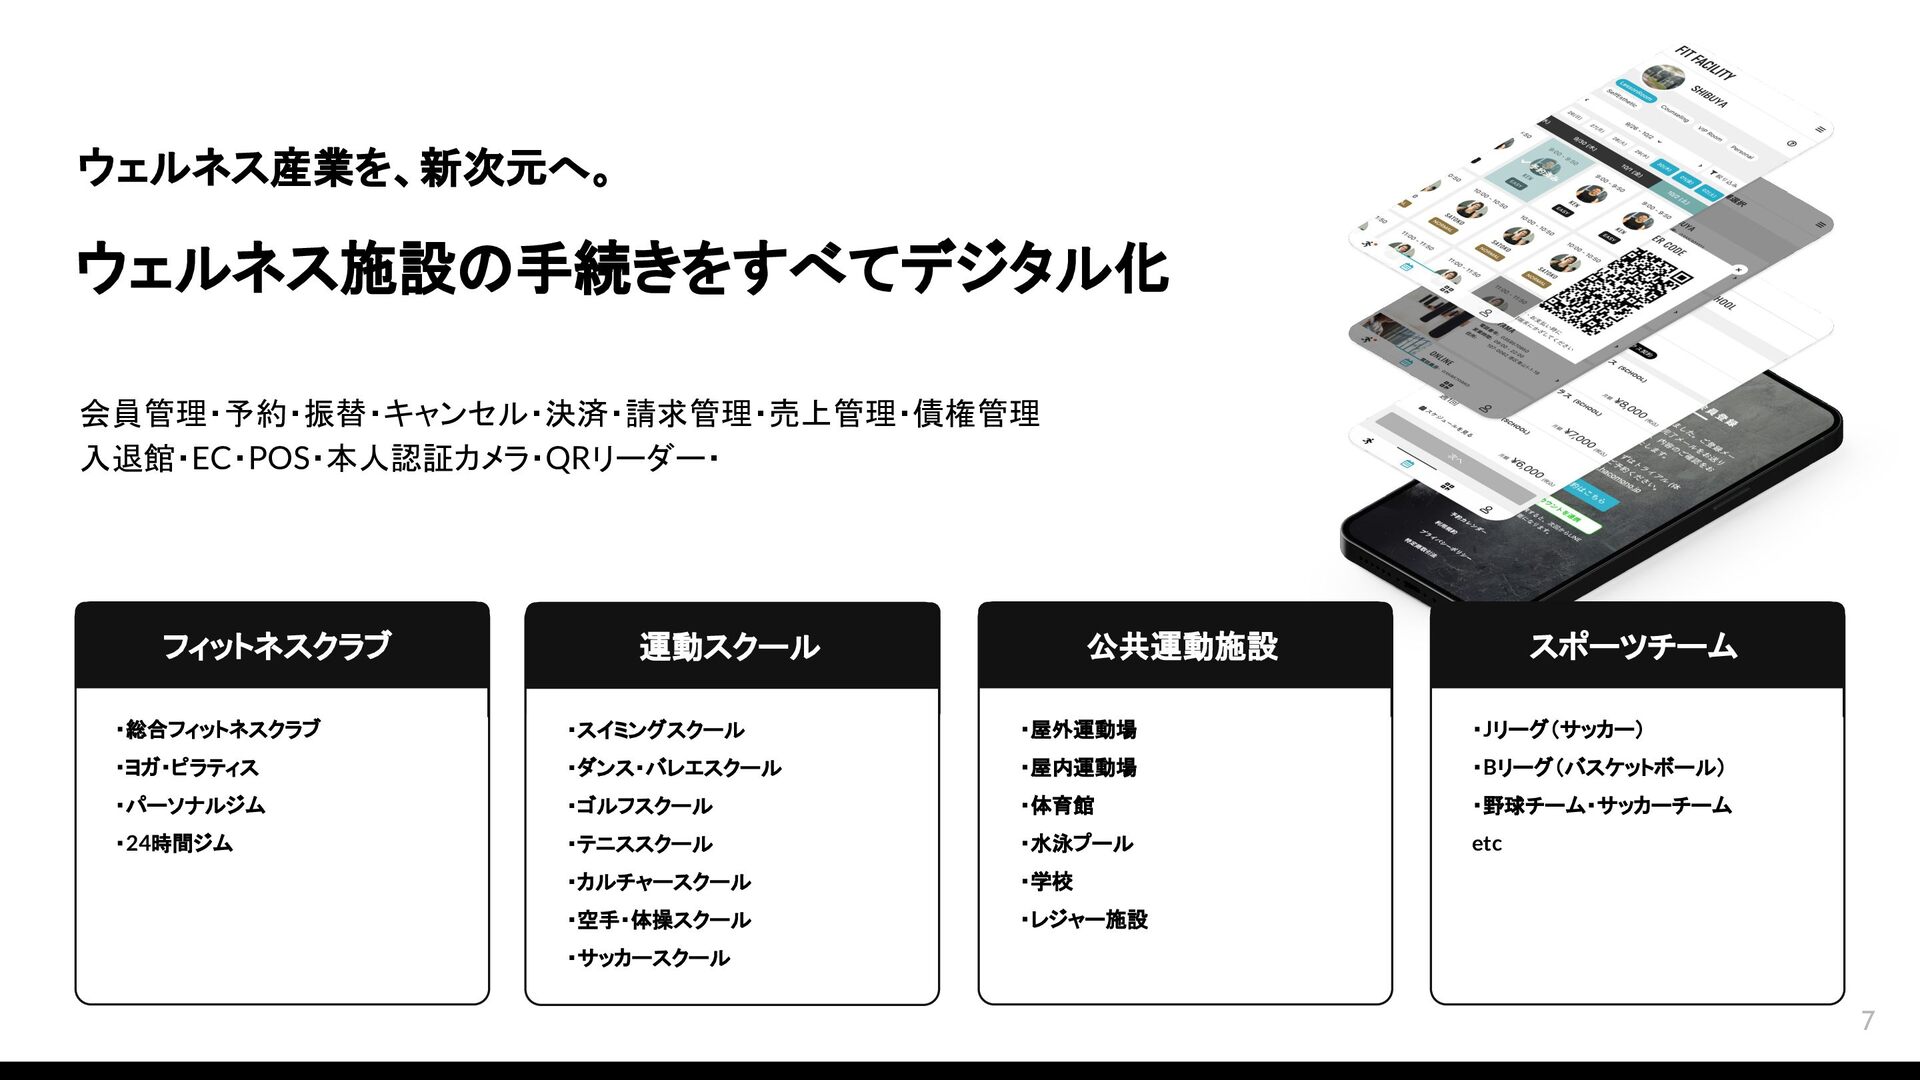
7 会員管理・予約・振替・キャンセル・決済・請求管理・売上管理・債権管理 入退館・EC・POS・本人認証カメラ・QRリーダー・ ・総合フィットネスクラブ ・ヨガ・ピラティス ・パーソナルジム ・24時間ジム フィットネスクラブ ・屋外運動場 ・屋内運動場
・体育館 ・水泳プール ・学校 ・レジャー施設 公共運動施設 ・Jリーグ(サッカー) ・Bリーグ(バスケットボール) ・野球チーム・サッカーチーム etc スポーツチーム ・スイミングスクール ・ダンス・バレエスクール ・ゴルフスクール ・テニススクール ・カルチャースクール ・空手・体操スクール ・サッカースクール 運動スクール ウェルネス施設の手続きをすべてデジタル化 ウェルネス産業を、新次元へ。 -
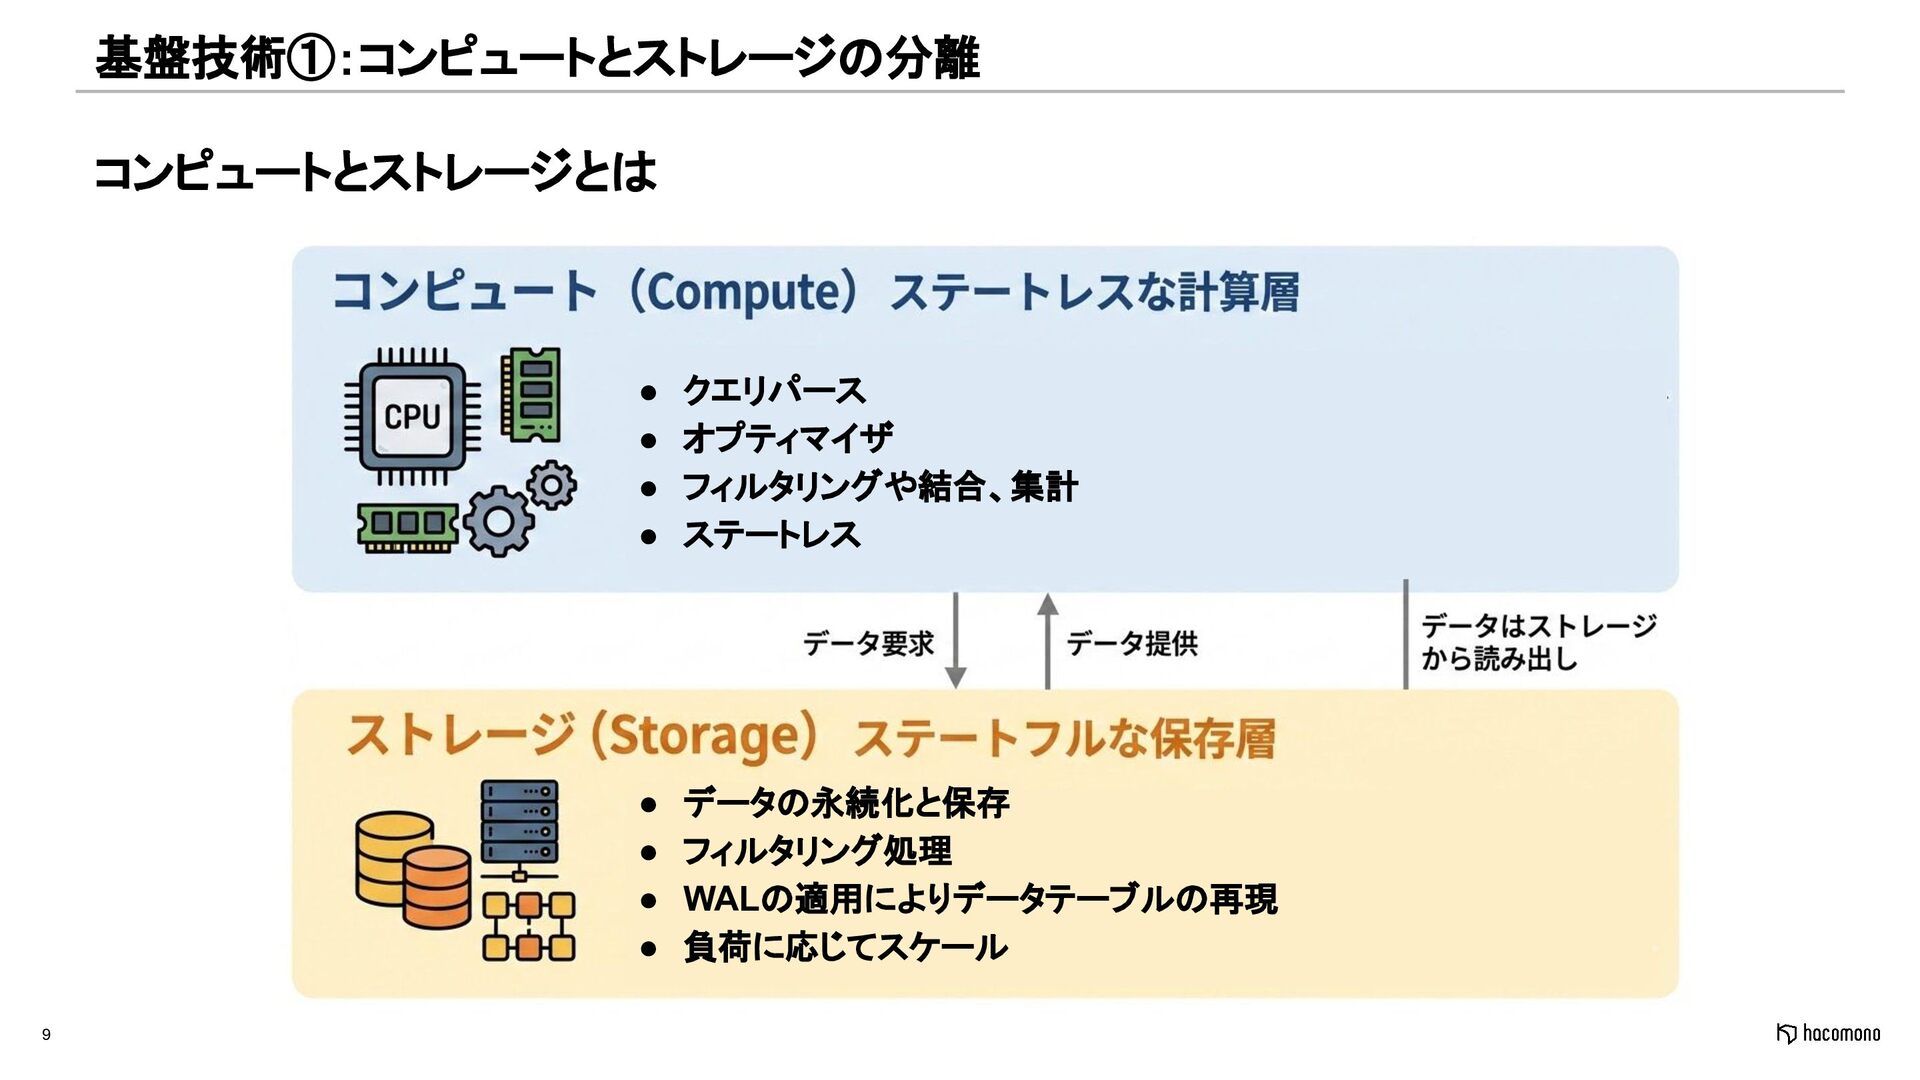
9 コンピュートとストレージとは 基盤技術①:コンピュートとストレージの分離 • クエリパース • オプティマイザ • フィルタリングや結合、集計 •
ステートレス • データの永続化と保存 • フィルタリング処理 • WALの適用によりデータテーブルの再現 • 負荷に応じてスケール -
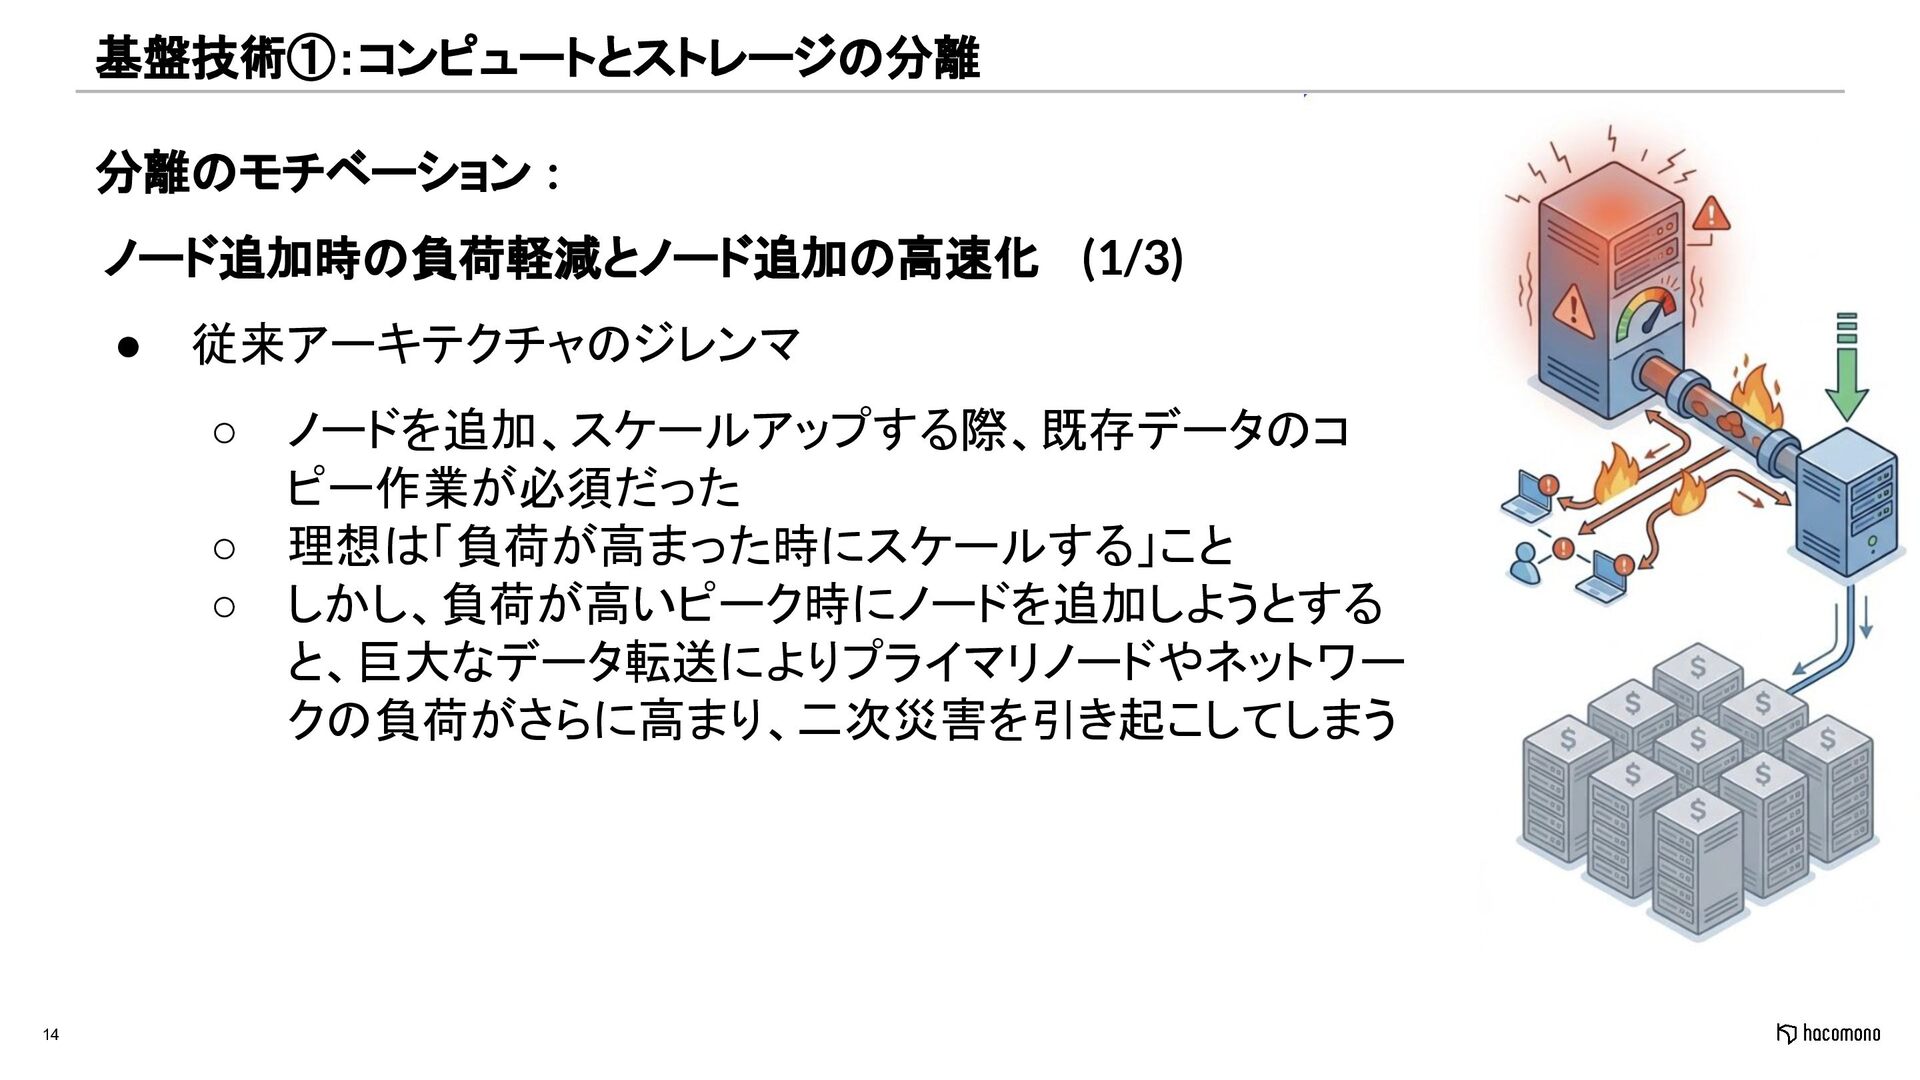
14 分離のモチベーション : ノード追加時の負荷軽減とノード追加の高速化 (1/3) • 従来アーキテクチャのジレンマ ◦ ノードを追加、スケールアップする際、既存データのコ ピー作業が必須だった
◦ 理想は「負荷が高まった時にスケールする」こと ◦ しかし、負荷が高いピーク時にノードを追加しようとする と、巨大なデータ転送によりプライマリノードやネットワー クの負荷がさらに高まり、二次災害を引き起こしてしまう 基盤技術①:コンピュートとストレージの分離 -
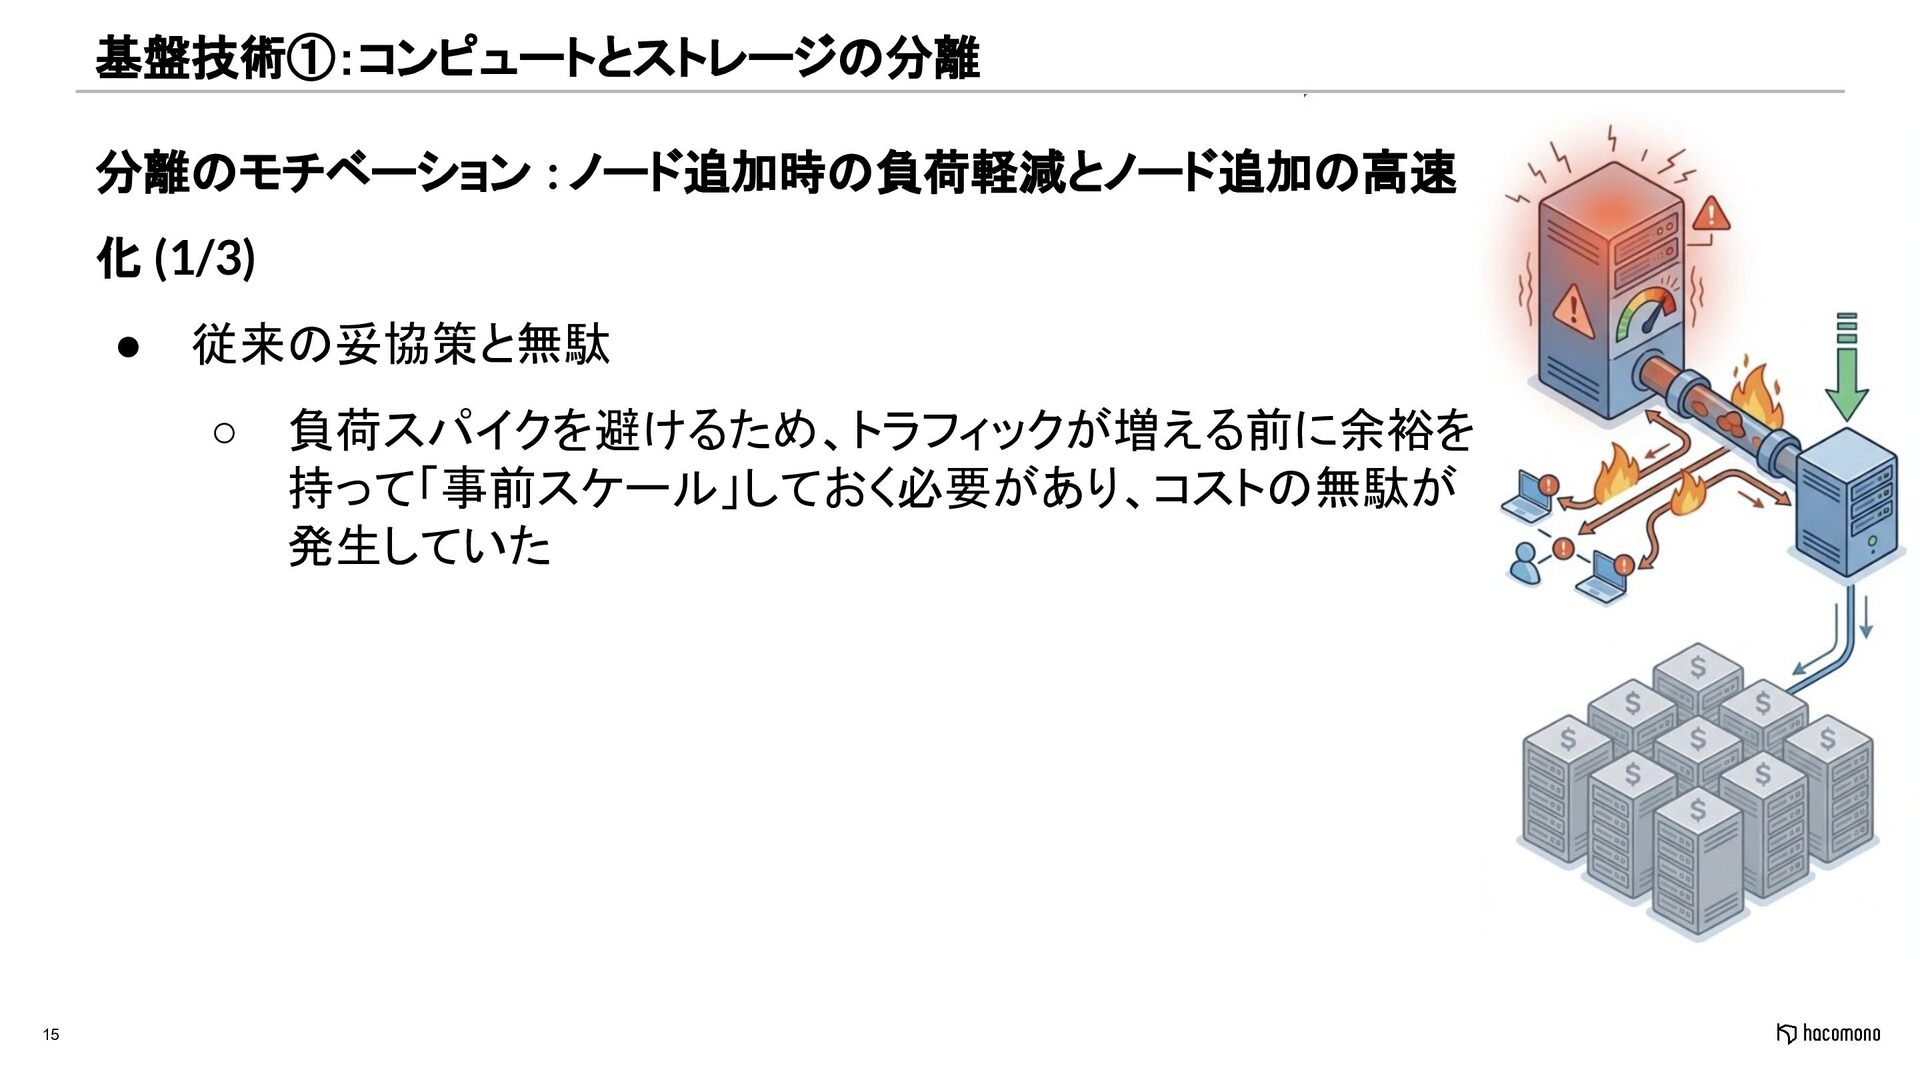
15 分離のモチベーション : ノード追加時の負荷軽減とノード追加の高速 化 (1/3) • 従来の妥協策と無駄 ◦ 負荷スパイクを避けるため、トラフィックが増える前に余裕を
持って「事前スケール」しておく必要があり、コストの無駄が 発生していた 基盤技術①:コンピュートとストレージの分離 -
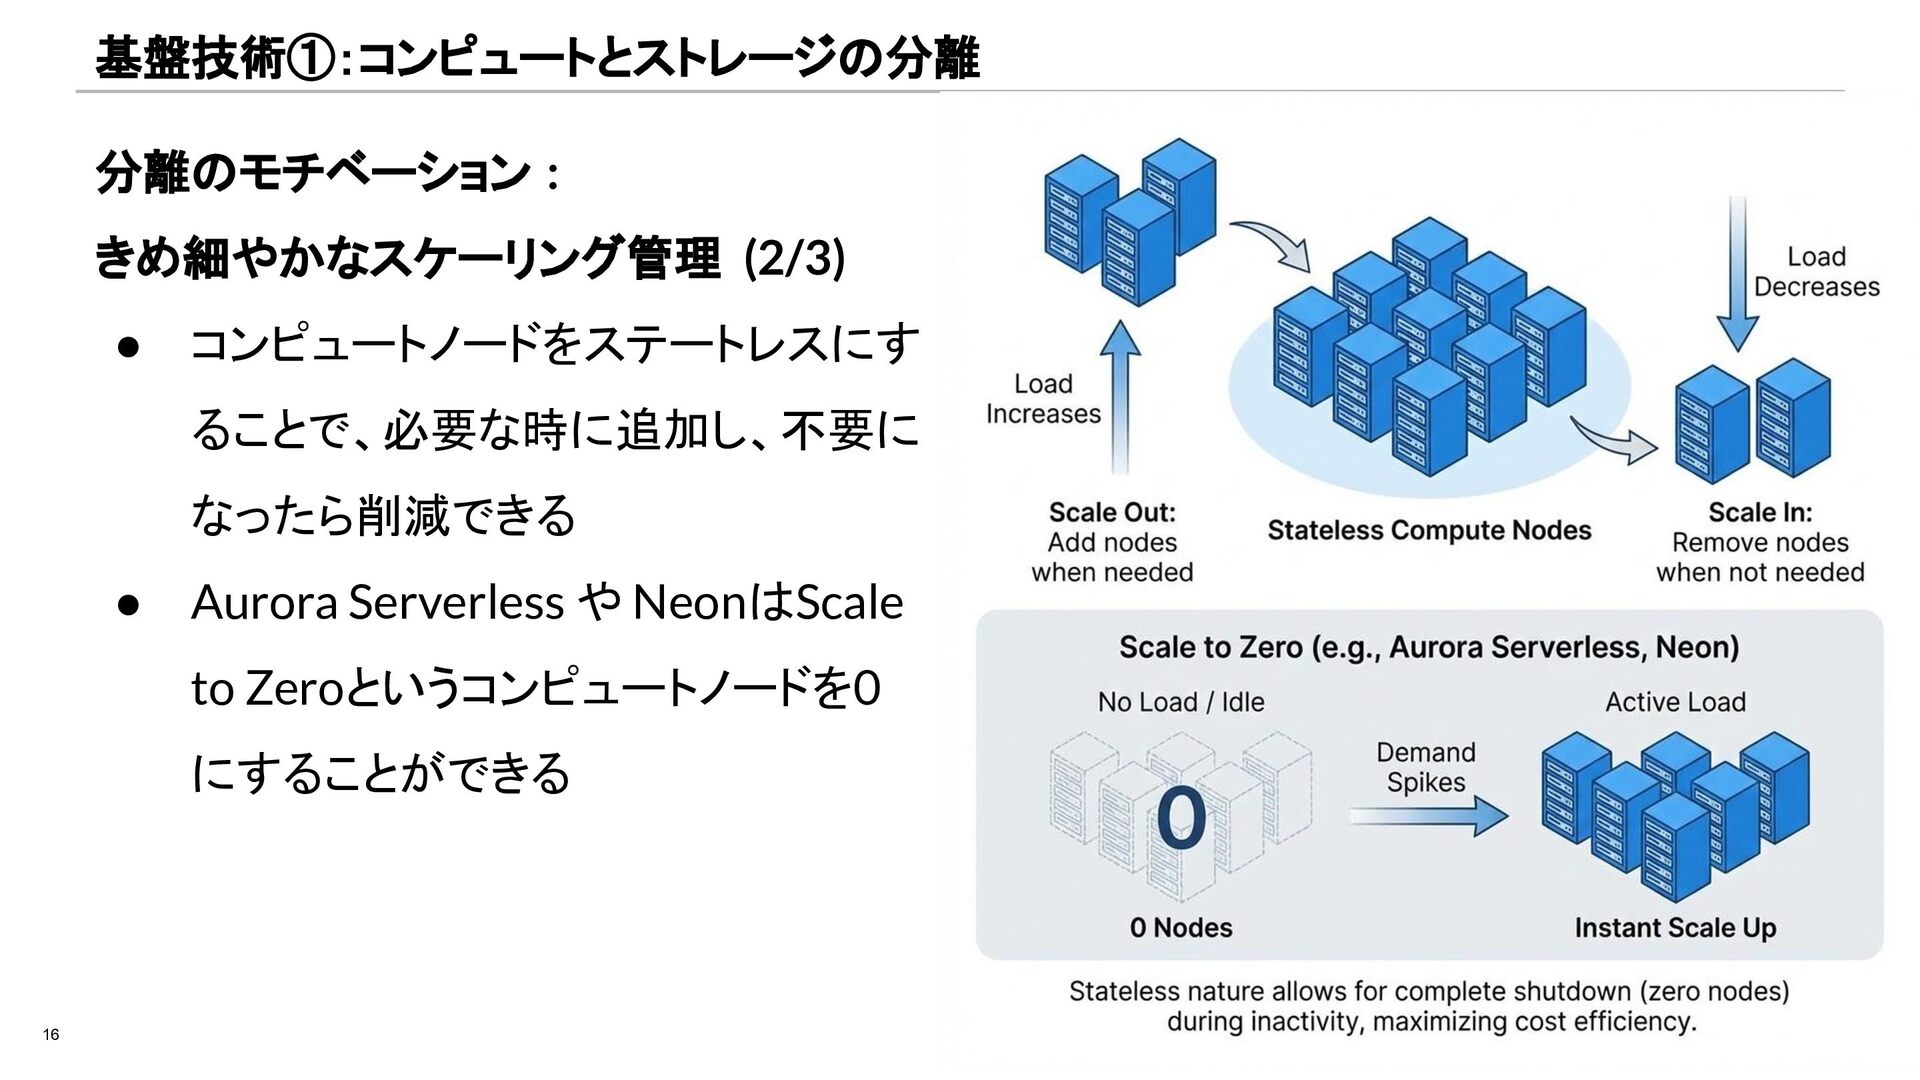
16 分離のモチベーション : きめ細やかなスケーリング管理 (2/3) • コンピュートノードをステートレスにす ることで、必要な時に追加し、不要に なったら削減できる •
Aurora Serverless や NeonはScale to Zeroというコンピュートノードを0 にすることができる 基盤技術①:コンピュートとストレージの分離 -
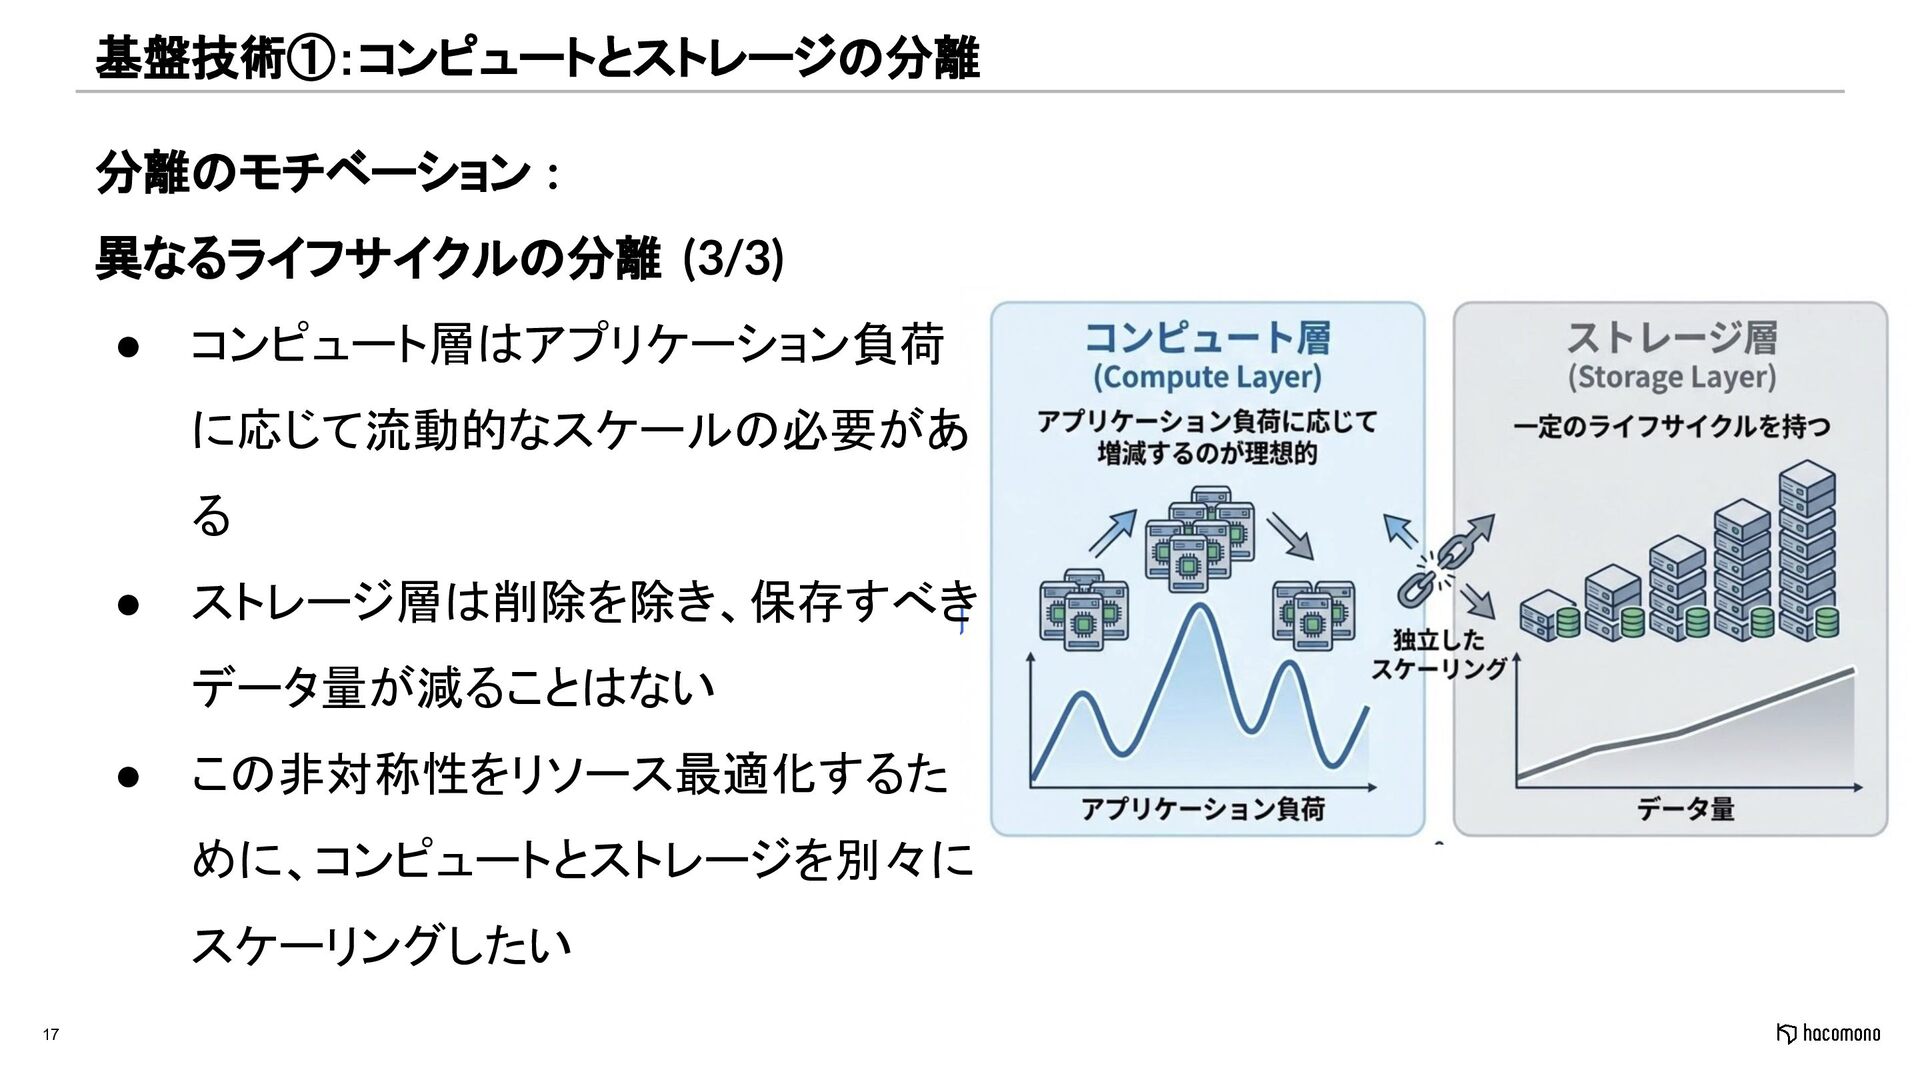
17 分離のモチベーション : 異なるライフサイクルの分離 (3/3) • コンピュート層はアプリケーション負荷 に応じて流動的なスケールの必要があ る •
ストレージ層は削除を除き、保存すべき データ量が減ることはない • この非対称性をリソース最適化するた めに、コンピュートとストレージを別々に スケーリングしたい 基盤技術①:コンピュートとストレージの分離 -
18 「The Log Is The Database」とログ適用型ストレージへの進化 • 従来のデータベースの常識 ◦ データページがデータベースの本体である
◦ WALは、あくまでクラッシュ時に本体を復旧するためのものだった 基盤技術①:コンピュートとストレージの分離 -
19 「The Log Is The Database」というパラダイムシフト • The Log Is
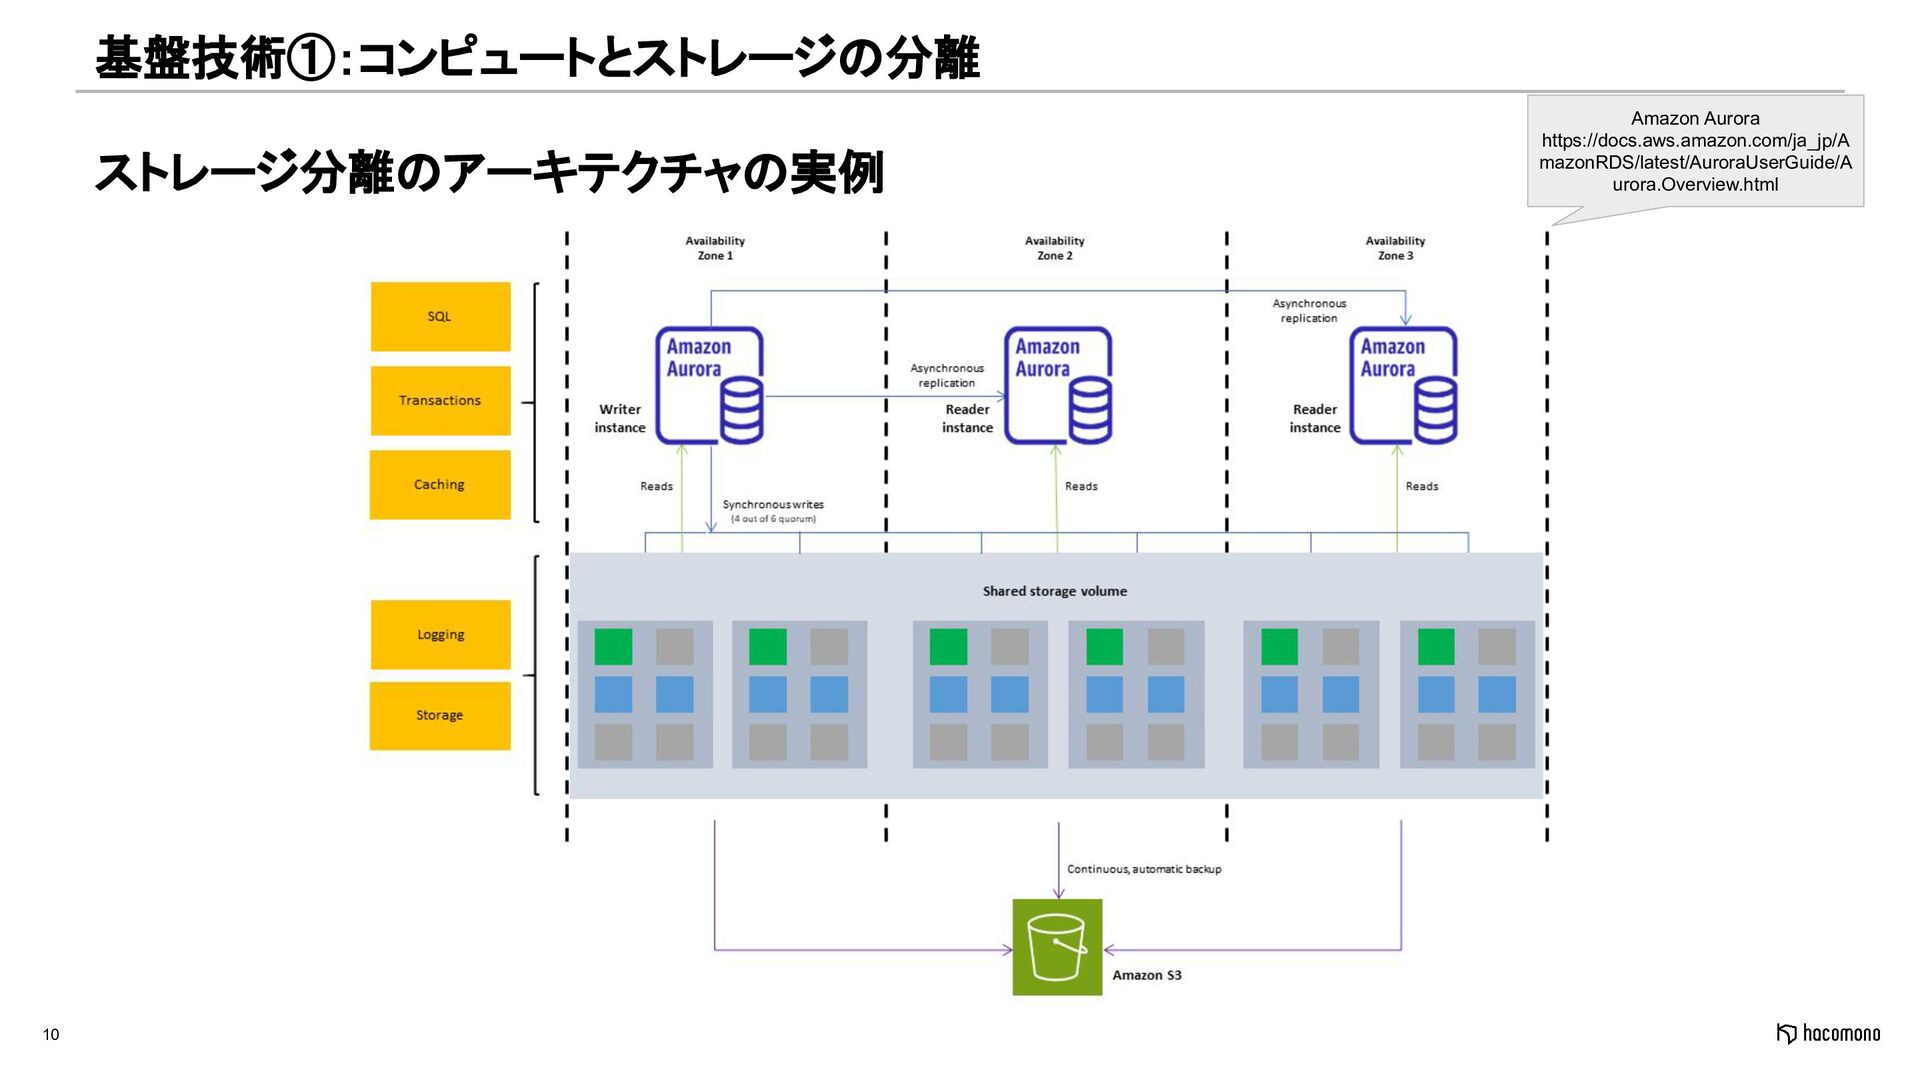
The Database の常識 ◦ 「ログこそがデータベースの本体である」 ◦ データページは、単に読み込みを速くするために、ログから作られた「キャッ シュ」または「マテリアライズドビュー」に過ぎない。 ◦ 商用データベースとして、この思想で分離をいち早く実現したのがAmazon Aurora 基盤技術①:コンピュートとストレージの分離 -
20 従来型アーキテクチャの限界 : ネットワーク帯域の壁 • 従来の仕組み(MySQL on EBSなど)では、数バイトのデータ更新でも、以下のす べてをストレージに書き込む必要があった。 ◦
WALの書き込み ◦ データページ全体の更新 ◦ Double-write bufferへの書き込み • コンピュート・ストレージ分離環境下において、データページそのものをネットワー ク経由でフラッシュする方式は、ネットワークI/O帯域を過剰に消費し、深刻なボト ルネックとなる。 基盤技術①:コンピュートとストレージの分離 -
21 ログ適用型ストレージへの進化と「計算のオフロード」 • ログ転送のみによるI/Oの劇的な削減 ◦ コンピュートノードからストレージノードへは、更新履歴である「WAL」のみを 送信する ◦ 10バイトの変更なら、ほぼ10バイトの通信で済むため、ネットワーク転送量を 最小化できる
• ストレージノードでの非同期マテリアライズ(Pushdown) ◦ 受信したWALをもとに、ストレージノード自身がCPU/メモリを用いて非同期で データページを再構築(マテリアライズ)する。 ◦ データページの構築処理をストレージ層にオフロードしプライマリノードの負 荷を下げている 基盤技術①:コンピュートとストレージの分離 -
22 ログ適用型アーキテクチャがもたらす運用上のメリット • 高速なクラッシュリカバリ ◦ 従来のDB: コンピュートノードが死んで再起動した際、起動時に大量のWAL を自力で読み込み、適用(リプレイ)する長い時間が必要だった。 ◦ ログ適用型DB:
ストレージノードが背後で「常に最新のデータページ」を作り 続けているため、コンピュートノードは起動してすぐにリクエストの受付を再開 できる。 • I/Oスパイクの排除 ◦ チェックポイント処理に伴う突発的な負荷遅延が原理的に発生しない。 基盤技術①:コンピュートとストレージの分離 -
23 コンピュートとストレージの分離のまとめ • 従来の仕組みだとノード追加時の負荷をプライマリノードが担当していた ◦ 分離で、プライマリーは影響を受けずノード追加を可能に • ダイナミックに必要なリソースを必要なだけ割り当てるために分離した ◦ 必要な分コンピュートを割り当て可能になった
• 分離をしたことで、コンピュートを全く割り当てないことも可能になった • ログ適用型ストレージでIOの削減や処理の分離、リカバリーの高速化が実現 基盤技術①:コンピュートとストレージの分離 -
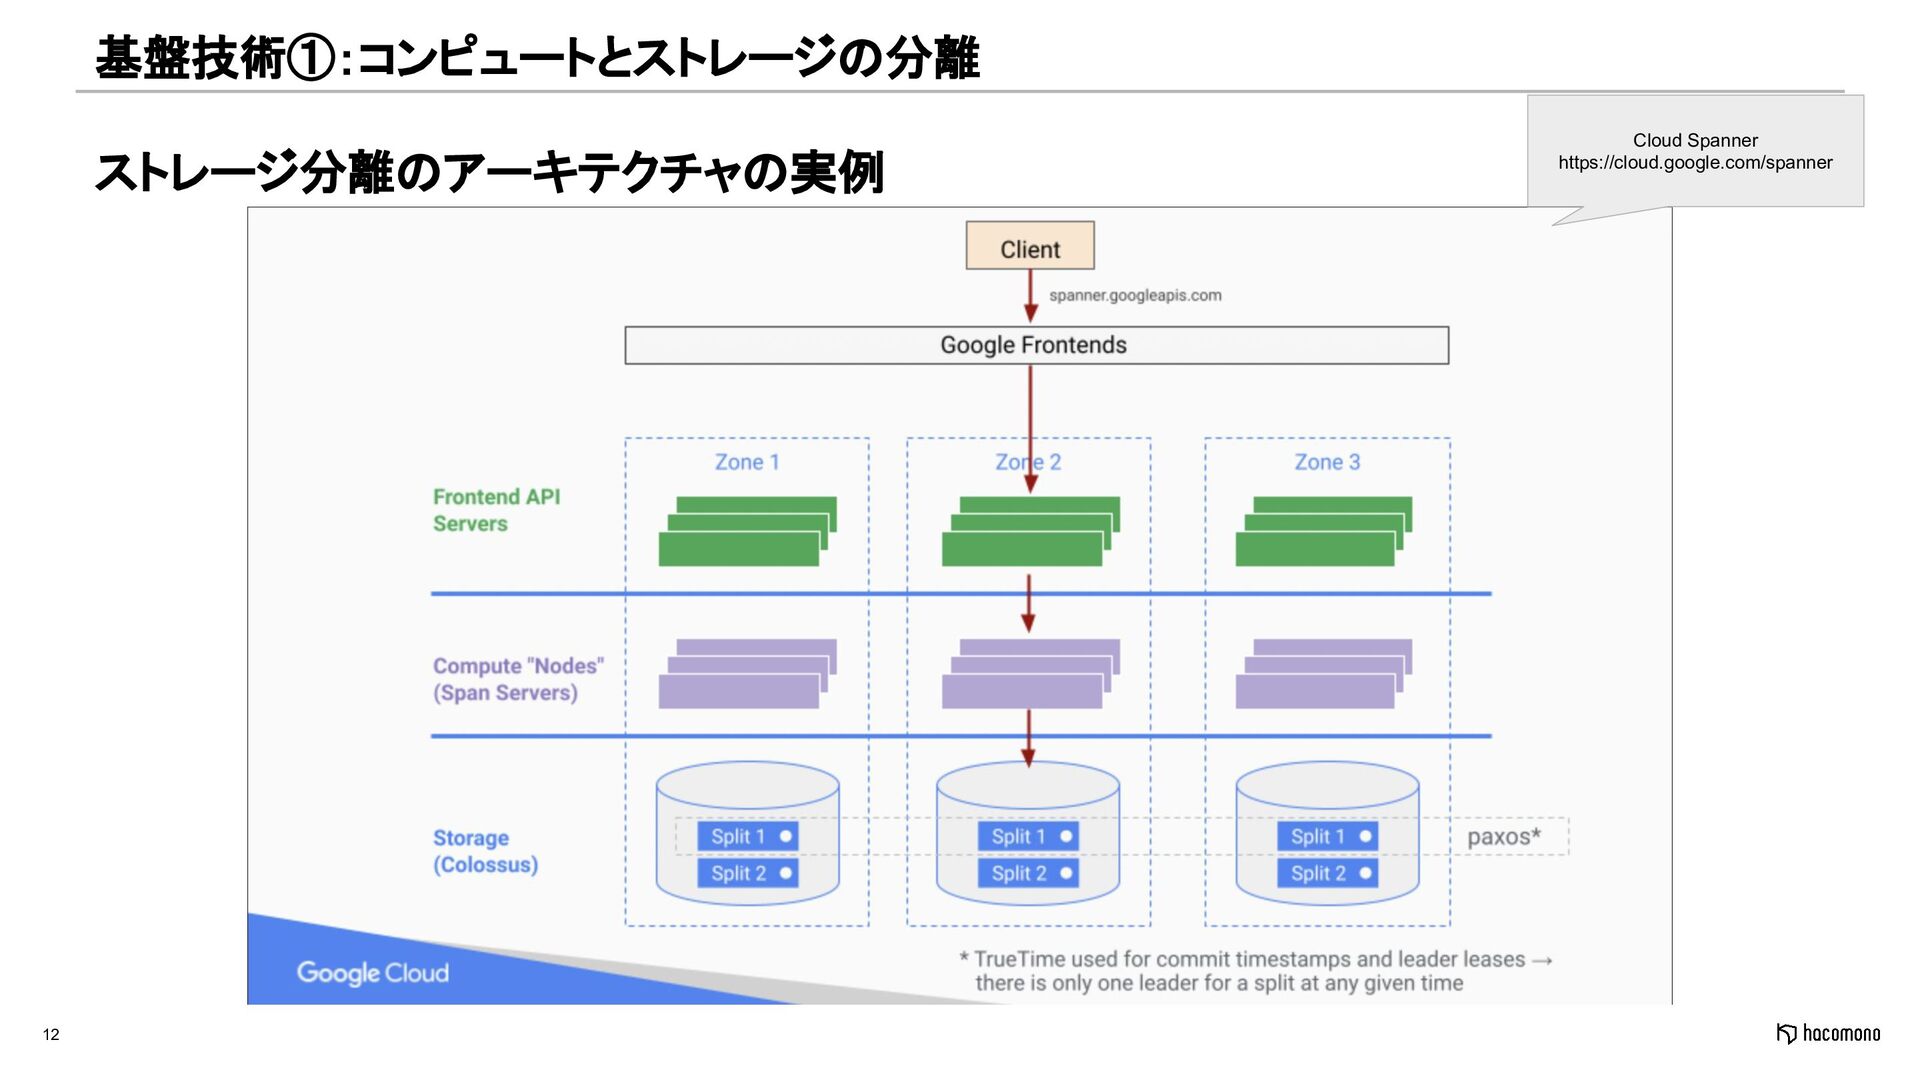
24 分散合意アルゴリズム? • クラスタで一度合意した値が覆らないことを保証する • NewSQLで普及しているものとしてPaxosとRaftがある • Paxosが用いられているもの ◦ Spanner,
Neon • Raftが用いられているもの ◦ TiDB(TiKV), etcd, CockroachDB, YugabyteDB, Oracle Database • 本日はRaftについて解説をします。 基盤技術②: Raft https://raft.github.io/ -
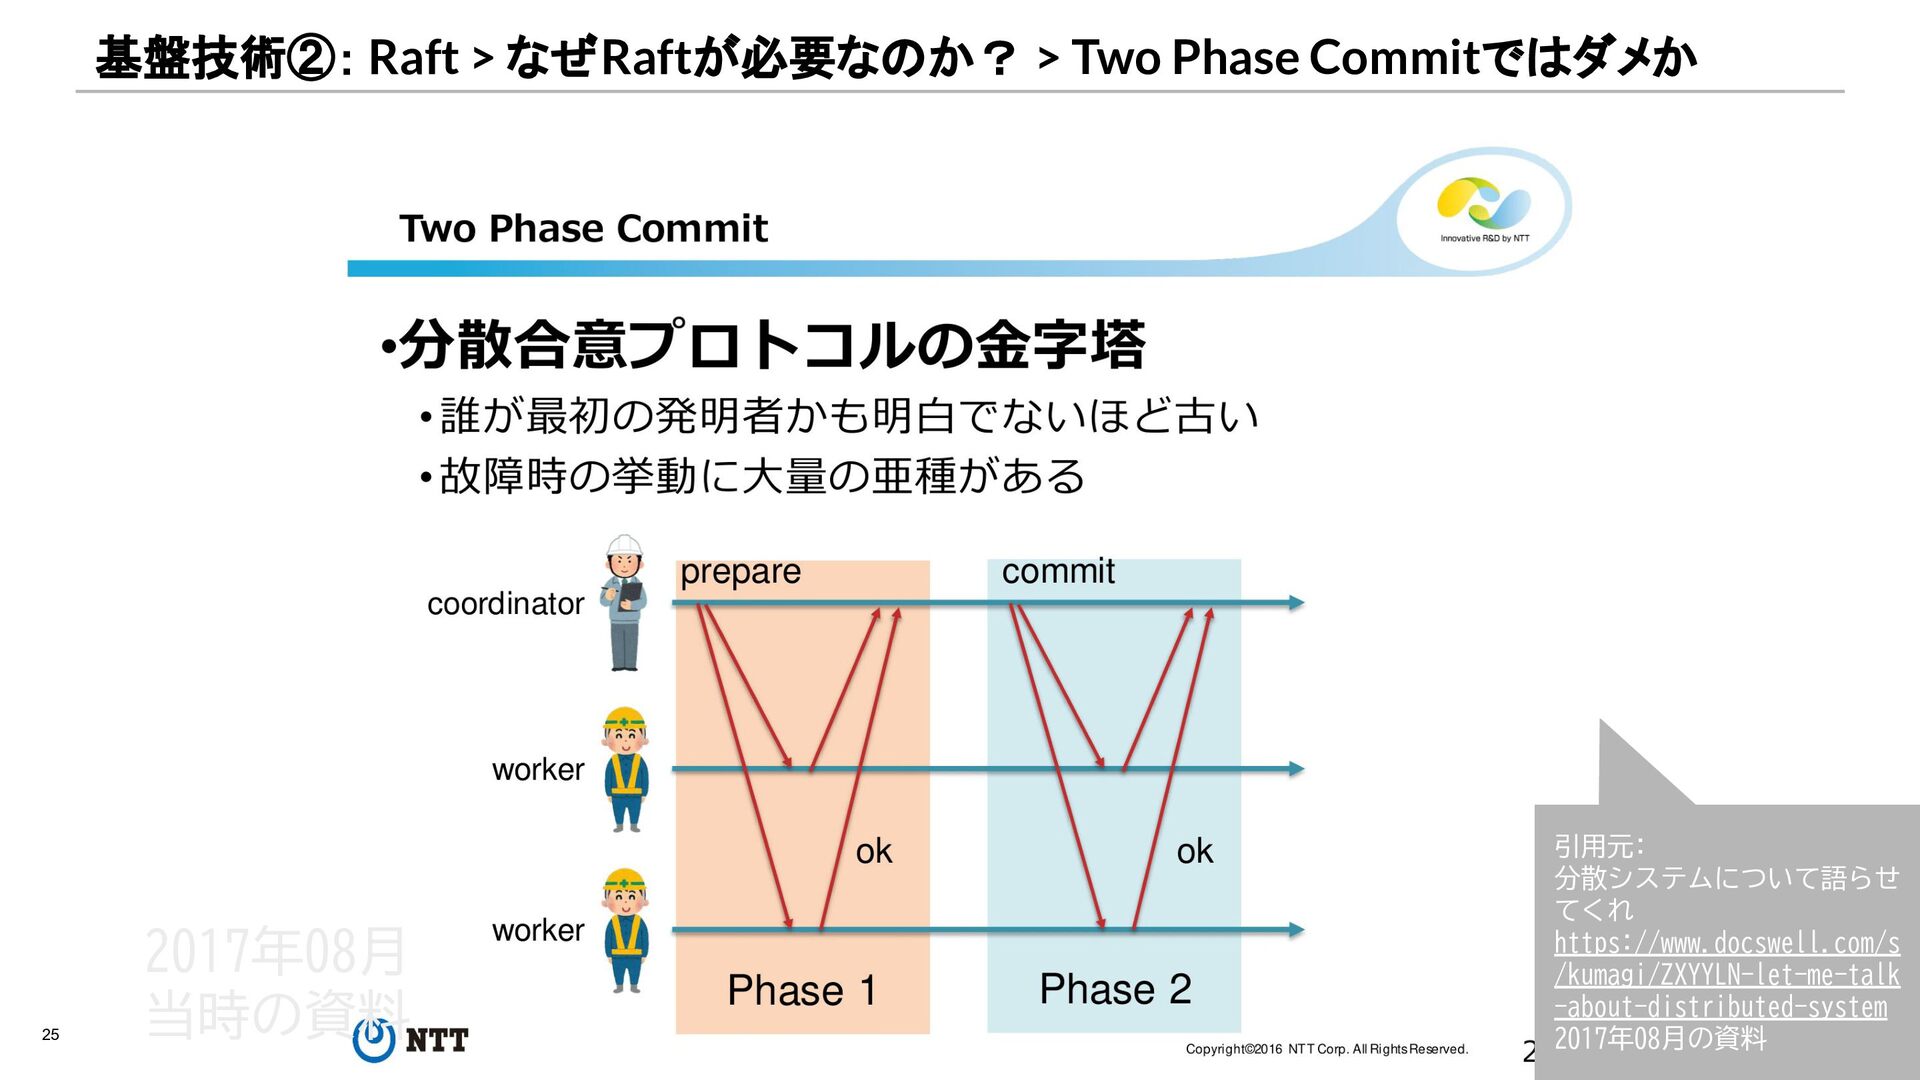
25 基盤技術②: Raft > なぜRaftが必要なのか? > Two Phase Commitではダメか 引用元:
分散システムについて語らせ てくれ https://www.docswell.com/s /kumagi/ZXYYLN-let-me-talk -about-distributed-system 2017年08月の資料 2017年08月 当時の資料 -
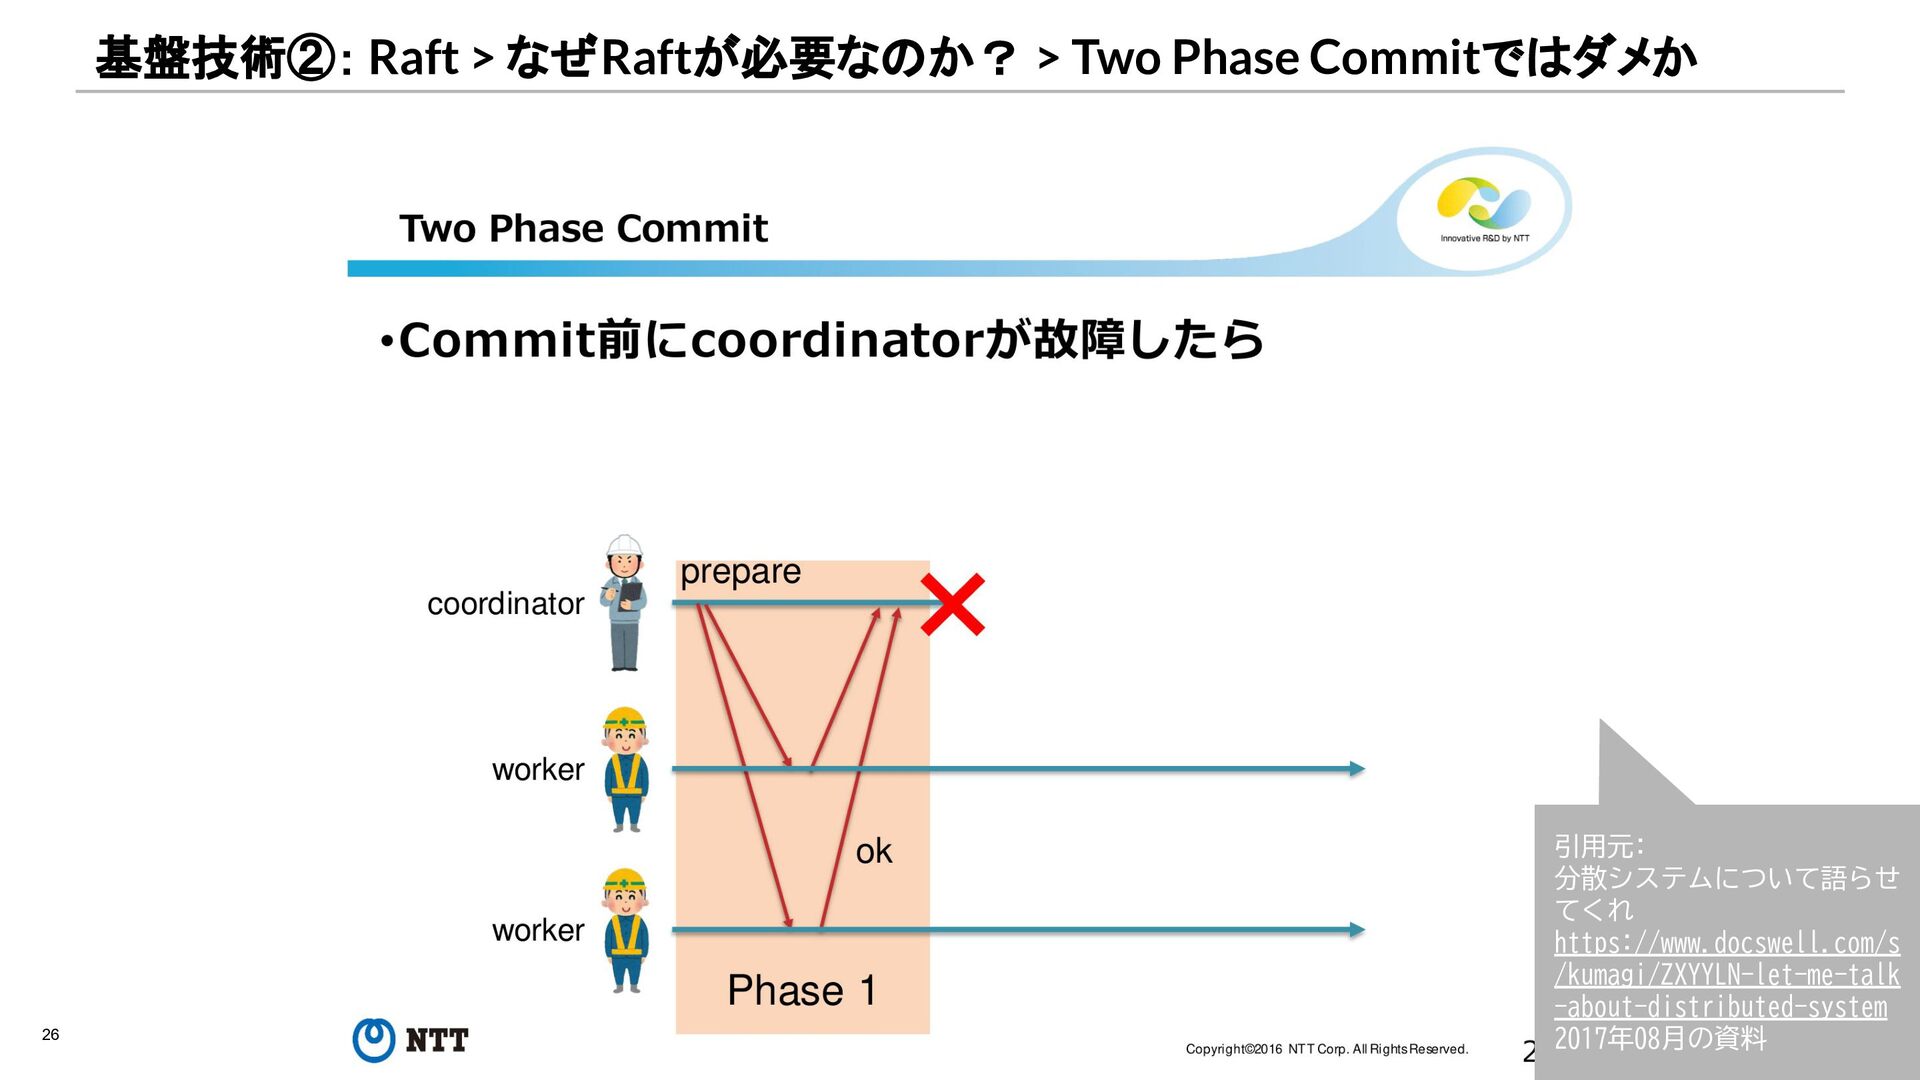
26 基盤技術②: Raft > なぜRaftが必要なのか? > Two Phase Commitではダメか 引用元:
分散システムについて語らせ てくれ https://www.docswell.com/s /kumagi/ZXYYLN-let-me-talk -about-distributed-system 2017年08月の資料 -
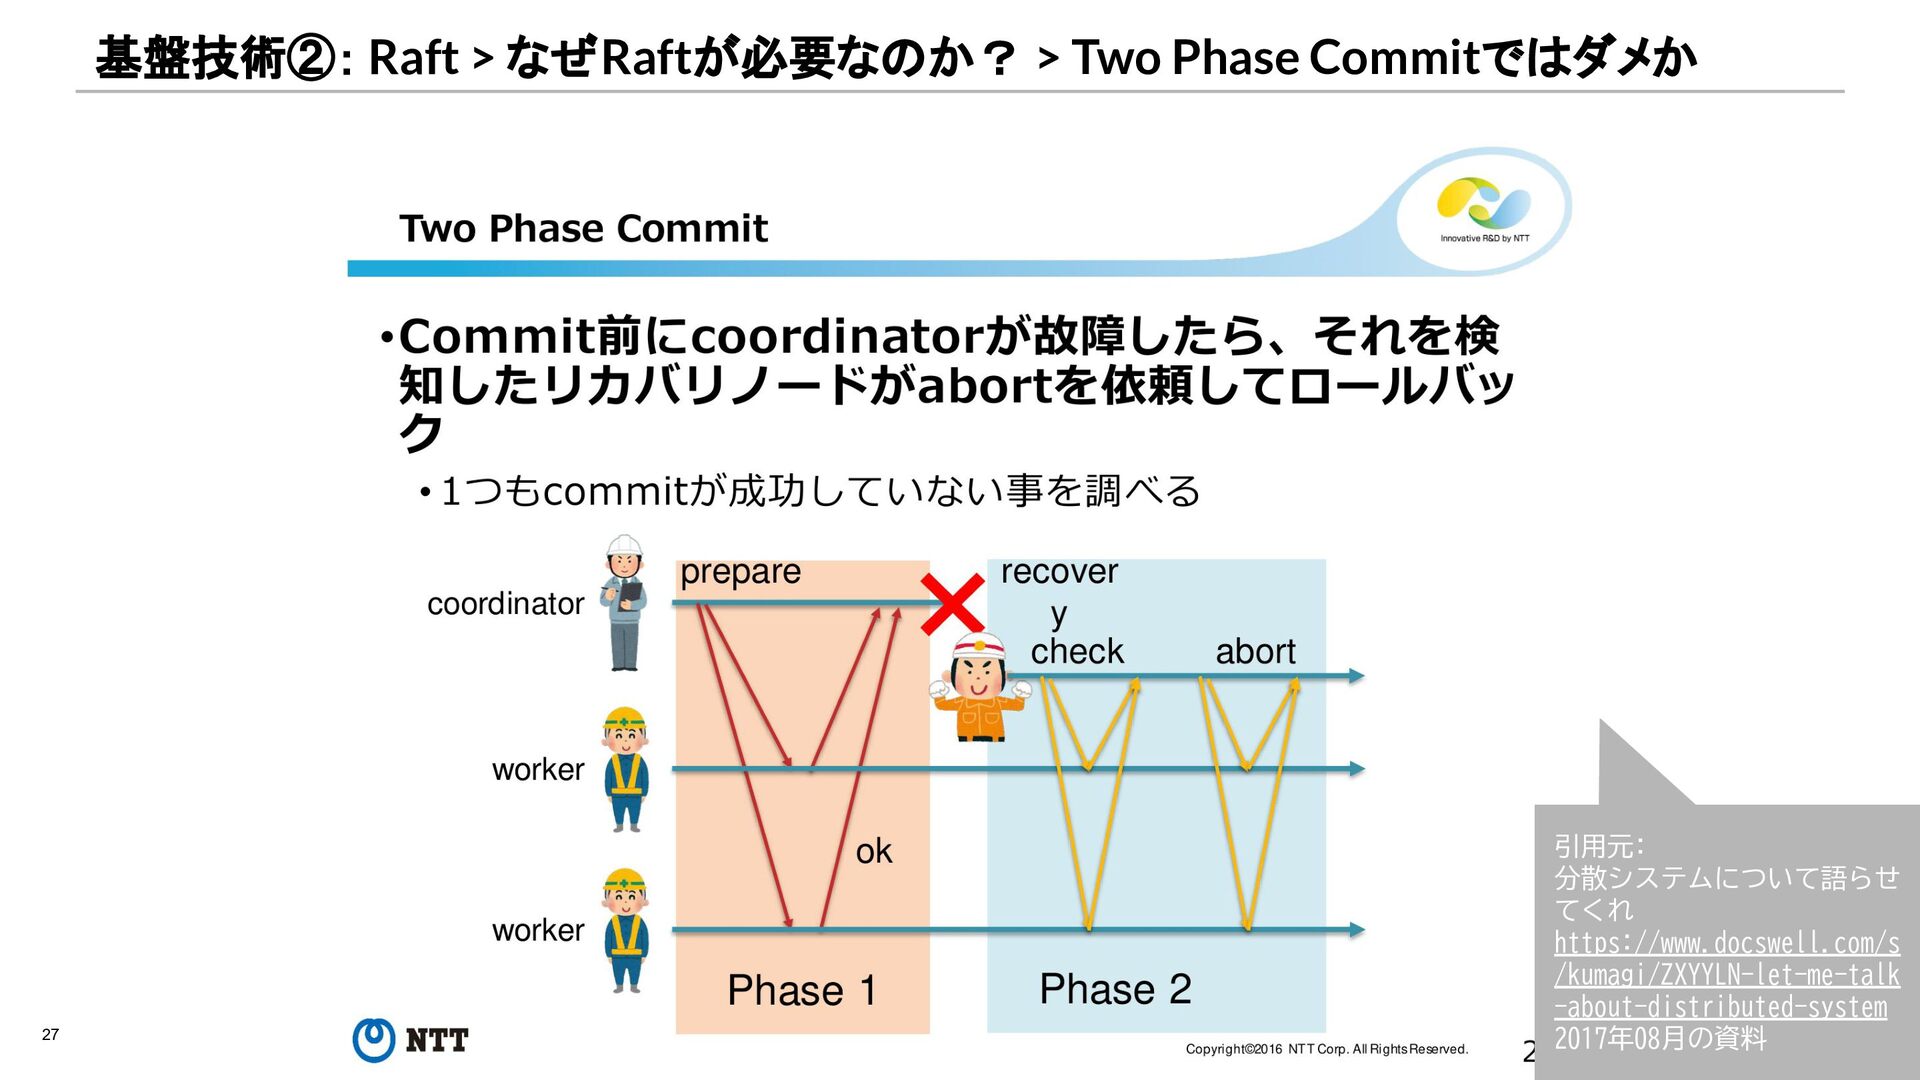
27 基盤技術②: Raft > なぜRaftが必要なのか? > Two Phase Commitではダメか 引用元:
分散システムについて語らせ てくれ https://www.docswell.com/s /kumagi/ZXYYLN-let-me-talk -about-distributed-system 2017年08月の資料 -
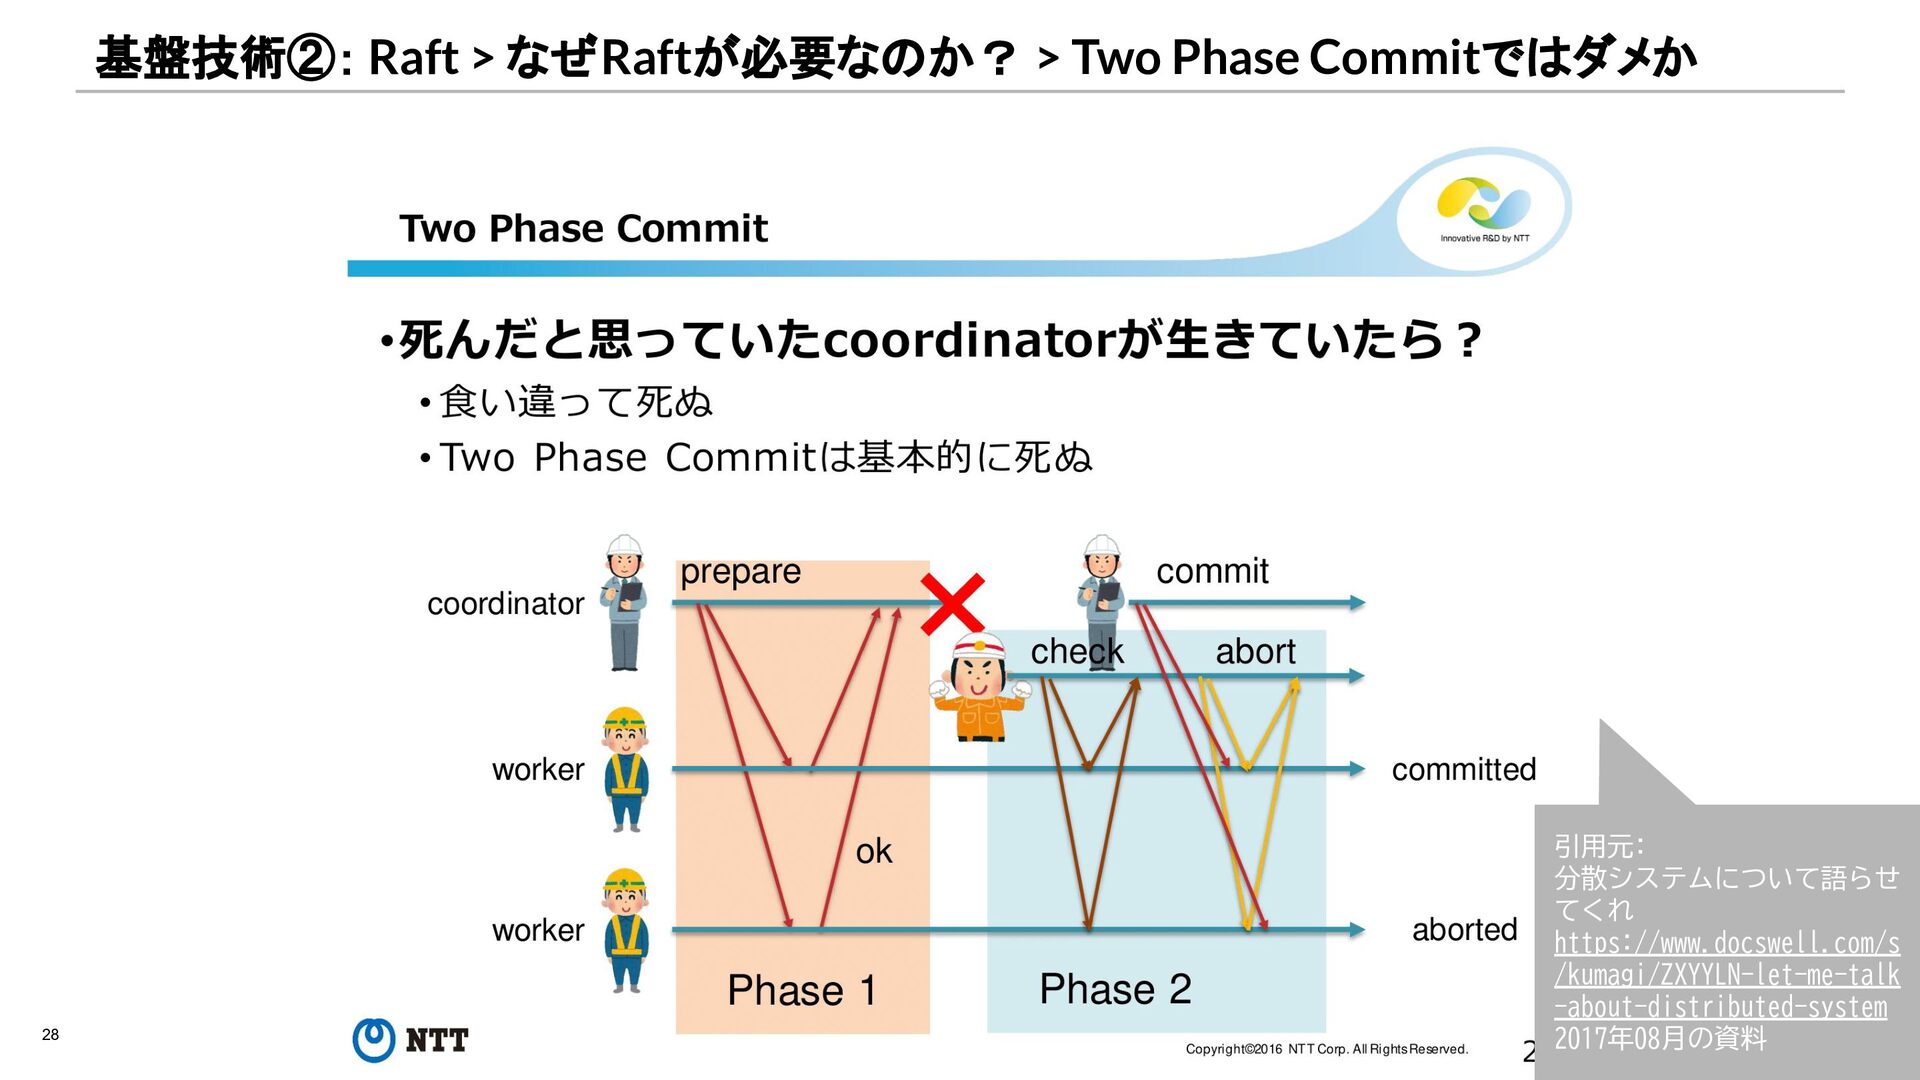
28 基盤技術②: Raft > なぜRaftが必要なのか? > Two Phase Commitではダメか 引用元:
分散システムについて語らせ てくれ https://www.docswell.com/s /kumagi/ZXYYLN-let-me-talk -about-distributed-system 2017年08月の資料 -
29 基盤技術②: Raft > なぜRaftが必要なのか? > Jepsen Test Jepsen Test
• オープンソースのテストフレームワーク • 分散システムの一貫性と信頼性を検証 • 意図的に故障を起こし故障時の一貫性や耐障害性を検証する • 検証内容 ◦ ネットワークパーティション ▪ 意図的にネットワークを分断させて、分断時の動作を確認する ◦ クラッシュ ▪ ノードやプロセスを意図的にクラッシュさせる ▪ クラッシュ時やクラッシュからの復帰時に不整合がないかをみる ◦ クロックスキュー ▪ 意図的に時刻ずらす ▪ ノードの時刻が正しいことに依存しているシステムを洗い出す ◦ 壊れたファイルシステム -
30 基盤技術②: Raft > なぜRaftが必要なのか? > Jepsen Test Jepsen Test
• オープンソースのテストフレームワーク • 分散システムの一貫性と信頼性を検証 • 意図的に故障を起こし故障時の一貫性や耐障害性を検証する • 検証内容 ◦ ネットワークパーティション ▪ 意図的にネットワークを分断させて、分断時の動作を確認する ◦ クラッシュ ▪ ノードやプロセスを意図的にクラッシュさせる ▪ クラッシュ時やクラッシュからの復帰時に不整合がないかをみる ◦ クロックスキュー ▪ 意図的に時刻ずらす ▪ ノードの時刻が正しいことに依存しているシステムを洗い出す ◦ 壊れたファイルシステム 本日はここを深堀りすることはできま せんが、興味がありましたら 「分散システムにおける一貫した時 刻の取り扱いの課題と解決策」につ いて書いた記事もご覧ください。 -
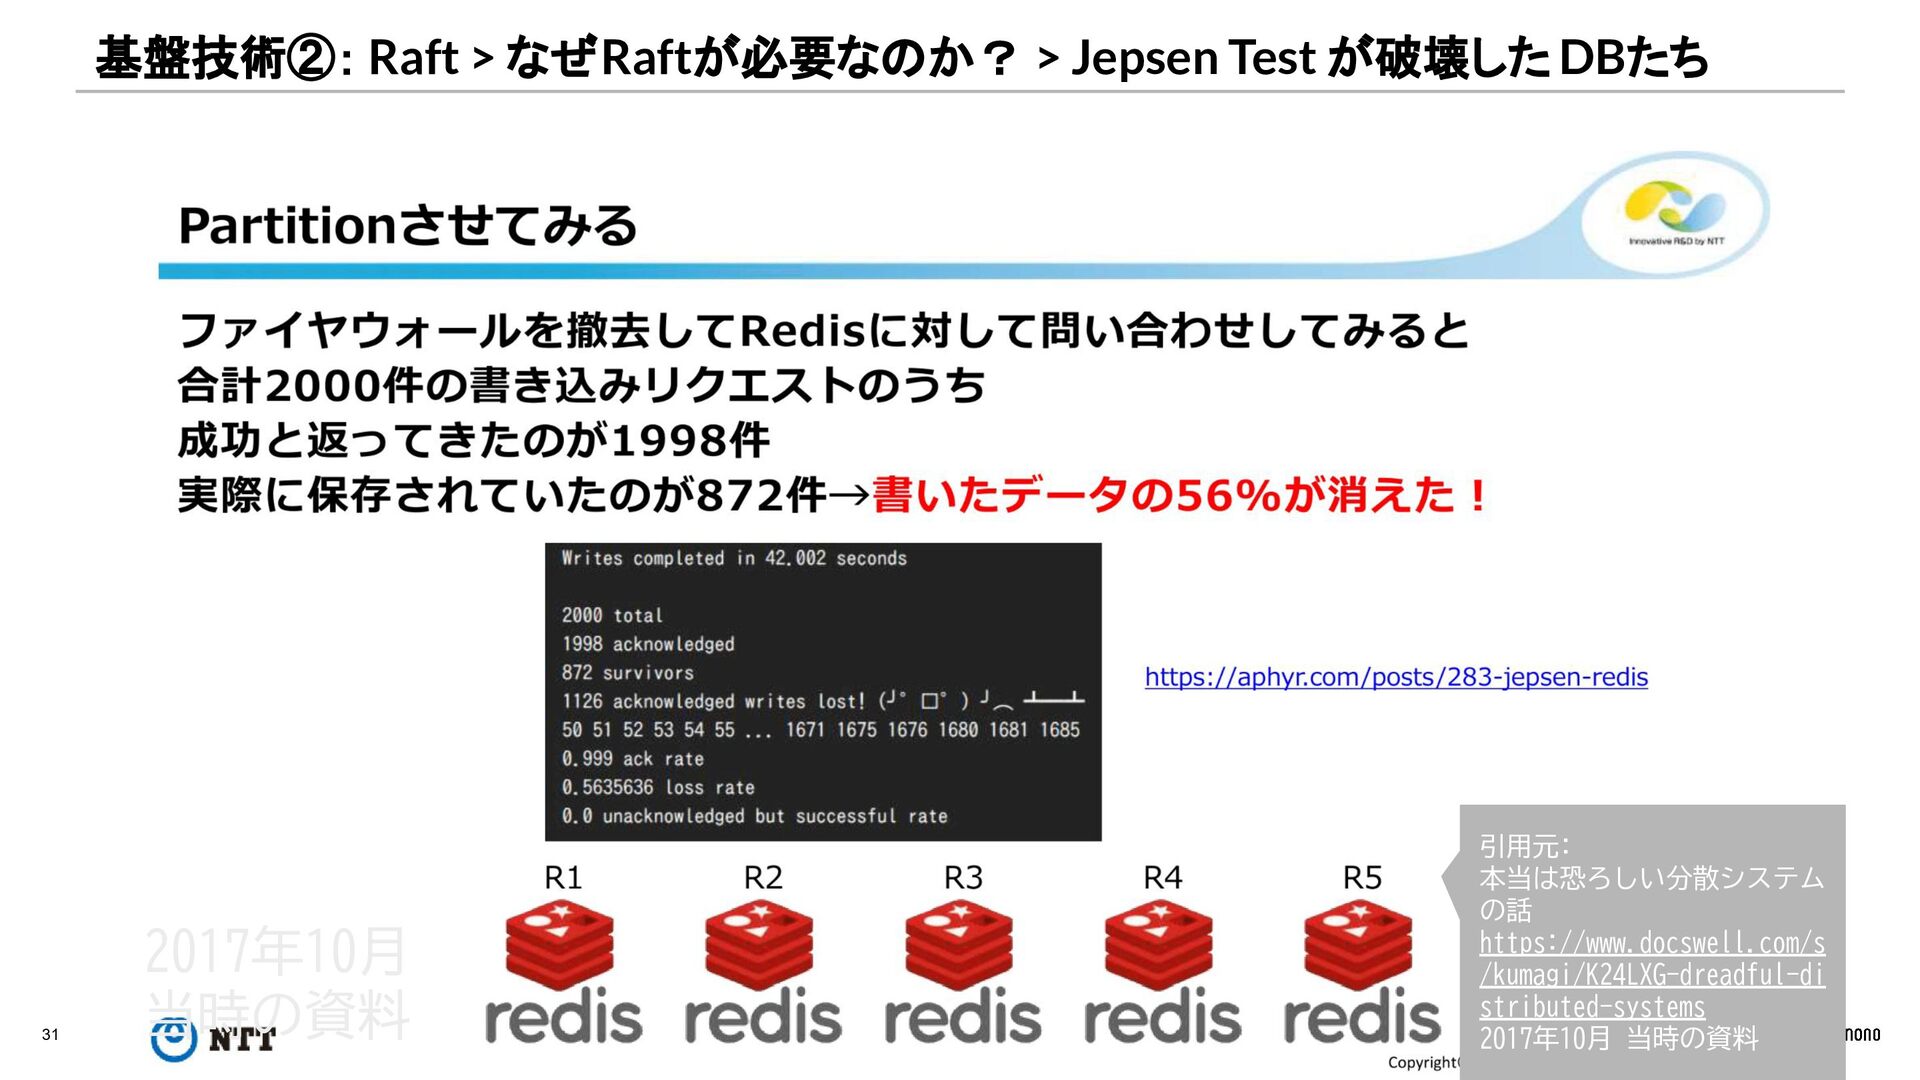
31 基盤技術②: Raft > なぜRaftが必要なのか? > Jepsen Test が破壊した DBたち
引用元: 本当は恐ろしい分散システム の話 https://www.docswell.com/s /kumagi/K24LXG-dreadful-di stributed-systems 2017年10月 当時の資料 2017年10月 当時の資料 -
34 基盤技術②: Raft > Raftはなにをしてくれるのか データの同期 • Raftではログレプリケーションと言います ◦ ログ?
▪ StateMachineに対する命令をログといいます。 ▪ ログ適用型ストレージでも出てきたDBへの操作コマンドのようなもの • 書き込み、アップデート、削除など -
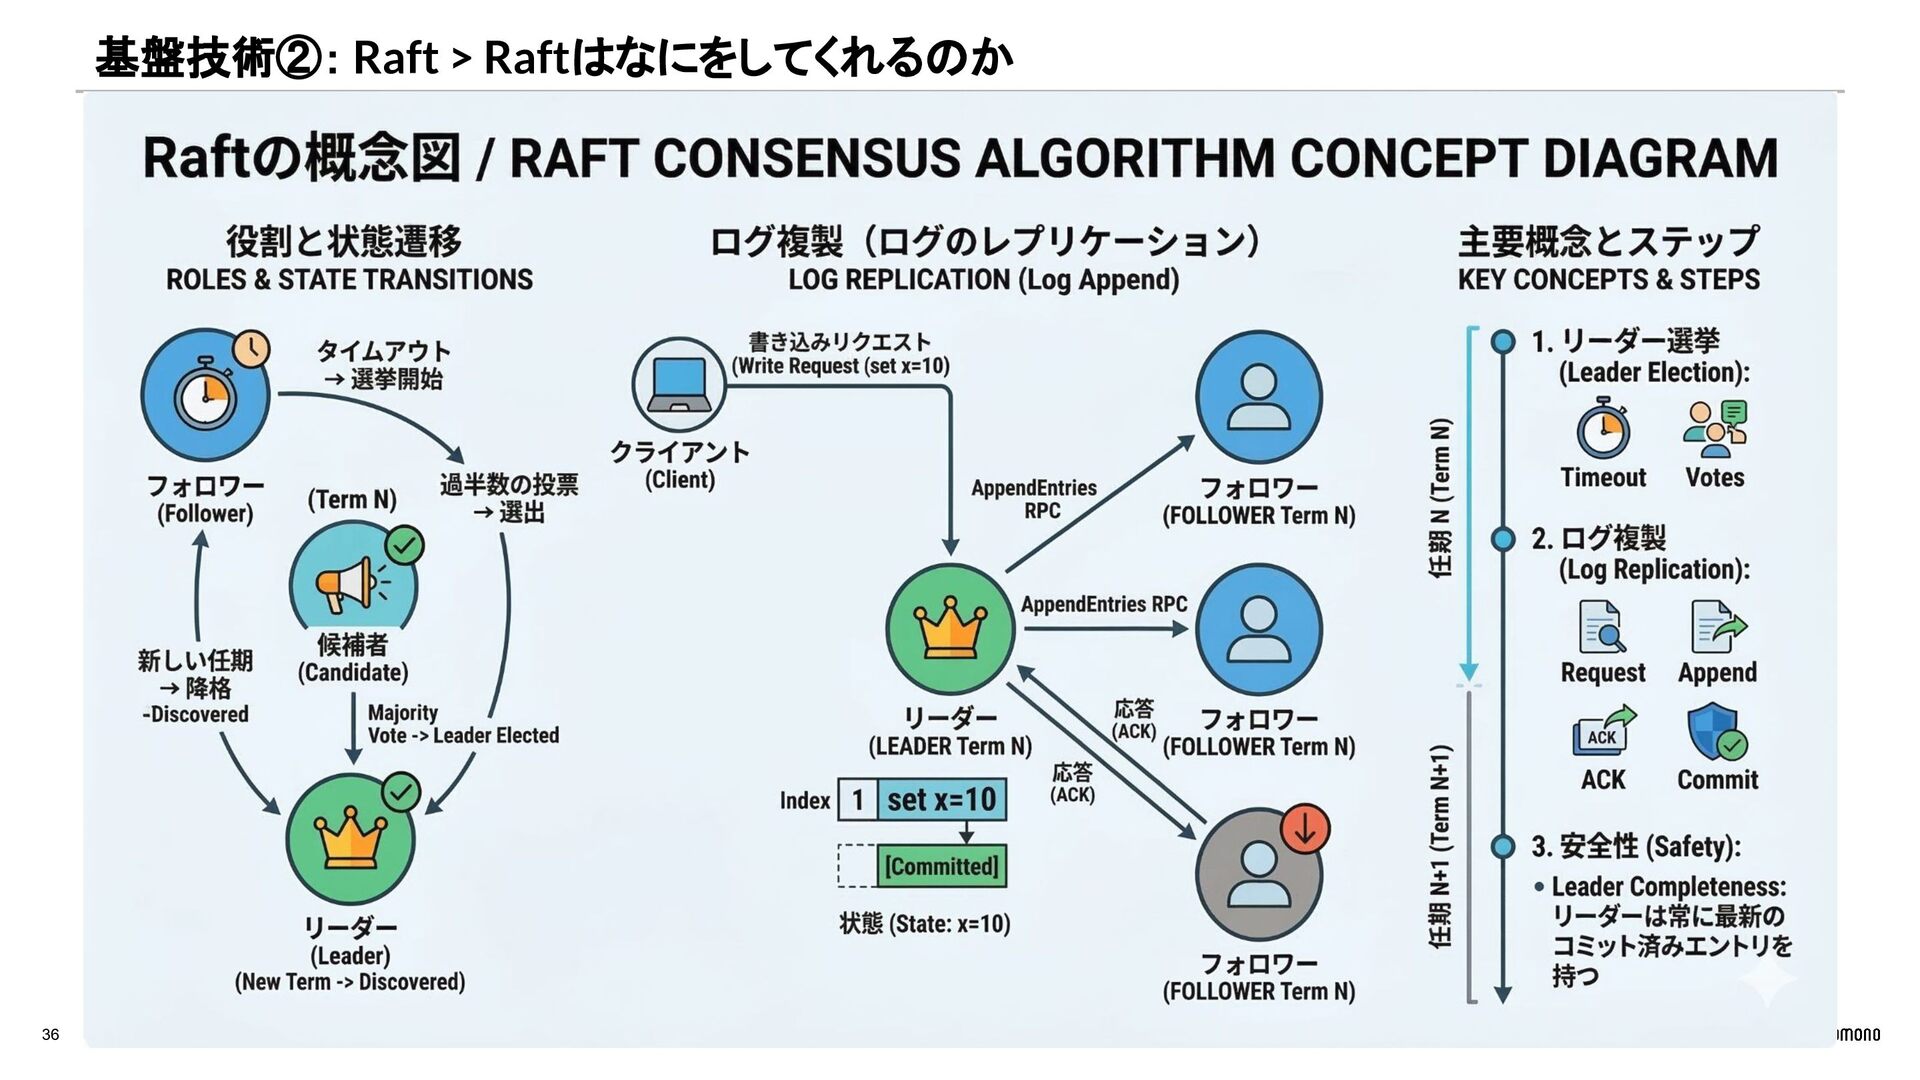
37 基盤技術②: Raft > Raftの仕組み > 用語 ノードの役割 • リーダー(leader)
◦ クライアントからのリクエストを受け取るノード ◦ フォロワーに命令を送信するノード • フォロワー(follower) ◦ リーダーからの命令を受け取るノード ◦ 主に可用性や冗長化のために存在する • 候補者(candidate) ◦ リーダー候補者 ◦ リーダーからのハートビートが届かなかった場合に遷移する -
38 基盤技術②: Raft > Raftの仕組み > 用語 • ターム(term) ◦
論理時計、単調増加する数値、候補者が現れる際に増加する • ログ・インデックス(log index) ◦ 単調増加するログのインデックスを示す数値 ◦ ターム+ログ・インデックスで一意のログを示すことができる • コミットインデックス(commit index) ◦ ログ・インデックスがどこまでコミット済みかを示す ▪ コミットには過半数のノードへの保存が必要 -
39 基盤技術②: Raft > Raftの仕組み > リーダー選出 • リーダーは必ず1つしか選出されない ◦
2つ以上になることはない ◦ 1つもいないことはある ▪ リーダーがクラッシュし、新たなリーダー選出されるまでの間 ▪ 投票割れ -
40 基盤技術②: Raft > Raftの仕組み > リーダー選出 選出の流れ(次のスライドにアニメーションがあります) • 選挙タイムアウト
◦ ハートビートが規定時間届かないと発動する • 候補者の立候補 ◦ 自らのタームを一つ増やし、自分に投票した上で他のノードに投票を求める • 投票 ◦ 他のノードは以下を満たす場合に投票する ▪ そのタームで投票をしていない ▪ 候補者のタームが自分以上 ▪ 候補者のログ・インデックスが自分と同じかより新しい -
41 基盤技術②: Raft > Raftの仕組み > リーダー選出 引用元: Raft -
The Secret Lives of Data https://thesecret livesofdata.com/r aft/ -
42 基盤技術②: Raft > Raftの仕組み > ログレプリケーション 引用元: Raft -
The Secret Lives of Data https://thesecret livesofdata.com/r aft/ -
43 基盤技術②: Raft > Raftの得意と不得意 得意 • 強い一貫性(強整合性)の維持 • ノードのクラッシュやクラッシュ後の復帰に対する安全性
• ネットワーク分断の環境下での正常な動作 -
44 基盤技術②: Raft > Raftの得意と不得意 不得意 • 低レイテンシでの処理 ◦ ミリ秒単位でのレイテンシが苦手
◦ 過半数のノード合意形成のための通信オーバーヘッドが大きい • スケーラビリティ/スループット ◦ リーダーノードが処理できる上限値 = スループットの上限 • リーダー障害時の可用性の低下 ◦ 新しいリーダーが選出されるまで、データの読み書きができない時間が生じる -
45 単一Raftの限界 • リーダーが保存できるデータ量を超えることができない • リーダーが処理できるスループット = 全体の処理できる限界値 データの細分化と Leaderの分散配置
• データを一定サイズの論理的な区画に分割する。 • 各データ範囲を独立したRaftグループを構成 • ノードを追加するとデータ範囲のリバランスが行われスケールアウトを実現する • データを分割する分、多くの範囲をスキャンしたりすると性能が低下する スケールの壁を越える工夫:「 Multi-Raft」 -
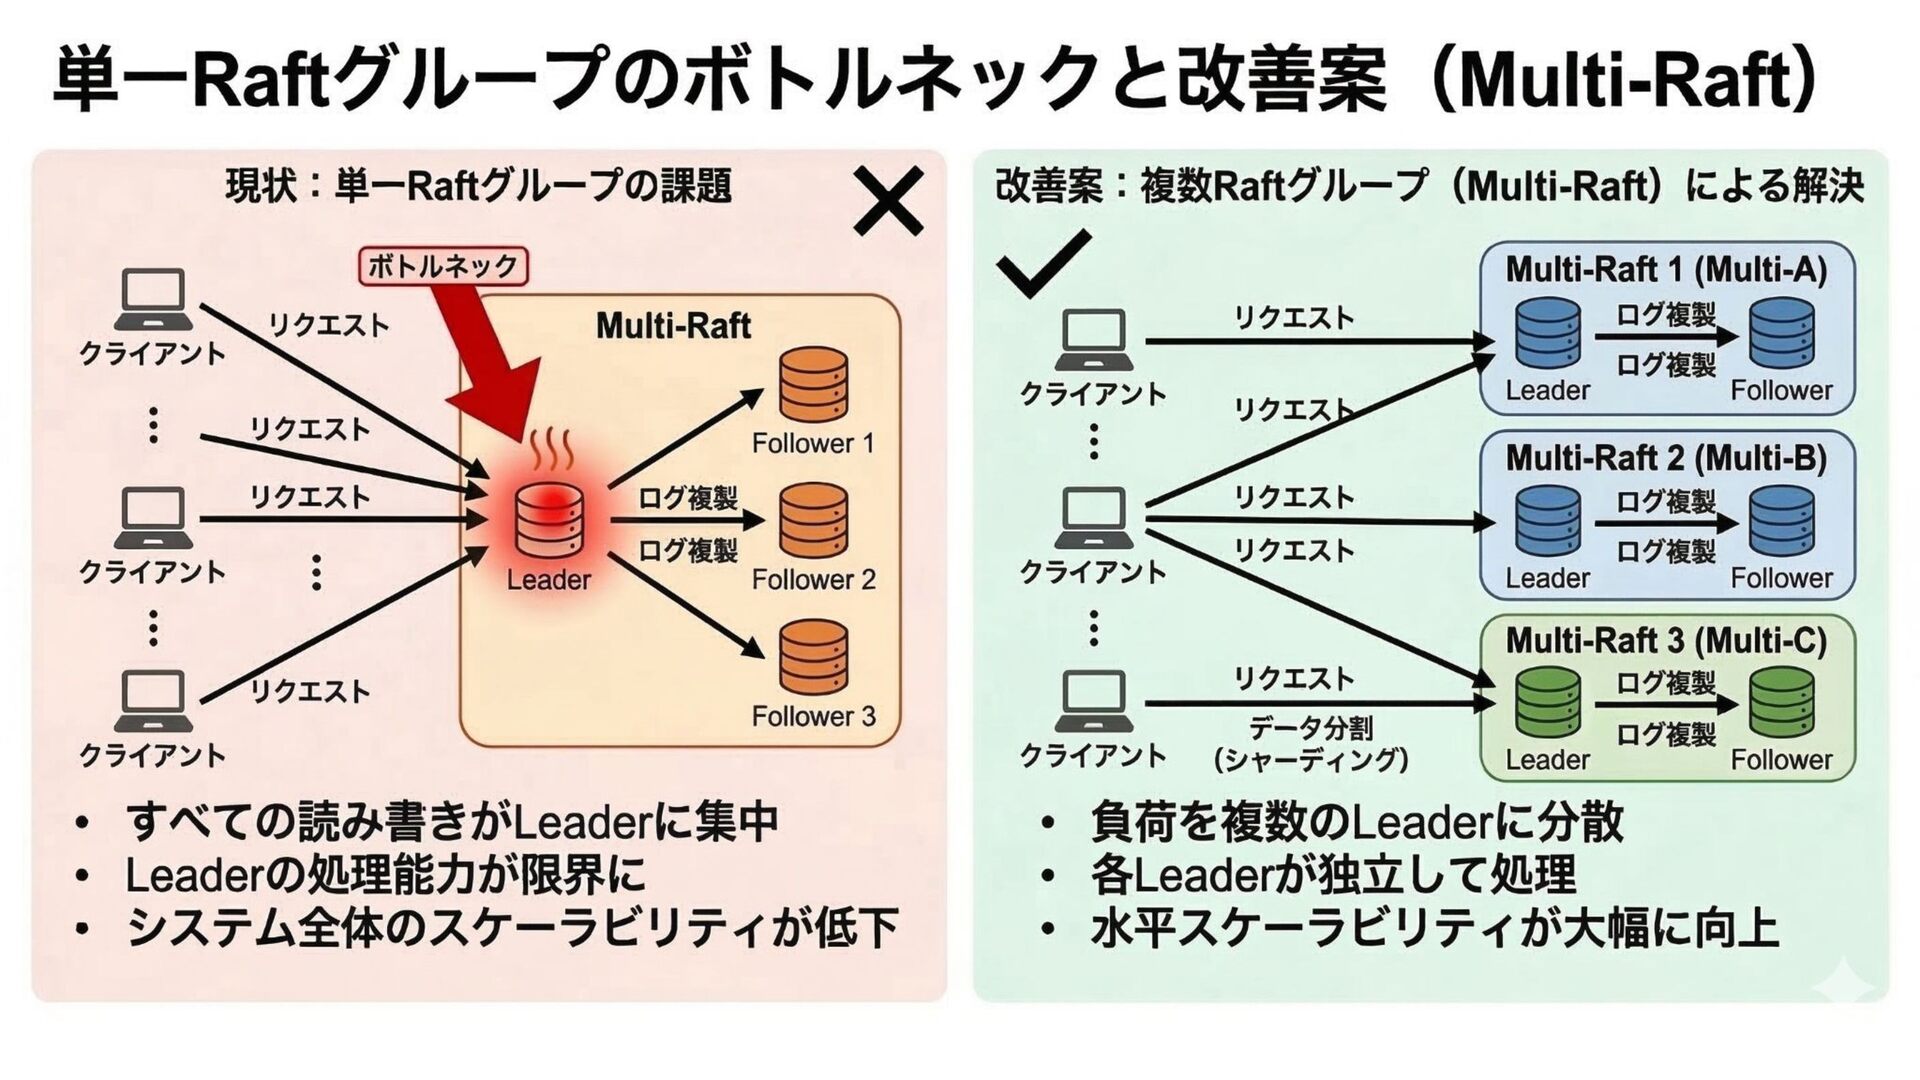
46 単一Raftグループの限界 • データ量やトラフィックが増加すると、単一のLeaderノードに通信とI/Oが集中する データの細分化と Leaderの分散配置 • データを一定サイズの論理的な区画に分割する。 ◦ Region,
Split… • 各Regionが独立したRaftグループを構成し、それぞれのLeaderを全ストレージ ノードに均等に配置 • ストレージノード追加時、Regionのリバランスが行われスケールアウトを実現す る。 • データを分割する分、多くの範囲をスキャンしたりすると性能が低下する スケールの壁を越える工夫:「 Multi-Raft」 -
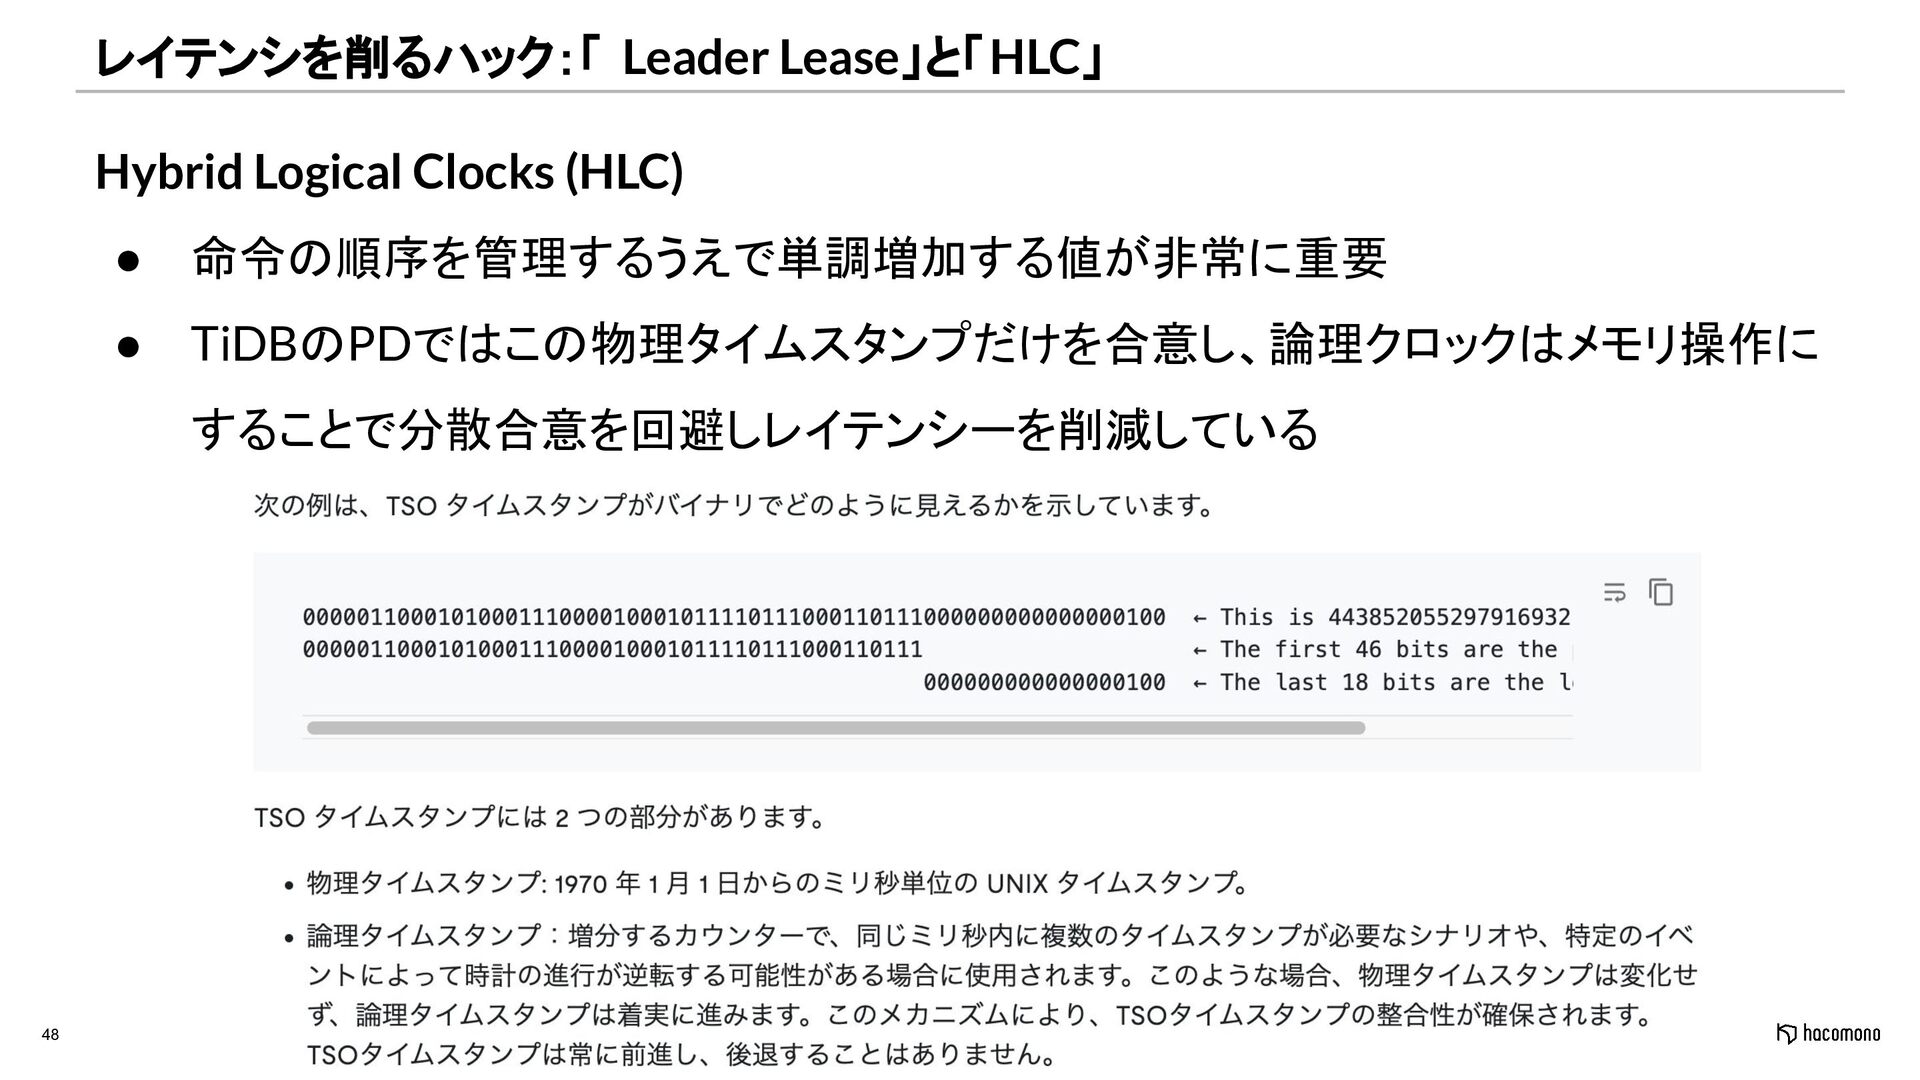
48 Hybrid Logical Clocks (HLC) • 命令の順序を管理するうえで単調増加する値が非常に重要 • TiDBのPDではこの物理タイムスタンプだけを合意し、論理クロックはメモリ操作に することで分散合意を回避しレイテンシーを削減している
レイテンシを削るハック:「 Leader Lease」と「HLC」 -
49 シーケンシャルな書き込みによるホットスポット • 従来のDBではB-Treeインデックスのフラグメンテーションを防ぐために Auto IncrementなIDが一般的な手法だった • 分散アーキテクチャにおいては、最新のID範囲を持つ特定の範囲を持つノードに 書き込みが集中し、システム全体のスループットが低下する。 対策:スキーマ設計の最適化や専用機能の利用
• UUIDの採用 • TiDBであればSHARD_ROW_ID_BITSの設定 運用上気をつけたい「落とし穴」 -
50 レイテンシの増加 • ストレージ分離によるネットワークIOのレイテンシ増加 • 分散合意によるレイテンシの増加 • 状況によるが、数十ms ~ 数百ms
の増加があり得る 対策: • 現状のシステムのレイテンシを計測する • NewSQLで同規模のクラスタを作成しトラフィックを流したときのレイテンシーを計 測 • 実際のアプリケーションでsleepなどを追加し遅延させて問題がないか確認 運用上気をつけたい「落とし穴」 -
51 NewSQLのストレージ分離と分散合意を用いたスケーラブルなアーキテクチャ • コンピュートとストレージの分離 ◦ 負荷やライフサイクルの違いに合わせて、独立した柔軟なスケーリング(リ ソース割当)を実現 • ログ適用型ストレージへの進化 ◦
ネットワークI/Oを最小化し、リカバリの高速化とアーキテクチャのシンプル化 ・スケーラビリティ向上を達成 • Raftによる分散合意/Raftの最適化 ◦ 強整合性とデータのレプリーケーション、障害復旧、分断耐性 ◦ 一方でレイテンシは増加する • NewSQLならではの運用上の注意点 ◦ 従来のシーケンシャルなIDがホットスポットを生む ◦ ストレージ分離や、分散合意のためのレイテンシが増加 まとめ -
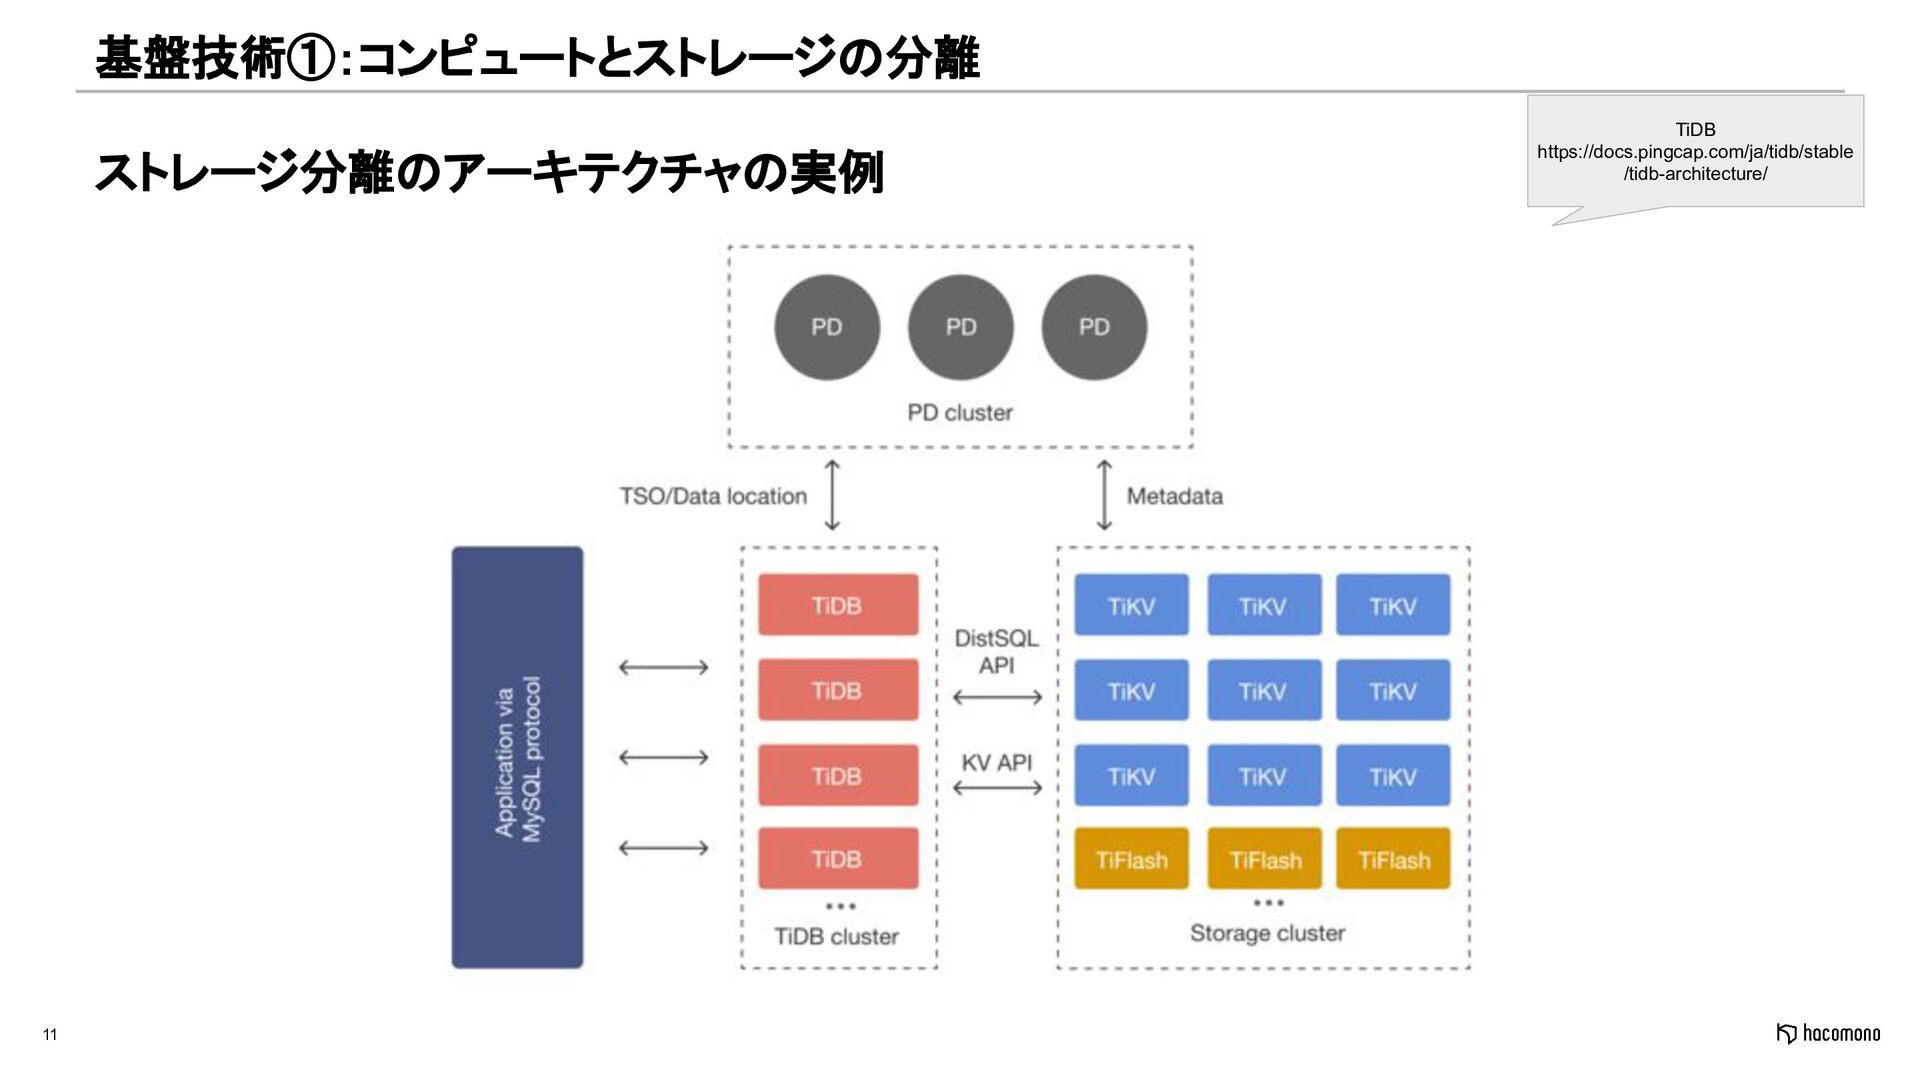
52 出典 • Amazon Aurora DB クラスター ◦ https://docs.aws.amazon.com/ja_jp/AmazonRDS/latest/AuroraUserGuide/Aurora.Overview.html •
TiDB Architecture ◦ https://docs.pingcap.com/ja/tidb/stable/tidb-architecture/ • Spanner: Always-on, virtually unlimited scale database ◦ https://cloud.google.com/spanner • NewSQL徹底入門 ◦ https://www.kodansha.co.jp/book/products/0000422073 ◦ ログ適用型ストレージ • Amazon Aurora: Design considerations for high throughput cloud-native relational databases ◦ https://www.amazon.science/publications/amazon-aurora-design-considerations-for-high-throughput-cloud-nativ e-relational-databases • 分散システムについて語らせてくれ ◦ https://www.docswell.com/s/kumagi/ZXYYLN-let-me-talk-about-distributed-system • The Secret Lives of Data - Raft Understandable Distributed Consensus ◦ https://thesecretlivesofdata.com/raft/ • TiDB のタイムスタンプ Oracle (TSO) ◦ https://docs.pingcap.com/ja/tidb/stable/tso/ • SHARD_ROW_ID_BITS | TiDB Docs ◦ https://docs.pingcap.com/ja/tidb/stable/shard-row-id-bits/