Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Pyspark - produtividade e poder de processamento
Search
Felipe cruz
November 10, 2015
Technology
80
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Pyspark - produtividade e poder de processamento
Felipe cruz
November 10, 2015
Transcript
30 slides
PySpark PySpark Produtividade e poder de processamento
Quem? Quem? github.com/felipecruz github.com/felipecruz @ @felipe felipej jcruz cruz
Agenda Agenda Map-Reduce Pyspark
Maior oferta feita em Maior oferta feita em uma semana
na uma semana na BOVESPA? BOVESPA?
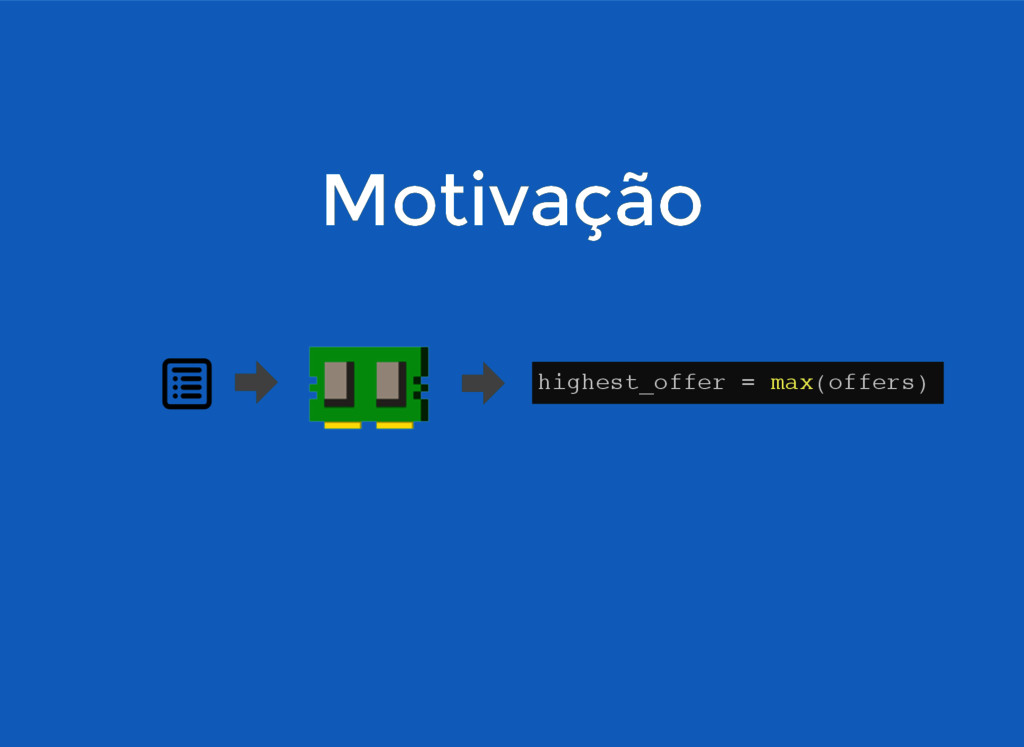
Motivação Motivação highest_offer = max(offers)
None
None
? ?
? ?
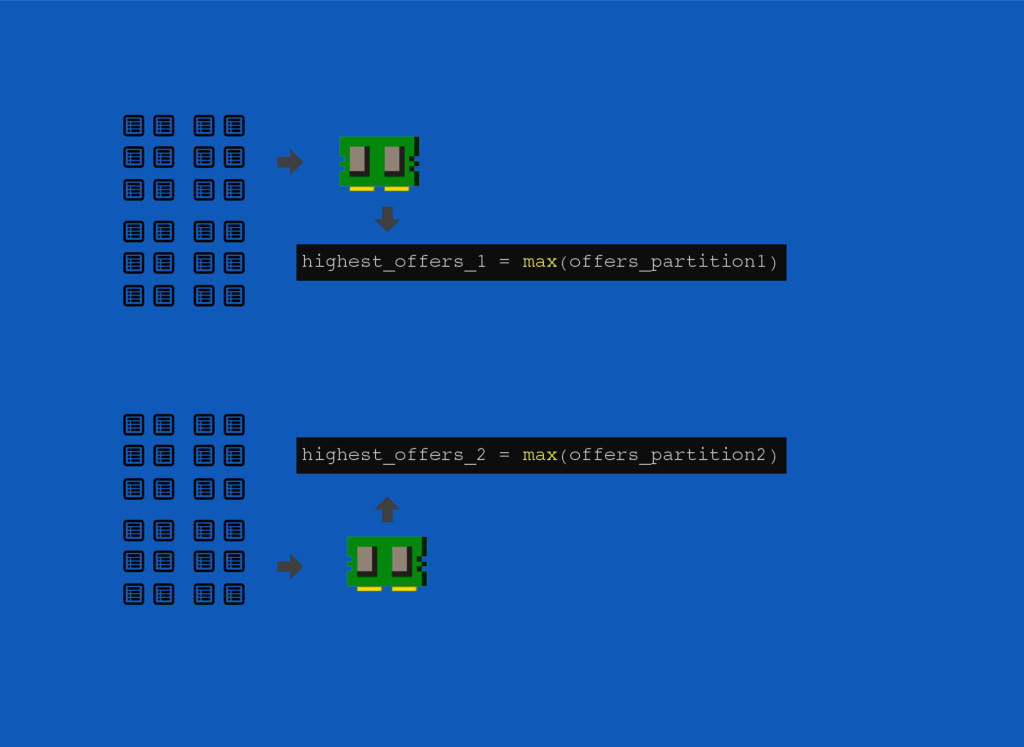
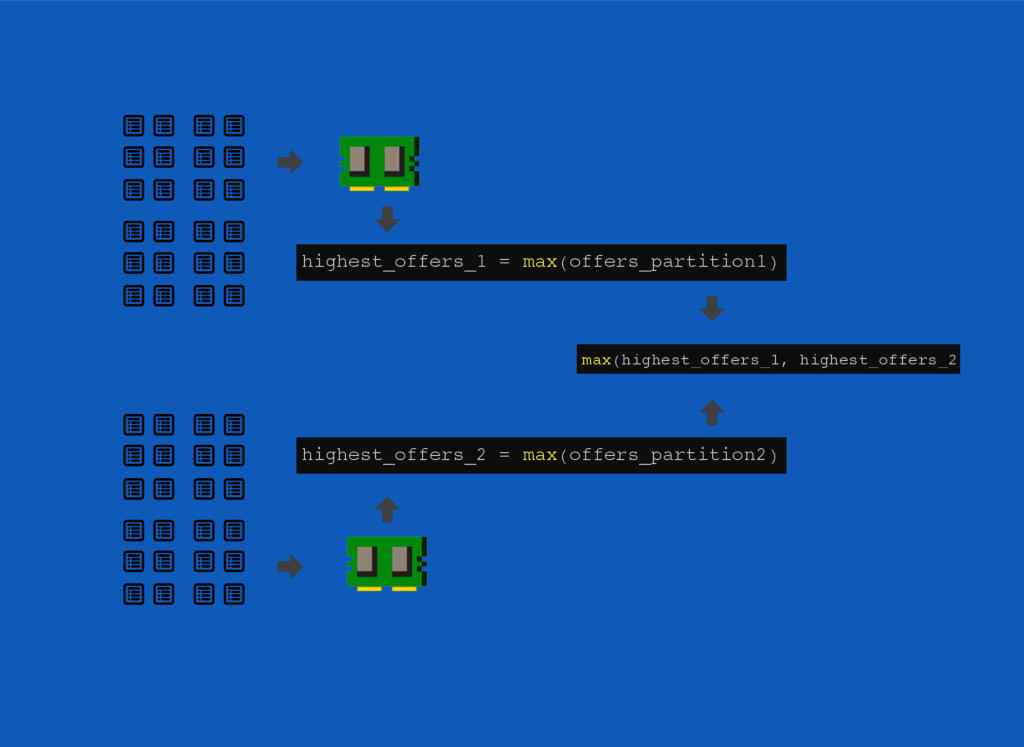
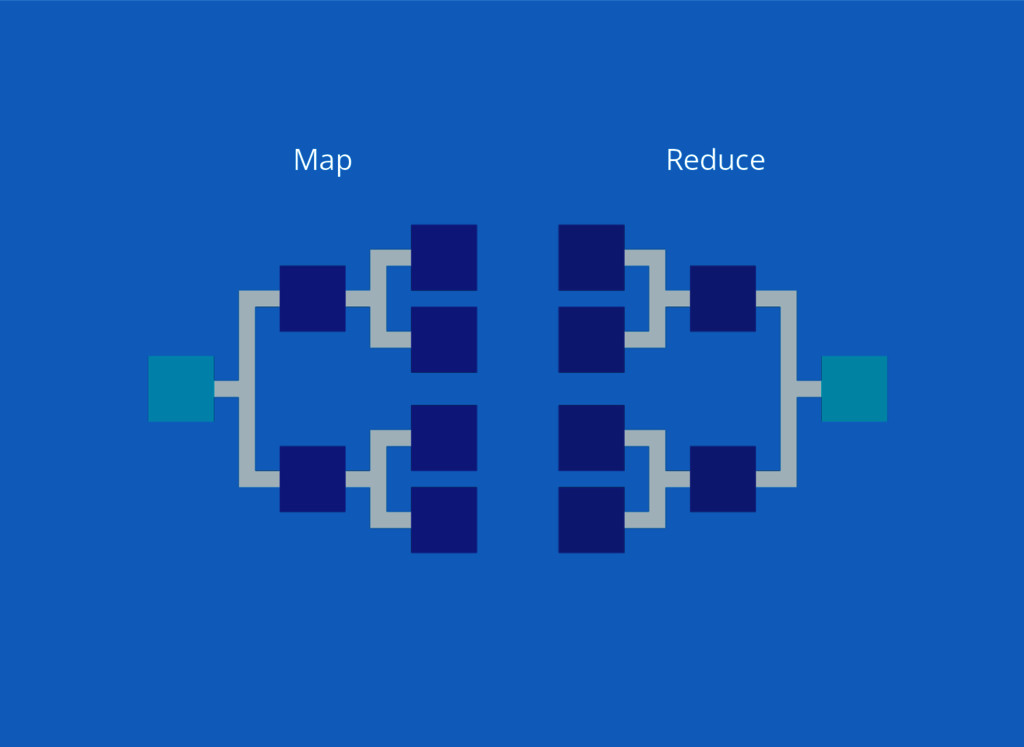
highest_offers_1 = max(offers_partition1) highest_offers_2 = max(offers_partition2)
highest_offers_1 = max(offers_partition1) highest_offers_2 = max(offers_partition2) max(highest_offers_1, highest_offers_2)
calma... calma...
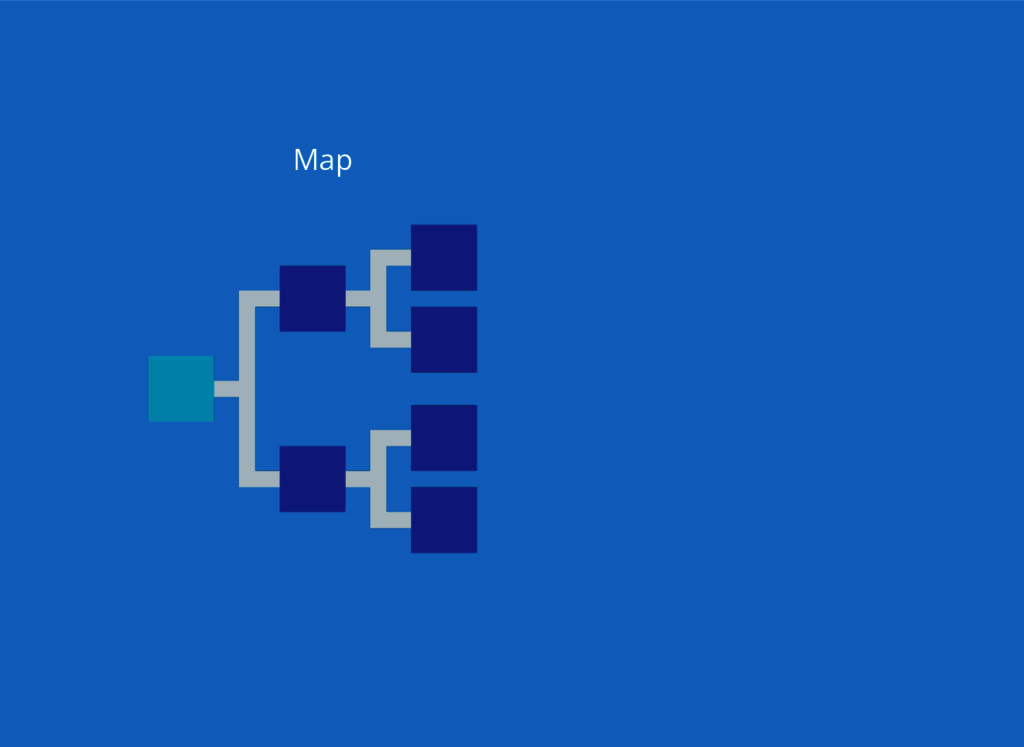
Map
Map Reduce
Map-Reduce Map-Reduce não é divisão e conquista (que pode ser
implementada com map-reduce)
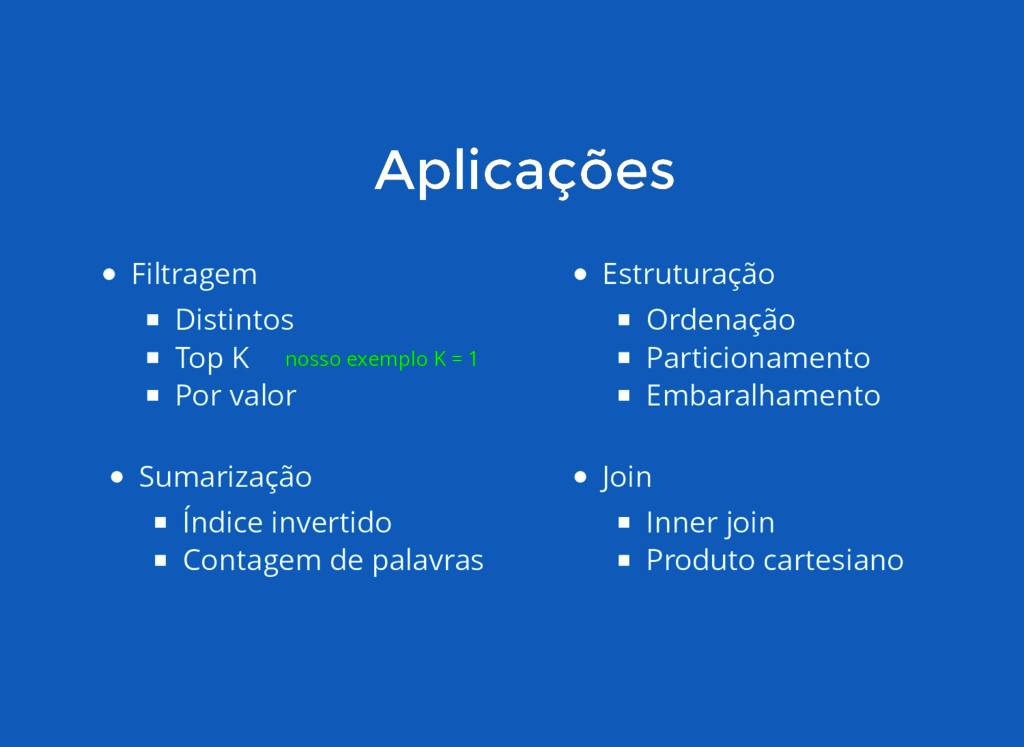
Aplicações Aplicações Filtragem Distintos Top K Por valor Sumarização Índice
invertido Contagem de palavras Estruturação Ordenação Particionamento Embaralhamento Join Inner join Produto cartesiano nosso exemplo K = 1
PySpark PySpark
Funcionalidades centrais Funcionalidades centrais Map-Reduce RDD, DataFrames & SQL MLlib
Streaming GraphX
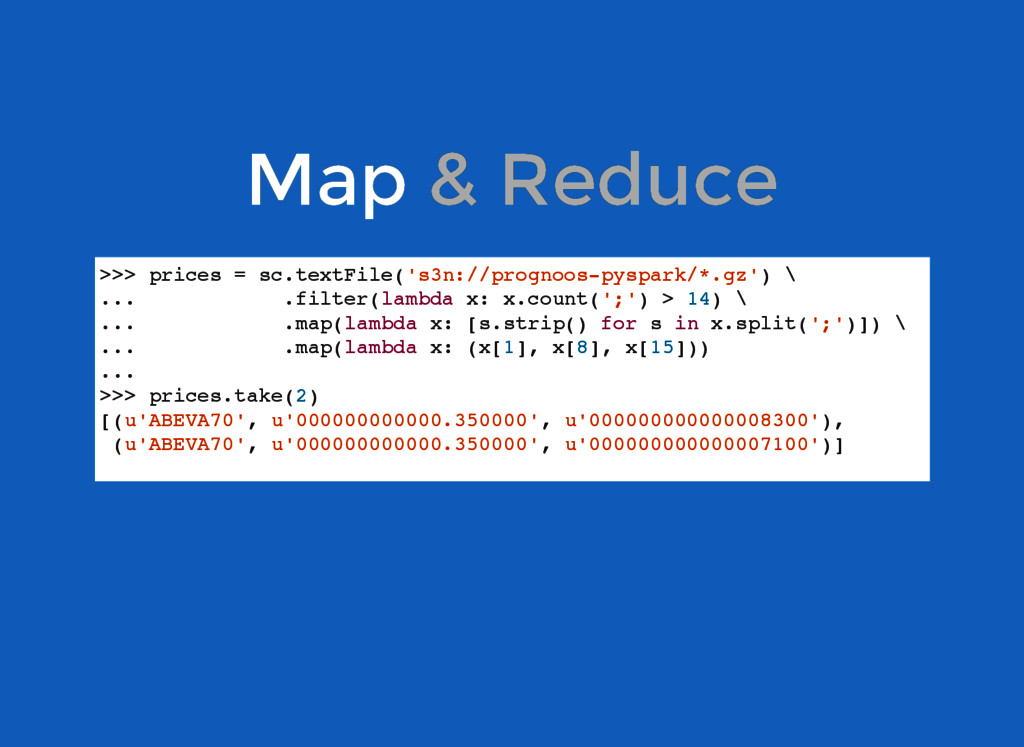
Map Map & Reduce & Reduce >>> prices = sc.textFile('s3n://prognoos-pyspark/*.gz')
\ ... .filter(lambda x: x.count(';') > 14) \ ... .map(lambda x: [s.strip() for s in x.split(';')]) \ ... .map(lambda x: (x[1], x[8], x[15])) ... >>> prices.take(2) [(u'ABEVA70', u'000000000000.350000', u'000000000000008300'), (u'ABEVA70', u'000000000000.350000', u'000000000000007100')]
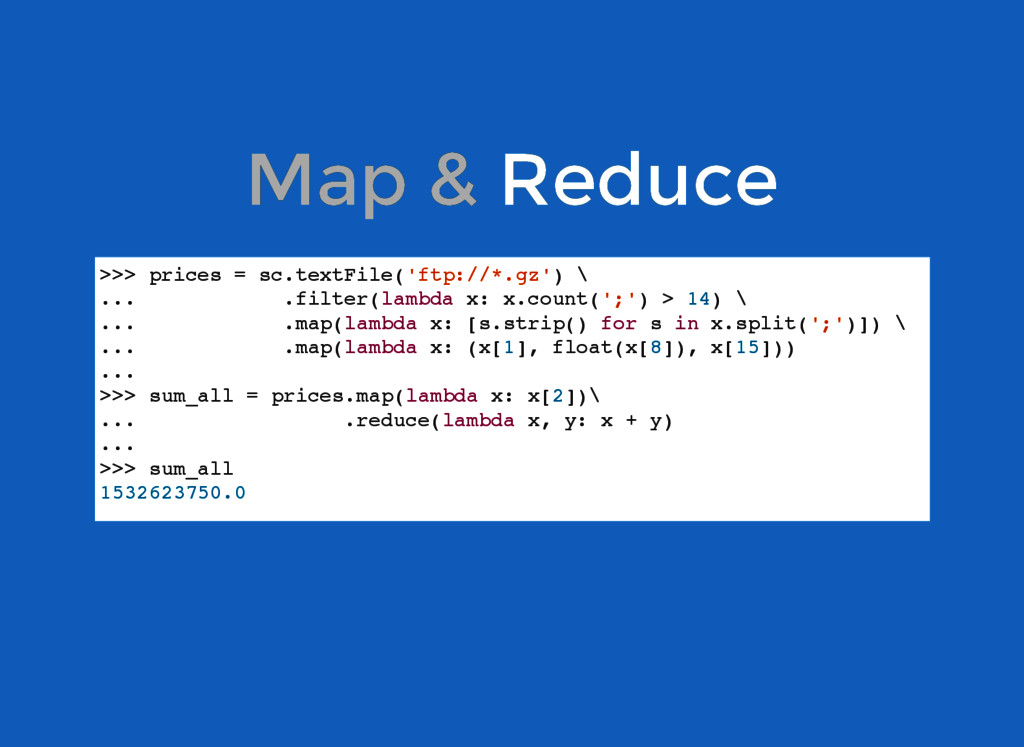
Map & Map & Reduce Reduce >>> prices = sc.textFile('ftp://*.gz')
\ ... .filter(lambda x: x.count(';') > 14) \ ... .map(lambda x: [s.strip() for s in x.split(';')]) \ ... .map(lambda x: (x[1], float(x[8]), x[15])) ... >>> sum_all = prices.map(lambda x: x[2])\ ... .reduce(lambda x, y: x + y) ... >>> sum_all 1532623750.0
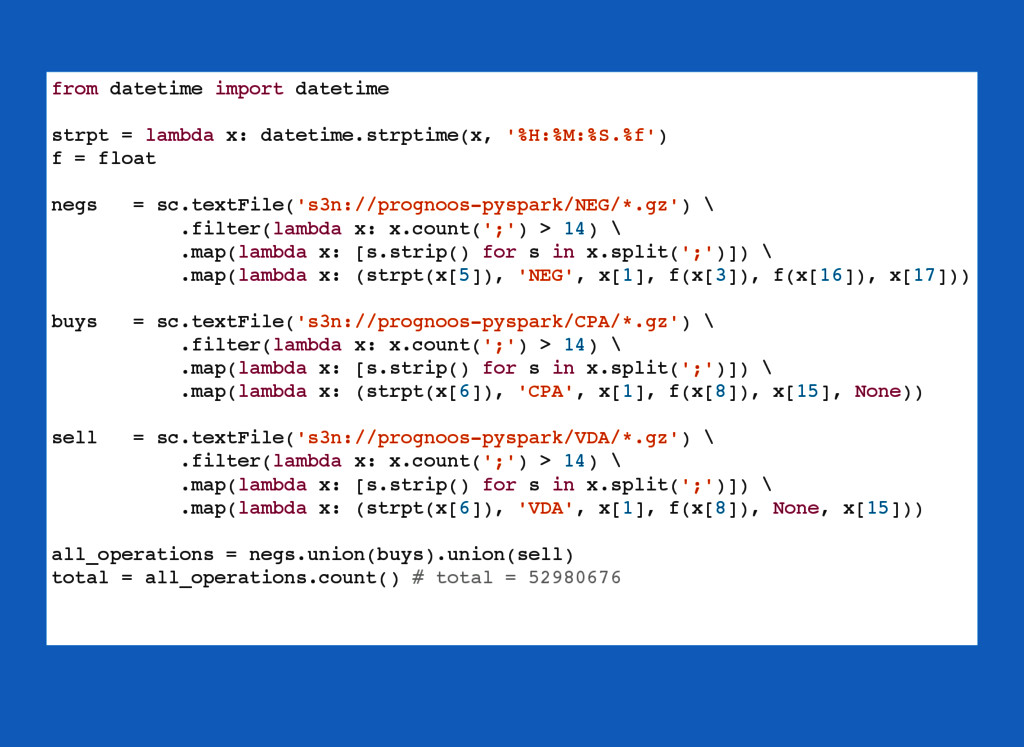
from datetime import datetime strpt = lambda x: datetime.strptime(x, '%H:%M:%S.%f')
f = float negs = sc.textFile('s3n://prognoos-pyspark/NEG/*.gz') \ .filter(lambda x: x.count(';') > 14) \ .map(lambda x: [s.strip() for s in x.split(';')]) \ .map(lambda x: (strpt(x[5]), 'NEG', x[1], f(x[3]), f(x[16]), x[17])) buys = sc.textFile('s3n://prognoos-pyspark/CPA/*.gz') \ .filter(lambda x: x.count(';') > 14) \ .map(lambda x: [s.strip() for s in x.split(';')]) \ .map(lambda x: (strpt(x[6]), 'CPA', x[1], f(x[8]), x[15], None)) sell = sc.textFile('s3n://prognoos-pyspark/VDA/*.gz') \ .filter(lambda x: x.count(';') > 14) \ .map(lambda x: [s.strip() for s in x.split(';')]) \ .map(lambda x: (strpt(x[6]), 'VDA', x[1], f(x[8]), None, x[15])) all_operations = negs.union(buys).union(sell) total = all_operations.count() # total = 52980676
... nem tudo são ... nem tudo são flores flores
data = sc.parallelize(['aa', 'bb', 'ab', 'bc']) def _filter(data): sts =
['a', 'b'] rets = [] for st in sts: rets.append((st, data.filter(lambda x: x.startswith(st)))) return rets rdds = _filter(data) for st, rdd in rdds: print((st, rdd.collect())) # ('a', ['bb', 'bc']) # ('b', ['bb', 'bc']) Python - Anti-pattern - não faça!!
DataFrames & SQL DataFrames & SQL
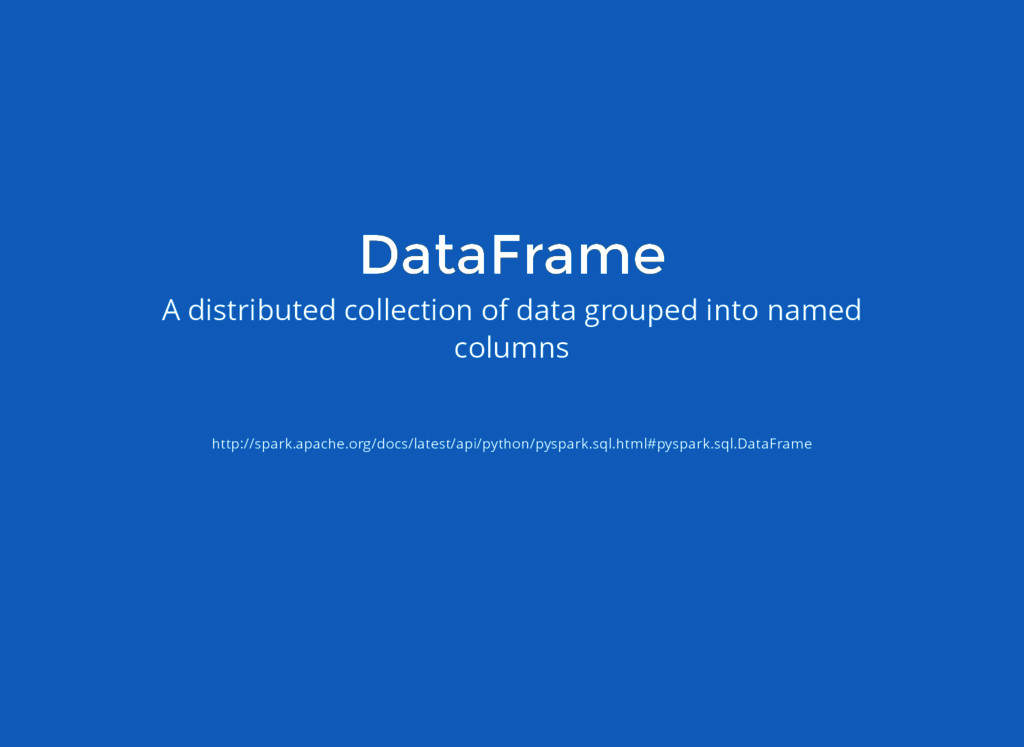
DataFrame DataFrame A distributed collection of data grouped into named
columns http://spark.apache.org/docs/latest/api/python/pyspark.sql.html#pyspark.sql.DataFrame
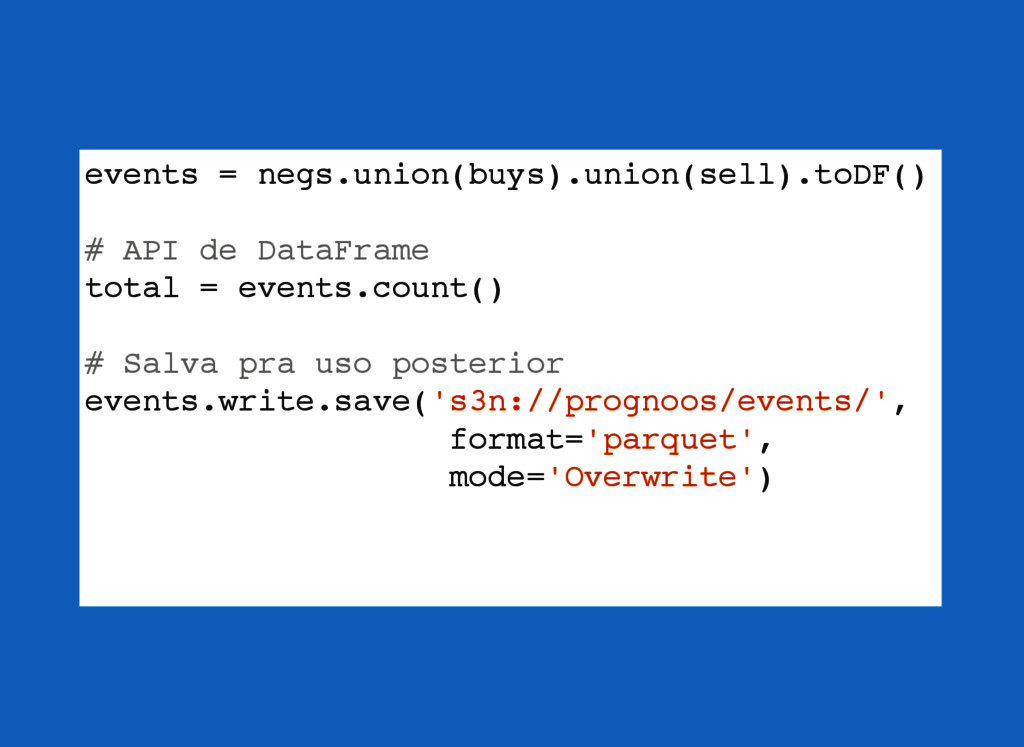
events = negs.union(buys).union(sell).toDF() # API de DataFrame total = events.count()
# Salva pra uso posterior events.write.save('s3n://prognoos/events/', format='parquet', mode='Overwrite')
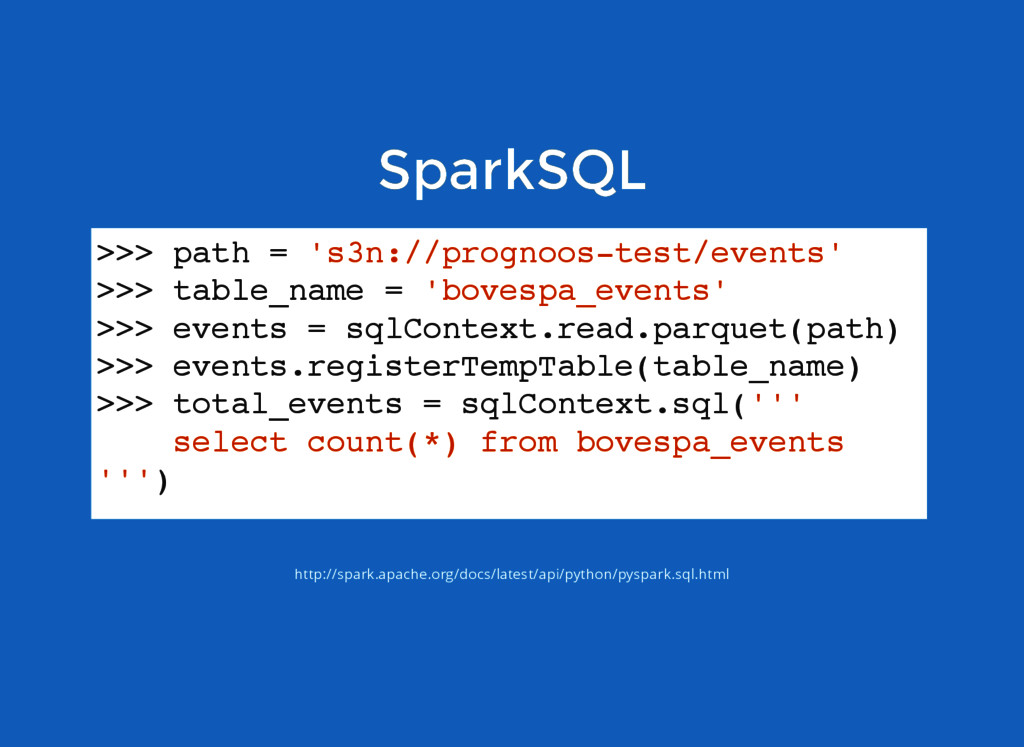
SparkSQL SparkSQL http://spark.apache.org/docs/latest/api/python/pyspark.sql.html >>> path = 's3n://prognoos-test/events' >>> table_name =
'bovespa_events' >>> events = sqlContext.read.parquet(path) >>> events.registerTempTable(table_name) >>> total_events = sqlContext.sql(''' select count(*) from bovespa_events ''')
Spark em produção Spark em produção Standalone Hadoop/Yarn Mesos
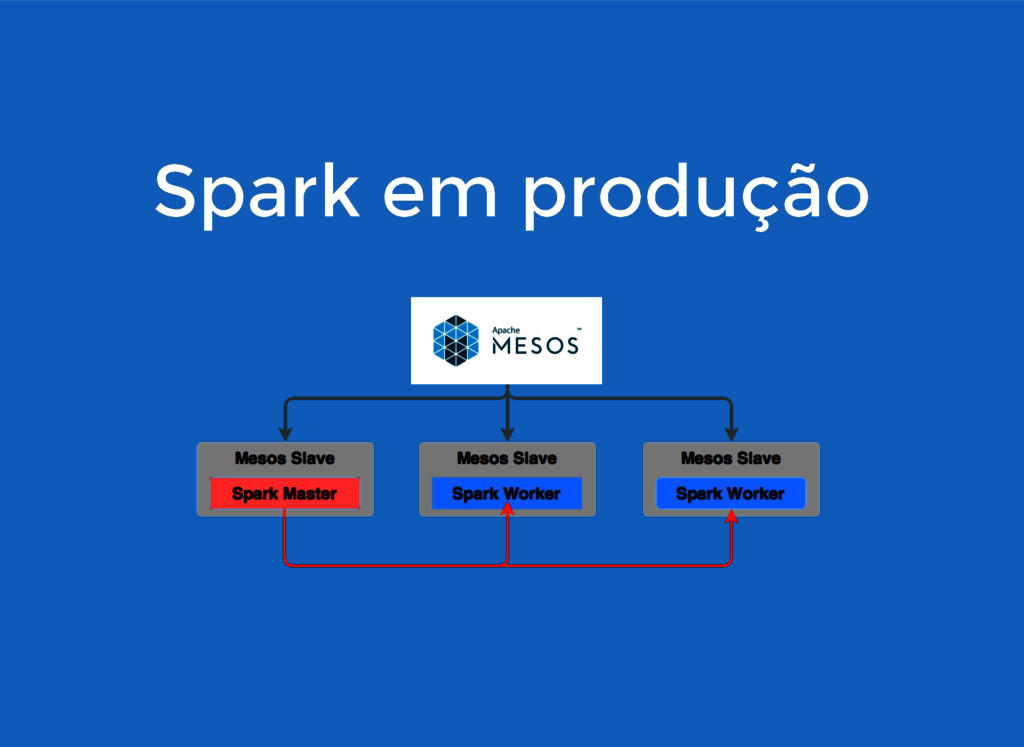
Spark em produção Spark em produção
Dúvidas? Dúvidas? @felipejcruz @felipejcruz github.com/felipecruz github.com/felipecruz
More Decks by Felipe cruz
See All by Felipe cruz
Recomendação - Algoritmos de Filtragem Colaborativa
felipecruz
0
460
Coleta Massiva de Dados
felipecruz
2
160
TDC 2014 - Machine Learning Guerrilha
felipecruz
0
300
Python & C - Formas de Integração
felipecruz
0
160
Other Decks in Technology
See All in Technology
自治体AIコンタクトセンター、何をどこに任せる?~Amazon Connect Customer +Amazon Bedrockの実践知~ / 20261107 Satoshi Torano
shift_evolve
PRO
1
130
20261113_JAWS_Osaka
takuyay0ne
0
170
Ebitengine製iOSアプリ公開ボタンを押す会
eiei114
0
120
Shared Signals Framework 仕様解説
oidfj
0
410
これからのデータエンジニアの役割について考える / Rethinking the Role of Data Engineers in the AI Era
okiyuki99
0
440
Sonnetだけで業務はまわる?
kintotechdev
1
110
Kiro 入門 (1 つのエージェントを、どの画面からでも) | 目指せ Kiro マスター 01
inariku
PRO
6
1.7k
2026-11-11 Tamachi.sre#7 PaCにインフラリソースの命を救われました。 / PaC saves the infra resource life
masasuzu
0
130
cdkd (CDK Direct)
gotok365
4
300
令和の今、あらためて IAM を考える。アクセスキーを「無くせない現実」との向き合い方
kazzpapa3
0
680
AIが会計業務の伴走者に。 マネーフォワード クラウド会計MCPサーバーで実現するAI前提の新しい業務プロセス
nobitabashi
0
110
Context != Context: One window, many lifecycles (AI Native DevCon, Nov 2026)
birgitta410
0
120
Featured
See All Featured
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
320
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
70
69k
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
480
First, design no harm
axbom
PRO
2
1.4k
My Coaching Mixtape
mlcsv
0
390
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
Exploring the relationship between traditional SERPs and Gen AI search
raygrieselhuber
PRO
4
4.4k
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
60k
Accessibility Awareness
sabderemane
1
300
Unlocking the hidden potential of vector embeddings in international SEO
frankvandijk
0
1k
Taking LLMs out of the black box: A practical guide to human-in-the-loop distillation
inesmontani
PRO
3
2.5k


 felipecruz
 shift_evolve
 takuyay0ne
 eiei114
 oidfj
 okiyuki99
 kintotechdev
 inariku
 masasuzu
 gotok365
 kazzpapa3
 nobitabashi
 birgitta410
 sabderemane
 madoxten
 tamaranovitovic
 axbom
 mlcsv
 aleyda
 raygrieselhuber
 cassininazir
 soudai
 frankvandijk
 inesmontani