Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
MoAコンペで気づいたこと
Search
fkubota
December 19, 2020
Programming
810
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
MoAコンペで気づいたこと
fkubota
December 19, 2020
More Decks by fkubota
See All by fkubota
相対性理論の入門の入門
fkubota
0
130
データドリブンな組織の不正検知
fkubota
0
2.5k
JupyterNotebookでのdebug入門(サンプルは説明欄にあります)
fkubota
6
14k
ルールベース画像処理のススメ
fkubota
17
16k
Kaggle日記について
fkubota
2
2.8k
鳥コンペで惨敗した話とコンペの取り組み方
fkubota
1
7.1k
クロマベクトルって何?
fkubota
3
2.8k
生産性と戦った僕の1年の記録とツールたち
fkubota
6
6.8k
Other Decks in Programming
See All in Programming
IBM Bob Dojo #1 仕様駆動開発入門
oniak3ibm
PRO
0
320
AHC070解法紹介
eijirou
0
150
動作中のプログラムの中身をリアルタイムに覗く / Realtime Debugger for CSharp with Roslyn
prota
1
1.7k
市販E-Readerを乗っ取れ 〜Embedded Swiftで電子ペーパーガジェットを制御する〜
trickart
0
230
コードレビューのボトルネックを"する側"と"される側"の両面から解消する
yub0n
2
1.2k
iOS 27でニュースアプリはどう変わる!? 〜日経電子版の新機能対応と、開発事例から〜
lynnswap
7
13k
モデルのリファクタリングが難しいと思ったら、そもそも複雑だったのはビジネス仕様だった ? / is-the-business-domain-the-real-complexity
hatsu38
0
430
Go × SIMDで高速化するベクトル検索 ~ルーフラインモデルでSIMDが効く境界を探れ! ~
po3rin
1
5.7k
速く作れる。その次は、速く確かめられる開発へ 〜AIネイティブ開発を支える、Shift Down〜 / Can build fast. Next, moving to development where we can verify fast.
rkaga
8
5.3k
TiDB Cloudのカスタムコントローラーによるオートスケール対応
takaidohigasi
0
140
[2026-09-26]空論ジェネリックプロセス~テスト資産とAIで紡ぐ、再現可能なパフォーマンスチューニングの話~
tosite
0
250
[ハンズオン]AIへの指示だけで「五目並べ」を作ってみよう
satoshi256kbyte
1
320
Featured
See All Featured
Crafting Experiences
bethany
1
360
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
510
Art, The Web, and Tiny UX
lynnandtonic
304
22k
Paper Plane (Part 1)
katiecoart
PRO
2
11k
Digital Projects Gone Horribly Wrong (And the UX Pros Who Still Save the Day) - Dean Schuster
uxyall
1
3.2k
SERP Conf. Vienna - Web Accessibility: Optimizing for Inclusivity and SEO
sarafernandez
2
1.6k
Jamie Indigo - Trashchat’s Guide to Black Boxes: Technical SEO Tactics for LLMs
techseoconnect
PRO
0
690
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
860
sira's awesome portfolio website redesign presentation
elsirapls
0
430
Fantastic passwords and where to find them - at NoRuKo
philnash
52
3.9k
The Illustrated Guide to Node.js - THAT Conference 2024
reverentgeek
1
550
The Hidden Cost of Media on the Web [PixelPalooza 2025]
tammyeverts
2
510
Transcript
MoAコンペで気づいたこと fkubota https://www.kaggle.com/fkubota
さっそくですが モデルの性能をtarget_columnごとで評価したことありますか? 僕はあります。 今回のコンペのmetricを見てみましょう。 これを変形してみます。 https://www.kaggle.com/c/lish-moa/overview/evaluation
row方向 column方向 mのみに依存
各カラム毎にscoreを出力できた!
ターゲットカラム毎に評価はできました。 1つ1つ結果を確認するのもいいですが、 もう少しおもしろいことをしましょう。
1の数(n)を数えてみる 17 18 24 190 301 仮説: nが小さいほど(学習が困難になって)lossが大きいのでは? n =
n vs logloss でプロット nが小さいほどうまく学習ができていない? ---> nが小さいほどloglossは大きくなる? 右のグラフを見る限りそうでもない。 仮説は否定された。なんでこうなるの? あと、右上に単調増加する意味ありげな形
これはなにかあるぞ。。。
そもそも、nが1とかだったら、 モデルに予測させるのではなく、 全部0埋めすればいいのでは? こいつら学習させることで きるんですか?
0で埋めるのが最適かはわからない。 0に近い値で埋めたほうがいいのは確か。 どの程度の一定値で埋めればいい? n=1, 2, 3, 4, 5のときに、様々な一定値で埋めて score_colを計算した。 横軸は、埋めた一定値の値。
縦軸はscore_col の値。 最適な一定値はnによって変わる。
実はこの最適な一定値は解析的に計算できる。 簡単に紹介(自分で計算してみてね)。
score_colを最小とするようなCをC_0とする (記号の雑さ、数学的な厳密性の欠如は今は目を瞑ってください m(_ _)m) これを解くと... 美しい感じの解出た! 直感的!!
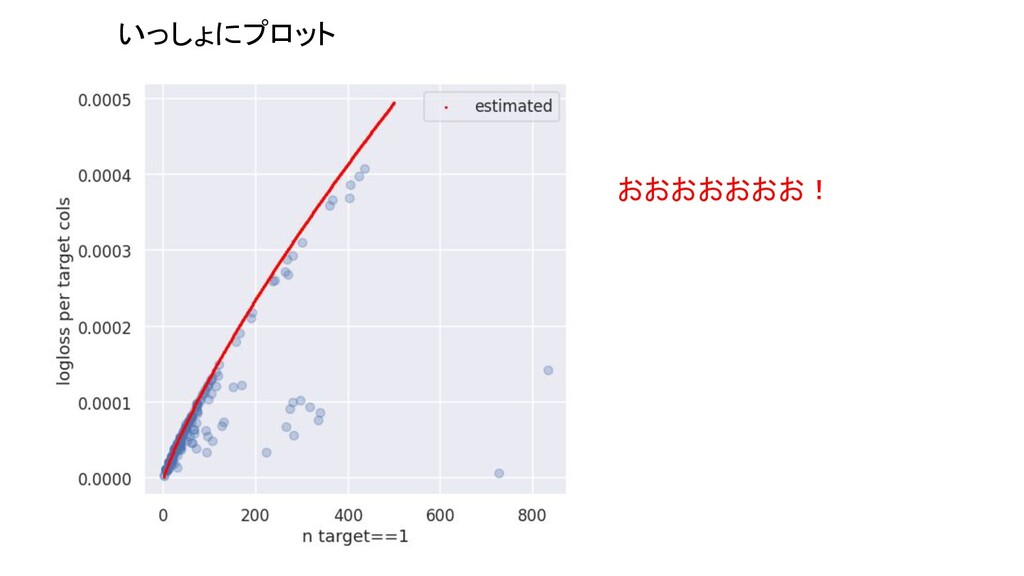
求めた解を使って、nごとにプロットしてみる おっ??
いっしょにプロット おおおおおおお!
つまり? 計算したloglossを赤色でプロットした。 見事に一致している部分が多くある。 赤色と重なっている青い部分はこう解釈できる。 「1は予測できないが、たまに1がtargetにある。すべて0 にpredictしてしまうとペナルティが大きくなってしまうの で、ちょうどいい感じの値を出しておこう」 モデルは、1を頑張って予測しようとしているのではな く、ペナルティが最小限になるような値を出力しているに 過ぎないと言える。
赤い線に近い値を取っているカラムは 全く学習していない!!!
シェイクの予感 - ほとんどの参加者は、この事に気づいていない - スコアに大きな影響があるのはnが大きいターゲット - おそらくほとんどのモデルはnが小さいターゲットはほとんど学習で きていない - モデルは、nが小さなターゲットではn(1が何個含まれているか?)し
か見ていない。 - testとtrainでnの数に大きな差があれば性能は極端に落ちる。 nが小さいtargetで性能を出せればシェイクアップはできる!!
コンペ後半は、n<200の部分だけの性能アップに注力 - focal loss - mixup - LabelSmoothing - etc….
mixupが一番効く!!
cool_rabbitさんによる実験 黄色: mixup なし 青色: mixupあり 良くなってる 悪くなってる アンサンブルの時、 このモデルはN<200
の部分だけを使うなどの工 夫をした
シェイクアップ!!!!
None


 fkubota
 oniak3ibm
 eijirou
 prota
 trickart
 yub0n
 lynnswap
 hatsu38
 po3rin
 rkaga
 takaidohigasi
 tosite
 satoshi256kbyte
 bethany
 jct
 lynnandtonic
 katiecoart
 uxyall
 sarafernandez
 techseoconnect
 cargoodrich
 elsirapls
 philnash
 reverentgeek
 tammyeverts