Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AIエージェントに脆弱性診断の仕事を奪われかけた ークローリングからコード全診断までの限界突破ー
Search
gree_tech
PRO
October 16, 2026
Technology
11
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AIエージェントに脆弱性診断の仕事を奪われかけた ークローリングからコード全診断までの限界突破ー
GREE Tech Conference 2026で発表された資料です。
https://techcon.gree.jp/2026/session/TrackA-3
gree_tech
PRO
October 16, 2026
More Decks by gree_tech
See All by gree_tech
多彩なデータに負けないデータ分析パイプライン構築
gree_tech
PRO
0
6
AI駆動で挑むプロダクト刷新 ── アーキテクチャ設計とワークフロー最適化の実践事例 ──
gree_tech
PRO
0
5
『ヘブンバーンズレッド』のリグレッションテストにおけるストーリーの自動プレイ
gree_tech
PRO
0
5
REALITYにTAチームができるまでの軌跡〜ミッション:ガチャ本数5倍に対応せよ!〜
gree_tech
PRO
0
4
イベント続きでもミスらないライブサービスゲーム公式サイト運用システム開発
gree_tech
PRO
0
4
20年間 SNS サービス「GREE」 を支えた技術の刷新と、長期運用サービスの Kubernetes へのリアーキテクト
gree_tech
PRO
0
13
グラフ基盤ワークフローで実現するLLMによる自動ゲームプレイ
gree_tech
PRO
0
5
アバター使っておもろいものを作り続けたい
gree_tech
PRO
0
2
爆速開発を支えるAIワークフローの現在地 ── AIが読めるデザインをどうつくるか
gree_tech
PRO
0
4
Other Decks in Technology
See All in Technology
Cognition AI Japan - ウェビナー2_テストQA_運用監視
cogakira
0
130
ai_cording_with_k8s_knowledge.pdf
mochizuki875
1
340
OpenSharing について熱く語る 〜AI アセットの共有について〜
kameitomohiro
0
260
Snapshot Testing in Practice: Predictable and Reliable SwiftUI Views
fespinoza
0
190
おそらく日本で唯一のDevRelインターン生として
husengs7
0
170
AgentCoreで実践するハーネスエンジニアリング
yakumo
1
300
12 個 Tool と、 4,096 Token
hlum
0
130
不可逆な意思決定を避けながら10億超の顧客データを AI Ready にするデータ基盤設計
baseballyama
1
310
AIがコードを書く時代に、エンジニアは何で自分の価値を証明するのか / In an era where AI writes code how do engineers prove their value
carta_engineering
2
850
メルペイ 会計システム概要と歴史
mewuto
0
210
会社説明資料
persolserverworks
0
9.7k
Kiro Crewをはじめよう
kizawa2020
1
140
Featured
See All Featured
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3.2k
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
430
The Cult of Friendly URLs
andyhume
79
7k
Scaling GitHub
holman
464
140k
Making Projects Easy
brettharned
120
6.8k
Helping Users Find Their Own Way: Creating Modern Search Experiences
danielanewman
31
3.4k
The innovator’s Mindset - Leading Through an Era of Exponential Change - McGill University 2025
jdejongh
PRO
1
370
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
300
Building Applications with DynamoDB
mza
96
7.2k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
580
Typedesign – Prime Four
hannesfritz
42
3.2k
StorybookのUI Testing Handbookを読んだ
zakiyama
31
7k
Transcript
AIエージェントに脆弱性診断の仕事を奪われかけた ークローリングからコード全診断までの限界突破ー グリーホールディングス株式会社 髙村 充、覚張 泰幸、瀧沢 和也
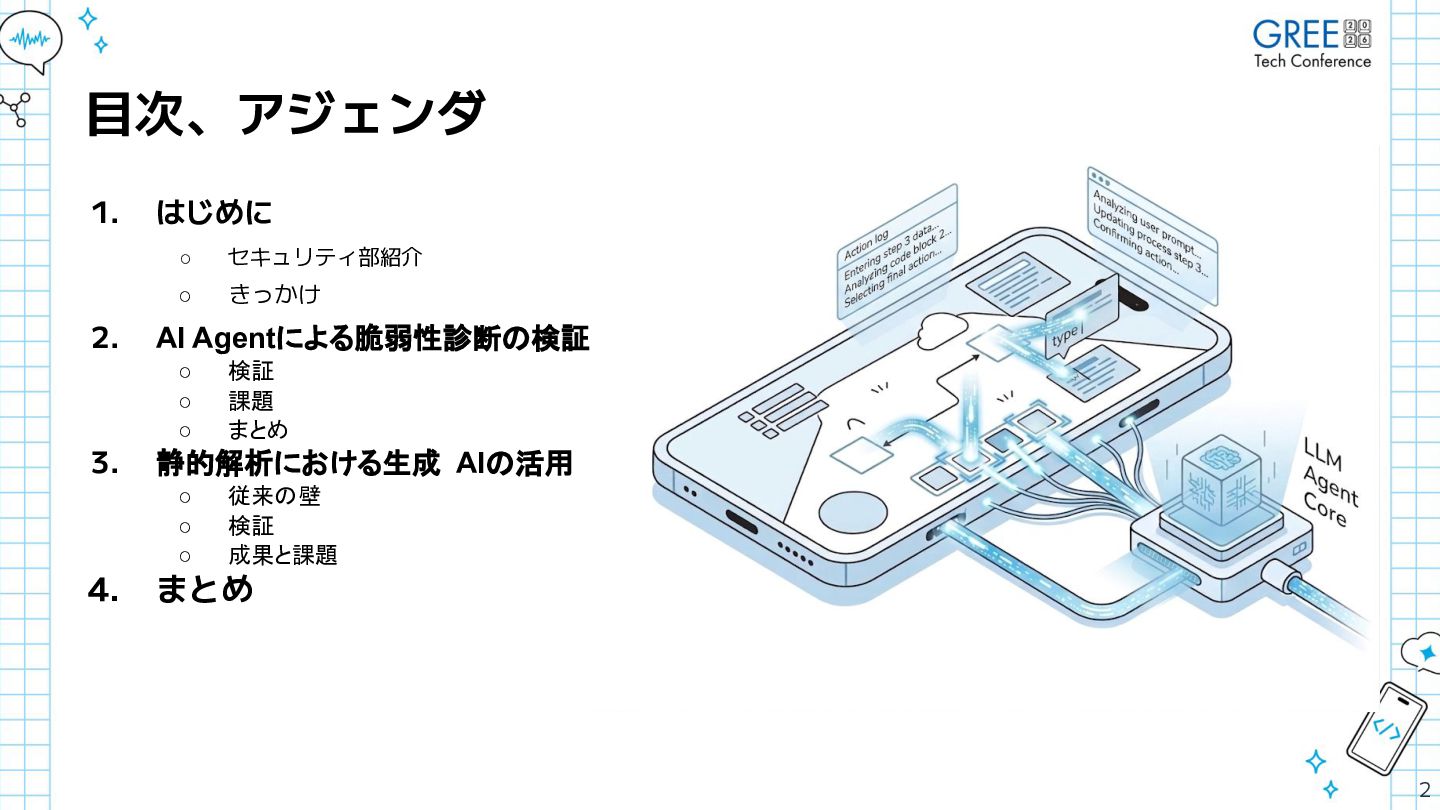
目次、アジェンダ 1. 2. はじめに ◦ セキュリティ部紹介 ◦ きっかけ AI Agentによる脆弱性診断の検証
◦ ◦ ◦ 3. 静的解析における生成 AIの活用 ◦ ◦ ◦ 4. 検証 課題 まとめ 従来の壁 検証 成果と課題 まとめ 2
はじめに 3
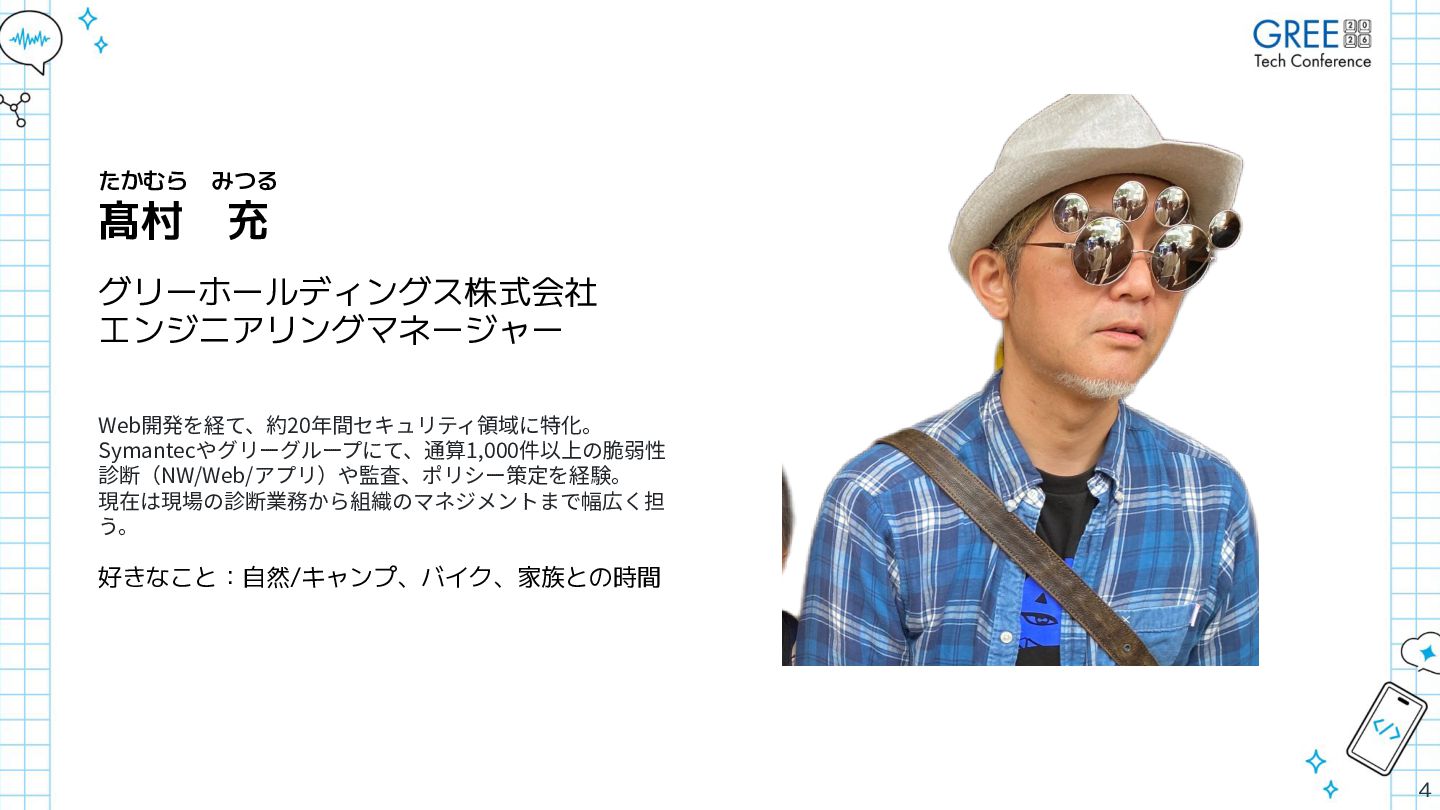
たかむら みつる 髙村 充 グリーホールディングス株式会社 エンジニアリングマネージャー Web開発を経て、約20年間セキュリティ領域に特化。 Symantecやグリーグループにて、通算1,000件以上の脆弱性 診断(NW/Web/アプリ)や監査、ポリシー策定を経験。 現在は現場の診断業務から組織のマネジメントまで幅広く担
う。 好きなこと:自然/キャンプ、バイク、家族との時間 4
覚張 泰幸 (かくはり やすゆき) グリーホールディングス株式会社シニア エンジニア カラオケ機器や商用車向けシステムをはじめと する複数の開発プロジェクトに携わった後、 2013年に株式会社ポケラボ(現:株式会社WFS) へ入社。ゲーム開発では複数のタイトルの開発
・運営に携わり、『戦乱のサムライキングダ ム』ではリードエンジニア、『SINoALICE-シ ノアリス-』では開発統括を歴任。現在はグ リーグループのセキュリティエンジニアとし て、脆弱性診断やセキュア開発の推進など、開 発現場に根ざしたセキュリティ強化に取り組ん でいる。 5
瀧沢 和也 グリーホールディングス株式会社 シニアエンジニア 2014年グリー株式会社(現:グリーホール ディングス株式会社)に新卒⼊社、広告事業 部⼦会社へ出向後に2017年よりセキュリティ 部にて脆弱性診断をメインに様々な業務に従 事 6
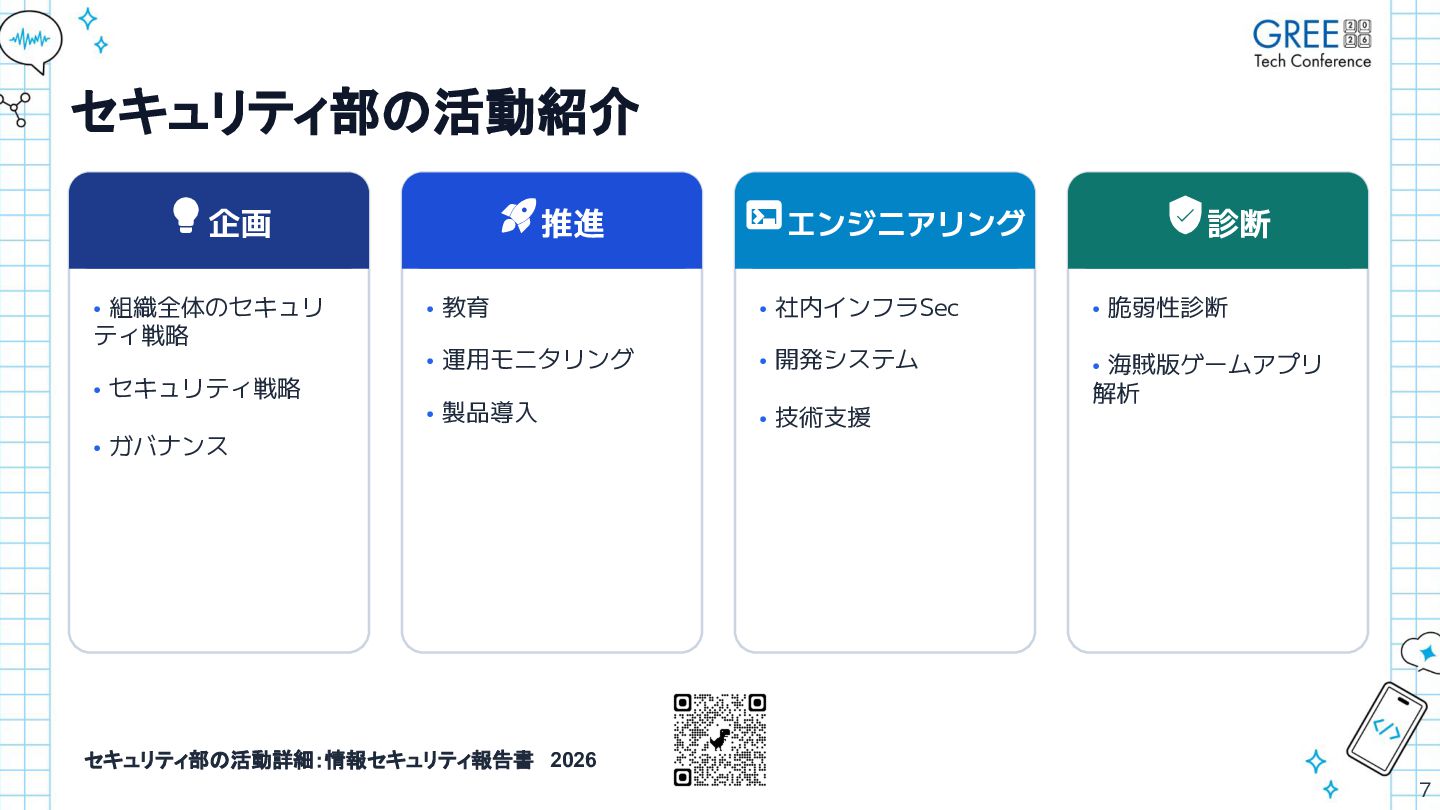
セキュリティ部の活動紹介 企画 • 組織全体のセキュリ ティ戦略 • セキュリティ戦略 推進
エンジニアリング 診断 • 教育 • 社内インフラSec • 脆弱性診断 • 運用モニタリング • 開発システム • 製品導入 • 技術支援 • 海賊版ゲームアプリ 解析 • ガバナンス セキュリティ部の活動詳細:情報セキュリティ報告書 2026 7
なぜ、やってみようと思ったのか RSAC 2026 と現地視察で受けた衝撃 8
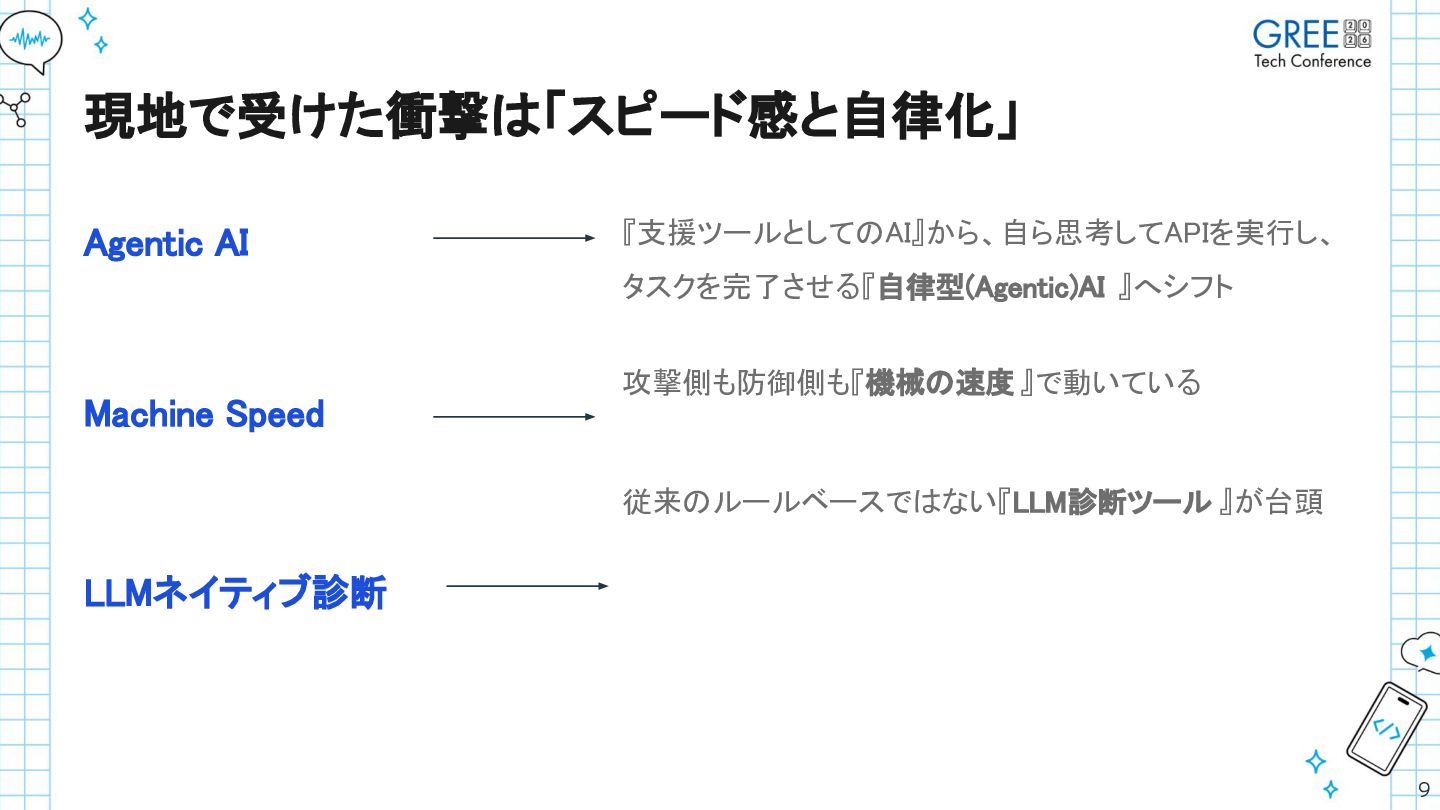
現地で受けた衝撃は「スピード感と自律化」 Agentic AI 『支援ツールとしてのAI』から、自ら思考してAPIを実行し、 タスクを完了させる『自律型(Agentic)AI 』へシフト Machine Speed 攻撃側も防御側も『機械の速度 』で動いている
従来のルールベースではない『LLM診断ツール 』が台頭 LLMネイティブ診断 9
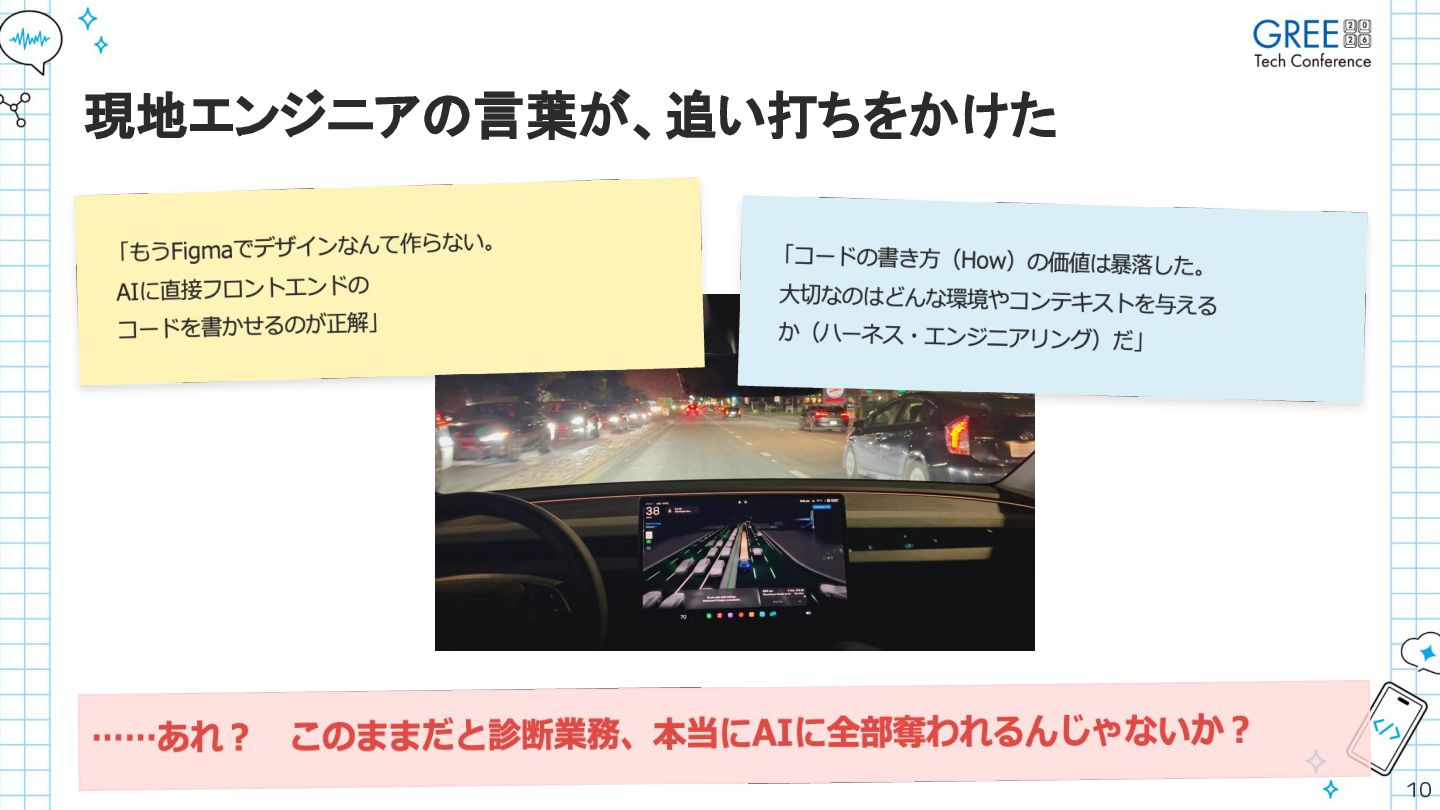
現地エンジニアの言葉が、追い打ちをかけた 10
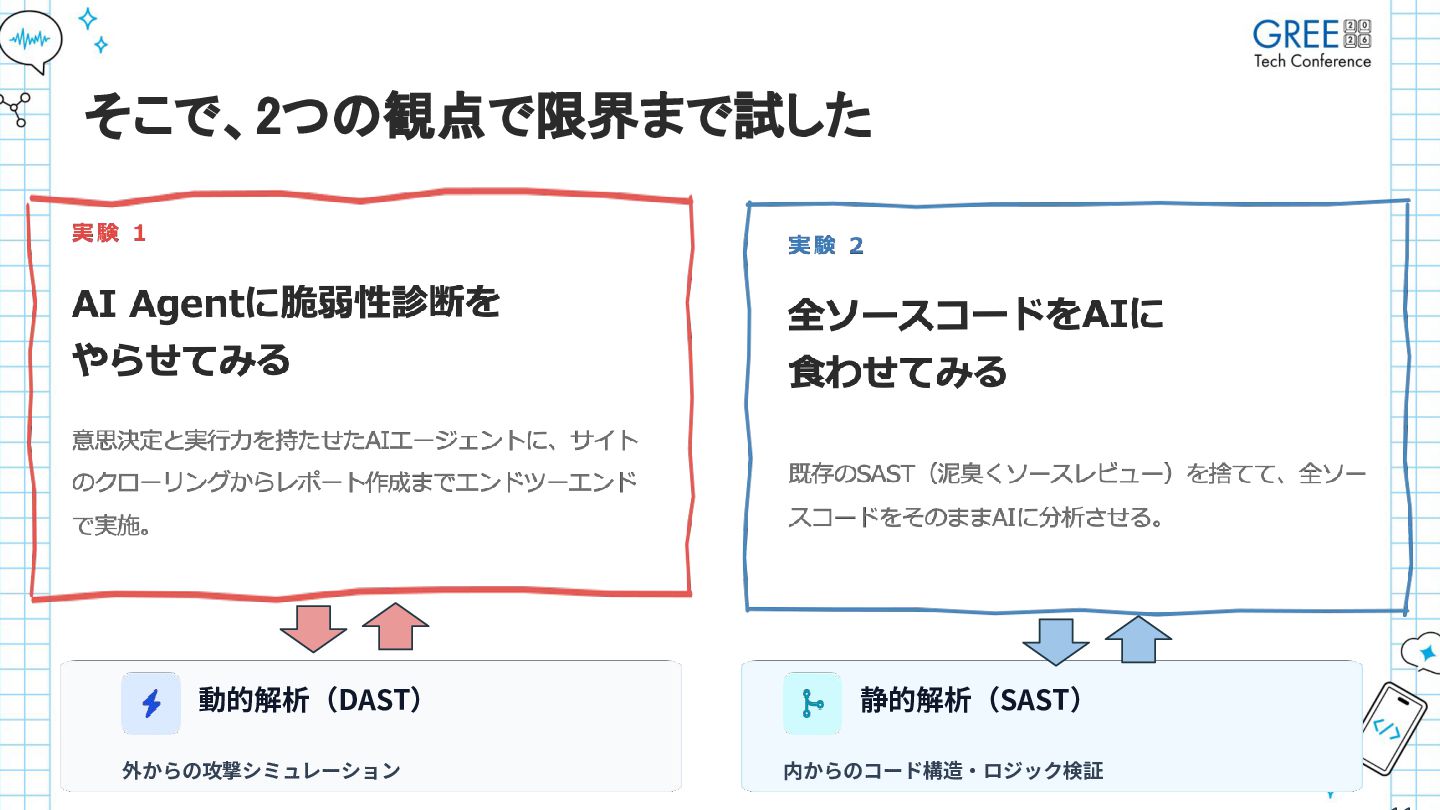
そこで、2つの観点で限界まで試した 動的解析(DAST) 外からの攻撃シミュレーション 静的解析(SAST) 内からのコード構造‧ロジック検証
AI Agent による脆弱性診断の検証 ⾃律型AIはWebセキュリティ診断の実務にどこまで通⽤するのか? 仮説検証からPoC作成、そして⼈間の介在価値を検証する BACKGROUND TARGET APP GOVERNANCE ⾃律的タスク遂⾏能⼒の進化
DVWA(ローカル)及び⾃社環境 厳格なスコープ管理‧許可環境下で実施 12
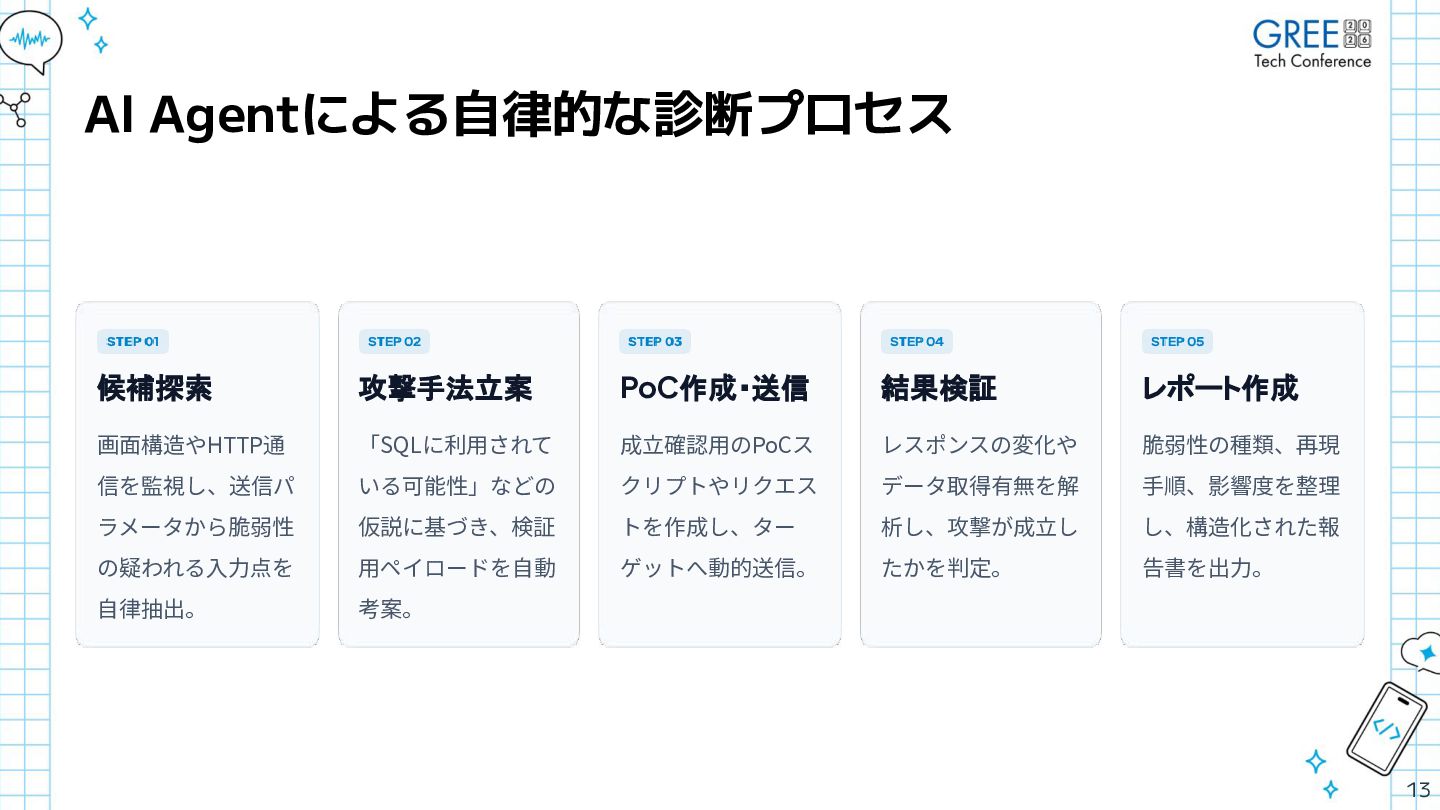
AI Agentによる自律的な診断プロセス 候補探索 攻撃手法立案 PoC作成・送信 結果検証 レポート作成 画⾯構造やHTTP通 「SQLに利⽤されて 成⽴確認⽤のPoCス
レスポンスの変化や 脆弱性の種類、再現 信を監視し、送信パ いる可能性」などの クリプトやリクエス データ取得有無を解 ⼿順、影響度を整理 ラメータから脆弱性 仮説に基づき、検証 トを作成し、ター 析し、攻撃が成⽴し し、構造化された報 の疑われる⼊⼒点を ⽤ペイロードを⾃動 ゲットへ動的送信。 たかを判定。 告書を出⼒。 ⾃律抽出。 考案。 13
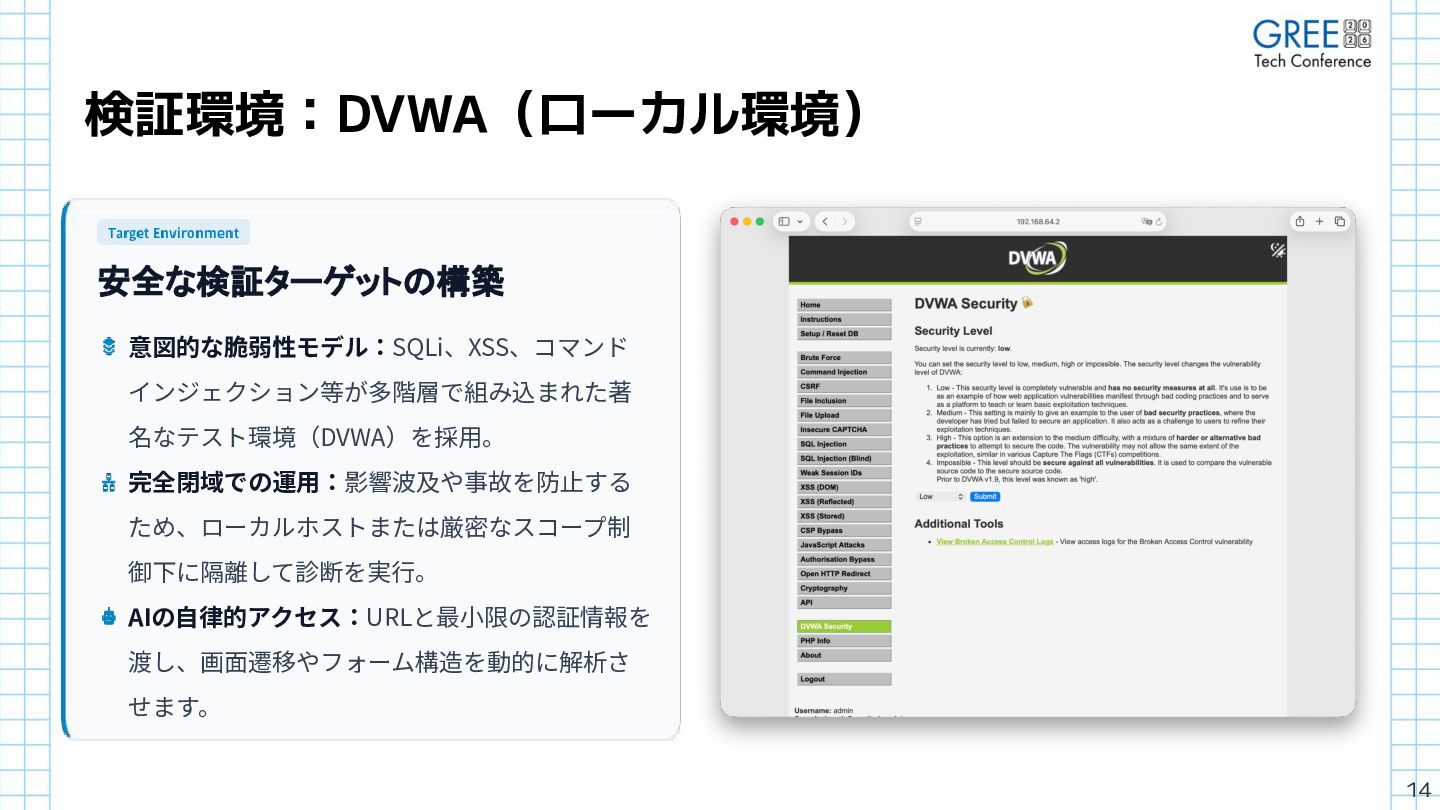
検証環境:DVWA(ローカル環境) 安全な検証ターゲットの構築 意図的な脆弱性モデル:SQLi、XSS、コマンド インジェクション等が多階層で組み込まれた著 名なテスト環境(DVWA)を採⽤。 完全閉域での運⽤:影響波及や事故を防⽌する ため、ローカルホストまたは厳密なスコープ制 御下に隔離して診断を実⾏。 AIの⾃律的アクセス:URLと最⼩限の認証情報を 渡し、画⾯遷移やフォーム構造を動的に解析さ
せます。 14
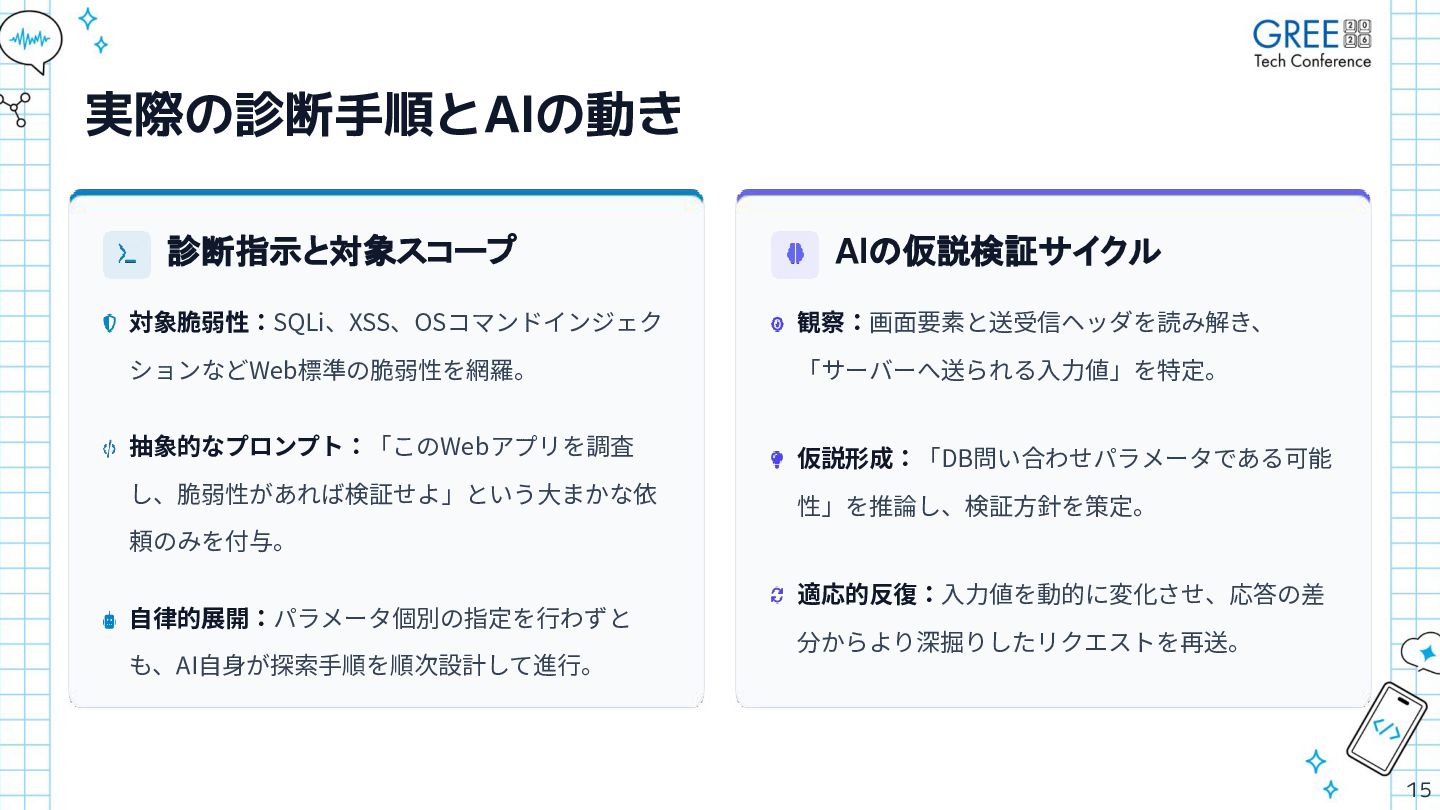
実際の診断手順とAIの動き 診断指示と対象スコープ AIの仮説検証サイクル 対象脆弱性:SQLi、XSS、OSコマンドインジェク 観察:画⾯要素と送受信ヘッダを読み解き、 ションなどWeb標準の脆弱性を網羅。 「サーバーへ送られる⼊⼒値」を特定。 抽象的なプロンプト:「このWebアプリを調査 し、脆弱性があれば検証せよ」という⼤まかな依 仮説形成:「DB問い合わせパラメータである可能
性」を推論し、検証⽅針を策定。 頼のみを付与。 ⾃律的展開:パラメータ個別の指定を⾏わずと も、AI⾃⾝が探索⼿順を順次設計して進⾏。 適応的反復:⼊⼒値を動的に変化させ、応答の差 分からより深掘りしたリクエストを再送。 15
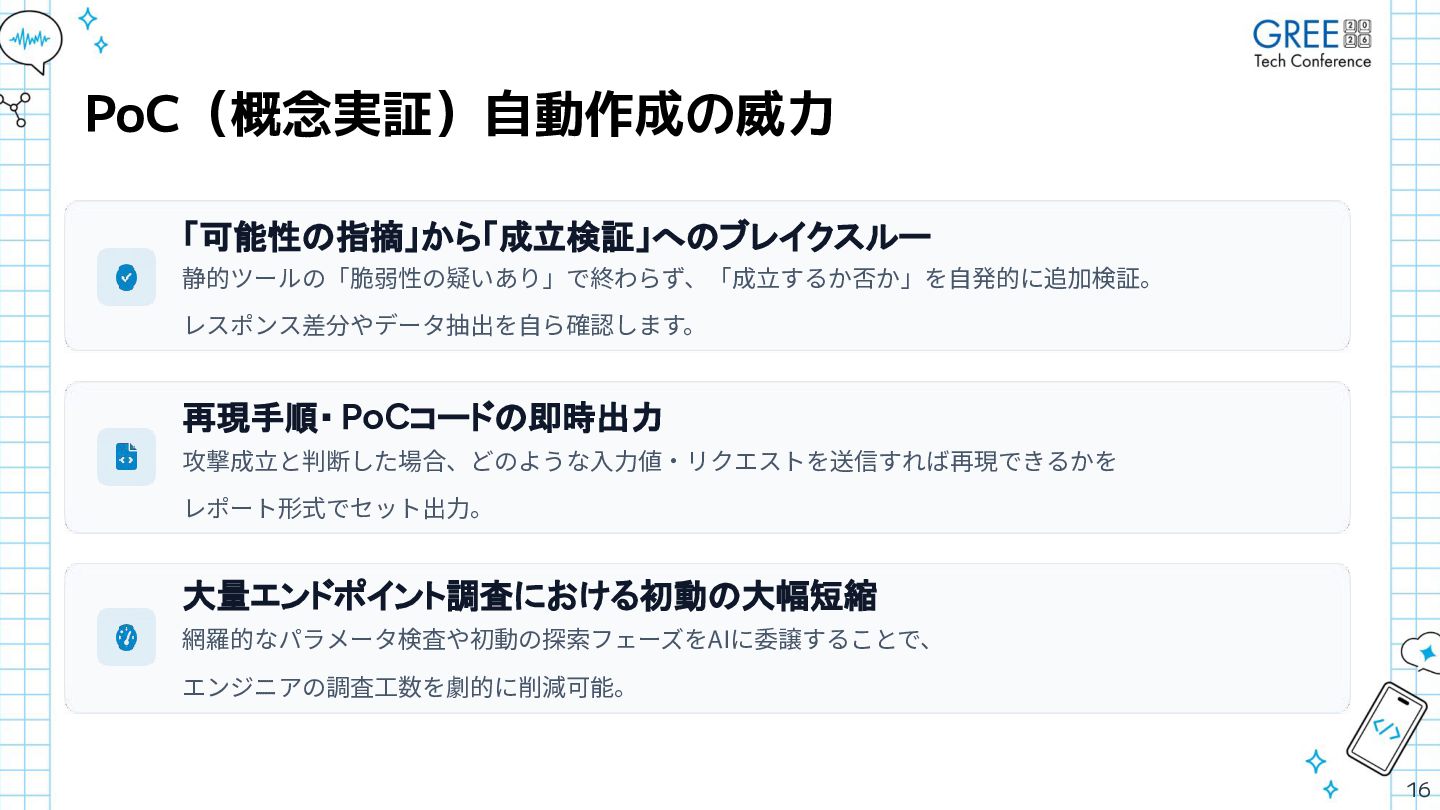
PoC(概念実証)自動作成の威力 「可能性の指摘」から「成立検証」へのブレイクスルー 静的ツールの「脆弱性の疑いあり」で終わらず、「成⽴するか否か」を⾃発的に追加検証。 レスポンス差分やデータ抽出を⾃ら確認します。 再現手順・ PoCコードの即時出力 攻撃成⽴と判断した場合、どのような⼊⼒値‧リクエストを送信すれば再現できるかを レポート形式でセット出⼒。 大量エンドポイント調査における初動の大幅短縮 網羅的なパラメータ検査や初動の探索フェーズをAIに委譲することで、
エンジニアの調査⼯数を劇的に削減可能。 16
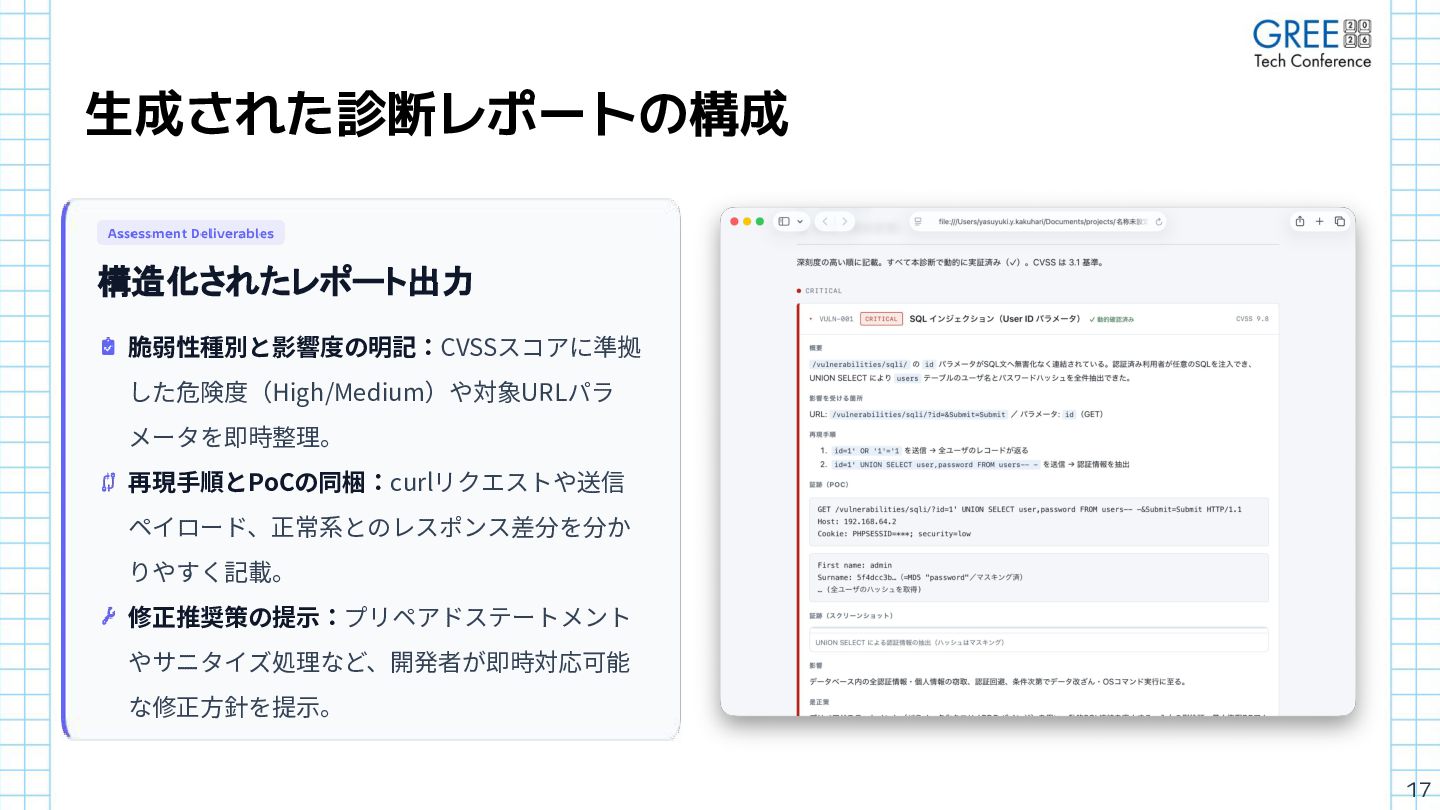
生成された診断レポートの構成 構造化されたレポート出力 脆弱性種別と影響度の明記:CVSSスコアに準拠 した危険度(High/Medium)や対象URLパラ メータを即時整理。 再現⼿順とPoCの同梱:curlリクエストや送信 ペイロード、正常系とのレスポンス差分を分か りやすく記載。 修正推奨策の提⽰:プリペアドステートメント やサニタイズ処理など、開発者が即時対応可能
な修正⽅針を提⽰。 17
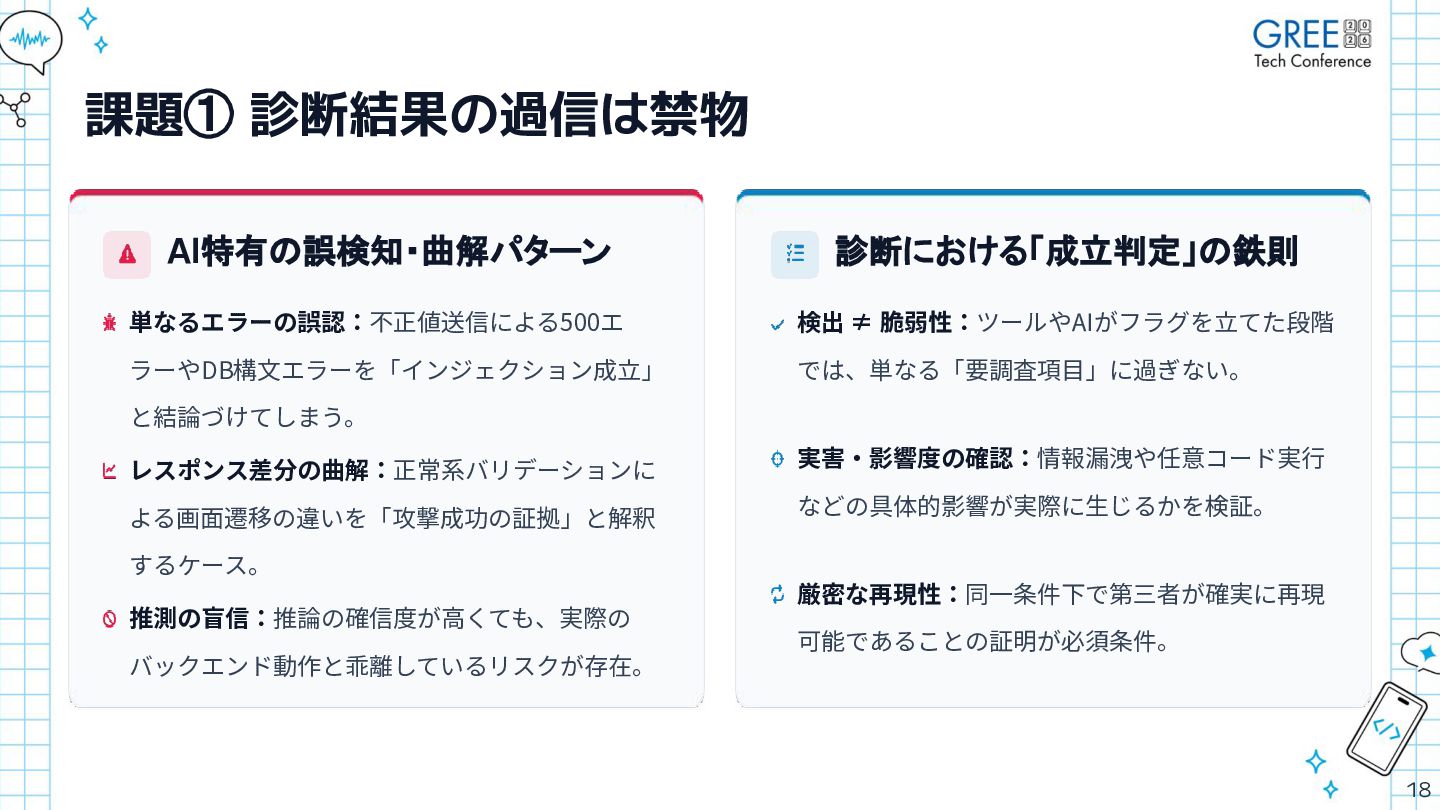
課題① 診断結果の過信は禁物 AI特有の誤検知・曲解パターン 診断における「成立判定」の鉄則 単なるエラーの誤認:不正値送信による500エ 検出 ≠ 脆弱性:ツールやAIがフラグを⽴てた段階 ラーやDB構⽂エラーを「インジェクション成⽴」 では、単なる「要調査項⽬」に過ぎない。
と結論づけてしまう。 レスポンス差分の曲解:正常系バリデーションに 実害‧影響度の確認:情報漏洩や任意コード実⾏ よる画⾯遷移の違いを「攻撃成功の証拠」と解釈 などの具体的影響が実際に⽣じるかを検証。 するケース。 厳密な再現性:同⼀条件下で第三者が確実に再現 推測の盲信:推論の確信度が⾼くても、実際の 可能であることの証明が必須条件。 バックエンド動作と乖離しているリスクが存在。 18
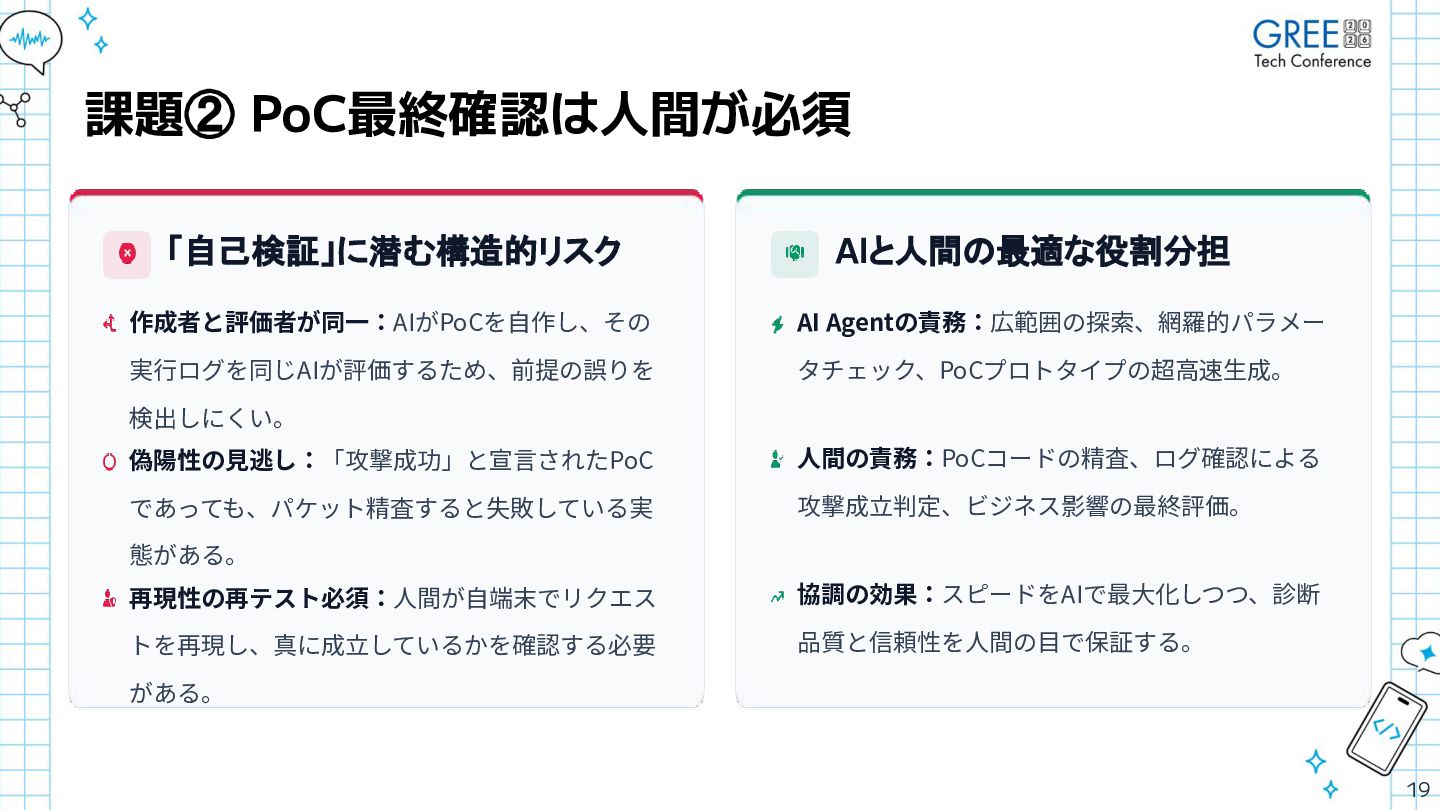
課題② PoC最終確認は人間が必須 「自己検証」に潜む構造的リスク AIと人間の最適な役割分担 作成者と評価者が同⼀:AIがPoCを⾃作し、その AI Agentの責務:広範囲の探索、網羅的パラメー 実⾏ログを同じAIが評価するため、前提の誤りを タチェック、PoCプロトタイプの超⾼速⽣成。 検出しにくい。
偽陽性の⾒逃し:「攻撃成功」と宣⾔されたPoC ⼈間の責務:PoCコードの精査、ログ確認による であっても、パケット精査すると失敗している実 攻撃成⽴判定、ビジネス影響の最終評価。 態がある。 再現性の再テスト必須:⼈間が⾃端末でリクエス 協調の効果:スピードをAIで最⼤化しつつ、診断 トを再現し、真に成⽴しているかを確認する必要 品質と信頼性を⼈間の⽬で保証する。 がある。 19
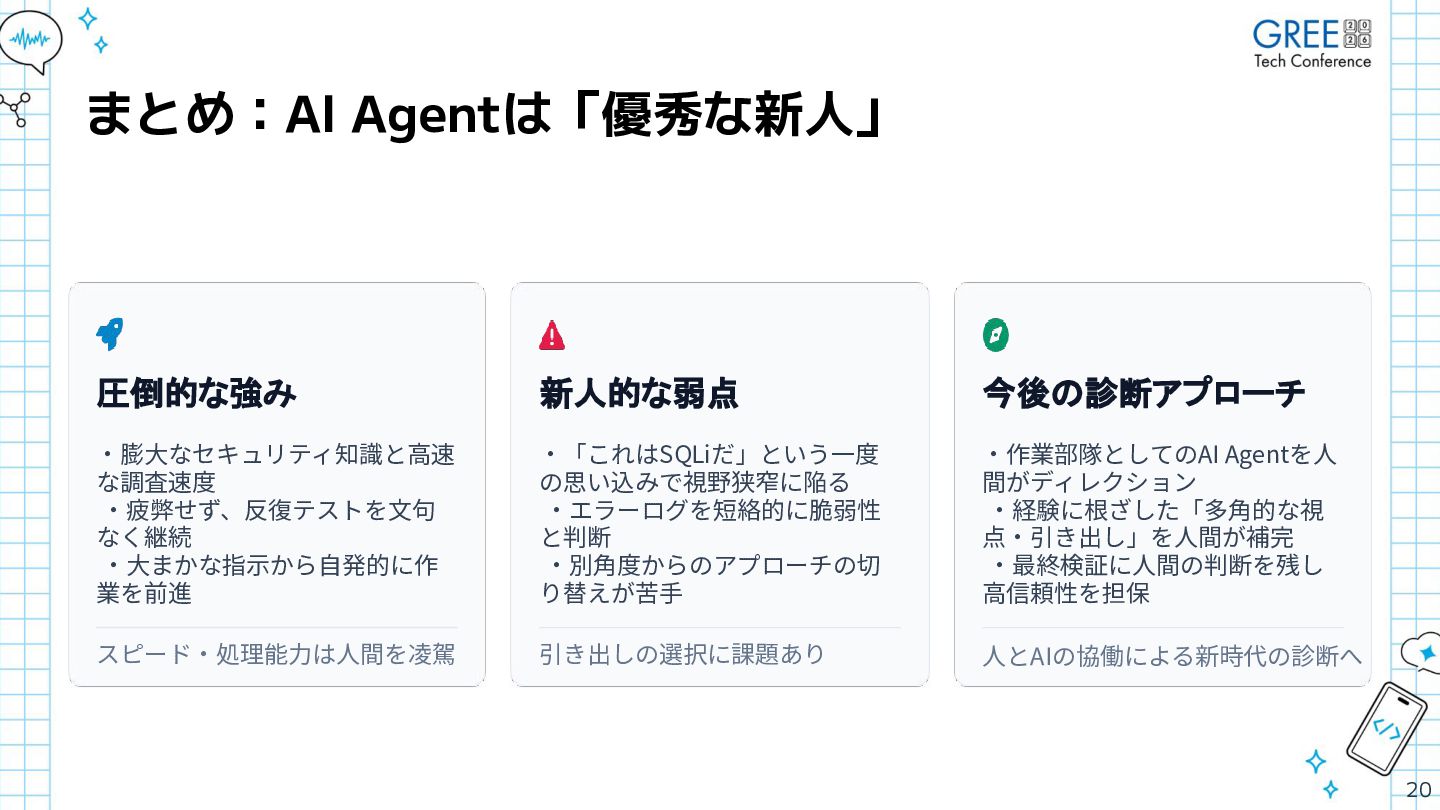
まとめ:AI Agentは「優秀な新人」 圧倒的な強み 新人的な弱点 今後の診断アプローチ ‧膨⼤なセキュリティ知識と⾼速 な調査速度 ‧疲弊せず、反復テストを⽂句 なく継続 ‧⼤まかな指⽰から⾃発的に作
業を前進 ‧「これはSQLiだ」という⼀度 の思い込みで視野狭窄に陥る ‧エラーログを短絡的に脆弱性 と判断 ‧別⾓度からのアプローチの切 り替えが苦⼿ ‧作業部隊としてのAI Agentを⼈ 間がディレクション ‧経験に根ざした「多⾓的な視 点‧引き出し」を⼈間が補完 ‧最終検証に⼈間の判断を残し ⾼信頼性を担保 スピード‧処理能⼒は⼈間を凌駕 引き出しの選択に課題あり ⼈とAIの協働による新時代の診断へ 20
静的解析における生成 AIの活用 21
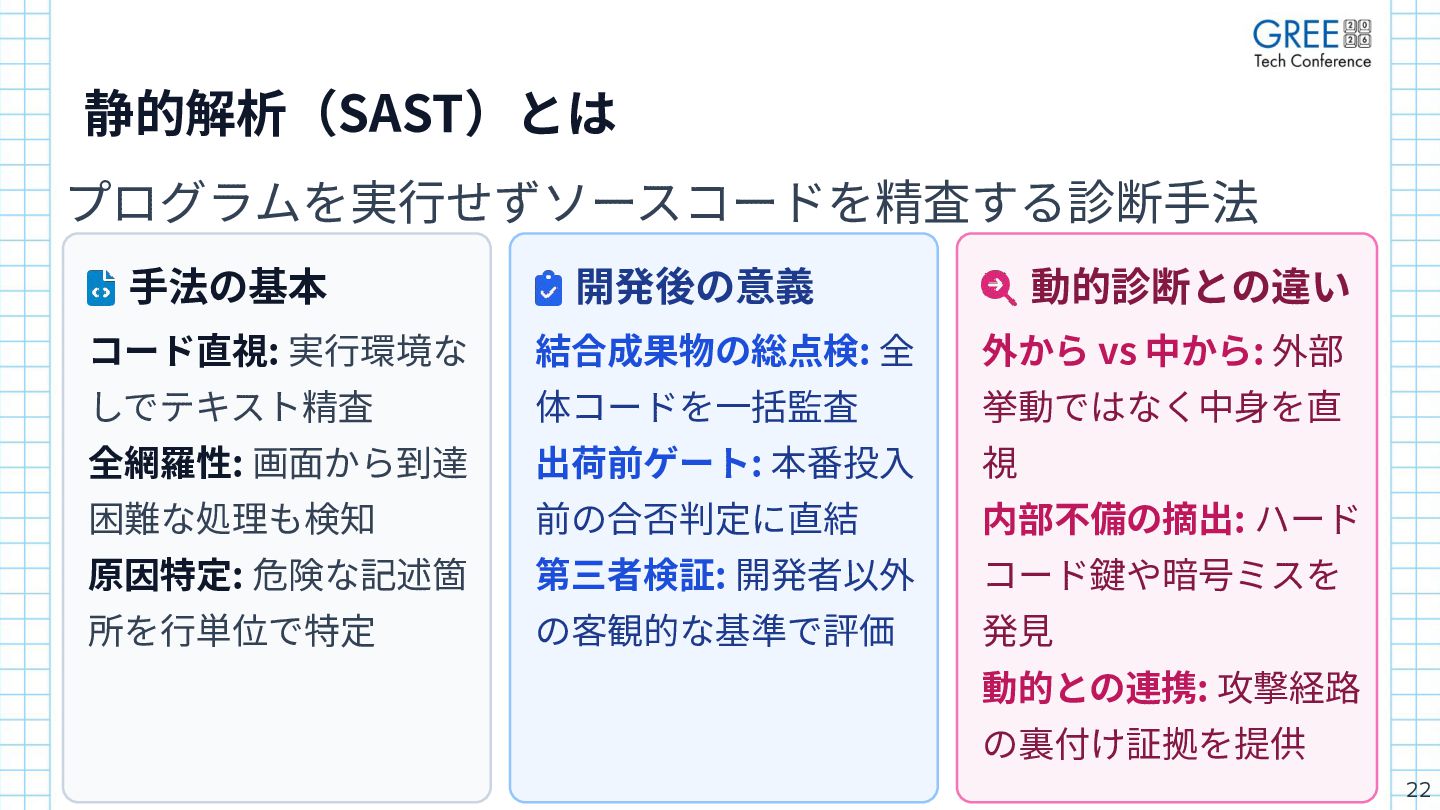
静的解析(SAST)とは プログラムを実⾏せずソースコードを精査する診断⼿法 ⼿法の基本 動的診断との違い 開発後の意義 コード直視: 実⾏環境な 結合成果物の総点検: 全 外から
vs 中から: 外部 しでテキスト精査 体コードを⼀括監査 挙動ではなく中⾝を直 全網羅性: 画⾯から到達 出荷前ゲート: 本番投⼊ 視 困難な処理も検知 前の合否判定に直結 内部不備の摘出: ハード 原因特定: 危険な記述箇 第三者検証: 開発者以外 コード鍵や暗号ミスを 所を⾏単位で特定 の客観的な基準で評価 発⾒ 動的との連携: 攻撃経路 の裏付け証拠を提供 22
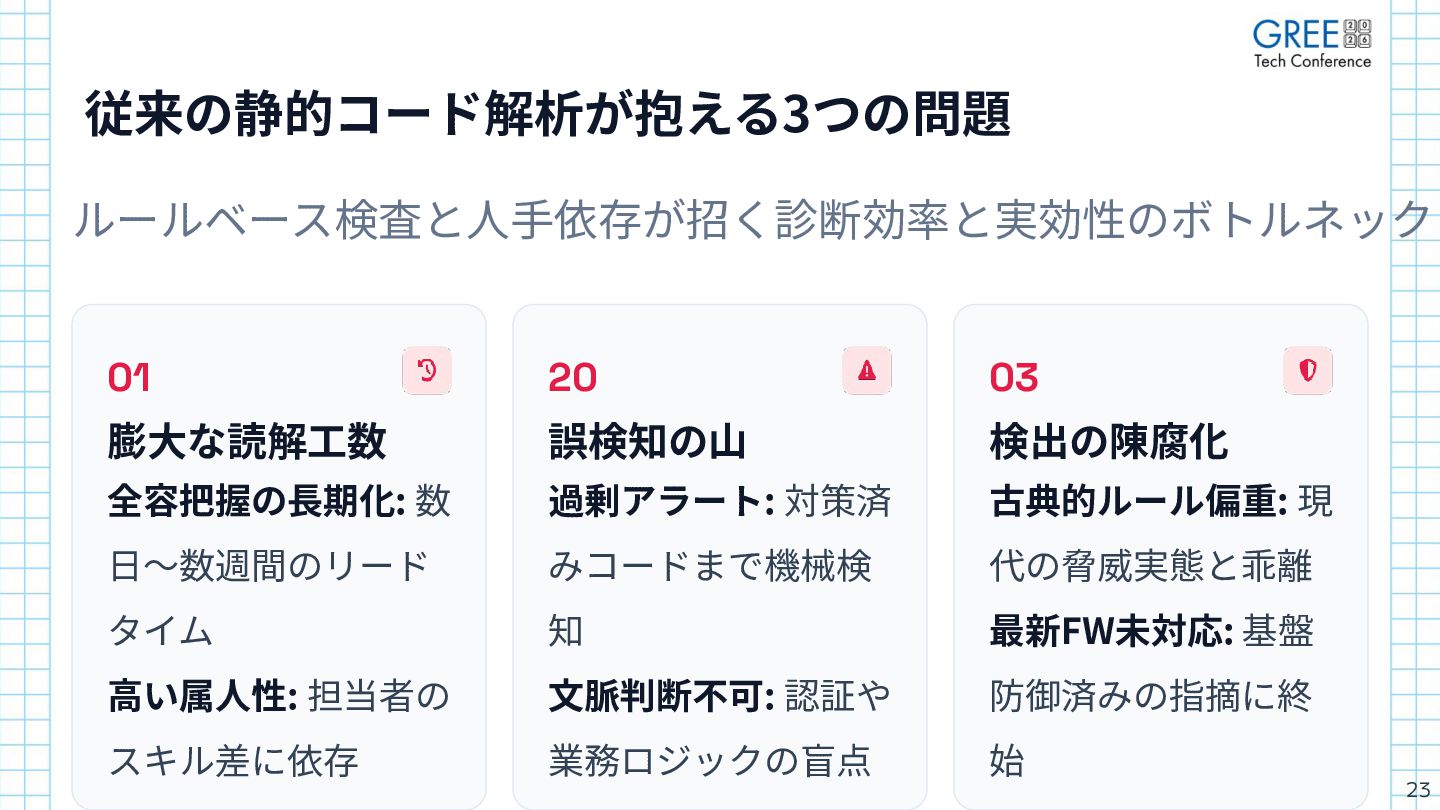
従来の静的コード解析が抱える3つの問題 ルールベース検査と⼈⼿依存が招く診断効率と実効性のボトルネック 01 20 03 膨⼤な読解⼯数 誤検知の⼭ 検出の陳腐化 全容把握の⻑期化: 数
過剰アラート: 対策済 古典的ルール偏重: 現 ⽇〜数週間のリード みコードまで機械検 代の脅威実態と乖離 タイム 知 最新FW未対応: 基盤 ⾼い属⼈性: 担当者の ⽂脈判断不可: 認証や 防御済みの指摘に終 スキル差に依存 業務ロジックの盲点 始 23
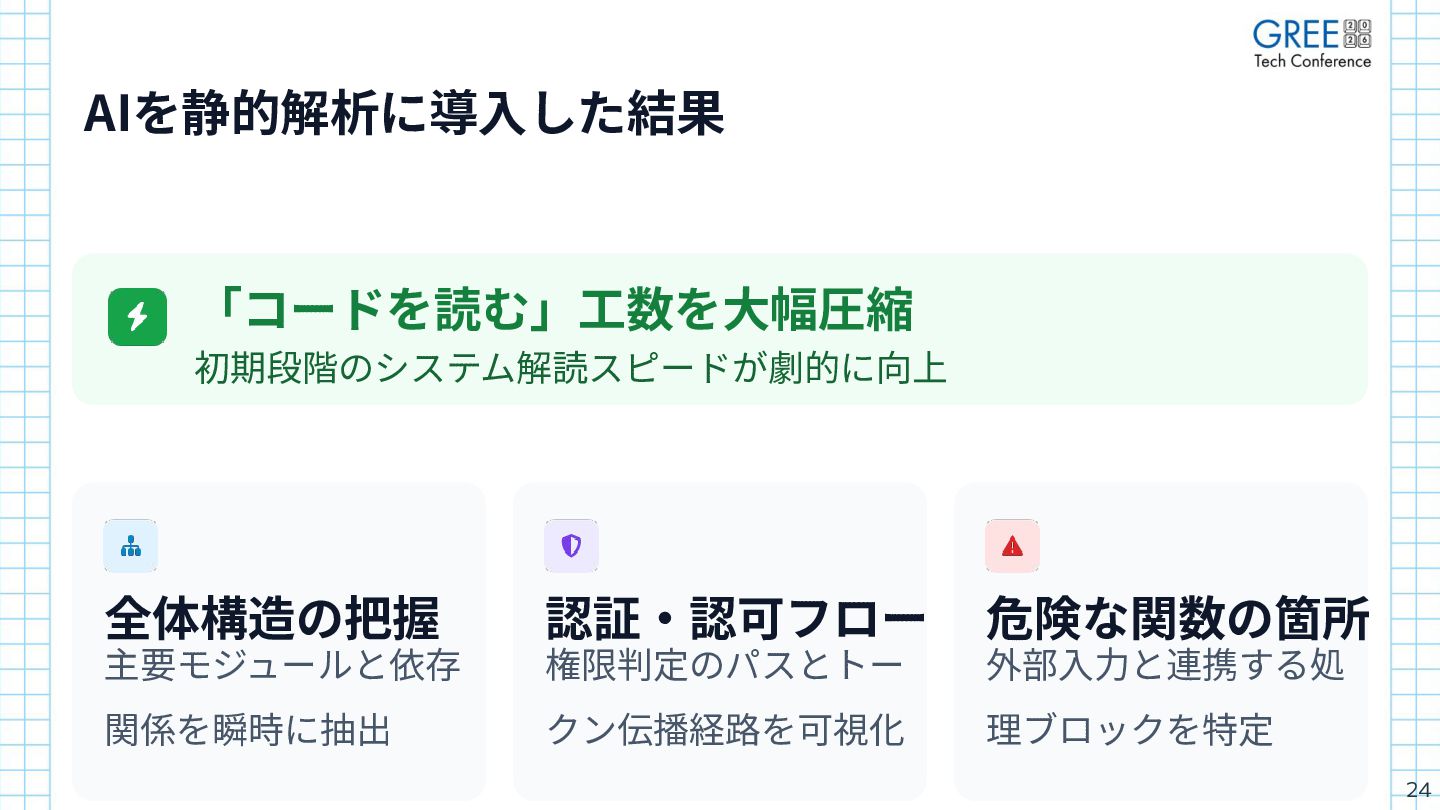
AIを静的解析に導⼊した結果 「コードを読む」⼯数を⼤幅圧縮 初期段階のシステム解読スピードが劇的に向上 全体構造の把握 認証‧認可フロー 危険な関数の箇所 主要モジュールと依存 権限判定のパスとトー 外部⼊⼒と連携する処 関係を瞬時に抽出
クン伝播経路を可視化 理ブロックを特定 24
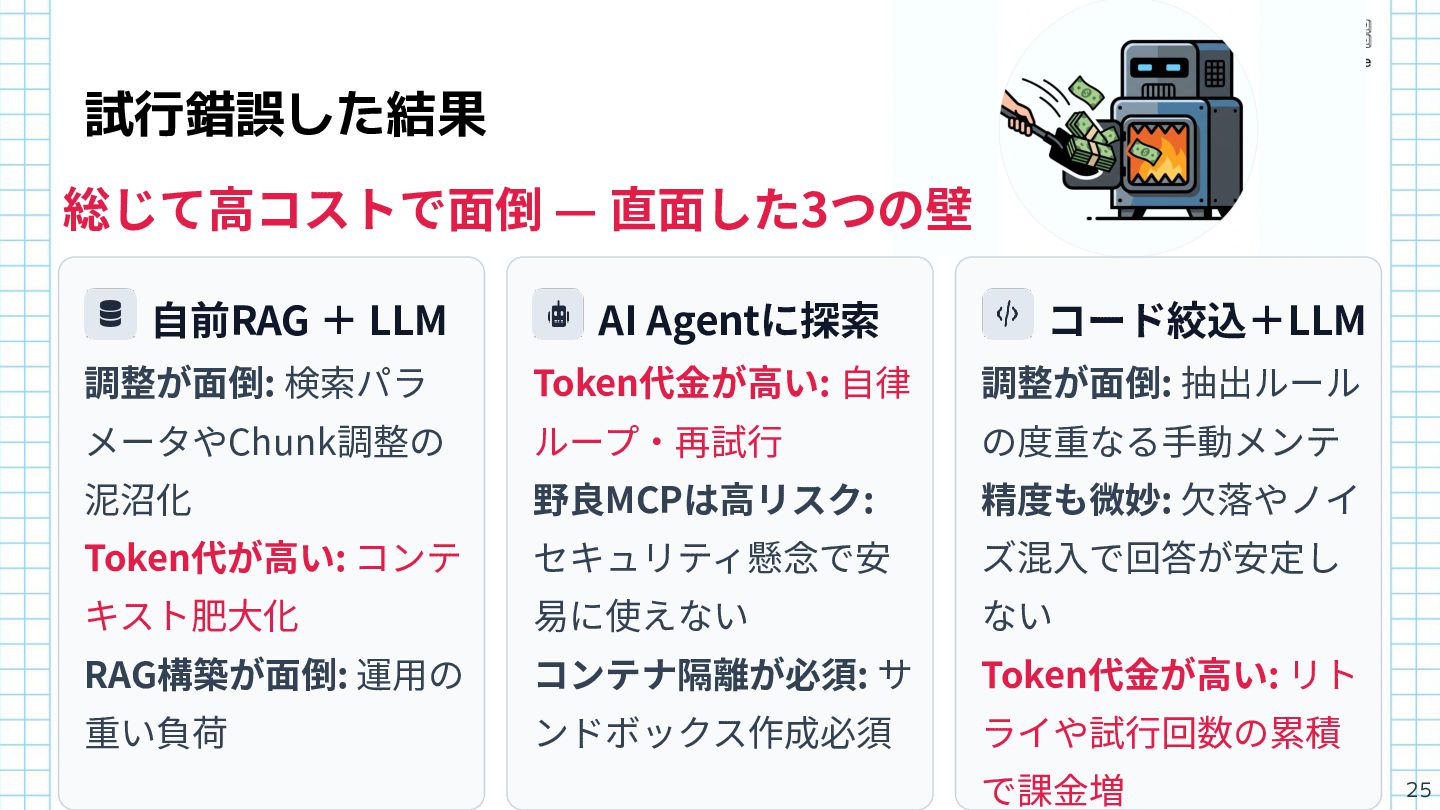
試行錯誤した結果 総じて⾼コストで⾯倒 — 直⾯した3つの壁 ⾃前RAG + LLM AI Agentに探索 コード絞込+LLM
調整が⾯倒: 検索パラ Token代⾦が⾼い: ⾃律 調整が⾯倒: 抽出ルール メータやChunk調整の ループ‧再試⾏ の度重なる⼿動メンテ 泥沼化 野良MCPは⾼リスク: 精度も微妙: ⽋落やノイ Token代が⾼い: コンテ セキュリティ懸念で安 ズ混⼊で回答が安定し キスト肥⼤化 易に使えない ない RAG構築が⾯倒: 運⽤の コンテナ隔離が必須: サ Token代⾦が⾼い: リト 重い負荷 ンドボックス作成必須 ライや試⾏回数の累積 で課⾦増 25
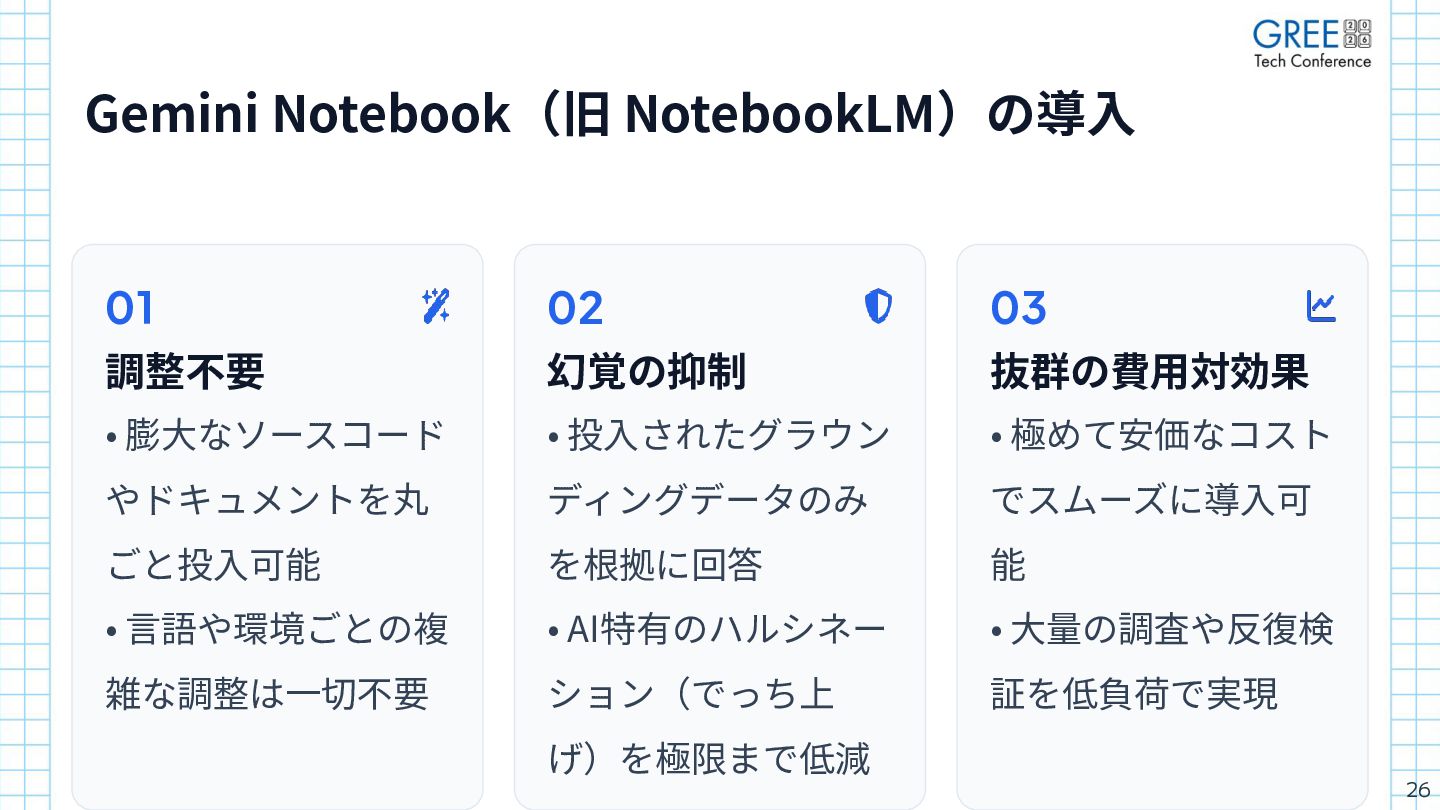
Gemini Notebook(旧 NotebookLM)の導⼊ 01 02 03 調整不要 幻覚の抑制 抜群の費⽤対効果 •
膨⼤なソースコード • 投⼊されたグラウン • 極めて安価なコスト やドキュメントを丸 ディングデータのみ でスムーズに導⼊可 ごと投⼊可能 を根拠に回答 能 • ⾔語や環境ごとの複 • AI特有のハルシネー • ⼤量の調査や反復検 雑な調整は⼀切不要 ション(でっち上 証を低負荷で実現 げ)を極限まで低減 26
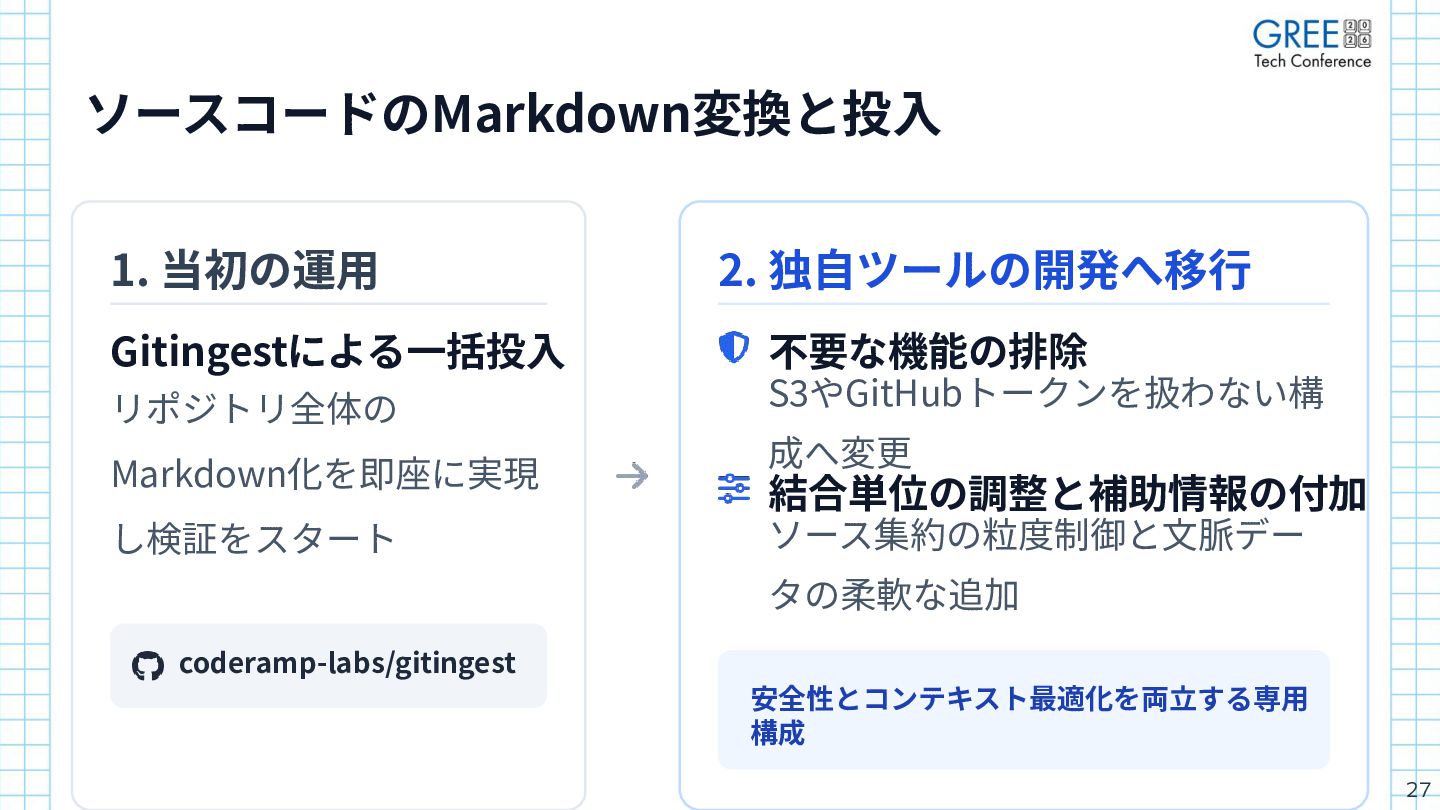
ソースコードのMarkdown変換と投⼊ 1. 当初の運⽤ 2. 独⾃ツールの開発へ移⾏ Gitingestによる⼀括投⼊ 不要な機能の排除 リポジトリ全体の S3やGitHubトークンを扱わない構 Markdown化を即座に実現
し検証をスタート 成へ変更 結合単位の調整と補助情報の付加 ソース集約の粒度制御と⽂脈デー タの柔軟な追加 coderamp-labs/gitingest 安全性とコンテキスト最適化を両⽴する専⽤ 構成 27
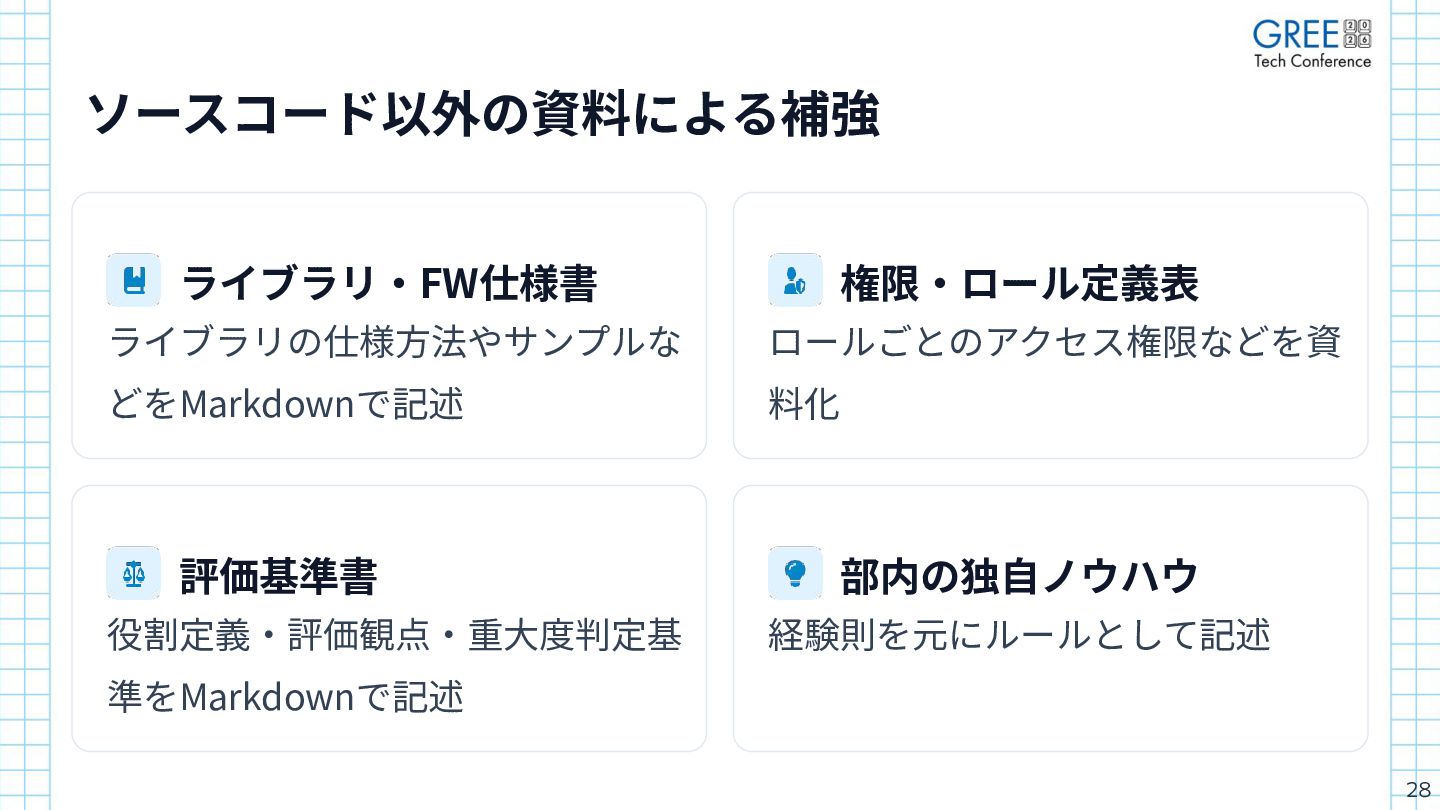
ソースコード以外の資料による補強 ライブラリ‧FW仕様書 権限‧ロール定義表 ライブラリの仕様⽅法やサンプルな ロールごとのアクセス権限などを資 どをMarkdownで記述 料化 評価基準書 役割定義‧評価観点‧重⼤度判定基 部内の独⾃ノウハウ
経験則を元にルールとして記述 準をMarkdownで記述 28
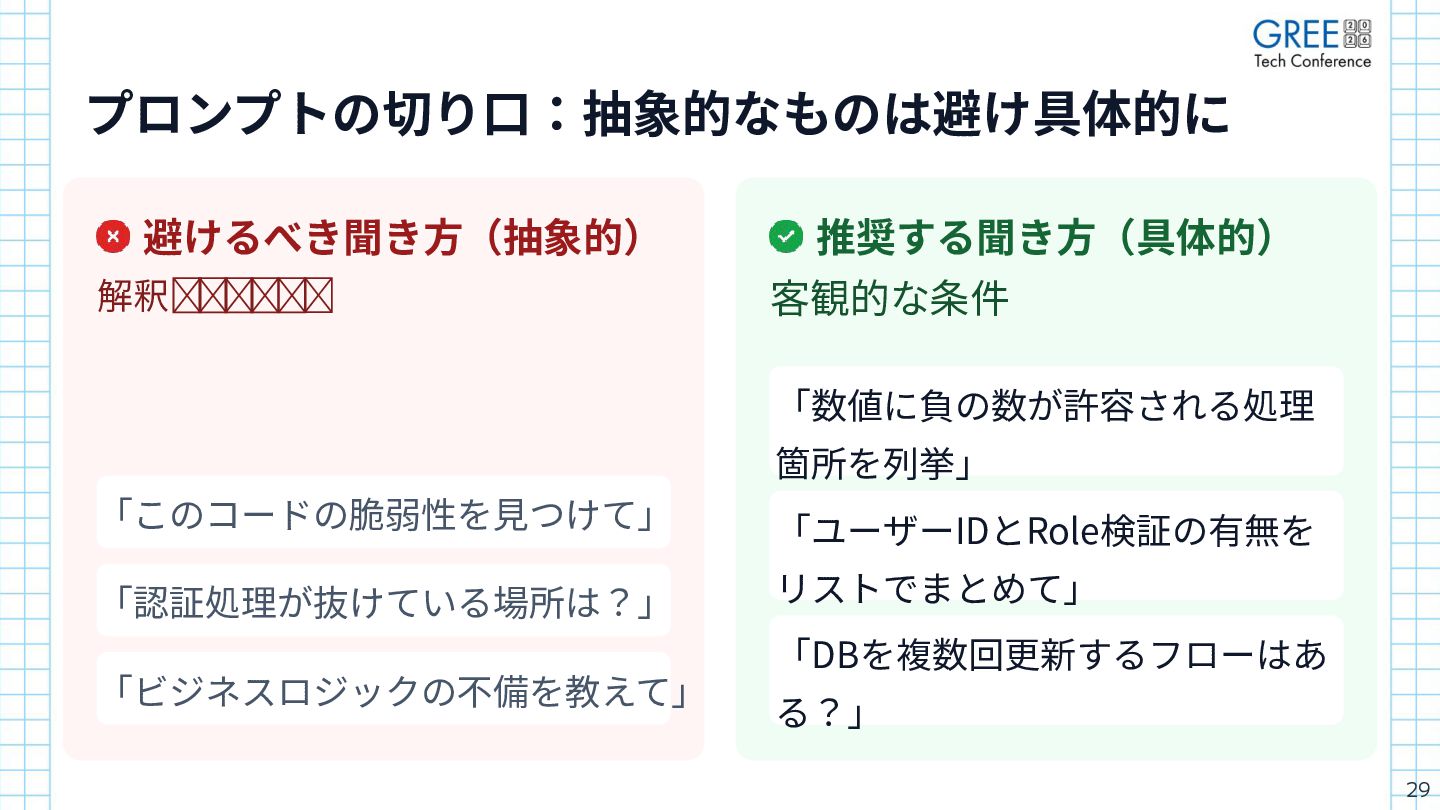
プロンプトの切り⼝:抽象的なものは避け具体的に 避けるべき聞き⽅(抽象的) 解釈余地が広すぎる 推奨する聞き⽅(具体的) 客観的な条件 「数値に負の数が許容される処理 箇所を列挙」 「このコードの脆弱性を⾒つけて」 「ユーザーIDとRole検証の有無を 「認証処理が抜けている場所は?」
リストでまとめて」 「DBを複数回更新するフローはあ 「ビジネスロジックの不備を教えて」 る?」 29
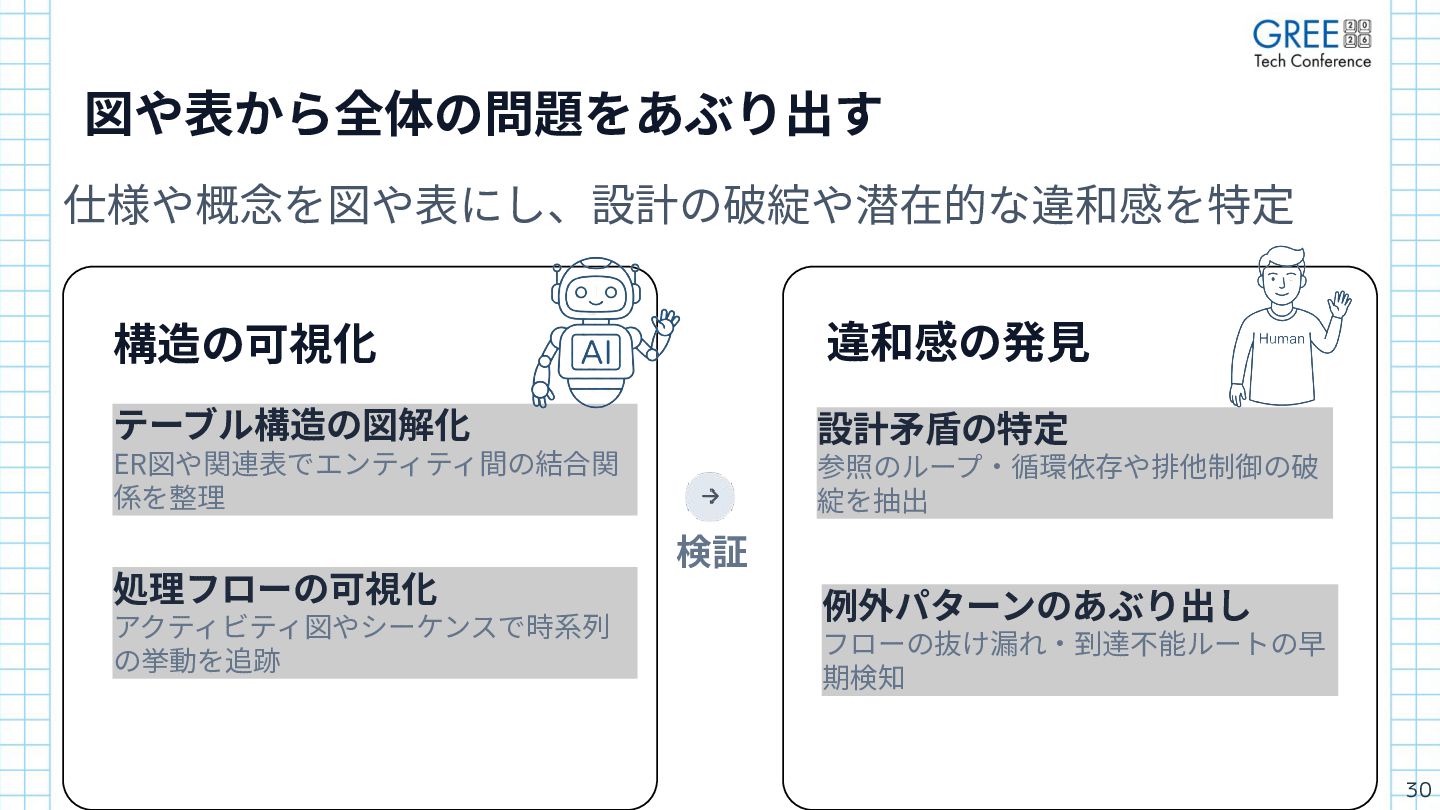
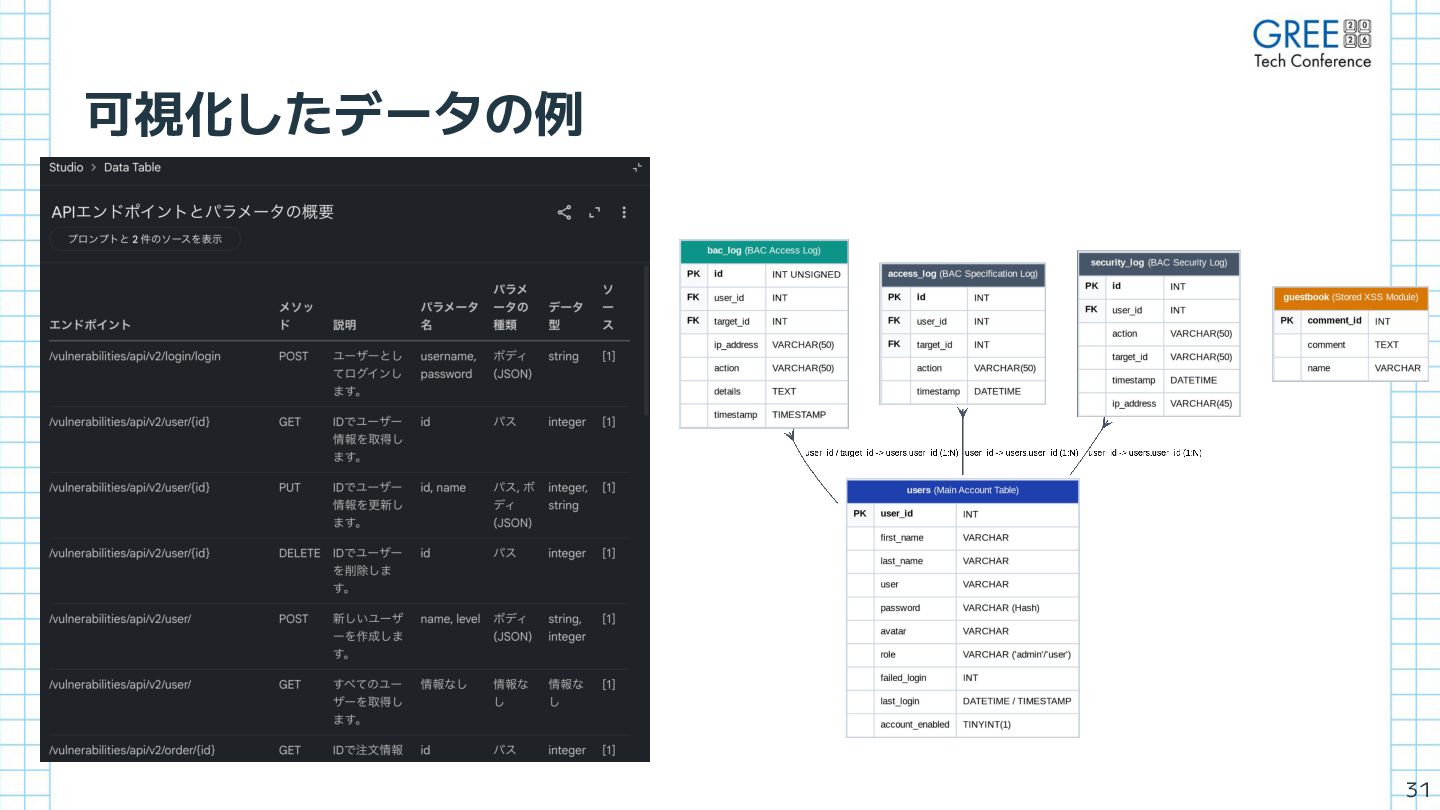
図や表から全体の問題をあぶり出す 仕様や概念を図や表にし、設計の破綻や潜在的な違和感を特定 構造の可視化 違和感の発⾒ テーブル構造の図解化 設計⽭盾の特定 ER図や関連表でエンティティ間の結合関 係を整理 参照のループ‧循環依存や排他制御の破 綻を抽出
検証 処理フローの可視化 アクティビティ図やシーケンスで時系列 の挙動を追跡 例外パターンのあぶり出し フローの抜け漏れ‧到達不能ルートの早 期検知 30
可視化したデータの例 31
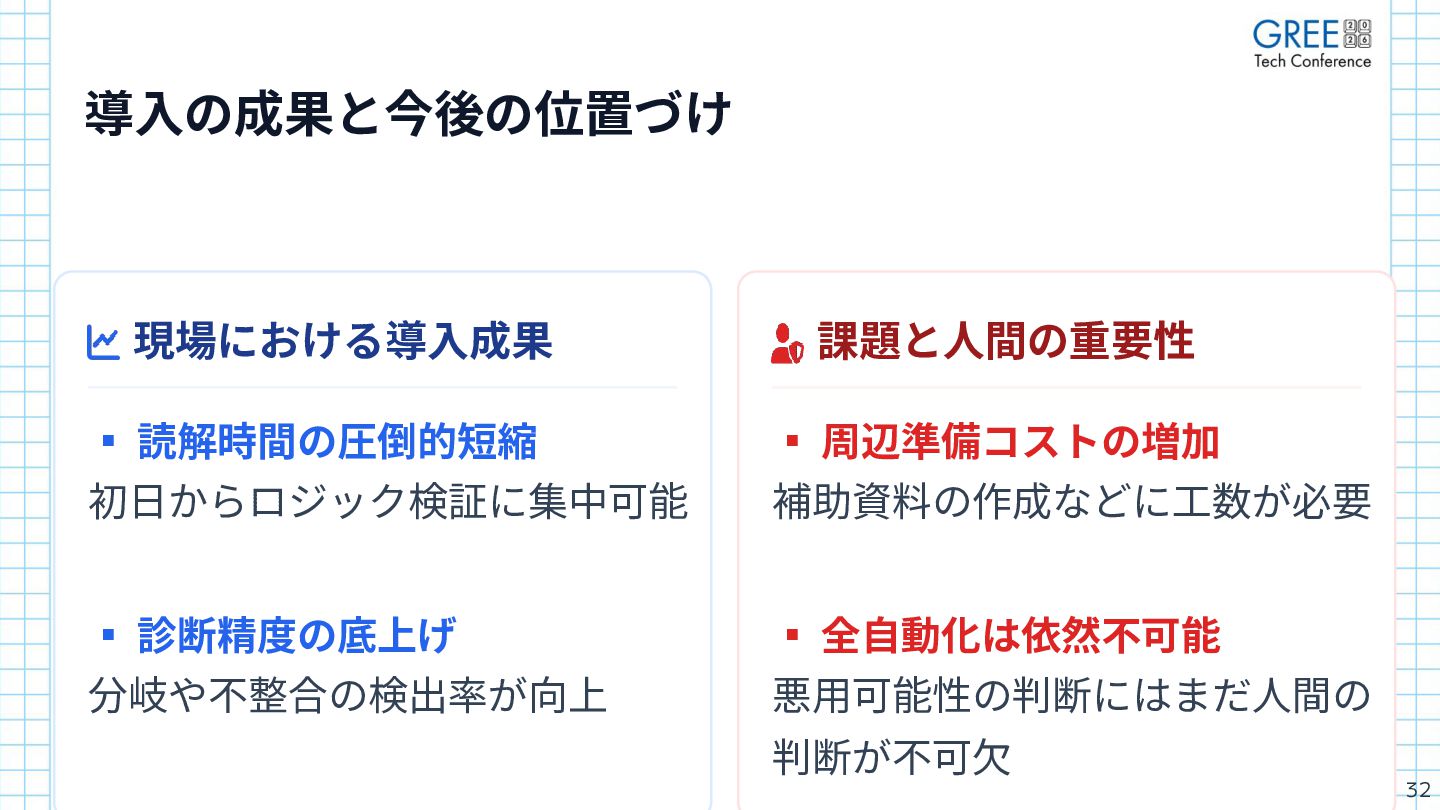
導⼊の成果と今後の位置づけ 現場における導⼊成果 課題と⼈間の重要性 ▪ 読解時間の圧倒的短縮 初⽇からロジック検証に集中可能 ▪ 周辺準備コストの増加 補助資料の作成などに⼯数が必要 ▪
診断精度の底上げ 分岐や不整合の検出率が向上 ▪ 全⾃動化は依然不可能 悪⽤可能性の判断にはまだ⼈間の 判断が不可⽋ 32
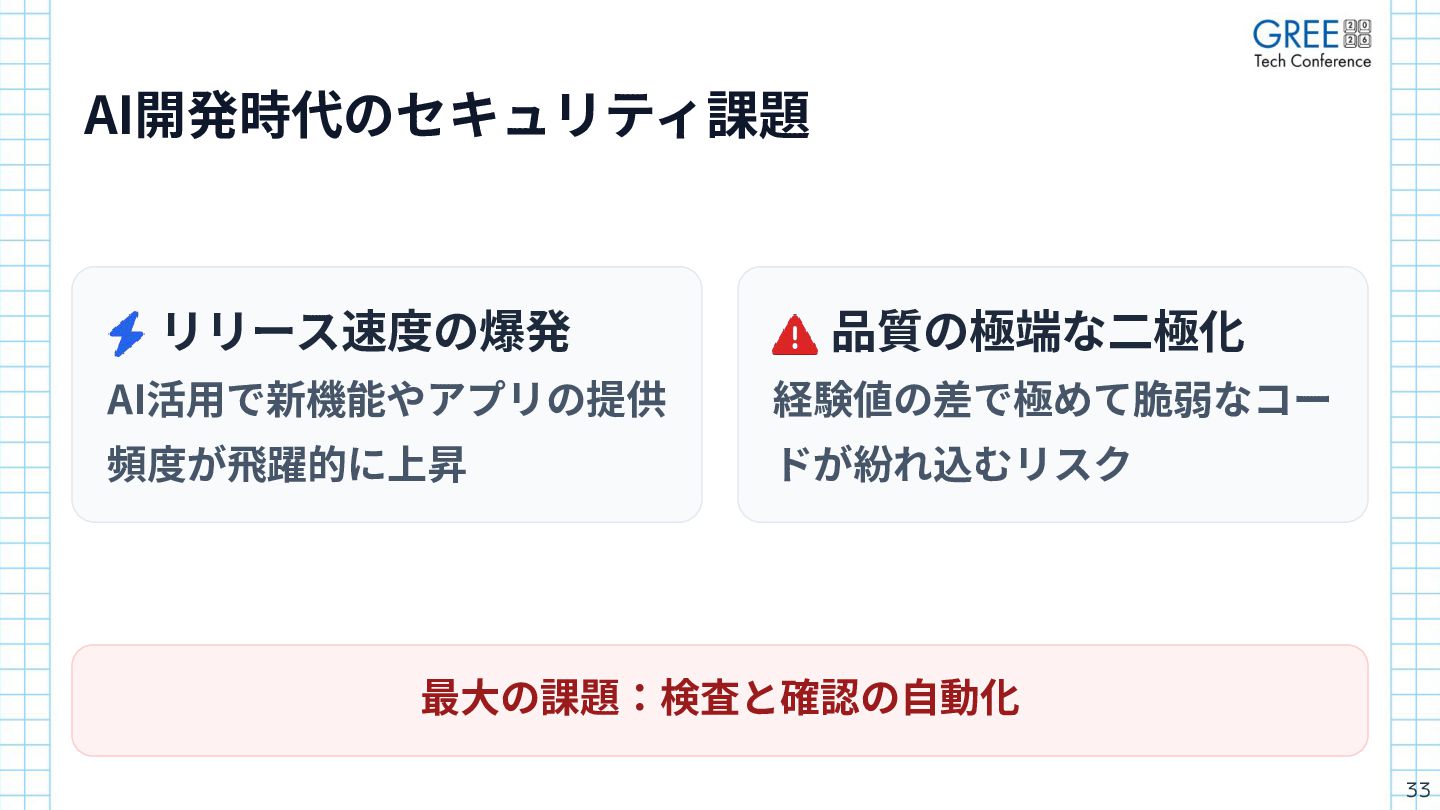
AI開発時代のセキュリティ課題 リリース速度の爆発 品質の極端な⼆極化 AI活⽤で新機能やアプリの提供 経験値の差で極めて脆弱なコー 頻度が⾶躍的に上昇 ドが紛れ込むリスク 最⼤の課題:検査と確認の⾃動化 33
まとめ 34
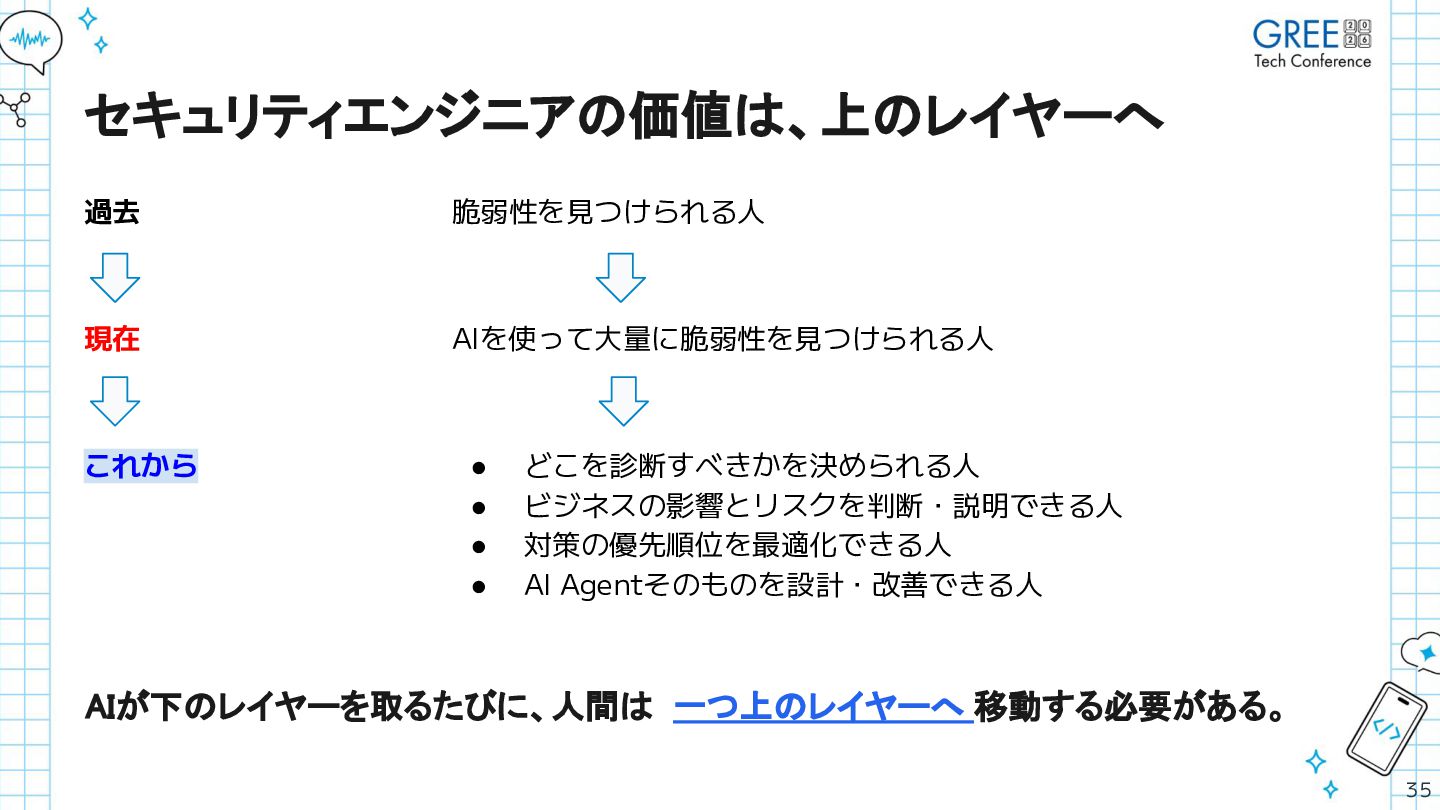
セキュリティエンジニアの価値は、上のレイヤーへ 過去 脆弱性を見つけられる人 現在 AIを使って大量に脆弱性を見つけられる人 これから • • • •
どこを診断すべきかを決められる人 ビジネスの影響とリスクを判断・説明できる人 対策の優先順位を最適化できる人 AI Agentそのものを設計・改善できる人 AIが下のレイヤーを取るたびに、人間は 一つ上のレイヤーへ 移動する必要がある。 35
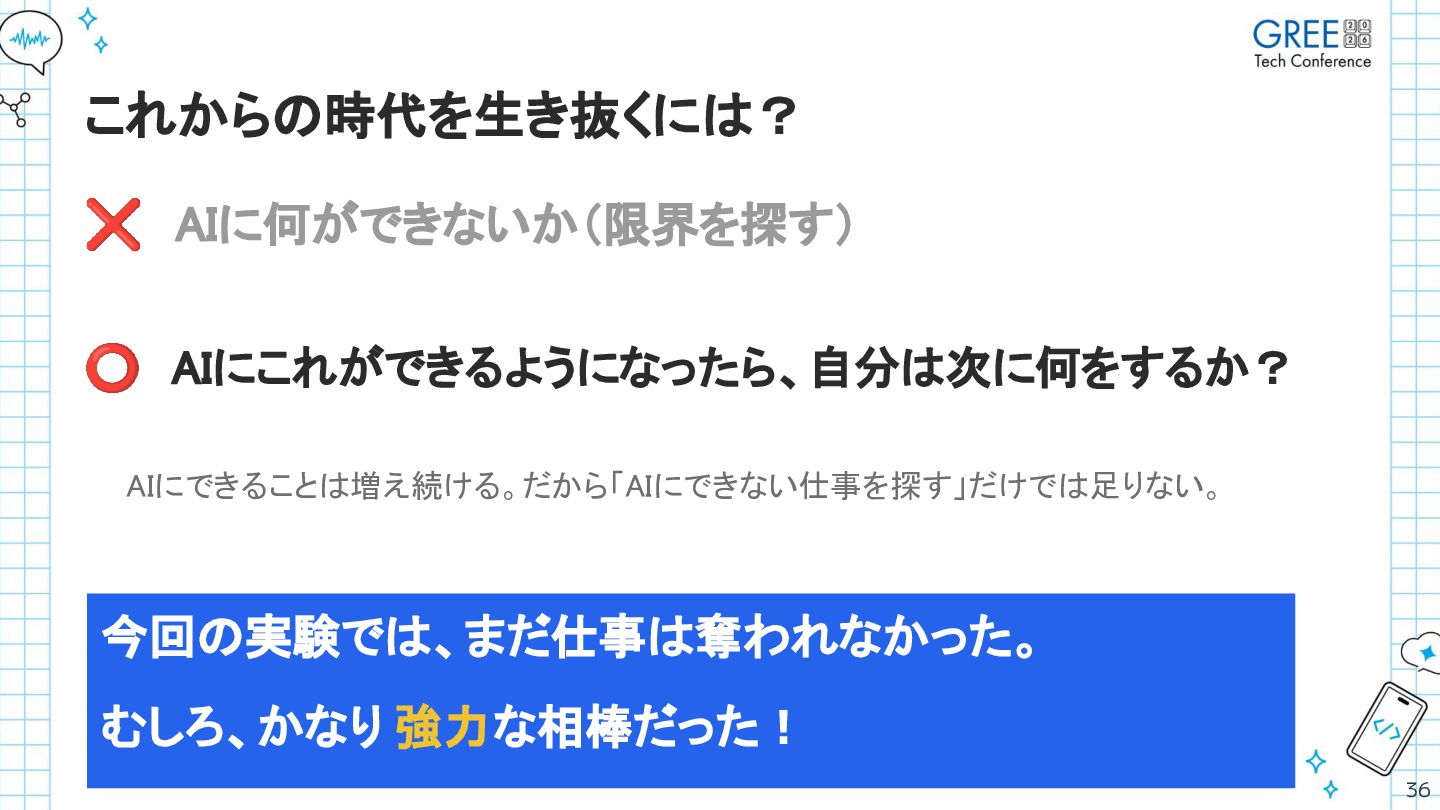
これからの時代を生き抜くには? ❌ AIに何ができないか(限界を探す) ⭕ AIにこれができるようになったら、自分は次に何をするか? AIにできることは増え続ける。だから「AIにできない仕事を探す」だけでは足りない。 今回の実験では、まだ仕事は奪われなかった。 むしろ、かなり 強力な相棒だった! 36
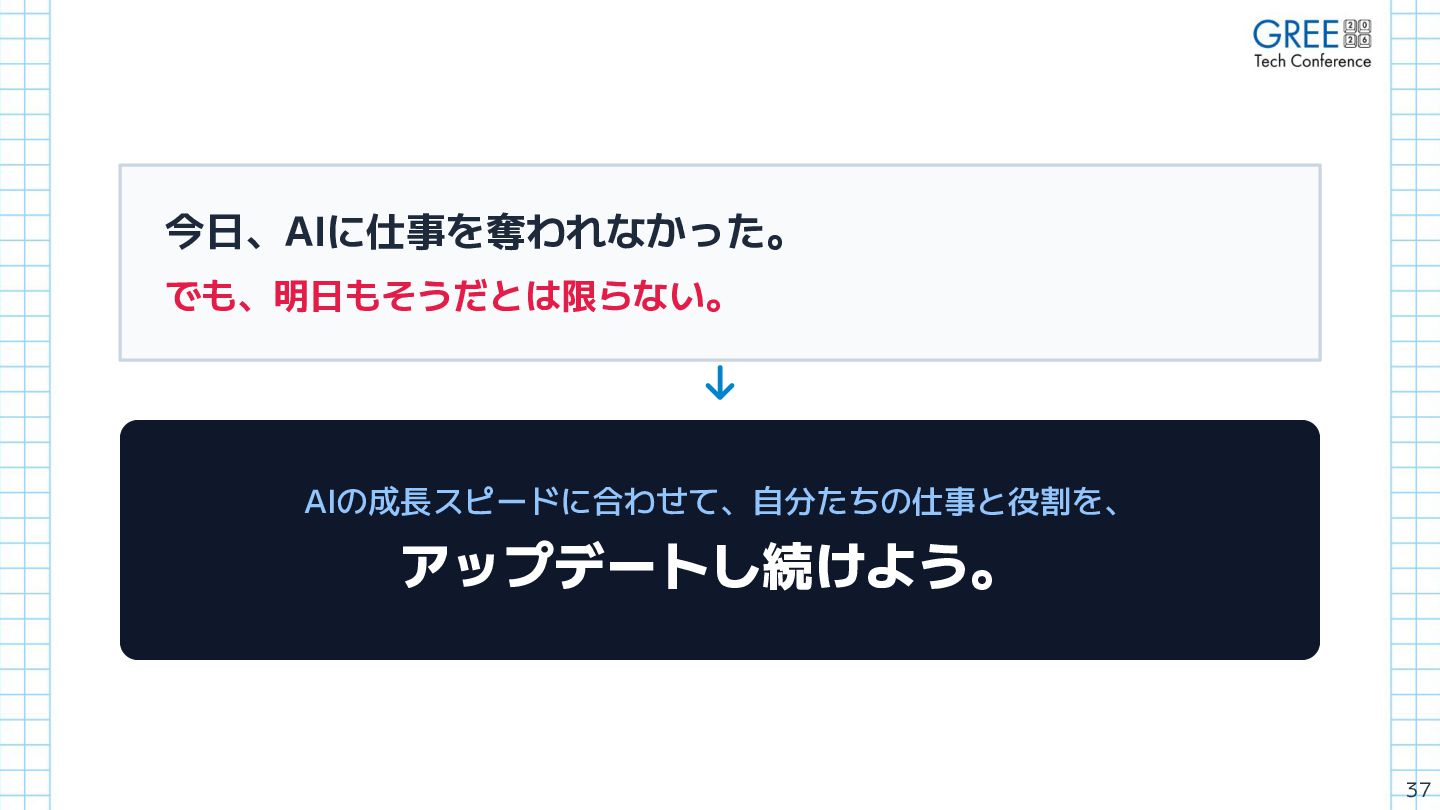
今日、AIに仕事を奪われなかった。 でも、明日もそうだとは限らない。 AIの成長スピードに合わせて、自分たちの仕事と役割を、 アップデートし続けよう。 37
ご清聴ありがとうございました 38
None


 gree_tech
 cogakira
 mochizuki875
 kameitomohiro
 fespinoza
 husengs7
 yakumo
 hlum
 baseballyama
 carta_engineering
 mewuto
 persolserverworks
 kizawa2020
 inesmontani
 marketingsoph
 andyhume
 holman
 brettharned
 danielanewman
 jdejongh
 mkilby
 mza
 mfonobong
 hannesfritz
 zakiyama