Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ゼロデイ攻撃対応の夜、AI は戦力になるのか
Search
Sponsored
·
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
gree_tech
PRO
November 13, 2026
Technology
10
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ゼロデイ攻撃対応の夜、AI は戦力になるのか
gree_tech
PRO
November 13, 2026
Transcript
17 slides
ゼロデイ攻撃対応の夜、 AI は戦力になるのか これからのインシデントコマンダーは君だ インフラ共通部 山下 史紘 Copyright © GREE,
Inc. All Rights Reserved.
自己紹介 名前 山下 史紘 略歴 2025 年に新卒入社 所属 株式会社グリー /
開発本部 / インフラ共通部 / サービスエンジニアリンググループ / ストラテジックソリューションチーム 領域 monitoring / コンテナ(EKS, ECS)/ AI Agent × 障害対応
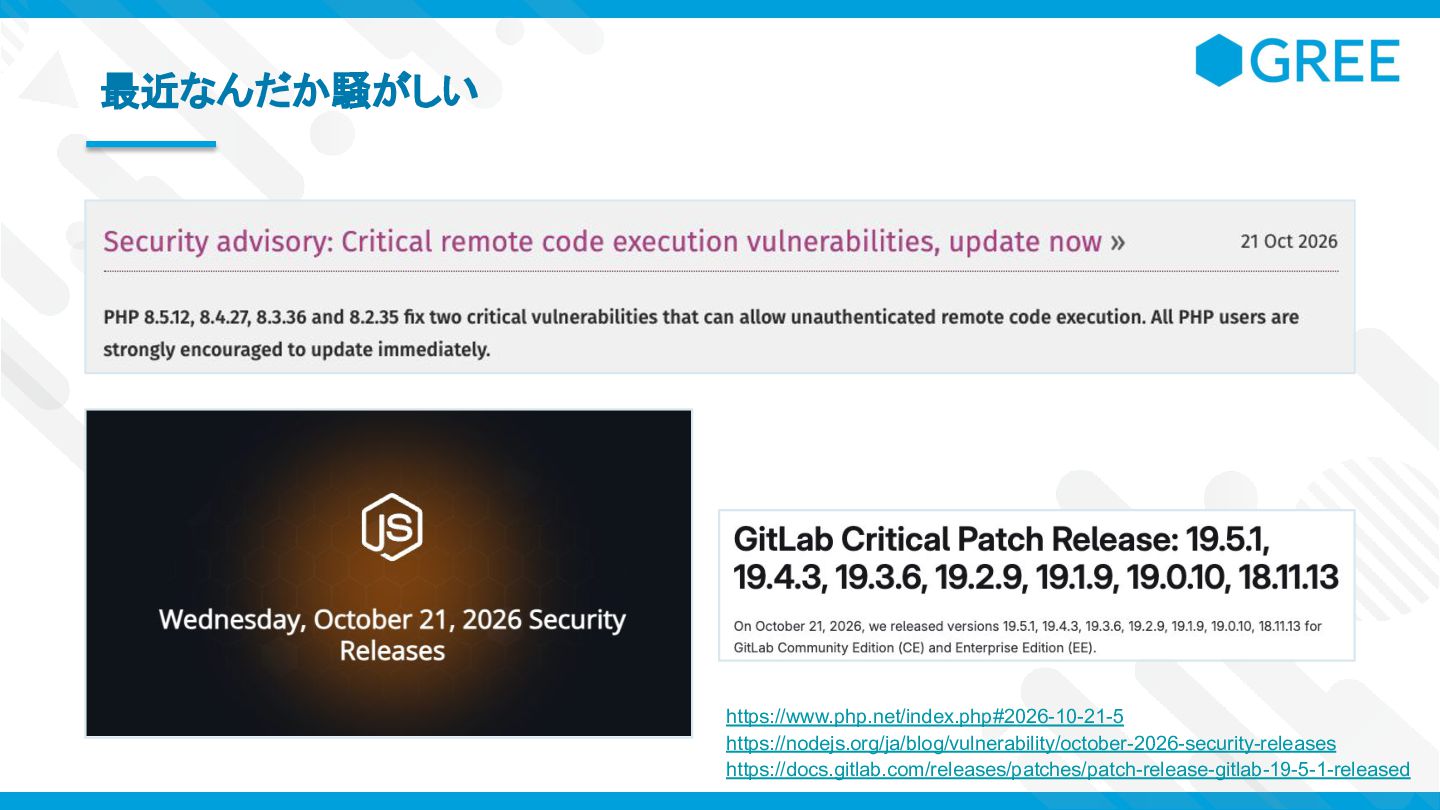
最近なんだか騒がしい https://www.php.net/index.php#2026-10-21-5 https://nodejs.org/ja/blog/vulnerability/october-2026-security-releases https://docs.gitlab.com/releases/patches/patch-release-gitlab-19-5-1-released
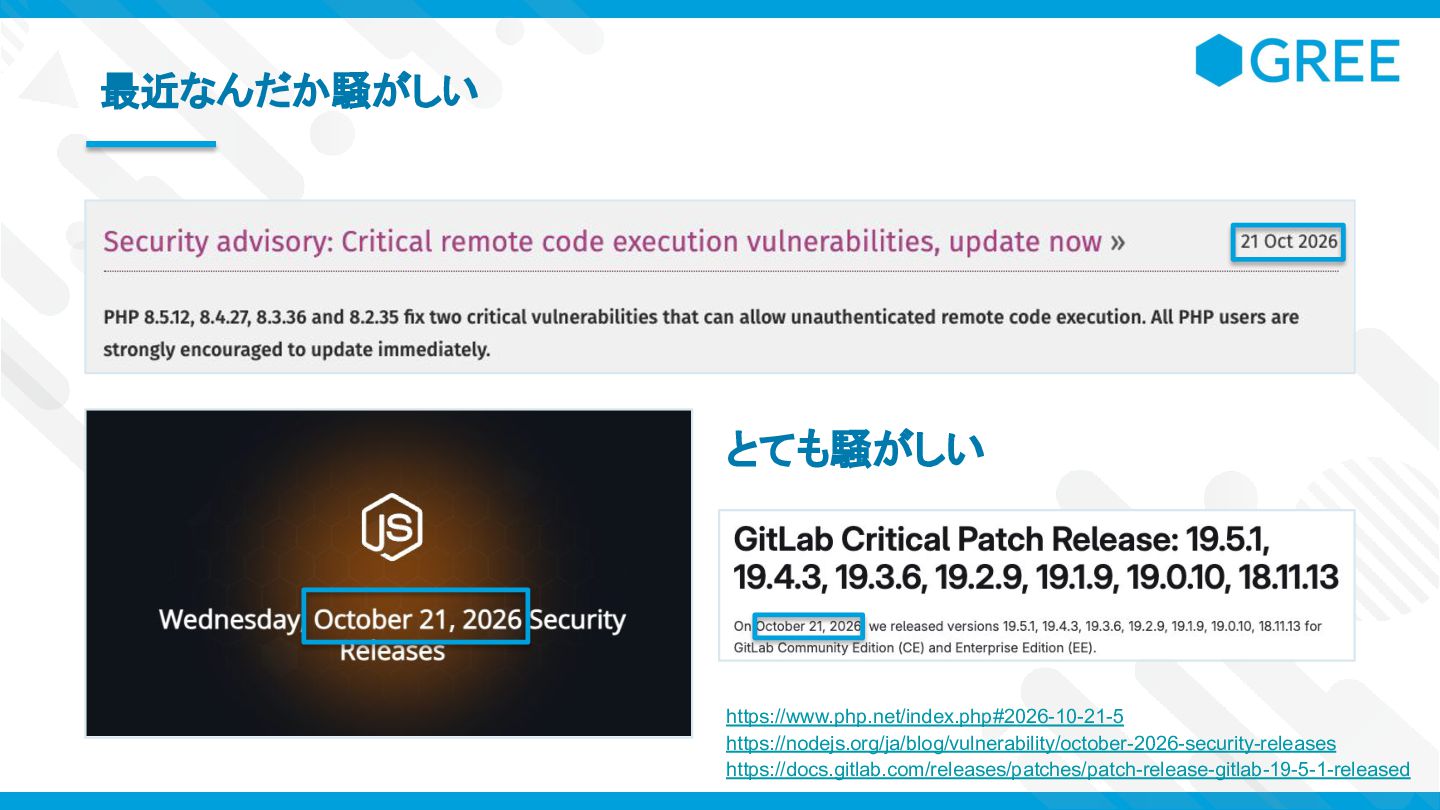
最近なんだか騒がしい とても騒がしい https://www.php.net/index.php#2026-10-21-5 https://nodejs.org/ja/blog/vulnerability/october-2026-security-releases https://docs.gitlab.com/releases/patches/patch-release-gitlab-19-5-1-released
ゼロデイ攻撃とは 脆弱性の修正パッチが提供される前に行われる攻撃 • 修正パッチを公開する前の脆弱性をついた攻撃が成功してしまう • 過去の事例 – ProxyLogon (2021) –
Log4Shell (2021) – php2shell (2026) 「ゼロデイ攻撃とは?」より引用 https://www.trendmicro.com/ja_jp/what-is/zero-day-attack.html
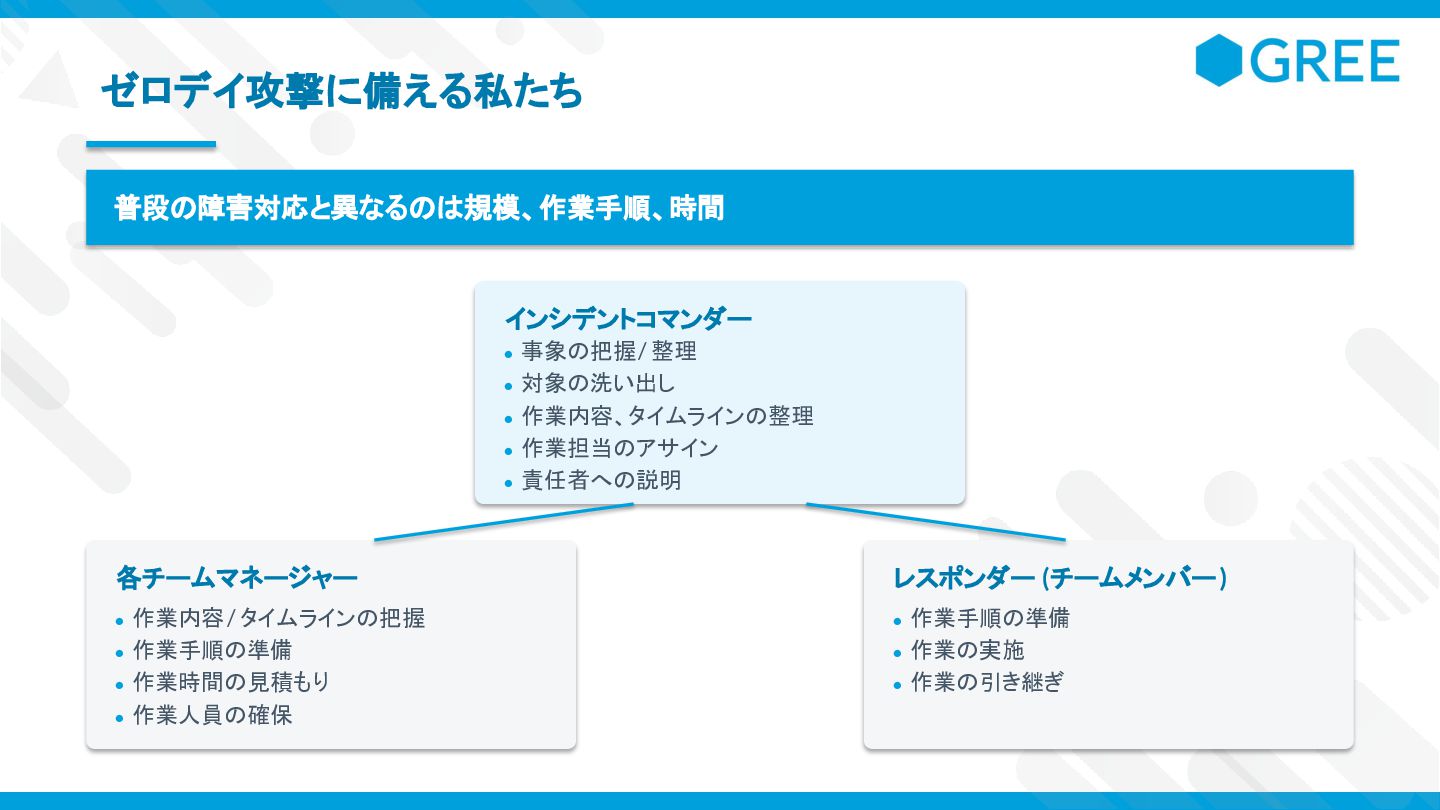
ゼロデイ攻撃に備える私たち 普段の障害対応と異なるのは規模、作業手順、時間 インシデントコマンダー • 事象の把握 / 整理 • 対象の洗い出し •
作業内容、タイムラインの整理 • 作業担当のアサイン • 責任者への説明 各チームマネージャー レスポンダー (チームメンバー) • 作業内容 / タイムラインの把握 • 作業手順の準備 • 作業手順の準備 • 作業の実施 • 作業時間の見積もり • 作業の引き継ぎ • 作業人員の確保
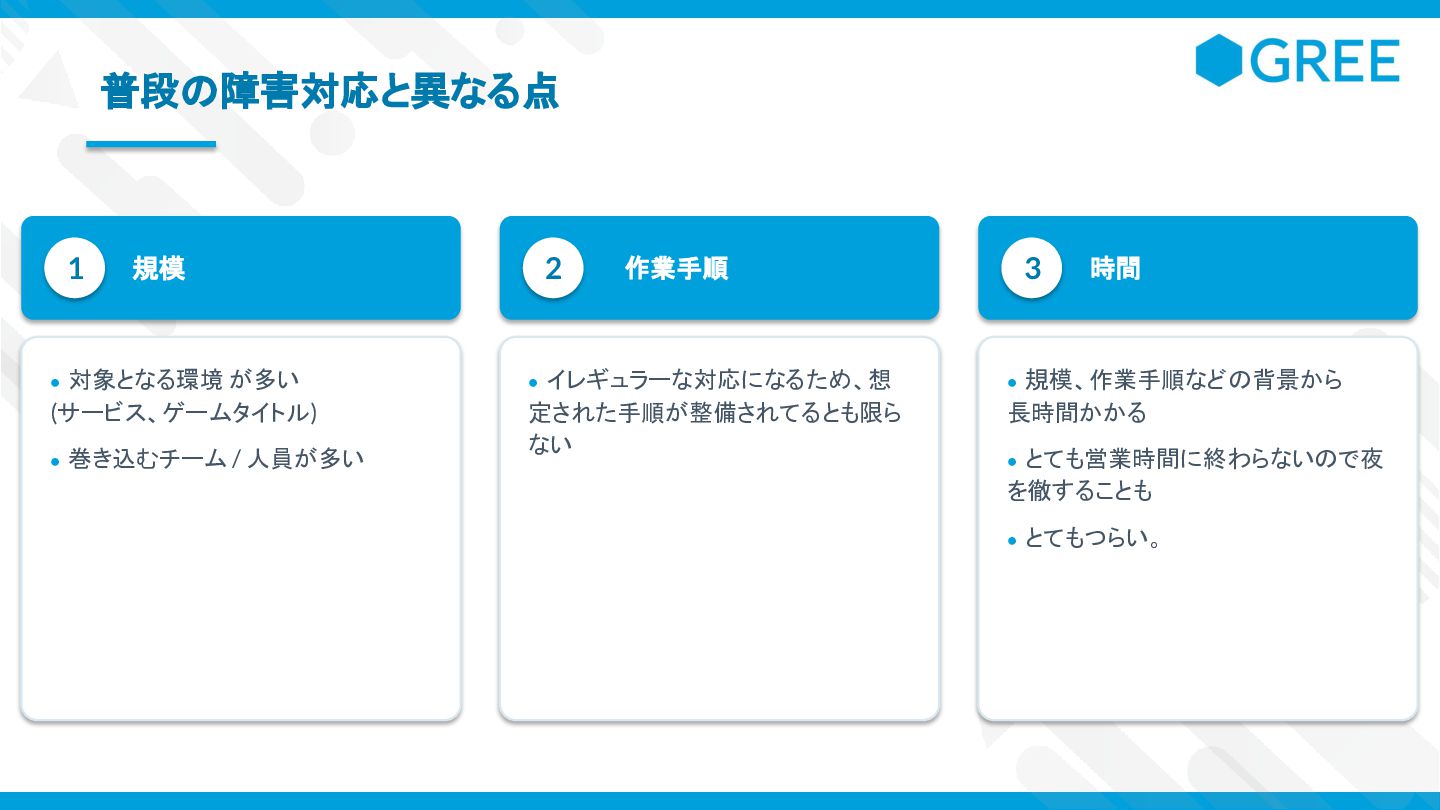
普段の障害対応と異なる点 1 規模 2 作業手順 3 時間 • 対象となる環境 が多い
• イレギュラーな対応になるため、想 • 規模、作業手順などの背景から (サービス、ゲームタイトル) 定された手順が整備されてるとも限ら ない 長時間かかる • 巻き込むチーム / 人員が多い • とても営業時間に終わらないので夜 を徹することも • とてもつらい。
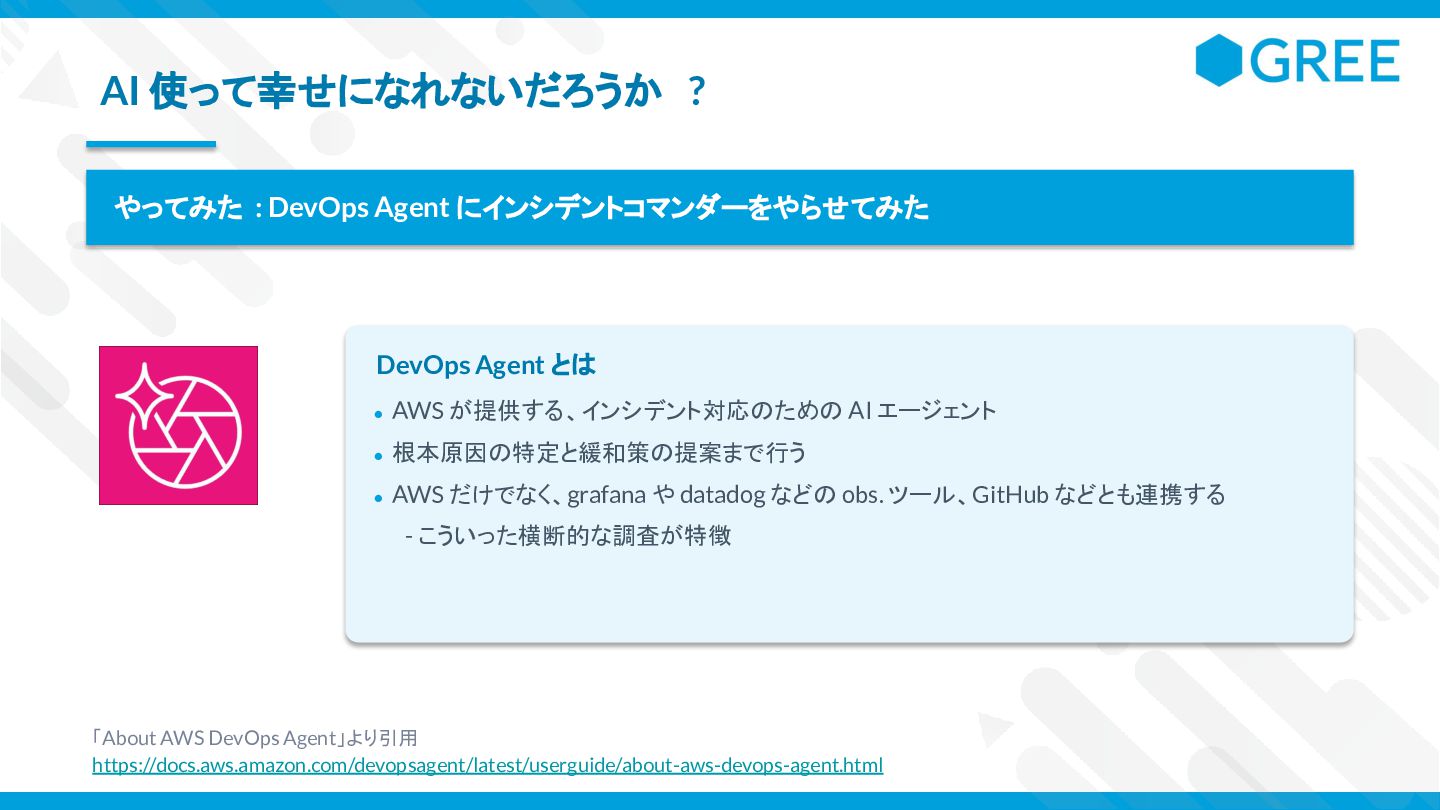
AI 使って幸せになれないだろうか ? やってみた : DevOps Agent にインシデントコマンダーをやらせてみた DevOps Agent
とは • AWS が提供する、インシデント対応のための AI エージェント • 根本原因の特定と緩和策の提案まで行う • AWS だけでなく、grafana や datadog などの obs. ツール、GitHub などとも連携する - こういった横断的な調査が特徴 「About AWS DevOps Agent」より引用 https://docs.aws.amazon.com/devopsagent/latest/userguide/about-aws-devops-agent.html
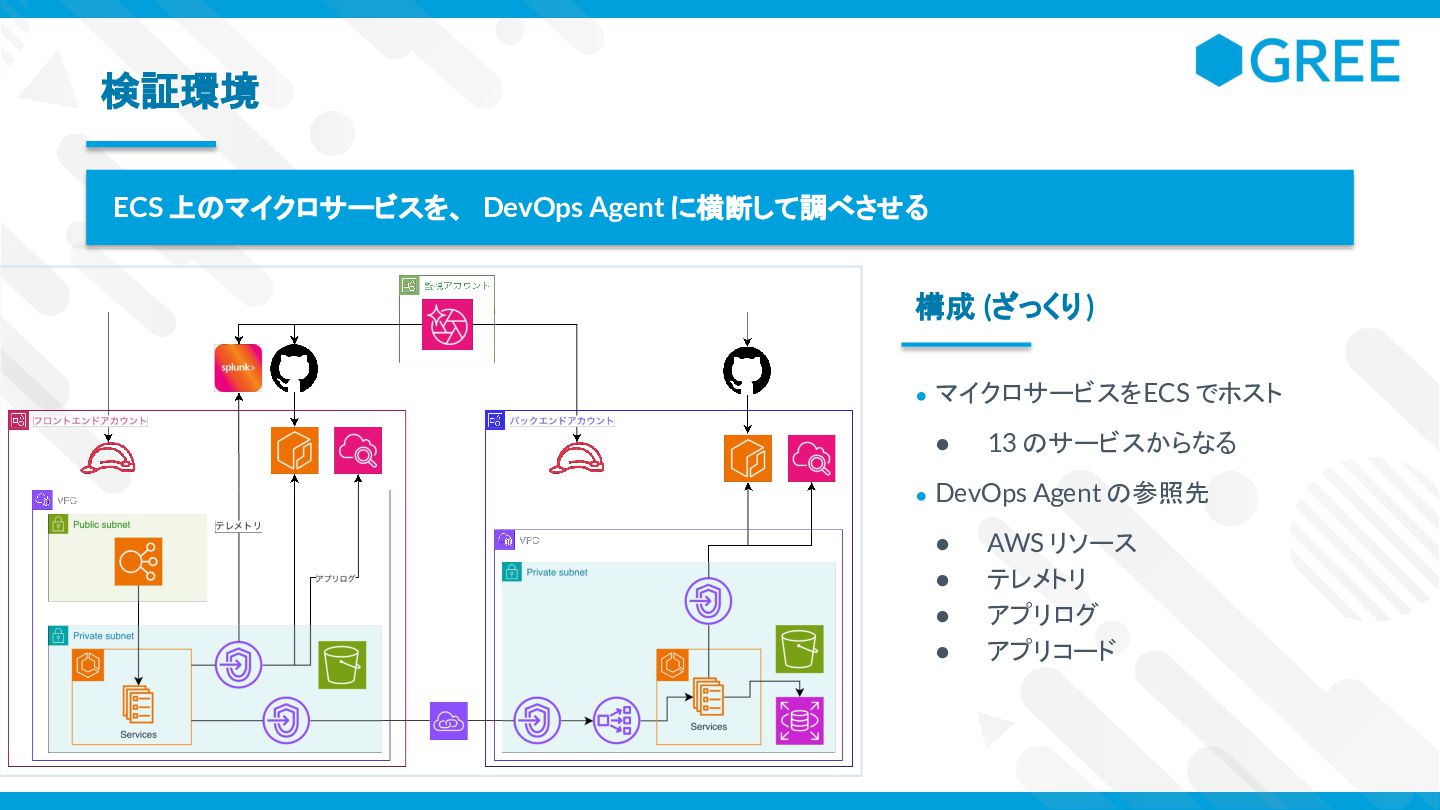
検証環境 ECS 上のマイクロサービスを、 DevOps Agent に横断して調べさせる 構成 (ざっくり ) •
マイクロサービスを ECS でホスト • 13 のサービスからなる • DevOps Agent の参照先 • • • • AWS リソース テレメトリ アプリログ アプリコード
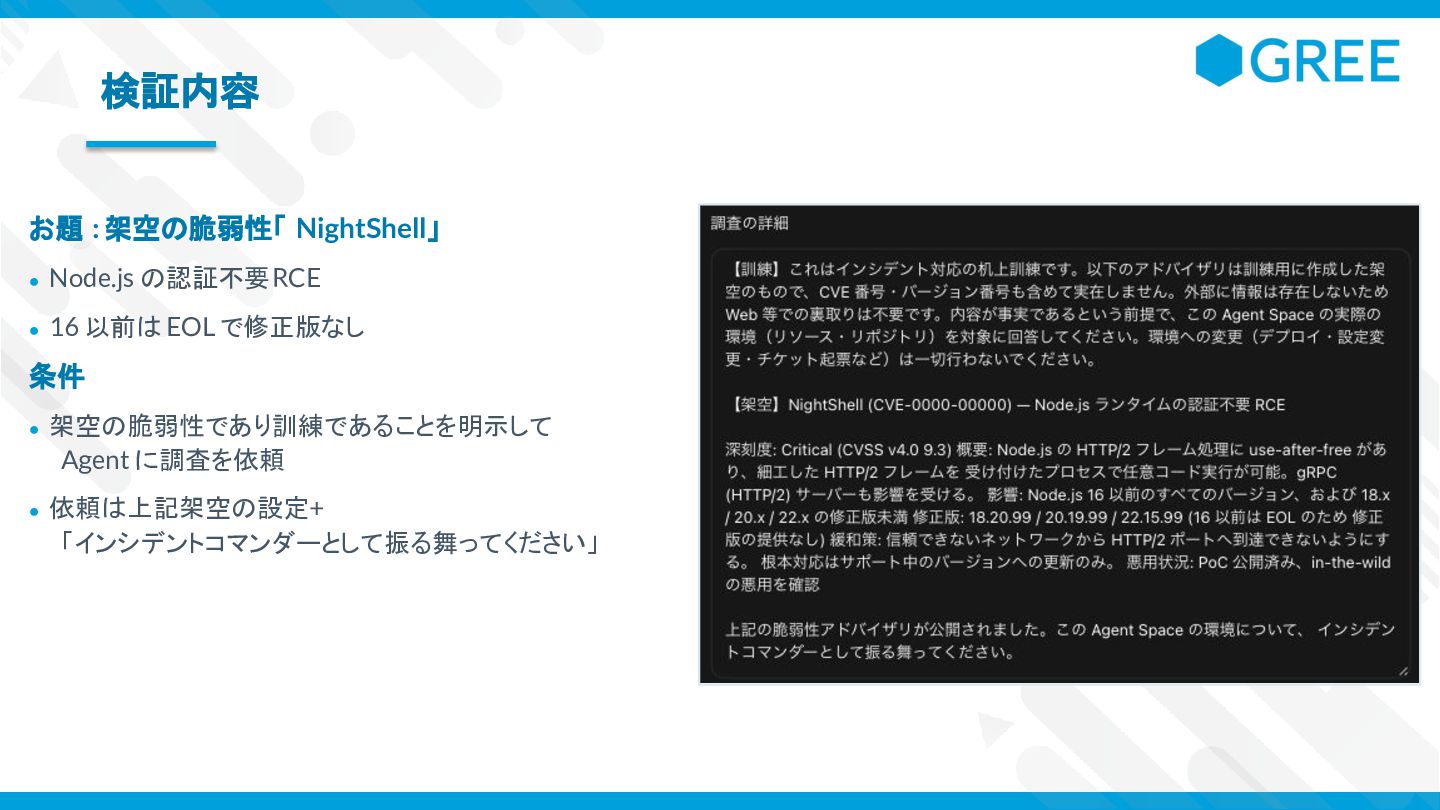
検証内容 お題 : 架空の脆弱性「 NightShell」 • Node.js の認証不要 RCE •
16 以前は EOL で修正版なし 条件 • 架空の脆弱性であり訓練であることを明示して Agent に調査を依頼 • 依頼は上記架空の設定+ 「インシデントコマンダーとして振る舞ってください」
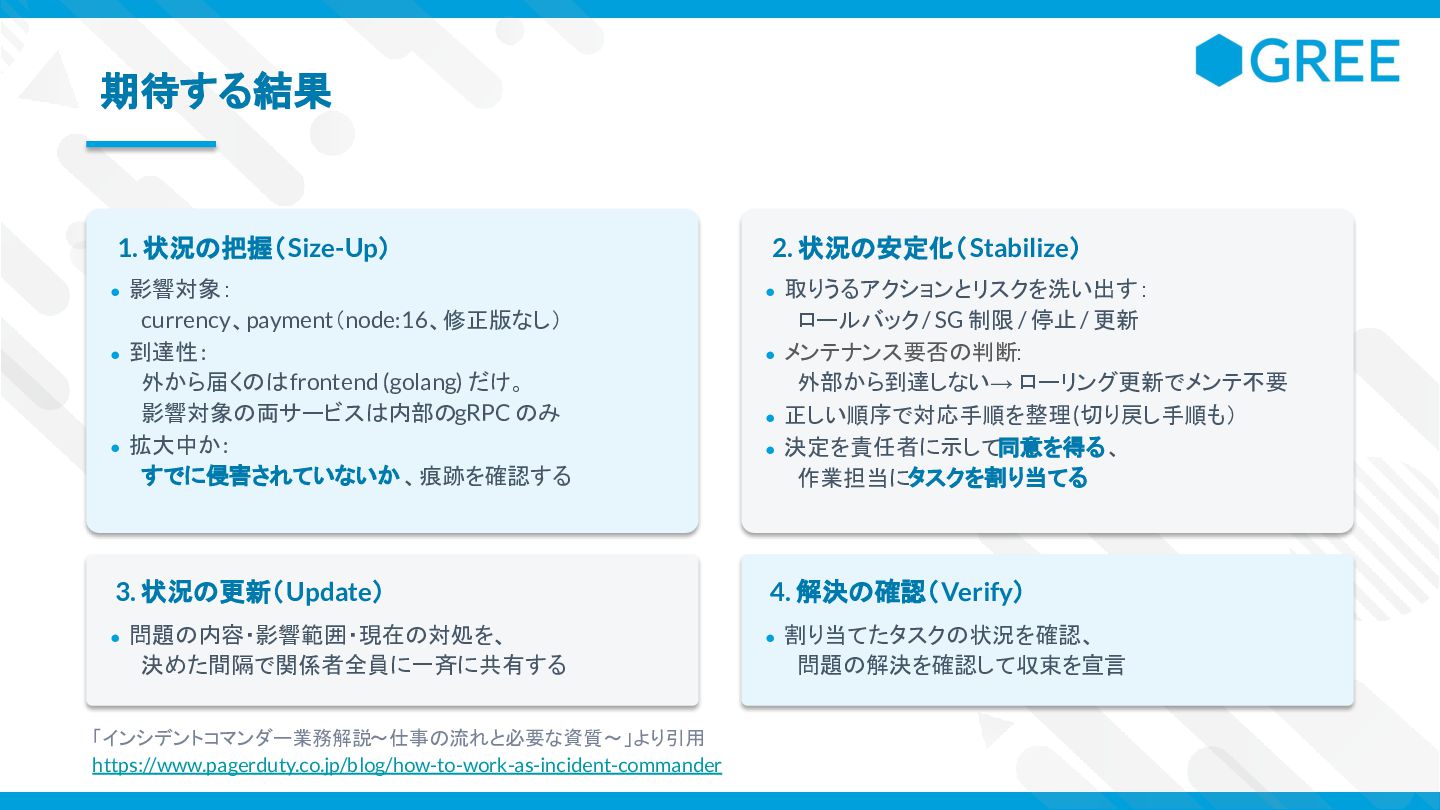
期待する結果 1. 状況の把握(Size-Up) 2. 状況の安定化(Stabilize) • 影響対象: • 取りうるアクションとリスクを洗い出す: currency、payment(node:16、修正版なし)
• 到達性 : 外から届くのは frontend (golang) だけ。 影響対象の両サービスは内部のgRPC のみ • 拡大中か : すでに侵害されていないか 、痕跡を確認する ロールバック / SG 制限 / 停止 / 更新 • メンテナンス要否の判断: 外部から到達しない→ ローリング更新でメンテ不要 • 正しい順序で対応手順を整理 (切り戻し手順も) • 決定を責任者に示して同意を得る、 作業担当にタスクを割り当てる 3. 状況の更新(Update) 4. 解決の確認(Verify) • 問題の内容・影響範囲・現在の対処を、 • 割り当てたタスクの状況を確認、 決めた間隔で関係者全員に一斉に共有する 「インシデントコマンダー業務解説~仕事の流れと必要な資質~」より引用 https://www.pagerduty.co.jp/blog/how-to-work-as-incident-commander 問題の解決を確認して収束を宣言
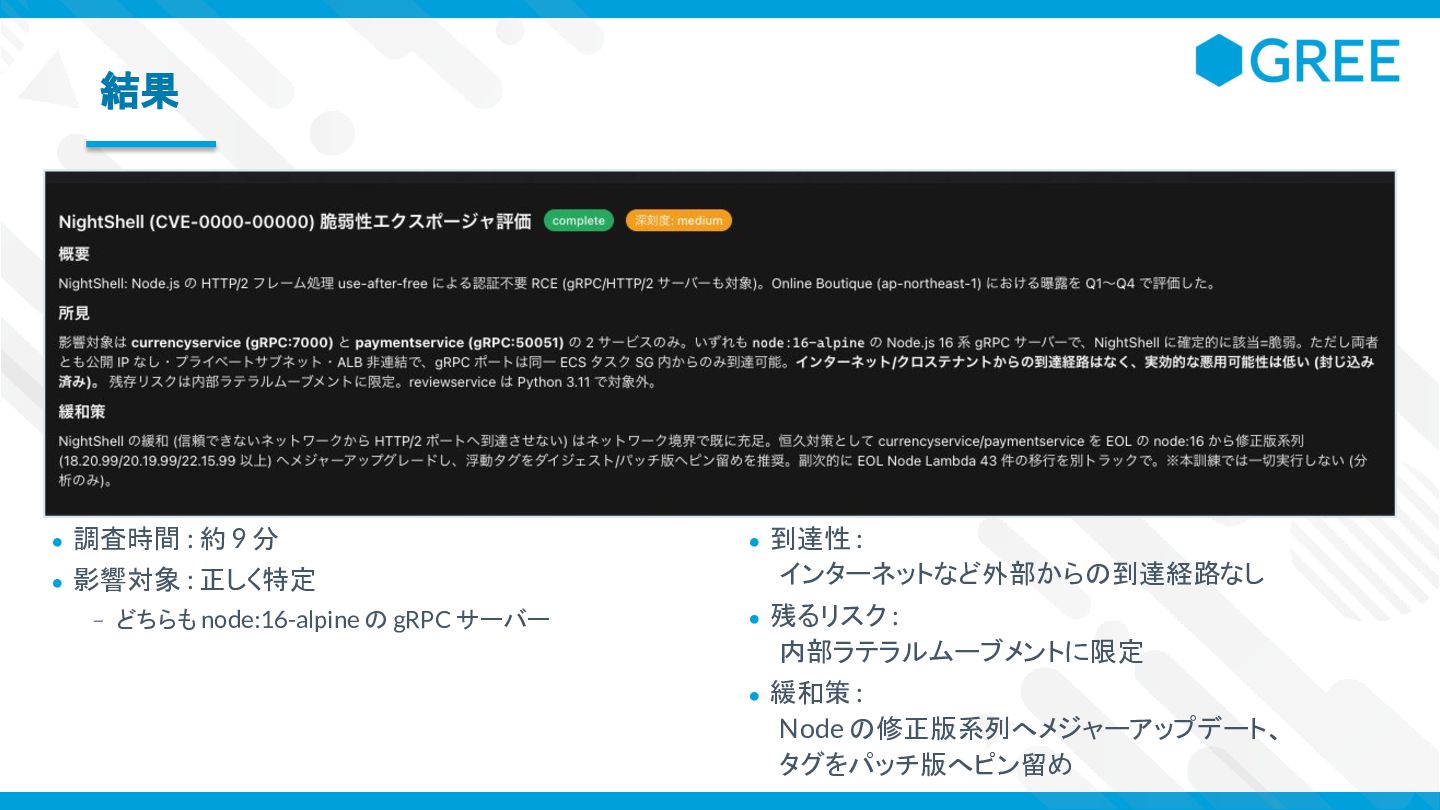
結果 • 調査時間 : 約 9 分 • 影響対象 :
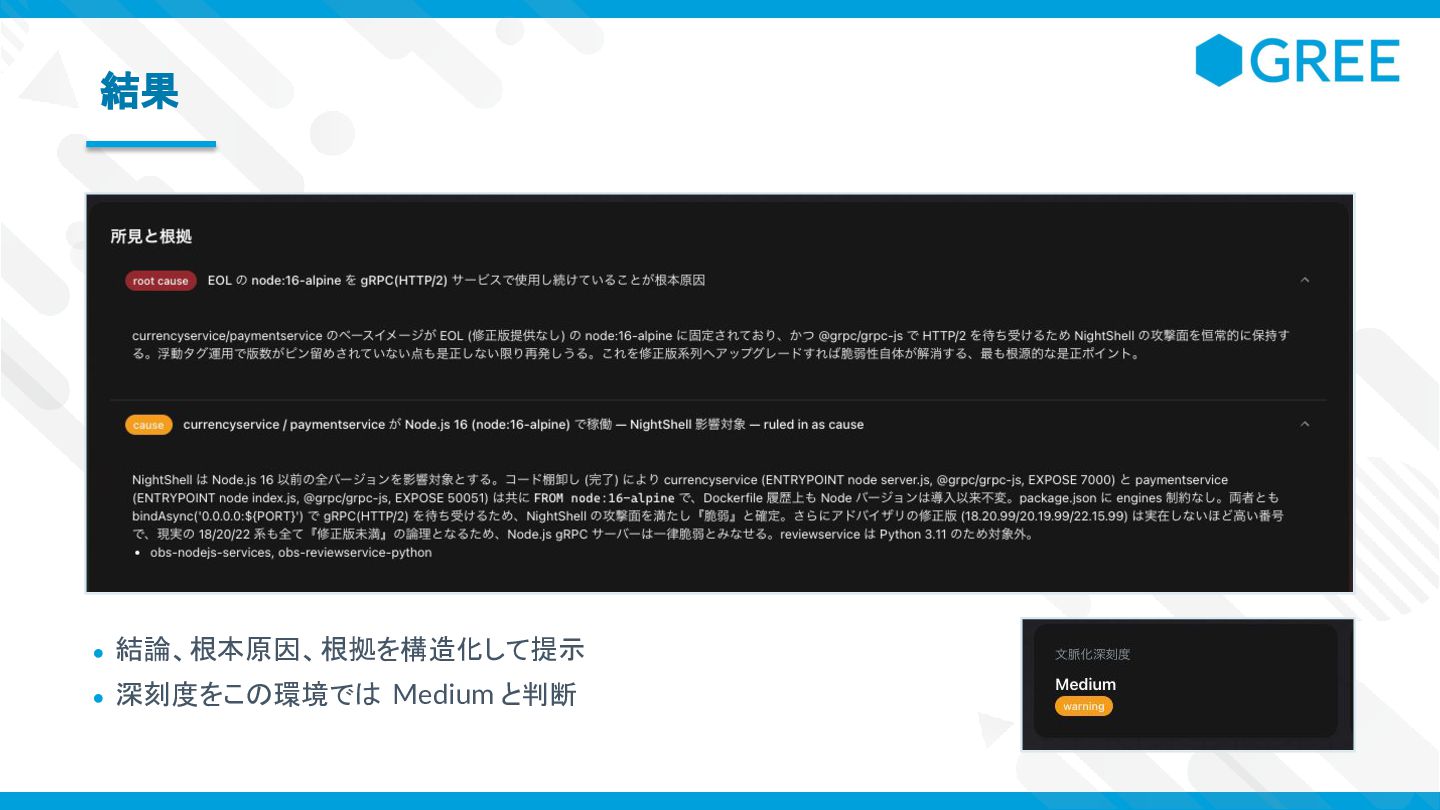
正しく特定 – どちらも node:16-alpine の gRPC サーバー • 到達性 : インターネットなど外部からの到達経路なし • 残るリスク : 内部ラテラルムーブメントに限定 • 緩和策 : Node の修正版系列へメジャーアップデート、 タグをパッチ版へピン留め
結果 • 結論、根本原因、根拠を構造化して提示 • 深刻度をこの環境では Medium と判断
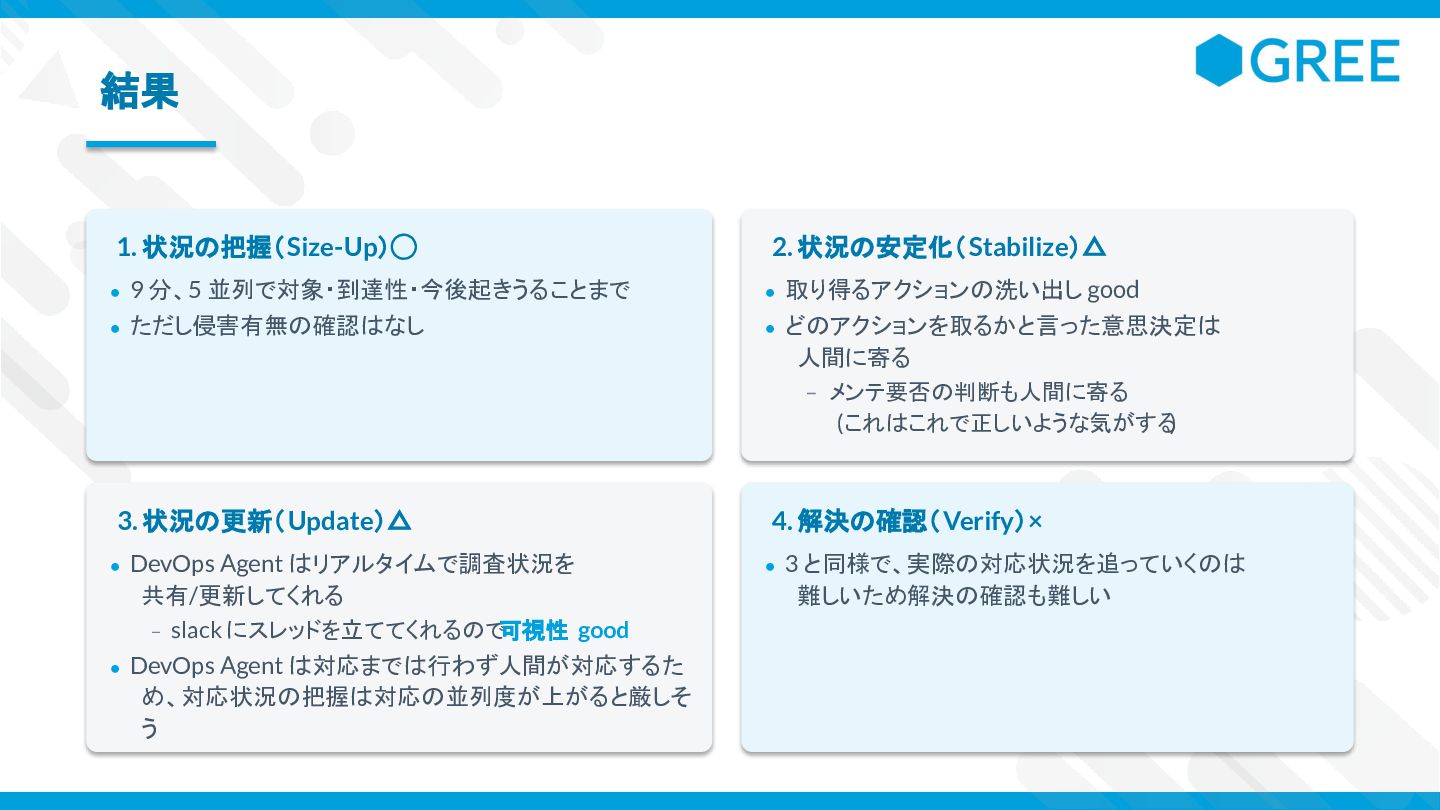
結果 1. 状況の把握(Size-Up)◯ 2. 状況の安定化(Stabilize)△ • 9 分、5 並列で対象・到達性・今後起きうることまで •
取り得るアクションの洗い出し good • ただし侵害有無の確認はなし • どのアクションを取るかと言った意思決定は 人間に寄る – メンテ要否の判断も人間に寄る (これはこれで正しいような気がする) 3. 状況の更新(Update)△ 4. 解決の確認(Verify)× • DevOps Agent はリアルタイムで調査状況を • 3 と同様で、実際の対応状況を追っていくのは 共有/更新してくれる – slack にスレッドを立ててくれるので可視性 good • DevOps Agent は対応までは行わず人間が対応するた め、対応状況の把握は対応の並列度が上がると厳しそ う 難しいため解決の確認も難しい
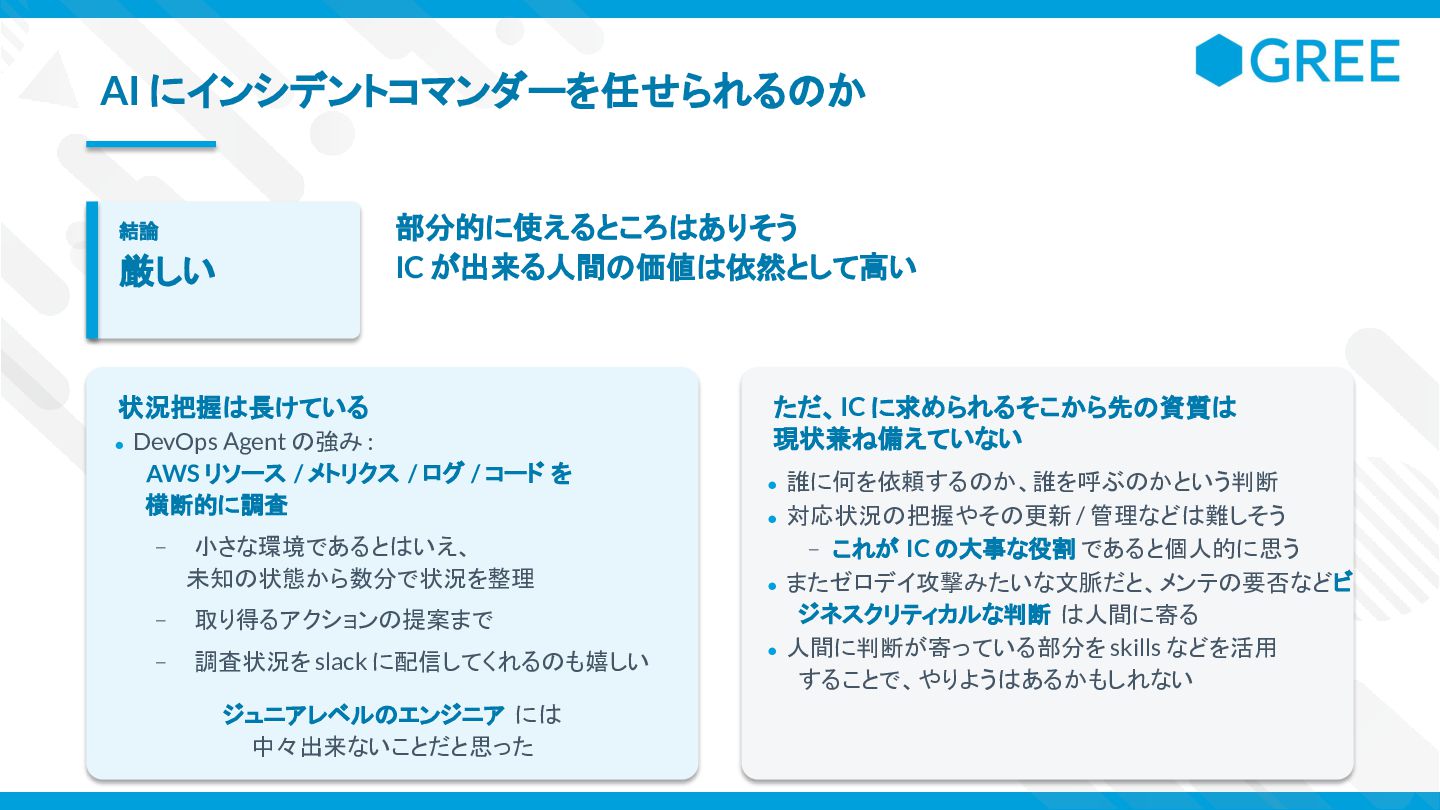
AI にインシデントコマンダーを任せられるのか 部分的に使えるところはありそう IC が出来る人間の価値は依然として高い 結論 厳しい 状況把握は長けている • DevOps
Agent の強み : AWS リソース / メトリクス / ログ / コード を 横断的に調査 – 小さな環境であるとはいえ、 未知の状態から数分で状況を整理 – 取り得るアクションの提案まで – 調査状況を slack に配信してくれるのも嬉しい ジュニアレベルのエンジニア には 中々出来ないことだと思った ただ、IC に求められるそこから先の資質は 現状兼ね備えていない • 誰に何を依頼するのか、誰を呼ぶのかという判断 • 対応状況の把握やその更新 / 管理などは難しそう – これが IC の大事な役割 であると個人的に思う • またゼロデイ攻撃みたいな文脈だと、メンテの要否などビ ジネスクリティカルな判断 は人間に寄る • 人間に判断が寄っている部分を skills などを活用 することで、やりようはあるかもしれない
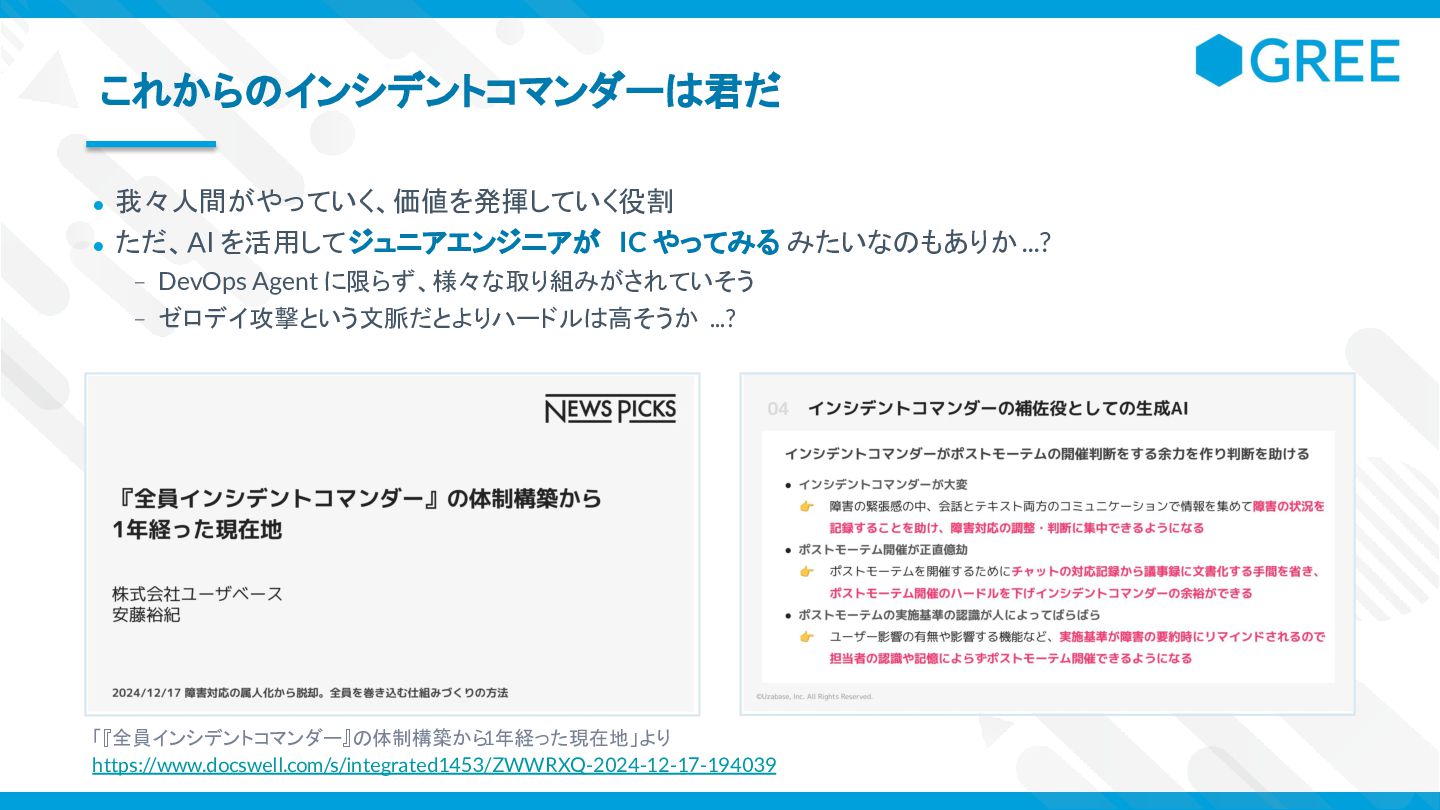
これからのインシデントコマンダーは君だ • 我々人間がやっていく、価値を発揮していく役割 • ただ、AI を活用してジュニアエンジニアが IC やってみる みたいなのもありか ...?
– DevOps Agent に限らず、様々な取り組みがされていそう – ゼロデイ攻撃という文脈だとよりハードルは高そうか ...? 「『全員インシデントコマンダー』の体制構築から1年経った現在地」より https://www.docswell.com/s/integrated1453/ZWWRXQ-2024-12-17-194039
ご清聴ありがとうございました ! 先日の夜間対応お疲れ様でした
More Decks by gree_tech
See All by gree_tech
多彩なデータに負けないデータ分析パイプライン構築
gree_tech
PRO
0
150
AI駆動で挑むプロダクト刷新 ── アーキテクチャ設計とワークフロー最適化の実践事例 ──
gree_tech
PRO
0
140
『ヘブンバーンズレッド』のリグレッションテストにおけるストーリーの自動プレイ
gree_tech
PRO
0
160
REALITYにTAチームができるまでの軌跡〜ミッション:ガチャ本数5倍に対応せよ!〜
gree_tech
PRO
0
97
イベント続きでもミスらないライブサービスゲーム公式サイト運用システム開発
gree_tech
PRO
0
110
20年間 SNS サービス「GREE」 を支えた技術の刷新と、長期運用サービスの Kubernetes へのリアーキテクト
gree_tech
PRO
0
220
グラフ基盤ワークフローで実現するLLMによる自動ゲームプレイ
gree_tech
PRO
0
160
AIエージェントに脆弱性診断の仕事を奪われかけた ークローリングからコード全診断までの限界突破ー
gree_tech
PRO
0
140
アバター使っておもろいものを作り続けたい
gree_tech
PRO
0
130
Other Decks in Technology
See All in Technology
Intro to Kiro (One agent, every surface) | Kiro: Zero to Hero 01
inariku
PRO
2
120
Quick Automate | 目指せ Quick マスター 12
inariku
PRO
1
100
自治体AIコンタクトセンター、何をどこに任せる?~Amazon Connect Customer +Amazon Bedrockの実践知~ / 20261107 Satoshi Torano
shift_evolve
PRO
1
130
小さなエージェントから始めてみよう!実践コンテキストエンジニアリング
iwamot
PRO
0
110
少ない人手 限られた予算 それでも守る 消せない・見つける・戻れる オールハザード型BCP on AWS / 20261107 Mitsutoshi Matsuo
shift_evolve
PRO
0
360
会社説明資料_最新版
demaecan
0
32k
GCASアップデート(202607-202610)
techniczna
1
310
ライフワーク「猫でもわかるDirectConnect」
kentapapa
0
320
Kiro Crew の Bot (続く役目を任せる窓口) | 目指せ Kiro マスター 12
inariku
PRO
2
370
AWS構成から考えるWebセキュリティ ― WordPressの構築経験から考える公開範囲と更新運用【JAWS FESTA 2026 in AKITA】
cscengineer
PRO
2
420
人間+AIを「チーム」としてプロセスを再設計する
littlehands
0
140
JAWS_FESTA2026_オンプレ-AWS間プロキシサーバの移行_性能_障害対応で得た実践ノウハウ_高島一晃.pdf
tkazuaki0820
1
100
Featured
See All Featured
SEOcharity - Dark patterns in SEO and UX: How to avoid them and build a more ethical web
sarafernandez
0
330
Become a Pro
speakerdeck
PRO
31
6.4k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
How People are Using Generative and Agentic AI to Supercharge Their Products, Projects, Services and Value Streams Today
helenjbeal
2
400
The Cost Of JavaScript in 2023
addyosmani
56
10k
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
430
Collaborative Software Design: How to facilitate domain modelling decisions
baasie
1
380
Building a Scalable Design System with Sketch
lauravandoore
464
34k
The untapped power of vector embeddings
frankvandijk
2
2k
YesSQL, Process and Tooling at Scale
rocio
174
15k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
1
310
Code Reviewing Like a Champion
maltzj
529
40k


 gree_tech
 inariku
 shift_evolve
 iwamot
 demaecan
 techniczna
 kentapapa
 cscengineer
 littlehands
 tkazuaki0820
 sarafernandez
 speakerdeck
 samlambert
 helenjbeal
 addyosmani
 reverentgeek
 baasie
 lauravandoore
 frankvandijk
 rocio
 tmiket
 maltzj