Share
Embed
グラフデータベースNeo4Jでアセットダウンロードの構成管理と最適化
CEDEC 2017 にて発表された資料です
http://cedec.cesa.or.jp/2017/session/ENG/s58df950a5b9f7/
Transcript
35 slides
-
⾃⼰紹介 • 鈴⽊ 清⼈ (スズキ キヨト) • グリー株式会社 • Wright
Flyer Studios事業本部 • リードエンジニア 2001年 横浜国⽴⼤学 ⼯学部 電⼦情報⼯学科卒業 2013年 グリー株式会社 ⼊社 グリーが⼤規模なサーバ負荷にどうやって対処しているのかを⾒たいと思って⼊社したら、な ぜか⾃ら負荷を作り出すための活動をすることに BIシステム、「天と⼤地と⼥神の魔法」のサーバアプリ開発を経て、「アナザーエデン」の各 種パイプラインの下回り全般を担当 -
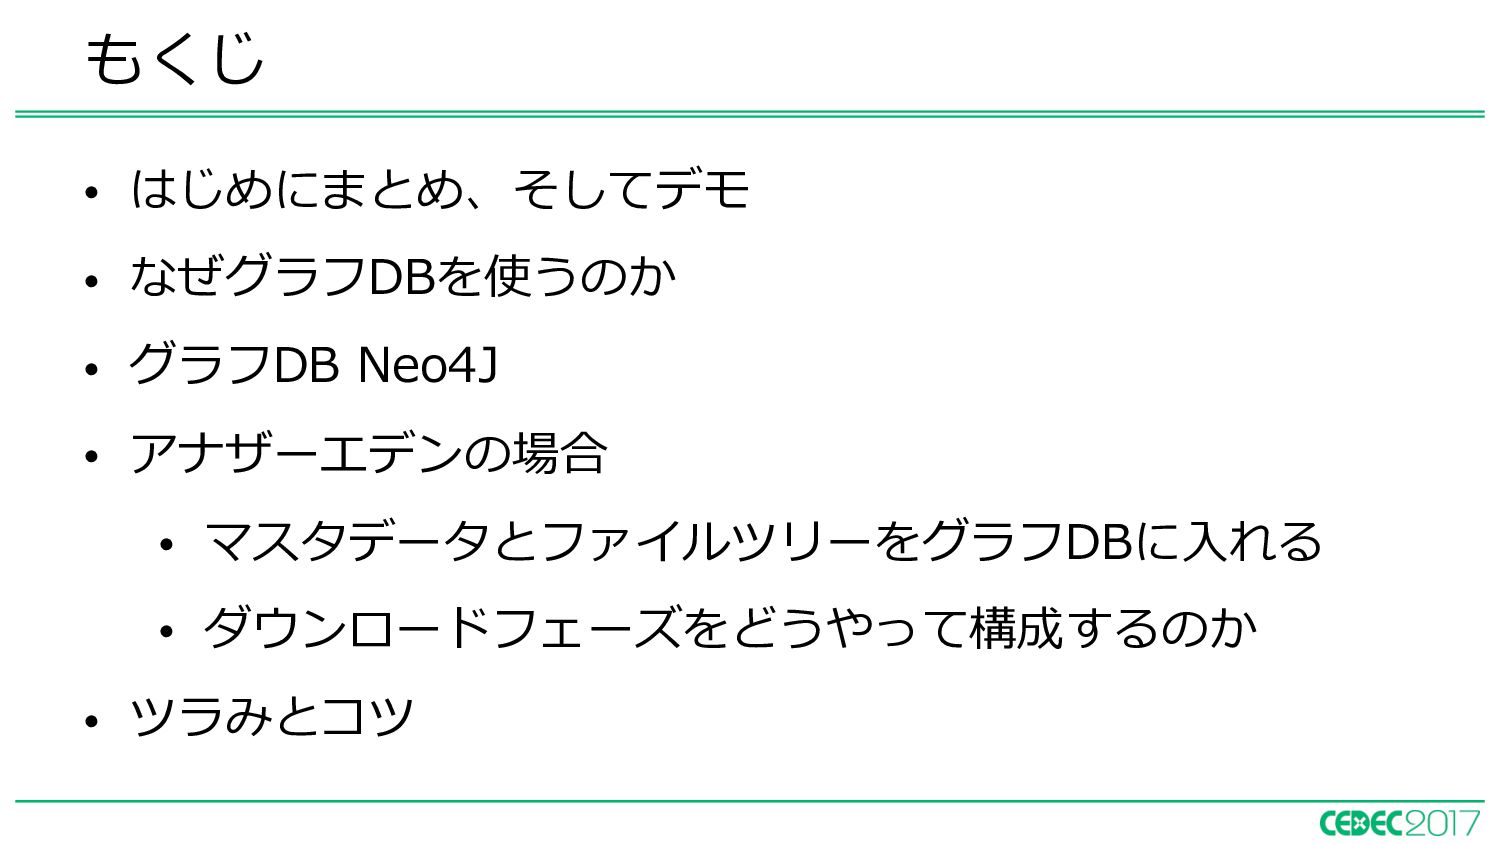
• はじめにまとめ、そしてデモ • なぜグラフDBを使うのか • グラフDB Neo4J • アナザーエデンの場合 •
マスタデータとファイルツリーをグラフDBに⼊れる • ダウンロードフェーズをどうやって構成するのか • ツラみとコツ もくじ -
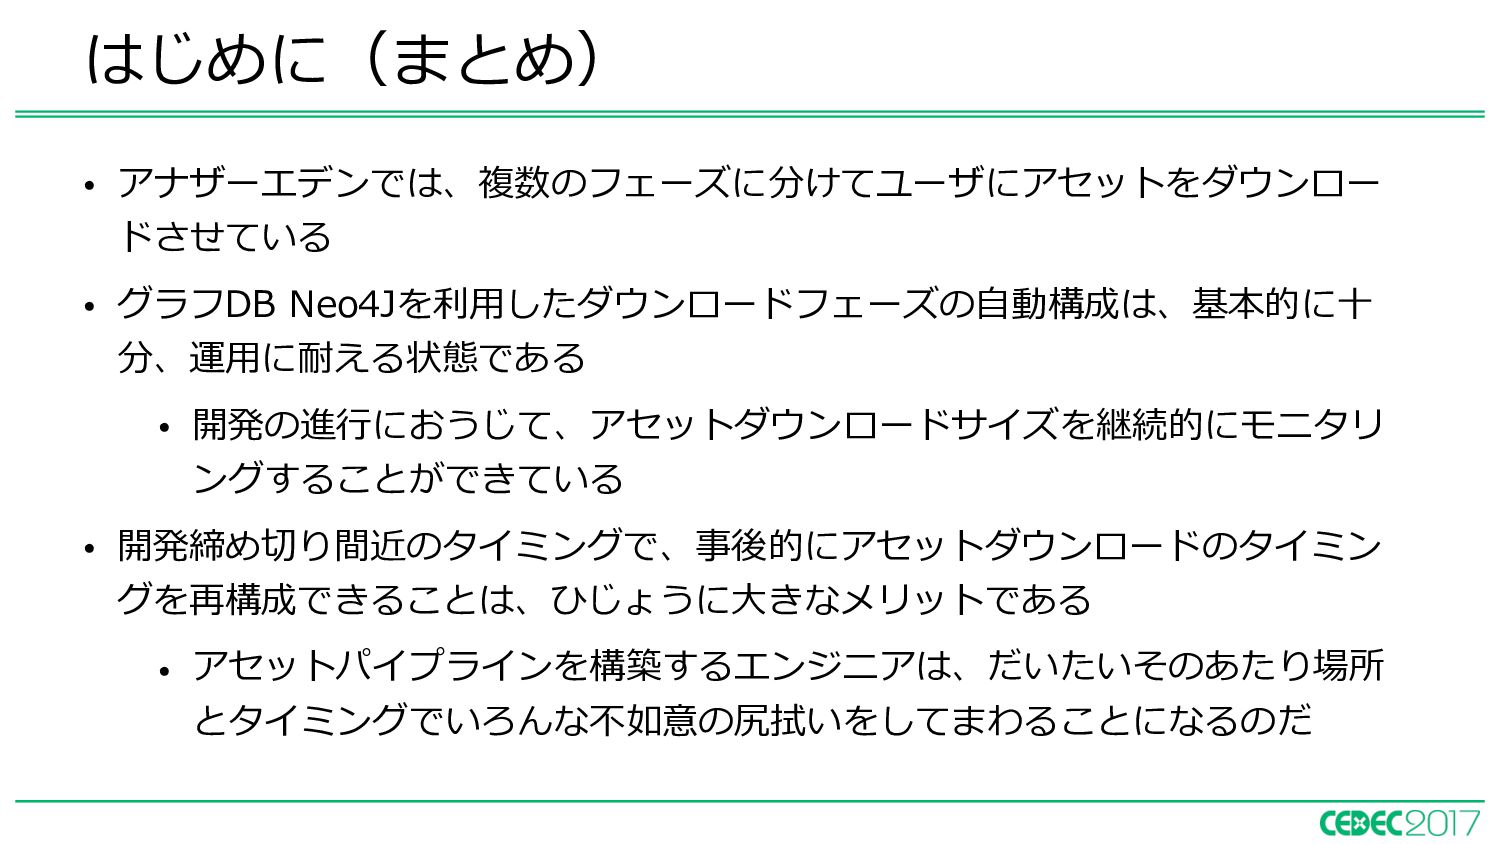
• アナザーエデンでは、複数のフェーズに分けてユーザにアセットをダウンロー ドさせている • グラフDB Neo4Jを利⽤したダウンロードフェーズの⾃動構成は、基本的に⼗ 分、運⽤に耐える状態である • 開発の進⾏におうじて、アセットダウンロードサイズを継続的にモニタリ ングすることができている
• 開発締め切り間近のタイミングで、事後的にアセットダウンロードのタイミン グを再構成できることは、ひじょうに⼤きなメリットである • アセットパイプラインを構築するエンジニアは、だいたいそのあたり場所 とタイミングでいろんな不如意の尻拭いをしてまわることになるのだ はじめに(まとめ) -
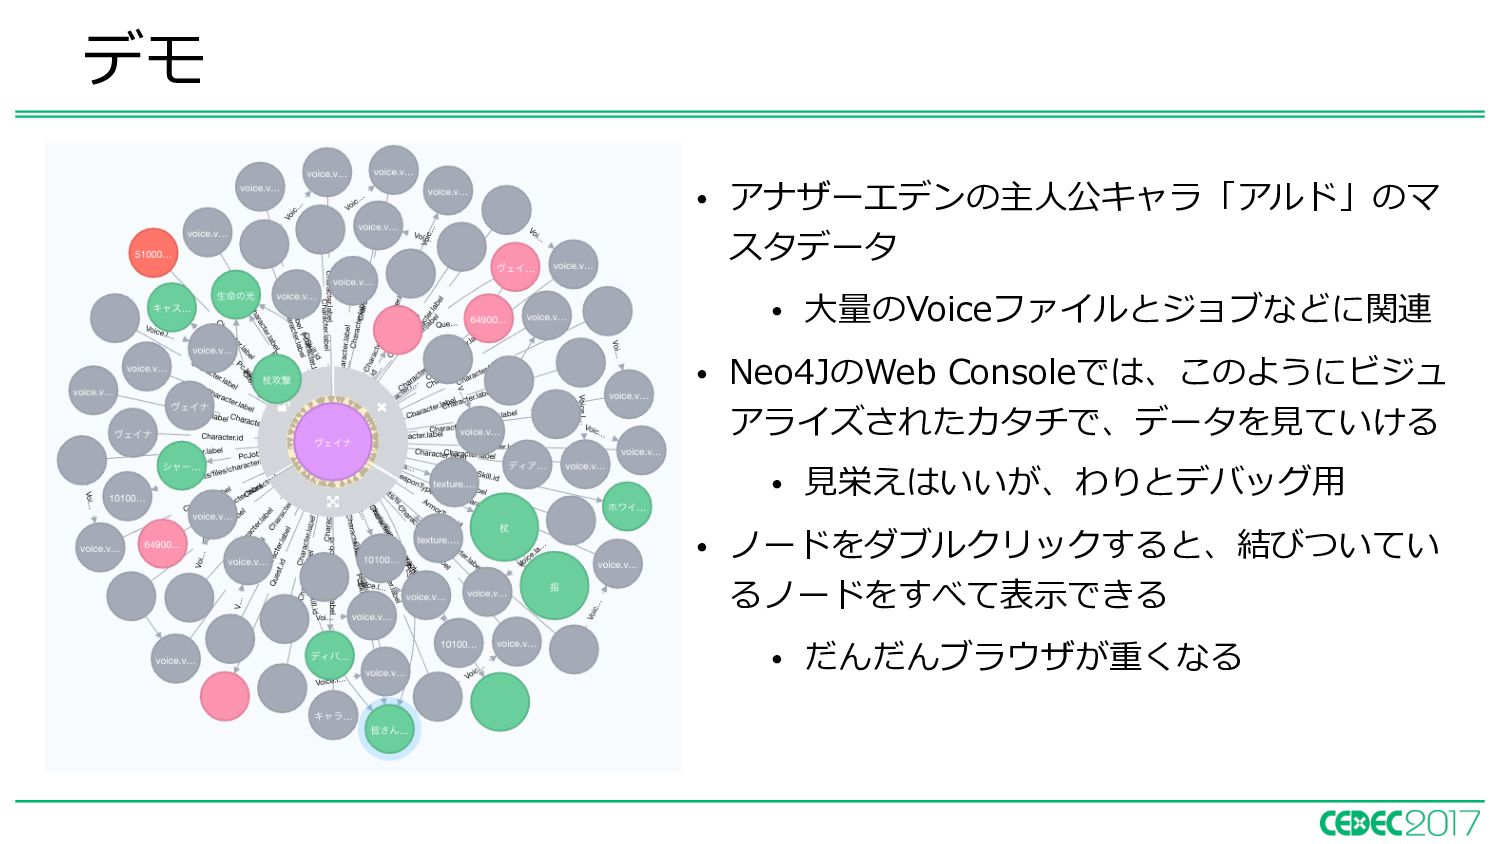
デモ • アナザーエデンの主⼈公キャラ「アルド」のマ スタデータ • ⼤量のVoiceファイルとジョブなどに関連 • Neo4JのWeb Consoleでは、このようにビジュ アライズされたカタチで、データを⾒ていける
• ⾒栄えはいいが、わりとデバッグ⽤ • ノードをダブルクリックすると、結びついてい るノードをすべて表⽰できる • だんだんブラウザが重くなる -
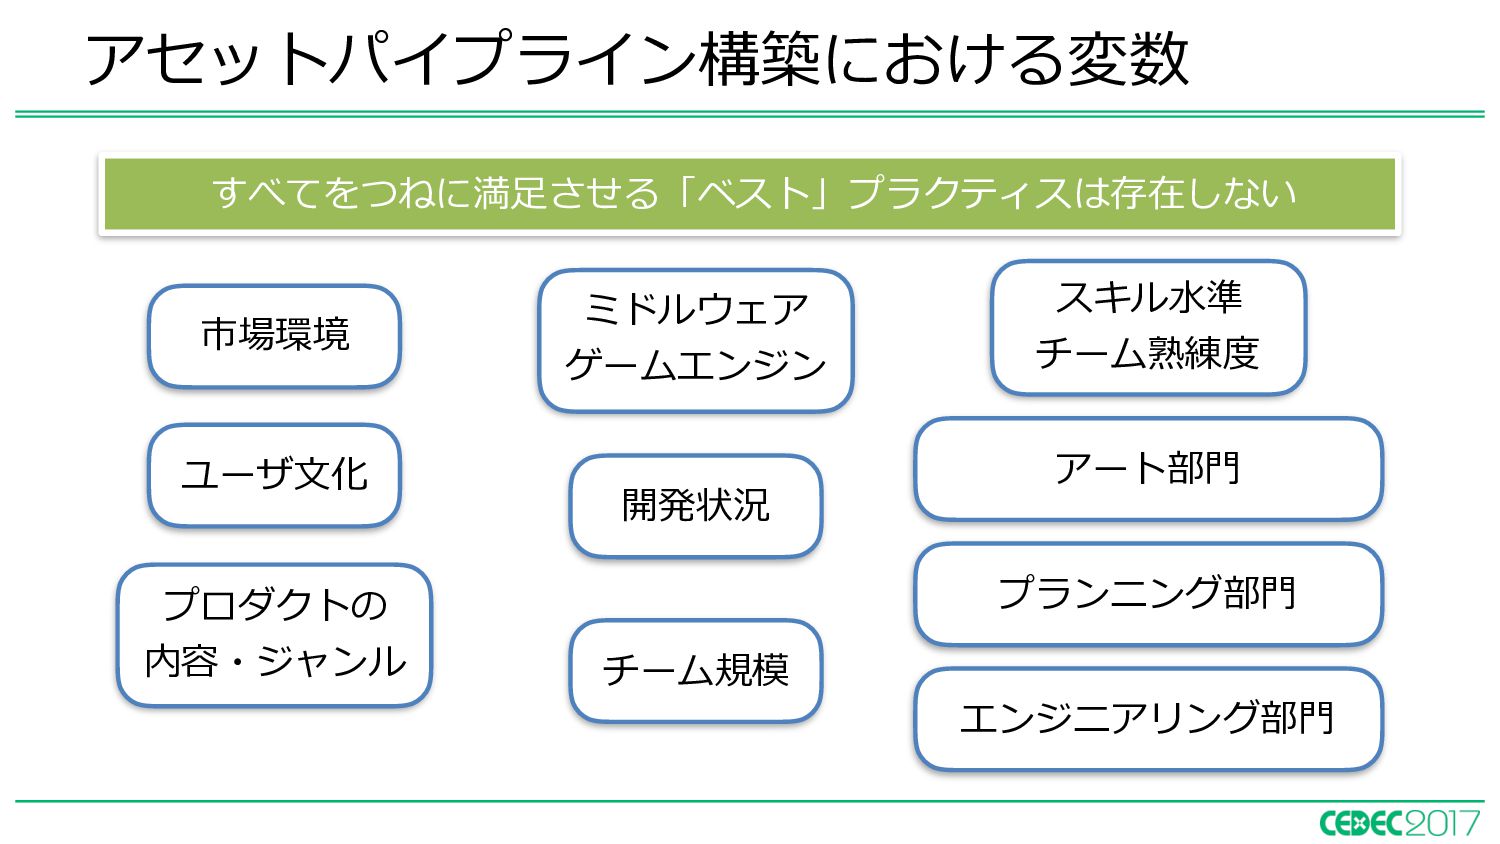
アセットパイプライン構築における変数 ミドルウェア ゲームエンジン 開発状況 市場環境 ユーザ⽂化 プロダクトの 内容・ジャンル チーム規模 スキル⽔準
チーム熟練度 プランニング部⾨ エンジニアリング部⾨ アート部⾨ すべてをつねに満⾜させる「ベスト」プラクティスは存在しない -
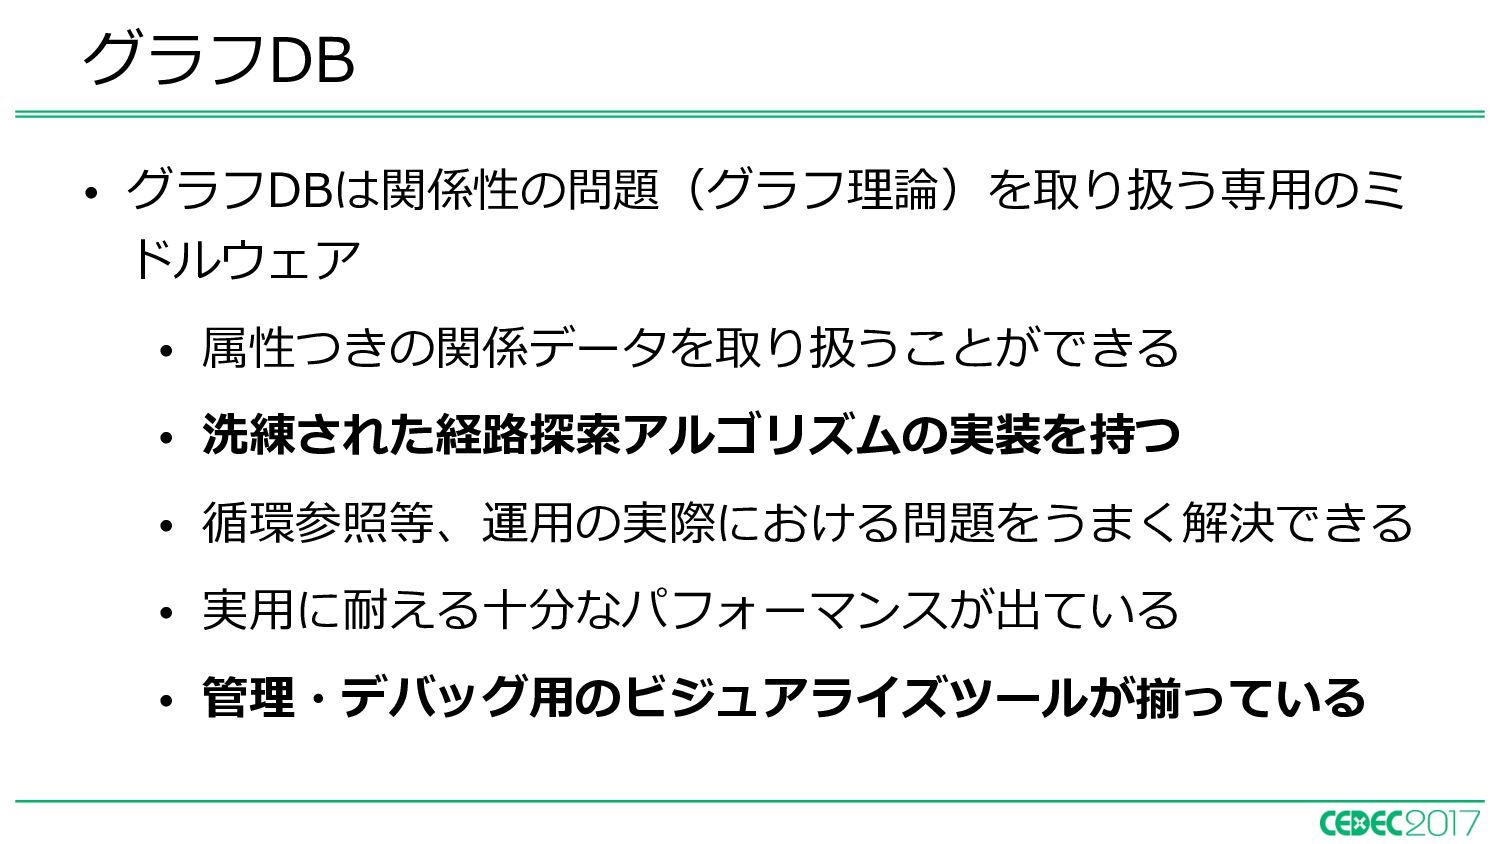
• グラフDBは関係性の問題(グラフ理論)を取り扱う専⽤のミ ドルウェア • 属性つきの関係データを取り扱うことができる • 洗練された経路探索アルゴリズムの実装を持つ • 循環参照等、運⽤の実際における問題をうまく解決できる •
実⽤に耐える⼗分なパフォーマンスが出ている • 管理・デバッグ⽤のビジュアライズツールが揃っている グラフDB -
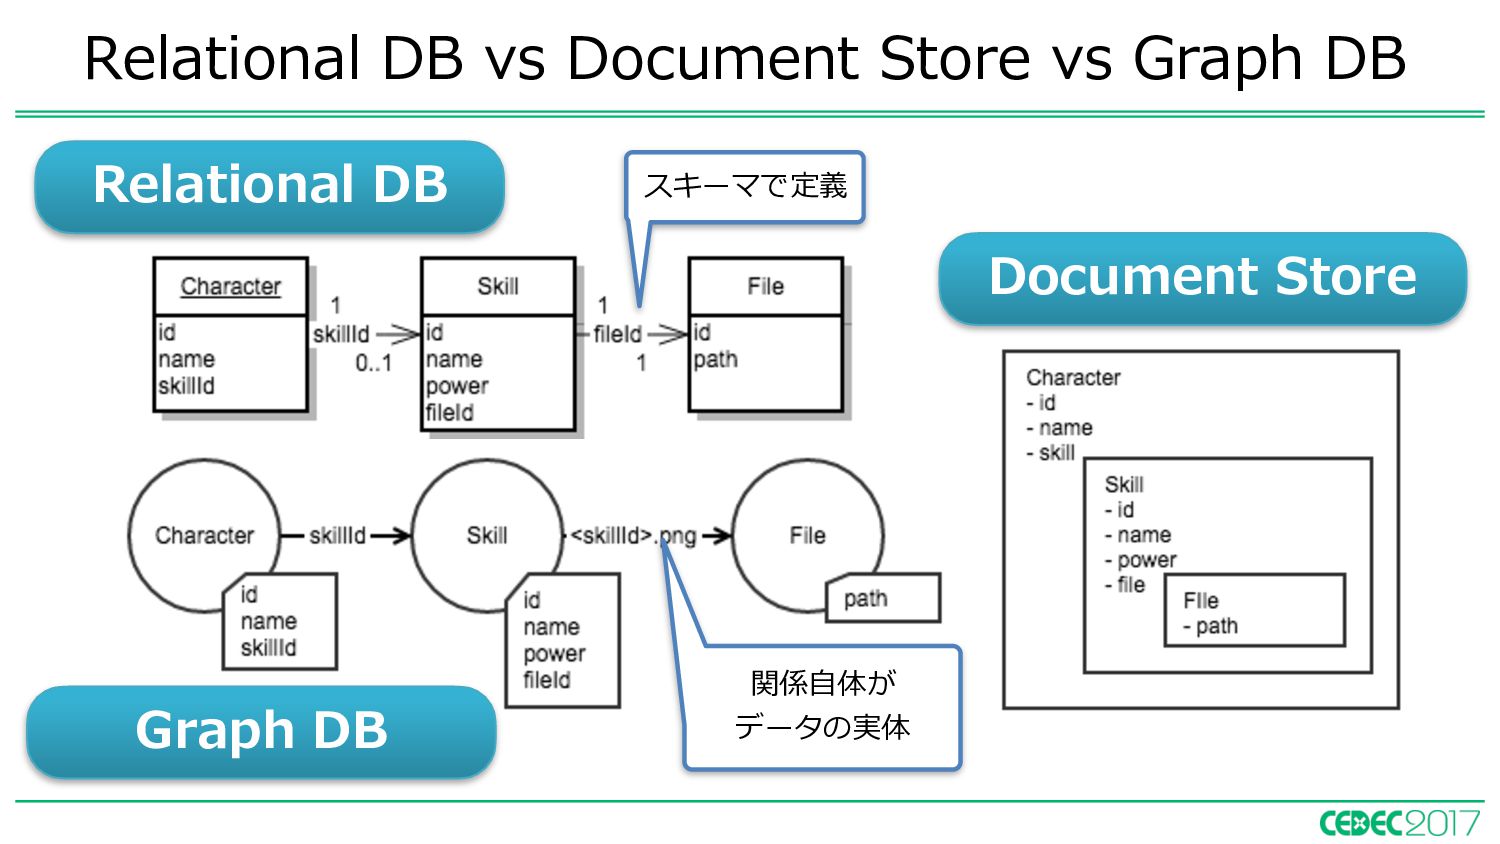
Relational DB vs Document Store vs Graph DB Relational DB
Document Store Graph DB スキーマで定義 関係⾃体が データの実体 -
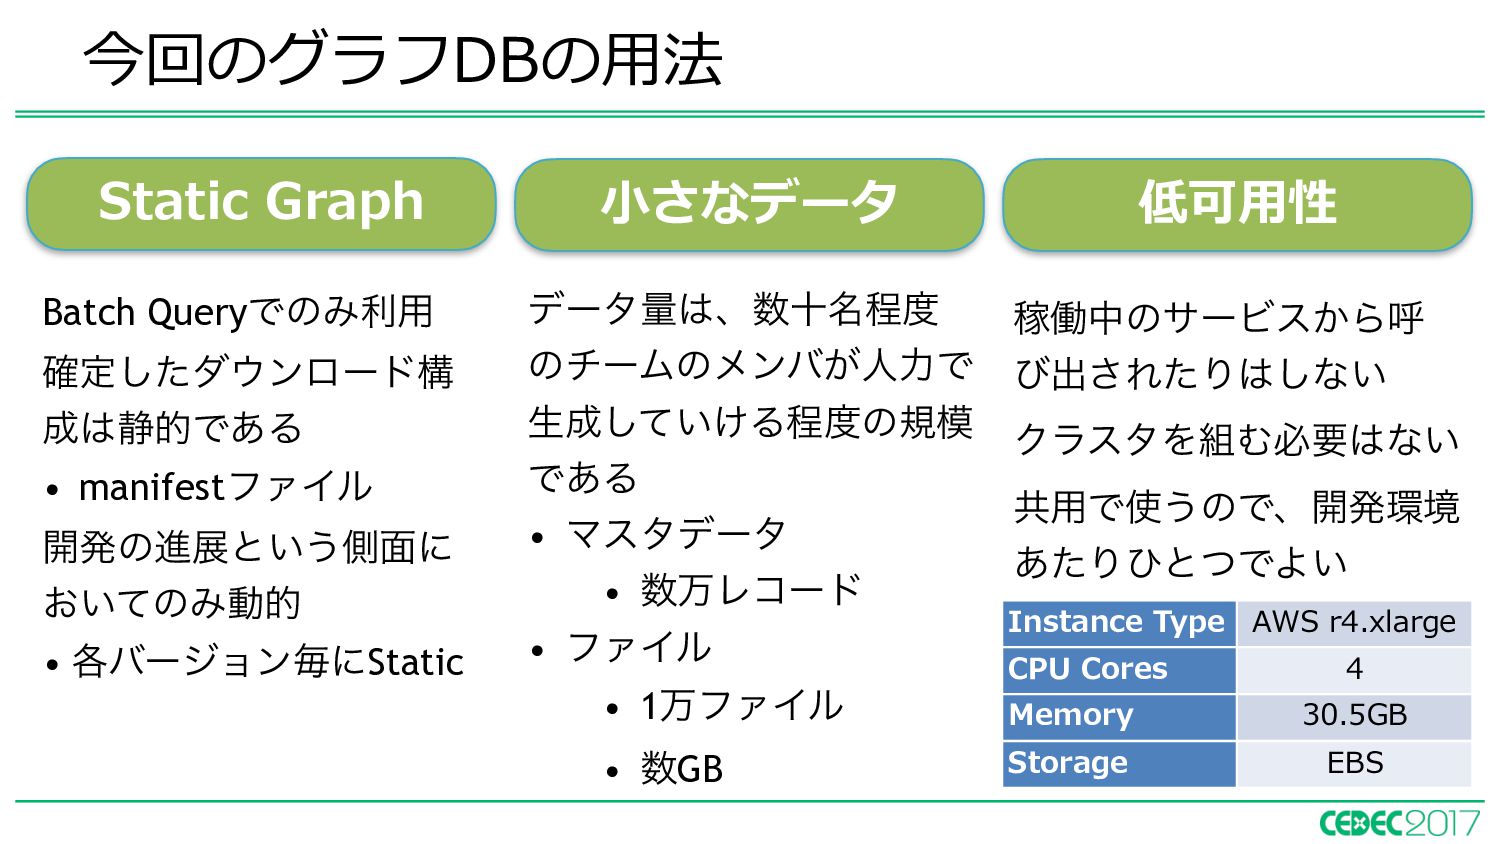
今回のグラフDBの⽤法 Static Graph ⼩さなデータ 低可⽤性 Batch QueryͰͷΈར༻ ֬ఆͨ͠μϯϩʔυߏ ੩తͰ͋Δ •
manifestϑΝΠϧ ։ൃͷਐలͱ͍͏ଆ໘ʹ ͓͍ͯͷΈಈత • ֤όʔδϣϯຖʹStatic ՔಇதͷαʔϏε͔Βݺ ͼग़͞ΕͨΓ͠ͳ͍ ΫϥελΛΉඞཁͳ͍ ڞ༻Ͱ͏ͷͰɺ։ൃڥ ͋ͨΓͻͱͭͰΑ͍ σʔλྔɺे໊ఔ ͷνʔϜͷϝϯό͕ਓྗͰ ੜ͍͚ͯ͠Δఔͷن Ͱ͋Δ • Ϛελσʔλ • ສϨίʔυ • ϑΝΠϧ • 1ສϑΝΠϧ • GB Instance Type AWS r4.xlarge CPU Cores 4 Memory 30.5GB Storage EBS -
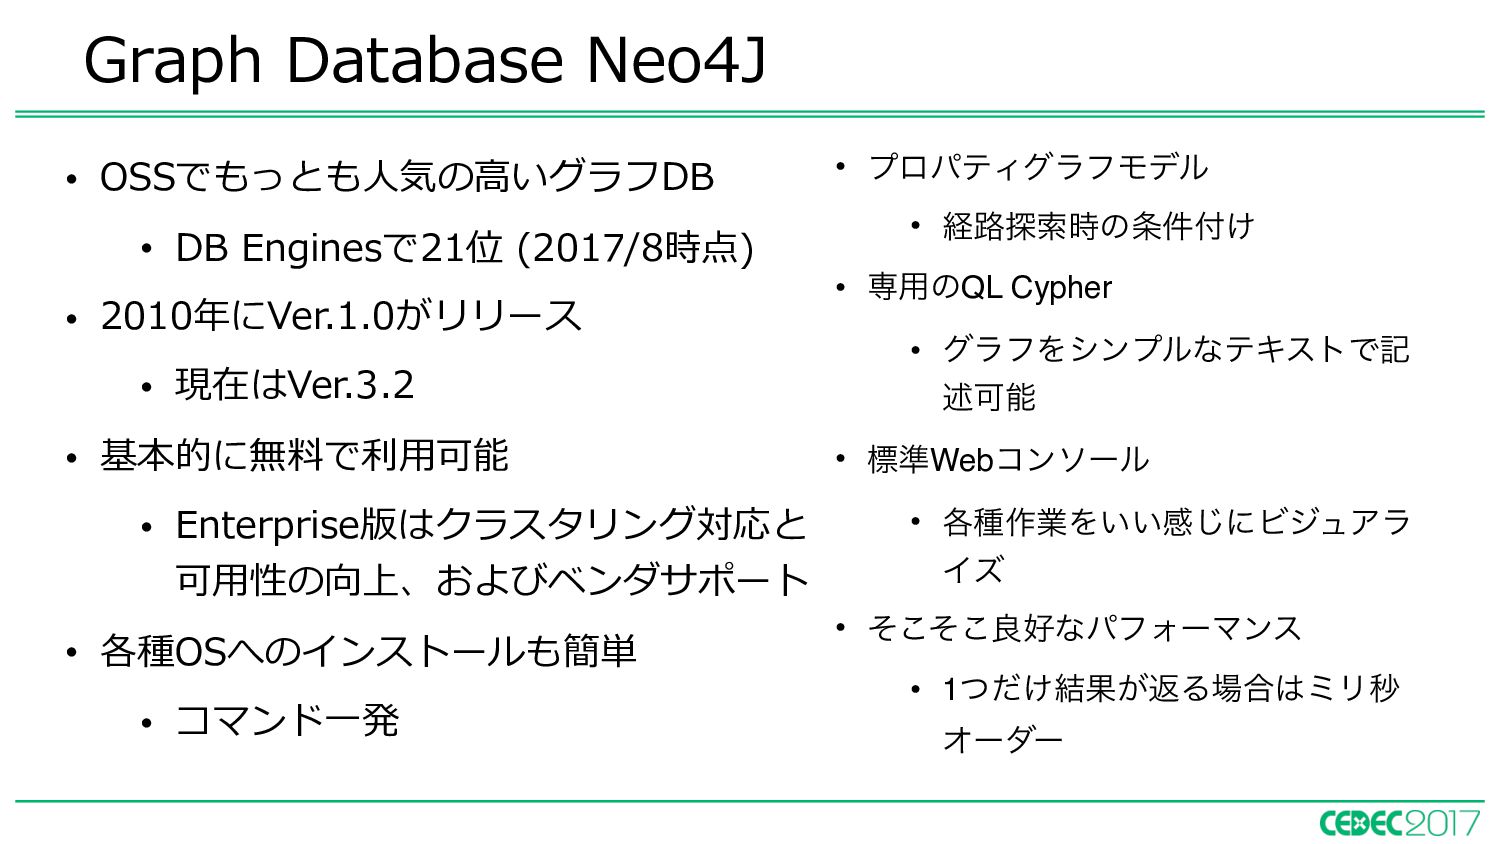
• OSSでもっとも⼈気の⾼いグラフDB • DB Enginesで21位 (2017/8時点) • 2010年にVer.1.0がリリース • 現在はVer.3.2
• 基本的に無料で利⽤可能 • Enterprise版はクラスタリング対応と 可⽤性の向上、およびベンダサポート • 各種OSへのインストールも簡単 • コマンド⼀発 Graph Database Neo4J • ϓϩύςΟάϥϑϞσϧ • ܦ࿏୳ࡧ࣌ͷ͚݅ • ઐ༻ͷQL Cypher • άϥϑΛγϯϓϧͳςΩετͰه ड़Մೳ • ඪ४Webίϯιʔϧ • ֤छ࡞ۀΛ͍͍ײ͡ʹϏδϡΞϥ Πζ • ͦͦ͜͜ྑͳύϑΥʔϚϯε • 1͚ͭͩ݁Ռ͕ฦΔ߹ϛϦඵ Φʔμʔ -
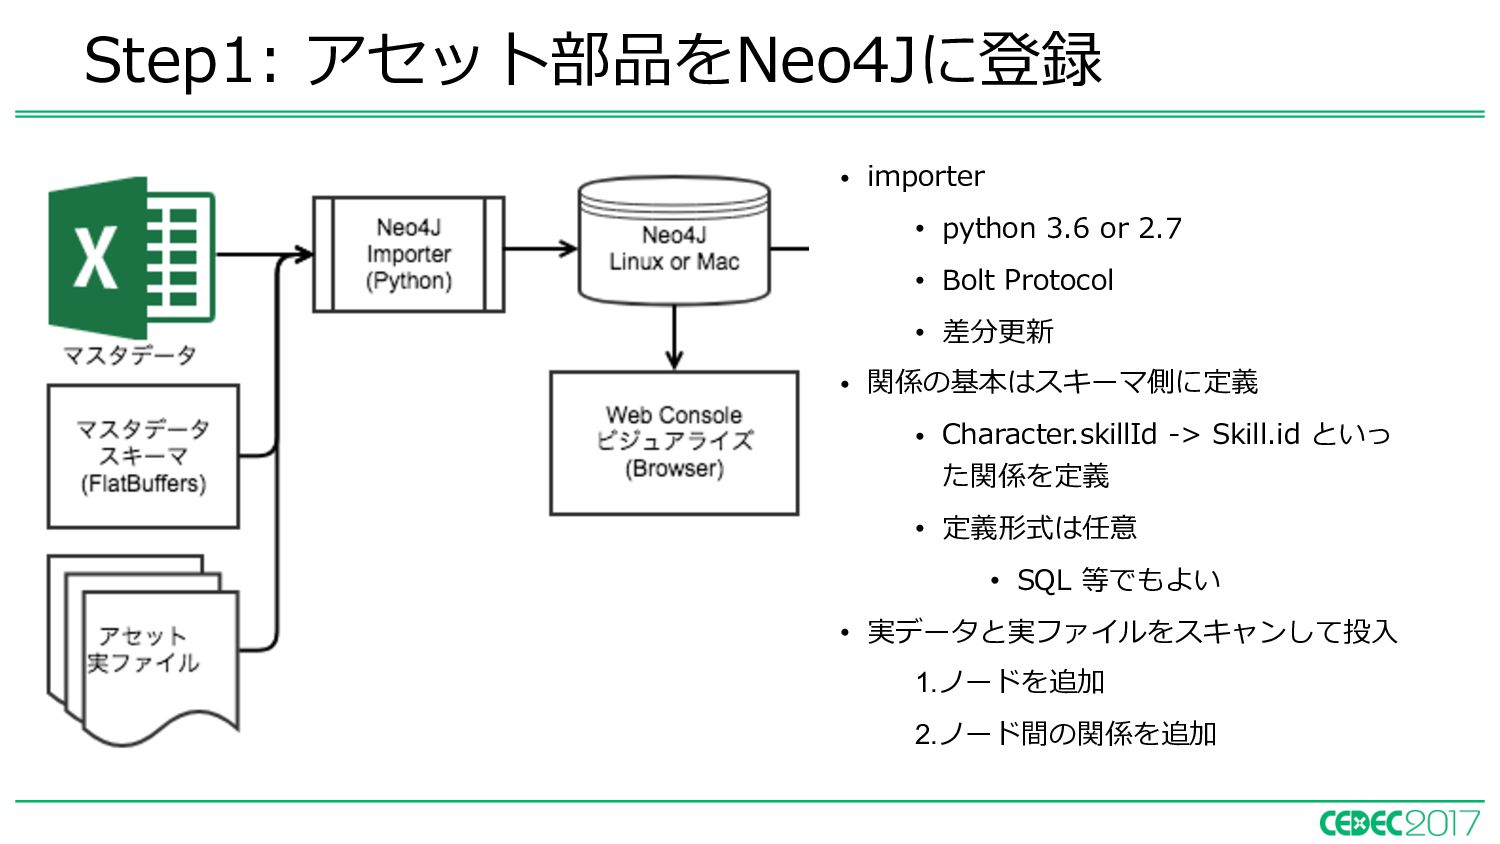
• importer • python 3.6 or 2.7 • Bolt Protocol
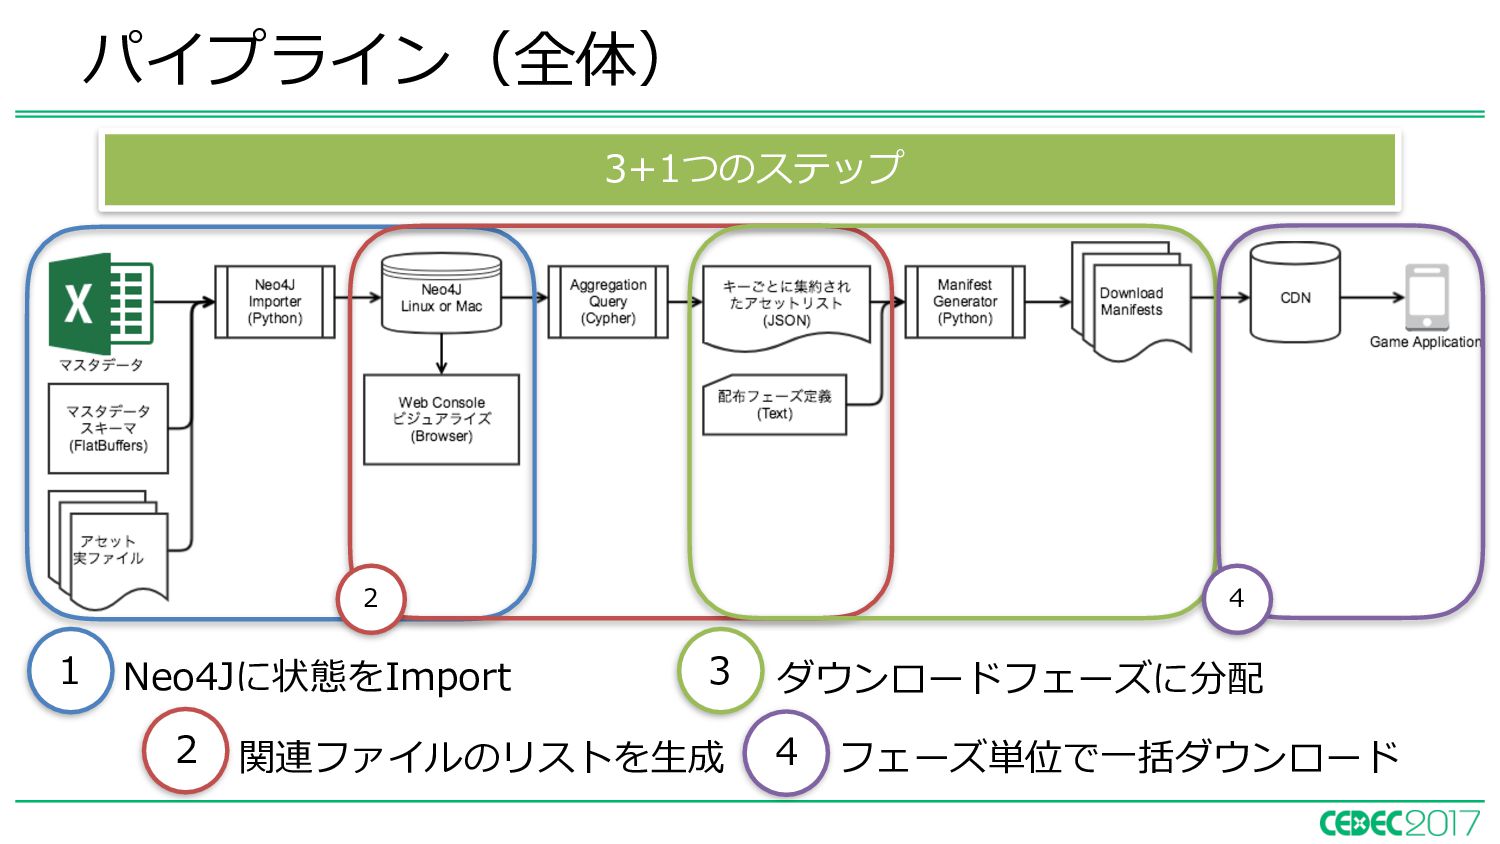
• 差分更新 • 関係の基本はスキーマ側に定義 • Character.skillId -> Skill.id といっ た関係を定義 • 定義形式は任意 • SQL 等でもよい • 実データと実ファイルをスキャンして投⼊ 1.ノードを追加 2.ノード間の関係を追加 Step1: アセット部品をNeo4Jに登録 -
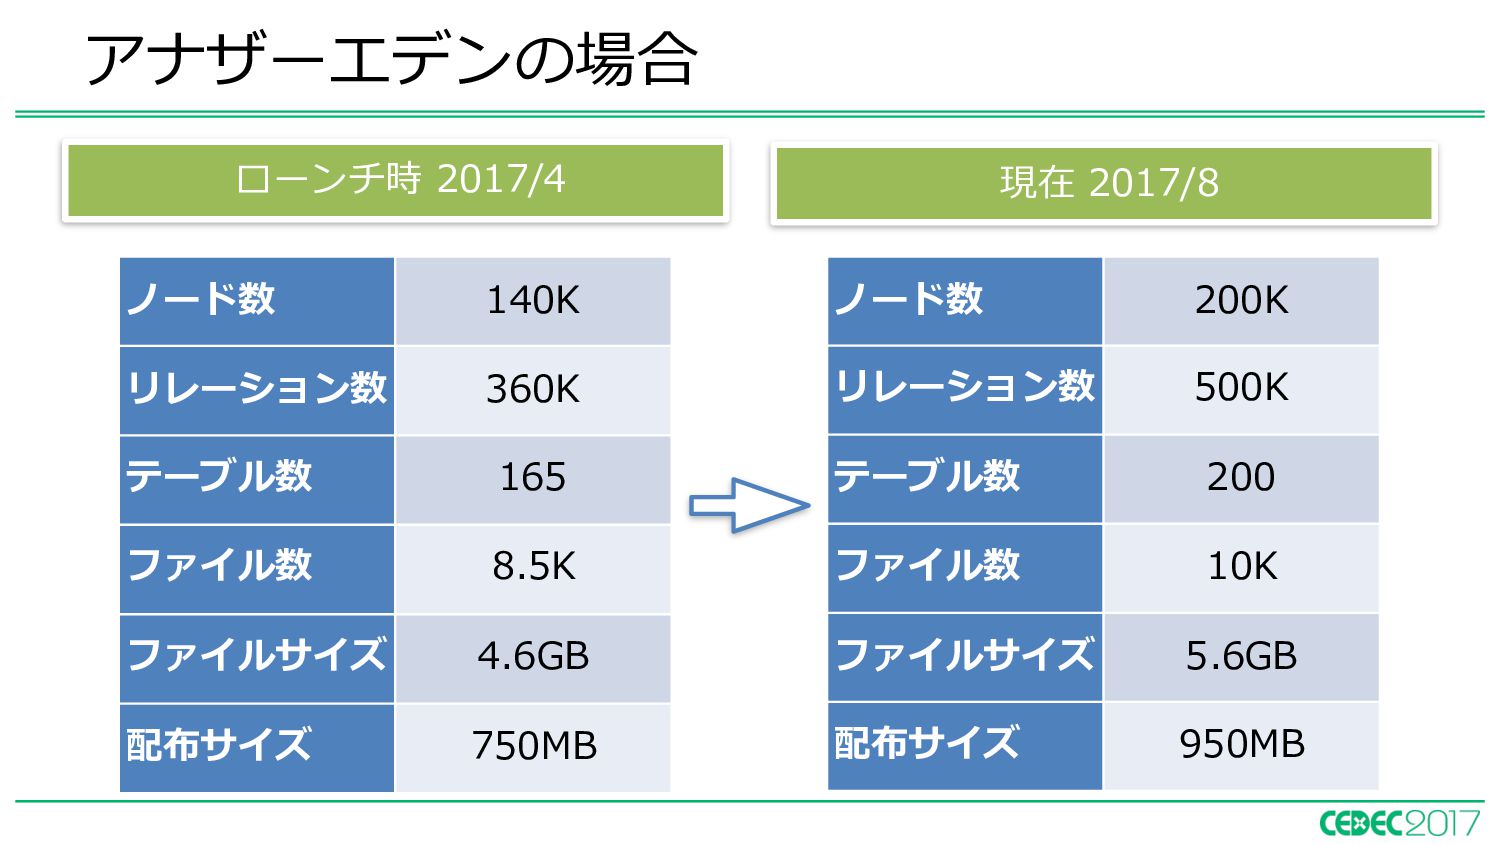
アナザーエデンの場合 ローンチ時 2017/4 現在 2017/8 ノード数 140K リレーション数 360K テーブル数
165 ファイル数 8.5K ファイルサイズ 4.6GB 配布サイズ 750MB ノード数 200K リレーション数 500K テーブル数 200 ファイル数 10K ファイルサイズ 5.6GB 配布サイズ 950MB -
関係を抽出するクエリの例 1 match p = (:Character)-[*1]->(:PcSkill) return p limit 1
24ms キャラクタとスキルの結びつきを1つ取得 -
関係を抽出するクエリの例 2 match p = (c:Character)-[]-(s:PcSkill)-[]-(e:PcSkillEffect)-[]- (b:BattleEffect)-[]-(g:`.png`) return p limit
1 6ms キャラクタ->スキル->スキルエフェクト->バトルエフェクト->ファイルと辿る -
関係を抽出するクエリの例 3 match p = shortestpath((c:Character)-[*]-(g:`.ogg`)) return p limit 1
8ms キャラクタと.oggファイルの最短経路を1つ抽出 -
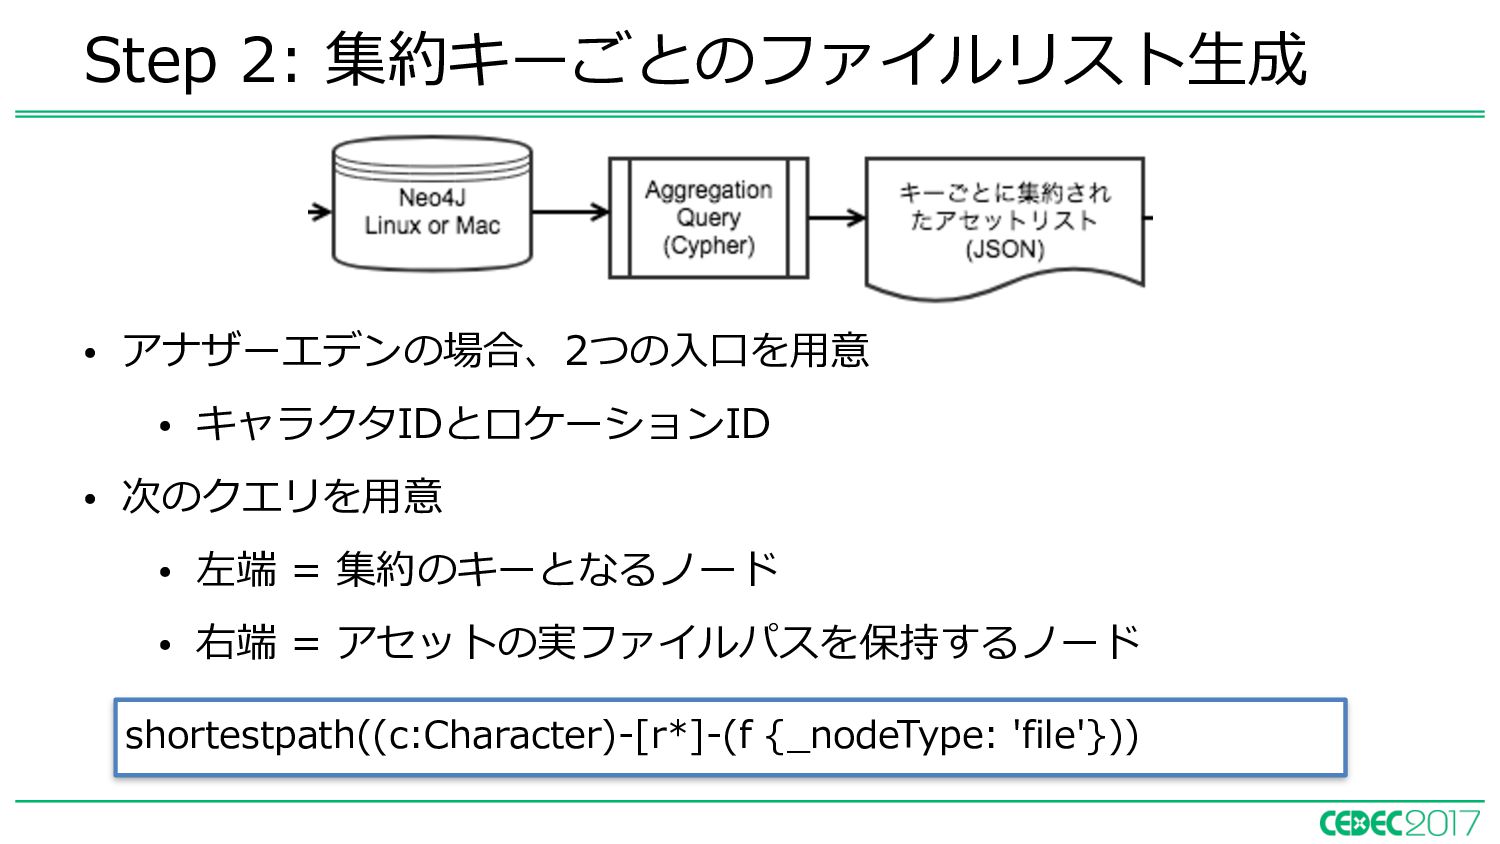
Step 2: 集約キーごとのファイルリスト⽣成 • アナザーエデンの場合、2つの⼊⼝を⽤意 • キャラクタIDとロケーションID • 次のクエリを⽤意 •
左端 = 集約のキーとなるノード • 右端 = アセットの実ファイルパスを保持するノード shortestpath((c:Character)-[r*]-(f {_nodeType: 'file'})) -
match p = shortestpath((c:Character)-[r*]-(f {_nodeType: 'file'})) with c, f, p,
reduce(cost = 0, n in nodes(p) | cost + n._cost) as cost where cost <= 60 and not any (x in relationships(p) where x.name = 'AreaList.id') and not any (x in relationships(p) where x.name = 'AreaObject.id') and not any (x in relationships(p) where x.name = 'Location.id') return c.id, f.realPath order by c.id, f.realPath; Characterに紐づくファイル数をIDごとに集約 実際の集約のクエリ コスト計算やガード条件で制御 -
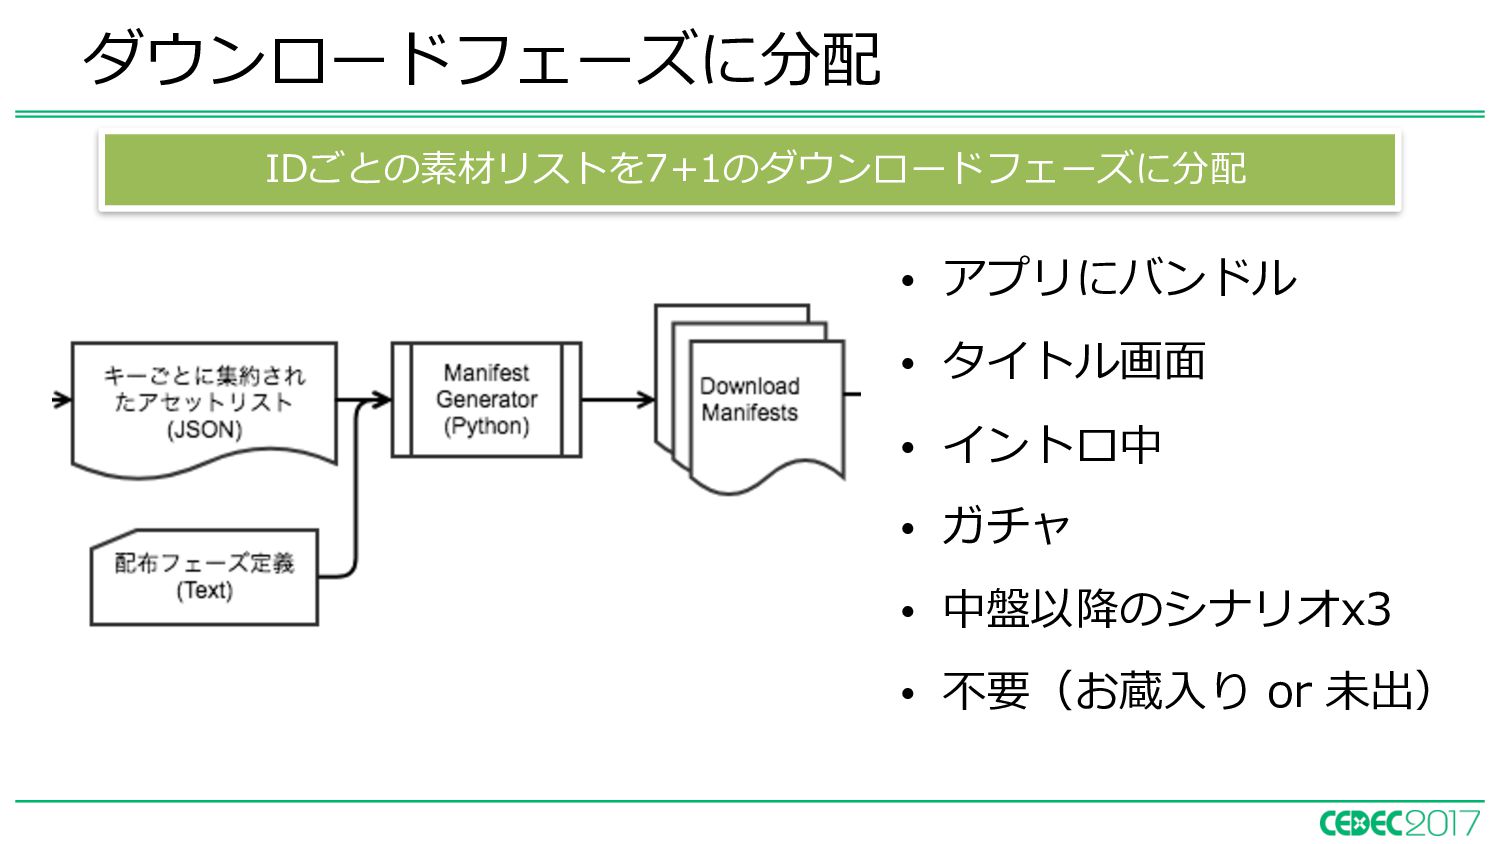
• アプリにバンドル • タイトル画⾯ • イントロ中 • ガチャ • 中盤以降のシナリオx3
• 不要(お蔵⼊り or 未出) ダウンロードフェーズに分配 IDごとの素材リストを7+1のダウンロードフェーズに分配 -
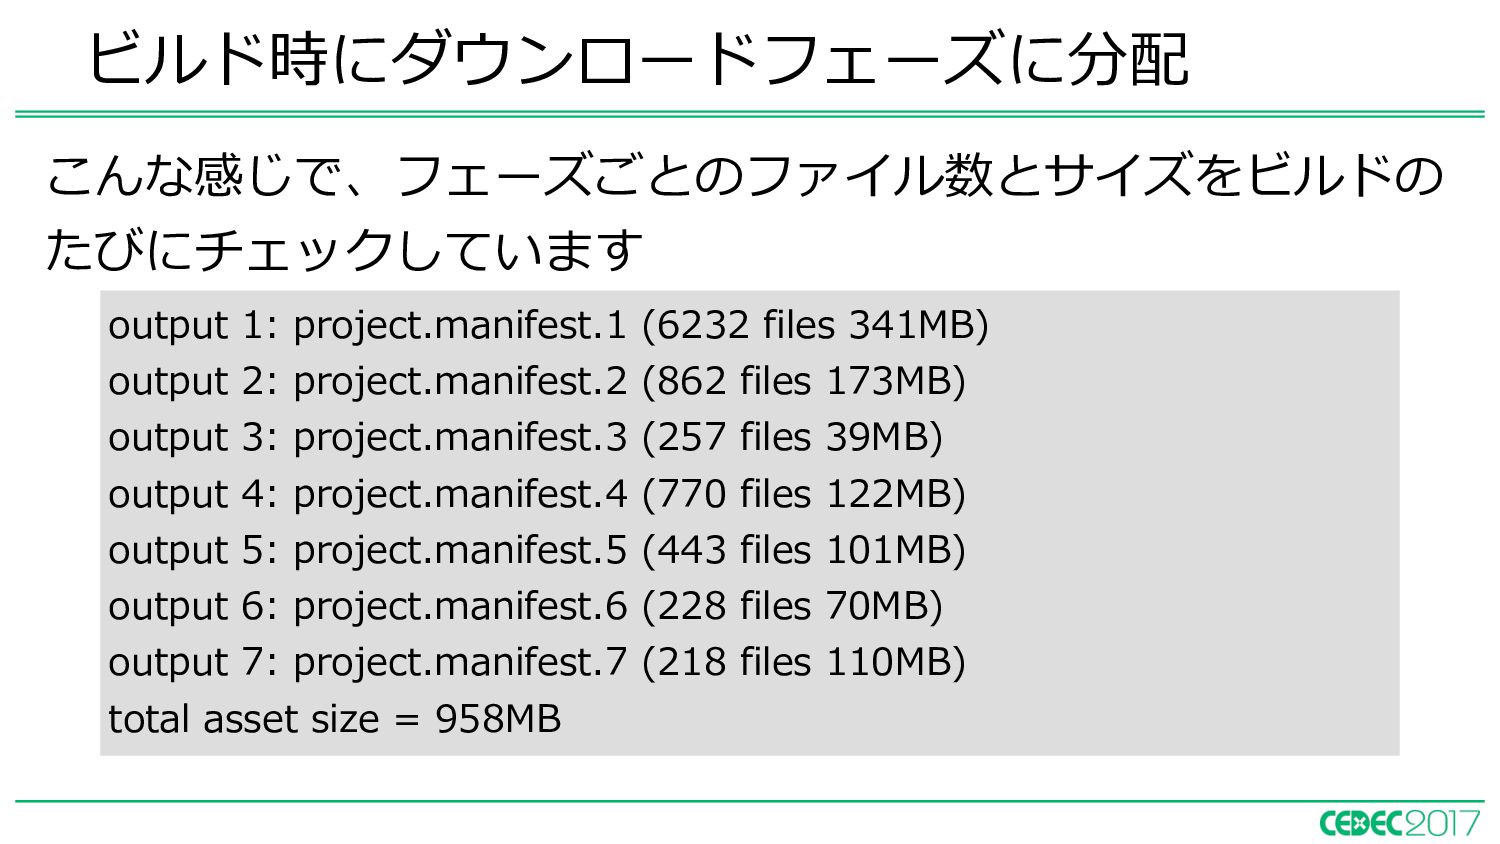
ビルド時にダウンロードフェーズに分配 output 1: project.manifest.1 (6232 files 341MB) output 2: project.manifest.2
(862 files 173MB) output 3: project.manifest.3 (257 files 39MB) output 4: project.manifest.4 (770 files 122MB) output 5: project.manifest.5 (443 files 101MB) output 6: project.manifest.6 (228 files 70MB) output 7: project.manifest.7 (218 files 110MB) total asset size = 958MB こんな感じで、フェーズごとのファイル数とサイズをビルドの たびにチェックしています -
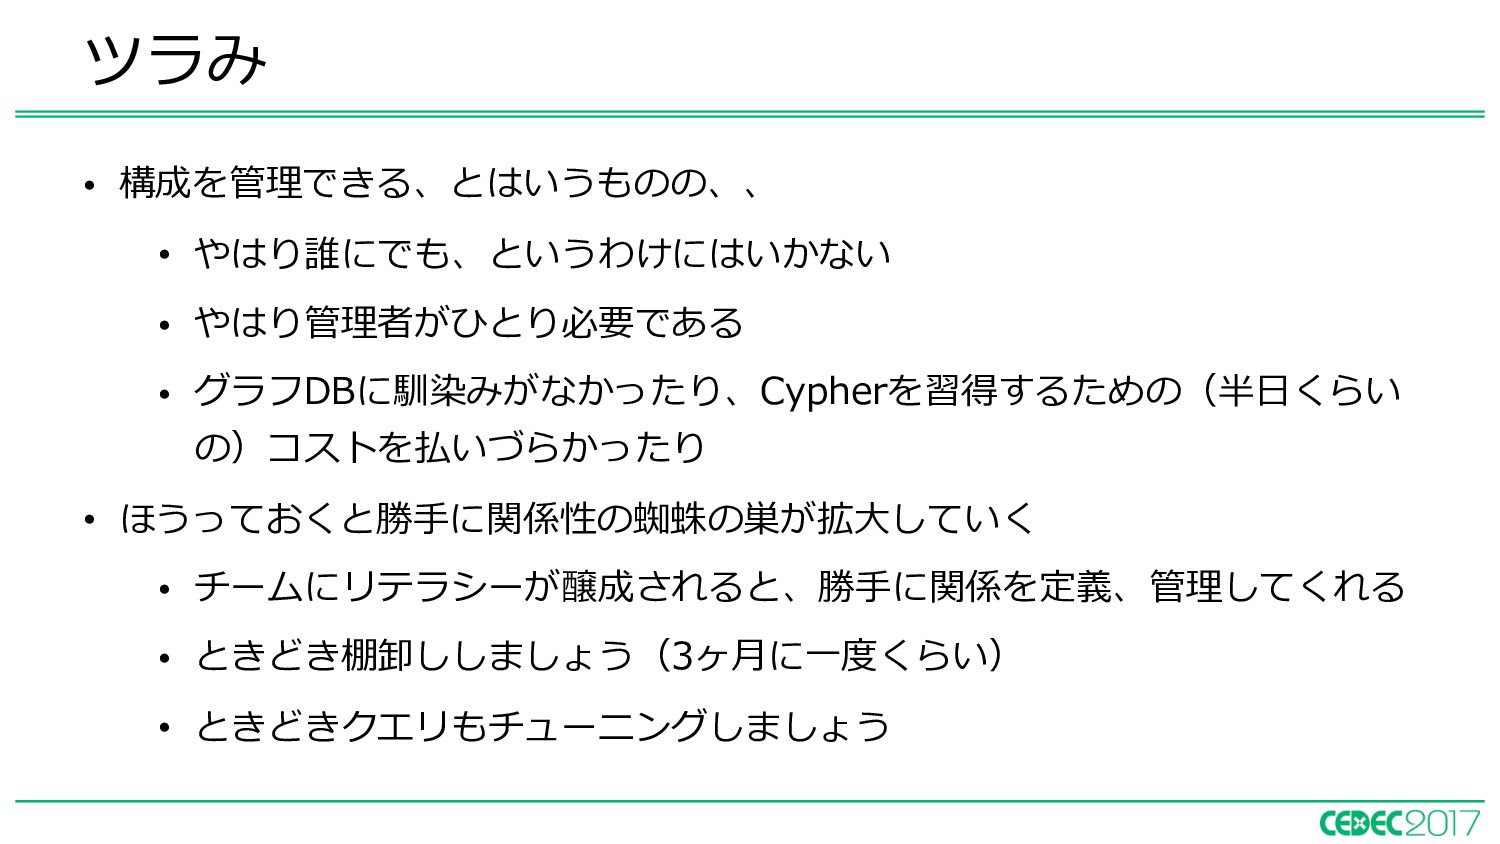
• 構成を管理できる、とはいうものの、、 • やはり誰にでも、というわけにはいかない • やはり管理者がひとり必要である • グラフDBに馴染みがなかったり、Cypherを習得するための(半⽇くらい の)コストを払いづらかったり •
ほうっておくと勝⼿に関係性の蜘蛛の巣が拡⼤していく • チームにリテラシーが醸成されると、勝⼿に関係を定義、管理してくれる • ときどき棚卸ししましょう(3ヶ⽉に⼀度くらい) • ときどきクエリもチューニングしましょう ツラみ -
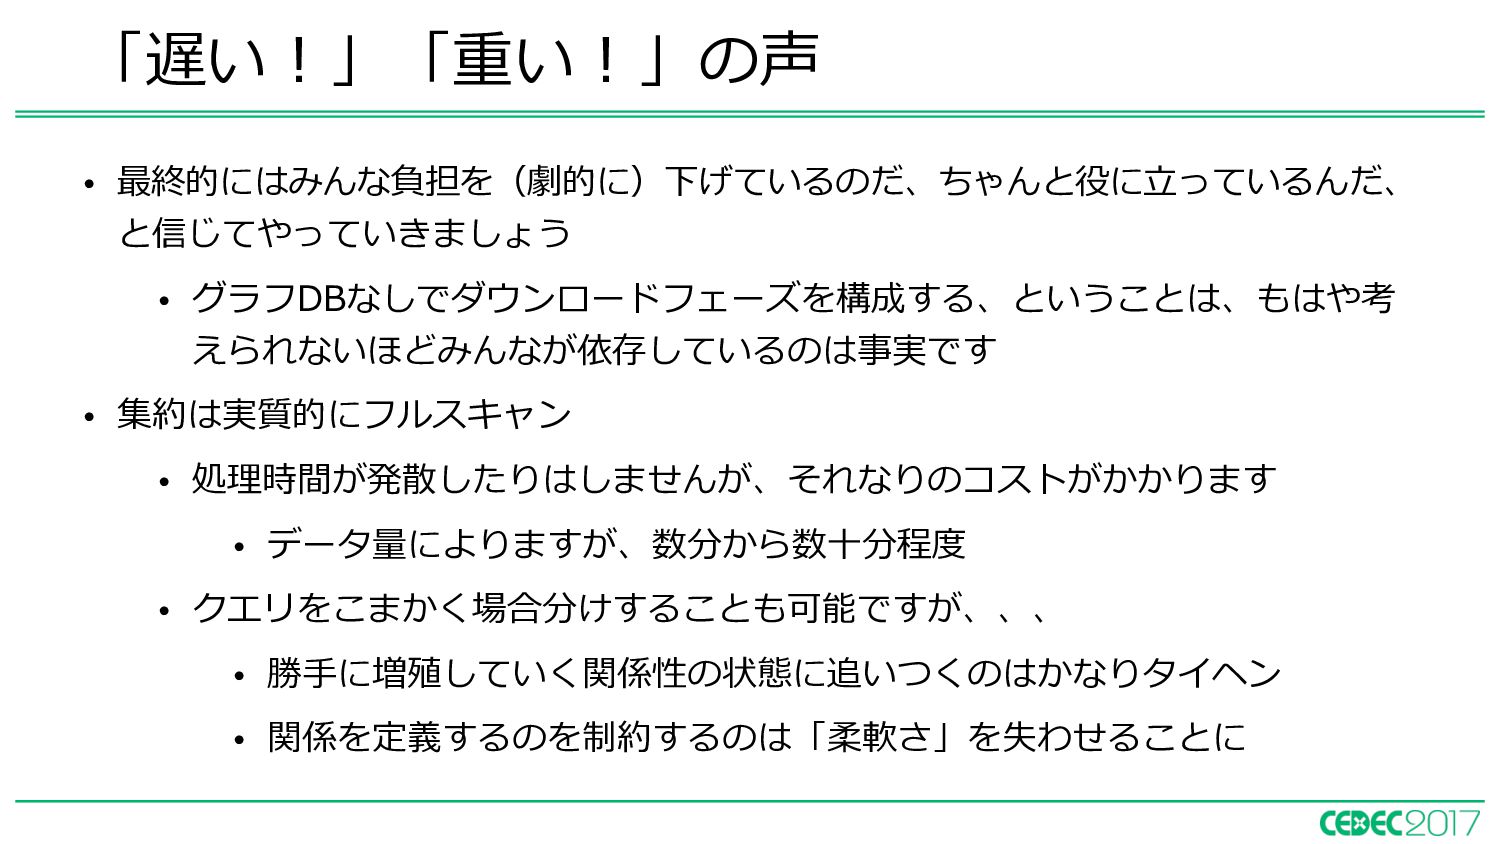
• 最終的にはみんな負担を(劇的に)下げているのだ、ちゃんと役に⽴っているんだ、 と信じてやっていきましょう • グラフDBなしでダウンロードフェーズを構成する、ということは、もはや考 えられないほどみんなが依存しているのは事実です • 集約は実質的にフルスキャン • 処理時間が発散したりはしませんが、それなりのコストがかかります
• データ量によりますが、数分から数⼗分程度 • クエリをこまかく場合分けすることも可能ですが、、、 • 勝⼿に増殖していく関係性の状態に追いつくのはかなりタイヘン • 関係を定義するのを制約するのは「柔軟さ」を失わせることに 「遅い!」「重い!」の声 -
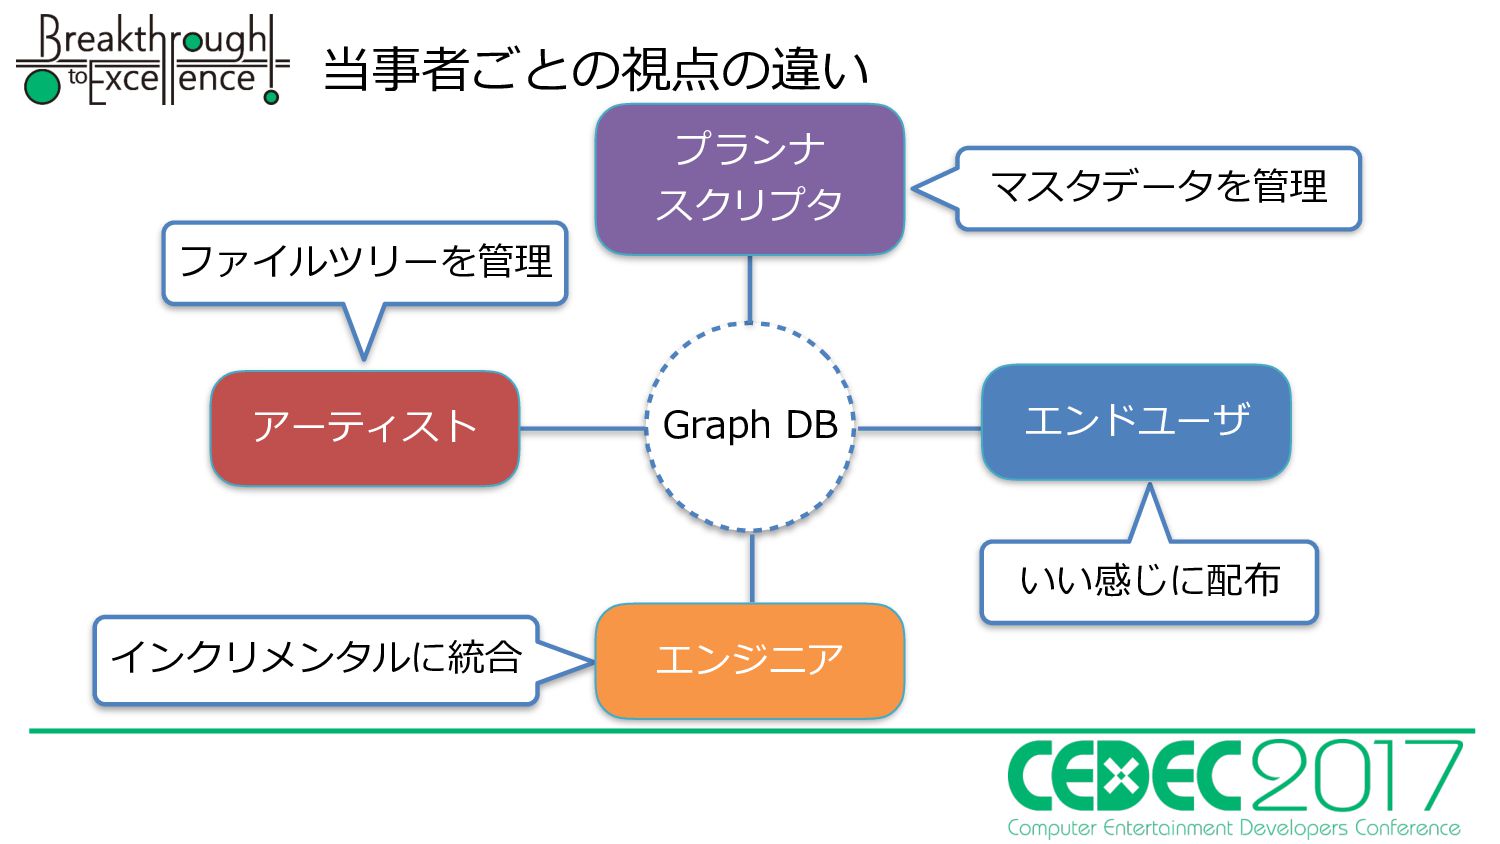
• 何をグラフDBに⼊れるべきか、をきちんと考えましょう • スキーマ+マスタデータ+ファイルツリーというのはひとつの例に すぎません • 重要なのは「各当事者間の関係性を動的に管理してあげる」こと、 そのためにグラフDBを使う、ということです • ⼊れるなら、はやめに⼊れましょう
• ⽇々、成⻑を続けるゲームアセットをインクリメンタルに統合して いけることが強みです • そのまま、かなりスムーズに運⽤に⼊ることができます 導⼊のコツ -
• ダウンロードフェーズ構築以外の⽤途も探していきましょう • 不満の声がやわらぎます • 素材の網羅的なデータベースなので探しものの役にたちます • 不要なファイルの抽出にも利⽤できるでしょう • 本番⽤のマスタデータDBにも使えるでしょう
• 運⽤設備構築とベンチマークとある程度の慣れが必要ですが • もちろんソーシャルグラフのDBに最適です • RDBのようなIndex Scanが不要なのはそれなりに⼤きいです 導⼊のコツ -
• Neo4J公式サイト • https://neo4j.com/ • Neo4J OʼReilly本 • https://neo4j.com/graph-databases-book/ •
FlatBuffers • https://google.github.io/flatbuffers/ 参考⽂献